Deze studie onderzoekt of relatiemarketingfactoren het systeem van sportaanbevelingen voor Chinese Super League-fans verbeteren. Het integreren van tevredenheid, vertrouwen, toewijding en wederkerigheid verbetert de nauwkeurigheid van Top-N aanbevelingen aanzienlijk, vooral onder schaars en long-tail omstandigheden. Resultaten tonen aan dat toewijding en wederkerigheid herhaald gedrag met hoge betrokkenheid aansturen, terwijl tevredenheid en vertrouwen vooral bijdragen aan vroege betrokkenheid.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Intelligente aanbevelingssystemen voor het voorspellen van consumptiegedrag van Chinese Super League-fans
In dit artikel
Samenvatting
Samenvatting
Het begrijpen en voorspellen van het consumptiegedrag van fans is een centrale uitdaging in de professionele sport, maar de meeste aanbevelingssystemen vertrouwen voornamelijk op historische interacties en besteden ze beperkte aandacht aan relatiemarketingfactoren die de betrokkenheid van fans bepalen. Om deze kloof aan te pakken, ontwikkelt deze studie MLP-PA (Multi-Layer Perceptron with Pyramid Attention) en onderzoekt of het integreren van de relationele toestanden van fans—zoals tevredenheid, vertrouwen, toewijding en wederkerigheid—de effectiviteit van aanbevelingen kan verbeteren over meerdere consumptiescenario's onder Chinese Super League (CSL)-fans. Met behulp van een multi-scenario dataset die ticketing, merchandise, lidmaatschap en digitale content omvat, tonen empirische resultaten aan dat aanbevelingen van MLP-PA aanzienlijk hogere Top-N-rangschikkingsnauwkeurigheid behalen dan conventionele collaboratieve filtermethoden, met bijzonder duidelijke verbeteringen in sparse- en long-tail settings. De analyse toont verder aan dat verschillende relatiefactoren samenhangen met verschillende consumptiepatronen: toewijding en wederkerigheid zijn sterker gekoppeld aan herhaald en hoogbetrokken gedrag, terwijl tevredenheid en vertrouwen vooral de eerste en kortetermijnreacties beïnvloeden. Deze bevindingen tonen aan dat relatiemarketingfactoren een substantiële en onderscheidende rol spelen in het consumptiegedrag van fans, en bieden bruikbare inzichten voor gepersonaliseerde betrokkenheidsstrategieën en digitale operaties in professioneel voetbal.
Inleiding
In de afgelopen jaren zijn aanbevelingssystemen een centraal onderdeel geworden van digitale platforms, waardoor gebruikers, producten en consumptiecontexten op elkaar afgestemd kunnen worden door middel van datagedreven personalisatie. Hoewel aanbevelingstechnologieën goed gevestigd zijn in domeinen zoals e-commerce en online media, blijft hun toepassing in professionele sport relatiefonderontwikkeld. In competities zoals de Chinese Super League (CSL) is het consumptiegedrag van fans zeer contextgevoelig en ontwikkelt het zich over de fases voor, op wedstrijddag en na de wedstrijd, waarbij aankoopbeslissingen nauw verbonden zijn met offline aanwezigheid, emotionele band en sociale identiteit. De meeste bestaande studies van sportaanbevelingen passen echter vooral collaboratieve filtering of contentgebaseerde technieken uit andere domeinen over en richten zich op kortetermijninteractiesignalen, zoals klikken of aankopen. Deze benaderingen negeren grotendeels de relationele dynamiek tussen fans en clubs—zoals vertrouwen, toewijding of wederkerigheid—die in sportmarketingonderzoek bekend staan als bepalend voor langdurige betrokkenheid en herhaalde consumptie2. Als gevolg hiervan hebben huidige modellen moeite om uit te leggen waarom vergelijkbare gedragsgeschiedenissen kunnen leiden tot uiteenlopende consumptie-uitkomsten onder verschillende relationele toestanden. Deze kloof benadrukt de noodzaak van aanbevelingsframeworks die verder gaan dan interactiefrequentie en expliciet rekening houden met relatiegedreven mechanismen in fan-besluitvorming3.
Vanuit een relatiemarketingperspectief vormen tevredenheid, vertrouwen, toewijding en wederkerigheid samen de kwaliteit van de relatie en zijn ze goed gevestigd als drijfveren van belangrijke fanresultaten, waaronder het aantal wedstrijden, aankoop van merchandise, ledenverlenging en mond-tot-mondreclame 4,5,6. Daarentegen blijven de meeste bestaande sportaanbevelingssystemen interacties tussen fan en item modelleren als grotendeels homogene gedragssignalen, waarbij weinig aandacht besteedt aan de relationele context die aan die interacties ten grondslag ligt. Deze vereenvoudiging beperkt hun vermogen om vast te leggen hoe verschillende relatiefactoren verschillende invloeden uitoefenen over consumptiefasen en betrokkenheidsintensiteiten, en helpt verklaren waarom modellen die uitsluitend op interactiegeschiedenis zijn gebaseerd vaak niet in het onderscheiden van kortetermijnreacties van aanhoudend, hoogbetrokken fangedrag.
Vanuit technisch oogpunt staan sportaanbevelingssystemen voor extra uitdagingen, waaronder asymmetrische impliciete feedback, ernstige long-tail sparsiteit en heterogene multi-touch interactiecontexten7. Traditionele collaboratieve filterbenaderingen en single-path deep modellen vertonen vaak beperkte cross-context generalisatie in dergelijke omgevingen en bieden weinig interpreteerbaarheid voor besluitvormingsondersteuning in marketingoperaties.
Methodologisch gezien heeft eerder onderzoek naar aanbevelingssystemen een reeks oplossingen voorgesteld om spaarzaamheid, heterogeniteit en langetermijnoptimalisatie aan te pakken. Grafgebaseerde en aandachtsgedreven modellen hebben het leren van representatie en de rangschikkingsprestaties verbeterd door het belang van buren te herwegen en interacties van hogere orde vast te leggen 8,9. Hybride architecturen die samenwerkingssignalen combineren met deep learning hebben vooruitgang geboekt in grootschalige aanbevelingstaken10. Op versterking leren gebaseerde benaderingen breiden optimalisatie verder uit naar langetermijndoelstellingen in plaats van myopische nauwkeurigheid11. Deze vooruitgang biedt waardevolle methodologische fundamenten voor het modelleren van complexe interacties onder schaarse feedback.
Desalniettemin blijven de meeste van deze benaderingen agnostisch ten opzichte van relatiemarketingconstructies en nemen ze niet expliciet variabelen zoals tevredenheid, vertrouwen, toewijding of wederkerigheid mee in het aanbevelingsproces. Deze beperking is vooral opvallend in professionele voetbalcontexten, waar de relaties tussen fan en club evolueren en waar verschillende relationele dimensies bekend staan om verschillende gedragsuitkomsten te domineren (bijvoorbeeld eerste aankoop versus herhaalde aanwezigheid)12,13,14,15.
Om deze kloof te dichten, stellen we MLP-PA (Multi-Layer Perceptron with Pyramid Attention) voor, een relatiebewust aanbevelingsraamwerk dat is afgestemd op het scenario van de Chinese Super League (CSL). Gebaseerd op een Neural Collaborative Filtering (NCF)-architectuur met een Multi-Layer Perceptron (MLP)-ruggengraat, behandelt het voorgestelde model tevredenheid, vertrouwen, commitment en wederkerigheid als eersteklas relationele kenmerken en injecteert het deze in een op aandacht gebaseerd priorkanaal. Een piramide-feature attention module wordt vervolgens gebruikt voor late fusion om selectief opvallende interactiepatronen over meerdere schalen te versterken, terwijl fan-, item- en contextuele representaties worden geïntegreerd. Door relatievariabelen expliciet te modelleren naast niet-lineaire interactiekenmerken, streeft MLP-PA ernaar zowel de voorspellende nauwkeurigheid als de interpreteerbaarheid in sportaanbevelingen te verbeteren.
Een empirische evaluatie van een zelfgebouwde CSL-dataset toont aan dat de voorgestelde aanpak consequent beter presteert dan klassieke baselines, waaronder UserCF, ItemCF en MF-BPR, op het gebied van Top-N ranking-metrics. Verdere analyse van modelvarianten wijst uit dat het opnemen van relatiebewuste aandacht helpt om de schaarsheid van long-tail en contextuele heterogeniteit te verminderen. De resultaten tonen ook gedifferentieerde rollen van relationele factoren. Commitment en wederkerigheid worden sterker geassocieerd met herhaald en hoogbetrokken gedrag, terwijl tevredenheid en vertrouwen vooral ondersteunen bij eerste en korte termijn reacties.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Deze studie gebruikt gedeïdentificeerde fan–item interactielogs en geanonimiseerde vragenlijstgegevens die uitsluitend voor onderzoeksdoeleinden zijn verzameld. Er werd geen persoonlijk identificeerbare informatie geraadpleegd, opgeslagen of verwerkt. Volgens institutionele en nationale richtlijnen vereiste deze studie geen formele goedkeuring van de ethische commissie of individuele geïnformeerde toestemming.
Datasetvoorbereiding en experimentele procedure
Stap 1. Datavoorbereiding en voorverwerking
Datasetvoorbereiding en experimentele procedures zijn ontworpen om ruwe gedragslogboeken en enquête-antwoorden om te zetten in een uniforme, reproduceerbare experimentele dataset die geschikt is voor modeltraining en evaluatie. Het proces richt zich op het opschonen van gegevens, anonimisering, feature-constructie, normalisatie en het uitlijnen van interactierecords met relatie-gerelateerde variabelen. Ruwe interactielogs werden eerst gescreend om onvolledige vermeldingen en gedupliceerde gebeurtenissen te verwijderen en zo de consistentie van de gegevens te waarborgen. Fan-identificaties en item-identificaties werden vervolgens geanonimiseerd via hashing om de privacy van gebruikers te beschermen. Meerdere vormen van interactie, waaronder browsen, klikken, kopen en aanwezigheidsvalidatie, werden gekoppeld aan impliciete feedbacksignalen, waarbij elke waargenomen interactie als een positief geval werd behandeld. Relatiegerelateerde variabelen—tevredenheid, vertrouwen, toewijding en wederkerigheid—werden verzameld uit vragenlijstantwoorden en gekoppeld aan de bijbehorende fan-identificaties. Ontbrekende vragenlijstwaarden werden aangepakt met behulp van gemiddelde imputatie binnen hetzelfde lidmaatschapsniveau om groepsniveaukenmerken te behouden. Continue features werden genormaliseerd met min–max scaling naar het bereik [0, 1] om vergelijkbaarheid tussen variabelen te waarborgen. Na de preprocessing werd de definitieve dataset opgeslagen in gestructureerde bestanden bestaande uit geanonimiseerde fan ID's, item-ID's, tijdstempels, contextuele tags en genormaliseerde relatievariabelen, die vervolgens consistent werden gebruikt in alle experimentele settings.
Verwachte productie:
Als resultaat van dit proces bevatten de output een opgeschoonde interactietabel, een genormaliseerde tabel van relatievariabelen die zijn uitgelijnd met ventilatoridentificaties, en een statistisch overzicht met het aantal fans, items en interacties in de uiteindelijke dataset.
Stap 2. Train/validatie/test splitsing en negatieve steekproef
Gegevens worden chronologisch opgesplitst op gebruikersniveau om informatielekken te voorkomen. Voor elke fan is de meest recente interactie gereserveerd voor testen, de op één na meest recente voor validatie, en de resterende interacties voor training. Negatieve monsters worden gegenereerd door niet-interacteerde items uniform uit de itemset te bemonsteren. Voor elke positieve interactie wordt tijdens de training een vast aantal negatieve monsters genomen (negatieve steekproefverhouding = 1:5). Dezelfde candidate set-constructie wordt consistent toegepast in alle modellen.
Verwachte productie:
Als resultaat van deze stap bevatten de output chronologisch gesplitste trainings-, validatie- en testdatasets, samen met vooraf gegenereerde negatieve steekproeflijsten die volgens de gespecificeerde steekproefverhouding zijn opgesteld.
Stap 3. Softwareomgeving en implementatie
Alle experimenten worden uitgevoerd in Python. Modeltraining en evaluatie worden uitgevoerd met PyTorch (versie ≥ 1.12). Bayesiaanse hyperparameteroptimalisatie wordt uitgevoerd met Optuna (versie ≥ 3.0). Trainingsscripts worden uitgevoerd op een werkstation dat is uitgerust met één NVIDIA GPU (≥ 8 GB geheugen). Configuratiebestanden specificeren datasetpaden, modelparameters en optimalisatie-instellingen om reproduceerbaarheid te waarborgen.
Stap 4. Modelconstructie en parameterspecificatie
Het MLP-PA-model bestaat uit een embeddinglaag, een meerlagige perceptron-ruggengraat, een relatie-aandachtkanaal en een piramide-aandachtfusiemodule. Belangrijke parameters zijn als volgt ingesteld: embedding dimension = 32; MLP verborgen lagen = [64, 32]; activatiefunctie = ReLU; optimizer = Adam met leersnelheid 0,001 en gewichtsafname 1e-5. De piramide-aandachtmodule gebruikt drie poolingschalen met kerngroottes {1, 2, 4} en een stap gelijk aan de kerngrootte. De aandachtsreductieratio is ingesteld op 4. Dropout met een snelheid van 0,3 wordt toegepast om overfitting te voorkomen. Vroegtijdig stoppen wordt geactiveerd als validatie NDCG@10 gedurende 10 opeenvolgende epochs niet verbetert.
Stap 5. Training en optimalisatie van hyperparameters
Het model wordt getraind met behulp van een paargewijze Bayesiaanse Personalized Ranking (BPR) verlies. Tijdens de training wordt de validatieprestaties aan het einde van elk tijdperk gemonitord. Bayesiaanse hyperparameteroptimalisatie zoekt naar leersnelheid, embeddinggrootte, dropoutpercentage, negatieve steekproefverhouding en aandachtgerelateerde parameters. Het optimalisatiedoel is validatie NDCG@10. Elke kandidaatconfiguratie wordt getraind met vroegtijdig stoppen om de rekenkosten te verlagen.
Verwachte productie:
Als gevolg van dit proces bevatten de output getrainde modelcheckpoints, validatielogs en de optimale hyperparameterconfiguratie die is geïdentificeerd via Bayesiaanse optimalisatie.
Stap 6. Evaluatie en resultaatgeneratie
Na training wordt het best presterende model (gebaseerd op validatie NDCG@10) geëvalueerd op de testset. Voor elke ventilator worden top-N aanbevelingslijsten gegenereerd en de prestaties worden gemeten met behulp van HR@K en NDCG@K. Aanvullende analyses, waaronder ablatiestudies en fase-geconditioneerde aandachtprofilering, worden uitgevoerd met hetzelfde evaluatieprotocol om vergelijkbaarheid te waarborgen.
Voltooiingscriteria
Het protocol wordt als voltooid beschouwd wanneer de volgende uitgangen worden verkregen: 1) Een volledig getraind MLP-PA-model met geoptimaliseerde hyperparameters; 2) Testset HR@K en NDCG@K resultaten voor alle basislijn- en ablatiemodellen; 3) Opgeslagen modelcontrolepunten, evaluatiemetrieken en reproduceerbare configuratiebestanden. Deze uitgangen maken gezamenlijk onafhankelijke replicatie van het voorgestelde aanbevelingssysteemprotocol mogelijk.
Commitment en vertrouwen relatiemarketingtheorie
De commitment–trust-theorie identificeert commitment en vertrouwen als de kernbepalende factoren van relatiekwaliteit. Door transactionele onzekerheid te verminderen en langetermijnoriëntatie en coöperatieve intentie te bevorderen, bevorderen deze factoren relationele continuïteit en waardecreatie16. Vertrouwen weerspiegelt het geloof van fans in de competentie, integriteit en welwillendheid van een club, wat het waargenomen risico en informatie-asymmetrie vermindert. Daardoor faciliteert hoger vertrouwen een onoprechte betrokkenheid met gepersonaliseerde aanbevelingen, gegevensautorisatie en betalingsprocessen, waardoor vroege en laag-commitment gedragingen langs de click-to-buy funnel worden ondersteund. Commitment daarentegen weerspiegelt de bereidheid van fans om tijd, financiële middelen en emotionele betrokkenheid te investeren om de relatie te onderhouden ondanks concurrerende alternatieven of tijdelijke ontevredenheid17. Omdat commitment nauw samenhangt met identiteitsafstemming, verzonken kosten en toegewijde investeringen, biedt het een stabielere verklaring voor gedrag met hoge kosten en veel betrokkenheid, zoals herhaalaankopen, ledenverlenging, opkomst in stadions en mond-tot-mondreclame18.
Op basis van deze onderscheidingen leiden we de volgende hypothesen af.
H1 (Vertrouwen → Ondersteunend Gedrag): Hoger vertrouwen vermindert beslissingswrijving en waargenomen risico, waardoor de kans op oppervlakkig gedrag zoals klikken, toevoeging-aan-winkelwagen-acties en eerste aankopen toeneemt.
H2 (Relatief Voordeel van Commitment): Van de vier relatiedimensies vertoont commitment de sterkste marginale verklarende kracht voor duurzaam en langetermijngedrag, waaronder herhaalaankopen, verlengingen en offline aanwezigheid, en de bijdrage aan voorspellende prestaties overstijgt die van tevredenheid en vertrouwen.
Theorie van sociale uitwisseling
De theorie van sociale uitwisseling benadrukt dat individuen normen van wederkerigheid en rechtvaardigheid volgen in herhaalde interacties19. Waargenomen wederkerigheid betekent dat fans het gevoel hebben dat er geven en nemen is van de club in waardeconcessies, emotionele reacties en toewijzing van middelen. Wanneer wederkerigheid als echt en duurzaam wordt gezien, zijn fans eerder geneigd om terug te keren via consumptie en bezoek, wat een positieve feedbackloopvormt. Tevredenheid is een functie van opgebouwde ervaringen ten opzichte van de verwachtingen. Via een verwachting–bevestigingsmechanisme bevordert het kortetermijnnaleving en positieve mond-tot-mondreclame, en biedt het vruchtbare bodem voor de ontwikkeling van vertrouwen en toewijding21.
Dienovereenkomstig leiden we af:
H3 (Tevredenheid → Ondersteunend Gedrag): Hogere tevredenheid vermindert spijt en verhoogt de directheid van reactie, wat het aankopen en de participatie op korte termijn stimuleert.
H4 (Wederkerigheid → Conversie en Terugkoop): Binnen een herhaald-spel kader versterken wederkerigheidssignalen de "Ik profiteer → ik geef terug"-uitwisselingsintensiteit, wat conversie- en terugkooppercentages aanzienlijk verbetert—vooral in prijsgevoelige of schaarste-contexten.
Door de twee theorieën te synthetiseren, tonen de vier dimensies duidelijke contextuele heterogeniteit in hun invloedspaden:
In contexten van onzekerheid of hoog waargenomen risico—nieuwe producten, dynamische prijzen, autorisatie/betaling met hoge inzet—oefent trust sterkere marginale effecten uit (ondersteunt H1).
In langetermijn/identiteitsgeïnspireerde contexten—seizoenspassen, opeenvolgende thuiswedstrijden, ledenverlenging—overheerst toewijding (ondersteunt H2).
Bij grote match-nodes of onder incentives/schaarste – beperkte voordelen, promoties – verhoogt wederkerigheid conversie en terugkoop sterker (ondersteunt H4).
Tevredenheid dient als de "basisgrond" en drijft kortetermijngedrag in bijna alle contexten positief aan (ondersteunt H3) en consolideert indirect vertrouwen en toewijding door de kwaliteit van de ervaring te verbeteren. In plaats van deze hypothesen te testen via structurele vergelijkingsmodellering, injecteren we de vier dimensies in een aandachtslaag, waardoor het model contextuele gewichten kan leren en de mechanismen kan bevestigen met ablatie-experimenten.
MLP
De multilayer perceptron (MLP) dient als de backbone representatie-leerling in ons framework.
(1) Input-mappinglaag.
De oorspronkelijke kenmerkvector wordt lineair eenmaal uitgebreid met een gewichtsmatrix 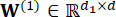 en bias b(1), wat resulteert in
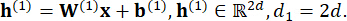 (1)
(2) Diepe niet-lineariteitslaag.
We stapelen lineaire, activatie- en normalisatielagen. De lineaire afbeelding gebruikt een volledig verbonden affiene transformatie:
z = Wx + b, (2)
Waarbij 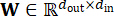 de gewichtsmatrix is,
 de biasvector, x de output van de vorige laag, en z de lineaire output. Om de activatiekenmerken van ReLU te matchen en de gradiënten stabiel te houden tijdens de training, passen we He-initialisatie toe voor W:
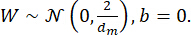 (3)
De activatiefunctie is ReLU, die bijzonder geschikt is voor diepe architecturen22. Wanneer x>0 is de afgeleide van ReLU een constante, wat effectief het probleem van de verdwijning-gradiënt bij sigmoidactivaties verlicht en zo de backpropagatie en convergentie23 versnelt. ReLU is ook computationeel eenvoudig (geen exponentiële cijfers) en van nature schaars (geeft nul voor x<0), wat redundante neuronresponsen vermindert en de generalisatie verbetert. De definitie is24
σ(x) = max(0,x), (4)
Elementgewijs toegepast op de lineaire output verkrijgen we:
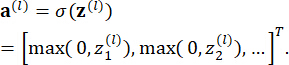 (5)
Na elke "lineaire → activatie" bewerking introduceren we Batch Normalization (BN) om gradiënten te stabiliseren en convergentie te versnellen. BN standaardiseert dynamisch functies binnen elke mini-batch, waardoor interne covariaatverschuiving wordt gemitigeerd, de trainingsstabiliteit verbetert en de gevoeligheid voor de leersnelheid wordt verminderd. BN heeft ook een milde regularisatie-effect, vergelijkbaar met het injecteren van ruis, wat helpt overfitting te voorkomen zonder de modelcapaciteit te schaden.
Laat de huidige mini-batch uitvoer zijn 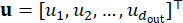 , De BN-transformatie voor het j-de kenmerk is
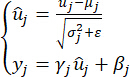 (6)
Waar μj en σj2 het batchgemiddelde en de variantie van het j-de kenmerk zijn, ε een kleine constante is voor numerieke stabiliteit, en γj, βj leerbare schaal- en verschuivingsparameters zijn die de niet-lineaire expressiviteit van het netwerk herstellen.
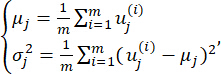 (7)
Hier is m de mini-batchgrootte, ε een kleine constante is voor numerieke stabiliteit, en γj zijn βj leerbare schaal-/schuifparameters die worden gebruikt om de niet-lineaire expressiviteit van het netwerk na normalisatie te herstellen.
(3) Feature-compressielaag
Na diepgaande feature-extractie voegen we een featurecompressielaag toe aan het einde van het MLP-blok om belangrijke informatie te behouden terwijl redundantie wordt onderdrukt, de rekenlast van latere modules wordt verminderd en milde regularisatie mogelijk wordt. Laat de invoervector zijn  . De gecomprimeerde uitgang is
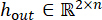 , met parameters
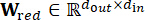 ,
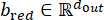 . De operatie is:
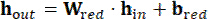 (8)
Piramide-aandacht (PA) mechanisme
Laat de laatste MLP-laagoutput zijn  . Om expliciete selectie over niet-lineaire interacties van hogere orde mogelijk te maken, herschikken
 we eerst per veld/kanaal in een matrix25:

 (9)
Waarbij C het aantal kanalen is en L de lengte per kanaal.
(1) Multi-scale feature constructie.
Langs de kenmerkas L pas je 1D-pooling toe met meerdere schalen om26 te verkrijgen
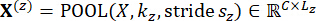 (10)
waarbij ks en stride de s-de toonladder definiëren.
(2) Focus per schaal kanaliseren.
Voor elke weegschaal bouw je een kanaalbeschrijving en aandachtgewichten27:
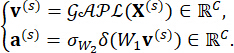 (11)
Waar δ(⋅) ReLU is, σ(⋅) Sigmoïde is,
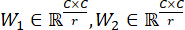 , r is de reductieverhouding.
Pas de gewichten kanaalgewijs toe:
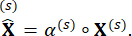 (12)
(3) Fusie en terugschrijven.
Projecteer elke schaal met GAPL naar een uniforme 1D-ruimte en fuseer ze:
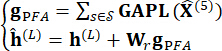 (13)
waarbij Ps fusiegewichten zijn en Wr een leerbare projectie is die wordt gebruikt in de residuele write-back.
Eindstand:
 (14)
Waar ⊙ het Hadamard-product (elementgewijze) aanduidt en  vectorconcatenatie.
Top-N taakformalisering en leerdoel
(1) Probleeminstelling.
Laat de fanset F zijn en de itemset I (tickets, merchandise, lidmaatschapsvoordelen en content). Impliciete feedback  geeft aan of de fan
 met het item
 heeft gecommuniceerd (klik, aankoop, aanwezigheid/validatie, enz.). De positieve steekproeven in de trainingsset zijn
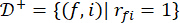 ,
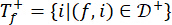 .
We injecteren de vier relatiemarketingvariabelen—tevredenheid, vertrouwen, toewijding, wederkerigheid—als vector: 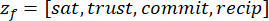 in de aandachtslaag om een contextbewuste relatierepresentatie
 te verkrijgen, die wordt samengevoegd met fan/item-embeddings
 om de score
 te produceren. Voor elk positief paar
 , trekken we meerdere negatieve met een vaste verhouding van
 tot vormen
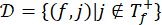 .
(2) Paargewijze doelstelling.
Om de relatieve rangschikking direct te optimaliseren, gebruiken we het BPR (Bayesian Personalized Ranking) verlies28:
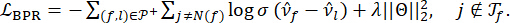 (15)
Hier 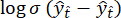 drukt de waarschijnlijkheid uit dat "de positieve score hoger is dan de negatieve score";
 is een L2 regularizer om overfitting te beheersen;
 duidt alle leerbare parameters aan.
(3) Afleiding en rangorde.
Tijdens het testmoment is de kandidaatverzameling . 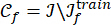 We berekenen scores , en geven de Top-N lijst29 terug:
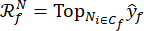 (16)
Ontwerp van aanbevelingsalgoritmen
Deze sectie beschrijft de volledige aanbevelingsworkflow die in deze studie is gebruikt, en behandelt de end-to-end pipeline van datapreprocessing tot modeltraining en online inferentie. De workflow legt uit hoe ruwe interactiegegevens tussen fan en item en relatievariabelen worden omgezet in gepersonaliseerde rangschikkingsscores door middel van representatieleren en aandachtgebaseerde modellering. De gedetailleerde procedure wordt als volgt uiteengezet.
Stap 1: Datavoorbereiding en normalisatie.
CSL-fan–item-interactielogs worden omgezet in impliciete feedbacksignalen. Ontbrekende waarden worden behandeld en de vier relatievariabelen—tevredenheid, vertrouwen, toewijding en wederkerigheid—worden genormaliseerd. De gegevens worden chronologisch opgesplitst in trainings-, validatie- en testsets, en voor elke positieve interactie worden meerdere negatieve steekproeven gegenereerd.
Stap 2: Relatie-aandacht codering.
De vier relatievariabelen worden ingevoerd in een aandachtsmodule om contextbewuste belangrijkheidsgewichten te leren, wat een compacte fanrelatierepresentatie voor downstream modellering oplevert.
Stap 3: Interactie-invoerconstructie.
Fan- en item-embeddings worden geleerd en gekoppeld aan de relatierepresentatie om de volledige featurevector te vormen voor elke fan–item-interactie.
Stap 4: Representatieleren.
De interactiekenmerken worden door een MLP-tak gestuurd om hoge-orde niet-lineaire patronen vast te leggen en een gefuseerde latente representatie te genereren.
Stap 5: Piramide-aandacht voor de functie.
Bovenop de MLP-output wordt een multi-scale feature-piramide opgebouwd. Kanaalgewijze aandacht en cross-scale fusie worden toegepast, en verbeterde functies worden geïntegreerd via residuele verbindingen om opvallende kanalen te versterken terwijl redundante worden onderdrukt.
Stap 6: Scoren en output.
De lineaire tak wordt gekoppeld aan de verbeterde niet-lineaire representatie en in de uitvoerlaag gevoerd om een voorkeurscore te berekenen voor elk fan–item-paar.
Stap 7: Training en optimalisatie.
Het model is geoptimaliseerd met behulp van een paargewijs rangschikkingsdoel. Een adaptieve optimizer wordt gebruikt samen met gewichtsafname, dropout en vroegtijdig stoppen om generalisatie te verbeteren en overfitting te beperken.
Stap 8: Bayesiaanse hyperparameteroptimalisatie.
Validatierangschikkingsstatistieken worden gebruikt als doel om automatisch te zoeken naar belangrijke hyperparameters, waaronder embedding-dimensies, netwerkdiepte en -breedte, leersnelheid, negatieve steekproefratio, uitvalpercentage en piramide- en aandachtgerelateerde parameters.
Stap 9: Afleiding en rangschikking.
Tijdens online inferentie worden voorkeurscores voor elke fan berekend ten opzichte van de kandidaat-item set om Top-N aanbevelingen te genereren, met optionele post-rankingstrategieën die rekening houden met vernieuwing, diversiteit en zakelijke beperkingen.
Experimentele validatie
Dataset en featureschema
We evalueren op een zelfgebouwde dataset die (via gehashte fan-ID's) gedeïdentificeerde CSL-clubinformatiesysteemlogs van fan–item impliciete interacties verbindt met een gelijktijdige relatie-enquête. De gegevens bestrijken vier zakelijke domeinen—tickets, merchandise, lidmaatschap en content—en omvatten evenementen voor browsen, klikken, toevoegen aan winkelwagen/favoriet, aankoop/ticketverkoop en validatie-evenementen in het stadion, met tijdstempels, contactpuntkanaal, contexttags en promotievlaggen. De periode is ≥ één volledig seizoen; De schaal is ongeveer zo groot als fans, items en evenementen die voldoende zijn voor diepgaand modelleren.
Featureschema en coderingen: Items-ItemID, ItemType, TeamTag, PriceBand (ID/categorie-embeddings); Fans—FanID, Regio, Lidmaatschapsniveau, Diensttijd (FanID geleerd als embedding; andere categorische/numerieke velden gestandaardiseerd); RQ-functies—Tevredenheid, Vertrouwen, Toewijding, Wederkerigheid opgeschaald tot [0,1] en doorgestuurd naar het Attention-kanaal, waarna het via PA met MLP-representaties worden gefuseerd; Context—PhaseTag, Channel, PromoFlag, Hour, Weekday (categoricals als embeddings; tijd komt voor met sinusvormige sin/cos-codering).
Hyperparameteroptimalisatie
Belangrijke hyperparameters van MLP-PA worden afgestemd via Bayesiaanse optimalisatie binnen een vooraf ingestelde zoekruimte, waarbij NDCG@10 op de validatieset als primaire target wordt gebruikt (met HR@10 als referentie) en vroegtijdig wordt gestopt om overfitting te beperken. Elke kandidaatconfiguratie wordt uitgevoerd onder meerdere willekeurige seeds en gemiddeld gemaakt. De definitieve ingezette instellingen worden gerapporteerd in Tabel 1.
| Hyperparameter | Beschrijving | Zoekgebied | Geselecteerde waarde |
| Embedding-dimensie | Grootte van fan/item embedding | {32, 64, 128} | 64 |
| MLP verborgen lagen | Aantal MLP-lagen | {2, 3, 4} | 3 |
| MLP verborgen eenheden | Eenheden per verborgen laag | {64, 128, 256} | 128 |
| Uitvalpercentage | Uitvalkans | [0.1, 0.5] | 0.3 |
| Leertempo | Initiële leersnelheid | [1e-4, 1e-2] | 1.00E-03 |
| Negatieve steekproefverhouding | Negatief per positief monster | {1, 3, 5, 10} | 5 |
Tabel 1: Definitieve hyperparameterinstellingen van het MLP-PA Model
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Convergentie en stabiliteit
Om het convergentiegedrag en de trainingsstabiliteit van het voorgestelde model te evalueren, vergelijken we de validatieprestaties met een standaard MLP-gebaseerde aanbevelingsmachine zonder piramidefeature-aandacht of relatiebewuste aandacht, die als controlemodel dient. Alle modellen worden getraind onder identieke datasplitsingen, optimalisatie-instellingen en stopcriteria om een eerlijke vergelijking te garandere...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Conceptuele en methodologische bijdragen
Deze studie draagt conceptueel bij door relatiedimensies – tevredenheid, vertrouwen, toewijding en wederkerigheid – te herkaderen niet als statische hulpkenmerken, maar als contextgevoelige relationele signalen waarvan de invloed varieert tussen de betrokkenheidsfasen. Het voorgestelde kader operationaliseert dit idee via een aandachtsgebaseerd mechanisme dat relationele aanwijzingen dynamisch herweegt ...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteur heeft geen belangenconflicten om op te geven.
Dankbetuigingen
De auteur wil de anonieme beoordelaars bedanken voor hun constructieve opmerkingen en suggesties, die hebben bijgedragen aan de duidelijkheid en kwaliteit van dit manuscript. Hij erkent ook de steun van de samenwerkende organisatie voor het bieden van toegang tot de gegevens die in deze studie zijn gebruikt. Alle meningen, bevindingen en conclusies die in dit artikel worden geuit, zijn die van de auteur en weerspiegelen niet noodzakelijkerwijs de standpunten van de aangesloten instellingen.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Python | https://www.python.org | 3.9.10 | |
| Deep learning framework | PyTorch | https://pytorch.org | >= 1.12 |
| Hyperparameter optimization library | Optuna | https://optuna.org | >= 3.0 |
| Hardware | NVIDIA GPU | https://www.nvidia.com | Single GPU, >= 8 GB geheugen |
| Dataset | Zelfgebouwde CSL-fandataset | N/A | Één volledig seizoen of langer; schaal voldoende voor diep modelleren |
| Interactiegegevens | Fan–item impliciete interactielogboeken | N/A | Niet apart geversioneerd |
| Enquêtegegevens | Relatie-vragenlijstgegevens | N/A | Niet apart geversioneerd |
| Gegevensvoorbewerkingsmethode | Hash-gebaseerde anonimisatie | N/A | Toegepast op fan- en item-identificatoren |
| Gegevensvoorbewerkingsmethode | Gemiddelde invulling binnen lidmaatschapsniveau | N/A | Toegepast op ontbrekende vragenlijstreacties |
| Gegevensvoorbewerkingsmethode | Min–max normalisatie | N/A | Bereik [0, 1] |
| Gegevenssplitsingsstrategie | Chronologische gebruikersniveausplitsing | N/A | Meest recente = test; op een na recentste = validatie; rest = training |
| Negatieve bemonstering | Uniforme negatieve bemonstering | N/A | Positief:negatief-verhouding = 1:5 |
| Modelbackbone | MLP (Multi-Layer Perceptron) | https://pytorch.org/docs/stable/nn.html | Verborgen lagen [128, 64, 32] (geoptimaliseerd) |
| Aandachtsmodule | Relatie-aandachtskanaal | N/A | Aangepaste module |
| Fusiemoduul | Pyramid Attention (PA) | N/A | Pooling-schalen {1, 2, 4}, stride = kernelgrootte, reductieverhouding = 4 |
| Optimalisator | Adam | https://pytorch.org/docs/stable/generated/torch.optim.Adam.html | Leertempo 0,001, gewichtsverval 1e-5 |
| Regularisatie | Dropout | https://pytorch.org/docs/stable/generated/torch.nn.Dropout.html | Tarief 0,3 |
Referenties
- Wang, L., et al. Drug combination recommendation model for systemic lupus erythematosus and antiphospholipid syndrome. Pharmaceutics. 18 (8), 1224(2025).
- Hu, X., Yuan, Z., Ma, Z. A robot control knowledge recommendation model PKGAT based on multimodal knowledge graph. Int J Softw Eng Knowl Eng. 35 (8), (2025).
- Ji, S. An intelligent recommendation model for disclosure of electricity market entities based on association rule mining algorithm. Electr Eng. , In press (2025).
- Xie, F., et al. Differential weighting and flexible residual GCN-based contrastive learning for recommendation. Symmetry. 17 (8), 1320(2025).
- Duan, J., et al. A deep recommendation model based on semantic information and correlation between items. J Intell Inf Syst. , In press (2025).
- Malakhatka, E., et al. Optimal time recommendation model for home appliances: HSB Living Lab dishwasher study. Energy Effic. 18 (1), 3(2024).
- Yuan, Q., Cong, G., Ma, Z., Sun, A., Magnenat-Thalmann, N. Time-aware point-of-interest recommendation. Proc Int ACM SIGIR Conf Res Dev Inf Retr, 36, 363-372 (2013).
- Alaoui, E. D., et al. Comparative study of filtering methods for scientific research article recommendations. Big Data Cogn Comput. 8 (12), 190(2024).
- Li, X., Hu, G. Design and implementation of an electronic journal resource recommendation system integrating user profile and knowledge graph. Front Comput Intell Syst. 10 (2), 74-78 (2024).
- Sami, A., et al. A deep learning-based hybrid recommendation model for internet users. Sci Rep. 14 (1), 29390(2024).
- Zhonghua, W. Intelligent recommendation model of tourist places based on collaborative filtering and user preferences. Appl Artif Intell. 37 (1), (2023).
- Wang, Q., Esquivel, A. J. Personalized movie recommendation system based on DDPG: Application and analysis of reinforcement learning in user preferences. Front Soc Sci Technol. 5 (18), (2023).
- Miao, L., et al. Study on two-tier EV charging station recommendation strategy under multi-factor influence. J Artif Intell. 5, 181-193 (2023).
- Yunni, X., et al. A quasi-Newton matrix factorization-based model for recommendation. Int J Web Serv Res. 20 (1), 1-15 (2023).
- Mourad, J., et al. Personalized PV system recommendation for enhanced solar energy harvesting using deep learning and collaborative filtering. Sustain Energy Technol Assess. 60, 103456(2023).
- Pfajfar, G., et al. Value of corporate social responsibility for multiple stakeholders and social impact: A relationship marketing perspective. J Bus Res. 143, 46-61 (2022).
- Khan, R. U., et al. The impact of customer relationship management and company reputation on customer loyalty: The mediating role of customer satisfaction. J Relatsh Mark. 21 (1), 1-26 (2022).
- Sheth, J. New areas of research in marketing strategy, consumer behavior, and marketing analytics: The future is bright. J Mark Theory Pract. 29 (1), 3-12 (2021).
- Mishra, M., Mund, P. Fifty-two years of consumer research based on social exchange theory: A review and research agenda using topic modeling. Int J Consum Stud. 48 (4), e13074(2024).
- Cook, K. S., Hahn, M. Social exchange theory: Current status and future directions. Theor Sociol. 50, 179-205 (2021).
- Naseer, A., Jalal, A. Multimodal objects categorization by fusing GMM and multilayer perceptron. Proc 5th Int Conf Adv Comput Sci (ICACS), , 1-7 (2024).
- Hussain, K., et al. Analyzing LULC transformations using remote sensing data: Insights from a multilayer perceptron neural network approach. Ann GIS. 30, 1-28 (2024).
- Mfetoum, I. M., et al. A multilayer perceptron neural network approach for optimizing solar irradiance forecasting in Central Africa with meteorological insights. Sci Rep. 14 (1), 3572(2024).
- Yu, Y., et al. Multi-scale spatial pyramid attention mechanism for image recognition: An effective approach. Eng Appl Artif Intell. 133, 108261(2024).
- Liu, H., et al. A deep convolutional neural network for the automatic segmentation of glioblastoma brain tumor: Joint spatial pyramid module and attention mechanism network. Artif Intell Med. 148, 102776(2024).
- Liu, M., et al. Vehicle object counting network based on feature pyramid split attention mechanism. Vis Comput. 40 (2), 663-680 (2024).
- Alvarado, O., et al. A systematic review of interaction design strategies for group recommendation systems. Proc ACM Hum-Comput Interact, 6 (CSCW2), 1-51 (2022).
- Zhao, Y. Design of garment style recommendation system based on interactive genetic algorithm. Comput Intell Neurosci. 2022, 9132165(2022).
- Nazer, L. H., et al. Bias in artificial intelligence algorithms and recommendations for mitigation. PLOS Digit Health. 2 (6), e0000278(2023).
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.