De huidige studie beschrijft een workflow voor nanoporesequencing van plasmiden wanneer de chromosomale sequentie al bekend is of niet van belang is. Een initiële plasmide-DNA-verrijkingsstap zorgt voor een optimale plasmidesequentiediepte en maximaliseert het aantal monsters dat per flowcel kan worden gesequenced.
Methodenartikel
Long-read plasmidvolgordebepaling en assemblage met behulp van op nanopore sequencing gebaseerde workflows
* These authors contributed equally
In dit artikel
Samenvatting
Samenvatting
De huidige studie beschrijft een workflow voor nanoporesequencing die is ontworpen om de plasmide-DNA-opbrengst en sequencingnauwkeurigheid te maximaliseren. Onderzoekers behandelen elke stap van het proces, waaronder plasmide-DNA-extractie, bibliotheekvoorbereiding met snelle streepjescodering en adapterligatie, het laden van de bibliotheek op een flowcel voor sequencing, basisoproep (in realtime of post-hoc), en sequentieassemblage met behulp van Autocycler. De auteurs specificeren ook de computervereisten, die grotendeels afhangen van of basecalling in realtime wordt uitgevoerd. De auteurs sequencen plasmiden die gezuiverd zijn uit tien klinische stammen met behulp van deze workflow. Om verschillen tussen gastheercelstam als variabele te elimineren, conjugeerden de auteurs deze klinische stammen ook met een gemeenschappelijke ontvangerstam en sequenceden de transconjuganten. Deze experimenten leverden plasmidassemblages op die overeenkomen met plasmidgroottes afgeleid uit gelmobiliteit en die, in tweederde van de gevallen, ook overeenkomen met kortgelezen gepolijste assemblages of binnen 0,05% paargewijze sequentie-identiteit vallen. De verrijking van plasmide-DNA-sequenties maximaliseert ook de efficiëntie van plasmidesequencing, waardoor parallelle sequencing van maximaal 24 monsters met optimale dekking mogelijk is. Dit protocol is geschikt voor plasmiden variërend van 4 tot 174 kb en verdraagt tot 72% chromosomale besmetting zonder de nauwkeurigheid te beïnvloeden. Dit protocol is ideaal voor situaties waarin de chromosomale sequentie al bekend is of niet van interesse, zoals voor plasmidesequentieverificatie, het verbeteren van de nauwkeurigheid van plasmidesequenties die al door WGS zijn verkregen, of het sequencen van plasmiden die door conjugatie worden gevangen. Het organisme dat wordt gebruikt om dit werk te illustreren is Escherichia coli, dat representatief is voor gastheren die worden gebruikt voor recombinante genexpressie en voor plasmidevangst via conjugatie.
Inleiding
Plasmiden zijn zelfreplicerende DNA-stukken die overal in bacteriën voorkomen. Ze zijn sterk variabel in grootte, variërend van <800 bp tot 2,5 Mbp, en volgen doorgaans een bimodale verdeling, met een kleinere piek die overeenkomt met multicopy, niet-conjugatieve plasmiden en een grotere piek die overeenkomt met laag-kopie, vaak conjugatieve plasmiden 1,2. Plasmiden spelen een sleutelrol in de microbiële ecologie en dragen genen die hun gastheren helpen zich aan te passen aan milieuproblemen of nieuwe ecologische niches te bereiken. Plasmiden dienen ook als platforms voor versnelde evolutie, bieden verhoogde genetische plasticiteit en bemiddelen horizontale genoverdracht tussen stammen, soorten, geslachten en zelfs families 3,4. Netwerk- en vergelijkende genomische analyses hebben de rol van het milieuresistent als een persistent reservoir voor klinisch relevante antibioticaresistentiegenen (ARG's) bevestigd, waardoor hun behoud en verspreiding over ecologische omgevingen mogelijk is5. Het volgen van plasmiden en hun lading antibioticaresistentie- en virulentiegenen helpt bij het identificeren van transmissieroutes6. Daarom is de identificatie en karakterisering van plasmiden van groot belang voor diverse toepassingen in de volksgezondheid, klinische microbiologie en biotechnologie.
De introductie van next-generation sequencing (NGS)-technologieën, die de high-throughput sequencing van onbekende DNA-templates mogelijk maken, heeft de deur geopend voor genomische karakterisering van microbiële isolaten. Whole genome sequencing (WGS) maakt het mogelijk om het ontstaan, de verspreiding en overdracht van nieuwe ziekteverwekkers, medicijnresistente stammen en vaccin-ontwijkende varianten te volgen. Het wordt ook steeds vaker gebruikt om transmissieroutes te identificeren tijdens klinische uitbraken, wat mogelijk interventies kan informeren voor toekomstige uitbraakpreventie7. Ten slotte maakt WGS het mogelijk om ARG's te profileren, wat therapeutische beslissingen kan informeren8, hoewel het koppelen van ARG's aan kwalitatieve en kwantitatieve fenotypes van antibioticaresistentie nog steeds in uitvoering is9.
De short-read (SR) sequencinggegevens die WGS doorgaans op schaal produceert, liggen echter doorgaans in het bereik van 400–500 bp. Deze grootte is korter dan de grootte van de meeste Mobile Genetic Elements (MGE's) en kan ze daarom niet10 resoluties geven. De in silico identificatie van plasmidesequenties in WGS-gegevens wordt verder bemoeilijkt door onvolledige dekking en door gedeelde sequenties tussen plasmiden en tussen bacteriële chromosomen en andere plasmiden10. Als gevolg hiervan zijn assemblages vaak sterk gefragmenteerd en onvolledig, waardoor hun subgenomische locatie (chromosomaal of plasmide) onmogelijk is om10 toe te wijzen.
Long-read (LR) sequencingtechnologie genereert zeer aaneengesloten assemblages die zich over meer herhalingen uitstrekken, wat de productie van complete plasmidassemblages aanzienlijk vergemakkelijkt. Er zijn in wezen twee soorten langgelezen, enkelmolecuultechnologieën beschikbaar: 11,12. Een van deze benaderingen, nanoporesequencing, wordt steeds populairder in microbiële genomica vanwege de lage kosten, snelle doorlooptijden en geschiktheid voor omgevingen met beperkte middelen 13,14.
Nanopore-sequencing-apparaten gebruiken flowcellen met arrays van duizenden nanoporiën. Het DNA wordt in de flowcel geladen, geopend door een motorisch eiwit met helicaseactiviteit, en gaat door de nanopore die wordt aangedreven door een stroomdifferentieel. Wanneer nucleotiden in een gegeven enkele streng door individuele nanoporiën gaan, wordt de stroom verstoord om een karakteristisch signaal te produceren dat wordt gemeten door een elektronische sensor die op elke porie is aangesloten. Dit signaal wordt gedecodeerd met behulp van basecalling-algoritmen, en de resulterende data wordt later samengesteld en geanalyseerd met behulp van diverse bio-informatica-tools.
In vergelijking met SR-sequencing-benaderingen heeft nanoporesequencing de neiging tot een lagere leeskwaliteit (lagere Q-scores) en genereert het inserties/deleties in homopolymeersequenties tijdens de data-analyse van elektrische signalen (basecalling)15. Er is ook opgemerkt dat nabijgelegen methylatie in native DNA systematische basecallfoutenkan veroorzaken. Een veelgebruikte oplossing is het opnemen van korte leesgegevens voor foutcorrectie na assemblage. Dit proces (bekend als "polijsten") verhoogt echter de kosten en complexiteit van de overheadmet 17. Het vergroten van de sequencing-dekking kan ook de nauwkeurigheid verbeteren, maar het is technisch gezien niet altijd haalbaar.
In 2024 werd aangetoond dat Oxford Nanopore Sequencing (ONT) R10.4.1 flowcellen en V14-chemie hoogwaardige en aaneengesloten assemblages voor G-bacteriën opleveren, terwijl fijnmalige analyses op enkel-nucleotide niveaus nog steeds profiteren van SR-sequencingdata18. De kloof tussen de nauwkeurigheid van LR- en SR-sequencing wordt echter geleidelijk dichtgedrukt. Diverse recente verbeteringen omvatten een preciezer databemonsteringsproces met een verhoogde sequencingsnelheid, de introductie van een nieuwe basecaller die is afgestemd op native bacteriële DNA en methylering, wat leidt tot verhoogde basecall-nauwkeurigheid19, en bijgewerkte analysetools zoals nieuwe algoritmen voor faseren, variantroepen en ster-alleel calling. Let ook op dat het nieuwste Dorado-algoritme V.0.9.0 ONT (2025) kan worden gebruikt voor het herbaseren aanroepen van ruwe squiggle-gegevens. Sommige WGS-studies rapporteren zelfs al de generatie van microbiële genomen door nanopore-sequencing van een kwaliteit waarvoor short-read polishing niet naar verwachting de consensussequentie significant zal verbeteren20,21.
Plasmiden bevatten vaak het grootste deel van de verworven resistentiegenen, met name in Enterobacteriaceae-isolaten22. Daarom maakt het oplossen van plasmidesequenties de contextualisering van AR-genen mogelijk, wat essentieel is voor het volgen van AMR-overdracht23,24. Nanopore-sequencing is al gebruikt om de micro-evolutie van blaKPC met plasmiden25 te onderzoeken. MinION-apparaten zijn ook gebruikt voor realtime benchtop-sequencing van plasmiden en resistentiegendetectie in klinische isolaten in ziekenhuisomgevingen26. Dat gezegd hebbende, is plasmideonderzoek nog geen onderdeel van de routine infectiepreventie.
Ondanks de aanzienlijke verbetering van LR-sequencing ten opzichte van SR-sequencing in het vermogen om plasmiden uit genomische sequentie27 te redden, blijven er enkele problemen bestaan. Langdurige assemblers zoals Flye28, Canu29 en Raven30 produceren chromosomale assemblages van hoge kwaliteit, maar worstelen met het samenstellen van plasmidsequenties. Dit komt deels door onvoldoende diepte van dekking omdat plasmide-DNA ondervertegenwoordigd is in WGS-sequencingdata31. Let op dat vanwege hun modulaire structuur, overvloed aan secundaire structuren en frequente aanwezigheid van herhalingen, de hoogwaardige assemblage voor plasmide-DNA-sequentie een hogere dekking vereist dan chromosomaal DNA (50x leesdiepte32).
Het verrijken van DNA-monsters met plasmidesequenties is een effectieve methode om de dekking dieper te maken, maar isolatie of verrijking van plasmide-DNA vóór DNA-sequencing is te duur of omslachtig voor klinische diagnostische toepassingen en kan bias veroorzaken door geselecteerde DNA-sequenties te verrijken. In 2017 werd plasmide-verrijkt DNA gebruikt om de volledige assemblage van plasmide-DNA in klinische monsters te proberen voor de detectie van ARGs24. Acht isolaten van zes verschillende Enterobacteriaceae-soorten werden gesequenced om de populatie- en plasmidstructurele diversiteit te maximaliseren. Na het proberen van verschillende assemblers bleek dat Canu/Canu+Pilon duidelijk beter presteerde dan anderen; Deze onderzoeksgroep probeerde ook een meta-assemblagebenadering die de resolutie van extra plasmidestructuren bereikte, wat resulteerde in de volledige assemblage van 78% van alle bekende plasmiden in de gesequencede monsters. De aanwezigheid van large-repeat structuren en (in mindere mate) problemen met DNA-extractie leverden echter aanzienlijke problemen op voor de detectie van alle single-contig plasmidassemblages24.
Meer recentelijk is adaptieve bemonstering als complementaire benadering voor de verrijking van laag-abundantie plasmidesequenties onderzocht door chromosomale sequenties in bacteriële isolatmonsters te verwerpen, hoewel deze methode bekende referentiesequenties33 vereist.
Hier beschrijven de auteurs protocollen voor ONT-sequencing die zijn aangepast voor monsters verrijkt met plasmide-DNA. Door een verhoogde representatie van plasmide-DNA te combineren met actuele protocollen voor bibliotheekvoorbereiding, flowcelltechnologie en sequentieassemblagetools, produceerde de workflow assemblages die overeenkwamen met de groottes afgeleid uit gelmobiliteit en in 2/3 van de gevallen ofwel overeenkwamen met SR-sequencing polishing of binnen 0,05% paargewijze sequentie-identiteit vielen. De verrijking van plasmide-DNA-sequenties maximaliseert ook de efficiëntie van plasmidesequencing, waardoor parallelle sequencing van maximaal 24 monsters met optimale dekking mogelijk is. De protocollen zijn niet bedoeld om standaard nanopore WGS-benaderingen te vervangen, maar om de nauwkeurigheid en efficiëntie van plasmidsequencing te maximaliseren in situaties waarin de chromosomale sequentie al bekend is of niet van belang is.
De workflow omvat plasmide-DNA-extractie, bibliotheekvoorbereiding met barcodering, adapterligatie naar een motoreiwit, het controleren van de flowcel, het laden van de bibliotheek op een flowcel voor sequencing, data-analyse van de elektrische signalen (in realtime of post hoc), sequentieassemblage met Autocycler34, en diverse downstream-analyses (Figuur 1).
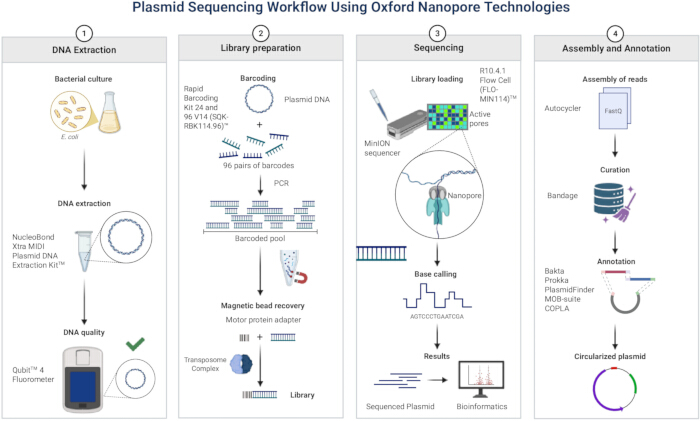
Figuur 1: Plasmidesequencing-workflow met Oxford Nanopore Technologies. Stap 1: DNA-extractie; Stap 2: Bibliotheekvoorbereiding; Stap 3: Sequencing; Stap 4: Assembleren en annoteren. Gemaakt in BioRender. Cortés, G. (2026) https://BioRender.com/u3b15st. Klik hier om een grotere versie van deze figuur te bekijken.
Protocol
1. Plasmide-DNA-extractie
OPMERKING: Dit protocol werd gebruikt om plasmide-DNA te extraheren uit een klinische Escherichia coli-stam en de bijbehorende transconjuganten met behulp van een commerciële Plasmid DNA Extraction Kit35. Gedetailleerde protocollen voor conjugatie zijn te vinden in36. Het protocol is geschikt voor zowel hoogkopie- als laagkopieplasmiden, variërend van ~3 kb tot ~200 kb. Grote plasmiden vereisen speciale aandacht omdat ze doorgaans een laag kopieaantal hebben (slechts 1–2 kopieën per cel), wat de DNA-opbrengst beperkt. Om dit te compenseren raadt het protocol aan om de celmassa en de volumes van lysis- en neutralisatiebuffers te vergroten om voldoende plasmide-DNA voor kolombinding te garanderen. Plasmiden tot 200 kb kunnen nog steeds worden teruggewonnen met dit protocol; de toepasbaarheid op megaplasmiden (>200 kb) is echter beperkt.
- Plasmide-extractie
- Dag 1: Steek monsters op Luria–Bertani (LB) agarplaten, aangevuld met het juiste antibioticum voor het selecteren van de respectievelijke plasmide-gedragen resistentiemarker en incubeer bij 37 °C gedurende 24 uur.
OPMERKING: Voeg carbenicilline (of geschikt antibioticum) toe aan LB bij een eindconcentratie van 100 μg/mL door 1 μL van een 100 mg/mL bouillonoplossing per mL medium toe te voegen. - Dag 2: Inoculeer 3–5 mL LB met het juiste antibioticummedium met één geïsoleerde kolonie vanaf dag 1. Broed met schudden bij 37 °C gedurende ~8 uur, of totdat de cultuur een OD₆₀₀₀ van 1–2 bereikt.
OPMERKING: Meting van OD600: Blank de spectrofotometer met vers LB-medium met het juiste antibioticum, doe vervolgens 1 mL kweek over in een schone cuvette en meet de OD op 600 nm. Als de meting het lineaire bereik overschrijdt, verdun dan de monster en meet je opnieuw. - Inoculeer 400 mL LB aangevuld met het juiste antibioticummedium met 400 μL van de starterkweek van dag 2. Incubeer met schudden bij 37 °C gedurende 8–12 uur, of totdat de OD600 1–2 bereikt (zoals eerder beschreven).
OPMERKING: Verhoog het kweekvolume boven 400 mL als OD600 niet binnen 12 uur 1–2 bereikt. Om het risico op plasmidverlies of -herschikking te verminderen, beperk passage in kweek zoveel mogelijk en houd de antibioticaselectie gedurende alle groeistappen. Verhoog het kweekvolume alleen wanneer een hogere DNA-opbrengst gewenst is. - Dag 3: De cultuur overbrengen in centrifugeflessen die passen bij het kweekvolume. Centrifugeer op 4200 x g gedurende 10 minuten, en suspendeer de pellet vervolgens opnieuw met de door de fabrikant aanbevolen reagensvolumes volgens de volgende formule:
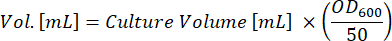
OPMERKING: Voorbeeld: Voor 400 mL van een bacteriecultuur met een lage kopie (OD600 = 2) om te worden gelyseerd, zijn de juiste volumes van de lysisbuffers RES, LYS en NEU elk 16 mL.
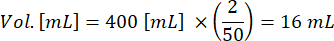
OPMERKING: als reagensvolumes voor resuspendie, lysis of neutralisatie niet correct zijn geschaald naar de totale cultuurbiomassa (OD600 × volume, of ODV), kan de lysis onvolledig zijn, neutralisatie inefficiënt en de neerslagvorming overdreven. Dit kan leiden tot een lagere plasmideopbrengst, verminderde zuiverheid en mogelijke verstopping van zuiveringskolommen. Het proportioneel schalen van buffervolumes, met behulp van de formule van de fabrikant (stap 1.1.4.), zorgt voor efficiënte lysis, volledige neutralisatie en een consistente terugwinning van hoogwaardig plasmide-DNA. - Voer cellysie uit, filterbevochtiging met de juiste buffer en neutralisatie zoals door de kit is aangegeven.
OPMERKING: Stapel twee filters als het neerslagvolume groot is, en pas de buffer proportioneel aan. Voer extra centrifugatiestappen uit als het supernatant ondoorzichtig blijft. Na neutralisatie kan het hoge volume neerslag extra centrifugatiestappen vereisen. Dit geldt voor de meeste klinische monsters van E. coli, mogelijk omdat ze de neiging hebben biofilm te vormen in cultuur37, waarbij een dikke matrix38 wordt afgescheiden. Overmatige neerslag in het lysaat kan de kolom verstoppen, de draintijd verlengen en mogelijk het monster besmetten met eiwitten. Als het supernatant schoon is, zijn deze extra stappen mogelijk niet nodig. - Centrifugeer het lysaat op 4200 x g gedurende 30 minuten. Breng het supernatant over in een nieuwe buis en centrifugeer opnieuw gedurende 30 minuten. Als het supernatant na deze spins ondoorzichtig blijft (Figuur 2), voer dan een extra centrifugatie uit bij 4200 x g.
OPMERKING: Het overbrengen van het lysaat naar een 50 mL kweekbuis tijdens centrifugatie kan het verwijderen van supernatanten vergemakkelijken, omdat neerslag soms niet goed pellett en dicht bij de buistop blijft hangen. Door de grote verwerkte volumes kan een enkele kolom verzadigd raken en geen extra monsters meer kunnen opvangen. Om de filtratiesnelheid te verhogen of de DNA-opbrengst te maximaliseren, kan het lysaat worden verdeeld over twee kolommen. - Voer EQU-, WASH- en ELU-stappen uit volgens de instructies van de kit.
- Slaan DNA neer met isopropanol.
OPMERKING: Incubeer bij -20 °C gedurende ~10 minuten als de pellet niet zichtbaar is. Het is echter over het algemeen het beste om het supernatant voorzichtig te verwijderen, in de hoop dat de pellet aan de buiswanden blijft kleven, ook al is hij niet zichtbaar. - Was DNA met ethanol zoals voorgeschreven. Voer extra wash uit als het eiwitprecipititatie blijft bestaan.
- Droog DNA bij kamertemperatuur (~20 °C) gedurende 15–30 minuten.
- Resuspendeer DNA in 100 μL nucleasevrij water; dit kleine volume helpt de concentratie te maximaliseren voor de voorbereiding van de Nanopore-bibliotheek.
OPMERKING: Dit is een handig stoppunt. Plasmide-DNA kan enkele maanden worden opgeslagen bij –20 °C. De extractiekit die in dit protocol wordt gebruikt, is zo ontworpen dat besmetting door chromosomaal (genomisch) DNA wordt geminimaliseerd door geoptimaliseerde bufferchemie, zachte lysis en lysaatklaringstappen, hoewel aanzienlijke chromosomale DNA-besmetting niet kan worden uitgesloten, en de auteurs vonden dit in de preps (zie resultaten).
- Dag 1: Steek monsters op Luria–Bertani (LB) agarplaten, aangevuld met het juiste antibioticum voor het selecteren van de respectievelijke plasmide-gedragen resistentiemarker en incubeer bij 37 °C gedurende 24 uur.
- DNA-opbrengst en kwaliteitscontrole
Kwantificeer DNA en beoordeel de kwaliteit ervan met behulp van fluorescerende kleurstoffen, die een grotere specificiteit en gevoeligheid bieden voor lage DNA-concentraties in vergelijking met UV-absorptiemethoden. Gebruik in dit protocol een fluorometerapparaat om DNA, RNA of eiwitmonstersnauwkeurig en handig te kwantificeren.- Fluorometerworkflow
- Breng DNA-monsters op kamertemperatuur. Bereid buizen voor standaarden en monsters.
OPMERKING: Bereken de juiste volumes kleurstof en buffer die in de werkoplossing moeten worden opgenomen op basis van het aantal monsters. Voor elke standaard en monster moet 200 μL werkoplossing worden bereid door de kleurstof in de buffer te verdunnen in een verhouding van 1:200. Het apparaat heeft een ingebouwde Reagentencalculator die ook voor deze berekeningen kan worden gebruikt. - Bereid de assaybuizen voor volgens Tabel 1.
- Laat elke buis een paar seconden vortexen voordat hij 2 minuten op kamertemperatuur incubeert.
- Kalibreer de fluorometer met behulp van de standaarden. Steek monsterbuisjes in en neem metingen op. Voor gedetailleerde instructies raadpleeg de Fluorometerhandleiding39.
OPMERKING: Voor typische plasmidpreparaten worden DNA-opbrengsten verwacht te variëren van ~50 tot 150 μg per 100–400 mL cultuur, afhankelijk van plasmidgrootte, kopieaantal en groeicondities. Typische nanopore-leeslengtes variëren van ~2 kb tot 20 kb, met mediane leeswaarden vaak rond de 5–10 kb voor standaard plasmiden. Ligatie-gebaseerde kits kunnen langere reads (>20 kb mediaan) produceren voor grotere plasmiden, maar de rapid kit zorgt voor snellere voorbereiding ten koste van iets kortere reads.
- Breng DNA-monsters op kamertemperatuur. Bereid buizen voor standaarden en monsters.
- Fluorometerworkflow
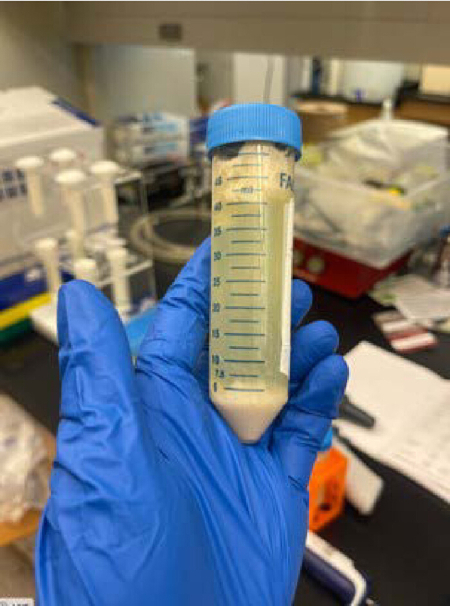
Figuur 2: Troebel lysaatsupernatant na één centrifugatiestap. Seriële centrifugatie is nodig totdat het supernatant is schoon om verstopping van de filtratiekolom te voorkomen. Klik hier om een grotere versie van deze figuur te bekijken.
| Standaard assaybuizen | Gebruikersvoorbeeld-assaybuizen | |
| Werkoplossing (kleurstof en buffer, 1:200) | 190 μL | 180–199 μL |
| Standaard (uit de kit) | 10 μL | – |
| Gebruikersvoorbeeld | – | 1–20 μL |
| Totaal volume in elke assaybuis | 200 μL | 200 μL |
Tabel 1: Reagensvolumes en hoeveelheden voor de fluorometer. Bedragen worden weergegeven voor één enkele steekproef; Een pool kan worden voorbereid op basis van het aantal te analyseren monsters.
2. Methode 2: Bibliotheekvoorbereiding
OPMERKING: Overwegingen. De bibliotheekvoorbereiding voor het sequencen van de geëxtraheerde plasmiden werd uitgevoerd volgens de instructies die bij de BarcodingKit 40 werden geleverd. Dit protocol gebruikt een kit die een transposase-gebaseerde benadering toepast om tegelijkertijd DNA te fragmenteren en barcode te fragmenteren, wat een snelle en gestroomlijnde workflow biedt die de hands-on tijd vermindert en de bibliotheekvoorbereiding vereenvoudigt.
- DNA-voorbereiding
- Dag 1: Programmeer een thermische cycler: 30 °C voor 2 minuten, daarna 80 °C voor 2 minuten.
- Ontdooi-kit onderdelen op kamertemperatuur, draai het om, en meng volgens Tabel 2.
OPMERKING: Als je een centrifuge gebruikt, draai dan op een lage snelheid van maximaal 330 x g. - Bereiding van DNA in nucleasevrij water: Overbreng 200 ng DNA naar 0,2 mL PCR-buizen en voeg een passend volume nucleasevrij water toe aan elk monster om het uiteindelijke volume op 10 μL te brengen. Meng door voorzichtig 10–15 keer te pipetten. Draai kort naar beneden in een microfuge of centrifuge op 330 x g om het pipetten in de volgende stappen te vergemakkelijken.
- Bereid mengsels voor in PCR-buizen zoals beschreven in Tabel 3.
- Meng door te pipetteren, en draai dan kort naar beneden.
- Incubeer PCR-buizen met het thermische cyclusprogramma vanaf Stap 1. Leg de buizen op ijs om af te koelen.
- Draai kort naar beneden.
- Native barcode-ligatie
- Monsters met een barcode in een schone 1,5 mL Eppendorf-buis. Zorg ervoor dat het totale volume niet meer dan 1000 μL bedraagt.
- Stil de kralen opnieuw op door te vortexen. Voeg een gelijke hoeveelheid kralen toe aan de gepoolde barcodesamples en meng door te flicken.
- Incubeer buizen 10 minuten op kamertemperatuur op een hulamixer.
- Bereid 2 ml 80% ethanol voor in nucleasevrij water.
- Draai het monster en de pellet door de buis tegen een magneet te houden. Houd de buis op de magneet, pipetteer het supernatant als afval.
OPMERKING: Elke magneet van geschikte sterkte en grootte, inclusief neodymiummagneten, kan dienen als een effectief alternatief voor het gebruik van een duur magneetrek. Magneten met een houdkracht van ongeveer 5–12 lb en een diameter van 0,3–1 inch zijn doorgaans geschikt voor standaard 0,2–1,5 mL buizen, waardoor supernatant tijdens de opruimstappen op basis van de kraal schoon kan worden verwijderd. - Was de pareltjes met 1 mL 80% ethanol terwijl je op de magneet zit. Verwijder ethanol. Herhaal de was.
OPMERKING: Het veranderen van de positie van de buis ten opzichte van de magneet kan het verwijderen van ethanol vergemakkelijken. Gebruik een extra lage snelheid spin om volledige korrelpelleting te garanderen als de pellet per ongeluk wordt verstoord. - Draai kort naar beneden en plaats de buis terug op de magneet. Pipette eventuele restanten van ethanol af. Droog het 30 seconden, maar droog de pellet niet tot het punt van barsten.
- Verwijder de magneet en suspendeer de kralen opnieuw in de elutionbuffer. Zie Tabel 4 voor de juiste volumes EB die gebruikt moeten worden, afhankelijk van het aantal gebruikte barcodes.
- Incubeer de buis 10 minuten op kamertemperatuur.
- Plaats de buis terug in de magneet totdat het eluaat vrij is.
- Kwantificeer de DNA-concentratie met 1 μL van het geëlueerde monster op de fluorometer om te garanderen dat bibliotheekvoorbereiding succesvol is uitgevoerd en om te voorkomen dat een Flow Cell wordt verspild aan een mislukte bibliotheek.
- Adapterligatie
- Breng 11 μL van de DNA-bibliotheek over in een nieuw buisje en label.
OPMERKING: Bewaar extra DNA bij -20 °C voor toekomstige sequencing-runs indien nodig. - Verdun de ontdooide Rapid Adapter in een nieuwe buis volgens tabel 5 en pipetteer op en neer om te mengen.
- Voeg 1 μL verdunde RA toe aan de 11 μL DNA-bibliotheek.
- Draai de buis om te mengen, draai kort omlaag om te zorgen dat het volledige volume zich onderaan de buis ophoopt.
- Breng 5 minuten op de bank.
- Breng 11 μL van de DNA-bibliotheek over in een nieuw buisje en label.
| Reagens | Ontdooi bij kamertemperatuur | Draai naar beneden | Mengen door te pipetteren |
| Snelle barcodes | Niet Bevroren | ✓ | ✓ |
| Rapid Adapter | Niet Bevroren | ✓ | ✓ |
| AMPure XP-kralen | ✓ | ✓ | Meng door direct voor gebruik te pipetteren of vortexen |
| Elutiebuffer | ✓ | ✓ | ✓ |
| Adapterbuffer | ✓ | ✓ | Mix door vortexen |
Tabel 2: Reagensvolumes en hoeveelheden voor de voorbereiding van de nanopore-bibliotheek. Handelingen die met elk reagens moeten worden uitgevoerd, zijn gemarkeerd (✓).
| Reagens | Volume/sample |
| 10 μL Sjabloon-DNA (200 ng uit de vorige stap) | 10 μL |
| 1,5 μL snelle barcodes, één voor elk monster | 1,5 μL |
| Totaal volume | 11,5 μL |
Tabel 3: Reagentia en volumes voor snelle streepjescodering. De volumes worden per DNA-monster getoond; een samengevoegde mix kan worden bereid en het DNA apart worden toegevoegd.
| 1-24 barcodes | 48 barcodes | 72 barcodes | 96 barcodes | |
| Volume van de Elutiebuffer | 15 μL | 30 μL | 45 μL | 60 μL |
Tabel 4: Elutiebuffervolumes gebruikt voor elke 24 barcodes. De volumes worden aangegeven op basis van het aantal barcodes.
| Reagens | Volume |
| Rapid Adapter (RA) | 1,5 μL |
| Adapter Buffer (ADB) | 3,5 μL |
| Totaal volume | 5μL |
Tabel 5: Reagentia en hoeveelheden voor adapter. De volumes kunnen worden aangepast afhankelijk van het aantal samples.
3. Flowcel-run
OPMERKING: Kies een standaard-output flowcel bij het sequencen van een klein aantal plasmiden met matige dekkingsbehoeften. Nanopore raadt aan om een flow cell-check uit te voeren om het aantal actieve poriën te bepalen; De flowcellen van nanopore devices moeten volgens de garantiecriteria minstens 800 actieve poriën hebben. Een enkele MinION-flowcel levert voldoende output voor het sequencen van meerdere DNA-monsters die zijn verrijkt met plasmide-DNA (zie meer details over multiplexing in de discussiesectie), terwijl het lagere kosten en meer flexibiliteit biedt dan een GRIDion- of Promethean-flowcel.
- Primen en laden van de flowcel
OPMERKING: R10.4.1 flowcellen (uitgebracht in 2022) werden gebruikt om dit protocol te ontwikkelen. Deze flowcellen hebben langere poriën met een dubbele lezer, wat resulteert in verbeterde homopolymeersequencing20,21. Dit sequencingprotocol en de Barcoding Kit zijn niet compatibel met andere flowcellen. Kies voor een high-output flow cell bij grootschalige multiplexing, met het oog op een hoge dekking, of het werken met grotere plasmiden of genomen. Denk aan het aantal samples en de doeldiepte om kosten, doorvoer en sequencingkwaliteit in balans te brengen.- Verwijder reagentia uit de koude opslag, waaronder sequencing buffer (SB), library beads (LIB) of library solution (LIS), rundereserumalbumine (BSA), flow cell tether (FCT) en flow cell flush (FCF). Ontdooi op ijs bij kamertemperatuur. Zodra de reagentia zijn ontdooid, vortex om te mengen, snel te draaien en op ijs te bewaren.
- Bereid de flowcel-priming voor door een verse DNA-buis te mengen met de reagentia die in Tabel 6 zijn vermeld. Meng door inversie en pipetten.
- Til het deksel van het apparaat op en plaats de flowcel. Oefen zachte druk uit om de juiste plaatsing te garanderen.
- Maak de primingpoort bloot door de kap opzij te duwen.
- Controleer op luchtbellen binnen of naast de primingpoort. Trek 20–30 μL vloeistof af om bellen te verwijderen.
OPMERKING: Verwijder niet meer dan 20–30 μL buffer. Poriën moeten te allen tijde ondergedompeld blijven in de buffer. Poriën die aan lucht worden blootgesteld, kunnen onbruikbaar worden. Zorg ervoor dat de buffer continu is in het zichtbare kanaal. - Haal 800 μL primingmengsel op en doe het in de primingpoort. Vermijd het introduceren van luchtbellen. Laat het apparaat 5 minuten staan.
- Zet de lib weer op door op en neer te pipetten.
OPMERKING: Stop direct opnieuw voordat je het gebruikt, want de lib stabiliseert snel. - Meng de DNA-bibliotheek met het juiste volume bibliotheekkralen in een nieuwe buis, zoals aangegeven in Tabel 7.
OPMERKING: De Rapid Barcoding kit die de auteurs gebruiken, gebruikt een transposase-gebaseerde aanpak om DNA te fragmenteren en barcodes te verbinden zonder bewuste groottekeuze, dus leeslengtes weerspiegelen voornamelijk het oorspronkelijke invoer-DNA. In tegenstelling tot ligatie-gebaseerde kits zoals de Native Barcoding Kits, bevat de Rapid Barcoding kit geen aparte buffers met korte of lange fragmenten. Hoewel langere DNA nog steeds lange reads kan genereren, is de verdeling variabeler en over het algemeen korter dan bij ligatie-gebaseerde bibliotheken die Long Fragment Buffer gebruiken om lange fragmenten te verrijken. Het ontbreken van buffers vereenvoudigt de workflow en vermindert de hands-on tijd, maar biedt minder controle over de distributie van de bibliotheekgrootte, wat de assemblagekwaliteit kan beïnvloeden. Ligatie-gebaseerde kits, door grote fragmenten selectief te verrijken en korte fragmenten te verwijderen, leveren doorgaans hogere mediane leeslengtes en verbeterde assemblagecontinuïteit op, vooral voor de novo assemblages en complexe genomen. - Stel de deksel van de samplepoort aan om de poort te onthullen. Laad 200 μL primingmengsel in de flowcel-primingpoort.
- Meng de voorbereide DNA-bibliotheek voorzichtig voordat je laadt.
- Doseer 75 μL van de DNA-bibliotheek met kralen in de monsterpoort, druppel voor druppel, zodat elke druppel kan worden opgenomen voordat je de volgende toevoegt.
- Breng de afdekking van de samplepoort opnieuw aan en sluit de primingpoort.
- Voeg het lichtscherm toe aan de flow-cel door de voorrand van het lichtscherm met de clip uit te lijnen en vervolgens de rest te laten zakken om de flow-cel te bedekken. Probeer het lichtscherm niet onder de clip te plaatsen. Het lichtscherm moet rond de afdekking zitten en het hele bovenste deel van de flow-cel beschermen tegen blootstelling aan licht.
OPMERKING: Installeer het lichtscherm op de flowcel zodra de bibliotheek is geladen voor optimale sequencing-output. Laat het aan tijdens eventuele volgende stappen totdat de bibliotheek uit de flow-cel is verwijderd. Het lichtschild is niet stevig bevestigd aan het apparaat; Behandel het voorzichtig om te voorkomen dat het verplaatst. - Sluit het deksel van het apparaat en begin met de sequencing.
- Start met de sequencing run-computationele eisen:
Minimum: 8-threads CPU, 16 GB RAM, 1070 NVIDIA GPU, 500 GB SSD
Aanbevolen: 16-threads CPU, 32 GB RAM, 2070 NVIDIA GPU, 1 TB SSD
OPMERKING: Zorg dat zowel de software als de computer up-to-date zijn en minstens 500 GB vrije opslag hebben om nieuwe bestanden te kunnen huisvesten. Software-updates en andere programma's kunnen de sequencing-run verstoren. Zorg ervoor dat je de software draait op een Windows- of Ubuntu-besturingssysteem.- Stel de run time-limiet in: afhankelijk van hoeveel plasmiden er worden gemultiplexed, stel je de run limit in. De standaard is 48 uur, een maximale tijd van 72 uur kan worden gelopen. Voor gedetailleerde instructies kunt u de handleiding raadplegen.
OPMERKING: de looptijd hangt af van multiplexing en plasmidgrootte in plaats van van het plasmidgetal. Het aantal monsters of plasmiden dat gemultiplexeerd kan worden, hangt af van de gewenste sequencingdiepte en de output van de flowcel. Voor typische plasmidsequencing biedt multiplexen van 20–24 monsters per standaard nanopore flowcel meestal voldoende dekking voor nauwkeurige assemblage en variantdetectie, uitgaande van plasmidgroottes onder ~200 kb. Grotere plasmiden of hogere dekkingsvereisten kunnen minder monsters per flowcell vereisen. Flowcellen met hogere output kunnen veel meer monsters (tot 96 of meer) per run ondersteunen, waardoor ze geschikt zijn voor high-throughput plasmidesequencing of projecten die zeer diepe dekking vereisen. Gebruikers moeten het aantal barcodes, plasmidgrootte en doeldiepte in balans brengen om ervoor te zorgen dat elk plasmid voldoende reads ontvangt voor volledige assemblage. - Schakel barcode trim in als je demultiplexing uitvoert tijdens het sequencen.
OPMERKING: Monitor de reads per barcode en stop de run wanneer voldoende dekking is bereikt om de levensduur van de flow cell te behouden. - Selecteer een supernauwkeurige basecalling-modus.
OPMERKING: Selecteer geen adaptieve sampling/barcodebalancering. Deze optie vermindert de leesoutput sterk en degradeert poriën sneller. Als je geen GPU hebt, is het beter om na het einde van de run nog niet te basecallen. - Selecteer de juiste rapid-barcode kit (24 of 96).
- Zorg dat het apparaat waterpas staat en start de sequencing op standaardinstellingen (minimum Q score 10)
OPMERKING: Dit is een handig stoppunt. Het apparaat kan 's nachts draaien. - Post-hoc basecalling (voor het geval de computer niet genoeg capaciteit heeft voor live basecalling of om de nauwkeurigheid van basecalling te verbeteren, waarbij de ruwe data opnieuw wordt geanalyseerd met verbeterde analysetools): open de voltooide sequencingrun in de software
OPMERKING: De volgende stappen gelden alleen als je geen live basecalling hebt geselecteerd. - Selecteer Basecalling en kies het supernauwkeurigheidsmodel (SUP).
- Selecteer de ruwe FAST5/POD5-gegevens en stel een uitvoermap in.
- Begin met het bellen van de base.
- Stel de run time-limiet in: afhankelijk van hoeveel plasmiden er worden gemultiplexed, stel je de run limit in. De standaard is 48 uur, een maximale tijd van 72 uur kan worden gelopen. Voor gedetailleerde instructies kunt u de handleiding raadplegen.
| Reagentia | Volume per stroomcel |
| Flow Cell Flush (FCF) | 1.170 μL |
| Bovin Serum Albumine (BSA) bij 50 mg/mL | 5 μL |
| Flowcel Tether (FCT) | 30 μL |
| Eindvolume in de buis | 1.205 μL |
Tabel 6: Reagentia en volumes voor het primen en laden van de flowcel. Volumes reagentia worden per flow-cel aangegeven.
| Reagentia | Volume per stroomcel |
| Sequencing-buffer (SB) | 37,5 μL |
| Bibliotheekkralen (LIB) of bibliotheekoplossing (LIS), indien gebruikt | 25,5 μL |
| DNA-bibliotheek | 12 μL |
| Totaal | 75 μL |
Tabel 7: Reagentia en volumes voor het laden van de bibliotheek. Er worden delen getoond voor de DNA-bibliotheek; Bibliotheekkralen (BID) moeten direct voor gebruik worden gemengd.
4. Methode 4: assemblage met een autocycler
OPMERKING: Er zijn veel opties voor het assembleren van reads tot contigs. Elke assembler heeft zijn positieve punten en zijn biases. Dit protocol raadt aan om Autocycler te gebruiken, die veel verschillende assemblies gebruikt en deze combineert tot één assembly. Dit is arbeidsintensiever en je kunt één assembler gebruiken om tijd te besparen. Laat Conda alsjeblieft in de terminal installeren om de juiste software te downloaden. Het aanvullende commandodocument bevat een link naar een omgevingsbestand om het systeem op te zetten.
- Beoordeel de run quality: Controleer de kwaliteit van de run vanuit de Minknow-software of uit het run report .html bestand om kwaliteitsindicatoren (opbrengst, Q-scores, lengte, distributie) te noteren. Optioneel beoordeel je FASTQ-bestanden met NanoPlot om de leeslengteverdeling, N50 en kwaliteitsscoreprofielen voor elke barcode te bevestigen. Ga alleen door als de sequencing yield- en read length-verdelingen consistent zijn met de verwachte plasmidgroottes.
- Barcodes verwijderen: Bepaal of barcode trim was ingeschakeld tijdens de sequencing run. Als barcodes niet zijn verwijderd, trim dan FASTQ-bestanden met Porechop (v0.2.4) en verifieer het succesvol verwijderen van barcode-adaptersequenties vóór downstream analyse.
- Trim reads: Trim lange reads met Filtlong (v0.3.1), waarbij ongeveer 5–10% van de laagste kwaliteit reads worden verwijderd terwijl ~90% van de totale opbrengst behouden blijft. Genereer een gefilterd FASTQ-bestand voor assembly. Als latere assemblages chimerische contigs produceren, verhoog dan de filterstrengheid door een minimale leeslengtedrempel van ≥3.000 bp af te dwingen en gefilterde reads te regenereren.
- Subsample en assembleer readsubsets: Subsample leest met Autocycler volgens aanbevolen instellingen en assembleer elke read subset met Raven (v1.8.3), Flye (v2.9.6), Canu (v2.3.0), miniasm (v0.3.0), Myloasm (v0.2.0), NECAT (v0.0.1), Plassembler (v1.8.1) en andere assemblies naar keuze. Let op contiglengtes en circularisatiestatus voor elke assemblage. Assemblers die circularisatie rapporteren (Raven, Flye, miniasm, Myloasem en Plassembler) moeten prioriteit krijgen voor plasmidreconstructie. Voor Canu- en NECAT-assemblages, identificeer kandidaat-plasmidcontigs op basis van verwachte plasmidgrootte uit cirkelvormige contigs in eerdere assemblies.
- Inspecteer en curate assemblies: Visualiseer elk assembly-grafiekbestand (.gfa) met Bandage (v0.9.0) en evalueer contigs op circulariteit, grootteconsistentie tussen assemblers en bewijs van chimerische joins. Verwijder lineaire contigs die geen ondersteuning hebben over meerdere assemblers en behoud cirkelvormige contigs met consistente grootteschattingen. Als veel assemblies chimerische joins bevatten, keer dan terug naar stap 4.3 en verhoog de minimale leeslengtedrempel (aanbevolen ≥3.000 bp). In gevallen waarin grote plasmiden circulariseerd zijn maar kleinere niet-ondersteunde contigs overblijven, verwijder kleine contigs vóór consensusgeneratie. Ga door naar Consensus-generatie en polijststappen kunnen in batch worden uitgevoerd, na handmatige curatie.
- Consensus genereren en de eindassemblage: Na handmatige curatie ga je verder met Autocycler-consensusgeneratie met behulp van de gecureerde assemblies. Voer de resterende Autocycler-commando's uit om de uiteindelijke consensus-plasmidesequentie te produceren. Gedetailleerde commandoregelinstructies en parameterinstellingen zijn beschikbaar in het Aanvullende Material.
- Polijsten: Zodra een volledige assemblage is gegenereerd, polijst je de assemblage met de getrimde lange reads met Medaka (v2.1.1) om de consensusnauwkeurigheid aanzienlijk te verbeteren.
OPMERKING: Hoewel extra polijstpatronen kunnen helpen bij consensusnauwkeurigheid, kunnen ze ook fouten veroorzaken. Het is best practice om een programma als DNAapler te gebruiken om de nieuwe contig te roteren voordat je polijst; Commando's zijn te vinden in de sectie Aanvullende Commando's.
5. Methode 5: Annotatie
OPMERKING: Er zijn veel effectieve annotatietools voor bacteriën. De volgende programma's worden aanbevolen voor een grondige annotatie.
- Bakta is uitstekend voor proteomische analyses omdat het momenteel actief wordt onderhouden en dient als de spirituele opvolger van Prokka41,42.
- Voor replicon-typering, plasmidemobiliteits-typen en conjugatie-typen is MOB-suite betrouwbaar6. MOB-suite kan plasmidefylogenie afleiden met behulp van mash distancing en kan insertiesequentieelementen (IS)43 identificeren.
- COPLA is ook een nuttig hulpmiddel voor plasmidetaxonomie. Copla's unieke benadering, die plasmiden classificeert in plasmide-taxonomische eenheden, wordt aanbevolen in het veld44.
OPMERKING: Plasmidfylogenie heeft historisch gezien aanzienlijke uitdagingen opgeleverd omdat plasmidemodulaire structuur en hoge recombinatiefrequentie sequentie-uitlijningen moeilijk maken. COPLA pakt deze uitdagingen aan door gemiddelde nucleotide-identiteiten (ANI) te berekenen.
Resultaten
Klinische E. coli-stammen
Om het gebruik van ONT voor het sequencen van plasmiden uit klinische stammen te illustreren, sequenceden de auteurs 10 stammen, die een genereuze gift waren van Dr. Stephen Salipante van de University of Washington. Deze stammen maakten deel uit van een verzameling van 312 bloed- of urine-afgeleide isolaten van Extraintestinal Pathogenic E. coli (ExPEC), verkregen tijdens routinematige klinische zorg in het University of Washington Medical Center45.
Plasmideconjugatie en karakterisering door gelmobiliteitsassay
Onderzoekers voerden ook een conjugatietest uit waarbij E. coli-stam LMB100 als ontvanger werd gebruikt. Conjugatie is een proces dat leidt tot de overdracht van een plasmide dat aanwezig is in een cel (de donor) naar een andere cel (de zogenaamde ontvanger)46. De overdracht vereist fysiek contact tussen de twee cellen en wordt doorgaans gedetecteerd met markers die de aanwezigheid van het conjugatieve plasmide in de ontvangende cellen aangeven. Dit stelde auteurs in staat verschillen in gastheerstam als variabele te elimineren en het gebruik van het protocol voor het sequencen van plasmiden verkregen door plasmidevangst (een methode die wordt gebruikt om plasmiden uit een bepaalde ecologische niche te profileren) te illustreren. Alle conjugatie-assays produceerden transconjuganten, wat de aanwezigheid van een conjugatief plasmide in de donoren bevestigde. Het protocol dat de auteurs volgden wordt beschreven in36. De groep identificeerde de plasmiden die aanwezig waren in de donor- en ontvangerstammen en schatte hun mobiliteit met pulsveld-gelelektroforese (PFGE). Een lijst van tien representatieve donorstammen is weergegeven in Tabel 8, en de geschatte groottes van de plasmiden die daarin aanwezig zijn, worden in de derde kolom weergegeven. Plasmiden buiten het resolutiebereik van de PFGE-gel zijn uitgesloten van deze tabel, maar de onderzoekers konden verschillende kleinere plasmiden van ongeveer ~4 kb (niet getoond) samenstellen.
| Donateurstam | Plasmide | Geschatte PFGE-grootte | Montagelengte | Gemiddelde diepte | bp Zero Depth | Dekkingspercentage | Gewijzigde posities | Pre-SR nauwkeurigheid % |
| blood_08 _0081 | pblood_08_ 0081_1 | 170000 | 171829 | 100 | 99.941803 | 54 | 0.0314 | 99.9686 |
| blood_08 _0081 | pBlood_08_ 0081_2 | 82000 | 85576 | 46.9 | 0 | 100 | 2 | 99.9977 |
| blood_d-08 _0094 | pBlood_d-08 _0094 | 179000 | 173334 | 382.6 | 3121 | 98.19943 | 2,347 | 98.646 |
| blood_08 _1447 | pBlood_08 _1447 | 97000 | 99624 | 36.2 | 0 | 100 | 0 | 100 |
| blood_10 _0913 | pBlood_10 _0913_1 | 70000 | 71788 | 49 | 4 | 99.994428 | 188 | 99.7381 |
| blood_10 _0913 | pBlood_10 _0913_2 | 112000 | 118727 | 41.2 | 126 | 99.893874 | 276 | 99.7675 |
| blood_1 1_184 | pBlood_11 _184_1 | 150000 | 146583 | 65.1 | 287 | 99.804206 | 134 | 99.9086 |
| blood_11_184 | pBlood_11 _184_2 | 75000 | 74263 | 82.1 | 0 | 100 | 32 | 99.9569 |
| blood_2011 _0238 | pBlood_ 2011_0238 | 170000 | 167286 | 110.9 | 0 | 100 | 0 | 100 |
| upec_108 | pUPEC_108 | 130500 | 131039 | 103.9 | 0 | 100 | 0 | 100 |
| upec_134 | pUPEC_134 | 160500 | 157829 | 169 | 0 | 100 | 0 | 100 |
| upec_271 | pUPEC_271 | 145500 | 144519 | 86 | 33311 | 76.950436 | 1,557 | 98.9226 |
| upec_90 | pUPEC_90 | 70000 | 74624 | 139.8 | 0 | 100 | 6 | 99.992 |
Tabel 8: Plasmidgrootteschattingen en sequencingnauwkeurigheidsmetrics voor een panel van 10 donorstammen. Plasmidegrootteschattingen op basis van PFGE of geassembleerde ONT-donorplasmidensequenties worden vermeld. De paargewijze vergelijkingen van alleen ONT en SR-sequentie gepolijste plasmidassemblages worden ook getoond als indicator van nauwkeurigheid. Meetwaarden zijn onder andere: assemblagelengte, gemiddelde diepte, nul-dieptegebieden, percentage dekking, gewijzigde posities en percentage pre-SR nauwkeurigheid.
ONT-gebaseerde plasmidsequencing outputmetrieken
De volgorde was gepland voor 24 uur. In totaal werden 24 monsters gemultiplexed. De technische gegevens voor elke steekproef, inclusief kwaliteitsscore (Q), lengte en dekking, worden vermeld in Tabel 9. Nanopore-sequencing leverde voldoende leesoutput en kwaliteit op voor alle geanalyseerde monsters. In alle bibliotheken genereerde sequencing gemiddeld 134.115 lezingen per monster, wat overeenkomt met een gemiddelde opbrengst van 576,2 Mb. Lezingen hadden een gemiddelde lengte van 8.797 bp met een gemiddelde N50 van 3.693 bp, wat voldoende leescontinuïteit voor plasmidassemblage bood. De gemiddelde leeskwaliteit score was Q16,0 met een mediaan van Q16,6, en individuele runs varieerden van Q13,7 tot Q18,0.
| Gesequencede vervorming | Reads (kb) | Bases (Mb) | Gemiddelde lengte | Maximale lengte | Minlengte | N50 | Mediaan lengte | Gemiddelde Q | Mediaan Q | |
| Blood_08_0081 donor | 109.8 | 261 | 5713 | 508418 | 78 | 2377 | 1351 | 14.5 | 15 | |
| Blood_08_0094 donor | 89.3 | 229 | 4177 | 114948 | 81 | 2565 | 1065 | 13.7 | 14 | |
| Blood_08_1447 donor | 87.5 | 246 | 5041 | 135147 | 75 | 2816 | 1609 | 15.1 | 15.7 | |
| Bblood_10_0913 donor | 247.7 | 1026 | 9260 | 174231 | 70 | 4143 | 1661 | 15.5 | 16.1 | |
| Blood_11_154 donor | 51.5 | 110 | 4172 | 91148 | 73 | 2127 | 1387 | 16.1 | 16.5 | |
| Blood_2011_0238 donor | 16.8 | 42 | 6707 | 104848 | 62 | 2534 | 845 | 15.3 | 15.2 | |
| UPEC_108 donor | 50.6 | 77 | 1915 | 90234 | 67 | 1525 | 1103 | 15.8 | 16.2 | |
| UPEC_134 donor | 50 | 143 | 7110 | 158393 | 72 | 2865 | 1133 | 16 | 16.2 | |
| UPEC_217 donor | 64 | 236 | 7512 | 144275 | 78 | 3678 | 1895 | 17.4 | 17.9 | |
| UPEC_90 donor | 52.9 | 157 | 5666 | 95944 | 72 | 2969 | 1593 | 16.8 | 17.2 | |
| Blood_08_0081 LMB100 transconjugant | 53.5 | 119 | 5162 | 225856 | 1 | 2232 | 1009 | 16 | 16.8 | |
| Blood_08_0094 LMB100 transconjugant | 160 | 442 | 7257 | 252176 | 1 | 2761 | 1083 | 17.3 | 18.2 | |
| Blood_08_1447 LMB100 transconjugant | 238 | 1029 | 10249 | 209221 | 1 | 4320 | 1857 | 17.7 | 18.7 | |
| Blood_10_0913 LMB100 transconjugant | 792.3 | 4341 | 11508 | 474325 | 1 | 5479 | 2731 | 17.7 | 18.8 | |
| Blood_11_184 LMB100 transconjugant | 42.5 | 281 | 17931 | 146626 | 87 | 6615 | 2448 | 16 | 16.7 | |
| Blood_2011_0238 LMB100 transconjugant | 147.7 | 585 | 9000 | 344203 | 1 | 3962 | 1781 | 18 | 18.9 | |
| UPEC_108 LMB100 transconjugant | 173.4 | 778 | 10127 | 168756 | 80 | 4485 | 2079 | 15.3 | 16.1 | |
| UPEC_134 LMB100 transconjugant | 105.4 | 667 | 17568 | 349230 | 71 | 6323 | 2232 | 15.5 | 16.3 | |
| UPEC_271 LMB100 transconjugant | 74.2 | 336 | 14521 | 342195 | 83 | 4520 | 1306 | 14.6 | 14.8 | |
| UPEC_90 LMB100 transconjugant | 75.2 | 418 | 15348 | 225661 | 83 | 5561 | 2016 | 15.7 | 16.4 | |
Tabel 9: NanoQ-rapport van sequencing output metrics voor een panel van 10 donorstammen. De sequencing output-metrics worden vermeld. Deze omvatten reads, bases, lengte (gemiddelde, mediaan, max en min), lengtes, N50 en Q (gemiddelde en mediaan) waarden van donoren en transconjuganten.
Plasmidassemblage en nauwkeurigheid
Plasmidsequenties werden samengesteld met Autocycler34. De groottes van de geassembleerde plasmidensequenties voor 10 van de monsters zijn vermeld in Tabel 8, vierde kolom, en deze kwamen in alle gevallen overeen met schattingen gebaseerd op PFGE-mobiliteit (vermeld in de derde kolom). De nauwkeurigheid werd beoordeeld door Medaka-gepolijste long-read assemblages te vergelijken met Medaka (v2.2.0) plus polypolish (v0.6.1) assemblages. De sequentie-identiteit werd berekend met behulp van dnadiff uit MUMmer (v3.2.4) (Tabel 8). Over alle geanalyseerde plasmiden (n = 12) hadden assemblages een gemiddelde lengte van 120,4 kb en werden ze ondersteund door een gemiddelde sequencingdiepte van 109x, met een dekking van gemiddeld 97,9% over plasmidsequenties. Voor het polijsten vertoonden assemblages een gemiddelde sequentie-identiteit van 99,74% ten opzichte van de SR-sequentie gepolijste assemblage.
Schatten van chromosomale besmetting
Om plasmiddekking en chromosomale contaminatie te schatten, werden reads gekoppeld aan geassembleerde plasmide-sequenties en aan de E. coli LMB100 chromosomale sequentie. Basecalled Nanopore-reads werden uitgelijnd met minimap2 (v2.2.6). De resulterende uitlijningen werden verwerkt met SAMtools (v1.1.7) om gesorteerde BAM-bestanden te genereren en mappingstatistieken te berekenen. De plasmidebedekking en gemiddelde diepte werden geschat met behulp van de dekking van SAMtools. De diepte van de plasmidsequencing varieerde tussen monsters, maar bleef ruim boven de minimale dekking die vereist is voor nauwkeurige assemblage (50–70 x). Een fractie van de reads werd naar het chromosoom gemapt, wat wijst op overdracht van gastheer-DNA tijdens plasmide-extractie (Tabel 10).
| Plasmiden | Totaal aantal leeservaringen | Chromosomale uitingen | % chromosomale metingen | Gemiddelde chromosomale dekking | Gemiddelde plasmidedekking | P:C-verhouding |
| pBlood_08_0081_2 | 53491 | 20116 | 37.61% | 5 | 1068 | 236 |
| pBlood_d-08_0094 | 160024 | 74827 | 46.76% | 37 | 1618 | 44 |
| pBlood_08_1447 | 238031 | 127967 | 53.76% | 62 | 7842 | 127 |
| pBlood_10_0913_1 | 792263 | 221610 | 27.97% | 87 | 7801 | 90 |
| pBlood_10_0913_2 | 792263 | 221610 | 27.97% | 87 | 7772 | 89 |
| pBlood_11_184_1 | 42494 | 15919 | 37.46% | 7 | 1637 | 250 |
| pBlood_11_184_2 | 42494 | 15919 | 37.46% | 7 | 2188 | 335 |
| pBlood_2011_0238 | 147680 | 80526 | 54.53% | 56 | 2965 | 53 |
| pUPEC_108 | 173409 | 107884 | 62.21% | 61 | 4008 | 65 |
| pUPEC_134 | 105418 | 68645 | 65.12% | 29 | 3640 | 127 |
| pUPEC_271 | 74232 | 53554 | 72.14% | 34 | 1202 | 35 |
| pUPEC_90 | 75193 | 30052 | 39.97% | 16 | 4488 | 278 |
Tabel 10: Schattingen van chromosomale DNA-besmetting. Chromosomale besmetting in plasmiden die uit ontvangende stammen zijn gezuiverd, werd gekwantificeerd als het aandeel van de reads dat overeenkomt met de LMB100-chromosomale sequentie ten opzichte van plasmidreads. Voor elk plasmide worden plasmide-reads, totale reads, chromosomale reads, gemiddelde chromosomale dekking, gemiddelde plasmide-dekking en P:C-ratio vermeld. Let op dat pBlood_08_0081_1 afwezig is omdat het niet bij de ontvanger kon worden teruggevonden, en deze schattingen werden uitgevoerd op ontvangers vanwege hun uniforme chromosomale achtergrond.
Chromosomale besmetting werd gekwantificeerd als het aandeel van de reads die in kaart zijn gebracht met de samengestelde LMB100-chromosomale sequentie ten opzichte van plasmide-reads. De chromosomale besmettingspercentages varieerden tussen 72,1% en 28,0%, met een gemiddelde van 46,9% (Tabel 10). De methode zal waarschijnlijk chromosomale contaminatie overschatten omdat lezingen die naar zowel het plasmide als het chromosoom worden gemapt als alleen chromosomale toewijzing, maar het geeft nog steeds een aanzienlijke chromosomale overdracht aan. Ondanks deze chromosomale overdracht reconstrueerde de assemblageworkflow met succes volledige plasmidsequenties, die nog steeds consistent waren met de grootte voorspeld van PFGE-mobiliteit over alle monsters (Tabel 8, derde en vierde kolom).
Representatieve donor-ontvangerparen van conjugatieve plasmiden
Stam upec271 werd tussen 2011 en 2013 geïsoleerd uit een urinemonster en werd toegewezen aan fylogroep B2 en sequentietype ST131. PFGE-analyse toonde de aanwezigheid van een band aan die overeenkomt met een plasmide van ongeveer 145 kb [Figuur 3A, (Donor)]. Short-read sequentieanalyse identificeerde de aanwezigheid van een IncF-replicon.
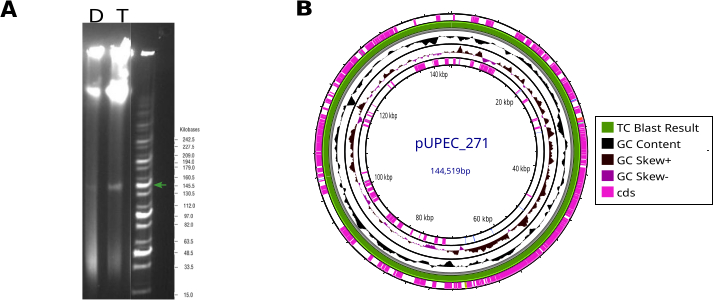
Figuur 3: Karakterisering van pUPEC271. (A) PFGE van donor en transconjugant. De PFGE-banden voor de donor (D) en de transconjugant (T) worden weergegeven; de groene pijlen geven de plasmidband aan die overeenkomt met pUPEC271. Het protocol dat voor PFGE wordt gebruikt, wordt beschreven in een studie36. (B) Kaart van pUPEC271. De transconjugant werd tegen de donor geblazen, en de consensus (die 100% identiek is) wordt weergegeven als de groene ring. Deze representatie werd gegenereerd met behulp van Proksee48. De buitenste ring toont de locatie van CDS, twee binnenste ringen geven het GC-gehalte en de scheefheid aan, en de binnenste ring toont de locatie van tRNA-genen. Klik hier om een grotere versie van deze figuur te bekijken.
De overdracht van dit plasmide, dat de auteurs pUPEC271 noemden, werd verder bevestigd door PFGE-analyse met het eerder beschreven protocol in36 [Figuur 3A, T(transconjugant)]. Plasmide-DNA gezuiverd uit de donor upec271-stam (pUPEC271_donor) werd gesequenced met behulp van nanopore. In overeenstemming met de grootte van de band op de PFGE-gel toonde de pUPEC271_donor sequentie een plasmide van 144.519 bp (Figuur 3B). Dit plasmide had een IncF-type replicon en bevatte resistentiegenen tegen zes verschillende klassen antibiotica (zie Aanvullende Tabel 1). De auteurs zuiverden ook DNA van een van de transconjuganten (pUPEC271_TC) en verkregen een sequentie identiek aan die van de donor. De uiteindelijke assemblage, vergeleken met pUPEC271_donor, is weergegeven in Figuur 3B. Dit bevestigde dat het conjugatieve plasmide dat aanwezig was in de donor was overgedragen aan de transconjugante stam. De technische gegevens zijn weergegeven in Tabel 9.
Stam Blood_10_0913 is een voorbeeld van een stam met meer dan één plasmide. Dit monster werd tussen 2008 en 2013 uit bloed genomen, en korte leessequencing gaf de aanwezigheid van twee replicons aan, een IncF en een IncY replicon. PFGE-analyse van deze stam identificeerde twee plasmiden van respectievelijk ongeveer 70 en 110 kb (Figuur 4A). Dit werd bevestigd door nanoporesequencing, die twee assemblages produceerde, respectievelijk 71.182 bp en 111.226 bp groot. De auteurs noemden deze twee plasmiden pBlood_10_0913_1 en pBlood_10_0913_2 (Figuur 4B). De assemblages slaagden er echter aanvankelijk niet in om te circulariseren vanwege de extensieve sequentiehomologie in het gedeelte van de plasmiden dat de conjugatiemachine draagt (het gedeelte van extensieve homologie wordt gemarkeerd in Figuur 4B). Het mislukte assemblagediagram, gemaakt met Bandage47 , wordt weergegeven in Figuur 4C. De volledige assemblage van de twee plasmiden was alleen mogelijk na agressief lezen culling van kortere leessequenties (< 3000 bp).
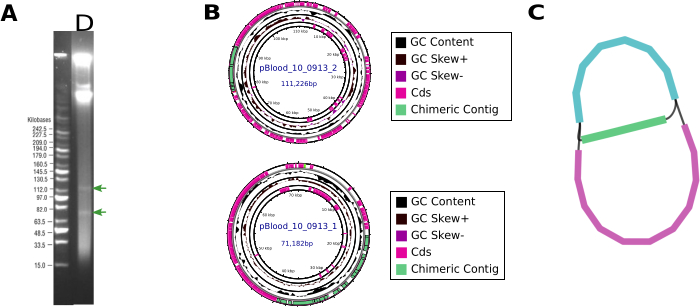
Figuur 4: Identificatie en assemblage van de plasmiden van Blood_10_0913 stam. (A) PFGE. De groene pijlen geven plasmidbanden aan. Het protocol dat voor PFGE wordt gebruikt, wordt beschreven in36 (B) Sequence assembly. Assemblage van de twee kleinere plasmiden die aanwezig zijn in het pBlood_10_0913 monster, pBlood_10_0913_2 en pBlood_10_0913_2. (C) Mislukte assemblage. Representatie van een samenstelling die uitvalt door de aanwezigheid van een gedeelde reeks tussen twee verschillende assemblages. Deze representatie werd gegenereerd met Bandage47. Klik hier om een grotere versie van deze figuur te bekijken.
Aanvullende tabel 1: Resistentiegenen gedragen door pUPEC271. De plasmidegrootte, replicons en resistentiegenen die geassocieerd zijn met pUPEC271 worden getoond. Klik hier om dit bestand te downloaden.
Aanvullende bevelen. Klik hier om dit bestand te downloaden.
Discussie
De identificatie en karakterisering van plasmiden is van groot belang voor de volksgezondheid, klinische microbiologie en microbiële ecologie, omdat ze het behoud en de verspreiding van adaptieve genen over ecologische omgevingen 1,5 faciliteren en dienen als platforms voor versnelde evolutie4. De introductie van NGS-technologieën maakte het mogelijk om met hoge doorvoer te sequencen genomen van microbiële isolaten en populaties, hoewel de post-assemblage identificatie van complete plasmiden of van plasmide-afgeleide contigs doorgaans long-read sequencing-sequencinggegevens vereisen omdat short-read sequencinggegevens geen herhaalde regio's groter zijn dan de grootte van de reads. ONT is een zeer populaire long-read sequencing-benadering geworden, met toepassingen die verder gaan dan whole genome sequencing en metagenomica en die plasmidsequencatieverificatie, detectie en karakterisering van epigenetische modificaties, RNA-sequencing en de evaluatie van de intrinsieke instabiliteit van tandemgenarrays omvatten (besproken in12,49).
Hier presenteren de onderzoekers een workflow voor ONT-sequencing van plasmiden, ontworpen voor situaties waarin de chromosomale sequentie al bekend is of niet van belang is. De reden hiervoor is dat plasmide-extractie arbeidsintensief, kostbaar en tijdrovend is (omdat de gastheerpopulatie in cultuur moet worden gekweekt en verwerkt), en het sequencen van het hele genoom met nanopore-technologie vaak voldoende is om volledige plasmidassemblages te verkrijgen terwijl hun genomische context wordt geboden. Voorbeelden waarbij het protocol nuttig is zijn onder andere de verificatie van een plasmidsequentie in de context van plasmidgenetische engineering50,51, het verbeteren van de nauwkeurigheid van plasmidsequenties die al door WGS24 zijn verkregen, of de karakterisering van plasmiden die zijn gevangen uit klinische of omgevingsmonsters door conjugatie.
DNA-extractie uit klinische en omgevingsmonsters kan enige aanpassing nodig hebben. Hier rapporteren de auteurs dat sommige van de klinische stammen die ze gebruikten een biofilmmatrix produceerden die de filters verstopte, waardoor meerdere pelleteringsstappen nodig waren en soms het toevoegen van twee filters noodzakelijk maakte. Ook is voor het sequencen van conjugatieve plasmiden een groter kweekvolume nodig in vergelijking met het sequencen van multicopy plasmiden, aangezien natuurlijk voorkomende middelgrote en grote plasmiden doorgaans een laag plasmide-kopienummer2 hebben.
Het protocol heeft het toestaan om plasmiden tussen 4 kb en 173 kb in grootte te sequencen. Dit bereik valt precies binnen de specificaties van de fabrikant (tussen 2 en 200 kb). Onlangs onderzocht een studie 23.000 plasmidesequenties die in NCBI waren afgezet en vond significante grootteverschillen afhankelijk van de bron, waarbij plasmiden van menselijke oorsprong de kleinste mediane grootte hadden (76 kb), en bodem- en plantenplasmiden de grootste (respectievelijk 215 en 427 kb); Plasmiden uit alle andere bronnen hadden een mediane grootte tussen 79 en 147 kB, dus dit protocol zou de meeste plasmiden moeten dekken, met uitzondering van megaplasmiden52 en plasmiden van bodem- of plantaardige oorsprong3.
De auteurs voegen een stap in plasmide-DNA toe om de nauwkeurigheid van plasmide-DNA-assemblages te verbeteren. De aanwezigheid van grote hoeveelheden chromosomaal DNA overspoelt celporiën op de sequencing flow-cel met niet-doelmetingen, waardoor de plasmide-DNA-diepte aanzienlijk wordt verminderd. Er is al een stap in plasmide-DNA geïmplementeerd om de volledige assemblage van plasmide-DNA in klinische monsters te proberen voor de detectie van ARGs24. Dit toonde aanzienlijke verbeteringen in de effectiviteit van het voltooien van plasmidassemblage met nanopore-only sequentie (78% volledige assemblages ten opzichte van de benchmark). Andere voorbeelden volgden50, 53, 54.
Om de leesnauwkeurigheid te verbeteren, gebruikten twee van deze studies een door nanopore ontwikkelde techniek genaamd "paired basecalling on pseudopaired reads"50,53. Deze aanpak houdt in dat de ruwe elektrische signalen van sense- en antisense-strengen van hetzelfde DNA-molecuul worden uitgelijnd, wat resulteert in een nauwkeurigheidsverbetering van ongeveer een orde van grootte. Gepaard basecalling op pseudogepaarde reads is compatibel met multiplexing, zolang de strategie het mogelijk maakt de voor- en achterste strengen van hetzelfde molecuul te identificeren. Het kan dus niet worden gebruikt in plasmiden die zijn gezuiverd uit monsters van een onbekend plasmidecomplement of een mengsel van plasmiden bevatten. Let op dat het aantal plasmiden in een genoom doorgaans varieert tussen 0 en 7 plasmiden (vooral in klinische isolaten)2,55.
De onderzoekers merkten een hoog niveau van chromosomale contaminatie op in de monsters (Tabel 10). Het besmettingsniveau van 10 geanalyseerde monsters lag tussen de 28 en 72% op basis van read mapping. Toen de onderzoekers deze sequentie echter normaliseerden naar de grootte van het chromosoom ten opzichte van het aanwezige plasmide(n), bleek dat plasmidsequenties gemiddeld 144 keer talrijker waren dan chromosomale sequenties. Het vertalen van dit aantal naar het niveau van plasmide-DNA-verrijking vereist dat je het plasmidekopie-aantal van de plasmiden in elk monster kent.
MinION-flowcellen produceren doorgaans een sequencing-output van ~30 GB, wat theoretisch het sequencen van ruim 96 plasmiden per run mogelijk maakt. In de praktijk wordt multiplexing ook beperkt door de limiet van 96 barcodes, waardoor 96 plasmiden de praktische bovengrens per flowcel vormen. Chromosomale DNA-contaminatie en een natuurlijke barcode-onbalans verminderen echter de effectieve leesdiepte per monster. Om voldoende leesdiepte voor elk monster te garanderen, is een meer conservatieve aanpak om ongeveer 24 plasmiden per flowcel te multiplexen. De aanbevolen diepte voor een nauwkeurige assemblage van de plasmidsequentie ligt tussen 50 en 70x32,56. In de illustratieve voorbeelden die in dit artikel worden gepresenteerd, hebben de auteurs 21 gemultiplexte monsters in één flowcel uitgevoerd en een gemiddelde diepte (109x) verkregen, die goed aansluit bij het aanbevolen monsteroptimum per flowcel.
Let op dat bij een overtollige leesdiepte de slag/niet gehaalde leespartities minder informatief zijn om de algehele leeskwaliteit te beoordelen. In plaats daarvan geven metrics die zijn afgeleid van de lengteverdeling een duidelijkere weergave van de kwaliteit van de dataset. Een van deze maatstaven is de N50, gedefinieerd als de leeslengte waarbij lezingen van die lengte of langer 50% van de totale basissen uitmaken. Deze waarde is zeer gevoelig voor kwaliteitscontrolestappen. Zo verwijdert het filteren van lage kwaliteit of korte reads met tools zoals Filtlong een aanzienlijk deel van de kortere tail van de distributie, waardoor de N50 wordt opgeblazen. Dit effect is duidelijk in Tabel 9.
De auteurs gebruikten de Rapid Barcode-kit van ONT, die een transposoom gebruikt om plasmide-DNA te fragmenteren, waardoor voorkennis van het restrictiepatroon van het plasmide niet vereist is. Een eerdere studie vond dat voor kleine plasmiden (<20 kb) enzymatische fragmentatie noodzakelijk is omdat kleine plasmiden circulair blijven tijdens de meeste DNA-extracties en daarom geen vrije uiteinden bevatten voor adapterligatie54. Die studie gebruikte geen barcodes, die extra vrije uiteinden genereren via PCR-amplificatie, dus in dit geval is dit waarschijnlijk een overbodig punt. OnRamp, een van de geavanceerde procedures voor routinematige plasmidvalidatie, voorkomt het gebruik van barcodes door volledige plasmide-reads te gebruiken voor assemblage, waardoor monstervoorbereiding54 wordt vereenvoudigd. In dit geval gaven de auteurs de voorkeur aan barcodes om drie redenen. De eerste is om een assemblage te bouwen, ongeacht de plasmidlengte. De tweede is het verdragen van chromosomale DNA-besmetting. De derde is dat dit de mogelijkheid opent om meerdere samples te multiplexen, zoals hierboven vermeld.
Een eerdere studie merkte op dat de aggregatie van verschillende assemblers het eindresultaat verbeterde door biases die in individueleassemblyplatforms waren ingebouwd te neutraliseren. Deze meta-analyse is een functie die is opgenomen in het assemblyprogramma dat de auteurs gebruiken, Autocycler34. In vergelijking met de eerdere versie, genaamd Trycycler57, is Autocycler iets meer geautomatiseerd; Het gebruikt verschillende subsets van de reads en (zoals eerder vermeld) voert het assemblies uit met meerdere assemblers om een nauwkeurigere consensusassembly te creëren. De meeste assemblers, zelfs de beste, zoals Flye28, Canu29 en Raven30, hebben echter moeite met de aanwezigheid van plasmiden met uitgebreide sequentiehomologie, het foutief samenvoegen van plasmide-sequenties of het genereren van meerdere kopieën van één plasmide, en zijn gevoelig voor het missen van kleine plasmiden58,59 (zie ook Figuur 4C). Wanneer dit gebeurt, kan het weglaten van lagere kwaliteit leesopdrachten en het verwijderen van korte lezingen leiden tot het oplossen van chimerische contigs.
Om de algehele nauwkeurigheid van de sequencingprotocollen vast te stellen, vergeleken de auteurs de ONT-only assemblages met assemblages die zijn verfijnd door het combineren van long-read en short-reads, wat (behalve PacBio-data) momenteel de gouden standaard is. De auteurs hadden ook gelgegevens die het aantal aanwezige plasmiden en hun geschatte grootte toonden (Tabel 8, derde kolom). De onderzoekers verzamelden met succes alle 13 plasmiden die in de 10 monsters werden gevonden en behaalden groottes die overeenkwamen met de geassembleerde sequenties. Dit is een groot succes, aangezien LR-sequentie-assemblers vaak falen in het assembleren van plasmiden met structureel complexe sequenties. Op een meer gedetailleerd niveau gaven paargewijze vergelijkingen tussen de twee sets sequenties een variabel nauwkeurigheidsniveau aan (Tabel 8). Vijf van de plasmide-assemblies hadden gebieden zonder dekking in de ONT-assemblies, vermoedelijk het resultaat van sequentie-artefacten toegevoegd tijdens de ONT-only sequentieassembly. Van de andere zeven vertoonden drie enkel-nucleotide-polymorfismen, met paargewijze verschillen tussen 0,0023 en 0,05%, en vier vertoonden perfecte concordantie. Het nauwkeurigheidsniveau lijkt niet te correleren met het niveau van plasmide-DNA-verrijking of sequencingdiepte, maar de aanwezigheid van meer dan één plasmide in een gegeven monster wel, mogelijk omdat het hebben van meer dan één plasmide de mate van sequentiecomplexiteit versterkt (Tabel 8). Samengevat is de workflow ontworpen om de opbrengst en nauwkeurigheid van plasmidensequenties te optimaliseren. Hoewel het in staat is plasmidesequenties samen te stellen, levert het een variabel niveau van nauwkeurigheid op nucleotideniveau. Het protocol kan worden gebruikt om plasmiden van een breed scala aan groottes te sequencen, tolereert minstens 72% chromosomale DNA-besmetting en kan (afhankelijk van plasmidgrootte en flowcelstatus) minstens 24 plasmiden in één flowcel accommoderen.
Openbaarmakingen
De auteurs hebben niets te onthullen.
Dankbetuigingen
We zijn Steve Salipante (University of Washington) zeer dankbaar voor het gule delen van een set klinische E. coli-stammen die in45 zijn gepubliceerd. Dit werk werd gedeeltelijk ondersteund door onderzoeksfondsen voor een Directorship in Innovation and Entrepreneurial Development Appointment van UCSC aan MC en door de University of California Alianza MX-subsidie "Genomic profiling of Tuberculosis isolates Among High-Burden and Vulnerable Populations in Mexico: insights into transmission and drug resistance" aan MC.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| 1.5 mL Eppendorf DNA LoBind tube | Sigma Aldrich | EP022431081 | Kan worden vervangen door een ander merk |
| 1.5 mL tube racks | Thermo Fisher Scientific | 22-313630 | Kan worden vervangen door een ander merk |
| 15 mL conical tubes | FALCON | 352096 | Kan worden vervangen door een ander merk |
| 15 mL tube racks | Thermo Fisher Scientific | 8850 | Kan worden vervangen door een ander merk |
| 2.0 mL microcentrifuge tubes | Fisherbrand | 05-408-138 | Kan worden vervangen door een ander merk |
| 250 mL sterile flasks | PYREX | 5320 | Kan worden vervangen door een ander merk |
| Carbenicillin | GOLD BIOTECHNOLOGY | C-103-50 | Kan worden vervangen door een ander merk |
| Centrifuge | Eppendorf | 5424R-PR-R | Kan worden vervangen door een ander merk |
| Centrifuge | Eppendorf | 5810R-P-R | Kan worden vervangen door een ander merk |
| Centrifuge bottles | Sigma Aldrich | B1283-4EA | Kan worden vervangen door een ander merk |
| Disposable Inoculating Loops: 1 µL | Fisherbrand | 22-363-595 | Kan worden vervangen door een ander merk |
| Electronic Digital Scale | Denver Instrument | APX-2001 | Kan worden vervangen door een ander merk |
| Ethanol | Fisher Scientific | 04-355-720 | Kan worden vervangen door een ander merk |
| Ethanol-resistant markers | Sharpie | 37001; 37002; 37003 | Kan worden vervangen door een ander merk |
| Flow cell (R10.4.1) | Oxford Nanopore Technologies | FLO-MIN114 | |
| Flow Cell Wash Kit | Oxford Nanopore Technologies | EXP-WSH004 | |
| Gloves | X-GEN | 44-100M | Elke merk van nitrilhandschoenen werkt |
| Ice bucket | Thermo Fisher Scientific | 432128 | Kan worden vervangen door een ander merk |
| Isopropanol | Fisher Scientific | BP26184 | Kan worden vervangen door een ander merk |
| MinION Sequencing Device | Oxford Nanopore Technologies | MIN-101B | |
| Native Barcoding Kit 96 V14 | Oxford Nanopore Technologies | SQK-NBD114.96 | |
| NucleoBond Xtra MIDI Plasmid DNA Extraction Kit | Takara | 740410.5 | |
| PCR tube racks | AXYGEN | R96PCRFSP | Kan worden vervangen door een ander merk |
| PCR tubes: (0.2 mL) | AXYGEN | PCR-02-C | Kan worden vervangen door een ander merk |
| Program autocycler v0.5.2 | Ryan Wick / University of Melbourne | ||
| Program bcftools v1.22 | Wellcome Sanger Institute (HTSlib / Samtools team) | ||
| Program bwa v0.7.19 | Heng Li, originally at the Broad Institute | ||
| Program canu v2.3 | University of California, Davis & Pacific Biosciences collaborators | ||
| Program flye v2.9.6 | University of California, San Diego (Pavel Pevzner lab) | ||
| Program medaka v2.1.1 | Oxford Nanopore Technologies | ||
| Program metamdbg v1.2 | INRIA | ||
| Program miniasm v0.3 | Heng Li | ||
| Program minimap2 v2.28 | Heng Li | ||
| Program minipolish v0.2.0 | Ryan Wick / University of Melbourne | ||
| Program porechop v0.2.4 | Ryan Wick / University of Melbourne | ||
| Program racon v1.5.0 | Genome Institute of Singapore | ||
| Program samtools v1.22.1 | Wellcome Sanger Institute (HTSlib / Samtools project) | ||
| Qubit™ 4 Fluorometer | Invitrogen | Q33226 | |
| Qubit™ Assay Tubes | Invitrogen | Q32856 | |
| Rapid Barcoding Kit 24 and 96 V14 | Oxford Nanopore Technologies | SQK-RBK114.96 | |
| Set of micropipettes that dispense between 1 – 10 μL (P10), 2 – 20 μL (P20), 20 – 200 μL (P200) and 200 – 1000 μL (P1000) | RAININ | 17008648; 17008650; 17008652; 17008653 | Micropipetten moeten gekalibreerd worden |
| Spectrophotometer | Thermo Scientific | 335905P | Kan worden vervangen door een ander merk |
| Sterilized tips for 10 μL, 200 μL and 1000 μL | Eclipse | 1011-260-000-9; 1018-260-000; 1019-260-000-9 | |
| Thermal cycler C1000 Touch | Bio-Rad | 1851196 | Kan worden vervangen door een ander merk |
| Water bath | Thermo Scientific | 51221052 | Kan worden vervangen door een ander merk |
Referenties
- Finks, S. S., Martiny, J. B. H. Plasmid-encoded traits vary across environments. mBio. 14 (1), e0319122(2023).
- Ramiro-Martinez, P., de Quinto, I., Lanza, V. F., Gama, J. A., Rodriguez-Beltran, J. Universal rules govern plasmid copy number. Nat Commun. 16 (1), 6022(2025).
- Redondo-Salvo, S., et al. Pathways for horizontal gene transfer in bacteria revealed by a global map of their plasmids. Nat Commun. 11 (1), 3602(2020).
- Rodriguez-Beltran, J., DelaFuente, J., Leon-Sampedro, R., MacLean, R. C., San Millan, A. Beyond horizontal gene transfer: the role of plasmids in bacterial evolution. Nat Rev Microbiol. 19 (6), 347-359 (2021).
- Castaneda-Barba, S., Top, E. M., Stalder, T. Plasmids, a molecular cornerstone of antimicrobial resistance in the one health era. Nat Rev Microbiol. 22 (1), 18-32 (2024).
- Robertson, J., Bessonov, K., Schonfeld, J., Nash, J. H. E. Universal whole-sequence-based plasmid typing and its utility to prediction of host range and epidemiological surveillance. Microb Genom. 6 (10), (2020).
- Conlan, S., et al. Single-molecule sequencing to track plasmid diversity of hospital-associated carbapenemase-producing Enterobacteriaceae. Sci Transl Med. 6 (254), 254ra126(2014).
- Zankari, E., et al. Identification of acquired antimicrobial resistance genes. J Antimicrob Chemother. 67 (11), 2640-2644 (2012).
- Eyre, D. W., et al. WGS to predict antibiotic MICs for Neisseria gonorrhoeae. J Antimicrob Chemother. 72 (7), 1937-1947 (2017).
- Arredondo-Alonso, S., Willems, R. J., van Schaik, W., Schurch, A. C. On the (im)possibility of reconstructing plasmids from whole-genome short-read sequencing data. Microb Genom. 3 (10), e000128(2017).
- Rhoads, A., Au, K. F. PacBio sequencing and its applications. Genomics Proteomics Bioinformatics. 13 (5), 278-289 (2015).
- Zhang, T., et al. Nanopore sequencing: flourishing in its teenage years. J Genet Genomics. 51 (12), 1361-1374 (2024).
- González, A., Fullaondo, A., Odriozola, A. Why are long-read sequencing methods revolutionizing microbiome analysis? Microorganisms. 13 (8), (2025).
- Wick, R. R., Holt, K. E. Polypolish: Short-read polishing of long-read bacterial genome assemblies. PLoS Comput Biol. 18 (1), e1009802(2022).
- Delahaye, C., Nicolas, J. Sequencing DNA with nanopores: Troubles and biases. PLoS One. 16 (10), e0257521(2021).
- Watson, M., Warr, A. Errors in long-read assemblies can critically affect protein prediction. Nat Biotechnol. 37 (2), 124-126 (2019).
- De Maio, N., et al. Comparison of long-read sequencing technologies in the hybrid assembly of complex bacterial genomes. Microb Genom. 5 (9), (2019).
- Lerminiaux, N., Fakharuddin, K., Mulvey, M. R., Mataseje, L. Do we still need Illumina sequencing data? Evaluating Oxford Nanopore Technologies R10.4.1 flow cells and the Rapid v14 library prep kit for Gram-negative bacteria whole genome assemblies. Can J Microbiol. 70 (5), 178-189 (2024).
- Dabernig-Heinz, J., et al. A multicenter study on accuracy and reproducibility of nanopore sequencing-based genotyping of bacterial pathogens. J Clin Microbiol. 62 (9), e0062824(2024).
- Sereika, M., et al. Oxford Nanopore R10.4 long-read sequencing enables the generation of near-finished bacterial genomes from pure cultures and metagenomes without short-read or reference polishing. Nat Methods. 19 (7), 823-826 (2022).
- Wick, R. R., Judd, L. M., Holt, K. E. Assembling the perfect bacterial genome using Oxford Nanopore and Illumina sequencing. PLoS Comput Biol. 19 (3), e1010905(2023).
- Paterson, D. L. Resistance in gram-negative bacteria: enterobacteriaceae. Am J Med. 119 (1), discussion S62-70 S20-S28 (2006).
- Peter, S., et al. Tracking of antibiotic resistance transfer and rapid plasmid evolution in a hospital setting by nanopore sequencing. mSphere. 5 (4), (2020).
- George, S., et al. Resolving plasmid structures in Enterobacteriaceae using the MinION nanopore sequencer: assessment of MinION and MinION/Illumina hybrid data assembly approaches. Microb Genom. 3 (8), e000118(2017).
- Dong, N., Yang, X., Zhang, R., Chan, E. W., Chen, S. Tracking microevolution events among ST11 carbapenemase-producing hypervirulent Klebsiella pneumoniae outbreak strains. Emerg Microbes Infect. 7 (1), 146(2018).
- Lemon, J. K., Khil, P. P., Frank, K. M., Dekker, J. P. Rapid nanopore sequencing of plasmids and resistance gene detection in clinical isolates. J Clin Microbiol. 55 (12), 3530-3543 (2017).
- Linde, J., et al. Comparison of Illumina and Oxford Nanopore Technology for genome analysis of Francisella tularensis, Bacillus anthracis, and Brucella suis. BMC Genomics. 24 (1), 258(2023).
- Bickhart, D. M., et al. Generating lineage-resolved, complete metagenome-assembled genomes from complex microbial communities. Nat Biotechnol. 40 (5), 711-719 (2022).
- Koren, S., et al. Canu: scalable and accurate long-read assembly via adaptive k-mer weighting and repeat separation. Genome Res. 27 (5), 722-736 (2017).
- Vaser, R., Sikic, M. Time-and memory-efficient genome assembly with Raven. Nat Comput Sci. 1 (5), 332-336 (2021).
- Lynch, M. D., Neufeld, J. D. Ecology and exploration of the rare biosphere. Nat Rev Microbiol. 13 (4), 217-229 (2015).
- Kruasuwan, W., et al. Comparative evaluation of commercial DNA isolation approaches for nanopore-only bacterial genome assembly and plasmid recovery. Sci Rep. 14 (1), 27672(2024).
- Ulrich, J. U., et al. Nanopore adaptive sampling effectively enriches bacterial plasmids. mSystems. 9 (3), e0094523(2024).
- Wick, R. R., Howden, B. P., Stinear, T. P. Autocycler: long-read consensus assembly for bacterial genomes. Bioinformatics. 41 (9), (2025).
- NucleoBond Xtra Plasmid DNA Purification User Manual. , Takara Bio USA. Available from: https://www.takarabio.com/documents/User%20Manual/NucleoBond%20Xtra%20Plasmid%20DNA%20Purification%20User%20Manual_Rev_15.pdf?srsltid=AfmBOorkdYVlr34yclNUgmBCn4imrn-gbvTafmkD2Yrnnch6fH-K_VwZ (2019).
- Mota-Bravo, L., et al. Detection of horizontal gene transfer mediated by natural conjugative plasmids in E. coli. J Vis Exp. (193), (2023).
- Hancock, V., Witso, I. L., Klemm, P. Biofilm formation as a function of adhesin, growth medium, substratum, and strain type. Int J Med Microbiol. 301 (7), 570-576 (2011).
- Hung, C., et al. Escherichia coli biofilms have an organized and complex extracellular matrix structure. mBio. 4 (5), e00645-e00713 (2013).
- Qubit 4 assays quick reference (Pub. No. MAN0017210 C.0). , Thermo Fisher Scientific. (2025).
- Rapid barcoding sequencing kit 96 v14. , Oxford Nanopore Technologies. Available from: https://store.nanoporetech.com/us/rapid-barcoding-sequencing-kit-96-v14.html (2026).
- Schwengers, O., et al. Bakta: rapid and standardized annotation of bacterial genomes via alignment-free sequence identification. Microb Genom. 7 (11), (2021).
- Seemann, T. Prokka: rapid prokaryotic genome annotation. Bioinformatics. 30 (14), 2068-2069 (2014).
- Singh, H., et al. Integrons: the hidden architects of bacterial adaptation, evolution, and the challenges of antimicrobial resistance. Antonie Van Leeuwenhoek. 118 (7), 90(2025).
- Redondo-Salvo, S., et al. COPLA, a taxonomic classifier of plasmids. BMC Bioinformatics. 22 (1), 390(2021).
- Salipante, S. J., et al. Large-scale genomic sequencing of extraintestinal pathogenic Escherichia coli strains. Genome Res. 25 (1), 119-128 (2015).
- Couturier, A., et al. Real-time visualisation of the intracellular dynamics of conjugative plasmid transfer. Nat Commun. 14 (1), 294(2023).
- Wick, R. R., Schultz, M. B., Zobel, J., Holt, K. E. Bandage: interactive visualization of de novo genome assemblies. Bioinformatics. 31 (20), 3350-3352 (2015).
- Grant, J. R., et al. Proksee: in-depth characterization and visualization of bacterial genomes. Nucleic Acids Res. 51 (W1), W484-W492 (2023).
- MacKenzie, M., Argyropoulos, C. An Introduction to nanopore sequencing: past, present, and future considerations. Micromachines (Basel). 14 (2), (2023).
- Emiliani, F. E., Hsu, I., McKenna, A. Multiplexed assembly and annotation of synthetic biology constructs using long-read nanopore sequencing. ACS Synth Biol. 11 (7), 2238-2246 (2022).
- Brown, S. D., Dreolini, L., Wilson, J. F., Balasundaram, M., Holt, R. A. Complete sequence verification of plasmid DNA using the Oxford Nanopore Technologies' MinION device. BMC Bioinformatics. 24 (1), 116(2023).
- Hall, J. P. J., Botelho, J., Cazares, A., Baltrus, D. A. What makes a megaplasmid? Philos Trans R Soc Lond B Biol Sci. 377 (1842), 20200472(2022).
- Brown Kav, A., Benhar, I., Mizrahi, I. A method for purifying high-quality and high-yield plasmid DNA for metagenomic and deep sequencing approaches. J Microbiol Methods. 95 (2), 272-279 (2013).
- Mumm, C., et al. Multiplexed long-read plasmid validation and analysis using OnRamp. Genome Res. 33 (5), 741-749 (2023).
- Balbuena-Alonso, M. G., et al. Genomic analysis of plasmid content in food isolates of E. coli strongly supports its role as a reservoir for the horizontal transfer of virulence and antibiotic resistance genes. Plasmid. 123-124, 102650(2022).
- Zhao, W., et al. Oxford nanopore long-read sequencing enables the generation of complete bacterial and plasmid genomes without short-read sequencing. Front Microbiol. 14, 1179966(2023).
- Wick, R. R., et al. Trycycler: consensus long-read assemblies for bacterial genomes. Genome Biol. 22 (1), 266(2021).
- Johnson, J., Soehnlen, M., Blankenship, H. M. Long read genome assemblers struggle with small plasmids. Microb Genom. 9 (5), (2023).
- Boostrom, I., Portal, E. A. R., Spiller, O. B., Walsh, T. R., Sands, K. Comparing long-read assemblers to explore the potential of a sustainable low-cost, low-infrastructure approach to sequence antimicrobial resistant bacteria with Oxford Nanopore sequencing. Front Microbiol. 13, 796465(2022).
Herprints en machtigingen
