Dit artikel presenteert een stapsgewijs protocol voor hoogprecisie eye-tracking dataverzameling in leesexperimenten bij mensen, waarbij hardware- en displayselectie, laboratoriuminrichting, deelnemersbeheer, kalibratie en validatie, online kwaliteitscontrole en preprocessing (eventdetectie en driftcorrectie) worden behandeld om data met een hoge nauwkeurigheid en precisie en reproduceerbare resultaten te verkrijgen.
Methodenartikel
Methodologisch protocol voor hoogwaardige gegevensverzameling tijdens eye tracking bij menselijk lezen
In dit artikel
Samenvatting
Samenvatting
Eye tracking is een centrale methodologische benadering voor het bestuderen van aandacht en taalverwerking tijdens het lezen. De validiteit en reproduceerbaarheid van resultaten zijn afhankelijk van de datakwaliteit, een heldere methodologie en consistente preprocessing. Dit artikel presenteert een uitgebreid stapsgewijs protocol voor het verzamelen van hoogwaardige eye-tracking data in leesstudies. Het protocol begint met de voorbereiding van de laboratoriumomgeving en de installatie van de apparatuur, gevolgd door het selecteren en configureren van eye-tracking hardware en software, en de voorbereiding van stimuli en het experimentele ontwerp. De administratie van participanten, geïnformeerde toestemming en de documentatie van linguïstische en psychometrische kenmerken worden uitgevoerd. Vervolgens worden kalibratie- en validatieprocedures doorgevoerd, waarbij het comfort van de participant en de datakwaliteit tijdens de dataverzameling nauwgezet online worden gemonitord. De preprocessing-pipeline omvat het exporteren van ruwe data in standaardformaten, datacleaning, en de detectie van fixaties en saccades (met gebruik van algoritmen op basis van snelheid en dispersie) met duidelijk gedefinieerde parameters, visuele inspectie op signaalverlies en ruisbeheersing, correctie voor verticale drift bij meerregelige tekst, en de extractie van standaard leesmaten (fixatieduur, saccade-metrieken, het overslaan van woorden en regressiesnelheden). Gedurende het protocol wordt er bijzondere nadruk gelegd op de afstemming tussen de onderzoeksvragen en de hardware-specificaties, het beheersen van drift door regelmatige controles, en gedetailleerde rapportage van alle kritieke parameters en beslissingen. Een succesvolle dataverzameling resulteert doorgaans in een stabiele validatienauwkeurigheid binnen gestelde limieten, lage dataverliespercentages en interpreteerbare distributies van fixatieduren en saccade-gedrag die bekende effecten reproduceren met betrekking tot woordlengte, frequentie en voorspelbaarheid. Het protocol is compatibel met desktop eye trackers, gangbare softwareomgevingen en zowel hoofdgestabiliseerde als hoofdvrije opstellingen, waarbij praktische problemen zoals lichtomstandigheden, reflecties van brillen en veranderingen in de houding van de participant worden geadresseerd. Deze studie presenteert een helder, praktisch protocol dat methodologische richtlijnen consolideert in een uniforme workflow. Het doel is om betrouwbare eye-tracking dataverzameling in leesonderzoek te ondersteunen, repliceerbaarheid en meta-analyses te bevorderen, de consistentie tussen laboratoria en groepen te verbeteren en uiteindelijk de wetenschappelijke geloofwaardigheid van leesonderzoek te versterken.
Inleiding
Eye tracking is een centrale methode voor het bestuderen van aandacht en taalverwerking tijdens het lezen, aangezien fixaties en saccades het momentane verbruik van visuele en cognitieve middelen bij de stimuli aangeven. Klassieke en hedendaagse reviews documenteren robuuste verbanden tussen oogbewegingen en theoretische constructen zoals de perceptuele span, het preview-voordeel en modellen van oogbewegingscontrole1,2. Om betrouwbare studies uit te voeren die deze verbanden onderzoeken, is methodologische striktheid bij de keuze van apparatuur, het experimentele ontwerp, de kalibratie en validatie, en de voorbewerking essentieel; anders leiden verslechteringen in de datakwaliteit tot vertekende schattingen en wordt de repliceerbaarheid ondermijnd3.
In het afgelopen decennium hebben verschillende inleidende werken en best-practice-artikelen de methodologische kennis van het vakgebied geconsolideerd. Een recente reeks over de fundamenten verbindt theorie met meetmethoden, bespreekt operationalisering en algoritmische variabiliteit, en biedt richtlijnen voor het kiezen van eye-trackers voor specifieke onderzoeksvragen4,5,6,7,8. Aanvullende richtlijnen presenteren best practices voor het selecteren van hardware, het waarborgen van accuratesse en precisie, het definiëren van maten en verslaglegging, met aanbevelingen voor het verminderen van bedreigingen voor de validiteit9. Inleidende bronnen voor leesonderzoek bieden daarnaast toegankelijke overzichten van experimenteel ontwerp, gangbare meetmethoden en analyse-pipelines10,1. In de toegepaste linguïstiek en leesonderzoek vatten domeinspecifieke reviews de selectie van meetmethoden en trackers samen en benadrukken zij taakafhankelijke beperkingen12,13,14,15,16,17.
Dit artikel vertaalt die richtlijnen naar een stapsgewijs protocol voor hoogprecisie eye-tracking datacollectie in leesstudies. In tegenstelling tot bestaande bronnen, die voornamelijk brede, theoretische best-practice richtlijnen bieden of zich nauw richten op specifieke analysetechnieken, operationaliseert dit protocol deze concepten tot een volledige, actiegerichte workflow. Het doel is om de dagelijkse laboratoriumpraktijk te vergemakkelijken door concrete, sequentiële instructies te bieden. Wat betreft de toepasbaarheid is dit protocol specifiek geoptimaliseerd voor strikt gecontroleerde laboratorium-leesexperimenten met gebruik van hoogfrequente, desktop-gebaseerde eye-trackers (bijv. 50-20 Hz) met hoofdstabiliserende opstellingen (kin- of voorhoofdsteunen). Het is het meest geschikt voor onderzoek dat strikte eisen stelt aan datakwaliteit, hoge ruimtelijke nauwkeurigheid en precisie — zoals studies die precieze fixaties op woordniveau of fijnmazige saccade-metrieken analyseren.
Het gebruik van head-free of naturalistische opstellingen is ook in populariteit aan het toenemen, waaronder in leesonderzoek, hoewel we de reikwijdte van dit artikel beperken tot laboratoriumstudies. We behandelen de selectie van hardware en software, de laboratoriumopstelling, de voorbereiding van stimuli, het beheer van participanten, kalibratie en validatie, online kwaliteitscontrole en preprocessing (inclusief eventdetectie en driftcorrectie). Door dit protocol te volgen, kunnen onderzoekers een datakwaliteit documenteren en bereiken die consistent is met de huidige standaarden, waardoor de transparantie, geloofwaardigheid en reproduceerbaarheid van bevindingen met betrekking tot lezen worden verbeterd.
Protocol
De ethische goedkeuring voor de gegevensverzameling van COST CA2131 werd verleend door de Research Ethics Committee van de Faculteit Filosofie aan de Jagiellonian Universiteit, Polen, onder protocolnummer 21.042.18_2024. Geïnformeerde toestemming is verkregen van alle deelnemers.
1. Voorbereiden van de laboratoriumomgeving en opstellen van de apparatuur
- Voorbereiding van de laboratoriumomgeving
- Controleer de licht- en omgevingsgeluidsomstandigheden. Ramen in de laboratoriumomgeving kunnen plotselinge veranderingen in pupilverwijding en lichtreflecties op de camera van de eye-tracker en de monitor veroorzaken. Verzamel indien mogelijk gegevens in een kamer zonder ramen of gebruik verduisteringsgordijnen om zonlicht te blokkeren. Gebruik kunstlicht en elimineer reflecterende lichtbronnen. Verifieer dat er geen reflecties op de monitor verschijnen; pas jaloezieën of hoeken aan totdat er geen reflecties meer overblijven. Zorg dat de kamer stil is en voorkom onderbrekingen (bijv. door signalering, deurbeveiliging). Gebruik externe signalen om onderbrekingen te vermijden (bijv. plaats een bordje aan de buitenkant met "Experiment gaande. Gelieve niet aan te kloppen of de kamer te betreden").
- Controleer de fysieke ergonomie. Gebruik een stabiele stoel die niet kan draaien; pas de tafelhoogte aan (indien mogelijk) om de houding te bewaren en kalibratieverlies door rotatie van de stoel te voorkomen.
- Vermijd sociale aanwezigheid. De aanwezigheid van een experimentator in dezelfde kamer kan de participant afleiden. Scheid de controlekamer van de kamer van de participant, of houd deze buiten het zicht, om effecten van sociale aanwezigheid te minimaliseren.
- Controleer de luchtventilatie. Ventileer de ruimte vóór en na de experimentsessies. Controleer de kamertemperatuur, aangezien participanten gedurende enige tijd stil moeten blijven zitten.
- Selectie van eye-tracking apparatuur
- Controleer de compatibiliteit tussen de onderzoeksdoelen en de meetwaarden. De doelen van een specifieke studie, en dus de doelmeetwaarden (afhankelijke variabelen), dienen aan te sluiten bij de mogelijkheden van de eye-tracking apparatuur. De institutionele beschikbaarheid van apparatuur kan beperkingen opleggen aan de reikwijdte van de beoogde studie. Controleer de drie belangrijkste kenmerken (sampling rate, precisie en nauwkeurigheid) van het eye-tracking systeem en hun potentieel om aan de onderzoeksbehoeften te voldoen. Het hoofddoel is om ervoor te zorgen dat de capaciteit van de eye-tracking apparatuur compatibel is met de doelen van de studie.
OPMERKING: Sampling rate = De sampling rate wordt uitgedrukt in Hz en weerspiegelt de grootte van de monsters die door de eye-tracker tijdens een bepaalde periode worden verzameld: een eye-tracker van 60 Hz verzamelt monsters elke 16 ms, terwijl een eye-tracker van 50 Hz monsters verzamelt elke 1 ms. Dit beïnvloedt de verschillende soorten meetwaarden, aangezien eye-trackers met een lage frequentie saccades die tijdens een periode van 16 ms begonnen, als fixaties kunnen registreren, of vice versa. Sampling wordt soms verward met data-nauwkeurigheid, maar dit zijn verschillende eigenschappen.
Precisie = De consistentie waarmee de eye-tracker in de loop van de tijd gegevens kan verzamelen.
Nauwkeurigheid = De mate van afwijking tussen het door de eye-tracker gedetecteerde fixatiepunt en het werkelijke fixatiepunt.
Bijvoorbeeld: bij het bestuderen van fixatiepunten op woorden, die worden beschreven in termen van de positie van de blik op de letters van een woord, is een veel hogere sampling rate (≥50-200 Hz), precisie en nauwkeurigheid vereist dan bij een studie die zich uitsluitend richt op het percentage regressieve saccades (vergeleken met progressieve saccades) tijdens het lezen. - Bepaal de methodologie voor de registratie van oogbewegingen. Gebruik een desktop eye-tracker met een hoge sampling rate, precisie en nauwkeurigheid. Gebruik hoofdstabilisatie met een kinsteun of een voorhoofdsteun. In het geval van head-free eye-tracking (remote eye-tracking), gebruik indien beschikbaar stickers op het voorhoofd van de participant om de gezichtsherkenning te verbeteren; vermijd bovendien reflecterende stickers, tenzij aanbevolen door de leverancier van de tracker.
OPMERKING: Het gebruik van draagbare eye-tracking apparatuur is zeldzaam in leesstudies vanwege de relatief lage sampling rate, precisie en nauwkeurigheid in vergelijking met desktop eye-trackers, evenals uitdagingen bij het analyseren van oogbewegingsgegevens. Echter, head-free of naturalistische opstellingen hebben het afgelopen decennium aan populariteit gewonnen, vergezeld van verbeterde datakwaliteit en geautomatiseerde analysepijplijnen, waardoor de reikwijdte van studies naar oogbewegingen tijdens het lezen is uitgebreid naar naturalistische omgevingen en lezen in VR-omgevingen.
- Controleer de compatibiliteit tussen de onderzoeksdoelen en de meetwaarden. De doelen van een specifieke studie, en dus de doelmeetwaarden (afhankelijke variabelen), dienen aan te sluiten bij de mogelijkheden van de eye-tracking apparatuur. De institutionele beschikbaarheid van apparatuur kan beperkingen opleggen aan de reikwijdte van de beoogde studie. Controleer de drie belangrijkste kenmerken (sampling rate, precisie en nauwkeurigheid) van het eye-tracking systeem en hun potentieel om aan de onderzoeksbehoeften te voldoen. Het hoofddoel is om ervoor te zorgen dat de capaciteit van de eye-tracking apparatuur compatibel is met de doelen van de studie.
- Installatie van hardware en software
- Hardware installeren. Meet de afstanden tussen het gezicht van de participant, de monitor en de eye-tracker. Stel de kijkafstand in volgens de fabrikant (bijv. ~60–70 cm) en de vereiste configuratiegeometrie, bij voorkeur met een platte 21–27 inch LCD-monitor (bijv. 24 inch op 60 cm, ~48° x 28° gezichtsveld) zodat alle tekst binnen het centrale visuele veld en het effectieve bereik van de tracker blijft. Controleer de kanteling en rotatie van de monitor, en de uitlijning tussen de blikvector en de overeenkomstige locatie op het scherm. Stel de monitorgrootte en verversingssnelheid in op de doelwaarden. Stel de schermresolutie in op de gespecificeerde waarde. Meet de luminantie van de monitor op een witte achtergrond op de gespecificeerde afstand. Noteer de luminantiewaarde in het sessierapport.
- Gebruik waar nodig LCD-monitoren met hoge verversingssnelheden (120 Hz of hoger, bijv. 14–240 Hz), vooral voor gaze-contingent taken en geverifieerde timing. Schakel variabele verversingstechnologieën (G-Sync/FreeSync) uit. Als de eye-tracker door verschillende onderzoekers wordt gebruikt voor verschillende experimenten, is het belangrijk om alle wijzigingen bij te houden die tijdens elke gegevensverzameling zijn aangebracht. Aan het einde van elke gegevensverzameling moet de opstelling worden teruggebracht naar de oorspronkelijke staat aan het begin van de sessie, of zoals gedefinieerd in het labprotocol.
- Software installeren. De meeste fabrikanten van eye-trackers leveren relevante software, Software Development Kits (SDK's) en/of libraries voor compatibiliteit en integratie met opensource software.
OPMERKING: Recentelijk blijven specifieke opstellingen een technische uitdaging die op maat gemaakte oplossingen vereist. Zo vereist de tijdsynchronisatie van een eye-tracker met aanvullende meetmethoden, zoals EEG en fNIRS, speciale hardware- en/of software-oplossingen om een passend niveau van time-locking te garanderen tussen de klok van de eye-tracker en de klok voor stimuluspresentatie, en/of schermverversings-desynchronisatie. Daarom bieden de meeste tools van fabrikanten een omgeving voor het ontwerpen van experimenten die voldoet aan de basisbehoeften van onderzoekers, zoals het presenteren van stimuli en het registreren van oogbewegingen. Een lijst met momenteel beschikbare softwarepakketten staat in de Tabel van Materialen.
- Hardware installeren. Meet de afstanden tussen het gezicht van de participant, de monitor en de eye-tracker. Stel de kijkafstand in volgens de fabrikant (bijv. ~60–70 cm) en de vereiste configuratiegeometrie, bij voorkeur met een platte 21–27 inch LCD-monitor (bijv. 24 inch op 60 cm, ~48° x 28° gezichtsveld) zodat alle tekst binnen het centrale visuele veld en het effectieve bereik van de tracker blijft. Controleer de kanteling en rotatie van de monitor, en de uitlijning tussen de blikvector en de overeenkomstige locatie op het scherm. Stel de monitorgrootte en verversingssnelheid in op de doelwaarden. Stel de schermresolutie in op de gespecificeerde waarde. Meet de luminantie van de monitor op een witte achtergrond op de gespecificeerde afstand. Noteer de luminantiewaarde in het sessierapport.
2. Het experiment ontwerpen en voorbereidend testen
- Voorbereiding van stimuli
- Bereid het leesmateriaal voor. Leesmaterialen worden meestal gepresenteerd in de vorm van zinnen of paragrafen, afhankelijk van de doelen van het onderzoek. Overweeg om leesmaterialen uit beschikbare bronnen te citeren in plaats van handmatig tekst te creëren, zolang deze methode overeenkomt met het doel van het onderzoek.
- Controleer de licentievoorwaarden voor teksthergebruik. Controleer de licentievoorwaarden voor alle teksten. Als de materialen uit gepubliceerde experimenten open source zijn en dus publiekelijk beschikbaar voor iedereen die ze wil gebruiken, is toestemming niet nodig. Vraag anders de vereiste toestemmingen aan vóór gebruik. Het is belangrijk om te controleren of stimuli kunnen worden gebruikt voor het experiment en of ze kunnen worden gedeeld als aanvullend materiaal.
- Bereid geformatteerde stimuli voor. Het formatteren van tekststimuli vereist het gebruik van passende lettertype-eigenschappen (type, grootte, letter-, woord- en regelafstand). Gebruik een monospace-lettertype met een geschikte lettergrootte en afstand, rekening houdend met de instellingen die in de literatuur worden gebruikt.
OPMERKING: Monospace-lettertypen, zoals Courier New, zijn aanbevolen lettertypen in lezesexperimenten die gebruikmaken van woordgebaseerde Areas of Interest (AOI's), aangezien deze lettertypen dezelfde pixelgrootte bieden voor verschillende alfanumerieke tekens en symbolen binnen het Latijnse alfabet. De onderzoeker moet de compatibiliteit van het lettertype, de interface en de specifieke eigenschappen van de stimuli controleren, zoals de presentatie van stimuli in niet-Latijnse tekens of leesrichtingen van rechts naar links, en of de softwaretools voor het experiment een methodologie bieden voor het automatisch specificeren van IA (Interest Area) of AOI (Area of Interest).
- Ontwerp van de experimentprocedure
- Voorbereiding van instructies
OPMERKING: Instructies zijn belangrijk omdat ze een aanzienlijke impact hebben op de oogbewegingen tijdens het lezen. Het gebruik van taakinstructies, zelfs in minimale vorm, is cruciaal. Een gebrek aan expliciete instructies kan onbedoelde gevolgen hebben die het blikgedrag van deelnemers beïnvloeden. Zo kan de ene deelnemer een latente aanname hebben over zorgvuldig lezen, terwijl de andere misschien oppervlakkig scant in plaats van natuurlijk leest voor begrip.- Presenteer gestandaardiseerde instructies op het scherm en log het beginstijdstip en de duur van de instructies; vermijd verbale aanwijzingen tijdens de opname. Een gebruikelijke praktijk is om de deelnemer te vragen te lezen voor begrip. In het geval dat van de deelnemers wordt verwacht dat ze lezen zoals ze dat in dagelijkse situaties doen, informeer de deelnemers dan dat ze natuurlijk worden geacht te lezen; dat wil zeggen, ze hoeven knipperen of herlezen niet te vermijden. Informeer deelnemers ook als er een aanvullende taak is, zoals begripsvragen (die belangrijk zijn om te garanderen dat deelnemers lezen voor begrip). Instructies kunnen variëren niet alleen per taak, maar ook per fase van het experiment (bijv. training versus hoofdtaak). Ter illustratie wordt hieronder een voorbeeld gegeven van instructies die tijdens een trainingsfase worden gebruikt18.
We beginnen nu met een trainingssessie. Hiervoor heeft u de vier gemarkeerde toetsen (A, B, C, D) nodig. Verdere instructies worden u zo getoond. Na de training zal uw prestatie worden geëvalueerd, wat één tot twee minuten in beslag zal nemen. Als uw trainingsprestatie onvoldoende is, zal het laatste deel van de training worden herhaald. Als deze voldoende is, keer ik terug naar de kamer. Wanneer u klaar bent, drukt u simpelweg op de spatiebalk. - Het is aan de onderzoeker om dergelijke instructies te gebruiken voor de trainingssessies van experimenten die zijn ontworpen voor het bestuderen van lezen. Gebruik desalniettemin de instructies voor de experimentsessie. Een voorbeeld van instructies voor de experimentfase die worden gebruikt in een algemene relevantie-instructieconditie (zowel met als zonder een vraag in de tekst) kan eruitzien als de onderstaande19.
U zult een reeks korte expositieve teksten lezen. We willen dat u de tekst zorgvuldig leest en zoveel mogelijk van de tekst begrijpt. Later, na het lezen, wordt u gevraagd een mondelinge samenvatting te geven van de hoofdideeën van de tekst om te zien hoe goed u heeft begrepen wat u heeft gelezen.
Een ander voorbeeld van een instructie wordt hieronder gegeven voor een experiment dat gebruikmaakt van zinsleestaken20.
Welkom bij ons leesonderzoek. In dit onderzoek krijgt u ongeveer honderd zinnen gepresenteerd. Deze zijn willekeurig geselecteerd uit verschillende bronnen. Ze zullen in willekeurige volgorde worden gepresenteerd. Lees ze stil, om de betekenis te begrijpen, in uw eigen, natuurlijke leestempo, op een vergelijkbare manier als u zinnen in een boek zou lezen. Na sommige zinnen kunt u begripsvragen krijgen. Beantwoord alstublieft de begripsvragen. Als u het antwoord niet weet, sla de vraag dan over. Er zal een pauze zijn in het midden van de sessie. U kunt op elk moment om een pauze vragen of de sessie verlaten als u zich ongemakkelijk voelt. Als u vragen heeft, informeer dan de experimentator. Druk anders op een knop om de procedure te starten.
- Presenteer gestandaardiseerde instructies op het scherm en log het beginstijdstip en de duur van de instructies; vermijd verbale aanwijzingen tijdens de opname. Een gebruikelijke praktijk is om de deelnemer te vragen te lezen voor begrip. In het geval dat van de deelnemers wordt verwacht dat ze lezen zoals ze dat in dagelijkse situaties doen, informeer de deelnemers dan dat ze natuurlijk worden geacht te lezen; dat wil zeggen, ze hoeven knipperen of herlezen niet te vermijden. Informeer deelnemers ook als er een aanvullende taak is, zoals begripsvragen (die belangrijk zijn om te garanderen dat deelnemers lezen voor begrip). Instructies kunnen variëren niet alleen per taak, maar ook per fase van het experiment (bijv. training versus hoofdtaak). Ter illustratie wordt hieronder een voorbeeld gegeven van instructies die tijdens een trainingsfase worden gebruikt18.
- Ontwerp van trials en blokken. Ontwerp de flow van het experiment door de presentatie van trials in blokken en de randomisatie van de volgorde van trials binnen en over de blokken heen te overwegen. Gebruik een fixatiekruis voor elke trial (50-80 ms) om ervoor te zorgen dat de initiële fixaties van de deelnemers op dezelfde locatie op het scherm zijn en verwijderd zijn van elk deel van de tekst.
Het ontwerp van een eye-tracking experiment, waarbij de pupilgrootte een afhankelijke variabele is, vereist dat de flow van het experiment dienovereenkomstig wordt aangepast, aangezien pupilgrootte geen momentane respons is zoals een fixatie-saccade-sequentie. Specifiek, in het geval van het gebruik van pupilgrootte als afhankelijke variabele, is het noodzakelijk om een pre-onset baseline-venster en zwart-schermintervallen met passende duur in te voeren om stabilisatie van de pupilgrootte te garanderen vóór de presentatie van de stimuli en de daaropvolgende trial. De onderzoeker moet recente studies over pupillometrie-richtlijnen raadplegen om ervoor te zorgen dat de geregistreerde pupilgegevens correct kunnen worden geïnterpreteerd als een afhankelijke variabele21,2. - Ontwerp van pauzes tussen blokken. Voer drift-correctieschermen en optionele korte pauzes tussen experimentblokken in om de datakwaliteit te waarborgen en vermoeidheid te verminderen. Voeg drift-controles toe na een vooraf gespecificeerd aantal trials, of wanneer de nauwkeurigheid zichtbaar afneemt (controleer of er sneltoetsen zijn om kalibratie/validatie tijdens het experiment te forceren); valideer opnieuw als de drift >1° van de visuele hoek is (gemiddelde van x- en y-coördinaten).
- Identificeer de doel-onafhankelijke variabelen. In leesstudies vormen specifieke eigenschappen van tekst, zoals woordfrequentie en de zinsvoorspelbaarheid van woorden, de belangrijkste doel-onafhankelijke variabelen. Maak een lijst van de onafhankelijke variabelen van het experiment, afhankelijk van de doelen van het onderzoek. In statistische analyses kunnen metrieken van onafhankelijke variabelen waardenormalisatie vereisen. Beoordeel de relevantie van elke variabele op basis van de eigenschappen van de stimuli.
- Sluit woorden aan het begin van de tekstregel uit van de analyse, aangezien fixaties op die woorden meestal niet nauwkeurig zijn: ze kunnen de eerste voorzichtige fixatie in de tekst/zin weerspiegelen of de eerste fixatie na een regelafbreking (een zogenaamde return-sweep), die in elk geval niet nauwkeurig zijn en gewoonlijk worden gevolgd door correctieve fixaties. Sluit het laatste woord van elke regel uit omdat deze woorden onderhevig zijn aan minder visuele crowding (door opvolgende woorden) en omdat fixaties op woorden aan het einde van de regel vaak de beëindiging van een trial of de programmering van een return-sweep naar de volgende tekstregel weerspiegelen.
OPMERKING: De duur van de eerste fixatie kan minder significant zijn in talen met veel functiewoorden, zoals lidwoorden voor zelfstandige naamwoorden (de analyseregio moet het lidwoord en het zelfstandig naamwoord bevatten, maar de eerste fixatie zal minder belangrijk zijn, omdat deze mogelijk alleen de verwerking van het lidwoord weerspiegelt).
- Sluit woorden aan het begin van de tekstregel uit van de analyse, aangezien fixaties op die woorden meestal niet nauwkeurig zijn: ze kunnen de eerste voorzichtige fixatie in de tekst/zin weerspiegelen of de eerste fixatie na een regelafbreking (een zogenaamde return-sweep), die in elk geval niet nauwkeurig zijn en gewoonlijk worden gevolgd door correctieve fixaties. Sluit het laatste woord van elke regel uit omdat deze woorden onderhevig zijn aan minder visuele crowding (door opvolgende woorden) en omdat fixaties op woorden aan het einde van de regel vaak de beëindiging van een trial of de programmering van een return-sweep naar de volgende tekstregel weerspiegelen.
- Identificeer de doel-afhankelijke variabelen. In leesstudies vormt een set oogbewegingsmetrieken, zoals de duur van de eerste fixatie, de duur van een enkele fixatie, de blikduur, het regressiepercentage en de kans op het overslaan van woorden, de belangrijkste doel-afhankelijke variabelen in relatie tot de doelen van het onderzoek. Specificeer de te analyseren oogbewegingsmetrieken. Gebruik deze metrieken als de basis van de statistische analyse.
OPMERKING: Vermijd het gebruik van elke taak waarbij de deelnemer op het toetsenbord moet typen, omdat dit kan vereisen dat men de kinsteun verlaat, waardoor de kalibratie verloren gaat. In plaats daarvan kunnen deelnemers de muis gebruiken om hun antwoord te selecteren. In gevallen waarin mondelinge feedback van de deelnemer noodzakelijk is tijdens de oogbewegingsregistratie, gebruik dan een voorhoofdssteun in plaats van een kinsteun, en vraag de deelnemer om verbaal te reageren of sta enkeltoets-responsen toe terwijl men op de voorhoofdssteun blijft.
- Voorbereiding van instructies
- Implementatie van de experimentprocedure
- Selecteer software voor stimuluspresentatie. Stel het experiment in met behulp van geschikte software voor stimuluspresentatie. Zowel door de fabrikant geleverde tools als algemene tools voor experimentontwerp kunnen worden gebruikt om tekst te presenteren en oogbewegingen te registreren. Houd bij het kiezen van software rekening met de beschikbare hardware-integraties (bijv. native ondersteuning voor hun eye tracker), de vereiste mate van timing-nauwkeurigheid en de voorkeur voor scripting versus GUI-gebaseerd ontwerp. Ongeacht het platform moet de software betrouwbare synchronisatie ondersteunen tussen stimulusgebeurtenissen (bijv. begin van het woord, begin van de zin) en de eye-tracking datastroom, zodat fixaties en saccades tijdens de analyse kunnen worden afgestemd op de overeenkomstige tekstelementen. Controleer bij het gebruik van externe software de compatibiliteit tussen de eye-tracker software en de externe software, vooral voor datavisualisatie en data-export.
OPMERKING: Voorbeelden van software: Experiment Builder (SR Research, voor EyeLink-systemen) biedt een grafische interface met ingebouwde ondersteuning voor drift-controles, kalibratieroutines en gebeurtenisberichten die naar de opnamecomputer worden verzonden. Open-source platforms zoals PsychoPy en OpenSesame bieden soortgelijke functionaliteit en zijn hardware-agnostisch, aangezien ze het ontwerpen van trials via een grafische interface of scripting mogelijk maken (bijv. Python in het geval van PsychoPy), de timing van stimuli controleren en regio's van interesse, ook wel Interest Areas (IA's) of Areas of Interest (AOI's) genoemd, rond woorden of regels tekst definiëren. Soms is de koppeling voor datavisualisatie en data-export niet eenvoudig voor onderzoekers aan het begin van hun carrière, en daarom kan het gemakkelijker zijn om in plaats daarvan de software van de fabrikant te gebruiken. Bijgevolg is een belangrijke overweging bij het kiezen van eye trackers het niveau van ondersteuning dat wordt geboden door de verschillende fabrikanten of de gemeenschap van ontwikkelaars. - Voer een pilot van het experiment uit. Test de geïmplementeerde experimentprocedure en controleer de geregistreerde gegevens om er zeker van te zijn dat het experiment verloopt zoals verwacht. Voer pilotstudies uit in de laboratoriumomgeving om te garanderen dat het experiment verloopt zoals verwacht door vooraf gedefinieerde succescriteria te monitoren. Controleer de geregistreerde gegevens om te bevestigen dat alles wat nodig is voor het onderzoek wordt geregistreerd.
- Selecteer software voor stimuluspresentatie. Stel het experiment in met behulp van geschikte software voor stimuluspresentatie. Zowel door de fabrikant geleverde tools als algemene tools voor experimentontwerp kunnen worden gebruikt om tekst te presenteren en oogbewegingen te registreren. Houd bij het kiezen van software rekening met de beschikbare hardware-integraties (bijv. native ondersteuning voor hun eye tracker), de vereiste mate van timing-nauwkeurigheid en de voorkeur voor scripting versus GUI-gebaseerd ontwerp. Ongeacht het platform moet de software betrouwbare synchronisatie ondersteunen tussen stimulusgebeurtenissen (bijv. begin van het woord, begin van de zin) en de eye-tracking datastroom, zodat fixaties en saccades tijdens de analyse kunnen worden afgestemd op de overeenkomstige tekstelementen. Controleer bij het gebruik van externe software de compatibiliteit tussen de eye-tracker software en de externe software, vooral voor datavisualisatie en data-export.
3. Werving en informeren van deelnemers
- Selectie van deelnemers
- Bepaal de vereisten voor de visuele conditie. Rekruteer deelnemers met een normaal of tot normaal gecorrigeerd gezichtsvermogen. Het is mogelijk om brillen en contactlenzen toe te staan, mits deze minimale reflecties vertonen (anti-reflectie, monitorhoek) volgens de richtlijnen van de fabrikant. Documenteer het type correctie (bril, contactlenzen) voor covariantiecontroles.
OPMERKING: Meestal zijn harde contactlenzen (die tegenwoordig minder gebruikelijk zijn) zeer moeilijk te tracken. Hoewel contactlenzen over het algemeen geen probleem vormen, kan er soms een luchtbel tussen de lens en het hoornvlies ontstaan, wat reflecties veroorzaakt die de tracking verstoren. Brillen met glimmende monturen kunnen de tracking ook beïnvloeden. Verklein bij glimmende glazen monturen het detectieveld (field-of-view) in de eye-tracker software. - Screen deelnemers op basis van specifieke individuele kenmerken, zoals leeftijd, leesvaardigheid, taalachtergrond en handigheid. Algemene exclusie- en inclusiecriteria, zoals dyslexie, tweetaligheid of leesstoornissen, kunnen de oogbewegingsgegevens beïnvloeden. Specificeer daarom, afhankelijk van de onderzoeksdoelen, de voorwaarden waaronder een lezer een geschikte deelnemer voor het experiment is, en bepaal zo de inclusie- en exclusiecriteria (zie Discussie).
- Controleer op visuele beperkingen. Zorg ervoor dat de deelnemer geen oncorrigeerbare visuele beperking heeft, zoals staar (zelfs na een operatie), glaucoom of maculadegeneratie.
- Controleer op neurologische aandoeningen. Zorg ervoor dat de deelnemer geen aandoening heeft waardoor zij zich ongemakkelijk voelen bij oogbewegingsregistraties. De meeste eye-trackers maken gebruik van nabij-IR LED's/lasers of gecertificeerde NIR LED/VCSEL-verlichting, die als oogveilig worden beschouwd. Bevestig de oogveiligheidscertificering van het apparaat (bijv. Class 1 IEC 60825-1, IEC/EN 62471 of soortgelijk). Informeer de deelnemer over de veiligheidsvoorschriften van de apparatuur (zoals de beschikbaarheid van een CE-certificaat van de fabrikant, algemeen bekend als een EU-conformiteitsverklaring, een document dat door de fabrikant is uitgegeven om te certificeren dat een product voldoet aan alle noodzakelijke Europese gezondheids-, veiligheids- en milieuregelgeving).
- Bepaal de vereisten voor de visuele conditie. Rekruteer deelnemers met een normaal of tot normaal gecorrigeerd gezichtsvermogen. Het is mogelijk om brillen en contactlenzen toe te staan, mits deze minimale reflecties vertonen (anti-reflectie, monitorhoek) volgens de richtlijnen van de fabrikant. Documenteer het type correctie (bril, contactlenzen) voor covariantiecontroles.
- Hygiëne vaststellen
- Neem voorzorgsmaatregelen met betrekking tot de persoonlijke afstand. Draag indien nodig wegwerpstouwen en een masker, aangezien het uitvoeren van experimentprotocollen een verkleinde persoonlijke afstand kan vereisen.
- Desinfecteer de apparatuur. Desinfecteer de kinsteun en andere accessoires met alcoholdoekjes volgens de huidige institutionele richtlijnen. Let erop dat er geen chemicaliën worden gebruikt die de apparatuur kunnen beschadigen. Raadpleeg de specificaties van de fabrikant. Deelnemers kunnen zich prettiger voelen als de reiniging in hun aanwezigheid plaatsvindt, specifiek voor de kinsteun en hoofdsteun, de muis of elk ander deel van de apparatuur waarmee zij in contact komen.
- Informatie verstrekken aan de deelnemer
- Informeer de deelnemer over de laboratoriumomgeving. Ontwerp een mondelinge instructiesessie waarin de experimentele onderzoeker de laboratoriumomgeving en de eye-trackingapparatuur aan de deelnemer introduceert.
- Informeer de deelnemer over het experiment. Geef een heldere uitleg over de context van het experiment (het doel en de geschatte duur van de studie; dit moet tijdens de pilots worden gecontroleerd), de incentive of betalingsprocedure, de bijdrage van de deelnemer aan het experiment en hun recht om op lange termijn de resultaten van de studie op te volgen. Informeer de deelnemer over wat wel en niet is toegestaan tijdens een registratiesessie. Vraag de deelnemer om te proberen het hoofd niet te veel te bewegen tijdens de registratie (indien er geen hoofdstabilisator is) of de kinsteun niet te verlaten, met de mededeling dat deze voorzorgsmaatregelen nodig zijn voor een hoogwaardige registratie van de gegevens (anders kunnen deelnemers het experiment altijd stopzetten en de sessie verlaten zonder reden op te geven).
- Verkrijg geïnformeerde toestemming. Geef deelnemers de ethische goedkeuring en toestemmingsdocumenten en leg deze uit voordat de sessie begint. Verkrijg bij volwassenen schriftelijke geïnformeerde toestemming nadat is vastgesteld dat zij het doel van de studie, wat er zal gebeuren en hun rechten begrijpen, inclusief de optie om vrijwillig deel te nemen, gegevensprivacy en het recht om zich terug te trekken. Verkrijg bij minderjarige deelnemers schriftelijke toestemming van een ouder of voogd en de instemming van de minderjarige. Ga pas door met kalibratie en registratie nadat alle vereiste toestemmings- en instemmingsformulieren zijn ingevuld. De procedures voor geïnformeerde toestemming verschillen aanzienlijk tussen volwassen en minderjarige deelnemers. De onderzoeker dient daarom de lokale institutionele richtlijnen te volgen.
OPMERKING: Als er tijdens het experiment een pauze of onderbreking optreedt, is revalidatie van de kalibratie vereist; als de revalidatie mislukt, is herkalibratie noodzakelijk.
4. Het uitvoeren van kalibratie en validatie
- Positionering van de deelnemer en afstellen van de apparatuur
- Positioneer de deelnemer. Verzoek de deelnemer om comfortabel te gaan zitten. Pas de stoel/tafel en/of de kinsteun aan om een stabiele hoofdhouding te waarborgen. Informeer de deelnemer dat dit de verwachte hoofdhouding is tijdens de kalibratie-, validatie- en opnamefasen.
- Stel de apparatuur af. Stel de eye-tracking apparatuur af door de camera van de eye tracker zo uit te lijnen dat de pupillen van de deelnemer duidelijk zichtbaar en detecteerbaar zijn. Sommige eye-tracking systemen voeren deze uitlijning automatisch uit, terwijl bij andere de focus van de camera handmatig moet worden aangepast.
OPMERKING: De onderzoeker dient te oefenen met het afstellen van de apparatuur en de kalibratie voordat de eigenlijke gegevensverzameling begint, om te voorkomen dat de deelnemer door deze stappen wordt belast.
- Uitvoeren van de kalibratie
- Informeer de deelnemer. Informeer de deelnemer over de kalibratieprocedure (bijv. door aan te geven dat er een reeks doelmarkeringen zal worden weergegeven en dat de deelnemer deze ongeveer een minuut lang moet volgen).
OPMERKING: Het wordt aanbevolen om voorzichtig te zijn met de woordkeuze tijdens het maken van de aanpassingen. De onderzoeker benadrukt bijvoorbeeld dat de procedure bedoeld is om de eye tracker te kalibreren voor de deelnemer, in plaats van de deelnemer te kalibreren voor de eye tracker. Bovendien is het belangrijk om ervoor te zorgen dat er geen video/afbeelding wordt opgenomen met de eye-tracking apparatuur. Hoewel het oog van de deelnemer zichtbaar is, wordt alleen de positie van het oog, omgezet in coördinaten, geregistreerd. - Voer de kalibratieprocedure uit. Instrueer de deelnemer om de doelmarkeringen te volgen en de hoofdhouding constant te houden; bijvoorbeeld door niet achterover te leunen na het beëindigen van de kalibratieprocedure. Instrueer deelnemers om zich te fixeren op het centrum van het kalibratiesymbool en hun ogen niet te bewegen totdat het symbool beweegt. Deelnemers hebben de neiging de beweging van het symbool te anticiperen, vooral tijdens de validatie, wat de foutmarge kan verhogen en tot onnodige kalibratiestappen kan leiden. Neem deze uitleg op in de instructies of in de toelichting op het kalibratie-/validatieproces.
OPMERKING: Fabrikanten bieden verschillende soorten symbolen aan voor het kalibratieproces (punten, kindvriendelijke symbolen, statische of krimpende symbolen, etc.) en verschillende kalibratie-instellingen (d.w.z. het aantal kalibratiepunten). Het is belangrijk om de verschillen in kalibratie bij deze diverse instellingen te controleren en degene te kiezen die het beste aansluit bij de behoeften van een specifieke studie. Als de stimuli bijvoorbeeld het hele scherm beslaan (bijv. een tekst met veel paragrafen), is het belangrijk om een kalibratie-instelling te hebben die een goede kalibratie van boven naar beneden waarborgt, inclusief de hoeken. Indien stimuli echter zinnen zijn die in het centrum van het scherm worden gepresenteerd, kan een kalibratie-instelling met minder punten volstaan. Daarnaast is de kalibratienauwkeurigheid voor de horizontale as, of x-coördinaat, bij die laatste belangrijker dan bij de eerste, waarbij een goede nauwkeurigheid in zowel de verticale als horizontale coördinaten vereist is. - Beëindig de kalibratieprocedure. Informeer de deelnemer over de validatieprocedure nadat de kalibratieprocedure is voltooid.
OPMERKING: Bij aanhoudende kalibratiefouten dient de uitlijning van de camera van de eye tracker, de lichtomstandigheden en de positionering van de deelnemer te worden gecontroleerd. Bij volwassen deelnemers kunnen reflecterende make-up, brillen of contactlenzen de tracking verstoren. Stel de deelnemer gerust, sta korte pauzes toe of herhaal de kalibratie indien nodig. Als de problemen aanhouden, kan het systeem opnieuw worden opgestart. Indien de problemen na het herstarten van het eye-tracking systeem aanhouden en er na verificatie van de configuratieparameters geen reden voor de kalibratiefout is gevonden, informeer de deelnemer dan dat de eye-tracking technologie nog onvoldoende is ontwikkeld en dat het een probleem is dat gerelateerd is aan de stand van de techniek en niet aan de deelnemer.
- Informeer de deelnemer. Informeer de deelnemer over de kalibratieprocedure (bijv. door aan te geven dat er een reeks doelmarkeringen zal worden weergegeven en dat de deelnemer deze ongeveer een minuut lang moet volgen).
- Uitvoeren van de validatie
- Voer de validatieprocedure uit. Start de validatieprocedure direct na de kalibratie.
- Controleer de foutmarges. Controleer de gemiddelde fout in de blikpositie en zorg dat deze binnen acceptabele limieten valt. Gewenst is doorgaans een visuele hoek van minder dan 1 graad (<1°), wat overeenkomt met ongeveer 4 tekens (waarbij 0.5 overeenkomt met ~2 tekens). Voer een herkalibratie uit als de fouten buiten deze limieten vallen. Accepteer bijvoorbeeld de kalibratie als de gemiddelde fout ≤0.5–1.0° is en de maximale fout per punt ≤1.5–2.0°; herkalibreer anders. Specificeer de frequentie van her-validatie (bijv. na elk blok of elke onderbreking). Ter illustratie van de criteria van een fabrikant, SR Research, voor het beoordelen van de kalibratiekwaliteit, worden fouten voor de meeste taken als acceptabel beschouwd bij een gemiddelde fout <1° en een maximale fout <1.5°; redelijk bij een gemiddelde fout <1°-1.5° en een maximale fout <1.5°-2°; en slecht wanneer deze waarden worden overschreden.
- Informeer de deelnemer. Instrueer de deelnemer om hun positie zo constant mogelijk te houden en informeer hen over het begin van de opnamesessie.
5. Gegevensverzameling
- Uitvoeren van de gegevensverzamelingsprocedure
- Opnamesessie starten. Start de opnamesessie en vermijd het verstoren van de deelnemer terwijl deze de taak uitvoert, zoals door het geven van verbale instructies.
- Deelnemer monitoren. Monitor het comfort van de deelnemer tijdens de gegevensopname. Zorg ervoor dat de deelnemer een stabiele houding behoudt zonder spanning of vermoeidheid. Let op tekenen van afleiding, droge ogen of ongemak door de kinsteun/voorhoofdssteun.
- Gegevensopname monitoren. Monitor de datakwaliteit tijdens de opname. Kalibreer opnieuw als de gemiddelde validatiefout of de online nauwkeurigheid 1° (of een vooraf vastgestelde nauwkeurigheidsdrempel) overschrijdt, of als de deelnemer van houding verandert.
- Logboek bijhouden. Houd een logboek bij van de opnamesessie door aantekeningen te maken van eventuele anomalieën die tijdens het experiment zijn waargenomen (bijv. een ongewoon lange kalibratieprocedure of een onbedoelde onderbreking tijdens de opname) voor inspectie na het experiment, waarbij een sessielogschema wordt gebruikt om het tijdstip van gebeurtenissen, onderbrekingen, het aantal uitgevoerde herkalibraties en hun fouten, driftcontroles en veranderingen in de verlichting te bewaken.
- Einde van de sessie
- Gegevens opslaan. Sla de ruwe gaze-gegevens op aan het einde van de experimentsessie, bij voorkeur met een systematische methode om de sessie te labelen (bijv. de datum van het experiment en het deelnemernummer, bijvoorbeeld 25071801 of 250718-P01 voor deelnemer 01 op 18 juli 2025; vermijd het gebruik van persoonlijk identificeerbare informatie over de deelnemer).
- Afscheid. Bedank de deelnemer en beantwoord eventuele vragen die zij over het experiment hebben; desinfecteer de apparatuur (zie stap 3.2.2).
- Gegevens controleren. Controleer de gegevens en de logboeken om er zeker van te zijn dat de sessie correct is voltooid.
6. Gegevensvoorbewerking en kwaliteitscontrole
- Exporteren, organiseren en opschonen van ruwe data
- Data exporteren. Exporteer ruwe gaze-data in een standaardformaat (bijv. .csv, .tsv, .edf) en standaardiseer uw sessie-ID (bijv. 25071801 of 250718-P01, zie 5.2.1).
- Data opschonen. Schoon de ruwe data op door algoritmen voor knipperdetectie en detectie van ontbrekende data toe te passen, met behulp van ingebouwde tools van de software van de fabrikant of aangepaste scripts, afgestemd op het apparaat of de bemonsteringssnelheid.
OPMERKING: Maak reservekopieën van de ruwe data tijdens het uitvoeren van de opschoonroutines.
- Detecteren van oogbewegingsgebeurtenissen
- Algoritme voor detectie van oogbewegingsgebeurtenissen selecteren. Selecteer en voer de procedures voor fixatiedetectie uit, waarbij de parameters van de algoritmen indien nodig worden aangepast. De representatieve algoritmen voor fixatie-identificatie omvatten voornamelijk snelheid-gebaseerde algoritmen (bijv. I-VT Velocity-Threshold Identification) en dispersie-gebaseerde algoritmen (bijv. I-DT Dispersion-Threshold Identification), enzovoort23. Elk algoritme heeft zijn eigen parameters.
OPMERKING: De software van fabrikanten hanteert standaard meestal een specifiek algoritme en een specifieke set veelgebruikte parameters. Het is de verantwoordelijkheid van de onderzoeker om een geschikt algoritme en de bijbehorende parameters te selecteren en dit te vermelden in de beschrijving van de methodologie van de studie, zoals dispersie-/snelheidsdrempels, een minimale drempel voor de fixatieduur (bijv. 60 ms of 10 ms) om fixaties korter dan deze waarde te elimineren, een maximale drempel voor de fixatieduur (bijv. 10 ms) om fixaties langer dan deze waarde te elimineren, het gebruikte smoothing-window en de samenvoegingsregels voor aangrenzende fixaties23. - Onterechte fixaties identificeren. Verwijder of label de fixaties buiten het weergavegebied. Verwijder of label fixaties die korter zijn dan een vooraf gedefinieerde minimale drempelwaarde en langer dan een vooraf gedefinieerde maximale drempelwaarde.
- Data visueel inspecteren. Inspecteer de data visueel met behulp van beschikbare visualisatietools om de validiteit van de data te waarborgen. Controleer op signaalverlies, overmatige ruis, ontbrekende samples of verschoven fixaties. Inspecteer na elke opnamesessie de data visueel met de visualisatietools die bij de eye-trackingsoftware worden geleverd (bijv. gaze plots, scanpaths, tijdreekssporen). Deze stap helpt om ervoor te zorgen dat de data van voldoende kwaliteit zijn voordat men overgaat tot preprocessing en analyse.
- Controleer in het bijzonder op signaalverlies en trackingproblemen door te zoeken naar lange gaten in gaze-patronen of regio's op de stimuli waar geen gaze-samples zijn geregistreerd. Frequent of langdurig verlies van tracking kan erop wijzen dat de sessie moet worden uitgesloten of herhaald.
- Om overmatige ruis te controleren, bestudeer de ruwe x/y-positie-sporen op plotselinge sprongen of foutieve samples die niet overeenkomen met de lay-out van de stimulus. Overmatige ruis kan wijzen op een slechte kalibratie, een onstabiele hoofdpositie of hardwareproblemen.
- Om ontbrekende of onregelmatige samples op te sporen, controleer of de bemonsteringssnelheid ongeveer is zoals verwacht (bijv. 50 Hz) en of er onverwachte clusters van ontbrekende samples zijn buiten de normale knipperingen.
- Om verschoven fixaties op te sporen, projecteer de fixaties over de gepresenteerde stimuli en verifieer of ze op de beoogde regels en woorden vallen. Systematische afwijkingen (bijv. fixaties die consistent buiten de tekst vallen) kunnen wijzen op kalibratiedrift of een incorrecte mapping tussen gaze-coördinaten en schermcoördinaten. De geregistreerde gaze-patronen moeten ruwweg de structuur van de tekst volgen (bijv. progressies van links naar rechts, regel voor regel), waarbij fixaties clusteren op woorden en de saccades daartussen relatief vloeiend verlopen. Een systematische afwijking van dit patroon, of frequent verlies van bruikbare data, kan uitsluiting van de getroffen data uit verdere analyse vereisen.
- Driftcorrectie uitvoeren. Voer waar nodig een verticale driftfoutcorrectie uit. Pas regelgewijze verticale driftcorrectie toe voor tekst met meerdere regels. Controleer de toepasbaarheid van gevalideerde methoden21.
OPMERKING: Figuur 1 toont een weergave van de stappen die betrokken zijn bij het ontwerpen van een eye-tracking experimentopzet en een data-analysepijplijn, zoals beschreven in de protocolsectie. De volgende sectie presenteert representatieve resultaten van geregistreerde sessies.
- Algoritme voor detectie van oogbewegingsgebeurtenissen selecteren. Selecteer en voer de procedures voor fixatiedetectie uit, waarbij de parameters van de algoritmen indien nodig worden aangepast. De representatieve algoritmen voor fixatie-identificatie omvatten voornamelijk snelheid-gebaseerde algoritmen (bijv. I-VT Velocity-Threshold Identification) en dispersie-gebaseerde algoritmen (bijv. I-DT Dispersion-Threshold Identification), enzovoort23. Elk algoritme heeft zijn eigen parameters.
Resultaten
Datakwaliteit en validatie
Succesvolle sessies leveren doorgaans een validatienauwkeurigheid op met een gemiddelde fout ≤0,5–1,0° en een maximale fout per punt <1,0–1,5° over de targets; rapporteer zowel de gemiddelde als de waarden per punt. Lever een histogram van de fout per punt en een tabel met een samenvatting van het gemiddelde ± SD en de maximale fout per sessie. Deze criteria stemmen overeen met de gangbare praktijk en de aanbevelingen van leveranciers; sessies die deze drempels overschrijden, moeten gedeeltelijk of volledig worden uitgesloten, afhankelijk van de studieregels. Figuur 2 toont een voorbeeld van een histogram van de fout per punt voor de kalibratienauwkeurigheid bij een 9-punts kalibratie, bestaande uit drie kalibratiepogingen.
Precisie en dataverlies
Rapporteer de precisie (bijv. de RMS –Root Mean Square– spreiding tussen monsters tijdens fixatie) en het dataverlies (% ontbrekende monsters per trial/sessie). Goede trialruns vertonen doorgaans een lage spreiding bij fixatie en een laag dataverlies (bijv. <5–10%, afhankelijk van de eye-trackingapparatuur en de opstelling). Vermeld de distributies van de percentages dataverlies en een scatterplot per trial van precisie tegenover verlies om uitschieters te identificeren. Raadpleeg de huidige literatuur voor definities en minimale rapportage-items3,4,5,6,7,8,9,10,11.
Driftgedrag (voor/na correctie)
Goede testruns vertonen kleine, vrijwel constante verticale verschuivingen die aanzienlijk worden verminderd door lijn-gewijze correctie, hetzij via geautomatiseerde driftcorrectie-algoritmen21, hetzij handmatig. Problematische runs vertonen daarentegen niet-monotone of grote residuele drift. Vermeld de mediane absolute verticale fout voor en na correctie. Controleer de toepasbaarheid van geautomatiseerde driftcorrectiemethoden.
Distributies van gangbare leesmaten
Verschaf samenvattende distributies voor de duur van de eerste fixatie (FFD), de duur van een enkelvoudige fixatie (SFD), de first-pass duration (FP), de totale/gaze duration (GD), de go-past time, de kans op overslaan (skipping probability) en de kans op regressie (regression-in probability). Bij bekwaam lezen van alfabetische tekst door volwassenen centreren fixatieduren zich doorgaans rond ~200–250 ms (met aanzienlijke scheefheid) en beslaan saccades gemiddeld ~7–9 tekens. Waarden die ver buiten deze bereiken liggen of sterk bimodale saccadedistributies moeten worden gecontroleerd om vast te stellen of ze wijzen op verwachte progressieve en regressieve saccades door taakbeperkingen of verwerkingsproblemen, in plaats van op timingfouten. De keuze en het bereik van de maten kunnen dienovereenkomstig variëren per populatie, specifieke talen en orthografieën. Figuur 3 toont een voorbeeldprotocol van een fixatieduursdistributie uit een representatieve sessie.
Controlemetingen
Een toename in woordlengte (lange woorden) leidt doorgaans tot een lagere overslaagsnelheid en langere fixatieduur op deze woorden. Aan de andere kant worden functiewoorden (bijv. lidwoorden of voorzetsels) meestal overgeslagen. Woorden met een hoge frequentie en zeer voorspelbare woorden op basis van de linguïstische context (binnen de tekst of zin) resulteren doorgaans in kortere eerste fixaties en kortere fixatieduren, en hogere overslaagsnelheden (het tegenovergestelde wordt verwacht bij woorden met een lage frequentie en lage voorspelbaarheid). Controleer of de data enkele van deze patronen repliceren, althans in één richting. Grote omkeringen kunnen duiden op driftfouten, een verkeerde uitlijning van woorden en fixaties, of fouten bij de gegevensverwerking.
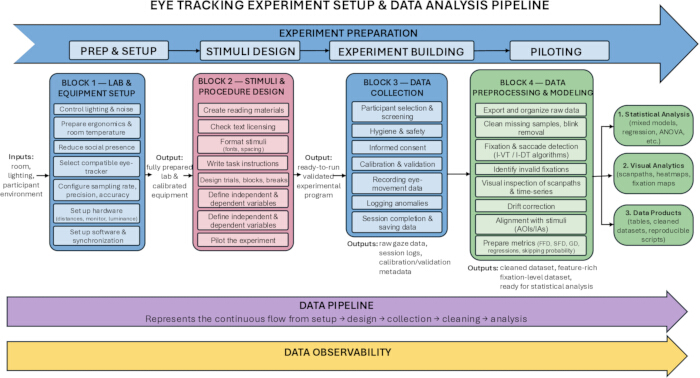
Figuur 1. Een weergave van de stappen die betrokken zijn bij het ontwerpen van een eye-tracking experimentopstelling en een pijplijn voor data-analyse. Klik hier om een grotere versie van deze figuur te bekijken.
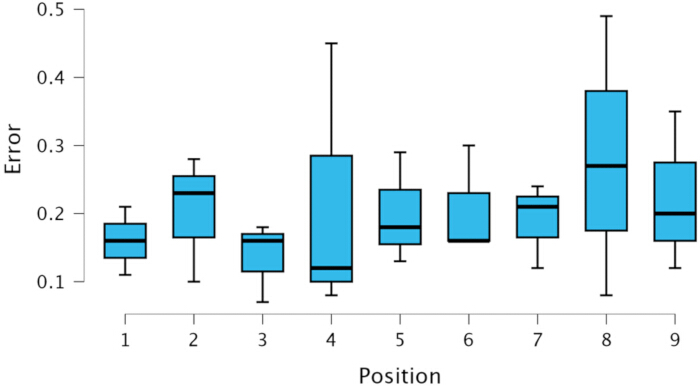
Figuur 2. Per-punt foutenhistorgram voor kalibratienauwkeurigheid voor een 9-punts kalibratie, bestaande uit drie kalibratiepogingen. Klik hier om een grotere versie van deze figuur te bekijken.
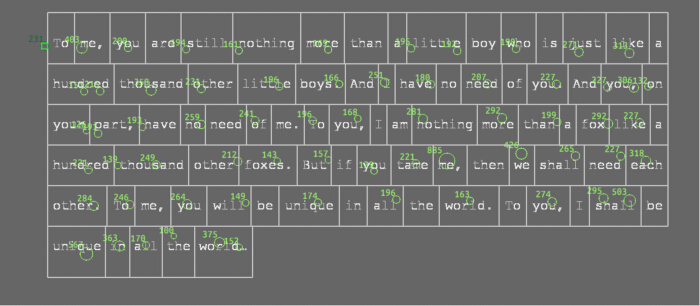
Figuur 3. Protocol van de distributie van fixatieduur uit een representatieve sessie; één deelnemer die een fragment uit de roman De Kleine Prins leest. De positie en de grootte van de cirkels tonen respectievelijk de fixatielocaties en -duuren. De getallen naast de cirkels geven de fixatieduren weer in ms. Klik hier om een grotere versie van deze figuur te bekijken.
Discussie
Het hier gepresenteerde protocol vat de belangrijkste stappen samen die nodig zijn om betrouwbare eye-trackinggegevens te verkrijgen in leesonderzoek. Hoewel veel van deze stappen mogelijk bekend zijn bij ervaren onderzoekers, zijn ze vaak verspreid over verschillende methodologische artikelen, documentatie van leveranciers en informele laboratoriumpraktijken. Door deze te organiseren in één enkele workflow, van laboratoriumvoorbereiding tot preprocessing, beogen we een praktische gids te bieden voor onderzoekers die nieuw zijn in eye-trackingstudies naar lezen. In vergelijking met algemene eye-trackingrichtlijnen of bronnen die zich voornamelijk richten op algoritmen voor de detectie van oogbewegingen, biedt dit protocol een end-to-end framework als antwoord op de eisen van leesonderzoek voor gegevensregistratie met een hoge ruimtelijke resolutie en bemonsteringsfrequentie.
Een centraal thema in alle fasen van de workflow is het belang van proactief datakwaliteitsbeheer, beginnend bij de omgevingscontrole en de installatie van de apparatuur. Kleine problemen, zoals reflecties op de monitor, instabiliteit van de stoel of inconsistente kijkafstanden, kunnen systematische biases veroorzaken in de fixatielocatie of precisie. Door deze factoren in een vroeg stadium aan te pakken, wordt de noodzaak voor uitgebreide post-hoc correcties geminimaliseerd en wordt een consistentere validatienauwkeurigheid ondersteund (gemiddelde fout ≤ 0,5–1°).
Het protocol benadrukt tevens het belang van de afstemming tussen de onderzoeksvragen en de hardwarekenmerken. Veel studies naar lezen vertrouwen op nauwkeurige ruimtelijke en temporele metingen van fixaties, landingsposities van saccades en regressies1,2. De keuze voor een eye-tracker met een passende bemonsteringsfrequentie, precisie en accuratesse is daarom essentieel, vooral voor maten zoals de landingspositie of parafoveale preview die gevoelig zijn voor kleine ruimtelijke fouten. Afhankelijk van de specifieke beperkingen van de studie kunnen deze methoden worden aangepast. Bij het werken met neurodivergente populaties die geen kinsteun kunnen verdragen, kunnen onderzoekers bijvoorbeeld overstappen op remote head-free trackers en het verlies aan ruimtelijke precisie compenseren door grotere lettertypen, ruimere regelafstand en bredere Interest Areas te gebruiken. Wanneer head-free systemen worden gebruikt, moeten onderzoekers rekening houden met toegenomen beweging en potentieel dataverlies. Hoewel remote trackers meer naturalistische opstellingen ondersteunen, blijft hoofdstabilisatie vandaag de dag nog steeds te prefereren voor de meeste leestaken.
Het experimenteel ontwerp is een andere sleutelfactor die zowel de datakwaliteit als de interpreteerbaarheid beïnvloedt. Gestandaardiseerde instructies op het scherm, randomisatie van trials en een passende blokstructuur helpen om een stabiel deelnemersgedrag gedurende de sessie te behouden. Het opnemen van driftchecks met regelmatige intervallen is bijzonder belangrijk bij leesexperimenten, aangezien zelfs kleine, geleidelijke afwijkingen kunnen accumuleren over tekstregels heen. Het protocol ondersteunt daarnaast het gebruik van taalafhankelijke lexicale normen en een transparante rapportage van onafhankelijke en afhankelijke variabelen, wat replicatie en vergelijking tussen studies vergemakkelijkt.
Tijdens de gegevensverzameling helpt continue monitoring van nauwkeurigheid, houding en het comfort van de deelnemer om grootschalig gegevensverlies te voorkomen. Actieve probleemoplossing is vaak nodig voor veelvoorkomende problemen. Zo kan de kalibratie in de hoeken van het scherm mislukken; het aanpassen van de monitor of de stoelhoogte kan dan het verlies van perifere tracking verhelpen. Problemen door reflecterende brillen of contactlenzen kunnen soms worden opgelost door de omgevingsverlichting aan te passen of de hoeken van de monitor te wijzigen. Het bijhouden van een gedetailleerd sessielogboek ondersteunt latere probleemoplossing en vergroot de transparantie door interrupties, herkalibraties en onverwachte gebeurtenissen te documenteren. Dit is steeds belangrijker omdat veel gepubliceerde studies tegenwoordig expliciete rapportage van kwaliteitsmetrieken vereisen, waaronder precisie en het percentage gegevensverlies.
De sectie over voorbewerking benadrukt consistente en goed gedocumenteerde keuzes bij de detectie van gebeurtenissen, driftcorrectie en reinigingsroutines. Omdat algoritmen en drempelwaarden voor fixatieclassificatie de resulterende maten sterk kunnen beïnvloeden, dienen onderzoekers alle parameterinstellingen te specificeren en te rechtvaardigen wanneer deze afwijken van de gebruikelijke standaardwaarden. Visuele inspectie blijft een cruciale stap, zelfs wanneer geautomatiseerde tools worden toegepast. Het protocol moedigt daarnaast aan om standaard kwaliteitsindicatoren te rapporteren, zoals validatienauwkeurigheid, precisie, dataverlies en driftgedrag, zodat studies op een betrouwbaardere wijze kunnen worden vergeleken.
Bovendien adviseert het protocol eenvoudige plausibiliteitscontroles van het leesgedrag, zoals de effecten van woordlengte, frequentie of voorspelbaarheid. Het reproduceren van deze canonieke patronen biedt een extra beveiliging tegen onopgemerkte aligneringsproblemen, problematische drift of fouten bij de voorbewerking. Deze controles vervangen geen volledige statistische analyse, maar bieden snelle feedback over de vraag of de gegevens zich gedragen zoals verwacht bij bekwaam lezen.
Naast de reeds genoemde details van het experimentele protocol is het belangrijk om de linguïstische en psychometrische kenmerken van de deelnemers te beschrijven. De belangrijkste reden hiervoor is de uitdaging waar experimentele onderzoekers voor staan met betrekking tot de vergelijkbaarheid van verschillende studies. Dit is bijzonder belangrijk in het tijdperk van open science, waarin openbaar beschikbare datasets kunnen worden gebruikt door onderzoekers die de data niet oorspronkelijk zelf hebben verzameld en daarom mogelijk niet op de hoogte zijn van potentiële idiosyncrasieën die voortvloeien uit variaties in de (socio)linguïstische achtergronden van de deelnemers.
Wat betreft de taalkundige achtergrond moet de moedertaal van de deelnemers worden genoteerd, en informatie over de door hen gebruikte dialecten moet worden verzameld om rekening te houden met eventuele dialectverschillen die de resultaten kunnen beïnvloeden. Indien deelnemers meer dan één taal spreken – een veelvoorkomende situatie in de huidige wereld – moet de vaardigheid in de tweede taal worden vastgelegd. In studies naar tweetaligheid of de verwerking van een tweede taal moet de vaardigheid in de tweede taal worden beoordeeld met behulp van gevalideerde instaptoetsen voor de tweede taal. Daarnaast kunnen relevante aspecten van de sociaaleconomische status worden geregistreerd (bijv. de leesgewoonten van de deelnemers).
Er moeten tests worden uitgevoerd om de psychometrische kenmerken van de deelnemers te beoordelen, zoals de werkgeheugencapaciteit en cognitieve flexibiliteit (met name bij tweetalige studies). Vanuit methodologisch perspectief dient men te overwegen welke tests worden geselecteerd, wat de cognitieve belasting en tijdsduur zijn, en wanneer deze metingen binnen het experimentele protocol worden afgenomen – ofwel vóór of na de eye-tracking sessie, of in een aparte sessie.
Het is essentieel om te onthouden dat bij leesonderzoeken het taalgedrag wordt gemeten en verklaard aan de hand van zowel de linguïstische kenmerken van de stimulus als de psychometrische kenmerken van de lezers (of andere kenmerken die relevant zijn voor het taalgedrag van de deelnemers)1,12,17,20. Om vergelijking tussen studies mogelijk te maken, moeten alle factoren die relevant kunnen zijn voor de interpretatie van de gegevens worden meegenomen. De keuze welke kenmerken worden opgenomen, hangt af van het doel van het onderzoek. De gegevens moeten vergelijkbaar zijn. Samenvattend moeten gegevens in voldoende detail worden verzameld en beschreven om elke potentiële gebruiker de grootst mogelijke flexibiliteit in het gebruik ervan te bieden. Deze overwegingen maken mogelijk geen deel uit van het protocol zelf, maar zijn relevant voor elk individueel onderzoek. In de huidige mondiale wetenschappelijke omgeving vergroten dergelijke details het toekomstige potentiële gebruik van de verzamelde gegevens.
Dit protocol kent beperkingen, in het bijzonder de afruil tussen datakwaliteit en ecologische validiteit, aangezien lezen op een statische monitor met een gefixeerde hoofdhouding het natuurlijk leesgedrag niet volledig weerspiegelt, en strikte visuele inclusiecriteria de representativiteit van de steekproef kunnen beperken. Bovendien verschillen eye-trackers aanzienlijk in coördinaatschalering, precisie van tijdstempels en gebeurtenisclassificatie. Een beperking van het huidige protocol is dat het niet verduidelijkt hoe deze variabiliteit de reproduceerbaarheid tussen laboratoria of hardwaremerken beïnvloedt. Het opstellen van richtlijnen voor validatie tussen verschillende apparaten en voor realistische toekomstige toepassingen, zoals het aanpassen van laboratoriumparadigma's naar immersieve Virtual Reality- of Augmented Reality-leesomgevingen en het ontwikkelen van digitale biomarkers voor cognitieve of attentionele stoornissen, zou een belangrijk hiaat opvullen.
Over het algemeen consolideert het protocol bestaande methodologische richtlijnen in een heldere en transparante workflow voor het verzamelen van hoogwaardige eye-trackinggegevens bij lezen. Door de stappen te volgen en de bijbehorende kwaliteitsmetrieken te rapporteren, kunnen onderzoekers de reproduceerbaarheid en geloofwaardigheid van leesstudies verbeteren en helpen bij het vestigen van een sterkere methodologische consistentie binnen het vakgebied.
Dankbetuigingen
Financiering: Dit project is ondersteund door COST–European Cooperation in Science and Technology (CA2131–Enabling multilingual eye-tracking data collection for human and machine language processing research (MultiplEYE), https://www.cost.eu/actions/CA2131)24, The Foundation for Science and Technology, Portugal (subsidies: UID/214/2025, UI/BD/15450/202), en het Jagiellonian University Strategic Programme Excellence Initiative Priority Research Area DigiWorld (ID.UJ) project “Cognitive Aspects of Interaction and Communication in Natural and Artificial Agents”. Wij danken Anna Maria Wilkosz voor haar vriendelijke technische ondersteuning.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Alcoholdoekjes (70% isopropyl) | Reinigingsmateriaal | Lokale laboratoriumleverancier | |
| Kinsteun met verstelbare hoogte | Apparaat voor hoofdstabilisatie | Diverse laboratoriumleveranciers | |
| Toestemmingsformulier en debriefingmateriaal | Documentatie | Institutioneel goedgekeurde sjablonen | |
| Eye tracker (bijv. SR Research EyeLink 10 Plus, Tobii Pro Fusion) | Eye-tracking hardware | SR Research Ltd., Tobii AB | |
| Software voor analyse van eye-trackinggegevens (Data Viewer, Tobii Pro Lab) | Software voor analyse van oogbewegingsgegevens | SR Research Ltd., Tobii AB | |
| Eye-tracking software (bijv. Experiment Builder, Tobii Pro Lab, PsychoPy) en hun SDK's | Software voor stimuluspresentatie en software development kits | SR Research Ltd., Tobii AB, Open source | |
| Generieke software voor data-analyse (R met lme4, ggplot2, JASP, Python met Pandas, NumPy, Matplotlib) | Preprocessing en analyse van gegevens | Open source, https://www.python.org, https://www.r-project.org, https://www.jasp.org | |
| Generieke software voor het ontwerpen van experimenten (PsychoPy) | Software voor stimuluspresentatie | Open source, https://www.psychopy.org | |
| Andere software van derden (bijv. E-Prime) | Software voor stimuluspresentatie | Psychology Software Tools, Inc. | |
| Geluidsgedempte kamer | Omgevingscontrole | Institutionele faciliteit | |
| Standaard 24-inch LCD-monitor (of kleiner) | Weergaveapparaat | Elke ISO-conforme fabrikant |
Referenties
- Rayner, K. Eye movements in reading and information processing: 20 years of research. Psychol Bull. 124, 372-422 (1998).
- Rayner, K. Eye movements and attention in reading, scene perception, and visual search. Q J Exp Psychol. 62, 1457-1506 (2009).
- Carter, B. T., Luke, S. G. Best practices in eye tracking research. Behav Res Methods. 52, 278-295 (2020).
- Hessels, R. S., et al. The fundamentals of eye tracking part 1: The link between theory and research question. Behav Res Methods. 56, 16(2024).
- Hooge, I. T. C., et al. The fundamentals of eye tracking part 2: From research question to operationalization. Behav Res Methods. 57, 73(2025).
- Nyström, M., et al. The fundamentals of eye tracking part 3: How to choose an eye tracker. Behav Res Methods. 57, 67(2025).
- Niehorster, D. C., et al. The fundamentals of eye tracking part 4: Tools for conducting an eye tracking study. Behav Res Methods. 57, 46(2025).
- Hessels, R. S., et al. The fundamentals of eye tracking part 5: The importance of piloting. Behav Res Methods. 57, 216(2025).
- Dunn, M. J., et al. Minimal reporting guideline for research involving eye tracking (2023 edition). Behav Res Methods. 56, 4351-4357 (2024).
- Eskenazi, M. A. Best practices for cleaning eye movement data in reading research. Behav Res Methods. 56, 2083-2093 (2024).
- Schotter, E. R., Dillon, B. A beginner’s guide to eye tracking for psycholinguistic studies of reading. Behav Res Methods. 57, 68(2025).
- Conklin, K., Pellicer-Sánchez, A. Using eye tracking in applied linguistics and second language research. Second Lang Res. 32 (3), 453-468 (2016).
- Pellicer-Sánchez, A. Eye-tracking in vocabulary research: Introduction to the special issue. Res Methods Appl Linguist. 3 (1), 100095(2024).
- Hutton, S. B. Eye-tracking methodology. Eye movement research: An introduction to its scientific foundations and applications. , Springer International Publishing. 277-308 (2019).
- Pokhoday, M. Y., et al. Eye tracking methods in psycholinguistics and parallel EEG recording. Neurosci Behav Physi. 53, 220-229 (2023).
- Azman, H., Mihat, W., Soh, O. K. Analyzing stimuli presentations and exit-interview protocols to improve wearable eye-tracking data collection guidelines for reading research. IJCALLT. 11 (2), 51-65 (2021).
- Papadopoulos, T. C., et al. Eye-tracking in reading research: A systematic review of studies with children of varying reading ability. Eur Psychol. , (2026).
- Garlichs, A., Lustig, M., Gamer, M., Blank, H. Protocol to study how expectations guide predictive eye movements and information sampling in humans. STAR Protoc. 6 (2), 103737(2025).
- Moreno, J., León, J., Kaakinen, J. K., Hyönä, Relevance instructions combined with elaborative interrogation facilitate strategic reading: Evidence from eye movements. J Psicol Educ. 27 (1), 51-65 (2020).
- Acartürk, C. Eyes on Text: Eye movements in reading and language processing. , John Benjamins. (2025).
- Steinhauer, S. R., Bradley, M. M., Siegle, G. J., Roecklein, K. A., Dix, A. Publication guidelines and recommendations for pupillary measurement in psychophysiological studies. Psychophysiology. 59 (4), e14035(2022).
- Papesh, M. H., Goldinger, S. D. Modern pupillometry: Cognition, neuroscience, and practical applications. , Springer. (2024).
- Salvucci, D. D., Goldberg, J. H. Identifying fixations and saccades in eye-tracking protocols. Proc Symposium Eye Tracking Res Appl, , 71-78 (2000).
- Jakobi, D. N., et al. MultiplEYE: creating a multilingual eye-tracking-while-reading corpus. Proc Symposium Eye Tracking Res Appl, , ACM. 111(2025).