Dit artikel stelt een methode voor de veiligheidsbewaking van productielijnen voor die You Only Look Once versie 11 (YOLOv11) integreert met convolutionele neurale netwerken. Het behaalde een gemiddelde gemiddelde precisie bij een intersection-over-union-drempelwaarde van 0,5 (mAP@0.5) van 0,91, een mAP@0.5:0.95 van 0,82 en 120 frames per seconde op een graphics processing unit, waarmee het beter presteerde dan de geëvalueerde basismodellen.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Methodenartikel
Real-time veiligheidsmonitoring van productielijnen met behulp van deep learning-gebaseerde objectdetectie en kenmerkverbetering
In dit artikel
Samenvatting
Samenvatting
Met de verdieping van Industrie 4.0 zijn de automatiserings- en intelligentieniveaus van productielijnen aanzienlijk verbeterd, waardoor er hogere eisen worden gesteld aan de real-time prestaties, nauwkeurigheid en veiligheid van monitoring. Traditionele monitoringsystemen, die vertrouwen op handmatige inspecties of eenvoudige beslissingen op basis van drempelwaarden, kampen over het algemeen met trage responstijden, hoge percentages foutieve alarmen en beperkte intelligentie. Daarom stelt dit artikel een veiligheidsmonitoringsysteem voor voor productielijnen dat You Only Look Once versie 11 (YOLOv11) integreert met een convolutioneel neuraal netwerk (CNN). Eerst werden de verkregen beelden voorbewerkt. Vervolgens werd YOLOv11 gebruikt om werknemers, apparatuur en potentiële gevaren in real-time te identificeren. Daarna werd een verbeterd CNN-netwerk met multi-scale feature-fusie en aandachtmechanismen geïntroduceerd om de mogelijkheden voor feature-extractie voor kleine en occluderende doelen te verbeteren. Ten slotte werden de detectieresultaten gefuseerd met de CNN-verbeterde features om de veiligheidsstatus te beoordelen. Experimenten werden uitgevoerd met behulp van een zelfgebouwde dataset voor productielijnveiligheid, waarbij de stochastic gradient descent (SGD) optimizer werd gebruikt met een momentum van 0,9, een initiële leerstroom van 0,01, weight decay van 0,0005, cosine-annealed leerstroomaanpassing, een batchgrootte van 32 en training gedurende 200 epochs. mAP@0,5 en de detectiesnelheid in frames per seconde (FPS) werden gebruikt als evaluatiemetrieken voor vergelijking met de geëvalueerde baseline-algoritmen. De resultaten tonen aan dat het voorgestelde systeem een mAP@0,5 van 0,91 en een detectiesnelheid van 120 FPS bereikte. Het demonstreerde tevens robuuste prestaties onder complexe omstandigheden, zoals schaduwvorming en variërende verlichting, wat de effectiviteit en het praktische toepassingspotentieel bij de veiligheidsmonitoring van productielijnen ondersteunt.
Inleiding
In de moderne industriële productie is veiligheid de hoeksteen voor het waarborgen van productie-efficiëntie en het welzijn van personeel. De productieomgeving omvat doorgaans snelle mechanische apparatuur, complexe technologische processen en samenwerkende operaties met meerdere taken. Elk klein potentieel veiligheidsrisico kan leiden tot ernstige productie-ongelukken, met aanzienlijke economische verliezen en zelfs dodelijke slachtoffers tot gevolg. Daarom is het van cruciaal belang een efficiënt, intelligent en real-time veiligheidstoezichtsysteem op te zetten om de veiligheid in de industriële productie te verbeteren1,2.
Traditionele methoden voor veiligheidsbewaking zijn voornamelijk gebaseerd op handmatige videobewaking en diverse sensoren (zoals infrarood-, rook- en trillingssensoren)3. Handmatige bewaking is niet alleen inefficiënt, maar ook gevoelig voor gemiste detecties door vermoeidheid van het bewakingspersoneel, en kan geen continue en uitgebreide dekking bieden. Hoewel sensoren een bepaalde functie voor vroegtijdige waarschuwing kunnen bieden, is hun detectiebereik beperkt en zijn ze gevoelig voor omgevingsinterferentie, wat leidt tot opvallende problemen met valse alarmen4. Intelligente bewakingssystemen zijn steeds meer een onderzoeksfocus geworden. Echtijdanalyse van een videostream met behulp van een deep learning-algoritme kan automatisch abnormale gebeurtenissen, onveilige gedragingen en potentiële gevaren identificeren, waardoor de intelligentie van het bewakingssysteem sterk verbetert4,5.
Objectdetectie is een kerntechnologie binnen intelligente monitoring. Als vertegenwoordigers van single-stage objectdetectoren tonen de You Only Look Once (YOLO)-reeksalgoritmen aanzienlijke voordelen. Van YOLOv1 tot YOLOv8 heeft deze verzameling algoritmen een voortdurende ontwikkeling doorgemaakt, met verbeteringen aan de netwerkarchitectuur, verliesfunctie en trainingsmethodologie, onder andere6,7. YOLOv11 heeft met name een hogere detectieprecisie bereikt terwijl een hoog beeldsnelheid gehandhaafd blijft, vooral bij complexe achtergronden en dicht opeengepakte doelen8.
Toch ondervindt YOLOv11, ondanks zijn uitstekende prestaties bij algemene objectdetectietaken, nog steeds uitdagingen in specifieke veiligheidsbewakingscenario's op productielijnen9. Bijvoorbeeld kan de detectie-accuratesse van YOLOv11 afnemen wanneer werknemers gedeeltelijk worden verhuld door apparatuur of wanneer veiligheidstekens klein zijn en sterk op de achtergrondkleur lijken. Dit vereist dat het model over sterkere mogelijkheden beschikt met betrekking tot functie-extractie en semantisch begrip10.
Convolutionele neurale netwerken (CNN's) beschikken over krachtige mogelijkheden bij het extraheren van beeldkenmerken11. Door diepere en complexere netwerkarchitecturen te ontwerpen, kunnen CNN's rijkere en meer abstracte beeldkenmerken leren. Het combineren van een CNN met YOLOv11 maakt gebruik van de snelle detectiemogelijkheden van YOLOv11 en de diepe kenmerkenextractie van het CNN, waardoor een robuustere en intelligente veiligheidsmonitoring opgebouwd wordt.
Op basis hiervan stelt dit artikel een veiligheidsbewakingssysteem voor productielijnen voor, dat gebruikmaakt van YOLOv11 en een CNN. De innovatieve aspecten van dit onderzoek zijn: (1) het voorstellen van een diepe fusie-architectuur van YOLOv11 en een verbeterde CNN; (2) het introduceren van fusie van kenmerken op meerdere schalen en een samengesteld aandachtsmechanisme om de herkenning van belangrijke veiligheidskenmerken te verbeteren; en (3) het verifiëren van de prestatievoordelen van het model op een zelf opgebouwde dataset van complexe scènes.
Ontwikkeling van YOLO-serie algoritmen
Sinds de eerste introductie door Redmon et al. in 201512 heeft het You Only Look Once (YOLO)-algoritme aanzienlijke belangstelling gewekt. In tegenstelling tot tweestadige detectoren die afhankelijk zijn van regiovoorstellingen, beschouwt YOLO objectdetectie als een regressietaak. Door rechtstreeks de klassen en posities van objecten in een afbeelding te voorspellen, verhoogt YOLO aanzienlijk de detectiesnelheid, waardoor het geschikt is voor gebruik in real-time13.
Als baanbrekend werk in deze serie bereikt YOLOv1 voor het eerst end-to-end doeldetectie14. YOLOv1 houdt in dat de ingangsafbeelding wordt opgedeeld in een roosterstructuur, waarbij elke roostercel, doorgaans georganiseerd in een S × S-indeling, verantwoordelijk is voor het detecteren van objecten die binnen zijn grenzen vallen.
Specifiek is de uitvoer van YOLOv1 een tensor. Van de S × S × (B × 5 + C) bevat de voorspelling van elke begrenzende rechthoek 5 elementen: coördinaat van het middelpunt (x,y), breedte w, hoogte h en betrouwbaarheid c. Het berekeningsproces is weergegeven in Vergelijking (1):
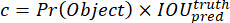 (1)
Daaronder stelt Pr(Object) de kans voor dat er zich een doelwit in het rooster bevindt, en IOU stelt de verhouding voor van de intersectie ten opzichte van de unie tussen de voorspelde begrenzende rechthoek en de werkelijke rechthoek. Elk rooster voorspelt ook een reeks klassenkansen, waarbij Pr de kans aangeeft dat het doelwit behoort tot de i-de klasse indien er een doelwit aanwezig is. De verliesfunctie van YOLOv1 bestaat uit drie hoofdcomponenten: het verlies voor coördinaatvoorspelling, het verlies voor betrouwbaarheidsschatting en het verlies voor categorievoorspelling15.
YOLOv2 introduceert Batch Normalisatie, een hoge-resolutie classificator en een multi-schaal trainingsstrategie, die de stabiliteit en nauwkeurigheid verbeteren16. YOLOv3 gebruikt Darknet-53 als basisnetwerk en put inspiratie uit het Feature Pyramid Network (FPN)-concept om doeldetectie te verbeteren17.
YOLOv4 heeft op basis van YOLOv3 talrijke optimalisaties doorgevoerd, waarbij technologieën zoals Cross Stage Partial Network (CSPNet)18, Path Aggregation Network (PANet)19 en Mosaic-data-verbetering zijn geïntroduceerd om de prestaties van het model verder te verbeteren. YOLOv5 heeft belangrijke bijdragen geleverd aan de engineering, met een gebruiksvriendelijkere en efficiëntere implementatie20.
De afgelopen jaren is de YOLO-serie blijven evolueren, met versies zoals YOLOv6, YOLOv7 en YOLOv8 die achtereenvolgens zijn uitgebracht. Door de introductie van de Extended Efficient Layer Aggregation Network (E-ELAN)-structuur en model re-parameterisatie-technieken, bereikt YOLOv7 nieuwe doorbraken op het gebied van zowel snelheid als nauwkeurigheid. Deze verbeteringen verhogen niet alleen de efficiëntie van het leerproces van kenmerken, maar optimaliseren ook de inferentieprestaties van het netwerk, waardoor YOLOv7 betere resultaten levert dan eerdere versies en vele gangbare detectoren bij diverse real-time objectdetectietaken. YOLOv8 optimaliseert de netwerkstructuur verder, hanteert een ankerloze ontwerpmethode, vereenvoudigt het model en verbetert de generalisatiecapaciteit21.
Voortbouwend op de voordelen van eerdere versies, is YOLOv11, gebruikt in dit onderzoek, geoptimaliseerd voor complexe industriële scenario's. De kernverbeteringen omvatten een netwerk voor functie-extractie, een efficiëntere module voor functiefusie en een robuustere ontwerp van de verliesfunctie. Deze verbeteringen stellen YOLOv11 in staat beter te presteren bij het verwerken van verduisteringen, kleine doelen en complexe achtergronden in productieomgevingen. YOLOv11 is een versie uit de YOLO-serie die is uitgegeven door Ultralytics. In vergelijking met YOLOv8 verbetert het de C3K2-module en het pad voor functiefusie, en introduceert een adaptieve ankerboxstrategie, waardoor een sterkere detectierobuustheid in industriële scenario's wordt geboden.
Grondslag en vooruitgang van het convolutionele neurale netwerk (CNN)
Het convolutionele neurale netwerk (CNN) is een cruciaal model dat het succes van deep learning binnen computervisie diepgaand heeft beïnvloed. Het werkt door lokale beeldfuncties te extraheren via convolutionele operaties en vervolgens de dimensionaliteit van de functies te verlagen via poolingoperaties, waardoor een hiërarchische beeldabstractie wordt bereikt22.
Een typisch CNN bestaat uit meerdere convolutie-, pooling- en volledig verbonden lagen. De convolutielag scant het invoerbeeld met een convolutiekern, berekent inwendige producten over lokale gebieden en genereert een kenmerkkaart. Het berekingsproces wordt weergegeven in Vergelijking (2):
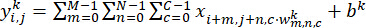 (2)
Waarbij x de invoerafbeelding is, wk en bk respectievelijk het gewicht en de bias van de convolutiekern zijn, en  de waarden zijn van de uitvoerende functiekaart op positie (i,j). De poolinglaag gebruikt meestal Max Pooling of Average Pooling. De volledig verbonden laag is verantwoordelijk voor het extraheren van kenmerken en het voorspellen van classificatiekansen.
Op basis hiervan ontwerpt dit artikel een CNN-featureverbeteringsmodule voor YOLOv11, die bestaat uit twee parallelle takken: een multischaalconvolutietak die 3 × 3- en 5 × 5-convolutiekernels gebruikt om multischaalkenmerken te extraheren; en een aandachtstak die achtereenvolgens de kanaalaandacht (Squeeze-and-Excitation) en ruimtelijke aandachtsmodules verbindt om de discriminerende kenmerken van belangrijke doelen te versterken. De uitgangen van de twee takken worden samengevoegd door middel van elementsgewijze optelling, en de overeenkomstige verliesfunctie voor featureverbetering staat weergegeven in formule (3):
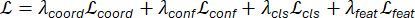 (3)
Lcoord is het regressieverlies van de coördinaten van de omkaderende rechthoek; Lconf is het verlies van de doelbetrouwbaarheid; Lcls is het verlies van de categorieclassificatie; Lfeat is het verlies van de functieverbetering, gebruikt om de discriminerende kenmerken van kleine doelen en verhulde doelen die zijn geëxtraheerd door de CNN-verbeteringsmodule te beperken; λcoord, λconf, λcls, λfeat zijn de gewichtscoëfficiënten van de overeenkomstige verliescomponenten. Voor deze taak is λfeat = 0,05 ingesteld, en de resterende gewichten worden gebalanceerd op basis van de vereisten van de detectietaak.
Klassieke CNN-structuren, zoals VGGNet23 en ResNet24, hebben groot succes behaald bij beeldclassificatietaken. Van deze architecturen vermindert ResNet effectief het probleem van het verdwijnende gradiënt bij het trainen van diepe netwerken, waardoor de opbouw van diepere en complexere netwerkstructuren wordt vergemakkelijkt.
In objectdetectietaken wordt CNN meestal gebruikt als functie-extractor (backbone). Bijvoorbeeld, Darknet, cross-stage partial Darknet (CSPDarknet), enzovoort, in de YOLO-serie algoritmen zijn allemaal gebaseerd op CNN25. Om de functie-extractiecapaciteiten te verbeteren, hebben onderzoekers tal van verbeterde CNN-structuren voorgesteld. Bijvoorbeeld, het Inception-module extraheert kenmerken parallel via convolutiekernels van meerdere schalen. DenseNet verbetert het hergebruik van kenmerken met behulp van dichte verbindingen. Het Squeeze-and-Excitation-netwerk past adaptief het belang van kenmerkkanalen aan via aandachtsmechanismen26.
In dit onderzoek ontwierpen we een verbeterde CNN-module om de mogelijkheden van YOLOv11 voor functie-extractie te verbeteren. Deze module combineert fusie van multischaalfuncties met een aandachtsmechanisme om op efficiëntere wijze cruciale veiligheidsinformatie in productielijnsituaties te detecteren.
Toepassingsstatus van deep learning in industriële veiligheidsmonitoring
Deep learning heeft aanzienlijke voet aan de grond gekregen in de industriële veiligheidsmonitoring. Op CNN-gebaseerde algoritmen worden ingezet om te bepalen of werknemers veiligheidshelmen op de juiste manier dragen, ongeoorloofde doordringing van gevaarlijke zones detecteren en de toestand van defecte apparatuur monitoren27.
Op het gebied van gedragsherkenning worden 3D-CNN's en recurrente neurale netwerken gebruikt om het operationele gedrag van werknemers te analyseren en potentieel onveilige handelingen te identificeren. Door bijvoorbeeld de houdingsequenties van werknemers te analyseren, kan worden vastgesteld of zij veiligheidsprocedures overtreden28.
YOLO en Faster R-CNN worden veel gebruikt voor detectie van personeel en apparatuur in realtime bewakingsvideo's. Zo is in de literatuur een systeem voorgesteld voor realtime detectie van helmen op basis van YOLOv5, wat de intelligentie van veiligheidsbeheer op bouwplaatsen doeltreffend verbetert29.
Hoewel er enige vooruitgang is geboekt in bestaand onderzoek, blijven verschillende uitdagingen bestaan. Ten eerste bevatten industriële omgevingen doorgaans complexe verlichting, verduistering en achtergrondinterferentie, wat strenge eisen stelt aan de robuustheid van het algoritme. Ten tweede is realtimeprestatie een belangrijke vereiste, en het algoritme moet hoge snelheid in de inferentie behalen terwijl de nauwkeurigheid behouden blijft. Tot slot richt bestaand onderzoek zich voornamelijk op detectie van een enkele taak en ontbeert het onderzoek naar fusie van multisource-informatie en uitgebreide analyse30.
In dit onderzoek beoogt het voorgestelde YOLOv11- en CNN-fusiemodel de hierboven genoemde uitdagingen aan te pakken en een uitgebreide, realtime bewaking van veiligheidsrisico’s op de productielijn te realiseren door de mogelijkheden op het gebied van functie-extractie en -fusie te verbeteren.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
YOLOv1- en CNN-algoritme
Algemene systeemarchitectuur
Het in dit artikel voorgestelde veiligheidsbewakingssysteem voor productielijnen maakt gebruik van een hybride architectuur die YOLOv1 combineert met een verbeterd CNN om real-time veiligheidsbewaking met hoge precisie en hoge snelheid te bereiken. Zoals weergegeven in Figuur 1, bestaat het systeem hoofdzakelijk uit een module voor input-voorbewerking, een YOLOv1-objectdetectiemodule, een CNN-kenmerkversterkingsmodule en een fusiebeslissingsmodule. Het inputbeeld wordt eerst genormaliseerd en uitgebreid door de voorbewerkingsmodule om het generalisatievermogen van het model te verbeteren. Vervolgens worden kenmerken geëxtraheerd door de CSPDarknet-backbone en wordt het receptieve veld uitgebreid door de spatial pyramid pooling-fast (SPPF)-module. Multi-schaal kenmerken worden na upsampling gefuseerd, waarna kanaal-aandacht (channel attention) en ruimtelijke aandacht (spatial attention) sequentieel op de gefuseerde kenmerken worden toegepast om de onderscheidende representatie van belangrijke doelwitten verder te verbeteren. De CNN-kenmerkversterkingsmodule is geplaatst na de outputs van de C3-, C4- en C5-lagen van het YOLOv1-backbone-netwerk en ontvangt multi-schaal feature maps met afmetingen van respectievelijk 80 × 80 × 256, 40 × 40 × 512 en 20 × 20 × 1.024. De CNN-kenmerkversterkingsmodule verbetert verder de kenmerkextractie voor kleine en occlusie-doelwitten. Ten slotte combineert de fusiebeslissingsmodule de detectieresultaten van YOLOv1 met de CNN-versterkte kenmerken en optimaliseert deze gezamenlijk via een ontworpen verliesfunctie om de nauwkeurige locatie, categorie en betrouwbaarheidsscore van het doelwit uit te voeren.
YOLOv1 detectie-framework
YOLOv1 heeft verschillende cruciale verbeteringen geïntroduceerd die profiteren van de sterktes van het single-stage detectie-framework van de YOLO-serie. De architectuur is verdeeld in drie hoofdcomponenten: een backbone-netwerk, een feature-fusienetwerk en een detectiekop. Het backbone-netwerk maakt gebruik van een verbeterde CSPDarknet-structuur. Het feature-fusienetwerk bevat cross-stage lokale verbindingen en depthwise separable convolutions, geïnspireerd door feature pyramid networks en path aggregation networks om multi-scale features effectief samen te voegen.
Module voor kenmerkverbetering
De module voor kenmerkverbetering is bedoeld om de gevoeligheid van het model voor cruciale veiligheidskenmerken te verbeteren. Deze verwerkt de kenmerkkaarten (feature maps) die door elke laag van het YOLOv1-backbonenetwerk worden geproduceerd, waarbij informatie over verschillende schalen wordt gefuseerd via upsampling- en downsampling-operaties. Specifiek legt de multi-scale branch de diversiteit in ruimtelijke schaal vast, terwijl de attention branch dynamisch belangrijke kanalen en positionele responsen versterkt. Deze twee branches werken niet onafhankelijk, maar zijn complementair en worden gefuseerd via residuele verbindingen en kenmerkrecalibratie. De kenmerkkaart die door de verbeteringsmodule op elke schaal wordt verwerkt, wordt via een 1 × 1 convolutie aangepast om overeen te komen met het aantal kanalen van de oorspronkelijke kenmerkkaart, en vervolgens via elementgewijze optelling gefuseerd met de oorspronkelijke YOLOv1-kenmerkkaart. De gefuseerde kenmerkkaart wordt vervolgens ingevoerd in het daaropvolgende Feature Pyramid Network (FPN) voor multi-scale fusie, waardoor een hiërarchische representatie van veiligheidskenmerken wordt gevormd. Om een naadloze integratie tussen de modules te waarborgen, wordt een end-to-end gezamenlijke trainingsstrategie gehanteerd, waarbij de verliesfunctie bestaat uit het YOLOv1-detectieverlies en het verlies voor kenmerkverbetering van de CNN-module.
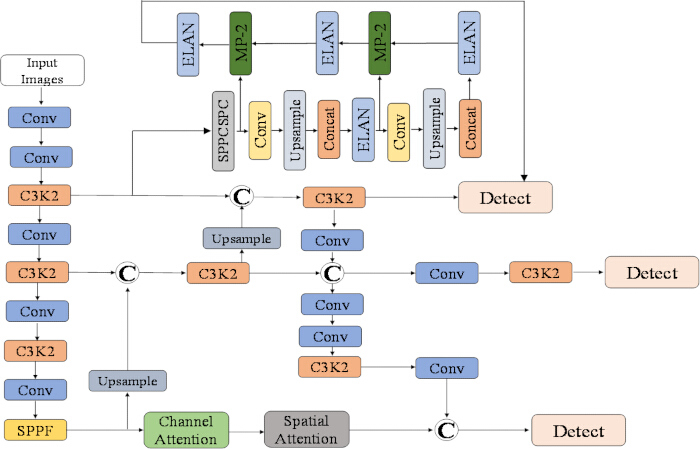
Figuur 1YOLOv1-CNN-algoritme. De module voor kenmerkverbetering is erop gericht de gevoeligheid van het model voor kritieke veiligheidskenmerken te versterken. Deze verwerkt kenmerkkaarten (feature maps) uit diverse lagen van de YOLOv1-backbone en fuseert kenmerken van verschillende schalen via upsampling- en downsampling-operaties. Daarnaast bevat de module kanaal- en ruimtelijke aandachtmechanismen. Om een naadloze integratie tussen de YOLOv11- en CNN-modules te waarborgen, wordt een gezamenlijke trainingsstrategie toegepast. Tijdens de training worden de parameters van beide modules end-to-end geoptimaliseerd. De verliesfunctie combineert het detectieverlies van YOLOv11 met het verlies voor kenmerkverbetering van de CNN-module. Klik hier om een grotere versie van deze figuur te bekijken.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Om de effectiviteit van het voorgestelde YOLOv1- en CNN-fusiemodel bij de veiligheidsbewaking van productielijnen te verifiëren, is een dataset samengesteld die diverse scenario's van veiligheidsrisico's omvat. Deze dataset bevat 12.0 afbeeldingen van productielijnscènes, verdeeld over trainings-, validatie- en testsets in een verhouding van 7:1,5:1,5, met een vaste random seed van 42. Het beslaat diverse werkomstandigheden, waaronder standaardverlichting, zwakke verlichting, gedeeltelijke occlusie, sterke occlusie, bewe...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Experimentele resultaten tonen aan dat het voorgestelde YOLOv11–CNN-fusiemodel de detectienauwkeurigheid en real-time prestaties voor de veiligheidsbewaking van productielijnen verbetert. Door gebruik te maken van de efficiënte single-stage detectie van YOLOv11 en de kenmerkverbetering van de CNN-module, identificeerde het systeem werknemers, apparatuur en gevaarlijke zones onder complexe verlichtings- en occlusieomstandigheden. Multi-scale kenmerkfusie en attention-mechanismen verbeterden het vermogen om zich op crucial...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs hebben geen belangenconflicten te verklaren.
Dankbetuigingen
Dit werk werd gedeeltelijk gefinancierd door de Taizhou University Scientific Research Foundation for Advanced Talents "Research on key technologies of precision detection for intelligent manufacturing" (TZXY2020QDJJ006).
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| COCO API | N/A | Beoordelingstool gebruikt voor de evaluatie van de nauwkeurigheid van targetdetectie en statistische analyse. | |
| CUDA 11.4 | NVIDIA | N/A | Parallel computing-platform gebruikt met het PyTorch 1.12 framework. |
| Edge TPU | N/A | Implementatieplatform gebruikt voor het testen van latentie en stroomverbruik; de gerapporteerde latentie was 18 ms en het stroomverbruik was 15 W. | |
| Jetson Xavier edge computing device | NVIDIA | Edge computing-apparaat gebruikt voor throughput-testen; de gerapporteerde verwerkingssnelheid was 70 FPS met een latentie van het 99ste percentiel binnen 50 ms. | |
| NVIDIA Tesla V100 GPU | NVIDIA | GPU gebruikt in de trainings-/evaluatieserver. | |
| PyTorch 1.12 | N/A | Deep learning framework gebruikt voor modeltraining en evaluatie. | |
| scikit-learn | N/A | Beoordelings-/statistische analysetool gebruikt voor modelevaluatie. | |
| Zelfgebouwde veiligheidsdataset voor productielijnen | N/A | N/A | Dataset van 12.000 afbeeldingen van productielijnscenario's in VOC-formaat, met standaardverlichting, lage verlichting, gedeeltelijke occlusie, zware occlusie, bewegingsonscherpte en complexe achtergronden; zes annotatiecategorieën: werknemers, veiligheidshelmen, robotarmen, gevarenzones, gereedschappen en voertuigen. |
| Trainingsserver | Server uitgerust met een NVIDIA Tesla V100 GPU en Ubuntu 20.04 besturingssysteem. | ||
| Ubuntu 20.04 besturingssysteem | N/A | Besturingssysteem gebruikt op de trainings-/evaluatieserver. | |
| VOC-annotatieformaat | N/A | N/A | Annotatieformaat gebruikt voor de zelfgebouwde veiligheidsdataset voor productielijnen. |
| YOLOv11 objectdetectiemodel | Ultralytics | N/A | Objectdetectiemodel gebruikt om werknemers, apparatuur en potentiële gevaren in realtime te detecteren. |
Referenties
- Ramadan MNA, Ali MAH, Jaber H, Alkhedher M. Blockchain-secured IoT-federated learning for industrial air pollution monitoring: a mechanistic approach to exposure prediction and environmental safety. Ecotoxicol Environ Saf. 2025;300:118442.
- Ahn J, et al. SafeFac: video-based smart safety monitoring for preventing industrial work accidents. Expert Syst Appl. 2023;215:119397.
- Natha S, et al. A scalable and generalized deep ensemble model for road anomaly detection in surveillance videos. Comput Mater Contin. 2024;81(3):3707-3729.
- Diallo AR, Homri L, Dantan JY. Reducing false alarms in fault detection: a comparative analysis between conformal prediction and classical methods applied to PCA and autoencoders. J Process Control. 2025;152:103495.
- Cheng X, Han Y, Zhang W. Development of intelligent monitoring system for soil erosion in pipeline engineering based on deep learning. Comput Electr Eng. 2025;126:110432.
- Yan H, et al. A global feature fusion and adaptive optimization method to enhance detection accuracy and computational efficiency based on YOLOv8. Alexandria Eng J. 2025;129:538-552.
- Samma H, Al-Azani S, El-Ferik S. UAV-based real-time face detection using YOLOv7. Transp Res Procedia. 2025;84:331-338.
- Gong X, Yu J, Zhang H, Dong X. AED-YOLO11: a small object detection model based on YOLO11. Digit Signal Process. 2025;166:105411.
- Li R, Xiao K, Lin S, Wu Z. Enhancing aquatic ecosystem monitoring through fish jumping behavior analysis and YOLOv5: applications in freshwater fish identification. J Environ Manage. 2025;391:126413.
- Zhang D, Gao Q, Chen Z, Lin Z. Semantic feature refinement of YOLO for human mask detection in dense crowded. J Vis Commun Image Represent. 2025;107:104399.
- Choi MJ, Ku DG, Lee SJ. Integrated YOLO and CNN algorithms for evaluating degree of walkway breakage. KSCE J Civ Eng. 2022;26(8):3570-3577.
- Li Y, et al. Underwater acoustic intelligent spectrum sensing with multimodal data fusion: an Mul-YOLO approach. Future Gener Comput Syst. 2025;173:107880.
- Jiang D, et al. Real-time tracker of chicken for poultry based on attention mechanism-enhanced YOLO-Chicken algorithm. Comput Electron Agric. 2025;237:110640.
- Yang X, et al. Automated concrete bridge damage detection using an efficient Vision Transformer-enhanced anchor-free YOLO. Engineering. 2025;51:311-326.
- Fuertes D, et al. People detection with omnidirectional cameras using a spatial grid of deep learning foveatic classifiers. Digit Signal Process. 2022;126:103473.
- Deepak GD, Bhat SK. Maximizing YOLOv2 efficiency: a study on multiclass detection of indoor objects. Results Eng. 2025;26:105405.
- Zhang C, et al. Personnel target detection in infrared environment based on YOLOv3-tinier network and its FPGA implementation. Infrared Phys Technol. 2025;150:106015.
- Zhou Y. A YOLO-NL object detector for real-time detection. Expert Syst Appl. 2024;238:122256.
- Asadollahpour E, Rahmannejad R, Asghari A, Abdollahipour A. Back analysis of closure parameters of Panet equation and Burger's model of Babolak water tunnel conveyance. Int J Rock Mech Min Sci. 2014;68:159-166.
- Anguchamy KK, Palanisamy V. Real-time object detection using improvised YOLOv4 and feature mapping technique for autonomous driving. Expert Syst Appl. 2025;280:127452.
- Khan AT, Jensen SM, Khan AR. Advancing precision agriculture: a comparative analysis of YOLOv8 for multi-class weed detection in cotton cultivation. Artif Intell Agric. 2025;15(2):182-191.
- Raushan R, Singhal V, Jha RK. Damage detection in concrete structures with multi-feature backgrounds using the YOLO network family. Autom Constr. 2025;170:105887.
- Zarboubi M, Bellout A, Chabaa S, Dliou A. CustomBottleneck-VGGNet: advanced tomato leaf disease identification for sustainable agriculture. Comput Electron Agric. 2025;232:110066.
- Xie F, et al. Wine variety traceability by data fusion of near-infrared spectroscopy and mid-infrared spectroscopy combined with GAF and ResNet. Chemom Intell Lab Syst. 2025;264:105468.
- Huang J, et al. Estimation of the orientation of potatoes and detection bud eye position using potato orientation detection you only look once with fast and accurate features for the movement strategy of intelligent cutting robots. Eng Appl Artif Intell. 2025;142:109923.
- Huang Y, et al. Human intrusion detection with distributed fiber optic data based on Squeeze-Excitation and hierarchical connection enhancement network. Opt Fiber Technol. 2025;94:104297.
- Qi R, et al. Mechanical fault diagnosis of on-load tap changers using time-frequency vibration analysis and a lightweight YOLO model. Measurement. 2025;256:118441.
- Yan J, Wang Z. YOLO V3+VGG16-based automatic operations monitoring and analysis in a manufacturing workshop under Industry 4.0. J Manuf Syst. 2022;63:134-142.
- Nazli NANM, et al. A real-time system for detecting personal protective equipment compliance using deep learning model YOLOv5. Procedia Comput Sci. 2024;245:647-656.
- Xiao Y, et al. The prediction of kiwi quality attributes based on multi-source data fusion comprehensive analysis model using HSI and FHSI. J Food Compos Anal. 2025;144:107645.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.