Deze studie presenteert een geautomatiseerd framework voor het prototypen van gebruikersinterfaces, waarin cognitieve ontwerpprincipes, perceptuele kleuremodellering en deep learning zijn geïntegreerd. Het systeem verbetert de toegankelijkheid, de duidelijkheid van de lay-out, de kleurharmonie en de consistentie over verschillende schermen, wat resulteert in coherente, gebruikersgerichte interfaceontwerpen.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Geautomatiseerd raamwerk voor het prototypen van gebruikersinterfaces dat cognitieve en visuele ontwerpprincipes integreert om de bruikbaarheid en lay-outhelderheid te verbeteren
In dit artikel
Samenvatting
Samenvatting
Effectief ontwerp van gebruikersinterfaces (UI) vereist een harmonieuze balans tussen visuele aantrekkingskracht, cognitieve bruikbaarheid en consistentie in de lay-out. Huidige benaderingen voor automatische UI-generatie richten zich echter primair op het visuele uiterlijk of componentdetectie en missen een uniform raamwerk dat cognitieve principes, kleurintelligentie en structurele redenering integreert. Bovendien kampen bestaande methoden met beperkte generalisatie van lay-outs, een gebrekkige interpreteerbaarheid, statische kleurselectie en inconsistent gedrag over verschillende schermen heen. In deze context stelt dit werk een geautomatiseerd UI-prototypingraamwerk voor dat componentdetectie op basis van het Faster region-based convolutional neural network (Faster R-CNN) en perceptuele kleurmodellering aangestuurd door de CIECAM02 uniforme kleurruimte (CAM02-UCS) integreert, verrijkt met cognitieve en visuele ontwerpprincipes. Faster R-CNN wordt gebruikt om UI-componenten te identificeren en hiërarchische structuren af te leiden uit grootschalige interface-datasets. Een verbeterde kleurgeneratiemodule analyseert merk- of referentieafbeeldingen om met behulp van CAM02-UCS perceptueel uniforme, harmonieuze en gebruiksvriendelijke kleurthema's te waarborgen. Deze outputs worden verder geoptimaliseerd via cognitieve ontwerpregels, waaronder Gestalt-groepering, de wetten van Fitts en Hick, op aandacht gebaseerde spatiëring en visuele hiërarchie-modellering, om automatisch verfijnde, taakgerichte UI-lay-outs te genereren. Experimenten uitgevoerd op de RICO-, ENRICO- en Guo's UI Color Datasets laten zien dat het voorgestelde systeem een nauwkeurigheid van 92,4% bij de componentdetectie behaalt, de duidelijkheid van de lay-out en de nauwkeurigheid van de leesvolgorde met 18,7% verbetert en kleurenpaletten produceert die door ontwerpers 24,5% harmonieuzer worden beoordeeld in vergelijking met referentiemethoden. Gebruikersbeoordelingen wijzen daarnaast op een afname van 31% in de waargenomen cognitieve belasting en een toename van 28% in ontwerpconsistentie over schermen heen. Deze bevindingen tonen aan dat de combinatie van deep learning-gebaseerd structureel begrip met perceptueel gefundeerde kleurmodellering en cognitieve ontwerpprincipes UI-prototypes oplevert die zeer efficiënt, esthetisch coherent en gebruiksvriendelijk zijn. Dit raamwerk vestigt een nieuwe, end-to-end benadering voor intelligente en mensgerichte geautomatiseerde UI-prototyping.
Inleiding
Grafische gebruikersinterfaces (GUI's) dienen als een fundamenteel communicatiemiddel tussen mensen en computersystemen en beïnvloeden de bruikbaarheid, toegankelijkheid en de algehele gebruikerservaring (UX) aanzienlijk1,2. Moderne softwaresystemen vertrouwen op intuïtieve en visueel aantrekkelijke interfaces om gebruikers aan te trekken en te behouden. Traditioneel omvat UI-ontwerp het creëren van grafische lay-outs die later door engineers worden vertaald naar front-endcode. Verschillen in platformspecifieke protocollen tussen besturingssystemen vereisen echter herhaaldelijke aanpassingen, wat de ontwikkelingscomplexiteit en de benodigde inspanning verhoogt. Geautomatiseerde UI-codegeneratie is daarom ontstaan als een belangrijke onderzoeksrichting om handmatige inspanningen te verminderen en de efficiëntie van de ontwikkeling te verbeteren.
Vroege benaderingen voor geautomatiseerde UI-generatie combineren traditionele beeldverwerkingstechnieken met deep learning-modellen voor regio-detectie en classificatie3,4. Momenteel passen dominante strategieën voor GUI-codegeneratie computer vision-technieken toe om UI-afbeeldingen te analyseren en deze om te zetten in gestructureerde front-end representaties5,6,7. Waar beeldverwerkingsmethoden vertrouwen op handmatig ontworpen kenmerken, extraheren deep learning-benaderingen hiërarchische representaties uit grootschalige datasets. Als gevolg hiervan hebben onderzoekers hybride benaderingen verkend die deep learning combineren met domeinspecifieke beeldverwerkingstechnieken om de robuustheid en nauwkeurigheid te verbeteren.
Kleur is een andere kritieke factor in UI-ontwerp, die de gebruikersperceptie, bruikbaarheid en esthetische aantrekkingskracht beïnvloedt1. Het handhaven van consistentie tussen de beeldinhoud en UI-kleurenschema's wordt uitdagend wanneer visuele inputs variëren in tint en context8,9,10. Bijgevolg heeft aanzienlijk onderzoek zich gericht op de automatische generatie van kleurenpaletten en perceptuele kleurmodellering. Bestaande methoden voor kleurgeneratie omvatten technieken gebaseerd op de CIELAB-kleurruimte11. Andere benaderingen maken gebruik van clusteringalgoritmen, zoals k-means, om dominante kleuren uit beelden te extraheren12. Als gevolg hiervan is er in recent werk in toenemende mate gekozen voor datagestuurde benaderingen op basis van machine learning voor kleurmodellering.
Parallel hiermee hebben deep learning-benaderingen de detectie van UI-componenten en het begrip van lay-outs aanzienlijk verbeterd. Neurale netwerken hebben een nauwkeurigere structurele parsing van mobiele interfaces mogelijk gemaakt13. Deze methoden richten zich echter primair op detectienauwkeurigheid en laten vaak aspecten op een hoger niveau over het hoofd, zoals cognitieve bruikbaarheid, lay-out-hiërarchie en interactie-efficiëntie. Generatieve modellen voor UI-lay-outsynthese zijn ook voorgesteld14,15, maar zij kampen met uitdagingen bij het handhaven van consistentie tussen schermen en het bieden van interpreteerbare ontwerpbeslissingen16. Andere benaderingen richten zich op visuele gelijkenis of renderingskwaliteit, maar missen een uniform kader dat componentsemantiek, kleurharmonie en bruikbaarheidsbeperkingen combineert17. Tekstherkenning is evenyens belangrijk voor het begrijpen van UI-inhoud. Technieken zoals convolutionele recurrente neurale netwerken (CRNN's) maken nauwkeurige herkenning van complexe tekstpatronen in interfaceschermen mogelijk18,19,20.
Verschillende systemen zijn voorgesteld om UI-code te genereren op basis van schetsen of afbeeldingen. Sketch2Code maakt gebruik van objectdetectie om schetsen om te zetten in coderepresentaties21,22, maar is gevoelig voor de beeldkwaliteit. REDRAW biedt een geautomatiseerde pijplijn voor gegevensverzameling en modeltraining, waarbij convolutionele en recurrente neurale netwerken worden gecombineerd om gestructureerde UI-representaties te genereren23,24. Latere studies hebben verbeterde evaluatiemetrieken geïntroduceerd om de kwaliteit van de gegenereerde UI te beoordelen25. Recentere benaderingen omvatten diffusie-gebaseerde en transformer-gebaseerde modellen voor lay-outgeneratie, zoals diffusion layout transformers zonder autoencoder-methoden, GUI-lay-outgeneratie met behulp van transformer-gebaseerde GUI-ordeninggrafieken en UI-lay-outgeneratie gestuurd door grote taalmodellen26,27,28. Een vergelijkend overzicht van deze benaderingen wordt gegeven in Tabel 1.
| Referenties en belangrijkste methode(n) | Doelingesteldheid | Voordelen | Nadelen |
| Geautomatiseerde generatie van kleurthema's voor beeldgebaseerde gebruikersinterfaces: extractie van prominente kleuren + perceptuele kleuremodellering via CAM02-UCS¹ | Automatisch genereren van UI-kleurthema's vanuit referentieafbeeldingen, waarbij harmonie en bruikbaarheid worden geoptimaliseerd. | Sterke perceptuele onderbouwing (CAM02-UCS); balanceert expliciet harmonie en bruikbaarheid (contrast en diversiteit); bevat een webgebaseerde implementatie en evaluatie door ontwerpers. | Uitsluitend gericht op kleur/thema (niet op lay-out of componentstructuur); regel- of heuristiekgebaseerde in plaats van end-to-end geleerde UI-synthese. |
| Het uniformeren van lay-outgeneratie met een ontkoppeld diffusiemodel (LDGM)²⁵ | Een uniforme, flexibele lay-outgeneratie voor grafische scènes en gebruikersinterfaces. | Geavanceerde diversiteit en controleerbaarheid voor lay-outgeneratie; ondersteunt conditionele generatie en meerdere attribuuttypen. | Diffusiegebaseerde outputs kunnen uitlijnings- of gedetailleerde lay-outproblemen vertonen tenzij ze worden beperkt; hogere modelcomplexiteit en inferentiekosten. |
| Diffusion Layout Transformers zonder autoencoder-methoden: transformer + diffusie voor lay-outgeneratie (geen autoencoder)²⁶ | Verbeter de getrouwheid en uitlijning voor benchmarks voor layoutgeneratie (FID-, uitlijnings- en overlapmetrieken). | Betere vastlegging van semantische correlaties tussen naburige objecten; sterke prestaties op FID- en uitlijningsmetrieken. | Richt zich primair op de geometrie van de lay-out (posities, formaten, categorieën) in plaats van op de UI-semantiek. |
| GUI-layoutgeneratie met Transformer-gebaseerde modellen vanuit GUI-arrangementsgrafen (GUI-AG's)²⁷ | Creëer GUI-lay-outs op basis van positionele/graafbeperkingen om ontwerpers te ondersteunen. | Graafrepresentaties leggen relationele beperkingen vast; de transformer maakt flexibele, op beperkingen geconditioneerde generatie mogelijk. | Kan expliciete constraint-grafieken van ontwerpers vereisen; beperkte nadruk op kleur en bruikbaarheidsmetrieken. |
| Genereren van UI-layouts met LLM's onder leiding van UI-grammatica: Large Language Models (LLM's) + hiërarchische UI-grammatica²⁸ | Onderzoek LLM's voor lay-outgeneratie en verbeter de uitlegbaarheid/controle via grammatica-representaties. | Hoge mate van controleerbaarheid en uitlegbaarheid; kan gebruikmaken van in-context learning van LLM's (GPT-type). | Werk in een vroeg stadium met beperkte empirische validatie; grammatontwerp en robuustheid over verschillende gebruikersinterfaces (UI's) |
Tabel 1: Vergelijking van bestaande methoden voor UI-kleurmodellering en lay-outgeneratie. De tabel vat representatieve benaderingen voor gebruikersinterface-ontwerp samen, waaronder de generatie van kleurenschema's, diffusiegebaseerde lay-outgeneratie, transformer-gebaseerde methoden en lay-outgeneratie gestuurd door grote taalmodellen. Voor elke methode worden de onderliggende techniek, het doel, de voordelen en de beperkingen gepresenteerd, waarbij de verschillen in perceptuele modellering, lay-outgeneratievermogen, controleerbaarheid en bruikbaarheidsoverwegingen worden benadrukt.
Ondanks deze vooruitgang blijft er een belangrijke beperking: geen enkel bestaand systeem integreert componentdetectie, perceptuele kleuremodellering, cognitieve ontwerpprincipes en consistentie van multiscreen-layouts gezamenlijk binnen één enkel end-to-end framework1. Huidige benaderingen optimaliseren doorgaans slechts één of twee aspecten — zoals detectie, layout of kleur — zonder rekening te houden met hun onderlinge afhankelijkheden. Deze fragmentatie benadrukt een kritische onderzoekskloof in de ontwikkeling van uniforme, mensgerichte geautomatiseerde UI-prototyping-systemen. In het bijzonder worden cognitieve ontwerpprincipes, zoals de Gestaltwetten, de wet van Fitts en de wet van Hick, vaak conceptueel behandeld in plaats van formeel te worden geïntegreerd in computationele modellen.
Om deze beperkingen aan te pakken, stelt deze studie een end-to-end geautomatiseerd UI-prototypingframework voor dat componentdetectie, perceptuele kleuremodellering en cognitieve ontwerpprincipes integreert binnen een uniform systeem. Het framework is ontworpen om de lay-outkwaliteit te verbeteren, de cognitieve belasting te verminderen, de kleurharmonie te verhogen en de algemene bruikbaarheid te vergroten. Deze verbeteringen worden gevalideerd via experimenten op de RICO-, ENRICO- en Guo's UI Color-datasets, waarmee de effectiviteit wordt aangetoond van het combineren van structurele, perceptuele en cognitieve aspecten binnen één enkele geautomatiseerde UI-prototypingpijplijn. Er wordt gehypothetiseerd dat de integratie van deep learning-gebaseerde componentdetectie, perceptuele kleuremodellering en cognitieve ontwerpprincipes binnen een uniform framework de kwaliteit van UI-prototypes aanzienlijk zal verbeteren in vergelijking met bestaande benaderingen. Specifiek stelt H1 dat het framework de lay-outkwaliteit verbetert, inclusief uitlijning, groepering en leesvolgorde. H2 stelt dat het framework de cognitieve belasting voor de gebruiker vermindert. H3 suggereert dat perceptuele kleuremodellering de kleurcoördinatie en visuele harmonie verbetert. H4 stelt dat de algemene bruikbaarheid en esthetische kwaliteit van UI-prototypes zijn verbeterd.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Deze studie maakt gebruik van openbaar beschikbare datasets en omvat geen menselijke of dierlijke proefpersonen.
Het voorgestelde geautomatiseerde framework voor UI-prototyping integreert deep learning-gebaseerd structureel begrip, perceptueel uniforme kleurmodellering en cognitieve ontwerpprincipes om coherente en gebruikersgerichte interfaceprototypes te genereren. De methodologie begint met een Faster R-CNN-architectuur die is getraind op de RICO- en ENRICO-datasets om UI-componenten te detecteren en hun hiërarchische relaties te extraheren, wat een nauwkeurige interpretatie van diverse schermlay-outs mogelijk maakt. De gedetecteerde componenten worden vervolgens verwerkt door een kleurintelligentiemodule, die merk- of afbeeldingsgebaseerde kleurkenmerken extraheert, perceptuele gelijkenis modelleert met behulp van CAM02-UCS en harmonieuze, contrastbewuste en toegankelijkheidsconforme kleurenpaletten genereert. Vervolgens worden cognitieve ontwerpprincipes—waaronder de Gestaltwetten van groepering, de wet van Fitts, de wet van Hick, aandachtgebaseerde spatiëring en beperkingen voor visuele hiërarchie—toegepast via een cognitieve optimalisatie-engine om de ruimtelijke organisatie en componentuitlijning te verfijnen. Ten slotte integreert een layout-redeneringslaag structurele, perceptuele en cognitieve beperkingen om consistent UI-prototypes over meerdere schermen te genereren die een balans bieden tussen bruikbaarheid, esthetiek en functionele helderheid. Deze geïntegreerde pijplijn waarborgt perceptuele coherentie, vermindert de cognitieve belasting en voldoet aan mensgerichte ontwerpprincipes. De volledige workflow van de voorgestelde methode is geïllustreerd in Figuur 1.
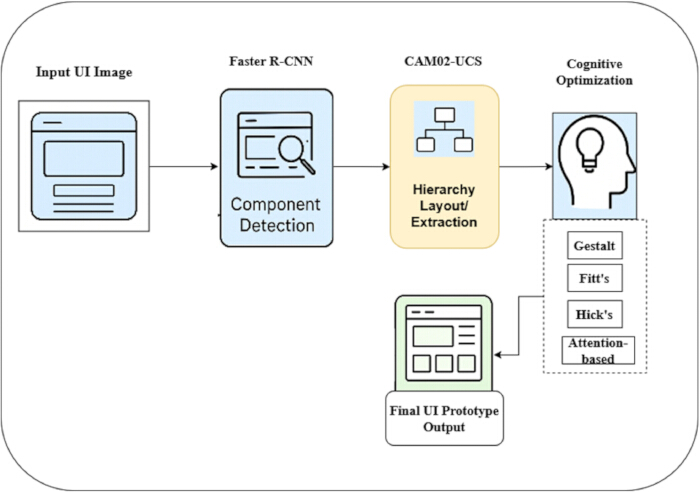
Figuur 1Algemene architectuur van het voorgestelde geautomatiseerde framework voor prototyping van gebruikersinterfaces. Het diagram illustreert de volledige pipeline, beginnend bij een input-UI-afbeelding. Componentdetectie wordt uitgevoerd met Faster R-CNN om interface-elementen te identificeren. De gedetecteerde componenten worden vervolgens verwerkt met behulp van CAM02-UCS-gebaseerde perceptuele modellering voor de extractie van hiërarchie en lay-out. Vervolgens wordt cognitieve optimalisatie toegepast op basis van Gestaltprincipes, de wet van Fitts, de wet van Hick en aandachtgebaseerde aanpassingen. Pijlen geven de datastroom tussen de modules aan, wat resulteert in het uiteindelijke UI-prototype als output. Klik hier om een grotere versie van deze figuur te bekijken.
Overzicht van het raamwerk
Figuur 1 illustreert de volledige workflow van het voorgestelde geautomatiseerde framework voor UI-prototyping, dat een ruwe UI-screenshot omzet in een cognitief verfijnd prototype. Het proces begint met de input-UI-afbeelding, die wordt doorgegeven aan de componentdetectiemodule op basis van Faster R-CNN. Deze module identificeert interface-elementen zoals knoppen, iconen, tekstvelden en containers, en geeft de bijbehorende bounding boxes en klasselabels uit. De gedetecteerde componenten worden vervolgens verwerkt in de fase van hiërarchie- en lay-outextractie. Op basis van ruimtelijke relaties en structurele patronen bouwt het systeem een hiërarchische lay-outboom die weerspiegelt hoe gebruikers de schermorganisatie van nature waarnemen. Deze representatie legt visuele groepering en structurele afhankelijkheden tussen UI-elementen vast. De geëxtraheerde lay-out wordt vervolgens verfijnd via cognitieve optimalisatie door mensgerichte ontwerpprincipes toe te passen. Hiertoe behoren Gestalt-groepering voor visuele clustering, de wet van Fitts voor het optimaliseren van de grootte en toegankelijkheid van touch-targets, de wet van Hick voor het verminderen van beslissingscomplexiteit en aandacht-gebaseerde spatiëring voor het verbeteren van de visuele hiërarchie. Als gevolg hiervan wordt de lay-out intuïtiever, leesbaarder en efficiënter voor gebruikersinteractie. Ten slotte wordt de geoptimaliseerde lay-out gecombineerd met perceptuele kleurmodellering om een coherent UI-prototype te genereren. De resulterende interface is structureel nauwkeurig, visueel harmonieus en afgestemd op de menselijke verwachtingen op het gebied van bruikbaarheid.
Het framework werd geïmplementeerd met PyTorch 2.0 op Ubuntu 2.04. De experimenten werden uitgevoerd op een systeem uitgerust met een NVIDIA RTX 4090 GPU (24 GB VRAM). Het Faster R-CNN-model maakte gebruik van een ResNet-50-backbone die was vooraf getraind op de ImageNet-dataset. De training werd uitgevoerd met de stochastic gradient descent (SGD)-optimizer met een learning rate van 0.01, een batchgrootte van 16 en maximaal 60 epochs. Om overfitting te voorkomen, werd early stopping toegepast met een validatieset bestaande uit 20% van de gegevens. Hoewel de training voor maximaal 60 epochs werd uitgevoerd, werd convergentie doorgaans eerder bereikt via early stopping op basis van het validatieverlies. De momentum en weight decay werden respectievelijk ingesteld op 0.9 en 0.05. Datagestuurde augmentatie omvatte normalisatie, willekeurige horizontale spiegeling, en willekeurig bijsnijden en schalen.
Voorbereiding van de dataset
Om het voorgestelde geautomatiseerde framework voor UI-prototyping te ondersteunen, werden drie complementaire datasets gebruikt: ENRICO29, RICO30 en de UI Color Dataset van Guo1. De RICO-dataset bevat 6.261 Android-UI-schermen verzameld uit 9.70 applicaties, wat een grootschalige diversiteit biedt voor componentdetectie en hiërarchische lay-outextractie. ENRICO bevat 1.464 hoogwaardige UI-screenshots die handmatig zijn gecategoriseerd in 20 designpatronen, wat een verbeterde generalisatie mogelijk maakt voor structurele redenering en modellering van lay-outconsistentie. De UI Color Dataset van Guo bestaat uit 128 gecureerde UI-afbeeldingen met geannoteerde kleurthema's, die worden gebruikt voor perceptuele kleuremodellering en palette-evaluatie. Vanwege de relatief kleine omvang kan deze dataset echter enige variabiliteit in lay-outkenmerken introduceren. Voor deze studie werd een gecombineerde dataset van 5.128 schermen voorbereid voor training en evaluatie. Specifiek werden ongeveer 4.0 afbeeldingen uit RICO gebruikt om het Faster R-CNN-model voor componentdetectie te trainen, 1.0 afbeeldingen uit ENRICO werden gebruikt voor het leren van lay-outpatronen en structurele consistentiemodellering, en 128 afbeeldingen uit de dataset van Guo werden gebruikt voor kleurevaluatietaken. Alle afbeeldingen werden genormaliseerd naar een resolutie van 480 × 80 pixels, omgezet naar een uniforme sRGB-kleurruimte en opnieuw geannoteerd met gestandaardiseerde bounding boxes en hiërarchische metadata om compatibiliteit tussen de datasets te waarborgen. Een overzicht van de in deze studie gebruikte datasets is weergegeven in Tabel 2. De RICO-dataset ondersteunt grootschalige detectie van UI-componenten en structurele analyse, terwijl ENRICO het vermogen van het model om lay-outpatronen te herkennen en cross-screen-consistentie af te dwingen, versterkt. De UI Color Dataset van Guo speelt, ondanks de kleinere omvang, een cruciale rol bij het evalueren van perceptuele kleurharmonie en contrastmodellering. Samen bieden deze datasets een uitgebreide en goed gebalanceerde basis voor de training, validatie en evaluatie van het voorgestelde geautomatiseerde framework voor UI-prototyping.
| Dataset | Totaal aantal beschikbare afbeeldingen | In de studie gebruikte afbeeldingen | Doel in het voorgestelde raamwerk |
| RICO-dataset30 | 66,261 | 4,000 | detectie van UI-componenten, extractie van structurele lay-out |
| ENRICO-dataset29 | 1,464 | 1,000 | Aanleerproces van ontwerppatronen, modellering van lay-outconsistentie |
| De UI-kleurendataset van Guo1 | 128 | 128 | Extractie van kleurthema's, perceptuele kleurevaluatie |
| Gecombineerd totaal | 67,853 | 5,128 | Uitgebreide dataset voor detectie, lay-out en kleurmodellering |
Tabel 2: Overzicht van de datasets gebruikt in het voorgestelde raamwerk. De tabel presenteert de datasets die zijn gebruikt voor training en evaluatie, waaronder de RICO-, ENRICO- en Guo’s UI Color-datasets. Er wordt melding gemaakt van het totale aantal beschikbare afbeeldingen, het in deze studie gebruikte subset en de specifieke rol van elke dataset bij componentdetectie, lay-outmodellering en perceptuele kleuranalyse binnen het voorgestelde raamwerk.
Er is gebruikgemaakt van een gestratificeerde steekproefstrategie om de diversiteit in UI-componenten, lay-outstructuren en kleurendistributies over de RICO-, ENRICO- en Guo-datasets te behouden. De dataset werd met behulp van gestratificeerde steekproeven opgesplitst in trainings- (70%), validatie- (15%) en testsubsets (15%). Afbeeldingen werden genormaliseerd met behulp van het gemiddelde (0,485, 0,456 en 0,406) en de standaarddeviatie (0,29, 0,24 en 0,25). Data-augmentatie omvatte willekeurige horizontale spiegeling (waarschijnlijkheid = 0,5) en willekeurige uitsnijding (schaalbereik: 0,8–1,0), gevolgd door het aanpassen van de grootte naar 24 × 24 pixels, toegepast tijdens de training.
Annotatie en voorbewerking van componenten
De RICO-, ENRICO- en Guo’s UI Color Dataset ondersteunen gezamenlijk de drie kernfunctionele componenten van het voorgestelde raamwerk voor geautomatiseerde UI-prototyping: componentdetectie, lay-outmodellering en perceptuele kleuroptimisatie. De RICO-dataset bevat een grootschalige collectie van meer dan 6.0 mobiele UI-schermen en wordt primair gebruikt voor het trainen van de module voor componentdetectie. De diversiteit ervan stelt het Faster R-CNN-model in staat om robuuste representaties te leren van veelvoorkomende UI-elementen, zoals knoppen, afbeeldingen en tekstvelden, over een breed scala aan applicaties. Dit garandeert een nauwkeurige detectie en lokalisatie van UI-componenten onder verschillende ontwerpomstandigheden. De ENRICO-dataset biedt hoogwaardige, patroon-gelabelde UI-schermen voor het leren van structurele relaties en lay-outpatronen. Hiermee kan het systeem inter-componentrelaties, hiërarchische organisatie en gangbare ontwerpsjablonen begrijpen. Deze dataset speelt een cruciale rol bij het modelleren van lay-outstructuren en het afdwingen van consistentie over meerdere schermen, waardoor het raamwerk lay-outs kan genereren die in overeenstemming zijn met vastgestelde ontwerpconventies. In tegenstelling hiermoe wordt Guo’s UI Color Dataset specifiek gebruikt voor perceptuele en cognitieve kleurmodellering. In tegenstelling tot RICO en ENRICO, die zich richten op structurele aspecten, bevat deze dataset gecureerde UI-afbeeldingen met geannoteerde kleurthema's. Deze annotaties worden gebruikt om modules voor kleurextractie en harmonie-evaluatie te trainen. Door kleurrelaties in kaart te brengen in perceptuele kleurruimtes zoals CAM02-UCS, leert het raamwerk kleurenpaletten te genereren die contrast, toegankelijkheid en esthetische coherentie in balans brengen. Samen vormen deze datasets een geïntegreerde pijplijn: RICO ondersteunt de componentdetectie, ENRICO maakt het begrip van lay-outpatronen en structurele consistentie mogelijk, en de dataset van Guo faciliteert de perceptuele kleuroptimisatie. Deze integratie zorgt ervoor dat de gegenereerde UI-prototypes structureel nauwkeurig, visueel harmonieus en cognitief geoptimaliseerd zijn.
Normalisatie werd uitgevoerd met een gemiddelde van [0.485, 0.456, 0.406] en een standaarddeviatie van [0.29, 0.24, 0.25]. Technieken voor data-augmentatie, waaronder random cropping, horizontale spiegeling en rotatie, werden toegepast om de generalisatie van het model te verbeteren. Daarnaast werden pixelwaarden geschaald naar het bereik [0, 1] en werden alle afbeeldingen aangepast naar een resolutie van 480 × 800 pixels om consistentie tussen datasets te waarborgen. Afbeeldingen die zijn geschaald naar 24 × 24 pixels worden gebruikt voor augmentatie tijdens de training, terwijl de oorspronkelijke resolutie van 480 × 80 pixels wordt behouden voor lay-outanalyse. Bounding boxes werden aangepast om irrelevante annotaties te filteren met behulp van vooraf gedefinieerde drempelwaarden. Om uniformiteit tussen datasets te bereiken, werden alle UI-elementen handmatig geannoteerd met de annotatietool LabelImg. Voorafgaand aan de annotatie werd een vooraf gedefinieerd schema vastgesteld om UI-elementen te classificeren in categorieën zoals knop, tekst, afbeelding, icoon en container. Voor de representatie van de bounding boxes werd een uniform coördinatensysteem toegepast, en hiërarchische informatie werd geconstrueerd op basis van ruimtelijke relaties tussen elementen en hun ouder-kindrelaties binnen de lay-outboom. Daarnaast werden richtlijnen opgesteld om een consistente annotatie van elementen, een correcte verwerking van overlappende componenten en de handhaving van minimale grootte-drempelwaarden over de RICO-, ENRICO- en Guo-datasets te garanderen.
Gedetailleerde wiskundige formuleringen voor de training van componentdetectie en de extractie van lay-outpatronen zijn opgenomen in Aanvullend Bestand 1.
Het Faster R-CNN-model werd getraind met SGD met een momentum van 0.9 en een weight decay van 0.005. De initiële leer-snelheid werd ingesteld op 0.01 en aangepast met een step decay-beleid op basis van de validatieprestaties. De training werd uitgevoerd gedurende maximaal 60 epochs met een batchgrootte van 16. Er werd gebruikgemaakt van early stopping om overfitting te voorkomen, met een validatieset bestaande uit 20% van de trainingsgegevens.
De afbeeldingsfunctie f(.) neemt gedetecteerde UI-elementen als input en produceert een hiërarchische lay-outrepresentatie als output. Deze berekent nabijheidsrelaties tussen UI-elementen op basis van ruimtelijke afstand en uitlijningscriteria, en construeert een nabijheidsmatrix om deze relaties weer te geven. Vervolgens wordt een clusteringalgoritme, zoals DBSCAN, toegepast om gerelateerde componenten te groeperen. Ten slotte worden de geclusterde elementen georganiseerd in hiërarchische structuren op basis van ouder-kindrelaties, waardoor een gestructureerde lay-outrepresentatie ontstaat.
Gedetailleerde formuleringen voor kleurenharmoniemodellering en het geünificeerde optimalisatiedoel zijn te vinden in Aanvullend Bestand 1.
Deze doelfunctie formaliseert wiskundig de integratie van structurele detectie, layout-redenering en perceptuele kleurmodellering, waardoor wordt gewaarborgd dat alle componenten van het framework gezamenlijk bijdragen aan het genereren van coherente en gebruikersgerichte UI-prototypes. Optimalisatie wordt op modulaire wijze uitgevoerd voor elke component van het framework. SGD wordt gebruikt voor het trainen van de componentdetectiemodule, terwijl de Adam-optimizer wordt gebruikt tijdens de gezamenlijke optimalisatie van de uniforme doelstelling. De gecombineerde doelstelling wordt gebruikt om de algehele systeemprestaties te sturen. Voor de fasen van gezamenlijke optimalisatie wordt de doelfunctie geminimaliseerd met behulp van de Adam-optimizer met een learning rate van 0.01 en een batch size van 16. De training wordt uitgevoerd voor maximaal 60 epochs, waarbij early stopping wordt toegepast wanneer de verandering in het validatieverlies minder dan 10−4 bedraagt gedurende vijf opeenvolgende epochs.
Componentdetectie met behulp van Faster R-CNN
Het voorgestelde raamwerk maakt gebruik van Faster R-CNN voor de automatische detectie van UI-componenten, waaronder knoppen, iconen, tekstvelden, afbeeldingen en containers. Faster R-CNN is uitermate geschikt voor deze taak omdat het een hoge nauwkeurigheid bij objectdetectie combineert met een efficiënte generatie van regio-voorstellen, wat essentieel is voor het verwerken van complexe UI-lay-outs met dicht op elkaar geplaatste elementen. Het model maakt gebruik van een ResNet-50 backbone, vooraf getraind op de ImageNet-dataset, om convolutionele feature-maps uit elk UI-scherm te extraheren. Tijdens de training werden de vroege lagen bevroren om algemene visuele kenmerken te behouden, terwijl de hogere lagen (conv4_x en conv5_x) werden gefinetuned voor UI-specifieke componentdetectie. Deze feature-maps leggen visuele structuren, randen, texturen en componentgrenzen vast. Tijdens de detectie identificeert het region proposal network (RPN) kandidaatregio's (anchors) die waarschijnlijk UI-componenten bevatten. Anchors worden gedefinieerd met behulp van meerdere schalen (128, 256 en 512) en aspectratio's (1:1, 1:2 en 2:1) om UI-elementen van verschillende grootten te accommoderen. Tijdens de training worden anchors met een intersection-over-union (IoU) groter dan 0,7 met de ground-truth boxes als positief gelabeld, terwijl die met een IoU kleiner dan 0,3 als negatief worden gelabeld; anchors met tussenliggende IoU-waarden worden genegeerd. Aan elke anchor wordt een waarschijnlijkheid toegewezen die de aanwezigheid van een component aangeeft. Non-maximum suppression (NMS) wordt vervolgens toegepast om redundante en overlappende voorstellen te verwijderen, waardoor een efficiënte lokalisatie van betekenisvolle UI-elementen wordt gegarandeerd, zelfs in overvolle interfaces. Zodra de kandidaatregio's zijn gegenereerd, wordt elk voorstel geclassificeerd in vooraf gedefinieerde componentcategorieën en worden de coördinaten van de bounding-box verfijnd. Een region of interest (ROI) Align-operatie extraheert feature-representaties van vaste grootte voor elk voorstel, die vervolgens door fully connected layers worden verwerkt voor classificatie en regressie. De classificatiebranch geeft klaswaarschijnlijkheden uit, terwijl de regressiebranch nauwkeurige bounding-box-coördinaten voorspelt. Het volledige Faster R-CNN-model wordt end-to-end getraind door een gezamenlijke verliesfunctie te optimaliseren die het RPN-verlies combineert met het uiteindelijke detectieverlies. Hierdoor is het systeem in staat om UI-componenten niet alleen nauwkeurig te herkennen, maar deze ook precies te lokaliseren over diverse interface-structuren. Een gedetailleerde beschrijving van de Faster R-CNN-componentdetectie, inclusief de RPN-fase, ROI-classificatie, bounding-box-verfijning en het uiteindelijke optimalisatiedoel, wordt gegeven in Aanvullend Bestand 1.
Algoritme S1 biedt de gedetailleerde workflow voor componentdetectie en structurele extractie (Aanvullend Bestand 1). Het beschrijft het volledige proces van automatische UI-componentdetectie en structurele extractie uit een ruwe schermafbeelding. De invoerafbeelding wordt eerst voorbewerkt en door een CNN-backbone geleid om diepe visuele kenmerken te extraheren. Deze kenmerken worden door het RPN gebruikt om kandidaat-boundingboxen te genereren, die vervolgens via classificatie en regressie worden verfijnd. NMS verwijdert redundante detecties om een nauwkeurige lokalisatie te waarborgen. Na de detectie worden componenten gegroepeerd op basis van ruimtelijke nabijheid met behulp van density-based spatial clustering of applications with noise (DBSCAN). Deze clusteringstap maakt de constructie van een hiërarchische UI-boom mogelijk die ouder-kindrelaties en logische groeperingen tussen componenten vastlegt. Deze hiërarchische weergave vormt de basis voor de daaropvolgende lay-outanalyse en het UI-begrip. Figuur 2 illustreert het Faster R-CNN componentdetectieproces op een mobiel UI-scherm. De invoerinterface (links) bevat UI-elementen zoals knoppen en tekstblokken, die automatisch worden omsloten door boundingboxen. Deze gedetecteerde regio's worden vervolgens geclassificeerd in componentcategorieën (bijv. Button en Text), zoals aangegeven door gelabelde verbindingen. De Faster R-CNN detectiemodule (rechts) verfijnt de coördinaten van de boundingboxen, wijst semantische labels toe en geeft gestructureerde informatie op componentniveau uit. Deze stap dient als een kritische basis voor downstream-processen, waaronder lay-outextractie, cognitieve optimalisatie en de generatie van UI-prototypes, door nauwkeurige, semantisch betekenisvolle weergaven van UI-componenten te leveren.
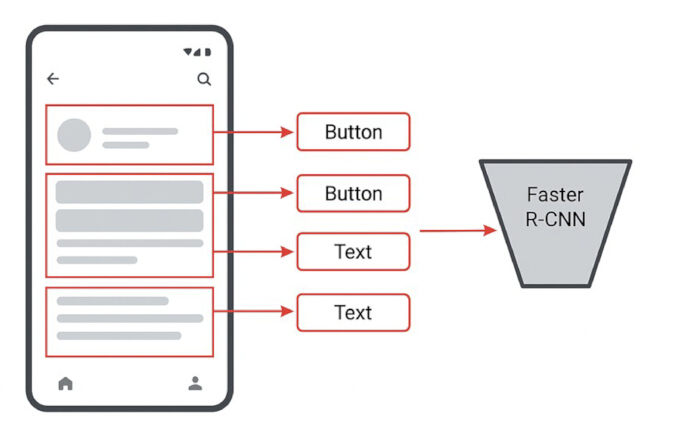
Figuur 2Componentdetectie van gebruikersinterface-elementen met behulp van Faster R-CNN. De figuur illustreert de detectie van UI-componenten van een screenshot van een invoerinterface. Regio's van belang worden geïdentificeerd met behulp van bounding boxes, en elementen zoals knoppen en tekstvelden worden geclassificeerd met Faster R-CNN. Pijlen geven de koppeling aan van gedetecteerde componenten naar hun bijbehorende semantische labels. Klik hier om een grotere versie van deze figuur te bekijken.
Extractie van lay-outpatronen en hiërarchische modellering
Na componentdetectie met behulp van Faster R-CNN wordt elk UI-element gerepresenteerd door een bounding box. Deze bounding boxes alleen geven echter niet aan hoe elementen structureel zijn georganiseerd binnen de interface, bijvoorbeeld welke elementen tot headers, navigatiebalken of gegroepeerde inhoudsregio's behoren. Om deze beperking aan te pakken, worden de gedetecteerde componenten getransformeerd in een logische UI-boom, waarbij elke component als een knoop wordt beschouwd en functioneel of visueel gerelateerde componenten worden gegroepeerd onder gemeenschappelijke parent-knopen. Om betekenisvolle lay-outgroepen te identificeren, worden clusteringstechnieken zoals DBSCAN of hiërarchische agglomeratieve clustering toegepast. Deze methoden analyseren ruimtelijke nabijheid en uitlijningspatronen tussen componenten om relaties tussen UI-elementen te detecteren. Op een wijze die analoog is aan menselijke ontwerppraktijken, leert het systeem veelvoorkomende structurele patronen te herkennen, zoals headers, footers, grids en inhoudsblokken. Zodra de groepering is vastgesteld, worden aanvullende structurele eigenschappen — waaronder uitlijning, gridorganisatie en leesvolgorde — geanalyseerd om een uitgebreide lay-outrepresentatie te construeren. Componenten die zijn uitgelijnd in kolommen van gelijke breedte kunnen bijvoorbeeld duiden op een kaartgebaseerde lay-out, terwijl verticaal gestapelde elementen kunnen duiden op een formulier- of feedgebaseerde interface. Door clustering, ruimtelijk redeneren en uitlijningsregels te integreren, construeert het framework een hiërarchische UI-boom die zowel visuele groepering als functionele relaties vastlegt. Deze hiërarchische representatie dient als basis voor de daaropvolgende verfijning van de lay-out en modellering van consistentie over meerdere schermen, waardoor het systeem in staat is om gestructureerde, coherente en gebruikersgerichte interface-ontwerpen te genereren.
Gedetailleerde formuleringen voor ruimtelijke afstand en uitlijningsgelijkenis zijn te vinden in Aanvullend Bestand 1.
Clustering voor lay-outgroepering (DBSCAN)
Om lay-outgroepen te identificeren, wordt DBSCAN toegepast. DBSCAN maakt gebruik van twee parameters: (1) ε = maximale afstand tussen naburige componenten en (2) = het minimum aantal componenten dat nodig is om een cluster te vormen. Voor deze analyse werden de DBSCAN-parameters empirisch geselecteerd op basis van de genormaliseerde UI-resolutie (480 × 80 pixels). De parameter voor de buurtafstand werd ingesteld op ε = 50 pixels om de ruimtelijke nabijheid tussen aangrenzende UI-componenten vast te leggen. Het minimum aantal punten dat nodig is om een cluster te vormen, werd ingesteld op MinPts = 3 om de vorming van insignificanten of schijnbare groepen UI-componenten te voorkomen.
De gedetailleerde formulering voor de constructie van de logische UI-boom is opgenomen in Aanvullend Bestand 1.
Perceptuele kleuremodellering met CAM02-UCS
Perceptuele kleuremodellering zorgt ervoor dat de kleuren die in de gegenereerde gebruikersinterface (UI) worden gebruikt, harmonieus, leesbaar en cognitief efficiënt zijn. Dominante kleuren worden geëxtraheerd uit invoerbronnen, zoals UI-afbeeldingen, met behulp van clusteringstechnieken. Specifiek wordt K-means clustering met K-means++ initialisatie toegepast gedurende 30 iteraties om representatieve kleurenpaletten te verkrijgen. De RGB-kleurruimte weerspiegelt echter de menselijke visuele waarneming niet nauwkeurig, wat betekent dat numeriek vergelijkbare kleuren perceptueel verschillend kunnen overkomen. Om deze beperking aan te pakken, worden alle geëxtraheerde kleuren getransformeerd naar CAM02-UCS, wat perceptueel uniform is. In deze ruimte komen gelijke afstanden overeen met gelijke waargenomen kleurverschillen, waardoor deze geschikt is voor het modelleren van kleurharmonie en contrast. Zodra ze zijn afgebeeld in CAM02-UCS, worden perceptuele kleurverschillen berekend met behulp van de Euclidische afstand, waardoor het systeem contrast, harmonie en variatie tussen kleuren kan kwantificeren. Kleuren die te veel op elkaar lijken worden gescheiden om de leesbaarheid te verbeteren, terwijl overmatig contrasterende kleuren worden gematigd om visueel ongemak te voorkomen. Het gegenereerde palet voldoet ook aan toegankelijkheidsnormen zoals WCAG AA en AAA, waardoor voldoende contrast tussen voorgrond- en achtergrondelementen wordt gegarandeerd. Bovendien wordt kleurharmonie afgedwongen door paletrelaties te beperken tot complementaire, analoge of triadische schema's, afhankelijk van het beoogde UI-thema. Dit zorgt ervoor dat het resulterende kleurenpalet niet alleen visueel aantrekkelijk is, maar ook functioneel toegankelijk en cognitief geoptimaliseerd. Om het palet verder te verfijnen, wordt een optimalisatieproces toegepast onder beperkingen van perceptuele gelijkenis, contrast, harmonie en merkconsistentie. Er wordt een primaire kleur geselecteerd (bijv. uit de merkidentiteit) en secundaire kleuren worden aangepast in termen van luminantie en chroma om de visuele hiërarchie te behouden. Een op regels gebaseerd evaluatiemechanisme beoordeelt kandidaatpaletten op basis van perceptuele afstanden en toegankelijkheidsmetrieken, waardoor de cognitieve belasting wordt geminimaliseerd terwijl de esthetische balans behouden blijft. Als resultaat produceert het raamwerk UI-kleurschema's die een coherentie, leesbaarheid en perceptuele consistentie op professioneel niveau vertonen.
Gedetailleerde wiskundige expressies voor perceptuele kleurmodellering op basis van CAM02-UCS worden verstrekt in Aanvullend Bestand 1.
Algoritme S2 (Aanvullend bestand 1) beschrijft de workflow voor perceptuele kleurextractie en optimalisatie op basis van CAM02-UCS onder harmonie- en toegankelijkheidsbeperkingen. In eerste instantie worden dominante kleuren uit de invoerafbeelding geëxtraheerd en getransformeerd naar CAM02-UCS om te garanderen dat kleurverschillen overeenkomen met de menselijke perceptie. De perceptuele afstanden tussen kleuren worden vervolgens berekend en beperkt binnen vooraf gedefinieerde grenzen om zowel helderheid als harmonie te behouden. Vervolgens wordt de toegankelijkheid afgedwongen door luminantiecontrastverhoudingen te evalueren volgens de WCAG-richtlijnen. Het uiteindelijke palet wordt verkregen door een gecombineerde doelfunctie te optimaliseren die een balans vindt tussen perceptuele spreiding, contrastvereisten en harmoniebeperkingen voor kleuren. Dit zorgt ervoor dat de gegenereerde UI-kleurschema's niet alleen visueel aantrekkelijk zijn, maar ook leesbaar, toegankelijk en perceptueel consistent.
Cognitieve ontwerpoptimalisatie
Cognitieve designoptimalisatie zorgt ervoor dat de automatisch gegenereerde UI-prototypes niet alleen visueel consistent zijn, maar ook gemakkelijk te begrijpen en te gebruiken. Deze module integreert belangrijke cognitieve ontwerpprincipes, waaronder de Gestaltprincipes, de wet van Fitts en de wet van Hick, om de schikking, groepering en spatiëring van UI-componenten te sturen. Gedetailleerde wiskundige formuleringen voor cognitieve designoptimalisatie worden verstrekt in Aanvullend Bestand 1.
Geïntegreerd doel voor cognitieve optimalisatie
De wiskundige expressie voor het geïntegreerde cognitieve optimalisatiedoel is opgenomen in Supplementary File 1. Coëfficiënten die het belang van visuele groepering, interactie-efficiëntie en beslissingscomplexiteit vertegenwoordigen, worden respectievelijk aangeduid met alpha, beta en gamma. In deze studie werden de waarden van alpha, beta en gamma empirisch bepaald met behulp van de validatiedataset. Voor het huidige experiment werden de coëfficiënten als volgt ingesteld: α = 0.5, β = 0.3 en γ = 0.2. Deze configuratie biedt een effectieve balans tussen visuele groepering, interactie-efficiëntie en beslissingssimpliciteit.
Consistentie over meerdere schermen en UI-generatie
Consistentie-modellering voor meerdere schermen zorgt ervoor dat verschillende schermen binnen een applicatie een coherente visuele identiteit, structurele lay-out en interactiepatronen delen. Terwijl gebruikers door schermen navigeren, ontwikkelen zij verwachtingen met betrekking tot de plaatsing van elementen, typografie, spatiëring en visuele hiërarchie. Om aan deze verwachtingen te voldoen, analyseert het systeem cross-screen patronen met behulp van sjablonen afgeleid van de RICO- en ENRICO-datasets. Deze sjablonen leggen veelvoorkomende UI-structuren vast, zoals home-detail lay-outs, lijst-detail patronen, meerstapsformulieren en dashboardflows. Door de plaatsing van componenten en het groeperingsgedrag te vergelijken, stelt het systeem een cross-screen structureel profiel op dat identificeert welke elementen consistent moeten blijven en welke mogen variëren. Zodra de structurele patronen zijn geïdentificeerd, dwingt het framework consistentie af in typografische schalen, spatiëringsverhoudingen, grid lay-outs en navigatieankers. Zo behouden headerbalken een consistente hoogte, behouden primaire knoppen een uniforme grootte en uitlijning, en volgen inhoudsblokken een voorspelbare visuele volgorde. Dit wordt bereikt via een proces van lay-outregularisatie dat elk scherm toetst aan globale structurele beperkingen. Als een scherm afwijkt van de aangeleerde sjablonen — zoals bij inconsistente padding of verkeerd uitgelijnde titels — past het systeem de lay-out automatisch aan om de coherentie te herstellen. Deze correcties helpen een naadloze UX te garanderen en verminderen de cognitieve schakelkosten tussen schermen. Het framework analyseert verder de navigatiegrafiek tussen schermen om consistentie in de interactiestroom te behouden. Veelvoorkomende navigatiepatronen, inclusief voorwaartse/achterwaartse overgangen, tabbladnavigatie en meerstapsworkflows, worden geïdentificeerd en afgedwongen. Elke overgang wordt gevalideerd om afstemming met het mentale model van de gebruiker te garanderen, waardoor de bruikbaarheid wordt verbeterd en verwarring wordt verminderd. Als gevolg hiervan minimaliseert het consistentiemodel voor meerdere schermen visuele ruis, vergroot het de vertrouwdheid en bevordert het een uniforme interactie-ervaring.
Gedetailleerde wiskundige formuleringen voor multiscreen-consistentie en UI-generatie zijn te vinden in Aanvullend bestand 1.
Ten slotte genereert de render-engine visuele outputs in formaten zoals SVG-wireframes, HTML/CSS-prototypes of pixelgebaseerde UI-mock-ups. De resulterende UI-schermen vertonen een correcte leesvolgorde, harmonieuze kleurrelaties, een precieze rasteruitlijning en een consistente visuele hiërarchie over meerdere schermen.
Algoritme S3 biedt de workflow voor de cognitieve-visuele lay-outoptimalisatie en multiscreen-consistentie (Aanvullend bestand 1). Algoritme S3 beschrijft het geïntegreerde cognitieve en structurele optimalisatieproces dat wordt gebruikt om gebruiksvriendelijke UI-lay-outs te genereren. Het combineert perceptuele groepering (Gestaltprincipes), interactie-efficiëntie (de wet van Fitts) en beslissingsmeting (de wet van Hick) binnen een uniform optimalisatiesysteem. Aanvankelijk worden de ruimtelijke relaties tussen componenten geëvalueerd om perceptuele groeperingen vast te stellen. Vervolgens wordt de interactie-efficiëntie geoptimaliseerd door de grootte en plaatsing van componenten aan te passen, terwijl de beslissingscomplexiteit wordt beheerst door het aantal keuzes dat aan gebruikers wordt gepresenteerd te beperken. Daarnaast dwingt het algoritme multiscreen-consistentie af door elk scherm af te stemmen op geleerde lay-outsjablonen, waardoor uniformiteit in typografie, spatiëring en structurele organisatie wordt gewaarborgd. Een multidoel-optimalisatiefunctie verfijnt vervolgens de lay-out door een balans te vinden tussen uitlijning, spatiëring en cognitieve kosten, wat resulteert in een interface die zowel visueel coherent als cognitief efficiënt is. In het algemeen zorgt dit algoritme ervoor dat gegenereerde multiscreen-lay-outs een hoog niveau van visuele consistentie, bruikbaarheid en perceptuele helderheid behouden.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Het voorgestelde geautomatiseerde UI-prototypingframework werd beoordeeld met behulp van een geïntegreerde dataset van 5.128 UI-schermen uit drie bronnen: 4.0 RICO-afbeeldingen, 1.00 ENRICO-schermen en 128 kleur-geannoteerde UI-monsters uit de UI Color Dataset van Guo. Deze gecombineerde dataset biedt een goed gebalanceerde benchmark voor het evalueren van de nauwkeurigheid van componentdetectie, de structurele helderheid van de lay-out, de consistentie over meerdere schermen en de perceptuele kleurharmonie.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
De resultaten tonen statistisch significante verbeteringen in bruikbaarheid, structurele organisatie en perceptuele kwaliteit (p < 0,05), waarmee de effectiviteit van het integreren van cognitieve ontwerpprincipes in geautomatiseerde UI-prototyping wordt bevestigd. In tegenstelling tot traditionele UI-generatiesystemen die primair vertrouwen op visuele detectie of regelgebaseerde heuristieken, integreert het voorgestelde framework Gestalt-groepering, hiërarchie-modellering, spatiëringsbeperkingen en perceptuele leesb...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs hebben geen belangenconflicten.
Dankbetuigingen
De auteurs erkennen de academische en institutionele ondersteuning verleend door het Wuhan College of Foreign Languages & Foreign Affairs, Keimyung University en het Shanghai Institute of Commerce and Foreign Languages tijdens de voltooiing van dit onderzoek.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| CPU (processor) | AMD Ryzen 9 7950X (16-core, 32-thread, 4.5–5.7 GHz) | Advanced Micro Devices (AMD), USA | Ryzen 9 7950X |
| CUDA Toolkit | Versie 11.8 | NVIDIA Corporation, USA | CUDA Toolkit 11.8 |
| cuDNN | Versie 8.9 | NVIDIA Corporation, USA | cuDNN v8.9 |
| Faster R-CNN | Model voor objectdetectie (met Region Proposal Network) | Meta AI Research / Detectron2 | Detectron2-framework |
| Matplotlib | Versie 3.7 | Matplotlib Development Team | v3.7.0 |
| NVIDIA RTX 4090 GPU | 24 GB GDDR6X videokaart | NVIDIA Corporation, Santa Clara, CA, USA | RTX 4090 |
| NumPy | Versie 1.24 | NumPy Developers | v1.24.0 |
| OpenCV | Versie 4.8 | OpenCV Foundation | v4.8.0 |
| PyTorch | Versie 2.0 | PyTorch Foundation (Meta AI) | v2.0.0 |
| ResNet-50 met FPN | Backbone CNN met Feature Pyramid Network | Microsoft Research / Detectron2 | ResNet-50-FPN |
| Scikit-learn | Versie 1.3 | Scikit-learn Developers | v1.3.0 |
| SciPy | Versie 1.10 | SciPy Community | v1.10.0 |
| Systeemgeheugen (RAM) | 64 GB DDR5 | Corsair / Kingston (of equivalent) | DDR5 64GB Kit |
| Besturingssysteem Ubuntu | Versie 22.04 LTS | Canonical Ltd., UK | Ubuntu 22.04 LTS |
Referenties
- Weingerl P. Automated image-based user interface color theme generation. Appl Sci. 2024;14:2850.
- Feng Z, Fang J, Cai B, Zhang Y. Guis2Code: Computer vision tool to generate code automatically from graphical user interface sketches. In: Proc Int Conf Artif Neural Netw; 2021; p. 53–65.
- Chen C, Zhang X, Yang Y, Li Y. GalleryDC: Design search knowledge discovery through auto-created GUI component gallery. Proc ACM Hum Comput Interact. 2019;3:1–22.
- Chen J, et al. Object detection for graphical user interface: Old-fashioned deep learning combination. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1202–1214.
- Xie M, et al. UIED: Hybrid tool for GUI element detection. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1655–1659.
- Gijsenij A, et al. Determining key colors from a design perspective using dE-means color clustering. Color Res Appl. 2023;48:69–87.
- Yuan LP, et al. InfoColorizer: Interactive recommendation of color palettes for infographics. IEEE Trans Vis Comput Graph. 2022;28:4252–4266.
- Cao Y, et al. Influences of color salience and location of website links on user performance and affective experience. Int J Hum Comput Interact. 2021;37:547–559.
- Liu W, Cao Y, Proctor RW. App icon color and border shape influence visual search efficiency and user experience. Int J Ind Ergon. 2021;84:103160.
- Yamin PAR, Park J, Kim HK, Hussain M. Effects of button colour and background on augmented reality interfaces. Behav Inf Technol. 2023;43:663–676.
- Deng L, Zhang ZR, Zhou FY, Liu RY. Effects of app icon border form and interface background color saturation. Adv Multimed. 2022;2022:1166656.
- Weingerl P, Hladnik A, Javoršek D. Machine learning model for extracting image prominent colors. Color Res Appl. 2020;45:409–426.
- Huang K, et al. WovenProbe: Probing possibilities for on-skin systems. In: Proc ACM Des Interact Syst Conf; 2021; p. 1193–1207.
- Dewez D, Guillemot C, Bailly G, Isenberg T. Dual body representations during an isomorphic 3D manipulation. IEEE Trans Vis Comput Graph. 2022;28:2047–2057.
- Kim J, Kim C, Nam KY. ThinkWrite: Design interventions for online petition deliberation. In: Proc CHI Conf Hum Factors Comput Syst Ext Abstr; 2022.
- Gao L, Wang Y, Müller S, Hudson SE. DataLev: Mid-air data physicalisation using acoustic levitation. In: Proc CHI Conf Hum Factors Comput Syst; 2023; p. 1–14.
- Khorsandi PM, Ogata M, Rekimoto J, Inami M. FabriCar: In-car media interactions using e-textile sensors. In: Proc ACM Des Interact Syst Conf; 2023; p. 764–776.
- Zhang Z, Ding Y, Huang C. Automatic front-end code generation via multi-head attention. In: Proc Int Conf Comput Eng Appl; 2023; p. 869–872.
- Jain V, et al. Sketch2code: Transformation of sketches to UI using deep neural network [preprint]. arXiv:1910.08930; 2019.
- Chai Y, et al. Dynamic prototype network for few-shot malware detection. IEEE Trans Knowl Data Eng. 2023;35:4754–4766.
- Qiu J, et al. AI security in 5G networks: Adversarial examples. IEEE Veh Technol Mag. 2020;15:95–100.
- Qiu J, et al. Automatic concept extraction from big data in smart city. IEEE Trans Comput Soc Syst. 2020;7:225–233.
- Xie M. UI2CODE: Computer vision-based reverse engineering of UI design [Internet]. GitHub; 2021. Available from: https://github.com
- Wang C, Bochkovskiy A, Liao HYM. CSPNet: Backbone enhancing learning capability of CNNs. In: Proc IEEE Conf Comput Vis Pattern Recognit Workshops; 2020; p. 1571–1580.
- Hui M, et al. Unifying layout generation with decoupled diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18434–18443.
- Wang Y, et al. Dolfin: Diffusion layout transformers without autoencoder. In: Proc Eur Conf Comput Vis; 2024; p. 513–530.
- Sobolevsky A, et al. GuiLGet: GUI layout generation with transformer [preprint]. arXiv:2304.09012; 2023.
- Lu Y, et al. UI layout generation with LLMs guided by UI grammar [preprint]. arXiv:2310.15455; 2023.
- Leiva LA, Hota A, Oulasvirta A. ENRICO: A dataset for mobile UI design modeling. In: Proc Int Conf Hum Comput Interact Mobile Devices Serv; 2020.
- Li G, et al. Learning to denoise mobile UI layouts. In: Proc CHI Conf Hum Factors Comput Syst; 2022; p. 1–15.
- Beltramelli T. pix2code: Generating code from a GUI screenshot. In: Proc ACM SIGCHI Symp Eng Interact Comput Syst; 2018.
- Zheng G, et al. LayoutDiffusion: Controllable diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18424–18433.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.