Deze studie evalueerde of interventies op het gebied van leefstijl en oncologische gynaecologische verpleegkunde de kwaliteit van leven verbeteren bij vrouwen met gynaecologische kankers. Een significante verbetering werd na 6 maanden alleen waargenomen in de subgroep met eierstokkanker, terwijl het algemene bewijs zeer onzeker bleef vanwege aanzienlijke heterogeniteit, kleine subgroepgroottes en methodologische beperkingen.
Onderzoeksartikel
Een meta-analyse van de impact van leefstijl- en gynaecologisch oncologisch verpleegkundige interventies op de verbetering van de kwaliteit van leven
* These authors contributed equally
In dit artikel
Samenvatting
Samenvatting
Deze meta-analyse evalueerde de impact van leefstijl- en gynaecologische oncologische verpleegkundige interventies op de kwaliteit van leven (QoL). Een systematische zoekactie die werd uitgevoerd tot juni 2026 identificeerde 1.123 records. Dertien gerandomiseerde gecontroleerde trials met 915 vrouwen met gynaecologische kanker werden geïncludeerd. De impact van leefstijl- en gynaecologische oncologische verpleegkundige interventies op de QoL werd geëvalueerd met behulp van gepoolde gemiddelde verschillen (MD's) met 95% betrouwbaarheidsintervallen, waarbij random-effects modellen werden gebruikt voor de algemene analyses en fixed-effect modellen voor de kankerspecifieke subgroepanalyses. Vergeleken met de controlegroep verbeterden interventies de QoL significant bij vrouwen met eierstokkanker (MD 4,28, 95% BI: 0,45–8,10, p = 0,03; I2 = 0%). Er ontstonden geen significante verschillen voor de QoL na 6 maanden bij gemengde kankers (MD 2,11, 95% BI: -0,90–5,12, p = 0,17; I2 = 71%), endometriumkanker na 6 maanden (MD 2,00, 95% BI: –1,49–5,49, p = 0,26; I2 = 0%) of gemengde kankers na 3 maanden (MD 6,43, 95% BI: –0,16–13,01, p = 0,06; I2 = 74%). Echter, uitgesproken heterogeniteit, uiteenlopende designs en interventies, kleine steekproefgroottes en een variabel risico op bias beperken de zekerheid van de bevindingen, wat een voorzichtige interpretatie en bevestiging via robuuste, gestandaardiseerde trials rechtvaardigt. Leefstijl- en gynaecologische oncologische verpleegkundige interventies verbeterden de QoL significant alleen bij vrouwen met eierstokkanker na 6 maanden. Desalniettemin rechtvaardigen aanzienlijke heterogeniteit, methodologische beperkingen en bewijsmateriaal met een zeer lage zekerheid een voorzichtige interpretatie, en zijn grotere gestandaardiseerde trials noodzakelijk.
Inleiding
Kanker die ontstaat in de vrouwelijke voortplantingsorganen wordt gynaecologische kanker genoemd. Gynaecologische kankers, waaronder maligniteiten van de cervix, eierstokken, baarmoeder, vagina en vulva, blijven een aanzienlijk probleem voor de volksgezondheid en treffen wereldwijd miljoenen vrouwen1. Deze tumoren zijn niet alleen fysiek verwoestend, maar veroorzaken ook aanzienlijke emotionele en psychologische distress. Ondanks vorderingen in de behandeling neemt de wereldwijde frequentie van deze tumoren toe, en de algemene prognose blijft ongunstig in verschillende regio's, met name daar waar de toegang tot gezondheidszorg beperkt is. Studies naar verpleegkundige zorg in de gynaecologische oncologie onderstrepen de noodzaak van uitgebreide, interdisciplinaire strategieën bij het patiëntenbeheer, gezien de aanzienlijke impact van deze maligniteiten op de kwaliteit van leven van vrouwen2. Omgekeerd gaan succesvolle verpleegkundige interventies verder dan het beheersen van fysieke symptomen zoals pijn en misselijkheid; ze omvatten ook emotionele ondersteuning, psychologische begeleiding, patiëntenvoorlichting en uitgebreid symptoombeheer. Deze interventies zijn cruciaal voor het verbeteren van patiëntuitkomsten, het helpen van vrouwen bij het navigeren door de complexiteit van behandelprotocollen en het waarborgen van holistische zorg.
De rol van verpleegkundige interventies in de kwaliteit van leven rechtvaardigt verder onderzoek, in het bijzonder naar hoe verschillende facetten van de verpleegkundige zorg de fysieke, emotionele en psychologische welzijn beïnvloeden binnen diverse patiëntenpopulaties3. Effectieve verpleegkundige zorg voor kankerpatiënten kan hun algemene welzijn verbeteren. Gynaecologisch-oncologische verpleegkundige zorg is een gespecialiseerd verpleegkundig vakgebied dat gericht is op het bieden van uitgebreide ondersteuning aan vrouwen met een diagnose van gynaecologische kanker. Gynaecologische kanker omvat granulosaceltumoren, melanoom van het geslachtskanaal, baarmoederhalskanker die geschikt is voor fertiliteitsbehoudende chirurgie en endometriumkanker4. De prevalentie van baarmoederhalskanker is in heel Europa afgenomen; het blijft echter een aanzienlijke uitdaging voor de volksgezondheid. Dit wordt benadrukt door statistieken uit 2018, die 61.000 nieuwe gevallen en 25.800 sterfgevallen aangeven. Overlevingsresultaten tonen regionale ongelijkheden aan, met een relatieve vijfjaarsoverleving van 62% tussen 2000 en 2007, variërend van 57% in Oost-Europa tot 67% in Noord-Europa.
Baarmoederhalskanker blijft een groot wereldwijd gezondheidsprobleem, ondanks de vooruitgang in preventie en behandeling. Deze ongelijkheden benadrukken de noodzaak van gerichte verpleegkundige interventies om de resultaten voor patiënten te verbeteren en zorgongelijkheden in verschillende omgevingen aan te pakken. Andere gynaecologische maligniteiten, zoals tumoren in de eierstokken, de baarmoeder en de vulva, vormen aanzienlijke gezondheidsuitdagingen. Eierstokkanker is wereldwijd de belangrijkste oorzaak van sterfte door gynaecologische kanker, met meer dan 300.000 nieuwe gevallen en 185.000 sterfgevallen per jaar. De overlevingstijden bij maligniteiten van de eierstokken en de baarmoeder zijn doorgaans hoger dan die bij baarmoederhalskanker; desondanks blijven er aanzienlijke verschillen bestaan tussen landen en regio's. Net als bij baarmoederhalskanker worden deze verschillen beïnvloed door de toegankelijkheid van de gezondheidszorg, methoden voor vroege detectie en behandelingsopties. Gerichte verpleegkundige interventies zijn essentieel voor deze kankersoorten om de uitkomsten te verbeteren en de kwaliteit van leven voor vrouwen wereldwijd te verhogen5.
Verpleegkundigen in de gynaecologische oncologie bieden holistische, patiëntgerichte zorg die verder gaat dan emotionele steun. Naast het bieden van emotionele steun faciliteren zij de behandelplanning, treden zij op als belangenbehartiger voor de behoeften van patiënten en begeleiden zij hen door het therapieproces. Effectieve therapieën omvatten symptoombestrijding, waaronder pijnverlichting, vermindering van vermoeidheid en controle van misselijkheid, psychologische therapie en educatieve programma's voor patiënten die zowel de emotionele als de fysieke uitkomsten verbeteren6. Multidisciplinaire behandelstrategieën die psychologische ondersteuning combineren met fysiotherapie zijn bijzonder effectief gebleken bij het verbeteren van de kwaliteit van leven. Bijgevolg zijn verpleegkundigen in de gynaecologische oncologie essentieel voor symptoombestrijding, patiënteneducatie en een integrale behandeling, waardoor de patiëntenuitkomsten worden verbeterd6. Deze gespecialiseerde verpleegkundige zorg omvat het toedienen van chemotherapie, het bewaken en interpreteren van vitale functies, het analyseren van behandelreacties en het bieden van uitgebreide ondersteuning, waarvoor allen specifieke training en vaardigheden in de oncologische verpleegkunde vereisen7.
Verpleegkundige zorg verbetert het welzijn van individuen aanzienlijk in diverse zorgomgevingen. Ziekenhuizen bieden behandeling, monitoren de toestand van patiënten en werken samen met het medische team. Verpleegkundigen in thuiszorgcentra bieden continue ondersteuning, houden toezicht op chronische ziekten en helpen patiënten bij het behouden van hun zelfstandigheid8. Kwaliteit van leven omvat fysiek, mentaal, emotioneel en sociaal welzijn. Verpleegkundige zorg is essentieel voor het verbeteren van deze facetten door middel van specifieke interventies. Continue zorg voor patiënten met chronische ziekten omvat het monitoren van vitale functies, het toedienen van medicatie en instructies in zelfmanagementtechnieken8. Deze verpleegkundige interventies beheren chronische ziekten effectief, waardoor symptomen worden verminderd en de fysieke gezondheid verbetert, wat leidt tot een hogere algehele kwaliteit van leven.
Gynaecologische kankers vormen een aanzienlijk volksgezondheidsprobleem voor vrouwen wereldwijd, met meer dan 1 miljoen diagnoses per jaar, wat leidt tot aanzienlijke fysieke beperkingen en psychosociale stoornissen, waardoor de kwaliteit van leven afneemt9. Onderzoek wijst uit dat maar liefst 40% van de vrouwen die gediagnosticeerd zijn met gynaecologische kankers aanzienlijk mentaal lijden, terwijl 60% melding maakt van een verslechtering van de gezondheidsgerelateerde kwaliteit van leven tijdens de behandeling (Global Cancer Statistics and Reports)10. Smits et al. vonden geen significante effecten van vergelijkbare behandelingen, wat het belang van de betrokkenheid van deelnemers en de kwaliteit van de implementatie bij het bepalen van de uitkomsten onderstreept11. De studie benadrukt de cruciale rol van verpleegkundigen bij ziektepreventie, het bevorderen van gezonde levensstijlen en het adresseren van de fysieke en emotionele behoeften van patiënten.
De huidige studie probeert via een systematische review en meta-analyse de effecten van leefstijlinterventies en gynaecologische oncologische verpleegkundige zorg op het verbeteren van de kwaliteit van leven van vrouwen met gynaecologische maligniteiten te beoordelen. De studie beoogt de impact van specifieke leefstijlinterventies en gynaecologische oncologische verpleegkundige zorg op essentiële aspecten van de kwaliteit van leven te evalueren, waaronder het fysieke, emotionele en sociale welzijn. Door zich te richten op gestandaardiseerde metingen van de kwaliteit van leven en expliciet gespecificeerde interventiestrategieën worden praktische gegevens geleverd over de effectiviteit van deze methoden. Deze studie onderzoekt specifiek de effecten op korte termijn (binnen zes maanden) van intensieve psychologische verpleegkundige zorg op het emotionele en sociale welzijn. Deze gerichte methodologie biedt een uitgebreide analyse van de impact van specifieke interventies op de uitkomsten van de kwaliteit van leven en levert bewijsmateriaal om gepersonaliseerde zorgstrategieën te onderbouwen.
Eerdere systematische reviews, waaronder die van Smits et al.11, evalueerden primair leefstijlinterventies bij vrouwen met endometrium- en eierstokkanker en bevatten relatief weinig studies. Sindsdien is er aanvullend bewijs beschikbaar gekomen, en er is nog geen systematische review waarin zowel leefstijlinterventies als verpleegkundige zorg in de gynaecologische oncologie uitgebreid zijn geëvalueerd over een breder scala aan gynaecologische maligniteiten. Daarom was het doel van deze systematische review en meta-analyse om het huidige bewijs met betrekking tot de effecten van deze interventies op de kwaliteit van leven te synthetiseren.
Protocol
Inclusiecriteria
Studies waren in aanmerking gekomen indien zij voldeden aan al de volgende criteria: (1) inclusie van vrouwen met een gynaecologische maligniteit; (2) evaluatie van een gedefinieerde leefstijlinterventie of een door verpleegkundigen geleide interventie; (3) rapportage van kwantitatieve gegevens over de kwaliteit van leven; en (4) het betreffen van ofwel vergelijkende studies (interventie versus controle) of observationele trajectstudies die relevante beschrijvende gegevens over de kwaliteit van leven verschaften (5) gepubliceerd waren in Nederlands. . Voor de kwantitatieve meta-analyse van interventie versus controle was een gelijktijdige vergelijkingsgroep vereist12Twee studies zonder comparator werden uitsluitend behouden voor narratieve synthese.13Er zijn geen geografische beperkingen toegepast.
Informatiebronnen
Het volledige proces voor de selectie van studies wordt in Figuur 1 weergegeven als een PRISMA-stroomschema. Er is gezocht in The Cochrane Library, Embase, Google Scholar, OVID en PubMed vanaf de start van de databases tot en met juni 2026. De opgehaalde records werden geïmporteerd in EndNote 20, waarna dubbele records werden verwijderd. Twee reviewers hebben onafhankelijk de titels en abstracts gescreend, gevolgd door een beoordeling van de volledige tekst van potentieel geschikte studies. Meningsverschillen werden via overleg opgelost. In overeenstemming met de vooraf vastgestelde geschiktheidscriteria werden alleen Engelstalige publicaties meegenomen voor inclusie.
Zoekstrategie
De zoekstrategie werd ontwikkeld met behulp van het PICOS-kader: Populatie—vrouwen met gynaecologische oncologie; Interventie—leefstijl- of verpleegkundige interventies; Vergelijking—gebruikelijke zorg of alternatieve interventies; Uitkomst—levenskwaliteit; Studieontwerp—geen beperkingen14. Een uitgebreide set trefwoorden en termen uit gecontroleerde vocabulaires werd in alle databanken gebruikt; de gedetailleerde zoekstrings voor elke databank zijn opgenomen in Tabel 113.
Selectieproces
Na het ophalen van de volledige teksten hebben twee reviewers onafhankelijk geverifieerd of elk rapport aan alle geschiktheidscriteria voldeed. Daarnaast hebben zij auteurslijsten, studienamen (bijv. SUCCEED, WALC, BENITA, TOPCAT‑G), wervingsperioden en studiecentra gecontroleerd om overlappende patiëntencohorten te identificeren. Potentieel overlappende patiëntencohorten werden geïdentificeerd en gedocumenteerd. Wanneer overlappende rapporten bijdroegen aan de primaire analyse, werd hun invloed geëvalueerd in een vooraf gespecificeerde sensitiviteitsanalyse waarbij de overlappende dataset werd uitgesloten.
Data-extractie en uitkomstmaten
Twee beoordelaars extraheerden onafhankelijk gegevens uit alle 15 geïncludeerde rapporten met behulp van een gestandaardiseerd, beproefd formulier voor gegevensextractie. Onenigheden werden bij consensus met de corresponderende auteur opgelost. Voor elke studie werd de volgende informatie geregistreerd: eerste auteur, publicatiejaar, land, onderzoeksopzet, kankertype, beschrijving van de interventie, beschrijving van de comparator, steekproefomvang per groep, leeftijd van de deelnemers en ziektestadium, instrument voor kwaliteit van leven (QoL), beoordeelde tijdstippen en alle numerieke QoL-gegevens (gemiddelden, spreidingsmaten en steekproefomvangen per arm)15.
Kwantitatieve pooling (13 vergelijkende studies)
Voor de meta-analyse van interventie versus controle werden de definitieve scores na interventie (gemiddelden en standaarddeviaties) geëxtraheerd op de vooraf vastgestelde tijdstippen (3 en 6 maanden) voor beide groepen. Wanneer een studie zowel definitieve scores als veranderscores rapporteerde, werden alleen de definitieve scores geëxtraheerd16. De methodologische aanpak voor de meta-analyse en de beoordeling van de studiekwaliteit volgde de vastgestelde Cochrane-richtlijnen17. Bij de keuze van het meta-analytische model werd rekening gehouden met de verwachte klinische en methodologische heterogeniteit tussen de studies18, en statistische heterogeniteit werd gekwantificeerd met behulp van de I2-statistiek zoals beschreven door Higgins et al.19. De 13 vergelijkende studies die zijn opgenomen in de kwantitatieve synthese worden samengevat in Tabel 220,21,22,23,24,25,26,27,28,29,30,31,32.
Uitkomstmaten voor kwaliteit van leven, uitlijning en effectmetriek
Het specifieke QoL-instrument dat in elke studie werd gebruikt, is genoteerd. De geïdentificeerde schalen waren onder meer de Functional Assessment of Cancer Therapy – General (FACT‑G), FACT‑Ovarian (FACT‑O), FACT‑Endometrial (FACT‑En), de European Organization for Research and Treatment of Cancer Quality of Life Questionnaire Core 30 (EORTC QLQ‑C30), de Short Form‑36 (SF‑36) en conditiespecifieke schalen. Voor alle instrumenten duidden hogere scores op een betere kwaliteit van leven, en er waren geen instrumenten met omgekeerde scoring opgenomen. Alle geëxtraheerde QoL-gegevens waren daarom afgestemd op dezelfde metriek, waarbij een positief gemiddeld verschil (MD) consistent in het voordeel van de interventiegroep was.
Voor de primaire meta-analyse werden de definitieve scores na de interventie geëxtraheerd in plaats van de scores ten opzichte van de nulmeting. Deze beslissing was gebaseerd op: (i) niet alle studies rapporteerden veranderingsscores of hun standaarddeviaties; (ii) definitieve scores weerspiegelen de absolute QoL-status na de behandeling, wat klinisch relevant is; en (iii) het gebruik van definitieve scores maximaliseerde het aantal studies dat gepoold kon worden. Wanneer een studie meerdere QoL-subschalen rapporteerde, kreeg de globale QoL-score of de totale FACT-G-score prioriteit als primaire uitkomstmaat; indien deze niet beschikbaar waren, werd de subschaal voor fysiek functioneren gebruikt, waarbij deze afwijking expliciet in een voetnoot bij Tabel 2 is vermeld.
Het ruwe MD werd gebruikt als maat voor het effect in plaats van het gestandaardiseerde gemiddelde verschil (SMD), omdat alle opgenomen instrumenten zijn gevalideerd om hetzelfde onderliggende construct—gezondheidsgerelateerde kwaliteit van leven—te meten op conceptueel vergelijkbare schalen (totale scores variëren van 0–100 of 0–148). Het MD is direct interpreteerbaar in de oorspronkelijke eenheden van deze schalen en is klinisch relevanter dan een SMD uitgedrukt in standaarddeviatie-eenheden. Gecorrigeerde schattingen (bijv. via ANCOVA-gecorrigeerde gemiddelden) werden niet gebruikt omdat de correctiecovariabelen sterk varieerden tussen de studies, wat de vergelijkbaarheid in gevaar zou brengen.
Conversies van de standaarddeviatie
Wanneer studies standaardfouten (SE's) of 95% betrouwbaarheidsintervallen rapporteerden in plaats van standaarddeviaties, werden deze omgezet naar SD's met behulp van standaardformules: SD = SE × √n voor SE's, en SD = √n × (bovenste CI – onderste CI) / (2 × 1.96) voor 95% CI's. Voor studies die medianen met interkwartielafstanden (IQR) presenteerden, werden gemiddelden of SD's niet geïmputeerd; dergelijke gegevens werden narratief geëxtraheerd en werden niet meegenomen in de gepoolde MD-berekeningen. Voor de 13 studies die bijdroegen aan de kwantitatieve synthese was dergelijke imputatie niet nodig.
Omgang met ontbrekende gegevens
Intention-to-treat (ITT)-schattingen werden bij voorkeur geëxtraheerd wanneer deze expliciet werden gerapporteerd, aangezien zij de meest conservatieve en onbevooroordeelde schatting van het behandelingseffect bieden. Wanneer ITT-gegevens niet beschikbaar waren, werden per-protocolgegevens of complete-case-gegevens geëxtraheerd zoals gerapporteerd door de oorspronkelijke auteurs. Ontbrekende gemiddelden, SD's of uitkomstwaarden werden niet geïmputeerd; het ontbreken van gegevens werd voor elke studie geregistreerd en meegewogen in de sensitiviteitsanalyse. Studies met niet-gerapporteerde SD's voor belangrijke tijdstippen werden genoteerd, en de corresponderende auteurs werden per e-mail benaderd om de ontbrekende statistieken op te vragen. Indien er binnen twee weken geen reactie werd ontvangen, werden de meest conservatieve beschikbare gegevens gebruikt (bijv. de gepoolde baseline SD als de SD na interventie ontbrak) of werd het specifieke tijdstip uitgesloten van pooling.
Meerdere interventiegroepen en gedeelde controles
Geen van de opgenomen studies presenteerde meer dan één actieve lifestyle- of verpleegkundige interventiegroep vergeleken met één gedeelde controlegroep, wat het splitsen van de controlegroep voor analyse zou hebben vereist. In de enige studie met een factorieel ontwerp (McCloy et al.30) werden gegevens geëxtraheerd uit de gecombineerde oefenings- en mindfulnessgroep en de controlegroep met gebruikelijke zorg om het poolen te vereenvoudigen en dubbeltellingen te voorkomen. Voor de overlappende SUCCEED-trialcohorten (Von Gruenigen et al.21 en McCarroll et al.23) werden beide rapporten in de extractietabel behouden. Voor de primaire meta-analyse werden beide datasets opgenomen (aangezien zij de QoL op hetzelfde tijdstip rapporteerden). In een vooraf gespecificeerde sensitiviteitsanalyse werd het laatste rapport uitgesloten om de impact van cohortduplicatie op de gepoolde schatting te beoordelen; de resultaten hiervan worden in de tekst gerapporteerd.
Niet-comparatieve observationele studies
Voor twee rapporten (Budisan et al.33 en Betea et al.34), waarbij een gelijktijdige controlegroep ontbrak, werden er geen vergelijkende gegevens tussen interventie en controle geëxtraheerd (d.w.z. er kon geen MD worden berekend). In plaats daarvan werden beschrijvende gegevens over het verloop van de QoL geëxtraheerd (binnen-groepsveranderingen over tijd) en narratief gepresenteerd in de tekst en in Tabel 2. Deze werden niet opgenomen in een forest plot of gepoolde kwantitatieve synthese.
Beoordeling van het risico op bias
Potentiële publicatiebias en andere effecten van kleine studies werden beoordeeld met behulp van zowel visuele inspectie van funnel plots als de lineaire regressietest van Egger (waarbij het gestandaardiseerde interventie-effect wordt geregreerd op de precisie ervan). Omdat de test van Egger een beperkte statistische kracht heeft wanneer het aantal studies klein is (over het algemeen <10), waren funnel plots en Egger-testen vooraf gespecificeerd en zouden deze alleen worden uitgevoerd voor meta-analyses bestaande uit 10 of meer studies. Voor uitkomsten met minder dan 10 bijdragende studies worden funnel plots en Egger p-waarden niet gerapporteerd, aangezien dergelijke testen onvoldoende kracht hebben en misleidende resultaten kunnen opleveren17.
Twee beoordelaars hebben onafhankelijk de methodologische kwaliteit van de 15 opgenomen rapporten beoordeeld, en onenigheden werden via overleg met de corresponderende auteurs opgelost. Omdat de opgenomen studies zowel bestonden uit gerandomiseerde gecontroleerde trials (RCT's; n = 13) als niet-gerandomiseerde observationele cohortstudies (n = 2; Budisan et al.33; Betea et al.34), zijn ontwerp specifieke instrumenten toegepast.
Voor RCT's (13 studies) werd de Cochrane RoB 2.0 tool gebruikt (herziene versie), waarbij elke studie werd geëvalueerd op vijf domeinen17: (1) Randomisatieproces -- sequentiegeneratie en toewijzingsverhulling; (2) Afwijkingen van de beoogde interventies -- blindering van deelnemers en personeel, en of de analyse intention‑to‑treat was; (3) Ontbrekende uitkomstgegevens -- volledigheid van de follow-up en de omgang met uitvallers; (4) Meting van de uitkomst -- blindering van de beoordelaars van de uitkomsten (met name relevant voor zelfgerapporteerde QoL, waarbij blindering minder haalbaar is maar toch in overweging wordt genomen); (5) Selectie van het gerapporteerde resultaat -- risico op selectieve rapportage van uitkomsten (gecontroleerd aan de hand van trial-registers of gepubliceerde protocollen indien beschikbaar).
Elk domein werd beoordeeld als laag risico, enkele zorgen of hoog risico. Vervolgens werd voor elke studie een algemeen oordeel over het risico op bias (risk-of-bias) toegewezen: laag (alle domeinen laag), enkele zorgen (één of meer domeinen met enkele zorgen) of hoog (elk domein beoordeeld als hoog risico of meerdere domeinen met enkele zorgen). Voor zelfgerapporteerde uitkomsten, zoals de kwaliteit van leven, is het blinderen van deelnemers vaak onhaalbaar; een oordeel van hoog risico werd daarom niet automatisch toegewezen bij het ontbreken van blindering van deelnemers. In plaats daarvan werd het gebrek aan blindering expliciet genoteerd als een potentiële bron van performance bias in de beoordeling van domein 2.
Voor niet-gerandomiseerde observationele cohortstudies (2 studies) hanteerden Budisan et al.33 en Betea et al.34 geen gelijktijdige vergelijkingsgroep, waardoor zij niet werden meegenomen in de kwantitatieve meta-analyse. Voor deze studies werd de Newcastle-Ottawa Scale (NOS) gebruikt, aangepast voor cohortstudies, om de selectie, vergelijkbaarheid (niet van toepassing vanwege het ontbreken van een vergelijker) en uitkomstvaststelling te beoordelen. Omdat zij echter geen controlegroep hadden, werden zij beschouwd als zijnde onder een hoog risico op confounding en selectiebias bij elke causale gevolgtrekking. Zij zijn uitsluitend voor beschrijvende doeleinden behouden; hun risicoprofielen voor bias hebben geen invloed op de gepoolde effectschattingen, maar zijn gedocumenteerd in Tabel 2.
Samenvatting van het risico op bias
Er is een samenvattende figuur van het risico op bias (traffic-light plot) gemaakt, waarin de beoordelingen op domeinniveau voor elke RCT worden weergegeven. Kort samengevat waren de meest voorkomende zorgen over de RCT's: (i) gebrek aan blindering van deelnemers en personeel voor leefstijlinterventies (domein 2 – enkele zorgen/hoog risico in 9 van de 13 studies), en (ii) incomplete uitkomstgegevens als gevolg van uitval (domein 3 – enkele zorgen in 4 studies). Geen enkele studie werd als laag risico beoordeeld over alle domeinen; de meerderheid (8/13) vertoonde enkele zorgen, en 5/13 werden beoordeeld als hoog risico over het geheel genomen, voornamelijk vanwege het gebrek aan blindering en kleine steekproefgroottes die leidden tot imprecisie.
Zekerheid van het bewijs (GRADE)
De algemene zekerheid van het bewijsmateriaal werd voor elke gepoolde uitkomst beoordeeld met behulp van de Grading of Recommendations Assessment, Development and Evaluation (GRADE)-raamwerk, conform het GRADE-handboek en met gebruik van de GRADEpro GDT-software. De zekerheid werd beoordeeld als hoog, matig, laag, of zeer laag over vijf domeinen: risico op bias, inconsistentie, indirectheid, imprecisie en publicatiebias. De beoordeelde uitkomsten omvatten (1) QoL na 6 maanden – algemene gynaecologische oncologie (gepoolde MD uit 9 vergelijkende studies); (2) QoL na 6 maanden – eierstokkanker (gepoolde MD uit 2 vergelijkende studies); (3) QoL na 6 maanden – endometriumcarcinoom (gepoold gemiddeld verschil uit 4 vergelijkende studies, inclusief overlappende SUCCEED-cohorten); (4) kwaliteit van leven na 3 maanden – algemene gynaecologische oncologie (gepoolde MD uit 6 vergelijkende studies).
Effectmaat en meta-analysemodel
Random-effects inverse-variance modellen werden gebruikt voor de algemene analyses van 6 maanden en 3 maanden, omdat er aanzienlijke klinische en methodologische heterogeniteit tussen de studies werd verwacht, waaronder verschillen in kankertypen, interventiecomponenten, intensiteit, duur en controlecondities18. Fixed-effect inverse-variance modellen werden gebruikt voor de subgroepanalyses van eierstok- en endometriumkanker, waarbij geen statistische heterogeniteit werd waargenomen (I2 = 0%). Heterogeniteit werd beoordeeld met behulp van de I2 statistiek19.
Heterogeniteit werd gekwantificeerd met behulp van de I2-statistiek, waarbij drempelwaarden van 25%, 50% en 75% respectievelijk stonden voor lage, matige en hoge heterogeniteit. Naast I2 werd τ2 gerapporteerd voor random-effects-analyses om de absolute grootte van de variantie tussen studies te kwantificeren. Alle analyses werden uitgevoerd met de meta en metafor packages in R (versie 4.3.1).
Rechtvaardiging voor het poolen ondanks aanzienlijke heterogeniteit en de omgang met heterogeniteit
Voor de primaire analyse van 6 maanden gaf I2 = 71% een aanzienlijke heterogeniteit aan. Pooling werd als passend beschouwd onder het random-effects model om de volgende redenen: (i) de gepoolde schatting vertegenwoordigt het gemiddelde effect over een reeks interventies en populaties, wat een legitieme samenvattende vraag is; (ii) het random-effects model incorporeert expliciet de variantie tussen studies (τ2) in de standaardfout, waardoor het risico op foutief smalle betrouwbaarheidsintervallen wordt verminderd; (iii) vooraf gespecificeerde subgroepanalyses werden uitgevoerd per kankertype (ovarium, endometrium) om klinische bronnen van heterogeniteit te verklaren; (iv) invloeds- en sensitiviteitsanalyses werden uitgevoerd om de robuustheid van de gepoolde schatting te beoordelen.
De beslissing om studies te poolen ondanks aanzienlijke statistische heterogeniteit werd geleid door de volgende principes: interpretatie van I2 — I2-waarden van 25%, 50% en 75% waren vooraf vastgesteld om respectievelijk lage, matige en hoge heterogeniteit te vertegenwoordigen. Een I2 die 75% overschrijdt, duidt op aanzienlijke heterogeniteit, wat pooling ongepast kan maken als de heterogeniteit niet zinvol kan worden verklaard door klinische of methodologische factoren. Voor de primaire algemene analyse over 6 maanden (I2 = 71%) waren subgroepanalyses per kankertype (ovarium, endometrium) vooraf vastgesteld om klinische bronnen van heterogeniteit te onderzoeken. Subgroepering reduceerde I2 aanzienlijk tot 0% in zowel de ovarium- als de endometriumsubgroepen, wat suggereert dat een groot deel van de totale heterogeniteit toewijsbaar is aan verschillen in kankertype en de daarmee geassocieerde interventiedoelen. Omdat deze subgroepen echter zeer weinig studies bevatten, kan er niet betrouwbaar worden geconcludeerd dat de heterogeniteit volledig is verklaard.
Het voortzetten van het poolen werd gerechtvaardigd geacht voor de algemene analyse over 6 maanden omdat: (i) het een samenvattend gemiddeld effect biedt over een breed scala aan interventies, wat een legitieme meta-analytische vraag is; (ii) τ2 expliciet wordt gerapporteerd om de variantie tussen studies te kwantificeren; (iii) invloedsanalyses zijn uitgevoerd om te controleren op resultaten die door uitschieters worden gedreven; en (iv) de gepoolde schatting niet wordt beschouwd als definitief of klinisch toepasbaar — deze wordt geïnterpreteerd als hypothese-genererend en wordt in de discussie voorzien van zware kanttekeningen.
In overeenstemming met het Cochrane Handbook, wanneer ik2 overschrijdt de 75% en subgroepanalyses de heterogeniteit niet overtuigend verklaren, moeten de gepoolde schattingen met uiterste voorzichtigheid worden geïnterpreteerd. Gezien het geringe aantal studies in de subgroepen kan er niet met zekerheid worden gesteld dat de heterogeniteit volledig is verklaard. Daarom wordt de primaire gepoolde schatting hoofdzakelijk gepresenteerd voor beschrijvende en verkennende doeleinden en vormt deze geen basis voor klinische aanbevelingen. Alle heterogeniteitsstatistieken (I2, τ2) en sensitiviteitsanalyses worden transparant gerapporteerd, zodat lezers de stabiliteit van de schattingen zelf kunnen beoordelen.
Subgroep-, sensitiviteits- en invloedsanalyses
Om bronnen van heterogeniteit te onderzoeken, werden de volgende vooraf gespecificeerde analyses uitgevoerd, zonder meta-regressie uit te voeren: 1) Voor subgroepanalyses werd de algemene uitkomst na 6 maanden gestratificeerd naar kankertype (ovarium, endometrium) om te onderzoeken of het effect verschilde per tumorgelokaliseerde plaats; 2) Sensitiviteitsanalyse (overlappende cohorten): Om de impact van de overlappende SUCCEED-trialcohorten te beoordelen (Von Gruenigen et al.21 en McCarroll et al.23), werd de subgroepanalyse voor endometrium herhaald met uitsluiting van McCarroll et al.23. 3) Leave-one-out invloedsanalyse: Elke studie werd sequentieel verwijderd, waarna het gepoolde MD en de I2 werden herberekend voor de algemene uitkomst na 6 maanden om vast te stellen of een enkele studie onevenredig de resultaten of de heterogeniteit beïnvloedde; 4) Vergelijking met fixed-effect model: Voor de volledigheid werden gepoolde schattingen ook berekend onder een fixed-effect model (inverse-variantie weging) om deze te vergelijken met de random-effects resultaten; elke substantiële discrepantie zou erop wijzen dat heterogeniteit tussen studies de schatting significant beïnvloedt.
Meta-regressie werd niet uitgevoerd om continue covariabelen (bijv. leeftijd, baseline QoL, duur van de interventie) te onderzoeken, omdat het aantal studies per subgroep (≤9 voor de algemene uitkomst na 6 maanden) onvoldoende is om betrouwbare regressiecoëfficiënten op te leveren. Bij <10 studies per covariabele is meta-regressie sterk onderpowered en gevoelig voor type I-fouten, en de beschikbare gegevens over covariabelen werden inconsistent gerapporteerd in de verschillende studies.
Publicatiebias
Geen van de gepoolde resultaten omvatte 10 of meer studies. Daarom zijn er geen funnel plots en regressietoetsen van Egger uitgevoerd, omdat deze beoordelingen onvoldoende statistische power zouden hebben en potentieel misleidend zouden zijn gezien het aantal beschikbare studies.
Resultaten
Studieoselectie
Een systematische literatuurzoekopdracht in PubMed, Embase, Cochrane Library, Ovid en Google Scholar tot juni 2026 identificeerde 1.123 records. Na het verwijderen van 897 duplicaten werden 226 records gescreend op basis van titel en abstract. Hiervan werden 124 records uitgesloten op basis van de geschiktheidscriteria. Er werd een beoordeling van de volledige tekst uitgevoerd voor 102 rapporten, waarvan er 89 werden uitgesloten; de redenen hiervoor zijn gedocumenteerd in het PRISMA-stroomdiagram (Figuur 1; Aanvullend Bestand 1). Uiteindelijk voldeden 15 rapporten aan de inclusiecriteria en werden deze opgenomen in de systematische review, bestaande uit 13 vergelijkende gerandomiseerde gecontroleerde trials en 2 niet-vergelijkende observationele studies. Dertien gerandomiseerde gecontroleerde trials leverden extraheerbare gegevens over interventie versus controle op voor kwantitatieve meta-analyse, terwijl twee observationele studies uitsluitend werden behouden voor narratieve synthese20,21,22,23,24,25,26,27,28,29,30,31,32.
Figuur 1 presenteert het PRISMA 2020-stroomdiagram waarin het screenings- en selectieproces gedetailleerd wordt beschreven. De 13 gerandomiseerde gecontroleerde studies leverden extraheerbare gegevens over interventie versus controle voor de kwantitatieve meta-analyse20,21,22,23,24,25,26,27,28,29,30,31,32.
Kenmerken van de studie
De kenmerken van de 15 opgenomen rapporten zijn samengevat in Tabel 2. Dertien vergelijkende RCT's leverden gegevens voor de kwantitatieve synthese, terwijl twee observationele studies uitsluitend werden behouden voor de narratieve synthese. Over de 13 vergelijkende RCT's verspreid werden 915 vrouwen geïncludeerd, waarbij 468 deelnemers werden toegewezen aan lifestyle- of verpleegkundige interventiegroepen en 447 aan controlegroepen, zoals oorspronkelijk gerapporteerd.
Voor de kwantitatieve meta-analyses droegen de 13 vergelijkende RCT's 915 deelnemers bij (468 interventie, 447 controle). De geïncludeerde RCT's werden gepubliceerd tussen 2009 en 2025 en werden uitgevoerd in meerdere landen, waaronder de Verenigde Staten, Denemarken, het Verenigd Koninkrijk, China, Egypte en Roemenië. De kankertypen omvatten eierstokkanker (2 studies), endometriumkanker (4 studies) en gemengde gynaecologische kankers (7 studies). De interventies varieerden sterk en omvatten: gestructureerde bewegingsprogramma's, dieetaanpassingen, begeleiding bij gewichtsverlies, psycho-educatieve sessies, door verpleegkundigen geleide follow-up, door de patiënt geïnitieerde zorg, app-gebaseerde mindfulness en gecombineerde leefstijlinterventies. De follow-upduur varieerde van 3 tot 6 maanden.
De instrumenten voor de beoordeling van de levenskwaliteit omvatten: Functional Assessment of Cancer Therapy–General (FACT-G), FACT-Ovarian (FACT-O), FACT-Endometrial (FACT-En), European Organization for Research and Treatment of Cancer Quality of Life Questionnaire Core 30 (EORTC QLQ-C30), Short Form-36 (SF-36) en aandoekingspecifieke schalen. Alle instrumenten werden zo gescoord dat hogere waarden duidden op een betere levenskwaliteit.
Beoordeling van het risico op bias
Het risico op bias werd beoordeeld met behulp van de Cochrane RoB 2.0-tool voor de 13 RCT's en de Newcastle-Ottawa Scale voor de 2 observationele cohortstudies. Een samenvatting van de oordelen op domeinniveau wordt gepresenteerd in het risk-of-bias traffic-light plot. Voor de RCT's waren de meest voorkomende methodologische zorgen: (1) Domein 2 (Afwijkingen van de beoogde interventies): Blinding van deelnemers en personeel voor leefstijlinterventies was in geen enkele studie haalbaar; 9 van de 13 studies (69%) werden beoordeeld als "some concerns" of "high risk" in dit domein; (2) Domein 3 (Ontbrekende uitkomstgegevens): Vier studies (31%) hadden onvolledige uitkomstgegevens vanwege uitvalpercentages die 20% overschreden, wat werd beoordeeld als "some concerns"; (3) - Domein 1 (Randomisatieproces): Zeven studies (54%) beschreven de sequentiegeneratie en toewijzingsverhulling adequaat; de overige studies hadden een onduidelijke of ontoereikende rapportage; (4) Domein 4 (Meting van de uitkomst): Alle studies maakten gebruik van gevalideerde zelfgerapporteerde QoL-instrumenten; echter werd de blinding van de beoordelaars van de uitkomsten niet consistent gerapporteerd; (5) Domein 5 (Selectie van het gerapporteerde resultaat): Zes studies (46%) hadden prospectief geregistreerde protocollen; voor de overige studies waren geen protocollen beschikbaar, wat zorgen opriep over selectieve rapportage van uitkomsten.
Algemene beoordelingen van het risico op bias: Geen enkele studie werd in alle domeinen als laag risico beoordeeld. Acht studies (62%) werden over het algemeen beoordeeld als "enige zorgen" en vijf studies (38%) werden over het algemeen beoordeeld als "hoog risico", voornamelijk vanwege een gebrek aan blindering en kleine steekproefgroottes, wat leidde tot imprecisie.
Voor de twee observationele cohortstudies (Budisan et al.33; Betea et al.34) leidde de afwezigheid van een gelijktijdige controlegroep tot een hoog risico op confounding en selectiebias voor elke causale inferentie. Deze studies werden uitsluitend behouden voor narratieve synthese en droegen niet bij aan de gepoolde schattingen van het effect.
Primaire uitkomsten
Kwaliteit van leven na 6 maanden – algemene gynaecologische oncologie
Negen vergelijkende RCT's leverden gegevens aan op het tijdstip van 6 maanden, bestaande uit 693 deelnemers (358 interventie en 335 controle). Het gepoolde gemiddelde verschil (MD) met gebruik van een random-effects model toonde geen statistisch significante verbetering in de kwaliteit van leven na 6 maanden vergeleken met de controlegroep (MD = 2.11; 95% CI: –0.90 tot 5.12; p = 0.17).
Figuur 2 presenteert het forest plot voor deze analyse. De heterogeniteit was aanzienlijk: I2 = 71%, τ2 = 10.60.
Kwaliteit van leven na 6 maanden – subgroep eierstokkanker
Twee studies (Zhou et al.25; Maurer et al.29) leverden specifieke gegevens voor eierstokkanker, met een totaal van 124 deelnemers (66 interventie, 58 controle). Het gepoolde MD wees op een statistisch significante verbetering in de kwaliteit van leven in het voordeel van de interventiegroep (MD 4.28; 95% CI 0.45–8.10; p = 0.03). Figuur 3 toont het forest plot voor deze analyse. De heterogeniteit was laag: I2 = 0%, τ2 = 0.
Kwaliteit van leven na 6 maanden – subgroep endometriumcarcinoom
Vier studies (Von Gruenigen et al.21; McCarroll et al.23; Rossi et al.24; Jeppesen et al.26) leverden gegevens voor endometriumcarcinoom, bestaande uit 172 deelnemers (92 interventie, 80 controle). Om de impact van de overlappende SUCCEED-trialcohorten te beoordelen, werd de subgroepanalyse voor het endometrium herhaald, waarbij McCarroll et al.23 werden uitgesloten. Het gepoolde MD veranderde marginaal van 2.00 (95% CI: –1.49–5.49) naar 1.87 (95% CI: –1.62–5.36), en I2 bleef 0%. De uitsluiting van McCarroll et al. veranderde de gepoolde schatting niet wezenlijk; het effect bleef statistisch niet significant en heterogeniteit bleef afwezig (I2 = 0%). Figuur 4 toont het forest plot voor deze analyse. De heterogeniteit was laag: I2 = 0%, τ2 = 0.
Kwaliteit van leven na 3 maanden – algemene gynaecologische oncologie
Zes vergelijkende studies (Von Gruenigen et al.21; Donnelly et al.22; McCarroll et al.23; Maurer et al.29; Elzeblawy Hassan et al.32; McCloy et al.30) rapporteerden resultaten na 3 maanden, met een totaal van 275 deelnemers (140 interventie en 135 controle). Het gepoolde MD toonde geen statistisch significant verschil tussen de interventie- en controlegroepen (MD 6.43, 95% CI: −0.16 tot 13.01, p = 0.06). Figuur 5 presenteert het forest plot voor deze analyse. De heterogeniteit was aanzienlijk (I2 = 74%, τ2 = 42.53).
Subgroepanalyses
Vooraf gespecificeerde subgroepanalyses per kankertype werden uitgevoerd om bronnen van heterogeniteit te onderzoeken. Voor de algemene uitkomst Gynaecologische Oncologie na 6 maanden: (1) subgroep eierstokkanker (2 studies): I2 = 0%, τ2 = 0; MD 4,28 (95% BI 0,45–8,10); (2) subgroep endometriumkanker (4 studies): I2 = 0%, τ2 = 0; MD 2,00 (95% BI: –1,49–5,49)
Onderverdeling naar kankertype verminderde de heterogeniteit aanzienlijk, van I2 = 71% in de totale analyse naar 0% binnen elke subgroep. Het geringe aantal studies binnen elke subgroep (respectievelijk 2 en 4) beperkt echter de precisie van deze schattingen voor de subgroepen.
Er is geen formele interactietest tussen subgroepen uitgevoerd omdat het aantal studies per subgroep (<10) onvoldoende was om betrouwbare interactieschattingen te verkrijgen. De schijnbare verschillen in statistische significantie tussen de eierstok- en endometriumsubgroepen mogen niet worden geïnterpreteerd als bewijs voor differentiële behandelingseffecten per kankertype.
Op dezelfde manier is er geen formele tijd-bij-interactietest uitgevoerd tussen de resultaten van 3 maanden en 6 maanden.
Gevoeligheidsanalyses
Uitsluiting van overlappende cohorten
Om de impact van de overlappende SUCCEED-trialcohorten (Von Gruenigen et al.21 en McCarroll et al.23) te beoordelen, werd de subgroepanalyse van het endometrium herhaald, waarbij McCarroll et al.23 werden uitgesloten.
Het gepoolde MD veranderde marginaal van 2.00 (95% CI: –1.49–5.49) naar 1.87 (95% CI: –1.62–5.36), en I2 bleef 0%. Dit geeft aan dat de dubbele cohort de puntschatting of de conclusie dat er geen significant effect is, niet wezenlijk heeft beïnvloed.
Voor de algemene uitkomst na 6 maanden veranderde het uitsluiten van McCarroll et al. het gepoolde MD van 2,11 (95% BI: −0,90–5,12) naar 2,33 (95% BI: −1,16–5,82), waarbij I2 veranderde van 71% naar ongeveer 72%. Het effect bleef statistisch niet significant, wat aangeeft dat de uitsluiting van de overlappende cohorte de algemene conclusie niet wezenlijk heeft veranderd.
Leave-one-out invloedsanalyse
Sequentiële verwijdering van individuele studies leverde gepoolde MD's op die varieerden van ongeveer 1.29 tot 4.33. De heterogeniteit bleef over het algemeen aanzienlijk na uitsluiting van de meeste studies; echter, het uitsluiten van McCorkle et al.20 reduceerde I2 tot 0%, wat aangeeft dat deze studie aanzienlijk bijdroeg aan de waargenomen heterogeniteit tussen de studies. De algemene bevindingen moeten daarom met voorzichtigheid worden geïnterpreteerd.
Vergelijking van fixed-effect modellen
Onder een model met vaste effecten was het gepoolde MD voor de algemene uitkomst na 6 maanden 3,80 (95% BI: 2,97–4,62), terwijl het random-effects model een MD van 2,11 opleverde (95% BI: −0,90–5,12). Het verschil in statistische significantie tussen de twee modellen geeft aan dat heterogeniteit tussen de studies de gepoolde inferentie materieel beïnvloedt. Gezien de aanzienlijke heterogeniteit (I2 = 71%) werd de random-effects schatting als geschikter beschouwd voor interpretatie.
Publicatiebias
Geen van de gepoolde uitkomsten omvatte 10 of meer studies. Daarom zijn er geen funnel plots en Egger-regressietests uitgevoerd, omdat deze beoordelingen onvoldoende statistische kracht zouden hebben en potentieel misleidend zouden zijn gezien het aantal beschikbare studies.
Hoewel er vanwege het geringe aantal studies geen formele beoordeling is uitgevoerd, kunnen publicatiebias en selectieve rapportage niet worden uitgesloten. De mogelijkheid dat negatieve bevindingen of nulresultaten ongepubliceerd zijn gebleven, moet daarom in overweging worden genomen bij de interpretatie van het bewijs.
Beschikbaarheid van gegevens
De dataset die tijdens de huidige studie is geanalyseerd, is beschikbaar via 10.5281/zenodo.21777130 (https://doi.org/10.5281/zenodo.21777130).
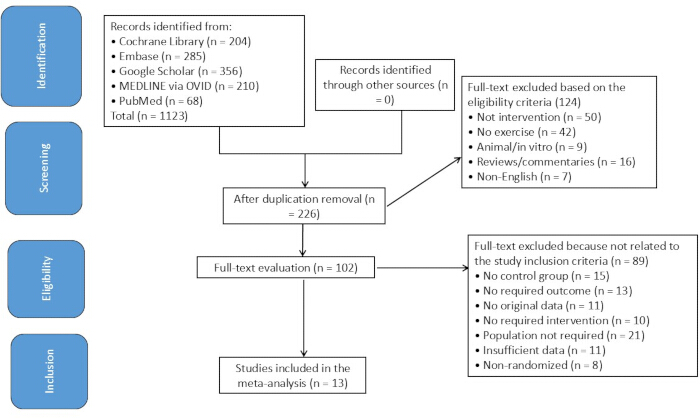
Figuur 1: PRISMA 2020 stroomdiagram van de studieselectie. Stroomdiagram dat de identificatie, screening, beoordeling van geschiktheid en inclusie illustreert van studies die lifestyle- en gynaecologische oncologische verpleegkundige interventies op de kwaliteit van leven bij vrouwen met gynaecologische kankers evalueren. Klik hier om een grotere versie van deze figuur te bekijken.
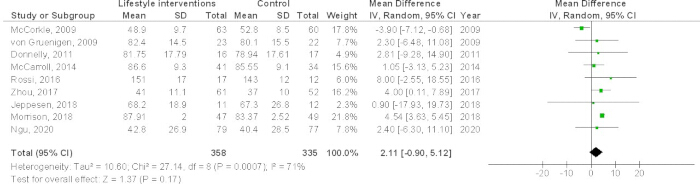
Figuur 2: Forest plot van de kwaliteit van leven na 6 maanden bij vrouwen met gynaecologische kanker. Forest plot die leefstijlinterventies en verpleegkundige interventies in de gynaecologische oncologie vergelijkt met controlegroepen wat betreft de kwaliteit van leven bij de follow-up na 6 maanden. De resultaten worden weergegeven als gemiddelde verschillen (MDs) met 95% betrouwbaarheidsintervallen (CIs) met gebruik van een random-effects model. Positieve MD-waarden zijn gunstig voor de interventiegroep. Heterogeniteit wordt gerapporteerd met behulp van de I2 statistiek. Klik hier om een grotere versie van deze figuur te bekijken.
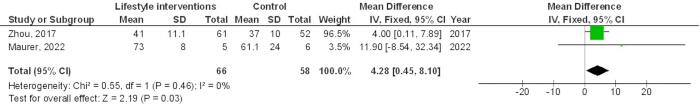
Figuur 3: Forest plot van de kwaliteit van leven na 6 maanden bij vrouwen met eierstokkanker. Forest plot die het effect van leefstijlinterventies en verpleegkundige interventies in de gynaecologische oncologie op de kwaliteit van leven bij de follow-up na 6 maanden laat zien bij vrouwen met eierstokkanker. Resultaten worden gepresenteerd als gemiddelde verschillen (MDs) met 95% betrouwbaarheidsintervallen (CIs). Positieve MD-waarden zijn gunstig voor de interventiegroep, en heterogeniteit wordt samengevat met de I2 statistiek. Klik hier om een grotere versie van deze figuur te bekijken.
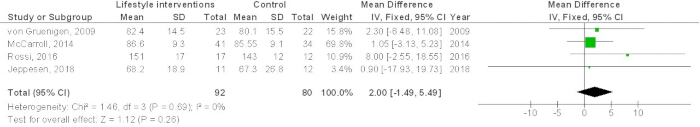
Figuur 4: Forest plot van de kwaliteit van leven na 6 maanden bij vrouwen met endometriumcarcinoom. Forest plot waarin leefstijlinterventies en verpleegkundige interventies in de gynaecologische oncologie worden vergeleken met controlegroepen voor de kwaliteit van leven bij de follow-up na 6 maanden onder vrouwen met endometriumcarcinoom. De resultaten worden uitgedrukt als gemiddelde verschillen (MD's) met 95% betrouwbaarheidsintervallen (CI's). Positieve MD-waarden zijn gunstig voor de interventiegroep, en heterogeniteit wordt gerapporteerd met behulp van de I2-statistiek. Klik hier om een grotere versie van deze figuur te bekijken.
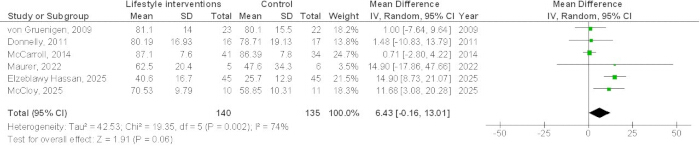
Figuur 5: Forest plot van de kwaliteit van leven na 3 maanden bij vrouwen met gynaecologische kanker. Klik hier om een grotere versie van deze figuur te bekijken.
Forest plot waarin leefstijl- en gynaecologisch-oncologische verpleegkundige interventies worden vergeleken met controlegroepen voor de kwaliteit van leven bij de follow-up na 3 maanden. De resultaten worden gepresenteerd als gemiddelde verschillen (MD's) met 95% betrouwbaarheidsintervallen (CI's) met behulp van een random-effectsmodel. Positieve MD-waarden zijn gunstig voor de interventiegroep. Heterogeniteit wordt gerapporteerd met behulp van de I2-statistiek.
Tabel 1: Database-zoekstrategieën gebruikt voor de literatuurstudie. Uitgebreide zoekstrategieën werden gebruikt om geschikte studies te identificeren in PubMed, Embase, Cochrane Library, Ovid en Google Scholar. De zoektermen combineerden gecontroleerde vocabulaires en vrije-tekst trefwoorden met betrekking tot gynaecologische kankers, leefstijlinterventies, oncologische verpleegkunde en kwaliteit van leven. Klik hier om deze tabel te downloaden.
Tabel 2: Kenmerken van de geïncludeerde RCT's. Samenvatting van de kenmerken van de geïncludeerde studies, waaronder studieopzet, kankertype, interventie en comparator, steekproefgrootte, instrument voor de beoordeling van de kwaliteit van leven, follow-upduur en geschiktheid voor inclusie in de kwantitatieve meta-analyse. Studies zonder een geschikte comparatorgroep werden uitsluitend opgenomen in de kwalitatieve synthese. Klik hier om deze tabel te downloaden.
Aanvullend bestand 1: PRISMA 2020-checklist. Ingevulde PRISMA 2020-checklist waarin de paginanummers van het manuscript worden aangegeven die corresponderen met elk rapportage-item, overeenkomstig de PRISMA 2020-verklaring voor het rapporteren van systematische reviews en meta-analyses.Klik hier om dit bestand te downloaden.
Discussie
De primaire analyse na 6 maanden toonde geen statistisch significante verbetering in de QoL voor gemengde gynaecologische kankers (MD 2.11, 95% CI: −0.90 tot 5.12, p = 0.17), terwijl een significante verbetering werd waargenomen in de subgroep met eierstokkanker (MD 4.28, 95% CI: 0.45–8.10, p = 0.03). Er werd geen significant effect waargenomen voor endometriumkanker na 6 maanden (MD 2.00, 95% CI: −1.49 tot 5.49, p = 0.26) of voor gemengde kankers na 3 maanden (MD 6.43, 95% CI: −0.16 tot 13.01, p = 0.06).
Deze bevindingen tonen geen significant algemeen voordeel voor de QoL na 6 maanden aan, hoewel er een significante verbetering werd waargenomen in de subgroep met eierstokkanker. De primaire analyse na 6 maanden vertoonde aanzienlijke heterogeniteit (I2 = 71%), en de GRADE-zekerheid van het bewijs voor alle samengevoegde uitkomsten werd beoordeeld als zeer laag. Bijgevolge moeten deze resultaten worden beschouwd als hypothese-genererend in plaats van praktijkveranderend.
Cruciaal is dat de schijnbare verschillen in significantie tussen kankertypen en tijdspunten niet formeel op interactie zijn getest en niet geïnterpreteerd mogen worden als bewijs voor differentiële effectiviteit. De geobserveerde patronen kunnen verschillen in studiepopulaties, interventiecomponenten, steekproefgroottes of toeval weerspiegelen, in plaats van werkelijke biologische of temporele verschillen. Eventuele conclusies over timing of tumorspecifieke effecten zijn speculatief en vereisen bevestiging in toekomstige head-to-head trials.
Vergelijking met vorige studies
De huidige bevindingen komen gedeeltelijk overeen met de eerdere systematische review van Smits et al.10, waarin leefstijlinterventies bij vrouwen met endometrium- en eierstokkanker werden geëvalueerd en waarin beperkt bewijs werd gevonden voor significante verbeteringen in de kwaliteit van leven. De bredere opname van verpleegkundige interventies en aanvullende studies gepubliceerd sinds 2015 biedt echter een actueler, zij het nog steeds onzeker, beeld. De zeer lage GRADE-zekerheid in deze review is aanzienlijk voorzichtiger dan de conclusies van sommige primaire studies, wat het resultaat is van de striktere methodologische beoordeling die in de huidige review is toegepast en de expliciete erkenning van de beperkingen die inherent zijn aan de bewijslast11.
Het waargenomen voordeel in de subgroep met eierstokkanker is consistent met eerder onderzoek van Zhou et al.25 en Maurer et al.29, die rapporteerden dat gestructureerde bewegingsinterventies het fysieke functioneren en het algemene welzijn van overlevers van eierstokkanker verbeterden. Dit kan worden verklaard door de aanzienlijke fysieke decompensatie, door chemotherapie geïnduceerde neuropathie en abdominale complicaties die de mobiliteit in deze populatie beïnvloeden, waardoor bewegingsinterventies bijzonder gunstig zijn. Het geringe aantal studies (n = 2) verhindert echter het trekken van robuuste conclusies.
In tegenstelling hiermee spreekt het nulresultaat voor baarmoederkanker na 6 maanden enkele eerdere positieve rapporten uit individuele trials tegen (bijv. Von Gruenigen et al.21; Rossi et al.24). De pooling van deze studies, inclusief overlappende cohorten uit de SUCCEED-trial, toonde geen significant effect aan, wat suggereert dat eerdere positieve bevindingen mogelijk overschat zijn vanwege kleine steekproefgroottes of publicatiebias. Het uitblijven van een significant effect kan ook de heterogene aard weerspiegelen van overlevers van baarmoederkanker, die vaak kampen met obesitas en het metabool syndroom, waarvoor intensievere of meer op maat gemaakte interventies nodig zijn om meetbare verbeteringen in de QoL te bewerkstelligen.
De huidige bevindingen komen ook overeen met die van Mokhtari-Hessari en Montazeri35, die substantiële verbeteringen in de QoL rapporteerden door verpleegkundige interventies bij borstkankerpatiënten. Op soortgelijke wijze stelden Aktas en Terzioglu36 vast dat thuisverpleging de QoL aanzienlijk verbeterde bij vrouwen die een behandeling kregen voor gynaecologische oncologie, en Ma et al.37 toonden aan dat intensieve psychologische verpleegkundige zorg negatieve stemmingen verlichtte en de QoL verbeterde bij patiënten met baarmoederhalskanker. Deze consistente signalen over verschillende kankertypes en omgevingen onderstrepen de potentiële waarde van comprehensive verpleegkundige zorg, hoewel de methodologische kwaliteit van het ondersteunende bewijs een punt van zorg blijft.
Aannemelijke mechanismen
Hoewel de gepoolde schattingen geen causaliteit kunnen vaststellen, kunnen verschillende mechanismen de waargenomen signalen in de kwaliteit van leven (QoL) verklaren. Gestructureerde lichaamsbeweging en dieetmodificaties verminderen pro‑inflammatoire cytokinen (bijv. IL‑6, TNF‑α) en C‑reactieve eiwitten, die geassocieerd worden met kanker‑gerelateerde vermoeidheid, pijn en depressie. Bij overlevers van endometrium- en borstkanker verlagen gewichtsverlies en lichaamsbeweging daarnaast de spiegels van oestrogeen en IGF‑1 niveaus, wat mogelijk van invloed is op het tumormetabolisme en de systemische energiebalans. Psychosociaal gezien, verpleegkundig‑leidde psychoeducatie, counseling en regelmatige follow-up‑omhoog kan de zelfregulatie verbeteren‑werkzaamheid, de angst voor recidive verminderen en de therapietrouw verbeteren. De meer consistente 6‑maand (tegenover 3‑effecten op de lange termijn (hoewel niet formeel getest) kunnen een weerspiegeling zijn van de tijd die nodig is om gedragsveranderingen tot gewoonte te maken en om biologische adaptaties te laten accumuleren. Geen van deze mechanismen is echter direct gemeten in de opgenomen studies; deze discussie is speculatief en bedoeld als leidraad voor toekomstig mechanistisch onderzoek.
Methodologische beperkingen
Ontbreken van prospectieve protocolregistratie: Een belangrijke beperking is de afwezigheid van registratie bij een prospectief register (bijv. PROSPERO, INPLASY of OSF Registries). Zonder een publiek toegankelijk, vooraf geregistreerd protocol bestaat er een potentieel voor rapportagebias of selectieve uitkomstbias, aangezien de beslissingen over studie selectie, data-extractie en analyse niet onafhankelijk geverifieerd kunnen worden aan de hand van een vooraf vastgesteld plan. Lezers dienen de gepoolde schattingen in dit kader te interpreteren.
Hoge heterogeniteit: De primaire analyse van 6 maanden vertoonde een I2 = 71%, wat volgens de richtlijnen van Cochrane wordt beschouwd als "aanzienlijk" en vaak een criterium is om niet te poolen. Hoewel subgrouping op basis van kankertype de I2 reduceerde tot 0% voor zowel de eierstok- als de endometriumsubgroepen, bevatte elke subgroep slechts enkele studies (respectievelijk 2 en 4), waardoor deze schattingen imprecies zijn. De heterogeniteit kan niet met zekerheid uitsluitend worden toegeschreven aan het kankertype. Andere plausibele bronnen—verschillen in interventie-intensiteit, duur, toedieningswijze, controlecondities, baseline-kenmerken van deelnemers en uitkomstmeting—werden niet formeel onderzocht vanwege onvoldoende covariabele gegevens. Gezien deze overwegingen moet het gepoolde MD voor de primaire analyse worden beschouwd als een wiskundig gegenereerde samenvatting in plaats van een klinisch betekenisvolle schatting.
Risico op bias: Geen enkele RCT werd als laag risico beoordeeld over alle domeinen van de Cochrane RoB 2.0. De meerderheid werd beoordeeld als "sommige zorgen" of "hoog risico," voornamelijk vanwege het gebrek aan blindering van deelnemers (onvermijdbaar bij leefstijlinterventies) en onvolledige uitkomstgegevens. De inclusie van overlappende cohorten uit de SUCCEED-studie vergroot kunstmatig het gewicht van die specifieke interventie in de subgroup met endometriumcarcinomen; een sensitiviteitsanalyse waarbij de duplicaten werden uitgesloten, veranderde de puntschatting niet materieel, maar het blijft een structurele beperking.
Insluiting van observationele studies: Twee van de 15 geïncludeerde rapporten misten volledig een controlegroep (Budisan et al.33; Betea et al.34). Hoewel deze studies werden behouden voor narratieve synthese om selectiebias te voorkomen, konden ze niet worden opgenomen in de gepoolde interventie-effecten en werden ze beschouwd als zijnde onderhevig aan een hoog risico op confounding en selectiebias.
Diversiteit van interventies en uitkomsten: De vergelijkende studies omvatten een breed scala aan interventies—gestructureerde bewegingsprogramma's, dieetmodificaties, begeleiding bij gewichtsverlies, psycho-educatieve sessies, nazorg onder leiding van een verpleegkundige, door de patiënt geïnitieerde zorg en app-gebaseerde mindfulness. Het samenvoegen van dergelijke diverse interventies onder de verzamelterm "leefstijl-/verpleegkundige interventie" geeft een schatting van het gemiddelde effect, maar dit gemiddelde is mogelijk niet van toepassing op een specifiek type interventie. Op dezelfde manier gebruikten alle studies, hoewel zij gezondheidsgerelateerde QoL maten, verschillende instrumenten (FACT-G, FACT-O, FACT-En, EORTC QLQ-C30, SF-36), wat indirecte heterogeniteit kan introduceren.
Publicatiebias kon niet betrouwbaar worden beoordeeld omdat geen van de gepoolde uitkomsten 10 of meer studies omvatte. Trechterdiagrammen en de regressietests van Egger werden daarom niet uitgevoerd. De kleine steekproefgroottes en de overhand van positieve studies in de literatuur wekken de mogelijkheid dat negatieve resultaten of nulbevindingen ongepubliceerd blijven.
Korte follow-up en gebrek aan subgroepanalyses: De meeste studies hanteerden korte follow-upperioden (3–6 maanden), wat het inzicht in de langetermijnstabiliteit van de verbeteringen in de QoL beperkte. Het ontbreken van uitgebreide subgroepanalyses (bijv. naar leeftijd, ziektestadium, sociaaleconomische status) belemmerde de identificatie van specifieke patiëntencategorieën die mogelijk het meeste baat hebben bij de interventie.
GRADE-zekerheid
De formele GRADE-beoordeling classificeerde de algemene zekerheid van het bewijs voor alle vier de gepoolde uitkomsten als ZEER LAAG. Dit oordeel weerspiegelt: (i) een ernstig tot zeer ernstig risico op bias over de included RCT's; (ii) een zeer ernstige inconsistentie voor de primaire uitkomst na 6 maanden (I2 = 71%); (iii) indirectheid voor de subgroep met endometriumcarcinoom, waarin voornamelijk overgewicht/obese overlevers waren opgenomen, wat de generaliseerbaarheid beperkt; en (iv) een ernstige tot zeer ernstige imprecisie vanwege de kleine totale steekproefgroottes per subgroep en brede betrouwbaarheidsintervallen die vaak de nulwaarde kruisen. Bijgevolg is het vertrouwen in de effectschattingen zeer beperkt; de werkelijke effecten zullen waarschijnlijk aanzienlijk verschillen van de gerapporteerde puntschattingen.
Klinische implicaties
Gezien de zeer lage zekerheid van het bewijs en de aanzienlijke heterogeniteit zijn deze bevindingen eerder hypothese‑genererend dan praktijk‑veranderend. Clinici dienen de routinematige ondersteunende zorg niet aan te passen op basis van deze gepoolde schattingen. Toch kunnen enkele voorzichtige observatiesten dienen als input voor gesprekken met patiënten: (i) beslissingen over ondersteunende zorg moeten worden geïndividualiseerd op basis van patiëntvoorkeuren en de klinische context; (ii) de subgroep met eierstokkanker vertoonde het enige statistisch coherente signaal (MD 4,28, 95% CI: 0,45–8,10), wat suggereert dat deze populatie mogelijk bijzonder profiteert van bewegingsinterventies, hoewel dit is gebaseerd op slechts twee kleine studies. De consistente positieve signalen over de studies heen onderstrepen het belang van uitgebreide verpleegkundige zorg, inclusief pijnmanagement, emotionele steun, patiëntenvoorlichting en zorgcoördinatie, als een kerncomponent van multidisciplinaire kankerzorg. Cruciaal is dat de schijnbare verschillen tussen kankertypes en tijdstippen niet formeel zijn getest op interactie en niet overgeïnterpreteerd mogen worden.
Toekomstig onderzoek
Deze review legt kritieke kennislacunes bloot die in toekomstig onderzoek moeten worden aangepakt. Hoog‑hoogwaardige, multicentrische RCT's zijn dringend nodig, met gestandaardiseerde en gemanualiseerde interventies, gepubliceerde protocollen, intentie‑naar‑behandelingsanalyses, langere follow-up‑omhoog (≥12 maanden) en vooraf gespecificeerde subgroepanalyses met formele interactietests. Mechanistische studies dienen biomarkerbeoordelingen (inflammatoire cytokinen, hormonale profielen) en gevalideerde psychosociale mediatoren (zelf‑effectiviteit, sociale steun) om te identificeren welke interventiecomponenten het meest effectief zijn en welke patiëntsubgroepen het meeste baat hebben. Economische evaluaties zijn tevens nodig om de kosten te beoordelen‑effectiviteit en de toewijzing van middelen informeren. Toekomstige systematische reviews met een bredere bewijslast zouden moeten overwegen of meta‑analyse passend blijft voor dergelijke diverse interventies, of dat een narratieve synthese informatiever zou zijn. Ten slotte, patiënt‑gecentreerde uitkomsten—inclusief domein‑specifieke QoL-maten en patiënt‑gemelde ervaringsmaten—moet prioriteit krijgen, waarbij de betrokkenheid van patiënten en het publiek bij het studieontwerp essentieel is om ervoor te zorgen dat het onderzoek gericht is op datgene wat het meest belangrijk is voor vrouwen met gynaecologische maligniteiten.
Deze meta-analyse vond geen statistisch significante verbetering in de algemene kwaliteit van leven (QoL) na 3 of 6 maanden bij vrouwen met gynaecologische kanker. Een significante verbetering werd waargenomen in de subgroep met eierstokkanker na 6 maanden, terwijl er geen significant effect werd waargenomen in de subgroep met endometriumcarcinoom. Echter rechtvaardigen aanzienlijke heterogeniteit, methodologische beperkingen, kleine subgroepen en bewijslast met zeer lage zekerheid een voorzichtige interpretatie. Grotere, goed ontworpen studies met gestandaardiseerde interventies en een langere follow-up zijn nodig om de effecten van leefstijl- en verpleegkundige interventies op de QoL bij vrouwen met gynaecologische maligniteiten te verduidelijken.
Openbaarmakingen
De auteurs hebben geen conflicten van belang te melden.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| EndNote | Clarivate Analytics | https://endnote.com | Referentiebeheer, deduplicatie, opmaak van citaties |
| GRADEpro GDT | McMaster University en Evidence Prime | McMaster University / Evidence Prime; https://gradepro.org | GRADE-zekerheidsbeoordeling (Online versie) |
| PRISMA 2020-checklist | PRISMA-verklaring | PRISMA-verklaring; https://www.prisma-statement.org | Rapportage van naleving |
| R | R Foundation for Statistical Computing | R Foundation; https://cran.r-project.org | Statistische analyse, sensitiviteitsanalyses, invloedsanalyses, figuren (Versie 4.3.1 of hoger) |
| R-pakket: meta | CRAN | CRAN; https://cran.r-project.org/package=meta | Meta-analysefuncties (pooling, heterogeniteit, forest plots, funnel plots) versie 6.0.0 of hoger |
| R-pakket: metafor | CRAN | CRAN; https://cran.r-project.org/package=metafor | REML-schatting, invloedsdiagnostiek, aanvullende meta-analytische functies (4.0.0 of hoger) |
| Review Manager | RevMan | Cochrane Collaboration; https://training.cochrane.org/online-learning/core-software-cochrane-reviews/revman[reference:14] | Meta-analyse (pooling, forestplots, heterogeniteit, risico op bias-beoordeling) Versie 5.4 |
Referenties
- Ackroyd SA, Shih YCT, Kim B, Lee NK, Halpern MT. A look at the gynecologic oncologist workforce – are we meeting patient demand Gynecol Oncol. 2021;163(2):229-36.
- Williams N, et al. The supportive care needs of women experiencing gynaecological cancer: a Western Australian cross-sectional study. BMC Cancer. 2018;18(1):912.
- Bizzarri N, et al. Building a personalized medicine infrastructure for gynecological oncology patients in a high-volume hospital. J Pers Med. 2022;12(1):3.
- Buckley L, Robertson S, Wilson T, Sharpless J, Bolton S. The role of the specialist nurse in gynaecological cancer. Curr Oncol Rep. 2018;20(10):83.
- Parkinson N, Pratt H. Clinical nurse specialists and the psychosexual needs of patients with gynaecological cancer. Br Menopause Soc J. 2005;11(1):33-5.
- Kobleder A, Mayer H, Gehrig L, Senn B. “Promoting continuity of care”—specialist nurses’ role experiences in gynaecological oncology: a qualitative study. J Clin Nurs. 2017;26(23-24):4890-8.
- Cook O, McIntyre M, Recoche K, Lee S. “Our nurse is the glue for our team”—multidisciplinary team members' experiences and perceptions of the gynaecological oncology specialist nurse role. Eur J Oncol Nurs. 2019;41:7-15.
- Lavdaniti M, et al. Factors influencing quality of life in breast cancer patients six months after the completion of chemotherapy. Diseases. 2019;7(1):26.
- Perry S, Kowalski TL, Chang CH. Quality of life assessment in women with breast cancer: benefits, acceptability and utilization. Health Qual Life Outcomes. 2007;5(1):24.
- Chhikara BS, Parang K. Global cancer statistics 2022: the trends projection analysis. Chem Biol Lett. 2023;10(1):451.
- Smits A, et al. The effect of lifestyle interventions on the quality of life of gynaecological cancer survivors: a systematic review and meta-analysis. Gynecol Oncol. 2015;139(3):546-52.
- Stroup DF, et al. Meta-analysis of observational studies in epidemiology: a proposal for reporting. JAMA. 2000;283(15):2008-12.
- Page MJ, et al. The PRISMA 2020 statement: an updated guideline for reporting systematic reviews. BMJ. 2021;372:n71.
- Liberati A, et al. The PRISMA statement for reporting systematic reviews and meta-analyses of studies that evaluate health care interventions: explanation and elaboration. J Clin Epidemiol. 2009;62(10):e1-34.
- Gupta S, et al. Efficacy of generic oral directly acting agents in patients with hepatitis C virus infection. J Viral Hepat. 2018;25(7):771-8.
- Adeiza SS, Aminul I. Meta-meta-analysis of the mortality risk associated with MRSA compared to MSSA bacteraemia. Infez Med. 2024;32(2):131-7.
- Higgins J, et al., editors. Cochrane handbook for systematic reviews of interventions. 2nd ed. Wiley & Sons; Chichester, UK; 2019.
- Sheikhbahaei S, et al. FDG-PET/CT and MRI for evaluation of pathologic response to neoadjuvant chemotherapy in patients with breast cancer: a meta-analysis of diagnostic accuracy studies. Oncologist. 2016;21(8):931-9.
- Higgins JP, Thompson SG, Deeks JJ, Altman DG. Measuring inconsistency in meta-analyses. BMJ. 2003;327(7414):557-60.
- McCorkle R, et al. Effects of a nursing intervention on quality of life outcomes in post-surgical women with gynecological cancers. Psychooncology. 2009;18(1):62-70.
- Von Gruenigen VE, et al. A randomized trial of a lifestyle intervention in obese endometrial cancer survivors: quality of life outcomes and mediators of behavior change. Health Qual Life Outcomes. 2009;7(1):17.
- Donnelly CM, et al. A randomised controlled trial testing the feasibility and efficacy of a physical activity behavioural change intervention in managing fatigue with gynaecological cancer survivors. Gynecol Oncol. 2011;122(3):618-24.
- McCarroll ML, et al. Self-efficacy, quality of life, and weight loss in overweight/obese endometrial cancer survivors (SUCCEED): a randomized controlled trial. Gynecol Oncol. 2014;132(2):397-402.
- Rossi A, et al. Feasibility of a physical activity intervention for obese, socioculturally diverse endometrial cancer survivors. Gynecol Oncol. 2016;142(2):304-10.
- Zhou Y, et al. Randomized trial of exercise on quality of life in women with ovarian cancer: Women’s Activity and Lifestyle Study in Connecticut (WALC). J Natl Cancer Inst. 2017;109(12).
- Jeppesen M, Jensen P, Hansen D, Christensen R, Mogensen O. Patient-initiated follow up affects fear of recurrence and healthcare use: a randomised trial in early-stage endometrial cancer. BJOG. 2018;125(13):1705-14.
- Morrison V, et al. Trial of optimal personalised care after treatment—gynaecological cancer (TOPCAT-G): a randomized feasibility trial. Int J Gynecol Cancer. 2018;28(2):401-11.
- Ngu SF, et al. Nurse-led follow-up in survivorship care of gynaecological malignancies—a randomised controlled trial. Eur J Cancer Care (Engl). 2020;29(6):e13325.
- Maurer T, et al. Randomised controlled trial testing the feasibility of an exercise and nutrition intervention for patients with ovarian cancer during and after first-line chemotherapy (BENITA-study). BMJ Open. 2022;12(2):e054091.
- McCloy K, et al. Management of fatigue in gynaecological cancer: a feasibility study of an app-based exercise and mindfulness intervention. Gynecol Oncol Rep. 2025;60:101807.
- Darwish EAF, Tayel SEA, Meleis MEH, Abou Elwafa HE, Shaaban Marouf FSA. A randomized controlled trial of the effect of a psychoeducational intervention program on quality of life of patients with gynecological cancers. Alex J Med. 2025;61(1):6-14.
- Elzeblawy Hassan H, Khalaf Gooda W, Ragabahmed T, Shehta Said Farag D. Marital, sexual satisfaction and quality of life among post-hysterectomy women: impact of nursing counseling guided by BETTER model. Egypt J Health Care. 2025;16(1):99-116.
- Budisan C, et al. Physical, emotional, and stress-related dynamics over six months in newly diagnosed epithelial ovarian cancer survivors. J Clin Med. 2025;14(14):5087.
- Betea R, et al. Quality-of-life trajectories and perceived stress in women treated for uterine cancer: a six-month prospective study. Healthcare (Basel). 2025;13(15):1787.
- Mokhtari-Hessari P, Montazeri A. Health-related quality of life in breast cancer patients: review of reviews from 2008 to 2018. Health Qual Life Outcomes. 2020;18(1):338.
- Aktas D, Terzioglu F. Effect of home care service on the quality of life in patients with gynecological cancer. Asian Pac J Cancer Prev. 2015;16(9):4089-94.
- Ma Y, Kamalibaike M, Xin C, Li L. Effect of the intensive psychological nursing on adverse mood and quality of life in patients with cervical cancer. Am J Transl Res. 2021;13(8):9633-8.