Dit protocol beschrijft de ontwikkeling en evaluatie van een op richtlijnen gebaseerde retrieval-augmented generation chatbot die inhoud ophaalt en samenvat uit webgebaseerde klinische richtlijnen voor kanker om referentie-gebaseerde antwoorden op gebruikersvragen te genereren.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Methodenartikel
Ontwikkeling van een op richtlijnen gebaseerde Retrieval-Augmented Generation Chatbot met verwijzing naar webgebaseerde klinische praktijkrichtlijnen voor kanker
In dit artikel
Samenvatting
Samenvatting
De brede beschikbaarheid van medische informatie op het internet heeft de toegang tot gezondheidsgerelateerde kennis voor patiënten verbeterd; Echter, het heeft ook de blootstelling aan onjuiste medische informatie vergroot. Kankerzorg omvat complexe informatie, waardoor het voor patiënten moeilijk is om nauwkeurige en op bewijs gebaseerde bronnen te identificeren. Grote taalmodellen maken natuurlijke taalinteractie mogelijk, maar veroorzaken vaak hallucinaties, waardoor hun toepassing in de levering van medische informatie beperkt wordt. Retrieval-augmented generation (RAG) heeft het potentieel om deze risico's te beperken door antwoorden te verankeren in externe referentiebronnen. Deze studie beschrijft de ontwikkeling en evaluatie van een op richtlijnen gebaseerde RAG-chatbot die gebruikmaakt van publiek toegankelijke, webgebaseerde klinische richtlijnen voor kanker. Het systeem extraheert URL's uit de inhoudsopgavepagina's van een richtlijn, verwerkt paginatekst met morfologische analyse en cosinusgelijkenis op basis van termfrequentie–inverse documentfrequentie, en construeert referentie-informatie van zeer relevante pagina's. Een groot taalmodel gebruikt deze referenties om antwoorden te genereren die beperkt zijn tot richtlijninhoud. De JLCS Guidebook for Lung Cancer Patients and Families werd als referentierichtlijn gebruikt. De vragensets omvatten zowel in-scope kankertypen die door de richtlijn worden behandeld als out-of-scope kankertypen om responscontrole te evalueren. Medische informatie werd succesvol geëxtraheerd uit de inhoudsopgavepagina's, waarbij 98% van de geëxtraheerde URL's referentiewaardige medische inhoud bevatte. Voor vragen binnen de scope genereerde de chatbot antwoorden door de richtlijninhoud samen te vatten, en er werden geen hallucinaties vastgesteld tijdens handmatige beoordeling onder de gedefinieerde testvoorwaarden. Voor vragen buiten de scope weigerde de chatbot consequent te antwoorden en gaf aan dat de beschikbare informatie onvoldoende was. De webstructuur van de richtlijn maakte efficiënt scrapen en organiseren van referentie-inhoud op URL-niveau mogelijk. Dit protocol biedt praktische richtlijnen voor het construeren van kunstmatige intelligentiesystemen die medische informatie leveren met behulp van webgebaseerde klinische praktijkrichtlijnen.
Inleiding
Het wijdverbreide gebruik van internet en sociale media heeft het voor patiënten gemakkelijker gemaakt om toegang te krijgen tot medische informatie 1,2. Kankerzorginformatie is vaak complex en uitgebreid, waardoor het voor patiënten bijzonder moeilijk is om bronnen te identificeren die nauwkeurig, relevant en gebaseerd zijn op wetenschappelijk bewijs3. Hoewel online bronnen het begrip van patiënten kunnen ondersteunen, bevatten ze ook aanzienlijke hoeveelheden onjuiste medische informatie3, wat de beslissingen van patiënten over hun zorg negatief kan beïnvloeden4. Omdat kankergerelateerde desinformatie patiëntuitkomsten kan beïnvloeden5, is er een toenemende behoefte aan kunstmatige intelligentie (AI)-systemen die individuele gebruikers kunnen helpen medische informatie te zoeken, samen te vatten en te interpreteren6.
Grote taalmodellen (LLM's) stellen gebruikers in staat informatie te benaderen via natuurlijke taalconversatie7; Echter, het ontstaan van desinformatie (d.w.z. hallucinaties) blijft een serieuze zorg in de medische sector 8,9,10,11. Een belangrijke bron van desinformatie is de kwaliteit en nauwkeurigheid van de trainingsdata die is gebruikt om de chatbot te ontwikkelen. Bovendien betekent het statische karakter van modeltraining dat kennis na verloop van tijd verouderd kan raken, waardoor LLM's in staat zijn actuele en contextueel passende informatie te leverenbeperkt 12,13. Deze beperkingen benadrukken het belang van effectieve kennisbeheerstrategieën om ervoor te zorgen dat chatbot-antwoorden accuraat, relevant en up-to-date blijven. Met name systemen die gemakkelijk toegang hebben tot en verwijzen naar actuele evidence-based bronnen, zoals richtlijnen voor klinische praktijk, zijn wenselijk in medische omgevingen, waar aanbevelingen en zorgstandaarden voortdurend evolueren. Om deze uitdaging aan te pakken, heeft retrieval-augmented generation (RAG), die antwoorden genereert door informatie uit externe kennisbronnen te integreren, steeds meer aandacht gekregenvan 10,13,14,15,16,17.
Hoewel RAG steeds vaker wordt toegepast op medische chatbots, is er weinig aandacht besteed aan hoe klinische praktijkrichtlijnen systematisch als referentiebronnen moeten worden opgenomen18. Veel richtlijnen voor de klinische praktijk zijn openbaar beschikbaar op het web; het blijft echter onduidelijk of hun bestaande webstructuur direct kan dienen als een opzoekframework voor RAG-systemen18. Daarnaast zijn praktische methoden voor het construeren van referentie-informatie zonder handmatige kennisontwikkeling nog niet goed vastgesteld.
In deze studie wilden we ontwerpprincipes vaststellen voor richtlijnreferentie-AI-systemen in de medische sector door het ontwikkelen en evalueren van een op richtlijnen gebaseerde RAG-chatbot die gebruikmaakt van publiek toegankelijke, webgebaseerde klinische richtlijnen voor kanker, waardoor eenvoudige en tijdige toegang tot richtlijngebaseerde informatie mogelijk wordt. Als proof of concept evalueerden we de technische haalbaarheid van richtlijnenopvraging, responsgeneratie en responsbeperking met behulp van de bestaande webstructuur van publiek beschikbare klinische praktijkrichtlijnen, met als doel een reproduceerbaar ontwikkelingsprotocol voor richtlijnreferentie-RAG-systemen voor te stellen.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Deze studie betreft geen menselijke proefpersonen die bescherming nodig hebben tegen risico's die bij onderzoek horen. Daarom vereist het geen beoordeling door een institutionele beoordelingscommissie volgens de Japanse ethische richtlijnen voor medisch onderzoek met menselijke proefpersonen19. Deze studie wordt gerapporteerd in overeenstemming met de Transparent Reporting of a Multivariable Model for Individual Prognosis or Diagnosis (TRIPOD)-LLM richtlijnen20.
Zie Figuur 1 voor een schematisch overzicht van het op richtlijnen gebaseerde RAG-chatbotprotocol.
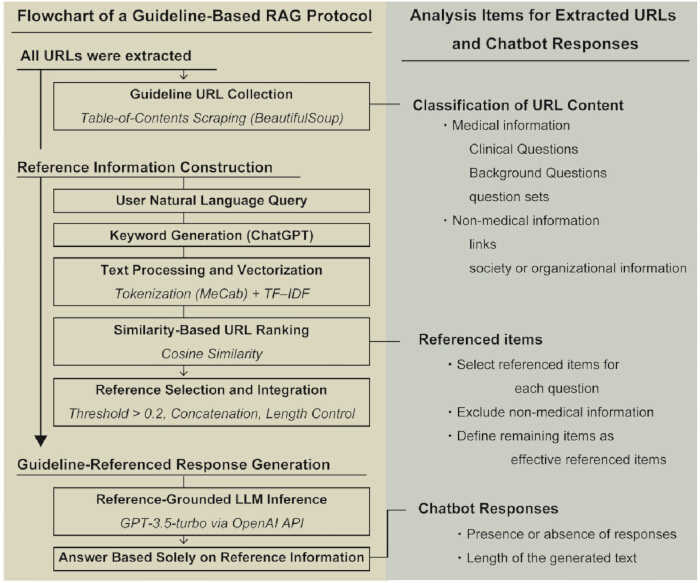
Figuur 1. Werkwijze van het Guideline-Based Retrieval-Augmented Generation (RAG) Chatbot Protocol. Schematisch overzicht van de op richtlijnen gebaseerde RAG-chatbotworkflow. URL's worden gehaald uit de inhoudsopgave van een webgebaseerde klinische praktijkrichtlijn en gebruikt om referentie-informatie te construeren. Gebruikerszoekopdrachten worden omgezet in trefwoorden, en de inhoud van de webpagina wordt verwerkt via tokenisatie, vectorisatie van termfrequentie–inverse documentfrequentie en cosinusgelijkheidsanalyse om relevante richtlijnpagina's te identificeren. Geselecteerde referentie-informatie wordt geïntegreerd en verstrekt aan een groot taalmodel om antwoorden te genereren op basis van uitsluitend de geraadpleegde richtlijninhoud. Het rechterpaneel vat de evaluatie-items samen die zijn gebruikt voor geëxtraheerde URL's, referentie-informatie en chatbotreacties. Klik hier om een grotere versie van deze figuur te bekijken.
1. Voorbereiding van referentie-informatie uit webgebaseerde richtlijnen
- Haal alle URL's uit de inhoudsopgavepagina's van de doelgerichte webgebaseerde klinische praktijkrichtlijnen met behulp van BeautifulSoup 4 (HTML parsing library) geïmplementeerd in de programmeertaal Python (versie 3.12).
OPMERKING: Implementeer het URL-extractiescript met de programmeertaal met de volgende pakketten: HTML parsing library (versie 4.12.3) en requests (webpage retrieval library; versie 2.32.3). Installeer pakketten met pip. De volledige broncode voor URL-extractie wordt verstrekt in Supplementair Bestand 1. Zie de Materiaaltabel voor details over de software. - Controleer handmatig alle geëxtraheerde URL's om succesvolle toegang en relevantie voor de doelgerichte klinische praktijkrichtlijn te bevestigen.
- Classificeer elke URL als bevattend met medische of niet-medische informatie. Voer URL-classificatie uit volgens één auteur (S.N.).
OPMERKING: Medische informatie werd gedefinieerd als referentie-richtlijninhoud, inclusief klinische vragen (CQ's), achtergrondvragen en vragenreeksen. Niet-medische informatie omvatte links, verenigings- of organisatiepagina's en andere aanvullende inhoud die niet geschikt was voor naslagwerk. - Verzamel de gevalideerde URL's in een Microsoft Excel-werkboek (.xlsx formaat), met één URL per rij geregistreerd. Sla de resulterende URL-lijst op als invoerdataset voor latere tekstopvraging, preprocessing en gelijkenisanalyses.
2. Trefwoordgeneratie op basis van gebruikerszoekopdrachten
- Voer de natuurlijke taalquery in in ChatGPT (Generative Pre-trained Transformer, versie 4o; sleutelwoordgeneratiemodel).
- Vraag het model om twee trefwoorden te extraheren die overeenkomen met de gebruikersquery.
- Gebruik de volgende prompt, geschreven in het Japans, voor trefwoordgeneratie:
"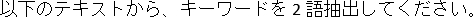 "
(Engelse vertaling: "Haal twee trefwoorden uit de volgende tekst.") - Voeg de natuurlijke taalzoekopdracht van de gebruiker toe aan deze instructie en dien deze in bij het sleutelwoordgeneratiemodel voor trefwoordgeneratie.
- Pas geen modelparameters handmatig aan. Voer trefwoordgeneratie uit met de standaardinstellingen van het sleutelwoordgeneratiemodel.
- Genereer twee trefwoorden voor elke gebruikerszoekopdracht. Bebehoud beide trefwoorden zonder verdere wijziging, filtering of handmatige selectie, en gebruik ze voor latere gelijkenisberekeningen.
- Sla de gegenereerde trefwoorden op in een Microsoft Excel-werkboek (.xlsx formaat). Voor elk record slaat je de originele gebruikersquery en de bijbehorende gegenereerde trefwoorden op voor latere gelijkenisgebaseerde opvraging.
3. Tekstverwerking en gelijkenisberekening
- Haal de volledige tekstinhoud op van elke geëxtraheerde URL met behulp van de webpagina-ophaalbibliotheek en HTML-parsingsbibliotheek. Haal tekstinhoud uit de HTML-bron met behulp van de BeautifulSoup get_text()-functie.
- Verwerk de geëxtraheerde webpaginatekst en gegenereerde trefwoorden vooraf door HTML-tags en niet-Japanse tekens te verwijderen.
- Voer Japanse morfologische analyse uit met MeCab (versie 0.996; Japanse morfologische analyzer) met het standaardwoordenboek. Behou alleen zelfstandige naamwoorden en voeg deze samen tot een spatie-gescheiden tekststring.
- Combineer de gegenereerde trefwoorden tot één tekstreeks en pas dezelfde preprocessing- en tokenisatieprocedures toe die voor webpaginatekst worden gebruikt.
- Genereer termfrequentie–inverse documentfrequentie (TF–IDF) vectoren uit de verwerkte webpaginatekst en trefwoordtekst met behulp van de TfidfVectorizer-implementatie in de scikit-learn-bibliotheek (versie 1.6.1) met standaardparameterinstellingen.
OPMERKING: Alle TfidfVectorizer-parameters bleven op hun standaardwaarden en er werden geen aangepaste parameterinstellingen toegepast. - Bereken de cosinusgelijkenis tussen elke webpaginavector en de zoekwoordvector met behulp van de cosinusgelijkheidsfunctie.
- Rangschik URL's in aflopende volgorde volgens cosinusgelijkheidsscores. Pas geen extra criteria toe om gelijke stand te beslissen.
- Selecteer pagina's met een cosinusgelijkenisscore van ≥0,2 als kandidaatreferentie.
OPMERKING: De cosinusgelijkenisdrempel (0,2) werd empirisch gekozen tijdens de systeemontwikkeling om het terugroepen van retrieval prioriteit te geven en te voorkomen dat mogelijk relevante richtlijninhoud wordt uitgesloten. - Houd alle kandidatenpagina's die aan de gelijkenisdrempel voldoen.
4. Constructie van referentie-informatie
- Haal achtereenvolgens de tekstinhoud van de geselecteerde pagina's uit de bovenkant van de gerangschikte lijst.
- Verbind de geëxtraheerde teksten tot één referentiedocument.
- Vervang vóór indiening bij de LLM regelnieuwe en opeenvolgende witspatietekens in de referentietekst door één spatie.
- Kort de samengevoegde referentietekst af tot de eerste 4.096 tekens voordat deze aan de LLM wordt gegeven.
OPMERKING: De afkortingslimiet was gebaseerd op tekens in plaats van tokens. Een limiet van 4.096 tekens werd empirisch geselecteerd om ervoor te zorgen dat de gecombineerde prompt- en referentieinformatie binnen de invoercapaciteit van het GPT-3.5-turbo-16k responsgeneratiemodel bleef.
5. AI-gebaseerde responsgeneratie
- Geef de geconstrueerde referentie-informatie en de oorspronkelijke gebruikersquery aan het responsgeneratiemodel via de application programming interface (API).
- Geef de AI instructies met de volgende prompt (volledig in het Japans geschreven) om ervoor te zorgen dat antwoorden uitsluitend worden gegenereerd op basis van de verstrekte referentiegegevens:
"Je bent een medisch informatie-assistent die begeleiding geeft aan kankerpatiënten. Genereer antwoorden uitsluitend op basis van de volgende referentiegegevens en gebruik geen eigen algemene kennis of redenering. De antwoorden moeten gedetailleerd en gemakkelijk te begrijpen zijn, ongeveer 500 tekens lang. Als de referentie-informatie niet voldoende informatie bevat om de vraag te beantwoorden, reageer dan met: 'Er is onvoldoende informatie in de tekst,' zonder gebruik te maken van speculatie of algemene kennis." - Geef de referentie-informatie en gebruikersquery samen in één gebruikersbericht. Structureer de invoer als: "Referentie-informatie: [referentietekst]" gevolgd door "Vraag: [gebruikersquery]".
- Genereer antwoorden met het responsgeneratiemodel met de volgende instellingen: temperatuur = 0,1, maximale uitvoerlengte = 1.024 tokens, n = 1, en stop = geen.
- Verkrijg het door AI gegenereerde antwoord voor latere evaluatie.
OPMERKING: Dien de referentiegegevens en gebruikersquery in als één enkel gebruikersbericht. Geef de responsgeneratie-instructies apart als een systeembericht.
6. Referentierichtlijn en vraagformulering
- Selecteer de JLCS Guidebook for Lung Cancer Patients and Families (Lung Guidebook)21, die gratis online beschikbaar is, als referentie-informatie voor het op richtlijnen gebaseerde RAG-chatbotsysteem.
- Creëer twee categorieën evaluatievragen op basis van het type kanker: thymische tumoren, die binnen de richtlijn vallen, en pediatrisch glioom, dat buiten de bestek van de geraadpleegde informatie valt.
- Formuleer vier vragen over diagnose en behandeling voor elk type kanker:
"Welke diagnostische methoden zijn beschikbaar voor XX (bijv. thymische of pediatrische glioom) tumoren?"
"Wat zijn de pathologische diagnostische benaderingen voor XX-tumoren?"
"Welke behandelingsopties zijn er beschikbaar voor XX-tumoren?"
"Wat zijn de chirurgische behandelingsopties voor XX-tumoren?" - Stuur vragen over kankertypen die door de genoemde online gids worden behandeld naar de chatbot. Stel bijvoorbeeld een vraag over de diagnose thymische tumor terwijl je de Longgids als referentie gebruikt.
- Stuur vragen buiten het bereik van de referentierichtlijn naar de chatbot om zijn vermogen te evalueren om geen externe of niet-gerelateerde informatie te gebruiken. Stel bijvoorbeeld een vraag over pediatrisch glioom terwijl je de Lung Guidebook als referentie gebruikt.
- Evalueer elke vraag in een onafhankelijke chatsessie. Neem geen gespreksgeschiedenis mee tussen de vragen door.
- Noteer de door AI gegenereerde antwoorden voor latere evaluatie.
7. Responsevaluatie
- Voer een handmatige controle uit van alle gegenereerde reacties.
- Beoordeel of elke reactie hallucinaties bevat.
- Beoordeel of elk antwoord wordt ondersteund door informatie uit de referentierichtlijn.
OPMERKING: Hallucinaties werden gedefinieerd als reacties die niet-bestaande gebeurtenissen, namen of termen bevatten die mogelijk medische schade konden veroorzaken14. Alle gegenereerde antwoorden werden door één auteur met 8 jaar ervaring in een universitair ziekenhuis beoordeeld op juistheid en afwezigheid van hallucinaties. Eventuele onzekerheid over responsclassificatie werd opgelost door overleg met een arts die coauteur is en meer dan 20 jaar ervaring heeft in kankerinformatiediensten bij het National Cancer Center Japan. - Beschouw een antwoord als alleen ondersteund wanneer alle klinisch relevante uitspraken direct kunnen worden bevestigd uit de opgehaalde referentierichtlijn zonder dat extra kennis of niet-onderbouwde inferentie vereist is.
- Classificeer elke respons met behulp van vooraf gedefinieerde uitkomstlabels. Classificeer antwoorden die alleen informatie bevatten die door de referentierichtlijn wordt ondersteund als "hallucinaties afwezig." Classificeer antwoorden met niet-onderbouwde of gefabriceerde informatie als "aanwezige hallucinatie."
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Terugvindbaarheid van medische inhoud via inhoudsopgavepagina's
De webscraping-architectuur verzamelde URL's van de inhoudsopgavepagina van de richtlijn. Uit de Longgids werden 106 URL's gehaald van de inhoudsopgavepagina, waarvan 104 (98%) medische informatie bevatten (Aanvullende Tabel 1). De effectiviteit van de chatbot-antwoorden op basis van de richtlijnen-inhoudspagina's wordt samengevat in Tabel 1. De c...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
In deze studie onderzochten we het nut van een op richtlijnen gebaseerde RAG-chatbot die een webgebaseerde klinische praktijkrichtlijn—de JLCS Guidebook for Lung Cancer Patients and Families—als referentiebron gebruikte. De chatbot genereerde antwoorden gebaseerd op de richtlijn door gebruik te maken van de webstructuur van de richtlijn en pagina's op te halen op basis van hun gelijkenis met gebruikerszoekopdrachten. Deze aanpak toonde aan dat gelijkenisgebaseerde retrieval gecombineerd ...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs verklaren geen concurrerende belangen.
Dankbetuigingen
De auteurs bedanken Kenichi Inoue, MD, PhD (Shonan Memorial Hospital Breast Center) voor zijn uitgebreide technische ondersteuning bij de ontwikkeling van de op richtlijnen gebaseerde retrieval-augmented generation chatbot. De auteurs bedanken ook Chikako Yamaki, PhD, en alle leden van het onderzoeksteam van het Institute for Cancer Control, National Cancer Center Japan (Tokio, Japan), voor het geven van waardevol advies over het onderwerp dat in dit artikel wordt behandeld. Daarnaast bedanken de auteurs Editage voor de Engelstalige redactie. Dit werk werd ondersteund door een Health and Labour Sciences Research Grant (R6–Cancer Control–23EA1026).
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Beautiful Soup 4 (versie 4.12.3) | Beautiful Soup Project | N/A | Python bibliotheek gebruikt voor URL-extractie en HTML-parsing |
| ChatGPT versie 4o | OpenAI | N/A | Gebruikt voor het genereren van trefwoorden |
| GPT-3.5-turbo | OpenAI | N/A | Gebruikt voor het genereren van reacties |
| JLCS Handleiding voor longkankerpatiënten en familie | Japan Lung Cancer Society | N/A | Webgebaseerde klinische praktijkrichtlijn gebruikt als referentie-informatie |
| MeCab (versie 0.996) | MeCab Project | N/A | Japanse morfologische analyzer |
| OpenAI API | OpenAI | N/A | Gebruikt voor AI-gebaseerde reactiegeneratie |
| Python (versie 3.12) | Python Software Foundation | N/A | Programmeeromgeving |
| Requests (versie 2.32.3) | Requests Project | N/A | Python bibliotheek gebruikt voor het ophalen van webpagina's |
| scikit-learn (versie 1.6.1) | scikit-learn Ontwikkelaars | N/A | Gebruikt voor TF–IDF vectorisatie en cosinus-similariteitsberekening. |
| urllib.parse | Python Software Foundation | N/A | Python bibliotheek gebruikt voor URL-normalisatie en -samenvoeging |
Referenties
- Helft PR, Hlubocky F, Daugherty CK. American oncologists' views of internet use by cancer patients: a mail survey of American Society of Clinical Oncology members. J Clin Oncol. 2003;21(5):942-947.
- Chen X, Siu LL. Impact of the media and the internet on oncology: survey of cancer patients and oncologists in Canada. J Clin Oncol. 2001;19(23):4291-4297.
- Goto Y, et al. Differences in the quality of information on the internet about lung cancer between the United States and Japan. J Thorac Oncol. 2009;4(7):829-833.
- Ogasawara R, et al. Reliability of cancer treatment information on the internet: observational study. JMIR Cancer. 2018;4(2):e10031.
- Johnson SB, Park HS, Gross CP, Yu JB. Complementary medicine, refusal of conventional cancer therapy, and survival among patients with curable cancers. JAMA Oncol. 2018;4(10):1375-1381.
- Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28(1):31-38.
- The Lancet Digital Health. ChatGPT: friend or foe? Lancet Digit Health. 2023;5(3):e102.
- Huang L, et al. A survey on hallucination in large language models: principles, taxonomy, challenges, and open questions. arXiv. 2023;2311.05232.
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):248.
- Yang R, et al. Retrieval-augmented generation for generative artificial intelligence in health care. npj Health Syst. 2025;2(2).
- Zakka C, et al. Almanac—retrieval-augmented language models for clinical medicine. NEJM AI. 2024;1(2):AIoa2300068.
- Chow JCL, Li K. Developing effective frameworks for large language model-based medical chatbots: insights from radiotherapy education with ChatGPT. JMIR Cancer. 2025;11:e66633.
- Chow JCL, Li K. Large language models in medical chatbots: opportunities, challenges, and the need to address AI risks. Information. 2025;16(7):549.
- Nishisako S, Higashi T, Wakao F. Reducing hallucinations and trade-offs in responses in generative AI chatbots for cancer information: development and evaluation study. JMIR Cancer. 2025;11:e70176.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-9474.
- Gao Y, et al. Retrieval-augmented generation for large language models: a survey. arXiv. 2023;2312.10997.
- Jeong M, Sohn J, Sung M, Kang JJB. Improving medical reasoning through retrieval and self-reflection with retrieval-augmented large language models. Bioinformatics. 2024;40:i119-i129.
- Lewis M, et al. Grounding large language models in clinical evidence: a retrieval-augmented generation system for querying UK NICE clinical guidelines. arXiv. 2025;2510.02967.
- Ministry of Education, Culture, Sports, Science and Technology; Ministry of Health, Labour and Welfare; Ministry of Economy, Trade and Industry. Ethical guidelines for medical and biological research involving human subjects [Article in Japanese]. Ministry of Health, Labour and Welfare.
- Gallifant J, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nat Med. 2025;31:60-69.
- The Japanese Lung Cancer Society. JLCS Guidebook for Lung Cancer Patients and Families. Available at: https://www.haigan.gr.jp/public/guidebook/2024/. Accessed January 21, 2026.
- Liu M, et al. Evaluating the effectiveness of advanced large language models in medical knowledge: a comparative study using Japanese national medical examination. Int J Med Inform. 2025;193:105673.
- Kudo T, Yamamoto K, Matsumoto Y. Applying conditional random fields to Japanese morphological analysis. In: Proceedings of the 2004 Conference on Empirical Methods in Natural Language Processing. 2004:230-237.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.