Deze prospectieve observationele studie beschrijft de ontwikkeling en interne validatie van een voorspellend model dat gebruikmaakt van parameters uit transabdominale en transperineale echografie in de eerste fase, gecombineerd met klinische kenmerken van de moeder, om de vroegtijdige identificatie van vrouwen met een risico op een verlengde tweede fase van de bevalling te vergemakkelijken.
Onderzoeksartikel
Ontwikkeling en interne validatie van een predictief model voor een verlengde tweede fase van de bevalling op basis van gegevens uit de eerste fase: een prospectieve observationele studie
22 weergaven
⸱
11 september 2026
* These authors contributed equally
In dit artikel
Samenvatting
Samenvatting
Verlenging van de tweede fase van de bevalling is geassocieerd met ongunstige maternale en neonatale uitkomsten, waardoor vroege risico-identificatie klinisch belangrijk is. Deze studie beoordeelde of de combinatie van transabdominale en transperineale echografieparameters, verkregen tijdens de eerste fase van de bevalling, een verlengde tweede fase kon voorspellen. In deze prospectieve observationele studie werden primipare vrouwen opgenomen die een transabdominale en transperineale echografie ondergingen tijdens de actieve eerste fase van de bevalling. De foetale positie, de progressiehoek (AOP), de afstand tussen het hoofd en de pubische symfyse, de afstand tussen het hoofd en het perineum en maternale klinische kenmerken werden genoteerd. De deelnemers werden ingedeeld in groepen met een normale (≤120 min) en een verlengde (>120 minuten) tweede fase. Least absolute shrinkage and selection operator (LASSO) regressie werd gebruikt om de belangrijkste predictoren te selecteren, en multivariabele logistieke regressie identificeerde onafhankelijke predictoren voor modelontwikkeling. De voorspellende prestatie werd geëvalueerd met behulp van receiver operating characteristic (ROC) curve-analyse, kalibratie en decision curve analysis (DCA) tijdens interne validatie. De analyse omvatte 159 primipare vrouwen (95 normaal en 64 verlengd). In vergelijking met de normale groep had de verlengde groep een hogere incidentie van foetale distress (31,2% vs 15,8%, p = 0,035) en lage Apgar-scores (70,3% vs 36,8%, p < 0,001). LASSO-regressie identificeerde vier belangrijke predictoren: maternale leeftijd, toename van de bodymassindex tijdens de zwangerschap, neonatale geboortegewicht en AOP; deze bleven allen onafhankelijke predictoren (p < 0,05). Het voorspellingsmodel behaalde een area under the ROC curve van 0,927 en vertoonde een goede discriminatie, kalibratie en klinische bruikbaarheid bij interne validatie. Echografieparameters uit de eerste fase, gecombineerd met maternale klinische kenmerken, kunnen de vroege identificatie van hoogrisico primipare vrouwen vergemakkelijken en het beheer tijdens de bevalling ondersteunen.
Inleiding
Langdurige arbeid is al lange tijd een groot aandachtspunt binnen de verloskundige praktijk. In het bijzonder draagt verlenging van de tweede fase niet alleen bij aan meer pijn bij de moeder, maar leidt het ook tot ongunstige neonatale uitkomsten.1Volgens de nieuwste richtlijnen van de Wereldgezondheidsorganisatie (WHO) is de normale duur van de tweede fase van de bevalling ≤120 min. Met andere woorden, een tweede fase die >120 min wordt beschouwd als verlengd. De wereldwijde incidentie van een verlengde tweede fase wordt geschat op 3%–8%.1,2Dergelijke verlenging verhoogt de risico's op infectie van de moeder, keizersneden, postpartumbloedingen, foetale distress, lage Apgar-scores (Appearance, Pulse, Grimace, Activity, Respiration) en perinatale mortaliteit.1Eerdere studies hebben aangetoond dat de leeftijd van de moeder, de toename van de bodymassindex (BMI) tijdens de zwangerschap en het geboortegewicht van de neonatus geassocieerd zijn met een verlengde tweede fase van de bevalling; hun voorspellende waarde blijft echter beperkt.3Daarom is het identificeren van effectievere predictoren van groot belang om tijdige klinische interventies te faciliteren, de voortgang van de bevalling te optimaliseren, het voorkomen van langdurige bevallingen te verminderen en de uitkomsten voor moeder en pasgeborene te verbeteren.
In recente jaren is echografische beeldvorming steeds meer geïntegreerd in de obstetrische zorg, in het bijzonder bij het intrapartale management, omdat het een objectieve beoordeling in realtime mogelijk maakt van de foetale positie, oriëntatie en afdaling3,4. Bewijzen suggereren dat intrapartale echografie een belangrijke rol speelt bij het voorspellen van de voortgang van de arbeid, het evalueren van de foetale status en het sturen van klinische besluitvorming met betrekking tot de wijze van bevalling5. Desalniettemin blijven er belangrijke hiaten in de huidige literatuur. Ten eerste hebben relatief weinig studies specifiek onderzoek gedaan naar het gebruik van echografische parameters om een verlengde tweede fase van de arbeid te voorspellen. Ten tweede, hoewel de positie van de foetale kop, de foetale positie en hun ruimtelijke relatie tot het materne bekken tijdens de eerste fase van de arbeid de duur van de tweede fase direct kunnen beïnvloeden6, blijven studies die deze echografische parameters uit de eerste fase evalueren in relatie tot verlenging van de tweede fase beperkt.
Tegen deze achtergrond verzamelde de huidige prospectieve observationele studie bevallingsgegevens uit één centrum tijdens de eerste fase van de arbeid. Echografieparameters werden verkregen via transabdominale en transperineale scanning, waaronder de afstand van het hoofd tot de symfyse (HSD), de progressiehoek (AOP) en de afstand van het hoofd tot het perineum (HPD). In tegenstelling tot eerdere echografie-gebaseerde studies, die zich primair richtten op het voorspellen van onmiddellijke bevallingsuitkomsten of de noodzaak van operatieve interventie tijdens de tweede fase van de arbeid, onderzocht de huidige studie specifiek de vroege voorspelling van een verlengde tweede fase van de arbeid op basis van echografieparameters uit de eerste fase. Deze parameters werden gecombineerd met demografische en klinische kenmerken van de moeder om hun voorspellende waarde voor een verlengde tweede fase van de arbeid te evalueren. Deze aanpak vult een belangrijke kennislacuna op, aangezien er geen eerdere studie was die multidimensionale echografiebevindingen uit de eerste fase integreerde met klinische kenmerken van de moeder in een voorspellend model voor verlenging van de tweede fase. Conform dit doel werd een voorspellend model ontwikkeld en intern gevalideerd. De verwachting is dat deze studie clinici voorziet van een objectief instrument voor de vroege identificatie van primiparae met een risico op een verlengde tweede fase van de arbeid tijdens de eerste fase van de arbeid, waardoor een meer geïndividualiseerd intrapartum management en verbeterde maternale en neonatale uitkomsten worden ondersteund.
Protocol
Deze studie is uitgevoerd in overeenstemming met de Verklaring van Helsinki en is goedgekeurd door de Ethische Commissie van het Yuyao Maternal and Child Health Hospital (Yuyao Second People’s Hospital) (goedkeuringsnummer YMCH-EC-2023KT-0012). Alle deelnemers hebben schriftelijke geïnformeerde toestemming gegeven.
Studiedeelnemers
Primipare vrouwen met een spontane begin van de bevalling die succesvol een vaginale bevalling ondergingen, werden geïncludeerd. Dit maakte een nauwkeurige registratie van de duur van de tweede fase mogelijk, wat vereist was voor het voorspellende model. De geschiktheidscriteria waren als volgt: (1) een zwangerschap van één foetus met een zwangerschapsduur van ≥37 weken; (2) hoofdpresentatie; en (3) geïnformeerde toestemming verkregen van zowel de deelnemer als haar familie. De exclusiecriteria omvatten het volgende: (1) absolute contra-indicaties voor een bevallingspoging vastgesteld tijdens de actieve fase (bijv. placenta previa, vasa previa, navelstrengprolaps); en/of (2) secundaire uterusinertie (gedefinieerd als het uitblijven van voortgang van de cervixdilatatie of foetale afdaling gedurende ≥4 u, ondanks oxytocine-augmentatie of amniotomie). Vrouwen die een inleiding van de bevalling ondergingen, werden eveneens uitgesloten.
Opvallend is dat vrouwen die een spoedoperatieve interventie nodig hadden (keizersnedé of instrumentele bevalling) vanwege acute foetale distress tijdens de tweede fase, werden behandeld volgens de klinische richtlijnen, maar niet zijn opgenomen in deze analyse om de volledigheid van de gegevens over de duur van de bevalling te waarborgen.
De steekproefomvang werd berekend op basis van de resultaten van een voorlopige studie (n = 30, waarbij de incidentie van verlenging van de tweede fase 20% was). Met α ingesteld op 0,05 en β op 0,20, uitgaande van een geschatte incidentie van verlenging van de tweede fase van ongeveer 20%, waren minimaal 150 deelnemers nodig om een significante voorspeller met een odds ratio (OR) ≥ 2,5 te detecteren. In totaal werden 159 vrouwen opgenomen in de definitieve analyse.
Verzameling van klinische gegevens
Maternale variabelen omvatten leeftijd, toename van de gestationele body mass index (BMI) (gedefinieerd als het verschil tussen de BMI vóór de zwangerschap en de BMI vóór de bevalling), zwangerschapsdiabetes, zwangerschapshypertensie, mentale toestand (beoordeeld met de Self-Rating Anxiety Scale, waarbij een score ≥50 duidt op angst), uterine inertie (specifiek verwijzend naar een klinisch beoordeeld hypotoon contractiepatroon, gedefinieerd als uterine contracties met intervallen >5 min of een duur van <30 s, onderscheiden van de definitie van arbeidsstilstand van het American College of Obstetricians and Gynecologists [ACOG]), en pariteit. Neonatale variabelen omvatten het geboortegewicht (kg), foetale distress (gedefinieerd als recurrente late of variabele vertragingen op de cardiotocografie of een basale foetale hartslag van <110 beats/min of >160 beats/min), en de Apgar-score (waarbij een score van <7 na 1 min als laag wordt geclassificeerd).
Zwangerschapsdiabetes werd gediagnosticeerd volgens de criteria van de International Association of Diabetes and Pregnancy Study Groups (nuchtere glucose 5,1–6,9 mmol/L of 1 u ≥10,0 mmol/L of 2 u 8,5–11,0 mmol/L bij de 75 g orale glucosetolerantietest tussen 24–28 weken). Zwangerschaps hypertensie werd gedefinieerd volgens de ACOG-richtlijnen (systolische bloeddruk ≥140 mmHg of diastolische bloeddruk ≥90 mmHg, twee keer gemeten met een tussenpoos van ≥4 u na 20 weken zwangerschap, zonder proteïnurie). Foetale distress op de cardiotocografie werd gedefinieerd als recurrente late deceleraties (≥50% van de contracties), recurrente variabele deceleraties met een duur van >60 s, verlengde deceleratie met een duur van 2–10 min, of een basale foetale hartslag van <110 of >160 beats/min gedurende ≥10 min (criteria van het National Institute for Health and Care Excellence [NICE]). Uterine inertie (hypotone contracties) werd gedefinieerd als contractie-intervallen >5 min of een contractieduur van <30 s over 30 min, beoordeeld via palpatie of tocodynamometrie. De mentale toestand (angst) werd bij opname (cervicale dilatatie < 4 cm) beoordeeld met de Self-Rating Anxiety Scale, waarbij een ruwe score van ≥50 (gestandaardiseerde index) als abnormaal werd geclassificeerd. Een lage Apgar-score werd gedefinieerd als een score van <7 na 1 min (WHO).
Omdat dit een observationele studie was, volgde het beheer van de arbeid de routineuze klinische praktijk zonder gestandaardiseerd protocol. Echter werden epidurale analgesie (ja/nee, timing, duur), oxytocine-augmentatie (ja/nee, totale dosis, duur), kunstmatig vruchtzakbreken (ja/nee, cervixdilatatie tijdens de procedure) en de wijze van bevalling (uitsluitend spontane vaginale bevalling, volgens de inclusiecriteria) systematisch geregistreerd. Er werd geen significante interactie waargenomen tussen deze variabelen en de primaire modelpredictoren.
Transabdominale en Transperineale Echografische Onderzoek in de Vroege Eerste Fase van de Arbeid
Echografische scanning werd uitgevoerd aan het begin van de actieve fase van de arbeid (cervixdilatatie ≥4 cm). De barende werd in rugligging geplaatst met een linkse zijligging van 15° na lediging van de blaas. Voor transperineale scanning werden de dijen licht abduceerd en geflecteerd. Alle beelden werden vastgelegd op het hoogtepunt van een uteruscontractie, wat werd vastgesteld via klinische palpatie in combinatie met externe tocodynamometrie (cardiotocografie) om het piekpunt van elke contractie te bevestigen. Elke meting werd herhaald tijdens drie afzonderlijke contracties, waarbij de gemiddelde waarde voor de analyse werd gebruikt. Echografische onderzoeken werden uitgevoerd met een draagbaar diagnostisch echografie-systeem (zie Tabel met Materialen). Voor transabdominale beeldvorming werd een convex probe (2–5 MHz) gebruikt; voor transperineale beeldvorming werd een hoogfrequent lineaire of kleine-voetafdruk convex probe (5–8 MHz) gebruikt. De beeldinstellingen werden gestandaardiseerd (diepte 6–10 cm, geoptimaliseerde gain en een enkele focuszone gepositioneerd bij de symfyse pubis).
Voor de beoordeling van de foetale positie werd met een transabdominale transversale scan de foetale oogkas, het cerebellum en de thalamische middellijn ten opzichte van het materne bekken geïdentificeerd om te bepalen of er sprake was van een occiput anterior (OA), transversale of posterior positie. Voor transperineale metingen werd de transducer voorzien van een steriele hoes en in het midsagittale vlak op het perineum geplaatst zonder overmatige druk. Anatomische referentiepunten omvatten de gehele symfysis pubica, de contour van de foetale schedel en de anorectale overgang.
De volgende parameters werden gemeten (Figuur 1A–D): de voortgangshoek (angle of progression, AOP), gedefinieerd als de hoek tussen de lange as van de symfyse pubis en een lijn die zich uitstrekt van de onderrand tot het diepste punt van de foetale schedel; de middenlijnhoek (midline angle, MLA), gedefinieerd als de hoek tussen de middenlijn van de foetale schedel (falx cerebri) en de anteroposterieure as van het moederlijke bekken; de afstand tussen hoofd en symfyse (head–symphysis distance, HSD), gedefinieerd als de afstand van de onderrand van de symfyse pubis tot het dichtstbijzijnde punt op de foetale schedel; en de afstand tussen hoofd en perineum (head–perineum distance, HPD), gedefinieerd als de kortste afstand van de buitenkant van de foetale schedel tot de huid van het perineum7.
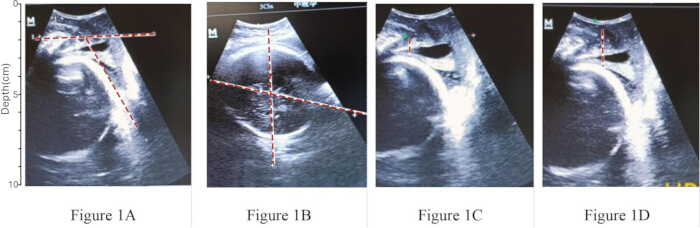
Figuur 1. Echografische metingen verkregen tijdens de eerste fase van de ontsluiting. (A) Meting van de progressiehoek (AOP), gedefinieerd als de hoek tussen de lange as van de symfyse pubis en een lijn die zich uitstrekt van de inferieure rand tot het diepste punt van de foetale schedel. (B) Meting van de middenlijnhoek (MLA), gedefinieerd als de hoek tussen de middenlijn van de foetale schedel (falx cerebri) en de anteroposterieure as van het bekken van de moeder. (C) Meting van de afstand tussen de schedel en de symfyse (HSD), gedefinieerd als de afstand van de inferieure rand van de symfyse pubis tot het dichtstbijzijnde punt op de foetale schedel. (D) Meting van de afstand tussen de schedel en het perineum (HPD), gedefinieerd als de kortste afstand van het buitenoppervlak van de foetale schedel tot de perineale huid van de moeder. Klik hier om een grotere versie van deze figuur te bekijken.
Elke meting werd drie keer uitgevoerd tijdens drie afzonderlijke contractiepieken, en de gemiddelde waarde werd gebruikt voor de analyse. Alle onderzoeken werden uitgevoerd door drie ervaren echografisten (elk met ≥10 jaar ervaring in obstetrische echografie), die vóór de studie een gestandaardiseerde training in intrapartum transperineale echografische metingen hadden voltooid. Competentie werd bevestigd door het behalen van een intraclass correlatiecoëfficiënt (ICC) van ≥0,90 ten opzichte van een gouden-standaard beoordelaar (senior auteur). De inter- en intra-waarnemer reproduceerbaarheid werden beoordeeld tijdens een pilotfase met 10 patiënten (niet opgenomen in de hoofdstudie), wat resulteerde in ICC's variërend van 0,89 tot 0,96 voor alle parameters (AOP, HSD, HPD en MLA).
Voor de acceptatie van beelden was een duidelijke visualisatie van de symfyse pubica, de contour van de foetale schedel en de anorectale junctie vereist. Beelden met overmatige druk van de transducer of slecht gevisualiseerde anatomische herkenningspunten werden verworpen en opnieuw verkregen. Echografen waren geblinderd voor de groepstoewijzing (normaal versus verlengde tweede fase) en voor klinische gegevens tijdens de beeldverwerving en meting. Gegevens werden dubbel ingevoerd met bereikcontroles, waarbij waarden buiten het bereik leidden tot een herbeoordeling van het beeld. Ontbrekende gegevens (<5%) werden behandeld via een complete-case analyse, nadat was bevestigd dat de gegevens willekeurig ontbraken (Little's missing completely at random test, p > 0,05).
Registratie en Groepering van de Arbeidsduur
Gedurende het gehele arbeidsproces werd het verloop van de bevalling voor elke deelnemer zorgvuldig gedocumenteerd. De eerste fase van de arbeid werd gedefinieerd als de periode vanaf het begin van regelmatige uteruscontracties tot volledige cervicale dilatatie (10 cm). De actieve fase van de arbeid werd gedefinieerd als een cervicale dilatatie ≥4 cm vergezeld gaande van geïntensiveerde, regelmatige uteruscontracties. De tweede fase van de arbeid werd gedefinieerd als de periode vanaf volledige cervicale dilatatie (10 cm) tot volledige expulsie van de foetus. Er werden echografische onderzoeken uitgevoerd tijdens de actieve fase van de eerste fase van de arbeid om de positie van de foetale kop, de foetale presentatie en gerelateerde echografieparameters te beoordelen. Volgens de richtlijnen van de Wereldgezondheidsorganisatie (WHO) mag een normale tweede fase van de arbeid 120 min2 niet overschrijden. Om een gestandaardiseerde onderzoeksdrempel voor alle primipara's in deze studie te handhaven, werden deelnemers op basis van dit 120-minuutencriterium in twee groepen ingedeeld: een groep met een normale tweede fase (≤120 min) en een groep met een verlengde tweede fase (>120 min).
Statistische analyse
Alle statistische analyses zijn uitgevoerd met SPSS versie 26.0 (RRID:SCR_002865) en R versie 4.1.0 (RRID:SCR_001905) (zie Tabel van Materialen). De volgende R-pakketten zijn gebruikt: glmnet (versie 4.1-2) voor least absolute shrinkage and selection operator (LASSO) regressie, rms (versie 6.2-0) voor de constructie en kalibratie van nomogrammen, pROC (versie 1.18.0) voor receiver operating characteristic (ROC) analyse, en rmda (versie 1.6) voor decision curve analyse (DCA). De normaliteit van continue variabelen is beoordeeld met de Shapiro–Wilk test om de keuze van descriptieve statistieken en vergelijkingsmethoden te sturen. Normaal verdeelde gegevens zijn weergegeven als gemiddelde ± standaarddeviatie (x̄ ± s) en vergeleken met de t-test voor onafhankelijke steekproeven, die robuust is voor lichte afwijkingen van normaliteit bij adequate steekproefgroottes. Niet-normaal verdeelde gegevens zijn weergegeven als de mediaan met interkwartielafstand (M [P25, P75]) en vergeleken met de Mann–Whitney U-test, die beoordeelt of één distributie de neiging heeft grotere waarden te hebben dan de andere, in plaats van strikt verschillen in medianen te testen. Categorische variabelen zijn weergegeven als aantallen en percentages (n [%]) en vergeleken met de chi-kwadraat (χ2) test of de exacte toets van Fisher wanneer de verwachte frequentie <5 was. Alle tests waren tweezijdig, en een p-waarde <0.05 werd beschouwd als statistisch significant. Variabelen met p <0.1 in de univariate analyse werden ingevoerd in de LASSO-regressie voor variabeleselectie. De LASSO-regressie is uitgevoerd met het glmnet-pakket met 10-voudige kruisvalidering om de optimale regularisatieparameter (λ) te bepalen. Het one-standard-error-criterium (de grootste λ binnen één standaardfout van de minimale kruisvalideringsfout) is toegepast om de meest beknopte set predictoren met niet-nulcoëfficiënten te selecteren. Voorafgaand aan het LASSO-fitting werden alle continue predictoren (maternel leeftijd, stijging van de BMI tijdens de zwangerschap, AOP, HSD, HPD en neonatale geboortegewicht) gecentreerd en gestandaardiseerd naar z-scores met de standaard glmnet-instelling (standardize = TRUE), zodat coëfficiënten gelijkmatig werden bestraft ongeacht de meeteenheden. De geselecteerde variabelen werden vervolgens ingevoerd in een multivariabel logistisch regressiemodel (enter-methode) om gecorrigeerde odds ratio's (aOR's) en 95% betrouwbaarheidsintervallen (CI's) te berekenen. De significantie van het model is beoordeeld met de likelihood ratio test.
Op basis van de coëfficiënten van de logistische regressie werd een predictief model geconstrueerd als Logit(P) = β0 + Σ(βiXi). Dit model werd gevisualiseerd als een nomogram met behulp van het rms-pakket, waarbij aan elke predictor een puntenwaarde werd toegekend die proportioneel was aan de regressiecoëfficiënt, en de totale punten werden gekoppeld aan de voorspelde kansen. De discriminatie werd geëvalueerd door de ROC-curve te plotten en de oppervlakte onder de curve (AUC) met het bijbehorende 95% BI te berekenen met behulp van het pROC-pakket (bootstrap-methode met 1.000 resamples). De optimale afkapwaarde voor de kans werd bepaald door de Youden-index (sensitiviteit + specificiteit − 1) te maximaliseren, waarbij de overeenkomstige sensitiviteit en specificiteit werden gerapporteerd. De kalibratie werd beoordeeld met een kalibratiecurve gegenereerd uit 1.000 bootstrap-resamples (rms-pakket), aangevuld met de Hosmer–Lemeshow goodness-of-fit test (een niet-significante p-waarde duidt op een goede kalibratie). Het klinische nut werd geëvalueerd met DCA via het rmda-pakket, dat het netto voordeel berekent over een bereik van drempelwaardekansen (0%–100%). Netto voordeel werd gedefinieerd als (ware positieven / n) − (valse positieven / n) × (drempelwaardekans / [1 − drempelwaardekans]). De algemene workflow van de studie is hierboven beschreven en geïllustreerd in Aanvullende Figuur 1. Dit model is exploratief; de predictor neonataal geboortegewicht verwijst naar het daadwerkelijke gewicht gemeten na de bevalling, en klinische predictie zou een herkalibratie van het model vereisen met gebruik van het geschatte foetale gewicht (EFW) verkregen vóór de bevalling.
Resultaten
Studiepopulatie en Groepsindeling
In totaal werden 159vrouwen in de laatste analyse opgenomen. Hiervan hadden 95 een normale duur van de tweede fase, terwijl 64 een verlengde tweede fase ondervonden (Tabel 1). Vergeleken met de normale groep had de verlengde groep significant hogere incidenties van foetale distress en lage Apgar-scores (beide p < 0,05). Er werd geen significant verschil in perinatale mortaliteit waargenomen tussen de groepen (p > 0,05).
| Variabele | Alles (N = 159) | Normale tweede fase (N = 95) | Verlengde tweede fase (N = 64) | p-waarde |
| Duur tweede fase (min) | 109 [40.5; 172] | 88.4 [40.5; 125] | 139 [100; 172] | <0.0001 |
| Foetale distress | 0.0347 | |||
| Afwezig | 124 (78.0%) | 80 (84.2%) | 44 (68.8%) | |
| Presenteren | 35 (22.0%) | 15 (15.8%) | 20 (31.2%) | |
| Lage Apgar-score | 0.0001 | |||
| Nee | 79 (49.7%) | 60 (63.2%) | 19 (29.7%) | |
| Ja | 80 (50.3%) | 35 (36.8%) | 45 (70.3%) | |
| Perinatale mortaliteit | 0.5653 | |||
| Afwezig | 156 (98.1%) | 94 (98.9%) | 62 (96.9%) | |
| Presenteren | 3 (1.89%) | 1 (1.05%) | 2 (3.12%) |
Tabel 1: Effect van een verlengde tweede fase van de bevalling op de klinische uitkomsten van de neonatus. Continue variabelen worden weergegeven als mediaan [interkwartielafstand (IQR)], en categorische variabelen worden weergegeven als aantal (%). De groep met een normale tweede fase van de bevalling bestond uit deelnemers met een duur van de tweede fase van ≤120 min, terwijl de groep met een verlengde tweede fase van de bevalling bestond uit deelnemers met een duur van de tweede fase van >120 min. Een lage Apgar-score (Appearance, Pulse, Grimace, Activity, and Respiration) werd gedefinieerd als een Apgar-score na 1 min <7. P-waarden vertegenwoordigen vergelijkingen tussen de groepen met een normale en een verlengde tweede fase van de bevalling.
Een vergelijking van de demografische en klinische kenmerken tussen de twee groepen wordt gepresenteerd in Tabel 2. Kraamvrouwen met een verlengde tweede fase hadden een hogere mediane moederlijke leeftijd en een grotere toename van de BMI tijdens de zwangerschap dan vrouwen met een normale tweede fase. De frequenties van zwangerschapsdiabetes, uterine inertie en een veranderde mentale toestand waren ook significant hoger in de verlengde groep (allemaal p < 0,05). Er werden geen significante verschillen tussen de groepen waargenomen wat betreft zwangerschapshypertensie of de zwangerschapsduur bij de bevalling (beide p > 0,05).
| Variabele | Totaal (N = 159) | Normale tweede fase (N = 95) | Verlengde tweede fase (N = 64) | P-waarde |
| Leeftijd (jaar) | 28.8 [19.4; 44.9] | 26.3 [19.4; 33.2] | 32.4 [22.3; 44.9] | <0.0001 |
| Toename BMI tijdens zwangerschap (kg/m²) | 11.4 ± 3.62 | 10.1 ± 3.33 | 13.3 ± 3.17 | <0.0001 |
| Zwangerschapsdiabetes | 0.0002 | |||
| Afwezig | 141 (88.7%) | 92 (96.8%) | 49 (76.6%) | |
| Aanwezig | 18 (11.3%) | 3 (3.16%) | 15 (23.4%) | |
| Zwangerschapshypertensie | 0.8723 | |||
| Afwezig | 124 (78.0%) | 75 (78.9%) | 49 (76.6%) | |
| Aanwezig | 35 (22.0%) | 20 (21.1%) | 15 (23.4%) | |
| Geboortegewicht neonatus (kg) | 2.61 [1.68; 4.60] | 2.46 [1.68; 2.85] | 3.39 [1.71; 4.60] | <0.0001 |
| Mentale toestand | 0.0017 | |||
| Veranderd | 139 (87.4%) | 90 (94.7%) | 49 (76.6%) | |
| Gezond | 20 (12.6%) | 5 (5.26%) | 15 (23.4%) | |
| Uterine inertie | <0.0001 | |||
| Afwezig | 123 (77.4%) | 85 (89.5%) | 38 (59.4%) | |
| Aanwezig | 36 (22.6%) | 10 (10.5%) | 26 (40.6%) | |
| Zwangerschapsduur (weken) | 38.1 ± 2.02 | 38.1 ± 1.99 | 37.9 ± 2.06 | 0.5156 |
Tabel 2: Vergelijking van demografische en klinische kenmerken tussen groepen. Continue variabelen worden weergegeven als respectievelijk gemiddelde ± standaarddeviatie (SD) of mediaan [interkwartielafstand (IQR)], afhankelijk van de relevantie. Categorische variabelen worden weergegeven als aantal (%). De toename van de bodymassa-index (BMI) werd gedefinieerd als het verschil tussen de BMI vóór de zwangerschap en de BMI vóór de bevalling. De groep met een normale tweede fase van de bevalling bestond uit deelnemers met een duur van de tweede fase van ≤120 min, terwijl de groep met een verlengde tweede fase van de bevalling bestond uit deelnemers met een duur van de tweede fase van >120 min. P-waarden vertegenwoordigen vergelijkingen tussen de twee groepen.
Klinische en echografische parameters tijdens de actieve eerste fase
Transabdominale en transperineale echografieparameters van de eerste fase werden vergeleken tussen de groepen met een normale en een verlengde tweede fase (Tabel 3). Het aandeel foetale positie OA was significant lager in de groep met een verlengde fase dan in de normale groep. Daarnaast waren AOP, HSD en HPD significant groter bij primigravidae die een verlengde tweede fase ondergingen (alle p < 0,05).
| Variabele | Alles (N = 159) | Normale tweede fase (N = 95) | Verlengde tweede fase (N = 64) | p-waarde |
| Foetale houding | <0.0001 | |||
| OA | 74 (46.5%) | 60 (63.2%) | 14 (21.9%) | |
| Niet-OA | 85 (53.5%) | 35 (36.8%) | 50 (78.1%) | |
| AOP (°) | 124 [64.3; 158] | 111 [64.3; 142] | 138 [123; 158] | <0.0001 |
| HSD (cm) | 1.97 ± 0.39 | 1.81 ± 0.33 | 2.21 ± 0.34 | <0.0001 |
| HPD (cm) | 4.61 ± 0.71 | 4.23 ± 0.56 | 5.17 ± 0.51 | <0.0001 |
Tabel 3: Vergelijking van transabdominale en transperineale echografieparameters tijdens de eerste fase van de arbeid. Continue variabelen worden weergegeven als het gemiddelde ± standaarddeviatie (SD) of de mediaan [interkwartielafstand (IQR)], afhankelijk van wat van toepassing is. Categorische variabelen worden weergegeven als aantal (%). OA, occiput anterior; non-OA, niet-occiput anterior; AOP, progressiehoek; HSD, afstand hoofd-symphyse; HPD, afstand hoofd-perineum. AOP werd gemeten in graden (°), terwijl HSD en HPD werden gemeten in centimeters (cm). De groep met een normale tweede fase van de arbeid bestond uit deelnemers met een duur van de tweede fase van ≤120 min, terwijl de groep met een verlengde tweede fase van de arbeid bestond uit deelnemers met een duur van de tweede fase van >120 min. P-waarden vertegenwoordigen vergelijkingen tussen de twee groepen.
Univariante analyse van potentiële predictoren
Er werden univariante analyses uitgevoerd om variabelen te identificeren die geassocieerd waren met een verlengde tweede fase van de bevalling (Tabel 4). Tien variabelen verschilden significant tussen de normale en de verlengde groepen (p < 0,10): moederlijke leeftijd, toename van de BMI tijdens de zwangerschap, zwangerschapsdiabetes, geboortegewicht van de neonaat, mentale toestand, uteruse inertie, foetale positie, AOP, HSD en HPD. Er werden geen significante verschillen tussen de groepen waargenomen voor zwangerschapshypertensie of zwangerschapsduur (beide p > 0,10). Variabelen met een p < 0,10 werden vervolgens ingevoerd in het LASSO-regressiemodel voor variabele selectie.
| Variabele | Totaal (N = 159) | Normale tweede fase (N = 95) | Verlengde tweede fase (N = 64) | Statistiek | P-waarde |
| Demografische en klinische kenmerken | |||||
| Leeftijd (jaar) | 28.8 [19.4; 44.9] | 26.3 [19.4; 33.2] | 32.4 [22.3; 44.9] | Z = −5.891 | <0.001 |
| Toename BMI tijdens zwangerschap (kg/m²) | 11.4 ± 3.62 | 10.1 ± 3.33 | 13.3 ± 3.17 | t = −5.912 | <0.001 |
| Zwangerschapsdiabetes, n (%) | 18 (11.3) | 3 (3.2) | 15 (23.4) | χ² = 15.207 | <0.001 |
| Zwangerschapshypertensie, n (%) | 35 (22.0) | 20 (21.1) | 15 (23.4) | χ² = 0.135 | 0.872 |
| Geboortegewicht neonatus (kg) | 2.61 [1.68; 4.60] | 2.46 [1.68; 2.85] | 3.39 [1.71; 4.60] | Z = −6.234 | <0.001 |
| Veranderde mentale status, n (%) | 139 (87.4) | 90 (94.7) | 49 (76.6) | χ² = 10.912 | 0.001 |
| Uterine inertie, n (%) | 36 (22.6) | 10 (10.5) | 26 (40.6) | χ² = 20.156 | <0.001 |
| Zwangerschapsduur (weken) | 38.1 ± 2.02 | 38.1 ± 1.99 | 37.9 ± 2.06 | t = 0.654 | 0.516 |
| Echografieparameters tijdens de eerste fase van de bevalling | |||||
| Foetale positie (niet-OA), n (%) | 85 (53.5) | 35 (36.8) | 50 (78.1) | χ² = 26.543 | <0.001 |
| AOP (°) | 124 [64.3; 158] | 111 [64.3; 142] | 138 [123; 158] | Z = −6.781 | <0.001 |
| HSD (cm) | 1.97 ± 0.39 | 1.81 ± 0.33 | 2.21 ± 0.34 | t = −7.445 | <0.001 |
| HPD (cm) | 4.61 ± 0.71 | 4.23 ± 0.56 | 5.17 ± 0.51 | t = −9.332 | <0.001 |
Tabel 4: Univariabele analyse van factoren geassocieerd met een verlengde tweede fase van de bevalling. Continue variabelen worden, afhankelijk van de toepasbaarheid, weergegeven als gemiddelde ± standaarddeviatie (SD) of als mediaan [interkwartielafstand (IQR)]. Categorische variabelen worden weergegeven als aantal (%). BMI, bodymassindex; OA, occiput anterior; non-OA, non-occiput anterior; AOP, progressiehoek; HSD, afstand hoofd-symphyse; HPD, afstand hoofd-perineum. Normaal verdeelde continue variabelen werden vergeleken met behulp van de onafhankelijke-steekproeven- t-test; continuïteitsvariabelen die niet normaal verdeeld waren, werden vergeleken met behulp van de Mann-Whitney- U test (gerapporteerd als de Z statistiek), en categorische variabelen werden vergeleken met behulp van de chi-kwadraat (χ2) test. Variabelen met P <0,10 werden beschouwd als in aanmerking komend voor inclusie in de least absolute shrinkage and selection operator (LASSO) regressieanalyse.
Variabeleselectie via Least Absolute Shrinkage and Selection Operator-regressie
Om een zuinig voorspellend model te construeren en tegelijkertijd het risico op overfitting en de invloed van multicollineariteit te verminderen, werden de 10 kandidaat-voorspellers die uit de univariate analyse naar voren kwamen (p < 0,10; Tabel 4) ingevoerd in het LASSO-regressiemodel voor variabeleselectie. De optimale regularisatieparameter (λ) werd bepaald middels 10-voudige kruisvalidatie. De coëfficiëntpadplot (Figuur 2A>) illustreert de progressieve krimp van de regressiecoëfficiënten naar nul naarmate λ toeneemt. De bijbehorende kruisvalidatiecurve (Figuur 2B>) toont de relatie tussen de kruisvalidatiefout en verschillende λ-waarden. De linker verticale stippellijn geeft de λ-waarde aan die de kruisvalidatiefout minimaliseerde, terwijl de rechter verticale stippellijn de grootste λ aangeeft binnen één standaardfout van het minimum (one-standard-error-criterium). Dat laatste werd gekozen om een zuiniger model te verkrijgen. Op basis van het one-standard-error-criterium werden vier voorspellers met niet-nulcoëfficiënten behouden: neonataal geboortegewicht (coëfficiënt = 0,50), toename van de BMI tijdens de zwangerschap (coëfficiënt = 0,12), maternale leeftijd (coëfficiënt = 0,05) en AOP (coëfficiënt = 0,03). Deze coëfficiënten vertegenwoordigen de gestandaardiseerde gepenaliseerde coëfficiënten uit het uiteindelijke LASSO-model bij de geselecteerde λ-waarde. De overige kandidaat-variabelen — HSD, HPD, zwangerschapsdiabetes, mentale toestand, uterine inertie en foetale positie — hadden coëfficiënten die tot nul waren gekrompen en werden daarom uitgesloten van de uiteindelijke set voorspellers. De behouden variabelen werden vervolgens ingevoerd in het multivariabele logistische regressiemodel om gecorrigeerde ORs met de bijbehorende 95% CIs te schatten.
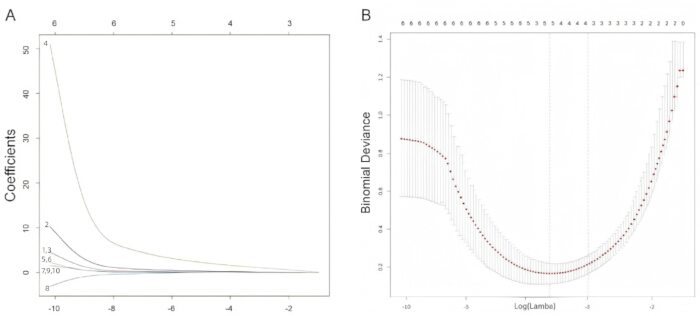
Figuur 2. Least absolute shrinkage and selection operator (LASSO) regressieanalyse voor selectie van predictoren. (A) Coëfficiëntpaden gegenereerd tijdens de least absolute shrinkage and selection operator (LASSO) regressie. De x-as vertegenwoordigt het logaritme van de regularisatieparameter (log λ), en de y-as vertegenwoordigt de gestandaardiseerde regressiecoëfficiënten. Elke curve illustreert de progressieve krimp van een individuele predictorcoëfficiënt naar nul naarmate de regularisatieboete toeneemt. De getallen bovenaan geven het aantal behouden variabelen aan bij elke waarde van λ. De genummerde coëfficiëntpaden komen overeen met de volgende kandidaat-predictoren: (1) moederlijke leeftijd, (2) toename van de bodymassindex (BMI) tijdens de zwangerschap, (3) zwangerschapsdiabetes, (4) neonatale geboortegewicht, (5) mentale toestand, (6) uterine inertie, (7) foetale positie, (8) angle of progression (AOP), (9) head–symphysis afstand (HSD), en (10) head–perineum afstand (HPD). (B) Plot van tienvoudige kruisvalidatie gebruikt om de optimale regularisatieparameter te bepalen. De x-as vertegenwoordigt log(λ), en de y-as vertegenwoordigt de binomiale deviantie. De punten geven de gemiddelde kruisvalidatiefout aan, en de foutbalken vertegenwoordigen ±1 standaardfout. De linker verticale stippellijn geeft de waarde van λ aan die de kruisvalidatiefout minimaliseert, terwijl de rechter verticale stippellijn de grootste λ aangeeft binnen één standaardfout van het minimum (one-standard-error criterium). Klik hier om een grotere versie van deze figuur te bekijken.
Multivariabele logistische regressie en onafhankelijke predictoren
De vier predictoren die behouden bleven in het LASSO-regressiemodel — moedersleeftijd, toename van het BMI tijdens de zwangerschap, neonataal geboortegewicht en AOP — werden ingevoerd in een multivariabel logistisch regressiemodel (Tabel 5). Alle vier de variabelen bleven onafhankelijk geassocieerd met een verlengde tweede fase van de bevalling na wederzijdse correctie (alle p < 0,05). In het herfitte multivariabele logistische regressiemodel had het neonatale geboortegewicht de grootste gecorrigeerde OR (aOR = 8,45, 95% CI: 3,21–22,24). De toename van het BMI tijdens de zwangerschap was eveneens onafhankelijk geassocieerd met een verlengde tweede fase van de bevalling (aOR = 1,38, 95% CI: 1,15–1,66). De moedersleeftijd (aOR = 1,18, 95% CI: 1,05–1,32) en AOP (aOR = 1,07, 95% CI: 1,02–1,12) waren op dezelfde wijze onafhankelijk geassocieerd met een verlengde tweede fase van de bevalling. Het multivariabele logistische regressiemodel was statistisch significant volgens de likelihood-ratiotest (p < 0,001). Omdat het neonatale geboortegewicht na de bevalling werd gemeten, is het huidige model exploratief en zou het herfit moeten worden met gebruik van het geschatte foetale gewicht vóór klinische toepassing.
| Variabele | β | SE | Wald χ² | P-waarde | aOR | 95% BI |
| Intercept | −15.92 | 3.01 | 27.98 | <0.001 | — | — |
| Moederlijke leeftijd (jaren) | 0.16 | 0.06 | 7.11 | 0.008 | 1.18 | 1.05–1.32 |
| Toename BMI tijdens zwangerschap (kg/m²) | 0.32 | 0.09 | 12.65 | <0.001 | 1.38 | 1.15–1.66 |
| Neonatale geboortegewicht (kg) | 4.26 | 0.9 | 22.41 | <0.001 | 8.45 | 3.21–22.24 |
| AOP (°) | 0.07 | 0.02 | 10.76 | 0.001 | 1.07 | 1.02–1.12 |
Tabel 5: Multivariabele logistische regressieanalyse ter identificatie van onafhankelijke predictoren voor een verlengde tweede fase van de bevalling. De tabel presenteert de resultaten van het multivariabele logistische regressiemodel, opgesteld met variabelen geselecteerd via least absolute shrinkage and selection operator (LASSO) regressie. β, regressiecoëfficiënt; SE, standaardfout; Wald χ2, Wald chi-kwadraatstatistiek; aOR, gecorrigeerde odds ratio; CI, betrouwbaarheidsinterval; BMI, body mass index; AOP, progressiehoek. Het intercept vertegenwoordigt de modelconstante. De algehele significantie van het model is beoordeeld met de likelihood ratio test (χ2 = 85.34, P <0.001).
Constructie van het predictieve model en nomogram
Op basis van de onafhankelijke predictoren en hun regressiecoëfficiënten, geïdentificeerd door de multivariabele logistische regressieanalyse (Tabel 5), werd een patiëntspecifiek predictief model geconstrueerd om de waarschijnlijkheid van een verlengde tweede fase van de bevalling bij primipara's te schatten. Het model wordt als volgt uitgedrukt:
Logit(P) = —15,92 + 0,16 ( leeftijd moeder ) +. 0,32 ( toename BMI tijdens zwangerschap ) + 4,26 ( geboortegewicht pasgeborene ) + 0,07( AOP )
Hier representeert P de voorspelde waarschijnlijkheid van een verlengde tweede fase van de bevalling.
Om de visualisatie van het model te vergemakkelijken, werd de regressievergelijking gepresenteerd als een nomogram (Figuur 3). Elke voorspeller correspondeert met een individuele puntenschaal. Bijvoorbeeld, een barende vrouw met een moederleeftijd van 28 jaar, een gestationele toename van het BMI van 12 kg/m2, een neonataal geboortegewicht (werkelijk geboortegewicht gemeten na de bevalling) van 3,6 kg en een AOP van 115° kan worden gescoord door elke waarde op de overeenkomstige as te lokaliseren, verticaal te projecteren naar de Punten-as, de individuele puntwaarden op te tellen om de Totale Punten te verkrijgen, en de totale score naar beneden te projecteren op de as voor het Risico op een Verlengde Tweede Fase om de voorspelde waarschijnlijkheid te schatten. Dit nomogram wordt uitsluitend voor illustratieve doeleinden gepresenteerd, omdat het het werkelijke neonatale geboortegewicht bevat. Klinische toepassing zou vereisen dat het model opnieuw wordt gefit met gebruik van het geschatte foetale gewicht.
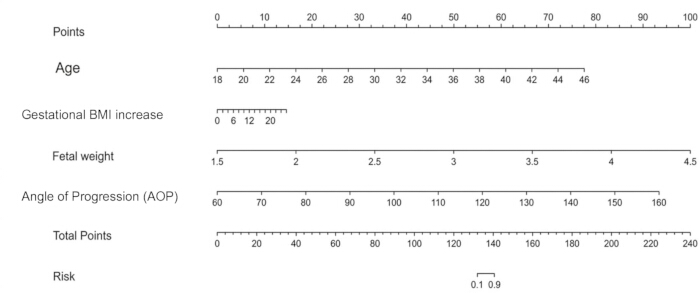
Figuur 3. Nomogram voor het voorspellen van de waarschijnlijkheid van een verlengde tweede fase van de bevalling. Het nomogram is opgesteld op basis van het multivariabele logistische regressiemodel met vier predictoren: moederlijke leeftijd, toename van de gestationele BMI, neonatale geboortegewicht (werkelijk geboortegewicht gemeten na de bevalling) en AOP. Om de voorspelde waarschijnlijkheid van een verlengde tweede fase van de bevalling te schatten, lokaliseert u elke predictorwaarde op de bijbehorende as en projecteert u deze verticaal naar de 'Points'-as om de toegewezen score te bepalen. Tel de individuele scores op om de 'Total Points' te verkrijgen, en projecteer vervolgens de totale score naar de 'Risk'-as om de voorspelde waarschijnlijkheid van een verlengde tweede fase van de bevalling te schatten. Het nomogram wordt uitsluitend ter illustratie gepresenteerd omdat het het werkelijke neonatale geboortegewicht bevat, dat vóór de bevalling niet beschikbaar is. Klinische toepassing zou vereisen dat het model opnieuw wordt gefit met behulp van EFW. Klik hier om een grotere versie van deze figuur te bekijken.
Modelvalidatie: Discriminatie, Kalibratie en Klinisch Nut
De voorspellende prestatie van het model werd intern geëvalueerd met betrekking tot discriminatie, kalibratie en klinisch nut. De modeldiscriminatie werd beoordeeld met behulp van de ROC-curve (Figuur 4). Het model behaalde een AUC van 0,927 (95% BI: 0,879–0,961), wat wijst op een uitstekende discriminatie. Met gebruik van de maximale Youden-index was de optimale kans-afkapwaarde 0,48. Bij deze drempelwaarde vertoonde het model een sensitiviteit van 85,9% en een specificiteit van 84,2% (Tabel 6).
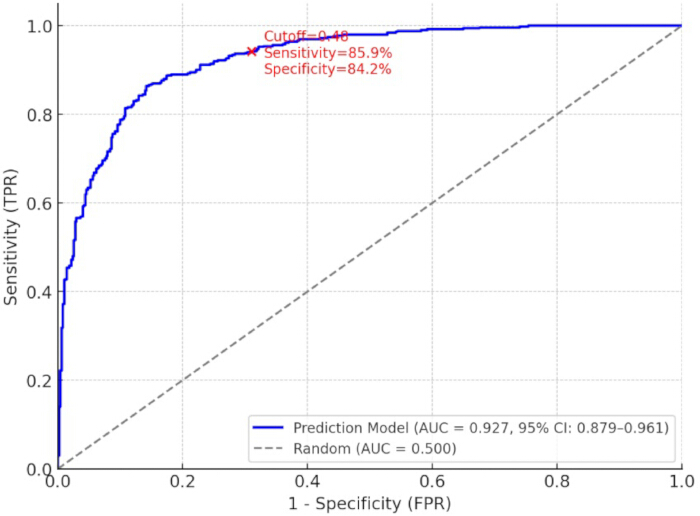
Figuur 4. Receiver operating characteristic (ROC)-curve ter evaluatie van de prestaties van het voorspellende model. De receiver operating characteristic (ROC)-curve demonstreert het vermogen van het voorspellende model om onderscheid te maken tussen normale en verlengde tweede fase van de bevalling. De blauwe curve representeert het voorspellende model, met een area under the curve (AUC) van 0,927 (95% betrouwbaarheidsinterval [CI]: 0,879–0,961). De optimale kans-afkapwaarde was 0,48, wat correspondeert met een sensitiviteit van 85,9% en een specificiteit van 84,2%. De grijze gestreepte diagonale lijn representeert een willekeurige classificatie (AUC = 0,500). De x-as representeert 1 − specificiteit (fout-positieve fractie [FPR]) en de y-as representeert sensitiviteit (correct-positieve fractie [TPR]). Klik hier om een grotere versie van deze figuur te bekijken.
| Parameter | Waarde | 95% BI |
| AUC (oppervlakte onder de curve) | 0.927 | 0.879–0.961 |
| Optimale afkapwaarde | 0.480 | — |
| Gevoeligheid | 85.90% | 75.0%–93.4% |
| Specificiteit | 84.20% | 75.3%–90.9% |
| PPV | 78.60% | 67.5%–87.3% |
| NPV | 89.80% | 81.9%–95.0% |
| Nauwkeurigheid | 84.90% | 78.3%–90.1% |
Tabel 6: Prestaties van het voorspellende model bij de optimale waarschijnlijkheidsafkapwaarde. De voorspellende prestatie van het multivariabele logistische regressiemodel werd geëvalueerd aan de hand van de oppervlakte onder de receiver operating characteristic (ROC)-curve (AUC). De optimale waarschijnlijkheidsafkapwaarde van 0,48 werd bepaald door de Youden-index te maximaliseren. Sensitiviteit vertegenwoordigt de proportie correct geïdentificeerde terecht-positieve gevallen, specificiteit vertegenwoordigt de proportie correct geïdentificeerde terecht-negatieve gevallen, de positief voorspellende waarde (PVW) vertegenwoordigt de waarschijnlijkheid dat deelnemers die als positief werden geclassificeerd daadwerkelijk een verlengde tweede fase van de arbeid hadden, en de negatief voorspellende waarde (NVW) vertegenwoordigt de waarschijnlijkheid dat deelnemers die als negatief werden geclassificeerd daadwerkelijk geen verlengde tweede fase van de arbeid hadden. CI, betrouwbaarheidsinterval.
De kalibratie van het model werd geëvalueerd met behulp van een bootstrap-kalibratiecurve gegenereerd uit 1.000 resamples, samen met de Hosmer–Lemeshow goodness-of-fit test (Figuur 5A). De kalibratiecurve volgde de ideale referentielijn nauwgezet, wat duidt op een goede overeenstemming tussen de voorspelde en waargenomen kansen. De Hosmer–Lemeshow goodness-of-fit test was statistisch niet significant (χ2 = 6.15, p = 0.630), wat consistent was met een adequate kalibratie in dit intern gevalideerde model. Het klinische nut werd geëvalueerd met behulp van DCA (Figuur 5B). Binnen het bereik van de drempelkans van ongeveer 10%–70% bood het voorspellende model een groter netto voordeel dan zowel de 'behandel-allemaal'- als de 'behandel-niemand'-strategie. Bij drempelkansen onder ongeveer 10% bood de 'behandel-niemand'-strategie een groter netto voordeel, terwijl bij drempelkansen boven ongeveer 70% de 'behandel-allemaal'-strategie vergelijkbaar of beter presteerde. Deze bevindingen geven aan dat het model klinisch voordeel kan bieden binnen een gemiddeld bereik van drempelkansen. Over het geheel genomen vertoonde het voorspellende model tijdens de interne validatie een uitstekende discriminatie, adequate kalibratie en een gunstig klinisch nut. Omdat de validatie echter beperkt was tot de dataset van de studie en het model het werkelijke neonatale geboortegewicht incorporeerde, zijn externe validatie en herfitting met gebruik van het geschatte foetale gewicht vereist vóór klinische implementatie.
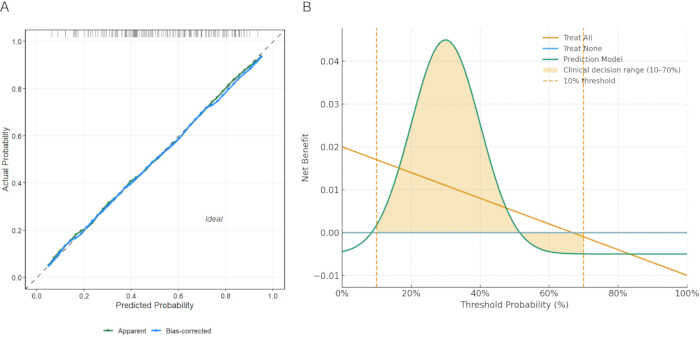
Figuur 5. Kalibratie- en beslissingscurve-analyses van het voorspellingsmodel. (A) Kalibratiecurve van het voorspellingsmodel gegenereerd met behulp van 1.000 bootstrap-resamples. De schijnbare curve vertegenwoordigt de modelprestaties in de studiedataset, de bias-gecorrigeerde curve vertegenwoordigt de bootstrap-gecorrigeerde kalibratie, en de diagonale stippellijn geeft de ideale overeenstemming tussen voorspelde en waargenomen waarschijnlijkheden aan. De Hosmer–Lemeshow goodness-of-fit test leverde χ2 = 6,15 en p = 0,630 op. (B) Beslissingscurve-analyse (DCA) die het klinische nut van het voorspellingsmodel evalueert over een reeks drempelwaarschijnlijkheden. De groene curve vertegenwoordigt het voorspellingsmodel, de oranje lijn vertegenwoordigt de 'behandel-alleen'-strategie en de blauwe lijn vertegenwoordigt de 'behandel-niemand'-strategie. Het gearceerde gebied geeft het in deze studie geëvalueerde bereik van de drempelwaarschijnlijkheid van 10%–70% aan, waarbij de verticale stippellijnen de lagere (10%) en hogere (70%) drempels markeren. De x-as vertegenwoordigt de drempelwaarschijnlijkheid en de y-as vertegenwoordigt het netto voordeel. Klik hier om een grotere versie van deze figuur te bekijken.
Beschikbaarheid van gegevens:
De gedeïdentificeerde dataset op deelnemersniveau die de bevindingen van deze studie ondersteunt, is opgenomen in Aanvullende Tabel 1. Deze dataset bevat de ruwe gegevens die zijn gebruikt voor alle statistische analyses, modelontwikkeling, interne validatie en de opstelling van de gerapporteerde tabellen en figuren.
Aanvullende Figuur 1. Algehele workflow van de studie voor de ontwikkeling en interne validatie van het voorspellende model. De workflow illustreert de werving van deelnemers en de beoordeling van de geschiktheid, het verzamelen van klinische kenmerken van de moeder en intrapartume echografische metingen tijdens de actieve eerste fase van de bevalling, de classificatie in groepen met een normale en een verlengde tweede bevallingsfase volgens het 120-minutencriterium van de Wereldgezondheidsorganisatie (WHO), de selectie van predictoren met behulp van least absolute shrinkage and selection operator (LASSO) regressie, de constructie van het multivariabele logistische regressiemodel en nomogram, en de interne modelevaluatie middels receiver operating characteristic (ROC) analyse, kalibratieanalyse en decision curve analysis (DCA). Klik hier om dit bestand te downloaden.
Aanvullende Tabel 1. Dataset op deelnemersniveau gebruikt voor modelontwikkeling en interne validatie. Deze tabel bevat de geanonimiseerde gegevens op deelnemersniveau die zijn gebruikt voor alle statistische analyses, inclusief de ontwikkeling en interne validatie van het voorspellende model. Variabelen omvatten de uitkomst van de tweede fase van de arbeid, de duur van de tweede fase, neonatale uitkomsten, demografische en klinische kenmerken van de moeder, en transabdominale en transperineale echografie-metingen verkregen tijdens de eerste fase van de arbeid. Body mass index (BMI) = BMI; occiput anterior (OA) = foetale occiput anterior positie; angle of progression (AOP) = progressiehoek; head–symphysis distance (HSD) = afstand hoofd-symphyse; en head–perineum distance (HPD) = afstand hoofd-perineum. Klik hier om dit bestand te downloaden.
Discussie
Door voortdurende verbeteringen in het obstetrische beheer is een verlengde tweede fase van de bevalling een steeds belangrijker factor geworden die de uitkomsten voor moeder en neonatus beïnvloedt. Eerdere studies hebben aangetoond dat een verlengde tweede fase van de bevalling geassocieerd is met een toegenomen complexiteit van de bevalling, hogere percentages keizersnedes en lagere Apgar-scores voor de neonatus1,2. Deze bevindingen benadrukken het klinische belang van het optimaliseren van de perinatale zorg en het implementeren van strategieën voor de vroegtijdige identificatie van vrouwen met een verhoogd risico op een verlengde tweede fase van de bevalling. Met behulp van demografische kenmerken, klinische eigenschappen en echografieparameters ontwikkelde en valideerde deze studie intern een predictiemodel voor een verlengde tweede fase van de bevalling en evalueerde het de potentiële klinische bruikbaarheid hiervan. De resultaten toonden aan dat maternale leeftijd, de toename van de BMI tijdens de zwangerschap, het geboortegewicht van de neonatus en AOP in het uiteindelijke multivariabele model onafhankelijk geassocieerd waren met een verlengde tweede fase van de bevalling, terwijl zwangerschapsdiabetes, uterusinertie en een veranderde mentale status in de univariate analyse wel geassocieerd waren met een verlengde tweede fase van de bevalling, maar niet werden behouden in het uiteindelijke predictiemodel. Door demografische, klinische en echografische gegevens te integreren in een multidimensionaal predictiemodel, biedt deze studie een objectief kader voor het identificeren van vrouwen met een verhoogd risico op een verlengde tweede fase van de bevalling tijdens de eerste fase van de bevalling. Een dergelijke vroegtijdige risicostratificatie kan een geïndividualiseerd intrapartum beheer faciliteren, inclusief nauwere monitoring van de voortgang van de bevalling en tijdige klinische besluitvorming, met als doel de uitkomsten voor moeder en neonatus te verbeteren.
Onze bevindingen gaven aan dat een verlengde tweede fase van de bevalling sterk geassocieerd was met ongunstige foetale uitkomsten. In overeenstemming met eerdere rapporten verhoogde een verlengde tweede fase van de bevalling significant de risico's op lage Apgar-scores en foetale distress3,8. Mechanistisch gezien kan deze associatie worden toegeschreven aan foetale hypoxie en verhoogde intra-uteriene stress tijdens een verlengde bevalling. Wanneer de foetale kop gedurende een langere periode gecomprimeerd blijft in het moederlijke bekken, kan de placentaire perfusie ontoereikend worden, wat leidt tot zuurstofgebrek en abnormale foetale hartslagpatronen die de onmiddellijke neonatale conditie kunnen verslechteren9. Vanuit een demografisch perspectief toonde deze studie aan dat een hogere moederlijke leeftijd, een grotere toename van de BMI tijdens de zwangerschap en zwangerschapsdiabetes geassocieerd waren met een verlengde tweede fase van de bevalling. In het bijzonder hadden oudere moeders een hoger risico op een verlengde bevalling, wat consistent is met eerder onderzoek10. Fysiologisch gezien kan een toenemende moederlijke leeftijd de rijping van de cervix en de contractiliteit van de uterus belemmeren, waardoor de voortgang van de bevalling wordt vertraagd. Een grotere toename van de BMI tijdens de zwangerschap en zwangerschapsdiabetes kunnen de voortgang van de bevalling verder beïnvloeden door de foetale grootte te vergroten en de contractiepatronen van de uterus te wijzigen. Daarnaast waren uterusinertie en een veranderde mentale toestand significant geassocieerd met een verlengde tweede fase van de bevalling in de univariate analyse. Deze bevindingen onderstrepen het belang van zorgvuldige monitoring van de uteruscontractiliteit en het psychologische welzijn van de moeder tijdens de bevalling, aangezien beide factoren indirect kunnen bijdragen aan een verlengde bevalling door het ritme en de kracht van de uteruscontracties te beïnvloeden. Echografieparameters spelen ook een belangrijke rol bij het voorspellen van een verlengde tweede fase van de bevalling11,12,13,14. In de huidige studie identificeerde de multivariabele logistische regressieanalyse AOP als een onafhankelijke voorspeller van een verlengde tweede fase van de bevalling (p < 0.05). HSD en HPD waren significant geassocieerd met een verlengde tweede fase van de bevalling in de univariate analyse, maar werden niet behouden in het uiteindelijke predictieve model na LASSO-variabeleselectie. Een verhoogde HSD geeft aan dat de foetale kop op een hogere positie in de bekkeninggang blijft, wat wijst op een belemmerde afdaling en een verhoogde kans op een verlengde tweede fase van de bevalling15,16,17. De AOP weerspiegelt zowel de afdaling als de rotatie van de foetale kop en heeft daarom een directe relatie met de voortgang van de bevalling6,18. Hoewel de foetale positie bepaald door transabdominale echografie niet werd behouden in het uiteindelijke predictieve model, blijft transabdominale echografie klinisch nuttig voor het identificeren van foetale malposities (bijv. occiput posterior of transversale posities) die een nauwere intrapartume beoordeling kunnen rechtvaardigen. Gezamenlijk suggereren deze bevindingen dat intrapartume echografie objectieve informatie verschaft over de foetale positie en de afdaling van de kop, wat kan helpen bij de vroege beoordeling van vrouwen met een verhoogd risico op een verlengde tweede fase van de bevalling. Door demografische kenmerken te integreren met echografieparameters, ontwikkelde deze studie een intern gevalideerd predictief model. LASSO-regressie identificeerde vier variabelen met niet-nul coëfficiënten—moederlijke leeftijd, toename van de BMI tijdens de zwangerschap, neonataal geboortegewicht en AOP—die vervolgens werden ingevoerd in het multivariabele logistische regressiemodel voor de schatting van aangepaste effectgroottes. Met gebruik van het one-standard-error criterium voor modelselectie behaalde het model een AUC van 0,927 tijdens de interne validatie, wat wijst op een uitstekende onderscheidende prestatie. Echter, omdat het model het werkelijke neonatale geboortegewicht bevat dat na de bevalling is gemeten, moet het als explorerend en illustratief worden beschouwd in plaats van direct toepasbaar in de klinische praktijk. Toekomstige klinische implementatie zou een nieuwe modelpassing vereisen met gebruik van het geschatte foetale gewicht in combinatie met onafhankelijke externe validatie. Binnen deze beperkingen kan de integratie van demografische kenmerken en echografieparameters een eardere risicostratificatie faciliteren en een geïndividualiseerd intrapartum management ondersteunen19,20,21,22.
Vergeleken met eerdere onderzoeken heeft de huidige studie verschillende belangrijke sterke punten. Ten eerste maakte de integratie van demografische kenmerken, klinische variabelen en echografieparameters een multidimensionale beoordeling mogelijk van factoren die geassocieerd zijn met een verlengde tweede fase van de bevalling. Ten tweede werd LASSO-regressie gebruikt voor variabeleselectie en coëfficiëntinkrimping, wat kan helpen bij het beheersen van multicollineariteit en het verbeteren van de modelstabiliteit wanneer gecorreleerde predictoren aanwezig zijn. Ten derde bood de steekproefomvang voldoende statistische kracht voor modelontwikkeling en interne validatie. Ondanks deze sterke punten moeten enkele beperkingen worden erkend. Ten eerste was dit een prospectieve enkelcentrumstudie, en alleen vrouwen die uiteindelijk een vaginale bevalling ondergingen, werden geïncludeerd. Bijgevolg werden vrouwen die tijdens de tweede fase een operatieve vaginale bevalling of een keizersnede ondergingen, uitgesloten, wat leidde tot selectiebias en de generaliseerbaarheid van de bevindingen beperkte. Bovendien hield de definitie van de uitkomst geen rekening met operatieve bevalling als concurrerende uitkomst bij vrouwen met een verlengde bevalling. Daarom is externe validatie in onafhankelijke multicentrische prospectieve cohorten vereist vóór klinische toepassing. Ten tweede waren alle beoordelingen van de modelprestaties, inclusief ROC-analyse, kalibratie en DCA, gebaseerd op interne validatie met behulp van dezelfde studiepopulatie, en was er geen onafhankelijk extern validatiecohort beschikbaar. Ten derde werden, hoewel epidurale analgesie, oxytocine-augmentatie en kunstmatig breken van de vliezen zijn geregistreerd, deze variabelen niet opgenomen in het uiteindelijke predictiemodel. Andere potentieel belangrijke factoren, waaronder kenmerken van de uteruscontracties, strategieën voor het management van de bevalling en pijnscores van de moeder, kunnen de voortgang van de bevalling ook beïnvloeden en zouden in toekomstige studies moeten worden geëvalueerd. Ten vierde blijven sommige echografische metingen operatorafhankelijk ondanks gestandaardiseerde training en een hoge interobserver-reproduceerbaarheid, en er werd slechts één beoordeling geanalyseerd die tijdens de actieve eerste fase van de bevalling was verkregen. Omdat de bevalling een dynamisch proces is, kan het middelen van drie metingen verkregen tijdens afzonderlijke contracties de willekeurige meetfout verminderen, maar kan het ook snelle veranderingen in de foetale afdaling maskeren. Toekomstige studies waarin seriële tijdgestempelde echografiebeoordelingen worden opgenomen, zoals veranderingen in AOP over tijd, kunnen de predictieve prestaties verbeteren23,24. Ten slotte werd het predictiemodel ontwikkeld met behulp van het werkelijke neonatale geboortegewicht gemeten na de bevalling om de fysiologische associatie met een verlengde tweede fase van de bevalling vast te stellen. Bijgevolg moet het model als verkennend worden beschouwd en is het niet direct toepasbaar voor klinische predictie tijdens de bevalling. Klinische implementatie zou herontwikkeling en externe validatie van het model vereisen met behulp van het geschatte foetale gewicht verkregen vóór de bevalling, in plaats van een eenvoudige substitutie in de huidige vergelijking. Omdat het geschatte foetale gewicht onderhevig is aan inherente meetfouten (doorgaans ±10%–15%), zouden de modelcoëfficiënten en prestaties opnieuw moeten worden geschat in een onafhankelijk cohort vóór klinisch gebruik. Daarnaast werd uterusinertie in deze studie gedefinieerd op basis van de waargenomen contractiefrequentie en -duur in plaats van de diagnostische criteria voor bevallingsstagnatie aanbevolen door ACOG of NICE, wat de directe vergelijking met andere studies kan beperken. Tot slot kan het gebruik van een vaste drempelwaarde van 120 min om een verlengde tweede fase van de bevalling te definiëren, zonder rekening te houden met de langere duur die acceptabel kan zijn bij vrouwen die epidurale analgesie ontvangen, de generaliseerbaarheid van het model verder beperken.
Toekomstig onderzoek zou alternatieve benaderingen moeten verkennen om de in deze studie onderzochte hypothese te bestuderen. Ten eerste, terwijl deze studie gebruikmaakte van een enkele echografische beoordeling aan het begin van de actieve fase van de bevalling, kunnen seriële metingen (bijv. veranderingen in AOP of de afstand van de hoofdprogressie over tijd) het dynamische proces van de foetale afdaling beter vastleggen en de voorspellende waarde kunnen verbeteren, zoals voorgesteld in recente studies23,24. Ten tweede, hoewel de combinatie van LASSO-regressie en multivariabele logistische regressie leidde tot een bondig en interpreteerbaar model, kunnen andere machine learning-benaderingen, waaronder random forests, support vector machines en gradient boosting, niet-lineaire relaties en complexe interacties tussen predictoren beter vastleggen, hoewel dit mogelijk ten koste gaat van de interpreteerbaarheid. Ten derde, omdat definities van een verlengde tweede fase van de bevalling variëren tussen klinische richtlijnen, inclusief langere drempelwaarden voor vrouwen die epidurale analgesie ontvangen, moet een herkalibratie van het model voor alternatieve definitie van de uitkomst worden onderzocht. Ten vierde zouden toekomstige modellen ontwikkeld moeten worden op basis van het geschatte foetale gewicht in plaats van het werkelijke geboortegewicht van de neonatus, en alternatieve sonografische methoden voor het schatten van het foetale gewicht, waaronder driedimensionale echotechnieken, kunnen helpen om meetfouten te verminderen. Ten slotte kan de integratie van continue intrapartum monitoringsgegevens, zoals de sterkte van de baarmoedersamentrekkingen of geautomatiseerde cardiotocografie-analyse, de risicostratificatie verder verbeteren. Een vergelijkende evaluatie van deze benaderingen kan helpen bij het identificeren van de optimale strategie voor het voorspellen van een verlengde tweede fase van de bevalling.
Een aanvullende beperking van deze studie is dat alleen vrouwen die succesvol een vaginale bevalling hadden, werden geïncludeerd om een nauwkeurige meting van de duur van de tweede fase te garanderen. Bijgevolg werden vrouwen die een operatieve vaginale bevalling of een keizersnede ondergingen na een verlengde tweede fase van de bevalling uitgesloten, hoewel zij wel aan de definitie van een verlengde bevalling in deze studie zouden hebben voldaan. Dit selectiecriterium kan hebben geleid tot een onderschatting van de werkelijke incidentie van een verlengde tweede fase van de bevalling en kan hebben gezorgd voor ascertainment bias bij de uitkomsten. Bovendien vormt een operatieve bevalling vóór voltooiing van de tweede fase een concurrerende uitkomst in plaats van een simpel non-event en is deze daarom niet opgenomen in het predictieve model. Bijgevolge schat het huidige model de waarschijnlijkheid van een verlengde tweede fase van de bevalling alleen bij vrouwen die uiteindelijk een vaginale bevalling bereiken en mag het niet worden gebruikt om de noodzaak van een operatieve bevalling te voorspellen. Externe validatie in bredere, niet-geselecteerde obstetrische populaties waarin operatieve bevallingen zijn opgenomen, zal noodzakelijk zijn om de generaliseerbaarheid en klinische toepasbaarheid van het model te bepalen. De waargenomen associatie tussen een verlengde tweede fase van de bevalling en nadelige uitkomsten, waaronder foetale distress en lage Apgar-scores, zelfs binnen een cohort beperkt tot vrouwen die een vaginale bevalling hadden, onderstreept het belang van een vroege risicobeoordeling. Het hoge percentage vaginale bevallingen in dit cohort weerspiegelt de inclusiecriteria van de studie en mag niet worden geïnterpreteerd als een indicatie dat operatieve interventie in de routinematige klinische praktijk onnodig was.
Het voorspellende model heeft verschillende potentiële toepassingen. Na herontwikkeling op basis van het geschatte foetale gewicht en onafhankelijke externe validatie, zou het geïntegreerd kunnen worden in elektronische patiëntendossiers om het risico van een individu op een verlengde tweede fase van de bevalling tijdens de actieve eerste fase te schatten, wat de realtime identificatie van vrouwen met een verhoogd risico vergemakkelijkt. Met gebruik van de optimale waarschijnlijkheidsgrenswaarde die in deze studie is vastgesteld (0,48), kan het model helpen bij de ondersteuning van een geïndividualiseerd intrapartum management, inclusief nauwere monitoring van moeder en foetus en tijdige klinische besluitvorming. Daarnaast zou het model risicostratificatie in toekomstige interventiestudies kunnen vergemakkelijken die strategieën voor bevallingsmanagement, epiduraalprotocollen of uterine stimulatie evalueren, door een meer gebalanceerde toewijzing van het basisrisico mogelijk te maken. Omdat de vereiste inputvariabelen routinematig tijdens de klinische zorg worden verzameld, kan het model ook een praktisch kader bieden voor toekomstige externe validatie en aanpassing aan andere obstetrische populaties, waaronder multipare vrouwen en vrouwen bij wie een inleiding van de bevalling plaatsvindt. Samenvattend maakte de integratie van transabdominale en transperineale echografieparameters uit de eerste fase met demografische en klinische kenmerken van de moeder de ontwikkeling mogelijk van een intern gevalideerd voorspellend model voor een verlengde tweede fase van de bevalling. De multidimensionale beoordeling toonde aan dat de leeftijd van de moeder, de toename van de BMI tijdens de zwangerschap, het neonatale geboortegewicht en AOP onafhankelijk geassocieerd waren met een verlengde tweede fase van de bevalling, en liet zien dat het model een uitstekende discriminatie met een goede kalibratie behaalde tijdens de interne validatie. Hoewel deze bevindingen de potentiële waarde van deze aanpak voor vroege intrapartum risicobeoordeling ondersteunen, moet het model als verkennend worden beschouwd omdat het het feitelijke neonatale geboortegewicht bevat en slechts intern is gevalideerd. Vóór klinische implementatie moet het model opnieuw worden ontwikkeld met gebruik van het geschatte foetale gewicht en extern worden gevalideerd in onafhankelijke, multicentrische cohorten. Toekomstige studies zouden ook de integratie van aanvullende predictoren moeten onderzoeken, waaronder kenmerken van uterine contracties, variabelen voor pijnmanagement en intrapartum interventies, om een uitgebreider en generaliseerbaar voorspellend model voor geïndividualiseerd bevallingsmanagement te ontwikkelen.
Openbaarmakingen
Belangenverstrengeling:
De auteurs verklaren dat er geen concurrerende financiële of niet-financiële belangen zijn in relatie tot dit werk.
Dankbetuigingen
De auteurs danken het verpleeg- en medisch personeel van de afdeling Verloskunde van het Yuyao Maternal and Child Health Hospital (Yuyao Second People’s Hospital) voor hun hulp bij de werving van deelnemers en de gegevensverzameling. Dit werk werd ondersteund door het Yuyao Municipal Health Science and Technology Program 2024 (Subsidie nr. 2024YYB03).
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Draagbaar diagnostisch echografie-systeem | Mindray | CAU-01040644 | Draagbaar diagnostisch echografie-systeem gebruikt voor transabdominale en transperineale beeldvorming; zie Protocol voor beeldinstellingen |
| Convexe echoprobe (2–5 MHz) | Mindray | C5-2 | Gebruikt voor transabdominale echografische beeldvorming |
| Hoge-frequentie lineaire of kleine-voetafdruk convexe echoprobe (5–8 MHz) | Mindray | 75L38EA | Gebruikt voor transperineale echografische beeldvorming |
| R-software | R Foundation for Statistical Computing | Version 4.1.0 | Statistische computersonderzoeksoftware (RRID:SCR_001905) |
| SPSS-software | IBM Corp. | Version 26.0 | Statistische analyse-software (RRID:SCR_002865) |
| Zelfscore-angstschaal | Gepubliceerd vragenlijst (Zung Self-Rating Anxiety Scale) | Niet van toepassing | Vragenlijst voor angstbeoordeling gebruikt bij opname |
Referenties
- American College of Obstetricians and Gynecologists, Society for Maternal-Fetal Medicine. Obstetric Care Consensus No. 1: Safe prevention of the primary cesarean delivery. Obstet Gynecol. 2014;123(3):693-711. doi:10.1097/01.AOG.0000444441.04111.1d.
- World Health Organization. WHO Guidelines Approved by the Guidelines Review Committee. World Health Organization; Geneva; 2015.
- Miyamoto K, et al. Prolonged second stage of labor in delivery using epidural analgesia is a risk factor for postpartum urinary retention. J Obstet Gynaecol Res. 2024;50(3):424-429. doi:10.1111/jog.15867.
- Kahrs BH. Ultrasound before operative vaginal delivery: Why and how. Minerva Obstet Gynecol. 2021;73(1):67-73. doi:10.23736/S2724-606X.20.04667-5.
- Yano E, et al. Anatomical identification of ischial spines applicable to intrapartum transperineal ultrasound based on magnetic resonance imaging of pregnant women. J Matern Fetal Neonatal Med. 2022;35(25):9736-9741. doi:10.1080/14767058.2022.2051007.
- Kahrs BH, Eggebø TM. Intrapartum ultrasound in women with prolonged first stage of labor. Am J Obstet Gynecol MFM. 2021;3(6):100427. doi:10.1016/j.ajogmf.2021.100427.
- Lee NMW, et al. Implementation of sonopartogram: Multicenter feasibility study. Ultrasound Obstet Gynecol. 2024;64(2):214-221. doi:10.1002/uog.27634.
- Saucedo AM, et al. First and second stage risk factors associated with perineal lacerations. Matern Child Health J. 2024;28(7):1228-1233. doi:10.1007/s10995-024-03919-1.
- Zhang M, et al. Risk factors for episiotomy during vaginal childbirth: A retrospective cohort study in Western China. J Evid Based Med. 2018;11(4):233-241. doi:10.1111/jebm.12316.
- Friedman EA, Cohen WR. The active phase of labor. Am J Obstet Gynecol. 2023;228(5 Suppl):S1037-S1049. doi:10.1016/j.ajog.2021.12.269.
- Kalache KD, et al. Transperineal ultrasound imaging in prolonged second stage of labor with occipitoanterior presenting fetuses: How well does the angle of progression predict the mode of delivery? Ultrasound Obstet Gynecol. 2009;33(3):326-330. doi:10.1002/uog.6294.
- Chan YT, et al. Relationship between intrapartum transperineal ultrasound measurement of angle of progression and head-perineum distance with correlation to conventional clinical parameters of labor progress and time to delivery. J Matern Fetal Neonatal Med. 2015;28(12):1476-1481. doi:10.3109/14767058.2014.958459.
- Chor CM, et al. Prediction of labor outcome using serial transperineal ultrasound in the first stage of labor. J Matern Fetal Neonatal Med. 2019;32(1):31-37. doi:10.1080/14767058.2017.1369946.
- Maged AM, et al. Measurement of the fetal occiput-spine angle during the first stage of labor as predictor of the progress and outcome of labor. J Matern Fetal Neonatal Med. 2019;32(14):2332-2337. doi:10.1080/14767058.2018.1432589.
- Gimovsky AC, Berghella V. Evidence-based labor management: Second stage of labor (part 4). Am J Obstet Gynecol MFM. 2022;4(3):100548. doi:10.1016/j.ajogmf.2021.100548.
- Barak O, et al. The routine use of intrapartum ultrasound in clinical decision-making during the second stage of labor: Does it have any impact on delivery outcomes? Gynecol Obstet Invest. 2018;83(1):9-14. doi:10.1159/000455847.
- Beck R, et al. Intrapartum sonography of fetal head in second stage of labor with neuraxial analgesia: A literature review and possible medicolegal aftermath. Eur Rev Med Pharmacol Sci. 2019;23(8):3159-3166. doi:10.26355/eurrev_201904_17673.
- Li N, et al. Risk factors and clinical prediction of shoulder dystocia in non-macrosomia. Zhonghua Fu Chan Ke Za Zhi. 2015;50(1):17-21. doi:10.3760/cma.j.issn.0529-567X.2015.01.005.
- Carvalho Neto RH, et al. Assessment of the angle of progression and distance perineum-head in the prediction of type of delivery and duration of labor using intrapartum ultrasonography. J Matern Fetal Neonatal Med. 2021;34(14):2340-2348. doi:10.1080/14767058.2019.1666818.
- Haberman S, et al. A novel partogram for stages 1 and 2 of labor based on fetal head station measured by ultrasound: A prospective multicenter cohort study. Am J Perinatol. 2021;38(S01):e14-e20. doi:10.1055/s-0040-1702989.
- Pan WL, et al. Accuracy of non-invasive methods for assessing the progress of labor in the first stage: A systematic review and meta-analysis. BMC Pregnancy Childbirth. 2022;22(1):608. doi:10.1186/s12884-022-04938-y.
- Ghi T, Dall'Asta A. Sonographic evaluation of the fetal head position and attitude during labor. Am J Obstet Gynecol. 2024;230(3 Suppl):S890-S900. doi:10.1016/j.ajog.2022.06.003.
- Nassr AA, et al. Intrapartum ultrasound measurement of angle of progression at the onset of the second stage of labor for prediction of spontaneous vaginal delivery in term singleton pregnancies: A systematic review and meta-analysis. Am J Obstet Gynecol. 2022;226(2):205-214. https://doi.org/10.1016/j.ajog.2021.07.031.
- Hans R, Reddy D, Shetty J. Serial intrapartum ultrasound to predict vaginal delivery using angle of progression and head-progression distance in term nulliparous women. Eur J Obstet Gynecol Reprod Biol. 2025;293:18-23.