Het werk stelt een end-to-end multimodaal raamwerk voor voor emotieanalyse dat gebruikmaakt van transformer-encoders, ontkoppelde emotierepresentaties en grafiekgebaseerde cross-modale aandacht met visuele mapping om de nauwkeurigheid van emotieherkenning over twee datasets te verbeteren.
Onderzoeksartikel
Visuele mapping van multimodale emotiekenmerken voor intelligent interactieontwerp
In dit artikel
Samenvatting
Samenvatting
Door machines in staat te stellen menselijke affectieve toestanden te begrijpen, te interpreteren en daarop te reageren, is de visuele mapping van multimodale emotiekenmerken essentieel voor het ontwerp van intelligente interfaces. Desondanks richten huidige algoritmen voor multimodale emotiedetectie zich primair op predictieve prestaties, waardoor er weinig inzicht wordt geboden in interpreteerbaarheid, interactiebewustzijn of cross-modale interacties op kenmerkniveau. Dit werk introduceerde een raamwerk voor de visuele mapping van multimodale emotieaspecten dat interactiegeoriënteerde visualisatie, interpreteerbaar representatieleerproces en emotiepredictie combineert. Zonder gebruik te maken van handmatig gecreëerde kenmerken, werden transformer-gebaseerde encoders gebruikt om hoogwaardige emotie-embeddings uit tekstuele, audio- en visuele modaliteiten te extraheren. Om de robuustheid te verbeteren, werden emotiespecifieke en modaliteitsspecifieke informatie gescheiden met behulp van een techniek voor ontkoppeld representatieleerproces. Daarnaast werd een grafiekgebaseerd cross-modaal attentienetwerk ontwikkeld om adaptieve attentieweging te gebruiken voor het simuleren van subtiele emotionele relaties tussen modaliteiten. Er werd een multi-view visuele mapping-module ontwikkeld om temporele emotietrajecten, cross-modale attentieverdelingen en latente emotie-embeddings weer te geven om de transparantie te verhogen. De Carnegie Mellon University Multimodal Opinion Sentiment and Emotion Intensity (CMU-MOSEI) dataset en de Chinese Multimodal Sentiment Analysis Dataset (CH-SIMS) werden gebruikt om het voorgestelde raamwerk te evalueren. Volgens de experimentele resultaten bood het voorgestelde raamwerk een verbeterde interpreteerbaarheid op kenmerkniveau en interactiebewuste visualisatie, terwijl het consistent beter presteerde dan representatieve baseline-technieken op het gebied van nauwkeurigheid, F1-score, correlatie en gemiddelde absolute fout. Bovendien faciliteerde de visuele mapping-module de kwalitatieve interpretatie van multimodale emotierepresentaties, cross-modale interacties en temporele emotiedynamiek, wat interactiebewuste visualisatie en analyse ondersteunde.
Inleiding
Het vermogen om menselijke sentimenten correct te identificeren en te begrijpen is cruciaal geworden voor het verbeteren van de interactie tussen mens en machine. Naast dat het essentieel is voor het verbeteren van de mens-computerinteractie, heeft emotieanalyse het potentieel om een reeks vakgebieden te revolutioneren, waaronder pre-diagnostische medische diagnostiek1, gedragsanalyse in het klaslokaal2, psychologische monitoring van patiënten3, vermoeidheidsdetectie in voertuigen4 en intelligent beheer in smart home-omgevingen5. Recente ontwikkelingen in affective computing en deep learning6 hebben de interesse vergroot in het creëren van real-time systemen die de complexiteit van menselijke emoties kunnen vastleggen.
Veel huidige methoden vertrouwen hoofdzakelijk op unimodale gegevens, zoals tekstuele, grafische of auditieve signalen7,8,9. Deze benaderingen schieten herhaaldelijk tekort bij het detecteren van subtiele signalen, zoals sarcasme of contextspecifieke nuances. Onderzoek is verschoven naar multimodale emotie-evaluatie, waarbij complementaire gegevens uit meerdere bronnen worden geïntegreerd om deze beperkingen te overwinnen10,11,12. De voordelen van het samenvoegen van meerdere modaliteiten zijn aangetoond door basismodellen zoals early fusion-long short-term memory (EF-LSTM)13, light and FM deep neural networks (LF-DNN)14, tensor fusion networks (TFN) en low-rank multimodale fusiebenaderingen. De meeste van deze benaderingen vertrouwen echter op offline kenmerkgeneratie en zijn niet geschikt voor dynamische situaties in de echte wereld.
Om rekening te houden met emotionele toestanden, zijn onderzoek en toepassingen voor multimodale emotie-identificatie de afgelopen tien jaar gegroeid15. Een van de meest uitdagende en significante onderzoeksgebieden van dit moment is de continue monitoring van emotionele toestanden met behulp van diverse gegevensbronnen16. Het concept van multimodaliteit ontstond heel natuurlijk met de opkomst van een dergelijk gevarieerd kennissysteem, en dit heeft geleid tot vele vorderingen in de toepassing van emoties binnen domeinen zoals affectieve informatica, mens-computerinteractie (HCI), leren, videogames, consumentenservice, medische zorg, evaluatie van de gebruikerservaring (UX), enz. Het is echter niet altijd eenvoudig geweest om emotieherkenningstechnieken toe te passen bij UX-evaluaties.
Een van de belangrijkste redenen om zich te richten op multimodale herkenning in plaats van unimodale methoden is het inherente nadeel van het vertrouwen op een enkele informatiebron. Unimodale systemen voor emotiedetectie kunnen een lagere nauwkeurigheid vertonen door ontbrekende of onduidelijke gegevens, terwijl MER-schema's betrouwbaarder zijn en een vollediger en grondiger begrip van expressieve toestanden bieden door meerdere gegevensbronnen te integreren17. Zo is gezichtstaal alleen mogelijk niet voldoende om gevoelens nauwkeurig te classificeren, vooral wanneer de gebaren complex of onduidelijk zijn. Het combineren van gezichtsuitdrukkingen met andere vormen van communicatie, zoals taal of fysieke aanwijzingen, kan echter de nauwkeurigheid van de herkenning van gevoelens verhogen.
Er is uitgebreid onderzoek gedaan naar emotieherkenning via verschillende modaliteiten. Vroege studies richtten zich op het identificeren van onderscheidende kenmerken uit verschillende modaliteiten, zoals grafische, akoestische of tekstgebaseerde input. Hoewel het steeds duidelijker wordt dat de integratie van diverse modaliteiten gebalanceerde emotionele informatie kan bieden, wat leidt tot een betrouwbaardere en nauwkeurigere detectie van sentiment. Dit segment bespreekt de belangrijkste vorderingen in enkelvoudige en multimodale emotieanalyse, met de nadruk op basisbenaderingen, hun tekortkomingen en de rationale voor onze methode.
Het initiële onderzoek naar emotieherkenning richtte zich hoofdzakelijk op een enkele modaliteit. Op het visuele gebied leidde baanbrekend onderzoek tot de categorisering van prototypische gezichtsbewegingen20. Latere ontwikkelingen omvatten technieken voor het vastleggen van temporele dynamiek, zoals visuele beweging21 en hidden Markov-modellen22, terwijl gezichtsreacties werden onderverdeeld in actie-eenheden met behulp van het Facial Action Coding System (FACS)23. LSTMs en convolutionele neurale netwerken (CNN's) zijn succesvol ingezet om betekenisvolle kenmerken rechtstreeks uit ruwe audiosignalen te extraheren; methodologieën voor audio-gebaseerde emotie-identificatie zijn geëvolueerd van conventionele signaalverwerking naar deep learning24. De extractie van contextuele sentimentsignalen bij tekstgebaseerde emotieanalyse is sterk verbeterd door recurrente neurale netwerken (RNN's) met attention-mechanismen en, recenter, door transformer-gebaseerde modellen. Ondanks hun prestaties zijn unimodale technieken intrinsiek niet in staat om de complexiteit van menselijke ervaringen nauwkeurig weer te geven, omdat ze de aanvullende informatie missen die in andere modaliteiten aanwezig is.
Enkele modellen op basis van attention-mechanismen, zoals het DialogXL-model25, werden in 2021 voorgesteld om omgevingsgegevens op langere termijn te verzamelen op het gebied van sentimentidentificatie in gesprekken. Kim et al.26 introduceerden in 2021 het EmoBERTa-model om de nauwkeurigheid van ERC te verhogen. Dit model maakt gebruik van sprekergegevens om de kenmerken van sprekers in gesprekken en hun interacties met elkaar te verbeteren. In 2022 presenteerden Li et al.27 de CoG-BART-methode. Deze organisatie maakt gebruik van supervised contrastive learning om het vermogen van het model om relevante gegevens te interpreteren te verbeteren. Er moet worden opgemerkt dat supervised learning een aanzienlijke hoeveelheid gelabelde gegevens vereist.
Een typisch voorbeeld van dergelijk werk is het Multimodal Interaction-Aware Representation (MIAR) framework28, dat feature-interactietokens en contrastieve uitlijning gebruikt om de generalisatie over modaliteiten te verbeteren. MIAR verbetert de modaliteitsuitlijning en behaalt sterke prestaties over meerdere datasets; het richt zich echter primair op voorspellende nauwkeurigheid zonder visuele mapping te adresseren. Op soortgelijke wijze legt het Cross-Attentional Audio-Visual Fusion model29 effectief fijnmazige audio-visuele interacties vast voor de voorspelling van valentie en arousal, maar is beperkt tot twee modaliteiten en mist visualisatiemogelijkheden. Temporele modelleringsbenaderingen gebaseerd op LSTM-netwerken en autoencoder-fusie leggen de temporele dynamiek van emoties succesvol vast, maar bieden beperkt inzicht in modaliteitsinteracties en de geleerde emotionele representaties. Recentelijk hebben transformer-gebaseerde methoden, zoals het Transformer-based Multimodal Fusion Network (TMFN)30, sterke prestaties aangetoond op CMU-MOSI en CMU-MOSEI via verbeterde multimodale fusie en contrastief leren. Desalniettemin blijven deze benaderingen primair prestatiegedreven en bieden ze beperkte ondersteuning voor uitlegbaarheid, interpretatie op feature-niveau en interactiegeoriënteerde visualisatie.
Om de integratie van tekstuele, akoestische en visuele gegevens te verbeteren, zijn verschillende multimodal emotion recognition-technieken voorgesteld. Hoewel vroege fusion-technieken zoals EF-LSTM en LF-DNN niet in staat waren om complexe cross-modale interacties vast te leggen, toonden zij wel de voordelen aan van het gebruik van multimodale informatie voor sentiment- en emotieanalyse. Hoewel de TFN de prestaties op benchmark-datasets zoals CMU-MOSI en CMU-MOSEI verbeterde en expliciete modellering van inter-modale interacties introduceerde, belemmerden de beperkte interpreteerbaarheid en de hoge computationele complexiteit het nut ervan. Om de modaliteitsuitlijning en dynamische feature-fusie te verbeteren, hebben modernere technieken zoals MIAR, cross-attentional fusion-modellen, TMFN en adaptieve multimodale transformers gebruikgemaakt van transformer-topologieën en attention-mechanismen. Deze methoden richtten zich primair op de predictieve prestaties en boden weinig inzicht in emotionele representaties op feature-niveau en cross-modale afhankelijkheden, ondanks het behalen van concurrerende resultaten op gangbare evaluatiemetrieken zoals nauwkeurigheid, F1-score en de gemiddelde absolute fout. Bovendien hebben weinig studies visualisatietechnieken ontwikkeld die latente emotie-embeddings, attention-distributies en temporele emotiedynamiek kunnen onthullen, of hebben zij grafiekgebaseerde modellering van inter-modale interacties geïntegreerd. De voorgestelde aanpak incorporeert multi-view visuele mapping, grafiekgebaseerde cross-modale attention-fusie en disentangled representation learning om deze tekortkomingen te overwinnen en de prestaties van multimodal emotion recognition te verbeteren.
Op soortige wijze stelt de Adaptive Multimodal Transformer32 uitwisselingsgebaseerde fusie voor om adaptief ruisgevoelige of ontbrekende modale informatie te beperken, waardoor de prestaties van de sentimentclassificatie worden verbeterd. Hoewel deze aanpak discrepanties in de distributie van modale informatie effectief kan aanpakken, is het ontwerp taakspecifiek voor sentimentanalyse en biedt het beperkt inzicht in de geleerde emotionele representaties. Een andere belangrijke bijdrage is het Multimodal Fusion Model33, dat CNN's, multiplicatieve LSTM's en transformer-gebaseerde attention integreert voor real-time multimodale emotieherkenning. Het model voert een volledige fusie uit op video-, audio- en tekstmodaliteiten en vertoont robuuste herkenningsprestaties. Desalniettemin richt het zich, net als andere bestaande modellen, primair op de voorspellende nauwkeurigheid en mist het expliciete kenmerken voor visualisatie en interactie-georiënteerde interpreteerbaarheid.
Concluderend kan worden gesteld dat, hoewel de huidige state-of-the-art benaderingen voor multimodale emotieherkenning aanzienlijk succes hebben geboekt bij het vastleggen van cross-modale interacties en het verbeteren van de voorspellingsnauwkeurigheid, de meeste hiervan gericht zijn op herkenninggestuurde taken. Er is weinig aandacht besteed aan de gebieden van interpreteerbaarheid op kenmerkniveau, het visualiseren van emotionele representaties in de beeldruimte en het integreren van het voorgestelde raamwerk voor intelligent interactieontwerp. Met deze uitdagingen in gedachten is het voorgestelde raamwerk geïntroduceerd.
De meeste huidige methoden richten zich primair op het verbeteren van de predictieve prestaties, terwijl ze weinig interpreteerbaarheid bieden van de geleerde emotionele representaties en cross-modale interacties, ondanks aanzienlijke vooruitgang in multimodale emotieherkenning28,29. Complexe interacties tussen tekstuele, akoestische en visuele modaliteiten zijn vaak moeilijk te modelleren voor huidige fusiestrategieën, vooral wanneer er sprake is van modaliteitsverschillen en informatiegebrek 28,31. Hoewel transformer-gebaseerde ontwerpen en aandachtmechanismen het representatieleerproces hebben verbeterd, worden hun transparantie en interpreteerbaarheid vaak beperkt door het gebrek aan een expliciete scheiding tussen emotiespecifieke en modaliteitsspecifieke informatie31,32,33. Daarnaast hebben slechts enkele studies onderzoek gedaan naar grafiekgebaseerde modellering van intermodale interacties of visualisatiekaders ontwikkeld die temporele emotiedynamiek, aandachtverdelingen en emotie-embeddings kunnen onthullen. Deze tekortkomingen tonen de noodzaak aan van een interpreteerbaar multimodaal raamwerk voor intelligente mens-machine-interactie dat interactiegeoriënteerde visuele mapping combineert met krachtig cross-modaal leren.
Dit werk presenteert een interpreteerbaar raamwerk voor de visuele mapping van multimodale emotieaspecten in het ontwerp van intelligente interfaces. Zonder de noodzaak van handmatig gecreëerde kenmerken maakt het systeem gebruik van end-to-end deep learning om hoogwaardige emotionele representaties te extraheren uit tekstuele, audio- en visuele modaliteiten. Cross-modale emotionele interacties worden gemodelleerd met behulp van een grafiekgebaseerd attention-fusie-mechanisme dat emotie-specifieke en modaliteits-specifieke informatie scheidt, waardoor ontward representatieleer mogelijk wordt en de interpreteerbaarheid en robuustheid verbeteren. Daarnaast is er een multi-view visualisatiemodule ontwikkeld om temporele emotiedynamiek, cross-modale attention-patronen en emotie-embeddings weer te geven. De effectiviteit en geschiktheid van het voorgestelde raamwerk in intelligente mens-machine interactiesystemen worden geëvalueerd via validatie op benchmark-datasets voor multimodale emotieherkenning.
Dit werk biedt een uniek raamwerk voor de visuele mapping van multimodale emotieaspecten dat verder gaat dan traditionele voorspellingsgerichte benaderingen om de gebrekkige modellering van cross-modale interacties en de beperkte interpreteerbaarheid in huidige multimodale emotie-identificatiesystemen te overwinnen. Binnen een enkele architectuur combineert de voorgestelde benadering transformer-gebaseerd multimodaal representatie-leren, ontklitte emotie-bewuste feature-modellering, graafgebaseerde cross-modale attention-fusie en interactiegeoriënteerde visualisatie. Het raamwerk scheidt emotiespecifieke en modaliteitsspecifieke representaties duidelijk om de interpreteerbaarheid, robuustheid en cross-modale consistentie te verbeteren, in tegenstelling tot huidige benaderingen die zich voornamelijk concentreren op classificatieprestaties. Daarnaast wordt een graafgebaseerd attention-mechanisme gepresenteerd om adaptieve modellering van inter-modale interacties mogelijk te maken door fijnmazige emotionele interafhankelijkheid tussen tekstuele, audio- en visuele modaliteiten vast te leggen. Er is een multi-view visuele mapping-module ontwikkeld om de transparantie te vergroten door temporele emotietrajecten, cross-modale attention-patronen en latente emotie-embeddings te onthullen, die intuïtieve inzichten bieden in het besluitvormingsproces van het model. Naast het bieden van verbeterde visualisatie en interpreteerbaarheid van multimodale emotionele dynamiek, toonde experimentele evaluatie op de CH-SIMS en CMU-MOSEI benchmark-datasets concurrerende prestaties in termen van nauwkeurigheid, F1-score, gemiddelde absolute fout en correlatie.
Protocol
Het voorgestelde werk beoogt het ontwerp van intelligente interactie te verbeteren door een interpreteerbaar raamwerk te bieden voor de visuele mapping van multimodale emotiekenmerken. In dit werk zijn de publiekelijk toegankelijke databanken CH-SIMS en CMU-MOSEI gebruikt. Beide datasets zijn verkregen uit hun officiële bronnen en zijn gebruikt in overeenstemming met de gebruiksrichtlijnen, onderzoeksnormen en licentievoorwaarden die door de respectievelijke makers zijn vastgesteld. De multimodale inhoud van de datasets, inclusief tekst-, audio- en videagegevens, is oorspronkelijk verzameld en geannoteerd door de datasetproviders, in overeenstemming met hun geautoriseerde deelnemersvergunningen en protocollen voor gegevensverzameling. Er was in deze studie geen sprake van directe interactie met mensen, geen werving van nieuwe deelnemers en geen verzameling van persoonlijk identificeerbare informatie. Elke analyse is uitgevoerd met behulp van publiek beschikbare onderzoeksdatasets. Bijgevolg vereiste onze secundaire data-analyse geen verdere ethische goedkeuring of beoordeling door een institutionele toetsingscommissie (IRB). De studie is uitgevoerd in overeenstemming met de passende institutionele normen die het gebruik van publiek beschikbare datasets, ethische onderzoeksprocedures en toepasselijke richtlijnen voor datagebruik reguleren.
Er is gebruikgemaakt van een op grafen gebaseerd cross-modaal aandachtmechanisme om emotiekarakteristieken over verschillende modaliteiten heen te leren, waarbij emotie- of modaliteitsspecifieke kenmerken worden gebruikt om het begrip te verbeteren. Een component voor multi-view visuele mapping wordt ingezet om real-time emotie-bewust interactief ontwerp te verbeteren, en de efficiëntie hiervan wordt geschat voor emotieherkenning. De resultaten tonen aan dat de voorgestelde methode zowel de interpreteerbaarheid als de efficiëntie verbetert voor emotie-bewuste intelligente gebruikersinterfaces in de echte wereld. Figuur 1 toont de architecturale workflow van het voorgestelde werk. Figuur 1 toont de volledige workflow van het gesuggereerde visuele mapping-framework voor multimodale emotie-kenlerlering in de context van intelligente interactiesystemen. De workflow begint met drie gesynchroniseerde inputmodaliteiten, namelijk tekst, audio en video, die respectievelijk complementaire emotionele informatie uit de linguïstische, prosodische en gezichtsuitdrukkingsmodaliteiten vastleggen. Een modaliteitsspecifieke transformer-encoder verwerkt elke modaliteit om hoogwaardige representaties van de ruwe inputgegevens te verkrijgen. De representaties worden vervolgens ingevoerd in een module voor ontward representatieleer (disentangled representation learning), waarbij de emotie-specifieke embeddings worden ontward van de modaliteitsspecifieke kenmerken om consistentie in de geleerde emoties over heterogene gegevensbronnen te waarborgen. De emotie-specifieke embeddings van elke modaliteit worden vervolgens geaggregeerd door een op grafen gebaseerd cross-modaal attentienetwerk, dat de intermodale emotionele afhankelijkheden modelleert en dynamische belangrijkheidsgewichten aan elke modaliteit toekent op basis van de interactiecontext. Tot slot biedt het framework zowel emotieclassificatie-outputs als interactie-inzichten, wat transparante emotie-bewuste besluitvorming en adaptief intelligent interactie-ontwerp faciliteert.
Multimodale data-acquisitie
De CH-SIMS- en CMU-MOSEI-datasets zijn twee bestaande publieke multimodale datasets waarin multimodale informatie is verzameld, zoals gesynchroniseerde video, audio en tekst. De CH-SIMS-dataset bestaat uit multimodale onderzoeken van Chinese personen, inclusief 2.281 videosegmenten, afgeleid van meerdere videosegmenten uit films, televisiedrama's en varietéshows. Onderzoeken naar multimodale analyse van emoties met behulp van multimodale data worden boeiender en haalbaarder door de toevoeging van bijbehorende audio en tekst aan deze videosegmenten. Een van de grootste multimodale datasets voor het onderzoek naar opinies, gevoelens en emoties is echter de CMU-MOSEI-dataset, die is verzameld uit meer dan 23.000 videoclips van zinnen uitgesproken door meer dan 1.000 sprekers over een verscheidenheid aan onderwerpen. De dataset werd willekeurig verdeeld in subsets voor training (70%), validatie (15%) en testen (15%), waarbij de klassendistributie werd behouden.
Tekstuele transcripties, audiosignalen en videoframes worden verkregen en tijdstempel-uitgelijnd om op een fijnmazig temporeel niveau overeen te komen. Integratie op frameniveau zorgt ervoor dat de voorgestelde representatie-learning en grafiekgebaseerde fusie-mechanismen gezamenlijk emotionele inhoud kunnen modelleren en benutten die voortvloeit uit visuele expressies, vocale tonen en linguïstische inhoud. Effectieve extractie van intermodale emotionele dynamiek wordt mogelijk gemaakt door dit type multimodale acquisitietechniek, wat essentieel is voor intelligent interactieontwerp en begrijpelijke visuele mapping.
Tabel 1 presenteert de belangrijkste structuren van de multimodale emotiedatasets die in de voorgestelde methode worden gebruikt. Om een breder scala aan gerelateerde gevoelens te verkrijgen, zoals gesproken woorden, stemintonaties en gezichtsuitdrukkingen, integreren CH-SIMS en CMU-MOSEI video-, audio- en tekstmodaliteiten uit deze datasets. Bovendien is er in CH-SIMS een beperkt aantal dataprofielen beschikbaar, wat een grondige analyse van modaliteitsinteracties en emotievariatie in China mogelijk maakt. Aan de andere kant is de CMU-MOSEI-dataset belangrijker voor het evalueren van de robuustheid van het representation learning en de bijbehorende visualisatiealgoritmen die in dit werk worden behandeld, aangezien deze een grote hoeveelheid data bevat over diverse talen, onderwerpen en geannoteerde emotieniveaus. Daarnaast vermindert het, vergeleken met eerder onderzoek, de moeilijkheden bij het selecteren van informatie tijdens het testen van modellen.
Multimodale preprocessing en synchronisatie
De tijdstempelannotaties van de CH-SIMS- en CMU-MOSEI-datasets werden gebruikt om tekstuele, auditieve en visuele modaliteiten te synchroniseren, waardoor een consistente multimodale representatieleering werd gewaarborgd. Elke uiting fungeerde als de fundamentele analyse-eenheid en was gekoppeld aan overeenkomstige audio- en videosegmenten binnen hetzelfde tijdsinterval. De uitlijning werd uitgevoerd op het niveau van de uiting. Het transcript werd in segmenten verdeeld op basis van de start- en eindtijdstempels van elke uiting. De correspondentie tussen transcript, audio en beeld werd vastgesteld door de overeenkomstige videoframes en audiosignalen te extraheren die binnen hetzelfde tijdsinterval vielen. Terwijl audiosegmenten werden verwerkt met Wav2Vec 2.0 om akoestische representaties te produceren, werden visuele frames uit het videosegment bemonsterd met een vooraf bepaalde frequentie en gecodeerd met de Vision Transformer (ViT). De RoBERTa-encoder werd gebruikt om tekstuele embeddings te creëren vanuit de transcripts van de uitingen. Temporele synchronisatie werd bereikt door alle modaliteitskenmerken uit te lijnen op één uitingsgrens, aangezien de drie modaliteiten kenmerksequenties van verschillende lengtes produceerden. Er werd gebruikgemaakt van een vast lengteformaat om sequenties van variërende lengtes te normaliseren. Langere sequenties werden ingekort tot de maximaal toegestane sequentielengte, terwijl kortere sequenties werden aangevuld met nulwaarden (zero-padding). Tijdens de training werden attention-masks gebruikt om gepadde elementen te scheiden van legitieme kenmerkposities. Modaliteitsspecifieke embeddings werden geprojecteerd in een gemeenschappelijke latente ruimte voorafgaand aan de fusie om de verschillende sequentielengtes tussen de modaliteiten te overbruggen. Dit garandeerde dimensionale consistentie en stelde het op grafen gebaseerde attention-mechanisme in staat om succesvol cross-modaal interactie-leren te faciliteren. Om de datakwaliteit en de integriteit van de synchronisatie te waarborgen, werden samples met corrupte bestanden, ontbrekende annotaties of incomplete modaliteitsinformatie uitgesloten van de studies.
Kenmerkextractie op basis van Transformers
Een deep learning-methode wordt gebruikt om hoogwaardige, emotiebewuste kenmerkrepresentaties te leren uit informatie over meerdere modaliteiten, zoals visuele, auditieve en tekstuele gegevens, op een end-to-end manier na het uitlijnen van de multimodale gegevens en eventuele benodigde voorbewerking. Door een transformer-encoder te gebruiken om intrinsiek discriminatieve kenmerkrepresentaties te leren uit ruwe multimodale gegevens, elimineert de voorgestelde methode de noodzaak voor feature engineering. Om consistentie te bevorderen over de datasets die in de voorgestelde aanpak worden gebruikt, wordt een embedding van vaste grootte geleerd voor elke modaliteit. Zo worden er 768-dimensionale kenmerkembeddings geleerd voor elk van de individuele modaliteiten, waaronder afbeeldingen, audio en tekst, die gezamenlijk een uniforme kenmerkruimte vormen die in de gehele aanpak wordt gebruikt, in het bijzonder een kenmerkextractieaanpak die wordt toegepast op de voorgestelde CH-SIMS dataset en de CMU-MOSEI dataset om hoogwaardige kenmerken te leren uit gegevens van verschillende groottes.
Visuele modaliteit: Vision transformer voor emotiebewuste frame-embeddings
Een Vision Transformer (ViT-Base) model werd gebruikt om visuele informatie uit videoframes te extraheren om emotie-relevante ruimtelijke representaties te verkrijgen. Voorafgaand aan de extractie van kenmerken werden de frames van elk videosegment geschaald naar (224 × 224) pixels en bemonsterd met regelmatige tijdsintervallen. Met een patchgrootte van 16 × 16 pixels produceert de ViT-Base architectuur een reeks visuele tokens die door 12 transformer-encoderlagen worden verwerkt. De verkregen representaties op frameniveau werden geprojecteerd in een 768-dimensionale embeddingruimte met behulp van een pretrained ViT-model als visuele backbone. De embeddings op frameniveau werden geaggregeerd via mean pooling om de uiteindelijke visuele representatie voor elk segment te creëren. Tijdens de training werden beeldnormalisatie en gangbare augmentatiemethoden, zoals random cropping en horizontaal spiegelen, gebruikt om de generalisatie te verbeteren. Het voorgestelde multimodale fusie-framework werd vervolgens gebruikt om deze visuele embeddings te combineren met tekstuele en auditieve representaties.
Om de temporele dynamiek in emotie te behouden, worden videokleuren uit de CH-SIMS- en CMU-MOSEI-datasets uniform gesampled voor de visuele modaliteit. De frames van elke video, 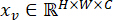 , kunnen worden opgesplitst in N secties van vaste grootte, die vervolgens worden afgeplat en invers worden overgebracht naar een latente embeddingruimte met dimensie
 . Er wordt een reeks gecreëerd door positionele embeddings en een leerbaar groeperingstoken toe te voegen:
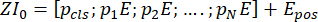 (1)
waarbij  staat voor de positionele codering en
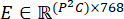 de patch-embeddingmatrix is.
Gestapelde transformer-encoderlagen, bestaande uit feed-forward netwerken en multi-head self-attention, worden gebruikt om de embedded patch-sequentie te verwerken. De transformatie op laag l wordt als volgt beschreven:
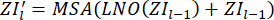 (2)
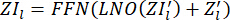 (3)
Om de emotiebewuste visuele kenmerkvector te verkrijgen, wordt de output die gelijk is aan de class-token geëxtraheerd als de kenmerkvector  . Om consistente visuele emotierepresentaties te realiseren ondanks verschillen in taal en inhoud tussen datasets, worden embeddings op frameniveau van elk videosegment gecombineerd om gezichtsuitdrukkingen en de evolutie van emoties vast te leggen.
Audiomodality met behulp van Wav2Vec 2.0 voor prosodie en semantische akoestische embeddings Contextuele spraakembeddings werden gegenereerd met een vooraf getrainde Wav2Vec 2.0-encoder als akoestische backbone. Voor elke zin werd een akoestische featurevector met een vaste lengte verkregen door de output-hidden representations te aggregeren middels mean pooling. Het Wav2Vec 2.0-model werd gebruikt om akoestische representaties uit audiosignalen te extraheren om contextuele en emotie-relevante spraakkenmerken vast te leggen. Vóór de feature-extractie werden de audio-opnames genormaliseerd en geresampled naar 16 kHz. Om synchronisatie tussen de tekstuele en visuele modaliteiten te waarborgen, werd elk audiofragment op uitingenniveau geïsoleerd met behulp van de tijdstempelgrenzen uit de dataset-annotaties. De vooraf getrainde akoestische encoder werd tijdens de modeltraining aangepast om de taakspecifieke adaptatie te verbeteren, waardoor de afgeleide representaties de emotionele aspecten van de spraaksignalen nauwkeuriger konden weergeven. Vervolgens werden grafiekgebaseerde cross-modale attention-fusie en disentangled representation learning uitgevoerd met behulp van de uiteindelijke audio-embeddings.
Voor de audio-modaliteit wordt Wav2Vec-2.0 gebruikt om spraaksignalen te modelleren die zijn afgeleid van de initiële spraakinformatie in de CH-SIMS en CMU-MOSEI datasets, waarbij direct audio-kenmerken die gerelateerd zijn aan emotie worden geëxtraheerd. Er bestaat een convolutionele kenkensecodering voor elk invoerspraaksignaal  :
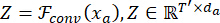 (4)
waarbij Z staat voor prosodische kenmerken op laag niveau, zoals melodie, toon en energie. Een transformer-gebaseerd contextnetwerk is nuttig voor de bovengenoemde structuren en representeert tijdgebaseerde afhankelijkheden over lange afstand:
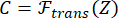 (5)
Prosodische en semantische akoestische gegevens, die essentieel zijn voor het uitdrukken van emotie, zijn opgenomen in deze contextuele akoestische representaties. Een audio-embedding van een specifieke lengte wordt gecreëerd door middel van een temporele pooling-procedure:
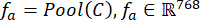 (6)
Het ontwerp vermijdt het gebruik van akoestische kenmerken zoals MFCC's en bereikt robuustheid door simpelweg representaties uit golfvormen te extraheren, gebruikmakend van Engelse spraakgegevens van CMU-MOSEI en Chinese spraakgegevens van CH-SIMS.
Tekstmodaliteit met behulp van RoBERTa voor contextuele emotie-embeddings
Voor de tekstuele modaliteit wordt de diepe bidirectionele transformer, RoBERTa, toegepast op de spraaktranscripties van de twee datasets om contextuele semantiek en affectieve betekenis te genereren. Op RoBERTa gebaseerde transformer-encoders werden gebruikt om tekstuele representaties uit de transcriptiedata te extraheren om contextuele semantische en emotionele informatie vast te leggen. Een vooraf getraind RoBERTa-model werd gebruikt voor de Engelstalige CMU-MOSEI-dataset, terwijl een Chinese RoBERTa-variant werd gebruikt voor de Chinese CH-SIMS-dataset om beter rekening te houden met taal-specifieke linguïstische kenmerken. De tekstvoorverwerking omvatte tokenisatie met gebruik van de juiste RoBERTa-tokenizer voor elke taal en tekstnormalisatie. Om consistente batchverwerking te waarborgen, werden inputsequenties omgezet in token-embeddings en vervolgens aangevuld (padded) of ingekort tot een vooraf bepaalde maximale sequentielengte. In overeenstemming met het RoBERTa-inputformaat werden speciale classificatie- en scheidingstokens geïntroduceerd. Een tekstuele embedding met vaste lengte werd verkregen door de gecontextualiseerde token-representaties, geproduceerd door de transformer-encoder, te aggregeren met behulp van de uiteindelijke [CLS]-equivalente zinrepresentatie. Om de geleerde representaties aan te passen aan de taak van emotieherkenning, werden de vooraf getrainde RoBERTa-encoders verfijnd via multimodale training. Het voorgestelde multimodale fusieraamwerk werd vervolgens gebruikt om de tekstuele embeddings samen te voegen met de audio- en visuele kenmerken.
De token-embeddings en positionele coderingen kunnen voor elke getokeniseerde input worden gecombineerd, 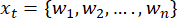 , om de inputrepresentatie te creëren in de deep bidirectional transformation techniek die bekend staat als
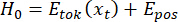 (7)
Deze vorm wordt weergegeven via de lagen van de L-transformer, die self-attention gebruikt om de contextafhankelijkheden tussen woorden te ontdekken:
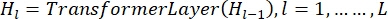 (8)
De contextuele emotie-embedding wordt verkregen met behulp van de uiteindelijke verborgen toestand van het classificatietoken:
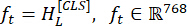 (9)
Sentimentpolariteit, intense emoties en geassocieerde implicaties zijn voorbeelden van emotiegerelateerde linguïstische kenmerken die door deze embedding worden gerepresenteerd. RoBERTa vergemakkelijkt taal-agnostische modellering. Hierdoor kan het systeem dezelfde embedding-grootte gebruiken voor zowel Engelse teksten uit de CMU-MOSEI-dataset als Chinese teksten uit de CH-SIMS-dataset.
Drie modaliteitsspecifieke kenmerkvectoren van 768 dimensies, respectievelijk voor de visuele fv, audio fa en tekstuele ft modaliteiten, worden geëxtraheerd door de voorgestelde stap van deep feature representation learning. In het ontwerp van de intelligente interactie creëren deze geleerde representaties een uniforme multimodale kenmerkruimte die dient als basis voor visuele mapping op kenmerkniveau, graafgebaseerde cross-modale fusie en disentangled representation learning.
Ontward representatie-leren
Na het aanleren van een diepe kenmerkrepresentatie kan aanvullende verwerking van de multimodale kenmerkvectoren uit de visuele, auditieve en tekstuele modaliteiten leiden tot een gedisjugeerde emotiebeschrijving. Indien de modaliteitsspecifieke kenmerkembeddings van de auditieve, visuele en tekstuele modaliteiten die in de vorige stap zijn gebruikt, respectievelijk worden weergegeven door fv, fa en ft, zodanig dat  en
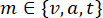 , is het doel van deze stap om alle modaliteitskenmerken te factoriseren in twee afzonderlijke latente weergaven, die de emotieweergaven bevatten nadat de voorgaande semantiek van elk van de verschillende modaliteiten in overweging is genomen.
Dit wordt bereikt door elke modaliteitskenmerk, fm , in twee parallelle projectienetwerken te voeden: een emotie-encoder  en een modaliteits-encoder
 , waarmee de twee coderingen worden gegenereerd.
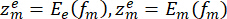 (10)
Waarbij  de latente eigenschap gekoppeld aan de emotie is, en
 een latente eigenschap vertegenwoordigt die specifiek is voor een modaliteit. Dit stelt emotiespecifieke embeddings in staat om herhaaldelijk te communiceren met een ruimte over meerdere inputs, waaronder audio, visuele gegevens en tekst, terwijl de unieke structurele gegevens die geassocieerd zijn met elke modaliteit behouden blijven.
Een effectieve scheiding wordt afgedwongen door reconstructie met onafhankelijkheidsbeperkingen. De reconstructie van de oorspronkelijke modaliteitskenmerk wordt gegeven door:
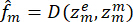 (11)
waarbij  een decodernetwerk is. Het reconstructieverlies behoudt de volgende gegevens:
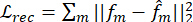 (12)
Bovendien beperkt orthogonaliteit, of decorrelatie, tussen emotie en modaliteitsspecifieke weergaven vaak de overlap van informatie:
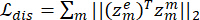 (13)
Door deze doelstellingen te behalen, kan het model emotievoorstellingen aanleren die betrouwbaar, begrijpelijk en resistent zijn tegen modaliteitsvariabiliteit. Latere grafiekgebaseerde crossmodale fusie en visual-mapping-kenmerken, met name voor intelligent interactieontwerp, leunen sterk op interpreteerbare, gestructureerde emotievoorstellingen.
Consistentie van emoties over modaliteiten heen
De toevoeging van emotieconsistentie verbetert duidelijk de effectiviteit van de fusie tussen de modaliteiten. Dit komt doordat fusiestrategieën geen rekening hoeven te houden met grote verschillen tussen de twee representaties, aangezien de modaliteitsspecifieke emotie-embeddings een latente ruimte delen. De gecombineerde illustratie van de twee emoties wordt als volgt beschreven  . Gewogen fusie zal stabieler zijn wanneer emotiespecifieke representaties consistent zijn, omdat variaties tussen signalen van verschillende modaliteiten geen invloed meer zullen hebben op het resultaat.
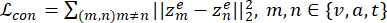 (14)
Door het afdwingen van een semantische uitlijning van emotionele informatie, minimaliseert dit doel discrepanties tussen modaliteiten en zorgt het ervoor dat de perceptie van emoties consistent blijft, ongeacht de modaliteit die wordt gebruikt om deze uit te drukken. Bijgevolg wordt er een samenhangende en affectieve representatieruimte gecreëerd door het projecteren van emotionele signalen verkregen uit spraaksignalen, gezichtsuitdrukkingen en linguïstische inhoud.
Impact op cross-modale fusie
Crossmodale fusie wordt effectiever wanneer emotieconsistentie tussen modaliteiten wordt geïntroduceerd. Fusiemechanismen hoeven niet langer te compenseren voor aanzienlijke representatieverschillen tussen modaliteiten, omdat de emotiespecifieke embeddings zijn uitgelijnd in een gemeenschappelijke latente ruimte. De gefuseerde emotierepresentatie is als volgt gedefinieerd:
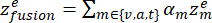 (15)
Waarbij αm het gewicht vertegenwoordigt van de aandacht die aan modaliteit m wordt gegeven. De gewogen fusie wordt stabieler en begrijpelijker wanneer emotiespecifieke representaties consistent zijn, aangezien het fusieresultaat complementair emotioneel bewijs vertoont in plaats van tegenstrijdige modaliteitssignalen.
Wiskundig gezien is het verlagen van de  variantie tussen verschillende emotiespecifieke representatietypes in relatie tot gelijk aan:
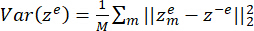 (16)
waarbij  de gemiddelde emotie-expressie vertegenwoordigt. Een verminderde variantie resulteert erin dat de inputmodaliteiten worden gewogen op basis van hun precieze emotionele significantie in plaats van modaliteitsruis, wat zorgt voor een verbeterde netwerkconvergentie en een nauwkeurigere aandachtbeoordeling.
Het uiteindelijke leerdoel van ontwarde emotievisualisaties is om fragmentatie, reconstructie en emotie-uniformiteit te combineren:
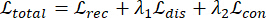 (17)
welke twee hyperparameters, λ1 en λ2, de relatie tussen cross-modale emotiebetrouwbaarheid en dissociatie regelen. Het voorgestelde model verkrijgt modaliteits-invariante, interpreteerbare en fuseerbare emotionele representaties om dit te bereiken, met een nadruk op het bieden van een solide basis voor latere grafiekgebaseerde fusie en representatie op kenmerkniveau in het ontwerp van intelligente interfaces.
Graafgebaseerde cross-modale attention-fusie
Een grafiekgebaseerd cross-modaal aandachtnetwerk werd gebruikt om fijnmazige emotionele relaties tussen modaliteiten te simuleren. Om de informatiestroom tussen modaliteiten te vergemakkelijken, werd een volledig verbonden multimodale graaf opgebouwd, waarbij elke modaliteitsspecifieke embedding (tekst, audio en visueel) werd weergegeven als een graafknooppunt. Modaliteitsrelaties werden gebruikt om de aangrenzingsmatrix van de graaf vast te stellen, die vervolgens werd verbeterd via een leerbare aandachtsmethode. Een gedeelde latente ruimte werd gecreëerd door de outputs van verschillende attention heads te concateneren en te projecteren. Een uniforme multimodale emotie-representatie werd vervolgens gegenereerd door knooppuntrepresentaties te aggregeren met behulp van attention-weighted pooling. De voorspellings- en visualisatiemodules voor interactiebewuste analyse en emotieherkenning ontvingen vervolgens deze gefuseerde representatie. De graaf-fusiemodule had een verborgen representatiedimensie van 256 en twee graaf-aandachtslagen, elk met acht attention heads. Om het relatieve belang van nabijgelegen modaliteiten vast te stellen, werden aandachtscoëfficiënten tussen verbonden knooppunten berekend en gestandaardiseerd met de softmax-functie. Elke graaf-aandachtslaag werd gevolgd door laagnormalisatie, residuele verbindingen en een dropout-percentage van 0,2 om de trainingsstabiliteit te verhogen en overfitting te verminderen. Nadat de outputs van verschillende attention heads waren geconcateneerd en geprojecteerd op een gemeenschappelijke latente ruimte, werden de knooppuntrepresentaties gecombineerd tot één enkele multimodale emotie-embedding met behulp van attention-weighted pooling. Daarna werd de gefuseerde representatie gebruikt voor multi-view visuele mapping en emotievoorspelling.
Diverse cross-modale interacties werden vastgelegd met behulp van multi-head graph attention. De softmax-functie werd gebruikt om de attention-coëfficiënten tussen verbonden knooppunten voor elk knooppunt te normaliseren. Om de trainingsstabiliteit te verhogen en overfitting te voorkomen, werden de gestapelde graph-attention-lagen van de graph-fusion-module gevolgd door residuele verbindingen, layer-normalisatie en dropout-regularisatie.
Laten we de termen afzonderlijk beschouwen als de representaties die overeenkomen met de specifieke emoties verzameld door de visuele, audio- en tekstmodaliteiten; elke component bevindt zich binnen de gedeelde latente ruimte  . De modellen voor de modaliteitsknooppunten gebruiken een notatie voor de graaf
 , waarbij de knooppunten van de verzameling
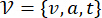 overeenkomen met de drie modaliteitsknooppunten zelf, om de emotionele afhankelijkheden die gedeeld worden tussen de verschillende modaliteitsrepresentaties expliciet te versterken.
Nadat er aan elke knoop in de graaf een emotiespecifieke kenmerkvector is toegewezen, hebben we:
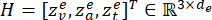 (18)
In tegenstelling tot traditionele fusiemethoden, waarbij vooraf bepaalde of vaste fusiegewichten worden gebruikt, leert de voorgestelde methode adaptieve randgewichten op basis van hun significantie en onderlinge afhankelijkheden, zowel over kanalen als over emotionele situaties heen.
Een Graph Attention Network (GAT) wordt gebruikt voor cross-modale fusie. Er wordt een attentiecoëfficiënt berekend voor elke knoop i en de naburige knopen, d.w.z. knoop j:
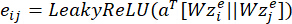 (19)
Het emotionele effect van het overschakelen van modus j naar modaliteit i wordt gemeten door de genormaliseerde gewichten αij.
Vervolgens wordt het gefuseerde uiterlijk van elke modaliteitsknoop berekend als een gewogen groepering van zijn buren:
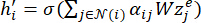 (20)
waarbij de activeringsfunctie  niet-lineair is. Uiteindelijk worden de bijgewerkte kenmerken van elke knoop gecombineerd om een globale gefuseerde emotierepresentatie te verkrijgen:
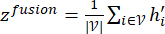 (21)
Het is een nuttige techniek voor interpreteerbare emotiemodellering en daaropvolgende visuele mapping, omdat het complementaire informatie uit verschillende modaliteiten vastlegt terwijl complexe intermodale relaties behouden blijven.
Algoritme 1 (Aanvullend bestand 1) biedt het algemene schema voor het uitvoeren van de grafiekgebaseerde cross-modale fusie. In eerste instantie wordt er een grafiek gemaakt waarbij de emotiespecifieke kenmerken gekoppeld zijn aan elk van de visuele, audio- en tekstuele modaliteiten. Vervolgens worden de aandachtsscores voor de knoopparen van elke grafiek berekend, die de combinatie van emotionele afhankelijkheid representeren. De aandachtsscores worden daarna genormaliseerd om de relatieve bijdrage van elke modaliteit aan de gespecificeerde emotionele context aan te geven, waardoor het leren van de attentiegewichten mogelijk wordt. De algemene emotie-embedding wordt in de laatste fase gegenereerd door de kenmerken die geassocieerd zijn met de knopen van de grafiek te aggregeren. In die zin is de algemene fusie van de multimodale kenmerken gekoppeld aan de gespecificeerde emoties, zoals beschreven in het algoritme, veelbelovend voor aanpasbaarheid, interpreteerbaarheid en contextuele intelligentie.
Figuur 2 toont de structuur en werking van het voorgestelde cross-modale attentienetwerk voor multimodale sentimentfusie. De emotiespecifieke embeddings, die onafhankelijk zijn afgeleid voor de tekst-, auditieve en videomodale modaliteiten, worden in eerste instantie doorgegeven aan attentiemechanismen op modaliteitsniveau die de relatieve belangrijkheid van linguïstische, vocale en gelaatsinformatie voor een gegeven emotionele context leren. De attentie-gewogen representaties van de modaliteiten worden vervolgens gecombineerd om een uniforme emotie-embedding te vormen, waarbij de attentiematrix de inter-modale afhankelijkheden en interactiesterkten vastlegt. De door het netwerk geleerde attentiematrix moduleert dynamisch de bijdragen van de modaliteiten, waardoor het netwerk zich kan concentreren op de sterkste instructieve modaliteit terwijl ruisachtige, minder informatieve modaliteiten worden genegeerd. De gefuseerde emotierepresentatie maakt een nauwkeurige emotieherkenning en fijnmazige analyse van emotionele toestanden mogelijk, zoals neutraal, omhelzing en bezorgdheid.
Module voor visuele mapping
Met behulp van de sectie voor visuele mapping, die specifiek hiervoor is ontwikkeld, kan een intelligente interactieontwerper de uniforme representatie van de emotionele toestand, op basis van de graaf, omzetten in een visuele vorm die begrijpelijk en gemakkelijk consumeerbaar is na het cross-modale fusieproces.
Om de latente emotionele representaties beter inzichtelijk te maken, werden dimensiereductietechnieken gebruikt om de geleerde multimodale emotie-embeddings te visualiseren. Na het reduceren van de kenmerkdimensionaliteit met behoud van het grootste deel van de variantie middels Principal Component Analysis (PCA), werden de embeddings geprojecteerd in een tweedimensionale ruimte voor weergave met t-distributed Stochastic Neighbor Embedding (t-SNE). Voor t-SNE werd een perplexity-waarde van 30, een learning rate van 200 en 1.000 optimalisatie-iteraties gebruikt. Emotiespecifieke clusters en modaliteitsrelaties werden gevisualiseerd met behulp van de verkregen projecties. De genormaliseerde cross-modale attention-gewichten, verkregen via het graafgebaseerde attention-netwerk, werden gebruikt om attention-heatmaps te maken. De relatieve bijdragen van tekstuele, audio- en visuele modaliteiten tijdens de emotievoorspelling worden in deze heatmaps weergegeven. De geleerde attention-coëfficiënten werden als randgewichten gebruikt om cross-modale interactiegrafen te creëren, wat visuele inspectie van inter-modale relaties en de informatiestroom binnen het fusiekader mogelijk maakte. Om de temporele emotionele dynamiek te onderzoeken, werden emotietraject-plots gemaakt door de ontwikkeling van latente emotie-embeddings over opeenvolgende uitingen te monitoren. Deze trajecten werpen licht op de manier waarop emotionele toestanden en modaliteitsbijdragen in de loop van de tijd evolueren. Matplotlib en Scikit-learn zijn de twee Python-pakketten die zijn gebruikt voor het maken van alle visualisaties. Om de interpreteerbaarheid, clusterformatie, modaliteitsbijdragen en temporele emotiedynamiek te evalueren, werden kwalitatieve analyses uitgevoerd op de embedding-visualisaties, interactiegrafen en attention-heatmaps.
Laat de variabele 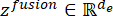 de gefuseerde representatie van de emotionele toestand door de graph attention network-functie representeren. In tegenstelling tot de visualisatie op outputniveau van de plots van de emotionele toestand, is het hoofddoel van de module om de representaties van de emotionele toestand en de bijbehorende gewichten van het aandachtmechanisme om te zetten in een begrijpelijke visuele vorm.
Met behulp van de geleerde αji wordt een attention heatmap gemaakt om de bijdrage van elke modaliteit visueel te onderzoeken. De binnenkomende attention-gewichten worden vervolgens bij elkaar opgeteld om een samengestelde belangrijkheidsscore voor elke modaliteit te bepalen:
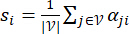 (22)
waarbij si de relatieve emotionele bijdrage van modaliteit I vertegenwoordigt. Om te helpen bij het creëren van een attention heatmap, worden de verkregen waarden genormaliseerd en toegewezen aan een kleurkaart, waardoor de gebruiker eenvoudig de prominente modaliteit bij verschillende tijdstappen of interactieve toestanden kan identificeren. Via diverse visuele, auditieve of tekstuele inputmodaliteiten helpt een dergelijke interface de gebruiker te begrijpen hoe het attention-mechanisme van het systeem werkt.
De geleerde graaf is specifiek gemodelleerd als een "gewogen interactiegraaf" om de crossmodale afhankelijkheid van menselijke emoties weer te geven. De modaliteit zelf wordt vertegenwoordigd door elke knoop in de graaf, en de sterkte van de interacties met betrekking tot menselijke emoties wordt weergegeven door gewichten in de vorm van αji op de zijden die hen verbinden. De bovenstaande gewogen graaf illustreert de intensiteit van menselijke emotionele interacties. De definitie van i en j is:
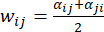 (23)
Dankzij deze wegingsfactoren worden de lijndikte of transparantie van de grafische visualisatie op passende wijze weergegeven. Dit maakt het gemakkelijker om te begrijpen hoe de modaliteiten met elkaar interageren. Met behulp van cross-modale interactiegrafieken kan de ontwerper beter begrijpen hoe emotionele indicatoren interageren tijdens het fusieproces.
De gefuseerde emotie-embeddings  op verschillende tijdstappen worden via een dimensionaliteitsreductie-algoritme, zoals PCA of t-SNE, teruggebracht naar een lager-dimensionale ruimte om de evolutie van temporele emoties weer te geven:
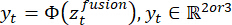 (24)
waarbij de projectiefunctie wordt weergegeven door  . Het ontstaan van 2D/3D emotietrajecten, die emotieovergangen, intensiteiten en stabiliteit in interacties laten zien, kan worden geïnterpreteerd als een intuïtieve weergave van de evolutie van emotionele toestanden over tijd. Deze aspecten kunnen worden gebruikt voor intelligente interactie, besluitvorming en real-time monitoring.
In tegenstelling tot conventionele emotiesystemen, die enkel koppelingen naar specifieke klassen of scores bieden, richt dit systeem zich op het demonstreren van hoe menselijke emoties daarbinnen worden gevormd. Het onthult zijn besluitvormingsproces door visualisaties van tussenliggende kenmerken aan te bieden, waaronder wegingsfactoren, interacties tussen modellen en de bijbehorende paden. Hierdoor kan de gebruiker begrijpen hoe elke factor — visueel, vocaal of linguïstisch — van invloed is op het genereren van de responsen op menselijke emoties.
Het koppelen van emoties aan begrijpelijke vormen via visuele representaties kan zo de kloof overbruggen tussen emotieanalyse met behulp van deep learning-methoden en de integratie daarvan voor het ontwerp van intelligente interfaces. De gegevens die met beide benaderingen zijn verzameld, kunnen vervolgens worden gebruikt om preciezere gebruikersinterfaces te creëren. De voorgestelde aanpak kan interactie-ontwerpers dus essentiële informatie verschaft voor het maken van nauwkeurigere gebruikersinterfaces. Met andere woorden wordt het begrip van emoties een zeer actief onderdeel van interactie-ontwerp. De nauwkeurigheid kan alleen toenemen wanneer emotiebegrip actief wordt geïntegreerd in het interactie-ontwerp.
De module voor visuele mapping maakt uitlegbaarheid mogelijk op een aantal onderling verbonden maar verschillende manieren: uitlegbaarheid op kenmerkniveau onthult de onderliggende representaties van emotie die door het DNN zijn gecreëerd, waardoor we de semantiek kunnen begrijpen die wordt gebruikt om elk emotiegerelateerd kenmerk te beschrijven; uitlegbaarheid op modaliteitsniveau maakt gebruik van gegevens uit de interactiegrafieken en de visuele attention heatmaps om te beschrijven hoe elke modaliteit — visueel, audio of tekstueel — bijdraagt aan de beslissingen die worden genomen om emoties uit te drukken; en tot slot stellen de trajecten die voortvloeien uit de emotie-embedding ons in staat om te begrijpen hoe elke visuele en tekstuele modaliteit in de loop van de tijd verandert vanuit een dynamisch interactieperspectief. Raadpleeg hiervoor Algoritme 2 (Aanvullend bestand 1).
De gefuseerde multimodale emotionele kenmerken worden via het voorgestelde visuele mapping-Algoritme 2 in kaart gebracht tot visueel significante representaties voor intelligent interactieontwerp. De graafgebaseerde multimodale attentiegewichten worden gebruikt om verschillen tussen de visuele, audio- en tekstuele invoerelementen op elk tijdstip te kwantificeren. Deze verschillen worden vervolgens gekoppeld aan visuele representaties om, middels heatmap-visuele elementen, de belangrijkste bronnen die de emoties beïnvloeden te accentueren. Om een inzichtelijk beeld te geven van de interactie tussen de invoerelementen en de emotionele evolutie over te brengen die wordt gegenereerd door de multimodale invoerelementen, worden vervolgens paarsgewijze interactiesterktes berekend om de multimodale interactiegewichten te creëren. Gelijktijdig wordt een weergave van de emotionele evolutie gecreëerd door de in de loop van de tijd verzamelde gefuseerde emotionele elementen in een laagdimensionale ruimte te mappen, om zo een continue evolutie van emotionele elementen te produceren.
Emotievoorspelling en interactie-feedback
De uitkomst van de gefuseerde emotierepresentatie, weergegeven als , wordt vervolgens gebruikt als functie voor zowel interactie-feedback als emotievoorspelling. Bovendien wordt emotievoorspelling beschreven als een multitaskmodel bestaande uit een regressietaak voor continue herkenning van emotie-intensiteit en een classificatietaak voor discrete emotieherkenning. Het volgende softmax-gebaseerde classificatiemodel wordt gebruikt voor discrete emotieherkenning:
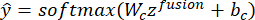 (25)
waarbij  de verwachte kansen voor de emotieklasse vertegenwoordigt en Wc en bc leerbare beperkingen zijn. Het cross-entropy verlies wordt gebruikt om het classificatiedoel te verbeteren:
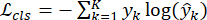 (26)
waarbij yk het ground-truth label is, en K het aantal emotieklassen. Een regressietak wordt parallel gebruikt om de emotie-intensiteit te schatten, wat resulteert in een voorspelling van diverse continue affectieve attributen, waaronder valentie en arousal. Geef het de volgende definitie:
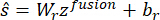 (27)
waarbij de verwachte score voor emotie-intensiteit wordt aangegeven door  . De mean-squared error loss wordt gebruikt om de regressietaak te verbeteren:
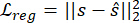 (28)
Over het algemeen worden de twee taken gecombineerd in het voorspellingsdoel:
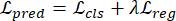 (29)
waarbij de doelstellingen van regressie en classificatie in evenwicht worden gebracht door λ. Er wordt gesuggereerd om de visualisatiemodule dynamisch aan te passen op basis van de geïdentificeerde emotionele staat om dit type interactiebewuste feedback mogelijk te maken. De interactiecontext op een bepaald tijdstip t wordt weergegeven door ct. De respons van de visualisatiemodule wordt gegeven door:
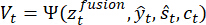 (30)
waarbij de visualisatie-adaptatiefunctie wordt weergegeven door  . Hierdoor is het mogelijk om de modaliteits-heatmaps, interactiegrafieken en emotietrajecten in real-time aan te passen op basis van verwachte veranderingen en emoties. Dit geeft aan dat het systeem aanzienlijke ondersteuning biedt voor feedback, naast het feit dat het goed presteert bij de voorspelling van de emotionele toestand.
Resultaten
Dit werk valideert het voorgestelde visuele mapping-raamwerk voor multimodale emotiekenmerken op het gebied van zowel interactiebewuste interpreteerbaarheid als voorspellende prestaties, gebruikmakend van twee benchmarkdatasets, CH-SIMS en CMU-MOSEI. Volgens de experimentele resultaten presteert de voorgestelde aanpak consistent beter dan huidige technieken voor multimodale emotieherkenning over een verscheidenheid aan metrieken, waaronder correlatie, nauwkeurigheid, F1-score en de gemiddelde absolute fout (MAE). De ontkoppelde emotie-representatie, het grafiekgebaseerde cross-modale fusiemechanisme en de end-to-end deep representation learning-strategie dragen allen bij aan deze verbetering door een stabielere en semantisch beter afgestemde emotiemodellering mogelijk te maken. De voorgestelde aanpak biedt rijkere inzichten op kenmerkniveau via visuele mapping, wat verder gaat dan kwantitatieve winst en het gemakkelijker maakt om modaliteitsbijdragen en emotionele dynamiek te begrijpen. Ondanks variaties in taal, culturele expressie en datasetgrootte wordt de bovengenoemde prestatiewinst consistent waargenomen in beide datasets, wat het sterke generalisatievermogen van het voorgestelde raamwerk aantoont.
De openbare datasets CH-SIMS en CMU-MOSEI voor multimodale emoties worden gebruikt in het voorgestelde werk. De CH-SIMS-dataset bestaat uit 2.281 videoclips uit films, tv-drama's en variety-shows. Gesynchroniseerde tekst-, audio- en visuele gegevens zijn beschikbaar in CH-SIMS. Zowel unimodale als multimodale sentimentlabels zijn ingedeeld in positieve, neutrale en negatieve categorieën. De grote Engelse multimodale dataset genaamd CMU-MOSEI bevat ongeveer 23.453 geannoteerde videoclips met meer dan 1.000 sprekers die over een breed scala aan onderwerpen discussiëren. Deze dataset bevat zowel continue annotaties van emotie-intensiteit, zoals valentie en arousal, als categorische emotielabels. Door ondersteuning te bieden voor diverse linguïstische, culturele en emotionele condities, versterkt experimenteren met deze twee datasets middels het voorgestelde framework de robuustheid en betrouwbaarheid. Tabel 2 toont de details van de simulatieomgeving.
De belangrijkste experimentele en implementatie-instellingen die zijn gebruikt om het voorgestelde raamwerk te beoordelen, zijn samengevat in deze simulatieomgeving. Om een uniforme dimensionaliteit van kenmerken over tekstgebaseerde, audio- en visuele modaliteiten te garanderen, worden transformer-gebaseerde encoders uniform toegepast. Er wordt gebruikgemaakt van een grafiekgebaseerd aandachtsmeganisme voor cross-modale fusie, waardoor adaptieve leerprocessen van intermodale afhankelijkheden met betrekking tot emotionele toestanden mogelijk worden.
Het voorgestelde raamwerk extraheert tekstuele, auditieve en visuele representaties met behulp van transformer-gebaseerde modaliteitsencoders. Volledig verbonden lagen met ReLU-activatie projecteren de modaliteitsspecifieke embeddings naar een gedeelde latente ruimte. Afzonderlijke emotie-specifieke en modaliteitsspecifieke encoders, elk met twee volledig verbonden lagen en niet-lineaire activatie en normalisatie, worden vervolgens gebruikt om ontwarde representaties te leren. De latente representaties worden geprojecteerd naar een 256-dimensionale kenmerkruimte, waar informatie voor elke modaliteit en emotie afzonderlijk wordt geleerd. Om modaliteitsinformatie te behouden en efficiënte ontwarring te bevorderen, worden reconstructiedecoders gebruikt. Voorafgaand aan de multimodale fusie en predictie modelleert de graafgebaseerde cross-modale attentiemodule emotionele afhankelijkheden tussen modaliteiten met behulp van de latente representaties. Het netwerk werd getraind met de Adam-optimizer met een initiële leercurve van 1 × 10⁻4 en een batchgrootte van 32. Early stopping werd toegepast op basis van het validatieverlies om overfitting te voorkomen. De totale doelfunctie bestond uit classificatie-, reconstructie- en representatie-consistentieverliezen, elk gewogen door afstelbare hyperparameters. De modeltraining werd uitgevoerd voor maximaal 100 epochs, en het best presterende model op de validatieset werd behouden voor testen.
Het voorgestelde raamwerk werd geëvalueerd aan de hand van classificatiemetrieken, waaronder Accuracy, Precision, Recall en de F1-score, samen met regressiemetrieken zoals de Mean Absolute Error (MAE). Precision, Recall en de F1-score werden berekend met macro-averaging om rekening te houden met de klasse-onbalans over de emotiecategorieën. Voor de classificatie-experimenten werden de vooraf gedefinieerde emotie-/sentimentlabels van de CH-SIMS- en CMU-MOSEI-datasets gebruikt als ground-truth klassen. Voor de regressiegebaseerde sentimentvoorspelling dienden de continue sentimentintensiteitsscores van de datasets als doelvariabelen. Confusiematrices werden gegenereerd om de voorspellingsprestaties per klasse en de misclassificatiepatronen te analyseren met een betrouwbaarheidsinterval van 95%. Om de robuustheid te waarborgen, werd elk experiment 5 keer herhaald met verschillende willekeurige initialisaties, en de gerapporteerde resultaten komen overeen met de gemiddelde prestatie ± standaarddeviatie over alle runs. Statistische significantie werd beoordeeld met behulp van passende hypothesetoetsprocedures, en betrouwbaarheidsintervallen werden berekend waar van toepassing. De trainingstijd werd gemeten als de totale verstreken tijd die nodig was voor modelconvergentie op het gespecificeerde hardwareplatform.
Een aantal representatieve baselinemodellen, waaronder early fusion en late fusion, kan worden vergeleken met de voorgestelde methode. TFN, LSTM-gebaseerde methoden, low-rank multimodale fusiemodellen, adaptieve multimodale transformers en nieuwe architecturen op basis van cross-modale aandacht. Deze baselines weerspiegelen geavanceerde technieken die zich primair richten op het verbeteren van de nauwkeurigheid van emotieherkenning via verschillende fusiemethoden. In tegenstelling tot deze methoden, die zich hoofdzakelijk concentreren op voorspelling op outputniveau, verbeteren het disentangled representation learning en de graafgebaseerde fusie van het voorgestelde raamwerk de interpreteerbaarheid en het bewustzijn van interacties. Voorbeelden van baselinemodellen die zijn geïmplementeerd met behulp van hun officiële repositories of publiek toegankelijke referentie-implementaties zijn LSTM Fusion, TFN, Low-Rank Multimodal Fusion (LMF), Adaptive-Graph en transformer-gebaseerde technieken. Indien beschikbaar werden de oorspronkelijke hyperparameterinstellingen van de auteurs gebruikt. Alle opnieuw getrainde baselines werden beoordeeld met behulp van dezelfde dataset-splits, preprocessing-technieken, optimalisatieparameters en evaluatiecriteria om een eerlijke vergelijking te waarborgen. De vergelijkingstabellen identificeren duidelijk de relevante referenties voor gegevens die direct uit eerdere publicaties zijn afgeleid.
Nauwkeurigheid
De nauwkeurigheid van de discrete emotieclassificatie wordt gemeten voor zowel CH-SIMS als CMU-MOSEI; de trend in nauwkeurigheid verschilt echter afhankelijk van de kenmerken van de twee datasets. Omdat CH-SIMS een middelgrote dataset is met een gelijk aantal sentimentcategorieën en zorgvuldig voorbewerkte videoclips, is de nauwkeurigheid hoog, wat suggereert dat het model subtiele multimodale emotionele informatie met weinig ruis kan vastleggen. Het nauwkeurig classificeren van emoties is echter uitdagend omdat CMU-MOSEI een grootschalige dataset is met sprekers van uiteenlopende achtergronden. Daarom geeft de nauwkeurigheid op de CMU-MOSEI-dataset, naast het vermogen van het model om sentiment te identificeren, aan in hoeverre het in staat is om te generaliseren en stand te houden in diverse interactiescenario's. De verbetering in nauwkeurigheid over de twee datasets laat zien dat de voorgestelde aanpak goed generaliseert over datasets met verschillende talen, groottes en niveaus van emotionele complexiteit.
De classificatienauwkeurigheden van de voorgestelde benadering en andere gangbare baselines op de CH-SIMS en CMU-MOSEI datasets worden weergegeven in Tabel 3. Zoals in Tabel 3 te zien is, behaalde het voorgestelde raamwerk de hoogste nauwkeurigheid op zowel de CH-SIMS als de CMU-MOSEI datasets, waarbij het de sterkste baseline (Adaptive-Graph) met respectievelijk ongeveer 3,3% en 3,1 procentpunt overtrof. Lagere waarden voor de standaarddeviatie wijzen daarnaast op een grotere stabiliteit over herhaalde experimentele runs. Traditionele LSTM-fusiebenaderingen vertonen een lagere nauwkeurigheid vanwege hun beperkte vermogen om complexe cross-modale relaties vast te leggen. TFN en LMF verbeteren de classificatienauwkeurigheid door cross-modale relaties te modelleren.
F1-score
Bij emotieclassificatieproblemen wordt de balans tussen recall en precisie gemeten met de F1-score. Voor multimodale datasets voor emotieclassificatie, die waarschijnlijk een oneven aantal klassen hebben, is deze maatstaf daarom geschikter. Bij emotieclassificatietaken wordt de balans tussen recall en precisie gemeten met de F1-score. Aangezien multimodale datasets voor emotieclassificatie naar verwachting ongebalanceerd zijn, is de F1-score meer passend. Hoe beter het model in staat is om emotieklassen te detecteren, des te hoger de F1-score.
Figuur 3 illustreert de evaluatie van de F1-score van de voorgestelde techniek ten opzichte van de baselines op de CH-SIMS-dataset. Het vermogen van de LSTM-gebaseerde baseline om complexe cross-modale emotionele relaties te modelleren wordt onthuld door de laagste F1-score. De F1-scores behaald door de geëvalueerde technieken op de CH-SIMS-dataset worden vergeleken in Figuur 3. Zoals aangetoond, presteren geavanceerdere graafgebaseerde en transformer-gebaseerde structuren routinematig beter dan meer conventionele fusiegebaseerde methoden. Met een F1-score van 0,71 scoorde het LSTM-model het laagst, gevolgd door TFN (0,74) en LMF (0,76). De F1-score werd verder verhoogd naar 0,79 met Adaptive-Graph, wat de waarde van het modelleren van inter-modale connecties aantoont. Met een F1-score van 0,82 presteerde het voorgestelde framework 3,8% beter dan Adaptive-Graph, 7,9% beter dan LMF, 10,8% beter dan TFN en 15,5% beter dan LSTM. Deze resultaten tonen aan dat het voorgestelde graafgebaseerde cross-modale aandachtsmechanisme en disentangled representation learning complementaire emotionele informatie over tekstuele, auditieve en visuele modaliteiten effectiever vastleggen, wat leidt tot betere classificatieprestaties.
De relatieve trends zijn consistent, hoewel alle methoden een lichte daling in de F1-score vertonen in vergelijking met CH-SIMS, zoals weergegeven in Figuur 4. De resultaten tonen een gestage verbetering in prestaties aan, van traditionele fusiemethoden naar graafgebaseerde multimodal learning-strategieën. De modellen met de laagste F1-score waren LSTM (0,69), TFN (0,72) en LMF (0,74). De prestaties van het Adaptive-Graph-model stegen naar 0,77, wat aantoont hoe effectief cross-modale verbindingen gemodelleerd kunnen worden. Het voorgestelde raamwerk presteerde beter dan alle andere benaderingen en behaalde de hoogste F1-score van 0,80. De verbetering ten opzichte van de sterkste baseline, Adaptive-Graph, demonstreert de bijdrage van het voorgestelde disentangled emotion representation learning en het graafgebaseerde cross-modale aandachtmechanisme bij het vastleggen van complementaire emotionele signalen over tekstuele, akoestische en visuele modaliteiten. Deze resultaten tonen aan dat het voorgestelde raamwerk voor multimodale emotieherkenning betrouwbaar en efficiënt is. De voorgestelde benadering vertoont een significante verbetering ten opzichte van zowel de graafgebaseerde benadering als de conventionele fusiemethode, wat het sterke generalisatievermogen van de methode verder bevestigt. De verbetering van de F1-score op de CMU-MOSEI-dataset toont aan dat de voorgestelde benadering een gebalanceerde prestatie bij emotieclassificatie kan bereiken, zelfs in ruisige, diverse omgevingen.
Precisie
In slimme communicatiesystemen is precisie cruciaal, omdat een onjuist emotioneel signaal de gebruikerservaring kan verslechteren. De verhouding tussen nauwkeurig voorspelde instanties van een specifieke emotie en het totaal aantal gevallen dat als die emotie is geprojecteerd, staat bekend als precisie. Omdat de ontwarde emotie-representaties minder ruis bevatten en minder vatbaar zijn voor misclassificatie binnen de modaliteit, presteert het voorgestelde model beter dan de basismodellen op de CH-SIMS dataset in Figuur 5.
In Figuur 5 wordt de nauwkeurigheid van verschillende multimodale emotieherkenningstechnieken op de CH-SIMS- en CMU-MOSEI-datasets vergeleken. Naarmate de modellen verschuiven van traditionele fusiegebaseerde technieken naar meer geavanceerde graafgebaseerde architecturen, stijgt de precisie gestaag. Het voorgestelde raamwerk bereikte de maximale precisie van 0,82 op de CH-SIMS-dataset, waarbij de precisie steeg van 0,71 voor LSTM naar 0,74, 0,76 en 0,79 voor respectievelijk TFN, LMF en Adaptive-Graph. Op de CMU-MOSEI-dataset steeg de precisie van 0,69 voor LSTM naar 0,72, 0,74 en 0,77 voor respectievelijk TFN, LMF en Adaptive-Graph. De voorgestelde methode behaalde de hoogste precisie van 0,80. Het voorgestelde raamwerk verhoogde de precisie met ongeveer 3,8% op CH-SIMS en 3,9% op CMU-MOSEI in vergelijking met de sterkste baseline (Adaptive-Graph). Deze resultaten tonen aan dat het voorgestelde 'disentangled representation learning' en het graafgebaseerde cross-modale aandachtsmecanisme fout-positieve voorspellingen succesvol verminderen door complementaire emotionele informatie uit tekstuele, acoustische en visuele modaliteiten vast te leggen. De impact van de irrelevante modaliteit wordt verder gemitigeerd door de graafgebaseerde cross-modale aandacht. De grotere diversiteit aan sprekers en linguïstische uitdrukkingen in het CMU-MOSEI-corpus zorgt ervoor dat de precisie voor alle modellen licht afneemt.
Herinnering
Bij taken voor emotieherkenning is de recall, een maatstaf voor het vermogen van een model om emotionele instanties die tot een specifieke klasse behoren correct te categoriseren, cruciaal omdat het gebrek aan emotionele informatie de kwaliteit van de interactie negatief kan beïnvloeden. Een hogere recall-waarde suggereert dat het model minder fout-negatieven en meer daadwerkelijke emotionele expressies identificeert. Recall kan worden beschouwd als een maat voor de efficiëntie waarmee emotionele informatie wordt geëxtraheerd uit tekst-, audio- en visuele modaliteiten in de context van multimodale emotieanalyse.
Het voordeel van de voorgestelde techniek ten opzichte van de referentiebenaderingen op de CH-SIMS en CMU-MOSEI datasets wordt getoond in de recall-vergelijking in Figuur 6. Naarmate modellen evolueren van conventionele fusiegebaseerde methoden naar meer geavanceerde graafgebaseerde multimodale structuren, laten de resultaten consistent winst in recall zien. De recall op de CH-SIMS dataset steeg van 0,70 voor LSTM naar 0,73, 0,75 en 0,78 voor TFN, LMF en Adaptive-Graph, respectievelijk; de maximale recall van 0,82 werd bereikt door het voorgestelde raamwerk. De voorgestelde benadering behaalde de beste recall van 0,80 op de CMU-MOSEI dataset, waarbij de recall steeg van 0,68 voor LSTM naar 0,71, 0,73 en 0,76 voor TFN, LMF en Adaptive-Graph, respectievelijk. Het voorgestelde raamwerk leverde relatieve verbeteringen op van ongeveer 5,1% op CH-SIMS en 5,3% op CMU-MOSEI in vergelijking met de sterkste referentie (Adaptive-Graph). Deze resultaten tonen aan dat door het vastleggen van complementaire emotionele signalen over tekstuele, akoestische en visuele modaliteiten, het voorgestelde ontkoppelde representatie-leren en graafgebaseerde cross-modale aandachtmechanisme succesvol het aantal fout-negatieve voorspellingen vermindert, waardoor de identificatie van emotieklassen in beide datasets wordt verbeterd. Omdat traditionele methoden een beperkte capaciteit hebben om complexe cross-modale relaties te modelleren, hebben zij de neiging lagere recall-waarden te hebben. Door modaliteitsrelaties explicieter te modelleren, behalen TFN en LMF matige winst. Door de gestructureerde relaties tussen de modaliteiten te simuleren, heeft de Adaptive-Graph methode de recall verder verbeterd. Voor beide datasets behaalt de voorgestelde methode de hoogste recall, wat duidt op een beter vermogen om emotionele instanties in verschillende interactiescenario's te detecteren. De verbetering is duidelijker zichtbaar in de grootschalige CMU-MOSEI dataset, wat de robuustheid en generalisatie van het voorgestelde raamwerk demonstreert.
Gemiddelde absolute fout (MAE)
De gemiddelde absolute fout (Mean Absolute Error, MAE) wordt gebruikt om de prestaties van taken voor de voorspelling van continue emotie-intensiteit te beoordelen, zoals de voorspelling van valentie of arousal. In tegenstelling tot nauwkeurigheid reflecteert MAE beter de nabijheid van de voorspelde emotionele intensiteit tot de werkelijke emotionele toestand. Daarom is MAE geschikter voor datasets zoals CH-SIMS en CMU-MOSEI, die over continue affectieve labels beschikken. Een lagere MAE-waarde duidt op een grotere nauwkeurigheid bij de voorspelling van de emotie-intensiteit.
De MAE-vergelijking tussen het voorgestelde raamwerk en de baseline-benaderingen op de CH-SIMS- en CMU-MOSEI-datasets wordt weergegeven in Tabel 4. Traditionele LSTM-gebaseerde fusiemethoden hebben de neiging hogere MAE-waarden te vertonen vanwege hun beperkte vermogen om complexe multimodale emotionele afhankelijkheden te modelleren. De TFN en LMF kunnen de MAE verlagen door multimodale interacties te modelleren, en de Adaptive-Graph-benadering verlaagt deze verder door modaliteitsgrafiekrelaties te leren. Het voorgestelde raamwerk behaalt de kleinste MAE over beide datasets, wat duidt op een nauwkeurigere schatting van de emotie-intensiteit. Het is vermeldenswaard dat de verbetering significanter is op de CMU-MOSEI-dataset, waar de grootschalige datavariabiliteit en sprekerscondities de voorspellingstaak uitdagender maken.
Confusiematrix voor CH-SIMS-dataset
De basismethoden van early fusion LSTM en TFN vertonen een aanzienlijke verwarring tussen de klassen neutrale en positieve emoties, afgaande op de verwarringsmatrices voor de CH-SIMS-dataset. Dit suggereert dat deze methoden minder effectief zijn in het identificeren van subtiele multimodale emotionele expressies. Aan de andere kant vertoont de voorgestelde methode duidelijk een sterke diagonale dominantie, met zeer weinig off-diagonale elementen, waardoor de scheidbaarheid van klassen wordt verbeterd. Het ontwarde emotie-leermechanisme van de voorgestelde methode zorgt voor een consistente representatie van emoties over modaliteiten heen, en de graph fusion-benadering verbetert het onderscheid tussen nauw verwante sentimentklassen. Figuur 7A–E toont de verwarringsmatrix voor de CH-SIMS-dataset met verschillende basismethoden.
Confusiematrix voor de CMU-MOSEI-dataset
Het voorgestelde raamwerk maakt gebruik van modaliteits-invariante emotie-embeddings en adaptieve attentiegewichten om het percentage misclassificaties aanzienlijk te verminderen, met name bij emotioneel ambigue inputs. Dit bevestigt dat het voorgestelde raamwerk goed functioneert in diverse grootschalige multimodale interactiescenario's. Vanwege de omvang van de dataset, de variatie tussen sprekers en het continue karakter van de sentimentlabels, vertonen de CMU-MOSEI-confusiematrices een hoger algemeen misclassificatiepercentage. De baseline-methoden vertonen een aanzienlijke mate van verwarring tussen verschillende emotiecategorieën. Figuur 8A–E toont de confusiematrix voor de CMU-MOSEI-dataset met diverse baseline-methoden.
Trainingstijd per epoch
De computationele afwegingen van geavanceerde multimodale fusietechnieken worden belicht door de vergelijking van de trainingstijd per epoch. Vanwege de transformer-encoders en graph attention-mechanismen vereist het voorgestelde model iets meer trainingstijd dan de eenvoudige fusiebenaderingen, maar deze toename is niet onhaalbaar. Het voorgestelde raamwerk vertoonde sterke prestaties op benchmark-datasets voor multimodale emotieanalyse en toont potentieel voor integratie in intelligente mens-machine-interactiesystemen. De geschiktheid voor real-time implementatie is echter in de huidige studie niet geëvalueerd en vereist verder onderzoek door analyses van latentie, doorvoersnelheid, geheugen en implementatie. Opmerkelijk is dat de verbeterde convergentiestabiliteit en de superieure voorspellende prestaties en interpreteerbaarheid de extra computationele kosten rechtvaardigen. Figuur 9 toont het resultaat van de trainingstijd per epoch voor de voorgestelde methode.
Ablatiestudie
Om de invloed van elk belangrijk element in het voorgestelde raamwerk te bepalen, zoals de visuele mappingmodule, de graafgebaseerde cross-modale fusie en de ontwarde emotie-representatie, is een ablatiestudie uitgevoerd. Om de impact te begrijpen, werd elk element één voor één weggelaten. Volgens de experimentele resultaten verbetert de graaffusiestrategie de modellering van cross-modale afhankelijkheden, en blijkt de bijdrage van de ontwarde emotie-representatie het belangrijkst voor de stabiliteit van de prestaties. De ondersteunende rol van de visuele mappingmodule wordt bevestigd door de geringe impact op de prestaties wanneer deze wordt verwijderd. De resultaten van de ablatiestudie onder dezelfde trainings- en evaluatiecondities worden weergegeven in Tabel 5. De grootste verslechtering van de prestaties werd waargenomen na het verwijderen van de graafgebaseerde cross-modale attentiemodule, waardoor de nauwkeurigheid daalde van 81.72% naar 77.88% en de F1-score van 0.823 naar 0.776. Dit onderstreept het belang van het modelleren van complexe inter-modale interacties. De rol van de module voor ontward representatieleren bij het verkrijgen van robuuste emotiespecifieke representaties werd aangetoond door het feit dat het weglaten hiervan de nauwkeurigheid met 2.78 procentpunt en de F1-score met 0.032 verlaagde. Het belangrijkste voordeel van de visuele mappingmodule is de interpreteerbaarheid in plaats van de classificatienauwkeurigheid, zoals blijkt uit de enigszins kleinere daling in voorspellingsprestaties bij verwijdering ervan. De configuratie 'Basic Fusion' presteerde het slechtst, wat aantoont dat de beste prestaties voor multimodale emotieherkenning het gecombineerde effect vereisen van alle voorgestelde modules.
DATAbeschikbaarheid:
De in deze studie gebruikte datasets zijn publiek beschikbare benchmark-datasets. De CMU-MOSEI-dataset wordt verstrekt door de Multimodal SDK van de Carnegie Mellon University en wordt beschreven in Zadeh et al. (2018) (https://doi.org/10.18653/v1/P18-1208), met toegang via https://multicomp.cs.cmu.edu/multimodal-language-analysis-in-the-wild-cmu-mosei-dataset-and-interpretable-dynamic-fusion-graph/. De CH-SIMS-dataset wordt beschreven in Yu et al. (2020) (https://doi.org/10.18653/v1/2020.acl-main.343) en is publiek toegankelijk via bronnen die door de auteurs zijn verstrekt, waaronder https://github.com/thuiar/MMSA. Alle experimenten zijn uitgevoerd met de officiële versies van deze datasets. De ruwe geëxtraheerde gegevens, verwerkte databestanden, resultaten van de voorbewerking, train/validatie/test-partities, afgeleide kenmerkrepresentaties en implementatiedetails ter ondersteuning van de bevindingen van deze studie zijn publiek beschikbaar in de Zenodo-repository op https://doi.org/10.5281/zenodo.21124921.
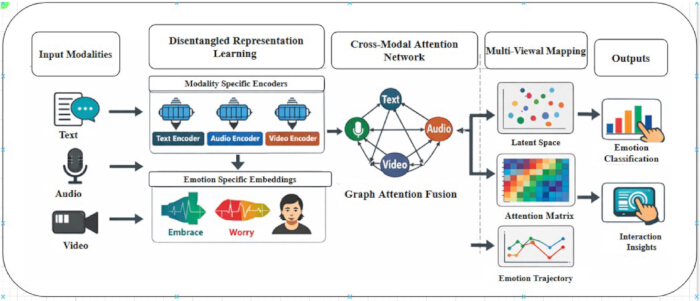
Figuur 1: Schematisch diagram van het voorgestelde framework voor visuele mapping van multimodale emotiekenmerken. Conceptuele illustratie van de algehele architectuur, met weergave van multimodale kenmerkextractie, disentangled representatieleren, graph-gebaseerde cross-modale attention-fusie en componenten voor visuele mapping voor interpreteerbare multimodale emotieanalyse.. Klik hier om een grotere versie van deze figuur te bekijken.
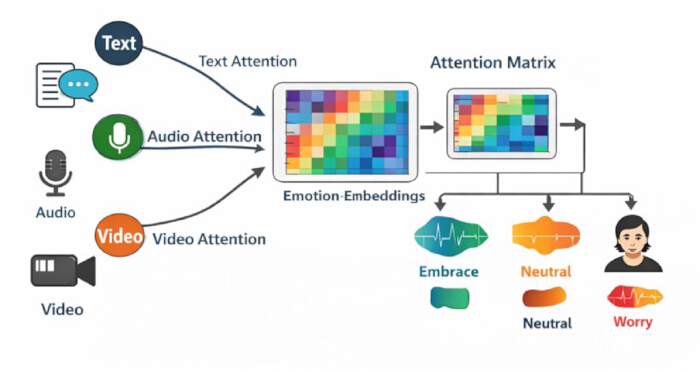
Figuur 2: Schematisch werkstroomdiagram van het voorgestelde computationele protocol.
Conceptuele weergave van de end-to-end verwerkingspijplijn, inclusief de fasen van datasetverwerving, preprocessing, modaliteitspecifieke kenmerkextractie, multimodale fusie, visualisatie en emotievoorspelling Klik hier om een grotere versie van deze figuur te bekijken.
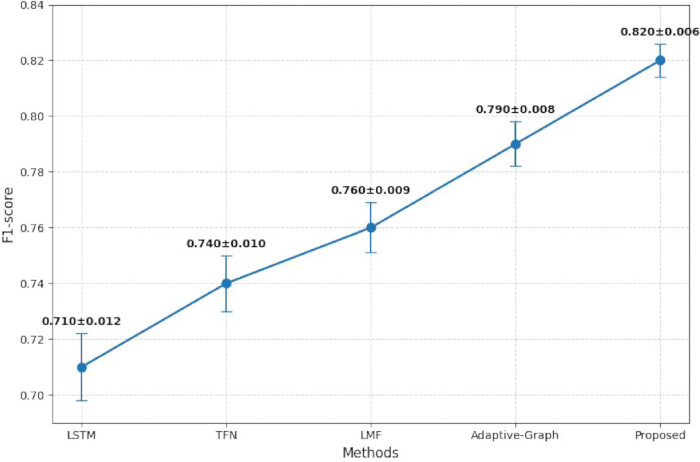
Figuur 3: Vergelijking van de F1-score prestaties op de CH-SIMS dataset. Gemiddelde F1-score waarden verkregen uit vijf onafhankelijke experimentele runs (n = 5) met verschillende random seed initialisaties. Foutenbalken representeren ±± één standaarddeviatie (SD). Hogere F1-score waarden duiden op een betere prestatie bij de emotieclassificatie. Klik hier om een grotere versie van deze figuur te bekijken.
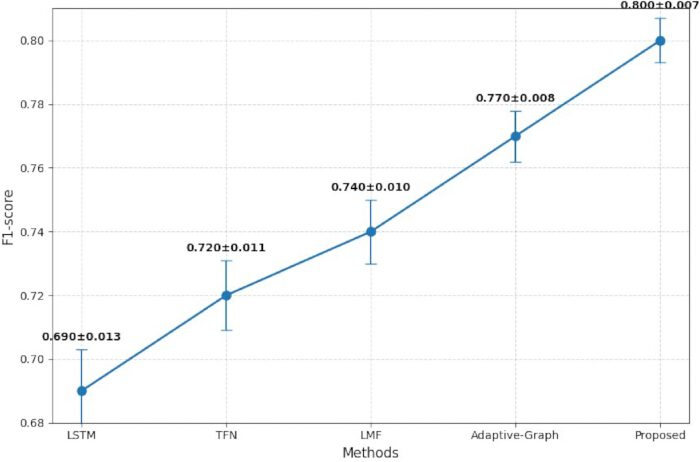
Figuur 4: Vergelijking van de F1-score prestaties op de CMU-MOSEI dataset. Gemiddelde F1-score waarden verkregen uit vijf onafhankelijke experimentele runs (n = 5) met verschillende random seed initialisaties. Foutbalken vertegenwoordigen ±± één standaarddeviatie (SD), en de bijbehorende gemiddelde ±± SD waarden worden boven elk datapunt weergegeven. Hogere F1-score waarden duiden op betere prestaties bij de emotieclassificatie. Klik hier om een grotere versie van deze figuur te bekijken.
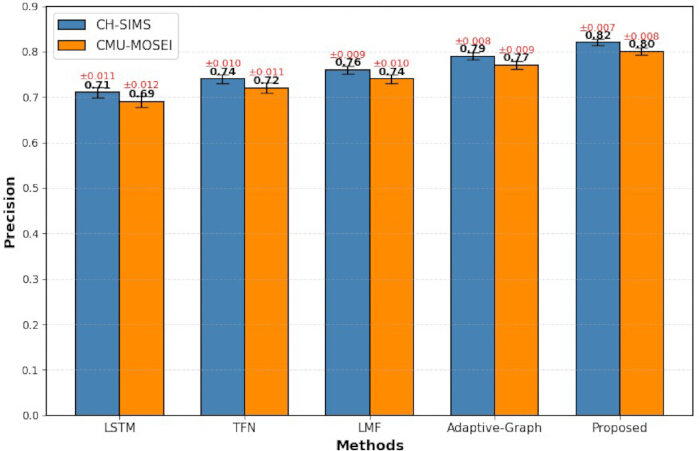
Figuur 5: Precisiteitsvergelijking op de CH-SIMS en CMU-MOSEI datasets. Gemiddelde precisiescores behaald door LSTM, TFN, LMF, Adaptive-Graph en het voorgestelde framework over vijf onafhankelijke experimentele runs (n = 5). Foutenbalken vertegenwoordigen ±± één standaarddeviatie (SD) berekend uit herhaalde runs met verschillende random seed initialisaties. Het voorgestelde framework behaalt de hoogste precisiteit op beide datasets, wat getuigt van een verbeterde discriminatie van emotieklassen door effectieve multimodale feature-learning en grafiekgebaseerde cross-modale fusie. Klik hier om een grotere versie van deze figuur te bekijken.
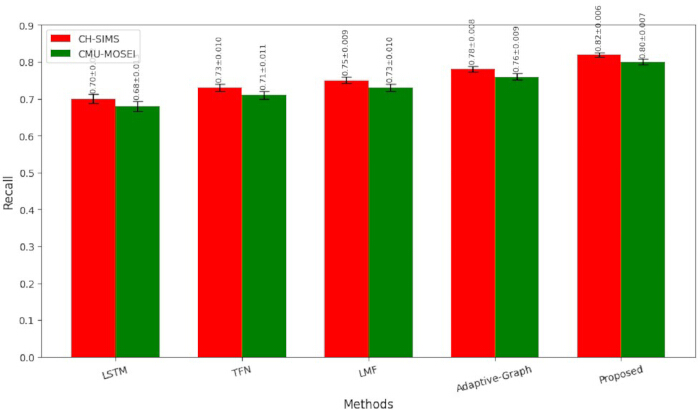
Figuur 6: Recall-vergelijking op de CH-SIMS- en CMU-MOSEI-datasets. Gemiddelde recall-scores behaald door LSTM, TFN, LMF, Adaptive-Graph en het voorgestelde framework over vijf onafhankelijke experimentele runs (n = 5). Foutenbalken geven ±± één standaarddeviatie (SD) aan, afgeleid van herhaalde experimenten. Het voorgestelde framework behaalt consequent de hoogste recall op beide datasets, wat duidt op een superieur vermogen om multimodale emotionele informatie vast te leggen en fout-negatieve voorspellingen te verminderen. Klik hier om een grotere versie van deze figuur te bekijken.
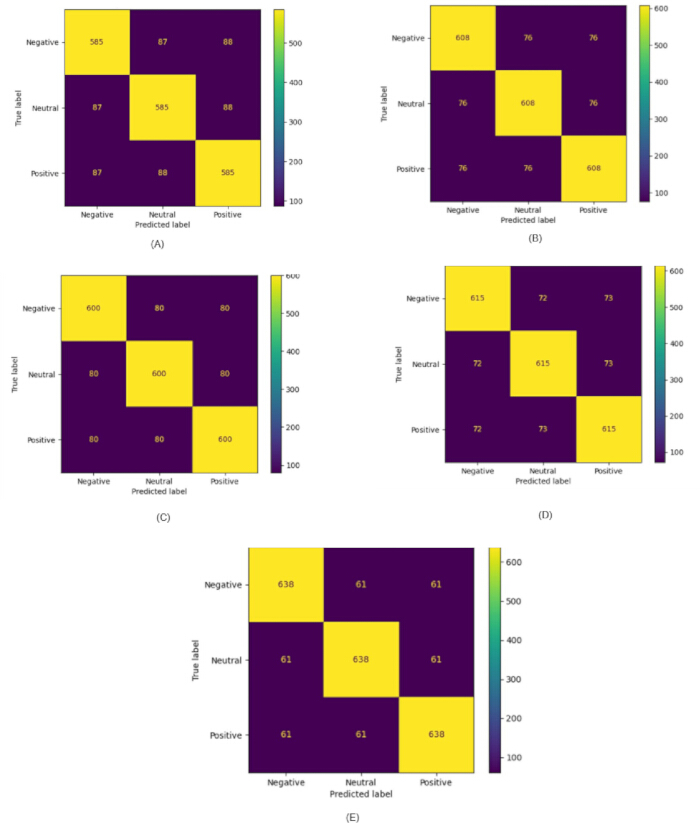
Figuur 7: Confusiematrix voor dataset CH-SIMS met diverse baseline-methoden. Rijen komen overeen met de ground-truth emotieklassen en kolommen komen overeen met de voorspelde klassen. Celwaarden vertegenwoordigen het percentage monsters genormaliseerd ten opzichte van elke ware klasse. De confusiematrix is berekend met behulp van de uitgespaarde CH-SIMS testpartitie. Hogere percentages op de diagonaal duiden op een betere herkenningsnauwkeurigheid voor de betreffende emotiecategorie. Confusiematrices van (A) Early fusion LSTM, (B) TFN, (C) LMF, (D) Adaptive Graph en (E) Voorgestelde methode op de CH-SIMS dataset. Klik hier om een grotere versie van deze figuur te bekijken.
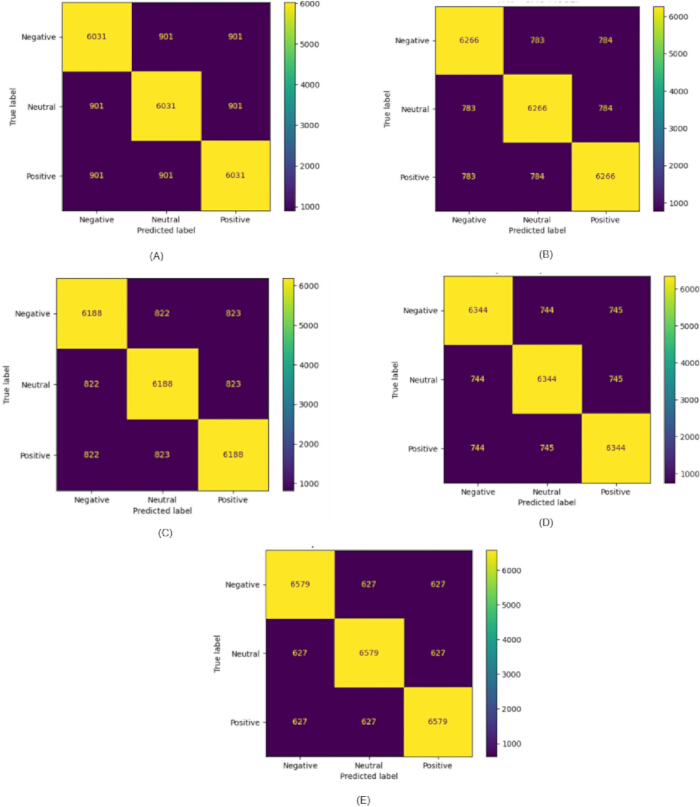
Figuur 8: Confusion matrix voor de CMU-MOSEI dataset met verschillende baseline-methoden. De rijen vertegenwoordigen de werkelijke emotielabels en de kolommen vertegenwoordigen de voorspelde labels. De waarden worden gerapporteerd als klasse-genormaliseerde percentages op de CMU-MOSEI testset. De matrix illustreert zowel correct geclassificeerde monsters (diagonale vermeldingen) als verwarring tussen emotiecategorieën (niet-diagonale vermeldingen). Confusion Matrix op CMU-MOSEI (A) Early fusion LSTM, (B) TFN, (C) LMF, (D) Adaptive Graph, en (E) Voorgestelde methode op de CMU-MOSEI dataset. Klik hier om een grotere versie van deze figuur te bekijken.
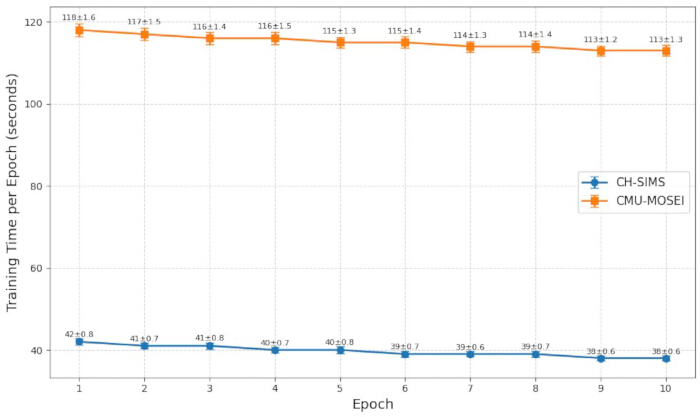
Figuur 9. Vergelijking van de trainingstijd per epoch op benchmark multimodale emotiedatasets.
Gemiddelde trainingstijd per epoch verkregen uit vijf onafhankelijke experimentele runs (n = 5) voor de CH-SIMS en CMU-MOSEI datasets onder identieke hardware- en software-instellingen. Foutenbalken representeren ±± één standaarddeviatie (SD), berekend uit herhaalde experimenten met verschillende random seed initialisaties. Lagere waarden duiden op een hogere computationele efficiëntie, terwijl stabiele trainingstijden over de runs wijzen op een verbeterde reproduceerbaarheid en trainingsconsistentie. Klik hier om een grotere versie van deze figuur te bekijken.
| Dataset | Modaliteiten | Aantal monsters | Taal | Labels voor emotie/sentiment |
| CH-SIMS34 | Video, Audio, Tekst | 2.281 videosegmenten | Chinees | Multimodale en unimodale sentimentlabels (negatief, neutraal, positief) |
| CMU-MOSEI35 | Video, Audio, Tekst | ~23.453 geannoteerde clips | Nederlands | Labels voor sentiment en emotie-intensiteit (continu en categorisch) |
Tabel 1: Beschrijving van de dataset. Overzicht van de in deze studie gebruikte datasets, modaliteiten, aantal monsters, taal, emotie-/sentimentlabels voor de CH-SIMS en CMU-MOSEI datasets.
| Component | Specificatie |
| Programmeerframework | Python met PyTorch |
| Visuele kenmerkextractor | Vision Transformer (ViT) |
| Audio kenmerkextractor | Wav2Vec 2.0 |
| Tekst kenmerkextractor | RoBERTa |
| Fusiestrategie | Graafgebaseerd cross-modaal attentienetwerk |
| Kenmerkdimensie | 768 per modaliteit |
| Trainingsoptimizer | Adam |
| Leersnelheid | 1.00E-04 |
| Batchgrootte | 16 |
| Hardware | NVIDIA GPU (bijv. RTX-serie) |
| Evaluatiedatasets | CH-SIMS, CMU-MOSEI |
| Latente dimensie | 2.56E+02 |
| Embedding-dimensie | 768 |
| Activatiefunctie | ReLU |
| Optimizer | Adam |
| Leersnelheid | 1.00E-04 |
| Batchgrootte | 32 |
| Epochs | 100 |
| Vroegtijdige stopzetting | Ingeschakeld |
| Verliesfunctie | Classificatie + Reconstructie + Consistentie |
Tabel 2: Simulatieomgeving. Experimentele opstelling en implementatiedetails van de simulatieomgeving, zoals modelgegevens, kenmerken, optimizer en gebruikte hardware.
| Methode | CH-SIMS nauwkeurigheid (%) | CMU-MOSEI Nauwkeurigheid (%) |
| LSTM (vroege/late fusie) | 72.84 ± 1.12 | 70.35 ± 1.26 |
| TFN | 74.91 ± 0.98 | 72.68 ± 1.10 |
| LMF | 76.23 ± 0.85 | 74.12 ± 0.94 |
| Adaptieve-graaf | 78.46 ± 0.73 | 76.89 ± 0.81 |
| Voorgestelde methode | 81.72 ± 0.61 | 79.94 ± 0.69 |
Tabel 3: Evaluatie van de nauwkeurigheid van de voorgestelde methode met basistechnieken op de CH-SIMS en CMU-MOSEI datasets. Resultaten worden gerapporteerd als gemiddelde ±± standaarddeviatie verkregen uit vijf onafhankelijke experimentele runs (n = 5) met verschillende willekeurige seed-initialisaties. Alle methoden werden geëvalueerd met identieke trainings-, validatie- en testpartities van hun respectievelijke datasets om een eerlijke vergelijking te waarborgen.
| Methode | CH-SIMS MAE ↓ | CMU-MOSEI MAE ↓ |
| LSTM (vroege/late fusie) | 0.412 ± 0.014 | 0.465 ± 0.016 |
| TFN | 0.387 ± 0.012 | 0.439 ± 0.014 |
| LMF | 0.361 ± 0.010 | 0.412 ± 0.012 |
| Adaptieve-graaf | 0.334 ± 0.009 | 0.379 ± 0.010 |
| Voorgestelde methode | 0.298 ± 0.007 | 0.341 ± 0.008 |
Tabel 4: Resultaat van de gemiddelde absolute fout. Resultaten worden gerapporteerd als gemiddelde ± standaarddeviatie, verkregen uit vijf onafhankelijke experimentele runs (n = 5) met verschillende willekeurige seed-initialisaties. Alle methoden werden geëvalueerd met identieke trainings-, validatie- en testpartities van hun respectievelijke datasets om een eerlijke vergelijking te waarborgen. Vergelijking van de MAE voor continue emotie-intensiteitsvoorspelling met behulp van het voorgestelde raamwerk en baseline-benaderingen op beide datasets.
| Modelvariant | Nauwkeurigheid (%) | F1-score |
| Volledig model | 81.72 ± 0.61 | 0.823 ± 0.008 |
| Zonder ontwarring | 78.94 ± 0.74 | 0.791 ± 0.010 |
| Zonder graaffusie | 77.88 ± 0.81 | 0.776 ± 0.011 |
| Zonder visuele mapping | 80.11 ± 0.66 | 0.807 ± 0.009 |
| Basis fusie | 74.91 ± 0.98 | 0.742 ± 0.013 |
Tabel 5: Resultaat van de ablatiestudie met baseline-methoden. Resultaten worden gerapporteerd als gemiddelde ±± standaarddeviatie verkregen uit vijf onafhankelijke experimentele runs (n = 5) met verschillende willekeurige seed-initialisaties. Alle methoden werden geëvalueerd met behulp van identieke trainings-, validatie- en testpartities van hun respectievelijke datasets om een eerlijke vergelijking te garanderen. Vergelijking van de prestaties tussen modelvarianten, wat de effectiviteit aantoont van leren uit ontwarde representaties, graafgebaseerde fusie en de visuele mapping-module.
Aanvullend bestand 1: Algoritme 1 en Algoritme 2.Klik hier om dit bestand te downloaden.
Discussie
De experimentele resultaten tonen aan dat het voorgestelde visual mapping-framework voor multimodale emotiekenmerken over de CH-SIMS- en CMU-MOSEI-datasets beter presteert dan huidige technieken voor multimodale emotieherkenning. Vergeleken met early en late fusion-modellen, zoals EF-LSTM en TFN, behaalt de voorgestelde techniek een hogere nauwkeurigheid en hogere F1-scores, wat de robuustheid bij het verwerken van diverse emotionele informatie aantoont. De verbetering van de methode kan worden toegeschreven aan de ontwarde emotievoorstelling, die modaliteitspecifieke ruis onderdrukt en emotieconsistentie waarborgt over de visuele, audio- en tekstmodaliteiten36.
Onlangs hebben transformer-gebaseerde multimodale modellen, zoals Adaptive Multimodal Transformers37 en MIAR38, indrukwekkende resultaten laten zien bij het modelleren van cross-modale afhankelijkheden. Desondanks zijn deze modellen primair gericht op voorspelling en missen ze mechanismen om interpreteerbaarheid op kenmerkniveau te ondersteunen. In tegenstelling hiermee combineert het voorgestelde systeem grafiekgebaseerde cross-modale aandacht met een visuele mappingmodule, waardoor een transparante analyse van modaliteits- en emotionele interacties mogelijk wordt. Dit is een cruciaal aspect dat momenteel ontbreekt in de literatuur, waar emotionele inferentie wordt behandeld als een black-box-proces.
Het voorgestelde raamwerk vertoonde een consistente prestatie over de benchmarkdatasets CH-SIMS en CMU-MOSEI. Hoewel het raamwerk potentiële toepassingen kan hebben in intelligente mens-machineinteractie, gezondheidsmonitoring, adaptieve leeromgevingen en andere emotiebewuste systemen, evalueerde de huidige studie de methode uitsluitend onder gecontroleerde benchmarkcondities. Er is geen sprake geweest van implementatie in de praktijk, beoordeling van de gebruikersinterface, bruikbaarheidsstudie of evaluatie met menselijke proefpersonen. Daarom moet de praktische effectiviteit van het raamwerk in operationele omgevingen nog worden onderzocht. Toekomstig werk zal zich richten op implementatiegerichte evaluaties, gebruikersgerichte studies, latentieanalyse, beoordeling van het geheugengebruik en interactieprestaties in real-time.
Bovendien tonen de prestatieverbeteringen in diverse culturele en linguïstische datasets de validiteit van het voorgestelde raamwerk aan. In tegenstelling tot eerdere werken die zijn gevalideerd op basis van een enkele dataset of een specifiek interactiescenario, vertoont het voorgestelde raamwerk robuuste prestaties over verschillende talen, sprekers en emotionele expressies heen. Daarom is het voorgestelde raamwerk zeer geschikt voor praktische intelligente interactiesystemen die een nauwkeurige emotieherkenning en interpreteerbare besluitvorming vereisen.
De interpreteerbaarheid van het voorgestelde framework werd beoordeeld via visualisatiegebaseerde analyse van de geleerde multimodale representaties. Specifiek werden latente emotie-embeddings, cross-modale attention-kaarten, modaliteitsinteractiegrafieken en temporele emotietrajecten onderzocht om inzicht te krijgen in het besluitvormingsproces van het model en de bijdragen van de modaliteiten. Het doel van de visuele mapping-module is om de transparantie te vergroten door het mogelijk maken van observaties van interacties op kenmerkniveau en emotionele dynamiek. Formele interpreteerbaarheidsmetrieken, evaluaties van attention-faithfulness en gebruikersstudies waren echter niet opgenomen in het huidige werk. Daarom moeten de gerapporteerde voordelen op het gebied van interpreteerbaarheid worden geïnterpreteerd als visualisatiegebaseerd bewijs en niet als kwantitatief gevalideerde verklaarbaarheidsmaten.
Vanuit een theoretisch standpunt levert dit onderzoek de volgende bijdragen aan multimodale affectieve computing: het stelt een systematische methode voor voor het modelleren van emoties die een duidelijk onderscheid maakt tussen emotiespecifieke en modaliteitsspecifieke representaties. Door emotionele consistentie over modaliteiten heen te garanderen in een gemeenschappelijke latente ruimte, bevordert het voorgestelde raamwerk hiermee de theorie van representatieleer in multimodale systemen. De integratie van grafiekgebaseerde attentiemechanismen formaliseert bovendien de afhankelijkheden tussen de verschillende modaliteiten bij het uiten van emoties.
Vanuit een praktisch perspectief is het voorgestelde raamwerk zeer nuttig voor intelligent interactie-ontwerp en emotiegevoelige gebruikersinterfaces. De visuele mappingmodule in het voorgestelde raamwerk stelt systeemontwerpers in staat om het effect van verschillende modaliteiten op emotievoorspelling te begrijpen, wat van groot belang is voor systeemontwerpers. Het voorgestelde raamwerk is zeer waardevol voor toepassingen zoals affectieve conversationele agenten, adaptieve learningsystemen, interfaces voor gezondheidsmonitoring en platforms voor de evaluatie van gebruikerservaringen.
Het voorgestelde raamwerk kent echter enkele beperkingen. Het gebruik van grafiek-attentiemechanismen en transformer-encoders verhoogt de complexiteit, wat problematisch kan zijn voor apparaten met beperkte capaciteiten. Bovendien negeert de huidige studie andere fysiologische signalen, zoals EEG en eye-tracking, om zich te concentreren op visuele, audio- en tekstmodaliteiten. De computationele efficiëntie van het voorgestelde raamwerk voor real-time implementatie is niet specifiek beoordeeld, ondanks het feit dat het concurrerende voorspellingsprestaties en verbeterde visualisatiemogelijkheden behaalde. Toekomstig onderzoek zal de implementatieprestaties in real-world intelligente interactiecontexten, inferentievertraging, doorvoer, geheugenverbruik en modelcompressietechnieken onderzoeken. Om de nauwkeurigheid van emotiemodellering en de responsiviteit van interacties verder te verbeteren, zal toekomstig onderzoek zich richten op de ontwikkeling van lichtgewicht modellen, real-time optimalisatie technieken en de integratie van aanvullende modaliteiten. De real-time implementatieprestaties zijn niet beoordeeld, en de inclusie van transformer-encoders en grafiekgebaseerde attentiemethoden verhoogt de rekencomplexiteit. Alleen de CH-SIMS en CMU-MOSEI benchmark-datasets werden gebruikt om de methodologie te valideren, wat dataset-specifieke biases kan introduceren en de generaliseerbaarheid naar andere domeinen, talen en gebruikerspopulaties kan beperken. Daarnaast bevat de huidige studie geen fysiologische signalen zoals EEG- of eye-trackinggegevens; in plaats daarvan is de focus gelegd op visuele, audio- en tekstuele modaliteiten. Hoewel grondige beschrijvingen van de implementatie en de simulatieomgeving de reproduceerbaarheid hebben verbeterd, zijn de broncode en vooraf getrainde modellen momenteel niet publiekelijk beschikbaar.
In dit werk wordt een nieuw visueel mapping-raamwerk voor multimodale emotie-kenmerklering gebruikt voor intelligent interactie-ontwerp. De voorgestelde methode integreert end-to-end transformer-gebaseerde representatieleer, ontwarde emotiemodellering en graafgebaseerde cross-modale aandacht om een hoge voorspellende nauwkeurigheid en interpreteerbaarheid te bereiken. Experimenten op de CH-SIMS en CMU-MOSEI datasets tonen aan dat het voorgestelde raamwerk beter presteert dan state-of-the-art multimodale emotieherkenningsmodellen wat betreft nauwkeurigheid en F1-score. Belangrijker nog is dat de voorgestelde visuele mapping-oplossing de kloof tussen emotieherkenning en interactiestrategie overbrugt en een nieuwe richting biedt voor het ontwerp van interpreteerbare, interactiebewuste multimodale affectieve computingsystemen.
Om een interpreteerbaar en intelligent interactieontwerp te faciliteren, introduceerde deze studie een nieuw visueel mapping-framework voor het leren van multimodale emotiekenmerken. Het voorgestelde systeem integreert succesvol emotiedetectie en interpreteerbaarheid binnen een enkele architectuur door het combineren van transformer-gebaseerde multimodale kenmerkextractie, ontkoppeld leren van emotierepresentaties, graafgebaseerde cross-modale attentiefusie en visuele mapping-methoden. Naast het bieden van duidelijke visuele representaties van modaliteitsbijdragen, cross-modale interacties en temporele emotiedynamiek, toonde de experimentele evaluatie op de CH-SIMS en CMU-MOSEI benchmark-datasets verbeterde prestaties ten opzichte van representatieve baselinemethoden over verschillende metrieken, waaronder Accuracy, Precision, Recall, F1-score en Mean Absolute Error (MAE). Deze studie is echter beperkt tot evaluaties op twee benchmark-datasets en bevat geen deployment-studies in de echte wereld, gebruikersgerichte evaluaties, kwantitatieve beoordelingen van de uitlegbaarheid en de integratie van fysiologische modaliteiten. Bovendien kunnen omgevingen met beperkte middelen tegen problemen aanlopen vanwege de computationele kosten van transformer-encoders en graafgebaseerde attentieprocessen. Hoewel toekomstig werk zich zal concentreren op uitgebreidere validatie over diverse datasets, integratie van aanvullende modaliteiten, bruikbaarheidsstudies, het vrijgeven van reproduceerbare bronnen en optimalisatie voor real-time deployment-scenario's, toont het voorgestelde framework over het algemeen het potentieel van interpreteerbare multimodale emotieanalyse voor affectieve computing en intelligente interactietoepassingen.
Openbaarmakingen
De auteurs hebben geen belangenconflicten.
Dankbetuigingen
De auteurs willen graag de steun erkennen van de School of Housing, Building and Planning, Universiti Sains Malaysia, Penang, Maleisië, en de School of Design Art, Changsha University of Science & Technology, Changsha, China. De auteurs betuigen tevens hun waardering aan de Xiamen Academy of Arts and Design, Fuzhou University, Xiamen, China, voor hun academische en onderzoeksondersteuning gedurende dit werk.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Adam | PyTorch Optimizer Library | https://pytorch-optimizers.readthedocs.io/en/latest/ (Learning Rate = 1 × 10⁻⁴) | Parameteroptimalisatie tijdens modeltraining |
| CH-SIMS | Originele Dataset Repository | Laatste Publieke Release | Benchmark-dataset voor Chinese multimodale sentiment- en emotieanalyse |
| CMU-MOSEI | CMU Multimodal SDK Repository | https://github.com/CMU-MultiComp-Lab/CMU-MultimodalSDK (Laatste Publieke Release) | Benchmark-dataset voor multimodale sentiment- en emotieherkenning |
| Disentangled Emotion Encoder | Custom Implementatie | https://pytorch-geometric.readthedocs.io/en/latest/(Dual Encoder Architectuur) | Scheiding van emotiespecifieke en modaliteitsspecifieke latente representaties |
| Graph Attention Network (GAT) | PyTorch Geometric | Multi-head GAT (https://pytorch-geometric.readthedocs.io/en/latest/) | Modellering van cross-modale emotionele relaties en adaptieve feature-fusie |
| Graph-Based Cross-Modal Attention Layer | Custom Implementatie | Multi-Head Attention Fusion | Leren van fijnmazige emotionele afhankelijkheden tussen modaliteiten |
| Matplotlib | Matplotlib Project | 3.7+ | Genereren van plots en visuele analyses |
| NetworkX | NetworkX Project | 3.0+ | Constructie en visualisatie van cross-modale interactiegrafen |
| NVIDIA GPU | NVIDIA Corporation | CUDA-compatibele GPU | Versnelling van training van transformers en graph neural networks |
| Principal Component Analysis (PCA) | Scikit-learn | sklearn.decomposition.PCA | Initiële reductie van hoog-dimensionale emotie-embeddings |
| Python | Python Software Foundation | 3.8+ | Kernprogrammeertaal voor de implementatie van het multimodale emotieanalyse-framework |
| PyTorch | PyTorch Foundation | 2.0+ | Ontwikkeling, training en optimalisatie van diepe neurale netwerken |
| RoBERTa | Hugging Face Transformers | https://huggingface.co/docs/transformers/index (roberta-base, 768-dim embeddings) | Extractie van contextuele linguïstische en semantische emotierepresentaties |
| Seaborn | Seaborn Project | 0.12+ | Genereren van attention heatmaps en statistische visualisaties |
| t-distributed Stochastic Neighbor Embedding (t-SNE) | Scikit-learn | scikit-learn.org (Perplexity = 30, Iteraties = 1000) | Visualisatie van latente emotieclusters en trajecten |
| Ubuntu Linux | Canonical Ubuntu | 20.04 LTS of later | Experimentele uitvoeringsomgeving |
| Vision Transformer (ViT-Base) | Google Research Vision Transformer | ViT-Base/16, 768-dim embeddings | Extractie van emotiegevoelige visuele representaties uit videoframes |
| Wav2Vec 2.0 | Meta AI Research | Base Model, 768-dim embeddings | Extractie van contextuele akoestische en spraakemotie-features |
Referenties
- Zhu X, et al. EMVAS: End-to-end multimodal emotion visualization analysis system. Complex Intell Syst. 2025;11:1-15.
- Zhu X, et al. A client-server based recognition system: Non-contact single/multiple emotional and behavioral state assessment methods. Comput Methods Programs Biomed. 2025;260:108564.
- Lasri I, Riadsolh A, Elbelkacemi M. Facial emotion recognition of deaf and hard-of-hearing students for engagement detection using deep learning. Educ Inf Technol. 2023;28:4069-4092.
- Saibene A, Assale M, Giltri M. Expert systems: Definitions, advantages and issues in medical field applications. Expert Syst Appl. 2021;177:114900.
- Poria S, Cambria E, Bajpai R, Hussain A. A review of affective computing: From unimodal analysis to multimodal fusion. Inf Fusion. 2017;37:98-125.
- Chatterjee R, et al. Real-time speech emotion analysis for smart home assistants. IEEE Trans Consum Electron. 2021;67(1):68-76.
- Zhu X, Huang Y, Wang X, Wang R. Emotion recognition based on brain-like multimodal hierarchical perception. Multimed Tools Appl. 2024;83:56039-56057.
- Khan M, El Saddik A, Alotaibi FS, Pham NT. AAD-Net: Advanced end-to-end signal processing system for human emotion detection and recognition using attention-based deep echo state network. Knowl Based Syst. 2023;270:110525.
- Chaturvedi I, Chen Q, Cambria E, McConnell D. Landmark calibration for facial expressions and fish classification. Signal Image Video Process. 2022;16:377-384.
- Li D, Liu J, Yang Z, Sun L, Wang Z. Speech emotion recognition using recurrent neural networks with directional self-attention. Expert Syst Appl. 2021;173:114683.
- Zhu X, et al. A review of key technologies for emotion analysis using multimodal information. Cogn Comput. 2024;16:1504-1530.
- Wang R, et al. Multimodal emotion recognition using tensor decomposition fusion and self-supervised multitasking. Int J Multimed Inf Retr. 2024;13:39.
- Fan C, Lin J, Mao R, Cambria E. Fusing pairwise modalities for emotion recognition in conversations. Inf Fusion. 2024;106:102306.
- Williams J, Kleinegesse S, Comanescu R, Radu O. Recognizing emotions in video using multimodal DNN feature fusion. Proceedings of Grand Challenge and Workshop on Human Multimodal Language. Melbourne, Australia. 2018;10.18653/v1/W18-3302.
- Zhao Z, Wang Y, Wang Y. Multi-level fusion of Wav2Vec 2.0 and BERT for multimodal emotion recognition. arXiv. 2022;arXiv:2207.04697.
- Middya AI, Nag B, Roy S. Deep learning based multimodal emotion recognition using model-level fusion of audio-visual modalities. Knowl Based Syst. 2022;244:108580.
- Maithri M, et al. Automated emotion recognition: Current trends and future perspectives. Comput Methods Programs Biomed. 2022;215:106646.
- Wu Y, Mi Q, Gao T. A comprehensive review of multimodal emotion recognition: Techniques, challenges, and future directions. Biomimetics. 2025;10(4):418.
- Zheng S, Zhang X, Liu Y, Li Z. CMFF: A cross-modal multi-layer feature fusion network for multimodal sentiment analysis. Appl Soft Comput. 2025;184(Pt B):113868.
- Yan L, Shi Y, Wei M, Wu Y. Multi-feature fusing local directional ternary pattern for facial expressions signal recognition based on video communication system. Alex Eng J. 2023;63:307-320.
- Guo X, Zhang Y, Lu S, Lu Z. Facial expression recognition: A review. Multimed Tools Appl. 2024;83(8):23689-23735.
- Liu ZT, Han MT, Wu BH, Rehman A. Audio emotion recognition based on convolutional neural network with attention-based bidirectional long short-term memory network and multitask learning. Appl Acoust. 2023;202:109178.
- Mirsamadi S, Barsoum E, Zhang C. Automatic audio emotion recognition using recurrent neural networks with local attention. 2017 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), New Orleans, LA, USA. 2017; 10.1109/ICASSP.2017.7952552.
- Gu T, He Z, Zhao H, Li M, Ying D. Aspect-based sentiment analysis with multi-granularity information mining and sentiment hint. Expert Syst Appl. 2024;252:124104.
- Shen W, Chen J, Quan X, Xie Z. DialogXL: All-in-one XLNet for multi-party conversation emotion recognition. Proc AAAI Conf Artif Intell. 2021;35(15):13789-13797.
- Kim T, Vossen P. EmoBERTa: Speaker-aware emotion recognition in conversation with RoBERTa. arXiv. 2021;arXiv:2108.12009.
- Li S, Yan H, Qiu X. Contrast and generation make BART a good dialogue emotion recognizer. Proc AAAI Conf Artif Intell. 2022;36(10):11002-11010.
- Zhu J, Yu J. MIAR: Modality interaction and alignment representation fusion for multimodal emotion. arXiv. 2026;arXiv:2601.02414.
- Praveen RG, Granger E, Cardinal P. Cross attentional audio-visual fusion for dimensional emotion recognition. 2021 16th IEEE International Conference on Automatic Face and Gesture Recognition (FG 2021), Jodhpur, India. 2021;10.1109/FG52635.2021.9667055.
- Salas-Cáceres J, López M, Martínez A, Rodríguez P. Multimodal emotion recognition based on a fusion of audio-visual information with temporal dynamics. Multimed Tools Appl. 2025;84:27327-27343.
- Fu J, Zhang Y, Wang L, Chen H. TMFN: A text-based multimodal fusion network with multi-scale feature extraction and unsupervised contrastive learning for multimodal sentiment analysis. Complex Intell Syst. 2025;11:133.
- Tuerhong G, Fu F, Wushouer M. Adaptive multimodal transformer based on exchanging for multimodal sentiment analysis. Sci Rep. 2025;15:27265.
- Gupta C, Sharma R, Patel S, Verma A. A multimodal fusion model for real-time environment emotion recognition using audio-visual-textual features. J Big Data. 2025;12:256.
- Yu W, Li X, Zhang H, Wang Z, Liu Z. CH-SIMS: A Chinese multimodal sentiment analysis dataset with fine-grained annotation of modality. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. 2020; 10.18653/v1/2020.acl-main.343.
- Zadeh A, et al. Multimodal language analysis in the wild: CMU-MOSEI dataset and interpretable dynamic fusion graph. Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics, Melbourne, Australia. 2018; 10.18653/v1/P18-1208.
- Zadeh A, Chen M, Poria S, Cambria E, Morency LP. Tensor fusion network for multimodal sentiment analysis. arXiv. 2017;arXiv:1707.07250.
- Tsai YHH, Bai S, Yamada M, Morency LP, Salakhutdinov R. Multimodal transformer for unaligned multimodal language sequences. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, Florence, Italy. 2019; 10.18653/v1/P19-1656.
- Moreno M, Rioseco P, Van Den Bosch H. Spectrum of the linearized Vlasov–Poisson equation around steady states from galactic dynamics. arXiv. 2023;arXiv:2305.05749.