Dit protocol implementeert een U-vormig deep learning-netwerk dat pinwheel-convolutie, dubbele aandacht en multi-schaal fusie integreert om colorectale poliepen te segmenteren.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Methodenartikel
Polypensegmentatienetwerk gebaseerd op Pinwheel-convolutie en dubbele aandacht voor de diagnose van colorectale precancereuze laesie
* These authors contributed equally
In dit artikel
Samenvatting
Samenvatting
Nauwkeurige segmentatie van colorectale poliepen is cruciaal voor de vroege preventie en diagnose van colorectale kanker. Door de hoge heterogeniteit van poliepen qua vorm, grootte en textuur, evenals de complexiteit van de darmomgeving (zoals plooien, speculaire reflecties en fecale residuen), ondervinden bestaande methoden nog steeds aanzienlijke uitdagingen bij grenslokalisatie en het detecteren van kleine poliepen. Om deze problemen aan te pakken, stelt dit artikel een Polyp Segmentation Network voor gebaseerd op Pinwheel Convolution and Dual Attention (PWD-Net). Het voorgestelde netwerk hanteert een U-vormige encoder–decoder-architectuur, waarbij een vooraf getrainde ResNet wordt gebruikt als encoder om meerlagige lokale functies te extraheren. Specifiek wordt een Pinwheel Convolution Module (PCM) geïntroduceerd op de bottleneck-laag om de globale geometrische structuur en multidirectionele contextuele informatie van poliepen vast te leggen via multi-angle geroteerde convolutiekernen. Een Dual-Attention Mechanism (DAM) dat kanaalaandacht en ruimtelijke aandacht integreert, is ontworpen om achtergrondruis adaptief te onderdrukken en polyp-regiokenmerken te versterken. Daarnaast wordt een Multi-scale Feature Fusion (MSF)-strategie toegepast om diepe semantische informatie te combineren met oppervlakkige randdetails, waardoor zowel volledigheid als precisie van segmentatieresultaten worden gegarandeerd. Experimenten uitgevoerd op de Kvasir-SEG en CVC-ClinicDB datasets tonen aan dat PWD-Net gemiddelde dobbelsteencoëfficiënten van respectievelijk 0,865 en 0,944 behaalt, en IoU-scores van respectievelijk 0,765 en 0,892, waarmee het bestaande state-of-the-art methoden aanzienlijk overtreft. Ablatiestudies verifiëren de effectiviteit van elke module, en cross-dataset-evaluaties bevestigen het sterke generalisatievermogen van het model. Deze studie biedt een zeer precisie en robuuste oplossing voor klinische poliepsegmentatie, met een grote waarde voor de vroege diagnose van colorectale precancereuze laesies en ondersteuning van computerondersteunde interventie.
Inleiding
Darmkanker is een van de meest voorkomende kwaadaardige tumoren ter wereld, met consequent hoge incidentie en sterftecijfers. Uit studies blijkt dat de meeste colorectale kankers ontstaan uit adenomateuze poliepen, een proces dat doorgaans 10–15 jaar duurt en een waardevol tijdsvenster biedt voor vroege opsporing en interventie. Een toename van 1% in het adenoomdetectiepercentage (ADR) kan het risico op colorectale kanker met ongeveer 3% verminderen, wat de sterfte van patiënten aanzienlijkverlaagt 1. Coloscopie, beschouwd als de gouden standaard voor screening op colorectale kanker, maakt directe verwijdering van poliepen tijdens onderzoek mogelijk, waardoor de incidentie en sterfte van kanker effectief worden verminderd.
Conventionele coloscopie hangt echter sterk af van de ervaring en het vaardigheidsniveau van endoscopisten. Factoren zoals subjectief oordeel, visuele vermoeidheid en afleiding kunnen leiden tot een mispercentage van 20%–30%, wat direct invloed heeft op de effectiviteit van screening2. Daarom is het ontwikkelen van computerondersteunde detectiesystemen (CAD) voor automatische segmentatie van colorectale poliepen van groot belang voor het verbeteren van ADR en het verminderen van gemiste diagnoses. Recente klinische onderzoeken hebben verder de interesse benadrukt om kunstmatige intelligentie te integreren in de endoscopische laesiebeoordelingsworkflows, wat de noodzaak van robuuste en reproduceerbare segmentatiemethoden benadrukt3.
In de afgelopen jaren heeft deep learning opmerkelijke vooruitgang geboekt in medische beeldanalyse, met name convolutionele neurale netwerken (CNN's), die een sterke capaciteit tonen in feature-extractie en representatie voor beeldsegmentatietaken4. Als klassiek medisch beeldsegmentatiemodel gebruikt U-Net een symmetrische encoder–decoder-architectuur en slaat het verbindingen over om nauwkeurige pixelniveausegmentatie te bereiken, waarmee het een benchmark wordt op dit gebied5. Voortbouwend op U-Net zijn veel verbeterde architecturen voorgesteld om complexe medische beeldsegmentatietaken aan te pakken. UNet++ vermindert de semantische kloof tussen encoder- en decoderfeaturemaps door geneste en dichte skipverbindingen6 te introduceren. ResUNet++ integreert residuele blokken, squeeze-and-excitatiemodules, gedilateerde convoluties en aandachtsmechanismen, en behaalt sterke prestaties in polypsegmentatie7. U2-Net gebruikt een tweelaagse, geneste U-vormige structuur om multischaal-feature-informatie vast te leggen8. Meer recentelijk is een op basis van diepe polypsegmentatienetwerken gebaseerd op dubbele encoder-decoder voorgesteld, waarbij parallelle coderings- en decoderpaden worden benut om de segmentatienauwkeurigheid verder te verbeteren9.
Ondertussen biedt de introductie van aandachtsmechanismen nieuwe oplossingen voor feature-verbetering en ruisonderdrukking. Attention U-Net gebruikt attention gates om zich te richten op doelgebieden terwijl irrelevante achtergrondinformatie wordt onderdrukt10. Het Dual Attention Network (DANet) weegt functies adaptief van zowel kanaal- als ruimtelijke dimensies11, waardoor de waarneming van kritieke kenmerken verbetert. Triple Attention Networks (TANet) verbeteren de segmentatieprestaties verder door adaptieve selectie van multi-scale functies12.
Met het succes van Transformer-architecturen in natuurlijke taalverwerking en computer vision13 zijn onderzoekers hun toepassing in medische beeldsegmentatie gaan onderzoeken. TransUNet was de eerste die een transformator gebruikte als encoder om langeafstandsafhankelijkheden effectief te modelleren14. Swin-UNet hanteert een pure Transformer-architectuur en bereikt efficiënte wereldwijde informatieaggregatie via een shifted-window-mechanisme15. UTNet stelt een hybride architectuur voor die de lokale feature-extractiecapaciteit van CNN's combineert met de wereldwijde modelleringscapaciteit van Transformers16.
Op het gebied van polypsegmentatie maakt Polyp-PVT gebruik van een pyramid vision Transformer om multischaal globale semantische informatie17 vast te leggen, terwijl multischaal geneste UNet het contextuele begrip verbetert door Transformers18 te integreren. Recente studies hebben ook negatieve correlatieleerstrategieën onderzocht voor cross-domein poliepsegmentatie19, Gompertz-augmented segmentatieverbetering20, en aandachtgebaseerde architecturen met grensbegeleiding21. Hoewel deze benaderingen de segmentatieprestaties enigszins verbeteren, kent poliepsegmentatie nog steeds verschillende uitdagingen. Ten eerste vertonen poliepen een hoge heterogeniteit in morfologie, grootte en textuur, variërend van micro-poliepen kleiner dan 5 mm tot grote poliepen van meer dan 30 mm, met vormen variërend van cirkelvormig en elliptisch tot sterk onregelmatige vormen. Ten tweede is de darmomgeving complex en variabel, waarbij slijmvliesplooien, spiegelreflexen, fecale resten en voedselresten ernstige achtergrondinterferentie veroorzaken. Ten derde hebben veel poliepen vage grenzen, kunnen gedeeltelijk verstopt zijn door plooien, of ondergedompeld zijn in darmvloeistoffen, waardoor nauwkeurige grenslokalisatie uiterst moeilijk is22.
Bestaande methoden kennen nog steeds duidelijke beperkingen in het aanpakken van deze uitdagingen. Traditionele CNN's zijn effectief in het extraheren van lokale textuur en randkenmerken; echter, vaste vierkante convolutiekerne zijn niet goed geschikt om diverse geometrische vormente vangen, vooral voor sterk onregelmatige poliepen, en kunnen ze multidirectionele geometrische kenmerken niet effectief modelleren. Transformer-gebaseerde methoden kunnen globale afhankelijkheden modelleren, maar zijn minder effectief in het vastleggen van fijne lokale details en randinformatie. Bovendien maakt hun hoge computationele complexiteit ze minder geschikt voor realtime klinische toepassingen24. Recente polypsegmentatiebenaderingen zoals PraNet, dat reverse attention-modules gebruikt om sleutelgebieden25 te verfijnen, grensgeleide cascade-aandachtnetwerken die grensfeature-extractie verbeteren26, en CAFE-Net, dat encoder- en decoderkenmerken samenvoegt via cross-attention mechanismen27, ondervinden nog steeds onvoldoende featurerepresentatie en onnauwkeurige grenslokalisatie bij het omgaan met kleine poliepen28, vervaagde grenzen en complexe achtergronden. Bovendien verwaarlozen de meeste methoden geometrische morfologie en benutten ze niet volledig multidirectionele contextuele informatie, wat resulteert in suboptimale segmentatie van onregelmatig gevormde poliepen.
Samenvattend missen huidige CNN-gebaseerde methoden het vermogen om multidirectionele geometrische kenmerken vast te leggen vanwege hun afhankelijkheid van vaste vierkante convolutiekeren. Transformer-gebaseerde benaderingen bieden globale modellering, maar offeren lokale grensprecisie op en brengen hoge rekenkosten met zich mee. Ondertussen zijn bestaande aandacht-versterkte en multischaal fusiestrategieën niet gezamenlijk geoptimaliseerd binnen een uniform kader dat specifiek is afgestemd op polipsegmentatie29. Deze hiaten motiveren de ontwikkeling van een methode die tegelijkertijd geometrische feature-modellering, adaptieve ruisonderdrukking en cross-scale feature-integratie aanpakt.
Om deze problemen aan te pakken, presenteert dit protocol een Polyp Segmentation Network gebaseerd op Pinwheel Convolution and Dual Attention (PWD-Net). Het voorgestelde netwerk integreert geometrische feature-modellering, multidimensionale aandachtsverbetering en multiscale feature-fusie, waardoor precieze segmentatie van complexe poliepen mogelijk wordt. De belangrijkste bijdragen van dit werk worden als volgt samengevat: de pinwheel convolutiemodule (PCM), geïnspireerd door de structuur van een pinwheel, wordt een nieuw ontwerp van een geroteerde convolutiekern voorgesteld dat multidirectionele geometrische kenmerken van poliepen vastlegt via convolutiebewerkingen onder meerdere hoeken (0°, 45°, 90°, 135°, 180°, 225°, 270° en 315°). Deze module vervangt de conventionele convolutielaag in het bottleneck-stadium, waardoor een effectieve waarneming van diverse randoriëntaties mogelijk wordt en de representatie van onregelmatig gevormde poliepen aanzienlijk verbetert. Het dual-attention mechanisme (DAM) behandelt achtergrondruis zoals plooien, reflecties en fecale residuen in coloscopiebeelden. Er wordt een dual-attention module ontworpen die kanaalaandacht en ruimtelijke aandacht integreert. Ingebed in skipverbindingen onderdrukt deze module adaptief achtergrondinterferentie en verbetert het de kenmerken van reacties in poliepgebieden door gezamenlijk te identificeren "wat" belangrijk is (kanaaldimensie) en "waar" het doel zich bevindt (ruimtelijke dimensie), zodat alleen verfijnde kenmerken betrokken zijn bij de volgende fusie. De multi-scale feature fusion strategy (MSF) behoudt zowel diepe semantische informatie als oppervlakkige randdetails via een hiërarchisch mechanisme dat in de decoder is geïntroduceerd. Door DAM-verbeterde encoderkenmerken geleidelijk te integreren met opgesamplede decoderfuncties, compenseert deze strategie effectief het ruimtelijke detailverlies veroorzaakt door downsampling, waardoor nauwkeurige detectie van kleine poliepen en precieze grensafbakening mogelijk is.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Deze studie gebruikt uitsluitend openbaar toegankelijke, geanonimiseerde coloscopiebeelddatasets (Kvasir-SEG). Er werden geen nieuwe gegevens verzameld over menselijke proefpersonen. Institutionele ethische goedkeuring en geïnformeerde patiënttoestemming waren niet vereist, zoals bevestigd door het institutionele beoordelingsbeleid voor retrospectieve analyses van gedeidentificeerde openbare datasets.
1. Datavoorbereiding
- Download de Kvasir-SEG dataset uit de officiële repository33 (https://datasets.simula.no/kvasir-seg/). De dataset bevat 1.000 poliepafbeeldingen met bijbehorende pixel-niveau grondwaarheidsmaskers.
- Splits de dataset willekeurig op in trainingssets (800 afbeeldingen), validatie (100 afbeeldingen) en testsets (100 afbeeldingen) met een verhouding van 8:1:1 met een vaste willekeurige seed (seed = 42). Controleer of er geen afbeeldingen overlappen tussen de drie subsets om datalekkage te voorkomen.
- Verander alle afbeeldingen en bijbehorende maskers van formaat naar 352 x 352 pixels met behulp van bilineaire interpolatie voor afbeeldingen en naaste-buur-interpolatie voor maskers.
- Normaliseer pixelwaarden naar [0, 1] door te delen door 255, en pas vervolgens ImageNet-kanaalgewijze gemiddelde aftrekking toe (0,485, 0,456, 0,406) en standaardafwijkingsnormalisatie (0,229, 0,224, 0,225).
- Pas de volgende augmentatietransformaties alleen toe op de trainingsset (niet op de validatie- of testsets): willekeurige horizontale flip (kans = 0,5); willekeurige verticale flip (kans = 0,5); willekeurige rotatie (bereik: −30° tot +30°, kans = 0,5); Willekeurige multi-schaal grootteverandering (schaalfactor: 0,75 tot 1,25, kans = 0,5)
OPMERKING: Pas identieke ruimtelijke transformaties toe op zowel het beeld als het bijbehorende masker om de uitlijning te behouden. Controleer de correctheid van augmentatie door visueel verschillende augmented image–maskerparen te inspecteren voordat de training begint.
2. Algemene architectuur
OPMERKING: Zie Figuur 1 voor de macro-niveau encoder–decoder ruggengraat van PWD-Net, en naar Figuur 2 voor de integratie en interactie van kernmodules binnen de featureflow. De algehele architectuur volgt een U-vormig encoder–decoder-ontwerp om schaalvariaties van poliepen en achtergrondinterferentie in coloscopiebeelden aan te kunnen.
- Backbone en coderingspad (Figuur 1)
- Gebruik een ResNet-50 die vooraf getraind is op ImageNet (afkomstig van de officiële PyTorch-modelzoo) als de backbone-encoder30. Fijn afstellen van alle encoderlagen tijdens de training.
- Voer het ingevoerde coloscopiebeeld (verkleind tot 352 x 352 pixels) door vijf fasen van resterende convolutionele blokken om hiërarchische kenmerken te extraheren. De ruimtelijke resolutie van featuremaps wordt geleidelijk van naar afgezwakt over de vijf fasen, terwijl de kanaalafmetingen overeenkomstig toenemen (64 → 128 → 256 → 512 → 1024).
- Bij de bottleneck (de diepste encoderlaag) vervang je de standaard convolutionele laag door de Pinwheel Convolution Module (PCM, beschreven in Sectie 3) om de globale geometrische morfologie en multidirectionele contextuele informatie op lage resolutie vast te leggen.
OPMERKING: De vijf encoder-fasen komen overeen met de standaard ResNet-50 laaggroepen: conv1, laag1, laag2, laag3 en laag4. Voorgetrainde gewichten bieden robuuste laag- en middelniveau-feature-initialisatie, waardoor de convergentietijd op kleine medische datasets wordt verminderd.
- Belangrijke componenten en interactie met kenmerken (Figuur 2 en Figuur 3)
- Pas het Dual-Attention Mechanism (DAM, beschreven in Sectie 4) toe op de uitgang van elke encoderfase voordat deze via skipverbindingen naar de decoder wordt gestuurd. Deze stap onderdrukt adaptief achtergrondruis die wordt gegenereerd door darmplooien en speculaire reflecties, terwijl de feature-respons in poliepgebieden wordt versterkt. Alleen de gefilterde features worden doorgegeven aan de overeenkomstige decoderlaag.
- In de decoder wordt de ruimtelijke resolutie geleidelijk hersteld door bilineaire upsampling. Op elke decoderlaag worden de opgesamplede features van de voorafgaande decoderfase samengevoegd met de DAM-versterkte encoderkenmerken met dezelfde ruimtelijke resolutie.
- Pas twee opeenvolgende convolutionele lagen toe (elk gevolgd door batchnormalisatie en ReLU-activatie) om de multi-schaal informatie te fuseren. Dit vormt de Multi-scale Feature Fusion (MSF) strategie zoals beschreven in Sectie 5.
OPMERKING: De decoder gaat van diepe naar ondiepe lagen (fase 5 → fase 1), waarbij wordt gewaarborgd dat diepe semantische lokalisatie-informatie en ondiepe randdetails effectief worden geïntegreerd op elk niveau.
- Outputgeneratie
- Pas een convolutionele laag toe, gevolgd door een Sigmoid-activatiefunctie, op de uiteindelijke decoderuitvoer om het voorspellingsmasker te genereren.
- Binariseer het voorspellingsmasker met een drempel van 0,5 om het uiteindelijke segmentatieresultaat te verkrijgen, waarbij pixels met een voorspelde kans ≥ 0,5 als poliepen worden geclassificeerd en de overige pixels als achtergrond.
3. Pinwheel Convolutiemodule (Figuur 3)
- De Pinwheel Convolution Module (PCM) vervangt de standaard bottleneck-convolutie om multidirectionele geometrische kenmerken van poliepen vast te leggen. Implementeer deze module als volgt:
- Definieer een basisconvolutiekerne W van grootte 3 x 3 met Cin de invoerkanalen en Cuit de uitgangskanalen.
- Definieer de verzameling rotatiehoeken Θ = {0°, 45°, 90°, ..., 315°}. Voor elke hoek θ ∈ Θ genereer je de geroteerde kern Wθ door bilineaire interpolatie-gebaseerde rotatie toe te passen op W. Alle acht geroteerde kernels delen dezelfde basisparameters; alleen de ruimtelijke ordening van gewichten verschilt.
- Voor elke hoek θ bereken je de richtingsspecifieke kenmerkkaart:

waarbij X de invoerkenschapskaart is. - Verzamel de acht directionele featurekaarten door kanaalgewijze concatenatie langs de kanaalas, wat een tensor van dimensie (8 x Cuit) x H x W oplevert. Vervolgens pas je een 1 x 1 convolutie toe om de kanaaldimensie terug te brengen naar Cout, gevolgd door batchnormalisatie en ReLU-activatie31:

OPMERKING: De rotatie en interpolatie worden uitgevoerd op de kerngewichten, niet op de invoerfeaturemap. Dit ontwerp maakt parameter-efficiënte, multidirectionele feature-extractie mogelijk zonder de invoerresolutie te verhogen. In de huidige implementatie geldt Cin = 1024 en Cuit = 1024 in de bottleneckfase, wat overeenkomt met de uitgangskanaaldimensie van de ResNet-50 laag4. Raadpleeg het aanvullende codepakket voor de volledige implementatie.
4. Dual-Attention Mechanisme (Figuur 4)
OPMERKING: Het Dual-Attention Mechanism (DAM) is in elke skipverbinding ingebouwd om achtergrondruis te onderdrukken en polyp-regiokenmerken te versterken vanuit zowel kanaal- als ruimtelijke dimensies.
- Kanaalaandacht
De kanaalaandachtsafdeling identificeert welke featurekanalen het meest informatief zijn. Gegeven een invoerkenmerk F ∈ RC×H×W:- Comprimeer de ruimtelijke afmetingen via Global Average Pooling om een kanaaldescriptor z te verkrijgen ∈ RC×1×1.
- Laat z door een tweelaagse MLP (volledig verbonden lagen) gaan met een reductieverhouding r = 16. De eerste laag verkleint de dimensie van C naar C/16 met ReLU-activatie; de tweede laag herstelt het van C/16 naar C met Sigmoid-activatie om de kanaalgewichtvector Ac te produceren:
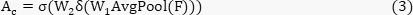
waarbij δ ReLU aanduidt en σ Sigmoid aanduidt.
- Ruimtelijke aandacht
De ruimtelijke aandachtstak bepaalt waar de doelgebieden zich bevinden:- Pas zowel maximale pooling als gemiddelde pooling toe langs de kanaaldimensie om twee 2D-featuremaps van grootte 1 x H x W te genereren.
- Verbind de twee afbeeldingen langs de kanaalas tot een 2 x H x W tensor. Pas een 7 x 7 convolutionele laag toe gevolgd door Sigmoid-activatie om de ruimtelijke gewichtskaart As ∈ R1×H×W te produceren:
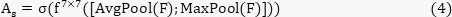
- Functiefusie
- Fuse de kanaal- en ruimtelijke aandacht-uitgangen met de invoerfunctie door element-gewijze vermenigvuldiging:

waarbij α en β leerbare balanscoëfficiënten zijn, beide geïnitialiseerd naar 0,5 en gezamenlijk bijgewerkt met de netwerkparameters via gradiëntgebaseerde optimalisatie tijdens de training.
OPMERKING: Raadpleeg het aanvullende codepakket (dam_module.py) voor de volledige implementatie.
- Fuse de kanaal- en ruimtelijke aandacht-uitgangen met de invoerfunctie door element-gewijze vermenigvuldiging:
5. Multi-scale Feature Fusie
- Pas de multi-scale feature fusion (MSF)-strategie toe in de decoder om ruimtelijk detailverlies in diepe features aan te pakken. Bij elke decoderfase voer je het volgende uit:
- Upgrade de feature map van de voorgaande decoderfase met een factor 2 met behulp van bilineaire interpolatie.
- Concateneer de opgesamplede features met de DAM-verbeterde encoderkenmerken van de bijbehorende ruimtelijke resolutie langs de kanaalas.
- Pas twee opeenvolgende 3 x 3 convolutionele lagen toe (elk gevolgd door batchnormalisatie en ReLU-activatie32) om de samengevoegde kenmerken te fuseren.
OPMERKING: Deze cross-level fusie zorgt ervoor dat de randdetails van poliepen (geboden door oppervlakkige encoderkenmerken) en semantische lokalisatie (geleverd door diepe features) gelijktijdig behouden blijven, wat fijnmazige segmentatieresultaten oplevert.
6. Verliesfunctie en trainingsconfiguratie
- Verliesfunctie
- Een hybride verliesfunctie L_total wordt toegepast om gezamenlijk het netwerk te optimaliseren, waarmee de alomtegenwoordige onbalans tussen voorgrond-achtergrondklassen in poliepsegmentatie wordt aangepakt.
Binaire kruis-entropie verlies (LBCE) meet de classificatienauwkeurigheid op pixelniveau:
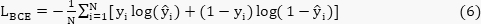
waarbij N het totale aantal pixels is, yi ∈ {0,1} het grondwaarheidslabel, en ŷi ∈ [0,1] de voorspelde waarschijnlijkheid is. - Dobbelsteenverlies (Ldobbelsteen) kwantificeert de gelijkenis tussen de voorspelde en grondwaarheidsgebieden:


waarbij ε een gladstrijkfactor is (ingesteld op 1 x 10⁻5) om deling door nul te vermijden.
Stel λ = 0,5 in om de bijdragen van de twee verliestermen in balans te brengen.
- Een hybride verliesfunctie L_total wordt toegepast om gezamenlijk het netwerk te optimaliseren, waarmee de alomtegenwoordige onbalans tussen voorgrond-achtergrondklassen in poliepsegmentatie wordt aangepakt.
- Trainingsconfiguratie
- Initialiseer de encoder met ImageNet-pretrained ResNet-50-gewichten. Initialiseer alle decoderlagen, PCM- en DAM-parameters met behulp van Kaiming-uniforme initialisatie.
- Configureer de optimizer en het trainingsschema als volgt. Gebruik de Adam-optimizer met β₁ = 0,9 en β₂ = 0,999. Stel de initiële leersnelheid in op 1 x 10⁻⁴. Pas een cosinus-annealing leersnelheidsschema toe met Tmax = 50 en ηmin = 1 x 10⁻⁶. Gebruik een batch van 16 en train het model voor 50 epochs.
- Train het model voor 50 epochs op de trainingsset (800 afbeeldingen). Aan het einde van elke epoch evalueer je het model op de validatieset (100 afbeeldingen) met de Dice-coëfficiënt als primaire monitoringsmaatstaf.
- Sla het modelcheckpoint op dat de hoogste dobbelsteencoëfficiënt op de validatieset behaalt. Gebruik dit checkpoint als het definitieve model voor alle daaropvolgende evaluaties op de testset.
OPMERKING: Vroegtijdig stoppen wordt niet expliciet toegepast. De strategie voor het selecteren van de checkpoint met de beste validatie dient als het criterium voor modelselectie. Alle experimenten worden uitgevoerd met behulp van de hardware- en softwareomgeving die in de Table of Materials is gespecificeerd. Training voor 50 epochs op 800 beelden duurt ongeveer 2 uur onder de beschreven configuratie. Alle gerapporteerde resultaten worden verkregen uit een enkele trainingsrun met behulp van het gespecificeerde willekeurige seed (seed = 42). Raadpleeg het aanvullende codepakket voor het volledige trainingsscript.
7. Pseudocode
- Gebruik Algoritme 1 als de volledige workflowkaart voor PWD Net. Koppel de PCM-, DAM-, hoofdarchitectuur- en trainingspijplijnblokken in het algoritme aan met de bijbehorende bestanden in het aanvullende codepakket.
- Voer het PCM-blok uit zoals weergegeven in regels 4 tot 12. Definieer een basis 3 x 3 convolutiekerne en genereer acht geroteerde kernen op 0°, 45°, 90°, 135°, 180°, 225°, 270° en 315° met behulp van bilineaire interpolatie.
- Houd dezelfde leerbare basisparameters voor alle geroteerde PCM-kernels. Voor elke rotatiehoek bereken je één richtingsspecifieke featuremap.
- Verbind de acht PCM-featurekaarten langs de kanaaldimensie. Pas een 1 x 1 convolutie, batchnormalisatie en ReLU-activatie toe om de oorspronkelijke kanaaldimensie te herstellen.
- Implementeer het DAM-blok dat wordt weergegeven in regels 14 tot 19. Pas Global Average Pooling toe om de kanaaldescriptor te genereren, en laat deze vervolgens door een tweelaagse MLP met een reductieverhouding van 16 lopen om kanaalgewichten te verkrijgen.
- Genereer de ruimtelijke aandachtskaart door kanaalgewijze gemiddelde pooling en maximale pooling toe te passen op de inputfunctie. Verbind de twee afbeeldingen en verwerk ze met een 7 x 7 convolutie gevolgd door Sigmoid-activatie.
- Fuse het DAM-kanaal en de ruimtelijke aandacht-uitgangen met de invoerfunctie door middel van elementgewijze vermenigvuldiging. Weeg de twee aandachtskaarten met leerbare coëfficiënten α en β, beide geïnitialiseerd op 0,5.
- Bouw de hoofdarchitectuur van PWD Net zoals weergegeven in regels 21 tot 32. Laat het invoerbeeld door vijf fasen van een vooraf getrainde ResNet 50-encoder lopen om e1 tot e5 te verkrijgen, waarbij de ruimtelijke resolutie afneemt van H x W naar H/32 x W/32.
- Breng PCM toe op e5 bij de bottleneck. Pas DAM toe op e1 naar e4 voordat je deze functies via skipverbindingen naar de decoder stuurt.
- Decodeer de featuremap van diepe naar ondiepe lagen. Op elk decoderniveau upsample je de vorige functie, verbind deze met de bijbehorende DAM-verbeterde encoderfunctie en pas je DoubleConv toe voor feature-fusie.
- Genereer de segmentatie-output met een 1 x 1 convolutie gevolgd door Sigmoid-activatie. Gebruik de resulterende pixelgewijze kanskaart als voorspeld masker.
- Voer de trainingslus uit zoals weergegeven in regels 34 tot 39. In elk tijdperk voer je de voortplanting uit via PWD Net en bereken je het voorspelde masker.
- Bereken het trainingsverlies als 0,5 x BCE-verlies plus 0,5 x dobbelsteenverlies. Werk alle leerbare parameters bij met de Adam optimizer via backpropagation.
Algoritme 1: PWD-Net Polyp Segmentatie
1: Invoer: Coloscopiefoto Ik ∈ RH×W×3
2: Output: Segmentatiemasker M ∈ {0,1}(H×W)
3:
4: functie PCM(X) ▷ Pinwheel Convolutiemodule
5: Definieer basiskern W (3 x 3), hoeken Θ = {0°, 45°, ..., 315°}
6: voor elke θ ∈ Θ doe
7: Wθ ← BilineairRotate(W, θ) ▷ Rotate kernel
8: Yθ ← Conv2d(X, Wθ) ▷ Richtingsspecifieke kenmerken
9: einde voor
10: Yuit ← ReLU(BN(Conv1 x 1(Concat({Yθ})))) ▷ Aggregaat
11: Yterugbrengen
12: einde functie
13:
14: functie DAM(F) ▷ Dubbel-aandacht Mechanisme
15: Ac ← Sigmoid(MLP(AvgPool(F))) ▷ Kanaalaandacht (r=16)
16: As ← Sigmoid (Conv7 x 7([AvgPool(F); MaxPool(F)])) ▷ Ruimtelijke aandacht
17: F' ← F ⊗ (α · Ac + β · As) ▷ Fuse met leerbare α, β (init=0.5)
18: terugkeer F'
19: einde functie
20:
21: functie PWD-Net(I)
22: Encoder: e1, e2, e3, e4, e5 ← ResNet50_Stages(I) ▷ 5-traps voorgetrainde encoder
23: Bottleneck: b ← PCM(e5) ▷ Pas PCM toe bij bottleneck
24: Sla verbindingen over: si ← DAM(ei) voor i = 1, 2, 3, 4 ▷ Filterencoderkenmerken
25: Decoder:
26: vloek4 ← DoubleConv(Concat(Up(b), s4))
27: 3 ← DoubleConv(Concat(Up(4), s3))
28: 2 ← DoubleConv(Concat(Up(d3), s2))
29: 1 ← DoubleConv(Concat(Up(d2), s1))
30: M ← Sigmoïde (Conv1 x 1(d1))
31: terugkeer M
32: einde functie
33:
34: Training:
35: voor elk tijdperk doe
36: M̂ ← PWD-Net(I)
37: L ← 0,5 · BCE(M̂, Mgt) + 0,5 · DiceLoss(M̂, Mgt) ▷ λ = 0,5
38: Werk parameters bij via backpropagatie (Adam optimaliseerr)
39: einde voor
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Experimentele opstelling
Dataset
De Kvasir SEG-dataset werd gebruikt om het segmentatiegedrag van PWD Net te evalueren op coloscopiebeelden met heterogene poliepverschijnselen. De dataset bevat 1.000 pixels geannoteerde poliepafbeeldingen en bevat variatie in polypgrootte, vorm, textuur, verlichting en achtergrondcomplexiteit, waardoor het geschikt is voor het beoordelen van kleine doeldetectie, grenslokalisatie en robuustheid tegen visuele...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Verschillende ontwerpkeuzes in het PWD-Net-protocol zijn cruciaal voor het behalen van betrouwbare segmentatieresultaten en verdienen zorgvuldige aandacht tijdens de implementatie. Ten eerste beïnvloedt de selectie en initialisatie van de encoder-backbone direct het convergentiegedrag en de uiteindelijke prestaties. Het protocol maakt gebruik van een ResNet-50-encoder die vooraf is getraind op ImageNet, en die robuuste laag- en middenniveau feature-initialisatie biedt. Dit is vooral bela...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs hebben niets te onthullen.
Dankbetuigingen
Deze studie werd gefinancierd door het National Key R&D Program of China (programmanummers 2022YFC3500200 en 2022YFC3500204).
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Adam Optimizer | — | — | Opgenomen in PyTorch |
| Albumentations | Albumentations Team | v1.0+ | Data augmentatie bibliotheek |
| CUDA Toolkit | NVIDIA | v11.3+ | GPU versnelling |
| Kvasir-SEG dataset | SimulaMet | — | https://datasets.simula.no/kvasir-seg/ |
| Matplotlib | Matplotlib Community | v3.4+ | Visualisatie van trainingscurven |
| NumPy | NumPy Community | v1.21+ | Numerieke berekening |
| NVIDIA Tesla P100 | NVIDIA | P100-PCIE-16GB | GPU voor training en inferentie |
| OpenCV | OpenCV Community | v4.5+ | Afbeeldingsvoorverwerking |
| Python | Python Software Foundation | v3.8+ | Programmeertaal |
| PyTorch | Meta Platforms | v1.12+ | Deep learning framework |
| ResNet-50 pretrained weights | PyTorch Model Zoo | — | ImageNet-1K vooraf getraind |
| Ubuntu | Canonical | 18.04+ | Besturingssysteem |