Het protocol voor de Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC) integreert quantum-geïnspireerde cognitieve modellering, data-voorbewerking, kenmerkselectie en hybride neurale leerprocessen om de interesses van studenten techniek te identificeren. Dit protocol presenteert een reproduceerbare, hybride, quantum-geïnspireerde machine learning-workflow voor educatieve analyse, gedemonstreerd via de identificatie van interesses van studenten techniek met behulp van multidimensionale educatieve data.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Datagestuurde identificatie van studenteninteresses voor intelligente systemen voor onderwijsbeheer in technische hogescholen
In dit artikel
Samenvatting
Samenvatting
Dit protocol presenteert een quantum-geïnspireerd computationeel raamwerk voor het identificeren van de interesses van studenten engineering met behulp van multidimensionale educatieve en gedragsgegevens. Het doel is om een systematische en reproduceerbare workflow te bieden die datapreprocessing, gedragspatroonanalyse, kenmerkselectie en hybride neurale leerprocessen integreert om educatieve besluitvorming en gepersonaliseerd leren te ondersteunen. De workflow begint met Box-Cox Robust IQR Scaling (BCRIS) om educatieve gegevens te preprocessen en te normaliseren door semantische ruis te verminderen en de datakwaliteit te verbeteren. Het leergedrag van studenten wordt vervolgens geanalyseerd met behulp van het Quantum Cognitive State Model (QCSM), dat gedragstransities en evoluerende leervoorkeuren onder onzekere omstandigheden representeert. Relevante kenmerken worden daarna geselecteerd met het Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS) algoritme om redundantie in kenmerken te verminderen en informatieve gedragskenmerken te identificeren. Ten slotte integreert de Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC) quantum-geïnspireerd leren met diepe neurale netwerken om de interesses van studenten te classificeren. Het protocol is gevalideerd met behulp van een publiek toegankelijke educatieve dataset. De prestaties van het model zijn geëvalueerd aan de hand van conventionele metrieken, waaronder nauwkeurigheid, F1-score en de area under the receiver operating characteristic curve (AUC), samen met de Interest Detection Precision (IDP), de Quantum Pattern Stability Index (QPSI) en de Cross-Domain Adaptability Gain (CDAG). Het raamwerk behaalde een totale classificatienauwkeurigheid van 96,17% op de geëvalueerde dataset. Dit protocol biedt een reproduceerbare computationele workflow voor het analyseren van multidimensionale educatieve gegevens ter ondersteuning van intelligent educatief beheer en toepassingen voor gepersonaliseerd leren.
Inleiding
Educatieve managementsystemen worden steeds vaker ingezet in de hele onderwijssector, gedreven door snelle vorderingen in de informatietechnologie en computernetwerken. De voortdurende groei van het hoger onderwijs is gepaard gegaan met een toename van het aantal studenten, in het bijzonder onder studenten engineering, wat heeft geleid tot een aanzienlijke toename van educatieve managementgegevens. Deze groei ondersteunt een duurzame onderwijsontwikkeling, versnelt de informatisering van het onderwijs en faciliteert de vestiging van gestandaardiseerde educatieve managementsystemen die de consistentie en efficiëntie van het onderwijsbeheer verbeteren. Machine Learning (ML) biedt computationele technieken waarmee systemen gegevens kunnen analyseren, kunnen leren van patronen en de voorspellende prestaties continu kunnen verbeteren zonder expliciete programmering1,2.
Onderwijskwaliteit is een fundamenteel onderdeel van het hoger onderwijs. In recente jaren zijn examens op grote schaal ingezet om het begrip van de cursusstof bij studenten techniek en hun vermogen om nieuwe kennis te verwerven te beoordelen, om zo continue verbeteringen in de onderwijskwaliteit te stimuleren. Leerlinggerichte omgevingen kunnen worden gecreëerd door gebruik te maken van diverse leerbronnen die beschikbaar zijn via online educatieve platforms en door meerdere leertheorieën toe te passen om in te spelen op de behoeften van verschillende leerlingen. Effectief onderwijs speelt een sleutelrol bij het verbeteren van de leerresultaten van studenten techniek aan universiteiten en hogescholen3,4. Bovendien bevordert effectief onderwijs een positieve leeromgeving, ondersteunt het het begrip van de cursusstof bij studenten en verbetert het de academische prestaties. Onderwijskwaliteit wordt gedurende het leerproces geëvalueerd aan de hand van meerdere indicatoren, waaronder de structuur van het curriculum, de klassikale omgeving en de inhoud van het onderwijs.
Hoger onderwijs bevordert de intellectuele, persoonlijke en sociale ontwikkeling van studenten. Tegelijkertijd zijn studentbetrokkenheid — inclusief gedragsmatige, emotionele en cognitieve dimensies — en academische persistentie belangrijke determinanten geworden voor leerresultaten. Hoge niveaus van studentbetrokkenheid dragen significant bij aan langdurig academisch succes5,6. Vooruitgang in educatieve technologie heeft nieuwe mogelijkheden gecreëerd voor datagestuurde educatieve analytics door complexe niet-lineaire relaties tussen de cognitieve, gedragsmatige en academische kenmerken van studenten te modelleren met behulp van Machine Learning (ML) en Deep Learning (DL) technieken.
Een grote uitdaging blijft de effectieve observatie en beoordeling van klasdynamiek, waarbij rekening wordt gehouden met het evoluerende gedrag van studenten. Traditionele benaderingen voor het evalueren van onderwijskwaliteit en het analyseren van het gedrag van studenten techniek zijn vaak tijdrovend en vatbaar voor subjectieve menselijke beoordeling. Onoplettendheid van studenten tijdens klasactiviteiten heeft een negatief effect op de leerresultaten en de academische prestaties7,8. Het behouden van een aanhoudende aandacht bij studenten techniek blijft echter uitdagend vanwege interne en externe afleidingen en schommelingen in de motivatie.
Het beoordelen en verbeteren van de betrokkenheid van studenten is steeds belangrijker geworden door de wijdverspreide adoptie van online leren, slimme klaslokalen en andere interactieve educatieve technologieën. Het waarborgen van inclusie over diverse groepen engineeringstudenten benadrukt verder de behoefte aan uitgebreide raamwerken die technologiegestuurde benaderingen integreren met educatieve praktijken, terwijl privacy en ethische normen worden gehandhaafd. Daarnaast blijven beperkte modeltransparantie en uitdagingen verbonden aan technologie-integratie9,10, waaronder methodologische bias en educatieve gelijkheid, de ontwikkeling belemmeren van voorspellende systemen die in staat zijn leerlingen te ondersteunen door middel van continue monitoring.
Machine learning-benaderingen worden op grote schaal gebruikt om educatieve uitdagingen aan te pakken, zoals het voorspellen van studentenrisico's en uitvalpercentages. Deze benaderingen hebben aangetoond in staat te zijn om studenten met een hoog risico te identificeren, waardoor interventies worden ondersteund die de academische prestaties verbeteren11. Er zijn ook op Artificial Intelligence (AI) gebaseerde educatieve managementsystemen ontwikkeld om zowel de administratieve als de academische processen binnen instellingen voor hoger onderwijs te verbeteren. Educatieve datasets bevatten gewoonlijk academische gegevens zoals vakcijfers, presentielijsten en inschrijvingsgeschiedenis12.
Eerdere studies hebben studentengedrag vanuit drie perspectieven geanalyseerd: evaluatiegegevens, methoden en resultaten13,14. Voorspellingsmodellen op basis van informatievaardigheden zijn ontwikkeld om de gedragskenmerken van studenten aan instellingen voor hoger onderwijs te analyseren. Deze studies richten zich primair op de beoordeling van leerlingengedrag met behulp van Deep Learning (DL)-methoden. Onderzoek naar intelligente beoordeling van docentengedrag bevindt zich echter nog in een vroeg stadium, wat de voortgang op dit gebied beperkt. Fast Region-based Convolutional Neural Networks (Fast R-CNN's) zijn toegepast op educatieve datasets om de detectie van klassikale activiteiten te verbeteren, waarbij significante prestatieverbeteringen ten opzichte van traditionele methoden werden aangetoond15.
Bi-Directional Long Short-Term Memory (Bi-LSTM)-modellen met geïntegreerde zelfmonitormechanismen hebben ook de nauwkeurigheid van cijfervoorspellingen voor studenten in het hoger onderwijs verbeterd. Op soortgelijke wijze hebben voorspellingsmodellen die zijn ontwikkeld met datasets van online leergedrag een verbeterde voorspellende prestatie aangetoond16,17,18. Daarnaast is k-means clustering (KMC) gebruikt om de kenmerken van verschillende studentengroepen te identificeren via clusteranalyse, wat inzicht biedt in studentengedrag ter ondersteuning van verbeteringen in het onderwijs, management en leren. Er zijn ook strategieën op basis van deep learning voorgesteld om de detectie en evaluatie van onderwijsgedrag in de klas te verbeteren. Bij deze benaderingen worden kenmerken van gedrag in de klas gebruikt om relaties tussen kenmerkrepresentaties en hypervlakken vast te stellen, gebruikmakend van lineair scheidbare startwaarden voor de Support Vector Machine (SVM)19,20. Uitdagingen zoals occlusie, fijnmazige gedragsdetails en omgevingsfactoren blijven echter de nauwkeurigheid van gedragsherkenning bij engineeringstudenten in klaslokalen beperken.
Deep learning is ook toegepast op de resultaatgerichte evaluatie van universitaire cursussen, waaronder onderwijskundige beoordelingen in politiek en ideologisch onderwijs21,22. De effectiviteit van deze voorspellingsmodellen is aangetoond met behulp van publiek beschikbare onderwijsdatasets. Feed-forward Spiking Neural Networks (FSNN's) zijn ingezet om de academische prestaties van studenten te voorspellen op basis van gegevens verzameld via online leerplatformen en learning management systemen. Zoals geïllustreerd in Figuur 1, bevat de voorgestelde computationele workflow een dataset voor onderwijskundige beoordeling om de interesses van engineeringstudenten te identificeren via opeenvolgende fasen van data-preprocessing, analyse van gedragspatronen, kenmerkselectie en classificatie. Tabel 123,24,25,26,27,28,29,30,31,32 vat representatieve methoden samen die in eerdere studies zijn gerapporteerd, samen met de gebruikte technieken en de bijbehorende beperkingen voor het identificeren van studenteninteresses binnen learning management systemen.
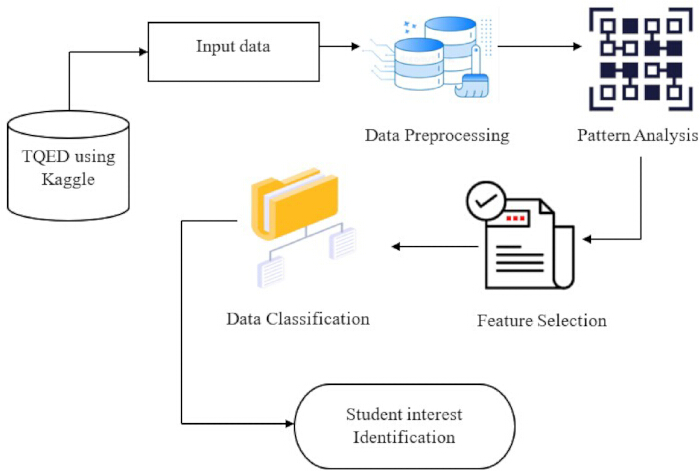
Figuur 1: Raamwerk voor de identificatie van studenteninteresses. Algemene workflow van het voorgestelde raamwerk voor de identificatie van interesses van engineeringstudenten, inclusief data-acquisitie, preprocessing, analyse van gedragspatronen, kenmerkselectie en classificatie. Klik hier om een grotere versie van deze figuur te bekijken.
Tabel 1: Analyse van studentengedrag in onderwijsmanagement. Samenvatting van representatieve methoden, technieken, datasets, evaluatiemetrieken en gerapporteerde beperkingen voor de analyse van studentengedrag in onderwijsmanagement. Klik hier om deze tabel te downloaden.
De Swin Transformer en het Lightweight Feature Pyramid Network (FPN) zijn toegepast op de detectie van het gedrag van studenten in de klas door multi-schaal feature maps efficiënt te verwerken33. Daarnaast is het Fruit-Fly-Optimized Adjustable Recurrent Neural Network (PFFO-ARNN) gebruikt om het online leergedrag van studenten te analyseren en het resultaat van cursussen te voorspellen34. Studies gebaseerd op gedragsgegevens van studenten, verzameld via leerbeheersystemen van universiteiten, hebben ook de inefficiëntie en de tijdrovende aard benadrukt van het monitoren van klasgedrag met conventionele deep learning-methoden35. Tabel 236,37,38,39,40,41,42,43,44,45,46,47 geeft een overzicht van representatieve classificatiemethoden, datasets, evaluatiemetrieken en gerapporteerde beperkingen voor intelligente systemen voor onderwijsbeheer in het technisch onderwijs.
Tabel 2: Op deep learning gebaseerde intelligente onderwijsbeheersystemen voor technisch onderwijs. Vergelijking van representatieve op deep learning gebaseerde onderwijsbeheersystemen, datasets, evaluatiemetrieken en gerapporteerde beperkingen. Klik hier om deze tabel te downloaden.
In een eerdere studie48 werd een model voor de beoordeling van de kwaliteit van blended learning ontwikkeld op basis van Deep Belief Networks (DBNs), waarbij een gemengde evaluatiestrategie werd voorgesteld voor het beoordelen van de onderwijskwaliteit aan universiteiten. De voorgestelde aanpak presteerde beter dan het conventionele Genetisch Algoritme (GA) wat betreft zowel de classificatienauwkeurigheid als de executietijd, met een nauwkeurigheid van meer dan 95% in minder dan 5,4 ms. Het model werd getraind met behulp van gelabelde educatieve datasets en geëvalueerd met een onafhankelijke teststrategie49,50. De gerapporteerde resultaten toonden een sterke voorspellende prestatie aan, met een Mean Absolute Error (MAE) van 0,593% en een Root Mean Square Error (RMSE) van 0,785%.
Recente architecturen met verbeterde aandacht, zoals KANFormer51, integreren multi-head self-attention met Kolmogorov-Arnold-netwerken om de voorspelling van studentenprestaties te verbeteren door complexe kenmerkinteracties vast te leggen. Transformer-gebaseerde modellen voor kennisregistratie hebben evenzo een verbeterde voorspellingsnauwkeurigheid en interpreteerbaarheid aangetoond door gebruik te maken van aandachtmechanismen om de leertrajecten van studenten te modelleren52. Hoewel transformer- en aandacht-gebaseerde architecturen de prestaties bij educatieve voorspellingstaken hebben verbeterd door contextuele afhankelijkheden en lange-afstandsinteracties tussen kenmerken te modelleren, richten deze benaderingen zich primair op het voorspellen van studentenprestaties of kennisregistratie, in plaats van op onzekerheidsbewuste identificatie van studenteninteresses via quantum-geïnspireerde cognitieve modellering, geoptimaliseerde kenmerkselectie en hybride meta-learning.
Ondanks recente vorderingen in machine learning en deep learning voor educatieve analyse, kennen bestaande methoden voor het identificeren van de interesses van studenten techniek verschillende beperkingen. Veel conventionele benaderingen richten zich hoofdzakelijk op de voorspellingsnauwkeurigheid, waarbij de veelzijdige aard van studentengedrag, waaronder evoluerende leervoorkeuren, gedragsmatige onzekerheid, contextuele relaties en semantische interacties, over het hoofd wordt gezien. Bovendien vertrouwen deze methoden vaak op conventionele feature engineering en deterministische leerstrategieën, die mogelijk niet in staat zijn om niet-lineaire gedragspatronen adequaat vast te leggen of zich aan te passen aan dynamische leeromgevingen. Bijgevolg is er een uitgebreider raamwerk nodig dat robuuste datapreprocessing, intelligente gedragsmodellering, adaptieve feature-selectie en hybride leertechnieken integreert om de analyse van complexe educatieve data te verbeteren.
Om deze beperkingen aan te pakken, integreert het voorgestelde raamwerk robuuste datapreprocessing, quantum-geïnspireerde gedragsmodellering, geoptimaliseerde kenmerkselectie en hybride quantum-klassiek neuraal leren in een uniforme computationele workflow voor het identificeren van de interesses van studenten engineering. Door deze complementaire componenten te combineren, biedt het voorgestelde protocol een systematische en reproduceerbare aanpak voor het analyseren van complexe educatieve gegevens ter ondersteuning van gepersonaliseerd leren en educatieve besluitvorming.
Het doel van deze studie is om het CQEI-framework te ontwikkelen en te valideren met behulp van multidimensionale educatieve en gedragsgegevens voor de identificatie van de interesses van studenten in de techniek. Het framework combineert robuuste gegevensvoorbehandeling, quantum-geïnspireerde modellering van cognitieve toestanden, geoptimaliseerde kenmerkselectie en de Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC) om het leergedrag van studenten te analyseren en een nauwkeurige interesse-identificatie te faciliteren. De prestaties worden geëvalueerd aan de hand van standaardmetrieken, waaronder nauwkeurigheid, F1-score en de oppervlakte onder de receiver operating characteristic-curve (AUC), samen met de Interest Detection Precision (IDP), de Quantum Pattern Stability Index (QPSI) en de Cross-Domain Adaptability Gain (CDAG). Door deze complementaire componenten te integreren in één enkele computationele workflow, biedt het voorgestelde framework een systematische benadering voor educatieve analyse en intelligente educatieve besluitvorming.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Voor deze studie is gebruikgemaakt van een openbaar beschikbare, geanonimiseerde dataset afkomstig uit de Kaggle-repository. Er zijn geen menselijke deelnemers direct geworven of betrokken, en er zijn geen persoonlijk identificeerbare gegevens verzameld. Daarom waren institutionele ethische goedkeuring en geïnformeerde toestemming niet vereist. De onderzoeksinstrumenten die in deze studie zijn gebruikt, staan vermeld in de Tabel met Materialen.
1. Overzicht van het CQEI-raamwerk
Het voorgestelde Quantum-Inspired Conceptual Education Intelligence (CQEI)-raamwerk integreerde data-preprocessings, gedragspatroonanalyse, kenmerkselectie en classificatie om de interesses van studenten techniek te identificeren met behulp van de Teaching Quality Evaluation Dataset, verkregen uit de Kaggle-repository. De dataset werd eerst gepreprocesst met de Box–Cox Robust IQR Scaling (BCRIS)-methode om semantische ruis te verminderen en de inputkenmerken te normaliseren. De gedragspatronen van studenten werden vervolgens geanalyseerd met het Quantum Cognitive State Model (QCSM). Daarna werd het Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS)-algoritme toegepast om informatieve kenmerken te identificeren en kenmerkredundantie te verminderen door quantum-optimale selectie, feedbacksignificantie en transiënte gedragsvariaties te modelleren. Ten slotte integreerde de Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC) quantum-geïnspireerd leren met diepe residuele semantische lagen om de interesses van studenten te identificeren.
De algemene workflow van het voorgestelde ML-HQNC-framework is weergegeven in Figuur 2. Het protocol bestond uit zes opeenvolgende fasen, beginnend met de acquisitie van de educatieve dataset uit de Kaggle-repository, gevolgd door datapreprocessing met behulp van Box–Cox Robust IQR Scaling (BCRIS), kenmerktransformatie en gedragsrepresentatie middels het Quantum Cognitive State Model (QCSM), en kenmerkselectie met behulp van het Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS) algoritme. De geselecteerde kenmerken werden vervolgens gebruikt voor modeltraining en validatie met de Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC), waarna het framework tot slot werd geëvalueerd op basis van nauwkeurigheid, F1-score, de oppervlakte onder de receiver operating characteristic curve (AUC), Interest Detection Precision (IDP), Quantum Pattern Stability Index (QPSI) en Cross-Domain Adaptability Gain (CDAG).
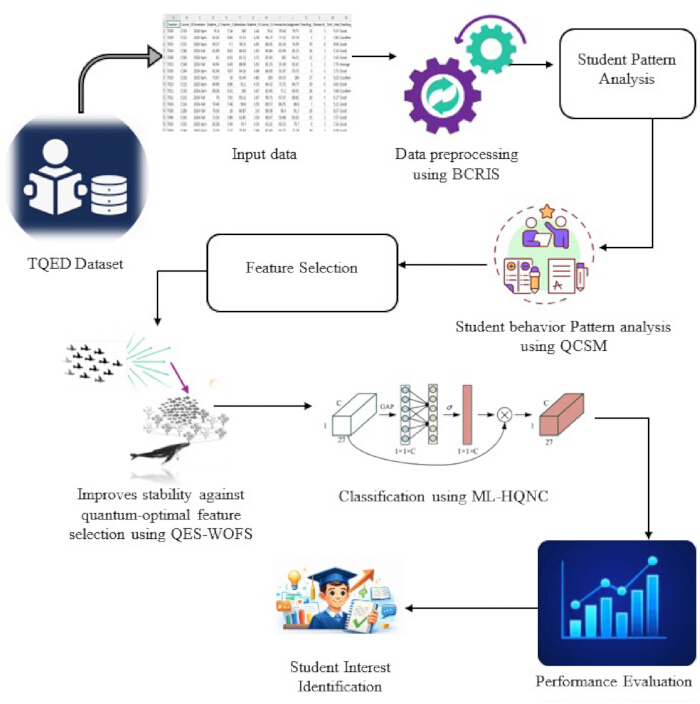
Figuur 2: Framework voor de Meta-Learning Hybride Quantum-Klassieke Neurale Classificator (ML-HQNC). Algemene architectuur van het voorgestelde ML-HQNC-framework dat Box–Cox Robuuste IQR-schaling (BCRIS) voor gegevensvoorbewerking, het Quantum Cognitieve Staatmodel (QCSM) voor gedragspatroonanalyse, het Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS)-algoritme voor kenmerkselectie en hybride quantum-klassieke neurale learning voor de classificatie van studenteninteresses integreert. Klik hier om een grotere versie van deze figuur te bekijken.
2. Dataset voor evaluatie van de onderwijskwaliteit
Het voorgestelde raamwerk is ontwikkeld met behulp van de publiek beschikbare Teaching Quality Evaluation Dataset, verkregen uit de Kaggle-repository. De dataset bevatte 1.014 onderwijsrecords met 14 multidimensionale kenmerken die academische prestaties, beoordelingsscores, aanwezigheid, instructiekenmerken en gedragsindicatoren van studenten vertegenwoordigen, verzameld via het Comprehensive Education Management Platform (CEMP). Deze attributen leverden de multidimensionale onderwijsinformatie die nodig was om de niet-lineaire relaties te modelleren die verbonden zijn aan het identificeren van de interesses van studenten in de techniek.
Zoals weergegeven in Figuur 3, werd de dataset verdeeld in trainings- (80%) en testsubsets (20%). In totaal werden 800 records gebruikt om het voorgestelde model te trainen, waarbij 200 records werden gereserveerd voor de prestatie-evaluatie. De dataset is publiekelijk beschikbaar via: https://www.kaggle.com/datasets/ziya07/teaching-quality-evaluation-dataset. De trainings- en testdatasets werden vervolgens verwerkt met behulp van het voorgestelde framework om het leermodel te construeren en de voorspellende capaciteit ervan te verbeteren.
Hoewel de onderliggende dataset de titel Teaching Quality Evaluation Dataset draagt, was het doel van deze studie om de interesses van studenten engineering te identificeren. De educatieve, gedragsmatige en instructieve kenmerken in de dataset dienden als inputvariabelen voor het trainen en evalueren van het voorgestelde raamwerk. Bijgevolg beschrijven alle gerapporteerde voorspellingsresultaten en prestatiemetrikken de effectiviteit van het raamwerk bij het identificeren van de interesses van studenten engineering, in plaats van het evalueren van de onderwijskwaliteit. Vóór de datapreprocessing werd de geïmporteerde dataset geverifieerd om te bevestigen dat alle 1.014 records succesvol waren geladen, het dataschema overeenkwam met het verwachte formaat en eventuele ontbrekende of dubbele records waren geïdentificeerd en behandeld.
3. Gegevensvoorbehandeling met behulp van box–cox robuuste IQR-schaling (BCRIS)
De Box–Cox Robust IQR Scaling (BCRIS)-methode werd gebruikt om de educatieve dataset voor te behandelen en te normaliseren door de Box–Cox-transformatie te combineren met robuuste schaling op basis van het interkwartielbereik (IQR) om de invloed van extreme waarden te verminderen. Symmetrie-correctie in combinatie met mediaan-gecentreerde normalisatie genereerde statistisch stabiele en schaalbare kenmerkrepresentaties die geschikt waren voor verdere analyse. Binnen het voorgestelde framework voor educatieve intelligentie transformeerde BCRIS multidimensionale educatieve, instructieve en gedragsmatige indicatoren in variantie-gecontroleerde kenmerkrepresentaties. Kenmerken waaronder attendance_rate, interactive_sessions_percentage en gerelateerde educatieve variabelen werden genormaliseerd om de consistentie van de trainings- en testdatasets te verbeteren. Gedetailleerde wiskundige uitleg is te vinden in Aanvullend Bestand 1 (Sectie S1). De BCRIS-methode bood een quantum-compatibele voorbehandelingsstrategie die heterogene educatieve gegevens normaliseerde voorafgaand aan de daaropvolgende statistische analyse, terwijl de onderliggende gedragskenmerken die nodig zijn voor downstream-modellering behouden bleven. Voorafgaand aan de gedragsanalyse werd de voorbehandelingspipeline geverifieerd om te garanderen dat de genormaliseerde dataset geen ongeldige of ontbrekende waarden bevatte, dat semantische ruis was verminderd en dat de verwerkte kenmerken geschikt waren voor daaropvolgende gedragsmodellering.
4. Kenmerktransformatie en gedragsrepresentatie met behulp van het quantum cognitive state model (QCSM)
Het Quantum Cognitive State Model (QCSM) werd geïmplementeerd om de dynamiek van de interesses van studenten techniek te modelleren met behulp van quantum-geïnspireerde probabilistische representaties. De interesse van de student werd weergegeven als een overlap van meerdere conceptuele toestanden die de hiërarchie van cognitieve concepten, onzekerheid, conceptuele overlap, gelijktijdige betrokkenheid bij meerdere onderwerpen, aarzelend of besluiteloos leergedrag en de waarschijnlijkheid van verschuivingen in leervoorkeuren weerspiegelden. De multidimensionale indicatoren uit de Engineering Teaching Quality Assessment-dataset, waaronder Student_Avg_Score, Attendance_rate en Student_Feedback_Rating, werden gerepresenteerd als amplitude-gewogen cognitieve transities binnen een genormaliseerde quantumtoestandsruimte. Het QCSM combineerde quantumtoestandstransities met interferentiegebaseerde conceptuele uitlijning om quantum-geïnspireerde cognitieve representaties te genereren die de stabiliteit en evolutie van de interesse van de student in de loop van de tijd weerspiegelden. Gedetailleerde wiskundige formuleringen worden gegeven in Supplementary File 1 (Sectie S2). Het QCSM modelleerde probabilistische cognitieve toestanden om kennisverwerving, conceptuele verandering, leerbetrokkenheid en vakinteresse weer te geven via genormaliseerde quantumtoestandsrepresentaties. Gedragsrepresentaties werden geverifieerd over alle studentgegevens om te garanderen dat de geëxtraheerde cognitieve-toestandskenmerken de leergedragingen en onderwerptransities nauwkeurig vastlegden.
5. Kenmerkselectie met behulp van het Quantum-Enhanced Swarm–Whale Optimization Feature Selector (QES-WOFS) algoritme
Het Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS) algoritme werd gebruikt om de optimale subset van kenmerken te identificeren en gedragskenmerken met een hoge informatiewaarde uit multidimensionale onderwijsgegevens te bepalen. Quantum-geïnspireerde zoekmechanismen verbeterden de integratie van globale en lokale zoekstrategieën voor kenmerkoptimalisatie. Onderwijsvariabelen, waaronder interactive_sessions_percentage, assignments_time_percentage en course_completion_rate, werden geëvalueerd op basis van hun correlatie met het doelresultaat. Kandidaat-subsets van kenmerken werden gemodelleerd met behulp van quantum-waarschijnlijkheidsrepresentaties, terwijl een quantum-tunnelingsmechanisme probabilistische overgangen voorbij lokale optima mogelijk maakte. Het belang van kenmerken werd geschat met behulp van de marginale likelihood om de bijdrage van elk kenmerk aan de classificatieprestaties en adaptieve zwermtoestanden te kwantificeren. Het QES-WOFS algoritme selecteerde stabiele en gedragsmatig betekenisvolle kenmerken, waardoor de robuustheid ten opzichte van ruis, variatie tussen semesters en periodieke gedragsschommelingen werd verbeterd.
Om de beperkingen te overwinnen die gepaard gaan met het onafhankelijk gebruiken van het Whale Optimization Algorithm (WOA) of Particle Swarm Optimization (PSO), combineerde het QES-WOFS-algoritme PSO-gebaseerde globale exploratie met WOA-gebaseerde lokale exploitatie. Een quantumtunnelingmechanisme maakte bovendien probabilistische overgangen voorbij lokale optima mogelijk, waardoor de populatiediversiteit werd vergroot, feature-redundantie werd verminderd en de convergentie naar een optimale feature-subset voor het identificeren van de interesse van engineeringstudenten werd verbeterd.
Gedetailleerde wiskundige formuleringen worden gegeven in Aanvullend Bestand 1 (Sectie S3). Het QES-WOFS-algoritme combineerde kwantumprobabilistische kenkensecodering, een PSO-aangepaste snelheidsstrategie en een op walvissen geïnspireerd spiraalzoekmechanisme om de meest informatieve educatieve kenmerken te identificeren. Hyperparameters werden empirisch geoptimaliseerd met behulp van de trainingsdataset. Kandidaatwaarden werden geëvalueerd via systematische experimenten, waarbij de combinatie die de hoogste validatieprestaties opleverde, werd geselecteerd. Specifiek werden de Box-Cox-transformatieparameter (λ = 0.25), de contrastieve verliesmarge (m = 1.0) en de kwantumtunnelcoëfficiënten (α = 0.7 en β = 0.3) geselecteerd op basis van validatienauwkeurigheid, F1-score en convergentiegedrag. Voorafgaand aan de training van de classifier werden de resultaten van de kenmerkselectie geverifieerd om er zeker van te zijn dat het QES-WOFS-algoritme de optimale subset van kenmerken had geselecteerd en redundante of weinig belangrijke kenmerken had verwijderd.
6. Model training en validatie met de meta-learning hybride quantum-klassieke neurale classifier (ML-HQNC)
De Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC) werd geïmplementeerd door diepe neurale netwerken te combineren met quantum-geïnspireerde berekeningen om de interesses van engineeringstudenten te identificeren. Multi-head quantum attention-mechanismen en diepe residuele semantische lagen legden complexe niet-lineaire relaties vast binnen multidimensionale educatieve gegevens, gerepresenteerd met behulp van variationele quantumcircuits (VQCs). Gedragsmatig afgeleide kenmerken, waaronder student_average_grade, attendance_rate en student_feedback_rating, werden geprojecteerd in een quantumtoestandsruimte, waarbij genormaliseerde inputs werden getransformeerd naar amplitudegebaseerde quantumrepresentaties om overlappende en probabilistische betrokkenheidspatronen te modelleren. Genormaliseerde gedragskenmerkvectoren van studenten werden berekend volgens de vergelijkingen in Aanvullend Bestand 1 (Sectie S4). De ML-HQNC classificeerde en identificeerde vervolgens de interesses van de engineeringstudenten.
De ML-HQNC-classificator maakte gebruik van een episodische meta-learningstrategie tijdens de training. Aan elke episode werd één willekeurig geselecteerde meta-learningtaak uit de trainingsdataset toegewezen. Terwijl de klassendistributie werd behouden, werden de trainingsgegevens verdeeld in een supportset (80%) en een queryset (20%). De supportset werd gebruikt voor taakspecifieke parameteradaptatie via de innerlijke optimalisatielus, terwijl de queryset het aangepaste model evalueerde en het meta-verlies berekende dat werd gebruikt om de gedeelde parameters bij te werken. In totaal werden er tijdens elke trainingscyclus 100 meta-learningtaken gegenereerd. Voor de adaptatie in de innerlijke lus werden vijf gradiënt-updatestappen met een innerlijke leer-snelheid van 0,001 gebruikt, terwijl de Adam-optimizer met een uiterlijke leer-snelheid van 0,0005 de meta-parameters optimaliseerde. Willekeurige taakbemonstering werd herhaald voor elke trainingsepoch om het model bloot te stellen aan diverse gedragspatronen en de generalisatie naar voorheen onbekende studentprofielen te verbeteren. De schatting van het verlies voor quantum contrastieve uitlijning wordt beschreven in Aanvullend bestand 1 (Vergelijkingen 41–45). De modeltraining werd geverifieerd om succesvolle convergentie zonder computationele fouten te garanderen en om vast te stellen dat de trainings- en validatieverliescurves waren gestabiliseerd over opeenvolgende epochs.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Het voorgestelde ML-HQNC-framework is geëvalueerd ten opzichte van Fast R-CNN, Bi-LSTM, CNN en XGBoost met behulp van conventionele classificatiemetrieken, waaronder accuratesse, precisie, recall, F1-score en de oppervlakte onder de receiver operating characteristic-curve (AUC), samen met de voorgestelde evaluatiemetrieken Interest Detection Precision (IDP), Quantum Pattern Stability Index (QPSI) en Cross-Domain Adaptability Gain (CDAG). De wiskundige definities van deze metrieken worden gegeven in Aanvullend bes...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Het voorgestelde ML-HQNC-framework demonstreerde verbeterde prestaties bij het identificeren van de interesse van studenten engineering door quantum-geïnspireerde gedragsmodellering, adaptieve kenmerkselectie en meta-learning te integreren in een uniforme computationele workflow. Vergeleken met Fast R-CNN, Bi-LSTM, CNN en XGBoost behaalde het framework consistent hogere prestaties over zowel de conventionele classificatiemetrieken als de voorgestelde gedragsevaluatiemetrieken. Deze bevindingen suggereren dat de combinati...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteur verklaart geen concurrerende belangen te hebben.
Dankbetuigingen
De auteur bedankt Bengbu University, Bengbu, China, voor het bieden van de academische ondersteuning en de onderzoeksomgeving die deze studie mogelijk hebben gemaakt. Dit werk werd ondersteund door het 2025 Annual School-Level Quality Engineering Project van Bengbu University (Nr. 2025zhkc1).
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Baseline-modellen (Fast R-CNN, Bi-LSTM, CNN, XGBoost) | Open-source implementaties | Fast R-CNN (2015); TensorFlow/Keras implementatie v2.16; XGBoost v2.1.1 | Benchmark-modellen gebruikt voor vergelijkende prestatie-evaluatie. |
| BCRIS Voorbewerkingsmodule | Ontwikkeld in deze studie | Versie 1.0 | Aangepaste voorbewerkingsmodule die de Box-Cox-transformatie en robuuste IQR-normalisatie implementeert. |
| Jupyter Notebook | Project Jupyter | Versie 7.2.2 | Interactieve ontwikkelomgeving gebruikt voor implementatie, training en testen. |
| ML-HQNC Classificator | Ontwikkeld in deze studie | Versie 1.0 | Voorgestelde hybride quantum-klassieke neurale netwerkclassificator met meta-learning raamwerk. |
| Python | Python Software Foundation | Versie 3.11.9 | Programmeertaal gebruikt voor modelontwikkeling en experimentatie. |
| PyTorch | PyTorch Foundation | Versie 2.5.1 | Deep learning raamwerk gebruikt voor modelimplementatie en training. |
| QCSM Model | Ontwikkeld in deze studie | Versie 1.0 | Voorgesteld Quantum Cognitive State Model voor representatie van gedragspatronen. |
| QES-WOFS Algoritme | Ontwikkeld in deze studie | Versie 1.0 | Voorgesteld Quantum-Enhanced Swarm–Whale Optimization Feature Selection algoritme. |
| Scikit-learn | Scikit-learn Developers | Versie 1.6.1 | Machine learning bibliotheek gebruikt voor voorbewerking, featureselectie en evaluatie. |
Referenties
- Xu Q, Deng H. Research on education management system based on machine learning and multidimensional data modeling. Applied Mathematics and Nonlinear Sciences. 2024;9(1). https://dialnet.unirioja.es/servlet/articulo?codigo=9386765
- Li D. An interactive teaching evaluation system for preschool education in universities based on machine learning algorithm. Comput Hum Behav. 2024;157:108211. https://doi.org/10.1016/j.chb.2024.108211
- Chunhua H, Kaabar MKA, Qiuju X, Zhang G. Fuzzy comprehensive evaluation of students' classroom experience in online teaching. International Journal of Emerging Technologies in Learning. 2023;18(21):79-88.
- He Z, et al. Assessment of influencing factors of college and universities' teaching effects using fuzzy and deep learning techniques. Scientific Reports. 2026;16:5168. https://doi.org/10.1038/s41598-026-35940-5
- Liu J. Innovation and practice of educational management system in colleges and universities based on the concept of data analysis education. Applied Mathematics and Nonlinear Sciences. 2023;9(1). https://www.researchgate.net/publication/377568313
- Li C, Cao Z. Deep learning-based AI model for predicting academic success and engagement among physical higher education students. Scientific Reports. 2025;15:45471. https://doi.org/10.1038/s41598-025-29000-7
- Kong Y, Dong R, Zhang H. Classroom behavior analysis and digital teaching quality evaluation based on spatiotemporal graph neural network. Discover Artificial Intelligence. 2025;5:404. https://doi.org/10.1007/s44163-025-00623-z
- Zedan F, Jabali RR, Raiyn J. Detecting student inattention using deep learning and behavioral analysis. Journal of International Education Practice. 2026;9(1):1-17.
- Feng F. Deep learning-based model for analyzing student engagement in activities. Scientific Reports. 2025;16:2552. https://doi.org/10.1038/s41598-025-32521-w
- Turkmenbayev A, et al. The application of machine learning in predicting student performance in university engineering programs: A rapid review. Frontiers in Education. 2025;10:1562586. https://doi.org/10.3389/feduc.2025.1562586
- Albreiki B, Zaki N, Alashwal H. A systematic literature review of student performance prediction using machine learning techniques. Education Sciences. 2021;11(9):552. https://doi.org/10.3390/educsci11090552
- Lai Q. Research on the refinement of college student education management based on artificial intelligence. Discover Artificial Intelligence. 2026;6:31. https://doi.org/10.1007/s44163-025-00651-9
- Yuanyuan L, et al. Research on the application framework of intelligent technologies to promote teachers' classroom teaching behavior evaluation. Frontiers of Education in China. 2023;18(1):12–35. https://doi.org/10.3868/s110-008-023-0012-8
- Shi Y, Sun F, Zuo H, Peng F. Analysis of learning behavior characteristics and prediction of learning effect for improving college students' information literacy based on machine learning. IEEE Access. 2023;11:50447-50461.
- Liu S, Zhang J, Su W. An improved method of identifying learner's behaviors based on deep learning. Journal of Supercomputing. 2022;78(10):12861-12872.
- Yang J. Accurate prediction and analysis of college students' performance from online learning behavior data. IEIE Transactions on Smart Processing and Computing. 2023;12(3):404-411.
- Xie Y, Zhang S, Liu Y. Abnormal behavior recognition in classroom pose estimation of college students based on spatiotemporal representation learning. Traitement du Signal. 2021;38(6):1769-1778.
- Shen X, Yuan C. A college student behavior analysis and management method based on machine learning technology. Wireless Communications and Mobile Computing. 2021;2021:6611630. https://doi.org/10.1155/2021/6611630
- Li G, et al. A convolutional neural network-based approach for the recognition and evaluation of classroom teaching behavior. Scientific Programming. 2021;2021:5513886. https://doi.org/10.1155/2021/5513886
- Feng C, et al. IMRMB-Net: A lightweight student behavior recognition model for complex classroom scenarios. PLoS ONE. 2025;20(2):e0318817. https://doi.org/10.1371/journal.pone.0318817
- Zhang Y, Liu T, Ru B. Effect evaluation and student behavior design method of moral education in colleges and universities under the environment of deep learning. Scientific Programming. 2022;2022:6056117. https://doi.org/10.1155/2022/6056117
- Liu C, Wang H, Yuan Z. A method for predicting the academic performances of college students based on education system data. Mathematics. 2022;10(19):3737. https://doi.org/10.3390/math10193737
- Vora DR, Iyer KR. Deep learning in engineering education: performance prediction using cuckoo-based hybrid classification. In: Machine Learning and Deep Learning in Real-Time Applications. Studies in Computational Intelligence, Vol. 841, pp. 187-218. Springer; Singapore; 2020.
- Li H, Liu Z. An intelligent educational system: analyzing student behavior and academic performance using multi-source data. Electronics. 2024;14(16):3328. https://doi.org/10.3390/electronics14163328
- Zhang Y, Li J. Deep learning-based model for predicting student learning behavior: a pathway to early intervention and enhanced outcomes. Journal of Computational Methods in Sciences and Engineering. 2025;25(2):1169-1184.
- Jia Q, He J. Student behavior recognition in classroom based on deep learning. Applied Sciences. 2024;14(18):7981. https://doi.org/10.3390/app14187981
- Luo H. Prediction of student decision-making behaviour based on machine learning algorithms. Pakistan Journal of Life and Social Sciences. 2024;22(2):11045-11058.
- Abdi A, Sedrakyan G, Veldkamp B. Students' feedback analysis model using deep learning-based method and linguistic knowledge for intelligent educational systems. Soft Computing. 2023;27(38):14073-14094.
- Ning X. Behavior recognition of college students based on improved deep learning algorithm. International Journal of Web-Based Learning and Teaching Technologies. 2023;18(1):1-16.
- Sravya MN, Prashanth D, Saifa S, Reddy LS. A comprehensive analysis of learning behaviour characteristics and predictive modeling of learning outcomes to enhance college-level academic performance. International Journal of Pharmacy and Medical Sciences. 2025;5(2):94-100.
- Kalita E, et al. Predicting student academic performance using Bi-LSTM: a deep learning framework with SHAP-based interpretability and statistical validation. Frontiers in Education. 2025;10:1581247. https://doi.org/10.3389/feduc.2025.1581247
- Alias MAH, Hambali N, Aziz MAA. Feature selection techniques and classification algorithms for student performance classification: a review. International Journal of Electrical and Computer Engineering. 2024;14(3):3230-3242.
- Wang Z, et al. Students' classroom behavior detection system incorporating deformable DETR with Swin Transformer and lightweight feature pyramid network. Systems. 2023;11(7):372. https://doi.org/10.3390/systems11070372
- Zou X. Design of student behavior analysis and management system based on deep learning. International Journal of High Speed Electronics and Systems. 2024;33(1):2450005. https://doi.org/10.1142/S012915642450005X
- Zhang Q. The impact of machine learning-based student behaviour detection on teaching in classroom scenarios. Journal of Information and Knowledge Management. 2025;24(1):2450101. https://doi.org/10.1142/S021964922450101X
- Yu C, Wang Y. College student management system based on K-means clustering algorithm. Int J New Dev Educ. 2022;4(2):28-33.
- Chen J, Lu H. Evaluation method of classroom teaching effect under intelligent teaching mode. Mobile Networks and Applications. 2022;27(3):1262-1270.
- Han X, Chen X. The evaluation model of engineering practice teaching with complex network analytic hierarchy process based on deep learning. Scientific Reports. 2025;15:14733. https://doi.org/10.1038/s41598-025-14733-x
- Guo S, et al. The analysis of teaching quality evaluation for college sports dance by convolutional neural network model and deep learning. Heliyon. 2024;10(8):e36067. https://doi.org/10.1016/j.heliyon.2024.e36067
- Gao Y. Deep learning-based strategies for evaluating and enhancing university teaching quality. Computers and Education: Artificial Intelligence. 2025;8:100362. https://doi.org/10.1016/j.caeai.2025.100362
- Li Y, Lu B. Intelligent educational systems based on adaptive learning algorithms and multimodal behavior modeling. PeerJ Computer Science. 2025;11:e3157. https://doi.org/10.7717/peerj-cs.3157
- Geng F, John AD, Chinnappan CV. Analysis of the teaching quality using novel deep learning-based intelligent classroom teaching framework. Progress in Artificial Intelligence. 2023;12(2):147-162.
- Veluri RK, et al. Learning analytics using deep learning techniques for efficiently managing educational institutes. Materials Today: Proceedings. 2022;51(Part 8):2317-2320.
- Chen W, Min L. The evaluation model of physical education teaching performance based on deep learning algorithm. Scalable Computing: Practice and Experience. 2025;26(3):458-466.
- Zhang Y. A comprehensive evaluation system for physical education teaching effectiveness supported by multimodal machine learning. Discover Artificial Intelligence. 2026;6:75. https://doi.org/10.1007/s44163-026-00075-x
- Pei Y, Lu G. Design of an intelligent educational evaluation system using deep learning. IEEE Access. 2023;11:29790-29799.
- Ding J, Su Y. A teaching management system for physical education in colleges and universities using the theory of multiple intelligences and SVM. Soft Computing. 2024;28(2):685-701.
- Li Y, Zhang L, Tian Y, Qi W. Research on teaching practice of blended higher education based on deep learning route. Computational Intelligence and Neuroscience. 2022;2022:5751843. https://doi.org/10.1155/2022/5751843
- Jiang X, Du Y, Zheng Y. Evaluation of physical education teaching effect using Random Forest model under artificial intelligence. Heliyon. 2024;10(1):e23576. https://doi.org/10.1016/j.heliyon.2024.e23576
- Li S, Liu T. Performance prediction for higher education students using deep learning. Complexity. 2021;2021:6620684. https://doi.org/10.1155/2021/6620684
- Alnasyan B, Basheri M, Alassafi MO, Alnasyan K. Kanformer: An Attention-Enhanced Deep Learning Model for Predicting Student Performance in Virtual Learning Environments. Social Network Analysis and Mining. 2025;15:25. https://doi.org/10.1007/s13278-025-01446-7
- Lu Y, Tong L, Cheng Y. Advanced Knowledge Tracing: Incorporating Process Data and Curricula Information via an Attention-Based Framework for Accuracy and Interpretability. Journal of Educational Data Mining. 2024;16(2):58-84.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.