Dit protocol beschrijft een deep learning-workflow voor semantische segmentatie, reconstructie en artistieke stijlsynthese van patronen uit immaterieel cultureel erfgoed, gebruikmakend van transformer-gebaseerde kenmerkextractie, adversariële reconstructie en ruimtelijk adaptieve beeldgeneratie ter ondersteuning van digitale preservering en creatieve erfgoedtoepassingen.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Reconstructie en artistieke stijlsynthese van patronen van immaterieel cultureel erfgoed, gestuurd door semantische segmentatie, met behulp van een deep learning-framework
In dit artikel
Samenvatting
Samenvatting
De digitale preservatie en reconstructie van patronen van immaterieel cultureel erfgoed (ICE) hebben toenemende aandacht gekregen door de vooruitgang in beeldsynthesetechnieken op basis van deep learning. Bestaande benaderingen op basis van SegCycle-SPADE hebben potentieel getoond voor de structurele segmentatie en artistieke reconstructie van traditionele ambachtelijke patronen; er blijven echter beperkingen bestaan, waaronder een beperkte diversiteit van datasets, onvoldoende integratie van culturele semantiek en inadequate preservatie van structurele patrooneigenschappen tijdens de reconstructie. Om deze uitdagingen aan te pakken, stelt deze studie een verbeterd SegCycle-SPADE-raamwerk voor voor de semantische segmentatie en artistieke reconstructie van ICE-patroontypen. Een Transformer-gebaseerd segmentatiemodel, SegFormer, wordt ingezet om motiefgrenzen en patroonregio's nauwkeurig te identificeren. Daarnaast wordt een Cross-Attention Cultural Feature Fusion Module geïntroduceerd om cultureel significante motieven te versterken en de kenmerkrepresentatie te verbeteren. Patroontranslatie en reconstructie worden uitgevoerd met CycleGAN, terwijl Spatially-Adaptive Denormalization (SPADE) wordt gebruikt voor artistieke stylesynthese om de semantische consistentie tussen segmentatiekaarten en gegenereerde beelden te behouden. Om de generalisatie van het model en de artistieke diversiteit te verbeteren, is het raamwerk getraind met zowel de Miao Batik culturele motiefdataset als de WikiArt-dataset. Experimentele resultaten tonen aan dat het voorgestelde attention-guided SegCycle-SPADE-raamwerk de segmentatienauwkeurigheid en de prestaties bij de reconstructie van erfgoedpatronen verbetert in vergelijking met bestaande reconstructiemethoden op basis van generative adversarial networks (GAN). Het voorgestelde raamwerk biedt een schaalbare oplossing voor door kunstmatige intelligentie ondersteunde documentatie van cultureel erfgoed, reconstructie en artistieke revitalisering van traditionele patroonontwerpen.
Inleiding
Cultureel erfgoed, dat zowel immateriële elementen zoals gewoonten, talen en overtuigingen, als materiële elementen zoals kunstwerken, gebouwen en geschreven verslagen omvat, is een fundamentele manifestatie van de menselijke geschiedenis, creativiteit en identiteit1. Het behoud van erfgoed streeft ernaar gemeenschappen in staat te stellen opnieuw contact te leggen met hun oorsprong en stelt toekomstige generaties in staat om te profiteren van hun collectieve culturele geheugen. Het bevordert daarnaast intercultureel begrip, waardering voor diverse tradities en gewoonten, en erkenning van verschillende historische narratieven. Deze culturele activa helpen ons de waarden, perspectieven en ervaringen van vorige generaties te begrijpen en dragen bij aan de vorming van hedendaagse sociale identiteiten en culturele continuïteit. De basisprincipes van het behoud van cultureel erfgoed worden geïllustreerd in Figuur 1.
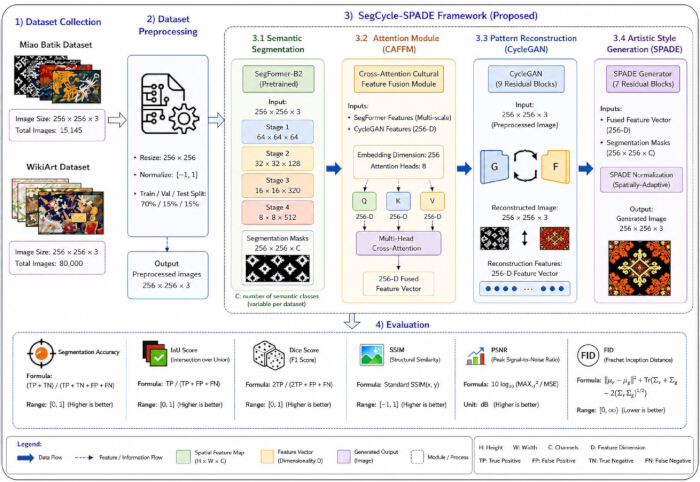
Figuur 1. Conceptueel overzicht van de reconstructie van culturele erfgoedpatronen met behulp van het SegCycle-SPADE-framework. Schematische illustratie van de voorgestelde aanpak voor het reconstrueren en verbeteren van patronen van immaterieel cultureel erfgoed. De workflow omvat datasetverzameling uit de Miao Batik- en WikiArt-datasets, beeldbewerking (preprocessing), semantische segmentatie met SegFormer-B2, feature-fusie met de Cross-Attention Cultural Feature Fusion Module (CAFFM), patroonreconstructie met CycleGAN, artistieke stylesynthese met SPADE en een uiteindelijke evaluatie met segmentatie- en reconstructiemetrieken. De pijlen geven de stroom van gegevens en feature-representaties binnen het framework aan. Klik hier om een grotere versie van deze figuur te bekijken.
Het collectieve geheugen en het culturele erfgoed van de menselijke samenleving zijn belichaamd in immaterieel cultureel erfgoed (ICE), dat dient als een belangrijk medium voor artistieke expressie en culturele identiteit. ICE staat echter voor aanzienlijke uitdagingen door de effecten van globalisering en digitalisering2,3,4. Veel bedreigde ICE-praktijken vereisen nieuwe benaderingen voor behoud en ontwikkeling vanwege het afnemende aantal vakbekwame ambachtslieden en de beperkte aanpassingscapaciteit aan moderne markten5,6. Als een belangrijk onderzoeksgebied binnen ICE legt duurzaam ontwerp de nadruk op de geïntegreerde ontwikkeling van cultuur, samenleving en milieu, en biedt het een praktisch pad voor het voortdurende behoud van ICE. Door middel van duurzame ontwerpbenaderingen kan ICE worden gerevitaliseerd terwijl het zich aanpast aan de behoeften van de hedendaagse samenleving7,8.
In deze studie verwijst de term “patronen van immaterieel cultureel erfgoed” naar visuele motiefrepresentaties die onderliggende immateriële culturele waarden communiceren en bewaren. Bijgevolg is het voorgestelde raamwerk erop gericht de culturele informatie die aan deze motieven is gekoppeld te bewaren en te documenteren, terwijl hun visuele vormen worden gereconstrueerd.
Miao-borduurwerk en batik zijn belangrijke vormen van Chinees immaterieel cultureel erfgoed (ICH) en weerspiegelen de geschiedenis, overtuigingen en tradities van de Miao-gemeenschap via symbolische motieven zoals vogels, vlinders en voorouderlijke totems9. Deze motieven zijn diep verankerd in rituele kleding en festivalpraktijken en dragen bij aan de lokale culturele en economische ontwikkeling10,11. Vooruitgang in digitale technologieën, in het bijzonder kunstmatige intelligentie (AI) en deep learning (DL), heeft nieuwe mogelijkheden gecreëerd voor het behoud, de analyse, de reconstructie en de documentatie van cultureel erfgoed. Guizhou Miao-batik, een van de best bewaard gebleven batiktradities in China, dient als een belangrijk medium voor het overdragen van de culturele kennis, overtuigingen, gewoonten en rituelen van het Miao-volk12,13,14,15,16.
Recente studies hebben het potentieel van DL aangetoond voor het behoud van cultureel erfgoed en patroonreconstructie, waarbij een verbeterde segmentatienauwkeurigheid (pixelnauwkeurigheid = 88,6%, gemiddelde intersection over union [IoU] = 78,1%) en reconstructieprestaties werden behaald in vergelijking met U-Net en DeepLabV3+1. Er blijven echter verschillende uitdagingen bestaan. Bestaande benaderingen op basis van generative adversarial networks (GAN) hebben vaak moeite om fijne structurele details in complexe patronen te behouden17, terwijl een beperkte diversiteit in datasets de generalisatie van modellen over culturele domeinen heen beperkt18. Daarnaast kunnen image-to-image vertaalmodellen zoals CycleGAN erin falen om de semantische consistentie tussen segmentatiekaarten en gegenereerde beelden te handhaven19, en het ontbreken van attention-mechanismen kan leiden tot het verlies van cultureel significante motiefdetails tijdens de reconstructie20. Daarom is een verbeterd framework nodig dat transformer-gebaseerde segmentatie, attention-gestuurd feature-leren en training met meerdere datasets integreert voor effectieve reconstructie van ICH-patronen.
Nieuwe mogelijkheden voor het behoud van cultureel erfgoed zijn ontstaan door de digitalisering van Miao-borduurwerk en de snelle vooruitgang van generatieve AI. Diffusiemodellen, een opkomende klasse van diepe generatieve modellen, hebben opmerkelijke prestaties getoond bij computervisietaken dankzij hun krachtige capaciteiten voor contentgeneratie21,22,23,24,25. Tijdens het omgekeerde diffusieproces leert het model geleidelijk om de oorspronkelijke invoergegevens te reconstrueren vanuit ruisige representaties26,27,28. Eerdere studies hebben ook de toepassing van driedimensionale reconstructie en computer-aided design (CAD)-technologieën onderzocht voor het behoud en de verspreiding van cultureel erfgoed.
Hoewel convolutionele neurale netwerken (CNN's) en GAN's goed presteren bij beeldgeneratie en het behoud van kenmerken, kampen ze nog steeds met uitdagingen met betrekking tot beperkte receptieve velden, mode collapse en trainingsinstabiliteit29. Transformer-gebaseerde architecturen, zoals SegFormer en Segmenter, zijn uitstekend in het vastleggen van globale context en semantische relaties; ze zijn echter rekenintensief en kunnen moeite hebben met fijnmazige details. Hoewel diffusiemodellen zoals Stable Diffusion sterke mogelijkheden voor beeldgeneratie tonen, missen ze vaak een precieze controle over de structurele en artistieke kenmerken van de gegenereerde ontwerpen. Bovendien maken de meeste bestaande benaderingen gebruik van onafhankelijke trainingsstrategieën die de effectieve informatie-uitwisseling en collaboratieve optimalisatie tussen segmentatie- en generatiecomponenten beperken, wat resulteert in een compromis tussen structurele nauwkeurigheid en artistieke authenticiteit30.
Recente diffusiemodellen, zoals latent diffusion en Stable Diffusion, bereiken hoogwaardige beeldsynthese maar vereisen iteratieve ruisonderdrukking, wat leidt tot verhoogde computationele kosten en inferentietijd. Bovendien blijft het behoud van fijne culturele motieven en structurele consistentie uitdagend zonder gespecialiseerde conditioneringsmechanismen. Generatieve modellen op basis van transformers leggen globale contextuele relaties effectief vast, maar vereisen vaak grootschalige datasets en aanzienlijke computationele middelen. In tegenstelling hiermee combineert het voorgestelde SegCycle-Spatially Adaptive Denormalization (SegCycle-SPADE) framework SegFormer-gebaseerde segmentatie, cross-attention featurefusie, CycleGAN-reconstructie en SPADE-gestuurde synthese om expliciete structurele begeleiding te bieden, waardoor het behoud van motieven, de semantische consistentie en de controleerbare reconstructie van culturele erfgoedpatronen worden verbeterd.
De meeste geavanceerde technieken voor semantische segmentatie maken gebruik van fully CNNs (FCNNs) met U-vormige architecturen31. Tijdens de encoderingsfase worden diepe kenmerken met grote receptieve velden geëxtraheerd via een reeks convolutie- en downsampling-operaties. De decoderingsfase herstelt progressief de ruimtelijke resolutie door upsampling, wat uiteindelijk semantische voorspelling op pixelniveau mogelijk maakt. Door het verlies aan ruimtelijke informatie tijdens downsampling te compenseren en de segmentatieprestaties in een breed scala aan toepassingen te verbeteren, maken skip-verbindingen het mogelijk om resolutie-informatie van verschillende encoder-niveaus direct in de decoder te integreren32.
Hoewel recente methoden op basis van GAN, CNN en diffusie veelbelovende resultaten hebben laten zien bij beeldgeneratie en het herstel van cultureel erfgoed, hebben zij vaak moeite om de semantische consistentie te behouden, fijne structurele motieven te bewaren en een reproduceerbare reconstructie over diverse culturele patronen te garanderen. De meeste bestaande benaderingen behandelen segmentatie, reconstructie en stijlsynthese als afzonderlijke processen, wat kan leiden tot het verlies van cultureel significante elementen en inconsistente resultaten. Om dit methodologische tekort aan te pakken, stelt deze studie een unified SegCycle-SPADE-framework voor dat SegFormer-gebaseerde semantische segmentatie, een nieuwe Cross-Attention Cultural Feature Fusion Module (CAFFM), CycleGAN-gebaseerde reconstructie en SPADE-gestuurde stijlsynthese integreert. Door structurele segmentatie-informatie expliciet te integreren met generatief kenleren, maakt het voorgestelde framework een betrouwbaardere, semantisch consistente en reproduceerbare reconstructie van ICH-motieven mogelijk, terwijl zowel de culturele authenticiteit als de artistieke kwaliteit behouden blijven.
In dit onderzoek worden drie belangrijke beperkingen van huidige benaderingen voor de reconstructie van cultureel erfgoed geïdentificeerd: (i) onvoldoende behoud van fijne structurele motieven in GAN-gebaseerde reconstructiemethoden; (ii) beperkte generalisatie als gevolg van training op kleine of domeinspecifieke datasets; en (iii) ontoereikende semantische consistentie tussen segmentatie-outputs en gegenereerde beelden in image-to-image translatiekaders. Daarnaast worden segmentatie, reconstructie en stijlsynthese gewoonlijk als afzonderlijke processen behandeld, wat leidt tot het verlies van cultureel belangrijke elementen tijdens de reconstructie. Door transformer-gebaseerde semantische segmentatie, cross-attention feature fusion, CycleGAN-reconstructie en SPADE-gestuurde artistieke synthese te combineren binnen één enkele architectuur, pakt het voorgestelde SegCycle-SPADE-raamwerk deze beperkingen aan en verbetert het het behoud van motieven, de semantische consistentie en de artistieke authenticiteit bij de reconstructie van ICH-patronen.
Het hoofddoel van deze studie is het ontwikkelen van een verbeterd SegCycle-SPADE-raamwerk voor semantische segmentatie-gestuurde artistieke reconstructie van ICH-patronen. Het raamwerk integreert SegFormer voor nauwkeurige segmentatie van culturele motieven, CycleGAN voor patroonreconstructie en SPADE voor stijlconsistente artistieke synthese. Om de kenmerkrepresentatie te verbeteren en fijne structurele details te behouden, is een CAFFM geïntroduceerd om een effectieve interactie tussen segmentatie- en generatieve kenmerken te faciliteren. Het voorgestelde raamwerk, getraind op de Miao Batik- en WikiArt-datasets, verbetert de authenticiteit van de reconstructie, de stijlconsistentie en het behoud van cultureel significante motieven.
Door semantische segmentatie, aandachtgestuurde kenfusie, patroonreconstructie en stijlsynthese te combineren binnen een uniforme architectuur, presenteert deze studie een nieuw SegCycle-SPADE-raamwerk voor de artistieke reconstructie van immaterieel cultureel erfgoed (ICH)-patronen. De belangrijkste bijdragen van dit werk zijn als volgt. Ten eerste is er een nieuw, door semantische segmentatie gestuurd reconstructieraamwerk ontwikkeld via de integratie van SegFormer, waardoor de nauwkeurige extractie en bewaring van complexe culturele motieven en structurele elementen mogelijk wordt. Ten tweede is er een nieuwe CAFFM geïntroduceerd om segmentatiekenmerken effectief te fuseren met generatieve representaties, waardoor het model in staat is om langeafstandsrelaties tussen culturele motieven en artistieke stijlpatronen vast te leggen. Ten derde verbetert de voorgestelde CAFFM het behoud van cultureel significante elementen, terwijl het visuele realisme en de structurele coherentie van de gereconstrueerde erfgoedpatronen worden verbeterd. Ten vierde, door CycleGAN voor de reconstructie van culturele patronen en SPADE voor segmentatiegestuurde artistieke synthese te integreren, waarborgt het raamwerk zowel semantische nauwkeurigheid als stilistische authenticiteit in de gegenereerde resultaten. Vijfde, om de generalisatie en artistieke diversiteit te verbeteren, is het model getraind met behulp van de Miao Batik-dataset voor culturele motieven voor het leren van culturele patronen en de WikiArt-dataset voor artistieke stijlrepresentatie. WikiArt dient als een hulpdataset om het generalisatievermogen, de robuustheid van het kenleerproces en de effectiviteit van de stijlbeheersing van het raamwerk te evalueren over diverse visuele contexten, in plaats van als een doelstijl voor directe toepassing in Miao-culturele erfgoedproducten. Ten slotte tonen experimentele resultaten aan dat het voorgestelde SegCycle-SPADE-raamwerk, in vergelijking met bestaande GAN-gebaseerde methoden voor de reconstructie van cultureel erfgoed, een verbeterde segmentatienauwkeurigheid, reconstructiekwaliteit en stilistische consistentie bereikt.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Het voorgestelde raamwerk van SegCycle-SPADE is ontworpen om traditionele culturele erfgoedpatronen te reconstrueren en te verbeteren via semantische segmentatie, kenmerkverbetering met behulp van attention, generatieve reconstructie en artistieke stijlsynthese. Deze studie maakte gebruik van openbaar beschikbare datasets van cultureel erfgoed en artistieke beelden, waaronder de Miao Batik-dataset en de WikiArt-dataset. Er waren geen menselijke deelnemers, patiëntgegevens, persoonlijke informatie, dierproeven of klinische dossiers betrokken bij het onderzoek; daarom waren goedkeuring van een institutionele ethische commissie en geïnformeerde toestemming niet vereist. Om te beginnen worden de Miao Batik culturele motieven-dataset en de WikiArt-dataset gebruikt voor de evaluatie. De Miao Batik-dataset werd beschreven in Quan et al. (2024)32 en bevat 15.148 geannoteerde afbeeldingen van traditionele Miao batik-motieven. Bestaande annotaties verstrekt door de makers van de dataset werden direct gebruikt, en er werden geen aanvullende handmatige annotaties gegenereerd in deze studie. Vervolgens wordt de voorbewerking van de beelden uitgevoerd door middel van herschalen, normaliseren, ruisonderdrukking en het maken van een segmentatiemasker. De exacte parameters voor voorbewerking worden beschreven in de paragraaf Data Preprocessing. Het voorgestelde raamwerk maakt gebruik van een transformer-gebaseerd model genaamd SegFormer-B2 voor de semantische segmentatie van de data. De methode is ontworpen om sleutelregio's van culturele motieven te detecteren en hun structuren te leren. De gesegmenteerde kenmerken worden vervolgens verbeterd via een attention-mechanisme, waarbij belangrijke informatie gerelateerd aan culturele motieven wordt benadrukt en irrelevante informatie wordt verworpen. De configuratie van het attention-mechanisme wordt beschreven in de paragraaf CAFFM. De verbeterde kenmerken worden vervolgens door CycleGAN geleid, waarbij beschadigde structuren worden gereconstrueerd via cyclisch leren. Tijdens de training werden onvolledige motiefmonsters kunstmatig gecreëerd door willekeurige masking- en gedeeltelijke occlusie-operaties toe te passen op de originele Miao Batik-afbeeldingen. Deze degradatieprocedures simuleerden ontbrekende motiefregio's en structurele schade die vaak worden waargenomen in verslechterde culturele erfgoedartefacten. De resulterende onvolledige beelden werden gebruikt als inputs voor de CycleGAN-reconstructiemodule, terwijl de overeenkomstige originele beelden dienden als reconstructiedoelen. De gereconstrueerde culturele erfgoedpatronen worden vervolgens verbeterd via SPADE, waarbij artistieke verbetering wordt uitgevoerd op basis van de gegenereerde segmentatiekaarten. De prestaties van het voorgestelde raamwerk worden geëvalueerd met behulp van kwantitatieve segmentatie- en beeldkwaliteitsmetrieken, terwijl de visuele authenticiteit van de gereconstrueerde culturele motieven kwalitatief wordt beoordeeld. Visuele authenticiteit werd beoordeeld via visuele inspectie van de gegenereerde culturele patronen en werd niet gebruikt als een onafhankelijke kwantitatieve metriek. De beoordeling richtte zich op motiefbehoud, semantische consistentie, culturele kenmerken, structurele coherentie en artistiek uiterlijk ten opzichte van de overeenkomstige referentie-culturele motieven. Kwantitatieve evaluatie van de modelprestaties werd uitgevoerd met behulp van Segmentation Accuracy, IoU, Dice Coefficient, Structural Similarity Index Measure (SSIM), Peak Signal-to-Noise Ratio (PSNR) en Fréchet Inception Distance (FID). Afbeelding 2 illustreert de algehele workflow van het voorgestelde SegCycle-SPADE raamwerk en vat de evaluatiemetrieken samen die in deze studie zijn gebruikt.
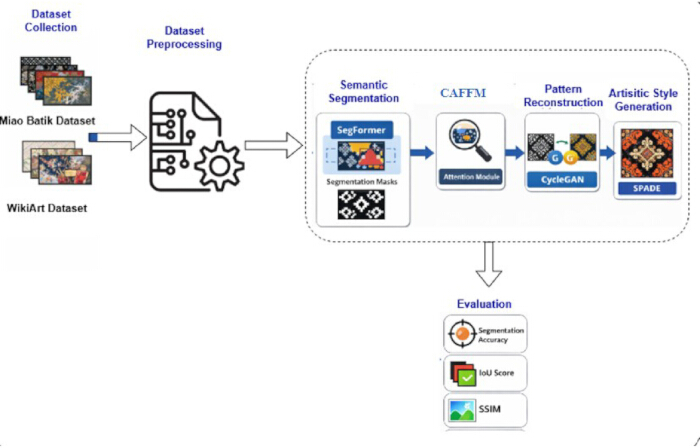
Figuur 2. Algemene Architectuur Workflow van het Voorgestelde SegCycle-SPADE Framework. Overzicht van de volledige SegCycle-SPADE workflow. Afbeeldingen uit de Miao Batik- en WikiArt-datasets ondergaan voorbehandeling voordat ze worden verwerkt via semantische segmentatie met SegFormer-B2, kenmerkverbetering met de CAFFM, patroonreconstructie met CycleGAN en artistieke stijlgeneratie met SPADE. De modelprestaties worden geëvalueerd met behulp van Segmentation Accuracy, Intersection over Union (IoU), Dice Coefficient, Structural Similarity Index Measure (SSIM), PSNR en Fréchet Inception Distance (FID), terwijl de visuele authenticiteit kwalitatief wordt beoordeeld. Klik hier om een grotere versie van deze figuur te bekijken.
Het SegCycle-SPADE-framework voor de reconstructie van patronen in cultureel erfgoed is ontworpen om meerdere DL-componenten te integreren voor nauwkeurige segmentatie, reconstructie en artistieke verbetering van motieven, zoals geïllustreerd in Figuur 2. Afbeeldingen uit de Miao Batik-dataset voor culturele motieven en de WikiArt-dataset worden gebruikt om diverse culturele patronen en artistieke stijlen te bieden. Aanvankelijk worden de afbeeldingen verwerkt met een op SegFormer gebaseerde semantische segmentatiemodule om culturele motieven te identificeren en af te bakenen van de achtergrond. De totale architectuur bestaat uit vier hoofdfasen. Ten eerste extraheert het SegFormer-model semantische segmentatiekaarten uit de afbeeldingen van de culturele patronen. Ten tweede integreert de CAFFM segmentatiekenmerken met generatieve representaties om het kenleren te verbeteren. Ten derde reconstrueert de CycleGAN-module culturele patronen met behulp van de gefuseerde kenmerkrepresentaties. Ten slotte genereert de SPADE-module stilistisch verbeterde resultaten, terwijl de structurele consistentie behouden blijft door middel van segmentatiegestuurde synthese. De verfijnde kenmerkkaarten worden vervolgens verwerkt door de CycleGAN-reconstructiemodule, die leert om onvolledige culturele motieven te herstellen door gedegradeerde patronen in kaart te brengen op hun overeenkomstige volledige vormen. Onvolledige motieven zijn gegenereerd door willekeurige maskering en partiële occlusie-operaties toe te passen op de originele Miao Batik-afbeeldingen, waardoor ontbrekende patroonregio's en structurele degradatie worden gesimuleerd zoals die vaak worden waargenomen in beschadigde culturele artefacten. Elke gedegradeerde afbeelding werd gekoppeld aan de overeenkomstige originele afbeelding, die diende als het reconstructiedoel tijdens de training. Deze strategie stelde de CycleGAN-module in staat om het herstel van ontbrekende motiefstructuren te leren, terwijl de semantische consistentie en cultureel significante kenmerken behouden bleven. Ten slotte produceert de SPADE-generator visueel verbeterde artistieke resultaten door de beeldsynthese afhankelijk te maken van de gegenereerde segmentatiekaarten, waardoor de structurele integriteit van de culturele motieven tijdens het proces van artistieke verbetering behouden blijft.
De volgende stappen maken deel uit van het voorgestelde SegCycle-SPADE-raamwerk.
Stap 1: Datasetverzameling
Twee datasets werden gebruikt om de doelstellingen van het leren van culturele patronen en het genereren van artistieke stijlen te bereiken. De Miao Batik Cultural Motif Dataset werd gebruikt om informatie over traditionele culturele patronen te verschaffen. De dataset is publiekelijk toegankelijk via Zenodo (https://doi.org/10.5281/zenodo.20807658) en bevat 15.148 geannoteerde afbeeldingen van traditionele Miao-batikmotieven. De bestaande annotaties die door de makers van de dataset werden verstrekt, werden direct gebruikt; in deze studie werden geen aanvullende handmatige annotaties gegenereerd. De WikiArt-dataset werd gebruikt om diverse artistieke stijlinformatie te verschaffen voor het genereren van artistieke stijlen en werd verkregen uit de publiekelijk toegankelijke WikiArt-repository (https://www.wikiart.org/).
Stap 2: Voorbewerking van gegevens
Alle afbeeldingen werden voorbewerkt door middel van schalen, normalisatie en ruisonderdrukking. Bestaande annotaties van culturele motieven, verkregen uit de originele datasetbronnen, werden gebruikt ter ondersteuning van de fase van semantische segmentatie. In het kader van deze studie zijn geen aanvullende annotatie- of heretiketteringsprocedures uitgevoerd.
Stap 3: Semantische patroonsegmentatie met behulp van SegFormer
Het SegFormer-model werd gebruikt voor de segmentatie van culturele motieven. De exacte SegFormer-backbone en de initialisatiestrategie worden beschreven in de subsectie Semantic Pattern Segmentation Using SegFormer. In het bijzonder werd de SegFormer-B2-architectuur met een ImageNet-voorgetrainde MIT-B2-backbone ingezet voor de semantische motiefsegmentatie. Dit model legt effectief globale contextuele informatie vast terwijl de complexe structurele details van traditionele culturele patronen behouden blijven.
Stap 4: CAFFM
De CAFFM combineert kenmerken van semantische segmentatie met generatieve representaties, waardoor het framework zowel de kenmerken van structurele motieven als informatie over de artistieke stijl kan leren. Details over de integratie van CAFFM worden gegeven in de subsectie CAFFM. De module bevindt zich tussen de op SegFormer gebaseerde fase van semantische segmentatie en de fase van generatieve reconstructie, waar het via multi-head cross-attention segmentatie-afgeleide structurele kenmerken fuseert met reconstructiekenmerken. Dit proces verbetert het behoud van culturele motieven en verhoogt het realisme van de gereconstrueerde resultaten.
Stap 5: Patroonreconstructie (CycleGAN)
De gefuseerde kenmerken worden vervolgens verwerkt door de CycleGAN-module om culturele patroonstructuren te reconstrueren. De CycleGAN-architectuur en de trainingsconfiguratie worden beschreven in de subsectie Pattern Reconstruction Using CycleGAN. De reconstructiemodule bestaat uit twee generatoren en twee discriminatoren, maakt gebruik van een residual-network generator-architectuur met negen residual blocks, hanteert een PatchGAN-discriminator en wordt getraind met behulp van adversarial en cycle-consistency losses. Deze configuratie maakt bidirectionele domeinmapping mogelijk en faciliteert de reconstructie van onvolledige culturele patroonstructuren.
Stap 6: Genereren van artistieke stijl (SPADE)
De gereconstrueerde patronen worden vervolgens verwerkt via de SPADE-module om segmentatie-gestuurde artistieke stijlsynthese uit te voeren. De configuratie van de SPADE-generator wordt beschreven in de subsectie Artistic Style Generation Using SPADE. De module maakt gebruik van SPADE-residuele blokken, ruimtelijk adaptieve normalisatielagen en semantische conditionering afgeleid van SegFormer-segmentatiekaarten en CAFFM-kenmerkrepresentaties. Door de beeldgeneratie te conditioneren op segmentatiekaarten, behouden de gesynthetiseerde resultaten de structurele uitlijning met de oorspronkelijke culturele motieven, terwijl ze artistieke stijlkenmerken integreren.
Stap 7: Prestatieschatting
Het voorgestelde raamwerk is geëvalueerd met behulp van meerdere metrieken voor segmentatie en beeldkwaliteitsbeoordeling, waaronder segmentatienauwkeurigheid, IoU, Dice Similarity Coefficient (Dice), SSIM, PSNR en FID. Om de experimentele consistentie te beoordelen, zijn alle experimenten vijf keer herhaald met verschillende willekeurige seeds, en worden de resultaten gerapporteerd als gemiddelde ± standaarddeviatie. Statistische significantie is geëvalueerd met gepaarde t-toetsen, met een significantiedrempel van p < 0,05.
Datasetverzameling
In het voorgestelde SegCycle-SPADE-framework worden twee datasets gebruikt voor het begrijpen van culturele patronen en het aanleren van stijlen. De eerste dataset die in het voorgestelde framework wordt gebruikt, is de Miao Batik culturele motieven-dataset. Deze dataset bevat culturele motieven van Miao Batik; dit zijn over het algemeen afbeeldingen van traditionele Miao Batik met motieven zoals dieren, planten en geometrische vormen, die worden gebruikt in de kunst van de Miao-etniciteit. Deze dataset bevat afbeeldingen met rijke textuurinformatie, wat doorgaans essentieel is voor het behoud van cultureel erfgoed. De tweede dataset die in het voorgestelde SegCycle-SPADE-framework wordt gebruikt, is de WikiArt-dataset. Deze dataset bevat een groot aantal kunstwerken, die over het algemeen uit verschillende stijlen komen. Deze dataset wordt gebruikt voor complex stijlanleren, wat doorgaans nuttig is voor het verbeteren van kunstwerken. Deze dataset bevat 80.000 kunstwerken in HD, met 27 verschillende ontwerpen, waardoor deze geschikter is voor DL-gebaseerde taken voor stijlgeneratie of -transformatie.
Miao Batik Dataset:
De Miao Batik-dataset (https://doi.org/10.5281/zenodo.20807658) bestaat uit 15.148 afbeeldingen van batikpatronen met cultureel significante motieven. De afbeeldingen bevatten diverse traditionele ontwerpen, zoals dierlijke motieven (bijv. vlinders en vissen), plantgebaseerde patronen en geometrische motieven met culturele symboliek. Deze dataset is een essentieel onderdeel van het voorgestelde raamwerk, omdat het authentieke culturele structuren biedt die de segmentatiemodule in staat stellen om motiefgrenzen nauwkeurig te identificeren en te behouden tijdens de patroonreconstructie (Tabel 1). In deze studie verwijzen cultureel belangrijke motieven naar symbolische visuele elementen die algemeen gedocumenteerd zijn in de literatuur over het culturele erfgoed van de Miao en vertegenwoordigd zijn in de annotaties van de dataset, waaronder vogels, vlinders, bloemmotieven en voorouderlijke totems. Deze motieven zijn geselecteerd op basis van hun gedocumenteerde culturele betekenis en hun terugkerende aanwezigheid in traditionele Miao-batik- en borduurontwerpen, in plaats van enkel op basis van hun frequentie of ruimtelijke compositie. De door experts begeleide motiefannotaties en segmentatielabels zijn verkregen uit de oorspronkelijke bron van de Miao Batik-dataset en zijn direct in deze studie gebruikt. De auteurs hebben geen aanvullende handmatige annotaties, heretikettering of door experts begeleide annotatieprocedures uitgevoerd. De bestaande annotaties die door de makers van de dataset werden verstrekt, zijn gebruikt voor de training en evaluatie van de semantische segmentatie.
| Parameter | Beschrijving |
| Naam van de dataset | Dataset van culturele patronen van Miao-batik |
| Bron van de dataset | Zenodo Repository (DOI: 10.5281/zenodo.20807658) |
| Domein | Immaterieel Cultureel Erfgoed (ICE) / Analyse van textielpatronen |
| Totaal aantal afbeeldingen | 15.148 afbeeldingen |
| Afbeeldingstype | Digitale afbeeldingen van traditionele Miao-batiktextielpatronen |
| Patrooncategorieën | Dierlijke motieven, plantaardige motieven en geometrische motieven |
| Culturele oorsprong | Miao-etnische cultuur, provincie Guizhou, China |
| Originele afbeeldingsresolutie | Hoge-resolutiebeelden (doorgaans ≥ 1.000 pixels aan de kortste zijde), vastgelegd als ruwe scans of foto's voorafgaand aan de voorbewerking |
| Trainingsresolutie | Afbeeldingen tijdens de voorbewerking aangepast naar 256 × 256 pixels |
| Beschikbaarheid van annotaties | Bestaande segmentatie-annotaties, verstrekt door de makers van de dataset, werden zonder wijzigingen gebruikt voor training en evaluatie. In deze studie zijn geen aanvullende handmatige annotaties, herlabeling of procedures voor expertbevestiging uitgevoerd. |
| Toepassing in deze studie | Segmentatie van culturele motieven, kenmerkextractie, behoud van motieven en patroonreconstructie |
Tabel 1: Kenmerken van de Miao Batik culturele patroondataset. Samenvatting van de Miao Batik culturele motiefdataset gebruikt voor semantische segmentatie, culturele patroonanalyse en motiefreconstructie. De tabel beschrijft de bron van de dataset, beeldkenmerken, motievcategorieën, culturele oorsprong, beeldresolutie en de rol ervan binnen het voorgestelde SegCycle-SPADE framework.
WikiArt-dataset:
De WikiArt-dataset [https://www.wikiart.org/] is een populaire grootschalige digitale kunstrepository die meer dan 80.000 afbeeldingen bevat uit 27 verschillende artistieke stijlen in Tabel 2. De stijlen omvatten renaissancekunst, impressionisme, kubisme en surrealisme. De dataset is zeer belangrijk in het voorgestelde raamwerk, aangezien deze kennis biedt waarmee de SPADE-module cultureel verrijkte patronen kan creëren terwijl de structurele informatie uit het segmentatieproces behouden blijft. De dataset bestaat uit 56.000 afbeeldingen voor training en 12.000 afbeeldingen voor zowel validatie als testen. De afbeeldingen in de dataset dragen bij aan een effectieve training van het DL-model.
| Parameter | Beschrijving |
| Naam van de dataset | WikiArt-dataset |
| Bron van de dataset | WikiArt Repository (https://www.wikiart.org/) |
| Domein | Digitale kunst en schilderijen |
| Totaal aantal afbeeldingen | Ongeveer 80.000 kunstwerken |
| Trainingsbeelden | 56,000 |
| Validatiebeelden | 12,000 |
| Testafbeeldingen | 12,000 |
| Artistieke stijlen | 27 artistieke stijlen, waaronder renaissance, impressionisme, kubisme, surrealisme, expressionisme, realisme en abstracte kunst |
| Originele beeldresolutie | De oorspronkelijke beeldresoluties variëren per kunstwerk en bron. Tijdens de voorbewerking zijn de afbeeldingen resized naar een uniforme resolutie van 256 × 256 pixels. |
| Trainingsresolutie | Afbeeldingen zijn tijdens de voorbewerking, voorafgaand aan het leren van de artistieke stijl en de segmentatie-gestuurde beeldsynthese, resized naar 256 × 256 pixels. |
| Datasetpartitionering | G estratificeerde willekeurige partitionering (70% training, 15% validatie en 15% testen) met gebruik van een vast random seed van 42 |
| Stijl-bemonsteringsstrategie | Er werd gebruikgemaakt van gestratificeerde proportionele steekproeftrekking om de distributie van de 27 artistieke stijlen over de trainings-, validatie- en testsets te behouden. |
| Toepassing in deze studie | Artistiek stijlonderzoek, stijlrepresentatie en segmentatiegestuurde artistieke synthese |
Tabel 2: Kenmerken van de WikiArt-dataset. Samenvatting van de WikiArt-dataset die is gebruikt voor het leren van artistieke stijlen en stijlgestuurde beeldsynthese. De tabel beschrijft de bron van de dataset, de beeldverdeling, de dekking van artistieke stijlen, de partitionering van de dataset, de beeldresolutie en de toepassing ervan binnen het voorgestelde SegCycle-SPADE-raamwerk.
De Miao Batik-dataset bevat 15.148 afbeeldingen die traditionele culturele motieven van de Miao vertegenwoordigen.32 De dataset is publiekelijk toegankelijk via Zenodo (https://doi.org/10.5281/zenodo.20807658). Voorafgaand aan de modeltraining werden alle afbeeldingen visueel geïnspecteerd, aangepast naar 256 × 256 pixels, genormaliseerd en gescreend op beschadigde of dubbele monsters. De kwaliteitscontrolescheiding leidde niet tot de uitsluiting van afbeeldingen; daarom werden alle 15.148 afbeeldingen behouden voor de daaropvolgende analyse. De dataset werd willekeurig verdeeld in subsets voor training (70%), validatie (15%) en testen (15%) met gebruik van een vaste random seed van 42 om de reproduceerbaarheid van de datasetverdelingen te waarborgen. De WikiArt-dataset werd geraadpleegd via de officiële WikiArt-repository (https://www.wikiart.org/) en bevat meer dan 80.000 kunstwerken verspreid over 27 artistieke stijlen. Voor de experimenten naar stijlerkenning werden 56.000 afbeeldingen gebruikt voor training, 12.000 voor validatie en 12.000 voor testen.
Preprocessing van gegevens
Voordat het voorgestelde SegCycle-SPADE-framework werd getraind, werden de Miao Batik culturele motief-dataset en de WikiArt-dataset onderworpen aan verschillende preprocessing-stappen om een consistente beeldkwaliteit en een nauwkeurige representatie van kenmerken te waarborgen. Dezelfde fundamentele preprocessing-pijplijn, bestaande uit Gaussische ruisonderdrukking, normalisatie, herschaling naar een consistente inputresolutie en verificatie van de beeldkwaliteit, werd op beide datasets toegepast. De datasets vervulden echter verschillende rollen binnen het framework. De WikiArt-dataset werd gebruikt voor het leren en synthetiseren van artistieke stijlen, terwijl de Miao Batik-dataset primair werd gebruikt voor de segmentatie en reconstructie van culturele motieven. Naast deze taakspecifieke rollen werden er geen dataset-specifieke wijzigingen in de preprocessing aangebracht. Om een consistente verwerking door het DL-model te garanderen, werden de beelden eerst herschaald naar een vaste resolutie. Deze stap was noodzakelijk omdat de beelden in beide datasets varieerden in resolutie, afhankelijk van de bron. Herschaling verbeterde de computationele efficiëntie en voorkwam dat dimensionale inconsistenties de training zouden beïnvloeden. De tweede preprocessing-stap was normalisatie, waarbij pixelwaarden werden geschaald naar een gestandaardiseerd bereik om gradiënt-updates tijdens de training te stabiliseren. De beelden werden vervolgens verwerkt met Gaussische filtering om ruis te verminderen die de structuren van de culturele motieven zou kunnen storen. Voor de Miao Batik-dataset werden bestaande segmentatiemaskers van culturele motieven, die rechtstreeks uit de oorspronkelijke bron van de dataset waren verkregen, zonder wijzigingen gebruikt voor de training en evaluatie van de semantische segmentatie. Er zijn geen nieuwe segmentatiemaskers specifiek voor deze studie gegenereerd.
Tenzij anders aangegeven, zijn vergelijkingen die gevestigde methoden beschrijven aangepast naar eerdere studies en worden deze dienovereenkomstig geciteerd. Vergelijkingen die de voorgestelde CAFFM en het gecombineerde SegCycle-SPADE optimalisatieraamwerk beschrijven, zijn door de auteurs voor deze studie ontwikkeld.
Laat een inputafbeelding uit de dataset worden weergegeven als Vergelijking 1:
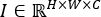 (1)
Hier verwijzen H, W en C respectievelijk naar de hoogte, breedte en het aantal kleurkanalen van de afbeelding. Alle afbeeldingen worden herschaald naar een vaste dimensie H′ × W′ zoals weergegeven in Vergelijking 2:
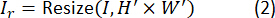
Hier, Ir is de herschalen afbeelding. De genormaliseerde pixelwaarden worden berekend volgens Vergelijking 3:
 (3)
Dit helpt om de trainingsprocedure te stabiliseren. Ruisfiltering wordt uitgevoerd met een Gaussisch filter, zoals weergegeven in Vergelijking 4:
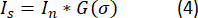
Hier is G(σ) een Gaussisch filter en * staat voor convolutie. Er werd gebruikgemaakt van een 5 × 5 kernel Gaussisch filter met een standaarddeviatie van σ = 1.0. Reflectieve padding werd toegepast op de randpixels om randartefacten te verminderen. Het ruisonderdrukkingsproces werd uitgevoerd direct na het laden van de afbeeldingen, voorafgaand aan de schaling en normalisatie. Om een uniforme voorbewerking gedurende de gehele studie te garanderen, werd dezelfde filterconfiguratie toegepast op elke afbeelding in de Miao Batik- en WikiArt-datasets. Voor de Miao Batik-dataset worden de segmentatiemaskers gemaakt volgens Vergelijking 5:

Hier is M een segmentatiemasker dat wordt gebruikt om het SegFormer-model te sturen.
De preprocessing-pipeline begint met de acquisitie van beelden uit de Miao Batik-dataset en de WikiArt-dataset, zoals weergegeven in Figuur 3. Tijdens de training zijn geen dataugmentatietechnieken toegepast. Na de preprocessing, die bestond uit het aanpassen van de grootte, normalisatie, Gaussische ruisonderdrukking en het voorbereiden van segmentatiemaskers, werden de beelden direct gebruikt voor de training, validatie en het testen van het voorgestelde SegCycle-SPADE-framework. De eerste stap van de preprocessing-pipeline omvat het schalen van de beelden naar een vaste grootte, waardoor het DL-model de beelden efficiënter kan verwerken. De tweede stap omvat normalisatie, waarbij pixelwaarden worden omgezet naar een gestandaardiseerd numeriek bereik om de convergentie van het model te vergemakkelijken. De derde stap omvat ruisonderdrukking, waarbij ongewenste ruis uit de beelden wordt verwijderd om de patroonherkenning te verbeteren. Daarnaast worden voor de Miao Batik-dataset de regio's met culturele motieven geannoteerd, wat de generatie van maskers mogelijk maakt die worden gebruikt in de segmentatiemodule van het voorgestelde model, zodat culturele motieven tijdens de generatie behouden blijven. De uiteindelijke output van deze fase is een schone dataset die gereed is voor de training van de segmentatie- en generatiemodules van het voorgestelde model.
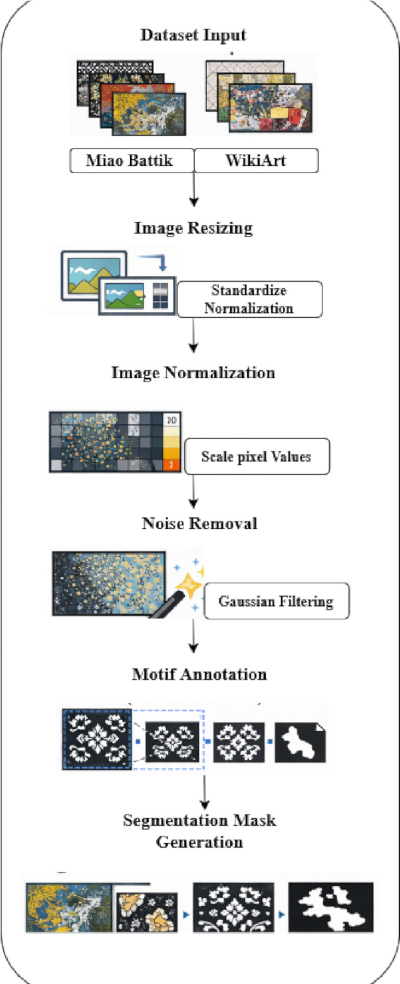
Figuur 3. Data-preprocessingspijplijn voor beelden van cultureel erfgoed. Workflow die de preprocessingsprocedures voor beelden illustreert die worden toegepast voorafgaand aan de modeltraining. De pijplijn omvat de acquisitie van de dataset, het herschalen van beelden, normalisatie, Gaussische ruisonderdrukking, bestaande annotaties van culturele motieven en de voorbereiding van segmentatiemaskers. De resulterende bewerkte beelden en maskers worden gebruikt als inputs voor semantische segmentatie en patroonreconstructie. Klik hier om een grotere versie van deze figuur te bekijken.
Elke afbeelding werd onderworpen aan een kwaliteitscontroleproces vóór de training van het model. De Miao Batik-dataset bevatte 15.148 afbeeldingen. Corrupte, dubbele en kwalitatief slechte monsters waren al aangepakt door de oorspronkelijke makers van de dataset; daarom werden er in deze studie geen extra afbeeldingen uitgesloten tijdens de screening voor kwaliteitscontrole. Bijgevolg werden alle 15.148 afbeeldingen behouden voor analyse. Afbeeldingen werden tijdens de preprocessing in RGB-formaat geladen en via bilineaire interpolatie aangepast naar een grootte van 256 × 256 pixels. Pixelwaarden werden geschaald van het bereik [0, 255] naar [0, 1] door te delen door 255. Vervolgens werd kanaalgewijze normalisatie toegepast met gemiddelde waarden van [0.485, 0.456, 0.406] en standaarddeviatiewaarden van [0.229, 0.224, 0.225] voor respectievelijk de rode, groene en blauwe kanalen. De preprocessing-pipeline omvatte het laden van afbeeldingen, RGB-conversie, schaling, pixelwaarde-schaling, normalisatie en tensorconversie. Indien nodig werden grijswaardenafbeeldingen omgezet naar het drie-kanaals RGB-formaat om de compatibiliteit met de DL-modellen te waarborgen. Na de preprocessing werden de afbeeldingen verdeeld in subsets voor training, validatie en testen. Alle fasen van het SegCycle-SPADE-framework — inclusief semantische segmentatie, feature-fusie, motiefreconstructie en SPADE-gebaseerde artistieke synthese — maakten gebruik van een consistente inputresolutie van 256 × 256 pixels.
Semantische patroonsegmentatie met behulp van SegFormer
Na deze voorbewerkingsstap worden de gereinigde en genormaliseerde afbeeldingen van de Miao Batik culturele motieven-dataset en de WikiArt-dataset ingevoerd in de semantische segmentatiemodule, gebaseerd op het voorgestelde SegFormer-B2-framework. Het doel van deze stap is om culturele motieven die aanwezig zijn in erfgoedpatronen correct te identificeren en te scheiden. Het voorgestelde framework van SegFormer is gebaseerd op een transformer-architectuur die een hiërarchische Transformer-encoder en een lichtgewicht MLP-decoder bevat om zowel globale contextuele informatie als gedetailleerde structurele informatie uit complexe erfgoedpatronen nauwkeurig vast te leggen. Het model extraheert eerst kenmerkrepresentaties op meerdere schalen uit de invoerafbeelding, gevolgd door de fusie van deze representaties via de decoder om nauwkeurige gesegmenteerde patronen te genereren. Dit zorgt ervoor dat de patronen in de erfgoedafbeelding correct worden gesegmenteerd in motieven zoals geometrische patronen, bloemmotieven en symbolische patronen, waardoor ze worden gescheiden van de achtergrond terwijl hun structurele integriteit behouden blijft. Deze structurele informatie wordt vervolgens gebruikt tijdens de latere fasen van patroongeneratie binnen het SegCycle-SPADE-framework.
Laat het voorbewerkte invoerbeeld worden weergegeven als Vergelijking 6:
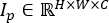 (6)
De SegFormer-encoder splitst de afbeelding in patches en extraheert hiërarchische kenmerken met behulp van transformer-lagen, zoals weergegeven in Vergelijking 71:
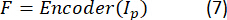
Hier geeft F de multiscale feature maps aan die zijn verkregen uit de transformer-encoder. Deze kenmerken coderen zowel lokale textuurpatronen als globale contextuele relaties tussen motiefregio's. Het SegFormer-model extraheert feature maps op verschillende schalen, zoals gedefinieerd in Vergelijking 8:
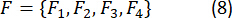
Het gebruik van multiscale-representaties vergemakkelijkt de detectie van patronen van verschillende grootten binnen culturele motieven. Ten slotte worden de kenmerken gecombineerd met behulp van de MLP-decoder, zoals weergegeven in Vergelijking 91:
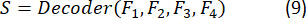
Hierbij staat S voor de uiteindelijke voorspelde segmentatiekaart.
De SegFormer-B2 backbone werd geïnitialiseerd met gewichten die voorafgetraind waren op ImageNet en vervolgens gefinetuned op de Miao Batik-dataset voor segmentatie van culturele motieven. Het voorafgetrainde checkpoint werd verkregen uit de officiële SegFormer-implementatie. Specifiek werd het ImageNet-1K voorafgetrainde MIT-B2 checkpoint (mit_b2.pth), geleverd door de officiële SegFormer-repository, gebruikt om de SegFormer-B2 backbone te initialiseren voorafgaand aan het finetunen. De voorafgetrainde gewichten komen overeen met de MIT-B2 backbone die is uitgebracht door de auteurs van SegFormer en dienden als het initialisatiemodel voor de training van de semantische segmentatie. De overige taakspecifieke lagen werden voor aanvang van de training geïnitialiseerd met de standaard PyTorch-procedures voor gewichtsinitialisatie.
In de architectuur wordt een vierstaps hiërarchische Transformer-encoder met overlappende patch-embeddings gebruikt. In de eerste fase werd de patch-grootte ingesteld op 7 × 7 met een stride van 4. Voor elk van de vier encoder-fasen waren de embedding-dimensies 64, 128, 320 en 512. Over de vier fasen waren er respectievelijk 1, 2, 5 en 8 multihead self-attention heads, en de bijbehorende encoder-dieptes waren 3, 4, 6 en 3 lagen. Multischalige kenmerken die uit de encoder werden gehaald, werden geaggregeerd met behulp van een lichtgewicht all-MLP-decoder. Voordat de uiteindelijke segmentatiekaart werd gemaakt, projecteerde de decoder kenmerken uit elke encoder-fase naar één enkele embedding-ruimte. Alle Transformer-blokken maakten gebruik van de Gaussian Error Linear Unit (GELU) activatiefunctie. Tijdens de training werd een dropout-rate van 0,1 gebruikt om de generalisatie te verbeteren en overfitting te verminderen.
Tijdens de trainingsfase ontvangt het SegFormer-framework de voorbewerkte afbeeldingen van beide datasets. De afbeeldingen uit de Miao Batik-dataset bevatten motiefregio's die dienen als labels voor het gesuperviseerde leren van het segmentatiemodel. De Transformer-encoder verwerkt de volledige afbeelding en legt langetermijnrelaties tussen afbeeldingscomponenten vast, wat bijzonder belangrijk is voor traditionele batikpatronen met ruimtelijk verspreide motieven. Het hiërarchische kenmerkextractiemechanisme legt gelijktijdig lokale structuren vast, zoals herhaalde geometrische texturen. De MLP-decoder verwerkt deze geëxtraheerde kenmerken en produceert een segmentatiemasker waarin de motiefregio's worden gemarkeerd. De segmentatiekaarten die in deze fase worden gegenereerd, worden vervolgens gebruikt als structurele inputs voor de attention-module en de fase van patroonreconstructie, waardoor wordt bijgedragen aan het behoud van de authenticiteit van de gegenereerde patronen.
Culturele motieven werden voor semantische segmentatie ingedeeld in verschillende klassen op basis van hun visuele en culturele kenmerken. De segmentatietaxonomie bestond uit diermotieven (bijv. vlinders, vissen, vogels en andere symbolische fauna), plantmotieven (bijv. bloemen, bladeren, ranken en botanische patronen), geometrische motieven (bijv. herhalende vormen, randen en abstracte geometrische structuren) en achtergrondgebieden die niet-motiefgebieden vertegenwoordigen. Segmentatiemaskers op pixelniveau werden gebruikt om elke pixel toe te wijzen aan een van de vooraf gedefinieerde klassen. Gehele getallen als labels werden als volgt gecodeerd: Label 0 = achtergrond, Label 1 = diermotieven, Label 2 = plantmotieven en Label 3 = geometrische motieven. De segmentatie-annotaties en motieflabels werden rechtstreeks verkregen uit de bron van de oorspronkelijke Miao Batik-dataset. In deze studie zijn geen aanvullende handmatige annotaties, heretiketteringen, grensverificaties of procedures voor expertbevestiging uitgevoerd. De bestaande annotaties die door de makers van de dataset werden verstrekt, zijn zonder wijzigingen gebruikt voor training en evaluatie.
Het SegFormer-model voor segmentatie van culturele motieven verwerkt de voorbehandelde afbeeldingen uit de Miao Batik-dataset en de WikiArt-dataset met behulp van een transformer-gebaseerd mechanisme voor nauwkeurige detectie van regio's met culturele patronen, zoals weergegeven in Figuur 4. Eerst wordt de invoerafbeelding die traditionele culturele motieven bevat, aan het SegFormer-model geleverd. De Transformer-encoder extraheert zowel globale contextuele informatie als lokale structurele kenmerken uit afbeeldingspatches. De resulterende multiscale-kenmerken worden doorgegeven aan de segmentatiedecoder, die gebruikmaakt van een Mix Feed-Forward Network om de kenmerkrepresentaties te verfijnen en de motiefdetectie te verbeteren. De output van het SegFormer-model is een segmentatiemasker dat pixels markeert die overeenkomen met culturele patronen, terwijl irrelevante achtergrondinformatie wordt onderdrukt. De geïsoleerde culturele patronen dienen vervolgens als structurele leidraad voor de volgende stadia van het SegCycle-SPADE-framework.
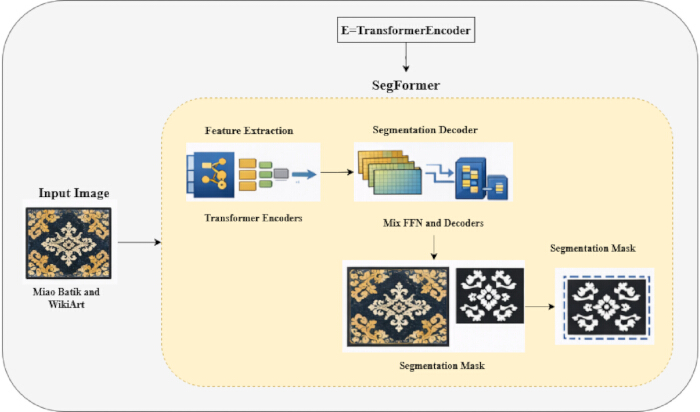
Figuur 4. Op SegFormer-B2 gebaseerde semantische segmentatie van culturele motieven. Architectuur van de SegFormer-B2 semantische segmentatiemodule die wordt gebruikt voor de extractie van culturele motieven en uitsluitend is getraind op de Miao Batik-dataset. Het raamwerk bestaat uit een Transformer-gebaseerde encoder voor multiscale kenmerkextractie en een lichtgewicht segmentatiedecoder voor het genereren van motiefmaskers. Het model voorspelt vier semantische klassen—dier, plant, geometrisch en achtergrond—waarbij de resulterende segmentatiemaskers cultureel significante motiefregio's identificeren terwijl irrelevante achtergrondinformatie wordt onderdrukt. Deze segmentatie-outputs bieden structurele sturing voor de daaropvolgende fasen van kenmerkfusie, reconstructie en artistieke synthese van het voorgestelde SegCycle-SPADE-raamwerk. Klik hier om een grotere versie van deze figuur te bekijken.
Binnen het voorgestelde raamwerk is het niet nodig om nieuwe segmentatie-annotaties aan te maken. De Miao Batik-dataset is verkregen uit een reeds bestaande openbare bron, en het model is getraind met behulp van de bijbehorende motiefinformatie die door de makers van de dataset is verstrekt. Tijdens het leerproces genereerde het SegFormer-model semantische segmentatiekaarten. Als gevolg hiervan waren voor de huidige studie geen aanvullende software voor handmatige annotatie, annotatierichtlijnen of kwaliteitscontroles voor annotaties vereist.
CAFFM
Om de interactie tussen de kenmerken van semantische segmentatie en de representaties van generatieve reconstructie te verbeteren, stelde de studie ook een CAFFM voor. De SegFormer-B2 encoder levert semantische feature maps aan de CAFFM-module, terwijl de CycleGAN-reconstructiestap generatieve feature maps levert. Eerst worden lineaire projectielagen gebruikt om beide feature-stromen te projecteren in een gemeenschappelijke embedding-ruimte. Voor de berekening van de cross-attention worden query (Q), key (K) en value (V) representaties gemaakt met behulp van de gegenereerde feature-tensoren. De relaties tussen structurele motiefinformatie en artistieke stilelementen worden vervolgens gemodelleerd met behulp van multihead cross-attention. Layer-normalisatie, residuale verbindingen en feed-forward lagen met GELU-activatie worden vervolgens toegepast op de gefuseerde feature-representaties. De op SPADE gebaseerde synthesestap ontvangt de output van de CAFFM-module, waardoor cultureel betekenisvolle thema's behouden blijven zonder dat dit ten koste gaat van de artistieke coherentie.
Om de compatibiliteit van kenmerken te garanderen, worden de invoerkenmerken eerst geprojecteerd met behulp van lineaire projectielagen op een gedeelde embedding-ruimte met een embedding-dimensie van 256. De onderlinge verbindingen tussen semantische structurele informatie en generatieve stijlrepresentaties worden vervolgens gemodelleerd met een MultiHead Cross-Attention-mechanisme met acht attention-heads. De berekening van de cross-attention maakt gebruik van Query (Q), Key (K) en Value (V) vectoren die worden gegenereerd door specifieke lineaire transformatielagen. Om de stabiliteit van de training te verhogen en de integriteit van de kenmerken te behouden, worden residuale verbindingen en Layer Normalization toegepast om de gefuseerde kenmerkrepresentaties verder te verbeteren. Niet-lineair kenlerleren wordt vervolgens verbeterd door het toepassen van een feed-forward-netwerk met de Gaussian Error Linear Unit (GELU) activatiefunctie. De module genereert een output-kenmerkrepresentatie met een dimensie van 256, die naar andere stadia wordt gestuurd voor creatieve synthese. De CAFFM combineert succesvol artistieke stijldata met culturele motiefstructuren door middel van een cross-attention-gebaseerde fusietechniek, wat de bewaring van motieven en de visuele coherentie in de gereconstrueerde culturele erfgoedpatronen verbetert.
In het voorgestelde systeem zijn de structurele kenmerken afgeleid van de Miao Batik-dataset, terwijl de stilistische kenmerken zijn geleerd van de WikiArt-dataset. Laat de feature map afgeleid van het SegFormer-segmentatienetwerk met beelden uit de Miao Batik-dataset worden aangeduid als Fs, terwijl de feature map afgeleid van de tak voor extractie van stijlkenmerken met WikiArt-beelden wordt aangeduid als Fa. De voorgestelde CAFFM combineert de twee feature-domeinen met behulp van een cross-attention-mechanisme om zowel de structurele als stilistische afhankelijkheden van culturele patronen te leren. Tabel 3 rapporteert alle architecturale kenmerken, inclusief embedding-dimensies, normalisatielagen, activatiefuncties en de configuratie van de attention-heads. Voor een invoerbeeldegrootte van 256 × 256 pixels produceerde de SegFormer-B2-encoder semantische feature maps van 64 × 64 × 128, terwijl de tak voor extractie van stijlkenmerken feature maps van 64 × 64 × 128 produceerde. Beide feature maps werden via leerbare lineaire lagen geprojecteerd naar een gedeelde embedding-ruimte van dimensie 256 voorafgaand aan de cross-attention-fusie.
| Parameter | Configuratie |
| Voorgesteld kader | SegCycle-SPADE |
| Model voor semantische segmentatie | SegFormer-B2 |
| Encoderstadia van SegFormer | 4 |
| Gewichtsinitialisatie | Op ImageNet-1K voorgetrainde SegFormer-B2 (MIT-B2 backbone) |
| Checkpoint-bron | Officiële NVIDIA SegFormer-repository (https://github.com/NVlabs/SegFormer); checkpoint: segformer.b2.512x512.ade.160k |
| Strategie voor fijnafstemming | End-to-end fine-tuning op de Miao Batik-dataset |
| Patch-embeddinggrootte | 7 × 7 |
| Patchstride | 4 |
| Embeddingdimensies | 64, 128, 320 en 512 |
| Dieptes van de encoder | 3, 4, 6 en 3 |
| Attention Heads | 1, 2, 5 en 8 |
| Decoder-type | All-MLP-decoder |
| Activatiefunctie | GELU |
| Uitvalpercentage | 0.1 |
| Module voor kenmerkverbetering | Cross-Attention Culturele Kenmerkenfusiemodule (CAFFM) |
| CAFFM-inbeddingsdimensie | 256 |
| CAFFM Attention Heads | 8 |
| CAFFM Fusieschalen | 4 |
| Reconstructiemodel | CycleGAN |
| Model voor Stijlgeneratie | SPADE |
| Culturele dataset | Miao Batik-dataset |
| Stijldata-set | WikiArt-dataset |
| Miao batik-afbeeldingen | 15,148 |
| WikiArt-afbeeldingen | Ongeveer 80.000 |
| Resolutie van de invoerafbeelding | 256 × 256 pixels |
| Kleurformaat | RGB |
| Interpolatiemethode | Bilineaire interpolatie |
| Ontruisingsmethode | Gaussische filtering |
| Grootte van de Gaussische kernel | 5 × 5 |
| Gaussiaanse sigma (σ) | 1 |
| Normalisatiebereik | [0, 1] |
| Batchgrootte | 16 |
| Aantal epochs | 100 |
| Optimizer | Adam |
| Leersnelheid | 0.0002 |
| Adam-parameters | β₁ = 0,5, β₂ = 0,999, ε = 1 × 10⁻⁸, weight decay = 0 |
| Verliesfuncties | segmentatieverlies, adversarieel verlies, cyclusconsistentieverlies, reconstructieverlies, motiefbehoudverlies en stijlconsistentieverlies |
| Strategie voor datasetopsplitsing | Training / Validatie / Testen |
| Trainingsset | 70% |
| Validatieset | 15% |
| Testset | 15% |
| Willekeurige seed | 42 |
| Evaluatiemetrieken | Segmentatienauwkeurigheid, IoU, Dice-coëfficiënt, SSIM, PSNR en FID |
| Programmeertaal | Python 3.8.10 |
| Deep Learning-framework | PyTorch 1.10.0 |
| Hardwareplatform | NVIDIA RTX 3090 GPU (24 GB VRAM), Intel Core i7 (11e generatie), 32 GB RAM |
| Operationele omgeving | Ubuntu 20.04 LTS |
Tabel 3: Experimentele opstelling en modelconfiguratie. Samenvatting van de architecturale componenten, trainingsconfiguratie, voorbewerkingsinstellingen, datasets, optimalisatieparameters, evaluatiemetrieken en de computationele omgeving die zijn gebruikt voor de implementatie en evaluatie van het voorgestelde SegCycle-SPADE-framework.
De attention-module brengt de feature map eerst in kaart naar query-, key- en value-representaties met behulp van Vergelijking 10:
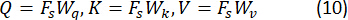
Hier, Wq, Wken Wv zijn leerbare gewichtsmatrices. De attentiegewichten worden berekend op basis van de overeenkomst tussen de query-vector en de key-vector met behulp van Vergelijking 1117:
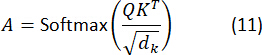
Hier is dk de dimensie van de sleutelvector. De verbeterde kenmerkrepresentatie wordt berekend door de aandachtsgewichten te vermenigvuldigen met de waardenmatrix met behulp van Vergelijking 12:
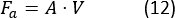
Hier, Fa is de verbeterde kenmerkrepresentatie van de kenmerkkaart. De verbeterde kenmerkrepresentatie wordt berekend door de oorspronkelijke segmentatiekenmerken te combineren met de verbeterde kenmerken die zijn verkregen met behulp van het aandachtmechanisme via Vergelijking 13:
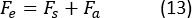
Hier is Fe de verbeterde feature map die wordt gebruikt voor patroonreconstructie. De CAFFM wordt uitgebreid met een multiscale cross-attention-mechanisme om features voor culturele motieven op verschillende schalen te extraheren. Laat Fsi de segmentatiefeatures op schaal i aanduiden, terwijl Faj de artistieke stijlfeatures op dezelfde schaal aanduidt. De uiteindelijke feature-representatie wordt gedefinieerd met behulp van Vergelijking 14:
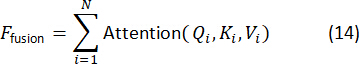
Hierbij stellen Qi, Ki en Vi respectievelijk de query-, key- en value-matrices voor op schaal i voor, en N duidt het aantal kenschalen aan. In deze studie is N = 4, wat overeenkomt met feature maps die zijn geëxtraheerd bij ruimtelijke resoluties van 1/4, 1/8, 1/16 en 1/32 van de grootte van het inputbeeld. Deze multischaal feature-representaties werden gefuseerd met behulp van leerbare attention-gewichten voorafgaand aan de reconstructie en artistieke synthese. De bovenstaande uitbreiding stelt de methode in staat om globale culturele motieven en texturen te extraheren om culturele patronen te reconstrueren. CAFFM is gepositioneerd tussen de op SegFormer gebaseerde segmentatiefase en de op SPADE gebaseerde creatieve synthesefase in het voorgestelde SegCycle-SPADE-systeem. Allereerst, terwijl CycleGAN gelijktijdig reconstructiekenmerken met stilistische en patroongerelateerde informatie genereert, herstelt SegFormer-B2 semantische feature maps die de structurele eigenschappen van culturele motieven beschrijven. De CAFFM-module ontvangt deze twee feature-stromen en maakt gebruik van cross-attention-gebaseerde fusie om relaties tussen structurele en artistieke representaties te identificeren. Om cultureel authentieke patronen te creëren terwijl de semantische consistentie en structurele kenmerken behouden blijven, worden de resulterende gefuseerde feature maps vervolgens naar de SPADE-module gestuurd voor segmentatie-gestuurde creatieve synthese.
Patroonreconstructie met behulp van CycleGAN
Zodra de fase van kenmerkverbetering op basis van aandacht is voltooid, bevatten de kenmerkkaarten de verbeterde structuren van de culturele motieven. De kenmerkkaarten kunnen echter nog steeds onvolledige of beschadigde patroonregio's bevatten. Daarom zal het voorgestelde raamwerk het CycleGAN-model gebruiken om het probleem van de patroonreconstructie aan te pakken. In het voorgestelde raamwerk zijn de twee domeinen de oorspronkelijke culturele motiefpatronen en de gereconstrueerde culturele motiefpatronen. Met behulp van de verbeterde kenmerken uit de vorige fasen zal het CycleGAN-model de culturele patronen reconstrueren terwijl de structurele consistentie behouden blijft. Dit zorgt ervoor dat culturele patronen, zoals geometrische patronen, bloempatronen en symbolische patronen, hun ruimtelijke schikking behouden. De oorspronkelijke Miao-batikbeelden werden onderworpen aan willekeurige maskering en gedeeltelijke occlusie-operaties om onvolledige of beschadigde culturele motieven te genereren. Deze degradatieprocedures simuleerden ontbrekende patroonregio's en structurele schade die vaak worden waargenomen in verslechterde culturele erfgoedartefacten. De gedegradeerde beelden werden gebruikt als inputs voor de reconstructiemodule, terwijl de overeenkomstige oorspronkelijke beelden dienden als referentiebeelden voor de prestatie-evaluatie en de beoordeling van de reconstructiekwaliteit. Deze strategie stelde het model in staat om het herstel van ontbrekende motiefstructuren te leren terwijl de semantische consistentie en culturele kenmerken werden behouden.
Laat X het domein van onvolledige culturele patronen zijn en Y het domein van gereconstrueerde culturele patronen. De twee generatoren leren een bidirectionele mapping uit te voeren met behulp van Vergelijking 15:
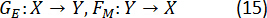
Hier wordt GE gebruikt om motiefstructuren te reconstrueren en FM wordt gebruikt om de patronen terug te mappen naar het oorspronkelijke domein. Het adversaire verlies wordt gebruikt om te garanderen dat de gereconstrueerde patronen realistisch zijn (Vergelijking 16)30
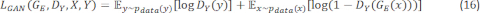
Hier is DY de discriminator die wordt gebruikt om echte en gereconstrueerde patronen te onderscheiden, en GE(x) staat voor het gegenereerde gereconstrueerde patroon. De CycleGAN dwingt daarnaast cyclusconsistentie af om de structurele indeling van culturele motieven te behouden (Vergelijking 17)30.
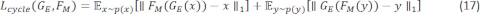
De uiteindelijke verliesfunctie wordt gedefinieerd met behulp van Vergelijking 1830:
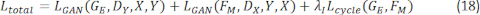
Hier geeft λi de wegingscoëfficiënt voor het cycle-consistency verlies aan, welke tijdens de training op 10 werd ingesteld, in overeenstemming met de oorspronkelijke CycleGAN-formulering. Deze waarde is gekozen om een balans te vinden tussen adversarial learning en reconstructieconsistentie tussen de bron- en doeldomeinen.
De CycleGAN-reconstructiemodule bestaat uit twee generatoren en twee discriminatoren voor bidirectionele beeldtranslatie. Elke generator volgt een residueel-netwerkarchitectuur bestaande uit een initiële 7 × 7 convolutielaag, gevolgd door twee downsampling-convolutielagen, negen residuele blokken en twee upsampling-lagen. Alle convolutiebewerkingen maken gebruik van een kernelgrootte van 3 × 3, behalve de inputlaag, die een 7 × 7 kernel gebruikt voor verbeterde kenmerkextractie. Instance Normalization wordt toegepast na elke convolutielaag om de trainingsstabiliteit te verbeteren, terwijl ReLU-activatie in het gehele generatornetwerk wordt gebruikt. De outputlaag maakt gebruik van een Tanh-activatiefunctie om genormaliseerde beeldoutputs te genereren. De discriminator volgt een 70 × 70 PatchGAN-architectuur bestaande uit een reeks convolutielagen met kernelgroottes van 4 × 4 en progressief toenemende kenmerkkanalen. Instance Normalization en LeakyReLU-activatie (negatieve helling = 0,2) worden in de discriminator ingezet om de kenmerkdiscriminatie en het adversariële leren te verbeteren. De CycleGAN-module ontvangt voorbehandelde afbeeldingen van culturele motieven als input en genereert gereconstrueerde patroonrepresentaties, die vervolgens naar de CAFFM worden gestuurd voor integratie met segmentatiekenmerken. De CycleGAN-training werd uitgevoerd met de Adam-optimizer (β₁ = 0,5, β₂ = 0,999) met een initiële leerterm van 0,0002. De leerterm werd gehandhaafd gedurende de eerste 100 epochs en vervolgens lineair afgebouwd naar nul over de resterende trainingsperiode. Er werd gebruikgemaakt van een replay-buffer met 50 eerder gegenereerde afbeeldingen om de training van de discriminator te stabiliseren. De generatoren en discriminatoren werden bijgewerkt met een update-ratio van 1:1, waarbij elke generator-update werd gevolgd door één discriminator-update tijdens elke trainingsiteratie.
Het reconstructieproces van de CycleGAN is gebaseerd op de verbeterde feature maps die zijn verkregen met behulp van het CAFFM-mechanisme in Figuur 5. De feature maps bevatten verbeterde culturele motieven die zijn verkregen uit de voorafgaande stadia van segmentatie en CAFFM. De feature maps dienen als input voor de eerste generator GE. De eerste generator GE leert de mapping die nodig is om de culturele patronen te reconstrueren. De outputs worden vervolgens gevoed aan de discriminator DY om onderscheid te maken tussen echte culturele patronen en gereconstrueerde patronen. De discriminator DY helpt de generator GE om realistische outputs te produceren. Om ervoor te zorgen dat culturele patronen tijdens de reconstructie niet worden vervormd, voert de tweede generator FM een cycle-consistency mapping uit. De tweede generator FM mapt de outputs terug naar het oorspronkelijke domein. De outputs worden vervolgens door de discriminator geëvalueerd om het realisme te waarborgen. De uiteindelijke outputs worden daarna doorgegeven aan de SPADE-module voor artistieke stijlgeneratie in de volgende fase van het voorgestelde SegCycle-SPADE-framework.
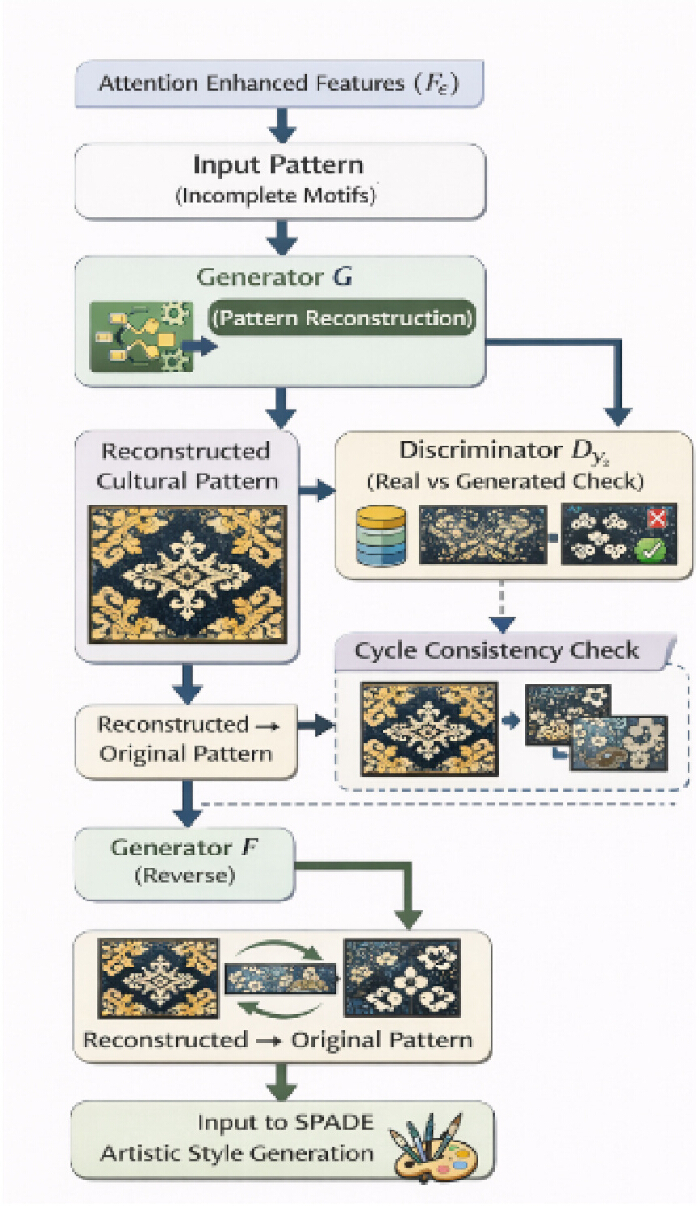
Figuur 5. Workflow voor patroonreconstructie op basis van CycleGAN. Workflow van de CycleGAN-reconstructiemodule. Aandachtsversterkte kenmerksrepresentaties worden als input aan het generatornetwerk geleverd om onvolledige culturele motieven te reconstrueren. De discriminator evalueert de gereconstrueerde outputs ten opzichte van referentiepatronen, terwijl cyclusconsistentie-mapping de structurele integriteit behoudt tijdens bidirectionele beeldtranslatie. De gereconstrueerde motieven worden vervolgens doorgezet naar de SPADE-module voor artistieke stijlsynthese. Klik hier om een grotere versie van deze figuur te bekijken.
Genereren van artistieke stijl met behulp van SPADE
Vervolgens worden de gereconstrueerde culturele motieven onderworpen aan de SPADE-module voor het genereren van de artistieke stijl. Het hoofddoel van de SPADE-module is om visueel rijkere texturen van de artistieke stijl toe te voegen aan de gereconstrueerde culturele motieven, zonder de structurele lay-out van de motieven in gevaar te brengen. De SPADE-module is een techniek voor conditionele beeldgeneratie die gebruikmaakt van het concept van beeldsegmentatie voor het genereren van beelden. Meerkanaals semantische kaarten, die overeenkwamen met de vooraf bepaalde motiefklassen, werden gecodeerd vanuit de semantische segmentatiemaskers die door SegFormer-B2 waren geproduceerd. De SPADE-generator ontving deze gecodeerde kaarten als conditionele inputs. De ruimtelijk adaptieve schalingsparameters (γ) en bias-parameters (β) werden gegenereerd door de semantische kaarten via convolutionele lagen binnen elke SPADE-laag te verwerken. De generator was hierdoor in staat om motiefgrenzen, structurele lay-outs en semantische informatie te behouden tijdens de artistieke synthese door deze parameters toe te passen op de genormaliseerde feature-activaties. Semantische begeleiding kon zowel de structurele reconstructie op hoog niveau als de texturesynthese op laag niveau beïnvloeden, aangezien het conditioneringsproces in verschillende lagen van de SPADE-generator werd uitgevoerd. Als gevolg hiervan bevatten de gecreëerde artistieke patronen stilistische kenmerken die waren verkregen uit de WikiArt-dataset, terwijl de culturele motiefstructuren die tijdens de segmentatiefase waren gevonden, behouden bleven.
De WikiArt-dataset, die werken uit 27 verschillende artistieke categorieën bevat — zoals Renaissance, Impressionisme, Cubisme, Expressionisme, Surrealisme, Realisme en Abstracte Kunst — werd gebruikt als de belangrijkste bron voor het begrijpen van artistieke stijlen. Om het model bloot te stellen aan een verscheidenheid aan creatieve kenmerken en de generalisatie van stijlen te verbeteren, werden tijdens de training willekeurig stijlbeelden uit de verschillende categorieën geselecteerd. De dataset werd onderverdeeld in trainings-, validatie- en testsubsets met een gebalanceerde vertegenwoordiging van artistieke categorieën om stijlbias te verminderen. Om een gebalanceerde vertegenwoordiging van alle 27 artistieke categorieën te waarborgen, werd gestratificeerde steekproeftrekking gebruikt. Monsters uit elke categorie werden proportioneel toegewezen aan de trainings-, validatie- en testsubsets, waarbij de oorspronkelijke klassendistributie behouden bleef. De CAFFM-module werd gebruikt om de stijlaspecten, afgeleid van WikiArt-beelden, samen te voegen met de reconstructiekenmerken geproduceerd door CycleGAN. Om het synthese-netwerk in staat te stellen artistieke kwaliteiten over te dragen terwijl de semantische structuur en de grenzen van culturele motieven uit de segmentatiekaarten behouden bleven, werden de resulterende gefuseerde representaties als conditioneringsinformatie geleverd aan de SPADE-generator. Dankzij deze stijlconditioneringstechniek was het voorgestelde raamwerk in staat om cultureel authentieke artistieke patronen te produceren met consistente structurele en stilistische representaties.
SPADE introduceert daarnaast ruimtelijk adaptieve parameters die afhankelijk zijn van de segmentatiekaart. De parameters kunnen worden gedefinieerd zoals weergegeven in Vergelijking 191:
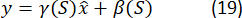
Hier is γ(S) de ruimtelijk variërende schaalparameter en β(S) de ruimtelijk variërende biasparameter. De parameters kunnen de generator helpen om verschillende texturen en stijlen te creëren, afhankelijk van de semantische regio in de afbeeldingen. Het uiteindelijke culturele kunstwerk kan worden gedefinieerd zoals weergegeven in Vergelijking 20:
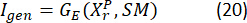
Hier is GE de SPADE-generator, XrP het gereconstrueerde patroon en SM de segmentatiekaart. Het uiteindelijke kunstwerk behoudt de structurele integriteit van culturele motieven terwijl het artistieke uiterlijk wordt verbeterd. Een samengestelde verliesfunctie die de nauwkeurigheid van de semantische segmentatie, het behoud van culturele motieven, de kwaliteit van de patroonreconstructie en de consistentie van de artistieke stijl in balans brengt, werd gebruikt om de voorgestelde SegCycle-SPADE-architectuur te optimaliseren. Een gewogen mengsel van segmentatieverlies (Lseg), adversarieel verlies (Ladv), cyclusconsistentieverlies (Lcycle), reconstructieverlies (Lrecon), motiefbehoudverlies (Lmotif) en stijlconsistentieverlies (Lstyle) werd gebruikt om het algemene trainingsdoel vast te stellen. De totale verliesfunctie is gedefinieerd in Vergelijking 21:
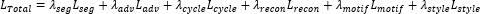 (21)
Om de structurele consistentie tussen de input en de gereconstrueerde culturele motieven te garanderen, werd de coëfficiënt voor het cycle-consistency-verlies ingesteld op 10. Om fijnmazige motiefkenmerken te behouden en de visuele nauwkeurigheid te verbeteren, werd de coëfficiënt voor het reconstructieverlies ingesteld op 5. Om de bewaring van cultureel essentiële structurele patronen tijdens de artistieke synthese te benadrukken, werd een coëfficiënt van 2 gebruikt voor het motiefbehoudverlies. Om artistieke stijltransfer te bevorderen zonder de semantische motiefstructuren onnodig te vervormen, werd de coëfficiënt voor het style-consistency-verlies aangepast naar 1. Om een gebalanceerde bijdrage te behouden tussen de productie van realistische beelden en nauwkeurige motiefsegmentatie, kregen het segmentatieverlies en het adversariële verlies een gelijk gewicht. De op kenmerken gebaseerde stijlrepresentaties van de WikiArt-dataset werden gebruikt om het style-consistency-verlies te berekenen. In het bijzonder werden artistieke stijleigenschappen vastgelegd met behulp van Gram-matrixcorrelaties die waren afgeleid van diepe feature maps. Het verschil in de Frobenius-norm tussen de Gram-matrices van het doelstijlafbeelding en de gegenereerde afbeelding werd gebruikt om het stijlverlies te berekenen, zoals weergegeven in Vergelijking 22:
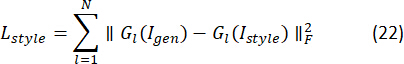
Hierbij is Gl de Gram-matrix berekend uit de lde feature-laag, Igen duidt de gegenereerde artistieke afbeelding aan, Istyle duidt de doelstijlafbeelding uit de WikiArt-dataset aan, en F duidt de Frobenius-norm aan. Deze formulering stelt het voorgestelde raamwerk in staat om artistieke kenmerken te behouden terwijl de structurele en semantische integriteit van culturele motieven gewaarborgd blijft.
De gefuseerde kenmerkrepresentaties geproduceerd door de CAFFM-module worden gebruikt als conditionerende inputs voor de SPADE-module, die dient als het artistieke synthesecomponent van het voorgestelde raamwerk. De SPADE-generator bestaat uit zeven SPADE-residuele blokken met een latente kenmerkdimensie van 256 kanalen en genereert outputbeelden met een resolutie van 256 × 256 pixels. Semantische segmentatiekaarten verkregen uit de SegFormer–CAFFM-module worden gedurende de gehele SPADE-residuele lagen als conditionerende inputs gebruikt. SPADE-lagen worden toegepast voorafgaand aan de activatiefuncties binnen elk residueel blok, wat segmentatie-gestuurde semantische conditionering mogelijk maakt. Door opeenvolgende upsampling- en convolutionele operaties wordt de latente kenmerkrepresentatie geleidelijk verfijnd om hoogresolutie artistieke patronen te genereren, terwijl de semantische consistentie en motiefstructuur behouden blijven. LeakyReLU-activatiefuncties worden in de gehele generator gebruikt, en een Tanh-activatiefunctie wordt toegepast op de outputlaag om genormaliseerde beelden te produceren.
Algoritme en workflow
Het SegCycle-SPADE-framework integreert semantische segmentatie, feature-fusie, patroonreconstructie en artistieke stijlsynthese binnen één geunifiederde trainingspijplijn. De workflow begint met datasetverwerving en preprocessing, inclusief het aanpassen van de beeldgrootte, normalisatie, ruisonderdrukking en het voorbereiden van segmentatiemaskers. De geprocesste beelden worden vervolgens verwerkt met het SegFormer-B2-segmentatienetwerk om semantische motiefrepresentaties te extraheren. De resulterende segmentatie-features worden via de CAFFM gefuseerd met reconstructie-features, waardoor interactie tussen structurele motiefinformatie en artistieke feature-representaties mogelijk wordt. De gefuseerde feature-maps worden vervolgens aangeleverd aan de CycleGAN-reconstructiemodule, die onvolledige culturele motiefstructuren herstelt terwijl de semantische consistentie behouden blijft. De gereconstrueerde patronen worden vervolgens doorgegeven aan de SPADE-generator voor segmentatie-gestuurde artistieke synthese, wat stilistische verbetering mogelijk maakt terwijl de motiefgrenzen en structurele authenticiteit behouden blijven. Tijdens de training worden de modelparameters geoptimaliseerd met behulp van de samengestelde verliesfunctie beschreven in Vergelijkingen 21 en 22, die een balans vindt tussen segmentatienauwkeurigheid, behoud van motieven, reconstructiekwaliteit en consistentie van de artistieke stijl. Een gedetailleerde stapsgewijze implementatieworkflow, inclusief het laden van de dataset, preprocessing, modelinitialisatie, trainingsiteraties, validatieprocedures, selectie van checkpoints en de uiteindelijke evaluatie, wordt beschreven in Aanvullend Bestand 1 (Algoritme 1). De volledige algoritmische workflow is geïmplementeerd met een batchgrootte van 16, een leersnelheid van 0,0002 en 100 trainingsepochen. Er is een vaste random seed van 42 gebruikt voor de datasetpartitionering, modelinitialisatie en alle trainingsexperimenten. Deze seed is consistent toegepast over de random number generators van Python, NumPy en PyTorch om reproduceerbaarheid te garanderen. De Adam-optimizer is geconfigureerd met β₁ = 0,5, β₂ = 0,999 en zonder gewichtsverval (weight decay = 0). Modelcheckpoints zijn geselecteerd op basis van de hoogste behaalde validatie-IoU-score op de validatiedataset.
Optimalisatie van de verliesfunctie
Om culturele motiefstructuren tijdens de reconstructie en artistieke synthese te behouden, maakt het voorgestelde raamwerk gebruik van een samengesteld optimalisatiedoel dat segmentatie-, adversariële-, cyclusconsistentie-, reconstructie-, motiefbewarings- en stijlconsistentieverliezen combineert. De volledige wiskundige formulering, wegingscoëfficiënten en de definitie van het stijlverlies worden gegeven in Vergelijkingen 21 en 22 in de subsectie Artistic Style Generation using SPADE. De component voor motiefbewaring bestraft structurele afwijkingen tussen de voorspelde motiefregio's en de overeenkomstige ground-truth segmentatiemaskers, waardoor het behoud van cultureel significante patroonstructuren gedurende het reconstructieproces wordt gestimuleerd.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Het voorgestelde SegCycle-SPADE-framework werd geëvalueerd met behulp van twee datasets: de Miao Batik-dataset van culturele motieven en de WikiArt-dataset. De Miao Batik-dataset bevat afbeeldingen van traditioneel cultureel erfgoed en werd hoofdzakelijk gebruikt voor taken op het gebied van semantische segmentatie en structurele reconstructie, terwijl de WikiArt-dataset diverse artistieke stijlen bevat en werd gebruikt voor het leren en genereren van artistieke stijlen. Afbeeldingen uit beide datasets werden verwerkt vi...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Het behoud en de digitale reconstructie van ICH-patronen hebben de afgelopen jaren steeds meer aandacht gekregen vanwege het geleidelijke verlies van traditionele ambachten. In eerdere studies is geprobeerd het verlies van cultureel erfgoed aan te pakken via DL-gebaseerde beeldverwerkingstechnieken. Zo stelden Quan et al.32 een raamwerk voor het behoud van cultureel erfgoed voor, gebaseerd op kennisgrafen en DL voor de batikcultuur van de Miao in Guizhou. Hoewel de studie gericht was op de digital...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
Belangenverstrengeling:
De auteurs verklaren dat er geen concurrerende belangen zijn.
Dankbetuigingen
De auteurs erkennen de academische en institutionele ondersteuning van Guangdong Engineering Polytechnic en South China Normal University tijdens de uitvoering van dit onderzoek. Dit onderzoek werd ondersteund door het National Social Science Fund General Project 2023 (Nr. 23BH161), getiteld “Digital Regeneration Museum: Research on the Activation and Communication of Chinese Classic Calligraphy and Painting Cultural Relics.”
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Adam-optimizer | PyTorch Optimizer Library | Adam | Optimalisatiealgoritme gebruikt tijdens modeltraining. |
| CUDA Toolkit | NVIDIA Corporation | CUDA 11.3 | GPU-acceleratie voor deep learning-berekeningen. |
| cuDNN | NVIDIA Corporation | cuDNN 8.2 | Acceleratiebibliotheek voor diepe neurale netwerken, gebruikt om training en inferentie te versnellen. |
| CycleGAN | University of California, Berkeley / Open Source | Officiële PyTorch-implementatie (https://github.com/junyanz/pytorch-CycleGAN-and-pix2pix) | Generatief adversarieel netwerk gebruikt voor de reconstructie van culturele motieven. |
| Pretrained ImageNet-gewichten | ImageNet / Open Source | mit_b2.pth (ImageNet-1K Pretrained Checkpoint) | Gebruikt om de SegFormer-B2-backbone te initialiseren vóór fine-tuning op de Miao Batik-dataset. |
| Intel-processor | Intel Corporation | Intel Core i7 (11e generatie) | CPU gebruikt voor beeldvoorverwerking, ondersteuning van modeltraining en inferentie. |
| Matplotlib | Matplotlib Development Team | Matplotlib 3.5.1 | Visualisatie van trainingscurven en evaluatieresultaten. |
| Miao Batik-dataset | Zenodo Repository | DOI: 10.5281/zenodo.20807658 | Dataset van culturele motieven met 15.148 afbeeldingen, gebruikt voor semantische segmentatie en patroonreconstructie. |
| NumPy | NumPy Developers | NumPy 1.21.5 | Numerieke berekeningen en datasetverwerking. |
| NVIDIA GPU | NVIDIA Corporation | NVIDIA RTX 3090 (24 GB VRAM) | Hardwareplatform gebruikt voor modeltraining en inferentie. |
| OpenCV | OpenCV Foundation | OpenCV 4.5.5 | Beeldvoorverwerking, herschalen, interpolatie en Gaussische ruisonderdrukking. |
| Besturingssysteem | Canonical Ltd. | Ubuntu 20.04 LTS | Experimentele uitvoeringsomgeving. |
| Pillow (PIL) | Python Imaging Library | Pillow 8.4.0 | Laden en manipuleren van afbeeldingen. |
| Python | Python Software Foundation | Python 3.8.10 | Programmeertaal gebruikt voor implementatie en experimentatie. |
| PyTorch | Meta AI | PyTorch 1.10.0 | Deep learning-framework gebruikt voor modeltraining en inferentie. |
| Random seed | Experimentele instelling | 42 | Vaste seed gebruikt voor datasetpartitionering, modelinitialisatie en experimentele reproduceerbaarheid. |
| Scikit-learn | Scikit-learn Developers | Scikit-learn 1.0.2 | Datasetpartitionering, statistische analyse en evaluatiemetrieken. |
| Seaborn | Open Source Community | Seaborn 0.11.2 | Statistische datavisualisatie. |
| SegFormer-B2 | NVIDIA Research / Open Source | SegFormer-B2 (MIT-B2 Backbone) | Op Transformer gebaseerd semantisch segmentatiemodel gebruikt voor segmentatie van culturele motieven. |
| Segmentatiemaskers / annotaties | Miao Batik-dataset | Inbegrepen bij dataset | Semantische segmentatielabels op pixelniveau, gebruikt voor motiefclassificatie en training. |
| SPADE | NVIDIA Research / Open Source | Officiële PyTorch-implementatie (https://github.com/NVlabs/SPADE) | Segmentatie-gestuurd beeldsynthesemodel gebruikt voor het genereren van artistieke patronen. |
| TorchVision | Meta AI | TorchVision 0.11.1 | Beeldverwerkingshulpmiddelen en datasettransformaties gebruikt met PyTorch. |
| WikiArt-dataset | WikiArt | https://www.wikiart.org/ | Artistieke stijldataset met meer dan 80.000 kunstwerken verdeeld over 27 artistieke stijlen, gebruikt voor stijlerkenning en synthese. |
Referenties
- Huang B, Mo L. SegCycle-SPADE: An end-to-end framework for semantic segmentation-based automated extraction and artistic reconstruction of traditional craft patterns using conditional GAN. PLoS ONE. 2025;20:e0329100.
- Yan Z, et al. Digital sustainability of heritage: Exploring indicators affecting the effectiveness of digital dissemination of intangible cultural heritage through qualitative interviews. Sustainability. 2025;17:1593.
- Yan Z, et al. Construction of digital dissemination effects evaluation indicator system of traditional techniques of intangible cultural heritage. npj Heritage Science. 2025;13:224.
- Imon SS. Intangible cultural heritage as a tourism product in the historic city of Macao. In: Sustainable Management of Historic Settlements in Asia: Role of Intangible Cultural Heritage. Springer Nature Singapore; Singapore. 2025. p.233-240.
- Buragohain D, et al. Digitalizing cultural heritage through metaverse applications: Challenges, opportunities, and strategies. Heritage Science. 2024;12:295.
- Ma Y. The ghostly ethics of mediatized shaping: Cultural memory creative transformation of Anhui’s ICH in reviving the craftsmanship. Journal of Current Social Issues Studies. 2025;2:240-249.
- Wanju T, Wang Z, Tu Y. ICH and e-commerce: Bridging tradition and modernity in cultural creative products. Journal of Economics, Management and Trade. 2025;31:1-8.
- Sun L, et al. Research on the redesign of China’s intangible cultural heritage based on sustainable livelihood—The case of Luanzhou shadow play empowering rural development. Sustainability. 2024;16:4555.
- Pan S, et al. Constructing a sustainable evaluation framework for AIGC technology in Yixing Zisha pottery: Balancing heritage preservation and innovation. Sustainability. 2025;17:910.
- Na Z, Sharul Azim SR. Research on innovative development of Miao embroidery intangible cultural heritage in Guizhou, China based on digital design. Journal of Business and Economic Review. 2024;9:85-94.
- Guo S, Canessa A. Ethnic elder poverty: Miao household livelihoods and elderly self-sufficiency practices in Midwest China. Culture, Agriculture, Food and Environment. 2023;45:55-68.
- Han D, Cong L. Miao traditional patterns: The origins and design transformation. Visual Studies. 2023;38:425-432.
- Dong B, et al. Spatial distribution and tourism competition of intangible cultural heritage: Take Guizhou, China as an example. Heritage Science. 2023;11:64-80.
- Chen Z, Ren X, Zhang Z. Cultural heritage as rural economic development: Batik production amongst China’s Miao population. Journal of Rural Studies. 2021;81:182-193.
- Zhennan LY, Yahaya SR. An aesthetic study on traditional batik design of Miao ethnicity in China. Kupas Seni. 2021;9:12-25.
- Fu X, Razmjooy N. Preserving and enhancing cultural heritage through art design using feature pyramid network optimized by modified builder optimization algorithm. Scientific Reports. 2025;15:42603.
- Liu X, Wan J, Wang N. Ancient painting inpainting with regional attention-style transfer and global context perception. Applied Sciences. 2024;14:8777.
- Xu Q, Iwasaki M. Image restoration model of wood-structured raw lacquer cultural relics based on diffusion generation network. Journal of Asian Architecture and Building Engineering. 2025:1-19.
- Cherian A, Sullivan A. Sem-GAN: Semantically-consistent image-to-image translation [conference presentation]. Presented at: IEEE Winter Conference on Applications of Computer Vision (WACV); 2019. doi: 10.1109/WACV.2019.00196.
- Rombach R, et al. High-resolution image synthesis with latent diffusion models [conference presentation]. Presented at: IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR); 2022. p.10684-10695. Available from: http://openaccess.thecvf.com/content/CVPR2022/papers/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR_2022_paper.pdf.
- Gendy GGH, Nabil S. Diffusion models for image super-resolution: State-of-the-art and future directions. Neurocomputing. 2025;617:128911.
- Kazerouni A, et al. Diffusion models in medical imaging: A comprehensive survey. Medical Image Analysis. 2023;88:102846.
- Yang L, et al. Diffusion models: A comprehensive survey of methods and applications. ACM Computing Surveys. 2023;56:1-39.
- Croitoru FA, Hondru V, Ionescu RT, Shah M. Diffusion models in vision: A survey. IEEE Transactions on Pattern Analysis and Machine Intelligence. 2023;45:10850-10869.
- Cao H, et al. A survey on generative diffusion models. IEEE Transactions on Knowledge and Data Engineering. 2024;36:2814-2830.
- Po R, et al. State of the art on diffusion models for visual computing. Computer Graphics Forum. 2024;43:e15063.
- Thampanichwat C, et al. Mindful architecture from text-to-image AI perspectives: A case study of DALL-E, Midjourney, and Stable Diffusion. Buildings. 2025;15:972.
- Li W. Enhanced automated art curation using supervised modified CNN for art style classification. Scientific Reports. 2025;15:7319.
- Chen C. Algorithm and tool development for creative generation of graphic design of folk houses and ancient buildings integrating cultural and creative elements. Scalable Computing: Practice and Experience. 2024;25:4729-4736.
- Liu B, Ji J, Gu L, Jiang Z. An integrated CycleGAN-diffusion approach for realistic image generation [conference presentation]. Presented at: International Conference on Signal Processing and Machine Learning; 2024. p.92-101. doi: 10.1117/12.3027121.
- Bao Q, Zhao J, Liu Z, Liang N. AI-assisted inheritance of Qinghua porcelain cultural genes and sustainable design using low-rank adaptation and stable diffusion. Electronics. 2025;14:725.
- Quan H, et al. Protection of Guizhou Miao batik culture based on knowledge graph and deep learning. Heritage Science. 2024;12:1-22.
- Sun H, et al. HRPGAN: A GAN-based model to generate high-resolution remote sensing images. IOP Conference Series: Earth and Environmental Science. 2020;428:012060.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. Available from: https://proceedings.neurips.cc/paper/2020/file/4c5bcfec8584af0d967f1ab10179ca4b-Paper.pdf.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.