Diabetische nefropathie (DN) gaat gepaard met mitochondriale dysfunctie. Met behulp van transcriptomics, netwerkfarmacologie en machine learning hebben we CAT, FABP1, MAOA en MAOB geïdentificeerd als kandidaat mitochondriaal-gerelateerde biomarkers voor Ligustri Lucidi Fructus. In db/db-muizen reguleerde LLF CAT en MAOA op, wat verdere mechanistische onderzoeken ondersteunt.
Onderzoeksartikel
Identificatie van mitochondria-gerelateerde kandidaat-biomarkers van Ligustri Lucidi Fructus bij diabetische nefropathie
In dit artikel
Samenvatting
Samenvatting
Mitochondriële dysfunctie en overmatige oxidatieve stress binnen de mitochondriën zijn cruciale pathologische factoren die bijdragen aan renale tubulaire beschadiging bij diabetische nefropathie (DN). Hoewel Ligustri Lucidi Fructus (LLF) traditioneel wordt gebruikt voor de behandeling van DN, blijven de betrokken mechanismen, in het bijzonder die met betrekking tot mitochondriën-geassocieerde genen en signaalpaden, onvoldoende begrepen. In deze studie werd differentiële expressieanalyse van de GSE142025-dataset gebruikt om differentieel tot expressie gebrachte genen (DEGs) gerelateerd aan DN te identificeren. Kenmerkende genen werden geselecteerd door de output van vier machine learning-modellen te kruisverwijzen. Genen die een significante differentiële expressie en consistente expressiepatronen in beide datasets vertoonden, werden verder geëvalueerd via receiver operating characteristic (ROC)-curve-analyse. Genen met een area under the curve (AUC) > 0,7 in beide datasets werden gedefinieerd als kandidaat-biomarkers. Analyses voor functionele verrijking, immuuninfiltratie, netwerkconstructie en moleculaire docking werden uitgevoerd. Een DN-muismodel werd gebruikt om de bloedglucose, urinaire microalbuminurie, histopathologie en de RT-qPCR-expressie van de kandidaat-biomarkers te beoordelen. CAT en MAOA waren significant upgereguleerd in vivo. De kandidaat-biomarkers waren verrijkt in pathways gerelateerd aan ribosoomfunctie, degradatie van valine, leucine en isoleucine, cytokine-cytokine receptor-interacties en peroxisomen. Ze waren negatief gecorreleerd met CD8+ T-cellen en geactiveerde mestcellen en positief gecorreleerd met geactiveerde NK-cellen en naïeve B-cellen. Taxifoline, beta-sitosterol en eriodictyol vertoonden bindingsenergieën onder -5 kcal/mol met de kandidaat-biomarkers. CAT en MAOA zijn veelbelovende kandidaten die verdere mechanistische onderzoeken rechtvaardigen.
Inleiding
Diabetische nefropathie (DN), de belangrijkste oorzaak van nierfalen in het eindstadium wereldwijd, is een van de meest voorkomende complicaties van diabetes mellitus. Pathologisch wordt het gekenmerkt door overmatige accumulatie van de extracellulaire matrix in zowel de glomerulaire als de tubulaire compartimenten, samen met verdikking en sclerose van de intrarenale bloedvaten2. DN wordt gewoonlijk geassocieerd met proteïnurie en hypertensie3. De ontwikkeling ervan is nauw verbonden met schade aan de vasculaire endotheelcellen, een versterkte ontstekingsreactie en verhoogde oxidatieve stress als gevolg van langdurige hyperglykemie4. De incidentie van DN stijgt wereldwijd, vooral bij diabetici van middelbare leeftijd en ouderen. Naarmate de ziekte vordert, kan dit leiden tot nierfalen in het eindstadium en zelfs tot cardiovasculaire complicaties, wat de kwaliteit van leven en de prognose van patiënten aanzienlijk verslechtert5. Ondanks vorderingen in diagnostische en therapeutische benaderingen voor DN, blijven vroege en nauwkeurige kandidaat-biomarkers voor diagnose ongrijpbaar, en effectieve behandelstrategieën om de pathologische processen om te keren ontbreken nog steeds. Daarom is er een dringende behoefte aan de ontwikkeling van nieuwe, gerichte anti-DN-geneesmiddelen.
Mitochondriën zijn essentieel voor de cellulaire bioenergetica, de synthese van metabole precursoren, calciumhomeostase, de productie van reactieve zuurstofsoorten (ROS), immuunsignalering en apoptose, die allen noodzakelijk zijn voor het behoud van de cellulaire en organismische stabiliteit6. Als de energiercentrales van de cel spelen mitochondriën een spilrol in fundamentele processen zoals glycolyse, de tricarboxylaatzuurcyclus en oxidatieve fosforylering7. Obesitas verstoort de Krebs-cyclus en de mitochondriale ademhalingsketen, wat leidt tot mitochondriale dysfunctie en een verhoogde ROS-productie. Verhoogde ROS-niveaus in de mitochondriale ademhalingsketen kunnen oxidatieve stress induceren, wat de ontstekingsreactie geassocieerd met obesitas verergert en apoptose bevordert8. Recent onderzoek heeft de significante rol van mitochondriale dysfunctie bij de pathogenese en progressie van DN benadrukt, inclusief verstoringen in het energiemetabolisme, excessieve ROS-generatie en versterkte apoptose-signalering9. Chronische mitochondriale dysfunctie versnelt de progressie van nierziekten10. Daarom zou het verbeteren van de mitochondriale functie een cruciale beschermende strategie tegen DN kunnen vormen.
Ligustri Lucidi Fructus (LLF) is een gedroogde, rijpe vrucht uit de Luteaceae-familie die bekend staat om zijn lever- en nierversterkende eigenschappen, evenals het vermogen om haar te donkeren en het gezichtsvermogen te verbeteren. Er is een natuurlijk voorkomend heteropolysacharide uit LLF geëxtraheerd, waarbij is aangetoond dat dit potentieel bezit de nieren tegen fibrose te beschermen11. In recente jaren is er toenemende aandacht voor het gebruik van LLF bij de behandeling van diabetische nefropathie (DN), waarbij opmerkelijke renoprotectieve effecten zijn aangetoond11,12,13. Bovendien is de complexe relatie tussen LLF en mitochondriën uitgebreid onderzocht en gevalideerd. In het bijzonder heeft een studie aangetoond dat LLF zijn gunstige effecten uitoefent door de mitochondriale functie te moduleren via activering van de AMPK-signaleringsroute14. Dit mechanisme beschermt mitochondriën effectief tegen schade veroorzaakt door oxidatieve stress. Deze bevindingen benadrukken verder de cruciale rol van LLF bij het behouden van het cellulaire energiemetabolisme en het verbeteren van de veerkracht van cellen tegen oxidatieve stress. Het precieze therapeutische mechanisme, met name met betrekking tot het herstel van de mitochondriale functie, is echter nog onvoldoende begrepen.
Het doel van deze studie was om de biologische mechanismen te ontrafelen die ten grondslag liggen aan het therapeutische effect van LLF op de mitochondriale functie bij DN. Openbare databases werden doorzocht met behulp van bio-informatica-instrumenten om kandidaat-biomarkers te identificeren die geassocieerd zijn met de renoprotectieve effecten van LLF, waarbij transcriptomische gegevens en informatie over actieve bestanddelen werden geïntegreerd. Verdere analyses, waaronder immuuninfiltratie, associatie met klinische kenmerken, m6A RNA-modificatie, functionele verrijking, constructie van regulatoire netwerken en moleculaire docking, suggereerden dat deze kandidaat-biomarkers een cruciale rol spelen bij het reguleren van de mitochondriale functie tijdens de behandeling van DN. In vivo validatie bevestigde verder hun significantie. Deze uitgebreide analyse verdiept ons begrip van de mechanismen waarmee LLF DN behandelt en biedt een solide basis voor de ontwikkeling van nieuwe therapeutische doelwitten op basis van mitochondriale dysfunctie.
Protocol
Gegevensverzameling
De genexpressiematrix en de bijbehorende klinische gegevens voor de datasets GSE142025 en GSE96804, welke gerelateerd zijn aan DN, werden opgehaald uit de Gene Expression Omnibus (GEO) database (https://www.ncbi.nlm.nih.gov/geo/)15. De trainingsset (GSE142025) bevatte niertestmonsters van 27 patiënten met DN en negen controles, die werden gesequenced met het GPL20301 platform. De validatieset (GSE96804) bestond uit sequencinggegevens van 41 DN-patiënten en 20 controles, verwerkt met het GPL17586 platform. Beide datasets richten zich op nierweefsel; de GSE96804 dataset onderzoekt specifiek de glomerulus, de primaire filtratie-eenheid van de nier (Figuur 1). De GSE142025 dataset (trainingsset) bestaat uit monsters van volledig nierweefsel en biedt een uitgebreid overzicht van het transcriptomische landschap van DN. De GSE96804 dataset (validatieset) richt zich daarentegen specifiek op glomerulair weefsel, wat de primaire locatie is van glomerulaire filtratieschade. Aangezien deze twee datasets niet direct werden samengevoegd vanwege verschillen in platform en weefsel, is er geen batch-effectcorrectie toegepast. In plaats daarvan werd cross-dataset validatie onafhankelijk uitgevoerd. Genen met consistente directionele veranderingen en een area under the curve (AUC) groter dan 0,7 in beide datasets werden geselecteerd als robuuste kandidaten, wat de generaliseerbaarheid over verschillende niervakken ondersteunt.
In totaal werden 1.136 mitochondrië-gerelateerde genen (MRG's) geëxtraheerd uit de MitoCarta3.0-database (https://www.broadinstitute.org/mitocarta). De actieve ingrediënten van LLF werden voorspeld met behulp van de Traditional Chinese Medicine Systems Pharmacology (TCMSP)-database (http://sm.nwsuaf.edu.cn/lsp/tcmsp.php), op basis van een drempelwaarde voor orale biobeschikbaarheid (OB) van ≥30% en een drempelwaarde voor drug-likeness (DL) van ≥0,18. Vervolgens werden potentiële doelwitgenen voor de actieve bestanddelen voorspeld met behulp van de Swiss Target Prediction-database (http://www.swisstargetprediction.ch/).
Analyse van differentiële expressie
De analyse van differentiële expressie van GSE142025 (DN vs. controle) werd uitgevoerd met het limma-pakket (v3.54.1), waarbij de significantiecriteria werden gesteld op P.adj < 0.05 en |log2FoldChange| > 0.516. Volcano-plots en heatmaps werden respectievelijk gevisualiseerd met de pakketten ggplot2 (v 3.3.6) en ComplexHeatmap (v 2.14.0)17,18. DEGs, MRGs en potentiële targetgenen van de actieve ingrediënten werden geintersecteerd, en de overlappende genen werden gedefinieerd als kandidaatgenen. Het netwerk dat de actieve ingrediënten en kandidaatgenen verbindt, werd geconstrueerd met behulp van Cytoscape-software (v 3.9.0)19.
Functionele verrijkingsanalyse en constructie van een eiwit-eiwitinteractie (PPI) netwerk
Gene Ontology (GO) en Kyoto Encyclopedia of Genes and Genomes (KEGG) verrijkingsanalyses voor kandidaatgenen werden uitgevoerd met het clusterProfiler-pakket (v 4.6.2) om hun biologische functies en geassocieerde signaleringspaden te onderzoeken (P.adjust < 0,05). De kandidaatgenen werden vervolgens ingevoerd in de STRING-database (https://cn.string-db.org/) om PPI-relaties op te halen (betrouwbaarheidsniveau ≥ 0,4), gevolgd door de constructie van een PPI-netwerk met behulp van Cytoscape (v 3.9.0)20.
Machine learning
Vier machine-learning-algoritmen, waaronder random forest (RF), k-nearest neighbor (KNN), partial least squares (PLS) en support vector machine met een radial basis kernel (SVM), werden geïmplementeerd met het caret-pakket (v6.0-93) op basis van de GSE142025-dataset. De kandidaatgenen die in de voorafgaande analyse waren geïdentificeerd, werden gebruikt als voorspellende variabelen, en de ziektestatus (DN of controle) werd gebruikt als uitkomst. Voor het KNN-model werd 10-voudige kruisvalidatie uitgevoerd met de trainControl-functie, waarbij tuneLength = 10. Het RF-model werd gefit met 20 bomen (ntree = 20); de PLS- en SVM-modellen werden gefit met de instellingen die waren geïmplementeerd in de oorspronkelijke caret-workflow.
Modelresidudistributies werden geëvalueerd met het DALEX-pakket (v2.4.3). Vervolgens werd een permutatiegebaseerde variabelebeoordeling uitgevoerd met de DALEX variable_importance-functie, waarbij de root mean square error (RMSE) als verliesfunctie werd gespecificeerd. De resulterende dropout_loss representeert de RMSE die is verkregen na permutatie van de overeenkomstige variabele21,22. In de oorspronkelijke analytische workflow werden variabelen met een dropout loss < 0,281 over alle modellen behouden, en genen die in alle vier de modellen voorkwamen, werden gedefinieerd als consensus-featuregenen voor daaropvolgende validatie.
De vier machine-learningmodellen werden primair gebruikt voor feature-prioritering in plaats van voor het construeren van een definitieve klinische classifier. Bijgevolg werd de diagnostische discriminatie vervolgens op individueel genniveau geëvalueerd met behulp van ROC-analyse in zowel de discovery- als de validatiedatasets.
Identificatie van kandidaat-biomarkers
In GSE142025 en GSE96804 werden expressieverschillen in kenmerkgenen tussen DN- en controlemonsters geëvalueerd met de Wilcoxon-test. Alleen genen met een significante differentiële expressie (P < 0,05) en concordante expressietrends over de twee datasets werden geselecteerd voor analyse van de receiver operating characteristic (ROC)-curve. Het pROC-pakket (v1.18.0) werd gebruikt om ROC-curves te genereren en de area under the curve (AUC) te berekenen, waarbij genen met een AUC > 0,7 in beide datasets werden geclassificeerd als kandidaat-biomarkers23.
Gene set enrichment analysis (GSEA)
De biologische functies en signaleringspaden die geassocieerd zijn met de kandidaat-biomarkers werden verder onderzocht met behulp van GSEA op de GSE142025-dataset. Eerst werd een Spearman-correlatieanalyse van de kandidaat-biomarkers met alle overige genen uitgevoerd met het psych-pakket (v2.2.9)24. De correlatiecoëfficiënten werden berekend en gerangschikt (van hoog naar laag). De referentie-genenset was c2.cp.kegg.v2023.1.Hs.symbols.gmt uit de Molecular Signatures Database (MSigDB, https://www.gsea-msigdb.org/gsea/msigdb/). Vervolgens werd GSEA uitgevoerd om de verrijking van de gerangschikte genen in de achtergrond-genenset te evalueren met behulp van het clusterProfiler-pakket (v4.6.2). Correctie voor meervoudig testen werd toegepast via de FDR-methode, en aangepaste P-waarden (aangeduid als P.adjust) werden als significant beschouwd indien deze < 0,05 waren.
m6A-modificatieanalyse
Om RNA-methyleringsmodificaties van kandidaat-biomarkers te onderzoeken, is de SRAMP-database (http://www.cuilab.cn/sramp/) gebruikt om m6A-modificatieplaatsen op kandidaat-biomarkers te voorspellen, waarbij de focus lag op posities met een hoge betrouwbaarheid binnen hun secundaire structuren. Vervolgens is de ENCORI-database (https://starbase.sysu.edu.cn/) gebruikt om m6A-gemodificeerde eiwitten te identificeren die interageren met kandidaat-biomarkers, waarbij de parameter |HepG2 (shRNA)| > 1 is gebruikt om sleuteleiwitten te screenen. Daarna is de RPISeq-database (http://pridb.gdcb.iastate.edu/RPISeq/) gebruikt om de waarschijnlijkheid van interacties tussen sleuteleiwitten en kandidaat-biomarkers te voorspellen. De RNA-sequenties van beide zijn in platte tekst geüpload om RF- en SVM-classifier-voorspellingsscores te genereren. Een interactie werd als significant beschouwd wanneer de score boven de 0,5 uitkwam25. De SRAMP-analyse werd uitgevoerd met de 'High'-drempelwaarde voor m6A-plaatsvoorspelling, gebruikmakend van de 'Transcript'-modus en standaardparameters. Voor de ENCORI-analyse is de 'miRNA-mRNA'-interactiefunctie gebruikt met de parameter 'HepG2 (shRNA)' > 1. Voor de RPISeq-analyse is de RF-classifier met standaardparameters gebruikt; scores > 0,5 wezen op een positieve interactie. Dit zijn computationele voorspellingen en geen experimenteel bewijs van m6A-modificatie of RNA-eiwitinteracties in nierweefsel. Het HepG2-shRNA-criterium is afgeleid van de vooraf berekende datasets van ENCORI en weerspiegelt mogelijk geen nierspecifieke regulatie.
Analyse van immueninfiltratie
Het CIBERSORT-algoritme werd toegepast om de proporties van 22 immuunceltypen te schatten in zowel controle- als DN-monsters uit GSE142025, met visualisatie via een heatmap gegenereerd met het ggplot2-pakket (v3.3.6)26. CIBERSORT werd uitgevoerd met gebruik van de LM22-signatuurmatrix, met 1.000 permutaties en uitgeschakelde kwantielnormalisatie (zoals aanbevolen voor microarray-data). Monsters met een CIBERSORT p < 0,05 werden behouden voor verdere analyse. CIBERSORT schat immuuncelfracties op basis van bulkexpressie van nierweefsel, wat compartimentspecifieke infiltratie (bijv. glomerulair versus tubulo-interstitieel) niet kan oplossen en infiltrerende leukocyten niet kan onderscheiden van residente immuuncellen. De gerapporteerde correlaties bevinden zich dus op weefselniveau en dienen te worden gevalideerd met spatiale methoden. De Spearman-correlatieanalyse tussen immuuncellen met een differentieel abundantieniveau en kandidaat-biomarkers werd uitgevoerd met het psych-pakket.
Constructie van netwerken en moleculaire docking
Micro-RNA's (miRNA's) die interageren met kandidaat-biomarkers werden voorspeld met behulp van de miRNet-database (https://www.mirnet.ca). Vervolgens werden long noncoding RNA's (lncRNA's) die gericht zijn op de geïdentificeerde miRNA's voorspeld via de TarBase- (http://www.diana.pcbi.upenn.edu/tarbase) en starbase-databases (http://starbase.sysu.edu.cn/). lncRNA's die in beide databases voorkwamen, werden geselecteerd voor de netwerkconstructie. Vervolgens werd een lncRNA-miRNA-mRNA-regulatienetwerk gebouwd met behulp van Cytoscape-software. Potentiële actieve ingrediënten die gericht zijn op kandidaat-biomarkers werden gekozen om een netwerk van actieve ingrediënten en biomarkers te construeren. Daarnaast werden actieve ingrediënten, kandidaat-biomarkers en pathways die in GSEA waren geïdentificeerd, in Cytoscape geïntegreerd om een netwerk van actieve ingrediënten-biomarkers-pathways te creëren.
Er werd een moleculaire docking-analyse uitgevoerd om de bindingsaffiniteit tussen potentiële actieve bestanddelen en kandidaat-biomarkers te beoordelen. De 3D-structuren van de biomarker-eiwitten werden verkregen in PDB-bestandsformaat uit de Research Collaboratory for Structural Bioinformatics Protein Data Bank (RCSB PDB, https://www.rscb.org/pdb). De 2D-structuren van de potentiële actieve bestanddelen werden in SDF-formaat opgehaald uit de PubChem-database (http://pubchem.ncbi.nlm.nih.gov). De moleculaire docking werd uitgevoerd met behulp van het CB-Dock-platform (http://clab.labshare.cn/cb-dock/php/blinddock.php). Een bindingsenergie van minder dan -5 kcal/mol duidde op een sterke bindingsaffiniteit27.
Bereiding en authenticatie van Ligustri Lucidi Fructus
Hier verwijst Ligustri Lucidi Fructus (LLF) naar de gedroogde rijpe vrucht van Ligustrum lucidum W. T. Aiton (Oleaceae). Het botanisch materiaal werd geauthenticeerd volgens de Chinese Farmacopee, en een bewijsexemplaar met nummer 20240506,20240911,20241103 werd gedeponeerd bij de Shanxi University of Traditional Chinese Medicine.
Voor de bereiding van het decoct werden 200 g gekwalificeerde LLF-plakjes gedurende 30 min bij kamertemperatuur geweekt in 1.000 mL gedestilleerd water. Het mengsel werd krachtig gekookt en vervolgens 60 min zachtjes laten sudderen. Het filtraat werd verzameld en het resterende kruidenmateriaal werd herhaaldelijk gedecocteerd met opnieuw 1.000 mL gedestilleerd water gedurende 60 min. De twee filtraten werden gecombineerd, gefilterd, gecentrifugeerd en onder vacuüm geconcentreerd om een uiteindelijke voorraadconcentratie van 1 g ruw drugmiddel/mL te verkrijgen (totaal volume van 100 mL). Het bereide decoct werd bewaard bij 4 °C voor kortstondig gebruik of bij −20 °C voor langdurige bewaring. De kwaliteit van LLF en het decoct werd strikt geïdentificeerd en geverifieerd volgens de normen van de Chinese Farmacopee om de betrouwbaarheid en reproduceerbaarheid van de experimenten te waarborgen.
Voor kwalitatieve identificatie werd dunne-laagchromatografie uitgevoerd. Kort samengevat werd een geschikt volume van het bereide decoct gecentrifugeerd en werd het supernatant geëxtraheerd met methanol. Na filtratie werden de monsteroplossing en de referentiestandaardoplossing van specnuezhenide op dezelfde silica gel G-plaat gespot. Na ontwikkeling, droging en inspectie onder ultraviolet licht vertoonde de vlek van de monsteroplossing een overeenstemmende kleur en positie met de referentieverbinding, waarmee het bestaan van de karakteristieke bioactieve component van LLF werd bevestigd.
Voor kwantitatieve kwaliteitscontrole werd detectie via hogedrukvloeistofchromatografie uitgevoerd. De analyse werd uitgevoerd met een C18-kolom en methanol-water als mobiele fase. De detectiegolflengte werd ingesteld op 224 nm. Het gehalte aan specnuezhenide in het decoct werd bepaald op basis van de standaardcurve. De resultaten toonden een stabiele en uniforme chemische samenstelling van het bereide decoct aan, waardoor een consistente drugskwaliteit tijdens het dierexperiment werd gewaarborgd.
Dierproeven
Twaalf mannelijke db/db-muizen van SPF-kwaliteit (8–9 weken oud) en zes leeftijd-gematched db/m-muizen werden gehouden in de SPF-dierfaciliteit van de Shanxi University of Traditional Chinese Medicine. Voorafgaand aan de experimenten werden de dieren 7 dagen geacclimatiseerd onder een cyclus van 12 u licht/12 u donker met ad libitum toegang tot voedsel en water. De studie werd goedgekeurd door de Ethiekcommissie van de Shanxi University of Traditional Chinese Medicine (Goedkeuringsnr. 2022DW167). Dieren met een gewichtsverlies van >20%, een moribunde toestand of onvermogen om toegang te krijgen tot voedsel of water werden humaan geëuthanaseerd vóór het geplande eindpunt van de studie. Aan het einde van de studie werden alle overgebleven muizen geëuthanaseerd via intraperitoneale injectie van pentobarbitalnatrium, gevolgd door cervicale dislocatie in overeenstemming met de institutionele protocollen.
Na de acclimatisatieperiode werd de vestiging van een DN-model in db/db-muizen bevestigd door een bloedglucosegehalte in de staartader van ≥ 16 mmol/L en microalbuminurie, aangetoond door een positieve urinestrip voor microalbumine. Na de succesvolle vestiging van het DN-model werden de db/db-muizen willekeurig verdeeld over twee groepen (n = 6 per groep): de DN-modelgroep (DN) en de LLF-behandelingsgroep (Treatment). Bovendien werden db/m-muizen (n = 6) gebruikt als controlegroep (Control). De dosering werd gekozen op basis van eerdere farmacodynamische studies van LLF bij diabetische ratten en werd omgerekend naar de menselijke equivalente dosis met behulp van normalisatie van het lichaamsoppervlak28. De Control- en DN-groepen kregen gedestilleerd water, terwijl de behandelingsgroep gedurende 8 weken 3,5 g/kg LLF ontving. Na 8 weken van toediening werden alle muizen geëuthanaseerd om serum, urine en nierweefsel te verzamelen voor vervolganalyses.
Bloed- en urine-indicatoren
Serumglucosewaarden werden geanalyseerd met een volledig automatische bloedbiochemie-analyser. De urinaire microalbumineconcentratie werd gemeten volgens de instructies van de kit (Aanvullend bestand 1).
Pathologische observatie van muisnierweefsels
Nierweefsels werden verwerkt voor histopathologisch onderzoek. Na fixatie in 4% paraformaldehyde werden de weefsels gewassen, gedehydrateerd, ingebed in paraffine en in coupes gesneden. Vervolgens werd hematoxyleen en eosine (HE) kleuring uitgevoerd, waarna de gekleurde coupes onder een optische microscoop werden onderzocht om pathologische veranderingen te evalueren.
Kwantitatieve reverse transcriptie polymerasekettingreactie (RT-qPCR)
RT-qPCR werd gebruikt om de expressie van de kandidaat-biomarkers in muisnierweefsel te bepalen. Totaal RNA werd geëxtraheerd volgens de instructies van de fabrikant, waarna de RNA-concentratie en -kwaliteit werden beoordeeld (Tabel 1). cDNA werd gesynthetiseerd uit het geëxtraheerde RNA met behulp van de cDNA Synthesis Kit. Amplificatie werd uitgevoerd met de primerparen vermeld in Tabel 1, waarbij GAPDH als referentiegen werd gebruikt. Relatieve expressieniveaus werden berekend met de 2−ΔΔCt methode13,26.
Statistische analyse
Alle statistische analyses zijn uitgevoerd met R-software (versie 4.2.2) in combinatie met de software die vereist was voor de overeenkomstige experimentele procedures. Tenzij anders aangegeven, waren alle statistische tests tweezijdig en werden verschillen als statistisch significant beschouwd bij P < 0,05. De transcriptomische analyse van differentiële expressie werd uitgevoerd met het limma-pakket. Genen met een aangepaste P < 0,05 en een absolute log2fold change groter dan 0,5 werden gedefinieerd als differentieel tot expressie gebracht.
Voor vergelijkingen van de expressie van kandidaatgenen tussen onafhankelijke DN- en controlesamples werden non-parametrische Wilcoxon rank-sum tests gebruikt, zoals aangegeven in de oorspronkelijke analytische workflow. Correlaties tussen kandidaatbiomarkers en immuuncelfracties werden beoordeeld met behulp van de rankcorrelatie van Spearman.
Experimentele gegevens worden weergegeven als het gemiddelde ± SD. Vergelijkingen tussen de drie onafhankelijke diergroepen werden uitgevoerd met behulp van een eenweg-variantieanalyse wanneer aan de aannames voor parametrische analyse werd voldaan. Voor post-hocvergelijkingen werd de test voor het kleinst significante verschil gebruikt wanneer de varianties homogeen waren, terwijl de T3-test van Dunnett werd gebruikt wanneer de varianties ongelijk waren. De baseline- en week-8-farmacodynamische metingen werden afzonderlijk geanalyseerd en gepresenteerd; er is geen conclusie getrokken met betrekking tot een interactie tussen groep en tijd. De R-scripts en brondata die zijn gebruikt voor de bio-informatica- en machine-learninganalyses zijn beschikbaar in Aanvullend bestand 1.
Resultaten
Om systematisch potentiële mitochondria-gerelateerde kandidaat-biomarkers voor LLF bij de behandeling van DN te onderzoeken, hebben we een analytische workflow bestaande uit vier fasen ontworpen (Figuur 1). In Fase I hebben we transcriptomische gegevens uit de dataset GSE142025 (trainingsset, gehele nier, n=36) en GSE96804 (validatieset, glomerulus, n = 61) geïntegreerd met 1.136 mitochondria-gerelateerde genen uit de MitoCarta 3.0-database en 517 voorspelde targets van 9 actieve bestanddelen uit de TCMSP-database. De overlap tussen deze drie gensets leverde 9 kandidaat-genen op. In Fase II werden vier machine learning-modellen (RF, KNN, PLS en SVM) toegepast om feature-genen te prioriteren, waarbij een RMSE < 0,281 als drempelwaarde werd gehanteerd. Cross-dataset validatie via ROC-analyse (AUC > 0,7 in beide datasets) identificeerde vier kandidaat-biomarkers: CAT, FABP1, MAOB en MAOA. In Fase III hebben we GSEA uitgevoerd om verrijkte KEGG-pathways te identificeren, immuuninfiltratie-analyse uitgevoerd met CIBERSORT, m6A-modificatievoorspellingen gedaan en lncRNA-miRNA-mRNA-, actieve bestanddeel–biomarker- en actieve bestanddeel–biomarker–pathway-netwerken geconstrueerd, gevolgd door molecular docking. In Fase IV werden de farmacodynamische effecten van LLF en veranderingen in de mRNA-expressie van de vier kandidaat-biomarkers geëvalueerd in een db/db-muismodel van DN.
Screening van kandidaatgenen voor LLF-behandeling van DN
In de GSE142025-dataset werden 3.810 DEG's geïdentificeerd tussen de DN- en controlegroepen, waaronder 1.904 upgereguleerde en 1.906 downgereguleerde DEG's (Figuur 2A,B). Dertien actieve bestanddelen van LLF werden voorspeld met behulp van de TCMSP-database, namelijk beta-sitosterol, kaempferol, taxifolin, Lucidumoside D, Lucidumoside D_qt, (20S)-24-ene-3,20-diol-3-acetate, eriodictyol, syringaresinol diglucoside_qt, Lucidusculine, Olitoriside, Olitoriside_qt, luteolin en quercetin (Tabel 2). Vier actieve bestanddelen — Lucidumoside D_qt, (20S)-24-ene-3,20-diol-3-acetate, syringaresinol diglucoside_qt en Olitoriside_qt — voorspelden geen potentiële doelgenen, terwijl de overige negen bestanddelen 517 potentiële doelgenen voorspelden. Door de 3.810 DEG's, 1.136 MRG's en 517 potentiële doelgenen te overlappen, werden negen kandidaatgenen geïdentificeerd: GPX1, BAX, CASP8, MAOA, MAOB, CAT, AKR1B10, ALDH2 en FABP1 (Figuur 2C). Vervolgens werd een netwerk van actieve bestanddelen en kandidaatgenen geconstrueerd (Figuur 2D). Deze negen kandidaatgenen waren verrijkt in 341 GO-termen, waaronder respons op toxische stoffen, katabool proces van organische hydroxyverbindingen en cellulaire detoxificatie (Figuur 2E). Daarnaast waren ze geassocieerd met 52 KEGG-paden, zoals tryptofaanmetabolisme, neurodegeneratieve paden en histidinemetabolisme (Figuur 2F).
Screening van kandidaat-biomarkers voor DN-behandeling in LLF
Het PPI-netwerk onthulde zeven knooppunten en acht verbindingen, waarbij MAOA, ALDH2, MAOB en AKR1B10 interacteerden (Figuur 3A). Genen met RMSE-waarden kleiner dan 0,281 over vier machine learning-modellen werden geïdentificeerd als kenmerkgenen: CAT, MAOB, MAOA, BAX en FABP1 (Figuur 3B-E). Expressieanalyse toonde aan dat CAT, FABP1, MAOB en MAOA significant verschilden tussen de DN- en controlegroepen en consistent waren in zowel de GSE142025- als GSE96804-datasets (Figuur 3F,G). Bovendien overschreden hun AUC-waarden in de ROC-curveanalyse 0,7 in beide datasets, wat aangeeft dat deze genen DN-monsters effectief konden onderscheiden van controlemonsters en kunnen dienen als kandidaat-biomarkers voor DN-behandeling in LLF (Figuur 4A-H).
Significante verrijking van kandidaat-biomarkers in ontstekings- en immuungerelateerde signaalpaden
GSEA identificeerde vier kandidaat-biomarkers die prominent verrijkt waren in het chemokine-signaleringspad en cytokine-cytokinereceptorinteracties (Figuur 5A-D). Hiervan vertoonde het peroxidase-signaleringspad een significante associatie met CAT, MAOA en MAOB.
Correlatie van kandidaatbiomarkers met immuuncellen
Opmerkelijke verschillen in de expressie van negen immuunceltypen - naïeve B-cellen, M0-macrofagen, M1-macrofagen, M2-macrofagen, geactiveerde mestcellen, geactiveerde NK-cellen, rustende memory CD4+ T-cellen, naïeve CD4+ T-cellen en CD8+ T-cellen — werden waargenomen tussen de DN- en controlemonsters (P < 0,05) (Figuur 6A,B). Een significante positieve correlatie (cor = 0,6) werd gevonden tussen naïeve B-cellen en geactiveerde NK-cellen, terwijl een significante negatieve correlatie (cor = -0,69) werd gedetecteerd tussen naïeve B-cellen en geactiveerde mestcellen (Figuur 6C). Alle kandidaatbiomarkers vertoonden sterke negatieve correlaties met CD8+ T-cellen en geactiveerde mestcellen en positieve correlaties met geactiveerde NK-cellen en naïeve B-cellen (Figuur 6D).
Interactie van belangrijke gemodificeerde m6A-proteïnen met kandidaat-biomarkers
De m6A RNA-methyleringsmodificatie heeft een diepgaand effect op de RNA-synthese en het metabolisme en is betrokken bij de pathogenese van diverse ziekten29. De locaties van de m6A-modificatieplaatsen in de kandidaat-biomarkers en hun posities met een hoge betrouwbaarheid in de secundaire structuren zijn weergegeven in Figuur 7A-H. Verdere analyse toonde aan dat belangrijke m6A-gemodificeerde proteïnen die interageren met CAT AQR en RBM22 omvatten, terwijl FABP1 interageerde met zowel SF3A3 als AQR. MAOA bleek te interageren met IGF2BP3 en IGF2BP2, en MAOB met TIA1 (Tabel 3).
Gunstig in silico bindingsvoorspellingen voor taxifoline, bèta-sitosterol en eriodictyol in LLF bij de behandeling van DN
In miRNet, CAT werd voorspeld om te interageren met 24 miRNA's, terwijl FABP1 was geassocieerd met vijf miRNA's. Daarnaast MAOB en MAOA waren respectievelijk gekoppeld aan 29 en 26 miRNA's. Hiervan werden 23 lncRNA's geïdentificeerd in zowel de TarBase- als de Starbase-database. Vervolgens werd een lncRNA-miRNA-mRNA-regulatienetwerk geconstrueerd, bestaande uit vier kandidaat-biomarkers, 74 miRNA's en 23 lncRNA's (Figuur 8A)Potentiële actieve bestanddelen die gericht zijn op de kandidaat-biomarkers omvatten luteoline, bèta-sitosterol, eriodictyol, kaempferol, quercetine en taxifoline (Figuur 8B)Bovendien werd een netwerk van actieve bestanddelen-biomarkers-signaalpaden vastgesteld op basis van de actieve bestanddelen, kandidaat-biomarkers en de vijf belangrijkste signaalpaden die via GSEA waren geïdentificeerd. (Figuur 8C)Bijvoorbeeld, taxifoline richtte zich op CAT in de peroxisoomroute. De bindingsenergieën tussen CAT en taxifoline (-8,8 kcal/mol), FABP1 en beta-sitosterol (-8,1 kcal/mol), en MAOB en eriodictyol (-9,8 kcal/mol) lagen allemaal onder de -5 kcal/mol, wat wijst op sterke affiniteiten tussen deze kandidaat-biomarkers en hun respectievelijke actieve bestanddelen27Taxifoline, bèta-sitosterol en eriodictyol werden geïdentificeerd als potentiële actieve bestanddelen met gunstige in silico bindingsvoorspellingen in LLF bij de behandeling van DN (Figuur 8D-F)Ze worden echter gepresenteerd als door de database voorspelde bestanddelen in plaats van bevestigde bioactieve tussenproducten van de waargenomen in vivo effecten.
Valideer kandidaat-biomarkers in het DN-muismodel
Farmacodynamische evaluatie van LLF bij de behandeling van DN-muizen
Tijdens de toedieningsperiode werden de bloedglucosespiegel en de urinary microalbuminegehaltes bij de muizen gemonitord (Figuur 9A-D). In vergelijking met de controlegroep waren de bloedglucose en het urinary microalbumine in de DN-modelgroep significant verhoogd (P < 0,01); in vergelijking met de DN-modelgroep waren de bloedglucosespiegels van de muizen in de behandelgroep significant verlaagd na 4 weken toediening (P < 0,01) en was het urinary microalbumine van de muizen in de behandelgroep significant verlaagd na 8 weken toediening (P < 0,05). De resultaten suggereren dat LLF gunstig kan zijn bij de behandeling van DN.
Pathologische evaluatie van LLF bij de behandeling van DN-muizen
Na HE-kleuring vertoonde de controlegroep duidelijke glomerulaire structuren in het nierweefsel. In tegenstelling hiermee vertoonde de DN-modelgroep, vergeleken met de normale groep, glomerulaire nucleaire pyknose en hyperchromasie, samen met infiltratie van ontstekingscellen rond de glomeruli. Behandeling met LLF verbeterde de pathologische schade in de nieren van db/db-muizen (Figuur 9E).
RT-PCR-analyse van de expressie van kandidaat-biomarkers in DN-muizen
Na de succesvolle totstandkoming van een DN-muismodel en de waarneming van een significante verbetering van de symptomen na behandeling met LLF, werd RT-qPCR verder gebruikt om de veranderingen in kandidaat-biomarkers te analyseren. In vergelijking met de controlegroep vertoonde de DN-groep een significant verlaagde expressie van CAT en MAOA (P < 0,05 of P < 0,001). Omgekeerd vertoonde de behandelgroep een significant hogere CAT- en MAOA-expressie dan de DN-groep (P < 0,05). Er werden echter geen statistisch significante verschillen waargenomen in de expressie van MAOB en FABP1 tussen de groepen (Figuur 9F-I).
Beschikbaarheid van gegevens
De in deze studie geanalyseerde datasets van genexpressie zijn publiekelijk toegankelijk via de Gene Expression Omnibus (GEO) onder de accessienummers GSE142025 en GSE96804. De R-scripts die zijn gebruikt voor de bio-informatische analyses, samen met de experimentele brondata (bloedglucose, urinaire microalbumine en RT-qPCR-gegevens), zijn opgenomen in Aanvullend bestand 1. Alle overige gebruikte databases, software en webbronnen in deze studie zijn vermeld in de Tabel met materialen.
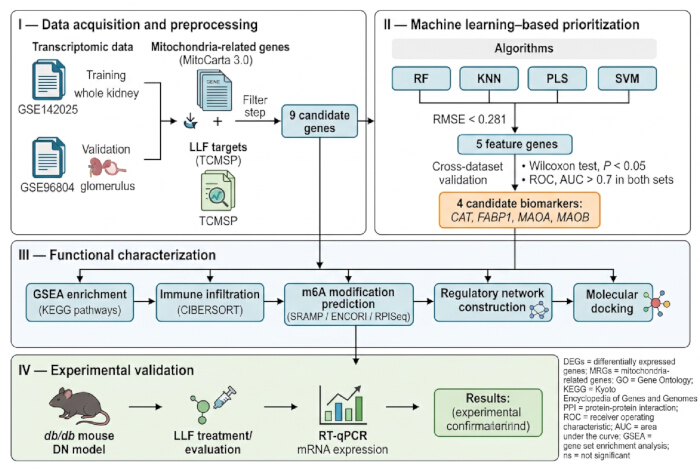
Figuur 1: Workflow van de studie. Transcriptomische datasets, mitochondria-gerelateerde genen en voorspelde targets van Ligustri Lucidi Fructus werden geïntegreerd om kandidaatgenen te identificeren. Vervolgens werden vier machine-learning algoritmen gebruikt om kenmerkgenen te prioriteren, gevolgd door cross-dataset validatie, functionele karakterisering en experimentele validatie in db/db-muizen. Afkortingen: DN = diabetische nefropathie; DEGs = differentieel tot expressie gebrachte genen; MRGs = mitochondria-gerelateerde genen; LLF = Ligustri Lucidi Fructus; RF = random forest; KNN = k-nearest neighbor; PLS = partial least squares; SVM = support vector machine; RMSE = root mean square error; GSEA = gene set enrichment analysis; RT-qPCR = reverse transcription quantitative polymerase chain reaction. Klik hier om een grotere versie van deze figuur te bekijken.
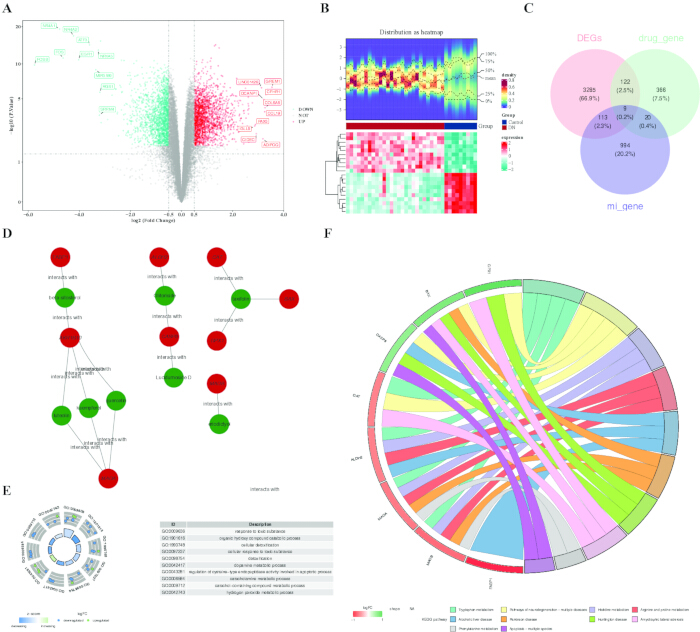
Figuur 2: Screening en functionele karakterisering van kandidaatgenen voor LLF-behandeling van DN. (A) Volcano plot die differentieel tot expressie gekomen genen toont tussen DN- en controlemonsters in GSE142025. (B) Heatmap van de top 10 upgereguleerde en top 10 gedownreguleerde genen, gerangschikt op |log2FC|. (C) Venn-diagram dat de doorsnede van DEGs, MRGs en voorspelde LLF-doelgenen laat zien. (D) Netwerk van actieve bestanddelen en kandidaatgenen. (E) Gene Ontology-verrijkingsanalyse van kandidaatgenen. De balkhoogte vertegenwoordigt de significantie van de verrijking en de z-score geeft de voorspelde richting van de functionele regulatie aan. (F) Kyoto Encyclopedia of Genes and Genomes-padverrijkingsanalyse van kandidaatgenen. Afkortingen: DN = diabetische nefropathie; LLF = Ligustri Lucidi Fructus; DEGs = differentieel tot expressie gekomen genen; MRGs = mitochondria-gerelateerde genen; GO = Gene Ontology; KEGG = Kyoto Encyclopedia of Genes and Genomes. Klik hier om een grotere versie van deze figuur te bekijken.
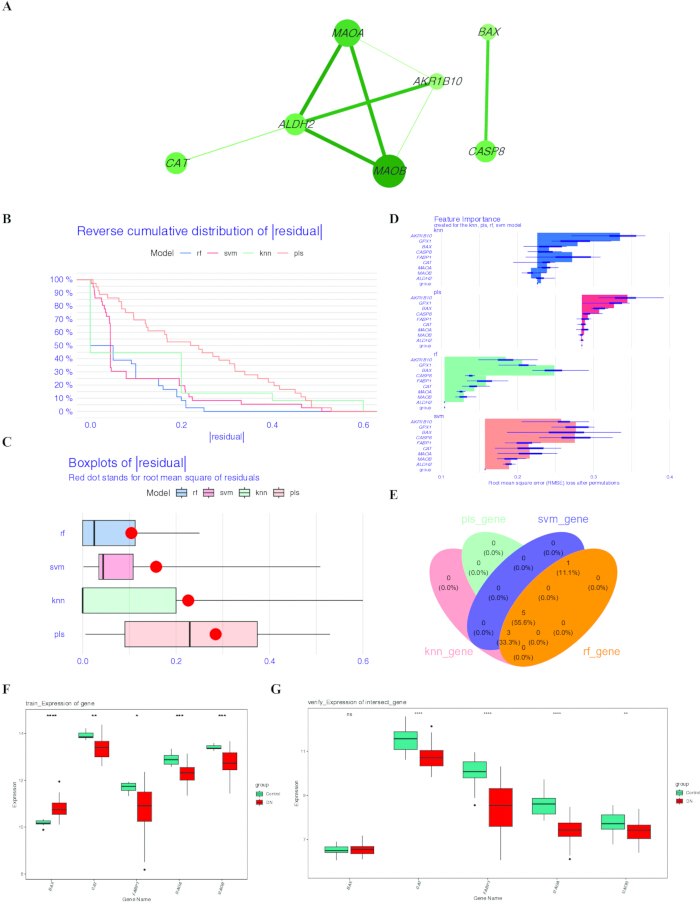
Figuur 3: Machine-learning-gebaseerde identificatie van kandidaat-biomarkers. (A) Protein-protein interactienetwerk van eiwitten gecodeerd door de kandidaatgenen. (B) Omgekeerde cumulatieve distributie van residuen voor de RF-, KNN-, PLS- en SVM-modellen. (C) Boxplots die de residu-distributies van de vier modellen tonen; het rode punt geeft de root mean square error aan. (D) RMSE-gebaseerde belangrijkheid van kandidaatgenen over de vier machine-learning-modellen. (E) Doorsnede van feature-genen die voldoen aan het criterium RMSE < 0.281 over alle vier de modellen. (F,G) Expressie van de geselecteerde feature-genen in respectievelijk GSE142025 en GSE96804. Afkortingen: RF = random forest; KNN = k-nearest neighbor; PLS = partial least squares; SVM = support vector machine; RMSE = root mean square error. Klik hier om een grotere versie van deze figuur te bekijken.
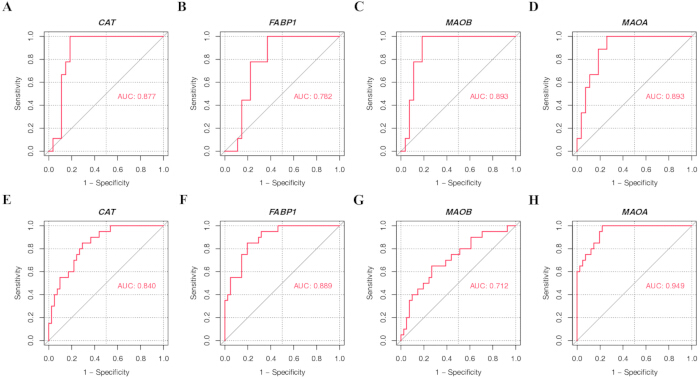
Figuur 4: Receiver operating characteristic-curves van de vier kandidaat-biomarkers. ROC-curves voor CAT, FABP1, MAOB en MAOA in de (A-D) GSE142025 trainingsdataset en (E-H) GSE96804 validatiedataset. De AUC representeert de oppervlakte onder de receiver operating characteristic-curve. Afkortingen: ROC = receiver operating characteristic; AUC = area under the curve. Klik hier om een grotere versie van deze figuur te bekijken.
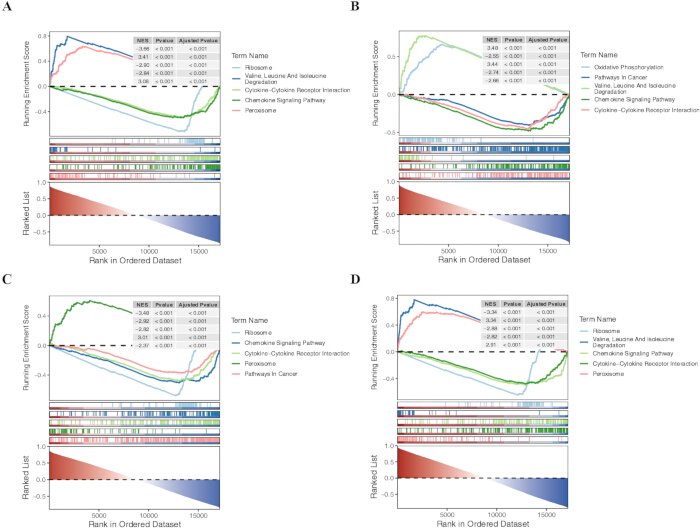
Figuur 5: Gene set enrichment-analyse van kandidaat-biomarkers. GSEA die significant verrijkte KEGG-paden laat zien geassocieerd met (A) CAT, (B) FABP1, (C) MAOA, en (D) MAOB in de GSE142025-dataset. Afkortingen: GSEA = gene set enrichment analysis; KEGG = Kyoto Encyclopedia of Genes and Genomes. Klik hier om een grotere versie van deze figuur te bekijken.
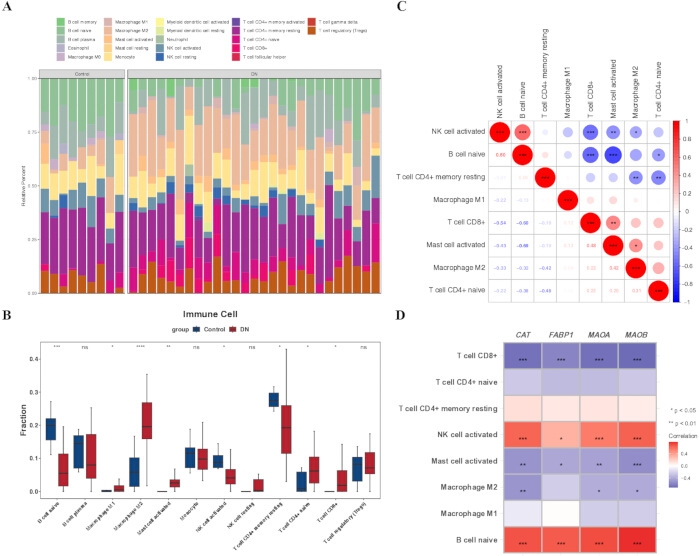
Figuur 6: Immuuncel-infiltratie en de associatie hiermee van kandidaat-biomarkers bij DN. (A) Relatieve proporties van 22 immuunceltypes geschat via CIBERSORT in DN- en controlemonsters. (B) Vergelijking van significant verschillende immuuncel-fracties tussen de DN- en controlegroepen. (C) Correlatiematrix tussen de differentieel abundante immuunceltypes. (D) Spearman-correlaties tussen de expressie van CAT, FABP1, MAOA en MAOB en de differentieel abundante immuunceltypes. Afkortingen: DN = diabetische nefropathie. Klik hier om een grotere versie van deze figuur te bekijken.
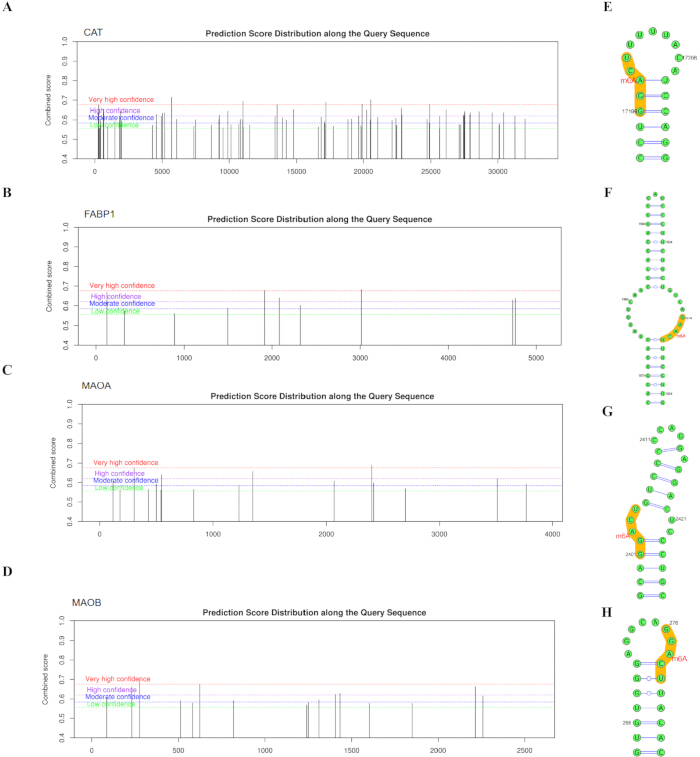
Figuur 7: Voorspelde m6A-modificatieplaatsen en RNA-secundaire structuren van kandidaat-biomarkertranscripten. Voorspelde m6A-modificatieplaatsen in (A) CAT, (B) FABP1, (C) MAOA en (D) MAOB. Voorspelde RNA-secundaire structuren die regio's met een hoge betrouwbaarheid voor m6A-associatie tonen van (E) CAT, (F) FABP1, (G) MAOA en (H) MAOB. Geel gemarkeerde regio's geven de voorspelde sequentieregio's aan die m6A-modificatieplaatsen bevatten. Afkorting: m6A = N6-methyladenosine. Klik hier om een grotere versie van deze figuur te bekijken.
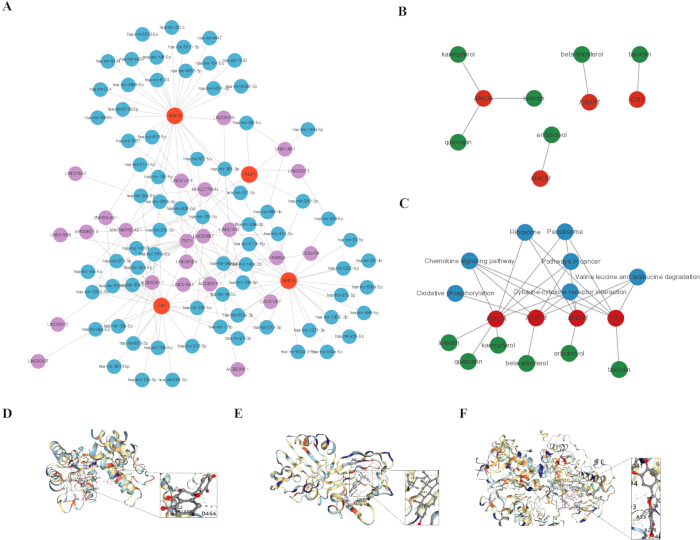
Figuur 8: Regulatoire netwerken en moleculaire docking van potentiële actieve bestanddelen van LLF. (A) Voorspeld lncRNA–miRNA–mRNA regulatoir netwerk met betrokkenheid van de kandidaat-biomarkers. (B) Netwerk van potentiële LLF actieve bestanddelen en kandidaat-biomarkers. (C) Netwerk van actieve bestanddelen–biomarkers–paden gebaseerd op de GSEA-resultaten. (D-F) Voorspelde moleculaire docking-conformaties van (D) CAT met taxifoline, (E) FABP1 met bèta-sitosterol en (F) MAOB met eriodictyol. Afkortingen: LLF = Ligustri Lucidi Fructus; lncRNA = long noncoding RNA; miRNA = microRNA; GSEA = gene set enrichment analysis. Klik hier om een grotere versie van deze figuur te bekijken.
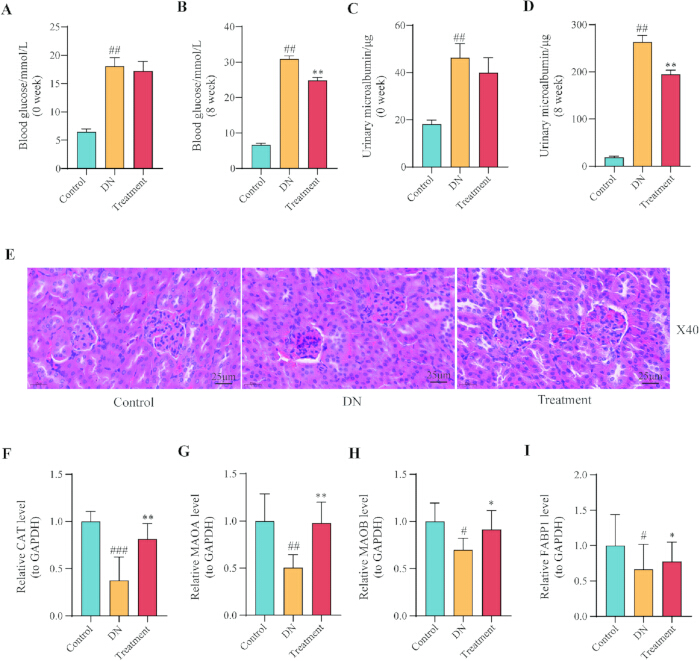
Figuur 9: Effecten van LLF-behandeling op biochemische indicatoren, renale histopathologie en expressie van kandidaat-biomarkers in db/db-muizen. (A,B) Bloedglucosewaarden respectievelijk bij baseline en in week 8. (C,D) Urinaire microalbuminewaarden respectievelijk bij baseline en in week 8. (E) Representatieve met hematoxyline en eosine gekleurde nierd doorsneden van de Controle-, DN- en Behandelingsgroepen (vergroting, ×40; schaalbalk = 25 µm). (F-I) Relatieve renale mRNA-expressieniveaus van respectievelijk Cat, Maoa, Maob en Fabp1, gemeten via RT-qPCR. #P < 0,05, ##P < 0,01 en ###P < 0,001 ten opzichte van de Controlegroep; *P < 0,05, **P < 0,01 en ***P < 0,001 ten opzichte van de DN-groep. Afkortingen: LLF = Ligustri Lucidi Fructus; DN = diabetische nefropathie; RT-qPCR = reverse transcription quantitative polymerase chain reaction. Klik hier om een grotere versie van deze figuur te bekijken.
| primer | sequenties |
| CAT F | TCACTGACGAGATGGCACAC |
| CAT R | ATCGAACGGCAATAGGGGTC |
| FABP1 F | CAATAGGTCTGCCCGAGGAC |
| FABP1 R | GTCATGGTCTCCAGTTCGCA |
| MAOB F | GCACTGAAACAGCCTCACAC |
| MAOB R | TCGTGCAGGGACATCCAAAG |
| MAOA F | ACTTACCCATTCCGTGGTGC |
| MAOA R | ACCACAGGGCAGATACCTCA |
| M-GAPDH F | CCTTCCGTGTTCCTACCCC |
| M-GAPDH R | GCCCAAGATGCCCTTCAGT |
Tabel 1: Primersequenties gebruikt voor RT-qPCR-analyse van muierniertweefsels. Afkortingen: F = forward primer; R = reverse primer; RT-qPCR = reverse transcription quantitative polymerase chain reaction.
| Molecuul-ID | Molecuulnaam | OB (%) | DL | Doelgetal |
| MOL000358 | bèta-sitosterol | 36.91 | 0.75 | 100 |
| MOL000422 | kaempferol | 41.88 | 0.24 | 103 |
| MOL004576 | taxifoline | 57.84 | 0.27 | 92 |
| MOL005146 | Lucidumoside D | 48.87 | 0.71 | 104 |
| MOL005147 | Lucidumoside D_qt | 54.41 | 0.47 | 0 |
| MOL005169 | (20S)-24-ene-3,20-diol-3-acetaat | 40.23 | 0.82 | 0 |
| MOL005190 | eriodictyol | 71.79 | 0.24 | 101 |
| MOL005195 | syringaresinol-diglucoside_qt | 83.12 | 0.8 | 0 |
| MOL005209 | Lucidusculine | 30.11 | 0.75 | 105 |
| MOL005211 | Olitoriside | 65.45 | 0.23 | 100 |
| MOL005212 | Olitoriside_qt | 103.23 | 0.78 | 0 |
| MOL000006 | luteoline | 36.16 | 0.25 | 102 |
| MOL000098 | quercetine | 46.43 | 0.28 | 103 |
Tabel 2: Dertien actieve bestanddelen van Ligustri Lucidi Fructus geïdentificeerd met behulp van de TCMSP-database. Afkortingen: OB = orale biobeschikbaarheid; DL = drug-likeness.
| mRNA | Eiwit | RF | SVM |
| CAT | AQR | 0.7 | 0.98 |
| CAT | RBM22 | 0.8 | 0.97 |
| FABP1 | AQR | 0.65 | 0.94 |
| FABP1 | SF3A3 | 0.7 | 0.8 |
| MAOA | IGF2BP2 | 0.75 | 0.97 |
| MAOA | IGF2BP3 | 0.75 | 0.97 |
| MAOB | TIA1 | 0.85 | 0.89 |
Tabel 3: Voorspelde interacties tussen vier mitochondriale biomarker-mRNA's en m6A-gerelateerde RNA-bindende eiwitten. CAT, FABP1, MAOA en MAOB duiden de humane biomarker-mRNA's aan; AQR, RBM22, SF3A3, IGF2BP2, IGF2BP3 en TIA1 duiden de RNA-bindende eiwitten aan. RF- en SVM-scores > 0,5 wijzen op voorspelde RNA-eiwitinteracties. Afkortingen: RF = random forest; SVM = support vector machine.
Aanvullend bestand 1. Bio-informaticascripts en experimentele brondata. Dit archief bevat de R-scripts die zijn gebruikt voor gegevensverwerking, differentieel expressie-analyse, functionele verrijking, machine learning, receiver operating characteristic-analyse, gene set enrichment-analyse, Spearman-correlatieanalyse en CIBERSORT immuuncel-infiltratieanalyse, samen met de brondata voor bloedglucose, urinaire microalbumine en RT-qPCR-experimenten. Klik hier om dit bestand te downloaden.
Discussie
LLF is een veelgebruikt traditioneel Chinees geneesmiddel, dat primair wordt ingezet om de lever en nieren te voeden en om diabetes en de daarmee gepaard gaande complicaties te behandelen. Momenteel zijn er geen specifieke medicijnen of therapieën voor DN, en de behandeling ervan berust hoofdzakelijk op hypoglycemische, hypolipidemische en antihypertensieve behandelingen30,31,32. Deze behandelingen kunnen de progressie van nierbeschadiging echter slechts bij een klein percentage van de patiënten vertragen33. LLF heeft aangetoond nierbeschermende effecten uit te oefenen in DN-ratmodellen door glucose- en lipidemetabolismeverstoringen te corrigeren en oxidatieve stress te verlichten34. Opvallend is dat, als orgaan met een uitzonderlijk hoog mitochondrieel gehalte en zuurstofverbruik, abnormale mitochondriale dynamiek in de nier een cruciale rol speelt in de pathogenese van DN35. Deze studie onthult een nieuw mechanisme waarbij LLF de mitochondriale functie kan beïnvloeden via specifieke kandidaat-biomarkers (CAT, FABP1, MAOB en MAOA) bij de behandeling van DN.
Eerdere studies hebben aangetoond dat catalase (CAT), vetzuurbindend eiwit 1 (FABP1), monoamine-oxidase B (MAOB) en monoamine-oxidase A (MAOA) in variërende mate betrokken zijn bij DN. CAT is betrokken bij het antioxidant-verdedigingssysteem en beschermt de nier tegen schade veroorzaakt door oxidatieve stress36. CAT, een centraal antioxidant-enzym in het lichaam, draagt bij aan de regulatie van het ontstaan en de progressie van DN door mitochondriale fysiologische processen te moduleren37. CAT katalyseert specifiek de ontbinding van waterstofperoxide (H₂O₂) tot water en zuurstof, waardoor ROS afkomstig uit de mitochondriën effectief worden weggevangen. Dit vermindert de door oxidatieve stress veroorzaakte schade aan de mitochondriale structuur en functie, behoudt de stabiliteit van het mitochondriale membraanpotentiaal en de efficiëntie van de oxidatieve fosforylering, waardoor glucose-geïnduceerde nierschade wordt beperkt en de progressie van DN wordt vertraagd38. Bovendien leidt een downregulatie van de CAT-expressie tot onvoldoende scavenging van mitochondriale ROS, wat mitochondriale fragmentatie en verstoring van de cristae verergert. Dit remt de mitochondriale fusie terwijl fissie wordt bevorderd, waardoor de mitochondriale dynamiek verder destabiliseert. Bijgevolg ontwikkelen intrinsieke cellen, zoals mesangiale cellen en podocyten, metabole stoornissen, wat de fibrose van het nierweefsel versnelt39.
FABP1, als lid van de familie van vetzuurbindende eiwitten, is primair betrokken bij het transport, metabolisme en de intracellulaire signalering van langketenige vetzuren. Er is aangetoond dat een abnormale expressie hiervan nauw geassocieerd is met diverse metabole ziekten en nierbeschadiging, waarbij het een cruciale regulerende rol speelt bij de ontwikkeling en progressie van diabetische nefropathie (DN)40. Onderzoek wijst uit dat FABP1 de progressie van DN moduleert door het lipidenmetabolisme te verstoren. Bij diabetes verstoort een abnormale expressie van FABP1 het transport en metabolisme van vetzuren. Overmatige vrije vetzuren en hun metabolieten hopen zich op in het nierweefsel, wat glomerulaire endotheelcellen en tubulaire epitheelcellen direct beschadigt en daarmee nierontsteking en fibrose verergert41. Tegelijkertijd verergert FABP1 de beschadiging van het nierweefsel door oxidatieve stress en hypoxie-geïnduceerde schade te mediëren. De uitscheiding in de urine kan toenemen voordat abnormale albuminespiegels in de urine optreden, wat een nieuw doelwit biedt voor vroege DN-screening en diagnose41,42. Bovendien speelt FABP1 een centrale regulerende rol in het mitochondriale vetzuurmetabolisme43. Studies tonen aan dat upregulatie van FABP1 de efficiëntie van het vetzuurtransport naar de mitochondriën significant verhoogt, de mitochondriale β-oxidatieactiviteit en de activiteit van enzymen in de tricarboxyliczuurcyclus verhoogt en daarmee het cellulaire energiemetabolisme verbetert44. Het mechanisme waarmee FABP1 de pathogenese van DN beïnvloedt via betrokkenheid bij mitochondriale processen blijft echter onduidelijk. In andere DN-gerelateerde aandoeningen zijn MAOB en MAOA, als enzymen betrokken bij het neurotransmittermetabolisme, geassocieerd met de progressie van DN, wat bijdraagt aan een onbalans in de redoxstatus van het weefsel. Deze studie bevestigt verder de cruciale rol van deze vier kandidaat-biomarkers bij DN, waarbij hun expressieniveaus afnemen in de DN-groep. Er wordt verondersteld dat het moduleren van de expressie van deze kandidaat-biomarkers kan helpen bij het verminderen van ontsteking en oxidatieve stress bij DN.
Op basis van GSEA-verrijkingsanalyse waren vier kandidaat-biomarkers—CAT, FABP1, MAOB en MAOA—verrijkt in meerdere signaalpaden, waaronder het chemokine-signaalpad, de cytokine-cytokinereceptorinteractie en peroxisoompaden. Chemokines zijn sleutelcomponenten van de immuunrespons die ontsteking bevorderen. Het peroxidase (POD)-pad is gekoppeld aan oxidatieve stress45. Er is gerapporteerd dat baicalin diabetische nefropathie (DN) verlicht door oxidatieve stress en ontsteking te verminderen, waarbij het mechanisme mogelijk de activering van het NrF2-gemedieerde antioxidant-signaalpad en de inhibitie van het MAPK-gemedieerde ontstekingspad omvat45. Bovendien kan dysregulatie van FABP1 in het lipidenmetabolisme bijdragen aan glomerulaire sclerose en interstitiële fibrose bij DN9. Deze bevindingen suggereren dat de kandidaat-biomarkers een kritieke rol spelen in de ontstekingsprocessen en oxidatieve stress bij DN. Het richten op deze kandidaat-biomarkers om de paden die zij beïnvloeden te moduleren, zou de ontsteking en oxidatieve stress geassocieerd met DN kunnen verminderen, waardoor de progressie ervan wordt vertraagd.
Bio-informatische analyse toonde aan dat de infiltratieniveaus van immuunsubsets, zoals CD8+ T-cellen, in DN-nierweefsel significant veranderden, en dat de toename van CD8+ T-cellen significant en negatief correleerde met de expressie van vier mitochondriële kandidaat-biomarkers (CAT, FABP1, MAOB, MAOA). Deze computationele voorspellingen zijn consistent met de pathologische observatieresultaten van dierproeven: HE-gekleurde coupes van de nieren van muizen in de DN-modelgroep vertoonden duidelijke infiltratie van ontstekingscellen rond de glomeruli; na LLF-interventie was de infiltratie van renale ontstekingscellen in de behandelgroep significant verminderd en was de pathologische schade verbeterd. Dit suggereert dat verhoogde infiltratie van ontstekingscellen een kenmerkend aspect is van DN-nierletsel, en dat LLF mogelijk een beschermende rol speelt door immuuninfiltratie te reguleren. Deze bevinding is consistent met eerdere studies: de infiltratie van CD8+ T-cellen is geassocieerd met de ontwikkeling van DN, en inhibitie van hun respons kan de ziekte verlichten46, wat renal letsel bij Adriamycine-nefropathie ook verergert47. Daarnaast verandert een verscheidenheid aan immuuncellen, zoals B-cellen, M1 / M2 macrofagen en NK-cellen, in de DN-pathologie48. De biomarker CAT kan de functie van immuuncellen bij DN beïnvloeden49, en MAOA kan het immuunmicro-milieu mogelijk beïnvloeden door macrofaagpolarisatie te reguleren. Deze resultaten duiden erop dat het renale beschermende effect van LLF nauw verbonden is met de regulatie van abnormale immuuninfiltratie, waaronder CD8+ T-cellen, waardoor ontstekingsschade wordt verminderd. De negatieve correlaties tussen vier kandidaat-biomarkers en CD8+ T-cellen en geactiveerde mestcellen suggereren dat deze genen het renale immuunmicro-milieu kunnen moduleren. De expressie van CAT is gelinkt aan macrofaagpolarisatie en T-celactiviteit in metabole weefsels. Onze CIBERSORT-schattingen zijn echter afgeleid van bulk-transcriptomen van nierweefsel, die geen onderscheid kunnen maken tussen immuencel-subtypes die infiltreren in glomerulaire versus tubulo-interstitiële compartimenten. De waargenomen correlaties moeten worden geïnterpreteerd als hypothese-genererende associaties en niet als bewijs voor causale immuunregulatie. Toekomstige studies met multiplex immunohistochemie of single-cell RNA-seq zijn vereist om deze interacties tussen immuunrespons en biomarkers te lokaliseren.
Eerdere studies hebben mitochondriale biomarkers bij DN gerapporteerd, waaronder OPA1, MFN2, DRP1, PGC-1α en SOD2. Onze bevindingen over CAT en MAOA vullen deze bestaande literatuur aan door peroxisomale en monoamine-oxidase-routes te belichten die minder aandacht hebben gekregen binnen de mitochondriale context van DN. Opmerkelijk is dat, hoewel SOD2 en GPX1 klassieke ROS-scavenging enzymen zijn, CAT specifiek gericht is op peroxisomaal H2O2, wat wijst op een afzonderlijk subcellulair compartiment voor de regulatie van oxidatieve stress.
Als natuurlijk flavonoid is aangetoond dat Taxifoline (TA) de bloedglucosespiegel, het urinezuur, creatinine en de seruminsulinespiegels bij diabetische ratten significant verlaagt, terwijl het ook pathologische nierveranderingen bij deze dieren vermindert50. β-sitosterol kan DN indirect verbeteren door de lipidebalans te reguleren en ontstekingsremmende effecten uit te oefenen. De β-sitosterolcomponenten in het Huangqi Gegen-decoctum (HGD) participeren in DN-gerelateerde pathways, waarbij moleculen zoals Vascular Endothelial Growth Factor A (VEGFA) en Interleukine-6 (IL-6) als doelwit dienen. Deze effecten omvatten ontstekingsremmende, anti-apoptotische, antioxidant- en autofagische werkingen, die renale fibrose en schade aan de nierschors verminderen en de nierfunctie verbeteren, waardoor de progressie van DN uiteindelijk wordt vertraagd51. Eriodictyol, een ander natuurlijk flavonoid, is aangetoond dat het beschermt tegen ischemische beroertes (IS) door oxidatieve stress en ontsteking in balans te brengen52. Hoewel er beperkte studies zijn naar eriodictyol in de context van DN, is er, gezien de associatie van de ziekte met ontsteking en oxidatieve stress, de hypothese dat het DN via soortgelijke mechanismen kan verlichten. Drug-voorspellingen in deze studie suggereren daarnaast dat Taxifoline, β-sitosterol en eriodictyol potentiële therapeutische effecten hebben bij DN. Moleculaire docking voorspelt mogelijke bindingsconformaties en affiniteiten, maar stelt geen in vivo target-engagement, biologische beschikbaarheid of farmacologische activiteit vast. Deze resultaten moeten worden geïnterpreteerd als hypothese-genererend en niet als bevestigend.
Eerdere netwerkfarmacologische studies naar diabetische nefropathie (DN) hebben zich grotendeels gericht op individuele signaleringspaden (bijv. AGE-RAGE, PI3K-AKT en MAPK) en hebben geen rekening gehouden met mitochondriële dysfunctie of multi-model machine learning ingezet om biomarkers te prioriteren. Onze studie introduceert drie methodologische en biologische verbeteringen: (1) de integratie van transcriptoom-brede differentieel tot expressie gebrachte genen (DEGs) met mitochondriële gensets en drug-target voorspellingen; (2) de toepassing van vier verschillende machine learning-modellen met cross-dataset validatie om robuuste kandidaten te prioriteren; en (3) de identificatie van peroxisomale (CAT) en monoamine-oxidase (MAOA/MAOB) paden—minder bestudeerd in de context van mitochondriën bij DN—als potentiële therapeutische assen.
Het gebrek aan statistisch significante veranderingen in de expressie van MaoB en Fabp1 in de muisnier kan te wijten zijn aan verschillende factoren. Ten eerste waren de twee Gene Expression Omnibus (GEO)-datasets die werden gebruikt voor de prioritering van kandidaten afgeleid van menselijke niermonsters (respectievelijk de gehele nier en de glomerulus), terwijl ons dierproefonderzoek muisnierweefsel gebruikte. Soortspecifieke verschillen in genregulatie kunnen de basale expressieniveaus en de respons op geneesmiddelen beïnvloeden. Ten tweede kan de relatief kleine steekproefomvang (n = 6 per groep) de statistische kracht hebben beperkt om gemiddelde effectgroottes te detecteren. Ten derde werd het weefsel 8 weken na de behandeling verzameld, wat mogelijk niet het optimale venster was voor het detecteren van transcriptomische veranderingen in MaoB en Fabp1, aangezien deze genen mogelijk gereguleerd worden op eiwit- of activiteitsniveau in plaats van op mRNA-niveau. Ten vierde kan weefselheterogeniteit — tussen de gehele nier en specifieke compartimenten — bijdragen aan de discrepanties. Verder onderzoek naar deze mogelijkheden is gerechtvaardigd.
Deze studie maakte gebruik van een integratieve bio-informatica- en machine learning-benadering om CAT, FABP1, MAOA en MAOB te identificeren als potentiële mitochondriale kandidaatgenen voor LLF bij DN. In vivo experimenten bevestigden dat LLF CAT en MAOA significant reguleert in nierweefsel, wat suggereert dat deze genen veelbelovende doelwitten zijn voor verder mechanistisch en therapeutisch onderzoek. In tegenstelling hiermee vertoonden MAOB en FABP1 niet-significante trends in dezelfde richting, wat het belang benadrukt van experimentele validatie bij het prioriteren van computationele voorspellingen. Deze bevindingen bieden een rationale voor toekomstige studies om mitochondriële therapeutische strategieën bij DN te onderzoeken.
Openbaarmakingen
De auteurs hebben geen belangenconflicten te verklaren.
Dankbetuigingen
Wij willen onze oprechte dank uitspreken aan alle personen en organisaties die ons gedurende dit onderzoek hebben ondersteund en bijgestaan. Deze studie werd ondersteund door de National Natural Science Foundation of China (No.81973486 en 82173974), de onderzoeksprojecten van de Traditional Chinese Medicine Administration van de provincie Shanxi (No.2024ZYYA021), het Discipline Project van de Shanxi University of Chinese Medicine (No.2026XK24) en het Scientific Research Fund project van de Shandong University of Chinese Medicine (No. KYZK2024Q13). Wij danken Qinqing Li, Associate Professor aan de Shanxi University of Chinese Medicine, die het botanisch materiaal heeft geauthenticeerd.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| 4% paraformaldehyde-weefselfixeeroplossing | Saiyin Biotechnology Co., Ltd. | 71033600 | |
| Absolute ethanol | Sinopharm Chemical Reagent Co., Ltd. | 10009218 | |
| Bloedglucosemeter | Sinocare Inc. | GA-3 | |
| Blood Urea Nitrogen (BUN) Assay Kit | Nanjing Jianwei Bioengineering Institute | C03-2-1 | |
| C57BLKS/J db/db-muizen | Changzhou Cavens Experimental Animal Co., Ltd. | SCXK (Su) 2021-0013 | |
| C57BLKS/J db/m-muizen | Changzhou Cavens Experimental Animal Co., Ltd. | SCXK (Su) 2021-0013 | |
| Centrifugeeren | Hunan Xiangyi Laboratory Instrument Development Co., Ltd. | HI650 | |
| Chloraalhydraat | Shanghai Aladdin Biochemical Technology Co., Ltd. | 302-17-0 | |
| Cytoscape (v3.9.0) | https://cytoscape.org | ||
| Database voor m6Een voorspelling van een modificatie | http://www.cuilab.cn/sramp/ | ||
| Database van actieve bestanddelen in traditionele Chinese geneeskunde | http://sm.nwsuaf.edu.cn/lsp/tcmsp.php | ||
| ENCORI / Starbase | https://starbase.sysu.edu.cn/ | ||
| Gene Expression Omnibus (GEO) | https://www.ncbi.nlm.nih.gov/geo/ | ||
| Hematoxylin- en eosinekleurset (HE) | Servicebio | C0105S | |
| Snelcentrifuge | Labnet, USA | C2500-R-230V | |
| Instrument voor analyse van immuuninfiltratie | https://cibersort.stanford.edu/ | ||
| Ligustri Lucidi Fructus | Sichuan Quanyirun Biotechnology Co., Ltd. | 20240506 | |
| Magnetische roerder | Jintan Zhongtian Instrument Factory, Jiangsu | T8-1 | |
| Microscoop | Olympus | BX53 | |
| Microtoom | Leica, Duitsland | RM 2016 | |
| Microvolume-spectrofotometer | Hangzhou Aosheng Instrument Co., Ltd. | Nano-300 | |
| miRNet | https://www.mirnet.ca | ||
| MitoCarta 3.0 | https://www.broadinstitute.org/mitocarta | ||
| R-pakket voor modelinterpretatie | https://cran.r-project.org/package=DALEX | ||
| Moleculair Dockingplatform | http://clab.labshare.cn/cb-dock/ | ||
| ELISA-kit voor microalbuminurie bij muizen | Fijne Test | EM0632 | |
| Teststrip voor microalbuminurie bij muizen | Guangzhou Huadu Gaoerbao Biotechnology Co., Ltd. | 20211203 | |
| ELISA-kit voor creatinine in muisserum | Abmart | AB5990A | |
| MSigDB | https://www.gsea-msigdb.org/gsea/msigdb/ | ||
| PCR-thermocycler | Roche | Roche LightCycler 480 | |
| R-software (v4.2.2) + R-pakketten | https://www.r-project.org / CRAN/Bioconductor | ||
| RCSB PDB | https://www.rcsb.org | ||
| RNA-extractiekit | Beijing Jumei Biotech Co., Ltd. | MF-036-01 | |
| RPISeq | http://pridb.gdcb.iastate.edu/RPISeq/ | ||
| RT-qPCR-kit | Beijing Jumei Biotech Co., Ltd. | MF949-T | |
| Salidroside | Sichuan Quanyirun Biotechnology Co., Ltd. | 20211009 | |
| Serum Creatinine Assay Kit | Nanjing Jianwei Bioengineering Institute | C011-2-1 | |
| SPF-dierfaciliteit | Shanxi Universiteit voor Traditionele Chinese Geneeskunde | ||
| SRAMP | SRAMP (Single-cell RNA-seq Analysis and Manipulation Pipeline) is een geïntegreerde tool voor de analyse van single-cell RNA-sequencing-data, die is ontworpen om onderzoekers te ondersteunen bij het efficiënt verwerken van complexe datasets. De pipeline biedt een gestroomlijnde workflow voor kwaliteitscontrole, normalisatie, clustering en celtype-identificatie, waardoor gebruikers in staat zijn biologische inzichten te verkrijgen uit single-cell transcriptoomprofielen. Met een focus op gebruiksvriendelijkheid en reproduceerbaarheid faciliteert SRAMP de overgang van ruwe sequencing-data naar betekenisvolle biologische conclusies. | ||
| U heeft geen brontekst opgegeven om te vertalen. Voeg alstublieft de Engelse tekst toe die u naar het Nederlands vertaald wilt hebben. | https://cn.string-db.org/ | ||
| SwissTargetPrediction | http://www.swisstargetprediction.ch/ | ||
| TCMSP | http://sm.nwsuaf.edu.cn/lsp/tcmsp.php | ||
| Tezhi Pigan | Sichuan Quanyirun Biotechnology Co., Ltd. | 20210602 | |
| Weefseldrijfbad | Wuhan Junjie | JK-6 |
Referenties
- Thipsawat S. Early detection of diabetic nephropathy in patient with type 2 diabetes mellitus: a review of the literature. Diabetes Vasc Dis Res. 2021;18(6):14791641211058856.
- Kanwar YS, Sun L, Xie P, Liu FY, Chen S. A glimpse of various pathogenetic mechanisms of diabetic nephropathy. Annu Rev Pathol. 2011;6:395-423.
- Santulli G, et al. Prediabetes increases the risk of frailty in prefrail older adults with hypertension: beneficial effects of metformin. Hypertension. 2024;81(7):1637-43.
- Jin Q, et al. Oxidative stress and inflammation in diabetic nephropathy: role of polyphenols. Front Immunol. 2023;14:1185317.
- Alicic RZ, Rooney MT, Tuttle KR. Diabetic kidney disease: challenges, progress, and possibilities. Clin J Am Soc Nephrol. 2017;12(12):2032-45.
- Harrington JS, et al. Mitochondria in health, disease, and aging. Physiol Rev. 2023;103(4):2349-422.
- Peña FJ, et al. An integrated overview on the regulation of sperm metabolism (glycolysis-Krebs cycle-oxidative phosphorylation). Anim Reprod Sci. 2022;246:106805.
- de Mello AH, Costa AB, Engel JDG, Rezin GT. Mitochondrial dysfunction in obesity. Life Sci. 2018;192:26-32.
- Shen Y, et al. Notoginsenoside Fc, a novel renoprotective agent, ameliorates glomerular endothelial cells pyroptosis and mitochondrial dysfunction in diabetic nephropathy through regulating HMGCS2 pathway. Phytomedicine. 2024;126:155445.
- Zhang PN, et al. Mitochondrial dysfunction and diabetic nephropathy: nontraditional therapeutic opportunities. J Diabetes Res. 2021;2021:1010268.
- Zhang JL, et al. Structural characterization and protective effect against renal fibrosis of polysaccharide from Ligustrum lucidum Ait. J Ethnopharmacol. 2023;302(Pt A):115898.
- Luan R, et al. The protective effect of ethyl acetate and n-butanol fractions of wine-steamed Ligustri Lucidi Fructus on diabetic nephropathy in rats. Evid Based Complement Alternat Med. 2021;2021:6512242.
- Luan R, et al. Pharmacodynamics, pharmacokinetics, and kidney distribution of raw and wine-steamed Ligustri Lucidi Fructus extracts in diabetic nephropathy rats. Molecules. 2023;28(2):791.
- Seo HL, et al. Liqustri lucidi Fructus inhibits hepatic injury and functions as an antioxidant by activation of AMP-activated protein kinase in vivo and in vitro. Chem Biol Interact. 2017;262:57-68.
- Yan M, et al. Identification of pyroptosis-related genes and potential drugs in diabetic nephropathy. J Transl Med. 2023;21(1):490.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47.
- Gustavsson EK, et al. ggtranscript: an R package for the visualization and interpretation of transcript isoforms using ggplot2. Bioinformatics. 2022;38(15):3844-6.
- Gu Z, Eils R, Schlesner M. Complex heatmaps reveal patterns and correlations in multidimensional genomic data. Bioinformatics. 2016;32(18):2847-9.
- Shannon P, et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-504.
- Wu T, et al. clusterProfiler 4.0: a universal enrichment tool for interpreting omics data. Innovation (Camb). 2021;2(3):100141.
- Dong H, et al. Identification through machine learning of potential immune-related gene biomarkers associated with immune cell infiltration in myocardial infarction. BMC Cardiovasc Disord. 2023;23(1):163.
- Pei B, et al. The development of prediction model for cuffed tracheal tube size from the middle finger in pediatrics: a concise and feasible approach. Transl Pediatr. 2023;12(12):2222-31.
- Robin X, et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77.
- Robles-Jimenez LE, et al. Worldwide traceability of antibiotic residues from livestock in wastewater and soil: a systematic review. Animals (Basel). 2021;12(1):60.
- Wang Y, et al. Bioinformatics analysis combined with clinical sample screening reveals that leptin may be a biomarker of preeclampsia. Front Physiol. 2022;13:1031950.
- Livak KJ, Schmittgen TD. Analysis of relative gene expression data using real-time quantitative PCR and the 2^−ΔΔCT method. Methods. 2001;25(4):402-8.
- Klejborowska G, et al. Synthesis, anticancer activity and molecular docking studies of N-deacetylthiocolchicine and 4-iodo-N-deacetylthiocolchicine derivatives. Bioorg Med Chem. 2021;32:116014.
- Reagan-Shaw S, Nihal M, Ahmad N. Dose translation from animal to human studies revisited. FASEB J. 2008;22(3):659-61.
- An Y, Duan H. The role of m6A RNA methylation in cancer metabolism. Mol Cancer. 2022;21(1):14.
- Mazzieri A, Porcellati F, Timio F, Reboldi G. Molecular targets of novel therapeutics for diabetic kidney disease: a new era of nephroprotection. Int J Mol Sci. 2024;25(7):3969.
- Breyer MD, Susztak K. The next generation of therapeutics for chronic kidney disease. Nat Rev Drug Discov. 2016;15(8):568-88.
- Leoncini G, et al. Blood pressure reduction and RAAS inhibition in diabetic kidney disease: therapeutic potentials and limitations. J Nephrol. 2020;33(5):949-63.
- Pofi R, et al. Diabetic nephropathy: focus on current and future therapeutic strategies. Curr Drug Metab. 2016;17(5):497-502.
- Arellano Buendía AS, et al. Immunomodulatory effects of the nutraceutical garlic derivative allicin in the progression of diabetic nephropathy. Int J Mol Sci. 2018;19(10):3107.
- Zhang X, Agborbesong E, Li X. The role of mitochondria in acute kidney injury and chronic kidney disease and its therapeutic potential. Int J Mol Sci. 2021;22(20):11253.
- Liu Y, et al. DsbA-L interacting with catalase in peroxisome improves tubular oxidative damage in diabetic nephropathy. Redox Biol. 2023;66:102855.
- Zhong Y, et al. Jujuboside A ameliorates high fat diet and streptozotocin induced diabetic nephropathy via suppressing oxidative stress, apoptosis, and enhancing autophagy. Food Chem Toxicol. 2022;159:112697.
- Zhong Y, et al. Dioscin relieves diabetic nephropathy via suppressing oxidative stress and apoptosis, and improving mitochondrial quality and quantity control. Food Funct. 2022;13(6):3660-73.
- Issac PK, et al. Protective effect of morin by targeting mitochondrial reactive oxygen species induced by hydrogen peroxide demonstrated at a molecular level in MDCK epithelial cells. Mol Biol Rep. 2022;49(6):4269-79.
- Abo El-Asrar M, Ismail EAR, Elnhrawy AM, Thabet RA. Fatty acid binding protein 1 (FABP1) and fatty acid binding protein 2 (FABP2) as a link between diabetic nephropathy and subclinical atherosclerosis in children and adolescents with type 1 diabetes. J Diabetes Complications. 2023;37(3):108414.
- Gholaminejad A, Fathalipour M, Roointan A. Comprehensive analysis of diabetic nephropathy expression profile based on weighted gene co-expression network analysis algorithm. BMC Nephrol. 2021;22(1):245.
- Tanaka M, et al. Urinary fatty acid-binding protein 4 is a promising biomarker for glomerular damage in patients with diabetes mellitus. J Diabetes Investig. 2025;16(4):670-9.
- Liu Y, et al. Gastric cancer adapts high lipid microenvironment via suppressing PPARG-FABP1 axis after arriving in the lymph node. Redox Biol. 2025;85:103759.
- Borús DL, et al. Fatty acid binding protein 1 (FABP1) depletion promotes an oxidative metabolic shift in Caco-2 colorectal cancer cells. Biochim Biophys Acta Mol Cell Biol Lipids. 2025;1870(7):159661.
- Chu Y, et al. Glutathione peroxidase-1 overexpression reduces oxidative stress, and improves pathology and proteome remodeling in the kidneys of old mice. Aging Cell. 2020;19(6):e13154.
- Zhang F, et al. Mesenchymal stem cells alleviate rat diabetic nephropathy by suppressing CD103+ DCs-mediated CD8+ T cell responses. J Cell Mol Med. 2020;24(10):5817-31.
- Cao Q, et al. Renal F4/80+ CD11c+ mononuclear phagocytes display phenotypic and functional characteristics of macrophages in health and in adriamycin nephropathy. J Am Soc Nephrol. 2015;26(2):349-63.
- Zhou W, et al. The landscape of immune cell infiltration in the glomerulus of diabetic nephropathy: evidence based on bioinformatics. BMC Nephrol. 2022;23(1):303.
- Bloch K, Shichman E, Vorobeychik M, Bloch D, Vardi P. Catalase expression in pancreatic alpha cells of diabetic and non-diabetic mice. Histochem Cell Biol. 2007;127(2):227-32.
- Zhao Y, et al. Taxifolin attenuates diabetic nephropathy in streptozotocin-induced diabetic rats. Am J Transl Res. 2018;10(4):1205-10.
- Ding S, Wang W, Song X, Ma H. Based on network pharmacology and molecular docking to explore the underlying mechanism of Huangqi Gegen Decoction for treating diabetic nephropathy. Evid Based Complement Alternat Med. 2021;2021:9928282.
- Guo S, et al. Correction: Eriodictyol: a review of its pharmacological activities and molecular mechanisms related to ischemic stroke. Food Funct. 2023;14(10):4949.