Deze studie onderzoekt het besluitvormings- en revisiegedrag van studenten Engelse taal- en letterkunde bij het vertalen van narratieven die gericht zijn op China, waarbij toetsaanslagregistraties en een danmu-corpus worden geïntegreerd om te onthullen hoe tekstuele prominentie de verwerkingsinspanning en de vertaalkwaliteit beïnvloedt.
Onderzoeksartikel
Besluitvorming en revisiegedrag bij vertalingen van het Chinees naar het Engels: bewijs uit vertalingen van China-gecentreerde narratieven door studenten Engelse taal en letterkunde
In dit artikel
Samenvatting
Samenvatting
Nu narratieven over China steeds vaker in internationale circulatie komen, is de vertaling van het Chinees naar het Engels een plek geworden van betekenisnegotiatie in plaats van een eenvoudige linguïstische overdracht. Voor studentvertalers reikt de primaire uitdaging verder dan lexicale selectie; het omvat de beslissing hoe cultuurspecifieke referenties, evaluerende standpunten en narratieve positionering moeten worden weergegeven voor lezers buiten de broncontext. Deze studie onderzoekt de real-time besluitvorming en revisiegedragingen van 72 studenten Engels die narratieven over China vertalen. Met behulp van een proces-productontwerp integreert het onderzoek keystroke-logginggegevens verzameld met Translog-II, evaluaties van de vertaalproducten en een aanvullend danmu-corpus (tijdsgesynchroniseerde commentaren) dat wordt behandeld als een laag van publieke relevantie in plaats van als een directe maatstaf voor linguïstische moeilijkheid op segmentniveau. Vertaalprocessen werden geanalyseerd op basis van pauzeduur, revisiefrequentie, revisielocatie en faseverdeling, terwijl de productkwaliteit werd beoordeeld via expertbeoordeling en gerichte codering van cultuurgerelateerde segmenten. Een corpus van 18.642 danmu-commentaren uit 24 Bilibili-video's werd gebruikt om publiek prominente narratieve thema's en cultureel gevoelige uitdrukkingen te identificeren. De resultaten laten zien dat cultuurrijke en evaluerend dichte segmenten leidden tot langere pauzes, een toename van recursieve revisies en intensievere reformuleringen halverwege het proces. Hoogwaardige vertalingen waren geassocieerd met selectieve, strategisch getimede revisies op discours- en culturele-adaptatieniveau, in plaats van met een hoger totaal aantal revisies. De overlap tussen danmu-prominente narratieve triggers en vertalsegmenten waar veel inspanning voor nodig was, wordt geïnterpreteerd als convergent bewijs van publieke relevantie en verwerkingsdruk bij de vertaler, niet als bewijs van causaliteit. De studie doet een stap voorwaarts in het onderzoek naar het vertaalproces door revisiegedrag te koppelen aan de vertaling van cultureel ingebedde narratieven en biedt implicaties voor de opleiding van vertalers in crossculturele communicatie.
Inleiding
In recente jaren is de vertaling van het discours over China verschoven van een relatief gespecialiseerde zorg naar een centraal vraagstuk in de internationale communicatie1. Wat bij een dergelijke vertaling op het spel staat, is niet simpelweg de overdracht van propositionele inhoud, maar de herformulering van publieke narratieven die politieke positionering, culturele inkadering en doelgroepgericht ontwerp bevatten. Onderzoek naar de vertaling van Chinees politiek discours heeft dit punt steeds duidelijker gemaakt: wanneer teksten worden vertaald voor lezers buiten China, worden keuzes over woordgebruik, modaliteit en tekstuele nadruk ook keuzes over hoe China in het buitenland wordt verteld en geïnterpreteerd2. Zodra het probleem op die manier wordt gekaderd, is een benadering die zich uitsluitend op het eindproduct richt onvoldoende. Een voltooide vertaling kan laten zien wat er is gekozen, maar kan niet aantonen wanneer er onzekerheid ontstond, waar de herformulering begon, of hoe concurrerende oplossingen zijn getest en verworpen3.
Deze beperkingen helpen verklaren waarom empirisch onderzoek naar het vertaalproces een belangrijke stroming binnen de vertaalwetenschap is geworden, waarbij tools voor proces-tracing worden gebruikt om pauzes, weglatingen, toevoegingen en het temporele verloop van besluitvorming vast te leggen, in plaats van deze indirect af te leiden uit de definitieve tekst4. Dit verdringt product-, sociologische, culturele of corpusgebaseerde benaderingen niet; het voegt juist bewijs toe over de momentane vorming van vertaalbeslissingen. Recent werk is verschoven van het beschrijven van geïsoleerde pauzes naar het modelleren van vertalen als een temporeel gestructureerde activiteit. De taxonomie van aarzeling-oriëntatie-stroom beschouwt vertaalgedrag bijvoorbeeld als een patroonmatige afwisseling tussen onzekerheid, zoeken en vloeiende productie, wat verklaart waarom bepaalde gedeelten van een taak onstabiel worden en leiden tot herformulering5. Deze verschuiving is bijzonder relevant bij studentenvertalingen, waarbij taalbeheersing, vakkennis en strategische controle zich gelijktijdig nog ontwikkelen6.
Bewijs uit gecombineerde eye-tracking en keystroke-logging laat zien dat beginnende vertalers hun aandacht niet gelijkmatig verdelen en dat de productie van de doeltekst vaak een belangrijke bron van cognitieve belasting wordt tijdens vertalingen van het Chinees naar het Engels7. Bijgevolg kan wat in het eindproduct lijkt op een lokaal formuleringsprobleem, in feite een bredere reorganisatie van aandacht en inspanning weerspiegelen tijdens het realtime proces8. Recent bewijs suggereert bovendien dat studenten die vertalen teksten kunnen produceren met een vergelijkbare oppervlakkige adequaatheid, terwijl ze aanzienlijk verschillen in de benodigde hoeveelheid inspanning, onzekerheid en zelfmonitoring. Een bevredigende uiteindelijke weergave kan nog steeds berusten op een fragiel of inefficiënt besluitvormingspad dat alleen via procesgevoelige meetmethoden kan worden vastgelegd9. Daarnaast wijst vergelijkend onderzoek uit dat vertaalexpertise een stabiele metacognitieve controle omvat over wanneer men moet pauzeren, zoeken, verder moet schrijven of moet terugkeren voor revisie10.
Revisie is precies het punt waarop dit verborgen cognitieve proces het meest zichtbaar wordt. Het is het stadium waarin vertalers terugkeren naar eerdere formuleringen, alternatieven testen en bepalen of een probleem lexicaal, syntactisch, discursief of cultureel van aard is. Bijgevolg moet revisie niet worden beschouwd als een laatste polijststap, maar als een kernindicator voor de ontwikkeling van de vertaler. Betere resultaten zijn gekoppeld aan de wijze waarop alternatieven tijdens de productie worden geconsolideerd, wat aantoont dat effectieve revisie selectief is, strategisch wordt getimed en reageert op bredere tekstuele eisen in plaats van een eenvoudige opeenstapeling van wijzigingen11,12,13.
De complexiteit van besluitvorming en revisie wordt sterker wanneer de brontekst een op China gerichte vertelling is in plaats van een neutrale informatieve passage. Dergelijke teksten leunen vaak op cultureel verzadigde aannames, historisch gesitueerde uitdrukkingen en evaluatieve aanwijzingen waarvan de betekenis afhangt van een gedeelde achtergrond in plaats van expliciete uiteenzetting14,15,16. De moeilijkheidsgraad van de tekst verandert de granulariteit van de verwerking; narratieve teksten met een culturele of evaluatieve dichtheid dwingen vertalers om in kleinere eenheden te werken, niet-lineaire handelingen uit te voeren en herhaaldelijk lokale herstructurering toe te passen8. Voor studentvertalers is het kernprobleem het beslissen hoeveel van die impliciete achtergrond moet worden uitgepakt of gereorganiseerd voor lezers buiten de oorspronkelijke discoursegemeenschap, zonder de culturele specificiteit weg te vagen.
Drie specifieke lacunes vormen de motivatie voor de huidige studie. Ten eerste worden metrieken van het vertaalproces, zoals pauzeduur, frequentie van lange pauzes, cursoronderbrekingen en het raadplegen van woordenboeken, vaak apart van revisietypologieën onderzocht, waardoor het moeilijk is om inzichtelijk te maken hoe besluitvormingsdruk zich later manifesteert als herformulering. Ten tweede hebben cultuurspecifieke narratieve categorieën minder procesgerichte aandacht gekregen dan algemene academische of expositieve teksten, hoewel narratieven met een focus op China vertalers vaak dwingen om gelijktijdig om te gaan met culturele belasting, evaluatieve dichtheid en gecomprimeerde achtergrondimplicaties14,15,16. In deze studie verwijst culturele belasting naar de dichtheid van cultuurgebonden referenties en gedeelde presupposities; evaluatieve dichtheid verwijst naar expliciete of impliciete standpunten, affectieve intensiteit en waardegeladen inkadering; en narratieve compressie verwijst naar de mate waarin achtergrondinformatie, causale relaties of sociale positionering zijn gecondenseerd tot korte tekstfragmenten. Ten derde worden vertaaltaken meestal uitsluitend ontworpen op basis van tekstinterne analyse, waarbij nauwelijks rekening wordt gehouden met de vraag of segmenten die als moeilijk worden geïdentificeerd, overeenkomen met punten die de publieke aandacht trekken in digitale circulatie. Danmu (tijdsgesynchroniseerde videocommentaren) kunnen fungeren als paratekst en participatieve discourse, waarbij wordt benadrukt wat het publiek opmerkt, betwist en herinterpreteert17,18; echter moet de prominentie van danmu worden beschouwd als een indicator op semantisch niveau van publieksbetrokkenheid, en niet als een directe vervanging voor taalkundige moeilijkheid op segmentniveau.
Om deze lacunes op te vullen, onderzoekt de huidige studie hoe studenten Engelse Taal- en Letterkunde beslissingen nemen en revisies doorvoeren terwijl zij China-georiënteerde narratieven vertalen van het Chinees naar het Engels. Door vertaalprocesgegevens en het digitale discours van het publiek in hetzelfde analytische kader te plaatsen, beoogt de studie niet alleen uit te leggen waar studentvertalers problemen ondervinden, maar ook waarom deze problemen geclusterd zijn rond specifieke soorten narratieve betekenissen.
Specifiek richt deze studie zich op vier onderzoeksvragen: (1) Welke besluitvormingspatronen kenmerken de Chinees-Engelse vertaling van China-georiënteerde narratieven door studenten Engelse taal en letterkunde? (2) Hoe variëren revisiegedragingen tussen segmenten met verschillende niveaus van culturele belasting en narratieve dichtheid? (3) Welke dimensies van revisiegedrag zijn geassocieerd met een hogere vertaalkwaliteit? en (4) Overlappen cultureel prominente punten die in danmu-discours zijn geïdentificeerd met de segmenten die de grootste verwerkingsinspanning tijdens het vertalen veroorzaken?
Overeenkomstig hiermee test de studie vier gekoppelde hypothesen in één enkele analytische reeks: H1 stelt dat segmenten met een hogere culturele belasting langere pauzes, grotere beslissingsonzekerheid en frequentere revisies zullen triggeren dan segmenten met een lagere culturele belasting; H2 onderscheidt twee paden en voorspelt dat evaluatieve dichtheid de vertraagde revisie zal verhogen, terwijl narratieve compressie de reformulering op discoursniveau zal verhogen; H3 voorspelt dat de vertaalkwaliteit sterker zal worden verklaard door de selectiviteit en timing van de revisie dan door het totale aantal revisies alleen; en H4 voorspelt dat danmu-saliente segmenten zullen overlappen met vertalsegmenten waarvoor veel inspanning nodig is, als een associatieve convergentie tussen de salientie voor het publiek en de verwerkingsdruk voor de vertaler.
Protocol
Alle methoden met menselijke proefpersonen werden uitgevoerd in overeenstemming met de institutionele richtlijnen en zijn goedgekeurd door de institutionele toetsingscommissie (IRB) of de ethische commissie voor onderzoek bij mensen van de Hanshan Normal University. Van alle deelnemers is voorafgaand aan het experiment geïnformeerde toestemming verkregen.
Conceptueel kader en onderzoeksontwerp
Deze studie maakte gebruik van een proces-product onderzoeksontwerp met een aanvullende discourslaag om te onderzoeken hoe door het publiek gegenereerde danmu-reacties de vertaling van ondertitelingen beïnvloeden. Het analytische kader integreerde tekstuele kenmerken, indicatoren van het vertaalproces en resultaten van de vertaalkwaliteit. In het bijzonder werd onderzocht of de aandacht van het publiek, weerspiegeld in de danmu-dichtheid, de cognitieve middelen van vertalers richtte op specifieke tekstuele kenmerken en of deze toewijzing van aandacht vervolgens invloed had op de vertaalkwaliteit.
Om dit kader te operationaliseren, stelde de studie eerst tekstkenmerken op segmentniveau vast op basis van vier dimensies: culturele belasting, evaluatieve dichtheid, narratieve compressie en danmu-opvallendheid. Culturele belasting verwees naar de aanwezigheid van cultuurspecifieke referenties die aanpassing of uitleg vereisten. Evaluatieve dichtheid mat de concentratie van emotioneel of attitudinaal geladen taal binnen een segment. Narratieve compressie legde vast in welke mate de semantische inhoud was gecondenseerd onder de beperkingen van de ondertiteling. Danmu-opvallendheid representeerde de mate van publieksaandacht gericht op elk ondertitelsegment, gekwantificeerd door het volume van gesynchroniseerde danmu-reacties. In tegenstelling tot conventionele maten voor vertaalmoeilijkheid, weerspiegelde danmu-opvallendheid sociaal verdeelde aandacht in plaats van intrinsieke tekstuele complexiteit. Een segment dat uitgebreide betrokkenheid van het publiek ontving, was niet noodzakelijkerwijs moeilijker te vertalen; in plaats daarvan vertegenwoordigde het een punt van verhoogde communicatieve betekenis binnen de kijkervaring.
Het analytische kader bestond uit drie onderling verbonden datasets. De dataset op deelnemerniveau bevatte individuele demografische kenmerken en vertaalexpertise. De proces-productdataset koppelde elk ondertitelsegment aan gedragsindicatoren die waren geëxtraheerd uit toetsenbordlogging, samen met kwaliteitsbeoordelingen van expertvertalingen. De danmu-dataset bevatte gesynchroniseerde publieksreacties die waren afgestemd op de timing van de ondertitels, waaruit danmu-salience-waarden waren berekend. Deze datasets werden gekoppeld via deelnemer- en segmentidentifiers, waardoor een gelijktijdige analyse van elk vertaald ondertitelsegment mogelijk was in relatie tot de kenmerken van de vertaler, het cognitieve verwerkingsgedrag, de aandacht van het publiek en de vertaalresultaten. De uiteindelijke geïntegreerde database bestond uit 216 volledige vertaalsessies en 3.168 waarnemingen op het niveau van deelnemer-tekst-segment, wat de empirische basis vormde voor de daaropvolgende proces-productanalyses.
Screening van deelnemers en achtergrondprofilering
De steekproef bestond uit 72 studenten Engelse taal en literatuur, geworven van een openbare universiteit in Zuid-China, gelijkmatig verdeeld over het tweede, derde en vierde jaar van de bachelorstudie (24 participanten per jaargroep). Alle participanten waren moedertaalsprekers van het Chinees die formele instructie kregen in Engels schrijven en vertalen. Om de vergelijkbaarheid binnen de populatie van vertaalstudenten te waarborgen, werden personen uitgesloten die langer dan 6 maanden in een Engelstalig land hadden gewoond of over een professionele vertaalcertificering beschikten. Participanten werden niet gestratificeerd in afzonderlijke experimentele groepen op basis van vertalervaring, culturele bekendheid of vaardigheid in de tweede taal. In plaats daarvan werden het studiejaar, recente scores van Engelse vaardigheidstoetsen, eerdere vakken in vertalen, een zelfbeoordeling van de bekendheid met cultuuronderwerpen gerelateerd aan China en de gemiddelde wekelijkse tijd besteed aan tweetalige praktijk vastgelegd en opgenomen als covariabelen op participantniveau in de statistische modellen. Deze verduidelijking lost ook de inconsistentie in het aantal participanten op die tijdens de peer review naar voren kwam: zowel het manuscript als de replicatiedataset bevatten 72 participanten, 216 taaksessies en 3.168 observaties op segmentniveau.
Selectie van brontekst en constructie van taken
De vertaalmaterialen bestonden uit drie eigentijdse, op China gerichte narratieve teksten, die specifiek voor deze studie zijn ontwikkeld om authentiek publiek discours te weerspiegelen en het reproduceren van auteursrechtelijk beschermd materiaal te vermijden. Elke tekst bevatte 205–225 Chinese karakters, maar verschilde systematisch in de interne kenmerken. Tekst A presenteert een relaas over het thuiskomen tijdens het Lentefestival met een matige culturele belasting en een relatief eenvoudige syntaxis. Tekst B vertelt een herinnering aan het Drakenbootfestival en bevat een hogere dichtheid aan cultuurspecifieke uitdrukkingen en impliciete achtergrondkennis. Tekst C beschrijft een narratief over livestreaming en e-commerce op het platteland, gekenmerkt door een dichte evaluatieve taal en een gecomprimeerde narratieve positionering.
De teksten werden systematisch gesegmenteerd op basis van clausuurgrenzen, gevolgd door betekeniseenheidsgrenzen, wat resulteerde in 44 analyseerbare eenheden over de drie vertaaltaken (Tabel 1). Voorafgaand aan de formele codering definieerde een codeerhandleiding de culturele lading, evaluatieve dichtheid en narratieve compressie met behulp van ordinale schalen van 1–5. Een pilotstudie met 12 studenten die niet deelnamen aan het hoofdexperiment bevestigde de beoogde kalibratie van de moeilijkheidsgraad, de duidelijkheid van de taakinstructies en de stabiliteit van de segmentgrenzen voor de uitlijning van de toetsaanslagen.
Constructie van een hulpcorpus en salience-mapping
Om publiekelijk opvallende narratieve aanwijzingen te identificeren, werd een aanvullend danmu-corpus samengesteld uit 24 Bilibili-video's die zijn geüpload tussen januari 2023 en december 2025. Video's werden alleen opgenomen als ze overeenkwamen met een van de drie semantische domeinen uit de bronteksten, meer dan 50.000 weergaven hadden verzameld, een dichte danmu-interactie bevatten en de export en thematische mapping van tijd-gesynchroniseerde reacties toelieten. Na het verwijderen van duplicaten en het filteren van emoji's, onomatopeische stopwoorden en irrelevante fragmenten, bestond het uiteindelijke corpus uit 18.642 reacties.
Inhoudswoorden werden gestandaardiseerd en geclusterd met behulp van trefwoordankers die gerelateerd waren aan de brontekst. Elk segment van de brontekst kreeg vervolgens een continue danmu-salientiescore, gebaseerd op een gewogen composiet van de genormaliseerde frequentie van trefwoordclusters, de concentratie van reacties binnen het overeenkomstige thematische cluster en de gemiddelde evaluatieve intensiteit. Deze procedure maakt vergelijkingen mogelijk tussen de verwerkingsinspanning van de vertaler en de salientie voor het publiek op het niveau van semantische clusters, in plaats van via directe lexicale matching. Omdat danmu de reacties van het publiek op online video's weerspiegelt en niet de experimentele vertaaltaak zelf, wordt danmu-salientie geïnterpreteerd als een externe indicator van publieksbetrokkenheid in plaats van als direct bewijs voor de linguïstische moeilijkheidsgraad van een bronsegment.
Experimentele procedure en gegevensregistratie
De vertaalsessies werden individueel uitgevoerd in een gecontroleerd computerlaboratorium onder gestandaardiseerde hardware-, software- en internettoegangscondities (Figuur 2). Na een oriëntatie van vijf minuten, waarbij de nadruk lag op het produceren van leesbaar Engels voor een internationaal publiek, voltooiden de deelnemers een drieminuten durende opwarmbeurt voor het typen in het Engels om de effecten van keyboardacclimatisatie te minimaliseren. De drie vertaalopdrachten werden opeenvolgend toegediend met behulp van Translog-II, waarbij de volgorde van de opdrachten werd gebalanceerd via een Latijns vierkant-ontwerp om potentiële vermoeidheid en volgorde-effecten gelijkmatig over de deelnemers te verdelen. De deelnemers kregen maximaal 20 minuten per tekst, gescheiden door rustintervallen van vijf minuten.
Hoewel het gebruik van het ingebouwde tweetalige woordenboek was toegestaan, waren machinale vertaalmachines en externe zoekmachines verboden. Alle toetsaanslagen, pauzes en cursorbewegingen werden automatisch geregistreerd en aangevuld met synchrone schermopnamen om niet-lineaire revisie-episoden te verifiëren. Na voltooiing van elke taak vulden de deelnemers een zelfrapportage over de moeilijkheidsgraad in, die uitsluitend werd gebruikt om te helpen bij het interpreteren van twijfelachtige coderingsgevallen.
Procesmeting en codering van variabelen
Toetsaanslaggegevens werden uitgelijnd met de vooraf gedefinieerde segmentstructuur. Een uitlijningsepisode begon bij de eerste toetsaanslag in de doeltaal die overeenkwam met een segment en eindigde wanneer de deelnemer definitief overging naar het volgende segment. Overlappende revisies werden opnieuw toegewezen met behulp van tijdstempel-cursorregistraties.
Het besluitvormingsgedrag werd gekwantificeerd aan de hand van vijf indicatoren: de duur van de eerste pauze vóór de vertaling van het initiële segment, de gemiddelde pauzeduur binnen een segment, de frequentie van pauzes langer dan twee seconden, het aantal raadplegingen van het woordenboek en het aantal cursor-gebaseerde onderbrekingen die duidden op afwijkingen van het lineaire conceptieproces (Tabel 2). Het revisiegedrag werd geclassificeerd langs twee dimensies: timing en functie. Timing maakte onderscheid tussen onmiddellijke lokale revisies en uitgestelde revisies die werden uitgevoerd nadat het conceptieproces het huidige segment was gepasseerd. Functionele codering classificeerde revisies als oppervlakkige revisies (correcties op vormniveau zonder semantische wijziging), betekenisrevisies (lexicale of syntactische wijzigingen), revisies op discoursniveau (aanpassingen in clausalerevaties of coherentie) en culturele adaptatierevisies (herformuleringen gericht op de doelgroep). Twee getrainde codeurs analyseerden onafhankelijk elke revisie-episode vóór de arbitrage en wezen één primaire functionele categorie toe aan elk event. De interbeoordelaarsbetrouwbaarheid was robuust voor alle gecodeerde maten. De ĸ van Cohen wees op substantiële overeenstemming voor de categorische codering van revisiefuncties (ĸ = 0,84, p < 0,001). Voor de ordinale variabelen op tekstniveau toonden intraclass-correlatiecoëfficiënten (ICC, two-way mixed-effects model, absolute agreement) een hoge betrouwbaarheid aan voor culturele belasting (ICC = 0,86), evaluatieve dichtheid (ICC = 0,78) en narratieve compressie (ICC = 0,82). Eventuele initiële coderingsverschillen werden vervolgens opgelost via gezamenlijke arbitrage.
Beoordeling van de vertaalkwaliteit
De vertaalkwaliteit werd onafhankelijk van de procesgegevens geëvalueerd door twee beoordelaars met een promotorieniveau en uitgebreide ervaring in vertaalinstructie. De beoordelaars waren blind voor de identiteit van de deelnemers en de procesmaten en pasten een rubric van 100 punten toe, gelijkmatig verdeeld over vijf dimensies: semantische nauwkeurigheid, linguïstische vloeiendheid, narratieve coherentie, culturele weergave en registergeschiktheid (Tabel 3). Scoreverschillen van meer dan acht punten leidden tot een gezamenlijke review en consensus-rescoring, waarbij het geoordeelde gemiddelde als definitieve score voor de vertaalkwaliteit werd gebruikt. De beoordelingsverslagen van vóór de adjudicatie werden bewaard om transparante rapportage van de interbeoordelaarsbetrouwbaarheid in de replicatiematerialen te faciliteren.
Statistische modellering
De analyses verliepen in drie opeenvolgende fasen. Ten eerste werden beschrijvende statistieken berekend om alle variabelen over de jaargroepen en teksttypen samen te vatten. Ten tweede werd de verwerkingsinspanning op segmentniveau geanalyseerd met behulp van mixed-effects regressiemodellen om rekening te houden met de geneste structuur van segmenten binnen teksten en herhaalde waarnemingen van individuele deelnemers. Afhankelijke variabelen, waaronder de duur van de eerste pauze en de revisiefrequentie, werden gemodelleerd als functies van culturele belasting, evaluatieve dichtheid, narratieve compressie en danmu-opvallendheid, terwijl er werd gecontroleerd voor de vaardigheid van de deelnemer. Om de statistische transparantie te verbeteren, werden correlaties tussen predictoren, diagnose van variantie-inflatie, 95% betrouwbaarheidsintervallen, schattingen van de effectgrootte en model-fit indices opgenomen.
Ten slotte werd de vertaalkwaliteit gemodelleerd om de voorspellende bijdragen van de timing van revisies en de revisiefunctie te evalueren ten opzichte van de totale revisiefrequentie. De overlap tussen danmu-saliente segmenten en vertaalsegmenten met een hoge inspanning werd beoordeeld met behulp van het bovenste kwintiel van elke distributie, een gestandaardiseerde samengestelde inspanningsindex en een kans-overlapanalyse. Er is geen explorerende factorenanalyse of structurele vergelijkingsmodellering uitgevoerd. Bijgevolg worden de bijbehorende figuren uitsluitend gepresenteerd als conceptuele, beschrijvende of op regressie gebaseerde samenvattingen.
Resultaten
Algemeen profiel van de vertaalsessies
Alle 72 deelnemers voltooiden de drie vertaalopdrachten onder gestandaardiseerde experimentele omstandigheden, wat resulteerde in 216 volledige vertaalsessies. Na segmentuitlijning bestond de definitieve analytische dataset uit 3.168 waarnemingen van deelnemer-tekst-segment. De gemiddelde tijd voor het voltooien van de taak over de steekproef was 998,4 s per tekst, met duidelijke verschillen tussen jaargroepen en bronteksten (Tabel 4; Figuur 3). Bijgevolg ondersteunen zowel het manuscript als de bijbehorende gegevens consequent een steekproefomvang van n = 72 deelnemers; alle figuren die subsets samenvatten, dienen deze subsets expliciet te identificeren.
Vierdejaarsstudenten voltooiden de vertaaltaken sneller en met minder onderbrekingen dan tweedejaarsstudenten. Dit verschil ging verder dan enkel de verwerkingssnelheid. De groep vierdejaars vertoonde daarnaast kortere gemiddelde duur van de eerste pauze, minder lange pauzes en een lager totaal aantal revisies, terwijl zij de hoogste scores voor vertaalkwaliteit behaalden. In contrast hiermee produceerden tweedejaarsstudenten de meeste revisies, waarvan het merendeel oppervlakkige aanpassingen en onmiddellijke lokale correcties waren. Gevorderde studenten vertoonden een hoger aandeel uitgestelde revisies en revisies voor culturele adaptatie, wat erop wijst dat superieure vertaalprestaties geassocieerd waren met selectieve revisiestrategieën in plaats van een groter revisievolume.
De verschillen tussen de drie bronteksten waren op vergelijkbare wijze uitgesproken. Tekst A resulteerde in de kortste voltooiingstijden, de minste lange pauzes en de laagste revisiedichtheid. Teksten B en C stelden beide hogere eisen aan de verwerking, zij het via verschillende mechanismen. Tekst B riep het hoogste aantal cultuurgerelateerde revisiegebeurtenissen op, terwijl tekst C de hoogste frequentie van revisies op discoursniveau en de langste gemiddelde pauzeduur binnen segmenten produceerde. De bron van de verwerkingsmoeilijkheid verschilde dus per tekst. In tekst B concentreerde de moeilijkheid zich rond cultuurgebonden verwijzingen en impliciete achtergrondaannames, terwijl deze in tekst C primair geassocieerd was met narratieve compressie en evaluatieve positionering.
Een eenweg-variantieanalyse bevestigde significante verschillen tussen de jaargroepen in de totale vertaalkwaliteit, F (2, 69) = 31,84, p < 0,001, met een groot effectformaat (η2 ≈ 0,48 gebaseerd op de gemiddelde scores op deelnemerniveau). Post-hoc vergelijkingen toonden aan dat vierdejaarsstudenten significant hogere scores behaalden dan derdejaarsstudenten, die op hun beurt beter presteerden dan tweedejaarsstudenten. Hetzelfde patroon werd waargenomen voor de duur van de eerste pauze, de frequentie van lange pauzes en de ratio van uitgestelde revisies. Gezamenlijk vestigen deze baseline-bevindingen twee belangrijke punten vast voor de daaropvolgende analyses. Ten eerste verschilden de drie bronteksten in verwerkingsmoeilijkheid en niet enkel in topische inhoud. Ten tweede was een hogere vertaalkwaliteit geassocieerd met een reorganisatie van de vertaalprocessen in plaats van met een eenvoudige vermindering van de verwerkingsinspanning.
Effecten van tekstuele salientie op besluitvorming en revisiegedrag
Om vast te stellen of tekstuele eigenschappen op segmentniveau de verwerkingsinspanning voorspelden, werden mixed-effects modellen geschat voor de duur van de eerste pauze, de frequentie van lange pauzes, de totale revisiedichtheid en de vertraagde revisiedichtheid. Culturele belasting, evaluatieve dichtheid, narratieve compressie en danmu-salience werden ingevoerd als vaste effecten, waarbij deelnemer en segment als random intercepts werden opgenomen (Tabel 5; Figuur 4). Screening van de predictoren bevestigde de afwezigheid van problematische multicollineariteit, waarbij alle Variance Inflation Factor (VIF)-waarden ruim onder de conservatieve drempelwaarde van 2,5 lagen (Maximum VIF = 1,45). Om de modelfit en het verklaarde deel van de variantie te evalueren, werden voor alle mixed-effects modellen zowel marginale als conditionele R2-waarden berekend (marginale R2 variërend van 0,08 tot 0,19; conditionele R2 variërend van 0,46 tot 0,64). De volledige variantiecomponenten voor random effects (intercepts voor deelnemer en segment) en de bijbehorende model-fit-indices zijn gedetailleerd beschreven in Tabel 5. Coëfficiëntschattingen worden geïnterpreteerd in samenhang met hun 95% betrouwbaarheidsintervallen in plaats van enkel op basis van p-waarden.
Culturele belasting vertoonde het sterkste en meest consistente effect over de modellen heen. In het model voor de eerste pauze was elke eenheid toename in de score voor culturele belasting geassocieerd met een toename van 0,91 s in de duur van de eerste pauze (b = 0,91, SE = 0,12, 95% CI [0,67, 1,15], p < 0,001). Culturele belasting verhoogde ook significant de frequentie van lange pauzes (b = 0,19, SE = 0,04, 95% CI [0,11, 0,27], p < .001) en de totale revisiedichtheid (b = 0,27, SE = 0,06, 95% CI [0,15, 0,39], p < .001). Zo vertraagden segmenten met een hoge culturele belasting niet alleen de initiële verwerking, maar verhoogden ze ook de waarschijnlijkheid van een daaropvolgende herformulering.
Narratieve compressie vertoonde een even robuust, maar verschillend patroon van effecten. Het was een sterke voorspeller van revisies op discoursniveau (b = 0,31, SE = 0,07, 95% BI [0,17, 0,45], p < .001) en verhoogde de gemiddelde pauzeduur binnen segmenten significant (b = 0,58, SE = 0,14, 95% BI [0,31, 0,85], p < .001). In praktische termen waren segmenten waarin substantiële achtergrondauditie werd samengevoegd tot korte tekstfragmenten minder geneigd tot onmiddellijke lexicale substitutie en eerder geneigd tot een bredere structurele heroverweging.
Evaluatieve dichtheid droeg ook significant bij, hoewel het primaire effect betrekking had op vertraagde revisie in plaats van de latentie van de initiële beslissing. In het model voor vertraagde revisie leverde evaluatieve dichtheid een positieve coëfficiënt op (b = 0.23, SE = 0.05, 95% CI [0.13, 0.33], p < .001). Het effect op de duur van de eerste pauze was relatief bescheiden (b = 0.34, SE = 0.13, 95% CI [0.09, 0.59], p = 0.010). Deze bevindingen suggereren dat evaluatieve aanwijzingen tijdens de initiële vertaling niet altijd als knelpunten in de verwerking werden herkend. In plaats daarvan werden ze vaak pas problematisch nadat een eerste concept was opgesteld, waardoor vertalers gedwongen werden om kwesties met betrekking tot standpunt, toon of narratieve adequaatheid opnieuw te overwegen.
De salientie van danmu bleef een significante voorspeller nadat er was gecontroleerd voor tekstinterne variabelen. Het voorspelde significant zowel de duur van de eerste pauze (b = 0.36, SE = 0.14, 95% CI [0.09, 0.63], p = 0.011) als de totale revisiedichtheid (b = 0.17, SE = 0.06, 95% CI [0.05, 0.29], p = 0.006). Hoewel de effectgrootte kleiner was dan die van de culturele belasting en narratieve compressie, suggereert de consistente bijdrage dat segmenten die meer publieke aandacht trekken in het danmu-corpus ook neigen naar een grotere verwerkingsinspanning tijdens de vertaling. Deze bevinding wordt geïnterpreteerd als convergent bewijs voor semantische salientie, in plaats van bewijs dat de danmu-frequentie direct de vertaalmoeilijkheid veroorzaakt.
Herzieningsgedrag en vertaal aberrantie
Vervolganalyses onderzochten of de vertaalkwaliteit beter verklaard kon worden door de totale hoeveelheid revisies of door hun temporele en functionele kenmerken. Het kwaliteitsmodel (Tabel 5) leverde een duidelijk patroon van resultaten op. Het totale aantal revisies voorspelde de vertaalkwaliteit niet significant (b = 0.04, 95% BI [-0.06, 0.14], p = 0.412), terwijl zowel de timing van de revisies als de revisiefunctie significante voorspellers waren. Specifiek waren de ratio van uitgestelde revisies (b = 1.12, 95% BI [0.39, 1.85], p = 0.003), revisies op discoursniveau (b = 1.76, 95% BI [0.96, 2.56], p < 0.001) en culturele adaptatierevisies (b = 2.04, 95% BI [1.14, 2.94], p < 0.001) allen positief geassocieerd met de vertaalkwaliteit. In contrast vertoonden oppervlakkige revisies een kleine maar statistisch significante negatieve associatie (b = -0.63, 95% BI [-1.18, -0.08], p = 0.028).
Deze bevindingen wijzen erop dat het aantal revisies alleen geen onderscheid kan maken tussen productieve herformulering en instabiel concepten schrijven (Figuur 5). Kwalitatieve inspectie van de vertaalscripts ondersteunde deze interpretatie. Bij vertalingen met een lagere score hadden revisies de neiging om geclusterd te zijn rond lokale lexicale substituties en grammaticale correcties, zonder diepere mismatches tussen Chinese narratieve signalen en Engelse retorische kaders op te lossen. Bij vertalingen met een hogere score hielden uitgestelde revisies vaak in dat de informatiestructuur werd gereorganiseerd, selectieve explicietering werd geïntroduceerd, of evaluatief taalgebruik werd aangepast om de toegankelijkheid voor een internationaal lezerspubliek te verbeteren. Representatieve vertaalde danmu-commentaren — waaronder "deze uitdrukking is zeer Chinees", "de achtergrond moet worden uitgelegd" en "buitenlandse doelgroepen begrijpen deze referentie mogelijk niet" — illustreren de typen cultureel saillante zorgen van het publiek die geassocieerd worden met de overeenkomstige segmentclusters. Deze voorbeelden worden uitsluitend gepresenteerd om de interpretatie te vergemakkelijken en mogen niet worden beschouwd als bewijs van de intenties van de deelnemers.
Overlap tussen danmu-salience en vertaalbottlenecks
De uiteindelijke analyse onderzocht of publiekelijk opvallende segmenten in het danmu-corpus overlapten met de segmenten die de grootste verwerkingsinspanning tijdens de vertaling veroorzaakten. Voor elk segment werd een samengestelde inspanningsindex berekend door de duur van de eerste pauze, de frequentie van lange pauzes en de revisiedichtheid te standaardiseren en op te tellen. De bovenste 20% van de segmenten op basis van deze samengestelde inspanningsindex werd vervolgens vergeleken met de bovenste 20% gerangschikt op basis van danmu-opvallendheid.
De overlap was aanzienlijk: zes van de negen segmenten met de hoogste inspanning kwamen ook voor tussen de negen meest danmu-opvallende segmenten, wat overeenkomt met een overlaprate van 66,7%. Omdat de vergelijking van het bovenste quintiel slechts negen segmenten betrof, was het betrouwbaarheidsinterval van Wilson relatief breed (95% BI ongeveer 35,4%–87,9%). Desondanks gaf een exacte analyse van toevalsoverlap aan dat een overlap van zes of meer segmenten onwaarschijnlijk zou zijn bij een willekeurige toewijzing (p ≈ .001). Op segmentniveau was de danmu-opvallendheid positief gecorreleerd met de samengestelde inspanningsindex (Spearman's ρ = 0,41, p = 0,006). De meeste overlappende segmenten kwamen voor in Tekst B en C en concentreerden zich op cultureel ingebedde referenties, digitaal ondernemerschap en evaluatieve positionering. Deze bevindingen suggereren dat het publieke discours dient als een externe indicator van waar de narratieve betekenis bijzonder opvallend wordt, hoewel de relatie correlationeel blijft en niet causaal is.
Samen tonen deze bevindingen aan dat de verwerkingsinspanning bij het vertalen van narratieven gericht op China segmentspecifiek is en primair wordt gevormd door culturele belasting, narratieve compressie en evaluatieve dichtheid. De vertaalkwaliteit hangt niet af van het totale revisievolume, maar van uitgestelde, discoursgevoelige en cultureel georiënteerde revisiestrategieën. Ten slotte ondersteunt de waargenomen overeenkomst tussen vertaalsegmenten met een hoge inspanning en narratieve punten die prominent zijn in danmu een associatieve relatie tussen de salientie voor het publiek en de verwerkingsinspanning van de vertaler, zonder te impliceren dat de danmu-salientie zelf de vertaalmoeilijkheid veroorzaakt.
DATAbeschikbaarheid:
Alle ruwe gegevens, bestanden van toetsaanslagregistraties, verwerkte observaties op segmentniveau, observaties op sessieniveau, danmu-videometadata en de eerste 5.000 getoonde danmu-reacties zijn opgenomen in het werkboek van de replicatiedataset. Het volledige bestand met danmu-reacties bevat 18.642 reacties en is samen met het datasetpakket gedeponeerd. De dataset is toegankelijk via de Zenodo-repository op https://doi.org/10.5281/zenodo.19289665.
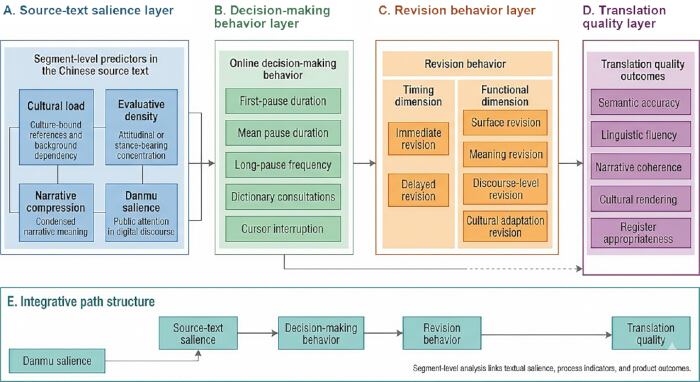
Figuur 1: Conceptueel kader van de studie. (A) Tekstuele predictoren op segmentniveau, waaronder culturele belasting, evaluatieve dichtheid, narratieve compressie en danmu-saliëns. (B) Procesindicatoren gebruikt om online besluitvormingsgedrag te operationaliseren, waaronder de duur van de eerste pauze, de gemiddelde pauzeduur, de frequentie van lange pauzes, woordenboekconsultaties en cursoronderbrekingen. (C) Tweedimensionale classificatie van revisiegedrag op basis van het tijdstip van revisie en de revisiefunctie. (D) Vijf dimensies gebruikt om de vertaalkwaliteit te evalueren: semantische accuratesse, linguïstische vloeiendheid, narratieve coherentie, culturele weergave en registerpassendheid. (E) Algemeen analytisch kader dat de relaties tussen brontekstsaliëns, besluitvormingsgedrag, revisiegedrag en vertaalkwaliteit weergeeft, waarbij danmu-saliëns dient als een externe indicator van de semantische prominentie voor het publiek. In deze studie is geen explorerende factoranalyse (EFA) of structurele vergelijkingsmodellering (SEM) uitgevoerd of gepresenteerd. Klik hier om een grotere versie van deze figuur te bekijken.
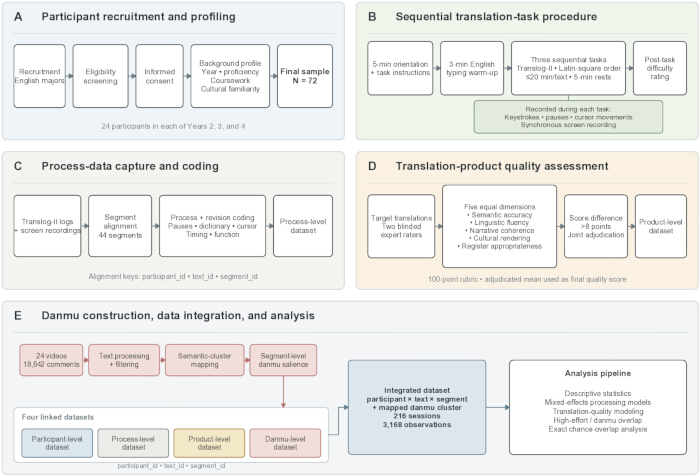
Figuur 2: Workflow van gegevensverzameling en gegevensuitlijning. (A) Werving van deelnemers, screening van geschiktheid, geïnformeerde toestemming en verzameling van achtergrondinformatie. (B) Toediening van de drie vertaalopdrachten in Translog-II onder gestandaardiseerde experimentele omstandigheden. (C) Verzameling van procesgegevens, inclusief toetsaanslagen, pauzes, cursorbewegingen, revisie-episodes en gesynchroniseerde schermopnamen. (D) Blinde deskundigenbeoordeling van de vertaalproducten, gevolgd door arbitrage bij verschillen in de scoren. (E) Constructie van het hulp-danmu-corpus en de uitlijning hiervan met datasets op deelnemer-, tekst-, segment-, proces- en productniveau om de uiteindelijke geïntegreerde dataset te genereren die wordt gebruikt voor inferentiële analyses. Klik hier om een grotere versie van deze figuur te bekijken.
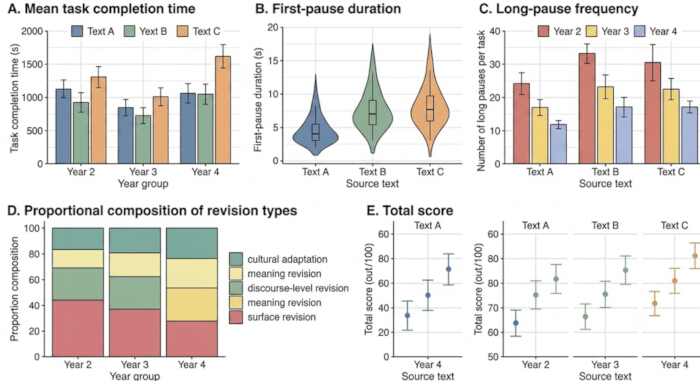
Figuur 3: Distributie van proces- en productmaten over leerjaren en bronteksten. (A) Gemiddelde taakvoltooiingstijd per brontekst en leerjaar. (B) Distributie van de duur van de eerste pauze over de drie bronteksten. (C) Frequentie van lange pauzes per brontekst en leerjaar. (D) Proportionele distributie van revisiecategorieën over leerjaren, inclusief oppervlakkige revisies, betekenisrevisies, revisies op discoursniveau en culturele aanpassingsrevisies. (E) Totale vertaalkwaliteitsscores per leerjaar voor elke brontekst. Gezamenlijk laten de panelen zien dat hogere leerjaren geassocieerd worden met minder verwerkingsonderbrekingen, selectievere revisiestrategieën en een hogere vertaalkwaliteit, terwijl teksten B en C een grotere verwerkingsvraag stellen dan tekst A. Klik hier om een grotere versie van deze figuur te bekijken.
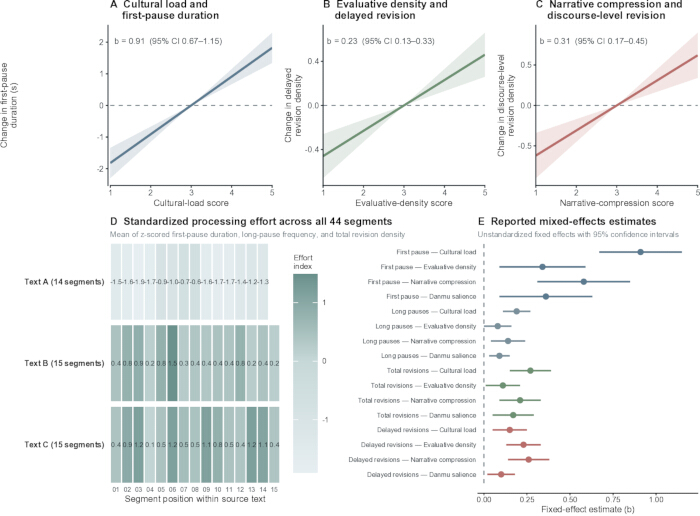
Figuur 4: Effecten van tekstuele saillantie op segmentniveau op het gedrag tijdens het vertaalproces. (A) Gefit marginaal effect van culturele belasting op de duur van de eerste pauze. (B) Gefit marginaal effect van evaluatieve dichtheid op de dichtheid van vertraagde revisies. (C) Gefit marginaal effect van narratieve compressie op de revisiedichtheid op discoursniveau. (D) Heatmap van de gestandaardiseerde index voor verwerkingsinspanning over alle segmenten van de brontekst, gegroepeerd per brontekst. (E) Gestandaardiseerde fixed-effect coëfficiënten geschat uit de mixed-effects regressiemodellen. De figuur demonstreert dat verschillende tekstuele kenmerken uiteenlopende verwerkingspaden activeren, waarbij culturele belasting, evaluatieve dichtheid en narratieve compressie via gedeeltelijk verschillende mechanismen bijdragen aan aarzeling en revisie. Klik hier om een grotere versie van deze figuur te bekijken.
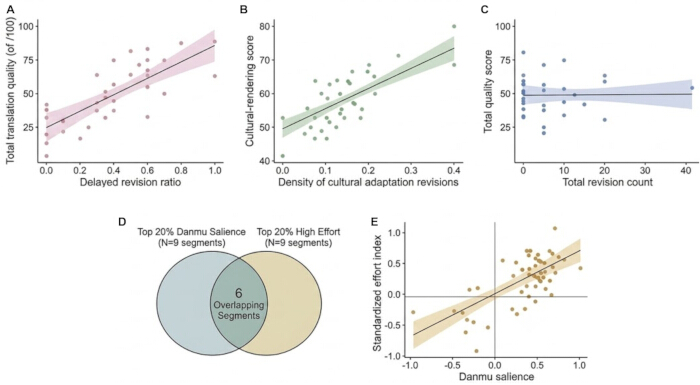
Figuur 5: Relaties tussen het vertaalproces, de vertaalkwaliteit en de danmu-salience. (A) Associatie tussen de ratio van vertraagde revisies en de totale score voor vertaalkwaliteit. (B) Relatie tussen revisies voor culturele adaptatie en de score voor culturele weergave. (C) Associatie tussen het totale aantal revisies en de algemene vertaalkwaliteit, wat de beperkte voorspellende waarde van enkel de hoeveelheid revisies aantoont. (D) Overlap tussen de bovenste 20% van de danmu-saliente segmenten en de bovenste 20% van de segmenten met een hoge vertaalinspanning. (E) Associatie op segmentniveau tussen danmu-salience en de gestandaardiseerde index voor verwerkingsinspanning. Gezamenlijk laten de panelen zien dat succesvolle vertaalprestaties geassocieerd zijn met strategisch getimede, functioneel gerichte revisies in plaats van enkel het volume aan revisies, en dat publiekelijk saliente narratieve segmenten ook cenderung samenvallen met vertaalbottlenecks. Klik hier om een grotere versie van deze figuur te bekijken.
| Tekst-ID | Narratief onderwerp | Chinese tekens | Aantal segmenten | Culturele-belastingsscore (1–5) | Evaluatieve-densiteitsscore (1–5) | Narratieve compressiescore (1–5) | Voorspelde moeilijkheidsgraad | Validatienota |
| Tekst A | verhaal over de terugkeer naar huis tijdens het Lentefestival | 212 | 14 | 3 | 2 | 3 | Matig | Uitgeprobeerd bij 12 studenten die niet aan het onderzoek deelnamen |
| Tekst B | Herinneringsverhaal over het Drakenbootfestival | 219 | 15 | 5 | 3 | 4 | Hoog | Uitgeprobeerd met 12 studenten die niet aan het onderzoek deelnamen |
| Tekst C | Plattelands-livestreaming en het narratief van lokale ontwikkeling | 223 | 15 | 4 | 5 | 4 | Hoog | Voorlopig getest met 12 studenten die niet aan het onderzoek deelnamen |
Tabel 1: Brontekstprofiel en segmentstructuur.
| Variabele | Niveau | Operationele definitie | Maateenheid |
| Duur eerste pauze | Segment | Tijd vanaf het begin van het segment tot de eerste relevante toetsaanslag in de doeltaal | Seconden |
| Gemiddelde pauzeduur binnen segment | Segment | Gemiddelde duur van alle pauzes binnen het segment | Seconden |
| Frequentie van lange pauzes | Segment | Aantal pauzes langer dan 2 seconden | Aantal |
| Woordenboekconsultaties | Segment | Aantal activeringen van het woordenboekvenster tijdens de verwerking van het segment | Aantal |
| Cursoronderbrekingen | Segment | Aantal cursorgebaseerde afwijkingen van het lineaire schrijfproces vóór stabiele voltooiing | Aantal |
| Onmiddellijke revisie | Segment | Revisie uitgevoerd voordat het schrijfproces voorbij het huidige lokale tekstgebied gaat | Aantal / dichtheid |
| Vertraagde revisie | Segment | Revisie uitgevoerd nadat het schrijfproces is voortgezet naar een later tekstgebied | Aantal / dichtheid |
| Oppervlakkige revisie | Revisiefunctie | Correctie op vormniveau zonder semantische verschuiving | Aantal / dichtheid |
| Betekenisrevisie | Revisiefunctie | Lexicale of syntactische wijziging die de betekenisuitdrukking beïnvloedt | Aantal / dichtheid |
| Revisie op discoursniveau | Revisiefunctie | Aanpassing van bijzinsrelaties, coherentie of informatievolgorde | Aantal / dichtheid |
| Revisie voor culturele adaptatie | Revisiefunctie | Op de doelgroep gerichte herformulering of explicitering van cultuurgebonden betekenis | Aantal / dichtheid |
| Samengestelde inspanningsindex | Segment | Gestandaardiseerde combinatie van duur eerste pauze, frequentie van lange pauzes en revisiedichtheid | z-score |
| Danmu-salientie | Segment / semantische cluster | Gewogen proxy voor semantische clusters gebaseerd op genormaliseerde trefwoordclusterfrequentie, commentaarconcentratie en evaluatieve intensiteit | Continue score |
Tabel 2: Operationele definities van procesvariabelen.
| Dimensie | Scorebereik | Focus van de score |
| Semantische nauwkeurigheid | 1-20 | Getrouwheid aan de betekenis van de bron, precisie van de overgedragen inhoud en afwezigheid van grote vervormingen |
| Taalkundige vloeiendheid | 1-20 | Grammaticaliteit, natuurlijkheid, idiomatiek en leesbaarheid op zinsniveau |
| Narratieve coherentie | 1-20 | Informatiestroom, koppeling van clausules, progressie en tekstuele stabiliteit |
| Culturele weergave | 1-20 | Omgang met cultuurgebonden referenties, explicitering, inkadering en interpretatieve toegankelijkheid |
| Passend register | 1-20 | Aansluiting bij de beoogde lezersgroep, stilistische geschiktheid en beheersing van de toon |
Tabel 3: Rubriek voor de beoordeling van de vertaalingskwaliteit.
| Sectie | Variabele | Jaar 2 (n = 24), gemiddelde ± SD | Jaar 3 (n = 24), gemiddelde ± SD | Jaar 4 (n = 24), gemiddelde ± SD |
| Sessieprofiel op deelnemerniveau | Taakvoltooiingstijd (sec) | 1070.84 ± 18.22 | 996.59 ± 20.08 | 927.76 ± 19.91 |
| Sessieprofiel op deelnemerniveau | Gemiddelde duur van de eerste pauze (sec) | 7.09 ± 0.50 | 6.65 ± 0.40 | 6.38 ± 0.41 |
| Sessieprofiel op deelnemerniveau | Frequentie van lange pauzes per taak | 21.04 ± 0.32 | 18.47 ± 0.30 | 16.31 ± 0.19 |
| Sessienprofiel op deelnemersniveau | Totaal aantal revisies per taak | 28.65 ± 2.87 | 26.24 ± 2.63 | 24.59 ± 2.42 |
| Revisieconfiguratie | Ratio van uitgestelde revisies | 0.45 ± 0.01 | 0.54 ± 0.01 | 0.63 ± 0.01 |
| Configuratie van de revisie | Herzieningsratio op discoursniveau | 0.37 ± 0.01 | 0.40 ± 0.01 | 0.45 ± 0.01 |
| Revisieconfiguratie | Herzieningsratio voor culturele adaptatie | 0.38 ± 0.01 | 0.42 ± 0.00 | 0.48 ± 0.01 |
| Revisieconfiguratie | Oppervlakterevisieverhouding | 0.04 ± 0.00 | 0.02 ± 0.00 | 0.00 ± 0.00 |
| Productkwaliteit | Totale kwaliteitsscore | 77.82 ± 4.65 | 84.03 ± 4.44 | 88.27 ± 4.56 |
| Productkwaliteit | Culturele weergavescore | 77.73 ± 4.49 | 83.95 ± 4.85 | 88.18 ± 4.86 |
Tabel 4: Beschrijvende statistieken voor proces- en productvariabelen.
| Uitkomstvariabele | Predictor | b | SE | 95% BI | t/z | p |
| Duur eerste pauze | Culturele belasting | 0.91 | 0.12 | [0.67, 1.15] | 7.58 | < 0.001 |
| Duur eerste pauze | Evaluatieve densiteit | 0.34 | 0.13 | [0.09, 0.59] | 2.62 | 0.01 |
| Duur eerste pauze | Narratieve compressie | 0.58 | 0.14 | [0.31, 0.85] | 4.14 | < 0.001 |
| Duur eerste pauze | Danmu-salientie | 0.36 | 0.14 | [0.09, 0.63] | 2.55 | 0.011 |
| Frequentie lange pauzes | Culturele belasting | 0.19 | 0.04 | [0.11, 0.27] | 4.75 | < 0.001 |
| Frequentie lange pauzes | Evaluatieve densiteit | 0.08 | 0.04 | [0.00, 0.16] | 2 | 0.046 |
| Frequentie lange pauzes | Narratieve compressie | 0.14 | 0.05 | [0.04, 0.24] | 2.8 | 0.005 |
| Frequentie lange pauzes | Danmu-salientie | 0.09 | 0.03 | [0.03, 0.15] | 3 | 0.003 |
| Totale revisiedensiteit | Culturele belasting | 0.27 | 0.06 | [0.15, 0.39] | 4.5 | < 0.001 |
| Totale revisiedensiteit | Evaluatieve densiteit | 0.11 | 0.05 | [0.01, 0.21] | 2.2 | 0.028 |
| Totale revisiedensiteit | Narratieve compressie | 0.21 | 0.06 | [0.09, 0.33] | 3.5 | < 0.001 |
| Totale revisiedensiteit | Danmu-salientie | 0.17 | 0.06 | [0.05, 0.29] | 2.75 | 0.006 |
| Vertraagde revisiedensiteit | Culturele belasting | 0.15 | 0.05 | [0.05, 0.25] | 3 | 0.003 |
| Vertraagde revisiedensiteit | Evaluatieve densiteit | 0.23 | 0.05 | [0.13, 0.33] | 4.6 | < 0.001 |
| Vertraagde revisiedensiteit | Narratieve compressie | 0.26 | 0.06 | [0.14, 0.38] | 4.33 | < 0.001 |
| Vertraagde revisiedensiteit | Danmu-salientie | 0.1 | 0.04 | [0.02, 0.18] | 2.5 | 0.013 |
| Totale kwaliteits-score | Totaal aantal revisies | 0.04 | 0.05 | [-0.06, 0.14] | 0.82 | 0.412 |
| Totale kwaliteits-score | Ratio vertraagde revisies | 1.12 | 0.37 | [0.39, 1.85] | 3.03 | 0.003 |
| Totale kwaliteits-score | Revisies op discoursniveau | 1.76 | 0.41 | [0.96, 2.56] | 4.29 | < 0.001 |
| Totale kwaliteits-score | Revisies culturele adaptatie | 2.04 | 0.46 | [1.14, 2.94] | 4.43 | < 0.001 |
| Totale kwaliteits-score | Oppervlakkige revisies | -0.63 | 0.28 | [-1.18, -0.08] | -2.25 | 0.028 |
| Totale kwaliteits-score | Jaargroep | 3.48 | 0.69 | [2.13, 4.83] | 5.04 | < 0.001 |
Tabel 5: Mixed-effects modellen die het procesgedrag op segmentniveau en de vertaalgeschiktheid voorspellen.
Discussie
De huidige resultaten tonen aan dat de moeilijkheidsgraad bij de Chinees-Engelse vertaling van narratieven met een focus op China niet gelijkmatig over een tekst is verdeeld. In plaats daarvan clustert deze in segmenten waar culturele referenties, evaluerende standpunten en gecomprimeerde narratieve betekenissen samenkomen. Dit ondersteunt een procesgebaseerde visie op vertaalmoeilijkheden, in plaats van een visie gebaseerd op een tekort aan woordenschat. Empirisch onderzoek naar het vertaalproces benadrukt dat vertalen een temporeel georganiseerde activiteit is waarbij aarzeling, oriëntatie en productie ongelijkmatig verdeeld zijn19. De geobserveerde concentratie van inspanning in deze studie weerspiegelt hoe specifieke segmenten een grotere interpretatieve druk uitoefenen, waardoor het lineaire conceptieproces sterker wordt verstoord dan bij andere segmenten. De toetsing van de hypothesen kan als volgt worden samengevat: H1 werd ondersteund omdat de culturele belasting leidde tot meer vroege aarzeling en een hogere revisiedichtheid; H2 werd verfijnd omdat evaluerende dichtheid en narratieve compressie via verschillende revisiepaden werkten; H3 werd ondersteund omdat de timing en functie van revisies de kwaliteit sterker voorspelden dan het totale aantal revisies; en H4 werd ondersteund als een associatieve overlap tussen de salientie van danmu en segmenten met een hoge inspanning, en niet als een causale relatie.
Wat betreft het revisiegedrag onthullen de gegevens dat het totale aantal revisies de vertaalkwaliteit niet voorspelt; in plaats daarvan zijn uitgestelde revisies, revisies op discoursniveau en culturele aanpassingen de belangrijkste drijfveren voor betere prestaties. Dit onderscheid suggereert dat revisie alleen productief is wanneer deze wordt uitgevoerd als een gestructureerde herevaluatie in plaats van als herhaaldelijke lokale correctie. In overeenstemming met onderzoek naar eye-tracking en keystroke-logging, dat aantoont dat beginnende vertalers hun inspanningen anders verdelen wanneer taken moeilijker worden, waren de sterkere studenten in deze studie niet simpelweg actiever7. Zij onderbraken selectief voorlopige oplossingen, beoordeelden deze in latere stadia opnieuw en richtten revisies op de narratieve of culturele passing. Bijgevolg zijn productscores alleen onvoldoende om de prestaties van vertalers te verklaren, aangezien vergelijkbare eindscores vaak voortkomen uit zeer verschillende procesverlopen9.
Dit fenomeen kan het best worden begrepen vanuit het perspectief van inspanningsconversie. Bij vertalingen met een lagere score bleef de cognitieve inspanning beperkt tot het lokale niveau—studenten pauzeerden, vervingen lexicale items of pasten lidwoorden aan, maar slaagden er niet in om diepere discrepanties tussen de implicaties van de brontekst en de kadering van de doeltekst op te lossen. Omgekeerd vertoonden scripts met een hogere score een conversie van inspanning naar structurele beslissingen die de tekst optimaliseerden voor de doellector. Parallel aan onderzoek naar de prestaties van studenten bij post-editing, bevestigen deze resultaten dat procesinspanning niet automatisch voordelig is; de waarde ervan hangt af van de conversie naar een interpreteerbare tekstuele verbetering20.
Bovendien activeren verschillende tekstuele eigenschappen verschillende procesmechanismen. Culturele belasting leidde consequent tot een toename van vroege aarzelingen en revisiedichtheid, terwijl narratieve compressie een sterke voorspeller was voor revisies op discoursniveau. Dit onderscheid verduidelijkt waarom moeilijke segmenten zich verschillend manifesteren tijdens het vertaalproces: sommige verstoren de cognitieve toegang in de initiële formulatiefase, terwijl andere pas problematisch worden bij het handhaven van de coherentie over grotere delen van het discours. In overeenstemming met studies die aantonen dat moeilijke teksten leiden tot kleinere verwerkingseenheden en intensievere onderbrekingen, onderstrepen deze bevindingen hoe gecomprimeerde culturele en evaluatieve betekenissen vertalers dwingen te schommelen tussen lokale expressie en globale narratieve inkadering8.
Een belangrijke methodologische bijdrage van deze studie is de integratie van danmu-opvallendheid als een laag van publieksdiscours. De aanzienlijke overlap tussen vertaalsegmenten met een hoge inspanning en danmu-opvallende segmenten wijst erop dat de knelpunten waar studenten tegenaan lopen vaak samenvallen met punten die in digitale verspreiding verhoogde aandacht van het publiek trekken. Dit verbindt vertaalmoeilijkheden aan participatief discours zonder deze twee constructen samen te voegen. Danmu-commentaren onthullen wat het publiek opmerkt of betwist in video-gemedieerde verspreiding, terwijl toetsaanslag- en revisiegegevens onthullen hoe student-vertalers semantisch gerelateerde segmenten van de brontekst verwerken. De meest plausibele interpretatie is daarom een common-cue verklaring: cultureel beladen referenties, gecomprimeerde achtergrondaannames en evaluatieve positionering kunnen gelijktijdig de aandacht van het publiek trekken en de verwerkingsdruk voor de vertaler verhogen21.
Pedagogisch gezien suggereert deze overlap dat narratieven met een focus op China circuleren in contexten waar betekenis publiekelijk en snel wordt onderhandeld, gestuurd door concurrerende prioriteiten zoals directheid, begrijpelijkheid en afstemming op het publiek22. Bijgevolg moet de vertalersopleiding verschuiven van het beschouwen van revisie als een generieke correctiefase naar het benadrukken van functionele en temporeel strategische interventies. De waargenomen knelpunten werden zelden door terminologie alleen veroorzaakt; ze ontstonden daar waar de narratieve betekenis afhankelijk was van cultureel gefundeerde aannames, relationele inkadering en selectieve toegang voor het publiek. Net als bij de verspreiding van Chinese etnische narratieve literatuur, vereist het overdragen van deze narratieven dat men verder kijkt dan lexicale getrouwheid om te bepalen hoe de lokale culturele betekenis moet worden hergestructureerd voor een bredere wereldwijde verspreiding23. De methode kan in de vertalersopleiding worden toegepast door gebruik te maken van toetsenaanslaglogs, schermopnamen en voorbeelden van publieksdiscours om studenten te helpen identificeren wanneer een segment explication, herordening, culturele inkadering of een aanpassing van het register vereist, in plaats van een eenvoudige lexicale vervanging.
De interpretatie van deze bevindingen kent enkele beperkingen. Ten eerste is danmu-salience een proxy op basis van semantische clusters voor publieksbetrokkenheid en geen directe maatstaf voor linguïstische moeilijkheidsgraad; bovendien kan het huidige correlationele ontwerp geen causaliteit vaststellen tussen publieke salience en vertaalinspanning. Toekomstig onderzoek zou de culturele belasting, evaluatieve dichtheid en narratieve compressie experimenteel kunnen manipuleren om causale paden te testen. Ten tweede is de steekproef beperkt tot vertaalstudenten van één universiteit, waarbij de ervaring van de deelnemers, culturele vertrouwdheid en vaardigheid in de tweede taal statistisch werden gecontroleerd in plaats van via volledig gestratificeerde steekproeftrekking. Replicatie met professionele vertalers, studenten van meerdere instellingen en bredere vaardigheidsniveaus zou de generaliseerbaarheid versterken. Ten derde waren de bronteksten door onderzoekers samengesteld en via een pilottest gekalibreerd voor de taak, maar toekomstige studies zouden aanvullende validatie moeten omvatten met behulp van authentieke publieke teksten en onafhankelijke panels voor materiaalontwikkeling. Ten vierde is de codering van culturele belasting, evaluatieve dichtheid, narratieve compressie en revisiefuncties afhankelijk van transparante operationele definities, onafhankelijke coderingsregisters en verifieerbare interbeoordelaarsbetrouwbaarheid naast het geoordeelde coderingsbestand. Toekomstig onderzoek zou keystroke logging kunnen combineren met eye-tracking, retrospectieve interviews, think-aloud-protocollen of post-editing-taken om de cognitieve mechanismen ten grondslag aan revisiebeslissingen te trianguleren.
Uiteindelijk verduidelijkt deze studie de procesmatige basis van de prestaties van studenten bij de Chinees-Engelse vertaling van narratieven gericht op China. Door toetsenbordlogginggegevens, productbeoordeling en digitaal publieksdiscours te koppelen, tonen de resultaten aan dat vertaalbottlenecks ontstaan op punten met een publiekelijk geladen narratieve betekenis. De doorslaggevende factor in crossculturele vertaling is niet het sheer volume van revisies, maar het vermogen van de vertaler om segmenten te herkennen die interpretatieve herstructurering vereisen en om de afronding strategisch uit te stellen tot er een stabiele, publieksgepaste oplossing is geformuleerd.
Openbaarmakingen
De auteurs hebben niets te melden.
Auteursbijdragen
Weijia Chen: Conceptualisering, methodologie, formele analyse, onderzoek, schrijven-origineel concept.
Chunming Wu: Studie-opzet, begeleiding bij formele analyse en dataverwerkingsprocedures, en review en feedback op herzieningen naar aanleiding van commentaren van reviewers.
Dankbetuigingen
Dit onderzoek werd financieel ondersteund door twee beurzen van de Hanshan Normal University. In het bijzonder betreft dit een gefaseerd onderzoeksresultaat van het programma First-Class Undergraduate Course (Offline First-Class Course) uit 2023 voor "Theory and Practice of Chinese–English Translation II" (goedkeuringsnummer YHS [2023] 172). Bovendien werd de studie ondersteund door het Teaching Quality and Teaching Reform Project uit 2025, aangewezen als Model Course for Curriculum-Based Ideological and Political Education voor "Chinese–English Translation" (goedkeuringsnummer YHSJ〔2025〕126). De auteurs betuigen hun dank voor de institutionele ondersteuning die is geboden voor de voltooiing van dit onderzoek.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Bilibili danmu-corpus | Bilibili | 24 video's; 18.642 reacties;https://www.bilibili.com | Constructie van het hulp-danmu-corpus en berekening van de danmu-saillantie op segmentniveau |
| Microsoft Excel | Microsoft Corporation | Excel 2021;https://www.microsoft.com/microsoft-365/excel | Datacleaning, organisatie van coderingen en voorlopig databeheer |
| R | R Foundation for Statistical Computing | R 4.3.1;https://www.r-project.org | Mixed-effects modellering, correlatieanalyse en het genereren van figuren |
| Schermopnamesoftware | Laboratoriumwerkstation | Lokale workstation utility; geen catalogusnummer | Verificatie van niet-lineaire revisie-episodes en back-up van procesgegevens |
| SPSS | IBM Corporation | SPSS Statistics 27.0;https://www.ibm.com/products/spss-statistics | Descriptieve statistiek, ANOVA en basisstatistische analyses |
| Translog-II | Copenhagen Business School / CRITT | Translog-II;https://sites.google.com/site/centretranslationinnovation/translog-ii | Toetsenaanslagregistratie en recording van pauzes, cursorbewegingen en revisie-episodes tijdens vertaalopdrachten |
Referenties
- Valdeón RA, Li S. Political discourse translation in contemporary Chinese and Western contexts. Translator. 2024;30(4):1-14.
- Du L, Afzaal M. Analyzing modality-mediated ideology in translated Chinese political discourses: An ideological square model approach. Humanit Soc Sci Commun. 2024;11:956.
- Carl M. Empirical translation process research: Past and possible future perspectives. Transl Cogn Behav. 2024;6(2):252-274.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589-1604.
- Carl M, et al. Hesitation, orientation, and flow: A taxonomy for deep temporal translation architectures. Ampersand. 2024;12:100164.
- Swar O, Mohsen M. Students' cognitive processes in L1 and L2 translation: Evidence from a keystroke logging program. Interact Learn Environ. 2023;31(10):6247-6263.
- Wang Y, Li S, Rasmussen YZ. Translators' allocation of cognitive resources in two translation directions: A study using eye-tracking and keystroke logging. Appl Sci. 2025;15(8):4401.
- Wang F, Xu Q. Processing of translation units by student and semi-professional translators in translating texts with different levels of translation difficulty. PLoS One. 2025;20(4):e0320809.
- Chen X, Yan JX. Examining student translators' writing and translation products: Quality, errors, and self-perceived mental workload. Interpret Transl Train. 2024;18(3):465-485.
- Dong D, Chen ML. Metacognitive strategies in translation: A comparative study of student and professional translators. Humanit Soc Sci Commun. 2025;12:890.
- Chen X, Yan JX. Investigating the processing effort in translation students' L2 writing and L2 translating: Evidence from keylogging. Humanit Soc Sci Commun. 2025;12:1810.
- Cao L, Doherty S, Lee JF. The process and product of translation revision: Empirical data from student translators using eye tracking and screen recording. Interpret Transl Train. 2023;17(4):548-565.
- Van Egdom GW, Schrijver I, Verplaetse H, Segers W. The impact of collaborative processes on target text quality in translator training. Interpret Transl Train. 2024;18(3):486-506.
- Riondel A. How to teach revision: Tips from an interview study. Interpret Transl Train. 2024;18(3):507-522.
- Lu S, Chen X. An experimental study on viewing perception and gratification of danmu subtitled online video streaming. J Spec Transl. 2024;42:217-238.
- Lei Y, Peng M, Han Y. Mistaken presuppositions and the translation of cultural texts: A study of two English translations of The Classic of Tea. Perspectives. 2025. doi:10.1080/0907676X.2025.2599854.
- Kim HR. Danmu as paratext: An exploratory study of paratextual functions in Chinese fan-subtitled videos. J Transl Stud. 2025;26(3):197-231.
- Wu X, Fitzgerald R. The danmu discourse of user engagement with cross-posted broadcast interviews in Chinese social media. Journalism. 2025;26(3):733-751.
- Yamada M, Carl M, Schaeffer MJ. Introduction to the special Ampersand issue on empirical translation process research. Ampersand. 2024;12:100179.
- Peng X, Wang X, Li X. When student translators meet with machine translation: The impacts of machine translation quality and perceived self-efficacy on post-editing performance. SAGE Open. 2024;14(4):21582440241291624.
- Yang Y. Making sense of the raw meat: A social semiotic interpretation of user translation on the danmu interface. Discourse Context Media. 2021;44:100550.
- Zeng D. Danmu subtitling as a self-regulative practice: A descriptive discourse analysis of Bilibili danmu subtitles from ethical perspectives. Front Psychol. 2025;16:1577260.
- Li Y, Cai X. The translation of ethnic literature: An analysis of the Chinese and English translations of the Yi folk narrative poem Ashima and their dissemination. Perspectives. 2025. doi:10.1080/0907676X.2025.2502935.