Deze studie ontwikkelt een gelaagd raamwerk voor prompt-optimalisatie op basis van DeepSeek om de competentie voor het overbrengen van Engels schrijven in crossculturele contexten te verbeteren. Via een prompt-keten van drie fasen en een quasi-experiment met 60 studenten Engelse taal en letterkunde tonen de resultaten een significante verbetering aan in de experimentele groep vergeleken met de controlegroep.
Onderzoeksartikel
Het optimaliseren van DeepSeek-prompts voor crossculturele instructie in Engels schrijven: een praktische studie naar transfercompetentie
In dit artikel
Samenvatting
Samenvatting
Om de beperking aan te pakken dat traditioneel onderwijs in Engels schrijven de systematische cultivering van taaltransfer verwaarloost en bestaande prompt-frameworks niet aansluiten bij het klassikale onderwijs, construeert deze studie een hiërarchisch transfer-trainingssysteem op basis van het DeepSeek-model. Dit systeem omvat vier progressieve taakniveaus: zin, paragraaf, discours en cultuur, waarbij alle taken in een triple-vorm zijn gedefinieerd. Er is een vijfdimensionale taakbibliotheek opgezet die syntaxis, structuur, cultuur, register en logica beslaat, waarbij gerichte prompts automatisch worden gegenereerd op basis van authentieke schrijfconcepten van studenten. Geïntegreerd met de Mixture of Experts (MoE)-architectuur van het model, is een geneste prompt-keten ontwikkeld om complexe opdrachten op te splitsen in drie opeenvolgende fasen: semantische reorganisatie, linguïstische revisie en culturele adaptatie. Met behulp van een quasi-experimenteel ontwerp rekruteerde dit onderzoek 60 tweedejaars studenten Engelse taal en letterkunde van één universiteit, die werden verdeeld over een experimentele groep en een controlegroep van elk 30 studenten voor een gefaseerde interventie van drie weken over drie trainingsrondes. Post-experimentele resultaten tonen aan dat de culturele transferscore van de experimentele groep steeg van 2.8 naar 4.5, vergeleken met een toename van slechts 0.3 in de controlegroep; de gemiddelde door docenten beoordeelde score verbeterde van 59.1 naar 74.4, tegenover een stijging van 60.1 naar 64.9 in de controlegroep. De meeste correlatiecoëfficiënten tussen de AI-score en de beoordeling door de docent overschreden 0.8, en meer dan 90% van de deelnemers keurde de AI-herschrijf- en structurele optimalisatiefuncties goed. Gezien de kleine steekproefomvang in deze trial is deze optimalisatiebenadering haalbaar voor implementatie in universitaire cursussen Engels schrijven.
Inleiding
Bij het onderwijzen van Engels schrijven in een transculturele context worden niet-moedertaalsprekers vaak geconfronteerd met de uitdaging van onvoldoende transfercapaciteit bij de overgang van taalkennis naar praktische toepassing1,2. Hoewel studenten beschikken over een zekere basis in grammatica en woordenschat, hebben zij moeite om zinspatronen, structuren en culturele uitdrukkingen effectief om te zetten in daadwerkelijke teksten. Dit resulteert in een geformaliseerde taalproductie en een beperkt denkvermogen, wat op zijn beurt de algehele schrijfkwaliteit beïnvloedt3. Daarnaast vergroten transculturele verschillen in taalstructuur, logische organisatie en pragmatische normen de complexiteit van de schrijftransfer verder4. In recente jaren hebben grote taalmodellen (LLM's) nieuwe technische ondersteuning geboden voor het onderwijs in schrijven5. Intelligente schrijftools, zoals DeepSeek, hebben sterke capaciteiten getoond in taalgeneratie en reconstructie. In de onderwijspraktijk blijven ze echter grotendeels beperkt tot oppervlakkige taalcorrectie en zijn ze nog niet diep geïntegreerd in het onderwijsproces, dat gericht is op het cultiveren van de transfercapaciteit. Ze missen een oriëntatie op onderwijsdoelen en beheersbaarheid van het generatiegedrag6,7. Veelgebruikte AI-ondersteunde schrijfapplicaties beperken hun functies meestal tot oppervlakkige correctie van grammaticale fouten in plaats van te richten op de ontwikkeling van systematische transfercompetentie, wat leidt tot een gebrekkige onderwijsoriëntatie bij de controle over de modeloutputs.
Bestaand onderzoek naar schrijfhulp voor ESL (Engels als tweede taal) valt uiteen in drie hoofdcategorieën: conventionele promptgestuurde feedback op het schrijven, generieke AI-interventies voor het polijsten van teksten en handmatige transfertraining. Ten eerste geeft algemeen onderzoek naar prompt engineering prioriteit aan de technische optimalisatie van vraag-en-antwoordinteracties en tekstherschrijving, zonder aansluiting bij hiërarchische transferdoelen voor het onderwijs8,9. Ten tweede richt typische ESL-begeleiding op basis van ChatGPT zich op de verbetering van de algemene schrijfnauwkeurigheid in plaats van op de gelaagde cultivatie van syntactische, structurele en cross-culturele transfer10. Ten derde ontbeert traditionele transferpedagogiek, die steunt op imitatie en contrastief schrijven, een gesloten feedbacklus die wordt ondersteund door intelligente tools11. In tegenstelling tot de voorgaande studies ontwikkelt dit onderzoek aangepaste, transfergeoriënteerde hiërarchische prompts die zijn afgestemd op meerlaagse onderwijsdoelstellingen, en bouwt het een samplegestuurde workflow voor de automatische generatie van prompts. Dit vormt een uniek gesloten trainingsmechanisme waarin modelgeneratie, feedback van de docent en revisie door de student worden gecombineerd.
Eerdere literatuur stelt een potentiële koppeling voor tussen linguïstische culturele divergentie, inherente structurele beperkingen van het model en onsamenhangende klaspraktijken, maar een dergelijke causale keten is in bestaande empirische studies nog onvoldoende empirisch geverifieerd en vormt de kernhypothese die in dit artikel wordt onderzocht12,13. Wat betreft de inherente kenmerken van DeepSeek die in dit artikel worden aangehaald, zijn de open instructie-interface en het op MoE gebaseerde expert-routingontwerp gedocumenteerd in bestaande technische modelrapporten en toegepast taalonderzoek. Voortbouwend op deze gedocumenteerde modelkenmerken, ontwerpt deze studie geneste promptketens om complexe crossculturele transfertaken te ontleden en ontwikkelt deze dynamische submodel-schedulingregels voor gedifferentieerde transferopdrachten. Centraal in de ontwikkeling van gestructureerde transfervaardigheden verkent het huidige werk gerichte DeepSeek-promptoptimalisatie, met als doel grote taalmodellen te transformeren van universele tekstbewerkingsinstrumenten naar gespecialiseerde transfer-trainingssystemen voor het onderwijs in Engels schrijven op het hoger onderwijs.
Binnen het vakgebied van onderzoek naar schrijven in een tweede taal is het transferfenomeen al lange tijd een kernonderwerp14,15. Traditionele taaltransfertheorie richt zich primair op de positieve en negatieve transfereffecten van de moedertaal op het proces van acquisitie van de doeltaal, met specifieke nadruk op fonetiek, vocabulaire en syntaxis16. Mirzayev E wees erop dat, bij instructie in Engels als tweede taal (ESL), negatieve transfer vanuit de eerste taal een sleutelfactor blijft die de ontwikkeling van de schrijfvaardigheid van studenten beperkt17. Naarmate het onderzoeksveld breder is geworden, heeft de academische gemeenschap de focus geleidelijk uitgebreid naar de transfer van schrijfstructuur18. Interlanguage-schrijven vertoont vaak taalfouten en fossilisatie als gevolg van meerdere factoren19. Tegelijkertijd heeft de cognitieve transfertheorie steeds meer aandacht gekregen20. Deze theorie benadrukt de verschillen in cognitieve organisatie en expressiepatronen tijdens het schrijfproces. Zo legt het westerse schrijven de nadruk op lineaire redenering en expliciete logica, terwijl de Chinese traditie de voorkeur geeft aan een spiraalvormige benadering en semantische ambiguïteit. Hier is sprake van een aanzienlijke spanning tussen beide. Taaltransfer omvat daarom niet alleen de conversie van taaleneheden, maar ook de adaptatie en transformatie van denkstructuren en culturele expressienormen op een dieper niveau, wat een belangrijke uitdaging vormt in het huidige Engels schrijfonderwijs21.
Bij het aanleren van transfervaardigheden maken bestaande studies vaak gebruik van strategieën zoals imiterend schrijven22, contrastief schrijven23 en vertaaltraining24 om het begrip en de toepassing van het transfermechanisme van de doeltaal bij leerlingen te verbeteren. Imiterend schrijven helpt bij het opbouwen van basisvaardigheden in het discours, maar kan gemakkelijk leiden tot structurele starheid; contrastief schrijven kan de taalstijl en het culturele bewustzijn verbeteren, maar mist systematische taakstratificatie en gepersonaliseerde feedback; vertaaltraining kan de herkenning van culturele metaforen bevorderen, maar zonder begeleiding kan dit gemakkelijk leiden tot semantische afwijkingen of pragmatische ongepastheid. De bovengenoemde strategieën leunen primair op handmatige demonstratie en empirische begeleiding25, missen een expliciete constructie van transferstrategieën en systematische feedbackmechanismen, en zijn moeilijk aan te passen aan individuele verschillen in taalbeheersing en cognitieve stijlen. Hoewel sommige studies hebben geprobeerd de transfertraining uit te breiden via gediversifieerde schrijftaken26,27, heeft het onderwijsproces nog geen gesloten lus van "transferdoel-taalgeneratie-strategiefeedback" gevormd; het internalisatie-effect van transferstrategieën is beperkt en de ontwikkeling van de transfervaardigheden van studenten in werkelijke schrijftaken is nog onvoldoende28.
Met de ontwikkeling van technologie voor grote taalmodellen heeft het ondersteunende potentieel ervan in het taalonderwijs steeds meer aandacht gekregen29. Generatieve AI-tools, vertegenwoordigd door ChatGPT (Chat Generative Pre-trained Transformer)30 en DeepSeek31, worden op grote schaal gebruikt in scenario's zoals het polijsten van teksten, het herschrijven van taal en het aanpassen van taalgebruik. Diasamidze et al. stelden vast dat ESL-studenten die ChatGPT gebruikten beter scoorden dan de traditionele onderwijsgroep op het gebied van grammaticale nauwkeurigheid, woordenschatrijkdom en het vermogen tot tekstorganisatie32. Bestaande toepassingen zijn echter grotendeels beperkt tot oppervlakkige taalverwerking en missen systematische begeleiding bij transferdoelen. Ranade wees erop dat prompt-gebaseerde projecten in huidige onderwijscenario'smostly gebaseerd zijn op algemene sjablonen, waardoor de gegenereerde inhoud een gebrek heeft aan contextuele aanpasbaarheid en taakspecifiek kenmerk33. Daarnaast vertrouwt de training van mainstream modellen op een open corpus en ontbreekt een diepe modellering van de verschillen in Chinese en Engelse culturele uitdrukkingen. In de gegenereerde tekst treden vaak culturele ongepastheden en onnatuurlijke pragmatiek op34,35, wat de diepgaande toepassing in het onderwijs over crossculturele schrijftransfer beperkt.
Protocol
Ethische goedkeuring
Voorafgaand aan het experiment hebben de auteurs goedkeuring (goedkeuringsnummer: NBCC-ETH-2026-037) verkregen van de hogeschool en zijn formulieren voor geïnformeerde toestemming verspreid onder alle deelnemende studenten. Alle studenten zijn duidelijk geïnformeerd over de onderzoeksdoelstellingen, de experimentele procedures en de regels voor datagebruik. Deelname was vrijwillig en deelnemers konden op elk moment stopzetten met de studie. Alle persoonsgegevens en schriftelijke werken werden geanonimiseerd om de privacy te beschermen en werden uitsluitend gebruikt voor academische analyse. Alle 60 deelnemers hebben het toestemmingsformulier ondertekend voordat zij deelnamen aan het onderzoek. Deelnemers werden geselecteerd uit twee parallelle cursussen Engels schrijven voor tweedejaarsstudenten aan dezelfde hogere beroepsopleiding, geworven via convenience sampling. De inclusiecriteria waren: het behalen van CET-6 met een score > 425, geen afwezigheid in dit semester en gemiddelde scores bij de laatste twee schrijfvaardigheidstoetsen. De exclusiecriteria waren: langdurig gebruik van commerciële AI-schrijfsoftware voor het Engels buiten de lessen en ernstige dyslexie.
Variabiliteit voor alle continue uitkomstvariabelen werd gerapporteerd als gemiddelde ± standaarddeviatie (SD). Alle analyses werden uitgevoerd met een steekproefomvang van n = 30 deelnemers per groep (experimentele groep vs. controlegroep), totaal N = 60. Voor longitudinale herhaalde-metingen data werd een herhaalde-metingen variantieanalyse (RM-ANOVA) gebruikt om de hoofdeffecten van groep en tijd, en de interactie tussen groep en tijd te onderzoeken. Independent-samples t-toetsen werden gebruikt voor post-hoc paarsgewijze vergelijkingen op individuele tijdstippen. De controlegroep ontving traditioneel schrijfonderwijs plus een generieke, gratis, niet-gepersonaliseerde AI-schrijftool (geen gelaagde prompts, geen transfer-georiënteerde templates). De instructie-uren, schrijfopdrachten, feedbackfrequentie en trainingsteksten waren identiek aan die van de experimentele groep, behalve het ontbreken van de in deze studie gebruikte gepersonaliseerde geneste prompt-keten en de interventie met de vijfstaps takenbibliotheek. De experimentele groep maakte gebruik van instructies gebaseerd op het DeepSeek-model om het schrijfonderwijs te optimaliseren, inclusief begeleiding via geneste prompt-ketens, output voor cross-culturele adaptatie en het "generatie-reflectie-regeneratie"-mechanisme. De controlegroep maakte daarentegen gebruik van traditionele onderwijsmethoden of niet-geoptimaliseerde AI-ondersteunde tools. Door de onderwijseffecten van de twee groepen te vergelijken, werd de effectiviteit van de op het grote taalmodel gebaseerde transfertrainingsmethode voor het verbeteren van het schrijftransfervermogen van studenten geverifieerd.
Algemeen onderzoeksidee
Deze studie was erop gericht het vermogen van studenten tot het overdragen van Engelse schrijfvaardigheden te verbeteren en effectieve methoden voor instructieontwerp te ontwikkelen, met een specifieke focus op het aanpassen van DeepSeek voor educatief gebruik. Ten eerste werd een strategie voor instructie-optimalisatie voorgesteld om model-prompts te herontwerpen. Dit verbeterde de afstemming van de gegenereerde output op meerdere transferdoelen in schrijfinstructie, waaronder syntactische structuur, paragraaflogica en culturele expressie. Ten tweede werden de schrijfopdrachten van docenten omgezet in gestructureerde en doelgerichte prompt-templates. Vervolgens werd een mapping-relatie vastgesteld tussen onderwijstaken en modelgedragingen. Dit verbeterde de controleerbaarheid van het model en waarborgde dat de gegenereerde inhoud pedagogisch relevant was. Ten slotte ontwikkelde de studie een gesloten-lus transfertrainingsproces: "generatie–reflectie–herschrijven–regeneratie". Dit proces moedigde studenten aan om transferstrategieën te identificeren en hun taaluitdrukking actief te verfijnen met ondersteuning van het model. Door herhaalde iteraties werden de cross-linguïstische en cross-culturele schrijftransfervaardigheden van de studenten continu versterkt. De stappen voor de transformatie van de zinsstructuur worden weergegeven in Figuur 1A–D.
Om de volledige operationele logica van het AI-ondersteunde schrijftrainingssysteem te verduidelijken en de reproduceerbaarheid te verbeteren, is de algemene implementatiewerkstroom samengevat in Tabel 1, waarin de kernonderdelen zijn opgenomen, waaronder de ruwe input, interventies van de docent, de toepassing van prompts, activiteiten van de student, de uiteindelijke output en de overeenkomstige evaluatiecriteria.
Taakconstructiestrategie gericht op transfer
Deze studie richtte zich op het cultiveren van het transfervermogen bij Engels schrijven. Er werd een transfertaakpad geconstrueerd dat vordert van oppervlakkig naar diep, waarbij studenten systematisch worden begeleid bij het beheersen en oefenen van taaltransferstrategieën op meerdere niveaus. Om de padstructuur als geheel te beschrijven, werd deze gedefinieerd als een taakset van vier niveaus:
T = {T1,T2,T3,T4} (1)
T1 staat voor de transfertaak op zinsniveau, die zich richt op basisoperaties van de grammaticaal structuur, zoals het uitbreiden van korte zinnen, het wijzigen van de lijdende of bedrijvende vorm en het vervangen van clausules, om studenten te helpen diverse methoden van zinsstructuur te beheersen. T2 is de transfertaak op paragraafniveau, die studenten aanstuurt om aandacht te besteden aan de organisatie en verbinding van informatie binnen de paragraaf, en hen traint om de structurele helderheid en coherentie van de expressie van de paragraaf te verbeteren door het extraheren van de kernzin en het aanpassen van de logica tussen zinnen. T3 staat voor de taak op discoursniveau, die zich verder uitstrekt tot de algehele logische lay-out en argumentatieritmiek van het hoofdstuk, en studenten begeleidt bij het construeren van een Engels artikel met een volledig argumentatiesysteem door de volgorde van paragrafen aan te passen en de structurele juxtapositie-relatie te optimaliseren. T4 is de transfertaak op cultureel niveau, waarbij studenten vereist wordt om impliciete culturele expressiekenmerken in teksten in de moedertaal te identificeren, zoals impliciete bewoordingen en semantische hints, en deze om te vormen tot directe expressies of logisch expliciete vormen die overeenkomen met de cultuur van de doeltaal. Het evolutieproces hiervan wordt weergegeven in Figuur 2. Om de uitvoerbaarheid en evaluatie van het taakontwerp te verbeteren, heeft deze studie elk taakniveau verder gedefinieerd als een tripelvorm:
Ti = (Si,Gi,Ei) (2)
Sj stelt het invoersample van de taak voor, Gi stelt de doeloverdrachtsoperatie voor, en Ei stelt de ondersteunende evaluatiecriteria voor. Door middel van deze gestructureerde expressie werd gewaarborgd dat elk taakniveau was gebaseerd op de beheersing van de strategie van het vorige niveau en was voorzien van overeenkomstige samples, doelbeschrijvingen en prestatiecriteria, wat een mechanisme bood voor de gestage vooruitgang van het overdrachtspad. Tijdens het proces van het construeren van het overdrachtstrainingssysteem, om een systematische dekking van taaktypen en een efficiënt beheer van onderwijsaanroepen te bereiken, heeft deze studie een gestructureerde taakbibliotheek gebouwd die vijf typen overdrachtsdoelen omvat, gebaseerd op de gangbare dimensies van taalconversie bij schriftelijke overdracht. De taakbibliotheek werd formeel als volgt uitgedrukt:
M = {(Dj,TDj)∣j = 1,2,3,4,5} (3)
Dj komt overeen met vijf transferdimensies: syntactische transfer, structurele transfer, culturele transfer, registertransfer en logische transfer; de taakset TDj die met elke dimensie is geassocieerd, vertegenwoordigt de bijbehorende subset van operaties. Tijdens het ontwikkelen van de taakbibliotheek hebben de auteurs eerst veelvoorkomende transfermoeilijkheden en soorten taalfouten samengevat en geclassificeerd op basis van een groot aantal echte schrijfvoorbeelden van studenten. In combinatie met de feitelijke onderwijsbehoeften en evaluatienormen zijn de verschillende transfertypen verdeeld in functionele gebieden, waarna de kernleerdoelen en operationele modi van elke taak zijn vastgesteld. Elke taak werd abstract weergegeven als de volgende triple-structuur:
Ti,j = (Si,j,Gi,j,Ci,j) (4)
Si,j representeert de invoersample van de taak, Gi,j is de beschrijving van het overdrachtstarget van de taak, en Ci,j is de evaluatie- en controledimensie van de taak. In de syntactische overdrachtstaak heeft deze studie een sequentie voor zinreorganisatie ontworpen die van eenvoudig naar moeilijk vorderde, waarbij zinverbinding, bijzinsnesting, conversie naar de lijdende vorm en aanverwante concepten werden behandeld, met als doel de vaardigheden van studenten in zinuitbreiding en grammaticale transformatie te verbeteren. De structurele overdrachtstaak richtte zich op het optimaliseren van de paragraaflogica, het versterken van de informatieorganisatie en het verbeteren van het vermogen tot logische constructie door het herschrijven van de hoofdzin, het sorteren van ondersteunende zinnen en het reconstrueren van oorzaak-gevolgrelaties en voorbeeldrelaties. De culturele overdrachtstaak was gebaseerd op een crosscultureel corpus en richt zich op pragmatische afwijkingen, zoals impliciete uitdrukkingen en eufemismen. Er werden expressieconversies ontworpen die dicht bij de werkelijke context liggen om de ontwikkeling van culturele aanpassingsvermogen te bevorderen. De registeroverdrachtstaak begeleidde studenten bij het transformeren van mondelinge uitingen naar academische taal en het beheersen van strategieën voor het wisselen van registers. De logische overdrachtstaak richtte zich op het construeren van redeneringsketens en het waarborgen van de duidelijkheid van de uitdrukking, terwijl training werd gegeven over het gebruik van voegwoorden, de explicitering van logische relaties en paragrafovergangen.
Op basis van actuele schrijfvoorbeelden van studenten ontwikkelde deze studie een proces voor promptgeneratie dat nauw verbonden is met onderwijstaken, met als doel de relevantie van de instructies en de praktische bruikbaarheid van de gegenereerde inhoud te vergroten. Het proces werd geleid door docenten, die tijdens het onderwijsproces representatieve tekstfragmenten van studenten selecteerden, waarbij de nadruk lag op typische transferproblemen zoals overbodige zinnen, chaotische structuren en ongepaste culturele uitdrukkingen. Vervolgens annoteerden zij de voorbeelden met transfertypes via de systeeminterface om de trainingsdoelstellingen te verduidelijken. Na ontvangst van de annotatie-informatie activeerde het systeem automatisch de module voor identificatie van de transfertaak. Daarna werd de invoer gekoppeld aan de vooraf gedefinieerde taakbibliotheek en prompt-sjabloonbibliotheek. Bij dit koppelingsproces werden factoren meegewogen zoals het transfertype, linguïstische kenmerken en de tekststructuur. Op basis van deze factoren selecteerde het systeem het meest geschikte sjabloon en genereerde een initiële prompt. Het systeem ondersteunde daarnaast gestructureerde optimalisatieverwerking. Annotaties van docenten werden omgezet in een gestandaardiseerd formaat dat eenvoudig door het model kan worden geïnterpreteerd. Relevante instructieve aanwijzingen werden in de prompt ingebed om het model te helpen zowel de bedoelingen van de docent als de vragen van de student nauwkeurig te begrijpen. Om de flexibiliteit en beheersbaarheid van de instructies te verbeteren, bevatte het systeem een module voor docentondersteuning. Deze module stelde docenten in staat om prompts te verfijnen door de instructieve begeleiding te wijzigen, contextinstellingen aan te passen en de toon en stijl te personaliseren. Hierdoor kregen docenten meer controle over het generatieproces en konden zij dit beter afstemmen op verschillende onderwijsscenario's.
Optimalisatiemechanisme voor Deepseek-commando's
Op basis van de praktische behoeften van training in het overdragen van vaardigheden bij het Engels schrijven, heeft deze studie vijf typen transfergeoriënteerde prompt-templates ontwikkeld. Deze templates werden ontworpen om het generatiegedrag van het grote taalmodel te sturen en te reguleren. De structurele transfer-template richtte zich op de paragraaforganisatie en de discoursstructuur. Hiermee konden studenten teksten herorganiseren door structuren te hanteren zoals inleiding–kern–conclusie, en door de logische stroom van ideeën te verbeteren. De syntactische transfer-template legde de nadruk op complexiteit op zinsniveau. Het stimuleerde het gebruik van diverse grammaticale structuren, waaronder de lijdende vorm, parallelle constructies en complexe bijzinnen, om de verfijning van de geschreven expressie te verhogen. De culturele transfer-template richtte zich op de culturele gepastheid in het schrijven. Het leidde studenten bij het aanpassen van uitdrukkingen die beïnvloed waren door hun moedertaal en cultuur naar vormen die natuurlijker en acceptabeler waren in Engelstalige contexten. De register-transfer-template richtte zich op stijlaanpassing en registerbeheersing. Het hielp studenten hun taalgebruik aan te passen aan verschillende schrijfdoelen, doelgroepen en genres. De logica-transfer-template was erop gericht de logische organisatie te versterken. Het bevorderde het effectieve gebruik van relaties zoals oorzaak en gevolg, vergelijking en contrast, en parallelle ontwikkeling, waardoor de coherentie en argumentatieve strengheid werden verbeterd. Samen dekten deze vijf templates de belangrijkste dimensies van schrijftransfer. Ze boden gestructureerde instructieve ondersteuning voor zowel het ontwerp van onderwijstaken als voor modelgebaseerde tekstgeneratie.
Elk sjabloontype volgde een uniform formaat om de universaliteit en aanpasbaarheid in verschillende onderwijssituaties te waarborgen. Het sjabloon bevatte vier kernelementen: ten eerste het instructiedoel, dat duidelijk de vereiste transfertaak aangaf; ten tweede de voorbeeldinput, die studenten voorzag van reële taalfragmenten als corpusbasis voor de effectiviteit van de instructie; ten derde de doeloutput, die de standaardstijl van de ideale taaloutput na transfer liet zien, zodat studenten deze konden vergelijken en gebruiken voor modeloptimalisatie; en ten vierde de gebruiksuggestie, waarin het taalniveau, het teksttype en de gebruiksstrategie die van toepassing waren op het sjabloon werden toegelicht, inclusief aanpasbare parameterprompts om de controle over de generatie en het effect van de pedagogische begeleiding te verbeteren.
Om de ontwerplogica en de praktische toepassing van de prompt-templates verder te illustreren, worden hieronder representatieve voorbeelden van vijf transfergerichte prompts gepresenteerd. Alle templates voldeden aan het uniforme raamwerk, dat bestond uit een instructiedoel, voorbeeldinput, doeloutput en een gebruiksuggestie. Studenten werden begeleid om eenvoudige zinnen uit te breiden, de stem van de zin te wijzigen en bijzinnen in te voegen om de syntactische diversiteit te vergroten. Gegeven het concept van de student "I study English writing. It is very important for cross-cultural communication", is de geoptimaliseerde output bijvoorbeeld "Learning English writing plays a vital role in improving learners’ ability of cross-cultural communication". Deze prompt was geschikt voor training op zinsniveau voor tweedejaars studenten Engelse taal학 op een gemiddeld moeilijkheidsniveau, waarbij de focus lag op basis syntactische reconstructie en stemtransformatie. Een ander type prompt was gericht op culturele transfer, met als doel Chinglish-uitdrukkingen te identificeren die beïnvloed zijn door inheems cultureel denken en zinnen te herschrijven naar natuurlijke Engelse pragmatische uitdrukkingen die conform de westerse culturele normen zijn. Neem de zin van de student "Many people think you must work hard if you want to succeed" als voorbeeld; de herziene versie was "People generally believe that diligence is the key to success". Deze prompt werd toegepast bij training voor transfer op cultureel niveau, waarbij de nadruk lag op het elimineren van impliciete Chinese denkpatronen en het stimuleren van expliciete expressie binnen de Engelse context.
Deze studie ontwikkelde daarnaast een drietraps geneste promptketen die de conceptversies van paragrafen van studenten als geunifiede input nam en in opeenvolgende fasen werd uitgevoerd. De eerste fase bestond uit semantische reorganisatie, waarbij de prompt de deelnemer vereiste om de zinnen van de gegeven paragraaf te herschikken, de logische volgorde van ideeën te optimaliseren en een volledige paragraaf met duidelijke topiczinnen te vormen. De tweede fase was de linguïstische revisie, waarbij werd gevraagd om de herziene paragraaf te herschrijven in formeel academisch Engels, colloquiale woorden te vervangen en op passende wijze complexe zinnen en passieve structuren te gebruiken. De derde fase was de culturele adaptatie, waarbij de prompt gebruikers leidde om de tekst te controleren op cultuur-pragmatische uitdrukkingen, culturele interferentie vanuit de moedertaal te verwijderen en de inhoud te polijsten om aan te sluiten bij Engelse cross-culturele schrijfconventies. De bovenstaande voorbeelden demonstreerden volledig de operationele modi van single-prompt templates en geneste promptketens. Op basis hiervan ontwierp de studie een complete gefaseerde promptketen in combinatie met de MoE-architectuur van DeepSeek.
Om de beperkingen van prompts in één ronde wat betreft generatiecontrole en de diepgang van de taakrespons te overwinnen, is in deze studie een geneste promptketenstructuur ontworpen met gefaseerde en continue kenmerken, waardoor hiërarchische begeleiding en de geleidelijke generatie van complexe transfertaken mogelijk worden. Dit mechanisme splitste een volledige transfertaak op in verschillende subdoelen en ontwierp overeenkomstige prompt-templates voor elk subdoel, die in serie werden verbonden in de logische volgorde van semantische reconstructie, aanpassing van de taalstijl en culturele pragmatische adaptatie, waardoor een generatieketen met contextafhankelijkheid ontstond. Deze studie implementeerde de optimalisatie van de geneste promptketen voor DeepSeek via de standaard open API. Het DeepSeek-model maakte van nature gebruik van een Mixture of Experts (MoE)-architectuur, uitgerust met een automatisch backend-expertsroutingsysteem, dat functioneert als een inherente interne redeneermodule onafhankelijk van externe prompts. De aangepaste meerstaps-prompts pasten enkel de inhoudelijke kenmerken van de modelinputs aan. In overeenstemming met de semantische, stilistische en culturele vereisten die in de geoptimaliseerde inputs waren ingebed, activeerde het native MoE-routingsmechanisme van het model autonoom de meest geschikte expertmodules tijdens de tekstgeneratie. Het driestaps-promptontwerp, gericht op semantische reorganisatie, stilistische aanpassing en culturele adaptatie, verfijnde enkel de inputteksten en interfereerde niet met de interne logica voor de selectie en toewijzing van experts door het model.
Wat betreft het operationele proces ontving het systeem door docenten geüploade studententeksten, overdroeg het doelannotaties en bepaalde het automatisch of de geneste ketenstructuur geactiveerd moest worden. Indien geactiveerd, voerde het systeem drie fasen opeenvolgend uit: de eerste fase was semantische reorganisatie, waarbij het structuuroverdrachtssjabloon werd aangeroepen om de paragraaforganisatie en logische verbanden te optimaliseren; de tweede fase was de aanpassing van de taalstijl, waarbij het taalsjabloon werd gebruikt om colloquiale uitdrukkingen om te zetten in academische schrijftaal; de derde fase was culturele adaptatie, waarbij het culturele overdrachtssjabloon werd aangeroepen om uitdrukkingen die niet conform de cultuur van de doeltaal zijn te identificeren en te vervangen, om zo authentiekere tekst te genereren.
Elke generatieronde gebruikte de output van de vorige ronde als input en behield de contextvectorcache om semantische coherentie te waarborgen. Docenten pasten de structuur van de promptketen aan in de systeeminterface, inclusief de selectie van sjablonen, de aanpassing van instructies en de wijziging van de volgorde. Het systeem ondersteunde daarnaast de functie "sjablonencombinatiepakket", waardoor docenten eenvoudig taken in batches konden hergebruiken of toewijzen. Bovendien beschikte het systeem over een ingebouwd mechanisme voor dynamische onderbreking en feedback, waarmee na elke generatie tussenresultaten werden verstrekt. Docenten annoteerden of pasten daaropvolgende instructies in realtime aan, waardoor een gesloten onderwijscyclus van "generatie-aanpassing-regeneratie" ontstond.
Modelgeneratie, evaluatie
In het proces van tekstgeneratie en -evaluatie op basis van het DeepSeek-model heeft deze studie een multidimensionaal automatisch scoremechanisme geconstrueerd om gegenereerde tekst systematisch te analyseren en kwantitatief te evalueren op drie aspecten: syntactische complexiteit, structurele standaardisatie en discoursecoherentie. Deze studie maakte gebruik van de spaCy dependency parser en de Coreferee-extensiemodule voor coreferentie-resolutie voor tekstkenmerkextractie en geautomatiseerde evaluatie. De spaCy dependency parser analyseerde de syntactische structuur van de Engelse tekst en extraheerde belangrijke indicatoren zoals de gemiddelde zinslengte en het aantal geneste clausules, wat een kwantitatieve analyse van de syntactische complexiteit mogelijk maakte. De Coreferee-extensiemodule voor coreferentie-resolutie, die binnen het spaCy-framework draait, identificeerde primair interne referentiële relaties in de tekst en beoordeelde de referentiële coherentie van het discours, waardoor technische ondersteuning werd geboden voor de geautomatiseerde score van de schrijfkwaliteit. Vanwege netwerkbeperkingen waren de bovengenoemde overzeese open-source websites niet toegankelijk.
Ten eerste evalueerde het systeem de syntactische complexiteit. Er werden kenmerken geëxtraheerd zoals de gemiddelde zinslengte, de diepte van clausis-inbedding en de zinsvariatie. Deze kenmerken werden verkregen via dependency parsing en diepe syntactische boommodellering. Op basis van de resultaten beoordeelde het systeem of studenten succesvol waren overgestapt van eenvoudige zinsstructuren naar complexere structuren. Ten tweede evalueerde het systeem de paragraaforganisatie. Er werden BERT-gebaseerde tekstrepresentaties gecombineerd met classificatiemodellen om belangrijke paragraafelementen te identificeren, waaronder de topiczin, ondersteunende zinnen en slotzinnen. Vervolgens werd een kaart van de paragraafstructuur opgesteld om vast te stellen of de organisatie conform de conventies van academisch Engels schrijven was. Ten derde beoordeelde het systeem de tekstuele coherentie. Er werd gekeken naar het gebruik van logische voegwoorden, de semantische consistentie tussen zinnen en de kwaliteit van referentiële koppelingen in de gehele tekst. Deze indicatoren werden gebruikt om de helderheid van de logische ontwikkeling en de vloeiende progressie van ideeën te evalueren. Om de topicconsistentie te meten, berekende het systeem de semantische gelijkenis met behulp van vectorgebaseerde representaties. Referentiële coherentie werd geëvalueerd via technieken voor coreferentie-resolutie, wat hielp bij het verminderen van semantische gaten en ambigue referenties. Ten slotte werden de scores van alle dimensies geïntegreerd in een uniforme scorevector. De resultaten werden gestandaardiseerd om een uitgebreid evaluatiesysteem te vormen, waardoor betrouwbare vergelijkingen tussen verschillende schrijfmonsters mogelijk werden.
Tijdens de fase van de handmatige evaluatie ontwikkelde deze studie een driedimensionaal scoresysteem voor training in schrijfoverdracht, bestaande uit de duidelijkheid van het overdrachtsgedrag, de natuurlijkheid van de uitdrukking en de culturele aanpasbaarheid, om de relevantie van de beoordeling door de docent en de effectiviteit van de feedback op het onderwijs te verbeteren. Het systeem combineerde ondersteunende functies om een organische combinatie van kwantitatieve scores en kwalitatieve commentaren te realiseren. Binnen de dimensie van het overdrachtsgedrag beoordeelden docenten het gebruik van overdrachtsstrategieën door studenten bij het herschrijven van teksten op basis van vooraf vastgestelde taakdoelstellingen. Het systeem bood een zij-aan-zij vergelijking van de oorspronkelijke tekst en de gegenereerde versie om docenten te helpen bepalen of handelingen zoals zinsaanpassingen en structurele reconstructie de vereiste vorm van overdracht effectief weerspiegelden.
De evaluatie van de natuurlijke expressie richtte zich op de vloeiendheid en authenticiteit van de taaluitvoer. Docenten gebruikten de door het systeem gegenereerde taalindicatoren om te beoordelen of de zinnen overeenkwamen met de uitdrukkingsgewoonten van moedertaalsprekers van het Engels en om te beoordelen of de grammaticale structuur, woordcollocatie en het zinsritme natuurlijk en passend waren. Via annotaties wezen zij daarnaast op problemen en suggereerden zij alternatieve formuleringen. De dimensie culturele aanpasbaarheid richtte zich op de adequaatheid van de cross-culturele pragmatiek. Docenten moesten vaststellen of de tekst ongepaste uitdrukkingen bevatte als gevolg van interferentie van de brontaalcultuur, zoals semantische ambiguïteit, retorische conflicten of vage waardeoordelen. Het systeem leverde voorbeelden van veelvoorkomende culturele afwijkingen in woordgebruik en stelde docenten in staat om in de opmerkingen de basis voor de aanpassing en de culturele contextvereisten toe te lichten, om zo studenten te begeleiden bij het verbeteren van hun bewustzijn van culturele overdracht en de nauwkeurigheid van hun expressie. Elke dimensie werd gescoord op een 5-puntsschaal en bevatte modules voor vrije annotaties en suggesties voor invulling. De uiteindelijke evaluatieresultaten werden gepresenteerd als een radardiagram.
Om de efficiëntie van de evaluatie te verbeteren en praktisch gebruik in het klaslokaal te ondersteunen, heeft deze studie een collaboratief beoordelingsmechanisme ontwikkeld dat AI-gebaseerde scoreverlening combineerde met evaluatie door de docent. Het systeem voerde eerst een multidimensionale beoordeling uit van de door DeepSeek gegenereerde tekst. Via de automatische scoremodule werden belangrijke aspecten geëvalueerd, zoals syntactische complexiteit, paragraaforganisatie en tekstuele coherentie. De scoregegevens werden vervolgens in realtime weergegeven op de interface van de docent. Docenten beoordeelden de gedetailleerde scores voor elke dimensie en pasten deze indien nodig aan op basis van hun professionele oordeel en inzicht in de transferprestaties van de studenten. Daarnaast voegden zij gerichte opmerkingen direct aan de tekst toe om feedback en instructieve suggesties te geven die mogelijk niet door de automatische scoreverlening werden vastgelegd. Voor elke evaluatiedimensie werd een vijfpuntsschaal gehanteerd. De interface bevatte ook modules voor vrije tekstannotaties en aanbevelingen om gepersonaliseerde feedback te vergemakkelijken. De evaluatieresultaten werden gevisualiseerd via een radardiagram, waardoor docenten snel de sterke en zwakke punten van studenten over verschillende transferdimensies konden identificeren.
Bovendien stelde het systeem docenten in staat om de weging van specifieke dimensies of de algemene scores aan te passen om deze af te stemmen op de onderwijskundige doelen. Deze functie zorgde ervoor dat de uiteindelijke evaluatie de werkelijke prestaties en leerbehoeften van de studenten nauwkeuriger weerspiegelde. Nadat de handmatige beoordeling was voltooid, integreerde het systeem automatisch de door de machine en de docent gegenereerde beoordelingsgegevens. Vervolgens werd er een visueel feedbackrapport opgesteld. Het rapport bevatte een radardiagram van de transferprestaties en een diagram voor versiebeheer. Deze visualisaties illustreerden duidelijk de veranderingen in de transfervaardigheden van studenten over meerdere ronden van tekstgeneratie en revisie, wat continue monitoring van de leerprogressie mogelijk maakte.
Transfertrainingsproces
In deze studie is een volledig proces voor transfertraining ontworpen. Allereerst wees de docent specifieke Engelse schrijftaken toe op basis van de leerdoelen en het feitelijke niveau van de studenten, waarbij het type transfer en de focus van de training werden verduidelijkt. Vervolgens genereerde het systeem automatisch de overeenkomstige prompt-instructies op basis van de door de docent vastgestelde taken en werd het DeepSeek-model aangeroepen om een eerste concept van de tekst te genereren, dat diende als basisdocument voor het herschrijven en de transfertraining door de studenten. Na ontvangst van het eerste concept moesten de studenten actief de in de tekst weerspiegelde transferkenmerken identificeren en de inhoud doelgericht herschrijven, waarbij zij de aangeleerde transferstrategieën gebruikten om de adequaatheid van de syntactische structuur, de paragraaforganisatie en de culturele uitdrukking te verbeteren. Na voltooiing van het herschrijven gaf de docent een gedetailleerde beoordeling van de door de student ingediende tekst, waarbij de effectiviteit van de transferstrategie werd benadrukt en specifieke suggesties voor verbetering en schrijsbegeleiding werden offered. Op basis van de feedback van de docent werd het DeepSeek-model opnieuw aangeroepen om een geoptimaliseerde versie te genereren, wat de studenten verder ondersteunde bij het verfijnen van hun teksten en het verdiepen van hun praktijk met transferstrategieën. Tot slot voltooide de student de indiening van het definitieve concept, vulde de tabel voor transfercognitie in, voerde een zelfevaluatie uit en vatte de transfermethoden en hun effecten samen, wat bijdroeg aan de verbetering van het metacognitieve vermogen en de internalisering van vaardigheden voor schrijftransfer. De voor deze studie ontworpen tabel voor transfercognitie is weergegeven in Tabel 2.
Voor alle items is een beoordelingsschaal van 1–5 gehanteerd, variërend van 1 (geen beheersing) tot 5 (volledige beheersing). Gegevens uit zelfevaluaties werden verzameld na drie ronden van opeenvolgende training; de scorenormen verwijzen naar vooraf gedefinieerde standaarden voor overdrachtoperaties in de vijfdimensionale taakbibliotheek.
Resultaten
Het onderwijzen van experimenteel ontwerp
Deze studie maakte gebruik van de basis open-source versie van DeepSeek, waarbij werd vertrouwd op de open API-interface van het platform voor programmaanroepen. De volledige set van vijf prompt-sjablongesteksten, vier niveaus van taakvoorbeeldvermeldingen, transfer-annotatiecategorielabels en regels voor de mapping van schrijffout-sjabloonmatching zijn samengesteld in de aanvullende bijlage. Het systeem had vaste aanroepparameters: een temperatuurcoëfficiënt van 0,7, en de gegenereerde lengte werd dynamisch beperkt op basis van het type schrijfvraag. Het volgde strikt een vaste sequentie van semantische reconstructie > stilistische aanpassing > culturele adaptatie, waarbij geneste prompt-chain aanroepen werden uitgevoerd. De modeloutput werd door de instructeur handmatig geselecteerd voor effectieve teksten in het klaslokaalonderwijs.
Voor deze studie werden drie fulltime docenten academisch Engels schrijven met meer dan 5 jaar ervaring uitgenodigd om deel te nemen aan de handmatige scoretoekenning. Alle beoordelaars ontvingen gestandaardiseerde training voorafgaand aan de officiële scoring, waarbij zij zich verdiepten in de beoordelingsdimensies, het 5-puntssysteem, culturele transfer, syntaxis, discours en andere scorendetails, waarna zij een kalibratie voorafgaand aan de scoring voltooiden. Alle essays van studenten werden onafhankelijk door twee docenten gescoord in een blinde, dubbelblinde scoringmodus. Indien het verschil tussen de scores van de twee beoordelaars meer dan 1 punt bedroeg (op een schaal van 5), trad een derde senior docent op als arbiter, waarbij het gemiddelde van de twee geldige scores als de uiteindelijke handmatige score voor dat monster werd gehanteerd. Twee groepen beoordelaars waren betrokken bij de evaluatiefase voor verschillende onderzoeksdoeleinden. Drie fulltime docenten academisch Engels schrijven met meer dan 5 jaar onderwijservaring voerden de blinde, dubbele scoring uit van alle schrijfmonsters van studenten in het formele experiment, en een derde senior docent fungeerde als arbiter wanneer scoreverschillen meer dan 1 punt bedroegen op de 5-puntsschaal. Daarentegen namen vijf beoordelaars deel aan de test voor interbeoordelaarsbetrouwbaarheid met behulp van de Intraclass Correlation Coefficient (ICC), die afzonderlijk werd uitgevoerd om de consistentie van de beoordelingsnormen tussen de beoordelaars te verifiëren. Het verschil in het aantal beoordelaars vloeit voort uit verschillende functionele vereisten: drie kern-docenten waarborgden de praktische scoring van de experimentele data, terwijl het uitgebreide panel van vijf beoordelaars robuuster bewijs leverde voor de betrouwbaarheid van het gehele evaluatiesysteem.
Syntactische complexiteit, BERT-tekststructuurscore en semantische gelijkenis worden allemaal gescoord binnen een bereik van 0–5 punten. De wegingen voor elke dimensie werden vastgesteld volgens de normen voor het onderwijs en onderzoek in het schrijven van vreemde talen: syntaxis 0,35, tekststructuur 0,35, en logica en cultuur 0,3. De wegingswaarden waren gebaseerd op volwassen kwantitatieve evaluatiesystemen voor schrijfwerk in hetzelfde vakgebied. De AI-automatische scoremodule werd gekalibreerd met drempelwaarden op basis van 15 vooraf geclassificeerde modeleessays. De menselijke scoretoekenning volgde een uniforme vijfpunts graderingsschaal. De machinescore en menselijke kalibratie werden gecombineerd voor een verificatie voorafgaand aan het experiment vóór de formele evaluatie.
De onderwijstaak werd uitgevoerd rondom de drieniveau-transferdoelen van "syntaxis-structuur-cultuur", met drie trainingsrondes van elk één week. De eerste ronde bestond uit herschrijven op zinsniveau om de syntactische diversiteit en de nauwkeurigheid van de uitdrukking te verbeteren; de tweede ronde omvatte structurele reconstructie op paragraafniveau om de organisatie van paragrafen en de logische coherentie te versterken; de derde ronde hield transfer op cultureel niveau in om het cross-culturele pragmatische bewustzijn en de aanpasbaarheid van de uitdrukking te versterken. Gezien de herhaalde metingen die bij identieke deelnemers werden verzameld tijdens de pretest, drie opeenvolgende trainingsronden en de posttest, werd een herhaalde-metingen variantieanalyse (RM-ANOVA) gehanteerd als primaire statistische methode om de hoofdeffecten van de groep (experimenteel vs. controle), de hoofdeffecten van het testmoment, en het interactie-effect tussen groep × tijd te onderzoeken, wat weerspiegelde of de scoreveranderingen gedurende de training verschilden tussen de twee cohorten. De aanname van sfericiteit werd geverifieerd via de test van Mauchly; de correctie van Greenhouse–Geisser werd toegepast indien de sfericiteit werd geschonden. T-toetsen voor onafhankelijke steekproeven werden uitsluitend gereserveerd voor post-hoc paarsgewijze vergelijkingen tussen groepen op individuele tijdstippen, terwijl de correlatie van Pearson en de d van Cohen respectievelijk werden gebruikt voor de consistentie van de scores en de kwantificering van de effectgrootte.
Alle statistische analyses waren vooraf vastgesteld vóór de gegevensverzameling. Er werden t-toetsen voor onafhankelijke steekproeven gebruikt om de schrijfindicatoren voor en na de interventie tussen twee groepen te vergelijken, waarbij de primaire nulhypothese uitging van geen intergroepsverschillen in de transferprestaties van het schrijven. Pearson-correlatieanalyse werd gebruikt om de lineaire associatie tussen de automatische AI-score en de handmatige beoordelingen van de docent te kwantificeren, en de d van Cohen werd berekend als de gestandaardiseerde effectgrootte voor de vergelijkingen tussen de groepen. De significantiedrempel werd vastgesteld op α = 0.05 voor alle hypothesetoetsingen, en er werden 95% betrouwbaarheidsintervallen berekend naast alle toetsstatistieken. SPSS 26.0 werd gebruikt voor alle statistische berekeningen. Er waren geen ontbrekende gegevens in de testscores van de studenten en de vragenlijst-datasets, aangezien alle deelnemers de volledige training van drie ronden en de relevante beoordelingen hadden voltooid; daarom was er geen imputatie of verwijdering van casussen voor ontbrekende waarden nodig.
Constructie van het evaluatie-indexsysteem
Om de prestaties van studenten bij de transfertraining voor Engels schrijven volledig te evalueren, heeft deze studie een multidimensionaal evaluatiesysteem opgezet dat de transferdoelen op drie niveaus van "syntaxis-structuur-cultuur" beslaat, waarbij taalvaardigheid, modelrespons, feedback vanuit het onderwijs en zelfcognitie zijn geïntegreerd en zes kernindicatoren zijn vastgesteld. Ten eerste was de "index voor schrijftransfer" een integrale evaluatieindicator die syntactische diversiteit, structurele helderheid en culturele aanpassingsvermogen omvatte, waarbij automatische scoring van het systeem en handmatige scoring door de docent werden gecombineerd voor kwantitatieve analyse. De "score voor syntactische complexiteit" maakte gebruik van natural language processing-technologie om kenmerken zoals de gemiddelde zinslengte, het aantal niveaus van clausulestructuren en de frequentie van het gebruik van werkwoordfrasen te extraheren om de rijkdom en complexiteit van de zinnen van de studenten te evalueren. De analyse van "overeenkomst met academische stijl" onderzocht, op basis van een NLP (Natural Language Processing)-model, het aandeel passieve vorm en het aandeel formele woordenschat om te bepalen of de tekst voldeed aan de stylnormen van het Engels academisch schrijven. Daarnaast introduceerde de studie een subjectieve evaluatiedimensie, waarbij via vragenlijsten voor docenten feedback werd verzameld over de acceptatie en praktische bruikbaarheid van de door het model gegenereerde suggesties om de werkelijke impact van AI-ondersteund onderwijs te beoordelen. "Veranderingen in de beoordelingscijfers van docenten" weerspiegelde de impact van AI-ondersteund onderwijs op de verbetering van de schrijfkwaliteit door de cijfers van docenten voor de essays van studenten voor en na het experiment te vergelijken. Ten slotte maakte de "Zelfevaluatie van de transfervaardigheid door de student" gebruik van de tabel voor transfercognitie om studenten te begeleiden bij het zelf evalueren van hun beheersing van structuur, syntaxis, cultuur en andere dimensies, waardoor hun metacognitieve bewustzijn en reflectievermogen werden vergroot. De specifieke beschrijvingen en databronnen voor elke indicator worden getoond in Tabel 3.
Syntactische en stilistische indicatoren werden automatisch berekend via dependency parsing en BERT-gebaseerde classificatie, met genormaliseerde scores variërend van 0 tot 5; de handmatige evaluatie maakt gebruik van een 5-puntsschaal. De berekeningsformules voor syntactische complexiteit gebruikten het totale aantal woorden/aantal clausules als de centrale noemer. Bron van ruwe gegevens: pretest- en posttest-schrijfopdrachten van alle 60 ingeschreven studenten.
Experimentele resultaten en analyse
Om de uitgebreide verschillen in prestaties van studenten op de drie dimensies van syntactische transfer, structurele transfer en culturele transfer intuïtief te presenteren, vergeleek Figuur 3 de gemiddelde schrijftransferindex van studenten in de experimentele groep en de controlegroep vóór en na het experiment: Figuur 3 toonde het verschil in gemiddelde scores tussen de experimentele groep en de controlegroep op de drie dimensies van syntactische transfer, structurele transfer en culturele transfer. De experimentele groep vertoonde na het experiment een significante verbetering in transfervermogen in elke dimensie, waarbij de buitenste cirkel van het radardiagram aanzienlijk groter is dan de binnenste cirkel, wat aangeeft dat de optimalisatiemethode voor instructies op basis van het DeepSeek-model een positief effect heeft op het bevorderen van de ontwikkeling van het Engelse schrijftransfervermogen van studenten. In contrast hiermee bleven de verschillende indicatoren voor transfervermogen van de controlegroep relatief ongewijzigd vóór en na het experiment. De algehele verbetering was beperkt, wat erop wijst dat traditionele onderwijsmethoden of AI-ondersteunende hulpmiddelen waarvan de systeeminstructies niet waren geoptimaliseerd, een beperkte rol spelen bij transfertraining. Het bleek uitdagend om het leerpotentieel van studenten bij multidimensionale taaltransfer effectief te stimuleren.
De gemiddelde schrijfoverdrachtsindexen van de experimentele groep op de dimensies syntactische overdracht, structurele overdracht en culturele overdracht waren vóór het experiment respectievelijk 3,0, 2,9 en 2,8. Na het experiment stegen deze naar 4,3, 4,1 en 4,5, met stijgingen van respectievelijk 1,3, 1,2 en 1,7, wat aangeeft dat de onderwijsmethode een goed interventie-effect had op verschillende niveaus van overdracht. De scores van de controlegroep vóór het experiment waren 3,0, 3,0 en 2,9. Na het experiment stegen de waarden naar respectievelijk 3,4, 3,3 en 3,2, wat significant lager is dan die van de experimentele groep. Het is bijzonder noteworthy dat de experimentele groep de meest significante verbetering liet zien op de dimensie van culturele overdracht, met een stijging van 2,8 naar 4,5, een toename van 1,7 punt, wat significant hoger is dan de toename van 0,3 punt van de controlegroep. Dit resultaat suggereert dat de voorgestelde onderwijsmethode een belangrijke rol speelt bij het helpen van studenten om Engelse culturele expressienormen te identificeren en zich daaraan aan te passen. Dit kwam niet alleen naar voren in aanpassingen van de taalvorm, maar ook in de verbetering van het interculturele pragmatische bewustzijn van de studenten en de diepgang van hun begrip van de culturele expressiegewoonten van de doeltaal. Taaloverdracht kwam primair tot uiting in syntactische complexiteit, aanpassing van taalstijl en andere aspecten. De studie maakte gebruik van geautomatiseerde NLP-technologie om een diepgaande analyse van de schrijfteksten van de studenten uit te voeren, waarbij belangrijke taalkenmerken werden geëxtraheerd en gecombineerd met scores van docenten om systematisch veranderingen in het taaloverdrachtsvermogen van studenten over drie rondes van taken te evalueren.
Syntactische complexiteit en linguïstische stijl
Wat betreft de syntactische complexiteit registreerde de studie de gemiddelde zinslengte en het aantal niveaus van clausuisonderbreking in de tekst die door studenten werd gegenereerd na voltooiing van de aangewezen schrijfopdracht in elke ronde van opdrachten. Deze twee indicatoren werden veelvuldig gebruikt om de complexiteit van de taaluitdrukking te meten. Ze weerspiegelden effectief het ontwikkelingsniveau van de studenten op het gebied van zinsdiversiteit en structureel organisatievermogen, zoals weergegeven in Figuur 4.
In de longitudinale evolutie van de syntactische complexiteit vertoonde de experimentele groep een duidelijke opwaartse trend over de drie rondes van taken, wat weerspiegelt dat de transfertraining de vaardigheid van studenten om hun taalstructuur uit te drukken effectief heeft bevorderd. Wat betreft de gemiddelde zinslengte steeg de experimentele groep van 12,5 woorden in Taak 1 naar 16,1 woorden in Taak 3, een toename van 3,6 woorden, wat significant hoger was dan de toename van slechts 0,9 woorden bij de controlegroep in dezelfde periode (van 12,4 naar 13,3). In dezelfde zin steeg, vanuit het perspectief van de structurele complexiteit gemeten aan de hand van het aantal lagen van clausale nesteling, de experimentele groep van 1,8 lagen naar 2,7 lagen, terwijl de controlegroep steeg van 1,7 naar 1,9 lagen, wat wijst op een relatief trage toename. Om verder te verifiëren of het verschil in syntactische complexiteit tussen de twee groepen studenten statistisch significant is, maakte de studie gebruik van onafhankelijke steekproef t-toetsen om de gemiddelde zinslengte en het aantal niveaus van clausale nesteling in de drie fasen van de taak te analyseren. De resultaten toonden aan dat er een significant verschil bestaat tussen de experimentele groep en de controlegroep wat betreft de gemiddelde zinslengte, t(58) = 4,23, p < 0,001, Cohen’s d = 0,98; er was ook een significant verschil in het aantal niveaus van clausale nesteling, t(58) = 3,15, p = 0,002, Cohen’s d = 0,78. Deze vergelijking toonde aan dat systematische transfertraining niet alleen het vermogen van studenten om complexe zinnen te construeren verbeterde, maar ook hun beheersing van grammaticaal organisatieprocesen versterkte. In het bijzonder vertoonden studenten in de experimentele groep tijdens de derde fase van de taak een grotere flexibiliteit in het gebruik van meerlaagse clausules en complexe zinsstructuren. Dit weerspiegelde een merkbare verschuiving in hun taaltransfer van een "functioneel" niveau naar een meer "strategisch" niveau. Het op transfer gerichte trainingspad verbeterde voortdurend de syntactische transfervaardigheden van de studenten, waardoor de beperkingen van enkelvoudige zinsformuleringen en de vaste uitdrukkingspatronen die vaak in traditioneel onderwijs worden gezien, effectief werden overwonnen. Wat betreft de adaptatie van de taalstijl extracteerde de studie de geschreven teksten van studenten vóór en na het experiment. Er werd gebruikgemaakt van een NLP-model om het aandeel formele woordenschat en de frequentie van het gebruik van de lijdende vorm vast te stellen als kernindicatoren voor het evalueren van de aansluiting bij de academische taalstijl. Deze indicatoren weerspiegelden of studenten over het taalbewustzijn en het uitdrukkingsvermogen beschikken om zich aan te passen aan de doelstijl in het Engels schrijven. De relevante resultaten zijn weergegeven in Figuur 5.
Figuur 5 toont de veranderingen in de matching van de academische stijl van de experimentele groep en de controlegroep voor en na de taak, waarbij hoofdzakelijk wordt gefocust op de twee kernindicatoren: het aandeel formele woordenschat en de gebruiksfrequentie van de lijdende vorm. Over het algemeen was het vermogen tot aanpassing van de academische stijl van de experimentele groep significant verbeterd na het voltooien van de transfertraining op basis van het DeepSeek-model, wat de effectiviteit van deze onderwijsmethode aantoont bij het cultiveren van het bewustzijn van studenten voor taalnormen en hun vermogen om zich aan academische stijlen aan te passen. Wat betreft het aandeel formele woordenschat steeg de experimentele groep van 0,42 voor de taak naar 0,56 na de taak, een relatief significante stijging. In contrast nam de controlegroep slechts licht toe, van 0,43 naar 0,48, wat wijst op een beperkte verbetering. Dit resultaat toonde aan dat de studenten in de experimentele groep, na het ontvangen van systematische promptbegeleiding en modelfeedback, meer geneigd waren om tijdens het schrijfproces formele woordenschat te gebruiken die voldoet aan de eisen van de academische stijl, waardoor hun taalstijl geleidelijk dichter bij de normen van het Engels academisch schrijven kwam te liggen. Wat betreft de frequentie van het gebruik van de lijdende vorm steeg de experimentele groep significant van 0,18 voor de taak naar 0,27 na de taak, wat een toename van 0,09 vertegenwoordigt; daarentegen steeg de controlegroep met slechts 0,02.
Om verder te verifiëren of de bovenstaande veranderingen statistisch significant zijn, voerde de studie een t-toets voor onafhankelijke steekproeven uit op de gegevens voor en na de taak. De resultaten toonden aan dat de experimentele groep een significante verbetering vertoonde in het aandeel formele woordenschat, t(58) = 3.89, p < 0.001, Cohen's d = 0.92; de toename in de frequentie van het gebruik van de lijdende vorm was eveneens significant, t(58) = 4.56, p < 0.001, Cohen’s d = 1.05. Dit toonde aan dat de studenten in de experimentele groep aanzienlijke vooruitgang hadden geboekt in de aanpassing van de taalstijl, en dat deze vooruitgang niet toevallig was, maar het resultaat van het gecombineerde effect van systematische promptbegeleiding en modelfeedback.
Statistische verificatie
Daarnaast is in de studie, om de betrouwbaarheid van door AI gegenereerde inhoud in de onderwijspraktijk verder te verifiëren, ook de gemiddelde score van door AI gegenereerde inhoud vergeleken met die van door docenten gegenereerde inhoud onder verschillende prompttypes. De consistentie tussen beide werd geëvalueerd door de Pearson-correlatiecoëfficiënt te berekenen. De relevante vergelijkingsresultaten zijn weergegeven in Tabel 4. Tabel 4 toont de consistentie tussen de door AI gegenereerde inhoud en de scores van docenten bij vijf typen transfergeoriënteerde prompts. Vanuit het perspectief van de gemiddelde score lag de AI-score over het algemeen iets lager dan de score van de docent. Toch bleef het verschil bij de meeste taaktypen binnen een redelijke marge, wat aantoont dat het DeepSeek-model een hoge stabiliteit en referentiewaarde heeft bij het evalueren van schrijfoverdrachtstaken. Bij de syntactische transferprompt was de gemiddelde score van de docent 4,1 en de AI-score 4,0, met een verschil van slechts 0,1 tussen beide. Bij de structurele en logische transferprompts was de AI-score slechts 0,1 punt lager dan de score van de docent, wat aangeeft dat het model de evaluatiecriteria van de docent beter kan simuleren bij deze taken, die een hoge mate van taalstructuur en duidelijke regels bevatten. In tegenstelling hiermee zijn de scoreafwijkingen bij de culturele transfer- en registertransferprompts relatief duidelijk, met AI-scores van respectievelijk 3,6 en 3,7, wat 0,2 lager is dan de scores van de docenten; dit weerspiegelt dat AI nog steeds bepaalde beperkingen heeft bij taken met een hoge subjectiviteit, zoals semantische implicaties en culturele pragmatiek. De interbeoordelaarsbetrouwbaarheid werd getoetst via ICC (n = 5 beoordelaars). De totale ICC voor handmatige scoring was 0,86, en de ICC's voor elke dimensie varieerden van 0,82 tot 0,89, wat duidt op een bevredigende overeenkomst tussen de beoordelaars.
Verdere analyse van de Pearson-correlatiecoëfficiënt onthulde dat de consistentie van de scores onder verschillende prompts op een hoog niveau lag, wat aangeeft dat de AI-score niet alleen qua waarde dicht bij het oordeel van de docent lag, maar ook een goede lineaire relatie vertoonde in de scoretrend. Hiervan was de consistentiecoëfficiënt van de prompt voor syntactische transfer het hoogst met 0,87, terwijl de prompts voor structurele transfer en logische transfer respectievelijk 0,83 en 0,85 waren, wat aantoont dat de evaluatieresultaten van de AI op het gebied van syntactische complexiteit, paragraaforganisatie en logische coherentie sterk overeenkomen met het oordeel van de docent. Dit kan te wijten zijn aan het feit dat deze taken duidelijke doelstellingen en kwantificeerbare taalkenmerken hebben, wat de herkenning door het model en een stabiel oordeel heeft gefaciliteerd. De correlatiecoëfficiënt van de prompt voor domeintransfer is 0,81. Hoewel deze licht was gedaald, werd nog steeds een sterk evaluatievermogen aangetoond, wat aangeeft dat de AI een zekere mate van beoordelingsvermogen bezat op het niveau van stilistische aanpassing. De consistentiecoëfficiënt van de prompt voor culturele transfer was echter slechts 0,79, wat lager was dan bij de andere typen, maar nog steeds binnen een acceptabel bereik lag.
Om de toepasbaarheid van verschillende soorten prompts in de onderwijspraktijk en de mate van acceptatie door docenten te onderzoeken, is een vragenlijst over de tevredenheid over prompt-reacties ontworpen. Vijf docenten Engels (genummerd T1–T5) werden uitgenodigd om de generatiesuggesties van vijf soorten prompts te beoordelen met behulp van een vijfpuntsschaal (zeer ontevreden tot zeer tevreden), zoals weergegeven in Figuur 6: de scores van de vijf docenten voor de vijf soorten prompts variëren enigszins, maar de algemene erkenning was hoog. Hiervan scoorden de prompts voor "syntactische transfer" en "culturele transfer" het hoogst, met een gemiddelde van 4,0, wat wijst op een sterke praktische toepasbaarheid en aanpasbaarheid in het onderwijs. In tegenstelling hiertoe scoort de prompt voor "registertransfer" relatief laag, met een gemiddelde van slechts 2,4, waarbij sommige docenten, zoals T4 en T5, de laagste scores gaven, wat aangeeft dat de begeleidende werking en aanpasbaarheid in onderwijstoepassingen nog verbetering behoeven.
Op individueel niveau waren er duidelijke verschillen in de score-tendensen van de docenten. De totale score van T1 was positief, wat duidt op een hoge mate van acceptatie van AI-ondersteund schrijven, terwijl de scores van T5 laag waren in meerdere Prompt-dimensies, met name bij "registeroverdracht" en "logicaoverdracht". Dit verschil kan gerelateerd zijn aan de onderwijservaring van de docenten, taalvoorkeur of bekendheid met AI-tools, wat suggereert dat toekomstige Prompt-ontwerpen gepersonaliseerde adaptatiemechanismen moeten overwegen om de acceptatie door verschillende groepen docenten te vergroten. Om het werkelijke effect van AI-ondersteund onderwijs op het verbeteren van de schrijfkwaliteit van studenten verder te verifiëren, vergeleken de onderzoekers de veranderingen in de totale scores van de experimentele groep en de controlegroep, zoals geëvalueerd door docenten, vóór en na het experiment. De vergelijkingsresultaten zijn weergegeven in Figuur 7.
Zoals getoond in Figuur 7, vertoonden de totale scores van de experimentele groep en de controlegroep, zoals geëvalueerd door docenten vóór en na het experiment, significante verschillen. Over het algemeen vertoonde de totale score van de experimentele groep een significante stijgende trend na de onderwijskundige interventie voor instructieoptimalisatie op basis van het DeepSeek-model. In tegenstelling hiermee was de scoreverandering in de controlegroep relatief gering. De gemiddelde docentenscore van de experimentele groep vóór het experiment was 59,1 punten, en de gemiddelde score na het experiment steeg significant naar 74,4 punten, wat een stijging van 15,3 punten vertegenwoordigt. Dit gaf aan dat AI-ondersteund onderwijs een positieve invloed had op de schrijfkwaliteit van de studenten. Uit de boxplot bleek dat het distributiebereik van de scores van de experimentele groep eveneens was uitgebreid. In het bijzonder ligt de scorebox na het experiment significant hoger dan daarvoor, en zijn de maximale bovenwaarde en minimale onderwaarde toegenomen, wat erop wijst dat het algemene niveau van de studenten significant is verbeterd. Daarentegen waren de scoreveranderingen in de controlegroep relatief beperkt. Vóór het experiment was de gemiddelde score van de controlegroep 60,1 punten, en na het experiment was dit 64,9 punten, wat een stijging van 4,8 punten vertegenwoordigt. Deze stijging was veel lager dan die van de experimentele groep, en de scorebox van de controlegroep veranderde nauwelijks vóór en na het experiment, wat aantoont dat traditionele onderwijsmethoden of niet-geoptimaliseerde AI-ondersteunende tools een beperkt effect hebben op het verbeteren van de schrijfkwaliteit.
Daarnaast maakte deze studie gebruik van de transfercognitietabel om studenten te begeleiden bij drie rondes van zelfbeoordeling met betrekking tot hun vaardigheidsontwikkeling op onder andere het gebied van structurele aanpassing, zinsvorming en culturele expressie, om zo de trend in de metacognitieve bewustwording van de studenten en hun beheersing van transferstrategieën te reflecteren. De resultaten worden weergegeven in Figuur 8Volgens de gegevens in het radardiagram van de zelfbeoordeling door studenten van hun transfervermogen, zoals weergegeven in Figuur 8de zelfbeoordeling van studenten in de vijf dimensies van structurele transfer, syntactische transfer, culturele transfer, registertransfer en logische transfer over de drie taskronden vertoonde een voortdurend stijgende trend. Dit wijst erop dat het vermogen van studenten om transferstrategieën toe te passen aanzienlijk is verbeterd onder de instructie-optimalisatieveleisinterventie op basis van het DeepSeek-model. In de eerste ronde van taken waren de zelfbeoordelingsscores van de studenten over het algemeen laag. Van de vijf dimensies scoorden "structurele transfer" en "logische transfer" respectievelijk 3,2 en 3,0, terwijl "culturele transfer" en "registertransfer" 2,5 en 2,7 scoorden, wat aangeeft dat studenten nog onervaren waren in het identificeren en gebruiken van transferstrategieën. Tegen de tweede ronde van taken waren de scores van elk item verbeterd, waarbij "structurele transfer" steeg naar 3,8, "syntactische transfer" naar 3,5 en "logische transfer" naar 3,7. Dit toonde aan dat studenten, met de begeleiding van docenten en de ondersteuning van modelfeedback, geleidelijk de kernpunten van basis-transferoperaties hadden onder de knie gekregen en deze in eerste instantie hadden toegepast op feitelijk schrijven. In de derde ronde van taken stegen de zelfbeoordelingsscores van de studenten significant, waarbij "structurele transfer" en "logische transfer" respectievelijk 4,5 en 4,3 bereikten, en de andere dimensies eveneens stabiliseerden boven de 4,0 punten. Dit toont het aanhoudende effect aan van meerdere ronden transfertraining bij het verbeteren van de beheersing van taalvormen en het tekstconstructievermogen van studenten. In dit stadium hadden studenten een basis cognitieve gesloten lus gevormd tussen het begrijpen, uitvoeren en reflecteren op transferstrategieën. Naast de feedback van de docent is in het onderzoek ook een tevredenheidsenquête over de AI-ondersteunde schrijffunctie verspreid onder alle studenten in de experimentele groep, waarbij in totaal 30 geldige vragenlijsten zijn verzameld. De vragenlijst beoordeelde de prestaties van de AI in drie functionele modules: herschrijfvoorstellen, structurele optimalisatie en culturele prompts, waarbij studenten opties moesten selecteren op basis van vijf niveaus van standaarden. De resultaten worden weergegeven in Tabel 5.
Volgens de resultaten van de enquête naar studenttevredenheid over AI-ondersteunde schrijffuncties, weergegeven in Tabel 5, gaven studenten in de experimentele groep over het algemeen positieve reacties op de prestaties van de AI in de drie functionele modules voor herschrijfsuggesties, structurele optimalisatie en culturele prompts, wat wijst op de goede toepassingsperspectieven van AI-ondersteunde schrijfsystemen bij het verbeteren van de efficiëntie van schrijftrainingen en de kwaliteit van de onderwijsondersteuning. Over het algemeen gaven meer dan 90% van de studenten aan "zeer tevreden" of "tevreden" te zijn met de twee functionele items "herschrijfsuggesties" en "structurele optimalisatie", waarbij "herschrijfsuggesties" de hoogste tevredenheid behaalde met 91%, wat aantoont dat studenten een hoge mate van erkenning hadden voor het vermogen van AI op het gebied van syntactische reconstructie en taalpolijsting. In vergelijking hiermee was de tevredenheid met de functie "culturele prompts" relatief lager. Desondanks bereikte deze 83%, wat aangeeft dat hoewel AI een zekere complexiteit en subjectiviteit vertoont bij het begeleiden van crossculturele expressie, de rol bij het ondersteunen van studenten om moedertaal-culturele interferentie te identificeren en aan te passen nog steeds door de meeste studenten werd erkend. Wat betreft ontevredenheid was het percentage studenten dat "ontevreden" of "zeer ontevreden" koos over de drie functies minder dan 5%, wat aantoont dat de AI-ondersteunde functies een goede bruikbaarheid en acceptatie hadden in de meeste toepassingsscenario's. Het is vermeldenswaard dat het aandeel studenten dat "gemiddeld" scoorde bij het item "culturele prompts" relatief hoog was, wat suggereert dat de huidige AI mogelijk niet volledig voldoet aan de verwachtingen van studenten bij het behandelen van kwesties rond culturele adaptatie, en dat er nog ruimte voor verbetering is. Een uitgebreide analyse onthult dat de op DeepSeek gebaseerde methode voor instructieoptimalisatie breed is erkend door studenten, in het bijzonder voor de ondersteuning van de taalvorm.
RM-ANOVA
Er werd een twee-weg herhaalde-metingen variantieanalyse (RM-ANOVA) uitgevoerd om de effecten van groep (tussen-proefpersonenfactor: experimentele groep vs. controlegroep) en tijd (binnen-proefpersonenfactor: pre-test, Taak 1, Taak 2, Taak 3, post-test), alsook hun interactie op de transferprestaties van het Engelse schrijven van studenten te onderzoeken. De toets van Mauchly wees op een schending van de assumptie van sfericiteit (p < 0.05), waardoor de Greenhouse–Geisser-correctie is toegepast om de vrijheidsgraden voor de binnen-proefpersoneffecten aan te passen. Alle analyses waren gebaseerd op n = 30 deelnemers per groep. De resultaten worden getoond in Tabel 6:
De resultaten van de ANOVA met herhaalde metingen en Greenhouse-Geisser-correctie wezen op significante hoofdeffecten van Groep, Tijd en de interactie Groep × Tijd over alle gemeten dimensies (p < 0,001). Voor de Overall Transfer Index werd een significant Groepseffect waargenomen (F(1,58) = 76,32), naast een significant Tijdseffect (F(2,14,124,12) = 92,75) en een significante interactie Groep × Tijd (F(2,14,124,12) = 68,49), wat suggereert dat veranderingen in de algehele transferprestaties over de tijd significant verschilden tussen de groepen.
Op vergelijkbare wijze vertoonde syntactische transfer significante effecten van Groep (F(1,58) = 52,18), Tijd (F(2,11,122,38) = 71,26) en de interactie tussen Groep × Tijd (F(2,11,122,38) = 45,73), wat duidt op differentiële ontwikkelingspatronen in het vermogen tot syntactische transfer tussen de groepen en meetmomenten. Voor Structurele Transfer werden eveneens significante effecten gevonden voor Groep (F(1,58)=48,65), Tijd (F(2,09,121,22) = 67,81) en de interactie (F(2,09,121,22) = 41,36), wat wijst op consistente verbeteringen met groepsspecifieke trajecten. Opmerkelijk genoeg vertoonde Culturele Transfer de sterkste effecten, met een significant Groepseffect (F(1,58) = 81,44), een uitgesproken Tijdeffect (F(2,07,119,96) = 98,52) en een robuuste Groep × Tijd-interactie (F(2,07,119,96) = 79,27), wat suggereert dat het meest substantiële en gedifferentieerde groeipatroon in deze dimensie lag. Overal vertoonden alle indices statistisch significante effecten, wat bevestigt dat de interventie een stabiele en gedifferentieerde impact had op de ontwikkeling van transfer in de loop van de tijd.
DATAbeschikbaarheid:
Alle gegevens die tijdens deze studie zijn gegenereerd of geanalyseerd, zijn opgenomen in dit artikel. De ruwe evaluatiegegevens zijn opgenomen in Aanvullende Tabel 1.
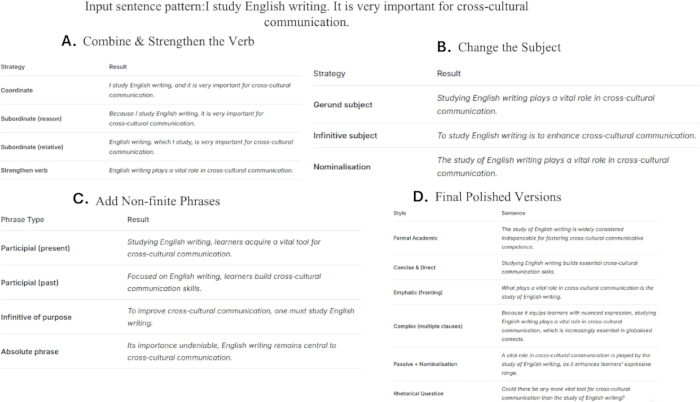
Figuur 1: Stappen voor de transformatie van de zinsstructuur. (A) Strategieën voor het combineren en versterken van werkwoorden om de zinsstructuur te verbeteren. (B) Alternatieve transformaties van het onderwerp, waaronder gerundia, infinitieven en genominaliseerde onderwerpen. (C) Gebruik van niet-eindige zinsneden om de variatie en beknoptheid van zinnen te vergroten. (D) Voorbeelden van gepolijste eindversies die een verbeterde academische stijl en interculturele Engelse uitdrukking aantonen. Klik hier om een grotere versie van deze figuur te bekijken.
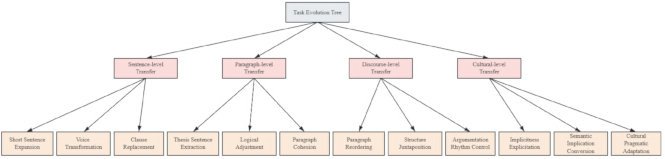
Figuur 2: Diagram van de evolutieboom van taken. Het presenteert de progressieve structuur van overdrachtstaken op vier niveaus, variërend van zin, paragraaf en discours tot het culturele niveau. Klik hier om een grotere versie van deze figuur te bekijken.
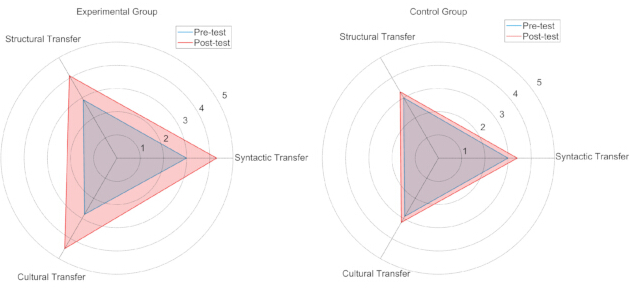
Figuur 3: Vergelijking van het vermogen tot schriftelijke transfer voor en na het experiment. Het radardiagram toont de pre-test- en post-testscores van de experimentele groep en de controlegroep op de dimensies syntactische, structurele en culturele transfer. Klik hier om een grotere versie van deze figuur te bekijken.
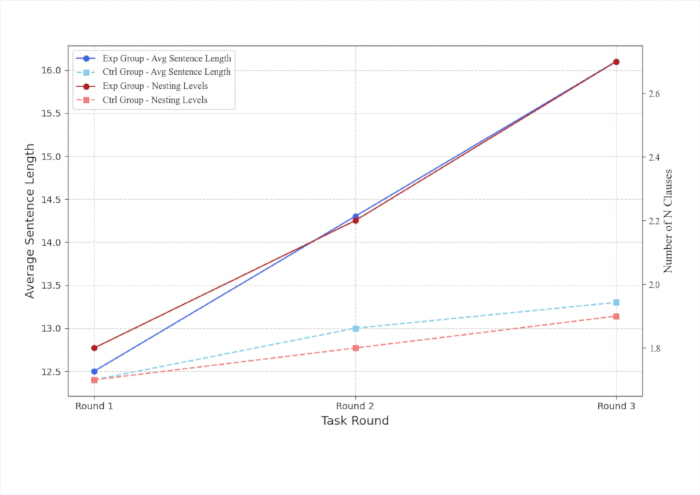
Figuur 4: Lijndiagram van de trend in syntactische complexiteit. De veranderingen in de gemiddelde zinslengte en de lagen van clausule-nesting over drie trainingstaken worden weergegeven. Klik hier om een grotere versie van deze figuur te bekijken.
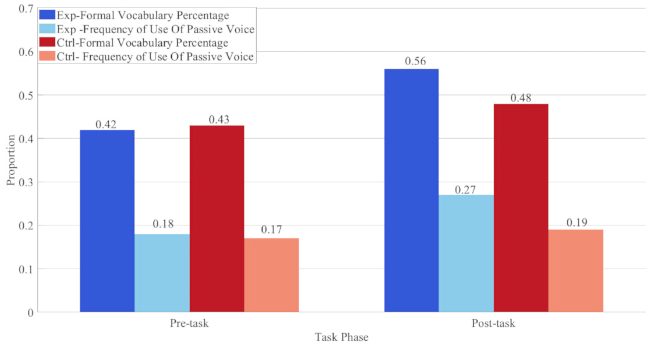
Figuur 5: Matching van academische terminologie. Deze figuur toont variaties in de proportie formele woordenschat en de frequentie van de lijdende vorm vóór en na de interventie. Klik hier om een grotere versie van deze figuur te bekijken.
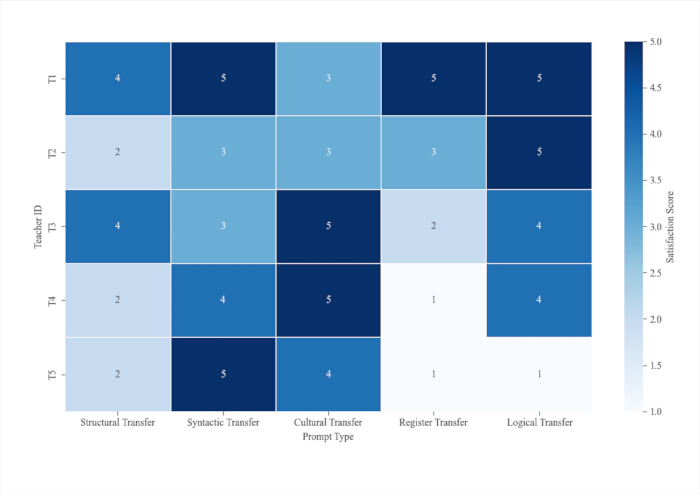
Figuur 6: Heatmap van de tevredenheid over prompt-antwoorden. Hier zijn de beoordelingen van vijf typen prompt-sjablonen van deelnemende docenten samengevat. Klik hier om een grotere versie van deze figuur te bekijken.
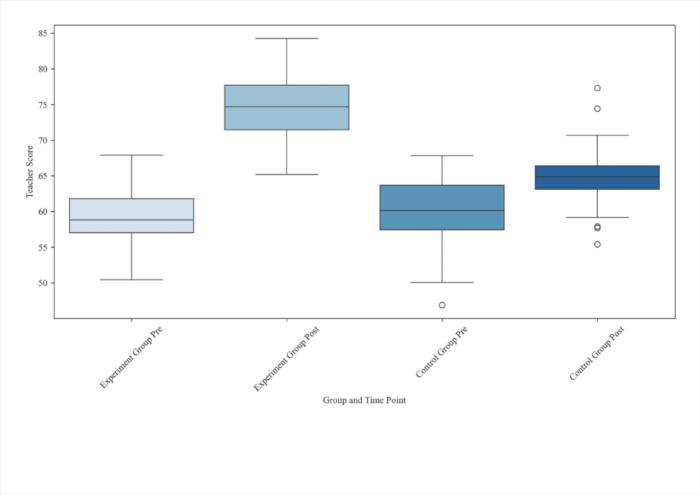
Figuur 7: Boxplot van veranderingen in de beoordelingen door docenten. De boxplot toont de distributie en de algemene veranderingen van door docenten beoordeelde schrijfscores voor twee groepen vóór en na het experiment. Klik hier om een grotere versie van deze figuur te bekijken.
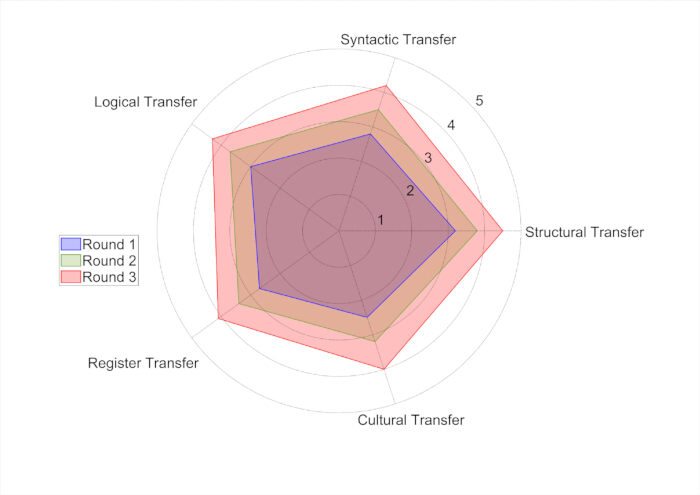
Figuur 8: Radardiagram van de door studenten zelf beoordeelde transfercapaciteit. Het toont de zelfevaluatiescores van studenten over vijf transferdimensies in drie trainingsronden. Klik hier om een grotere versie van deze figuur te bekijken.
| Houdt u rekening met de volgende stappen bij het uitvoeren van dit protocol: **Benodigdheden** * Steriele 15 ml Falcon-buizen * Centrifuge * Pipetten en pipetpunten * IJsschaal * Microcentrifuge * Vries-centrifuge **Procedure** 1. **Voorbereiding van de monsters**: Plaats de cellen in een steriele 15 ml Falcon-buis en centrifugeer deze gedurende 5 minuten bij 300 x g bij 4 °C. 2. **Verwijderen van het medium**: Giet het supernatant voorzichtig weg zonder de celpellet te verstoren. 3. **Wassen van de cellen**: Voeg 10 ml koud phosphate-buffered saline (PBS) toe aan de buis, resuspendeer de cellen door zachtjes te pipetteren en centrifugeer opnieuw gedurende 5 minuten bij 300 x g bij 4 °C. 4. **Lysis van de cellen**: Voeg 1 ml koud lysisbuffer toe aan de celpellet. Meng de buffer met de cellen door de buis voorzichtig te schudden of door middel van vortexen gedurende 30 seconden op een lage snelheid. 5. **Incubatie**: Laat de cellen 15 minuten incuberen op ijs om de lysis te voltooien. 6. **Klarificatie van het lysaat**: Centrifugeer het mengsel gedurende 10 minuten bij 15.000 x g bij 4 °C in een microcentrifuge om celresten en onoplosbare fracties te pelletteren. 7. **Ophalen van het supernatant**: Draag het heldere supernatant over naar een nieuwe, gekoelde microcentrifugebuis. Dit supernatant bevat de oplosbare eiwitfractie. 8. **Opslag**: Bewaar de monsters onmiddellijk bij -80 °C voor verdere analyse of gebruik ze direct in vervolgexperimenten. | Bediening door de docent | Prompttype | Studentbediening | Uitvoer | Evaluatiecriteria |
| Originele schrijfconcepten van studenten (zinnen/paragrafen/essays) | 1. Label overdrachtstypen en taakniveaus 2. Pas promptparameters aan indien nodig | Enkelvoudige transfer-prompt / Drietraps geneste promptketen | 1. Leer transferstrategieën 2. Herzie concepten op basis van AI-feedback 3. Voltooi de zelfevaluatie | Door AI herziene tekst + Definitieve herziene versie van de student | Syntactische complexiteit, structurele rationaliteit, culturele adequaatheid, logische coherentie, standaardisatie van het register (schaal 0–5) |
Tabel 1: Samenvattende tabel van de workflow. Deze tabel vat de volledige operationele workflow van de AI-ondersteunde training voor de overdracht van Engels schrijven samen, inclusief de inputmaterialen, de handelingen van docent en student, de typen prompts, de uiteindelijke resultaten en de bijbehorende evaluatiecriteria.
| Projectcategorie | Inhoud |
| Begrip van de missiedoelstellingen | Beschrijf kort de migratiedoelen van deze ronde schrijftaken, zoals structurele aanpassingen, culturele adaptatie en taalconversie. |
| Gebruikte migratiestrategie | Geef own de migratiestrategieën op die u heeft toegepast (meerdere selecties zijn toegestaan): |
| Structurele aanpassing | |
| Zinsvorming | |
| Taalwisseling | |
| Culturele manifestatie | |
| Versterking van de logische samenhang | |
| Overig: _______ | |
| Herschrijf voorbeelden en instructies | Selecteer 1–2 herschreven zinnen, toon de versies vóór en na de herschrijving, en leg de redenen voor de wijzigingen en de beoogde transferdoelen uit. |
| Moeilijkheden en twijfels die zijn ondervonden | Beschrijf eventuele uitdagingen die u tijdens de migratie bent tegengekomen of vragen die u had over een specifieke uitdrukking. |
| Zelfbeoordelingsscore (uit 5 punten) | Beoordeel uw herschreven tekst op basis van de volgende drie aspecten: |
| • Nauwkeurigheid van de toepassing van de strategie (/5) | |
| • Natuurlijke vloeiendheid van uitdrukking (/5) | |
| • Culturele fit (/5) | |
| Toekomstige doelen voor verbetering van het schrijfproces | Beschrijf kort de overdraagbaarheid die u in de volgende trainingsronde wilt versterken of optimaliseren |
Tabel 2: Tabel voor transfercognitie. Een schaal van 1–5 (1 = geen beheersing, 5 = volledige beheersing) is gehanteerd voor de zelfbeoordeling van studenten met betrekking tot strategieën voor schrijftransfer.
| Naam van de indicator | Beschrijving | Gegevensbron |
| Schrijfoverdrachtindex (0–5) | Een kwantitatieve indicator die het taaloverdrachtvermogen uitgebreid meet, waarbij drie niveaus worden bestreken: syntaxis, structuur en cultuur. | Automatische scoring door het systeem + handmatige scoring door docenten |
| Syntactische complexiteitsscore | Inclusief gemiddelde zinslengte, aantal ingebedde clausules, rijkdom van werkwoordfrasen, enz. | Automatische NLP-analyse |
| Overeenstemming van academische stijl | Voldoet het aan de normen voor Engels academisch schrijven? | Oordeel over modellen voor natuurlijke taalverwerking |
| Tevredenheid over het antwoord op de prompt | Acceptatie en praktische evaluatie door docenten van door modellen gegenereerde suggesties | Vragenlijst voor docenten |
| Wijzigingen in de beoordeling van de docentenbeoordeling | Vergelijking van de scores van docenten vóór en na het experiment om de verbetering in schrijfkwaliteit weer te geven | Beoordelingsgegevens van docenten |
| Zelfbeoordeeld transfervermogen van studenten | Studenten beoordelen zelf hun beheersing van verschillende transferdimensies | Vul het formulier voor migratiebewustzijn in |
Tabel 3: Overzicht van evaluatie-indicatoren, beschrijvingen en gegevensbronnen. Deze tabel verduidelijkt de definities, meetmethoden en oorspronkelijke gegevensbronnen voor elke kern-evaluatie-indicator in deze studie.
| Type prompt | Gemiddelde beoordeling door docenten | Gemiddelde AI-score | Pearson-correlatiecoëfficiënt |
| Structurele transfer | 4 | 3.9 | 0.83 |
| Syntactische transfer | 4.1 | 4 | 0.87 |
| Culturele transfer | 3.8 | 3.6 | 0.79 |
| Registertransfer | 3.9 | 3.7 | 0.81 |
| Logische transfer | 4.2 | 4.1 | 0.85 |
Tabel 4: Vergelijking van de consistentie tussen door AI gegenereerde inhoud en beoordelingen van docenten. De resultaten tonen de consistentie aan tussen door AI gegenereerde inhoud en beoordelingen van docenten over verschillende prompt-typen.
| Functie-items | Zeer tevreden | Tevreden | Over het algemeen | Ontevreden | Zeer ontevreden |
| Suggestie voor herschrijving | 66% | 25% | 7% | 1.50% | 0.50% |
| Structurele optimalisatie | 60% | 30% | 7% | 2% | 1% |
| Culturele tips | 55% | 28% | 12% | 3.50% | 1.50% |
Tabel 5: Enquêtegegevens over de tevredenheid van studenten met AI-ondersteunde functies.De statistieken tonen de verdeling van de tevredenheid van studenten voor AI-herschrijving, structurele optimalisatie en culturele promptfuncties.
| Meten | Groep F(df) | Tijd F(df)GG | Groep × Tijd F(df)GG | p |
| Algemene Transferindex | 76.32 (1, 58) | 92.75 (2.14, 124.12) | 68.49 (2.14, 124.12) | <0.001 |
| Syntactische overdracht | 52.18 (1, 58) | 71.26 (2.11, 122.38) | 45.73 (2.11, 122.38) | <0.001 |
| Structurele overdracht | 48.65 (1, 58) | 67.81 (2.09, 121.22) | 41.36 (2.09, 121.22) | <0.001 |
| Culturele overdracht | 81.44 (1, 58) | 98.52 (2.07, 119.96) | 79.27 (2.07, 119.96) | <0.001 |
Tabel 6: Samenvatting van de resultaten van de repeated-measures ANOVA. Hierin worden de resultaten van de two-way repeated-measures ANOVA voor de algemene schrijfoverdrachtprestatie en de drie subdimensies daarvan gepresenteerd, inclusief de hoofdeffecten van groep, tijd en de interactie tussen groep en tijd. Afkortingen: GG = Greenhouse–Geisser-correctie.
Aanvullende Tabel 1: Evaluatie van ruwe gegevens. Bevat de ruwe gegevens die zijn gebruikt in alle analyses in deze studie.Klik hier om dit bestand te downloaden.
Discussie
Dit onderzoek construeert een multi-level raamwerk voor instructie-optimalisatie, gebaseerd op de MoE-architectuur van DeepSeek, voor het onderwijs in cross-culturele transfer bij het Engels schrijven. Centraal staan vier niveaus van progressieve taken, variërend van zinsniveau tot culturele dimensies, en een gestandaardiseerde takenbibliotheek met vijf categorieën; het onderzoek realiseert automatische promptgeneratie op basis van werkelijke schrijfvoorbeelden van studenten en stelt geneste promptketens in drie fasen vast om complexe cross-culturele adaptieve taken te ontleden. In tegenstelling tot conventioneel generiek promptontwerp, dat beperkt blijft tot tekstuele polijsting, koppelt de voorgestelde oplossing de promptcompilatie nauw aan taaltransfer-onderwijsdoelstellingen en bouwt een gesloten onderwijsstroom op van modelgeneratie, annotatie door de docent en iteratieve revisie door de student. Vanuit het perspectief van disciplineprogressie breidt dit werk de praktische grenzen van prompt engineering binnen de tweede taalverwerving uit, door een kwantificeerbaar pad voor sjabloonconstructie te bieden om parameterkenmerken van grote taalmodellen te combineren met gerichte training in EFL-klaslokalen. Het verrijkt daarnaast het empirische bewijs voor onderzoek naar cross-culturele pragmatische transfer in een door AI ondersteunde omgeving, ter aanvulling op bestaande onderzoeksresultaten die zich uitsluitend richten op syntactische negatieve transferfouten36,37.
Empirische quasi-experimentele gegevens bevestigen dat de experimentele groep een duidelijke vooruitgang boekte op basis van indicatoren voor syntactische, structurele en culturele transfer, maar verschillende inherente beperkingen beperken de generaliseerbaarheid van de onderzoeksresultaten. Vanwege de onderzoeksomstandigheden maakte de studie gebruik van niet-gerandomiseerde klasindelingen zonder blindering van de beoordelaars, en alle monsters werden geselecteerd uit studenten Engelse taal- en letterkunde van één enkele universiteit, waardoor het moeilijk is om interferentie van de autonome leerbehoefte van de leerlingen en de langdurige onderwijsgewoonten van de docenten tijdens de scorevariatie uit te sluiten. Daarnaast duurde deze interventie slechts drie weken, wat neerkomt op een kortetermijntrainingsprogramma. In combinatie met het single-center steekproefontwerp, waarbij alle deelnemers werden geworven van één beroepsopleiding, zijn de geobserveerde positieve effecten mogelijk niet volledig stabiel in de langdurige onderwijspraktijk. Daarom moeten de onderzoeksresultaten met voorzichtigheid worden geïnterpreteerd, en is het ongepast om de conclusies direct te generaliseren naar verschillende typen hogescholen, langere onderwijscycli of studentengroepen met een variërende taalvaardigheid.
Bij de praktische inzet in het onderwijs vertoont het huidige systeem voor prompt-optimalisatie in combinatie met het DeepSeek-model merkbare beperkingen en typische foutgevallen. Wat betreft taken voor culturele en registeroverdracht produceert het model af en toe pragmatisch ongepaste uitdrukkingen of rigide resultaten bij stijlconversie wanneer teksten met subtiele culturele connotaties en contextafhankelijke stilistische eisen worden verwerkt38,39; daarnaast slaagt het er niet in om impliciet inheems cultureel denken in lange en complexe paragrafen nauwkeurig te identificeren, wat leidt tot een onvolledige herziening van Chinglish-uitdrukkingen. Bij automatische scoreverlening daalt de consistentie van de AI-evaluatie aanzienlijk voor sterk subjectieve culturele pragmatische items, en het kan genuanceerde verschillen in retorische expressie en interculturele implicaties niet effectief onderscheiden. Bovendien is de drietraps geneste promptketen gevoelig voor semantische afwijkingen bij iteratieve generatie over meerdere ronden, waarbij fouten uit de eerste fase van semantische reorganisatie worden overgenomen en versterkt in de daaropvolgende stappen van taalkundige herziening en culturele adaptatie40,41.
Wat betreft de trend voor vervolgontwikkeling kan verdere verbetering worden ingezet vanuit drie praktische dimensies. Ten eerste kan de schaal van de taakbibliotheek worden uitgebreid door een schrijfcorpus te verzamelen van studenten die geen hoofdvak Engels hebben en studenten met verschillende niveaus van taalvaardigheid, om de compatibiliteit van sjablonen voor gediversifieerde lerende groepen te versterken. Ten tweede kan continue fine-tuning van lichtgewicht DeepSeek-submodules worden gecombineerd om de afwijking in AI-scores voor culturele overdracht te verkleinen, aangezien uit de huidige statistieken is gebleken dat deze minder consistent zijn in vergelijking met evaluaties door docenten. Ten derde kan het volledige systeem voor promptoptimalisatie worden geïntegreerd in conventionele online platforms voor het leren van vreemde talen om automatische langetermijngegevensverzameling te realiseren voor continue iteratieve optimalisatie van de promptregels. Met de voortdurende verrijking van crosslinguale culturele corpusbronnen wordt verwacht dat het voorgestelde technische kader in vervolgonderzoek kan worden uitgebreid naar tweetalig vertaalonderwijs en cursussen interculturele communicatie.
Openbaarmakingen
De auteurs verklaren dat er geen financiële belangenverstrengeling is.
Dankbetuigingen
Dit werk werd ondersteund door het Zhejiang Provincial Education Planning Project 2026: Research on Reconstruction of Teaching Competency Framework and Promotion Strategies of Higher Vocational Teachers Under Digital and Intelligent Empowerment (Project No.: ZWT26024; Approval No.: 2026SCG360).
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| BERT Pre-trained Language Model | https://github.com/google-research/bert | Tekstrepresentatie, herkenning van paragraafstructuur, berekening van semantische gelijkenis en tekstclassificatie ondersteunen de automatische scoretoekenning van geschreven inhoud. | |
| Coreferee | Explosion AI | https://github.com/explosion/coreferee | Referentiële relaties in de tekst worden geïdentificeerd en de referentiële coherentie van het discours wordt beoordeeld ter ondersteuning van de automatische scoretoekenning van schrijfkwaliteit. |
| DeepSeek Large Language Model | DeepSeek AI | https://chat.deepseek.com/ | Op basis van de MoE-modelarchitectuur zijn instructie-optimalisatie en het ontwerp van prompt-woordketens uitgevoerd. Het model gebruikt vaste parameters: een temperatuurcoëfficiënt van 0.7, en de gegenereerde lengte wordt dynamisch beperkt op basis van het vraagtype. |
| spaCy | Explosion AI | https://github.com/explosion/spaCy | De afhankelijkheidssyntaxisstructuur van Engelse tekst wordt geanalyseerd, en indicatoren zoals de gemiddelde zinslengte en het aantal geneste bijzinnen worden geëxtraheerd om de syntactische complexiteit te kwantificeren. |
| SPSS 26.0 | IBM | https://www.ibm.com/products/spss-statistics | Statistische analyses zoals Repeated Measures ANOVA (RM-ANOVA), onafhankelijke steekproeven t-toets, Pearson-correlatieanalyse, berekening van de effectgrootte (Cohen’s d) en een betrouwbaarheidstoets (ICC) zijn uitgevoerd. |
Referenties
- Maqsood M, Zahid A, Asghar T, et al. Issues in teaching English in a cultural context. Migr Lett. 2024; 21(4): 1020–1027.
- Tran NT, Nguyen TT, Pham HH. Exploring the challenges of L1 negative transfer among Vietnamese English language learners: a qualitative study. rEFLections. 2024; 31(2): 837–857.
- Zhu P. Cultural dimensions as guidelines in handling language problems for effective written communication across cultures. Int J Linguist Lit Transl. 2023; 6(12): 85–95.
- Zeng Z, Nair SM, Wider W. A comparative study of Chinese EFL undergraduates' pragmatic competence in English letter writing between urban and suburban universities. World J Engl Lang. 2022; 12(6): 377–388.
- Litvinova TA, Mikros GK, Dekhnich OV. Writing in the era of large language models: a bibliometric analysis of the research field. Nauchnyi Rezultat Voprosy Teoreticheskoi i Prikladnoi Lingvistiki. 2024; 10(4): 5–16.
- Long M. Cultivating interdisciplinary foreign language talents through interdisciplinary synergy of on-campus teaching and off-campus practices under the new liberal arts. Educ Rev USA. 2025; 9(5): 520–526.
- Voss E, Cushing ST, Ockey GJ, et al. The use of assistive technologies including generative AI by test takers in language assessment: a debate of theory and practice. Lang Assess Q. 2023; 20(4-5): 520-532.
- Manyasa J. When language transfer is negative: analysis of morpho-syntactic interference errors by learners of French in Tanzanian higher learning institutions. J Foreign Lang. 2021; 13(1): 165-190.
- Fikri N. The study of language transfer in EFL students' translation work. J Pendidik Nonformal. 2023; 1(1): 9.
- Ahmat A, Yang Y, Ma B, et al. Cross-lingual prompting method with semantic-based answer space clustering. Appl Intell. 2025; 55(2): 1-17.
- Maity S, Deroy A, Sarkar S. Investigating large language models for prompt-based open-ended question generation in the technical domain. SN Comput Sci. 2024; 5(8): 1-32.
- Wu W, Cao Y, Yi N, et al. Detecting and reducing the factual hallucinations of large language models with metamorphic testing. Proc ACM Softw Eng. 2025; 2(FSE): 1432-1453.
- Kaganovich P, Münz-Manor O, Ezra-Tsur E. Style transfer of modern Hebrew literature using text simplification and generative language modeling. CEUR Workshop Proc. 2023; 1613: 73-95.
- Yuan Y. Influence of native language transfer on senior high school English writing. Theory Pract Lang Stud. 2021; 11(2): 170-176.
- Jiamin M. The influence of cultural factors on language transfer in second language acquisition. Res J Engl Lang Lit. 2024; 12(1): 186-195.
- Zhang L. Native language transfer in vocabulary acquisition: an empirical study from connectionist perspective. J Lang Teach Res. 2023; 14(2): 446-458.
- Mirzayev E. The influence of first language interference on ESL writing skills. EuroGlob J Linguist Lang Educ. 2024; 1(1): 33-39.
- Fujiwara Y, Iwao T, Ito H, et al. Exploring the transfer of topic-comment structures called unagi-sentences in Asian L2 Englishes: cross-proficiency-level and cross-varietal studies. Asian Englishes. 2025; 27(1): 25-40.
- Guo Q. Interlanguage and its implications to second language teaching and learning. Pac Int J. 2022; 5(4): 8-14.
- Vereeck A, Janse M, De Herdt K, et al. Why Plato needs psychology: proposal for a theoretical framework underpinning research on the cognitive transfer effects of studying classical languages. Psiholoska Obzorja. 2023; 32: 121-130.
- Zhang W. Study on the negative transfer of mother tongue on college students. Int J Front Sociol. 2023; 5(16): 164-171.
- Li C. A review of theories, pedagogies and vocabulary learning tasks of English vocabulary learning apps for Chinese EFL learners. J China Comput Assist Lang Learn. 2024; 4(2): 346-375.
- Nsengimana I, Niyibizi E, Ngabonziza JDA. The impact of language transfers on learners' writing skills in English learning among students in Mahama Refugee Camp, Rwanda. Afr J Empir Res. 2024; 5(3): 605-613.
- Jovein S K, Sharifabad E D, Yazdani M. On the relationship between university translator training programs and the translation market requirements: The case of English translation graduates and postgraduates of Imam Reza International University. Journal of Critical Studies in Language and Literature. 2024; 5(6): 1-13.
- Qin X. Collaborative inquiry in action: a case study of lesson study for intercultural education. Asian Pac J Second Foreign Lang Educ. 2024; 9(1): 66-91.
- Sun L, Asmawi A. The effect of WeChat-based instruction on Chinese EFL undergraduates’ business English writing performance. International Journal of Instruction. 2023; 16(1): 43-60.
- Moro G, Piscaglia N, Ragazzi L, et al. Multi-language transfer learning for low-resource legal case summarization. Artificial Intelligence and Law. 2024; 32(4): 1111-1139.
- Sun Y. A study of college English writing teaching based on dynamic assessment. Pac Int J. 2023; 6(1): 83-88.
- Jeon J, Lee S. Large language models in education: a focus on the complementary relationship between human teachers and ChatGPT. Educ Inf Technol. 2023; 28(12): 15873-15892.
- Kostka I, Toncelli R. Exploring applications of ChatGPT to English language teaching: opportunities, challenges, and recommendations. TESL-EJ. 2023; 27(3): n3-n22.
- Antara IMAR, Anggreni NPY. Analyzing grammatical errors in EFL students' opinion essays using DeepSeek AI: patterns and pedagogical implications. Stilistika. 2025; 13(2): 210-218.
- Diasamidze L, Tedoradze T. Enhancing ESL students' writing skills through natural language processing model ChatGPT. Eurasia Proc Educ Soc Sci. 2024; 35: 230-238.
- Ranade N, Saravia M, Johri A. Using rhetorical strategies to design prompts: a human-in-the-loop approach to make AI useful. AI Soc. 2025; 40(2): 711-732.
- Zhou W, Gao B. Construction and application of English-Chinese multimodal emotional corpus based on artificial intelligence. Int J Hum Comput Interact. 2025; 41(3): 1782-1793.
- Chen B, Bao L, Zhang R, et al. A multi-strategy computer-assisted EFL writing learning system with deep learning incorporated and its effects on learning: a writing feedback perspective. J Educ Comput Res. 2024; 61(8): 60-102.
- Jeon H. Designing teaching for transfer in English for academic purposes. RELC Journal. 2024; 55(2): 567-577.
- Pei Y J. Construction of a" Feedback-Revision" Teaching Model for Senior High School English Continuation Writing Based on Generative AI. International Journal of Educational Development. 2026; 3(1): 16-25.
- Holubnycha L, Kuznetsova O, Shchokina T, et al. AI-Powered Teaching: Literature Review of ChatGPT's Impact on University Educators. International Journal of Interactive Mobile Technologies. 2025; 19(15): 41.
- Almuhanna M A. Teachers' perspectives of integrating AI-powered technologies in K-12 education for creating customized learning materials and resources. Education and Information Technologies. 2025; 30(8): 10343-10371.
- Hastomo T, Mandasari B, Widiati U. Scrutinizing Indonesian pre-service teachers’ technological knowledge in utilizing AI-powered tools. Journal of education and learning (EduLearn). 2024; 18(4): 1572-1581.
- Cai H, Lu L, Han B, et al. Exploring pre-service teachers’ reflection mediated by an AI-powered teacher dashboard in video-based professional learning: a pilot study. Educational technology research and development. 2025; 73(2): 1129-1154.