Deze studie integreerde netwerkfarmacologie, moleculaire docking, moleculaire dynamica en MM-PBSA om potentiële eiwitinteracties van glutathion-responsieve abasische site-trapping prodrugs in NSCLC te prioriteren. Verbinding 5 werd geprioriteerd voor follow-up van MMP9 en SRC; deze blijven echter computationele kandidaten. De bevindingen dienen als hypothesevorming en vereisen biochemische en celgebaseerde validatie.
Onderzoeksartikel
In silico prioritering van potentiële eiwitinteracties voor glutathion-responsieve prodrugs voor het vangen van abasische sites bij niet-kleincellige longkanker
In dit artikel
Samenvatting
Samenvatting
Niet-kleincellige longkanker (NSCLC) blijft een belangrijke oorzaak van kankergerelateerde mortaliteit, en de effectiviteit van de behandeling wordt vaak beperkt door verworven resistentie en systemische toxiciteit. Glutathion-responsieve prodrugs die abasische sites vangen, hebben in eerdere experimentele studies selectieve antikankeractiviteit getoond, maar het blijft vast te stellen of hun vrijgekomen metabolieten ook betekenisvolle interacties vertonen met kanker-relevante eiwitten. Hier werd een geïntegreerde in silico workflow, bestaande uit netwerkfarmacologie, moleculaire docking, moleculaire dynamica (MD) en moleculaire mechanica Poisson-Boltzmann oppervlakte-analyse (MM-PBSA), gebruikt om testbare protein-interactiehypotheses te prioriteren voor twee glutathion-responsieve prodrugs (Compound 1 en Compound 2), hun aminooxy-bevattende producten (Compound 4 en Compound 5) en een bijbehorend niet-vangend controlepaar (Compound 3 en Compound 6). Eenentwintig overlappende targets geassocieerd met de verbindingen en de ziekte werden geïdentificeerd, waarbij AKT serine/threonine kinase 1 (AKT1), epidermal growth factor receptor (EGFR), tumor necrosis factor (TNF), matrix metalloproteïnase 9 (MMP9) en SRC proto-oncogeen non-receptor tyrosine kinase (SRC) werden geprioriteerd op basis van de proteïne-proteïne interactietopologie. Compound 5 produceerde de meest gunstige enkele AutoDock Vina score met MMP9 (-8.418 kcal·mol⁻1) en vertoonde relatief persistente docking-afgeleide poses over de MD-trajecten van MMP9 en SRC. De hoogst gerangschikte MMP9-pose vertoonde echter geen directe coördinatie van het katalytische Zn2⁺ ion of directe binding met His401, Glu402, His405 of His411, waardoor er geen canonieke MMP9-inhiberende bindingsmodus kan worden toegekend. MD- en MM-PBSA-analyses karakteriseren enkel het gedrag van het traject en de relatieve energetische rangschikking van deze complexen; ze bewijzen geen intracellulaire target-binding, enzymremming of padregulatie. De vastgestelde abasische-site-vangende activiteit en de nieuw voorspelde proteïne-interacties worden daarom behandeld als afzonderlijke, potentieel parallelle hypothesen in plaats van een aangetoonde mechanistische keten. Over het algemeen prioriteren de resultaten specifieke verbinding-target-paren voor toekomstig onderzoek, maar stellen ze geen multi-target anti-NSCLC-mechanisme vast.
Inleiding
Niet-kleincellige longkanker (NSCLC) is het meest voorkomende histologische subtype van longkanker en blijft wereldwijd een belangrijke oorzaak van kankergerelateerde mortaliteit1. Hoewel er aanzienlijke vooruitgang is geboekt in doelgerichte therapie en precisie-oncologie, wordt de langetermijneffectiviteit van de behandeling nog vaak ondermijnd door verworven resistentie, beperkte duur van de respons en behandelingsgerelateerde toxiciteit2. Middelen die gericht zijn op de epidermal growth factor receptor (EGFR) hebben de uitkomsten bij moleculair geselecteerde patiënten verbeterd, maar tijdens de behandeling ontwikkelt zich bijna onvermijdelijk resistentie, wat leidt tot een dringende behoefte aan therapeutische strategieën die werken via alternatieve of complementaire mechanismen3,4. Conventionele platina-gebaseerde chemotherapie blijft een belangrijk onderdeel van de behandeling, maar het klinisch voordeel wordt beperkt door cumulatieve toxiciteit en resistentie bij langdurig gebruik5,6. Samen benadrukken deze beperkingen de noodzaak om antitumorale middelen te identificeren die zowel mechanistisch verschillend zijn als selectief worden geactiveerd in de tumoromgeving.
Onder de endogene DNA-laesies zijn abasische of apyrimidinische sites zeer overvloedig en biologisch relevant, waarbij elke dag duizenden laesies in elke cel worden gegenereerd7. Wanneer deze laesies niet efficiënt worden hersteld, kunnen ze worden omgezet in strengbreuken, wat genomische instabiliteit en celdood kan bevorderen8,9. Apurinisch/apyrimidinisch endonuclease 1 is een centraal enzym in het base-excisieherstelpad omdat het abasische sites splitst en verdere herstelprocessen mogelijk maakt10,11. Deze afhankelijkheid van herstel heeft van schade geassocieerd met abasische sites een aantrekkelijk doelwit gemaakt voor de ontwikkeling van antikankermedicijnen12. Op basis van deze rationale werden eerder glutathion-responsieve prodrugs ontwikkeld die abasische sites vangen om gebruik te maken van de verhoogde glutathionomgeving in tumorcellen. Hun glutathion-getriggerde producten bevatten een aminooxy-functionaliteit die in staat is om aldehydische abasische sites te vangen, en eerder experimenteel werk toonde selectieve cytotoxiciteit, celcyclusstop en apoptose aan in H1299-cellen13. Deze gegevens ondersteunen het component van de verbinding waarin DNA-laesies worden gevangen. Ze tonen echter niet aan dat MMP9, SRC, EGFR, AKT1 of TNF stroomafwaarts van het vangen van abasische sites worden gereguleerd. Elke interactie met een eiwitdoelwit die in de huidige computationele analyse wordt geïdentificeerd, moet daarom worden beschouwd als een aparte hypothese, tenzij beide processen in hetzelfde biologische systeem worden aangetoond.
De huidige studie is ontworpen rond dit onderscheid. Het eerste niveau van de biologische rationale is de eerder vastgestelde glutathione-responsieve afgifte en de chemie voor het vangen van abasische sites14. Het tweede niveau, hier onderzocht, is een verkennende vraag: of de moeder-prodrugs of hun vrijgekomen producten computationeel compatibel zijn met geselecteerde kanker-geassocieerde eiwitten. Netwerkfarmacologie werd gebruikt om kandidaateiwitten te prioriteren, gevolgd door docking, MD- en MM-PBSA-analyses om geselecteerde eiwit-ligandcomplexen te onderzoeken15,16. Deze berekeningen waren niet bedoeld om aan te tonen dat de voorspelde eiwitten het bekende DNA-schadefenotype mediëren, noch om een causaal verband vast te stellen tussen het vangen van abasische sites en oncogene signalering. In plaats daarvan werd de workflow gebruikt om een gerangschikte set experimenteel testbare hypothesen te genereren die later kunnen worden geëvalueerd via assays voor directe binding, enzymactiviteit, signaalpaden, DNA-schade en fenotype.
Protocol
Goedkeuring van een institutionele toetsingscommissie was niet vereist omdat deze studie volledig computationeel was en geen menselijke deelnemers, gewervelde dieren, van patiënten afgeleide biologische monsters of identificeerbare persoonsgegevens betrok. Geïnformeerde toestemming was daarom niet van toepassing. Alle gebruikte databases, softwarepakketten, krachtvelden en computationele middelen in dit protocol staan vermeld in de Tabel met Materialen.
Studieverbindingen en analytische workflow
Eerder gerapporteerde glutathion-responsieve verbindingen voor het vangen van abasische sites werden als studiemoleculen gebruikt17. Verbinding 1 en Verbinding 2 werden geselecteerd als de ouder-prodrugs omdat glutathion-getriggerde splitsing respectievelijk de amino-oxy-bevattende producten Verbinding 4 en Verbinding 5 genereert. Verbinding 4 en Verbinding 5 werden geselecteerd voor structurele analyse omdat zij de vrijgekomen soorten vertegenwoordigen die de abasische-site-reactieve amino-oxygroep behouden. Verbinding 3 werd opgenomen als een passende glutathion-responsieve structurele controle; het splitsingsproduct ervan, Verbinding 6, mist de amino-oxyfunctionaliteit die nodig is voor het covalent vangen van abasische-site-aldehyden. Bijgevolg werden Verbindingen 1–3 opgenomen in de reverse target prediction om de ouder-scaffolds te vergelijken, werden Verbinding 4 en Verbinding 5 geëvalueerd tegen de geprioriteerde eiwitten, en werd Verbinding 6 gebruikt als het negatieve-controle-ligand in de SRC MD-vergelijking. De SRC–Verbinding 6-trajectorie werd opgenomen om een passende structurele comparator te bieden voor het amino-oxy-bevattende Verbinding 5-systeem, en niet als bewijs dat de amino-oxygroep zelf de SRC-binding bepaalt. De chemische structuren en activeringsrelaties van Verbindingen 1–6 worden getoond in Figuur 1. Dit ontwerp houdt de gevestigde chemie voor het vangen van DNA-laesies bewust gescheiden van de huidige hypothese-genererende analyse van mogelijke eiwitinteracties.
Voorspelling van verbinding-geassocieerde targets
De tweedimensionale structuren van Compound 1, Compound 2 en Compound 3 werden opgeslagen in MDL MOL-formaat en omgezet in canonieke simplified molecular-input line-entry system (SMILES)-strings met behulp van Open Babel versie 3.1.1 met het canonieke SMILES-uitvoerformaat18. Elke geëxporteerde string werd opnieuw geïmporteerd en de geregenereerde structuur werd visueel gecontroleerd aan de hand van de overeenkomstige tweedimensionale structuur voordat deze werden ingediend bij SwissTargetPrediction, waarbij de soort werd beperkt tot Homo sapiens19. Voorspelde targets met kanswaarden ongelijk aan nul werden behouden. De verkregen targetlijsten voor de drie verbindingen werden samengevoegd, dubbele vermeldingen werden verwijderd en de overgebleven targets werden gestandaardiseerd naar officiële menselijke gensymbolen vóór verdere analyse. De gestandaardiseerde verbinding-target-paren werden als netwerktabel geïmporteerd in software voor netwerkvisualisatie en -analyse, waarbij verbindingen en voorspelde targets werden weergegeven als knopen en verbinding-target-relaties als randen, om de voorspelde targetrelaties te visualiseren20.
Ophalen van ziektegerelateerde targets en identificatie van overlappende targets
Ziekte-geassocieerde targets werden opgehaald uit de GeneCards-database met behulp van de zoekterm “lung cancer H1299”21. Er werd een drempelwaarde voor de relevantiescore van meer dan 0,27 toegepast om genen met een sterkere relevantie voor deze zoekopdracht te behouden. Gensymbolen werden gestandaardiseerd en dubbele vermeldingen werden handmatig verwijderd. De overlap tussen de voorspelde targets van de verbinding en de ziekte-geassocieerde targets werd geïdentificeerd met behulp van een online tool voor Venn-diagram/doorsnedingsanalyse22. Alleen de overlappende targets werden behouden voor daaropvolgende analyses van eiwit-eiwitinteracties (PPI), verrijking en targetprioritering.
Analyse van proteïne-proteïne interacties en screening van kern-targets
De overlappende targets werden ingevoerd in de Search Tool for the Retrieval of Interacting Genes/Proteins (STRING) versie 11.5, waarbij de soort werd beperkt tot Homo sapiens en de minimaal vereiste interactiescore werd ingesteld op 0.40023. De resulterende PPI-gegevens werden geïmporteerd in Cytoscape versie 3.10.0 voor visualisatie en topologieanalyse. Met behulp van een plugin voor netwerktopologieanalyse werden de graad (degree), betweenness centrality en closeness centrality berekend voor elke node in het oorspronkelijke PPI-netwerk van 21 nodes; de resulterende waarden werden vervolgens gebruikt voor de sequentiële filtering op basis van de mediaan, zoals hieronder beschreven24. De centraliteitsmetrieken werden berekend op het oorspronkelijke PPI-netwerk van 21 nodes en daarna gebruikt voor sequentiële filtering. De mediane graad van het oorspronkelijke netwerk was 12, en nodes met een graad ≥ 12 werden behouden, wat resulteerde in 13 kandidaten. Binnen deze 13 kandidaten was de mediane betweenness centrality 0.031293 en de mediane closeness centrality 0.769231. Het tweede filter behield nodes met een betweenness centrality ≥ 0.031293 en een closeness centrality > 0.769231, wat leidde tot vijf hub-kandidaten: AKT1, EGFR, TNF, MMP9 en SRC. De gerapporteerde centraliteitswaarden werden overgenomen uit het oorspronkelijke netwerk van 21 nodes in plaats van opnieuw te worden berekend na subsetting. De uiteindelijke vijf hub-kandidaten werden gebruikt voor de daaropvolgende structurele analyse. De oorspronkelijke topologiemetrieken komen overeen met een ongericht PPI-netwerk bestaande uit 21 nodes en 116 edges.
Verrijkingsanalyse van Gene Ontology en Kyoto Encyclopedia of Genes and Genomes
De overlappende targets werden onderworpen aan Gene Ontology (GO) en Kyoto Encyclopedia of Genes and Genomes (KEGG) verrijkingsanalyses met behulp van de Database for Annotation, Visualization and Integrated Discovery (DAVID), waarbij de soort beperkt bleef tot Homo sapiens25. GO-verrijking werd geëvalueerd voor biologisch proces (BP), cellulaire component (CC) en moleculaire functie (MF), evenals voor KEGG-signaleringspaden. Voor deze verkennende analyse werd een nominale p < 0,10 gehanteerd als drempelwaarde voor de inclusie van verrijkingsvermeldingen; Benjamini-gecorrigeerde p-waarden, Bonferroni-waarden, false discovery rates en Fisher's exact test-waarden werden gerapporteerd in de supplementaire tabellen, maar werden niet gebruikt om de behouden set te definiëren. De behouden vermeldingen werden gerangschikt op basis van de nominale p-waarde. Voor verdere visualisatie en interpretatie werden de top 20 KEGG-paden en de top 10 termen van elke GO-categorie behouden. Staafdiagrammen en bubble plots werden gegenereerd met behulp van een online bioinformatica-visualisatietool.
Voorbereiding van receptoren en liganden voor moleculaire docking
De kristalstructuren van de geprioriteerde eiwitten werden opgehaald uit de RCSB Protein Data Bank (PDB): AKT1, PDB ID 3O96; EGFR, PDB ID 5UWD; TNF, PDB ID 2AZ5; MMP9, PDB ID 1GKC; en SRC, PDB ID 2H8H. Eiwitstructuren die werden gebruikt voor docking werden voorbereid in moleculaire visualisatiesoftware door co-gekristalliseerde liganden en watermoleculen te verwijderen, gevolgd door verwerking in software voor docking-voorbereiding. Voor MMP9 werd een ongewijzigde kopie van PDB 1GKC apart bewaard als kristallografische referentie voor de katalytische Zn2⁺-omgeving en de bindingsmodus van N2-[(2R)-2-{[formyl(hydroxy)amino]methyl}-4-methylpentanoyl]-N,3-dimethyl-L-valinamide (NFH). In keten A van 1GKC wordt het katalytische Zn2⁺ gecoördineerd door His401, His405 en His411 op respectievelijk 2,21, 2,23 en 2,22 Å, terwijl de twee NFH-zuurstofatomen Zn2⁺ coördineren op 2,07 en 2,38 Å; Glu402 is het katalytische zuur/base-residu. Deze kristallografische contacten werden gebruikt als een positieve structurele referentie voor het evalueren van de docking-interactiekaart van Compound 5. Voor SRC werd PDB 2H8H gebruikt voor de SRC MD-berekeningen. Deze structurele vergelijkingen werden uitsluitend gebruikt voor interpretatie en werden niet beschouwd als bewijs voor enzymremming of intracellulaire target-engagement.
De driedimensionale structuren van Compound 4 en Compound 5 werden verkregen uit PubChem en geoptimaliseerd door energieminimalisatie in moleculaire modelleringssoftware26. Liganden werden geprotoneerd onder fysiologische omstandigheden en geminimaliseerd met behulp van het Merck molecular force field 94 (MMFF94) totdat de energiegradiënt onder de 0,01 kcal·mol⁻1·Å⁻1 lag. Waterstofatomen werden toegevoegd, Gasteiger-ladingen werden toegewezen en roteerbare bindingen werden gedefinieerd in software voor docking-preparatie. Compound 6, het glutathion-splitsingsproduct van de niet-trapping Compound 3-controle, werd klaargemaakt met dezelfde workflow en gedockt aan SRC uitsluitend om de startpositie te genereren voor de matched control MD-trajectorie. Bijgevolg werd Compound 6 noch geïntroduceerd als een aanvullend voorspelde therapeutische ligand, noch gebruikt ter ondersteuning van een multi-target mechanisme.
Procedure voor moleculaire docking
Moleculaire docking werd uitgevoerd met moleculaire dockingsoftware volgens een semiflexibel dockingprotocol, waarbij de receptoren rigide werden gehouden en de liganden flexibel bleven27,28. Voor elke receptor werd de dockingbox gecentreerd op de positie van het co-gekristalliseerde ligand, zodat het zoekgebied overeenkwam met de experimenteel gedefinieerde bindingspocket. De afmetingen van de dockingbox werden ingesteld op 24 Å × 24 Å × 24 Å voor AKT1, EGFR en SRC, 26 Å × 26 Å × 26 Å voor MMP9 en 28 Å × 28 Å × 28 Å voor TNF. De exhaustiveness werd ingesteld op 32, het aantal output-poses werd ingesteld op 20 en het energiebereik werd ingesteld op 4 kcal·mol⁻1. De best gerangschikte conformatie van elke dockingrun werd behouden voor interactieanalyse.
Om de interne betrouwbaarheid van de docking-opstelling te beoordelen, werd elk cocristalliseerde ligand opnieuw gedockt in de bijbehorende receptorpocket met behulp van dezelfde parameters, waarbij een root mean square deviation (RMSD) van de zware atomen onder 2,0 Å werd gehanteerd als acceptatiecriterium. De uiteindelijke poses werden geïnspecteerd met moleculaire visualisatiesoftware. Voor het MMP9–Compound 5-complex werd de behouden interactiekaart specifiek onderzocht op geannoteerde directe ligandcoördinatie aan het katalytische Zn2⁺-ion en op contacten met His401, Glu402, His405 en His411, en werd de ligandpositie vergeleken met de kristallografische NFH-pose in PDB 1GKC. Een kwantitatieve metaalcoördinatieafstand werd alleen gerapporteerd wanneer directe ligand-Zn2⁺-coördinatie duidelijk zichtbaar was in de behouden pose; anders werd dit als niet van toepassing aangemerkt in plaats van afgeleid. Een MMP9-dockingpose die deze canonieke kenmerken van de katalytische site miste, werd dus gecategoriseerd als niet-canonieke en werd niet geïnterpreteerd als bewijs voor enzymatische inhibitie van MMP9. In algemene zin werden AutoDock Vina-scores en dockingposes gebruikt voor relatieve prioritering en hypothesevorming, en niet als bewijs voor bindingsaffiniteit of intracellulaire target-engagement.
Protocol voor moleculaire dynamica
Proteïne-ligandcomplexen die waren geselecteerd voor MD-analyse werden geconstrueerd op basis van de uit docking afgeleide bindingsposes. MD-berekeningen werden uitgevoerd met GROMACS29. Proteïnen werden geparametriseerd met behulp van het CHARMM36 force field, terwijl ligandatoomtypen en parameters werden toegewezen met het tweede-generatie General Amber Force Field (GAFF2)30,31. Austin Model 1-bond charge correction (AM1-BCC) partiële ladingen werden gegenereerd via instrumenten voor kleine-molecuulparametrisering en ligand-topologiegeneratie; software voor ligand-topologiegeneratie genereerde vervolgens de GROMACS-compatibele ligand-topologiebestanden32,33,34. Elk complex werd geplaatst in een TIP3P waterbox onder periodieke randvoorwaarden met een minimale afstand van solute tot box van 1.0 nm. Natrium- en chloride-ionen werden toegevoegd om de nettolading in elk systeem te neutraliseren, en extra NaCl werd toegevoegd om een uiteindelijke ionsterkte van 0.15 M te bereiken.
Energieminimalisatie werd uitgevoerd met behulp van het steepest-descent-algoritme totdat de maximale kracht onder de 1000 kJ·mol⁻1·nm⁻1 zakte. De geminimaliseerde systemen werden vervolgens geëquilibreerd onder condities van constant aantal deeltjes, druk en temperatuur (NPT) bij 310 K en 1 bar, waarbij positionele restricties werden toegepast op de backbone van het eiwit. De temperatuur werd geregeld met de V-rescale-thermostaat en de druk met de Parrinello-Rahman-barostaat. Lange-afstands elektrostatische interacties werden berekend met de particle mesh Ewald-methode. De short-range elektrostatische cutoff en de van der Waals-cutoff werden beide ingesteld op 1.0 nm, en alle bindingen met waterstofatomen werden beperkt met behulp van het linear constraint solver (LINCS)-algoritme. Productietrajecten werden gegenereerd voor 150 ns met een integratietijdstap van 2 fs, waarbij de coördinaten elke 10 ps werden opgeslagen voor nadienere analyse.
Trajectanalyse
Trajectorie-analyses werden uitgevoerd op de geëquilibreerde delen van de productietrajectorieën. De RMSD van de eiwitbackbone en de RMSD van het ligand werden berekend na een kleinste-kwadratenfitting op de initiële referentieconformatie. Root mean square fluctuation (RMSF)-waarden werden per residu berekend met behulp van Cα-atomen. Waterstofbruganalyse tussen elk ligand en de bijbehorende receptor werd uitgevoerd met een donor-acceptor-afstandsafkap van 3.5 Å en een donor-waterstof-acceptor-hoekafkap van 30°. De bezettingsgraad van waterstofbruggen werd gedefinieerd als de proportie van de geanalyseerde frames waarin een specifieke waterstofbrug aanwezig was. Deze metrieken werden gebruikt om de structurele stabiliteit, de flexibiliteit op residuniveau en de persistentie van intermoleculaire contacten over de drie MD-trajectorieën te karakteriseren.
Berekening van de vrije bindingsenergie via Molecular Mechanics Poisson-Boltzmann Surface Area (MM-PBSA)
De vrije bindingsenergie werd berekend met de MM-PBSA-methode, geïmplementeerd met MM-PBSA-analysesoftware op de geëquilibreerde segmenten van de MD-trajectorieën35. Voor elk eiwit-ligandcomplex werden de laatste 50 ns van de 150 ns productietrajectorie gebruikt voor de vrije-energieanalyse. In totaal werden 500 gelijkmatig verdeelde frames bemonsterd met intervallen van 100 ps vanaf 100,0 ns tot 149,9 ns; het eindpunt van 150,0 ns werd uitgesloten van de bemonsterde set. De totale vrije bindingsenergie werd berekend als de som van de van der Waals-energie, de elektrostatische energie, de polaire solvatatie-energie en de niet-polaire solvatatie-energietermen:
ΔG_bind = ΔE_vdW + ΔE_ele + ΔG_polar + ΔG_nonpolar (1)
Er is geen entropiecorrectie toegepast. De gemiddelde vrije bindingsenergieën en standaarddeviaties werden berekend over alle gesamplede frames.
Controles voor reproduceerbaarheid en computationele validatie
Alle gennamen die werden gebruikt in de stappen voor doelwitvoorspelling, het ophalen van ziekte-doelwitten en de intersectie-analyse werden gestandaardiseerd naar officiële menselijke gensymbolen vóór de downstream-analyse. Identieke docking-parameters werden gehanteerd voor alle receptor-ligandparen. De docking-opstelling werd technisch gecontroleerd door het corresponderende co-gekristalliseerde ligand terug te docken in elke receptorpocket, gebruikmakend van dezelfde zoekinstellingen en de vooraf gespecificeerde acceptatiedrempel voor de RMSD van zware atomen van <2.0 Å. Het kristallografische MMP9–NFH-complex werd behouden als de positieve structurele referentie voor de katalytische Zn2⁺-omgeving, terwijl SRC–Compound 6 diende als de passende non-trapping comparator voor de SRC-trajectanalyse. MD-trajecten werden gecontroleerd op temperatuur- en drukstabiliteit en op de afwezigheid van abnormale drift in het box-volume voordat ze werden opgenomen in daaropvolgende analyses. Alle inputbestanden, receptorstructuren, ligand-topologiebestanden, docking-configuratiebestanden, MD-parameterbestanden en MM-PBSA frame-selectiegegevens werden gearchiveerd om computationele reproduceerbaarheid te ondersteunen.
Resultaten
Voorspelling van verbinding-geassocieerde targets en identificatie van overlappende targets
Omgekeerde targetvoorspelling van verbindingen 1–3 leverde 212 potentiële menselijke targets op. Parallel daaraan identificeerde ziekte-target-opvraging uit GeneCards, met gebruik van het trefwoord “lung cancer H1299” en een relevantiescore-drempelwaarde groter dan 0,27, 188 NSCLC-geassocieerde targets. Intersectieanalyse tussen de voorspelde targets van de verbindingen en de pool van ziekte-geassocieerde targets leverde 21 overlappende targets op, die werden behouden voor alle opeenvolgende analyses. De overlap tussen de twee targetsets wordt getoond in Figuur 2. Deze resultaten geven aan dat de bestudeerde verbindingen convergeerden op een beperkte subset van ziekterelevante targets in plaats van op een diffuse, aspecifieke targetruimte.
Analyse van proteïne-proteïne interacties en screening van kern-targets
De 21 overlappende targets werden geïmporteerd in STRING om een PPI-netwerk te construeren. Het resulterende netwerk bevatte 21 nodes en 116 edges. De node-degree waarden in Supplementary Table 1 tellen op tot 232, wat consistent is met 116 ongerichte edges. Centraliteitswaarden werden berekend voor dit oorspronkelijke netwerk. De mediane degree was 12; door een degree ≥ 12 toe te passen, bleven 13 kandidaten over. Onder deze 13 kandidaten was de mediane betweenness centrality 0,031293 en de mediane closeness centrality 0,769231. De toepassing van betweenness centrality ≥ 0,031293 in combinatie met closeness centrality > 0,769231 prioritiseerde vijf hub-kandidaten: AKT1, EGFR, TNF, MMP9 en SRC. De waarden die worden weergegeven voor de behouden subsets zijn de centraliteitsmetrieken van het oorspronkelijke netwerk met 21 nodes die tijdens het filteren zijn meegenomen; deze werden niet opnieuw berekend voor subnetwerken van 13 of 5 nodes. Hun netwerkcentraliteit werd uitsluitend gebruikt om kandidaten te rangschikken voor daaropvolgende structuurgebaseerde evaluatie en mag niet worden geïnterpreteerd als bewijs dat zij biologische targets van de verbindingen zijn. Supplementary Table 1, Supplementary Table 2 en Supplementary Table 3 rapporteren respectievelijk de metrieken voor het initiële netwerk met 21 nodes, de 13 kandidaten die na de eerste screeningsstap zijn behouden, en de uiteindelijke vijf hub-kandidaten. De sequentiële PPI-netwerkscreening en de uiteindelijke vijf hub-kandidaten worden getoond in Figure 3A, Figure 3B, Figure 3C, en Figure 3D.
Enrichingsanalyse van Gene Ontology en Kyoto Encyclopedia of Genes and Genomes
Functionele verrijkingsanalyse van de 21 overlappende targets identificeerde 121 KEGG-paden die voldeden aan het nominale inclusiecriterium p < 0,10. De 20 hoogst gerangschikte paden worden weergegeven in Figuur 4A. Onder deze paden waren endocriene resistentie, kankerpaden, proteoglycanen bij kanker, EGFR-tyrosinekinaseremmer-resistentie en het ErbB-signaalpad bijzonder prominent. Deze paden zijn nauw verbonden met tumorproliferatie, overleving, invasie en behandelresistentie bij NSCLC. De volledige verrijkingsstatistieken voor alle 121 behouden KEGG-paden die voldeden aan de nominale p < 0,10 zijn opgenomen in Aanvullende Tabel 4.
GO-verrijkingsanalyse identificeerde verder 177 BP-termen, 29 CC-termen en 61 MF-termen die voldeden aan hetzelfde nominale inclusiecriterium p < 0,10. De 10 hoogst gerangschikte termen per categorie worden weergegeven in Figuur 4B, Figuur 4C, en Figuur 4D. De dominante biologische processen omvatten de positieve regulatie van proliferatie van vasculair-geassocieerde gladde spiercellen, de G2/M-overgang van de mitotische celcyclus, signalering van de insulin-like growth factor-receptor, eiwitfosforylering, negatieve regulatie van apoptose en signaaltransductie. De belangrijkste termen voor cellulaire componenten waren de nucleus, membraanvlotten, focale adhesie, plasmamembraan en de telomere regio van het chromosoom. In contrast hiermee omvatten de belangrijkste termen voor moleculaire functies, weergegeven in Figuur 4D, proteïnekinase-activiteit, proteïne-serinekinase-activiteit, ATP-binding, proteïne-serine/threoninekinase-activiteit, proteïne-tyrosinekinase-activiteit, RNA-polymerase II CTD-heptapeptide-repeatkinase-activiteit, kinase-activiteit, histon H2AXY142-kinase-activiteit, histon H3Y41-kinase-activiteit en binding van identieke eiwitten. De volledige verrijkingsstatistieken voor BP, CC en MF zijn opgenomen in Aanvullende Tabel 5, Aanvullende Tabel 6 en Aanvullende Tabel 7. Samen geven deze verrijkingsresultaten aan dat de intersecterende doelset geconcentreerd is in signalering, overlevingsregulatie en oncogene respons-processen die relevant zijn voor de progressie van NSCLC.
Prioritering van metaboliet-doelwitcomplexen op basis van moleculaire docking
Moleculaire docking werd uitgevoerd tussen Compound 4 en Compound 5 en de vijf eiwitten die op basis van netwerktopologie waren geprioriteerd. De waarden vermeld in Tabel 1 zijn AutoDock Vina-dockingscores en geen experimenteel gemeten vrije bindingsenergie. Compound 5 leverde de meest gunstige enkele score op met MMP9 (-8,418 kcal·mol⁻1), gevolgd door Compound 4 met MMP9 (-7,840 kcal·mol⁻1). Compound 5 scoorde ook gunstiger dan Compound 4 voor AKT1 en EGFR, terwijl Compound 4 iets gunstiger scoorde voor SRC (-6,549 tegenover -6,204 kcal·mol⁻1) en TNF (-5,436 tegenover -5,299 kcal·mol⁻1). Bijgevolg vertoonde Compound 5 geen uniform scorevoordeel over de vijf eiwitten. De dockingresultaten werden uitsluitend gebruikt om representatieve complexen te prioriteren voor verdere structurele analyse.
Representatieve dockingconformaties zijn weergegeven in Figuur 5. In de interactiekaart van de best scorende MMP9–Compound 5 interactie bevonden de getoonde contacten zich nabij Ala417 en Pro421, met afstanden van respectievelijk ongeveer 3.0 Å en 2.4 Å. Er werd geen directe coördinatie tussen Compound 5 en ZN2⁺ genoteerd in de behouden interactiekaart van de beste pose, en er werden geen directe contacten met His401, Glu402, His405 of His411 getoond. Dit staat in contrast met de 1GKC kristallografische referentie, waarin His401, His405 en His411 de katalytische ZN2⁺ coördineren op 2.21, 2.23 en 2.22 Å, en de reverse-hydroxamaatremmer NFH dezelfde ZN2⁺ coördineert via twee zuurstofatomen op 2.07 en 2.38 Å. Omdat directe coördinatie tussen Compound 5 en ZN2⁺ niet werd genoteerd in de behouden interactiekaart, is er geen coördinatieafstand voor Compound 5-ZN2⁺ toegekend; dit wordt geïnterpreteerd als de afwezigheid van aangetoonde directe coördinatie in de behouden kaart, en niet als een gemeten metaalseparatiewaarde. Een driedimensionale vergelijking met de MMP9–NFH kristallografische referentie is weergegeven in Aanvullende Figuur 1. De geometrie verschilt daarom van een canonische zinkafhankelijke inhibitoire bindingsmodus, en het huidige dockingresultaat ondersteunt de classificatie van Compound 5 als een MMP9-remmer niet. MMP9 werd alleen behouden voor MD-analyse om te bepalen of deze specifieke non-canonische dockinggeometrie gedurende de trajectie aanhield. Voor de andere complexen vertoonde Compound 5 voorspelde contacten met AKT1 en SRC, terwijl Compound 4 ook gedefinieerde dockinginteracties vormde met MMP9 en SRC. In overeenstemming met Figuur 5F beschrijven deze waarnemingen voorspelde interacties en relatieve dockingscores, en geen experimenteel geverifieerde affiniteiten.
Drie complexen werden geselecteerd voor MD-analyse voor vergelijkende, in plaats van bevestigende, doeleinden. MMP9–Compound 5 werd geselecteerd omdat dit de meest gunstige individuele docking-score had, maar een niet-canonieke MMP9-pose vertoonde die een voorzichtige structurele follow-up vereiste. SRC–Compound 5 werd geselecteerd als tweede kandidaatcomplex, en SRC–Compound 6 werd opgenomen als de bijbehorende non-trapping controle-trajectorie. De overeenkomstige initiële conformaties worden getoond in Figuur 6A, Figuur 6B, en Figuur 6C. Dit ontwerp maakte het mogelijk om de persistentie van geselecteerde docking-geometrieën te vergelijken zonder MD-stabiliteit te beschouwen als bewijs voor target engagement of functionele regulatie.
Moleculaire dynamica-analyse
Om de persistentie van geselecteerde op docking gebaseerde geometrieën onder dynamische waterige omstandigheden te vergelijken, werden 150 ns MD-trajecten gegenereerd voor de MMP9–Compound 5 en SRC (PDB 2H8H)–Compound 5 complexen, waarbij SRC (PDB 2H8H)–Compound 6 werd opgenomen als het overeenkomstige negatieve-controle-traject. De initiële conformaties worden getoond in Figuur 6A, Figuur 6B, en Figuur 6C. Over deze trajecten vertoonde Compound 5 een lagere ligand RMSD (Figuur 6D) in de MMP9- en SRC-systemen dan Compound 6 in SRC. Het MMP9–Compound 5 traject bereikte een relatief regime met weinig fluctuaties, het SRC–Compound 5 traject stabiliseerde na een initiële aanpassingsperiode, en het SRC–Compound 6 traject vertoonde grotere fluctuaties. Deze verschillen wijzen op een grotere persistentie van de geselecteerde docking-poses van Compound 5 tijdens MD. Ze tonen niet aan dat Compound 5 MMP9 of SRC bindt in cellen, en het MMP9-traject heft de afwezigheid van een canonische katalytische-ZN2⁺ interactie in de startpose niet op.
De RMSD van de eiwitbackbone vertoonde een vergelijkbaar patroon. De MMP9–Compound 5-trajectorie ging na ongeveer 30 ns over in een relatief stabiel backbone-regime, terwijl de SRC–Compound 5-trajectorie een later plateau vertoonde en de SRC–Compound 6-trajectorie grotere fluctuaties liet zien. Deze observaties beschrijven uitsluitend het gedrag van de trajectorieën. Een stabiele eiwitbackbone- of ligandtrajectorie kan geen intracellulaire target-bezetting, enzymremming of signaleringsmodulatie aantonen. De RMSD-profielen van de eiwitbackbone voor alle drie de systemen zijn opgenomen in Aanvullende Figuur 2.
Trajectanalyse
Analyses van de bezettingsgraad van waterstofbruggen en residu-fluctuaties werden gebruikt om de persistentie van contacten binnen de MD-trajectorieën te beschrijven (Figuur 7A). Verbinding 5 vertoonde een waterstofbrug met een hoge bezettingsgraad met Arg95 in de MMP9-trajectorie (>85%) en een terugkerende interactie met Leu325 in de SRC-trajectorie (>70%), terwijl representatieve contacten in de SRC–Verbinding 6 controle lagere bezettingsgraden vertoonden. Deze residuen worden niet gepresenteerd als bewijs voor functionele target-modulatie; de bezettingswaarden geven enkel aan hoe vaak de gespecificeerde contacten voorkwamen tijdens de geanalyseerde trajectorieën.
RMSF-analyse van de residuen in de bindingspocket toonde systeem-specifieke verschillen in lokale flexibiliteit (Figuur 7B). Het SRC–Compound 6 traject vertoonde verschillende grotere lokale fluctuaties dan het SRC–Compound 5 traject, terwijl het MMP9–Compound 5 traject een relatief beperkt fluctuatieprofiel vertoonde binnen zijn eigen set bindingspocket-residuen. Omdat MMP9 en SRC verschillende eiwitten zijn, werden hun RMSF-waarden op residu-niveau niet geïnterpreteerd als een directe residue-voor-residu vergelijking. Samen met de bezettingsgraad van waterstofbruggen karakteriseren deze resultaten de persistentie van contacten en de lokale flexibiliteit, wat helpt bij het prioriteren van complexen voor experimentele toetsing. Ze stellen MMP9 of SRC niet vast als intracellulaire targets en tonen niet aan dat een van beide eiwitten het antikankerfenotype van de verbindingen medieert.
Berekening van de vrije bindingsenergie via moleculaire mechanica Poisson-Boltzmann oppervlakte-analyse
De MM-PBSA-schattingen berekend uit de geëquilibreerde trajectsegmenten worden getoond in Figuur 8. Het MMP9–Compound 5-complex leverde een ΔG_bind-schatting op van -19,65 ± 6,43 kcal·mol⁻1, het SRC–Compound 5-complex leverde -17,72 ± 6,84 kcal·mol⁻1 op, en de SRC–Compound 6-controle leverde -10,37 ± 5,61 kcal·mol⁻1 op. Binnen dit computationele protocol was de relatieve energetische rangschikking derhalve MMP9–Compound 5, gevolgd door SRC–Compound 5 en SRC–Compound 6. Deze waarden zijn methodeafhankelijke schattingen afgeleid van een eindig trajectsegment, waarbij geen entropiecorrectie is toegepast. Ze werden daarom uitsluitend gebruikt voor vergelijking binnen de studie en mogen niet worden geïnterpreteerd als experimenteel gemeten bindingsaffiniteiten of als bewijs voor functionele eiwitmodulatie.
Op basis van docking, MD, contact-occupancy, residue-fluctuation en MM-PBSA analyses werd Compound 5 computationeel geprioriteerd voor vervolgonderzoek in de MMP9- en SRC-complexen. De convergentie tussen deze berekeningen versterkt de rationale voor de keuze van deze paren voor opeenvolgende experimenten, maar valideert MMP9 of SRC niet als directe intracellulaire targets. In het bijzonder sluiten de niet-canonieke MMP9-pose en het ontbreken van aangetoonde katalytische ZN2⁺-coördinatie de afleiding van een canoniek MMP9-inhibitiemechanisme uit op basis van de huidige structurele gegevens.
Conclusies afgeleid van de resultaten
De computationele workflow gaf prioriteit aan 21 overlappende ziekte-geassocieerde targets en identificeerde AKT1, EGFR, TNF, MMP9 en SRC als topologische hub-kandidaten. Structuurgebaseerde analyses gaven Compound 5 vervolgens prioriteit voor experimentele follow-up in de MMP9- en SRC-complexen. Deze bevindingen tonen geen directe target-engagement, MMP9- of SRC-inhibitie, pathway-regulatie of een causaal mechanistisch verband aan tussen eiwitinteracties en het eerder vastgestelde abasic-site-trapping-effect. De studie ondersteunt daarom een reeks testbare computationele hypothesen in plaats van een experimenteel vastgesteld multi-target anti-NSCLC-mechanisme.
BESCHIKBAARHEID VAN GEGEVENS:
De dataset die de bevindingen van deze studie ondersteunt, is publiekelijk beschikbaar in Wang X, Peng Z, Xing Y, Xue L. In silico prioritization of potential protein interactions for glutathione-responsive abasic site-trapping prodrugs in non-small cell lung cancer [dataset]. Figshare; 2026. doi:10.6084/m9.figshare.33313620.v1.
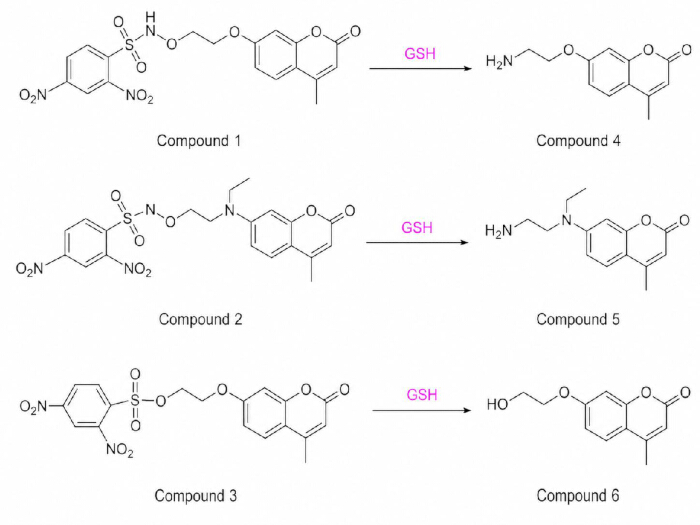
Figuur 1: Chemische structuren en glutathione-getriggerde conversierelaties van de bestudeerde verbindingen. Verbinding 1 en Verbinding 2 zijn glutathione-responsieve prodrugs die respectievelijk de aminooxy-bevattende metabolieten Verbinding 4 en Verbinding 5 vrijgeven. Verbinding 3 is een bijpassende glutathione-responsieve structurele controle die Verbinding 6 genereert, welke de aminooxy-functionaliteit voor het vangen van abasische sites mist. Verbindingen 1–3 werden gebruikt voor reverse target prediction, Verbinding 4 en Verbinding 5 voor hub-target docking, en Verbinding 6 als negatieve controleligand in de SRC-moleculaire dynamicavergelijking. Afkortingen: SRC, SRC proto-oncogen, non-receptor tyrosinekinase. Klik hier om een grotere versie van deze figuur te bekijken.
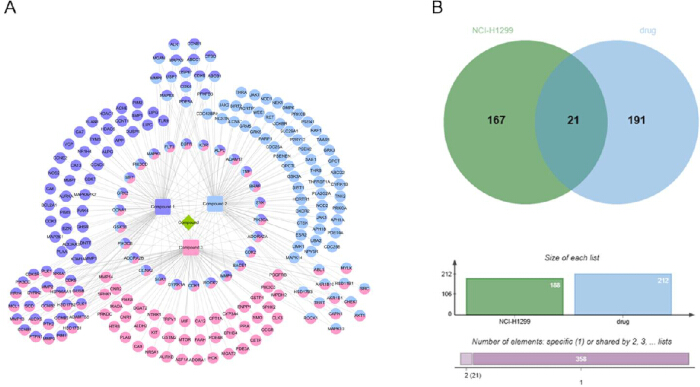
Figuur 2: Overlap tussen de door verbindingen voorspelde targets en targets geassocieerd met niet-kleincellige longkanker. (A) Netwerk van verbinding-targets gegenereerd uit de resultaten van de inverse target-voorspelling voor verbindingen 1–3. (B) Venn-diagram dat de overlap toont tussen de door verbindingen voorspelde targets en ziekte-geassocieerde targets die zijn opgehaald met de H1299 longkanker-query. De 21 overlappende targets werden behouden voor proteïne-proteïne interactie-analyse, enrichmement-analyse en daaropvolgende prioritering op basis van structuur. Klik hier om een grotere versie van deze figuur te bekijken.
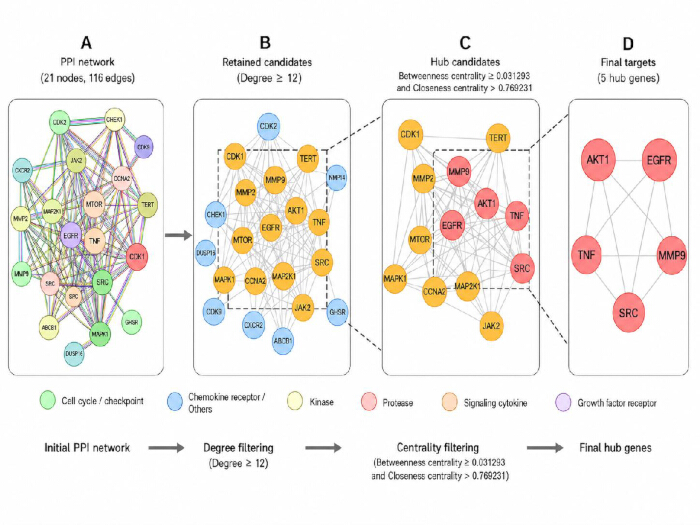
Figuur 3: Protein-protein interactienetwerk en screening van kern-targets. (A) Protein-protein interactienetwerk van de 21 overlappende targets (116 randen). (B) Eerste screeningsstap met Degree ≥ 12, waarbij 13 kandidaten behouden bleven. (C) Tweede screening van de 13 behouden kandidaten met betweenness centrality ≥ 0.031293 en Closeness centrality > 0.769231, wat resulteerde in vijf hub-kandidaten. (D) De uiteindelijke vijf hub-kandidaten: AKT1, EGFR, TNF, MMP9 en SRC. Centraliteitswaarden die werden gebruikt voor de sequentiële filters werden berekend op het oorspronkelijke netwerk van 21 knopen en 116 randen en werden overgenomen in plaats van na de vorming van elke subset opnieuw te worden berekend. Afkortingen: AKT1, AKT serine/threonine kinase 1; EGFR, epidermal growth factor receptor; TNF, tumor necrosis factor; MMP9, matrix metalloproteinase 9; SRC, SRC proto-oncogene, non-receptor tyrosine kinase. Klik hier om een grotere versie van deze figuur te bekijken.
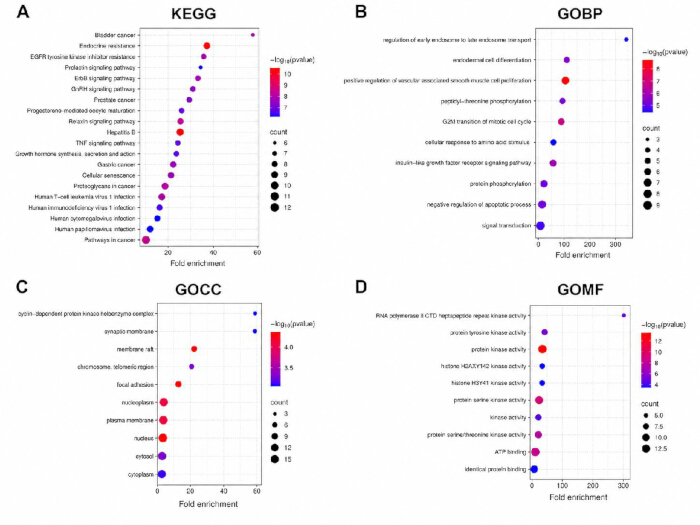
Figuur 4: Functionele verrijkingsanalyse van de intersecterende targets. (A) Bubble plot van de top 20 verrijkte Kyoto Encyclopedia of Genes and Genomes-paden. (B) Staafdiagram van de top 10 verrijkte Gene Ontology-termen voor biologische processen. (C) Staafdiagram van de top 10 verrijkte Gene Ontology-termen voor cellulaire componenten. (D) Staafdiagram van de top 10 verrijkte Gene Ontology-termen voor moleculaire functies. De fold enrichment is weergegeven op de x-as in de uiteindelijke visualisatie; de grootte van de bellen in paneel A weerspiegelt het aantal genen. Alle onderliggende KEGG- en GO-vermeldingen in de aanvullende tabellen 4–7 voldeden aan het nominale inclusiecriterium p < 0.10; de uitgezette paden/termen waren de hoogst gerangschikte op basis van de nominale p-waarde. Waarden gecorrigeerd voor meervoudig testen zijn vermeld in de aanvullende tabellen, maar zijn niet gebruikt voor inclusie. Klik hier om een grotere versie van deze figuur te bekijken.
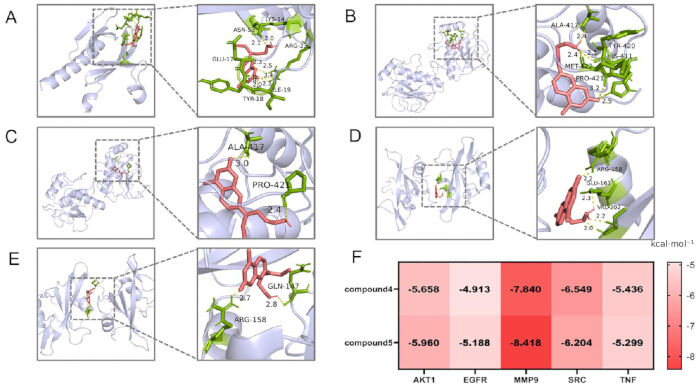
Figuur 5: Moleculaire docking-poses en AutoDock Vina-scores van Compound 4 en Compound 5 met de geprioriteerde eiwitten. (A) Voorspelde docking-pose van Compound 5 met AKT1. (B) Voorspelde docking-pose van Compound 4 met MMP9. (C) Hoogst gerangschikte voorspelde pose van Compound 5 met MMP9; de weergegeven contacten bevinden zich nabij Ala417 en Pro421, terwijl er geen directe katalytische ZN2⁺-coördinatie of direct contact met His401, Glu402, His405 of His411 is geannoteerd. De pose wordt daarom niet gepresenteerd als een canonieke inhiberende bindingsmodus voor MMP9. Een referentievergelijking van de interactiekaart met de NFH-gebonden MMP9-kristalstructuur (PDB 1GKC), inclusief de crystallografische ZN2⁺-coördinatieafstanden, is opgenomen in Aanvullende Figuur 3. (D) Voorspelde docking-pose van Compound 4 met SRC. (E) Voorspelde docking-pose van Compound 5 met SRC. (F) Heatmap van AutoDock Vina docking-scores (kcal·mol⁻1) voor Compound 4 en Compound 5 tegen de vijf geprioriteerde eiwitten. Meer negatieve waarden duiden op gunstigere Vina-scores binnen dit docking-protocol; dit zijn geen experimenteel gemeten bindingsaffiniteiten. Afkortingen: AKT1, AKT serine/threonine kinase 1; MMP9, matrix metalloproteinase 9; NFH, N2-[(2R)-2-{[formyl(hydroxy)amino]methyl}-4-methylpentanoyl]-N,3-dimethyl-L-valinamide; SRC, SRC proto-oncogeen, non-receptor tyrosine kinase; PDB, Protein Data Bank; Ala, alanine; Pro, proline; His, histidine; en Glu, glutamaat. Klik hier om een grotere versie van deze figuur te bekijken.
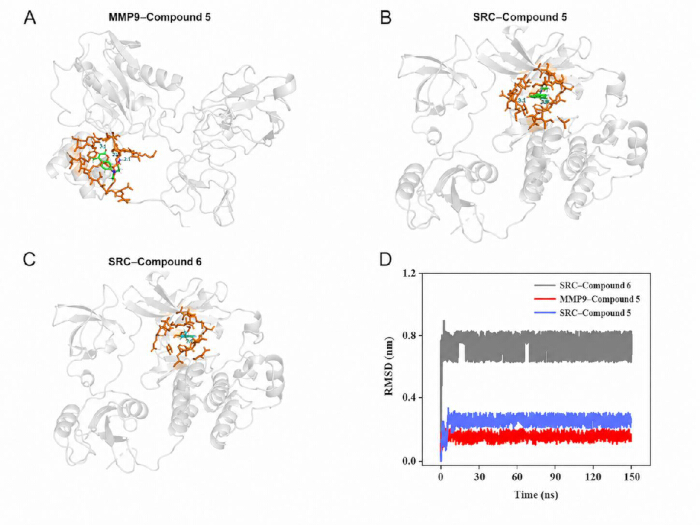
Figuur 6: Structureel overzicht en ligand-stabiliteitsanalyse van de MD-complexen. (A) Initiële docking-conformatie van Compound 5 met MMP9, gebruikt als startstructuur voor MD. (B) Initiële docking-conformatie van Compound 5 met SRC (PDB 2H8H). (C) Initiële docking-conformatie van Compound 6 met SRC (PDB 2H8H); Compound 6 is het glutathion-splitsingsproduct van controle Compound 3 en mist de aminooxy abasische-site-trapping functionaliteit. (D) Ligand root mean square deviation ten opzichte van de initiële docking-pose over de 150 ns trajecten voor MMP9–Compound 5, SRC–Compound 5 en SRC–Compound 6. Het paneel vergelijkt de persistentie van de pose tijdens MD en demonstreert geen intracellulaire target-binding. Afkortingen: MD, moleculaire dynamica; MMP9, matrix metalloproteïnase 9; SRC, SRC proto-oncogen, non-receptor tyrosinekinase; PDB, Protein Data Bank; RMSD, root mean square deviation. Klik hier om een grotere versie van deze figuur te bekijken.
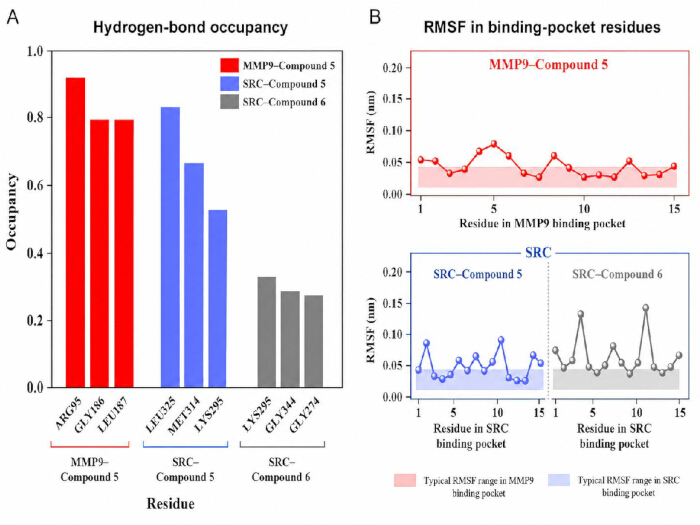
Figuur 7: Kenmerken van de dynamische interactie tijdens moleculaire dynamica-analyse. (A) Bezetting van representatieve waterstofbruggen tussen ligand en eiwit tijdens de 150 ns trajecten voor MMP9–Compound 5, SRC–Compound 5 en SRC–Compound 6. (B) Root mean square fluctuation van residuen in de bindingspocket. Het MMP9-profiel wordt geïnterpreteerd binnen het MMP9-systeem, terwijl de profielen van SRC–Compound 5 en SRC–Compound 6 een directe vergelijkende analyse binnen SRC bieden. Deze analyses beschrijven de persistentie van contacten en de lokale flexibiliteit tijdens MD en tonen geen intracellulaire target-binding of functionele modulatie van MMP9 of SRC aan. Afkortingen: MD, moleculaire dynamica; MMP9, matrix metalloproteïnase 9; SRC, SRC proto-oncogen, non-receptor tyrosinekinase; RMSF, root mean square fluctuation. Klik hier om een grotere versie van deze figuur te bekijken.
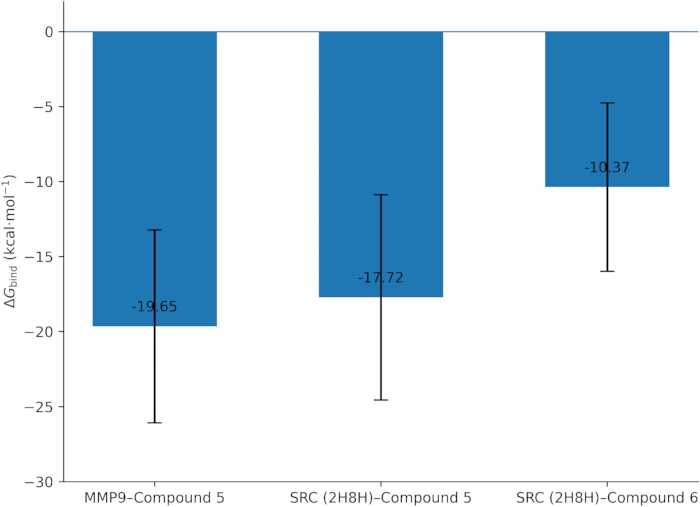
Figuur 8: Energetische schattingen op basis van Molecular mechanics Poisson-Boltzmann surface area voor de geanalyseerde complexen. Geschatte ΔG_bind-waarden verkregen via de molecular mechanics Poisson-Boltzmann surface area-methode uit de geëquilibreerde trajectsegmenten van de complexen MMP9–Compound 5, SRC (PDB 2H8H)–Compound 5 en SRC (PDB 2H8H)–Compound 6. Waarden worden gepresenteerd als gemiddelde ± standaarddeviatie en worden gebruikt voor relatieve vergelijking binnen de studie in plaats van als experimenteel gemeten bindingsaffiniteiten. Figuur 8 gebruikt het label ΔG_bind (kcal·mol⁻1) op de y-as, consistent met de vergelijking en terminologie die in de Methoden en Resultaten worden gebruikt. Afkortingen: MMP9, matrix metalloproteïnase 9; SRC, SRC proto-oncogen, non-receptor tyrosinekinase; PDB, Protein Data Bank; ΔG_bind, vrije bindingsenergie; MM-PBSA, molecular mechanics Poisson–Boltzmann surface area. Klik hier om een grotere versie van deze figuur te bekijken.
| Verbinding | AKT1 (kcal·mol⁻¹) | EGFR (kcal·mol⁻¹) | MMP9 (kcal·mol⁻¹) | SRC (kcal·mol⁻¹) | TNF (kcal·mol⁻¹) |
| Verbinding 4 | -5.658 | -4.913 | -7.840 | -6.549 | -5.436 |
| Verbinding 5 | -5.960 | -5.188 | -8.418 | -6.204 | -5.299 |
Tabel 1: AutoDock Vina-dockingscores van Compound 4 en Compound 5 tegenover de vijf geprioriteerde eiwitten. AutoDock Vina-dockingscores (kcal·mol⁻1) voor Compound 4 en Compound 5 met AKT1, EGFR, MMP9, SRC en TNF. Meer negatieve waarden duiden op gunstigere scores binnen het gespecificeerde dockingprotocol. Deze waarden zijn computationele scores en mogen niet worden beschreven als experimenteel gemeten vrije bindingsenergieën of affiniteiten. Afkortingen: AKT1, AKT serine/threonine kinase 1; EGFR, epidermale groeifactorreceptor; MMP9, matrixmetalloproteïnase 9; SRC, SRC proto-oncogeen, non-receptor tyrosinekinase; TNF, tumornecrosefactor.
Aanvullende figuur 1: Structurele vergelijking van de MMP9–NFH kristallografische referentie en de best scorende MMP9–Compound 5 docking-pose. (A) Katalytische ZN2⁺-omgeving van het MMP9–NFH referentiecomplex (PDB 1GKC), met weergave van His401, His405, His411, Glu402 en de getoonde NFH-coördinatieafstanden. (B) Best scorende docking-pose van Compound 5 met weergave van de getoonde Ala417- en Pro421-contacten. (C) Alternatief driedimensionaal aanzicht van dezelfde docking-pose van Compound 5. De vergelijking dient als structurele referentie en bewijst geen MMP9-remming. Afkortingen: MMP9, matrix metalloproteïnase 9; NFH, N2-[(2R)-2-{[formyl(hydroxy)amino]methyl}-4-methylpentanoyl]-N,3-dimethyl-L-valinamide; PDB, Protein Data Bank; Ala, alanine; Pro, proline; His, histidine; Glu, glutamaat.Klik hier om dit bestand te downloaden.
Aanvullende figuur 2: Root mean square deviation van de eiwitbackbone tijdens moleculaire dynamica-analyse. Profielen van de root mean square deviation van de eiwitbackbone voor de MMP9–Compound 5, SRC (PDB 2H8H)–Compound 5, en SRC (PDB 2H8H)–Compound 6 systemen over de volledige moleculaire dynamica-trajecten. De laatste grafiek maakt gebruik van de gestandaardiseerde labels MMP9–Compound 5, SRC–Compound 5, en SRC–Compound 6, met assen weergegeven als RMSD (nm) and Time (ns). De profielen beschrijven het tijdsafhankelijke conformationele gedrag tijdens MD en mogen niet worden geïnterpreteerd als bewijs voor cellulaire binding of eiwitregulatie. Afkortingen: MMP9, matrix metalloproteïnase 9; SRC, SRC proto-oncogen, non-receptor tyrosinekinase; PDB, Protein Data Bank; RMSD, root mean square deviation; MD, moleculaire dynamica.Klik hier om dit bestand te downloaden.
Aanvullende figuur 3: Vergelijking van de katalytische ZN2⁺-omgeving van MMP9 in het 1GKC-NFH referentiecomplex en de best gerangschikte docking-positie van Compound 5. In het kristallografische MMP9–NFH referentiecomplex (PDB 1GKC) coördineren His401, His405 en His411 de katalytische ZN2⁺ op respectievelijk 2,21, 2,23 en 2,22 Å, en coördineren twee NFH-zuurstofatomen ZN2⁺ op 2,07 en 2,38 Å; Glu402 is het katalytische zuur/base-residu. In tegenstelling hiermee vertoont de behouden, best gerangschikte interactiekaart van Compound 5 contacten met Ala417 (3,0 Å) en Pro421 (2,4 Å), maar geen geannoteerde directe ZN2⁺-coördinatie of directe contacten met His401, Glu402, His405 of His411. Bijgevolg is er geen coördinatieafstand voor Compound 5-ZN2⁺ toegewezen. Deze vergelijking ondersteunt de classificatie van de positie van Compound 5 als een niet-canonieke voorspelde associatie in plaats van een canonische zink-afhankelijke inhiberende bindingsmodus. Afkortingen: MMP9, matrix metalloproteïnase 9; PDB, Protein Data Bank; Ala, alanine; Pro, proline; His, histidine; Glu, glutamaat.Klik hier om dit bestand te downloaden.
Aanvullende Tabel 1: Topologische metrieken voor het initiële eiwit-eiwitinteractienetwerk met 21 knopen en 116 randen. Topologische parameters voor alle 21 knopen met kruisende doelen vóór de screening op basis van centraliteit, inclusief gemiddelde kortste padlengte, betweenness-centraliteit, closeness-centraliteit, clusteringcoëfficiënt, graad, excentriciteit, buurtconnectiviteit, radialiteit, stress en topologische coëfficiënt. De knoopgraden tellen op tot 232, wat overeenkomt met 116 ongerichte randen.Klik hier om dit bestand te downloaden.
Aanvullende Tabel 2: Topologische metrieken van het oorspronkelijke netwerk voor de 13 kandidaten die na screening op basis van graad zijn behouden. Topologische parameters voor de 13 knooppunten die zijn behouden na het toepassen van het graadcriterium op het initiële netwerk van 21 knooppunten en 116 randen. Deze waarden zijn de metrieken van het oorspronkelijke netwerk van 21 knooppunten en 116 randen die zijn meegenomen voor de daaropvolgende filterstap op basis van betweenness- en closeness-centraliteit; ze zijn niet opnieuw berekend op een subnetwerk van 13 knooppunten.Klik hier om dit bestand te downloaden.
Aanvullende Tabel 3: Topologische metrieken van het oorspronkelijke netwerk voor de uiteindelijke vijf hub-kandidaten die na sequentiële filtering zijn behouden. Topologische parameters van het oorspronkelijke netwerk met 21 knopen en 116 verbindingen voor de uiteindelijke vijf hub-kandidaten, AKT1, EGFR, TNF, MMP9 en SRC, die na sequentiële filtering zijn behouden. Deze meegenomen waarden dienen uitsluitend ter ondersteuning van netwerkgebaseerde prioritering en vertegenwoordigen geen metrieken die opnieuw zijn berekend op een subnetwerk van vijf knopen, noch stellen zij de eiwitten vast als experimenteel gevalideerde drugtargets. Afkortingen: AKT1, AKT serine/threonine kinase 1; EGFR, epidermal growth factor receptor; TNF, tumor necrosis factor; MMP9, matrix metalloproteinase 9; SRC, SRC proto-oncogene, non-receptor tyrosine kinase.Klik hier om dit bestand te downloaden.
Aanvullende tabel 4: Volledige Kyoto Encyclopedia of Genes and Genomes-verrijkingsresultaten voor 121 pathways die voldoen aan het nominale p < 0,10 inclusiecriterium. Volledige Kyoto Encyclopedia of Genes and Genomes-verrijkingsstatistieken voor alle 121 behouden pathways onder de 21 intersecterende targets (nominaal p < 0,10), inclusief gene ratio, genenaantallen, lijsttotalen, populatie-hits, populatietotalen, p-waarden, Benjamini-waarden, fold enrichment, Bonferroni-waarden, false discovery rates en Fisher's exact test-waarden. De 20 hoogst gerangschikte pathways zijn gevisualiseerd in Figuur 4A. Het nominale p-waarde criterium bepaalde de inclusie; Benjamini-, Bonferroni- en false discovery rate-waarden worden gerapporteerd ter transparantie en werden niet gebruikt om de behouden set te definiëren.Klik hier om dit bestand te downloaden.
Aanvullende Tabel 5: Volledige resultaten van de verrijking van biologische processen volgens de Gene Ontology (177 termen die voldoen aan de nominale p < 0,10). Volledige verrijkingsstatistieken voor alle 177 behouden Gene Ontology biologische procestermen (nominale p < 0,10), inclusief genratio, aantal genen, totaal van de lijst, populatiehits, populatietotaal, p-waarde, Benjamini-waarde, fold enrichment, Bonferroni-waarde, false discovery rate en de waarde van de exacte test van Fisher. De 10 hoogst gerangschikte termen zijn gevisualiseerd in Figuur 4B. Het criterium van de nominale p-waarde bepaalde de inclusie; gecorrigeerde waarden worden gerapporteerd ter transparantie en werden niet gebruikt om de behouden set te definiëren.Klik hier om dit bestand te downloaden.
Aanvullende tabel 6: Volledige resultaten van de verrijking van cellulaire componenten volgens de Gene Ontology (29 termen die voldoen aan de nominale p < 0,10). Volledige verrijkingstatistieken voor alle 29 behouden termen voor cellulaire componenten van de Gene Ontology (nominale p < 0,10), inclusief genratio, aantal genen, lijsttotaal, populatiehits, populatietotaal, p-waarde, Benjamini-waarde, fold enrichment, Bonferroni-waarde, false discovery rate en de waarde van de exacte test van Fisher. De 10 hoogst gerangschikte termen zijn gevisualiseerd in Figuur 4C. Het criterium van de nominale p-waarde bepaalde de inclusie; aangepaste waarden worden gerapporteerd ter transparantie en werden niet gebruikt om de behouden set te definiëren.Klik hier om dit bestand te downloaden.
Aanvullende tabel 7: Volledige resultaten van de verrijking van moleculaire functies in de Gene Ontology (61 termen die voldoen aan de nominale p < 0,10). Volledige verrijkingsstatistieken voor alle 61 behouden Gene Ontology-termen voor moleculaire functies (nominale p < 0,10), inclusief genratio, aantal genen, lijsttotaal, populatiehits, populatietotaal, p-waarde, Benjamini-waarde, fold-verrijking, Bonferroni-waarde, false discovery rate en de waarde van de exacte test van Fisher. De 10 hoogst gerangschikte termen zijn gevisualiseerd in Figuur 4D. Het criterium van de nominale p-waarde bepaalde de inclusie; gecorrigeerde waarden worden gerapporteerd ter transparantie en werden niet gebruikt om de behouden set te definiëren.Klik hier om dit bestand te downloaden.
Discussie
De huidige studie moet worden geïnterpreteerd binnen een mechanistisch kader van twee niveaus. Het eerste niveau wordt ondersteund door eerder experimenteel werk: glutathione-responsieve activering laat een aminooxy-bevattende soort vrij die aldehydische abasische sites kan vangen, en de verbindingenklasse vertoonde selectieve cytotoxiciteit, effecten op de celcyclus en apoptose in H1299-cellen. Het tweede niveau is verkennend en vormt de focus van het huidige werk: computationele targetvoorspelling en structuurgebaseerde analyses suggereren dat dezelfde chemische reeks mogelijk ook compatibel is met geselecteerde kanker-geassocieerde eiwitten. Geen enkel experiment in deze studie bewijst dat de voorspelde eiwitinteracties in cellen plaatsvinden of dat ze stroomafwaartse gevolgen zijn van het vangen van abasische sites. De twee niveaus zijn daarom bewust gescheiden gehouden in plaats van gecombineerd tot een bewezen multi-target mechanisme.
Op netwerkniveau waren de 21 intersecterende targets verrijkt in kankerspecifieke en resistentiegerelateerde pathways, waarbij AKT1, EGFR, TNF, MMP9 en SRC centrale posities innamen in het PPI-netwerk. Deze resultaten zijn nuttig voor de prioritering van kandidaten, maar netwerkcentraliteit en verrijking kunnen niet aantonen dat een verbinding fysiek bindt aan een eiwit of een pathway verandert. Hub-eiwitten moeten daarom worden beschouwd als kandidaten voor gerichte validatie. Het vaststellen van een functionele rol zou directe perturbatie- of target-engagement-experimenten vereisen in dezelfde NSCLC-cellijn die is gebruikt om het cellulaire fenotype te meten.
MMP9 illustreert waarom dit onderscheid belangrijk is. Verbinding 5 had de meest gunstige enkele docking-score met MMP9, maar de behouden interactiekaart van de top-pose annoteerde geen directe coördinatie van het katalytische Zn2+ ion of directe betrokkenheid van His401, Glu402, His405 of His411. In de 1GKC kristallografische referentie coördineren His401, His405 en His411 Zn2+ op 2.21, 2.23 en 2.22 Å, terwijl de twee NFH zuurstofatomen Zn2+ coördineren op 2.07 en 2.38 Å; Glu402 is het katalytische zuur/base residu. De kaart van Verbinding 5 toonde daarentegen contacten nabij Ala417 en Pro421. Aanvullende Figuur 3 presenteert de vergelijking van de referentie-interactiekaarten. Omdat directe coördinatie tussen Verbinding 5 en Zn2+ niet werd geannoteerd, werd er geen coördinatieafstand tussen Verbinding 5 en Zn2+ toegewezen. Bijgevolg wordt het huidige structurele resultaat het best beschreven als een niet-canonieke voorspelde associatie met MMP9, en niet als bewijs voor inhibitie van de katalytische site. De daaropvolgende MD-trajectorie test enkel of die specifieke docking-pose over tijd persistent blijft; het kan een niet-canonieke docking-geometrie niet omzetten in een bewijs van enzymatische inhibitie36,37. MMP9 dient daarom een kandidaat voor biochemische testing te blijven in plaats van een primair of gevalideerd target. MMP9 is uitgebreid besproken in relatie tot kankerinvasie, remodellering van de tumor-micro-omgeving en MMP9-gerichte therapeutische strategieën38,39.
Dezelfde bewijsgrens is van toepassing op SRC. Het traject van SRC–Compound 5 vertoonde aanhoudendere contacten dan de SRC–Compound 6 controle, maar MD-stabiliteit is niet gelijk aan intracellulaire targetbezetting40,41. Het gebruik van Compound 6 biedt een passende vergelijking voor het niet-trapping splitsingsproduct en versterkt de interne structurele vergelijking, maar het bewijst niet dat de aminooxy-functionaliteit verantwoordelijk is voor de SRC-binding of dat de SRC-signalering in cellen is gewijzigd. Directe beoordeling van totaal SRC, p-SRC/SRC, stroomafwaartse signaleringsmarkers en orthogonale target-engagement metingen zouden vereist zijn om een dergelijke claim te ondersteunen.
MM-PBSA levert evenzo een relatief energetische schatting voor de gesamplede trajecten in plaats van een experimentele affiniteitsmeting. De gunstigere schattingen voor MMP9–Compound 5 en SRC–Compound 5 vergeleken met SRC–Compound 6 zijn consistent met de vergelijkende trajectobservaties, maar de berekeningen zijn gevoelig voor de gesamplede conformaties en methodologische benaderingen, en de huidige analyse bevatte geen entropiecorrectie. Overeenstemming tussen docking, MD en MM-PBSA verhoogt daarom enkel de interne computationele consistentie; het stelt geen functionele modulatie van MMP9 of SRC vast.
De relatie tussen het vangen van abasische sites en de voorspelde eiwitinteracties blijft onduidelijk. Eén mogelijkheid is dat het door glutathion vrijgekomen aminooxy-steunframe zijn gevestigde activiteit voor het vangen van DNA-laesies behoudt, terwijl het tegelijkertijd onafhankelijke, parallelle interacties heeft met geselecteerde eiwitten. Een andere mogelijkheid is dat sommige voorspelde eiwitinteracties niet plaatsvinden bij biologisch relevante concentraties of niet bijdragen aan het fenotype. De huidige gegevens kunnen deze mogelijkheden niet onderscheiden. Het aantonen van een mechanische brug zou een gelijktijdige meting van DNA-schaderesponsen en veranderingen in eiwitpaden na behandeling met de verbinding vereisen, gevolgd door perturbatie-experimenten die aantonen dat het wijzigen van een kandidaat-doelwit het antikankerfenotype verandert.
Toekomstige experimentele validatie dient te worden uitgevoerd in H1299-cellen, hetzelfde cellulaire model dat is gebruikt in de eerdere experimentele karakterisering van deze chemische reeks. Een gefaseerde strategie zou eerst Verbinding 5 vergelijken met het vehikel en de bijbehorende niet-trapping Verbinding 6, gebruikmakend van concentratie-responstests voor viabiliteit, apoptose, celcyclus, migratie/invasie en γH2AX-assays om de fenotypische context en DNA-schade vast te stellen42. Vervolgens dient MMP9 te worden onderzocht via gelatinezymografie en proteïne-expressieanalyse, terwijl SRC-signalering moet worden beoordeeld via totaal SRC en Tyr416-gefosforyleerd SRC, waarbij de p-SRC/SRC-ratio als de belangrijkste signaleringsmeting wordt gebruikt. De directe associatie tussen verbinding en proteïne moet onafhankelijk worden geëvalueerd met een orthogonale methode voor target-engagement, zoals surface plasmon resonance43. Een kandidaat-interactie mag pas als experimenteel ondersteund worden beschouwd wanneer het bewijs voor directe binding overeenkomt met de bijbehorende cellulaire functionele readout. Genetische of farmacologische perturbatie van MMP9 of SRC zou een verdere test bieden om vast te stellen of een van beide kandidaten causaal bijdraagt aan het H1299-fenotype. Dit gefaseerde kader bewaart het onderscheid tussen de eerder vastgestelde abasische-site-trapping-activiteit en de computationeel geprioriteerde MMP9/SRC-interactiehypothesen, terwijl het een directe route definieert voor daaropvolgende experimentele toetsing.
Openbaarmakingen
De auteurs verklaren dat zij geen concurrerende financiële belangen of andere belangenconflicten hebben met betrekking tot dit werk. De financiers hebben geen rol gespeeld bij het ontwerp van de studie; bij de verzameling, analyse of interpretatie van de gegevens; bij het schrijven van het manuscript; of bij de beslissing om de resultaten te publiceren.
Dankbetuigingen
Dit werk werd ondersteund door het Youth Project van het Liaoning Provincial Department of Education (JYTQN2023441), het Doctoral Research Initiation Project van het Liaoning Provincial Joint Fund of the Science and Technology Department (2023-BSBA-151), en het Young Scientific and Technological Talent Support Project van de Jinzhou Medical University (JYQT202305). ChatGPT (OpenAI) is tijdens de herziening van het manuscript gebruikt voor taalbewerking, organisatie en ondersteuning bij de revisie. De auteurs hebben de wetenschappelijke inhoud, de interpretatie van de gegevens en de definitieve bewoordingen beoordeeld en geverifieerd, en dragen de volledige verantwoordelijkheid voor het manuscript.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| ACPYPE | ACPYPE-ontwikkelaars / Bio2Byte | Versie 2023.11.14 | Generatie en conversie van topologiedossiers van kleine moleculaire liganden naar GROMACS-compatibele indeling. |
| AmberTools (Antechamber) | AMBER-ontwikkelteam | AmberTools 23.3 | Toewijzing van AM1-BCC gedeeltelijke ladingen en generatie van GAFF2-ligandparameters. |
| AutoDock Vina | Forli Lab, Scripps Research | Versie 1.2.5 | Moleculaire docking en generatie van gerangschikte eiwit-ligandposities. |
| AutoDockTools (MGLTools) | Centrum voor Computationele Structuurbiochemie, Scripps Research | Versie 1.5.7 | Voorbereiding van receptor en ligand, toewijzing van Gasteiger-ladingen, definitie van roteerbare bindingen en conversie naar PDBQT. |
| BIOVIA Discovery Studio Visualizer | Dassault Systèmes BIOVIA | Versie 2025 | Visualisatie van dockingposities en inspectie van eiwit-ligandinteracties. |
| CHARMM36-krachtveld | MacKerell Laboratory / CHARMM-krachtveldontwikkelaars | CHARMM36 | Eiwitparameterisatie voor moleculaire dynamica-berekeningen; CHARMM36 werd consistent gebruikt gedurende de gehele studie (niet CHARMM36m). |
| Chem3D Ultra (ChemOffice Professional) | Revvity Signals Software | Versie 22.2 | Energie-minimalisatie van liganden met behulp van het MMFF94-krachtveld. |
| Verbindingen 1–6 | Eerder gesynthetiseerd zoals beschreven in Li et al., ACS Chemical Biology (2022) | NVT | Glutathion-responsieve ouderprodrugs, vrijgekomen producten en overeenkomstige niet-vastleggende controlegroep gebruikt in de computationele werksstroom. |
| cytoHubba | cytoHubba-ontwikkelaars / Cytoscape App Store | Versie 0.1 | Analyse van graad, tussencentraalheid en nabijheidscentraalheid voor prioritering van hub-doelen. |
| Cytoscape | Cytoscape Consortium | Versie 3.10.0 | Visualisatie en topologische analyse van verbinding-doel en PPI-netwerken. |
| DAVID Bioinformatics Resources | Laboratorium voor Humane Retrovirologie en Immunoinformatica, Frederick National Laboratory for Cancer Research | Webbron | Gene Ontology- en KEGG-verrijkingsanalyse; nominale p < 0,10 werd gebruikt als exploratief selectiecriterium; gecorrigeerde waarden werden gerapporteerd maar niet gebruikt om de behouden set te bepalen. |
| GAFF2 | AMBER-ontwikkelteam | GAFF2 | Parameterisatie van ligand-krachtveld. |
| GeneCards Human Gene Database | GeneCards Suite / LifeMap Sciences, Inc. / Weizmann Institute of Science | Webbron | Ophalen van ziektegeassocieerde doelen met behulp van de zoekopdracht 'longkanker H1299'. |
| gmx_MMPBSA | gmx_MMPBSA-ontwikkelteam | Versie 1.6.3 | MM-PBSA-bindingsvrij-energieberekeningen uit GROMACS-moleculaire dynamica-trajecten; 500 frames werden bemonsterd van 100,0–149,9 ns met intervallen van 100 ps, waarbij het eindpunt van 150,0 ns werd uitgesloten; er werd geen entropiecorrectie toegepast. |
| GROMACS | GROMACS-ontwikkelteam | Versie 2024.4 | Generatie en analyse van moleculaire dynamica-trajecten. |
| Microbioinfo online visualisatieplatform | Shanghai Newcore Biotechnology Co., Ltd. / Microbioinfo | Webbron | Generatie van verrijkingsstaafdiagrammen en bubbelplots. |
| Open Babel | Open Babel-ontwikkelteam | Versie 3.1.1 | Conversie van structuurbestanden naar canonieke SMILES voor invoer in SwissTargetPrediction. |
| PubChem | Nationaal Centrum voor Biotechnologie-informatie, U.S. National Library of Medicine, NIH | Webbron | Ophalen van driedimensionale ligandstructuren. |
| PyMOL Molecular Graphics System | Schrödinger, LLC | Versie 2.5.4 | Voorbereiding van eiwitten, structurele visualisatie en inspectie van dockingposities. |
| RCSB Protein Data Bank | Research Collaboratory for Structural Bioinformatics (RCSB) | PDB-ID's: 3O96; 5UWD; 2AZ5; 1GKC; 2H8H | Ophalen van eiwitstructuren voor respectievelijk AKT1, EGFR, TNF, MMP9 en SRC. |
| STRING | STRING Consortium | Versie 11.5 | Constructie van eiwit-eiwitinteractienetwerk; Homo sapiens; minimale vereiste interactiescore 0,400; de oorspronkelijke topologische metrieken horen bij het 21-knooppunten, 116-kanten ongerichte PPI-netwerk. |
| SwissTargetPrediction | Molecular Modeling Group, Universiteit van Lausanne / SIB Swiss Institute of Bioinformatics | Webbron | Omgekeerde doelvoorspelling voor verbindingen 1–3; soort beperkt tot Homo sapiens. |
| TIP3P-watermodel | Geïmplementeerd in GROMACS | TIP3P | Driepunts expliciet-oplosmiddel watermodel gebruikt voor het oplossen van eiwit-ligandcomplexen. |
| Venny | BioinfoGP, Centro Nacional de Biotecnología (CNB-CSIC) | Versie 2.1 | Snijpunt van lijsten met voorspelde verbinding-doelen en ziektegeassocieerde doelen. |
Referenties
- Sung H, et al. Global cancer statistics 2020: GLOBOCAN estimates of incidence and mortality worldwide for 36 cancers in 185 countries. CA Cancer J Clin. 2021;71:209-49.
- Herbst RS, Morgensztern D, Boshoff C. The biology and management of non-small cell lung cancer. Nature. 2018;553:446-54.
- Kim J, et al. Updates on the treatment of epidermal growth factor receptor-mutant non-small cell lung cancer. Cancer. 2025;131:e35778.
- Lin Y, Wang X, Jin H. EGFR-TKI resistance in NSCLC patients: mechanisms and strategies. Am J Cancer Res. 2014;4:411-35.
- Dasari S, et al. Pharmacological effects of cisplatin combination with natural products in cancer chemotherapy. Int J Mol Sci. 2022;23:1532.
- Ellie S, et al. Chemotherapy drugs cyclophosphamide, cisplatin and doxorubicin induce germ cell loss in an in vitro model of the prepubertal testis. Sci Rep. 2018;8:1773.
- De Bont R, van Larebeke N. Endogenous DNA damage in humans: a review of quantitative data. Mutagenesis. 2004;19:169-85.
- Ciccia A, Elledge SJ. The DNA damage response: making it safe to play with knives. Mol Cell. 2010;40:179-204.
- David SS, Williams SD. Chemistry of glycosylases and endonucleases involved in base-excision repair. Chem Rev. 1998;98:1221-62.
- Robson CN, Hickson ID. Isolation of cDNA clones encoding a human apurinic/apyrimidinic endonuclease that corrects DNA repair and mutagenesis defects in E. coli xth (exonuclease III) mutants. Nucleic Acids Res. 1991;19:5519-23.
- Sczepanski JT, et al. Rapid DNA-protein cross-linking and strand scission by an abasic site in a nucleosome core particle. Proc Natl Acad Sci U S A. 2010;107:22475-80.
- Krokan HE, Bjørås M. Base excision repair. Cold Spring Harb Perspect Biol. 2013;5:a012583.
- Li X, et al. Selective antitumor activity and photocytotoxicity of glutathione-activated abasic site trapping agents. ACS Chem Biol. 2022;17:797-803.
- Hopkins AL. Network pharmacology: the next paradigm in drug discovery. Nat Chem Biol. 2008;4:682-90.
- Meng XY, et al. Molecular docking: a powerful approach for structure-based drug discovery. Curr Comput Aided Drug Des. 2011;7:146-57.
- Hollingsworth SA, Dror RO. Molecular dynamics simulation for all. Neuron. 2018;99:1129-43.
- Genheden S, Ryde U. The MM/PBSA and MM/GBSA methods to estimate ligand-binding affinities. Expert Opin Drug Discov. 2015;10:449-61.
- O'Boyle NM, et al. Open Babel: an open chemical toolbox. J Cheminform. 2011;3:33.
- Daina A, Michielin O, Zoete V. SwissTargetPrediction: updated data and new features for efficient prediction of protein targets of small molecules. Nucleic Acids Res. 2019;47:W357-64.
- Shannon P, et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13:2498-504.
- Stelzer G, et al. The GeneCards Suite: from gene data mining to disease genome sequence analyses. Curr Protoc Bioinformatics. 2016;54:1.30.1-1.30.33.
- Oliveros JC. Venny: an interactive tool for comparing lists with Venn's diagrams [Internet]. BioinfoGP, CNB-CSIC; 2007-2015.
- Szklarczyk D, et al. The STRING database in 2021: customizable protein-protein networks and functional characterization of user-uploaded gene/measurement sets. Nucleic Acids Res. 2021;49:D605-12.
- Chin CH, et al. cytoHubba: identifying hub objects and subnetworks from complex interactome. BMC Syst Biol. 2014;8:S11.
- Sherman BT, et al. DAVID: a web server for functional enrichment analysis and functional annotation of gene lists (2021 update). Nucleic Acids Res. 2022;50:W216-21.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51:D1373-80.
- Eberhardt J, et al. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61:3891-8.
- Gerek ZN, Ozkan SB. A flexible docking scheme to explore the binding selectivity of PDZ domains. Protein Sci. 2010;19:914-28.
- Abraham MJ, et al. GROMACS: high-performance molecular simulations through multi-level parallelism from laptops to supercomputers. SoftwareX. 2015;1-2:19-25.
- Best RB, et al. Optimization of the additive CHARMM all-atom protein force field targeting improved sampling of backbone and side-chain dihedral angles. J Chem Theory Comput. 2012;8:3257-73.
- Vassetti D, Pagliai M, Procacci P. Assessment of GAFF2 and OPLS-AA general force fields in combination with the water models TIP3P, SPCE, and OPC3 for the solvation free energy of druglike organic molecules. J Chem Theory Comput. 2019;15:1983-95.
- Jakalian A, Jack DB, Bayly CI. Fast, efficient generation of high-quality atomic charges. AM1-BCC model: II. Parameterization and validation. J Comput Chem. 2002;23:1623-41.
- Sousa da Silva AW, Vranken WF. ACPYPE—AnteChamber PYthon Parser interfacE. BMC Res Notes. 2012;5:367.
- Case DA, et al. AmberTools. J Chem Inf Model. 2023;63:6183-91.
- Valdés-Tresanco MS, et al. gmx_MMPBSA: a new tool to perform end-state free-energy calculations with GROMACS. J Chem Theory Comput. 2021;17:6281-91.
- Islam MT, Jang NH, Lee HJ. Natural products as regulators against matrix metalloproteinases for the treatment of cancer. Biomedicines. 2024;12:794.
- Mondal S, et al. Matrix metalloproteinase-9 (MMP-9) and its inhibitors in cancer: a minireview. Eur J Med Chem. 2020;194:112260.
- Rashid ZA, Bardaweel SK. Novel matrix metalloproteinase-9 (MMP-9) inhibitors in cancer treatment. Int J Mol Sci. 2023;24:12133.
- Kessenbrock K, Plaks V, Werb Z. Matrix metalloproteinases: regulators of the tumor microenvironment. Cell. 2010;141:52-67.
- Vandooren J, Van den Steen PE, Opdenakker G. Biochemistry and molecular biology of gelatinase B or matrix metalloproteinase-9 (MMP-9): the next decade. Crit Rev Biochem Mol Biol. 2013;48:222-72.
- Merchant N, et al. Matrix metalloproteinases: their functional role in lung cancer. Carcinogenesis. 2017;38:766-80.
- Chabanon RM, et al. Targeting the DNA damage response in immuno-oncology: developments and opportunities. Nat Rev Cancer. 2021;21:701-17.
- Das S, et al. Surface plasmon resonance as a fascinating approach in target-based drug discovery and development. TrAC Trends Anal Chem. 2024;171:117501.