Dit protocol beschrijft een op enquêtes gebaseerde workflow om te onderzoeken hoe technologische kenmerken van Agentic AI zich verhouden tot cognitief overschot, psychologische veiligheid en AI-mens taakherverdeling onder 331 medewerkers. Gedeeltelijke kleinste-kwadratenstructurele vergelijkingsmodellering met multi-groepsanalyse onthult rolgebaseerde verschillen tussen leiders en medewerkers.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Hoe agentische AI werken hervormt: De rollen van cognitief overschot, psychologische veiligheid en AI-mens taakherverdeling
In dit artikel
Samenvatting
Samenvatting
Deze studie onderzoekt hoe de technologische kenmerken van Agentic AI zich verhouden tot de psychologische toestand en gedragsreacties van medewerkers in organisaties. Met gebruik van de Job Demands-Resources (JD-R) theorie en Conservation of Resources (COR) theorie, conceptualiseren we Agentic AI technologische kenmerken (AITC) als een hoger orde construct dat autonome planning, multitool-orkestratie en proactieve feedback omvat, en stellen we voor dat deze kenmerken functioneren als functiebronnen die geassocieerd zijn met een groter cognitief overschot en psychologische veiligheid, die op hun beurt verband houden met AI-mens taakherverdeling. We onderzoeken verder of deze relaties verschillen tussen leiders en personeel. Een dwarsdoorsnede, anonieme online enquête werd via een online enquêteplatform uitgevoerd onder deelnemers die via een onderzoekspanel werden gerekruteerd met doelgerichte niet-waarschijnlijkheidssteekproef; de geschiktheid was beperkt tot volwassenen met huidige of eerdere AI-gerelateerde werkervaring, en gescreende, aandacht gecontroleerde antwoorden leverden een eindsteekproef op van 331 medewerkers (171 leiders, 160 medewerkers). Alle constructen werden gemeten met gevalideerde schalen die zijn aangepast aan de Agentic AI-context op 7-punts Likert-schalen. De gegevens werden geanalyseerd met behulp van gedeeltelijke kleinste-kwadratenstructurele vergelijkingsmodellering (PLS-SEM), waarbij een tweefasenaanpak werd toegepast voor de tweede-orde constructie, bootstrapping met 5.000 resamples voor directe en indirecte effecten, en multi-groep analyse (MGA) voor vergelijkingen tussen leiders en medewerkers. Het meetmodel toonde acceptabele betrouwbaarheid en validiteit, en de structurele resultaten waren consistent met het getheoriseerde resource-gainmodel: AITC was positief geassocieerd met cognitief overschot, psychologische veiligheid en taakherverdeling, met significante bemiddelingsroutes en sterkere AITC-resource-associaties tussen leiders. Door zich te richten op psychologische mechanismen in plaats van technische prestaties, breidt deze studie opkomend Agentic AI-onderzoek uit en biedt praktische implicaties voor rolgedifferentieerde AI-adoptiestrategieën.
Inleiding
De proliferatie van Agentic AI herdefinieert de rol van kunstmatige intelligentie in industrieën en het organisatieleven 1,2. Agentische AI kan worden gedefinieerd als een geavanceerde vorm van kunstmatige intelligentie die veranderende omgevingen waarneemt, doelen onafhankelijk stelt via redeneermechanismen en reeksen van acties orkestreert met minimale menselijke controle 3,4. Het onderscheidt zich op drie punten van traditionele AI, inclusief conventionele generatieve AI-tools: autonomie, omdat agentische systemen doelen nastreven met minimale menselijke tussenkomst in plaats van vooraf geprogrammeerde regelsuit te voeren 5,6; kernfunctie, omdat hun doel is om complexe workflows te automatiseren in plaats van losse taken7; en architectuur, omdat ze meerdere grote taalmodellen, application programming interfaces (API's) en agents coördineren in plaats van te vertrouwen op één model7. Deze capaciteiten zijn gebaseerd op de bepalende technologische kenmerken die in deze studiezijn onderzocht 8,9. Autonome planning (AP) betekent dat, gegeven het doel van een gebruiker, het systeem het onafhankelijk opsplitst in subtaken en het plan aanpast naarmate de beperkingen veranderen10; Zo kan een medewerker een eenregelige instructie geven en een werkbaar meerstapsprojectplan ontvangen. Multi-tool orchestration (MTO) betekent dat het systeem externe tools en API'sselecteert, sequencet en integreert 1,11,12; bijvoorbeeld het combineren van webzoekopdrachten, documenteditors en data-analysetools om één samenhangend rapport te produceren. Proactieve feedback (PF) betekent dat het systeem fouten, ontbrekende informatie en risicovolle aannames markeert voordat het wordt gevraagd10,13; bijvoorbeeld het herinneren van een medewerker aan validatie- of compliancecontroles tijdens de uitvoering van taken. We richten ons op deze drie kenmerken, gezamenlijk Agentic AI technologische kenmerken (AITC) genoemd, omdat het de functionele capaciteiten zijn die agentische AI onderscheiden van traditionele AI in dagelijks werk 7,10; eigenschappen zoals transparantie, controleerbaarheid en verklaarbaarheid zijn belangrijk voor AI-vertrouwen in het algemeen, maar zijn niet specifiek voor het agentische paradigma, en we behandelen ze daarom als randvoorwaarden voor toekomstig onderzoek in plaats van als focale dimensies.
Ondanks de snelle verspreiding van Agentic AI op werkplekken, heeft de bestaande literatuur zich vooral gericht op de technische architectuur, operationele efficiëntie en taakautomatiseringsmogelijkheden, terwijl er relatief weinig aandacht is besteed aan hoe deze kenmerken de psychologische toestand en gedragsreacties van werknemers hervormen.. Deze weglating is belangrijk omdat het herverdelen van taken tussen mensen en AI geen puur technische aanpassing is, maar een psychologisch en organisatorisch ingebed proces: medewerkers moeten bestaande workflows uitdagen, rolgrenzen herdefiniëren en nieuwe vormen van samenwerking met intelligente systemen accepteren16,17. Dergelijke veranderingen vinden niet automatisch plaats simpelweg omdat geavanceerde technologie beschikbaar is. Het doel van deze studie is dan ook drieledig: onderzoeken of AITC functioneren als werkbronnen die samenhangen met cognitief overschot, psychologische veiligheid en AI-menselijke taakherverdeling; het onderzoeken van de bemiddelende en sequentieel bemiddelende rollen van cognitief overschot en psychologische veiligheid; en om te onderzoeken of deze structurele relaties verschillen tussen leiders en medewerkers. De nieuwigheid van deze studie is drieledig. Ten eerste conceptualiseert en operationaliseert het de technologische kenmerken van Agentic AI—autonome planning, multitool-orkestratie en proactieve feedback—als een hogere orde werkbron binnen het JD-R-kader, in plaats van AI-adoptie als een ongedifferentieerde context te behandelen. Ten tweede introduceert het AI-mens taakherverdeling als een domeinspecifieke, technologie-geïmplementeerde vorm van taakopstellen, verschillend van zowel generiek werkopstellen als top-down digitale transformatieresultaten. Ten derde levert het, voor zover wij weten, het eerste multigroepsbewijs dat de resourcegenererende associaties van Agentic AI systematisch verschillen tussen leiders en medewerkers.
De theoretische redenering integreert de Job Demands-Resources (JD-R) theorie en de Conservation of Resources (COR) theorie. De JD-R-theorie stelt dat elke baan bestaat uit baaneisen, de fysieke, emotionele en cognitieve aspecten van werk die langdurige inspanning vereisen, en de werkgelegenheidsmiddelen, de aspecten die de eisen verminderen, het bereiken van doelen ondersteunen en persoonlijke ontwikkeling stimuleren; Hun balans bepaalt betrokkenheid, welzijn en prestaties18,19. COR-theorie voegt een dynamisch mechanisme toe: individuen streven ernaar waardevolle hulpbronnen te verkrijgen, te behouden en te beschermen, en opgehoopte middelen starten winstspiralen waarin bestaande middelen worden herinvesteerd om verdere middelen te verwerven 20,21,22. Vanuit dit gezamenlijke perspectief kan AITC niet alleen worden gezien als technische kenmerken, maar als een nieuwe vorm van werkbron: door het absorberen van repetitieve en cognitief belastende taken zoals planning en diagnostische analyse, verminderen agentische systemen de eisen en besparen ze de cognitieve energie en tijd van medewerkers15,23. Wij definiëren cognitief overschot (CS) als het reservoir van cognitieve energie en discretionaire tijd die beschikbaar wordt wanneer dergelijke routinetaken aan technologie worden gedelegeerd, en die opnieuw kan worden geïnvesteerd in collectieve participatie, samenwerking en het creëren van nieuwe waarde24. CS is dus conceptueel verschillend van werkbetrokkenheid, wat een affectief-motiverende staat is, en van loutere tijdsbeschikbaarheid, omdat het een converteerbare voorraad persoonlijke middelen in de COR-zin20,24 aanduidt. CS is eveneens verschillend van psychologische loskoppeling en herstel, die het herstel van uitgeputte energie van werk betreft, en van tijdsovervloed, wat de subjectieve perceptie van voldoende tijd aanduidt; CS verwijst daarentegen naar vrijgemaakte cognitieve capaciteit die beschikbaar blijft voor herinvestering tijdens het werk zelf. In COR-termen vertegenwoordigt opgehoopte CS een resourcewinst die het welzijn van het beroep zou moeten ondersteunen door uitputting en burn-out te bufferen, terwijl de opname ervan door extra routinematige eisen een verliesvan middelen 20, 23, 24 zou betekenen. Of geconserveerde tijd daadwerkelijk wordt omgezet in een overschoot kan afhangen van individuele kenmerken zoals AI-geletterdheid, van werklastnormen die bespaarde tijd kunnen absorberen met extra eisen, en van de organisatiecultuur; We behandelen het resource-gain-pad daarom als een hypothese die getest moet worden, in plaats van als een aanname.
H1: AITC wordt positief geassocieerd met CS.
Psychologische veiligheid (PS) wordt gedefinieerd als het geloof dat iemands werkomgeving veilig is voor het nemen van interpersoonlijke risico's, zoals het toegeven van fouten, het vragen om hulp en het uitdagen van de status quo25,26. Hoewel psychologische veiligheid vaak is bestudeerd als een teamklimaat, conceptualiseert en meet deze studie het als een individuele perceptie, in overeenstemming met ons individueel niveau enquête-ontwerp27,28. Wanneer agentische systemen leergerichte feedback en ondersteunende hulpmiddelen bieden, kunnen de interpersoonlijke kosten van experimenteren en het blootleggen van fouten dalen, omdat werknemers hun werk kunnen testen en corrigeren voordat ze het aan anderen presenteren26,28. We erkennen echter dat de tegenovergestelde dynamiek aannemelijk is: waar agentische systemen worden ingezet voor surveillance of foutopsporing, kan het waargenomen interpersoonlijke risico en wantrouwenmet 29,30 toenemen. Omdat de hier onderzochte kenmerken van ondersteunende aard zijn in plaats van evaluatief, veronderstellen we een positieve associatie terwijl we deze tweezijdige mogelijkheid als een belangrijke grensvoorwaarde behandelen.
H2: AITC is positief geassocieerd met PS.
Wij definiëren AI-mens taakherverdeling (AHTR) als de zelfinitiatieve herverdeling van taken door medewerkers tussen zichzelf en AI-systemen, waarbij routinewerk aan AI wordt gedelegeerd en hun eigen strategische en creatieve verantwoordelijkheden wordt uitgebreid. Wij positioneren AHTR als een domeinspecifieke vorm van jobcreatie. In het JD-R-gebaseerde model van Tims en Bakker omvat job crafting het vergroten van banenbronnen, toenemende uitdagingseisen en het afnemen van hindernissen17,31; in de typologie van Wrzesniewski en Dutton omvat het taak-, relationele en cognitieve vorming32. AHTR komt het meest overeen met het opstellen van taken die via technologie worden uitgevoerd: het gelijktijdig overdragen van routinetaken aan AI vermindert de vraag naar hindernissen en mobiliseert een nieuwe functiebron 17,23,32. Het is smaller dan een algemene digitale transformatie-uitkomst omdat het discretionaire, door medewerkers geïnitieerde veranderingen in taakgrenzen omvat, in plaats van top-down organisatieherontwerp33. Wij geven prioriteit aan taakherverdeling boven relationele en cognitieve vorming omdat de herverdeling van taken de meest directe gedragsinterface is tussen medewerkers en agentische systemen en direct waarneembaar is bij vroege adoptie, terwijl relationeel en cognitief crafting doorgaans voortkomen als downstream adaptaties31,32. In tegenstelling tot eerdere studies die AI-adoptie behandelen als een contextueel voorloper van algemene job crafting16,34, modelleren wij de herverdeling zelf als het focale craftinggedrag. Omdat zo'n herverdeling gevestigde werkprocessen verstoort, zijn werknemers eerder geneigd deze uit te voeren wanneer ze over voldoende cognitieve middelen beschikken om hun werk opnieuw in te richten en zich psychologisch veilig voelen om de bijbehorende interpersoonlijke risico's te nemen16,34. Binnen de gain-spiral logica van de COR-theorie functioneert psychologische veiligheid ook als een contextuele bron die de ophoping van cognitief surplus22 beschermt en versterkt.
H3: CS is positief geassocieerd met AHTR.
H5: PS is positief geassocieerd met AHTR.
H6: PS is positief geassocieerd met CS.
H9: AITC is positief geassocieerd met AHTR.
Door deze argumenten te integreren, wordt verwacht dat AITC zich niet alleen direct maar ook indirect verhoudt tot AHTR, via de resource-gain routes van cognitieve overschotten en psychologische veiligheid.
H4: CS bemiddelt de relatie tussen AITC en AHTR.
H7: PS bemiddelt de relatie tussen AITC en AHTR.
H8: PS en CS bemiddelen achtereenvolgens de relatie tussen AITC en AHTR.
Ten slotte interpreteren en reageren medewerkers niet uniform op Agentic AI. Gibson, Cooper en Conger beschreven de perceptuele afstand tussen leiders en hun teams als cognitieve discrepantie met betrekking tot dezelfde organisatorische doelstellingen, geworteld in asymmetrieën in informatietoegang, verantwoordelijkheid, risicoblootstelling en werkervaring35. Voortbouwend op deze visie bekleden leiders en medewerkers structureel verschillende functies met betrekking tot AI-adoptie: leiders dragen strategische verantwoordelijkheid en hebben de neiging AI te presenteren als een op uitbreiding gerichte bron voor productiviteit en datagedreven besluitvorming, terwijl medewerkers relatief meer worden blootgesteld aan automatiseringsgerelateerde baanonzekerheid en leeroverload20,30. We behandelen deze patronen als tendensen die empirisch getest moeten worden, in plaats van vaste disposities van een van beide groepen. Dergelijke rolgebaseerde discrepanties kunnen heterogene patronen genereren in de relaties tussen AITC, CS, PS en AHTR, maar empirisch onderzoek dat deze groepsverschillen expliciet vastlegt blijft beperkt.
H10a: De associaties van AITC met CS en PS verschillen per leiderschap en personeel.
H10b: De associaties van PS en CS met AHTR verschillen tussen leiders en medewerkers.
Het onderstaande protocol beschrijft de volledige workflow, van participatiewerving en screening via survey-administratie, gegevensopschoning, metingsvalidatie, schatting van structurele modellen, mediatie-analyse en multi-groepsanalyse (MGA) (Figuur 1), zodat de procedure onafhankelijk kan worden gerepliceerd. Het onderzoeksmodel wordt weergegeven in Figuur 2: AITC, gemodelleerd als een tweede-orde constructie bestaande uit AP, MTO en PF, verhoudt zich direct en indirect tot AHTR via CS en PS, waarbij PS ook betrekking heeft op CS; het verschil tussen leiders en stafrollen wordt onderzocht via MGA.
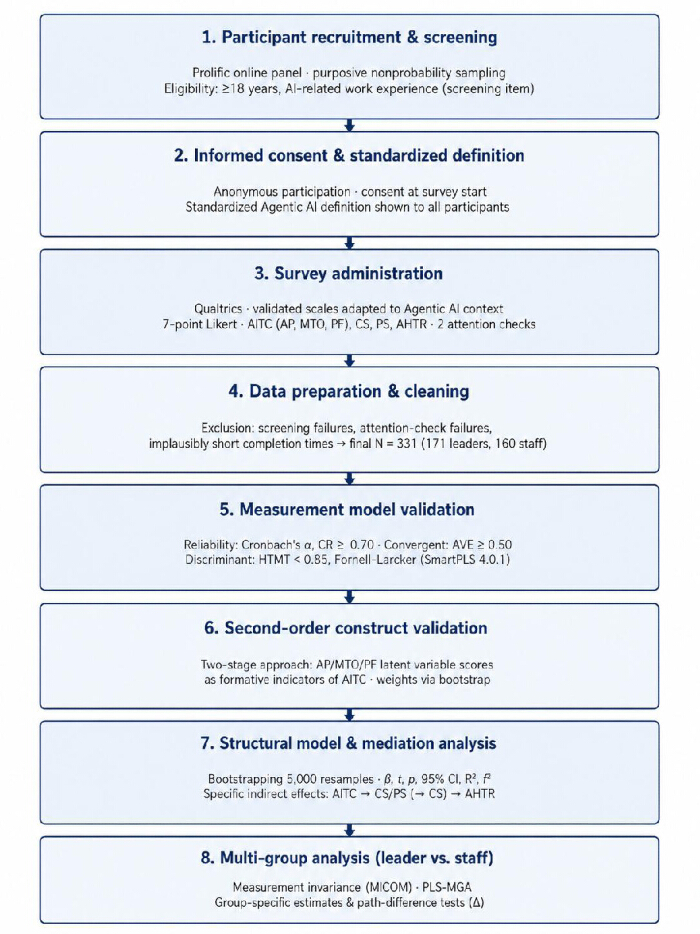
Figuur 1. Algemene studie-ontwerp workflow. Schema van het volledige onderzoeksprotocol. Deelnemers werden via het online panel gerekruteerd met doelgerichte niet-kanssteekproef en gescreend op AI-gerelateerde werkervaring; de in aanmerking komende respondenten vulden een anonieme enquête in waarin alle constructen werden gemeten op 7-punts Likert-schalen. Na het schoonmaken van de gegevens (screeningfouten, aandachtcontrolefouten en ongelooflijk korte voltooiingstijden verwijderd; eind N = 331), werd het meetmodel gevalideerd (betrouwbaarheid: Cronbach's α, samengestelde betrouwbaarheid; convergente validiteit: gemiddelde variantie extraherd; discriminante validiteit: HTMT en Fornell-Larcker), werd het tweede-orde construct gevalideerd via de tweefasenbenadering, en werden het structurele model, bemiddelingsroutes en leider-staf multigroepanalyse geschat op 5.000 Bootstrap resamples. Klik hier om een grotere versie van deze figuur te bekijken.
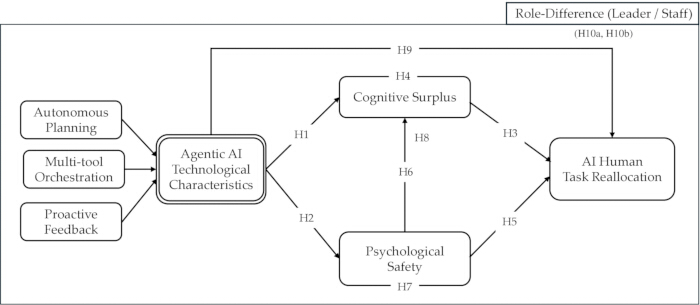
Figuur 2. Voorgesteld onderzoeksmodel. Conceptueel model van veronderstelde relaties. Agentische AI-technologische kenmerken (AITC), een tweede-orde constructie bestaande uit autonome planning (AP; het vermogen van het systeem om doelen op te splitsen in subtaken en plannen te herzien), multi-tool orkestratie (MTO; de capaciteit om meerdere tools en API's te selecteren, te sequencen en te integreren) en proactieve feedback (PF; het vermogen om fouten en risico's ongevraagd te markeren), wordt verondersteld positief geassocieerd te zijn met cognitieve surplus (CS; het reservoir van cognitieve energie en discretionaire tijd vrijgekomen wanneer routinetaken aan AI worden gedelegeerd), psychologische veiligheid (PS; de perceptie dat de werkomgeving veilig is voor interpersoonlijk risiconemen), en AI-mens taakherverdeling (AHTR; de zelfinitiatieve herverdeling van taken door medewerkers tussen zichzelf en AI) (H1, H2, H9). CS en PS worden verondersteld positief geassocieerd te zijn met AHTR (H3, H5), PS met CS (H6), en CS en PS om individueel en sequentieel de AITC-AHTR-relatie (H4, H7, H8) te bemiddelen. Pijlen vertegenwoordigen veronderstelde structurele paden; H10a/H10b duiden op hypothetische leider-stafverschillen die zijn getest via multi-groep analyse. Klik hier om een grotere versie van deze figuur te bekijken.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Alle procedures werden uitgevoerd in overeenstemming met de ethische normen voor onderzoek met menselijke deelnemers aan de aSSIST University en Dong-A University. Omdat alle antwoorden werden geanonimeerd bij verzameling en er op geen enkel moment persoonlijk identificeerbare informatie werd verzameld, heeft de Institutional Review Board van aSSIST University vastgesteld dat de studie was vrijgesteld van volledige beoordeling op grond van Artikel 15 van de Bioethics and Safety Act van de Republiek Korea en Artikel 13 van de Handhavingsregel. De enquête begon met een informatie- en toestemmingspagina waarin werd gesteld dat deelname beperkt was tot personen die momenteel in dienst waren en betrokken waren bij een AI-project, waarbij het doel van het onderzoek werd beschreven en het vrijwillige karakter van deelname, de anonimiteit van de antwoorden en het beoogde gebruik van de gegevens werden uitgelegd; alleen respondenten die expliciet instemden, gingen door naar de vragenlijst. De toestemmingspagina is beschikbaar in Aanvullend Dossier 1.
Bepaling van steekproefgrootte
Een a priori power-analyse werd uitgevoerd vóór de dataverzameling met G*Power 3.1.9.7 (RRID: SCR_013726) voor de lineaire meervoudige regressiefamilie, waarbij het grootste aantal voorspellers werd gespecificeerd gericht op één endogeen construct in het model; in deze studie wordt AHTR voorspeld door drie constructies (AITC, CS en PS). Met een gemiddelde effectgrootte (f2 = 0,15), α = 0,05 en statistische kracht van 0,80, was de vereiste minimale steekproef 77 gevallen; de G*Power-protocoluitgang wordt geleverd in Aanvullend Bestand 2. De minimale steekproefgrootte werd gecontroleerd met de inverse wortelmethode voor PLS-SEM36, waarbij ongeveer 155 gevallen nodig zijn om een minimale gestandaardiseerde padcoëfficiënt van ongeveer 0,20 te detecteren op het 5% significantieniveau met 80% vermogen. Ten slotte werd het rekruteringsdoel gesteld om beide minima aanzienlijk te overtreffen, om het bootstrappen van indirecte effecten en split-sample multi-groep analyse te ondersteunen; de uiteindelijke steekproef (N = 331; leiders n = 171, personeel n = 160) voldeed aan de minimale steekproefvereiste binnen elke subgroep.
Werving en screening van deelnemers
Deelnemers werden gerekruteerd via het online onderzoekspanel met behulp van doelgerichte niet-kanssteekproeven; dat wil zeggen, de steekproef werd bewust beperkt tot respondenten die voldeden aan een a priori inhoudelijk criterium—huidige of eerdere werkervaring met AI—in plaats van willekeurig uit de algemene bevolking te worden getrokken. De geschiktheid was beperkt tot respondenten van 18 jaar of ouder. AI-gerelateerde werkervaring werd operationeel gemaakt via het screeningsitem "Welke van de volgende beschrijft uw huidige situatie het beste?", gepresenteerd vóór de hoofdvragenlijst; alleen respondenten die aangaven momenteel werkzaam te zijn en momenteel betrokken te zijn bij AI-gerelateerd werk, gingen door, terwijl de overige opties (werkzaam maar niet betrokken bij AI-werk; niet werkzaam maar eerder betrokken; niet werkzaam en niet betrokken) direct screen-out veroorzaakten. De gegevensverzameling vond plaats in één sessie op 8 februari 2026 (10:28–13:30), en deelnemers werden gecompenseerd met GBP 6,98 per uur volgens het fair-paybeleid van het platform. Dubbele deelname werd voorkomen via de unieke deelnemersidentificaties van het platform en de instellingen voor het voorkomen van dubbele antwoorden van het enquêteplatform. Het aantal respondenten per fase werd geregistreerd om de inclusie/uitsluitingsworkflow te documenteren: 537 reacties werden geregistreerd; 151 werden door de screeningsvragen weggelaten (386 over); 40 werden verwijderd omdat ze niet slaagden voor de aandachtcontroles, waaronder rechte lijnen (346 over); en 15 werden verwijderd vanwege ongelooflijk korte voltooiingstijden (onder ongeveer 180 seconden), wat het uiteindelijke monster van N = 331 opleverde.
Gestandaardiseerde definitie en surveyinstructies
Deelnemers werden geïnformeerd dat de enquête onderzocht hoe Agentic AI organisaties en hun leden kan beïnvloeden. Aan het begin van de enquête kregen alle deelnemers een korte gestandaardiseerde definitie van Agentic AI te zien, in overeenstemming met de definitie in de Inleiding—een geavanceerd AI-systeem dat wordt gekenmerkt door autonome planning, multi-tool orkestratie en proactieve feedback dat doelgerichte acties uitvoert met beperkte menselijke controle (Figuur 1, stap 2). De geschiktheid was beperkt tot respondenten die momenteel in dienst waren en betrokken waren bij een AI-project, wat een relevante werkgerelateerde basis bood voor het beantwoorden van de vragenlijst. Er werd geen apart begrip van een controlepunt toegevoegd; De gestandaardiseerde definitie diende daarom als contextuele oriëntatie in plaats van als een geverifieerde begripscontrole. Deelnemers kregen de instructie om elk item te beantwoorden op basis van hun daadwerkelijke ervaring met het gebruik of werken met dergelijke Agentic AI-systemen in organisatorische contexten.
Ontwikkeling en beheer van onderzoeksinstrumenten
De vragenlijst is ontwikkeld op basis van gevalideerde meetschalen die zijn aangepast aan de organisatorische context van Agentic AI. Tabel 1 geeft elk item, de bronschaal en beschrijvende statistieken weer weer: AP-, MTO- en PF-items zijn aangepast van recente Agentic AI-concepten 7,8; CS-items uit generatieve-AI cognitieve brononderzoek37; PS-items uit Plomp et al.38; en AHTR-items uit JD-R-gebaseerde job crafting-schalen17,39 aangepast aan taakherverdeling. Alle constructen werden gemeten op 7-punts Likert-schalen variërend van 1 ("sterk oneens") tot 7 ("sterk overeens"). De enquête was georganiseerd in blokken die de toestemmingspagina, screening, AITC-items (AP, MTO, PF), CS, PS, AHTR en demografische en controlekenmerken omvatten; het instrument bevatte ook aanvullende schalen (AI-geletterdheid en rolbreedte-zelfeffectiviteit) die buiten het kader van het huidige model vallen en hier zijn verzameld maar niet geanalyseerd, gerapporteerd voor transparantie. De enquête werd gehost op het online enquêteplatform; De terugknop was uitgeschakeld zodat respondenten eerdere antwoorden niet konden herzien, en items werden in een vaste volgorde binnen blokken gepresenteerd. De mediane voltooiingstijd was 7 minuten en 44 seconden. Twee aandachtscontrole-items met instructed-response werden ingebouwd als enquête-flow-takken die de enquête sloten bij een fout antwoord: (i) een feitelijke check, "Is AI een afkorting voor Artisjokinformatie?" (correct antwoord: Nee), en (ii) een schaalbegripscontrole die bevestigt dat antwoorden zijn geregistreerd op een 7-punts Likert-schaal variërend van "sterk oneens" tot "volledig eens". Voorafgaand aan de hoofdafloop werd een pilottest uitgevoerd met 124 respondenten om de duidelijkheid van de enquête-items, de algemene onderzoeksstroom, de invulduur en de haalbaarheid van de vragenlijst te evalueren; De invulduur werd beoordeeld om ongewoon korte antwoorden te identificeren en te bevestigen dat de lengte van de enquête passend was voor de doelgroepen. De pilottest wees niet op formuleringsproblemen die een wijziging van items vereisten, en er werden geen formuleringswijzigingen aangebracht vóór de hoofdenquête. Daarnaast werden de pilotgegevens geanalyseerd met behulp van PLS-SEM als voorlopige validatieprocedure om indicatorprestaties, constructbetrouwbaarheid, convergente validiteit, discriminante validiteit, collineariteit en de plausibiliteit van de voorgestelde structurele relaties te beoordelen; De resultaten ondersteunden de geschiktheid van het instrument voor de hoofdonderzoek.
| Constructie | Item | Vraag | Gemiddeld | STDEV | VIF | Bron | |||
| AITC | AP | AP1 | Wanneer ik een doel geef, helpt de AI een meerstappenplan te maken om het te bereiken. | 5.81 | 0.9 | 1.44 | Abou Ali, M., et al. (2025); Sapkota, R., et al. (2025) | ||
| AP2 | De AI kan haar plan aanpassen wanneer beperkingen of vereisten veranderen. | 5.75 | 0.99 | 1.37 | |||||
| AP3 | De AI verdeelt complex werk in beheersbare subtaken zonder stapsgewijze instructies nodig te hebben. | 5.33 | 1.37 | 1.33 | |||||
| MTO | MTO1 | De AI kan meerdere tools of apps (bijv. zoeken, documenten, datatools) combineren om een taak uit te voeren. | 5.69 | 1.11 | 1.5 | ||||
| MTO2 | De AI stelt de juiste tool(s) voor en gebruikt deze in de juiste volgorde om een deliverable te produceren. | 5.36 | 1.04 | 1.64 | |||||
| MTO3 | De AI helpt de output van verschillende tools te integreren tot één samenhangend resultaat. | 5.61 | 1.01 | 1.63 | |||||
| PF | PF1 | De AI wijst proactief fouten, ontbrekende informatie of risicovolle aannames in mijn werk aan. | 4.9 | 1.44 | 1.68 | ||||
| PF2 | De AI stelt verbeteringen voor voordat ik expliciet om feedback vraag. | 5.07 | 1.38 | 1.85 | |||||
| PF3 | De AI doet me denken aan checkpoints (bijvoorbeeld validatie, naleving, kwaliteit) om herwerking te voorkomen. | 5.02 | 1.4 | 1.6 | |||||
| CS | CS1 | Het gebruik van AI heeft mijn mentale energie vrijgemaakt om me te richten op complexer en betekenisvoller werk. | 5.59 | 1.28 | 2.07 | Liu, Y., Sheng, F., & Liu, R. (2025) | |||
| CS2 | Sinds ik AI gebruik, heb ik meer tijd voor strategisch denken en probleemoplossing. | 5.61 | 1.23 | 2.38 | |||||
| CS3 | De werklast van routinetaken is aanzienlijk verminderd, waardoor ik ruimte heb voor nieuwe initiatieven. | 5.42 | 1.28 | 2.23 | |||||
| CS4 | Ik voel me mentaal minder uitgeput aan het einde van de werkdag omdat AI repetitieve taken afhandelt. | 5.15 | 1.5 | 1.91 | |||||
| PS | PS1 | Op mijn werkplek is het veilig om een risico te nemen dat gerelateerd is aan het gebruik van AI op nieuwe manieren. | 4.74 | 1.37 | 1.52 | Plomp et al. (2019) | |||
| PS2 | Mijn manager moedigt experimenteren met AI aan en is tolerant tegenover fouten. | 4.52 | 1.61 | 1.68 | |||||
| PS3 | Ik voel me comfortabel om mijn stem te laten horen als ik zorgen heb over hoe AI in mijn team wordt ingezet. | 5.48 | 1.24 | 1.32 | |||||
| PS4 | Mijn collega's steunen me als ik nieuwe manieren probeer om met AI te werken. | 5.26 | 1.32 | 1.48 | |||||
| PS5 (uitgesloten) | Ik ben niet bang voor negatieve gevolgen als ik innovatieve toepassingen van AI in mijn werk voorstel. | 4.47 | 1.59 | 1.23 | |||||
| AHTR | AHTR1 | Ik draag bewust routinetaken (zoals gegevensinvoer, rapportopmaak) over naar AI zodat ik me kan richten op werk met een hogere waarde. | 5.12 | 1.35 | 1.68 | Tims, M., & Bakker, A. B. (2010); Li, W. et al. (2024) | |||
| AHTR2 | Ik zoek actief naar mogelijkheden om AI te gebruiken voor taken die ik eerder handmatig heb gedaan. | 5.58 | 1.28 | 1.84 | |||||
| AHTR3 | Sinds ik AI gebruik, heb ik nieuwe of uitgebreide verantwoordelijkheden op me genomen die strategischer of creatiever zijn. | 5.18 | 1.3 | 1.58 | |||||
| AHTR4 (uitgesloten) | Ik onderhandel met mijn manager over welke taken AI moet afhandelen en welke ik moet doen. | 4.09 | 1.65 | 1.23 | |||||
| AHTR5 | Ik heb mijn werk opnieuw ontworpen door routinewerk te herverdelen naar AI, waardoor ik mezelf vrijmaak voor betekenisvollere taken. | 4.92 | 1.35 | 1.67 | |||||
Tabel 1: Meetitems, bronnen, beschrijvende statistieken en volledige collineariteitsbeoordeling. Volledig onderzoeksinstrument. Elk item wordt vermeld met zijn construct (AITC-dimensies AP, MTO, PF; CS; PS; AHTR), itemcode, formulering, gemiddelde, standaarddeviatie (STDEV), volledige collineariteitsvariatie-inflatiefactor (VIF; waarden <3,3 duiden op het ontbreken van common method variantie-contaminatie), en de bronschaal waarvan deze is aangepast. Alle items werden gemeten op 7-punts Likert-schalen (1 = sterk oneens, 7 = sterk overeen). PS5 en AHTR4 werden verwijderd tijdens de evaluatie van het meetmodel vanwege lage buitenbelastingen. AITC = Agentische AI-technologische kenmerken; AP = autonome planning; MTO = multitool-orkestratie; PF = proactieve feedback; CS = cognitief overschot; PS = psychologische veiligheid; AHTR = AI-mens taakherverdeling. Klik hier om deze tabel te downloaden.
Datavoorbereiding en -opschoning
De ruwe antwoorden werden geëxporteerd in CSV-formaat. Gevallen die niet aan het screeningscriterium voldeden of aan een van beide aandachtscontrole-items werden uitgesloten, evenals antwoorden met substantiële ontbrekende gegevens (gedwongen responsinstellingen geminimaliseerd binnen de enquête); De resulterende uitsluitingstellingen in elke fase zijn vastgelegd in Protocolsectie 2 (537 geregistreerd → 331 behouden). De opgeslagen gegevens werden geïnspecteerd op consistentie en gescreend op onoplettende responspatronen: rechtlijnige reacties werden verwijderd via de aandachtscontroles, en reacties met ongelooflijk korte voltooiingstijden (minder dan ongeveer 180 seconden) werden uitgesloten. Variabelen werden vervolgens gecodeerd voor analyse (bijv. Rol: Leider = 1, Staf = 0; Geslacht: Man = 1, Vrouwelijk = 0) zoals gedocumenteerd in Tabel 2, werden categorische controles zoals de industrie dummy-gecodeerd met k-1 indicatoren, en werd de definitieve dataset geïmporteerd in de PLS-SEM-software. Een codeboek waarin elke variabele wordt gekoppeld aan de itemtekst, codering en constructie wordt geleverd als Supplementair Bestand 2.
Evaluatie van meetmodellen
Met behulp van de PLS-SEM-software werd elk waargenomen item toegewezen aan zijn latente constructie, en werden alle eerste-orde constructies (AP, MTO, PF, CS, PS, AHTR) gespecificeerd als reflectief. AITC werd gespecificeerd als een tweede-orde constructie bestaande uit AP, MTO en PF en werd geschat met de twee-traps benadering 40,41,42: de scores van latente variabelen werden eerst verkregen voor de eerste-orde constructies en vervolgens gebruikt (AP_LVS, MTO_LVS, PF_LVS) als formatieve indicatoren van AITC. Het PLS-algoritme werd uitgevoerd met het padwegingsschema, maximaal 3.000 iteraties en een stopcriterium van 10−7. Interne consistentiebetrouwbaarheid werd geëvalueerd aan de hand van Cronbachs drempels voor α en samengestelde betrouwbaarheid (CR) van 0,7043, waarbij α waarden van 0,5–0,6 werden als marginaal acceptabel beschouwd voor korte schalen in opkomende onderzoekscontexten43; convergente validiteit werd geëvalueerd tegen de gemiddelde variantie geëxtraheerde (AVE) drempel van 0,5044; en discriminantvaliditeit werd geëvalueerd met behulp van de heterotrait-monotraitverhouding (HTMT <0,85, conservatieve drempel)45 en het Fornell-Larcker-criterium44. Waar betrouwbaarheids- of convergente validiteitscriteria niet werden gehaald, werden externe belastingen geïnspecteerd en werden slecht presterende indicatoren verwijderd terwijl de inhoud validiteit behouden bleef, waarbij elke verwijdering en de onderbouwing ervan werden gedocumenteerd; in deze studie werden PS5 en AHTR4 verwijderd vanwege lage buitenbelastingen, wat de convergente validiteit van PS en AHTR verbeterde.
Structureel model en mediatieanalyse
De structurele paden werden gespecificeerd in overeenstemming met het onderzoeksmodel (Figuur 2), en collineariteit tussen predictorconstructies werd onderzocht met behulp van inwendige variantie-inflatiefactoren (VIF < 5.0)36 en volledige collineariteit VIF's (<3.3)46,47. De padsignificantie werd geschat door bootstrapping met 5.000 hermonsters met behulp van percentielbetrouwbaarheidsintervallen en tweezijdige testen, en gestandaardiseerde padcoëfficiënten (β), steekproefgemiddelden (M), standaarddeviaties (STDEV), t-waarden, p-waarden, 95% betrouwbaarheidsintervallen, R2 en effectgroottes (f2) werden gerapporteerd. De voorspellende kracht buiten de steekproef werd beoordeeld met PLSpredict met 10 keer en 10 herhalingen; voor elke endogene indicator werd de Q2-voorspelling(>0 geeft voorspellende relevantie aan) geïnspecteerd, en werden de PLS-SEM-voorspellingsfouten (RMSE en MAE) vergeleken met de lineair-model (LM) benchmark48. Voor de mediatie-analyse werden de indirecte effecten van AITC op AHTR via CS, via PS en via het sequentiële PS → CS-pad gespecificeerd, en elk specifiek indirect effect werd geëvalueerd met behulp van de bootstrap-verdeling (5.000 resamples), waarbij een indirect effect significant werd beoordeeld wanneer het 95% betrouwbaarheidsinterval nul uitsloot.
Multi-groep analyse
Respondenten werden ingedeeld in leider- en stafgroepen op basis van zelfgerapporteerde organisatorische rol (Rol: Leider = 1, Personeel = 0; Tabel 2); De leidersgroep bestond uit teamleiders/supervisors, managers/afdelingshoofden en leidinggevenden/senior leiderschap, en de stafgroep bestond uit medewerkers op stafniveau. Voordat padcoëfficiënten werden vergeleken, werd meetinvariantie tussen groepen vastgesteld met behulp van de metingsinvariantie van samengestelde modellen (MICOM) procedure45. Stap 1 (configuratie-invariantie) werd vervuld door identieke modelspecificatie over groepen, en stap 2 (compositionele invariantie) werd ondersteund voor alle constructen, met oorspronkelijke correlaties op of boven hun 5% kwantielen en niet-significante permutatiewaarden p-waarden (AHTR c = 0,999, p = 0,524; AITC c = 0,954, p = 0,205; CS c = 1,000, p = 0,800; PS c = 0,976, p = 0,073), waarmee partiële meetinvariantie wordt vastgesteld en de multigroepsvergelijking wordt gerechtvaardigd (volledige MICOM-resultaten in Aanvullend Bestand 3). Het model werd vervolgens afzonderlijk geschat voor elke groep, en padverschillen werden getest met bootstrap-gebaseerde PLS-MGA, waarbij eenzijdige en tweezijdige p-waarden werden gerapporteerd voor het leider-stafverschil (Δ) van elk pad; Groepsspecifieke padcoëfficiënten, T-waarden en p-waarden werden gerapporteerd voor alle directe en indirecte paden, samen met de grootte van elk verschil tussen groepen.
Rapportage, verificatie en probleemoplossing
Alle betrouwbaarheids-, validiteit-, structurele, mediatie- en MGA-uitkomsten werden gecompileerd; de resultaattabellen werden geëxporteerd; en elke gerapporteerde statistiek werd verifiërd aan de hand van de door software gegenereerde output om consistentie te waarborgen tussen tabellen, figuren en tekst. Voor probleemoplossing gelden de volgende richtlijnen: als veel antwoorden niet slagen voor screening of aandachtscontroles, verfijn dan de geschiktheidseisen en verduidelijken we de instructies van de enquête; als betrouwbaarheid (CR < 0,70) of convergente validiteit (AVE < 0,50) criteria niet worden gehaald, beoordeel dan de buitenste belastingen en verwijder zwakke indicatoren terwijl de theoretische dekking behouden blijft; als collineariteit wordt vastgesteld (VIF boven de drempels), hervalueer constructspecificaties en elimineer redundante indicatoren; Als bemiddelings- of groepseffecten niet significant zijn, herbekijk dan de toereikendheid van de steekproef en construeer operationalisering vóór interpretatie; en gebruik een voldoende aantal bootstrap-resamples (bijv. 5.000) om schattingen te stabiliseren.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Kenmerken van deelnemers
Tabel 2 toont de demografische kenmerken van de uiteindelijke steekproef (N = 331). De steekproef bestond uit 65,0% mannelijke en 35,0% vrouwelijke respondenten, met een relatief evenwichtige verdeling tussen leiders (51,7%, n = 171) en personeel (48,3%, n = 160). De grootste leeftijdsgroep was jonger dan 30 jaar (46,5%), gevolgd door 31–40 jaar (32,0%); 76,4% had een bachelor- of masterdiploma. De res...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Deze studie onderzocht hoe de technologische kenmerken van Agentic AI zich verhouden tot de psychologische middelen en het taakherverdelingsgedrag van medewerkers, en of deze relaties verschillen tussen organisatorische rollen. Met behulp van een cross-sectionele enquête onder 331 AI-ervaren medewerkers en PLS-SEM met bemiddeling en multigroepsanalyse, waren de resultaten consistent met het veronderstelde resource-gainmodel: AITC was positief geassocieerd met cognitieve overschotten, psy...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs geven geen belangenconflicten aan.
Een generatieve AI-tool (ChatGPT, OpenAI) werd gebruikt voor taalbewerking; alle inhoud werd beoordeeld en geverifieerd door de auteurs, die ook controleerden dat AI-ondersteund bewerken geen verschuivingen in terminologie of toon tussen secties introduceerde.
Dankbetuigingen
Dit werk werd ondersteund door onderzoeksfinanciering van aSSIST University.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Prolific | Prolific | https://www.prolific.com/ | Online survey panel aanbieder |
| Qualtrics | Qualtrics, LLC | https://www.qualtrics.com/ | Enquêtecodering |
| SmartPLS | SmartPLS GmbH | versie 4.0.1, https://www.smartpls.com/ | PLS-SEM analyse |
Referenties
- Chawla C, Chatterjee S, Gadadinni SS, Verma P, Banerjee S. Agentic AI: The building blocks of sophisticated AI business applications. Journal of AI, Robotics & Workplace Automation. 2024;3(3):196–210.
- Lu C, et al. The AI scientist: Towards fully automated open-ended scientific discovery. arXiv [Preprint]. 2024. arXiv:2408.06292. Available from: https://arxiv.org/abs/2408.06292.
- Xie J, Chen Z, Zhang R, Wan X, Li G. Large multimodal agents: A survey. arXiv [Preprint]. 2024. arXiv:2402.15116. Available from: https://arxiv.org/abs/2402.15116.
- Du H, Thudumu S, Vasa R, Mouzakis K. A survey on context-aware multi-agent systems: Techniques, challenges and future directions. arXiv [Preprint]. 2024. arXiv:2402.01968. Available from: https://arxiv.org/abs/2402.01968.
- Acharya DB, Kuppan K, Divya B. Agentic AI: Autonomous intelligence for complex goals - a comprehensive survey. IEEE Access. 2025;13:18912–18936.
- Calegari R, Ciatto G, Mascardi V, Omicini A. Logic-based technologies for multi-agent systems: A systematic literature review. Auton Agent Multi Agent Syst. 2021;35(1):1.
- Sapkota R, Roumeliotis KI, Karkee M. AI agents vs. Agentic AI: A conceptual taxonomy, applications and challenges. Inf Fusion. 2026;126:103599.
- Abou Ali M, Dornaika F, Charafeddine J. Agentic AI: A comprehensive survey of architectures, applications, and future directions. Artif Intell Rev. 2025;59(1):11.
- Buyya R. Agentic artificial intelligence (AI): Architectures, taxonomies, and evaluation of large language model agents. arXiv [Preprint]. 2026. arXiv:2601.12560. Available from: https://arxiv.org/abs/2601.12560.
- Nisa U, Shirazi M, Saip MA, Pozi MSM. Agentic AI: The age of reasoning - a review. J Autom Intell. 2025. doi:10.1016/j.jai.2025.08.003.
- Singh A, Ehtesham A, Kumar S, Khoei TT. Enhancing AI systems with agentic workflows patterns in large language model. In: 2024 IEEE World AI IoT Congress (AIIoT); Seattle, WA; 2024:527–532.
- Zeng A, et al. AgentTuning: Enabling generalized agent abilities for LLMs. In: Findings of the Association for Computational Linguistics: ACL 2024; Bangkok, Thailand; 2024:3053–3077.
- Liu X, Zhang L, Wei X. Generative artificial intelligence literacy: Scale development and its effect on job performance. Behav Sci (Basel). 2025;15(6):811.
- Wooldridge M, Jennings NR. Intelligent agents: Theory and practice. Knowl Eng Rev. 1995;10(2):115–152.
- Masterman T, Besen S, Sawtell M, Chao A. The landscape of emerging AI agent architectures for reasoning, planning, and tool calling: A survey. arXiv [Preprint]. 2024. arXiv:2404.11584. Available from: https://arxiv.org/abs/2404.11584.
- Sha C, Chai T. When digital-AI transformation sparks adaptation: Job crafting and AI knowledge in job insecurity contexts. Front Psychol. 2025;16:1612245.
- Tims M, Bakker AB. Job crafting: Towards a new model of individual job redesign. SA J Ind Psychol. 2010;36(2):1–9.
- Bakker AB, Hakanen JJ, Demerouti E, Xanthopoulou D. Job resources boost work engagement, particularly when job demands are high. J Educ Psychol. 2007;99(2):274–284.
- Bakker AB, Demerouti E, Sanz-Vergel A. Job demands-resources theory: Ten years later. Annu Rev Organ Psychol Organ Behav. 2023;10(1):25–53.
- Hobfoll SE, Shirom A. Conservation of resources theory: Applications to stress and management in the workplace. In: Golembiewski RT, ed. Handbook of Organizational Behavior. 2nd ed. Marcel Dekker; New York; 2000:57–80.
- Hobfoll SE. Conservation of resources: A new attempt at conceptualizing stress. Am Psychol. 1989;44(3):513–524.
- Hobfoll SE, Halbesleben J, Neveu JP, Westman M. Conservation of resources in the organizational context: The reality of resources and their consequences. Annu Rev Organ Psychol Organ Behav. 2018;5(1):103–128.
- Bakker AB, Demerouti E. Job demands-resources theory: Taking stock and looking forward. J Occup Health Psychol. 2017;22(3):273–285.
- Shirky C. Cognitive Surplus: How Technology Makes Consumers into Collaborators. Penguin Press; New York; 2010.
- Edmondson A. Psychological safety and learning behavior in work teams. Adm Sci Q. 1999;44(2):350–383.
- Zhao G, Kumar N, Wang C, Liu Z. Bridging the AI gap: How AI-oriented leadership empowers non-technical employees in AI-based innovation engagement. Leadersh Organ Dev J. 2026;47(3):498–514.
- Edmondson AC, Lei Z. Psychological safety: The history, renaissance, and future of an interpersonal construct. Annu Rev Organ Psychol Organ Behav. 2014;1(1):23–43.
- Kim BJ, Kim MJ, Lee J. The dark side of artificial intelligence adoption: Linking artificial intelligence adoption to employee depression via psychological safety and ethical leadership. Humanit Soc Sci Commun. 2025;12(1):1–14.
- Cardon PW, Ma H, Fleischmann C. Recorded business meetings and AI algorithmic tools: Negotiating privacy concerns, psychological safety, and control. Int J Bus Commun. 2023;60(4):1095–1122.
- Raisch S, Krakowski S. Artificial intelligence and management: The automation-augmentation paradox. Acad Manage Rev. 2021;46(1):192–210.
- Tims M, Bakker AB, Derks D. Development and validation of the job crafting scale. J Vocat Behav. 2012;80(1):173–186.
- Wrzesniewski A, Dutton JE. Crafting a job: Revisioning employees as active crafters of their work. Acad Manage Rev. 2001;26(2):179–201.
- Grant AM, Parker SK. Redesigning work design theories: The rise of relational and proactive perspectives. Acad Manag Ann. 2009;3(1):317–375.
- Liu Q, Tian Q, Li X, Tan H. How does organizational AI adoption affect employees’ job crafting behaviors? An approach-avoidance perspective. Front Psychol. 2025;16:1690238.
- Gibson CB, Cooper CD, Conger JA. Do you see what we see? The complex effects of perceptual distance between leaders and teams. J Appl Psychol. 2009;94(1):62–76.
- Hair JF, et al. Partial Least Squares Structural Equation Modeling (PLS-SEM) Using R: A Workbook. Springer; Cham; 2021:1–56.
- Liu Y, Sheng F, Liu R. Generative AI adoption and employee outcomes: A conservation of resources perspective on job crafting, career commitment, and the moderating role of liking of AI. Humanit Soc Sci Commun. 2025;12:1376.
- Plomp J, Tims M, Khapova SN, Jansen PG, Bakker AB. Psychological safety, job crafting, and employability: A comparison between permanent and temporary workers. Front Psychol. 2019;10:974.
- Li W, et al. Embracing artificial intelligence (AI) with job crafting: Exploring trickle-down effect and employees’ outcomes. Tour Manag. 2024;104:104935.
- Gaskin J, Godfrey S, Vance A. Successful system use: It’s not just who you are, but what you do. AIS Trans Hum Comput Interact. 2018;10(2):57–81.
- Marakas G, Johnson R, Clay PF. The evolving nature of the computer self-efficacy construct: An empirical investigation of measurement construction, validity, reliability and stability over time. J Assoc Inf Syst. 2007;8(1):2.
- Loch KD, Straub DW, Kamel S. Diffusing the Internet in the Arab world: The role of social norms and technological culturation. Global Information Systems. 2008;143–175.
- Nunnally JC. Psychometric Theory. 2nd ed. McGraw-Hill; New York; 1978.
- Fornell C, Larcker DF. Evaluating structural equation models with unobservable variables and measurement error. J Mark Res. 1981;18(1):39–50.
- Henseler J, Ringle CM, Sarstedt M. A new criterion for assessing discriminant validity in variance-based structural equation modeling. J Acad Mark Sci. 2015;43(1):115–135.
- Kock N. Common method bias in PLS-SEM: A full collinearity assessment approach. Int J e-Collab. 2015;11(4):1–10.
- Kock N, Lynn GS. Lateral collinearity and misleading results in variance-based SEM: An illustration and recommendations. J Assoc Inf Syst. 2012;13(7):2.
- Shmueli G, et al. Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict. Eur J Mark. 2019;53(11):2322–2347.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: A critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879–903.
- Podsakoff PM, MacKenzie SB, Podsakoff NP. Sources of method bias in social science research and recommendations on how to control it. Annu Rev Psychol. 2012;63(1):539–569.
- Harman HH. Modern Factor Analysis. 3rd ed. University of Chicago Press; Chicago; 1976.
- Podsakoff PM, Organ DW. Self-reports in organizational research: Problems and prospects. J Manage. 1986;12(4):531–544.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.