Dit protocol presenteert een reproduceerbare deep learning-workflow die gebruikmaakt van multichannel cyclusinggegevens en engineered features om de gezondheidstoestand, de resterende levensduur en de energieopslagprestaties van lithium-ionbatterijen te voorspellen.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Methodenartikel
Een reproduceerbare deep learning-workflow voor het voorspellen van de prestaties van lithium-ionbatterijen met behulp van multichannel cycling-data
In dit artikel
Samenvatting
Samenvatting
Dit protocol presenteert een reproduceerbare deep-learning workflow voor het voorspellen van de prestaties van lithium-ionbatterijen met behulp van multichannel cyclusergegevens. Om beperkingen in bestaande datagestuurde modellen met betrekking tot de integratie van informatie uit meerdere bronnen en kenmerkrepresentatie aan te pakken, maakt de methode gebruik van vijf openbaar beschikbare batterijdatasets. De inputs omvatten ruwe operationele signalen, waaronder spanning, stroom, capaciteit, temperatuur, interne weerstand en coulombische en energetische efficiëntie, samen met berekende kenmerken zoals incrementele capaciteit, differentiaalspanning en energiedoorvoer. Het protocol beschrijft gestandaardiseerde voorbewerkingsprocedures voor het construeren van temporele tensoren op batterijniveau over meerdere observatievensters. Om de reproduceerbaarheid te verbeteren, evalueert de workflow kandidaat-neurale netwerkarchitecturen, waaronder deep neural networks, convolutional neural networks (CNN's), long short-term memory (LSTM) netwerken, CNN–LSTM en transformer-gebaseerde modellen, met behulp van vaste random seeds, herhaalde evaluatieruns en omgevingsregistratie. Representatieve resultaten toonden aan dat de CNN–LSTM-architectuur met geïntegreerde multichannel gegevens en berekende kenmerken een gunstige voorspellende prestatie behaalde onder de geëvalueerde modellen. De geselecteerde configuratie behaalde een gemiddelde absolute fout van 0,024 en een R2-waarde van 0,955 voor de schatting van de gezondheidstoestand (state-of-health), terwijl een hoge voorspellende prestatie behouden bleef voor de schatting van de resterende levensduur en de ontlaadbare energie. Ablatie- en robuustheidsanalyses toonden verder de bijdrage van multichannel kenmerkintegratie en de stabiliteit van de op reproduceerbaarheid gerichte workflow over herhaalde evaluaties aan. Deze gestandaardiseerde methodologie biedt een reproduceerbaar kader voor batterijlevenscyclusbeheer en voorspellende modellering onder diverse bedrijfsomstandigheden.
Inleiding
Lithium-ionbatterijen zijn cruciaal voor de wereldwijde transitie naar hernieuwbare energie vanwege hun hoge energiedichtheid, verlengde cyclusduur en lage zelfontladingspercentages bij toepassingen variërend van draagbare elektronica tot energieopslagsystemen op netwerkschaal. Langdurige werking leidt echter onvermijdelijk tot geleidelijke capaciteitsdegradatie en een toename van de interne weerstand1. Deze prestatieafname vermindert niet alleen de economische levensvatbaarheid, maar introduceert ook ernstige veiligheidsrisico's, waaronder thermische runaway. Naarmate de implementatie van grootschalige energieopslagsystemen versnelt, is het beheer van de batterijlevenscyclus steeds complexer geworden2. Traditionele monitoring op basis van drempelwaarden en handmatige inspectieprotocollen zijn onvoldoende voor dynamische bedrijfsomgevingen3. Bovendien is de afhankelijkheid van één enkele parameter ontoereikend om de gezondheidstoestand (SOH) of de resterende bruikbare levensduur (RUL) van de batterij nauwkeurig te voorspellen onder fluctuerende laad- en ontlaadsnelheden, omgevingstemperaturen en variaties in de ontladingsspanning4. Hoewel de huidige workflow primair is gevalideerd met behulp van in het laboratorium gecontroleerde cyclusdatasets, kunnen de multichannel-architectuur en het temporele modelleringskader toekomstige aanpassingen ondersteunen voor de dynamische bedrijfsomstandigheden die worden aangetroffen in elektrische voertuigtoepassingen en variabele milieuomgevingen.
Batterijdegradatie is een zeer complex, niet-lineair elektrochemisch proces dat wordt aangedreven door de groei van de solid electrolyte interphase, verlies van actief lithium en structurele verslechtering van elektrodematerialen. Historisch gezien is toestandschatting vertrouwd op equivalentencircuitmodellen of elektrochemische-fysische partiële differentiaalvergelijkingen (PDE's)5. Hoewel deze fysische modellen waardevolle mechanistische inzichten bieden, kampen ze met aanzienlijke computationele overhead en uitdagingen bij parameteridentificatie bij het verwerken van gekoppelde multikanaalsignalen. Bijgevolg is hun real-time implementatie in ingebedde batterijbeheersystemen (BMS'en) ernstig beperkt door complexe diffusiekinetiek en omgevingsvariabiliteit onder condities van hoge ontlaadsnelheden6. In tegenstelling hiertoe concentreert de voorgestelde deep-learning (DL) workflow het grootste deel van de computationele vraag in de offline trainingsfase, terwijl het getrainde model tijdens de implementatie relatief snelle inferentie uitvoert. Dit raamwerk kan daarom toekomstige implementatie in resource-beperkte BMS'en en edge-computingomgevingen ondersteunen.
Onlangs zijn datagedreven DL-benaderingen naar voren gekomen als krachtige instrumenten vanwege hun uitzonderlijke mogelijkheden voor niet-lineaire fitting. Desondanks vertonen bestaande DL-methodologieën twee belangrijke beperkingen. Ten eerste vertrouwen veel benaderingen primair op degradatiecurven van de capaciteit op een enkel tijdstip of specifieke ontladingsspanningsdrempels, terwijl de inherente ruimtelijk-temporele correlaties tussen multichannel-cyclingsresponsen, zoals spanning, stroom en temperatuur, worden genegeerd. Deze beperking vermindert de robuustheid van het model onder bedrijfsscenario's met meerdere condities7. Eerdere studies hebben aangetoond dat het negeren van thermische toestanden tijdens complexe bewerkingen de accumulatie van voorspellingsfouten kan versnellen8,9. Ten tweede bestaat er in toegepaste machine learning (ML) een aanhoudende uitdaging wat betreft de reproduceerbaarheid. Variaties in experimentele condities, onvoldoende beschreven preprocessing-pipelines en arbitrair gekozen hyperparameters van neurale netwerken zorgen er vaak voor dat anders robuuste modellen falen tijdens cross-dataset validatie10. Om het risico op informatielekkage tijdens de preprocessing en voorspellingen van vroege cycli te verminderen, leidt de voorgestelde workflow normalisatieschaalfactoren en baselines van engineered-features uitsluitend af uit de trainingsdatasets voorafgaand aan externe validatie en cross-dataset evaluatie.
Om deze kritieke hiaten op te vullen, is het algemene doel van dit protocol het presenteren van een geautomatiseerde, zeer reproduceerbare DL-workflow voor het voorspellen van de energieopslagprestaties van lithium-ionbatterijen met behulp van multichannel-cyclisgegevens. De rationale achter deze methode is om de complexe langetermijnafhankelijkheden die geassocieerd worden met batterijdegradatie expliciet vast te leggen door cross-modale tijdreeksgegevens te integreren binnen een hoogdimensionale neurale netwerkarchitectuur. Een belangrijk voordeel van dit protocol ten opzichte van bestaande natuurkundige en DL-benaderingen is de holistische standaardisatie, die een complete pijplijn vaststelt die loopt van preprocessen van ruwe signalen en feature engineering tot modeltraining en onzekerheidsevaluatie. Hoewel hybride neurale netwerkarchitecturen eerder zijn onderzocht, legt de huidige workflow de nadruk op gestandaardiseerde multichannel-integratie door elektrochemische cyclisvariabelen af te stemmen op engineered degradatiekenmerken binnen een op reproduceerbaarheid gericht trainingskader. In tegenstelling tot veel eerder gerapporteerde workflows bevat dit protocol gestandaardiseerde parameterconfiguraties, vaste random seeds, herhaalde evaluatieruns en uitgebreide monitoring van de omgeving om de reproduceerbaarheid over heterogene batterijdatasets en laboratoriuminstellingen te verbeteren. Daarnaast vergelijkt de workflow systematisch meerdere neurale netwerkarchitecturen om de voorspellende stabiliteit en prestaties over verschillende inputconfiguraties te evalueren. Binnen de geëvalueerde datasets en experimentele instellingen vertoonde de convolutional neural network–long short-term memory (CNN–LSTM) architectuur gunstige voorspellende prestaties ten opzichte van de geëvalueerde standalone CNN- en transformer-gebaseerde modellen door lokale feature-extractie te combineren met temporele sequentiemodellering over lange afstand, terwijl een gematigde computationele complexiteit behouden bleef. Dit protocol is zeer geschikt voor onderzoekers en ingenieurs die reproduceerbare en omgevingsadaptieve voorspellende modellen willen ontwikkelen voor batterijlevenscyclusbeheer.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Institutionele ethische goedkeuring was niet vereist voor deze studie omdat het onderzoek uitsluitend gebruikmaakte van publiekelijk beschikbare datasets van lithium-ion batterijcycli en geen menselijke deelnemers, proefdieren of biologische monsters omvatte.
1. Data-acquisitie en organisatie
- Verkrijg multichannel cycling-datasets
- Download lithium-ion batterij cycling-datasets uit publiek toegankelijke batterij-repositories die laad-ontlaad cycling-gegevens bevatten. Verkrijg de CALCE-, SANYO-, PANASONIC-, KOKAM- en GOTION-datasets rechtstreeks vanuit hun respectievelijke institutionele open-access repositories of digitale object-identifier links om de consistentie van de datasetversies te waarborgen.
- Selecteer batterijmonsters die volledige cyclusnummers, capaciteitsmetingen en ten minste één continue laad-ontlaadcurve bevatten. Verifieer de continuïteit door te bevestigen dat er geen onderbreking van meer dan twee uur optreedt binnen een enkele cyclus en dat zowel de constant-stroom- als de constant-spanningsfasen volledig zijn geregistreerd.
- Filter ruwe cycling-gegevens
- Filter de ruwe cycling-gegevens om monsters te behouden die metingen bevatten van temperatuur, interne weerstand, coulombische efficiëntie en energie-efficiëntie. Sluit batterijcellen die deze verplichte statuskanalen missen uit de analyseworkflow, omdat de daaropvolgende multichannel feature-fusie een volledige set van fysische invoervariabelen vereist.
- Verwijder cycli die onvolledige gegevens, inconsistente tijdstempels, ongedefinieerde testprocedures of onduidelijke beëindigingsvoorwaarden voor het laden en ontladen bevatten. Definieer anomale cycli als cycli die plotselinge capaciteitsdalingen vertonen van meer dan 5% tussen opeenvolgende cycli, spanningsmetingen buiten het chemiespecifieke werkingsbereik, of niet-monotone tijdstempelintervallen.
- Construeer een temporele batterijdatabase
- Organiseer de behouden cycling-gegevens chronologisch om een tijdreeksdatabase op batterijniveau te construeren.
- Sla de verwerkte datasets op met Hierarchical Data Format versie 5 (HDF5). Handhaaf een gestandaardiseerde mappenstructuur georganiseerd op datasetbron, chemisch systeem en individuele batterijcel-identifier.
- Wijs unieke identifiers toe aan individuele batterijcellen vóór de dataset-partitionering. Implementeer groepering op basis van de batterijcel-identifier tijdens de train-test splitting om ervoor te zorgen dat alle opeenvolgende cycli van één enkele fysieke batterij uitsluitend binnen één dataset-subset blijven.
OPMERKING: Bewaar de oorspronkelijke ruwe datasets afzonderlijk vóór preprocessing, normalisatie, resampling of feature engineering.
- Definieer observatievensters
- Construeer multichannel observatievensters met behulp van de eerste 50 cycli, de eerste 100 cycli en de eerste 20% van de totale levenscyclus van de batterij. Bereken de 20% levenscyclusdrempel door de totale cyclusduur vóór de capaciteitsdegradatie aan het einde van de levensduur te vermenigvuldigen met 0,2.
- Lijm spannings-, stroom-, capaciteits-, temperatuur-, interne weerstands- en efficiëntiemetingen binnen elk observatievenster uit voordat de tensorconstructie plaatsvindt.
- Formatteer de uiteindelijke inputstructuur als een driedimensionale tensor bestaande uit de lengte van het observatievenster, 128 gestandaardiseerde intra-cyclus bemonsteringspunten en de geordende multichannel feature-set.
2. Gegevensvoorbehandeling en feature engineering
- Voorbewerking van ruwe cycleringsgegevens
- Voer een uniforme voorbewerking uit op de ruwe cycleringsdatasets om de datakwaliteit over alle batterijbronnen te standaardiseren. Voer alle procedures voor voorbewerking, synchronisatie en standaardisatie uit met Python 3.10, waarbij de Pandas-bibliotheek wordt gebruikt voor tijdreeksmanipulatie en SciPy voor numerieke interpolatie.
- Verwijder uitschieters, detecteer ontbrekende waarden, kalibreer tijdstempels, identificeer laad-ontlaadfases en normaliseer bemonsteringsfrequenties vóór de verdere analyse. Pas een aangepaste Z-score drempelmethode toe met een afwijzingscriterium van meer dan 3.0 voor anomaliedetectie.
- Detecteer ontbrekende waarden automatisch door NaN-vlagidentificatie in alle numerieke arrays. Maak onderscheid tussen laad- en ontlaadfases op basis van de stroompolariteit door positieve stroomwaarden toe te wijzen aan laadcycli en negatieve stroomwaarden aan ontlaadcycli.
- Reconstrueer ontbrekende signalsegmenten met behulp van stuksgewijze kubische Hermite-interpolatiepolynomen om de elektrochemische temporele dynamiek tijdens de uitlijning van faseovergangen te behouden.
- Resampling van cycleringscurves
- Voer resampling van cycleringscurves uit wanneer variaties in bemonsteringsdichtheid of signaaldrift in de datasets worden gedetecteerd. Activeer automatische resampling telkens wanneer het interval tussen opeenvolgende metingen met meer dan 10% afwijkt ten opzichte van de mediane bemonsteringsfrequentie van de overeenkomstige cycleringsfase.
- Standaardiseer het aantal bemonsteringspunten binnen elke cyclus om platformspecifieke variaties in de registratie te verminderen. Projecteer alle temporele sequenties op een vast ruimtelijk raster met behulp van eendimensionale lineaire interpolatie.
- Comprimeer of breid elk laad-ontlaadprofiel uit tot exact 128 equidistant bemonsteringspunten vóór de tensorconstructie.
- Normalisatie van continue variabelen
- Normaliseer alle continue variabelen vóór de modeltraining om de convergentie van het netwerk te stabiliseren en schaalgerelateerde bias te verminderen. Pas Min-Max schaling toe om alle continue variabelen om te zetten naar een numeriek bereik tussen 0 en 1.
- Bereken alle normalisatieparameters uitsluitend op basis van de trainingsdataset. Pas de bevroren schalingsparameters toe op de validatie- en testdatasets om het risico op temporele datalekken (forward temporal data leakage) tijdens voorspellingen van vroege cycli te verminderen.
- Constructie van multichannel-inputtensoren
- Verdeel de continue cycleringsgegevens voor elke batterij in temporele segmenten met een vaste lengte. Structureer de temporele segmenten volgens de vooraf gedefinieerde observatievensters die overeenkomen met de eerste 50 cycli, de eerste 100 cycli of de eerste 20% van de levenscyclus van de batterij.
- Lijn metingen van spanning, stroom, capaciteit, temperatuur, interne weerstand en efficiëntie binnen elk temporeel segment uit vóór de tensorconstructie.
- Concateneer de uitgelijnde kenmerkmatrices tot een driedimensionale tensor met het formaat (N × 128 × C), waarbij N de lengte van het observatievenster vertegenwoordigt, 128 de gestandaardiseerde intra-cyclus bemonsteringspunten aanduidt en C het totale aantal fysieke en berekende kenmerkkanalen vertegenwoordigt.
- Extractie van berekende kenmerken
- Extraheer berekende elektrochemische kenmerken uit de ruwe cycleringssignalen om de identificatie van degradatiepatronen te verbeteren. Bereken kenmerken van incrementele capaciteit en differentiële spanning door dQ/dV en dV/dQ te berekenen over het gestandaardiseerde bemonsteringsraster.
- Pas Savitzky–Golay-filtering toe om vloeiende curves van de incrementele capaciteit en differentiële spanning te genereren.
- Extraheer degradatie-indicatoren, waaronder verschuivingen in piekspanning, spanningsverschillen bij faseovergangen en variaties in energie-throughput per cyclus, uit de gefilterde elektrochemische kenmerken.
3. Constructie en training van het DL-model
- Kandidaat-voorspellingsmodellen construeren
- Construeer een gestandaardiseerd trainings- en evaluatiekader voor alle voorspellingsmodellen getoond in Figuur 1A. Implementeer de DL-workflow met PyTorch versie 2.0 of hoger.
- Voer de trainingsworkflow uit met modulaire Python-scripts voor gegevensladen, modelinitialisatie, optimalisatie en evaluatie.
- Bereid traditionele ML-baselinemodellen voor, waaronder lineaire regressie, random forest en gradient-boosted decision-tree modellen. Configureer het random-forest-model met 100 bomen en een maximale diepte van 10.
- Configureer het gradient-boosted decision-tree-framework met een leercurve van 0,1 en een maximale boomdiepte van 5 via de Scikit-learn bibliotheek.
- Bereid DL-kandidaatarchitecturen voor, waaronder multilayer perceptron, eendimensionale CNN, LSTM-netwerk, CNN–LSTM en transformer-gebaseerde modellen.
- Standaardiseer de kernhyperparameters voor alle DL-architecturen door de AdamW-optimizer, Gaussian error linear unit-activeringsfuncties, een verborgen dimensie van 128 en een dropout-rate van 0,2 toe te passen.
- De CNN–LSTM-architectuur configureren
- Configureer de CNN–LSTM-architectuur om multichannel-cyclingsinformatie uit de input-tensoren te fuseren (Figuur 1B). Construeer de hybride architectuur door de convolutionele feature-extractor te koppelen aan twee gestapelde recurrente lagen met elk 128 verborgen eenheden.
- Beëindig de architectuur met drie parallelle volledig verbonden regressiekoppen voor de gelijktijdige voorspelling van SOH, RUL en ontlaadbare energie.
- Verwerk de multichannel-input-tensoren via drie opeenvolgende eendimensionale convolutionele lagen met kernelgroottes van 3, 5 en 7 om multiscale gelokaliseerde features te extraheren.
- Pas batchnormalisatie toe na elke convolutionele laag om de gradiëntstabiliteit tijdens de optimalisatie te verbeteren.
- Vorm de convolutionele feature-maps om tot continue temporele sequenties vóór de sequentiemodellering.
- Voed de gecodeerde temporele sequenties in gestapelde recurrente lagen om lange-termijn degradatieafhankelijkheden over de vooraf gedefinieerde observatievensters vast te leggen.
- Datasets partitioneren voor modeltraining
- Partitioneer de verwerkte batterijcel-datasets in trainings-, validatie- en testsubsets met een verhouding van 70:15:15. Voer de dataset-split uit met een vaste random seed-waarde van 42.
- Pas gestratificeerde steekproefname toe op basis van batterijchemie om gebalanceerde degradatiedistributies over alle dataset-subsets te behouden.
- Voer de datasetpartitionering strikt uit op batterijcelniveau in plaats van individuele cycli te randomiseren, om sequentiële degradatietrajecten te behouden.
- Behandel elke batterijcel als een ondeelbare eenheid tijdens het partitioneren om informatielekkage tussen datasets te voorkomen.
- Verifieer de isolatie van de datasets programmatisch door de intersectie van batterijcel-identificatoren over de trainings-, validatie- en testsubsets te berekenen en te bevestigen dat er geen overlap bestaat.
- Stel een externe testdataset samen met de volledige GOTION lithium-ijzerfosfaat (LFP) dataset voor out-of-distribution evaluatie en cross-dataset generalisatiebeoordeling.
- Maak de broncode, omgevingsconfiguratiebestanden en verwerkte datasetpartities publiekelijk beschikbaar via een toegewezen GitHub-repository om methodologische transparantie en reproduceerbaarheid te ondersteunen.
- Modeltraining initialiseren
- Stel de regressieverliesfunctie in op de gemiddelde kwadratische fout vóór de training. Bereken het globale trainingsdoel door de verlieswaarden van elk voorspellingsdoel met gelijke weging te aggregeren.
- Stel de initiële leercurve in op 1 × 10⁻³ en selecteer een batchgrootte van 32 of 64, afhankelijk van de datasetgrootte.
- Gebruik een batchgrootte van 64 voor datasets met meer dan 5.000 cycli om de hardwarebenutting te verbeteren. Gebruik een batchgrootte van 32 voor kleinere datasets om de optimalisatiestabiliteit te verbeteren.
OPMERKING: Selecteer deze hyperparameters via een preliminaire grid-search-evaluatie om de convergentiesnelheid en gradiëntstabiliteit over verschillende observatievensters in balans te brengen.
- Trainingscontroles toepassen
- Pas een dynamische leercurve-scheduler toe op basis van veranderingen in het validatieverlies. Verlaag de leercurve met een factor 0,5 als het validatieverlies gedurende 5 opeenvolgende epochs niet verbetert.
- Houd tijdens de optimalisatie een minimale drempelwaarde voor de leercurve aan van 1 × 10⁻⁵.
- Stop de modeltraining na maximaal 100 epochs om overfitting te verminderen.
- Pas early stopping toe als het validatieverlies gedurende 15 opeenvolgende epochs niet afneemt. Herstel de modelgewichten die overeenkomen met de best presterende validatie-iteratie.
- Reproduceerbaarheidsgegevens bijhouden
- Stel een vaste random seed-waarde van 42 in vóór de modelinitialisatie en training.
- Pas de vaste random seed consistent toe over de Python random-module, NumPy en de PyTorch-backend, terwijl nondeterministische CUDA-operaties worden uitgeschakeld.
- Registreer de softwareomgeving, versies van afhankelijkheden, parameterinstellingen, datapartities en trainingsoutputs voor elke experimentele run.
- Voer alle DL-workflows uit met Ubuntu 22.04 met CUDA 11.8-acceleratie op een workstation uitgerust met een NVIDIA RTX 3090 graphics processing unit of equivalent hardware.
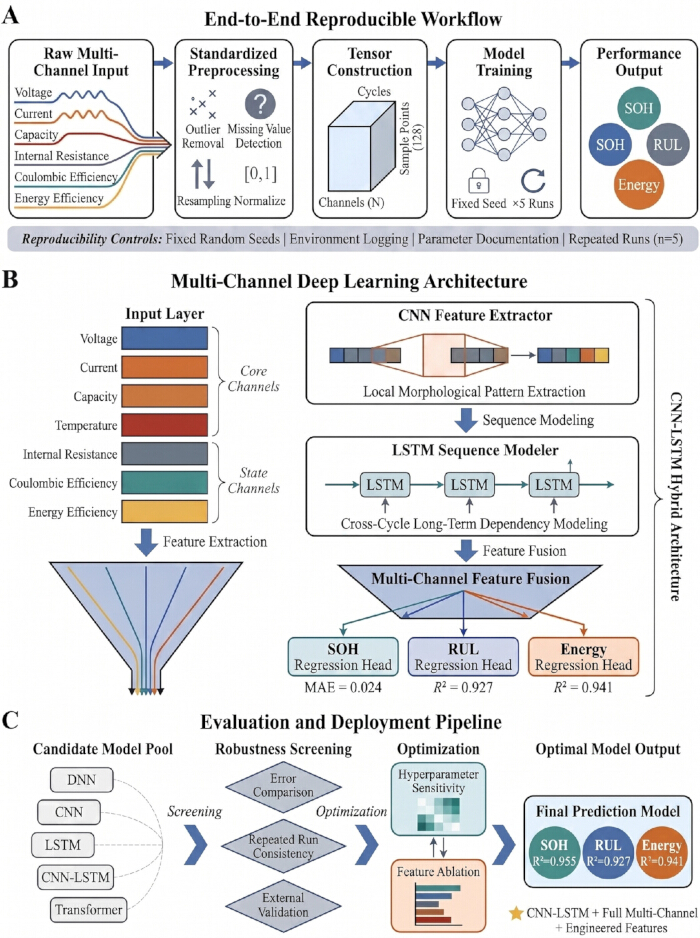
Figuur 1. Reproduceerbare deep-learning (DL) workflow voor de voorspelling van de prestaties van multi-channel lithium-ionbatterijen. (A) End-to-end reproduceerbare workflow die multi-channel data-acquisitie, gestandaardiseerde preprocessing, tensorconstructie, modeltraining en de voorspelling van batterijprestatie-indicatoren illustreert. Reproduceerbaarheidscontroles omvatten vaste random seeds, herhaalde trainingsruns, parameter-tracking en omgevingslogging. (B) Hybride CNN–LSTM-architectuur gebruikt voor multi-channel feature-extractie, temporele sequentiemodellering, feature-fusie en voorspelling van de state of health (SOH), resterende levensduur (RUL) en ontlaadbare energie. (C) Evaluatie- en implementatiepijplijn die screening van kandidaatmodellen, robuustheidsevaluatie, hyperparameter-optimalisatie en de definitieve modelselectie laat zien. Klik hier om een grotere versie van deze figuur te bekijken.
4. Modelbeoordeling en doelwitvoorspelling
- Modelvoorspellingen genereren
- Verwerk de doelsets van de testbatterij via elk getraind model. Laad de gepreprocessede testdatasets als geserialiseerde PyTorch-tensoren vóór de inferentie.
- Voer de forward inference pass uit met een contextmanager die gradiënten uitschakelt om onbedoelde parameter-updates tijdens de evaluatie te voorkomen.
- Genereer gelijktijdige voorspellingen voor elke prestatie-indicator met behulp van de getrainde regressiekoppen.
- Extraheer simultane outputs van de drie parallelle regressiekoppen die zijn geconfigureerd voor SOH-, RUL- en ontlaadbare-energievoorspellingen.
- Voorspellingsdoelen berekenen
- Bereken de SOH door de huidige beschikbare capaciteit te vergelijken met de initiële batterijcapaciteit.
- Definieer de initiële batterijcapaciteit als de maximale ontlaadcapaciteit die is geregistreerd tijdens de eerste drie stabilisatiecycli.
- Bereken de SOH als de verhouding tussen de capaciteit van de huidige cyclus en de vastgestelde baseline van de initiële capaciteit.
- Schat de RUL door de operationele drempel te identificeren waarbij de stabiele batterijcapaciteit stopt.
- Definieer de einde-levensduur als het cyclusnummer waarop de batterijcapaciteit onomkeerbaar daalt tot onder 80% van de nominale nominale capaciteit.
- Bereken de RUL als het resterende aantal cycli vanaf het huidige observatiepunt tot de gedefinieerde drempel voor de einde-levensduur.
- Voorspel de ontlaadbare energie op basis van de geregistreerde ontlaadcondities.
- Bereken de ground-truth ontlaadbare energie door het product van de ontlaadspanning en de ontlaadstroom over het ontlaadinterval numeriek te integreren met de trapeziemethode.
- Voorspellende prestaties evalueren
- Bereken de mean absolute error (MAE), root mean square error (RMSE), mean absolute percentage error (MAPE) en de determinatiecoëfficiënt (R2) voor elk voorspellingsdoel.
- Bereken alle evaluatiemetrieken met de metrics-module van Scikit-learn met gestandaardiseerde statistische formuleringen.
- Pas identieke metriekberekeningen toe over alle modellen, datasets en inputconfiguraties om de consistentie van de evaluatie te behouden.
- Aggregeer alle prestatiemetrieken over de gepoolde batterijmonsters binnen de onafhankelijke testdataset om de algemene generalisatie van het model te evalueren.
- Gestratifiseerde prestaties rapporteren
- Bereken het gemiddelde en de standaarddeviatie voor elke evaluatiemetriek over herhaalde experimentele runs.
- Leid de gerapporteerde statistische maten af uit vijf onafhankelijke modelinitialisaties.
- Rapporteer 95% betrouwbaarheidsintervallen samen met de gemiddelde prestatiemetrieken om de voorspellende onzekerheid te kwantificeren.
- Vergelijk de modelprestaties over verschillende lengtes van het observatievenster en inputkanaalconfiguraties.
- Stratificeer de vergelijkende analyse met observatievensters die overeenkomen met 50 cycli, 100 cycli en 200 cycli.
- Evalueer de voorspellende prestaties over meerdere inputconfiguraties, variërend van inputs met alleen capaciteit tot volledige multichannel tensorintegratie. Raadpleeg Figuur 1C voor de workflow van evaluatie, robuustheidsscreening en implementatieselectie.
5. Analyse van reproduceerbaarheid, robuustheid en gevoeligheid
- Verifieer reproduceerbaarheid en robuustheid
- Hanteer identieke datapartities, preprocessing-workflows en experimentele procedures voor alle reproduceerbaarheidsevaluaties die worden weergegeven in Figuur 2A.
- Bereken de variatiecoëfficiënt voor de primaire evaluatiemetrieken over herhaalde proeven om de consistentie van de reproduceerbaarheid te beoordelen.
- Herhaal alle evaluatieprocedures met behulp van dezelfde gestandaardiseerde trainings- en testworkflow.
- Initialiseer elke herhaalde evaluatie met gerandomiseerde netwerkgewichten, terwijl dezelfde deterministische procedures voor het laden en shuffelen van data behouden blijven.
- Voer herhaalde trainingsexperimenten uit
- Train de predictiemodellen herhaaldelijk onder identieke experimentele omstandigheden met behulp van vooraf gedefinieerde vaste random-seed-waarden om een reproduceerbare gewichtsinitialisatie te garanderen.
- Voer vijf onafhankelijke trainingsruns uit met identieke datasetpartities om datagestuurde variabiliteit te verminderen.
- Bereken de uiteindelijke prestatiemetrieken door de evaluatiemetrieken die zijn verkregen uit de vijf herhaalde trainingsruns te middelen.
- Aggregeer de uiteindelijke robuustheidsmetrieken met behulp van de gemiddelde evaluatiescores in plaats van het combineren van ruwe predictietensors.
- Evalueer de gevoeligheid voor hyperparameters
- Pas de leerfactor, batchgrootte, dimensie van de verborgen laag en dropout-ratio afzonderlijk aan tijdens de gevoeligheidsanalyse.
- Evalueer leerfactoren variërend van 1 × 10⁻⁴ tot 1 × 10⁻², batchgroottes variërend van 32 tot 128, verborgen dimensies variërend van 32 tot 256 en dropout-ratio's variërend van 0,1 tot 0,5.
- Registreer de overeenkomstige veranderingen in de predictieve nauwkeurigheid na elke aanpassing van de hyperparameters.
- Kwantificeer de variatie in predictieve prestaties met behulp van RMSE en R2.
- Voer feature-ablatieanalyse uit
- Verwijder geselecteerde inputkanalen, waaronder temperatuur, interne weerstand en engineered-feature-vectoren, uit de multichannel-inputstream.
- Voer feature-ablatie uit met behulp van een leave-one-out-strategie door telkens één featuregroep te verwijderen, terwijl de resterende multichannel-inputstructuur behouden blijft.
- Vergelijk de resulterende predictieve prestaties na elk experiment met feature-verwijdering om de bijdrage van individuele featuregroepen aan de modelstabiliteit en nauwkeurigheid te evalueren.
- Kwantificeer de relatieve bijdrage van elke featuregroep door de procentuele toename in de gemiddelde absolute fout te berekenen ten opzichte van het volledig geïntegreerde multichannel-baselinemodel. Raadpleeg Figuur 2B voor de workflow van de robuustheidsevaluatie en gevoeligheidsanalyse
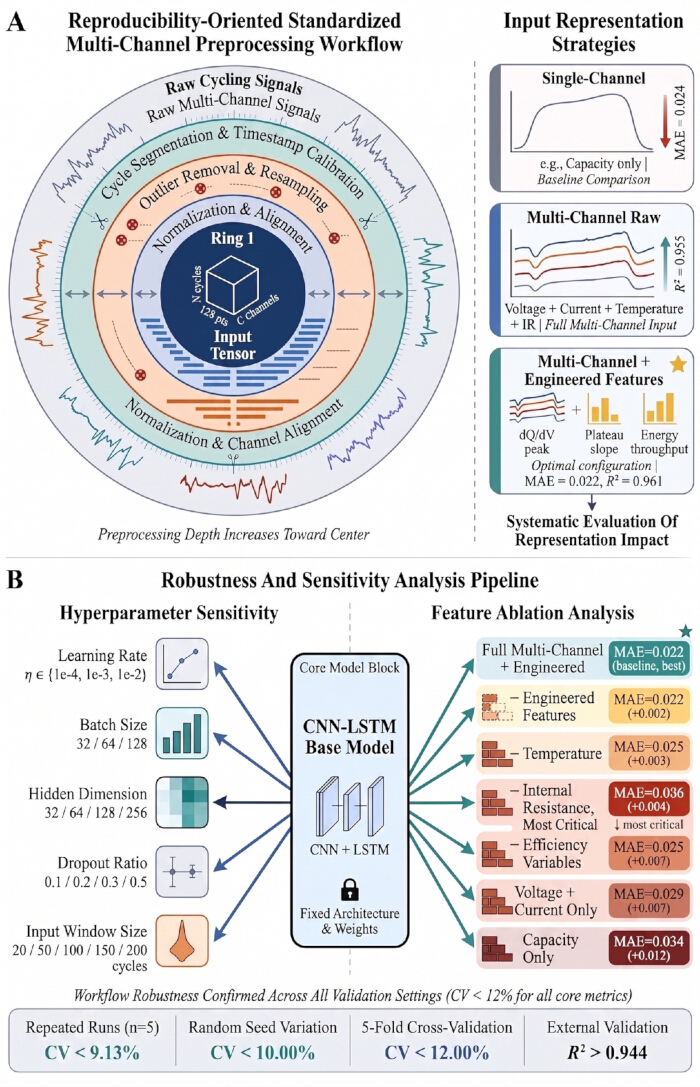
Figuur 2. Gestandaardiseerde workflow voor preprocessing, robuustheidsevaluatie en sensitiviteitsanalyse. (A) Gestandaardiseerde multichannel preprocessing-workflow die de verwerking van ruwe cyclussignalen, tijdstempelkalibratie, verwijdering van uitschieters, resampling, normalisatie, kanaaluslijning en tensorconstructie illustreert. Strategieën voor inputrepresentatie vergelijken single-channel inputs, multichannel ruwe inputs en multichannel inputs gecombineerd met engineered features. (B>) Pipeline voor robuustheids- en sensitiviteitsanalyse die systematische hyperparameterperturbatie, evaluatie van herhaalde runs, feature-ablatieanalyse, kruisvalidering en externe validatie van de CNN–LSTM-workflow laat zien. Klik hier om een grotere versie van deze figuur te bekijken.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Meerkanaals cyclussignalen en datadistributie
Representatieve multichannel cycling-signalen en prestatieverdelingen werden geanalyseerd om het gedrag van de cycling-respons van lithium-ionbatterijen te karakteriseren. De studie maakte gebruik van vijf lithium-ionbatterij-datasets die meerdere chemische systemen vertegenwoordigen, waaronder lithiumcobaltoxide (LCO), nikkelcobaltaluminiumoxide (NCA), nikkelmangaancobaltoxide (NMC) en LFP (Tabel 1). Kernvariabele...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
De reproduceerbare DL-workflow die in dit protocol wordt beschreven, demonstreerde een nauwkeurige voorspelling van de prestaties van lithium-ionbatterijen met behulp van multichannel cyclisgegevens. De workflow behaalde een test-MAE van 0,024 en een R2-waarde van 0,955 voor de SOH-schatting onder de geëvalueerde experimentele omstandigheden, wat het potentiële nut voor batterijlevenscyclusbeheer en toepassingen voor het monitoren van energieopslag ondersteunt11,
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs verklaren geen concurrerende financiële belangen of belangenverstrengelingen te hebben.
Dankbetuigingen
De auteurs erkennen de institutionele ondersteuning vanuit het Department of Physics aan de Southern University of Science and Technology en Homerton College, University of Cambridge, die de academische omgeving en computationele middelen boden die noodzakelijk waren voor dit onderzoek. De auteurs danken tevens de onderzoeksinstellingen en bijdragers die de open-access datasets voor lithium-ionbatterijen, waaronder CALCE, SANYO, PANASONIC, KOKAM en GOTION, publiekelijk beschikbaar hebben gesteld, waardoor deze uitgebreide multikanalige analyse mogelijk is gemaakt.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| CALCE batterijdataset | Center for Advanced Life Cycle Engineering (CALCE), University of Maryland | https://calce.umd.edu/battery-data | Bron van multichannel lithium-ion batterijcycleringsgegevens voor modeltraining en -validatie |
| CUDA Toolkit | NVIDIA | Versie 11.8 | GPU-acceleratie voor DL-modeltraining |
| GOTION IFP20100140A dataset | Mendeley Data | https://doi.org/10.17632/vpw4t7ytbx.2 | Externe validatie en multichannel batterijdegradatieanalyse |
| KOKAM SLPB533459H4 dataset | Mendeley Data | https://doi.org/10.17632/7w4y4fzzbb.1 | Multichannel batterijdegradatiemodellering en -validatie |
| Matplotlib | Matplotlib Development Team | Versie 3.7.1 | Visualisatie van modelprestaties, sensitiviteitsanalyse en reproduceerbaarheidsresultaten |
| NumPy | NumPy Developers | Versie 1.24.3 | Numerieke berekeningen en tensorconstructie |
| PANASONIC NCR18650BD dataset | Mendeley Data | https://doi.org/10.17632/wykht8y7tg.1 | Bron van multichannel cycleringsgegevens en extractie van engineered-features |
| Pandas | Pandas Developers | Versie 2.0.3 | Dataorganisatie, preprocessing en beheer van tabelgegevens |
| PyTorch | PyTorch Foundation | Versie 2.0.1 | Constructie en training van deep-learning-architecturen, inclusief het CNN–LSTM-model |
| Python | Python Software Foundation | Versie 3.10.12 | Preprocessing van gegevens, feature engineering, modeltraining en -evaluatie |
| SANYO UR18650E dataset | NASA Prognostics Data Repository | https://ti.arc.nasa.gov/tech/dash/groups/pcoe/prognostic-data-repository/ | Bron van multichannel cycleringsgegevens voor reproduceerbaarheidsevaluatie en modelvalidatie |
| Scikit-learn | Scikit-learn Developers | Versie 1.2.2 | Implementatie van baseline-model, datasetpartitionering en berekening van prestatiemetrieken |
Referenties
- Lu J, Xiong R, Tian J. Deep learning to estimate lithium-ion battery state of health without additional degradation experiments. Nat Commun. 2023;14:2760.
- Zhang H, Li Y, Zheng S. Battery lifetime prediction across diverse ageing conditions with inter-cell deep learning. Nat Mach Intell. 2025;7:270–7.
- Zhang Y, et al. State-of-health estimation for lithium-ion batteries via incremental energy analysis and hybrid deep learning model. Batteries. 2025;11(6):217.
- Liu C, et al. Deep learning for state of health estimation of lithium-ion batteries in electric vehicles: A systematic review. Energies. 2025;18(6):1463.
- Chen C, Wei J, Li Z. Remaining useful life prediction for lithium-ion batteries based on a hybrid deep learning model. Processes. 2023;11(8):2333.
- Chen B, et al. Lithium-ion battery state of health estimation based on feature reconstruction and Transformer-GRU parallel architecture. Energies. 2025;18(5):1236.
- Zhao W, Ding W, Zhang S, Zhang Z. Enhancing lithium-ion battery lifespan early prediction using a multi-branch vision transformer model. Energy. 2024;302:131816.
- Hu J, et al. Early prediction of lithium-ion battery degradation with a generative pre-trained transformer. Nat Commun. 2026;17:126.
- Li Y, et al. Accurate and adaptive state of health estimation for lithium-ion battery based on patch learning framework. Measurement. 2025;250:117083.
- Geng M, et al. Interpretable deep learning with uncertainty quantification for lithium-ion battery SOH estimation. Energy. 2025;335:138027.
- Li Y, et al. State-of-health prediction of lithium-ion batteries using feature fusion and a hybrid neural network model. Energy. 2025;319:135163.
- Zhou J, et al. Deep learning estimation of state of health for lithium-ion batteries using multi-level fusion features of discharge curves. J Power Sources. 2025;653:237781.
- Wang Y, et al. A comprehensive review of machine learning-based state of health estimation for lithium-ion batteries: Data, features, algorithms, and future challenges. Renew Sustain Energy Rev. 2025;224:116125.
- Severson KA, et al. Data-driven prediction of battery cycle life before capacity degradation. Nat Energy. 2019;4(5):383–91.
- Wu R, et al. Confidence-aware quantile Transformer for reliable degradation prediction of battery energy storage systems. Reliab Eng Syst Saf. 2025;260:111019.
- Yang H, et al. Privacy-preserving collaborative battery fault warning for massive electric vehicles by heterogeneous data from charging stations. Nat Commun. 2026;17:974.
- Liu Y, et al. A hybrid deep learning approach for remaining useful life prediction of lithium-ion batteries based on discharging fragments. Appl Energy. 2024;358:122555.
- Bockrath S, Lorentz V, Pruckner M. State of health estimation of lithium-ion batteries with a temporal convolutional neural network using partial load profiles. Appl Energy. 2023;329:120307.
- Zhang Z, et al. Multi-cycle charging information guided state of health estimation for lithium-ion batteries based on pre-trained large language model. Energy. 2024;313:133993.
- Li Z, Zhang X, Gao W. State of health estimation of lithium-ion battery during fast charging process based on BiLSTM-Transformer. Energy. 2024;311:133418.
- Bao X, et al. Hybrid deep neural network with dimension attention for state-of-health estimation of lithium-ion batteries. Energy. 2023;278:127734.
- He N, et al. Early prediction of battery lifetime based on graphical features and convolutional neural networks. Appl Energy. 2024;353:122048.
- Rieger LH, et al. Uncertainty-aware and explainable machine learning for early prediction of battery degradation trajectory. Digit Discov. 2023;2(1):112–22.
- Li H, et al. A cross-material lithium-ion battery state of health estimation method based on three-stage domain adaptation. Energy. 2025;139376.
- Han T, et al. Source-free dynamic weighted federated transfer learning for state-of-health estimation of lithium-ion batteries with data privacy. IEEE Trans Power Electron. 2024;39(11):15085–100.
- Rhyu J, et al. Systematic feature design for cycle life prediction of lithium-ion batteries during formation. Joule. 2025;9(5):101884.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.