Het voorgestelde MSCNN-LSTM-framework integreert multi-scale ruimtelijke kenmerkextractie met temporele sequentiemodellering voor actieherkenning in sportvideo's, waarbij fijnmazige ruimtelijke kenmerken en temporele bewegingspatronen worden vastgelegd, terwijl er concurrerende classificatieprestaties worden behaald op benchmark-datasets van sportacties.
Onderzoeksartikel
Actieherkenning in sportvideo's met behulp van multiscale convolutionele netwerken met temporele modellering op basis van Long Short-Term Memory (LSTM)
In dit artikel
Samenvatting
Samenvatting
Actieherkenning in sportvideo's blijft uitdagend vanwege complexe bewegingsdynamiek, occlusie en een hoge intra-klassevariabiliteit. Hoewel bestaande deep learning-benaderingen, waaronder CNN-BiLSTM en modellen gebaseerd op transfer learning, effectiviteit hebben aangetoond bij de herkenning van menselijke activiteiten, kan hun prestatie beperkt zijn in sportsituaties met snelle, diverse bewegingen. Veel bestaande methoden vertrouwen op convolutionele filters op één schaal, die mogelijk niet effectief zowel fijnmazige als grove bewegingskenmerken gelijktijdig kunnen vastleggen. Om deze beperking aan te pakken, stelt deze studie een Multi-Scale Convolutional Neural Network (MSCNN) voor, geïntegreerd met een Long Short-Term Memory (LSTM) netwerk voor actieherkenning in sportvideo's. Het MSCNN extraheert ruimtelijke representaties op meerdere receptieve velden via parallelle convolutionele kernels, waardoor het leren van zowel gedetailleerde als contextuele bewegingskenmerken mogelijk wordt. Deze kenmerken worden vervolgens verwerkt door de LSTM om temporele afhankelijkheden en bewegingscontinuïteit over opeenvolgende frames vast te leggen. De experimentele evaluatie werd uitgevoerd op de benchmarkdatasets UCF11, UCF Sports en JHMDB. Het voorgestelde MSCNN-LSTM-model behaalde classificatienauwkeurigheden van respectievelijk 98,3%, 95,4% en 81,7%, waarmee het beter presteerde dan de in deze studie geëvalueerde vergelijkende benaderingen. Een ablatiestudie demonstreerde verder de bijdrage van multi-scale kenmerkextractie en temporele modellering aan de algehele prestatie. Deze bevindingen tonen het potentieel van het voorgestelde raamwerk aan om ruimtelijke en temporele informatie te combineren voor actieherkenning in sportvideo's.
Inleiding
Het herkennen van menselijke activiteiten heeft uitgebreide toepassingen in diverse praktijkdomeinen, waaronder intelligente bewaking, anomaliedetectie, actiegebaseerde audiovisuele retrieval en patiëntbewaking in de gezondheidszorg1,2. Actieherkenning, in het bijzonder in videostreams van bewakingssystemen en sociale mediaplatforms, heeft een aanzienlijk potentieel voor anomaliedetectie en gebeurtenisbegrip3. Menselijke acties worden in videoanalyse geïdentificeerd door de observatie van verschillende lichaamsdelen, zoals de handen en benen. In tegenstelling tot statische beelden is een enkel frame vaak onvoldoende om een actie weer te geven4. De initiële houding bij voetbal- en touwspringactiviteiten kan bijvoorbeeld in een enkel frame vergelijkbaar lijken. De verschillen tussen deze acties worden pas duidelijk wanneer ze worden geobserveerd over een reeks frames die bewegingspatronen en interacties van het menselijk lichaam met zijn omgeving vastleggen5,6,7. De afkortingen die in dit manuscript worden gebruikt, zijn samengevat in Tabel 1 om de leesbaarheid te verbeteren en consistentie in de terminologie te waarborgen.
| Afkorting | Volledige vorm |
| AI | Artificiële Intelligentie |
| AUC (area onder de curve) | Oppervlakte onder de curve |
| BiLSTM | Bidirectioneel Long Short-Term Memory |
| CNN | Convolutioneel Neuraal Netwerk |
| CUDA | Compute Unified Device Architecture |
| F1-score | Harmonisch gemiddelde van precisie en recall |
| GPU | grafische verwerkingseenheid |
| HAR | Herkenning van menselijke activiteiten |
| JHMDB | Joint Human Motion DataBase |
| LSTM (Long Short-Term Memory) | Long Short-Term Memory |
| mAP-T | Temporele gemiddelde gemiddelde precisie |
| MCC | Matthews-correlatiecoëfficiënt |
| MSCNN | Multi-schaal convolutioneel neuraal netwerk |
| ROC | Receiver Operating Characteristic |
| TSI | Temporele Stabiliteitsindex |
| UCF | University of Central Florida |
| VRAM | Video Random Access Memory |
Tabel 1: Lijst van afkortingen gebruikt in het manuscript. Veelgebruikte afkortingen en acroniemen gedurende de studie en hun bijbehorende volledige vormen.
Snelle en accurate classificatie van sportvideo's is belangrijk voor een breed scala aan toepassingen8,9,10, waaronder sportanalyse, eventdetectie, inhoudelijke retrieval en aanbevelingssystemen11,12,13. Met de snelle groei van sportgerelateerde video-inhoud zijn de beperkingen van eerdere analytische kaders steeds duidelijker geworden14. Bijgevolg is er een groeiende vraag naar robuuste benaderingen die in staat zijn om de complexiteit en de dynamische aard van sportactiviteiten aan te pakken. Traditionele methoden voor sportvideoclassificatie hebben grotendeels vertrouwd op handmatige descriptoren, zoals optical flow en Histogram of Oriented Gradients (HOG), om bewegingspatronen en activiteiten in sportvideo's te karakteriseren15.
ConvNets, die een opmerkelijk succes hebben behaald bij de classificatie van statische beelden, zijn ook toegepast op videoanalyse. Actieherkenning blijft echter uitdagender omdat video's dynamische spatiotemporele informatie bevatten. Huidige benaderingen op basis van deep learning kunnen over het algemeen worden ingedeeld in drie groepen: two-stream netwerken16, 3D convolutionele netwerken en computationeel efficiënte architecturen. Om temporele informatie uit optische flow te leren, maken two-stream netwerken gebruik van een extra ConvNet17,18, hoewel deze benadering computationeel kostbaar is. Hoewel 3D convolutionele architecturen zoals C3D, I3D en R3D temporele informatie direct kunnen modelleren, verhogen ze het aantal parameters aanzienlijk, waardoor optimalisatie uitdagender wordt. Computationeel efficiënte methoden proberen de modelcomplexiteit te verminderen door gedecomposeerde 3D-operaties te verkennen.
Bovendien kunnen hybride modellen spatiotemporele bewegingspatronen uit sensorinputs effectief leren, aangezien CNN's lokale ruimtelijke kenmerken kunnen extraheren en LSTM's temporele contextinformatie kunnen vastleggen. Recente studies waarin CNN- en recurrente neurale netwerkarchitecturen zijn gecombineerd, hebben bemoedigende resultaten opgeleverd18,19,20. Omdat LSTM's echter informatie comprimeren tijdens de sequentieverwerking, kan ruis die tijdens de kenmerkextractie wordt geïntroduceerd de herkenningsprestaties beïnvloeden. Om dit probleem aan te pakken, hebben verschillende studies aandachtmechanismen geïntegreerd21,22. Aandachtmechanismen stellen het model in staat om zich te concentreren op kenmerken die het meest relevant zijn voor de herkenningstaak, waardoor de classificatieprestaties worden verbeterd.
Hoewel diepe bidirectionele LSTM-modellen in combinatie met CNN-gebaseerde kenmerkextractie veelbelovende resultaten hebben behaald voor het herkennen van menselijke activiteiten, blijven er verschillende uitdagingen bestaan bij het uitbreiden van deze raamwerken naar actieherkenning in sportvideo's. Ten eerste maken bestaande CNN-LSTM-architecturen vaak gebruik van convolutionele kenmerkextractie op één enkele schaal, wat hun vermogen kan beperken om acties vast te leggen die plaatsvinden op meerdere ruimtelijke en temporele resoluties, zoals de gelijktijdige beweging van spelers en objecten in sportscènes. Multi-schaal convolutionele netwerken, waaronder 3D CNN's23 en two-stream CNN's, hebben het belang aangetoond van het vastleggen van ruimtelijke en bewegingskenmerken op verschillende schalen, hoewel dit concept minder is onderzocht in LSTM-gebaseerde hybride systemen. Ten tweede richten de meeste eerdere CNN-BiLSTM-modellen24 zich primair op kortetermijn temporele afhankelijkheden, terwijl continuïteit van beweging over lange afstand en interacties tussen objecten, die gebruikelijk zijn in teamsporten, mogelijk niet adequaat worden weergegeven. Veel benaderingen op basis van transfer learning, zoals MobileNetV2 en ResNet, vertrouwen op statische framekenmerken en maken geen volledig gebruik van temporele aandachtmechanismen of adaptieve multi-schaal kenmerkfusie25. Bovendien zijn de meeste bestaande modellen primair geëvalueerd op benchmark-datasets zoals UCF11 en JHMDB. Recente sportspecifieke datasets die complexe camerabewegingen en activiteitspatronen vastleggen, zoals SoccerNet en FineGym, blijven onderbelicht. Deze beperkingen benadrukken de noodzaak van een raamwerk voor multi-schaal convolutionele kenmerkextractie geïntegreerd met temporele geheugenmodules, zoals LSTM- of BiLSTM-netwerken, om zowel fijnmazige ruimtelijke representaties als temporele afhankelijkheden over lange afstand beter vast te leggen bij actieherkenning in sportvideo's.
Daarnaast kunnen CNN's lokale ruimtelijke kenmerken extraheren, terwijl LSTM's de temporele context kunnen modelleren. Hybride CNN-RNN-architecturen hebben daarom veelbelovende prestaties getoond bij het herkennen van menselijke activiteiten26,27. Recente studies hebben conventionele CNN-LSTM-frameworks uitgebreid door complementaire leerstrategieën te integreren om de herkenning van menselijke activiteiten te verbeteren. Zo zijn aandachtmechanismen geïntroduceerd om taakrelevante kenmerken te benadrukken en minder informatieve representaties te onderdrukken, waardoor de herkenningsprestaties verbeteren28. Andere benaderingen hebben multi-task learning toegepast om actieherkenning en temporele segmentatietaken gezamenlijk te optimaliseren, wat de leerefficiëntie en kenmerkrepresentatie verbetert29. Ondanks deze vorderingen kunnen bestaande methoden nog steeds een beperkt vermogen hebben om visueel vergelijkbare acties te onderscheiden, omdat fijnmazige ruimtelijke en temporele kenmerken niet altijd effectief worden vastgelegd. Tabel 2 vat de sterke punten en beperkingen van bestaande benaderingen samen30.
| Referentie / Jaar | Gebruikte methode | Dataset(s) | Prestatiegegevens | Belangrijkste sterke punten | Beperkingen |
| Hassan et al. (2024)1 | KFDI (Key Frame Dynamic Image) | UCF11 | Nauwkeurigheid: 85,3% | Efficiënte selectie van keyframes en verbeterde representatie van dynamische beelden. | Gevoelig voor fouten bij frame-selectie; beperkte temporele modellering. |
| Zhou et al. (2023)24 | Dilated CNN + BiLSTM + Residual Block | UCF11, UCF Sports | Nauwkeurigheid: UCF11: 89 en UCF Sports: 92,2% | Integreert ruimtelijk en temporeel leren; legt multi-schaal informatie vast. | Rekenkundig intensief; risico op overfitting bij kleine datasets. |
| Ullah et al. (2025)34 | Local–Global Feature + QSVM | UCF11 | Nauwkeurigheid: 82,6% | Combineert handmatig ontworpen features en deep features voor robuuste herkenning. | Handmatige tuning vereist; beperkte schaalbaarheid. |
| Shin et al. (2025)25 | ViT-ReT (Vision Transformer + Recurrent Transformer) | UCF11, UCF50, UCF101 en JHMDB | Nauwkeurigheid: UCF11: 97,73%; UCF50: 98,81%; UCF101: 98,46%; JHMDB: 83,38% | Legt ruimtelijke en temporele afhankelijkheden over lange afstand vast. | Hoge rekenkosten en datagegevensvereisten. |
| Su et al. (2024)23 | 3D-CNN | UCF11 | Nauwkeurigheid: 85,1% | End-to-end spatiotemporeel feature-leren. | Hoge geheugen- en GPU-vereisten. |
| Karuppannan et al. (2024)35 | Deep Autoencoder + CNN | UCF11 | Nauwkeurigheid: 96,2% | Leert compacte feature-representaties. | Beperkte temporele modellering op lange termijn. |
| Sahoo et al. (2020)36 | HAR-Depth | KTH, UCF sports, JHMDB, UCF101 en HMDB51 | Nauwkeurigheid: KTH: 97,67%; UCF Sports: 95,00%; JHMDB: 73,13%; UCF101: 92,97%; HMDB51: 69,74% | Effectief dieptegebaseerd temporeel leren. | Vereist nauwkeurige diepteschatting en uitgebreide voorbewerking. |
Tabel 2: Vergelijking van bestaande deep learning-methoden voor actieherkenning in sportvideo's. Samenvatting van representatieve deep learning-benaderingen, inclusief datasets, methodologische kenmerken, voordelen en beperkingen, waarbij de onderzoekslacunes worden benadrukt die door het voorgestelde MSCNN-LSTM-raamwerk worden aangepakt.
Er is een raamwerk voorgesteld voor gezichtsanimaties aangestuurd door audiosynchronisatie, waarbij een Facial Denoiser Model (FDM) wordt gecombineerd met een Local-to-global Latent Diffusion Model (LG-LDM) om emotioneel expressieve gezichtsanimaties te genereren. Een Emotion-centric Vector Quantized Variational Autoencoder (EVQ-VAE) werd ingezet om gedetailleerde driedimensionale gezichtsgeometrie en subtiele expressievariaties te reconstrueren31. Daarnaast is er een occlusie-bewust robotisch grijpraamwerk ontwikkeld dat gebruikmaakt van binoculair stereozicht voor doelwitsegmentatie, lokalisatie, occlusie-inferentie en de schatting van de grijppositie voor meerdere doelwitten onder occlusieomstandigheden32. Verder is een tweestapsraamwerk geïntroduceerd voor het extraheren van de grond uit puntenwolken met behulp van rasterprojectie en adaptieve bin-verdeling, waarbij hoogte- en krommingswaarschijnlijkheden werden gebruikt om grond-obstakelgrenzen te verfijnen na een grove extractie via rastergebaseerde kenmerkanalyse33.
Ondanks aanzienlijke vorderingen in actieherkenning op basis van deep learning, hebben bestaande methoden nog steeds moeite met de hoge variabiliteit en complexiteit van sportvideo's, waaronder snelle bewegingen, camerabewegingen en interacties tussen meerdere spelers. Veel traditionele CNN- of LSTM-gebaseerde modellen werken op een enkele ruimtelijke schaal en kunnen daarom moeite hebben om zowel lokale als globale bewegingspatronen effectief vast te leggen. Bovendien blijft het behoud van temporele coherentie in sequenties van lange duur of overlappende acties een uitdaging. Hoewel methoden voor transfer learning de kenmerkextractie hebben verbeterd, is hun aanpassing aan sportspecifieke datasets relatief onderbelicht gebleven.
Deze studie heeft als doel het ontwikkelen en evalueren van een Multi-Scale Convolutional Neural Network–Long Short-Term Memory (MSCNN-LSTM) framework voor actieherkenning in sportvideo's door multi-schaal ruimtelijke kenmerkextractie te integreren met LSTM-gebaseerde temporele modellering om zowel fijnmazige ruimtelijke kenmerken als langdurige temporele afhankelijkheden vast te leggen. Het voorgestelde framework maakt gebruik van complementaire convolutionele kernels en multi-level kenmerkfusie om de representatie van complexe sportacties onder uitdagende omstandigheden te verbeteren. De prestaties werden geëvalueerd op de benchmarkdatasets UCF11, UCF Sports en JHMDB aan de hand van nauwkeurigheid, precisie, recall, F1-score, mean Average Precision over Time (mAP-T), Temporal Stability Index (TSI), de kappacoëfficiënt van Cohen (κ), de Matthews Correlation Coefficient (MCC) en de Area Under the ROC Curve (AUC). Experimentele resultaten toonden concurrerende prestaties aan in vergelijking met de in deze studie geëvalueerde methoden, wat het potentieel van het framework benadrukt voor sportanalyse, monitoring van atletenprestaties, geautomatiseerde eventdetectie en het begrip van sportvideo's.
Protocol
Deze studie maakte gebruik van een tweestaps deep learning-framework voor actieherkenning in sportvideo's, waarin een Multi-Scale Convolutional Neural Network (MSCNN) is geïntegreerd met een Long Short-Term Memory (LSTM)-netwerk. Publiekelijk beschikbare benchmarkdatasets, namelijk UCF11, UCF Sports en JHMDB, werden gebruikt voor de ontwikkeling en evaluatie van het model. Er zijn geen nieuwe gegevens verzameld van menselijke participanten, en er is geen toegang gekregen tot of verwerkt persoonlijk identificeerbare informatie. Omdat de studie bestond uit de secundaire analyse van publiekelijk beschikbare, geanonimiseerde datasets en geen directe menselijke deelname inhield, waren institutionele ethische goedkeuring en geïnformeerde toestemming niet vereist.
De workflow bestond uit frame-sampling en temporele normalisatie, gevolgd door kenmerkextractie met behulp van de MSCNN-module. De geëxtraheerde kenmerken werden vervolgens verwerkt met een LSTM-netwerk voor temporele modellering en daarna doorgegeven aan een multi-klasse classificatielaag. Ten slotte werd het model getraind en geëvalueerd met behulp van de geselecteerde benchmark-datasets. Figuur 1 illustreert de algemene architectuur van het voorgestelde raamwerk.
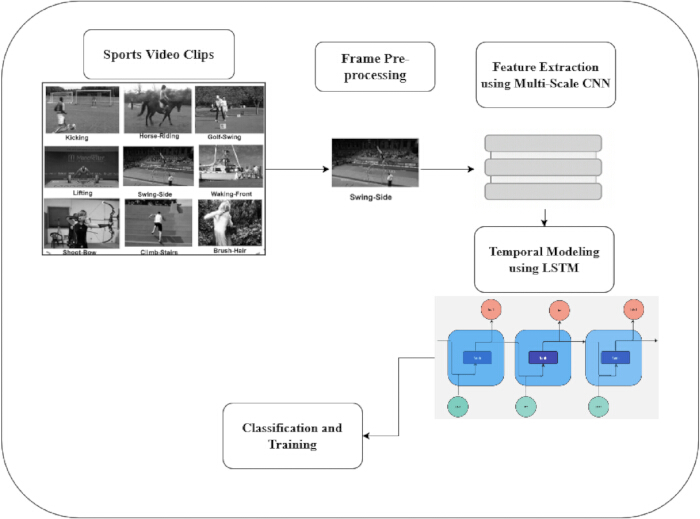
Figuur 1: Voorgesteld MSCNN-LSTM-framework voor actieherkenning in sportvideo's. Algemene workflow die de videovoorbewerking, multi-schaal ruimtelijke kenmerkextractie, temporeel sequentieel leren en actieclassificatie illustreert. Klik hier om een grotere versie van deze figuur te bekijken.
Figuur 1 illustreert de workflow van het voorgestelde framework voor actieherkenning in sportvideo's, gebaseerd op een hybride MSCNN-LSTM-architectuur. Het proces begint met sportvideoclips die verschillende atletische acties bevatten, waaronder trappen, paardrijden en golfslagen. De ruwe video's werden tijdens de voorverwerkingsfase ontbonden in individuele frames, waarbij de frames werden bijgesneden, gestandaardiseerd en voorbereid voor modelinvoer. De voorbewerkte frames werden vervolgens ingevoerd in de MSCNN-module voor kenmerkextractie. De multi-scale convolutionele architectuur legt ruimtelijke kenmerken vast bij verschillende receptieve velden, waardoor zowel lokale als contextuele informatie uit de sportvideoframes kan worden geëxtraheerd. De geëxtraheerde kenmerkvectoren werden vervolgens verwerkt door het LSTM-netwerk om temporele afhankelijkheden en de evolutie van beweging over opeenvolgende frames te modelleren. Ten slotte gebruikte de classificatie- en trainingsmodule de geleerde spatiotemporele representaties om de actiecategorie voor elke videoclip te voorspellen. Het voorgestelde framework bestond uit vier opeenvolgende stappen, beginnend met gegevensverzameling en voorbewerking met behulp van de UCF11 (YouTube Actions), UCF Sports en JHMDB benchmark-datasets. Elke sportvideo werd omgezet in een reeks frames, die werden herschaald, genormaliseerd en uitgebreid via rotatie, spiegeling en bijsnijden om de robuustheid tegen omgevingsvariaties te verbeteren. De voorbewerkte frames werden vervolgens verwerkt door het voorgestelde Multi-Scale Convolutional Neural Network (MSCNN), waarbij parallelle convolutionele takken met 3 × 3, 5 × 5 en 7 × 7 kernels complementaire lokale en contextuele ruimtelijke kenmerken extraheerden. Deze multi-scale kenmerken werden geconcateneerd en verfijnd met behulp van batch-normalisatie en max-pooling om compacte kenmerkrepresentaties te genereren. De resulterende kenmerken op frameniveau werden vervolgens geleverd aan een Long Short-Term Memory (LSTM)-netwerk om temporele afhankelijkheden over opeenvolgende frames te modelleren. De uiteindelijke LSTM-outputs werden afgeplat en door volledig verbonden lagen met ReLU-activatie geleid, gevolgd door een Softmax-classifier om de actiecategorie te voorspellen. Het netwerk werd getraind met de Adam-optimizer met een cross-entropy verliesfunctie en dropout-regularisatie om overfitting te verminderen. De modelprestaties werden tenslotte geëvalueerd op de UCF11, UCF Sports en JHMDB benchmark-datasets met behulp van nauwkeurigheid, precisie, recall en F1-score.
1. Gegevensverzameling en voorbewerking
In deze studie werden drie publiek beschikbare benchmark-datasets voor sport en menselijke acties gebruikt. Deze datasets bevatten real-world sportbeelden met variërende camerabewegingen, standpunten en achtergrondcomplexiteit. Specifiek maakte de studie gebruik van UCF11 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php), die 11 actiecategorieën bevat, verzameld uit 1.168 YouTube-video's van ongeveer 25 personen, met meerdere monsters per actie. De Joint-Annotated Human Motion Database (JHMDB)34,35 bevat 21 actieklassen en 928 geannoteerde video's. De UCF Sports-dataset bestaat uit 10 actieklassen en 150 videosequenties, vastgelegd vanuit broadcastbronnen met een resolutie van 720 × 480 pixels (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php).
Gezamenlijk beslaan deze datasets zowel individuele als teamsporten en bieden ze variatie in temporele duur en visuele schaal voor het evalueren van het voorgestelde MSCNN-LSTM-framework voor actieherkenning. Als onderdeel van het proces voor kwaliteitscontrole van de gegevens werden de datasets UCF11, UCF Sports en JHMDB gecontroleerd op beschadigde video's, dubbele bestanden en fragmenten met onvolledige annotaties. Er werden geen monsters geïdentificeerd die aan deze exclusiecriteria voldeden; daarom werden alle beschikbare video's behouden voor nadere analyse. De datasets werden vervolgens onderverdeeld in trainings- (70%), validatie- (15%) en testsets (15%) met behulp van een consistente strategie voor willekeurige splitsing. Figuur 2 toont representatieve afbeeldingen die zijn gebruikt voor training en evaluatie.
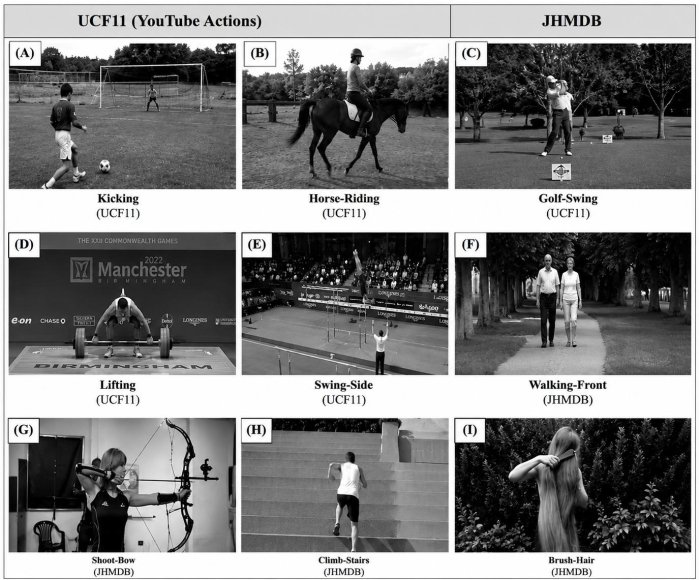
Figuur 2: Representatieve frames uit de benchmark-datasets voor sportactherkenning. Panelen (A–D) tonen voorbeelden uit de UCF11 (YouTube Actions) dataset, panelen (E–H) uit de UCF Sports dataset en panelen (I–L) uit de JHMDB dataset. De frames illustreren variaties in actieklassen, gezichtspunten, achtergronden, verlichtingscondities en bewegingscomplexiteit. Klik hier om een grotere versie van deze figuur te bekijken.
Het voorgestelde actieherkenningsmodel werd geëvalueerd op de benchmark-datasets UCF11, UCF Sports en JHMDB, zoals samengevat in Tabel 3. Deze datasets vertegenwoordigen diverse bewegingspatronen en uitdagende omgevingscondities. De UCF11 (YouTube Actions) dataset bevat sportacties uit 11 klassen, verkregen onder variërende belichting, standpunten en achtergrondcondities. De UCF Sports dataset bestaat uit 150 veldsportvideo's van professionele uitzendingen, met realistische bewegingssequenties. De JHMDB dataset biedt gedetailleerde annotaties van menselijke bewegingen voor 21 fijnmazige actiecategorieën en dient als benchmark-dataset voor spatiotemporele actieherkenning. Samen werden deze datasets gebruikt om de modelprestaties te evalueren in sport- en menselijke-actiescenario's. Het netwerk werd getraind met de Adam-optimizer gedurende 100 epochs met een batchgrootte van 32, een initiële leersnelheid van 0.001 en een cross-entropy verliesfunctie. Het model met het laagste validatieverlies werd geselecteerd voor de definitieve evaluatie. Alle experimenten maakten gebruik van een vast random seed van 42. Early stopping en reductie van de leersnelheid bij een plateau werden toegepast om de convergentie te verbeteren, en gradient clipping met een drempelwaarde van 5.0 werd gebruikt tijdens de LSTM-training om exploderende gradiënten te voorkomen. Het voorgestelde MSCNN-LSTM model bevatte ongeveer 15 miljoen trainbare parameters. De hardware- en softwareconfiguratie die voor de implementatie is gebruikt, is samengevat in Tabel 4. Omdat de klassendistributies voldoende gebalanceerd waren, werden er geen aanvullende procedure voor klassenweging of resampling toegepast. Vergelijkingsmodellen werden geïmplementeerd met de hyperparameters die in hun oorspronkelijke studies werden gerapporteerd, waarbij de trainingsinstellingen waar mogelijk werden geharmoniseerd. Prestatiewaarden werden gerapporteerd als het gemiddelde ± standaarddeviatie van vijf onafhankelijke runs met verschillende willekeurige initialisaties. Verschillen tussen het voorgestelde model en de vergelijkingsmodellen werden geëvalueerd met gepaarde t-toetsen bij een significantiedrempel van p < 0.05.
| Dataset | Aantal klassen | Aantal video's | Resolutie (px) | U heeft geen brontekst opgegeven om te vertalen. Voer alstublieft de Engelse tekst in die u naar het Nederlands vertaald wilt hebben. | Beschrijving |
| UCF11 (YouTube-acties) | 11 | 1168 | Variabel (≈ 320×240) | University of Central Florida | Bevat 11 menselijke handelingen uit sporten (bijv. basketballen, duiken, golfswing, voetbaljongleren). Video's zijn verzameld van YouTube met een grote variatie in verlichting, standpunt en achtergrond. |
| UCF-sporten | 10 | 150 | 720×480 | UCF Sports Action-dataset | Bevat sportactiviteiten zoals duiken, paardrijden, golfswings, hardlopen en gewichtheffen, opgenomen uit echte broadcast-tvbeelden (BBC, ESPN). |
| JHMDB | 21 | 928 | 320×240 | Max Planck Institute for Intelligent Systems | Bevat dagelijkse en sportactiviteiten zoals vangen, springen, haar borstelen, schieten en rennen, met bijbehorende annotaties voor bewegings- en pose-analyse. |
Tabel 3: Kenmerken van de benchmark-datasets gebruikt voor training en evaluatie. Overzicht van de UCF11-, UCF Sports- en JHMDB-datasets, inclusief het aantal actieklassen, videovoorbeelden, datasetkenmerken en hun rollen bij modeltraining, validatie en testen.
| Gebruikte parameters | Beschrijving |
| Programmeertaal | Python 3.8.18 [4] |
| Deep Learning-framework | TensorFlow 2.15.0 [1] |
| GPU-accelerator | NVIDIA GeForce RTX 3090 (24 GB VRAM) [1] |
| CPU | Intel Core i9 @ 3,5 GHz × 16 kernen |
| Besturingssysteem | Windows 11 |
| Geheugen (RAM) | 64 GB DDR4 |
| Optimizer | Adam (leersnelheid = 0,001) |
| Batchgrootte | 32 |
| Aantal epochs | 100 |
| Activatiefuncties | ReLU (CNN-lagen), Softmax (outputlaag) |
| Uitvalpercentage | 0.5 |
Tabel 4: Simulatieomgeving en hyperparameterconfiguratie van het voorgestelde MSCNN-LSTM-model. Hardware-specificaties, softwareomgeving, optimizer-instellingen, leerfrequentie, batchgrootte, aantal epochs, inputdimensies en andere hyperparameters die zijn gebruikt tijdens de training en evaluatie van het model.
2. Voorbewerking
Voorafgaand aan de training werd elke ruwe video omgezet in een tijdgebonden reeks frames, waarna deze werd genormaliseerd, temporeel bemonsterd en uitgebreid. Elke inputvideo V werd eerst omgezet in een reeks frames en gerepresenteerd als een 4D-tensor V ∈ RT×H×W×C, waarbij T het aantal frames is, H × W i de frame-index aanduidt, en C het aantal kleurkanalen aangeeft (3 voor RGB). De preprocessing-pijplijn bestond uit frame-extractie, ruimtelijke herschaling gevolgd door center- of random cropping naar een vaste resolutie (H′, W′), intensiteitsnormalisatie per pixel en optionele data-augmentatie, waaronder random flipping, schaling en color jittering, voorafgaand aan de feature-extractie. Concreet werd de intensiteitsnormalisatie geïmplementeerd als standaard score-normalisatie zoals in vgl. (1).
 (1)
waarbij μ, σ de kanaalgemiddelden en standaarddeviaties zijn die zijn berekend over de trainingset, of als min-max schaling zoals in Vergelijking (2).
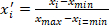 (2)
Na normalisatie werd elk frame weergegeven als F̃t ∈ RH′×W′×C′ en de resulterende videotensor werd weergegeven als V′ ∈ RT×H′×W′×C. In een multi-schaal convolutionele frontend worden meerdere ruimtelijke feature maps van het receptieve veld verkregen door het toepassen van verschillende 2-D (of 3-D voor vroege spatiotemporele convoluties) convoluties met verschillende kernelgroottes; vervolgens werd voor elk frame of kort videoclipje een temporele feature-representatie gegenereerd en doorgestuurd naar de LSTM-module. Het oorspronkelijke artikel maakt gebruik van MobileNetV2 en vervolgens Deep BiLSTM voor temporele modellering; exact dezelfde bovenstaande preprocessing-pipeline is volledig compatibel met een vervanging door multi-schaal conv + LSTM.
3. Bemonstering en temporele normalisatie
Aangezien videolengtes T variëren tussen en binnen datasets, bemonsteren we frames uniform of resamplen we deze temporeel om de multi-scale convolutie + LSTM een vaste inputlengte N te geven in termen van frames of korte fragmenten. Uniforme frame-indices kunnen worden berekend zoals in Vergelijking (3),
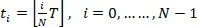 (3)
dus, de bemonsterde framevolgorde is Vs = {F̃t0, …, F̃tN−1}. Wanneer een fijnere temporele getrouwheid vereist is, voeren we lineaire temporele interpolatie uit: voor elke opnieuw bemonsterde fractionele tijd τ ∈ [0, T−1] berekend zoals in vgl. (4).
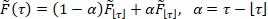 (4)
zodat de geresamplede sequentie Vs precies N frames heeft en een vloeiende beweging behoudt. Alternatief levert sampling via korte aaneengesloten clips (temporele vensterlengte w met stapgrootte s) een set clip-tensoren op waarbij elke clip Cj ∈ RT×H′×W′×C en j = 0, …, ⌊(T − w)/s⌋. Voor temporele normalisatie binnen het netwerk is een eenvoudige temporele pooling op meerdere schalen effectief: gegeven een temporele feature-sequentie X = {x1, …, xN} gegenereerd door multi-scale convs, worden de gepoolde features toegepast zoals in Eq. (5).
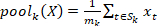 (5)
waar Sk is de temporele ondersteuning voor schaal k (bijv. Sk kunnen niet-overlappende blokken of gedilateerde indices zijn) en mk = |Sk|.
Voorafgaand aan de extractie van kenmerken werden alle video's geschaald naar 224 × 224 pixels en gesampled op 25 frames per seconde. Voor elk experiment werd een constante sequentielengte van 32 frames gebruikt. De technieken voor data-augmentatie omvatten onder andere random cropping (schaal = 0.8–1.0), random rotatie (±15°), random horizontale spiegeling (waarschijnlijkheid = 0.5) en aanpassing van de helderheid (±20%). Om de pixelwaarden te standaardiseren, werden de ImageNet-gemiddelden [0.485, 0.456, 0.406] en standaarddeviaties [0.229, 0.224, 0.225] gebruikt. Voor elke videosequentie werd uniforme frameselectie toegepast voor temporele sampling. Langere films werden uniform bijgesneden of gesampled om een consistente sequentielengte te behouden, terwijl video's met minder dan 32 frames werden aangevuld met nullen (zero-padding). Deze instellingen werden constant toegepast gedurende de training en evaluatie.
4. Kenmerkextractie met behulp van MSCNN
Een Multi-Scale Convolutional Neural Network (MSCNN) werd ingezet om de ruimtelijke representatie van acties in sportvideo's te verbeteren. Conventionele convolutionele neurale netwerken die vertrouwen op een enkele kerngrootte kunnen beperkt zijn in hun vermogen om kenmerken op meerdere ruimtelijke schalen vast te leggen. Omdat sommige sportacties vergelijkbare visuele kenmerken vertonen, kan het voor een convolutionele architectuur met een enkele schaal moeilijk zijn om zowel lokale als globale kenmerken gelijktijdig vast te leggen. Om deze beperking aan te pakken, maakt het voorgestelde framework gebruik van convolutionele kernen van verschillende groottes om multi-scale kenmerkextractie en kenmerkfusie uit te voeren.
In de voorgestelde netwerkarchitectuur werden 1 × 1 convolutiekernels gebruikt om informatie over kanalen heen te organiseren en om de dimensionaliteit van de input-featuremaps te verlagen. Bovendien verhogen deze lagen de expressieve capaciteit van het netwerk door aanvullende feature-transformaties en niet-lineaire representaties te introduceren. Convolutiekernels van verschillende groottes maken de extractie van ruimtelijke informatie op meerdere schalen mogelijk. Sequentiële normalisatie wordt uitgevoerd na gewogen multi-schaal feature-fusie om de trainingsstabiliteit te verbeteren. Om problemen met het verdwijnen van gradiënten (gradient vanishing) en het exploderen van gradiënten (gradient explosion) tijdens het trainen van diepe netwerken te beperken, maakt de voorgestelde architectuur gebruik van residuale verbindingen en LSTM-gebaseerde temporele modellering.
Het ontwerp op meerdere schalen verbetert het vermogen van het netwerk om kenmerken bij verschillende ruimtelijke resoluties vast te leggen en verbetert de capaciteit voor kenmerkrepresentatie. Bovendien wordt de conventionele N × N convolutiekernel ontbonden in N × 1 en 1 × N convolutiebewerkingen. De N × 1 en 1 × N convoluties die in de MSCNN-module worden gebruikt, zijn ontworpen om complementaire directionele en multi-schaal ruimtelijke kenmerken uit individuele videoframes vast te leggen. Deze convolutiebewerkingen verbeteren de ruimtelijke kenmerkrepresentatie door patronen op verschillende schalen van het receptieve veld te extraheren. Temporele relaties tussen opeenvolgende frames worden vervolgens gemodelleerd door de LSTM-module, die de reeks door MSCNN geëxtraheerde kenmerken verwerkt om langetermijn-temporele afhankelijkheden voor actieherkenning te leren.
Elke sportvideo V = {F1, F2, …, FT} wordt ontleed in T frames. Om ruimtelijke variaties te coderen, zoals de houding van de speler, bewegingsonscherpte en de baan van de bal, werken convolutionele takken op drie verschillende schalen s ∈ {1, 2, 3}, overeenkomend met kernelgroottes van 3 × 3, 5 × 5 en 7 × 7. Elke tak extraheert feature maps zoals beschreven in vgl. (6):
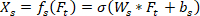 (6)
Waarbij Ws en bs de convolutionele gewichten en biases zijn op schaal s, en σ de ReLU-activatie is. De multi-scale fusielaag aggregeert kenmerken zoals in vgl. (7):
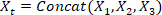 (7)
Deze gefuseerde feature-tensor bevat zowel fijnmazige bewegingskenmerken als contextuele informatie over grote gebieden, zoals groepsactiviteiten. Figuur 3 illustreert enkel de feature-extractiemodule van de MSCNN. De LSTM-laag (256 hidden units), dense laag (128 neuronen) en dropout-laag (0,5) die worden gebruikt voor temporele modellering en classificatie, worden afzonderlijk weergegeven in Figuur 4.
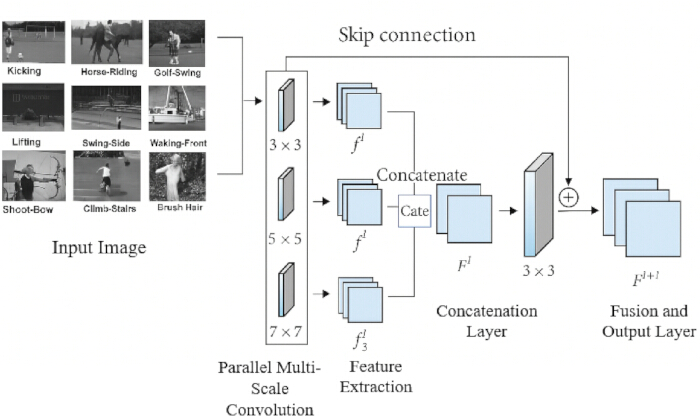
Figuur 3: Voorgestelde module voor kenmerkextractie van het Multi-Scale Convolutional Neural Network (MSCNN). Drie parallelle convolutionele takken met kernelgroottes van 3 × 3, 5 × 5 en 7 × 7 extraheren complementaire multi-schaal ruimtelijke kenmerken, die worden gefuseerd voorafgaand aan temporele modellering door het LSTM-netwerk. Klik hier om een grotere versie van deze figuur te bekijken.
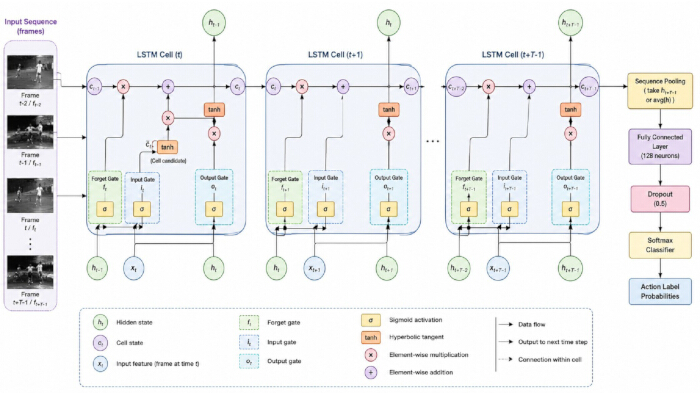
Figuur 4: Voorgestelde LSTM-architectuur voor actieherkenning in sportvideo's. De LSTM-module modelleert temporele afhankelijkheden via invoer-, vergeet- en uitvoerpoortoperaties over opeenvolgende videoframes. Klik hier om een grotere versie van deze figuur te bekijken.
Figuur 3 illustreert de voorgestelde module voor kenmergextractie met een Multi-Scale Convolutional Neural Network (MSCNN) voor actieherkenning in sportvideo's. Inputvideoframes werden parallel verwerkt via drie convolutionele takken met kernelgroottes van 3 × 3, 5 × 5 en 7 × 7, elk met 64 filters om complementaire fijnmazige en grofmazige ruimtelijke kenmerken vast te leggen. De outputs werden verfijnd met Batch Normalization, ReLU-activatie en 2 × 2 max pooling, vervolgens geconcateneerd en gefuseerd door een 1 × 1 convolutie met 128 filters. Een residual skip connection behield laag-niveau ruimtelijke informatie en verbeterde de gradiëntstroom. De gefuseerde feature maps werden afgeplat en doorgegeven aan een LSTM-laag met 256 hidden units voor temporele modellering, gevolgd door een volledig verbonden laag met 128 neuronen, ReLU-activatie en een dropout-rate van 0,5 vóór de uiteindelijke classificatie met behulp van een Softmax-laag. De multi-scale feature maps (f1l, f2Het lijkt erop dat u alleen de letter "l" heeft ingevoerd. Voer aub de Engelse brontekst in die u wilt laten vertalen naar het Nederlands., en f3Het lijkt erop dat u slechts een enkele letter heeft ingevoerd. Voer alstublieft de volledige Engelse brontekst in die u wilt laten vertalen naar het Nederlands.) werden geconcateneerd om de gefuseerde representatie te vormen (FHet lijkt erop dat er geen brontekst is meegeleverd om te vertalen. Voer alstublieft de Engelse tekst in die u naar het Nederlands vertaald wilt hebben.), wat verder werd verfijnd door een 3 × 3 convolutie om de output-featuremap voor de volgende laag te genereren. Deze hiërarchische architectuur maakte het mogelijk om complementaire ruimtelijke kenmerken op meerdere receptieve velden te leren, waardoor de prestaties bij de herkenning van sportacties werden verbeterd.
5. Temporele modellering met behulp van LSTM
Om de tijdsgebaseerde evolutie over de videoranden te modelleren, werd de geaggregeerde kenmerksequentie aan het LSTM-systeem geleverd om dynamische afhankelijkheden en bewegingscontinuïteit vast te leggen. Voor elke inputvideo hebben we eerst multiscale CNN-kenmerken per frame geëxtraheerd. Stel dat de videoframes I1, …, IT zijn. Voor elk frame t en elke schaal s produceert de multi-scale convolutionele encoder een kenmerkvector ft(s) ∈ Rd. Vervolgens worden de schalen gefuseerd tot een enkele framedescriptor via projectie + concatenering of een gewogen som, zoals in vgl. (8):
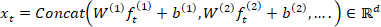 (8)
Voer vervolgens de reeks {xt}tT=1 in een LSTM in om de temporele dynamiek te modelleren. In de standaard LSTM-notatie zijn bij tijdstip t de poorten en toestanden weergegeven in vgl. (9) tot (13):
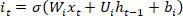 (9)
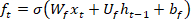 (10)
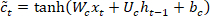 (11)
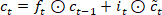 (12)
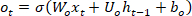 (13)
Hier is σ de sigmoid-activatie, ⊙ is elementgewijze vermenigvuldiging.) Hoewel bidirectionele LSTM-architecturen kunnen worden gebruikt om zowel de eerdere als de toekomstige temporele context vast te leggen, maakt het voorgestelde framework gebruik van een standaard LSTM om temporele afhankelijkheden over sequentiële videoframes te modelleren. Deze ontwerpkeuze is consistent met de MSCNN-LSTM-architectuur die in deze studie wordt gepresenteerd. Na het verwerken van het fragment werd een fragmentrepresentatie verkregen (bijv. de laatste verborgen toestand of temporele pooling): z = Poolt(vt).
Figuur 4 illustreert de workflow van de voorgestelde LSTM-architectuur voor sportactieherkenning. Het netwerk ontving een reeks videoframes of door CNN geëxtraheerde kenmerken en verwerkte deze over opeenvolgende tijdstappen (t−2, t−1 en t). Elke LSTM-cel bestond uit een inputgate, een forgetgate en een outputgate, die de informatiestroom door het netwerk reguleerden. De inputgate voegde nieuwe informatie toe aan de celtoestand, de forgetgate verwijderde irrelevante temporele informatie en de outputgate genereerde de verborgen toestand die naar de volgende tijdstap werd doorgegeven. De celtoestand behield langdurige temporele afhankelijkheden, terwijl de verborgen toestand kortstondige temporele informatie vastlegde. Na sequentiële verwerking werden de LSTM-outputs gepoold om een temporele kenmerkrepresentatie te genereren, die werd doorgegeven aan een volledig verbonden laag en een Softmax-classifier om de overeenkomstige sportactie te voorspellen. Het netwerk werd getraind met de Adam-optimizer gedurende 100 epochs met een batchgrootte van 32, een initiële leerstemming van 0,001 en een cross-entropy verliesfunctie. Het model met het laagste validatieverlies werd geselecteerd voor de uiteindelijke evaluatie. Om reproduceerbaarheid te garanderen, werden alle experimenten uitgevoerd met een vast random seed van 42. Early stopping en leerstemmingsverlaging bij een plateau werden toegepast om de convergentie te verbeteren, en gradient clipping met een drempelwaarde van 5,0 werd toegepast tijdens de LSTM-training om exploderende gradiënten te voorkomen. Het voorgestelde MSCNN-LSTM-model bevatte ongeveer 15 miljoen trainbare parameters.
De uiteindelijke klassenscores en waarschijnlijkheden maken gebruik van een lineaire laag + softmax zoals in vgl. (14):
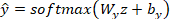 (14)
Train door de kruisentropieverlies over de gelabelde clips te minimaliseren, zoals beschreven in Eq. (15):
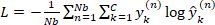 (15)
waarbij Nb de grootte van de batch is, C het aantal klassen, en y(n) de one-hot ground truth. Regularisatie (dropout op xt/LSTM-outputs, weight decay). Gradient clipping wordt toegepast om de stabiliteit voor lange sportsequenties te verbeteren.
Resultaten
Het voorgestelde MSCNN-LSTM-model werd getraind en geëvalueerd op de UCF11 (YouTube Actions), UCF Sports en JHMDB-datasets, die diverse sportacties, gezichtspunten en bewegingspatronen bevatten. Omdat de klassedistributies voldoende in balans waren, werden er geen aanvullende klassewegings- of resamplingsprocedures toegepast. Vergelijkingsmodellen werden geïmplementeerd met behulp van de hyperparameters die in hun oorspronkelijke studies zijn gerapporteerd, waarbij de trainingsinstellingen waar mogelijk zijn geharmoniseerd. Resultaten werden gerapporteerd als het gemiddelde ± standaarddeviatie van vijf onafhankelijke runs met verschillende willekeurige initialisaties. Verschillen tussen het voorgestelde model en de vergelijkingsmodellen werden geëvalueerd met gepaaide t-toetsen bij een significantiedrempel van p < 0,05.
Figuur 5 vergelijkt de classificatienauwkeurigheid over de drie datasets. Het MSCNN-LSTM-model behaalde de hoogste nauwkeurigheid, met 98,3% voor UCF11, 95,4% voor UCF Sports en 81,7% voor JHMDB. Deze waarden waren hoger dan die van de Dilated CNN–BiLSTM-, Two-Stream LSTM- en ViT-ReT-modellen. De lagere nauwkeurigheid voor JHMDB weerspiegelde de grotere moeilijkheid om fijnmazige acties in video's met een lagere resolutie te herkennen.
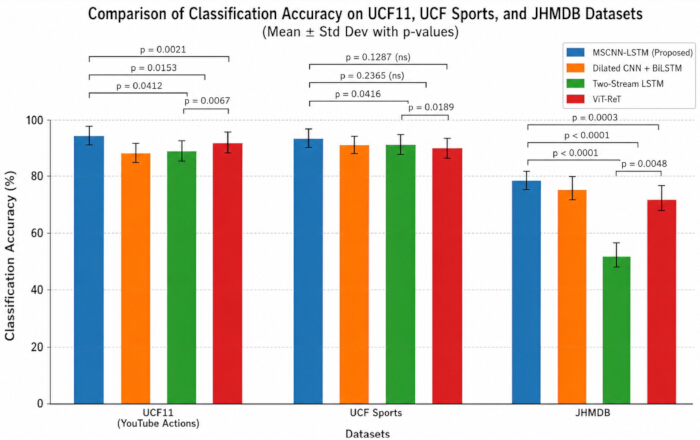
Figuur 5: Vergelijking van de classificatienauwkeurigheid (%) van verschillende deep learning-modellen op sportvideodatasets. Classificatienauwkeurigheid van MSCNN-LSTM, ViT-ReT, Two-Stream LSTM en Dilated CNN + BiLSTM op de UCF11, UCF Sports en JHMDB-datasets. Resultaten zijn weergegeven als gemiddelde ± SD van vijf onafhankelijke runs (n = 5). Foutenbalken representeren één standaarddeviatie. Statistische significantie is beoordeeld met tweezijdige gepaarde t-toetsen (p < 0,05). Klik hier om een grotere versie van deze figuur te bekijken.
Het voorgestelde model behaalde ook de hoogste precisie over alle datasets, met waarden van ongeveer 96% op UCF11, 93% op UCF Sports en 78% op JHMDB (Figuur 6). De recall-waarden waren respectievelijk ongeveer 95%, 94% en 77% (Figuur 7), terwijl de overeenkomstige F1-scores ongeveer 95,5%, 93,5% en 77,5% waren (Figuur 8). Deze resultaten gaven aan dat het model een gunstig evenwicht behield tussen het correct identificeren van actieklassen en het beperken van fout-positieve voorspellingen.
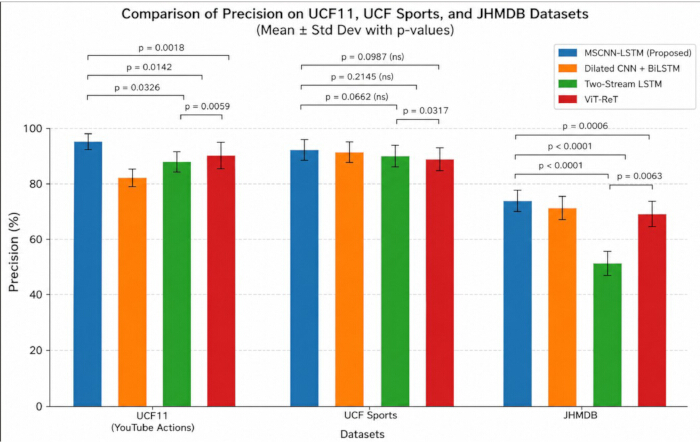
Figuur 6: Vergelijking van de precisie (%) van verschillende deep learning-modellen op sportvideodatasets. Precisiewaarden worden gerapporteerd als gemiddelde ± SD van vijf onafhankelijke runs (n = 5). Foutbalken vertegenwoordigen één standaarddeviatie. Statistische significantie is beoordeeld met behulp van tweezijdige gepaarde t-toetsen (p < 0,05). Klik hier om een grotere versie van deze figuur te bekijken.
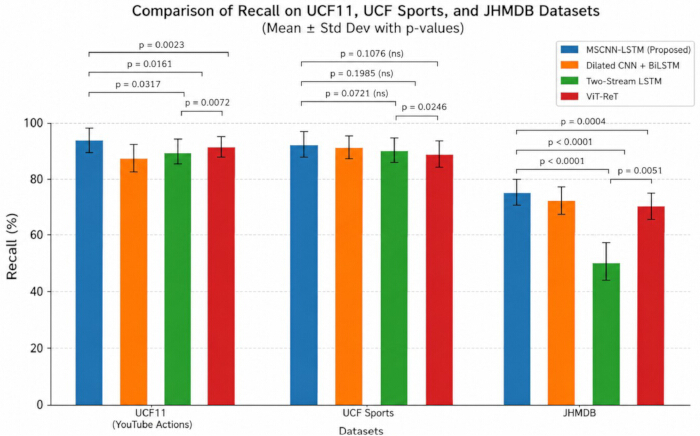
Figuur 7: Vergelijking van de recall (%) van verschillende deep learning-modellen op sportvideodatasets.Recall-waarden zijn gerapporteerd als gemiddelde ± SD uit vijf onafhankelijke runs (n = 5). Foutenbalken vertegenwoordigen één standaarddeviatie. Statistische significantie is beoordeeld met tweezijdige gepaarde t-toetsen (p < 0,05). Klik hier om een grotere versie van deze figuur te bekijken.
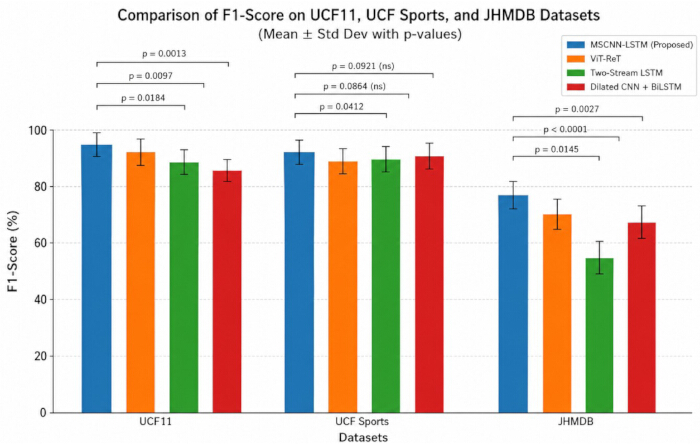
Figuur 8: Vergelijking van de F1-score (%) van verschillende deep learning-modellen op sportvideodatasets. F1-scores worden gerapporteerd als gemiddelde ± SD over vijf onafhankelijke runs (n = 5). Foutenbalken vertegenwoordigen één standaarddeviatie. Statistische significantie werd beoordeeld met behulp van tweezijdige gepaarde t-toetsen (p < 0.05). Klik hier om een grotere versie van deze figuur te bekijken.
Tabel 5 presenteert de resultaten van de kappa van Cohen en de correlatiecoëfficiënt van Matthews. Op UCF11 behaalde het voorgestelde model κ = 0.96 en MCC = 0.96, vergeleken met κ/MCC-waarden van 0.92/0.92 voor ViT-ReT, 0.90/0.90 voor Two-Stream LSTM en 0.87/0.87 voor Dilated CNN–BiLSTM. Op UCF Sports behaalde de MSCNN-LSTM κ = 0.95 en MCC = 0.94, waarmee de overeenkomstige waarden van ViT-ReT (0.90/0.90), Two-Stream LSTM (0.88/0.89) en Dilated CNN–BiLSTM (0.84/0.85) werden overtroffen. Op JHMDB behaalde het voorgestelde model κ = 0.83 en MCC = 0.84, vergeleken met 0.74/0.75 voor ViT-ReT, 0.70/0.71 voor Two-Stream LSTM en 0.71/0.72 voor Dilated CNN–BiLSTM. Deze resultaten toonden een sterkere overeenstemming aan tussen de voorspelde labels en de ground-truth labels voor het voorgestelde model.
| Model | Dataset | Cohen's kappa (κ) | Matthews correlatiecoëfficiënt (MCC) |
| Dilated CNN + BiLSTM [4] | UCF11 (YouTube Actions) | 0.87 ± 0.01 | 0.88 ± 0.01 |
| UCF Sports | 0.84 ± 0.02 | 0.85 ± 0.02 | |
| JHMDB | 0.71 ± 0.03 | 0.72 ± 0.03 | |
| Two-Stream LSTM [38] | UCF11 (YouTube Actions) | 0.90 ± 0.01 | 0.91 ± 0.01 |
| UCF Sports | 0.88 ± 0.02 | 0.89 ± 0.02 | |
| JHMDB | 0.70 ± 0.03 | 0.71 ± 0.03 | |
| ViT-ReT (Vision Transformer + Recurrent Transformer) [6] | UCF11 (YouTube Actions) | 0.92 ± 0.01 | 0.92 ± 0.01 |
| UCF Sports | 0.90 ± 0.01 | 0.90 ± 0.01 | |
| JHMDB | 0.74 ± 0.02 | 0.75 ± 0.02 | |
| Voorgestelde MSCNN–LSTM | UCF11 (YouTube Actions) | 0.96 ± 0.01 | 0.96 ± 0.01 |
| UCF Sports | 0.95 ± 0.01 | 0.94 ± 0.01 | |
| JHMDB | 0.83 ± 0.02 | 0.84 ± 0.02 |
Tabel 5: Vergelijking van Cohen's kappa (κ) en de Matthews correlatiecoëfficiënt (MCC) over verschillende deep learning-modellen. Prestatievergelijking van MSCNN-LSTM, ViT-ReT, Two-Stream LSTM en Dilated CNN + BiLSTM op de UCF11-, UCF Sports- en JHMDB-datasets. Hogere waarden duiden op een sterkere overeenstemming tussen voorspelde en werkelijke labels en een grotere betrouwbaarheid van de classificatie. Waarden worden gerapporteerd als gemiddelde ± SD van vijf onafhankelijke runs (n = 5).
Figuur 9 presenteert de receiver operating characteristic-curven. De voorgestelde MSCNN-LSTM behaalde AUC-waarden van 0,975 op UCF11, 0,961 op UCF Sports en 0,937 op JHMDB. De consistent hoge AUC-waarden wezen op een sterke discriminatie tussen actieklassen over datasets met verschillende complexiteit.
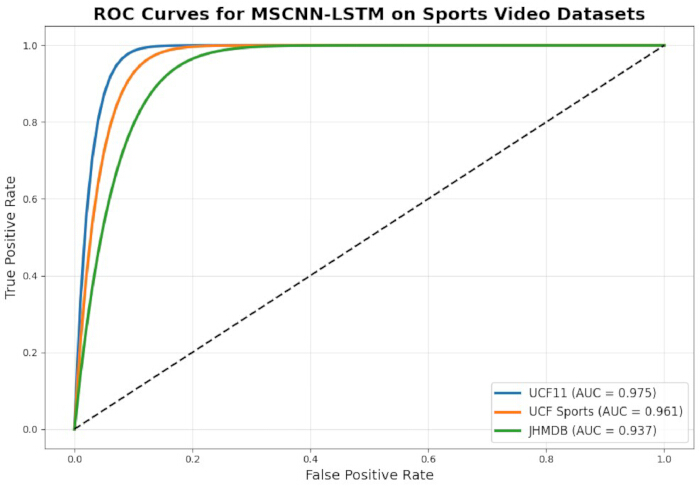
Figuur 9: Receiver operating characteristic (ROC)-curves van het voorgestelde MSCNN-LSTM-model. ROC-curves voor de UCF11-, UCF Sports- en JHMDB-datasets die de afruil tussen de true positive rate en de false positive rate illustreren. De area under the curve (AUC) vat de discriminatieve prestaties van het model samen over verschillende classificatiedrempels. Klik hier om een grotere versie van deze figuur te bekijken.
De resultaten van de temporele prestaties zijn samengevat in Tabel 6. Op UCF11 behaalde het voorgestelde model een mAP-T van 98,3%, een nauwkeurigheid op frameniveau van 96,5% en een TSI van 0,95. Op UCF Sports waren de overeenkomstige waarden 95,4%, 94,0% en 0,93. Op JHMDB behaalde het model een mAP-T van 81,7%, een nauwkeurigheid op frameniveau van 78,9% en een TSI van 0,88 (Tabel 7). Deze waarden waren hoger dan die van de vergelijkingsmodellen en wezen op een verbeterde temporele coherentie en voorspellingsstabiliteit over zowel korte als lange actiesequenties.
| Methode | Dataset | mAP-T (%) | Nauwkeurigheid op frameniveau (%) | Temporele stabiliteitsindex (TSI) |
| Dilated CNN + BiLSTM4 | UCF11 (YouTube Actions) | 93.6 ± 0.8 | 91.8 ± 0.9 | 0.87 ± 0.01 |
| UCF Sports | 90.2 ± 1.0 | 89.1 ± 1.1 | 0.83 ± 0.02 | |
| JHMDB | 72.4 ± 1.5 | 70.3 ± 1.7 | 0.78 ± 0.03 | |
| Two-Stream LSTM38 | UCF11 (YouTube Actions) | 94.8 ± 0.7 | 92.6 ± 0.8 | 0.89 ± 0.01 |
| UCF Sports | 91.3 ± 0.9 | 90.0 ± 1.0 | 0.85 ± 0.02 | |
| JHMDB | 73.8 ± 1.4 | 71.5 ± 1.6 | 0.79 ± 0.03 | |
| ViT-ReT (Vision Transformer + Recurrent Transformer)6 | UCF11 (YouTube Actions) | 95.5 ± 0.6 | 93.4 ± 0.7 | 0.90 ± 0.01 |
| UCF Sports | 92.4 ± 0.8 | 91.2 ± 0.9 | 0.87 ± 0.01 | |
| JHMDB | 74.6 ± 1.3 | 72.8 ± 1.4 | 0.81 ± 0.02 | |
| . | UCF11 (YouTube Actions) | 98.3 ± 0.5 | 96.5 ± 0.6 | 0.95 ± 0.01 |
| UCF Sports | 95.4 ± 0.7 | 94.0 ± 0.8 | 0.93 ± 0.01 | |
| JHMDB | 81.7 ± 1.1 | 78.9 ± 1.3 | 0.88 ± 0.02 |
Tabel 6: Vergelijking van temporele prestatiemetrieken voor actieherkenning in sportvideo's. Experimentele resultaten van de gemiddelde Average Precision over temporele segmenten (mAP-T), nauwkeurigheid op frameniveau en de Temporal Stability Index (TSI) voor verschillende deep learning-modellen over de benchmark-datasets. Waarden worden gerapporteerd als gemiddelde ± SD van vijf onafhankelijke runs (n = 5).
| Configuratie | Multi-schaal CNN (MSCNN) | LSTM (Long Short-Term Memory) | Nauwkeurigheid (%) | F1-score (%) | mAP-T (%) |
| Alleen CNN-baseline | ✗ | ✗ | 90.4 ± 1.2 | 89.8 ± 1.3 | 88.9 ± 1.4 |
| CNN + LSTM | ✗ | ✓ | 93.1 ± 0.9 | 92.4 ± 1.0 | 91.7 ± 1.1 |
| Alleen MSCNN | ✓ | ✗ | 94.2 ± 0.8 | 93.6 ± 0.9 | 92.8 ± 1.0 |
| Voorgestelde MSCNN-LSTM | ✓ | ✓ | 98.3 ± 0.5 | 97.8 ± 0.6 | 97.1 ± 0.6 |
Tabel 7: Ablatiestudie van het voorgestelde MSCNN-LSTM-framework. Prestatiebijdrage van de MSCNN- en LSTM-componenten onder identieke trainings- en evaluatieomstandigheden. Waarden worden gerapporteerd als gemiddelde ± SD van vijf onafhankelijke runs (n = 5).
Figuur 10, Figuur 11, Figuur 12 tonen respectievelijk de rijgenormaliseerde verwarringsmatrices voor UCF11, UCF Sports en JHMDB. Alle drie de matrices vertoonden een duidelijke diagonale dominantie, wat aangeeft dat de meeste actieklassen correct werden geïdentificeerd. Beperkte fouten buiten de diagonaal traden hoofdzakelijk op tussen acties met vergelijkbare visuele of bewegingskenmerken. De JHMDB-matrix vertoonde een relatief grotere klassenverwarring, wat consistent is met de lagere kwantitatieve prestaties die werden waargenomen bij deze uitdagendere dataset.
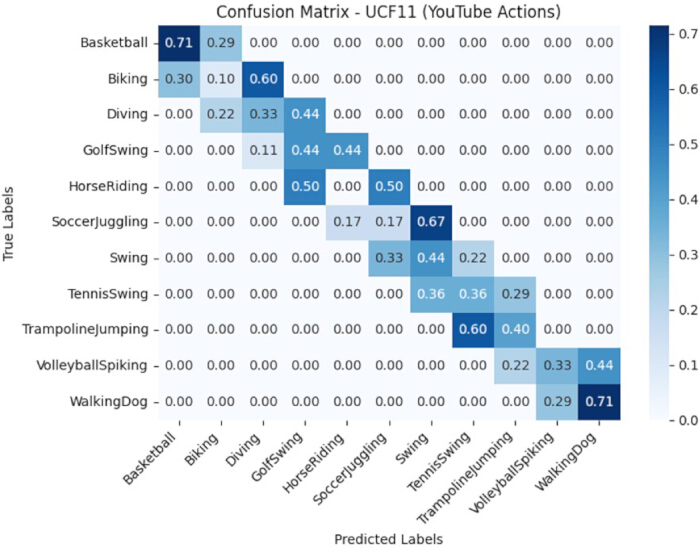
Figuur 10: Rij-genormaliseerde confusiematrix van het voorgestelde MSCNN-LSTM-model op de UCF11-dataset. Elke rij is genormaliseerd naar één, en de diagonale elementen vertegenwoordigen de recall per klasse in plaats van de algehele classificatienauwkeurigheid, welke apart wordt gerapporteerd. Klik hier om een grotere versie van deze figuur te bekijken.
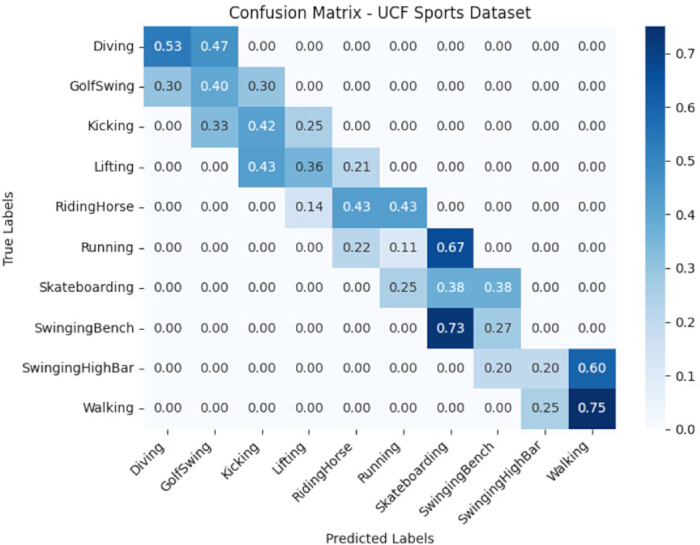
Figuur 11: Rij-genormaliseerde verwarringstabel van het voorgestelde MSCNN-LSTM-model op de UCF-sportdataset.Elke rij is genormaliseerd naar één, en de diagonale vermeldingen vertegenwoordigen de recall per klasse in plaats van de algemene classificatienauwkeurigheid, die afzonderlijk wordt gerapporteerd. Klik hier om een grotere versie van deze figuur te bekijken.
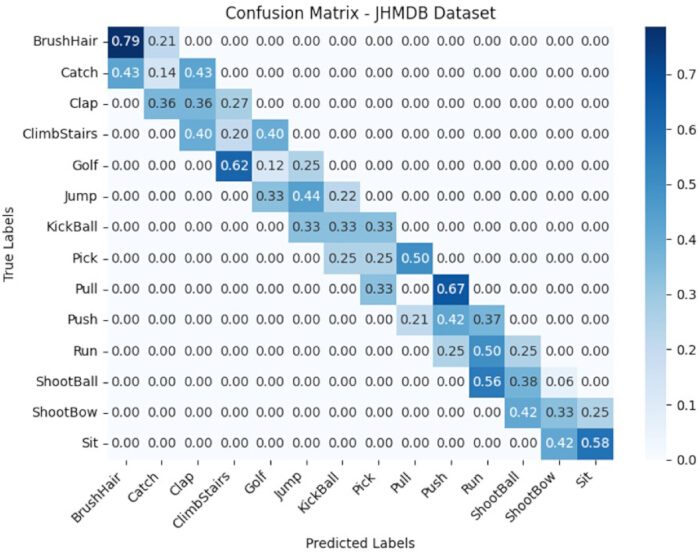
Afbeelding 12: Rij-genormaliseerde confusiematrix van het voorgestelde MSCNN-LSTM-model op de JHMDB-dataset.Elke rij is genormaliseerd naar één, en de diagonale elementen vertegenwoordigen de recall per klasse in plaats van de algemene classificatienauwkeurigheid, welke afzonderlijk wordt gerapporteerd. Klik hier om een grotere versie van deze afbeelding te bekijken.
Over het geheel genomen presteerde het voorgestelde MSCNN-LSTM-raamwerk consistent beter dan de geëvalueerde vergelijkingsmodellen op basis van classificatie-, overeenkomst-, discriminatie- en temporele stabiliteitsmaten. De bevindingen ondersteunden de hypothese dat de combinatie van multi-schaal ruimtelijke kenmerkextractie met LSTM-gebaseerde temporele modellering de herkenning van sportacties verbeterde over datasets met variërende bewegingscomplexiteit, beeldkwaliteit en standpuntcondities.
DATAbeschikbaarheid:
De datasets die tijdens de huidige studie zijn geanalyseerd, zijn openbaar beschikbaar via de volgende bronnen: de UCF11 (YouTube Actions) dataset (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php) en de UCF Sports dataset (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php). Om de reproduceerbaarheid van deze studie te ondersteunen, zijn de preprocessing-pipeline, de dataset-partitionering (generatie van train/validatie/test-splits), implementatiebestanden, configuratiebestanden en de ondersteunende documentatie die in de experimenten zijn gebruikt, gedeponeerd in de Zenodo-repository en zijn openbaar beschikbaar via https://doi.org/10.5281/zenodo.21020947.
Discussie
Het voorgestelde MSCNN-LSTM-framework presteerde consistent beter dan de geëvalueerde benaderingen over de benchmark-datasets UCF11, UCF Sports en JHMDB. Eerdere methoden gebaseerd op Dilated CNN–BiLSTM, Vision Transformer-architecturen en 3D CNN's hebben effectief spatiotemporeel kenlerleren aangetoond, maar kunnen worden beperkt door een hoge computationele complexiteit, aanzienlijke trainingsvereisten of onvoldoende representatie van fijnmazige bewegingspatronen23,24,25. In contrast hiermee integreerde het voorgestelde framework multi-schaal ruimtelijke kenmerkextractie met LSTM-gebaseerde temporele modellering, waardoor zowel lokale bewegingsdetails als lange-termijn temporele afhankelijkheden konden worden vastgelegd. Deze integratie verbeterde de herkenning van complexe sportacties, verminderde interklasse-verwarring en verbeterde de temporele consistentie, in het bijzonder op de meer uitdagende JHMDB-dataset. Deze resultaten geven aan dat het voorgestelde framework een gebalanceerde representatie bood van ruimtelijke en temporele informatie in vergelijking met de geëvalueerde CNN-, recurrente- en transformer-gebaseerde benaderingen.
Vanuit een theoretisch perspectief bood het MSCNN-LSTM-raamwerk een geunifiederde aanpak voor multi-schaal feature-fusie en sequentieel temporeel leren36,37. Het gebruik van hiërarchische receptieve velden maakte de extractie van ruimtelijke informatie op verschillende schalen mogelijk, terwijl de LSTM afhankelijkheden over opeenvolgende videoframes modelleerde. Dit ontwerp breidde de conventionele CNN-LSTM-pijplijn uit door lokale en contextuele ruimtelijke informatie te behouden voorafgaand aan de temporele modellering. De consistente prestaties over datasets met uiteenlopende actieklassen, bewegingspatronen en camerastandpunten ondersteunden verder de robuustheid van de voorgestelde architectuur.
Vanuit een praktisch perspectief toonde het raamwerk potentieel voor geautomatiseerde sportanalyse, beoordeling van atletenprestaties, eventdetectie en het begrijpen van sportvideo's. Verdere validatie onder operationele omstandigheden in de echte wereld is echter vereist vóór implementatie. Hoewel de architectuur sterke herkenningsprestaties behaalde, moet de geschiktheid voor apparaten met beperkte middelen of cloudgebaseerde analyseplatforms worden bevestigd via aanvullende evaluatie van de computationele kosten, inferentietijd, geheugenvereisten en energieverbruik.
De ablatiestudie demonstreerde de complementaire bijdragen van de MSCNN- en LSTM-componenten. De MSCNN verbeterde de extractie van ruimtelijke kenmerken door representaties op meerdere schalen van het receptieve veld te leren, terwijl de LSTM de temporele modellering verbeterde door bewegingsafhankelijkheden over opeenvolgende frames vast te leggen. De volledige MSCNN-LSTM-configuratie behaalde de beste prestaties, wat aangeeft dat multi-schaalse ruimtelijke kenmerkextractie en temporele sequentiemodellering gezamenlijk hebben bijgedragen aan de waargenomen verbetering in actieherkenning.
Over het algemeen combineerde het voorgestelde MSCNN-LSTM-framework effectief ruimtelijke en temporele representatie-learning voor actieherkenning in sportvideo's. Evaluatie op de UCF11-, UCF Sports- en JHMDB-datasets toonde een verbeterde prestatie aan in vergelijking met de geëvalueerde deep learning-benaderingen. Deze resultaten ondersteunden de hypothese dat de integratie van multi-schaal convolutionele kenmerken met LSTM-gebaseerde temporele modellering de herkenning van complexe sportacties verbetert. Desondanks is validatie op grotere, diversere en cross-domein datasets vereist om de generaliseerbaarheid en toepasbaarheid in de praktijk vast te stellen.
Er moeten enkele beperkingen in overweging worden genomen. Ten eerste was de evaluatie beperkt tot publiek beschikbare benchmark-datasets en is deze mogelijk niet volledig representatief voor de diversiteit en complexiteit van sportomgevingen in de echte wereld. Ten tweede, hoewel vaste partities voor training, validatie en testen werden gebruikt, konden datasetbias en onbedoelde datalekken niet volledig worden uitgesloten. Ten derde kunnen de gerapporteerde prestaties variëren afhankelijk van de samenstelling van de dataset, de initialisatie van het model, de voorbewerkingsprocedures en de trainingsinstellingen. Daarnaast verhoogden de multi-schaal convolutionele en temporele modelleringscomponenten de computationele vereisten, wat de implementatie op apparaten met beperkte middelen kan beïnvloeden. Het raamwerk werd bovendien niet geëvalueerd met behulp van externe datasets of real-time productiescenario's.
Transformer-gebaseerde videomodellen hebben sterke prestaties getoond op grootschalige datasets voor actieherkenning, maar vereisen vaak aanzienlijke rekenmiddelen en uitgebreide trainingsgegevens. Het voorgestelde MSCNN-LSTM-raamwerk biedt een alternatieve benadering door multi-scale ruimtelijke kenmerkextractie te combineren met recurrente temporele modellering. Toekomstig werk zou zich moeten richten op cross-dataset validatie, real-time inferentie, computationele optimalisatie, onzekerheidsschatting en hybride architecturen die transformer-gebaseerde aandachtmechanismen integreren met het voorgestelde multi-scale CNN-LSTM-raamwerk38.
Openbaarmakingen
De auteurs verklaren dat er geen belangenverstrengeling is.
Dankbetuigingen
Dit onderzoek is uitgevoerd bij het Center of Artificial Intelligence Technology (CAIT), Faculty of Information Science and Technology, Universiti Kebangsaan Malaysia. De auteurs betuigen hun dank voor de institutionele ondersteuning en de ter beschikking gestelde onderzoeksfaciliteiten. Dit werk heeft geen specifieke financiering ontvangen van enige publieke, commerciële of non-profit financieringsinstantie.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| GeForce RTX 3090 GPU | NVIDIA Corporation | RTX 3090, 24 GB VRAM | Gebruikt voor training en inferentie van deep learning-modellen |
| Intel Core i9 Processor | Intel Corporation | 16-Core, 3.5 GHz | Gebruikt voor datapreprocessing en berekeningen |
| Systeemgeheugen | Generic | 64 GB DDR4 RAM | Ondersteunt grootschalige videoverwerking |
| Python programmeertaal | Python Software Foundation | Versie 3.8.18 | Primaire programmeertaal voor implementatie |
| TensorFlow | Versie 2.15 | Deep learning-framework gebruikt voor modelontwikkeling | |
| Besturingssysteem | Microsoft Corporation | Windows 11 | Modelontwikkeling en experimentatie |
| CUDA Toolkit | NVIDIA Corporation | CUDA 11.8 | GPU-acceleratie voor modeltraining |
| cuDNN | NVIDIA Corporation | cuDNN 8.9.7 | Acceleratiebibliotheek voor diepe neurale netwerken |
| OpenCV | Open Source | Versie 4.8.1 | Extractie en preprocessing van videoframes |
| NumPy | Open Source | Versie 1.24.4 | Numerieke berekeningen en array-verwerking |
| Scikit-learn | Open Source | Versie 1.3.2 | Prestatie-evaluatie en statistische analyse |
| Matplotlib | Open Source | Versie 3.7.5 | Visualisatie van experimentele resultaten |
| UCF11 Dataset | University of Central Florida | Publieke dataset | Benchmarkdataset voor sportactieherkenning |
| UCF Sports Dataset | University of Central Florida | Publieke dataset | Benchmarkdataset voor sportactieherkenning |
| JHMDB Dataset | Max Planck Institute for Informatics | Publieke dataset | Benchmarkdataset voor menselijke beweging en actieherkenning |
Referenties
- Hassan N, Miah ASM, Shin J. A deep bidirectional LSTM model enhanced by transfer-learning-based feature extraction for dynamic human activity recognition. Appl Sci. 2024;14:603. https://doi.org/10.3390/app14020603
- Egawa R, et al. Dynamic fall detection using graph-based spatial temporal convolution and attention network. Electronics. 2023;12:3234. https://doi.org/10.3390/electronics12153234
- Riahi M, Eslami M, Safavi SH, Torkamani Azar F. Human activity recognition using improved dynamic image. IET Image Process. 2020;14:3223–3231. https://doi.org/10.1049/iet-ipr.2020.0372
- Muhammad K, et al. Human action recognition using attention-based LSTM network with dilated CNN features. Future Gener Comput Syst. 2021;125:820–830. https://doi.org/10.1016/j.future.2021.06.017
- Al-Obaidi S, Al-Khafaji H, Abhayaratne C. Making sense of neuromorphic event data for human action recognition. IEEE Access. 2021;9:82686–82700. https://doi.org/10.1109/ACCESS.2021.3085769
- Wensel J, Ullah H, Munir A. ViT-ReT: Vision and recurrent transformer neural networks for human activity recognition in videos. IEEE Access. 2023;11:72227–72249. https://doi.org/10.1109/ACCESS.2023.3293445
- Vrskova R, Hudec R, Kamencay P, Sykora P. Human activity classification using the 3DCNN architecture. Appl Sci. 2022;12:931. https://doi.org/10.3390/app12020931
- Ullah A, et al. Action recognition using optimized deep autoencoder and CNN for surveillance data streams of non-stationary environments. Future Gener Comput Syst. 2019;96:386–397. https://doi.org/10.1016/j.future.2019.01.041
- Jaouedi N, Boujnah N, Bouhlel MS. A new hybrid deep learning model for human action recognition. J King Saud Univ Comput Inf Sci. 2020;32:447–453. https://doi.org/10.1016/j.jksuci.2018.08.001
- Zebhi S, Al-Modarresi SMT, Abootalebi V. Converting video classification problem to image classification with global descriptors and pre-trained network. IET Comput Vis. 2020;14:614–624. https://doi.org/10.1049/iet-cvi.2020.0023
- Cust E, Sweeting AJ, Ball K, Robertson S. Machine and deep learning for sport-specific movement recognition: A systematic review. J Sports Sci. 2019;37:568–600. https://doi.org/10.1080/02640414.2018.1504613
- Cao S, Wang B, Zhang W, Ma L. Visual consensus modeling for video-text retrieval. In Proc AAAI Conf Artif Intell. 2022:167–175. https://doi.org/10.1609/aaai.v36i1.19890
- Yu H, et al. Fine-grained video captioning for sports narrative. In Proc IEEE Conf Comput Vis Pattern Recognit (CVPR). 2018:6006–6015. https://doi.org/10.1109/CVPR.2018.00628
- Browne P, Sweeting AJ, Woods CT, Robertson S. Methodological considerations for furthering the understanding of constraints in applied sports. Sports Med Open. 2021;7:22. https://doi.org/10.1186/s40798-021-00307-9
- Gao T, et al. Sports video classification method based on improved deep learning. Appl Sci. 2024;14:948. https://doi.org/10.3390/app14020948
- Dong Z, Xie M, Li X. Multi-scale receptive fields convolutional network for action recognition. Appl Sci. 2023;13:3403. https://doi.org/10.3390/app13063403
- Liu S, et al. Human memory update strategy: A multi-layer template update mechanism for remote visual monitoring. IEEE Trans Multimed. 2021;23:2188–2198. https://doi.org/10.1109/TMM.2020.3009234
- Liu S, Liu D, Muhammad K, Ding W. Effective template update mechanism in visual tracking with background clutter. Neurocomputing. 2021;458:615–625. https://doi.org/10.1016/j.neucom.2021.05.032
- Haque MN, et al. GRU-based attention mechanism for human activity recognition. In Proc ICASERT. 2019:1–6. https://doi.org/10.1109/ICASERT.2019.8934521
- Al-qaness MA, Dahou A, AbdElaziz M, Helmi A. Multi-ResAtt: Multilevel residual network with attention for human activity recognition using wearable sensors. IEEE Trans Ind Inform. 2022;19:144–152. https://doi.org/10.1109/TII.2022.3147850
- Duan F, et al. A multi-task deep learning approach for sensor-based human activity recognition and segmentation. IEEE Trans Instrum Meas. 2023;72:2514012. https://doi.org/10.1109/TIM.2023.3264512
- Gomes E, et al. Machine learning algorithms for activity-intensity recognition using accelerometer data. Sensors. 2021;21:1214. https://doi.org/10.3390/s21041214
- Su C, et al. A novel model for fall detection and action recognition combining lightweight 3D-CNN and ConvLSTM networks. Pattern Anal Appl. 2024;27:3. https://doi.org/10.1007/s10044-023-01234-5
- Zhou T, et al. Behavior recognition based on improved density clustering and context-guided Bi-LSTM model. Multimed Tools Appl. 2023;82:45471–45488. https://doi.org/10.1007/s11042-023-14678-9
- Shin J, et al. Video-based human activity recognition using hybrid deep learning model. Comput Model Eng Sci. 2025;143:3615. https://doi.org/10.32604/cmes.2025.058341
- Vrskova R, Hudec R, Kamencay P, Sykora P. A new approach for abnormal human activities recognition based on ConvLSTM architecture. Sensors. 2022;22:2946. https://doi.org/10.3390/s22082946
- Vijeikis R, Raudonis V, Dervinis G. Efficient violence detection in surveillance. Sensors. 2022;22:2216. https://doi.org/10.3390/s22062216
- Rendón-Segador F, et al. ViolenceNet: Dense multi-head self-attention with bidirectional ConvLSTM for detecting violence. Electronics. 2021;10:1601. https://doi.org/10.3390/electronics10131601
- Kalfaoglu E, Kalkan S, Alatan A. Late temporal modeling in 3D CNN architectures with BERT for action recognition. In Proc ECCV Workshops. 2020. https://doi.org/10.1007/978-3-030-66823-5_43
- Moaaz M, Mohamed E. Violence detection in surveillance videos using deep learning. Inf Bull Fac Comput Artif Intell. 2020;2:6.
- Song W, et al. Expressive 3D facial animation generation based on local-to-global latent diffusion. IEEE Trans Vis Comput Graph. 2024;30:7397–7407. https://doi.org/10.1109/TVCG.2024.3456213
- Li L, Cherouat A, Snoussi H, Wang T. Grasping with occlusion-aware ally method in complex scenes. IEEE Trans Autom Sci Eng. 2025;22:5944–5954. https://doi.org/10.1109/TASE.2024.3434610
- Li R, et al. UE-Extractor: A grid-to-point ground extraction framework for unstructured environments. IEEE Robot Autom Lett. 2025;10:5991–5998. https://doi.org/10.1109/LRA.2025.3563127
- Jhuang, H., Gall, J., Zuffi, S., Schmid, C., Black, M. J. Towards understanding action recognition. Proceedings of the IEEE International Conference on Computer Vision. 3192–3199, doi:10.1109/ICCV.2013.396 (2013).
- OpenMMLab. MMAction2: JHMDB dataset preparation. GitHub. https://github.com/open-mmlab/mmaction2/tree/main/tools/data/jhmdb (2026).
- Ullah W, Khalid YN, Khan SH. A novel deep hybrid framework with ensemble-based feature optimization for HAR. arXiv preprint arXiv:2508.18695. 2025. https://arxiv.org/abs/2508.18695
- Karuppannan K, Darmanayagam SE, Cyril SR. Human action recognition using fusion-based discriminative features and LSTM classification. Concurr Comput Pract Exp. 2022;34:e7250. https://doi.org/10.1002/cpe.7250
- Sahoo SP, et al. HAR-depth: A novel framework for human action recognition using sequential learning and depth estimated history images. IEEE Trans Emerg Top Comput Intell. 2020;5:813–825. https://doi.org/10.1109/TETCI.2020.3006543