Deze studie stelt een algoritme voor dat de hiërarchische visuele kenmerken die door een verschoven venster hiërarchische transformatorencoder worden vastgelegd, nauw koppelt aan de voorafgaande diepte van de Manhattan 3D-begrenzingsbox die door lijnsegmentdetectie wordt gegenereerd, waardoor een zeer precisie semantische reconstructie van complexe binnenscènes wordt bereikt.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Een semantische parsingsmethode voor beelden van binnenscènes gebaseerd op voorafgaande kennis van gebouwstructuur
In dit artikel
Samenvatting
Samenvatting
Om semantische voorspellingsdiscontinuïteiten en fysieke randvervormingen veroorzaakt door meubelocclusie in complexe binnenscènes aan te pakken, stelt dit artikel een semantische parsingsmethode voor die gebruikmaakt van gebouw-structuur voorafgaan. Het schema gebruikt een shifted-window hiërarchische transformatorencoder om multi-scale visuele kenmerken te extraheren en combineert een gradient-direction-consistentie lijnsegmentdetectie-algoritme om een Manhattan 3D-begrenzingsbox te construeren. Deze begrenzingsdoos wordt omgezet in een getekend afstandsveld (SDF) voordat discrete geometrische contouren worden gecodeerd in een continu fysisch potentiaalveld. Een structuurgestuurd kruis-aandacht mechanisme dwingt de visuele signalen uit te lijnen met echte 3D-orthogonale geometrische grenzen, waardoor de continuïteit van kenmerken in occludeerde gebieden wordt hersteld. Een ruimtelijke nabijheidsgraaf die is opgebouwd uit superpixelknooppunten stuurt een Graph Convolutioneel Netwerk (GCN) aan om kenmerken te aggregeren, wat zorgt voor macroscopische semantische consistentie binnen het fysieke dragende vlak. Een combinatie van pixelniveau cross-entropieverlies en een speciaal ontworpen structureel consistentieverlies versterkt de beperkingen, waardoor voorspellingen buiten de grenzen worden bestraft. Experimenten over meerdere onafhankelijke runs tonen aan dat de gemiddelde intersectie over union (mIoU) 68,7% bereikt met een standaarddeviatie van 0,2%, en de structurele grens F1-score 76,4% met een standaarddeviatie van 0,3%, wat de robuuste prestaties van de voorgestelde modules bevestigt. Met een enkele afbeeldingsknoop van 256 bleef de gemiddelde inferentietijd 61 ms.
Inleiding
Semantische analyse van binnenscènebeelden neemt een kernpositie in binnen driedimensionale ruimtelijke cognitie en intelligente ruimtelijke redeneeropdrachten 1,2. Visuele feature-extractie in echte fysieke omgevingen wordt vaak ernstig belemmerd door complexe ruimtelijke indelingen3. Het oplossen van de semantische discontinuïteit en fysieke randvervorming van de funderingsstructuur van het gebouw Funderingsstructuur veroorzaakt door grootschalige meubelocclusie is belangrijk voor ruimtelijk cognitieonderzoek 4,5. Het nauwkeurig verwijderen van interferentie door rommelige objecten en het herstellen van de fysieke continuïteit van dezelfde muur en vloer bepaalt direct de nauwkeurigheid van driedimensionale scène-reconstructie en globale ruimtelijke logica-analyse6. De semantische discontinuïteit veroorzaakt door grootschalige meubelocclusie en het structurele reparatie-effect van de voorgestelde building-prior guidance worden geïllustreerd in Figuur 1, waar de geblokkeerde rood-groen-blauwe (RGB) input in Tabel 1A, baseline maskervervorming in Figuur 1B en structuur-voor-reparatieresultaat in Figuur 1C worden vergeleken onder dezelfde binnenscènecondities.
Om te voldoen aan de nauwkeurigheidseisen van ruimtelijk logisch redeneren, ondervinden huidige mainstream pixelgestuurde visuele netwerken meerdere obstakels bij het omgaan met complexe binnenomgevingen 7,8. Binnenruimtes zijn vaak gevuld met dicht meubilair en rommelig meubilair, wat resulteert in een aanzienlijk verlies van lage visuele grenssignalen in de beelden9. Conventionele mechanismen voor het extractie van kenmerken zijn te veel afhankelijk van lokale tweedimensionale kleur- en textuurreacties, en missen een macroscopisch begrip van de rigide orthogonale wetten van driedimensionale, door mensen gemaakte structuren10. Deze beperking van het lokale receptieve veld maakt het gemakkelijk onderbroken dat de voortplanting van kenmerken wordt onderbroken, waardoor het moeilijk wordt om de globale topologie over occlusies11 uit te breiden. Momenteel is er een dringende behoefte om het kernprobleem van semantische voorspellingsdiscontinuïteiten en ernstige vervormingen van fysieke grenzen veroorzaakt door occlusie en interferentie12 op te lossen.
Om structurele gebreken in gebouwfunderingen veroorzaakt door occlusie en interferentie aan te pakken, heeft de academische gemeenschap een verscheidenheid aan gerichte interventiemaatregelen ontwikkeld13. Crossmodale feature-aggregatienetwerken compenseren effectief de inherente tekortkomingen van een enkele visuele modaliteit in ruimtelijke waarneming door dieptekaarten of tekstpriors toe te voegen ter ondersteuning van rood-groen-blauwe (RGB) beelden14,15. Grensperceptie en adaptieve contextselectiekaders injecteren fysieke contourverbeteringsstrategieën in de feature-decodeerfase, wat de edge fit van voorspellingsresultaten in complexe scènes aanzienlijk verbetert16,17. Inferentiemodellen gebaseerd op GCN's en mechanismen voor feature-interactie verbeteren de gladheid van features en macrosemantische consistentie in homogene regio's aanzienlijk door knooppuntniveauverbindingen te construeren18,19. Het integreren van expliciete Manhattan-structurele priors in de visuele feature-extractiepijplijn handhaaft geometrische consistentiegrenzen, wat de problemen met featurediscontinuïteit veroorzaakt door uitgebreide occlusie van voorgrondobjecten20 aanpakt.
Om de kernuitdaging van semantische voorspellingsfouten en ernstige vervormingen van fysieke grenzen die samenhangen met het bouwen van infrastructuur aan te pakken, wordt een semantisch parsingkader voorgesteld gebaseerd op een gesloten-lus koppelingsmechanisme dat architecturale priors verwerkt. Dit kader overstijgt naïeve engineeringpijplijnen door een bidirectionele mapping alignment te vestigen tussen continue geometrische potentiaalvelden en discrete visuele feature-variëteiten, waardoor een niet-triviale synergie ontstaat die occlusiefouten corrigeert via structurele wetten. Dit schema maakt gebruik van een multischaal visueel backbone-netwerk en een lijnsegmentdetectie-algoritme gebaseerd op vanishing-point schatting om lokale uiterlijkkenmerken en orthogonale randpriors te verkrijgen die de Manhattan 3D-begrenzingsbox parallel vertegenwoordigen, en deze vervolgens om te zetten in een SDF. Het algoritme maakt gebruik van een structuurgestuurd cross-attention mechanisme, waarbij visuele kenmerken als queryvectoren worden gebruikt en SDF-kenmerken worden behandeld als sleutels en waarden voor dot-productberekeningen, waardoor het visuele signaal wordt gedwongen uitgelijnd te zijn met de echte 3D-geometrische grens in de featureruimte. Een ruimtelijke nabijstandsgrafiek, geconstrueerd uit superpixelknopen en ruimtelijke coplanariteitsrandkenmerken, wordt in een GCN gevoerd om cross-node-featureaggregatie en berichtuitwisseling uit te voeren. Het end-to-end parameteroptimalisatieproces maakt gezamenlijk gebruik van pixel-niveau cross-entropie en een aangepaste structurele consistentieverliesfunctie, die voorspelde pixels die de gebouw-prior grens overschrijden strikt beperkt en bestraft. De volledige semantische parsingpijplijn wordt samengevat in Figuur 2, die RGB-beeldinvoer, geometrische prior extractie, cross-attention uitlijning, superpixel graph redenering en semantisch maskerdecodering verbindt binnen een uniforme architectuur.
Vroege scene-parsingnetwerken vertrouwden op convolutionele operaties om lokale uiterlijk-texturen vast te leggen, maar door beperkingen in lokale receptieve velden vertoonden ze onvoldoende semantische coherentie van grootschalige doelen21,22. Eerdere studies hebben de zelf-aandagmodule van de visuele Transformer-architectuur toegepast om globale contextuele informatie te extraheren en langeafstandspixelassociatiekenmerken te construeren23,24. Cross-modale multi-view feature-aggregatiestrategieën extraheren de driedimensionale geometrische ruimtelijke kenmerken van de scène door dieptekaart-puntwolken en tekstcommando-invoer te fuseren25,26. Hybride aandachtsmechanismen voor feature-fusie gericht op specifieke domeinen zijn geleidelijk volwassen geworden. Door het bouwen van feature-interactiebruggen hebben ze het energieverlies en de feature-sparsiteit bij multischaaltransmissie van visuele signalen aanzienlijk verminderd en de robuustheid van complex-structuurparsing verbeterd. Geavanceerde encoderontwerpen integreren en afleiden gezamenlijk ruimtelijke details uit het hoogfrequente domein naast globale en lokale kenmerken, waardoor het netwerk in staat wordt om fijnkorrelige semantische categorieën met hoge gelijkenis te onderscheiden en de nauwkeurigheid van het parsing binnen de deurverbetert 27,28. Recente ontwikkelingen in semantische segmentatiearchitecturen bieden waardevolle referenties voor het optimaliseren van computationele efficiëntie en ruimtelijke waarneming. Modellen die zijn ontworpen voor dichte voorspelling en multi-scale contextuele aggregatie extraheren fijnkorrelige geometrische kenmerken uit complexe achtergronden. Feature-ontkoppeling en synergetische fusiestrategieën pakken de semantische ambiguïteit in grensgebieden aan. Lichtgewicht aandachtsmechanismen en gegated aggregatiemodules optimaliseren de parameterverdeling, waardoor inferentie wordt versnellen en lokale structurele details behouden blijven. Het implementeren van deze efficiënte architectonische ontwerpen biedt theoretische richtlijnen om de rekenkundige overhead van niet-Euclidische topologische inferentieoperaties bij binnenscèneparsing te verminderen.
Gebouwstructuur-priors en 3D-indelingsschatting worden gebruikt om lokale visuele parsingfouten te corrigeren29. Eerdere studies hebben orthogonale en parallelle geometrische kenmerken van binnengebouwen als inferentiebeperkingen geëxtraheerd om netwerkvoorspellingsbias veroorzaakt door rommelige binnenachtergronden te verminderen.30,31. Bestaande schema's gebruiken lijnsegmentdetectie-algoritmen en beeldablatiepuntanalysetechnieken om Manhattan 3D-begrenzingsboxen te genereren die de fysieke grenzen van kamers in kaart brengen en helpen bij de lokalisatie van onderliggende visuele kenmerken32. De gezamenlijke architectuur van de grensbewustzijnsmodule en de multi-schaal context integreren impliciet voorafgaande structurele informatie in het hoogdimensionale feature-decodeerproces, waardoor het netwerk semantische maskers moet uitvoeren die nauw aansluiten bij de echte fysieke contouren, waardoor de scherpte en vervaging van objectranden effectief verbetert33. Semi-supervised of zwak gecontroleerde verliesfunctieontwerpen met randversterkingseigenschappen zijn breed onderzocht. Door te vertrouwen op rigoureuze wiskundige formules om onafhankelijk pixelclassificatiegedrag dat ruimtelijke topologische regels schendt te straffen, worden de geometrische gladheid en structurele integriteit van het uiteindelijke segmentatieresultaat gegarandeerd vanuit de bron van gradiëntoptimalisatie34.
Sommige studies hebben grafneurale netwerken gebruikt om cross-domein aggregatie van visuele kenmerken en redeneren over topologische relaties in hoogdimensionale ruimte35 uit te voeren. Het superpixelsegmentatie-algoritme aggregeert aangrenzende pixelblokken met vergelijkbare kleurrespons- en textuurkenmerken vooraf in onafhankelijke verbonden knooppunten. Het superpixelsegmentatie-algoritme comprimeert de rekenkundige redundantie van de grafiekstructuur op beeldniveau en behoudt de basis geometrische topologie van afbeelding36. De GCN, gebouwd op de hoogdimensionale knooppuntkenmerkvector, en de nabijheidsmatrix die ruimtelijke nabijheid weergeeft, zorgt voor efficiënte directionele transmissie en interactieve fusie van multi-scale visuele informatie langs de fysisch verbonden graaf in het ruimtelijke domein37,38. De toepassing van de temporele informatieverbeteringsmodule en het hybride multi-scale skip-verbindingsmechanisme onderdrukt de overmatige gladmaking en homogenisatie van knooppuntkenmerken die ontstaan tijdens het proces van meerlaagse diepe berichtuitwisseling39. De multi-scale graph wavelet transform technologie en de pseudo-label element learning optimization strategy optimaliseren het anti-achtergrondruismechanisme van de node feature updateformule, zodat features met dezelfde semantische attributen een coöperatieve responsmodus behouden in complex network topology40. Het graafgebaseerde redeneermechanisme brengt regelmatige pixelroosters in kaart naar niet-Euclidische topologische ruimten om feature-aggregatieberekeningen uit te voeren van onregelmatige gebouwstructuren en interieurcomponenten41.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Indoor RGB-scènesdatasets en hun semantische annotaties werden voorbereid vóór netwerktraining. De grootschalige indoor 3D-dataset en RGB-D indoor scene dataset (zie de Table of Materials) zijn verkregen uit hun officiële archieven. Binnenopnames met meubelocclusie, verlichtingsvariatie, muurgrensonderbreking en complexe ruimtelijke indelingen werden behouden om aan te sluiten bij het doelparsingscenario. Semantische labels werden omgezet in geïndexeerde enkelkanaals PNG-annotatiemaskers, en alle RGB-afbeeldingen en semantische maskers werden verkleind tot 512 × 512 pixels. Online data-augmentatie werd toegepast tijdens de training, met willekeurige horizontale flipping bij een kans van 0,5, willekeurige helderheidsscaling tussen 0,8 en 1,2, en willekeurige rotatie tussen −10° en +10° om de structurele indelingsverdeling te verbreden. RGB-kanalen werden genormaliseerd met gemiddelde waarden van 0,485, 0,456 en 0,406 en standaarddeviatiewaarden van 0,229, 0,224 en 0,225. De grootschalige indoor 3D-benchmark volgde de officiële release-verdeling die in deze studie werd gebruikt, met 1201 trainingsscènes en 312 validatiescènes voor modelontwikkeling en validatie. De RGB-D indoor scene benchmark volgde het officiële evaluatieprotocol, met 795 trainingsbeelden en 654 testbeelden. Er werd geen extra procentuele splitsing toegepast op deze twee publieke benchmarks.
Een visueel transformer-backbone-netwerk met verschoven-venster (zie de Table of Materials) werd geïnitialiseerd als de backbone van de moving-window transformer-encoder. De patch-embedding was geconfigureerd als 4 x 4 pixels. De embedding-afmetingen van de vier hiërarchische fasen werden ingesteld op 128, 256, 512 en 1024, en het aantal transformatorblokken in de vier fasen werd ingesteld op 2, 2, 18 en 2. De grootte van het lokale aandachtsvenster werd ingesteld op 7 x 7, en het aantal aandachtshoofden op 4, 8, 16 en 32 voor de vier hiërarchische fasen. Niet-lineaire continue activatiefuncties werden gebruikt in alle perceptronlagen van meerdere lagen. Ruimtelijke downsampling werd uitgevoerd via patch-merging operaties met een stap van 2 na elke hiërarchische fase. De kernnetwerkarchitectuur en hyperparameters van de convolutionele inferentiemodule werden samengevat in Tabel 1.
Vervolgens werd het extraheren van zelfaandachtskenmerken in verschoven vensters uitgevoerd op de invoerkenmerkkaarten. Elke featurekaart was verdeeld in niet-overlappende lokale vensters met ruimtelijke afmetingen van 7 × 7. Regelmatige raamaandacht en verschoven raam werden afgewisseld tussen aangrenzende transformatorblokken met verschoven raam. De cyclische shiftafstand werd ingesteld op 3 pixels, en er werd relatieve positionele bias-codering toegepast binnen elk lokaal aandachtsvenster. Lokale visuele kenmerken werden geaggregeerd via multi-head self-attention om hiërarchische, multi-scale feature-representaties te genereren.
Manhattan structurele priors werden geëxtraheerd uit indoor RGB-afbeeldingen. Structurele randsegmenten werden gedetecteerd met behulp van een gradient-direction-consistentie lijnsegmentdetectie-algoritme. Dominante structurele richtingen werden geclusterd via een random sample consensus (RANSAC) algoritme (zie de Materiaaltabel) gebaseerd op nulpuntschatting. Drie onderling orthogonale Manhattan-richtingen werden gereconstrueerd om de Manhattan 3D-begrenzingsboxrepresentatie te genereren. De gereconstrueerde structurele grens werd omgezet in een SDF-kaart door de minimale Euclidische afstand van elke pixel tot het dichtstbijzijnde grenslijnsegment te berekenen.
Structuurgestuurde cross-attention kenmerken werden gegenereerd nadat de visuele kenmerken en SDF-voorafgaande functies waren verkregen. De visuele featurevariëteit werd afgebeeld naar de query-tensor Q via de lineaire transformatiematrix W sub Q element van dubbel geslagen cap R naar de formatiematrix W sub Q element van dubbel geslagen cap R naar de formatiematrix 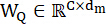 . Het continue afstandsveld daarvoor werd afgebeeld op de sleuteltensor K en de waardetensor V via de transformatiematrices
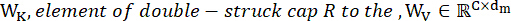 , en de modeldimensie werd ingesteld op 512. Multi-head modulatie verdeelde de projectieruimte in 8 onafhankelijke subruimten, waarbij elke head een dimensie van 64 had. De ruimtelijke indeling vooraf projecteerde discrete pixelcoördinaten in een continu potentiaalveld en genereerde de structurele affiniteitsmatrix S als expliciete additief ruimtelijke bias voor het moduleren van de dot-productgelijkenismatrix. De visuele kenmerktensor werd gebruikt als querybron omdat semantische parsing vereist dat elke visuele locatie actief structureel consistent bewijs uit de geometrische voorgaande ruimte haalt. De SDF werd daarvoor gebruikt als sleutel- en waardebron omdat deze continue grensafstand en binnen-buiten structurele aanwijzingen opslaat, afgeleid van de Manhattan-indeling. De dotproductterm mat de compatibiliteit tussen het semantische uiterlijk en de geometrische prior, terwijl de additieve structurele term λS de aandachtsgewichten verplaatste naar pixels op hetzelfde fysisch vlak of nabij dezelfde architectonische contour. De coëfficiënt λ vertegenwoordigde het vertrouwen in de geëxtraheerde structurele prior en bepaalde in hoeverre rigide orthogonale beperkingen in de aandachtsverdeling werden opgenomen. Deze formulering verminderde de diffusie van cross-boundary features veroorzaakt door meubelocclusie en behield adaptieve relaxatie in niet-Manhattan layouts. De structuurgeleide aandachtverdeling werd berekend volgens Vergelijking 1.
Vergelijking 1: 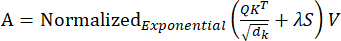
waarbij A de structuurgeleide aandachtsaggregatiematrix aanduidt, Q de querytensor die wordt gegenereerd uit visuele kenmerken, K de sleuteltensor die wordt gegenereerd uit SDF-voorgaande kenmerken, V de waardetensor die wordt gegenereerd uit structurele priorrepresentaties, dk de kenmerkdimensie van de sleuteltensor, λ de adaptieve structurele wegingscoëfficiënt die wordt gebruikt om de geometrische betrouwbaarheid van lokale regio's te identificeren en starre orthogonale beperkingen in niet-Manhattan ruimtelijke beperkingen te ontspannen layouts, en S duidt de SDF-affiniteitsmatrix aan. De verdeling door dk stabiliseerde de schaal van aandachtslogits en voorkwam dat grote feature-dimensies overgeconcentreerde aandachtsgewichten produceerden. De genormaliseerde exponentiële functie (zie de Tabel van Materiaal) transformeerde de gemoduleerde gelijkenisscores in een genormaliseerde ruimtelijke verdeling, waardoor elke pixel structurele voorinformatie kon aggregeren op basis van semantische en geometrische consistentie. Dit ontwerp verklaart waarom visuele uiterlijk en architectonische grenspriors op aandachtsniveau worden samengevoegd in plaats van door directe feature-concatenatie.
De superpixeltopologiegrafiek is geconstrueerd uit de structuur-uitgelijnde featuremap. De featuremap werd gesegmenteerd met behulp van een algoritme voor ruimtelijke regiogeneratie. Het superpixelgetal werd ingesteld op 256, de compactheidscoëfficiënt op 10, de Gaussische gladmakingscoëfficiënt op 1,0 en het iteratiegetal op 10. Ruimtelijke nabijheidsbeperkingen werden gehandhaafd door het gewicht van de afstandsmetriek tijdens clustering in te stellen op een constante verhouding van 1,0 tot de feature-kleurruimteafstand, waardoor uniforme knooppuntgeneratie over dichte rommelgrenzen behouden bleef. Pixels met homogene semantische responsen werden geaggregeerd tot superpixelknooppunten. Grafranden werden geconstrueerd volgens ruimtelijke nabijheidrelaties, SDF-affiniteitssterkte en coplanaire geometrische consistentiebeperkingen. Het constructieproces van de structurele affiniteitsmatrix en topologische connectiviteit wordt weergegeven in Figuur 3, waarin wordt getoond hoe SDF-geleiding werd omgezet in ruimtelijke relaties op grafniveau.
De grafiekformulering werd geïntroduceerd om dichte pixelwijze redenering om te zetten in node-gewijze ruimtelijke redenering over homogene structurele gebieden. Elke superpixelknoop vertegenwoordigde een lokaal gebied met een vergelijkbare semantische respons en ruimtelijke continuïteit, terwijl elke rand een betrouwbaar pad voor feature-overdracht vertegenwoordigde, onderhevig aan nabijheid, afstand-veld affiniteit en coplanair-consistentiebeperkingen. Dit ontwerp verminderde de invloed van geïsoleerde ruisachtige pixels en maakte occludeerde wand-, vloer- en plafondgebieden mogelijk om berichten te ontvangen van fysiek aangrenzende knooppunten. De randconstructie diende daarom als een wiskundige brug tussen continue SDF-geleiding en discrete niet-Euclidische graafredenering.
Een drielaags graf convolutioneel redeneernetwerk werd geconfigureerd met verborgen feature-dimensies van 512, 256 en 128. De convolutionele laag van de graaf voerde feature-gladmaking uit over de grafiekstructuur op basis van de ruimtelijke relaties tussen de knooppunten. De zelf-lus adjacency behield de oorspronkelijke staat van elke knoop tijdens het doorgeven van berichten, waardoor voorkomen dat de kenmerken van een kleine structurele regio werden gewist door omliggende grote gebieden. Symmetrische normalisatie schaalde de elementen van de nabijheid matrix met het product van de inverse vierkantswortels van de knoopgraden, zodat knooppunten met hoge en lage graad tijdens voortplanting bijdroegen onder vergelijkbare numerieke groottes. Feed-forward propagatie voerde lokale ruimtelijke aggregatie uit, waarbij elke knooptoestand hoogdimensionale kenmerken van aangrenzende coplanaire clusters absorbeerde voordat de elementgewijze niet-lineaire rectificatiefunctie werd toegepast. Deze formulering maakte de grafiekconvolutielaag een benaderde semantische diffusie langs fysiek betekenisvolle binnenvlakken in plaats van onbeperkte gladstrijking over de grenzen van niet-gerelateerde objecten. Grafiekknoopkenmerken werden geëvalueerd volgens Vergelijking 2.
Vergelijking 2: 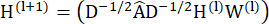
De projectie van dichte pixelfeatures naar superpixelknooppunten, het doorgeven van grafconvolutieberichten en coördinaten-terugprojectie worden weergegeven in Figuur 4, waarin het feature-aggregatiepad van reguliere beeldroosters naar een niet-Euclidische topologie en terug naar een dichte semantische representatie wordt verduidelijkt. De projectie van dichte pixelkenmerken in Figuur 4A naar superpixelknooppunten in Figuur 4B, het doorgeven van grafconvolutieberichten in Figuur 4C en de coördinaten-backprojectie in Figuur 4D verduidelijken het feature-aggregatiepad van reguliere beeldroosters naar een niet-Euclidische topologie en terug naar een dichte semantische representatie.
waarbij H(l) de knoopkenschapstensor van de l-de grafconvolutielaag aanduidt, Â de adjacentiematrix met zelflusverbindingen, D de graadmatrix die overeenkomt met de adjacentiematrix, W(l) de leerbare gewichtmatrix van de l-de graafconvolutielaag aanduidt, en σ de activatiefunctie van de gerectificeerde lineaire eenheid. De term ÂH(l) aggregeerde kenmerken van aangrenzende superpixelknooppunten, terwijl D−1/2 en D−1/2 de bijdrage van knooppunten met verschillende verbindingsdichtheden in balans brachten. De leerbare matrix W(l) projecteerde geaggregeerde knoopkenmerken in een nieuwe semantische ruimte, waardoor de graaflaag structurele consistentie kon onderscheiden van gewone ruimtelijke nabijheid. De niet-lineaire activatie behield het verschil in responsen tussen coplanaire en niet-coplanaire regio's na feature-aggregatie.
Semantische segmentatiekenmerken werden ontcijferd na graafredenering. De decoder werd geconstrueerd met drie bilineaire interpolatie-upsampling-fasen en cross-layer skip-connection fusieoperaties. Ondiepe ruimtelijke encoderkenmerken werden gekoppeld aan hoog-niveau semantische decoderkenmerken via kanaalgewijze fusie. De featureresolutie werd hersteld naar de oorspronkelijke beeldgrootte, en de uiteindelijke semantische kansvoorspellingskaart werd gegenereerd via een convolutielaag van 1 × 1.
Het volledige semantische parsingsnetwerk werd getraind met een ontkoppelde gewicht-decay optimizer (zie de Materiaaltabel). De initiële leersnelheid werd ingesteld op 0,0001, de gewichtsvervalcoëfficiënt op 0,01 en de batchgrootte op 8 voor beide publieke benchmarks. De eerste momentvervalsnelheid werd ingesteld op 0,9, de tweede op 0,999, en de numerieke stabiliteitsepsiloncoëfficiënt op 1 × 10⁻8. Het validatieverlies werd aan het einde van elke epoch gemonitord, en checkpoints werden opgeslagen wanneer de mIoU op de validatieset toenam. Het netwerk werd getraind voor 300 epochs met behulp van een polynomiale leersnelheidsvervalstrategie met een vervalkracht van 0,9. Vijf onafhankelijke trainingsruns werden uitgevoerd met verschillende willekeurige seed-initialisaties om een statistisch rigoureuze evaluatiebaseline vast te stellen. Het netwerk werd gezamenlijk geoptimaliseerd met behulp van pixelniveau cross-entropieverlies en structurele consistentieverlies. Alle experimenten werden uitgevoerd op een computerplatform uitgerust met hooggeheugen parallelle computerhardware, en gedetailleerde hardware-informatie werd gerapporteerd in de Table of Materials.
Gesamentlike optimalisatie dwong geometrische randuitlijning af door de ruimtelijke gradiëntgrootte van de klasse-kanstensor te berekenen. Het structurele consistentieverlies werd gebruikt als een regularizer, waarbij de norm van de ruimtelijke voorspellingsgradiënten werd vermenigvuldigd met de continue SDF-waarden. De wiskundige redenering was dat veranderingen in semantische categorieën zich moesten concentreren nabij reële architectonische contouren, waar de SDF naar nul toe gaat, terwijl vlakke wand-, vloer- en plafondinterieurs soepele semantische antwoorden moesten behouden. Wanneer een grote voorspellingsgradiënt ver van een structurele grens leek, verhoogde de afstandsveldterm de straf en ontmoedigde valse semantische overgangen binnen een homogeen fysisch vlak. Wanneer een voorspellingsgradiënt verscheen nabij een nul-afstandscontour, bleef de straf beperkt en behield legitieme klasseovergangen langs architectonische grenzen. Semantische overgangsgebieden werden beperkt om uit te lijnen met de nul-afstandscontouren van de SDF, zoals gegeven door Vergelijking 3.
Vergelijking 3: 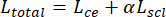
waarbij Ltotaal de uiteindelijke optimalisatiedoelfunctie aanduidt, Lce het pixelniveau kruis-entropieverlies, Lscl het verlies voor structurele consistentie en α de gewichtscoëfficiënt voor structureel verliesverlies. De kruis-entropieterm bood pixelniveau semantische supervisie via annotatiemaskers, terwijl de term structurele consistentie geometrische regularisatie oplegde met behulp van architecturale priors. De wegingscoëfficiënt α gebalanceerde categorieherkenning en grensuitlijning, waardoor wordt voorkomen dat de optimalisatie lokale labelnauwkeurigheid of starre structurele contouren overpast. Dit gezamenlijke doel verbond visuele semantiek, fysieke grensconsistentie en trainbare netwerkparameters binnen een geïntegreerde optimalisatiedoelstelling.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Experimentele opstelling
Deze studie gebruikte twee standaard indoor scene parsing datasets, een grootschalige indoor 3D-dataset en een RGB-D indoor scene dataset, om de prestaties te evalueren en het model af te stemmen. De grootschalige binnen-3D-dataset bevat realistisch gescande, complexe fysieke ruimte-scènes en hoge resolutie RGB-weergaven, met hoogprecisie, pixel-voor-pixel 3D puntwolk-semantische labels en 2D-ruimtelijke projectie-segm...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Het algoritme van dit artikel koppelt de hiërarchische visuele kenmerken die door een shifted-window hiërarchische transformatorencoder worden vastgelegd nauw aan de eerdere diepte van de Manhattan 3D-begrenzingsbox die wordt gegenereerd door lijnsegmentdetectie, waardoor een zeer precisie semantische reconstructie van complexe binnenscènes wordt bereikt. Een structuurgestuurd kruis-aandachtmechanisme dwingt het visuele signaal om zich uit te lijnen met de werkelijke geometrische grens d...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs verklaren dat zij geen financiële belangenconflicten hebben.
Dankbetuigingen
Financiering: Belangrijk Onderzoeks- en Ontwikkelingsprogramma van Shaanxi (Programma nr. 2024CY2-GJHX-76).
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| AdamW optimizer | PyTorch Contributors | https://pytorch.org/ | |
| CCANet | Zihao Z. et al. | https://doi.org/10.1109/TCDS.2024.3455356 | |
| CMPFFNet | Zhou W. et al. | https://doi.org/10.1109/TASE.2023.3332021 | |
| ConvNeXt | Meta AI Research | https://github.com/facebookresearch/ConvNeXt | |
| InternImage | OpenGVLab | https://github.com/OpenGVLab/InternImage | |
| Mask2Former | Meta AI Research | https://github.com/facebookresearch/Mask2Former | |
| MaskDINO | IDEA-Research | https://github.com/IDEA-Research/MaskDINO | |
| NYUv2 | http://cs.nyu.edu/~silberman/datasets/nyu_depth_v2.html | ||
| OneFormer | SHI Labs | https://github.com/SHI-Labs/OneFormer | |
| RANSAC algorithm | scikit-learn developers | https://scikit-learn.org/ | |
| ScanNet V2 | http://www.scan-net.org/ | ||
| SegFormer | NVIDIA | https://github.com/NVlabs/SegFormer | |
| SGCA_GCN | Authors of this study | Proposed method (N/A) | |
| Softmax function | PyTorch Contributors | https://pytorch.org/ | |
| Swin Transformer | Microsoft Research | https://github.com/microsoft/Swin-Transformer |
Referenties
- Zhang Z et al. CCANet: cross-modality comprehensive feature aggregation network for indoor scene semantic segmentation. IEEE Trans Cogn Dev Syst. 2024;17:366–378.
- Cui Y et al. Improving the segmentation of confusable indoor structures using point convolution and sparse vector attention. Geospat Inf Sci. 2025:1–22.
- Yang L, Cai H. Cost-efficient image semantic segmentation for indoor scene understanding using weakly supervised learning and BIM. J Comput Civ Eng. 2023;37:04022062–04022082.
- Uckan T, Aslan C, Hark C. A comprehensive hybrid approach for indoor scene recognition combining CNNs and text-based features. Sensors. 2025;25(17):5350. doi:10.3390/s25175350.
- Sun R et al. Training indoor and scene-specific semantic segmentation models to assist blind and low-vision users in activities of daily living. IEEE Open J Eng Med Biol. 2025;6:533–539.
- Ye S, Hu Y, Lin M. Indoor scene reconstruction with fine-grained details using hybrid representation and normal prior enhancement. IEEE Trans Vis Comput Graph. 2024;31:5275–5287.
- Naseer A et al. Multimodal scene recognition using semantic segmentation and deep learning integration. PeerJ Comput Sci. 2025;11. doi:10.7717/peerj-cs.2858.
- Bae JH, Yu GH, Lee JH. Superpixel image classification with graph convolutional neural networks based on learnable positional embedding. Appl Sci. 2022;12:9176–9190.
- Zhang H, Zou J, Zhang L. EMS-GCN: an end-to-end mixhop superpixel-based graph convolutional network for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2022;60:1–16.
- Mu Y, Ou L, Chen W. Superpixel-based graph convolutional network for UAV forest fire image segmentation. Drones. 2024;8:142–158.
- Khatun Z, Jonsson H Jr, Tsirilaki M. Beyond pixel: superpixel-based MRI segmentation through traditional machine learning and graph convolutional network. Comput Methods Programs Biomed. 2024;256:108398–108412.
- Yongyin L, Caixia Y. Cross-attention swin transformer for detailed segmentation of ancient architectural color patterns. Front Neurorobot. 2024;18:1513488–1513508.
- Zhou X, Zhou L, Gong S. Swin transformer embedding dual stream for semantic segmentation of remote sensing imagery. IEEE J Sel Top Appl Earth Obs Remote Sens. 2023;17:175–189.
- Ning X, Jiang L, Li W. Swin-MGNet: swin transformer-based multiview grouping network for 3D object recognition. IEEE Trans Artif Intell. 2024;6:747–758.
- Ke A, Luo J, Cai B. UNet-like network fused swin transformer and CNN for semantic image synthesis. Sci Rep. 2024;14:16761–16779.
- Li Y et al. IED-GCN: an internal and external decoupled graph convolutional network for landslide susceptibility assessment. IEEE Trans Geosci Remote Sens. 2025;63:1–17.
- He T, Chen J. DC-GCN: a lightweight graph convolutional network integrating local and global context for semantic segmentation. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:28283–28299. doi:10.1109/JSTARS.2025.3626006.
- Imani M. Superpixel-based graph convolutional neural network for polarimetric synthetic aperture radar image classification. Sci Rep. 2026;16:4736. doi:10.1038/s41598-025-34965-6.
- Wang S, Feng S, Wang Z. Structural prior-guided and feature-enhanced transformer with masked image modeling pretraining for retinal layers and fluid segmentation in macular edema OCT images. Biomed Opt Express. 2025;16:5096–5117.
- Yuan Z et al. Structure-aware progressive multimodal fusion network for RGB-T crack segmentation. J Imaging. 2025;11(11):384. doi:10.3390/jimaging11110384.
- Xu S, Shen R, Liu E. A structure-prior-guided adaptive context selection network for remote sensing semantic segmentation. Electron Lett. 2025;61. doi:10.1049/ell2.70161.
- Minaee S, Boykov Y, Porikli F. Image segmentation using deep learning: a survey. IEEE Trans Pattern Anal Mach Intell. 2021;44:3523–3542.
- Zhou E, Murray AT, Baik J. Mapping 3D classroom seats based on partial object point cloud completion. Cartogr Geogr Inf Sci. 2024;51:404–420.
- Nishi T, Kawasaki S, Iewaki K. M3R-CNN: on effective multimodal fusion of RGB and depth cues for instance segmentation in bin picking. Adv Robot. 2023;37:1143–1157.
- Zhou W, Xiao Y, Yan W. CMPFFNet: cross-modal and progressive feature fusion network for RGB-D indoor scene semantic segmentation. IEEE Trans Autom Sci Eng. 2023;21:5523–5533.
- Zhou W, Xiao Y, Liu Y. FIMKD: feature implicit mapping knowledge distillation for RGB-D indoor scene semantic segmentation. IEEE Trans Artif Intell. 2024;5:6488–6499.
- Liu J, Jiang Z, Xu X. Multi-robot collaborative complex indoor scene segmentation via multiplex interactive learning. CAAI Trans Intell Technol. 2025;10:1646–1660.
- Zhang S, Xie M. MIPANet: optimizing RGB-D semantic segmentation through multimodal interaction and pooling attention. Front Phys. 2024;12:1411559–1411572.
- Li JW et al. Construction of a multiscale feature fusion model for indoor scene recognition and semantic segmentation. Sci Rep. 2025;15:14701. doi:10.1038/s41598-025-95465-1.
- Liang X et al. Indoor building structure segmentation in unorganized point clouds based on corner feature. Eng Constr Archit Manag. 2025. doi:10.1108/ECAM-10-2024-1433.
- Wu LF, Wei D, Xu CA. CFANet: the cross-modal fusion attention network for indoor RGB-D semantic segmentation. J Imaging. 2025;11(6):177. doi:10.3390/jimaging11060177.
- Fan L, Zhou Y, Liu H. Combining swin transformer with UNet for remote sensing image semantic segmentation. IEEE Trans Geosci Remote Sens. 2023;61:1–11.
- Wang Z, Liao Z, Zhou B. SwinURNet: hybrid transformer-CNN architecture for real-time unstructured road segmentation. IEEE Trans Instrum Meas. 2024;73:1–16.
- Zhang H et al. Frequency-domain-guided swin transformer and global-local feature integration for remote sensing images semantic segmentation. IEEE Trans Geosci Remote Sens. 2025;63:5612611. doi:10.1109/TGRS.2025.3535724.
- Li GY, Chen J, Jang SI. SwinCross: cross-modal swin transformer for head and neck tumor segmentation in PET-CT images. Med Phys. 2024;51:2096–2107.
- Tang Y, Hu X, Ke T. Semantic segmentation of high-resolution remote sensing imagery via an end-to-end graph attention network with superpixel embedding. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:7236–7252.
- Wang R, Nie Y, Geng J. Multiscale superpixel-guided weighted graph convolutional network for polarimetric SAR image classification. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:3727–3741.
- Li S, Wu K, Liu H. Hyperspectral image classification based on multiscale feature search graph convolutional network with meta pseudo-labels. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:23485–23504.
- Yang B, Cheng X, Guo J. Temporal information-enhanced graph convolutional network with superpixel-pixel gated knowledge dynamic selection for change detection in satellite time series. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:18399–18412.
- Zhang H, Ku J, Zhao J. Multi-scale graph wavelet convolutional network for hyperspectral image classification. Front Remote Sens. 2025;6:1637820. doi:10.3389/frsen.2025.1637820.
- Zhou Q, Wang L, Gao G. Boundary-guided lightweight semantic segmentation with multiscale semantic context. IEEE Trans Multimedia. 2024;26:7887–7900.
- Xu X, Yen GG, Zhao C. Boundary-based active domain adaptation for semantic segmentation under adverse conditions. IEEE Trans Neural Netw Learn Syst. 2025;36:14721–14734.
- Tang Y, Feng S, Zhao C. A semantic change detection network based on boundary detection and task interaction for high-resolution remote sensing images. IEEE Trans Neural Netw Learn Syst. 2025;36:17184–17198.
- Guan L, Yuan X. Dynamic weighting and boundary-aware active domain adaptation for semantic segmentation in autonomous driving environment. IEEE Trans Intell Transp Syst. 2024;25:18461–18471.
- Fenglei W, Xin G, Zongze Z. A boundary-enhanced semantic segmentation model for buildings. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:5733–5748.
- Shan K, Tan L, Li Y, Jia T. Multi-scale boundary-aware network for remote sensing image semantic segmentation. Sci Rep. 2026;16:3797. doi:10.1038/s41598-025-33943-2.
- Wu D, Guo Z, Li A. Conditional boundary loss for semantic segmentation. IEEE Trans Image Process. 2023;32:3717–3731.
- Li Y, Zhang C, Wang H. Boundaries matter: a novel multibranch semisupervised semantic segmentation method. IEEE Intell Syst. 2024;40:35–44.
- Wang JQ, Chen T, Zheng L. A multiscale remote sensing semantic segmentation model with boundary enhancement based on UNetFormer. Sci Rep. 2025;15:14737. doi:10.1038/s41598-025-99663-9.
- Jung H, Choi HS, Kang M. Boundary enhancement semantic segmentation for building extraction from remote sensed image. IEEE Trans Geosci Remote Sens. 2021;60:1–12.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.