Dit protocol beschrijft de implementatie van een interoperabel webplatform dat op FHIR gebaseerde klinische gegevens integreert met Retrieval-Augmented Generation en multi-agent grote taalmodellen voor klinische besluitvormingsondersteuning. De workflow maakt reproduceerbare implementatie, gestandaardiseerde gegevensintegratie en evaluatie van door kunstmatige intelligentie (AI) ondersteunde medische gegevensanalyse mogelijk.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Interoperabel webplatform op basis van grote taalmodellen voor medische data-analyse: een protocol voor klinische beslissingsondersteuning
In dit artikel
Samenvatting
Samenvatting
Klinische besluitvorming wordt vaak belemmerd door gefragmenteerde elektronische gezondheidsdossiers en beperkte interoperabiliteit tussen heterogene zorginformatiesystemen. Dit artikel presenteert een stapsgewijs protocol voor de implementatie van een interoperabel webplatform dat klinische gegevens integreert via de Fast Healthcare Interoperability Resources (FHIR)-standaard, samen met Retrieval-Augmented Generation (RAG), Large Language Models (LLMs) en een multi-agent klinisch redeneringskader ter ondersteuning van medische data-analyse en klinische besluitvormingsondersteuning. Het protocol beschrijft de volledige workflow, inclusief de configuratie van de computationele omgeving, preprocessing van klinische datasets, FHIR-gebaseerde dataintegratie, constructie van de vectordatabase, retrieval-configuratie, prompt engineering, multi-agent orchestratie en systeemevaluatie. Representatieve resultaten tonen het vermogen van het platform aan om klinisch relevante en contextueel consistente antwoorden te genereren, terwijl de semantische interoperabiliteit over heterogene databronnen wordt verbeterd. De systeemprestaties werden geëvalueerd met aanvullende kwantitatieve en semantische metrieken, waaronder BLEU, ROUGE, BERTScore en cosinus-overeenkomst. Er is een kwalitatieve beoordeling uitgevoerd met gebruik van publiek toegankelijke, volledig geanonimiseerde benchmark-gezondheidsdatasets om de reproduceerbaarheid van de voorgestelde methodologische workflow te evalueren. De voorgestelde architectuur combineert gestandaardiseerde interoperabiliteit in de gezondheidszorg met retrieval-enhanced taalmodellen om het contextuele redeneren te verbeteren, hallucinaties te verminderen en reproduceerbare AI-ondersteunde klinische workflows te faciliteren. Dit protocol biedt een schaalbaar en reproduceerbaar kader voor onderzoekers en ontwikkelaars die interoperabele, privacybewuste en intelligente zorgsystemen willen implementeren voor klinische besluitvormingsondersteuning, medische data-analyse en toekomstig translationeel onderzoek.
Inleiding
Gezondheidsinformatie wordt routinematig gegenereerd in ziekenhuizen, diagnostische centra, laboratoria en poliklinieken, en blijft vaak verspreid over heterogene informatiesystemen. Deze fragmentatie beperkt de interoperabiliteit en belemmert de tijdige toegang tot volledige patiëntendossiers, wat aanhoudende uitdagingen creëert voor de klinische zorg, dataintegratie en het management van de gezondheidszorg1,2,3,4.
De gevolgen van deze fragmentatie worden bijzonder duidelijk in klinische workflows die afhankelijk zijn van tijdige toegang tot patiënteninformatie. Wanneer zorgverleners geen volledige en geïntegreerde medische dossiers kunnen opvragen, wordt de klinische beoordeling bemoeilijkt, wat het risico op onvolledige besluitvorming vergroot en de efficiëntie van de zorgverlening vermindert, met name in noodsituaties5,6.
Recente ontwikkelingen in kunstmatige intelligentie (AI), in het bijzonder Large Language Models (LLMs), hebben het scala aan computationele benaderingen voor toepassingen in de gezondheidszorg uitgebreid. Deze modellen zijn onderzocht voor taken zoals diagnostische ondersteuning, klinische triage en beslissingsondersteuning. Zo evalueerden Jahan et al.5 het gebruik van LLMs bij biomedische taken, terwijl Taylor et al.7 fijngestemde modellen onderzochten voor digitale screening van de mentale gezondheid en bemoedigende resultaten rapporteerden in gespecialiseerde klinische omgevingen.
De toepassing van LLM's is ook uitgebreid naar meer gespecialiseerde klinische domeinen. Song et al. 49 onderzochten hun gebruik bij de diagnose van pneumoconiose, terwijl Chien et al.8 deze modellen toepasten om werkbelastingspatronen bij informele zorgverleners te analyseren. In de oogheelkunde stelden Xue et al.9 een vraag-antwoord-systeem voor voor de diagnose van glaucoom, terwijl Tan et al.3 en Wu et al.10 melding maakten van het gebruik van LLM's in hybride diagnostische systemen en consultaties binnen de traditionele Chinese geneeskunde.
Het gebruik van LLM's is niet beperkt tot directe klinische toepassingen. Zhang et al.11 onderzochten hun toepassing voor emotieherkenning in scenario's rondom geestelijke gezondheidszorg, terwijl Sarzaeim et al.12 intelligente politiesystemen exploreerden die mogelijk ook kunnen bijdragen aan analyses gerelateerd aan de volksgezondheid. Deze studies illustreren de brede toepasbaarheid van LLM-gebaseerde benaderingen over verschillende domeinen binnen de gezondheidszorg.
Hoewel LLM's de mogelijkheden voor toepassingen in de gezondheidszorg hebben uitgebreid, blijft hun integratie in klinische omgevingen gepaard gaan met belangrijke technische, organisatorische en regelgevende uitdagingen. Praktische implementatie vereist een passende computationele infrastructuur, effectief databeheer en naleving van regelgevende kaders zoals de Algemene Verordening Gegevensbescherming (AVG) en de Braziliaanse Algemene Gegevensbeschermingswet (LGPD). Deze kaders stellen eisen aan de veilige en ethische verwerking van gevoelige gezondheidsinformatie, terwijl zij kwesties adresseren met betrekking tot privacy, betrouwbaarheid en algoritmische bias in door AI ondersteunde systemen voor de gezondheidszorg13,14.
Interoperabiliteit tussen heterogene bronnen van gezondheidszorggegevens, waaronder elektronische patiëntendossiers (EPD's), medische beeldvormingssystemen en Internet of Things (IoT)-apparaten, vormt nog steeds een grote technische uitdaging voor de implementatie van AI-ondersteunde oplossingen in de gezondheidszorg. In deze context bieden gestandaardiseerde interoperabiliteitskaders zoals HL7 FHIR een gestructureerd mechanisme voor het uitwisselen van klinische informatie tussen verschillende systemen, waarbij de semantische consistentie behouden blijft en schaalbare integratie wordt ondersteund.
Dit werk presenteert een interoperabel webplatform dat Large Language Models integreert met interoperabiliteitsstandaarden voor de gezondheidszorg om medische data-analyse in heterogene klinische omgevingen te ondersteunen. De voorgestelde architectuur combineert HL7 FHIR-gebaseerde dataintegratie met Retrieval-Augmented Generation (RAG) en een framework voor multi-agent verwerking om contextbewuste AI-ondersteunde analyse te bieden, terwijl de naleving van de toepasselijke gegevensbeschermingseisen wordt gewaarborgd, inclusief de Braziliaanse Algemene Gegevensbeschermingswet (LGPD).
Dit protocol beschrijft een interoperabele architectuur voor het integreren van heterogene klinische gegevens met behulp van vastgestelde standaarden voor interoperabiliteit in de gezondheidszorg. Daarnaast wordt de implementatie van een multi-agent verwerkingspijplijn gedetailleerd, gebaseerd op grote en kleine taalmodellen (LLM's en SLM's), samen met een evaluatiekader dat kwantitatieve metrieken en kwalitatieve analyses combineert om het gedrag van het voorgestelde platform te beoordelen.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Deze studie omvatte geen werving van menselijke deelnemers, geen toegang tot identificeerbare patiëntendossiers en geen experimenten met dieren. Het protocol is uitsluitend ontwikkeld en geëvalueerd met gebruik van publiek toegankelijke en volledig geanonimiseerde datasets voor methodologische validatie. Er is geen toegang tot persoonlijke gezondheidsinformatie verkregen of verwerkt. Daarom was goedkeuring van een Institutionele Toetsingscommissie (IRB) of een Medisch Ethische Toetsingscommissie niet vereist. Het protocol is ontwikkeld in overeenstemming met de geldende principes voor gegevensbescherming, waaronder de Braziliaanse Algemene Gegevensbeschermingswet (LGPD), ter ondersteuning van toekomstige toepassingen met klinische gegevens.
Datasetselectie en preprocessing
Het voorgestelde protocol werd geëvalueerd met behulp van openbaar beschikbare en volledig geanonimiseerde klinische datasets, bestaande uit gestructureerde elektronische patiëntendossiers (EPD's), gegevens van klinische vraag-en-antwoordsets en medische beelddatasets voor methodologische validatie. Voorafgaand aan de integratie in het platform ondergingen de datasets gestandaardiseerde voorbehandelingsprocedures, waaronder datanormalisatie, verwijdering van inconsistente of onvolledige records, mapping naar HL7 FHIR-bronnen, tekstzuivering, segmentatie in retrieval-chunks en het genereren van embeddings voor vectorindexering. Deze voorbehandelingsstappen waarborgden de semantische consistentie tussen heterogene databronnen, wat de interoperabiliteit faciliteerde en de reproduceerbaarheid van de voorgestelde workflow mogelijk maakte, terwijl voldaan werd aan de geldende principes voor gegevensprivacy.
De datasets zijn verkregen uit openbaar toegankelijke benchmark-repositories die veelvuldig worden gebruikt in onderzoek naar kunstmatige intelligentie en digitale gezondheidszorg. Ze zijn geselecteerd om heterogene klinische informatie te representeren, waaronder gestructureerde elektronische patiëntendossiers (EPD's), ongestructureerde klinische narratieven, taken voor klinische vraag-en-antwoordsystemen en metadata van medische beeldvorming. In plaats van een specifieke klinische cohort te evalueren, richt het protocol zich op het demonstreren van een reproduceerbare implementatieworkflow die kan worden aangepast aan verschillende datasets uit de gezondheidszorg. De diversiteit van deze benchmark-datasets maakt validatie mogelijk van de interoperabiliteitspipeline, Retrieval-Augmented Generation (RAG) en het multi-agent redeneerkader over meerdere klinische datamodaliteiten.
Configuratie van de experimentele omgeving
De experimentele omgeving werd geconfigureerd om het interoperabele platform onder gecontroleerde en reproduceerbare omstandigheden te evalueren. De architectuur bestaat uit modules voor gegevensingestie, interoperabiliteitslagen, grote taalmodellen (LLM's) en evaluatiecomponenten, georganiseerd in een enkele verwerkingspipeline voor de analyse van medische gegevens. Figuur 1 illustreert de volledige workflow, van de ingestie van klinische gegevens tot het genereren van diagnostische outputs.
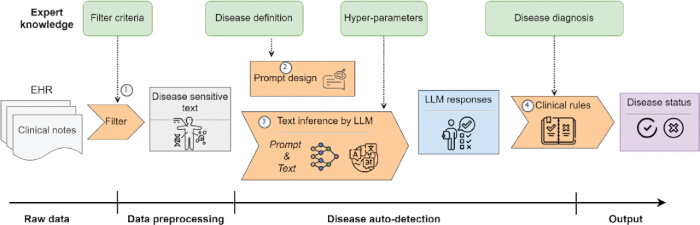
Figuur 1: Algemene systeemworkflow die de verwerkingspijplijn illustreert van ruwe klinische gegevens naar de output van de ziektestatus. Het proces begint met de inname van elektronische patiëntendossiers (EHR), gevolgd door gegevensfiltering en voorbewerking om ziektegevoelige informatie te extraheren. Een fase voor gestructureerd prompt-ontwerp integreert expertkennis, ziektedefinities en hyperparameters, wat een effectieve interactie met het Large Language Model (LLM) mogelijk maakt. Het LLM voert tekstinferentie uit om contextbewuste antwoorden te genereren, die vervolgens via klinische regels worden geëvalueerd om de uiteindelijke ziektestatus te bepalen. De workflow benadrukt de integratie van gegevensvoorbewerking, kennisgestuurde prompting en AI-gebaseerde inferentie ter ondersteuning van de klinische besluitvorming. Klik hier om een grotere versie van deze figuur te bekijken.
Architectuur voor interoperabiliteit in de gezondheidszorg
De backend-infrastructuur maakt gebruik van een modulaire architectuur op basis van RESTful API's om de communicatie tussen de platformcomponenten te ondersteunen (Figuur 2). Deze architectuur faciliteert heterogene klinische informatie, waaronder gestructureerde elektronische patiëntendossiers (EPD's), artsaantekeningen en metadata afgeleid van medische beeldvormingssystemen. Omdat deze gegevens afkomstig zijn uit meerdere bronnen en formaten, wordt interoperabiliteit bereikt via gestandaardiseerde datamodellen, in het bijzonder het Fast Healthcare Interoperability Resources (FHIR)-raamwerk15,16,17..De adoptie van FHIR ondersteunt de gestructureerde informatie-uitwisseling, terwijl de schaalbaarheid en flexibiliteit in gedistribueerde gezondheidszorgomgevingen behouden blijven. HL7-gebaseerde communicatiemechanismen zijn ook geïntegreerd om de integratie met legacy klinische systemen te vergemakkelijken, die nog steeds veelvuldig worden gebruikt in zorginstellingen16,17.
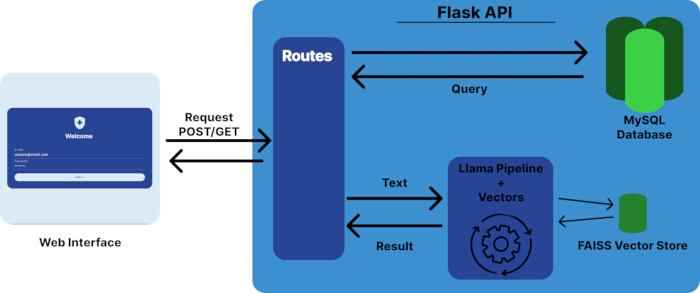
Figuur 2: Systeemarchitectuur van het voorgestelde interoperabele platform. De webinterface communiceert met de backend via een Flask API met behulp van HTTP POST/GET-aanvragen. De API beheert de routing, queryverwerking en interactie met zowel gestructureerde als ongestructureerde gegevensbronnen. Een MySQL-database slaat gestructureerde klinische gegevens op, terwijl een op FAISS gebaseerde vectorstore similarity search ondersteunt voor retrieval-operaties. De op LLaMA gebaseerde pipeline verwerkt tekstuele inputs en genereert antwoorden met behulp van vectorrepresentaties, wat Retrieval-Augmented Generation (RAG) mogelijk maakt. De architectuur benadrukt de integratie van webservices, databasebeheer, vectorretrieval en inferentie van grote taalmodellen in één unified systeem. Klik hier om een grotere versie van deze figuur te bekijken.
Configuratie van multi-agent workflows
De multi-agent architectuur is georganiseerd in gespecialiseerde functionele agenten die verantwoordelijk zijn voor verschillende stadia van de workflow. Een preprocessingsagent voert datanormalisatie en FHIR-mapping uit, gevolgd door een retrieval-agent die verantwoordelijk is voor de semantische zoekopdracht binnen de vectordatabase. Een reasoning-agent integreert de opgehaalde context met het LLM om antwoorden te genereren, terwijl een validatieagent de consistentie en opmaak van de output verifieert voordat het definitieve antwoord wordt teruggegeven. De coördinatie van de agenten volgt een sequentiële orchestratiestrategie waarbij de output van elke agent dient als input voor de volgende fase, wat een reproduceerbare en modulaire implementatie waarborgt.
Integratie van klinische gegevens
De data-integratielaag aggregeert informatie uit meerdere klinische bronnen en bereidt deze voor op verdere verwerking. De preprocessing omvat datanormalisatie, tokenisatie en entity-uitlijning om de semantische consistentie tussen heterogene datasets te verbeteren. Omdat klinische informatie varieert in structuur en kwaliteit, helpen deze bewerkingen om ruis te verminderen en de interactie met AI-modellen te vergemakkelijken. Er werden ook gestructureerde mapping-strategieën toegepast om verschillende dataformaten te harmoniseren en de compatibiliteit met de verwerkingspipeline te behouden, zoals geïllustreerd in Figuur 315,16,17.
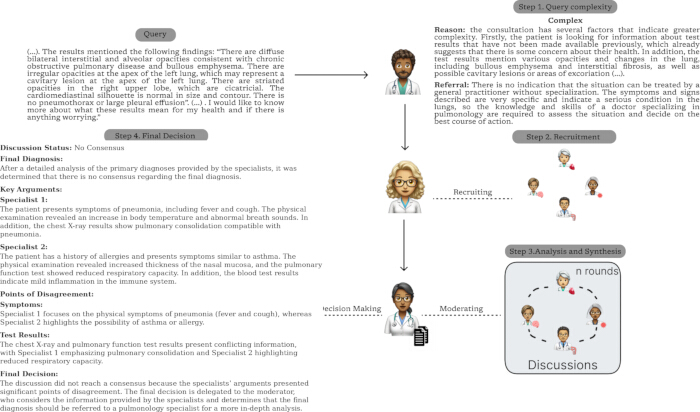
Figuur 3: Gedetailleerd voorbeeld van het klinische redeneerproces met meerdere agenten. De figuur illustreert hoe een klinische vraag in meerdere stadia wordt geanalyseerd, waaronder de beoordeling van de complexiteit, de werving van specialisten, collaboratieve discussie en de uiteindelijke besluitvorming. Dit proces demonstreert het vermogen van het systeem om redeneerstrategieën dynamisch aan te passen op basis van de complexiteit van de vraag, wat zowel de efficiëntie als de diagnostische nauwkeurigheid in scenario's voor klinische beslissingsondersteuning verbetert. Klik hier om een grotere versie van deze figuur te bekijken.
Configureer de Retrieval-Augmented Generation-pijplijn
Retrieval-Augmented Generation (RAG) is geïntegreerd om contextbewuste analyse mogelijk te maken door informatieophaal te combineren met de generatieve mogelijkheden van grote taalmodellen. Gebruikersvragen worden via embedding-modellen omgezet in vectorrepresentaties en via een semantische gelijkeniszoekopdracht vergeleken met de vectordatabase om de meest relevante contextuele passages op te halen. De opgehaalde documenten worden vervolgens gecombineerd met de oorspronkelijke vraag voordat de inferentie door het LLM plaatsvindt. Deze strategie helpt bij het verstrekken van contextuele informatie tijdens het genereren van antwoorden en wordt geassocieerd met een verbeterde feitelijke consistentie en verminderde hallucinaties in kennisintensieve toepassingen, waaronder de gezondheidszorg18,19. Figuur 1 en Figuur 3 illustreren de algemene workflow voor het ophalen van gegevens en het bijbehorende redeneerproces.
Voor elk gebruikersverzoek wordt de uiteindelijke prompt dynamisch samengesteld door de oorspronkelijke query te combineren met de meest relevante contextuele passages die uit de vectordatabase zijn opgehaald. De opgehaalde informatie wordt vóór de inferentie als contextueel bewijs geïntegreerd, waardoor het taalmodel in staat is om reacties te genereren die gebaseerd zijn op de opgehaalde kennis over de gezondheidszorg, terwijl de semantische consistentie behouden blijft en ongefundereerde generaties worden verminderd.
Prompt engineering en multi-agent redeneren
Het protocol maakt gebruik van gestructureerde promptingstrategieën om de contextuele interpretatie tijdens het genereren van antwoorden te verbeteren. Deze promptingtechnieken helpen, samen met geavanceerde inferentiemechanismen, om het redeneerproces in complexe klinische scenario's te sturen en zijn in overeenstemming met recente ontwikkelingen die in de literatuur zijn gerapporteerd20.
De architectuur omvat een multi-agent framework dat is samengesteld uit gespecialiseerde modules die verschillende functies binnen de verwerkingspijplijn uitvoeren, waaronder datavalidatie, contextfiltering, ondersteuning bij klinisch redeneren en verificatie van de output. De modulaire organisatie maakt het mogelijk dat taken sequentieel of parallel worden uitgevoerd, wat flexibiliteit biedt voor verschillende verwerkingsvereisten (Figuur 4). Door deze activiteiten over meerdere agenten te verdelen, wordt de afhankelijkheid van één enkel taalmodel verminderd en wordt een robuustere verwerkingsworkflow ondersteund. Deze architecturale strategie is consistent met recente ontwikkelingen in gedistribueerde kunstmatige intelligentie en het ontwerp van intelligente systemen21,22.
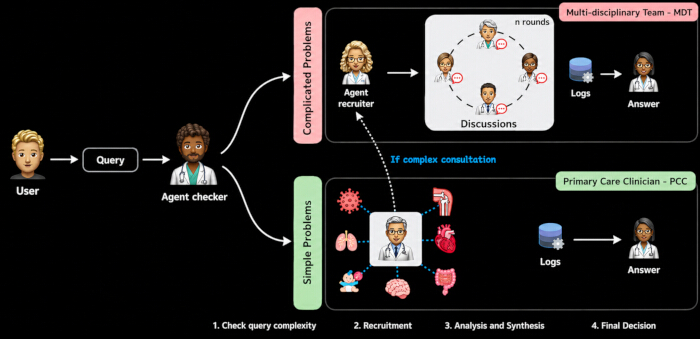
Figuur 4: Multi-agent beslissingskader voor klinisch redeneren. Het proces begint met een query van de gebruiker, die wordt geëvalueerd door een agent-checker die verantwoordelijk is voor het beoordelen van de complexiteit van de query. Voor complexe gevallen rekruteert het systeem dynamisch een multidisciplinair team (MDT) van gespecialiseerde agenten die deelnemen aan iteratieve discussierondes om het probleem te analyseren en kennis te synthetiseren voordat er een definitieve beslissing wordt genomen. Voor eenvoudigere gevallen wordt de query afgehandeld door een agent voor eerstelijnszorg (PCC), wat een snellere generatie van het antwoord mogelijk maakt. Deze adaptieve architectuur balanceert efficiëntie en analytische diepgang, waardoor de beslissingskwaliteit en de schaalbaarheid van het systeem in gezondheidszorgtoepassingen worden verbeterd. Klik hier om een grotere versie van deze figuur te bekijken.
Prestatie-evaluatie
De systeemprestaties werden geëvalueerd aan de hand van complementaire metrieken die zowel de linguïstische kwaliteit als de semantische consistentie van de gegenereerde output vastleggen. BLEU werd toegepast om de syntactische gelijkenis te meten op basis van n-gram overlap23, terwijl ROUGE de recall en de dekkingsgraad van de inhoud beoordeelde, in het bijzonder bij taken voor samenvatting en informatie-extractie24. De semantische gelijkenis werd geëvalueerd met BERTScore, dat gebruikmaakt van contextuele embeddings afgeleid van transformer-gebaseerde modellen om gegenereerde teksten en referentieteksten te vergelijken25. Aanvullende analyses omvatten perplexiteit en cosinus-gelijkenis om respectievelijk het modelvertrouwen en de semantische coherentie te onderzoeken26,27.
De geselecteerde evaluatiemetrieken bieden complementaire perspectieven op de systeemprestaties door lexicale en semantische analyses te combineren. Deze combinatie is bijzonder relevant in zorgtoepassingen, waar contextuele interpretatie net zo belangrijk is als lexicale gelijkenis. Het platform werd geëvalueerd in een gecontroleerde computationele omgeving die zowel cloudgebaseerde als lokale implementatie ondersteunt. Lokale uitvoering van LLM's werd als optie opgenomen om te voldoen aan vereisten voor gegevensprivacy en om de afhankelijkheid van externe diensten te verminderen bij het verwerken van gevoelige klinische informatie. Deze implementatiestrategie is compatibel met kaders voor gegevensbescherming en kan worden aangepast aan verschillende operationele omgevingen4.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
De systeemprestaties werden beoordeeld met behulp van complementaire kwantitatieve metrieken samen met kwalitatieve analyse om zowel de linguïstische nauwkeurigheid als de semantische consistentie van de gegenereerde outputs te onderzoeken. Deze evaluatiestrategie combineert lexicale en semantische maten om een bredere karakterisering te geven van het modelgedrag bij taalgeneratietaken die verband houden met de gezondheidszorg.
Tabel 1 presenteert de kwantitatieve resultaten v...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
De evaluatie die in deze studie wordt gepresenteerd, vormt een methodologische validatie die is uitgevoerd met gebruik van publiekelijk beschikbare en volledig geanonimiseerde benchmark-datasets uit de gezondheidszorg. Er is geen prospectieve klinische validatie uitgevoerd met betrokkenheid van zorgprofessionals of de werving van patiënten, aangezien het doel van dit werk is om een reproduceerbaar implementatieprotocol aan te tonen in plaats van klinische effectiviteit.
De bevindingen van deze...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs verklaren dat er geen concurrerende financiële belangen of persoonlijke relaties zijn die het in dit manuscript beschreven werk zouden hebben kunnen beïnvloeden. Generatieve kunstmatige intelligentie (AI)-tools werden uitsluitend gebruikt ter ondersteuning bij het redigeren van de taal, het corrigeren van de grammatica en het verbeteren van de leesbaarheid van het manuscript. Alle wetenschappelijke inhoud, het onderzoeksontwerp, de methodologie, de data-analyse, de interpretatie van de resultaten en de redactionele beslissingen zijn ontwikkeld, geverifieerd en goedgekeurd door de auteurs, die de volledige verantwoordelijkheid dragen voor de inhoud van dit manuscript.
Dankbetuigingen
De auteurs willen het Laboratory of Embedded and Distributed Systems (LESC) van de Federal University of Ceará (UFC) bedanken voor het ter beschikking stellen van de onderzoeksomgeving en de technische discussies die de ontwikkeling van dit werk hebben ondersteund. De auteurs erkennen tevens de ontwikkelaars en beheerders van de open-source software, de interoperabiliteitsstandaarden en de openbaar beschikbare datasets die gedurende deze studie zijn gebruikt.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| FAISS | Meta Platforms Inc. | Versie 1.8.0 | Vectordatabase gebruikt voor similarity search in de Retrieval-Augmented Generation (RAG)-pipeline. |
| FHIR-standaard | HL7 International | Release 4 (R4) | Zorginteroperabiliteitsstandaard aangenomen voor gestructureerde uitwisseling van klinische gegevens. |
| Kolf | Palletprojecten | Versie 3.0.3 | Python webframework gebruikt voor de implementatie van de RESTful backend-API. |
| HL7-standaard | HL7 International | Versie 2.x | Verouderd berichtprotocol gebruikt voor interoperabiliteit met ziekenhuisinformatiesystemen. |
| HTTP REST API | Maatwerkimplementatie | N/A | RESTful communicatielaag tussen frontend, backend, database en AI-services. |
| LangChain | LangChain Inc. | Versie 0.3.x | Framework dat wordt gebruikt voor de integratie van LLM's, prompt engineering en workflows voor Retrieval-Augmented Generation. |
| LangGraph | LangChain Inc. | Versie 0.2.x | Framework dat wordt gebruikt voor het orkestreren van de klinische redeneringsworkflow met meerdere agenten. |
| LLaMA 3.1 8B Instruct | Meta Platforms Inc. | Versie 3.1 | Groot taalmodel ingezet voor klinisch redeneren en natuurlijke taalgeneratie. |
| MySQL Community Server | Oracle Corporation | Versie 8.0 | Relationele database gebruikt voor het opslaan van gestructureerde klinische gegevens. |
| Ollama | Ollama Inc. | Versie 0.9.x | Lokale inferentiemachine gebruikt voor het uitvoeren van grote taalmodellen met behoud van de privacy van de patiënt. |
| Python | Python Software Foundation | Versie 3.11 | Programmeertaal die is gebruikt voor de implementatie van het volledige platform. |
| PyTorch | Linux Foundation | Versie 2.4 | Deep learning-framework gebruikt voor inferentie van Large Language Models. |
| Pipeline voor opvraagversterkte generatie (Retrieval-Augmented Generation, RAG) | Maatwerkimplementatie | Omdat er geen brontekst is verstrekt, kan er geen vertaling worden gegenereerd. Voer aub de tekst in die vertaald moet worden. | AI-framework dat semantische retrieval combineert met LLM-inferentie voor contextbewuste responsgeneratie. |
| Sentence Transformers | Hugging Face Inc. | all-MiniLM-L6-v2 | Embeddingmodel dat wordt gebruikt voor het genereren van dense vectorrepresentaties voor semantische documentopvraag. |
| Ubuntu Linux | Canonical Ltd. | Versie 24.04 LTS | Besturingssysteem gebruikt voor ontwikkeling en experimentele evaluatie. |
| Visual Studio Code | Microsoft Corporation | Versie 1.100 | Geïntegreerde ontwikkelomgeving gebruikt voor software-implementatie en debugging. |
Referenties
- Chukwu E, Garg L. A systematic review of blockchain in healthcare: frameworks, prototypes, and implementations. IEEE Access. 2020;8:21196-21214. doi:10.1109/ACCESS.2020.2969881.
- Al-Nbhany WANA, Zahary AT, Al-Shargabi AA. Blockchain-IoT healthcare applications and trends: a review. IEEE Access. 2024;12:4178-4212. doi:10.1109/ACCESS.2023.3349187.
- Tan Y, et al. MedChatZH: a Chinese medical large language model. Comput Biol Med. 2024;172:108290.
- OLLAMA TEAM. Ollama: Run Large Language Models locally. Version 0.x. San Francisco: Ollama, 2024.
- Jahan I, Laskar MTR, Peng C, Huang JX. A comprehensive evaluation of large language models on benchmark biomedical text processing tasks. Comput Biol Med. 2024;171:108189. doi:10.1016/j.compbiomed.2024.108189.
- Liu X, Zhou Y, Wang Z, et al. Disease topic modeling of users' inquiry texts: a text mining-based PQDR-LDA model for analyzing the online medical records. IEEE Trans Eng Manag. 2023.
- Taylor N, Kormilitzin A, Lorge I, Nevado-Holgado A, Cipriani A, Joyce DW. Model development for bespoke large language models for digital triage assistance in mental health care. Artif Intell Med. 2024;157:102988.
- Song M, et al. PneumoLLM: a large language vision model for pneumonia diagnosis. Med Image Anal. 2024;97:103248.
- Chien SC, Yen CM, Chang YH, Chen YE, Liu CC, Hsiao YP, et al. Using large language model (LLM) to identify high-burden informal caregivers in long-term care. Comput Methods Programs Biomed. 2024;255:108329. doi:10.1016/j.cmpb.2024.108329.
- Xue X, Zhang D, Sun C, et al. Xiaoqing: a Q&A model for glaucoma based on LLMs. Comput Biol Med. 2024;174:108399.
- Wu D, Nie L, Mumtaz RA, Agarwal K. A LLM-based hybrid-transformer diagnosis system in healthcare. IEEE J Biomed Health Inform. 2024.
- Zhang Y, et al. LLM-enhanced multi-teacher knowledge distillation for modality-incomplete emotion recognition in daily healthcare. IEEE J Biomed Health Inform. 2024.
- Sarzaeim P, Mahmoud QH, Azim A. A framework for LLM-assisted smart policing system. IEEE Access. 2024;12:74915-74929. doi:10.1109/ACCESS.2024.3404862.
- Leme RS, Blank M. Lei Geral de Proteção de Dados e segurança da informação na área da saúde. Cad Ibero-Am Direito Sanit. 2020;9(3):210-224. doi:10.17566/ciads.v9i3.690.
- Zaganelli MV, Binda Filho DL. O sigilo médico e os dados sensíveis na telemedicina à luz da Lei Geral de Proteção de Dados. RECIIS. 2023;17(3):729-740. doi:10.29397/reciis.v17i3.3689.
- Tabari P, Costagliola G, De Rosa M, Boeker M. State-of-the-art Fast Healthcare Interoperability Resources (FHIR)-based data model and structure implementations: systematic scoping review. JMIR Med Inform. 2024.
- Martinez T, et al. HL7 systems and interoperability ecosystems in modern healthcare. IEEE Rev Biomed Eng. 2024.
- Chen L, et al. HL7 integration and semantic interoperability in distributed healthcare networks. IEEE J Biomed Health Inform. 2024.
- Liu W, Li W, Huang W, Gao Y. Security framework for medical data sharing. Telemed E-Health. 2024.
- Basile LJ, Carbonara N, Panniello U, Pellegrino R. How can technological resources improve the quality of healthcare service? IEEE Trans Eng Manag. 2024;71:5771-5781. doi:10.1109/TEM.2022.3192405.
- Singh A, et al. Prompt engineering in large language models: a survey using SWOT analysis [preprint]. arXiv. 2024
- Chen L, Chen Y, Liang W, Li X, Li KC, Wang J, Xiong N. MASS: a multiattribute sketch secure data sharing scheme for IoT wearable medical devices based on blockchain. IEEE Internet Things J. 2025;12(2):1990-2001. doi:10.1109/JIOT.2024.3468733.
- Autoridade Nacional de Proteção de Dados (BR). Diretrizes para agentes de tratamento de pequeno porte. Brasília (DF): ANPD; 2021.
- Patel R, Kim H. Interoperability in EHR. IEEE Transactions on Biomedical Engineering, v. 70, n. 8, p. 2341-2354, ago. 2023. DOI: 10.1109/TBME.2023.3241567.
- Zhang T, Kishore V, Wu F, Weinberger KQ, Artzi Y. BERTScore: evaluating text generation with BERT. In: International Conference on Learning Representations (ICLR); 2020.
- Chen X, Lu X, Li Q, Li D, Zhu F. Integration of LLM and Human-AI Coordination for Power Dispatching With Connected Electric Vehicles Under SAGVNs. IEEE Trans Veh Technol. 2025;74(2):1992-2002. doi:10.1109/TVT.2024.3434969
- Zhou S, Chen C, Gu HH. Testing and evaluating SNOMED CT web browsers' textual search feature. In: Proceedings of the IEEE International Conference on Bioinformatics and Biomedicine (BIBM); 2019.
- McPeak G, Sautmann A, George O, Hallal A, Simal EA, Schwartz AL, Abaluck J, Ravi N, Pless R. An LLM's medical testing recommendations in a Nigerian clinic: potential and limits of prompt engineering for clinical decision support. In: Proceedings of the 2024 IEEE 12th International Conference on Healthcare Informatics (ICHI); 2024.
- LLAMA TEAM, AI @ META. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783, 2024. Disponível em: https://arxiv.org/abs/2407.21783.
- Conselho Nacional de Saúde (BR). Resolução nº 466, de 12 de dezembro de 2012. Aprova as diretrizes e normas regulamentadoras de pesquisas envolvendo seres humanos. Brasília (DF): Ministério da Saúde; 2012.
- Singhal K, Azizi S, Tu T, et al. Large language models encode clinical knowledge. Nature. 2023;620:172-180. doi:10.1038/s41586-023-06291-2.
- Sahoo P, et al. A systematic survey of prompt engineering in large language models [preprint]. arXiv. 2024. Available from: https://arxiv.org/abs/2402.07927
- Yan Y, Hou Y, Xiao Y, Zhang R, Wang Q. KNOWNET: guided health information seeking from LLMs via knowledge graph integration. IEEE Trans Vis Comput Graph. 2024.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.