Dit protocol genereert structuurbewuste kledingrepresentaties door semantische componentanalyse, topologiemodellering, dual-stream feature-codering en structuurgestuurde fusie te integreren. Het stelt onderzoekers in computer vision en kledingontwerp in staat om kledingstukken op te zoeken en ontwerpreferenties te vergelijken op basis van de organisatie van componenten en de silhouetindeling, in plaats van op kleur of textuur.
Methodenartikel
Een protocol voor het leren van kenmerken in afbeeldingen op basis van de topologie van kledingcomponenten op afbeeldingniveau voor het ophalen van ontwerpreferenties
In dit artikel
Samenvatting
Samenvatting
Methoden voor het terugvinden van kledingafbeeldingen leggen vaak de nadruk op kleur en textuur, wat kan leiden tot verwarring tussen kledingstukken die een vergelijkbaar uiterlijk hebben, maar verschillen in de lay-out van hun componenten. Deze studie presenteert een component-bewust feature-learning-protocol voor het terugvinden van kledingafbeeldingen en het vergelijken van ontwerpreferenties. Het protocol analyseert semantische kledingregio's, construeert een graaf van kledingcomponenten op beeldniveau, codeert uiterlijk en componentrelaties parallel en fuseert beide representaties met behulp van verliesfuncties voor structurele consistentie, structurele relaties en structurele discriminatie. DeepFashion2-afbeeldingen worden gestandaardiseerd naar 512 x 512 pixels, geanalyseerd met HRNet-W48, gecodeerd met ResNet-50 en graafconvolutie, en geëvalueerd via structurele retrieval en clustering. Het volledige model behaalde een index voor structurele consistentie van 0,81, een index voor structurele discriminatie van 0,71, een Recall@5 van 89,2%, een gemiddelde gemiddelde precisie (mean average precision) van 86,4% en een silhouette-coëfficiënt van 0,74. Het protocol ondersteunt het terugvinden van kledingstructuren, structurele vergelijking en het lokaliseren van verschillen wanneer het oppervlakkige uiterlijk de constructie van het kledingstuk niet betrouwbaar representeert.
Inleiding
Door de voortdurende integratie van computervisie en kunstmatige intelligentie in de kledingindustrie is de analyse van kledingafbeeldingen geleidelijk uitgebreid van basisherkenningstaken naar ontwerpgerichte analyse en beslissingsondersteuning1,2. In het ontwerpproces van kleding hangt het onderscheid tussen ontwerpschema's meer af van de structurele samenstelling en componentrelaties dan van eenvoudige verschillen in uiterlijk, waardoor de structurele expressiviteit van kenmerken van kledingafbeeldingen bij ontwerpondersteuning een sleutelfactor is die de effectiviteit van de analyse beïnvloedt3,4. De meeste bestaande visuele methoden vertrouwen echter nog steeds op textuur, kleur en globale contouren als hun primaire kenmerken, waardoor het moeilijk is om kledinghiërarchieën en constructieverschillen tijdens het ontwerpproces systematisch te analyseren5,6. Daarom is de ontwikkeling van een structuurbewuste methode voor het leren van beeldkenmerken voor ontwerpondersteuning van kleding belangrijk voor het verbeteren van de objectiviteit en consistentie van de ontwerpanalyse7. Dit protocol is geschikt wanneer kledingstukken vergelijkbare kleuren, texturen of globale contouren delen, maar verschillen in componentorganisatie, verbindingspatronen of ruimtelijke indeling. Onder deze omstandigheden hebben representaties die gericht zijn op het uiterlijk de neiging om structureel verschillende ontwerpen dicht bij elkaar in de kenmerkruimte te plaatsen, wat de betrouwbaarheid van retrieval en ontwerpvergelijking verzwakt. Het protocol richt zich op taken waarbij relaties tussen kledingcomponenten de primaire basis vormen voor structurele retrieval, ontwerpbeoordeling en gelokaliseerde verschilanalyse.
Wat betreft dataschaal, modelcomplexiteit en taakdiversiteit heeft het huidige onderzoek naar de automatische analyse en het begrip van kledingafbeeldingen aanzienlijke vooruitgang geboekt8,9. In praktische toepassingen is structurele kledinginformatie echter vaak impliciet opgenomen in segmentatie- of detectieresultaten en wordt deze niet meegenomen in de uniforme modellering van de kenmerkleerfase, wat resulteert in een gebrek aan stabiel onderscheid tussen verschillende structurele ontwerpen in de kenmerkruimte10,11. De ruimtelijke relaties, hiërarchische beperkingen en topologische structuren tussen kledingonderdelen zijn niet expliciet gecodeerd, waardoor het voor kenmerkrepresentaties moeilijk is om structurele verschillen op ontwerpniveau te weerspiegelen12,13. De afwezigheid van expliciete structurele modellering beperkt de analytische granulariteit en de betrouwbaarheid van beslissingen van kenmerken van kledingafbeeldingen in scenario's voor ontwerpondersteuning, wat een grote barrière vormt voor de ontwikkeling van intelligente ontwerpsystemen met een dieper semantisch begrip14.
Om het leren en de analyse van kenmerken van kledingafbeeldingen te ondersteunen, hebben relevante studies verschillende technische richtingen onderzocht15. Methoden voor semantische segmentatie en kledingparsing hebben een fijnmazige afbakening van kledingregio's en componenten mogelijk gemaakt via annotatie op pixelniveau, wat een basis biedt voor de extractie van structurele informatie16,17. Methoden voor het ophalen van kleding op basis van beeldzoekopdrachten hebben topologie en kleur-textuurfusie, globale en lokale attention-uitlijning, kledingparsing, representaties op meerdere schalen en granulariteiten, en residuele attention met kenmerkselectie geïntegreerd. Deze methoden richten zich op cataloguszoekopdrachten, matching van consument naar winkel, cross-domein productretrieval en visueel zoeken in e-commerce. Hun toepassingsinstellingen zijn nauw verwant aan het ophalen van ontwerpreferenties, omdat elke methode kledingafbeeldingen rangschikt op basis van een visuele query, hoewel hun representaties geen getypeerde component-adjacentie en verticale volgderelaties behouden gedurende de kenmerkfusie18,19,20. Ondertussen heeft onderzoek naar ontwerp- en aanbevelingsscenario's geleidelijk multimodale fusie, relatiemodellering en stijlanalyse geïntroduceerd, waardoor de toepassingsgrenzen van visuele kledingkenmerken zijn uitgebreid21,22. Hoewel deze methoden vooruitgang hebben geboekt in hun respectievelijke taken, zijn hun kernkenmerken nog steeds grotendeels gebaseerd op uiterlijke beschrijvingen en is structurele informatie niet uniform gemodelleerd als een inherente beperking voor kenmerkleren, waardoor het moeilijk is om te voldoen aan de behoeften van ondersteuning bij kledingontwerp voor structurele uitlijning en structurele vergelijking23.
Om het onvoldoende vermogen tot structurele differentiatie bij kledingontwerpondersteuning aan te pakken, stelt dit artikel een methode voor voor het leren van beeldkenmerken op basis van de perceptie van de kledingstructuur. Deze methode integreert resultaten van kledinganalyse en sleutelstructurele informatie in de invoerfase van kledingbeelden, waarbij kledingcomponentregio's, ruimtelijke relaties en hiërarchische verbindingen gezamenlijk worden gemodelleerd. Codering van structurele relaties en visuele kenmerkuitlijning integreren expliciet kledingbeperkingen in het proces van kenmerkleren, wat resulteert in een representatie die zowel het visuele uiterlijk als de structurele consistentie behoudt. Dit kenmerk karakteriseert structurele verschillen in kleding binnen een uniforme ruimte, wat een stabiele basis biedt voor daaropvolgende structurele gelijkenheidsanalyse, structurele clustering en besluitvorming ter ondersteuning van het ontwerp, waardoor het probleem van kenmerkverwarring veroorzaakt door het gebrek aan structurele modellering in bestaande methoden wordt verlicht. In tegenstelling tot algemene visuele retrieval-strategieën die structurele informatie behandelen als losjes verbonden hulpattributen, construeert dit raamwerk een kenmerkmodulatiemechanisme dat is gecentreerd rond topologische relaties. Dit mechanisme stimuleert de geleerde representatie om de zichtbare organisatie van kledingregio's te volgen, terwijl textuurgedomineerde responsen worden verminderd. Elke graafknoop duidt een semantische regio op beeldniveau aan, en elke graafrelatie beschrijft een zichtbare nabijheid of een genormaliseerde relatieve positie in het beeldvlak. De resulterende embedding ondersteunt de vergelijking van componentindeling en silhouetorganisatie over verschillende kledingbeelden heen. Deze regio's en relaties zijn geen patroondelen, naadverbindingen, constructielandmerken of graderingsparameters. In vergelijking met uiterlijk-gestuurde retrieval-methoden behoudt het protocol de expliciete componenttopologie gedurende het gehele proces van kenmerkleren, in plaats van structurele informatie te behandelen als een resultaat van een downstream-analyse. In vergelijking met benaderingen waarbij structurele aanwijzingen slechts als hulpinput worden geïntroduceerd, behouden de dual-stream codering en de topologie-consistente fusie de geometrische relaties terwijl textuurgedomineerde responsen worden verminderd. De resulterende representatie ondersteunt het ophalen van kledingstructuren, structurele clustering, screening van ontwerpreferenties en gelokaliseerde analyse van ontwerpverschillen, terwijl het bewijs op componentniveau biedt dat interpreteerbaar blijft binnen het kledingontwerpproces. Onderzoek dat relevant is voor dit protocol omvat het leren van kenmerken van kledingbeelden, modellering van kledingstructuren, structuurbewuste representatie en visuele analyse voor ondersteuning bij kledingontwerp.
Op het niveau van de kenmerkrepresentatie heeft onderzoek naar kledingafbeeldingen zich lange tijd gericht op verschijningsmodellering, diepe kenmerkextractie en multischaalrepresentatie24,25. Vroeg werk maakte gebruik van convolutionele neurale netwerken voor end-to-end modellering van kledingafbeeldingen voor classificatie-, reproductie- en similariteitsmatchingstaken26,27. Vervolgens werden multischaal-kenmerkfusie en cross-domeinleren geïntroduceerd om verschillen in kledingafbeeldingen onder verschillende kijkhoeken, houdingen en opnameomstandigheden te verminderen28,29. Bij reproductietaken werden aandachtmechanismen en kenmerkcompressiestrategieën gebruikt om de onderscheidend vermogen van kenmerken en de computationele efficiëntie te verbeteren30,31. Deze methoden bereiken een betrouwbare discriminatie van het uiterlijk, maar hun kenmerkleerprocessen richten zich nog steeds op globale visuele informatie en missen systematische representaties van interne kledingstructuren32. Samengestelde modereproductiemethoden combineren verder een referentieafbeelding met tekstuele aanpassingsinstructies, maar hun query-modaliteit verschilt van het hier bestudeerde protocol met enkel afbeeldingen. Deze worden besproken als een verwante commerciële reproductierichting en zijn niet opgenomen in de kwantitatieve vergelijking, omdat extra tekstinvoer een gecontroleerde evaluatie van de afbeelding-query zou verhinderen.
Nu de analyse van kledingbeelden is verschoven van uiterlijke discriminatie naar structureel begrip, heeft onderzoek zich steeds meer gericht op het modelleren van kledingcomponenten, geometrische relaties en topologische verbindingen33. Semantische segmentatienetwerken hebben analyse op het niveau van kledingcomponenten bereikt via kenmerkprojectie en multi-attention-mechanismen, wat een betrouwbare basis biedt voor de extractie van structurele informatie34,35. Methoden voor keypoint-detectie en structurele topologiemodellering hebben de relatie tussen kledingcontouren en lokale structuren verder gekarakteriseerd, waardoor het vermogen van het model om geometrische kenmerken van kleding weer te geven is verbeterd36,37. Verscheidene studies hebben graafstructuren en relationele redeneringsnetwerken geïntroduceerd om relaties tussen kledingcomponenten te modelleren, waardoor de fijnmazige herkenning en de prestaties bij cross-domein retrieval zijn verbeterd38,39. Deze werken hebben de belangrijke rol van structurele informatie bij visuele analyse bevestigd, maar structuur wordt hoofdzakelijk gebruikt als een hulphenmerk of een tussenresultaat, en een systeem voor kenmerkleren met structurele beperkingen als kern is nog niet ontwikkeld40.
Binnen de ondersteuning van kledingontwerp hebben deze ontwikkelingen bijgedragen aan ontwerpaanbevelingen, stijlanalyse, de constructie van interactieve systemen en structuurgeoriënteerde ontwerpevaluatie41. Onderzoek naar aanbevelingssystemen heeft kledingcombinaties en gepersonaliseerde aanbevelingen gerealiseerd door visuele kenmerken te integreren met gebruikersvoorkeuren42. Werk gerelateerd aan ontwerpondersteuning heeft nieuwe wegen verkend voor intelligente ontwerpondersteuning door generatieve modellen, stijlonmodellering en mechanismen voor mens-computerinteractie te combineren43. Onderzoek naar virtueel passen, maatmeting en stijltransfer heeft de toepassing van visuele kledinganalyse gedurende het gehele ontwerp- en productieproces verbreed. Hoewel deze studies de technische vormen van ondersteuning bij kledingontwerp hebben verrijkt, worden hun kernvisuele kenmerken nog steeds primair gedreven door het uiterlijk en ontbreekt een uniforme representatie van de ontwerpstructuur voor analyse. In tegenstelling hiermee behandelt dit artikel de kledingstructuur als de belangrijkste beperking voor de kenmerkrepresentatie en biedt het een visuele representatiemethode voor structurele analyse bij de ondersteuning van kledingontwerp.
Ondanks deze ontwikkelingen behandelen recente methoden in generatief ontwerp structurele condities vaak als losse ruimtelijke richtingsmatrices binnen diffusieprocessen. Hedendaagse frameworks voor structurele parsing representeren topologieën als hulpsemantische labels, gescheiden van de primaire visuele embeddingruimte. Het voorgestelde framework verandert dit mechanisme door een op graaf-prior gebaseerde topologische beperking te definiëren die het visuele feature-leren op componentniveau expliciet moduleert. De consistentiedoelstelling op meerdere niveaus stimuleert kledingstukken met vergelijkbare componentlay-outs op beeldniveau om dicht bij elkaar te blijven in de feature-ruimte, terwijl kledingstukken met verschillende organisaties van zichtbare regio's worden gescheiden. Deze doelstelling vermindert de textuurafhankelijkheid in de geëvalueerde retrieval-setting, maar creëert geen invariantie voor veranderingen in materiaal, pose of achtergrond. Dit protocol moet worden geselecteerd wanneer de invoerafbeelding een voldoende zichtbaar individueel kledingstuk bevat, semantische componenten identificeerbare grenzen behouden en de analytische doelstelling een structurele vergelijking op componentniveau vereist in plaats van grove categorieherkenning. Het is bedoeld voor onderzoekers in computer vision, onderzoekers in kledingontwerp en digitale kledingontwikkelingsteams die betrokken zijn bij structuurgevoelige visuele analyse. Het is niet bedoeld voor taken die uitsluitend gericht zijn op kleur- of materiaalherkenning, of voor afbeeldingen waarin de topologie van het kledingstuk grotendeels verborgen is. Het volgende protocol presenteert de workflow vanaf datasetpreparatie en semantische waarschijnlijkheidsmapping tot geometrische relatieconstructie, dual-stream feature-codering, structuurgestuurde fusie en consistentiegebaseerde optimalisatie. De complete workflow is samengevat in Figuur 1.
Protocol
Deze studie maakt gebruik van openbaar toegankelijke datasets van kledingafbeeldingen en werft geen menselijke proefpersonen, verzamelt geen persoonlijk identificeerbare informatie, voert geen dierproeven uit en maakt geen gebruik van biologische materialen. Institutionele ethische goedkeuring en geïnformeerde toestemming zijn niet van toepassing.
1. Softwareomgeving en projectconfiguratie
- Plaats de vrijgegeven projectbestanden in een directory met voldoende opslagruimte en open een terminal in de worteldirectory van het project.
- Voer conda env create -f environment.yml uit om de softwareomgeving te creëren. Voer conda activate garment_structure uit om de omgeving te activeren.
- Voer python --version, conda --version, pip show numpy, pip show torch, pip show torchvision en nvidia-smi uit. Sla de volledige output van de commando's op in software_versions.txt.
- Gebruik dezelfde geregistreerde omgeving voor preprocessing, training, inferentie, efficiëntiemeting en evaluatie. Noteer de bestandsnaam en SHA-256 waarde van het HRNet-W48 checkpoint, de identificatie en SHA-256 waarde van de op ImageNet gepretrainde ResNet-50 gewichten, de releasebron van DeepFashion2 en de identificatie van de broncode-repository in hetzelfde bestand.
- Maak de directories data_raw, data_processed, parser_outputs, structural_priors, feature_outputs, checkpoints, logs en evaluation_results aan onder de worteldirectory van het project.
- Open configs/protocol.yaml. Voer de DeepFashion2 directory in bij dataset_root, het pad naar het gepretrainde HRNet-W48 checkpoint bij parser_checkpoint en de outputdirectory van het project bij output_root.
- Stel input_height in op 512, input_width op 512, batch_size op 32, structural_categories_per_batch op 8, samples_per_category op 4, random_seed op 42, feature_dimension op 512, structural_constraint_weight op 1.0, structural_relationship_weight op 0.5, structural_discrimination_weight op 1.0 en separation_threshold op 0.3.
- Stel de optimizer in op mini-batch stochastic gradient descent. Stel initial_learning_rate in op 0.0001, momentum op 0.9, weight_decay op 0.0005, max_epochs op 120, learning_rate_schedule op multi-step decay en learning_rate_decay_factor op 0.1. Voer de geverifieerde decay-epochs die in de vrijgegeven configuratie worden gebruikt in bij learning_rate_milestones.
- Voer python tools/export_experiment_tables.py --config configs/protocol.yaml --output evaluation_results uit. Exporteer de volledige modelconfiguratie naar model_setting_statistics.csv. Verifieer of het geëxporteerde bestand de invoerbeeldafmeting, het invoerformaat, de batchcompositie, de optimizer, de learning rate, het learning-rate schema, het aantal epochs, de weight decay, het momentum, de augmentatiekansen, de feature-dimensie, de gewichten van het structurele verlies, de separation threshold, de random seeds, de regel voor checkpoint-selectie en het aantal onafhankelijke runs registreert.
- Verwachte output: Bevestig dat de softwareomgeving start zonder afhankelijkheidsfouten, dat software_versions.txt het verslag van de omgeving bevat, dat alle outputdirectories bestaan en dat configs/protocol.yaml geldige absolute paden en numerieke instellingen bevat.
OPMERKING: Gebruik dezelfde omgeving en configuratiebestand tijdens de gegevensverwerking, modeltraining, inferentie en evaluatie. Bewaar een kopie van configs/protocol.yaml bij elk getraind checkpoint.
PROBLEEMOPLOSSING: Als de creatie van de omgeving stopt omdat een pakket niet beschikbaar is, verwijder dan de onvolledige omgeving, verifieer de pakketkanalen in environment.yml en creëer de omgeving opnieuw. Als nvidia-smi geen grafische verwerkingseenheid rapporteert, stop dan de modeltraining en herstel de grafische driver en CUDA runtime. Als er tijdens de uitvoering een directoryfout optreedt, vervang dan relatieve paden door absolute paden en verifieer de schrijfrechten voor output_root.
2. Acceptatie van inputafbeeldingen, constructie van de dataset en voorbewerking
- Gebruik uitsluitend bestanden met de extensies JPG, JPEG of PNG. Gebruik 8-bits RGB-afbeeldingen die één hoofd kledingstuk bevatten.
- Behoud 8-bits RGB-afbeeldingen met een breedte en hoogte van ten minste 512 pixels en één identificeerbaar hoofd kledingstuk. Verwerp een afbeelding wanneer de voorgrond van het kledingstuk minder dan 15% van het totale afbeeldingsvlak beslaat, wanneer meer dan 5% van de grens van het kledingstukmasker samenvalt met de rand van de afbeelding, wanneer een secundair kledingstukgebied meer dan 10% van het gebied van het hoofd kledingstuk overschrijdt, wanneer het geschatte occlusiegebied meer dan 20% van het masker van het hoofd kledingstuk overschrijdt, of wanneer de variantie van de Laplacian-respons lager is dan 100.
- Registreer de afbeeldingsidentificatie, de gemeten waarde, de geactiveerde uitsluitingsregel en het annotatiepad in excluded_samples.csv.
- Pas de acceptatieregels voor de input toe op de DeepFashion2-bronafbeeldingen vóór de structurele labeling en datapartitionering. Registreer elke geaccepteerde en verworpen afbeeldingsidentificatie, de oorspronkelijke dataset-split, de identificatie van de kledingstukannotatie, de identificatie van het bronpaar, de ratio van het voorgrondgebied, de ratio van het randcontact, de occlussieratio, de blur-score en de uiteindelijke behoudstatus in data_filtering_manifest.csv.
- Voer python tools/prepare_data.py --config configs/protocol.yaml uit.
- Lees de bounding box van het kledingstuk uit de datasetannotatie. Vergroot de bounding box met 5% van de breedte en hoogte, zonder de afbeeldingsgrenzen te overschrijden.
- Crop het kledingstukgebied, behoud de oorspronkelijke beeldverhouding, voeg zero padding toe om een vierkante afbeelding te vormen en schaal de gepadde afbeelding naar 512 x 512 pixels.
- Zet de herschalen afbeelding om naar een RGB-tensor met floating-point waarden. Deel elke pixelwaarde door 255.
- Normaliseer de rode, groene en blauwe kanalen met gemiddelden van 0,485, 0,456 en 0,406 en standaarddeviaties van 0,229, 0,224 en 0,225.
- Pas bij trainingsafbeeldingen horizontale spiegeling toe met een kans van 0,5 en willekeurige wissen (random erasure) met een kans van 0,2. Pas alleen deterministisch croppen, padden, schalen en normaliseren toe op validatie- en testafbeeldingen.
- Voer python tools/assign_structural_levels.py --config configs/protocol.yaml uit nadat de zevenkanaals componentkaarten en de matrices voor gedeelde grenzen en verticale volgorde zijn gegenereerd. Bereken voor elke behouden afbeelding het aantal actieve knopen, het aantal verbonden componenten, het aantal takknopen, het aantal onafhankelijke cycli en het langste gerichte pad van de verticale volgorde. Definieer een takknoop als een actieve knoop die verbonden is met ten minste drie andere actieve knopen in de shared-boundary graph.
- Wijs S1 toe wanneer de graaf verbonden is, geen onafhankelijke cyclus bevat, geen takknoop bevat en een langste verticale-volgorde-pad heeft van maximaal twee randen. Wijs S2 toe wanneer de graaf verbonden is, geen onafhankelijke cyclus bevat, precies één takknoop bevat en een langste verticale-volgorde-pad heeft van maximaal twee randen. Wijs S3 toe wanneer de graaf verbonden is, geen onafhankelijke cyclus bevat en ten minste twee takknopen of een verticale-volgorde-pad van ten minste drie randen bevat. Wijs S4 toe wanneer de graaf verbonden is, precies één onafhankelijke cyclus bevat en een verticale-volgorde-pad heeft van maximaal twee randen. Wijs S5 toe wanneer de graaf ten minste twee onafhankelijke cycli bevat of één onafhankelijke cyclus bevat samen met een verticale-volgorde-pad van ten minste drie randen.
- Pas de regels toe in de volgorde S5, S4, S3, S2 en S1 en sla de berekende graafstatistieken, het toegewezen niveau en de regelidentificatie op in structural_level_manifest.csv.
- Genereer de voorlopige S1–S5 labels automatisch vanuit de opgeslagen componentmaskers en relatiematrices. Markeer een sample als structureel ambigu wanneer de componentgraaf meer dan één verbonden component bevat, wanneer de gemiddelde maximale componentwaarschijnlijkheid binnen de voorgrond van het kledingstuk lager is dan 0,60, wanneer een actieve component minder dan 1% van de voorgrond van het kledingstuk beslaat, of wanneer het toegewezen structurele niveau verandert nadat de breedte van het randcontact is gewijzigd van één pixel naar twee pixels.
- Dien elk ambigu sample in bij twee auteurs voor onafhankelijke inspectie van de bronafbeelding, componentkaart, shared-boundary matrix, verticale-volgorde-matrix en de voorlopige graaf. Behoud het label wanneer de twee inspecties overeenstemmen. Dien een onenigheid in bij een derde auteur en gebruik de meerderheidsbeslissing als definitief label. Sluit een sample uit wanneer er na review geen stabiele componentrelatie is hersteld. Registreer het automatische label, de review-labels, de reden van onenigheid, het definitieve label en de uitsluitingsstatus in structural_label_audit.csv.
- Bereken de SHA-256 waarde van elk behouden bronbestand en bereken een 64-bits perceptuele hash van de genormaliseerde crop van het kledingstuk. Plaats afbeeldingen met identieke SHA-256 waarden in dezelfde exact-duplicaatgroep. Plaats afbeeldingen waarvan de perceptuele hashes een Hamming-afstand van maximaal vier hebben in dezelfde near-duplicaatgroep, nadat is geverifieerd dat ze afkomstig zijn van hetzelfde kledingstuk-instantie.
- Voeg alle afbeeldingen die dezelfde DeepFashion2-bronpaaridentificatie of kledingstukidentiteit delen samen in één brongroep. Sla de bestandshashes, perceptuele hashes, bronidentificaties en identificaties van de duplicaatgroep op in duplicate_group_manifest.csv.
- Voer de datapartitionering uit op brongroepniveau in plaats van op individueel afbeeldingsniveau. Wijs elke exact-duplicaatgroep, near-duplicaatgroep en bronidentiteitsgroep volledig toe aan één subset. Controleer alle cross-subset paren na de partitionering en schrijf elk gedetecteerd identiteitsconflict, hashconflict en perceptuele-hashconflict naar leakage_audit.csv. Bouw de manifests opnieuw op totdat leakage_audit.csv geen onopgeloste cross-subset records meer bevat.
- Stratificeer de brongroepen op basis van de definitieve S1-S5 labels en wijs volledige groepen toe aan de trainings-, validatie- en testsubsets volgens de geverifieerde allocatie in Tabel 1. Rapporteer het exacte aantal afbeeldingen en het aantal brongroepen voor elk structureel niveau en elke subset.
- Bereken de gerealiseerde percentages voor training, validatie en test vanuit de uiteindelijke behouden cohort in plaats van vanuit de ongefilterde dataset. Gebruik geen validatieafbeeldingen, testafbeeldingen, ambigu uitgesloten afbeeldingen of afbeeldingen die behoren tot hun duplicaatgroepen tijdens het leren van parameters, het bepalen van drempelwaarden, het aanpassen van structurele-niveau regels of het selecteren van checkpoints.
- Sla de verwerkte afbeeldingen op in data_processed/images. Sla train_manifest.csv, validation_manifest.csv, test_manifest.csv, pair_manifest.csv en structural_level_manifest.csv op in data_processed/manifests.
- Lees de definitieve structurele labels, reviewstatus, identificaties van de duplicaatgroep, identificaties van de brongroep en subsetlabels uit de verwerkte manifests. Tel de automatisch geaccepteerde samples, handmatig gereviewde samples, ambiguïteitsuitsluitingen, duplicaatuitsluitingen, brongroepen, trainingsafbeeldingen, validatieafbeeldingen en testafbeeldingen voor S1 tot en met S5.
- Bereken de gerealiseerde subsetratio's, het gemiddelde aantal actieve knopen, het gemiddelde aantal takknopen, het gemiddelde aantal onafhankelijke cycli, de gemiddelde verticale-volgorde diepte en het gemiddelde aantal getypeerde randen. Sla de volledige statistieken op in evaluation_results/dataset_statistics.csv.
- Verwachte output: Bevestig dat elke geaccepteerde afbeelding een 8-bits RGB-afbeelding is met een afmeting van 512 x 512 pixels en beschikt over één filterrecord, één definitief structureel-niveau label, één brongroepidentificatie, één duplicaatgroepidentificatie, één subsetlabel en één geldig annotatiepad. Bevestig dat elk ambigu sample een volledig reviewrecord heeft. Bevestig dat geen enkele bronidentificatie, exact-duplicaatgroep, near-duplicaatgroep of kledingstukidentiteit in meer dan één subset voorkomt. Bevestig dat de aantallen afbeeldingen in train_manifest.csv, validation_manifest.csv, test_manifest.csv en dataset_statistics.csv identiek zijn.
OPMERKING: Bewaar de originele onbewerkte afbeeldingen in data_raw. Pas geen willekeurige augmentatie toe op validatie- of testafbeeldingen.
PROBLEEMOPLOSSING: Als cropping een kraag, mouw, zoom of broekspijp verwijdert, herstel dan de oorspronkelijke annotatie en vergroot de behouden randmarge. Als een kledingstuk er uitgerekt uitziet, controleer dan of de vierkante padding aanwezig is vóór het schalen. Als een verwerkte afbeelding één kanaal of vier kanalen bevat, zet het bronbestand dan om naar 8-bits RGB en voer de preprocessing opnieuw uit. Als er duplicaatidentificaties voorkomen tussen subsets, bouw dan alle subset-manifests opnieuw op vóór de training.
3. Visuele componentparsing met voorgrondbeperking en waarschijnlijkheidsmapping
- Voer python tools/parse_components.py --config configs/protocol.yaml uit.
- Laad het vooraf getrainde HRNet-W48 kledingstuk semantische parsing checkpoint uit parser_checkpoint. Verifieer dat het checkpoint de kledingstukcomponentcategorieën produceert die zijn gedefinieerd door de dataset-annotatiemap. Zet het semantische parsingnetwerk in de evaluatiemodus en schakel de gradiëntberekening uit.
- Lees de bewerkte afbeeldingen uit train_manifest.csv, validation_manifest.csv en test_manifest.csv in opeenvolgende volgorde.
- Extraheer één zevenkanaals semantische responstensor uit elke invoerafbeelding en stel K in op zeven gedurende de gehele workflow. Gebruik de vaste categorievolgorde Upper Trim Region, Neckline Region, Bodice Region, Left Lower-Garment Region, Right Lower-Garment Region, Middle Lower-Garment Region en Hem Region. Bewaar deze volgorde in waarschijnlijkheidskaarten, componentmatrices, grafiekmatrices, kenmerkmatrices, manifesten en visualisatiebestanden.
- Pas softmax toe langs de kanaaldimensie om de semantische component-waarschijnlijkheidskaart P te genereren. Verifieer dat de waarschijnlijkheden over alle K kanalen bij elke pixel optellen tot één binnen een tolerantie van 0,0001.
- Laad het voorgrondmasker van het kledingstuk uit de dataset-annotatie en lijn dit uit met de bewerkte afbeelding van 512 x 512. Stel de waarschijnlijkheid van elke component buiten de voorgrond van het kledingstuk in op nul. Normaliseer de componentwaarschijnlijkheden binnen het voorgrondmasker opnieuw langs de kanaaldimensie.
- Verifieer dat elk actief componentgebied binnen de voorgrond van het kledingstuk blijft. Verwerp het geparste monster als een gekleurd componentgebied zich uitstrekt tot in de omringende muur, vloer, gordijn of een ander achtergrondgebied. Registreer de identifier van de verworpen afbeelding en de parsingfout in parsing_quality_log.csv.
- Bereken de voorgrondekkingsratio voor elke component en markeer componenten met gefragmenteerde gebieden of niet-ondersteunde geïsoleerde gebieden voor handmatige inspectie.
- Sla de semantische responstensor op in parser_outputs/logits. Sla de waarschijnlijkheidskaart op in parser_outputs/probability_maps. Sla een kleurgecodeerde componentpreview op in parser_outputs/previews.
- Verwachte output: Bevestig dat elke geaccepteerde afbeelding één zevenkanaals voorgrond-beperkte waarschijnlijkheidskaart met een ruimtelijke grootte van 512 x 512 pixels, één zevenkanaals semantische responstensor en één preview-afbeelding produceert. Bevestig dat kanaalindices één tot zeven de vaste componentvolgorde volgen zoals gedefinieerd in stap 3.4. Bevestig dat alle gekleurde componentgebieden binnen de voorgrond van het kledingstuk blijven en dat achtergrondpixels een componentwaarschijnlijkheid van nul hebben. Bevestig dat de bestandsidentifier overeenkomt met de bijbehorende invoer in het bronmanifest.
OPMERKING: Behoud continue componentwaarschijnlijkheden binnen de voorgrond van het kledingstuk tijdens structurele modellering. Behandel de resulterende gebieden als visuele analysegebieden. Interpreteer hun grenzen niet als naadlijnen, snijlijnen, contouren van patroondelen, darts, inkepingen of graderingreferenties.
PROBLEEMOPLOSSING: Als alle kanalen bijna uniforme waarschijnlijkheden vertonen, verifieer dan parser_checkpoint, de RGB-kanaalvolgorde en de beeldnormalisatie. Als een component afwezig blijft in een gehele subset, vergelijk dan de annotatie-index met de output-kanaalindex van de parser. Als componentkleuren doorlopen in de achtergrond, verifieer dan de uitlijning van het voorgrondmasker, de interpolatie-instellingen en de annotatiecoördinaten vóór de constructie van de graaf. Als een visueel gebied meerdere niet-gerelateerde kledinggebieden beslaat, markeer het monster dan als een parsingfout en sluit het uit van de generatie van de structurele prior. Als kanaalwaarschijnlijkheden niet optellen tot één, pas dan softmax toe langs de kanaaldimensie in plaats van langs een van de ruimtelijke dimensies. Als een outputbestand ontbreekt, lokaliseer dan de laatste bewerkte identifier in het parserlogboek en hervat het parsen vanaf de volgende identifier.
4. Modellering van geometrie van componenten op beeldniveau en ruimtelijke relaties
- Laad de ondiepe visuele kenmerktensor en de bijbehorende waarschijnlijkheidskaart P voor elke afbeelding.
- Vermenigvuldig elke ruimtelijke kenmerkvector met de waarschijnlijkheid die is toegewezen aan de bijbehorende semantische component.
- Sommeer de gewogen kenmerkvectoren over de ruimtelijke dimensies en deel de som door de totale waarschijnlijkheidsmassa van de component.
- Wijs een nulvector en een indicator voor een inactieve knoop toe aan elke component met een nul-waarschijnlijkheidsmassa.
- Pas L2-normalisatie toe op elke actieve component-embedding en stapel de embeddings volgens de vaste volgorde van de semantische componenten.
- Bereken de horizontale en verticale middencoördinaten in het beeldvlak van elke visuele component op basis van de waarschijnlijkheidsverdeling die beperkt is tot de voorgrond. Normaliseer de coördinaten op basis van de breedte en hoogte van de afbeelding.
- Bereken de horizontale en verticale spreiding in het beeldvlak van elke visuele component in hetzelfde genormaliseerde coördinaatsysteem. Gebruik deze waarden uitsluitend om de omvang van het zichtbare gebied in de bewerkte afbeelding te beschrijven.
- Creëer zeven graafknooppunten volgens de vaste componentvolgorde en behoud inactieve componenten als nulknopen. Constructeer een 7 x 7 gedeelde-grensvlakmatrix op basis van acht-naburige contacten tussen voorgrondcomponentmaskers. Constructeer een 7 x 7 verticale-volgordematrix met behulp van de vaste relaties van Upper Trim Region naar Neckline Region, van Neckline Region naar Bodice Region, van Bodice Region naar elke regio van het onderkledingstuk, en van elke regio van het onderkledingstuk naar Hem Region. Sla elke geldige relatie in beide richtingen op.
- Voeg een zelflus toe voor elke actieve knoop vóór de graafconvolutie, en houd relaties die verbonden zijn met inactieve knopen op nul.
- Bereken de relatieve verplaatsing van het midden en de relatieve ruimtelijke dispersie tussen elk geordend paar semantische componenten. Stapel de paarsgewijze geometrische waarden om de geometrische relatietensor te vormen.
- Bereken het dot-product tussen elk paar genormaliseerde component-embeddings. Pas rijgewijze softmax toe op de resulterende overeenkomstmatrix en gebruik de waarden als relatiegewichten.
- Vermenigvuldig de geometrische relatietensor met de overeenkomstige relatiegewichten en aggregeer de gewogen relaties voor elke component.
- Sla de component-embeddingmatrix, de component-middenmatrix, de ruimtelijke dispersiematrix, de gedeelde-grensvlakmatrix, de verticale-volgordematrix, de zelflusmatrix, de relatiegewichtmatrix, het masker voor inactieve knopen, de mapping van componentlabels en de structurele prior-representatie op in structural_priors. Sla elke matrix met zeven rijen en zeven kolommen op waar van toepassing. Het volledige constructieproces van de voorgrondbeperkte componentkaart naar de prior voor de topologie van kledingcomponenten op beeldniveau wordt getoond in Figuur 2.
- Genereer de componentgraaf-overlay voor elk visualisatievoorbeeld op basis van de voorgrondbeperkte waarschijnlijkheidskaart, de component-middenmatrix, de getypeerde adjacency-matrix, het masker voor inactieve knopen en de mapping van componentlabels.
- Plaats elke actieve knoop op het overeenkomstige componentmidden. Teken doorgetrokken lijnen voor gedeelde voorgrondgrenzen en gestippelde lijnen voor vooraf gedefinieerde verticale-volgorderelaties.
- Sla elke graaf-overlay op in structural_priors/visualizations met behulp van de identificatie van de bronafbeelding. Registreer het pad van de bronafbeelding, het pad van de waarschijnlijkheidskaart, het pad van het componentmidden, het pad van de getypeerde adjacency, het pad van het masker voor inactieve knopen, de identificatie van het semantische parsing-checkpoint en het pad van de graaf-overlay in component_graph_visualization_manifest.csv.
- Verwachte output: Bevestig dat elke afbeelding een component-embeddingmatrix met K rijen produceert, een getypeerde adjacency-matrix met K rijen en K kolommen, een relatiegewichtmatrix met K rijen en K kolommen, een masker voor inactieve knopen met K waarden, en één structurele prior-representatie op beeldniveau. Bevestig dat elk geselecteerd visualisatievoorbeeld een componentgraaf-overlay produceert waarin actieve knopen binnen de overeenkomstige kledingregio's blijven.
OPMERKING: Behoud dezelfde volgorde van visuele componenten in alle matrices, manifests, grafen, kenmerkbestanden en graaf-overlays. Behandel componentmiddelen, ruimtelijke spreidingswaarden en graafrelaties als beschrijvers van kledingregio's in het beeldvlak. Interpreteer de componentgraaf niet als een menselijk pose-skelet en leid de knopen niet af van anatomische gewrichtscoördinaten. Converteer deze beschrijvers niet naar naadlengtes, kromningsstraal, dart-inname, inkepingposities, draadrichtingen, grading-stappen of afmetingen van patroondelen.
PROBLEEMOPLOSSING: Als een matrix een niet-numerieke waarde bevat, controleer dan de noemer van de waarschijnlijkheidsmassa en de coördinaatnormalisatie. Als relatiegewichten zich concentreren op één component, trek dan het maximum van de rij af van de overeenkomstmatrix vóór de softmax. Als het aantal graafknooppunten tussen afbeeldingen verschilt, controleer dan of inactieve componenten aanwezig blijven als nulvectoren in plaats van te worden verwijderd.
5. Structuurbewuste feature-codering met dubbele stroom
- Laad de op ImageNet voorgetrainde ResNet-50-gewichten en verwijder de laatste pooling- en classificatielagen.
- Sluis elke genormaliseerde kledingafbeelding door ResNet-50 en extraheer de appearance-tensor vanuit de backbone-fase die is vastgelegd door appearance_stage in configs/protocol.yaml. Verifieer de fasenaam, het aantal outputkanalen en de output-spatiële dimensies die door de geselecteerde backbone-fase worden gegenereerd voor een invoerafbeelding van 512 x 512 pixels. Gebruik dezelfde fase in elke trainings-, inferentie-, ablatie- en vergelijkingsrun.
- Pas de grootte van de semantische waarschijnlijkheidskaart aan naar de spatiële grootte van de appearance-feature-tensor via bilineaire interpolatie. Vermenigvuldig de appearance-feature-tensor met elke herschalen component-waarschijnlijkheidskaart en aggregeer vervolgens de gewogen responsen over de spatiële dimensies.
- Sluis elke component-appearance-embedding door de channel-recalibration-laag zoals gedefinieerd in configs/protocol.yaml. Noteer het laagtype, de inputdimensie, de outputdimensie, de reductieratio, de activatiefunctie en de regel voor parameter-sharing. Stapel de resulterende zeven componentvectoren in de vaste semantische volgorde om de appearance-feature-matrix te vormen.
- Sluis elke geometrische relatievector door de structurele projectielaag en stel de outputdimensie in op 512. Construeer de componentgraaf met de relatie-gewichtsmatrix en het inactieve-knoopmasker.
- Pas twee grafische convolutionele lagen toe met een inputdimensie van 512 en een outputdimensie van 512. Pas batchnormalisatie toe na elke grafische convolutionele laag en gebruik vervolgens LeakyReLU. Noteer de negative-slope-waarde die door LeakyReLU wordt gebruikt. Pas het inactieve-knoopmasker na elke laag toe om nul-features te behouden voor inactieve componenten.
- Pas semantische uitlijning toe met de genormaliseerde component-embeddings en stapel de resulterende vectoren om de structurele feature-matrix te vormen.
- Verwachte output: Bevestig dat elke afbeelding één appearance-feature-matrix en één structurele feature-matrix produceert. Bevestig dat beide matrices K rijen en 512 kolommen bevatten.
OPMERKING: Houd inactieve componenten als nulvectoren en behoud de componentvolgorde die is vastgesteld tijdens de constructie van de structurele prior.
PROBLEEMOPLOSSING: Als de twee feature-matrices verschillende aantallen rijen bevatten, inspecteer dan de semantische categorietoewijzing en de afhandeling van inactieve knopen. Als matrixvermenigvuldiging een dimensiefout rapporteert, verifieer dan of zowel de output van de structurele projectie als de appearance-kanaaldimensies 512 zijn. Als structurele features nul blijven voor alle actieve componenten, verifieer dan of de graafranden en relatiegewichten aan de huidige batch zijn toegevoegd.
6. Structuurgeleide kenmerkfusie
- Pas de structuurgestuurde feature-fusion sequentie toe zoals weergegeven in Figuur 3. Leid de structurele featurematrix door de fusion-weight laag en pas de activeringsfunctie toe die is gedefinieerd door fusion_activation in configs/protocol.yaml. Noteer de naam van de activering, de inputdimensie, de outputdimensie en of parameters worden gedeeld over de zeven componentknopen.
- Verifieer dat de gegenereerde structurele gewichtsmatrix K rijen en 512 kolommen bevat.
- Vermenigvuldig de appearance featurematrix element voor element met de structurele gewichtsmatrix.
- Concateneer de gemoduleerde appearance-matrix en de structurele featurematrix langs de kanaaldimensie.
- Concateneer de 512-dimensionale gemoduleerde appearance-vector en de 512-dimensionale structurele vector voor elk component om een 1024-dimensionale vector te vormen. Leid de geconcateneerde vector door de fusion projection-laag en reduceer de dimensie van 1024 naar 512.
- Voeg de oorspronkelijke structurele featurematrix toe aan de geprojecteerde matrix via een residuale verbinding.
- Stapel de gefuseerde componentvectoren in de vaste semantische volgorde en pas L2-normalisatie toe op de afgeplatte structuurbewuste representatie.
- Sla de structurele gewichtsmatrix, de gemoduleerde appearance-matrix, de gefuseerde componentmatrix en de uiteindelijke structuurbewuste representatie op in feature_outputs.
- Verwachte output: Bevestig dat elke afbeelding één gefuseerde componentmatrix produceert met K rijen en 512 kolommen en één genormaliseerde structuurbewuste featurevector gekoppeld aan de identificatie van de bronafbeelding.
OPMERKING: Bewaar de structurele gewichtsmatrix en de gefuseerde componentmatrix voor responsvisualisatie en lokale differentieanalyse.
PROBLEEMOPLOSSING: Als de gefuseerde waarden blijven groeien, inspecteer dan de output van de activering en de normalisatielaag. Als alle structurele gewichten naar dezelfde waarde tenderen, verifieer dan of structurele features variëren tussen afbeeldingen en of de fusion-laag gradiënten ontvangt. Als featurebestanden en afbeeldingsidentificaties niet overeenkomen, herbouw dan het outputmanifest vóór training of evaluatie van de retrieval.
7. Modeltraining en optimalisatie van de consistentie
- Laad de vijf willekeurige seed-waarden die zijn vastgelegd in configs/seeds.yaml. Stel voor elke run dezelfde willekeurige seed in voor Python, NumPy, PyTorch CPU-operaties en alle CUDA-apparaten. Schakel deterministische algoritmen in, schakel de cuDNN benchmark-modus uit en leg de exacte vijf seed-waarden vast in de bijbehorende run-directory.
- Laad het verwerkte trainingsmanifest, het paarmanifest, de waarschijnlijkheidskaarten en de structurele priors.
- Stel elke trainingsbatch samen met acht structurele categorieën en vier monsters met variërende verschijning uit elke categorie.
- Bereken het structurele consistentieverlies uit positieve monsterparen die dezelfde structurele prior delen.
- Bereken het structurele relatieconsistentieverlies uit de paarsgewijze afstanden tussen component-kenmerken.
- Bereken het structurele discriminatieverlies uit negatieve monsterparen met heterogene structuren en pas de scheidingsdrempel van 0.3 toe.
- Combineer het uiterlijkdoel, het structurele consistentiedoel, het structurele relatiedoel en het structurele discriminatiedoel met de gewichten die zijn opgeslagen in configs/protocol.yaml. Het optimalisatieproces van de kenmerkruimte, gestuurd door de drie structurele doelen, wordt getoond in Figuur 4.
- Voer python train.py --config configs/protocol.yaml uit. Werk alle trainbare parameters bij met mini-batch stochastische gradiëntafdaling met behulp van de initiële leersnelheid, momentum, gewichtsverval, aantal epochs, vervalfactor en verval-epochs zoals gedefinieerd in Stap 1.8. Leg de leersnelheid na elke epoch vast in het trainingslogboek.
- Leg na elke epoch het totale verlies, het uiterlijkverlies, het structurele consistentieverlies, het structurele relatieverlies, het structurele discriminatieverlies, de leersnelheid, de Structural Consistency Index (SCI), de Structural Discrimination Index (SDI) en de Recall@5 vast.
- Evalueer het model op validation_manifest.csv na elke epoch. Sla het checkpoint op dat geassocieerd is met de hoogste validatie-SCI in checkpoints/selected_model.pth.
- Herhaal de training vijf keer met vijf vastgelegde willekeurige seeds. Sla elk configuratiebestand, trainingslogboek en geselecteerde checkpoint op in een aparte run-directory.
- Verwachte output: Bevestig dat elke run een trainingslogboek, een validatielogboek, een metricbestand op epoch-niveau en één geselecteerde checkpoint produceert. Bevestig dat de geselecteerde checkpoint gebaseerd is op validatieprestaties in plaats van testprestaties.
OPMERKING: Gebruik in elk modelvergelijkings- en ablatie-experiment dezelfde trainings-, validatie- en testmanifesten.
PROBLEEMOPLOSSING: Als een verlies niet-numeriek wordt, stop dan de training, inspecteer de waarschijnlijkheidsmassa's van de componenten, verlaag de leersnelheid met een factor 10 en start opnieuw vanaf het laatste geldige checkpoint. Als de validatie-SCI ongewijzigd blijft terwijl het trainingsverlies afneemt, controleer dan of graafpropagatie- en fusieparameters gradiënten ontvangen. Als het grafische geheugen is uitgeput, verlaag dan de batchgrootte en behoud een effectieve batchgrootte van 32 via gradiëntaccumulatie. Als de validatieprestaties scherp veranderen tussen runs, controleer dan de vastgelegde willekeurige seed en de volgorde van het datamanifest.
8. Inferentie, retrieval, clustering en outputverificatie
- Voer python infer.py --config configs/protocol.yaml --checkpoint checkpoints/selected_model.pth uit. Genereer waarschijnlijkheidskaarten, structurele priors, uiterlijk-kenmerkmatrices, structurele kenmerkmatrices, gefuseerde componentmatrices en uiteindelijke kenmerkvectoren voor elke testafbeelding.
- Sla alle inferentie-outputs op onder feature_outputs/test en leg hun paden vast in test_feature_manifest.csv. Bereken de cosinusovereenkomst tussen elk query-kenmerk en alle gallery-kenmerken. Sorteer de gallery-identificatoren in aflopende volgorde van overeenkomst. Sla de vijf hoogst gerangschikte resultaten voor elke query op in evaluation_results/retrieval_results.csv.
- Laad voor elk retrieval-sample dat is geselecteerd voor visualisatie de getypeerde adjacentiematrix, de relatie-gewichtsmatrix, de component-centrummatrix, het inactieve-knooppuntmasker, de componentlabel-mapping en de gefuseerde componentmatrix van de query-afbeelding. Laad dezelfde bestanden voor het hoogst gerangschikte resultaat gegenereerd door het structuur-bewuste model.
- Render de componentgraaf van de query en de componentgraaf van de retrieved-afbeelding op basis van hun opgeslagen componentcentra en getypeerde adjacentiematrices. Behoud de vaste componentvolgorde en relatietypes die tijdens de model-inferentie zijn gebruikt.
- Render de getypeerde adjacentiematrix van de query als een categorische matrix. Gebruik afzonderlijke matrixwaarden voor inactieve, gedeelde-rand en verticale-volgorde relaties. Label de horizontale en verticale assen met de componentidentificatoren die zijn opgeslagen in de componentlabel-mapping.
- Pas L2-normalisatie toe op de gefuseerde componentmatrix van de query en de gefuseerde componentmatrix van de retrieved-afbeelding. Bereken de cosinusovereenkomst tussen elk query-component en elk retrieved-afbeelding-component. Sla de resulterende K × K component-correspondentiematrix op in evaluation_results/structural_retrieval_evidence.
- Laad voor elk referentie-doelpaar dat is geselecteerd voor lokale verschilanalyse de getypeerde adjacentiematrix, de component-centrummatrix, de ruimtelijke-dispersiematrix, de relatie-gewichtsmatrix en de gefuseerde componentmatrix van beide afbeeldingen.
- Bereken het absolute verschil tussen de twee getypeerde adjacentiematrices. Bereken de absolute verschillen in component-centrumverplaatsing, ruimtelijke dispersie en relatiewichten met behulp van de vaste componentvolgorde. Sla de resulterende topologie-verschilmatrix en geometrische-relatie-verschilmatrix op in evaluation_results/structural_difference_evidence.
- Bereken de L2-afstand tussen overeenkomstige rijen van de twee gefuseerde componentmatrices. Normaliseer de afstanden op componentniveau en wijs deze toe aan de knooppunten van de doel-componentgraaf. Verhoog de randbreedte op basis van het genormaliseerde verschil in relatiegewicht. Sla de resulterende post-fusie component-verschilgraaf op.
- Leg de afbeeldingidentificatoren, matrixpaden, graafpaden, componentvolgorde, checkpoint-identificator en visualisatie-outputpaden vast in structural_visualization_manifest.csv. Genereer alle structurele visualisaties programmatisch vanuit de vastgelegde bestanden; voeg geen graafknooppunten, grafranden of matrixwaarden handmatig toe.
- Pas K-Means met vijf clusters toe op de uiteindelijke kenmerkvectoren en sla de clustertoewijzingen op in evaluation_results/cluster_assignments.csv. Voer python evaluate.py --config configs/protocol.yaml --feature_dir feature_outputs/test uit.
- Bereken SCI, SDI, Recall@5, de mean Average Precision (mAP) en de silhouetcoëfficiënt voor elke run. Gebruik SCI om de compactheid te beoordelen van genormaliseerde kenmerken die hetzelfde structurele label delen, en gebruik SDI om de scheiding tussen verschillende structurele labels te beoordelen. Gebruik Recall@5 om te beoordelen of een relevante structurele match voorkomt in de korte retrieval-lijst, en gebruik mAP om de rangschikkingskwaliteit over de gehele gallery te beoordelen. Gebruik de silhouetcoëfficiënt uitsluitend voor de clusteranalyse.
- Bereken het rekenkundig gemiddelde en de steekproefstandaarddeviatie over vijf onafhankelijke runs. Behoud de vijf waarden op run-niveau voor elke methode en metriek. Pas geen min-max-normalisatie, rangnormalisatie of herschaling toe op basis van de vergeleken methoden. Voer een gepaarde t-test uit met resultaten verkregen onder hetzelfde random seed en leg de toetsstatistiek en de exacte tweezijdige significantiewaarde vast.
- Vergelijk het aantal verwerkte testidentificatoren, kenmerkbestanden, retrieval-records en clustertoewijzingen. Los elke mismatch op voordat de evaluatieresultaten worden gerapporteerd of geïnterpreteerd.
- Verwachte output: Bevestig dat elke testafbeelding één volledig inferentierecord, één retrieval-lijst, één clustertoewijzing en één set evaluatie-inputs heeft. Bevestig dat elke retrieval-case die is geselecteerd voor visualisatie een query-componentgraaf, een retrieved-afbeelding-componentgraaf, een getypeerde adjacentiematrix en een gefuseerde-componentcorrespondentiematrix heeft.
- Bevestig dat elke structurele verschil-case een topologie-verschilmatrix, een geometrische-relatie-verschilmatrix, een post-fusie component-verschilgraaf, een ruimtelijke verschil-heatmap en een response-overlay heeft. Bevestig dat alle visualisatiebestanden via structural_visualization_manifest.csv zijn gekoppeld aan hun bronmatrices. Sla de pure heatmap, de doelafbeelding-overlay, het voorgrondmasker en de coördinaten van de regio met de hoogste respons op voor elke gevisualiseerde case.
- Accepteer een berekende verschilrespons alleen wanneer de dominante regio met hoge respons overlapt met de voorgrond van het kledingstuk en wordt ondersteund door de overeenkomstige verandering in getypeerde adjacentie, de verandering in geometrische relatie en het bewijs van de post-fusie componentafstand. Als de sterkste respons voornamelijk buiten de voorgrond van het kledingstuk valt, inspecteer dan de parsing-output, de componentgraaf en het fusie-record.
OPMERKING: Gebruik het checkpoint dat is geselecteerd uit de validatieset voor inferentie op de testset. Selecteer of vervang geen checkpoint op basis van testset-metrieken. Gebruik dezelfde componentvolgorde, inactieve-knooppuntregel, relatietype-codering en normalisatieproces bij het genereren van grafen en matrices tijdens inferentie en visualisatie.
PROBLEEMOPLOSSING: Als de inferentie stopt voordat alle testafbeeldingen zijn verwerkt, zoek dan de laatste identificator in het inferentielogboek en hervat vanaf de volgende identificator. Als retrieval-resultaten worden gedomineerd door kleurovereenkomst, inspecteer dan de structural-prior- en fusie-outputs en verifieer of het laden van het checkpoint succesvol was. Als de evaluatie dubbele identificatoren rapporteert, herbouw dan test_feature_manifest.csv en verwijder dubbele records vóór herberekening. Als K-Means een leeg cluster produceert, verifieer dan de kenmerknormalisatie en voer de clustering opnieuw uit met het vastgelegde random seed.
9. Vergelijkende modelevaluatie
- Voer python compare_models.py --config configs/protocol.yaml uit.
- Train en evalueer ResNet-50, Part-based Convolutional Baseline (PCB), GCN, FashionGraph, Swin Transformer, CLIP, Topology Feature Histogram with Color and Texture Fusion, Attention-Guided Cascade Network, MMFL-Net, FARE-RNET en de voorgestelde methode met dezelfde training-, validatie- en testmanifesten.
- Gebruik voor elke methode dezelfde afbeeldinggrootte, voorbehandelingsbewerkingen, trainingsepochen, effectieve batchgrootte, evaluatiequery's en metriekimplementatie.
- Behoud global average pooling voor ResNet-50. Pas horizontale-strip uitlijning toe in PCB. Pas een vaste grafiek van kledingstukken op afbeeldingniveau toe in GCN. Pas attribuutgestuurde dynamische grafiekinferentie toe in FashionGraph. Gebruik de standaard afbeeldingencodeurs van Swin Transformer en CLIP. Implementeer Topology Feature Histogram with Color and Texture Fusion met behulp van topologie-, kleur- en textuurdescriptoren. Implementeer een Attention-Guided Cascade Network met behulp van globale en lokale kenvertakkingen met kledingparsing. Implementeer MMFL-Net met behulp van multi-schaal en multi-granulariteitskenvertakkingen. Implementeer FARE-RNET met behulp van residuele aandacht, kenmerkselectie en gedilateerde contextuele codering.
- Gebruik alleen de image-query tak van elke vergelijkingsmethode. Train elke trainbare methode opnieuw op het gemeenschappelijke trainingsmanifest en selecteer het checkpoint op basis van het gemeenschappelijke validatiemanifest. Genereer een gerangschikte galerijlijst voor elke testquery.
- Projecteer elke geleerde embedding naar 512 dimensies via een geregistreerde trainbare lineaire laag wanneer de oorspronkelijke dimensie afwijkt. Pas L2-normalisatie toe vóór de cosinus-gelijkenis rangschikking. Gebruik voor alle methoden dezelfde toewijzing van query-galerij en dezelfde metriekimplementatie.
- Herhaal elke vergelijkingsmethode met dezelfde vijf willekeurige seeds. Rapporteer het gemiddelde en de steekproefstandaarddeviatie van SCI, SDI, Recall@5, mAP en de silhouette-coëfficiënt. Voer voor elke metriek een tweezijdige gepaarde t-toets uit tussen de voorgestelde methode en elke vergelijkingsmethode met de resultaten die zijn verkregen onder dezelfde willekeurige seed. Noteer de vijf waarden op run-niveau, de toetsingsstatistiek, de vrijheidsgraden en de exacte p-waarde in evaluation_results/comparison_metrics.csv.
- Bereken SCI, SDI, Recall@5, mAP en de silhouette-coëfficiënt voor elke methode. Sla alle waarden op run-niveau en geaggregeerde waarden op in evaluation_results/comparison_metrics.csv.
- Verwachte output: Bevestig dat comparison_metrics.csv dezelfde metriekvelden en hetzelfde aantal onafhankelijke runs bevat voor elke vergelijkingsmethode.
OPMERKING: Wijzig de datapartities, de metriekcode of de toewijzing van query-galerij niet tussen de vergelijkingsmethoden.
PROBLEEMOPLOSSING: Als een vergelijkingsmodel een kenmerkdimensie produceert die afwijkt van 512, voeg dan een enkele geregistreerde lineaire projectielaag toe vóór de metriekberekening en train die laag met het overeenkomstige model. Als een model niet convergeert onder de gemeenschappelijke leerfrequentie, gebruik dan de leerfrequentie die is gespecificeerd door de gepubliceerde implementatie en behoud alle overige experimentele condities. Noteer elke methode-specifieke instelling in het vergelijkingslogboek.
Resultaten
Alle gerapporteerde experimenten werden uitgevoerd met de hardware- en softwareomgeving zoals gedocumenteerd in Tabel 2 en de Tabel met Materialen. Gedurende de preprocessie, training, inferentie en evaluatie werden dezelfde versies van de graphicsdriver, CUDA, cuDNN, Python, NumPy, PyTorch en torchvision gebruikt. De volledige hardware- en softwareomgeving is samengevat in Tabel 2 en de Tabel met Materialen. Tabel 1 geeft een overzicht van de verwerkte trainings-, validatie- en testdatasets samen met de topologiestatistieken op beeldniveau. Tabel 2 vat de gemeenschappelijke configuratie samen die is gebruikt voor alle vergelijkingsmethoden.
Resultaten van de vergelijkende evaluatie
De vergelijkende evaluatie volgde de gangbare datapartities, preprocessing-operaties, trainingscontroles en metriekdefinities zoals gespecificeerd in secties 7–9 van het protocol. Tabel 3 vergelijkt algemene visuele encoders, part-aligned modellen, grafiekgebaseerde kledingrepresentaties, cross-domein fashion retrieval-netwerken, topology-and-appearance fusiemethoden en e-commerce visuele retrieval-methoden, alle geëvalueerd met hetzelfde image-query protocol. De domeinspecifieke methoden omvatten Topology Feature Histogram with Color and Texture Fusion (TFH-CT), Attention-Guided Cascade Network (AGC-Net), Multi-scale and Multi-granularity Feature Learning Network (MMFL-Net) en Fashion Retrieval using Residual Network with Egret Swarm Optimization (FARE-RNET). Alle evaluatiemetrieken in Tabel 3 worden gerapporteerd als het gemiddelde en de steekproefstandaarddeviatie over vijf onafhankelijke runs met gebruik van dezelfde random seeds, trainingsmanifest, validatiemanifest, testmanifest, query-gallery toewijzing en metriekimplementatie. De gepaarde p-waarden werden afzonderlijk berekend voor SCI, SDI, Recall@5, mAP en de silhouette-coëfficiënt door elke methode te vergelijken met de voorgestelde methode onder overeenkomstige random-seed condities. Deze resultaten vormen de kwantitatieve basis voor de daaropvolgende structurele visualisatie, retrieval, clustering en ontwerpgeoriënteerde analyses.
Representatieve protocolresultaten en interpretatie
Een succesvolle uitvoering van het protocol is herkenbaar wanneer de op beeldniveau gereconstrueerde componentgraaf, opgesteld uit de opgeslagen parsing- en graafbestanden, elke actieve node binnen de overeenkomstige kledingregio plaatst en de relatietypen bewaart die zijn vastgelegd in de getypeerde adjacentiematrix, zoals weergegeven in Figuur 5C. De structuurbewuste respons moet geconcentreerd blijven op de voorgrond van het kledingstuk, zoals te zien is in Figuur 5D. Figuur 6E toont een verwacht retrieval-resultaat waarbij de voorgestelde methode de invloed van de rode achtergrond vermindert en kledingstukken voor het bovenlichaam terugvindt in plaats van niet-gerelateerde rode objecten. Figuur 6B–G demonstreert tevens dat de retrieval-ranking wordt ondersteund door componentrelaties op beeldniveau en componentcorrespondentie na fusie. Dit resultaat weerspiegelt het herstel van de grove kledingcategorie, hoewel de mouwlengte en lokale topologie nog steeds variëren tussen de teruggevonden monsters.
Veelvoorkomende foutgevallen omvatten de door textuur gedomineerde activatie in Figuur 5B, de door achtergrondkleur gestuurde retrieval in de bovenste rij van Figuur 6, en de residuele achtergrondactivatie in Figuur 7. Figuur 7 moet worden geïnterpreteerd als gedeeltelijke lokalisatie, omdat de dominante respons het vergrote silhouet van het onderlichaam en de rechter kledingrand volgt, terwijl residuele activatie aanwezig blijft in aangrenzende achtergrondregio's. De lokalisatie wordt slechts als structureel ondersteund beschouwd wanneer de topologie-verschilmatrix, de geometrische-relatie-verschilmatrix, de post-fusie component-verschilgraaf en de ruimtelijke respons consistente kledingregio's identificeren. Een ruimtelijk hotspot zonder overeenkomstige wijzigingen in de matrix of componenten duidt op visuele interferentie in plaats van structureel bewijs.
Een protocolrun wordt als geldig beschouwd wanneer elke geaccepteerde afbeelding een genormaliseerde semantische waarschijnlijkheidskaart produceert, een relatiematrix met K rijen en K kolommen, uiterlijke en structurele kenmerkenmatrices met K rijen en 512 kolommen, en een eindige gefuseerde kenmerkenvector die gekoppeld is aan de juiste afbeeldingsidentificator. Visuele inspectie moet bevestigen dat de topologie de kledingcomponenten volgt, dat de foreground-respons de background-respons overtreft en dat retrieval-resultaten worden gestuurd door de kledingcategorie en -structuur in plaats van door de achtergrondkleur. Gefragmenteerde waarschijnlijkheidskaarten, ontbrekende componentknopen, niet-numerieke matrices, diffuse background-responsen of door kleur gedomineerde retrieval duiden op een mislukte uitvoering en vereisen inspectie van het parsen, de graafconstructie, de feature-fusie of het laden van checkpoints.
Visuele analyse van responsen van kledingcomponenten op beeldniveau
Figuur 5 vergelijkt de ResNet-50 baseline met het component-bewuste model met gebruikmaking van dezelfde kledingafbeelding. Figuur 5B toont de class activation map voor de appearance baseline. Figuur 5C presenteert de graaf van kledingcomponenten op beeldniveau, gereconstrueerd vanuit de foreground-restricted probability map, de component center matrix, de typed adjacency matrix, het inactive-node mask en de component label mapping die zijn gegenereerd in protocolsecties 3 en 4. Figuur 5D presenteert de activatierespons van de gefuseerde representatie. Er is geen menselijke pose-estimator of annotatie van menselijke gewrichten gebruikt om Figuur 5C te genereren.
De basisrespons was geconcentreerd op lokale textuurregio's in het onderkledingstuk en volgde niet consistent de volledige rand van het kledingstuk, zoals weergegeven in Figuur 5B. In Figuur 5C komt elke knoop overeen met het centrum van een actieve regio van een kledingcomponent, terwijl elke rand een gedeelde voorgrondrand of een vooraf gedefinieerde verticale volgorde-relatie vertegenwoordigt. De graaf weerspiegelt de organisatie van de kledingregio's en stelt geen menselijke anatomische gewrichten voor. De structuurbewuste respons besloeg de belangrijkste voorgrond van het kledingstuk, terwijl in de meeste achtergrondgebieden een lagere activatie behouden bleef, zoals weergegeven in Figuur 5D. Deze resultaten geven aan dat de componentgraaf en de feature-fusiemodule de textuurgedomineerde activatie in de geëvalueerde afbeelding hebben verminderd.
Analyse van structurele gelijkenis van kleding en resultaten van het ontwerpnaslagwerk
Figuur 6 presenteert de retrieval-rangschikking samen met het structurele bewijs dat is gebruikt voor de interpretatie ervan. De query-componentgraaf in Figuur 6B registreert actieve kledingstukregio's en hun getypeerde relaties, terwijl de matrix in Figuur 6C het relatiepatroon blootlegt dat aan de graafpropagatie is geleverd. De basislijnresultaten in Figuur 6D blijven gedomineerd worden door rode uiterlijkkenmerken. De structuurbewuste resultaten in Figuur 6E behouden de categorie kledingstukken voor het bovenlichaam over verschillende kleuren en achtergronden heen. De componentgraaf van het hoogst gerangschikte resultaat in Figuur 6F maakt een directe vergelijking met de query-graaf mogelijk, en de correspondentiematrix in Figuur 6G onthult of componenten met dezelfde identificatoren uitgelijnd blijven na structuurgestuurde fusie. De diagonale correspondentie dient gezamenlijk te worden geïnterpreteerd met ontbrekende knopen en gewijzigde graafrelaties. Sterke gelijkenis in uiterlijk zonder overeenstemming in de graaf vormt geen succesvolle structurele retrieval.
De opgehaalde kledingstukken behouden de grove categorie, maar verschillen in mouwconfiguratie en lokale componentrelaties wijzen op een onvolledige fijnmazige correspondentie. De voorgestelde methode behaalde een Recall@5 van 89,2% en een mAP van 86,4%, zoals vermeld in Tabel 3. Deze kwantitatieve waarden beschrijven de rankingprestaties, terwijl Figuur 6B–G tussenliggend structureel bewijs levert ter ondersteuning van de interpretatie. De conclusie van het ophaalproces is daarom beperkt tot een verbeterde resistentie tegen interferentie van achtergrondkleuren en een sterkere organisatie van componenten op beeldniveau onder de geteste query.
Respons op structurele verschillen en ondersteuning bij ontwerpanalyse
de zuivere verschil-respons-heatmap in Figuur 7H laat zien dat de dominante respons geconcentreerd is op het vergrote silhouet van het onderlichaam en de rechter kledingrand van de doelafbeelding. De overlay in Figuur 7I laat zien dat de sterkste respons gealigneerd blijft met de voorgrond van het hoofdကledingstuk, terwijl zwakkere activatie in de aangrenzende gordijn- en wandregio's aanwezig blijft als residuele achtergrondinterferentie. De ruimtelijke respons dient te worden geïnterpreteerd in samenhang met de componentgrafiek en het matrixbewijs gepresenteerd in Figuren 7C–GEen respons wordt alleen als een geldig structureel verschil beschouwd wanneer de regio van het kledingstuk met de hoge respons consistent is met de wijziging in nabijheid, de wijziging in geometrische relatie en het patroon van de componentafstand na fusie.
Een structureel verschil wordt alleen geaccepteerd wanneer de getypeerde wijziging in nabijheid in Figuur 7E of de wijziging in de geometrische relatie in Figuur 7F gepaard gaat met een toegenomen componentafstand in Figuur 7G en een op de voorgrond uitgelijnde ruimtelijke respons in Figuur 7H,I. De vergrote regio van het onderlichaam en de rand van het kledingstuk aan de rechterkant voldoen aan dit cross-stage criterium. Activering over het gordijn en de muur komt niet overeen met wijzigingen in componentknopen, relatiepatronen of gefuseerde componentafstanden, en wordt daarom verworpen als niet-structurele residuele interferentie. Het resultaat ondersteunt lokalisatie van verschillen op beeldniveau, maar stelt geen variatie in stikpatronen of constructieparameters vast.
Analyse van de ruimtelijke distributie van kenmerken en structurele clusteranalyse
Analyse van de distributie van de latente kenmerkruimte onthult het vermogen van het model om de structurele semantiek van kleding te onderscheiden. Deze analyse onderzoekt of de structurele prior kledingstukken met verschillende topologische configuraties organiseert in afzonderlijke kenmerkmanifolds. Er werden vijf representatieve structurele categorieën uit de testset geselecteerd: shirts met korte mouwen, broeken, rokken, lange jassen en jurken. De hoogdimensionale kenmerkvectoren werden geprojecteerd op een tweedimensionaal vlak met behulp van t-distributed stochastic neighbor embedding (t-SNE). De cohesie van vergelijkbare monsters en de scheiding van onvergelijkbare monsters werden beoordeeld om de organisatie van de structurele semantiek in de kenmerkruimte te karakteriseren. De t-SNE-distributie van de structuurbewuste kenmerkruimte wordt weergegeven in Figuur 8.
De t-SNE-projectie vormde vijf hoofdkenmerkregio's met beperkte overlap tussen naburige categorieën, zoals weergegeven in Figuur 8ARepresentatieve monsters die overeenkomen met de vijf categorieregio's worden getoond in Figuur 8BDe SCI van 0,81 weerspiegelt de compactheid van monsters met hetzelfde structurele label, en de SDI van 0,71 weerspiegelt de scheiding tussen monsters met verschillende structurele labels, zoals gerapporteerd in Tabel 3 en gevisualiseerd in Figuur 8Deze indices moeten worden geïnterpreteerd als maten voor de distributie in de kenmerkruimte en stellen geen vals-positieve ratio direct vast. Tops met korte mouwen en rokken bevonden zich in verschillende hoofdregio's in de geprojecteerde kenmerkruimte, terwijl een klein aantal monsters nabij aangrenzende categoriegrenzen bleef, zoals weergegeven in Figuur 8ABroeken en jurken vertoonden ook een duidelijke scheiding van naburige categorieën. Deze distributie geeft aan dat de graph prior bijdroeg aan de structurele organisatie op categorieniveau zonder volledige clusterscheiding te produceren. De evaluatie scheidt de representatiekwaliteit van de effectiviteit van de retrieval. SCI beoordeelt of kledingstukken met hetzelfde structurele label compact blijven in de geleerde kenmerkruimte, terwijl SDI beoordeelt of kledingstukken met verschillende structurele labels gescheiden blijven. Deze metrieken komen overeen met het doel voor structurele representatie van het protocol. Recall@5 meet of een structureel relevant kledingstuk verschijnt binnen de eerste vijf opgehaalde resultaten, terwijl mAP de rankingkwaliteit meet over alle relevante gallery-samples. Deze metrieken komen overeen met het doel voor design-reference retrieval. De silhouette-coëfficiënt werd uitsluitend gebruikt om de clusteringprestaties te evalueren, aangezien SCI en SDI de organisatie van de kenmerkruimte reeds karakteriseren.
Figuur 9 rapporteert de ruwe resultaten van vijf runs voor vier representatieve methoden zonder cross-methode normalisatie. Figuur 9A presenteert SCI en SDI op hun oorspronkelijke schaal, terwijl Figuur 9B Recall@5 en mAP als percentages presenteert. De markeringen van de individuele runs en de foutlijnen van de standaarddeviatie tonen de variatie die gepaard gaat met de modeltraining, in plaats van enkel de geaggregeerde rangschikking. De baseline op basis van uiterlijke kenmerken behaalde een SCI van 0,62, terwijl de voorgestelde methode een SCI van 0,81 en een SDI van 0,71 behaalde (Tabel 3 en Figuur 9A). De SCI- en SDI-resultaten duiden op een sterkere compactheid binnen labels en een betere scheiding tussen labels onder de geëvalueerde setting. De voorgestelde methode behaalde een Recall@5 van 89,2% en een mAP van 86,4% (Tabel 3 en Figuur 9B). Deze retrieval-metrieken beoordelen verschillende rangschikkingseigenschappen en worden apart geïnterpreteerd van SCI en SDI. De consistente volgorde van methoden over de vier metrieken geeft overeenstemming aan tussen de representatiekwaliteit en de retrieval-prestaties, maar dit impliceert niet dat de relatieve verbetering identiek is over de vier evaluatiedimensies.
Ablatie-experimenten en analyse van de effectiviteit van structurele modules
Het ablatie-experiment vergelijkt het volledige model met varianten waarin de structurele prior of de fusiemodule is verwijderd. Alle drie de configuraties maken gebruik van dezelfde referentie- en doelafbeeldingen, waardoor een directe vergelijking van de achtergrondrespons en de lokalisatieconcentratie mogelijk is. De variant zonder de structurele prior verwijdert de grafiek van het kledingstukcomponent op beeldniveau en de bijbehorende relatiebeperkingen, en vertrouwt uitsluitend op de convolutionele backbone voor het extraheren van uiterlijkkenmerken; de variant zonder fusie behoudt de grafiekinferentie maar verwijdert de kenmerkpiramide, waarbij alleen hoogwaardige semantische kenmerken worden gebruikt. Gevisualiseerde verschil-heatmaps onthullen de specifieke rollen van elke module bij ruisonderdrukking en randdefinitie; een kwalitatieve vergelijking van de structurele verschilresponsen onder verschillende moduleconfiguraties wordt getoond in Figuur 10.
De responskaarten in Figuur 10C–E zijn weergegeven met een gedeelde responsschaal en identieke overlay-instellingen. De variant zonder de structure prior produceerde een sterke activatie in de linkerachtergrond en rond niet-gerelateerde omgevingsregio's, zoals te zien is in Figuur 10C. De variant zonder de fusiemodule verminderde een deel van die respons buiten het kledingstuk, maar behield nog steeds een bredere spreiding over het onderste kledingstuk en de omliggende regio aan de rechterzijde, zoals te zien is in Figuur 10D. Het volledige model zorgde voor een verdere contractie van de dominante respons richting de voorgrond van het hoofd kledingstuk, zoals te zien is in Figuur 10E. Figuur 10F visualiseert direct het verschil in foreground-beperkte responsen tussen de non-fusievariant en het volledige model, wat aantoont dat het volledige model residuele laterale spreiding onderdrukt terwijl de belangrijkste kledingstuk-uitgelijnde respons behouden blijft. Deze resultaten geven aan dat de structure prior voornamelijk omgevingsruis verminderde en dat de fusiemodule de responsconcentratie en structurele uitlijning verder verbeterde. Figuur 10E vertegenwoordigt een relatieve verbetering in plaats van een volledige verwijdering van de achtergrondactivatie.
Tabel 4 rapporteert SCI, SDI en Recall@5 voor de varianten zonder de structurele prior, zonder de fusiemodule en met het volledige model. Het verwijderen van de structurele prior verminderde de SCI van 0,81 naar 0,65 en verlaagde de Recall@5 van 89,2% naar 74,5%. Het verwijderen van de fusiemodule verminderde de SDI van 0,71 naar 0,64 en verlaagde de Recall@5 van 89,2% naar 85,1%, een afname van 4,1 procentpunt. Deze resultaten geven aan dat de structurele prior een grotere invloed had op de structurele consistentie en het ophalen, terwijl feature-fusie de uitlijning tussen uiterlijk en structurele informatie verbeterde.
De efficiëntieanalyse vergelijkt de computationele kosten van het volledige model met de ResNet-50 baseline. De ResNet-50 baseline vereiste 25,6 miljoen parameters en 4,1 miljard floating-point operaties. Het volledige structuurbewuste model vereiste 29,3 miljoen parameters en 5,4 miljard floating-point operaties. De gemiddelde inferentietijd was 15 milliseconden per afbeelding voor de baseline en 22 milliseconden per afbeelding voor het volledige model, een toename van 7 milliseconden. Dit resultaat wijst op een meetbare computationele kost die in overweging moet worden gebracht bij de implementatie van het protocol in tijdgevoelige workflows (Tabel 5). Het gewicht van de structurele beperking werd bepaald op basis van de validatieset voorafgaand aan de uiteindelijke testevaluatie. De validatie Recall@5 werd onderzocht bij gewichten voor de structurele beperking van 0,1, 0,3, 0,5, 0,8, 1,0, 1,2, 1,5 en 2,0. Voor elke volgende trainings- en testrun werd een gewicht van 1,0 vastgesteld. Figuur 11 documenteert de op validatie gebaseerde selectie van een gewicht van 1,0 voor de structurele beperking.
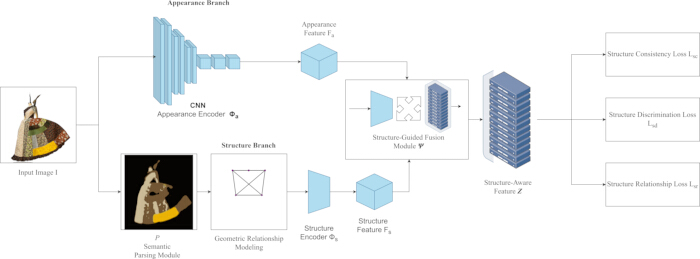
Figuur 1: Algemene workflow van het structuurbewuste protocol voor het leren van kenmerken van kledingafbeeldingen. De invoerafbeelding van het kledingstuk wordt verwerkt door een tak voor uiterlijke kenmerken en een tak voor structurele kenmerken die gebruikmaakt van semantische parsing en ruimtelijke graafmodellering. De twee representaties worden verwerkt door de structuurgestuurde fusiemodule om het uiteindelijke structuurbewuste kenmerk te genereren. Structureel consistentieverlies, structureel discriminatieverlies en structureel relatieverlies beperken gezamenlijk de kenmerkruimte. De figuur laat zien hoe het uiterlijk van het kledingstuk en de componenttopologie worden geïntegreerd gedurende het leren van kenmerken. Klik hier om een grotere versie van deze figuur te bekijken.
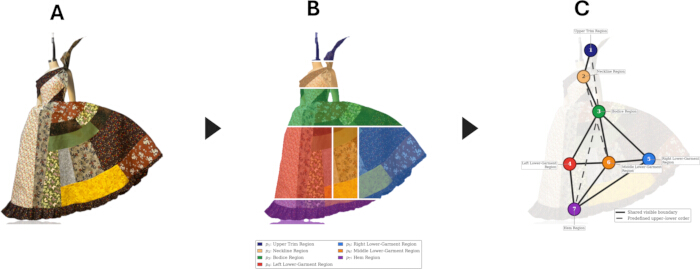
Figuur 2: Constructie van een prior voor de topologie van kledingcomponenten op beeldniveau. (A) De invoerafbeelding van het kledingstuk I. (B) De op de voorgrond beperkte visuele componentenkaart P, waarin zeven kleuren kledingregio's op beeldniveau aanduiden. Alle achtergrondpixels zijn uitgesloten van de componentkanalen. (C) De relatiegrafiek van componenten op beeldniveau G. Knooppunten representeren zichtbare kledingregio's, doorgetrokken lijnen representeren gedeelde grenzen op de voorgrond, en gestreepte relaties representeren een vooraf gedefinieerde verticale volgorde. De kaart en grafiek ondersteunen beeldopvraging en vergelijking van visuele structuren. Ze representeren geen patronen, naadgeometrie, coupenaden, graderingsparameters of snijinstructies. Klik hier om een grotere versie van deze figuur te bekijken.
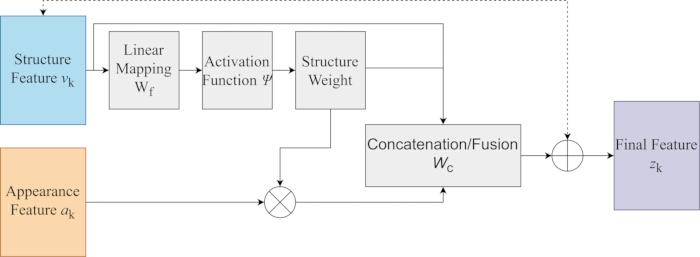
Figuur 3: Structuurgeleide feature-fusiemodule. De structurele feature wordt getransformeerd door de lineaire mapping en activatiefunctie Ψ om een structureel gewicht te genereren. Het structurele gewicht moduleert de uiterlijke feature via elementgewijze vermenigvuldiging. De gemoduleerde uiterlijke feature en de structurele feature worden geconcateneerd en geprojecteerd door Wc, waarna de residuele structurele feature wordt toegevoegd om de uiteindelijke component-feature te genereren. De figuur laat zien dat structurele informatie de weging van de uiterlijke feature reguleert vóór de uiteindelijke fusie. Klik hier om een grotere versie van deze figuur te bekijken.
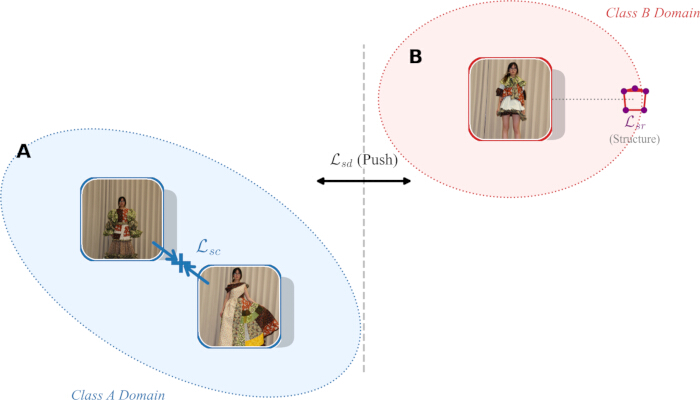
Figuur 4: Optimalisatie van de kenmerkruimte onder structurele consistentiebeperkingen. (A) Monsters die tot dezelfde structurele klasse behoren, worden dichter bij elkaar getrokken door het structurele consistentieverlies, terwijl hun interne componentrelaties behouden blijven door het structurele relatieverlies. (B) Monsters uit verschillende structurele klassen worden uit elkaar geduwd door het structurele discriminatieverlies. De figuur laat zien hoe de drie structurele doelstellingen gezamenlijk de compactheid binnen de klasse en de scheiding tussen klassen vergroten. Klik hier om een grotere versie van deze figuur te bekijken.
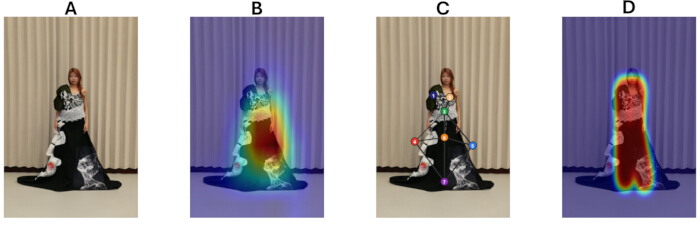
Figuur 5: Representatieve responsen van kledingkenmerken en visualisatie van de component-graaf. (A) De inputafbeelding van het kledingstuk. (B) De klasse-activatierespons van de ResNet-50 appearance-baseline. (C) De component-graaf van het kledingstuk op beeldniveau is gereconstrueerd op basis van de foreground-restricted componentmap, de componentcentrummatrix, de getypeerde adjacentiematrix, het inactieve-knooppuntmasker en de componentlabelmapping, die zijn opgeslagen tijdens Protocolsecties 3 en 4. Knooppunten duiden actieve kledingregio's aan, doorgetrokken randen duiden gedeelde voorgrondgrenzen aan en gestreepte randen duiden vooraf gedefinieerde verticale-ordereleaties aan. (D) De activatierespons van de gefuseerde component-bewuste representatie. De vergelijking toont het verschil tussen textuurgedomineerde activatie en door kledingregio's geleide activatie. Klik hier om een grotere versie van deze figuur te bekijken.
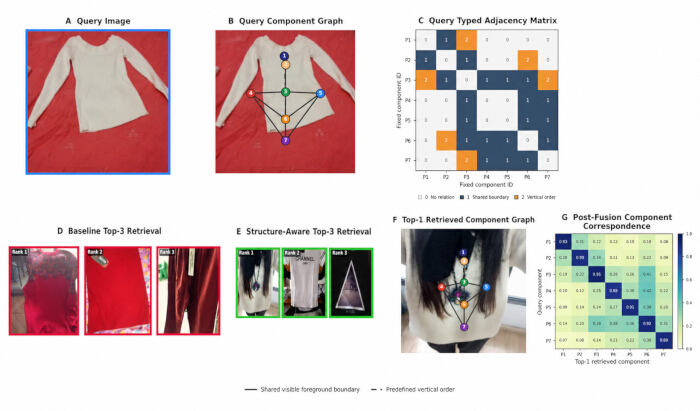
Figuur 6Ophaalresultaten en intermediair structureel bewijs onder interferentie van een rode achtergrond. (A) De query-afbeelding. (B) De query-componentengrafiek wordt gegenereerd op basis van de opgeslagen componentencentra en de getypeerde adjacentiematrix. (C) De ingevoerde query-adjacentiematrix, waarbij de matrixwaarden onderscheid maken tussen inactieve relaties, gedeelde voorgrondgrenzen en vooraf gedefinieerde verticale-volgorde-relaties. (D) De drie beste retrievalresultaten werden gegenereerd door de baseline voor uiterlijk. (E) De drie beste resultaten werden behaald met de structuurbewuste representatie. (F) De componentengrafiek van het hoogst gerangschikte structuurbewuste resultaat. (G) De correspondentiematrix van componenten na fusie tussen de query en het hoogst gerangschikte resultaat. Een sterke diagonale correspondentie duidt op overeenstemming tussen componenten met dezelfde identificatoren, terwijl zwakke of verschoven responsen duiden op ontbrekende of foutief gematchte componentorganisatie. De opvraagresultaten behouden de grove categorie van het bovenlichaam, maar vestigen geen volledige overeenstemming in mouwconfiguratie en lokale topologie. Klik hier om een grotere versie van deze figuur te bekijken.
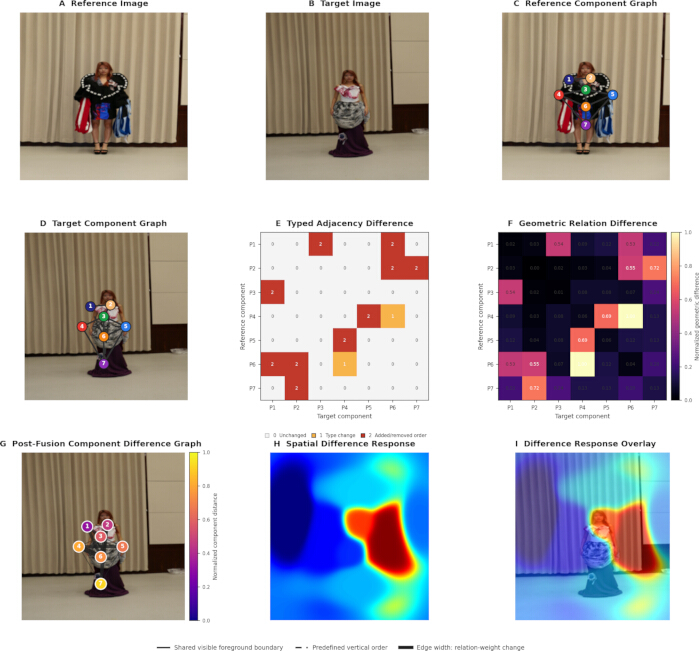
Figuur 7: Traceren van structurele verschillen van kledingtopologie op afbeeldingsniveau naar ruimtelijke respons. (A) De referentieafbeelding. (B) De doelafbeelding. (C) De referentiegraaf van componenten. (D) De doelgraaf van componenten. Beide grafieken zijn gereconstrueerd op basis van de opgeslagen componentcentra en getypeerde adjacentiematrices. (E) De getypeerde adjacentieverschildenmatrix. (F) Het geometrische relatieverschil is afgeleid van de verplaatsing van het componentcentrum, ruimtelijke dispersie en veranderingen in het relatiegewicht. (G) De graaf van componentverschillen na fusie, waarbij de knoopintensiteit de genormaliseerde afstand tussen overeenkomstige gefuseerde componentvectoren vertegenwoordigt en de lijndikte de verandering in relatiegewicht vertegenwoordigt. (H) De zuivere heatmap van de ruimtelijke verschilrespons is gerenderd met dezelfde vaste responsschaal als de overlay. (I) De respons als overlay op de doelafbeelding. Een structureel verschil wordt alleen geaccepteerd wanneer de verandering in adjacentie, de verandering in geometrische relatie, de verandering in componentafstand en de op de voorgrond afgestemde hitte-respons consistent blijven. Achtergrondactivatie zonder overeenkomend bewijs van componenten of relaties wordt beschouwd als residuele interferentie in plaats van een geldig verschil in kledingstructuur. Klik hier om een grotere versie van deze figuur te bekijken.
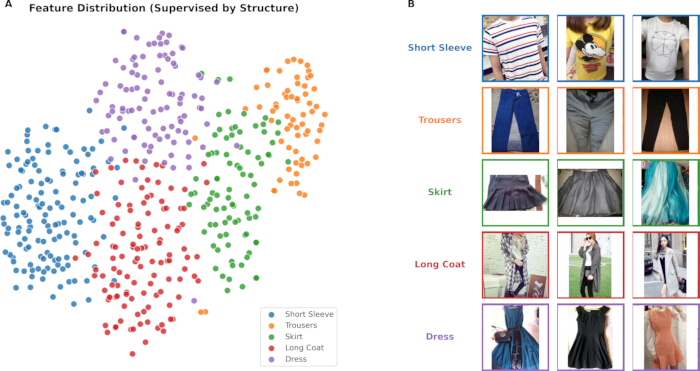
Figuur 8: Structuurbewuste clustering in de kenmerkruimte. (A) De t-SNE-projectie van korte mouw tops, broeken, rokken, lange jassen en jurken. De vijf categorieën vormen hoofdkenmerkregio's met beperkte overlap nabij de grenzen daartussen. (B) Representatieve testafbeeldingen toegewezen aan de vijf kledingcategorieën, waarbij de randkleur overeenkomt met de categoriekleur in (A). De figuur toont de structurele organisatie op categorieniveau, terwijl een klein aantal monsters nabij aangrenzende categorieregio's behouden blijft. Klik hier om een grotere versie van deze figuur te bekijken.
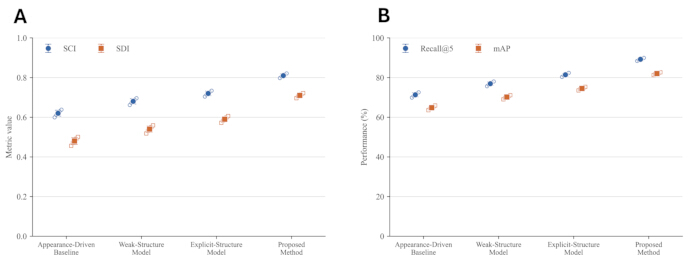
Figuur 9: Ruwe prestatievergelijking over kenmerkruimte-structuur en retrieval-ranking-doelstellingen. (A) SCI en SDI voor de op uiterlijk gebaseerde baseline, het model met zwakke structuur, het model met expliciete structuur en de voorgestelde methode. (B) Recall@5 en mAP voor dezelfde vier methoden. Grote markeringen geven het rekenkundig gemiddelde over vijf onafhankelijke runs aan, foutlijnen geven de steekproefstandaarddeviatie aan en kleine markeringen geven de resultaten op run-niveau aan. SCI en SDI worden weergegeven op een vaste schaal van nul tot één, terwijl Recall@5 en mAP worden weergegeven op een vaste percentageschaal van nul tot honderd. Er is geen min-max-normalisatie of cross-method herschaling toegepast. Klik hier om een grotere versie van deze figuur te bekijken.
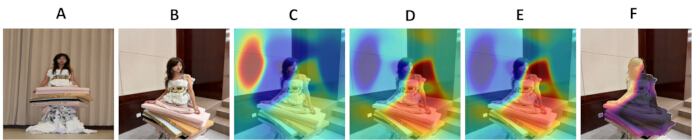
Figuur 10: Structurele verschilresponsen onder verschillende moduleconfiguraties. (A) De referentieafbeelding. (B) De doelafbeelding. (C) De respons van de variant zonder de structurele prior. (D) De respons van de variant zonder de fusiemodule. (E) De respons van het volledige model. (C–E) zijn weergegeven met dezelfde genormaliseerde responsschaal, kleurkaart en overlay-instellingen. (F) Het op de voorgrond beperkte absolute responsverschil tussen de non-fusievariant en het volledige model. Het volledige model behoudt de belangrijkste kleding-uitgelijnde respons, terwijl de residuele verspreiding buiten de belangrijkste structurele regio wordt verminderd. De vergelijking laat zien dat de structurele prior interferentie buiten de kleding vermindert en dat de fusiemodule de structurele respons verder verscherpt. Klik hier om een grotere versie van deze figuur te bekijken.
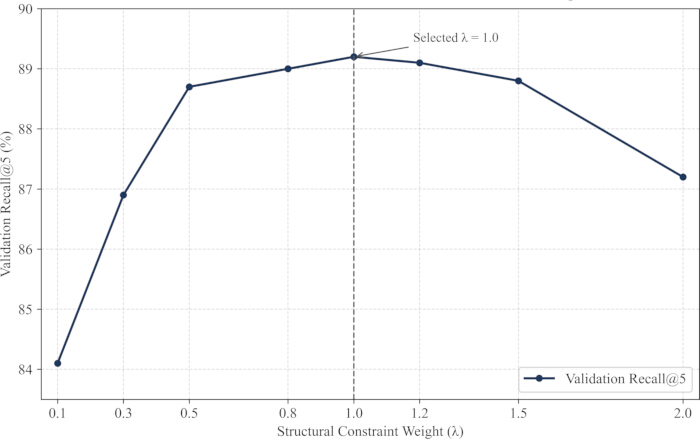
Figuur 11: Validatiegebaseerde selectie van het structurele beperkingsgewicht. De Validation Recall@5 wordt gerapporteerd bij structurele beperkingsgewichten van 0,1, 0,3, 0,5, 0,8, 1,0, 1,2, 1,5 en 2,0. Elk punt geeft het rekenkundig gemiddelde over vijf validatieruns aan, en elke foutenbalk geeft de steekproefstandaarddeviatie aan. Het gewicht werd vastgesteld op 1,0 vóór de uiteindelijke testevaluatie. Deze figuur documenteert de parameterselectieprocedure en vormt geen onafhankelijke architecturale bijdrage. Klik hier om een grotere versie van deze figuur te bekijken.
Tabel 1: Toewijzing van de dataset en topologiestatistieken op beeldniveau over de kledingstuk-subsets S1 tot S5. De tabel rapporteert de aantallen beelden voor training, validatie, test en het totaal, samen met het gemiddelde aantal semantische componenten, het aantal actieve knopen, het aantal getypeerde randen en het aantal geannoteerde referentiepunten op het beeldvlak voor elk structureel niveau. Alle waarden zijn gegenereerd vanuit de verwerkte datamanifesten. De aantallen beelden voor training, validatie en test zijn verkregen uit de definitieve subset-manifesten na structurele revisie, controle op duplicaatgroepen en inspectie op datalekken, terwijl de topologiestatistieken zijn berekend uit de definitieve graafrecords met gebruik van dezelfde componentvolgorde en relatiedefinities als die zijn toegepast tijdens de modelevaluatie. Klik hier om dit bestand te downloaden.
Tabel 2: Instellingen voor de computationele omgeving, inputconfiguratie, augmentatie, representatie, optimalisatie, verlies en reproduceerbaarheid die gedurende het protocol zijn gebruikt. De tabel vermeldt de exacte versies van het besturingssysteem, de processor, het geïnstalleerde geheugen, de grafische verwerkingseenheid, het grafisch geheugen, de grafische driver, CUDA, cuDNN, Python, NumPy, PyTorch en torchvision, samen met de afbeeldinggrootte, batchconstructie, optimizer, learning-rate schema, aantal epochs, random seeds, representatiedimensies en structurele doelgewichten. Elke waarde is gekoppeld aan software_versions.txt, configs/protocol.yaml of het overeenkomstige trainingsverslag. Klik hier om dit bestand te downloaden.
Tabel 3: Kwantitatieve vergelijking van algemene visuele representatiemodellen, graafgebaseerde kledingmodellen en domeinspecifieke moderecuparatiemethoden. De tabel rapporteert de recuperatiefocus, query-modaliteit, SCI, SDI, Recall@5, mAP en silhouetcoëfficiënt voor elf methoden onder dezelfde datapartities en evaluatieprotocollen. Elke metriek wordt gerapporteerd als het gemiddelde en de steekproefstandaarddeviatie over vijf onafhankelijke runs. De gerapporteerde p-waarden zijn verkregen uit tweezijdige gepaarde t-toetsen waarbij elke vergelijkingsmethode werd vergeleken met de voorgestelde methode, gebruikmakend van resultaten die zijn geproduceerd onder dezelfde vijf willekeurige seeds. De voorgestelde methode dient als referentierij. Klik hier om dit bestand te downloaden.
Tabel 4: Ablatieresultaten voor de structuur-prior en de feature-fusiemodule. De tabel rapporteert SCI, SDI en Recall@5 voor de variant zonder de structurele prior, de variant zonder de fusiemodule en het volledige model. Het verwijderen van de structuur-prior leidt tot een grotere afname in SCI en Recall@5, terwijl het verwijderen van de fusiemodule de SDI en de respons-uitlijning vermindert. Het volledige model behaalt de hoogste waarde voor alle drie de metrieken. Klik hier om dit bestand te downloaden.
Tabel 5: Computationele efficiëntie van de ResNet-50 baseline en het volledige structuurbewuste model. De tabel vermeldt de trainbare parameters, floating-point bewerkingen per afbeelding en de gemiddelde inferentietijd per afbeelding onder de exacte hardware- en softwareomgeving zoals gedocumenteerd in Tabel 2 en de Materialenlijst. Beide modellen gebruiken dezelfde beeldresolutie, inferentie-batchinstellingen, voorbewerkingstappen en timingsprocedure. Het volledige model voegt 3,7 miljoen parameters, 1,3 miljard floating-point bewerkingen en 7 milliseconden inferentietijd per afbeelding toe ten opzichte van de baseline. Klik hier om dit bestand te downloaden.
Discussie
De meest kritische protocolfasen zijn de kleding-behoudende voorbewerking en de semantische componentparsing met voorgrondbeperking. Componentcentra, ruimtelijke dispersiewaarden, gedeelde grensrelaties, verticale volgrelaties, relatiegewichten en gefuseerde representaties worden allemaal afgeleid van de parsing-output. Grenslekkage, samengevoegde componentregio's, ontbrekende componentregio's en onjuiste kanaaltoewijzingen planten zich voort via de graafconstructie en kenfusering. Deze fouten kunnen graafbestanden produceren met geldige dimensies, terwijl de gerepresenteerde componentrelaties inconsistent blijven met het bronkledingstuk. Daarom moeten de waarschijnlijkheidskaart, de voorgrondbeperking, de componentpreview en het record van de parsingkwaliteit worden geverifieerd voordat de structurele prior wordt geaccepteerd.
De constructie van de graaf en de fusie van kenmerken vereisen een vaste volgorde van semantische componenten. De graaf is afgeleid van voorgrondcomponenten van kledingstukken en hun relaties in het beeldvlak. De figuren voor retrieval en verschil-lokalisatie leggen het structurele verwerkingspad bloot in plaats van enkel de uiteindelijke gerangschikte afbeeldingen of respons-heatmaps te tonen. Getypeerde adjacency-matrices documenteren discrete componentrelaties, geometrische relatiematrices documenteren de genormaliseerde ruimtelijke organisatie, en post-fusie componentmatrices documenteren de representatie die wordt gebruikt voor retrieval en lokalisatie. Structurele conclusies mogen alleen worden geaccepteerd wanneer deze tussenliggende representaties overeenstemmen met de uiteindelijke visuele output. De componentgraaf maakt geen gebruik van anatomische referentiepunten, menselijke gewrichtscoördinaten of een netwerk voor pose-estimatie. Een graaf-overlay mag alleen worden geaccepteerd wanneer de knopen en relatietypen zijn gereproduceerd vanuit de opgeslagen component- en adjacency-bestanden. Inactieve componenten moeten nulvectoren blijven met indicatoren voor inactieve knopen, en de matrices voor uiterlijke en structurele kenmerken moeten elk K rijen en 512 kolommen bevatten vóór de fusie. Deze controles voorkomen dat knoopmisuitlijningen en dimensiefouten worden geïnterpreteerd als modelgedrag.
Het oplossen van problemen moet beginnen bij de vroegste ongeldige tussenliggende output. Uniforme waarschijnlijkheidskaarten wijzen op fouten in het checkpoint, de normalisatie of de categorie-index; niet-numerieke structurele matrices wijzen op ongeldige waarschijnlijkheidsnoemers of coördinaatschaling; diffuse responsen en kleurgedomineerde retrieval wijzen op zwakke structurele priors, mislukte fusie of het onjuist laden van checkpoints. Trainingslogs moeten de gradiënten in de graaf en fusielagen bevestigen, evenals de op validatie gebaseerde selectie van checkpoints. Een visuele hitte-respons mag niet als een op zichzelf staande structurele conclusie worden gebruikt. Deze moet worden gecontroleerd aan de hand van het opgeslagen voorgrondmasker, de getypeerde wijziging in adjacentie, de geometrische relatiematrix en de graaf van componentverschillen na fusie. Residuele activatie buiten de voorgrond van het kledingstuk duidt op een beperkte responsspecificiteit in plaats van een gevalideerd structureel verschil.
In vergelijking met op uiterlijk gebaseerde retrieval introduceert het protocol de componenttopologie voorafgaand aan de metrieklearning. In vergelijking met zwakke structurele beperkingen en graafmodellen met een vaste topologie passen semantische relatiegewichten de graafpropagatie aan het huidige kledingstuk aan. Het volledige model behaalde een SCI van 0,81, een SDI van 0,71, een Recall@5 van 89,2%, een mAP van 86,4% en een silhouette-coëfficiënt van 0,74, zoals gerapporteerd in Tabel 3. De aanvullende structurele modules verhoogden het aantal parameters van 25,6 miljoen naar 29,3 miljoen en de inferentietijd van 15 naar 22 milliseconden per afbeelding, zoals gerapporteerd in Tabel 4. De technische bijdrage van het protocol ligt in de constructie van een graaf van kledingcomponenten op afbeeldingniveau, de parallelle codering van uiterlijk en componentrelaties, het structuurgeleide feature-fusiemechanisme en de doelstellingen voor structurele consistentie, relatie en discriminatie. De validatiescan in Figuur 11 dient uitsluitend om een vaste trainingscoëfficiënt te bepalen en wordt niet gepresenteerd als een bijdrage aan het netwerkarchitectuur- of objectieve-functiedesign.
Het protocol blijft gevoelig voor ernstige occlusie, overlappende kledingstukken, kleine bronafbeeldingen, variaties in pose, complexe achtergronden en kledingstukken waarvan de zichtbare organisatie niet overeenstemt met het vaste schema van zeven regio's. Asymmetrische ontwerpen, afneembare lagen, dicht gedrapeerde stoffen, meerlaagse onderkleding en overlappende decoratieve regio's kunnen meerdere semantische regio's samenvoegen of componentrelaties introduceren die ontbreken in de huidige graafdefinitie. Occlusie kan een actieve component onderdrukken, het probabiliteitszwaartepunt verschuiven en een geldige gedeelde-grensrelatie verwijderen. Figuur 6 toont herstel van de categorie van het grove bovenlichaam, maar een onvolledige matching van de mouwtopologie, terwijl Figuren 7 en 10 behoud responsen in aangrenzende achtergrondgebieden. Deze resultaten tonen aan dat geldige tensordimensies en grafconnectiviteit geen semantisch correcte structurele interpretatie garanderen. De huidige studie ondersteunt daarom beeldgebaseerde retrieval, clustering en lokalisatie van verschillen, in plaats van de efficiëntie van de ontwerpworkflow of directe schatting van patroonparameters. Alle kwantitatieve experimenten in de huidige studie zijn uitgevoerd op de behouden en structureel opnieuw gelabelde DeepFashion2-cohort. De huidige resultaten stellen geen robuustheid vast over onafhankelijke datasets met verschillende kledingtaxonomieën, annotatiestandaarden, culturele kledingcategorieën, beeldbronnen of acquisitieomgevingen. Overdracht naar een andere dataset kanten vereisen dat de zeven componentkanalen opnieuw worden toegewezen en het getypeerde relatieschema wordt gereconstrueerd. De gerapporteerde conclusies zijn daarom beperkt tot de geëvalueerde datadistributie en de componentdefinitie op beeldniveau.
Binnen deze beperkingen biedt het protocol een reproduceerbare reeks van kledingstukafbeeldingen naar component-bewuste representaties via semantische parsing, geometrische relatiemodellering, dual-stream codering en structuurgeleide fusie. Toekomstige validatie zal gebruikmaken van onafhankelijke kledingsets met verschillende annotatiesystemen, kledingcategorieën, houdingen en achtergrondcondities. Er zal ook worden onderzocht of de huidige mapping van zeven regio's moet worden uitgebreid voor asymmetrische, gelaagde, afneembare en cultuurspecifieke kledingstructuren. Handgetekende ontwerpschetsen, variaties in stoffen en geparametriseerde patroonaanpassingen blijven aparte toepassingsrichtingen die taakspecifieke gegevens en evaluatieprocedures vereisen. De professionele bruikbaarheid en de efficiëntie van de ontwerpbeoordeling vereisen een afzonderlijk gedocumenteerde studie met menselijke proefpersonen, met gedefinieerde deelnemers, evaluatiecriteria en statistische procedures.
Openbaarmakingen
De auteurs hebben geen belangenconflicten om te verklaren.
Dankbetuigingen
Dit werk werd ondersteund door de tweede reeks provinciale sleutelprojecten voor de hervorming van het onderwijs voor bachelors tijdens het 14e Vijfjarenplan, onder het project getiteld Teaching Reform and Exploration of “Clothing and Apparel Design” Based on the “Three Integration, Three Fusion” Joint Construction Model (Project nr. JGZD2024096).
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Centrale Processoreenheid | Intel Corporation | Intel Core i9-13900K, 24 kernen, 32 threads, tot 5,80 GHz | |
| Conda | Anaconda, Inc., anaconda.com | Miniconda3 23.11.0 | |
| CUDA Toolkit | NVIDIA Corporation, developer.nvidia.com | CUDA 11.8 | |
| cuDNN | NVIDIA Corporation, developer.nvidia.com | cuDNN 8.9.7 | |
| DeepFashion2-dataset | The Chinese University of Hong Kong, github.com/switchablenorms/DeepFashion2 | Officiële DeepFashion2 release, Versie 1.0 | |
| grafische verwerkingseenheid | NVIDIA Corporation | NVIDIA GeForce RTX 4090, 24 GB GDDR6X | |
| HRNet-W48 Controlepunt voor Semantische Analyse | HRNet-project, github.com/HRNet/HRNet-Semantic-Segmentation | hrnet_w48_garment_parser_7class.pth, project checkpoint Versie 1.0 | |
| Op ImageNet voorgetrainde ResNet-50-gewichten | PyTorch Foundation, pytorch.org | ResNet50_Weights.IMAGENET1K_V2 | |
| Matplotlib | Matplotlib Development Team, matplotlib.org | Versie 3.8.2 | |
| NumPy | NumPy-ontwikkelaars, numpy.org | Versie 1.26.4 | |
| NVIDIA-stuurprogramma voor videokaarten | NVIDIA Corporation | Versie 546.33 | |
| OpenCV-Python | OpenCV Team, opencv.org | Versie 4.8.1.78 | |
| Besturingssysteem | Microsoft Corporation | Windows 11 Pro 23H2, 64-bit, OS-build 22631.3155 | |
| Pandas | Pandas Development Team, pandas.pydata.org | Versie 2.1.4 | |
| Python | Python Software Foundation, python.org | Versie 3.10.13 | |
| PyTorch | PyTorch Foundation, pytorch.org | Versie 2.1.2 met CUDA 11.8 | |
| PyYAML | PyYAML-project, pyyaml.org | Versie 6.0.1 | |
| scikit-learn | scikit-learn-ontwikkelaars, scikit-learn.org | Versie 1.3.2 | |
| SciPy | SciPy-ontwikkelaars, scipy.org | Versie 1.11.4 | |
| Broncode-repository | Aanvullend broncode-archief ingediend bij het manuscript | Protocol voor kledingtopologie, versie 1.0 | |
| Opslagapparaat | Samsung Electronics | Samsung 990 PRO NVMe SSD, 2 TB | |
| Systeemgeheugen | Kingston Technology | Kingston FURY Beast DDR5, 64 GB, 2 × 32 GB, 5600 MHz | |
| torchvision | PyTorch Foundation, pytorch.org | Versie 0.16.2 met CUDA 11.8 | |
| Werkstation | Op maat gebouwd deep-learning workstation | Intel Core i9-13900K, NVIDIA GeForce RTX 4090, 64 GB geheugen, 2 TB NVMe SSD |
Referenties
- Xiang Z, Zhu C, Qian M, Shen Y, Shao Y. FashionSegNet: a model for high-precision semantic segmentation of clothing images. Vis Comput. 2024;40:1711-1727. doi:10.1007/s00371-023-02881-3.
- Sun K, Zhang J, Zhang P, Yuan K, Li G. TsrNet: a two-stage unsupervised approach for clothing region-specific textures style transfer. J Vis Commun Image Represent. 2023;91:103778. doi:10.1016/j.jvcir.2023.103778.
- Yang N, Ma X. Enhanced composed fashion image retrieval with a multi-hop reasoning framework. Sci Rep. 2025;15:32217. doi:10.1038/s41598-025-17402-6.
- Karthika Priya D, Sathyabama B. FARE-RNET: fashion cloth retrieval via Egret Swarm Optimization-based Convolutional Attention Module integrated ResNet. Int J Comput Intell Syst. 2026;19:29. doi:10.1007/s44196-025-00979-1.
- Köktürk Güzel BE. Efficient image retrieval in fashion: leveraging clustering and principal component analysis for search space reduction. Erzincan Univ J Sci Technol. 2024;17:638-649. doi:10.18185/erzifbed.1500279.
- Zhang X, Sun H, Ma J. Research on clothing image retrieval combining topology features with color texture features. Mathematics. 2024;12:2363. doi:10.3390/math12152363.
- Abbas W, Zhang Z, Asim M, Chen J, Ahmad S. AI-driven precision clothing classification: revolutionizing online fashion retailing with hybrid two-objective learning. Information. 2024;15:196. doi:10.3390/info15040196.
- Shirkhani S, Mokayed H, Saini R, Hum YC. Study of AI-driven fashion recommender systems. SN Comput Sci. 2023;4:514. doi:10.1007/s42979-023-01932-9.
- Balloni E, Pietrini R, Frontoni E, Mancini A, Paolanti M. OutfitAI: shop the outfit with a deep learning-based intelligent expert system. Multimed Tools Appl. 2025;84:40195-40214. doi:10.1007/s11042-025-20753-x.
- Kachbal I, El Abdellaoui S. Computer vision for fashion: a systematic review of design generation, simulation, and personalized recommendations. Information. 2026;17:11. doi:10.3390/info17010011.
- Saranya MS, Geetha P. Cross-domain fashion cloth retrieval via novel attention-guided cascade neural network and clothing parsing. Comput Vis Image Underst. 2023;235:103777. doi:10.1016/j.cviu.2023.103777.
- Ning T, Gao Y, Han Y. Segmentation of ethnic clothing patterns with fusion of multiple attention mechanisms. Complex Intell Syst. 2024;10:5759-5770. doi:10.1007/s40747-024-01457-5.
- Jiang A, Liu L, Fu X, Liu L, Peng W. Clothing hierarchical feature representation and association learning for cross-modal fashion retrieval. J Comput Aided Des Comput Graph. 2025;37:654-667. doi:10.3724/SP.J.1089.2023-00263.
- An H, Lee KY, Choi Y, Park M. Conceptual framework of hybrid style in fashion image datasets for machine learning. Fash Text. 2023;10:18. doi:10.1186/s40691-023-00338-8.
- Adel M, Mohammed AM, Elsaid AH, Abdelatey A. Deep learning for new fashion product demand prediction: integrating visual similarity and demand correction in cold-start scenarios. Int J Data Sci Anal. 2026;22:9. doi:10.1007/s41060-025-00888-8.
- Tang Y, Ye D, Tao F, Du G. Enhanced group relation learning via aligned attention masking for fashion product captioning. J King Saud Univ Comput Inf Sci. 2025;37:170. doi:10.1007/s44443-025-00195-z.
- Lyu X, Li X, Zhang Y, Lu W. Two-stage method for clothing feature detection. Big Data Cogn Comput. 2024;8:35. doi:10.3390/bdcc8040035.
- Tang G, Yu F, Li H, Shi Y, Liu L, Peng T, et al. ClothSeg: semantic segmentation network with feature projection for clothing parsing. J Vis Commun Image Represent. 2023;97:103980. doi:10.1016/j.jvcir.2023.103980.
- Cao S, Chai W, Hao S, Zhang Y, Chen H, Wang G. DiffFashion: reference-based fashion design with structure-aware transfer by diffusion models. IEEE Trans Multimedia. 2024;26:3962-3975. doi:10.1109/TMM.2023.3318297.
- Hou J, Lu Y, Yang Y, Liu Z. PDN: a priori dictionary network for fashion parsing. Appl Sci. 2024;14:3509. doi:10.3390/app14083509.
- Moratelli N, Barraco M, Morelli D, Cornia M, Baraldi L, Cucchiara R. Fashion-oriented image captioning with external knowledge retrieval and fully attentive gates. Sensors. 2023;23:1286. doi:10.3390/s23031286.
- Islam T, Miron A, Liu X, Li Y. Deep learning in virtual try-on: a comprehensive survey. IEEE Access. 2024;12:29475-29502. doi:10.1109/ACCESS.2024.3368612.
- Yan H, Zhang H, Liu L, Zhou D, Xu X, Zhang Z, et al. Toward intelligent design: an AI-based fashion designer using generative adversarial networks aided by sketch and rendering generators. IEEE Trans Multimedia. 2023;25:2323-2338. doi:10.1109/TMM.2022.3146010.
- Xie Z, Zhou Z, Wang Z, Ding H, Ma L. Multi-scale spatial feature-guided cloth landmark estimation. J Comput Aided Des Comput Graph. 2022;34:1763-1771. doi:10.3724/SP.J.1089.2022.19189.
- Jiang J, Wu D, Deng H, Long Y, Tang W, Li X, et al. HAIGEN: towards human-AI collaboration for facilitating creativity and style generation in fashion design. Proc ACM Interact Mob Wearable Ubiquitous Technol. 2024;8:107. doi:10.1145/3678518.
- Danner M, Brake E, Kosel G, Kyosev Y, Rose K, Rätsch M, et al. AI-assisted pattern generator for garment design. Commun Dev Assem Text Prod. 2024;5:195-206. doi:10.25367/cdatp.2024.5.p195-206.
- Bao C, Zhang X, Chen J, Miao Y. MMFL-net: multi-scale and multi-granularity feature learning for cross-domain fashion retrieval. Multimed Tools Appl. 2023;82:37905-37937. doi:10.1007/s11042-022-13648-8.
- Yang G. Clothing design style recommendation using optimized semantic-preserved generative adversarial network. J Electr Syst. 2024;20 Suppl 3:2396-2409. doi:10.52783/jes.3064.
- Wang Z, Tao X, Zeng X, Xing Y, Xu Z, Bruniaux P. Design of customized garments towards sustainable fashion using 3D digital simulation and machine learning-supported human-product interactions. Int J Comput Intell Syst. 2023;16:16. doi:10.1007/s44196-023-00189-7.
- Wu J, Huang Y, Gao M, Gao Z, Zhao J, Zhang H, et al. A two-stream hybrid convolution-transformer network architecture for clothing-change person re-identification. IEEE Trans Multimedia. 2024;26:5326-5339. doi:10.1109/TMM.2023.3331569.
- Khalid M, Keming M, Hussain T. Design and implementation of clothing fashion style recommendation system using deep learning. Rom J Inf Technol Autom Control. 2021;31:123-136. doi:10.33436/v31i4y202110.
- Wang Y, Liu L, Fu X, Liu L. MCCP: multi-modal fashion compatibility and conditional preference model for personalized clothing recommendation. Multimed Tools Appl. 2024;83:9621-9645. doi:10.1007/s11042-023-15659-5.
- Ma J, Sun H, Yang D, Zhang H. Personalized fashion recommendations for diverse body shapes and local preferences with contrastive multimodal cross-attention network. ACM Trans Intell Syst Technol. 2024;15:82. doi:10.1145/3637217.
- Yu Z, Zhao Y, Hong B, Jin Z, Huang J, Cai D, et al. Apparel-invariant feature learning for person re-identification. IEEE Trans Multimedia. 2022;24:4482-4492. doi:10.1109/TMM.2021.3119133.
- Peng D, Liu R, Lu J, Zhang S. Unsupervised multi-modal modeling of fashion styles with visual attributes. Appl Soft Comput. 2022;115:108214. doi:10.1016/j.asoc.2021.108214.
- Mathews A, Sejal N, Venugopal KR. Analysis of content based image retrieval using deep feature extraction and similarity matching. Int J Adv Comput Sci Appl. 2022;13:646-655. doi:10.14569/IJACSA.2022.0131277.
- Zhang C, Ji X, Cai L. Clothing recommendation with multimodal feature fusion: price sensitivity and personalization optimization. Appl Sci. 2025;15:4591. doi:10.3390/app15084591.
- Zhao M, Gao S, Ma J, Zhang Z. Joint clothes image detection and search via anchor-free framework. Neural Netw. 2022;155:84-94. doi:10.1016/j.neunet.2022.08.011.
- Fontanini T, Ferrari C. Would your clothes look good on me? Towards transferring clothing styles with adaptive instance normalization. Sensors. 2022;22:5002. doi:10.3390/s22135002.
- Kim S, Moon H, Oh J, Lee Y, Kwon H, Kim S. Automatic measurements of garment sizes using computer vision deep learning models and point cloud data. Appl Sci. 2022;12:5286. doi:10.3390/app12105286.
- Chang YH, Zhang YY. Deep learning for clothing style recognition using YOLOv5. Micromachines. 2022;13:1678. doi:10.3390/mi13101678.
- de Medeiros Dantas IJ, Curth M, Freire AG. Exploring databases for training models in machine learning in the fashion industry. DAT J. 2024;9:157-174. doi:10.29147/datjournal.v9i2.877.
- Zhu S, Zou X, Qian J, Wong WK. Learning structured relation embeddings for fine-grained fashion attribute recognition. IEEE Trans Multimedia. 2024;26:1652-1664. doi:10.1109/TMM.2023.3284593.