Deze studie presenteert een tweestapsraamwerk voor hyperspectrale en LiDAR landbedekkingsclassificatie met behulp van MetaFormer-kenmerkextractie en bidirectionele flow-matching voor cross-modale uitlijning vóór fusie. Evaluatie op drie openbare benchmarkdatasets demonstreert concurrerende classificatieprestaties onder vaste benchmarkprotocollen.
Onderzoeksartikel
Continue cross-modale vectorveld-learning voor hyperspectrale en LiDAR-landbedekkingsclassificatie
In dit artikel
Samenvatting
Samenvatting
Multimodale classificatie via remote sensing speelt een belangrijke rol in toepassingen zoals stedelijke mapping en milieumonitoring. Echter, heterogene kenmerkdistributies over verschillende sensormodaliteiten kunnen leiden tot een verkeerde uitlijning van kenmerken en semantische inconsistentie, wat de effectiviteit van multimodale fusie beperkt. Bestaande benaderingen voor multimodale fusie, waaronder convolutionele, grafiekgebaseerde, attention-gebaseerde, contrastieve, transportgeoriënteerde en sequentiegebaseerde methoden, kunnen complementaire informatie benutten, maar lijnen modaliteitspecifieke kenmerkdistributies mogelijk niet adequaat uit. Deze studie stelt FlowErs voor, een tweedelig multimodaal classificatiekader dat deze uitdaging aanpakt via multimodale flow matching. De werkhypothese is dat het verminderen van discrepanties tussen gepaarde kenmerkdistributies vóór de kenmerkfusie de landbedekkingsclassificatie verbetert onder vaste benchmarkprotocollen. In de eerste fase extraheren modaliteitsspecifieke MetaFormer-encoders hiërarchische representaties uit hyperspectrale beelden (HSI) en light detection and ranging (LiDAR) data. Een multimodale flow matching-module leert vervolgens tijdgeconditioneerde snelheidsvelden om gepaarde kenmerkdistributies te transporteren naar een gedeelde latente representatie met behulp van een bidirectionele mean-squared-error-doelfunctie. In de tweede fase wordt de vooraf getrainde uitlijningsmodule hergebruikt om multimodale representaties uit te lijnen voordat een lichtgewicht fusie-head pixelgewijze classificatie uitvoert. Evaluatie op drie openbare benchmarkdatasets toonde een maximale algehele nauwkeurigheid (OA) van 97,56% onder vaste benchmark-splits. De prestaties varieerden per landbedekkingsklasse, en de studie bespreekt klasse-specifieke beperkingen en de invloed van klasse-onbalans op geaggregeerde metrieken. De huidige evaluatie is beperkt tot experimenten met vaste splits zonder statistische analyse van herhaalde runs of computationele profilering. Toekomstig werk zal de statistische robuustheid, computationele efficiëntie en cross-regionale generalisatie onderzoeken.
Inleiding
Nauwkeurige classificatie van landgebruik en landbedekking (LULC) met behulp van remote sensing-beelden is essentieel voor een breed scala aan praktische toepassingen, waaronder stedelijke ontwikkeling, milieumonitoring, rampenbeheer en duurzame ontwikkeling1. Multimodale remote sensing-gegevens, waaronder hyperspectrale beelden (HSI), light detection and ranging (LiDAR) en synthetic aperture radar (SAR), zijn de afgelopen jaren steeds vaker beschikbaar geworden. Deze toegenomen beschikbaarheid heeft de mogelijkheden van remote sensing voor fijnmazige landbedekkingsclassificatie aanzienlijk uitgebreid2. Deze sensing-modaliteiten leggen verschillende maar complementaire kenmerken van het aardoppervlak vast. HSI biedt rijke spectrale informatie voor het karakteriseren van de materiaalsamenstelling, terwijl LiDAR nauwkeurige structurele en hoogte-informatie levert3. De integratie van deze heterogene gegevensbronnen kan leiden tot meer onderscheidende, ruistolerante en semantisch uitgebreide kenmerkrepresentaties dan elke modaliteit afzonderlijk4.
Niettemin blijft de effectieve exploitatie van multimodale gegevens een langdurige uitdaging5. Een primaire moeilijkheid vloeit voort uit de inherente heterogeniteit van sensoringsmodaliteiten, die verschillen in ruimtelijke resolutie, ruiseigenschappen, statistische distributies en kenmerksemantiek6. Bijvoorbeeld, hetzelfde landbedekkingsobject kan worden gerepresenteerd als een hoogdimensionale spectrale signatuur in HSI en als ijle geometrische structuren in LiDAR7. Bijgevolg bevinden modaliteitsspecifieke kenmerken zich vaak in verschillende kenmerkvariëteiten, waardoor directe kenmerkfusie inefficiënt of potentieel misleidend is. Bovendien gaan veel bestaande multimodale fusiebenaderingen, waaronder methoden op basis van convolutie, aandacht en Transformers, impliciet ervan uit dat kenmerken die uit verschillende sensoren zijn geëxtraheerd, al ruimtelijk en semantisch zijn uitgelijnd8. Deze aanname is echter vaak niet geldig in praktische toepassingen. Eenvoudige kenmerkconcatenatie of pixelgewijze fusie kan cross-modale discrepanties niet adequaat vastleggen, wat potentieel kan leiden tot instabiele optimalisatie en verminderde generalisatieprestaties. Verder kunnen aandachtgebaseerde fusiemethoden, hoewel ze de interactie tussen kenmerken verbeteren, een beperkte modellering bieden van lange-afstands cross-modale afhankelijkheden die vereist zijn voor grootschalige of hoge-resolutie landbedekkingsclassificatie9. Bijgevolg blijft de effectieve uitlijning van heterogene kenmerkrepresentaties een grote uitdaging in multimodale remote sensing, omdat incompatibele embeddings de integratie van complementaire informatie kunnen beperken.
Om deze uitdaging aan te pakken, wordt cross-modale uitlijning geformuleerd als een conditioneel kenmerktransportprobleem. Flow matching biedt een wiskundig onderbouwd kader voor het leren van continue en omkeerbare afbeeldingen tussen heterogene kenmerkdistributies10. Het transporteert de ene distributie naar een andere via een tijdsafhankelijk snelheidsveld dat is geparametriseerd door een gewone differentiaalvergelijking (ODE), waardoor continue transformaties tussen kenmerkvariëteiten worden bevorderd11. In tegenstelling tot diffusiemodellen, die vertrouwen op stochastische ruisperturbaties of impliciete distributiematching via adversarial training, leert flow matching deterministische, bijectieve transformaties tussen gestructureerde kenmerkruimtes12. Deze kenmerken maken flow matching zeer geschikt voor multimodale teledetectie, waarbij HSI, LiDAR en SAR elk hoogdimensionele kenmerkvariëteiten vertegenwoordigen die complementaire eigenschappen van het aardoppervlak vastleggen13. Bijgevolg biedt flow matching een fundamentele aanpak voor het vaststellen van cross-modale correspondentie via continu kenmerktransport, terwijl geometrische consistentie tijdens de kenmerkuitlijning wordt bevorderd. Onder geschikte regulariteitsaannames kan een ODE-flow een omkeerbare afbeelding bieden; exacte omkeerbaarheid en fysieke interpreteerbaarheid zijn echter in de huidige studie niet empirisch geëvalueerd. De werkhypothese is dat het verminderen van discrepanties tussen gepaarde kenmerkdistributies vóór de kenmerkfusie de geaggregeerde landbedekkingsclassificatie verbetert onder vaste benchmark-splitsingen.
Gedreven door deze overwegingen bevat het voorgestelde raamwerk, FlowErs, een stroomgebaseerde uitlijningsfase binnen een architectuur in twee fasen. In de eerste fase wordt een bidirectioneel stroomnetwerk getraind om de kenmerkmanifolds van elke modaliteit uit te lijnen. Specifiek extraheren modaliteitsspecifieke MetaFormer-backbones hiërarchische kenmerk-embeddings, en wordt een flow-matching-doel geoptimaliseerd om monsters tussen modaliteitsspecifieke kenmerkdistributies te transporteren. Dit proces zorgt voor een vloeiende en omkeerbare transformatie tussen kenmerkruimten, waardoor representaties die tot dezelfde semantische klasse behoren, nauwer worden uitgelijnd binnen een gedeeld latent domein. In de tweede fase wordt de vooraf getrainde flow-aligner bevroren, en worden nieuwe multimodale inputs getransformeerd voordat ze worden gefuseerd door een lichtgewicht classifier. Deze ontkoppelde trainingsstrategie scheidt geometrische uitlijning van semantische classificatie, waardoor de twee fasen complementaire doelen kunnen optimaliseren. De uitlijningsmodule is bedoeld om discrepanties in de kenmerkdistributie te verminderen vóór de kenmerkfusie en claimt geen aangetoonde garantie voor volumebewaring. Bovendien biedt FlowErs een expliciete formulering voor kenmerktransport voor multimodale fusie, hoewel de robuustheid voor registratiefouten in de huidige studie niet afzonderlijk is geëvalueerd.
De belangrijkste bijdragen van deze studie worden als volgt samengevat. FlowErs wordt geïntroduceerd als een tweestapsraamwerk voor multimodale landbedekkingsclassificatie. In het voorgestelde raamwerk worden eerst modaliteitsspecifieke kenmerken geëxtraheerd met behulp van MetaFormer-encoders en vervolgens uitgelijnd via een flow-gebaseerde module vóór een lichtgewicht kenmerkfusie. Dit ontkoppelde ontwerp ondersteunt efficiënte optimalisatie terwijl de flexibiliteit over verschillende detectiemodaliteiten behouden blijft. Daarnaast onderzoekt deze studie conditional flow matching als een kenmerktransportmechanisme voor gepaarde cross-modale kenmerkuitlijning in multimodale remote sensing. De bidirectionele flow-module voorspelt tegengestelde snelheidstargets voor gepaarde kenmerkrepresentaties vóór de kenmerkfusie, waardoor een expliciete uitlijningsstrategie wordt geboden voorafgaand aan de multimodale integratie. Bovendien is het voorgestelde raamwerk geëvalueerd op drie openbare benchmark-datasets, waarbij een maximale totale nauwkeurigheid (OA) van 97,56% werd behaald onder de meegeleverde vaste benchmark-splits. Beperkingen op klasseniveau en de reikwijdte van de huidige evaluatie zijn ook expliciet gedocumenteerd.
Recente vorderingen in flow matching hebben dit gevestigd als een krachtig raamwerk voor generatieve modellering dat diffusie-, energie- en transportgebaseerde modellen verenigt. In plaats van stochastische trajecten te simuleren, zoals bij diffusiemodellen, leert flow matching een deterministische ODE die een eenvoudige prior-distributie, zoals Gaussische ruis, transporteert naar de doeldata-distributie via een leerbaar snelheidsveld15. Deze formulering relateert score-estimatie direct aan dichtheidsevolutie, wat resulteert in vloeiendere waarschijnlijkheidstrajecten en stabielere trainingsdynamiek. Een belangrijk voordeel van flow matching is de deterministische en computationeel efficiënte formulering. Rectified flow-modellen16 vereenvoudigen transporttrajecten verder tot bijna rechte paden, wat de numerieke stabiliteit verbetert en hoogwaardige monstergeneratie mogelijk maakt met relatief weinig integratiestappen. Latere studies, waaronder consistentiemodellen17, hebben diffusie-geïnspireerde doelstellingen geïntegreerd in compacte flow-gebaseerde raamwerken om vergelijkbare of verbeterde monsterkwaliteit te bereiken met efficiënte inferentie. Daarnaast kan flow-gebaseerde training gebruikmaken van vooraf getrainde diffusie-backbones, wat het gebruik van grootschalige generatieve priors faciliteert terwijl de samplingkosten worden verlaagd. Recente studies hebben flow matching uitgebreid naar een breed scala aan toepassingen. Zo onderzochten Hu et al.18 transformer-backbones en manipulaties in de latente ruimte voor controleerbare en combineerbare beeldbewerking met behulp van flow matching. Andere toepassingen omvatten beeldsynthese19, diagnose van lagerdefecten20 en multitarget, multinaad robotlassen21. Collectief tonen deze studies aan dat flow matching toepasbaar is buiten hoge-resolutie en conditionele beeldsynthese, terwijl het een goed gevestigde theoretische basis biedt met potentieel voor domeingeneralisatie. Door continue, deterministische transportkaarten te leren, biedt flow matching een balans tussen efficiëntie, controleerbaarheid en generatieve getrouwheid. De ODE-gebaseerde formulering biedt een unified perspectief op moderne generatieve modellering en vormt een theoretische basis voor toepassingen die betrekking hebben op multimodale datarepresentatie en kenmerkenuitlijning.
Multimodale classificatie via remote sensing heeft tot doel de beperkingen van individuele sensormodaliteiten te overwinnen door complementaire informatie van HSI, multispectrale beelden, LiDAR en SAR te integreren. Vroege fusiebenaderingen vertrouwden op handmatig ontworpen kenmerken of kernel-gebaseerde algoritmen, zoals support vector machines (SVMs), maar werden beperkt door een hoge dimensionaliteit en onvoldoende cross-modale interactie22. Vooruitgang in deep learning heeft gestructureerde fusiestrategieën mogelijk gemaakt, waaronder vroege, intermediaire en late fusie, waarbij fusie op kenmerkniveau een praktisch evenwicht biedt tussen informatie-integratie en computationele complexiteit23. Convolutionele neurale netwerken (CNNs) leggen lokale ruimtelijk-spectrale informatie effectief vast, terwijl Transformer-gebaseerde architecturen lange-afstandsafhankelijkheden modelleren tegen hogere computationele kosten24. Bijgevolg zijn hybride CNN–Transformer architecturen steeds populairder geworden omdat ze de complementaire sterktes van beide benaderingen combineren. Representatieve voorbeelden zijn fusiemethoden op aangrenzende schalen die contextuele informatie verbeteren via cross-scale interacties25 en multilvl-raamwerken die ondiepe CNN-kenmerken combineren met diepe Transformer-representaties met behulp van adaptieve attentiemechanismen26. Gezamenlijk benadrukken deze studies het belang van effectieve cross-scale en cross-modale interactie voor het verminderen van kenmerkredundantie en het verbeteren van de semantische representatie.
Recente ontwikkelingen hebben ook complementaire strategieën voor multimodale leerprocessen verkend. Zo verminderen methoden voor low-rank representatie, zoals het framework gebaseerd op de Ebbinghaus-curve, overfitting door de manifold-structuur te behouden terwijl redundante informatie wordt onderdrukt27. Parallel daaraan is gedistribueerd multimodaal leren onderzocht om privacy- en communicatiebeperkingen in praktische toepassingen aan te pakken. Zo projecteert FedFusion ondiepe kenmerken naar low-rank subruimtes om gefedereerd multimodaal leren mogelijk te maken28. Gezamenlijk illustreren deze studies drie complementaire onderzoeksrichtingen: hybride CNN-Transformer-architecturen voor het balanceren van lokale en globale kenmerkmodellering, low-rank leren voor het verminderen van redundantie en ruis, en gedistribueerd leren voor schaalbare en privacybewuste implementatie. Niettemin blijven er belangrijke uitdagingen bestaan, waaronder modaliteitsonbalans, de beperkte beschikbaarheid van gelabelde gegevens en de afweging tussen modelcompressie en classificatienauwkeurigheid. Deze uitdagingen hebben geleid tot voortgezet onderzoek naar lichtgewicht, generaliseerbare multimodale fusie-frameworks. Recente benaderingen voor multimodale uitlijning hebben daarnaast cross-modale aandacht, contrastief leren, grafiekgebaseerde fusie, domeinadaptatie en distributiematchingsstrategieën geïntegreerd. In tegenstelling hiermee formuleert FlowErs multimodale uitlijning als gepaarde, tijdsgeconditioneerde kenmerktransport en wordt het gepresenteerd als een complementaire uitlijningsstrategie in plaats van een universele vervanging voor bestaande benaderingen.
Protocol
Voor deze studie werden uitsluitend openbaar beschikbare benchmark-datasets (Houston2013, Augsburg en MUUFL) gebruikt voor landcoverclassificatie via remote sensing. Er waren geen menselijke deelnemers, dierproeven of nieuw verzamelde biologische monsters betrokken. Daarom was geen institutionele ethische goedkeuring vereist.
Overzicht van de studie
Het voorgestelde FlowErs-framework voert multimodale landcoverclassificatie uit via een tweestaps leerstrategie. De algemene workflow is geïllustreerd in Figuur 1A–C. Het framework bestaat uit drie hoofdcomponenten: (i) MetaFormer-gebaseerde encoders die hiërarchische kenmerkrepresentaties extraheren uit heterogene waarnemingsmodaliteiten, (ii) een multimodale flow matching (MFM)-module die cross-modale kenmerkdistributies expliciet aligneert, en (iii) een lichtgewicht classificatiekop die landcovercategorieën voorspelt op basis van de gefuseerde kenmerkrepresentaties. De algemene workflow extraheert eerst modaliteitsspecifieke kenmerken, aligneert deze kenmerken vervolgens binnen een gedeelde latente ruimte via conditionele flow matching, en voert tot slot pixelgewijze landcoverclassificatie uit met behulp van de gealigneerde multimodale representaties.
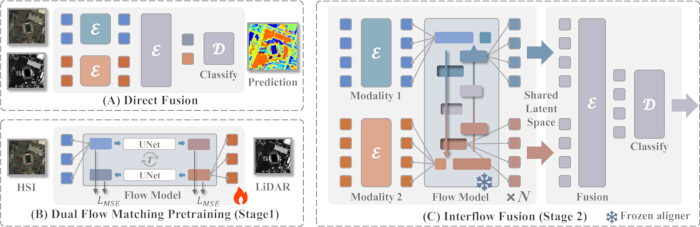
Figuur 1: Overzicht van het voorgestelde FlowErs-framework voor multimodale landcover-classificatie. (A) Conventionele directe feature-fusie, waarbij modaliteitsspecifieke features geëxtraheerd uit hyperspectrale beelden (HSI) en light detection and ranging (LiDAR)-gegevens direct worden geconcatenereerd vóór de classificatie. (B) Fase 1: Bidirectionele multimodale flow-matching pretraining. Een tijdsgeconditioneerd U-Net leert continu bidirectioneel feature-transport tussen modaliteitsspecifieke feature-representaties met gebruik van een mean-squared-error loss om heterogene feature-distributies uit te lijnen. (C) Fase 2: Interflow-fusie. De gepretrainde flow-matching module wordt bevroren en opnieuw gebruikt om modaliteitsspecifieke feature-representaties uit te lijnen vóór lichtgewicht feature-fusie en pixelgewijze landcover-classificatie. E, encoder; D, decoder; T, tijd-embedding; , mean-squared-error loss; S, gedeelde latente representatie. Klik hier om een grotere versie van deze figuur te bekijken.
Het voorgestelde raamwerk scheidt kenmerkuitlijning van semantische classificatie via een trainingsstrategie in twee fasen. Tijdens de eerste fase wordt de MFM-module getraind om bidirectioneel kenmerktransport tussen modaliteitsspecifieke kenmerkmanifolds te leren. Tijdens de tweede fase wordt de vooraf getrainde flow-uitlijningsmodule bevroren en hergebruikt om multimodale kenmerkrepresentaties uit te lijnen voorafgaand aan lichtgewicht kenmerkfusie en classificatie. Dit ontkoppelde ontwerp stelt de uitlijningsmodule en het classificatienetwerk in staat om complementaire doelstellingen te optimaliseren, terwijl verschillen in kenmerkdistributie vóór de multimodale fusie worden verminderd.
Theoretisch Overzicht
Flow matching is een onlangs voorgesteld paradigma voor generatieve modellering dat een continue deterministische transformatie leert tussen twee kansverdelingen. In tegenstelling tot diffusiemodellen, die stochasticiteit introduceren via ruisperturbaties, parametriseert flow matching direct een leerbaar snelheidsveld dat één kansverdeling continu naar een andere transporteert. Deze formulering van continu transport maakt kenmerkuitlijning via een ODE mogelijk, waardoor gepaarde kenmerkrepresentaties van verschillende sensorische modaliteiten langs een gedeeld traject kunnen evolueren voordat kenmerkfusie plaatsvindt. In de huidige studie wordt conditionele flow matching toegepast om bidirectioneel kenmerktransport te leren tussen modaliteitsspecifieke embeddings die zijn geëxtraheerd door de MetaFormer-encoders. Het model wordt getraind met een conditionele flow-matching-doelfunctie die de discrepantie tussen voorspelde en doel-snelheidsvelden over geïnterpoleerde kenmerkrepresentaties minimaliseert. De volledige wiskundige formulering, theoretische afleiding, sturende vergelijkingen en de trainingsdoelstelling worden beschreven in Aanvullend Bestand 1.
Probleemformulering
Landbedekkingsclassificatie op basis van multimodale remote sensing-data omvat het leren van semantische representaties uit heterogene detectiemodaliteiten, zoals HSI en LiDAR. Deze modaliteiten vertonen verschillende detectiekenmerken. HSI verkrijgt rijke spectrale informatie met honderden kanalen ( ), terwijl LiDAR fijnmazige structurele informatie biedt met relatief weinig kanalen (
 ). Deze onbalans tussen spectrale rijkdom en structurele schaarste creëert een aanzienlijk domeinkloof in de kenmerkdistributies, waardoor directe kenmerkfusie suboptimaal en potentieel instabiel is.
Formeel, gegeven een paar multimodale inputs, 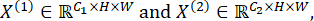 is het doel om een pixelgewijze semantische kaart te voorspellen volgens Vergelijking 1:
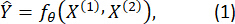
Hier is 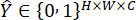 de one-hot gecodeerde labeltensor, C duidt het totaal aantal landbedekkingscategorieën aan, en θ representeert alle leerbare modelparameters. De Houston2013-dataset heeft een beeldgrootte van 349 × 1905 pixels met 144 hyperspectrale (HSI) banden en 1 LiDAR-band. De Augsburg-dataset heeft een beeldgrootte van 1152 × 480 pixels met 224 HSI-banden en 1 LiDAR-band. De MUUFL-dataset heeft een beeldgrootte van 325 × 220 pixels met 64 HSI-banden en 2 LiDAR-banden. Voor alle datasets werden de input-beeldpatches vóór de training aangepast naar 32 × 32 pixels.
Conventionele multimodale benaderingen fuseren modaliteitsspecifieke kenmerken via concatenatie of aandachtmechanismen, waarbij impliciet wordt aangenomen dat verschillende modaliteiten zich in een compatibele kenmerkruimte bevinden. Deze aanname is echter zelden van toepassing op remote sensing-gegevens, omdat modaliteitsspecifieke statistische distributies en ruimtelijk-spectrale kenmerken aanzienlijk verschillen.
Om dit verschil expliciet te overbruggen, wordt een flow matching-module geïntroduceerd,  . De module is geparametriseerd door
 en leert continue bidirectionele transformaties tussen modaliteitsspecifieke kenmerkmanifolds. Specifiek (Vergelijking 2),
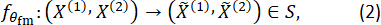
Hier, S duidt de gedeelde latente ruimte aan waarin de modaliteitsspecifieke kenmerkrepresentaties geometrisch zijn uitgelijnd. Vervolgens worden de uitgelijnde kenmerkrepresentaties gefuseerd en geclassificeerd volgens Vergelijking 3 als volgt:
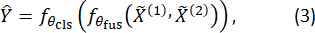
Hier denoteren  en
 respectievelijk de feature-fusie- en classificatiemodules. Deze formulering definieert het algemene FlowErs-framework. In plaats van uitsluitend te vertrouwen op impliciete statistische feature-fusie, introduceert het voorgestelde framework een expliciet flow-gebaseerd uitlijningsmechanisme dat modaliteitsspecifieke feature-representaties continu transporteert naar een gedeelde latente ruimte voorafgaand aan de multimodale feature-fusie en semantische voorspelling.
MetaFormer-encoder
FlowErs voert cross-modale feature-uitlijning uit met behulp van lichtgewicht modaliteitsspecifieke encoders die informatieve en geometrisch consistente feature-representaties leren uit elke sensorische modaliteit. Zoals geïllustreerd in Figuur 2, wordt elke modaliteit verwerkt door een onafhankelijke encoder gebaseerd op de MetaFormer-architectuur. MetaFormer generaliseert het fundamentele Transformer-ontwerp door token-mixing te ontkoppelen van kanaaltransformatie zonder expliciet self-attention te berekenen. Dit ontwerp maakt een efficiënte verwerking van hoogdimensionale HSI mogelijk, terwijl het aanpasbaar blijft voor modaliteiten met weinig kanalen, zoals LiDAR.
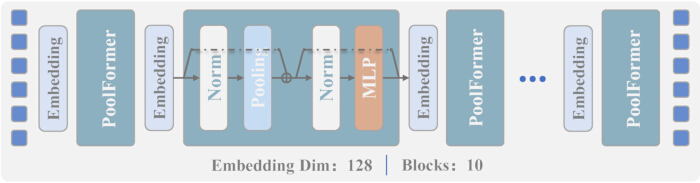
Figuur 2: Architectuur van de modaliteitspecifieke MetaFormer-encoder die wordt gebruikt in het voorgestelde FlowErs-framework. De encoder transformeert modaliteitspecifieke inputs in hiërarchische kenmerkrepresentaties via herhaalde embedding- en PoolFormer-blokken. Elk PoolFormer-blok bestaat uit normalisatie, pooling-gebaseerde token-mixing, residuele optelling, normalisatie en een multilayer perceptron (MLP). De resulterende hiërarchische kenmerkrepresentaties worden doorgestuurd naar de multimodale flow-matching-module voor cross-modale kenmerkuitlijning. Norm, normalisatie; MLP, multilayer perceptron. Klik hier om een grotere versie van deze figuur te bekijken.
Voor elke modaliteit  , transformeert de MetaFormer-encoder
 , de input
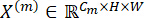 tot een hiërarchie van latente kenmerkrepresentaties (Vergelijking 4):
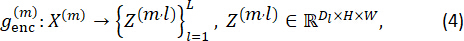
Hierbij staat L voor het totale aantal encoder-trappen en Dl voor de embedding-dimensie in trap l. De MetaFormer-encoder bestaat uit drie trappen (N = 3) met embedding-dimensies van respectievelijk 64, 128 en 256. De bijbehorende aantallen PoolFormer-blokken per trap zijn 2, 6 en 2, conform de progressieve hiërarchische architectuur die in het manuscript wordt beschreven.
Elke encoder begint met een 1 × 1 convolutie die de invoerkanalen projecteert naar een gemeenschappelijke embeddingruimte (Vergelijking 5):
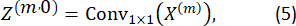
Deze projectielaag wordt gevolgd door L gestapelde MetaFormer-blokken. Elk blok bestaat uit twee residuele operaties: (i) token-mixing via ruimtelijke pooling om contextuele informatie te aggregeren en (ii) kanaaltransformatie via een multilayer perceptron (MLP) om spectrale-ruimtelijke kenmerkrepresentaties te verfijnen. Deze operaties worden uitgedrukt met Vergelijking 6 en 7 als volgt:
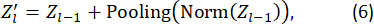

Hier duidt Pooling(·) ruimtelijke contextaggregatie op basis van average-pooling en duidt MLP(·) een tweelaags convolutioneel feed-forward netwerk aan waarin GELU-activatie en dropout-regularisatie zijn opgenomen.
De encoder volgt een hiërarchische architectuur waarin de embedding-dimensie progressief toeneemt over opeenvolgende fasen (bijvoorbeeld, 64  128 256). Dit progressieve ontwerp stelt diepere lagen in staat om steeds rijkere spatiale-spectrale informatie te coderen, terwijl de representatieve capaciteit van de geleerde kenmerken wordt verbeterd. De implementatie maakt gebruik van een 3 × 3 pooling-kernel, een MLP-verborgen dimensie van 128 en een dropout-rate van 0,1. Alle convolutionele lagen binnen de MetaFormer-encoder maken gebruik van 1 × 1 kernels met een stride van 1 en zonder padding. De pooling-operator maakt gebruik van 3 × 3 average pooling met een stride van 1 en een padding van 1. Batchnormalisatie (BatchNorm2d) wordt in de gehele encoder toegepast. De MLP heeft een verborgen dimensie van 128, maakt gebruik van de GELU-activeringsfunctie en hanteert een dropout-rate van 0,1. De drie encoderfasen bevatten respectievelijk 2, 6 en 2 PoolFormer-blokken, en deze architecturale instellingen worden consistent op alle fasen toegepast.
In vergelijking met encoders op basis van Transformers elimineert de MetaFormer-encoder de kwadratische computationele kosten die gepaard gaan met self-attention, terwijl de modaliteitsspecifieke bias tijdens de kenmerkextractie wordt verminderd. De pooling-gebaseerde token mixer aggregeert efficiënt de lokale ruimtelijke context, waarna de cross-modale uitlijning wordt uitgevoerd door de flow matching-module. Bijgevolg leveren de op het hoogste niveau geproduceerde kenmerkrepresentaties van de encoder semantisch informatieve en geometrisch consistente inputs voor de multimodale kenmerkuitlijning.
Multimodale Flow Matching
De belangrijkste uitdaging na de kenmerkextractie is de uitlijning van heterogene kenmerkrepresentaties afkomstig van verschillende sensorische modaliteiten die zich op verschillende kenmerkmanifolds bevinden. Directe concatenatie van  en
 levert vaak slechte resultaten op vanwege inconsistente kenmerkdistributies en modaliteitsspecifieke biases. FlowErs pakt deze uitdaging expliciet aan door een MFM-module te introduceren die continue, bidirectionele transformaties tussen de twee kenmerkruimten leert, zoals conceptueel geïllustreerd in Figuur 1B.
Laat 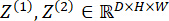 de kenmerkrepresentaties aanduiden die door de MetaFormer-encoders zijn geëxtraheerd. Een continu stroomveld, geparametriseerd door de interpolatietijd
 , wordt met behulp van Vergelijking 8 als volgt gedefinieerd:
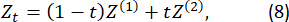
Hier correspondeert t = 0 met de bronmodaliteit en t = 1 met de doelmodaliteit.
Het flow matching-model, is geïmplementeerd als een tijdgeconditioneerd U-Net dat het onmiddellijke snelheidsveld voorspelt dat de transformatie langs dit interpolatietraject bepaalt. Elke flow-voorspeller bestaat uit drie downsampling-blokken (64 128 256 512) en drie corresponderende upsampling-blokken (512 256 128 64) met behulp van 3 × 3 convoluties, batch-normalisatie en rectified linear unit (ReLU) activatie. De tussenliggende tijd-embeddings hebben respectievelijk dimensies 128, 256, 512, 256 en 128. De tijd-embedding maakt gebruik van een vaste sinusvormige positionele codering. ODE-integratie wordt uitgevoerd met de forward Euler-methode met een vaste stapgrootte. Tijdens de training werd het aantal integratiestappen ingesteld op 6, terwijl standaard 5 integratiestappen werden gebruikt tijdens de inferentie. Het werkelijke aantal iteraties van de integratielus wordt berekend als 
Het voorspelde snelheidsveld wordt gegeven door Vergelijking 9 als volgt:
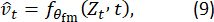
Hier geeft  de voorspelde momentane snelheid aan. Het model leert de verplaatsing
 te benaderen, waardoor continue transformaties tussen modaliteitsspecifieke kenmerkruimten worden gestimuleerd. Het trainingsdoel is geformuleerd als een tijdsgeconditioneerd bidirectioneel gemiddeld kwadratisch foutverlies (MSE) als volgt (Vergelijking 10):
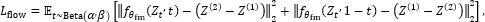 (10)
Het samplen van t uit de gespecificeerde bètaverdeling stelt het model bloot aan tussenliggende interpolatietoestanden, maar vestigt geen exacte cyclusconsistentie. In tegenstelling tot alignment-methoden op basis van diffusie is de voorgestelde flow-matching formulering deterministisch, vereist deze geen stochastisch samplen tijdens inferentie en kan deze worden getraind met zowel gelabelde als ongelabelde gegevens.
Een getraind flow-model dient vervolgens als een deterministische uitlijningsoperator die modaliteitsspecifieke kenmerkrepresentaties projecteert in een gedeelde latente ruimte S. De uitgelijnde representaties worden als volgt verkregen (Vergelijking 11):
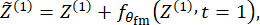
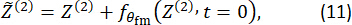
Hier  en
 duiden de uitgelijnde kenmerkrepresentaties aan. Flow-gebaseerde uitlijning wordt toegepast op de tussenliggende kenmerkrepresentaties van de eerste twee encoder-stadia (Stadium 1 en 2), met respectievelijk embedding-dimensies van 64 en 128. De kenmerken van de encoder op het hoogste niveau (Stadium 3, embedding-dimensie 256) worden niet verwerkt door de flow-matching-module. In plaats daarvan worden deze kenmerken direct geconcateneerd en doorgegeven aan de classifier voor multimodale predictie.
Dit bidirectionele uitlijningsmechanisme transporteert modaliteitsspecifieke kenmerkrepresentaties geleidelijk naar een gedeelde latente ruimte via een continu stroomveld. Bijgevolg worden deze nauwer op elkaar afgestemd vóór de multimodale kenmerkfusie, wat semantisch consistente en geometrisch compatibele kenmerkrepresentaties oplevert voor de daaropvolgende classificatie.
Trainingspijplijn
FlowErs maakt gebruik van zowel gelabelde als ongelabelde data, terwijl een stabiele cross-modale uitlijning wordt behouden via een trainingsstrategie in twee fasen, zoals geïllustreerd in Figuur 1(B,C). Tijdens de eerste fase wordt een modaliteits-invariante uitlijningsmodule aangeleerd via unsupervised flow matching. Tijdens de tweede fase wordt supervised classificatie uitgevoerd met behulp van de uitgelijnde latente representaties, waarbij de vooraf getrainde flow-uitlijningsmodule wordt hergebruikt.
Stap 1: Ongecontroleerde Flow-pretraining
Uitgaande van multimodale beeldparen worden  modaliteitsspecifieke kenmerkrepresentaties,
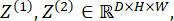 geëxtraheerd met behulp van de MetaFormer-encoders. Intermediaire kenmerkrepresentaties worden gegenereerd met behulp van de interpolatie gedefinieerd in Vergelijking 8, waarbij
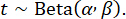 De flow-matching-module,
 , wordt geoptimaliseerd door de bidirectionele tijd-geconditioneerde doelfunctie gedefinieerd in Vergelijking 10 te minimaliseren zonder gebruik te maken van klassenlabels. Tijdens deze fase worden alleen de flow-matching-parameters,
 , bijgewerkt, waardoor het model geometrie-bewuste correspondenties kan leren van zowel gelabelde als ongelabelde monsters voorafgaand aan de gesuperviseerde classificatie. Fase 1 (flow-matching-pretraining) werd uitgevoerd met de AdamW-optimizer met een learning rate van 1 × 10⁻4, een weight decay van 1 × 10⁻2 en een cosine annealing learning-rate schema. Voor de Houston2013- en Trento-datasets werden batch-groottes van 16 gebruikt, terwijl voor de Augsburg- en MUUFL-datasets batch-groottes van 32 werden gebruikt. De flow-matching-module werd gedurende 2.000 epochs gepretrained met behulp van zowel gelabelde als ongelabelde monsters. De random seed werd vastgelegd op 3407. Alle experimenten werden uitgevoerd met PyTorch op een enkele NVIDIA A100 GPU (80 GB geheugen).
Stadium 2: Gesuperviseerde classificatie met een gedeelde aligner
De vooraf getrainde flow-matchingmodule wordt hergebruikt tijdens de gesuperviseerde training en wordt toegepast op de eerste twee encoderstadia in plaats van op alle kenmerkniveaus. De uitgelijnde kenmerkrepresentaties worden vervolgens gefuseerd met behulp van de classificatiekop om pixelgewijze voorspellingen te genereren. Gesuperviseerde optimalisatie minimaliseert het gemaskeerde cross-entropieverlies (Vergelijking 12):
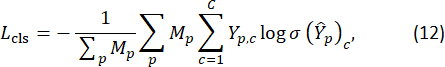
Hierbij staat M voor het labelmasker, Y voor de one-hot gecodeerde ground-truth labels en σ(·) voor de softmax-functie. Tijdens Fase 2 (gesuperviseerde training) bleef de vooraf getrainde flow-matching module volledig bevroren en diende deze als een vaste cross-modale alignment-operator. De vooraf getrainde gewichten werden aan het begin van Fase 2 geladen en werden tijdens de gesuperviseerde training niet bijgewerkt. Alleen de parameters van de MetaFormer-encoder en de classifier werden geoptimaliseerd. De gesuperviseerde training werd uitgevoerd met de AdamW-optimizer met dataset-specifieke leerpercentages van 1 × 10⁻4 (Houston2013), 1 × 10⁻3 (Augsburg), 1 × 10⁻2 (MUUFL) en 1 × 10⁻5 (Trento). Het weight decay werd ingesteld op 1 × 10⁻2 voor alle datasets behalve MUUFL, waarvoor een waarde van 5 × 10⁻2 werd gebruikt. Afhankelijk van de dataset werden batchgroottes van 16 of 32 gehanteerd. Modellen werden getraind gedurende 100 epochs (Houston2013 en MUUFL), 200 epochs (Augsburg) en 20 epochs (Trento) met gebruik van een cosine annealing leerpercentage-schema. CrossEntropyLoss met gemiddelde reductie werd gebruikt als verliesfunctie. Er werd geen early stopping toegepast; in plaats daarvan werd het modelcheckpoint dat de hoogste totale nauwkeurigheid (OA) op de testset behaalde, geselecteerd als het definitieve model. De volledige implementatieworkflow van de tweefasige trainingsprocedure is samengevat in Aanvullend bestand S1 (Algoritme S1).
Deze ontkoppelde trainingsstrategie scheidt geometrische uitlijning van semantische discriminatie. Tijdens Fase 1 leert het model continue bidirectionele kenmerkmappingen met behulp van de flow-matching-doelfunctie. Tijdens Fase 2 biedt de vooraf getrainde uitlijningsmodule een gemeenschappelijke kenmerktransportoperatie voorafgaand aan de multimodale kenmeksfusie, terwijl het classificatienetwerk klassediscriminerende representaties leert uit de uitgelijnde latente ruimte. Het hergebruiken van de vooraf getrainde aligner bevordert een consistente kenmerkuitlijning vóór de fusie, maar wordt niet gepresenteerd als een onafhankelijke garantie voor verbeterde generalisatie.
Experimentele datasets
Het voorgestelde raamwerk werd geëvalueerd met behulp van drie representatieve benchmarkdatasets voor multimodale remote sensing: Houston201329, Augsburg30 en MUUFL31.
De Houston2013-dataset werd vrijgegeven als onderdeel van de IEEE GRSS Data Fusion Contest. Het representeert een divers stedelijk landschap in Houston, VS, en bevat 15 landbedekkingsklassen, waaronder woongebieden, wegen, vegetatie en waterlichamen. De dataset bevat HSI met 144 spectrale banden die het zichtbare tot nabij-infrarode spectrum beslaan, samen met een enkelbandig, op LiDAR gebaseerd digitaal oppervlaktmodel (DSM) met een ruimtelijke resolutie van 2.5 m. De complexe stedelijke texturen en aanzienlijke spectrale variabiliteit binnen klassen maken deze dataset uitdagend voor een nauwkeurige landbedekkingsclassificatie.
De Augsburg-dataset is verzameld boven een dichtbebouwd stedelijk gebied in Duitsland. Deze bestaat uit hyperspectrale beelden met 224 spectrale banden die het golflengtebereik van 400–1000 nm beslaan, samen met gecoregistreerde LiDAR-hoogtegegevens. De dataset bevat 17 geannoteerde landbedekkingsklassen, waaronder bebouwing, kale bodem, asfalt, vegetatie en schaduw, met een ruimtelijke resolutie van 2 m. In vergelijking met Houston2013 vertoont Augsburg sterkere spectrale correlaties en een grotere klassendiversiteit, wat een uitdagende benchmark biedt voor het evalueren van cross-modale feature-alignment en generalisatie.
De MUUFL Gulfport-dataset is verzameld over een universiteitscampus en is representatief voor een semi-urbane omgeving met overvloedige vegetatie en kleine door mensen gemaakte structuren. De dataset bevat geruisvrije hyperspectrale beelden met 64 banden, samen met dual-band LiDAR-metingen bestaande uit hoogte- en intensiteitsinformatie. Het bevat 11 landdekklasse en vertoont fijne ruimtelijke details, gemengde pixels en variërende verlichtingsomstandigheden, waardoor het zeer geschikt is voor het evalueren van multimodale feature-fusie voor de classificatie van kleine objecten.
Gezamenlijk omvatten deze drie benchmark-datasets een aanzienlijke variatie in ruimtelijke resolutie (1–2,5 m), spectrale dimensionaliteit (64–224 banden), scenecomplexiteit en landbedekkingssamenstelling. Bijgevolg bieden ze een diverse benchmark voor het evalueren van de effectiviteit en generaliseerbaarheid van multimodale landbedekkingsclassificatiemethoden. De belangrijkste kenmerken van de datasets zijn samengevat in Tabel 1. De train/test-verdelingen voor alle drie de datasets komen overeen met de officiële benchmark-splits die zijn verstrekt door de oorspronkelijke dataleveranciers. Specifiek maakt de Houston2013-dataset gebruik van de officiële verdeling van de 2013 IEEE GRSS Data Fusion Contest, bestaande uit 2.832 trainingssamples en 12.197 testsamples. De Augsburg-dataset maakt gebruik van de officieel verstrekte mask_train- en mask_test-annotaties, wat resulteert in 4.538 trainingssamples en 47.896 testsamples. De MUUFL-dataset maakt gebruik van de officiële train_test_gt.mat-verdeling, die 28.645 trainingssamples en 24.283 testsamples bevat. Voor elke dataset werd een image patch van 32 × 32 pixels, gecentreerd op elke gelabelde pixel, geëxtraheerd als een individueel trainings- of testsample. Er is geen aanvullende gegevenssplitsing of resampling uitgevoerd.
| Eigenschap | Houston2013 | Augsburg | MUUFL |
| HSI-beeldgrootte (pixels) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| LiDAR-beeldgrootte (pixels) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| HSI-spectrale banden | 144 | 224 | 64 |
| LiDAR-banden | 1 | 1 | 2 |
| HSI-golflengtebereik | 0.38–1.05 µm | 0.40–1.00 µm | 375–1050 nm |
| LiDAR-golflengtebereik | Niet van toepassing | Niet van toepassing | Niet van toepassing |
| Ruimtelijke resolutie (HSI) | 2.5 m | 2.0 m | 0.54 m × 1.00 m |
| Ruimtelijke resolutie (LiDAR) | 2.5 m | 2.0 m | 0.60 m × 0.78 m |
| Aantal landbedekkingsklassen | 15 | 17 | 11 |
Tabel 1: Kenmerken van de drie multimodale remote sensing benchmark-datasets die zijn gebruikt voor evaluatie. De tabel geeft een overzicht van de afbeeldingsdimensies, spectrale kenmerken, ruimtelijke resoluties en het aantal landbedekkingsklassen voor de Houston2013, Augsburg en MUUFL benchmark-datasets die zijn gebruikt om het voorgestelde FlowErs-framework te evalueren.
Implementatiedetails
Het FlowErs-framework werd geïmplementeerd in PyTorch en getraind en geëvalueerd met behulp van een graphics processing unit (GPU) met 80 GB geheugen. De training werd uitgevoerd gedurende 100 epochs met een batchgrootte van 16. Er werd gebruikgemaakt van de AdamW-optimizer met een initiële leerstroom van 1 × 10⁻⁴ en een weight decay van 1 × 10⁻². Een cosine annealing learning-rate scheduler werd gebruikt om de leerstroom gedurende de training bij te werken. Een dropout-rate van 0,1 werd toegepast om de generalisatie van het model te verbeteren en overfitting te verminderen. De cross-entropy verliesfunctie werd gebruikt voor gesuperviseerde optimalisatie. Voor de reproduceerbaarheid werden alle experimenten geïnitieerd met een vaste random seed van 3407. De meegeleverde train/test-partities werden gebruikt zonder een aanvullende validatiesplit te creëren. Elke inputpatch werd voor de training aangepast naar 32 × 32 pixels. Er werd geen data-augmentatie, expliciete correctie van beeldregistratie of aanvullende normalisatie van de data-loader toegepast. Pixels die geassocieerd waren met negatieve labels werden uitgesloten van de berekening van het gesuperviseerde verlies. De behandeling van ontbrekende of ruisende pixels werd niet afzonderlijk geëvalueerd.
Evaluatiemetrieken
Drie algemeen aanvaarde evaluatiemetrieken werden gebruikt om de classificatieprestaties te beoordelen: OA, gemiddelde nauwkeurigheid (AA) en de Kappa-coëfficiënt (k). OA meet de proportie correct geclassificeerde monsters ten opzichte van alle monsters, AA vertegenwoordigt de gemiddelde classificatienauwkeurigheid over alle landbedekkingsklassen, en de Kappa-coëfficiënt kwantificeert de overeenkomst tussen de voorspelde en referentieclassificaties, gecorrigeerd voor toevallige overeenkomst. Hogere waarden voor alle drie de metrieken duiden op betere classificatieprestaties. Alle waarden vermeld in Tabel 2–6 zijn fixed-split puntschattingen verkregen met de random seed 3407. Er zijn geen betrouwbaarheidsintervallen, statistische significantietoetsen of p-waarden gerapporteerd.
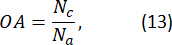
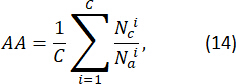
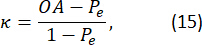
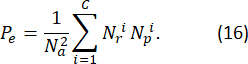
Hierbij geven Nc en Na respectievelijk het totale aantal correct geclassificeerde monsters en het aantal geëvalueerde monsters aan.  en
 geven respectievelijk het aantal correct geclassificeerde monsters en het totale aantal monsters voor de i-de klasse aan. Bij de berekening van de Kappa-coëfficiënt geeft Pe de waarschijnlijkheid aan dat overeenstemming bij toeval optreedt, en
 en
 geven respectievelijk de referentie- en voorspelde monsteraantallen voor de i-de klasse aan.
Resultaten
De algemene evaluatieworkflow van het voorgestelde FlowErs-framework is weergegeven in Figuur 1, waarin de tweestaps multimodale classificatiestrategie wordt samengevat. Het modaliteitsspecifieke kenmerkenextractieproces op basis van de MetaFormer-encoder wordt getoond in Figuur 2en de belangrijkste kenmerken van de drie benchmarkdatasets die voor evaluatie zijn gebruikt, zijn samengevat in Tabel 1De classificatieprestaties werden vervolgens geëvalueerd op de benchmarkdatasets MUUFL, Houston2013 en Augsburg met behulp van de OA, AA en de kappacoëfficiënt (κ) gedefinieerd in de sectie Protocol.
Vergelijking met andere methoden
Verschillende benchmark-netwerken voor multimodale classificatie werden opgenomen om een uitgebreide vergelijking van het voorgestelde raamwerk te bieden. DFINet32 integreert hyperspectrale en multispectrale informatie met behulp van een depth-wise cross-attention-module om de kenmerkinteractie via meerdere verliesdoelstellingen te verbeteren. DSHFNet33 introduceert een dynamische hiërarchische fusiestrategie die fijnmazige en grofmazige representaties progressief combineert. MDL-Middle34 maakt gebruik van een fusiestrategie voor kenmerken in de tussenlaag om informatie uit meerdere waarnemingsmodaliteiten in balans te brengen. CMCL35 beschouwt HSI- en LiDAR-gegevens als complementaire weergaven van dezelfde scène en past contrastief leren toe samen met dubbele fijnafstemming om de uitlijning van kenmerken te verbeteren. Two-Branch36 maakt gebruik van een dual-path convolutionele architectuur die elke modaliteit onafhankelijk verwerkt vóór de kenmerkfusie. ExViT37 voert multimodale patchverwerking uit met behulp van parallelle Transformer-branches met cross-modale attention-modules. DSymFuse38 breidt de dual-branch Transformer-architectuur uit via hiërarchische lokale-globale kenmerkfusie. CTPMSN39 combineert convolutionele en Transformer-architecturen met text-visuele prompt-uitlijning om de semantische consistentie en klassendiscriminatie te verbeteren. De vergelijkingswaarden zijn verkregen uit de geciteerde publicaties of hun gerapporteerde evaluatieprotocollen en zijn niet gegenereerd met behulp van een uniforme implementatie of een gemeenschappelijk experimenteel raamwerk. Daarom moeten deze vergelijkingen worden geïnterpreteerd als beschrijvende benchmarkvergelijkingen en niet als gecontroleerde head-to-head evaluaties.
MUUFL-dataset
De classificatieresultaten verkregen voor de MUUFL Gulfport-dataset zijn samengevat in Tabel 2, en representatieve classificatiekaarten worden gepresenteerd in Figuur 3A–J. Op de gerapporteerde vaste benchmark-splitsing behaalde het voorgestelde raamwerk een OA van 95,24% en een Kappa-coëfficiënt van 93,69%, vergeleken met respectievelijk 93,99% en 92,03% voor CTPMSN. De prestaties op klasseniveau varieerden per landbedekkingscategorie. Vergeleken met CTPMSN behaalde het voorgestelde raamwerk hogere classificatienauwkeurigheden voor de klassen Bomen, Grotendeels Gras en Gemengd Oppervlak met respectievelijk 2,73%, 3,16% en 1,86%. Daarentegen bleef de klasse Gele Stoeprand uitdagend vanwege het beperkte aantal beschikbare monsters, en de gerapporteerde nauwkeurigheid hiervan was lager dan die van verschillende vergelijkingsmethoden. Bijgevolg moet de waargenomen verbetering in de geaggregeerde prestaties niet worden geïnterpreteerd als een indicatie van superieure prestaties voor elke individuele landbedekkingsklasse. De kwalitatieve vergelijking in Figuur 3A–I toont de classificatiekaarten die door de geëvalueerde methoden zijn gegenereerd, terwijl Figuur 3J de corresponderende ground-truth referentiekaart presenteert, die de ruimtelijke distributie van de landbedekkingsklassen over de MUUFL Gulfport-dataset illustreert.
| Klasse | DFINet | DSHFNet | MDL-Middle | CMCL | Two-Branch | ExVit | DSymFuse | CTPMSN | FlowErs |
| Bomen | 89.2 | 74.91 | 87.31 | 84.86 | 91.32 | 92.64 | 91.24 | 95.55 | 98.28 |
| Grotendeels gras | 72.98 | 84.63 | 76.38 | 86.54 | 80.65 | 77.48 | 79.57 | 88.92 | 92.08 |
| Gemengd oppervlak | 69.22 | 34.77 | 68.33 | 54.75 | 67.92 | 82.07 | 82.23 | 87.92 | 89.78 |
| Aarde/zand | 76.68 | 87.06 | 78.74 | 84.45 | 78.32 | 93.74 | 89.17 | 97.27 | 93.55 |
| Weg | 86.68 | 81.09 | 83.76 | 86.25 | 84.34 | 90.35 | 85.6 | 94.52 | 95.94 |
| Water | 100 | 99.25 | 88.52 | 98.53 | 100 | 99.38 | 100 | 100 | 97.56 |
| Schaduw | 83.29 | 90.65 | 92.12 | 97.72 | 84.89 | 91.47 | 91 | 95.98 | 90.54 |
| Gebouw | 93.26 | 90.22 | 89.69 | 97.54 | 93.76 | 89.27 | 96.29 | 96.29 | 98.26 |
| Stoep | 57.34 | 53.09 | 77.06 | 77.98 | 71.32 | 73.54 | 79.62 | 88.07 | 79.61 |
| Gele stoeprand | 84.28 | 1.03 | 96.75 | 80.62 | 81.41 | 93.72 | 91.57 | 97.37 | 48.91 |
| Stoffen panelen | 97.92 | 92.79 | 99.41 | 98.41 | 99.21 | 99.41 | 100 | 99.41 | 93.13 |
| Totale nauwkeurigheid (OA) | 83.87 | 74.29 | 83.54 | 82.45 | 85.61 | 89.94 | 88.78 | 93.99 | 95.24 |
| Gemiddelde nauwkeurigheid (AA) | 82.76 | 73.23 | 84.37 | 85.9 | 85.1 | 90.12 | 89.54 | 94.68 | 88.88 |
| Kappa-coëfficiënt (κ × 100) | 79.82 | 67.92 | 78.84 | 78.37 | 81.22 | 85.37 | 85.37 | 92.03 | 93.69 |
Tabel 2: Classificatieprestaties (%) van verschillende methoden op de MUUFL-benchmarkdataset. Classificatieprestaties per klasse samen met de algehele nauwkeurigheid (OA), gemiddelde nauwkeurigheid (AA) en Kappa-coëfficiënt (κ) verkregen door het voorgestelde FlowErs-framework en concurrerende methoden op de MUUFL-benchmarkdataset.
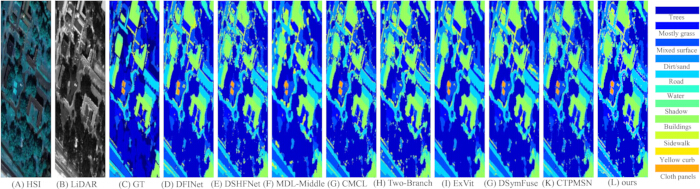
Figuur 3: Representatieve resultaten van de landbedekkingsclassificatie voor de MUUFL benchmark-dataset. (A) Hyperspectrale beelden (HSI). (B) Light detection and ranging (LiDAR) beeld. (C) Ground-truth (GT) referentiekaart. (D–L) Classificatiekaarten gegenereerd door respectievelijk DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN en het voorgestelde FlowErs-framework. De kleurengids identificeert de landbedekkingsklassen die in elke classificatiekaart worden weergegeven.Klik hier om een grotere versie van deze figuur te bekijken.
Houston2013-dataset
De classificatieresultaten verkregen voor de Houston2013-dataset worden gepresenteerd in Tabel 3, en representatieve classificatiekaarten worden getoond in Figuur 4A–J. Op de gerapporteerde vaste benchmark-splitsing behaalde het voorgestelde raamwerk een OA van 97,56% en een Kappa-coëfficiënt van 97,39%. Vergeleken met de gerapporteerde CTPMSN-resultaten vertoonde het voorgestelde raamwerk een ongeveer 3,8 procentpunt hogere OA. Verbeteringen werden ook waargenomen voor de klassen 'Residential' en 'Highway', met gerapporteerde stijgingen van respectievelijk ongeveer 2,4 en 0,5 procentpunt. De klasse 'Commercial' bleef echter relatief uitdagend en vertoonde een lagere classificatienauwkeurigheid dan verschillende concurrerende methoden, wat mogelijk de spectrale en ruimtelijke gelijkenis met andere stedelijke landbedekkingscategorieën weerspiegelt. Over het algemeen duiden de geaggregeerde resultaten op een verbeterde classificatieprestatie op deze benchmark, terwijl wordt aangetoond dat de prestaties per individuele klasse varieerden. De kwalitatieve vergelijking in Figuur 4A–I toont de classificatiekaarten die zijn gegenereerd door de geëvalueerde methoden, terwijl Figuur 4J de overeenkomstige ground-truth referentiekaart presenteert, die de ruimtelijke distributie van de landbedekkingsklassen over de Houston2013-dataset illustreert.
| Klasse | DFINet | DSHFNet | MDL-Midden | CMCL | Twee-takig | ExVit | DSymFuse | CTPMSN | FlowErs |
| Gezond gras | 82.39 | 85.58 | 83.1 | 82.91 | 80.31 | 81.67 | 80.06 | 96.96 | 100 |
| Gestrest gras | 100 | 94.65 | 85.06 | 95.68 | 92.44 | 100 | 78.67 | 94.27 | 96.94 |
| Kunstgras | 100 | 98.12 | 99.6 | 94.93 | 99.23 | 99.01 | 99.41 | 99.41 | 99.84 |
| Boom | 100 | 93.09 | 91.57 | 93.37 | 98.75 | 98.96 | 95.55 | 96.21 | 99.6 |
| Bodem | 98.76 | 99.91 | 98.86 | 99.43 | 99.2 | 99.91 | 98.67 | 99.43 | 100 |
| Water | 94.5 | 93.1 | 100 | 97.3 | 95.32 | 100 | 95.8 | 100 | 97.6 |
| Residentieel | 87.5 | 66.65 | 97.64 | 92.58 | 90.87 | 93.28 | 87.22 | 86.86 | 99.29 |
| Commercieel | 91.53 | 76.29 | 88.13 | 87.96 | 95.31 | 89.27 | 85.85 | 94.61 | 84.07 |
| Weg | 84.19 | 36.29 | 85.93 | 80.76 | 82.63 | 89.42 | 93.29 | 88.07 | 92.73 |
| Snelweg | 69.32 | 89 | 74.42 | 57.41 | 66.69 | 71.33 | 67.95 | 81.66 | 99.74 |
| Spoorweg | 96.76 | 94.78 | 84.54 | 79.57 | 93.44 | 92.88 | 79.13 | 97.7 | 99.72 |
| Parkeerplaats 1 | 83.27 | 88.39 | 95.39 | 52.83 | 85.67 | 89.63 | 91.07 | 93.28 | 95.42 |
| Parkeerplaats 2 | 85.36 | 96.46 | 87.37 | 92.42 | 86.17 | 89.47 | 84.21 | 95.09 | 99.18 |
| Tennisbaan | 100 | 97.3 | 95.14 | 83.04 | 98.72 | 97.89 | 100 | 100 | 99.72 |
| Hardloopbaan | 99.21 | 100 | 100 | 97.02 | 100 | 97.97 | 100 | 100 | 99.83 |
| Totale nauwkeurigheid (OA) | 91.21 | 85.02 | 89.55 | 83.87 | 90.01 | 91.57 | 87.57 | 93.74 | 97.56 |
| Gemiddelde nauwkeurigheid (AA) | 92.42 | 87.55 | 91.05 | 85.76 | 90.98 | 92.32 | 89.09 | 94.9 | 97.58 |
| Kappa-coëfficiënt (κ × 100) | 91.09 | 83.59 | 87.59 | 82.76 | 89.1 | 90.85 | 85.29 | 93.21 | 97.39 |
Tabel 3: Classificatieprestaties (%) van verschillende methoden op de Houston2013 benchmarkdataset. Classificatieprestaties per klasse samen met de totale nauwkeurigheid (OA), gemiddelde nauwkeurigheid (AA) en Kappa-coëfficiënt (κ) verkregen door het voorgestelde FlowErs-framework en concurrerende methoden op de Houston2013 benchmarkdataset.
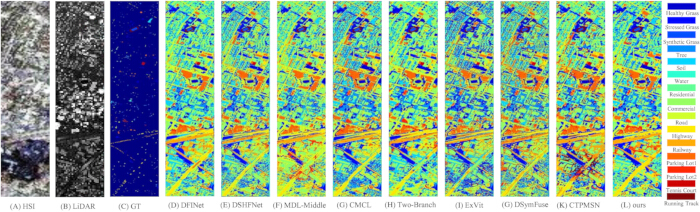
Figuur 4: Representatieve resultaten van de landbedekkingsclassificatie voor de Houston2013 benchmark-dataset. (A) Hyperspectrale beelden (HSI). (B) Light detection and ranging (LiDAR) beeld. (C) Ground-truth (GT) referentiekaart. (D–L) Classificatiekaarten gegenereerd door respectievelijk DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN en het voorgestelde FlowErs-framework. De kleurenlegenda identificeert de landbedekkingsklassen die in elke classificatiekaart zijn weergegeven. Klik hier om een grotere versie van deze figuur te bekijken.
Augsburg-dataset
De classificatieresultaten die zijn behaald voor de Augsburg-dataset zijn samengevat in Tabel 4, en representatieve classificatiekaarten worden gepresenteerd in Figuur 5A–J. Deze dataset wordt gekenmerkt door aanzienlijke intra-klasse variatie en een complexe achtergrondstructuur. Op de gerapporteerde vaste benchmark-splitsing behaalde het voorgestelde raamwerk een OA van 97,56% en een AA van 89,21%. In vergelijking met de vermelde benchmarkmethoden rapporteerde het voorgestelde raamwerk hogere classificatienauwkeurigheden voor de klassen Industrieel en Commercieel met respectievelijk ongeveer 14 en 45 procentpunten. Het verschil tussen OA en AA geeft aan dat de algehele prestatie werd beïnvloed door de klassefrequentie, terwijl AA de gemiddelde prestatie over alle klassen weerspiegelt. Bijgevolg moet de gerapporteerde OA worden geïnterpreteerd in samenhang met de resultaten per klasse, omdat de classificatieprestaties varieerden tussen de individuele landbedekkingscategorieën. De kwalitatieve vergelijking in Figuur 5A–I toont de classificatiekaarten die zijn geproduceerd door de geëvalueerde methoden, terwijl Figuur 5J de overeenkomstige ground-truth referentiekaart presenteert, die de ruimtelijke distributie van de landbedekkingsklassen over de Augsburg-dataset illustreert.
| Klasse | DFINet | DSHFNet | MDL-Midden | CMCL | Twee-takig | ExVit | DSymFuse | CTPMSN | FlowErs |
| Bomen | 96.41 | 98.21 | 91.72 | 94.27 | 95.85 | 93.64 | 90.58 | 93.36 | 99.57 |
| Residentieel | 96.88 | 42.08 | 95.19 | 69.84 | 92.75 | 97.71 | 96.32 | 97.37 | 98.97 |
| Industrieel | 58.2 | 47.29 | 62.61 | 35.22 | 72.66 | 65.82 | 72.45 | 64.6 | 86.41 |
| Lage planten | 92.22 | 51.75 | 87.76 | 80.27 | 88.9 | 84.88 | 89.65 | 96.72 | 99.58 |
| Toewijzing | 55.87 | 95.94 | 50.86 | 89.33 | 72.86 | 46.85 | 62.91 | 58.69 | 91.22 |
| Commercieel | 10.98 | 50.91 | 24.24 | 45.59 | 20.32 | 24.49 | 17.22 | 29.73 | 74.3 |
| Water | 22.87 | 67.78 | 29.04 | 54.87 | 36.82 | 24.49 | 13.27 | 15.53 | 74.39 |
| Algehele nauwkeurigheid (OA) | 88.78 | 56.59 | 87.74 | 75.94 | 87.29 | 87.72 | 88.35 | 91.56 | 97.56 |
| Gemiddelde nauwkeurigheid (AA) | 62.29 | 65.47 | 63.06 | 67.61 | 67.78 | 62.56 | 63.2 | 65.14 | 89.21 |
| Kappa-coëfficiënt (κ × 100) | 84.32 | 46.78 | 82.69 | 67.83 | 82.58 | 82.49 | 83.36 | 87.88 | 96.48 |
Tabel 4: Classificatieprestaties (%) van verschillende methoden op de Augsburg-benchmarkdataset. Per-klasse classificatieprestaties samen met de totale nauwkeurigheid (OA), gemiddelde nauwkeurigheid (AA) en Kappa-coëfficiënt (κ) verkregen door het voorgestelde FlowErs-raamwerk en concurrerende methoden op de Augsburg-benchmarkdataset.
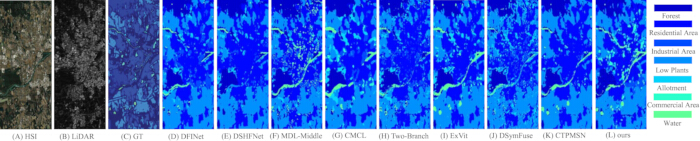
Figuur 5: Representatieve resultaten van de landbedekkingsclassificatie voor de Augsburg benchmark-dataset. (A) Hyperspectrale beelden (HSI). (B) Light detection and ranging (LiDAR) beeld. (C) Ground-truth (GT) referentiekaart. (D–L) Classificatiekaarten gegenereerd door respectievelijk DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN en het voorgestelde FlowErs-framework. De kleurenlegenda identificeert de landbedekkingsklassen die in elke classificatiekaart zijn weergegeven. Klik hier om een grotere versie van deze figuur te bekijken.
Om een nauwkeurigere visuele vergelijking van uitdagende regio's te vergemakkelijken, worden in Figuur 6 vergrote weergaven van representatieve ROI's uit de MUUFL-, Houston2013- en Augsburg-datasets gepresenteerd. Deze vergrote weergaven benadrukken objectgrenzen en fijne ruimtelijke structuren die minder duidelijk zichtbaar zijn in de classificatiekaarten van de volledige scène, zoals getoond in Figuren 3–5, wat aanvullend kwalitatief bewijs levert voor de classificatieprestaties over de drie benchmarkdatasets.
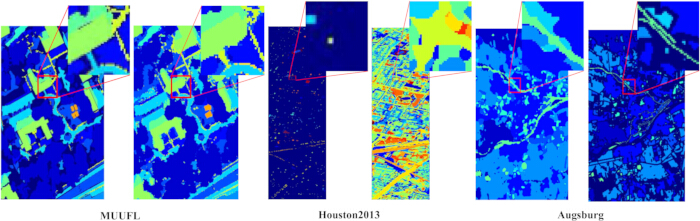
Figuur 6: Vergrote weergaven van representatieve interessegebieden (ROIs) uit de MUUFL-, Houston2013- en Augsburg-datasets. Representatieve ROIs uit de MUUFL-, Houston2013- en Augsburg-datasets zijn vergroot om de visuele vergelijking van classificatiedetails op fijne schaal te vergemakkelijken. Rode kaders geven de geselecteerde gebieden aan, en de bijbehorende vergrote weergaven lichten objectgrenzen, kleine structuren en andere uitdagende gebieden uit die moeilijk waarneembaar zijn in de classificatiekaarten van de volledige scène, zoals getoond in Figuren 3–5. Deze vergrote weergaven bieden een aanvullende kwalitatieve beoordeling van de classificatieresultaten. Klik hier om een grotere versie van deze figuur te bekijken.
Ablatiestudie
Effect van de multimodale flow-matchingmodule:
Om de bijdrage van de MFM-module te evalueren, werden ablatie-experimenten uitgevoerd met drie modelconfiguraties: het volledige FlowErs-framework (Baseline), een model zonder de MFM-module (w/o MFM) en een vereenvoudigd model dat gebruikmaakt van unidirectionele stroomuitlijning (Single Flow). De overeenkomstige kwantitatieve resultaten zijn samengevat in Tabel 5.
| Methode | MUUFL | Houston2013 | Augsburg | ||||||
| OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | |
| Nulmeting | 95.24 | 88.88 | 93.69 | 97.56 | 97.58 | 97.39 | 97.56 | 89.21 | 96.48 |
| zonder MFM | 92.87 | 86.02 | 91.05 | 95.31 | 95.28 | 94.97 | 95.12 | 87.06 | 93.98 |
| Enkelvoudige stroom | 94.38 | 87.43 | 92.72 | 96.58 | 96.47 | 96.22 | 96.47 | 88.36 | 95.47 |
Tabel 5: Ablatiestudie van het voorgestelde FlowErs-raamwerk op de benchmarkdatasets MUUFL, Houston2013 en Augsburg. De classificatieprestaties worden gerapporteerd voor het volledige model (Baseline) en twee ablatievarianten aan de hand van de totale nauwkeurigheid (OA), de gemiddelde nauwkeurigheid (AA) en de Kappa-coëfficiënt (κ).
Vergeleken met het Baseline-model resulteerde de verwijdering van de MFM-module in lagere OA-, AA- en Kappa-waarden over alle drie de benchmark-datasets. De Single Flow-configuratie produceerde een tussenliggende prestatie tussen het volledige model en het model zonder MFM, wat aangeeft dat unidirectionele feature-alignment een deel van de waargenomen prestatieverbetering behield, zonder de geaggregeerde prestaties van de bidirectionele implementatie te bereiken. Deze waarnemingen suggereren dat de bidirectionele flow-alignment-module heeft bijgedragen aan de gerapporteerde prestaties onder de geëvalueerde benchmark-instellingen. De gerapporteerde verschillen vertegenwoordigen fixed-split puntschattingen verkregen met een enkel random seed en moeten daarom beschrijvend worden geïnterpreteerd in plaats van als bewijs van statistische significantie.
Over de drie benchmarkdatasets heen werden de grootste geaggregeerde prestatieverschillen tussen de Baseline en de ablatiemodellen waargenomen bij de MUUFL-dataset, terwijl relatief kleinere verschillen werden waargenomen bij de Houston2013-dataset. Voor het volledige model werden verbeteringen in zowel OA als AA waargenomen ten opzichte van de ablatieconfiguraties, wat wijst op een hogere geaggregeerde classificatieprestatie samen met een verbeterde gemiddelde klasseprestatie onder de geëvalueerde benchmark-splits. Deze bevindingen stemmen overeen met de hypothese van de studie dat kenmerkuitlijning vóór multimodale fusie de classificatieprestaties kan verbeteren; herhaalde experimenten en statistische analyses zijn echter niet uitgevoerd in de huidige studie.
Effect van het aantal flow-integratiestappen:
Om de invloed van het aantal stappen van stroomintegratie binnen de MFM-module verder te evalueren, werd het aantal integratiestappen gevarieerd van 2 tot 10. De overeenkomstige classificatieresultaten zijn samengevat in Tabel 6. De parameter voor de integratiestap reguleert de discretisatie van het continue kenmerktransportproces tijdens multimodale uitlijning, waarbij kleinere waarden staan voor een grovere discretisatie en grotere waarden voor een fijnere discretisatie. Zoals getoond in Tabel 6, werden de hoogste vaste-split puntramingen over de geëvalueerde metrieken behaald toen het aantal integratiestappen 6 bedroeg. De prestaties verbeterden over het algemeen naarmate het aantal integratiestappen toenam van 2 naar 6, waarna de gerapporteerde prestaties relatief stabiel bleven of licht afnamen over de drie benchmarkdatasets. Deze observaties geven aan dat de nominale instelling van zes integratiestappen de hoogste geaggregeerde prestaties leverde onder de geëvalueerde benchmarkcondities. Omdat de gerapporteerde resultaten zijn gebaseerd op een enkel willekeurig startpunt (random seed) en vaste benchmarksplits, moeten deze verschillen beschrijvend worden geïnterpreteerd en niet als bewijs van statistisch significante prestatieverschillen.
| Stappen flow-integratie | MUUFL | Houston2013 | Augsburg | ||||||
| OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | |
| 2 | 92.37 | 84.63 | 90.12 | 95.73 | 96.12 | 95.64 | 94.86 | 85.73 | 92.76 |
| 3 | 93.58 | 85.47 | 90.98 | 96.32 | 96.48 | 96.01 | 95.61 | 86.48 | 93.51 |
| 4 | 94.31 | 86.51 | 91.76 | 96.88 | 96.92 | 96.57 | 96.18 | 87.34 | 94.12 |
| 5 | 94.92 | 87.62 | 92.54 | 97.18 | 97.22 | 97.05 | 96.89 | 88.02 | 95.07 |
| 6 | 95.24 | 88.88 | 93.69 | 97.56 | 97.58 | 97.39 | 97.56 | 89.21 | 96.48 |
| 7 | 95.12 | 88.56 | 93.5 | 97.49 | 97.44 | 97.31 | 97.34 | 88.84 | 96.21 |
| 8 | 94.95 | 88.22 | 93.2 | 97.31 | 97.29 | 97.17 | 96.98 | 88.46 | 95.82 |
| 9 | 94.63 | 87.75 | 92.85 | 97.09 | 97.03 | 96.88 | 96.45 | 87.92 | 95.28 |
| 10 | 94.21 | 86.97 | 92.18 | 96.77 | 96.81 | 96.61 | 95.87 | 87.03 | 94.61 |
Tabel 6: Effect van het aantal flow-integratiestappen op de classificatieprestaties voor de MUUFL-, Houston2013- en Augsburg-benchmarkdatasets. De classificatieprestaties worden gerapporteerd als totale nauwkeurigheid (overall accuracy, OA), gemiddelde nauwkeurigheid (average accuracy, AA) en de Kappa-coëfficiënt (κ) voor verschillende aantallen flow-integratiestappen. Zes integratiestappen komen overeen met de configuratie die is gebruikt in het uiteindelijke FlowErs-framework.
Van de geëvalueerde datasets vertoonde de MUUFL-dataset de grootste variatie in prestaties naarmate het aantal integratiestappen veranderde, terwijl de Houston2013-dataset relatief kleinere veranderingen liet zien en tegelijkertijd de hoogste gerapporteerde prestaties behaalde bij zes integratiestappen. De Augsburg-dataset vertoonde een vergelijkbare trend met een relatief bescheiden variatie in prestaties bij verschillende stapinstellingen. Gezamenlijk suggereren deze waarnemingen dat een gematigd aantal flow-integratiestappen de hoogste gerapporteerde classificatieprestaties leverde voor de geëvalueerde datasets. De huidige analyse bevat geen herhaalde experimenten, onzekerheidsschattingen, computationeel profiel, robuustheid tegen ontbrekende modaliteiten of ruisgevoelige inputs, of generalisatie over verschillende regio's, en daarom worden er geen conclusies getrokken met betrekking tot deze aspecten.
De evaluatie over de drie benchmark-datasets toonde concurrerende geaggregeerde classificatieprestaties onder de gerapporteerde vaste benchmark-splits, met een maximale OA van 97,56%. De ablatie-experimenten toonden aan dat de volledige bidirectionele flow-matching-configuratie consistent hogere geaggregeerde prestaties behaalde dan de overeenkomstige ablatie-modellen over de geëvalueerde datasets. Klasse-analyses wezen uit dat de classificatieprestaties varieerden tussen landbedekkingscategorieën, waarbij minderheidsklassen en spectraal vergelijkbare categorieën relatief uitdagend bleven en bijdroegen aan het waargenomen verschil tussen OA en AA bij ongebalanceerde datasets. De huidige evaluatie is gebaseerd op vaste split-puntschattingen verkregen met een enkel random seed en bevat geen onzekerheidsschattingen van herhaalde runs, statistische significantietoetsing, computationele profilering, gevoeligheid voor ruimtelijke misregistratie, robuustheid tegen ontbrekende of ruisige modaliteiten, of generalisatie over regio's heen. Deze aspecten rechtvaardigen verder onderzoek in toekomstige studies.
Beschikbaarheid van gegevens:
De openbare benchmark-datasets die in deze studie zijn gebruikt, zijn beschikbaar via de oorspronkelijke aanbieders. De implementatiematerialen, voorspellingskaarten en evaluatieresultaten zijn openbaar beschikbaar via de Zenodo-repository op https://doi.org/10.5281/zenodo.21395701.
Aanvullend bestand 1: Wiskundige formulering en trainingsalgoritme van het FlowErs-raamwerk.Dit aanvullende bestand biedt de volledige wiskundige formulering die ten grondslag ligt aan het voorgestelde FlowErs-raamwerk, inclusief de continue stroomformulering (Vergelijkingen S1–S2), de kansstroomvergelijking (Vergelijking S3), het optimale stroompad (Vergelijkingen S4–S5), het conditionele flow-matching trainingsdoel (Vergelijking S6) en de bijbehorende theoretische eigenschappen. Het bestand bevat ook Algoritme S1, waarin de volledige tweestaps trainingsworkflow wordt samengevat, bestaande uit ongesuperviseerde flow-matching pretraining gevolgd door gesuperviseerde multimodale classificatie.
Discussie
De huidige studie introduceert FlowErs, een multimodaal remote sensing-framework dat cross-modale feature-uitlijning scheidt van semantische classificatie via een tweestaps leerstrategie. In plaats van heterogene modaliteits-specifieke features direct te fuseren, lijnt het voorgestelde framework eerst de feature-representaties uit met behulp van conditional flow matching vóór de multimodale fusie en classificatie. Dit ontwerp pakt de langdurige uitdaging aan van heterogene feature-distributies tussen HSI en LiDAR, waarbij verschillen in detectiemechanismen vaak de effectiviteit van conventionele fusiestrategieën op basis van concatenatie of attention beperken23,26,35,36,37,38,39. Door multimodale uitlijning te formuleren als continu feature-transport, breidt FlowErs recente ontwikkelingen in flow matching vanuit generatieve modellering uit naar representatie-leren voor multimodale remote sensing15,16,17,18,19,20,21. Onder de geëvalueerde benchmarkcondities behaalde het voorgestelde framework concurrerende geaggregeerde classificatieprestaties op de Houston2013-, Augsburg- en MUUFL-datasets, terwijl de bijbehorende ablatiestudie de bijdrage van de bidirectionele flow-uitlijningsmodule aan de gerapporteerde fixed-split prestaties verder ondersteunde.
De gerapporteerde bevindingen suggereren dat expliciete feature-uitlijning vóór multimodale fusie de compatibiliteit van heterogene feature-representaties die uit verschillende sensorieke modaliteiten zijn geëxtraheerd, kan verbeteren. Eerdere multimodale remote sensing-methoden vertrouwden primair op convolutionele netwerken, Transformer-gebaseerde architecturen, attention-mechanismen, contrastief leren of prompt-gestuurde fusie om de feature-interactie te versterken23,26,35,36,37,38,39. Hoewel deze benaderingen sterke classificatieprestaties hebben laten zien, gaan de meeste ervan ervan uit dat modaliteitspecifieke embeddings direct gefuseerd kunnen worden na de feature-extractie. In tegenstelling hiermee introduceert FlowErs een tussenliggende geometrische uitlijningsfase die modaliteitspecifieke features continu transporteert naar een gedeelde latente ruimte vóór de classificatie. De evaluatie per klasse laat zien dat de geaggregeerde prestatieverbeteringen niet uniform waren verdeeld over alle landcover-categorieën. Zo bleven verschillende minderheidsklassen en spectraal vergelijkbare urbane categorieën relatief moeilijk te classificeren, en het waargenomen verschil tussen OA en AA, in het bijzonder voor de Augsburg-dataset, weerspiegelt de invloed van klasse-onbalans in combinatie met variabele prestaties op klasseniveau. Bijgevolg moeten de gerapporteerde geaggregeerde metrieken worden geïnterpreteerd in samenhang met de resultaten per klasse, in plaats van als bewijs voor uniforme verbeteringen in elke categorie.
De ablatie-experimenten ondersteunen het voorgestelde ontwerp verder. Het verwijderen van de multimodale flow matching-module leidde tot een afname van de geaggregeerde classificatieprestaties over alle drie de benchmarkdatasets, terwijl de variant met flow in één richting consequent presteerde tussen het volledige model en het model zonder flow-uitlijning. Deze waarnemingen zijn consistent met de werkhypothese dat bidirectioneel kenmerktransport de cross-modale correspondentie kan verbeteren vóór de kenmerkfusie onder de geëvalueerde benchmarkcondities. Evenzo toonde de analyse van de flow-integratie aan dat een tussenliggende discretisatie van het geleerde transporttraject de hoogste geaggregeerde prestaties opleverde, waarbij zes integratiestappen het nominale werkpunt vertegenwoordigen in de huidige implementatie. De prestatiewinst werd marginaal of nam licht af bij extra integratiestappen, wat suggereert dat een steeds fijnere discretisatie mogelijk afnemende meeropbrengsten biedt onder de geëvalueerde experimentele condities. Of dit werkpunt generaliseert naar andere datasets, sensormodaliteiten of netwerkarchitecturen moet nog worden onderzocht.
Bij de interpretatie van de huidige resultaten moeten enkele beperkingen in overweging worden genomen. Ten eerste was de evaluatie beperkt tot drie openbaar beschikbare benchmark-datasets met vaste train/test-partitioneringen en een enkele random seed. Bijgevolg zijn onzekerheid bij herhaalde runs, betrouwbaarheidsintervallen, statistische significantietoetsing en inter-run variabiliteit niet geëvalueerd. Ten tweede zijn de vergelijkingsmethoden overgenomen uit hun respectievelijke publicaties in plaats van opnieuw te zijn geïmplementeerd binnen een gemeenschappelijk experimenteel kader; daarom moeten de gerapporteerde vergelijkingen descriptief worden geïnterpreteerd en niet als gecontroleerde head-to-head reproducties. Ten derde is de robuustheid voor ontbrekende modaliteiten, ruisachtige observaties, ruimtelijke misregistratie en cross-region generalisatie niet onderzocht. Daarnaast biedt flow matching weliswaar een theoretisch kader voor continu en potentieel inverteerbaar kenmerktransport15,16,17, maar de exacte inverteerbaarheid, topologiebehoud en fysieke interpreteerbaarheid van de geleerde transformaties zijn in de huidige studie niet empirisch geverifieerd. Computationele kenmerken, waaronder inferentietijd, geheugenverbruik en de complexiteit van floating-point operaties, zijn evenmin afzonderlijk geprofileerd.
Alternatieve benaderingen voor het bestuderen van multimodale uitlijning blijven evolueren. Recente studies hebben contrastief leren, grafiekgebaseerde fusie, low-rank representatieleer, prompt-gestuurd multimodaal leren, gefedereerd leren en hybride convolutionele-Transformer-architecturen onderzocht om de integratie van multimodale kenmerken te verbeteren23,26,27,28,35,36,37,38,39. Deze strategieën blijven complementair in plaats van wederzijds uitsluitend, en toekomstig onderzoek kan combinaties van expliciet flow-gebaseerd kenmerktransport met deze bestaande uitlijningsparadigma's onderzoeken. Naast landbedekkingsclassificatie kan continue kenmerkuitlijning mogelijk ook toepasbaar zijn op gerelateerde multimodale remote sensing-taken, waaronder semantische segmentatie, verandingsdetectie, objectherkenning, milieumonitoring, rampenbeoordeling, precisielandbouw en stedelijke mapping, waarbij complementaire detectiemodaliteiten in toenemende mate beschikbaar zijn2,3,4,5,6,7,8,9,23.
Toekomstig onderzoek zou het voorgestelde raamwerk moeten evalueren onder meer diverse experimentele omstandigheden door het integreren van statistische analyses van herhaalde runs, computationele profilering, robuustheid tegen ontbrekende of ruisgevoelige modaliteiten, gevoeligheid voor fouten in de ruimtelijke registratie en evaluatie van overdracht tussen regio's. Aanvullende studies die alternatieve flow-parameterisaties, verschillende encoder-architecturen en grotere multimodale benchmark-datasets onderzoeken, zouden de generaliseerbaarheid en praktische toepasbaarheid van de voorgestelde methodologie verder verduidelijken. Gezamenlijk geven de huidige resultaten aan dat expliciete kenmerkuitlijning via conditional flow matching een veelbelovende aanvullende strategie vormt voor multimodale classificatie van remote sensing, terwijl er tegelijkertijd diverse mogelijkheden worden benadrukt voor verdere methodologische ontwikkeling en uitgebreide evaluatie.
Openbaarmakingen
Belangenverstrengeling:
De auteurs verklaren dat er geen belangenverstrengelingen zijn.
Dankbetuigingen
Dit werk werd financieel ondersteund door het Project voor Wetenschappelijk Onderzoek van de Shaanxi A&F University (subsidie nr. ZK25-38) en het Onderwijsdepartement van de provincie Shaanxi (subsidie nr. 24JK0734).
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| AdamW-optimizer | PyTorch Foundation | Inbegrepen in PyTorch | Gebruikt voor modeloptimalisatie. PyTorch 2.5.0 is gebruikt. |
| Augsburg benchmark-dataset | Hu J et al. (Earth System Science Data, 2022); Remote Sensing Technology, LMU Munich | https://doi.org/10.5281/zenodo.7185498 | Openbare multimodale remote sensing benchmark-dataset gebruikt voor model-evaluatie. |
| CUDA Toolkit | NVIDIA | CUDA Toolkit 12.4; https://developer.nvidia.com/cuda-12-4-0-download-archive | Gebruikt voor GPU-versnelde modeltraining en inferentie. |
| Grafische verwerkingseenheid (GPU) | NVIDIA Corporation | NVIDIA A100 80 GB PCIe | Gebruikt voor modeltraining en evaluatie. |
| Houston2013 benchmark-dataset | IEEE Geoscience and Remote Sensing Society Data Fusion Contest | http://www.grss-ieee.org/community/technical-resources/data-fusion/2013-grss-data-fusion-contest/ | Openbare hyperspectrale beeld- en LiDAR benchmark-dataset gebruikt voor model-evaluatie. |
| MUUFL Gulfport benchmark-dataset | University of Florida (Gader P et al., Technical Report REP-2013-570) | https://github.com/GatorSense/MUUFLGulfport | Openbare hyperspectrale beeld- en LiDAR benchmark-dataset gebruikt voor model-evaluatie. |
| Besturingssysteem | Canonical Ltd. | Ubuntu 22.04 LTS; https://ubuntu.com | Computationele omgeving gebruikt voor modelontwikkeling, training en evaluatie. |
| PyTorch | PyTorch Foundation | PyTorch 2.5.0; https://pytorch.org/get-started/previous-versions/#v250 | Deep learning-framework gebruikt om het FlowErs-model te implementeren, te trainen en te evalueren. |
| Python | Python Software Foundation | Python 3.11; https://www.python.org/downloads/release/python-3110/ | Programmeertaal gebruikt om de computationele workflow te implementeren en uit te voeren. |
Referenties
- Geng X, et al. Fast and effective: Progressive hierarchical fusion classification for remote sensing images. IEEE Trans Multimed. 2024;26:9776–89.
- Tian F, et al. HireNet: Hierarchical-relation network for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–10.
- Ye Z, et al. A multiscale incremental learning network for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Li Q, Chen Y, He X, Huang L. Co-training transformer for remote sensing image classification, segmentation, and detection. IEEE Trans Geosci Remote Sens. 2024;62:1–18.
- Qin A, et al. Deep updated subspace networks for few-shot remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Wang S, et al. Personalized multiparty few-shot learning for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Yang JY, et al. Multifrequency graph convolutional network with cross-modality mutual enhancement for multisource remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Zhou G, Qian L, Gamba P. A novel iterative self-organizing pixel matrix entanglement classifier for remote sensing imagery. IEEE Trans Geosci Remote Sens. 2024;62:1–21.
- Zhu J, et al. MVP: Meta visual prompt tuning for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–13.
- Gat I, et al. Discrete flow matching. Adv Neural Inf Process Syst. 2024;37:133345–85.
- Miller BK, Chen RT, Sriram A, Wood BM. FlowMM: Generating materials with Riemannian flow matching [Internet]. 2024 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2406.04713
- Xin Y, et al. Confidence-weighted dual-teacher networks with biased contrastive learning for semi-supervised semantic segmentation in remote sensing images. IEEE Trans Geosci Remote Sens. 2024;62:1–16.
- He Y, et al. IGroupSS-Mamba: Interval group spatial-spectral Mamba for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Liao D, Wang Q, Lai T, Huang H. Joint classification of hyperspectral and LiDAR data based on Mamba. IEEE Trans Geosci Remote Sens. 2026;19:11445–61.
- Lipman Y, et al. Flow matching for generative modeling [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=PqvMRDCJT9t
- Liu X, et al. Flow straight and fast: Learning to generate and transfer data with rectified flow [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=XVjTT1nw5z
- Geng Z, et al. Consistency models made easy [conference paper]. Presented at: 13th International Conference on Learning Representations (ICLR); 2025. Available from: https://openreview.net/forum id=1x7sJYh37d
- Hu VT, et al. Latent space editing in transformer-based flow matching [conference paper]. Presented at: AAAI Conference on Artificial Intelligence; 2024;38:2247–55. Available from: https://doi.org/10.1609/aaai.v38i3.28014
- Jeong J, Kim K, Kim W, Kim NJ. Real-time person image synthesis using a flow matching model [Internet]. 2025 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2505.03562
- Kakesh MH, et al. An efficient data generation method based on flow matching for bearing fault diagnosis under imbalanced data conditions. IEEE Trans Energy Convers. 2026;1–11.
- Chu Z, et al. End-to-end seam tracking with flow matching-based diffusion policy [conference paper]. Presented at: International Conference on Machine Intelligence and Nature-Inspired Computing (MIND); Xiamen, China; 2025. p. 304–9. Available from: https://doi.org/10.1109/MIND67540.2025.11351867
- Melgani F, Bruzzone L. Classification of hyperspectral remote sensing images with support vector machines. IEEE Trans Geosci Remote Sens. 2004;42:1778–90.
- Li J, et al. Deep learning in multimodal remote sensing data fusion: A comprehensive review. Int J Appl Earth Obs Geoinf. 2022;112:102926.
- Vaswani A, et al. Attention is all you need [Internet]. 2017 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/1706.03762
- Zhuang Y, Chen M, Zhu D. UWASR-GAN: An attention-guided multi-scale residual framework for underwater image enhancement in underwater Internet of Things applications. IEEE Internet Things J. 2026;12:29452–71.
- Ma X, Zhang X, Pun MO, Liu M. A multilevel multimodal fusion transformer for remote sensing semantic segmentation. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Xie W, Lu Y, Li D, Li Y. Ebbinghaus-curve guided low-rank component-induced attention for multisource remote sensing classification. IEEE Trans Geosci Remote Sens. 2024;62:1–12.
- Li D, Xie W, Li Y, Fang L. FedFusion: Manifold-driven federated learning for multi-satellite and multi-modality fusion. IEEE Trans Geosci Remote Sens. 2023;62:1–13.
- Debes C, et al. Hyperspectral and LiDAR data fusion: Outcome of the 2013 GRSS data fusion contest. IEEE J Sel Top Appl Earth Obs Remote Sens. 2014;7:2405–18.
- Hu J, et al. MDAS: A new multimodal benchmark dataset for remote sensing. Earth Syst Sci Data Discuss. 2022:1–26.
- Gader P, et al. MUUFL Gulfport hyperspectral and LiDAR airborne data set. University of Florida; Gainesville (FL); Technical Report REP-2013-570; 2013.
- Gao Y, et al. Hyperspectral and multispectral classification for coastal wetland using depthwise feature interaction network. IEEE Trans Geosci Remote Sens. 2021;60:1–15.
- Feng Y, Song L, Wang L, Wang X. DSHFNet: Dynamic scale hierarchical fusion network based on multiattention for hyperspectral image and LiDAR data classification. IEEE Trans Geosci Remote Sens. 2023;61:1–14.
- Hong D, et al. More diverse means better: Multimodal deep learning meets remote-sensing imagery classification. IEEE Trans Geosci Remote Sens. 2020;59:4340–54.
- Feng Z, et al. Cross-modal contrastive learning for remote sensing image classification. IEEE Trans Geosci Remote Sens. 2023;61:1–13.
- Xu X, et al. Multisource remote sensing data classification based on convolutional neural network. IEEE Trans Geosci Remote Sens. 2017;56:937–49.
- Yao J, et al. Extended vision transformer (ExViT) for land use and land cover classification: A multimodal deep learning framework. IEEE Trans Geosci Remote Sens. 2023;61:1–15.
- Chang H, et al. Deep symmetric fusion transformer for multimodal remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;63:1–15.
- Wang A, et al. CTPMSN: Enhancing multimodal remote sensing classification with composite text prompts. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:27960–27978.