Dit protocol beschrijft een gestructureerde methodologie voor servicedesign voor het diagnosticeren van complexe problemen in publieke dienstverleningsprocessen voor aanvragen en consultaties met een laag risico. De aanpak integreert stakeholdermapping, journey mapping, co-design en low-fidelity prototyping, samen met een gesimuleerde, taakgerichte evaluatie van gebruikersgedrag, besluitvorming en de bruikbaarheid van servicematerialen voorafgaand aan de implementatie.
Methodenartikel
Een systemisch service design-visualisatieprotocol voor complexe problemen in laag-risico publieke dienstverlening en consultatieprocessen
21 weergaven
⸱
11 september 2026
In dit artikel
Samenvatting
Samenvatting
Complexe problemen in de publieke dienstverlening met 'wicked'-kenmerken, waaronder meerdere actoren, gefragmenteerde informatie, onduidelijke verantwoordelijkheidsgrenzen en het ontbreken van één onbetwiste oplossing, zijn moeilijk te structureren binnen routinematige administratieve omgevingen. Dit artikel presenteert een systematisch visualisatieprotocol voor servicedesign voor laag-risico toepassingen in de publieke dienstverlening en consultatieprocessen, gedefinieerd als administratieve diensten die geen bepalende factor zijn voor medische behandelingen, juridische status, financiële geschiktheid, kinderbescherming, disciplinaire uitkomsten of andere beslissingen met een grote impact op rechten. Het protocol integreert stakeholdermapping, journey mapping van de publieke dienstverlening, Double Diamond co-design en low-fidelity prototype-testen om gefragmenteerde administratieve uitdagingen te vertalen naar actiegerichte, co-ontworpen serviceconcepten en deze te evalueren aan de hand van gesimuleerde taken. In een representatief traject voor een laag-risico administratieve toepassing toonde gesimuleerd taakonderzoek met 28 deelnemers (12 baseline- en 12 post-prototype taakgegevens) kortere voltooiingstijden (178,4 ± 49,6 s–121,7 ± 38,2 s), minder fouten (1,86 ± 0,91–0,79 ± 0,63 fouten per taak) en een hoger taaksucces (62,5%–82,1%) na blootstelling aan de via het protocol gegenereerde materialen. Deze bevindingen vormen taakgebaseerd bewijs voor de bruikbaarheid, aangezien de vaste pre-/post-volgorde leereffecten kan bevatten. Dit reproduceerbare protocol biedt een gestructureerde, visueel gedreven benadering voor het diagnosticeren van complexe problemen in de publieke dienstverlening en het prototypen van oplossingen in laag-risico publieke serviceomgevingen.
Inleiding
Organisaties in de publieke sector worden steeds vaker geconfronteerd met complexe uitdagingen die zich niet laten oplossen met eenvoudige administratieve aanpassingen. Deze kwesties worden gekenmerkt door de betrokkenheid van meerdere actoren, gefragmenteerde verantwoordelijkheden, ongelijke toegang tot informatie en spanningen tussen gestandaardiseerde administratieve procedures en uiteenlopende behoeften van gebruikers. In plaats van te beweren dat dergelijke problemen kunnen worden opgelost via een volledig reproduceerbare formule, behandelt dit protocol ze als begrensde, risicoarme serviceproblemen met kenmerken van 'wicked problems' die kunnen worden gestructureerd, gevisualiseerd en verkend via reproduceerbare facilitatiestappen1,2. In de routinematige levering van publieke diensten manifesteren deze problemen zich als operationele storingen: burgers hebben moeite om de benodigde materialen te identificeren, frontoffice-personeel krijgt te maken met repetitieve vragen en administrateurs handhaven regels die voor eindgebruikers niet direct zichtbaar zijn.
Om deze complexiteiten aan te pakken, is innovatie in de publieke dienstverlening verschoven van interne efficiëntiehervormingen naar participatieve, gebruikersgerichte benaderingen. Huidig onderzoek geeft aan dat co-creatie en co-productie burgers, professionals en organisaties in staat stellen om gezamenlijk bij te dragen aan service-innovatie3,4,5. Deze participatieve verschuiving brengt echter een methodologische uitdaging met zich mee. Hoewel diverse belanghebbenden het erover eens kunnen zijn dat een dienst inefficiënt is, bereiken zij zelden consensus over waar de structurele tekortkoming zich bevindt, wie er het meest door wordt getroffen of welke specifieke interventies vereist zijn.
Dit protocol is bedoeld voor onderzoekers in service design, onderzoekers in openbaar bestuur, teams voor serviceverbetering van gemeenten of universiteiten, en getrainde facilitators die een reproduceerbare aanpak nodig hebben om klachten van meerdere actoren om te zetten in visueel diagnostisch materiaal vóór de implementatie. Het is het meest geschikt voor toepassingen met een laag risico, zoals consultatie, registratie, statuscontrole en follow-updiensten, waarbij gebruikers vereisten moeten interpreteren, materialen moeten voorbereiden, door meerdere servicestadia moeten gaan en moeten coördineren met meerdere actoren. Het mag niet worden gebruikt als primaire methode voor besluitvorming in noodsituaties, sterk gestandaardiseerde transacties met vastgestelde éénstaps-procedures, juridische arbitrage, medische behandeling, kinderbescherming, beslissingen over immigratiestatus, bepalingen van financiële steun, disciplinaire processen, of in elke setting waar toegang tot identificeerbare dossierstukken vereist is.
In vergelijking met op zichzelf staande stakeholderanalyses, journey mapping of participatieworkshops, koppelt de voorgestelde workflow actor-mapping, stagespecifieke service-analyses, co-designed probleemformulering en gesimuleerde prototype-testen binnen één controleerbare sequentie. Deze integratie helpt teams te voorkomen dat zij direct overgaan van brede ontevredenheid naar oplossingsideeën zonder eerst vast te stellen wie erdoor wordt beïnvloed, waar de knelpunten optreden en welke materialen veilig getest kunnen worden. Recente reviews over co-design in de publieke sector en de volksgezondheid benadrukken evenzo de noodzaak van transparante processen, expliciete facilitatie en een zorgvuldige evaluatie van participatie en machtsdynamieken4,6,7,8,9.
Service design biedt een praktisch kader voor het aanpakken van deze uitdaging via visuele, participatieve en prototypegeoriënteerde methoden6,8,10. In plaats van servicefalen te behandelen als abstracte beleidstekortkomingen, onderzoekt service design de interacties tussen gebruikers, personeel, touchpoints en backstage-processen. Bijgevolg wordt co-design in toenemende mate voorgesteld binnen het openbaar bestuur als een middel om burgers te betrekken bij het definiëren van complexe problemen4,7,1. Co-designinitiatieven schieten echter vaak tekort wanneer ze geen gestructureerd mechanisme hebben om subjectieve ervaringen van belanghebbenden te vertalen naar testbare materialen voor publieke diensten, of wanneer ze er niet in slagen machtsverschillen tussen deelnemers expliciet te beheren.
Een rigoureuze methodologische transitie vereist de sequentiële integratie van specifieke analytische instrumenten. Stakeholder-mapping dient als diagnostische basislijn door de betrokkenheid, invloed, afhankelijkheden en informatie-asymmetrieën van actoren te verduidelijken12. Journey mapping wordt vervolgens gebruikt om specifieke knelpunten en ambiguïteiten in de verantwoordelijkheid over opeenvolgende dienstverleningsfasen te identificeren13. Vervolgens biedt het Double Diamond-framework een gestructureerd pad om deze in kaart gebrachte tekortkomingen om te zetten in actiegerichte ontwerpuitdagingen, waarbij divergente probleemanalyse wordt gescheiden van convergente oplossingsontwikkeling7,8,14. Ten slotte maakt het testen van low-fidelity prototypes het mogelijk om co-ontworpen concepten veilig te evalueren vóór de implementatie—een essentiële stap bij publieke diensten, waar voortijdige wijzigingen de toegang voor burgers kunnen verstoren of de administratieve werklast kunnen verhogen15,16.
Ondanks de toenemende methodologische richtlijnen voor deze instrumenten, blijft reproduceerbaarheid een kritieke beperking in de literatuur over co-design van publieke diensten6,7,8,17. Veel studies beschrijven designworkshops in algemene termen, waardoor de precieze analytische stappen die nodig zijn voor onafhankelijke replicatie onduidelijk blijven. Een rigoureuze methode moet vaste fasen, gedefinieerde tijdsallocaties, gestandaardiseerde score-regels, consistente visuele outputs en transparante beslissingscriteria vaststellen. Bovendien moet er een duidelijk onderscheid worden gemaakt tussen de evaluatie van vroege, taakgerichte bruikbaarheid en bredere claims met betrekking tot de prestaties van agentschappen in de praktijk.
Dit artikel presenteert een systematisch protocol voor service design-visualisatie, ontwikkeld om complexe problemen met meerdere actoren in risicoarme innovaties van publieke diensten te structureren4,6,16,17. Het protocol is specifiek ontworpen voor toepassingen in publieke diensten en consultatieprocessen, en integreert sequentieel stakeholdermapping, journey mapping, een Double Diamond-workshop en prototype-testen. Het algemene doel is om onderzoekers en praktijkprofessionals te voorzien van een zeer reproduceerbare stap-voor-stapbenadering om van gefragmenteerde klachten over diensten over te gaan naar visuele diagnose, een objectieve probleemdefinitie en het empirisch testen van co-ontworpen serviceconcepten.
Protocol
De representatieve toepassing die in dit artikel wordt beschreven, is goedgekeurd door het Ethics Committee on Human Research Protection van de City University of Macau, Macau, China (Goedkeuringsnr. 2600AL2401; geldig van 10 januari 2026 tot 10 januari 2028). Voorafgaand aan hun deelname is van alle deelnemers schriftelijke of elektronische geïnformeerde toestemming verkregen. Het protocol omvatte geen medische interventies, kwetsbare populaties, misleiding, biologische monsters, private financiële gegevens, individuele prestatie-evaluaties of toegang tot officiële administratieve registers. De onderzoeksinstrumenten die voor het protocol zijn gebruikt, staan vermeld in de Tabel met Materialen.
1. Werving van deelnemers en definitie van de context
- Selecteer een publieke dienstverleningsapplicatie en een consultatieproces met een laag risico om te evalueren, zoals een gemeentelijk, universitair of gemeenschappelijk administratief traject dat informatiezoekacties, verduidelijking van geschiktheid, voorbereiding van materialen, indiening van aanvragen, verwerking, kennisgeving en follow-up ondersteuning vereist.
- Sluit contexten uit die betrekking hebben op medische behandelingen, de afhandeling van juridische zaken, immigratiestatus, kinderbescherming, bepaling van financiële steun, disciplinaire procedures, noodbesluiten of officiële administratieve dossiers.
- Beschouw een publieke dienstverleningskwestie als geschikt voor dit protocol wanneer deze ten minste drie complexe of "wicked"-achtige kenmerken vertoont: betrokkenheid van meerdere belanghebbendengroepen, onduidelijke verantwoordelijkheidsgrenzen, herhaaldelijke coördinatiefouten tussen actoren, onvolledige of inconsistente service-informatie en de afwezigheid van één overeengekomen oplossing.
OPMERKING: Presenteer het protocol niet als een oplossing voor een volledig "wicked problem". Presenteer het als het structureren van een begrensd publiek dienstverleningsprobleem met een laag risico voor diagnose, co-design en gesimuleerde tests. - Recruteer 80 – 120 deelnemers voor de vragenlijstfase op basis van hun bekendheid met het gebruik, de levering, coördinatie of het management van publieke diensten.
- Gebruik deze steekproefgrootte als een pragmatisch planningsdoel om stabiele beschrijvende stakeholderprofielen over verschillende rolgroepen heen te ondersteunen, terwijl het haalbaar blijft voor een niet-interventionele studiedesign van de dienstverlening.
- Selecteer deelnemers die alle belangrijke stakeholderrollen vertegenwoordigen die betrokken zijn bij het proces van de publieke dienstverlening.
- Stel een subgroep van 20–30 deelnemers samen om deel te nemen aan de co-design workshop en de prototypetests.
- Vorm 4–6 workshopgroepen met gemengde rollen, waarbij elke groep klein genoeg blijft om actieve deelname te ondersteunen.
- Zorg ervoor dat elke groep met gemengde rollen ten minste drie stakeholdercategorieën bevat, zoals burgers, eerstelijns personeel, maatschappelijk werkers of administrateurs.
- Scheid burgers en dienstverleners tijdens de initiële discussies over stakeholder-mapping als er machtsongelijkheden worden verwacht.
- Voer na de initiële discussies een synthese met gemengde rollen uit. Gebruik tijdens deze synthese gestructureerde beurten, stil schrijven van ideeën, anonieme kaartinzendingen en anoniem dot-voting om te voorkomen dat administrateurs of professioneel personeel de bijdragen van burgers domineren.
- Besteed zorgvuldige aandacht aan de werving van deelnemers, rolvoorbereiding en omstandigheden die gebruikers in staat stellen om ideeën bij te dragen in plaats van enkel te reageren op door experts gedefinieerde problemen7,9,18.
- Instrueer alle deelnemers om geen identificeerbare namen, identiteitsnummers, huisadressen, telefoonnummers, dossier-ID's, medische dossiers, juridische dossiers, inkomensgegevens of prestatiebestanden van instanties te openbaren.
- Ken niet-identificeerbare deelnemerscodes toe (bijv. P001 en P002).
- Train alle facilitators vóór de gegevensverzameling met hetzelfde facilitatiescript, voorbeeldkaarten van knelpunten, een rubric voor designuitdagingen en voorbeelden van prototype-scores.
- CRUCIALE STAP: Kalibreer facilitators door hen onafhankelijk ten minste vijf voorbeeld-knelpunten en vijf concept-statements van "Hoe kunnen we" te classificeren.
OPMERKING: Facilitators moeten een overeenstemming van ten minste 80% bereiken over beslissingen betreffende inclusie, clustering en revisie voordat zij verdergaan. - Bespreek discrepanties totdat facilitators een overeenstemming van ten minste 80% bereiken over beslissingen betreffende inclusie, clustering en revisie.
- Gebruik indien mogelijk ten minste twee facilitators: één hoofdfacilitator om de discussie te leiden en één waarnemer om de timing, de balans in deelname en afwijkingen van het protocol te registreren.
- Als meerdere facilitators parallelle groepen leiden, voer dan na elke belangrijke fase een debriefing van 15–20 min uit en documenteer eventuele verschillen in prompts of interpretatieregels in het auditblad.
WAARSCHUWING: Nadat de werving van deelnemers, toestemming, training van facilitators en voorbereiding van materialen zijn voltooid, kunnen onderzoekers pauzeren voordat zij Fase 1 starten. Hervat pas nadat is bevestigd dat alle deelnemers toegewezen codes hebben en dat alle werkbladen geen identificerende informatie bevatten.
2. Voorbereiding van protocolmaterialen
- Bereid de protocolmaterialen voor voordat u begint met de uitvoering.
- Bereid het informatieformulier voor deelnemers, de anonieme rolgebaseerde vragenlijst, het werkblad voor stakeholder-mapping, het scoreblad voor stakeholders met vijf punten, het sjabloon voor het in kaart brengen van de publieke dienstverleningsreis (journey-mapping), de pain-point kaarten, het sjabloon voor de design challenge, de oplossingskaarten, het selectieblad voor prototypes, de kalibratierubriek voor de facilitator, de vellen voor gesimuleerde taken, de checklist voor equivalentie van taaksets, de rubriek voor prototype-scoring, het codeerblad, de analysesyntax of workflow-notities en de checklist voor anonimisering.
- Ken aan elk studespecifiek materiaal een stabiele interne identificatiecode en een versienummer toe.
- Organiseer het sjabloon voor journey-mapping in zeven standaardfasen: informatiezoektocht, verduidelijking van geschiktheid of vereisten, voorbereiding van materialen, indiening van de aanvraag, interdepartementale verwerking, melding van de uitkomst en follow-up ondersteuning.
- Pas de namen van de fasen alleen aan nadat is gedocumenteerd hoe de geselecteerde dienst verschilt van het standaard administratieve aanvraagpad met een laag risico.
- Behoud dezelfde volgorde van contactpunten, verantwoordelijke actoren, informatie-inputs, outputs, pijnpunten en downstream-gevolgen.
- Ontwerp gesimuleerde scenario's voor de publieke dienstverlening voor de prototype-taakbladen zonder enige echte persoonlijke, administratieve of overheidsgegevens op te nemen.
- Raadpleeg Tabel 1 voor de fasen, tijdsallocaties, materialen en vooraf gedefinieerde outputs die vereist zijn voor het protocol.
- Raadpleeg Tabel 2 voor de items voor gegevensverzameling, scoringsregels, validiteitsdrempels en gegevensbeschermingscontroles.
- Gebruik servicedesignmethoden om complexe problemen in de publieke dienstverlening zichtbaar, bespreekbaar en testbaar te maken19.
Tabel 1: Protocolfasen, timing, benodigde materialen en vooraf gedefinieerde resultaten. De workflow van het protocol bevat de hoofdactiviteiten, deelnemers, geschatte tijdsbesteding, benodigde materialen en verwachte resultaten voor elke fase.Klik hier om deze tabel te downloaden.
Tabel 2: Metrieken voor gegevensverzameling, methoden, exclusiecriteria en maatregelen voor gegevensbescherming.De verzamelde metrieken in elke fase van het protocol, de overeenkomstige methoden voor gegevensverzameling, de vooraf gedefinieerde exclusiecriteria en de maatregelen die zijn genomen om de vertrouwelijkheid van deelnemers en de gegevensintegriteit te waarborgen.Klik hier om deze tabel te downloaden.
3. Fase 1: Stakeholdermapping
- Instrueer de deelnemers om het werkblad voor stakeholder-mapping te gebruiken om individueel vijf tot acht actoren op te sommen die betrokken zijn bij het geselecteerde proces van de publieke dienstverlening.
- Besteed 25–35 min aan de stakeholder-mappingfase.
- Raadpleeg Figuur 1 voor de algemene workflow van het visualisatieprotocol.
- Vraag de deelnemers om elke opgesomde actor op vier dimensies te beoordelen met een vijfpunts-schaal met ankerpunten (1 = zeer laag; 5 = zeer hoog): invloed op het resultaat van de dienstverlening, afhankelijkheid van andere actoren, toegang tot informatie over de dienstverlening en coördinatiedruk.
- Geef schriftelijke voorbeelden voordat de deelnemers de beoordelingen invullen.
- Definieer een hoge invloed als een actor wiens beslissing, vertraging of interpretatie het resultaat van de dienstverlening aanzienlijk beïnvloedt.
- Definieer een hoge afhankelijkheid als een actor die het proces van de dienstverlening niet kan voltooien zonder informatie, bevestiging of actie van andere actoren.
- Bereken de gemiddelde score voor elke stakeholdergroep op elke dimensie.
- Markeer een verschil van twee punten of meer tussen stakeholdergroepen op dezelfde dimensie als een perceptiekloof, omdat dit een verschuiving van ten minste 40% van de vijfpunts-schaal vertegenwoordigt en groot genoeg is om een workshopdiscussie te rechtvaardigen in plaats van minimale ruis in de beoordeling.
- Neem elke gemarkeerde perceptiekloof over in de workshopdiscussie.
- Gebruik de resultaten van de stakeholder-mapping om actorrollen, afhankelijkheden, invloed en informatieasymmetrieën zichtbaar te maken voordat het herontwerpproces begint20.
- Stel een actor-relatieprofiel op met stakeholdercategorieën, gemiddelde dimensiescores en gemarkeerde perceptiekloven.
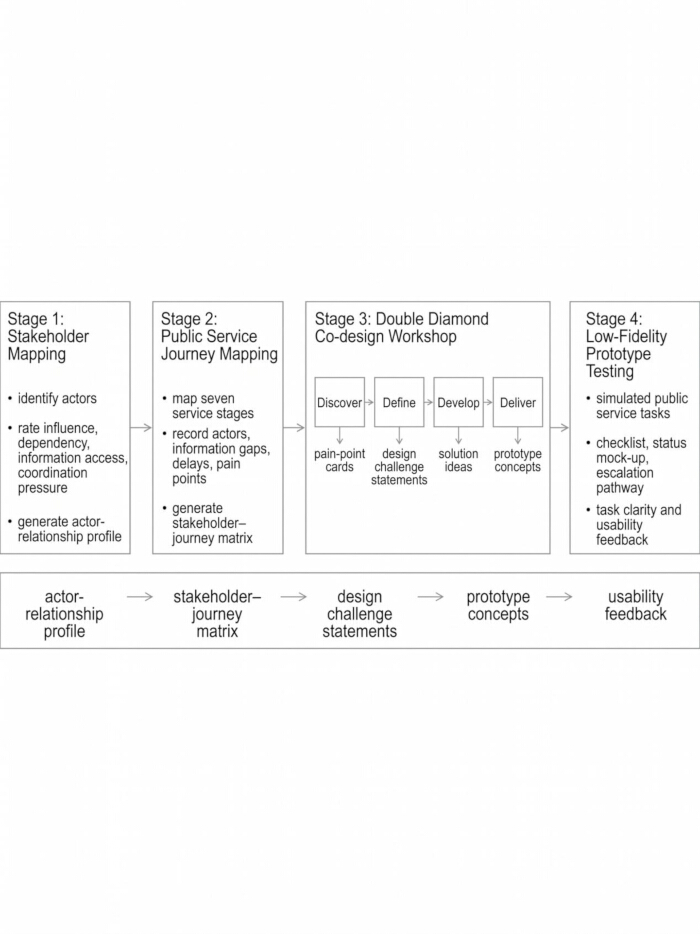
Figuur 1: Algemene workflow van het visualisatieprotocol voor publieke dienstverlening.De workflow bestaat uit vier verbonden fasen: stakeholdermapping, mapping van de klantreis in de publieke dienstverlening, Double Diamond co-design en prototype-testen. De resultaten omvatten actor-relatieprofielen, stakeholder-reismatrices, design challenge-verklaringen, prototypeconcepten en vroege bruikbaarheidsterugkoppeling. De fasen Discover, Define, Develop en Deliver van het Double Diamond-framework zijn gemarkeerd om de overgang van divergente exploratie naar convergente oplossingsontwikkeling te illustreren. Klik hier om een grotere versie van deze figuur te bekijken.
4. Fase 2: Journey mapping van de publieke dienstverlening
- Begeleid de workshopsubgroep bij het in kaart brengen van het zevenfasige serviceproces.
- Reserveer 45–60 min voor deze fase.
- Instrueer de deelnemers om voor elke fase de hoofdactor, inputinformatie, outputinformatie, communicatiekanaal, typische vertraging, pijnpunt, ernst en downstreamgevolgen te registreren.
- Vraag de deelnemers om de ernst van elk pijnpunt te beoordelen op een schaal van vijf punten (1 = gering ongemak; 5 = ernstige storing die waarschijnlijk de toegang tot de dienst beïnvloedt, een formele klacht uitlokt of een grote escalatie veroorzaakt).
- CRUCIALE STAP: Voeg pijnpunten alleen samen wanneer ze betrekking hebben op dezelfde fase van de journey, hetzelfde type informatiegat of verantwoordelijkheidsambiguïteit bevatten en een vergelijkbaar downstreamgevolg produceren.
- Behoud pijnpunten die door slechts één deelnemer zijn gemeld in het ruwe codeerbestand. Geef deze pijnpunten geen prioriteit, tenzij ze een ernstscore van 4 of 5 krijgen.
- Genereer een geïntegreerde stakeholder-journeymatrix (Figuur 2) om de aanwezigheid van pijnpunten (P), informatiegaten (I), verantwoordelijkheidsambiguïteit (R) en herontwerpmogelijkheden (O) in de matrixcellen te visualiseren.
- Gebruik journey mapping om servicedisrupties over sequentiële touchpoints te lokaliseren, in plaats van ontevredenheid of vertraging te behandelen als één geaggregeerde uitkomst21.
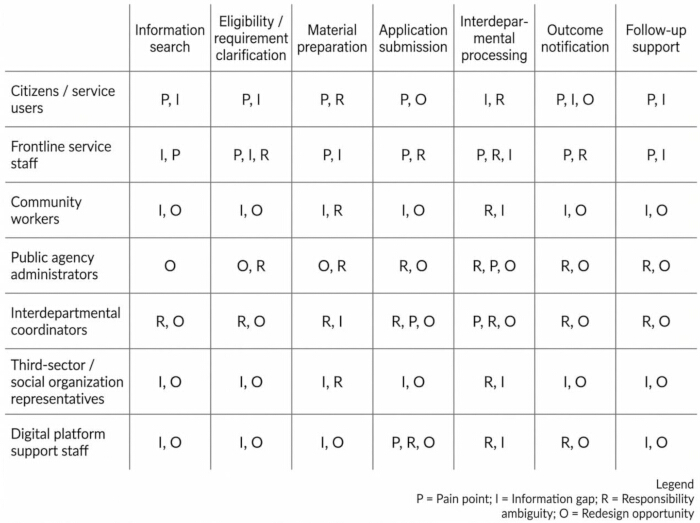
Figuur 2: Geïntegreerde stakeholder-journey matrix voor de visualisatie van problemen in publieke dienstverlening. De matrix organiseert zeven fasen van de publieke dienstverlening op de horizontale as en de belangrijkste stakeholdergroepen op de verticale as. Elke cel geeft de aanwezigheid van specifieke serviceproblemen aan, aangeduid door de volgende afkortingen: P = pijnpunt; I = informatiehiaat; R = onduidelijkheid over verantwoordelijkheid; O = kans op herontwerp. De matrix dient als visuele brug tussen stakeholder-mapping en co-design door stakeholderrollen te koppelen aan problemen die specifiek zijn voor een bepaalde fase van de dienstverlening. Klik hier om een grotere versie van deze figuur te bekijken.
5. Fase 3: Double Diamond co-design workshop
- Voer de Double Diamond co-designworkshop uit tijdens een sessie van 2,5–3 uur.
- Pas het Double Diamond-framework toe om divergente exploratie te scheiden van convergente besluitvorming7,8,14.
- Zorg ervoor dat burgers, zorgverleners in de eerste lijn, beheerders en partnerorganisaties deelnemen aan co-creatie of co-design, in plaats van uitsluitend te vertrouwen op door experts geleide interne hervormingen4,22.
- Voer de Discover-fase uit (30–40 min).
- Instrueer de deelnemers om de stakeholder-journey matrix door te nemen en ontbrekende pain-point kaarten toe te voegen.
- Zorg ervoor dat elke geldige pain-point kaart de fase van de journey, de getroffen actor, de dienstverleningsstoring, het informatiegat of de onduidelijkheid over verantwoordelijkheid, en het gevolg stroomafwaarts vastlegt.
- Voer de Define-fase uit (40–50 min).
- Vraag elke deelnemer om in stilte de drie pain-point kaarten te selecteren die de ernstigste, actor-overschrijdende dienstverleningsstoringen het best vertegenwoordigen.
- Gebruik anonieme dot-voting of een schriftelijke rangschikking voorafgaand aan de open discussie om statuseffecten en machtsongelijkheid te verminderen.
- Cluster de geselecteerde kaarten op basis van de fase van de journey, de getroffen actor, het informatiegat of de onduidelijkheid over verantwoordelijkheid, en het gevolg stroomafwaarts.
- Vraag de facilitator om elk cluster hardop voor te lezen en te bevestigen dat de deelnemers ermee instemmen dat de kaarten dezelfde dienstverleningsstoring beschrijven.
- Zet elk cluster om in één designuitdaging in de vorm van een "Hoe kunnen we"-stelling.
- Zorg ervoor dat elke designuitdaging de getroffen actor, de problematische fase van de journey, de dienstverleningsstoring en de gewenste richting van de verbetering specificeert.
- Screen elke designuitdaging met een rubric van vier items die de specificiteit, de duidelijkheid van de actor, de koppeling aan in kaart gebrachte bewijslast en de haalbaarheid voor low-fidelity prototype-testen evalueert.
- Herzie elke stelling waarin een actor wordt weggelaten, waarin meerdere niet-gerelateerde storingen worden gecombineerd, waarin voortijdig een oplossing wordt voorgesteld, of die niet getest kan worden met gesimuleerde dienstenmateriaal.
- Leg de oorspronkelijke conceptversie, de reden voor herziening en de uiteindelijke gevalideerde stelling vast in het audit-blad.
WAARSCHUWING: Onderzoekers kunnen pauzeren na goedkeuring van de definitieve designuitdagingen en hervatten wanneer de oplossingskaarten en prototype-selectiebladen zijn voorbereid. - Voer de Develop-fase uit (50–60 min).
- Instrueer de deelnemers om voor elke designuitdaging ideeën voor serviceverbetering te genereren en deze op oplossingskaarten te noteren.
- Sluit ideeën uit die echte casusgegevens, individuele geschiktheidsrecords, grote juridische of beleidswijzigingen, of identificeerbare administratieve dossiers vereisen.
- Voer de Deliver-fase uit (30–40 min).
- Vraag de deelnemers om elk oplossingsidee te scoren op een schaal van vijf punten op basis van de verwachte impact op de dienstverlening, de haalbaarheid van implementatie, overeenstemming tussen stakeholders en geschiktheid voor testen via gesimuleerde taken.
OPMERKING: Selecteer prototypeconcepten met een gemiddelde score van ten minste 4,0 voor zowel haalbaarheid als testbaarheid. Deze drempelwaarde is vereist om ervoor te zorgen dat de prototypes levensvatbaar zijn voor testen via gesimuleerde taken zonder implementatieknelpunten.
6. Fase 4: Testen van het low-fidelity prototype
- Ontwikkel low-fidelity prototypes voor de geprioriteerde concepten.
- Bereid drie prototypeformaten voor: een checklist voor servicevereisten op één pagina, een mock-up voor het volgen van de servicestatus en een follow-up- of escalatiepad.
- CRUCIALE STAP: Maak twee overeenkomstige takensets voordat u begint met testen. Zorg ervoor dat de takensets in balans zijn wat betreft beslissingsstappen, leestijd, vereiste velden, scenario-complexiteit en de verwachte voltooiingstijd.
- Stem de takensets af op het aantal beslissingsstappen, de leestijd, de vereiste velden, de scenario-complexiteit en de verwachte voltooiingstijd.
- Piloteer de overeenkomstige takensets met drie tot vijf gebruikers die niet aan de studie deelnemen.
- Herzie de takensets als de gemiddelde voltooiingstijd met meer dan 10% verschilt.
- Voer gesimuleerde publieke servicetaken uit om de prototypes te evalueren.
- Gebruik indien mogelijk een counterbalanced design of een controlegroepontwerp om bekendheid met de taak te onderscheiden van blootstelling aan het prototype.
- Als alle deelnemers de basistaken voltooien voordat de taken na blootstelling aan het prototype worden uitgevoerd, noteer dit dan als een potentieel risico op een leereffect in de secties Protocol, Resultaten en Discussie.
- Voorzie elke deelnemer van vier basistaakscenario's vóór de blootstelling aan het prototype.
- Bied na blootstelling aan het prototype vier vergelijkbare, maar niet identieke, taakscenario's aan.
- Stel een maximale tijdslimiet van 5 min in voor elke taak.
- Lees identieke taakinstructies voor aan elke deelnemer.
- Geef geen hints tijdens het uitvoeren van de taak. Beperk verduidelijkingen uitsluitend tot procedurele vragen.
- Meet de voltooiingstijd van de taak in seconden vanaf de presentatie van de taak tot het definitieve antwoord.
- Registreer de taak als onvoltooid, ken een voltooiingstijd van 300 s toe en codeer het taaksucces als 0 als een deelnemer de taak niet binnen 5 min voltooit.
- Codeer een taak alleen als succesvol wanneer de deelnemer het juiste antwoord selecteert of alle vereiste beslissingsstappen binnen de tijdslimiet voltooit.
- Bereken het aantal fouten door het tellen van gemiste, incorrecte of onnodige beslissingsstappen.
- Meet de door de deelnemer beoordeelde duidelijkheid direct na elke taak met behulp van een vijfpuntschaal (1 = zeer onduidelijk; 5 = zeer duidelijk).
- Vraag de deelnemers na voltooiing van alle taken om de bruikbaarheid van het prototype en de adoptie-intentie te beoordelen.
OPMERKING: Prototype-testen beoordeelt de taakgerichte duidelijkheid en bruikbaarheid van de door het protocol gegenereerde materialen, in plaats van verbeteringen in de prestaties van de publieke dienstverlening23.
7. Data-analyse en kwaliteitscontrole
- Sluit vragenlijstantwoorden uit die in minder dan 3 min zijn ingevuld, antwoorden met meer dan 20% ontbrekende waarden, identieke antwoorden op alle Likert-schaalitems of antwoorden met inconsistente rolgegevens.
- Vat de gegevens van de vragenlijst samen met behulp van gemiddelden en standaarddeviaties voor continue variabelen, en frequenties en percentages voor categorische variabelen.
- Codeer de gegevens van de stakeholder- en journey mapping met behulp van het gestructureerde codeerschema. Laat twee onderzoekers onafhankelijk ten minste 20% van het materiaal coderen voorafgaand aan een consensusdiscussie, en rapporteer vervolgens het percentage overeenstemming en de kappa van Cohen of een gelijkwaardige betrouwbaarheidsstatistiek.
- Analyseer de resultaten van de workshop door het tellen van geldige pain-pointkaarten, probleemclusters, ontwerpuitdagingsverklaringen, oplossingsideeën, haalbaarheidsbeoordelingen en geselecteerde prototypeconcepten.
- Bereken de protocolspecifieke bruikbaarheidsscore van het prototype op basis van vijf items op een vijfpuntschaal: duidelijkheid van de vereisten, zichtbaarheid van de status, duidelijkheid van de volgende stap, gemak van taakvoltooiing en vertrouwen in het gebruik van het materiaal. Transformeer de ruwe score (variërend van 5 tot 25) naar een schaal van 0-100 met de formule:
bruikbaarheidsscore = (ruwe score - 5) / 20 x 10017 - Analyseer de gegevens van de prototype-tests om taakgerelateerde duidelijkheids- en bruikbaarheidsindicatoren te extraheren. Gebruik IBM SPSS Statistics (Analyze > Compare Means > Paired-Samples T Test; Analyze > Nonparametric Tests > Related Samples; Analyze > Descriptive Statistics > Crosstabs > Statistics > McNemar) of gelijkwaardige R-commando's (t.test(..., paired = TRUE), wilcox.test(..., paired = TRUE), en mcnemar.test()) om de toetsingsstatistiek, de exacte P-waarde, het 95% betrouwbaarheidsinterval indien beschikbaar en de effectgrootte te exporteren.
- Interpreteer P-waarden beschrijvend met een vooraf gedefinieerde alfa van 0,05 en benadruk de richting, grootte en consistentie van het effect over de indicatoren24.
- Aggregeer herhaalde taakgegevens naar het deelnemerniveau of gebruik een geschikt model voor herhaalde metingen als vier taken per conditie gelijktijdig worden geanalyseerd.
OPMERKING: Behandel niet alle taakgegevens als statistisch onafhankelijk, tenzij deze aanname expliciet wordt gerechtvaardigd. - CRUCIALE STAP: Documenteer alle beslissingen over datacleaning, codering, matching van taaksets en statistische analyse in een auditblad om de reproduceerbaarheid te waarborgen. Zorg ervoor dat alle gedeïdentificeerde gegevens worden opgeslagen in wachtwoordbeveiligde bestanden die alleen toegankelijk zijn voor het onderzoeksteam
Resultaten
Insluiting van deelnemers en haalbaarheid van het protocol
Het protocol is succesvol geïmplementeerd, met 100 geldige vragenlijstresponses (een voltooiingspercentage van 89,3%) en een specifieke subgroep van 28 deelnemers die de workshop- en prototype-testfasen hebben voltooid. De behouden deelnemers vertegenwoordigden zeven stakeholdercategorieën die betrokken zijn bij het publieke dienstverleningsproces: burgers of dienstgebruikers (n = 32), frontoffice-personeel (n = 18), maatschappelijk werkers (n = 14), beheerders van overheidsinstanties (n = 12), interdepartementale coördinatoren (n = 8), vertegenwoordigers van de derde sector (n = 10) en ondersteunend personeel voor digitale platforms (n = 6).
De 28 workshopdeelnemers werden verdeeld over vijf groepen met gemengde rollen, waarbij elke groep ten minste drie stakeholdercategorieën bevatte. Alle groepen voltooiden stakeholdermapping, journey mapping, Double Diamond co-design en prototype-testen, wat resulteerde in actor-relatieprofielen, stakeholder-journey-matrices, gevalideerde design challenge-verklaringen, prototypeconcepten en gesimuleerde taaktestgegevens (Tabel 3). De gestructureerde mappingfasen vereisten minder interventies van de facilitator dan de probleemdefinitiefasen.
Tabel 3: Inclusie van deelnemers, samenstelling van belanghebbenden en stadia van protocolimplementatie.Werving en inclusie van deelnemers, samenstelling van de belanghebbendengroep, deelname aan workshops, voltooiing van het protocol en de implementatieresultaten over de vier protocolstadia. Klik hier om deze tabel te downloaden.
Visualisatie-outputs: stakeholder- en journey-mapping
Tijdens de fase van stakeholder-mapping werden negen actorgroepen geïdentificeerd, waarvan er zeven consistent in alle groepen voorkwamen en de verticale as van de stakeholder-journey-matrix vormden. Beheerders van overheidsinstanties hadden de hoogste gemiddelde invloedsscores, terwijl burgers de hoogste afhankelijkheidsscores en de laagste scores voor informatietoegang hadden. Er werden negen perceptiekloven geïdentificeerd, gedefinieerd als scoreverschillen van twee punten of meer. De grootste kloof deed zich voor in de waargenomen informatietoegang tussen burgers en beheerders.
De fase van journey-mapping leverde 126 ruwe beweringen over knelpunten op. Na gestructureerde samenvoeging op basis van de fasen in het traject en de downstream-gevolgen bleven 38 unieke verstoringen in de dienstverlening over, waarvan er 12 voldeden aan de vooraf gedefinieerde prioritisatiecriteria (frequentie ≥10% of ernst ≥4,0). De meeste geprioriteerde verstoringen traden op tijdens de materiaalfase, de verduidelijking van de geschiktheid en de interdepartementale verwerking. Deze bevindingen zijn samengevat in de geïntegreerde stakeholder-journey-matrix (Figuur 2).
Co-design transformatie en prototypegeneratie
Tijdens de Double Diamond co-design workshop genereerden de deelnemers 94 geldige pain-point kaarten, die werden gegroepeerd in 14 probleemgebieden. Van de 17 initiële design challenge statements moesten er zes worden herzien omdat ze geen richting voor verbetering boden, de betrokken actor te breed definieerden of een oplossing voorstelden voordat het probleem duidelijk was gedefinieerd. Na revisie op basis van een rubric werden 11 design challenge statements behouden.
Tijdens de ontwikkelingsfase genereerden de deelnemers 32 ideeën voor serviceverbetering. Door de vooraf gedefinieerde drempelwaarden voor haalbaarheid en testbaarheid toe te passen (scores ≥4,0), werd dit aantal teruggebracht tot zes geselecteerde concepten. Drie low-fidelity prototypeconcepten werden gekozen voor taakgebaseerde tests: een eenpagina-checklist voor servicevereisten, een mock-up voor het bijhouden van de servicestatus en een gedefinieerd escalatiepad (Figuur 3). De numerieke resultaten van alle visualisatie- en co-designfasen zijn samengevat in Tabel 4.
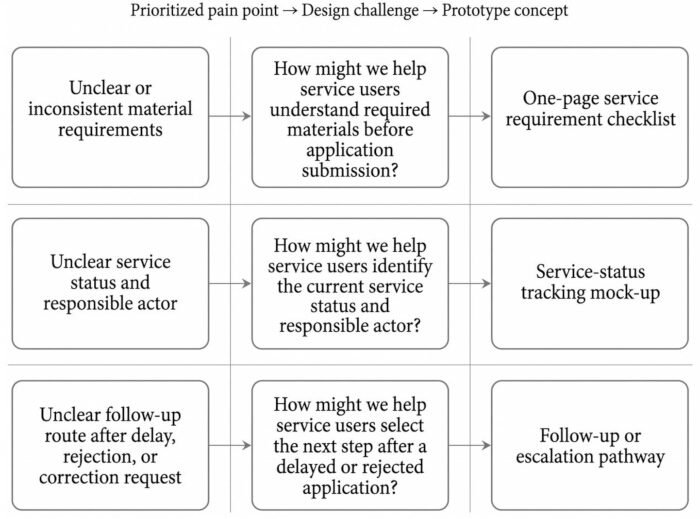
Figuur 3: Transformatiepad van pijnpunt naar prototype. De figuur illustreert drie transformatiepaden van geprioriteerde pijnpunten naar ontwerpuitdagingen en prototypeconcepten met lage getrouwheid (low-fidelity). Ontwerpuitdagingen worden gepresenteerd in het “Hoe kunnen we”-formaat, een collaboratieve ontwerptechniek die wordt gebruikt om problemen te formuleren als open kansen voor het genereren van oplossingen. De getoonde voorbeelden omvatten: (1) onduidelijke of inconsistente materiaaleisen naar een checklist voor service-eisen op één pagina; (2) onduidelijke servicestatus en verantwoordelijke actor naar een mock-up voor het bijhouden van de servicestatus; en (3) onduidelijke follow-uproutes na vertragingen, afwijzingen of correctieverzoeken naar een follow-up- of escalatiepad. Klik hier om een grotere versie van deze figuur te bekijken.
Tabel 4: Door het protocol gegenereerde outputs en resultaten van kwantitatieve taakgerichte testen. De outputs die in elke fase van het protocol zijn gegenereerd, samen met de kwantitatieve resultaten van de gesimuleerde taakgerichte prototype-evaluatie, omvatten bruikbaarheids- en prestatie-indicatoren. Klik hier om deze tabel te downloaden.
Resultaten van prototype-testen op basis van taken
Het protocol leverde 224 gesimuleerde taakgegevens op van 28 deelnemers, bestaande uit 112 baseline- en 112 post-prototype taakgegevens. De via het protocol gegenereerde materialen waren geassocieerd met verbeterde prestaties tijdens de gesimuleerde taken. We hebben een gepaarde steekproefanalyse uitgevoerd op deelnemerniveau (n = 28) om rekening te houden met intra-individuele correlaties over herhaalde taken. De gemiddelde tijd voor taakvoltooiing nam significant af van 178,4 ± 35,8 s bij baseline naar 121,7 ± 28,4 s na het prototype (gemiddeld verschil = −56,7 s; 95% BI, −68,3 – −45,1 s; Cohen’s dz = −1,92; gepaarde t-test, P < 0,001). Op dezelfde manier nam het gemiddeld aantal fouten per deelnemer af van 1,86 ± 0,61 naar 0,79 ± 0,44 (gemiddeld verschil = −1,07 fouten; 95% BI, −1,27 – −0,87; Cohen’s dz = −2,05; gepaarde t-test, P < 0,001). De succespercentages van de taken werden geanalyseerd met behulp van een Wilcoxon signed-rank test op de succesproporties per deelnemer, wat een significante verbetering liet zien (Z = −4,12, P < 0,001). De gemiddelde beoordelingen van de duidelijkheid verbeterden ook significant op deelnemerniveau, waarbij ze stegen van 3,1 ± 0,5 naar 4,2 ± 0,4 (gemiddeld verschil = 1,10 punten; 95% BI, 0,94 tot 1,26; Cohen’s dz = 2,71; gepaarde t-test, P < 0,001).
Het algemene slagingspercentage van de taken steeg van 62,5% (70/112 taakgegevens) bij de nulmeting naar 82,1% (92/112 taakgegevens) na blootstelling aan het prototype, wat een toename van 19,6 procentpunt vertegenwoordigt (95% BI, 8,2 tot 31,1 procentpunt; vergelijking van twee proporties, P = 0,001). Omdat de geaggregeerde aantallen wijzen op 22 extra geslaagde taakgegevens na blootstelling aan het prototype, produceerden alle haalbare gepaarde discordantietabellen een exact McNemar-sensitiviteitsresultaat onder P < 0,01, wat dezelfde directionele conclusie ondersteunt terwijl de reconstructie van niet beschikbare discordante paren op individueel niveau wordt vermeden.
De door deelnemers gerapporteerde uitkomsten waren consistent met deze operationele bevindingen. De gemiddelde beoordelingen van de helderheid stegen van 3,1 ± 0,7 naar 4,2 ± 0,5 op de vijfpuntschaal (n = 112 taakrecords per conditie; gemiddeld verschil = 1,10 punten; 95% BI, 0,94 tot 1,26; gestandaardiseerd gemiddeld verschil op samenvattingsniveau = 1,81; P op samenvattingsniveau < 0,001). De definitieve materialen behaalden een protocolspecifieke bruikbaarheidsscore van 78,4 ± 9,6 en een beoordeling van de adoptieintentie van 4,1 ± 0,6 (Figuur 4). Deze bruikbaarheidsscores werden berekend op basis van de vijf protocolspecifieke studie-items in plaats van de gestandaardiseerde System Usability Scale (SUS). Open feedback ondersteunde deze bevindingen: 21 van de 28 deelnemers rapporteerden een verbeterde visuele helderheid van de stakeholder-journey matrix, 17 van de 28 rapporteerden duidelijkere acteursrollen, 19 van de 28 rapporteerden duidelijkere servicefasen en 20 van de 28 bevestigden de praktische bruikbaarheid van de prototype-materialen.
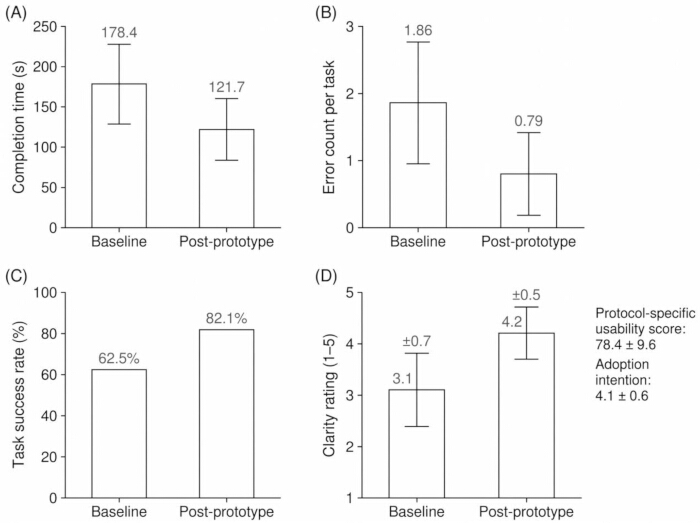
Figuur 4: Resultaten van taakgerichte duidelijkheid en bruikbaarheid na blootstelling aan het prototype. (A) Gemiddelde voltooiingstijd van de taak (s). (B) Gemiddeld aantal fouten per taak. (C) Taaksuccespercentage (%). (D) Door de deelnemer beoordeelde duidelijkheid (schaal 1–5). Aanvullende metrieken in paneel (D) omvatten de protocolspecifieke bruikbaarheidsscore en de adoptieintentie. De staven representeren de gemiddelden op deelnemerniveau, en de foutenbalken geven de standaarddeviatie (SD) aan. Vergelijkingen tussen de baseline- en post-prototypecondities werden uitgevoerd op deelnemerniveau en waren statistisch significant (P < 0,001) voor de voltooiingstijd, het aantal fouten, de duidelijkheid en het taaksuccespercentage. Klik hier om een grotere versie van deze figuur te bekijken.
Discussie
Dit protocol biedt een systematische, reproduceerbare methode voor het structureren van complexe problemen in publieke dienstverleningsomgevingen met een laag risico. Door sequentieel stakeholdermapping, journey mapping, Double Diamond co-design en low-fidelity prototype-testen te integreren, vertaalt de methode gefragmenteerde klachten van meerdere actoren naar testbare service-interventies, terwijl een duidelijk onderscheid wordt bewaard tussen gesimuleerd bewijs van bruikbaarheid en actuele administratieve prestaties. De representatieve resultaten tonen aan dat uitdagingen in de publieke dienstverlening zelden beperkt blijven tot één enkele procedurele stap; ze zijn in plaats daarvan verdeeld over gebruikers, frontoffice-personeel en backoffice-beheerders. Een belangrijke bijdrage van dit protocol is het vermogen om deze multi-actor afhankelijkheden en informatieasymmetrieën zichtbaar te maken voordat de ontwikkeling van oplossingen begint.
Een centraal onderdeel van dit protocol is de stakeholder-journey matrix. In publieke diensten met meerdere actoren hebben stakeholders vaak verschillende interpretaties over waar servicefouten ontstaan. De matrix functioneert als een boundary object: een tastbaar artefact dat aanpasbaar is over verschillende conceptuele grenzen heen, terwijl een gemeenschappelijke identiteit tussen de deelnemende groepen behouden blijft, waardoor consensus over verschillende rollen heen en collaboratief ontwerp worden gefaciliteerd25,26. Door diffuse ontevredenheid van gebruikers te vertalen naar observeerbare, fase-specifieke gebeurtenissen, vermindert de matrix het risico op een vage probleemformulering en voorkomt het dat workshopdeelnemers terugvallen op vertrouwde maar ineffectieve administratieve aanpassingen.
De gestructureerde toepassing van het Double Diamond-framework ondersteunt een gecontroleerde overgang van probleemexploratie naar een uitvoerbare herontwerping van de dienstverlening. De resultaten geven aan dat de overstap van brede klachten naar precieze "Hoe kunnen we"-ontwerpuitdagingen vaak de meest veeleisende fase van het proces is, waarvoor actieve facilitatie, expliciete screeningscriteria en gedocumenteerde revisies nodig zijn. Zonder deze structurele beperkingen (het specificeren van de betrokken actor, de fase in de klantreis, de tekortkoming in de dienstverlening en de beoogde verbetering) kunnen co-designsessies generieke oplossingen opleveren die de in kaart gebrachte tekortkomingen in de dienstverlening niet aanpakken. De directe koppeling tussen een geprioriteerd pijnpunt (bijv. onduidelijke materiaaleisen) en het corresponderende prototype (bijv. een checklist van één pagina) illustreert de generatieve validiteit van het protocol.
Het is belangrijk om het onderscheid te maken tussen de resultaten van de taakgerichte prototype-testen die met dit protocol worden gegenereerd en beweringen van daadwerkelijke organisatorische verbetering. De waargenomen afnames in de tijd voor taakvoltooiing en de foutmarges geven aan dat de co-ontworpen materialen duidelijk en bruikbaar zijn onder gesimuleerde omstandigheden. Echter is prototyping in een vroeg stadium binnen de publieke sector primair bedoeld om het leerproces te ondersteunen en risico's te beperken voorafgaand aan de implementatie16,27. De vaste pre/post-testsequentie die in de representatieve toepassing is gebruikt, kan bovendien leiden tot taakbekendheid of leereffecten, aangezien deelnemers de baselinetaken voltooiden vóór de taken na het prototype. Toekomstige implementaties zouden gebruik moeten maken van tegengebalanceerde taakvolgordes, gematchte controlegroepen of repeated-measures-modellen om prototype-effecten te onderscheiden van leereffecten.
Het oplossen van veelvoorkomende protocolfouten is essentieel voor de reproduceerbaarheid. Als stakeholdermapping slechts generieke actormarkeringen oplevert, moeten facilitators de deelnemers vragen om de beslissings-, informatie- of coördinatieafhankelijkheid die aan elke actor is gekoppeld, te specificeren. Als journey maps veranderen in klachtenlijsten, moeten facilitators elke kaart terugvoeren naar een specifieke fase van de journey, de betrokken actor, het informatiegat en het gevolg stroomafwaarts.
Aanpassingen van het protocol worden verwacht wanneer de workflow wordt overgebracht naar verschillende omgevingen van publieke dienstverlening. Voor universitaire administratieve diensten kunnen de labels van de fasen de nadruk leggen op registratie, beroepsprocedures en ondersteuningsprocessen. Bij het herontwerpen van zorgpaden voor poliklinische patiënten moeten ethische waarborgen en goedkeuringen voor klinisch bestuur worden uitgebreid. Voor de coördinatie van sociale voorzieningen kunnen data-beschermingseisen tussen verschillende instanties leiden tot de noodzaak van strengere de-identificatie en verwijzingscontroles. Culturele, administratieve en bestuurlijke verschillen kunnen daarnaast invloed hebben op de mate waarin deelnemers procedures vrijelijk bekritiseren, hoe de autoriteit binnen gemengde groepen is verdeeld, en of anoniem stemmen of een aparte mapping van gebruiker en zorgverlener vereist is.
Bij de toepassing van deze methode moeten enkele beperkingen in overweging worden genomen. Ten eerste is het protocol specifiek ontworpen voor consultatieve en administratieve diensten met een laag risico. Toepassing in omgevingen met een hoog risico, zoals medische interventies of juridische uitspraken, zou aanzienlijk verbeterde ethische waarborgen, domeinexpertise en dataprotocollen vereisen. Ten tweede kan het scheiden van gebruikers- en providergroepen tijdens de initiële mappingfase weliswaar de onderdrukking van negatieve feedback verminderen, maar inherente machtsongelijkheden kunnen nog steeds de collaboratieve dynamiek beïnvloeden tijdens de synthese met gemengde rollen. Ten derde blijft het succes van de Define-fase afhankelijk van de expertise van de facilitator. Onafhankelijke onderzoeksgroepen dienen daarom gebruik te maken van gestandaardiseerde training voor facilitators, kalibratie-oefeningen, observatielijsten en debriefings na de sessie voordat resultaten uit verschillende omgevingen met elkaar worden vergeleken.
Concluderend biedt dit systematische visualisatieprotocol een gestructureerde, ethisch begrensde benadering voor het diagnosticeren en prototypen van oplossingen voor complexe problemen in de publieke dienstverlening. Het bevordert innovatie in de publieke sector voorbij abstracte beleidsdiscussies door een reproduceerbare toolkit te bieden die de brug slaat tussen door experts geleide hervormingen en gebruikersgericht ontwerp. Toekomstig onderzoek dient dit protocol toe te passen op aanvullende domeinen van de publieke dienstverlening, waaronder gemeentelijke digitale diensten, universitaire administratieve diensten, onderwijsondersteuning, het herontwerpen van poliklinische zorgpaden en de coördinatie van sociale voorzieningen. Toekomstige studies zouden ook moeten evalueren hoe prototypes die in gecontroleerde workshops zijn ontwikkeld, presteren na implementatie in routinematige administratieve workflows.
Openbaarmakingen
De auteurs verklaren dat er geen concurrerende belangen zijn.
Dankbetuigingen
De auteurs danken alle deelnemers, waaronder burgers, medewerkers in de frontlinie en beheerders van overheidsinstanties, voor hun deelname aan de vragenlijsten, co-designworkshops en prototype-testsessies. Hun bijdragen en inzichten in publieke dienstverleningservaringen met meerdere actoren hebben de ontwikkeling van dit systematische visualisatieprotocol voor servicedesign ondersteund.
De auteurs danken tevens de institutionele en academische ondersteuning verleend door de Faculty of Innovation and Design van de City University of Macau; het College of Art and Design van de Shenzhen University; en het College of Art and Design van de Guangdong Baiyun University. Dit onderzoek heeft geen specifieke subsidie ontvangen van enige financieringsinstantie in de publieke, commerciële of non-profitsector.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Analysesyntaxis of workflow-notities | Onderzoeksteam | PSD-VP-S17 v1.1 | Voor het documenteren van de SPSS- of equivalente R-workflow voor gepaarde vergelijkingen, Wilcoxon-toetsen, McNemar-gevoeligheidscontroles, effectgroottes, betrouwbaarheidsintervallen en het rapporteren van de resultaten. |
| Anonieme rolgebaseerde vragenlijst | Onderzoeksteam | PSD-VP-S02 v1.1 | Voor het verzamelen van informatie over de rol van belanghebbenden en basispercepties van het geselecteerde openbare dienstverleningsproces. |
| De-identificatiechecklist | Onderzoeksteam | PSD-VP-S14 v1.1 | Om ervoor te zorgen dat namen van deelnemers, ID-nummers, adressen, case-ID's en administratieve gegevens niet worden verzameld of openbaar gemaakt. |
| Sjabloon voor design challenge | Onderzoeksteam | PSD-VP-S07 v1.1 | Om geclusterde pijnpunten om te zetten in gestructureerde, testbare 'Hoe zouden we'-uitspraken. |
| Kalibratierubriek voor facilitator | Onderzoeksteam | PSD-VP-S15 v1.1 | Om de voorbereiding van de facilitator, voorbeeldcodering, revisie van challenge-uitspraken en consistentie tussen facilitators te standaardiseren. |
| Beoordelingsblad voor belanghebbenden met vijf punten | Onderzoeksteam | PSD-VP-S04 v1.1 | Om de invloed, afhankelijkheid, informatiegang en coördinatiedruk van elke belanghebbende te beoordelen. |
| IBM SPSS Statistics | IBM Corporation | Versie 26.0 of later | Voor het uitvoeren van beschrijvende analyses, gepaarde t-toetsen, Wilcoxon-voorwaardelijke rangtoetsen en McNemar-toetsen voor de resultaten van prototype-testen. |
| Materialen voor low-fidelity prototypes | Onderzoeksteam | PSD-VP-S10 v1.1 | Voor het ontwikkelen en testen van dienstvoorstellen in een vroeg stadium, inclusief een vereistenchecklist, mock-up van de servicestatus en een follow-up traject. |
| Microsoft Excel | Microsoft Corporation | Microsoft 365 of equivalent | Voor het organiseren van vragenlijstgegevens, het berekenen van beschrijvende statistieken, het beheren van coderingsbladen en het opstellen van samenvattende tabellen. |
| Pijnpuntkaarten | Onderzoeksteam | PSD-VP-S06 v1.1 | Voor het vastleggen van dienstverleningsstoringen, informatiekloven, onduidelijkheid over verantwoordelijkheden, getroffen actoren en downstream-gevolgen. |
| Informatieblad voor deelnemers | Onderzoeksteam | PSD-VP-S01 v1.1 | Om het doel van de studie, de procedures, de rechten van de deelnemers en de vereisten voor toestemming vóór deelname toe te lichten. |
| Wachtwoordbeveiligde gegevensopslag | Institutioneel of computersysteem van het onderzoeksteam | Toegang beperkt tot onderzoeksteam | Voor de veilige opslag van gede-identificeerde vragenlijstgegevens, workshopresultaten, coderingsbestanden en verslagen van taaktesten. |
| Score-rubriek voor prototype | Onderzoeksteam | PSD-VP-S12 v1.1 | Om de duidelijkheid, bruikbaarheid, taaksucces, het aantal fouten en de adoptieintentie van het prototype te beoordelen. |
| Selectieblad voor prototypes | Onderzoeksteam | PSD-VP-S09 v1.1 | Voor het selecteren van prototypeconcepten die voldoen aan vooraf gedefinieerde drempels voor haalbaarheid en testbaarheid. |
| Sjabloon voor journey mapping van openbare diensten | Onderzoeksteam | PSD-VP-S05 v1.1 | Om het openbare dienstverleningsproces in kaart te brengen over informatiezoektocht, verduidelijking van vereisten, materiaalfase, indiening, verwerking, kennisgeving en follow-up ondersteuning. |
| Bladen voor gesimuleerde taken | Onderzoeksteam | PSD-VP-S1 v1.1 | Om de taakvoltooiing, beslissingsnauwkeurigheid en duidelijkheid vóór en na blootstelling aan het prototype te evalueren. |
| Oplossingskaarten | Onderzoeksteam | PSD-VP-S08 v1.1 | Voor het documenteren van ideeën voor serviceverbetering die zijn gegenereerd tijdens de Double Diamond co-design workshop. |
| Werkblad voor stakeholder-mapping | Onderzoeksteam | PSD-VP-S03 v1.1 | Om 5-8 actoren te identificeren die betrokken zijn bij het openbare dienstverleningsproces en om de rollen en afhankelijkheden van actoren te visualiseren. |
| Gestructureerd coderingsblad | Onderzoeksteam | PSD-VP-S13 v1.1 | Voor het coderen van stakeholder-mappinggegevens, resultaten van journey mapping, pijnpuntclusters en workshopresultaten. |
| Checklist voor equivalentie van taaksets | Onderzoeksteam | PSD-VP-S16 v1.1 | Voor het documenteren van de matching tussen baseline- en post-prototypetaken op basis van beslissingsstappen, leestekstlengte, vereiste velden, complexiteit en voltooiingstijd tijdens de pilot. |
Referenties
- Rittel HWJ, Webber MM. Dilemmas in a general theory of planning. Policy Sci. 1973;4(2):155-69.
- Suoheimo M, Vasques R, Rytilahti P. Deep diving into service design problems: Visualizing the iceberg model of design problems through a literature review on the relation and role of service design with wicked problems. Des J. 2021;24(2):231-51.
- Voorberg WH, Bekkers V, Tummers LG. A systematic review of co-creation and co-production: Embarking on the social innovation journey. Public Manag Rev. 2015;17(9):1333-57.
- Schwoerer K, Keppeler F, Mussagulova A, Puello S. CO-DESIGN-ing a more context-based, pluralistic, and participatory future for public administration. Public Adm. 2022;100(1):72-97.
- Edelmann N, Mergel I. Co-production of digital public services in Austrian public administrations. Adm Sci. 2021;11(1):https://doi.org/10.3390/admsci11010022
- Blomkamp E. Systemic design practice for participatory policymaking. Policy Des Pract. 2022;5(1):12-31.
- Vargas C, et al. Exploring co-design: A systematic review of concepts, processes, models, and frameworks used in public health research. J Public Health. 2025;47(4):https://doi.org/10.1093/pubmed/fdaf084
- Wacnik P, Daly SR, Verma A. Participatory design: A systematic review and insights for future practice. Des Sci. 2025;11:https://doi.org/10.1017/dsj.2025.10009
- Udoewa V. An introduction to radical participatory design: Decolonising participatory design processes. Des Sci. 2022;8:https://doi.org/10.1017/dsj.2022.24
- Stickdorn M, Schneider J. This is service design thinking: Basics, tools, cases. BIS Publishers; Amsterdam; 2011. https://www.wiley.com/en-us/This+is+Service+Design+Thinking%3A+Basics%2C+Tools%2C+Cases-p-9781118156308
- Blomkamp E. The promise of co-design for public policy. Aust J Public Adm. 2018;77(4):729-43.
- Bryson JM. What to do when stakeholders matter: Stakeholder identification and analysis techniques. Public Manag Rev. 2004;6(1):21-53.
- Folstad A, Kvale K. Customer journeys: A systematic literature review. J Serv Theory Pract. 2018;28(2):196-227.
- Design C. Eleven lessons: Managing design in eleven global brands. Design Council; London; 2007. https://www.idi-design.ie/content/files/ElevenLessons_Design_Council_2.pdf
- Steen M, Manschot M, De Koning N. Benefits of co-design in service design projects. Int J Des. 2011;5(2):53-60.
- Not E, et al. Designing a digital environment to support the co-production of public services: Balancing multiple requirements and governance concepts. Digit Gov: Res Pract. 2024;5(3):https://doi.org/10.1145/3603632
- Excellence UGCfPS. Design thinking for public service excellence. UNDP Global Centre for Public Service Excellence; Singapore; 2014. https://www.undp.org/publications/designthinking-public-service-excellence
- Osborne SP. The new public governance? Public Manag Rev. 2006;8(3):377-87.
- Hartley J. Innovation in governance and public services: Past and present. Public Money Manage. 2005;25(1):27-34.
- Freeman RE. Strategic management: A stakeholder approach. Pitman; Boston; 1984.
- Stickdorn M, Hormess ME, Lawrence A, Schneider J. This is service design doing: Applying service design thinking in the real world. O'Reilly Media; Sebastopol; 2018. https://www.thisisservicedesigndoing.com/
- Bovaird T. Beyond engagement and participation: User and community coproduction of public services. Public Adm Rev. 2007;67(5):846-60.
- Donetto S, Pierri P, Tsianakas V, Robert G. Experience-based co-design and healthcare improvement: Realizing participatory design in the public sector. Des J. 2015;18(2):227-48.
- Tomczak M, Tomczak E. The need to report effect size estimates revisited: An overview of some recommended measures of effect size. Trends Sport Sci. 2014;21(1):19-25.
- Sanders EBN, Stappers PJ. Co-creation and the new landscapes of design. CoDesign. 2008;4(1):5-18.
- Star SL, Griesemer JR. Institutional ecology, 'translations' and boundary objects: Amateurs and professionals in Berkeley's Museum of Vertebrate Zoology, 1907-39. Soc Stud Sci. 1989;19(3):387-420.
- Liedtka J. Why design thinking works. Harv Bus Rev. 2018;96(5):72-9.