Deze studie integreert publieke transcriptomics van pediatrische pneumonie, single-cell RNA-sequencing van longen van muizen, screening van verbindingen afgeleid van Paeonia, moleculaire docking en moleculaire dynamicasimulaties om neutrofiel-geassocieerde inflammatoire targets en voorspelde catechin-interacties te identificeren voor toekomstige validatie.
Onderzoeksartikel
Effecten van Paeonia-afgeleide catechine op neutrofielen-gerelateerde ontsteking bij pneumonie
In dit artikel
Samenvatting
Samenvatting
Longontsteking bij kinderen gaat vaak gepaard met overmatige ontstekingsreacties en immuundysregulatie, wat kan leiden tot ernstige klinische uitkomsten. Catechine heeft anti-inflammatoire activiteit getoond bij meerdere ziektebeelden, maar de rol en moleculaire mechanismen bij longontsteking blijven onduidelijk. Publieke bulk RNA-sequencinggegevens van pediatrische longontsteking (GSE261482) en publieke single-cell RNA-sequencinggegevens van muizenlongen uit een experimenteel model voor longontsteking (GSE295484) werden geanalyseerd met behulp van weighted gene co-expression network analysis, differentiële expressieanalyse, celtype-annotatie en gene set enrichment analysis. Interacties tussen catechine en geselecteerde eiwitten werden beoordeeld middels moleculaire docking en moleculaire dynamicasimulaties. Er werd een sleutelgenmodule geïdentificeerd die geassocieerd was met kenmerken gerelateerd aan longontsteking, waarbij 18 kandidaatgenen werden gescreend, die voornamelijk verrijkt waren in inflammatoire en immuungerelateerde pathways. Single-cell analyse toonde aan dat deze genen voornamelijk verrijkt waren in neutrofielen en alveolaire macrofagen, met een toename van de proportie neutrofielen onder inflammatoire omstandigheden. MMP9, PYGL en GADD45A werden geselecteerd als kandidaatgenen. Docking- en dynamicasimulaties ondersteunden stabiele voorspelde interacties tussen catechine en deze geselecteerde eiwitten. Catechine kan geassocieerd zijn met ontstekingspaden gerelateerd aan longontsteking door het moduleren van neutrofiel-geassocieerde pathways en interactie met belangrijke immuungerelateerde eiwitten. Deze studie biedt een overzicht op systeemniveau van de werking van catechine bij longontsteking en belicht potentiële targets voor verdere experimentele validatie.
Inleiding
Longontsteking is een veelvoorkomende en potentieel ernstige luchtwegaandoening bij kinderen, primair veroorzaakt door infectieuze agentia zoals Mycoplasma pneumoniae. Het vormt een belangrijk onderdeel van ambulante pneumonie en is geassocieerd met aanzienlijke morbiditeit als gevolg van overmatige ontstekingsreacties en immuunregulatiestoornissen1,2. Toenemend bewijs suggereert dat inflammatoire cytokinen, waaronder tumornecrosefactor-α (TNF-α) en interleukine-6 (IL-6), een cruciale rol spelen bij de ziekteprogressie door de rekrutering van immuuncellen, weefselbeschadiging en pulmonale dysfunctie te bevorderen3. Ondanks vorderingen in de antimicrobiële therapie blijven de moleculaire mechanismen die ontsteking bij pediatrische pneumonie aansturen onvolledig begrepen4.
Flavonoïden hebben aanzienlijke aandacht getrokken vanwege hun ontstekingsremmende en antioxidatieve eigenschappen5. Catechine, een natuurlijk voorkomend polyfenol dat veelvuldig wordt aangetroffen in thee en plantaardige voedingsmiddelen, zou oxidatieve stress en inflammatoire reacties in diverse ziektemodellen kunnen verminderen6. Vorige studies hebben aangetoond dat catechine pro-inflammatoire signaleringscascades kan onderdrukken, waaronder de MAPK- en NF-κB-paden, en de expressie van cytokinen kan reguleren, waardoor ontsteking en metabole dysfunctie worden verlicht7. De meeste bestaande studies richten zich echter op metabole of cardiovasculaire aandoeningen, terwijl de rol van catechine bij respiratoire inflammatoire ziekten, in het bijzonder pneumonie, onvoldoende is onderzocht. Daarnaast blijven de moleculaire doelwitten en mechanismen die ten grondslag liggen aan de door catechine gemedieerde bescherming bij pneumonie onduidelijk.
Deze studie was erop gericht de potentiële moleculaire mechanismen van catechine bij pneumonie te onderzoeken. Er werd verondersteld dat catechine ontstekingsreacties zou kunnen verminderen door interacties aan te gaan met sleutelproteins en signaleringspaden die betrokken zijn bij immuunregulatie. Om deze hypothese te toetsen, werden netwerkfarmacologie, moleculaire docking, moleculaire dynamicasimulaties en analyses van single-cell RNA-sequencing geïntegreerd om systematisch kandidaatgenen te identificeren en hun interacties met catechine te evalueren. De distributie van immuuncellen en genexpressiepatronen werden verder geanalyseerd om de rol van neutrofielen en macrofagen in de ziekteprogressie te onderzoeken.
De resultaten toonden een stabiele voorspelde binding tussen catechine en geselecteerde eiwitten, waaronder PYGL, MMP9 en GADD45A, waarbij de structurele stabiliteit gedurende de moleculaire dynamicasimulaties behouden bleef. Daarnaast onthulde single-cell-analyse significante veranderingen in de proporties van immuuncellen, met name neutrofielen, onder inflammatoire omstandigheden. Deze bevindingen suggereren dat catechine geassocieerd kan zijn met ontstekingsremmende mechanismen die de functie van immuuncellen en belangrijke signaleringspaden betrekken. Deze studie biedt een overzicht op systeemniveau van potentiële catechine-geassocieerde mechanismen bij pneumonie en ondersteunt verdere validatie van catechine als kandidaat-verbinding voor onderzoek naar inflammatoire luchtwegaandoeningen.
Protocol
Deze studie omvatte een secundaire analyse van publiek toegankelijke, gedeïdentificeerde datasets uit de Gene Expression Omnibus-database. Er zijn geen nieuwe menselijke deelnemers, dierproeven of klinische monsters geworven, verzameld of gegenereerd voor deze studie. De ethische goedkeuring en geïnformeerde toestemming voor de oorspronkelijke datasets waren de verantwoordelijkheid van de oorspronkelijke studies die de gegevens hebben gegenereerd. Daarom was er geen aanvullende goedkeuring van een ethische commissie vereist voor de huidige secundaire analyse.
Gegevensverzameling en voorbewerking
Bulk RNA-sequencing (RNA-seq) data werden verkregen uit de Gene Expression Omnibus (GEO) dataset GSE2614828. De expressiematrix die in deze studie is gebruikt, bevatte 177 volbloedmonsters, waaronder 139 pediatrische pneumoniamonsters en 38 gezonde controlemonsters. De beschikbare metadata omvatten geslacht, etiologische classificatie, afnamebuis, batch en ziektestatus. Pneumoniamonsters werden geannoteerd als definitief bacterieel (DB), definitief viraal (DV), waarschijnlijk bacterieel (PB), waarschijnlijk viraal (PV) of onbekend (U) volgens de annotatie van de oorspronkelijke dataset.
Single-cell RNA-sequencing (scRNA-seq) data werden verkregen uit de GEO-dataset GSE2954849, afkomstig van longweefsels van C57BL/6 wild-type muizen in een experimenteel longontstekingmodel. De dataset omvatte pasgeboren muizen (PND05) en juveniele muizen (PND12) die waren blootgesteld aan kamerlucht, PBS of E. coli en werden verzameld 48 u of 96 u na aspiratie.
Gewogen gen-co-expressienetwerkanalyse (WGCNA)
Voor de constructie van het co-expressienetwerk werd de expressiematrix eerst gefilterd om genen met een lage expressie te verwijderen. Nadat de genen met lage expressie waren verwijderd, werd de variabiliteit beoordeeld met behulp van de mediane absolute afwijking (MAD). De 5.000 genen met de hoogste MAD-waarden werden geselecteerd voor de gewogen gen-co-expressienetwerkanalyse (WGCNA) in R. Er werd een soft-thresholding power van 15 toegepast, omdat dit voldeed aan het criterium voor schaalonvrije topologie van R2> 0,8. Deze drempelwaarde werd gebruikt om de gewogen adjacentiematrix te construeren, die vervolgens werd getransformeerd naar een topologische overlapmatrix (TOM). Genmodules werden vervolgens gedetecteerd vanuit de op de TOM gebaseerde hiërarchische clusteringboom. Om modules te identificeren die gerelateerd zijn aan kenmerken geassocieerd met pneumonie, werden module-eigengenen berekend en getest op correlatie met de ziektestatus en etiologie.
Analyse van differentiële expressie
De groepen met pneumonie en gezonde controles werden vergeleken met behulp van het limma R-pakket om differentieel tot expressie gebrachte genen te identificeren. Correctie voor meervoudig testen werd uitgevoerd met de Benjamini-Hochberg-methode. Genen werden alleen als differentieel tot expressie gebracht aangemerkt wanneer aan beide drempelwaarden werd voldaan: |log2 fold change| > 1 en een gecorrigeerde p-waarde < 0,05.
Identificatie van actieve verbindingen afgeleid van Paeonia en voorspelling van targets
Om systematisch bioactieve verbindingen in Paeonia en hun potentiële biologische targets te identificeren, is een strategie van integratie van meerdere databases toegepast om betrouwbaarheid en volledigheid te waarborgen, conform gevestigde frameworks voor netwerkfarmacologie. Ten eerste werden actieve verbindingen van Paeonia opgehaald uit de Traditional Chinese Medicine Systems Pharmacology Database (TCMSP, https://tcmsp-e.com) en andere openbare databases, waaronder ETCM en literatuurbronnen. Verbindingen werden gescreend op basis van farmacokinetische parameters, waaronder orale biobeschikbaarheid (OB ≥ 30%) en drug-likeness (DL ≥ 0,18), om kandidaat-bioactieve bestanddelen te identificeren.
Potentiële eiwitdoelen werden voorspeld met behulp van complementaire ligandgebaseerde benaderingen. SwissTargetPrediction (http://www.swisstargetprediction.ch) werd gebruikt om waarschijnlijke menselijke doelen te identificeren door verbindingstructuren te vergelijken met liganden van bekende activiteit, waarbij alleen voorspellingen met een waarschijnlijkheid ≥ 0,1 werden behouden. Om de dekking van de doelen te verbreden, werd ook de Similarity Ensemble Approach (SEA, http://sea.bkslab.org) gebruikt om te screenen op mogelijke off-target associaties over eiwitfamilies heen, inclusief interacties die niet door canonieke doelvoorspellingen werden vastgelegd. Ter verdere aanvulling op de ligandgebaseerde voorspelling werd de PharmMapper Server (http://lilab.ecust.edu.cn/pharmmapper/) ingezet voor reverse pharmacophore mapping tegen een uitgebreide menselijke eiwitdatabank, waarbij doelen met genormaliseerde fit-scores ≥ 0,7 werden geselecteerd. Daarnaast werden experimenteel gevalideerde verbinding-doelinteracties verzameld uit openbare databanken, waaronder DrugBank en BindingDB, om de betrouwbaarheid van de doelidentificatie te verbeteren. Alle voorspelde doelen werden vervolgens gestandaardiseerd naar officiële gensymbolen met behulp van de UniProt-databank (https://www.uniprot.org), waarbij het organisme werd beperkt tot “Homo sapiens.” Dubbele vermeldingen werden verwijderd om de nauwkeurigheid van de gegevens te waarborgen. De geïntegreerde doelset werd gedefinieerd als de unie van alle voorspelde en gevalideerde doelen voor Paeonia, wat de potentiële moleculaire basis van de farmacologische effecten ervan vertegenwoordigt. Omdat catechine werd geïdentificeerd als een van de uit Paeonia afgeleide actieve verbindingen en een goed gedocumenteerde ontstekingsremmende activiteit heeft, werd deze geselecteerd als de representatieve verbinding voor daaropvolgende moleculaire docking- en moleculaire dynamicasimulaties.
Functionele verrijkingsanalyse
Functionele verrijking werd beoordeeld voor Gene Ontology (GO) biologische processen en Kyoto Encyclopedia of Genes and Genomes (KEGG) pathways met behulp van het clusterProfiler R-pakket. Verrijkte termen werden behouden wanneer de false discovery rate (FDR) < 0,05 was.
Single-cell RNA-sequencinganalyse en downstreamanalyse
Single-cell RNA-sequencinggegevens werden verwerkt in Seurat. De verwerkte GSE295484-matrix werd gebruikt voor de downstreamanalyse, en na import is er geen aanvullende filtering op celniveau toegepast. De verwerkte matrix bevatte 90.883 cellen en 26.511 genen. Voor de kwaliteitscontrole-plots werden referentiedrempelwaarden gebruikt van 200 en 8.000 gedetecteerde genen per cel en 1,4% mitochondriale reads. De gegevens werden genormaliseerd, geschaald en onderworpen aan een hoofdcomponentanalyse (PCA). Vervolgens werd celclustering uitgevoerd, en uniform manifold approximation and projection (UMAP) werd gebruikt om de celpopulaties in een gereduceerde dimensionale ruimte te visualiseren. Celidentiteiten werden toegekend op basis van canonieke markergenen. Markergenen werden geïdentificeerd met FindAllMarkers met only.pos = TRUE, min.pct = 0,25 en logfc.threshold = 0,25.
Om de activiteit van kandidaat-genensets op single-cell niveau te evalueren, werd AUCell-analyse uitgevoerd met het AUCell R-pakket. Cellen werden gescoord op basis van de expressie van vooraf gedefinieerde gen-signaturen, en de verrijkingspatronen werden gevisualiseerd op UMAP-plots. Voor GSE295484 werden de proporties van immuuncelpopulaties, inclusief alveolaire macrofagen en neutrofielen, berekend voor de groepen kamerlucht, PBS en E. coli op 48 u en 96 u na aspiratie. Verschillen tussen groepen werden beoordeeld met behulp van non-parametrische statistische tests. Neutrofiel-markergenen werden geïdentificeerd uit de single-cell dataset en gecombineerd met eerder geïdentificeerde kandidaat-genen om sleutelgenen geassocieerd met neutrofielen te verkrijgen voor verdere analyse.
Moleculaire docking
Moleculaire docking werd uitgevoerd met AutoDock Vina, waarbij de preparatie van de receptor en ligand werd gedaan met AutoDock Tools. De kristalstructuren van de doeleiwitten werden verkregen uit de Protein Data Bank (PDB), waaronder GADD45A (PDB ID: 2KG4), MMP9 (PDB ID: 6ESM) en PYGL (PDB ID: 3DDS). De eiwitstructuren werden vóór de docking verwerkt door watermoleculen en co-gekristalliseerde liganden te verwijderen. Vervolgens werden polaire waterstofatomen toegevoegd en werden Gasteiger-ladingen toegewezen.
De driedimensionale catechine-structuur werd verkregen uit PubChem en voorbereid in AutoDock Tools. Vervolgens werd AutoDock Vina gebruikt om catechine te docken met elk doeleiwit en om de voorspelde bindingsaffiniteit en het interactiepatroon te beoordelen. De parameters van de docking-gridbox waren als volgt: GADD45A-catechine, center_x = 0.131, center_y = -0.002, center_z = -0.018, size_x = 47.25, size_y = 47.25, size_z = 47.25; MMP9-catechine, center_x = -0.434, center_y = 43.036, center_z = 14.868, size_x = 47.25, size_y = 47.25, size_z = 47.25; PYGL-catechine, center_x = 88.408, center_y = -80.795, center_z = 105.959, size_x = 100.45, size_y = 100.45, size_z = 100.45.
Moleculaire dynamicasimulatie
Het AMBER14SB-krachtveld werd gebruikt voor de proteïnecomponenten. Ligandparameters werden gegenereerd met het GAFF2-krachtveld via sobtop_1.0 (dev3.1), en RESP-ladingen werden toegewezen. TIP3P-water werd gebruikt om elk proteïne-ligandcomplex te solvateren in een kubieke simulatiebox. De toevoeging van Na⁺ en Cl⁻ ionen hielp bij het neutraliseren van het systeem en het bereiken van een ionische concentratie van 0.15 M. De particle mesh Ewald (PME)-methode werd gebruikt voor langeafstandselektrostatische interacties met een cutoff van 1 nm. Bindingsbeperkingen werden toegepast met behulp van het LINCS-algoritme. Om sterische hinder te elimineren, werd energieminimalisatie uitgevoerd met steepest-descent en conjugate-gradient methoden.
Na equilibratie werden productie-MD-simulaties uitgevoerd onder NPT-condities bij 310 K en 1 bar, gecontroleerd door de Nosé–Hoover-thermostaat en de Parrinello–Rahman-barostaat. Elke simulatie werd gedraaid voor 100 ns met een tijdstap van 2 fs.
Statistische analyse
Alle statistische analyses werden uitgevoerd met R-software. Correlatieanalyses werden uitgevoerd met gebruik van de Pearson- of Spearman-methode, afhankelijk van de geschiktheid. Groepsvergelijkingen werden uitgevoerd met non-parametrische tests, waaronder de Kruskal-Wallis-toets. Een p-waarde < 0,05 werd beschouwd als statistisch significant.
Resultaten
Identificatie van een sleutelgenmodule geassocieerd met pediatrische pneumonie via WGCNA
Om genmodules te identificeren die geassocieerd zijn met pediatrische pneumonie, werd WGCNA uitgevoerd op transcriptomische data van volbloed van patiënten met pneumonie en gezonde controles. Sample-clusteringanalyse onthulde geen duidelijke uitschieters, wat wijst op een goede datakwaliteit voor verdere analyse (Figuur 1A). PCA demonstreerde verder een duidelijke scheidingstrend tussen de pneumonie- en gezonde groepen, wat suggereert dat er verschillende transcriptomische profielen zijn tussen de condities (Figuur 1B). Om een schaalonvafhankelijk netwerk te construeren, werden genen gerangschikt op basis van de mediane absolute afwijking; de top 5.000 genen werden geselecteerd voor de netwerkconstructie en de soft-thresholding power werd ingesteld op 15 op basis van het criterium van de scale-free topology fit index (R2 > 0,8) terwijl een relatief lage gemiddelde connectiviteit werd behouden (Figuur 1C). Met behulp van deze drempel waarde identificeerde hiërarchische clustering meerdere genmodules met verschillende expressiepatronen (Figuur 1D). Analyse van de relatie tussen modules en eigenschappen onthulde dat verschillende modules significant gecorreleerd waren met klinische fenotypes. Opvallend was dat de blauwe module een sterke correlatie vertoonde met zowel de ziektestatus (pneumonie vs. gezond) als de etiologische classificatie, wat suggereert dat deze een potentiële rol speelt in de ziekteprogressie en de respons van de gastheer (Figuur 1E).
Bovendien toonde scatterplot-analyse van modulelidmaatschap versus gen-significantie binnen de blauwe module een sterke positieve correlatie aan (cor = 0.6, p = 2.1e−35), wat aangeeft dat genen die sterk verbonden waren binnen de module ook sterk geassocieerd waren met het klinische kenmerk (Afbeelding 1F).
Associatie van de blauwe module met de etiologie van bacteriële pneumonie
Om genexpressieverschillen tussen verschillende pneumonie-etiologieën verder te onderzoeken, werd WGCNA uitgevoerd met meerdere klinische classificaties, waaronder controles (C), definitief bacterieel (DB), definitief viraal (DV), waarschijnlijk bacterieel (PB), waarschijnlijk viraal (PV) en onbekende (U) groepen. Analyse van de relatie tussen modules en kenmerken onthulde dat verschillende modules significante correlaties vertoonden met specifieke etiologische subtypes. Met name de blauwe module vertoonde de sterkste positieve correlatie met de DB-groep, wat suggereert dat deze mogelijk betrokken is bij gastresponsreacties die specifiek zijn voor bacteriële infecties (Figuur 2A).
Het dendrogram van de genclustering en de bijbehorende moduletoewijzing bevestigden verder de robuustheid van de moduleconstructie en de duidelijke scheiding van genclusters (Figuur 2B). Binnen de blauwe module toonde de analyse van het modulelidmaatschap tegenover de gensignificantie een significante positieve correlatie aan (cor = 0,41, p = 7,8e−14), wat suggereert dat sterk verbonden genen binnen deze module ook sterk geassocieerd waren met het etiologische kenmerk (Figuur 2C).
Bovendien onthulde een vergelijking van de expressie van het module-eigengen tussen verschillende etiologische groepen significante verschillen in de blauwe module (Kruskal-Wallis toets, p = 1.5e−13). Specifiek vertoonde de blauwe module een verhoogde expressie in de groepen met bacteriële pneumonie, in het bijzonder in de DB-subgroep, in vergelijking met andere etiologische categorieën (Figuur 2D).
Achttien Paeoniaop basis van afgeleide verbindingen geïdentificeerde kandidaatgenen geassocieerd met pediatrische pneumonie, vastgesteld door integratieanalyse
Om kandidaatgenen te identificeren die geassocieerd zijn met pediatrische pneumonie en potentieel Paeonia-geassocieerde targets werd eerst een differentieel expressieonderzoek uitgevoerd tussen longontstekingpatiënten en gezonde controles. Op basis van deze criteria werden 1.110 differentieel tot expressie gebrachte genen (DEGs) geïdentificeerd tussen monsters van longontsteking en gezonde controles, waaronder 524 upgereguleerde en 586 downgereguleerde genen. De 524 upgereguleerde DEGs zijn opgenomen in Aanvullende tabel S1 (zie ook Figuur 3A). Om de belangrijkste genen verder te verfijnen, werden pneumonie-gerelateerde DEG's gekruist met genen die geassocieerd zijn met het DB-fenotype en voorspelde targets van PaeoniaDeze integratieve analyse leverde 18 overlappende genen op, wat wijst op hun potentiële rollen bij de ziekteprogressie en Paeonia-geassocieerde responsen (Figuur 3B).
Er werd een netwerk van interacties tussen verbindingen en targets geconstrueerd om de relaties tussen actieve componenten van Paeonia en de geïdentificeerde kandidaatgenen te visualiseren, waaruit een uitgebreide connectiviteit tussen verbindingen en targets bleek (Aanvullende Tabel S2 en Figuur 3C). Om de biologische functies van deze 18 genen te onderzoeken, werden functionele verrijkingsanalyses uitgevoerd. GO-verrijking van biologische processen koppelde de kandidaatgenen voornamelijk aan immuun- en ontstekingsfuncties, waaronder regulatie van de ontstekingsrespons, peptidehormoonrespons, positieve regulatie van het metabolisme van reactieve zuurstofspecies en regulatie van type II interferon-gemedieerde signalering (Figuur 3D). KEGG-analyse toonde verder aan dat de genen verrijkt waren in ontstekings- en immuungerelateerde pathways, zoals de IL-17- en NF-κB-signaleringspathways, evenals metabole en endocriene gerelateerde pathways, waaronder glucagonsignalering en steroïdhormoonbiosynthese (Figuur 3D).
Verrijking van kandidaatgenen in neutrofielen en alveolaire macrofagen in single-cell transcriptomische analyse
Om de cellulaire distributie van kandidaatgenen in een experimentele context van pneumonie te onderzoeken, werd de muizenlong scRNA-seq dataset GSE295484 geanalyseerd. Er werd een kwaliteitscontroleanalyse uitgevoerd om de betrouwbaarheid van de gegevens te evalueren. De distributies van het aantal gedetecteerde genen, UMI-counts en de percentages mitochondriële en ribosomale genen wezen op een algehele hoge kwaliteit van de single-cell data in de verwerkte matrix (Figuur 4A). Scatterplots toonden de referentiedrempelwaarden voor gendetectie en mitochondriaal gehalte die zijn gebruikt bij de visualisatie van de kwaliteitscontrole (Figuur 4B).
Na normalisatie en dimensiereductie werden de cellen geclusterd en gevisualiseerd met behulp van UMAP. Er werden verschillende celpopulaties geïdentificeerd, waaronder neutrofielen, alveolaire macrofagen, monocyten, epitheelcellen en andere immuun- en stromale celtypen, wat de cellulaire heterogeniteit van de longmicro-omgeving tijdens pneumonie aantoont (Figuur 4C). Om de activiteit van de 18 kandidaatgenen op single-cell niveau te beoordelen, werd een AUCell-analyse uitgevoerd. De resultaten toonden aan dat de gensignatuur voornamelijk verrijkt was in neutrofielen en alveolaire macrofagen, zoals blijkt uit de hogere AUC-scores in deze celpopulaties (Figuur 4D).
Inflammatoire genen geassocieerd met targets van Paeonia-afgeleide verbindingen in een muismodel voor bacteriële pneumonie
Om de dynamiek van immuuncellen in het experimentele muismodel voor pneumonie verder te onderzoeken, werden de proporties alveolaire macrofagen en neutrofielen geanalyseerd in de groepen kamerlucht, PBS en E. coli op 48 u en 96 u na aspiratie. Na 48 u vertoonden alveolaire macrofagen een opvallende afname bij E. coli-infectie in vergelijking met de condities met lucht en PBS, terwijl neutrofielen een aanzienlijke toename in celproportie vertoonden (Figuur 5A). Een vergelijkbare trend werd waargenomen na 96 u, waarbij de proporties neutrofielen verhoogd bleven als reactie op E. coli -stimulatie, terwijl alveolaire macrofagen relatief lagere niveaus vertoonden. Deze resultaten wijzen op een prominente expansie van neutrofielen tijdens een bacteriële infectie. Om de functionele kenmerken van neutrofielen te verkennen, werden neutrofiel-markergenen geïdentificeerd en werd er een functionele verrijkingsanalyse uitgevoerd. KEGG-verrijking associeerde de neutrofiel-markergenen met inflammatoire signalering, waaronder de TNF-, MAPK- en C-type lectine-receptorpaden (Figuur 5B). GO-biologische procestermen waren eveneens geconcentreerd in immuunresponsfuncties, zoals leukocytenmigratie, leukocyt cel-cel adhesie, positieve regulatie van de afweerrespons en respons op moleculen van bacteriële oorsprong (Figuur 5B). Om sleutelgenen te identificeren die neutrofielenactiviteit, pneumonie en Paeonia-targets verbinden, werden de neutrofiel-markergenen gekruist met de eerder geïdentificeerde 18 kandidaatgenen. Deze analyse leverde drie overlappende genen op: MMP9, PYGL en GADD45A (Aanvullende Tabel S3 en Figuur 5C). Ten slotte liet visualisatie van genexpressie op single-cell niveau zien dat deze drie genen voornamelijk tot expressie kwamen in neutrofielenpopulaties (Figuur 5D), wat hun potentiële rol in neutrofielen-gemedieerde inflammatoire responsen verder ondersteunt.
Voorspelde bindingsaffiniteit van catechine aan geselecteerde eiwitten in moleculaire docking
Om potentiële interacties tussen catechine en eiwitten verder te evalueren, werd een moleculaire docking-analyse uitgevoerd tussen de geselecteerde eiwitten (MMP9, PYGL en GADD45A) en catechine, een actieve verbinding afgeleid van Paeonia. De kristalstructuren van GADD45A, MMP9 en PYGL werden verkregen uit de Protein Data Bank, en de 3D-structuur van catechine werd opgehaald uit de PubChem-database. De docking-resultaten suggereerden dat catechine kon binden aan sites van alle drie de geselecteerde eiwitten, met bindingsenergieën van −6,3 kcal/mol voor GADD45A, −7,6 kcal/mol voor MMP9 en −8,0 kcal/mol voor PYGL (Figuur 6). Van deze geselecteerde eiwitten vertoonde catechine de sterkste voorspelde bindingsaffiniteit met PYGL, gevolgd door MMP9 en GADD45A, wat wijst op een potentiële preferentiële interactie met een eiwit dat gerelateerd is aan het metabolisme.
Op moleculair niveau vormde catechine meerdere waterstofbruggen en hydrofobe interacties met sleutelaminozuurresiduen in elk eiwit. In GADD45A interacteerde catechine met residuen zoals GLN33 en TRP135. In MMP9 werd een stabiele waterstofbinding waargenomen met residuen waaronder GLN227, TYR248 en HIS236. Op soortgelijke wijze vormde catechine in PYGL meerdere waterstofbruggen met residuen zoals LYS554 en ASN631, wat bijdroeg aan de bindingsstabiliteit. Naast waterstofbinding onthulde de interactieanalyse van derwaalskrachten en π-gerelateerde interacties, wat wijst op een multi-modaal bindingspatroon dat de stabiliteit van de voorspelde ligand-eiwitcomplexen verhoogt. Collectief suggereren deze resultaten dat catechine stabiele voorspelde complexen kan vormen met MMP9, PYGL en GADD45A. De therapeutische relevantie van deze interacties vereist echter verdere experimentele validatie.
Voorspelde stabiele interacties tussen catechine en geselecteerde eiwitten
Op basis van de docking-poses verkregen bij moleculaire docking werden moleculaire dynamicasimulaties van 100 ns uitgevoerd om de stabiliteit van de catechine-eiwitcomplexen verder te evalueren. RMSD-analyse toonde aan dat alle drie de eiwit-ligandcomplexen tijdens de simulatieperiode een evenwicht bereikten. Hiervan vertoonden de PYGL-catechine- en MMP9-catechinecomplexen relatief stabiele RMSD-fluctuaties, terwijl het GADD45A-catechinecomplex iets hogere fluctuaties vertoonde, maar binnen een acceptabel bereik bleef (Figuur 7A). De Rg-analyse wees uit dat alle complexen gedurende de simulatie een stabiele structurele compactheid behielden, met minimale variatie over de tijd (Figuur 7B). Evenzo demonstreerde SASA-analyse stabiele blootstellingsniveaus voor alle complexen, wat hun structurele stabiliteit verder ondersteunt (Figuur 7C). Waterstofbrug-analyse onthulde persistente interacties tussen catechine en de geselecteerde eiwitten. Het PYGL-catechinecomplex behield over de tijd een hoger aantal waterstofbruggen in vergelijking met MMP9 en GADD45A, wat wijst op sterkere en stabielere bindingsinteracties (Figuur 7D).
De flexibiliteit op residuniveau werd geëvalueerd met behulp van RMSF. De resultaten lieten zien dat de meeste residuen een lage fluctuatie vertoonden, waarbij slechts enkele regio's een hogere flexibiliteit vertoonden, wat aangeeft dat ligandbinding geen grote structurele instabiliteit in de eiwitten veroorzaakte (Figuur 7E). Gezamenlijk suggereren deze bevindingen dat catechine stabiele voorspelde complexen vormt met MMP9, PYGL en GADD45A, waarbij de sterkste stabiliteit werd waargenomen bij de PYGL–catechine-interactie. Deze resultaten ondersteunen stabiele voorspelde interacties tussen catechine en de geselecteerde eiwitten, wat computationeel bewijs levert voor verdere experimentele validatie.
Beschikbaarheid van gegevens:
In deze studie zijn publiek beschikbare datasets geanalyseerd. De bulk RNA-seq dataset is beschikbaar via de Gene Expression Omnibus (GEO) onder toegangsnummer GSE261482 (https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE261482), en de scRNA-seq dataset van de long van de muis is beschikbaar onder toegangsnummer GSE295484 (https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE295484). De verwerkte output die in het artikel is gebruikt, wordt verstrekt als Aanvullende Tabel S1, Aanvullende Tabel S2 en Aanvullende Tabel S3.
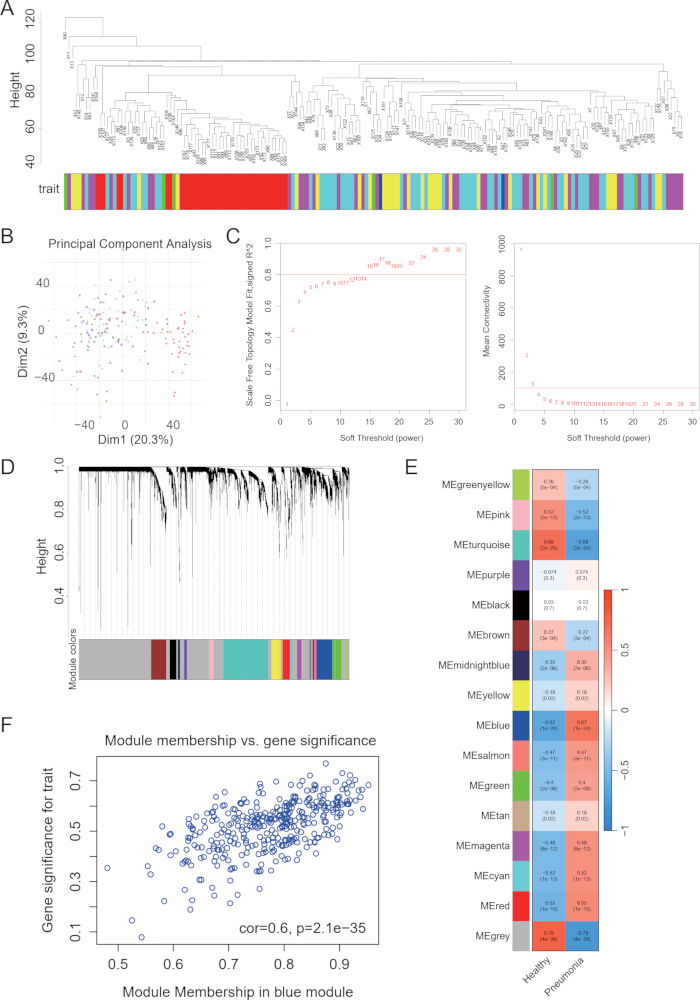
Figuur 1. WGCNA-constructie en identificatie van ziekte-geassocieerde modules (A) Monsterclustering is uitgevoerd op basis van de genexpressieprofielen, en de bijbehorende kenmerkannotaties worden onder het dendrogram weergegeven. (B) De principale componentenanalyse toont de distributie van monsters langs de eerste twee principale componenten. (C) De soft-thresholding power werd geëvalueerd met behulp van de scale-free topology fit-index en de gemiddelde connectiviteit. (D) Genen werden geclusterd op basis van topologische overlap, en moduletoewijzingen zijn aangegeven met kleuren. (E) Correlaties tussen module eigengenen en klinische kenmerken worden weergegeven als een heatmap. (F) De relatie tussen modulemembership en gensignificantie wordt getoond voor genen in de blauwe module. Klik hier om een grotere versie van deze figuur te bekijken.
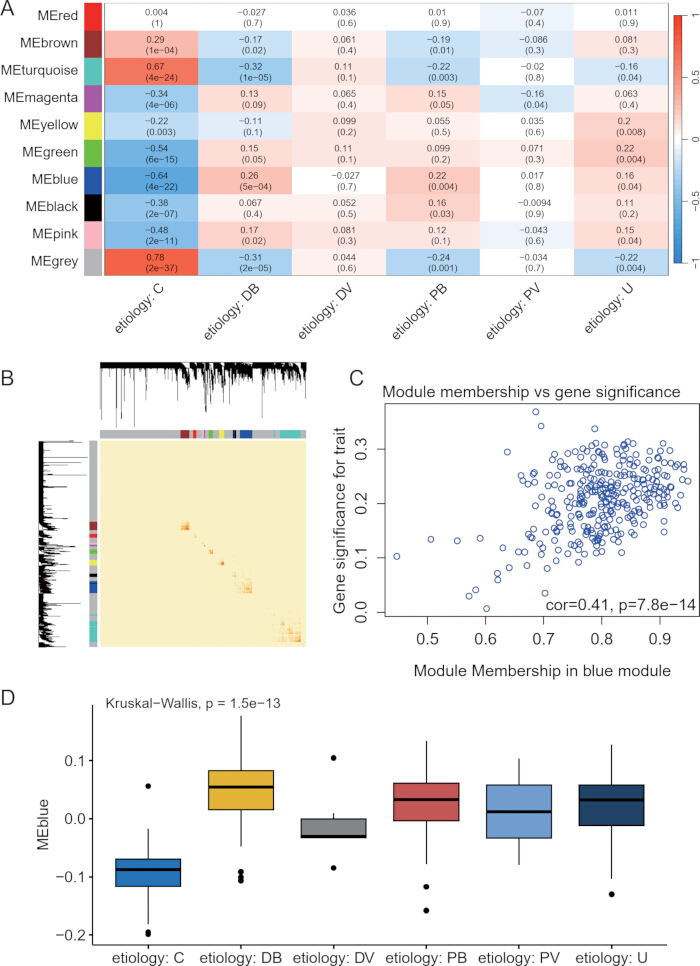
Figuur 2. WGCNA-analyse gebaseerd op pneumonie-etiologie. (A) Module eigengene-correlaties worden weergegeven voor etiologiegroepen, waaronder controle, definitief bacterieel, definitief viraal, waarschijnlijk bacterieel, waarschijnlijk viraal en onbekend. (B) Genmodules werden toegewezen op basis van het dendrogram van clustering op basis van topologische overlap. (C) Module-lidmaatschap en gensignificantie zijn uitgezet voor de blauwe module. (D) De expressie van de blauwe module eigengene wordt vergeleken tussen de etiologiegroepen. Afkortingen: WGCNA = weighted gene co-expression network analysis; C = controle; DB = definitief bacterieel; DV = definitief viraal; PB = waarschijnlijk bacterieel; PV = waarschijnlijk viraal; U = onbekend. Klik hier om een grotere versie van deze figuur te bekijken.
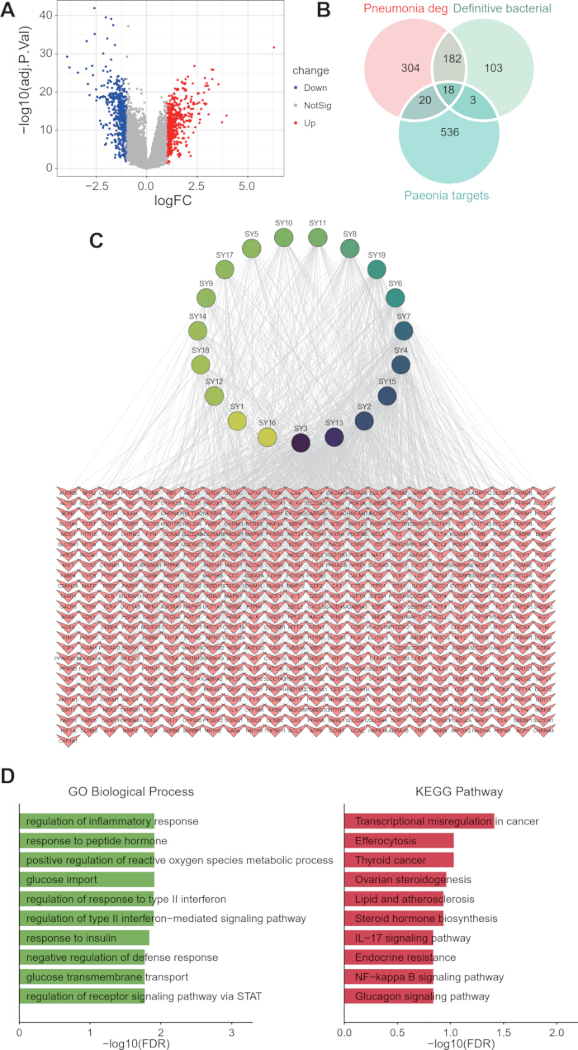
Figuur 3. Identificatie en functionele analyse van kandidaatgenen. (A) Volcano plot die de differentieel tot expressie gebrachte genen tussen pneumonie- en controlemonsters weergeeft. (B) Venn-diagram dat de overlap laat zien tussen pneumonie-DEG's, definitieve bacteriële gerelateerde genen en Paeonia-doelgenen. (C) Interactienetwerk tussen verbindingen en doelen van de actieve componenten van Paeonia en kandidaatgenen. (D) Staafdiagrammen die de verrijking van Gene Ontology-biologische processen (links) en KEGG-pathwayverrijking (rechts) voor de overlappende genen weergeven. Klik hier om een grotere versie van deze figuur te bekijken.
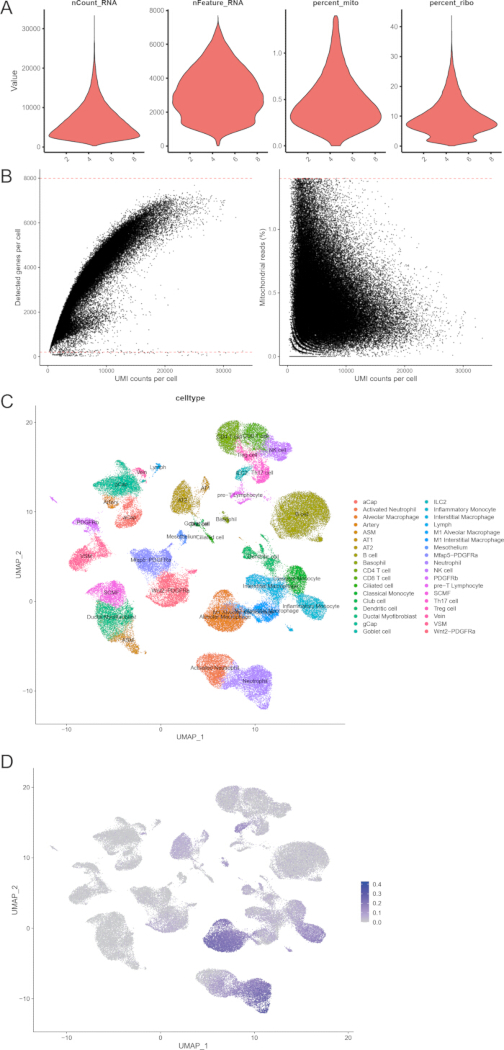
Figuur 4. Single-cell transcriptomische analyse van pneumonie. (A) Violin plots vatten de kwaliteitscontrolemetrieken samen, waaronder nCount_RNA, nFeature_RNA, het percentage mitochondriale genen en het percentage ribosomale genen. (B) Spreidingsdiagrammen die de relaties tonen tussen UMI-counts, gedetecteerde genen per cel en het percentage mitochondriale genen. (C) UMAP-visualisatie van celclusters geannoteerd naar celtypen. (D) UMAP-plot die de AUCell-scores voor de kandidaat-genhandtekening over individuele cellen toont. Klik hier om een grotere versie van deze figuur te bekijken.
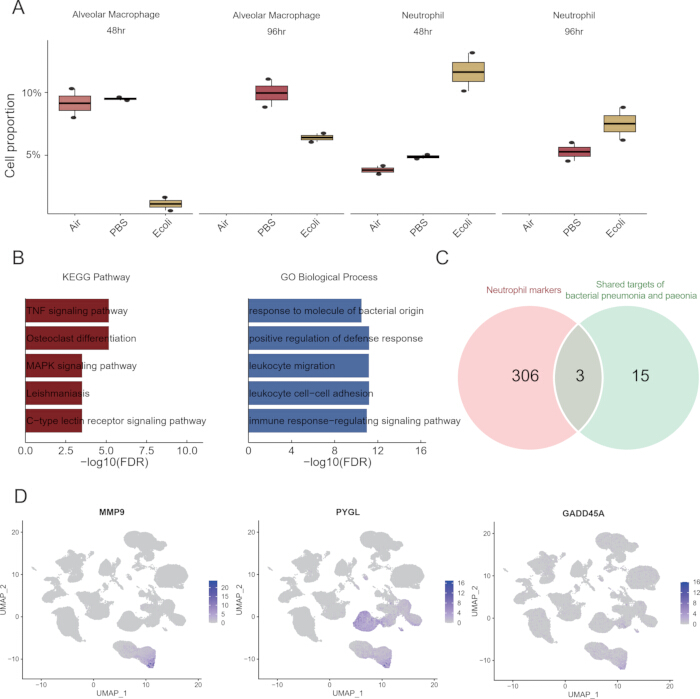
Figuur 5. Neutrofielendynamiek en identificatie van sleutelgenen. (A) Boxplots die de celproporties van alveolaire macrofagen en neutrofielen tonen onder verschillende condities (lucht, PBS en E. coli) op 48 u en 96 u. (B) Staafdiagrammen die de verrijking van KEGG-paden (links) en GO-biologische processen (rechts) tonen voor neutrofiele markergenen. (C) Venn-diagram dat de overlap toont tussen neutrofiele markergenen en gedeelde targets van bacteriële pneumonie en Paeonia. (D) UMAP-plots die de expressiepatronen van MMP9, PYGL en GADD45A over verschillende celpopulaties tonen. Klik hier om een grotere versie van deze figuur te bekijken.
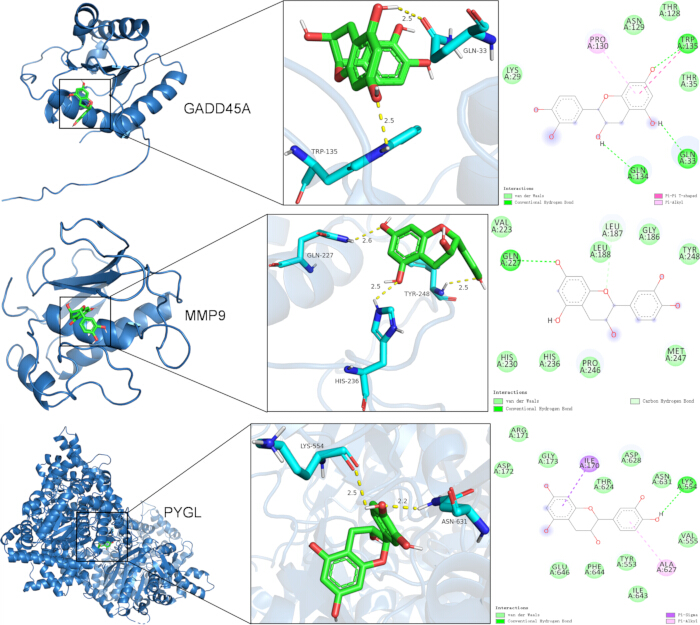
Figuur 6. Moleculaire docking van catechine met geselecteerde eiwitten. Driedimensionale structuren van eiwit-ligandcomplexen die de binding van catechine aan GADD45A (boven), MMP9 (midden) en PYGL (onder) tonen. Vergrote panelen tonen de bindingsregio's en contacten met belangrijke aminozuurresiduen. De tweedimensionale diagrammen presenteren waterstofbruggen en andere interacties tussen catechine en de geselecteerde eiwitten. Klik hier om een grotere versie van deze figuur te bekijken.
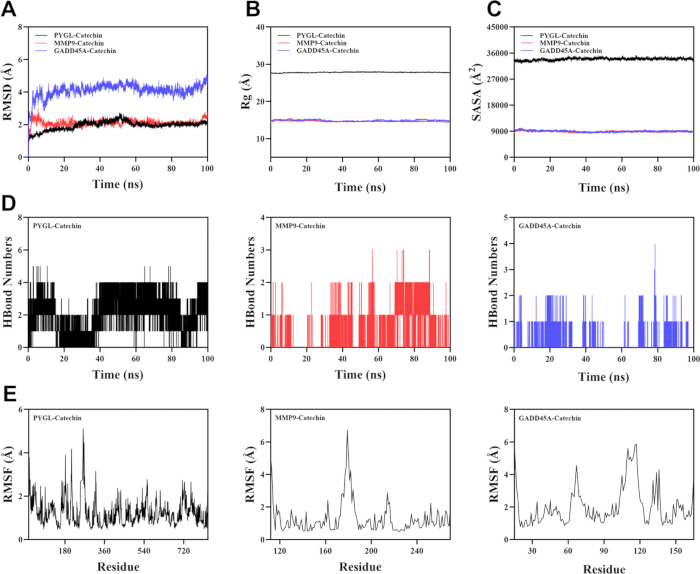
Figuur 7Moleculaire dynamicasimulaties van proteïne-ligandcomplexen. (A) Root-mean-square-deviatie (RMSD) van de complexen tijdens de simulatie. (B) De gyratie-straal verandert in de loop van de tijd. (C) Solvent-toegankelijk oppervlak tijdens de simulatie. (D) Aantallen waterstofbruggen tussen catechine en de doelwitproteïnen gedurende de tijd. (E) Root mean square-fluctuatie van proteïneresiduen in elk complex. Afkortingen: RMSD = root mean square-deviatie; Rg = gyratie-straal; SASA = oplosmiddel-toegankelijk oppervlak; RMSF = root mean square-fluctuatie. Klik hier om een grotere versie van deze figuur te bekijken.
Aanvullende Tabel S1. Opgereguleerde differentieel tot expressie gebrachte genen in pediatrische pneumonie vergeleken met gezonde controlemonsters, inclusief gensymbolen, log2 fold changes, P-waarden, gecorrigeerde P-waarden en gerelateerde limma-statistieken. Klik hier om dit bestand te downloaden.
Aanvullende Tabel S2. Interactietabel tussen Paeonia-verbindingen en doelwitten gebruikt voor netwerkanalyse, inclusief identificatiecodes van verbindingen, namen van verbindingen en geassocieerde doelwitgenen. Klik hier om dit bestand te downloaden.
Aanvullende Tabel S3. Tabel met markergenen voor individuele cellen uit GSE295484, inclusief P-waarden, gemiddelde log2-vouwwijzigingen, expressiepercentages, gecorrigeerde P-waarden, celclusterannotaties en gensymbolen. Klik hier om dit bestand te downloaden.
Discussie
Longontsteking is wereldwijd een belangrijke oorzaak van ziekte en sterfte bij zuigelingen en jonge kinderen, wat een aanzienlijke belasting vormt voor de volksgezondheid1. De pathogenese van pediatrische longontsteking is complex en omvat meerdere onderling verbonden processen, waaronder overmatige ontstekingsreacties, oxidatieve stress en ontregeling van immuun- en metabole paden2,10,11. Eerdere studies hebben gesuggereerd dat ongecontroleerde activering van aangeboren immuuncellen, in het bijzonder neutrofielen en macrofagen, bijdraagt aan longweefselschade door de afgifte van pro-inflammatoire cytokinen, proteolytische enzymen en reactieve zuurstofspecies (ROS)12. Ondanks vorderingen in antimicrobiële en ondersteunende therapieën blijven effectieve strategieën die gericht zijn op deze onderliggende moleculaire mechanismen beperkt. Daarom is het identificeren van nieuwe therapeutische middelen die ontsteking kunnen moduleren en de immuunhomeostase kunnen herstellen van groot belang.
Fytochemicaliën, en in het bijzonder catechinen, trekken steeds meer aandacht vanwege hun goed gedocumenteerde ontstekingsremmende, antioxidante en immunomodulerende eigenschappen13,14,15. De precieze moleculaire mechanismen waarmee catechine zijn beschermende effecten bij pneumonie uitoefent, blijven echter grotendeels onduidelijk. Deze studie heeft systematisch onderzoek gedaan naar potentiële catechine-geassocieerde mechanismen bij pediatrische pneumonie middels een integratieve benadering waarin transcriptomics, single-cell RNA-sequencing, moleculaire docking en moleculaire dynamicasimulaties werden gecombineerd.
In overeenstemming met de initiële hypothese toonden de resultaten aan dat de blauwe module die door WGCNA werd geïdentificeerd, significant geassocieerd was met zowel de ziektestatus als de etiologische classificatie, wat suggereert dat deze module een kerntranscriptieprogramma vertegenwoordigt dat betrokken is bij pediatrische pneumonie. Verdere integratie van differentiële expressieanalyse en Paeonia targetvoorspelling onthulde 18 overlappende genen, die verrijkt waren in immuungerelateerde pathways, waaronder de ontstekingsrespons, reactieve zuurstofspecies-metabolisme en type II interferon-signalering16,17. Deze bevindingen ondersteunen verder de opvatting dat gedereguleerde immuunresponsen en oxidatieve stress centrale drijfveren zijn van de ziekteprogressie.
Analyse van single-cell RNA-sequencing onthulde verder dat de kandidaat-genenset voornamelijk verrijkt was in neutrofielen en alveolaire macrofagen, wat de centrale rol van aangeboren immuuncellen bij de progressie van pneumonie benadrukt. De proporties neutrofielen namen significant toe onder E. coli -stimulatie, in het bijzonder na 48 h en 96 h, wat duidt op aanhoudende activatie tijdens acute inflammatie; dit is consistent met hun dubbele rol bij pathogeenklaring en weefselschade via inflammatoire mediatoren en ROS18. Verdere analyse identificeerde drie sleutelgenen—MMP9, PYGL en GADD45A—als potentiële schakels tussen immuunresponsen, metabole regulatie en cellulaire stress. Terwijl MMP9 betrokken is bij remodeling van de extracellulaire matrix en inflammatoire infiltratie19, en GADD45A stress- en immuunresponsen reguleert, suggereert PYGL een rol voor metabole herprogrammering bij immuunactivatie20,21. Moleculaire docking- en dynamicasimulaties suggereerden een stabiele voorspelde binding van catechine aan deze geselecteerde eiwitten, ondersteund door gunstige bindingsenergieën en stabiele RMSD-, Rg- en SASA-profielen, samen met persistente waterstofbruggen en lage RMSF-waarden. Deze bevindingen suggereren dat catechine geassocieerd kan zijn met deze inflammatoire en metabole targets, maar directe regulatoire effecten vereisen verdere experimentele validatie22.
Naast de ontstekingsremmende effecten kan catechine mogelijk ook een beschermende rol spelen door oxidatieve stress en de metabole balans te moduleren. De verrijking van ROS-gerelateerde pathways suggereert dat catechine oxidatieve schade kan verminderen door de antioxidantcapaciteit te verhogen, wat consistent is met eerdere rapporten over de antioxidatieve eigenschappen van catechinen. Bovendien benadrukt de betrokkenheid van metabole enzymen zoals PYGL een potentiële rol van catechine bij het reguleren van het immunometabolisme, een opkomend concept bij ontstekingsziekten.
Verschillende beperkingen van deze studie moeten worden erkend. Ten eerste was deze studie primair gebaseerd op publiek beschikbare transcriptomische datasets en computationele analyses, en de voorspelde mechanismen zijn nog niet experimenteel gevalideerd. Hoewel moleculaire docking en moleculaire dynamicasimulaties wezen op stabiele interacties tussen catechine en de kandidaat-doelwitproteïnen, bewijzen deze bevindingen geen functionele inhibitie, activatie of therapeutische effectiviteit. Verdere biochemische assays, cellulaire experimenten en in vivo studies zijn vereist om de regulerende effecten van catechine op MMP9, PYGL en GADD45A te valideren en de therapeutische relevantie bij pneumonie te bepalen. Ten tweede was de beschikbare klinische informatie voor de dataset van pediatrische pneumonie beperkt. De GSE261482 dataset leverde transcriptomische data uit volbloed van pediatrische pneumoniepatiënten en gezonde controles, samen met metadata waaronder geslacht, etiologische classificatie, afnamebuis, batch en ziektestatus.
Echter waren gedetailleerde klinische variabelen, waaronder individuele leeftijd, de ernst van de pneumonie, de behandelstatus op het moment van afname en andere informatie over het ziekteverloop, niet volledig beschikbaar in de GEO-metadata die in deze studie zijn gebruikt. Daarom konden er geen verdere gestratificeerde analyses worden uitgevoerd op basis van klinische ernst, behandelstadium of leeftijdsgroep. Ten derde waren de bulk RNA-seq- en single-cell RNA-seq-datasets afgeleid van verschillende biologische contexten. GSE261482 werd gegenereerd uit volbloedmonsters van pediatrische patiënten, terwijl GSE295484 werd gegenereerd uit longweefsels van C57BL/6 wild-type muizen in een experimenteel pneumoniemodel. De resultaten van de single-cell analyse moeten daarom worden geïnterpreteerd als ondersteunend bewijs voor de cellulaire context van inflammatoire celpopulaties en de distributie van kandidaatgenen, in plaats van als directe validatie in menselijke pediatrische pneumonie. Bovendien representeert het E. coli-geïnduceerde muismodel voor pneumonie niet volledig de heterogene etiologieën van pediatrische pneumonie, waaronder bacteriële, virale, waarschijnlijk bacteriële, waarschijnlijk virale en onbekende oorzaken.
Ten slotte was de selectie van MMP9, PYGL en GADD45A gebaseerd op integratieve bio-informatische screening en bekende biologische relevantie, maar hun precieze rollen in neutrofiel-geassocieerde ontsteking en catechine-gemedieerde regulatie moeten nog worden bevestigd. Toekomstige studies met pediatrische klinische cohorten, menselijke single-cell datasets, doelspecifieke functionele assays en experimentele pneumoniemodellen zijn nodig om deze bevindingen te valideren en het translationele potentieel van catechine te verduidelijken.
Samenvattend suggereert deze studie dat catechine geassocieerd kan zijn met neutrofiel-gerelateerde ontstekingsreacties en geselecteerde genen die betrokken zijn bij immuunregulatie, oxidatieve stress en metabole routes bij longontsteking. Via een integratieve analyse van bulk RNA-sequencing, single-cell RNA-sequencing, moleculaire docking en moleculaire dynamicasimulaties identificeerde deze studie een ziekte-geassocieerde genmodule en werden MMP9, PYGL en GADD45A geselecteerd voor docking- en simulatieanalyses met catechine. De verrijking van kandidaatgenen in neutrofielen en alveolaire macrofagen, samen met de stabiele voorspelde interacties waargenomen tussen catechine en de geselecteerde eiwitten, ondersteunt een potentieel mechanisme voor verdere experimentele validatie. Over het algemeen bieden deze bevindingen een perspectief op systeemniveau over potentiële catechine-geassocieerde mechanismen bij longontsteking, maar verdere experimentele en klinische studies zijn nodig om deze waarnemingen te valideren en hun therapeutische relevantie te verduidelijken.
Openbaarmakingen
De auteurs hebben geen belangenconflicten om te verklaren.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| AMBER14SB force field Type: Krachtveld | Proteïnekrachtveld voor moleculaire dynamicasimulaties | ||
| AUCell R package Type: R-pakket | Single-cell genenset-activiteitsscoring | ||
| AutoDock Tools Type: Software | Preparatie van receptor en ligand | ||
| AutoDock Vina Type: Software | Moleculaire docking | ||
| BindingDB Type: Database | BindingDB | Experimenteel gevalideerde interacties tussen verbinding en target; URL/versie niet vermeld in het manuscript | |
| clusterProfiler R package Type: R-pakket | GO- en KEGG-enrichmentanalyse | ||
| DrugBank Type: Database | DrugBank | Experimenteel gevalideerde interacties tussen verbinding en target; URL/versie niet vermeld in het manuscript | |
| ETCM database Type: Database | ETCM | Screening van actieve verbindingen uit Paeonia; URL/versie niet vermeld in het manuscript | |
| GAFF2 force field Type: Krachtveld | Ligandkrachtveld voor moleculaire dynamicasimulaties | ||
| GROMACS 2022 Type: Software | GROMACS | Moleculaire dynamicasimulatie | |
| GSE261482 Type: Publieke bulk RNA-seq dataset | Gene Expression Omnibus (GEO) | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE261482 | Whole-blood expressiegegevens van pediatrische pneumonie en gezonde controles |
| GSE295484 Type: Publieke scRNA-seq dataset | Gene Expression Omnibus (GEO) | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE295484 | Single-cell RNA-sequencinggegevens van muizenlongen uit een experimenteel pneumoniemodel |
| limma R package Type: R-pakket | Differentieel expressieanalyse | ||
| PharmMapper Server Type: Database/tool | PharmMapper | http://lilab.ecust.edu.cn/pharmmapper/ | Reverse pharmacophore mapping |
| Protein Data Bank (PDB) Type: Database | Protein Data Bank | Proteïnestructuren voor GADD45A (2KG4), MMP9 (6ESM) en PYGL (3DDS) | |
| PubChem database Type: Database | PubChem | Driedimensionale catechine-structuur | |
| R software Type: Software | R Project | Statistische analyses | |
| Seurat R package Type: R-pakket | Kwaliteitscontrole, normalisatie, clustering, UMAP-visualisatie en celannotatie van single-cell RNA-sequencing | ||
| Similarity Ensemble Approach (SEA) Type: Database/tool | SEA | http://sea.bkslab.org | Voorspelling van potentiële off-target interacties |
| sobtop_1.0 (dev3.1) Type: Software | Generatie van ligandparameters | ||
| SwissTargetPrediction Type: Database/tool | SwissTargetPrediction | http://www.swisstargetprediction.ch | Voorspelling van compound targets |
| TIP3P water model Type: Watermodel | Solvatatie van proteïne-ligandcomplexen | ||
| Traditional Chinese Medicine Systems Pharmacology Database (TCMSP) Type: Database | TCMSP | https://tcmsp-e.com | Screening van actieve verbindingen uit Paeonia |
| UniProt database Type: Database | UniProt | https://www.uniprot.org | Standaardisatie van gensymbolen |
| WGCNA R package Type: R-pakket | Weighted gene co-expression network analysis |
Referenties
- Chen L, Chen Y, Huang J, Zhang J. LncRNA LINC00707 serves as a sponge of miR-382-5p to alleviate lipopolysaccharide (LPS)-induced WI-38 cell injury through upregulating NKAP in infantile pneumonia. Autoimmunity. 2022;55(5):328-38.
- Li S et al. miRNA-302e attenuates inflammation in infantile pneumonia through the RelA/BRD4/NF-κB signaling pathway. Int J Mol Med. 2019;44(1):47-56.
- Kennedy II DE et al. Contribution of Puma to inflammatory resolution during early pneumococcal pneumonia. Front Cell Infect Microbiol. 2022;12:886901.
- Wang C et al. Suppressing neutrophil itaconate production attenuates Mycoplasma pneumoniae pneumonia. PLoS Pathog. 2024;20(11):e1012614.
- Shen N et al. Plant flavonoids: classification, distribution, biosynthesis, and antioxidant activity. Food Chem. 2022;383:132531.
- Peng X, McClements DJ, Liu X, Liu F. EGCG-based nanoparticles: synthesis, properties, and applications. Crit Rev Food Sci Nutr. 2025;65(12):2177-98.
- Li T et al. Synergistic anti-inflammatory effects of quercetin and catechin via inhibiting activation of TLR4-MyD88-mediated NF-κB and MAPK signaling pathways. Phytother Res. 2019;33(3):756-67.
- Viz-Lasheras S et al. A diagnostic host-specific transcriptome response for Mycoplasma pneumoniae pneumonia to guide pediatric patient treatment. Nat Commun. 2025;16(1):673.
- Michki SN et al. Age-dependent immune responses and resident cell dynamics in young mice following pneumonia. iScience. 2026;29(1):114219.
- Jin M et al. Catechin-functionalized cationic lipopolymer based multicomponent nanomicelles for lung-targeting delivery. Adv Mater. 2024;36(17):e2302985.
- Shin-Ya M et al. Effects of tea, catechins and catechin derivatives on Omicron subvariants of SARS-CoV-2. Sci Rep. 2023;13(1):16577.
- Zheng Q, Li J, Yang L. Systematic investigation of catechin/cyclodextrin encapsulated polymeric nanospheres for the treatment and nursing care of pediatric pneumonia-causing human pathogens. Microb Pathog. 2025;205:107524.
- Zhang Y et al. Anti-inflammatory effect of chlorogenic acid in Klebsiella pneumoniae-induced pneumonia by inactivating the p38MAPK pathway. Int J Med Microbiol. 2023;313(2):151576.
- Gleeson K, Reynolds HY. Life-threatening pneumonia. Clin Chest Med. 1994;15(3):581-602.
- Ross SM. Resveratrol: the anti-inflammatory effects of a phytochemical compound on pneumonia, respiratory syncytial virus, and severe acute respiratory syndrome (SARS-CoV-2). Holist Nurs Pract. 2023;37(2):110-2.
- Hu H et al. Hybrid biomimetic membrane coated particles-mediated bacterial ferroptosis for acute MRSA pneumonia. ACS Nano. 2023;17(12):11692-712.
- Dong L et al. A ROS-responsive nanoprodrug-engineered phage biotherapy for precision treatment of multidrug-resistant Gram-negative bacterial pneumonia. J Control Release. 2025;382:113708.
- Wiegman CH et al. Oxidative stress in ozone-induced chronic lung inflammation and emphysema: a facet of chronic obstructive pulmonary disease. Front Immunol. 2020;11:1957.
- Jiang T et al. Dual role of Baimao-Longdan-Congrong-Fang in inhibiting Staphylococcus aureus virulence factors and regulating TNF-α/TNFR1/NF-κB/MMP9 axis. Phytomedicine. 2025;139:156477.
- Zhang H et al. The attenuated Mycoplasma bovis strain promotes apoptosis of bovine macrophages by upregulation of CHOP expression. Front Microbiol. 2022;13:925209.
- Borella R et al. Metabolic reprograming shapes neutrophil functions in severe COVID-19. Eur J Immunol. 2022;52(3):484-502.
- Xu Y et al. Exosomal miR-155-5p drives widespread macrophage M1 polarization in hypervirulent Klebsiella pneumoniae-induced acute lung injury via the MSK1/p38-MAPK axis. Cell Mol Biol Lett. 2023;28(1):92.