Dit protocol voor gedragswetenschappen en psychologische beoordeling standaardiseert het online afnemen van vragenlijsten, de scoreberekening, de screening van datakwaliteit en de reproduceerbare analyse om internetverslaving en problemen met emotieregulatie bij universiteitsstudenten te beoordelen.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Methodenartikel
Een gestandaardiseerd vragenlijstprotocol voor de beoordeling van internetverslaving en emotieregulatie bij universiteitsstudenten
In dit artikel
Samenvatting
Samenvatting
Internetgebruik is diep geworteld in het universitaire leven, maar problematisch internetgebruik kan niet adequaat worden geëvalueerd op basis van blootstellingstijd alleen. Bewijs suggereert dat maladaptieve of compulsieve patronen van internetgebruik geassocieerd zijn met problemen bij emotieregulatie, maar inconsistenties in de volgorde van vragenlijsten, geschiktheidscriteria, screeningsdrempels, scoreprocedures en analytische rapportage blijven de vergelijkbaarheid tussen studies beperken. Dit methodenartikel presenteert een gestandaardiseerd vragenlijstprotocol voor gedragswetenschappelijke en psychologische assessmentstudies die internetverslaving en problemen met emotieregulatie onder universiteitsstudenten onderzoeken. De workflow omvat een vaste volgorde van vragenlijsten, vooraf gespecificeerde geschiktheidscriteria, instellingen voor verplichte antwoorden, op pilotstudies gebaseerde drempels voor voltooiingstijd, sequentiële screening van datakwaliteit, gestandaardiseerde scoring van de Internet addiction test en de 16-item difficulties in emotion regulation scale, en reproduceerbare beschrijvende, correlationele en multivariabele regressieanalyses. Het protocol specificeert daarnaast de archivering van ruwe antwoorden, screeningslogs, README/codeboekbestanden en de uiteindelijke analyse-klare dataset. Een representatieve implementatie wordt gerapporteerd om de uitvoering van het protocol te demonstreren, in plaats van om de instrumenten te valideren of de prevalentie vast te stellen. In die implementatie werden 520 studenten uitgenodigd en werden 480 vragenlijsten ingeleverd. Na sequentiële uitsluiting van dubbele inzendingen, te snelle antwoorden, gefaalde attentiechecks, patroonmatig antwoorden, logische inconsistentie en ontbrekende kerngegevens, bleven 452 geldige vragenlijsten over. De vooraf gedefinieerde analytische demonstratie onderzocht de associatie tussen de totaalscore van de Internet addiction test en de totaalscore van de difficulties in emotion regulation scale. De behouden steekproef vertoonde een gemiddelde totaalscore voor de Internet addiction test van 51.94 en een gemiddelde totaalscore voor de Difficulties in emotion regulation scale van 35.95. Problemen met emotieregulatie namen toe naarmate de ernst van de internetverslaving toenam, en de associatie bleef evident na correctie voor demografische en gedragsmatige covariabelen. Dit protocol biedt een transparante workflow die kan worden herhaald, gecontroleerd en aangepast voor toekomstige cross-sectionele, repeated-measure of longitudinale studies in universitaire populaties.
Inleiding
Het gebruik van internet is een gewoon onderdeel geworden van het universiteitsleven, inclusief academisch werk, sociale communicatie, entertainment, informatiebehoefte en emotionele coping. Om deze reden moet het internetgedrag van studenten niet simpelweg worden geïnterpreteerd als schermtijd of de tijd die online wordt doorgebracht. Eerder bewijs toonde aan dat problematisch internetgebruik al zichtbaar was bij jongeren en universitaire populaties voordat de huidige mobiele-platformomgeving zeer verzadigd raakte1. Recentere onderzoeken binnen universiteiten geven verder aan dat problematisch internetgebruik veelvoorkomend genoeg is om een systematische beoordeling te vereisen in plaats van een informele beschrijving2.
Universitaire studenten vormen een bijzonder relevante populatie voor gestandaardiseerde beoordeling, omdat academische druk, sociale transitie, zelfstandig wonen en toegenomen autonomie vaak in dezelfde ontwikkelingsfase samenvallen. Deze eisen worden frequent beheerd via dezelfde digitale apparaten en platforms die mogelijk ook moeilijk te reguleren zijn. Een meta-analytische review toonde aan dat problematisch internetgebruik bij studenten geassocieerd is met meerdere geestelijke gezondheidsuitkomsten, wat de interpretatie ondersteunt dat het gaat om een breder gedragsmatige en psychologische zorg in plaats van een beperkt probleem met technologiegebruik3. Waargenomen stress is ook gekoppeld aan internetverslavingspatronen bij studenten, wat suggereert dat emotionele en contextuele druk in overweging moeten worden genomen bij het ontwerpen van vragenlijstonderzoeken in dit vakgebied4.
Het huidige protocol gebruikt de term “internetverslaving” wanneer specifiek wordt verwezen naar het construct dat wordt gemeten door de Internet Addiction Test en de bijbehorende vastgestelde scorecategorieën. De bredere term “problematisch internetgebruik” wordt gebruikt bij de bespreking van de uitgebreidere literatuur over maladaptief, excessief of functioneel belemmerend internetgerelateerd gedrag. “Compulsief internetgebruik” wordt uitsluitend gebruikt wanneer de geciteerde literatuur de nadruk legt op controleverlies, drang of repetitief gebruik ondanks negatieve gevolgen. Deze termen zijn derhalve verwant, maar worden niet als volledig uitwisselbaar beschouwd. Wanneer het protocol wordt uitgevoerd met de Internet Addiction Test, blijft “internetverslaving” behouden als de instrument-specifieke terminologie; wanneer alternatieve of herziene instrumenten worden gebruikt, dient de terminologie te worden afgestemd op de constructlabels en diagnostische aannames van de gekozen meetmethode.
Emotieregulatie biedt een plausibel psychologisch instappunt om te begrijpen waarom sommige studenten overgaan van frequent internetgebruik naar maladaptief internetgebruik. Een prospectieve studie van één jaar toonde aan dat problemen met emotieregulatie relevant waren voor zowel het latere ontstaan als de remissie van internetverslaving bij studenten aan het hoger onderwijs5. Deze bevinding is belangrijk voor het ontwerp van het protocol, omdat emotieregulatie niet louter een aanvullende correlaat is; het kan beïnvloeden hoe studenten het internet gebruiken om stress te vermijden, te verminderen of te beheersen. Tegelijkertijd blijft sociaal functioneren relevant. Problematisch internetgebruik is in verband gebracht met sociale vaardigheden bij universiteitsstudenten, wat aangeeft dat interpersoonlijke en emotionele factoren samen met variabelen voor digitaal gebruik moeten worden beoordeeld6. Tijdens de COVID-19-periode kwam problematisch internetgebruik bij Chinese universiteitsstudenten ook voor in combinatie met bredere psychologische problemen, wat de noodzaak van gestructureerde beoordeling in universitaire omgevingen verder ondersteunt7.
Een verdere uitdaging is dat digitaal gedrag heterogeen is. Studenten kunnen digitale platforms gebruiken voor studie, sociaal contact, entertainment, gezondheidsinformatie of tijdelijke emotionele verlichting, en niet al het hoogfrequente gebruik is schadelijk. Een systematische review van digitaal gebruik gerelateerd aan de geestelijke gezondheid door universiteitsstudenten toonde aan dat digitale betrokkenheid meerdere psychologische doeleinden kan dienen8. Het vakgebied heeft daarom procedures nodig die gewoon hoogfrequent gebruik onderscheiden van problematisch of gedisreguleerd gebruik. Recent bewijs over problematisch smartphonegebruik bij universiteitsstudenten suggereert op soortgelijke wijze dat het risico afhangt van het gedragspatroon, de functie en de context, in plaats van enkel de duur9. Om deze reden combineert het huidige protocol de duur van het internetgebruik, gebruik laat op de avond, de primaire online activiteit en een gestandaardiseerde symptoomscore, in plaats van te vertrouwen op één enkele blootstellingsindicator.
Meting is een andere belangrijke bron van inconsistentie. De internetverslavingstest blijft een van de meest gebruikte instrumenten voor het beoordelen van symptomen van internetverslaving, maar de dimensionaliteit en interpretatie hiervan zijn per setting verschillend geweest. Systematisch psychometrisch bewijs geeft aan dat het instrument uitgebreid is gebruikt, terwijl er nog steeds vragen blijven bestaan over de factorstructuur en de interpretatie van de score10. Vergelijkbare zorgen zijn gerapporteerd bij steekproeven van studenten aan hogescholen en universiteiten, waarbij het wijdverbreide gebruik van de schaal de onzekerheid over het gemeten construct niet volledig heeft weggenomen11. Validatiestudies in Spaanse en Peruaanse universitaire populaties tonen eveneens aan dat het instrument adequaat kan presteren, maar dat het psychometrische gedrag ervan moet worden beschouwd binnen de doelpopulatie waarin het wordt toegepast12,13.
Het protocol is daarom ontworpen om stabiel te zijn in de workflow, maar aanpasbaar in de keuze van de instrumenten. De Internet addiction test wordt hier gebruikt vanwege het historische gebruik, de beschikbare drempelwaarden en de vergelijkbaarheid met eerder onderzoek onder universiteitsstudenten. Het protocol vereist echter niet dat de Internet addiction test onbeperkt het voorkeursinstrument blijft. Indien diagnostische kaders evolueren of indien nieuwere instrumenten geschikter worden voor een specifieke populatie, kan dezelfde workflow behouden blijven terwijl de schaalspecifieke module, het scorebereik, de ernst-drempelwaarden, de codeboekvermeldingen en de README-documentatie worden vervangen. Elke dergelijke vervanging dient plaats te vinden voordat de formele gegevensverzameling begint en moet worden gerapporteerd als een protocolwijziging in plaats van een ad hoc analytische aanpassing.
Het methodologische probleem dat in dit artikel wordt behandeld, is niet simpelweg dat studies naar internetverslaving en emotieregulatie tot verschillende conclusies komen. Veel studies verschillen namelijk in de volgorde van de vragenlijsten, de selectiecriteria, de instellingen van het enquêteplatform, de afhandeling van dubbele reacties, de procedures voor aandachtcontroles, de drempelwaarden voor voltooiingstijd, de regels voor ontbrekende gegevens, de verificatie van de scoren en de rapportage van analyse-klare bestanden. Deze verschillen maken het moeilijk om resultaten te vergelijken, te reproduceren en op te nemen in latere bewijssyntheses. Het huidige protocol speelt in op deze leemte door de volgorde van toediening, de screeningslogica, de scorestructuur en het analytische pad vast te leggen op een manier die transparant kan worden herhaald, gecontroleerd en gewijzigd. De bijdrage is daarom protocolgeoriënteerd: het biedt een reproduceerbare workflow voor observationele gedragswetenschappelijke studies en psychologische beoordelingen bij universitaire populaties, in plaats van het voorstellen van een nieuw psychologisch construct of het presenteren van een prevalentiestudie als hoofduitkomst.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
De studie, getiteld “A Standardized Questionnaire Protocol for Internet Addiction and Emotion Regulation Assessment in University Students,” werd beoordeeld en goedgekeurd door de Ethics and Academic Committee van Zhengzhou University of Economics and Business onder goedkeuringsnummer 20260113004 voordat de werving van deelnemers begon14. De studie maakte gebruik van een cross-sectioneel, anoniem online vragenlijstonderzoek onder fulltime universiteitsstudenten in de leeftijd van 18–24 jaar en werd uitgevoerd in overeenstemming met de institutionele ethische vereisten en de Verklaring van Helsinki. Elektronische geïnformeerde toestemming werd verkregen voordat toegang tot de vragenlijst werd verleend. Deelnemers ontvingen een elektronisch informatieblad waarin het doel van de studie, de procedures, het vrijwillige karakter van de deelname en de databeschermingsmaatregelen werden beschreven; zij waren vrij om op elk gewenst moment zonder sancties terug te trekken. Er werd geen direct identificeerbare persoonlijke informatie verzameld in het hoofdenquêtebestand, waaronder naam, studentennummer, exact adres, telefoonnummer, persoonlijk e-mailadres of socialmedia-account. Door het platform gegenereerde identificatienummers werden uitsluitend gebruikt voor het screenen op dubbele reacties en werden verwijderd vóór de analyse van de dataset. Alle gegevens werden veilig opgeslagen en geanalyseerd in gedeïdentificeerde vorm. Deze workflow van de vragenlijst is niet prospectief geregistreerd vóór de werving van deelnemers. Echter, alle kerncomponenten van het protocol, inclusief de vergrendelde versie van de vragenlijst, README/codeboek, screeningslogboek, score-regels, analysesyntaxis en analyse-waardige workflowbestanden, zijn gearchiveerd en worden verstrekt als aanvullende workflowmaterialen om de reproduceerbaarheid en auditeerbaarheid te ondersteunen.
Door het platform gegenereerde respons-identificatoren en apparaat- of accountgebonden technische identificatoren werden uitsluitend gebruikt voor het screenen op dubbele responsen en zijn verwijderd uit de uiteindelijke geanonimiseerde analytische dataset. De kernvariabelen en scoreregels zijn samengevat in Tabel 1, en het volledige variabelenwoordenboek is opgenomen in Aanvullende Tabel 1. De vragenlijstbestanden, het codeboek, het screeningslogboek, het outputplan en de analyseready-workflowmaterialen zijn opgenomen in Aanvullend Bestand 1.
| Domein | Variabele | Codering/Score | Rol in protocol |
| Geschiktheid | Leeftijd | Jaren; geschikte range 18–24 | Geschiktheidsvariabele en covariaat |
| Demografie | Geslacht | 1 = man; 2 = vrouw; 3 = liever niet zeggen | Beschrijvende variabele en regressiecovariaat |
| Demografie | Academisch jaar | 1 = eerste jaar; 2 = tweede jaar; 3 = derde jaar; 4 = vierde jaar of hoger; 5 = postgraduaat | Beschrijvende variabele |
| Demografie | Disciplinaire categorie | 1 = geestes- en sociale wetenschappen; 2 = natuur- en technologische wetenschappen; 3 = bedrijfskunde en management; 4 = kunst en ontwerp; 5 = overig | Beschrijvende variabele |
| Demografie | Type verblijf | 1 = studentenhuis op de campus; 2 = huurwoning buiten de campus; 3 = ouderlijk huis; 4 = overig | Beschrijvende variabele |
| Demografie | Maandelijkse kosten van levensonderhoud | 1 = <1.000 CNY; 2 = 1.000–1.999 CNY; 3 = 2.000–2.999 CNY; 4 = ≥3.000 CNY | Beschrijvende variabele |
| Internetgebruik | Internetgebruik op doordeweekse dagen | 1 = <2 h; 2 = 2–3,9 h; 3 = 4–5,9 h; 4 = ≥6 h | Gedragsmatige covariaat |
| Internetgebruik | Internetgebruik in het weekend | 1 = <2 h; 2 = 2–3,9 h; 3 = 4–5,9 h; 4 = ≥6 h | Gedragsmatige covariaat |
| Internetgebruik | Primaire online activiteit | 1 = studie; 2 = sociale media; 3 = gaming; 4 = entertainment/video; 5 = winkelen; 6 = gemengd gebruik; 7 = overig | Beschrijvende variabele |
| Internetgebruik | Primair toegangsapparaat | 1 = smartphone; 2 = tablet; 3 = laptop/desktop; 4 = gemengde apparaten | Beschrijvende variabele |
| Internetgebruik | Gebruik laat op de avond na 23:00 | 1 = nooit; 2 = minder dan een keer per week; 3 = 1–2 nachten/week; 4 = 3–5 nachten/week; 5 = bijna elke nacht | Gedragsmatige covariaat en variabele voor screening op logische consistentie |
| Kernschaal | IAT-totaalscore | Som van 20 items; elk item gescoord 1–5; totaal bereik 20–100 | Primaire onafhankelijke variabele |
| Kernschaal | IAT-ernstgroep | 20–39 = normaal gebruik; 40–69 = problematisch gebruik; 70–100 = ernstig problematisch gebruik | Groeperingsvariabele |
| Kernschaal | DERS-16-totaalscore | Som van 16 items na de vereiste omgekeerde codering; totaal bereik 16–80 | Primaire afhankelijke variabele |
| Kernschaal | DERS-16-subschalen | Berekend volgens de vaste DERS-16-scoresleutel | Beschrijvende resultaten van emotieregulatie |
| Covariaat | Slaapduur | 1 = <6 h; 2 = 6–6,9 h; 3 = 7–7,9 h; 4 = ≥8 h | Correctievariabele |
| Covariaat | Wekelijkse fysieke activiteit | 0 = geen; 1 = 1–2 sessies; 2 = 3–4 sessies; 3 = ≥5 sessies | Correctievariabele |
| Covariaat | Academische stress | 1 = laag; 2 = matig; 3 = hoog | Correctievariabele |
| Kwaliteitscontrole | Aandachtcontrole | 1 = geslaagd; 0 = gezakt | Uitsluitingscriterium |
| Kwaliteitscontrole | Voltooiingstijd | Voltooiingsduur in seconden | Tijdsgebaseerde screeningsvariabele |
| Kwaliteitscontrole | Aantal langere reeksen antwoorden | Maximale reekslengte van identieke antwoorden over de 36 gescorede schaalitems | Screeningsvariabele voor patroonantwoorden |
| Kwaliteitscontrole | Binnen-persoon SD | Standaarddeviatie binnen de persoon over de 36 gescorede schaalitems | Screeningsvariabele voor invariante antwoorden |
| Kwaliteitscontrole | Vlag voor logische consistentie | 0 = geen inconsistentie; 1 = inconsistentie gedetecteerd | Screeningsvariabele voor logische consistentie |
Tabel 1: Kernvariabelen, coderingsstructuur en score-regels gebruikt in het gestandaardiseerde vragenlijstprotocol. Deze tabel vat de kernvariabelen voor geschiktheid, demografie, internetgebruik, schaal, covariabele en kwaliteitscontrole samen die in de hoofdworkflow worden gebruikt. Het bevat de coderingswaarden, scorebereiken, score-regels en rollen van de belangrijkste variabelen die worden gebruikt voor het afnemen van de vragenlijst, screening, scoring en analyse. Afkortingen: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale. Klik hier om deze tabel te downloaden.
1. Stel de studiepopulatie, de structuur van de vragenlijst en de surveyflow samen
- Definieer de doelpopulatie en de geldige steekproef
- Werv studenten voor een fulltime bachelor- of masteropleiding in de leeftijd van 18–24 jaar die de vragenlijst zelfstandig op een mobiele telefoon of computer kunnen invullen. Leg de taalversie van de vragenlijst vast en gebruik schaalversies die zijn gevalideerd of op passende wijze zijn aangepast voor de doelgroep studenten.
- Documenteer eventuele aanpassingen op het gebied van toegankelijkheid of taal vóór de gegevensverzameling wanneer internationale studenten, studenten met een beperking of meertalige studentengroepen worden geïncludeerd.
- Beperk de deelname tot één ingevulde reactie per deelnemer. Gebruik de functies voor apparaatbeperking, accountbeperking, cookiebeperking of geauthenticeerde links van het enquêteplatform indien beschikbaar.
OPMERKING: Wanneer hetzelfde deelnemeraccount reacties genereert vanaf meerdere apparaten, identificeer en reconcileer deze records dan tijdens de screening op duplicaten met behulp van de accountgebonden identifier, het tijdstip, de status van de vragenlijst en de gelijkenis van het reactiepatroon. - Stel de minimale uiteindelijke geldige steekproef vast op 450 vragenlijsten en zet de werving voort totdat de geschoonde dataset na screening boven deze drempelwaarde blijft.
OPMERKING: Wanneer ernstig problematisch internetgebruik of een andere kleine subgroep een primair analysedoel is, stel dan een hoger wervingsdoel vast voordat de gegevensverzameling begint. - Registreer het aantal genodigden, het aantal ingediende reacties, het aantal uitgesloten personen bij elke vooraf gespecificeerde screeningsstap en het uiteindelijke aantal behouden deelnemers, zodat de deelnemersstroom later kan worden samengevat in Figuur 1.
- Stel de vragenlijst op in een vaste volgorde
- Stel de vragenlijst samen in de volgende volgorde: geïnformeerde toestemming, demografische informatie, internetgebruiksgedrag, Internet Addiction Test, Difficulties in emotion regulation scale short form, slaapduur, wekelijkse fysieke activiteit en ervaren academische stress. Houd deze volgorde voor alle deelnemers ongewijzigd. Randomiseer de volgorde van de kernschalen niet.
- Leg leeftijd, geslacht, academisch jaar, disciplinecategorie, type verblijf en maandelijkse kosten voor levensonderhoud vast met behulp van gesloten antwoordcategorieën. Markeer alle demografische items als verplicht.
OPMERKING: Neem voor geslacht de opties man, vrouw en liever niet zeggen op. Behoud "liever niet zeggen" in beschrijvende analyses. Codeer geslacht in regressieanalyses met behulp van indicatorvariabelen waarbij man de referentiecategorie is, inclusief aparte indicatoren voor vrouw en liever niet zeggen. Verwijder deelnemers niet uitsluitend omdat zij "liever niet zeggen" selecteren. - Leg de duur van het internetgebruik op doordeweekse dagen, de duur van het internetgebruik in het weekend, de primaire online activiteit, het primaire toegangsapparaat en het internetgebruik laat op de avond na 23:00 vast. Codeer nachtgebruik als 1 = nooit, 2 = minder dan één keer per week, 3 = 1–2 nachten per week, 4 = 3–5 nachten per week en 5 = bijna elke nacht.
- Leg de academische periode vast waarin de vragenlijst wordt afgenomen. In de representatieve implementatie werd de enquête afgenomen tijdens een regulier onderwijkssemester, buiten de weken van de eindexamens, specifiek tijdens semesterweek 6–7.
- Afname en scoren van de kerninstrumenten
- Neem de Internet addiction test van 20 items af als verplichte schaal en score elk item van 1 tot 5. Som alle 20 items op om een totaalscore tussen 20 en 100 te verkrijgen, en classificeer 20–39 als normaal gebruik, 40–69 als problematisch gebruik en 70–100 als ernstig problematisch gebruik15.
- Gebruik "internetverslaving" bij het rapporteren van IAT-gebaseerde scores en ernstgroepen. Gebruik "problematisch internetgebruik" alleen bij verwijzingen naar de bredere literatuur of constructen die niet op de IAT zijn gebaseerd.
- Neem de Difficulties in emotion regulation scale short form van 16 items direct na de internetverslavingstest af en score elk item van 1 tot 5. Codeer items 1, 6 en 8 omgekeerd vóór de sommatie, en bereken vervolgens een totaalscore tussen 16 en 80, waarbij hogere scores wijzen op grotere moeilijkheden bij emotieregulatie16.
- Genereer vijf subschaalscores voor nonacceptatie, doelen, impuls, strategieën en helderheid nadat de omgekeerde codering is geverifieerd.
- Controleer de coderingsrichting van alle omgekeerde items opnieuw voordat de totale en subschaalscores worden berekend. Gebruik dezelfde DERS-16 score-sleutel voor elke deelnemer en documenteer de score-sleutel in de README/codebook.
- Wanneer een herzien of alternatief instrument voor internetverslaving wordt gebruikt, vervang dan de schaalspecifieke module voordat de gegevensverzameling begint en werk de itemnamen, het scorebereik, de drempelwaarden voor ernst, de scoringssyntax, de README/codebook, de screenshots van de vragenlijst en de Tabel met Materialen bij.
- Voeg covariabelen en één aandachtvraag toe
- Registreer de slaapduur als <6 h, 6–6,9 h, 7–7,9 h en ≥8 h. Registreer de frequentie van wekelijkse fysieke activiteit als 0, 1–2, 3–4 en ≥5 sessies. Registreer de ervaren academische stress als laag, matig of hoog. Definieer één fysieke activiteitssessie als ≥20 min matige of intensieve activiteit.
- Voeg één aandachtvraag met een gestuurd antwoord toe in het gedragsgedeelte en vereis dat de deelnemer één specifieke antwoordoptie selecteert. De aandachtvraag die in de representatieve implementatie werd gebruikt was: "Om te bevestigen dat u zorgvuldig leest, selecteer voor dit item '3 = soms'". Markeer elke vragenlijst die faalt voor dit item voor uitsluiting tijdens het schoonen17.
CRUCIALE STAP: Wijzig de bewoording van items, antwoordopties, schaalvolgorde, uitsluitingsdrempels, instellingen van het enquêteplatform, coderingsregels of statistische analyseregels niet nadat de formele gegevensverzameling is begonnen.
OPMERKING: Vat de kernvariabelen, coderingswaarden, scorebereiken en scoringsregels samen in Tabel 1. Vermeld het volledige variabelenwoordenboek, statusvelden van bestanden, screeningsvlaggen, technische identifiervelden, dataset-trackingvariabelen, bestandsnamen en softwareversies in Aanvullende Tabel 1 en de README/codebook.
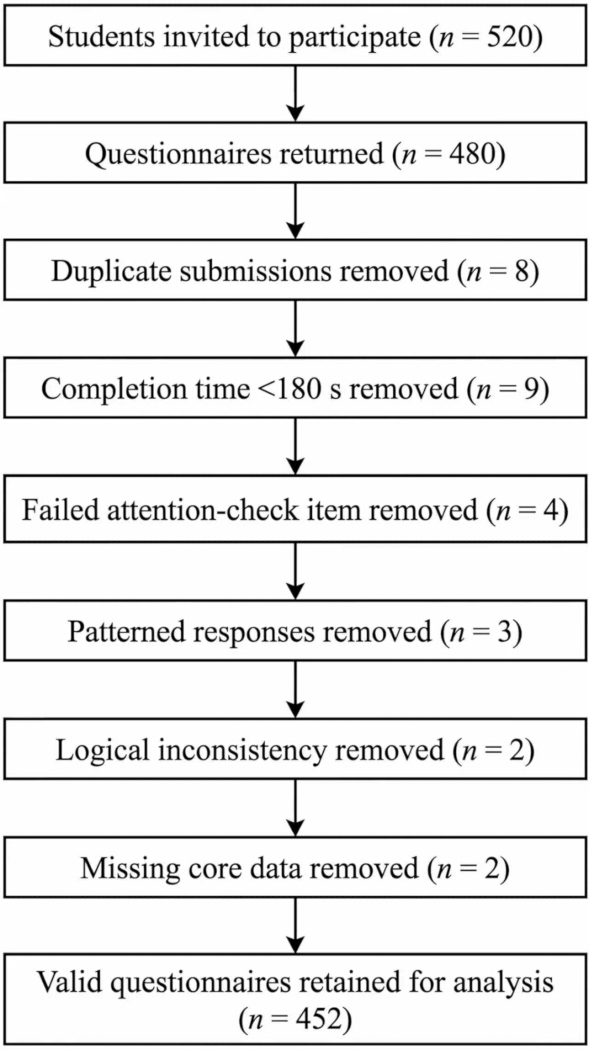
Figuur 1: Vloeiend schema van de vragenlijst voor werving, screening, exclusie en uiteindelijke analytische retentie.Dit stroomdiagram toont de progressie van uitgenodigde studenten naar ingeleverde vragenlijsten, via sequentiële screening van de datakwaliteit en exclusie op basis van vooraf vastgestelde criteria, tot de uiteindelijke retentie van valide vragenlijsten voor analyse. De figuur geeft het aantal uitgenodigde studenten, ingeleverde vragenlijsten, geëxcludeerde records bij elke screeningsstap en de uiteindelijke analytische steekproef weer. Klik hier om een grotere versie van deze figuur te bekijken.
2. Voer een pilottest van de vragenlijst uit en leg de definitieve veldversie vast
- Voer een pilottest uit met de volledige vragenlijst
- Neem de volledige vragenlijst af bij 20–30 studenten die voldoen aan de formele inclusiecriteria, maar die niet worden opgenomen in de uiteindelijke dataset.
- Registreer de voltooiingstijd en schriftelijke feedback over de duidelijkheid, de antastbaarheid (responsbelasting), technische toegang, de volgorde van de items, het begrip van de aandachtsvragen en eventuele dubbelzinnigheid in de demografische of gedragsmatige antwoordopties.
- Registreer de omvang van de pilotsteekproef, de mediane voltooiingstijd, het interkwartielbereik, de minimale en maximale voltooiingstijd en alle tekstuele wijzigingen die na de pilottest zijn aangebracht.
- Bij de representatieve implementatie bestond de pilot uit 25 studenten, was de mediane voltooiingstijd 540 s en werd de verwachte voltooiingstijd vastgesteld op 6–8 min.
- Herzie dubbelzinnige formuleringen, dubbele betekenissen, onduidelijke antwoordopties of software-weergaveproblemen die tijdens de pilottest zijn geïdentificeerd, en leg vervolgens de definitieve versie van de vragenlijst vast voordat deze formeel wordt uitgebracht.
OPMERKING: Als de studie meertalige studenten, ouderen, adolescenten of studenten met een beperking omvat, voer dan aanvullende cognitieve tests of pilottests met subgroepen uit voordat de formele release plaatsvindt.
- Stel de operationele instellingen en exportregels vast
- Maak een nieuw enquêteproject aan in het geselecteerde online enquêteplatform. Voer de toestemmingspagina in als de eerste pagina en stel het toestemmingsitem in als een verplicht vertakkingsitem.
- Configureer de enquête zodanig dat deelnemers die geen toestemming geven de enquête automatisch verlaten zonder de inhoud van de vragenlijst te zien.
- Voer alle demografische items, items over internetgebruik, de IAT, DERS-16, covariabelen en aandachtsvragen in met de vastgelegde bewoordingen en antwoordcategorieën. Stel alle kernitems in als verplicht.
- Activeer de automatische registratie van starttijd, eindtijd, voltooiingsduur, responsstatus en de door het platform gegenereerde responsidentificatie.
- Schakel controles voor één respons per deelnemer in wanneer beschikbaar, inclusief geauthenticeerde enquête-links, apparaatbeperkingen, cookie-gebaseerde herhalingspreventie, account-gebaseerde herhalingspreventie of instellingen voor het beoordelen van dubbele responsen. Registreer de ingeschakelde controles in de README/codeboek.
- Schakel de verzameling van onnodige directe identificatoren uit. Als het platform standaard het IP-adres registreert, schakel IP-opslag dan uit of vervang dit door een niet-identificerend veld voor het screenen van dubbelen, indien toegestaan door het institutionele beleid.
OPMERKING: Wanneer IP-adressen of apparaatmetadata tijdelijk worden bewaard voor het screenen van dubbelen, bewaar deze dan uitsluitend in het versleutelde ruwe bestand, beperk de toegang tot de studieanalist en verwijder ze voordat de definitieve analytische dataset wordt opgesteld. - Specificeer of pauzeren en hervatten is toegestaan. In dit protocol is een formele opslag- en terugkeerfunctie over verschillende sessies heen niet ingeschakeld. Deelnemers kunnen alleen pauzeren binnen dezelfde open browsersessie, en de geregistreerde voltooiingstijd omvat de volledige verstreken tijd.
- Exporteer het ruwe resultatenbestand bij afsluiting van de enquête in zowel spreadsheet- als comma-separated-value-formaat18. Exporteer daarnaast een enquête-naar-documentbestand of een PDF/A-kopie met de definitieve bewoordingen van de vragenlijst, de itemvolgorde, de vertakkingsinstellingen, de instellingen voor verplichte items en de coderingsstructuur. Sla deze bestanden op met versienummers in de naam.
- Bereken de mediane voltooiingstijd van de pilot en stel de drempelwaarde voor een minimale geldige voltooiing vast op ongeveer een derde van die waarde. Stel de definitieve ondergrens vast op 180 s en pas deze uniform toe tijdens de formele screening.
- Omdat deze afkapwaarde is afgeleid van de pilotsteekproef, moet de drempelwaarde opnieuw worden vastgesteld wanneer het protocol wordt geïmplementeerd bij een wezenlijk andere populatie, op een ander platform, in een andere taalversie of binnen een andere institutionele setting.
OPMERKING: Archiveer de screenshots van de definitieve vragenlijst, de export van de definitieve vragenlijst, de README/codeboek, het pilotlogboek, de bewoordingen van de aandachtsvragen, het sjabloon voor het screeningslogboek, de exportinstellingen en de statistische syntaxis als aanvullende of auditbestanden.
3. Publiceer de vragenlijst en bewaar de ruwe dataset
- Werving van deelnemers via vaste kanalen
- Verstuur één gestandaardiseerde uitnodiging via communicatiegroepen voor studenten, klasenkanalen of institutionele mailinglijsten gedurende een vaste verzamelperiode van 14 dagen.
- Vermeld zowel in de uitnodiging als op de toestemmingspagina het doel van het onderzoek, de verwachte voltooiingstijd van 6–8 min, de anonieme verwerking van gegevens, de vrijwillige deelname en de afwezigheid van academische sancties of beloningen bij niet-deelname.
- Toon de toestemmingspagina voordat er vragenlijstitems verschijnen en vereis actieve instemming vóór toegang. Sta geen toegang tot de kern van de vragenlijst toe zonder een bevestigend antwoord op de toestemmingsvraag.
- Vermeld op de toestemmingspagina dat deelnemers kunnen stoppen vóór de definitieve indiening en dat onvolledige antwoorden niet worden gebruikt in de definitieve analyse.
- Gebruik dezelfde vergrendelde versie van de vragenlijst over alle wervingskanalen heen. Indien meerdere wervingskanalen worden gebruikt, registreer het kanaal alleen wanneer dit vooraf is vastgesteld als een onderzoeksvariabele.
- Behoud van het ruwe retourbestand
- Bewaar alle geretourneerde records, inclusief onvolledige en later uitgesloten indieningen, in het ruwe exportbestand. Exporteer de volledige dataset onmiddellijk na afsluiting van de enquête en sla deze op als raw_returns_YYYYMMDD.csv en raw_returns_YYYYMMDD.xlsx.
- Bewaar de oorspronkelijke indieningstijd, de voltooiingsduur, de responsstatus, de door het platform gegenereerde respons-identifier en de apparaat- of accountgebonden technische identifier in het ruwe bestand. Overschrijf deze velden niet tijdens latere opschoning.
- Sla één alleen-lezen kopie van de ruwe data op voordat de screening begint. Bewaar het ruwe bestand, het screeningslogboek en de definitieve analytische dataset in afzonderlijke mappen. Beperk de toegang tot het ruwe bestand dat technische identifiers bevat tot uitsluitend geautoriseerd onderzoekspersoneel.
WAARSCHUWING: Verzamel geen direct identificeerbare informatie, zoals volledige naam, studentnummer, exact studentenadres, persoonlijk telefoonnummer, persoonlijk e-mailadres of socialmediaccount, in het hoofdbestand van de enquête.
OPMERKING: Pauzeer de workflow na de ruwe export, sla één alleen-lezen kopie van de ruwe dataset op en start de opschoning opnieuw uitsluitend vanaf die bewaard gebleven kopie.
4. Screen de terugontvangen vragenlijsten en genereer de definitieve analytische dataset
- Pas de screeningvolgorde in een vaste volgorde toe
- Sorteer alle teruggeleverde records op apparaatgebonden identifier, accountgebonden identifier indien beschikbaar, tijdstempel, status van de vragenlijst en responsgelijkenis. Identificeer eerst dubbele inzendingen. Behoud het vroegste volledige record wanneer twee of meer inzendingen van dezelfde deelnemer afkomstig zijn binnen dezelfde verzamelcyclus.
- Indien meerdere inzendingen worden gedetecteerd van hetzelfde geauthenticeerde account maar van verschillende apparaten, behandel deze dan als dubbele inzendingen van dezelfde deelnemer. Behoud het vroegste volledige record en sluit latere volledige records uit. Als het vroegste record onvolledig is en een later record volledig is, behoud dan het vroegste volledige record.
- Verwijder records met een voltooiingstijd <180 s, beoordeel records die in 180–240 s zijn voltooid, en verwijder als vierde stap records die niet voldoen aan het attention-check item voor gerichte responsen. Documenteer het aantal verwijderingen per stap in screening_log_v1.xlsx19.
- Voer voor records die in 180–240 s zijn voltooid een handmatige beoordeling uit op basis van het attention-check resultaat, de vlag voor long-string responding, de standaarddeviatie binnen de persoon en de vlag voor logische consistentie.
- Behoud een record met een grensgeval voor de snelheid alleen wanneer er geen extra vlag voor datakwaliteit aanwezig is. Noteer elke beslissing over grensgevallen van snelheid in het screeninglogboek.
- Verwijder gepatroneerde, inconsistente of onvolledige records
- Verwijder alle vragenlijsten die long-string responding vertonen, gedefinieerd als 18 of meer opeenvolgende identieke responsen over de 36 gescorede schaalitems, of een standaarddeviatie binnen de persoon ≤0.25 over deze items.
- Verwijder elke vragenlijst die onmogelijke gedragscombinaties vertoont. Definieer “de hoogste responscategorie op bijna alle items van de internetverslavingstest” als een score van 5 op ten minste 18 van de 20 IAT-items.
OPMERKING: De regel voor logische inconsistentie wordt geactiveerd wanneer een respondent zowel internetgebruik op doordeweekse dagen als in het weekend rapporteert in de laagste duurcategorie (<2 h per dag), nachtelijk internetgebruik codeert als “bijna elke nacht,” en een score van 5 behaalt op ten minste 18 van de 20 IAT-items. Pas deze regel pas toe nadat de screening op dubbelen, voltooiingstijd, attention-checks en gepatroneerde responsen is voltooid. - Verwijder alle vragenlijsten met ontbrekende waarden in enig IAT-item, enig DERS-16 item of enige vooraf gespecificeerde covariaat.
OPMERKING: Deze complete-case regel wordt gebruikt omdat de online enquête verplichte kernitems gebruikt en omdat het representatieve regressiemodel een vaste set covariaten vereist. Wanneer ontbrekende covariaatgegevens 5% overschrijden, gebruik dan een vooraf gespecificeerde alternatieve methode voor ontbrekende gegevens, zoals multiple imputatie. - Ken één anoniem studie-ID toe aan elk behouden record en sla het resterende bestand op als analytic_dataset_v1.csv en analytic_dataset_v1.xlsx.
- Verwijder door het platform gegenereerde responsidentifiers, apparaatgebonden identifiers, accountgebonden identifiers, IP-adressen indien behouden tijdens de screening, tijdstempels en vrijtekst-beoordelingsnotities uit de uiteindelijke analytische dataset. Behoud alleen het anonieme studie-ID en de analysevariabelen.
CRUCIALE STAP: Pas de screeningvolgorde in dezelfde volgorde toe op elk record en voeg eerder uitgesloten gevallen in latere fasen niet opnieuw toe. Wijs het eerste geactiveerde uitsluitingscriterium toe als de primaire reden voor uitsluiting en noteer secundaire vlaggen alleen als aantekeningen in het screeninglogboek.
OPMERKING: Vat de uiteindelijke uitsluitingsaantallen per reden samen in Tabel 2, en zorg dat deze aantallen identiek zijn aan de deelnemersstroom die later wordt gerapporteerd in Figuur 1.
| Screeningsvolgorde | Screeningsitem | Operationele regel | Screeningactiviteit | Documentatieregel |
| Stap 1 | Behoud van ruwe exportgegevens | Exporteer alle geretourneerde records onmiddellijk na sluiting van de enquête en sla deze op als raw_returns_JJJMMDD.csv en raw_returns_JJJMMDD.xlsx | Bewaar één alleen-lezen kopie voordat er met de reiniging wordt begonnen | Archiveren in map met ruwe gegevens |
| Stap 2 | Controle van toestemming en toegang | Identificeer records zonder actieve elektronische geïnformeerde toestemming vóór toegang tot de vragenlijst | Sluit dossiers zonder toestemming uit van de analytische workflow | Registreer uitgesloten of ontoegankelijke records in screening_log_v1.xlsx wanneer deze behouden blijven in de export van het platform |
| Stap 3 | Screening op duplicaten | Identificeer records die dezelfde apparaatgebonden identifier of accountgebonden identifier delen binnen dezelfde verzamelcyclus en die overeenkomen op basis van geslacht, leeftijd, academisch jaar en ten minste 80% identieke antwoorden op de vragenlijst | Behoud het vroegste volledige record en sluit alle latere duplicaten uit | Registreer het aantal uitgesloten records en de bijbehorende raw_record_id-waarden in screening_log_v1.xlsx; ken de primaire exclusion_reason = 1 toe |
| Stap 4 | Reconciliatie van duplicaten over meerdere apparaten | Identificeer meerdere volledige inzendingen van hetzelfde geauthenticeerde deelnemersaccount via verschillende apparaten | Behandel deze records als dubbele indieningen; behoud het vroegste volledige record | Registreer de accountbeperkte identificatiecode en de behouden raw_record_id in screening_log_v1.xlsx; ken aan latere records de primaire exclusion_reason = 1 toe |
| Stap 5 | Screening van de voltooiingstijd | Identificeer alle vragenlijsten met voltooiingstijd <180 s | Sluit al dergelijke records automatisch uit | Registreer het aantal uitgesloten gevallen in screening_log_v1.xlsx; wijs de primaire exclusion_reason = 2 toe |
| Stap 6 | Review van grensnelheden | Identificeer alle vragenlijsten met een voltooidingstijd van 180–240 s | Beoordeel elk record handmatig aan de hand van attention-check, long-string, within-person SD- en logica-flags; behoud deze alleen als er geen aanvullende flag aanwezig is. | Registreer elke casus als retained_after_manual_review = 1 of excluded_after_manual_review = 1 in screening_log_v1.xlsx |
| Stap 7 | Screening voor aandachtstests | Identificeer alle records die niet voldoen aan het attention-check-item met gestuurde respons | Sluit alle mislukte records uit die nog niet in een eerdere stap zijn uitgesloten | Registreer het aantal uitgesloten gevallen in screening_log_v1.xlsx; ken de primaire exclusion_reason = 3 toe |
| Stap 8 | Screening op gepatroneerde respons | Identificeer records met 18 of meer opeenvolgende identieke responsen over de 36 gescorede schaalitems, of een intra-individuele SD ≤0,25 over deze items | Sluit alle dergelijke records uit die nog niet in een eerdere stap zijn uitgesloten | Registreer het aantal uitgesloten gevallen in screening_log_v1.xlsx; wijs de primaire exclusion_reason = 4 toe |
| Stap 9 | Screening op logische consistentie | Identificeer records die de vooraf gespecificeerde onmogelijke gedragcombinatie vertonen: zowel weekday_internet_use als weekend_internet_use gecodeerd als <2 u, late_night_use gecodeerd als bijna elke nacht, en een score van 5 op ten minste 18 van de 20 IAT-items | Sluit alle dergelijke records uit die nog niet in een eerdere stap zijn uitgesloten | Registreer het aantal uitgesloten gevallen en de reviewnotitie in screening_log_v1.xlsx; wijs de primaire exclusion_reason = 5 toe |
| Stap 10 | Screening op ontbrekende kernen | Identificeer records met ontbrekende waarden in IAT_1–IAT_20, DERS_1–DERS_16, age, sex, weekday_internet_use, weekend_internet_use, sleep_duration, physical_activity of academic_stress; “prefer not to say” voor sex wordt beschouwd als een geldig antwoord en niet als een ontbrekende waarde | Sluit alle dergelijke records uit die nog niet in een eerdere stap zijn uitgesloten | Registreer het aantal uitgesloten gevallen in screening_log_v1.xlsx; wijs de primaire exclusion_reason = 6 toe |
| Stap 11 | Primaire uitsluitingstoewijzing | Identificeer records die voldoen aan meer dan één exclusiecriterium | Wijs het eerste getriggerde criterium in de vooraf gespecificeerde screeningsvolgorde toe als de primaire reden voor uitsluiting | Noteer secundaire vlaggen uitsluitend in de reviewnotities; wijs geen meerdere primaire redenen toe |
| Stap 12 | Verwijdering van technische identificatoren | Identificeer platformgegenereerde responsidentificatoren, apparaatbeperkte identificatoren, accountbeperkte identificatoren, tijdstempels en alle tijdelijk bewaarde technische metadata in het opgeschoonde bestand | Verwijder deze velden uit de definitieve analytische dataset nadat de screening is voltooid | Verwijdering van documenten in screening_log_v1.xlsx |
| Stap 13 | Finale retentie | Bewaar alle records die alle voorgaande screeningsstappen hebben doorstaan | Ken één anonieme studie-ID toe aan elk behouden record | Opslaan als analytic_dataset_v1.csv en analytic_dataset_v1.xlsx |
| Stap 14 | Samenvatting van de screening | Tel het aantal verwijderde items bij elke stap en het uiteindelijke aantal behouden items | Vat de definitieve tellingen samen voor rapportage in het manuscript | Houd de aantallen in Tabel 2 identiek aan Figuur 1 |
| Stap 15 | Bewaring van het audit trail | Bewaar het ruwe bestand, het screeningslogboek en de uiteindelijke analytische dataset als afzonderlijke bestanden | Overschrijf, voeg samen of bewerk gearchiveerde bronbestanden niet handmatig | Sla apart op in mappen voor ruwe gegevens, screening en analyse |
Tabel 2: Vooraf vastgestelde screeningsvolgorde, uitsluitingsdrempels, screeningsacties en documentatieregels voor het opschonen van vragenlijsten. Deze tabel vat de vaste screeningsvolgorde samen die is gebruikt voor het opschonen van de ingediende vragenlijsten, inclusief controles van toestemming en toegang, screening op duplicaten, reconciliatie van meerdere apparaten, screening op voltooiingstijd, beoordeling van grensgevende snelheid, falen van aandachtstests, patroonmatig reageren, logische inconsistentie, ontbrekende kerngegevens, verwijdering van technische identificatiekenmerken, definitieve retentie en het behoud van de audit trail. Afkortingen: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale. Klik hier om deze tabel te downloaden.
5. Score variabelen, verifieer de betrouwbaarheid en bereid het analyseklaar bestand voor
- Genereer totaalscores, subschaalscores en afgeleide categorische variabelen
- Tel de 20 IAT-itemscores op om de totale internetverslavingsscore te genereren, en sla vervolgens zowel de continue score als de ernstklasse met drie niveaus op in het analyse-klare bestand.
- Codeer DERS-16 Items 1, 6 en 8 omgekeerd, bereken de totaalscore en vijf subschaalscores, en voeg alle afgeleide variabelen toe aan dezelfde dataset op deelnemerniveau.
- Voer een bereikcontrole uit vóór de scoreberekening. Bevestig dat alle IAT- en DERS-16-itemwaarden tussen 1–5 liggen, alle omgekeerd gecodeerde waarden tussen 1–5 liggen, IAT-totaalscores tussen 20–100 liggen en DERS-16-totaalscores tussen 16–80 liggen. Noteer de output van de bereikcontrole in het scorelogboek.
- Codeer covariabelen opnieuw naar vaste analytische categorieën
- Codeer de duur van het internetgebruik op doordeweekse dagen en in het weekend opnieuw als <2 u, 2–3.9 u, 4–5.9 u en ≥6 u. Codeer nachtelijk internetgebruik opnieuw als nooit, <1 nacht/week, 1–2 nachten/week, 3–5 nachten/week en bijna elke nacht.
- Codeer de slaapduur, de frequentie van fysieke activiteit en de waargenomen academische stress opnieuw met behulp van de vooraf gespecificeerde categorieregels gedefinieerd in sectie 1.4 en sla de opnieuw gecodeerde waarden op onder vaste variabelenamen in dezelfde dataset.
- Codeer geslacht voor regressie met behulp van twee indicatorvariabelen: vrouw versus man en liever niet zeggen versus man. Vermeld de codering in de tabelvoetnoot en de README/codebook.
- Verifieer de score-integriteit en interne consistentie
- Bereken Cronbach’s alfa voor de IAT-totaalscore en de DERS-16-totaalscore vóór de inferentiële analyse. Controleer de itemcodering, omgekeerde codering en onmogelijke itembereiken opnieuw als een van de alfa-waarden <0.70 is20. Vermeld de Cronbach’s alfa-waarden in de sectie Representatieve Resultaten.
- Bereken item-totaalcorrelaties of alfa-indien-item-verwijderd-waarden als een van beide schalen een onverwacht lage interne consistentie vertoont. Verwijder geen schaalitems uit de primaire analyse, tenzij itemverwijdering vooraf was gespecificeerd of de studie expliciet is ontworpen als een psychometrische validatiestudie.
- Sla de definitieve analyse-klare dataset op samen met een README-bestand waarin variabelenamen, coderingsregels, exclusiedrempels, bestandsnamen, softwareversies, vragenlijstversie, scoresyntax, regressiemodelspecificatie en procedures om dezelfde dataset opnieuw te genereren, worden vermeld.
6. Analyseer de gegevens en bewaar reproduceerbare resultaten
- Genereer beschrijvende statistieken en groepsvergelijkingen
- Rapporteer continue variabelen als gemiddelde ± standaarddeviatie en categorische variabelen als frequentie en percentage. Vat demografische kenmerken, internetgebruikgedrag en schaalscores samen met behulp van de vooraf gedefinieerde outputstructuur.
- Rapporteer de steekproefomvang die voor elke analyse is gebruikt. Gebruik de behouden analytische steekproef als noemer, tenzij een tabel duidelijk anders vermeldt.
- Vergelijk de totale DERS-16 scores en subschaalscores over de drie IAT-ernstgroepen en gebruik tweezijdige toetsing met α = 0.05 voor de primaire analyses. Rapporteer gestandaardiseerde effectgroottes waar passend.
OPMERKING: Rapporteer voor groepsvergelijkingen η2 of partiële η2 voor variantieanalyse, of een equivalente non-parametrische effectgrootte als er een non-parametrische toets wordt gebruikt. Interpreteer vergelijkingen van de subgroep met ernstig problematisch gebruik met voorzichtigheid wanneer de subgroep klein is. - Bereken de Pearson-correlatie tussen de totale IAT-score en de totale DERS-16 score wanneer beide variabelen een acceptabel distributiegedrag vertonen; gebruik anders de Spearman-correlatie als sensitiviteitsanalyse. Rapporteer n, r of ρ, het 95% betrouwbaarheidsinterval indien gegenereerd door de statistische software, de p waarde en de interpretatie van de grootte.
- Pas het gecorrigeerde regressiemodel toe en archiveer de outputs
- Gebruik de totale DERS-16 score als afhankelijke variabele en de totale IAT-score als primaire onafhankelijke variabele. Voer leeftijd, geslacht, internetgebruik op doordeweekse dagen, internetgebruik in het weekend, slaapduur, fysieke activiteit en ervaren academische stress in als covariabelen. Dit model is de vooraf gedefinieerde analytische demonstratie van de gestandaardiseerde workflow.
- Evalueer de regressie-aannames en modelstabiliteit voordat het gecorrigeerde regressiemodel wordt geïnterpreteerd. Inspecteer residual-versus-fitted plots voor lineariteit en homoscedasticiteit, inspecteer een Q-Q plot of normaliteitstoets voor de residuverdeling, en bereken variantie-inflatiefactoren om multicollineariteit te beoordelen.
- Rapporteer deze diagnostieken in de sectie Representatieve Resultaten of in de aanvullende analyse-output.
- Indien residuele heteroscedasticiteit wordt gedetecteerd, rapporteer dan heteroscedasticiteits-robuuste standaardfouten als sensitiviteitsanalyse.
- Indien invloedrijke observaties aanwezig zijn, rapporteer dan of de primaire coëfficiënt voor de totale IAT-score materieel ongewijzigd blijft na invloedsdiagnostiek. Verwijder geen invloedrijke observaties tenzij aan een vooraf gespecificeerde regel voor datakwaliteit is voldaan.
- Rapporteer niet-gestandaardiseerde coëfficiënten, standaardfouten, gestandaardiseerde coëfficiënten, p waarden, model R2, gecorrigeerde R2, model F-statistiek en het VIF-bereik voor het gecorrigeerde model. Vermeld de steekproefomvang in de tabeltitel of de tabelvoetnoot.
- Indien interacties, subgroepeffecten of mediatieroutes worden getest, specificeer deze analyses dan vóór de gegevensverzameling of label ze als exploratief. Het kernprotocol vereist geen interactietoetsing, tenzij subgroepverschillen een vooraf gedefinieerd studiedoel zijn.
- Sla alle statistische syntaxis, outputtabellen, residuplots, VIF-output, betrouwbaarheidsoutput en gegenereerde figuren op onder versiebeheerde bestandsnamen. Genereer alle rapporteerbare outputs opnieuw direct vanuit analytic_dataset_v1 in plaats van vanuit handmatig bewerkte bestanden.
OPMERKING: Houd de protocoltekst gericht op de replicatie van de workflow. Presenteer de gedetailleerde representatieve statistieken, subgroepfiguren, regressiediagnostieken, multicollineariteitsbeoordeling en modeloutputs in de sectie Representatieve Resultaten.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Studieproces en uiteindelijke analytische retentie
De resultaten tonen de uitvoering van de gestandaardiseerde workflow van de vragenlijsten aan, in plaats van een onafhankelijke validatie van de Internet addiction test of de DERS-16. Gedurende het enquêtevenster van 14 dagen werden 520 universiteitsstudenten uitgenodigd om deel te nemen, waarvan 480 vragenlijsten werden ingeleverd. De screening werd uitgevoerd in de vooraf vastgestelde volgorde. Ten eerste werden 8 dubbele in...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
De belangrijkste bijdrage van dit artikel is de gestandaardiseerde workflow voor het vragenlijstonderzoek, en niet zozeer de geobserveerde representatieve associatie tussen internetverslaving en problemen met emotieregulatie. De implementatie toonde aan dat een vaste volgorde van elektronische toestemming, demografische gegevens, internetgebruikgedrag, IAT-scoring, DERS-16-scoring, verzameling van covariabelen, sequentiële screening van datakwaliteit en reproduceerbare regressieanalyse kan worden uitgevoerd in een steekp...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteur heeft niets te melden.
Dankbetuigingen
Dit werk werd ondersteund door het Soft Science Project van de provincie Henan uit 2025, “Research on the Impact and Optimization Path of Changes in School Age Population on the High Quality Development of Private Higher Education in Henan Province” (Project nr. 252400410490), en het Doctoral Research Fund Project van de Zhengzhou University of Economics and Business uit 2025, “Research on the Formation Mechanism and Public Sentiment Guidance Mechanism of College Students’ Network Cluster Behavior.” De auteur bedankt de Zhengzhou University of Economics and Business voor de institutionele ondersteuning.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Analyseklare dataset | Studie-specifiek intern document | analytic_dataset_v1.csv en analytic_dataset_v1.xlsx | Definitieve geanonimiseerde dataset gebruikt voor alle rapporteerbare descriptieve, betrouwbaarheids-, correlatie- en regressieanalyses |
| Analysesyntaxis | Studie-specifiek intern document | analysis_syntax_v1.R of equivalent scriptbestand | Gebruikt om scoringverificatie, betrouwbaarheidscontroles, descriptieve statistieken, correlatieanalyse, regressiemodellering, VIF-berekening en diagnostische output te reproduceren |
| Bewoording van attention-check item | Studie-specifiek intern document | attention_check_v1.txt | Vastgelegde bewoording van het attention-check item met gerichte respons dat tijdens het afnemen van de vragenlijst werd gebruikt |
| DERS-16 vragenlijst | Originele schaalbron of geautoriseerde/aangepaste versie van de vragenlijst | 16-item Difficulties in Emotion Regulation Scale korte vorm | Gebruikt om problemen met emotieregulatie te beoordelen; de scoring volgt de vastgelegde DERS-16 scoringkey zoals gedocumenteerd in het codeboek |
| Elektronisch informatieblad en toestemmingspagina | Studie-specifiek intern document | consent_form_v1.pdf of toestemmingspagina van het platform | Gebruikt om studie-informatie te verstrekken en elektronische geïnformeerde toestemming te verkrijgen vóór toegang tot de vragenlijst |
| Blad met bestandnaamconventies | Studie-specifiek intern document | file_naming_convention_v1.xlsx | Gebruikt om namen te standaardiseren voor ruwe, opgeschoonde, analytische, screening-log, codeboek- en outputbestanden |
| Definitieve screenshots van de vragenlijst | Studie-specifiek intern document | questionnaire_screenshots_v1.pdf | Gebruikt om de vastgelegde weergave van de enquête, itemvolgorde, responsankers en instellingen voor verplichte items te documenteren |
| Geïntegreerde ontwikkelomgeving | Posit | RStudio Desktop | Gebruikt voor het beheren van scripts, logs en reproduceerbare analyseworkflows |
| Internet Addiction Test vragenlijst | Originele schaalbron of geautoriseerde/aangepaste versie van de vragenlijst | 20-item Internet Addiction Test | Gebruikt om symptomen van internetverslaving te beoordelen en normaal gebruik, problematisch gebruik en ernstig problematisch gebruik te classificeren |
| Online enquêteplatform | Qualtrics | XM Platform; institutioneel of gelicentieerd account | Gebruikt voor het bouwen van de vragenlijst, afdwingen van verplichte items, beheren van toestemmingsgebaseerde toegang, beperken van herhaalde indieningen indien ingeschakeld, en exporteren van responsgegevens |
| Optioneel menu-gestuurd statistisch pakket | IBM | SPSS Statistics | Gebruikt wanneer een GUI-gebaseerde analyseworkflow vereist is voor descriptieve statistieken, betrouwbaarheidscontroles of regressieanalyse |
| README/codeboekbestand | Studie-specifiek intern document | README_v1.txt of codebook_v1.xlsx | Gebruikt voor het documenteren van variabelenamen, coderingsregels, scorebereiken, omgekeerde coderingsregels, exclusiedrempels, bestandsnamen en softwareversies |
| Alleen-lezen archiefkopie | Portable document format | PDF/A of door instelling goedgekeurde archief-PDF | Gebruikt om het vastgelegde enquête-instrument, de toestemmingspagina en protocol-ondersteunende documenten te bewaren |
| Werkmap screeninglog | Studie-specifiek intern document | screening_log_v1.xlsx | Gebruikt voor het documenteren van dubbel-screening, screening op voltooiingstijd, mislukte attention-checks, patroonmatig reageren, logische inconsistentie, ontbrekende gegevens, beslissingen bij handmatige beoordeling en definitieve behouden aantallen |
| Spreadsheet-software | Microsoft | Microsoft Excel werkmap-formaat (.xlsx) | Gebruikt voor screeninglogs, variabelenwoordenboek, handmatige beoordelingsgegevens en voorbereiding van aanvullende werkmappen |
| Statistische computeromgeving | R Foundation / CRAN | R 4.5.3 | Gebruikt voor scoringverificatie, descriptieve statistieken, betrouwbaarheidscontroles, correlatieanalyse, regressieanalyse, VIF-berekening en diagnostische output |
| Aanvullend bestand 1 | Studie-specifiek aanvullend bestand | Supplementary File 1.xlsx | Bevat materialen voor de vragenlijstworkflow, codeboek, screeninglog, outputplan en analyseklare workflowmaterialen |
| Aanvullende tabel S1 | Studie-specifieke aanvullende tabel | Supplementary Table S1 | Biedt het volledige variabelenwoordenboek, aanwezigheid van bestanden, coderingsstructuur, technische identificatievelden, screeningsvariabelen en dataset-trackingvelden |
| Exportdocument van de enquête | Qualtrics | Survey-to-Word export of PDF-export | Gebruikt om de definitieve bewoording van de vragenlijst, itemvolgorde, vertakkingsinstellingen, instellingen voor verplichte items en responscodering te archiveren |
| Exportformaat van de enquête | Qualtrics | CSV-export | Gebruikt voor het bewaren van ruwe antwoorden en export van analyseklare gegevens |
Referenties
- Moreno MA, et al. Problematic internet use among US youth: a systematic review. Arch Pediatr Adolesc Med. 2011;165:797-805.
- Ramón-Arbués E, et al. Prevalence and factors associated with problematic internet use in a population of Spanish university students. Int J Environ Res Public Health. 2021;18:7620.
- Cai Z, et al. Associations between problematic internet use and mental health outcomes of students: a meta-analytic review. Adolesc Res Rev. 2023;8:45-62.
- Gong Z, Wang L, Wang H. Perceived stress and internet addiction among Chinese college students: mediating effect of procrastination and moderating effect of flow. Front Psychol. 2021;12:632461.
- Tsai JK, et al. Relationship between difficulty in emotion regulation and internet addiction in college students: a one-year prospective study. Int J Environ Res Public Health. 2020;17:4766.
- Romero-López M, Pichardo C, De Hoces I, García-Berbén T. Problematic internet use among university students and its relationship with social skills. Brain Sci. 2021;11:1301.
- Xie X, et al. Problematic internet use was associated with psychological problems among university students during COVID-19 outbreak in China. Front Public Health. 2021;9:675380.
- Montagni I, et al. Mental health-related digital use by university students: a systematic review. Telemed J E Health. 2020;26:131-146.
- Candussi CJ, Kabir R, Sivasubramanian M. Problematic smartphone usage, prevalence and patterns among university students: a systematic review. J Affect Disord Rep. 2023;14:100643.
- Moon SJ, Hwang JS, Kim JY, Shin AL, Bae SM, Kim JW. Psychometric properties of the Internet Addiction Test: a systematic review and meta-analysis. Cyberpsychol Behav Soc Netw. 2018;21:473-484.
- Jelenchick LA, Becker T, Moreno MA. Assessing the psychometric properties of the Internet addiction test in US college students. Psychiatry Res. 2012;196:296-301.
- Tafur-Mendoza AA, Acosta-Prado JC, Zárate-Torres RA, Ramírez-Ospina DE. Assessing the psychometric properties of the Internet addiction test in Peruvian university students. Int J Environ Res Public Health. 2020;17:5782.
- Fernández-Villa T, Molina AJ, García-Martín M, Llorca J, Delgado-Rodríguez M, Martín V. Validation and psychometric analysis of the Internet addiction test in Spanish among college students. BMC Public Health. 2015;15:953.
- World Medical Association. World Medical Association Declaration of Helsinki: ethical principles for medical research involving human subjects. JAMA. 2013;310:2191-2194.
- Wei Z, Hassan NC, Hassan SA, Ismail N, Gu X, Dong J. Psychometric validation of Young’s Internet addiction test among Chinese undergraduate students. PLoS One. 2025;20:e0320641.
- Bjureberg J, et al. Development and validation of a brief version of the Difficulties in emotion regulation scale : the DERS-16. J Psychopathol Behav Assess. 2016;38:284-296.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK: Research and Methods. 2023;32:3-38.
- Broman KW, Woo KH. Data organization in spreadsheets. Am Stat. 2018;72:2-10.
- Leiner DJ. Too fast, too straight, too weird: non-reactive indicators for meaningless data in internet surveys. Surv Res Methods. 2019;13:229-248.
- Taber KS. The use of Cronbach’s alpha when developing and reporting research instruments in science education. Res Sci Educ. 2018;48:1273-1296.
- Gioia F, Rega V, Boursier V. Problematic Internet use and emotional dysregulation among young people: a literature review. Clin Neuropsychiatry. 2021;18:41-54.
- Chen M, Zhang X. Factors influencing internet addiction among university students: the mediating roles of self-control and anxiety. Acta Psychol (Amst). 2024;250:104535.
- Akbari M, Seydavi M, Sheikhi S, Spada MM. Problematic smartphone use and sleep disturbance: the roles of metacognitions, desire thinking, and emotion regulation. Front Psychiatry. 2023;14:1137533.
- Wang S, Cheng Y, Yang Y, Lu B. The impact of physical activity on internet addiction among college students: the chain mediation role of rumination and mindfulness. BMC Public Health. 2025;25:3643.
- Struminskaya B, Sakshaug JW. Ethical considerations for augmenting surveys with auxiliary data sources. Public Opin Q. 2023;87:619-633.
- Yin J, et al. Associations between both smartphone addiction and objectively measured smartphone use and sleep quality and duration among university students: a cross-sectional study. JMIR Ment Health. 2025;12:e77796.
- Hainagiu SM, Neagu SN. Caught in the Web—emotional regulation difficulties and internet addiction among Romanian medical and technical university students: a pilot cross-sectional study. Healthcare (Basel). 2025;13:2528.
- Guo C, Chen M, Ji X, Li J, Ma Y, Zang S. Association between internet addiction and sleep quality in medical students: a longitudinal study. Front Psychol. 2025;16:1517590.
- Barker M, Chue Hong NP, Katz DS, Lamprecht AL, Martinez-Ortiz C, Psomopoulos F, et al. Introducing the FAIR Principles for research software. Sci Data. 2022;9:622.
- Nosek BA, Alter G, Banks GC, Borsboom D, Bowman SD, Breckler SJ, et al. Promoting an open research culture. Science. 2015;348:1422-1425.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.