In deze retrospectieve studie in één centrum werd een logistisch regressiemodel ontwikkeld en intern gevalideerd voor vertraagde cerebrale ischemie na aneurysmatische subarachnoïdale bloeding. Bij 680 patiënten vertoonden zes vroege klinische, laboratorium- en beeldvormingsvariabelen een voorlopige voorspellende waarde. Verdere externe validatie is vereist voordat het model klinisch kan worden toegepast.
Onderzoeksartikel
Interne validatie van een klinisch voorspellingsmodel voor vertraagde cerebrale ischemie na aneurysmatische subarachnoïdale bloeding
In dit artikel
Samenvatting
Samenvatting
Vertraagde cerebrale ischemie (DCI) is een belangrijke oorzaak van secundair neurologisch letsel na een aneurysmatische subarachnoïdale bloeding (aSAH). Deze retrospectieve single-center studie ontwikkelde en evalueerde voorspellingsmodellen voor DCI met behulp van gegevens van 680 volwassen patiënten met aSAH die werden behandeld tussen juli 2022 en december 2024. De patiënten werden middels een uitkomst-gestratificeerde 8:2 splitsing verdeeld in een trainingscohort van 544 patiënten en een intern validatiecohort van 136 patiënten. DCI trad op bij 175 patiënten in het trainingscohort en bij 42 patiënten in het interne validatiecohort. De selectie van predictoren werd in het trainingscohort uitgevoerd met behulp van least absolute shrinkage and selection operator-regressie met 10-voudige kruisvalidatie. Zes variabelen werden behouden: leeftijd, cerebraal oedeem, hypoalbuminemie, gemodificeerde Fisher-graad, Hunt-Hess-graad en de graad van de World Federation of Neurological Surgeons. Logistische regressie, extreme gradient boosting, light gradient boosting machine, support vector machine en k-nearest neighbor-modellen werden vergeleken. Logistische regressie vertoonde een area under the receiver operating characteristic curve van 0,832 (95% betrouwbaarheidsinterval, 0,758–0,906) in het interne validatiecohort. De kalibratieshelling, het kalibratie-intercept en de Brier-score waren respectievelijk 0,98, 0,02 en 0,168, hoewel betrouwbaarheidsintervallen voor deze kalibratieschattingen niet beschikbaar waren. De bevindingen vertegenwoordigen de voorlopige prestaties in één enkel intern validatiecohort. Onvolledige reproduceerbaarheidsgegevens, de afwezigheid van het model-intercept, het gebrek aan op resampling gebaseerde optimisme-correctie en het ontbreken van externe validatie beletten momenteel de berekening van de waarschijnlijkheid op patiëntniveau en de klinische implementatie.
Inleiding
Er zijn verschillende voorspellingsmodellen voorgesteld voor DCI na aSAH, maar veel daarvan werden beperkt door kleine steekproefgroottes, een onvolledige beoordeling van de kalibratie, onvoldoende verslaglegging van de procedures voor modelontwikkeling en een gebrek aan externe validatie. Veel studies hebben zich hoofdzakelijk gericht op discriminatie, terwijl kalibratie, reproduceerbaarheid en de beoordeling van de klinische impact minder consistent zijn gerapporteerd. Daarom moet de prestatie van het model worden geëvalueerd met transparante methoden en voorzichtig worden geïnterpreteerd wanneer de validatie beperkt is tot één enkel centrum.
De huidige studie had als doel voorspellingsmodellen voor DCI te ontwikkelen en intern te evalueren met behulp van routinematig beschikbare vroege klinische, laboratorium- en beeldvormingsvariabelen. Vijf modelleringsbenaderingen werden vergeleken met gebruik van dezelfde set geselecteerde predictoren. Het beoogde voorspellingstijdstip was na de initiële opname, het laboratoriumonderzoek en de beeldvormingsbeoordeling, maar vóór de belangrijkste risicoperiode voor DCI. De modellen werden ontwikkeld voor onderzoeksgebaseerde risicoschatting en waren niet bedoeld om DCI te diagnosticeren, het klinisch oordeel te vervangen of onafhankelijk de behandeling te bepalen. Externe validatie, recalibratie en testen van de klinische impact zijn vereist voordat ze klinisch kunnen worden toegepast.
Vertraagde cerebrale ischemie (DCI) is een van deze secundaire insulten die behoren tot de meest klinisch significante en potentieel voorkombare aandoeningen na een aSAH. DCI is een complicatie die gewoonlijk enkele dagen na de ictus optreedt, doorgaans binnen 3–14 dagen, en gekoppeld is aan nieuwe focale neurologische uitval, verslechtering van het bewustzijnsniveau en/of het ontstaan van een cerebraal infarct bij opeenvolgende neuroimaging. Hoewel er verschillen zijn in de diagnostische praktijk tussen verschillende instellingen, gaat DCI altijd gepaard met een langdurig verblijf op de intensive care, een hoog verbruik van middelen en een slechte neurologische prognose. De gerapporteerde incidentie van DCI is doorgaans 30–40 procent, wat de prevalentie en de significante prognostische implicaties onderstreept1,2,3,4,5,6. Opvallend is dat DCI geen proces met een enkelvoudig pad is. Hoewel de focus altijd heeft gelegen op cerebrale vasospasmen van grote vaten, laat toenemend bewijs ook zien dat vroegtijdige hersenbeschadiging, corticale spreading depolarization, neuroinflammatie, microtrombose, endotheeldisfunctie, verminderde autoregulatie en microcirculatoir falen allemaal bijdragen aan het ischemische risico. Deze multifactoriële pathofysiologie helpt verklaren waarom behandelingen gericht op vasospasmen infarcten geassocieerd met DCI mogelijk niet volledig kunnen voorkomen en waarom patiënten met een hoog risico moeilijk te identificeren zijn in de gebruikelijke klinische setting.
De risicostratificatie van DCI na aSAH is een prioriteit, omdat het door tijdige identificatie van hoogrisicopatiënten mogelijk is om hen nauwer te monitoren en preventieve of curatieve maatregelen prompt te escaleren7. Monitoringsplannen in de klinische praktijk kunnen het gebruik omvatten van frequentere neurologische tests, transcraniële Doppler-echografie, geavanceerde beeldvormingstechnieken zoals CT-perfusie, optimalisatie van de hemodynamiek en het intravasculaire volume, strikte naleving van de nimodipine-therapie en vroege identificatie van neurologische verslechtering, zoals hydrocefalus, rebleeding, insulten, infecties of metabole ontregeling. Desondanks hebben globale ernstschalen en de ervaring van clinici de neiging om klinische beslissingen meer te beïnvloeden dan gepersonaliseerde, datagestuurde schattingen van de DCI-waarschijnlijkheid8,9,10. Eén reden hiervoor is dat uit de literatuur blijkt dat risicofactoren heterogeen zijn en dat de wisselwerking tussen patiëntfactoren, de hoeveelheid bloeding, fysiologische ontregelingen en neurologische gradatieschalen niet-lineair en complex kan zijn. Vorige onderzoekers hebben potentiële voorspellers van DCI onderzocht, waaronder leeftijd, hypertensie, neurologische status bij aanvang, kenmerken van het aneurysma, laboratoriumindices (zoals serumnatrium en albumine), beeldkenmerken die duiden op de bloedingslast en perioperatieve of behandelgerelateerde factoren. Conventionele regressietechnieken zijn nuttig geweest, maar kunnen beperkt zijn wanneer voorspellers gecorreleerd zijn, wanneer de relatie tussen de voorspellers en het risico niet-lineair is, of wanneer er interacties tussen de variabelen bestaan11. Tegelijkertijd zijn er meerdere instrumenten (meestal nomogrammen) voorgesteld om het DCI-risico te beoordelen. Hoewel nomogrammen haalbaar en visueel aantrekkelijk zijn, zijn de meeste gebaseerd op kleine steekproeven, bevatten ze weinig variabelen en kunnen ze overfit zijn of onvoldoende gevalideerd. Bovendien zijn modellen die in één centrum zijn ontwikkeld en getest mogelijk niet direct vertaalbaar naar andere instellingen vanwege verschillen in patiëntenpopulatie, beeldinterpretatie, behandeling en DCI-diagnostische drempelwaarden.
Machine learning-methoden kunnen traditionele klinische voorspellingsmodellen aanvullen, omdat ze de exploratie van meer dimensies van klinische gegevens en de observatie van complexere trends mogelijk maken zonder dat er rigide lineaire aannames gedaan hoeven te worden. ML-gebaseerde voorspellingsmodellen vinden de laatste jaren steeds meer toepassingen op het gebied van cerebrovasculaire aandoeningen, waaronder de voorspelling van uitkomsten en complicaties, alsook beslissingsondersteuning12,13,14. Veelgebruikte machine learning-algoritmen omvatten ensemble-boommethoden zoals Extreme Gradient Boosting (XGBoost) en Light Gradient Boosting Machine (LightGBM), kernel-gebaseerde classificeerders zoals support vector machines (SVMs), en afstand-gebaseerde classificeerders zoals k-nearest neighbors (KNN). De modellen zijn in principe in staat om niet-lineariteiten en interacties beter te modelleren dan traditionele benaderingen15. Er zijn echter ook praktische zorgen verbonden aan ML-modellen, zoals het risico op overfitting, een verminderde interpreteerbaarheid en de noodzaak om preprocessingsstappen, tuning, kalibratie, evaluatie en validatie uit te voeren. Het is vermeldenswaard dat in een breed scala aan klinische scenario's een goed gespecificeerde logistische regressie net zo goed, of zelfs effectiever kan presteren dan complexere algoritmen, vooral wanneer het aantal predictoren klein is en de signaal-ruisverhouding matig is. Daarom is een vergelijkende analyse van verschillende algoritmen met vergelijkbare predictoren en evaluatiemetrieken nodig om een model te identificeren dat correleert met prestaties en klinische toepasbaarheid16,17,18.
Er zijn eerder verschillende voorspellingsmodellen voor vertraagde cerebrale ischemie voorgesteld; velen hiervan kampen echter met belangrijke beperkingen, waaronder kleine steekproefgroottes, een beperkte beoordeling van de kalibratie, een gebrek aan directe vergelijkingen tussen algoritmen en onvoldoende validatie. Bovendien leggen eerdere studies vaak de nadruk op discriminatie, terwijl metrieken voor kalibratie en klinisch nut, die essentieel zijn voor toepasbaarheid in de praktijk, onderbelicht blijven. De huidige studie pakt deze tekortkomingen aan door een voorspellingsmodel te ontwikkelen in een relatief grote cohort, systematische selectie van predictoren te implementeren met behulp van least absolute shrinkage and selection operator (LASSO) regressie, meerdere machine learning-algoritmen te vergelijken binnen een uniform modelleringskader en discriminatie, kalibratie en beslissingsanalytische prestaties uitgebreid te evalueren.
Er zijn verschillende voorspellingsmodellen voorgesteld voor DCI na aSAH, maar velen hebben belangrijke beperkingen, waaronder kleine cohorten, beperkte beoordeling van de kalibratie, onvolledige rapportage over de modelontwikkeling en een gebrek aan externe of temporele validatie. Daarnaast rapporteren veel studies alleen discriminatie, terwijl kalibratie en decision-curve-analyse minder consistent worden gepresenteerd. De huidige studie lost het probleem van externe validatie niet op. In plaats daarvan biedt het een single-center ontwikkelings- en interne validatiestudie met gebruikmaking van routinematig beschikbare klinische, laboratorium- en beeldvormingsvariabelen. De beoogde toepassing is vroege risicostratificatie na opname en de initiële behandeling van het aneurysma, vóór het belangrijkste risicovenster voor DCI. Het model kan clinici helpen patiënten te identificeren die nauwere neurologische monitoring, vasculaire beeldvormingssurveillance, correctie van fysiologische afwijkingen en vroege beoordeling door het neurocritical care-team nodig hebben. Het is niet bedoeld om het klinisch oordeel te vervangen, DCI te diagnosticeren of de behandeling te sturen zonder externe validatie en testen van de klinische impact. In eerdere studies zijn verschillende modellen voorgesteld voor het voorspellen van DCI na aSAH, maar velen waren beperkt door kleine steekproefgroottes, onvolledige rapportage van de kalibratie, beperkte vergelijkingen tussen modelleringsmethoden of een gebrek aan externe validatie. De huidige studie claimt niet een klinisch gevalideerd besluitvormingsinstrument te leveren. In plaats daarvan is het doel om een voorspellingsmodel te ontwikkelen en intern te valideren met gebruik van routinematig beschikbare vroege klinische, laboratorium- en beeldvormingsvariabelen uit een single-center cohort. De beoogde toepassing is vroege risicostratificatie na opname en de initiële behandeling van het aneurysma, vóór de belangrijkste risicoperiode voor DCI. In deze setting zou een hoog voorspeld risico een nauwere neurologische beoordeling, vasculaire monitoring, correctie van fysiologische afwijkingen en vroege beoordeling door neurocritical care ondersteunen. Het model is niet bedoeld om DCI te diagnosticeren of het oordeel van de clinicus te vervangen.
Protocol
De studie werd goedgekeurd door de Institutionele Ethiekcommissie van het Yulin First Hospital, provincie Shaanxi, China. Omdat het ging om een retrospectieve analyse van routinematig verzamelde ziekenhuisgegevens, en omdat alle gegevens vóór de analyse waren geanonimiseerd, is de vereiste voor schriftelijke geïnformeerde toestemming kwijtgescholden. De studie werd uitgevoerd in overeenstemming met de institutionele vereisten voor gegevensbescherming en de principes van de Verklaring van Helsinki.
Data en methoden
Studiepopulatie en ontwerp
Dit was een retrospectieve cohortstudie in één centrum, uitgevoerd in het Yulin First Hospital in de provincie Shaanxi, China. De ziekenhuisgegevens van patiënten die tussen juli 2022 en december 2024 werden opgenomen met aSAH werden gescreend. In aanmerking komende patiënten waren volwassenen van 18 jaar of ouder met een diagnose van aSAH, bevestigd door craniale en intracraniale vasculaire beeldvorming. Van patiënten werd vereist dat zij binnen 72 h na het begin van de symptomen waren opgenomen en dat zij tijdens de indexopname een aneurysmabehandeling hadden ondergaan.
Patiënten werden uitgesloten indien zij een traumatische subarachnoïdale bloeding, een niet-aneurismatische subarachnoïdale bloeding, een ernstige reeds bestaande hematologische aandoening, een andere grote intracraniële aandoening die de beoordeling van de uitkomst beïnvloedde, onvoldoende dossiers voor DCI-evaluatie, of een overlijden in het ziekenhuis vóór een adequate DCI-beoordelingsperiode hadden. Het uitsluiten van vroege sterfgevallen in het ziekenhuis kan leiden tot survivorship bias, omdat de meest ernstige gevallen mogelijk uit de analyse worden verwijderd. Daarom moeten de bevindingen worden geïnterpreteerd als voornamelijk van toepassing op patiënten die lang genoeg overleefden voor een DCI-evaluatie.
Gegevensverzameling
Klinische, laboratorium-, beeldvormings- en behandelingsgerelateerde variabelen werden uit het elektronisch medisch dossier geëxtraheerd met behulp van een vooraf gedefinieerd data-extractieformulier. De geëxtraheerde variabelen omvatten demografische factoren, medische voorgeschiedenis, kenmerken van het aneurysma, de vroege neurologische graad, vroege beeldvormingsbevindingen, laboratoriumresultaten, de behandelingsaanpak en ziekenhuiscomplicaties. Het beoogde voorspellingsmoment was na voltooiing van de initiële opname en perioperatieve beoordeling, maar vóór het belangrijkste risikovenster voor DCI.
Leeftijd, geslacht, bodymassindex, rookstatus, alcoholgebruik, hypertensie, diabetes, aneurysmagrootte, locatie van het aneurysma, gemodificeerde Fisher-graad, Hunt-Hess-graad, World Federation of Neurological Surgeons-graad, intraventriculaire bloeding en herbloeding werden genoteerd op basis van opnamegegevens en initiële beeldvorming. Laboratoriumvariabelen, waaronder hemoglobine, serumalbumine en serumnatrium, werden verkregen uit de vroegst beschikbare bloedtest vóór het voorspellingsmoment. Cerebraal oedeem werd beoordeeld aan de hand van baseline-beeldvorming of onmiddellijke post-behandelingsbeeldvorming die beschikbaar was vóór de DCI-diagnose. Variabelen die pas na het begin van DCI werden geregistreerd, zijn niet gebruikt voor de modelontwikkeling om informatielekkage te beperken.
Anemie werd gedefinieerd als hemoglobine <110 g/L bij vrouwelijke patiënten en <120 g/L bij mannelijke patiënten. Hypoalbuminemie werd gedefinieerd als serumalbumine <35 g/L. Hyponatriëmie werd gedefinieerd als serumnatrium <130 mmol/L.
Patiënten werden behandeld volgens het institutionele zorgpad voor aSAH. De standaardbehandeling omvatte vroege clipping of coiling van het aneurysma, neurologische observatie, bloeddrukcontrole, vocht- en elektrolytenmanagement en surveillance op complicaties, waaronder hydrocefalie, rebleeding, insulten, infecties, vasospasmen en DCI. Nimodipine werd gebruikt, tenzij er sprake was van contra-indicaties. De monitoring van vasospasmen werd uitgevoerd middels neurologisch onderzoek, vasculaire beeldvorming en transcraniële Doppler-echografie wanneer dit klinisch geïndiceerd was. Hydrocefalie werd, indien nodig, behandeld door afvoer van het hersenvocht. Hemodynamische optimalisatie en rescue-therapie werden toegepast op basis van de beoordeling van het behandelteam. Omdat de intensiteit van de behandeling en de details van de rescue-therapie niet volledig waren vastgelegd in de retrospectieve dataset, konden deze factoren niet volledig in het model worden gecorrigeerd en werden zij als een beperking beschouwd.
Diagnose van DCI
DCI werd gedefinieerd als een nieuw focaal neurologisch defect, een afname van het bewustzijnsniveau of een nieuw cerebraal infarct op follow-up computertomografie of magnetische resonantie-imaging, optredend tijdens het verwachte risicovlak voor DCI en niet verklaarbaar door een andere oorzaak. Het risicovlak voor DCI werd gedefinieerd als dag 3–14 na de hemorragische ictus. Alternatieve verklaringen, waaronder herbloeding, hydrocefalie, insulten, infectie, metabole stoornissen, sedatieve effecten en procedure-gerelateerde infarcten, werden beoordeeld voordat een gebeurtenis als DCI werd geclassificeerd.
De beoordeling van de uitkomsten werd uitgevoerd door twee clinici met ervaring in de behandeling van aSAH, waaronder één neurochirurg en één neuroloog/arts neuro-intensive care. De beoordelaars bekeken de klinische verslagen, neurologische onderzoeken, beeldvormingsrapporten en follow-up beeldvorming. Tijdens de beoordeling van de uitkomsten waren zij geblindeerd voor de uiteindelijke modeluitvoer. Meningsverschillen werden opgelost via consensusdiscussies, waarbij de relevante beeldvorming en de klinische tijdlijn werden bekeken. De formele inter-beoordelaarsbetrouwbaarheid werd niet gemeten; deze beperking is toegevoegd omdat de classificatie van DCI een klinisch oordeel kan vereisen.
Berekening van de steekproefomvang
De steekproefomvang werd geschat op basis van de vuistregel van 10 gebeurtenissen per variabele (EPV)11. Met 20 kandidaat-predictoren en een verwachte incidentie van DCI van ongeveer 35%, was een minimale steekproefomvang van 20 × 10 / 0,35 ≈ 572 patiënten vereist. Onze uiteindelijke cohort van 680 patiënten overtrof deze vereiste. Hoewel de events-per-variable (EPV) regel als algemene richtlijn is toegepast, kan moderne predictieve modellering, in het bijzonder machine learning-algoritmen, flexibelere overwegingen met betrekking tot de steekproefomvang vereisen. De uiteindelijke cohortomvang werd als adequaat beschouwd om modelstabiliteit te waarborgen, het risico op overfitting te minimaliseren en een betrouwbare schatting van de modelperformantie-metrieken mogelijk te maken.
Modelontwikkeling en validatie
Patiënten werden toegewezen aan een trainingscohort van 544 patiënten en een intern validatiecohort van 136 patiënten met behulp van een uitkomstgestratificeerde 8:2 splitsing. Uitkomststratificatie werd gebruikt om een vergelijkbare proportie DCI-gebeurtenissen in de twee cohorten te behouden. DCI trad op bij 175 van de 544 patiënten in het trainingscohort en bij 42 van de 136 patiënten in het interne validatiecohort. Het 8:2 hold-out ontwerp is behouden omdat dit de vooraf gespecificeerde strategie voor modelontwikkeling was en een apart cohort bood voor een voorlopige interne prestatiebeoordeling.
De selectie van predictoren werd uitsluitend uitgevoerd in de trainingscohort met behulp van least absolute shrinkage and selection operator-regressie met 10-voudige kruisvalidatie. De geselecteerde strafparameter was λ = 0.031. Zes predictoren werden behouden: leeftijd, hersenoedeem, hypoalbuminemie, gemodificeerde Fisher-graad, Hunt-Hess-graad en World Federation of Neurological Surgeons-graad.
Modellen voor logistische regressie, extreme gradient boosting, light gradient boosting machine, support vector machine en k-dichtstbijzijnde buren werden ontwikkeld met behulp van dezelfde set geselecteerde predictoren. Alle procedures voor voorbewerking, selectie van predictoren en modelontwikkeling waren beperkt tot de trainingscohort. De interne validatiecohort werd niet gebruikt tijdens de selectie van predictoren of de modeloptimalisatie en werd pas geëvalueerd na de modelontwikkeling.
De numerieke random seed die werd gebruikt voor de oorspronkelijke cohorttoewijzing is niet bewaard gebleven in de gearchiveerde analyseregisters en kon retrospectief niet worden geverifieerd. Bootstrap-optimismecorrectie en herhaalde k-fold interne validatie waren evenmin beschikbaar. Daarom wordt de huidige analyse beschreven als een enkele hold-out interne validatie in plaats van een optimismecorrectie of een herhaald cross-gevalideerde prestatiebeoordeling.
Reproduceerbaarheid van machine learning
Voor de selectie van LASSO-predictoren werd 10-voudige kruisvalidatie toegepast binnen de trainingscohort. Continue predictoren werden gestandaardiseerd wanneer dit vereist was door het modelleringsalgoritme, en categorische predictoren werden weergegeven met behulp van vooraf gedefinieerde binaire klinische categorieën. De validatiecohort werd niet gebruikt voor afstemming of modelselectie.
De gearchiveerde analysematerialen bevatten niet de definitieve tuning-grids, geselecteerde hyperparameters, volledige pakketversies, de oorspronkelijke random seed of een bevestigde procedure voor klasse-onbalans voor XGBoost, LightGBM, SVM en KNN. Deze instellingen zijn daarom niet gereconstrueerd of geschat. De vergelijkingen tussen de machine-learning-modellen moeten bijgevolg worden geïnterpreteerd als verkennende vergelijkingen van algoritmen in plaats van volledig reproduceerbare experimenten voor modelontwikkeling. Informatie over de reproduceerbaarheid, zowel beschikbaar als niet beschikbaar, dient te worden samengevat in Aanvullende Tabel 1.
Biascontrole & sensitiviteitsanalyse
Opeenvolgende geschikte patiënten werden geïncludeerd om selectiebias te verminderen. Gestandaardiseerde variabeledefinities en een gestructureerd data-extractieformulier werden gebruikt om informatiebias te verminderen. Predictoren werden beperkt tot informatie die beschikbaar was vóór het beoogde tijdstip van de DCI-voorspelling om informatielekkage te verminderen. Predictorselectie, preprocessing en modelontwikkeling werden uitsluitend uitgevoerd in de trainingscohort.
De aangepaste Fisher-graad, de Hunt-Hess-graad en de WFNS-graad vertegenwoordigen gerelateerde aspecten van de bloedingslast en de neurologische ernst. Hoewel alle drie de variabelen behouden bleven na LASSO-selectie, zijn de numerieke waarden van de variantie-inflatiefactor en de resultaten van een sensitiviteitsmodel waarin overlappende ernstschalen waren uitgesloten, niet opgenomen in de gearchiveerde analyse-output. Deze analyses konden niet worden gereconstrueerd uit de geaggregeerde tabellen, omdat correlaties op patiëntniveau en de output van de gefitte modellen vereist zijn. Daarom werden de individuele coëfficiënten van deze ernstmaten niet geïnterpreteerd als onafhankelijke of causale effecten. Ze werden uitsluitend behouden als componenten van het voorspellingsmodel dat in de trainingscohort was geselecteerd.
Interpreteerbaarheid van het model
Men geloofde dat klinische toepasbaarheid modelinterpreteerbaarheid als een cruciaal element vereiste. In het meest effectieve model werden de effecten van predictoren overwogen om de klinische plausibiliteit en de overeenstemming met bestaande pathofysiologische kennis over vertraagde cerebrale ischemie te beoordelen. Deze methode maakte een duidelijke beoordeling van het modelgedrag mogelijk en verbeterde het potentieel voor klinische vertaling.
Ontbrekende gegevens
Ontbrekende gegevens op variabelenniveau werden geëvalueerd tijdens de datapreparatie. De oorspronkelijke aantallen en percentages ontbrekende gegevens per kandidaatvariabele vóór imputatie zijn echter niet bewaard gebleven in de gearchiveerde analyseresultaten en konden niet nauwkeurig worden gereconstrueerd uit de geaggregeerde tabellen. Bijgevolg is er geen aanname van volledige data gedaan en zijn er geen niet-geverifieerde percentages van ontbrekende gegevens gerapporteerd.
Een geverifieerde aanvullende tabel met ontbrekende gegevens moet rechtstreeks worden gegenereerd uit de oorspronkelijke gedeïdentificeerde dataset op patiëntniveau. Aanvullende Tabel 2 moet voor elke kandidaatvariabele het aantal en het percentage ontbrekende waarnemingen vóór de gegevensverwerking rapporteren, de methode die is gebruikt om de ontbrekende gegevens aan te pakken, en het aantal waarnemingen dat is opgenomen in de uiteindelijke analyse. Het onvermogen om het oorspronkelijke, variabele-specifieke patroon van ontbrekende gegevens te herstellen, werd beschouwd als een beperking van het huidige rapport.
Statistische Analyse
De selectie van predictoren werd uitgevoerd in de trainingscohort met behulp van LASSO-regressie met 10-voudige kruisvalidatie. De discriminatie werd beoordeeld aan de hand van het oppervlak onder de receiver operating characteristic-curve met 95% betrouwbaarheidsintervallen. De kalibratie werd beschreven met behulp van kalibratieplots en puntschattingen van de kalibratieshelling, het kalibratie-intercept en de Brier-score. Bootstrap-betrouwbaarheidsintervallen voor de kalibratiematen waren niet beschikbaar.
Drempelwaarde-afhankelijke classificatiematen werden berekend op basis van de beschikbare verwarringsmatrices voor interne validatie. De exacte numerieke kansdrempel die is gebruikt om de gearchiveerde verwarringsmatrices te genereren, is niet bewaard gebleven en kon niet worden geverifieerd. Daarom werden deze maten beschrijvend geïnterpreteerd en werden ze niet gebruikt als de primaire basis voor modelselectie. De decision-curve analyse werd eveneens als verkennend beschouwd, omdat het exact vooraf gespecificeerde drempelwaardebereik en de netto-voordeeluitvoer op patiëntniveau niet bewaard zijn gebleven. Een tweezijdige P waarde onder 0,05 werd beschouwd als statistisch significant.
Resultaten
Vergelijking van uitgangskenmerken tussen trainings- en interne validatiecohorten
In totaal werden 680 patiënten met aSAH opgenomen. De trainingscohort bestond uit 544 patiënten, waarvan er 175 DCI ontwikkelden, terwijl de interne-validatiecohort bestond uit 136 patiënten, waarvan er 42 DCI ontwikkelden. Het DCI-incidentiepercentage was 32,2% in de trainingscohort en 30,9% in de interne-validatiecohort. De uitgangskenmerken zijn weergegeven in tabel 1. Aangezien sommige gearchiveerde tabelvermeldingen inconsistenties in de noemer bevatten, dient de tabel te worden geverifieerd aan de hand van de oorspronkelijke patiëntspecifieke dataset vóór definitieve indiening.
| Variabele | Trainingscohort (n = 544) | Interne validatiecohort (n = 136) | t/χ²/Z | P-waarde | SMD | Correctienotitie |
| Leeftijd, jaren | 62,88 ± 9,41 | 63,25 ± 9,52 | 0,409 | 0,693 | 0,039 | |
| Geslacht | 0,429 | 0,512 | 0,063 | |||
| Mannelijk | 180 (33,09) | 41 (30,15) | ||||
| Vrouwelijk | 364 (66,91) | 95 (69,85) | ||||
| BMI, kg/m² | 23,46 ± 3,56 | 23,61 ± 3,65 | 0,437 | 0,662 | 0,042 | |
| Rookgeschiedenis | 0,118 | 0,731 | 0,033 | |||
| Ja | 101 (18,57) | 27 (19,85) | ||||
| Nee | 443 (81,43) | 109 (80,15) | ||||
| Alcoholgebruik | 0,417 | 0,518 | 0,062 | |||
| Ja | 118 (21,69) | 33 (24,26) | ||||
| Nee | 426 (78,31) | 103 (75,74) | ||||
| Historie van hypertensie | 0,348 | 0,555 | 0,057 | |||
| Ja | 329 (60,48) | 86 (63,24) | ||||
| Nee | 215 (39,52) | 50 (36,76) | ||||
| Historie van diabetes | 0,116 | 0,733 | 0,033 | Validatie 'Nee'-aantal gecorrigeerd om op te tellen tot 136. | ||
| Ja | 70 (12,87) | 19 (13,97) | ||||
| Nee | 474 (87,13) | 117 (86,03) | ||||
| Aneurysmadiameter, mm | 0,213 | 0,645 | 0,044 | |||
| >10 | 288 (52,94) | 75 (55,15) | ||||
| ≤10 | 256 (47,06) | 61 (44,85) | ||||
| Aneurysmalocatie | 0,980 | 0,322 | 0,095 | |||
| Anterieure circulatie | 448 (82,35) | 107 (78,68) | ||||
| Posterieure circulatie | 96 (17,65) | 29 (21,32) | ||||
| Cerebraal oedeem | 0,612 | 0,434 | 0,075 | |||
| Ja | 125 (22,98) | 27 (19,85) | ||||
| Nee | 419 (77,02) | 109 (80,15) | ||||
| Lage hemoglobine | 0,684 | 0,408 | 0,079 | Validatie 'Nee'-aantal gecorrigeerd om op te tellen tot 136. Trainingsaantal is in conflict met Tabel 2; verifieer aan de hand van de definitieve dataset. | ||
| Ja | 147 (27,02) | 32 (23,53) | ||||
| Nee | 397 (72,98) | 104 (76,47) | ||||
| Hypoalbuminemie | 0,367 | 0,545 | 0,058 | |||
| Ja | 115 (21,14) | 32 (23,53) | ||||
| Nee | 429 (78,86) | 104 (76,47) | ||||
| Hyponatriëmie | 0,186 | 0,666 | 0,041 | |||
| Ja | 331 (60,85) | 80 (58,82) | ||||
| Nee | 213 (39,15) | 56 (41,18) | ||||
| Gemodificeerde Fisher-score | 0,249 | 0,618 | 0,048 | |||
| ≥III | 259 (47,61) | 68 (50,00) | ||||
| I–II | 285 (52,39) | 68 (50,00) | ||||
| Hunt-Hess-score | 0,178 | 0,673 | 0,040 | Validatie ≥III-aantal gecorrigeerd van 53 naar 63 om op te tellen tot 136; verifieer tegenover de definitieve dataset. | ||
| ≥III | 263 (48,35) | 63 (46,32) | ||||
| I–II | 281 (51,65) | 73 (53,68) | ||||
| WFNS-score | 0,249 | 0,618 | 0,048 | |||
| ≥III | 277 (50,92) | 66 (48,53) | ||||
| I–II | 267 (49,08) | 70 (51,47) | ||||
| Chirurgische aanpak | 0,717 | 0,397 | 0,081 | |||
| Endovasculaire behandeling | 449 (82,54) | 108 (79,41) | ||||
| Clipping | 95 (17,46) | 28 (20,59) | ||||
| Chirurgische tijd, h | 2,78 ± 0,81 | 2,81 ± 0,79 | 0,388 | 0,698 | 0,037 | |
| Intraventriculaire bloeding | 0,383 | 0,536 | 0,059 | |||
| Ja | 134 (24,63) | 37 (27,21) | ||||
| Nee | 410 (75,37) | 99 (72,79) | ||||
| Herbloeding | 0,784 | 0,376 | 0,085 | |||
| Ja | 98 (18,01) | 29 (21,32) | ||||
| Nee | 446 (81,99) | 107 (78,68) |
Tabel 1: Basiseigenschappen van de trainings- en interne validatiecohorten. Continue variabelen zijn weergegeven als gemiddelde ± standaarddeviatie en categorische variabelen als n (%). P-waarden en gestandaardiseerde gemiddelde verschillen vergelijken de twee cohorten. Afkortingen: BMI, body mass index; SMD, gestandaardiseerd gemiddeld verschil. Klik hier om deze tabel te downloaden.
Vergelijking van uitgangskenmerken tussen de groep zonder DCI en de groep met DCI in de trainingsset
Binnen de trainingsset trad vertraagde cerebrale ischemie (DCI) op bij 175 patiënten (32,17%), terwijl 369 patiënten (67,83%) geen DCI ontwikkelden. De incidentie van DCI in de interne validatiecohort was vergelijkbaar, wat wijst op een stabiele prevalentie van uitkomsten. Vergelijkende analyses tussen de non-DCI- en DCI-groepen onthulden verschillende statistisch significante verschillen (Tabel 2). Patiënten die DCI ontwikkelden, waren significant ouder (P = 0,026), wat suggereert dat er een leeftijdsafhankelijke gevoeligheid bestaat voor secundaire ischemische letsels. Radiologisch bewijs van vroege hersenbeschadiging, met name hersenoedeem, was duidelijk vaker aanwezig bij DCI-patiënten (P = 0,001). Laboratoriumafwijkingen, waaronder hypoalbuminemie (P = 0,007), hyponatriëmie (P = 0,048) en lage hemoglobinespiegels (P < 0,001), waren significant geassocieerd met het optreden van DCI. Neurologische ernstmarkeringen toonden de sterkste associaties. Een verhoogde gemodificeerde Fisher-score (≥III) kwam significant vaker voor bij DCI-patiënten (P < 0,001), wat een sterke relatie aangeeft tussen bloedingsbelasting en vertraagde ischemische complicaties. Evenzo waren een hogere Hunt–Hess-score en een hogere score volgens de World Federation of Neurological Surgeons (WFNS) sterk geassocieerd met de ontwikkeling van DCI (beide P < 0,001). Daarentegen toonden demografische variabelen, levensstijlfactoren, aneurysmamorfologie, chirurgische aanpak en duur van de ingreep geen statistisch significante verschillen.
| Variabele | Niet-DCI-groep (n = 369) | DCI-groep (n = 175) | t/χ²/Z | P-waarde | Correctienoot |
| Leeftijd, jaren | 62,25 ± 9,54 | 64,22 ± 9,75 | 2,234 | 0,026 | |
| Geslacht | 0,638 | 0,424 | |||
| Mannelijk | 118 (31,98) | 62 (35,43) | |||
| Vrouwelijk | 251 (68,02) | 113 (64,57) | |||
| BMI, kg/m² | 23,43 ± 3,56 | 23,52 ± 3,72 | 0,271 | 0,786 | |
| Rookgeschiedenis | 0,351 | 0,554 | |||
| Ja | 66 (17,89) | 35 (20,00) | |||
| Nee | 303 (82,11) | 140 (80,00) | |||
| Alcoholgebruik | 0,046 | 0,837 | |||
| Ja | 81 (21,95) | 37 (21,14) | |||
| Nee | 288 (78,05) | 138 (78,86) | |||
| Historie van hypertensie | 2,960 | 0,085 | |||
| Ja | 214 (57,99) | 115 (65,71) | |||
| Nee | 155 (42,01) | 60 (34,29) | |||
| Historie van diabetes | 0,463 | 0,496 | |||
| Ja | 45 (12,20) | 25 (14,29) | |||
| Nee | 324 (87,80) | 150 (85,71) | |||
| Aneurysmadiameter, mm | 0,380 | 0,538 | |||
| >10 | 192 (52,03) | 96 (54,86) | |||
| ≤10 | 177 (47,97) | 79 (45,14) | |||
| Aneurysmalocatie | 3,602 | 0,058 | |||
| Anterieure circulatie | 296 (80,22) | 152 (86,86) | |||
| Posterieure circulatie | 73 (19,78) | 23 (13,14) | |||
| Cerebraal oedeem | 10,410 | 0,001 | |||
| Ja | 70 (18,97) | 55 (31,43) | |||
| Nee | 299 (81,03) | 120 (68,57) | |||
| Lage hemoglobine | 23,965 | <0,001 | Totaal verschilt van Tabel 1; verifieer tegenover de definitieve dataset. | ||
| Ja | 122 (33,06) | 82 (46,86) | |||
| Nee | 247 (66,94) | 93 (53,14) | |||
| Hypoalbuminemie | 7,283 | 0,007 | |||
| Ja | 66 (17,89) | 49 (28,00) | |||
| Nee | 303 (82,11) | 126 (72,00) | |||
| Hyponatriëmie | 3,914 | 0,048 | |||
| Ja | 214 (57,99) | 117 (66,86) | |||
| Nee | 155 (42,01) | 58 (33,14) | |||
| Gewijzigde Fisher-score | 58,679 | <0,001 | |||
| ≥III | 134 (36,31) | 125 (71,43) | |||
| I–II | 235 (63,69) | 50 (28,57) | |||
| Hunt-Hess-score | 39,909 | <0,001 | |||
| ≥III | 144 (39,02) | 119 (68,00) | |||
| I–II | 225 (60,98) | 56 (32,00) | |||
| WFNS-score | 28,137 | <0,001 | |||
| ≥III | 159 (43,09) | 118 (67,43) | |||
| I–II | 210 (56,91) | 57 (32,57) | |||
| Chirurgische aanpak | 0,691 | 0,406 | |||
| Endovasculaire behandeling | 308 (83,47) | 141 (80,57) | |||
| Clipping | 61 (16,53) | 34 (19,43) | |||
| Chirurgische tijd, h | 2,74 ± 0,82 | 2,85 ± 0,76 | 1,496 | 0,135 | |
| Intraventriculaire bloeding | 0,163 | 0,687 | |||
| Ja | 89 (24,12) | 45 (25,71) | |||
| Nee | 280 (75,88) | 130 (74,29) | |||
| Herbloeding | 1,168 | 0,280 | |||
| Ja | 71 (19,24) | 27 (15,43) | |||
| Nee | 298 (80,76) | 148 (84,57) |
Tabel 2: Basiskenmerken van patiënten met en zonder vertraagde cerebrale ischemie in de trainingscohort. Continue variabelen zijn weergegeven als gemiddelde ± standaarddeviatie, en categorische variabelen als n (%). P-waarden vergelijken patiënten met en zonder DCI. Afkortingen: DCI, vertraagde cerebrale ischemie; WFNS, World Federation of Neurological Surgeons. Klik hier om deze tabel te downloaden.
Uitkomstverdeling in de interne validatiecohort
In de interne validatiecohort (n = 136) trad vertraagde cerebrale ischemie (DCI) op bij 42 patiënten (30,9%), terwijl 94 patiënten (69,1%) geen DCI ontwikkelden. De prevalentie van de uitkomst was vergelijkbaar met die in de trainingsdataset, wat de stabiliteit van de gebeurtenisverdeling over de datasets ondersteunt.
Kenmerkenselectie
De selectie van voorspellers werd uitgevoerd in de trainingscohort met behulp van LASSO-regressie met 10-voudige cross-validatie. De geselecteerde strafparameter was λ = 0,031. Zes voorspellers behielden coëfficiënten ongelijk aan nul: leeftijd, cerebraal oedeem, hypoalbuminemie, aangepaste Fisher-graad, Hunt-Hess-graad en WFNS-graad. Alle geselecteerde voorspellers waren beschikbaar vóór het beoogde voorspeltijdstip. Figuur 1A,B toont de coëfficiënttrajecten en de cross-validatiecurve die werden gebruikt voor de selectie van voorspellers.
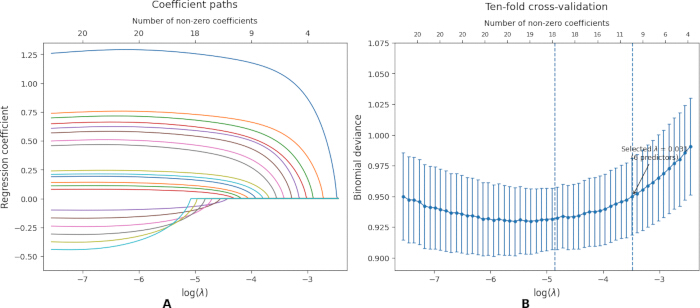
Figuur 1: LASSO-gebaseerde selectie van voorspellers voor vertraagde cerebrale ischemie na aneurysmatische subarachnoïdale bloeding. (A) Coëfficiënttrajecten van kandidaat-voorspellers over waarden van log(λ). Elke curve stelt één kandidaat-voorspeller voor, en de getallen op de bovenste as geven het aantal behouden niet-nul coëfficiënten aan bij elke strafwaarde. (B) Tienvoudige cross-validatiecurve voor binomiale deviantie. Punten geven de gemiddelde cross-gevalideerde deviantie aan, foutmarges geven standaardfouten aan, en verticale stippellijnen geven de strafwaarden met minimaal fout en één standaardfout aan. De uiteindelijk geselecteerde strafparameter was λ = 0.031. LASSO, least absolute shrinkage and selection operator; DCI, delayed cerebral ischemia. Klik hier om een grotere versie van dit figuur te bekijken.
Ontwikkeling en evaluatie van het model
Alle vijf modellen zijn ontwikkeld met behulp van dezelfde zes geselecteerde voorspellers. In de interne validatiecohort toonde logistische regressie een AUC van 0,832 (95% BI, 0,758–0,906), SVM toonde een AUC van 0,811 (95% BI, 0,729–0,893), XGBoost toonde een AUC van 0,777 (95% BI, 0,690–0,864), LightGBM toonde een AUC van 0,755 (95% BI, 0,672–0,838) en KNN toonde een AUC van 0,708 (95% BI, 0,613–0,803) (Tabel 3).
| Dataset | Model | AUC | 95% BI | Nauwkeurigheid | Gevoeligheid | Specifiteit | F1-score | Correctienotitie |
| Training | XGBoost | 0.916 | 0.888–0.944 | 0.848 | 0.853 | 0.847 | 0.682 | |
| Training | Logistische regressie | 0.833 | 0.794–0.872 | 0.816 | 0.71 | 0.81 | 0.594 | |
| Training | LightGBM | 0.751 | 0.707–0.794 | 0.69 | 0.781 | 0.669 | 0.489 | |
| Training | SVM | 0.807 | 0.762–0.852 | 0.809 | 0.704 | 0.833 | 0.583 | |
| Training | KNN | 0.915 | 0.896–0.935 | 0.754 | 0.878 | 0.696 | 0.607 | KNN AUC gecorrigeerd op basis van de legenda van Figuur 2 om overeen te komen met de tabelwaarde. |
| Validatie | XGBoost | 0.777 | 0.690–0.864 | 0.755 | 0.608 | 0.794 | 0.507 | |
| Validatie | Logistische regressie | 0.832 | 0.758–0.906 | 0.809 | 0.714 | 0.851 | 0.698 | Classificatiemetrics opnieuw berekend op basis van de verwarringsmatrix uit Tabel 6. |
| Validatie | LightGBM | 0.755 | 0.672–0.838 | 0.696 | 0.799 | 0.669 | 0.522 | |
| Validatie | SVM | 0.811 | 0.729–0.893 | 0.779 | 0.69 | 0.819 | 0.659 | Classificatiemetrics opnieuw berekend op basis van de verwarringsmatrix uit Tabel 6. |
| Validatie | KNN | 0.708 | 0.613–0.803 | 0.647 | 0.715 | 0.629 | 0.456 |
Tabel 3: Discriminatie- en classificatieprestaties van voorspellingsmodellen in de trainings- en interne validatiecohorten. AUC-waarden worden gerapporteerd met 95% betrouwbaarheidsintervallen. Accuraatheid, sensitiviteit, specificiteit en F1-score werden berekend bij de vooraf gespecificeerde classificatiedrempel. Afkortingen: AUC, oppervlakte onder de ROC-curve (receiver operating characteristic); CI, betrouwbaarheidsinterval; KNN, k-dichtstbijzijnde buren; LightGBM, lichte gradient boosting-machine; SVM, support vector machine; XGBoost, extreme gradient boosting. Classificatiematen die afhankelijk zijn van de drempelwaarde werden niet als primaire basis gebruikt voor modelvergelijking, omdat de exacte kansdrempel die werd gebruikt in de gearchiveerde analyse niet kon worden geverifieerd. Klik hier om deze tabel te downloaden.
De betrouwbaarheidsintervallen overlapten, en logistische regressie werd niet als statistisch superieur beschouwd ten opzichte van de andere modellen. Logistische regressie werd behouden als het hoofdmodel omdat het een stabiele interne discriminatie bood en een direct interpreteerbare modelstructuur had. De resultaten geven de prestaties weer in één interne validatiecohort dat apart is gehouden, en vormen geen correctie voor optimisme, noch tijdelijke of externe validatie (Figuur 2A–D).
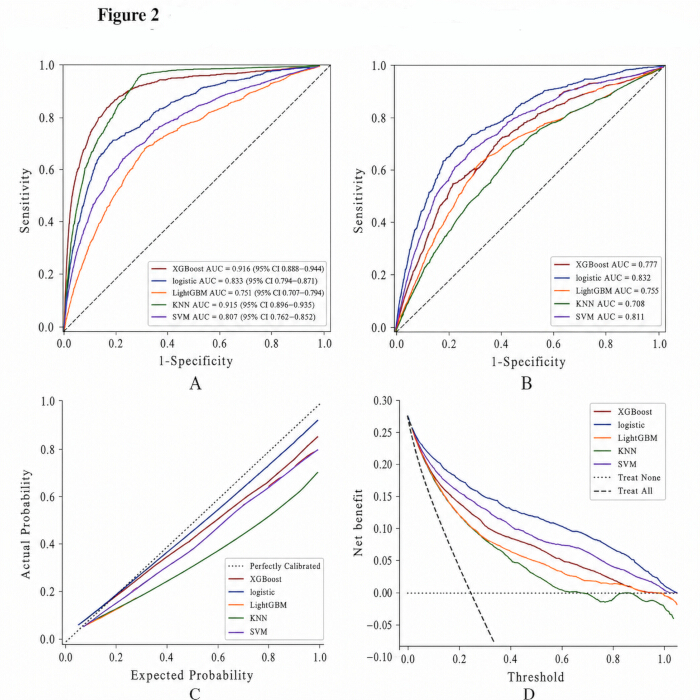
Figuur 2: Prestaties van voorspellingsmodellen met betrekking tot discriminatie, calibratie en beslissingscurven.
(A) Ontvanger-opererende-karakteristieke curven in de trainingscohort. (B) Ontvanger-opererende-karakteristieke curven in de interne validatiecohort. De curvelabels geven het oppervlak onder de ontvanger-opererende-karakteristieke curve (AUC) weer, met 95% betrouwbaarheidsintervallen. (C) Calibratiecurven die voorspelde en geobserveerde kansen op DCI vergelijken; de stippellijn op de diagonaal geeft perfecte calibratie aan. (D) Beslissingscurve-analyse die netto-baat weergeeft over verschillende drempelkansen. De horizontale stippellijn stelt de strategie van geen behandeling voor, terwijl de streeplijn de strategie van behandeling van alle patiënten voorstelt. AUC, oppervlak onder de ontvanger-opererende-karakteristieke curve; DCI, vertraagde cerebrale ischemie; KNN, k-dichtstbijzijnde-buur; LightGBM, light gradient boosting machine; SVM, support vector machine; XGBoost, extreme gradient boosting. Klik hier om een grotere versie van deze afbeelding te bekijken.
Verkennende beslissingscurve-analyse
Een beslissingscurve-analyse werd uitgevoerd als een verkennende beoordeling van het netto voordeel. De exacte vooraf gespecificeerde drempelkansbereik en de patiëntspecifieke netto-voordeeluitkomst werden echter niet bewaard in de gearchiveerde analysegegevens. Daarom kunnen de bevindingen van de beslissingscurve geen klinische bruikbaarheid aantonen of een klinisch geschikte interventiedrempel vaststellen.
Elke ogenschijnlijke netto-voordeel ten opzichte van behandel-alle of behandel-geen strategieën dient alleen te worden opgevat als een voorlopig patroon binnen de huidige interne dataset. Externe validatie, prospectieve drempelwaardekeuze, beoordeling van klinische gevolgen en een formele klinische impactstudie zijn vereist voordat het model bruikbaar kan worden geacht voor besluitvorming over patiëntbeheer (Figuur 3).
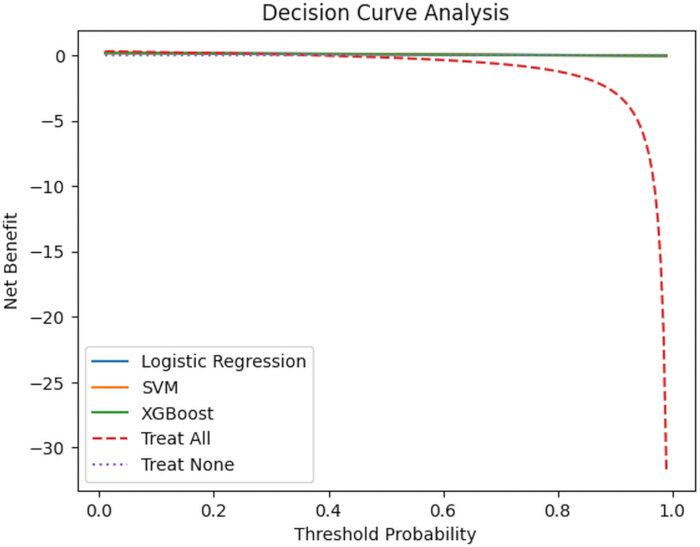
Figuur 3: Beslissingscurve-analyse van geselecteerde voorspellingsmodellen in de interne validatiecohort. Netto-baat wordt uitgezet tegen drempelkans voor logistische regressie, SVM en XGBoost-modellen. De streeplijn 'behandel-alle' stelt de strategie voor om alle patiënten te monitoren, terwijl de stippellijn 'behandel-geen' het niet monitoren van patiënten voorstelt. Een model wordt klinisch nuttig geacht bij drempelkansen waarbij de netto-baatcurve boven beide referentiestrategieën ligt. SVM, support vector machine; XGBoost, extreme gradient boosting. Klik hier om een grotere versie van dit figuur te bekijken.
Meervariabel logistisch regressiemodel
Het uiteindelijke logistische regressiemodel omvatte leeftijd, cerebraal oedeem, hypoalbuminemie, gewijzigde Fisher-graad, Hunt-Hess-graad en WFNS-graad. De regressiecoëfficiënten, odds ratios, 95% betrouwbaarheidsintervallen en P-waarden staan weergegeven in tabel 4. De leeftijd had een coëfficiënt van 0,038, terwijl de coëfficiënten voor cerebraal oedeem, hypoalbuminemie, gewijzigde Fisher-graad ≥ III, Hunt-Hess-graad ≥ III en WFNS-graad ≥ III respectievelijk 0,842, 0,615, 1,274, 0,933 en 0,781 bedroegen.
| Voorspeller | β-coëfficiënt | Kansratio (OR) | 95% BI | P-waarde | Interpretatienotitie |
| Intercept | [invoegen uit definitieve modeloutput] | — | — | — | Vereist voor risicoberekening op patiëntniveau. |
| Leeftijd | 0.038 | 1.039 | 1.012–1.067 | 0.004 | Alleen voorspellende associatie; niet causaal. |
| Cerebrale oedeem | 0.842 | 2.321 | 1.541–3.496 | <0.001 | Gemeten vóór DCI-diagnose. |
| Hypoalbuminemie | 0.615 | 1.85 | 1.206–2.837 | 0.005 | Vroegst beschikbare albuminespiegel vóór tijdstip van voorspelling. |
| Gemodificeerde Fisher-graad ≥III | 1.274 | 3.575 | 2.401–5.324 | <0.001 | Marker voor ernst; interpreteren met voorzichtigheid wegens collineariteit. |
| Hunt-Hess-graad ≥III | 0.933 | 2.542 | 1.674–3.861 | <0.001 | Marker voor ernst; interpreteren met voorzichtigheid wegens collineariteit. |
| WFNS-graad ≥III | 0.781 | 2.184 | 1.447–3.298 | <0.001 | Marker voor ernst; interpreteren met voorzichtigheid wegens collineariteit. |
Tabel 4: Uiteindelijk multivariabele logistische regressiemodel voor de voorspelling van vertraagde cerebrale ischemie. Regressiecoëfficiënten, odds ratios, 95% betrouwbaarheidsintervallen en P-waarden worden weergegeven voor voorspellers die zijn behouden na LASSO-selectie. Alle voorspellers werden beoordeeld vóór het beoogde voorspeltijdstip. Afkortingen: CI, betrouwbaarheidsinterval; DCI, vertraagde cerebrale ischemie; OR, odds ratio; WFNS, World Federation of Neurological Surgeons. De numerieke logistische regressieconstante was niet beschikbaar in de gearchiveerde modeluitvoer. Daarom kunnen de gerapporteerde coëfficiënten niet worden gebruikt om individuele voorspelde kansen te berekenen. De coëfficiënten geven voorspellende associaties weer en mogen niet worden geïnterpreteerd als onafhankelijke causale effecten. Klik hier om deze tabel te downloaden.
Deze coëfficiënten beschrijven voorspellende associaties binnen de ontwikkelingscohort. Ze mogen niet worden geïnterpreteerd als onafhankelijke causale effecten, omdat de gewijzigde Fisher-score, de Hunt-Hess-score en de WFNS-score overlappende dimensies van ziekteseveriteit vertegenwoordigen, en numerieke collineariteitsdiagnostiek niet beschikbaar was. De variabelen werden behouden als onderdelen van het voorspellingsmodel, in plaats van als bevestigde onafhankelijke risicofactoren.
Prestaties van de kalibratie
De calibratie werd samengevat in de interne validatiecohort aan de hand van puntschattingen van de calibratiehelling, het calibratie-intercept en de Brier-score. Logistische regressie had een calibratiehelling van 0,98, een calibratie-intercept van 0,02 en een Brier-score van 0,168. De overeenkomstige waarden waren 0,94, 0,05 en 0,182 voor SVM; 0,88, 0,09 en 0,201 voor XGBoost; 0,91, 0,07 en 0,194 voor LightGBM; en 0,92, 0,06 en 0,190 voor KNN (Tabel 5).
Bootstrap-betrouwbaarheidsintervallen voor deze kalibratiematen waren niet beschikbaar omdat de individuele voorspelde kansen die nodig zijn voor herbemonstering niet zijn bewaard in de gearchiveerde analyse-uitvoer. Daarom worden de kalibratie-resultaten gepresenteerd als voorlopige puntschattingen binnen de interne validatiecohort en mogen ze niet worden geïnterpreteerd als bewijs van kalibratie in andere instellingen of patiëntenpopulaties (Figuur 4).
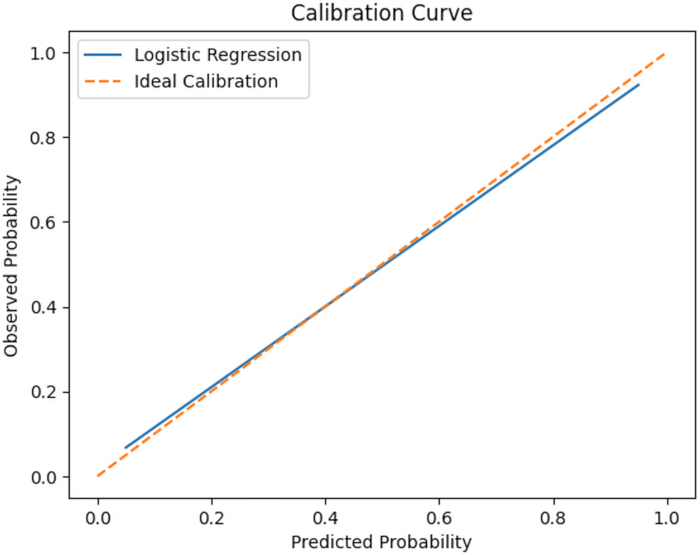
Figuur 4: Kalibratie van het logistische regressiemodel in de interne validatiecohort. De doorgetrokken lijn toont de relatie tussen voorspelde en geobserveerde kansen op late cerebrale ischemie. De diagonale stippellijn stelt een perfecte kalibratie voor; een betere overeenstemming tussen de twee lijnen duidt op een betere kalibratieprestatie. DCI, late cerebrale ischemie. Klik hier om een grotere versie van dit figuur te bekijken.
| Model | Calibratiehelling | 95% BI calibratiehelling | Calibratieafsnijpunt | 95% BI calibratieafsnijpunt | Brier-score | 95% BI Brier-score | Correctienotitie |
| Logistische regressie | 0.98 | [insert bootstrap 95% CI] | 0.02 | [insert bootstrap 95% CI] | 0.168 | [insert bootstrap 95% CI] | Voeg bootstrap-betrouwbaarheidsintervallen uit de definitieve analyse toe indien beschikbaar. |
| SVM | 0.94 | [insert bootstrap 95% CI] | 0.05 | [insert bootstrap 95% CI] | 0.182 | [insert bootstrap 95% CI] | |
| XGBoost | 0.88 | [insert bootstrap 95% CI] | 0.09 | [insert bootstrap 95% CI] | 0.201 | [insert bootstrap 95% CI] | |
| LightGBM | 0.91 | [insert bootstrap 95% CI] | 0.07 | [insert bootstrap 95% CI] | 0.194 | [insert bootstrap 95% CI] | |
| KNN | 0.92 | [insert bootstrap 95% CI] | 0.06 | [insert bootstrap 95% CI] | 0.19 | [insert bootstrap 95% CI] |
Tabel 5: Kalibratieprestaties van voorspellingsmodellen in de interne validatiecohort. Een kalibratierichtingscoëfficiënt van 1,0 en een kalibratieafsnijpunt van 0 duiden op ideale kalibratie. Lagere Brier-scores duiden op betere algehele voorspellingsnauwkeurigheid. Afkortingen: KNN, k-dichtstbijzijnde-buur; LightGBM, light gradient boosting machine; SVM, support vector machine; XGBoost, extreme gradient boosting. Kalibratierichtingscoëfficiënt, kalibratieafsnijpunt en Brier-score worden gerapporteerd als puntschattingen. Bootstrap-betrouwbaarheidsintervallen waren niet beschikbaar. Deze resultaten beschrijven alleen voorlopige kalibratie binnen de apart gehouden interne validatiecohort. Klik hier om deze tabel te downloaden.
Uit de foutenmatrix afgeleide metrieken.
De beschikbare interne validatieconfusiematrix voor logistische regressie bevatte 30 echte positieven, 80 echte negatieven, 14 valse positieven en 12 valse negatieven. De opnieuw berekende nauwkeurigheid was 0,809, de sensitiviteit was 0,714, de specificiteit was 0,851, de positieve voorspellende waarde was 0,682, de negatieve voorspellende waarde was 0,870 en de F1-score was 0,698.
Voor SVM bevatte de verwarringsmatrix 29 echte positieven, 77 echte negatieven, 17 valse positieven en 13 valse negatieven. De herberekende nauwkeurigheid was 0,779, de gevoeligheid was 0,690, de specificiteit was 0,819, de positieve voorspellende waarde was 0,630, de negatieve voorspellende waarde was 0,856 en de F1-score was 0,659 (Tabel 6).
| Maatstaf | Logistische regressie | SVM | Berekeningsopmerking |
| Waar positief | 30 | 29 | Validatiecohort |
| Waar negatief | 80 | 77 | Validatiecohort |
| Valselijk positief | 14 | 17 | Validatiecohort |
| Valselijk negatief | 12 | 13 | Validatiecohort |
| Nauwkeurigheid | 0.809 | 0.779 | (TP + TN) / totaal |
| Gevoeligheid | 0.714 | 0.69 | TP / (TP + FN) |
| Specifiteit | 0.851 | 0.819 | TN / (TN + FP) |
| Positieve voorspellende waarde | 0.682 | 0.63 | TP / (TP + FP) |
| Negatieve voorspellende waarde | 0.87 | 0.856 | TN / (TN + FN) |
| F1-score | 0.698 | 0.659 | 2TP / (2TP + FP + FN) |
Tabel 6: Prestatiemetingen afgeleid van de verwarringsmatrix voor logistische regressie en SVM in de interne validatiecohort. De metrieken werden berekend uit de gearchiveerde verwarringsmatrices; echter, de exacte drempelwaarde werd niet bewaard. Geef de exacte drempelwaarde aan in de voetnoot van de tabel. Afkortingen: NPV, negatieve voorspellende waarde; PPV, positieve voorspellende waarde; SVM, support vector machine. De verwarringsmatrices werden verkregen uit de interne validatiecohort. De opnieuw berekende nauwkeurigheid, sensitiviteit, specificiteit, positieve voorspellende waarde, negatieve voorspellende waarde en F1-score voor logistische regressie waren respectievelijk 0,809, 0,714, 0,851, 0,682, 0,870 en 0,698. De overeenkomstige SVM-waarden waren 0,779, 0,690, 0,819, 0,630, 0,856 en 0,659. De exacte classificatiedrempel die werd gebruikt in de oorspronkelijke analyse, is niet bewaard gebleven en dient geverifieerd te worden voordat de definitieve inzending wordt gedaan. Klik hier om deze tabel te downloaden.
Deze waarden werden opnieuw berekend rechtstreeks uit dezelfde verwarringsmatrices om numerieke consistentie te waarborgen. Echter, de exacte kansdrempel die werd gebruikt in de oorspronkelijke classificatie-analyse, werd niet bewaard. Daarom worden de op de drempel gebaseerde maten beschrijvend gerapporteerd en zouden ze niet als primaire basis mogen dienen voor modelvergelijking totdat de drempel is geverifieerd aan de hand van de oorspronkelijke analysecode (Tabel 7).
| Subgroep | AUC (Logistische regressie) |
| Leeftijd ≥65 jaar | 0.821 |
| Leeftijd <65 jaar | 0.836 |
| Gemodificeerde Fisher ≥III | 0.844 |
| Gemodificeerde Fisher I–II | 0.801 |
| Clipping | 0.825 |
| Endovasculaire behandeling | 0.835 |
Tabel 7: Exploratieve subgroeponderzoeksanalyse van het logistische regressiemodel. AUC-waarden worden gerapporteerd per leeftijd, gewijzigde Fisher-graad en behandelingsgroep. Deze analyses zijn exploratief en mogen niet worden geïnterpreteerd als bewijs voor de generaliseerbaarheid van het model. Voeg de steekproefomvang van elke subgroep, het aantal gebeurtenissen van DCI en het 95% betrouwbaarheidsinterval voor elke subgroep toe.
Afkortingen: AUC, oppervlakte onder de ROC-curve; DCI, vertraagde cerebrale ischemie. Klik hier om deze tabel te downloaden.
Verkennende subgroepevaluatie
De gearchiveerde subgroepuitvoer bevatte AUC-puntschatters volgens leeftijd, gewijzigde Fisher-graad en behandelingsaanpak. Echter, de steekproefomvang van de subgroepen, het aantal DCI-gebeurtenissen in de subgroepen, 95% betrouwbaarheidsintervallen en formele toetsen op interactie of heterogeniteit waren niet beschikbaar. Daarom werden de bevindingen van de subgroepen als incompleet en exploratief beschouwd. Ze werden niet gebruikt om te beweren dat de modelprestaties robuust, consistent of generaliseerbaar waren over patiëntsubgroepen.
Prestaties bij risicostratifcatie
In de gearchiveerde output van de risicostratifcatie werden geobserveerde DCI-percentages gerapporteerd van 10,2%, 33,6% en 69,1% voor de voorgestelde lage-, intermediaire- en hoge-risicocategorieën. De bijbehorende groepsaantallen, DCI-gebeurtenistellingen, betrouwbaarheidsintervallen en een vooraf gespecificeerde klinische of statistische onderbouwing voor de kansdrempels waren echter niet beschikbaar. Daarom werd de analyse als exploratief beschouwd en werd deze niet gebruikt om beweringen over gevalideerde risicoscheiding of klinische toepasbaarheid te ondersteunen (Tabel 8).
| Risicocategorie | Kansbereik | Geobserveerde DCI-incidentie |
| Laag risico | <0.20 | 10,2% |
| Matig risico | 0,20–0,50 | 33,6% |
| Hoog risico | >0,50 | 69,1% |
Tabel 8: Waargenomen incidentie van vertraagde cerebrale ischemie over modelafgeleide risicocategorieën in de interne validatiecohort. Risicocategorieën werden gedefinieerd aan de hand van voorspelde kansen uit het uiteindelijke logistische regressiemodel. Klik hier om deze tabel te downloaden.
Definitief logistisch regressiemodel
De gearchiveerde regressie-uitvoer bevatte de coëfficiënten voor de zes geselecteerde voorspellers, maar niet de numerieke modelintercept. Omdat de intercept nodig is om een individuele voorspelde kans te berekenen, kon er geen volledige voorspelvergelijking op patiëntniveau worden gerapporteerd. De onvolledige vergelijking is daarom verwijderd in plaats van voltooid met een veronderstelde of gereconstrueerde waarde.
De coëfficiënten weergegeven in tabel 4 kunnen worden gebruikt om de richting en relatieve omvang van de verbanden van voorspellers binnen het aangepaste model te beschrijven, maar mogen niet worden gebruikt om patiëntspecifieke DCI-kansen te berekenen. Een volledige voorspellingsvergelijking kan pas worden gegeven nadat het intercept wordt hersteld uit het oorspronkelijke aangepaste model of opnieuw wordt gegenereerd door het authentieke dataset op patiëntniveau opnieuw te analyseren.
Logit(DCI) = [intercept] + 0,038 × leeftijd + 0,842 × cerebraal oedeem + 0,615 × hypoalbuminemie + 1,274 × gewijzigde Fisher-score ≥III + 0,933 × Hunt-Hess-score ≥III + 0,781 × World Federation of Neurological Surgeons-score ≥III.
De voorspelde kans op DCI werd berekend als:
P(DCI) = 1 / [1 + exp(−Logit)].
Binaire voorspellers werden gecodeerd als 1 wanneer de voorwaarde aanwezig was en als 0 wanneer afwezig. Gewijzigde Fisher-score ≥III, Hunt-Hess-score ≥III en World Federation of Neurological Surgeons-score ≥III werden gecodeerd als 1 wanneer de patiënt de drempelwaarde bereikte, en anders als 0. Het intercept wordt niet gerapporteerd omdat dit vereist is voor de berekening van patiëntspecifieke kansen. Deze vergelijking dient alleen gebruikt te worden voor onderzoeksinterpretatie totdat externe validatie en herbewerking zijn voltooid.
De gewijzigde Fisher-score, de Hunt-Hess-score en de score van de World Federation of Neurological Surgeons geven alle drie de ziekte ernst weer en kunnen gedeeltelijk overlappende klinische betekenis hebben. Aangezien numerieke collineariteitsdiagnostiek en een volledig gevoeligheidsmodel waarin overlappende ernstschalen zijn uitgesloten niet beschikbaar waren, interpreteert het manuscript deze variabelen niet als onafhankelijke causale voorspellers. Ze worden alleen behouden als onderdeel van een voorspellingsmodel dat is geselecteerd in de trainingscohort. Deze beperking verlaagt het vertrouwen in de onafhankelijke bijdrage van elke ernstschaal en dient in toekomstige externe validatiestudies te worden aangepakt.
GEGEVENSBESCHIKBAARHEID:
De volledige patiëntspecifieke ziekenhuisgegevensset is niet openbaar beschikbaar omdat deze gevoelige klinische informatie bevat en onderworpen is aan institutionele ethische en gegevensbeschermingsvereisten. Toegang tot een geanonimiseerde analytische gegevensset kan worden overwogen door het Institutioneel Ethisch Comité van het Yulin First Hospital na indiening van een methodologisch onderbouwd onderzoeksvoorstel, bewijs van ethische goedkeuring en een passende overeenkomst inzake gegevensgebruik. De gedeelde gegevensset bevat geen namen, ziekenhuisidentificatienummers, exacte data, contactgegevens en andere directe of indirecte identificatoren. Een geverifieerd variabelenoverzicht, analyse-scripts, Supplementary Table 1 met beschrijving van modelontwikkeling en reproduceerbaarheidsinformatie, en Supplementary Table 2 met verslag van variabele-specifieke ontbrekende waarden worden verstrekt, voor zover toegestaan door het institutionele beleid. Demonstratie- of synthetische gegevenssets worden niet voorgesteld als de originele klinische studiegegevens.
Supplementaire Tabel 1: Reproduceerbaarheidsdetails en definitieve hyperparameters voor modelontwikkeling. Deze tabel rapporteert de willekeurige startwaarde, software- en pakketversies, voorverwerkingstappen, imputatieprocedure, cross-validatieaanpak, afstelraster en definitieve hyperparameters voor XGBoost, LightGBM, SVM en KNN.Klik hier om dit bestand te downloaden.
Supplementaire Tabel 2: Samenvatting van ontbrekende gegevens en strategie voor verwerking van kandidaat-predictoren. Voor elke kandidaat-predictor worden het aantal en het percentage ontbrekende waarnemingen, de imputatiemethode en of de variabele is behouden voor analyse gerapporteerd.Klik hier om dit bestand te downloaden.
Discussie
In deze studie is een voorspellingsmodel ontwikkeld en intern gevalideerd voor DCI na aSAH, gebruikmakend van vroege klinische, laboratorium- en beeldvormingsvariabelen. Na selectie van de predictoren bleven zes variabelen over: leeftijd, hersenoedeem, hypoalbuminemie, gemodificeerde Fisher-graad, Hunt-Hess-graad en de graad van de World Federation of Neurological Surgeons. Onder de geëvalueerde modellen vertoonde logistische regressie een stabiele interne discriminatie en een aanvaardbare kalibratie. Omdat de validatiecohort uit hetzelfde centrum en dezelfde periode afkomstig was als de trainingscohort, moeten de resultaten worden geïnterpreteerd als uitsluitend voorlopige interne validatie.
De geselecteerde predictoren zijn klinisch plausibel in de context van aSAH. Een hogere gemodificeerde Fisher-graad weerspiegelt een grotere bloedingslast, terwijl de Hunt-Hess- en WFNS-graden de neurologische ernst bij presentatie beschrijven14,15. Hersenoedeem kan wijzen op vroegtijdige hersenschade, terwijl een hogere leeftijd kan duiden op een verminderde fysiologische reserve. Hypoalbuminemie kan een weerspiegeling zijn van systemische ziekte, ontsteking, voedingsstatus of endotheelkwetsbaarheid19,20. Deze associaties werden echter geïdentificeerd voor predictie en mogen niet als causaal worden geïnterpreteerd. Daarnaast meten de gemodificeerde Fisher-, Hunt-Hess- en WFNS-graden gerelateerde aspecten van de ernst van de aandoening. Omdat VIF-waarden en numerieke sensitiviteitsanalyses niet beschikbaar waren, kon de onafhankelijke bijdrage van elke gradatieschaal niet worden vastgesteld.
Complexere machine-learning-methoden vertoonden geen duidelijk voordeel ten opzichte van logistische regressie in de hold-out interne validatiecohort. Logistische regressie vertoonde de hoogste validatie-AUC, maar de betrouwbaarheidsintervallen overlapten met die van de andere modellen. Complexe algoritmen kunnen niet-lineaire patronen vastleggen, maar ze kunnen ook overfitten wanneer de set predictoren klein is en de gegevens afkomstig zijn van één centrum. Logistische regressie werd daarom behouden als het hoofdmodel vanwege de interpreteerbaarheid en stabiele interne discriminatie. Desondanks beperken onvolledige gegevens over hyperparameters en softwareversies de reproduceerbaarheid van de machine-learning-vergelijkingen.
Het huidige model heeft geen vastgestelde klinische rol. Hoewel een hoger geschat risico theoretisch een nauwere neurologische observatie of een eerdere beoordeling door een specialist zou kunnen ondersteunen, kunnen waarschijnlijkheden op patiëntniveau momenteel niet worden berekend omdat het onderscheppingspunt van het model niet beschikbaar is. Daarnaast waren het drempelbereik van de besliscurve, de prestaties van de subgroepen en de resultaten van de risicocategorieën onvolledig gedocumenteerd. Het model mag daarom niet worden gebruikt als zelfstandig diagnostisch instrument, monitoringsregel of als basis voor behandelbeslissingen. Volledige reconstructie van het model, externe validatie, recalibratie en een prospectieve evaluatie van de klinische impact zijn vereist voordat implementatie in overweging kan worden genomen.
Deze studie kent enkele beperkingen. Ten eerste was het een retrospectief onderzoek dat in één centrum is uitgevoerd, wat de generaliseerbaarheid beperkt. Ten tweede werd de prestatie van het model geëvalueerd met een enkele, op uitkomst gestratificeerde 8:2 hold-out split. Bootstrap-optimismcorrectie, herhaalde k-fold validatie, temporele validatie en externe validatie waren niet beschikbaar. Ten derde zijn de oorspronkelijke random seed, de uiteindelijke machine-learning hyperparameters, tuning grids, de procedure voor klassenimbalans en de volledige versies van de softwarepakketten niet bewaard gebleven, wat de computationele reproduceerbaarheid beperkt. Ten vierde was het numerieke onderscheppingspunt van de logistische regressie niet beschikbaar, waardoor de berekening van individuele voorspelde waarschijnlijkheden niet mogelijk was. Ten vijfde zijn de gemodificeerde Fisher-graad, Hunt-Hess-graad en WFNS-graad gerelateerde ernstmatige maatstaven, terwijl VIF-diagnostiek en numerieke sensitiviteitsanalyses, waarbij overlappende schalen werden uitgesloten, niet beschikbaar waren. Ten zesde zijn de betrouwbaarheidsintervallen voor de kalibratieshelling, het kalibratie-onderscheppingspunt en de Brier-score niet berekend. Ten zevende konden de exacte classificatiedrempel en het DCA-drempelbereik niet worden geverifieerd. Ten achtste ontbraken bij de subgroep- en risicostratificatie-analyses volledige noemers, aantallen gebeurtenissen, betrouwbaarheidsintervallen en formele interactietests. Ten negende is het oorspronkelijke variabele-specifieke patroon van ontbrekende gegevens niet bewaard gebleven. Ten slotte werden vroege overlijdens in het ziekenhuis uitgesloten, wat kan hebben geleid tot survivorship bias. Deze beperkingen betekenen dat het model als voorlopig moet worden beschouwd en niet mag worden gebruikt voor klinische besluitvorming voordat er een volledige heranalyse en onafhankelijke externe validatie hebben plaatsgevonden.
Deze studie ontwikkelde en evalueerde voorspellingsmodellen voor DCI na aSAH met behulp van vroege klinische, laboratorium- en beeldvormingsvariabelen21. Na LASSO-selectie werden zes predictoren behouden: leeftijd, cerebraal oedeem, hypoalbuminemie, gemodificeerde Fisher-graad, Hunt-Hess-graad en WFNS-graad22,23,24,25,26,27,28,29. Logistische regressie behaalde een AUC van 0,832 (95% BI) in de hold-out interne validatiecohort en leverde een interpreteerbare modelstructuur op29,30. De analyse was echter gebaseerd op een enkele interne splitsing, en volledige resamplingsgebaseerde validatie, externe validatie en informatie over computationele reproduceerbaarheid waren niet beschikbaar. De bevindingen moeten daarom worden geïnterpreteerd als voorlopige resultaten van modelontwikkeling in plaats van als bewijs voor een klinisch gevalideerd voorspellingsinstrument.
Deze retrospectieve studie in één centrum ontwikkelde en evalueerde voorspellingsmodellen voor DCI na aSAH met behulp van zes vroege klinische, laboratorium- en beeldvormingsvariabelen. Logistische regressie vertoonde een voorlopig onderscheidend vermogen in een enkele interne validatiecohort (hold-out) en leverde een interpreteerbare modelstructuur op31,32,33,34. Echter, onvolledige reproduceerbaarheidsgegevens, de afwezigheid van een numeriek snijpunt (intercept), het ontbreken van validatie op basis van resampling, een onvolledige onzekerheidsanalyse en een gebrek aan externe validatie beletten de berekening van de waarschijnlijkheid op patiëntniveau en het klinisch gebruik. Heranalyse met gebruikmaking van de authentieke dataset op patiëntniveau, volledige rapportage van de instellingen voor modelontwikkeling en onafhankelijke multicentrische validatie zijn vereist.
Dankbetuigingen
De auteurs betuigen hun dank aan het personeel van de medische dossiers van het Yulin First Hospital voor de ondersteuning bij het ophalen van geanonimiseerde klinische gegevens. Deze medewerkers hebben niet deelgenomen aan het ontwerp van de studie, de beoordeling van de uitkomsten, de statistische modellering, de interpretatie van de resultaten, de voorbereiding van het manuscript of de goedkeuring van het definitieve manuscript en voldeden daarom niet aan de criteria voor auteurschap.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Elektronisch medisch dossiersysteem | Yulin First Hospital | Niet van toepassing | Bron van retrospectieve klinische gegevens; het exacte commerciële platform is niet bewaard gebleven in de gearchiveerde verslagen. |
| IBM SPSS Statistics | IBM Corporation | Versie 25.0 | Descriptieve en inferentiële statistische analyse. |
| K-nearest neighbor implementatie | Pakket/bron niet bewaard | Niet beschikbaar | Exploratief machine-learning model; het exacte pakket en de versie moeten worden hersteld uit de oorspronkelijke code-omgeving. |
| LightGBM | Microsoft / open-source project | Versie niet beschikbaar | Exploratief gradient-boosting model; de exacte pakketversie en hyperparameters zijn niet bewaard gebleven. |
| R statistische software | R Foundation for Statistical Computing | Versie 4.3.2 | Statistische modellering en interne prestatiebeoordeling. |
| Support vector machine implementatie | Pakket/bron niet bewaard | Niet beschikbaar | Exploratief machine-learning model; het exacte pakket, de kernel-instellingen en de versie zijn niet bewaard gebleven. |
| XGBoost | Open-source project | Versie niet beschikbaar | Exploratief gradient-boosting model; de exacte pakketversie en hyperparameters zijn niet bewaard gebleven. |
Referenties
- Caylor MM, MacDonald RL. Pharmacological prevention of delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2024;40(1):159–169.
- Shah VA, Gonzalez LF, Suarez JI. Therapies for delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2023;39(1):36–50.
- Clarke JV, et al. Microvascular platelet aggregation and thrombosis after subarachnoid hemorrhage: a review and synthesis. J Cereb Blood Flow Metab. 2020;40(8):1565–1575.
- Dodd WS, et al. Pathophysiology of delayed cerebral ischemia after subarachnoid hemorrhage: a review. J Am Heart Assoc. 2021;10(15). doi:10.1161/JAHA.121.021845.
- Stragier H, et al. Pathophysiological mechanisms underlying early brain injury and delayed cerebral ischemia in the aftermath of aneurysmal subarachnoid hemorrhage: a comprehensive analysis. Front Neurol. 2025;16:1587091. doi:10.3389/fneur.2025.1587091.
- Xiao ZK, et al. Risk factors for the development of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage: a systematic review and meta-analysis. World Neurosurg. 2025;193:427–446.
- Sirsat MS, Fermé E, Câmara J. Machine learning for brain stroke: a review. J Stroke Cerebrovasc Dis. 2020;29(10):105162. doi:10.1016/j.jstrokecerebrovasdis.2020.105162.
- Mao M, et al. Construction of a nomogram model for predicting delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage patients. Sci Rep. 2025;15(1):17739. doi:10.1038/s41598-025-01693-w.
- Connolly ES Jr, et al. Guidelines for the management of aneurysmal subarachnoid hemorrhage: a guideline for healthcare professionals from the American Heart Association/American Stroke Association. Stroke. 2012;43(6):1711–1737.
- Vergouwen MD, et al. Definition of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage as an outcome event in clinical trials and observational studies: proposal of a multidisciplinary research group. Stroke. 2010;41(10):2391–2395.
- Riley RD, et al. Calculating the sample size required for developing a clinical prediction model. BMJ. 2020;368. doi:10.1136/bmj.m441.
- Veldeman M, et al. Delayed cerebral ischaemia prevention and treatment after aneurysmal subarachnoid haemorrhage: a systematic review. Br J Anaesth. 2016;117(1):17–40.
- Azzam AY, et al. Prediction of delayed cerebral ischemia followed aneurysmal subarachnoid hemorrhage: a machine-learning based study. J Stroke Cerebrovasc Dis. 2024;33(4):107553. doi:10.1016/j.jstrokecerebrovasdis.2023.107553.
- Jeong TS, et al. Factors related to the development of shunt-dependent hydrocephalus following subarachnoid hemorrhage in the elderly. Turk Neurosurg. 2018;28(2):226–233.
- Becerril-Gaitan A, et al. The effect of age on cerebral vasospasm and delayed cerebral ischemia in patients with aneurysmal subarachnoid hemorrhage. World Neurosurg. 2024;187–e1024.
- Hayman EG, et al. Mechanisms of global cerebral edema formation in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2017;26(2):301–310.
- Fistouris P, et al. The impact of intracranial blood clearance on brain edema as a predictor of delayed cerebral infarction following subarachnoid hemorrhage. Cerebrovasc Dis. Published online June 28, 2025:1–8.
- Liu JP, et al. Analysis of risk factors for delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage [in Chinese]. Chin J Cerebrovasc Dis. 2017;14(1):10–14.
- Guo X, et al. Admission albumin-globulin ratio associated with delayed cerebral ischemia following aneurysmal subarachnoid hemorrhage. Front Neurol. 2024;15:1438728. doi:10.3389/fneur.2024.1438728.
- Sanicola HW, et al. Pathophysiology, management, and therapeutics in subarachnoid hemorrhage and delayed cerebral ischemia: an overview. Pathophysiology. 2023;30(3):420–442.
- Wang L, et al. Risk factors and predictive models of poor prognosis and delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage complicated with hydrocephalus. Front Neurol. 2022;13:1014501. doi:10.3389/fneur.2022.1014501.
- Raatikainen E, et al. Prognostic value of the 2010 consensus definition of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage. J Neurol Sci. 2021;420:117261. doi:10.1016/j.jns.2020.117261.
- Shah AH, Snow R, Wendell LC, et al. Association of hemoglobin trend and outcomes in aneurysmal subarachnoid hemorrhage: a single center cohort study. J Clin Neurosci. 2023;107:77–83.
- Jiang C, et al. Risk and prognostic factors for rupture of intracranial aneurysms during endovascular embolization. World Neurosurg. 2019;129–e649.
- Naraoka M, et al. Role of microcirculatory impairment in delayed cerebral ischemia and outcome after aneurysmal subarachnoid hemorrhage. J Cereb Blood Flow Metab. 2022;42(1):186–196.
- Hu P, et al. Effect of surgical clipping versus endovascular coiling on the incidence of delayed cerebral ischemia in patients with aneurysmal subarachnoid hemorrhage: a multicenter observational cohort study with propensity score matching. World Neurosurg. 2023;172–e388.
- Ching T, et al. Opportunities and obstacles for deep learning in biology and medicine. J R Soc Interface. 2018;15(141):20170387. doi:10.1098/rsif.2017.0387.
- Jiang F, et al. Artificial intelligence in healthcare: past, present and future. Stroke Vasc Neurol. 2017;2(4):230–243.
- Coulibaly AP, Provencio JJ. Aneurysmal subarachnoid hemorrhage: an overview of inflammation-induced cellular changes. Neurotherapeutics. 2020;17(2):436–445.
- Gris T, et al. Innate immunity activation in the early brain injury period following subarachnoid hemorrhage. J Neuroinflammation. 2019;16(1):253. doi:10.1186/s12974-019-1629-7.
- Wu Z, et al. Study on the predictive value of laboratory inflammatory markers and blood count-derived inflammatory markers for disease severity and prognosis in COVID-19 patients: a study conducted at a university-affiliated infectious disease hospital. Ann Med. 2024;56(1):2415401. doi:10.1080/07853890.2024.2415401.
- Okugawa Y, et al. Lymphocyte–C-reactive protein ratio as a promising new marker for predicting surgical and oncological outcomes in colorectal cancer. Ann Surg. 2020;272(2):342–351.
- Xie L, et al. The systemic inflammation response index as a significant predictor of short-term adverse outcomes in acute decompensated heart failure patients: a cohort study from southern China. Front Endocrinol (Lausanne). 2024;15:1444663. doi:10.3389/fendo.2024.1444663.
- Yan F, et al. Association between the stress hyperglycemia ratio and 28-day all-cause mortality in critically ill patients with sepsis: a retrospective cohort study and predictive model establishment based on machine learning. Cardiovasc Diabetol. 2024;23(1):163. doi:10.1186/s12933-024-02265-4.