Deze studie presenteert een reproduceerbare bio-informatica-pipeline die transcriptomics, machine learning en immuuninfiltratie-analyse integreert om potentiële diagnostische biomarkers en regulatoire netwerken bij chronisch obstructieve longziekte (COPD) te identificeren.
Onderzoeksartikel
UPP1 als diagnostische biomarker: Inzichten uit integratieve bio-informatica en analyses van immuuninfiltratie bij COPD
* These authors contributed equally
In dit artikel
Samenvatting
Samenvatting
COPD is een progressieve ademhalingsziekte die wordt gekenmerkt door aanhoudende beperking van de luchtstroom en chronische ontsteking, maar de rol van N4-acetylcytidine (ac4C) RNA-modificatie in de pathogenese ervan is grotendeels nog niet onderzocht. Deze studie was erop gericht om systematisch te screenen op ac4C-gerelateerde genen (ac4C-RGs) uit een gepubliceerde database en hun regulerende netwerken bij COPD te onderzoeken, om zo potentiële biomarkers te identificeren voor verdere mechanistische studies, zonder uit te gaan van een directe regulerende relatie tussen een specifiek gen en ac4C-modificatie. Differentieel tot expressie gebrachte genen (DEGs) werden geïdentificeerd op basis van transcriptomische profielen, en weighted gene co-expression network analysis (WGCNA) werd toegepast om belangrijke co-expressiemodules te ontdekken. Er werd een kruisanalyse uitgevoerd tussen DEGs, significante modules en ac4C-RGs. Belangrijke genen werden gescreend met behulp van LASSO-regressie, XGBoost en random forest-algoritmen, gevolgd door de constructie van een diagnostisch model op basis van logistische regressie. De prestaties van het model werden geëvalueerd via receiver operating characteristic (ROC) curve-analyse, area under the curve (AUC) met 95% betrouwbaarheidsintervallen, beoordeling van de kalibratiecurve en decision curve analysis (DCA). In totaal werden 160 overlappende genen geïdentificeerd, en zes hub-genen (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B en B4GALT2) werden consistent geselecteerd door alle drie de machine learning-algoritmen. Het diagnostische model vertoonde een goede discriminatieve prestatie, met AUC's van 0,766, 0,759 en 0,723 in respectievelijk de trainings-, interne test- en externe validatiesets. Regulatore netwerkanalyse suggereerde potentiële ceRNA-assen en interacties van transcriptiefactoren, terwijl immuuninfiltratieprofilering significante correlaties onthulde tussen belangrijke genen en meerdere immuuncel-subsets. Analyse van geneesmiddel-geninteracties en moleculaire docking wezen erop dat fluorouracil, capecitabine en 5-benzylacyclouridine mogelijk gunstige voorspelde bindingsaffiniteiten vertonen met UPP1. Concluderend werden PTRF, PRKCDBP, UPP1, TOR3A, FAM168B en B4GALT2 geïdentificeerd als potentiële ac4C-gerelateerde biomarkers bij COPD, mogelijk betrokken bij immuun- en metabole regulatie, wat een basis biedt voor toekomstige functionele onderzoeken en therapeutische exploratie.
Inleiding
COPD is een chronische en heterogene respiratoire aandoening die wordt gekenmerkt door een progressieve beperking van de luchtstroom als gevolg van afwijkingen in de alveolaire structuren en de luchtwegen1,2. Een protease-antiprotease-onbalans, oxidatieve stress, chronische ontsteking en cellulaire senescentie vormen de kern van de pathofysiologische mechanismen van COPD, wat leidt tot structurele destructie en functionele beperking van het longweefsel3,4. Bovendien wordt COPD beïnvloed door meerdere risicofactoren, waaronder langdurig roken, milieuvervuiling, beroepsmatige blootstelling, luchtweginfecties en genetische vatbaarheid5,6. COPD heeft een aanzienlijke last opgelegd aan de wereldeconomie. Er wordt voorspeld dat het tussen 2020 en 2050 jaarlijks 0,111% van het mondiale bbp zal beslaan7. Hoewel huidige therapeutische strategieën, zoals bronchodilatatoren, geïnhaleerde corticosteroïden, pulmonale rehabilitatie en langdurige zuurstoftherapie, de symptomen kunnen verlichten, blijft het stoppen van de ziekteprogressie een uitdaging. Vanwege de uitgesproken klinische heterogeniteit variëren de patiëntuitkomsten sterk8. Daarom zijn er dringend nieuwe diagnostische biomarkers en prognostische indicatoren nodig om het beheer van COPD te verbeteren en de overleving van patiënten te verhogen.
RNA-modificatie verwijst naar de chemische verandering van RNA-moleculen, die de RNA-structuur en -functie kan wijzigen om de genexpressie te reguleren9,10. Veelvoorkomende RNA-modificaties zijn onder meer N6-methyladenosine (m6A), pseudouridine (Ψ), 5-methylcytosine (m5C) en ac4C11. De ac4C-modificatie speelt een cruciale rol bij het behoud van de mRNA-stabiliteit en het bevorderen van de mRNA-translatie12,13. NAT10 is het enige bekende eukaryote enzym dat de ac4C-modificatie katalyseert, en de activiteit ervan is essentieel voor de vorming van deze modificatie14. Studies hebben een sterke correlatie aangetoond tussen oxidatieve stress, cellulaire senescentie, inflammatie en ac4C-modificatie. Zo vertonen CD4+ T-lymfocyten in colonweefsels van personen met inflammatoire darmziekten (IBD) duidelijk verhoogde niveaus van NAT1015. NAT10 versterkt de ac4C-acetylering van de chemokines CCL2 en CXCL1, waardoor de infiltratie van macrofagen en neutrofielen wordt bevorderd en de inflammatoire schade wordt verergerd16. De cellulaire respons op oxidatieve stress kan ac4C-modificatie omvatten, zoals blijkt uit de sterke toename van ac4C-niveaus onder oxidatieve stress. Daarnaast bevordert NAT10 PM2.5-geïnduceerde longfibrose door TGFB1 mRNA te stabiliseren via ac4C-modificatie, waardoor epitheliale-mesenchymale transitie wordt in gang gezet17. De rol van ac4C-modificatie bij COPD is echter grotendeels onontdekt, wat de noodzaak voor verder onderzoek op dit gebied benadrukt.
De GEO-database werd in deze studie gebruikt om DEGs te identificeren tussen COPD-patiënten en controles. Een gepubliceerde lijst van ac4C-RGs, samengesteld uit multiomics-data18, werd vervolgens geïntegreerd met de DEGs om overlappende kandidaten te identificeren. Gezien het feit dat ac4C-modificatie bekend staat om haar invloed op ontsteking en oxidatieve stress – sleutelprocessen bij COPD – hypotheseerden we dat genen die geassocieerd zijn met het ac4C-regulatienetwerk mogelijk ontreguleerd zijn bij COPD. De overlappende genen werden echter niet beschouwd als directe substraten van NAT10 of genen die direct door ac4C worden gereguleerd; in plaats daarvan werden ze beschouwd als kandidaten geassocieerd met het ac4C-gerelateerde netwerk. Sleutelgenen werden gescreend met behulp van meerdere machine learning-algoritmen, gevolgd door de constructie en validatie van een diagnostisch model. Vervolgens werden relevante pathways bepaald die betrokken zijn bij de pathogenese van COPD, en werden potentiële doelgerichte geneesmiddelen voorspeld. Tot slot werden RT-qPCR-assays uitgevoerd om de expressieniveaus van sleutelgenen te bevestigen, wat een eerste inzicht gaf in de pathofysiologie van COPD en potentiële wegen voor therapeutisch onderzoek.
Protocol
Verklaring van de ethische commissie
Deze studie is uitgevoerd in overeenstemming met de Verklaring van Helsinki. Het protocol is goedgekeurd door de Ethische Commissie van het Shenzhen Luohu Hospital of Traditional Chinese Medicine (goedkeuringsnummer 2024-LHQZYYYXLL-KY-039), en van alle deelnemers is voorafgaand aan de inschrijving schriftelijke geïnformeerde toestemming verkregen. Details over de gebruikte onderzoeksinstrumenten en materialen in dit protocol zijn terug te vinden in de Tabel met Materialen.
Gegevensbron en verwerking
Genexpressie-datasets gerelateerd aan COPD werden verkregen uit de Gene Expression Omnibus (GEO). De dataset GSE54837 werd gebruikt als transcriptome-dataset, en de dataset GSE112811 diende als validatieset (Tabel 1). De ac4C-RG's werden verzameld uit de literatuur18. DEGs tussen de COPD- en controlegroepen werden geïdentificeerd met behulp van het R-pakket limma. DEGs werden als statistisch significant beschouwd indien |log2FC| > 0 en p < 0,05. Volcano-plots werden gegenereerd om de algemene distributie van veranderingen in genexpressie te visualiseren.
Constructie van WGCNA
WGCNA werd uitgevoerd op de GSE54837-dataset met behulp van R om COPD-gerelateerde modules te identificeren. Voorafgaand aan de netwerkconstructie werden uitschieter-monsters geïdentificeerd en verwijderd via een hiërarchische clusteringanalyse met de hclust-functie, gebruikmakend van de average linkage-methode en een Euclidische afstandsterminologie. De optimale soft-thresholding power (β = 10) werd geselecteerd om een scale-free topology fit index R2 ≥ 0,85 te bereiken, waarbij een balans werd gezocht tussen de schaalvrije topologie en de gemiddelde connectiviteit. Er werd een adjacentiematrix opgesteld en getransformeerd naar een topologische overlapmatrix (TOM). Genmodules werden geïdentificeerd met het dynamic tree-cutting-algoritme (deepSplit = 2, minClusterSize = 50). Modules met eigengene-correlaties > 0,75 werden vervolgens samengevoegd met de mergeCloseModules-functie. De module-eigengenes werden daarna gecorreleerd met klinische kenmerken (COPD-status, leeftijd, geslacht en rookstatus) met behulp van Pearson-correlatiecoëfficiënten om COPD-geassocieerde modules voor verdere analyse te identificeren.
Screening, verrijkingsanalyse en PPI-netwerkanalyse van overlappende genen
Er werd een Venn-diagram gegenereerd met het R-pakket ggvenn om genen te identificeren die overlappen tussen de DEGs, MEsalmon-modulegenen en ac4C-RGs. Functionele verrijkingsanalyse van de overlappende genen werd uitgevoerd met behulp van de Gene Ontology (GO) en Kyoto Encyclopedia of Genes and Genomes (KEGG) databases met het R-pakket clusterProfiler. Informatie over eiwit-eiwitinteracties (PPI) werd verkregen uit de STRING-database (https://string-db.org/) om interacties op eiwitniveau tussen de overlappende genen te analyseren. Cytoscape-software werd gebruikt om het resulterende PPI-netwerk te visualiseren.
Identificatie van sleutelgenen via machine learning
Er werden drie machinelearningtechnieken toegepast: least absolute shrinkage and selection operator (LASSO)-regressie, extreme gradient boosting (XGBoost) en random forest (RF). LASSO-regressie werd geïmplementeerd met het glmnet-pakket, waarbij 10-voudige kruisvalidatie werd gebruikt om de optimale strafparameter λ te bepalen. De parameter type.measure werd ingesteld op "deviance" en de parameter family op "binomial". De optimale λ werd geselecteerd op basis van het λmin-criterium, dat de kruisgevalideerde deviantie minimaliseert, wat resulteerde in 17 genen. XGBoost werd uitgevoerd met het xgboost-pakket met de volgende hyperparameters: nrounds = 100, max_depth = 6, eta = 0,3, subsample = 0,8, colsample_bytree = 0,8 en eval_metric = "logloss". De belangrijkheid van kenmerken werd gerangschikt op basis van de gain-metriek, waarbij de top 30 genen werden geselecteerd. Random forest werd geïmplementeerd met het randomForest-pakket met ntree = 200. De belangrijkheid van kenmerken werd gerangschikt op basis van de gemiddelde afname in Gini, waarbij de top 30 genen werden geselecteerd. De door de drie machinelearningmethoden geselecteerde genen werden met elkaar gesneden om sleutelgenen te identificeren voor daaropvolgende analyses.
Het opbouwen en beoordelen van het logistische regressiemodel voor risicovoorspelling
De GSE54837-dataset werd willekeurig verdeeld in een trainingsset (70%) en een testset (30%). Er werd een logistisch regressiemodel opgebouwd op basis van de trainingsset met behulp van de glm-functie uit het MASS-pakket, waarbij de expressieniveaus van sleutelgenen als inputkenmerken dienden. De prestaties van het model werden geëvalueerd met ROC-curves die zijn gegenereerd met het pROC-pakket. De 95% betrouwbaarheidsintervallen voor de AUC werden berekend via 2.000 bootstrap-replicaten. De kalibratie van het model werd beoordeeld met kalibratiecurves die zijn gegenereerd met 1.000 bootstrap-resamples (rms-pakket). DCA werd uitgevoerd met het dca-pakket om het netto klinische voordeel over een reeks drempelwaarschijnlijkheden te evalueren. Er werd een nomogram geconstrueerd met behulp van de nomogram-functie uit het rms-pakket om geïndividualiseerde risicoschatting te vergemakkelijken.
De regressievergelijking was:
logit(P) = 0.5823 + 0.6010 × UPP1 - 0.6563 × PTRF + 0.3853 × B4GALT2 - 0.3972 × FAM168B + 0.1848 × PRKCDBP - 0.4787 × TOR3A. (1)
Hierbij staat P voor de voorspelde waarschijnlijkheid van COPD, en elke coëfficiënt staat voor de bijdrage van de overeenkomstige genexpressiewaarde aan de log odds van COPD.
Expressieanalyse, GeneMANIA-netwerk en moleculair regulatoir netwerk
Genexpressieniveaus tussen de COPD- en controlegroepen in de GSE54837-dataset werden vergeleken met behulp van de Wilcoxon rank-sum test. Boxplots werden gegenereerd met het ggplot2-pakket om de distributie van de expressieniveaus te visualiseren, waarbij de mediaan, het interkwartielbereik (IQR) en individuele datapunten werden weergegeven. GeneMANIA werd gebruikt om gennetwerken te construeren en functionele interacties te voorspellen. De zoekopdracht werd uitgevoerd met standaardparameters: species = Homo sapiens, maximum aantal gerelateerde genen = 20. Het resulterende netwerk werd gedownload en gevisualiseerd, waarbij de kleuren van de verbindingen de interactietypes aangeven. Er werd een competitief endogeen RNA (ceRNA)-netwerk geconstrueerd om post-transcriptionele regulatiemechanismen te onderzoeken. miRNA's die zich richten op de zes sleutelgenen werden voorspeld met behulp van twee onafhankelijke databases: DIANA-microT (score ≥ 0,8) en miRanda (score ≥ 140, energie ≤ −20 kcal/mol). De intersectie van miRNA's die door beide databases waren geïdentificeerd, werd gebruikt om miRNA-mRNA-paren te construeren. Vervolgens werden lncRNA's die zich richten op deze miRNA's voorspeld met behulp van de StarBase-database. Een lncRNA-miRNA-mRNA-regulatienetwerk werd geconstrueerd en gevisualiseerd met Cytoscape. Transcriptionele regulatierelaties werden voorspeld met behulp van ChIP-X Enrichment Analysis Version 3 (ChEA3). Voor elk sleutelgen met voorspelde TF's werden de top 10 transcriptiefactoren met de hoogste enrichment-scores geselecteerd. Er werd een TF-target-regulatienetwerk geconstrueerd in Cytoscape.
Gene set enrichment-analyse en beoordeling van immuuncelinfiltratie
Gene set enrichment analysis (GSEA) werd uitgevoerd met het clusterProfiler-pakket om de biologische functies van elk sleutelgen te onderzoeken. Voor elk sleutelgen werden de monsters verdeeld in groepen met een hoge en lage expressie op basis van de mediaanwaarde. Differentiele expressieanalyse tussen de twee groepen werd uitgevoerd met limma, en de resulterende genenlijst werd gerangschikt op basis van de signed log₂ fold-change. GSEA werd uitgevoerd met de gseGO-functie voor GO-biologische proces termen en de gseKEGG-functie voor KEGG-paden, met de volgende parameters: minGSSize = 10, maxGSSize = 500, pvalueCutoff = 0,05 en nPerm = 1.000. De relatieve abundantie van 28 immuunceltypen werd geschat met single-sample gene set enrichment analysis (ssGSEA), geïmplementeerd in het GSVA-pakket. Een gecureerde genenset-signatuurmatrix bestaande uit markergenen voor 28 immuunceltypen werd verkregen uit eerdere literatuur19. Voor elk monster werd de gsva-functie toegepast met method = "ssgsea", ssgsea.norm = TRUE en kcdf = "Gaussian". Spearman-correlatiecoëfficiënten tussen de ssGSEA-enrichment scores en de expressieniveaus van de zes sleutelgenen werden berekend met de cor.test-functie. De p waarden werden gecorrigeerd voor meervoudig testen met de Benjamini-Hochberg-methode. De correlatiematrix werd gevisualiseerd als een heatmap met behulp van het pheatmap-pakket.
Medicijnvoorspelling, moleculaire docking en ziekteassociatieanalyse
Potentiële therapeutische verbindingen die zich richten op sleutelgenen werden geïdentificeerd met behulp van de DrugBank-database. Een interactienetwerk van "medicijnen gericht op sleutelgenen" werd geconstrueerd in Cytoscape om voorspelde interacties tussen medicijnen en genen te visualiseren. Moleculaire docking werd uitgevoerd met het CB-Dock2-platform om bindingsaffiniteiten te beoordelen. De 3D-proteïnestructuur van humaan UPP1 werd opgehaald uit de Protein Data Bank (PDB ID: 7B8T). Moleculaire structuren van medicijnen (SMILES-formaat) werden verkregen via PubChem. Docking werd uitgevoerd met de AutoDock Vina-engine en de resultaten werden gerangschikt op basis van de vrije bindingsenergie (ΔG, in kcal/mol). Dockingcomplexen werden gevisualiseerd met PyMOL. Associaties tussen sleutelgenen en menselijke ziekten gerelateerd aan blootstelling aan omgevingsfactoren werden onderzocht met behulp van de Comparative Toxicogenomics Database (CTD). Elk gen werd afzonderlijk opgevraagd, waarna de tien sterkst geassocieerde ziekten werden geëxtraheerd en gevisualiseerd met behulp van radardiagrammen.
RT-qPCR protocol
Perifere veneuze bloedmonsters werden verzameld van acht COPD-patiënten en acht gezonde controles in het Shenzhen Luohu Hospital of Traditional Chinese Medicine. COPD werd gediagnosticeerd volgens de criteria van de Global Initiative for Chronic Obstructive Lung Disease (GOLD), gedefinieerd als een post-bronchodilator FEV1/FVC < 0,70. De controlegroep bestond uit gezonde vrijwilligers, matchend op leeftijd en geslacht, zonder voorgeschiedenis van respiratoire aandoeningen en met normale longfunctietests (FEV1% voorspeld ≥ 80% en FEV1/FVC ≥ 0,70). De basisinformatie van de patiënten wordt weergegeven in Tabel 2. Totaal RNA werd geëxtraheerd uit de COPD-bloedmonsters met behulp van een blood RNA extraction kit. Voor de cDNA-synthese werden 500 ng totaal RNA reverse-getranscribeerd met een cDNA synthesis kit inclusief verwijdering van genomisch DNA, volgens het bijgeleverde protocol. Het resulterende cDNA werd verdund tot 150 ng/μL.
RT-qPCR werd uitgevoerd met een SYBR Green-gebaseerde qPCR master mix op een real-time PCR-systeem. Elke reactie van 10 μL bevatte 5 μL 2x SYBR Green master mix, 0,5 μL van respectievelijk de forward- en reverse-primers (10 μM), 1 μL verdund cDNA (15 ng/μL) en 3 μL nucleasevrij water. De cycluscondities bestonden uit een initiële denaturatie bij 95 °C gedurende 5 min, gevolgd door 40 cycli van 95 °C gedurende 10 s en 60 °C gedurende 30 s, met een uiteindelijke smeltcurve-analyse van 60 °C tot 95 °C om de specificiteit van de amplificatie te verifiëren. Alle reacties werden in technische triplicaten uitgevoerd. β-actin werd gebruikt als intern referentiegen. De primerefficiëntie voor elk doelgen werd gevalideerd met behulp van standaardcurve-verdunningsreeksen en varieerde van 90% tot 110%. Genexpressieniveaus werden genormaliseerd naar β-actin, en de relatieve expressie werd berekend met de 2-ΔΔCt methode. Statistische vergelijkingen tussen de COPD- en controlegroepen werden uitgevoerd met de Mann-Whitney U-toets.
Statistische analyse
Netwerkvisualisaties werden gemaakt met Cytoscape en statistische analyses werden uitgevoerd met R-software. Tenzij anders aangegeven, werd de Mann-Whitney U-toets gebruikt voor niet-normaal verdeelde gegevens en de t-toets van Student voor normaal verdeelde gegevens om twee groepen te vergelijken. Een waarde van p < 0,05 werd beschouwd als statistisch significant.
Resultaten
Identificatie van overlappende genen, verrijkingsanalyse en constructie van het PPI-netwerk
Uit de GSE54837-dataset werden 3.371 DEGs geïdentificeerd, waaronder 1.675 upgereguleerde en 1.696 downgereguleerde DEGs. De top 10 genen met de meest significante up- en downregulatie worden getoond in Figuur 1A. Er werd hiërarchische clustering uitgevoerd op de GSE54837-gegevens (Aanvullende Figuur 1A), en er werd een soft-thresholding power van 10 toegepast om een schaalvrije netwerktopologie te waarborgen (Figuur 1B). Gene co-expression-modules werden geconstrueerd met de dynamic tree cut-methode met een minimale modulegrootte van 50 genen, waarbij aan elke module een specifieke kleur werd toegewezen (Aanvullende Figuur 1B). Modules met eigengene-correlaties > 0,75 werden vervolgens samengevoegd (Aanvullende Figuur 1C, Figuur 1C), wat resulteerde in 14 verschillende modules. Op basis van Pearson-correlatieanalyse tussen module-eigengenes en klinische kenmerken vertoonde de MEsalmon-module (bestaande uit 5.226 genen) de meest significante positieve correlatie met COPD (r = 0,35, p = 7 x 10⁻8, Figuur 1D). Venn-analyse identificeerde 160 overlappende genen tussen de 3.371 DEGs, de 5.226 MEsalmon-modulegenen en de 2.118 ac4C-RGs (Figuur 1E). Functionele verrijkingsanalyse van deze 160 genen toonde aan dat significante GO-termen onder meer enkelstrengs RNA-binding, regulatie van het mRNA-metabolisme en de RIG-I-signaleringsroute omvatten (Figuur 1F). Daarnaast demonstreerde KEGG-analyse dat deze genen primair verrijkt waren in Fc gamma R-gemedieerde fagocytose, de mRNA-surveillance-route en focale adhesie (Figuur 1G). Het PPI-netwerk van de overlappende genen bevatte 118 knopen en 196 randen (Figuur 1H).
Identificatie van zes sleutelgenen bij COPD
Om potentiële sleutelgenen te identificeren onder de 160 overlappende kandidaten, werden drie machine learning-algoritmen toegepast. Eerst werd LASSO-regressie uitgevoerd, waarbij cross-validatie werd gebruikt om de optimale strafparameter (λ) ≈ 0,091 te bepalen (Figuur 2A). De coëfficiëntprofielplot gaf aan dat 17 genen werden behouden bij de optimale λ-waarde (Figuur 2B). XGBoost-analyse identificeerde de top 30 genen met de hoogste gain, waaronder PTRF, WBP11 en LDOC1L een hoge voorspellende waarde vertoonden (Figuur 2C). Het RF-algoritme rangschikte op soortgelijke wijze de top 30 genen op basis van hun Gini-importance scores, waarbij PTRF, RFX5 en PRKCDBP tot de meest voorspellende behoorden (Figuur 2D). Intersectieanalyse van de genen die door de drie methoden waren geselecteerd, identificeerde zes overlappende sleutelgenen: PTRF, PRKCDBP, UPP1, TOR3A, FAM168B en B4GALT2 (Figuur 2E).
Constructie van het diagnostische model en expressieanalyse van sleutelgenen
Met gebruik van 70% van de GSE54837-dataset als trainingsset werd een logistisch regressiemodel opgezet waarin de zes sleutelgenen waren opgenomen. ROC-curve-analyse wees op een matige diagnostische prestatie, met AUC's van 0,766 (95% BI: 0,691–0,8417), 0,759 (95% BI: 0,6368–0,8817) en 0,723 (95% BI: 0,6085–0,8596) voor respectievelijk de trainings-, interne test- en externe validatiesets (Figuur 3A–C). Kalibratieanalyse bevestigde een hoge betrouwbaarheid, en DCA wees op een duidelijk netto klinisch voordeel over een breed scala aan drempelwaarschijnlijkheden in zowel de trainingssets (Figuur 3D–E) als de validatiesets (Figuur 3F–G). Er werd een nomogram geconstrueerd om de bijdrage van elk gen te visualiseren en individuele risicoschattingen te vergemakkelijken (Figuur 3H). Expressieanalyse toonde aan dat B4GALT2, PRKCDBP en UPP1 significant upregulated waren in COPD-monsters, terwijl FAM168B, PTRF en TOR3A downregulated waren (Figuur 3I).
Regelend netwerk en functionele analyse van sleutelgenen bij COPD
Een functioneel interactienetwerk bestaande uit de top 20 genen die het meest gerelateerd zijn aan de geïdentificeerde hub-genen werd geconstrueerd met behulp van GeneMANIA-analyse (Figuur 4A). Fysieke interacties vormden het grootste deel van de verbindingen, gevolgd door co-expressiecorrelaties en gedeelde proteinedomeinen. Functionele annotatie wees op een significante verrijking van processen zoals het katabole proces van nucleobase-bevattende kleine moleculen, het nucleoside-katabole proces en plasma-membraan rafts. Post-transcriptionele regulatie werd onderzocht door miRNA-voorspellingen van de DIANA-microT- en miRanda-databanken te kruisen, waarbij acht overlappende miRNA's werden geïdentificeerd (Figuur 4B). Vervolgens werd een lncRNA-miRNA-mRNA-regulatieruif geconstrueerd. Volgens het Sankey-diagram werden twee van de geïdentificeerde miRNA's, beide geassocieerd met de regulatie van FAM168B, voorspeld als doelwit van zeven lncRNA's; voor de overige vijf hub-genen werden geen dergelijke regulatoire interacties geïdentificeerd (Figuur 4C). Transcriptionele regulatie werd verder onderzocht met het ChEA3-platform, waarmee upstream transcriptiefactoren (TF's) werden voorspeld voor B4GALT2, UPP1, FAM168B en TOR3A. De top tien TF's voor elk gen werden geselecteerd om een TF-doelwit-regulatienetwerk te construeren (Figuur 4D). GSEA werd uitgevoerd om de biologische functies van de zes sleutelgenen te onderzoeken. UPP1 was significant verrijkt in biologische processen zoals het diacylglycerol-metabole proces en het purinenucleoside-trifosfaat-biosyntheseproces, evenals in pathways waaronder het proteasoom en het metabolisme van xenobiotica door cytochroom P450 (Figuur 4E–F). Verrijkingsresultaten voor de overige vijf sleutelgenen zijn opgenomen in Aanvullende Figuur 2A–J.
Immuuninfiltratie van UPP1 en voorspelling van medicijndoelen bij COPD
De immuuninfiltratieniveaus van 28 typen immuuncellen werden geëvalueerd in controle- en COPD-groepen met behulp van het ssGSEA-algoritme. Bij COPD-patiënten vertoonden geheugen B-cellen, myeloïde-afgeleide suppressorcellen en geactiveerde dendritische cellen significant hogere enrichmentscores. In tegenstelling hiermee vertoonden type 1 T-helpercellen, geactiveerde B-cellen en onrijpe B-cellen significant lagere enrichmentscores (Figuur 5A). Er moet worden opgemerkt dat ssGSEA relatieve schattingen van de immuuncelverrijking verschaft op basis van transcriptomische gegevens, in plaats van directe metingen van immuuncelproporties. Correlatieanalyse onthulde dat de zes sleutelgenen differentiële associatiepatronen vertoonden met immuuncelsubsets. Specifiek waren UPP1, PRKCDBP en B4GALT2 positief gecorreleerd met de infiltratieniveaus van geheugen B-cellen, geactiveerde dendritische cellen en myeloïde-afgeleide suppressorcellen (Spearman ρ > 0,4, p < 0,05), terwijl PTRF, TOR3A en FAM168B negatieve correlaties vertoonden met type 1 T-helpercellen en geactiveerde B-cellen (Spearman ρ < −0,3, p < 0,05). De volledige correlatiematrix wordt gepresenteerd in de heatmap (Figuur 5B). Geneesmiddelvoorspellingsanalyse identificeerde UPP1 als het enige gen onder de zes kandidaten met voorspelde interacties met kleine moleculen. Drie verbindingen, waaronder fluorouracil, capecitabine en 5-benzylacyclouridine, werden uit de database geïdentificeerd als potentiële UPP1-interacterende verbindingen (Figuur 5C). Deze verbindingen worden voornamelijk gebruikt in de oncologie of in experimentele settings, en hun relevantie voor COPD vereist verder onderzoek. Berekeningen van de vrije bindingsenergie onthulden dat 5-benzylacyclouridine de sterkste bindingsaffiniteit vertoonde, wat duidt op een relatief hogere voorspelde bindingsaffiniteit (Tabel 3). Moleculaire docking-visualisaties voor alle drie de verbindingen wezen op gunstige voorspelde bindingsconformaties met UPP1, wat consistent is met computationele docking-voorspellingen en niet met experimentele validatie (Figuur 5D–F). Daarnaast gaf CTD-analyse aan dat alle zes de sleutelgenen sterk geassocieerd waren met verschillende ziektefenotypes, waaronder vertraagde effecten van prenatale blootstelling, gewichtsverlies, hepatomegalie en ontsteking (Figuur 5G–L).
RT-qPCR-validatie van belangrijke diagnostische genen in klinische monsters
Om de expressieniveaus van sleutelgenen te valideren, werden bloedmonsters verzameld van acht COPD-patiënten en acht controlesubjects; deze analyse werd beschouwd als een preliminaire validatie vanwege de beperkte steekproefomvang. Zoals getoond in Figuur 6A–F, waren PTRF, TOR3A en FAM168B significant gedownreguleerd, terwijl PRKCDBP en UPP1 significant opgereguleerd waren in COPD-monsters, wat consistent is met de trends waargenomen in de bio-informatische analyse. Daarentegen werd er geen significant verschil waargenomen voor de expressie van B4GALT2 tussen de twee groepen. Dit verschil kan worden toegeschreven aan de beperkte steekproefomvang of verschillen in monstertypes tussen datasets en klinische specimens.
VERKLAARING OVER DATAbeschikbaarheid:
Alle RNA-sequencinggegevens zijn verkregen uit de Gene Expression Omnibus-database (GEO, https://www.ncbi.nlm.nih.gov), waarbij GSE54837 is geselecteerd als de trainingsset en GSE112811 als de validatieset. De in deze analyse gebruikte code kan worden verkregen via https://doi.org/10.5281/zenodo.21771476.
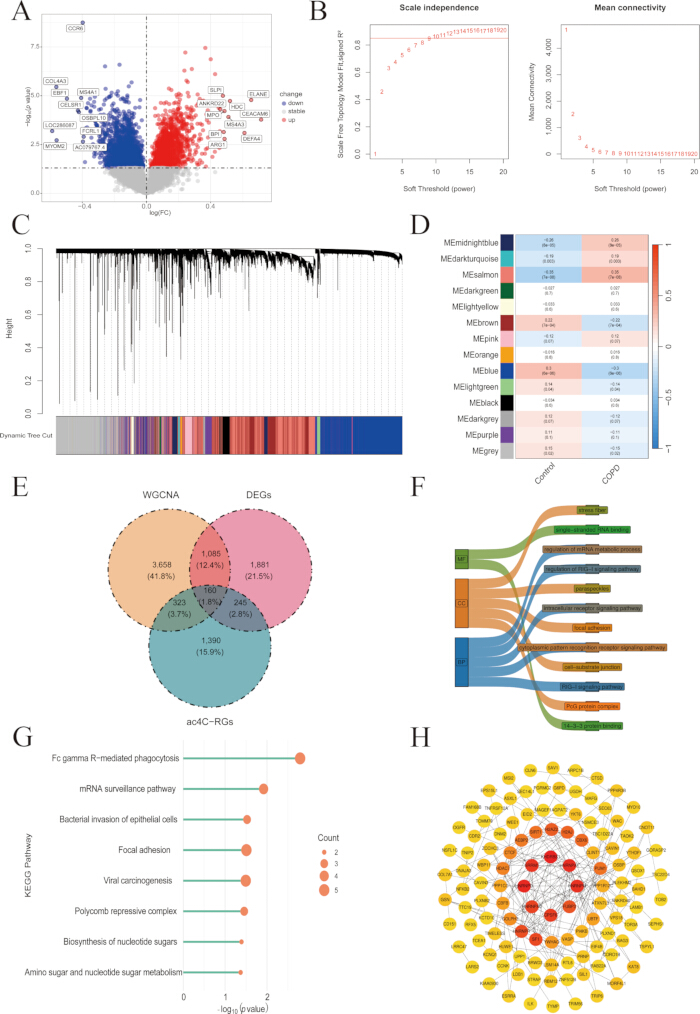
Figuur 1: Identificatie van overlappende genen, enrichment-analyse en constructie van het PPI-netwerk. (A) Volcano plot van DEGs in de GSE54837-dataset. (B) Screening van de soft threshold. (C) Dendrogram van moduleclustering (na samenvoeging). (D) Heatmap van de correlatie tussen modules en eigenschappen. (E) Venn-diagram voor de identificatie van overlappende genen. (F) Mulberry-diagram van de GO-enrichment-analyse, met de belangrijkste enrichmementresultaten van de intersectiegenen in MF, CC en BP. (G) Lollipop-diagram van de KEGG-signaleringsroute-enrichment-analyse, waarbij de grootte van de bubbel het aantal verrijkte genen vertegenwoordigt. (H) PPI-netwerk van de overlappende genen; knopen vertegenwoordigen eiwitten en randen vertegenwoordigen eiwit-eiwitinteracties. Afkortingen: DEGs = differentieel tot expressie gebrachte genen; PPI = eiwit-eiwitinteractie; GO = Gene Ontology; MF = moleculaire functie; CC = cellulaire component; BP = biologisch proces; KEGG = Kyoto Encyclopedia of Genes and Genomes; ac4C-RGs = N4-acetylcytidine-gerelateerde genen. Klik hier om een grotere versie van deze figuur te bekijken.
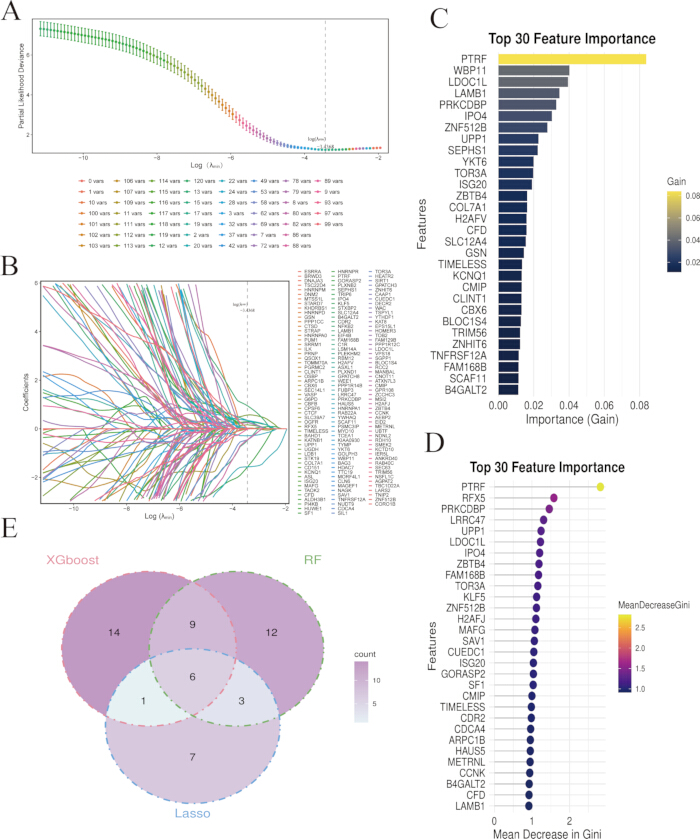
Figuur 2: Identificatie van zes sleutelgenen bij COPD. (A) LASSO-kruisvalidatiecurve. (B) LASSO-regressiecoëfficiënt-paadiagram. Naarmate λ toeneemt, convergeren de coëfficiënten van onbelangrijke genen naar 0. (C) XGBoost-rangschikking van kenmerkbelang. De x-as representeert de gain-waarde, de y-as representeert de gennaam en de kleurdiepte representeert het belang. (D) RF-rangschikking van kenmerkbelang. De x-as representeert de gemiddelde afname in Gini. (E) Het Venn-diagram van overlappende genen verkregen door kruisanalyse van de drie algoritmen. Afkortingen: LASSO = least absolute shrinkage and selection operator; XGBoost = extreme gradient boosting; RF = random forest. Klik hier om een grotere versie van deze figuur te bekijken.
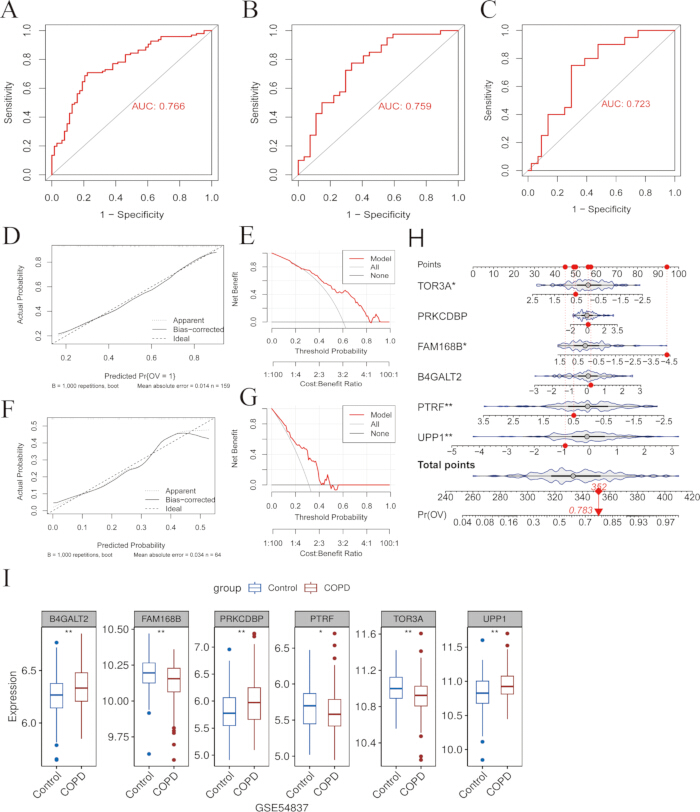
Figuur 3: Constructie van een diagnostisch model en expressieanalyse van sleutelgenen. (A) ROC-curve van de trainingset. (B) ROC-curve van de interne testset. (C) ROC-curve van de externe validatieset. (D) Kalibratiecurve van de trainingset. (E) DCA van de trainingset. (F) Kalibratiecurve van de externe validatieset. (G) DCA van de externe validatieset. (H) Nomogram van zes sleutelgenen. Voor de voorspelling van het individuele risico op COPD wordt aan elk gen een overeenkomstige score toegekend. (I) Expressieanalyse van zes sleutelgenen in COPD- en controlemonsters van de GSE54837-dataset. Afkortingen: ROC = receiver operating characteristic; AUC = area under the curve; DCA = decision curve analysis; COPD = chronische obstructieve longziekte. Klik hier om een grotere versie van deze figuur te bekijken.
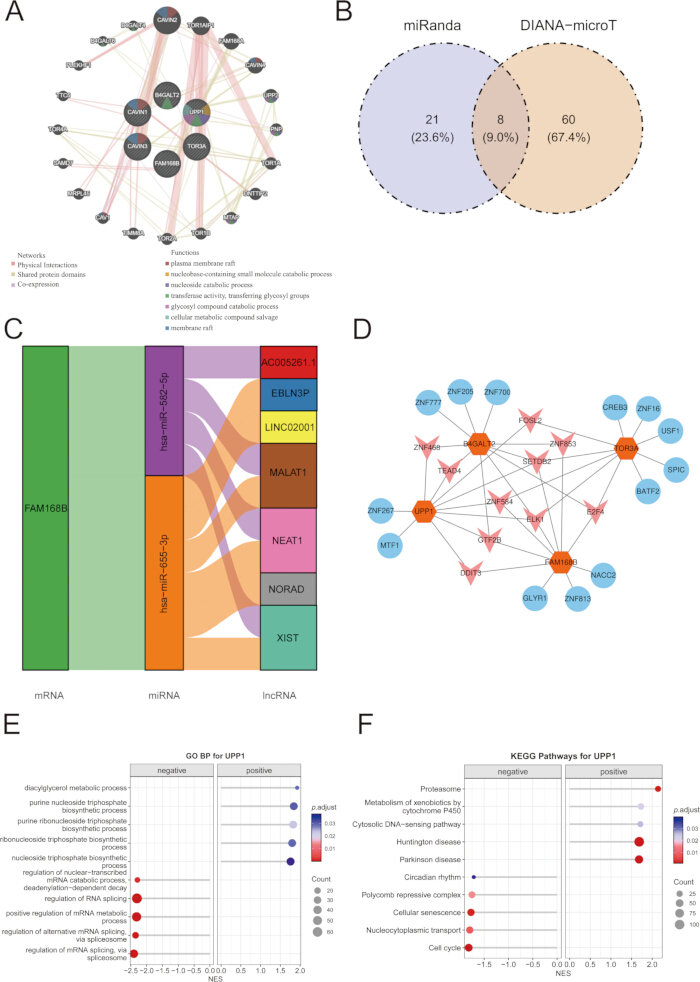
Figuur 4: Regulerend netwerk en functionele betekenis van sleutelgenen bij COPD. (A) GeneMANIA-analyseresultaten van 6 sleutelgenen. De kleur van de lijnen geeft de correlatie tussen genen aan, en de kleur van de knooppunten geeft verschillende functionele categorieën aan. (B) Venn-diagram van de kruisanalyse van de DIANA-microT- en miRanda-databanken. (C) Mulberry-diagram van het ceRNA-regulerende netwerk. (D) Potentieel regulerend netwerk van transcriptiefactoren. Blauwe knooppunten representeren transcriptiefactoren en oranje knooppunten representeren doelgenen. (E) GSEA-verrijkingsanalyse van enkelvoudige genen voor UPP1, inclusief GO. (F) GSEA-verrijkingsanalyse van enkelvoudige genen voor UPP1, inclusief KEGG. Afkortingen: GO = Gene Ontology; KEGG = Kyoto Encyclopedia of Genes and Genomes. Klik hier om een grotere versie van deze figuur te bekijken.
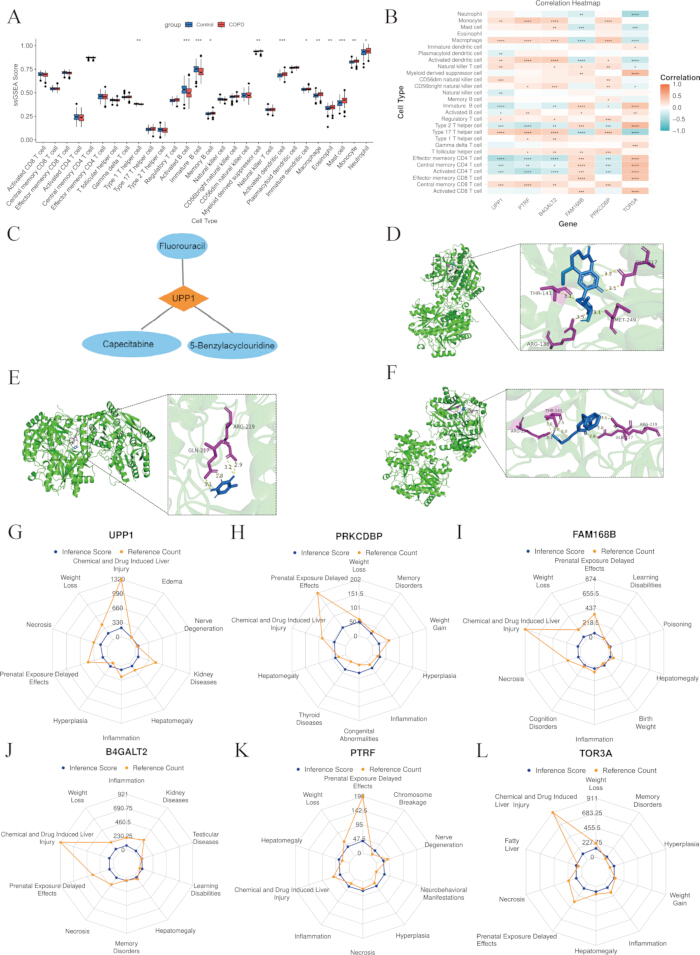
Figuur 5: Immuuninfiltratie van sleutelgenen en voorspelling van drugtargets bij COPD. (A) Verschillen in immuuncelovervloed tussen groepen. (B) Heatmap van de correlatie tussen immuuncellen en sleutelgenen. (C) Interactienetwerk tussen sleutelgenen en voorspelde geneesmiddelen. (D) Moleculaire docking van fluorouracil met UPP1. (E) Moleculaire docking van capecitabine met UPP1. (F) Moleculaire docking van 5-benzylacyclouridine met UPP1. Voor elke verbinding toont de linker afbeelding de algehele dockingconformatie en de rechter afbeelding de lokale bindingsinteracties. (G) CTD-analyse van B4GALT2. (H) CTD-analyse van FAM168B. (I) CTD-analyse van PRKCDBP. (J) CTD-analyse van PTRF. (K) CTD-analyse van TOR3A. (L) CTD-analyse van UPP1. Klik hier om een grotere versie van deze figuur te bekijken.
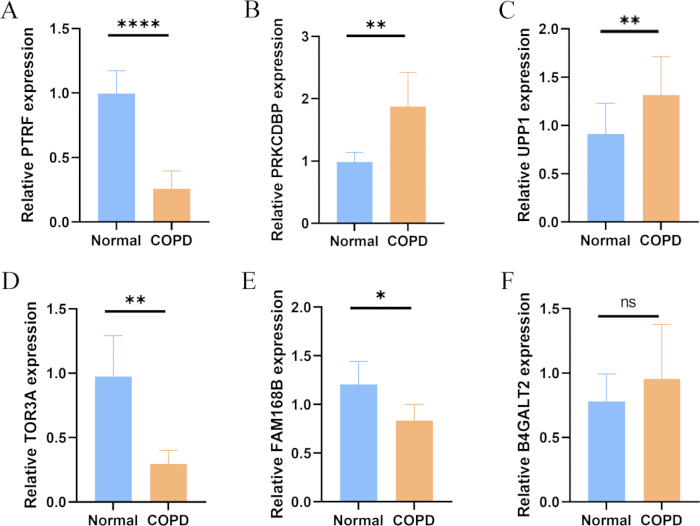
Figuur 6: RT-qPCR-validatie van sleutelgenexpressie in COPD- en controlemonsters. (A) Relatieve expressie van PTRF. (B) Relatieve expressie van PRKCDBP. (C) Relatieve expressie van UPP1. (D) Relatieve expressie van TOR3A. (E) Relatieve expressie van FAM168B. (F) Relatieve expressie van B4GALT2. ns = niet significant, p > 0,05; * p < 0,05; ** p < 0,01; *** p < 0,001; **** p < 0,0001. Afkorting: RT-qPCR = reverse transcription quantitative polymerase chain reaction. Klik hier om een grotere versie van deze figuur te bekijken.
Aanvullende figuur 1: GSE54837-dataset monsters en genmodule-clustering. (A) Monsterclusterdiagram van de GSE54837-dataset. (B) Dendrogram van de moduleclustering vóór het samenvoegen. Genen werden gegroepeerd met behulp van de dynamische tree-cut-methode om verschillende modules te identificeren. (C) Hiërarchisch clustering-dendrogram van module-eigengenen. Modules met vergelijkbare expressiepatronen werden geclusterd op basis van de gelijkenis van hun eigengenen.Klik hier om dit bestand te downloaden.
Aanvullende figuur 2: GSEA-verrijkingsanalyse. (A) GO-analyse van PRKCDBP. (B) KEGG-analyse van PRKCDBP. (C) GO-analyse van PTRF. (D) KEGG-analyse van PTRF. (E) GO-analyse van TOR3A. (F) KEGG-analyse van TOR3A. (G) GO-analyse van FAM168B. (H) KEGG-analyse van FAM168B. (I) GO-analyse van B4GALT2. (J) KEGG-analyse van B4GALT2. Afkortingen: GO = Gene Ontology; KEGG = Kyoto Encyclopedia of Genes and Genomes.Klik hier om dit bestand te downloaden.
| Dataset | Controles | Patiënten | Sequencingplatform |
| GSE54837 | 90 | 136 | GPL570 |
| GSE112811 | 44 | 20 | GPL570 |
Tabel 1: Genexpressie-datasets gebruikt in de studie. Kenmerken van de GSE54837- en GSE112811-datasets die respectievelijk zijn gebruikt voor modelontwikkeling/interne testen en externe validatie.
| Patiënt | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
| Geslacht (V/M) | M | M | M | F | M | M | M | M |
| Leeftijd (jaren) | 69 | 72 | 75 | 73 | 68 | 70 | 69 | 71 |
| Rookstatus | Ja | Ja | Stoppen met roken (2 jaar) | Nee | Ja | Ja | Ja | Stoppen met roken (5 jaar) |
| Pakjaren | 20 per dag / 30 jaar | 15 per dag / 35 jaar | 20 per dag / 50 jaar | 20 per dag / 40 jaar | 30 per dag / 40 jaar | 15 per dag / 40 jaar | 20 per dag / 30 jaar | |
| COPD-groep | 2 | 3 | 3 | 2 | 2 | 3 | 2 | 3 |
Tabel 2: Baseline-kenmerken van de studieparticipanten. Baseline demografische en klinische kenmerken van de COPD-patiënten en gezonde controles die zijn opgenomen in de RT-qPCR-validatie.
| Moleculaire naam | Gen | Score(kcal/mol) |
| 5-Benzylacyclouridine | UPP1 | -9.6 |
| Capecitabine | UPP1 | -6.1 |
| Fluorouracil | UPP1 | -5.5 |
Tabel 3: Moleculaire dockingresultaten voor UPP1 en kandidaatverbindingen.
Voorspelde moleculaire dockingresultaten voor de interactie van UPP1 met fluorouracil, capecitabine en 5-benzylacyclouridine, inclusief hun bindingsaffiniteiten.
Discussie
De geconserveerde RNA-modificatie ac4C, die voornamelijk voorkomt in boodschapper-RNA (mRNA) en transfer-RNA (tRNA), verbetert de mRNA-stabiliteit en translatie-efficiëntie20. NAT10 is de enige bekende RNA-acetyltransferase die de ac4C-modificatie medieert21. Studies hebben aangetoond dat NAT10 is opgereguleerd in longepitheelcellen van COPD-patiënten. Knockdown van NAT10 verstoort de mitochondriale functie en transcriptomische responsen22. Op basis van geïntegreerde multi-omics-analyse identificeerde deze studie zes sleutelgenen die nauw geassocieerd zijn met COPD en ontwikkelde een diagnostisch model, dat een matige diagnostische prestatie en potentiële waarde voor verder onderzoek vertoonde. Verdere analyse onthulde de sleutelrollen van deze genen in transcriptionele regulatie, ceRNA-netwerken en de immuunmicro-omgeving. Daarnaast werden potentiële gerichte geneesmiddelen voorspeld, wat inzicht geeft in de pathogenese van COPD en de ontwikkeling van gepersonaliseerde precisiebehandelingsstrategieën faciliteert. We hebben genen geïdentificeerd die zowel differentieel tot expressie kwamen bij COPD als aanwezig waren in een eerder gepubliceerde ac4C-gerelateerde genlijst met behulp van WGCNA en differentiële expressieanalyse. Het is belangrijk op te merken dat deze genen zijn geselecteerd op basis van hun associatie met het ac4C-regulatieve netwerk, en niet op basis van bewezen mechanische verbanden met NAT10 of ac4C-acetylering, wat resulteerde in een totaal van 160 kandidaatgenen. Zes sleutelgenen (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B en B4GALT2) werden geïdentificeerd via machine learning-algoritmen. Hiervan speelt PTRF een kritische rol bij huisstofmijt (HDM)-geïnduceerde luchtweginflammatie door het reguleren van IL-33-ZBP1-gemedieerde macrofaagnecroptose, wat suggereert dat het betrokken kan zijn bij chronische inflammatoire longcondities zoals COPD23. Lai et al.24 demonstreerden dat exogene uridine-toediening ferroptose in macrofagen remt via het Nrf2/SLC7A11/GPX4-pad, waardoor acute longschade veroorzaakt door sepsis wordt verlicht. Hoewel opregulering van UPP1, een sleutelenzym in het uridine-metabolisme, werd waargenomen in longweefsel uit modellen voor acute longschade, moet de exacte rol — en of deze opregulering een beschermende respons of een gevolg van weefselschade vertegenwoordigt — nog verder worden opgehelderd. Deze bevinding suggereert echter dat UPP1 een potentiële associatie kan hebben met de pathofysiologische processen van inflammatoire longziekten zoals COPD, wat verder onderzoek rechtvaardigt. De overige vier sleutelgenen zijn minder onderzocht bij longgerelateerde aandoeningen, maar op basis van hun functies in andere ziekten en onze huidige bevindingen hypotheseren we potentiële pathways waardoor ze kunnen bijdragen aan de pathogenese van COPD.
Op basis van de zes kerngenen hebben we een diagnostisch model voor COPD geconstrueerd en de goede voorspellende prestaties ervan gevalideerd. Expressieanalyse toonde aan dat UPP1, B4GALT2 en PRKCDBP significant waren opgereguleerd, terwijl FAM168B, PTRF en TOR3A duidelijk waren neergereguleerd bij COPD. Hoewel B4GALT2 als opgereguleerd werd geïdentificeerd in de datasetanalyse, werd er bij de RT-qPCR-validatie geen significant verschil waargenomen. Deze discrepantie kan worden toegeschreven aan de beperkte steekproefgrootte, cohortheterogeniteit en verschillen in monsterbronnen tussen de openbare datasets en klinische bloedmonsters. Gene set enrichment-analyse onthulde dat deze kerngenen significant verrijkt waren in RNA-splicing en mRNA-verwerking, alsook in pathways zoals de celcyclus en nicotineverslaving. Irreversibele celcyclusstop is erkend als een primair mechanisme ten grondslag aan cellulaire senescentie, wat aanzienlijk kan bijdragen aan de pathofysiologie van COPD25,26. Verdere analyse wees uit dat het door DNA-schade geïnduceerde senescence-associated secretory phenotype (SASP) de aanhoudende progressie van COPD kan bevorderen door chronische ontsteking in stand te houden en longweefselschade te verergeren27. Een eerdere studie besprak ook de genetische verbanden ten grondslag aan nicotineverslaving en COPD28. Hoewel roken de primaire risicofactor is voor COPD, ontwikkelt slechts een klein deel van de rokers de ziekte, wat suggereert dat genetische factoren een belangrijke rol spelen in zowel COPD als nicotineafhankelijkheid. Liu et al.29 vatten de rollen van RNA-bindende eiwitten (RBPs) bij COPD en pulmonale hypertensie (PH) samen, waarbij zij hun betrokkenheid bij pulmonale vasculaire remodellering en ontstekingsreacties benadrukken via de regulatie van mRNA-splicing en post-transcriptionele genexpressie, waardoor hun potentieel als biomarkers en therapeutische doelwitten wordt onderstreept. Samenvattend verdiepen de in deze studie geïdentificeerde kerngenen en bijbehorende pathways niet alleen ons begrip van de pathogenese van COPD, maar bieden ze ook een solide basis voor de ontwikkeling van toekomstige diagnostische biomarkers en gerichte therapeutische strategieën.
Het ceRNA-netwerk omvat verschillende RNA-soorten, waaronder lncRNA's, circRNA's en mRNA's, die competitief binden aan gedeelde miRNA's, waardoor wederzijdse regulerende relaties ontstaan die de genexpressie beïnvloeden30. Dit complexe netwerk is betrokken bij talrijke fysiologische en pathologische processen en draagt bij aan het verduidelijken van genregulerende mechanismen en de pathogenese van ziekten zoals kanker en chronische inflammatoire aandoeningen. Zo construeerden Wang et al. een ceRNA-coexpressienetwerk bestaande uit 11 lncRNA's, vijf miRNA's en 16 mRNA's, waarbij het kernsubnet geassocieerd was met veranderingen in de proporties van immuuncellen en de longfunctie bij COPD31. Op soortgelijke wijze ontwikkelden Zhang et al.32 een circRNA-miRNA-mRNA ceRNA-netwerk op basis van mononucleaire cellen uit perifeer bloed van mannelijke rokers, waarbij zij gedereguleerde circRNA's en sleutelpaden in relatie tot COPD identificeerden. Onze coexpressienetwerkanalyse onthulde dat de sleutelgenen hoofdzakelijk functionele verbindingen vestigden via fysieke interacties, coexpressie en gedeelde proteinedomeinen, en significant verrijkt waren in meerdere metabolisme-gerelateerde paden. Op basis van deze bevindingen construeerden we verder een transcriptiefactor (TF)-target regulerend netwerk en een miRNA-lncRNA-mRNA regulerende as. Deze resultaten suggereren dat de sleutelgenen in COPD coöperatief gereguleerd kunnen worden via meerlaagse mechanismen waarbij lncRNA's, transcriptiefactoren en miRNA's betrokken zijn.
Immuuninfiltratie weerspiegelt de immuunstatus door de distributie en activiteit van immuuncellen in weefsels of bloed aan te geven. Op basis hiervan werden potentiële kandijdaat-geneesmiddelen voorspeld met behulp van computationele screening, gevolgd door moleculaire dockingsimulaties om de bindingsaffiniteit en stabiliteit met doeleiwitten te beoordelen. Samen faciliteren deze analyses de identificatie van nieuwe therapeutische middelen en bieden ze diepere inzichten in ziektemechanismen. In deze studie waren zes sleutelgenen positief gecorreleerd met de meeste immuuncelinfiltraties. Geneesmiddelvoorspelling identificeerde potentiële interacties tussen UPP1 en fluorouracil, capecitabine en 5-benzylacyclouridine, waarbij dat laatste de sterkste bindingsaffiniteit vertoonde, wat verder werd bevestigd door moleculaire docking. Opvallend is dat fluorouracil en capecitabine primair worden gebruikt als antitumorogene middelen en in deze studie werden geïdentificeerd als database-voorspelde UPP1-interagerende verbindingen in plaats van gevalideerde therapeutische opties voor COPD. Eerdere studies hebben gerapporteerd dat lokale toediening van fluorouracil de luchtwegdoorgankelijkheid kan verbeteren in gevallen van ernstige luchtwegobstructie33. Echter, ander bewijs geeft aan dat fluorouracil en capecitabine pulmonale toxiciteit kunnen induceren, vooral bij patiënten met reeds bestaande longaandoeningen34. Daarom vereist hun potentiële relevantie voor COPD verdere experimentele en veiligheidsverificatie. Bovendien gaf de CTD-analyse aan dat alle zes sleutelgenen geassocieerd waren met meerdere pathologische processen. Collectief biedt de geïntegreerde analyse van immuuninfiltratie, geneesmiddelvoorspelling en moleculaire docking nieuwe moleculaire doelwitten en een theoretische basis voor de precisiebehandeling van COPD, waardoor de ontwikkeling en klinische translatie van gerelateerde geneesmiddelen wordt bevorderd.
Desalniettemin moeten enkele beperkingen worden erkend. De studie vertrouwde op openbare datasets met relatief beperkte monsterbronnen, wat batch-effecten en potentiële overfitting van het model kan introduceren. De RT-qPCR-validatie werd uitgevoerd in een kleine cohort, en de waargenomen inconsistentie in de expressie van B4GALT2 suggereert mogelijke cohortheterogeniteit. Daarnaast waren de analyses van immuuninfiltratie en geneesmiddelvoorspelling computationeel van aard en vereisen zij verdere experimentele validatie. Bovendien is ons diagnostische model, als bio-informatica-onderzoek in de ontdekkingsfase, primair geëvalueerd met behulp van AUC-waarden met 95% betrouwbaarheidsintervallen. Uitgebreide prestatiemetrieken zoals sensitiviteit, specificiteit, predictieve waarden en gedetailleerde kalibratiestatistieken zijn niet volledig beoordeeld vanwege de retrospectieve aard van de openbare datasets en de beperkte steekproefgroottes. Daarom moet ons model worden beschouwd als een proof-of-concept-instrument, en is de klinische bruikbaarheid ervan onderworpen aan verdere validatie in grotere prospectieve cohorten.
Door middel van integratieve bio-informatica- en machine learning-analyses identificeerde deze studie zes sleutelgenen die significant geassocieerd zijn met COPD. Er werd een robuust diagnostisch model opgezet, dat een betrouwbare voorspellende prestatie demonstreerde over meerdere cohorten. Functionele analyses onthulden dat deze genen deelnemen aan kritieke regulerende netwerken met betrekking tot transcriptionele en post-transcriptionele regulatie, infiltratie van immuuncellen en pathways gerelateerd aan nicotineverslaving en de celcyclus. Drug prediction- en moleculaire docking-analyses markeerden UPP1 als een veelbelovend therapeutisch doelwit, waarbij verschillende kandidaatverbindingen sterke bindingsaffiniteiten vertoonden. Over het geheel genomen verbeteren deze bevindingen ons begrip van de pathofysiologie van COPD en bieden ze waardevolle moleculaire doelwitten voor toekomstige therapeutische ontwikkeling en strategieën voor precisiegeneeskunde.
Openbaarmakingen
De auteurs verklaren geen belangenconflicten. Geïnformeerde toestemming is verkregen van alle proefpersonen die aan de studie hebben deelgenomen.
Dankbetuigingen
Wij danken het Shenzhen Luohu Hospital of Traditional Chinese Medicine voor het ter beschikking stellen van de klinische faciliteiten en de administratieve ondersteuning die essentieel waren voor deze studie. Ten slotte zijn wij dankbaar aan alle patiënten en gezonde vrijwilligers die aan dit onderzoek hebben deelgenomen; hun bijdrage was onmisbaar voor dit werk. Dit werk werd ondersteund door het Sanming Project of Medicine in Shenzhen (No. SZZYSM202401018), de Luohu District Priority Specialty Funds (No. LX202402021) en de Luohu District Priority Specialty Funds (No. LX202302064).
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| β-actine-primers | Tsingke | Omdat er geen brontekst is verstrekt, kan ik geen vertaling produceren. Voer aub de tekst in die u vertaald wilt hebben. | Voorwaarts: 5’-CATGTACGTTGCTATCCAGGC-3’ Omkeren: 5’-CTCCTTAATGTCACGCACGAT-3’ |
| B4GALT2-primers | Tsingke | Omdat er geen brontekst is verstrekt, kan ik geen vertaling produceren. Lever alstublieft de Engelse tekst aan die u vertaald wilt hebben naar het Nederlands. | Voorwaarts: 5’-GGGCAGACTGCTGATCGAG-3’ Omkeren: 5’-CCGGTGTCTAAAGGGGATGAT-3’ |
| CB-Dock2 | LabShare | Online | Moleculaire docking |
| clusterProfiler | Bioconductor | v4.14.6 | Enrichmingsanalyse |
| Cytoscape | Cytoscape Consortium | v3.8.3 | Netwerkvisualisatie |
| DrugBank | University of Alberta | Online | Medicamentvoorspelling |
| FAM168B-primers | Tsingke | Omdat u geen brontekst heeft verstrekt, is er geen inhoud om te vertalen. Voer aub de Engelse tekst in die u naar het Nederlands vertaald wilt hebben. | Voorwaarts: 5’-TCTGGGGTTCCCTATGCAAAT-3’ Omkeer: 5’-GTAGGATTCGCTCCAGGATACA-3’ |
| glmnet | CRAN | v4.1 | LASSO-regressie |
| GSVA (Gene Set Variation Analysis) | Bioconductor | v1.52.3 | ssGSEA-analyse |
| Hifair III Supermix voor synthese van de eerste cDNA-streng | Gisten | 11141ES | cDNA-synthese |
| Hieff RTPCR SYBR Green Master Mix | YEASEN | 11201ES | qPCR-amplificatie |
| limma | Bioconductor | v3.54.0 | Differentiële expressie |
| LightCycler 480 II-systeem | Roche | LightCycler 480 II | Real-time PCR |
| PTRF-primers | Tsingke | Omdat er geen brontekst is verstrekt, kan ik geen vertaling produceren. Voer aub de Engelse tekst in die u vertaald wilt hebben. | Voorwaarts: 5’-GGGCCGTAGACCAGATCCA-3’ Omkeren: 5’-CTTGCTCACCGTATTGCTCGT-3’ |
| PRKCDBP-primers | Tsingke | Omdat er geen brontekst is verstrekt, kan ik geen vertaling produceren. Voer aub de Engelse tekst in die u vertaald wilt hebben naar het Nederlands. | Voorwaarts: 5’-CACGTTCTGCTCTTCAAGGAG-3’ Omkeren: 5’-TGTACCTTCTGCAATCCGGTG-3’ |
| R-software | R Foundation | v4.4.2 | Statistische informatica |
| randomForest | CRAN | v4.7 | Random Forest |
| RNA-isolatiekit MolPure Blood RNA Kit | GISTEN | 19241ES50 | RNA-extractie |
| STRING-database | EMBL | Online | PPI-netwerk |
| TOR3A-primers | Tsingke | Omdat er geen brontekst is verstrekt, kan ik geen vertaling produceren. Stuur a.u.b. de Engelse tekst die u vertaald wilt hebben. | Voorwaarts: 5’-CCCTTGCTCTGTCGTTCCAC-3’ Omgekeerd: 5’-CCCGTCCCGATACAGGTTC-3’ |
| UPP1-primers | Tsingke | Omdat er geen brontekst is verstrekt, kan ik geen vertaling uitvoeren. Voer a.u.v. de tekst in die u vertaald wilt hebben. | Voorwaarts: 5’-CTGTCAGTCATGGTATGGGCA-3’ Omkeren: 5’-GAGCACCGGGCATAGTACA-3’ |
| WGCNA (Weighted Gene Co-expression Network Analysis) | CRAN | v1.72 | Co-expressienetwerk |
| XGBoost | CRAN | v1.7 | XGBoost-algoritme |
Referenties
- Hogg JC. Pathophysiology of airflow limitation in chronic obstructive pulmonary disease. Lancet. 2004;364(9435):709-21.
- Baraldo S, Turato G, Saetta M. Pathophysiology of the small airways in chronic obstructive pulmonary disease. Respiration. 2012;84(2):89-97.
- Fischer BM, Pavlisko E, Voynow JA. Pathogenic triad in COPD: oxidative stress, protease-antiprotease imbalance, and inflammation. Int J Chron Obstruct Pulmon Dis. 2011;6:413-21.
- Pandey KC, De S, Mishra PK. Role of proteases in chronic obstructive pulmonary disease. Front Pharmacol. 2017;8:512.
- Wang L, Xie J, Hu Y, Tian Y. Air pollution and risk of chronic obstructed pulmonary disease: the modifying effect of genetic susceptibility and lifestyle. EBioMedicine. 2022;79:103994.
- Elonheimo HM, et al. Environmental substances associated with chronic obstructive pulmonary disease-a scoping review. Int J Environ Res Public Health. 2022;19(7):3945.
- Chen S, et al. The global economic burden of chronic obstructive pulmonary disease for 204 countries and territories in 2020-50: a health-augmented macroeconomic modelling study. Lancet Glob Health. 2023;11(8):e1183-e93.
- Rutten-van Mölken MP, et al. Costs and effects of inhaled corticosteroids and bronchodilators in asthma and chronic obstructive pulmonary disease. Am J Respir Crit Care Med. 1995;151(4):975-82.
- Ontiveros RJ, Stoute J, Liu KF. The chemical diversity of RNA modifications. Biochem J. 2019;476(8):1227-45.
- Roundtree IA, Evans ME, Pan T, He C. Dynamic RNA modifications in gene expression regulation. Cell. 2017;169(7):1187-200.
- Wang C, et al. RNA modification in cardiovascular disease: implications for therapeutic interventions. Signal Transduct Target Ther. 2023;8(1):412.
- Zhang W, et al. ac4C acetylation regulates mRNA stability and translation efficiency in osteosarcoma. Heliyon. 2023;9(6):e17103.
- Qiu L, Jing Q, Li Y, Han J. RNA modification: mechanisms and therapeutic targets. Mol Biomed. 2023;4(1):25.
- Luo J, Cao J, Chen C, Xie H. Emerging role of RNA acetylation modification ac4C in diseases: current advances and future challenges. Biochem Pharmacol. 2023;213:115628.
- Li H, et al. RNA cytidine acetyltransferase NAT10 maintains T cell pathogenicity in inflammatory bowel disease. Cell Discov. 2025;11(1):19.
- Wang JN, et al. NAT10 exacerbates acute renal inflammation by enhancing N4-acetylcytidine modification of the CCL2/CXCL1 axis. Proc Natl Acad Sci U S A. 2025;122(17):e2418409122.
- Shenshen W, et al. NAT10 accelerates pulmonary fibrosis through N4-acetylated TGFB1-initiated epithelial-to-mesenchymal transition upon ambient fine particulate matter exposure. Environ Pollut. 2023;322:121149.
- Liu J, et al. Unveiling ac4C modification pattern: a prospective target for improving the response to immunotherapeutic strategies in melanoma. J Transl Med. 2025;23(1):287.
- Su F, et al. Multimodal single-cell analyses outline the immune microenvironment and therapeutic effectors of interstitial cystitis/bladder pain syndrome. Adv Sci (Weinh). 2022;9(18):e2106063.
- Schiffers S, Oberdoerffer S. ac4C: a fragile modification with stabilizing functions in RNA metabolism. RNA. 2024;30(5):583-94.
- Jiao L, et al. Emerging role of N-acetyltransferase 10 in diseases: RNA ac4C modification and beyond. Mol Biomed. 2025;6(1):46.
- Zheng N, et al. Regulatory roles of NAT10 in airway epithelial cell function and metabolism in pathological conditions. Cell Biol Toxicol. 2023;39(4):1237-56.
- Du J, et al. PTRF-IL33-ZBP1 signaling mediating macrophage necroptosis contributes to HDM-induced airway inflammation. Cell Death Dis. 2023;14(7):432.
- Lai K, et al. Uridine alleviates sepsis-induced acute lung injury by inhibiting ferroptosis of macrophage. Int J Mol Sci. 2023;24(6):5093.
- Kumari R, Jat P. Mechanisms of cellular senescence: cell cycle arrest and senescence associated secretory phenotype. Front Cell Dev Biol. 2021;9:645593.
- Ogrodnik M, Salmonowicz H, Jurk D, Passos JF. Expansion and cell-cycle arrest: common denominators of cellular senescence. Trends Biochem Sci. 2019;44(12):996-1008.
- Kumar M, Seeger W, Voswinckel R. Senescence-associated secretory phenotype and its possible role in chronic obstructive pulmonary disease. Am J Respir Cell Mol Biol. 2014;51(3):323-33.
- Pérez-Rubio G, et al. Role of genetic susceptibility in nicotine addiction and chronic obstructive pulmonary disease. Rev Invest Clin. 2019;71(1):36-54.
- Liu Y, Wang R, Jiang T. RNA-binding proteins as a molecular link between COPD and pulmonary hypertension. Int J Med Sci. 2025;22(8):1979-91.
- Marques TM, Gama-Carvalho M. Network approaches to study endogenous RNA competition and its impact on tissue-specific microRNA functions. Biomolecules. 2022;12(2):332.
- Wang J, Xia B, Ma R, Ye Q. Comprehensive analysis of a competing endogenous RNA co-expression network in chronic obstructive pulmonary disease. Int J Chron Obstruct Pulmon Dis. 2023;18:2417-29.
- Zhang J, et al. Construction of a ceRNA network and screening of potential biomarkers and molecular targets in male smokers with chronic obstructive pulmonary disease. Front Genet. 2024;15:1376721.
- Celikoğlu F, Celikoğlu SI. Intratumoural chemotherapy with 5-fluorouracil for palliation of bronchial cancer in patients with severe airway obstruction. J Pharm Pharmacol. 2003;55(10):1441-8.
- Chan AK, Choo BA, Glaholm J. Pulmonary toxicity with oxaliplatin and capecitabine/5-fluorouracil chemotherapy: a case report and review of the literature. Onkologie. 2011;34(8-9):443-6.