Dit protocol integreert multidimensionale transcriptomische gegevens met machine learning om verouderings- en mitochondrië-gerelateerde genen in gedilateerde cardiomyopathie te identificeren voor de ontdekking van biomarkers en moleculaire subtypering.
Onderzoeksartikel
Identificatie van hubgenen gerelateerd aan veroudering en mitochondriën bij gedilateerde cardiomyopathie
In dit artikel
Samenvatting
Samenvatting
Gedilateerde cardiomyopathie (DCM) wordt gekenmerkt door dilatatie van de linker ventrikel en systolische dysfunctie en is geassocieerd met mitochondriële dysfunctie en immuun-inflammatoire activatie. Echter zijn de verouderingsgerelateerde moleculaire signaturen en mitochondriële regulatiestromen bij DCM nog onvoldoende begrepen. In deze studie werden zes bulk-transcriptomische datasets en één single-cell RNA-sequencing dataset uit de Gene Expression Omnibus-database geanalyseerd. Na datanormalisatie, batchcorrectie en celtype-annotatie werden verouderings- en mitochondriën-gerelateerde kandidaatgenen geïdentificeerd middels differentiële expressieanalyse, weighted gene co-expression network analysis en de constructie van proteïne-proteïne interactienetwerken. Kerngenen werden verder gescreend met behulp van least absolute shrinkage and selection operator regressie, random forest en support vector machine-recursive feature elimination. Analyses van immuuncelinfiltratie, cel-celcommunicatie en moleculaire subtypering werden uitgevoerd om de cardiale immuunmicro-omgeving bij DCM te karakteriseren. In totaal werden 66 verouderingsgerelateerde genen en 16 mitochondriën-gerelateerde genen geassocieerd met DCM, welke hoofdzakelijk verrijkt waren in de hypoxia-inducible factor-1 signalering, oxidatieve fosforylering en stikstofoxidesynthase-gerelateerde pathways. Machine learning en single-cell RNA-sequencing analyses identificeerden SERPINE1, TGFB2, CYBB en TLR2 als kerngenen. CYBB en TLR2 waren sterk tot expressie gebracht in monocyten en macrofagen, terwijl SERPINE1 en TGFB2 voornamelijk tot expressie kwamen in stromale cellen. Analyse van het immuunlandschap toonde een verhoogde pro-inflammatoire macrofaagactivatie en een veranderde cel-celcommunicatie in DCM-monsters. Op basis van de expressie van kerngenen werden DCM-monsters verdeeld in twee moleculaire subtypes, respectievelijk geassocieerd met vasculaire endotheliale groeifactor-signalering en primaire galzuurbiosynthese. Dit protocol biedt een geïntegreerd kader voor het identificeren van kandidaatbiomarkers en moleculaire subtypes bij DCM.
Inleiding
Dilate cardiomyopathie (DCM) is een myocardiale aandoening die wordt gekenmerkt door dilatatie van de linker ventrikel en een verminderde systolische functie. Het is de op een na meest voorkomende oorzaak van hartfalen en de belangrijkste indicatie voor harttransplantatie wereldwijd1. Populatiegebaseerde studies schatten de prevalentie op ongeveer 1 op de 250 volwassenen, met een hogere prevalentie bij mannen en een aanzienlijk deel van de gevallen dat toe te schrijven is aan monogene varianten2. Deze bevindingen wijzen erop dat zowel genetische vatbaarheid als omgevingsfactoren bijdragen aan het ontstaan en de progressie van DCM.
De pathogenese van DCM omvat onderling verbonden processen, waaronder inflammatoire activatie, oxidatieve stress, apoptose van cardiomyocyten en ontregelde profibrotische signalering. Inflammatoire genetische polymorfismen, waaronder varianten in de promoter van tumornecrosefactor-α, zijn geassocieerd met de vatbaarheid voor virale DCM3. Verhoogde oxidatieve stress is eveneens geassocieerd met de dood van cardiomyocyten en linkerventrikeldisfunctie bij menselijke DCM-subtypes4. Daarnaast bevordert aberrante activatie van Wnt/β-catenin- en calcineurine/nuclear factor of activated T cells-signalering myocardiale hypertrofie en interstitiële fibrose, wat bijdraagt aan de progressie van de ziekte5,6. Mitochondriële dysfunctie is een andere belangrijke component van DCM, aangezien cardiomyocyten een hoge energiebehoefte hebben. Verstoring van de mitochondriële biogenese, calciumhomeostase, mitofagie en de integriteit van het mitochondriële DNA kan de oxidatieve fosforylering belemmeren en bijdragen aan progressieve cardiale dysfunctie7,8,9,10.
Ondanks deze mechanistische bevindingen blijven er belangrijke kennishiaat bestaan. In het bijzonder zijn de temporele en causale relaties tussen mitochondriale structurele remodellering en bioenergetische dysfunctie tijdens de initiatie en progressie van DCM nog niet volledig gedefinieerd11. Verschillende therapeutische strategieën zijn onderzocht. Stamceltherapie heeft regeneratief potentieel getoond via paracriene, cytoprotectieve en immunomodulerende effecten, maar optimalisatie van celbronnen, toedieningsroutes en overleving na transplantatie blijft noodzakelijk12. Gentherapeutische benaderingen, waaronder levering op basis van adeno-geassocieerde virussen en genoomredigering op basis van clustered regularly interspaced short palindromic repeats, bieden evenzo potentiële precisbehandelingsstrategieën. Beperkingen met betrekking tot cardiale tropisme, vectorimmunogeniciteit en veiligheid op lange termijn blijven echter onopgelost13.
Openbare transcriptomische datasets uit repositories zoals de Gene Expression Omnibus (GEO) worden op grote schaal gebruikt voor de ontdekking van biomarkers bij DCM. Deze bronnen bieden toegang tot multicentrische klinische cohorten, ondersteunen kosteneffectieve en reproduceerbare onderzoeken en kunnen de statistische power verhogen door middel van cross-dataset integratie14. Transcriptomische profilering maakt bovendien genoombrede screening van kandidaatgenen, moleculaire subtypering en analyse op routeniveau mogelijk15. Openbare datasets hebben echter inherente beperkingen, waaronder technische batch-effecten, klinische en etiologische heterogeniteit, een beperkte capaciteit voor causale inferentie en onvolledige longitudinale of prognostische informatie16. Daarom zijn bevindingen afgeleid van openbare transcriptomische datasets het meest geschikt voor het genereren van hypothesen en het prioriteren van kandidaat-biomarkers, en vereisen zij validatie in onafhankelijke cohorten en experimentele modellen.
Veel bio-informatische studies naar DCM vertrouwen primair op differentiële expressieanalyse, wat kan leiden tot fout-positieve resultaten en geen volledig beeld geeft van gen-co-expressienetwerken of cellulaire heterogeniteit binnen het hartweefsel. Om deze beperkingen aan te pakken, maakte de huidige studie gebruik van een geïntegreerde analytische strategie waarin complementaire methoden werden gecombineerd. Bulk-transcriptomanalyse verschaft expressieprofielen op weefselniveau die geschikt zijn voor case-controlvergelijkingen. Weighted gene co-expression network analysis (WGCNA) identificeert genmodules die geassocieerd zijn met fenotypische kenmerken en maakt het mogelijk om functioneel gerelateerde gensets prioriteit te geven in plaats van individuele differentieel tot expressie gebrachte genen. Protein-protein interaction (PPI)-netwerkanalyse identificeert sterk verbonden genen op basis van de netwerktopologie. Drie machine learning-algoritmen — least absolute shrinkage and selection operator regressie, random forest en support vector machine-recursive feature elimination — werden gebruikt om kandidaat-biomarkers in de geïntegreerde datasets te identificeren¹⁷. Single-cell RNA-sequencing (scRNA-seq) werd vervolgens ingezet om celtype-specifieke expressiepatronen en intercellulaire communicatienetwerken te onderzoeken18.
Hoewel mitochondriële dysfunctie en verouderingsgerelateerde moleculaire veranderingen afzonderlijk zijn onderzocht bij DCM, blijven hun gecombineerde associaties met ziektegerelateerde transcriptionele veranderingen onvoldoende verkend. De huidige studie integreerde meerdere bulk-transcriptomische en scRNA-seq-datasets om verouderings- en mitochondrië-gerelateerde hub-genen bij DCM te identificeren, de cardiale immuunmicro-omgeving te karakteriseren en moleculaire subtypen te onderzoeken op basis van de geïdentificeerde genen. Deze geïntegreerde aanpak werd gebruikt om kandidaat-biomarkers te prioriteren en een basis te bieden voor daaropvolgende mechanistische en validatiestudies.
Protocol
Alle dierprocedures zijn beoordeeld en goedgekeurd door de Ethiekcommissie voor Laboratoriumdieren van het Tweede Affiliated Hospital van de Henan University of Chinese Medicine (Goedkeuringsnr. HNSZYYYJS2023011150). Alle procedures zijn uitgevoerd in overeenstemming met de Richtlijnen voor Ethische Beoordeling van Laboratoriumdierenwelzijn (GB/T 35892-2018) en de 3R-principes van Replacement, Reduction en Refinement. De reagentia, databases, software en apparatuur die in deze studie zijn gebruikt, staan vermeld in de Tabel met materialen.
1. Databronnen en experimentele materialen
Mannelijke SPF-grade CTNTR141W transgene muizen met een spontaan fenotype van gedilateerde cardiomyopathie (DCM) en een lichaamsgewicht van 25 ± 2 g werden gebruikt als modelgroep. Leeftijdsmatchende mannelijke SPF-grade C57BL/6J muizen met een lichaamsgewicht van 25 ± 2 g werden gebruikt als controlegroep. Elke groep bestond uit 12 muizen. Alle dieren werden verkregen van instellingen met geldige vergunningen voor de productie van laboratoriumdieren en werden gehuisvest in een SPF-grade barrièreomgeving bij 22 ± 2 °C en een relatieve vochtigheid van 40%–60% onder een licht/donkercyclus van 12 u, met vrije toegang tot gesteriliseerd voer en water. Na 1 week acclimatisatie werden alle muizen gedurende nog eens 4 weken onder dezelfde omstandigheden gehouden voorafgaand aan de beoordeling van de hartfunctie en de monstername. Alle muizen waren 6–8 weken oud bij aanvang van het experiment. De muizen werden diep geanestheseerd en geëuthanaseerd door cervicale dislocatie.
Zeven openbare transcriptomische datasets van myocardweefsel uit de linker ventrikel van patiënten met DCM werden opgehaald uit de Gene Expression Omnibus (GEO)19 database. Deze datasets bestonden uit zes bulk-transcriptomische datasets en één single-cell RNA-sequencing (scRNA-seq) dataset, GSE145154. Zowel CD45-positieve als CD45-negatieve fracties werden in de analyse meegenomen. Beide CD45-positieve en CD45-negatieve cel-fracties werden gecombineerd vóór clustering. De monsteridentiteit werd gebruikt als de belangrijkste batchvariabele voor Harmony-integratie. Normale monsters van de linker ventrikel en monsters van de linker ventrikel met DCM uit GSE145154 werden opgenomen, specifiek GSM4307515, GSM4307516, GSM4307520 en GSM4307521. De in deze studie gebruikte datasets waren GSE145154, GSE5406, GSE42955, GSE57338, GSE79962, GSE116250 en GSE141910. Alle monsters die geen DCM betroffen werden uitgesloten, en alleen controlemonsters (controlegroep) en DCM-monsters (DCM-groep) werden behouden. Er werden geen monsters verwijderd na kwaliteitscontrole. De monsterinformatie van de opgenomen GEO-datasets is als volgt samengevat: GSE5406 bevatte 102 monsters (16 controle- en 86 DCM-monsters); GSE42955 bevatte 17 monsters (5 controle- en 12 DCM-monsters); GSE57338 bevatte 231 monsters (136 controle- en 95 DCM-monsters); GSE79962 bevatte 20 monsters (11 controle- en 9 DCM-monsters); GSE116250 bevatte 51 monsters (14 controle- en 37 DCM-monsters); en GSE141910 bevatte 322 monsters (161 controle- en 161 DCM-monsters).
2. Preprocessing van bulk-transcriptoomgegevens
Ruwe expressiematrices en klinische annotatiebestanden voor de zes bulk-datasets werden gedownload met behulp van het GEOquery-pakket20. Voor de Affymetrix-microarray-datasets werden ruwe CEL-bestanden opgehaald, en voor de RNA-seq-datasets werden ruwe count-matrices opgehaald. Achtergrondcorrectie, kwantielnormalisatie en expressieberekening voor de microarray-gegevens werden uitgevoerd met het robust multi-array average-algoritme, geïmplementeerd in het affy-pakket21.
RNA-seq countdata werden genormaliseerd met de trimmed mean of M-values methode in het edgeR-pakket22 en omgezet naar log₂-getransformeerde counts per million waarden. Probe-identificatoren werden omgezet naar officiële gensymbolen met behulp van platformspecifieke annotatiebestanden. Wanneer meerdere probes aan hetzelfde gen waren gekoppeld, werd de gemiddelde expressiewaarde berekend.
Technische batch-effecten tussen datasets werden verwijderd met behulp van het ComBat-algoritme in het sva-pakket23. De bron van de dataset en het detectieplatform werden gespecificeerd als batch-factoren. Principal component analysis werd uitgevoerd vóór en na de batchcorrectie om de effectiviteit van de verwijdering van batch-effecten te evalueren.
3. Preprocessing van single-cell transcriptoomgegevens en celannotatie
De genexpressiematrix uit GSE145154 werd geïmporteerd in Seurat om een Seurat-object te construeren met Seurat versie 524. Cellen van lage kwaliteit werden uitgesloten op basis van de volgende drempelwaarden: 200–6.000 gedetecteerde genen per cel, een totaal aantal unieke moleculaire identifiers groter dan 500, en een percentage mitochondriale genen lager dan 25%. Cellen die buiten deze kwaliteitscontrole-drempelwaarden vielen, werden uitgesloten als cellen van lage kwaliteit of geruptureerde cellen. We hebben cellen van lage kwaliteit uitsluitend uitgesloten op basis van de hierboven beschreven kwaliteitscontrole-drempelwaarden.
Log-normalisatie werd uitgevoerd met de functie NormalizeData met een schaalfactor van 10.000. De 3.000 meest variabele genen werden geselecteerd met de functie FindVariableFeatures middels de vst-methode. De gegevens werden geschaald met ScaleData, gevolgd door principale componentenanalyse voor lineaire dimensionaliteitsreductie.
Batch-effecten werden gecorrigeerd met het Harmony-algoritme25 via de RunHarmony-functie, waarbij de monsteridentiteit werd gespecificeerd als de groeperingsvariabele. De eerste 15 hoofdcomponenten werden gebruikt om cellen te clusteren met de functies FindNeighbors en FindClusters. De clustering werd uitgevoerd met het Leiden-algoritme bij een resolutie van 0,15. Niet-lineaire dimensionaliteitsreductie en visualisatie werden uitgevoerd met uniform manifold approximation and projection.
Celtypen werden geannoteerd met behulp van canonieke markergenen in combinatie met geautomatiseerde annotatie via het SingleR-pakket26. De markergenen waren als volgt: B-cellen, IGKC, MS4A1 en CD79A; cardiomyocyten, TNNI3, MYL2 en ACTC1; endotheelcellen, VWF, PECAM1 en EGFL7; macrofagen, C1QC, C1QB en C1QA; monocyten, S100A8, S100A9 en G0S2; natural killer-cellen, NKG7, GNLY en CCL5; gladde spiercellen, MYL9, TAGLN en ACTA2; stromale cellen, FBLN1, LUM en DCN; en T-cellen, CD3E, CD3G en CD3D.
4. Differentieel expressie-analyse en gene set enrichment scoring
Er werd een lineair model geconstrueerd met behulp van het limma-pakket27 om de genexpressie tussen de DCM-groep en de gezonde controlegroep te vergelijken. Genen met een P-waarde < 0,05 en een absolute fold change groter dan 1,5, wat overeenkomt met een absolute log₂ fold change groter dan 0,58, werden gedefinieerd als significant differentieel tot expressie gebracht.
Er werd een single-sample gene set enrichment analysis uitgevoerd om de enrichment scores voor de verouderingsgerelateerde en mitochondria-gerelateerde genensets in elk monster te berekenen28. Verschillen in enrichment scores tussen de DCM-groep en de gezonde controlegroep werden geëvalueerd met de Wilcoxon rank-sum test, waarbij een P-waarde < 0,05 als statistisch significant werd beschouwd.
Op single-cell niveau werden de scores voor verouderingsgerelateerde en mitochondriale modules berekend met de AddModuleScore-functie in Seurat. Verschillen in modulescores tussen groepen werden beoordeeld met de Wilcoxon rank-sum test.
Genetische signatures gerelateerd aan veroudering zijn opgehaald uit de CellAge-database (https://genomics.senescence.info/cells/), en mitochondria-gerelateerde genensets zijn verkregen via GeneCards (https://www.genecards.org/). De volledige genenlijsten die voor de scoring zijn gebruikt, zijn opgenomen in Aanvullend bestand 1.
5. Constructie van het gewogen gen-co-expressienetwerk
De top 5000 proteïne-coderende genen met de hoogste expressievariantie in bulk transcriptomische data werden behouden voor de netwerkconstructie. De functie pickSoftThreshold werd toegepast om de scale-free topology fit index te berekenen onder verschillende soft-thresholding powers. De optimale drempelwaarde werd bepaald als de minimale power die een scale-free netwerk opleverde met een R2 waarde boven de 0,9. Overeenkomstig werd een soft-thresholding power van β = 5 gehanteerd voor de daaropvolgende netwerkanalyse.
Een gewogen co-expressienetwerk met tekens werd geconstrueerd met behulp van de blockwiseModules-functie met een minimale modulegrootte van 30. Pearson-correlatiecoëfficiënten werden berekend tussen elk module-eigengene en de verrijkingsscore voor veroudering of mitochondriën. Modules met een absolute correlatiecoëfficiënt groter dan 0,4 en P < 0,001 werden beschouwd als significant geassocieerde modules.
Genen binnen significant geassocieerde modules werden gekruist met differentieel tot expressie gebrachte genen om kandidaatgenen voor veroudering geassocieerd met DCM en kandidaatgenen voor mitochondriën geassocieerd met DCM te identificeren.
6. Functionele verrijkingsanalyse
Functionele verrijkingsanalyses, waaronder Gene Ontology (GO)- en Kyoto Encyclopedia of Genes and Genomes (KEGG)-pathwayanalyses, werden uitgevoerd op kandidaatgenen met behulp van het clusterProfiler-pakket29. De GO-verrijking omvatte drie standaardcategorieën: biologisch proces, cellulaire component en moleculaire functie.
Alle analyses werden uitgevoerd met annotatie voor de menselijke soort, false discovery rate (FDR) voor P-waarde correctie en een q-waardedrempel van 0,05. Genensets werden beperkt tot een grootte van 10–500 genen, en termen met een FDR < 0,05 werden gedefinieerd als statistisch significant. Ten slotte werden de GO-verrijkingsresultaten gevisualiseerd via gegroepeerde staafdiagrammen, terwijl de KEGG-verrijkingsresultaten werden weergegeven met behulp van bubble plots.
7. Constructie van het PPI-netwerk en screening van hub-genen
Kandidaatgenen werden ingevoerd in de STRING-database versie 11.530, waarbij het organisme werd ingesteld op Homo sapiens en de drempelwaarde voor interactiebetrouwbaarheid werd ingesteld op een gecombineerde score groter dan 0,7. Niet-verbonden knooppunten werden verborgen en de interactiegegevens werden geëxporteerd in tab-gescheiden waardenformaat.
De interactiedata werden geïmporteerd in Cytoscape versie 3.9.1 voor visualisatie31. Topologische scores van de knopen werden berekend met de CytoHubba-plugin32 met behulp van drie algoritmen: Degree, maximum neighborhood component en maximal clique centrality.
Centrale functionele modules binnen het netwerk werden geïdentificeerd met de MCODE-plugin33 met de volgende standaardparameters: degree cutoff, 2; k-core, 2; node score cutoff, 0,2; en maximale diepte, 100. Genen die door alle drie de topologische algoritmen in de top 10 waren geplaatst, werden gekruist met genen in het MCODE-kernsubnetwerk om de uiteindelijke eiwit-eiwitinteractie hub-genen te identificeren.
8. Op machine learning gebaseerde selectie van kerngenen en constructie van het diagnostisch model
Om reproduceerbaarheid en een gebalanceerde representatie te garanderen, werd de geïntegreerde bulk-transcriptomische dataset willekeurig gesplitst in trainings- en validatiesets in een verhouding van 7:3 met behulp van een vast willekeurig startgetal (seed = 123456). Deze splitsing werd gestratificeerd naar ziektegroep (DCM vs. controle) om consistente klasseproporties in beide sets te behouden. Voorafgaand aan de splitsing werden batch-effecten van verschillende datasetbronnen gecorrigeerd met het sva-pakket, en de geïntegreerde monsters werden tijdens de willekeurige toewijzing behandeld als een uniforme cohort.
Drie algoritmen voor machine learning werden toegepast om kandidaatgenen te screenen. Ten eerste werd LASSO-logistische regressie uitgevoerd via de cv.glmnet-functie in het glmnet-pakket34. Er werd een binair classificatiemodel met 5-voudige kruisvalidatie geconstrueerd, waarbij de AUC als evaluatiemaatstaf werd gehanteerd. Genen met coëfficiënten ongelijk aan nul bij lambda.min werden behouden als kandidaatgenen.
Ten tweede werd een random forest-classificatiemodel met 500 beslisbomen gebouwd met behulp van het randomForest-pakket35. Het aantal variabelen dat voor elke splitsing werd gesampled, werd ingesteld op de vierkantswortel van het totale aantal kenmerken. De genbelangrijkheid werd gekwantificeerd op basis van de Gini-coëfficiënt, waarbij de 10 genen met de hoogste belangrijkheidsscores werden behouden.
Ten derde werd SVM-RFE-analyse uitgevoerd met de rfe-functie in het caret-pakket36. Het aantal kenmerken werd ingesteld op een bereik van 1–10, en er werd gebruikgemaakt van 5-voudige kruisvalidatie voor de training van het model. Uiteindelijk werd de gensubset met de optimale kruisvalidatienauwkeurigheid geselecteerd.
Genen die door alle drie de algoritmen werden geïdentificeerd, werden gedefinieerd als de uiteindelijke kernset van verouderings- en mitochondrië-gerelateerde genen bij DCM. Vervolgens werden diagnostische modellen geconstrueerd met behulp van 10 classificatie-algoritmen: beslissingsboom, gradient boosting machine, boosted generalized linear model, k-dichtstbijzijnde buren, logistische regressie, neuraal netwerk, partiële kleinste kwadraten, random forest, support vector machine en extreme gradient boosting.
Receiver operating characteristic-curves werden gegenereerd met het pROC-pakket37. De oppervlakte onder de curve, accuratesse, sensitiviteit en specificiteit werden berekend om de diagnostische prestaties in de trainings- en validatiesets te evalueren.
Een SHapley Additive exPlanations-analyse werd uitgevoerd om de bijdrage van elk kerngen aan de modelvoorspellingen te berekenen38. Er werden samenvattingsplots en waterfall-plots per monster gegenereerd. Een definitief diagnostisch model met een area under the curve groter dan 0,8 in de validatieset werd beschouwd als zijnde van een goede diagnostische prestatie.
9. Inferentie van cel-celcommunicatie
Netwerken van cel-celcommunicatie in de cardiale micro-omgeving werden geïnferred met behulp van het CellChat-pakket39. Er werd een CellChat-object geconstrueerd met behulp van de CellChatDB.human-database. Differentieel tot expressie gebrachte liganden en receptoren werden geïdentificeerd met identifyOverExpressedGenes, en significante interactieparen werden gefilterd met identifyOverExpressedInteractions.
Communicatiekansen tussen celtypen werden berekend met behulp van computeCommunProb. Het globale communicatienetwerk op celtypeniveau werd geaggregeerd met aggregateNet. Het aantal interacties en de communicatiesterkte tussen elk paar celtypen werden gekwantificeerd en gevisualiseerd met behulp van heatmaps en staafdiagrammen.
10. Kwantificering van immuuncelinfiltratie
Verrijkingsscores voor 28 immuunceltypen werden voor elk bulkmonster berekend met behulp van single-sample gene set enrichment analysis28 en een immuuncelsignatuur-genenset40. De Wilcoxon rank-sum test werd gebruikt om de verrijkingsscores van immuuncellen tussen de DCM- en gezonde controlegroepen te vergelijken. P < 0,05 werd beschouwd als statistisch significant.
Er werd een Pearson-correlatieanalyse uitgevoerd om de associatie tussen de expressieniveaus van kerngenen en de verrijkingsscores van immuuncellen te evalueren. Alle correlaties met P < 0,05 werden als statistisch significant beschouwd.
11. Consensus-clustering voor moleculaire subtypering
Ongesuperviseerde consensus-clustering van DCM-monsters werd uitgevoerd met kern-genexpressieprofielen via het ConsensusClusterPlus-pakket41. De clusteringparameters werden ingesteld op een maximaal aantal clusters van 6, 1000 resamplingsiteraties en een resamplingsfractie van 0,8. Voor de clustering werd partitioning around medoids met Euclidische afstand toegepast, en er werd gebruikgemaakt van een vaste random seed om de reproduceerbaarheid te waarborgen.
Het optimale aantal subtypen werd bepaald op basis van de delta area plot en consensus cluster stabiliteitsscores, waarbij uiteindelijk K = 2 werd vastgesteld. Vervolgens werd een principale componentanalyse uitgevoerd om de duidelijke scheiding tussen de twee moleculaire subtypen te verifiëren.
Gene set variation analysis42 werd toegepast om monster-specifieke KEGG-padverrijkingsscores te berekenen. Het limma-pakket27 werd gebruikt om differentiële padactivatie tussen subtypen te detecteren, waarbij een P-waarde van minder dan 0,05 als statistisch significant werd gedefinieerd.
12. Echocardiografische beoordeling van de hartfunctie
Muizen werden geanestheseerd via intraperitoneale injectie van 1% natriumpentobarbital (30 mg/kg) en in rugligging gefixeerd op een thermostatische operatietafel. Na het verwijderen van de borstharen werd echogel gelijkmatig aangebracht op het precordiale gebied.
Tweedimensionaal-geleide M-mode echocardiografie werd uitgevoerd op het niveau van de papillaire spieren van het linker ventrikel met behulp van een ultrasoonsysteem voor kleine dieren. Drie opeenvolgende stabiele hartcycli werden vastgelegd om de diameters van het linker ventrikel aan het einde van de diastole en systole, de ejectiefractie en de fractionele verkorting te meten. Alle echocardiografische beoordelingen werden blind uitgevoerd door een professionele echoscopist.
Uit elke groep werden willekeurig drie muizen geselecteerd voor echocardiografisch onderzoek, en deze 6 dieren in totaal werden vervolgens geofferd voor het verzamelen van myocardweefsel en ELISA-metingen. De overige proefdieren ondergingen aanvullende parallelle laboratoriumanalyses en hun gegevens zijn niet opgenomen in de huidige studie.
13. Verzameling van myocardweefsel, proteïne-extractie en enzyme-linked immunosorbent assay
Na echocardiografische beoordeling werden de muizen geëuthanaseerd onder diepe anesthesie. Hartweefsels werden snel geoogst via mediale thoracotomie, en het myocard van de linker ventrikel werd op ijs gedissekeerd. Geïsoleerde weefsels werden grondig gespoeld met ijskoud fosfaatgebufferde zoutoplossing om resterend intracardiaal bloed te verwijderen. Nadat overtollige vloeistof met steriel filterpapier was weggedept, werden de monsters onmiddellijk ingevroren in vloeibare stikstof en bewaard bij −80 °C voor daaropvolgende proteïne-extractie, waarbij herhaalde vries-dooi-cycli strikt werden vermeden.
Bevroren myocardweefsels werden gewogen en op ijs gesneden in fragmenten van ongeveer 1 mm3. De weefsels werden gelyseerd in ijskoude RIPA-lysebuffer met protease- en fosfataseremmers in een gestandaardiseerde verhouding van 100 µL buffer per 10 mg weefsel. Monsters werden op ijs volledig mechanisch gehomogeniseerd en 30 min geïncubeerd om volledige cellyse te bereiken.
Lysaten werden gecentrifugeerd bij 12.000 × g gedurende 15 min bij 4 °C. De resulterende supernatanten werden verzameld in enzymvrije buizen en de totale eiwitconcentratie werd bepaald met een bicinchonininezuur-eiwitassaykit volgens de protocollen van de fabrikant. Alle monsters werden genormaliseerd naar een identieke eiwitconcentratie met lysisbuffer.
De eiwitexpressieniveaus van de vier hubgenen in myocardiale lysaten werden gemeten met behulp van de overeenkomstige enzyme-linked immunosorbent assay (ELISA) kits. Seriële verdunningen van standaarden en genormaliseerde weefsellysaten werden in duplo (100 µL per putje) toegevoegd aan vooraf gecoate microplaten. De platen werden 2 h geïncubeerd bij kamertemperatuur en grondig gewassen met de bij de kit geleverde wasbuffer.
Elke put werd aangevuld met enzym-geconjugeerd antilichaam en gedurende 1 h bij kamertemperatuur geïncubeerd, gevolgd door een grondige wasbeurt. Vervolgens werd de substraat-chromogeenoplossing toegevoegd en werden de platen gedurende 20 min bij kamertemperatuur in het donker geïncubeerd. De kleurreactie werd beëindigd met de stopoplossing en de absorbentiewaarden werden gemeten bij 450 nm (referentiegolflengte: 570 nm) met behulp van een full-wavelength microplate reader.
14. Statistische analyse
Alle statistische analyses en datavisualisaties werden uitgevoerd met R versie 4.2.3. Voor de ELISA-concentratiemetingen van elk doelgen (TGFB2, SERPINE1, CYBB, TLR2) werd eerst de Shapiro-Wilk-test toegepast om de normaliteit van de gegevens in de Controle- en DCM-groepen afzonderlijk te beoordelen. Vervolgens werd een F-test gebruikt om de homogeniteit van de varianties tussen de twee groepen te evalueren. De methode voor de intergroepsvergelijking werd bepaald op basis van de resultaten van de variantiehomogeniteitstest: indien de varianties homogeen waren (P ≥ 0,05), werd een ongepaarde Student's t-test gebruikt om de gemiddelde waarden tussen de groepen te vergelijken; indien de varianties heterogeen waren (P < 0,05), werd de gecorrigeerde Welch's t-test voor de analyse gebruikt. Alle tests waren tweezijdig en de drempelwaarde voor statistische significantie werd vastgesteld op P < 0,05. De gegevens werden gevisualiseerd als boxplots met daarop geprojecteerde individuele datapunten (jitter). De P-waarden van alle tests en het type toegepaste t-test werden gedetailleerd geannoteerd op elke grafiek.
Resultaten
Gegevensvoorbewerking en analyse van differentiële expressie
Alle zes bulk-transcriptomische datasets ondergingen gestandaardiseerde voorbewerking en correctie voor batch-effecten voorafgaand aan de verdere analyse. Microarray-gegevens werden genormaliseerd met behulp van het robust multi-array average-algoritme, terwijl RNA-seq count-gegevens werden genormaliseerd met de trimmed mean of M-values-methode. Het ComBat-algoritme werd toegepast om technische batch-effecten te verwijderen die geassocieerd waren met de bron van de dataset en het detectieplatform. Principale componentenanalyse toonde aan dat monsters vóór de correctie clusterden op basis van de bron van de dataset, maar na de correctie gelijkmatiger verdeeld waren, zonder zichtbare scheiding per batch.
De analyse van differentiële expressie tussen de groepen met gedilateerde cardiomyopathie (DCM) en de gezonde controles (HC) werd uitgevoerd met het limma-pakket. De heatmap van de 20 meest significant differentieel tot expressie gekomen genen toonde een scheiding van de expressieprofielen tussen de twee groepen (Figuur 1A). In totaal werden 1.473 differentieel tot expressie gekomen genen geïdentificeerd met drempelwaarden van P-waarde < 0,05 en |log₂ fold change| > 0,58. Hiervan waren 819 genen upgereguleerd en 654 genen downgereguleerd in de myocardiale monsters van DCM (Figuur 1B).
Vervolgens werd gene set enrichment-analyse voor individuele monsters gebruikt om verrijkingsscores te berekenen voor de verouderingsgerelateerde en mitochondriëgerelateerde gensets in elk monster. Beide scores verschilden significant tussen de DCM- en HC-groepen (Figuur 1C).
Gewogen gen-co-expressienetwerkanalyse
Gewogen gen-co-expressienetwerkanalyse werd uitgevoerd om genmodules te identificeren die geassocieerd zijn met de scores voor veroudering en mitochondriale verrijking. De 5.00 eiwitcoderende genen met de hoogste expressievariantie in de bulkdataset werden gebruikt om het netwerk te construeren. Bij een soft-thresholding power van β = 5 overschreed de scale-free topology fit index R2 = 0,9, waarmee voldaan werd aan het criterium voor een schaaloverschrijdend netwerk (Figuur 1D).
Hiërarchische clustering en het samenvoegen van modules identificeerden drie genmodules. Alle drie de modules waren significant gecorreleerd met de score voor veroudering. De turquoise module vertoonde de sterkste correlatie met de score voor veroudering (r = 0.69, P < 0.001). Voor de mitochondriële score waren de blauwe en grijze modules significant gecorreleerd, waarbij de blauwe module de sterkste associatie vertoonde (r = 0.56, P < 0.001; Figuur 1E). De turquoise module werd daarom geselecteerd voor de screening van verouderingsgerelateerde genen, en de blauwe module werd geselecteerd voor de screening van mitochondrië-gerelateerde genen.
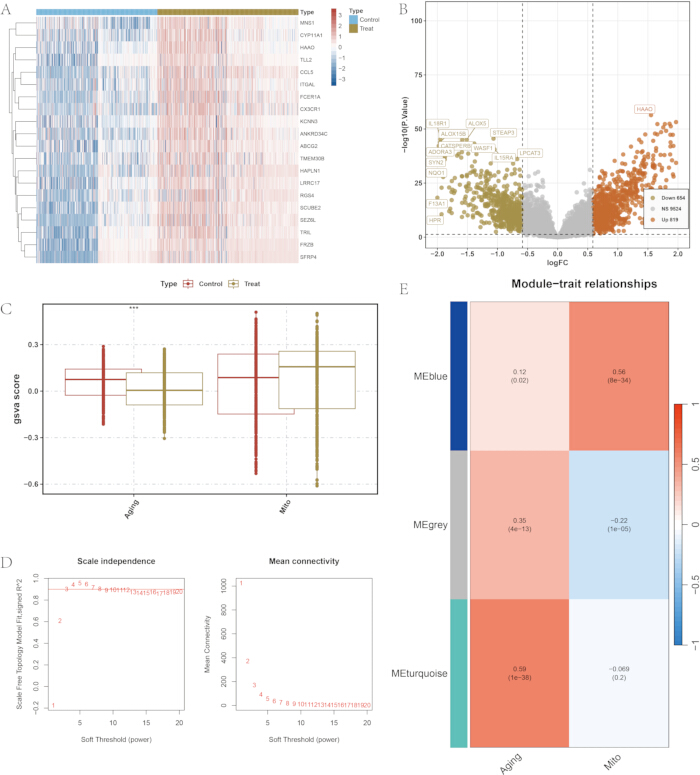
Figuur 1Differentiële expressieanalyse en constructie van een gewogen gen-co-expressienetwerk. (A) Heatmap van de 20 meest significant differentieel tot expressie gekomen genen tussen de groepen met gedilateerde cardiomyopathie (DCM) en de gezonde controlegroep (HC). (B) Volcano-plot van alle differentieel tot expressie gebrachte genen. Rood geeft upgereguleerde genen aan, groen geeft downregulated genen aan en grijs geeft niet-significante genen aan. De drempelwaarden waren P-waarde < 0,05 en |log₂ fold change| > 0.58. (C) Boxplots van single-sample gene set enrichment analysis-scores voor de verouderingsgerelateerde en mitochondriëgerelateerde gensets. (D) Selectie van de soft-threshold voor gewogen gen-co-expressienetwerkanalyse, met weergave van de scale-free topology fit-index en de gemiddelde connectiviteit over verschillende soft-thresholding-machten. (E) Heatmap van correlaties tussen module-eigengenen en de scores voor veroudering en mitochondriën. Klik hier om een grotere versie van deze figuur te bekijken.
Identificatie van kandidaatgenen gerelateerd aan veroudering en mitochondria
Kandidaatgenen werden geïdentificeerd door de intersectie te bepalen tussen de differentieel tot expressie gebrachte genen, genen in de geselecteerde modules van de gewogen gen-co-expressie netwerkanalyse en de overeenkomstige referentiegenensets. Deze analyse identificeerde 6 DCM-geassocieerde kandidaatgenen voor veroudering (Figuur 2A) en 16 DCM-geassocieerde kandidaatgenen voor mitochondria (Figuur 2B).
Gene Ontology-verrijkingsanalyse toonde aan dat de kandidaatgenen gerelateerd aan veroudering verrijkt waren in biologische processen, waaronder de biosynthese van stikstofmonoxide-synthase en de organisatie van de collageenhoudende extracellulaire matrix (Figuur 2C). De kandidaatgenen gerelateerd aan mitochondriën waren verrijkt in termen geassocieerd met het mitochondriale energiemetabolisme, waaronder het binnenmembraan van het mitochondrium en het ademhalingsketencomplex (Figuur 2D).
Analyse met de Kyoto Encyclopedia of Genes and Genomes toonde aan dat de kandidaatgenen gerelateerd aan veroudering verrijkt waren in de signaalpaden van hypoxia-inducible factor-1, phosphoinositide 3-kinase-proteïnekinase B en advanced glycation end product-receptor voor advanced glycation end product (Figuur 2E). De kandidaatgenen gerelateerd aan mitochondria waren verrijkt in paden waaronder oxidatieve fosforylering (Figuur 2F).
De differentiële expressiepatronen van de 6 kandidaatgenen gerelateerd aan veroudering tussen de DCM- en HC-groepen werden gevisualiseerd met een expressieheatmap (Figuur 2G). De expressiepatronen van de 16 mitochondria-gerelateerde kandidaatgenen werden gevisualiseerd met boxplots (Figuur 2H).
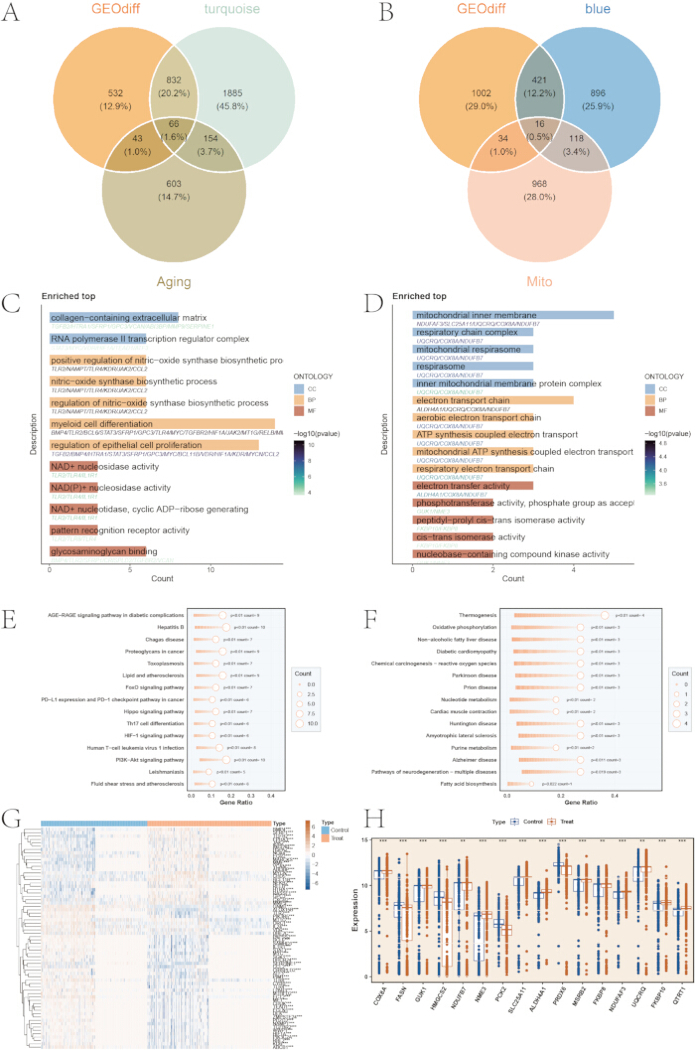
Figuur 2Screening en functionele verrijking van kandidaatgenen. (A) Venn-diagram dat de overlap laat zien tussen differentieel tot expressie gebrachte genen, genen uit de modules van de gewogen gen-co-expressienetwerkanalyse en de referentie-genenset voor veroudering. (B) Venn-diagram dat de overlap laat zien tussen differentieel tot expressie gekomen genen, genen uit de module van de gewogen gen-coexpressienetwerkanalyse en de referentiegenenset voor mitochondriën. (C) Gene Ontology-verrijkingsanalyse van kandidaatgenen gerelateerd aan veroudering. (D) Gene Ontology-verrijkingsanalyse van mitochondriën-gerelateerde kandidaatgenen. (E) Kyoto Encyclopedia of Genes and Genomes pathway-verrijkingsanalyse van kandidaatgenen gerelateerd aan veroudering. (F) Kyoto Encyclopedia of Genes and Genomes-padverrijkingsanalyse van mitochondrië-gerelateerde kandidaatgenen. (G) Expressie-heatmap van de 6 kandidaatgenen die gerelateerd zijn aan veroudering in de DCM- en HC-groepen. (H) Expressie-boxplots van de 16 mitochondriaal gerelateerde kandidaatgenen in de DCM- en HC-groepen. Klik hier om een grotere versie van deze figuur te bekijken.
Celtype-annotatie van de single-cell RNA-sequencing dataset
De GSE145154 single-cell RNA-sequencing dataset werd gebruikt voor validatie op single-cell resolutie. Na kwaliteitscontrolefiltering, log-normalisatie en Harmony-batchcorrectie waren cellen uit verschillende monsters verspreid over de uniform manifold approximation and projection-ruimte zonder zichtbare monsterspecifieke scheiding. Met behulp van de eerste 15 hoofdcomponenten en een clusteringresolutie van 0,15 werden de cellen verdeeld in 9 clusters (Figuur 3A).
Canonieke markergenen en geautomatiseerde annotatie met SingleR identificeerden 9 belangrijke celtypen: macrofagen, natural killer-cellen, T-cellen, B-cellen, endotheelcellen, gladde spiercellen, monocyten, stromale cellen en cardiomyocyten (Figuur 3B). De expressiepatronen van celtype-specifieke markergenen bevestigden deze annotaties (Figuur 3C).
Mitochondriële modulescores werden voor elke cel berekend met de AddModuleScore-functie en verschilden significant tussen de groep met gedilateerde cardiomyopathie en de gezonde controlegroep (P < 2,22 × 10⁻16; Figuur 3D). Verouderingsgerelateerde modulescores verschilden ook significant tussen de twee groepen (P < 2,22 × 10⁻16; Figuur 3E). Projectie van de mitochondriële scores op de uniform manifold approximation and projection-ruimte liet zien dat hoge scores voornamelijk werden waargenomen in cardiomyocyten (Figuur 3F). In tegenstelling hiermee werden hoge verouderingsgerelateerde scores voornamelijk waargenomen in macrofagen (Figuur 3G).
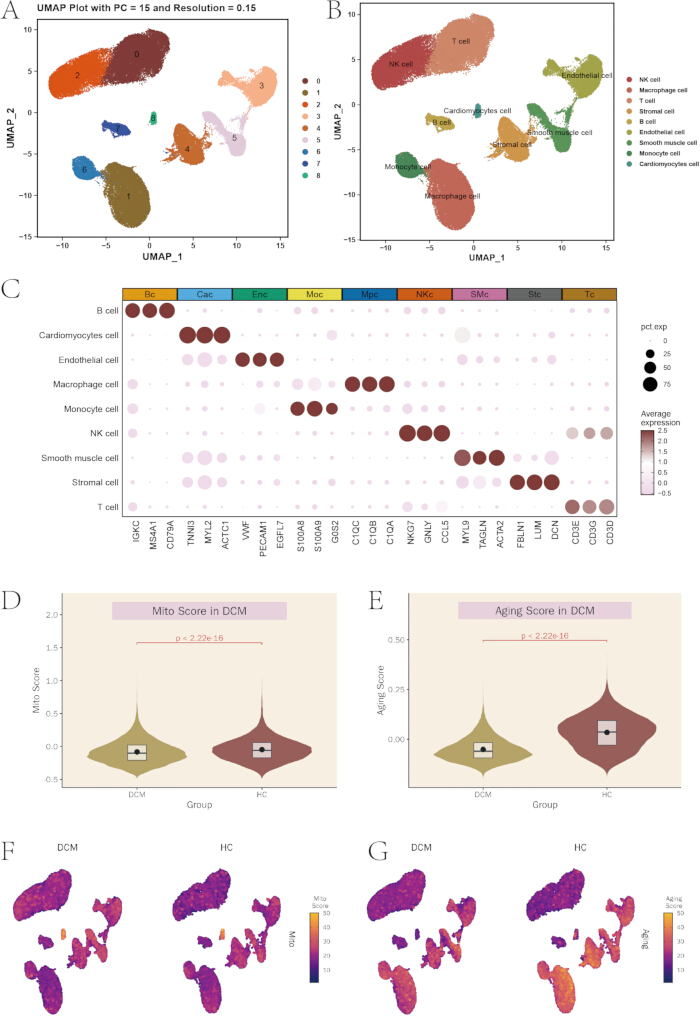
Figuur 3Annotatie van het single-cell transcriptoom en module-scoreanalyse. (A) Uniform Manifold Approximation and Projection-plot van celclusters, gegenereerd met behulp van de eerste 15 hoofdcomponenten en een clusteringresolutie van 0,15. (B) Uniform manifold approximation and projection-plot van de geannoteerde celtypen. (C) Bubble plot die de expressie van canonieke markergenen over verschillende celtypes laat zien. (D) Violinplot van de scores van de mitochondriale module in de DCM- en HC-groepen. (E) Violinplot van de scores van de verouderingsgerelateerde modules in de DCM- en HC-groepen. (F) Uniform manifold approximation and projection-plot die de distributie van mitochondriale modulescores over de cellen weergeeft. (G) Uniform Manifold Approximation and Projection-plot die de distributie van scores van verouderingsgerelateerde modules over de cellen weergeeft. Klik hier om een grotere versie van deze figuur te bekijken.
Constructie van het eiwit-eiwitinteractienetwerk
De gecombineerde set van 6 verouderingsgerelateerde en 16 mitochondrië-gerelateerde kandidaatgenen werd ingevoerd in de STRING-database versie 11.5 om een eiwit-eiwitinteractienetwerk te construeren met een betrouwbaarheidsdrempel van combined score > 0,7. Het netwerk werd geïmporteerd in Cytoscape voor visualisatie en topologische analyse (Figuur 4A).
Analyses van graad, maximale clique-centraliteit, maximale buurtcomponent en MCODE werden gebruikt om sterk verbonden knooppunten en kernsubnetwerken te identificeren. De subnetwerken die met deze methoden zijn geïdentificeerd, worden weergegeven in Figuur 4B–E.
De top 10 genen gerangschikt op basis van Degree, maximale clique-centraliteit en maximale neighborhood component werden gekruist met genen in het MCODE-kernsubnetwerk. Deze analyse identificeerde 10 kandidaatgenen: TGFB2, TLR2, SERPINE1, CYBB, KDR, TLR4, HIF1A, CCL2, MMP9 en CXCR2.
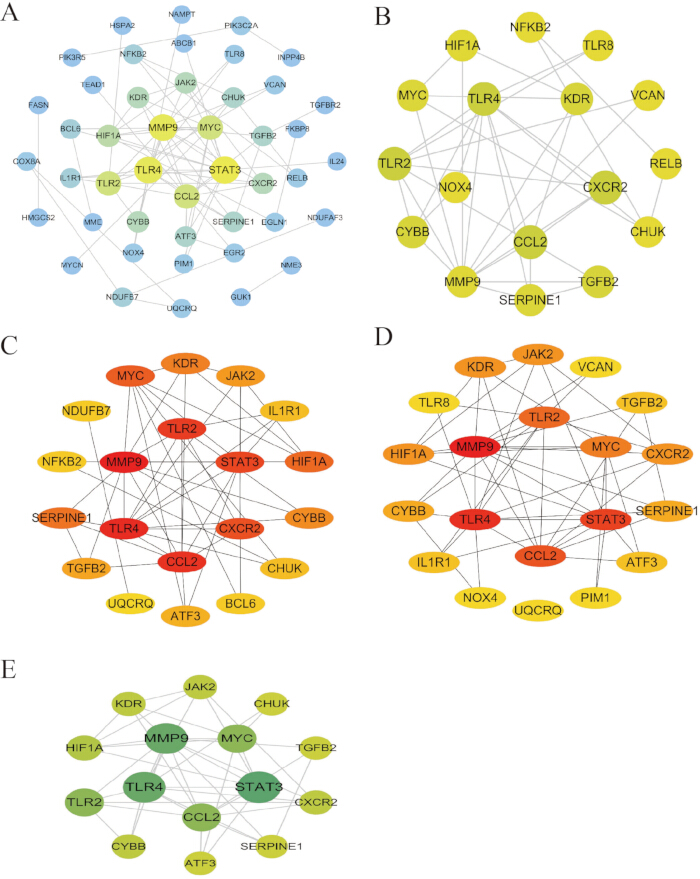
Figuur 4Constructie van het eiwit-eiwitinteractienetwerk en screening van hub-genen.
(A) Algemeen proteïne-proteïne-interactienetwerk van de kandidaatgenen. (B) Kernsubnetwerk geïdentificeerd met behulp van MCODE. (C) Kernsubnetwerk geïdentificeerd met behulp van maximale clique-centraliteit. (D) Kernsubnetwerk geïdentificeerd met behulp van maximum neighborhood component. (E) Kernsubnetwerk geïdentificeerd op basis van graad. Klik hier om een grotere versie van deze figuur te bekijken.
Screening van hub-genen op basis van machine learning
Drie machine learning-algoritmen—least absolute shrinkage and selection operator logistische regressie, random forest en support vector machine-recursive feature elimination—werden toegepast om hub-genen te screenen uit de 10 kandidaten voor eiwit-eiwitinteracties. Alle analyses werden uitgevoerd met een vast random seed (set.seed(12345)) en 5-voudige kruisvalidatie. In het LASSO-model werden genen met niet-nulcoëfficiënten bij de optimale lambda (lambda.min) behouden als kandidaten (Figuur 5A).
In het support vector machine-recursive feature elimination-model werd de hoogste cross-validatienauwkeurigheid van 0.859 bereikt wanneer 10 kenmerken waren opgenomen (Figuur 5B), met een overeenkomstige minimale foutmarge van 0.141 (Figuur 5C). Het random forest-model met 50 beslissingsbomen vertoonde een stabiele convergentie van de out-of-bag foutmarge (Figuur 5D). De rangschikking van genbelangrijkheid op basis van de Gini-coëfficiënt plaatste TGFB2, TLR2, SERPINE1 en CYBB tussen de hoogst gerangschikte genen (Figuur 5E). De intersectie van genen die door alle drie de algoritmen waren geselecteerd, leverde vier uiteindelijke hub-genen op: CYBB, SERPINE1, TGFB2 en TLR2 (Figuur 5F).
Er werd een SHapley Additive exPlanations-analyse uitgevoerd om de bijdrage van elk hubgen aan de voorspellingen van het model te evalueren. TGFB2 had de hoogste gemiddelde absolute SHapley Additive exPlanations-waarde van 0,249, gevolgd door SERPINE1 met 0,103, CYBB met 0,083 en TLR2 met 0,078 (Figuur 6A). De samenvattingsplot toonde de distributie en richting van de genbijdragen over de monsters (Figuur 6B). Afhankelijkheidsplots illustreerden de relatie tussen individuele genwaarden en modelbijdragen (Figuur 6C), terwijl watervalgrafieken per monster de bijdrage van elk gen aan individuele voorspellingen lieten zien (Figuur 6D).
Diagnostische classificatiemodellen op basis van de vier hub-genen werden vervolgens geconstrueerd met behulp van 10 classificatiealgoritmen. In de trainingset behaalden de meeste algoritmen area under the curve-waarden boven 0,85 (Figuur 6E). In de interne validatieset behaalden de meeste algoritmen area under the curve-waarden boven 0,78 (Figuur 6F).
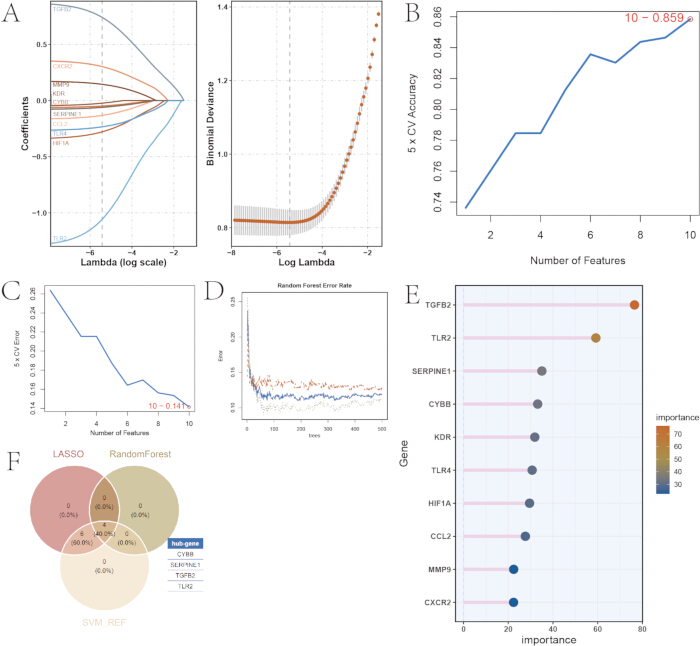
Figuur 5Machine learning-gebaseerde screening van hub-genen. (A) Traject van de regressiecoëfficiënten van de Least Absolute Shrinkage and Selection Operator en optimale selectie van lambda. (B) Cross-validatie-accuraatheidscurve voor het support vector machine-recursive feature elimination-model. (C) Kruisvalidatiefoutcurve voor het support vector machine-recursieve kenmerkeliminatiemodel. (D) Curve van de out-of-bag foutmarge voor het random forest-model. (E) Rangschikking van genbelangrijkheid op basis van de Gini-coëfficiënt in het random forest-model. (F) Venn-diagram met de hub-genen die zijn geïdentificeerd door de drie machine learning-algoritmen. Klik hier om een grotere versie van deze figuur te bekijken.
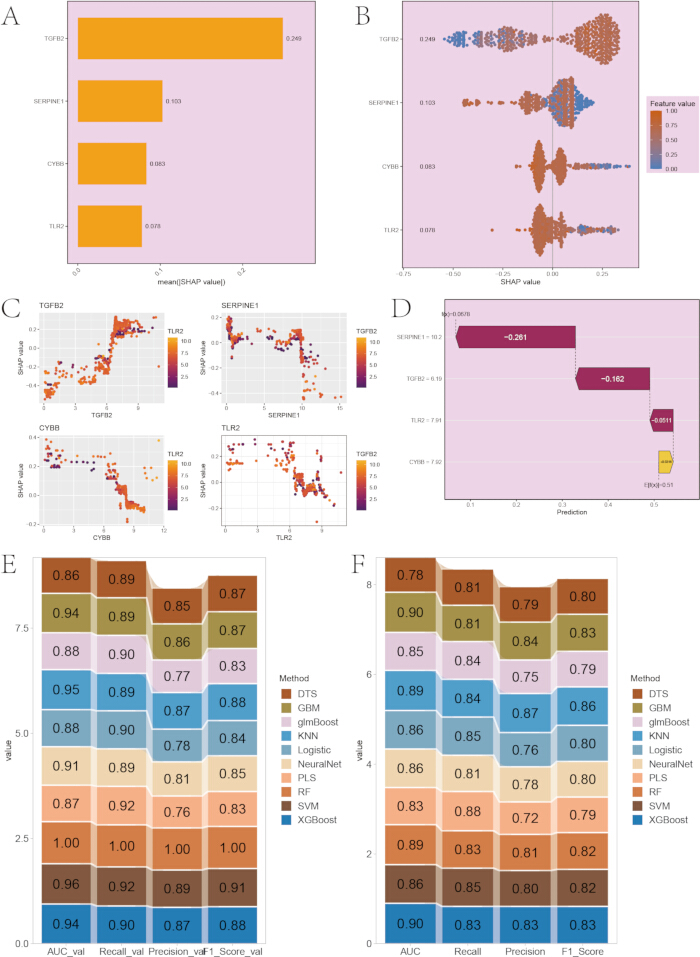
Figuur 6Evaluatie van het diagnostische model en SHapley Additive exPlanations-analyse. (A) Gemiddelde absolute SHapley Additive exPlanations-waarden voor de vier hub-genen. (B) SHapley Additive exPlanations-samenvattingsplot die de distributie en richting van genbijdragen weergeeft. (C) SHapley Additive exPlanations-afhankelijkheidsplots voor elk hub-gen. (D) SHapley Additive exPlanations waterfall-plot voor een representatieve steekproef. (E) Heatmap van de diagnostische prestaties van 10 classificatiealgoritmen in de trainingset. (F) Heatmap van de diagnostische prestaties van 10 classificatiealgoritmen in de validatieset. Klik hier om een grotere versie van deze figuur te bekijken.
Validatie op single-cell niveau en analyse van cel-celcommunicatie
De expressiepatronen van de vier hub-genen werden op single-cell niveau geëvalueerd. Analyse van de celtypeverdeling toonde aan dat CYBB en TLR2 sterk tot expressie kwamen in monocyten en macrofagen, terwijl SERPINE1 en TGFB2 hoofdzakelijk tot expressie kwamen in stromale cellen (Figuur 7A).
Vioolplots toonden aan dat de expressie van CYBB significant verschilde tussen de groep met gedilateerde cardiomyopathie en de gezonde controlegroep (Figuur 7B). SERPINE1 (Figuur 7C), TGFB2 (Figuur 7D) en TLR2 (Figuur 7E) verschilden eveneens significant tussen de groepen. Alle vier de genen waren significant upgereguleerd in de groep met gedilateerde cardiomyopathie ten opzichte van de gezonde controles, met P < 0,01 voor elke vergelijking.
Cel-celcommunicatienetwerken in de cardiale micro-omgeving werden afgeleid met behulp van CellChat en een ligand-receptor-database. Het aantal en de algehele sterkte van de cel-celinteracties verschilden tussen de geglede cardiomyopathie- en controlegroepen (Figuur 7F). Er werd ook een differentiële communicatiesterkte tussen celtypen waargenomen (Figuur 7G). Monocyten, macrofagen, cardiomyocyten en stromale cellen waren de belangrijkste deelnemers aan het communicatienetwerk.
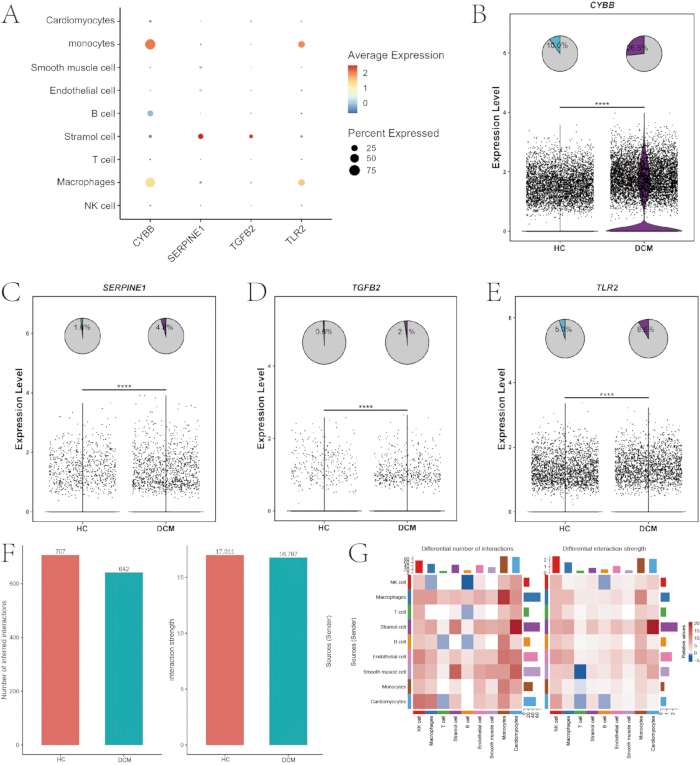
Figuur 7Single-cel validatie van hubgenen en analyse van cel-celcommunicatie. (A) Bubble plot die de expressie van de vier hub-genen over de verschillende celtypen weergeeft. (B) Vioolplot van de CYBB-expressie in de DCM- en HC-groepen. (C) Violinplot van de SERPINE1-expressie in de DCM- en HC-groepen. (D) Violinplot van de TGFB2-expressie in de DCM- en HC-groepen. (E) Violin plot van de TLR2-expressie in de DCM- en HC-groepen. (F) Staafdiagram dat het aantal en de totale sterkte van cel-celinteracties weergeeft. (G) Heatmap die de differentiële sterkte van de cel-celcommunicatie tussen groepen weergeeft. Klik hier om een grotere versie van deze figuur te bekijken.
Analyse van immuuncelinfiltratie
Verrijkingsscores voor 28 immuuncel-subsets werden voor elk bulkmonster berekend met behulp van single-sample gene set enrichment analysis. De abundantie van de meeste immuunceltypen verschilde significant tussen de groepen met gedilateerde cardiomyopathie en de gezonde controlegroep (Figuur 8A).
Vervolgens werd een Pearson-correlatieanalyse uitgevoerd om de relatie tussen de expressie van hub-genen en de verrijkingsscores van immuuncellen te beoordelen. De expressie van CYBB was significant gecorreleerd met de abundantie van meerdere immuunceltypen (Figuur 8B). Vergelijkbare correlaties werden waargenomen voor SERPINE1 (Figuur 8C), TGFB2 (Figuur 8D) en TLR2 (Figuur 8E). CYBB, SERPINE1 en TLR2 vertoonden positieve correlaties met verschillende populaties aangeboren immuuncellen, waaronder monocyten en macrofagen.
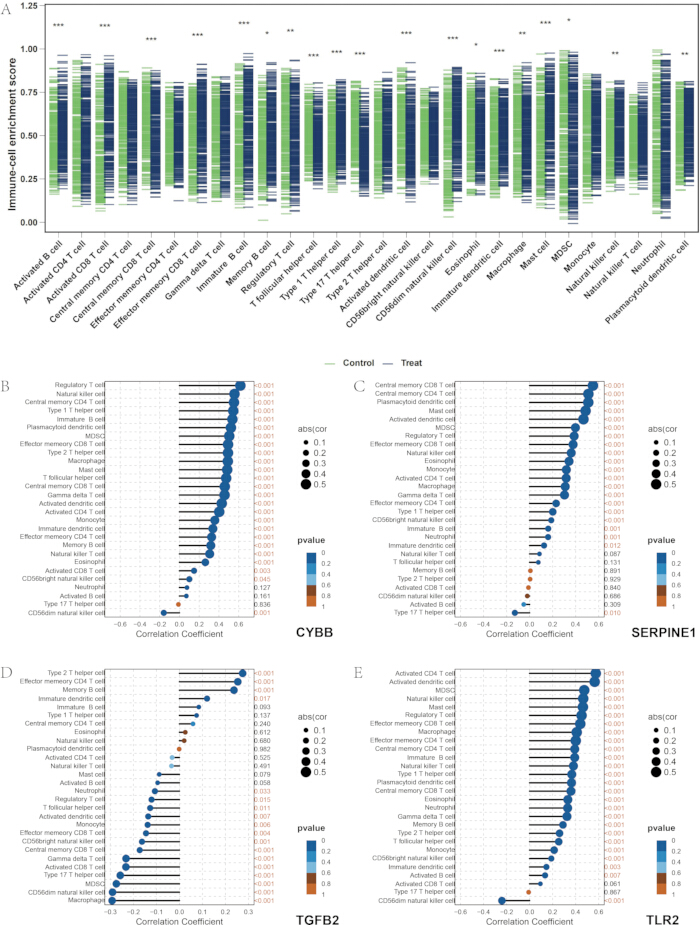
Figuur 8Infiltratie van immuuncellen en correlatieanalyse. (A) Boxplots van verrijkingsscores voor 28 immuunceltypen in de DCM- en HC-groepen. (B) Lollipop-plot die de correlaties tussen CYBB-expressie en de abundantie van immuuncellen weergeeft. (C) Lollipop-plot die de correlaties tussen SERPINE1-expressie en de abundantie van immuuncellen weergeeft. (D) Lollipop-plot die de correlaties tussen TGFB2-expressie en de abundantie van immuuncellen weergeeft. (E) Lollipop-diagram dat de correlaties tussen TLR2-expressie en de abundantie van immuuncellen weergeeft. Klik hier om een grotere versie van deze figuur te bekijken.
Moleculaire subtypering van gedilateerde cardiomyopathie
Er werd ongesuperviseerde consensusclustering uitgevoerd op monsters van gedilateerde cardiomyopathie op basis van de expressieprofielen van de vier hub-genen. De consensusclusteringmatrix ondersteunde scheiding bij K = 2 (Figuur 9A). De delta area plot bevestigde verder dat K = 2 het optimale aantal clusters was, waarbij de monsters werden verdeeld in twee moleculaire subtypes, C1 en C2 (Figuur 9B).
De expressieniveaus van CYBB, SERPINE1 en TLR2 verschilden significant tussen de twee subtypen (Figuur 9C). De abundantie van meerdere immuuncelsubsets verschilde ook tussen de subtypen (Figuur 9D). Gene set variation analyse toonde een relatieve activatie van de signaleringsroute van de vasculaire endotheliale groeifactor in het C1-subtype, terwijl de biosynthese van primaire galzuren en glycosphingolipiden verrijkt waren in het C2-subtype (Figuur 9E). Principal component analyse toonde een scheiding tussen de monsters die aan de twee subtypen waren toegewezen (Figuur 9F).
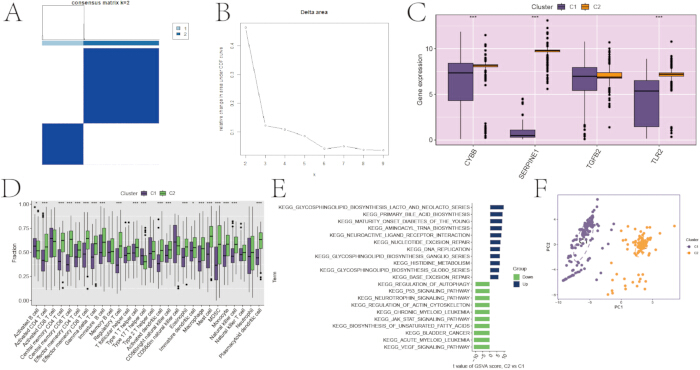
Figuur 9Consensusclustering voor moleculaire subtypering van gedilateerde cardiomyopathie. (A) Consensusclusteringmatrix bij K = 2. (B) Delta-oppervlakteplot gebruikt om het optimale aantal clusters te bepalen. (C) Boxplots van de expressie van hub-genen in de twee moleculaire subtypen. (D) Boxplots van de overvloed aan immuuncellen in de twee moleculaire subtypes. (E) Heatmap van differentieel verrijkte Kyoto Encyclopedia of Genes and Genomes-paden tussen de twee moleculaire subtypen. (F) Principal component analysis-plot dat de scheiding tussen de twee moleculaire subtypen laat zien. Klik hier om een grotere versie van deze figuur te bekijken.
In vivo validatie in het muismodel voor gedilateerde cardiomyopathie
CTNTR141W transgene muizen met een spontaan fenotype van gedilateerde cardiomyopathie werden gebruikt voor in vivo validatie. In vergelijking met leeftijd-gematchte wild-type C57BL/6J controlemuizen vertoonden de transgene muizen een significant verhoogde linksventriculaire eind-diastolische diameter en een verlaagde linksventriculaire ejectiefractie, wat consistent is met ventriculaire dilatatie en systolische dysfunctie (Figuur 10A).
Totaal eiwit werd geëxtraheerd uit myocardweefsel van de linker ventrikel, en de concentraties van de door de vier hub-genen gecodeerde eiwitten werden gemeten via een enzyme-linked immunosorbent assay (ELISA) na normalisatie van het totaal eiwit op basis van bicinchonininezuur. Alle assays werden in dubbeltoets uitgevoerd. Standaardcurven hadden correlatiecoëfficiënten (R2) ≥ 0,9, en de variatiecoëfficiënten tussen dubbele wells waren lager dan 10%. Statistische significantie tussen de Controle- en DCM-groepen werd geëvalueerd met behulp van ofwel de t-test van Student of de t-test van Welch, afhankelijk van de gelijkheid van de varianties die werd beoordeeld via de F-test (normaliteit werd bevestigd door de Shapiro-Wilk-test). Myocardiale eiwitniveaus die overeenkomen met alle vier de hub-genen waren significant verhoogd in de muizen met gedilateerde cardiomyopathie (DCM) vergeleken met de controles (Figuur 10B). Voor de ELISA-validatie werden 3 biologische replica's (individuele muizen) per groep opgenomen. Voor de ELISA-validatie werden drie onafhankelijke biologische replica's per groep opgenomen. Deze bevindingen moeten als preliminair worden beschouwd en behoeven bevestiging in een grotere cohort.
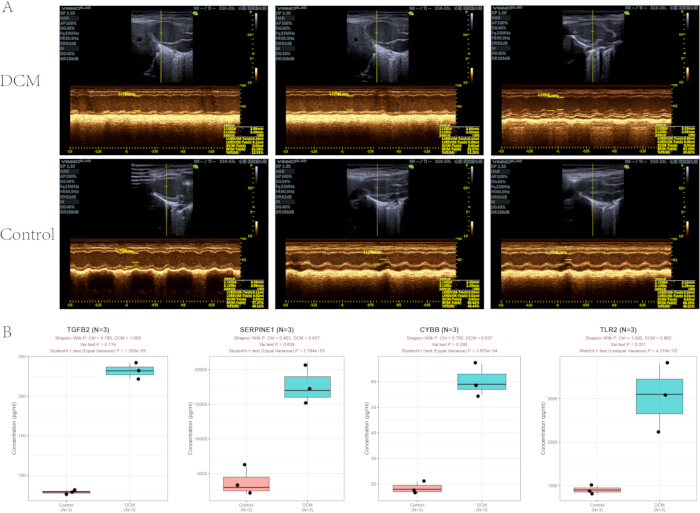
Figuur 10: In vivo validatie in het CTNTR141W transgene muismodel voor gedilateerde cardiomyopathie. (A) Representatieve M-mode echocardiografische beelden van CTNTR141W transgene DCM-muizen en wild-type controlemuizen. (B) ELISA-kwantificering van vier eiwitten afgeleid van hub-genen in myocardweefsel van de linker ventrikel van muizen. Boxplots tonen de eiwitconcentraties voor de Controle- en DCM-groepen (n = 3 biologische replica's per groep). Voor elke boxplot: de doorgetrokken horizontale lijn in de box geeft de mediaan aan; de boven- en ondergrenzen van de box vertegenwoordigen het 75ste en 25ste percentiel (interkwartielafstand, IQR); de bovenste en onderste snorharen lopen uit tot de maximale en minimale datapunten die geen uitschieters zijn binnen 1,5 × IQR; individuele zwarte stippen komen overeen met onafhankelijke biologische replica's van individuele dieren. De y-as geeft de absolute eiwitconcentratie aan: pg/mL voor TGFB2 en CYBB, ng/mL voor TLR2 en SERPINE1. Statistische vergelijkingen tussen twee groepen zijn uitgevoerd met de t-toets van Student (gelijke variantie) of de t-toets van Welch (ongelijke variantie), waarbij de normaliteit is geverifieerd met de Shapiro-Wilk-toets en de homogeniteit van de variantie is beoordeeld met de F-toets. Beperking: de ELISA-resultaten verkregen uit n = 3 replica's zijn preliminaire exploratieve bevindingen, en toekomstige validatie met een grotere steekproefomvang is gerechtvaardigd. Klik hier om een grotere versie van deze figuur te bekijken.
Beschikbaarheid van gegevens:
De zes bulk-transcriptomische datasets en de ene single-cell RNA-sequencing dataset die in deze studie zijn geanalyseerd, zijn openbaar beschikbaar in de Gene Expression Omnibus-database onder de accessionnummers GSE5406, GSE4295, GSE5738, GSE7962, GSE16250, GSE141910 en GSE145154. De single-cell analyse omvatte de monsters GSM4307515, GSM4307516, GSM4307520 en GSM4307521 uit GSE145154. Alle overige gegevens die tijdens deze studie zijn gegenereerd of geanalyseerd, samen met de computationele code, zijn opgenomen in dit gepubliceerde artikel en de bijbehorende aanvullende informatiebestanden. Meer specifiek bevat Aanvullend Bestand 1 de volledige genlijsten gerelateerd aan veroudering en mitochondriën, de immuunsignatuur van 28 cellen, aangepaste analytische scripts, genormaliseerde transcriptomische datamatrices, brondata voor ELISA-assays en de ruwe brondata ten grondslag aan alle figuren in het manuscript.
Aanvullend bestand 1: Genensets gerelateerd aan veroudering en mitochondriën, immuunhandtekeningen, analysescripts, genormaliseerde transcriptomische gegevens en brondata voor figuren. Klik hier om dit bestand te downloaden.
Discussie
De geïntegreerde meerlaagse workflow combineerde bulk-transcriptomische meta-analyse, constructie van gewogen gen-co-expressienetwerken, ensemble machine learning, single-cell transcriptomische validatie en in vivo verificatie in diermodellen. Vier hub-genen die gerelateerd zijn aan veroudering en mitochondriën, CYBB, SERPINE1, TGFB2 en TLR2, werden geïdentificeerd als kandidaat-diagnostische biomarkers voor gedilateerde cardiomyopathie (DCM). Integratie van zes onafhankelijke transcriptomische datasets van de linker ventrikel uit de Gene Expression Omnibus-repository, inclusief microarray- en RNA-sequencing-platforms, verminderde de bias van individuele datasets en vergrootte de statistische basis van de analyse43,44,45. Gewogen gen-co-expressienetwerkanalyse in combinatie met vooraf gedefinieerde genensets gerelateerd aan veroudering en mitochondriën maakte de identificatie van kenmerk-geassocieerde functionele modules mogelijk, in plaats van enkel te vertrouwen op differentieel expressie-analyse46. Ensemble machine learning verminderde de algoritme-specifieke bias geassocieerd met individuele feature-selectiemethoden47,48, terwijl SHapley Additive exPlanations-analyse de bijdrage van elk hub-gen aan de modelvoorspellingen kwantificeerde49. Validatie over bulk-myocardiale transcriptomen, single-cell transcriptomen en een transgeen muismodel karakteriseerde verder de cellulaire distributie en de myocardiale proteïneniveaus van de geselecteerde genen50.
Batchcorrectie was een kritische stap in de geïntegreerde analyse, omdat resterende dataset-specifieke variatie de differentieel expressie-analyse en module-trait associaties zou kunnen beïnvloeden. De bron van de dataset en het detectieplatform werden daarom als batchfactoren in het ComBat-model opgenomen. Resterende dataset-afhankelijke clustering in principal component analysis-plots zou wijzen op onvolledige correctie en potentiële systematische bias44. De soft-thresholding power was daarnaast belangrijk voor de constructie van het gewogen gene co-expression netwerk. De minimumwaarde die een scale-free topology fit index van R2 > 0,9 opleverde, werd geselecteerd, wat resulteerde in β = 5. Een lagere waarde kan leiden tot gefragmenteerde of functioneel niet-informatieve modules, terwijl een hogere waarde de genconnectiviteit kan verzwakken en de statistische power van de module-trait correlatieanalyse kan verminderen46. Drempelwaarden voor kwaliteitscontrole van single-cell data werden aangepast aan hartweefsel, aangezien cardiomyocyten een hoge metabole activiteit hebben. Een strikte filteringsstrategie met een afkapwaarde voor het percentage mitochondriale genen onder de 25% en een bereik van 200–6.000 gedetecteerde genen werd geïmplementeerd om gebroken en kwalitatief slechte cellen te verwijderen terwijl cardiomyocyten behouden bleven50. Een vaste random seed, ingesteld via set.seed(12345), werd gebruikt voor het splitsen van de dataset, modeltraining en cross-validatie om variatie tussen herhaalde machine learning-analyses te verminderen47.
Genotypebevestiging, gestandaardiseerde huisvesting en consistente echocardiografische metingen waren essentieel voor het behoud van de fenotypische stabiliteit in de dierproeven. CTNTR141W-transgene muizen ontwikkelen linkerventrikeldilatatie en systolische dysfunctie na de gespecificeerde acclimatisatie- en voedingsperiode51. Genotypeverificatie vóór de groepering is noodzakelijk om niet-transgene dieren uit te sluiten en een foutieve fenotypeclassificatie te voorkomen. Echocardiografische metingen moeten consistent worden uitgevoerd op het niveau van de papillairspieren van het linkerventrikel, waarbij de metingen worden gemiddeld over drie opeenvolgende stabiele hartcycli. Variatie in de beeldpositie of de diepte van de anesthesie kan de variabiliteit in de metingen van de ejectiefractie van het linkerventrikel vergroten51. De kwaliteit van de enzyme-linked immunosorbent assay werd geëvalueerd aan de hand van correlatiecoëfficiënten van de standaardcurve, R2 ≥ 0,99, en variatiecoëfficiënten < 10% tussen dubbele wells. Een slechte lineariteit van de standaardcurve of inconsistente dubbele metingen kunnen leiden tot systematische fouten in de schattingen van de proteïneconcentratie.
Tijdens de implementatie van de workflow kunnen verschillende analytische problemen optreden. Aanhoudende batchseparatie na ComBat-correctie kan wijzen op collineariteit tussen batchvariabelen en klinische factoren, onvoldoende filtering van genen met een lage expressie of niet-gemodelleerde technische variatie. Klinische covariabelen zoals leeftijd en geslacht kunnen, indien beschikbaar, als beschermde variabelen worden opgenomen, en genen met nul-expressie in meer dan 70% van de monsters kunnen worden verwijderd om ruis te verminderen44. Aanvullende correctie met removeBatchEffect kan worden overwogen wanneer er residuele separatie overblijft. Een onverwacht hoog of laag aantal differentieel tot expressie gebrachte genen kan een evaluatie vereisen van de monsterheterogeniteit, normalisatie, uitschieters en de selectie van drempelwaarden27. Lage module-trait correlaties kunnen worden aangepakt door de variantiedrempel, de soft-thresholding power en extreme trait-waarden opnieuw te beoordelen. Uitbreiding van de 5.000 naar de 7.500 meest variabele genen of vervanging van single-sample gene set enrichment analysis door gene set variation analysis kan de modulatedetectie verbeteren46. Een overschot aan geïsoleerde knopen in het eiwit-eiwitinteractienetwerk kan aanpassing van de STRING-betrouwbaarheidsdrempel of uitbreiding van de kandidaatgenset vereisen30. Matige prestaties van machine learning kunnen wijzen op distributieverschillen tussen de trainings- en validatiesets, redundantie van kenmerken of groepsonevenwicht. Gestratificeerde steekproefname, reductie van redundante kenmerken of oversampling van de minderheidsklasse kan deze effecten verminderen47. Ambigue single-cell clustering kan een herbeoordeling van de Harmony-correctie, de selectie van hoofdcomponenten en de annotatie van markergenen vereisen50.
Er moet rekening worden gehouden met enkele beperkingen. De transcriptomische datasets werden retrospectief verkregen uit openbare repositories, waardoor de oorspronkelijke studieontwerpen en klinische confounders niet konden worden gecontroleerd. De klinische annotaties waren onvolledig over de datasets heen, en de meeste datasets bevatten geen gedetailleerde informatie over etiologie, medicatiegeschiedenis, leeftijd van de patiënt en langetermijnuitkomsten. Deze beperkingen verhinderden de evaluatie van associaties tussen de geselecteerde genen en prognose, behandelrespons of chronologische veroudering52. Ondanks batchcorrectie kan er sprake blijven van residuele technische variatie. De analyse was primair gebaseerd op messenger RNA-expressie en bevatte geen geïntegreerde epigenomische, proteomische of metabolomische gegevens. Bijgevolg konden eiwitactiviteit, post-translationele regulatie en stroomopwaartse mechanismen niet worden bepaald. Er was slechts één single-cell dataset opgenomen, wat de evaluatie van cellulaire heterogeniteit over DCM-etiologieën beperkt50. Het CTNTR141W-transgene model representeert primair erfelijke DCM geassocieerd met een cardiale troponine T-mutatie en reproduceert mogelijk geen idiopathische, virale of ischemische vormen van de ziekte51. Soortverschillen tussen muizen en mensen beperken daarnaast de directe klinische translatie. Validatie op eiwitniveau was beperkt tot myocardweefsel van muizen, en er werden geen grote klinische cohorten gebruikt of vergelijkingen met gevestigde biomarkers uitgevoerd. De vier hub-genen zijn niet specifiek voor DCM en kunnen ook veranderd zijn bij andere cardiovasculaire of inflammatoire aandoeningen. Bovendien was de selectie van kandidaten gebaseerd op vooraf gedefinieerde genensets gerelateerd aan veroudering en mitochondriën. Deze hypothesegestuurde strategie kan genen uitsluiten die buiten de geselecteerde referentiesets vallen, terwijl de intersectie over drie machine learning-algoritmen genen kan weglaten die door slechts één methode zijn geïdentificeerd48.
Het analytische raamwerk kan toekomstige moleculaire subtypering, biomarker-validatie en multi-omics studies bij DCM ondersteunen. Het vier-genenpanel kan worden geëvalueerd in onafhankelijke cohorten van perifeer bloed of myocardiaal weefsel alvorens het als diagnostisch instrument of hulpmiddel voor subtypering wordt beoordeeld. De subtypes C1 en C2 vertoonden verschillende immuun- en metabole padprofielen, wat een basis biedt voor de daaropvolgende validatie van subtype-specifieke biologische kenmerken15. De geselecteerde genen kunnen daarnaast worden onderzocht in molecular docking, cellulaire en functionele studies. TLR2 en CYBB zijn geassocieerd met inflammatoire signalering en de productie van reactieve zuurstofverbindingen, terwijl TGFB2 en SERPINE1 geassocieerd zijn met fibrose en cardiale remodellering53. Integratie met proteomische, metabolomische, epigenomische, genome-wide association en Mendeliaanse randomisatiedata kan helpen bij het evalueren van regulatoire relaties en potentiële causale associaties54. De workflow kan ook worden aangepast voor transcriptomische studies naar hypertrofische cardiomyopathie, ischemische cardiomyopathie en hartfalen door de ziektespecifieke datasets en referentiegenensets te vervangen45. Toekomstige integratie van single-cell assays voor transposase-accessible chromatin sequencing en ruimtelijke transcriptomica kan aanvullende informatie verschaffen over cellulaire regulatie en ruimtelijke expressie. De waargenomen verrijking van verouderingsgerelateerde signatures in macrofagen en mitochondriale signatures in cardiomyocyten was consistent met eerdere rapporten over inflammatoire en mitochondriale processen bij hartziekten55,56,57.
Deze studie kent enkele beperkingen die erkend moeten worden. In het bijzonder waren de commerciële ELISA-kits die werden gebruikt voor de eiwitkwantificering officieel gevalideerd voor de detectie van doeleiwitten in serummonsters. In de huidige studie werden myocardiale weefsellysaten gebruikt als detectiematrix in plaats van serum. Hoewel gedurende de gehele assay consistente procedures voor monstervoorbehandeling en experimentele uitvoering strikt zijn toegepast om de betrouwbaarheid en vergelijkbaarheid van de experimentele gegevens te waarborgen, kan het gebrek aan officiële validatie door de fabrikant voor deze ELISA-kits in myocardiale weefsellysaatmonsters leiden tot mogelijke subtiele afwijkingen in de kwantitatieve eiwitresultaten. Daarom vormt het gebruik van serum-specifieke ELISA-kits voor myocardiale weefsellysaten een methodologische beperking van deze studie.
Openbaarmakingen
De auteur verklaart geen concurrerende belangen te hebben.
Dankbetuigingen
De publiek beschikbare gegevens verstrekt via de Gene Expression Omnibus-database worden gratefully erkend. De reviewers en redacteurs worden even tevns bedankt voor hun constructieve commentaren op het manuscript. Dit werk werd ondersteund door het Provincial Department-Level Scientific Research Project (Grant No. 2021JDZX2026), “Mechanism of Yiqi Huoxue Formula in Attenuating Atherosclerotic Vascular Remodeling via KLF2-Nrf2-Mediated Inflammatory Regulation.”
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Aquasonic Clear echogel | Parker Laboratories, Inc. | Mar-34 | Gebruikt voor echocardiografische beeldvorming bij kleine dieren. |
| BCA-proteïne-assaykit | Thermo Fisher Scientific | 23227 | Detectie bij 562 nm; bereik, 20–2,000 µg/mLgebruikt voor kwantificering van het totale eiwitgehalte van lysaten van muizenhart. |
| CellAge-database | Genomische bronnen voor menselijke veroudering | https://genomics.senescence.info/cells/ | Bron van verouderingsgerelateerde gensignaturen. |
| CytoHubba, Cytoscape-plugin | Cytoscape App Store | Versie 0.1 | Gebruikt voor de score van de knoopentopologie in eiwit-eiwitinteractienetwerken. |
| Cytoscape | Cytoscape Consortium | Versie 3.9.1 | Wordt gebruikt voor de visualisatie van eiwit-eiwitinteractienetwerken. |
| Microplaatlezer met volledig golflengtebereik | Thermo Fisher Scientific | Multiskan FC | Wordt gebruikt om de absorbentie in ELISA-assays te meten. |
| Gene Expression Omnibus | National Center for Biotechnology Information | https://www.ncbi.nlm.nih.gov/geo/ | Openbare repository gebruikt voor het verkrijgen van transcriptomische datasets. |
| GeneCards | Weizmann Institute of Science | https://www.genecards.org/ | Bron van mitochondria-gerelateerde genensets. |
| Halt Protease- en Fosfataseremmercocktail, 100×, EDTA-vrij | Thermo Fisher Scientific | 78441 | Bewaard bij 4 °C; toegevoegd aan RIPA-buffer bij 10 µL/mL vlak voor gebruik. |
| Vloeibare stikstof | Lokale leverancier van laboratoriumgassen | Niet van toepassing | Wordt gebruikt voor het snap-freezen van myocardweefsel. |
| Mannelijke SPF-grade C57BL/6J-muizen, 6–8 weken oud, 25 ± 2 g | Beijing Vital River Laboratory Animal Technology Co., Ltd. | Niet van toepassing | Dierproductievergunning nr. SCXK (Jing) 2021-0006; gebruikt als normale controles. |
| Mannelijke transgene DCM-muizen van SPF-kwaliteit (CTNTR141W), 6–8 weken oud, 25 ± 2 g | Institute of Laboratory Animal Science, Chinese Academy of Medical Sciences | Niet van toepassing | Vergunning voor dierproductie nr. SCXK (Jing) 2021-0065; gebruikt als het spontane DCM-model. |
| MCODE, Cytoscape-plugin | Cytoscape App Store | Versie 2.0.2 | Wordt gebruikt om functionele kernsubnetwerken in eiwit-eiwitinteractienetwerken te identificeren. |
| Muis CYBB ELISA-kit | Biogradetech | A-QEK09250-96wells | In deze studie gebruikt om CYBB te meten in lysaten van myocardiaal weefsel van muizen. |
| Muis PAI-1 ELISA-kit | EK-BIO | ML30970 | In deze studie gebruikt om PAI-1, het door SERPINE1 gecodeerde eiwit, te meten in lysaten van myocardiale weefsel uit muizen. |
| Muis TGF-β2 ELISA-kit | ElaBoX | SEKM-0036 | Gebruikt in deze studie om TGF- te metenβ2 in lysaten van myocardweefsel van muizen. |
| Muis TLR-2 ELISA-kit | Solarbio | SEKM-0163 | In deze studie gebruikt om TLR-2 te meten in lysaten van myocardweefsel van muizen. |
| Fosfaatgebufferde zoutoplossing, pH 7,4, calcium- en magnesiumvrij | Biologische Industrieën | 02-024-1ACS | Steriel 1× oplossing; bewaard bij 4 °C; gebruikt voor het wassen van weefsel en verdunning. |
| R-pakket: caret | CRAN | Versie 6.0-94 | Gebruikt voor support vector machine-recursieve kenmerkeliminatie. |
| R-pakket: CellChat | CellChat-ontwikkelaars | Versie 1.6.1 | Gebruikt voor inferentie van cel-celcommunicatie op basis van single-cell RNA-sequenceringsgegevens. |
| R-pakket: clusterProfiler | Bioconductor | Versie 4.8.3 | Gebruikt voor functionele verrijkingsanalyse. |
| R-pakket: ConsensusClusterPlus | Bioconductor | Versie 1.64.0 | Gebruikt voor ongesuperviseerde consensusclustering. |
| R-pakket: edgeR | Bioconductor | Versie 3.42.4 | Gebruikt voor normalisatie van RNA-sequencinggegevens met de trimmed mean of M-values-methode. |
| R-pakket: GEOquery | Bioconductor | Versie 2.68.0 | Wordt gebruikt om gegevens te downloaden uit de Gene Expression Omnibus. |
| R-pakket: glmnet | CRAN | Versie 4.1-8 | Gebruikt voor logistische regressie met de least absolute shrinkage and selection operator. |
| R-pakket: limma | Bioconductor | Versie 3.56.2 | Gebruikt voor differentieel expressieanalyse en statistische modellering. |
| R-pakket: pROC | CRAN | Versie 1.18.5 | Gebruikt voor de analyse van de receiver operating characteristic-curve. |
| R-pakket: randomForest | CRAN | Versie 4.7-1.2 | Gebruikt voor random forest machine learning. |
| R-pakket: Seurat | CRAN | Versie 5.0.1 | Wordt gebruikt voor de analyse van single-cell RNA-sequencingdata. |
| R-pakket: SingleR | Bioconductor | Versie 2.2.0 | Gebruikt voor geautomatiseerde celtype-annotatie. |
| R-pakket: sva | Bioconductor | Versie 3.48.0 | Gebruikt voor ComBat batch-effectcorrectie. |
| Gekoelde centrifuge | Sigma-Aldrich | SIGMA 3-K | Gebruikt voor centrifugatie van myocardiale weefsellysaten. |
| RIPA-lysis- en extractiebuffer | Thermo Fisher Scientific | 89900 | Klaar voor gebruik 1× oplossing; bewaard bij 4 °C; voor gebruik aangevuld met protease- en fosfataseremmers. |
| Echografie-beeldvormingssysteem voor kleine dieren | VINNO Technology Co., Ltd. | VINN06LAB | Gebruikt voor echocardiografische beoordeling van de hartfunctie. |
| Natriumpentobarbital | Sinopharm Chemical Reagent Co. | 20040428 | Bereid als een 1% oplossing, 10 mg/mL, in steriele zoutoplossing; gebruikt voor intraperitoneale anesthesie bij 30 mg/kg. |
| STRING-database | STRING-consortium | Versie 11.5 | Gebruikt voor de constructie van proteïne-proteïne-interactienetwerken. |
| TGrinder H24 weefselhomogenisator | TIANGEN | OSE-TH-01 | Gebruikt om myocardweefsel van muizen te homogeniseren in RIPA-buffer bij 6,0 m/s gedurende 30–60 s over 2–3 cycli. |
| Thermostatisch dierenplatform/verwarmde operatietafel voor kleine dieren | Shanghai Yuyan Scientific Instrument Co., Ltd. | T-30350 | Gebruikt om muizen te houden op 37 °C tijdens echocardiografie; bedrijfsbereik, van kamertemperatuur tot 50 °C. |
Referenties
- Pinto YM et al. Proposal for a revised definition of dilated cardiomyopathy, hypokinetic non-dilated cardiomyopathy, and its implications for clinical practice: a position statement of the ESC working group on myocardial and pericardial diseases. Eur Heart J. 2016;37(23):1850-1858. https://doi.org/10.1093/eurheartj/ehv727
- Newman NA, Burke MA. Dilated Cardiomyopathy: A Genetic Journey from Past to Future. Int J Mol Sci. 2024;25(21):11460. https://doi.org/10.3390/ijms252111460
- Mishra B et al. Tumour necrosis factor-alpha promoter polymorphism and its association with viral dilated cardiomyopathy in Indian population: a pilot study. Indian J Med Microbiol. 2015;33(1):16–20. https://doi.org/10.4103/0255-0857.148368
- Frustaci A et al. Oxidative myocardial damage in human cocaine-related cardiomyopathy. Eur J Heart Fail. 2015;17(3):283-290. https://doi.org/10.1002/ejhf.219
- Ni B et al. The role of β-catenin in cardiac diseases. Front Pharmacol. 2023;14:1157043. https://doi.org/10.3389/fphar.2023.1157043
- Kuwahara K et al. TRPC6 fulfills a calcineurin signaling circuit during pathologic cardiac remodeling. J Clin Invest. 2006;116(12):3114-3126. https://doi.org/10.1172/JCI27702
- He SL et al. Mitochondrial-related gene expression profiles suggest an important role of PGC-1alpha in the compensatory mechanism of endemic dilated cardiomyopathy. Exp Cell Res. 2013;319(17):2604–2616. https://doi.org/10.1016/j.yexcr.2013.07.017
- Luczak ED et al. Mitochondrial CaMKII causes adverse metabolic reprogramming and dilated cardiomyopathy. Nat Commun. 2020;11(1):4416. https://doi.org/10.1038/s41467-020-18165-6
- Li E et al. BMAL1 regulates mitochondrial fission and mitophagy through mitochondrial protein BNIP3 and is critical in the development of dilated cardiomyopathy. Protein Cell. 2020;11(9):661–679. https://doi.org/10.1007/s13238-020-00713-1
- Alila-Fersi O et al. First description of a novel mitochondrial mutation in the MT-TI gene associated with multiple mitochondrial DNA deletion and depletion in family with severe dilated mitochondrial cardiomyopathy. Biochem Biophys Res Commun. 2018;497(4):1049-1054. https://doi.org/10.1016/j.bbrc.2018.02.162
- Ramaccini D et al. Mitochondrial Function and Dysfunction in Dilated Cardiomyopathy. Front Cell Dev Biol. 2020;8:624216. https://doi.org/10.3389/fcell.2020.624216
- Yang J et al. Stem cells in the treatment of myocardial injury-induced cardiomyopathy: mechanisms and efficient utilization strategies. Front Pharmacol. 2025;16:1600604. https://doi.org/10.3389/fphar.2025.1600604
- Van Linthout S et al. State of the art and perspectives of gene therapy in heart failure. A scientific statement of the Heart Failure Association of the ESC, the ESC Council on Cardiovascular Genomics and the ESC Working Group on Myocardial & Pericardial Diseases. Eur J Heart Fail. 2025;27(1):5–25. https://doi.org/10.1002/ejhf.3516
- Alimadadi A, Munroe PB, Joe B, Cheng X. Meta-Analysis of Dilated Cardiomyopathy Using Cardiac RNA-Seq Transcriptomic Datasets. Genes (Basel). 2020;11(1):60. https://doi.org/10.3390/genes11010060
- Verdonschot J et al. Clustering of Cardiac Transcriptome Profiles Reveals Unique Subgroups of Dilated Cardiomyopathy Patients. JACC Basic Transl Sci. 2023;8(4):406–418. https://doi.org/10.1016/j.jacbts.2022.10.007
- Zhu T et al. Identification and Verification of Feature Biomarkers Associated With Immune Cells in Dilated Cardiomyopathy by Bioinformatics Analysis. Front Genet. 2022;13:874544. https://doi.org/10.3389/fgene.2022.874544
- Li H et al. Identification of Centrosome Duplication-Related Biomarkers in Hypertrophic Cardiomyopathy Through Integrative Multi-Omics, Single-Cell Transcriptomics, and Experimental Validation. J Am Heart Assoc. 2026;15(12):e047416. https://doi.org/10.1161/JAHA.125.047416
- Ni L et al. Dissecting and validation the biomarker of heart failure progression in patients with atherosclerosis by single-cell sequencing, bioinformatics, and machine learning. Front Genet. 2025;16:1587274. https://doi.org/10.3389/fgene.2025.1587274
- Barrett T et al. NCBI GEO: archive for functional genomics data sets--update. Nucleic Acids Res. 2013;41(Database issue):D991–D995. https://doi.org/10.1093/nar/gks1193
- Davis S, Meltzer PS. GEOquery: a bridge between the Gene Expression Omnibus (GEO) and BioConductor. Bioinformatics. 2007;23(14):1846-1847. https://doi.org/10.1093/bioinformatics/btm254
- Irizarry RA et al. Exploration, normalization, and summaries of high density oligonucleotide array probe level data. Biostatistics. 2003;4(2):249-264. https://doi.org/10.1093/biostatistics/4.2.249
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics. 2010;26(1):139–140. https://doi.org/10.1093/bioinformatics/btp616
- Leek JT et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883. https://doi.org/10.1093/bioinformatics/bts034
- Butler A et al. Integrating single-cell transcriptomic data across different conditions, technologies, and species. Nat Biotechnol. 2018;36(5):411-420. https://doi.org/10.1038/nbt.4096
- Korsunsky I et al. Fast, sensitive and accurate integration of single-cell data with Harmony. Nat Methods. 2019;16(12):1289-1296. https://doi.org/10.1038/s51592-019-0619-0
- Aran D et al. Reference-based analysis of lung single-cell sequencing reveals a transitional profibrotic macrophage. Nat Immunol. 2019;20(2):163-172. https://doi.org/10.1038/s41590-018-0276-y
- Ritchie ME et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. https://doi.org/10.1093/nar/gkv007
- Barbie DA et al. Systematic RNA interference reveals that oncogenic KRAS-driven cancers require TBK1. Nature. 2009;462(7269):108-112. https://doi.org/10.1038/nature08460
- Yu G et al. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284-287. https://doi.org/10.1089/omi.2011.0118
- Szklarczyk D et al. STRING v11: protein-protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607–D613. https://doi.org/10.1093/nar/gky1131
- Shannon P et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504. https://doi.org/10.1101/gr.1239303
- Chin CH et al. cytoHubba: identifying hub objects and sub-networks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11. https://doi.org/10.1186/1752-0509-8-S4-S11
- Bader GD, Hogue CW. An automated method for finding molecular complexes in large protein interaction networks. BMC Bioinformatics. 2003;4:2. https://doi.org/10.1186/1471-2105-4-2
- Friedman J, Hastie T, Tibshirani R. Regularization Paths for Generalized Linear Models via Coordinate Descent. J Stat Softw. 2010;33(1):1-22. https://doi.org/10.18637/jss.v033.i01
- Touw WG et al. Data mining in the Life Sciences with Random Forest: a walk in the park or lost in the jungle. Brief Bioinform. 2013;14(3):315-326. https://doi.org/10.1093/bib/bbs034
- Chicco D. Ten quick tips for machine learning in computational biology. BioData Min. 2017;10:35. https://doi.org/10.1186/s13040-017-0155-3
- Robin X et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. https://doi.org/10.1186/1471-2105-12-77
- Lundberg SM et al. From Local Explanations to Global Understanding with Explainable AI for Trees. Nat Mach Intell. 2020;2(1):56-67. https://doi.org/10.1038/s42256-019-0138-9
- Jin S et al. Inference and analysis of cell-cell communication using CellChat. Nat Commun. 2021;12(1):1088. https://doi.org/10.1038/s41467-021-21246-9
- Charoentong P et al. Pan-cancer Immunogenomic Analyses Reveal Genotype-Immunophenotype Relationships and Predictors of Response to Checkpoint Blockade. Cell Rep. 2017;18(1):248–262. https://doi.org/10.1016/j.celrep.2016.12.019
- Wilkerson MD, Hayes DN. ConsensusClusterPlus: a class discovery tool with confidence assessments and item tracking. Bioinformatics. 2010;26(12):1572–1573. https://doi.org/10.1093/bioinformatics/btq170
- Hänzelmann S, Castelo R, Guinney J. GSVA: gene set variation analysis for microarray and RNA-seq data. BMC Bioinformatics. 2013;14:7. https://doi.org/10.1186/1471-2105-14-7
- Zheng Y et al. Exploring Key Genes to Construct a Diagnosis Model of Dilated Cardiomyopathy. Front Cardiovasc Med. 2022;9:865096. https://doi.org/10.3389/fcvm.2022.865096
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-127. https://doi.org/10.1093/biostatistics/kxj037
- Koslow M, Mondaca-Ruff D, Xu X. Transcriptome studies of inherited dilated cardiomyopathies. Mamm Genome. 2023;34(2):312-322. https://doi.org/10.1007/s00335-023-09978-z
- Zhang B, Horvath S. A general framework for weighted gene co-expression network analysis. Stat Appl Genet Mol Biol. 2005;4:Article17. https://doi.org/10.2202/1544-6115.1128
- Lin M et al. Machine learning and multi-omics integration: advancing cardiovascular translational research and clinical practice. J Transl Med. 2025;23(1):388. https://doi.org/10.1186/s12967-025-06425-2
- Climente-González H et al. Interpretable machine learning leverages proteomics to improve cardiovascular disease risk prediction and biomarker identification. Commun Med (Lond). 2025;5(1):170. https://doi.org/10.1038/s43856-025-00872-0
- Shah P et al. Predicting cardiovascular risk with hybrid ensemble learning and explainable AI. Sci Rep. 2025;15(1):17927. https://doi.org/10.1038/s41598-025-01650-7
- Chaffin M et al. Single-nucleus profiling of human dilated and hypertrophic cardiomyopathy. Nature. 2022;608(7921):174-180. https://doi.org/10.1038/s41586-022-04817-8
- Juan F et al. The changes of the cardiac structure and function in cTnTR141W transgenic mice. Int J Cardiol. 2008;128(1):83-90. https://doi.org/10.1016/j.ijcard.2008.03.006
- Russell-Hallinan A et al. Single-Cell RNA Sequencing Reveals Cardiac Fibroblast-Specific Transcriptomic Changes in Dilated Cardiomyopathy. Cells. 2024;13(9):752. https://doi.org/10.3390/cells13090752
- Knowlton KU. Dilated Cardiomyopathy. Circulation. 2019;139(20):2339-2341. https://doi.org/10.1161/CIRCULATIONAHA.119.040037
- Smith GD, Ebrahim S. Mendelian randomization: prospects, potentials, and limitations. Int J Epidemiol. 2004;33(1):30-42. https://doi.org/10.1093/ije/dyh132
- Chen R et al. Macrophages in cardiovascular diseases: molecular mechanisms and therapeutic targets. Signal Transduct Target Ther. 2024;9(1):130. https://doi.org/10.1038/s41392-024-01840-1
- Liu R et al. Tead1 is essential for mitochondrial function in cardiomyocytes. Am J Physiol Heart Circ Physiol. 2020;319(1):H89-H99. https://doi.org/10.1152/ajpheart.00732.2019
- Sharma S et al. SOD2 deficiency in cardiomyocytes defines defective mitochondrial bioenergetics as a cause of lethal dilated cardiomyopathy. Redox Biol. 2020;37:101740. https://doi.org/10.1016/j.redox.2020.101740