Deze studie presenteert RareCode, een ongesuperviseerd deep learning-framework dat anomalieën in histopathologische beelden van colorectale kanker detecteert door de Codebook Activation Rarity (CAR) te analyseren, met het potentieel om pre-screening te ondersteunen zonder gelabelde trainingsgegevens.
Onderzoeksartikel
RareCode: Een unsupervised deep learning-framework voor anomaliedetectie in histopathologische beelden van colorectale kanker
In dit artikel
Samenvatting
Samenvatting
Ongecontroleerde anomaliedetectie in histopathologische beelden is uitgebreid onderzocht met behulp van reconstructiegebaseerde benaderingen die reconstructiefouten meten, maar deze methoden slagen er vaak niet in om subtiele, semantische pathologische variaties vast te leggen vanwege de inherente heterogeniteit van weefseltexturen. Om deze beperking aan te pakken, presenteert deze studie RareCode, een op vectorquantisatie gebaseerd raamwerk dat het detectieparadigma uitbreidt voorbij reconstructie op pixelniveau om analyse van codeboekactivatie op semantisch niveau te integreren. De kerninnovatie is de Codebook Activation Rarity (CAR)-scoring, die de activatiefrequentie van elke codeboekvermelding profileert tijdens training op uitsluitend normale monsters en infrequent activaties markeert als anomalie-indicatoren tijdens de inferentiefase, waardoor reconstructiefouten worden aangevuld met discriminatie op semantisch niveau. Voortbouwend op dit CAR-mechanisme op één schaal, wordt verder een Multi-scale Hierarchical Codebook (MHC)-module geïntroduceerd, die codeboeken van verschillende groottes met leerbare fusiegewichten gebruikt om pathologische patronen vast te leggen die variëren van grove structuren op weefselniveau tot fijne details op cellulair niveau. Door gebruik te maken van het multi-schaal ontwerp worden hiërarchische anomalie-heatmaps gegenereerd bij elke codeboekgranulariteit, wat pathologen interpreteerbare, multidimensionale visuele lokalisatie-aanwijzingen biedt die aangeven waar en op welk structureel niveau anomalieën voorkomen. Vijfvoudige kruisvalidatie op een klinisch geannoteerde dataset van histopathologische beelden van colorectale kanker, verkregen van het Shenzhen People's Hospital, toont aan dat RareCode een area under the curve (AUC) van 96,82% behaalt, waarmee het beter presteert dan de baseline-methoden. Per-klasse analyse toonde een sterkere prestatie voor cancerdetectie (AUC = 9,44%, specificiteit = 94,21%) dan voor ontstekkingsdetectie (AUC = 94,30%, specificiteit = 60,4%). Deze bevindingen suggereren dat CAR-analyse een veelbelovende ongecontroleerde benadering kan bieden voor histopathologische anomaliedetectie, wat mogelijk kan helpen bij klinische prescreening bij de diagnose van colorectale kanker.
Inleiding
Betrouwbare histopathologische screening op colorectale kanker blijft beperkt door de noodzaak van expertannotatie en handmatige beoordeling, vooral wanneer inflammatoire laesies en maligniteiten overlappende morfologie vertonen1,2. Deze beperkingen stimuleren de ontwikkeling van ongesuperviseerde computationele benaderingen die leren van normaal weefsel zonder dat uitputtende annotaties van abnormale weefsels vereist zijn3,4.
De klinische urgentie van geautomatiseerde histopathologische screening wordt onderstreept door de groeiende disbalans tussen de diagnostische vraag en de beschikbare pathologische expertise, waarbij de diagnostische werkdruk per Amerikaanse patholoog in een enkel decennium met meer dan 40% is gestegen terwijl het aantal pathologen bleef afnemen5. Bij colorectaal carcinoom (CRC) zijn georganiseerde screeningsprogramma's geassocieerd met sterftecijferreducties van 29-68%6, maar de capaciteit voor handmatige pathologische beoordeling blijft beperkt door de beschikbaarheid van personeel. Een geautomatiseerd prescreeningssysteem dat verdachte gevallen betrouwbaar identificeert voor prioritaire beoordeling zou kunnen helpen deze druk te verlichten en de doorlooptijden van de diagnostiek te verbeteren. Het implementeren van dergelijke systemen vereist echter zowel een hoge sensitiviteit om het missen van fout-negatieven te voorkomen als een adequate specificiteit om overmatige vals-positieve meldingen te vermijden7.
Ongecontroleerde anomaliedetectie (unsupervised anomaly detection, UAD) is steeds relevanter geworden in de medische beeldanalyse8 omdat het normale weefseldistributies kan modelleren zonder dat er abnormale trainingslabels nodig zijn3,9,10. Op reconstructie gebaseerde modellen, waaronder autoencoders, variational autoencoders, generative adversarial networks en geheugen-geaugmenteerde varianten, identificeren anomalieën via reconstructiefouten, maar decoders met een hoge capaciteit kunnen abnormale regio's nog steeds met hoge getrouwheid reconstrueren1,12,13,14,15,16,17. Kenmerkgebaseerde methoden zoals PatchCore en PaDiM maken gebruik van vooraf getrainde representaties, hoewel kenmerken die zijn geleerd van natuurlijke afbeeldingen mogelijk microscopische atypie in de histopathologie niet volledig vatten18,19,20,21. Pathologiestudie-specifieke foundation-modellen en diffusie-gebaseerde anomaliedetectoren bieden krachtige alternatieven, maar hun data-vereisten of computationele kosten kunnen hun directe gebruik bij high-throughput screening beperken2,23. Recente geautomatiseerde en evolutionaire methoden, zoals EvoAAE24 en MoARNN-AM25, illustreren verder de waarde van adaptieve modeloptimalisatie voor anomaliedetectie, hoewel hun toepassingscontexten verschillen van histopathologische beeldanalyse. In contrast hiermee leggen methoden op basis van vectorquantisatie (VQ) discrete codebook-beperkingen op die identity mapping kunnen verminderen; bestaande VQ-gebaseerde benaderingen vertrouwen echter nog steeds primair op ruimtelijke reconstructiefouten en benutten de semantische informatie die besloten ligt in codebook-activatiepatronen onvoldoende26,27.
Hoewel de bovengenoemde methoden veelbelovende prestaties vertonen in algemene domeinen, staat hun toepassing op complexe histopathologische scenario's voor specifieke uitdagingen. Histopathologische beelden worden gekenmerkt door complexe weefselheterogeniteit over meerdere structurele niveaus28. In de praktijk wordt beeldanalyse gewoonlijk uitgevoerd op lokale beeldfragmenten die uit weefselcoupes zijn geëxtraheerd, en pathologische diagnostiek is inherent cross-scale: pathologen beoordelen de klier- en weefselmorfologie bij lage vergroting, terwijl ze nucleair pleomorfisme en mitosefiguren bij hoge vergroting onderzoeken29. Wij identificeren drie belangrijke beperkingen van de huidige benaderingen: Ten eerste vertonen pathologische anomalieën en normaal weefsel een hoge gelijkenis in visuele kenmerken op laag niveau, zoals kleuringsstijlen en lokale texturen, waardoor reconstructiegebaseerde methoden er niet in slagen subtiele anomalieën te detecteren, aangezien zowel normale als abnormale monsters een vergelijkbare reconstructiekwaliteit op semantisch niveau kunnen produceren. Ten tweede maken de meeste bestaande methoden gebruik van feature-extractie op één enkele schaal, waardoor het moeilijk is om gelijktijdig abnormale kenmerken op zowel weefsel- als cellulair niveau vast te leggen30,31. Ten derde kunnen mainstream methoden weliswaar heatmaps op pixelniveau genereren, maar slagen ze er vaak niet in om de hiërarchische kenmerken van anomalieën intuïtief vast te leggen, wat het nut van dergelijke modellen als klinische diagnostische hulpmiddelen beperkt.
Om de bovenstaande uitdagingen aan te pakken, stellen wij RareCode voor, een UAD-framework dat codeboek-activatiepatronen en hiërarchische feature-representatie op meerdere abstractieniveaus onderzoekt. Het framework introduceert drie hoofdcomponenten: (1) het Codebook Activation Rarity (CAR) Scoring Mechanism, dat zeldzaamheidsscores berekent op basis van activatiefrequenties van vermeldingen die uitsluitend op normale monsters zijn getraind, waardoor normale monsters van anomale monsters op semantisch niveau worden onderscheiden en complementaire discriminerende signalen worden geleverd ten opzichte van traditionele ruimtelijke reconstructiefouten. (2) de Multi-scale Hierarchical Codebook (MHC) Fusion Architecture, die pathologische kenmerken op meerdere granulariteitsniveaus vastlegt — van grove structurele patronen tot fijnmazige cellulaire details — door gebruik te maken van codeboeken met variërende capaciteiten, waarbij adaptieve fusie wordt bereikt via leerbare gewichten. (3) de Hierarchical Interpretable Localization Module, die de multi-schaalarchitectuur benut om anomalie-heatmaps op verschillende granulariteiten te genereren, waardoor pathologen worden voorzien van multi-schaal semantisch interpreteerbare diagnostische referentiekaders.
De primaire hypothese van deze studie was dat activatiefrequentieprofielen van codeboeken, afgeleid van codeboeken die uitsluitend zijn getraind op normale colorectale histopathologische beelden, semantische informatie die relevant is voor anomalieën zouden coderen die verder gaat dan de reconstructiefout op pixelniveau, en dat multi-schaalintegratie van deze complementaire signalen de discriminatie van beelden met kankereus of inflammatoir weefsel ten opzichte van normale beelden zou verbeteren vergeleken met representatieve UAD-methoden, primair beoordeeld op basis van de AUC. Om deze hypothese te testen, hebben we RareCode geëvalueerd met behulp van 5-voudige kruisvalidatie op een klinisch geannoteerde CRC-dataset en hebben we ablatie- en lokalisatieanalyses uitgevoerd om de bijdragen en interpreteerbaarheid van de kerncomponenten te onderzoeken.
Protocol
Deze studie werd goedgekeurd door de Commissie voor Klinisch Onderzoek en Ethische Zaken van het Shenzhen People's Hospital (Goedkeuringsnummer LL-KY-2025300-01). De verplichting tot het verkrijgen van geïnformeerde toestemming werd opgeheven door de ethische commissie, aangezien dit retrospectieve onderzoek gebruikmaakte van bestaande histopathologische afbeeldingen en klinische materialen zonder directe patiëntcontacten of interventies. Alle klinische gegevens en histopathologische afbeeldingen werden geanonimiseerd vóór analyse, en er werden geen persoonsgegevens gebruikt in dit onderzoek. Alle voor dit onderzoek gebruikte gegevens werden verwerkt overeenkomstig de ethische normen van de instellingsspecifieke en nationale onderzoekscommissies.
Kaderoverzicht
De algehele architectuur van het voorgestelde UAD-kader, RareCode, is geïllustreerd in Figuur 1Het kader maakt gebruik van een parallelle dual-branch-architectuur. Voor elke 512 x 512 ingangsafbeelding worden niet-overlappende 32 x 32 en 64 x 64 patches geëxtraheerd als respectievelijk fijnschalige en grofschalige ingangen. De 64 x 64 patches worden eerst herschaald naar 32 x 32 voordat ze aan het netwerk worden doorgegeven, zodat beide branches dezelfde encoder-decoder ingangsgrootte delen terwijl ze verschillende receptieve velden behouden. Encoders in elke branch projecteren de geëxtraheerde kenmerken naar een latente ruimte, waar de MHC-module discretisatiebeperkingen oplegt. Vervolgens reconstrueren decoders de afbeelding uit gekwantiseerde kenmerken om reconstructiefouten in het ruimtelijke domein te berekenen. Het CAR-mechanisme meet vervolgens de mate van semantische afwijking door codebookactiveringsfrequenties in kaart te brengen. Tot slot combineert het model reconstructiescores en CAR-scores via een gewogen combinatie om afbeeldingsniveau afwijkingscores te verkrijgen. Het RareCode-kader wordt end-to-end getraind met uitsluitend normale samples en vereist geen annotaties van afwijkingen. De dual-branch-architectuur werd gebruikt om zowel lokale cellulaire kenmerken als bredere klierstructuren te kunnen vastleggen. De MHC-module werd gebruikt om deze kenmerken te modelleren met codebooks van verschillende capaciteit.
Encoder-decoder-architectuur
RareCode construeert structureel onafhankelijke encoders en decoders voor de fijnschalige en grofschalige takken. Elke tak gebruikt hetzelfde encoder-decoderontwerp, maar deelt geen parameters. De encoder bestaat uit vier convolutieblokken, elk bestaande uit een 3 × 3-convolutie, batchnormalisatie, ReLU-activatie en dropout. De kanaalbreedte neemt toe van 64 naar 128, vervolgens naar 256, en de uiteindelijke feature map wordt afgevlakt en geprojecteerd naar een 64-dimensionale latente representatie. De decoder weerspiegelt de encoder met een volledig verbonden projectielaag, gevolgd door vier getransponeerde convolutielagen, waarbij elke patch wordt gereconstrueerd naar de oorspronkelijke invoergrootte van het netwerk. De reconstructiefout wordt berekend als de gemiddelde kwadratische fout tussen de invoer en de gereconstrueerde patches. Door deze encoder-decoderstructuur te combineren met discrete codebookbeperkingen, leert RareCode compacte representaties van normaal weefsel en meet het afwijkingen tijdens inferentie.
Multischaal hiërarchische codeboek
Om ziekteverschijnselen vast te leggen op meerdere niveaus van abstractie—van brede weefselstructuren tot gelokaliseerde cellulaire variaties—de MHC-module maakt gebruik van K discrete codeboeken  met verschillende capaciteiten n1, n2, ..., nK. In de uiteindelijke FourScales-configuratie bevat elke tak vier codeboeken met respectievelijk 64, 128, 256 en 512 invoerposities, waarbij elke codeboekinvoerpositie een 64-dimensionale embedding heeft. Voor elke gecodeerde patch-feature wordt de dichtstbijzijnde codeboekinvoerpositie geselecteerd op basis van Euclidische afstand. De gekwantiseerde uitvoer van de verschillende codeboeken wordt vervolgens samengevoegd met behulp van leerbare gewichten die genormaliseerd zijn over de codeboeken heen. Kleinere codeboeken, vanwege de sterkere compressiebeperkingen, worden verwacht grofkorrelige, prototypische patronen te coderen die lokale variaties abstract weergeven, terwijl grotere codeboeken fijnkorreligere kenmerken behouden die specifiekere structurele eigenschappen vastleggen. Voor elk codeboek
 , waarbij ek(i)
 Rd geeft de i-de insluitingsvector in het k-de codeboek aan, continue kenmerken worden via opzoeking van de dichtstbijzijnde buur (Eq. 1 en 2) afgebeeld op de discrete codeboekruimte:
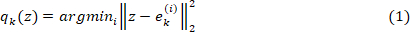

Om adaptieve fusie van multischaalkenmerken te realiseren, introduceren we leerbare gewichten. Na softmax-normalisatie wordt een gewogen sommatie uitgevoerd over de gekwantiseerde uitvoer van elk codeboek (verg. 3):
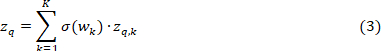
waar σ(·) staat voor de softmax-functie, die ervoor zorgt dat de gewichten voldoen aan Σk σ(wk) = 1. Dit ontwerp stelt het model in staat om automatisch de bijdrageverhoudingen van codeboeken op verschillende granulariteitsniveaus aan te passen op basis van de semantische inhoud van de invoerkenmerken.
Om het leerproces van de codeboekoptimalisatie te verbeteren, gebruiken we de standaard VQ-verliesfunctie (Vgl. 4):
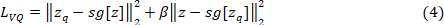
waar sg[·] duidt de stop-gradiëntoperatie aan, en β = 0,25 is de gewichtscoëfficiënt van het commitment-verlies. De eerste term stimuleert codeboekvectoren om zich te bewegen richting de uitvoer van de encoder, terwijl de tweede term de uitvoer van de encoder stimuleert om consistent te blijven met hun overeenkomstige codeboekvectoren. Het volledige mechanisme van multi-schaal VQ is geïllustreerd in Figuur 2.
Beoordeling van de zeldzaamheid van codeboekactivatie
CAR meet semantische afwijkingen op basis van codeboek-activatiestatistieken, geschat uit normale trainingsvoorbeelden. Na het trainen van het model werden alle normale trainingsafbeeldingen zonder gegevensverrijking door de encoder en de MHC-module geleid. Voor elke tak en elk codeboek werd de toewijzingsindex van elke patch-feature geregistreerd, en het aantal toewijzingen aan elk codeboek-element werd geteld. De tellingen werden vervolgens genormaliseerd om de activatiefrequentieverdeling voor dat codeboek te verkrijgen (Vgl. 5):

Tijdens de inferentie werd elke testafbeelding verwerkt via dezelfde procedure van patch-extractie, codering en toewijzing aan het dichtstbijzijnde codewoordenboek. Voor elke toegewezen codewoordenboekvermelding wordt de zeldzaamheidsscore berekend als de negatieve logaritme van de activeringsfrequentie in de normale trainingsset (Vgl. 6):

waar ε is een kleine constante die wordt gebruikt voor numerieke stabiliteit. Een codeboekitem met lage frequentie krijgt derhalve een hogere zeldzaamheidsscore, wat suggereert dat de overeenkomstige patch-feature minder consistent is met de geleerde verdeling van normaal weefsel. Zeldzaamheidsscores op patch-niveau werden gemiddeld binnen elk beeld en over de fijne en grove schaalstructuren heen om een beeldniveau-zeldzaamheidsrespons te verkrijgen.
Om de activatiefrequentierariteit aan te vullen, berekenen we ook een percentielgebaseerde kwantisatie-afstandsscore (Eq. 7):
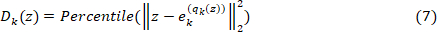
Deze score is afgeleid van de Euclidische afstand tussen elke gecodeerde kenmerkvector en de dichtstbijzijnde codeboekvermelding. De afstandsverdeling wordt geschat op basis van normale trainingsmonsters, en de afstanden van testmonsters worden omgezet in percentielscores. Hogere percentielscores geven aan dat het gecodeerde kenmerk moeilijker is weer te geven met behulp van de geleerde prototypen van het normale codeboek.
De uiteindelijke CAR-score combineert activatiezeldzaamheid en kwantisatie-afstand over alle codeboeken heen, gebruikmakend van de leerbare codeboekgewichten (Eq. 8):
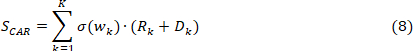
Dezelfde genormaliseerde codebookgewichten die worden gebruikt voor multischaalfusie van kenmerken, worden toegepast op fusie op scoresniveau, waardoor consistentie wordt behouden tussen representatieleren en afwijkingsscorering. De resulterende CAR-score wordt op afbeeldingsniveau berekend en vervolgens gecombineerd met de reconstitutiescore om de uiteindelijke afwijkingsscore te verkrijgen. Het algehele CAR-scoringsmechanisme is geïllustreerd in Figuur 3.
Definitieve berekening van de anomalie-score
We combineren fouten in de ruimtelijke reconstitutie met semantische CAR-scores. Voordien worden beide scores afzonderlijk genormaliseerd met behulp van percentielgebaseerde min-max-normalisatie om de invloed van extreme uitbijters te verkleinen. De uiteindelijke anomalie-score op beeldniveau wordt vervolgens gedefinieerd als (Vgl. 9):
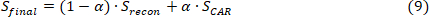
waar Sreconstructie geeft de genormaliseerde gemiddelde kwadratische reconstructiefout aan, die de reconstructiekwaliteit van de sample in pixelruimte weerspiegelt; SCAR is de CAR-score zoals hierboven beschreven, die graden van semantische afwijking weergeeft. De hyperparameter α [0,1] regelt de relatieve weging tussen de twee componenten, waarbij optimale waarden worden bepaald op validatiesets.
Trainingsdoelstelling
Het RareCode-framework wordt end-to-end getraind met alleen normale samples. Het totale trainingsverlies bestaat uit de volgende componenten (Vgl. 10):

Elke term is als volgt gedefinieerd: Reconstructieverlies: 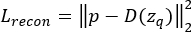 , het meten van de gemiddelde kwadratische fout tussen invoerpatches p en gereconstrueerde patches D(zq) na kwantisering. Dit verlies wordt afzonderlijk toegepast op de 32 × 32-patch tak (
 ) en 64 × 64 patch-vertakking (
 ) om effectief leren van kenmerken op beide ruimtelijke schalen te waarborgen.
Beschrijving van de dataset
Om RareCode te evalueren, zijn experimenten uitgevoerd op een klinisch geannoteerde histopathologische beeldverzameling van colorectale kanker (CRC) die beelden bevat van colorectale weefselsecties gekleurd met hematoxyline en eosine (H&E)&E), verkregen van Shenzhen People's ziekenhuis. Alle afbeeldingen in deze dataset zijn afkomstig van echte klinische gevallen. De afbeeldingen zijn gedigitaliseerd bij 40x vergroting met een oorspronkelijke resolutie van 1024 × 1024 pixels. Om de betrouwbaarheid en kwaliteit van de annotaties te waarborgen, zijn alle labels van de steekproefcategorieën gezamenlijk beoordeeld en bevestigd door twee of meer senior professionele pathologen volgens een dubbelblinde protocol.
Op basis van histopathologische kenmerken werd de dataset onderverdeeld in drie klassen: normaal weefsel (1.226 afbeeldingen), kanker (1.215 afbeeldingen) en ontsteking (1.214 afbeeldingen). In de binaire UAD-instelling werden kanker- en ontstekingsmonsters beschouwd als afwijkend, terwijl normale monsters dienden als referentieverdeling. Deze formulering weerspiegelt de beoogde triagetask om gevallen die verdere pathologische beoordeling vereisen, te scheiden van gevallen die morfologisch normaal zijn.
Alle H&E-gekleurde afbeeldingen werden herschaald naar 512 × 512 pixels voordat ze als netwerkinput worden gebruikt. Voor de evaluatie werd gestratificeerde 5-voudige kruisvalidatie toegepast. In elke vouw werden de normale monsters eerst verdeeld in trainings-, validatie- en aparte testdeelverzamelingen. RareCode werd uitsluitend getraind op de normale trainingsmonsters. De validatiedeelverzameling, die eveneens uitsluitend normale monsters bevatte, werd gebruikt voor modelselectie, afstemming van hyperparameters en selectie van het fusiegewicht αDe apart gehouden testset, bestaande uit niet eerder gezien normale monsters en afwijkende monsters waaronder kanker en ontsteking, werd uitsluitend gebruikt voor de definitieve beoordeling van de prestaties en niet gebruikt voor het trainen van het model, de selectie van hyperparameters of α selectie. De representatieve categorieën, de opbouw van de dataset en het validatieprotocol zijn weergegeven in Figuur 4.
Implementatiedetails
Het voorgestelde RareCode-framework en de vergelijkingsmodellen zijn geïmplementeerd met behulp van PyTorch. Alle experimenten zijn uitgevoerd op een werkstation uitgerust met een enkele NVIDIA GeForce RTX 4060 Ti GPU (16 GB). Voor de configuratie van de netwerkarchitectuur, om kenmerken op verschillende ruimtelijke schalen te kunnen vastleggen, verwerkt de dual-branch architectuur niet-overlappende patches op twee schalen: 32 × 32 pixels (kleiner receptief veld, lokale textuurstrepen vastleggend) en 64 × 64 pixels (groter receptief veld, waardoor een breder ruimtelijk verband wordt vastgelegd), respectievelijk. De continue dimensie van de functie-embedding die door beide takencoders wordt geproduceerd, is uniform ingesteld op 64. In de MHC-module configureren we vier codeboeken met verschillende capaciteiten voor elke tak, met discrete prototype-aantallen van respectievelijk 64, 128, 256 en 512.
Tijdens de optimalisatie werd het netwerk end-to-end getraind gedurende 50 epochs met een batchgrootte van 8. We gebruiken de AdamW-optimizer voor gewichtsupdates, met een initiële leersnelheid van 5 × en gewichtsverval om overfitting te voorkomen. Daarnaast werd, om een vlotte convergentie tijdens de training te garanderen, gebruikgemaakt van een leerfrequentie-schema met cosinus-annealing, waardoor een fijnere optimalisatie in latere trainingsfases mogelijk werd. De patch-groottes en codeboek-groottes werden geselecteerd om een balans te bieden tussen multi-schaalrepresentatie en computationele kosten. De uiteindelijke FourScales-configuratie werd ondersteund door ablatie-analyse, en α werd geselecteerd op basis van de validatieset alvorens de testset te evalueren.
Voor de afbraak van de decodercomplexiteit is een variant met een complexe decoder geïmplementeerd op basis van de FourScales-configuratie. Deze variant gebruikte dezelfde datasplitsing, codeboekgroottes, trainingsepochs, optimizer, leerfrequentie, op validatie gebaseerde α selectie en evaluatiemetingen als het FourScales-model. De basise decoder werd vervangen door een EMCAD-stijl decoder met multi-schaal depthwise convolutieblokken en Convolutional Block Attention Modules (CBAM). Na elk van de eerste drie getransponeerde-convolutie-omhoogsamplingstappen, parallel 3 × 3, 5 × 5 en 7 × 7 diepteconvoluties werden toegepast, gevolgd door 1 × 1 puntsgewijze fusie, batchnormalisatie, ReLU-activatie, een residuverbinding en CBAM-aandacht. CBAM omvatte kanaalaandacht op basis van gemiddelde- en max-poolingdescriptoren en ruimtelijke aandacht met behulp van een 7 × 7 convoluties. De laatste fase maakte gebruik van getransponeerde convolutie en sigmoid-activatie om 32 te reconstrueren × 32 patches.
Resultaten
Vergelijking met basismethoden
Om het RareCode-framework te evalueren, werden meerdere representatieve UAD-methoden geselecteerd als basismethoden, variërend van reconstructie-gebaseerde methoden (CAE32, VAE12, SAE33, MAE34, PatchSAE35), geheugenversterkte reconstructie (MemAE36), kennisdistillatie (STFPM37), synthetische anomaliegeneratie (DRAEM38) en vooraf getrainde functie-extractie (PatchCore18). De selectie van basismethoden richtte zich op methoden die kunnen worden getraind of toegepast binnen vergelijkbare computationele budgetten en data-aannames (alleen toegang tot ongelabelde normale trainingsmonsters), zodat prestatieverschillen methodologische bijdragen weerspiegelen in plaats van verschillen in de omvang van vooraf getrainde data. Om een eerlijke vergelijking te waarborgen, werden alle methoden beoordeeld met dezelfde 5-voudige data-opdeling, dezelfde preprocessing-pijplijn, dezelfde evaluatiemetingen en in dezelfde computationele omgeving. Modellen werden getraind volgens hetzelfde UAD-protocol, gebruikmakend van alleen normale trainingsmonsters, waarbij hyperparameters en drempelwaarden werden geselecteerd op de validatieset en de uiteindelijke prestaties uitsluitend werden beoordeeld op de apart gehouden testset. Tabel 1 vat de resultaten van 5-voudige kruisvalidatie samen, en Figuur 5 biedt vergelijkingen in multi-metrische radardiagrammen.
Zoals weergegeven in Tabel 1 en Figuur 5, bereikt RareCode gunstige prestaties qua detectie en statistische stabiliteit op de CRC-dataset. Wat betreft AUC, RareCode (96,82 ± 0,23%) presteert beter dan meerdere op reconstructie gebaseerde basismodellen, inclusief MemAE (94,97 ± 0,81%). Statistische analyse bevestigt dat RareCode alle op reconstructie gebaseerde basismodellen overtreft (gepaarde t-toetsen, p < 0,05), waarbij de verbetering ten opzichte van MemAE statistisch significant was (p < 0,01). RareCode vertoont een lage prestatievariantie (standaardafwijking van 0,23%), wat wijst op consistente stabiliteit over de verschillende validatievouwen heen. De beperkte effectiviteit van DRAEM, gebaseerd op synthetische afwijkingen, weerspiegelt waarschijnlijk het feit dat eenvoudige textuur-overlaystrategieën niet voldoende in staat zijn complexe pathologische atypieën adequaat te simuleren.
Wat betreft specificiteit bereikt RareCode 58,24 ± 5,99%, wat beter presteert dan alle vergelijkingsmethoden bij het verlagen van het percentage fout-positieve resultaten. Dit vertegenwoordigt een verbetering van ongeveer 25 procentpunten ten opzichte van de baseline die alleen reconstructie gebruikt (NoCAR, 33,76%), wat de CAR-mechanisme demonstreert's bijdrage aan het verminderen van valse positieven. De lagere specificiteit van STFPM en PatchCore, die afhankelijk zijn van kenmerken die zijn getraind op natuurlijke beelden, weerspiegelt mogelijk gedeeltelijk de domeingap tussen natuurlijke en histopathologische afbeeldingen. Opvallend is dat STFPM en DRAEM een hoge specificiteitsvariantie vertonen±33,53% en ±7,09%), waarbij de specificiteit per fold varieert van bijna nul tot matige niveaus, hetgeen zorg wekt over hun betrouwbaarheid bij toepassing.
Prestaties van detectie per klasse
Per klasse-analyse werd uitgevoerd door kanker- en ontstekingsmonsters afzonderlijk te vergelijken met normale monsters (Tabel 2). RareCode behaalde een betere prestatie voor de detectie van kanker (AUC = 99,44 ± 0,12%, herroeping = 98,13 ± 0,29%, specificiteit = 94,21 ± 2,22%) dan voor de detectie van ontsteking (AUC = 94,30 ± 0,44%, herinnering = 96,55 ± 0,78%, specificiteit = 60,44 ± 4,34%). Deze bevindingen suggereren dat RareCode een sterker onderscheid kan tonen voor maligne afwijkingen dan voor inflammatoire veranderingen, terwijl de grens tussen inflammatie en normaal weefsel aanzienlijk bijdraagt aan de verlaagde algehele specificiteit.
Ablatiestudie
Om de bijdragen van de belangrijke componenten binnen het RareCode-kader te onderzoeken, zijn ablatie-experimenten uitgevoerd om het effect van het CAR-mechanisme en de MHC-module op de detectieprestaties te beoordelen. De resultaten zijn beschreven in Tabel 3. Zoals weergegeven in Figuur 6A, het toevoegen van CAR aan de alleen-reconstructie-basellijn verbeterde de AUC van 92,81% naar 95,92%, en multi-schaal codebook-fusie verhoogde de AUC verder naar 96,82%. Figuur 6B laat zien dat CAR ook de specificiteit verbeterde, deze verhogend van 33,76% in de NoCAR-basellijn naar 58,24% in het volledige FourScales-model. Deze resultaten ondersteunen de aanvullende waarde van zeldzaamheid van codebook-activatie en multi-schaalfusie.
Daarnaast is een decoder-complexiteitsafbraak uitgevoerd met behulp van de FourScales-configuratie. Zoals weergegeven in Tabel 3, de complex-decoder variant met multi-schaal depthwise convolutieblokken en Convolutional Block Attention Modules (CBAM) liet een lagere AUC zien dan het basismodel FourScales (95,17 ± 0,44% versus 96,82 ± 0,23%). Dit resultaat suggereert dat, binnen de huidige VQ-AE-gebaseerde RareCode-instelling, het vergroten van de decodercapaciteit de prestaties van anomaliedetectie niet verbeterde en de effectiviteit van de codebook-beperkte representatie mogelijk verlaagde.
Hiërarchische ruimtelijke responsanalyse
Om de ruimtelijke responsen te onderzoeken die worden gegenereerd door RareCode, werden op vlak van afbeelding de reconstructiefouten op patch-niveau en de zeldzaamheidskaarten van de codebook geaggregeerd en vergeleken tussen normale en afwijkende monsters. Energieverhouding, Cohen's d en AUC werden gebruikt om de responsafscheiding op beeldniveau te kwantificeren. Gedetailleerde resultaten zijn gepresenteerd in Tabel 4 en Figuur 7 en Figuur 8.
De resultaten tonen aan dat codebook-rariteitscores op alle schalen een verhoogde respons vertonen bij anomalieën (energieverhoudingen > 1). Codeboeken met een kleinere capaciteit (Codeboek 64) bereiken een betere differentiatie op lokalisatieniveau (78,79% AUC), wat overeenkomt met de verwachting dat hogere compressietarieven het leren van meer abstracte, prototypische patronen bevorderen die gevoeliger zijn voor afwijkingen van normale weefselarchetypen. Reconstructiefout alleen biedt een aanzienlijke capaciteit voor het detecteren van afwijkingen (93,31% AUC), terwijl CAR-scores aanvullende signalen leveren uit de semantische frequentiedimensie.
Kwalitatief onderzoek van Figuur 7 toonde aan dat verhoogde responsen in kankerspecimens overlaptten met onregelmatige en dichte klieren, nucleaire vergroting, hyperchromasie, pseudostratificatie en verlies van epitheliale polariteit. In inflammatoire monsters werden sterkere responsen waargenomen rond vervormde klieren en dichte infiltraten van ontstekingscellen. Codeboeken met een lagere capaciteit neigden ernaar bredere architectonische afwijkingen vast te leggen, terwijl codeboeken met een hogere capaciteit meer gelokaliseerde, op cellulair niveau gerichte responsen opleverden. Deze bevindingen bieden een kwalitatieve morfologische interpretatie, maar geen pixelniveau-validatie.
Analyse van fusieparameters
Het fusiegewicht α balanceert de bijdragen van de ruimtelijke reconstructiefout en de CAR-score aan de uiteindelijke anomalie-score. Optimaal α waarden voor elke fold werden bepaald via een rasterzoekopdracht (stapgrootte 0,05) op de validatiesets, met de resultaten weergegeven in Tabel 5 en Figuur 9. Optimaal α waarden concentreren zich voornamelijk in het bereik van 0,85 tot 0,95, met een gemiddelde van 0,90 ± 0,05. Bij optimale configuraties bereikt het model een gemiddelde AUC van 96,82 ± 0,23% op testsets. Hogere optimale gewichten (ongeveer 0,90) geven aan dat CAR-scores meer bijdragen aan de uiteindelijke detectie dan de reconstructiefout, terwijl de reconstructiefout aanvullende lokale beperkingen biedt. In vergelijking met de α = 0 in de gevoeligheidsanalyse (AUC = 93,29%), verbeterde de validatie-geselecteerde fusie-instelling de AUC met ongeveer 3,53 procentpunten.
Samenvattend, wordt in dit onderzoek het RareCode-raamwerk gepresenteerd voor ongecontroleerde anomaliedetectie in histopathologische beelden, met als doel het identiteitsafbeeldingsprobleem dat traditionele generatieve modellen tegenkomen, te verlichten. Het CAR-mechanisme vermindert de overmatige afhankelijkheid van pixelniveau-reconstructiefouten, terwijl de MHC-module hiërarchische functievoorstellingen op meerdere granulariteitsniveaus biedt, waardoor aanvullende anomaliediscriminatie op verschillende abstractieniveaus mogelijk wordt. Experimenten op de CRC-dataset tonen aan dat RareCode een AUC van 96,82% behaalt, waarbij per-klasse-analyse effectieve kankerdetectie aantoont (AUC = 99,44%) en een sterkere discriminatie voor kanker dan voor ontsteking, wat suggereert dat de overlapping tussen ontsteking en normaal weefsel nog steeds een grote uitdaging vormt. Ablatiestudies bevestigen dat de integratie van discrete semantische kenmerken uit VQ met multischaal weefselmorfologische representaties de detectieprestaties verbetert. RareCode'een hoge sensitiviteit (98,40%) en matige specificiteit (58,24%) duiden op het potentieel als voorselectietool voor het prioriteren van verdachte histopathologische afbeeldingen; echter zal het daadwerkelijke effect op de werkdruk van pathologen een prospectieve beoordeling van de werksstroom vereisen.
Gegevensbeschikbaarheid:
De histopathologische beeldgegevensset van CRC die in dit onderzoek is gebruikt, is verkregen van Shenzhen People's Hospital onder instellingsethische goedkeuring (Goedkeuringsnummer LL-KY-2025300-01). Vanwege patiëntprivacy en instellingsspecifieke beleidsregels voor gegevensdeling is de dataset niet openbaar beschikbaar. Toegang kan worden verleend op redelijke aanvraag aan de corresponderende auteur, onder voorbehoud van instellingsethische goedkeuring en gegevensgebruiksafspraken. De broncode voor het RareCode-framework is openbaar beschikbaar op https://github.com/XL-alg/RareCode.
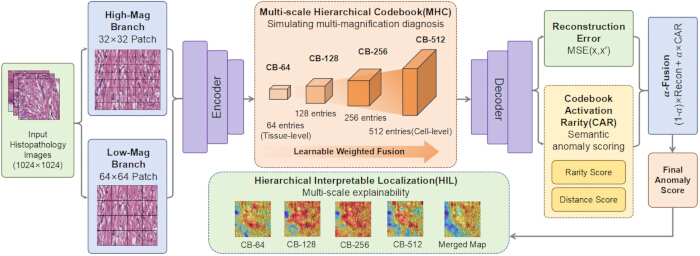
Figuur 1: Algemene architectuur en gegevensstroom van het RareCode-framework. A 512 × 512 H&E-gekleurd histopathologisch beeld wordt verdeeld in niet-overlappende 32 × 32 en 64 × 64 patches als input op fijne en grove schaal. De twee takken coderen de patches naar latente embeddings, passen Multi-schaal Hiërarchische Codebook (MHC) discretisatie toe en reconstrueren de patches om reconstrueerfout-scores te berekenen. Parallel daaraan schat het Codebook Activatie Zeldzaamheid (CAR)-mechanisme semantische zeldzaamheid af op basis van codebook activatiefrequentieprofielen die zijn geleerd uit normale trainingsmonsters. Gegenormeerde reconstrueerscores en CAR-scores worden vervolgens gecombineerd om de uiteindelijke anomalie-score op beeldniveau te genereren, terwijl responsen op patch-niveau terug worden geprojecteerd naar het beeldvlak voor hiërarchische lokalizatie. Klik hier om een grotere versie van deze afbeelding te bekijken.
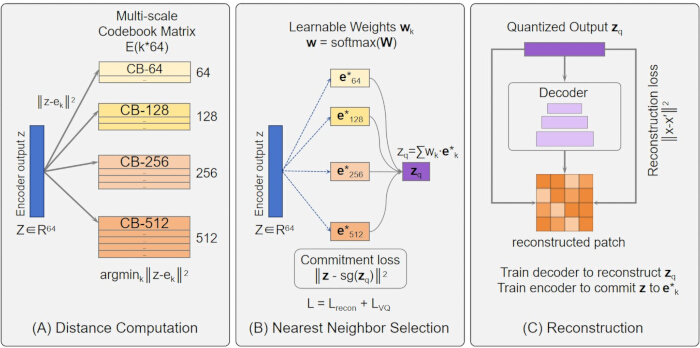
Figuur 2: Multischaal vector kwantisatiemechanisme. (A) Afstandsberekening tussen coderingsuitvoerfuncties en codeboek-embeddingsvectoren. (B) Selectie van de dichtstbijzijnde buur en gewogen fusie over codeboeken met capaciteiten van 64, 128, 256 en 512.C) Reconstructie uit gekwantiseerde kenmerken via getransponeerde convolutiedecoder. Klik hier om een grotere versie van deze afbeelding te bekijken.
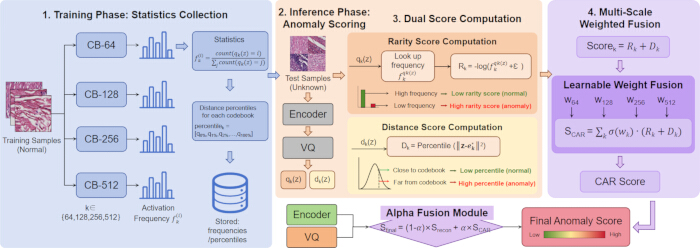
Figuur 3: CAR-scoremechanisme Deze afbeelding illustreert vier stadia: Stadium 1: activatiefrequentiestatistieken worden uitsluitend berekend op normale trainingsmonsters. Stadium 2: testmonsters verkrijgen activatie-indexen en -afstanden via de encoder en vectorkwantisering. Stadium 3: zeldzaamheidsscores en afstandsscores worden berekend op basis van frequentieprofielen van de trainingsset. Stadium 4: scores van elke codeboekschaal worden gecombineerd via leerbare gewichten om de uiteindelijke CAR-score te produceren. Klik hier om een grotere versie van deze afbeelding te bekijken.
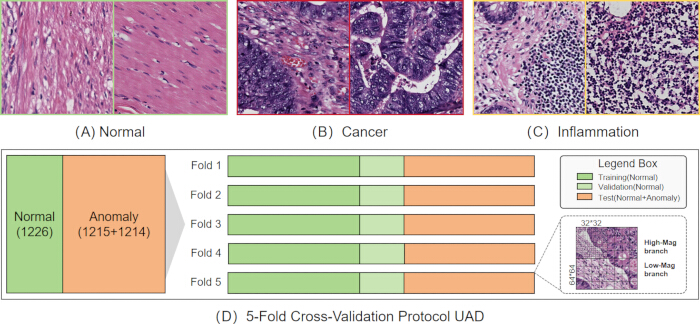
Figuur 4: Samenstelling van de CRC-dataset en experimenteel protocol (A–C) Representatief H&E-gekleurde histopathologische afbeeldingen van normaal colorectaal weefsel, colorectaal carcinoom en colorectale ontsteking.D) 5-voudige cross-validatieprotocol voor UAD, waarbij normale monsters werden gebruikt voor training en validatie, terwijl achtergehouden normale en afwijkende monsters werden gebruikt voor testen. Afbeeldingen werden gedigitaliseerd bij 40x vergroting en verwerkt tot 32 × 32 en 64 × 64 blokken. Groen, lichtgroen en oranje geven respectievelijk de trainings-, validatie- en testsets aan. Klik hier om een grotere versie van deze afbeelding te bekijken.
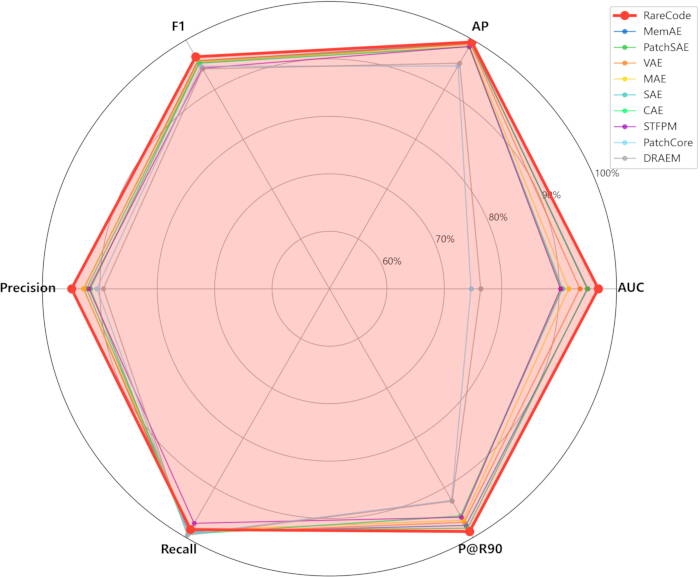
Figuur 5: Radargrafiek met multi-metrische vergelijking van anomaliedetectiemethoden. Radargrafiek met vergelijking van RareCode en basismethoden op basis van AUC, gemiddelde precisie (AP), F1-score, precisie, recall en precisie bij 90% recall (P@R90). Alle waarden geven het gemiddelde prestatieniveau weer over 5-voudige cross-validatie. Klik hier om een grotere versie van deze afbeelding te bekijken.
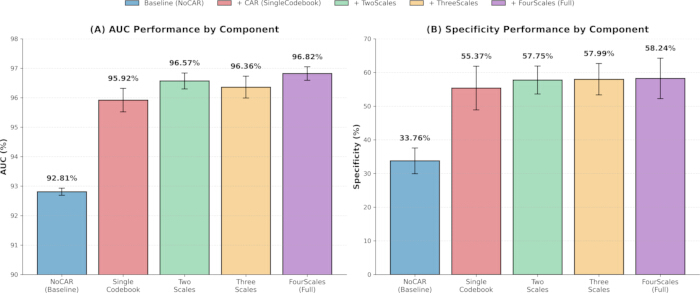
Figuur 6: Incrementele bijdrage-analyse van componenten van een ablatiestudie. (A) Vergelijking van AUC-prestaties die de geleidelijke verbetering weergeeft van de alleen-reconstructie-benaderlijn (NoCAR) via enkele-codeboek naar multi-schaalconfiguraties.B) Vergelijking van de specificiteitsprestaties ter illustratie van het CAR-mechanisme's effect op de reductie van valse positieven. Alle foutmarges geven de standaarddeviatie (SD) weer over 5-voudige kruisvalidatie. Klik hier om een grotere versie van deze afbeelding te bekijken.
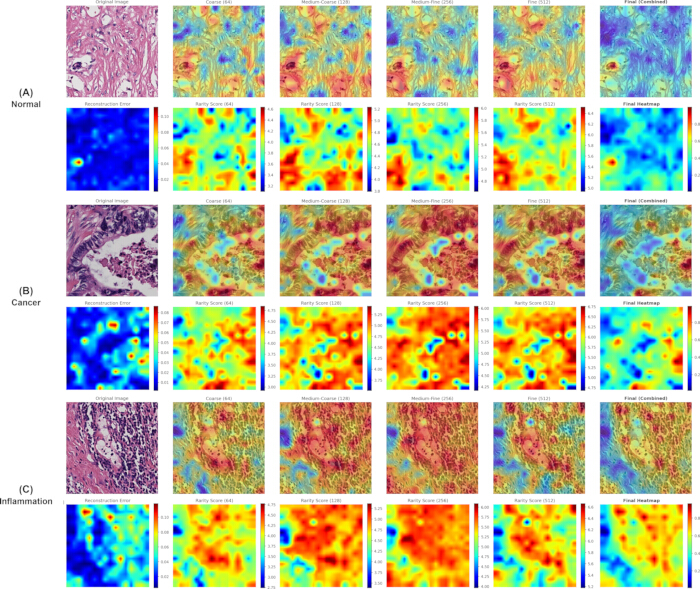
Figuur 7: Hiërarchische localisatiewarmtekaarten op basis van een multischaal codeboek. Representatieve voorbeelden worden getoond voor (A) normaal, (B) kanker, en (C) ontstekingsmonsters. Elke rij bevat de originele afbeelding, de overlay, de reconstructiefout-kaart, zeldzaamheidsscore-kaarten van codeboeken met verschillende capaciteiten (64, 128, 256 en 512), en de uiteindelijke gefuseerde lokaliseringskaart. Codeboeken met een kleinere capaciteit benadrukken grofkorrelige patronen door sterkere compressie-abstractie, terwijl codeboeken met een grotere capaciteit fijnere structurele details behouden. Gebieden met een hoge respons komen kwalitatief overeen met histopathologische kenmerken gerelateerd aan kanker of ontsteking, maar zijn niet gevalideerd met pixelniveau-expertannotaties. Klik hier om een grotere versie van deze afbeelding te bekijken.
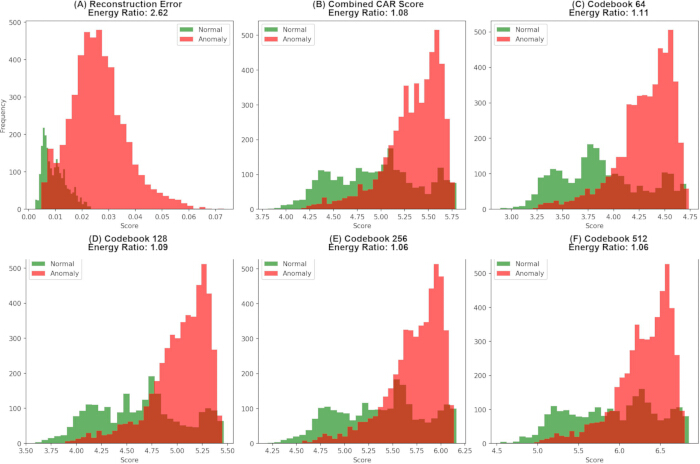
Figuur 8: Distributionshistogrammen van verschillende scoretypes. Histogrammen vergelijken scoreverdelingen tussen normale en afwijkende monsters voor (A) reconstructiefout, (B) gecombineerde CAR-score, (C) Codeboek 64, (D) Codeboek 128, (E) Codeboek 256, en (F) Codeboek 512. Groene en rode histogrammen geven respectievelijk normale en afwijkende monsters aan. Klik hier om een grotere versie van deze afbeelding te bekijken.
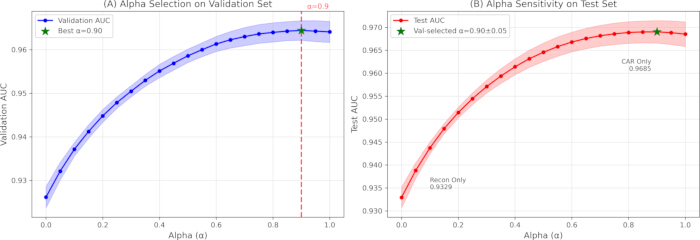
Figuur 9: Gevoeligheidsanalyse van de alfa-parameter (A) Validatie-set AUC gebruikt voor α selectie (B) AUC van testset onder verschillende α waarden. De validatie-geselecteerde α waarden varieerden van 0,85 tot 0,95, met een gemiddelde van 0,90 ± 0,05, in overeenstemming met Tabel 5. De AUC-variatie bleef onder de 0,5% wanneer α varieerde binnen het bereik [0,70; 1,00], wat wijst op een stabiele prestatie over een breed parameterbereik. Klik hier om een grotere versie van deze afbeelding te bekijken.
| Methode | AUC (%) | AP (%) | F1 (%) | Precisie (%) | Terugroepen (%) | Specificiteit (%) | P@R90 (%) |
| CAE | 90.37 ± 0.94 | 98.62 ± 0.18 | 95.34 ± 0.15 | 91.64 ± 0.40 | 99.35 ± 0.22 | 28.14 ± 3.88 | 95.66 ± 0.32 |
| SAE | 90.58 ± 0.94 | 98.66 ± 0.18 | 95.34 ± 0.15 | 91.67 ± 0.40 | 99.32 ± 0.24 | 28.46 ± 3.97 | 95.71 ± 0.30 |
| VAE | 93.60 ± 0.82 | 99.13 ± 0.12 | 95.86 ± 0.19 | 92.81 ± 0.49 | 99.12 ± 0.29 | 39.07 ± 4.70 | 96.94 ± 0.43 |
| MAE | 91.65 ± 2.75 | 98.76 ± 0.50 | 95.61 ± 0.60 | 92.87 ± 1.56 | 98.55 ± 0.55 | 39.74 ± 14.32 | 96.55 ± 0.97 |
| MemAE | 94.97 ± 0.81 | 99.35 ± 0.11 | 95.78 ± 0.33 | 92.82 ± 1.07 | 98.95 ± 0.60 | 39.15 ± 9.99 | 97.57 ± 0.33 |
| PatchSAE | 94.86 ± 0.36 | 99.34 ± 0.05 | 95.39 ± 0.13 | 92.32 ± 0.27 | 98.67 ± 0.12 | 34.91 ± 2.57 | 98.13 ± 0.24 |
| STFPM | 90.23 ± 3.05 | 98.70 ± 0.44 | 94.32 ± 0.21 | 91.90 ± 3.51 | 97.14 ± 3.38 | 29.82 ± 33.53 | 95.93 ± 1.96 |
| DRAEM | 76.34 ± 2.82 | 95.34 ± 0.90 | 94.19 ± 0.07 | 89.39 ± 0.65 | 99.56 ± 0.65 | 6.19 ± 7.09 | 92.69 ± 0.57 |
| PatchCore | 74.64 ± 1.82 | 94.76 ± 0.55 | 94.73 ± 0.05 | 90.52 ± 0.15 | 99.36 ± 0.12 | 17.49 ± 1.54 | 92.54 ± 0.15 |
| RareCode | 96.82 ± 0.23 | 99.59 ± 0.03 | 96.63 ± 0.15 | 94.93 ± 0.67 | 98.40 ± 0.48 | 58.24 ± 5.99 | 98.80 ± 0.10 |
Tabel 1: Vergelijkingsresultaten met basismethoden (5-voudige kruisvalidatie). Prestaties van RareCode en negen basismethoden voor UAD bij detectie op de CRC-dataset. De metrieken omvatten AUC, gemiddelde precisie (AP), recall, specificiteit, F1-score, precisie bij 90% recall (P@R90) en precisie. Alle waarden geven het gemiddelde weer ± SD over 5-voudige cross-validatie. Vetgedrukte waarden geven de beste prestatie aan voor elke metriek.
| Categorie | AUC (%) | AP (%) | F1 (%) | Recall (%) | Specificiteit (%) |
| Kanker | 99.44 ± 0.12 | 99.86 ± 0.03 | 98.34 ± 0.17 | 98.13 ± 0.29 | 94.21 ± 2.22 |
| Ontsteking | 94.30 ± 0.44 | 98.48 ± 0.12 | 93.44 ± 0.29 | 96.55 ± 0.78 | 60.44 ± 4.34 |
Tabel 2: Detectieprestaties per klasse over anomalie-subtypen. Afzonderlijke evaluatie van RareCode's detectieprestaties voor kanker- en ontstekingsmonsters ten opzichte van normale monsters. Per-klasse-metrieken, inclusief AUC, AP, F1-score, recall en specificiteit, werden berekend met behulp van klasse-specifieke optimale drempels.
| Variant | Codeboekconfiguratie | CAR | AUC (%) | AP (%) | F1 (%) | Specificiteit (%) | P@R90 (%) |
| NoCAR |  | | 92.81 ± 0.12 | 99.05 ± 0.02 | 95.30 ± 0.08 | 33.76 ± 3.82 | 96.72 ± 0.12 |
| SingleCodebook | [256] |  | 95.92 ± 0.40 | 99.47 ± 0.05 | 96.25 ± 0.14 | 55.37 ± 6.51 | 98.31 ± 0.43 |
| TwoScales | [128, 512] | | 96.57 ± 0.27 | 99.56 ± 0.04 | 96.45 ± 0.12 | 57.75 ± 4.14 | 98.75 ± 0.12 |
| DrieSchaal | [128, 256, 512] | | 96.36 ± 0.37 | 99.53 ± 0.05 | 96.52 ± 0.17 | 57.99 ± 4.65 | 98.60 ± 0.23 |
| FourScales | [64, 128, 256, 512] | | 96.82 ± 0.23 | 99.59 ± 0.03 | 96.63 ± 0.15 | 58.24 ± 5.99 | 98.80 ± 0.10 |
| FourScales + complex decoder | [64, 128, 256, 512] | | 95.17 ± 0.44 | 99.39 ± 0.06 | 95.32 ± 0.20 | 53.83 ± 21.45 | 98.40 ± 0.37 |
Tabel 3: Resultaten van ablatiestudie. Prestatievergelijking van RareCode-configuraties met progressieve toevoeging van componenten: alleen-reconstructie-basismodel (NoCAR), single-codebook CAR (SingleCodebook) en multi-schaalconfiguraties (TwoScales, ThreeScales, FourScales). Er is ook een extra afbraak van decodercomplexiteit opgenomen met gebruik van de FourScales-configuratie. De gebruikte metrieken zijn AUC, gemiddelde precisie (AP), F1-score, specificiteit en precisie bij 90% herinnering (P@R90).
| Scoretype | Energieverhouding | Cohen's d | AUC (%) |
| Reconstructiefout | 2.623 | 2.006 | 93.31 |
| Gecombineerde CAR | 1.078 | 1.002 | 74.85 |
| Codeboek 64 | 1.109 | 1.207 | 78.79 |
| Codeboek 128 | 1.085 | 1.067 | 76.19 |
| Codeboek 256 | 1.065 | 0.916 | 72.80 |
| Codeboek 512 | 1.064 | 0.833 | 70.38 |
Tabel 4: Analyse op beeldniveau van op lokalisatie gebaseerde responsen. De fout in de gemiddelde beeldreconstructie en de reacties op zeldzaamheid van de codeboeken werden vergeleken tussen normale en afwijkende monsters met behulp van de energieverhouding, Cohen's d, en AUC.
| Vouw | Optimaal α | Val AUC (%) | Test AUC (%) |
| 1 | 0.95 | 96.22 | 96.91 |
| 2 | 0.9 | 96.38 | 96.39 |
| 3 | 0.85 | 96.71 | 96.82 |
| 4 | 0.85 | 96.22 | 96.93 |
| 5 | 0.95 | 96.72 | 97.05 |
| Gemiddelde | 0.90 ± 0.05 | 96.45 ± 0.23 | 96.82 ± 0.23 |
Tabel 5: Optimale alfa-waarden over de verschillende delen. Optimale fusiegewicht alpha bepaald via grid search (stapgrootte 0,05) op validatiesets voor elke cross-validatie-fold, met gemiddelde en SD-statistieken.
Discussie
De resultaten suggereren dat codeboek-activatiepatronen complementaire informatie kunnen bieden ten opzichte van ruimtelijke reconstructiefouten. De verbetering van NoCAR naar het volledige FourScales-model ondersteunt de potentiële bijdrage van CAR-scoring, terwijl de geselecteerde fusiegewichten erop wijzen dat semantische zeldzaamheid een belangrijke rol kan spelen in de uiteindelijke anomaliescore. Een mogelijke verklaring is dat CRC-gerelateerde abnormaliteiten verschillende morfologische schalen kunnen beslaan, van nucleaire atypie tot verstoring van de klierarchitectuur, en daarom baat kunnen hebben bij kenmerkrepresentaties op meerdere granulariteiten14. Het huidige model legt verschillende ruimtelijke omvang vast met 32 × 32 en 64 × 64 patches bij hetzelfde vergrotingsniveau; toekomstige integratie met frameworks voor de verwerking van whole-slide images (WSI) kan hiërarchische analyse op slide-niveau verder ondersteunen39.
Klinisch gezien kan RareCode het best worden beschouwd als een triage-instrument voor pre-screening in plaats van als een autonoom diagnostisch systeem. De hoge recall (98,40%) wijst op een relatief laag risico op het missen van anomale gevallen40, terwijl de matige specificiteit (58,24%) waarschijnlijk de moeilijkheid weerspiegelt om inflammatoire veranderingen te onderscheiden van normaal weefsel in een ongesuperviseerde setting. De hogere kankerspecifieke specificiteit (94,21%) suggereert bovendien dat vals positieven minder frequent voorkomen voor het meest klinisch kritieke subtype. Deze prestatiekenmerken ondersteunen het potentiële gebruik van RareCode als pre-screeningtool voor het prioriteren van gevallen die een deskundige beoordeling vereisen en het stroomlijnen van de pathologische review5,6.
Bevindingen per klasse kunnen de potentiële rol van RareCode bij triage verder ondersteunen. De relatief sterkere prestaties voor kanker dan voor ontsteking kunnen het gevolg zijn van de meer uitgesproken architecturale en cytologische afwijkingen die vaak worden gezien in maligne weefsel, waaronder verlies van polariteit, nucleair pleomorfisme en stromale desmoplasie14,39. In tegenstelling hiermee kunnen inflammatoire veranderingen nauwer overlappen met benigne weefselvariaties, wat gedeeltelijk de lagere ontsteking-specifieke specificiteit zou kunnen verklaren. Daarom moet de algehele specificiteit met voorzichtigheid worden geïnterpreteerd, waarbij kankerdetectie dient als een klinisch belangrijk gebruiksscenario en niet als een definitieve autonome diagnose.
De potentiële foutmodi van RareCode moeten worden geïnterpreteerd in de context van het leerdoel voor één klasse. Omdat het model patronen van normaal weefsel leert in plaats van ziekte-specifieke categorieën, kunnen niet-neoplastische veranderingen zoals regeneratief epitheel, fibrose, necrose of uitgesproken ontsteking ook hoge anomaliescores krijgen. Omgekeerd kunnen subtiele dysplasie of goed gedifferentieerd carcinoom met een bijna normale klierarchitectuur zwakkere responsen veroorzaken. Technische factoren, waaronder variatie in kleuring, weefselplooien, coupesectie-artefacten, defocus en beeldcompressie, kunnen ook de reconstructiefouten en de activatiefrequenties van het codeboek beïnvloeden. Deze overwegingen suggereren dat klinische vertaling kwaliteitscontrole van de beelden, harmonisatie van kleuringen, scanner-bewuste kalibratie en multicenter-validatie zou vereisen39,41.
Reikwijdte van de baseline-vergelijkingen. De experimentele evaluatie in deze studie richt zich op methoden die werken onder vergelijkbare data- en computationele aannames—specifiek methoden die end-to-end getraind kunnen worden met uitsluitend kleinschalige, ongelabelde normale monsters, zonder dat externe pretraining-corpora vereist zijn. Deze reikwijdte omvat de belangrijkste paradigma's in ongesuperviseerde anomaliedetectie: reconstructie-gebaseerd (CAE, VAE, SAE, MAE, PatchSAE), geheugen-geaugmenteerd (MemAE), kennisdistillatie (STFPM), synthetische augmentatie (DRAEM) en pretrained feature matching (PatchCore). Wij erkennen dat twee categorieën methoden niet als directe baselines zijn opgenomen. Ten eerste maken pathologie-specifieke foundation models (UNI, CONCH, CTransPath) gebruik van pretraining op miljoenen gecureerde pathologiebeelden, en hun prestatievoordelen zijn primair toe te schrijven aan de schaal en diversiteit van de pretrainingdata in plaats van aan het mechanisme voor anomaliedetectie; een directe vergelijking zou dus de bijdragen van de pretrainingdata verwarren met de bijdragen van de detectiemethodologie. De suboptimale prestaties van STFPM en PatchCore—die beide gebruikmaken van ImageNet-pretrained backbones—illustreren empirisch de impact van de domeinkloof wanneer algemene pretrained features worden toegepast op histopathologische scenario's, en suggereren dat pathologie-specifieke pretraining deze kloof kan overbruggen. Ten tweede leggen diffusie-gebaseerde anomaliedetectiemethoden, hoewel veelbelovend, een aanzienlijk hogere computationele overhead op tijdens de inferentie (meestal zijn honderden iteratieve denoising-stappen vereist), wat hun toepasbaarheid in high-throughput klinische screeningsworkflows beperkt waarbij verwerkingsefficiëntie een praktische vereiste is. Toekomstig werk zal onderzoeken of het integreren van pathologie-specifieke pretrained encoders in de RareCode-architectuur—ter vervanging van de huidige end-to-end-getrainde encoder—de detectieprestaties verder kan verbeteren terwijl de interpretatievoordelen van het CAR-mechanisme behouden blijven.
Enkele beperkingen moeten worden erkend. Ten eerste was de validatie beperkt tot een dataset van CRC uit één centrum, en is verdere multicentrische evaluatie over verschillende instellingen, scanners en kleuringsprotocollen nodig. Ten tweede, hoewel de kankerspecifieke specificiteit bemoedigend was, bleef de algehele specificiteit beïnvloed door de grens tussen ontsteking en normaal weefsel. Ten derde waren annotaties op pixelniveau door experts niet beschikbaar; daarom konden de Dice-coëfficiënt en IoU niet worden berekend, en was de evaluatie van de lokalisatie beperkt tot kwalitatieve visualisatie en analyse op beeldniveau van geaggregeerde ruimtelijke responsen. Ten vierde zijn formele reader-studies nog steeds nodig om te bepalen of hiërarchische heatmaps de diagnostische nauwkeurigheid of de efficiëntie van de beoordeling kunnen verbeteren. Ten slotte voert RareCode momenteel analyses uit op patch- en beeldniveau, en zou implementatie op WSI-niveau integratie met aanvullende verwerkingsframeworks vereisen39,41,42.
Toekomstig onderzoek zou RareCode moeten evalueren op publieke benchmarks en multicenter cohorten na integratie met WSI-verwerkingsframeworks. Prospectieve lezersstudies kunnen helpen bij het beoordelen van de potentiële impact op de diagnostische nauwkeurigheid, de beoordelingstijd en de interobservatorovereenkomst42. Aanvullende richtingen omvatten het verbeteren van de computationele efficiëntie, het uitbreiden van het model naar multiclass anomalie-subtypering en het integreren van multiple-instance learning voor diagnose op slide-niveau28,39.
Openbaarmakingen
De auteurs verklaren dat zij geen bekende concurrerende financiële belangen of persoonlijke relaties hebben die invloed zouden hebben kunnen uitoefenen op het in dit artikel beschreven werk. Tijdens de voorbereiding van dit werk hebben we ChatGPT gebruikt om de taal en leesbaarheid van het manuscript te verbeteren en om te helpen bij het genereren van code voor datavisualisatie. Na het gebruik van dit instrument hebben we de inhoud waar nodig beoordeeld en bewerkt, en dragen we de volledige verantwoordelijkheid voor het gepubliceerde artikel.
Dankbetuigingen
Dit onderzoek werd ondersteund door het Yong Dai Academician's Workstation (Diagnostic Technology for Autoimmune Diseases) (Wan Ke Science and Technology [2023] No. 317), het Graduate Innovation Fund Project van het Hefei National Research Center for Health Science and Technology Joint Research Center for Occupational Medicine and Health Open Fund (No.OMH-2023-04) en het Clinical and Translational Research Project van de provincie Anhui (No.20242761020132).
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| GeForce RTX 4060 Ti GPU | NVIDIA | N/A | 16 GB VRAM; één GPU gebruikt voor alle experimenten (RRID:SCR_02858) |
| Matplotlib | Matplotlib-ontwikkelteam | Versie 3.8.4 | Datavisualisatie en figuurgeneratie (RRID:SCR_08624) |
| NumPy | NumPy-ontwikkelaars | Versie 1.26.4 | Numerieke informatica en array-bewerkingen (RRID:SCR_0863) |
| pandas | pandas-ontwikkelteam | Versie 2.2.3 | Dataorganisatie en tabulaire resultaatverwerking (RRID:SCR_018214) |
| Kussen | Bijdragers aan de Python Imaging Library / Pillow | Versie 10.3.0 | Afbeeldingladen en preprocessing |
| Python | Python Software Foundation | Versie 3.12.3 | Programmeertaal gebruikt voor modelontwikkeling en data-analyse (RRID:SCR_08394) |
| PyTorch | Meta Platforms, Inc. | Versie 2.7.0+cu18 | Deep learning-framework gebruikt voor modelimplementatie en -training (RRID:SCR_018536) |
| scikit-learn | scikit-learn-ontwikkelaars | Versie 1.4.2 | Kruisvalidatie, train-test splitting en evaluatiemetrieken (RRID:SCR_0257) |
| SciPy | SciPy-ontwikkelaars | Versie 1.13.1 | Statistische analyse (RRID:SCR_08058) |
| torchvision | PyTorch-project | Versie 0.2.0+cu18 | Beeldvoorverwerking en datatransformatie |
| tqdm | tqdm-ontwikkelaars | Versie 4.6.4 | Monitoring van de voortgang van training en evaluatie |
Referenties
- Fan J, Sun Q, Di Y, et al. DIPathMamba: A domain-incremental weakly supervised state space model for pathology image segmentation. Med Image Anal. 2025;103:103563.
- Nan T, Zheng S, Qiao S, et al. Deep learning quantifies pathologists' visual patterns for whole slide image diagnosis. Nat Commun. 2025;16(1):5493.
- Lagogiannis I, Meissen F, Kaissis G, et al. Unsupervised pathology detection: a deep dive into the state of the art. IEEE Trans Med Imaging. 2024;43(1):241-252.
- Tian Y, Liu F, Pang G, et al. Self-supervised pseudo multiclass pre-training for unsupervised anomaly detection and segmentation in medical images. Med Image Anal. 2023;90:102930.
- Metter DM, Colgan TJ, Leung ST, et al. Trends in the US and Canadian pathologist workforces from 2007 to 2017. JAMA Netw Open. 2019;2(5):e194337.
- Shaukat A, Levin TR. Current and future colorectal cancer screening strategies. Nat Rev Gastroenterol Hepatol. 2022;19(8):521-531.
- Ancker JS, Edwards A, Nosal S, et al. Effects of workload, work complexity, and repeated alerts on alert fatigue in a clinical decision support system. BMC Med Inform Decis Mak. 2017;17(1):36.
- Litjens G, Kooi T, Ehteshami Bejnordi B, et al. A survey on deep learning in medical image analysis. Med Image Anal. 2017;42:60-88.
- Stepec D, Skocaj D. Unsupervised detection of cancerous regions in histology imagery using image-to-image translation. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops. 2021:3785-3792.
- Li Y, Lao Q, Kang Q, et al. Self-supervised anomaly detection, staging and segmentation for retinal images. Med Image Anal. 2023;87:102805.
- Hinton GE, Salakhutdinov RR. Reducing the dimensionality of data with neural networks. Science. 2006;313(5786):504-507.
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: Proceedings of the 2nd International Conference on Learning Representations (ICLR). 2014.
- Goodfellow IJ, Pouget-Abadie J, Mirza M, et al. Generative adversarial nets. In: Advances in Neural Information Processing Systems. 2014;27:2672-2680.
- Lu S, Zhang W, Zhao H, et al. Anomaly detection for medical images using heterogeneous auto-encoder. IEEE Trans Image Process. 2024;33:2770-2782.
- Yang Z, Zhang T, Soltani Bozchalooi I, et al. Memory-augmented generative adversarial networks for anomaly detection. IEEE Trans Neural Netw Learn Syst. 2022;33(6):2324-2334.
- Huyan N, Quan D, Zhang X, et al. Unsupervised outlier detection using memory and contrastive learning. IEEE Trans Image Process. 2022;31:6440-6454.
- Jézéquel L, Beaudet J, Histace A, et al. Unified anomaly detection via multi-scale contrasted memory. IEEE Trans Image Process. 2026;35:2802-2815.
- Roth K, Pemula L, Zepeda J, et al. Towards total recall in industrial anomaly detection. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022:14298-14308.
- Defard T, Setkov A, Loesch A, et al. PaDiM: a patch distribution modeling framework for anomaly detection and localization. In: International Conference on Pattern Recognition. Cham: Springer; 2021:475-489.
- Zingman I, Stierstorfer B, Lempp C, et al. Learning image representations for anomaly detection: application to discovery of histological alterations in drug development. Med Image Anal. 2024;92:103067.
- Jiang Y, Cao Y, Shen W. Prototypical learning guided context-aware segmentation network for few-shot anomaly detection. IEEE Trans Neural Netw Learn Syst. 2025;36(7):12016-12026.
- Wang X, Zhao J, Marostica E, et al. A pathology foundation model for cancer diagnosis and prognosis prediction. Nature. 2024;634(8035):970-978.
- Frotscher A, Kapoor J, Wolfers T, et al. Unsupervised anomaly detection in medical imaging using aggregated normative diffusion. Med Image Anal. 2026;109:103895.
- Zeng GQ, Yang YW, Lu KD, et al. Evolutionary adversarial autoencoder for unsupervised anomaly detection of industrial Internet of Things. IEEE Trans Reliab. 2025;74(3):3454-3468.
- Lu KD, Zhang BX, Xu Y, et al. MoARNN-AM: multi-objective automated recurrent neural network with attention mechanism for cyber-attack detection of UAV. IEEE Trans Consum Electron. 2026;72(1):1738-1749.
- van den Oord A, Vinyals O, Kavukcuoglu K. Neural discrete representation learning. In: Advances in Neural Information Processing Systems. 2017;30:6306-6315.
- Ghafourian A, Shui H, Upadhyay D, et al. Targeted collapse regularized autoencoder for anomaly detection: black hole at the center. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10348-10358.
- Gao Z, Mao A, Dong Y, et al. SMMILe enables accurate spatial quantification in digital pathology using multiple-instance learning. Nat Cancer. 2025;6(12):2025-2041.
- Wang X, Liu H, Zhang Y, et al. Joint modeling histology and molecular markers for cancer classification. Med Image Anal. 2025;102:103505.
- Jin H, Shen J, Cui L, et al. Dynamic graph based weakly supervised deep hashing for whole slide image classification and retrieval. Med Image Anal. 2025;101:103468.
- Schmitz R, Madesta F, Nielsen M, et al. Multi-scale fully convolutional neural networks for histopathology image segmentation: from nuclear aberrations to the global tissue architecture. Med Image Anal. 2021;70:101996.
- Masci J, Meier U, Ciresan D, et al. Stacked convolutional auto-encoders for hierarchical feature extraction. In: International Conference on Artificial Neural Networks. Berlin: Springer; 2011:52-59.
- Ng A. Sparse autoencoder. CS294A Lecture Notes. 2011;72:1-19.
- He K, Chen X, Xie S, et al. Masked autoencoders are scalable vision learners. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022:16000-16009.
- Lim H, Choi J, Choo J, et al. Sparse autoencoders reveal selective remapping of visual concepts during adaptation. In: Proceedings of the 13th International Conference on Learning Representations (ICLR). 2025.
- Gong D, Liu L, Le V, et al. Memorizing normality to detect anomaly: memory-augmented deep autoencoder for unsupervised anomaly detection. In: Proceedings of the IEEE/CVF International Conference on Computer Vision. 2019:1705-1714.
- Wang G, Han S, Ding E, et al. Student-teacher feature pyramid matching for anomaly detection. In: Proceedings of the 32nd British Machine Vision Conference (BMVC). 2021.
- Zavrtanik V, Kristan M, Skocaj D. DRAEM: a discriminatively trained reconstruction embedding for surface anomaly detection. In: Proceedings of the IEEE/CVF International Conference on Computer Vision. 2021:8330-8339.
- Niazi MKK, Parwani AV, Gurcan MN. Digital pathology and artificial intelligence. Lancet Oncol. 2019;20(5):e253-e261.
- Raab SS, Grzybicki DM, Janosky JE, et al. Clinical impact and frequency of anatomic pathology errors in cancer diagnoses. Cancer. 2005;104(10):2205-2213.
- Schömig-Markiefka B, Pryalukhin A, Hulla W, et al. Quality control stress test for deep learning-based diagnostic model in digital pathology. Mod Pathol. 2021;34(12):2098-2108.
- Steiner DF, MacDonald R, Liu Y, et al. Impact of deep learning assistance on the histopathologic review of lymph nodes for metastatic breast cancer. Am J Surg Pathol. 2018;42(12):1636-1646.