Dit protocol demonstreert een gestructureerde en controleerbare workflow voor het verwerken van geanonimiseerde gegevens uit vragenlijsten over het welzijn van undergraduate studenten, van de ruwe export en screening van responsen tot schaalscoren, betrouwbaarheidscontroles, regressiediagnostiek, verificatie van figuurbronnen en analytische outputs die klaar zijn voor visualisatie.
Methodenartikel
Een gestructureerde workflow voor het screenen, scoren en visualiseren van vragenlijstgegevens over het welzijn van bachelorstudenten
In dit artikel
Samenvatting
Samenvatting
Vragenlijstonderzoeken worden veelvuldig gebruikt om het welzijn van studenten te onderzoeken, maar de procedurele route van ruwe antwoorden naar analyseerbare variabelen, statistische tabellen en visuele output is vaak onvoldoende gedocumenteerd. Dit protocol demonstreert een gestructureerde en controleerbare workflow voor het verwerken van geanonimiseerde gegevens uit welzijnsvragenlijsten van undergraduate studenten, verzameld met meerdere secties op basis van Likert-type schalen. De workflow begint met ethische goedkeuring, documentatie van toestemming, configuratie van de vragenlijst en export van ruwe data, en gaat vervolgens over in screening van antwoorden, controle op dubbele antwoorden, omgang met ontbrekende gegevens, itemcodering, omgekeerde scoreberekening, betrouwbaarheidsbeoordeling, beschrijvende analyse, correlatieanalyse, contrastieve groepvergelijking, regressiemodellering, diagnostische controle en de voorbereiding van bronnen voor visualisatie. De voorbeeldvragenlijst maakt gebruik van gedocumenteerde en studie-aangepaste schaalsecties gebaseerd op de Depression Anxiety Stress Scales-21, de Tuckman Procrastination Scale, de Psychological Sense of School Membership Scale, literatuur over de meting van higher-order thinking en documentatie van schalen voor subjectief welzijn. Negatieve emoties, academisch uitstelgedrag, schoolverbondenheid, higher-order thinking en subjectief welzijn worden gebruikt als voorbeeldvariabelen op schaalniveau om te laten zien hoe antwoorden op itemniveau kunnen worden omgezet in traceerbare analytische output. Representatieve resultaten omvatten een tabel met de screeningflow, een demografische samenvatting, beschrijvende statistieken en bereikverificatie, schattingen van de interne consistentie, een correlatiematrix, resultaten van contrastieve vergelijkingen, regressiecoëfficiënten, residu- en invloedsdiagnostiek en bronbestanden voor figuren. Het protocol benadrukt vooraf vastgestelde beslisregels, een gekoppelde schaalmap, een screeninglogboek voorafgaand aan de analyse, verificatie van omgekeerde scores en numerieke bronverificatie voor figuren. In plaats van het voorstellen van een nieuwe psychometrische schaal, het valideren van een meetmodel of het vaststellen van causale relaties, biedt deze methode een praktische en controleerbare procedure voor onderzoekers die gegevens over het welzijn van undergraduate studenten uit vragenlijsten moeten screenen, scoren, analyseren en visualiseren. De workflow kan worden aangepast voor gerelateerde vragenlijstonderzoeken wanneer de schaalmap, ethische goedkeuring, scoreregels, drempelwaarden voor antwoordscreening en bronbestanden voor visualisatie vóór de analyse zijn gedefinieerd.
Inleiding
Subjectief welzijn is een belangrijke uitkomst in studentenonderzoek, omdat het weerspiegelt hoe studenten hun leven, emotionele ervaringen, sociale relaties en dagelijks functioneren binnen leeromgevingen evalueren. In het hoger onderwijs is het welzijn van studenten multidimensionaal en beperkt het zich niet enkel tot levenstevredenheid of psychische nood1. Vragenlijstgegevens blijven daarom nuttig wanneer onderzoekers emotionele, gedragsmatige, sociale, cognitieve en met welzijn gerelateerde ervaringen binnen hetzelfde analytische kader willen onderzoeken.
De waarde van vragenlijstgegevens hangt niet alleen af van de geselecteerde constructen, maar ook van de manier waarop ruwe antwoorden worden omgezet in analytische variabelen. Veel studies rapporteren schaalscores, correlatiematrices, groepvergelijkingen of regressiemodellen zonder de tussenliggende beslissingen te tonen die de ruwe gegevens verbinden met de uiteindelijke tabellen en figuren. Ontbrekende antwoorden worden mogelijk inconsistent behandeld, items met omgekeerde scoren kunnen foutief gecodeerd zijn, dubbele inzendingen kunnen in de dataset blijven staan en onoplettende antwoorden kunnen als geldige observaties worden beschouwd. Beslissingen over ontbrekende gegevens moeten daarom worden gepland, gedocumenteerd en gerapporteerd, in plaats van te worden behandeld als een onzichtbare post hoc-stap2. Gegevens uit online vragenlijsten vereisen daarnaast expliciete regels voor antwoordkwaliteit, omdat snelheid (speeding), straight-lining, inconsistente antwoorden en andere patronen van geringe inspanning de descriptieve statistieken, betrouwbaarheidsschattingen en geobserveerde associaties kunnen vervormen3.
De nieuwheid van dit protocol ligt in het gekoppelde auditspoor van de ruwe export van de vragenlijst tot de uiteindelijke statistische en visuele resultaten. Specifiek voegt de workflow een voltooide schaalmap, een screeningslogboek voor de pre-analyse, een controlepunt voor omgekeerde scoren, een logboek voor scoreverificatie, numerieke bronverificatie voor figuren en een auditspoor toe dat elke tabel of figuur koppelt aan het bronbestand. Dit onderscheidt de methode van standaardpraktijken voor het opschonen van enquêtegegevens, schaalscoring, betrouwbaarheidstests of visualisatie. In plaats van enkel te vermelden dat de gegevens van de vragenlijst zijn opgeschoond en geanalyseerd, specificeert het protocol welk bestand is vergrendeld, welk bestand is gescreend, welke regels zijn toegepast, welke schaalscores zijn gegenereerd en welke geverifieerde numerieke tabel is gebruikt om elke visuele weergave te creëren.
De workflow wordt gedemonstreerd met geanonimiseerde vragenlijstgegevens van studenten die vijf variabelen op schaalniveau bevatten: negatieve emotie, academische uitstelgedrag, schoolgebondenheid, hoger-orde denken en subjectief welzijn. Deze constructen zijn geselecteerd om emotionele, gedragsmatige, schoolcontextuele, cognitieve en resultaatgerichte voorbeelden te bieden binnen één gestructureerde en controleerbare workflow. Academisch uitstelgedrag is in verband gebracht met latere mentale gezondheidsproblemen bij universiteitsstudenten, waaronder depressie, angst en stressgerelateerde uitkomsten4. Schoolgebondenheid en subjectief welzijn zijn onder studentenpopulaties ook nauw met elkaar verbonden, wat de inclusie van maatstaven voor gebondenheid en welzijn binnen hetzelfde raamwerk voor vragenlijstverwerking ondersteunt5. In dit protocol worden deze constructen echter gebruikt om de workflow te demonstreren en niet om een causaal psychologisch model vast te stellen.
Een centraal kenmerk van het protocol is de scheiding van dataverwerkingsbeslissingen en de inhoudelijke interpretatie. De schaalmap wordt opgesteld vóór de analyse, de criteria voor de kwaliteit van de responsen worden vastgesteld vóór de scoreberekening van de schaal, de verificatie van de omgekeerde scoren wordt voltooid vóór de statistische toetsing, en figuren worden pas gegenereerd nadat de bijbehorende numerieke brontabellen zijn gecontroleerd. Deze volgorde is belangrijk omdat Likert-type responsschalen een zorgvuldige afstemming vereisen tussen de formulering van de items, de responshulpmiddelen, de scorerichting en de statistische behandeling6. Het protocol geeft daarnaast prioriteit aan transparante preprocessering en scoreverificatie boven modelcomplexiteit. Predictieve of multivariabele modellen kunnen nuttig zijn in studentenonderzoek7, en grafische samenvattingen kunnen de interpretatie verbeteren mits ze gekoppeld blijven aan geverifieerde numerieke matrices8, maar beide zijn afhankelijk van een transparante voorbereiding van de inputvariabelen. Om deze reden gebruikt de workflow correlatieanalyse, contrastieve groepvergelijking, regressiemodellering, diagnostische controle en visualisatie als voorbeeldmodules in plaats van als verplichte inhoudelijke claims.
Dit protocol is bedoeld voor onderzoekers die een praktische workflow nodig hebben voor het verwerken van vragenlijstgegevens over het welzijn van geanonimiseerde studenten. Het is geschikt wanneer antwoorden op vragenlijstitems worden geëxporteerd vanuit een online platform, schaalvariabelen berekend moeten worden op basis van Likert-type items, en het doel is om transparante beschrijvende, correlationele, groepvergelijkende, regressie- en diagnostische resultaten te genereren die klaar zijn voor visualisatie. Het is niet ontworpen om causale relaties vast te stellen, nieuwe schalen te valideren, confirmatieve factoranalyse te vervangen, tests voor meetinvariantie te vervangen of als alternatief te dienen voor item-responsmodellering of latente-variabelenmodellering. De bijdrage is procedureel: het maakt het pad van de vragenlijstgegevens naar de gerapporteerde tabellen en figuren zichtbaar, reproduceerbaar en controleerbaar. Deze focus is consistent met huidige zorgen over de kwaliteit van online enquêtegegevens9, regressie- en invloedscontroles10 en controleerbare analyseworkflows op basis van vragenlijsten11.
Protocol
Deze studie met menselijke deelnemers is beoordeeld en goedgekeurd door de Ethiekcommissie van het College of Aeronautics, Guizhou Open University (Goedkeuringsnr. GZOU-EDU-2024-015). De commissie heeft vastgesteld dat de studie in aanmerking kwam voor een ethische vrijstelling, omdat er gebruik werd gemaakt van anonieme, vrijwillige vragenlijstprocedures en er niet meer dan een minimaal risico voor de deelnemers bestond. Alle deelnemers gaven elektronische geïnformeerde toestemming voordat zij de vragenlijst invulden en konden op elk moment stoppen met antwoorden zonder sancties. Omdat verschillende items betrekking hadden op negatieve emoties, stress, eenzaamheid, hulpeloosheid, ontevredenheid of gerelateerde welzijnservaringen, bevatten de toestemmingspagina en de laatste pagina van de vragenlijst contactgegevens van de onderzoeker en de instelling voor deelnemers die ongemak ervoeren. De dataset die in dit protocol is gebruikt, werd geanonimiseerd vóór screening, scoring, analyse en visualisatie. De volledige vragenlijst is beschikbaar als Aanvullend Bestand 1.
1. Bereid de vragenlijst, de ethische documentatie en de workflow-artefacten voor
- Definieer de in aanmerking komende populatie, de studieomgeving, de constructen van de vragenlijst en de geplande analytische resultaten voordat de vragenlijst wordt geprogrammeerd.
- Stel een ethische aanvraag op waarin de doelpopulatie, het wervingskanaal, de inhoud van de vragenlijst, de geschatte voltooiingstijd, de bescherming van de anonimiteit, de gegevensopslag, de procedure voor intrekking, informatie voor deelnemersondersteuning en de geplande analyses worden beschreven.
- Sla het document van ethische goedkeuring of vrijstelling, de formulering van de toestemming, de wervingstekst, de versie van de vragenlijst, de informatie voor deelnemersondersteuning en de geplande workflow op in de projectmap voordat de gegevensverzameling begint.
- Definieer de doelpopulatie als fulltime bachelorstudenten die ten minste 18 jaar oud zijn, momenteel ingeschreven staan bij het hoger onderwijs, in staat zijn de vragenlijst te begrijpen en in staat zijn geïnformeerde toestemming te geven.
- Definieer de exclusiecriteria vóór de werving. Sluit respondenten uit die geen toestemming geven, niet voldoen aan de definitie van de doelpopulatie, dubbele antwoorden indienen, de drempelwaarde voor ontbrekende gegevens overschrijden of voldoen aan de gecombineerde criteria voor ongeldige antwoorden zoals beschreven in stap 1.4.
- Plaats de verklaring van geïnformeerde toestemming aan het begin van de vragenlijst. Vermeld het doel van de studie, het vrijwillige karakter van de deelname, de geschatte voltooiingstijd van 12 min, de bescherming van de anonimiteit, het recht op intrekking, het gegevensgebruiksplan, de contactgegevens van de onderzoeker en de contactgegevens voor ondersteuning.
- Verzamel geen direct identificeerbare informatie, waaronder studentenidentificatienummers, nationale identificatienummers, mobiele telefoonnummers, persoonlijke e-mailadressen, studentenadres of andere persoonlijke identificatiekenmerken.
- Rangschik de vragenlijst in deze volgorde: geïnformeerde toestemming, demografische informatie, items voor negatieve emoties, items voor academische uitstelgedrag, items voor schoolgebondenheid, items voor hoger-orde denken en items voor subjectief welzijn.
- Selecteer de broninstrumenten voordat de vragenlijst wordt geprogrammeerd. In dit protocol werd negatieve emotie beoordeeld met de 21-item Depression Anxiety Stress Scales-21, academisch uitstelgedrag met de 16-item Tuckman Procrastination Scale, schoolgebondenheid met de 18-item Psychological Sense of School Membership Scale, hoger-orde denken met een set van 20 items voor hoger-orde denken aangepast uit gepubliceerde literatuur over de meting van hoger-orde denken, en subjectief welzijn met een 20-item schaal voor subjectief welzijn voor onderzoek naar studenten in het hoger onderwijs12,13,14,15,16.
- Stel een vastgelegde schaalmap op voordat de vragenlijst wordt geprogrammeerd. Neem de naam van het construct, de oorspronkelijke naam van de schaal, de oorspronkelijke citatie, de taalversie, de status van toestemming of autorisatie, de vertaal- of adaptatieprocedure, de itemcode, de formulering van het item, het antwoorbereik, de antwoordankers, de score-richting, de status van omgekeerd gescoorde items, de uiteindelijke variabele op schaalniveau en de score-regel op.
- Beschrijf een itemset alleen als een gevalideerde schaal wanneer het broninstrument, de citatie, het validatiebewijs en de adaptatie- of vertaalstatus zijn gedocumenteerd. Identificeer elke door de auteur ontwikkelde of studiespecifieke itemset in Tabel 1 en Aanvullend bestand 1.
- Leg het meetkader vast voordat de gegevensverzameling begint. Voltooi voor vertaalde of aangepaste instrumenten de vertaling, review, afstemming en pilotcontrole voordat de werving begint.
- Bereid een workflow-auditpakket voor dat het vastgelegde vragenlijstbestand, de schaalmap, de checklist voor export van ruwe gegevens, het screeningslogboek, het scoreverificatielogboek, het analyselogboek, het sjabloon voor de figuurbronnentabel en het analysesyntax- of scriptbestand bevat.
- Gebruik versienummers in de bestandsnamen voor alle workflow-artefacten.
- Definieer de vereiste kolommen voor elk auditbestand.
- Het screeningslogboek bevat record-ID, screeningscriterium, vlagstatus, exclusiestatus, reden voor exclusie, beslisdatum en initialen van de beoordelaar.
- De schaalmap bevat de naam van het construct, de bron van de schaal, de itemcode, de formulering van het item, het antwoorbereik, de antwoordankers, de status van omgekeerde scoring, de uiteindelijke variabelenaam, de score-regel en de status van toestemming of adaptatie.
- Het scoreverificatielogboek bevat de itemcode, het oorspronkelijke waardenbereik, het recoderede waardenbereik, de formule voor omgekeerde scoring, het resultaat van de bereikcontrole, de status van discrepantie, de gemaakte correctie en de datum van correctie.
- De figuurbronnentabel bevat het figuurnummer, het paneelnummer, de brontabel, de uitgezette variabelen, de weergegeven statistiek, de steekproefgrootte en de verificatiestatus.
- Definieer de analytische workflow voordat de vragenlijst wordt geprogrammeerd: toediening van de enquête, export van ruwe gegevens, screening van antwoorden, scoring van schalen, betrouwbaarheidsbeoordeling, beschrijvende analyse, correlatieanalyse, vergelijking van hoge-lage groepen, regressiemodellering, diagnostische controles en voorbereiding van visualisatie17.
- Structureer het protocol rond beslissingen, operaties en verificatieresultaten in plaats van softwaremenupaden.
- Stel workflow-bronnen beschikbaar wanneer dit is toegestaan door institutionele richtlijnen en tijdschriftbeleid, waaronder het vragenlijstbestand, de schaalmap, het sjabloon voor het screeningslogboek, het sjabloon voor het scorelogboek, het analysesyntax- of scriptbestand en de figuurbronnentabellen.
OPMERKING: Figuur 1 toont de route van de voorbereiding van de vragenlijst naar de export van ruwe gegevens, screening van antwoorden, scoring van schalen, statistische analyse, diagnostische controles en visualisatie-output. Tabel 1 rapporteert het broninstrument, het aantal items, het antwoorbereik, het scorekader, de regel voor omgekeerde scoring, de status van toestemming of adaptatie en de uiteindelijke variabele op schaalniveau voor elk construct.
2. Configureer en verspreid de vragenlijst
- Bevestig dat het platform voor de vragenlijst consent gating, verplichte items, controle op dubbele indieningen, timestamp-registratie en registratie van de responstijd ondersteunt.
- Maak de vragenlijst aan met behulp van het online enquêteplatform dat is vermeld in de Tabel met Materialen. Programmeer de vragenlijst volgens de vastgestelde schaalmap.
- Vergelijk de geprogrammeerde vragenlijst item voor item met de vastgestelde schaalmap voordat de enquête-link wordt vrijgegeven. Noteer eventuele correcties in het studielogboek.
- Stel het item voor geïnformeerde toestemming in als het eerste verplichte item. Beëindig de vragenlijst automatisch wanneer een deelnemer selecteert: "Ik ga niet akkoord met deelname."
- Programmeer de secties voor demografische gegevens en psychologische schalen volgens de volgorde die is vastgelegd in Stap 1.8. Gebruik itemcodes die overeenkomen met de schaalmap.
- Stel items van de psychologische schaal alleen als verplicht in wanneer dit is toegestaan door de ethische goedkeuring of vrijstelling en wanneer deelnemers zich zonder sancties kunnen terugtrekken. Als geforceerde antwoorden niet zijn toegestaan, leg dan de regel voor ontbrekende gegevens vast vóór de gegevensverzameling.
- Toon de responsankers vóór elke schaalsectie en houd de ankers consistent binnen elke schaal18.
- Schakel herhaalde indieningen uit wanneer het enquêteplatform deze functie biedt. Bewaar alle anonieme apparaat-, browser-, platform- of indieningsidentificatoren die nodig zijn voor de controle op dubbele antwoorden.
- Schakel de automatische registratie van de indieningstijd en de voltooiingsduur in.
- Stel de openingsperiode van de vragenlijst in op 7 kalenderdagen, of gebruik het verzamelvenster dat is goedgekeurd door de ethische commissie.
- Verstuur de link naar de vragenlijst via het goedgekeurde institutionele wervingskanaal. Geef dezelfde schriftelijke instructies aan alle deelnemers.
- Sluit de vragenlijst nadat het vooraf gespecificeerde verzamelvenster is beëindigd.
OPMERKING: Bewaar de wervingstekst, de link naar de vragenlijst, de openings- en sluitingsdata, de platforminstellingen, de toestemmingstekst, de definitieve versie van de vragenlijst en de exportinstellingen van het platform in het studielogboek.
3. Exporteer en beveilig de ruwe gegevens
- Exporteer de ingevulde vragenlijstresponses onmiddellijk na het sluiten van het verzamelvenster als een spreadsheetbestand.
- Sla het eerste geëxporteerde bestand op als de vergrendelde ruwe dataset. Bewerk dit bestand niet.
- Maak één werkkopie aan voor screening, scoring en analyse. Benoem het bestand met de datum, het versienummer en de projectidentificatie.
- Bevestig dat het geëxporteerde bestand één rij per respondent bevat en één kolom per demografische variabele, vragenlijstitem, tijdstempelvariabele, platformvariabele of afgeleid platformveld.
- Sla de vergrendelde ruwe dataset, de werkkopie, de schaalmatrix, het vragenlijstbestand, het studielogboek, het screeningslogboek, het scoringsverificatielogboek, het analyselogboek, de figuur-brontabellen en het syntax- of scriptbestand op in een wachtwoordbeveiligde projectmap.
- Controleer of de dataset geen direct identificeerbare informatie bevat. Verwijder elk onverwacht identificatieveld uit de werkkopie vóór de analyse en noteer de veldnaam, de reden voor verwijdering, de datum van verwijdering en de verantwoordelijke reviewer in het studielogboek.
- Controleer de indirecte identificeerbaarheid voordat gegevens op deelnemerniveau worden gedeeld of gepubliceerd. Beoordeel kleine demografische cellen die zijn ontstaan door combinaties van geslacht, leeftijd, jaarniveau, instellingscategorie en academische studierichting. Als een cel minder dan vijf respondenten bevat, combineer dan categorieën, onderdruk de cel of lever alleen geaggregeerde gegevens.
- Noteer de status van de gegevensbeschikbaarheid in het studielogboek, inclusief of gegevens op deelnemerniveau beschikbaar zijn, beperkt zijn vanwege ethische of privacyvereisten, of zijn vervangen door een geaggregeerde workflowdataset.
- Maak een screeningslogboek aan vóór de gegevensopschoning. Noteer de ruwe steekproefgrootte, het screeningscriterium, het aantal gemarkeerde records, het aantal verwijderde records, het aantal behouden records, de reden voor uitsluiting, de beslisdatum en de initialen van de reviewer.
- Maak een analyse-tracebestand aan vóór de statistische analyse. Noteer de softwarenaam, softwareversie, het besturingssysteem, de bestandsnamen, de gegevensversie, de script- of syntaxversie en de datum van elke analyserun.
OPMERKING: Gebruik de vergrendelde ruwe dataset uitsluitend voor verificatie. Voer alle screening, scoring en analyse uit met de werkkopie.
4. Screen responsen en stel de analytische dataset samen
- Pas vooraf vastgestelde uitsluitings- en kwaliteitscontroleregels toe voordat u enige score op schaalniveau berekent.
- Pas de screeningsregels toe op de werkkopie in deze volgorde: toestemmingsstatus, geschiktheid, dubbele indieningen, ontbrekende gegevens, responstijd, rechtlijnig antwoorden (straight-lining), waarden buiten het bereik en gecombineerde indicatoren voor responskwaliteit.
- Leg na elke screeningsoperatie het aantal gemarkeerde, verwijderde en behouden records vast in het screeningslogboek. Overschrijf eerdere versies van het werkbestand niet.
- Verwijder alle records waarin het item voor geïnformeerde toestemming is gemarkeerd als "Nee" of onbeantwoord is gelaten.
- Verwijder alle records die niet voldoen aan de inclusiecriteria zoals gedefinieerd in stap 1.4.
- Screen op dubbele indieningen met behulp van anonieme responsidentificatoren, indieningstijd, vlaggen voor dubbele indieningen van het platform en herhaalde responspatronen.
- Behoud de eerste volledige indiening wanneer dubbele vermeldingen worden gedetecteerd, tenzij er een gedocumenteerde reden is om een latere volledige respons te behouden.
- Corrigeer alle regels voor responskwaliteit voordat de schaalscores worden berekend. Tabel 2 vat de uitsluitingsdrempels, markeringsdrempels, rationale, literatuurondersteuning en het plan voor sensitiviteitsanalyse samen dat in de workflow is gebruikt.
- Screen op ontbrekende gegevens. Verwijder een respondent wanneer meer dan 20% van alle schaalitems ontbreekt. Vervang een geïsoleerd ontbrekend item alleen door de gemiddelde score van de respondent voor dezelfde schaal wanneer ten minste 80% van die schaal is ingevuld. Imputeer geen demografische variabelen, tenzij de variabele in geen enkele analyse wordt gebruikt.
- Registreer het aantal respondenten dat is uitgesloten vanwege meer dan 20% ontbrekende schaalitems en het aantal dat binnen-schaal gemiddelde imputatie heeft ontvangen. In de huidige dataset werden 4 respondenten uitgesloten vanwege meer dan 20% ontbrekende schaalitems, en 21 respondenten ontvingen binnen-schaal gemiddelde imputatie voor 37 geïsoleerde ontbrekende items.
- Screen op responstijd. Markeer responsen die in minder dan 180 s zijn voltooid. Behandel deze waarde als een vlag voor te snel antwoorden (speeding) in plaats van als een automatische uitsluitingsregel.
- Screen op rechtlijnige responsen. Markeer een respons wanneer dezelfde optie is geselecteerd voor meer dan 90% van alle Likert-schaalitems. Behandel deze waarde als een vlag voor responspatronen in plaats van als een automatische uitsluitingsregel.
- Screen op aanvullende indicatoren voor lage inzet, waaronder bewijs van dubbele indieningen, onmogelijke tijdstempels, herhaalde responsstrings over verschillende indieningen of conflicten tussen platformmetadata en de inhoud van de vragenlijst.
- Verwijder een gemarkeerde respons alleen wanneer ten minste twee kwaliteitscontrole-indicatoren wijzen op ongeldig antwoorden, zoals een extreem korte voltooiingstijd gecombineerd met rechtlijnig antwoorden, bewijs van dubbele indiening of onmogelijke platformmetadata19.
- Registreer alle gemarkeerde records, zelfs wanneer ze behouden blijven. In de huidige dataset werden 19 responsen gemarkeerd voor een voltooiingsduur < 180 s, 8 responsen gemarkeerd voor >90% rechtlijnig antwoorden, en 13 records uitgesloten omdat ze voldeden aan twee of meer indicatoren voor responskwaliteit.
- Screen op waarden buiten het bereik. Bevestig dat items voor negatieve emoties binnen 1–4 vallen, items voor academisch uitstelgedrag, schoolgebondenheid en hoger-orde denken binnen 1–5 vallen, en items voor subjectief welzijn binnen 1–6 vallen.
- Correcteer een waarde alleen wanneer de oorspronkelijke export duidelijk een opmaakfout vertoont. Wijzig geldige psychologische scores niet omdat ze ongebruikelijk hoog of laag lijken.
- Genereer een tabel met de screeningsstroom waarin de ingediende vragenlijsten, uitsluitingen op basis van toestemming en geschiktheid, uitsluitingen van dubbelen, uitsluitingen vanwege ontbrekende gegevens, vlaggen voor responskwaliteit, gecombineerde kwaliteitscontrole-uitsluitingen, imputaties van geïsoleerde items, behouden analytische gevallen en de uiteindelijke analytische steekproefomvang worden gerapporteerd.
- Vul de tabel met de screeningsstroom in met behulp van het vergrendelde screeningslogboek en bewaar een geëxporteerd auditrecord van de screeningsbeslissingen. In de huidige dataset was de screeningsstroom als volgt: ingediende vragenlijsten, n = 448; uitsluitingen wegens toestemming of geschiktheid, n = 6; verwijderde dubbele indieningen, n = 5; records uitgesloten vanwege >20% ontbrekende schaalitems, n = 4; records uitgesloten vanwege twee of meer indicatoren voor responskwaliteit, n = 13; uiteindelijke analytische dataset, n = 420.
- Sla de behouden records op als de analytische dataset. Gebruik een nieuwe versiebeheerde bestandsnaam en bewaar het screeningslogboek samen met de analytische dataset.
OPMERKING: Behoud geldige extreme scores, tenzij er sprake is van een gedocumenteerd probleem met de responskwaliteit.
5. Score de psychologische schalen
- Zet antwoorden op itemniveau pas om in variabelen op schaalniveau nadat de screening van de antwoorden is voltooid en de analytische dataset is opgeslagen.
- Codeer alle Likert-type items volgens de antwoordcategorieën in de vastgelegde vragenlijst en de score-regels in de schaalmap.
- Laat de oorspronkelijke itemvariabelen ongewijzigd. Maak afzonderlijke afgeleide variabelen aan voor gecodeerde of omgepoleerde items.
- Score elke schaal volgens de vastgelegde schaalmap en het bijbehorende broninstrument of scorehandboek.
- Voer de ompoling uit voor de aangewezen items voor subjectief welzijn voordat de score voor subjectief welzijn wordt berekend. Voor de antwoordschaal 1–6 wordt elk omgepoleerd item berekend als 7 minus de oorspronkelijke score; voeg _R toe aan de naam van de afgeleide variabele.
- Gebruik de omgepoleerde variabelen, en niet de oorspronkelijke variabelen, bij het berekenen van het subjectieve welzijn.
- Bereken elke score op schaalniveau als het gemiddelde van de behouden items: negatieve emotie, academische procrastinatie, schoolverbondenheid, hoger-orde denken en subjectief welzijn.
- Benoem de uiteindelijke variabelen op schaalniveau als Negative emotion, Academic procrastination, School belongingness, Higher-order thinking en Subjective well-being.
- Verifieer de minimum- en maximumwaarde van elke variabele op schaalniveau aan de hand van het theoretische antwoordbereik. Controleer de codering, de ompoling en de behandeling van ontbrekende waarden opnieuw als een score buiten het verwachte bereik valt.
- Verifieer de richting van elke schaal aan de hand van de schaalmap vóór de inferentiële analyse. Hogere scores moeten de beoogde richting van het construct weerspiegelen.
- Voer een audit van de ompoling uit vóór de analyse. Herbereken de omgepoleerde items voor een willekeurige subset van records of voor alle omgepoleerde items indien haalbaar, en noteer het resultaat van de audit in het logboek voor scoreverificatie.
- Indien er een scorefout wordt gedetecteerd, corrigeer dan de afgeleide variabele, genereer de betreffende schaalscore opnieuw, werk het logboek voor scoreverificatie bij en voer alle daaropvolgende analyses en figuurbronstabellen opnieuw uit op basis van de gecorrigeerde analytische dataset.
OPMERKING: Beschouw ompoling en bereikverificatie als vereiste controlepunten vóór correlatieanalyse, groepvergelijking, regressiemodellering of visualisatie.
6. Beoordeel de interne consistentie en beschrijvende eigenschappen
- Bereken de interne consistentie, gecorrigeerde item-totaalcorrelaties en beschrijvende statistieken voor elke schaal met behulp van de itemvariabelen die zijn gedefinieerd in de vergrendelde schaalmap.
- Noteer de Cronbach's alpha, het itemnummer, de geldige steekproefgrootte, de gecorrigeerde item-totaalcorrelaties en de alpha-bij-item-verwijdering-waarden voor elke schaal.
- Gebruik een Cronbach's alpha van 0,70 als de minimale acceptabele betrouwbaarheidsdrempel voor deze workflow. Controleer voordat u een item verwijdert de bewoording van het item, de scorerichting, de omgekeerde score, de uitlijning met het construct en de documentatie van het broninstrument20.
- Bereken McDonald's omega als aanvullende betrouwbaarheidsschatting wanneer de analyseomgeving dit ondersteunt. Rapporteer omega samen met Cronbach's alpha wanneer de twee schattingen leiden tot verschillende interpretaties van de betrouwbaarheid.
- Inspecteer elk item met een negatieve of zeer lage gecorrigeerde item-totaalcorrelatie voordat verwijdering wordt overwogen. Behandel dit in eerste instantie als een mogelijk probleem met de codering, de omgekeerde score of de uitlijning met het construct.
- Verwijder een item niet enkel om de Cronbach's alpha te verhogen. Het verwijderen van een item moet worden gerechtvaardigd door de scorehandleiding, de bewoording van het item, de gecorrigeerde item-totaalcorrelatie, de conceptuele passing en gedocumenteerde scoreverificatie.
- Bereken beschrijvende statistieken voor alle vijf de variabelen op schaalniveau, inclusief het gemiddelde, de standaarddeviatie, het minimum, het maximum, de scheefheid (skewness) en de kurtosis.
- Controleer op vloer- of plafondeffecten door het aandeel respondenten bij de minimale en maximale mogelijke scores voor elke schaal te noteren.
- Noteer de betrouwbaarheidsschattingen, item-totaaldiagnostiek, beschrijvende statistieken en alle scorebeslissingen in het analyselogboek.
OPMERKING: Cronbach's alpha wordt gebruikt als betrouwbaarheidscontrole, niet als een volledige psychometrische validatieprocedure. Wanneer een formele evaluatie van de meting vereist is, vul deze workflow dan aan met McDonald's omega, confirmatieve factoranalyse, toetsing van meetinvariantie, item-responsmodellering of andere methoden voor latente variabelen.
7. Voer correlatieanalyse uit
- Gebruik de vijf geverifieerde variabelen op schaalniveau: negatieve emotie, academisch uitstelgedrag, schoolverbondenheid, hoger-orde denken en subjectief welbevinden.
- Inspecteer de distributies en bivariante spreidingsdiagrammen voor elk paar variabelen op schaalniveau voordat de Pearson-correlaties worden berekend.
- Beoordeel of de variabelen een bijna continue scorevariatie, ernstige scheefheid, niet-lineaire relaties of invloedrijke uitschieterpatronen vertonen.
- Bereken de Pearson-correlatiecoëfficiënten en tweezijdige p-waarden voor alle paren variabelen op schaalniveau wanneer de aannames acceptabel zijn voor descriptieve associatieanalyse.
- Noteer de correlatiecoëfficiënt, de p-waarde, de steekproefomvang en de richting van de associatie voor elk variabelenpaar.
- Rapporteer de correlatiecoëfficiënten tot op drie decimalen.
- Vergelijk de richting van elke coëfficiënt met de schaalkaart. Controleer de itemscore opnieuw als een coëfficiënt in strijd is met de beoogde richting van het construct.
- Sla de geverifieerde correlatiematrix op als de numerieke brontabel voor de correlatie-heatmap in de sectie Representatieve Resultaten.
- Wanneer de distributies duidelijk scheef zijn, gevoeligheid voor ordinaal-schaalniveaus vereist is, of wanneer spreidingsdiagrammen monotone maar niet-lineaire associaties suggereren, herhaal dan de analyse met de Spearman-correlatie en vergelijk de richting en relatieve grootte van de associaties.
- Noteer of de Pearson- en Spearman-resultaten tot dezelfde inhoudelijke interpretatie hebben geleid.
OPMERKING: Gebruik de correlatieanalyse zowel als een descriptieve controle van de associatie als een audit van de score-richting.
8. Maak groepen met een hoog en laag subjectief welzijn aan
- Gebruik de geschoonde en gescoorde analytische dataset. Keer voor de groepsconstructie niet terug naar de ruwe export.
- Gebruik de continue score voor subjectief welbevinden als de primaire uitkomstmaat voor regressiemodellering. Gebruik de hoog-laag groepering uitsluitend voor contrastieve profielvergelijking.
- Sorteer de respondenten op subjectief welbevinden van hoog naar laag.
- Pas de vooraf vastgestelde regel van 27% voor extremegroepen toe om de groepen met hoog en laag subjectief welbevinden te definiëren. Documenteer de rationale voor deze drempelwaarde in Tabel 2 en in het analyselogboek.
- Wijs respondenten in de bovenste 27% toe aan de groep met hoog subjectief welbevinden en respondenten in de onderste 27% aan de groep met laag subjectief welbevinden.
- Behoud de middelste 46% in de volledige analytische dataset voor beschrijvende statistiek, correlatieanalyse, geslachtvergelijking en regressiemodellering, maar sluit deze gevallen uit van het hoog-laag contrast.
- Maak een groeperingsvariabele aan met de naam Subjectieve welbevindingsgroep. Codeer de bovenste groep als Hoog, de onderste groep als Laag en de overige respondenten als Middel.
- Bevestig dat de hoge en lage groepen het beoogde aantal gevallen bevatten. Indien er gelijke scores voorkomen op de grens van 27%, pas dan de vooraf vastgestelde regel voor het omgaan met gelijke scores toe en leg deze beslissing vast in het analyselogboek.
- Voer een sensitiviteitscontrole uit wanneer de grens van 27% leidt tot een onstabiele groepssamenstelling vanwege gelijke scores of een kleine steekproefomvang. Gebruik een alternatieve vooraf vastgestelde regel, zoals tertielgroepering, en rapporteer of de interpretatie ongewijzigd blijft.
OPMERKING: De hoog-laag groepering is een beschrijvende contrastprocedure. Deze mag de continue score voor subjectief welbevinden in het primaire regressiemodel niet vervangen.
9. Vergelijking tussen groepen met een hoog en laag subjectief welzijn
- Filter de analytische dataset om alleen respondenten te behouden die zijn gecodeerd als Hoog of Laag in de groeperingsvariabele voor subjectief welzijn.
- Vergelijk de hoge en lage groepen op negatieve emotie, academische uitstelgedrag, schoolverbondenheid en hoger-orde denken.
- Inspecteer vóór de groepvergelijking de groepsspecifieke verdelingen, steekproefgroottes en variantie-gelijkheid voor elke variabele.
- Gebruik een t-toets voor onafhankelijke steekproeven wanneer de aannames over verdeling en variantie acceptabel zijn. Gebruik de t-toets van Welch wanneer de aanname van variantie-gelijkheid niet wordt ondersteund.
- Noteer groepsgemiddelden, standaarddeviaties, gemiddelde verschillen, t-waarden, vrijheidsgraden, p-waarden en 95% betrouwbaarheidsintervallen.
- Bereken Cohen's d voor elk groepsverschil en interpreteer de effectgrootte samen met de p-waarde.
- Inspecteer of de richting van elk groepsverschil consistent is met de constructdefinities en de correlatiematrix.
- Sla de geverifieerde groepvergelijkingstabel op als de numerieke bron voor elke visualisatie van de groepvergelijking.
- Rapporteer deze analyse als een contrast tussen extreme profielen van subjectief welzijn.
OPMERKING: Interpreteer de hoog-laagvergelijking niet als causaal bewijs.
10. Onderzoek sekseverschillen
- Verwijder het high-low groepsfilter en keer terug naar de volledige analytische dataset.
- Gebruik geslacht als beschrijvende groeperingsvariabele in plaats van als causale blootstelling.
- Vergelijk vrouwelijke en mannelijke respondenten op negatieve emotie, academische uitstelgedrag, schoolverbondenheid, hoger-orde denken en subjectief welzijn.
- Inspecteer vóór de vergelijking de groepsspecifieke steekproefgroottes, ontbrekende gegevens, distributies en variantiegelijkheid.
- Gebruik een t-toets voor onafhankelijke steekproeven wanneer de aannames acceptabel zijn. Gebruik de t-toets van Welch wanneer de aanname van variantiegelijkheid niet wordt ondersteund.
- Noteer groepsgemiddelden, standaarddeviaties, gemiddelde verschillen, t-waarden, vrijheidsgraden, p-waarden, 95% betrouwbaarheidsintervallen en Cohen's d-waarden.
- Interpreteer geslachtsverschillen beschrijvend en rapporteer effectgroottes met p-waarden.
- Gebruik de resultaten van de geslachtsvergelijking niet om post hoc uitsluiting, schaalmodificatie of causale interpretatie te rechtvaardigen.
OPMERKING: Geslachtsvergelijkingen zijn opgenomen als beschrijvende subgroepcontroles binnen deze cross-sectionele vragenlijstworkflow.
11. Schat het regressiemodel
- Gebruik het subjectieve welzijn als de afhankelijke variabele.
- Gebruik negatieve emotie, academische uitstelgedrag, schoolverbondenheid en hoger-orde denken als gelijktijdige predictoren op schaalniveau21.
- Gebruik de continue variabelen op schaalniveau die tijdens de schaalscoren zijn aangemaakt. Vervang de continue score voor subjectief welzijn niet door de hoog-laag groeperingsvariabele.
- Fit het primaire model met behulp van simultane multiple lineaire regressie.
- Noteer de niet-gestandaardiseerde coëfficiënten, gestandaardiseerde coëfficiënten, standaardfouten, t-waarden, p-waarden, 95% betrouwbaarheidsintervallen, R2, aangepaste R2, tolerantie en de variantie-inflatiefactor.
- Gebruik variantie-inflatiefactorwaarden onder de 5,00 als drempelwaarde voor de afwezigheid van ernstige multicollineariteit.
- Inspecteer bivariate spreidingsdiagrammen, partiële regressieplots of component-plus-residuenplots om te beoordelen of de associaties tussen de predictoren en het subjectieve welzijn bij benadering lineair zijn.
- Beoordeel de onafhankelijkheid van de residuen met behulp van de Durbin-Watson-statistiek.
- Beoordeel de normaliteit van de residuen met behulp van een residuen-Q-Q-plot en, indien passend voor de steekproefomvang, een formele normaliteitstoets.
- Beoordeel homoscedasticiteit met behulp van een plot van gestandaardiseerde residuen tegenover gestandaardiseerde voorspelde waarden.
- Sla gestandaardiseerde residuen, gestandaardiseerde voorspelde waarden, leverage-waarden en de afstand van Cook op voor diagnostische controle.
- Schat een aanvullend aangepast model in inclusief de vier psychologische predictoren en de demografische variabelen die in de steekproefbeschrijving worden vermeld, waaronder geslacht, leeftijd, jaarniveau, instellingscategorie en academische studierichting, wanneer deze variabelen beschikbaar zijn en adequaat verdeeld zijn.
- Vergelijk het primaire model met het aanvullende aangepaste model. Noteer of de richting, grootte en statistische interpretatie van de vier psychologische predictoren stabiel blijven na demografische aanpassing.
- Sla de geverifieerde gestandaardiseerde coëfficiënten en 95% betrouwbaarheidsintervallen van het primaire model op als de numerieke brontabel voor de coëfficiëntenplot in de sectie Representatieve Resultaten22.
OPMERKING: Interpreteer regressiecoëfficiënten als conditionele associaties, niet als causale effecten. Het demografisch aangepaste model wordt gebruikt in een sensitiviteitsanalyse om te beoordelen of de conclusies van de workflow stabiel blijven na correctie voor beschikbare achtergrondvariabelen.
12. Diagnoseer het regressiemodel
- Inspecteer de gestandaardiseerde residuen van het gefitte regressiemodel. Markeer gevallen met absolute gestandaardiseerde residuen groter dan 3,00.
- Inspecteer de leverage-waarden en de afstand van Cook voor invloedrijke waarnemingen.
- Markeer waarnemingen met een afstand van Cook groter dan 4/n als potentieel invloedrijk, waarbij n de analytische steekproefomvang is. Behandel een afstand van Cook groter dan 1,00 als een referentiedrempel voor ernstige invloed in plaats van als de enige screeningsgrens.
- Inspecteer de plot van residuen versus voorspelde waarden op nonlineariteit, ongelijke variantie en ongebruikelijke clustering.
- Inspecteer de Q-Q-plot van de residuen en het resultaat van de normaliteitstoets van de residuen. Leg vast of de beoordeling van de normaliteit het gebruik van het lineaire model voor beschrijvende associatieanalyse ondersteunt.
- Noteer de Durbin-Watson-statistiek en bepaal of de onafhankelijkheid van de residuen acceptabel is.
- Toets alle gemarkeerde gevallen aan het screeningslogboek, het scoringsverificatielogboek en de geschiktheidscriteria.
- Behoud gemarkeerde gevallen wanneer deze geldige waarnemingen vertegenwoordigen en geen data-invoerfouten, scoringsfouten, dubbele indieningen, schendingen van de geschiktheid of gedocumenteerde problemen met de responskwaliteit weerspiegelen.
- Corrigeer of verwijder een gemarkeerd geval alleen wanneer het auditspoor een gedocumenteerde procedurele fout, geschiktheidsfout, coderingsfout, scoringsfout of data-invoerfout identificeert.
- Voer het regressiemodel opnieuw uit na elke gedocumenteerde correctie en vergelijk de coëfficiënten, betrouwbaarheidsintervallen, R2, gecorrigeerde R2 en diagnostische outputs met het oorspronkelijke model.
- Voer een gevoeligheidsanalyse voor invloed uit door het model opnieuw te fitten na het uitsluiten van gevallen met een afstand van Cook groter dan 4/n. Rapporteer of de inhoudelijke interpretatie verandert.
- Noteer de definitieve diagnostische beslissing in het analyselogboek, inclusief het aantal gevallen gemarkeerd door gestandaardiseerde residuen, het aantal gemarkeerd door een afstand van Cook groter dan 4/n, de maximale afstand van Cook, de Durbin-Watson-statistiek en de conclusie uit de controles op normaliteit en lineariteit van de residuen.
OPMERKING: Verwijder invloedrijke gevallen niet enkel om de modelfit te verbeteren. Verwijdering of correctie moet gebaseerd zijn op een gedocumenteerde reden uit het auditspoor.
Resultaten
Analytische dataset gegenereerd na screening van de responsen
De workflow voor de screening van de responsen resulteerde in een analytische dataset van 420 geanonimiseerde studentendossiers uit 448 ingediende vragenlijsten. In het screeningslogboek werd elk beslismoment geregistreerd. Zes dossiers werden verwijderd omdat niet aan de eisen voor toestemming of geschiktheid werd voldaan, vijf dubbele inzendingen werden verwijderd, vier dossiers werden uitgesloten omdat meer dan 20% van alle schaalitems ontbrak, en 13 dossiers werden uitgesloten omdat ze voldeden aan twee of meer indicatoren voor responskwaliteit. Negentien responsen werden gemarkeerd vanwege een voltooiingstijd <180 s, acht responsen werden gemarkeerd vanwege >90% straight-line responding, en 21 respondenten kregen within-scale mean imputation voor 37 geïsoleerde ontbrekende items. De uiteindelijke analytische dataset bevatte geen direct identificeerbare deelnemersinformatie, geen van de behouden casussen overschreed de drempelwaarde voor uitsluiting wegens ontbrekende gegevens, en alle behouden itemresponsen vielen binnen de vooraf gedefinieerde responsbereiken. De screeningsflow is samengevat in Tabel 3.
De behouden steekproef bestond uit 275 vrouwelijke respondenten en 145 mannelijke respondenten, wat respectievelijk 65,5% en 34,5% van de analytische dataset vormde. De gemiddelde leeftijd was 20,1 ± 1,2 jaar. De respondenten waren verdeeld over vier studiejaren van de bacheloropleiding, waarbij jaar 1 tot en met jaar 4 verantwoordelijk waren voor 27,1%, 27,4%, 25,5% en 20,0% van de steekproef. De dataset omvatte daarnaast drie institutionele categorieën en vijf categorieën voor academische hoofdrichtingen. Geen enkele gepubliceerde demografische cel bevatte minder dan vijf respondenten na evaluatie van de categorieën. De demografische kenmerken van de analytische dataset zijn samengevat in Tabel 4.
Constructie van schalen, verificatie van het bereik en voorbeelden van suboptimale workflows
Na de codering van de items en de omkeerscoreing werden vijf variabelen op schaalniveau berekend: negatieve emotie, academische uitstelgedrag, schoolverbondenheid, hoger order denken en subjectief welzijn. Elke score bleef binnen het theoretische antwoordbereik. De scores voor negatieve emotie varieerden van 1.048 tot 3.143 op een schaal van 1-4. Academisch uitstelgedrag, schoolverbondenheid en hoger order denken varieerden respectievelijk van 1.312 tot 4.250, 2.333 tot 4.444 en 2.350 tot 4.850 op hun respectievelijke schalen van 1–5. Subjectief welzijn varieerde van 2.000 tot 5.300 op een schaal van 1–6. De verificatie van de omkeerscoreing wees geen discrepantie aan tussen de afgeleide omkeerscore-variabelen en de vastgelegde score-regel in de uiteindelijke analytische dataset. Deze controles bevestigden dat de itemcodering, omkeerscoreing, verwerking van ontbrekende items en scoreaggregatie waren voltooid zonder detecteerbare bereikfouten.
De workflow genereerde ook suboptimale auditvoorbeelden die illustreren hoe fouten of twijfelachtige resultaten worden gedetecteerd vóór de definitieve analyse. Tijdens een auditronde werd een onjuist afgeleide, omgekeerd gescorede waarde voor subjectief welzijn gedetecteerd, omdat het logboek voor scoreverificatie de oorspronkelijke waarde, de verwachte formule “reversed score = 7-original score”, de afgeleide waarde en het uiteindelijke schaalbereik vergeleek. De afgeleide variabele werd gecorrigeerd, de score voor subjectief welzijn werd opnieuw gegenereerd en alle daaropvolgende beschrijvende, correlatie-, vergelijkings-, regressie-, diagnostische en figuurbron-outputs werden opnieuw uitgevoerd. In een ander tussenliggend werkbestand werd tijdens de bereikverificatie een itemwaarde buiten het bereik geïdentificeerd, die werd herleid tot de verwerking van het spreadsheet in plaats van tot de vergrendelde ruwe export. De werkkopie werd gecorrigeerd en gedocumenteerd zonder enige geldige extreme respons te wijzigen. Ook werd een betrouwbaarheidswaarschuwing beoordeeld toen één item een lagere gecorrigeerde item-totaalcorrelatie vertoonde dan andere items in dezelfde schaal; omdat de bewoording van het item, de scorerichting en de afstemming op het construct correct waren, is het item behouden. Een mismatch in een conceptvisualisatie werd geïdentificeerd toen een figuur niet overeenkwam met de geverifieerde numerieke brontabel; de figuur werd opnieuw gegenereerd vanuit de geverifieerde tabel en het figuurbron-record werd bijgewerkt. Deze voorbeelden tonen aan dat de workflow niet alleen succesvolle resultaten genereert, maar via het auditspoor ook codeerfouten, bereikproblemen, betrouwbaarheidswaarschuwingen, mismatches tussen figuur en bron en zorgen over de responskwaliteit detecteert.
Beschrijvende eigenschappen en interne consistentie
De vijf variabelen op schaalniveau vertoonden bruikbare variatie. De gemiddelde score voor negatieve emoties was 2,099 ± 0,391 en de gemiddelde score voor academische uitstelgedrag was 2,639 ± 0,484. Schoolgebondenheid en hogerdenkend vermogen vertoonden matig hoge gemiddelde waarden, respectievelijk 3,343 ± 0,390 en 3,627 ± 0,418. De gemiddelde score voor subjectief welzijn was 3,784 ± 0,543. Geen enkele schaal vertoonde een duidelijk bodem- of plafondeffect, en het aandeel respondenten op het theoretische minimum of maximum was voor elke schaal lager dan 2,0%.
De interne consistentie was acceptabel voor alle vijf de schalen. De waarden van Cronbach's alpha varieerden van 0,834 tot 0,899, waarmee de vooraf vastgestelde drempelwaarde van 0,70 werd overschreden. Negatieve emotie vertoonde de hoogste interne consistentie, met een Cronbach's alpha van 0,899, gevolgd door subjectief welzijn met 0,895. De waarden van McDonald's omega varieerden van 0,842 tot 0,906, en de omega-schattingen veranderden de interpretatie van de betrouwbaarheid niet. Bij de beoordeling van de gecorrigeerde item-totaalcorrelaties werden geen items geïdentificeerd die verwijderd moesten worden. De descriptieve statistieken en betrouwbaarheidsschattingen zijn gerapporteerd in Tabel 5.
Correlatiestructuur tussen variabelen op schaalniveau
De correlatiematrix werd gebruikt als beschrijvende maat voor associatie en als controle voor de score-richting. Voordat de Pearson-correlaties werden berekend, werden de schaalverdelingen en bivariante spreidingsdiagrammen geïnspecteerd. Geen enkele variabele vertoonde ernstige scheefheid of kurtosis, en geen enkel bivariant diagram vertoonde een sterk niet-lineair patroon dat een beschrijvende Pearson-correlatieanalyse ongeldig zou maken. Subjectief welzijn was negatief gecorreleerd met negatieve emotie (r = -0,496) en academische uitstelgedrag (r = -0,294), en positief gecorreleerd met schoolgebondenheid (r = 0,481) en hogerdenkend vermogen (r = 0,386). De overige associaties volgden dezelfde scorelogica: negatieve emotie was positief geassocieerd met academisch uitstelgedrag (r = 0,270) en negatief geassocieerd met schoolgebondenheid (r = -0,346) en hogerdenkend vermogen (r =-0,205); academisch uitstelgedrag was negatief geassocieerd met schoolgebondenheid (r = -0,222) en hogerdenkend vermogen (r = -0,134); en schoolgebondenheid was positief geassocieerd met hogerdenkend vermogen (r = 0,310). De volledige Pearson-correlatiematrix wordt gepresenteerd in Tabel 6.
Een gevoeligheidscontrole met de Spearman-methode leverde dezelfde directionele interpretatie op voor alle variabeleparen. De Spearman-correlaties tussen subjectief welbevinden en de vier predictoren waren ρ = -0,502 voor negatieve emotie, ρ = -0,301 voor academische uitstelgedrag, ρ = 0,477 voor schoolgevoel en ρ = 0,392 voor hoger-orde denken. De geverifieerde Pearson-matrix werd gebruikt als de numerieke brontabel voor visualisatie. Figuur 2A presenteert de volledige correlatie-heatmap over de vijf variabelen op schaalniveau. Figuur 2B toont de vier correlaties met het subjectieve welbevinden.
Contrastieve demonstratie met groepen met een hoog en laag subjectief welzijn
De groeperingsregel van 27% werd gebruikt als een contrastieve demonstratie van de workflow en niet als een inhoudelijke classificatie van welzijnsprofielen in de echte wereld. De regel resulteerde in twee groepen van gelijke grootte: 113 respondenten in de groep met een hoog subjectief welzijn en 113 in de groep met een laag subjectief welzijn. De middelste 194 respondenten werden behouden in de volledige analytische dataset, maar uitgesloten van deze contrastieve vergelijking. Geen enkele grensverbinding veranderde de groepsindeling.
Deze module heeft aangetoond dat de workflow een vooraf gespecificeerde groeperingsvariabele kan genereren, de analytische dataset kan filteren, groepspecifieke beschrijvende statistieken kan berekenen, geschikte groepsvergelijkingen op basis van aannames kan uitvoeren en een geverifieerde brontabel voor visualisatie kan exporteren. De groep met een hoog subjectief welzijn vertoonde minder negatieve emoties dan de groep met een laag subjectief welzijn (1,864 ± 0,358 vs. 2,335 ± 0,343; gemiddeld verschil = -0,472) en minder academische uitstelgedrag (2,455 ± 0,476 vs. 2,801 ± 0,483; gemiddeld verschil = -0,346). Schoolverbondenheid en hoger-orde denken waren hoger in de groep met een hoog subjectief welzijn, met gemiddelde verschillen van respectievelijk 0,454 en 0,351. Alle vier de vergelijkingen waren significant (p < 0,001), met Cohen’s d-waarden van -1,346 voor negatieve emoties, -0,722 voor academisch uitstelgedrag, 1,279 voor schoolverbondenheid en 0,860 voor hoger-orde denken. De t-test van Welch werd gebruikt wanneer de aanname van gelijke varianties niet werd ondersteund; anders werd de standaard t-test voor onafhankelijke steekproeven behouden. Deze resultaten mogen niet worden geïnterpreteerd als bewijs dat de geselecteerde predictoren werkelijke welzijnsprofielen van studenten definiëren, aangezien de groepen zijn samengesteld op basis van de uitkomstvariabele en vervolgens zijn vergeleken op gecorreleerde variabelen. De vergelijking tussen de hoge en lage groep is samengevat in Tabel 7.
Beschrijvende vergelijking naar geslacht
Geslacht werd onderzocht als beschrijvende groeperingsvariabele. Vrouwelijke respondenten vertoonden een iets hogere gemiddelde score voor negatieve emoties dan mannelijke respondenten (2,129 ± 0,380 vs. 2,042 ± 0,407). Dit verschil was statistisch significant, maar klein in omvang (p = 0,033; Cohen’s Het lijkt erop dat u slechts één letter heeft ingevoerd. Wilt u de tekst aanleveren die vertaald moet worden? = 0,224). Academisch uitstelgedrag, schoolgevoel, hoger-orde denken en subjectief welbevinden vertoonden geen betekenisvolle sekseverschillen. De gemiddelden voor subjectief welbevinden waren bijna identiek tussen vrouwelijke en mannelijke respondenten (3,781 ± 0,521 versus 3,789 ± 0,583; p = 0,887; Cohen’s d = -0,015). De t-toets van Welch t-controles van de testgevoeligheid hebben de interpretatie van de resultaten van de vergelijking tussen de geslachten niet veranderd. De resultaten van het verschil tussen de geslachten worden gepresenteerd in Tabel 8.
Regressiemodel als voorbeeld van modelgeneratie en diagnostische controle
Het meervoudig lineaire regressiemodel werd gebruikt als voorbeeld voor het genereren, diagnosticeren en verifiëren van een model op basis van gescorede vragenlijstgegevens. Subjectief welbevinden werd ingevoerd als de afhankelijke variabele, terwijl negatieve emotie, academische uitstelgedrag, schoolgevoel en hoger-orde denken gelijktijdig werden ingevoerd als predictoren op schaalniveau. Het doel van deze module was om coëfficiëntextractie, controles op multicollineariteit, residuendiagnostiek, invloedsbeoordeling, demografisch gecorrigeerde sensitiviteitsanalyse en de voorbereiding van figuren en bronnen te demonstreren.
Het model verklaarde een matig deel van de variantie in het subjectieve welzijn, met R2 = 0,411 en gecorrigeerde R2 = 0,406. Negatieve emotie vertoonde de grootste negatieve gestandaardiseerde coëfficiënt (B = -0,450, gestandaardiseerde β = -0,324). Academische uitstelgedrag vertoonde eveneens een negatieve coëfficiënt (B = -0,130, gestandaardiseerde β = -0,116). Schoolgebondenheid en hoger-orde denken vertoonden respectievelijk positieve gestandaardiseerde coëfficiënten van β = 0,275 en β = 0,218. Alle vier de predictoren waren statistisch significant in het gefitte model: negatieve emotie, schoolgebondenheid en hoger-orde denken bij p < 0,001, en academische uitstelgedrag bij p = 0,004. Er was geen sprake van multicollineariteit, aangezien alle waarden van de variantie-inflatiefactor onder de 1,24 lagen. Deze regressieresultaten zijn representatieve outputs voor modelcontrole en vormen geen definitieve psychologische verklaring voor het welzijn van studenten. Tabel 9 bevat de volledige regressieoutput.
Een aanvullend demografisch gecorrigeerd model werd geschat door geslacht, leeftijd, jaarniveau, institutionele categorie en academische studierichting toe te voegen aan de vier psychologische predictoren. Het gecorrigeerde model verklaarde een vergelijkbaar deel van de variantie, met R2 = 0,427 en een gecorrigeerde R2 = 0,414. De richting en statistische interpretatie van de vier psychologische predictoren bleven ongewijzigd na de demografische correctie. Het demografisch gecorrigeerde sensitiviteitsmodel is samengevat in Tabel 10. Figuur 3A toont de gestandaardiseerde coëfficiënten en 95% betrouwbaarheidsintervallen voor de vier predictoren. Figuur 3B presenteert de diagnostische weergave op basis van gestandaardiseerde voorspelde waarden, gestandaardiseerde residuen en de afstand van Cook.
Regressiediagnostiek en modelbehoud
Regressiediagnostiek gaf niet aan dat het gefitte model werd bepaald door een enkel invloedrijk record. De bivariante en partiële regressieplots vertoonden geen sterke nonlineariteit. De plot van residuen tegenover voorspelde waarden vertoonde geen ernstige heteroscedasticiteit of ongebruikelijke clustering. De Durbin-Watson-statistiek was 1.93, wat wijst op een acceptabele onafhankelijkheid van de residuen. De Q-Q-plot van de residuen liet geen ernstige afwijking van normaliteit zien. Een formele normaliteitstoets van de residuen was statistisch significant, W = 0.992, p = 0.031, maar de Q-Q-plot en de steekproefomvang rechtvaardigden het behoud van het lineaire model voor beschrijvende associatieanalyse.
Twee records hadden absolute gestandaardiseerde residuen groter dan 3,00. Geen enkel record had een Cook's distance groter dan 1,00. Met gebruik van de gevoeligere drempelwaarde van Cook's distance >4/n, waarbij n = 420 en 4/n = 0,0095, werden 17 records gemarkeerd als potentieel invloedrijk. De grootste Cook's distance was 0,037. De gemarkeerde residu- en invloedsgevallen werden gecontroleerd aan de hand van het screeningslogboek, het verificatielogboek voor scores en de geschiktheidscriteria. Geen van deze gevallen vertoonde bewijs van invoerfouten, onjuiste scoring, dubbele antwoorden, gebrek aan geschiktheid of gedocumenteerde problemen met de antwoordkwaliteit; daarom zijn deze gevallen behouden in het definitieve model. Een gevoeligheidscontrole voor invloed, waarbij gevallen met een Cook's distance >4/n werden uitgesloten, leverde dezelfde interpretatie van de workflow op als het primaire model. De maximale absolute verandering in gestandaardiseerde coëfficiënten was 0,026, en de gecorrigeerde R2 veranderde van 0,406 naar 0,405. De diagnostische resultaten en de resultaten van de gevoeligheidsanalyse zijn samengevat in Tabel 11.
Interne verificatie van de analytische pipeline
De workflow werd herhaald vanaf de geschoonde en gescorede analytische dataset met gebruik van dezelfde scoringsregels, beslisdrempels en analyse-tracebestanden. Interne consistentieanalyse, beschrijvende statistieken, correlatieanalyse, vergelijkingen tussen hoge en lage groepen, geslachtsvergelijkingen, regressiemodellering, diagnostische controles en de voorbereiding van visualisatiebronnen werden herhaald. De herhaalde resultaten kwamen overeen met de oorspronkelijke beschrijvende statistieken, de correlatiematrix, de waarden van de groepvergelijkingen, de regressiecoëfficiënten, de diagnostische outputs en de visualisatiebronbestanden. Dit bevestigde de computationele stabiliteit van de analytische pipeline wanneer deze werd toegepast op dezelfde vastgelegde analytische dataset. Deze controle vormt geen onafhankelijke procedurele reproduceerbaarheid, waarvoor een onafhankelijke analist de volledige workflow vanaf de vastgelegde ruwe export zou moeten toepassen om tot dezelfde gedocumenteerde resultaten te komen.
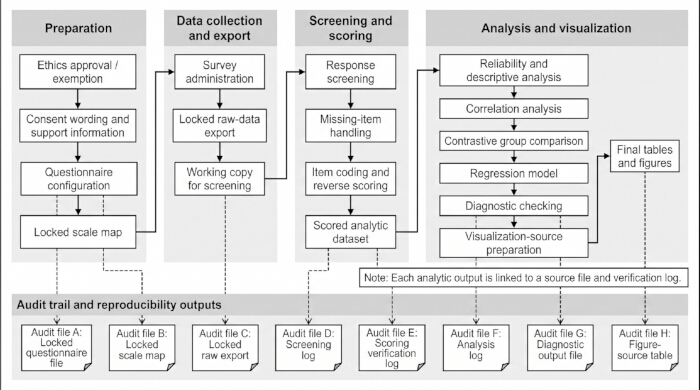
Figuur 1: Workflow voor de gegevensverwerking van subjectief welzijn op basis van vragenlijsten. Het schema toont de volgorde van het protocol en de belangrijkste audit-outputs, waaronder ethische voorbereiding, configuratie van de vragenlijst, afname van de enquête, export van ruwe gegevens, schaaloverzicht, screeningslogboek, gescoorde analytische dataset, geverifieerde analysetabellen, regressiediagnostiek, bronbestanden voor figuren en visualisatie-outputs. Klik hier om een grotere versie van deze figuur te bekijken.
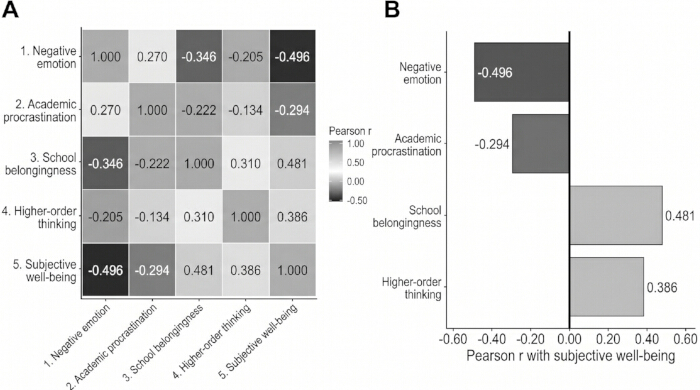
Figuur 2: Correlatiestructuur tussen variabelen op schaalniveau. (A) Pearson-correlatieheatmap gegenereerd op basis van de geverifieerde correlatiematrix in Tabel 6. (B) Op subjectief welzijn gericht correlatieprofiel gegenereerd vanuit dezelfde geverifieerde brontabel. Alle vijf de variabelen op schaalniveau worden weergegeven: negatieve emotie, academisch uitstelgedrag, schoolgevoel, hoger-orde denken en subjectief welzijn. Klik hier om een grotere versie van deze figuur te bekijken.
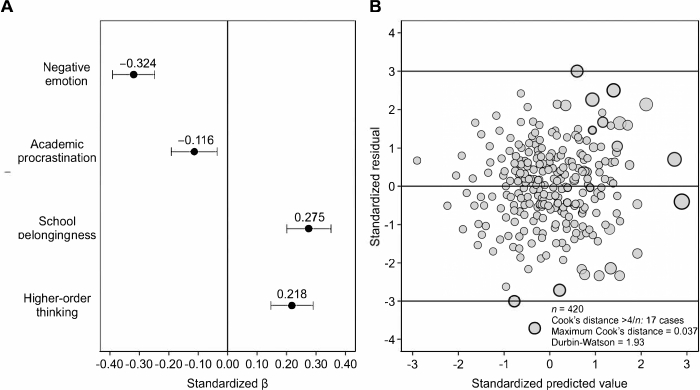
Figuur 3: Regressiecoëfficiënt en diagnostische visualisatie. (A) Gestandaardiseerde regressiecoëfficiënten en 95% betrouwbaarheidsintervallen gegenereerd uit de primaire regressieoutput in Tabel 9. (B) Regressiediagnostisch overzicht gegenereerd uit gestandaardiseerde voorspelde waarden, gestandaardiseerde residuen en Cook's distance-waarden samengevat in Tabel 11. Grotere Cook's distance-waarden duiden op observaties met een grotere potentiële invloed op het gefitte model. Klik hier om een grotere versie van deze figuur te bekijken.
Tabel 1: Structuur van de vragenlijst en kader voor de scoreberekening.Deze tabel vat het meetkader samen, inclusief de naam van het construct, het broninstrument, de broncitatie, de status van aanpassing of documentatie, het itemnummer, het antwoordbereik, de scorerichting, de vereiste voor omgekeerde scoren, de scoremethode, de uiteindelijke variabele op schaalniveau en de rol in het protocol. Klik hier om deze tabel te downloaden.
Tabel 2: Screeningscriteria voor responsen en analytische beslissingscriteria. Deze tabel bevat de vooraf vastgestelde criteria voor de screening van toestemming, de screening van geschiktheid, de controle op dubbele responsen, de omgang met ontbrekende gegevens, het markeren van responsduur, het detecteren van rechtlijnige responsen, geldige responsbereiken, betrouwbaarheidsbeoordeling, classificatie van hoge-lage groepen, regressiediagnostiek en gevoeligheidscontroles. Klik hier om deze tabel te downloaden.
Tabel 3: Screeningsstroom van ingediende vragenlijsten naar de uiteindelijke analytische dataset. Deze tabel vermeldt het aantal ingediende vragenlijsten, gemarkeerde records, verwijderde records, behouden records en verificatiebronnen bij elke screeningsstap. De voltooiingstijd en straight-line responding werden beschouwd als vlaggen voor de responskwaliteit in plaats van automatische uitsluitingscriteria. Klik hier om deze tabel te downloaden.
Tabel 4: Demografische kenmerken van de analytische dataset. Deze tabel vat de behouden geanonimiseerde studentengegevens samen na de responscontrole, inclusief geslacht, leeftijd, jaar van de undergraduate studie, instellingscategorie en categorie van de academische hoofdvakstudie. Demografische cellen zijn beoordeeld op het risico van indirecte identificeerbaarheid voordat ze werden gerapporteerd. Klik hier om deze tabel te downloaden.
Tabel 5: Beschrijvende statistieken, bereikverificatie en interne consistentie van de vijf variabelen op schaalniveau.Deze tabel rapporteert het itemnummer, het theoretische bereik, het waargenomen bereik, het gemiddelde, de standaarddeviatie, Cronbach's alpha, McDonald's omega en de vloer-/plafondconcentratie voor negatieve emotie, academische uitstelgedrag, schoolgebondenheid, hogerdenkend vermogen en subjectief welbevinden. Klik hier om deze tabel te downloaden.
Tabel 6: Pearson-correlatiematrix van variabelen op schaalniveau. Deze tabel presenteert de Pearson-correlatiecoëfficiënten tussen negatieve emoties, academische uitstelgedrag, schoolgevoel, hoger-orde denken en subjectief welbevinden. De matrix werd gebruikt als beschrijvende output van associaties en als stap voor de verificatie van de score-richting. Klik hier om deze tabel te downloaden.
Tabel 7: Contrastieve vergelijking tussen groepen met een hoog en laag subjectief welzijn. Deze tabel vergelijkt negatieve emoties, academisch uitstelgedrag, schoolgebondenheid en hoger-orde denken tussen respondenten in de bovenste 27% en de onderste 27% van de scores voor subjectief welzijn. De vergelijking demonstreert de workflow voor groepering en vergelijking in plaats van een inhoudelijke classificatie van welzijnsprofielen. Klik hier om deze tabel te downloaden.
Tabel 8: Beschrijvende vergelijking naar geslacht. Deze tabel rapporteert beschrijvende vergelijkingen van negatieve emotie, academische uitstelgedrag, schoolgebondenheid, hoger-orde denken en subjectief welzijn naar geslacht. Geslacht werd behandeld als een beschrijvende groeperingsvariabele. Klik hier om deze tabel te downloaden.
Tabel 9: Primair meervoudig lineair regressiemodel dat subjectief welzijn voorspelt. Deze tabel presenteert het primaire regressiemodel waarin subjectief welzijn de afhankelijke variabele was, en negatieve emotie, academische uitstelgedrag, schoolgevoel en hoger-orde denken gelijktijdig werden ingevoerd als predictoren op schaalniveau. Waarden voor standaardfout, betrouwbaarheidsinterval en variantie-inflatiefactor zijn opgenomen. Klik hier om deze tabel te downloaden.
Tabel 10: Demografisch gecorrigeerd regressie-sensitiviteitsmodel dat subjectief welzijn voorspelt. Deze tabel rapporteert de vier psychologische predictoren na correctie voor geslacht, leeftijd, bachelorjaar, instellingscategorie en academische studierichting. Categorische demografische variabelen zijn ingevoerd met behulp van dummy-codering. Standaardfout, betrouwbaarheidsinterval en waarden voor de variantie-opblazingsfactor (VIF) zijn opgenomen. Klik hier om deze tabel te downloaden.
Tabel 11: Regressiediagnostiek en controles van invloedsgevoeligheid. Deze tabel vat de resultaten van residuen, invloed en modeldiagnostiek samen, waaronder gestandaardiseerde residuen, Cook's afstand > 1,00, Cook's afstand > 4/n, maximale Cook's afstand, Durbin-Watson-statistiek, residu-Q-Q-plot, normaliteitstoets voor residuen, plot van residuen versus voorspelde waarden, lineariteitscontrole en invloedsgevoeligheidsanalyse. Klik hier om deze tabel te downloaden.
Aanvullend bestand 1: Vragenlijststructuur, herkomst van schalen en scorendocumentatie.Dit aanvullende bestand bevat de volgorde van afname van de vragenlijst, de bewoording van de geïnformeerde toestemming, demografische variabelen, documentatie van de gebruikte instrumenten, itemcodes, responsankers, informatie over adaptatie en documentatiestatus, scoorrichting, regels voor omgekeerde scoren, de constructie van de definitieve variabelen op schaalniveau, regels voor de omgang met ontbrekende items, koppelingvelden voor de kwaliteit van de respons, regels voor bereikverificatie en referentiekoppelingen voor de vijf constructen van de vragenlijst. Het dient als aanvullende vragenlijst/codeboek voor het documenteren van de programmering, scoring en verificatie van de schalen in de workflow. Klik hier om dit bestand te downloaden.
Discussie
Dit protocol standaardiseert een veelvoorkomend maar vaak ondergerapporteerd proces in welzijnsstudies op basis van vragenlijsten: de overgang van ruwe antwoordgegevens naar gescreende data, gescorede schaalvariabelen, statistische outputs en bestanden die klaar zijn voor visualisatie. De bijdrage hiervan is niet de ontwikkeling van een nieuwe theorie over subjectief welzijn of het voorstellen van een causaal model. In plaats daarvan biedt de workflow een auditeerbaar traject voor de configuratie van de vragenlijst, screening van antwoorden, scoring van schalen, betrouwbaarheidscontroles, beschrijvende analyse, associatieanalyse, regressiediagnostiek en verificatie van figuurbronnen. Dit onderscheid is belangrijk omdat auditeerbaarheid in enquêtegebaseerd vragenlijstonderzoek afhangt van procedurele beslissingen die vaak worden genomen voordat de statistische interpretatie begint, waaronder welke records worden behouden, hoe omgegaan wordt met ontbrekende items, hoe items met omgekeerde scoring worden verwerkt en hoe numerieke brontabellen worden gekoppeld aan visuele outputs. Door deze beslissingen expliciet te maken, worden twijfelachtige meetpraktijken in schaalgebaseerd onderzoek verminderd23 en wordt een transparantere onderzoekscultuur ondersteund24.
Een centraal kenmerk van het protocol is het gebruik van concrete audit-artefacten in plaats van enkel verbale beschrijvingen. De herziene workflow koppelt elk construct aan het broninstrument, het itembereik, de responsankers, de score-richting, de regel voor omgekeerde scoren, de uiteindelijke variabele op schaalniveau en informatie over de adaptatie of documentatiestatus. Het audit-spoor omvat het vergrendelde vragenlijstbestand, de vergrendelde schaalmap, de vergrendelde ruwe export, het screeningslogboek, het scoreverificatielogboek, het analyselogboek, het diagnostische outputbestand en de tabel met figuurbronnen. Deze bestanden verduidelijken welke versie van de vragenlijst is afgenomen, welke records zijn uitgesloten of behouden, hoe de scores zijn gegenereerd en welke geverifieerde tabel is gebruikt om elke figuur te maken. Wanneer gegevens op deelnemerniveau niet openbaar gedeeld kunnen worden, kan een synthetische dataset met dezelfde variabelestructuur en voltooide screenings-/scorelogboeken lezers in staat stellen de computationele workflow te testen zonder toegang te krijgen tot identificeerbare of indirect identificeerbare records. Deze op artefacten gebaseerde structuur is consistent met het FAIR-principe dat herbruikbare onderzoeksresultaten een duidelijke herkomst, structuur en toegangsvoorwaarden vereisen25.
De representatieve resultaten dienen te worden geïnterpreteerd als output van de workflow en niet als substantieel bewijs voor de psychologische determinanten van het welzijn van studenten. De vergelijking tussen hoog en laag subjectief welzijn is opgenomen om te demonstreren hoe een vooraf gespecificeerde groeperingsregel kan worden geïmplementeerd, gecontroleerd en gerapporteerd; het mag niet worden geïnterpreteerd als een real-world classificatie van welzijnsprofielen. Evenzo demonstreert het regressiemodel hoe gescorede vragenlijstgegevens kunnen worden gemodelleerd, gecontroleerd op multicollineariteit, geëvalueerd met residuele en invloedsdiagnostiek, en gekoppeld aan een geverifieerde figuur-brontabel. Het stelt niet vast dat negatieve emotie, academische uitstelgedrag, schoolverbondenheid of hoger-orde denken het subjectieve welzijn causaal bepaalt. Omdat alle belangrijke variabelen op één tijdstip via dezelfde zelfrapportagevragenlijst zijn verzameld, kunnen common-method bias, effecten van responsstijlen en een gedeelde meetcontext niet worden uitgesloten26.
Deze workflow vervangt bovendien geen volledige psychometrische validatie. Cronbach's alfa, McDonald's omega, controles van het waargenomen bereik, item-totaal reviews en verificatie van omgekeerde scoren zijn nuttige kwaliteitscontroles voor een controleerbare score-workflow, maar zij stellen geen factoriële validiteit, meetinvariantie, itemrespons-eigenschappen of vergelijkbaarheid tussen groepen vast. Studies die de vragenlijst gebruiken voor substantieel theoretisch onderzoek dienen een bevestigende factoranalyse uit te voeren, meetinvariantie te testen over relevante demografische of institutionele groepen en, indien 적당, aanvullende validiteitscontroles uit te voeren27. Daarom moet het huidige protocol worden beschouwd als een controleerbaar kader voor gegevensverwerking en rapportage, en niet als een volledige validatiestudie voor de opgenomen constructen.
De workflow werd gedemonstreerd bij een steekproef van één undergraduate student, gebruikmakend van zelfgerapporteerde vragenlijstgegevens verzameld op één enkel tijdstip, zonder externe validatie. De overdraagbaarheid naar andere populaties, disciplines, instellingen, talen en culturele settings mag niet worden verondersteld. Indien de workflow in een andere context wordt hergebruikt, moet de schaalkaart opnieuw worden opgebouwd in plaats van mechanisch te worden gekopieerd. Onderzoekers dienen de herkomst van de items, de status van vertaling of adaptatie, de culturele en contextuele afhankelijkheid van welzijnsitems, antwoordankerpunten, regels voor omgekeerde scoren, scoreinterpretatie en lokale ethische vereisten te beoordelen. Vertalings- en adaptatieprocedures vereisen expliciete documentatie in plaats van informele tekstwijzigingen28, en de interpretatie van educatieve en psychologische testscores moet gekoppeld blijven aan bewijsvoering voor het beoogde gebruik en de populatie29.
In de praktijk is het protocol vooral nuttig als een controleerbaar kader voor gegevensverwerking en rapportage in vragenlijstgebaseerd welzijnsonderzoek. Het helpt onderzoekers om beslissingen over opschoning, scoring, diagnostiek en visualisatie zichtbaar te maken voordat de interpretatie begint. Toekomstige toepassingen zouden de workflow moeten testen over onafhankelijke steekproeven, verschillende institutionele omgevingen, longitudinale ontwerpen en onafhankelijk gerepliceerde analyseteams. Externe validatie, vooraf geregistreerde beslisregels, gedeelde synthetische datasets, ingevulde voorbeeldlogboeken voor screening/scoring en onafhankelijke replicatie door analisten zouden de overdraagbaarheid en geloofwaardigheid van de workflow verder versterken.
Openbaarmakingen
De auteurs hebben geen belangenconflicten te verklaren.
Dankbetuigingen
De auteurs danken de studenten die hebben deelgenomen aan de vragenlijst voor hun steun tijdens de gegevensverzameling. De auteurs danken tevens de betreffende docenten en onderzoeksassistenten voor hun hulp bij de distributie van de vragenlijsten, de organisatie van de gegevens, de verificatie van de resultaten en de opstelling van de tabellen en figuren. Dit werk heeft geen specifieke financiering ontvangen.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| broom R package | CRAN | R package | Gebruikt om regressie-outputs om te zetten in gestructureerde coëfficiënt- en modelsamenvattingstabellen. |
| car R package | CRAN | R package | Gebruikt voor de verificatie van de variantie-inflatiefactor en ondersteuning bij regressiediagnostiek. |
| Depression Anxiety Stress Scales-21 brondocumentatie | Psychology Foundation of Australia | Lovibond and Lovibond, 1995 | Brondocumentatie voor het gedeelte over negatieve emoties. De workflow maakte gebruik van aan de studie aangepaste bewoordingen die in lijn zijn met recente beoordelingen van negatieve emotionele toestanden. |
| dplyr R package | CRAN | R package | Gebruikt voor datafiltering, hercodering, groepering, samenvattingen van de screeningsflow en het voorbereiden van analysetabellen. |
| ggplot2 R package | CRAN | R package | Gebruikt voor het genereren van de correlatie-heatmap, de correlatieplot voor subjectief welzijn, de regressiecoëfficiëntplot en de diagnostische weergave. |
| Brondocumentatie voor de meting van hoger-orde denken | Springer Nature | DOI: 10.1038/s41598-024-70908-3 | Brondocumentatie voor het gedeelte over hoger-orde denken. De workflow maakte gebruik van een aan de studie aangepaste set items die in lijn zijn met analytisch, evaluatief, reflectief, integratief en evidence-based denken. |
| IBM SPSS Statistics | IBM Corp. | Version 29.0.2.0 | Gebruikt voor beschrijvende statistieken, Cronbach’s alpha, Pearson-correlatie, t-toetsen voor onafhankelijke steekproeven en Welch’s t-toets, meervoudige lineaire regressie, Durbin-Watson-statistiek, gestandaardiseerde residuen, leverage-waarden, Cook’s distance en variantie-inflatiefactoren. |
| psych R package | CRAN | R package | Gebruikt voor psychometrische samenvattingen, verificatie van Cronbach’s alpha en McDonald’s omega. |
| Psychological Sense of School Membership Scale brondocumentatie | Wiley | Psychol Sch. 1993;30(1):79-90 | Brondocumentatie voor het gedeelte over schoolverbondenheid. De workflow maakte gebruik van aan de studie aangepaste bewoordingen die in lijn zijn met waargenomen acceptatie, connectie, ondersteuning en verbondenheid binnen de schoolomgeving. |
| R statistische omgeving | R Foundation for Statistical Computing | Version 4.4.2 | Gebruikt voor secundaire analytische verificatie, McDonald’s omega, Spearman-gevoeligheidscontroles, voorbereiding van regressie-outputs, voorbereiding van diagnostische outputs en voorbereiding van visualisatiebronnen. |
| readxl R package | CRAN | R package | Gebruikt om spreadsheet-exports van vragenlijsten te importeren in de R-verificatieworkflow. |
| Subjective Well-being Scale for Chinese Citizens brondocumentatie | Scientific & Academic Publishing | DOI: 10.5923/j.ijap.20190905.01 | Brondocumentatie voor het gedeelte over subjectief welzijn. De workflow maakte gebruik van aan de studie aangepaste bewoordingen en omgekeerd gescoorde items die in lijn zijn met tevredenheid over het leven, zinvolheid, ondersteuning, vooruitgang, ontevredenheid, hulpeloosheid en stressgerelateerde welzijnservaringen. |
| Aanvullend bestand 1: Structuur van de vragenlijst en documentatie van de schaal | Auteurs | Supplementary File 1 | Biedt de structuur van de afgenomen vragenlijst, de volgorde van constructen, de herkomst van de schaal, itemcodes, responsankers, score-richting, regels voor omgekeerde scoring, constructie van scores op schaalniveau en informatie over de documentatiestatus. |
| Tuckman Procrastination Scale brondocumentatie | SAGE Publications | Educ Psychol Meas. 1991;51(2):473-480 | Brondocumentatie voor het gedeelte over academische uitstelgedrag. De workflow maakte gebruik van aan de studie aangepaste bewoordingen die in lijn zijn met academische vertraging en het uitstelgedrag van taken. |
| Wenjuanxing online vragenlijstplatform | Changsha Ranxing Information Technology Co., Ltd. | Web-based platform | Gebruikt voor elektronische toestemming, programmering van de vragenlijst, verzamelen van itemresponsies, vastleggen van tijdstempels, registratie van voltooiingsduur, controle op dubbele indieningen en export van ruwe responsen. |
Referenties
- 1. Khatri P et al. Student well-being in higher education: scale development and validation with implications for management education. Int J Manag Educ. 2024;22(1):100933.
- Mirzaei A, Carter SR, Patanwala AE, Schneider CR. Missing data in surveys: key concepts, approaches, and applications. Res Social Adm Pharm. 2022;18(2):2308-16.
- Gummer T, Roßmann J, Silber H. Using instructed response items as attention checks in web surveys: properties and implementation. Sociol Methods Res. 2021;50(1):238-64.
- Johansson F et al. Associations between procrastination and subsequent health outcomes among university students in Sweden. JAMA Netw Open. 2023;6(1):e2249346.
- Li X, Kuo YL, Huggins TJ. Perceived feedback and school belonging: the mediating role of subjective well-being. Front Psychol. 2024;15:1450788.
- Sönning L. Ordinal response scales: psychometric grounding for design and analysis. Res Methods Appl Linguist. 2024;3(3):100156.
- Song P et al. Predictive analysis of college students’ academic procrastination behavior based on a decision tree model. Humanit Soc Sci Commun. 2024;11:869.
- Dudáš A. Graphical representation of data prediction potential: correlation graphs and correlation chains. Vis Comput. 2024;40(10):6969-82.
- Niessen ASM, Meijer RR, Tendeiro JN. Detecting careless respondents in web-based questionnaires: which method to use? J Res Pers. 2016;63:1-11.
- Parsons J, Bao L. A unified approach for outliers and influential data detection: the value of information in retrospect. Stat. 2022;11(1):e442.
- Donche V et al. Careless responding in online student learning surveys: profiles and impact on data quality. Frontline Learn Res. 2026;13(3):1-14.
- Lovibond SH, Lovibond PF. Manual for the Depression Anxiety Stress Scales. 2nd ed. Psychology Foundation; Sydney; 1995.
- Tuckman BW. The development and concurrent validity of the Procrastination Scale. Educ Psychol Meas. 1991;51(2):473-80.
- Goodenow C. The psychological sense of school membership among adolescents: scale development and educational correlates. Psychol Sch. 1993;30(1):79-90.
- Li D, Fan X, Meng L. Development and validation of a higher-order thinking skills (HOTS) scale for major students in the interior design discipline for blended learning. Sci Rep. 2024;14:20287.
- Huang L, Xing Z. A nationwide study on Subjective Well-being Scale for Chinese Citizens (SWBS-cc). Int J Appl Psychol. 2019;9(5):117-27.
- DeSimone JA, Harms PD, DeSimone AJ. Best practice recommendations for data screening. J Organ Behav. 2015;36(2):171-81.
- Revilla MA, Saris WE, Krosnick JA. Choosing the number of categories in agree-disagree scales. Sociol Methods Res. 2014;43(1):73-97.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK Res Methods. 2023;32(1):3-38.
- McNeish D. Thanks coefficient alpha, we’ll take it from here. Psychol Methods. 2018;23(3):412-33.
- Romeo I, Stanislaw H, McCreary J, Hawley M. The importance of belonging for well-being in college students. PLOS Ment Health. 2024;1(1):e0000057.
- Kastellec JP, Leoni EL. Using graphs instead of tables in political science. Perspect Polit. 2007;5(4):755-71.
- Flake JK, Fried EI. Measurement schmeasurement: questionable measurement practices and how to avoid them. Adv Methods Pract Psychol Sci. 2020;3(4):456-65.
- Nosek BA et al. Promoting an open research culture. Science. 2015;348(6242):1422-5.
- Wilkinson MD et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: a critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879-903.
- Vandenberg RJ, Lance CE. A review and synthesis of the measurement invariance literature: suggestions, practices, and recommendations for organizational research. Organ Res Methods. 2000;3(1):4-70.
- van de Vijver FJR, Hambleton RK. Translating tests: some practical guidelines. Eur Psychol. 1996;1(2):89-99.
- American Educational Research Association, American Psychological Association, National Council on Measurement in Education. Standards for educational and psychological testing. American Educational Research Association; Washington, DC; 2014.