Dit protocol beschrijft een geïntegreerde batterij van 60 minuten — pavloviaanse naar operante angstconditionering met vermijding, angstverwerving–extinctie–reacquisitie met sociale stimuli, en probabilistisch beloningsleren — waarbij huidgeleiding, gedrag en beoordelingen per fase gelijktijdig worden geregistreerd om per deelnemer indices van dreiging en beloningsleren bij volwassenen af te leiden.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Methodenartikel
Associatief leren en nadelige ervaringen in de kindertijd: een multisysteemprotocol
In dit artikel
Samenvatting
Samenvatting
Negatieve ervaringen in de kindertijd (ACE's) zijn gevestigde transdiagnostische risicofactoren voor angst en depressie bij volwassenen, maar de neurocognitieve mechanismen die vroege tegenspoed met symptomen verbinden, blijven onduidelijk binnen een uniform kader. Dit protocol presenteert een geïntegreerde, multisysteem experimentele batterij die dreigingsdiscriminatie, veiligheidsleren en beloningsgevoeligheid vastlegt binnen één laboratoriumsessie. Achtendertig gezonde volwassenen voltooiden drie gedragsparadigma's — Pavloviaanse-naar-operante angstconditionering met vermijding (Experiment 1), angstverwerving-extinctie-reacquisitie met sociale stimuli (Experiment 2) en probabilistisch beloningsleren (Experiment 3) — samen met gevalideerde zelfrapportages over tegenspoed in de kindertijd (CTQ-SF), positieve ervaringen in de kindertijd (BCE), depressie (PHQ-9) en angst (GAD-7, STAI). Meerkanaals gegevens werden gelijktijdig verzameld: de huidgeleidingsrespons (SCR) als fysiologische index van autonome opwinding, knopdrukvermijding en probabilistische keuzes als gedragsindices, en fase-per-fase subjectieve beoordelingen van verwachting, dreiging en opluchting. Elk paradigma produceerde zijn canonieke effect: Pavloviaanse discriminatie op SCR (p = 0,009, ηp2 = 0,12), verwachting (p < 0,001, ηp2 = 0,58) en dreigingsbeoordelingen (p < 0,001, ηp2 = 0,35); operante opluchting waarbij onderscheid werd gemaakt tussen vermijdbare en onvermijdbare dreiging (p < 0,001, d = 0,86); differentieel autonoom reageren aanwezig bij acquisitie maar niet bij extinctie in Experiment 2 (acquisitie p = 0,008; extinctie p = 0,168), samenlopend met aanhoudende declaratieve kennis van de contingentie (p < 0,001, d = 3,08); en probabilistisch beloningsleren boven het toevalsniveau in Experiment 3 (M = 73%, p < 0,001, d = 1,97). Het multisysteem-ontwerp onthulde dissociaties die bij een enkel kanaal over het hoofd zouden zijn gezien, in het bijzonder een verminderde autonome respons naast aanhoudende subjectieve dreiging. Per-deelnemer indices afgeleid van het protocol waren gevoelig voor individuele verschillen in ervaringen in de kindertijd, met illustratieve moderatieanalyses gerapporteerd in het aanvullende materiaal. Het protocol biedt een draagbaar, schaalbaar kader voor het indexeren van hoe vroege tegenspoed de verwerking van dreiging en beloning in de volwassenheid herkalibreert.
Inleiding
Nadelige ervaringen in de kindertijd (Adverse Childhood Experiences, ACEs), waaronder misbruik, verwaarlozing en disfunctie binnen het huishouden, komen wereldwijd veel voor, met percentages die in veel populaties de 60% overschrijden1. Syntheses van onderzoek geven aan dat de meeste kinderen tijdens hun ontwikkeling worden blootgesteld aan ten minste één nadelige gebeurtenis2. ACEs zijn erkende transdiagnostische risicofactoren voor psychopathologie op volwassen leeftijd3 en dragen bij aan een geschat aandeel van 30% van de angststoornissen en 40% van de depressiegevallen1. Ondanks dit sterke verband vertrouwen veelgebruikte klinische beoordelingen op categorische diagnoses en retrospectieve zelfrapportages, die vatbaar zijn voor recall bias en geen real-time neurocognitieve processen vastleggen4.
Om deze beperkingen te overwinnen, is er een toenemende nadruk op transdiagnostische benaderingen die zich richten op onderliggende mechanismen, in het bijzonder associatief leren. Associatief leren, dat zowel Pavloviaanse als operante conditionering omvat, biedt een kader om te begrijpen hoe individuen relaties tussen omgevingsprikkels, gedragingen en uitkomsten coderen om de besluitvorming te sturen4,5. Binnen dit kader stelt de theorie van latente kwetsbaarheid dat vroege tegenspoed neurobiologische aanpassingen teweegbrengt, zoals verhoogde waakzaamheid, die aanvankelijk adaptief zijn in onvoorspelbare omgevingen, maar in latere, veiligere contexten maladaptief kunnen worden6,7.
Bewijs suggereert dat ACE's invloed hebben op zowel dreigings- als beloningsgerelateerde leerprocessen. Individuen met een geschiedenis van tegenspoed vertonen vaak een verminderd onderscheid tussen geconditioneerde gevaarsignalen (CS+) en veiligheidssignalen (CS−), wat duidt op een veranderd dreigingsleren8. Parallel hiermee is vroegkinderlijk tegenspoed geassocieerd met een verminderde beloningsgevoeligheid, wat zich uit in een lagere nauwkeurigheid en een tragere acquisitie van beloningscontingenties8. Onder omstandigheden van onzekerheid kunnen deze individuen ook een verhoogde keuzevariabiliteit vertonen en een neiging hebben om uit te gaan van een willekeurige beloningslevering, wat consistent is met vroege blootstelling aan volatiele omgevingen5,9.
Deze leerpatronen worden verder gevormd door beschermende en toestandafhankelijke factoren. Positieve ervaringen in de kindertijd (Benevolent Childhood Experiences, BCEs) kunnen de effecten van tegenspoed op leersystemen bufferen10, terwijl huidige affectieve toestanden, zoals angst, conditioneringsprocessen kunnen moduleren11. Fysiologische maten van autonome opwinding, waaronder de huidgeleidingsrespons (Skin Conductance Response, SCR), bieden objectieve indices voor deze processen en worden veelvuldig gebruikt in conditioneringsparadigma's12.
Een belangrijke beperking in de huidige literatuur is het gebruik van geïsoleerde taken die het leren van dreiging of beloning onafhankelijk van elkaar beoordelen, wat het vermogen beperkt om geïntegreerde neurocognitieve functies vast te leggen1. Het huidige protocol vult dit gat op door een gestandaardiseerd kader te bieden dat gedragsmatige en fysiologische maten over meerdere leerdomeinen combineert. Specifiek omvat het protocol drie experimentele componenten: (1) een paradigma dat overgangen van Pavloviaanse naar operante conditionering beoordeelt, (2) een taak voor sociale angstextinctie en (3) een taak voor probabilistisch beloningsleren8.
De rationale voor deze specifieke combinatie van paradigma's is niet dat een van deze drie taken in isolatie gevoeliger is voor vroege tegenspoed dan de vele andere beschikbare, gevestigde leerparadigma's; het is een rationale van meting. In hun systematische review van 81 studies (38 dreiging, 43 beloning) toonden Ruge et al.1 aan dat de literatuur die ACE's koppelt aan associatief leren heterogeen blijft en, op cruciale punten, niet doorslaggevend is, juist omdat studies doorgaans één enkele taak inzetten, één enkel responskanaal registreren en tegenspoed op niet-geharmoniseerde manieren operationaliseren. Ter illustratie: de helft van de gedragsstudies naar beloningsleren rapporteerde een afgevlakte leercurve, terwijl de andere helft nulresultaten rapporteerde; de beperkte literatuur over extinctie wordt gedomineerd door nulbevindingen en door rapporten waarin de voorafgaande acquisitiefase ontbreekt; en er is geen uitkomstmaat naar voren gekomen die universeel betrouwbaarder is, waardoor verschillende responskanalen geen uitwisselbare proxies voor elkaar zijn. Hun expliciete aanbeveling is een verschuiving naar within-subject, multi-domein en multi-kanaal protocollen die indices op individueel niveau opleveren. De huidige triade volgt die aanbeveling omdat de drie taken drie computationeel dissocieerbare eisen beslaan die geen enkel enkel paradigma dekt, en waarvan de theorie van latente kwetsbaarheid7 voorspelt dat tegenspoed deze op verschillende manieren vormgeeft: (i) discriminatie tussen dreiging en veiligheid gecombineerd met instrumentele controleerbaarheid, waarbij opluchting fungeert als de veronderstelde bekrachtiger van vermijding13; (ii) inhibitoir (veiligheids)leren en de terugkeer van angst, onderzocht met sociale gezichtsstimuli11, het ecologisch relevante stimulusdomein voor interpersoonlijke mishandeling; en (iii) bekrachtigingsleren onder probabilistische onzekerheid, wat per deelnemer computationele parameters oplevert (leersnelheid alpha, inverse temperatuur beta)8. Omdat alle drie de taken bij dezelfde deelnemer worden afgenomen, is het ontwerp zodanig opgezet dat kan worden vastgesteld of ACE-gerelateerde veranderingen domein-generiek zijn — een globale recalibratie van associatief leren, zoals Hanson et al.8 voorstellen en zoals een neurocomputationeel account van latente kwetsbaarheid zou voorspellen6 — of valentie-specifiek, beperkt tot dreiging. Een studie met een enkele taak kan per definitie niet tussen deze concurrerende hypothesen beslissen.
De batterij is ontworpen om een set expliciete, directionele voorspellingen te testen, die de huidige steekproef onvoldoende power heeft om te beoordelen en die hier worden vermeld als doelstellingen voor studies met adequate power. In overeenstemming met het patroon van verminderd leren dat is beschreven door Ruge et al.1, wordt voorspeld dat een hogere ACE-belasting geassocieerd zal zijn met (i) een verminderde CS+/CS−-discriminatie in Experiment 1, gedreven door een afgezwakte respons op de CS+ en verwacht uitgesprokener in het autonome kanaal (SCR) dan in de declaratieve verwachting, die mogelijk intact blijft; (ii) een sterkere vermijdingsrespons en een hogere subjectieve verlichting bij de vermijdbare CS+, consistent met relief-reinforced avoidance13; (iii) een tragere extinctie en een snellere, grotere terugkeer van angst bij re-acquisitie in Experiment 2, een effect waarvan wordt voorspeld dat het wordt versterkt door de sociale (gezichts)stimuli die ecologische relevantie hebben voor interpersoonlijke tegenspoed11; en (iv) een lagere keuzeaccuraatheid, een lagere leersnelheid (alpha) en een grotere keuzevariabiliteit (lagere beta) in Experiment 38. Cruciaal is dat de drie taken gezamenlijk informatief zijn over een vijfde, discriminerende voorspelling: als de ACE-gerelateerde verandering domeingeneriek is, moet de afzwakking in alle drie de taken verschijnen; als deze valentie-specifiek is, moet deze beperkt blijven tot de twee dreigingsparadigma's en afwezig zijn bij probabilistisch beloningsleren. Omdat responskanalen gelijktijdig worden geregistreerd, is een verdere voorspelling testbaar — dat ACE-effecten kanaalafhankelijk zullen zijn in plaats van uniform, zodat conclusies getrokken uit een enkel kanaal niet kunnen worden gegeneraliseerd naar de andere.
Experiment 1 past het Pavloviaans-naar-operante angstconditioneringsparadigma aan met vermijding en proef-voor-proef opluchtingbeoordelingen ontwikkeld door San Martín et al.13, waarbij twee CS+-prikkels (één vermijdbaar, één onvermijdbaar) en één CS− worden gebruikt om Pavloviaanse discriminatie te scheiden van instrumentele controle over de aversieve uitkomst. In het oorspronkelijke paradigma werden de beoordelingen van de US-verwachting tijdens de Pavloviaanse acquisitiefase retrospectief aan het einde van de fase door de onderzoeker beoordeeld, in plaats van op proef-voor-proef basis. In de huidige aanpassing werden subjectieve beoordelingen van verwachting, dreiging en opluchting gelijktijdig gedurende de gehele taak op fase-voor-fase basis verzameld met behulp van visuele analoge schalen, waardoor continue monitoring van de leerdynamiek over de verschillende fasen mogelijk was.
Experiment 2 past het protocol voor angstverwerving en -extinctie aan met sociale (gezichts)stimuli van Dibbets en Evers9, en breidt dit uit met een korte re-acquisitietest om de snelle hervorming van de geconditioneerde respons te evalueren (savings-effect).
Experiment 3 past de probabilistische beloningsleertaak die is geïntroduceerd door Hanson et al.8 aan voor de studie naar leerverschillen gerelateerd aan vroege tegenspoed, met twee beloningscontingenties (80/20 en 70/30) die schattingen mogelijk maken van reinforcement-learning parameters per deelnemer (Q-learning Alpha en Beta). Door deze drie paradigma's te integreren binnen één laboratoriumsessie, maakt het huidige protocol een directe binnen-deelnemervergelijking mogelijk van dreigings- en beloningsleerprocessen die doorgaans afzonderlijk worden bestudeerd. Naast de nauwkeurigheid per trial en de Q-learning parameters, genereert de analysepijplijn ook individuele hellingen van de leertrajecten op basis van een lineair mixed model, die beschikbaar zijn voor gebruik in grotere steekproeven.
Twee verschillende doelen moeten hier strikt gescheiden worden, omdat ze niet equivalent zijn. Het eerste doel is vaststellen dat een batterij van dit type kan worden uitgevoerd als één geïntegreerde sessie van 60 min en dat elk van de componenten het canonieke effect oproept waarvoor het is ontworpen; het reproduceren van canonieke effecten is voldoende bewijs voor dit eerste doel. Het tweede doel is vaststellen dat de resulterende indices sensitief en specifiek zijn voor de gevolgen van tegenspoed in de kindertijd; het reproduceren van canonieke effecten is hiervoor onvoldoende bewijs, en de huidige steekproef heeft onvoldoende power om dit aan te tonen. De hoofddoelstelling van dit verslag is daarom de technische en methodologische haalbaarheid van de geïntegreerde batterij: of dreigingsverwerving, instrumentele vermijding met opluchting, extinctie en terugkeer van angst bij sociale stimuli, en probabilistisch beloningsleren gelijktijdig kunnen worden verworven via autonome, gedragsmatige en zelfrapportagekanalen binnen één sessie, en of de pijplijn stabiele, herbruikbare indices per deelnemer oplevert (differentiële SCR-contrasten, het operante opluchtingcontrast, Q-learning alfa- en betaparameters en individuele hellingen van de leertrajecten). De beoordeling van ACE-gerelateerde veranderingen in het leren vormt een secundair, exploratief en illustratief doel: de hier gerapporteerde analyses van individuele verschillen zijn bedoeld om de meetcapaciteit van het protocol aan te tonen en om de kandidaat-indices beschikbaar te maken voor toekomstig werk, niet om specifiek trauma-leerpaden te testen. Het protocol biedt dus kandidaat-indices; of deze beschikken over de sensitiviteit en specificiteit die vereist is om de neurocognitieve gevolgen van tegenspoed in de kindertijd te karakteriseren, moet nog worden vastgesteld in grotere, idealiter met extremegroepen verrijkte en vooraf geregistreerde steekproeven1,14.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Het huidige protocol beschrijft de procedures en instrumentatie die worden gebruikt om de huidgeleidingsrespons (Skin Conductance Response, SCR) te meten bij gezonde deelnemers van 18 jaar of ouder, in overeenstemming met de vereisten van de ethische commissie. Voordat zij deelnamen aan het onderzoek, hebben alle deelnemers een formulier voor geïnformeerde toestemming ondertekend, waarin ook de mogelijkheid was opgenomen om na zes maanden opnieuw te worden benaderd voor een follow-up assessment. Alle in dit document beschreven procedures zijn goedgekeurd door de Wetenschappelijke Ethische Commissie van de Universidad de los Andes (ID: CEC2025023).
OPMERKING: Dit protocol biedt een gedetailleerde beschrijving van de volledige experimentele workflow (Figuur 1>), inclusief de planning van deelnemers, laboratoriumvoorbereiding, acquisitie van fysiologische signalen, data-organisatie en de verwerking van gegevens na het experiment. Daarnaast beschrijft het de trainingsprocedure voor het personeel die is geïmplementeerd om ervoor te zorgen dat SCR-opnames consistent, gestandaardiseerd en betrouwbaar worden verzameld over alle experimentele sessies heen.
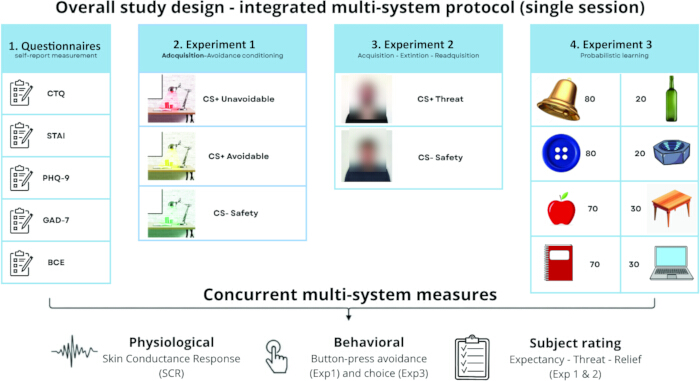
Figuur 1: Algemeen schema van het onderzoeksontwerpElke deelnemer voltooide één laboratoriesessie die bestond uit drie opeenvolgende gedragsparadigma's: Pavloviaanse-naar-operante angstconditionering met vermijding (Experiment 1), angstverwerving-extinctie-reacquisitie met sociale stimuli (Experiment 2) en probabilistisch beloningsleren (Experiment 3). Daarnaast werden zelfrapportages over tegenslagen in de kindertijd (CTQ-SF), positieve ervaringen in de kindertijd (BCE) en huidige symptomen (PHQ-9, GAD-7, STAI) verzameld. Multi-channel data — huidgeleidingsrespons, gedrag (vermijding, probabilistische keuzes) en subjectieve beoordelingen (verwachting, dreiging, opluchting) — werden gelijktijdig geregistreerd. Per deelnemer berekende indices werden ingevoerd in individuele-verschilanalyzes (zie Aanvullend bestand 2). Klik hier om een grotere versie van deze figuur te bekijken.
1. Training van het personeel
- Train elk teamlid in drie opeenvolgende fasen om gestandaardiseerde en nauwkeurige datametingen te garanderen.
- Voer interne proeven uit waarbij elk personeelslid monsters neemt en alle drie de experimenten uitvoert volgens de respectievelijke protocollen, zodat de cursist vertrouwd raakt met de apparatuur en de omgang met deelnemers.
- Laat elke cursist vervolgens monsters nemen van echte deelnemers onder toezicht van ten minste één van de hoofdonderzoekers, om hun vermogen om het protocol uit te voeren te verifiëren en eventuele fouten te corrigeren.
- Stel de assistent pas machtig om autonoom monsters te nemen en nieuwe deelnemers in te plannen nadat het volledige protocol correct onder toezicht is toegepast.
2. Planning
- Werving en planning van deelnemers via sociale media, waarbij de algemene doelstellingen van het onderzoek en de participatiecriteria worden verstrekt.
- Maak een digitale poster en verspreid deze via de wervingskanalen om zoveel mogelijk potentiële deelnemers te bereiken.
- Instrueer geïnteresseerde kandidaten om contact op te nemen met het onderzoeksteam via e-mail en plan een sessie op een dag die schikt voor de deelnemer.
- Stuur de deelnemer een link naar de online vragenlijst, getiteld "The Invisible Marks: The Role of Associative Learning in the Relationship between Adverse Childhood Experiences and Mental Health in Adulthood."
- Begin de vragenlijst met een formulier voor geïnformeerde toestemming en vereis dat de deelnemer dit leest en accepteert voordat er verdere items worden gepresenteerd.
- Voeg aan de vragenlijst een sociodemografische sectie en de volgende gevalideerde psychometrische schalen toe: Patient Health Questionnaire-9 (PHQ-9)15, Generalized Anxiety Disorder Screener (GAD-7)16, State-Trait Anxiety Inventory (STAI)17, Childhood Trauma Questionnaire—Short Form (CTQ-SF)18 en Benevolent Childhood Experiences (BCEs)10.
3. Voorbereidingen
- Zorg ervoor dat er ten minste één medewerker in het laboratorium aanwezig is voordat de deelnemer arriveert. Bereid de experimentele omgeving voor, controleer de juiste werking van de apparatuur en bevestig dat aan alle protocolvereisten is voldaan voordat de sessie begint:
- Zet de laboratoriumcomputer aan en controleer of het besturingssysteem, de experimentele software en alle randapparatuur correct functioneren.
- Bevestig dat de experimentele bestanden en het gegevensacquisitiesysteem klaar zijn voor gebruik.
- Open en beoordeel het dagelijkse run-bestand voordat de deelnemer het laboratorium betreedt.
- Stel de bijbehorende identificatiecode (ID) vast die aan de binnenkomende deelnemer is toegewezen.
- Controleer de uitvoeringsvolgorde van de experimentele condities volgens de vooraf gedefinieerde counterbalancing.
- Zorg ervoor dat de deelnemer aan de juiste experimentele volgorde is toegewezen voordat er aan gegevensacquisitie wordt begonnen.
OPMERKING: Het dagelijkse run-bestand bevat alle benodigde informatie om de ID van de deelnemer toe te wijzen en de uitvoeringsvolgorde van het experiment te bepalen, terwijl de vereiste counterbalancing over alle experimentele condities behouden blijft. Bijvoorbeeld, een deelnemer kan de ID "015" krijgen toegewezen. - Organiseer de gegevensopslag op de laboratoriumcomputer in de gestandaardiseerde mappenstructuur die vereist is voor de geautomatiseerde verwerkingspipeline: één hoofdmap per experiment, één submap per counterbalancing-conditie en één map per deelnemer-ID, plus twee globale mappen voor de verwerkte gegevens en de geconsolideerde databases (zie Supplementary File 1).
- Maak de deelnemermap aan die overeenkomt met de ID en de counterbalancing-conditie zoals vermeld in het dagelijkse run-bestand voordat de gegevensacquisitie begint, en volg gedurende de sessie de conventies voor mappen en bestandsnamen zoals gespecificeerd in Supplementary File 1, aangezien de pre-processing- en databasescripts bestanden op basis van pad en naam lokaliseren.
OPMERKING: De mappenstructuur, de labels voor de counterbalancing-submappen, de conventies voor bestandsnamen en een uitgewerkt voorbeeld zijn opgenomen in Supplementary File 1. Afwijkingen van deze conventies zorgen ervoor dat de geautomatiseerde pipeline de bestanden van de deelnemer niet kan lokaliseren. - Controleer of de experimentele tafel volledig vrij is van externe of afleidende objecten. Sta alleen het gegevensacquisitiesysteem en de randapparatuur van de computer die nodig zijn voor het experiment toe op de tafel.
- Nodig de deelnemer op een rustige en professionele manier uit om de kamer binnen te komen.
- Vraag de deelnemer om alle persoonlijke eigendommen opzij te leggen in de daarvoor bestemde ruimte.
- Instrueer de deelnemer om het mobiele apparaat op stil te zetten om onderbrekingen of afleidingen tijdens de experimentele sessie te voorkomen.
- Vraag de deelnemer om alle accessoires van de niet-dominante hand te verwijderen, in het bijzonder ringen, armbanden of elk object aan de middel- en ringvinger, aangezien deze de metingen kunnen beïnvloeden.
- Begeleid de deelnemer om comfortabel te gaan zitten in de stoel voor de laboratoriumcomputer.
- Geef de deelnemer een geprinte fysieke kopie van het document voor geïnformeerde toestemming (informed consent).
- Geef de deelnemer voldoende tijd om het document te lezen en indien nodig vragen te stellen.
- Bevestig dat het toestemmingsformulier correct is ondertekend voordat er een experimentele procedure wordt gestart.
OPMERKING: De procedure voor geïnformeerde toestemming wordt in fysieke vorm herhaald conform de vereisten van de ethische commissie en om een fysieke reservekopie van de toestemmingsdocumentatie van de deelnemer te behouden.
4. Experimentele opstelling
OPMERKING: De experimentele opstelling moet een strikt en gestandaardiseerd protocol volgen om te garanderen dat alle fysiologische metingen onder identieke gecontroleerde omstandigheden bij alle deelnemers worden verkregen.
- Schakel het acquisitiesysteem in en controleer of het apparaat correct is verbonden met de laboratoriumcomputer en wordt herkend door de software van het acquisitiesysteem (zie Figuur 2A–E).
- Bevestig opnieuw dat alle vereiste modules en randapparatuur correct functioneren voordat u overgaat tot de voorbereiding van de deelnemer.
- Neem twee elektroden voor elektrodermale activiteit (EDA) (zie Figuur 2F).
- Breng een kleine hoeveelheid geleidende gel aan op het contactoppervlak van elke elektrode (zie Figuur 2G,H).
- Zorg ervoor dat de geleidende gel gelijkmatig over het elektrode-oppervlak is verdeeld om het elektrische contact met de huid van de deelnemer te verbeteren en de signaalkwaliteit te optimaliseren.
OPMERKING: Als er geen geleidende gel op de elektroden wordt aangebracht, kan het geregistreerde signaal overmatige ruis bevatten en kan de kwaliteit van de meting van de huidgeleidingsrespons (SCR) ernstig worden aangetast. - Plaats de elektroden op de niet-dominante hand van de deelnemer.
- Bevestig één elektrode aan de eerste falanx van de middelvinger (derde vinger) en de tweede elektrode aan de eerste falanx van de ringvinger (vierde vinger) (zie Figuur 2I).
- Controleer of beide elektroden stevig zijn bevestigd en een stabiel contact met de huid behouden zonder ongemak voor de deelnemer te veroorzaken.
- Plaats de polsband om de pols van de deelnemer.
- Laat de EDA-elektroden tijdens de kalibratiefase losgekoppeld blijven van de polsband (zie Figuur 2J).
- Schakel de polsband in om draadloze communicatie met het fysiologische acquisitiesysteem tot stand te brengen.
- Bevestig dat het apparaat succesvol is gedetecteerd.
OPMERKING: Gedurende de gehele experimentele sessie moet speciale aandacht worden besteed aan de polsband. De medewerkers moeten continu controleren of het apparaat ingeschakeld en verbonden blijft voordat het experiment start, aangezien elke onderbreking in de communicatie de fysiologische registratie kan beïnvloeden. - Start het acquisitieproces in de acquisitiesoftware.
- Wacht op het kalibratievenster, dat automatisch op het scherm verschijnt zodra de acquisitie begint.
- Voer de kalibratieprocedure uit terwijl de elektroden losgekoppeld blijven van de polsband.
- Volg de kalibratieinstructies van de software tot de procedure is voltooid.
- Sluit na een succesvolle kalibratie de EDA-elektroden aan op de polsband (zie Figuur 2K).
- Controleer in de software of het signaal van de huidgeleidingsrespons (SCR) correct wordt geacquireerd.
- Instrueer de deelnemer om de niet-dominante hand gedurende het gehele experiment volledig stil te houden.
- Leg uit dat onnodige bewegingen, vingercontracties of veranderingen in houding ruis in het SCR-signaal kunnen introduceren.
- Vraag de deelnemer om tijdens de sessie een comfortabele en ontspannen houding aan te nemen.
- Voorzie de deelnemer van een koptelefoon voordat de experimentele taak start.
- Controleer of de koptelefoon correct functioneert en of de deelnemer de tijdens het experiment gepresenteerde auditieve stimuli duidelijk kan waarnemen.
- Start de experimentele taak in PsychoPy19.
- Wanneer de PsychoPy-interface opent, voert u de naam van de deelnemer in het aanvullende venster in dat daarom vraagt.
- Voer de toegewezen ID van de deelnemer precies zo in als gespecificeerd in het dagelijkse logbestand voordat u het experiment start.
OPMERKING: Volgend op het vorige voorbeeld moet de deelnemer-ID die in PsychoPy wordt ingevoerd "015" zijn.
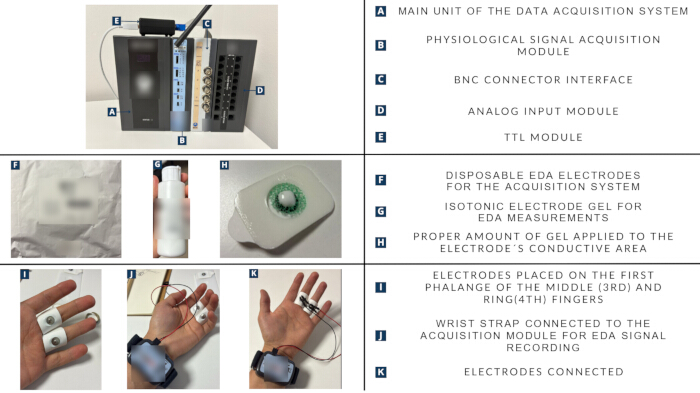
Figuur 2: Acquisitiesysteem, materialen en elektrodeplaatsing voor het registreren van de huidgeleiding. (AHoofdeenheid Biopac MP20.B) Module voor acquisitie van fysiologische signalen (PPG/EDA). (C) Connectormodule voor sensoren. (D) Analoge ingangsmodule. (E) TTL-module voor communicatie tussen PsychoPy en AcqKnowledge. (F) Wegwerpelektroden (EL507A). (G) Isotoon gel (GEL101A) om het huidcontact te verbeteren. (H) Aanbrengen van de gel op de elektrode. (I) Elektroden geplaatst in het eerste falanx van de derde en vierde vinger van de niet-dominante hand. (J) Plaatsing van de polsband op de niet-dominante hand voor de meting van de SCR. (K) Elektroden aangesloten na het kalibratieproces. Klik hier om een grotere versie van deze figuur te bekijken.
5. Begin van het experiment
- Leg vóór het begin van de experimentele taak aan de deelnemer in detail uit hoe er gereageerd moet worden op de vragen die tijdens het experiment worden gepresenteerd.
- Zorg ervoor dat de deelnemer het volgende duidelijk begrijpt: (i) de te gebruiken reactiemethode tijdens de taak, (ii) de betekenis van de instructies op het scherm, en (iii) het belang van alert blijven en het minimaliseren van onnodige bewegingen gedurende het hele experiment.
- Beantwoord alle resterende vragen van de deelnemer voordat de opnamesessie begint.
- Voer een definitieve controle uit van de volledige experimentele opstelling om te bevestigen dat alle systemen correct functioneren volgens het vastgestelde protocol, waaronder: de communicatie van het fysiologische acquisitiesysteem, de aansluiting van de polsband, de SCR-signaalinformatie, de uitvoering van PsychoPy, de audioweergave via de hoofdtelefoon en de correcte registratie van de deelnemer-ID.
- Zodra alle systemen zijn geverifieerd en de deelnemer bevestigt klaar te zijn om te beginnen, start de experimentele taak.
- Verlaat de experimentele ruimte zodra de taak is gestart, om externe invloeden en afleidingen tijdens de data-acquisitie te minimaliseren.
- Blijf in de nabijheid en beschikbaar voor het geval dat technische assistentie of ondersteuning van de deelnemer nodig is, en wacht tot de deelnemer de sessie heeft voltooid.
6. Tussen experimenten door
- Ga de experimenteerruimte opnieuw binnen zodra de deelnemer de taak heeft voltooid en stop de fysiologische registratie in de acquisitiesoftware.
- Sla de fysiologische registratie op in de map van de deelnemer als een acquisitiebestand en exporteer vervolgens dezelfde registratie naar het MATLAB-formaat met events, zodat het geëxporteerde bestand de stimulusmarkers bevat die door PsychoPy via de TTL-module zijn gegenereerd; de export produceert daarnaast een apart markerbestand.
OPMERKING: De event- en markerinformatie is vereist voor de pre-processing pipeline (Sectie 8) om het signaal per trial en per stimulustype te segmenteren. - Sla het PsychoPy-outputspreadsheet dat aan het einde van de taak is gegenereerd op in dezelfde map van de deelnemer. Gebruik de gestandaardiseerde conventie voor bestandsbenaming, zoals beschreven in Supplementary File 1, voor alle vier de bestanden.
OPMERKING: Aan het einde van elk experiment moet de map van de deelnemer het acquisitiebestand, het geëxporteerde MATLAB-bestand, het markerbestand en het PsychoPy-spreadsheet bevatten. Exacte namen, paden en een uitgewerkt voorbeeld zijn gegeven in Supplementary File 1. - Koppel voorzichtig de EDA-elektroden bij de deelnemer los, waarbij u ervoor zorgt dat er geen overmatige beweging of ongemak optreedt tijdens het verwijderen.
- Open de volgende PsychoPy-experimentele taak en start de acquisitiesoftware opnieuw op ter voorbereiding op het volgende experiment.
- Herhaal de volledige voorbereidings- en acquisitieprocedure beginnend bij stap 4.1.
OPMERKING: De volledige experimentele sessie bestaat uit drie onafhankelijke experimenten. Daarom moet, zodra het tweede experiment is voltooid, dezelfde hierboven beschreven procedure worden herhaald voor het derde experiment. - Zorg er aan het einde van de volledige experimentele sessie voor dat de deelnemer drie submappen heeft voor elke experimentele taak, die elk alle eerder genoemde bestanden bevatten.
OPMERKING: De geschatte duur van elke experimentele taak was voorheen bepaald om medewerkers in staat te stellen de deelnemer te monitoren en de correcte werking van het acquisitiesysteem gedurende de sessie te verifiëren. De geschatte duur van elk experiment is als volgt:
Experiment_1: ongeveer 24 min.
Experiment_2: ongeveer 17 min.
Experiment_3: ongeveer 8 min.
Rekening houdend met de voorbereiding, kalibratie, overgangsperioden tussen experimenten en de afrondingsprocedure, heeft de volledige experimentele sessie een geschatte duur van 60 min.
7. Beëindiging van de experimenten
- Beëindig de fysiologische registratiesessie zodra alle drie de experimentele taken zijn voltooid.
- Stop het acquisitieproces in de acquisitiesoftware als dit nog niet is gebeurd.
- Koppel de EDA-elektroden los van de polsband en verwijder de polsband van de pols van de deelnemer.
- Laat de deelnemer de EDA-elektroden zelf verwijderen om ongemak te minimaliseren en een veilige verwijdering van de huid te garanderen.
- Verifieer of alle experimentele bestanden en fysiologische registraties correct zijn opgeslagen voordat de sessie wordt afgerond.
- Bedank de deelnemer voor de medewerking en bied een lichte snack aan als blijk van waardering nadat de experimentele procedure is voltooid.
OPMERKING: Als er tijdens de fysiologische registratie problemen optreden door technische storingen, waaronder maar niet beperkt tot: verlies van communicatie tussen de polsband en de module van het fysiologische acquisitiesysteem, onverwachte uitschakeling van de polsband, loszittende of gedeeltelijk losgelaten elektroden, of tijdelijke signaalonderbrekingen of overmatige ruis veroorzaakt door verbindingsproblemen, moet het experiment worden voortgezet zoals gepland en mag de deelnemer de experimentele sessie niet herhalen.
8. Voorbewerking van de gegevens
OPMERKING: Zodra de experimentele sessie is voltooid en alle fysiologische opnames correct zijn opgeslagen, moeten de SCR-gegevens een gestandaardiseerde voorbewerkingsprocedure ondergaan voorafgaand aan de analyse.
- Voer het MATLAB-script Ledalab_Format uit om de datastructuur van de fysiologische opname die is geëxporteerd uit de acquisitiesoftware te reorganiseren, zodat deze compatibel is met Ledalab, een MATLAB-gebaseerde toolbox ontworpen voor de analyse van EDA-signalen.
OPMERKING: Definieer in de Ledalab_Format.mat code het pad van het {Identification_Code}.mat-bestand als een invoervariabele. Hierdoor kan het geëxporteerde fysiologische opnamebestand worden geconverteerd naar een formaat dat correct kan worden gelezen en verwerkt door Ledalab. Zodra het conversieproces is voltooid, moet er een nieuw MATLAB-bestand worden gegenereerd en opgeslagen in de bijbehorende deelnemersmap volgens de volgende naamgevingsconventie: Ledalab_{Identification_Code}.mat. Volgend op het eerdere voorbeeld: als de gegevens van Experiment_1 worden geconverteerd voor deelnemer "015", moet het resulterende bestand Ledalab_015.mat heten. - Open Ledalab; selecteer in de menubalk linksboven File > Import Data > Matlab File (*.mat). Laad vervolgens het onlangs gegenereerde databestand dat correspondeert met de experimentele conditie van de deelnemer.
- Voer de bemonsteringsparameters in het configuratievenster in dat Ledalab weergeeft zodra het bestand is geladen.
- De oorspronkelijke acquisitiefrequentie van het SCR-signaal is 20 Hz. Om de rekenlast te verminderen, moet het signaal worden gedownsampled naar 10 Hz met de volgende parameters: Target sampling frequency: 10 Hz, Downsampling factor: 200, Resampling method: Steps.
- Voer na voltooiing van de downsampling-procedure een continuous decomposition analysis (CDA)20 uit in Ledalab om het EDA-signaal te ontleden in tonische en fasische componenten.
- Selecteer in de menubalk Analysis > Continuous Decomposition Analysis (Extraction of Continuous Phasic/Tonic Activity).
- Wacht tot het configuratievenster op het scherm verschijnt.
- Selecteer in dit venster de optie Optimize om de analyseparameters automatisch aan te passen.
- Zodra het optimalisatieproces is voltooid, klikt u op Apply om de CDA-analyse te starten.
- Zodra de CDA-analyse is voltooid, selecteert u Results > Event-related Analysis, waarna er een configuratievenster op het scherm verschijnt.
- Stel de minimale amplitudedrempel in op de standaardwaarde van Ledalab van 0,01 µS en laat de z-scale optie niet geselecteerd. De event-markers die zijn geëxporteerd uit de acquisitiesoftware markeren het begin van de geconditioneerde stimulus en het begin van de ongeconditioneerde stimulus afzonderlijk, zodat de event-gerelateerde analyse voor beide een respons teruggeeft. Stel het responsvenster als volgt in:
- Voor Experiment 1: gebruik 0 s tot 9 s na de event-marker.
- Voor Experiment 2: gebruik 0 s tot 6 s na de event-marker.
- Exporteer het resultaat als een spreadsheet-bestand. Ledalab genereert een spreadsheet met de relevante fysiologische en event-gerelateerde informatie die uit het SCR-signaal is geëxtraheerd.
OPMERKING: Het responsvenster komt overeen met de volledige duur van de geconditioneerde stimulus in elke taak (Supplementary Table 1: 9 s in Experiment 1 en 6 s in Experiment 2), zodat de door de CS opgewekte respons het gehele CS-US-interval beslaat en niet wordt beïnvloed door de ongeconditioneerde respons, die afzonderlijk op zijn eigen event-marker wordt gescoord. Respondsen die onder de drempel van 0,01 µS vallen, worden door Ledalab als nul genoteerd en als nul in de analyse behouden; verwijder deze niet, omdat dit de gemiddelde respons van deelnemers met een lage respons zou opdrijven. - Herhaal de volledige procedure voor pre-processing, downsampling en CDA voor Experiment 2 (zie de OPMERKING hieronder voor Experiment 3, dat een andere procedure volgt en geen CDA-output vereist).
OPMERKING: Aan het einde van de pre-processing fase moet elke experimentele map een aanvullend spreadsheet-bestand bevatten dat correspondeert met de resultaten van de CDA-analyse gegenereerd door Ledalab. Dit bestand moet vervolgens worden geconverteerd naar .xlsx-formaat voor opslag, organisatie en verdere analyse. Experiment 3 volgt een andere pre-processing procedure. Voor dit experiment moet alleen het MATLAB-script worden gebruikt; de CDA-output is niet nodig, enkel de alfa- en betawaarden. Wanneer het script wordt uitgevoerd voor "Experiment_3", extraheert het automatisch de alfa- en betawaarden, voegt deze samen met de gedragsinformatie en slaat de resulterende spreadsheet op in Global_Data/Exp_3. - Voer kwaliteitscontrole van het signaal uit, bepaal non-responders en hanteer artefacten.
- Toon vóór elke statistische analyse het volledige gedownsamplede huidgeleidingsspoor van elke deelnemer in Ledalab en inspecteer dit visueel van de eerste tot de laatste event-marker. Voer deze inspectie voor elke deelnemer en voor elke taak afzonderlijk uit, aangezien de signaalkwaliteit kanaal- en taakspecifiek is.
- Verwerp een volledig spoor en behandel het SCR-kanaal van die taak als ontbrekend voor die deelnemer als een van de volgende zaken wordt waargenomen: (i) een vlak of afwezig signaal over de gehele taak, wat duidt op verlies van draadloze communicatie met de polsband, een uitgeschakelde polsband of een losgelaten elektrode; (ii) een tonisch huidgeleidingsniveau onder 0,05 µS dat gedurende de taak aanhoudt, wat duidt op onvoldoende elektrode-huidcontact in plaats van lage arousal; (iii) oninterpreteerbare drift of een plotselinge, aanhoudende toename van de amplitude die niet tijd-gekoppeld is aan enig event; of (iv) verzadiging van het bereik van de versterker.
OPMERKING: Herhaal de sessie niet en sluit de deelnemer niet uit van andere taken of van de gedrags- en zelfrapportagekanalen. - Definieer een deelnemer als een non-responder voor een bepaalde taak als geen enkele fasische respons de drempel van 0,01 µS bereikt of overschrijdt bij enig event van die taak, inclusief de ongeconditioneerde stimulus-events van de versterkte trials — dat wil zeggen, als de deelnemer geen meetbare electrodermale respons produceert, zelfs niet op de aversieve uitkomst zelf.
- Sluit een non-responder uit van elk kanaal van die taak — zowel huidgeleiding, gedrag als subjectieve ratings — omdat de afwezigheid van enige electrodermale respons, zelfs op de ongeconditioneerde stimulus, aangeeft dat het electrodermale systeem in die sessie niet meetbaar was, en vragen oproept over de vraag of de deelnemer überhaupt betrokken was bij de contingentie.
- Behoud die deelnemer in de twee overige taken. Maak dit onderscheid met technisch signaalverlies (een losgelaten elektrode of een polsband die de draadloze communicatie verloor), waarbij de deelnemer wel reageerde maar het signaal niet werd geregistreerd: behandel daar het SCR-kanaal van die taak als ontbrekend en behoud de gedrags- en subjectieve gegevens van die taak, die niet worden beïnvloed door de electrodermale signaalkwaliteit.
- Rapporteer het percentage non-responders en het percentage technisch verlies afzonderlijk voor elke taak.
- Identificeer bewegingsartefacten op het spoor als (i) abrupte stijgende transiënten die niet tijd-gekoppeld zijn aan enige event-marker, of (ii) trapvormige verschuivingen in het tonische niveau veroorzaakt door vingercontractie, een houdingsverandering of het wrijven van de elektroden tegen de stoel of het bureau.
- Markeer elke trial die een zodanig artefact bevat binnen het scorevenster en sluit deze uit op trial-niveau; sluit de deelnemer niet uit.
- Sluit een deelnemer uit van elk kanaal van een taak, en niet alleen van de SCR-analyse, als meer dan 25% van de trials van die taak als artefact-gecontamineerd zijn gemarkeerd: de resterende trials ondersteunen geen stabiele schatting per deelnemer meer, en de opnamecondities van die sessie zijn onvoldoende voor elk kanaal. Behoud die deelnemer in de twee overige taken.
- Transformeer de amplitudes op trial-niveau met log(SCR + 1) vóór het middelen, om de positief scheve verdeling van electrodermale amplitudes te normaliseren; zet elke negatieve CDA-waarde, een zeldzaam gevolg van baseline drift, om in nul vóór de transformatie.
- Aggregeer de getransformeerde trials om één waarde per deelnemer, per fase en per stimulus te verkrijgen.
- Rapporteer de analytische n afzonderlijk voor elk kanaal (SCR, gedrag, ratings) en voor elke taak, omdat kanaalspecifiek verlies ertoe leidt dat deze n uiteenlopen.
- Registreer elke beslissing genomen in stappen 8.14.1–8.14.9 in een kwaliteitslogboek per deelnemer met daarin: deelnemer-ID, taak, counterbalancing conditie, spoor geaccepteerd of verworpen (met reden), bereik van het tonische niveau, aantal en identiteit van artefact-verworpen trials, percentage artefact-verworpen trials, status als non-responder en de uiteindelijke analytische n-bijdrage voor elk kanaal.
- Sla het kwaliteitslogboek op bij de geconsolideerde databases, zodat kanaalspecifiek gegevensverlies auditeerbaar en reproduceerbaar is.
OPMERKING: In de huidige steekproef voldeed geen enkele deelnemer aan het non-responder criterium van stap 8.14.3 en overschreed geen enkele deelnemer de 25% artefactdrempel van stap 8.14.6; bijgevolg werd geen enkele deelnemer uitgesloten van alle kanalen van een taak. De divergenties in de analytische n zijn van twee onafhankelijke soorten: technisch verlies van het electrodermale kanaal, waardoor de gedrags- en subjectieve registraties van die taak intact blijven, en onvolledige gedrags- of zelfrapportagegegevens (een niet voltooide taak of ontbrekende visueel-analoge responsen), die onafhankelijk zijn van de electrodermale signaalkwaliteit. De exacte analytische n voor elk kanaal en elke taak wordt gerapporteerd in de paragraaf over de analytische steekproef van de Representative Results. Experiment 3 bevat geen SCR-kanaal, dus de n daarvan weerspiegelt gedragsverlies in plaats van electrodermaal verlies. Het expliciet rapporteren van deze criteria pakt het gebrek aan harmonisatie in de operationalisatie en rapportage van electrodermale uitkomsten aan, zoals benadrukt door Ruge et al.1.
9. Databanken
- Voer het Python-script Data_Bases.py uit om voor elke deelnemer de fysiologische metingen uit de SCR-registraties samen te voegen met de reacties die tijdens de experimentele taak zijn verzameld.
OPMERKING: Het script integreert de informatie uit de fysiologische registraties die via Ledalab zijn verwerkt, de CDA-analyse-outputs en de PsychoPy-antwoordspreadsheets die tijdens het experiment zijn gegenereerd. - Controleer na de succesvolle uitvoering van het script of er een geconsolideerde spreadsheet is gegenereerd die zowel fysiologische als gedragsmatige informatie voor een enkele deelnemer bevat en is opgeslagen in de map Global_Data.
OPMERKING: In navolging van het vorige voorbeeld: als Experiment_1 wordt geselecteerd voor analyse, zal het Python-script automatisch door de mappen van alle deelnemers lopen die aan dat experiment zijn gekoppeld, de CDA-outputs samenvoegen met de bijbehorende gedragsgegevens voor elke deelnemer en een individueel spreadsheetbestand genereren voor elke deelnemer in de map Global_Data/Exp_1 . - Zodra de individuele deelnemersdatabanken zijn gegenereerd, gebruikt u het Python-script Completed_Bases_Per_Experiment.py om de gegevens van alle deelnemers voor elke experimentele taak samen te voegen.
OPMERKING: Het script combineert de informatie uit alle deelnemermappen in één uniforme database voor elk experiment, wat verdere statistische analyse en gegevensverwerking vergemakkelijkt. Als de procedure succesvol is voltooid, worden er drie definitieve spreadsheets gegenereerd, elk behorend bij een van de drie experimenten:
Eén spreadsheet voor Experiment_1
Eén spreadsheet voor Experiment_2
Eén spreadsheet voor Experiment_3 - Sla de resulterende volledige databanken op in de map Complete_Data_Bases.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Analytisch monster
In totaal voltooiden 38 gezonde volwassenen de volledige experimentele sessie en de batterij van zelfrapportagevragenlijsten (CTQ-SF, BCE, PHQ-9, GAD-7, STAI). De steekproefgrootte per analyse varieerde licht door kanaalspecifiek dataverlies, niet door uitval van deelnemers. Steekproefgroottes per analyse: Experiment 1 — SCR- en beoordelings-ANOVA's (Pavloviaanse en operante fasen), n = 37; operante knopdruk-ANOVA, n = 38. Experiment 2 — beoordelingsanalyses...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
De huidige resultaten bevestigen de technische en methodologische haalbaarheid van een geïntegreerde batterij in één sessie die dreigingsverwerving met instrumentele controle, veiligheidsleren, terugkeer van angst en probabilistisch beloningsleren omvat. In een steekproef van 35 tot 38 gezonde volwassenen (de analytische steekproefgroottes verschilden licht tussen de experimenten vanwege kanaalspecifieke signaalverlies en niet door uitval van deelnemers) reproduceerde elk paradigma zijn canonieke effect: differentiële su...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs verklaren dat er geen concurrerende financiële of niet-financiële belangen zijn.
Dankbetuigingen
De auteurs danken alle deelnemers voor hun tijd en betrokkenheid, evenals de research assistants en het laboratoriumteam van de Universidad de los Andes. Dit onderzoek werd ondersteund door de Agencia Nacional de Investigacion y Desarrollo de Chile (ANID) via Fondecyt Iniciacion-beurs #11250037 (hoต้องonderzoeker: Maria Consuelo San Martin). R.C.V werd ondersteund door het National Center for Artificial Intelligence CENIA FB210017, Basal ANID.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| AcqKnowledge software | BIOPAC Systems Inc. | ACK100W (Windows) / ACK100M (Mac) | Software voor acquisitie en analyse van fysiologische signalen. RRID:SCR_014279 (verifiëren met huidige SciCrunch-vermelding). |
| afex (R-pakket) | Singmann, Bolker, Westfall, Aust & Ben-Shachar | Versie 1.5-1 | R-pakket voor factoriële experimenten. Gebruikt voor alle repeated-measures ANOVA's (Experimenten 1-3) via aov_ez(). RRID:SCR_022761 (verifiëren met huidige SciCrunch-vermelding). |
| ARTool (R-pakket) | Wobbrock, Findlater, Gergle & Higgins | Versie 0.11.2 | Aligned Rank Transform voor non-parametrische factoriële ANOVA. Gebruikt voor de Phase x Stimulus ANOVA op huidgeleiding in Experiment 2, waarvan de distributie non-Gaussisch is. |
| Benevolent Childhood Experiences (BCE) schaal | Narayan, Rivera, Bernstein, Harris & Lieberman (2018) | Publiek domein instrument (10 items) | Spaanse adaptatie gebruikt. Geen RRID toegewezen aan dit instrument; citeer het originele validatieartikel. |
| BioNomadix polsband (zender) | BIOPAC Systems Inc. | BN-PPGED-T | Draagbare zender voor EDA- en PPG-signalen. Gebruikt in combinatie met de BioNomadix-ontvangermodule. |
| Childhood Trauma Questionnaire - Short Form (CTQ-SF) | Bernstein et al. (2003) | Gevalideerde retrospectieve zelfrapportage van 28 items | Vijf subschalen (EA, PA, SA, EN, PN). Geen RRID; citeer het originele validatieartikel. Spaanse adaptatie gebruikt. |
| Geleidingsgel voor EDA-elektroden | BIOPAC Systems Inc. | GEL101A | Isotone gel voor huidgeleidingsmetingen. |
| Wegwerpbare Ag/AgCl EDA-elektroden | BIOPAC Systems Inc. | EL507A | Wegwerpelektroden voor huidgeleidingsregistratie. |
| Generalized Anxiety Disorder Scale (GAD-7) | Spitzer, Kroenke, Williams & Löwe (2006) | Zelfrapportage van 7 items | Gevalideerde Spaanse versie gebruikt. Geen RRID voor het instrument; citeer het origineel. |
| ggplot2 (R-pakket) | Wickham | Versie 4.0.3 | Plot-systeem gebaseerd op de grammar-of-graphics. RRID:SCR_014601 (verifiëren met huidige SciCrunch-vermelding). |
| Koptelefoon (over-ear) | HyperX (HP Inc.) | Cloud III | Bedrade gesloten gaming-headset; gebruikt voor het afspelen van de auditieve ongeconditioneerde stimulus tijdens angstconditionering. |
| Ledalab | Benedek & Kaernbach (2010) | Open-source MATLAB toolbox v3.2.5 | Continuous Decomposition Analysis (CDA) van huidgeleidingssignalen. Geen RRID toegewezen (citeer in plaats daarvan het originele artikel). |
| lme4 (R-pakket) | Bates, Maechler, Bolker & Walker | Versie 1.1-37 | Lineaire mixed-effects modellen. Gebruikt om de hellingen van de leertrajecten per deelnemer in Experiment 3 te schatten. RRID:SCR_015654 (verifiëren met huidige SciCrunch-vermelding). |
| MATLAB | MathWorks | R2025a | Gebruikt om Ledalab en de SCR pre-processing pipeline uit te voeren. RRID:SCR_001622. |
| Patient Health Questionnaire-9 (PHQ-9) | Kroenke, Spitzer & Williams (2001) | Zelfrapportage van 9 items | Gevalideerde Spaanse versie gebruikt. Geen RRID voor het instrument; citeer het origineel. |
| Fysiologische data-acquisitie-unit (PsychoPy) | BIOPAC Systems Inc. | MP200 | Hoofdunit voor acquisitie van fysiologische signalen. Gecombineerd met de draadloze BioNomadix EDA-module. |
| Python | Python Software Foundation | Versie 3.12 | Gebruikt voor de pre-processing pipeline die de Ledalab-output samenvoegt met de PsychoPy gedragsregistraties (Data_Bases.py, Completed_Bases_Per_Experiment.py). RRID:SCR_008394 (verifiëren met huidige SciCrunch-vermelding). |
| R (statistische rekenomgeving) | R Foundation for Statistical Computing | Versie 4.5.0 | Omgeving waarin alle statistische analyses zijn uitgevoerd. Moderatiemodellen zijn geschat via ordinary least squares regressie met de lm() functie van het basis stats-pakket, waarbij predictoren z-gestandaardiseerd zijn en de interactieterm is berekend als hun product; er is geen gespecialiseerd moderatiepakket gebruikt. RRID:SCR_001905 (verifiëren met huidige SciCrunch-vermelding). |
| State-Trait Anxiety Inventory (STAI) | Spielberger et al. (1983) | STAI Formulier Y (40 items, SAI + TAI) | Gevalideerde Spaanse versie gebruikt. Geen RRID voor het instrument; citeer het origineel. |
| Monitor voor stimuluspresentatie | Samsung | LS22D300GALXZS (S22D300, 22-inch LED) | Scherm gebruikt voor visuele CS+ / CS- stimuli en ratingschalen. |
Referenties
- Ruge J, et al. How adverse childhood experiences get under the skin: a systematic review, integration and methodological discussion on threat and reward learning mechanisms. eLife. 2024;13:e92700.
- Madigan S, et al. Adverse childhood experiences: a meta-analysis of prevalence and moderators among half a million adults in 206 studies. World Psychiatry. 2023;22(3):463-71.
- Teicher MH, Gordon JB, Nemeroff CB. Recognizing the importance of childhood maltreatment as a critical factor in psychiatric diagnoses, treatment, research, prevention, and education. Mol Psychiatry. 2022;27(3):1331-8.
- Smith KE, Pollak SD. Children's value-based decision making. Sci Rep. 2022;12:5953.
- Montague PR, Hyman SE, Cohen JD. Computational roles for dopamine in behavioural control. Nature. 2004;431(7010):760-7.
- Gerin MI, et al. A neurocomputational investigation of reinforcement-based decision making as a candidate latent vulnerability mechanism in maltreated children. Dev Psychopathol. 2017;29(5):1689-705.
- McCrory EJ, Viding E. The theory of latent vulnerability: reconceptualizing the link between childhood maltreatment and psychiatric disorder. Dev Psychopathol. 2015;27(2):493-505.
- Hanson JL, et al. Early adversity and learning: implications for typical and atypical behavioral development. J Child Psychol Psychiatry. 2017;58(7):770-8.
- van den Bos W, Güroğlu B, van den Bulk BG, Rombouts SARB, Crone EA. Better than expected or as bad as you thought? The neurocognitive development of probabilistic feedback processing. Front Hum Neurosci. 2009;3:52.
- Narayan AJ, Rivera LM, Bernstein RE, Harris WW, Lieberman AF. Positive childhood experiences predict less psychopathology and stress in pregnant women with childhood adversity. Child Abuse Negl. 2018;78:19-30.
- Dibbets P, Evers EAT. The influence of state anxiety on fear discrimination and extinction in females. Front Psychol. 2017;8:347.
- Sperl MFJ, Panitz C, Hermann C, Mueller EM. A pragmatic comparison of noise burst and electric shock unconditioned stimuli for fear conditioning research with many trials. Psychophysiology. 2016;53(7):1017-34.
- San Martín C, Jacobs B, Vervliet B. Further characterization of relief dynamics in the conditioning and generalization of avoidance: effects of distress tolerance and intolerance of uncertainty. Behav Res Ther. 2020;124:103526.
- McLaughlin KA, DeCross SN, Jovanovic T, Tottenham N. Mechanisms linking childhood adversity with psychopathology: learning as an intervention target. Behav Res Ther. 2019;118:101-9.
- Kroenke K, Spitzer RL, Williams JBW. The PHQ-9: validity of a brief depression severity measure. J Gen Intern Med. 2001;16(9):606-13.
- Spitzer RL, Kroenke K, Williams JBW, Löwe B. A brief measure for assessing generalized anxiety disorder: the GAD-7. Arch Intern Med. 2006;166(10):1092-7.
- Spielberger CD. Manual for the State-Trait Anxiety Inventory (Form Y). Consulting Psychologists Press; Palo Alto (CA); 1983.
- Bernstein DP, et al. Development and validation of a brief screening version of the Childhood Trauma Questionnaire. Child Abuse Negl. 2003;27(2):169-90.
- Peirce J, et al. PsychoPy2: experiments in behavior made easy. Behav Res Methods. 2019;51(1):195-203.
- Benedek M, Kaernbach C. A continuous measure of phasic electrodermal activity. J Neurosci Methods. 2010;190(1):80-91.
- Lonsdorf TB, et al. Don't fear "fear conditioning": methodological considerations for the design and analysis of studies on human fear acquisition, extinction, and return of fear. Neurosci Biobehav Rev. 2017;77:247-85.
- LeDoux JE, Moscarello J, Sears R, Campese V. The birth, death and resurrection of avoidance: a reconceptualization of a troubled paradigm. Mol Psychiatry. 2017;22(1):24-36.
- Wobbrock JO, Findlater L, Gergle D, Higgins JJ. The aligned rank transform for nonparametric factorial analyses using only ANOVA procedures. Presented at: Proceedings of the SIGCHI Conference on Human Factors in Computing Systems (CHI '11); New York (NY); 2011.
- Fritz MS, MacKinnon DP. Required sample size to detect the mediated effect. Psychol Sci. 2007;18(3):233-9.
- Bouton ME. Learning and behavior: a contemporary synthesis. Sinauer Associates; Sunderland (MA); 2007.
- Rescorla RA, Wagner AR. A theory of Pavlovian conditioning: variations in the effectiveness of reinforcement and nonreinforcement. In: Black AH, Prokasy WF, editors. Classical Conditioning II: Current Research and Theory. Appleton-Century-Crofts; New York (NY); 1972.
- McClelland GH, Judd CM. Statistical difficulties of detecting interactions and moderator effects. Psychol Bull. 1993;114(2):376-90.
- Maier SF, Seligman MEP. Learned helplessness at fifty: insights from neuroscience. Psychol Rev. 2016;123(4):349-67.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Herprints en machtigingen
Dit artikel is gepubliceerd
Video binnenkort beschikbaar