Deze studie presenteert een op Explainable AI gebaseerd Industry 5.0 cyber-fysiek samenwerkingskader dat gebruikmaakt van een CNN-transformer en SHAP voor het detecteren van industriële akoestische anomalieën op de MIMII-dataset. Edge-computing-integratie ondersteunt interpreteerbaar, mensgericht voorspellend onderhoud.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Door uitlegbare AI ondersteunde cyber-fysieke samenwerking voor duurzame productie in Industrie 5.0
In dit artikel
Samenvatting
Samenvatting
In deze studie presenteren we een innovatieve benadering voor de duurzame productie van industriële onderdelen met behulp van een cyber-fysiek collaboratiesysteem gebaseerd op uitlegbare kunstmatige intelligentie (XAI) voor Industrie 5.0. Uit onderzoek is gebleken dat huidige cyber-fysieke menselijke systemen (CPHS'en) AI slechts in beperkte mate integreren en vaak een gebrek aan uitlegbaarheid vertonen. Er is daarom een behoefte om hun schaalbaarheid en flexibiliteit te verbeteren, in overeenstemming met de beginselen van Industrie 5.0: veerkracht, levensvatbaarheid op lange termijn en mensgerichtheid. Om deze tekortkomingen aan te pakken, introduceren we een architectuur die deep learning en uitlegbare AI integreert in het Cyber-Physical System (CPS) ecosysteem om slimme, uitlegbare besluitvorming mogelijk te maken. Specifiek maken we gebruik van de Malfunctioning Industrial Machine Investigation and Inspection (MIMII) dataset voor het detecteren van machinefouten op basis van akoestische signalen. Audiosignalen ondergaan een spectrale transformatie om spectrogrambeelden te genereren, die vervolgens worden verwerkt door een convolutioneel neuraal netwerk (CNN) voor ruimtelijke kenmerksextractie en een transformer-encoder voor temporele kenmerken. Om de transparantie te vergroten en human-in-the-loop samenwerking te faciliteren, helpt een benadering op basis van Shapley additive explanations (SHAP) operators om het besluitvormingsproces van het systeem te begrijpen door de inputkenmerken die de modelvoorspellingen beïnvloeden te highlighten. Daarnaast wordt het raamwerk toegepast in een op edge-computing gebaseerd cyber-fysiek systeem om een lage latentie en een laag energieverbruik te bereiken terwijl er tijdige responsen worden geboden, wat helpt bij het waarborgen van een duurzame productieomgeving. Experimentele resultaten tonen aan dat de voorgestelde CNN-Transformer architectuur een nauwkeurigheid van 98,5% behaalt en beter presteert dan bestaande CPHS-systemen, terwijl een lage latentie behouden blijft. Het gebruik van uitlegbare AI in een dergelijk cyber-fysiek collaboratiesysteem vergroot het vertrouwen van de operator aanzienlijk en maakt een naadloze mens-machine samenwerking mogelijk.
Inleiding
De overgang van Industrie 4.0, waarbij de nadruk lag op technologie, mechanisatie en communicatie, naar het nieuwe Industrie 5.0-model, dat technologische vooruitgang combineert met aanpassingsvermogen, duurzame ontwikkeling en mensgerichtheid, heeft de dynamische evolutie van industriële systemen beïnvloed1,2. De Europese Commissie definieert Industrie 5.0 als een paradigma dat zich niet alleen richt op productiviteit en efficiëntie, maar ook op de drie pijlers van mensgerichtheid, duurzaamheid en veerkracht. Het is belangrijk op te merken dat recent onderzoek de rol van AI-systemen, mens-machine samenwerking en duurzame productie heeft aangewezen als de belangrijkste drijfveren van Industrie 5.0-omgevingen3,4. Traditionele onderhoudsmethoden zijn in deze evoluerende industriële omgeving niet langer voldoende. Om veerkracht mogelijk te maken in complexe, instabiele contexten, moet onderhoud evolueren naar een meer aanpasbare en systemische vorm5. Sinds 2011 is Industrie 4.0 het dominante model voor industriële transformatie in Europa geweest, waarbij de digitale transformatie van bedrijven werd aangemoedigd om de bedrijfsvoering te verbeteren en beschikbare middelen te maximaliseren4. Het is daarom essentieel om de efficiëntie te verhogen zonder menselijke arbeid in de productie te elimineren, terwijl de gezondheid en veiligheid van werknemers worden beschermd. Om deze reden zijn bedrijven en academici begonnen met het definiëren van de beginselen van het Industrie 5.0-paradigma5,6,7, mede gemotiveerd door het Japanse concept van Society 5.08,9,10,11. Ondanks de toegenomen nadruk op duurzaam onderhoud in recente literatuur blijven de meeste bestaande systematische evaluaties gefragmenteerd of domeinspecifiek, waarbij een allesomvattend kader dat veerkracht, duurzaamheid en AI integreert, ontbreekt. Zo onderzoeken auteurs duurzame onderhoudspraktijken voor specifieke systemen of strategieën, waaronder duurzaam totaal productief onderhoud (STPM), terwijl onderzoekers spreken over het integreren van duurzaamheidsthema's in onderhoudstechnieken12,13,14. Auteurs voerden een uitgebreide beoordeling uit van criteria voor de adoptie van duurzaamheid en benadrukten technologische factoren die ervoor zorgen dat productie een positieve duurzame impact heeft15. Desondanks zijn duurzaamheid, veerkracht en AI-gebaseerde besluitvorming binnen het Industrie 5.0-paradigma in geen van deze werken volledig geïntegreerd. Als gevolg hiervan richten afzonderlijke onderhoudsmethoden zich vaak op duurzaamheid. SHAP onderscheidt zich van andere technieken voor uitlegbare kunstmatige intelligentie (XAI) vanwege de theoretisch onderbouwde methode voor kenmerkattributie16,17,18.
Data-gestuurde besluitvorming wordt mogelijk gemaakt door AI, maar nauwkeurige modellen vereisen vaak grote hoeveelheden gegevens. Conventionele technieken voor machine learning (ML), zoals beslisbomen, logistieke regressie en lineaire regressie, presteren vaak slecht in sterk niet-lineaire situaties omdat ze uitgaan van relatief eenvoudige datadistributies19. Diepe neurale netwerken (DNN's) omzeilen deze beperkingen door complexe kenmerkrepresentaties te leren uit massale datasets20. Volgens onderzoeken21 presteren diepere netwerken vaak beter dan ondiepe structuren bij complexe besluitvormingstaken, maar hun toenemende diepte en parametercomplexiteit maken het model minder interpreteerbaar22.
Een cyber-fysiek systeem (CPS) is een cruciale ondersteunende technologie voor productie binnen Industrie 5.0, omdat het gedistribueerde intelligentie, embedded computers, fysieke processen en communicatie combineert. Om flexibele, intelligente en real-time industriële operaties mogelijk te maken, integreren moderne CPS'en snel edge computing, edge AI en het groene Internet of Things (G-IoT)23,24. Duurzaamheid en veerkracht zijn in recente studies naar Maintenance 4.0 en smart maintenance sterk benadrukt. Terwijl eerdere werken de betekenis van Maintenance 4.0-technologie in duurzame productie hebben onderzocht en modelleringskaders voor duurzaam onderhoud hebben voorgesteld, hebben bibliometrische en systematische studies smart maintenance-technologieën beoordeeld25,26,27,28. Verder onderzoek heeft de integratie van duurzaam onderhoud in Industrie 4.0-omgevingen en duurzaamheidsgeoriënteerde productiesystemen onderzocht29,30,31,32. Het Operator 4.0-concept33, mensgerichte Industrie 5.0-kaders34 en socio-economische perspectieven35 hebben allemaal aanzienlijke aandacht besteed aan mensgericht onderhoud. Daarnaast zijn vooruitgang in digitaal onderhoud36, predictief en prescriptief onderhoud37,38 en duurzame onderhoudsstrategieën39,40 in recente studies benadrukt. Ondanks deze vooruitgang blijft het onderzoek versnipperd en bieden weinig studies een samenhangend paradigma dat uitlegbare AI, duurzaamheid, veerkracht en mensgerichte cyber-fysieke samenwerking integreert. Cyber-fysieke systemen (CPS'en) hebben, ondanks hun toenemende inzet, geen volledige autonomie bereikt, en het Industrie 5.0-paradigma streeft daar ook niet naar. Industrie 5.0 legt daarentegen meer nadruk op menselijk toezicht, samenwerking en besluitvorming. Door menselijk denken en samenwerking in cyber-fysieke processen te betrekken, breiden cyber-menselijke systemen, zoals human-in-the-loop CPS'en (HiLCPSs)41, mensgerichte CPS'en (HCPSs)42,43 en cyber-fysieke menselijke systemen (CPHSs)44, traditionele CPS'en uit. Deze integratie verbetert de aanpassingscapaciteit, transparantie, veiligheid en veerkracht door real-time samenwerking tussen intelligente systemen en menselijke operators mogelijk te maken45,46.
De detectie van audio-anomalieën in de industrie is sterk verbeterd door nieuwe architecturen, waaronder de Vision Transformer (ViT), Audio Spectrogram Transformer (AST), Conformer en self-supervised learning; de integratie daarvan met uitlegbare cyber-fysische systemen voor Industrie 5.0 blijft echter beperkt. Zonder de integratie van uitlegbaarheid, edge-implementatie en human-in-the-loop beslissingsondersteuning in één enkel framework, richt het huidige onderzoek zich primair op classificatienauwkeurigheid of op post hoc XAI-gebaseerde interpreteerbaarheid. Deze studie stelt een nieuwe, door Explainable AI ondersteunde CNN-Transformer cyber-fysische collaboratiearchitectuur voor die edge computing, temporele afhankelijkheidsmodellering, SHAP-gebaseerde uitlegbaarheid, spatiale kenleereffecten en mensgerichte beslissingsondersteuning combineert om duurzame productie binnen Industrie 5.0 mogelijk te maken en deze beperkingen te overwinnen.
Hierdoor blijft er een aanzienlijk onderzoekstekort bestaan. Huidige technieken voor akoestische anomaliedetectie op basis van CNN/Transformers geven prioriteit aan classificatieprestaties, maar missen cyber-fysieke samenwerking en uitlegbaarheid. Hoewel kaders voor Industrie 5.0 conceptuele mensgerichte modellen bieden, integreren deze geen uitlegbaar deep learning, edge-intelligentie en door de operator ondersteunde besluitvorming in één enkel systeem; XAI-gebaseerde technieken voor voorspellend onderhoud vergroten wel de transparantie, maar functioneren onafhankelijk van CPHS-architecturen. Daarom ontbreekt er nog steeds een enkel cyber-fysiek menselijk systeem voor Industrie 5.0 dat precieze auditieve anomaliedetectie, SHAP-gebaseerde uitlegbaarheid, edge-gebaseerde implementatie en human-in-the-loop samenwerking integreert.
Dit artikel stelt een nieuw, door Explainable AI ondersteund CNN-Transformer cyber-fysiek samenwerkingsparadigma voor Industrie 5.0 voor om deze beperkingen te overwinnen. De voorgestelde architectuur combineert edge computing-implementatie, CNN-gebaseerde ruimtelijke kenmertextractie, Transformer-gebaseerd leren van temporele afhankelijkheden, SHAP-gebaseerde uitlegbaarheid en mens-in-de-lus beslissingsondersteuning in één enkel CPHS-framework. In tegenstelling tot huidige methoden die deze elementen onafhankelijk behandelen, biedt het voorgestelde framework een geïntegreerde oplossing die gelijktijdig de prestaties van anomaliedetectie, modeltransparantie, operationele efficiëntie en mensgerichte samenwerking voor duurzame productie verbetert.
Het hoofddoel van deze studie is het creëren van een cyberfysisch menselijk systeem (CPHS) met Explainable AI voor duurzame productie binnen Industrie 5.0, door SHAP-gebaseerde uitlegbaarheid, edge computing en mens-in-de-lus beslissingsondersteuning te combineren met een hybride CNN-Transformer-gebaseerde methode voor akoestische anomaliedetectie. In het bijzonder beoogt het voorgestelde raamwerk de nauwkeurigheid van anomaliedetectie te verbeteren terwijl er duidelijke, begrijpelijke voorspellingen worden geboden, wat een efficiënte edge-implementatie faciliteert en coöperatieve besluitvorming tussen intelligente systemen en menselijke operators stimuleert. Door gelijktijdig hoge detectieprestaties, uitlegbaarheid, een lage latentie en mensgerichte cyberfysische samenwerking te realiseren, pakt deze geïntegreerde architectuur de tekortkomingen van huidige raamwerken voor akoestische anomaliedetectie, XAI-gebaseerd predictief onderhoud en CPHS aan.
De voorgestelde architectuur presenteert een geïntegreerd, door Explainable AI ondersteund cyberfysisch menselijk systeem (CPHS) voor Industrie 5.0, in tegenstelling tot huidige technieken voor akoestische anomaliedetectie, die zich primair richten op classificatienauwkeurigheid. Binnen één enkele architectuur combineert het CNN-gebaseerde ruimtelijke kenmerkextractie, Transformer-gebaseerde temporele modellering, SHAP-gebaseerde uitlegbaarheid, edge computing en human-in-the-loop beslissingsondersteuning. De voorgestelde architectuur pakt cruciale kwesties aan op het gebied van transparantie, operatorondersteuning en cyberfysische samenwerking door nauwkeurige anomaliedetectie te fuseren met begrijpelijke besluitvorming en real-time edge-implementatie. De belangrijkste wetenschappelijke bijdrage van dit werk is de integratie op systeemniveau, waardoor de voorgestelde aanpak zich onderscheidt van eerder onderzoek dat zich uitsluitend richt op anomaliedetectie, explainable AI of frameworks voor Industrie 5.0.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
De voorgestelde methodologie maakt gebruik van een systeembestuurde Industry 5.0 Cyber-physical human system (CPHS)-benadering die uitlegbare deep learning combineert met een cyber-fysiek samenwerkingskader mogelijk gemaakt door edge computing om duurzame productieprocessen te ondersteunen. Ten eerste wordt het probleem aangepakt door bepaalde beperkingen van huidige CPHS-oplossingen te herkennen, zoals een gebrek aan AI-gestuurde intelligentie, uitlegbaarheid en mensgerichte samenwerking. Om deze uitdagingen aan te pakken, maakt de voorgestelde oplossing gebruik van de MIMII-dataset voor conditiemonitoren van industriële machines middels akoestische signaalverwerking.
Het voorgestelde raamwerk begint met het invoeren van de gegenereerde spectrogrammen in een CNN-model dat ruimtelijke kenmerken extraheert door significante frequentiepatronen te herkennen die geassocieerd zijn met verschillende machinetoestanden. De geëxtraheerde ruimtelijke kenmerken worden omgezet in sequenties en ingevoerd in een transformer-encoder-module om temporele afhankelijkheden via self-attention vast te leggen. De getransformeerde kenmerkrepresentatie wordt vervolgens doorgegeven aan een volledig verbonden classifiermodule om machinetoestanden te classificeren als normaal of abnormaal. Daarnaast wordt, om transparantie te waarborgen en mensgerichte besluitvorming te faciliteren, de SHAP-uitlegbaarheidsbenadering gebruikt om voorspellingen toe te lichten door significante tijd-frequentiegebieden in de modeloutput te selecteren. Het ontworpen model zal worden geïmplementeerd in een edge-enabled CPS-omgeving, waardoor real-time inferentie mogelijk is met een lage computationele latentie en een laag energieverbruik. Bovendien zal een human-in-the-loop-schema worden geïntegreerd om menselijke operators in staat te stellen validaties uit te voeren op basis van de uitlegbaarheidsresultaten. De prestaties worden gevalideerd met behulp van nauwkeurigheid, precisie, recall en de F1-score, evenals andere systeemmetrieken zoals latentie en energie-efficiëntie.
Het voorgestelde raamwerk is een door XAI aangestuurd CPHS-mechanisme voor duurzame productie in de context van Industrie 5.0, en de workflow ervan wordt gepresenteerd als een pijplijn van data-acquisitie tot intelligente besluitvorming en uitvoering, zoals weergegeven in Figuur 1. In de beginfase van de procedure voor data-acquisitie worden geluidssignalen verzameld van machines in industrieën zoals motoren, pompen en lagers met behulp van datasets waaronder MIMII. De zo verkregen datasignalen worden doorgezet naar de volgende fase, aangeduid als data-preprocessing, waar ze worden onderworpen aan filtering, normalisatie en segmentatie. De gesegmenteerde datasignalen worden tenslotte omgezet in een spectrogram met behulp van de short-time Fourier transform (STFT) op de laag voor kenmerkrepresentatie.
Vervolgens gebruikt de AI-modellocatie de spectrogrambeelden om via de CNN-module kenmerken te extraheren, waarbij ruimtelijke patronen en anomalieën worden geïdentificeerd. Daarna worden de geëxtraheerde kenmerken hervormd en ingevoerd in de transformer-encoder, die via self-attention-mechanismen temporele afhankelijkheden en langetermijnrelaties leert. De resulterende kenmerkvectoren worden met behulp van de classificatielaag geclassificeerd als normaal of abnormaal. Om transparantie in het voorspellingsproces te waarborgen, gebruikt de explainability-laag SHAP om significante tijd-frequentiegebieden in het spectrogram te markeren.
Daarnaast is er een "human-in-the-loop"-proces waarbij operators de resultaten van het model interpreteren en feedback geven. In de implementatielaag draait het model op een edge-gebaseerde CPHS-infrastructuur, wat zorgt voor een snelle inferentie en een laag energieverbruik, terwijl er optioneel een koppeling is met cloudsystemen voor opslagvereisten of geavanceerde analyses. Samen waarborgt het raamwerk een nauwkeurige foutdetectie, verklaarbaarheid en efficiënte real-time werking in overeenstemming met de eisen van Industrie 5.0.
Probleemdefinitie en vereistenanalyse
Cyber-fysieke menselijke systemen (CPHS) in Industry 5.0-omgevingen beloven intelligentie, duurzaamheid en mensgerichtheid. Toch worden hedendaagse frameworks voor het bouwen van CPHS belemmerd door een gebrek aan geavanceerde AI-gestuurde mogelijkheden, uitlegbaarheid en adequate ondersteuning voor mens-machinecollaboratie. Inderdaad zijn conventionele CPHS gebaseerd op regelgebaseerde of oninterpreteerbare modellen, wat de aanpassing aan veranderende industriële omstandigheden belemmert en het vertrouwen van operators in automatisering beperkt. Bovendien kunnen conventionele CPHS geen hoogwaardige data effectief analyseren, zoals industriële akoestische signalen die zowel ruimtelijke (d.w.z. frequentie) als tijdsafhankelijke componenten bevatten, welke essentieel zijn voor voorspellend onderhoud. Daarom is het noodzakelijk om een framework te creëren dat machineanomalieën met hoge precisie kan detecteren, uitleg kan geven en aan de edge kan opereren, waardoor CPS wordt gefaciliteerd.
Hier is x(t) het akoestische ingangssignaal, S(f,t) de spectrogramrepresentatie van het signaal,  het label en θ de parameterset van de CNN-Transformer-architectuur. Symbolen die in volgende vergelijkingen worden gebruikt, worden direct na hun eerste verschijning geïntroduceerd om de mathematische correctheid te waarborgen.
Vanuit een wiskundig oogpunt kan de taak worden geformaliseerd als een probleem van gesuperviseerd leren. Laat het industriële akoestische signaal worden aangeduid als x(t). De STFT van x(t) wordt berekend volgens de formule:
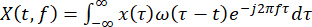 (1)
waarbij ω(.) de vensterfunctie is en f de frequentie. Het gegenereerde spectrogram 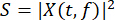 dient als input voor het deep learning-algoritme. Het doel is om de afbeeldingsfunctie te trainen
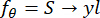 (2)
waarbij het klasselabel is (ofwel normaal of abnormaal), en waarbij S de spectrogram-input is, y het voorspelde outputlabel is en θ de set leerbare parameters van de CNN-Transformer-architectuur is. Het optimalisatieprobleem is geformuleerd als de minimalisatie van het classificatieverlies:
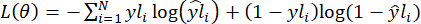 (3)
onderworpen aan de beperkingen van minimale latentie  , energie-efficiëntie
 , en interpreteerbaarheid, waarbij de verklaring ∅(SHAP) het belang van kenmerken in het voorspellingsproces vastlegt,
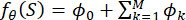 (4)
waarbij  de bijdrage van elke individuele feature is. In overeenstemming met het voorgaande omvatten de ontwerpeisen het volgende: (i) betrouwbare anomaliedetectie op basis van hybride deep learning, (ii) interpreteerbare outputs voor menselijke interventie en (iii) implementatie in een edge-enhanced CPS-framework.
Datasetverwerving en preprocessing
In dit verband is de MIMII Dataset13 geselecteerd om het voorgestelde CPHS-framework op basis van Explainable AI te beoordelen. Deze dataset is een veelgebruikte benchmark voor het detecteren van anomalieën in industriële machines met behulp van akoestische signalen. Deze database bevat geluidsopnamen van diverse machines, zoals glijrails, ventilatoren, pompen en kleppen, onder zowel normale als defecte bedrijfsomstandigheden. Voor elke machine variëren de opnamen per instelling en ruisomgeving. Dit maakt de dataset geschikt voor het trainen en evalueren van modellen onder industriële real-time omstandigheden.
Hoewel de MIMII-dataset veelvuldig wordt gebruikt in studies naar ongesuperviseerde anomaliedetectie die tijdens de training uitsluitend vertrouwen op normale monsters, bevat deze expliciete annotaties van zowel normale als abnormale machinestanden. Het probleem is geformuleerd als een gesuperviseerde binaire classificatietaak om het vermogen van de voorgestelde, op Explainable AI gebaseerde CNN-Transformer-architectuur te testen om gezonde van defecte machinestanden te scheiden. Specifiek worden de officiële MIMII-labels gebruikt, waarbij klasselabel 0 wordt toegekend aan normale monsters en klasselabel 1 aan abnormale monsters.
Tabel 1 toont de details van de beschrijving van de dataset. In het huidige onderzoek worden ongeveer 12.000 opnames van akoestische signalen beschouwd, waaronder zowel normale als defecte machinebedrjfgingen. Conform de vereisten zijn alle opnames in deze studie vastgelegd op 16 kHz en hebben ze een duur van 10 s. Hoewel de dataset ongeveer 12.000 opnames bevat, is een klasse-gebalanceerde subset van 2.000 testopnames uitsluitend geselecteerd om de confuse matrix te visualiseren. Alle gerapporteerde prestatiemetrieken zijn berekend met gebruik van de volledige testset (ongeveer 2.400 opnames). Verder zijn de trainings- en testmonsters gescheiden in een verhouding van 80:20 voor de modeltraining. Deze database is zeer geschikt voor Industry 5.0-toepassingen omdat deze realtime ruiscondities bevat. De verdeling van de opnames die in deze studie is gebruikt, staat in Tabel 2. Uit deze dataset zijn ongeveer 12.000 opnames geselecteerd die alle machinetypen en signaal-ruisverhouding (SNR)-condities dekken voor de experimenten met gesuperviseerde binaire classificatie met een 80:20 train/test-splitsing; hierin worden de industriële machinetypen, de bijbehorende machine-ID's, het totale aantal normale en abnormale akoestische opnames, de SNR-condities en de experimentele train/test-partitie getoond die is gebruikt voor de gesuperviseerde binaire classificatie.
Het experiment werd uitgevoerd met versie 1.0 van de MIMII (Malfunctioning Industrial Machine Investigation and Inspection) dataset, die vier typen industriële machines bevat: ventilatoren, pompen, kleppen en glijrails. De gegevens werden verzameld van verschillende machine-ID's (ID00–ID06, afhankelijk van het machinetype) en condities. De MIMII-database bevat gegevens die zijn verkregen bij signaal-ruisverhoudingen (SNR's) van −6 dB, 0 dB en +6 dB. Normale gegevens komen overeen met de gezonde conditie van de industriële machine, terwijl anomale gegevens overeenkomen met een abnormale conditie. De klassen werden gelabeld op basis van de annotatie van de database, waarbij normale gegevens werden gelabeld als klasse 0 en anomale gegevens als klasse 1.
Een eerlijke evaluatieprocedure vereiste dat de splitsing tussen de trainings- en testsets plaatsvond op het niveau van de oorspronkelijke audio-opname, voorafgaand aan alle stappen voor splitsing, augmentatie of het maken van spectrogrammen. Bijgevolg konden audiosegmenten van dezelfde opname niet in zowel de trainings- als de testset voorkomen. Voor het evaluatie-experiment werden opnames met verschillende signaal-ruisverhoudingen (−6 dB, 0 dB en +6 dB) gebruikt, wat de mogelijkheid bood om het voorgestelde raamwerk onder diverse industriële omstandigheden te evalueren.
Om datalekken te voorkomen, werd de train/test-splitsing uitgevoerd op basis van het originele audiobestand, voorafgaand aan enige segmentatie of spectrogramgeneratie. Segmenten van dezelfde audio-opname van 10 s werden exclusief toegewezen aan óf de trainingsset óf de testset, waarbij geen segmenten in beide sets voorkwamen. Daarna werden spectrogrammen gegenereerd en apart voor elke dataset uitgebreid door middel van augmentatie. Op deze manier wordt het probleem van datalekken vermeden, waardoor een te optimistische beoordeling van de prestaties wordt voorkomen.
Preprocessing van de dataset
De onbewerkte akoestische signalen uit de MIMII-dataset worden vervolgens verwerkt om de signaalkwaliteit te verbeteren en effectieve kenmerkextractie mogelijk te maken. Het ingangssignaal wordt aangeduid met x(t), waarbij t de tijd is. Het eerste proces is ruisfiltering, waarbij achtergrondgeluiden worden gefilterd met behulp van een filterfunctie zodanig dat:
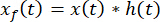 (5)
waarbij ∗ het convolutieproces vertegenwoordigt en h(t) de impulsrespons van het filter is. Dit proces verbetert de helderheid van het akoestische signaal en minimaliseert de effecten van ruis die vaak voorkomen in industriële omgevingen. Signaalnormalisatie wordt gebruikt om ervoor te zorgen dat de amplitudes van alle audiosignalen vergelijkbaar zijn voordat ze in het deep learning-model worden gevoerd. Het genormaliseerde signaal, aangeduid als xn(t), wordt als volgt berekend:
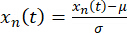 (6)
waarbij μ en σ respectievelijk de gemiddelde waarde en de standaarddeviatie van het ingangssignaal zijn. Door deze procedure is gegarandeerd dat alle ingangssignalen een gemiddelde van nul en een eenheidsvariantie hebben. Ten slotte wordt het genormaliseerde ingangssignaal voor de verwerking opgedeeld in meerdere kleine segmenten. Gegeven dat de lengte van het volledige signaal T is, wordt dit met behulp van een sliding window-functie onderverdeeld in N overlappende frames, elk met een lengte L:
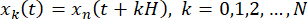 (7)
waarbij H de hopgrootte is. Het spectrogram kan worden gedefinieerd door de onderstaande formule:
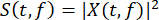 (8)
De op deze manier verkregen spectrogrammen worden ingevoerd in het CNN-transformer-gebaseerde framework om ruimtelijke en temporele kenmerken te extraheren voor een succesvolle anomaliedetectie. Figuur 2 toont de preprocessing-pijplijn.
Figuur 2 illustreert een verticale voorverwerkingspijplijn die kan worden toegepast op akoestische gegevens verkregen in de industrie. Eerst worden de ruwe audiosignalen uit de MIMII-dataset geëxtraheerd en naar de fase voor ruisonderdrukking gestuurd om ruis te verminderen. Daarna volgt het normaliseren van het signaal om inconsistenties in amplitude te verwijderen, zodat het signaal consistent is. Het signaal wordt vervolgens opgesplitst in kleinere, overlappende secties. Na de segmentatie worden STFT-transformaties op de gegevens toegepast om tijdsdomeinsignalen om te zetten in tijd-frequentiesignalen. Vervolgens wordt het vermogensspectrum berekend als onderdeel van het genereren van het spectrogram van het signaal. Voorbewerkte spectrogrammen zullen dus de output zijn van dit proces en worden gebruikt in het voorgestelde CNN-transformer-model.
Genereren van spectrogrammen
Na datanormalisatie en segmentatie worden akoestische signalen via de Short-Time Fourier Transform (STFT) omgezet in een tijd-frequentievertegenwoordiging. Het resulterende spectrogram biedt een visuele weergave van veranderingen in de frequentiesamenstelling gedurende de analyseperiode. In industriële omgevingen uiten machinefouten zich meestal als frequentiepatronen, waardoor spectrogrammen nuttiger zijn voor het detecteren van machineanomalieën.
De resulterende verwerkte gegevens worden daarom omgezet in spectrogrambeelden om onderscheid te maken tussen normale en abnormale instanties binnen de machines. De audiodata worden omgezet in meerdere spectrogrammen om het leermodel in staat te stellen lokale frequentiecomponenten en temporele veranderingen binnen het machineproces te analyseren. Deze beelden worden gebruikt als inputgegevens voor het CNN-transformer-model, waarbij het CNN de ruimtelijke (frequentie)patronen verwerkt en de Transformers de temporele relaties behandelen.
Algoritme 1: Genereren van spectrogrammen uit akoestische signalen
Input: Ruw audiosignaal x(t)
Output: Spectrogram S(t, f)
Stap 1: Laad audiosignaal x(t)
Stap 2: Pas ruisonderdrukking toe
Stap 3: Normaliseer signaal xn(t)
Stap 4: Segmenteer het signaal in frames:
voor k = 1 tot N doe
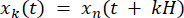
einde lus
Stap 5: Pas een windowfunctie w(t) toe op elk segment
Stap 6: Bereken STFT:
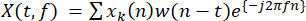 (9)
Stap 7: Bereken de magnitude:
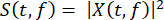 (10)
Stap 8: Sla spectrogram S(t, f) op
Stap 9: Spectrogramdataset teruggeven
Het proces van het genereren van spectrogrammen begint met het verkrijgen van het oorspronkelijke audiosignaal, gevolgd door voorbewerkingsstappen zoals ruisonderdrukking en signaalnormalisatie om de integriteit en kwaliteit van het signaal te waarborgen. Daarna wordt de genormaliseerde audio opgedeeld in meerdere overlappende vensters om de temporele kenmerken van zowel lange- als kortetermijnperioden vast te leggen. Om spectrale lekkage te voorkomen, wordt elk van de fragmenten vermenigvuldigd met de vensterfunctie voordat ze door de Short-Time Fourier Transform worden geleid. Vervolgens wordt het getransformeerde signaal weergegeven als een complexwaardige functie in het frequentiedomein, en worden de magnitudes hiervan gekwadrateerd. Zo wordt de energie van de frequenties over de gegeven tijd weergegeven door de spectrogrammen. Ten slotte worden ze opgeslagen als beeldachtige gegevens en ingevoerd in het neurale netwerk voor training.
Ruimtelijke kenmerkextractie met behulp van CNN
Na het proces van het maken van spectrogrammen worden de resulterende tijd-frequentiebeelden als input gebruikt en aan een Convolutional Neural Network (CNN) gevoed. Uitgaande van het inputspectrogram als  , waarbij H het frequentiedomein is en W het tijddomein. Het doel van het gebruik van het CNN is hier om discriminatieve ruimtelijke kenmerken uit het inputspectrogram te leren. Deze discriminatieve ruimtelijke kenmerken helpen bij het onderscheiden van normaal en abnormaal machinegedrag in een industriële omgeving.
Een basisbewerking die wordt uitgevoerd door het Convolutional Neural Network (CNN) is convolutie. Convolutie met een bepaald filter  wordt als volgt gegeven:
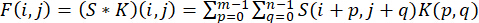 (11)
De hierboven beschreven operatie stelt het neurale netwerk in staat om lokale ruimtelijke kenmerken, zoals randen, frequenties en harmonische inhoud, in het spectrogram te identificeren. Dit gebeurt via meerdere filteroperaties die diverse kenmerkrepresentaties genereren, wat resulteert in verschillende feature maps. De convolutie wordt gevolgd door een niet-lineaire activatiefunctie, zoals hieronder wordt getoond:
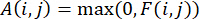 (12)
Deze niet-lineariteit stelt het netwerk in staat om complexe relaties tussen variabelen vast te leggen en te representeren. De volgende fase in een convolutioneel neuraal netwerk omvat de toepassing van pooling-operaties. De gangbare techniek van max pooling wordt wiskundig als volgt uitgedrukt:
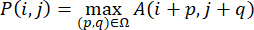 (13)
waarbij Ω verwijst naar het pooling-venster. Pooling helpt om translatie-invariantie te bereiken en alleen de relevante informatie te behouden terwijl redundantie wordt geëlimineerd. Van laag-niveau variabelen zoals frequenties tot complex machinegedrag kunnen hoger-niveau kenmerken hiërarchisch worden geëxtraheerd met behulp van een convolutioneel neuraal netwerk. Bijgevolg kunnen keniskaarten (feature maps) worden gebruikt om de uiteindelijke output van het netwerk weer te geven:
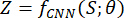 (14)
waar de leerbare parameters van het CNN worden weergegeven. De feature maps bevatten rijke ruimtelijke informatie en worden omgezet in sequenties om als input te dienen voor de transformer-encoder in de volgende fase. Het hierboven beschreven proces van ruimtelijke kenmerkextractie is essentieel om het model in staat te stellen minuscule anomalieën in industriële akoestische signalen te detecteren.
Figuur 3 demonstreert hoe ruimtelijke kenmerken horizontaal worden geëxtraheerd uit het spectrogram-inputsignaal met behulp van een CNN-model. Het begint met het input-spectrogram, dat de tijd-frequentie-eigenschappen van het audiosignaal in een picturale vorm codeert. Het input-spectrogram wordt vervolgens door een convolutionele laag geleid, waarin verschillende typen filters ruimtelijke kenmerken zoals frequentiebanden, randen en texturen extraheren, waardoor feature maps worden gegenereerd. Daarna ondergaan de geëxtraheerde feature maps een niet-lineaire activatiefunctie, de rectified linear unit (ReLU), waardoor het neurale netwerk afhankelijkheden in de inputgegevens kan detecteren. De feature maps worden vervolgens door een pooling-laag geleid, waarbij de grootte van de map wordt gereduceerd terwijl de belangrijkste kenmerken behouden blijven. Dit proces van convolutionele, activatie- en pooling-lagen herhaalt zich meerdere keren, waardoor een hiërarchie van kenmerkrepresentatie ontstaat die begint bij eenvoudige kenmerken en evolueert naar meer geavanceerde kenmerken die gerelateerd zijn aan machinebewerkingen.
Temporele modellering met behulp van een transformer-encoder
Zodra de ruimtelijke kenmerken met behulp van het CNN zijn geëxtraheerd, is de volgende stap het afleiden van high-level feature maps die de frequentiegebaseerde patronen vastleggen die uit het spectrogram zijn geleerd. De resulterende feature maps worden vervolgens afgeplat en omgevormd tot sequenties om temporele informatie in het akoestische signaal vast te leggen. Uitgaande daarvan dat de feature maps worden weergegeven door 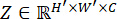 , waarbij H', W', en C respectievelijk de hoogte, breedte en kanalen zijn, wordt de volgende sequentie afgeleid:
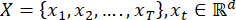 (15)
waarbij T de sequentielengte vertegenwoordigt en d de kenmerkdimensie is. De Transformer gebruikt vervolgens de bovenstaande sequentie om lange-termijn afhankelijkheden te modelleren met behulp van een self-attention mechanisme. In tegenstelling tot conventionele recurrente modellen verwerkt het transformer-model elk element van de sequentie parallel en gebruikt het attention-gewichten om de relatieve relevantie van elk onderdeel te bepalen. Het attention-mechanisme werkt door gebruik te maken van Query Q, Key K en Value V vectoren die voor elke input xt worden gegenereerd volgens:
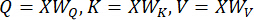 (16)
waarbij WQ, WK, WV trainbare gewichten zijn. De overeenkomsten tussen de elementen worden bepaald via:
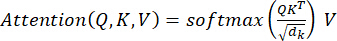 (17)
dk is de dimensie van de belangrijke vectoren. Deze procedure maakt het voor het model eenvoudiger om afhankelijkheden van verre tijdstappen in het signaal te leren en zich uitsluitend te concentreren op de relevante tijdssegmenten. Om de leercapaciteit van het netwerk te vergroten, wordt multihead attention gebruikt, wat verwijst naar het proces waarbij meerdere attention-heads parallel leren van de input:
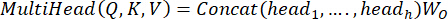 (18)
Elke head richt zich op verschillende kenmerken van de temporele inputsequentie. Dit wordt gevolgd door feed-forward neurale netwerken en residuele verbindingen:
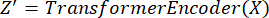 (19)
De resulterende gecodeerde sequentie legt zowel de ruimtelijke als de temporele kenmerken van de input vast. Deze sequentie wordt naar de classificatielaag gestuurd om anomalieën te detecteren.
Figuur 4 toont het algemene proces van temporele modellering met behulp van een transformer-encoder op kenmerken die uit het CNN zijn geëxtraheerd. Eerst worden de uit het CNN geëxtraheerde feature maps gebruikt; deze bevatten ruimtelijke informatie uit het spectrogram. De feature maps worden afgeplat tot een sequentie, waarbij elk item overeenkomt met een tijdstempel. Daarna gaat de sequentie door een lineaire transformatie die de data omzet in vectoren van een specifieke dimensie. Omdat transformer-modellen niet in staat zijn om temporele afhankelijkheden vast te leggen, wordt er ook positionele codering toegevoegd aan de embedding-vectoren om de temporele structuur van de sequentie te behouden. Ten slotte gaat de sequentie door een transformer-encoder, bestaande uit een stapel van meerdere lagen, waarin een multi-head self-attention-mechanisme wordt gebruikt om het model in staat te stellen verbanden tussen tijdstempels in de sequentie te leren. Het feed-forward neurale netwerk verbetert deze embeddings verder, terwijl residuele verbindingen ervoor zorgen dat gradiënten efficiënt propageren. Het proces wordt herhaald over de gestapelde transformer-encoderlagen, die progressief complexere temporele interacties vastleggen. Uiteindelijk worden de sequentie-embeddings via pooling (bijv. average pooling of het classificatietoken (CLS)) gecombineerd tot een representatie met een vaste lengte, wat resulteert in een globale temporele kenmerkrepresentatie.
Classificatielaag
Na temporele codering met de transformer-encoder zullen de outputs een reeks gecodeerde vectoren zijn, elk met kenmerken die gerelateerd zijn aan zowel de ruimtelijke als de temporele aspecten van het ingangssignaal. De eerste stap naar classificatie vanuit de gecodeerde outputs is om al deze kenmerken te aggregeren tot één enkele vector. Dit wordt bereikt door ofwel mean pooling toe te passen op de reeks kenmerkvectoren, of door gebruik te maken van de zogenaamde "classificatietoken". Stel dat de output van de Transformer 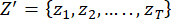 is, waarbij elke
 . Het geaggregeerde kenmerk h wordt berekend als:
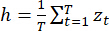 (20)
Vervolgens vertegenwoordigt de geaggregeerde kenmerkvector h de input in een compacte vorm en dient deze als input voor de classifier. Het classificatiegedeelte bestaat uit één of meer dense lagen, die de geleerde representatie transformeren naar de outputruimte. Een dense laag implementeert een transformatie die als volgt is gedefinieerd:
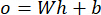 (21)
waarbij o de output (logits) is, b de bias-vector is en W de gewichtsmatrix is. Deze laatsten zijn de class-scores in een niet-genormaliseerde vorm. Om nonlineariteit in het model te integreren, worden vaak activatiefuncties zoals ReLU gebruikt. Ten slotte wordt een softmax-activatiefunctie op de logits toegepast om een waarschijnlijkheid voor elke klasse te verkrijgen:
 (22)
waarbij C het aantal klassen vertegenwoordigt, (C = 2; normaal en abnormaal). De klaspredictie zal worden gebaseerd op de maximale probabiliteitswaarde. Tijdens de training worden de optimale waarden van de modelparameters verkregen door het minimaliseren van het cross-entropy verlies tussen de werkelijke en voorspelde labels, waardoor een nauwkeurige classificatie van machinetoestanden wordt bereikt. Samenvattend vervult de classificatielaag een essentiële functie bij het transformeren van de temporele kenmerken, geëxtraheerd met behulp van de Transformer-architectuur, naar praktische beslissingen. Door een correct onderscheid te maken tussen gezonde en defecte machinetoestanden, worden anomaliedetectie en intelligente besluitvorming mogelijk binnen het Industry 5.0-paradigma.
Figuur 5 laat zien hoe de classificatielaag werkt, die volgt op de transformer Encoder. Het proces begint met de output van de gecodeerde sequentie, waarbij elke vector temporele informatie bevat die uit de input is geleerd. Deze vectoren worden gecombineerd tot één enkele vector, bekend als de globale kenmerkvector. De volgende stap is om de globale kenmerkvector door verschillende dichte neurale netwerklaag te leiden. In elke dichte laag worden matrixvermenigvuldigingen uitgevoerd om lineaire combinaties van de inputs te creëren. Daarna kan een niet-lineaire activatiefunctie, zoals ReLU, worden toegepast om de flexibiliteit bij het leren van beslissingsgrenzen te vergroten. Aan het einde van de laatste dichte laag zijn er logit-scores voor elke klasse. Deze logit-scores kunnen via de Softmax-functie worden gebruikt om waarschijnlijkheidsscores voor elke klasse te berekenen. Deze waarschijnlijkheidsscores worden gebruikt om te bepalen of de input behoort tot Klasse 0 (Normaal) of Klasse 1 (Abnormaal).
Verklaarbaarheid met behulp van SHAP
Nadat het model de ingangssignalen heeft geclassificeerd, worden voorspellingen gegenereerd op basis van het feit of de machine normaal of abnormaal functioneert. Binnen de Industry 5.0-omgeving is het echter niet voldoende om enkel voorspellingen te produceren; het systeem moet ook transparantie en uitlegbaarheid bieden om de menselijke besluitvorming te ondersteunen. Het volgende raamwerk maakt gebruik van SHAP, een op speltheorie gebaseerd model dat het belang van elk kenmerk bij het bepalen van de voorspelling kwantificeert. Hierbij kent SHAP gewichten toe aan kenmerken, waardoor men het relatieve belang van verschillende secties van het spectrogram-ingangssignaal voor de totale voorspelling kan evalueren.
De wiskundige formulering van SHAP is gebaseerd op een decompositie van het model f(x):
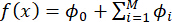 (23)
waarbij ∅0 de basiswaarde (gemiddelde modeloutput) is, ∅i het effect is van de i-de feature, en M het aantal inputfeatures is. Voor de doeleinden van deze studie zijn de features de tijd-frequentiebins uit het spectrogram. SHAP-waarden zijn positief als ze bijdragen aan de waarschijnlijkheid van de abnormale toestand en anders negatief. Deze formulering garandeert een unieke, lokaal consistente verklaring voor elke voorspelling. De SHAP-methode kan worden toegepast op een getraind CNN-transformer-model om een verklaring te geven op basis van feature-belangrijkheid. De visuele weergave zal de belangrijkste tijd-frequentiebins in het spectrogram tonen die het besluitvormingsproces beïnvloeden. Bijvoorbeeld, abnormaal gedrag van de apparatuur kan leiden tot bepaalde hoogenergetische frequentiebanden die het SHAP-raamwerk identificeert als belangrijke bijdragers aan het besluitvormingsproces.
Bovendien kan SHAP de samenwerking tussen mensen en machines in een cyber-fysische omgeving bevorderen. Dit komt doordat voorspellingen kunnen worden uitgelegd met behulp van intuïtieve visualisaties, waardoor operators en beslissingssystemen voorspellingen kunnen verifiëren, het probleem kunnen analyseren en passende stappen kunnen ondernemen. Dit vergroot niet alleen het vertrouwen, maar maakt AI-gebaseerde productieprocessen ook betrouwbaar en verantwoordelijk. Door deep learning-algoritmen die voldoen aan de huidige prestatienormen te integreren met SHAP, dat voor uitlegbaarheid zorgt, voldoet de voorgestelde architectuur aan de vereisten van Industrie 5.0.
Algoritme 2: SHAP-gebaseerde uitlegbaarheid voor modelvoorspelling
Input: Getraind model f(x), input-spectrogram S
Output: SHAP-waarden  en verklarende kaart
Stap 1: Voer spectrogram S in een getraind model in
Stap 2: Bereken de voorspelling: y = f(S)
Stap 3: Initialiseer een SHAP-explainer gericht op deep learning
Stap 4: Bereken de SHAP-waarden:
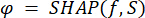
Stap 5: Voor elk kenmerk i in S:
Bereken de bijdrage 
Stap 6: Genereer verklarende kaart:
Markeer regio's met een hoge 
Stap 7: Visualiseer het belang van kenmerken (heatmap)
Stap 8: Retourneer SHAP-waarden en verklarende kaart
Het op SHAP gebaseerde uitlegbaarheidsalgoritme begint met het verkrijgen van een voorbewerkte spectrogramafbeelding als input, die vervolgens in de getrainde CNN-transformer-architectuur wordt gevoerd om voorspellingen te doen (bijv. normale of abnormale machineconditie). Nadat de voorspellingen met behulp van de getrainde architectuur zijn gedaan, wordt de SHAP-methode gebruikt om het model te interpreteren. In het bijzonder worden de SHAP-waarden (ϕ) voor elke inputfeature berekend om vast te stellen welke tijd-frequentiecomponenten van de input het meest bijdragen aan de voorspelling. Om deze waarden te berekenen, moeten de modeluitgangen voor inputs met en zonder bepaalde features worden vergeleken.
Na het berekenen van de SHAP-waarden voor elk kenmerk kan de invloed ervan op de voorspelling worden geëvalueerd aan de hand van het teken en de grootte van de SHAP-waarde. Zo zijn kenmerken met hogere SHAP-waarden waarschijnlijker bepalend voor de uitkomst, waarbij een positief of negatief teken aangeeft dat het kenmerk de voorspelling respectievelijk richting de normale of abnormale klasse stuurt. Op basis van de resultaten kan een verklarende kaart in de vorm van een heatmap worden opgesteld.
Ten slotte geeft het algoritme zowel de SHAP-waarden als de visualisaties weer, wat inzicht biedt in hoe mensen de besluitvorming van het model kunnen analyseren. De techniek maakt het proces transparanter en stelt mensen in staat om betrokken te zijn bij de besluitvorming, waardoor wordt gewaarborgd dat zowel de voorspellingen van het algoritme als de betrouwbaarheid ervan worden gerealiseerd in de door AI aangestuurde industrie. Om de betrouwbaarheid van de uitlegbare analyse te verbeteren, werden representatieve testmonsters geselecteerd uit nauwkeurig gediagnosticeerde anomale instanties van diverse machinestypes. Terwijl een globale SHAP-analyse van de kenmerkbelangrijkheid werd uitgevoerd door SHAP-waarden over de gehele testdataset te aggregeren om consistent invloedrijke tijd-frequentielocaties te identificeren, werden lokale SHAP-uitleggingen gegenereerd voor deze representatieve gevallen. Zonder dat er expertannotatie vereist is, biedt deze geïntegreerde lokale en globale analyse een betrouwbare interpretatie van de modelvoorspellingen.
Edge-ondersteunde CPS-integratie
Deze voorgestelde oplossing wordt gebruikt binnen het edge-enabled CPS, dat gericht is op het bereiken van efficiëntie, duurzaamheid en industriële operaties in realtime. Zodra het model is getraind, zal de CNN-transformer worden geïmplementeerd via een edge computing-benadering. De betreffende edge computing-laag bevindt zich dicht bij de apparaten van het industriële Internet of Things (IIoT), waaronder de sensoren en machines. In plaats van alle verzamelde gegevens naar de cloud te verzenden, voert het edge-apparaat inferentie uit op het binnenkomende akoestische signaal zonder dit eerst over te dragen. Hierdoor kan het systeem machineafwijkingen vrijwel direct detecteren en de nodige stappen ondernemen voordat de situatie verder verslechtert. Een ander voordeel van deze edge-enabled benadering is de verbeterde latentie en efficiëntie, aangezien gegevens worden geanalyseerd dicht bij het punt van generatie. Met andere woorden, in tegenstelling tot de cloudbenadering, waarbij de inferentietijd Tinf
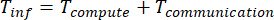 (24)
De latentie zal in het algemeen aanzienlijk worden verminderd door een afname van Tcommunication. Een ander voordeel is het verminderde bandbreedteverbruik en de energie die wordt verbruikt bij het continu verzenden van gegevens. Dit systeem is daarom schaalbaar en duurzaam voor grote industriële installaties met talrijke aangesloten apparaten. Bovendien maakt het CPS interactie mogelijk met de fysieke laag (machines), de AI (rekenlaag) en de menselijke laag.
Samenwerking met menselijke tussenkomst (human-in-the-loop)
Een cruciaal onderdeel van het voorgestelde Industrie 5.0 CPS, waarbij menselijke operatoren actief betrokken zijn bij het besluitvormingsproces naast AI-modellen, is human-in-the-loop samenwerking. Volgens het ontworpen raamwerk wordt het systeem namelijk geen autonome 'black box', maar stelt het operatoren in staat om ermee te interacteren en uitlegbare voorspellingsresultaten te observeren in de vorm van SHAP-verklaringen. De betreffende voorspellingen hebben betrekking op de uitkomsten (normaal/abnormaal), vergezeld van visualisaties van delen van de spectrogrammen die voor deze voorspellingen zijn gebruikt.
Een dergelijke interactie helpt operators om beter te begrijpen hoe de voorspelling precies tot stand komt en welke factoren daaraan bijdragen. Menselijke betrokkenheid houdt in dat de resultaten van het systeem worden geverifieerd en dat operators deze, indien nodig, kunnen overrulen op basis van hun professionele oordeel. Samenwerking met menselijke operators maakt het systeem vertrouwbaardiger, efficiënter, veiliger en betrouwbaarder, wat helpt bij het voorkomen van fouten.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Het gepresenteerde cyber-fysische collaboratiesysteem met geïntegreerde Explainable AI werd experimenteel getest op ongeveer 12.000 audio-opnames uit de MIMII Dataset, die zowel normale als abnormale machinecondities bevat. De trainingsdataset bestond uit ongeveer 9.600 datarecords, terwijl de testdataset ongeveer 2.400 audio-samples omvatte. Op basis van de resultaten bereikte het voorgestelde CNN-transformer-model een classificatienauwkeurigheid van 98,5% op de testdataset, 0,97–0,98. Dit komt overeen met de resultaten...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
De experimentele resultaten tonen aan dat de voorgestelde CNN-transformer-architectuur beter presteert dan individuele algoritmen door ruimtelijke en temporele kenleerprocessen effectief te integreren. Volgens de ablatiestudie extraheert de CNN weliswaar frequentiegebaseerde discriminatieve kenmerken uit spectrogrammen, maar de transformer-encoder verbetert de modelprestaties door temporele afhankelijkheden over lange afstand in akoestische signalen vast te leggen. Bovendien illustreert de confusiematrix zeer weinig fout...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
Een AI-tool (ChatGPT) is uitsluitend gebruikt om te helpen bij het redigeren van de taal en het verbeteren van de grammatica, helderheid en leesbaarheid. AI-tools zijn niet gebruikt om wetenschappelijke gegevens te genereren, experimenten uit te voeren, resultaten te analyseren, bevindingen te interpreteren of wetenschappelijke conclusies te trekken. Alle wetenschappelijke inhoud, gegevensanalyse, interpretatie en de definitieve versie van het manuscript zijn onafhankelijk beoordeeld, geverifieerd en goedgekeurd door de auteurs, die de volledige verantwoordelijkheid dragen voor de nauwkeurigheid en integriteit van het werk. De auteurs hebben geen belangenconflicten om te melden.
Dankbetuigingen
FINANCIERING: Dit werk werd ondersteund door het Key Project on Higher Education Teaching Reform in Shaanxi Province (Project Nr. 23BG053); de Scientific Research Foundation for High-Level Talents of Shaanxi Polytechnic University (Project Nr. BSJ-2023-08); en het Scientific Research Project of Shaanxi Polytechnic University (Project Nr. 2024YKYB-006). De auteurs danken Shaanxi Polytechnic University, Xianyang, China, en Xi’an Traffic Engineering University, Xi’an, China, hartelijk voor het ter beschikking stellen van de faciliteiten en de institutionele ondersteuning die dit onderzoek mogelijk hebben gemaakt.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Scaal voor Sociale Steun | Gepubliceerde academische schaal; oorspronkelijk ontwikkeld door Park en herzien/aangevuld door Kim | Versie met 25 items; 5-punts Likert-responsformaat; geen commercieel catalogusnummer | Meet de waargenomen sociale steun onder beginnende leraren in het vroeg ankeronderwijs op het gebied van emotionele steun, informatieve steun, materiële steun en evaluatieve steun. Totale Cronbach’s alpha = 0,96. |
| Scaal voor Zelfeffectiviteit van Leraren | Gepubliceerde academische schaal; oorspronkelijk ontwikkeld door Enochs en Riggs; studieversie aangepast voor het Chinees | Versie met 25 items; 5-punts Likert-responsformaat; geen commercieel catalogusnummer | Beoordeelt de effectiviteit van leraren in de Chinese context van de vooropleiding voor het vroeg kinderonderwijs op basis van algemene zelfeffectiviteit van leraren en persoonlijke zelfeffectiviteit van leraren. Totale Cronbach’s alpha = 0,96. |
| Scaal voor Interactie tussen Leraar en Kind | Gepubliceerde academische schaal; ontwikkeld door Lee en getoetst door het expertpanel van de studie voor gebruik in China | Versie met 30 items; 5-punts Likert-responsformaat; geen commercieel catalogusnummer | Beoordeelt de door de leraar zelfgerapporteerde competentie in de interactie met het kind in plaats van de waargenomen kwaliteit van de interactie in de klas. Bevat emotionele interactie, verbale interactie en gedragsmatige interactie; totale Cronbach’s alpha = 0,94. |
| Formulier Demografische Gegevens | Onderzoeksteam, samenwerking tussen Sichuan University of Arts and Science / Daegu University | Aangepast onderdeel van de vragenlijst voor de studie; geen commercieel catalogusnummer | Verzamelde kenmerken van deelnemers, waaronder geslacht, educatieve achtergrond, professionele categorie, locatie van de stage, duur van de stage, type stage en type kleuterklas. |
| Script voor Deelnemersinformatie en Geïnformeerde Toestemming | Onderzoeksteam; goedgekeurd door de ethische commissie voor onderzoek van Daegu University | Nummer ethische goedkeuring: XXX; lokale goedkeuringsregistratie ter verificatie | Gebruikt voorafgaand aan de distributie van de vragenlijst om het doel van de studie en de inhoud van de enquête uit te leggen en geïnformeerde toestemming te verkrijgen van deelnemende beginnende leraren in het vroeg kinderonderwijs. |
| Pakket Vragenlijst voor Pilotonderzoek | Onderzoeksteam en expertpanel | Pilotversie gebruikt 1–5 juni 2024; geen commercieel catalogusnummer | Pilot-test van de duidelijkheid en geschiktheid van de schaal voor professionele percepties, de schaal voor sociale steun, de schaal voor zelfeffectiviteit van leraren, de schaal voor interactie tussen leraar en kind, en de demografische items bij 50 beginnende leraren in het vroeg kinderonderwijs. |
| Procedure voor Beoordeling door Expertpanel | Onderzoeksteam; expertpanel bestaande uit twee professoren in het vroeg kinderonderwijs, één directeur van een kleuterschool, drie stagebegeleiders en het onderzoeksteam | Consensusgebaseerde inhoudelijke review; geen commercieel modelnummer | Gebruikt om items van de schaal te herzien op ambiguïteit, geschiktheid, semantische duidelijkheid, ontwikkelingsgeschiktheid en culturele relevantie voorafgaand aan de formele enquête. |
| Geprinte Vragenlijsten Ter Plaatse | Onderzoeksteam; lokale institutionele enquêtebenodigdheden | Papieren enquêteformulieren; geen commercieel catalogusnummer | Gebruikt voor het ter plaatse afnemen van de vragenlijst. In de uiteindelijke steekproef werden 336 geldige vragenlijsten ter plaatse verkregen voordat deze werden gecombineerd met de online vragenlijsten. |
| Tencent | WeChat mobiele applicatie; versie dient geverifieerd te worden uit het apparaat/app-record gebruikt tijdens juni–juli 2024 | Gebruikt als online distributiekanaal voor het afnemen van de vragenlijst; 27 ingevulde online vragenlijsten werden verzameld via de online/WeChat-route. | |
| Procedure voor Werving via Telefoon en Persoonlijk | Onderzoeksteam | Gestandaardiseerde wervingsprocedure; geen commercieel catalogusnummer | Gebruikt om contact op te nemen met instellingen/deelnemers, het doel van de studie en de inhoud van de enquête uit te leggen, en geïnformeerde toestemming te ondersteunen vóór het afnemen van de vragenlijst. |
| SPSS Statistics | IBM | Versie 27.0 | Gebruikt voor beschrijvende statistieken, Pearson-correlatiecoëfficiënten, betrouwbaarheidsanalyse met Cronbach’s alpha, normaliteitstests met behulp van scheefheid en kurtosis, en de single-factor test van Harman’s voor common method bias. |
| SPSS Amos | IBM | Versie 26.0 | Gebruikt voor bevestigende factoranalyse, structurele vergelijkingsmodellering, multi-group measurement invariance testing, bootstrap-testen van indirecte effecten en vergelijkingen van alternatieve modellen. |
| Microsoft Excel | Microsoft | Microsoft 365 Excel of lokaal geïnstalleerde Excel-versie; verifieer exact lokaal buildnummer vóór indiening | Aanbevolen/gebruikt als werkmapomgeving voor het organiseren van gecodeerde enquêtegegevens, data-dictionary, aanvullende tabellen en de JoVE-materialenlijst. De exacte lokale versie dient door de auteurs te worden geverifieerd. |
| Fit-indexcriteria voor Structurele Vergelijkingsmodellering | Gepubliceerde methodologische richtlijnen; referenties van Schreiber et al. en Kline geciteerd in het manuscript | Geen commercieel catalogusnummer; criteria toegepast in het statistische analyseplan | Definieert en rapporteert model-fit indices, waaronder de chi-kwadraatstatistiek, chi-kwadraat gedeeld door vrijheidsgraden, Tucker-Lewis Index, Comparative Fit Index, Adjusted Goodness-of-Fit Index, Incremental Fit Index, Root Mean Square Error of Approximation, en Standardized Root Mean Square Residual. |
| Bootstrap Mediatie Testprocedure | SPSS Amos / statistisch analyseplan onderzoeksteam | 5.000 bootstrap-steekproeven; 95% bias-gecorrigeerde betrouwbaarheidsintervallen | Gebruikt om indirecte associaties via de effectiviteit van de leraar te testen. Indirecte effecten werden als significant beschouwd wanneer het 95% bias-gecorrigeerde betrouwbaarheidsinterval nul niet bevatte. |
| Procedure voor Measurement Invariance Testing | SPSS Amos / statistisch analyseplan onderzoeksteam | Multi-group bevestigende factoranalyse; ΔCFI < ,010 en ΔRMSEA < ,015 criteria | Gebruikt om configurale, metrische en scalaire invariantie over geslacht, programmatype, stageduur en instelling te evalueren voordat de gepoolde SEM-schattingen werden geïnterpreteerd. |
Referenties
- Fraga-Lamas P, Barros D, Lopes SI, Fernández-Caramés TM. Mist and edge computing cyber-physical human-centered systems for Industry 5.0: A cost-effective IoT thermal imaging safety system. Sensors (Basel). 2022;22(21):8500.
- Breque M, De Nul L, Petridis A. Industry 5.0: Towards a sustainable, human-centric and resilient European industry. Brussels: European Commission; 2021:https://research-and-innovation.ec.europa.eu/knowledge-publications-tools-and-data/publications/all-publications/industry-50-towards-sustainable-human-centric-and-resilient-european-industry_en.
- Sariişik G, Demir S. Industry 5.0: A human-centric paradigm for sustainable and resilient industrial transformation. Journal of Social Perspective Studies. 2025;2(2):50–66.
- Liu X et al. Evaluating the interactions of multi-dimensional value for sustainable product-service systems with a grey DEMATEL-ANP approach. J Manuf Syst. 2021;60:449–458.
- Di Nardo M et al. The maintenance in Industry 4.0: Assistance and implementation [conference paper]. Presented at: 32nd European Safety and Reliability Conference; Dublin, Ireland; 2022. p. 2286–2292. https://hdl.handle.net/20.500.12607/48222.
- Kagermann H, Lukas WD, Wahlster W. Industrie 4.0: Mit dem Internet der Dinge auf dem Weg zur 4. industriellen Revolution. VDI Nachrichten. 2011;(13):2–3. https://www.dfki.de/fileadmin/user_upload/DFKI/Medien/News_Media/Presse/Presse-Highlights/vdinach2011a13-ind4.0-Internet-Dinge.pdf.
- Council for Science, Technology and Innovation. Report on the Fifth Science and Technology Basic Plan. Tokyo: Cabinet Office, Government of Japan; 2015:https://www8.cao.go.jp/cstp/kihonkeikaku/5basicplan_en.pdf.
- Nahavandi S. Industry 5.0—A human-centric solution. Sustainability (Basel). 2019;11(16):4371.
- Paschek D, Mocan A, Draghici A. Industry 5.0—The expected impact of the next industrial revolution [conference paper]. Presented at: MakeLearn and TIIM International Conference; Piran, Slovenia; 2019. p. 125–132. https://toknowpress.net/ISBN/978-961-6914-25-3/papers/ML19-017.pdf.
- Maddikunta PKR et al. Industry 5.0: A survey on enabling technologies and potential applications. J Ind Inf Integr. 2022;26:100257.
- Longo F, Padovano A, Umbrello S. Value-oriented and ethical technology engineering in Industry 5.0: A human-centric perspective for the design of the factory of the future. Appl Sci (Basel). 2020;10(12):4182.
- Gong Y, Chung YA, Glass J. AST: Audio Spectrogram Transformer [conference paper]. Presented at: Interspeech 2021; Brno, Czech Republic; 2021. p. 571–575. https://www.isca-archive.org/interspeech_2021/gong21b_interspeech.html.
- Purohit H et al. MIMII dataset: Sound dataset for malfunctioning industrial machine investigation and inspection [conference paper]. Presented at: 4th Workshop on Detection and Classification of Acoustic Scenes and Events; New York, NY; 2019. p. 209–213. https://dcase.community/documents/workshop2019/proceedings/DCASE2019Workshop_Purohit_21.pdf.
- Hallioui A et al. A review of sustainable total productive maintenance. Sustainability (Basel). 2023;15(16):12362.
- Vasić S et al. Identification of criteria for enabling the adoption of sustainable maintenance practice: An umbrella review. Sustainability (Basel). 2024;16(2):767.
- Barredo Arrieta A et al. Explainable artificial intelligence: Concepts, taxonomies, opportunities, and challenges toward responsible AI. Inf Fusion. 2020;58:82–115.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions [conference paper]. Presented at: 31st International Conference on Neural Information Processing Systems; Long Beach, CA; 2017. p. 4765–4774. https://papers.nips.cc/paper/7062-a-unified-approach-to-interpreting-model-predictions.
- Du M, Liu N, Hu X. Techniques for interpretable machine learning. Commun ACM. 2020;63(1):68–77.
- Sarker IH. Machine learning: Algorithms, real-world applications and research directions. SN Comput Sci. 2021;2(3):160.
- Saxe A, Nelli S, Summerfield C. If deep learning is the answer, what is the question? Nat Rev Neurosci. 2021;22(1):55–67.
- Piccialli F et al. A survey on deep learning in medicine: Why, how and when? Inf Fusion. 2021;66:111–137.
- Li Z et al. A survey of convolutional neural networks: Analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2022;33(12):6999–7019.
- Gil M, Albert M, Fons J, Pelechano V. Engineering human-in-the-loop interactions in cyber-physical systems. Inf Softw Technol. 2020;126:106349.
- Krugh M, Mears L. A complementary cyber-human systems framework for Industry 4.0 cyber-physical systems. Manuf Lett. 2018;15:89–92.
- Jasiulewicz-Kaczmarek M et al. Recent advances in smart and sustainable maintenance [invited-session proposal]. Presented at: 10th IFAC Conference on Manufacturing Modelling, Management and Control; Nantes, France; 2022. https://hub.imt-atlantique.fr/mim2022/wp-content/uploads/2021/12/7a519.pdf.
- Jasiulewicz-Kaczmarek M, Gola A. Maintenance 4.0 technologies for sustainable manufacturing—An overview. IFAC-PapersOnLine. 2019;52(10):91–96.
- Saihi A, Ben-Daya M, As’ad RA. Maintenance and sustainability: A systematic review of modeling-based literature. J Qual Maint Eng. 2023;29(1):155–187.
- Bastas A. Sustainable manufacturing technologies: A systematic review of the latest trends and themes. Sustainability (Basel). 2021;13(8):4271.
- Franciosi C, Iung B, Miranda S, Riemma S. Maintenance for sustainability in the Industry 4.0 context: A scoping literature review. IFAC-PapersOnLine. 2018;51(11):903–908.
- Franciosi C et al. Measuring maintenance impacts on the sustainability of manufacturing industries: From a systematic literature review to a framework proposal. J Clean Prod. 2020;260:121065.
- Vrignat P, Kratz F, Avila M. Sustainable manufacturing, maintenance policies, prognostics and health management: A literature review. Reliab Eng Syst Saf. 2022;218:108140.
- Durán O, Aguilar J, Capaldo A, Arata A. Fleet resilience: Evaluating maintenance strategies in critical equipment. Appl Sci (Basel). 2021;11(1):38.
- Ciccarelli M, Papetti A, Germani M. Exploring how new industrial paradigms affect the workforce: A literature review of Operator 4.0. J Manuf Syst. 2023;70:464–483.
- Madzik P et al. Human-centricity in Industry 5.0—Revealing hidden research topics by unsupervised topic modeling using latent Dirichlet allocation. Eur J Innov Manag. 2025;28(1):113–138.
- Farivar F, Klarin A, Kanani-Moghadam V. Industry 5.0: A socio-technical system perspective on human agency and institutional legitimacy. J Manag Organ. 2026;32(4):1168–1189.
- Karki BR, Porras J. Digitalization for sustainable maintenance services: A systematic literature review. Digit Bus. 2021;1(2):100011.
- Santiago RAdF et al. Data-driven models applied to predictive and prescriptive maintenance of wind turbines: A systematic review of approaches based on failure detection, diagnosis, and prognosis. Energies (Basel). 2024;17(5):1010.
- Carvalho JN, Silva FR, Nascimento EGS. Challenges of the biopharmaceutical industry in the application of prescriptive maintenance in the Industry 4.0 context: A comprehensive literature review. Sensors (Basel). 2024;24(22):7163.
- Santos ACdJ, Cavalcante CAV, Wu S. Maintenance policies and models: A bibliometric and literature review of strategies for reuse and remanufacturing. Reliab Eng Syst Saf. 2023;231:108983.
- Orošnjak M, Brkljač N, Ristić K. Fostering cleaner production through the adoption of sustainable maintenance: An umbrella review with a questionnaire-based survey analysis. Clean Prod Lett. 2025;8:100095.
- Ji Z, Zhou Y, Wang B, Zang J. Human–cyber–physical systems in the context of new-generation intelligent manufacturing. Engineering (Beijing). 2019;5(4):624–636.
- Wang B et al. Toward human-centric smart manufacturing: A human–cyber–physical systems perspective. J Manuf Syst. 2022;63:471–490.
- Jiao J, Zhou F, Gebraeel NZ, Duffy V. Towards augmenting cyber-physical-human collaborative cognition for human–automation interaction in complex manufacturing and operational environments. Int J Prod Res. 2020;58(16):5089–5111.
- Yilma BA, Panetto H, Naudet Y. Systemic formalisation of cyber-physical-social systems: A systematic literature review. Comput Ind. 2021;129:103458.
- Zhou Y, Yu FR, Chen J, Kuo YH. Cyber-physical-social systems: A state-of-the-art survey, challenges and opportunities. IEEE Commun Surv Tutor. 2020;22(1):3
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.