Deze studie evalueert een trainingsprotocol voor collaboratieve virtual reality in een grote gedeelde ruimte door de ruimtelijke aanwezigheid, teamcoördinatie, leerbetrokkenheid, cognitieve belasting, veiligheid en kortetermijn leerresultaten te vergelijken over drie trainingscondities.
Onderzoeksartikel
Vergelijkende evaluatie van desktop-, room-scale- en grootruimte co-gelokaliseerde collaboratieve virtual reality in immersieve training
In dit artikel
Samenvatting
Samenvatting
Collaboratieve virtual reality in een grote, gezamenlijke ruimte biedt een trainingsomgeving waarin deelnemers zich kunnen bewegen, communiceren en acties kunnen coördineren binnen een gedeelde immersieve ruimte. Er is echter nog beperkt bewijs voor de vraag of deze configuratie de ruimtelijke aanwezigheid, teamcoördinatie en leerbetrokkenheid verbetert ten opzichte van samenwerking via de desktop of gedistribueerde room-scale virtual reality. Deze studie evalueerde een enkelcentrisch, driedelig experimenteel protocol met 126 deelnemers, verdeeld over 42 teams van drie personen. Teams werden gerandomiseerd naar een collaboratieve desktopsimulatie, gedistribueerde collaboratieve room-scale virtual reality of collaboratieve virtual reality in een grote, gezamenlijke ruimte. Alle teams voltooiden een oriëntatie van 8 min, een collaboratieve taak op het gebied van noodlogistiek en ruimtelijke navigatie van 20 min, directe evaluaties na de training en een retentietest na 2 weken. De primaire uitkomingsmaten waren de ruimtelijke aanwezigheid, zelfbeoordeelde teamcoördinatie, door waarnemers beoordeelde teamcoördinatie en leerbetrokkenheid. Secundaire uitkomingsmaten omvatten kennisscores, cognitieve belasting, simulatorongemak en taakprocesindicatoren. De groep met collaboratieve virtual reality in een grote, gezamenlijke ruimte vertoonde een hogere ruimtelijke aanwezigheid, teamcoördinatie en leerbetrokkenheid dan de vergelijkingsgroepen. De kenniswinst was gunstiger in de conditie met de grote ruimte, terwijl de gecorrigeerde kennis na de training en de retentiekennis na 2 weken niet significant verschilden tussen de condities. De cognitieve belasting nam niet significant toe en het simulatorongemak bleef gemiddeld mild. Deze bevindingen wijzen erop dat collaboratieve virtual reality in een grote, gezamenlijke ruimte mogelijk het meest nuttig is voor trainingstaken die ruimtelijke oriëntatie, rolgebaseerde coördinatie en actieve teambetrokkenheid vereisen, in plaats van enkel voor kortstondige kennisverwerving.
Inleiding
Immersieve virtuele realiteit faciliteert simulatiegebaseerde training in omgevingen die anderszins gevaarlijk of ontoegankelijk zijn, door visuele aandacht en lichaamsbeweging te koppelen aan gesitueerde praktijk1. Recent onderzoek is verschoven van novelty-demonstraties naar evidence-based implementatie2, maar er blijft een belangrijke vraag over welke hardware- en ruimtelijke configuraties collaboratief leergedrag het beste ondersteunen. Ruimtelijke presentie beïnvloedt aandacht en belichaming (embodiment)3,4, terwijl subjectieve immersie alleen mogelijk onvoldoende is voor complexe teambaserede operaties. Productieve samenwerking vereist gedeelde doelstellingen, taakinterdependentie en wederzijdse monitoring in realtime5.
Recent wetenschappelijk onderzoek heeft het begrip van co-gelokaliseerde virtual reality en belichaamde samenwerking bij het ondersteunen van teamwork verbeterd. Empirisch bewijs blijft echter inconsistent wat betreft de pedagogische effecten van verschillende ruimtelijke structuren6. De belangrijkste bijdrage van deze studie is de systematische evaluatie van drie functioneel verschillende collaboratieve omgevingen: desktop-collaboratieve simulatie, room-scale gedistribueerde virtual reality en groot-ruimtelijke co-gelokaliseerde collaboratieve virtual reality. Deze condities vertegenwoordigen verschillende configuraties van teamgebaseerde simulatie en maken een vergelijking mogelijk van visuele immersie en gedeelde fysieke locomotie over verschillende collaboratieve trainingsomgevingen heen. De fysieke indelingen van de drie configuraties zijn geïllustreerd in Figuur 1.
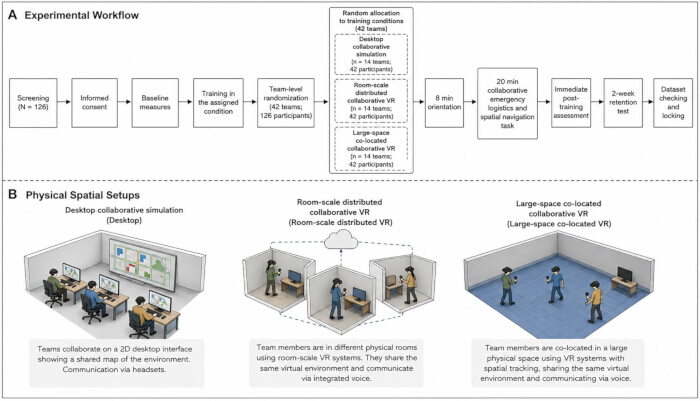
Figuur 1: Experimentele workflow en fysieke ruimtelijke opstellingen van de drie collaboratieve trainingscondities. (A) Overzicht van de experimentele workflow, van de screening van participanten en randomisatie op teamniveau (N = 126 participanten; 42 teams) tot de retentietest na 2 weken. (B) Schematische illustratie van de drie trainingsomgevingen. Links: Collaborative desktopsimulatie, waarbij teamleden navigeren via afzonderlijke werkstations en communiceren via toegewezen audiokanalen zonder immersieve visuele blootstelling. Midden: Gedistribueerde collaborative virtual reality op kamerschaal, waarbij participanten visuele immersie en live teamcommunicatie ervaren terwijl ze zich binnen afzonderlijke fysieke trackinggebieden van 3 m × 3 m bevinden. Rechts: Co-located collaborative virtual reality in een grote ruimte, waarbij teamleden een onbelemmerde ruimte van 8 m × 8 m delen, wat gesynchroniseerde fysieke locomotie, belichaamde ruimtelijke referentie en real-time co-navigatie mogelijk maakt. Klik hier om een grotere versie van deze figuur te bekijken.
Het trainingsprotocol maakte gebruik van een scenario voor collaboratieve noodlogistiek en ruimtelijke navigatie. In tegenstelling tot individuele procedurele training vereist dit scenario een gedeelde fysieke oriëntatie, verbale coördinatie in realtime en belichaamde ruimtelijke actie. Deze kenmerken bieden een gestructureerde setting voor het evalueren van de mogelijkheden van co-gelokaliseerde collaboratieve virtual reality in grote ruimtes. Figuur 2 illustreert de interfaces en interactiemodi die zijn gebruikt in de virtual reality- en desktopcondities. De theorie van belichaamd leren geeft aan dat ruimtelijke manipulatie agency kan ondersteunen wanneer dit is afgestemd op de taakeisen7, terwijl de cognitieve belastingstheorie aangeeft dat effectief groepswerk afhangt van het verdelen van cognitieve eisen zonder onnodige coördinatielast te introduceren8.
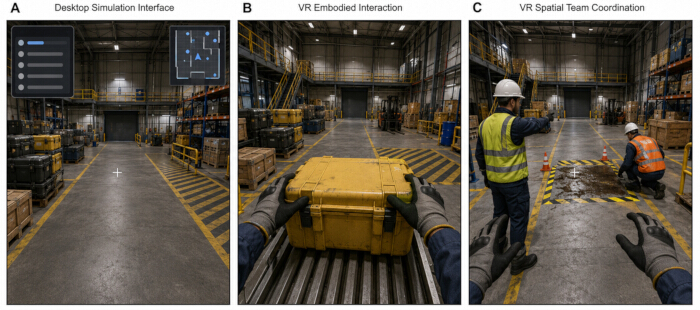
Figuur 2: Vergelijking van interfaces en paradigma's voor taakuitvoering over verschillende trainingscondities. Het scenario voor collaboratieve noodlogistiek en ruimtelijke navigatie was gestandaardiseerd voor alle groepen, waarbij de interactiemodaliteit het belangrijkste verschil vormde. (A) Collaboratieve simulatie-interface voor desktop, eerste-persoonszicht. Deelnemers navigeren door de industriële omgeving met behulp van toetsenbord- en muisinvoer en vertrouwen op een centraal vizier en tweedimensionale grafische gebruikersinterface-elementen, waaronder een minimap en een takenlijst, voor ruimtelijke oriëntatie. (B) Immersieve virtual reality belichaamde interactie. In de immersieve condities voeren deelnemers taken uit, waaronder het verzamelen en hanteren van hulpbronnen, via directe fysieke manipulatie met behulp van getrackte handgebaren in plaats van muisklikken. (C) Ruimtelijke teamcoördinatie in de co-located collaboratieve virtual reality-conditie in een grote ruimte. Teamleden coördineren rolspecifieke acties, waaronder die van de navigator, de resource manager en de safety checker, via real-time zichtbaarheid van avatars, ruimtelijke wijsgebaren en een gedeelde fysieke oriëntatie rond gevarenzones. Klik hier om een grotere versie van deze figuur te bekijken.
Bijgevolg werden de effecten van de drie trainingsconfiguraties geëvalueerd op het gebied van ruimtelijke presentie, teamcoördinatie en leerbetrokkenheid. Omdat immersieve omgevingen een sterke subjectieve betrokkenheid kunnen opwekken9, werden deze uitkomsten samen met de kennisverwerving na de training en de korte-termijnretentie beschouwd om onmiddellijke betrokkenheid te onderscheiden van blijvend leren. Omdat locomotie en immersieve blootstelling ook fysieke eisen stellen, werd simulatorongemak gemonitord als een implementatie-uitkomst10.
Protocol
Deze studie met menselijke participanten is uitgevoerd in overeenstemming met de Verklaring van Helsinki en de institutionele vereisten voor gedrags- en educatief onderzoek. Het studieprotocol is goedgekeurd door de Human Research Ethics Committee van Shenyang City University (goedkeuringsnummer SU1992837; goedkeuringsdatum: 18 januari 2025). Alle participanten gaven vóór deelname schriftelijke geïnformeerde toestemming. De participanten werden geïnformeerd dat de studie bestond uit immersieve virtual reality-blootstelling, het uitvoeren van taken in teams, het invullen van vragenlijsten, gedragsobservatie en korte follow-up tests. Deelname was vrijwillig en terugtrekking was te allen tijde toegestaan zonder academische, professionele of institutionele gevolgen. Alle studiegegevens zijn geanonimiseerd vóór de analyse. Elke participant kreeg een numerieke participantencode en elk team kreeg een aparte teamcode. Namen, studentnummers, telefoonnummers, gezichtsafbeeldingen of direct identificeerbare audio-opnamen zijn niet opgenomen in de analytische dataset. Apparatuurcategorieën, softwareversies en bijbehorende replicatiebronnen staan vermeld in de Table of Materials.
1. Onderzoeksopzet en setting
Deze voltooide studie maakte gebruik van een single-center, three-arm, parallel-group experimenteel ontwerp om te onderzoeken of co-located collaboratieve virtual reality in een grote ruimte geassocieerd was met een sterkere ruimtelijke aanwezigheid, teamcoördinatie en leerbetrokkenheid tijdens immersieve training. De drie trainingscondities waren collaboratieve desktopsimulatie, room-scale gedistribueerde collaboratieve virtual reality en co-located collaboratieve virtual reality in een grote ruimte.
De condities werden ontworpen als functionele vergelijkers in plaats van als een volledige factoriële ontbinding van immersie, collaboratie en loopruimte. De desktopconditie vertegenwoordigde collaboratie zonder blootstelling aan een immersief head-mounted display. De room-scale gedistribueerde collaboratieve virtual reality-conditie vertegenwoordigde immersieve teamcollaboratie in afzonderlijke kleine trackinggebieden. De large-space co-located collaboratieve virtual reality-conditie combineerde een immersieve visuele ervaring, gedeelde fysieke beweging en real-time belichaamde teaminteractie binnen één enkele getrackte trainingsruimte. Groepsverschillen werden daarom geïnterpreteerd als verschillen tussen de volledige trainingsconfiguraties in plaats van als effecten die toeschrijfbaar waren aan een enkel onderdeel. Deze structuur is gekozen omdat onderzoek naar immersief leren ruimtelijke aanwezigheid, agency en betrokkenheid beschouwt als mechanismen waarmee virtuele omgevingen het leergedrag kunnen beïnvloeden11.
De studie werd uitgevoerd in het Immersive Learning and Human-Computer Interaction Laboratory van de deelnemende instelling van 3 maart 2025 tot 18 juli 2025. De werving en nulmetingen vonden plaats van 3 maart tot 25 april 2025. De interventiesessies werden uitgevoerd van 10 maart tot 30 mei 2025. De retentiebeoordelingen na 2 weken werden voltooid tussen 24 maart en 16 juni 2025. De gegevenscontrole, de scoretoekenning door waarnemers en het vastleggen van de dataset werden voltooid op 18 juli 2025.
Alle sessies werden uitgevoerd in hetzelfde laboratoriumcomplex om de verlichting, temperatuur, internetverbinding, taakinstructies en supervisie door de onderzoekers te controleren. De conditie voor collaboratieve virtual reality in een grote gedeelde ruimte maakte gebruik van een ongehinderd trackinggebied van 8 m × 8 m. De conditie voor gedistribueerde collaboratieve virtual reality op kamerschaal maakte gebruik van drie gescheiden gemarkeerde gebieden van 3 m × 3 m. De conditie voor collaboratieve simulatie op het bureaublad maakte gebruik van individuele computerwerkstations die gescheiden waren door akoestische scheidingswanden, zodat deelnemers uitsluitend via het toegewezen communicatiekanaal konden communiceren.
Deelnemers werden vóór de randomisatie toegewezen aan teams van drie personen. Het team werd als trainingseenheid gebruikt omdat de taak vereiste dat rollen verdeeld werden uitgevoerd, wat verbale coördinatie, gedeeld situationeel bewustzijn en gezamenlijke probleemoplossing vereiste. De randomisatie vond plaats op teamniveau om contaminatie tussen deelnemers binnen dezelfde sessie te voorkomen. De algemene workflow van de studie en de fysieke configuratie van de drie condities zijn weergegeven in Figuur 1.
2. Deelnemers en screening van geschiktheid
Deelnemers werden geworven vanuit bachelor- en masteropleidingen aan de deelnemende instelling. De wervingsberichten beschreven de studie als een immersieve trainingsstudie met virtual reality, teamcoördinatie en leerbeoordeling. In de berichten werd geen uitgesproken superioriteit van een specifieke trainingsconditie vermeld. Geïnteresseerde deelnemers vulden een online screeningsformulier in voordat de laboratoriumafspraken werden ingepland.
Deelnemers waren in aanmerking gekomen indien zij tussen de 18 en 35 jaar oud waren, een normale of gecorrigeerde normale visus hadden, de taal van de training begrepen, niet eerder hadden deelgenomen aan hetzelfde virtuele trainingsscenario en veilig gedurende ten minste 30 min konden staan en bewegen. Deelnemers werden uitgesloten als zij melding maakten van ernstige bewegingsziekte, ongecontroleerde epilepsie, een recent musculoskeletale letsel dat het lopen of het evenwicht beïnvloedde, een ongecorrigeerde visuele beperking, ernstige vertigo, een ernstige ongecorrigeerde gehoorbeperking, een huidige acute ziekte of enige medische aandoening waardoor blootstelling aan immersieve virtuele realiteit onveilig was. Deelnemers werden daarnaast uitgesloten als zij uitgebreide voorafgaande ervaring hadden met het exacte trainingsscenario of eerder hadden deelgenomen aan pilot-testen van hetzelfde systeem.
De geschiktheid werd in twee stappen geverifieerd. Een onderzoeksassistent bekeek eerst het online screeningsformulier. De onderzoeker van de sessie bevestigde vervolgens de geschiktheid mondeling op de dag van het onderzoek voorafgaand aan de toestemming. Deelnemers die melding maakten van mild voorafgaand bewegingsongemak werden niet automatisch uitgesloten, maar werden nauwer gevolgd en kregen de herinnering dat deelname onmiddellijk gestopt kon worden indien er ongemak optrad. Het volledige screeningsformulier, de geschiktheidscriteria, de nulmeting-vragenlijst, de responsformaten en de coderingsregels zijn opgenomen in Aanvullend Bestand 1.
Er is een a priori powerberekening uitgevoerd met G-Power software om de benodigde steekproefomvang voor het experimentele ontwerp te bepalen. Uitgaande van een gemiddelde verwachte effectgrootte van f = 0,25 op basis van eerdere literatuur over immersief collaboratief leren, een alfaniveau van 0,05 en een statistische power van 0,80 voor een analyse met drie groepen, waren minimaal 111 deelnemers vereist. Om rekening te houden met de teamstructuur van drie personen en een gebalanceerde groepstoewijzing over de condities te behouden, is de uiteindelijke steekproef uitgebreid naar 126 deelnemers, bestaande uit 42 onafhankelijke teams. Omdat de interventie op teamniveau werd uitgevoerd, zijn teamidentificaties behouden voor clusteringaanpassing, door waarnemers beoordeelde coördinatiescores en sensitiviteitscontroles.
3. Randomisatie, toewijzingsverhulling en blindering
Nadat alle leden van een team van drie personen de bevestiging van deelnamecriteria hadden voltooid, werd het team via een door de computer gegenereerde blokrandomisatielijst met een vaste blokgrootte van zes teams willekeurig toegewezen aan een van de drie trainingscondities. De toewijzingsvolgorde werd vóór de gegevensverzameling gegenereerd met een randomisatiepakket in de statistische computeromgeving, met een reproduceerbare seed van 20250301.
De toewijzingsverhulling werd gewaarborgd door middel van opeenvolgend genummerde, ondoorzichtige en verzegelde enveloppen, die waren voorbereid door een onderzoeker die onafhankelijk was van de werving van deelnemers en de uitvoering van de interventie. Het randomisatiedossier werd bewaard in een wachtwoordbeveiligd spreadsheet en was niet toegankelijk voor de beoordelaars van de uitkomsten.
De toewijzing werd pas onthuld na voltooiing van de baseline-vragenlijst en de kennistest voorafgaand aan de training. De onderzoeker van de sessie opende de volgende verzegelde toewijzingsenvelop direct vóór het opstellen van de apparatuur. Blindering van de deelnemers voor de vorm van de fysieke training was niet mogelijk omdat de drie condities zichtbaar van elkaar verschilden. De deelnemers werden niet geïnformeerd over welke conditie naar verwachting beter zou presteren.
Twee waarnemers beoordeelden de teamcoördinatie op basis van gestandaardiseerde schermopnamen. De waarnemers waren blind voor de hypothesen van de studie, de labels van de trainingscondities en de resultaten van de vragenlijsten, en waren niet betrokken bij de uitvoering van de training. Videobestanden werden vóór de scoretoekenning hernoemd met behulp van neutrale teamcodes. Interface-labels die de conditie identificeerden, werden waar mogelijk bijgesneden of gemaskeerd voordat de waarnemers de scores toekenden.
4. Trainingsscenario en taakstructuur
Het trainingsscenario was ontworpen als een collaboratieve taak voor noodlogistiek en ruimtelijke navigatie in een gesimuleerde industriële trainingsomgeving. Van elk team van drie personen werd vereist dat zij virtuele middelen lokaliseerden, ruimtelijke signalen interpreteerden, route-informatie communiceerden, rolspecifieke acties coördineerden en een reeks missiestappen voltooiden binnen een vastgesteld tijdsbestek.
Elke deelnemer bekleedde een van de drie rollen: navigator, resource manager of veiligheidscontroleur. De navigator interpreteerde de routebeschrijving en de volgorde van de bestemmingen. De resource manager identificeerde en verzamelde virtuele items die relevant waren voor de taak. De veiligheidscontroleur hield risico's in de gaten, bevestigde de procedurele volgorde en gaf het team een seintje vóór de definitieve indiening.
Het scenario bestond uit vier zones: een oriëntatiezone, een resourcezone, een gevarenzone en een voltooiingszone. Elk team voltooide acht vereiste subtaken: het identificeren van de doellocatie, het selecteren van drie correcte resources uit zes mogelijke resources, het vermijden van twee onjuiste routevertakkingen, het reageren op drie gevaarssignalen, het overdragen van informatie tussen teamleden en het indienen van de uiteindelijke taakvolgorde. De maximale taaktijd was 20 min. Teams die niet alle vereiste subtaken binnen 20 min voltooiden, werden bij het bereiken van de tijdslimiet gestopt, waarna het aantal voltooide subtaken werd geregistreerd.
Voorafgaand aan de hoofdtaak voltooiden alle deelnemers een gestandaardiseerde oriëntatie van 8 min. De eerste 3 min werden besteed aan de introductie van de studieregels en veiligheidsprocedures. De volgende 3 min werden gebruikt voor de introductie van de interfacebedieningen. De laatste 2 min boden de deelnemers de gelegenheid om te oefenen met bewegen, selecteren en communiceren in een neutrale oefenomgeving die geen objecten, routes, gevaren of antwoorden bevatte die in het hoofdscenario werden gebruikt. Er zijn geen prestatiegegevens uit de oefenomgeving geanalyseerd.
Dezelfde leerinhoud, taakvolgorde, doelantwoorden, routestructuur, waarschuwingen voor gevaren en scorecriteria werden in alle drie de condities gebruikt. De condities verschilden in interactiemodaliteit, graad van immersie, fysieke beweging en ruimtelijke configuratie. De immersieve omgevingen werden ontwikkeld met behulp van een commercieel real-time driedimensionaal ontwikkelplatform. Multiplayer-netwerking en synchronisatie van de ruimtelijke status werden geïmplementeerd met een specifiek multiplayer-synchronisatieframework dat werkt via een lokale gigabit Ethernet-architectuur. De deelnemers die waren toegewezen aan de immersieve virtual reality-condities maakten gebruik van head-mounted displays met een hoge resolutie, voorzien van geïntegreerde koptelefoons en microfoons. Voor de ruimtelijke tracking werd een infrarood laser-gebaseerd trackingsysteem met vier basisstations gebruikt. Voor de implementatie van de avatars werden inverse kinematiek-algoritmen gebruikt om real-time telemetrie van het hoofd en de handcontrollers te koppelen aan gearticuleerde werkers-avatars.
5. Controle van de procedure en verfijning van de metingen voorafgaand aan het onderzoek
Voorafgaand aan de formele gegevensverzameling werden alle vragenlijstitems, items van de kennistest, regels voor de waarnemersbeoordeling en taakprocedures beoordeeld door twee onderzoekers met ervaring in immersief leren en één onderzoeker met ervaring in educatieve meetkunde. De beoordeling richtte zich op de helderheid van de items, de afstemming tussen rol en taak, de consistentie van de scoreverlening, de formulering van de veiligheidsvoorschriften en de afstemming van de constructen.
Er is een pilotprocedure-controle uitgevoerd van 17 februari tot 21 februari 2025 met zes deelnemers die voldeden aan dezelfde geschiktheidscriteria als de formele steekproef. In de pilot werden de taaktiming, het comfort van de headset, de bewegingsveiligheid, de duidelijkheid van de instructies, de tijd voor het invullen van de vragenlijsten, de nauwkeurigheid van de data-export en de haalbaarheid van de waarnemersbeoordeling onderzocht. De pilotgegevens werden uitsluitend gebruikt om de bewoordingen, de timing van de opstelling, de veiligheidsinstructies en de procedures voor de log-export te verfijnen. Deze deelnemers werden niet opgenomen in de uiteindelijke steekproef en hun gegevens werden niet meegenomen in de formele analyse.
6. Conditie voor collaboratieve simulatie op het bureaublad
In de conditie voor collaboratieve simulatie op het bureaublad maakte elke deelnemer gebruik van een individueel werkstation dat was aangesloten op een 1080p-monitor van 24 inch. De invoerapparaten bestonden uit een computermuis en toetsenbord, en audiocommunicatie werd verzorgd via een USB-headset en microfoon. Deelnemers zaten aan afzonderlijke werkstations en kregen de instructie om niet buiten het systeem te communiceren.
De desktopsimulatie maakte gebruik van dezelfde virtuele omgeving, taakobjecten, routevolgorde, gevarenmeldingen en scoringslogica als de virtual reality-condities. Het cameragezicht was in de eerste persoon. Zoals geïllustreerd in Figuur 2A, navigeerden deelnemers in de desktopgroep met behulp van toetsenbordinvoer en interacteerden zij met virtuele hulpmiddelen via muisklikken door een vast tweedimensionaal monitorbeeld. Het gezichtsveld, de bewegingssnelheid, de interactieafstand en de audio-instellingen waren vastgelegd vóór de gegevensverzameling en werden tussen de sessies niet gewijzigd. Eén onderzoeker bewaakte de technische stabiliteit tijdens elke sessie, maar gaf geen advies over de taak nadat het hoofdscenario was begonnen.
7. Conditie voor gedistribueerde collaboratieve virtual reality op kamerschaal
In de conditie voor gedistribueerde collaboratieve virtual reality op kamerschaal betraden de drie deelnemers hetzelfde virtuele scenario vanuit afzonderlijke gemarkeerde trackingsgebieden van 3 m × 3 m. Elke deelnemer maakte gebruik van een head-mounted display en handheld controllers. Teamleden communiceerden via het toegewezen spraakkanaal en voltooiden dezelfde rolgebaseerde teamtaak, maar konden niet fysiek samen navigeren in een gedeelde grote trackingruimte.
Voorafgaand aan de hoofdtaak werden de pasvorm van de headset, de interpupillaire afstand, het begrenzing-systeem en de banden van de controllers aangepast. De deelnemers kregen de instructie om onmiddellijk te stoppen bij het optreden van duizeligheid, misselijkheid, oogvermoeidheid, hoofdpijn, balansverlies of angst. Gedurende de hele sessie bleef een onderzoeker zich binnen 2 m van elk actief trackinggebied bevinden om de veiligheid te bewaken, zonder instructies voor de taak te geven.
Wanneer een deelnemer de gemarkeerde grens overschreed, werd de sessie gepauzeerd en werd de deelnemer opnieuw gepositioneerd. Als er sprake was van matig ongemak, gedefinieerd als een zelfgerapporteerde score voor ongemak van 5 of hoger op een willekeurig item van de 0–10 schaal, werd de sessie gepauzeerd en mocht de deelnemer gaan zitten om te herstellen. Als een item voor ongemak een score van 7 of hoger bereikte, werd de sessie beëindigd.
8. Conditie voor collaboratieve virtual reality in een grote gedeelde ruimte
Bij de conditie voor collaboratieve virtual reality in een grote gedeelde ruimte betrad elk team van drie personen hetzelfde getrackte trainingsgebied van 8 m × 8 m. Elke deelnemer droeg een head-mounted display, hield twee controllers vast en werd vertegenwoordigd door een rolspecifieke avatar die zichtbaar was voor de andere teamleden. Teamleden communiceerden verbaal in realtime terwijl ze zich fysiek door de gedeelde trainingsruimte bewogen. Het systeem synchroniseerde de locatie van de deelnemers, handbewegingen, objectselectie en wijzigingen in de taakstatus. Zoals getoond in Figuur 2B en Figuur 2C, voerden deelnemers in de immersieve condities taken uit met behulp van driedimensionale ruimtelijke handgebaren met getrackte controllers en fysieke hoofddraaiing voor een gezichtsveld van 360°.
Voor de conditie met de grote ruimte werden dezelfde taakinhoud en dezelfde tijdslimiet van 20 min gebruikt als bij de andere condities. De fysieke beweging werd gekalibreerd zodat de virtuele route binnen het gemarkeerde veiligheidsgebied bleef. In de headset verscheen een veiligheidsgrens wanneer deelnemers de rand van de trackingzone naderden. Voorafgaand aan de hoofdtaak werden de vloerruimte, kabelvrije beweging, de pasvorm van de headset, de trackingstabiliteit, de audio-input en de respons van de controller gecontroleerd. Deelnemers kregen de instructie om natuurlijk fysiek lopen te gebruiken in plaats van kunstmatige locomotietechnieken om door de virtuele omgeving te navigeren. Fysiek contact tussen teamleden was verboden. Als twee deelnemers binnen 0,5 m van elkaar kwamen, werd er een neutrale veiligheidsherinnering gegeven zonder taakinformatie.
Elke sessie in de grote ruimte werd begeleid door twee onderzoekers. Eén onderzoeker hield het systeemdashboard en de opnamestatus in de gaten. De tweede onderzoeker stond buiten het actieve trackinggebied en hield toezicht op de veiligheid van de deelnemer. De taak werd gepauzeerd als de tracking gedurende meer dan 10 s verloren ging, als een deelnemer ongemak meldde of als een deelnemer de veiligheidsgrens overschreed. Indien de onderbreking minder dan 2 min duurde en de deelnemer wilde doorgaan, werd de taak hervat vanaf de laatst opgeslagen status. Indien de onderbreking langer duurde dan 2 min, werd de sessie als onvoltooid geregistreerd en behouden in de intention-to-treat dataset.
9. Uitkomstmaten en tijdstippen van beoordeling
Beoordelingen werden uitgevoerd bij de nulmeting, direct na de training en 2 weken na de training. De nulmetingen omvatten demografische gegevens, eerdere ervaring met virtual reality en teamtraining, bekendheid met gaming en een kennistest van 30 punten voorafgaand aan de training. De metingen direct na de training omvatten ruimtelijke aanwezigheid, zelfgerapporteerde en door waarnemers beoordeelde teamcoördinatie, leerbetrokkenheid, cognitieve belasting, ongemak bij het gebruik van de simulator, kennis na de training en indicatoren voor taakprestaties. Bij de follow-up na 2 weken werd dezelfde kennistest van 30 punten gebruikt, met items in een andere volgorde en kleine variaties in de bewoordingen. Het beoordelingsschema is weergegeven in Tabel 1.
Tabel 1: Samenvatting van primaire en secundaire maten. Deze tabel vat de variabelen, meetschalen, tijdstippen van beoordeling en gegevensbronnen samen voor de primaire uitkomsten, secundaire leeruitkomsten en veiligheids- en procesmaten die gedurende het experimentele protocol zijn geëvalueerd. Klik hier om deze tabel te downloaden.
Ruimtelijke aanwezigheid werd direct na de training gemeten met een schaal van 8 items en 7 punten, aangepast van gevestigde dimensies van aanwezigheid12. Scores werden gemiddeld wanneer ten minste 80% van de items was ingevuld; anders werd de score als ontbrekend gecodeerd. De volledige items en scoreregels zijn opgenomen in Aanvullend Bestand 1.
Zelfbeoordeelde teamcoördinatie werd gemeten met een aangepaste schaal van zes items en 7 punten, die communicatieduidelijkheid, rolbewustzijn, wederzijdse monitoring, timing van assistentie, gedeeld begrip van de taak en foutherstel omvatte. In een pilottest met 20 deelnemers werden de duidelijkheid en structuur van de items beoordeeld, en een explorerende factoranalyse identificeerde één dominante factor. De interne consistentie in de hoofdsteekproef was Cronbach’s α = 0,88. De scores per deelnemer werden berekend als het gemiddelde van de ingevulde items, en de scores op teamniveau als het gemiddelde van de drie scores van de deelnemers. De volledige items en scorecriteria zijn opgenomen in Aanvullend Bestand 1.
De door waarnemers beoordeelde teamcoördinatie werd geëvalueerd met een aangepaste rubric die communicatietiming, roluitvoering, wederzijdse ondersteuning, ruimtelijke coördinatie en foutherstel besloeg. Elk domein werd gescoord van 0–20, wat resulteerde in een totale score van 0–100. De rubric werd onderworpen aan een expertreview, en twee waarnemers voltooiden 10 h training voorafgaand aan de formele scoring. De interbeoordelaarsbetrouwbaarheid werd geëvalueerd met een two-way random-effects intraclass correlatiecoëfficiënt (ICC) voor absolute overeenkomst, waarbij een ICC ≥ 0,75 vereist was vóór de definitieve scoring. Verschillen in de totaalscore van meer dan 12 punten werden via consensus opgelost; anders werd het gemiddelde van de twee scores gebruikt. De volledige rubric en de procedure voor reconciliatie zijn opgenomen in Supplementary File 1.
De betrokkenheid bij het leren werd onmiddellijk na de training gemeten met een korte schaal van 12 items met 7 punten13. De scores werden gemiddeld over de ingevulde items, waarbij hogere waarden duidden op een sterkere betrokkenheid. De interne consistentie werd beoordeeld met Cronbach's alpha. De cognitieve belasting werd beoordeeld aan de hand van vijf 1–7 scores voor mentale belasting, fysieke belasting, tijdsdruk, inspanning en frustratie14. De volledige items en scoringsregels zijn opgenomen in Aanvullend Bestand 1.
De kennisverwerving werd beoordeeld met een toets van 30 punten, bestaande uit 20 vragen met één enkel beste antwoord en vijf korte scenario-beoordelingsvragen. Voor de pretest, post-test en de retentietest na 2 weken werd hetzelfde blauwdruk gebruikt, waarbij de items opnieuw zijn geordend en equivalente tekstuele wijzigingen zijn doorgevoerd. Een toename van ten minste 3 punten van de pretest naar de post-test werd gedefinieerd als een praktisch betekenisvolle beschrijvende verbetering. De toetsblauwdruk, score-regels enHet beoordelingsrubriek zijn opgenomen in Supplementary File 1.
Het ongemak bij de simulator werd beoordeeld vóór de blootstelling, na de oriëntatie en na de hoofdtaak aan de hand van vijf symptoombeoordelingen op een schaal van 0–10. Het gemiddelde van deze vijf items vormde de ongemaksindex. Sessies werden gestaakt indien een item een score van 7 of hoger bereikte. Indices na de taak van boven de 6 vereisten minimaal 15 min monitoring, en indices van 5 of hoger vereisten een follow-up van 24 h. De volledige regels voor de veiligheidsscores zijn opgenomen in Supplementary File 1.
Indicatoren voor taakprestaties omvatten de voltooiingsstatus, de voltooiingstijd, het selecteren van de juiste middelen, het correct afhandelen van gevaarsmeldingen, routefouten en veiligheidsonderbrekingen. Aan onvolledige teams werd een voltooiingstijd van 1.200 s toegewezen. Definities van uitkomsten, timing, scorebereiken, gegevensbronnen en analyseniveaus zijn samengevat in Tabel 1 en nader toegelicht in Aanvullend Bestand 1.
10. Procedure voor gegevensverzameling
Elke sessie volgde dezelfde volgorde. De deelnemers arriveerden 15 min vóór het geplande tijdstip van de training. De identiteit werd bevestigd aan de hand van de afsprakenlijst, de geschiktheid werd opnieuw gecontroleerd, het toestemmingsformulier werd toegelicht en procedurele vragen werden beantwoord. Vervolgens tekenden de deelnemers het toestemmingsformulier en ontvingen zij deelnemerscodes. De verwachte superieuriteit van een bepaalde conditie werd niet besproken.
De deelnemers vulden de nulmetingsvragenlijst en de kennistest voorafgaand aan de training in op een laboratoriumtablet. De nulmetingsfase duurde ongeveer 12 min. Na voltooiing van de nulmeting werd de teamtoewijzing bekendgemaakt en werd de toegewezen trainingsopstelling voorbereid. De voorbereiding van de apparatuur duurde ongeveer 5 min voor de desktopconditie, 8 min voor de room-scale gedistribueerde collaboratieve virtual reality-conditie en 10 min voor de large-space co-gelokaliseerde collaboratieve virtual reality-conditie. De voorbereiding van de apparatuur werd niet meegeteld als blootstelling aan de training.
Alle deelnemers voltooiden vervolgens de gestandaardiseerde oriëntatie van 8 min. De hoofttaak begon direct na de oriëntatie en duurde maximaal 20 min. Tijdens de hoofttaak werd er geen instructie, geen hints en geen corrigerende feedback gegeven. Technische ondersteuning was beperkt tot het herstellen van de systeemfunctie, het aanpassen van de pasvorm van de headset, het herpositioneren van deelnemers binnen de veiligheidsgrens of het herhalen van eerder gegeven veiligheidsinstructies. Na de taak verwijderden de deelnemers de apparatuur en voltooiden zij de vragenlijst en de kennistoets na de training bij individuele stations. De evaluatie na de training duurde ongeveer 15 min.
De retentietest van 2 weken werd online afgenomen 14 dagen na de trainingssessie, met een acceptabel venster voor voltooiing van dag 13 tot en met dag 16. Deelnemers ontvingen één herinnering 24 h vóór de vervaldatum en één herinnering op dag 15 als de test nog niet was voltooid. Antwoorden die na dag 16 waren ingediend, bleven behouden in de ruwe dataset, maar werden uitgesloten van de primaire retentieanalyse. Het werkelijke aantal dagen tussen de training en de follow-up werd geregistreerd voor de sensitiviteitsanalyse.
11. Kwaliteitscontrole van gegevens
Elektronische vragenlijsten bevatten bereikcontroles voor belangrijke uitkomstmaten, terwijl demografische items konden worden overgeslagen. Inzendtijden werden geregistreerd, en vragenlijsten die in minder dan een derde van de mediane voltooiingstijd waren ingevuld, werden gemarkeerd voor beoordeling. Systeemlogs werden na elke sessie geëxporteerd en binnen 48 h vergeleken met de sessieverslagen; inconsistenties werden opgelost aan de hand van tijdstempelopnames.
Door observatoren beoordeelde coördinatiescores werden onafhankelijk ingevoerd door twee observatoren. Verschillen in de totaalscore van meer dan 12 punten werden gemarkeerd voor consensusbeoordeling, en de definitieve scores werden vastgelegd vóór de analyse op groepsniveau. Scores van schalen met meerdere items werden berekend wanneer ten minste 80% van de items was ingevuld; anders werden de scores als missend gecodeerd. Niet beantwoorde kennisvragen met één juist antwoord werden gescoord als 0. Korte scenario-beoordelingsitems werden onafhankelijk gescoord door twee beoordelaars, waarbij onenigheid van meer dan 1 punt werd beoordeeld door een derde beoordelaar.
De uiteindelijke dataset werd vergrendeld na verificatie van de geschiktheidsgegevens, deelnemer- en teamcodes, vragenlijstbereiken, kennisscores, waarnemersbeoordelingen, systeemlogs, de validiteit van de retentietest, gegevensfusies en ontbrekende waarden. Gedetailleerde regels voor de scoreberekening, opschoning en het vergrendelen van de dataset worden beschreven in Supplementary File 1.
12. Veiligheidsmonitoring en stopcriteria
Gedurende alle trainingssessies werd de veiligheidsmonitoring uitgevoerd. Voorafgaand aan de blootstelling werden de deelnemers eraan herinnerd dat er tijdens de virtual reality-training ongemak kon optreden en dat zij op elk gewenst moment konden stoppen. Tijdens de taak werden houding, balans, bewegingssnelheid en verbale tekenen van ongemak gemonitord. De taak werd onmiddellijk stopgezet als een deelnemer melding maakte van ernstige duizeligheid, misselijkheid, visueel ongemak, hoofdpijn, angst, balansverlies of de wens om te stoppen.
Vooraf gedefinieerde stopcriteria werden consistent toegepast. De sessie werd stopgezet als een van de ongemaksitems een score van 7 of hoger bereikte op de schaal van 0–10, als een deelnemer tweemaal de veiligheidsgrens overschreed in één sessie, als het verlies van tracking langer dan 2 min duurde, als een storing van de apparatuur normale interactie verhinderde, of als werd geoordeeld dat voortgezette deelname een veiligheidsrisico vormde. Gestopte sessies werden gedocumenteerd met een formulier voor sessie-onderbreking. Deelnemers werden na het stoppen geplaatst en gemonitord totdat de symptomen terugkeerden naar een mild niveau, gedefinieerd als alle ongemaksitems onder de 3. Geen enkele deelnemer mocht het laboratorium verlaten terwijl er sprake was van matig of ernstig ongemak.
13. Databeheer en vertrouwelijkheid
Alle gegevens werden opgeslagen in een gedeïdentificeerde projectmap op een versleutelde institutionele schijf. Het koppelingsbestand dat de identiteiten van deelnemers aan de deelnemerscodes verbond, werd apart bewaard en was uitsluitend toegankelijk voor de hoofdonderzoeker. Vragenlijstgegevens, taaklogs, beoordelingen door waarnemers en scores van kennistests werden uitsluitend samengevoegd met behulp van deelnemers- en teamcodes, en de analytische dataset bevatte geen persoonlijke identificatiekenmerken.
De gegevens werden georganiseerd op deelnemer- en teamniveau. Bestanden op deelnemerniveau bevatten identificatoren, conditietoewijzing, demografische variabelen, vragenlijstresultaten, kennisresultaten en taakgerelateerde variabelen. Bestanden op teamniveau bevatten teamidentificatoren, conditietoewijzing, door waarnemers beoordeelde coördinatie, taakvoltooiing, voltooiingstijd, middelenselectie, omgang met gevaren, routefouten en veiligheidsonderbrekingen. Ruwe scores van waarnemers werden apart bewaard voordat deze werden gemiddeld of via consensus werden opgelost. Variabeledefinities, coderingsbereiken en de datasetstructuur zijn opgenomen in Aanvullend bestand 1.
14. Statistische analyse
De primaire uitkomsten waren ruimtelijke aanwezigheid, zelfgerapporteerde teamcoördinatie, door waarnemers beoordeelde teamcoördinatie en leerbetrokkenheid. De secundaire uitkomsten omvatten kennis na de training, retentie na 2 weken, cognitieve belasting, ongemak bij het gebruik van de simulator, voltooiing van de taak, voltooiingstijd en taakprocesindicatoren. De trainingscondities bestonden uit desktop collaborative simulation, room-scale distributed collaborative virtual reality en large-space co-located collaborative virtual reality.
Variabelen op deelnemer- en teamniveau werden samengevat met behulp van passende beschrijvende statistieken. De baseline-kenmerken omvatten leeftijd, geslacht, eerdere ervaring met virtual reality, bekendheid met gaming, eerdere ervaring met teamtraining en voorkennis. Omdat de randomisatie op teamniveau plaatsvond, werden intraclass-correlatiecoëfficiënten berekend om de afhankelijkheid binnen teams te beoordelen. Primaire uitkomsten op deelnemerniveau werden geanalyseerd met lineaire mixed-effects-modellen, waarbij de trainingsconditie als vast effect en de teamidentificatie als random intercept werden gebruikt. De modellen maakten gebruik van restricted maximum likelihood-schatting en bevatten beschikbare gegevens onder de aanname van missing-at-random. Er werd geen imputatie toegepast op de primaire vragenlijstuitkomsten. Geschatte marginale gemiddelden werden vergeleken met behulp van Tukey-gecorrigeerde pairwise contrasts. Door waarnemers beoordeelde coördinatie werd op teamniveau geanalyseerd.
De Benjamini-Hochberg-procedure voor de false discovery rate werd toegepast op de vier primaire uitkomsten als sensitiviteitsanalyse. Alle gerandomiseerde teams en deelnemers werden geanalyseerd volgens de oorspronkelijke toewijzing. Scores van schalen met meerdere items werden berekend wanneer ten minste 80% van de items was ingevuld; anders werden de scores als missend gecodeerd. De normaliteit van de residuen werd beoordeeld met Q-Q-plots en Shapiro-Wilk-toetsen, en de homogeniteit van de variantie werd beoordeeld met de toets van Levene. Sterk non-normale verdelingen werden onderzocht met de Kruskal-Wallis-toets als sensitiviteitsanalyse.
Effectgroottes werden gerapporteerd met p-waarden. Resultaten van de variantieanalyse bevatten eta-kwadraat en partiële eta-kwadraat; paarsgewijze vergelijkingen bevatten Cohen’s d met 95% betrouwbaarheidsintervallen; en mixed-effects modellen rapporteerden geschatte gemiddelde verschillen met 95% betrouwbaarheidsintervallen. Statistische significantie werd gedefinieerd als tweezijdig p < 0,05. Associaties tussen ruimtelijke aanwezigheid, teamcoördinatie, leerbetrokkenheid en kennisresultaten werden onderzocht met behulp van Pearson- of Spearman-correlaties, naar gelang van de situatie. De statistische syntax voor beschrijvende analyses, mixed-effects modellen, coördinatieanalyse op teamniveau, aanpassing voor meerdere uitkomsten, toetsing van aannames, kennisanalyses en correlatieanalyses is opgenomen in Aanvullend Bestand 1.
Resultaten
Deelnemersstroom en analysepopulaties
In totaal werden 126 deelnemers geïncludeerd en toegewezen aan 42 teams van drie personen. Veertien teams werden toegewezen aan elke trainingsconditie, wat resulteerde in 42 deelnemers in de groep voor desktop collaboratieve simulatie, 42 in de groep voor room-scale gedistribueerde collaboratieve virtual reality en 42 in de groep voor large-space co-located collaboratieve virtual reality. Alle teams voltooiden de toegewezen trainingssessie en werden behouden in de intention-to-treat dataset.
De hoeveelheid ontbrekende gegevens was laag en was niet geconcentreerd in één specifieke conditie. Scores voor ruimtelijke aanwezigheid waren beschikbaar voor 124 deelnemers, waaronder 41 in de desktopgroep, 42 in de room-scale groep en 41 in de large-space groep. Zelfbeoordeelde scores voor teamcoördinatie waren beschikbaar voor 123 deelnemers, met 41 deelnemers per groep. Scores voor leerbetrokkenheid waren beschikbaar voor 122 deelnemers, waaronder 40 in de desktopgroep, 41 in de room-scale groep en 41 in de large-space groep. Scores voor simulator-ongemak waren beschikbaar voor 124 deelnemers, waaronder 42 in de desktopgroep, 41 in de room-scale groep en 41 in de large-space groep. Geldige scores voor kennisretentie na 2 weken waren beschikbaar voor 122 deelnemers, waaronder 40 in de desktopgroep, 41 in de room-scale groep en 41 in de large-space groep. Door waarnemers beoordeelde teamcoördinatie was beschikbaar voor alle 42 teams. De doorstroom van deelnemers, de toewijzing, de onmiddellijke beoordeling en de voltooiing van de follow-up zijn samengevat in Figuur 3.
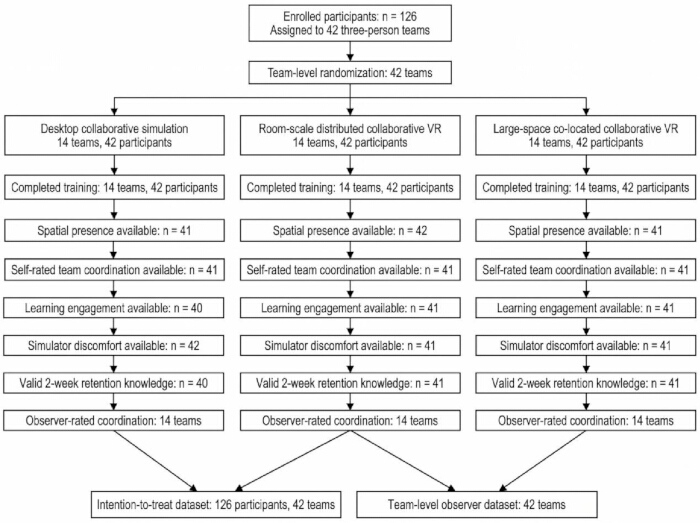
Figuur 3: Deelnemersstroom en analysepopulaties. Het stroomdiagram toont de inschrijving, de toewijzing van 126 deelnemers aan 42 teams van drie personen, de voltooiing van de training, de onmiddellijke beoordeling, de door waarnemers beoordeelde coördinatiescores en de geldige follow-upgegevens na 2 weken over de drie trainingscondities. Klik hier om een grotere versie van deze figuur te bekijken.
Basiskenmerken
De demografische kenmerken en trainingsgerelateerde kenmerken bij aanvang waren grotendeels vergelijkbaar tussen de drie condities. De uiteindelijke steekproef bestond uit jongvolwassen bachelor- en masterstudenten. De drie groepen waren vergelijkbaar wat betreft leeftijd, eerdere blootstelling aan virtual reality, bekendheid met gaming of simulaties, eerdere ervaring met teamgebaseerde training en eerdere training in noodlogistiek, navigatie of industriële veiligheid.
De scores voor kennis voorafgaand aan de training waren ook vergelijkbaar tussen de groepen. De gemiddelde scores voor kennis voorafgaand aan de training waren 16,17 ± 3,09 in de groep voor collaboratieve desktopsimulatie, 16,10 ± 3,61 in de groep voor gedistribueerde collaboratieve virtual reality op kamerschaal, en 15,55 ± 3,23 in de groep voor co-gelokaliseerde collaboratieve virtual reality in een grote ruimte. De ongecorrigeerde vergelijking tussen de groepen was niet statistisch significant, F(2, 123) = 0,44, p = 0,647, η2 = 0,007.
De basiskenmerken en de metingen voorafgaand aan de training worden weergegeven in Tabel 2. Voorafgaand aan de inferentiële hypothesetoetsing gaven diagnostische evaluaties aan dat de primaire continue variabelen voldeden aan de aannames van residuele normaliteit en homogeniteit van de variantie. De interne consistentie was hoog voor alle psychometrische instrumenten, met Cronbach's alfa-coëfficiënten van 0,86 voor ruimtelijke aanwezigheid, 0,88 voor zelfgerapporteerde teamcoördinatie en 0,91 voor leerbetrokkenheid. Alle statistisch significante groepsverschillen voor de primaire uitkomsten bleven significant na correctie voor de false discovery rate volgens de Benjamini-Hochberg methode.
Tabel 2: Baseline-kenmerken en pre-training metingen. Deze tabel rapporteert de demografische gegevens van de deelnemers, eerdere ervaringen met virtual reality en trainingen, bekendheid met gaming of simulaties, eerdere relevante trainingsgeschiedenis en de kennisscores vóór de training over de drie experimentele condities. Klik hier om deze tabel te downloaden.
Ruimtelijke aanwezigheid
De ruimtelijke aanwezigheid werd geanalyseerd met een lineair mixed-effects model, waarbij de trainingsconditie als vast effect en de teamcode als random intercept werden gebruikt. Voor de mixed-effects modeltesten werd gebruikgemaakt van Satterthwaite-gecorrigeerde vrijheidsgraden. Het model toonde een significant effect van de trainingsconditie op de ruimtelijke aanwezigheid aan, F(2, 39) = 23.91, p < 0.001. De geschatte marginale gemiddelden waren 4.13 voor de groep met de collaboratieve desktopsimulatie, 5.00 voor de groep met de distributed collaborative virtual reality op kamerschaal, en 5.42 voor de groep met de co-located collaborative virtual reality in een grote ruimte.
Tukey-gecorrigeerde paarsgewijze vergelijkingen toonden aan dat de ruimtelijke presentie hoger was in de groep met de grote ruimte dan in de desktopgroep, geschat gemiddeld verschil = 1.29, 95% CI: 0.86 – 1.72, p < 0.001. De ruimtelijke presentie was ook hoger in de groep met de grote ruimte dan in de room-scale groep, geschat gemiddeld verschil = 0.42, 95% CI: 0.04 – 0.80, p = 0.027. De room-scale groep scoorde hoger dan de desktopgroep, geschat gemiddeld verschil = 0.87, 95% CI: 0.45 – 1.29, p < 0.001.
Voor de beschrijvende vergelijking waren de niet-gecorrigeerde gemiddelde scores ± standaarddeviatie (SD) 4,13 ± 0,91 in de desktopgroep, 5,00 ± 0,79 in de room-scale-groep en 5,42 ± 0,80 in de large-space-groep. De niet-gecorrigeerde variantieanalyse (ANOVA) toonde hetzelfde patroon, F(2, 121) = 25,68, p < 0,001, η2 = 0,298. De distributies van de primaire uitkomsten worden getoond in Figuur 4, en de bijbehorende mixed-effects- en beschrijvende statistieken zijn samengevat in Tabel 3.
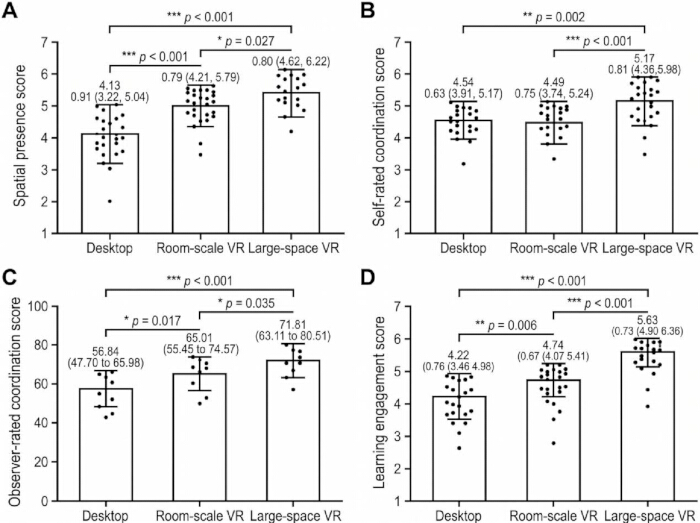
Figuur 4: Primaire uitkomsten over de trainingscondities. (A) Ruimtelijke aanwezigheid. (B) Zelfgerapporteerde teamcoördinatie. (C) Door waarnemer beoordeelde teamcoördinatie. (D) Betrokkenheid bij het leren. Ruimtelijke aanwezigheid, zelfgerapporteerde teamcoördinatie en betrokkenheid bij het leren waren uitkomsten op deelnemerniveau; door waarnemer beoordeelde teamcoördinatie werd op teamniveau geanalyseerd. Foutenbalken geven de standaarddeviatie aan. Klik hier om een grotere versie van deze figuur te bekijken.
Tabel 3: Primaire uitkomsten. Deze tabel vat de ruimtelijke aanwezigheid, de zelfgerapporteerde teamcoördinatie, de door waarnemers beoordeelde teamcoördinatie en de leerbetrokkenheid samen over de drie trainingscondities. De bijbehorende inferentiële statistische modellen en gevoeligheidscontroles voor de false discovery rate worden ook gepresenteerd. Klik hier om deze tabel te downloaden.
Teamcoördinatie
Zelfgerapporteerde teamcoördinatie werd op deelnemerniveau geanalyseerd met behulp van een lineair mixed-effects model, waarbij de trainingsconditie als vast effect en de teamcode als random intercept werden gebruikt. Het model toonde een significant effect van de trainingsconditie, F(2, 39) = 9.96, p < 0.001. De geschatte marginale gemiddelden waren 4.54 in de desktopgroep, 4.49 in de room-scale groep en 5.17 in de large-space groep.
Met de Tukey-correctie aangepaste vergelijkingen lieten zien dat de zelfgerapporteerde teamcoördinatie hoger was in de groep met een grote ruimte dan in de desktopgroep, geschat gemiddeld verschil = 0,63, 95% BI: 0,25 – 1,01, p = 0,002. De groep met een grote ruimte scoorde ook hoger dan de groep op kamerschaal, geschat gemiddeld verschil = 0,68, 95% BI: 0,29 – 1,07, p < 0,001. De desktopgroep en de groep op kamerschaal verschilden niet significant, geschat gemiddeld verschil = 0,05, 95% BI: −0,33 – 0,43, p = 0,942. Voor de beschrijvende vergelijking waren de niet-gecorrigeerde gemiddelde ± SD-scores 4,54 ± 0,63 in de desktopgroep, 4,49 ± 0,75 in de groep op kamerschaal en 5,17 ± 0,81 in de groep met een grote ruimte. De niet-gecorrigeerde ANOVA leverde hetzelfde directionele patroon op, F(2, 120) = 10,84, p < 0,001, η2 = 0,153.
De door waarnemers beoordeelde teamcoördinatie werd, zoals vooraf gespecificeerd, op teamniveau geanalyseerd. De interbeoordelaarsbetrouwbaarheid overschreed de vooraf gedefinieerde drempelwaarde, met een intraclass correlatiecoëfficiënt voor random-effects met twee wegeffecten van ICC = 0,84. Drie teamopnames vertoonden verschillen in de totale score van de waarnemers van meer dan 12 punten en werden via een consensusreview opgelost. De door waarnemers beoordeelde coördinatie verschilde significant tussen de condities, F(2, 39) = 10,92, p < 0,001, η2 = 0,359. De gemiddelde scores op teamniveau waren 56,84 ± 9,14 in de desktopgroep, 65,01 ± 9,56 in de room-scale groep en 71,81 ± 8,70 in de large-space groep. Met de Tukey-methode gecorrigeerde vergelijkingen lieten een hogere door waarnemers beoordeelde coördinatie zien in de large-space groep dan in de desktopgroep, gemiddeld verschil = 14,97, 95% BI: 7,33 – 22,61, p < 0,001. De large-space groep scoorde ook hoger dan de room-scale groep, gemiddeld verschil = 6,80, 95% BI: 0,42 – 13,18, p = 0,035. De room-scale groep scoorde hoger dan de desktopgroep, gemiddeld verschil = 8,17, 95% BI: 1,31 – 15,03, p = 0,017. Zowel de zelfbeoordeelde als de door waarnemers beoordeelde coördinatie vertoonden dezelfde groepsrangorde, waarbij de large-space groep de hoogste coördinatiescores behaalde op beide meetinstrumenten.
Betrokkenheid bij het leren
De betrokkenheid bij het leren werd geanalyseerd met behulp van een lineair mixed-effectsmodel, waarbij de trainingsconditie als vast effect en de teamcode als random intercept werden gebruikt. Het model toonde een significant effect van de trainingsconditie aan, F(2, 39) = 37,46, p < 0,001. De geschatte marginale gemiddelden waren 4,22 in de desktopgroep, 4,74 in de room-scale-groep en 5,63 in de large-space-groep. Tukey-gecorrigeerde paarsgewijze vergelijkingen toonden aan dat de betrokkenheid hoger was in de large-space-groep dan in de desktopgroep, geschat gemiddeld verschil = 1,41, 95% BI: 1,03 – 1,79, p < 0,001. De betrokkenheid was ook hoger in de large-space-groep dan in de room-scale-groep, geschat gemiddeld verschil = 0,89, 95% BI: 0,53 – 1,25, p < 0,001. De room-scale-groep scoorde hoger dan de desktopgroep, geschat gemiddeld verschil = 0,52, 95% BI: 0,15 – 0,89, p = 0,006.
Voor een beschrijvende vergelijking waren de niet-gecorrigeerde gemiddelde scores ± SD 4,22 ± 0,76 in de desktopgroep, 4,74 ± 0,67 in de room-scale-groep en 5,63 ± 0,73 in de groep met grote ruimte. De niet-gecorrigeerde ANOVA toonde hetzelfde patroon, F(2, 119) = 40,00, p < 0,001, η2 = 0,402.
Gevoeligheidscontroles van de false discovery rate voor primaire uitkomsten
De Benjamini-Hochberg-procedure voor de false discovery rate werd toegepast op de vier vooraf vastgestelde primaire uitkomsten: ruimtelijke aanwezigheid, zelfgerapporteerde teamcoördinatie, door de waarnemer beoordeelde teamcoördinatie en leerbetrokkenheid. Alle vier de primaire uitkomsten bleven statistisch significant na correctie. De gevoeligheidscontrole van de false discovery rate leverde hetzelfde patroon voor de primaire uitkomsten op als de hoofdanalyses.
Kennisresultaten en retentie
De kennis direct na de training werd geanalyseerd met behulp van een mixed-effects model, waarbij de trainingsconditie als vast effect, de kennis vóór de training als covariaat en de teamcode als random intercept werden gebruikt. Het aangepaste model toonde een niet-significant groepseffect voor de kennis na de training, F(2, 39) = 2.14, p = 0.131. De geschatte marginale gemiddelden waren 20.12 voor de desktopgroep, 20.96 voor de room-scale groep en 21.85 voor de large-space groep. Ter beschrijvende vergelijking waren de gemiddelde kennisscores na de training 20.09 ± 4.04 in de desktopgroep, 21.00 ± 4.57 in de room-scale groep en 21.84 ± 3.95 in de large-space groep. De niet-aangepaste vergelijking tussen de groepen was statistisch niet significant, F(2, 123) = 1.83, p = 0.165, η2 = 0.029.
De kenniswinst van de nulmeting tot de beoordeling direct na de training werd geëvalueerd als een secundaire exploratieve inferentiële uitkomst. De gemiddelde winsten waren 3,93 ± 2,88 punten in de desktopgroep, 4,91 ± 2,12 punten in de room-scale groep en 6,30 ± 2,75 punten in de large-space groep. Het ongecorrigeerde groepseffect was significant, F(2, 123) = 8,77, p < 0,001, η2 = 0,125. Met de Tukey-correctie aangepaste vergelijkingen lieten een grotere kenniswinst zien in de large-space groep dan in de desktopgroep, gemiddeld verschil = 2,37, 95% BI: 0,96 – 3,78, p < 0,001. De large-space groep vertoonde ook een grotere winst dan de room-scale groep, gemiddeld verschil = 1,39, 95% BI: 0,14 – 2,64, p = 0,026. De room-scale en desktopgroepen verschilden niet significant, gemiddeld verschil = 0,98, 95% BI: −0,31 – 2,27, p = 0,171.
Bij de follow-up na 2 weken werd de retentiekennis geanalyseerd onder deelnemers met geldige retentie-antwoorden binnen het vooraf gedefinieerde venster van dag 13–dag 16. Het aangepaste mixed-effects model, waarbij werd gecorrigeerd voor de kennis vóór de training en waarbij de teamcode als random intercept werd opgenomen, vertoonde een niet-significant groepseffect, F(2, 39) = 1.68, p = 0.199. De gemiddelde retentiescores waren 18,70 ± 4,55 in de desktopgroep, 19,62 ± 4,37 in de room-scale groep en 20,42 ± 4,38 in de large-space groep. De niet-gecorrigeerde groepvergelijking was eveneens statistisch niet significant, F(2, 119) = 1.53, p = 0.220, η2 = 0.025. De secundaire leeruitkomsten zijn samengevat in Tabel 4.
Tabel 4: Secundaire leerdoelen over de verschillende trainingscondities. Deze tabel rapporteert de kennis vóór de training, de kennis direct na de training, de kenniswinst en de kennisretentie na 2 weken over de drie trainingscondities. Aangepaste mixed-effects modellen worden gepresenteerd voor de secundaire leerdoelen. Klik hier om deze tabel te downloaden.
Cognitieve belasting en simulator-ongemak
De cognitieve belasting werd geanalyseerd als een secundair uitkomstpunt. De gemiddelde cognitieve belasting was 4,22 ± 0,69 in de desktopgroep, 4,49 ± 0,62 in de room-scale groep en 4,13 ± 0,82 in de groep met de grote ruimte. Het niet-gecorrigeerde groepseffect was F(2, 123) = 2,92, p = 0,058, η2 = 0,045. Dit resultaat bereikte de vooraf gedefinieerde significantiedrempel niet.
Het ongemak door de simulator verschilde tussen de condities. De gemiddelde index voor ongemak na de taak was 1,37 ± 0,71 in de desktopgroep, 2,18 ± 0,79 in de room-scale groep en 2,42 ± 0,58 in de grote-ruimtegroep. Het ongecorrigeerde groepseffect was significant, F(2, 121) = 25,72, p < 0,001, η2 = 0,298. De ongemakscores waren hoger in de twee virtual reality-groepen dan in de desktopgroep, terwijl de gemiddelde waarden binnen het milde bereik bleven. Geen enkele deelnemer voldeed aan het vooraf gedefinieerde stopcriterium van een score ≥7 voor een willekeurig ongemakitem. Zeven deelnemers hadden een index voor ongemak na de taak van ≥5 en kregen contact voor symptoomresolutie na 24 u. Van deze deelnemers hadden vier een index voor ongemak na de taak van >6 en werden zij daarnaast gedurende ten minste 15 min in het laboratorium gemonitord voordat zij vertrokken. Alle zeven deelnemers rapporteerden symptoomresolutie zonder medische verwijzing. Geen enkele sessie werd beëindigd vanwege ongemak door de simulator, en er werden geen bijwerkingen geregistreerd die klinische zorg vereisten. Cognitieve belasting en ongemak door de simulator worden getoond in Figuur 5.
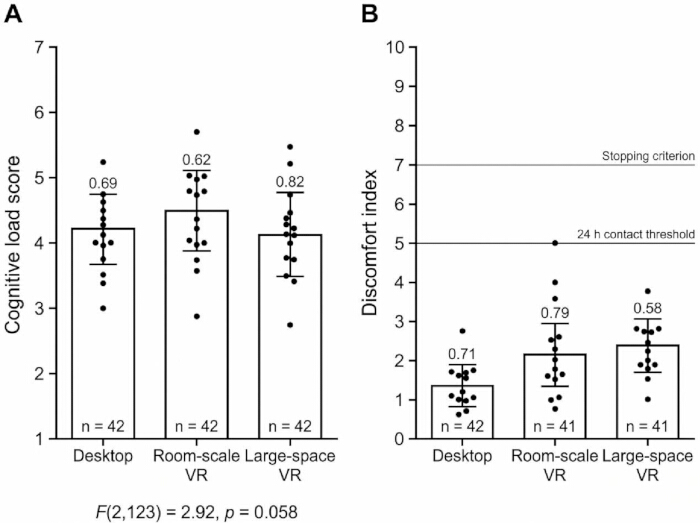
Figuur 5: Cognitieve belasting en simulator-ongemak bij verschillende trainingscondities. (A) Cognitieve belasting, gescoord van 1 – 7, waarbij hogere scores duiden op een grotere waargenomen werklast. (B) Simulator-ongemak na de taak, gescoord van 0 – 10 en gebaseerd op misselijkheid, duizeligheid, oogvermoeidheid, hoofdpijn en balansproblemen. Foutenbalken geven de standaarddeviatie aan. Klik hier om een grotere versie van deze figuur te bekijken.
Indicatoren voor het taakproces
Indicatoren voor het taakproces werden gebruikt om de teamprestaties tijdens de 20 min durende collaboratieve trainingstaak te beschrijven. De taakvoltooiing was 71,4% in de desktopgroep, 78,6% in de room-scale groep en 85,7% in de large-space groep. De gemiddelde voltooiingstijd was 1.041,6 ± 162,4 s in de desktopgroep, 984,3 ± 151,8 s in de room-scale groep en 931,7 ± 139,6 s in de large-space groep. Omdat voor onvolledige teams een tijdslimiet van 1.200 s was vastgesteld, werd de voltooiingstijd beschrijvend geïnterpreteerd.
Het gemiddelde aantal correct geselecteerde hulpmiddelen was 2,21 ± 0,70 in de desktopgroep, 2,43 ± 0,65 in de room-scale groep en 2,64 ± 0,50 in de large-space groep. Het gemiddelde aantal correct afgehandelde gevarenmeldingen was respectievelijk 1,93 ± 0,83, 2,21 ± 0,70 en 2,50 ± 0,65. Het gemiddelde aantal routefouten was 2,07 ± 1,14 in de desktopgroep, 1,50 ± 0,94 in de room-scale groep en 1,00 ± 0,78 in de large-space groep. Veiligheidsonderbrekingen kwamen zelden voor in alle condities, met gemiddelden van respectievelijk 0,21 ± 0,43, 0,29 ± 0,47 en 0,36 ± 0,50. De status van taakvoltooiing, de voltooiingstijd, de correcte selectie van hulpmiddelen, correct afgehandelde gevarenmeldingen, routefouten en veiligheidsonderbrekingen zijn samengevat in Tabel 5.
Tabel 5: Indicatoren van het taakproces en veiligheidsgebeurtenissen. Deze tabel vat objectieve maatstaven voor de taakprestatie samen, waaronder voltooiingspercentages, fouten bij routenavigatie en de omgang met gevaren. Monitoring van ongemak in de simulator en geregistreerde ongewenste klinische gebeurtenissen worden ook gerapporteerd. Klik hier om deze tabel te downloaden.
Samenhang tussen aanwezigheid, coördinatie, betrokkenheid en leren
Psychometrische responsen op deelnemerniveau werden geaggregeerd tot clustergemiddelden op teamniveau voordat ze werden geïntegreerd met door observatoren beoordeelde coördinatiematen. Correlatieanalyses op teamniveau toonden positieve associaties aan tussen ruimtelijke aanwezigheid en leerbetrokkenheid (r = 0.57), zelfbeoordeelde teamcoördinatie (r = 0.26) en door observatoren beoordeelde coördinatie (r = 0.32).
Het correlatiepatroon wees op een matige overlap tussen aanwezigheid, coördinatie en betrokkenheid, terwijl de correlaties met kenniswinst kleiner waren. Het correlatiepatroon wees op overlap tussen aanwezigheid, coördinatie en betrokkenheid, terwijl de associaties met kenniswinst kleiner waren. Deze analyses waren exploratief en leggen geen causale paden vast tussen de gemeten uitkomsten. De correlatiematrix wordt getoond in Figuur 6.
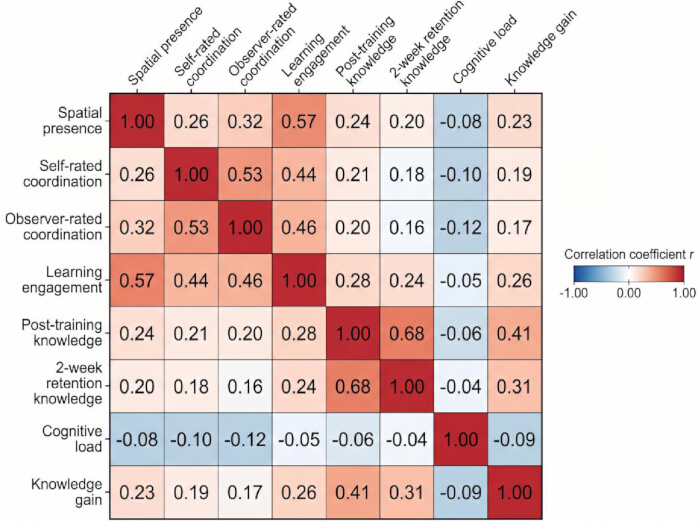
Figuur 6: Correlatiematrix voor aanwezigheid, coördinatie, betrokkenheid en leerresultaten. De heatmap toont de Pearson-correlatiecoëfficiënten tussen ruimtelijke aanwezigheid, zelfbeoordeelde teamcoördinatie, door waarnemer beoordeelde teamcoördinatie, leerbetrokkenheid, kennis na training, kennisretentie na 2 weken, cognitieve belasting en kenniswinst. Klik hier om een grotere versie van deze figuur te bekijken.
De groep in de collaboratieve virtual reality met co-locatie in een grote ruimte vertoonde een hogere ruimtelijke aanwezigheid, zelfbeoordeelde teamcoördinatie, door waarnemers beoordeelde teamcoördinatie en leerbetrokkenheid dan de vergelijkingsgroepen. Deze resultaten van de primaire uitkomstmaten bleven significant na correctie voor teamclustering en na aanpassing voor de false discovery rate. Wat betreft de secundaire uitkomstmaten was de kenniswinst gunstiger voor de groep in de grote ruimte, terwijl de gecorrigeerde kennis na training en de kennisretentie na 2 weken niet significant verschilden tussen de condities. De cognitieve belasting verschilde niet significant tussen de groepen, en het ongemak in de simulator bleef gemiddeld mild, ondanks hogere scores in de virtual reality-condities.
DATABESCHIKBAARHEID:
De geanonimiseerde analytische dataset, het datadictionary, de score-rubrieken en de statistische syntax die zijn gebruikt om de reproduceerbaarheid te ondersteunen, zijn publiek toegankelijk in de Zenodo-repository - https://zenodo.org/records/21991446. Aanvullende rapportagechecklist, blauwdrukken van instrumenten, score-regels en dataset-documentatie worden verstrekt in Aanvullend Bestand 1.
Aanvullend bestand 1: Reproductiematerialen voor de Large-Space Collaborative Virtual Reality Training Study.Dit bestand bevat de deelnemersvragenlijst, het blauwdrukontwerp van de kennistoets, de door waarnemers beoordeelde rubric voor coördinatie, het datadictionary, de score- en opschoningsregels, een overzicht van de statistische syntaxis, de structuur van de geanonimiseerde analytische dataset en een rapportagechecklist. Klik hier om dit bestand te downloaden.
Discussie
Deze studie onderzocht of een collaboratieve virtual reality-configuratie in een grote ruimte waarbij deelnemers fysiek samen geplaatst waren (co-located), leidde tot andere trainingservaringen dan desktop-collaboratie en gedistribueerde collaboratieve virtual reality op kamerschaal. De sterkste en meest consistente resultaten werden waargenomen voor ruimtelijke aanwezigheid, teamcoördinatie en leerbetrokkenheid. Deze uitkomsten zijn verschillend: ruimtelijke aanwezigheid weerspiegelt in hoeverre deelnemers zichzelf als aanwezig binnen de trainingsruimte ervoeren; coördinatie weerspiegelt informatie-uitwisseling, roluitvoering en foutherstel; en betrokkenheid weerspiegelt de cognitieve en gedragsmatige betrokkenheid bij de taak. De conditie in de grote ruimte produceerde hogere scores in alle drie de domeinen na correctie voor teamclustering en aanpassing voor de false discovery rate. Dit patroon is consistent met het bredere standpunt dat collaboratieve virtual reality niet alleen functioneert als een weergavetechnologie, maar ook als een taakecologie waarin gedeelde actie, communicatie en omgevingsstructuur gezamenlijk het leergedrag vormgeven15.
De bevinding met betrekking tot de ruimtelijke aanwezigheid is relevant omdat de drie trainingscondities verschilden in de organisatie van beweging en co-aanwezigheid. De desktopconditie ondersteunde samenwerking zonder immersieve lichamelijke plaatsing. De gedistribueerde conditie op kamer-schaal bood een immersieve visuele ervaring en live teamcommunicatie, maar de deelnemers bleven zich in afzonderlijke kleine trackinggebieden bevinden. De conditie in de grote ruimte voegde gedeelde fysieke co-navigatie toe, waardoor deelnemers konden bewegen, zich konden oriënteren en konden handelen binnen dezelfde getrackte omgeving. De geobserveerde toename in ruimtelijke aanwezigheid mag daarom niet uitsluitend worden toegeschreven aan de loopruimte, maar eerder aan de volledige trainingsconfiguratie waarin lichamelijke beweging, een gedeelde ruimtelijke referentie en real-time zichtbaarheid van het team werden gecombineerd. Deze interpretatie is consistent met onderzoek naar aanwezigheid waaruit blijkt dat immersieve systemen de aanwezigheid kunnen versterken wanneer sensorimotorische contingenties, ruimtelijke bijwerkingen en omgevingscoherentie het gevoel ondersteunen zich te bevinden binnen de gemedieerde omgeving16. De resultaten voor de coördinatie vertoonden een vergelijkbaar patroon. De groep in de grote ruimte vertoonde een hogere zelfgerapporteerde en door waarnemers beoordeelde coördinatie. Zelfgerapporteerde coördinatie kan beïnvloed zijn door plezier of nieuwheid, terwijl de door waarnemers beoordeelde coördinatie gebaseerd was op zichtbare communicatietiming, roluitvoering, wederzijdse ondersteuning, ruimtelijke coördinatie en fouthersteltijd. Gedeelde ruimtelijke informatie kan daarom een gemeenschappelijk referentiekader hebben geboden voor het organiseren van teamacties. Dit patroon is consistent met onderzoek naar computer-ondersteund collaboratief leren, dat aangeeft dat samenwerking afhankelijk is van communicatiekanalen, gedeelde representaties, taakinterdependentie en monitoring van de teamvoortgang17.
De betrokkenheid bij het leren nam ook toe in de groep met de grote ruimte, hoewel deze bevinding met voorzichtigheid moet worden geïnterpreteerd in relatie tot de effectiviteit van het leren. De combinatie van een hogere onmiddellijke kenniswinst met niet-significante, gecorrigeerde resultaten na de training en bij de retentie geeft aan dat een sterkere experiëntiële betrokkenheid niet consistent overeenkwam met een sterkere retentie van kennis. Een eenmalige blootstelling kan daarom leiden tot grotere immersie en gedragsmatige betrokkenheid zonder dat dit noodzakelijkerwijs duurzame verschillen in kennisverwerving oplevert. De voordelen van collaboratieve omgevingen met een grote ruimte waren het meest duidelijk zichtbaar in ruimtelijke coördinatie en actieve situationele betrokkenheid, in plaats van in duurzame cognitieve retentie. Betrokkenheid blijft een voorwaarde voor leren, maar geen garantie voor retentie. Onderzoek naar immersief leren geeft op soortgelijke wijze aan dat presence en betrokkenheid de aandacht en taakparticipatie kunnen ondersteunen, terwijl duurzaam leren ook afhankelijk is van het instructieontwerp, feedback, voorkennis en mogelijkheden voor herhaalde oefening18. De cognitieve belasting nam niet significant toe in de groep met de grote ruimte, ondanks de fysieke beweging en de live teamcoördinatie die bij deze conditie vereist waren. De gedistribueerde conditie op kamerschaal vertoonde de hoogste gemiddelde cognitieve belasting, hoewel het groepsverschil de vooraf gedefinieerde significantiedrempel niet bereikte. Gedistribueerde collaboratie vereiste dat deelnemers via spraak coördineerden terwijl ze in afzonderlijke kleine ruimtes handelden, waardoor de coördinatie-eisen mogelijk behouden bleven zonder het gedeelde fysieke referentiekader dat wel beschikbaar was in de conditie met de grote ruimte. De cognitieve belastingtheorie geeft op soortgelijke wijze aan dat collaboratief leren het meest effectief is wanneer de taakstructuur het cognitieve werk verdeelt zonder onnodige communicatielast toe te voegen19.
Het ongemak door de simulator was hoger in de twee virtual reality-condities dan in de desktopconditie, hoewel de gemiddelde scores mild bleven. Geen enkele deelnemer voldeed aan het stopcriterium waarbij een item voor ongemak de waarde 7 bereikte, en er traden geen bijwerkingen op die klinische zorg vereisten. Co-located collaboratieve virtual reality in een grote ruimte brengt veiligheidsoverwegingen met zich mee, omdat het de blootstelling aan een head-mounted display, lichaamsbeweging en de nabijheid van teamleden combineert. De geïmplementeerde waarborgen elimineerden het ongemak niet, maar hielden de symptomen binnen een beheersbaar bereik in deze steekproef. Voor een bredere institutionele implementatie zijn gestandaardiseerde procedures voor probleemoplossing vereist. De pasvorm van de headset en de kalibratie van de interpupillaire afstand zijn belangrijk om oogvermoeidheid te verminderen. Verlies van ruimtelijke tracking of verhoogde netwerklatentie vereist het onmiddellijk pauzeren van de simulatie, terwijl storingen in het audiokanaal lokale procedures voor het resetten van de hardware vereisen. Veiligheid bij co-located beweging vereist daarnaast instructies om uitsluitend te lopen en fysieke begrenzingen om het risico op botsingen te verminderen. Deze procedures zijn consistent met het standpunt dat cybersickness en ongemak moeten worden beschouwd als ontwerp- en monitoringsaspecten bij virtual reality-trainingen, in plaats van als incidentele bijwerkingen20.
De studie heeft ook methodologische waarde omdat de vergelijking verder ging dan een simpel contrast tussen virtual reality en niet-virtual reality. Desktopcollaboratie, gedistribueerde immersieve collaboratie en co-gelokaliseerde collaboratie in een grote ruimte werden als afzonderlijke configuraties geëvalueerd. Dit ontwerp maakte het mogelijk om de veranderingen te onderzoeken die geassocieerd zijn met ruimtelijk gedeelde immersieve collaboratie, in plaats van enkel visuele immersie of verbale coördinatie. De waargenomen verschillen waren het sterkst voor presence, coördinatie en betrokkenheid, en minder sterk voor behouden kennis. Dit patroon ondersteunt niet de algemene conclusie dat grotere of meer immersieve systemen alle leerresultaten verbeteren. Co-gelokaliseerde collaboratieve virtual reality in een grote ruimte is daarom mogelijk het meest toepasbaar wanneer training ruimtelijke oriëntatie, rolverdeling, wederzijdse monitoring in realtime en gecoördineerde beweging vereist, in plaats van eenvoudige feitelijke recall21.
Er moeten verschillende beperkingen in overweging worden genomen. De studie werd uitgevoerd op één instelling met deelnemers van jongvolwassen bachelor- en masterstudenten, wat de generaliseerbaarheid naar oudere trainees, professionele noodhulpteams en leerlingen met beperkte technologische ervaring beperkt. De taak omvatte gestructureerde noodlogistiek en ruimtelijke navigatie, en in domeinen met een lagere ruimtelijke afhankelijkheid kunnen andere patronen optreden. De prestatie-evaluatie was gebaseerd op subjectieve vragenlijsten, beoordelingen door menselijke waarnemers en basis systeemslogs. Gedetailleerde gedragstelemetrie, waaronder communicatiefrequentie, cumulatieve spreektijd, bewegingssynchronisatie en gerichte blikgedragingen, werd niet geregistreerd, wat de kwantificering van de gedetailleerde mechanismen van teaminteractie en coördinatie-efficiëntie beperkt. Toekomstig onderzoek zou fysiologische metingen moeten bevatten, waaronder continue hartslagvariabiliteit en electrodermale activiteit, samen met uitgebreide ruimtelijke telemetrie. Onafhankelijke, niet-collaboratieve controlegroepen voor fysieke beweging zijn ook nodig om effecten geassocieerd met interpersoonlijke samenwerking te onderscheiden van effecten geassocieerd met verhoogde fysieke locomotie. De cohort van deelnemers was gebaseerd op haalbaarheid en afkomstig van één academische instelling, en de psychometrische instrumenten en observationele rubrieken werden ontwikkeld of aangepast voor dit immersieve paradigma. Hoewel de interne betrouwbaarheid en constructvaliditeit werden geëvalueerd, blijven zelfrapportagemetingen vatbaar voor novum-effecten. De integratie van vragenlijstgegevens op deelnemerniveau met waarnemerscores op teamniveau introduceerde tevens structurele complexiteit; cluster-gemiddelde aggregatie en mixed-effects modellering werden gebruikt om de analytische niveaus af te stemmen, maar toekomstige studies zouden prioriteit moeten geven aan parallelle multimodale gegevensverzameling op dezelfde operationele analyse-eenheid. De follow-up periode van 2 weken stelt niet vast of de effecten over langere perioden aanhouden of overgaan in prestaties in de echte wereld. Daarnaast waren de drie trainingsconfiguraties holistische omgevingsvergelijkers in plaats van componenten van een volledig factorieel ontwerp. Visuele immersie, fysieke locomotie, lichaamsbewustzijn en gedeelde fysieke co-locatie bleven daarom verstrengeld, waardoor het onmogelijk was de geobserveerde verschillen toe te schrijven aan één enkele component. Toekomstige studies zouden deze factoren moeten scheiden via factoriële manipulatie en herhaalde trainingsexposities en operationele transfertaken moeten opnemen om vast te stellen of verbeteringen in coördinatie aanhouden in klinische of industriële omgevingen22.
Openbaarmakingen
De auteurs hebben geen belangenconflicten.
AUTEURSBIJDRAGEN:
Fu Bo conceptualiseerde de studie, ontwikkelde de experimentele protocollen, beheerde de gegevensverzameling en schreef het eerste concept van het manuscript. Meng Na hield toezicht op de technische implementatie van de virtual reality-simulatieplatforms, droeg bij aan de statistische programmering en herzag het manuscript samen voor de kritische intellectuele inhoud. Beide auteurs hebben de definitieve versie voor indiening goedgekeurd
Dankbetuigingen
De auteurs willen de School of Intelligence and Engineering aan de Shenyang City University bedanken voor de ondersteuning van dit onderzoek. Bijzondere waardering gaat uit naar het Key Laboratory of Virtual- Real Interaction and Digital Twin Technology Innovation voor het ter beschikking stellen van de apparatuur en ruimtelijke faciliteiten die nodig waren voor het uitvoeren van de co-located collaboratieve virtual reality-experimenten in grote ruimtes. Zij betuigen daarnaast hun oprechte dank aan alle bachelor- en masterstudenten die zich vrijwillig hebben aangemeld voor de immersieve trainingssessies. Hun inzet en medewerking waren essentieel voor de succesvolle voltooiing van deze studie. Dit werk werd ondersteund door het Liaoning Applied Basic Research Program 2025 (Grant No. 2025JH2/101330049); de Natural Science Foundation of Liaoning Province 2024 (Grant No. 2024-MS-255); de Fundamental Research Funds for Universities of Liaoning Provincial Department of Education 2025 (Grant No. LJ212513220006); en de Fundamental Research Funds for Universities of Liaoning Provincial Department of Education 2024 (Grant No. LJ212413220001).
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| contactformulier voor symptoomresolutie na 24 u | Door het onderzoek ontwikkeld follow-upformulier | Versie 1.0 | Gebruikt om de resolutie van symptomen te documenteren voor deelnemers met een post-task discomfort index ≥5 |
| Akoestische scheidingswanden | Algemene leverancier van laboratoriummeubilair | Standaard mobiele akoestische scheidingswand, ongeveer 160–180 cm hoogte | Wordt gebruikt om desktopdeelnemers te scheiden en communicatie buiten het kanaal te voorkomen |
| Alcoholvrije desinfecterende doekjes | Algemene leverancier van laboratoriumhygiëne | Apparaatveilige desinfecterende doekjes | Wordt gebruikt voor het reinigen van head-mounted displays, controllers, microfoons, toetsenborden, muizen en gedeelde oppervlakken tussen sessies |
| Analytische dataset | Door het onderzoek gegenereerd bestand | analytische_dataset.csv | Geanonimiseerde dataset op deelnemerniveau met één rij per deelnemer |
| Nulmeting vragenlijst | Vragenlijst ontwikkeld voor de studie | Versie 1.0, definitief februari 2025 | Gebruikt voor het verzamelen van demografische informatie, eerdere ervaring met virtual reality, bekendheid met gaming en eerdere ervaring met teamtraining |
| Afbakeningstape | Algemene leverancier van laboratoriumveiligheidsmiddelen | Antislip vloermarkeringstape | Gebruikt om 3 m te markeren × gebieden op kamerschaal van 3 m en de 8 m × trainingsgebied van 8 m met grote ruimte |
| Schaal voor cognitieve belasting | Studie-aangepast formulier voor de beoordeling van de werklast | versie met 5 items | Onmiddellijk na de training gebruikt; de items hebben betrekking op mentale belasting, fysieke belasting, tijdsdruk, inspanning en frustratie |
| Computermuis | Algemene leverancier van computerapparatuur | Standaard bedrade of draadloze muis | Gebruikt voor interactie in de conditie van collaboratieve simulatie op het bureaublad |
| Logboek voor datareiniging | Door studie gegenereerd bestand | data_opschoning_logboek.xlsx | Registreert scorecorrecties, controles op ontbrekende gegevens, afstemming van waarnemer-scores en beslissingen over het vastzetten van de dataset |
| Datadictionary | Door de studie gegenereerd bestand | Versie 1.0 | Definieert variabelenamen, labels, coderingsregels, scorebereiken, regels voor missende waarden en analyseniveaus |
| Desktopmonitor | Algemene leverancier van computerapparatuur | 24-inch monitor, minimaal 1.920 × 1.080-resolutie | Gebruikt in de conditie van collaboratieve simulatie op de desktop |
| Desktop-workstation | Algemene leverancier van computerapparatuur | Minimale configuratie: Intel i5-processor of equivalent, 16 GB RAM, dedicated videokaart, Windows 10 of later | Gebruikt voor desktopsimulatie, lokale monitoring, het afnemen van vragenlijsten en gegevensverwerking |
| Wegwerpmondkapjes voor headsets | Algemene leverancier van hygiëneproducten | Standaard wegwerpgelaatskappen voor head-mounted displays | Gebruikt voor de hygiëne van deelnemers tijdens virtual reality-sessies |
| Checklist voor noodstop | Door het onderzoek ontwikkeld veiligheidsformulier | Versie 1.0 | Wordt gebruikt voor het documenteren van stopcriteria, ongemakkelijke gebeurtenissen, veiligheidsonderbrekingen en follow-up van symptoomresolutie |
| Versleutelde institutionele opslag | Deelnemende instelling | Toegangsgecontroleerde versleutelde projectmap | Wordt gebruikt voor het opslaan van gedeïdentificeerde datasets, scorebestanden, opnamen en syntaxisbestanden |
| Rubriek voor door de waarnemer beoordeelde coördinatie | Binnen de studie ontwikkelde beoordelingsrubriek | versie met 5 domeinen en 100 punten | Gebruikt door twee geblindeerde waarnemers om de timing van de communicatie, de uitvoering van rollen, wederzijdse ondersteuning, ruimtelijke coördinatie en foutherstel te beoordelen |
| Dataset van waarnemersscores | Door studie gegenereerd bestand | waarnemers_scores.csv | Bevat observerscores op domeinniveau vóór het middelen of de consensusbeoordeling |
| Online vragenlijstplatform | Institutioneel of gelicentieerd enquêtesysteem | Versie actief tijdens de gegevensverzameling van 2025 | Gebruikt voor screening, nulmetingsvragenlijst, vragenlijst na training en retentietest na 2 weken |
| Pakket voor paarsgewijze vergelijking | R-pakket | emmeans versie actueel met R 4.3.2 | Gebruikt voor geschatte marginale gemiddelden en Tukey-gecorrigeerde paarsgewijze vergelijkingen |
| Toestemmingsformulier voor deelnemers | Door de studie goedgekeurd document | Ethisch goedgekeurde versie | Gebruikt vóór de nulmeting en randomisatie |
| Vragenlijst voor deelnemers | In het kader van de studie ontwikkelde vragenlijst | Versie 1.0 | Bevat screeningsitems, baseline-items, schalen voor ruimtelijke aanwezigheid, zelfbeoordeelde teamcoördinatie, leerbetrokkenheid, cognitieve belasting en ongemak |
| Draagbare stoelen | Algemene leverancier van laboratoriummeubilair | Standaard laboratoriumstoel | Gebruikt voor de zitplaatsen van deelnemers tijdens de toestemming, vragenlijsten, het herstel en de monitoring na de taak |
| R statistische software | R Foundation for Statistical Computing | R versie 4.3.2 | Gebruikt voor datareiniging, betrouwbaarheidsanalyse, mixed-effects-modellen, correlatieanalyse en het opstellen van figuren |
| Pakket voor betrouwbaarheidsanalyse | R-pakket | psych-versie actueel met R 4.3.2 | Gebruikt om Cronbach te berekenen’Cronbach's alfa en intraclass-correlatiecoëfficiënt |
| Trackinggebieden op kamerschaal | Laboratorium van de deelnemende instelling | Drie gescheiden 3 m × 3 m gemarkeerde ruimtes | Gebruikt voor de conditie van gedistribueerde collaboratieve virtuele realiteit op kamerschaal |
| Veiligheidsmonitoringsformulier | Door het onderzoek ontwikkeld formulier | Versie 1.0 | Wordt gebruikt voor het registreren van ongemaksscores, grensoverschrijdingen, onderbrekingen in de tracking en de herstelstatus |
| Schermopnamesoftware | Generieke commerciële of open-source software voor schermopname | Versie actief tijdens de gegevensverzameling van 2025 | Wordt gebruikt voor het genereren van gestandaardiseerde opnamen voor door waarnemers beoordeelde coördinatie |
| Sessiechecklist | Door de studie ontwikkelde checklist | Versie 1.0 | Wordt gebruikt voor het documenteren van aanwezigheid, bevestiging van geschiktheid, installatie van apparatuur, veiligheidscontroles, voltooiing van taken en onderbrekingen |
| Schaal voor simulatorongemak | Binnen de studie ontwikkelde symptomenchecklist | 5-items, 0–10 versie | Gebruikt vóór blootstelling, na oriëntatie en direct na de training |
| Schaal voor ruimtelijke aanwezigheid | Studie-aangepaste vragenlijst | 8-items versie | Direct na de training gebruikt; responsbereik 1–7 |
| SPSS statistische software | IBM Corp. | IBM SPSS Statistics versie 29.0 | Gebruikt voor beschrijvende statistiek, ANOVA, Welch ANOVA, chi-kwadraattoetsen en controles van aannames |
| Statistisch syntaxbestand | Door studie gegenereerd bestand | R-syntaxisbestand, Versie 1.0 | Gebruikt voor het reproduceren van datareiniging, mixed-effects modellen, ANOVA, correlatieanalyse en het genereren van output |
| Module voor export van systemlogboeken | Door de studie ontwikkelde exportfunctie | Versie 1.0, vastgelegd vóór de formele gegevensverzameling | Geëxporteerde starttijd van de taak, eindtijd van de taak, voltooiingsstatus, objectselecties, reacties op gevaren, routefouten en onderbrekingen |
| Dataset op teamniveau | Door studie gegenereerd bestand | team_niveau_dataset.csv | Bevat door waarnemers beoordeelde coördinatiescores en taakprocesindicatoren op teamniveau |
| Virtual reality-trackingsysteem | Commerciële leverancier van virtual reality-hardware | Compatibel met geselecteerde headsets en controllers | Gebruikt om de positie van de deelnemer en de handbewegingen te volgen |
| Virtuele trainingsomgeving | Op maat gemaakte trainingssoftware | Versie 1.0, vergrendeld vóór formele gegevensverzameling | Het scenario voor collaboratieve noodlogistiek en ruimtelijke navigatie is uitgevoerd |
| Stemcommunicatiemodule | Ingebouwde of geïntegreerde communicatiemodule | Versie vastgelegd vóór formele gegevensverzameling | Gebruikt voor toegewezen team-spraakcommunicatiekanalen |
Referenties
- Dede C. Immersive interfaces for engagement and learning. Science. 2009;323(5910):66-69.
- Radianti J, Majchrzak TA, Fromm J, Wohlgenannt I. A systematic review of immersive virtual reality applications for higher education: Design elements, lessons learned, and research agenda. Comput Educ. 2020;147:103778. https://doi.org/10.1016/j.compedu.2019.103778
- Cummings JJ, Bailenson JN. How immersive is enough A meta-analysis of the effect of immersive technology on user presence. Media Psychol. 2016;19(2):272-309.
- Makransky G, Petersen GB. The Cognitive Affective Model of Immersive Learning (CAMIL): A theoretical research-based model of learning in immersive virtual reality. Educ Psychol Rev. 2021;33(4):937-958.
- Dillenbourg P. What do you mean by collaborative learning In: Dillenbourg P, editor. Collaborative-learning: Cognitive and computational approaches. Oxford: Elsevier; 1999. p. 1-19.
- van der Meer N, van der Werf V, Brinkman WP, Specht M. Virtual reality and collaborative learning: A systematic literature review. Front Virtual Real. 2023;4:1159905. https://doi.org/10.3389/frvir.2023.1159905
- Johnson-Glenberg MC. Immersive VR and education: Embodied design principles that include gesture and hand controls. Front Robot AI. 2018;5:81. https://doi.org/10.3389/frobt.2018.00081
- Kirschner F, Paas F, Kirschner PA. A cognitive load approach to collaborative learning: United brains for complex tasks. Educ Psychol Rev. 2009;21(1):31-42.
- Fredricks JA, Blumenfeld PC, Paris AH. School engagement: Potential of the concept, state of the evidence. Rev Educ Res. 2004;74(1):59-109.
- Kourtesis P, Linnell J, Amir R, Argelaguet F, MacPherson SE. Cybersickness in virtual reality: The role of individual differences, cognitive functions, and virtual reality locomotion. Virtual Worlds. 2024;3(1):62-93.
- Dalgarno B, Lee MJW. What are the learning affordances of 3-D virtual environments Br J Educ Technol. 2010;41(1):10-32.
- Schubert T, Friedmann F, Regenbrecht H. The experience of presence: Factor analytic insights. Presence Teleoper Virtual Environ. 2001;10(3):266-281.
- O’Brien HL, Cairns P, Hall M. A practical approach to measuring user engagement with the refined User Engagement Scale (UES) and new User Engagement Scale Short Form (UES-SF). Int J Hum-Comput Stud. 2018;112:28-39.
- Hart SG, Staveland LE. Development of NASA-TLX (Task Load Index): Results of empirical and theoretical research. In: Hancock PA, Meshkati N, editors. Human mental workload. Amsterdam: North-Holland; 1988. p. 139-183.
- De Back TT, Tinga AM, Nguyen P, Louwerse MM. Learning in immersed collaborative virtual environments: Design and implementation. Interact Learn Environ. 2023;31(8):5364-5382.
- Slater M, Sanchez-Vives MV. Enhancing our lives with immersive virtual reality. Front Robot AI. 2016;3:74. https://doi.org/10.3389/frobt.2016.00074
- Roschelle J, Teasley SD. The construction of shared knowledge in collaborative problem solving. In: O’Malley C, editor. Computer supported collaborative learning. Berlin: Springer; 1995. p. 69-97.
- Merchant Z, Goetz ET, Cifuentes L, Keeney-Kennicutt W, Davis TJ. Effectiveness of virtual reality-based instruction on students' learning outcomes in K-12 and higher education: A meta-analysis. Comput Educ. 2014;70:29-40.
- Sweller J. Cognitive load during problem solving: Effects on learning. Cogn Sci. 1988;12(2):257-285.
- Stanney KM, Kennedy RS, Drexler JM, editors. Cybersickness is not simulator sickness. Proceedings of the Human Factors and Ergonomics Society Annual Meeting; 1997.
- Lindgren R, Johnson-Glenberg M. Emboldened by embodiment: Six precepts for research on embodied learning and mixed reality. Educ Res. 2013;42(8):445-452.
- Howard MC. A meta-analysis and systematic literature review of virtual reality rehabilitation programs. Comput Hum Behav. 2017;70:317-327.