Deze studie stelt een hybride model voor kostprognoses voor elektriciteitsnetten voor, dat fysieke kostenquota combineert met dynamische macro-economische/technologische aanpassingen en residuele compensatie op basis van XGBoost. Met een bereikte MAPE van 2,34% balanceert het model nauwkeurigheid en interpreteerbaarheid, waardoor wordt voldaan aan de eisen voor regelgevende transparantie bij het vaststellen van tarieven.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Retrospectieve voorspelling met behulp van provinciale rastergegevens en een quotumgebaseerd hybride fysisch-AI-model
In dit artikel
Samenvatting
Samenvatting
De wereldwijde energietransitie en de lopende hervormingen van de elektriciteitsmarkt vereisen dat netbeheerders een betrouwbare energievoorziening in balans brengen met steeds strengere regelgeving voor transport- en distributietarieven. Traditionele budgetteringsmethoden op basis van historische extrapolatie weerspiegelen vaak niet de fysieke basis van de activabeheersing, terwijl datagestuurde machinelearning-modellen weliswaar een hoge voorspellingsnauwkeurigheid bereiken, maar missen de transparantie die nodig is voor wettelijke kostenverificatie. Om de afweging tussen voorspellingsnauwkeurigheid en interpreteerbaarheid aan te pakken, stelt deze studie een hybride kostenvoorspellingsmodel voor op basis van kostenquota. Het raamwerk gebruikt gestandaardiseerde operationele quota als fysieke budgetteringsbasis en bevat een dynamisch mechanisme voor quota-evolutie, aangestuurd door macro-economische omstandigheden en technologische vooruitgang. Extreme Gradient Boosting (XGBoost) wordt ingezet om niet-lineaire residuen buiten de op quota gebaseerde schattingen vast te leggen, terwijl SHAP (Shapley Additive exPlanations) wordt gebruikt om de bijdrage van belangrijke kostendrijvers te interpreteren. Het model is geëvalueerd met behulp van 16 jaar geanonimiseerde operationele gegevens van een provinciaal elektriciteitsnet in China. Er werd een gemiddelde absolute percentagefout (MAPE) van 2,34% behaald, waarmee de voorspellingsfouten met respectievelijk 61,8%, 46,6% en 34,1% werden verminderd ten opzichte van SARIMAX, standalone XGBoost en Attention-LSTM-modellen. Het voorgestelde raamwerk integreert principes van technische kostenquota met verklaarbare kunstmatige intelligentie, waardoor zowel nauwkeurige langetermijnkostenvoorspellingen als een transparant beslissingsondersteunend instrument voor de verificatie van wettelijk toegestane kosten worden geboden.
Inleiding
De wereldwijde energietransitie brengt het beheer van assets in het elektriciteitsnet en de operationele praktijken in een nieuw kader door de integratie van gedistribueerde hernieuwbare energieopwekking, de toename van extreme weersomstandigheden en de grootschalige inzet van IoT-technologieën; al deze factoren vereisen een grotere operationele flexibiliteit en meer onderhoudsbronnen om de systeembetrouwbaarheid te waarborgen1,2. Tegelijkertijd hebben elektriciteitsregulatoren het toezicht op transmissie- en distributietarieven verscherpt via kaders zoals het Britse RIIO en de rate-of-return reviews van de Federal Energy Regulatory Commission in de VS, waarbij de nadruk ligt op transparantie in de kostenverantwoording3. China heeft op soortige wijze een reguleringsmechanisme voor "toegestane kosten plus een redelijk rendement" ingevoerd, waarbij nutsbedrijven duidelijke verbanden moeten aantonen tussen technische activiteiten en financiële uitgaven4. Nutsbedrijven beschikken echter vaak niet over transparante kwantitatieve instrumenten die fysieke asset-operaties koppelen aan kostenprognoses, wat de effectiviteit van de regulatoire kostenverificatie beperkt5.
Bestaande prognosebenaderingen hebben belangrijke beperkingen in deze omgeving6. Traditionele methoden, waaronder incrementele budgettering en ARIMA-gebaseerde modellen, gaan uit van relatief stabiele historische patronen en presteren vaak slecht bij structurele veranderingen veroorzaakt door economische schommelingen of extreem weer7. Omgekeerd bieden moderne machine learning-modellen, zoals LSTM- en Transformer-architecturen, een hoge voorspellende nauwkeurigheid voor korte termijn prognoses, maar missen zij de technische interpreteerbaarheid die vereist is voor regelgevende besluitvorming8,9. Hoewel recente hybride prognosebenaderingen statistische technieken combineren met machine learning, negeren ze over het algemeen de gestandaardiseerde technische kostenquota die ten grondslag liggen aan de boekhoudsystemen van elektriciteitsnetten10. Om deze beperkingen aan te pakken, stelt deze studie een quota-gestuurd hybride prognosekader voor dat dynamische quota-evolutie combineert met machine learning-gebaseerde residu-correctie, waardoor de technische interpreteerbaarheid behouden blijft terwijl de nauwkeurigheid van de prognoses wordt verbeterd.
Een belangrijke onderzoeksrichting vloeit voort uit prikkelregulering in natuurlijke monopoliesectoren, waaronder het RPI-X-mechanisme in het Verenigd Koninkrijk en het kader voor de verificatie van toegestane kosten in China11. Deze studies evalueren hoofdzakelijk de operationele efficiëntie met behulp van Data Envelopment Analysis (DEA) en Stochastic Frontier Analysis (SFA)12. Voorgaand onderzoek heeft de langetermijnrelaties tussen kapitaaluitgaven (CAPEX), operationele uitgaven (OPEX) en kostenefficiëntie onderzocht ter ondersteuning van tariefregulering13,14. Hoewel deze benaderingen waardevolle macro-economische inzichten bieden, worden de resultaten doorgaans uitgedrukt als relatieve efficiëntiescores in plaats van monetaire voorspellingen die geschikt zijn voor de jaarlijkse budgettering15,16. Bovendien gaan frontier-modellen over het algemeen uit van relatief stabiele fysieke activastructuren en bedrijfsomstandigheden, wat hun vermogen beperkt om abrupte kostenwijzigingen vast te leggen die worden veroorzaakt door veroudering van activa, vervanging van infrastructuur of snelle vraaggroei17,18.
Een tweede onderzoeksrichting richt zich op statistische en op kunstmatige intelligentie gebaseerde voorspellingsmodellen. In vroege studies werden meervoudige lineaire regressie en autoregressieve geïntegreerde voortschrijdende gemiddelde modellen met exogene variabelen (ARIMAX) gebruikt voor kostenvoorspellingen19. Recentelijk hebben support vector regression, random forests, XGBoost, LSTM en Transformer-modellen de voorspellingsprestaties aanzienlijk verbeterd door nonlineaire relaties en hoogdimensionale kenmerkruimtes te benutten20,21,22. Deze benaderingen bevatten vaak macro-economische indicatoren zoals elektriciteitsvraag, producentenprijsindexen (PPI) en klimaatvariabelen23. De exploitatiekosten van het elektriciteitsnet vloeien echter voort uit technische activiteiten, activaveroudering, onderhoudsplanning en managementbeslissingen, en niet enkel uit macro-economische variabelen24. Bijgevolg functioneren puur datagestuurde modellen vaak als "black boxes," waardoor het moeilijk is om voorspelde kosten te verklaren tijdens regelgevende reviews of verificaties van toegestane kosten25,26.
Het beheer van engineering-kostenquota biedt een potentiële oplossing voor deze uitdaging27. Activity-based costing (ABC) vertrouwt al lang op gestandaardiseerde operationele quota om de behoeften op het gebied van arbeid, materiaal, apparatuur en onderhoud voor routinematige netwerkoperaties te schatten28. Grote Chinese nutsbedrijven hebben uitgebreide quotadatabanken ontwikkeld die inspectie-, onderhouds-, test-, reparatie- en apparatuurvervangingsactiviteiten bestrijken. Desondanks worden deze engineeringnormen voornamelijk gebruikt voor projectafwikkeling en auditing in plaats van voor dynamische langetermijnvoorspellingen29,30. Bovendien worden quotanormen doorgaans slechts om de paar jaar herzien, waardoor ze onvoldoende reageren op veranderende grondstofprijzen, technologische vooruitgang en operationele praktijken31. Het toepassen van quotasystemen over miljoenen gedistribueerde activa brengt bovendien aanzienlijke computationele uitdagingen met zich mee voor grootschalige voorspellingen32.
Ondanks aanzienlijke vorderingen in statistische voorspellingen, machine learning en engineering-kostenbeheer, is er geen bestaand raamwerk dat gestandaardiseerde engineering-kostenquota, dynamische macro-economische aanpassingen en uitlegbare machine learning effectief integreert in een unified voorspellingsmodel voor regelgevende kostenverificatie. Er werd gehypothetiseerd dat de combinatie van dynamisch evoluerende kostenquota met XGBoost-gebaseerd residuelleren de nauwkeurigheid van langetermijnvoorspellingen kan verbeteren, terwijl de engineering-transparantie die vereist is voor regelgevende besluitvorming behouden blijft. Om deze hypothese te testen, is een hybride quota-gestuurd voorspellingsraamwerk ontwikkeld dat fysieke kostenmodellering, macro-economische en technologische aanpassingsmechanismen, XGBoost-residucompensatie en SHAP-gebaseerde modelinterpretatie integreert. De voorgestelde aanpak beoogt zowel nauwkeurige langetermijnkostenvoorspellingen als transparant bewijs te leveren ter ondersteuning van de verificatie van toegestane kosten onder moderne regelgeving voor de elektriciteitsmarkt.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Deze studie maakte gebruik van geanonimiseerde operationele en financiële gegevens verzameld van een provinciaal elektriciteitsnet in Oost-China. Alle gegevens werden geaggregeerd en gedeïdentificeerd vóór de analyse, en er werden geen persoonlijk identificeerbare of gevoelige informatie op individueel niveau opgenomen. Daarom was ethische goedkeuring niet vereist. De toegang tot en analyse van de gegevens waren in overeenstemming met de geldende gegevensbeschermingsvoorschriften en institutionele overeenkomsten die betrekking hebben op informatie in de energiesector.
Overzicht van het voorspellingskader
Om natuurkundig gebaseerde en datagestuurde voorspellingsbenaderingen te integreren, is een hybride voorspellingsraamwerk ontwikkeld dat technische kostenquota combineert met machine learning. In plaats van simpelweg meerdere algoritmen te combineren, volgt het raamwerk het principe dat fysische modellen de basisvoorspelling vaststellen, terwijl machine learning de residuele fouten compenseert. Dit ontwerp zorgt ervoor dat het voorspellingsproces is gebaseerd op de fysische mechanismen die ten grondslag liggen aan de productie- en operationele activiteiten van het elektriciteitsnet, in plaats van uitsluitend te vertrouwen op extrapolatie van historische kosten.
Het raamwerk stelt eerst een hiërarchische koppeling vast tussen activa van het elektriciteitsnet, gestandaardiseerde operationele activiteiten en financiële kostenrekeningen. Productie- en exploitatiekosten worden beschouwd als monetaire representaties van de middelen die door fysieke activa worden verbruikt—waaronder onderstations, transmissieleidingen, distributieverdelers, meetapparaten en digitale inspectieapparatuur—tijdens routinematige activiteiten zoals inspectie, onderhoud, testen, reparatie en vervanging. Kostenquota dienen als de schakel tussen meetbare technische werklasten en de bijbehorende financiële uitgaven.
Zoals geïllustreerd in Figuur 1, fungeren kostenquota als gestandaardiseerde accounting-eenheden die zijn ingebed in het gehele proces van exploitatie en onderhoud van activa, in plaats van als abstracte regels voor financiële allocatie. Werkbelastingen van activa op het laagste niveau worden omgezet in gestandaardiseerde exploitatiequota en vervolgens gekoppeld aan kostencategorieën, waaronder arbeid, materialen, bouwmachines, uitbesteelde diensten en noodvoorraden. Deze hiërarchische koppeling behoudt de technische interpreteerbaarheid en regelgevende traceerbaarheid gedurende het voorspellingsproces en biedt de fysieke basis voor het construeren van het statische basisquotamodel.
Overzicht van de methodologische workflow
Het voorgestelde voorspellingskader bestaat uit drie opeenvolgende fasen: (1) de constructie van een fysieke basislijn met behulp van workloadquota op activaniveau, (2) de dynamische evolutie van kostenquota via macro-economische en technologische aanpassingen, en (3) machinaal leren-gebaseerde residuele compensatie om systematische niet-lineaire effecten vast te leggen. Zoals geïllustreerd in Figuur 1, stelt het kader een hiërarchische mapping vast van activa op het laagste niveau en gestandaardiseerde operationele activiteiten naar voorspellingen van productie- en exploitatiekosten. De implementatiedetails van elke fase worden beschreven in de volgende subsecties.
Fysiek basiskostenmodel gebaseerd op workloads op activaniveau
De productie- en exploitatiekosten van een elektriciteitsnet, Ctotal, bestaan uit uitgaven die verbonden zijn aan meerdere bedrijfsactiviteiten, waaronder het beheer van onderstations, het onderhoud van transmissielijnen, het beheer van het distributienetwerk, klantenservice en ondersteunende systemen. In deze studie wordt ervan uitgegaan dat de basisexploitatiekosten worden bepaald door de werklast die wordt gegenereerd door elke gestandaardiseerde operationele activiteit en het bijbehorende kostenquotum.
De statische basislijnkost wordt als volgt berekend:
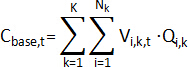 (1)
waarbij Vi,k,t de werklast aanduidt die geassocieerd is met het i-de actief of de operationele taak binnen bedrijfscategorie k tijdens periode t, en Qi,k de overeenkomstige gestandaardiseerde eenheidskost vertegenwoordigt zoals gedefinieerd door het engineering-kostenquotumsysteem. De bedrijfscategorie omvat belangrijke operationele functies zoals het onderhoud van onderstations, inspectie van transmissieleidingen, exploitatie van het distributienetwerk en klantenservice. De dubbele sommatie aggregeert de kosten van alle gestandaardiseerde operationele activiteiten om de theoretische basisuitgaven te schatten die nodig zijn om een normale netbedrijfsvoering te handhaven.
Vergelijking (1) stelt de fysieke relatie vast tussen technische werklasten en financiële uitgaven door gestandaardiseerde operationele activiteiten direct te koppelen aan kostenrekeningen. In tegenstelling tot puur statistische voorspellingsmodellen biedt deze formulering een interpreteerbare technische basis die dient als fundament voor daaropvolgende dynamische quotumaanpassingen en residuele correcties op basis van machine learning. De vergelijking is ontwikkeld op basis van de operationele praktijken en het kostenquotumsysteem dat wordt gebruikt door provinciale elektriciteitsnetbedrijven in China. Tabel 1 vat de notatie samen die in Vergelijking (1) wordt gebruikt, inclusief werklast (Vi,k,t), gestandaardiseerde eenheidskosten (Qi,k), het aantal operationele taken (Nk) en de index voor de bedrijfscategorie (k).
Dynamisch evolutiemechanisme van quota onder externe omgevingsverstoringen
Gestandaardiseerde kostenquota (Qi,k) bieden een fysiek interpreteerbare basislijn, maar houden geen rekening met veranderingen in macro-economische omstandigheden of technologische vooruitgang. Om hun toepasbaarheid op lange termijn te verbeteren, is een dynamisch evolutiemechanisme geïntroduceerd om de basisquota aan te passen in reactie op zowel prijsinflatie als technologiegestuurde efficiëntiewinsten.
De eerste aanpassing houdt rekening met veranderingen in de inkoopkosten als gevolg van macro-economische inflatie. De exploitatie en het onderhoud van het elektriciteitsnet zijn sterk afhankelijk van bulkmaterialen, waaronder koper, aluminium en siliciumstaal, waarvan de prijzen nauw verbonden zijn met schommelingen in de producentenprijsindex (PPI). Omdat  is een index met een basiswaarde van 10, wordt deze eerst omgezet in een gestandaardiseerd inflatiecijfer:
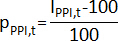 (2)
Op basis hiervan, de prijscorrectiefunctie  wordt gedefinieerd als:
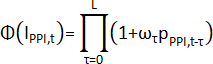 (3)
waar  is een lag-gewichtsvector met een lengte van L bevredigend
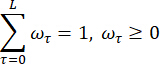
De vertragingsstructuur representeert de vertraagde overdracht van macro-economische inflatie naar de inkoopkosten binnen de toeleveringsketen van het elektriciteitsnet. Door de PPI-index om te zetten in een gestandaardiseerd inflatiepercentage wordt het cumulatieve effect van prijsveranderingen behouden, terwijl schaalvertekening die gepaard gaat met het directe gebruik van indexwaarden wordt vermeden. Vergelijkingen (2) and (3) zijn aangepast van gevestigde macro-economische inflatiecorrectiemodellen, waarbij de vertragingsstructuur is gekalibreerd voor inkoopcycli in de energiesector3,34.
Technologische vooruitgang werd geïmplementeerd via een kostenreductiefactor die de verbeteringen in de operationele efficiëntie weerspiegelt als gevolg van vorderingen zoals inspectie met onbemande luchtvaartuigen, intelligente robotica en digitale onderhoudstechnologieën. De technologische aanpassingsfactor is als volgt gedefinieerd:
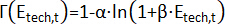 (4)
In dit gedeelte zijn α en β empirische elasticiteitscoëfficiënten die zijn geschat uit historische panelgegevens met behulp van niet-lineaire kleinste kwadraten. Om ervoor te zorgen dat de factor technologische vooruitgang altijd een redelijke vermindering van de kosten per eenheidskota vertegenwoordigt, beperkt het proces van parameterestimatie 0 < Γ(Etech,t) ≤ 1. Er dient te worden opgemerkt dat deze factor primair de langetermijnverbetering van de efficiëntie weerspiegelt die voortvloeit uit de substitutie van volwassen technologie. Vergelijking (4) is oorspronkelijk voor dit werk ontwikkeld, waarbij het concept van de leercurve uit de literatuur over energietechnologiekosten35,36 is aangepast aan netonderhoudswerkzaamheden. Aanvullende kosten die kunnen ontstaan tijdens de vroege fase van de implementatie van digitale apparatuur, zoals de parallelle werking van oude en nieuwe systemen, platformintegratie, communicatietests en extra onderhoud, worden niet geforceerd afgetrokken van het basisquota; in plaats daarvan worden deze geïdentificeerd door de daaropvolgende compensatiemodule voor residuen op basis van machine learning:
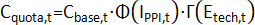 (5)
waarbij Cbasis,t duidt de statische basiskosten aan, berekend op basis van workloads van assets op het laagste niveau en gestandaardiseerde quota voor operationele kosten; legt het transmissie-effect van macro-prijsfluctuaties op de prijzen van materialen, apparatuur en externe diensten vast; en Γ(Etechniek,t) weerspiegelt de op efficiëntie gebaseerde reductie in de eenheidskosten voor exploitatie en onderhoud na technologische rijping. Door middel van het bovenstaande mechanisme van dynamische evolutie blijft de quotumbaseline niet langer een statische boekhoudkundige basis, maar kan deze adaptief worden aangepast aan veranderingen in economische omgevingen en technologische omstandigheden. Vergelijking (5) is origineel voor dit werk en vertegenwoordigt de innovatieve integratie van prijs- en technologiecorrecties in het raamwerk van de quotumbaseline.
Systematische niet-lineaire residu-vastlegging onder quotumbeperkingen
Ondanks complexe evolutionaire correcties genereert het quotamodel onvermijdelijk systematische afwijkingen bij onvoorspelbare weersomstandigheden gerelateerd aan rampen en plotselinge beleidsrichtlijnen, zoals verhoogde kosten voor de afhandeling van klachten van klanten tijdens tijdelijke perioden van tariefvermindering. Deze afwijking vormt de residuterm aan beide zijden van de vergelijking:
Rt=Cactual,t-Cquota,t (6)
Aangezien conventionele fysische regels dit aspect niet kunnen verklaren, kan machine learning deze beperkingen aanpakken. Om de vloek van dimensionaliteit die wordt veroorzaakt door hoogdimensionale kenmerken te vermijden, gebruikt deze studie het XGBoost-algoritme op basis van beslisboom-ensembles om de niet-lineaire relatie Rt37,38 te modelleren. Er is een kenmerkmatrix voor sterke verstoringen Xt gedefinieerd, inclusief meteorologische kenmerken zoals het aantal extreme vorstdagen per jaar Dice en de intensiteit van het macrobeleid.
Voor een niet-lineaire compensator die bestaat uit regressiebomen, de generatielogica van het voorspelde residu  kan worden uitgedrukt als39:
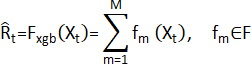 (7)
waarbij F de ruimte van alle mogelijke classificatie- en regressieboomstructuren aanduidt. Om de balans tussen passingsnauwkeurigheid en het voorkomen van overfitting te bewaken, wordt in de m-de iteratie een geregulariseerde doelfunctie geconstrueerd en geminimaliseerd, die een strafterm voor structurele complexiteit bevat:
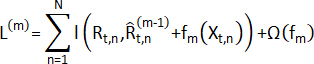 (8)
waar  is een convexe verliesfunctie die het verschil tussen het werkelijke residu en het voorspelde residu meet. In dit artikel wordt Huber Loss gebruikt om de robuustheid van het model tegen abnormale piekuitgaven te verbeteren. De regularisatieterm
 wordt gebruikt om de complexiteit van de boomstructuur te beperken en is als volgt gedefinieerd:
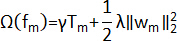 (9)
waarbij Tm het aantal bladknooppunten in de m-de boom vertegenwoordigt, wm de overeenkomstige bladgewichtsvector vertegenwoordigt, en γ en λ respectievelijk de strafcoëfficiënt voor het aantal bladknooppunten en de regularisatiecoëfficiënt voor het gewicht aanduiden.
De definitieve voorspellingsvergelijking is:
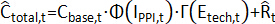 (10)
Verder uitgebreid als:
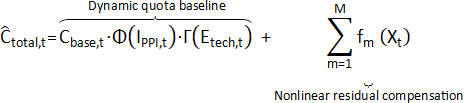 (11)
De bovenstaande formule stelt de gesloten-lusstructuur van het voorgestelde voorspellingsmodel wiskundig voor. De uiteindelijke vraag naar productie- en operationele kosten wordt niet direct door het machine learning-model gegenereerd; in plaats daarvan wordt deze verkregen door de niet-lineaire residuele compensatie, geïdentificeerd door de machine learning-module, op te tellen bij de dynamische quota-basislijn. Van deze componenten weerspiegelen prijs- en technologiefactoren primair de dynamische evolutie van de quota-basislijn, terwijl factoren die moeilijk expliciet via regels te karakteriseren zijn, zoals klimaatshocks, beleidsverstoringen en pieken in reparatiegebeurtenissen, worden vastgelegd door de residuele compensatiemodule voor machine learning. Vergelijkingen (10) en (1) zijn origineel voor dit werk en synthetiseren de fysieke basislijn met de op ML gebaseerde residuele vastlegging tot een geünificeerd voorspellingskader.
Figuur 2 laat zien dat de voorspellingsresultaten van het voorgestelde model een duidelijke hiërarchische generatielogica vertonen. Enerzijds biedt het basisquotum een stabiele, transparante en controleerbare fysieke basis voor de kostenbehoefte; anderzijds maken prijsaanpassingen, technologie-effecten en residuen van externe schokken het mogelijk voor het model om zich aan te passen aan dynamische veranderingen in complexe omgevingen. In vergelijking met black-box-modellen die direct voorspelde waarden genereren, kan deze decompositiestructuur duidelijk onthullen "waarom kosten stijgen of dalen", waardoor de interpreteerbaarheid van de modelresultaten bij budgetbeoordelingen en de regulering van transport- en distributietarieven wordt verbeterd.
Gegevensbronnen en verzamelprocedures
Theoretische modellen moeten strikt worden gevalideerd aan de hand van empirische gegevens om hun praktische bruikbaarheid aan te tonen. Aangezien de kernfinanciële gegevens van de energiesector gevoelige informatie bevatten over de operaties van de nationale infrastructuur, extraheert deze studie hoogpreciese, geanonimiseerde maandelijkse boekhoudgegevens van een typisch provinciaal elektriciteitsnet in Oost-China, omwille van het gemak aangeduid als E-Grid, over een periode van 16 opeenvolgende kalenderjaren van 2010 tot 2025. Deze provincie heeft een typische economische cyclus doorgemaakt, waarbij de verschuiving plaatsvond van groei gedreven door traditionele zware industrie naar hoogwaardige productie, waarbij het samengestelde jaarlijkse groeipercentage van de schaal van de netactiva 7,4% bedroeg. De complexe evolutie van de kostenstructuur is daarom mogelijk relevant voor andere snel ontwikkelende netwerksystemen. De gegevens zijn afkomstig uit drie primaire bronnen: (1) interne exploitatie- en onderhoudslogboeken waarin werkbelasting op activaniveau, inspectiefrequenties en reparatiegebeurtenissen zijn vastgelegd; (2) financieel-boekhoudkundige systemen die maandelijkse kostenoverzichten verschaffen voor arbeid, materialen, apparatuur en uitbesteelde diensten; en (3) externe milieudatabanken, waaronder meteorologische gegevens van de China Meteorological Administration en macro-economische indicatoren van het National Bureau of Statistics.
Kwaliteitscontrole en behandeling van ontbrekende gegevens
Voor meer dan 130 initiële indicatoren, geïntegreerd uit systemen uit meerdere bronnen, is een strikte kwaliteitscontroleprocedure geïmplementeerd. Ontbrekende datapunten, die minder dan 3% van de totale waarnemingen besloegen, werden behandeld via lineaire interpolatie voor continue variabelen met temporele trends, en via modus-imputatie voor categorische indicatoren. Uitschieters werden geïdentificeerd met de methode van het interkwartielafstand (IQR); waarden die meer dan 3,0 keer de IQR boven het derde kwartiel uitkwamen, werden gewinsoriseerd tot het 99ste percentiel om de data-integriteit te waarborgen en vervorming door extreme waarden te beperken.
Overwegingen met betrekking tot de steekproefomvang
De dataset bestaat uit 192 maandelijkse waarnemingen (januari 2010–december 2025), waarvan 156 waarnemingen (2010–202) zijn toegewezen voor training en validatie en 36 waarnemingen (2023–2025) zijn gereserveerd voor out-of-sample testen. Hoewel deze steekproefomvang relatief bescheiden is voor deep learning-toepassingen, is deze geschikt voor het XGBoost-algoritme, dat specifiek is ontworpen om goed te presteren met kleine tot middelgrote tabulaire datasets door middel van regularisatie- en tree-pruning-mechanismen. Om potentiële risico's op overfitting te beperken, zijn (1) strikte regularisatieboetes toegepast (γ = 0.1, λ = 1.0), (2) early stopping met een patience van 50 rondes, en (3) conservatieve beperkingen voor de boomdiepte (max depth = 5). Deze maatregelen waarborgen gezamenlijk de stabiliteit en generalisatie van het model, ondanks de beperkte steekproefomvang.
Datasegmentatie en heterogene integratie uit meerdere bronnen
Voor een rigoureuze toetsing werden de gegevens van januari 2010 tot en met december 202 toegewezen aan het trainings-validatieinterval, bestaande uit 156 waarnemingen, dat wordt gebruikt om de quota-evolutiefactoren en het quota-compensatieresidueelnetwerk te trainen. De periode januari 2023–december 2025 is gereserveerd als de externe out-of-sample testset, bestaande uit 36 waarnemingen. Waarom is deze periode gekozen als definitief testgebied? De reden is dat deze drie jaar samenvielen met de versnelling van de constructie van nieuwe typen energiesystemen, verergerd door grootschalige extreme hittegolven gerelateerd aan El Niño en de snelle en ongelijkmatige groei van gedistribueerde hernieuwbare energieopwekking. Het elektriciteitsnet stond onder ongekende druk wat betreft de toeleveringsketens van materialen en de toewijzing van reparatiepersoneel.
De wetenschappelijke selectie en kwantitatieve definitie van kostendrijvende factoren vormen de basis om ervoor te zorgen dat het residuale netwerk van machine learning systematische schommelingen effectief kan vastleggen. Op basis van de beheerslogica van standaardexploitatiekosten in energiesystemen doorbreekt deze studie de eendimensionale benadering van traditionele financiële prognoses, die enkel rusten op historische kasstromen, en reconstrueert in plaats daarvan de feature engineering vanuit vier kerngrenzen: de schaal van fysieke activa, exploitatie- en onderhoudsomstandigheden, macro-economische evolutie en de externe klimatologische omgeving, gebruikmakend van oorspronkelijke exploitatielogboeken en externe systeemhoofdboeken. In het feitelijke modelleringsproces is voor meer dan 130 oorspronkelijke indicatoren die voortvloeien uit multi-bron systeemintegratie gebruikgemaakt van Pearson-correlatietesten om hoogcollineaire redundante variabelen te elimineren, met een drempelwaarde van |r| > 0,85. Op basis van de voorkennis van senior experts uit het energienet zijn uiteindelijk 42 kerninputfeatures geselecteerd om de featurematrix Xt te vormen. Om de onderliggende datastructuur en distributie van de inputtensor duidelijk weer te geven, selecteert Tabel 2 12 representatieve kernfeatures uit de vier bovengenoemde evaluatiedimensies en vat hun beschrijvende statistieken over de observatieperiode samen.
Om de ruimtelijk-topologische basis van het multi-bron kenkensysteem verder te illustreren, presenteert Figuur 3 een geanonimiseerde schematische topologie van het onderzochte provinciale elektriciteitsnet. De figuur toont de overlay van onderstations op spanningsniveau, transmissiecorridors, gedistribueerde clusters van hernieuwbare energie, lastcentra en representatieve zones met omgevingsverstoringen. De topologie helpt verklaren waarom productie- en exploitatiekosten gezamenlijk worden beïnvloed door de schaal van activa, de netwerkstructuur, de intensiteit van noodreparaties en externe klimatologische schokken. Het biedt tevens een basis voor de ruimtelijke interpretatie van de residu-sturende variabelen die in de XGBoost-compensatiemodule worden gebruikt.
Tabel 2 laat zien dat verklarende variabelen over verschillende bedrijfsdimensies duidelijk verschillende statistische vormen vertonen. Variabelen voor fysieke activa die endogene dynamiek van ondernemingsontwikkeling vertegenwoordigen, zoals onderstationcapaciteit en lijnlengte, hebben relatief stabiele standaarddeviaties en scheefheidswaarden geconcentreerd tussen 0,1 en 0,8. Hun algemene datastructuur is ongeveer normaal verdeeld, wat objectief de eigenschap van een gestage ontwikkeling van het elektriciteitsnet in de cyclus van infrastructuurconstructie weerspiegelt. In scherp contrast hiermee staan de meteorologische variabelen en externe omgevingsstoringsvariabelen onderaan de tabel. Bijvoorbeeld, het cumulatieve aantal dagen met een waarschuwingsniveau voor hoge temperaturen over de afgelopen 90 dagen en de impactindex voor lijnuitschakelingen vertonen een extreem sterke rechtsscheefheid, met scheefheidswaarden van respectievelijk 2,15 en 2,45. Deze typische heavy-tailed distributie bevestigt een objectief pijnpunt dat in de werkelijke exploitatie en het onderhoud van het elektriciteitsnet niet genegeerd kan worden: hoewel extreme weersomstandigheden relatief zelden voorkomen over een jaarlijkse tijdlijn, veroorzaken ze zodra ze optreden vaak exponentiële stijgingen in de inzet van reparatiearbeid en het verbruik van reserveonderdelen. Vanuit een ander perspectief onthullen de hoge nonuniformiteit en extreme-waarde scheefheid in de distributie van deze multi-source kenmerken de theoretische beperkingen van traditionele lineaire tijdreeksmodellen, zoals ARIMAX, die gebaseerd zijn op aannames van normaliteit en homoscedasticiteit bij het traceren van complexe kosten van het elektriciteitsnet. Dit bevestigt niet alleen verder de rationaliteit van het introduceren van een machine learning-module buiten de fysieke boekhoudkundige basislijn, maar biedt ook solide statistische ondersteuning voor de keuze van het XGBoost-boommodel in dit artikel, dat efficiënt om kan gaan met ijle kenmerkdistributies en niet-lineaire mappings om kostenresiduen te benaderen.
Opzet van het systeem voor hyperparameteroptimalisatie en evaluatie
Na het bepalen van de inputruimte van de kenmerken heeft de instelling van de modelhyperparameters direct invloed op de fitningsprestaties van het residu-benaderingsnetwerk. Aangezien het XGBoost-compensatienetwerk meerdere parameters bevat, waaronder de boomdiepte (max depth), de leersnelheid en regularisatieboetetermen, en deze parameters niet-lineaire interacties vertonen, heeft conventionele grid search niet alleen een hoge computationele complexiteit, maar neigt deze in hoogdimensionale ruimtes ook vast te lopen in lokale minima. Daarom introduceert deze studie de Tree-structured Parzen Estimator (TPE), een Bayesiaanse optimalisatiemethode, in het proces van parameteroptimalisatie. Het TPE-algoritme kan opeenvolgende bemonsteringsrichtingen dynamisch sturen met behulp van feedback van de verliesfunctie uit eerdere evaluaties. Door een posterior kernel density estimate (KDE) van de doelvariabele te construeren, wordt de zoekruimte voor parameters adaptief vernauwd, waardoor het model de globale optimale hyperparameterconfiguratie kan benaderen zonder hoge computationele kosten te maken. Het optimalisatiedoel van TPE was het minimaliseren van de RMSE van de validatie over 100 iteraties, met vroege stopzetting (early stopping) na 50 ronden zonder verbetering.
Na het voltooien van de parameteroptimalisatie op de interne validatieset, wordt in deze studie de gemiddelde absolute procentuele afwijking (MAPE) gebruikt om de relatieve afwijking in de voorspelde sequentie te kwantificeren. Dit is gedaan om de uiteindelijke prestaties van elk model objectief te evalueren op de out-of-sample testset en om te voldoen aan de kwantitatieve beoordelingsvereisten van regelgevers voor kostenverificatie. Tegelijkertijd is de root-mean-square error (RMSE) geïntroduceerd om tegemoet te komen aan de praktische behoefte om extreme fouten bij kostenvoorspellingen in de bedrijfsvoering te beheersen, door zwaardere straffen op te leggen aan grotere fouten. Tot slot kwantificeert de determinatiecoëfficiënt, R2, de algemene verklarende kracht van de regressie ten opzichte van de werkelijke variantie van het doelonderwerp.
De wiskundige definities van de indicatoren zijn als volgt:
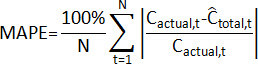 (12)
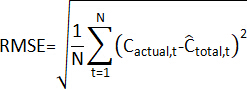 (13)
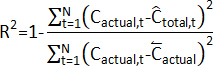 (14)
waar  staat voor de werkelijke productie- en exploitatiekosten in periode t,
 staat voor de door het model voorspelde kosten,
 staat voor de gemiddelde werkelijke kosten in de teststeekproef, en N is het aantal monsters in de testset.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Panoramische vergelijking van voorspellingsnauwkeurigheid met dimensiereductie
Wanneer alle met Tree-structured Parzen Estimator (TPE) geoptimaliseerde modellen werden geëvalueerd op de out-of-sample testset van 2023–2025, die fluctuaties in het post-pandemisch herstel en extreme hitte-gebeurtenissen omvatte, konden de prestaties van mainstream voorspellingsalgoritmen objectief worden vergeleken. Om een rigoureuze en uitgebreide evaluatie te bieden, werden vier benchmarkmodell...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Deze studie demonstreert dat de integratie van industriële kostenquota met machine learning een interpreteerbaar en nauwkeurig kader biedt voor de langetermijnvoorspelling van kosten voor het elektriciteitsnet. De resultaten tonen aan dat klimaatgerelateerde variabelen, in het bijzonder extreme dagen met hoge temperaturen en impactindices voor lijnuitval, de dominante drijfveren zijn van kostenresiduen, wat de toenemende invloed van externe verstoringen op de uitgaven van nutsbedrijven benadrukt. Deze bevindingen suggere...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
Alle auteurs verklaren dat er geen belangenverstrengeling is.
AUTEURSBIJDRAGE:
Xiaohui Wang bedacht en ontwierp de studie, ontwikkelde de methodologie, voerde de formele analyse uit en schreef het oorspronkelijke manuscript. Tong Li droeg bij aan de datacuratie, software-implementatie en validatie. Yanchao Lu droeg bij aan de ontwikkeling van de methodologie, het onderzoek en de interpretatie van de gegevens. Quanfeng Lv leverde middelen, hield toezicht op de gegevensverwerving en beoordeelde het manuscript kritisch. Fan Liu leidde het project, droeg bij aan de conceptualisering en interpretatie van de resultaten, zorgde voor de financiering en herzag het manuscript kritisch. Alle auteurs hebben de definitieve versie van het manuscript beoordeeld en goedgekeurd
Dankbetuigingen
Dit werk werd ondersteund door het Technologieproject van de State Grid Corporation of China, onder de naam "Research on Production and Operation Cost Allocation Analysis and Asynchronous Optimization Technology" (Projectnummer: 520600250029-183-ZN).
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Geanonimiseerde maandelijkse boekhoudingsdataset van E-Grid | Provinciaal elektriciteitsnet in Oost-China | N/A | Geanonimiseerde dataset van maandelijkse productie- en exploitatiekosten (2010–2025) bestaande uit 192 waarnemingen, inclusief gegevens over fysieke activa, exploitatie en onderhoud, macro-economische gegevens en milieugegevens. Gebruikt voor modelontwikkeling (156 waarnemingen) en out-of-sample testen (36 waarnemingen). |
| Matplotlib plot-bibliotheek | Matplotlib development team | 3.5.2 | Gebruikt voor het genereren van figuren in het manuscript en grafische outputs, waaronder modelprestatieplots, topologievisualisaties, residu-diagnostiek, radarcharts en SHAP-gerelateerde visuele samenvattingen. |
| NumPy numerieke rekenbibliotheek | NumPy developers | 1.22.3 | Gebruikt voor numerieke array-operaties, matrixberekeningen en reproductiecontrole. Waar relevant is een vaste random seed van 42 toegepast. |
| Pandas datamanipulatiebibliotheek | pandas development team | 1.4.2 | Gebruikt voor data-import, integratie, herstructurering, filtering en preprocessing, inclusief imputatie van ontbrekende waarden, uitlijning van tijdreeksen en voorbereiding van model-inputvariabelen. |
| Python programmeeromgeving | Python Software Foundation | 3.9.13 | Programmeeromgeving gebruikt voor het implementeren van de volledige forecasting-workflow, inclusief data-preprocessing, feature engineering, modeltraining, hyperparameter-optimalisatie, predictie, statistische toetsing en prestatie-evaluatie. |
| Scikit-learn machine learning-bibliotheek | scikit-learn contributors | 1.0.2 | Gebruikt voor data-preprocessing, splitsing tussen training en validatie, aanvullende model-evaluatie en statistische procedures, waaronder Pearson-correlatieanalyse en berekening van geselecteerde prestatie-indicatoren. |
| SciPy wetenschappelijke rekenbibliotheek | SciPy contributors | 1.9.0 | Gebruikt voor statistische berekeningen, inclusief Pearson-correlatieanalyse en ondersteunende procedures voor outlier-behandeling en winsorisatie. |
| Implementatie van Tree-structured Parzen Estimator | Optuna contributors | 3.1.0 | Bayesiaanse optimalisatie-implementatie gebruikt om XGBoost-hyperparameters af te stemmen, waaronder maximale boomdiepte, learning rate en regularisatieparameters. De Tree-structured Parzen Estimator werd geïmplementeerd via het open-source Optuna-pakket. |
| XGBoost softwarebibliotheek | DMLC / XGBoost contributors | 1.7.1 | Op beslissingsbomen gebaseerde ensemble learning-bibliotheek gebruikt voor niet-lineaire residu-compensatie. Het model implementeerde een geregulariseerde doelfunctie met Huber-verlies en boomcomplexiteit-boetes, zoals beschreven in Vergelijkingen 7–9. |
Referenties
- Rao H, Li J, Sun X. Demand forecasting and allocation optimization of green power grid supply chain based on machine learning algorithm: A study based on the whole-process data of power grid materials. Sustainability. 2025;17(3):1247.
- Huang C, et al. Demand response for industrial micro-grid considering photovoltaic power uncertainty and battery operational cost. IEEE Trans Smart Grid. 2021;12(4):3043-3055.
- Phuangpornpitak N, Prommee W. A study of load demand forecasting models in electric power system operation and planning. GMSARN Int J. 2016;10:19-24.
- Nasir J, et al. A hybrid LMD–ARIMA–machine learning framework for enhanced forecasting of financial time series: Evidence from the NASDAQ Composite Index. Mathematics. 2025;13(15):2389.
- Matos C, et al. Model for integrating the electricity cost consumption and power demand into aggregate production planning. Appl Sci. 2022;12(15):7577.
- Valenzuela J, Mazumdar M, Kapoor A. Influence of temperature and load forecast uncertainty on estimates of power generation production costs. IEEE Trans Power Syst. 2000;15(2):668-674.
- Khan F, et al. A hybrid vector autoregressive model for accurate macroeconomic forecasting: An application to the US economy. Mathematics. 2025;13(11):1706.
- Fatema I, Kong X, Fang G. Electricity demand and price forecasting model for sustainable smart grid using comprehensive long short-term memory. Int J Sustain Eng. 2021;14(6):1714-1732.
- Singh AK, Ibraheem SK, Muazzam M, Chaturvedi DK. An overview of electricity demand forecasting techniques. Netw Complex Syst. 2013;3(3):38-48.
- Iftikhar H, et al. A novel hybrid framework for forecasting stock indices based on nonlinear time series models. Comput Stat. 2025;40(8):4163-4186.
- Jiang P, Li R, Lu H, Zhang X. Modeling of electricity demand forecast for power system. Neural Comput Appl. 2020;32(11):6857-6875.
- Chan SC, et al. Load/price forecasting and managing demand response for smart grids: Methodologies and challenges. IEEE Signal Process Mag. 2012;29(5):68-85.
- Hernandez L, et al. A survey on electric power demand forecasting: Future trends in smart grids, microgrids and smart buildings. IEEE Commun Surv Tutor. 2014;16(3):1460-1495.
- Zareipour H, Canizares CA, Bhattacharya K. Economic impact of electricity market price forecasting errors: A demand-side analysis. IEEE Trans Power Syst. 2009;25(1):254-262.
- Botterud A. Forecasting renewable energy for grid operations. In: Renewable Energy Integration. Academic Press; 2017:133-143.
- Mirowski P, Chen S, Ho TK, Yu CN. Demand forecasting in smart grids. Bell Labs Tech J. 2014;18(4):135-158.
- Sobu A, Wu G. Optimal operation planning method for isolated micro grid considering uncertainties of renewable power generations and load demand. In: IEEE PES Innovative Smart Grid Technologies [conference proceedings]. IEEE; 2012. Available at: https://ieeexplore.ieee.org/
- Han B, et al. Optimal design of an on-grid microgrid considering long-term load demand forecasting: A case study. Distrib Gener Altern Energy J. 2020;35:345-362.
- Tripathy SC. Demand forecasting in a power system. Energy Convers Manag. 1997;38(14):1475-1481.
- Adshead NS, Price DH. Demand forecasting and cost performance in a model of a real manufacturing unit. Int J Prod Res. 1987;25(9):1251-1265.
- Gellert A, et al. A study on forecasting electricity production and consumption in smart cities and factories. Int J Inf Manage. 2019;49:546-556.
- Hernández L, et al. A multi-agent system architecture for smart grid management and forecasting of energy demand in virtual power plants. IEEE Commun Mag. 2013;51(1):106-113.
- Klingler AL, Teichtmann L. Impacts of a forecast-based operation strategy for grid-connected PV storage systems on profitability and the energy system. Sol Energy. 2017;158:861-868.
- Ghalehkhondabi I, Ardjmand E, Weckman GR, Young WA. An overview of energy demand forecasting methods published in 2005–2015. Energy Syst. 2017;8(2):411-447.
- Aderibigbe AO, et al. Enhancing energy efficiency with AI: A review of machine learning models in electricity demand forecasting. Eng Sci Technol J. 2023;4(6):341-356.
- Arumugham V, et al. An artificial-intelligence-based renewable energy prediction program for demand-side management in smart grids. Sustainability. 2023;15(6):5453.
- Dudek G, Piotrowski P, Baczyński D. Intelligent forecasting and optimization in electrical power systems: Advances in models and applications. Energies. 2023;16(7):3024.
- Liu N, et al. A hybrid forecasting model with parameter optimization for short-term load forecasting of micro-grids. Appl Energy. 2014;129:336-345.
- Mohammad AA, et al. Mathematical and statistical modelling of electricity demand forecasting using artificial neural networks and SARIMA: Implications for energy supply chain planning. Alex Eng J. 2026;139:98-108.
- Singh AR, et al. A blockchain-enabled multi-agent deep reinforcement learning framework for real-time demand response in renewable energy grids. Energy Strateg Rev. 2025;62:101905.
- Lu R, et al. Data-driven real-time price-based demand response for industrial facilities energy management. Appl Energy. 2021;283:116291.
- Kondaiah VY, Saravanan B, Sanjeevikumar P, Khan B. A review on short-term load forecasting models for micro-grid application. J Eng. 2022;2022(7):665-689.
- Lee BL, Wilson C, Simshauser P, Majiwa E. Deregulation, efficiency and policy determination: An analysis of Australia's electricity distribution sector. Energy Econ. 2021;98:105210.
- Wang Y, et al. Transmission network expansion planning considering wind power and load uncertainties based on multi-agent DDQN. Energies. 2021;14(19):6073.
- Ding Q, Zhao H. Study on e-commerce logistics cost control methods in the context of COVID-19 prevention and control. Soft Comput. 2021;25(18):11955-11963.
- Duan Y, Xu Z, Chen H, Wang Y. Novel machine learning approach for enhanced smart grid power use and price prediction using advanced Shark Smell-tuned flexible support vector machine. Sci Rep. 2025;15(1):20909.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining [conference proceedings]. San Francisco, CA, USA; 2016. Available at: https://doi.org/10.1145/2939672.2939785
- Lin KY, et al. Predictive maintenance in industrial systems: An XGBoost-based approach for failure time estimation and resource optimization. J Ind Prod Eng. 2025;42(8):876-899.
- Ajayi OO, Kurien AM, Djouani K, Dieng L. A proactive predictive model for machine failure forecasting. Machines. 2025;13(8):663.
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Chen H, Gao T, Wang L, Guo P. Explainable machine learning methods for predicting electricity consumption in a long-distance crude oil pipeline. Sci Rep. 2025;15(1):43305.
- Neubauer A, Brandt S, Kriegel M. Explainable multi-step heating load forecasting: Using SHAP values and temporal attention mechanisms for enhanced interpretability. Energy AI. 2025;20:100480.
- Ahmad T, Chen H. Potential of three variant machine-learning models for forecasting district-level medium-term and long-term energy demand in smart grid environment. Energy. 2018;160:1008-1020.
- Masa-Bote D, et al. Improving photovoltaics grid integration through short-time forecasting and self-consumption. Appl Energy. 2014;125:103-113.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.