Dit protocol beschrijft een reproduceerbare kwantum–klassieke hybride workflow voor het classificeren van de ziekte van Parkinson uit menselijke spraakopnames, inclusief datapreprocessing, implementatie van kwantumcircuits, modeltraining en kruisvalidatie voor onafhankelijke replicatie.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Een reproduceerbaar kwantum-klassiek hybride protocol voor het classificeren van de ziekte van Parkinson uit menselijke stemopnames
In dit artikel
Samenvatting
Samenvatting
De ziekte van Parkinson is een progressieve neurodegeneratieve aandoening waarvoor toegankelijke, goedkope screeningsmethoden beperkt blijven. Sustained-vocale stemopnamen bevatten meetbare akoestische biomarkers die geassocieerd zijn met ziektegerelateerde dysfonie en die zonder gespecialiseerde apparatuur kunnen worden verkregen. Dit protocol beschrijft een vier-qubit kwantum–klassiek hybride convolutioneel neuraal netwerk (QI-HCNN) dat een geparametriseerd kwantumcircuit combineert met een oppervlakkige klassieke classificatielaag om de ziekte van Parkinson te classificeren met behulp van dimensionaal gereduceerde akoestische stemkenmerken. Het protocol vergelijkt de voorgestelde aanpak ook met een dimensionaliteitsgematcht klassiek neuraal netwerk en gradiënt-boosted boomclassifiers die zijn getraind op zowel de gereduceerde als volledige featuresets. Met behulp van een publiek beschikbaar, gedeïdentificeerd dataset bestaande uit 195 spraakopnamen van 31 individuen, bereikte de QI-HCNN een oppervlakte onder de ontvanger-bedieningskarakteristiekcurve van 0,78 met behulp van drievoudige gestratificeerde kruisvalidatie, vergeleken met 0,87 voor het gematchte klassieke neurale netwerk en 0,94–0,95 voor de gradient-boosted baselines die respectievelijk op de gereduceerde en volledige featuresets waren getraind. Een gecontroleerde ablatieanalyse toonde aan dat een van de twee verstrengelingsoperaties in het circuit de gemeten uitgang niet kon beïnvloeden volgens ontwerp, terwijl de overige verstrengelingsoperatie de classificatieprestaties verminderde in plaats van verbeterde ten opzichte van een niet-verstrengelde variant. Patiëntgegroepeerde kruisvalidatie toonde verder aan dat prestatieschattingen aanzienlijk verschilden afhankelijk van de personen die aan de testset waren toegewezen, wat de beperkte cohortgrootte weerspiegelde. Dit protocol biedt daarom een volledig gespecificeerde en onafhankelijk reproduceerbare kwantum-klassieke basislijn, samen met een data-ondersteunde evaluatie van de sterke en beperkte punten van het huidige circuitontwerp, en vormt een methodologische basis voor toekomstige onderzoeken in plaats van het ondersteunen van claims over diagnostische gereedheid.
Inleiding
De ziekte van Parkinson is een chronische neurodegeneratieve aandoening veroorzaakt door het progressieve verlies van dopaminerge neuronen in de substantia nigra, die wereldwijd meer dan 10 miljoen mensen treft en een aanzienlijke en groeiende last voor de volksgezondheidvormt. De ziekte veroorzaakt zowel motorische symptomen, waaronder tremor, stijfheid en bradykinesie, als niet-motorische symptomen zoals slaapstoornissen en anosmie. Klinische diagnose is voornamelijk gebaseerd op neurologisch onderzoek met behulp van gestandaardiseerde motorische beoordelingsschalen, aangevuld met dopaminetransporterbeeldvorming, waar beschikbaar; Beide benaderingen vereisen echter specialistische expertise en infrastructuur die niet uniform toegankelijk zijn, en vroege klinische beoordeling blijft subjectief2. Omdat er momenteel geen ziekte-modificerende therapie beschikbaar is, is vroege opsporing waardevol, vooral omdat het vroeger symptomatisch beheer en longitudinale monitoring mogelijk maakt. Deze behoefte heeft de ontwikkeling gemotiveerd van goedkope, schaalbare en niet-invasieve screeningsbenaderingen die klinische evaluatie kunnen aanvullen in plaats van vervangen.
Vocale stoornissen behoren tot de vroegst meetbare veranderingen die geassocieerd worden met de ziekte van Parkinson en gaan vaak vooraf aan openlijke motorische symptomen3. Aanhoudende fonatie van een vastgehouden klinker levert een gecontroleerd signaal waaruit akoestische kenmerken, waaronder jitter, shimmer, harmonisch-ruisverhouding, recurrence period density entropie en detrended fluctuation analysis, kunnen worden afgeleid. Deze functies bevatten herhaaldelijk diagnostisch relevante informatie en kunnen worden verkregen met consumentenopnameapparatuur 4,5. Een publiek beschikbare benchmarkdataset, afgeleid van dergelijke opnames, is een standaard testplatform voor deze taak geworden, en klassieke machine learning-methoden toegepast op de volledige featureset, waaronder ondersteunende vectormachines, willekeurige bossen en gradiënt-boosted trees, hebben waarden voor area-onder-de-ontvanger-operatieve karakteristiekcurve gerapporteerd die naderen tot 0,99 6,7,8, wat suggereert dat de classificatietaak bijna is opgelost wanneer de volledige set kenmerken en passende strategieën voor het omgaan met klasse-onbalans worden gebruikt. Quantum machine learning is opgekomen als een alternatief computationeel paradigma voor biomedische classificatietaken, waarbij geparametriseerde quantumcircuits superpositie en verstrengeling gebruiken om feature-interacties met relatief weinig trainbare parameters te representeren, en schakelinggradiënten analytisch kunnen worden berekend met de parameter-shift-regel in plaats van eindige-differentie-benaderingen9. Veel gepubliceerde studies die "kwantum" of "kwantum-geïnspireerde" neurale netwerken voor biomedische toepassingen beschrijven, implementeren echter volledig klassieke architecturen die kwantum-geïnspireerde wiskundige formalismen hanteren zonder een daadwerkelijk geparametriseerd kwantumcircuit uit te voeren op een simulator of kwantumhardware10. Recente ontwikkelingen in de detectie van de ziekte van Parkinson omvatten ook hybride convolutionele neurale netwerk-transformatorarchitecturen11, aandachtgebaseerde deep-learningmethoden voor magnetische resonantiebeeldvorming (MRI)12, en lichtgewicht convolutionele neurale netwerken ontworpen voor computationeel efficiënte diagnose13, wat de snelle uitbreiding van kunstmatige intelligentiebenaderingen over meerdere datamodaliteiten illustreert. In bredere zin is niet-invasieve computerondersteunde diagnose succesvol uitgebreid naar andere biomedische toepassingen, waaronder hybride machine learning- en deep-learning-pijplijnen voor medische beeldvorming14. Vergelijkende evaluaties van deep-learning architecturen op dezelfde publieke spraakdataset tonen verder de sterke prestaties aan die kunnen worden behaald met conventionele full-feature klassieke modellen15.
Deze ontwikkelingen benadrukken een specifieke methodologische behoefte aan een reproduceerbaar kwantum–klassiek hybride convolutioneel neuraal netwerk (QI-HCNN) model dat (i) een echt, volledig gespecificeerd geparametriseerd kwantumcircuit uitvoert; (ii) wordt gebenchmarkt met identieke invoerkenmerken tegen zowel een architectonisch gematcht klassiek neuraal netwerk als een sterke klassieke basislijn; en (iii) wordt geëvalueerd met een protocol dat expliciet de belangrijkste bronnen van bias in kleine biomedische datasets onderzoekt, waaronder klassenonevenwicht, demografische verwarring en patiëntniveau-datalekkage tijdens kruisvalidatie.
Het algemene doel van dit protocol is het bieden van een volledig reproduceerbare QI-HCNN-workflow voor de classificatie van de ziekte van Parkinson met behulp van menselijke stemopnames. Het protocol beschrijft een vier-qubit geparametriseerd kwantumcircuit dat gebruikmaakt van hoekcodering, twee gecontroleerd-NOT-gebaseerde verstrengelingslagen en een trainbare variatielaag die is geoptimaliseerd met de parameter-shift-regel, gekoppeld aan een oppervlakkige klassieke classificatiekop en toegepast op een viercomponentige principal-component representatie van een publiek beschikbare spraakopnamedataset. De workflow specificeert, op een niveau dat voldoende is voor onafhankelijke replicatie, alle preprocessingprocedures, volledige circuitconstructie, klassieke trainingsconfiguratie en evaluatieprocedures, inclusief vergelijkingen met een dimensionaliteitsgematcht klassiek neuraal netwerk, dimensionaliteitsgematchte en volledige feature-gradient-boosted boombaselines, gecontroleerde circuitcomponent-ablaties, patiëntgegroepeerde kruisvalidatie om gevoeligheid voor tegengehouden deelnemers te evalueren, en expliciete statistische significantie-toetsing. In plaats van alleen gunstige resultaten te presenteren, is het protocol ontworpen om transparant te rapporteren wanneer individuele schakelcomponenten de prestaties niet meetbaar verbeteren, waardoor een reproduceerbaar methodologisch kader wordt geboden dat toekomstige ontwikkeling van QI-HCNN-architectuur voor biomedische classificatietaken in kleine cohorten kan ondersteunen.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Dit protocol gebruikt een openbaar beschikbaar, gedeïdentificeerd, spraakopname-dataset van derden. Er werden geen nieuwe gegevens verzameld van menselijke proefpersonen door de auteurs, en er was geen aanvullende goedkeuring van de institutionele beoordelingscommissie (IRB) vereist voor deze studie. De dataset die wordt beschreven in de subsectie Dataset Acquisition and Participant-Level Data Handling is oorspronkelijk verzameld onder institutionele ethische goedkeuring door Little et al.3, bevat geen direct identificerende deelnemersinformatie (alleen geanonimiseerde registratie-identificaties) en is openbaar beschikbaar voor onderzoeksgebruik. Bevestig, volgens uw institutionele beleid, of secundaire analyse van deze openbaar beschikbare dataset ethische beoordeling vereist. Bij de instelling van de auteurs werd retrospectieve secundaire analyse van deze volledig gedeidentificeerde, publiek gearchiveerde dataset als vrijgesteld van volledige IRB-beoordeling.
Datasetverwerving en gegevensverwerking op deelnemersniveau
De Parkinson's Disease Classification-dataset (UCI Machine Learning Repository, Dataset ID 174), oorspronkelijk beschreven door Little et al.3, werd gedownload. De dataset bevatte 195 opnames van aanhoudende klinkers /a/ fonatie van 31 personen (23 gediagnosticeerd met de ziekte van Parkinson en 8 gezonde controlepersonen; leeftijdsbereik 46–85 jaar). Omdat de repository geen versiegeschilderde DOI biedt, werd de exacte downloaddatum vastgelegd en gerapporteerd in de Materiaaltabel. De dataset werd geleverd als een CSV-bestand (CSV) (parkinsons.csv). Er was geen decompressie of bestandsconversie nodig, en het bestand werd direct geïmporteerd met de read_csv-functie uit de Pandas-bibliotheek (zie Materiaaltabel).
De gedownloade dataset werd geverifieerd op 195 rijen en 24 kolommen, bestaande uit één kolom met registratieidentificatie (formaat: phon_R01_S  subject
 _ opname), 22 continue akoestische featurekolommen (Tabel 1) en één binaire kolom met klasse-label (status: 1 = Parkinson Disease; 0 = gezonde controle). Tabel 1 werd gebruikt als referentie voor alle akoestische kenmerken en featurecategorieën gedurende het protocol.
| Categorie | Representatieve kenmerken | Klinische betekenis |
| Grondfrequentie | MDVP:Fo(Hz), MDVP:Fhi(Hz), MDVP:Flo(Hz) | Gemiddelde, maximale en minimale grondfrequentie van fonatie; weerspiegelt de stabiliteit van de trillingen van de stembanden. |
| Jitter (frequentieverstoring) | MDVP:Jitter(%), MDVP:Jitter(Abs), MDVP:RAP, MDVP:PPQ, Jitter:DDP | Variatie van cyclus tot cyclus in toonhoogteperiode, wat een verminderde larynxmotorische controle weerspiegelt. |
| Shimmer (amplitude-verstoring) | MDVP:Shimmer, MDVP:Shimmer(dB), Shimmer:APQ3, Shimmer:APQ5, MDVP:APQ, Shimmer:DDA | Variatie in signaalamplitude van cyclus tot cyclus, wat een ademende of onstabiele fonatie weerspiegelt. |
| Geluidsmaatregelen | NHR, HNR | Verhouding van ruis tot harmonische (tonale) componenten van het spraaksignaal. |
| Niet-lineaire dynamica / fractale schaal | RPDE, D2, DFA, spread1, spread2, PPE | Metingen van niet-lineaire vocale dynamiek, periodiciteit en langeafstandscorrelaties in de tijd die samenhangen met trillingen van de stembanden. |
Tabel 1: Akoestische kenmerkcategorieën gebruikt voor de classificatie van de ziekte van Parkinson. De 22 akoestische stemkenmerken die uit de Parkinson's Disease Classification-dataset zijn gehaald, zijn gegroepeerd in vijf featurecategorieën: fundamentele frequentie, jitter, shimmer, ruismetingen en niet-lineaire dynamica. Representatieve kenmerken worden voor elke categorie vermeld, samen met hun bijbehorende klinische betekenis. MDVP, Multidimensionaal Stemprogramma; RAP, relatief gemiddelde verstoring; PPQ, toonhoogteperiode verstoringsquotiënt; APQ, amplitude-verstoringsquotiënt; DDP, verschil in verschillen tussen perioden; DDA, gemiddeld absoluut verschil van amplitudes; NHR, ruis-harmonische verhouding; HNR, harmonie-ruisverhouding; RPDE, recurrence period density entropie; D2, correlatiedimensie; DFA, detrended fluctuation analysis; PPE, toonhoogte-entropie.
Voor elke opname werd een deelnemeridentificatie geëxtraheerd door de substring vóór de laatste onderscore in de opnamenaam te parsen. Zo werden phon_R01_S01_1 en phon_R01_S01_2 toegewezen aan deelnemer S01. Participant identifiers, in plaats van opname-identifiers, werden vervolgens gebruikt voor alle gegroepeerde of leave-one-participant-out validatieprocedures zoals beschreven in de subsectie Evaluatieprotocol, omdat opnames verkregen van dezelfde deelnemer akoestisch gecorreleerd zijn. Na extractie werd een frequentietabel van de identificaties gegenereerd en geïnspecteerd om te bevestigen dat alle 195 opnames waren toegewezen aan precies 31 unieke deelnemers, dat geen opname ontoegewezen was gebleven en dat het aantal opnames per deelnemer overeenkwam met de brondocumentatie van de dataset.
De klassenverdeling werd getabeld op zowel het opnameniveau (147 opnames van de ziekte van Parkinson, 75,4%; 48 opnames van gezonde, 24,6%) als het deelnemersniveau (23 van de 31 deelnemers, 74,2%, gediagnosticeerd met de ziekte van Parkinson). Beide verdelingen werden gerapporteerd omdat de klassenonbalans op registratie- en deelnemersniveau niet identiek is en de evaluatie van de latere lijn beïnvloedt.
Het ontbreken van leeftijds- of geslachtsgematchte Parkinson- en gezonde controlegroepen in de brondataset werd gedocumenteerd als een studiebeperking en meegenomen naar de Discussie omdat deze eigenschap de oorspronkelijke dataverzameling weerspiegelt en niet kan worden gecorrigeerd via downstream preprocessing.
Preprocessing-pijplijn
Alle preprocessingprocedures werden onafhankelijk uitgevoerd binnen elke trainingsfolder van de kruisvalidatieprocedure zoals beschreven in de subsectie Evaluatieprotocol . Zowel Min–Max-normalisatiestappen als principal component analysis (PCA) werden aangepast met alleen de trainingspartitie van elke vouw. De aangepaste transformaties werden vervolgens toegepast op de bijbehorende vastgehouden testpartitie zonder te refitten om informatielekkage van de testpartitie naar de preprocessingparameters te voorkomen.
De 22 ruwe akoestische kenmerken in elke trainingspartitie werden genormaliseerd met een Min–Max-scaler met een outputbereik van [0, π]. De aangepaste scaler werd vervolgens toegepast op zowel de trainings- als testpartitities van de overeenkomstige vouw (Vergelijking 1). Vergelijking 1 volgt de standaard Min–Max-normalisatieformulering en is gedefinieerd voor het huidige protocol. Min–Max-normalisatie werd uitgevoerd met de MinMaxScaler-klasse van scikit-learn (versie 1.8.0) met feature_range=(0, π), copy=True, en clip=False.
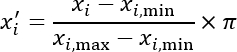 (1)
Een PCA-model met n_components = 4 werd aangepast met alleen de genormaliseerde trainingsgegevens. De aangepaste PCA-transformatie werd vervolgens toegepast op zowel de trainings- als testpartitionen. Het aandeel van de totale variantie dat door de vier behouden hoofdcomponenten werd verklaard, werd voor elke vouw geregistreerd. In de hier gerapporteerde analyses verklaarden de vier behouden hoofdcomponenten 81,5% van de totale variantie (respectievelijk 50,3%, 16,3%, 9,4% en 5,5%). PCA werd uitgevoerd met de PCA-klasse met n_components=4, svd_solver="volledig", whiten=False en random_state=42.
Omdat PCA negatieve componentscores kan genereren, werd een tweede Min–Max-scaler met een outputbereik van [0, π] gemonteerd met behulp van de PCA-getransformeerde trainingspartitie. De gemonteerde scaler werd vervolgens toegepast op zowel de trainings- als testwanden. Elke getransformeerde testpartitiewaarde die buiten het interval [0, π] viel, werd naar de dichtstbijzijnde grens geknipt omdat de scaler alleen met de trainingspartitie was ingebouwd. Er waren geen nul-variantiekenmerken aanwezig in de dataset. Het bereik van elk kenmerk over alle 195 opnames was strikt positief; daarom ontstond er geen deel-door-nul conditie. Dit werd bevestigd door te verifiëren dat de geschaalde output noch NaN noch oneindige waarden bevatte.
De vier opnieuw genormaliseerde hoofdcomponenten werden achtereenvolgens toegewezen als rotatiehoeken voor qubits 0, 1, 2 en 3 tijdens de hoekcoderingsprocedure beschreven in de subsectie Quantum Circuit Construction . De eerste hoofdcomponent werd toegewezen aan qubit 0, de tweede aan qubit 1, de derde aan qubit 2 en de vierde aan qubit 3. Dit voltooide de preprocessing-pijplijn en bracht de verwerkte klassieke kenmerken over naar het kwantumcircuit. Na de tweede Min–Max-schaalstap werden alle uitvoerwaarden bevestigd binnen het interval [0, π]. Testpartitiewaarden die door floating-point afronding net buiten dit bereik vielen, werden met de clipfunctie uit NumPy (versie 2.4.4) naar de dichtstbijzijnde grens geclipt. Deze procedure zorgde ervoor dat alle vier de invoeren van de hoekcoderingslaag geldige rotatiehoeken binnen het interval waren [0, π].
Quantumschakelingsconstructie
Het vier-qubit-circuit werd opgebouwd met behulp van de toestandvectorsimulator die in de Materiaaltabel staat en de hieronder beschreven poortvolgorde. Supplementary Coding File 1 werd gebruikt als de volledige uitvoerbare schakelingimplementatie, inclusief alle hulpfuncties voor poortconstructie en parameterverschuivingsgradiëntberekening. Figuur 1 toont de volledige workflow van voorverwerking van spraakopname via de vier schakelingenlagen, de klassieke nabewerkingskop en de uiteindelijke classificatie.
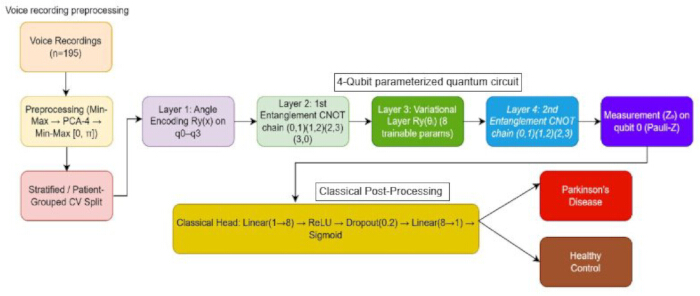
Figuur 1. Systeemarchitectuur en workflow van kwantumcircuits. Werkwijze voor de classificatie van de ziekte van Parkinson uit menselijke stemopnames. Het diagram toont spraakopname-preprocessing, gestratificeerde of patiëntgegroepeerde kruisvalidatie, vier-qubit geparametriseerde quantumcircuit-uitvoering, single-qubit Pauli-Z meting op qubit 0, klassieke postprocessing en de uiteindelijke binaire classificatie als Parkinson of gezonde controle. CNOT, gecontroleerde-NIET poort; PCA, hoofdcomponentanalyse; ReLU, gerectificeerde lineaire eenheid. Klik hier om een grotere versie van deze figuur te bekijken.
Een register met vier qubits werd geïnitialiseerd in de computationele basistoestand ∣0000.
Voor de hoekcoderingslaag werd een Ry (xi) rotatiepoort toegepast op qubit i, waarbij i = 0,1,2,3, gebruikmakend van de vier hoeken die door de preprocessing-pijplijn worden geproduceerd (Vergelijking 2). Vergelijking 2 beschrijft de standaard hoekcoderingsprocedure die wordt gebruikt in geparametriseerde kwantumcircuits, consistent met het geparametriseerde kwantumcircuitleerkader van Mitarai et al.9, en werd hier toegepast in de specifieke vier-qubitconfiguratie die voor het huidige protocol is gedefinieerd.
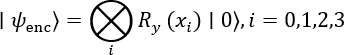 (2)
Voor de eerste verstrengelinglaag werd een cirkelvormige keten van gecontroleerde-NIET-poorten toegepast in de volgende controle-doelvolgorde: (0,1), (1,2), (2,3) en (3,0).
Voor de variatielaag werden de acht trainbare parameters w0 tot en met w7 geïnitialiseerd door onafhankelijke steekproefneming vanuit een normale verdeling met een gemiddelde van 0 en een standaarddeviatie van 0,3. Het willekeurige zaad werd vastgelegd in de Materiaalkundige Tafel. De acht variatiekwantumparameters werden geïnitialiseerd met behulp van numpy.random.default_rng(42 + fold_index).normal(0, 0,3, size = 8), waarbij fold_index het nul-gebaseerde vouwgetal is, waardoor fold-specifieke maar reproduceerbare initialisaties mogelijk zijn. Voor elke qubit i = 0,1,2 en 3 werd een Rz(wi) poort toegepast, gevolgd door een Ry(wi+4) poort (Vergelijking 3). Vergelijking 3 beschrijft een variatie-(trainbare) kwantumlaag die consistent is met het algemene geparametriseerde kwantumcircuitleerkader geïntroduceerd door Mitarai et al.9 en hier werd geïnstantieerd met behulp van de specifieke poortvolgorde en parameterisatie die voor het huidige protocol is gedefinieerd.
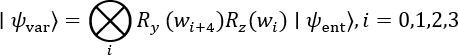 (3)
Voor de tweede verstrengelingslaag werd een open keten van gecontroleerde-NIET-poorten toegepast in de volgende controle-doelvolgorde: (0,1), (1,2) en (2,3). Deze keten was niet teruggesloten tot qubit 0.
De verwachtingswaarde van de Pauli-operator op alleen qubit 0,  , werd berekend met behulp van een toestandsvector-inwendig product. De circuituitvoering gebruikte een aangepaste toestandvectorsimulator die werd geïmplementeerd met standaard numerieke arraybewerkingen (Supplementary Coding File 1; qhcnn.py). Complex128 precision (numpy.complex128) werd overal gebruikt. Verwachtingswaarden werden analytisch berekend uit het toestandsvector inwendig product; daarom werd er geen shotgebaseerde bemonstering uitgevoerd. Er was geen extern quantumcomputing-framework vereist. Als een sampling-gebaseerde simulator of quantumapparaat in plaats van de toestandvectorsimulator was gebruikt, zouden herhaalde berekeningsmetingen van qubit 0 zijn uitgevoerd, en zouden de resulterende bitfrequenties zijn omgezet naar een verwachtingswaarde (Vergelijking 4). Vergelijking 4 is de standaard kwantummechanische verwachtingswaardeformule en werd hier toegepast op de enkel-qubit Pauli-observable die voor het huidige protocol is gedefinieerd. Omdat er geen steekproef op basis van schoten werd uitgevoerd, was er geen meetfoutbeperking nodig. De simulator gebruikte big-endian qubitindexering, waarbij qubit 0 overeenkomt met het meest significante bit van de toestandvectorindex. Deze conventie werd expliciet meegenomen bij het construeren van de Pauli-observabel om te garanderen dat de juiste verwachtingswaarde werd gemeten.
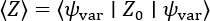 (4)
De gradiënt van met betrekking tot elk van de acht variatieparameters werd berekend met behulp van de parameterverschuivingsregel. Het circuit werd tweemaal geëvalueerd voor elke parameter tijdens elke gradiëntberekening, eenmaal bij θ + π/2 en eenmaal bij θ - π/2 (Vergelijking 5). Vergelijking 5 is de standaard parameterverschuivingsregel die werd geïntroduceerd door Mitarai et al.9 en hier zonder aanpassing werd toegepast.
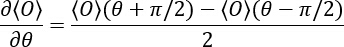 (5)
De tweede verstrengelingslaag, zoals hierboven gespecificeerd, paste nooit een gecontroleerde-NIET-poort toe met qubit 0 als doelwit. Omdat een gecontroleerde-NIET-poort de gereduceerde toestand van zijn controlequbit ongewijzigd laat, kan de tweede verstrengelingslaag niet veranderen , ongeacht de traineerbare parameterwaarden. Om de tweede verstrengelingslaag de gemeten output in een aangepast protocol te laten beïnvloeden, zou qubit 0 als doel moeten worden opgenomen, bijvoorbeeld door de keten te sluiten met een extra (3,0) gecontroleerde-NIET-poort, of een multiqubit-observabele moet worden gemeten in plaats van een verwachtingswaarde van één qubit. De oorspronkelijk gespecificeerde tweede verstrengelingslaag werd in dit protocol behouden, en de gemeten bijdrage werd expliciet gerapporteerd in de Resultatensectie in plaats van stilzwijgend gecorrigeerd omdat dit circuitgedrag deel uitmaakt van de huidige bevindingen.
Klassieke nabewerkingslaag
De klassieke postverwerkingsfase bestond uit een feed-forward neuraal netwerk dat werd geïmplementeerd met behulp van de standaard array-gebaseerde numerieke bewerkingen vermeld in de Table of Materials. De enkele scalaire circuituitgang,  , werd toegewezen aan acht verborgen eenheden met behulp van een volledig verbonden laag, gevolgd door een rectified linear unit (ReLU) activatie. Tijdens de training werd een dropoutlaag met een retentiekans van 0,8 (dropoutpercentage = 0,2) toegepast. De acht verborgen eenheden werden vervolgens toegewezen aan één uitvoereenheid met behulp van een tweede volledig verbonden laag, en een sigmoid-activatiefunctie werd toegepast om de uiteindelijke klasse-waarschijnlijkheid, ŷ (Vergelijking 6), te genereren. Vergelijking 6 definieert de specifieke klassieke postverwerkingsarchitectuur die in het huidige protocol wordt gebruikt en omvat standaard lineaire, gerectificeerde lineaire eenheid (ReLU) en sigmoïde operaties.
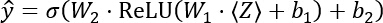 (6)
De matrices voor het gewicht van de eerste en tweede laag werden geïnitialiseerd door onafhankelijke steekproefneming vanuit een normale verdeling met een gemiddelde van 0 en een standaarddeviatie van 0,5, terwijl alle biastermen werden geïnitialiseerd tot 0. Dezelfde random-number-generator instantie en seed die werden gebruikt voor de initialisatie van de kwantumvariatieparameters werden ook gebruikt voor de klassieke laag om run-to-run reproduceerbaarheid te waarborgen. Specifiek werden de klassieke gewichtmatrices geïnitialiseerd met numpy.random.default_rng(42 + fold_index).normal(0, 0,5, size=...), terwijl alle bias-termen op nul werden geïnitialiseerd. Een enkele gezaadde random-number-generator instance, geïnitialiseerd met 42 + fold_index, werd aan het begin van elke crossvalidatiefolder gemaakt en sequentieel hergebruikt voor kwantumparameterinitialisatie, klassiek gewicht-initialisatie, mini-batch shuffling en dropout-maskergeneratie, in plaats van aparte onafhankelijke seedstreams voor elk proces te gebruiken.
Tijdens de training werd dropout toegepast door bij elke voorovergang een nieuw bemonsterd binair masker te genereren met behulp van de inverted-dropout-conventie, waarbij overgebleven eenheden werden geschaald met 1/0,8. Tijdens validatie en testen werd de uitval volledig uitgeschakeld en werd het volledige, ongeschaalde netwerk gebruikt voor inferentie.
Het gecombineerde QI-HCNN-model bevatte 33 trainbare parameters: acht quantumvariatieparameters uit het quantumcircuit en 25 klassieke parameters. De klassieke component bestond uit acht gewichten en acht biases in de eerste volledig verbonden laag, samen met acht gewichten en één bias in de tweede volledig verbonden laag. De gewicht- en bias-tensorafmetingen waren 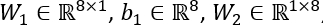 en
 . De klassieke nabewerkingslaag werd volledig geïmplementeerd met standaard numerieke arraybewerkingen zonder een extra machine-learning kader. Alle klassieke berekeningen werden uitgevoerd met float64 (dubbelprecisie) rekenkunde.
Model Training
Het kwantumcircuit beschreven in de subsectie Kwantumschakelingconstructie en de klassieke naverwerkingslaag beschreven in de subsectie Klassieke Postverwerkingslaag werden gecombineerd tot één end-to-end trainbaar model. Alle 33 trainbare parameters werden gezamenlijk geoptimaliseerd met de Adam-optimizer met een initiële leersnelheid van 0,01 en gewichtsafname, geïmplementeerd als L2-straf van , toegepast alleen op de klassieke gewichtsmatrices. De Adam-optimizer werd handmatig geïmplementeerd met standaard numerieke arraybewerkingen met de volgende instellingen: leersnelheid = 0,01, β1 = 0,9, β2 = 0,999, ∈ = 1 × 10⁻⁸, en gewichtsafname = 1 × 10⁻⁴, toegepast alleen op de klassieke gewichtmatrices en niet op de biastermen of quantumvariatieparameters.
Binaire kruisentropie werd gebruikt als verliesfunctie. Voor de post-split-klassenafbalanceringsprocedure beschreven in de subsectie Evaluatieprotocol, werd de verliesbijdrage van elk trainingsmonster gewogen met de omgekeerde frequentie van zijn klasse binnen de trainingspartitie van de huidige fold. Voor het onevenwichtige protocol werden uniforme steekproefgewichten toegekend. Binaire kruis-entropie werd berekend als het gemiddelde verlies over alle monsters binnen elke mini-batch met behulp van de standaard binaire kruis-entropieformulering.
Het model werd getraind voor 30 epochs met behulp van mini-batches van 16 monsters. Trainingssteekproeven werden aan het begin van elk tijdperk willekeurig geschud met behulp van numpy.random.default_rng(42 + fold_index).permutation(n) om een willekeurige steekproefvolgorde te genereren. Wanneer het aantal trainingsmonsters niet gelijkmatig deelbaar was door 16, werd de uiteindelijke kleinere mini-batch behouden en verwerkt op de werkelijke grootte in plaats van weggegooid.
Tijdens de training werd een stapleerschema toegepast. Het leertempo werd met 0,7 vermenigvuldigd na elke 10 voltooide epochs, specifiek aan het begin van epochs 11 en 21.
De gradiënten voor de acht kwantumvariatieparameters werden berekend met behulp van de parameterverschuivingsregel beschreven in de subsectie Kwantumschakelingconstructie . De gradiënten voor de 25 klassieke parameters werden berekend met standaard omgekeerde modus differentiatie via alleen de klassieke laag. De output van het kwantumcircuit, , en de parameterverschuivingsgradiënten dienden als interface tussen het kwantumcircuit en de klassieke laag. Alle 33 parameters werden bijgewerkt met dezelfde Adam-optimizer-instantie.
Validatie-gebaseerde vroege stoptechniek werd niet toegepast. Elk model werd getraind voor het vaste schema van 30 epochs, en de gebleekte test-partition prestaties werden gerapporteerd na voltooiing van het laatste epoch. Alle modelparameters (kwantumvariatieparameters, klassieke gewichtmatrices en biastermen) werden onafhankelijk opnieuw geïntialiseerd aan het begin van elke kruisvalidatiefolder met behulp van het fold-specifieke random seed (42 + fold_index). Parameters werden niet gedeeld over folds of baseline runs.
De rekenkundige omgeving, inclusief processor, geheugen, softwareversies en een berammede wandkloktrainingstijd per vouw, werd vastgelegd in de Materiaalkundige Tafel.
Evaluatieprotocol
De modelprestaties werden geëvalueerd met behulp van zowel opname- als deelnemerniveau kruisvalidatieprocedures, samen met basismodelvergelijkingen, klasse-balanceringsanalyses, circuitablatie-experimenten, statistische significantietests en feature-importance analyses.
Voor de primaire evaluatie werden de 195 stemopnames verdeeld in drie gestratificeerde plooien met behulp van een vast willekeurig zaad, terwijl de opnameniveau Parkinson/gezonde-controle-ratio van 75,4%/24,6% binnen elke vouw behouden bleef. Het model beschreven in de voorgaande secties werd getraind met twee vouwen en geëvalueerd op de resterende vastgehouden vouw, en deze procedure werd herhaald totdat elke vouw eenmaal als testpartitie had gediend. Nauwkeurigheid, precisie, recall, F1-score en oppervlakte onder de receiver operating characteristic curve (AUC–ROC) werden berekend voor elke vouw en gerapporteerd als het gemiddelde ± standaarddeviatie over de drie vouwen. Primaire drievoudige gestratificeerde kruisvalidatie werd geïmplementeerd met behulp van de StratifiedKFold-klasse met n_splits=3, shuffle=True, en random_state=42.
Binaire klassevoorspellingen werden gegenereerd door een vaste waarschijnlijkheidsdrempel van 0,50 toe te passen op de voorspelde klassenkans, ŷ, geproduceerd door de klassieke nabewerkingslag. Nauwkeurigheid, precisie, herinnering en F1-score werden berekend uit deze drempelvoorspellingen, terwijl AUC–ROC direct werd berekend uit de continue waarschijnlijkheidswaarden zonder drempel. Precisie, herinnering en F1-score werden berekend met behulp van metriekfuncties met zero_division=0, waarbij een waarde van 0,0 werd toegekend aan elke ongedefinieerde metriek. Dergelijke ongedefinieerde aandoening deed zich tijdens de gerapporteerde experimenten niet voor.
Basismodellen werden geëvalueerd met identieke vouwpartities en identieke viercomponentige voorbewerkte feature-representatie die door de preprocessing-pijplijn werd gegenereerd. Een klassieke meerlaagse perceptron met één verborgen laag van acht door ReLU geactiveerde eenheden, architectonisch afgestemd op het klassieke component van het hybride model maar zonder het kwantumcircuit, werd getraind met de Adam-optimizer met een L2-straf van 1 × 10⁻⁴. Een gradiënt-boosted boomclassifier werd ook getraind met dezelfde viercomponentenrepresentatie met 200 bomen, een maximale boomdiepte van 3, een leersnelheid van 0,1 en klasseweging gelijk aan de inverse klassefrequentie binnen elke trainingsvouw. Daarnaast werd een tweede gradient-boosted boomclassifier getraind met de volledige 22-feature-representatie die werd gegenereerd na de initiële Min–Max-normalisatie, zonder PCA of kwantumfeature-codering toe te passen. Dit model gebruikte 300 bomen, een maximale boomdiepte van 4, een leersnelheid van 0,05 en dezelfde inverse trainingsvouw-klassewegingsstrategie. De klassieke meerlagige perceptronbaseline werd geïmplementeerd met MLPClassifier met hidden_layer_sizes=(8,), activation="relu", solver="adam", alpha=1 × 10⁻4, batch_size="auto", learning_rate_init=0,001, max_iter=500, early_stopping=False, shuffle=True en random_state=42. De standaard Glorot (Xavier) uniforme gewicht-initialisatie die door de implementatie werd geleverd, werd gebruikt. De gradiënt-boosted boombaselines werden geïmplementeerd met XGBoost 3.3.0 met doel = "binair:logistic", eval_metric = "logloss", tree_method = "auto", subsample = 1.0, colsample_bytree = 1.0, reg_alpha = 0, reg_lambda = 1 en random_state = 42.
Om het effect van post-split klassenbalans te evalueren, werd de primaire kruisvalidatieprocedure herhaald voor het QI-HCNN-model met steekproefweging ingeschakeld. Balanceringsgewichten werden uitsluitend berekend uit de trainingspartitie van elke vouw na het splitsen van trein/test en werden niet berekend vanuit de overeenkomstige vastgehouden testverdeling.
Experimenten met ablatie van circuitcomponenten werden uitgevoerd door de volledige preprocessing-, trainings- en evaluatieworkflow vier keer te herhalen, waarbij alleen de twee verstrengelingslagen van het quantumcircuit werden aangepast. De vier schakelingsvarianten omvatten: (i) het volledige circuit dat beide verstrengelingslagen bevat; (ii) het circuit waarbij de eerste verstrengelingslaag is verwijderd en de tweede behouden blijft; (iii) het circuit waarbij de eerste verstrengelingslaag behouden is en de tweede is verwijderd; en (iv) het circuit waarbij beide verstrengelingslagen zijn verwijderd. Identieke vouw-partitionen, willekeurige seeds en trainingsconfiguraties werden in alle vier de experimenten behouden, zodat eventuele waargenomen prestatieverschillen uitsluitend konden worden toegeschreven aan de verstrengeling-laag configuratie.
Als robuustheidsbeoordeling werd door deelnemers gegroepeerde kruisvalidatie uitgevoerd door de 31 deelnemers, in plaats van de 195 opnames, te verdelen in vijf groepen van elk zes tot zeven deelnemers. Tijdens elke iteratie werd het model getraind met opnames van deelnemers in vier groepen en geëvalueerd aan de hand van opnames van deelnemers uit de overige groep, zodat geen enkele deelnemer opnames bijdroeg aan zowel de trainings- als testpartitities van dezelfde groep. Nauwkeurigheid, precisie, recall, F1-score en AUC–ROC werden gerapporteerd als het gemiddelde ± standaarddeviatie over de vijf deelnemend-gegroepeerde vouwen voor het QI-HCNN-model, het klassieke multilayer perceptron en de vier-feature gradient-boosted baseline. Participant-gegroepeerde kruisvalidatie werd geïmplementeerd met de GroupKFold-klasse met n_splits=5, waarbij de participant-identifiers als groeperingsvariabele dienden. Omdat GroupKFold de groepen niet schudt, werden deelnemers toegewezen volgens de standaard deterministische volgorde van de implementatie, wat resulteerde in folds met elk zes of zeven deelnemers.
De statistische significantie werd geëvalueerd door gepaarde Wilcoxon-teken-rang tests toe te passen op de per-fold AUC–ROC-waarden die werden verkregen voor de primaire evaluatie- en basismodellen. Exacte p-waarden en het bijbehorende aantal gepaarde waarnemingen werden gerapporteerd omdat de statistische kracht van deze test beperkt is wanneer slechts een klein aantal vouwen beschikbaar is. Vier pargewijze AUC–ROC-vergelijkingen werden a priori gedefinieerd: (1) QI-HCNN versus de klassieke meerlaagse perceptron; (2) QI-HCNN versus de PCA-gematchte, gradiënt-versterkte boombasislijn; (3) de klassieke meerlagige perceptron versus de PCA-gematchte, gradiënt-versterkte boombaseline; en (4) het ongebalanseerde QI-HCNN-model versus het post-split-gebalanceerde QI-HCNN-model. Er werd geen meervoudige vergelijkingscorrectie toegepast omdat de analyses verkennend waren en het beperkte aantal vouwen de statistische kracht aanzienlijk verminderde.
Feature-importance analyse werd uitgevoerd met behulp van de gradient-boosted tree classifier die getraind was op de volledige representatie van 22 features. Gain-gebaseerde feature-importance-scores werden geëxtraheerd en gerangschikt voor alle originele akoestische kenmerken. Afzonderlijk werd PCA alleen voor rapportagedoeleinden op de volledige dataset aangepast en niet gebruikt tijdens modelevaluatie. Voor elk origineel akoestisch kenmerk werden de absolute belastingen over de vier behouden hoofdcomponenten opgeteld, en de kenmerken werden gerangschikt op basis van deze waarden. Zowel rangschikkingsmethoden als hun overlapping werden gerapporteerd. Voor de gain-based feature-importance analyse leverde de gradient-boosted tree-implementatie unieke floating-point gainwaarden op, en er kwamen geen gelijke slagen voor. Voor de belastingrangschikkingen van hoofdcomponenten werden gelijken in de opgetelde absolute belastingwaarden opgelost volgens de oorspronkelijke volgorde van de featurekolom in de dataset.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Alle numerieke waarden die in de tekst worden gerapporteerd, worden verzoend met, en identiek aan, die in Figuren 2–8 en Tabellen 2–4 worden weergegeven. Elke figuur werd direct gegenereerd uit de code in Supplementary Coding File 1 in plaats van handmatig voorbereid, wat de consistentie tussen de gerapporteerde numerieke waarden en de uitgeplotte gegevens waarborgde.
Primaire kruisvalidatieprestaties<...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Dit protocol specificeert een volledig reproduceerbare QI-HCNN-architectuur voor de classificatie van de ziekte van Parkinson uit spraakopnames, waarin elke gate, parameter-initialisatiekeuze, preprocessingstap en evaluatieprocedure op een niveau wordt beschreven dat voldoende is voor onafhankelijke implementatie. Het voorgestelde circuit wordt gebenchmarkt met identieke invoerfuncties en identieke cross-validation fold-partities tegen een architectonisch afgestemde klassieke multilayer ...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
Belangenconflict:
De auteurs verklaren dat zij geen concurrerende financiële of niet-financiële belangen hebben met betrekking tot dit werk.
Dankbetuigingen
Dit werk werd niet gefinancierd door een organisatie of instantie, technisch noch financieel. De auteurs bedanken de beheerders van de UCI Machine Learning Repository voor het bieden van publieke toegang tot de spraakopname-dataset die in deze studie werd gebruikt.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Adam optimizer | Standaard numerieke optimalisatie-implementatie | Aangepaste implementatie; NumPy 2.4.4 | Gezamenlijke optimalisatie van kwantum- en klassieke parameters; Model Training |
| Binaire cross-entropy verlies implementatie | Aangepaste implementatie met behulp van NumPy | NumPy 2.4.4; gemiddeld verlies (gemiddelde reductie) per mini-batch | Trainingsverliesfunctie; Model Training |
| Gradient-boosted boomclassificator | XGBoost open-source gradient-boosting bibliotheek | XGBoost 3.3.0; objective="binary:logistic"; eval_metric="logloss"; tree_method="auto"; random_state=42 | PCA-gematchte en volledige functieklassieke baselines; Evaluatieprotocol |
| Machine-learning bibliotheek | scikit-learn open-source machine-learning bibliotheek | scikit-learn 1.8.0 | Min–Max schalen, hoofdcomponentenanalyse, gestratificeerde cross-validatie, deelnemersgroep gegroepeerde cross-validatie, meerlaagse perceptron baseline en evaluatiemetrieken |
| Numerieke bibliotheek voor berekeningen | NumPy open-source numerieke bibliotheek voor berekeningen | NumPy 2.4.4 | Kern array bewerkingen, statevector simulatie, parameter initialisatie en handmatige gradient berekening |
| Parkinson's Ziekte Classificatie dataset | Little, McSharry, Roberts, Costello en Moroz; gedistribueerd door de UCI Machine Learning Repository | UCI Dataset ID 174; 195 opnames van 31 deelnemers; benaderd op 19 juni 2025 | Bron voor duurzame klinker stemopname dataset; https://archive.ics.uci.edu/dataset/174 |
| Wetenschappelijke bibliotheek voor berekeningen | SciPy open-source wetenschappelijke bibliotheek voor berekeningen | SciPy 1.17.1 | Wilcoxon signed-rank statistische significantie test; Evaluatieprotocol |
| Statevector simulator | Aangepaste statevector simulator (Aanvullende Coderingsbestand 1; qhcnn.py) | Pure NumPy implementatie; complex128 (double) precisie; geen externe backend vereist | Uitvoering van de vier-qubit quantum circuit; Quantum Circuit Constructie |
| Tabelgegevens bibliotheek | Pandas open-source data-analyse bibliotheek | Pandas 3.0.2 | Gegevens laden, inspectie en tabelbewerkingen |
| Werkstation berekeningsomgeving | Locale CPU werkstation (cloud-gehoste Linux container) | x86_64 CPU; Ubuntu Linux; Python 3; geen GPU of kwantumhardware gebruikt; geschatte wandklok training tijd van 30–60 seconden per fold | Berekeningsomgeving gebruikt voor alle training en evaluatie; CPU-gebaseerde statevector simulatie; geen GPU of kwantumhardware vereist |
Referenties
- Rabie H, Akhloufi MA. A review of machine learning and deep learning for Parkinson's disease detection. Discov Artif Intell. 2025;5:24.
- Devi SVA, et al. Hybrid deep learning methods for enhancing Parkinson's disease early detection [conference presentation]. Presented at: 4th International Conference on Smart Applications, Data and Living (ICSADL); 2025; Bhimdatta, Nepal. IEEE. p. 1462-1469. Available from: https://doi.org/10.1109/ICSADL65848.2025.10933259.
- Little MA, et al. Exploiting nonlinear recurrence and fractal scaling properties for voice disorder detection. Biomed Eng Online. 2007;6:23.
- Costantini G, et al. Artificial intelligence-based voice assessment of patients with Parkinson's disease off and on treatment. Sensors (Basel). 2023;23(4):2293.
- Gunduz H. Deep learning-based Parkinson's disease classification using vocal feature sets. IEEE Access. 2019;7:115540-115551.
- Naeem I, et al. Voice biomarkers as prognostic indicators for Parkinson's disease using machine learning techniques. Sci Rep. 2025;15:12129.
- Ebrahimzadeh E, et al. Explainable machine learning for early detection of Parkinson's disease in aging populations using vocal biomarkers. Front Aging Neurosci. 2025;17:1672971.
- Alishah S. An explainable ensemble and deep learning framework for accurate and interpretable Parkinson's disease detection from voice biomarkers. Diagnostics (Basel). 2025;15(22):2892.
- Mitarai K, Negoro M, Kitagawa M, Fujii K. Quantum circuit learning. Phys Rev A. 2018;98(3):032309.
- Alissa M, et al. Parkinson's disease diagnosis using convolutional neural networks and figure-copying tasks. Neural Comput Appl. 2022;34(2):1433-1453.
- Kumari GRP, Ravi Kanth M, Kamal MV. Parkinson's disease early detection using hybrid attentive CNN-transformer model. Neural Comput Appl. 2025;37(32):26523-26543.
- Palakayala R, Kuppusamy P. AttentionLUNet: a hybrid model for Parkinson's disease detection using MRI brain. IEEE Access. 2024;12:91752-91769.
- Wang X, et al. A light-weight CNN model for efficient Parkinson's disease diagnostics [conference presentation]. Presented at: IEEE International Symposium on Computer-Based Medical Systems (CBMS); 2023; L'Aquila, Italy. IEEE. p. 616-621. Available from: https://doi.org/10.1109/CBMS58004.2023.00289.
- Haq I, et al. Lung nodules localization and report analysis from computerized tomography (CT) scan using a novel machine learning approach. Appl Sci. 2022;12(24):12614.
- Alzaidi A, et al. Comparative study of deep learning models for Parkinson's disease detection using the UCI vocal dataset. TBench. 2025;5(2):10021
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.