Deze studie onderzoekt de relatie tussen systemische lupus erythematosus en recidiverend voldragen zwangerschapsverlies en identificeert IFI27 als een kandidaat-biomarker voor toekomstig onderzoek.
Onderzoeksartikel
Mendeliaanse randomisatie en bio-informatica identificeren IFI27 als een kandidaat-biomarker voor recidiverend zwangerschapsverlies bij systemische lupus erythematosus
* These authors contributed equally
In dit artikel
Samenvatting
Samenvatting
Systemische lupus erythematosus (SLE) is geassocieerd met ongunstige zwangerschapsuitkomsten, maar de causale relatie met recidiverend zwangerschapsverlies (RPL) en hun gedeelde moleculaire kenmerken blijven onduidelijk. In deze studie werden bidirectionele two-sample Mendelian randomization (MR) en transcriptomische bio-informatica-analyses geïntegreerd om deze relatie te onderzoeken en potentiële gedeelde biomarkers te identificeren. FinnGen en UK Biobank werden geselecteerd omdat zij grote, niet-overlappende genome-wide association study (GWAS) samenvattende statistieken van Europese afkomst bieden. Differentieel tot expressie gebrachte genen (DEGs) werden geïdentificeerd uit GSE61635 (bloed; |log₂ fold change| > 1) en GSE165004 (endometrium; |log₂ fold change| > 0.5) met een aangepaste P < 0.05, gevolgd door functionele verrijking, eiwit-eiwitinteractie (PPI)-analyse, hub-gene screening, least absolute shrinkage and selection operator (LASSO) regressie, externe validatie met GSE50772 en GSE198700, receiver operating characteristic (ROC)-analyse en single-sample gene set enrichment analysis (ssGSEA). Genetisch voorspelde SLE was geassocieerd met een statistisch significante, maar kwantitatief bescheiden toename van spontane miskramen (inverse-variance weighted [IVW] odds ratio [OR] = 1.01, 95% betrouwbaarheidsinterval [CI] = 1.00–1.02; P < 0.001). De instrumentsterkte was adequaat, en sensitiviteitsanalyses detecteerden geen wezenlijke heterogeniteit, directionele pleiotropie of invloedrijke enkele variant. Vijfenzestig gedeelde DEGs waren verrijkt in antivirale immuunresponsen, celadhesie en apoptose-gerelateerde processen. IFI27 was consistent overexpressed in SLE-bloed maar underexpressed in het RPL-endometrium en chorionvlokken, terwijl CXCL11 geen consistente externe validatie vertoonde. Retrospectieve ROC-analyses leverden areas under the curve (AUCs) op van 0.822 voor SLE en 0.872 voor RPL. Computationeel afgeleide ssGSEA-scores toonden correlaties tussen IFI27-expressie en verschillende immuuncelsignaturen, waaronder T helper 2 (Th2)-cellen. Deze bevindingen identificeren IFI27 als een potentiële biomarker die gedeeld wordt door SLE en RPL; prospectieve klinische en experimentele studies zijn echter vereist om de biologische en klinische significantie hiervan te valideren.
Inleiding
Systemische lupus erythematosus (SLE) is een complexe auto-immuunziekte die wordt gekenmerkt door multisysteembetrokkenheid en chronische immuundysregulatie1. De pathologische afwijkingen bij SLE worden primair toegeschreven aan verstoorde adaptieve immuunresponsen en de depositie van antigeen-antilichaamcomplexen, wat leidt tot auto-immuun-gemedieerde weefselschade en orgaanschade2,3. De wereldwijde incidentie van SLE is ongeveer 5,14 (1,4–15,13) gevallen per 100.000 persoonsjaren, met een geschatte incidentie van 8,82 (2,4–25,99) gevallen per 100.000 persoonsjaren bij vrouwen4. SLE treft personen van alle leeftijden, maar komt voornamelijk voor bij vrouwen in de reproductieve leeftijd5,6. Zwangere patiënten met SLE hebben een verhoogd risico op ongunstige zwangerschapsuitkomsten, waaronder recidiverende miskramen, doodgeboorten, vroeggeboorten en intra-uteriene groeivertraging7,8. Recidiverend zwangerschapsverlies (RPL) wordt gedefinieerd als twee of meer miskramen vóór 20–24 weken van de zwangerschap9. De gerapporteerde prevalentie is ongeveer 2,6%10, waardoor het een klinisch significante reproductieve complicatie is. Ongeveer 20% van de zwangere patiënten met SLE krijgt te maken met een miskraam11, en SLE wordt erkend als een belangrijke risicofactor voor RPL12. Voorgestelde mechanismen omvatten hormonale veranderingen en immuundysregulatie. Biomarkers zoals anticardiolipine-antilichamen en lupusanticoagulans zijn onderzocht als potentiële voorspellers van ongunstige zwangerschapsuitkomsten bij patiënten met SLE11. Deze auto-antilichamen kunnen binden aan placentaire trofoblastcellen, de signalering, proliferatie en invasie van trofoblasten wijzigen, de hormoon- en cytokinesecretie moduleren en apoptose verhogen, waardoor ze bijdragen aan verslechterde zwangerschapsuitkomsten13. Daarnaast wordt bèta-2 glycoproteïne I (β2-GPI), een belangrijk antigeen bij het antifosfolipidensyndroom, tot expressie gebracht in placentawefsel. Binding van anti-β2-GPI-antilichamen aan β2-GPI remt de groei en differentiatie van trofoblasten, wat resulteert in placentaire defecten. Deze interactie bevordert ook een pro-inflammatoire omgeving die wordt gekenmerkt door destructieve cytokineproductie en complementactivatie, wat bijdraagt aan placentale trombose en recidiverende miskramen14,15. Eerdere studies misten echter vaak uitgebreide analyses van lokale reproductieve weefsels, zoals de decidua, wat het vermogen beperkte om systemische biomarkers te correleren met lokale pathologische veranderingen. Bovendien blijven de behandeling van zwangerschappen gecompliceerd door SLE en de preventie van ongunstige zwangerschapsuitkomsten een uitdaging. Genetische vatbaarheid draagt bij aan de ontwikkeling van SLE, en genetische variatie is ook betrokken bij de pathogenese van RPL16,17. Desalniettemin blijft het onduidelijk of er een causaal verband bestaat tussen SLE en RPL, evenals wat de moleculaire mechanismen en gedeelde genen zijn die ten grondslag liggen aan hun gelijktijdige voorkomen.
Mendeliaanse randomisatie (MR) is een gevestigde benadering voor causale inferentie die genetische varianten gebruikt als instrumentele variabelen om de causale effecten van blootstellingen op ziekte-uitkomsten te schatten18. Door gebruik te maken van de relatie tussen genotype en fenotype, vermindert MR de bias door confounding en omgekeerde causaliteit in vergelijking met conventionele observationele studies. Parallel hieraan hebben vorderingen in genomische microarray-platforms en high-throughput sequencing bio-informatische analyses mogelijk gemaakt om potentiële diagnostische biomarkers en therapeutische targets te identificeren via transcriptomische profilering. De integratie van deze complementaire benaderingen kan een uitgebreider begrip bieden van de relatie tussen SLE en RPL door causale genetische bewijzen te combineren met ziekte-geassocieerde genexpressiepatronen. Daarom was deze studie erop gericht om de potentiële causale relatie tussen SLE en RPL te onderzoeken, gedeelde kandidaat-biomarkers en biologische pathways te identificeren, en targets te prioriteren voor toekomstige validatie. Om deze doelstellingen te bereiken, werd de analytische workflow als volgt vooraf gespecificeerd: bidirectionele MR om de causale richting te evalueren; onafhankelijke analyses van differentiële genexpressie gevolgd door transcriptomische integratie; proteïne-proteïne interactie (PPI) netwerkanalyse en least absolute shrinkage and selection operator (LASSO) regressie voor de prioritering van biomarkers; externe expressievalidatie en receiver operating characteristic (ROC) analyse; en single-sample gene set enrichment analysis (ssGSEA) om associaties met immuuncel-signaturen te evalueren. Deze stapsgewijze workflow is samengevat in Figuur 1.
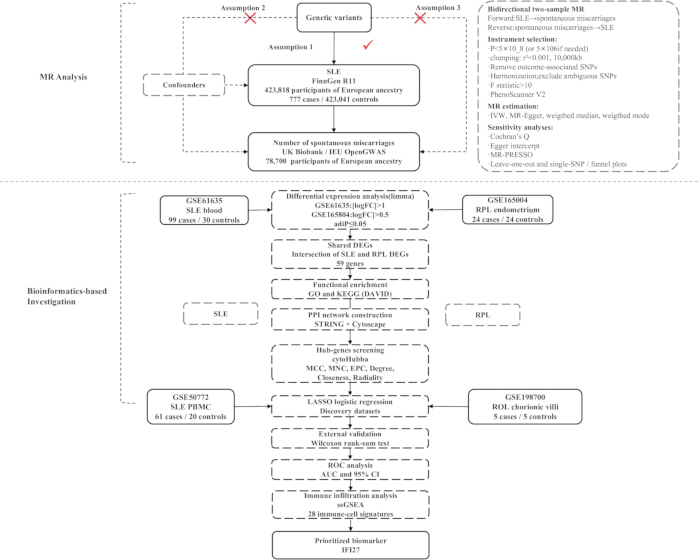
Figuur 1. Onderzoeksopzet en analytische workflow.
Het bovenste paneel illustreert de bidirectionele two-sample Mendeliaanse randomisatie (MR)-analyse die de associatie tussen systemische lupus erythematosus (SLE) en het aantal spontane miskramen evalueert met behulp van samenvattende statistieken uit genome-wide association studies (GWAS). De selectie van instrumenten, linkage disequilibrium clumping, Mendeliaanse randomisatie (MR)-analyses en sensitiviteitsanalyses zijn samengevat. Het onderste paneel schetst de bio-informatica workflow, inclusief differentieel expressie-analyse, identificatie van gedeelde differentieel tot expressie gebrachte genen (DEGs), functionele enrichmementanalyse, constructie van een proteïne-proteïne interactie (PPI)-netwerk, hub-gen screening, least absolute shrinkage and selection operator (LASSO)-regressie, externe validatie, receiver operating characteristic (ROC)-analyse, single-sample gene set enrichment analysis (ssGSEA) en prioritering van de kandidaat-biomarker IFI27. IVW, inverse-variance weighted; KEGG, Kyoto Encyclopedia of Genes and Genomes; GO, Gene Ontology. Klik hier om een grotere versie van deze figuur te bekijken.
Protocol
Ethische goedkeuring was niet vereist voor de huidige studie, omdat deze uitsluitend bestond uit secundaire analyses van openbaar beschikbare, gedeïdentificeerde samenvattende statistieken van genoombrede associatiestudies (GWAS) en transcriptomische datasets. Er zijn geen nieuwe deelnemers geworven, er zijn geen biologische monsters verzameld en er is geen toegang gekregen tot identificeerbare informatie op individueel niveau. De oorspronkelijke FinnGen-, UK Biobank- en Gene Expression Omnibus-studies meldden dat ethische goedkeuring en geïnformeerde toestemming waren verkregen in overeenstemming met hun respectievelijke institutionele, nationale en databasespecifieke vereisten. Alle datasets die in de huidige studie zijn gebruikt, werden geraadpleegd en geanalyseerd in overeenstemming met de toepasselijke gebruiksrichtlijnen van de database, de voorwaarden voor data-toegang en de ethische richtlijnen. De auteurs hebben geen pogingen ondernomen om deelnemers te re-identificeren. Aanvullende schriftelijke geïnformeerde toestemming was daarom niet vereist voor deze secundaire analyse. De inhoud van deze studie bestaat uit twee delen: MR-analyse en bio-informatica-analyse (Figuur 1). Deze studie was volledig computationeel en maakte gebruik van openbaar beschikbare samenvattende GWAS- en transcriptomische datasets. Er zijn geen reagentia of verbruiksartikelen voor het natte laboratorium gebruikt.
MR-analyse
Gegevensbronnen, acquisitie en preprocessing van GWAS-samenvattingsstatistieken:
De GWAS-samenvattingsstatistieken voor lupus erythematosus werden verkregen uit FinnGen Release 11 (finngen_R11_L12_LUPUS; RRID:SCR_022254), een populatiegebaseerde Finse cohort. Het fenotype werd gedefinieerd met ICD-10-code L93 en omvatte 423.818 deelnemers, bestaande uit 777 gevallen en 423.041 controles. Het FinnGen-bestand met samenvattingsstatistieken werd gedownload van het openbare gegevensportaal van FinnGen in een gecomprimeerd tabgescheiden formaat en geïmporteerd in R met de functie read_exposure_data() of read_outcome_data() in TwoSampleMR, afhankelijk van of de dataset als blootstelling of uitkomst werd gebruikt. De rsID, het chromosoom, de genomische positie, het effectallel, het andere allel, de frequentie van het effectallel, de bèta-coëfficiënt, de standaardfout en de associatie P-waarde werden behouden.
Samenvattende statistieken voor het aantal spontane miskramen werden verkregen uit de UK Biobank via de IEU OpenGWAS-bron (ukb-b-419; RRID:SCR_012815), bestaande uit 78.700 deelnemers. In de forward-analyse werden associaties van de geselecteerde FinnGen single-nucleotide polymorfismen (SNP's) met de uitkomst opgehaald met behulp van extract_outcome_data(outcomes = "ukb-b-419", proxies = FALSE). In de reverse-analyse werden SNP's geassocieerd met lupus erythematosus opgehaald met behulp van extract_instruments(outcomes = "finngen_R11_L12_LUPUS", clump = FALSE), waarna de overeenkomstige SNP-associaties werden geëxtraheerd uit het bestand met samenvattende statistieken van de UK Biobank. De kenmerken van de GWAS-datasets die zijn gebruikt in de bidirectionele MR-analyses zijn samengevat in Tabel 1.
| Kenmerk | Steekproefomvang | Afkomst | Consortium | Jaar | GWAS-datasetidentificatiecode |
| Lupus erythematosus | 4,23,818 | Europees | FinnGen (RRID: SCR_022254) | 2024 | finngen_R11_L12_LUPUS |
| Aantal spontane miskramen | 78,700 | Europees | UK Biobank (RRID: SCR_012815) | 2018 | ukb-b-419 |
Tabel 1: Samenvattende statistieken van de genome-wide association study (GWAS) die zijn gebruikt voor de bidirectionele Mendeliaanse randomisatie-analyse.
De tabel vat de publiek beschikbare genome-wide association study-datasets samen die zijn gebruikt als blootstellings- en uitkomstbronnen voor de voorwaartse en omgekeerde Mendeliaanse randomisatie-analyses, inclusief steekproefgrootte, afkomst, gegevensbron, jaar van publicatie en dataset-identificatie.
FinnGen en UK Biobank werden geselecteerd omdat ze grote, publiek toegankelijke datasets bieden van overwegend Europese afkomst, afgeleid van niet-overlappende bronpopulaties, en voldoende variantdekking bevatten voor twee-staps MR. Er werd geen overlap tussen de exposure- en outcome-steekproeven gerapporteerd. Omdat alleen data op samenvattingsniveau werden gebruikt, is er geen toegang gekregen tot genotypedata op individueel niveau, is er geen aanvullende normalisatie op deelnemerniveau uitgevoerd en zijn er geen deelnemers door de huidige onderzoekers uitgesloten. We hebben vertrouwd op de kwaliteitscontroleprocedures op steekproef- en variantniveau die zijn geïmplementeerd door de oorspronkelijke GWAS-consortia. Tijdens de huidige analyse is aanvullende kwaliteitscontrole op variantniveau uitgevoerd via significantiefiltering, linkage disequilibrium clumping, allel-harmonisatie, beoordeling van de instrumentsterkte en screening op pleiotropie, zoals hieronder beschreven.
FinnGen Release 11 rapporteert genomische posities volgens GRCh38/hg38, terwijl de geharmoniseerde datasets van IEU OpenGWAS en de referentieresource voor linkage disequilibrium GRCh37-compatibele variantannotaties gebruiken. Daarom werden blootstellings- en uitkomstvarianten primair gekoppeld op basis van stabiele rsID's in plaats van chromosoom-positiecoördinaten. Er is geen directe positionele matching tussen builds uitgevoerd. Varianten zonder een eenduidige rsID of met inconsistente allelinformatie over de datasets heen werden uitgesloten vóór de MR-analyse. De samenvattende statistieken van FinnGen Release 11 gebruiken GRCh38, terwijl OpenGWAS-gegevens zijn geharmoniseerd naar de referentierectieconventie die wordt gebruikt voor Build 37. Koppeling via rsID is daarom essentieel wanneer deze twee bronnen worden gecombineerd.
Studie-opzet van MR:
We hebben ons strikt gehouden aan de STROBE-MR-richtlijnen (Aanvullend Bestand 1)19. Een bidirectioneel two-sample MR-ontwerp werd gebruikt om de relatie tussen genetisch voorspelde lupus erythematosus en het aantal spontane miskramen te evalueren. In de voorwaartse analyse werd lupus erythematosus behandeld als de blootstelling en het aantal spontane miskramen als de uitkomst. In de omgekeerde analyse werden de blootstelling en uitkomst omgewisseld, en werd de volledige workflow van instrumentselectie, linkage disequilibrium clumping, data-harmonisatie, causale schatting en sensitiviteitsanalyse herhaald. Single-nucleotide polymorfismen (SNP's) werden gebruikt als instrumentele variabelen (IV's). De volledige workflow werd in de volgende volgorde uitgevoerd: acquisitie en formattering van de GWAS-samenvattende statistieken; selectie van blootstellings-geassocieerde SNP's; verwijdering van gedupliceerde of onvolledig geannoteerde varianten; linkage disequilibrium clumping; extractie van de overeenkomstige uitkomstassociaties; uitsluiting van SNP's die direct geassocieerd zijn met de uitkomst; harmonisatie van blootstellings- en uitkomstallelen; berekening van de instrumentsterkte; screening op potentiële storende fenotypes; schatting van causale effecten; beoordeling van heterogeniteit en horizontale pleiotropie; Mendelian Randomization Pleiotropy RESidual Sum and Outlier (MR-PRESSO) uitschieterdetectie; en leave-one-out en single-SNP sensitiviteitsanalyses. Alle MR-analyses werden geïmplementeerd met R versie 4.4.2 (RRID:SCR_001905), TwoSampleMR versie 0.6.6 (RRID:SCR_019010), MRPRESSO versie 1.0 (RRID:SCR_023697) en forestploter versie 1.1.2. De MR-analyse was gebaseerd op drie kernaannames. Ten eerste, volgens de relevantie-aanname, moeten de geselecteerde SNP's sterk geassocieerd zijn met de blootstelling. Ten tweede, volgens de onafhankelijkheids-aanname, moeten de geselecteerde SNP's onafhankelijk zijn van factoren die de blootstelling-uitkomstassociatie verstoren. Ten derde, volgens de exclusion-restriction-aanname, mogen de geselecteerde SNP's de uitkomst alleen beïnvloeden via de blootstelling20 (Figuur 1).
Methoden voor SNP-selectie:
De selectie van instrumenten werd in de volgende volgorde uitgevoerd: (1) selecteer op blootstelling geassocieerde SNP's bij P < 5 × 10⁻⁸; wanneer het aantal instrumenten onvoldoende was, werd P < 5 × 10⁻⁶ gebruikt; (2) gebruik de functie clump_data() om linkage disequilibrium clumping uit te voeren bij R2 < 0,001 en een genetische afstand van 10.000 kb, waarbij de criteria werden versoepeld naar R2 < 0,01 binnen 5.000 kb, alleen wanneer dit noodzakelijk was om een analyseerbare set instrumenten te behouden; (3) filter SNP's uit die significant geassocieerd zijn met de uitkomst met behulp van een drempelwaarde van P = 5 × 10⁻⁵; (4) gebruik de functie harmonise_data() om de allelen van blootstelling en uitkomst te harmoniseren en palindromische of anderszins ambigue varianten uit te sluiten; (5) bereken de instrumentsterkte als F = β2/SE2, en sluit SNP's met F < 10 uit; en (6) screen de behouden SNP's in PhenoScanner V2 op fenotypen die de relatie tussen SLE en zwangerschapsverlies kunnen verstoren21. Antifosfolipidenantilichamen (aPL) kunnen een gemeenschappelijke risicofactor zijn voor SLE en het aantal spontane miskramen. Individuele SNP's werden gezocht in PhenoScanner V2. Alle kandidaat-SNP's werden opgezocht in PhenoScanner V2 met behulp van de standaard GWAS-catalogus om alle gerapporteerde associaties uit genome-wide association studies (GWAS) op te halen. De significantiedrempel werd vastgesteld op P < 1 × 10⁻5, en de standaard referentiegenoomversie (GRCh37) werd gebruikt. Omdat de studiepopulatie van Europese afkomst was, werd het zoeken naar proxy-varianten ingeschakeld met behulp van het Europese referentiepanel (proxies = "EUR"), met een LD-drempel van R2 > 0,8 binnen een venster van 1.000 kb. Alle overige zoekparameters werden op hun standaardinstellingen gelaten. SNP's die significante associaties vertoonden met de vooraf gespecificeerde storende factor, antifosfolipidenantilichamen (aPL), werden beschouwd als potentieel pleiotroop en werden uitgesloten van de uiteindelijke set instrumentele variabelen om schending van de exclusiebeperking-aanname van de Mendeliaanse randomisatie te minimaliseren. De instrumentele SNP's die behouden zijn voor de voorwaartse en omgekeerde MR-analyses zijn respectievelijk vermeld in Aanvullende Tabellen 1 en 2.
Statistische analyse:
Na de selectie van instrumenten en harmonisatie van allelen werden de causale schattingen berekend met de mr()-functie in TwoSampleMR. De analytische workflow werd in de volgende volgorde uitgevoerd. Ten eerste werd het algehele causale effect geschat met vier MR-methoden: inverse-variance weighting (IVW), MR-Egger regressie, de gewogen mediaan en de gewogen modus. Effectschattingen voor het aantal spontane miskramen en SLE werden gerapporteerd als odds ratio's met bijbehorende 95% betrouwbaarheidsintervallen en P-waarden. De IVW-methode werd aangewezen als de primaire analyse omdat deze een hoge statistische power biedt wanneer alle opgenomen SNP's valide instrumentele variabelen zijn en horizontale pleiotropie afwezig is. Echter, de IVW-schatting kan vertekend zijn wanneer horizontale pleiotropie aanwezig is22. MR-Egger regressie werd primair gebruikt om causale inferenties te evalueren bij de aanwezigheid van potentiële horizontale pleiotropie23. De gewogen mediaanbenadering vereist dat ten minste 50% van het analytische gewicht afkomstig is van valide IV's. Deze methode is optimaal wanneer heterogeniteit aanwezig is maar horizontale pleiotropie afwezig is24. De gewogen modus identificeert clusters van instrumentele variabelen met soortgelijke causale effecten en schat het effect op basis van het grootste cluster25. De effectschattingen verkregen met de vier MR-methoden worden gepresenteerd in Figuur 2. Ten tweede werd de heterogeniteit tussen de SNP-specifieke causale schattingen geëvalueerd met de Q-test van Cochran, geïmplementeerd via de mr_heterogeneity()-functie. De Q-statistiek vertegenwoordigt de gewogen som van de gekwadrateerde afwijkingen van de individuele SNP-schattingen ten opzichte van de algehele causale schatting. Een P-waarde van de Q-test < 0,05 werd beschouwd als bewijs voor heterogeniteit, waarna een random-effects IVW-model werd toegepast. Bij afwezigheid van significante heterogeniteit werd een fixed-effects IVW-model gebruikt26. Ten derde werd directionele horizontale pleiotropie beoordeeld met de MR-Egger intercept-test, geïmplementeerd met de mr_pleiotropy_test()-functie. Een intercept die significant verschilt van nul bij P < 0,05 werd beschouwd als bewijs voor directionele horizontale pleiotropie. Ten vierde werd de MR-PRESSO procedure uitgevoerd met de mr_presso()-functie in het MRPRESSO-pakket (RRID:SCR_023697) om SNP's met uitschieters in pleiotrope effecten te detecteren27. Wanneer uitschieters werden gedetecteerd, werden deze verwijderd en werd de causale analyse herhaald met de resterende instrumenten. De MR-PRESSO globale test werd gebruikt om de algehele horizontale pleiotropie te beoordelen, en de distortie-test werd overwogen bij de evaluatie of de verwijdering van uitschieters de causale schatting wezenlijk veranderde. Ten vijfde werd een leave-one-out sensitiviteitsanalyse uitgevoerd met de mr_leaveoneout()-functie. In deze analyse werd elke SNP sequentieel uitgesloten en werd de gepoelde causale schatting opnieuw berekend met de resterende SNP's. De resultaten werden gevisualiseerd met mr_leaveoneout_plot() om te bepalen of de algehele associatie onevenredig werd gedreven door een enkel instrument. Ten zesde werden individuele SNP-specifieke schattingen gegenereerd met de mr_singlesnp()-functie. Deze schattingen werden gebruikt om funnel plots te construeren met mr_funnel_plot() om visueel asymmetrie te beoordelen die mogelijk toe te schrijven is aan directionele horizontale pleiotropie. Samenvattende forest plots werden gegenereerd met forestploter (versie 1.1.2) om de effectschattingen en betrouwbaarheidsintervallen weer te geven die verkregen zijn uit de verschillende MR-methoden. De forward MR scatter plot, SNP-specifieke forest plot, leave-one-out analyse en funnel plot worden respectievelijk gepresenteerd in Aanvullende Figuren 1–4.
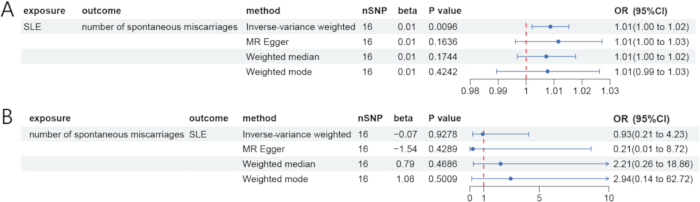
Figuur 2. Resultaten van de bidirectionele Mendeliaanse randomisatieanalyse.
(A) Forest plot van de voorwaartse Mendeliaanse randomisatie- (MR) analyse met systemische lupus erythematosus (SLE) als blootstelling en het aantal spontane miskramen als uitkomst. (B) Forest plot van de omgekeerde MR-analyse met het aantal spontane miskramen als blootstelling en SLE als uitkomst. Effectschattingen worden gepresenteerd als odds ratio's (ORs) met 95% betrouwbaarheidsintervallen (CIs) voor de inverse-variance weighted, MR-Egger, weighted median en weighted mode methoden. SNP, single-nucleotide polymorfisme. Klik hier om een grotere versie van deze figuur te bekijken.
Een causaal verband werd als ondersteund beschouwd wanneer de IVW-schatting statistisch significant was bij P < 0.05, de MR-Egger-, gewogen mediaan- en gewogen modus-schattingen richtingen vertoonden die consistent waren met de IVW-schatting, en de resultaten niet wezenlijk werden beïnvloed door heterogeniteit, pleiotropie, MR-PRESSO of leave-one-out sensitiviteitsanalyses. Alle statistische tests waren tweezijdig.
Bioinformatica-analyse
Microarray-data:
De transcriptomische datasets werden verkregen uit de Gene Expression Omnibus (GEO; RRID:SCR_005012) database28. De verwerkte Series Matrix-bestanden, metadata van de monsters en platform-annotatiebestanden werden gedownload voor GSE61635, GSE165004, GSE50772 en GSE198700. Het platform, de weefselbron, de steekproefgrootte en de analysecategorie van elke dataset zijn samengevat in Tabel 2. Omdat de datasets waren gegenereerd vanuit verschillende weefsels en microarray-platforms, werd elke dataset onafhankelijk gepreprocesserd en geanalyseerd. Expressiematrices van verschillende datasets werden niet direct samengevoegd en er werd geen cross-platform batchcorrectie toegepast. Cross-dataset integratie werd uitgevoerd op het niveau van gensymbolen, pas nadat de differentiële expressieanalyse onafhankelijk binnen elke discovery-dataset was voltooid.
| GEO-dataset | Ziekte | Platform | Weefsel (Homo sapiens) | Casussen | Controles | Experimenttype | Bijdrager | Datasetcategorie |
| GSE61635 | Systemische lupus erythematosus (SLE) | GPL570 | Volbloed | 99 | 30 | Expressie-microarray | Greidinger EL | Discovery-dataset |
| GSE165004 | Recidiverend zwangerschapsverlies (RPL) | GPL16699 | Endometrium | 24 | 24 | Expressie-microarray | Keleş ID29 | Discovery-dataset |
| GSE50772 | Systemische lupus erythematosus (SLE) | GPL570 | Mononucleaire cellen uit perifeer bloed (PBMCs) | 61 | 20 | Expressie-microarray | Kennedy WP30 | Validatiedataset |
| GSE198700 | Recidiverend zwangerschapsverlies (RPL) | GPL13534 | Chorionvlokken | 5 | 5 | Expressie-microarray | Li Y31 | Validatieset |
Tabel 2: Transcriptomische datasets gebruikt voor de bioinformatische analyses.
De tabel geeft een overzicht van de Gene Expression Omnibus (GEO) transcriptomische datasets die zijn opgenomen in de discovery- en validatieanalyses, inclusief ziekte, microarray-platform, weefselbron, steekproefgrootte, experimenttype, oorspronkelijke onderzoeksbijdrager en datasetcategorie.
GSE61635 werd gegenereerd met behulp van het Affymetrix Human Genome U133 Plus 2.0 Array-platform (GPL570) en bestond uit 99 whole-blood arrays van patiënten met SLE, inclusief herhaalbezoeken van sommige patiënten, en 30 arrays van onafhankelijke gezonde controles. De gedeponeerde expressiematrix was door de oorspronkelijke onderzoekers onderworpen aan een robuuste multiarray average achtergrondcorrectie, quantile-normalisatie, probe-set samenvatting en log2-transformatie. Daarom werd er geen tweede achtergrondcorrectie of quantile-normalisatie uitgevoerd. Patiëntidentificatoren werden geëxtraheerd uit de GEO-metadata en behouden voor repeated-measures modellering.
GSE165004 werd gegenereerd met het Agilent SurePrint G3 Human Gene Expression v2 8×60K Microarray-platform (GPL16699). De volledige dataset bevatte 24 vruchtbare controles, 24 patiënten met RPL en 24 patiënten met onverklaarbare onvruchtbaarheid. Alleen de 24 RPL-monsters en 24 vruchtbare controlemonsters die waren verzameld op dag 19–21 van de menstruatiecyclus werden meegenomen; de 24 monsters van onverklaarbare onvruchtbaarheid werden uitgesloten omdat ze buiten de vooraf gedefinieerde vergelijking vielen29. De door de depositaris genormaliseerde expressiematrix werd gebruikt, en er werd geen aanvullende normalisatie tussen de arrays toegepast nadat vergelijkbare monsterverdelingen waren bevestigd met behulp van boxplots en dichtheidsplots.
GSE50772 werd gebruikt als een onafhankelijke SLE-validatiedataset en bevatte monsters van perifere bloedmononucleaire cellen van 61 patiënten met SLE en 20 gezonde controles, gegenereerd met GPL57030. GSE198700 werd gegenereerd met GPL13534 en bevat monsters van choriale villi van vijf patiënten met RPL en vijf controles van electieve abortussen31. De gedeponeerde expressiematrix werd in haar geheel geïmporteerd en eenmaal getransformeerd met log2(x + 1), aangezien de gedeponeerde expressiewaarden op een niet-logaritmische schaal waren verstrekt. Deze transformatie werd toegepast op de volledige expressiematrix voorafgaand aan de kwaliteitscontrole op monsterniveau, probe-annotatie, samenvatting op genniveau, validatie van kandidaatgenen, differentiële expressieanalyse, groepvergelijkingstesten en ROC-analyse. Kandidaatgenen werden niet afzonderlijk getransformeerd en er werd geen extra logaritmische transformatie uitgevoerd tijdens de daaropvolgende validatieanalyses. Voor alle datasets werden monsteridentiteiten, ziektestatus, weefselherkomst en groeplabels vóór de analyse gecontroleerd aan de hand van de overeenkomstige GEO-metadata. De kwaliteitscontrole omvatte de beoordeling van bibliotheekgroottes of expressieverdelingen, monster-specifieke boxplots, principale componentenanalyse, hiërarchische clustering en heatmaps van monster-afstanden. Er werden geen extra monsters uitgesloten na de kwaliteitscontrolebeoordeling.
Differentiële expressieanalyse:
Differentiële expressieanalyses werden onafhankelijk uitgevoerd voor GSE61635 en GSE165004 met limma versie 3.60.6 (RRID:SCR_010943). Alle expressiematrices waren zo georganiseerd dat de genen in de rijen en de monsters in de kolommen stonden. De drempelwaarde voor differentiële expressie werd vastgesteld op |log₂ fold change| > 1 voor GSE61635 en |log₂ fold change| > 0.5 voor GSE165004, met een Benjamini–Hochberg (BH)-gecorrigeerde P < 0.05. Volcano plots werden gegenereerd met ggplot2 versie 3.5.1 (RRID:SCR_014601). Heatmaps van de 50 meest significante differentiële tot expressie gekomen genen (DEGs), gerangschikt op gecorrigeerde P-waarde, werden gegenereerd met pheatmap versie 1.0.12 (RRID:SCR_016418). Gedeelde DEGs werden geïdentificeerd door de officiële gensymbolen uit de significante SLE- en RPL-DEG-lijsten te kruisen met de base R intersect()-functie en werden gevisualiseerd met ggvenn versie 0.1.16 (RRID:SCR_025300). De heatmaps van de differentiële expressie, de volcano plots en de intersectie van de SLE- en RPL-DEG-lijsten worden gepresenteerd in Figuur 3.
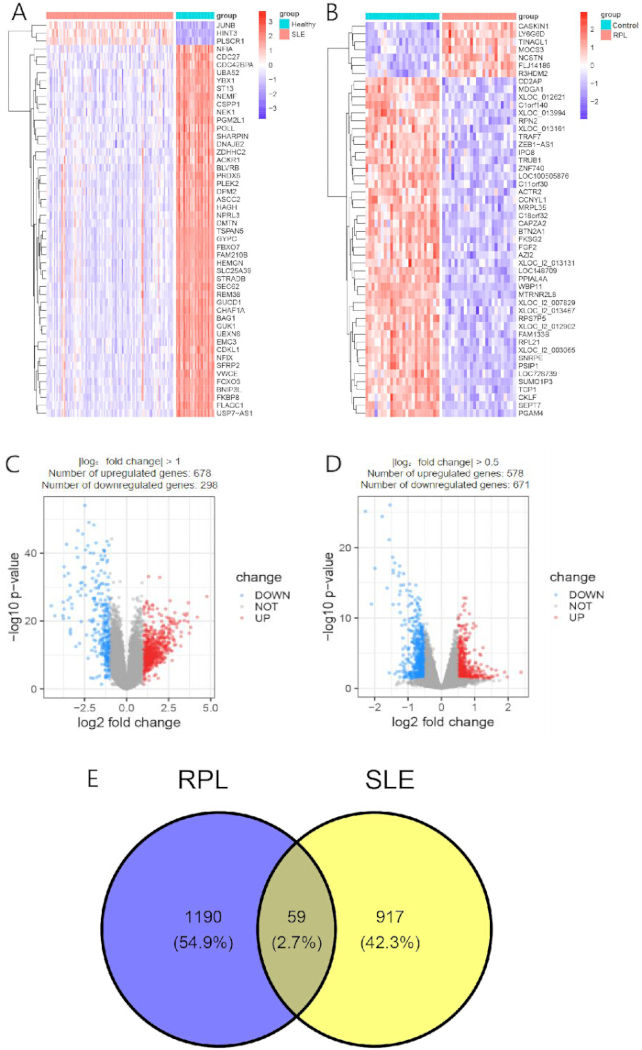
Figuur 3. Differentieel tot expressie gekomen genen bij systemische lupus erythematosus en recidiverend zwangerschapsverlies.
(A) Heatmap van de 50 meest significante differentieel tot expressie gekomen genen (DEGs) tussen patiënten met systemische lupus erythematosus (SLE) en gezonde controles in GSE61635. (B) Heatmap van de 50 meest significante DEGs tussen patiënten met recidiverend zwangerschapsverlies (RPL) en fertile controles in GSE165004. (C) Volcano plot van differentiële genexpressie in GSE61635. (D) Volcano plot van differentiële genexpressie in GSE165004. (E) Venn-diagram dat de overlap laat zien tussen de significante DEG-lijsten van de SLE- en RPL-discovery datasets. DEGs, differentieel tot expressie gekomen genen. Klik hier om een grotere versie van deze figuur te bekijken.
Functionele verrijkingsanalyse van intersectie-DEG's:
Voor analyse op moleculair niveau van de functies van de DEG's werd de online tool DAVID (versie 2021; RRID:SCR_001881)32 gebruikt om functionele Gene Ontology (GO) en Kyoto Encyclopedia of Genes and Genomes (KEGG) pathway-verrijkingsanalyses uit te voeren. Officiële humane gensymbolen werden geüpload als identifier-type, en Homo sapiens werd geselecteerd als soort. De aangepaste achtergrondpopulatie bestond uit de intersectie van alle genen die de probe-annotatie en kwaliteitscontrole hadden doorstaan en meetbaar waren in zowel GSE61635 als GSE165004. De minimale drempelwaarde voor het aantal genen werd ingesteld op 2, en de maximale EASE-score, die de gemodificeerde eenzijdige Fisher's exacte P-waarde van DAVID vertegenwoordigt, werd ingesteld op 0,05. Meervoudige vergelijkingen werden gecontroleerd met behulp van de Benjamini-Hochberg-procedure, zoals vermeld in de "Benjamini"-kolom van DAVID. Functionele termen werden als statistisch significant beschouwd wanneer de EASE-score < 0,05 was en de Benjamini-gecorrigeerde P-waarde < 0,05 was. De volledige DAVID-output, inclusief termnamen, aantal genen, EASE-scores, Benjamini-gecorrigeerde P-waarden, input-genkoppelingen en achtergrond-genkoppelingen, werd geëxporteerd als een tab-gescheiden bestand. De website CNSknowall werd gebruikt om de gefilterde DAVID-resultaten te visualiseren. De GO- en KEGG-verrijkingsresultaten worden gepresenteerd in Figuur 4A.
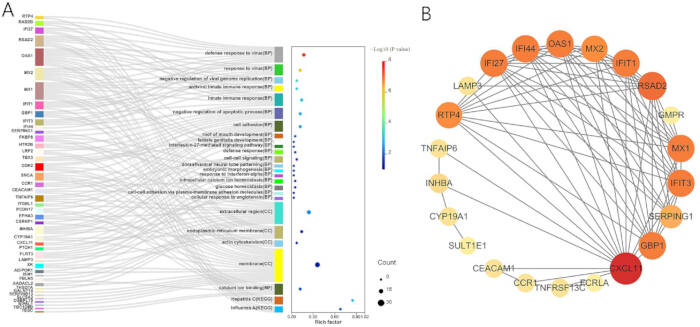
Figuur 4Functionele verrijkingsanalyse en eiwit-eiwitinteractienetwerk van de gedeelde differentieel tot expressie gebrachte genen.
(A) Gene Ontology (GO) en Kyoto Encyclopedia of Genes and Genomes (KEGG) verrijkingsanalyses van de 59 gedeelde differentieel tot expressie gebrachte genen (DEGs). Het Sankey-diagram illustreert de relaties tussen genen en verrijkte GO-termen, en de bijbehorende bubble plot vat de verrijkte GO- en KEGG-termen samen op basis van de rich factor, het aantal genen en de statistische significantie. (B) Proteïne-proteïne interactie (PPI) netwerk opgebouwd uit de 59 gedeelde DEGs met behulp van STRING en gevisualiseerd in Cytoscape. De grootte en kleur van de knopen weerspiegelen de netwerkconnectiviteit, en de randen geven voorspelde proteïne-proteïne associaties aan. BP, biologisch proces; CC, cellulaire component; MF, moleculaire functie. Klik hier om een grotere versie van deze figuur te bekijken.
PPI-netwerk en identificatie van kerngenen:
De gedeelde DEGs werden geüpload naar STRING versie 11.0 (RRID:SCR_005223)33 waarbij Homo sapiens als organisme was geselecteerd (taxonomische identifier: 9606). Het volledige STRING-netwerk werd gebruikt, waarbij zowel functionele als fysieke eiwitassociaties werden toegestaan. Alle beschikbare bewijskanalen waren ingeschakeld, inclusief experimenteel bewijs, gecureerde databases, co-expressie, text mining, genbuurt, genfusie en gen-co-occurencie.
De minimale vereiste interactiescore werd ingesteld op 0,400, wat overeenkomt met een gemiddelde betrouwbaarheid. Er werden geen aanvullende first-shell of second-shell interactoren toegevoegd; daarom bevatte het netwerk uitsluitend eiwitten die gecodeerd werden door de ingediende gedeelde DEGs. Netwerkverbindingen werden weergegeven via de confidence mode en geëxporteerd als een tab-gescheiden waardenbestand met daarin de interagerende eiwitten en gecombineerde STRING-scores. STRING-betrouwbaarheidsscores representeren de mate van zekerheid dat een associatie bestaat, in plaats van de grootte of bindingssterkte van de interactie.
Het STRING-netwerkbestand werd geïmporteerd in Cytoscape versie 3.10.0 (RRID:SCR_003032)34. Nodes zonder interactie met een ander ingediend eiwit werden verwijderd voorafgaand aan de analyse van de netwerktopologie35. Het resterende netwerk werd behandeld als een ongericht netwerk. De gecombineerde STRING-scores werden behouden als edge-attributen voor visualisatie, terwijl de cytoHubba-rangschikkingen werden gegenereerd met behulp van de standaard ongewogen topologische definities. Het resulterende PPI-netwerk wordt gepresenteerd in Figuur 4B.
Hub-genen werden gerangschikt met cytoHubba versie 0.1 (RRID:SCR_017677) aan de hand van zes algoritmen: Maximal Clique Centrality (MCC), Maximum Neighborhood Component (MNC), Edge Percolated Component (EPC), Degree, Closeness en Radiality36. Voor elk algoritme werden de genen in aflopende volgorde gerangschikt en werden de top 10 genen behouden. Kandidaten voor netwerkhubs werden gedefinieerd op basis van de strikte intersectie van de zes top-10-lijsten. Een gen werd dus alleen als netwerkhub behouden wanneer het voorkwam in de top 10 genen die door alle zes de algoritmen waren gegenereerd. De rangschikkingen en de intersectieprocedure werden geëxporteerd en gearchiveerd. De top 10 genen die door elk cytoHubba-algoritme zijn geïdentificeerd, worden gepresenteerd in Tabel 3.
| Rangschikking | Maximal Clique Centrality (MCC) | Maximum Neighborhood Component (MNC) | Edge-gepercoleerde component (EPC) | Graad | Nabijheid | Radialiteit |
| 1 | RSAD2 | RSAD2 | RSAD2 | RSAD2 | RSAD2 | RSAD2 |
| 2 | RTP4 | RTP4 | RTP4 | RTP4 | RTP4 | RTP4 |
| 3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 |
| 4 | IFI27 | IFI27 | IFI27 | IFI27 | IFI27 | IFI27 |
| 5 | IFI44 | IFI44 | IFI44 | IFI44 | IFI44 | IFI44 |
| 6 | GBP1 | GBP1 | GBP1 | GBP1 | GBP1 | GBP1 |
| 7 | MX1 | MX1 | MX1 | MX1 | MX1 | MX1 |
| 8 | OAS1 | OAS1 | OAS1 | OAS1 | OAS1 | OAS1 |
| 9 | IFIT1 | IFIT1 | IFIT1 | IFIT1 | IFIT1 | IFIT1 |
| 10 | CXCL11 | CXCL11 | CXCL11 | CXCL11 | CXCL11 | CXCL11 |
Tabel 3: Top 10 hubgenen geïdentificeerd door zes cytoHubba-rankingsalgoritmen.
Gedeelde differentieel tot expressie gebrachte genen werden gerangschikt met behulp van zes netwerktopologie-algoritmen die zijn geïmplementeerd in de cytoHubba-plugin van Cytoscape. De top 10 gerangschikte genen per algoritme worden gepresenteerd ter vergelijking tussen Maximal Clique Centrality (MCC), Maximum Neighborhood Component (MNC), Edge Percolated Component (EPC), Degree, Closeness en Radiality.
LASSO-regressie voor de identificatie van kerngenen:
LASSO-logistische regressie werd onafhankelijk uitgevoerd in de SLE- en RPL-discovery-datasets met behulp van glmnet versie 4.1-8 (RRID:SCR_015505). De predictor-matrix bestond uit de genormaliseerde expressiewaarden van de netwerkhub-kandidaten, waarbij de monsters in de rijen en de genen in de kolommen stonden. De ziektestatus werd gecodeerd als 1 en de controlestatus als 0. Een binomiaal gegeneraliseerd lineair model met een pure LASSO-penalty werd gefit met family = "binomial" en alpha = 1. Predictor-variabelen werden intern gestandaardiseerd met standardize = TRUE, en er werd een intercept opgenomen. Klas-gestratificeerde 10-fold toewijzingen werden afzonderlijk gegenereerd voor de SLE- en RPL-datasets met behulp van eigen base R-code. Binnen elk stratum van de ziektestatus werden monsterindexen willekeurig gepermuteerd en zo gelijk mogelijk verdeeld over de 10 folds met behulp van sample(rep(seq_len(10), length.out = n)). Er werd een random seed van 123 ingesteld vóór het genereren van de fold-toewijzingen voor elke dataset om reproduceerbaarheid te garanderen. Omdat elke groep met ziektestatus meer dan 10 monsters bevatte, bevatte elke cross-validatie-fold zowel cases als controls. De resulterende integer-vectoren (foldid_sle en foldid_rpl) werden meegegeven aan het foldid-argument van cv.glmnet(), en dezelfde fold-toewijzingen werden gebruikt voor alle geëvalueerde λ-waarden binnen de overeenkomstige dataset.
De modellen werden gefit met family = "binomial", alpha = 1, nfolds = 10, type.measure = "deviance", standardize = TRUE, intercept = TRUE, nlambda = 100, thresh = 1 × 10⁻7, en maxit = 100000. De penalty-parameter werd geselecteerd met behulp van lambda.min, gedefinieerd als de lambda-waarde die de minimale gemiddelde cross-gevalideerde binomiale deviance oplevert. De meer conservatieve lambda.1se, gedefinieerd als de grootste lambda binnen één standaardfout van de minimale cross-validatiefout, werd genoteerd als sensitiviteitsresultaat. De LASSO-procedure werd afzonderlijk toegepast op GSE61635 en GSE165004. Genen met niet-nulcoëfficiënten in beide ziekte-specifieke modellen werden gedefinieerd als gedeelde door LASSO geselecteerde kandidaatgenen. Door de L1-regularisatieterm te introduceren, reduceert de methode de coëfficiënten van minder informatieve genen effectief tot nul, waardoor er featureselectie plaatsvindt37. De coëfficiëntprofielen en 10-voudige cross-validatiecurves voor de SLE- en RPL-discovery-datasets worden gepresenteerd in Figuur 5.
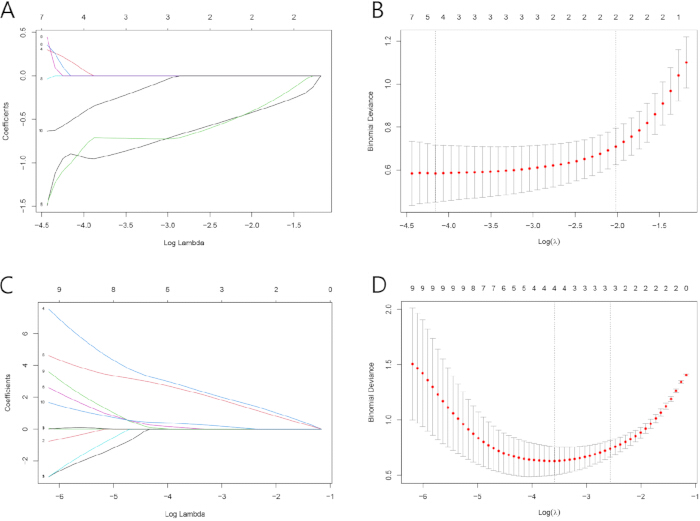
Figuur 5. Least absolute shrinkage and selection operator (LASSO) regressieanalyse van de netwerkhubgenen.
(A) Coëfficiëntprofielen gegenereerd door LASSO logistische regressie voor de discovery-dataset van systemische lupus erythematosus (SLE) (GSE61635). (B) Tienvoudige cross-validatiecurve gebruikt om de optimale strafparameter (λ) voor het SLE-model te bepalen. (C) Coëfficiëntprofielen gegenereerd door LASSO logistische regressie voor de discovery-dataset van recidiverend zwangerschapsverlies (RPL) (GSE165004). (D) Tienvoudige cross-validatiecurve gebruikt om de optimale strafparameter (λ) voor het RPL-model te bepalen. De getallen langs de bovenste x-as geven het aantal niet-nul regressiecoëfficiënten aan bij elke waarde van λ. De verticale stippellijnen geven λ_min en λ_1se aan. Klik hier om een grotere versie van deze figuur te bekijken.
Validatie van de diagnostische waarde van kerngenen:
De expressiepatronen van de via LASSO geselecteerde kandidaatgenen werden geëvalueerd in de onafhankelijke SLE-dataset GSE50772 en de onafhankelijke RPL-dataset GSE198700. Externe datasets werden pas gebruikt nadat de selectie van kandidaatgenen in GSE61635 en GSE165004 was voltooid. In de validatiedatasets werd geen aanvullende kenmerkselectie of modelpassing uitgevoerd. De expressie van kandidaatgenen werd tussen patiënten en controles vergeleken met behulp van de tweezijdige Wilcoxon rank-sum test. Wanneer er meer dan één kandidaatgen binnen een dataset werd getest, werden de resulterende P-waarden gecorrigeerd met de Benjamini–Hochberg-procedure. Een kandidaatgen werd als extern gerepliceerd beschouwd wanneer de expressie significant verschilde tussen patiënten en controles na correctie voor meervoudig testen en de richting consistent was met de overeenkomstige discoverieset. De expressiepatronen van de kandidaatgenen in de discovery- en validatiedatasets worden gepresenteerd in Figuur 6.
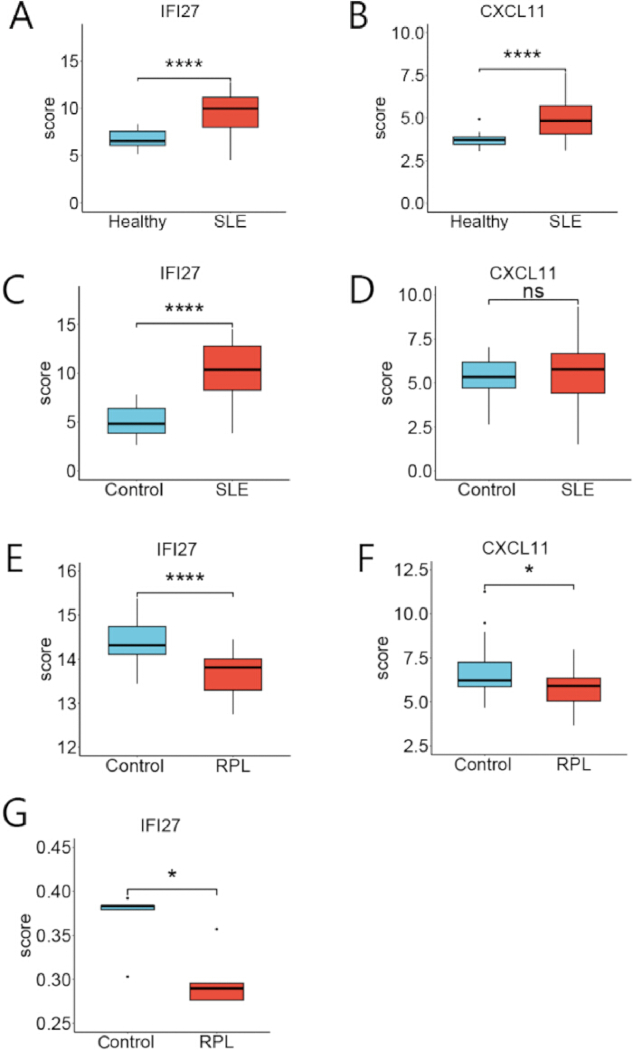
Figuur 6. Expressie van IFI27 en CXCL11 in de discovery- en validatiesets.
(A,B) Expressie van respectievelijk IFI27 en CXCL11 in de discoveryset voor systemische lupus erythematosus (SLE) (GSE61635). (C,D) Expressie van respectievelijk IFI27 en CXCL11 in de onafhankelijke SLE-validatieset (GSE50772). (E,F) Expressie van respectievelijk IFI27 en CXCL11 in de discoveryset voor recidiverend zwangerschapsverlies (RPL) (GSE165004). (G) Expressie van IFI27 in de onafhankelijke RPL-validatieset (GSE198700). Genexpressie werd tussen groepen vergeleken met behulp van de tweezijdige Wilcoxon rank-sum test. P-waarden werden gecorrigeerd met de Benjamini–Hochberg-methode wanneer meerdere kandidaatgenen binnen dezelfde dataset werden getest. P < 0.05; **** P < 0.0001; ns, niet significant. Klik hier om een grotere versie van deze figuur te bekijken.
Receiver operating characteristic (ROC)-analyses werden uitgevoerd met pROC versie 1.18.5 (RRID:SCR_024286)38. Voor elk kandidaatgen in elke discovery-dataset werd een aparte ROC-curve gegenereerd. De oppervlakte onder de ROC-curve (AUC) en het bijbehorende tweezijdige 95% betrouwbaarheidsinterval werden berekend met de methode van DeLong. De explorerende diagnostische afkapwaarde werd bepaald aan de hand van de maximale Youden-index. Betrouwbaarheidsintervallen voor de afkapwaarde, sensitiviteit en specificiteit werden berekend met 2.000 gestratificeerde bootstrap-replicaten waarbij de random seed op 123 was ingesteld. De AUC werd gebruikt als een drempelwaarde-onafhankelijke maat voor discriminatie39. Omdat de datasets retrospectief waren en werden gegenereerd met verschillende weefsels, platforms en normalisatieprocedures, werden de op de Youden-index gebaseerde afkapwaarden afzonderlijk binnen elke dataset berekend en behandeld als explorerende dataset-specifieke drempelwaarden. Ze werden niet beschouwd als gestandaardiseerde klinische afkapwaarden en werden niet direct tussen platforms overgedragen. De externe ROC-resultaten vertegenwoordigen transcriptomische validatie in plaats van prospectieve klinische validatie. pROC ondersteunt DeLong-betrouwbaarheidsintervallen voor AUC's en optimalisatie van de Youden-index via coords(), terwijl betrouwbaarheidsintervallen voor ROC-coördinaten kunnen worden geschat met gestratificeerde bootstrap-resampling. De ROC-curves en samenvattingen van de discriminatie van kandidaatgenen in de SLE- en RPL-discovery-datasets worden gepresenteerd in Figuur 7.
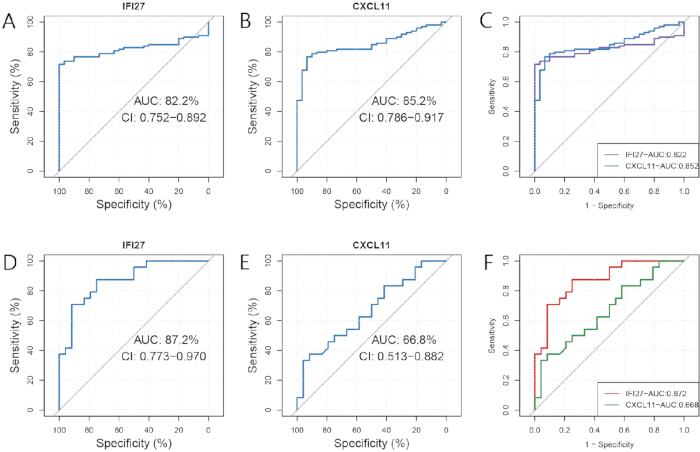
Figuur 7. Receiver operating characteristic-analyse van de kandidaatgenen.
(A) Receiver operating characteristic (ROC)-curve voor IFI27 in de discovery-dataset voor systemische lupus erythematosus (SLE). (B) ROC-curve voor CXCL11 in de SLE discovery-dataset. (C) Overzicht van de diagnostische prestaties van IFI27 en CXCL11 in de SLE discovery-dataset. (D) ROC-curve voor IFI27 in de discovery-dataset voor recidiverende zwangerschapsverliezen (RPL). (E) ROC-curve voor CXCL11 in de RPL discovery-dataset. (F) Overzicht van de diagnostische prestaties van IFI27 en CXCL11 in de RPL discovery-dataset. De waarden voor het oppervlak onder de curve (AUC) worden gepresenteerd met 95% betrouwbaarheidsintervallen (CIs). Klik hier om een grotere versie van deze figuur te bekijken.
ssGSEA immuunfiltratie:
Gezien de rollen van immuuncel-dysregulatie bij de pathogenese van SLE en RPL40,41, werd de verrijking van immuuncellen computationeel afgeleid in de discovery-datasets GSE61635 en GSE165004. De analyse werd afzonderlijk binnen elke dataset uitgevoerd, en de datasets werden niet samengevoegd. De collectie gen-signaturen van immuuncellen bestond uit de marker-gensets voor 28 immuuncelpopulaties zoals beschreven door Charoentong et al.42. De oorspronkelijke supplementaire tabel met gen-signaturen werd omgezet in een benoemde gen-setlijst met behulp van officiële humane gensymbolen. Dubbele symbolen binnen elke gen-set werden verwijderd. Genen die ontbraken in de overeenkomstige expressiematrix werden verworpen, en gen-sets die na identifier-mapping minder dan vijf overeenkomstige genen bevatten, werden uit die dataset uitgesloten. Single-sample gene set enrichment analysis (ssGSEA) werd uitgevoerd met GSVA versie 1.52.3 (RRID:SCR_021058) en GSEABase versie 1.66.0. In GSVA versie 1.52.3 is een methode-specifiek parameterobject vereist. De volgende parameters werden gebruikt: minSize = 5, maxSize = 500, alpha = 0.25, normalize = TRUE, en checkNA = "yes.”
De alpha-parameter werd ingesteld op 0.25 en de uiteindelijke normalisatie van de ssGSEA-score werd ingeschakeld. Genensets werden beperkt tot 5–500 genen na matching met de expressiematrix. Er werd gebruikgemaakt van single-threaded uitvoering om consistente berekeningen over verschillende systemen te garanderen. De kcdf-parameter werd niet gebruikt omdat dit geen parameter is van de ssgseaParam()-procedure in GSVA-versie 1.52.3. ssGSEA produceert relatieve gene-set-verrijkingsscores op monsterniveau in plaats van experimenteel gemeten immuunceltellingen of absolute celfracties43. De GSVA 1.52.3-workflow vereist een methodespecifiek parameterobject, en de ssGSEA-parameters omvatten alpha, scorenormalisatie en limieten voor de grootte van de genenset.
Voor elke immuuncelhandtekening werden de ssGSEA-scores tussen de ziekte- en controlegroepen vergeleken met de tweezijdige Wilcoxon rank-sum test. De P-waarden voor de 28 celtypevergelijkingen werden binnen elke dataset afzonderlijk gecorrigeerd met de Benjamini–Hochberg-methode. Immuuncelhandtekeningen met een gecorrigeerde P-waarde < 0,05 werden beschouwd als differentieel verrijkt.
Spearman-rangcorrelaties werden berekend tussen de expressie van kandidaatgenen en de ssGSEA-score van elke immuuncelsignatuur binnen elke dataset. De P-waarden van de correlaties werden gecorrigeerd met de Benjamini–Hochberg-methode voor alle combinaties van kandidaatgenen en immuuncellen binnen die dataset. Correlaties werden als statistisch significant beschouwd bij een gecorrigeerde P-waarde < 0,05. Correlatiematrices werden gevisualiseerd met ggcorrplot versie 0.1.4.1, en grafieken voor groepvergelijkingen werden gegenereerd met ggplot2 versie 3.5.1.
Ruw genormaliseerde ssGSEA-scores werden gebruikt voor alle statistische tests. Heatmaps en gestapelde visualisaties werden uitsluitend gebruikt voor beschrijvende presentatie. De scores werden niet beschreven als directe proporties van immuuncellen, en waargenomen associaties werden geïnterpreteerd als computationele correlaties in plaats van experimenteel aangetoonde cel-geninteracties. De verrijkingsprofielen van immuuncelsignaturen, groepvergelijkingen en correlaties met de expressie van kandidaatgenen worden gepresenteerd in Figuur 8.
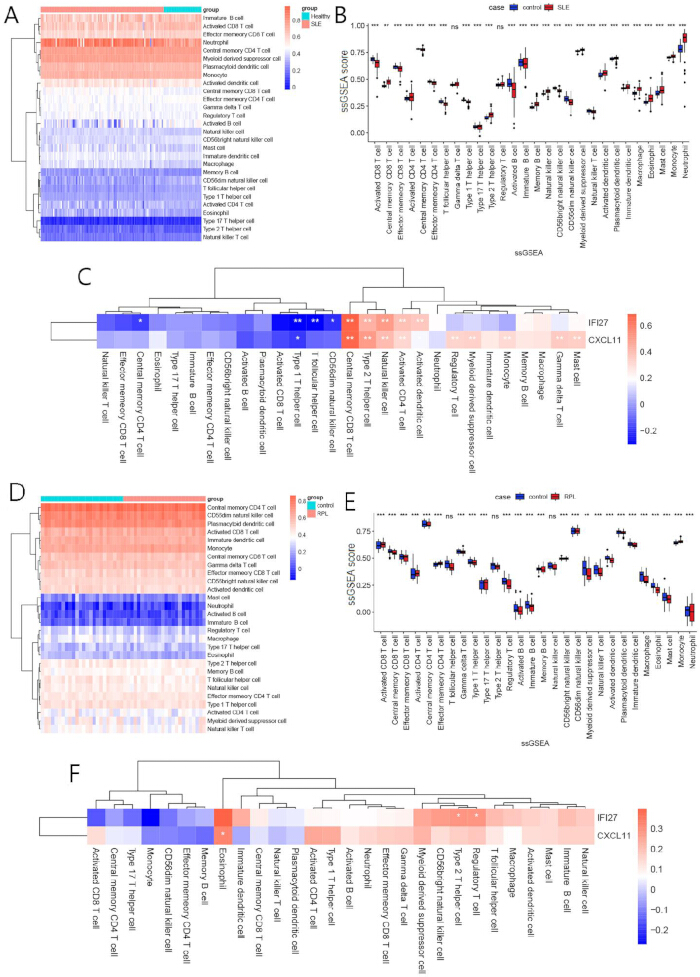
Figuur 8. Verrijking van immuuncelsignaturen en correlaties met de gedeelde kandidaatgenen bij systemische lupus erythematosus en recidiverend zwangerschapsverlies.
(A) Hiërarchische clustering heatmap van single-sample gene set enrichment analysis (ssGSEA) scores voor 28 immuuncelsignaturen in de discovery dataset van systemische lupus erythematosus (SLE). (B) Vergelijking van immuuncelsignatuur ssGSEA scores tussen patiënten met SLE en gezonde controles. (C) Spearman-correlatie heatmap die de associaties laat zien tussen de expressie van IFI27 en CXCL11 en de 28 immuuncelsignatuur ssGSEA scores in de SLE discovery dataset. (D) Hiërarchische clustering heatmap van ssGSEA scores voor 28 immuuncelsignaturen in de discovery dataset van recidiverend zwangerschapsverlies (RPL). (E) Vergelijking van immuuncelsignatuur ssGSEA scores tussen patiënten met RPL en fertile controles. (F) Spearman-correlatie heatmap die de associaties laat zien tussen de expressie van IFI27 en CXCL11 en de 28 immuuncelsignatuur ssGSEA scores in de RPL discovery dataset. Correlaties werden berekend met de rangcorrelatie van Spearman, en P waarden werden gecorrigeerd met de Benjamini-Hochberg-methode. * P < 0.05; ** P < 0.01; *** P < 0.001; ns, niet significant. Klik hier om een grotere versie van deze figuur te bekijken.
Resultaten
MR-analyse
Na selectie van instrumenten en harmonisatie van de gegevens werden 16 SNPs behouden voor de forward MR-analyse, waarbij SLE werd beschouwd als de blootstelling en het aantal spontane miskramen als het uitkomstcriterium. Gedetailleerde informatie over de instrumentele variabelen wordt gegeven in Aanvullende tabel 1. Alle behouden SNPs hadden F-statistieken groter dan 10, wat aangeeft dat bias door zwakke instrumenten onwaarschijnlijk was. Elk behouden SNP werd ook gescreend met PhenoScanner V2, en er werd geen SNP geassocieerd met aPL gevonden. MR-PRESSO-analyse identificeerde geen uitbijters. Cochran’De Q-toets toonde geen significante heterogeniteit tussen de SNP-specifieke schattingen (Q = 16,12, P = 0,31); daarom is een vast-effecten IVW-model toegepast. De MR-Egger intercepttoets wees niet op directionele horizontale pleiotropie (P = 0,69). De IVW-analyse toonde een statistisch significante, maar kwantitatief bescheiden positieve associatie aan tussen genetisch voorspeld SLE en het aantal spontane miskramen (kansratio [OR] = 1,01, 95% betrouwbaarheidsinterval [BI] = 1,00–1.02, P < 0.01; Figuur 2A). De effectschattingen verkregen met MR-Egger regressie (OR = 1,01, 95% BI = 1,00–1.03, P = 0,16), de gewogen mediaanmethode (OR = 1,01, 95% BI = 1,00–1.02, P = 0,17) en de gewogen modusmethode (OR = 1,01, 95% BI = 0,99–1.03, P = 0,42) waren in dezelfde richting als de IVW-schatting, hoewel ze individueel niet statistisch significant waren. Analyse met weglating van één SNP tegelijk toonde aan dat het weglaten van één enkele SNP de gepoolde schatting niet wezenlijk veranderde, en de bij benadering symmetrische funnelplot gaf visueel geen aanwijzingen dat het resultaat werd bepaald door sterke gerichte pleiotropie. De bijbehorende spreidingsplot, de forestplot per SNP, de analyse met weglating van één SNP en de funnelplot zijn weergegeven in Aanvullende figuren 1–4.
In de reverse MR-analyse werden 16 SNPs behouden na selectie van het instrument, en alle hadden F-statistieken groter dan 10Aanvullende tabel 2). MR-PRESSO-analyse identificeerde geen uitbijters. Cochran’De Q-toets toonde geen significante heterogeniteit aan (Q = 13,41, P = 0,50), en de MR-Egger-intercepttest gaf geen aanwijzingen voor directionele horizontale pleiotropie (P = 0,41). De IVW-schatting wees niet op een associatie tussen het genetisch voorspelde aantal spontane miskramen en de risico op SLE (OR = 0,93, 95% BI = 0,21–4.23, P = 0.93; Figuur 2BSamengevat ondersteunen de MR-resultaten een bescheiden associatie in voorwaartse richting, van genetisch voorspeld SLE naar het aantal spontane miskramen, terwijl de reverse-analyse geen associatie ondersteunde van het genetisch voorspelde aantal spontane miskramen naar het risico op SLE.
Bioinformaticaanalyse
Differentiële expressieanalyse:
Differentieel expressieanalyse van GSE61635 identificeerde 976 differentieel tot expressie gebrachte genen (DEGs) tussen de SLE- en gezonde-controlegroepen, waaronder 678 opgereguleerde en 298 neergereguleerde genen (Figuur 3C). Analyse van GSE165004 identificeerde 1.249 differentieel tot expressie gebrachte genen (DEGs) tussen de RPL- en controlegroepen, waaronder 578 opgereguleerde en 671 neergereguleerde genen (Figuur 3D). Hittekaarten met de 50 meest significante DEG's in de twee ontdekkingsdatasets worden gepresenteerd in Figuur 3A en Figuur 3B. Daarnaast werden 59 gemeenschappelijke DEG’s geïdentificeerd in de twee datasets (Figuur 3E). Deze gedeelde DEG's vormden de genenset die werd gebruikt voor de daaropvolgende functionele verrijking- en netwerkanalyses.
Functionele verrijkaningsanalyse van intersectie-DEG's:
De 59 gedeelde differentieel tot expressie gebrachte genen (DEGs) werden onderworpen aan GO- en KEGG-padwayverrijkingsanalyses met behulp van DAVID. Binnen de categorie biologisch proces waren de gedeelde DEGs verrijkt in verdedigingsreactie tegen virus, reactie op virus, negatieve regulatie van virale genoomrePLICATIE, antivirale aangeboren immuunreactie, negatieve regulatie van het apoptotische proces en celadhésie. Verrijkte termen voor cellulair component omvatten extracellulaire regio, membraan van het endoplasmatisch reticulum, actine-cytoskelet en membraan. Calciumionenbinding werd geïdentificeerd onder de verrijkte moleculaire functietermen. KEGG-analyse toonde verrijking in padwegen gerelateerd aan hepatitis C en influenza AFiguur 4A). Deze bevindingen geven aan dat de gedeelde differentieel tot expressie komende genen (DEG's) voornamelijk geassocieerd waren met antivirale en immuungerelateerde biologische processen, waardoor functionele context wordt geboden voor de genen die gemeenschappelijk zijn aan de SLE- en RPL-onderzoeksdatasets.
PPI-netwerk en identificatie van hubgenen
De 59 gedeelde DEG's werden geüpload naar STRING om een PPI-netwerk te construeren met een minimale interactiebetrouwbaarheidsscore van 0,400. Het resulterende netwerk bevatte 59 knooppunten en 80 verbindingen. Het netwerk werd geïmporteerd in Cytoscape versie 3.10.0 voor visualisatie, en geïsoleerde knooppunten werden verwijderd vóór topologische analyse.Figuur 4B). De hub-genrangschikking werd uitgevoerd met behulp van de cytoHubba-plugin. Zes algoritmen werden toegepast: Maximal Clique Centrality (MCC), Maximum Neighborhood Component (MNC), Edge Percolated Component (EPC), Degree, Closeness en Radiality. Dezelfde 10 genen werden geïdentificeerd onder de hoogstgerangschikte genen die door alle zes algoritmen werden gegenereerd: RSAD2, RTP4, IFIT3, IFI27, IFI44, GBP1, MX1, OAS1, IFIT1 en CXCL11 (Tabel 3). Deze genen werden daarom behouden als kandidaat-netwerkhubs voor de daaropvolgende LASSO-regressie.
LASSO-regressie identificeerde IFI27 en CXCL11 als gedeelde kandidaatgenen
De 10 kandidaat-hubgenen werden onderworpen aan LASSO-regressieanalyse in de SLE- en RPL-discoverydatasets. In de SLE-dataset behielden vier genen een coëfficiënt ongelijk aan nul bij de geselecteerde lambda-waarde: IFIT3, IFI27, IFI44 en CXCL11, met coëfficiënten van respectievelijk 2,575, 0,057, 2,359 en 0,307 (Figuur 5A,). In de RPL-dataset behielden vier genen een coëfficiënt ongelijk aan nul: IFI27, GBP1, OAS1 en CXCL11, met coëfficiënten van −0.897, 0.167, −1,007, en −0,519, respectievelijk (Figuur 5C, D). Vergelijking van de genen geselecteerd door de twee ziekte-specifieke modellen identificeerde IFI27 en CXCL11 als gedeelde, door LASSO geselecteerde kandidaatgenen. Deze twee genen werden vervolgens geëvalueerd in de ontdekkings- en externe validatiegegevenssets.
Externe validatie van IFI27- en CXCL11-expressie
De expressiepatronen van de twee kandidaatgenen werden geëvalueerd aan de hand van de onafhankelijke validatiedatasets GSE50772 en GSE198700, afkomstig uit de GEO-database. In GSE61635 waren zowel IFI27 als CXCL11 significant upgereguleerd in de SLE-groep in vergelijking met gezonde controles (Figuur 6A,). In de onafhankelijke SLE-validatiereeks (GSE50772) bleef IFI27 significant opgereguleerd (Figuur 6C), terwijl CXCL11 niet significant verschilde tussen de groepen (Figuur 6D). In de RPL-ontdekkingsdataset (GSE165004) waren zowel IFI27 als CXCL11 significant onderregulerig in de RPL-groep in vergelijking met de controlegroep (Figuur 6E,). In de onafhankelijke RPL-validatiedataset (GSE198700) bleef IFI27 significant onderregulerig in de RPL-groep (Figuur 6G), terwijl CXCL11 niet werd aangetoond. Over het geheel genomen toonde IFI27 consistente differentiële expressie in zowel de SLE- als RPL-discovery- als validatiedatasets. Daarentegen werd CXCL11 niet consistent gerepliceerd in de externe validatiedatasets. Daarom werd IFI27 verkozen tot gedeelde kandidaat-biomarker voor verdere analyses.
Verkennende evaluatie van diagnostische differentiatie
Receiver operating characteristic (ROC)-analyse werd uitgevoerd om het vermogen van IFI27- en CXCL11-expressie te beoordelen om ziektevoorbeelden te onderscheiden van controles in de geanalyseerde retrospectieve transcriptomische datasets. Voor SLE leverde IFI27 een oppervlak onder de ROC-curve (AUC) op van 0,822 (95% BI = 0,752–0.892; Figuur 7A), terwijl CXCL11 een AUC opleverde van 0,852 (95% BI = 0,786–0.917; Figuur 7B). Een vergelijking van de ROC-curves voor de twee kandidaatgenen in de SLE-dataset is weergegeven in Figuur 7C. Voor RPL leverde IFI27 een AUC op van 0,872 (95% BI = 0,773–0.970; Figuur 7D), terwijl CXCL11 een AUC opleverde van 0,668 (95% BI = 0,513–0.882; Figuur 7E). Een vergelijking van de ROC-curves voor de twee kandidaatgenen in de RPL-dataset is weergegeven in Figuur 7FIFI27 liet AUC-waarden groter dan 0,80 zien in beide ziektedatasets en vertoonde consistentere externe validatie dan CXCL11 over de expressiedatasets heen. Deze bevindingen ondersteunen IFI27 als kandidaat-biomerk voor verdere evaluatie. Aangezien de ROC-analyses zijn uitgevoerd met retrospectieve openbare transcriptoomdatasets, dienen de resultaten geïnterpreteerd te worden als verkennend bewijs voor transcriptoomdiscriminatie, en niet als prospectieve klinische diagnostische validatie.
Computational beoordeling van immuuninfiltratie
ssGSEA werd uitgevoerd om de verrijking van 28 immuuncel-signaturen in de ontdekkingsdatasets GSE61635 en GSE165004 te beoordelen. De warmtekaarten van immuuncelverrijking voor de SLE- en RPL-datasets worden weergegeven in Figuur 8A,, respectievelijk, terwijl de overeenkomstige groepvergelijkingen van ssGSEA-scores worden weergegeven in Figuur 8B,. In de SLE-dataset verschilden meerdere immuuncelsignaturen significant tussen patiënten met SLE en gezonde controlepersonen, waaronder die van CD8+ T-cellen, CD4+ T-cellen, B-cellen, dendritische cellen, type 1 helper-T (Th1)-cellen, type 2 helper-T (Th2)-cellen, type 17 helper-T (Th17)-cellen, natuurlijke moordcellen, macrofagen, eosinofiele granulocyten, mestcellen, monocyten en neutrofiele granulocyten (Figuur 8B). In de RPL-dataset waren de ssGSEA-scores voor geactiveerde CD8+ T-cellen, geactiveerde CD4+ T-cellen, effectorgeheugen CD4+ T-cellen, Th17-cellen en monocyten hoger in de RPL-groep dan in de controlegroep. Daarentegen waren de ssGSEA-scores voor regulatorische T-cellen (Treg) en macrofagen lager in de RPL-groep dan in de controlegroep (Figuur 8E). Correlatieanalyse toonde aan dat, in de SLE-dataset, de expressie van IFI27 en CXCL11 positief gecorreleerd was met de ssGSEA-scores van geactiveerde CD4+-T-cellen, natuurlijke moordcellen, Th2-cellen en centrale geheugen-CD8+-T-cellen, en negatief gecorreleerd met de ssGSEA-score van Th1-cellen (Figuur 8C). In de RPL-dataset was de expressie van IFI27 positief gecorreleerd met de ssGSEA-scores van Treg- en Th2-cellen, terwijl de expressie van CXCL11 positief gecorreleerd was met de eosinofiel-ssGSEA-score (Figuur 8F).
Gegevensbeschikbaarheid:
Er zijn in dit onderzoek geen nieuwe primaire gegevens van menselijke proefpersonen gegenereerd. Alle analyses waren uitsluitend gebaseerd op openbaar beschikbare samenvattende statistieken van genoomwijd associatieonderzoeken (GWAS) en transcriptomische datasets. De samenvattende statistieken van het SLE-GWAS zijn verkregen uit FinnGen Release 11 (toegangsnummer: finngen_R11_L12_LUPUS). De samenvattende statistieken voor het aantal spontane miskramen zijn verkregen uit de IEU OpenGWAS-bron (toegangsnummer: ukb-b-419), gebaseerd op gegevens van de UK Biobank. De transcriptomische datasets zijn verkregen uit de National Center for Biotechnology Information Gene Expression Omnibus (GEO) onder toegangsnummers GSE61635, GSE165004, GSE50772 en GSE198700. De openbaar beschikbare datasets kunnen worden geraadpleegd in de volgende databanken:
-- FinnGen Release 11: https://r11.finngen.fi/
-- IEU OpenGWAS: https://gwas.mrcieu.ac.uk/
-- Gene Expression Omnibus (GEO): https://www.ncbi.nlm.nih.gov/geo/
De verwerkte gegevens die de bevindingen van dit onderzoek ondersteunen, zijn opgenomen in het artikel en de aanvullende materialen. Er zijn geen gegevens op individueel niveau of persoonlijk identificeerbare gegevens van deelnemers geraadpleegd of bewaard. De analytische werkvloei is uitgevoerd met behulp van openbaar beschikbare software en pakketten, zoals beschreven in het Protocol.
Aanvullend bestand 1. Ingevulde STROBE-MR-rapportagechecklist.
Voltooid Versterking van de rapportage van observationele studies in de epidemiologie met behulp van Mendeliaanse randomisatie (STROBE-MR) checklist waarin aangegeven is waar elk aanbevolen rapportage-item in het manuscript wordt behandeld Klik hier om dit bestand te downloaden.
Aanvullende figuur 1. Spreidingsdiagram van de forward Mendeliaanse randomisatie-analyse.
Streudiagram dat de associaties weergeeft tussen de genetische effecten van de instrumentele enkelvoudige nucleotidepolymorfismen (SNPs) op systemische lupus erythematosus (SLE) en het aantal spontane miskramen. Elk punt stelt één SNP voor, met horizontale en verticale foutmarges die de standaardfouten van de SNP-effectschattingen aangeven. Regressielijnen komen overeen met de methode van omgekeerd variantiegewogen, MR-Egger, gewogen mediaan en gewogen modus voor Mendeliaanse randomisatie. Klik hier om dit bestand te downloaden.
Aanvullende figuur 2. Causale schattingen op basis van enkelvoudige nucleotidepolymorfismen uit de voorwaartse Mendeliaanse randomisatie-analyse.
Forestplot die de schatting van het causale effect weergeeft voor elke instrumentele single-nucleotide polymorfisme (SNP) op de associatie tussen systemische lupus erythematosus (SLE) en het aantal spontane miskramen. Zwarte punten geven de SNP-specifieke effectschattingen weer met 95% betrouwbaarheidsintervallen. Rode punten geven de algehele causale effectschattingen weer, verkregen met behulp van de inverse-variance weighted- en MR-Egger-methoden. De verticale streeplijn geeft het nuleffect aan. Klik hier om dit bestand te downloaden.
Aanvullende figuur 3. Leave-one-out gevoeligheidsanalyse van de forward Mendelian randomization-analyse.
Forestplot met de resultaten van de leave-one-out-sensitiviteitsanalyse voor de associatie tussen systemische lupus erythematosus (SLE) en het aantal spontane miskramen. Elk zwart bolletje stelt de algehele, met de inverse variantie gewogen, causale effectschatting voor na sequentiële uitsluiting van één instrumentele single-nucleotide polymorfisme (SNP), waarbij de horizontale lijnen de bijbehorende 95% betrouwbaarheidsintervallen aangeven. Het rode bolletje stelt de algehele, met de inverse variantie gewogen, schatting voor op basis van alle instrumentele SNPs. De verticale stippellijn geeft het nuleffect aan. Klik hier om dit bestand te downloaden.
Supplementaire figuur 4. Funnelplot van de forward Mendeliaanse randomisatie-analyse.
Stroomdiagram dat de distributie weergeeft van de SNP-specifieke causale effectschattingen voor de associatie tussen systemische lupus erythematosus (SLE) en het aantal spontane miskramen. Elk punt stelt één instrumentele enkelvoudige nucleotidepolymorfisme (SNP) voor. De verticale lijnen geven de algehele causale effectschattingen weer, verkregen met behulp van de inverse-variance weighted- en MR-Egger-methoden. De y-as geeft de inverse van de standaardfout (1/SE) weer. Klik hier om dit bestand te downloaden.
Aanvullende tabel 1. Geselecteerde instrumentele enkelnucleotidepolymorfismen voor de forward Mendeliaanse randomisatie-analyse.
De tabel geeft de instrumentele enkelvoudige nucleotidepolymorfismen (SNPs) weer die zijn gebruikt voor de voorwaartse Mendeliaanse randomisatie-analyse van systemische lupus erythematosus en het aantal spontane miskramen, inclusief het dichtstbijzijnde geannoteerde gen, chromosoom, genoompositie, effectallel, frequentie van het effectallel, effectgrootte (Beta), standaardfout (SE), P waarde en F-statistiek. Chromosomale posities zijn gebaseerd op de gebruikte bron-genoomassemblage in de genoomwijd verenigingsstudie. De F-statistiek werd berekend als Beta2/SE2. Klik hier om dit bestand te downloaden.
Aanvullende tabel 2. Instrumentele enkelvoudige nucleotidepolymorfismen geselecteerd voor de reverse Mendeliaanse randomisatie-analyse.
De tabel geeft de instrumentele enkelvoudige nucleotidepolymorfismen (SNPs) weer die zijn gebruikt voor de reverse Mendeliaanse randomisatie-analyse, met het aantal spontane miskramen als blootstelling en systemische lupus erythematosus als uitkomst, inclusief het dichtstbijzijnde geannoteerde gen, chromosoom, genoompositie, effectallel, frequentie van het effectallel, effectgrootte (Beta), standaardfout (SE), P waarde en F-statistiek. Chromosomale posities zijn gebaseerd op de gebruikte bron-genoomassemblage in de genoomwijd verenigingsstudie. De F-statistiek werd berekend als Beta2/SE2. Klik hier om dit bestand te downloaden.
Discussie
Via bidirectionele MR-analyse in combinatie met multidimensionale bio-informatische analyses identificeerde deze studie een positieve causale associatie tussen SLE en RPL, terwijl er systematisch werd gescreend op gedeelde transcriptomische biomarkers. Voor zover wij weten is dit de eerste studie waarin bidirectionele MR, transcriptomische analyses en immuun-infiltratieanalyses zijn geïntegreerd om deze relatie te onderzoeken. Hoewel de waargenomen MR-effectgrootte bescheiden was (IVW OR = 1,01), werd de associatie consistent ondersteund door meerdere complementaire MR-methoden en sensitiviteitsanalyses zonder bewijs voor substantiële heterogeniteit, horizontale pleiotropie of invloedrijke uitschieters, wat suggereert dat de waargenomen relatie statistisch robuust maar kwantitatief klein is. Daarom moeten de huidige bevindingen worden geïnterpreteerd als bewijs dat een bescheiden genetische bijdrage van SLE aan de vatbaarheid voor RPL ondersteunt, in plaats van een groot klinisch effect. Door causale inferentie te integreren met transcriptomische validatie en immuun-infiltratieanalyses, biedt deze studie een reproduceerbaar kader voor het prioriteren van kandidaat-biomarkers voor complexe immuun-gemedieerde reproductieve stoornissen. Een studie uitgevoerd in Egypte tussen 2007 en 2021, waaraan 123 vrouwen met SLE en in totaal 201 zwangerschappen deelnamen, rapporteerde dat 20,4% van de zwangerschappen bij vrouwen met SLE resulteerden in foetaal verlies44. Eerdere studies hebben evenzo gesuggereerd dat SLE een belangrijke risicofactor is voor RPL omdat immuundysregulatie de kans op zwangerschapsverlies kan verhogen12.
Bioinformatica-analyses onthulden dat de 59 gedeelde differentieel tot expressie gebrachte genen (DEGs) primair verrijkt waren in pathways gerelateerd aan antivirale immuunresponsen, celadhesie en de regulatie van apoptose. Virale infecties kunnen bijdragen aan de pathogenese van SLE. Patiënten met SLE vertonen vaak een dysfunctie van zowel de aangeboren als de adaptieve immuunresponsen45,46, waardoor zij vatbaarder zijn voor virale infecties. Deze verhoogde vatbaarheid kan bijdragen aan zwangerschapsverlies via mechanismen zoals placentale ontsteking en letsel aan placentacellen47. Aangezien trofoblastcellen een essentieel onderdeel van de placenta vormen, zijn veranderingen in de autofagie en het biologische gedrag van deze cellen ook geassocieerd met het voorkomen van RPL48,49. Samen suggereren deze waarnemingen dat immuundysregulatie geassocieerd met SLE de uitkomsten van de zwangerschap kan beïnvloeden door de functie van trofoblastcellen te beïnvloeden. Verdere analyses identificeerden IFI27 en CXCL11 als kandidaat-hubgenen die gedeeld worden door SLE en RPL. Echter kreeg IFI27 prioriteit voor daaropvolgende analyses omdat het een grotere biologische consistentie vertoonde over onafhankelijke datasets. Hoewel beide genen werden geselecteerd door het LASSO-model, vertoonde alleen IFI27 een consistente differentiële expressie in zowel de discovery- als de externe validatiedatasets, terwijl CXCL11 niet consistent werd gerepliceerd in de validatiedatasets. Bovendien vertoonde IFI27 een sterkere diagnostische discriminatie voor RPL en bleef het significant dysgereguleerd in datasets van zowel bloed als reproductieweefsel. Collectief ondersteunen deze bevindingen IFI27 als een robuustere kandidaat-biomarker dan CXCL11, hoewel aanvullende experimentele validatie noodzakelijk is. Validatie met behulp van de SLE-dataset GSE50772 en de RPL-dataset GSE198700 demonstreerde dat de expressie van IFI27 consistent dysgereguleerd bleef over de validatiedatasets. Opmerkelijk was dat IFI27 overexpressie vertoonde in bloedmonsters van patiënten met SLE, wat consistent is met eerdere studies50, maar dat het gedownreguleerd was in endometrium- en chorionvlokmonsters van patiënten met RPL. Dit contrasterende patroon kan verschillen weerspiegelen tussen systemische immuundysregulatie en de lokale immuunomgeving bij de maternaal-fetale interface bij SLE gecompliceerd door RPL.
IFI27 is een interferon-gestimuleerd gen dat betrokken is bij antivirale immuniteit, interferon-signalering en gastheerimmuunresponsen na een virale infectie51,52. Bij een normale zwangerschap is de expressie van IFI27 aanzienlijk verhoogd in trofoblastcellen53, wat wijst op een belangrijke fysiologische rol bij het behoud van de trofoblastfunctie. In contrast hiermee toonden onze analyses een verminderde IFI27-expressie aan in het endometrium en de choriale villi van patiënten met RPL. Hoewel dit resultaat afwijkt van enkele eerdere rapporten54, moet het met voorzichtigheid worden geïnterpreteerd, omdat de huidige studie transcriptomische datasets uit verschillende weefsels integreerde in plaats van gematchte materno-foetale monsters. Eén mogelijke verklaring is dat chronische systemische type I interferon-activatie bij SLE aanhoudende interferon-signalering in circulerende immuuncellen induceert, terwijl het tegelijkertijd receptor-desensitisatie, immuunuitputting of compensatoire negatieve-feedbackmechanismen op de materno-foetale interface bevordert. Alternatief kunnen weefselspecifieke epigenetische regulatie of verschillen in cellulaire samenstelling tussen perifeer bloed en reproductieve weefsels de lokale IFI27-expressie onderdrukken, ondanks systemische interferon-activatie. Deze hypothesen blijven speculatief en vereisen mechanistische validatie met behulp van gematcht maternaal bloed, endometriumweefsel en trofoblastmonsters, idealiter op single-cell niveau, om weefselspecifieke en celtypespecifieke regulatiemechanismen te onderscheiden55.
Analyse van de immuunfiltratie wees op significante verschillen in immuuncelsignaturen bij zowel SLE als RPL, primair gekenmerkt door veranderingen in CD4+ T-cel-gerelateerde populaties. De expressie van IFI27 correleerde positief met Th2-celverrijking bij beide ziekten; deze bevindingen vertegenwoordigen echter computationele correlaties afgeleid van ssGSEA in plaats van experimenteel geverifieerde biologische interacties. Eerdere studies hebben aangetoond dat perifeer bloed van patiënten met SLE verminderde proporties Th1- en Treg-cellen bevat, maar verhoogde proporties Th2-cellen56,57, wat consistent is met onze bevindingen. Tijdens een normale zwangerschap verschuift de Th1/Th2-immuunbalans op de materno-foetale interface naar een Th2-dominante staat58. Daarom kan een verminderde expressie van IFI27 in reproductieve weefsels wijzen op veranderingen in de lokale immuunhomeostase die geassocieerd zijn met een verminderde materno-foetale tolerantie, hoewel nog experimenteel moet worden vastgesteld of IFI27 dit proces direct reguleert.
Er moeten enkele beperkingen worden erkend. Ten eerste, hoewel de MR-analyses een causaal verband ondersteunden, was het geschatte genetische effect relatief klein, wat suggereert dat SLE slechts één component is van de multifactoriële pathogenese van RPL. Ten tweede omvatte de transcriptomische integratie datasets die waren gegenereerd uit verschillende weefsels (perifeer bloed, endometrium en choriovilli), microarray-platforms en onafhankelijke cohorten, wat biologische en technische heterogeniteit kan introduceren ondanks de consistente validatie van IFI27. Ten derde omvatte het externe validatiecohort voor choriovilli een beperkt aantal monsters, wat de statistische power en generaliseerbaarheid kan hebben verminderd. Ten vierde, omdat de openbaar beschikbare datasets beperkte klinische informatie bevatten, konden belangrijke factoren, waaronder ziekteactiviteit, antifosfolipidenantilichaamstatus, medicatieblootstelling, zwangerschapsstadium en andere klinische covariabelen, niet volledig worden geëvalueerd. Ten slotte, hoewel PhenoScanner-screening potentiële pleiotrope confounding in de MR-analyses minimaliseerde, kan residuele confounding niet volledig worden uitgesloten.
Vanuit een translationeel perspectief moet IFI27 momenteel worden beschouwd als een kandidaat-biomarker en niet als een klinisch gevalideerde diagnostische marker. Voor klinische implementatie zijn prospectieve multicenterstudies nodig om de diagnostische prestaties in diverse populaties te valideren, gestandaardiseerde assay-platforms en diagnostische drempelwaarden vast te stellen, en te bepalen hoe het stadium van de zwangerschap, de ziekteactiviteit en immunosuppressieve behandeling de expressie van IFI27 beïnvloeden. Functionele experimenten, samen met ruimtelijke transcriptomica en single-cell transcriptomische analyses, zullen essentieel zijn om te verduidelijken of IFI27 actief bijdraagt aan de materno-fetale immuunregulatie of simpelweg interferon-gestuurde immuunactivatie weerspiegelt.
Openbaarmakingen
Belangenverstrengeling:
De auteurs verklaren dat zij geen concurrerende financiële of niet-financiële belangen hebben.
Dankbetuigingen
Dit werk werd ondersteund door het Beijing Municipal Administration of Traditional Chinese Medicine Major Difficult Diseases Integration of Traditional Chinese and Western Medicine Key Project (2023BJSZDYNJBXTGG-003), het National-Level Public Welfare Scientific Research Fund for Basic Research Business of Institutes (ZZ16-XRZ-038) en het High-Level Chinese Medical Hospital Promotion Project (HLCMHPP2023087). De financieringsbronnen hebben geen rol gespeeld in het ontwerp van de studie, de gegevensverzameling, de gegevensanalyse, de interpretatie van de gegevens, het opstellen van het manuscript of de beslissing om het manuscript ter publicatie in te dienen. De auteurs danken de onderzoekers en deelnemers van de FinnGen-studie, de UK Biobank en het National Center for Biotechnology Information Gene Expression Omnibus (GEO) voor het publiekelijk beschikbaar stellen van hun datasets. De auteurs erkennen tevens het FinnGen-consortium, dat Finse biobankmonsters integreert met landelijke gezondheidsregistergegevens via samenwerkingen tussen Finse onderzoeksorganisaties, biobanken en internationale partners.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| collectie van 28 gen-signaturen voor immuuncellen | Gepubliceerde aanvullende bron voor gensignaturen | Aanvullende lijst met markergenen voor immuuncellen beschreven door Charoentong et al. (Referentie 42) | Niet van toepassing RRID: Niet beschikbaar Doel / opmerkingen: Immuuncelsignaturen gebruikt voor ssGSEA. |
| CNSknowall | CNSknowall webplatform | DAVID-outputbestanden | Niet van toepassing RRID: Niet beschikbaar Doel / opmerkingen: Visualisatie van gefilterde resultaten van functionele verrijking. |
| Computerwerkstation | Institutionele computeromgeving | Niet van toepassing | Niet van toepassing RRID: Niet van toepassing Doel / opmerkingen: Computationele analyses. |
| Verbruiksartikelen | Niet van toepassing | Niet van toepassing | Niet van toepassing RRID: Niet van toepassing Doel / opmerkingen: Er zijn geen verbruiksartikelen voor het natte laboratorium gebruikt. |
| Cytoscape | Cytoscape Consortium | Niet van toepassing | 3.10.0 RRID: SCR_003032 Doel / opmerkingen: Eiwit–visualisatie van eiwitinteractienetwerken en topologische analyse. |
| cytoHubba | Cytoscape App Store | Niet van toepassing | 0.1 RRID: SCR_017677 Doel / opmerkingen: Hub-genrangschikking met behulp van MCC, MNC, EPC, graad, closeness en radialiteit. |
| DAVID Functionele Annotatietool | National Institutes of Health / National Cancer Institute | Geüploade gedeelde DEG- en achtergrondgenenlijsten | 2021 RRID: SCR_001881 Doel / opmerkingen: Gene Ontology- en KEGG-pathway-verrijkingsanalyse. |
| Europees LD-referentiepanel | 1000 Genomes Project / IEU OpenGWAS | Europees panel fase 3 (GRCh37-compatibele varianten) | Fase 3 RRID: Niet gerapporteerd Doel / opmerkingen: Clumping van linkage disequilibrium via de OpenGWAS/TwoSampleMR-workflow. |
| FinnGen | FinnGen Consortium | finngen_R11_L12_LUPUS | Release 11 RRID: SCR_022254 Doel / opmerkingen: GWAS-samenvattingsstatistieken voor lupus erythematosus. |
| forestploter | CRAN | Niet van toepassing | 1.1.2 RRID: Niet beschikbaar Doel / opmerkingen: Forest plot-visualisatie van Mendeliaanse randomisatie-schattingen. |
| Gene Expression Omnibus (GEO) | National Center for Biotechnology Information | GSE61635; GSE165004; GSE50772; GSE198700 | Niet van toepassing RRID: SCR_005012 Doel / opmerkingen: Bron van transcriptomische datasets voor ontdekking en validatie. |
| Gene Ontology | Gene Ontology Consortium | GO-termen geraadpleegd via DAVID | DAVID 2021 annotaties RRID: SCR_002811 Doel / opmerkingen: Annotatie van biologische processen, cellulaire componenten en moleculaire functies. |
| ggcorrplot | CRAN | Niet van toepassing | 0.1.4.1 RRID: Niet beschikbaar Doel / opmerkingen: Visualisatie van kandidaatgen–correlatiematrices van immuuncellen. |
| ggplot2 | CRAN | Niet van toepassing | 3.5.1 RRID: SCR_014601 Doel / opmerkingen: Volcanoplots, boxplots en andere statistische grafieken. |
| ggvenn | CRAN | Niet van toepassing | 0.1.16 RRID: SCR_025300 Doel / opmerkingen: Visualisatie van gedeelde differentieel tot expressie gebrachte genen. |
| glmnet | CRAN | Niet van toepassing | 4.1-8 RRID: SCR_015505 Doel / opmerkingen: LASSO logistische regressie en kruisvalidatie. |
| GSE165004 | NCBI GEO | GSE165004 / GPL16699 | Verwerkte seriesmatrix RRID: SCR_005012 Doel / opmerkingen: RPL endometrium-ontdekkingsdataset. |
| GSE198700 | NCBI GEO | GSE198700 / GPL13534 | Verwerkte Series Matrix RRID: SCR_005012 Doel / opmerkingen: Onafhankelijke validatiedataset van chorionvlokken bij RPL. |
| GSE50772 | NCBI GEO | GSE50772 / GPL570 | Verwerkte seriesmatrix RRID: SCR_005012 Doel / opmerkingen: Onafhankelijke validatiedataset van perifere mononucleaire bloedcellen bij SLE. |
| GSE61635 | NCBI GEO | GSE61635 / GPL570 | Verwerkte Seriematrix RRID: SCR_005012 Doel / opmerkingen: Discovery-dataset van volbloed bij SLE. |
| GSEABase | Bioconductor | Niet van toepassing | 1.66.0 RRID: Niet beschikbaar Doel / opmerkingen: Beheer van immuuncel-genensets voor ssGSEA. |
| GSVA | Bioconductor | Niet van toepassing | 1.52.3 RRID: SCR_021058 Doel / opmerkingen: Single-sample genenset-verrijkingsanalyse (ssGSEA). |
| IEU OpenGWAS | MRC Integrative Epidemiology Unit | ukb-b-419; finngen_R11_L12_LUPUS | Niet van toepassing RRID: Niet gerapporteerd Doel / opmerkingen: Ophalen van GWAS-samenvattingsstatistieken en geharmoniseerde genetische associatiegegevens. |
| Kyoto Encyclopedia of Genes and Genomes (KEGG) | Kanehisa Laboratories | KEGG-pathways geaccesseerd via DAVID | DAVID 2021 annotaties RRID: SCR_012773 Doel / opmerkingen: Pathway-enrichmentannotatie. |
| limma | Bioconductor | Niet van toepassing | 3.60.6 RRID: SCR_010943 Doel / opmerkingen: Analyse van differentiële expressie. |
| MRPRESSO | Verbanck et al. | Niet van toepassing | 1 RRID: SCR_023697 Doel / opmerkingen: Detectie van horizontale pleiotropie en uitschieters in instrumentele variabelen. |
| pheatmap | CRAN | Niet van toepassing | 1.0.12 RRID: SCR_016418 Doel / opmerkingen: Expressie-heatmaps. |
| PhenoScanner V2 | PhenoScanner Consortium | Fenotypevragen op SNP-niveau | Versie 2 RRID: Niet beschikbaar Doel / opmerkingen: Screening van behouden SNP's op potentiële verstorende fenotypeassociaties. |
| pROC | CRAN | Niet van toepassing | 1.18.5 RRID: SCR_024286 Doel / opmerkingen: ROC-curves, AUC's, DeLong-betrouwbaarheidsintervallen, Youden-index-afkapwaarden en bootstrap-betrouwbaarheidsintervallen. |
| R | R Foundation for Statistical Computing | Niet van toepassing | 4.4.2 RRID: SCR_001905 Doel / opmerkingen: Statistische computeromgeving. |
| Reagentia | Niet van toepassing | Niet van toepassing | Niet van toepassing RRID: Niet van toepassing Doel / opmerkingen: Er zijn geen nat-laboratoriumreagentia gebruikt. |
| provide the source text for translation. | STRING-consortium | Homo sapiens (taxon 9606); minimale interactiescore 0,400 | 11 RRID: SCR_005223 Doel / opmerkingen: Eiwit–constructie van eiwitinteractienetwerken. |
| TwoSampleMR | MRC Integrative Epidemiology Unit | Niet van toepassing | 0.6.6 RRID: SCR_019010 Doel / opmerkingen: Bidirectionele twee-steekproef Mendeliaanse randomisatie, data-extractie, harmonisatie, causale schatting en sensitiviteitsanalyses. |
| UK Biobank | UK Biobank | ukb-b-419 | samenvattende dataset 2018 RRID: SCR_012815 Doel / opmerkingen: GWAS-samenvattingsstatistieken voor het aantal spontane miskramen. |
Referenties
- Petri M. Pregnancy and systemic lupus erythematosus. Best Pract Res Clin Obstet Gynaecol. 2020;64:24-30.
- Zhao X, et al. Advances in drug therapy for systemic lupus erythematosus. Curr Med Chem. 2021;28(7):1251-1268.
- Stanescu II, et al. Salivary biomarkers of inflammation in systemic lupus erythematosus. Ann Anat. 2018;219:89-93.
- Tian J, Zhang D, Yao X, Huang Y, Lu Q. Global epidemiology of systemic lupus erythematosus: A comprehensive systematic analysis and modelling study. Ann Rheum Dis. 2023;82(3):351-356.
- Palma Dos Reis CR, et al. Prediction of adverse pregnancy outcomes in women with systemic lupus erythematosus. Clin Rev Allergy Immunol. 2020;59(2):287-294.
- Venne K, Scott S, Bernatsky S, Vinet E. Induced abortions in women with systemic lupus erythematosus. Lupus. 2021;30(4):484-488.
- Kim JW, et al. Lupus low disease activity state achievement is important for reducing adverse outcomes in pregnant patients with systemic lupus erythematosus. J Rheumatol. 2021;48(5):707-716.
- Braga A, et al. Systemic lupus erythematosus and pregnancy: A Portuguese case-control study. Clin Rev Allergy Immunol. 2022;62(2):324-332.
- Dimitriadis E, Menkhorst E, Saito S, Kutteh WH, Brosens JJ. Recurrent pregnancy loss. Nat Rev Dis Primers. 2020;6(1):98.
- Quenby S, et al. Miscarriage matters: The epidemiological, physical, psychological, and economic costs of early pregnancy loss. Lancet. 2021;397(10285):1658-1667.
- Valeff NJ, Ventimiglia MS, Diao L, Jensen F. Lupus and recurrent pregnancy loss: The role of female sex hormones and B cells. Front Endocrinol (Lausanne). 2023;14:1233883.
- Gao R, Zeng X, Qin L. Systemic autoimmune diseases and recurrent pregnancy loss: Research progress in diagnosis and treatment. Chin Med J (Engl). 2021;134(17):2140-2142.
- Pantham P, Abrahams VM, Chamley LW. The role of anti-phospholipid antibodies in autoimmune reproductive failure. Reproduction. 2016;151(5):R79-R90.
- Meroni PL, et al. Updating on the pathogenic mechanisms of antiphospholipid antibody-associated pregnancy loss. Clin Rev Allergy Immunol. 2008;34(3):332-337.
- Blank M, Shoenfeld Y. Antiphospholipid antibody-mediated reproductive failure in antiphospholipid syndrome. Clin Rev Allergy Immunol. 2010;38(2–3):141-147.
- Babker A, et al. Frequency of ACE I/D and PAI-1 4G/5G polymorphisms in women with recurrent pregnancy loss in Sudan. Biomed Pharmacol J. 2025;18(3):1953-1961.
- Babker AM, et al. Detection of human platelet antigen polymorphisms (HPA-1 and HPA-3) and factor XIII mutation in Sudanese women with recurrent pregnancy loss. BMC Res Notes. 2024;17(1):66.
- Grover S, Del Greco MF, Stein CM, Ziegler A. Mendelian randomization. Methods Mol Biol. 2017;1666:581-628.
- Skrivankova VM, et al. Strengthening the reporting of observational studies in epidemiology using Mendelian randomization: The STROBE-MR statement. JAMA. 2021;326(16):1614-1621.
- Emdin CA, Khera AV, Kathiresan S. Mendelian randomization. JAMA. 2017;318(19):1925-1926.
- Burgess S, Thompson SG, CRP CHD Genetics Collaboration. Avoiding bias from weak instruments in Mendelian randomization studies. Int J Epidemiol. 2011;40(3):755-764.
- Hemani G, et al. The MR-Base platform supports systematic causal inference across the human phenome. eLife. 2018;7:e34408.
- Bowden J, Davey Smith G, Burgess S. Mendelian randomization with invalid instruments: Effect estimation and bias detection through Egger regression. Int J Epidemiol. 2015;44(2):512-525.
- Bowden J, Davey Smith G, Haycock PC, Burgess S. Consistent estimation in Mendelian randomization with some invalid instruments using a weighted median estimator. Genet Epidemiol. 2016;40(4):304-314.
- Hartwig FP, Davey Smith G, Bowden J. Robust inference in summary data Mendelian randomization via the zero modal pleiotropy assumption. Int J Epidemiol. 2017;46(6):1985-1998.
- Burgess S, Butterworth A, Thompson SG. Mendelian randomization analysis with multiple genetic variants using summarized data. Genet Epidemiol. 2013;37(7):658-665.
- Verbanck M, Chen CY, Neale B, Do R. Detection of widespread horizontal pleiotropy in causal relationships inferred from Mendelian randomization between complex traits and diseases. Nat Genet. 2018;50(5):693-698.
- Barrett T, et al. NCBI GEO: Archive for functional genomics data sets—update. Nucleic Acids Res. 2013;41(Database issue):D991-D995.
- Keleş İD, et al. Gene pathway analysis of the endometrium at the start of the window of implantation in women with unexplained infertility and unexplained recurrent pregnancy loss: Is unexplained recurrent pregnancy loss a subset of unexplained infertility? Hum Fertil (Camb). 2023;26(5):1129-1141.
- Kennedy WP, et al. Association of the interferon signature metric with serological disease manifestations but not global activity scores in multiple cohorts of patients with SLE. Lupus Sci Med. 2015;2(1):e000080.
- Matsumoto Y, et al. Characteristic DNA methylation profiles of chorionic villi in recurrent miscarriage. Sci Rep. 2022;12(1):11673.
- Sherman BT, Lempicki RA. Systematic and integrative analysis of large gene lists using DAVID bioinformatics resources. Nat Protoc. 2009;4(1):44-57.
- Szklarczyk D, et al. STRING v11: Protein–protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607-D613.
- Shannon P, et al. Cytoscape: A software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504.
- Jia P, Zheng S, Long J, Zheng W, Zhao Z. dmGWAS: Dense module searching for genome-wide association studies in protein–protein interaction networks. Bioinformatics. 2011;27(1):95-102.
- Chin CH, et al. cytoHubba: Identifying hub objects and subnetworks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11.
- Mohammadi M. A projection neural network for the generalized Lasso. IEEE Trans Neural Netw Learn Syst. 2020;31(6):2217-2221.
- Kumar R, Indrayan A. Receiver operating characteristic (ROC) curve for medical researchers. Indian Pediatr. 2011;48(4):277-287.
- de Hond AAH, Steyerberg EW, van Calster B. Interpreting area under the receiver operating characteristic curve. Lancet Digit Health. 2022;4(12):e853-e855.
- Xu H, et al. Single-cell transcriptomics reveals CCL3+ classical monocyte subset linked to autoimmune pathogenesis. J Inflamm Res. 2025;18:16273-16291.
- Zych M, et al. Surface immune checkpoints as potential biomarkers in physiological pregnancy and recurrent pregnancy loss. Int J Mol Sci. 2024;25(17):9378.
- Charoentong P, et al. Pan-cancer immunogenomic analyses reveal genotype-immunophenotype relationships and predictors of response to checkpoint blockade. Cell Rep. 2017;18(1):248-262.
- Liu J, Lu J, Wang G, Gu L, Li W. Prognostic characteristics of a six-gene signature based on ssGSEA in sarcoma. Aging (Albany NY). 2024;16(2):1536-1554.
- Mokbel A, et al. Pregnancy outcomes among Egyptian women with systemic lupus erythematosus: A prospective cohort study. Lupus. 2023;32(4):521-530.
- Illescas-Montes R, Corona-Castro CC, Melguizo-Rodríguez L, Ruiz C, Costela-Ruiz VJ. Infectious processes and systemic lupus erythematosus. Immunology. 2019;158(3):153-160.
- Banko A, et al. Epstein-Barr virus infection as a potential indicator of the occurrence and clinical presentation of systemic lupus erythematosus. Front Immunol. 2023;14:1307589.
- Nigro G, et al. Role of infections in recurrent spontaneous abortion. J Matern Fetal Neonatal Med. 2011;24(8):983-989.
- Yang D, et al. YY1-PVT1 affects trophoblast invasion and adhesion by regulating mTOR pathway-mediated autophagy. J Cell Physiol. 2020;235(10):6637-6646.
- Guan D, et al. Immunologic insights in recurrent spontaneous abortion: Molecular mechanisms and therapeutic interventions. Biomed Pharmacother. 2024;177:117082.
- Zhao X, et al. Identification of key biomarkers and immune infiltration in systemic lupus erythematosus by integrated bioinformatics analysis. J Transl Med. 2021;19(1):35.
- Villamayor L, et al. The IFN-stimulated gene IFI27 counteracts innate immune responses after viral infections by interfering with RIG-I signaling. Front Microbiol. 2023;14:1176177.
- Lim FY, et al. High-frequency home self-collection of capillary blood correlates IFI27 expression kinetics with SARS-CoV-2 viral clearance. J Clin Invest. 2023;133(23):e173715.
- Apps R, et al. Genome-wide expression profile of first-trimester villous and extravillous human trophoblast cells. Placenta. 2011;32(1):33-43.
- Li Y, et al. RNA sequencing of decidua reveals differentially expressed genes in recurrent pregnancy loss. Reprod Sci. 2021;28(8):2261-2269.
- Dankers W, et al. Failing maternal-fetal tolerance in SLE (FaMaLE): A prospective cohort study for finding the molecular mechanisms behind pregnancy complications. Lupus Sci Med. 2025;12(1):e001668.
- Xiang S, et al. Imbalance of helper T cell type 1, helper T cell type 2, and associated cytokines in patients with systemic lupus erythematosus: A meta-analysis. Front Pharmacol. 2022;13:988512.
- Tu J, et al. UC-BSC exosomes regulate Th17/Treg balance in patients with systemic lupus erythematosus via miR-19b/KLF13. Cells. 2022;11(24):4123.
- Wang W, et al. T helper (Th) cell profiles in pregnancy and recurrent pregnancy loss: Th1/Th2/Th9/Th17/Th22/Tfh cells. Front Immunol. 2020;11:2025.