Dit artikel bestudeert een dynamisch optimalisatiealgoritme voor planning dat Transformer en PPO-reinforcement learning integreert, met een focus op frequente resourceconflicten en responstijden bij het plannen van vakbondsactiviteiten.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Dynamisch plannings- en hulpbronoptimalisatiealgoritme voor vakbondsactiviteiten door integratie van Transformer en reinforcement learning
In dit artikel
Samenvatting
Samenvatting
Om het probleem van verminderde organisatorische efficiëntie aan te pakken, veroorzaakt door frequente conflicten bij de toewijzing van middelen en vertraagde reacties bij de planning van vakbondsactiviteiten, stelt dit artikel een dynamisch planningsalgoritme voor dat Transformer en PPO (Proximal Policy Optimization) integreert. In de specifieke implementatie is eerst een uniforme modelleringsstructuur voor planningsscenario's ontworpen om activiteits-, personeels- en middelenstatussen om te zetten in tensor-inputs, waardoor integratie van multidimensionale beperkingen wordt gerealiseerd. Vervolgens wordt het multi-head attention-mechanisme van de Transformer gebruikt om de tijdreeksen van historische activiteitsaanvragen en de status van middelen te coderen, multidimensionale ruimtelijk-temporele kenmerken te extraheren en de perceptie van conflictrisico's te verbeteren. Daarna worden, op basis van de coderingsresultaten en het PPO-strategienetwerk, planningsacties gegenereerd vanuit de huidige status om de aanpassingscapaciteit van de strategie aan complexe omgevingen te vergroten. Ten slotte worden de stabiliteit van de strategie tijdens iteratie en een verbeterde planningsprestatie gegarandeerd door middel van de pruning-update en het correctiemechanisme van de advantage-functie. Experimenten hebben aangetoond dat bij een taakdichtheid van 1000 de gemiddelde besluitingstijd van het planningsalgoritme 0,72s is en de gemiddelde responstijd 1,59s, wat duidt op een hoge reactiesnelheid en besluitvormingsefficiëntie. Over zeven activiteitstypen en complexiteitsniveaus ligt het conflictpercentage van middelen tussen 0,05–0,12; de gemiddelde benuttingsgraad van middelen tussen 0,75–0,86; en de planningsstabiliteitsindex tussen 0,8–0,91, waardoor frequente conflicten bij de toewijzing van middelen effectief worden verminderd en een hoge planningsstabiliteit wordt bereikt. Onder omstandigheden met een hoge gelijktijdigheid bedragen de index voor middelenbalans en de index voor robuustheid van strategieoverdracht respectievelijk 0,88 en 0,85, wat wijst op een goede aanpassingscapaciteit aan taken met een hoge gelijktijdigheid.
Inleiding
Activiteiten van vakbonden omvatten de complexe planning van meerdere taken en middelen, waardoor het systeem over efficiënte dynamische reactiecapaciteiten moet beschikken1,2. De vereisten voor activiteiten veranderen frequent en de distributie van personeel en locatieressources is complex, wat gemakkelijk kan leiden tot planningsconflicten en verspilling van middelen3,4. Het nauwkeurig vastleggen van de geschiedenis van activiteiten en de real-time status van resources, evenals het verbeteren van het vermogen om potentiële conflicten te identificeren en hierop te reageren, zijn essentieel voor het verhogen van de operationele efficiëntie van de organisatie5,6. De integratie van geavanceerde tijdreeksmodelleringstechnologie en reinforcement learning-algoritmen kan leiden tot een diepgaand begrip en intelligente optimalisatie in complexe planningsomgevingen, wat helpt bij het maximaliseren van de benutting van middelen, het versnellen van de planningsrespons en het bevorderen van de intelligente upgrade van het beheer van vakbondsactiviteiten.
Bestaande planningsbenaderingen in de praktijk zijn echter grotendeels regelgebaseerd en statisch, waardoor ze niet kunnen worden aangepast aan frequente taakwijzigingen en schommelingen in resources, wat vaak resulteert in langere responstijden en ernstige resourceconflicten. Bij het plannen van vakbondsactiviteiten zijn de taaktypen zeer divers; het resourcegebruik is sterk beperkt en verandert frequent; en de afhankelijkheden tussen activiteiten en de concurrentie om resources vormen een complexe planningskaart7,8. In de praktijk kan de activiteitensplanning niet efficiënt worden afgestemd op de beschikbare tijdvensters van resources zoals personeel en locaties9,10, en er ontstaan vaak conflicten, wat de algehele coherentie van de organisatorische operaties verzwakt11,12. Het planningssysteem wordt niet geconfronteerd met één enkel optimalisatiedoel, maar eerder met een balans tussen multidimensionale indicatoren, zoals het minimaliseren van resourceconflicten, het maximaliseren van de responssnelheid, de stabiliteit van de planningsstrategie en de taakvoltooiingsgraad13,14, die typische kenmerken van multi-objectieve optimalisatie vertonen. Daarnaast vertonen vakbondsactiviteiten duidelijke fasen en cycli, en planningsstrategieën moeten zich dynamisch aanpassen aan de variërende resource-vraagstructuren in verschillende taakstadia. Statische plannen die eenmaal zijn gegenereerd, kunnen een executieomgeving met hoogfrequente wijzigingen niet ondersteunen15,16. De bestaande planningslogica ontbeert een diepgaand onderzoek naar historisch taakgedrag en patronen in wijzigingen van de resourcestatus. Het is niet in staat om nauwkeurige voorspellingen en strategische deducties voor de toekomst te bieden17,18. De planningsstrategie van het systeem reageert traag op plotselinge taken en tijdelijke wijzigingen in resources, wat de algehele duurzaamheid van de operatie beïnvloedt19,20. Het bouwen van een planningssysteem met voorspelbaarheid, flexibiliteit en stabiliteit is een belangrijke technische vereiste geworden in praktische toepassingen. Dit vereist dat het model beschikt over hoogdimensionale informatieperceptie, sequentiegeheugen en strategiemigratiecapaciteiten, en dat het robuuste besluitvorming en resourcebalans handhaaft in een multi-taakomgeving, om zo een intelligente, optimale coördinatie van de planning van vakbondsactiviteiten mogelijk te maken.
Talrijke studies hebben verschillende oplossingen voorgesteld voor het dynamische planningsprobleem. Hiervan heeft de combinatie van deep learning en reinforcement learning een sterke aanpasbaarheid en optimalisatievermogen getoond. Sommige wetenschappers maken gebruik van LSTM (Long Short-Term Memory)21,22 om tijdreeksgegevens te modelleren en combineren dit met reinforcement learning-strategieën om het planningsgedrag te optimaliseren, waarmee bepaalde resultaten zijn behaald. Een ander type onderzoek maakt gebruik van een heuristische methode op basis van een greedy-algoritme, waarbij de nadruk ligt op de eenvoud en efficiëntie van planningsbeslissingen, wat geschikt is voor scenario's met duidelijke regels23,24. Andere studies hebben de toepassing van deep Q-network (DQN) op planning onderzocht, waarbij verbeterde strategieën werden bereikt via benadering van de waardefunctie25,26. Deze methoden kampen echter met problemen zoals onvoldoende vastlegging van langetermijnafhankelijkheden, instabiele strategie-updates en grote responstijden bij complexe en veranderende scenario's van gecombineerde activiteiten, waardoor het moeilijk is om te voldoen aan de planningsbehoeften van taken met een hoge dichtheid en grote diversiteit. Daarom is de vraag hoe een planningsalgoritme kan worden gebouwd met efficiënte kenmerkextractie en stabiele strategie-updatecapaciteiten een knelpunt geworden dat in het huidige onderzoek moet worden doorbroken.
In onderzoek naar multi-domein planning is de Transformer-architectuur toegepast op diverse tijdreeksvoorspellings- en planningsoptimalisatietaken vanwege het multi-head self-attention mechanisme, dat effectief langetermijn temporele afhankelijkheden vastlegt27,28. In combinatie met het PPO-algoritme in reinforcement learning wordt de strategie stabiel en efficiënt bijgewerkt door de doelfunctie te trimmen; deze benadering heeft goede prestaties getoond in velden zoals robotica en intelligente productie29,30,31. Enkele studies hebben geprobeerd de Transformer te integreren met reinforcement learning voor complexe grondstoffenplanning32. Echter, bij de dynamische planning van vakbondsactiviteiten behandelen weinig studies de combinatie van diverse activiteitstypen en complexe resourcebeperkingen. Sommige onderzoeken hebben graph neural networks gebruikt om de relatie tussen resources en taken te modelleren, waardoor de nauwkeurigheid van conflictidentificatie is verbeterd33,34. Enkele wetenschappers hebben resourceplanning geoptimaliseerd op basis van edge computing om de efficiëntie en prestaties van het model te verhogen35,36. Dergelijke methoden hebben echter nog steeds beperkte modelleringsmogelijkheden voor de temporele context. Op basis hiervan stelt dit artikel voor om een Transformer te gebruiken om historische activiteits- en resourcestatussequenties te coderen, gecombineerd met het PPO-beleidnetwerk, om een hoge perceptie van conflictrisico's en een stabiele update van planningsstrategieën te bereiken om in te spelen op de veranderende en complexe planningsbehoeften van vakbondsactiviteiten.
Recentere studies hebben de optimalisatie van resourcesplanning vanuit verschillende perspectieven onderzocht, zoals VM-consolidatie voor energie-efficiëntie in cloud computing37, authenticatiealgoritmen in cellulaire netwerken38, verbeterde VM-consolidatie met live migratie voor duurzame cloud computing39, verkeersoptimalisatie met behulp van wachttijdvoorspelling en evolutieve algoritmen40, en blockchain-gebaseerde cloudopslag met verbeterde optimalisatie en integriteitsbewaring41. Hoewel deze werken waardevolle inzichten bieden in resource-allocatie en optimalisatiealgoritmen, richten ze zich primair op cloudinfrastructuur, telecommunicatie of opslagsystemen en adresseren ze niet specifiek de beperkingen van activiteiten van meerdere typen, dynamische personeel-locatie resourceconflicten en de real-time planningsvereisten die inherent zijn aan het beheer van vakbondsactiviteiten. Dit onderscheid onderstreept verder de behoefte aan een specifiek planningsraamwerk dat is afgestemd op de organisatorische context van vakbondsactiviteiten.
Bestaande planningsmethoden voor vakbondsactiviteiten slagen er vaak niet in om langetermijn spatiotemporele afhankelijkheden vast te leggen en beleidsstabiliteit te behouden bij dynamische veranderingen, wat leidt tot trage responstijden en hoge resourceconflicten. Om deze hiaten in het onderzoek op te vullen, stelt deze studie een planningsoptimalisatiemodel voor op basis van het principe dat Transformer multi-head attention historische sequenties effectief kan coderen voor conflictvoorspelling, en dat Proximal Policy Optimization (PPO) met een clipped objective zorgt voor stabiele en adaptieve beleidsupdates. Specifiek wordt Transformer toegepast om activiteits- en resourcestatussequenties te coderen, waarbij belangrijke spatiotemporele kenmerken worden geëxtraheerd om de vooruitziendheid bij conflicten te verbeteren, en wordt PPO gecombineerd voor efficiënte generatie van planningsacties en stabiele updates. Er is een uniforme constraint-matrix ontworpen om activiteiten, personeel en locaties in kaart te brengen, waardoor de herkenning van complexe afhankelijkheden wordt verbeterd. De kerninnovaties van dit werk omvatten: (1) de integratie van temporele codering en reinforcement learning specifiek voor de planning van vakbondsactiviteiten; (2) een conflictbewust attention-mechanisme dat prioriteit geeft aan risicoperceptie; en (3) een pruning-update met correctie van de advantage-functie om strategische robuustheid bij hoge gelijktijdigheid te garanderen. Uitgebreide experimenten onder diverse taakdichtheden en complexiteiten valideren de superioriteit van het model ten opzichte van bestaande methoden wat betreft responssnelheid, resourcebenutting en stabiliteit, waardoor een praktische en schaalbare intelligente planningsoplossing voor vakbondsactiviteitenbeheer wordt geboden.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Figuur 1 toont de structuur van een planningssysteem voor vakbondsactiviteiten dat tijdreeksmodellering en reinforcement learning integreert. De invoerlaag integreert activiteitsschema's, resourcebeschikbaarheid en informatie over tijdvensters van personeel, en construeert via de constraint graph-module een multidimensionale conflictrelatiematrix voor taken en resources. De transformer voert multi-head attention-codering uit over de historische reeks van activiteits- en resourcestatussen, waardoor hidden states met temporele afhankelijkheden worden gegenereerd. De beleidsmodule gebruikt de coderingsresultaten om actiedistributies en statusestimaties te genereren, en voert planningsbeslissingen uit na het samplen van acties. De uitvoeringsresultaten worden teruggekoppeld naar de omgeving, waarbij de resourcestatus wordt bijgewerkt en onmiddellijke beloningen worden gegenereerd. Op basis hiervan construeert de optimalisatiemodule een clipping-doelfunctie, evalueert de advantage-functie en corrigeert de schatting van het waardenetwerk om beleidsdrift te beperken en stabiele updates van het planningsgedrag te waarborgen. Er wordt een gesloten dataloop gevormd tussen de modules om een zeer gevoelige perceptie van resourceconflicten en adaptieve strategie-updates in dynamische omgevingen te bereiken, waardoor de intelligente responscapaciteit en de efficiëntie van de resourceallocatie van het planningssysteem voor vakbondsactiviteiten in scenario's met meerdere taken en strikte beperkingen worden verbeterd.
Scenariomodellering van de planning van vakbondsactiviteiten
Alle aanvragen voor activiteiten in het planningssysteem zijn georganiseerd in discrete planningssequenties op basis van tijdstappen. Elke activiteit is gedefinieerd met duidelijke start- en eindtijden, resourcecategorieën, fasen en prioriteitsniveaus. De gebruiksstatus van de locatie wordt gemodelleerd als een tweedimensionale tijdslotmatrix, waarbij de horizontale as de gestandaardiseerde tijdseenheid vertegenwoordigt en de verticale as het nummer van de ruimtelijke resource. De status van de resource wordt gemarkeerd als beschikbaar of bezet, wat een initiële resourceverdelingskaart met een statische structuur vormt. De planningsinformatie van het personeel wordt uitgebreid in de tijd-identiteitsdimensie om een continue tijdvenstervector te construeren, waarin voor elk element de taak-idle status van het personeel en het afdelingsnummer worden geregistreerd. Alle invoerinformatie wordt geïntegreerd in een driedimensionale tensorstructuur, waarbij denotes de discrete tijdstap, denotes het aantal resource-entiteiten, en denotes de overeenkomstige code voor het resourcegebruiksattribuut (zoals of deze bezet is, het activiteitsnummer, de gebruiksprioriteit, enz.). Deze structuur stelt het planningssysteem in staat om de resourceconfiguratie op elk gewenst moment uit te lezen, waardoor een uniforme weergave van verschillende typen resourcestatuses wordt gewaarborgd.
Nadat de taakinformatie aan het model is gekoppeld, wordt de taakintensiteitsvector vastgesteld op basis van de activiteitsprioriteit en de periode van het resourcegebruik. De taakcombinaties die conflict kunnen veroorzaken, worden gemarkeerd via de detectiemethode voor overlap van tijdvensters. Conflictcombinaties worden omgezet in knoopsets, en randsets worden geconstrueerd op basis van gedeelde resource-types en perioden om impliciete afhankelijkheden expliciet weer te geven. De uiteindelijke geconstrueerde taakgraaf bevat grensgegevens over tijdsvolgorde, resource-overlap of conflictbeperkingen, wat een structurele basis biedt voor daaropvolgende conflictdetectie en het genereren van planningsstrategieën. Deze structuur behoudt het dynamische karakter van taakplanning en de continue veranderingen in de status van resources, en ondersteunt real-time waarneming van wijzigingen in de planningsbeperkingen.
Conflictdetectie gebruikt de schaarse overlappende regio's van de tijd- en resourcedimensies in de tensorstructuur als initiële condities voor het oordeel. Het implementeert statische relatie-encoderingsverwerking voor taakparen met overlappende planningsdoelen. Er wordt een graafstructuur G=(V,E,C) geconstrueerd, waarbij V de set actieve knopen vertegenwoordigt, E de randen vertegenwoordigt die zijn gegenereerd op basis van resourceconflicten, en C de conflictgewicht-encoderingsmatrix is voor de randen. De conflictgewichtfunctie is gedefinieerd in de volgende vorm:
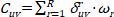 (1)
Hierbij is Cuv het conflictgewicht tussen activiteiten u en v; u, v zijn activiteitsindices; R is het totaal aantal resourcetypes; δuvr ∈ {0,1} geeft aan of de tijdsvensters van activiteiten u en v overlappen op resource r; ωr is het conflictgevoeligheidsgewicht van resource r. Deze functie voert een gewogen som van conflictintensiteiten uit, waarbij rekening wordt gehouden met verschillen in het belang van resourceconflicten voor de planningsresultaten, terwijl een kwantificeerbare uitdrukking van de verdeling van de conflictsterkte behouden blijft.
De bovenstaande structuur van de conflictgraaf wordt via een ijlmatrixrepresentatie omgezet in een matrix van restrictiegrenzen. Elk item in de matrix bevat de mate van resourceconflict. De matrix is ingebed in het beslissingsproces voor planning om te bepalen of taken parallel kunnen worden gepland, terwijl de action-shielding-logica zich in het beleidsnetwerk bevindt. Om periodieke activiteitsaggregatie en bursts van taken met een hoge dichtheid aan te pakken, is een dynamisch update-mechanisme geïmplementeerd om wijzigingen in de taakstatus te monitoren en de inhoud van de matrix in realtime aan te passen wanneer resources worden vrijgegeven of toegevoegd, waardoor de continuïteit en consistentie van de planningsgrens gedurende de taakevolutie wordt gewaarborgd.
De toepassing van deze conflictgraafstructuur stelt het planningssysteem in staat om potentiële knelpunten in resources en patronen van taaloverlap visueel te modelleren, waardoor de efficiëntie van de ontkoppelingsanalyse van het beslissingsnetwerk bij complexe scenario's met beperkingen wordt verbeterd. Het planningsgedrag is niet langer afhankelijk van regelgebaseerde logische matching. In plaats daarvan wordt gezocht naar het optimale pad in de beperkingsruimte, wat het vermogen vergroot om lokale resourceconflicten dynamisch in balans te brengen met de globale taalkaart. Het systeem kan de planningsstabiliteit en taalcoherentie behouden in een omgeving waarin resources fluctueren en taken frequent worden toegevoegd of verwijderd.
Figuur 2 toont een netwerkstructuurdiagram op basis van de gewichtsrelatie van taakconflicten. Elke knoop in de figuur vertegenwoordigt een te plannen taak, en de lijnen tussen de knopen geven conflicten in het resourcegebruik aan. De dikte van de rand weerspiegelt het gewicht van het conflict. Hoe ernstiger het conflict, hoe dikker de lijn. De gewichtsberekening integreert resource-overlap en combineert de conflictsgevoeligheid van verschillende resources om een samengestelde conflictintensiteit tussen taken te vormen. De grafstructuur onthult dat sommige taken dicht verbonden gebieden vormen, wat wijst op aanzienlijke concurrentie voor resourcebenutting. Dit type lokale conflictaggregatie is de primaire bron van resource-bottlenecks en taakvertragingen in het planningsproces, waardoor het planningsalgoritme dienende prioriteitsbemiddelingsdoelen kan stellen. De schikking van de knopen maakt gebruik van een force-directed layout-strategie om taken met een hoog conflict automatisch te aggregeren, waardoor het planningssysteem sleuteltaakgroepen kan identificeren en de strategieverdeling kan optimaliseren, wat de algehele planningscoherentie en resourcecoördinatie verbetert.
Codering van de historische toestandsvolgorde
Op basis van de geconstrueerde conflictgraaf en de restrictiematrix is de volgende stap het coderen van de historische sequenties van activiteiten en resourcetoestanden, zodat de temporele patronen die ten grondslag liggen aan deze restricties kunnen worden geëxtraheerd voor daaropvolgende besluitvorming. De kerninformatie in het planningsscenario bestaat uit activiteitsverzoeken, wijzigingen in de resourcestatus en feedbackgegevens van taken. Deze informatie vormt meerdere heterogene tijdreeksen, die overeenkomen met attributen zoals tijdstippen van gebeurtenissen, identifiers voor resourcegebruik en de uitvoeringsstatus van activiteiten. Om de verwerkingsstructuur te uniformeren, wordt elk inputtype gecodeerd als een vectorsequentie van gelijke lengte, en wordt er een uniforme tijdindex vastgesteld om de uitlijning van toestanden onder tijdsynchronisatie te waarborgen. De inputeenheid op elk moment wordt weergegeven door een concatenatie van drie sets kenmerkvectoren: de activiteitskenmerkvector representeert het taaktype, de prioriteit en het fasenummer; de resourcekenmerkvector registreert de huidige resourcebezetting, de resterende capaciteit en de positie van het beschikbare venster; de feedbackkenmerkvector beschrijft of de taak op het vorige moment vlot is uitgevoerd en of er een resourceconflict of vertragingsgebeurtenis heeft plaatsgevonden.
Alle kenmerken worden lineair getransformeerd en afgebeeld op dezelfde dimensionale ruimte om een gestandaardiseerde embedding-matrix X ∈ ℝT×d te verkrijgen, waarbij T het aantal tijdstappen vertegenwoordigt en d de uniforme embedding-dimensie is. Om de temporele structuur te behouden, wordt de inputmatrix element voor element toegevoegd aan de positie-coderingsmatrix P om de positiebewuste input te vormen:
Z = X + P (2)
Z is de uiteindelijke inputsequentie, die dient als de input voor het daaropvolgende aandachtmechanisme. Het ontwerp van de positiecodering maakt gebruik van een vast sinus- en cosinusfunctiesjabloon om lekkage van toekomstige informatie te voorkomen en ervoor te zorgen dat causale beperkingen tijdens de codering strikt worden nageleefd. De bovenstaande structuur stelt het model in staat om taakkenmerken, resourcestatus en tijdpositie gelijktijdig waar te nemen. Het beschikt over een complete basis voor statusgeheugen, waardoor een hoge-resolutie, uniforme structuur wordt geboden voor het daaropvolgende aandachtmechanisme.
De attention-module verwerkt de inputsequentie om potentiële relaties tussen meerdere tijdstappen vast te leggen. Meerdere groepen attention heads worden gebruikt om de sequentie afzonderlijk te verwerken, waardoor de gevoeligheid van het model voor verschillende soorten paden van toestands-evolutie wordt vergroot. Elke attention head genereert een query-matrix Q, een key-matrix K en een value-matrix V uit de inputsequentie, berekent de gewichtsdistributiematrix en genereert een gewogen representatie. De output van een single-head attention is:
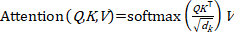 (3)
dk is het aantal kenmerkdimensies per head. In deze formule QK⊤ staat voor de gelijkenis tussen momenten, √dk wordt gebruikt voor numerieke stabiliteit, en de softmax-functie zorgt voor gewichtsnormalisatie. Verschillende attention-heads richten zich op verschillende combinaties van tijdstappen, en de dynamische afhankelijkheden die zij vastleggen zijn eveneens divers, wat helpt bij het onthullen van impliciete regels zoals voorlopers van taakconflicten, patronen in het hulpbronnenverbruik en abnormale feedbacktrends.
Alle outputs van de attention heads worden geconcateneerd en door een lineaire transformatielaag geleid om een uniforme coderingssequentie te genereren, die dient als de statusinput voor het netwerk voor de generatie van de planningsstrategie. Deze sequentie bedigt het traject van het taakgedrag, de kenmerken van resourcewijzigingen en de impact van eerdere uitvoeringsafwijkingen in het huidige planningsvenster, waardoor het probleem van hoge historische afhankelijkheid in planningsgedrag en schaarse kenmerkexpressie effectief wordt aangepakt. Residu-verbindingen en laagnormalisatiemodules zijn geïntegreerd in de coderingsoutputlaag om de trainingsstabiliteit en de behoudcapaciteiten van de expressie van het diepe netwerk te verbeteren.
De resulterende sequentie van verborgen toestanden behoudt niet alleen informatie over de tijdsontwikkeling, maar reageert ook op veranderingen die voortvloeien uit plotselinge taken of tijdelijke mismatches in resources, wat getuigt van een sterke aanpassingscapaciteit. Dit structurele ontwerp voorkomt de noodzaak voor expliciete regeldefinities, maakt gestructureerde modellering van dynamische planningsomgevingen mogelijk en ondersteunt daaropvolgende beleidsmodules bij het genereren van planningsoplossingen met globale consistentie en lokale aanpassingscapaciteit onder multi-objectieve condities.
Genereren van dynamische planningsstrategieën
De gecodeerde sequenties van verborgen toestanden, waarin zowel temporele afhankelijkheden als informatie over resourceconflicten zijn ingebed, worden vervolgens ingevoerd in het beleidsnetwerk om planningsacties te genereren die zich aanpassen aan de huidige omgeving. De sequentie van verborgen toestanden die door de coderingsmodule wordt gegenereerd, dient als input voor het netwerk voor planningsstrategieën. De set toestandsvectoren op elk moment vormt de huidige observatiedexpressie van de omgeving, waarbij de evolutie van taakkenmerken, trends in resourcegebruik en historische feedbacktrajecten worden gedekt. De dimensie van de toestandsrepresentatie en de lengte van het tijdvenster zijn vast, en de continuïteit van toestandsveranderingen wordt vastgelegd via een sliding-update-mechanisme. Voordat de toestandsvector naar het beleidsnetwerk wordt gestuurd, wordt deze genormaliseerd en kenmerk-geherorganiseerd om ervoor te zorgen dat de input een stabiele numerieke distributie behoudt in de hoogdimensionale ruimte, waardoor gradiëntexplosies en convergentieschommelingen worden verminderd.
De structuur van het beleidsnetwerk maakt gebruik van een outputmodule met twee takken, waarbij de ene tak de actieverdeling genereert en de andere de schatting van de toestands-waardefunctie produceert. De actieruimte omvat alle planbare taken en toewijsbare resources. Het screeningsmechanisme voor kandidaten filtert illegale of redundante combinaties van operaties uit om een beperkte, legale set acties te vormen. De beleidstak produceert een waarschijnlijkheidsverdeling π(at|st), waarbij at de planningsactie op het tijdstapmoment vertegenwoordigt en st de huidige toestandsinput is. Er wordt gebruikgemaakt van een gestandaardiseerde Gaussian sampling- of softmax sampling-strategie om acties uit de verdeling te selecteren voor de feitelijke planning. De andere output is de schatting van de toestands-waardefunctie, die de verwachting van de beloning op lange termijn bij de gegeven toestand vertegenwoordigt en wordt gebruikt voor de evaluatie en update van het beleid.
In het beleidsnetwerk past de verborgen laag activatiefuncties en batchnormalisatie toe om de niet-lineaire expressiviteit te verbeteren en de convergentie van het netwerk te versnellen. In het besluitvormingsproces worden de uitvoeringsprioriteit, de kosten voor resourceplanning en de historische prestaties van verschillende taken beschouwd als attentiefactoren; deze worden via een specifieke gewichtsmatrix toegepast op het mechanisme voor actieselectie om een adaptief aanpasbaar beleidsoutput-raamwerk te vormen. Dit ontwerp voorkomt dat er wordt vertrouwd op vaste regels, waardoor de flexibiliteit van de strategie bij het omgaan met plotselinge conflicten en structurele knelpunten wordt vergroot.
De planningsstrategie maakt gebruik van een willekeurig bemonsteringsmechanisme om de feitelijke actiesequentie te genereren. In elke planningscyclus wordt een uitvoerbare actie gesampled uit de huidige actieverdeling, waarna de status van de resources en de markering van de taaknode worden bijgewerkt. Nadat de actie is uitgevoerd, berekent het systeem de onmiddellijke feedbackbeloning op basis van de resourcewijzigingen en de resultaten van de taakvoortgang om de impact van deze planningsronde op het algemene doel te meten. Het ontwerp van de beloning houdt rekening met meerdere dimensies, waaronder de voltooiingsgraad van taken, de efficiëntie van het resourcegebruik en de mate van conflictonderdrukking. Via uitgebreide indicatoren wordt er feedback verstrekt aan de module voor strategie-updates.
Het gehele planningsproces construeert een Markov-beslissingsketen en maakt gebruik van de empirische trajectbemonstermethode om de staat-actie-beloningsvolgorde vast te leggen, aangeduid als (st, at, rt, st+1). Strategie-optimalisatie is gebaseerd op de constructie van de advantage-functie, waarbij de advantage-schatting in de volgende vorm wordt gedefinieerd:
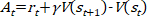 (4)
At represents de advantagewaarde, rt is de huidige onmiddellijke beloning, γ is de kortingsfactor voor de beloning, en V(st) en V(st+1) zijn respectievelijk de uitgangen van de staatswaardefunctie in de huidige en de volgende staat. De advantage-functie weerspiegelt de mate van superioriteit van de huidige actie ten opzichte van de gemiddelde prestatie van de strategie. Deze wordt gebruikt om de daaropvolgende verbetering van de strategie te sturen. Als At > 0, betekent dit dat de huidige actie beter is dan de gemiddelde verwachting en dat de waarschijnlijkheid ervan moet worden verhoogd; anders moet de neiging tot selectie ervan worden verminderd.
Tijdens het proces van strategie-update wordt een mechanisme voor het afkappen van de doelverdeling toegepast om strategie-oscillaties veroorzaakt door excessieve update-amplitudes te voorkomen, waardoor het bereik van verandering tussen de nieuwe en oude strategieën wordt beperkt en de continuïteit en stabiliteit van de netwerkoutput worden behouden. Er wordt een nauwe koppeling tot stand gebracht tussen de actieverdeling en de feedbackbeloning, waardoor de strategie onmiddellijk kan reageren op veranderingen in complexe beperkingen. Dit mechanisme handhaaft de stabiliteit van de besluitvorming en een rationele resourceplanning in situaties waarin taken frequent veranderen of resources plotseling niet overeenstemmen, waardoor problemen zoals dubbele toewijzing, resourcecongestie of achterstanden in de taakwachtrij effectief worden vermeden. Het planningssysteem kan een betere operationele staat behouden bij variërende taakdichtheden en resourcetekorten, wat sterke adaptieve vermogens demonstreert.
Iteratie van de strategie en stabiel update-mechanisme
Om ervoor te zorgen dat de gegenereerde planningsstrategieën stabiel blijven en niet verslechteren over herhaalde trainingsrondes, wordt in deze subsectie een iteratief update-mechanisme met clipping en voordeelcorrectie geïntroduceerd. Het truncatie-update-interval tussen de oude en nieuwe strategieën wordt vastgesteld, en de clipping-doelfunctie wordt gebruikt om de strategiedrift te beperken ter voorkoming van planningsschokken tijdens het update-proces van de strategie. Het waarderingsnetwerk wordt gecorrigeerd in combinatie met de voordeelfunctie om de nauwkeurigheid van de planning op lange termijn te verbeteren.
De waarschijnlijkheidsverdeling van de actie-output van het beleidsnetwerk is gevoelig voor drastische schommelingen tijdens continue planningsiteraties, wat kan leiden tot instabiel gedrag of een ongeorganiseerde toewijzing van resources. Om de planningsschok veroorzaakt door beleidsdrift te verminderen, is een afgebroken update-interval ontworpen om het bereik van de verandering tussen het nieuwe en het oude beleid te beheersen, en is er een restrictieterm geconstrueerd om de doelfunctie te verfijnen. De historische beleidswaarschijnlijkheid wordt geregistreerd in de bemonsteringsronde, en de ratio-term wordt geconstrueerd met de huidige beleidswaarschijnlijkheid. Het doel voor de beleidsupdate is vastgesteld als:
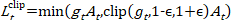 (5)
Hier geeft gt = πθ(at|st)/πθold(at|st) de waarschijnlijkheidsratio aan tussen de nieuwe en de oude policies; ε is de clipping-drempel die het bereik van de policy-update begrenst. Wanneer de ratio de grens overschrijdt, wordt in plaats daarvan de clipping-waarde gebruikt om te voorkomen dat de strategie excessieve gradiënten produceert uit extreme monsters, waardoor wordt gewaarborgd dat de aanpassing van de netwerkparameters binnen het vooraf ingestelde bereik blijft. Deze structuur beperkt dynamisch het bereik van wijzigingen in de outputstrategie voor elke planningsronde, waardoor de gladheid en consistentie van de strategie-output bij dichte taakdistributies behouden blijft en de jitter-rate van het planningsgedrag aanzienlijk wordt verminderd.
De doelfunctie van het beleid wordt tijdens het updateproces uitgebreid met regularisatie- en entropiebeloningstermen om de diversiteit van de actiedistributie te vergroten en voortijdige convergentie te onderdrukken. Elke ronde van beleidsupdates maakt gebruik van meerdere batches van ervaringstraject-steekproeven voor rollende training, waardoor de breedte van de dekking in de toestandsruimte behouden blijft. Wanneer de kansverdeling van de outputactievolgorde voor en na de update wordt vergeleken, wordt de afwijkingsgraad van de distributie berekend, waarbij een harde drempelwaarde het acceptabele verstoringsbereik van het beleid filtert. Dit mechanisme biedt begrenzingscontrole voor het migreren van planningsbeleid over cycli heen, waardoor overfitting als gevolg van drastische veranderingen in de resourcestatus wordt onderdrukt.
Strategie-updates zijn afhankelijk van de toestandsbeoordeling die wordt geleverd door de waardefunctie. Afwijkingen in de schatting van de toestands-waarde kunnen de correctheid van de advantage-functie direct beïnvloeden, waardoor de richting van de strategie-iteratie verandert. Om de nauwkeurigheid van de waardebepaling te verbeteren, is een backtracking-mechanisme voor meerdere tijdreeksen geconstrueerd, waarbij de verdisconteerde cumulatieve waarde van toekomstige beloningen wordt gebruikt om de huidige toestands-waarde te corrigeren. De backtracking-beloning hanteert de structuur van Generalized Advantage Estimation (GAE), die als volgt wordt gedefinieerd:
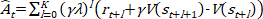 (6)
Ât is de gecorrigeerde voordeelwaarde; λ is de backtracking-balanscoëfficiënt; rt+l representeert de onmiddellijke beloning van de (t+l)-de stap; V(st+l) is de staatswaarde die wordt gegenereerd door het waarderingsnetwerk. Deze structuur integreert kortetermijn-, onmiddellijke feedback en langetermijnverwachtingen van de staat om afwijkingen in de responsvoorspellingen van de strategie voor toekomstige resourceconflicten, piekbelastingen en taakaccumulatie te corrigeren. λ regelt de backtracking-diepte en past zich automatisch aan tijdens perioden van drastische fluctuaties in de resource-dynamiek om de robuustheid van de respons van het waarderingsnetwerk op plotselinge gebeurtenissen te verhogen.
De multischaal tijdsonafhankelijke structuur die is ingebed in de advantage-functie stelt het waarderingsnetwerk in staat om langetermijntrends van resources te modelleren. Bij het detecteren van afwijkingen in de beleidsoutput wordt de consistentie-index van het beleidsgedrag gebruikt om te beoordelen of het netwerk een overmatige reactie vertoont op de waarderingsfout. Feedback-verschilresiduen monitoren het gedrag van de beleidsupdate, waarbij het trainingsdoel en de amplitude van de gewichtupdate van de waardefunctie dynamisch worden gecorrigeerd. Het waardenetwerk en het beleidsnetwerk worden gezamenlijk geoptimaliseerd om ervoor te zorgen dat de waardeschatting niet afwijkt van het doel voor taakvoltooiing, terwijl wordt voorkomen dat hoogfrequente planning de status van resourceconflicten onjuist beoordeelt.
Dit stabiele mechanisme voor beleidsupdates kan de controleerbaarheid en consistentie van beleidsgedragsupdates in een hoogdimensionale dynamische taakomgeving effectief handhaven, waardoor de efficiëntie van de taakdekking en de flexibiliteit van het hulpbronnengebruik worden verbeterd en een continu iteratieve intelligente planningsstructuur wordt gevormd. Planningsgedrag voorkomt dat er in de langetermijnevolutie wordt vastgelopen in een lokaal optimum en verhoogt de algehele aanpassingscapaciteit aan veranderingen in taakpatronen en schommelingen in hulpbroncycli.
Figuur 3A toont de trend in de waarde van de doelfunctie als functie van het aantal trainingsiteraties onder verschillende truncation-drempelwaarden. De horizontale as is het aantal trainingsiteraties en de verticale as is de numerieke waarde van de clipped doelfunctie. ε is ingesteld op 0,1, 0,2 en 0,3, wat verschillende graden van sterkte van de policy drift-controle vertegenwoordigt. De curve die correspondeert met een kleinere ε-waarde fluctueert minder en de doelfunctie blijft stabiel. Wanneer ε = 0,1, ligt de totale waarde van de doelfunctie tussen 0,8 en 1, wat de geleidelijkheid en stabiliteit van de strategie-update aantoont. Een grotere ε-waarde leidt echter tot uitgesproken fluctuaties. Wanneer ε = 0,3, ligt de totale waarde van de doelfunctie tussen 0,65 en 0,95 en vertoont de curve van de doelfunctie een grotere oscillatieamplitude, wat het risico op ernige afwijkingen in het strategie-updateproces weerspiegelt. Hoe kleiner de drempelwaarde, hoe stabieler de strategie, wat geschikt is voor scheduling-omgevingen met hoge beperkingen. Figuur 3B toont de veranderingen in de generalized advantage estimate onder verschillende backtracking-balanscoëfficiënten. λ is respectievelijk ingesteld op 0,8, 0,9 en 1,0 om de backtracking-diepte van toekomstige beloningen te controleren. De curve laat zien dat hoe hoger λ is, hoe kleiner de GAE-fluctuatie, hoe vloeiender de langetermijntrend en hoe nauwkeuriger de potentiële impact van scheduling-gedrag na meerdere stappen wordt vastgelegd. De curve met een λ van 0,8 vertoont uitgesproken periodieke fluctuaties, wat aangeeft dat deze gevoeliger is voor onmiddellijke beloningen en beter geschikt is voor kortstondige, plotselinge taken. In tegenstelling hiermee richt een λ van 1,0 zich meer op langetermijntrendmodellering en is deze geschikt voor scenario's met periodieke taken.
Analyse van computationele complexiteit en schaalbaarheid
De computationele complexiteit van het voorgestelde Transformer-PPO-framework wordt bepaald door twee hoofdonderdelen: de Transformer-encoder en de PPO-beleidsoptimalisatie.
Voor de Transformer-encoder met L lagen, H attention heads, embeddingdimensie d en inputsequentielengte T (het historische tijdvenster), is de tijdcomplexiteit per forward pass O(L·T2·d + L·T·d2), waarbij de T2-term voortvloeit uit het self-attention-mechanisme. In de implementatie zijn L = 3, H = 4, d = 128 en is T vastgesteld op 100 tijdstappen, wat resulteert in een beheersbare computationele overhead. Voor langere historische vensters wordt de kwadratische term T2 de dominante factor; in de praktijk omvat de planning van vakbondsactiviteiten echter doorgaans eindige historische horizonten (bijv. rollende vensters van een kwartaal of een jaar), en de resolutie van de tijdstappen kan worden aangepast om een balans te vinden tussen nauwkeurigheid en efficiëntie.
Voor het PPO-component zijn het beleidsnetwerk en het waardenetwerk lichtgewicht MLP's (256 en 128 neuronen per verborgen laag), waarvan de inferentiecomplexiteit O(d·m) is, waarbij m het aantal verborgen eenheden is, wat verwaarloosbaar is in vergelijking met de Transformer-encoder. De beleidsupdate tijdens de training omvat meerdere epochs van mini-batch gradiëntupdates, met een complexiteit van O(B·E·d2), waarbij B de batchgrootte is en E het aantal update-epochs.
Wat betreft de schaalbaarheid vertoont het raamwerk drie gunstige eigenschappen. Ten eerste kan het aandachtmechanisme geparallelliseerd worden over tijdstappen, wat efficiënte GPU-acceleratie mogelijk maakt. Ten tweede is de modelgrootte onafhankelijk van het aantal activiteiten of resources, aangezien de restrictiematrix dynamisch per planningsstap wordt geconstrueerd in plaats van als vaste parameters te worden ingebed. Hierdoor kan hetzelfde getrainde model worden ingezet voor vakbonden van verschillende schalen zonder dat hertraining nodig is. Ten derde kunnen voor scenario's op extreem grote schaal de historische vensterlengte T en de embedding-dimensie d worden verkleind als compromis, of kan de sparse attention-variant worden geadopteerd om de O(T2) complexiteit te reduceren tot O(T log T) of O(T).
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Experimentele gegevens
Om de prestaties van het in dit artikel gepresenteerde Transformer-PPO dynamische planningsalgoritme uitgebreid te evalueren, maakt het experiment gebruik van activiteitsbeheergegevens van een grote ondernemingsvakbond over de afgelopen drie jaar als benchmark-dataset. Deze dataset bevat meer dan 5.000 activiteitsgegevens van diverse typen, waaronder vergaderingen, trainingen en entertainment, met planningsinformatie voor meerdere resources, zoals locaties, apparatuur en person...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
De experimentele resultaten tonen aan dat het voorgestelde Transformer-PPO-algoritme consequent beter presteert dan de basismethoden (LSTM-PPO, greedy search en DQN) op alle evaluatiemetrieken. De superieure prestaties kunnen worden toegeschreven aan twee sleutelfactoren. Ten eerste legt het multi-head self-attention-mechanisme van de Transformer effectief langdurige temporele afhankelijkheden in activiteits- en resourcestatussequenties vast, waardoor proactieve identificatie van potentiële conflicten mogelijk wordt. Dit...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs verklaren dat zij geen financiële belangenconflicten hebben.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Python 3.9 | Python Software Foundation | https://www.python.org/downloads/release/python-390/ | Kern programmeertaal |
| PyTorch 1.12 | Meta AI | https://pytorch.org/get-started/previous-versions/ | Deep learning framework (Transformer/PPO-implementatie) |
| NumPy 1.23 | NumPy Developers | https://numpy.org/doc/stable/release/1.23.0-notes.html | Bibliotheek voor numerieke berekeningen |
| Matplotlib 3.5 | Matplotlib Development Team | https://matplotlib.org/stable/users/installing.html | Visualisatie van resultaten |
| Union activity scheduling dataset | Interne database van een samenwerkende onderneming (geanonimiseerd) | Niet openbaar beschikbaar vanwege geheimhoudingsovereenkomst; onderzoekers kunnen contact opnemen met de corresponderende auteur voor toegang | Meer dan 5.000 activiteitsgegevens (vergaderingen, trainingen, entertainment) van een grote ondernemingsvakbond over drie jaar |
| NVIDIA A100 GPU | |||
| PyTorch |
Referenties
- Bosire RK, Muya J, Matula D. Employee recognition programs and employee output as moderated by workers’ union activities: evidence from Kenyatta National Hospital (KNH), Kenya. Saudi J Bus Manag Stud. 2021;6(3):61-70.
- Carneiro B, Costa HA. Digital unionism as a renewal strategy? Social media use by trade union confederations. J Ind Relat. 2022;64(1):26-51.
- Geelan T. Introduction to the special issue: the internet, social media and trade union revitalization—still behind the digital curve or catching up? New Technol Work Employ. 2021;36(2):123-39.
- Hennebert MA, Pasquier V, Lévesque C. What do unions do…with digital technologies? An affordance approach. New Technol Work Employ. 2021;36(2):177-200.
- Panagiotopoulos P. Digital audiences of union organising: a social media analysis. New Technol Work Employ. 2021;36(2):201-18.
- Wang W, Seifert R. Trade-union-engendered employee trust in senior management: a case study of digitalisation. Ind Relat J. 2024;55(6):472-91.
- Katsabian T. Collective action in the digital reality: the case of platform-based workers. Mod Law Rev. 2021;84(5):1005-40.
- Holgate J. Trade unions in the community: building broad spaces of solidarity. Econ Ind Democr. 2021;42(2):226-47.
- Ovi RP, Rana MS, Jodder PK, Sarkar B. Performance evaluation of e-service delivery of union digital centers at the local level using composite indexing method: a study of Batiaghata upazilla in Khulna district. Inf Dev. 2024;40(4):620-34.
- Crossan J, et al. Colours of democracy: trade union banners and the contested articulations of democratic spatial practices. Trans Inst Br Geogr. 2023;48(1):23-38.
- Victor C, Kavishe AM. The challenges faced by trade unions in improving employee welfare and strategies to address them: a case of the Tanzania Union of Government and Health Employees (TUGHE) at the National Health Insurance Fund (NHIF). Afr J Empir Res. 2025;6(1):189-200.
- Rogalewski A. Trade unions challenges in organising Polish workers: a comparative case study of British and Swiss trade union strategies. Eur J Ind Relat. 2022;28(4):385-404.
- Pacetti V, Rossi P, Romens AI. Remotizzare, o non remotizzare: questo è il dilemma. Imprese e sindacati di fronte alla remotizzazione ibrida del lavoro. Stato Merc. 2023;43(3):421-49.
- Hunt T, Connolly H. COVID-19 and the work of trade unions: adaptation, transition and renewal. Ind Relat J. 2023;54(2):150-66.
- Joyce S, Stuart M, Forde C. Theorising labour unrest and trade unionism in the platform economy. New Technol Work Employ. 2023;38(1):21-40.
- Dupuis M. Algorithmic management and control at work in a manufacturing sector: workplace regime, union power and shopfloor conflict over digitalisation. New Technol Work Employ. 2025;40(1):81-101.
- Suryadevara S. Real-time task scheduling optimization in WirelessHART networks: challenges and solutions. Int J Adv Eng Technol Innov. 2022;1(3):29-55.
- Roşu D, Cojanu F, Ştefănică V, et al. Experimental management of work collectives through social and socialization activities. J Phys Educ Sport. 2022;22(7):1742-47.
- Ahmed AAA, et al. Multi-project scheduling and material planning using Lagrangian relaxation algorithm. Ind Eng Manag Syst. 2021;20(4):580-87.
- Gao H, et al. TBDB: token bucket-based dynamic batching for resource scheduling supporting neural network inference in intelligent consumer electronics. IEEE Trans Consum Electron. 2024;70(1):1134-44.
- Ouhame S, Hadi Y, Ullah A. An efficient forecasting approach for resource utilization in cloud data centers using a CNN-LSTM model. Neural Comput Appl. 2021;33(16):10043-55.
- Valarmathi K, Kanaga Suba Raja S. Resource utilization prediction technique in the cloud using a knowledge-based ensemble random forest with an LSTM model. Concurr Eng. 2021;29(4):396-404.
- Yang Y, Shen H. Deep reinforcement learning enhanced greedy optimization for online scheduling of batched tasks in cloud HPC systems. IEEE Trans Parallel Distrib Syst. 2022;33(11):3003-14.
- Tang B, Luo J, Obaidat MS, Vijayakumar P. Container-based task scheduling in a cloud-edge collaborative environment using a priority-aware greedy strategy. Cluster Comput. 2023;26(6):3689-705.
- Zhang Y, Zou YH, Zhang XD. Manufacturing resource scheduling based on a deep Q-network. Wuhan Univ J Nat Sci. 2022;27(6):531-38.
- Mangalampalli S, et al. DRLBTSA: deep reinforcement learning-based task-scheduling algorithm in cloud computing. Multimed Tools Appl. 2024;83(3):8359-87.
- Wang Y, Wang Q, Chu X. Energy-efficient online scheduling of transformer inference services on GPU servers. IEEE Trans Green Commun Netw. 2022;6(3):1649-59.
- Liu L, et al. Dynamic sparse attention for scalable transformer acceleration. IEEE Trans Comput. 2022;71(12):3165-78.
- He X, et al. Channel assignment and power allocation for throughput improvement with PPO in B5G heterogeneous edge networks. Digit Commun Netw. 2024;10(1):109-16.
- Liu H, et al. A new multi-domain cooperative resource scheduling method using proximal policy optimization. Neural Comput Appl. 2024;36(9):4931-45.
- Jin J, Xu Y. Optimal policy characterization enhanced proximal policy optimization for multitask scheduling in cloud computing. IEEE Internet Things J. 2022;9(9):6418-33.
- Chavva M, Veera S. Dynamic cost-aware language models: a real-time framework for optimizing cloud resource recommendations. Int J Mach Learn Sustain Dev. 2023;5(2):1-15.
- Zhao Z, et al. Link scheduling using graph neural networks. IEEE Trans Wirel Commun. 2023;22(6):3997-4012.
- Zhang Z, et al. A resource optimization scheduling model and algorithm for heterogeneous computing clusters based on GNN and RL. J Supercomput. 2024;80(16):24138-72.
- Chai F, et al. Joint multi-task offloading and resource allocation for mobile edge computing systems in satellite IoT. IEEE Trans Veh Technol. 2023;72(6):7783-95.
- Luo Q, et al. Resource scheduling in edge computing: a survey. IEEE Commun Surv Tutor. 2021;23(4):2131-65.
- Gupta A, Namasudra S, Kumar P. An enhanced strategy for energy-efficient cloud computing environment through VM consolidation. In: Dagur A, Singh K, Mehra PS, Shukla DK, editors. Intelligent Computing and Communication Techniques. Boca Raton (FL): CRC Press; 2025. p. 330–34. https://doi.org/10.1201/9781003530176-46
- Sombo B, Apeh ST, Edeoghon IA. Review on authentication algorithms in cellular communication networks. Cloud Comput Data Sci. 2025;6(1):54-66.
- Gupta A, Kumar P, Namasudra S. Sustainable cloud computing: an enhanced energy-efficient VM consolidation approach using live migration. Iran J Comput Sci. 2026;9:27. doi:10.1007/s42044-025-00385-y.
- García F, et al. Traffic optimization through waiting prediction and evolutive algorithms. Int J Interact Multimed Artif Intell. 2025;9(3):96-103.
- Sharma P, Namasudra S, Lorenz P. Blockchain-based cloud storage system with enhanced optimization and integrity preservation. Presented at: IEEE International Conference on Communications (ICC); Rome, Italy; 2023. p. 3744-49.
- Ding F, et al. Transformer-enhanced DQN approach for energy- and cost-efficient large-scale dynamic workflow scheduling in a heterogeneous environment. IEEE Internet Things J. 2024;11(22):37351-67.
- Yu H, Tang N, Zhu Z, Guo Z. Flexible job-shop scheduling via gated recurrent unit and deep reinforcement learning. Knowl Based Syst. 2025;330:114734. doi:10.1016/j.knosys.2025.114734.
- Do KH, et al. Graph Neural PPO for joint user association and resource allocation in Open RAN [conference paper]. Presented at: 40th International Conference on Information Networking (ICOIN); Hanoi, Vietnam; 2026. p. 37-42.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.