Deze studie onderzoekt elektroencefalografie-biomarkers om onderscheid te maken tussen de ziekte van Alzheimer, frontotemporale dementie en gezonde controles. Random Forest-modellen die gebruikmaken van root mean square, power spectral density en entropiekenmerken werden geïnterpreteerd met behulp van uitlegbare kunstmatige intelligentie en effectgrootte-analyse. Het verwijderen van entropiekenmerken met een lage impact verbeterde de classificatieprestaties, wat resulteerde in een testnauwkeurigheid van 94%.
Onderzoeksartikel
Fusie van multidomein elektroencefalografie-biomarkers voor machinaal leren-gebaseerde classificatie van dementie
In dit artikel
Samenvatting
Samenvatting
Electroencefalografie (EEG) is onderzocht als een niet-invasieve benadering om hersenactiviteit bij neurodegeneratieve aandoeningen te karakteriseren. Deze studie evalueerde of multidomein EEG-biomarkers onderscheid konden maken tussen de ziekte van Alzheimer (AD), frontotemporele dementie (FTD) en gezonde controles (HC). De openbaar beschikbare dataset bevatte EEG-opnamen in rusttoestand met gesloten ogen van 88 deelnemers, waaronder 36 met AD, 23 met FTD en 29 gezonde controles. Multidomein EEG-biomarkers en demografische kenmerken werden geëxtraheerd voor classificatie via machine learning. De uit het EEG afgeleide kenmerken omvatten root-mean-square (RMS), spectrale vermogensdichtheid (PSD) en entropiematen. Een Random Forest-classifier werd getraind met de gecombineerde set kenmerken en geïnterpreteerd met behulp van uitlegbare kunstmatige intelligentie. Analyses van kenmerkstabiliteit en de effectgrootte van Cohen’s d werden uitgevoerd om de bijdragen van de kenmerken te evalueren, gevolgd door een ablatieanalyse. Op entropie gebaseerde kenmerken vertoonden de laagste bijdrage aan de classificatie. Het volledige multidomeinmodel behaalde een trainingsnauwkeurigheid van 96% en een testnauwkeurigheid van 92%. Na verwijdering van de entropiekenmerken steeg de testnauwkeurigheid naar 94%. Deze resultaten beschrijven de classificatieprestaties van de geselecteerde multidomein EEG- en demografische kenmerken binnen het Random Forest-raamwerk.
Inleiding
De ziekte van Alzheimer (AD) is een progressieve neurologische aandoening die gepaard gaat met een verslechtering van de cognitieve en motorische functies. De prevalentie neemt aanzienlijk toe met de leeftijd, en dementie is een belangrijke oorzaak van morbiditeit en mortaliteit bij ouderen1,2,3,4,5. Omdat diagnose en ziekteclassificatie uitdagend blijven, is de analyse van hersensignalen onderzocht als een middel om neurofysiologische veranderingen die geassocieerd worden met dementie te karakteriseren.
Elektro-encefalografie (EEG) is een niet-invasieve methode voor het registreren van de elektrische activiteit van de hersenen en is onderzocht bij de ziekte van Alzheimer en andere neurologische aandoeningen6,7,8,9,10,11. EEG-signalen weerspiegelen elektrische potentialen die worden gegenereerd door neuronale activiteit en worden niet-invasief geregistreerd vanaf meerdere locaties op de hoofdhuid12,13,14. Hersenactiviteit wordt gewoonlijk gekarakteriseerd aan de hand van de delta-, theta-, alpha-, beta- en gamma-frequentiebanden15. De ziekte van Alzheimer is geassocieerd met EEG-vertraging, verminderde signaalcomplexiteit en gewijzigde synchronisatie16. Spectrale analyses hebben een toename van de delta- en theta-activiteit gerapporteerd, samen met een afname van de alpha- en beta-activiteit bij personen met AD vergeleken met gezonde controles17,18,19. Eerdere EEG-classificatiestudies hebben hoge prestaties gerapporteerd bij het onderscheiden van AD van gezonde controles (HC) en frontotemporale dementie (FTD) van HC. Daarentegen is discriminatie tussen AD en FTD over het algemeen uitdagender gebleken10,11.
Methoden voor machine learning zijn gebruikt om patronen in EEG-signalen te identificeren die geassocieerd worden met neurologische ziekten20,21. Kenmerkextractie is daarom een belangrijk onderdeel van EEG-gebaseerde classificatie. In eerdere studies zijn spectrale, temporele, complexiteits- en functionele connectiviteitskenmerken onderzocht in combinatie met machine learning-modellen3,15,22,23. Spectrale kenmerken zijn bijzonder relevant omdat ze frequentieafhankelijke veranderingen in de hersenactiviteit kwantificeren, waaronder de verminderde alfa-activiteit en verhoogde theta-activiteit die zijn gerapporteerd bij AD23,24,25,26.
Verschillende EEG-gebaseerde studies hebben diverse combinaties van kenmerken, classificatoren en validatiestrategieën geëvalueerd. Connectiviteitsgebaseerde analyse is gebruikt om AD, FTD en HC te onderscheiden, waarbij de gerapporteerde classificatieprestaties varieerden afhankelijk van de vergelijking en de procedure voor kenmerkselectie27. Fourier-gebaseerde kenmerken zijn eveneens geëvalueerd voor het onderscheiden van AD, milde cognitieve stoornis (MCI) en gezonde controles, hoewel beperkingen bestonden uit beperkte preprocessing en mogelijke overfitting in verband met de validatiestrategie28. Niet-lineaire EEG-complexiteitsmaten hebben discriminatief potentieel getoond voor AD-classificatie, waarbij sommige een hoge nauwkeurigheid, sensitiviteit en specificiteit behaalden, hoewel hun toepasbaarheid op MCI en discriminatie van ziektestadia beperkt blijft21.
Deep learning-methoden gebaseerd op tijd-frequentie EEG-representaties zijn ook onderzocht voor de multiclass-classificatie van AD, MCI en HC29. Hoewel er melding is gemaakt van hoge classificatieprestaties, omvatten de beperkingen kleine of geselecteerde cohorten, klasse-onbalans, heterogene ernst van de ziekte, een gebrek aan externe validatie en een verminderde interpreteerbaarheid van de modellen29. De validatiestrategie is eveneens een belangrijke methodologische overweging. Deelnemer-onafhankelijke benaderingen hebben aangetoond dat conventionele cross-validatie op epoch-niveau de prestaties kan overschatten wanneer epochs van dezelfde deelnemer voorkomen in zowel de trainings- als de testsets30. Deze beperking is bijzonder relevant bij het vergelijken van classificatieresultaten tussen studies die verschillende validatieschema's gebruiken.
Complexiteits- en connectiviteitsmaten zijn ook geëvalueerd met behulp van support vector machine-classificatoren, waarbij fasegebaseerde connectiviteit en multiscale entropie variërende niveaus van discriminatieve prestaties vertoonden31,32. Ander werk waarin kenmerken zijn gebruikt die zijn afgeleid van Fourier- en wavelet-analyses, rapporteerde variabele prestaties bij vergelijkingen tussen AD, MCI en HC, waarbij multiclass-classificatie over het algemeen moeilijker bleek dan binaire classificatie14. Op entropie en synchronie gebaseerde benaderingen hebben daarnaast discriminatie tussen AD- en controlegroepen aangetoond, hoewel de kenmerken van de controlepopulatie de waargenomen effectgrootte kunnen beïnvloeden2.
De huidige studie evalueert een multidomein-kenmerkenset bestaande uit root-mean-square (RMS), power spectral density (PSD) en entropiematen geëxtraheerd uit EEG-frequentiebanden, samen met leeftijd als demografische variabele. RMS representeert de signaalamplitude binnen elke frequentieband, terwijl PSD de vermogensdichtheid in het frequentiedomein representeert. Entropie is opgenomen als een maat voor signaalcomplexiteit. Deze kenmerken bieden complementaire beschrijvingen van de EEG-activiteit en worden geëvalueerd met behulp van een Random Forest-classifier. De studie onderzoekt verder de belangrijkheid van kenmerken, de stabiliteit van kenmerken, uitlegbare kunstmatige intelligentie en effectgrootte-analyse om de relatieve bijdrage van de geëxtraheerde kenmerken te beoordelen. De huidige studie onderzoekt de effectiviteit van multidomein EEG-kenmerken, waaronder spectrale, temporele en op complexiteit gebaseerde maten, bij het onderscheiden van de ziekte van Alzheimer (AD), frontotemporale dementie (FTD) en gezonde controles (HC) met behulp van machine learning. Er wordt ook onderzocht welke EEG-frequentieband-kenmerken het sterkst bijdragen aan de classificatie bij gebruik van power spectral density (PSD), root-mean-square (RMS) en entropiematen. Daarnaast vergelijkt de studie de bijdragen van vermogensgebaseerde kenmerken, waaronder PSD en RMS, met die van entropiegebaseerde kenmerken en evalueert de bijdrage van leeftijd aan het classificatiemodel.
Protocol
Een schematisch overzicht van de workflow voor EEG-preprocessing, kenmerkextractie en classificatie wordt getoond in Figuur 1. De materialen en software die in de studie zijn gebruikt, staan vermeld in de Tabel met Materialen.
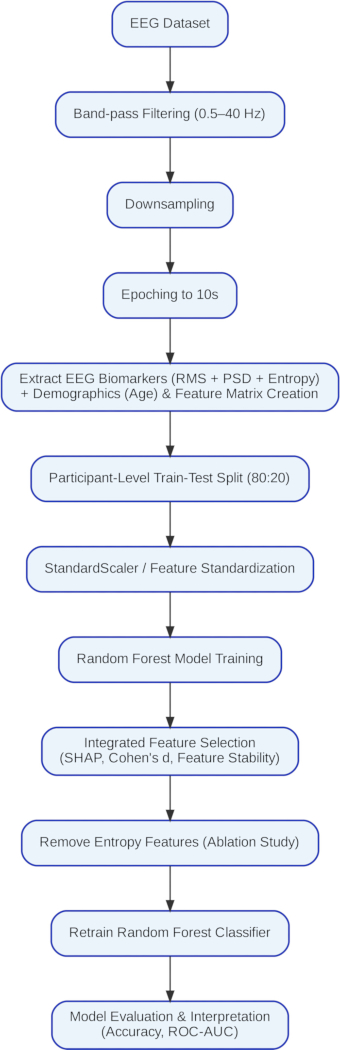
Figuur 1: Workflow van de EEG-preprocessing, kenmerkextractie en classificatie-pijplijn. Schematisch overzicht van de workflow van de studie, inclusief EEG-gegevensverificatie, banddoorlaatfiltering en her-referentie, extractie van root mean square (RMS), power spectral density (PSD) en entropie-kenmerken, toevoeging van leeftijd, train-test splitsing, ontwikkeling van het Random Forest-model, kenmerkstabiliteitsanalyse, SHAP-analyse, Cohen’s d effectgrootte-analyse, geïntegreerde kenmerkselectie, entropie-kenmerk ablatie, hertraining van het model en prestatie-evaluatie. Klik hier om een grotere versie van deze figuur te bekijken.
1. Gegevensverwerving
De openbaar toegankelijke EEG-dataset in rusttoestand is verkregen uit de OpenNeuro-repository (dataset ds004504, versie 1.0.9)33. De labels van de deelnemers en de demografische informatie zijn geverifieerd. De dataset bestond uit 88 deelnemers, waaronder 36 deelnemers met de ziekte van Alzheimer (AD), 23 met frontotemporale dementie (FTD) en 29 gezonde controles (HC).
2. Import van EEG-registraties
Voor elke deelnemer werd de EEG-registratie geladen met behulp van de MNE-Python bibliotheek. Elk EEG-bestand werd gecontroleerd om te bevestigen dat het toegankelijk was, succesvol geïmporteerd kon worden en een geldige deelnemer-identificatie bevatte. Registraties met ontbrekende of beschadigde bestanden werden uitgesloten. De oorspronkelijke EEG-bemonsteringsfrequentie van 500 Hz werd in deze fase behouden. De signalen werden gedownsampled om de rekenlast te verminderen, terwijl alle klinisch relevante EEG-informatie voor deze studie behouden bleef.
3. Banddoorlaatfiltering
De continue EEG-registraties werden gefilterd met een vierde-orde banddoorlaatfilter met een lage afsnijfrequentie van 0.5 Hz en een hoge afsnijfrequentie van 40 Hz.
4. Gemiddelde referentiemeting en epoching
Gemiddelde referentiemeting (common average referencing, CAR) werd toegepast op de gefilterde EEG-opnames. Bij elk tijdstip werd het gemiddelde signaal over alle beschikbare EEG-kanalen berekend en van elk kanaal afgetrokken. De gerefenceerde EEG-signalen werden behouden voor verdere analyse. Elke gerefenceerde EEG-opname werd gesegmenteerd in epochs van vaste lengte met behulp van de functie make_fixed_length_epochs() in MNE-Python. Er werd een epoch-duur van 10 s met 0 s overlap gebruikt.
5. Validatie van epochs
Voor elke deelnemer werden alleen volledige epochs van 10 s behouden. Elk overgebleven EEG-segment korter dan 10 s aan het einde van een opname werd verworpen. Elke behouden epoch werd vervolgens gebruikt als een individueel monster voor kenmerkextractie.
6. Voorbereiding van kenmerken
Hoewel gegevens van de Mini-Mental State Examination (MMSE) beschikbaar waren in de brondata-set, werden deze uitgesloten van de huidige analyse. De geëxtraheerde EEG-kenmerken werden samengevoegd met demografische informatie van de deelnemers, waaronder leeftijd en diagnostische labels, verkregen uit het metadata-bestand participants.csv. De deelnemer-identificatie werd gebruikt als gemeenschappelijke sleutel, en alleen deelnemers met zowel EEG-kenmerkrecords als overeenkomstige demografische informatie werden behouden.
De multidomein-kenmerkenmatrix bevatte vijf root mean square (RMS)-kenmerken (delta_rms, theta_rms, alpha_rms, beta_rms en gamma_rms), vijf power spectral density (PSD)-kenmerken (delta_psd, theta_psd, alpha_psd, beta_psd en gamma_psd) en vijf entropiekenmerken (delta_entropy, theta_entropy, alpha_entropy, beta_entropy en gamma_entropy). Leeftijd werd meegenomen als aanvullende demografische variabele. Omdat leeftijdsverdelingen kunnen variëren tussen diagnostische groepen, kon demografische confounding niet volledig worden uitgesloten. De diagnostische groep, gedefinieerd als AD, HC of FTD, werd toegewezen alsHet doellabel.
7. Preprocessing van gegevens en train-test partitionering
Tijdens de preprocessing werden de opnames gedownsampled van 500 Hz naar 250 Hz om de computationele vereisten te verminderen, terwijl de relevante EEG-frequentie-informatie behouden bleef.
De dataset werd op subjectniveau opgesplitst in trainings- (80%) en testsets (20%) met behulp van een grouped splitting-strategie. Voorspellingen op subjectniveau werden vervolgens verkregen via majority voting over de voorspelde epochs die toebehoorden aan elke deelnemer. Voor de primaire evaluatie werd een subject-level grouped train-test split gebruikt om te voorkomen dat epochs van dezelfde deelnemer in beide subsets voorkwamen. Voorspellingen op subjectniveau werden verkregen via majority voting over de voorspelde epochs die toebehoorden aan elke deelnemer. De dataset werd gecontroleerd op ontbrekende waarden, waarbij ontbrekende observaties werden verwijderd of, indien van toepassing, geïmputeerd. Diagnostische labels werden gecodeerd. Een StandardScaler werd gefit op de trainingsdata en vervolgens toegepast op zowel de trainings- als de testdatasets.
8. Ontwikkeling van het Random Forest-model
Een Random Forest-classifier werd geïnitialiseerd met 80 bomen, een maximale boomdiepte van 10, maximaal vier kenmerken, minimaal vijf monsters per blad en een random state van 42. De classifier werd getraind met behulp van de gestandaardiseerde trainingsdataset.
9. Model-evaluatie
Klasselabels werden voorspeld voor zowel de trainings- als de testdatasets. Er werd een confusiematrix opgesteld, en de accuratesse, precisie, recall en F1-score werden berekend samen met het classificatierapport. De accuratesse van de training en het testen werd genoteerd.
Zorg er bij de evaluatie per deelnemer voor dat alle epochs van een bepaalde deelnemer uitsluitend werden toegewezen aan óf de trainings- óf de testsubset. De Random Forest-classifier werd getraind met dezelfde hyperparameters als in de primaire analyse.
10. Kruisvalidatie
Als aanvullende procedure voor model-evaluatie werd een gestratificeerde vijf-voudige kruisvalidatie uitgevoerd met shuffle = True en random_state = 30. De gemiddelde nauwkeurigheid en standaarddeviatie over de vijf folds werden berekend. Deze analyse werd apart beschouwd van de primaire holdout-evaluatie op subjectniveau.
11. Analyse van de stabiliteit van kenmerken
De stabiliteit van de kenmerken werd beoordeeld door de training van het Random Forest 10 keer te herhalen met willekeurige seeds van 0 tot en met 9. Voor elke run werden de testnauwkeurigheid en de scores voor het belang van de kenmerken geregistreerd. Het gemiddelde en de standaarddeviatie van de score voor het belang van de kenmerken voor elke voorspeller werden berekend over de 10 runs, en de voorspellers werden gerangschikt op basis van hun stabiliteit. Deze analyse werd gebruikt om de consistentie van de rangschikking van de kenmerken te beoordelen, in plaats van om de primaire evaluatie op subjectniveau te vervangen.
12. Analyse met uitlegbare kunstmatige intelligentie
SHAP TreeExplainer werd toegepast op het getrainde Random Forest-model. SHAP-waarden werden berekend om de bijdrage van elk kenmerk aan de voorspellingen van het model te schatten. Voor elk kenmerk werd de gemiddelde absolute SHAP-waarde berekend, waarna de kenmerken werden gerangschikt op basis van hun SHAP-bijdragen. Kenmerken met consistent lage SHAP-waarden werden geïdentificeerd en vergeleken met de resultaten van de analyses naar kenmerkstabiliteit en de d van Cohen. Kenmerken die consistent lage bijdragen vertoonden, werden geselecteerd voor daaropvolgende ablatie en hertraining van het model.
13. Statistische analyse van de effectgrootte
Cohen’s d werd berekend voor elke EEG-biomarker voor de vergelijkingen AD versus HC, AD versus FTD en FTD versus HC. De grootte van het effect werd geïnterpreteerd met drempelwaarden van 0,20 voor een klein effect, 0,50 voor een gemiddeld effect en 0,80 voor een groot effect.
14. Geïntegreerde kenmerkselectie
De resultaten van de Random Forest-analyse van kenmerkbelang, de SHAP-analyse en de Cohen’s d-analyse werden vergeleken. Predictoren die consistent een laag kenmerkbelang, een lage SHAP-bijdrage en kleine effectgroottes vertoonden, werden geïdentificeerd als kandidaten voor verwijdering.
15. Ablatie van kenmerken
Entropiekenmerken werden geëvalueerd in een exploratieve ablatieanalyse, waarna een gereduceerde kenmerkenmatrix bestaande uit RMS, PSD en leeftijd werd samengesteld. De Random Forest-classifier werd opnieuw getraind met behulp van dezelfde hyperparameters. De modeltraining, het testen, de kruisvalidatie en de receiver operating characteristic (ROC)-analyse werden herhaald met gebruik van de gereduceerde kenmerkenset.
16. ROC-analyse
Klassewaarschijnlijkheden werden verkregen uit de geoptimaliseerde Random Forest-classifier. Multiklasse ROC-curven werden gegenereerd met behulp van een one-versus-rest-strategie. De klasse-specifieke waarden voor het oppervlak onder de curve (AUC) en de gemiddelde AUC werden berekend.
17. Vergelijking van de prestaties
De prestaties van het volledige kenmerkenmodel werden vergeleken met die van het gereduceerde kenmerkenmodel dat was verkregen na entropie-kenmerkenablatie.
Resultaten
Het Random Forest-model behaalde een trainingsnauwkeurigheid van 96% en een testnauwkeurigheid van 92%. De macro-gemiddelde F1-score was 92%, terwijl de gewogen-gemiddelde F1-score eveneens 92% was, wat wijst op vergelijkbare prestaties over de drie klassen. De classificatieprestaties waren het hoogst voor de klasse ziekte van Alzheimer (AD), terwijl de klasse frontotemporale dementie (FTD) een relatief lagere prestatie vertoonde, zoals weergegeven in Tabel 1.
Een receiver operating characteristic (ROC)-analyse werd gebruikt om de klassenscheiding over verschillende classificatiedrempels te evalueren. Zoals getoond in Figuur 2, was de area under the ROC curve (AUC) voor alle drie de klassen groter dan 0,98, wat duidt op een hoge scheidbaarheid tussen de AD-, FTD- en gezonde controlegroepen (HC).
SHAP-analyse met behulp van TreeExplainer werd uitgevoerd om de bijdragen van kenmerken aan het Random Forest-classificatiemodel te evalueren. De samenvattende staafgrafiek in Figuur 3 toonde de relatieve bijdrage van de spectrale vermogensdichtheid (PSD), de root mean square (RMS), entropie en demografische kenmerken. Kenmerken met hogere absolute SHAP-waarden droegen sterker bij aan de modelvoorspellingen, terwijl entropie-gerelateerde kenmerken relatief lage bijdragen vertoonden.
De analyse van de kenmerkstabiliteit werd uitgevoerd door de Random Forest-training te herhalen over de gespecificeerde willekeurige seeds. De testnauwkeurigheid en de scores voor kenmerkbelang werden voor elke run geregistreerd, waarna het gemiddelde en de standaarddeviatie van het kenmerkbelang werden berekend. Het model behaalde in deze analyse een gemiddelde classificatienauwkeurigheid van 95%, met een standaarddeviatie van 0,17%. Deze herhaalde runs werden primair gebruikt om de consistentie van de rangschikking van kenmerken te evalueren en werden apart beschouwd van de primaire holdout-evaluatie op subjectniveau. Leeftijd werd hoog gerangschikt in de analyse van de kenmerkstabiliteit, zoals weergegeven in Tabel 2. De kenmerken theta_psd en theta_rms werden ook hoog gerangschikt, terwijl alpha_psd, alpha_rms, beta_psd en beta_rms een matig kenmerkbelang vertoonden.
Cohen’s d werd berekend om de omvang van de groepsverschillen te beoordelen, zoals gepresenteerd in Tabel 3. Attenuatie van de alfaband (alpha_rms, d = 0,97; alpha_psd, d = 0,87) en toegenomen theta-activiteit (theta_rms, d = 0,72) vertoonden de grootste gerapporteerde verschillen tussen deelnemers met AD en gezonde controles. Deze bevindingen waren consistent met de corticale vertraging die is gerapporteerd in EEG-studies naar dementie34. Op entropie gebaseerde kenmerken vertoonden relatief kleinere effectgroottes. Vergelijkingen tussen AD en FTD leverden voornamelijk kleine tot matige effectgroottes op.
Kenmerken van de alfaband vertoonden grote effectgroottes voor de vergelijkingen AD-versus-HC en FTD-versus-HC. Voor AD versus HC waren de gerapporteerde effectgroottes −0,87 voor alpha_psd en −0,97 voor alpha_rms. Voor FTD versus HC was de attenuatie van de alfaband −0,73. Het kenmerk theta_psd vertoonde een effectgrootte van 0,61 voor AD versus HC, terwijl theta_rms een effectgrootte van 0,72 vertoonde. Kleinere verschillen werden waargenomen voor AD versus FTD.
Kenmerken van de bètaband vertoonden voornamelijk kleine tot matige groeps-effectgroottes. De beta_psd-effectgroottes waren −0,35 voor AD versus HC en −0,41 voor AD versus FTD, terwijl beta_rms grotendeels kleine effecten vertoonde. Kenmerken van de gammaband vertoonden matige effecten voor enkele vergelijkingen. De gamma_psd-effectgrootte was 0,47 voor FTD versus HC en 0,20 voor AD versus HC, terwijl gamma_rms een effectgrootte van 0,50 vertoonde voor FTD versus HC.
Delta PSD en RMS vertoonden kleine positieve effectgroottes voor AD versus HC (respectievelijk 0.29 en 0.34) en FTD versus HC (respectievelijk 0.25 en 0.25). Effectgroottes voor AD versus FTD lagen dicht bij nul. Delta-entropie vertoonde kleine effectgroottes over alle drie de vergelijkingen (0.08, 0.20 en −0.11).
Analyses van kenmerkstabiliteit, SHAP en effectgrootte wezen op relatief lage bijdragen van de entropiekenmerken. Bijgevolg werd een ablatieanalyse uitgevoerd door de entropiekenmerken uit te sluiten en RMS, PSD en leeftijd te behouden. Na de kenmerkablatie behaalde het Random Forest-model een trainingsnauwkeurigheid van 96% en een testnauwkeurigheid van 94%. Dit resultaat werd geïnterpreteerd als een verkennende vergelijking binnen het geëvalueerde raamwerk voor kenmerkselectie. De precisie, recall, F1-score en support voor de klassen AD, HC en FTD worden gepresenteerd in Tabel 4.
De prestaties vóór en na de ablatie van entropie-kenmerken worden vergeleken in Tabel 5. De testnauwkeurigheid steeg van 92% naar 94% na het verwijderen van entropie. De klasse-specifieke wijzigingen worden gepresenteerd in Tabel 6. Voor FTD steeg de precisie met 4% en de F1-score met 2%. De recall voor de HC-groep steeg met 4%, terwijl de precisie met 2% afnam. De macro-gemiddelde en gewogen-gemiddelde prestatiemaatstaven stegen met ongeveer 1%–2% na de kenmerkablatie.
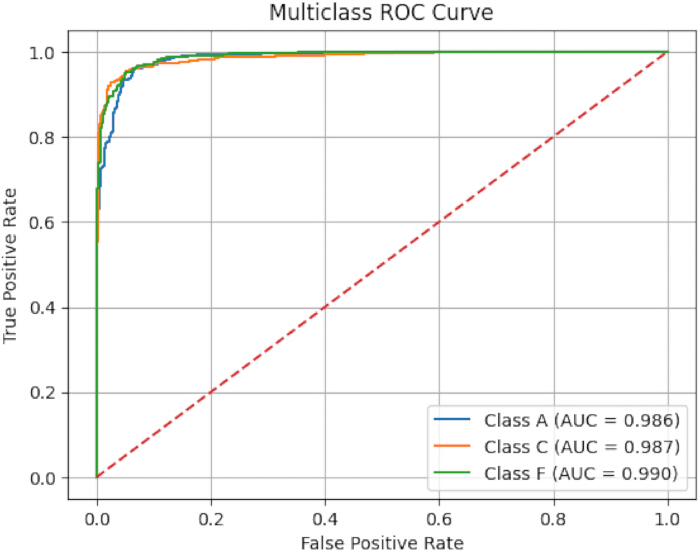
Figuur 2: Receiver operating characteristic-curves voor de ziekte van Alzheimer, frontotemporale dementie en gezonde controles. Multiclass receiver operating characteristic (ROC)-curves gegenereerd met de one-versus-rest-strategie voor de ziekte van Alzheimer (klasse A), frontotemporale dementie (klasse F) and gezonde controles (klasse C). De area under the curve (AUC) werd berekend voor elke klasse. Klik hier om een grotere versie van deze figuur te bekijken.
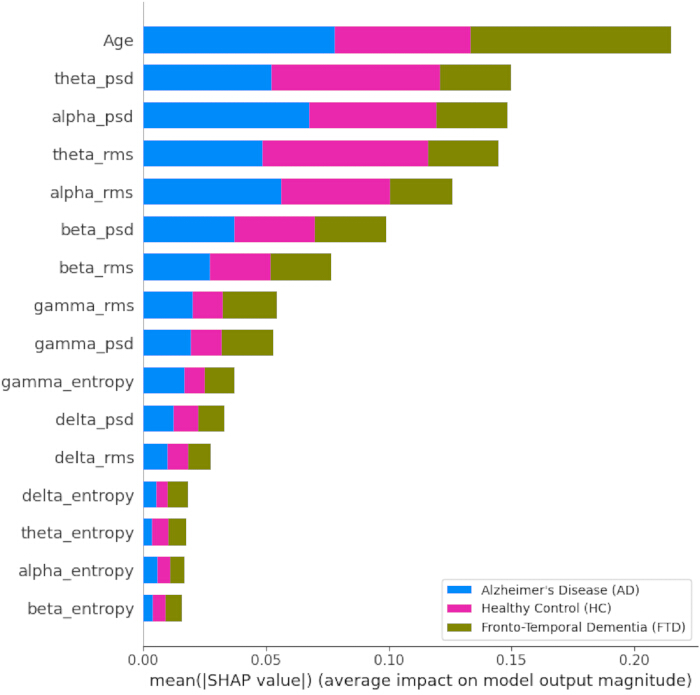
Figuur 3: SHAP-samenvattingsanalyse van het getrainde Random Forest-model. Samenvattend staafdiagram dat de relatieve bijdrage van EEG-afgeleide en demografische kenmerken aan het Random Forest-classificatiemodel laat zien. Gemiddelde absolute SHAP-waarden werden gebruikt om de bijdragen van root mean square (RMS), power spectral density (PSD), entropie en leeftijdskenmerken te rangschikken. Klik hier om een grotere versie van deze figuur te bekijken.
| Precisie | Recall | F1-score | Ondersteuning | |
| ziekte van Alzheimer | 0.92 | 0.95 | 0.94 | 579 |
| Controle | 0.93 | 0.92 | 0.93 | 480 |
| Frontotemporale dementie | 0.93 | 0.87 | 0.9 | 314 |
| Macro-gemiddelde | 0.93 | 0.92 | 0.92 | 1373 |
| Gewogen gemiddelde | 0.93 | 0.92 | 0.92 | 1373 |
Tabel 1: Classificatierapport van de testgegevens. Precisie, recall, F1-score en support voor de klassen ziekte van Alzheimer, gezonde controle en frontotemporale dementie in de testdataset, samen met de macro-gemiddelde en gewogen-gemiddelde prestatiematen.
| Kenmerk | Gemiddelde | Standaarddeviatie |
| Leeftijd | 0.1966 | 0.0017 |
| theta_psd | 0.0936 | 0.0027 |
| theta_rms | 0.0911 | 0.0023 |
| alpha_psd | 0.0824 | 0.0022 |
| alpha_rms | 0.0824 | 0.0024 |
| beta_psd | 0.0638 | 0.0013 |
| beta_rms | 0.0629 | 0.0012 |
| gamma_psd | 0.0534 | 0.001 |
| gamma_rms | 0.0527 | 0.0014 |
| delta_psd | 0.0403 | 0.0007 |
| delta_rms | 0.0359 | 0.001 |
| gamma_entropy | 0.0326 | 0.0008 |
| alpha_entropy | 0.0325 | 0.0006 |
| beta_entropy | 0.0283 | 0.0009 |
| theta_entropy | 0.0258 | 0.0004 |
| delta_entropy | 0.0255 | 0.0005 |
Tabel 2: Kenmerkstabiliteitsrangschikking van het Random Forest-model. Gemiddelde waarden voor kenmerkbelang en de bijbehorende variabiliteit, verkregen uit herhaalde Random Forest-training met willekeurige seeds van 0 – 9. Kenmerken werden gerangschikt op basis van hun stabiliteit over de runs.
| Kenmerk | AD vs. HC | AD vs. FTD | FTD vs. HC |
| Delta PSD | 0.293 | -0.069 | 0.253 |
| Theta PSD | 0.612 | 0.23 | 0.355 |
| Alpha PSD | -0.869 | -0.219 | -0.64 |
| Beta PSD | -0.352 | -0.408 | 0.201 |
| Gamma PSD | 0.201 | -0.326 | 0.468 |
| Delta-entropie | 0.081 | 0.199 | -0.111 |
| Theta-entropie | 0.208 | 0.033 | 0.163 |
| Alpha-entropie | -0.061 | 0.071 | -0.137 |
| Beta-entropie | -0.37 | -0.042 | -0.332 |
| Gamma-entropie | -0.338 | 0.047 | -0.391 |
| Delta RMS | 0.342 | 0.041 | 0.251 |
| Theta RMS | 0.718 | 0.354 | 0.318 |
| Alpha RMS | -0.977 | -0.205 | -0.73 |
| Beta RMS | -0.494 | -0.365 | 0.015 |
| Gamma RMS | 0.187 | -0.33 | 0.5 |
Tabel 3: Vergelijking van de effectgrootte van Cohen’s d tussen diagnostische groepen. Waarden van Cohen’s d voor EEG-biomarkers voor de vergelijkingen tussen de ziekte van Alzheimer versus gezonde controles, de ziekte van Alzheimer versus frontotemporale dementie, en frontotemporale dementie versus gezonde controles.
| Precisie | Recall | F1-score | Ondersteuning | |
| ziekte van Alzheimer | 0.94 | 0.95 | 0.94 | 579 |
| Controle | 0.91 | 0.96 | 0.94 | 480 |
| Frontotemporale dementie | 0.97 | 0.89 | 0.92 | 314 |
| Macro-gemiddelde | 0.94 | 0.93 | 0.93 | 1373 |
| Gewogen gemiddelde | 0.94 | 0.94 | 0.94 | 1373 |
Tabel 4: Classificatierapport na feature-ablatie. Precisie, recall, F1-score en support voor de klassen ziekte van Alzheimer, gezonde controle en frontotemporale dementie na verwijdering van entropie-features en hertraining van het Random Forest-model.
| Metriek | Vóór ablatie | Na ablatie | Verandering |
| Trainingsnauwkeurigheid | 0.96 | 0.96 | 0% verandering |
| Testnauwkeurigheid | 0.92 | 0.94 | +2% verbetering |
| Macro-precisie | 0.93 | 0.94 | +1% verbetering |
| Macro-recall | 0.92 | 0.93 | +1% verbetering |
| Macro F1-score | 0.92 | 0.93 | +1% verbetering |
| Gewogen precisie | 0.93 | 0.94 | +1% verbetering |
| Gewogen recall | 0.92 | 0.94 | +2% verbetering |
| Gewogen F1-score | 0.92 | 0.94 | +2% verbetering |
Tabel 5: Vergelijking van de prestaties vóór en na kenmerkablatie. Vergelijking van prestatiemetrieken van het model voor de volledige multidomein-kenmerkset en de gereduceerde kenmerkset verkregen na verwijdering van entropiekenmerken.
DATAbeschikbaarheid:
De verwerkte CSV-dataset die is gebruikt voor modelontwikkeling en analyse wordt verstrekt als Aanvullend bestand 1. De code voor de voorbewerking is beschikbaar in een Python-notebook via https://colab.research.google.com/drive/1PwidMZCbbIHdthDhat5OEZa7ya6f0-aC?usp=sharing, en de code voor de modelbouw en analyse is beschikbaar via https://colab.research.google.com/drive/1q8wYJjQpofAqZGYxz9xHKB0emGF4YGwM?usp=sharing. De verwerkte CSV-dataset kan ook opnieuw worden gegenereerd met behulp van de verstrekte code voor de voorbewerking
| Klasse | Metriek | Voorafgaand aan | Na | Wijziging |
| ziekte van Alzheimer | Precisie | 0.92 | 0.94 | 0.02 |
| Herinnering | 0.95 | 0.95 | Geen wijziging | |
| F1-score | 0.94 | 0.94 | Geen wijziging | |
| Controle | Precisie | 0.93 | 0.91 | −2% |
| Recall | 0.92 | 0.96 | 0.04 | |
| F1-score | 0.93 | 0.94 | 0.01 | |
| FTD | Precisie | 0.93 | 0.97 | 0.04 |
| Recall | 0.87 | 0.89 | 0.02 | |
| F1-score | 0.9 | 0.92 | 0.02 |
Tabel 6: Prestatieveranderingen per klasse voor en na kenmerkablatie. Veranderingen in precisie, recall en F1-score voor de klassen ziekte van Alzheimer, gezonde controle en frontotemporale dementie na het verwijderen van entropiekenmerken.
Aanvullend bestand 1: Verwerkte EEG-kenmerkendataset op epoche-niveau gebruikt voor modelontwikkeling en analyse. Klik hier om dit bestand te downloaden.
Discussie
De Random Forest-classifier werd gebruikt om elektro-encefalografie (EEG)-monsters in de groepen ziekte van Alzheimer (AD), frontotemporale dementie (FTD) en gezonde controles (HC) te classificeren op basis van multidomein-kenmerken, waaronder power spectral density (PSD), root mean square (RMS) en entropiematen. Leeftijd werd meegenomen als complementaire demografische variabele. Omdat de leeftijdsverdelingen tussen de diagnostische groepen konden verschillen, kon demografische confounding niet volledig worden uitgesloten, waardoor de gerapporteerde prestaties de gecombineerde bijdrage van demografische en elektrofysiologische informatie weerspiegelden. De analyse onderzocht het vermogen van multidomein EEG-kenmerken om onderscheid te maken tussen de AD-, FTD- en HC-groepen en beoordeelde de bijdrage van kenmerken uit de delta-, theta-, alfa-, bèta- en gamma-banden aan de classificatie35. Analyses naar kenmerkstabiliteit en effectgrootte gaven aan dat op vermogen gebaseerde kenmerken, waaronder PSD en RMS, sterker bijdroegen dan kenmerken op basis van entropie. De geëxtraheerde EEG-biomarkers weerspiegelden daarnaast patronen die geassocieerd zijn met een vertraging van ritmes en een verminderde alfa-activiteit.
Eerdere studies hebben EEG-kenmerken op basis van entropie, PSD en RMS geëvalueerd met behulp van verschillende machine learning-benaderingen2,14,27,28,36,37. Entropie werd gebruikt om de complexiteit en onregelmatigheid van het EEG te karakteriseren, terwijl PSD werd gebruikt om spectrale kenmerken te kwantificeren2,14,27,28,36. RMS is ook geëvalueerd als een kenmerk van frequentiebanden37. Met gebruikmaking van dezelfde onderliggende dataset paste eerder werk PSD-gebaseerde binaire classificatie toe met leave-one-subject-out validatie33. De huidige analyse combineerde daarentegen RMS, entropie en PSD over de alfa-, beta-, gamma-, theta- en deltabanden binnen een multiclass-classificatiekader. Een lichtgewicht EEG-transformer werd op dezelfde dataset geëvalueerd met een leave-one-subject-out binaire classificatiestrategie. Een lichtgewicht EEG-transformer die op dezelfde dataset werd geëvalueerd met een leave-one-subject-out binaire classificatiestrategie rapporteerde een nauwkeurigheid van 83,28%. Directe numerieke vergelijking met de huidige resultaten moet voorzichtig worden geïnterpreteerd omdat de classificatietaak en validatieprocedures verschilden38.
Kenmerken van de alfaband vertoonden de grootste effectgroottes voor het differentiëren van AD ten opzichte van HC en FTD ten opzichte van HC, en een toegenomen theta-activiteit droeg daarnaast bij aan de differentiatie van AD ten opzichte van HC. Kenmerken van de betaband vertoonden kleinere effecten tussen de groepen, terwijl kenmerken op basis van entropie een relatief beperkte discriminerende waarde hadden. Kenmerken van de gammaband vertoonden matige effecten voor sommige vergelijkingen, waaronder FTD versus HC. In eerdere studies is melding gemaakt van een lagere alfapower en een veranderde theta-activiteit bij AD en aanverwante diagnostische vergelijkingen23,25,39. Entropie is ook beschreven als een potentieel informatieve biomarker bij neurodegeneratieve ziekten36, wat aantoont dat de bijdrage ervan kan variëren afhankelijk van de dataset, de definitie van de kenmerken en de analytische benadering.
Support vector machines werden veelvuldig gebruikt in eerdere EEG-classificatiestudies3,21,24,37. De Random Forest-classifier die in de huidige analyse is gebruikt, leverde schattingen van de kenmerkbelangrijkheid (feature importance) en was toepasbaar op de gestructureerde set van kenmerken die in deze studie is gebruikt40,41. Na ablatie van de entropiekenmerken werden respectievelijk nauwkeurigheden van 96% voor training en 94% voor testen behaald. De verwijdering van entropiekenmerken was geassocieerd met een verbeterde modelprestatie, wat de lagere relatieve bijdrage ondersteunt die voor deze kenmerken werd waargenomen in de stabiliteits-, SHAP- en effectgrootte-analyses. Deep learning- en transformer-gebaseerde benaderingen zijn ook toegepast op EEG-classificatie, hoewel dergelijke benaderingen over het algemeen grotere datasets vereisen en zijn ontworpen voor hoger-dimensionale of sequentiële representaties27,39,42,43,44,45.
EEG-signalen zijn ruisgevoelig en niet-stationair, en ensemble-modellen op basis van beslisbomen kunnen robuustheid bieden bij het analyseren van gestructureerde kenmerkrepresentaties. In de huidige studie werden RMS, PSD, entropie en leeftijd geëvalueerd als complementaire inputs voor het Random Forest-model. RMS representeerde de signalamplitude binnen frequentiebanden, PSD representeerde het spectrale vermogen en entropie representeerde de signaalcomplexiteit. De resultaten gaven aan dat PSD en RMS sterker bijdroegen aan de classificatie binnen het geëvalueerde kader dan entropie. Leeftijd droeg ook bij aan het model, hoewel de opname hiervan de mogelijkheid van demografische confounding introduceerde. Toekomstig onderzoek zou aanvullende demografische variabelen en alternatieve machine learning- of deep learning-benaderingen in grotere datasets kunnen evalueren om de generaliseerbaarheid en classificatieprestaties verder te beoordelen.
Openbaarmakingen
Er zijn geen bekende concurrerende financiële belangen, persoonlijke relaties, financiële relaties of andere activiteiten gedeclareerd die het in deze studie gerapporteerde werk zouden hebben kunnen beïnvloeden.
Dankbetuigingen
De openbaar beschikbare EEG-dataset die in deze studie is gebruikt en de bijdragen van de onderzoekers die de dataset toegankelijk hebben gemaakt voor onderzoeksdoeleinden worden erkend. Er is geen specifieke financiering ontvangen van publieke, commerciële of non-profit financieringsinstanties.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Google Colab | [confirm environment]colab runtime | Cloudgebaseerde computationele omgeving gebruikt voor het uitvoeren van de analyse-notebooks | |
| MNE-Python | MNE-Python project | 1.12.1 | Gebruikt voor EEG-preprocessing, referentiebepaling, filtering en epoch-segmentatie |
| NumPy | NumPy project | (2.0.2) | Gebruikt voor numerieke berekeningen en array-gebaseerde computaties |
| OpenNeuro EEG dataset | OpenNeuro | ds004504, (1.0.9) | Openbaar beschikbare resting-state EEG-dataset met opnames van AD, FTD en HC |
| Python | Python Software Foundation | [3.12.13 (main, Mar 4 2026, 09:23:07) [GCC 11.4.0]] | Programmeeromgeving gebruikt voor gegevensverwerking en modelontwikkeling |
| scikit-learn | scikit-learn project | 1.6.1 | Gebruikt voor preprocessing, gegroepeerde data-splitting, Random Forest-classificatie en prestatie-evaluatie |
| SciPy | SciPy project | (1.16.3) | Gebruikt voor signaalverwerking en statistische berekeningen |
| SHAP | SHAP project | 0.52.0 | Gebruikt voor analyse van uitlegbare kunstmatige intelligentie met TreeExplainer |
Referenties
- Rodrigues PM, et al. Early prediction of Alzheimer's with the electroencephalogram. Procedia Comput Sci. 2016;100:865–71. https://doi.org/10.1016/j.procs.2016.09.236
- Houmani N, et al. Diagnosis of Alzheimer's disease with electroencephalography in a differential framework. PLoS One. 2018;13(3):e0193607. https://doi.org/10.1371/journal.pone.0193607
- Tripanpitak K, et al. Biomarkers for Alzheimer's disease and mild cognitive impairment: recent advances in task-based EEG. J Alzheimers Dis. 2025 [Epub ahead of print].
- Kung HC, Hoyert DL, Xu J, Murphy SL. Deaths: final data for 2005. Natl Vital Stat Rep. 2008;56(10):1-120.
- Falk TH, Fraga FJ, Trambaiolli L, Anghinah R. EEG amplitude modulation analysis for semi-automated diagnosis of Alzheimer's disease. EURASIP J Adv Signal Process. 2012;2012(1):192. https://doi.org/10.1186/1687-6180-2012-192
- Lehmann C, et al. Application and comparison of classification algorithms for recognition of Alzheimer's disease in electrical brain activity (EEG). J Neurosci Methods. 2007;161(2):342–50. https://doi.org/10.1016/j.jneumeth.2006.10.023
- Campanharo AS, Doescher E, Ramos FM. Automated EEG signals analysis using quantile graphs. In: Ferrández Vicente JM, Álvarez-Sánchez JR, de la Paz López F, Adeli H, editors. International Work-Conference on Artificial Neural Networks (IWANN 2017). Cham: Springer; 2017. p. 95–103. https://doi.org/10.1007/978-3-319-59147-6_9
- Adeli H, Ghosh-Dastidar S, Dadmehr N. Alzheimer's disease: models of computation and analysis of EEGs. Clin EEG Neurosci. 2005;36(3):131–40. https://doi.org/10.1177/155005940503600303
- Zheng H, Xiong X, Zhang X. Multi-threshold recurrence rate plot: a novel methodology for EEG analysis in Alzheimer's disease and frontotemporal dementia. Brain Sci. 2024;14(6):565. https://doi.org/10.3390/brainsci14060565
- Zheng X, et al. Diagnosis of Alzheimer's disease via resting-state EEG: integration of spectrum, complexity, and synchronisation signal features. Front Ageing Neurosci. 2023;15:1288295. https://doi.org/10.3389/fnagi.2023.1288295
- Abd Rahman F, Othman MF, Shaharuddin NA. Analysis methods of EEG signals: a review in EEG applications for brain disorders. J Teknol. 2015;72(2):41-6.
- Jackson AF, Bolger DJ. The neurophysiological bases of EEG and EEG measurement: a review for the rest of us. Psychophysiology. 2014;51(11):1061–71. https://doi.org/10.1111/psyp.12283
- Fouad IA, Labib FEZM. Identification of Alzheimer's disease from central lobe EEG signals utilising machine learning and a residual neural network. Biomed Signal Process Control. 2023;86:105266. https://doi.org/10.1016/j.bspc.2023.105266
- Fiscon G, et al. Combining EEG signal processing with supervised methods for Alzheimer's patients' classification. BMC Med Inform Decis Mak. 2018;18(1):35. https//doi.org/10.1186/s12911-018-0613-7
- Dauwels J, Vialatte F, Cichocki A. Diagnosis of Alzheimer's disease from EEG signals: where are we standing? Curr Alzheimer Res. 2010;7(6):487–505. https://doi.org/10.2174/156720510792231720
- Jelic V, Kowalski J. Evidence-based evaluation of diagnostic accuracy of resting EEG in dementia and mild cognitive impairment. Clin EEG Neurosci. 2009;40(2):129-42.
- Coben LA, Danziger WL, Berg L. Frequency analysis of the resting awake EEG in mild senile dementia of Alzheimer type. Electroencephalogr Clin Neurophysiol. 1983;55(4):372–80. https://doi.org/10.1016/0013-4694(83)90124-4
- Cibils D. Dementia and qEEG (Alzheimer's disease). Suppl Clin Neurophysiol. 2002;54:289-94.
- Ramírez-Arias FJ, et al. Evaluation of machine learning algorithms for the classification of EEG signals. Technologies. 2022;10(4):79. https://doi.org/10.3390/technologies10040079
- Hosseini MP, Hosseini A, Ahi K. A review on machine learning for EEG signal processing in bioengineering. IEEE Rev Biomed Eng. 2021;14:204–18. https://doi.org/10.1109/RBME.2020.2969915
- Vicchietti ML, Ramos FM, Betting LE, Campanharo AS. Computational methods of EEG signals analysis for Alzheimer's disease classification. Sci Rep. 2023;13(1):8184.
- Rahimi P, Noroozian M, Hatami J, Sadeghi M. Differential role of electroencephalography between mild cognitive impairment and Alzheimer disease during spatial working memory task. Iran J Neurodevelop Disord. 2025;4(1):101-10.
- Wang J, et al. Alzheimer's disease diagnosis using rhythmic power changes and phase differences: a low-density EEG study. Front Aging Neurosci. 2025;16:1485132. https://doi.org/10.3389/fnagi.2024.1485132
- Senkaya Y, Kurnaz C, Ozbilgin F. Enhancing Alzheimer's diagnosis with machine learning on EEG: a spectral feature-based comparative analysis. Diagnostics (Basel). 2025;15(17):2190. https://doi.org/10.3390/diagnostics15172190
- McBride JC, et al. Spectral and complexity analysis of scalp EEG characteristics for mild cognitive impairment and early Alzheimer's disease. Comput Methods Programs Biomed. 2014;114(2):153–63. https://doi.org/10.1016/j.cmpb.2014.01.019
- Al-Nuaimi AH, Jammeh E, Sun L, Ifeachor E. Changes in the EEG amplitude as a biomarker for early detection of Alzheimer's disease. In: 2016 38th Annual International Conference of the IEEE Engineering in Medicine and Biology Society (EMBC); 2016; Orlando, FL, USA. Piscataway: IEEE; 2016. p. 993–6. https://doi.org/10.1109/EMBC.2016.7590869
- Ma Y, Bland JKS, Fujinami T. Classification of Alzheimer's disease and frontotemporal dementia using electroencephalography to quantify communication between electrode pairs. Diagnostics (Basel). 2024;14(19):2189. https://doi.org/10.3390/diagnostics14192189
- Fiscon G, et al. Alzheimer's disease patients classification through EEG signals processing. In: 2014 IEEE Symposium on Computational Intelligence and Data Mining (CIDM); 2014; Orlando, FL, USA. IEEE; 2014. p. 105–12. https://doi.org/10.1109/CIDM.2014.7008655
- Fouladi S, et al. Efficient deep neural networks for classification of Alzheimer’s disease and mild cognitive impairment from scalp EEG recordings. Cogn Comput. 2022;14(4):1247–68. https://doi.org/10.1007/s12559-022-10022-y
- Miltiadous A, et al. Alzheimer’s disease and frontotemporal dementia: A robust classification method of EEG signals and a comparison of validation methods. Diagnostics. 2021;11(8):1437. https://doi.org/10.3390/diagnostics11081437
- Nobukawa S, et al. Classification methods based on complexity and synchronization of electroencephalography signals in Alzheimer’s disease. Front Psychiatry. 2020;11:255. https://doi.org/10.3389/fpsyt.2020.00255
- Huggins CJ, et al. Deep learning of resting-state electroencephalogram signals for three-class classification of Alzheimer’s disease, mild cognitive impairment and healthy ageing. J Neural Eng. 2021;18(4):046087. https://doi.org/10.1088/1741-2552/ac1a80
- Miltiadous A, et al. DICE-net: a novel convolution–transformer architecture for Alzheimer detection in EEG signals. IEEE Access. 2023;11:71840–58. https://doi.org/10.1109/ACCESS.2023a.3294618
- Miller R. Theory of the normal waking EEG: from single neurones to waveforms in the alpha, beta and gamma frequency ranges. Int J Psychophysiol. 2007;64(1):18–23. https://doi.org/10.1016/j.ijpsycho.2006.07.009
- Thomas JS, Thivakaran TK. Data mining algorithms and statistical techniques for identification of schizophrenia: A survey. In: 2020 International Conference on Smart Technologies in Computing, Electrical and Electronics (ICSTCEE); 2020; Bengaluru, India. IEEE; 2020. p. 246–51. https://doi.org/10.1109/ICSTCEE49637.2020.9276856
- Cacciotti A, et al. EEG entropy insights in the context of physiological aging and Alzheimer's and Parkinson's diseases: a comprehensive review. Geroscience. 2024;46(6):5537–57. https://doi.org/10.1007/s11357-024-01200-5
- Subhashree S, Eric PV. A unique EEG-Hyfusion fully automated stacked model for classification of Alzheimer's disease and frontotemporal dementia. J Vis Exp. 2026;(228):e69762.
- Miltiadous A, et al. A dataset of scalp EEG recordings of Alzheimer's disease, frontotemporal dementia and healthy subjects from routine EEG. Data (Basel). 2023;8(6):95. https://doi.org/10.3390/data8060095
- Malakouti SM, Menhaj MB, Suratgar AA. Enhanced epilepsy detection using discrete wavelet transform and bandpass filtering on EEG data: integration of ART-based and LVQ models. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.02.001
- Durga P, et al. An ensemble model for detection of Parkinson's disease by comparing numerous machine learning models and XGBoost based on vocal features. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.01.001
- Behnamian A, et al. A systematic approach for variable selection with random forests: achieving stable variable importance values. IEEE Geosci Remote Sens Lett. 2017;14(11):1988–92. https://doi.org/10.1109/LGRS.2017.2745049
- Macia G, Liddell A, Doyle V. Conversational AI with large language models to increase the uptake of clinical guidance. Clin eHealth. 2024;7:147–52. https://doi.org/10.1016/j.ceh.2024.07.001
- Zhao W. Research on the deep learning of small sample data based on transfer learning. AIP Conf Proc. 2017;1864(1):020018. https://doi.org/10.1063/1.4992835
- Hassan U, Singhal A. Convolutional neural network framework for EEG-based ADHD diagnosis in children. Health Inf Sci Syst. 2024;12(1):44. https://doi.org/10.1007/s13755-024-00303-x
- Jeong T, Park U, Kang SW. Novel quantitative electroencephalogram feature image adapted for deep learning: verification through classification of Alzheimer’s disease dementia. Front Neurosci. 2022;16:1033379. https://doi.org/10.3389/fnins.2022.1033379