Dit protocol beschrijft hoe een multiview Vision Mamba U-Shaped Network-framework voor medische beeldsegmentatie wordt opgebouwd, getraind en geëvalueerd, waardoor reproduceerbare segmentatie van huidlaesies en buikorganen mogelijk wordt gemaakt door gestandaardiseerde datasetvoorbereiding, modelimplementatie en prestatie-evaluatie.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Methodenartikel
Multi-view Vision Mamba U-Shaped Network Framework voor Medische Beeldsegmentatie
In dit artikel
Samenvatting
Samenvatting
Medische beeldsegmentatie vereist computationele methoden die globale context, lokale grenzen en multiscale anatomische structuren nauwkeurig vastleggen, terwijl ze reproduceerbaar blijven in verschillende toepassingen. Dit artikel presenteert een protocol voor het construeren, trainen en evalueren van een Multi-view Vision Mamba U-Shaped Network-framework voor tweedimensionale medische beeldsegmentatie. Het protocol biedt een reproduceerbare workflow die onder meer openbare datasetverwerving, voorverwerking van beelden en maskers, netwerkconstructie, modeltraining, selectie van checkpoints en kwantitatieve en kwalitatieve prestatiebeoordeling omvat. Het framework bevat multiview-feature-scanning om complementaire ruimtelijke, contour-, schaal- en grensinformatie vast te leggen en past multistage feature fusion toe binnen een U-vormige encoder-decoder architectuur om feature-integratie tijdens segmentatie te verbeteren. Het protocol wordt aangetoond met behulp van openbaar beschikbare datasets over huidlaesie en segmentatie van buikorganen. Onder de beschreven implementatieworkflow bereikt het framework concurrerende segmentatieprestaties met behulp van standaard evaluatiemetrics. Door de procedures in dit protocol te volgen, kunnen onderzoekers de modelimplementatie reproduceren, het netwerk trainen met gedefinieerde experimentele settings, segmentatieprestaties evalueren en de workflow aanpassen voor gerelateerde medische beeldsegmentatietaken die reproduceerbare deep learning-analyse vereisen.
Inleiding
Segmentatie van medische beelden is een fundamentele taak op het gebied van computer vision en medische beeldanalyse 1,2,3. Het houdt in dat een afbeelding wordt opgedeeld in meerdere regio's of objecten voor verdere analyse en verwerking. Deze technologie is vooral belangrijk in medische beeldvorming omdat ze clinici helpt pathologische gebieden te identificeren en te lokaliseren, waardoor de diagnostische nauwkeurigheid en behandelingsplanning verbetert. Met de vooruitgang van medische beeldvormingstechnologieën, zoals magnetische resonantiebeeldvorming (MRI), computertomografie (CT) en positronemissietomografie (PET), is de vraag naar nauwkeurige medische beeldsegmentatietechnieken blijven toenemen. Huidige methoden voor medische beeldsegmentatie kunnen globaal worden ingedeeld in drie hoofdbenaderingen: convolutioneel neuraal netwerk (CNN)-gebaseerde methoden4, Transformer-gebaseerde methoden5, en toestandsruimtemodel (SSM)-gebaseerde methoden 6,7. CNN-gebaseerde methoden maken doorgaans gebruik van U-vormige netwerkarchitecturen voor medische beeldsegmentatie. De meest gebruikte architectuur in deze categorie is U-Net8, die de effectiviteit van een U-vormige encoder–decoder-architectuur voor biomedische beeldsegmentatie aantoonde. U-Net3+ combineert dichte skipverbindingen van UNet++9 met full-scale skipverbindingen om multiscale feature-aggregatie te verbeteren. CNN-gebaseerde methoden hebben echter beperkte mogelijkheden om langetermijnafhankelijkheden vast te leggen en modelleren daarom mogelijk niet effectief langetermijncontextuele informatie.
Transformer-gebaseerde methoden vangen effectief langeafstandsafhankelijkheden vast via het zelf-aandachtmechanisme, dat parallelle berekening mogelijk maakt en verschillende aandachtsgewichten toekent aan verschillende interessegebieden. UNETR++10 introduceert de Efficient Paired Attention (EPA)-module om het aantal parameters en de rekenkosten te verminderen. nnFormer11 combineert verwevende convolutionele en zelf-aandacht operaties en introduceert een lokaal-globaal volume-gebaseerd zelf-aandachtsmechanisme voor het leren van volumetrische representaties in driedimensionale (3D) medische beeldsegmentatie. H2Former12 stelt een efficiënte hiërarchische hybride Vision Transformer voor die aandachtsmechanismen combineert met CNN-gebaseerde feature-extractie in de encoder. Transformer-gebaseerde methoden vertonen echter kwadratische computationele complexiteit met toenemende sequentielengte, wat resulteert in aanzienlijk hogere rekenkosten. Figuur 1 illustreert de motivatie voor MVM-UNet en vergelijkt de voorgestelde multiview scanningsstrategie met bestaande SSM-gebaseerde segmentatiekaders.
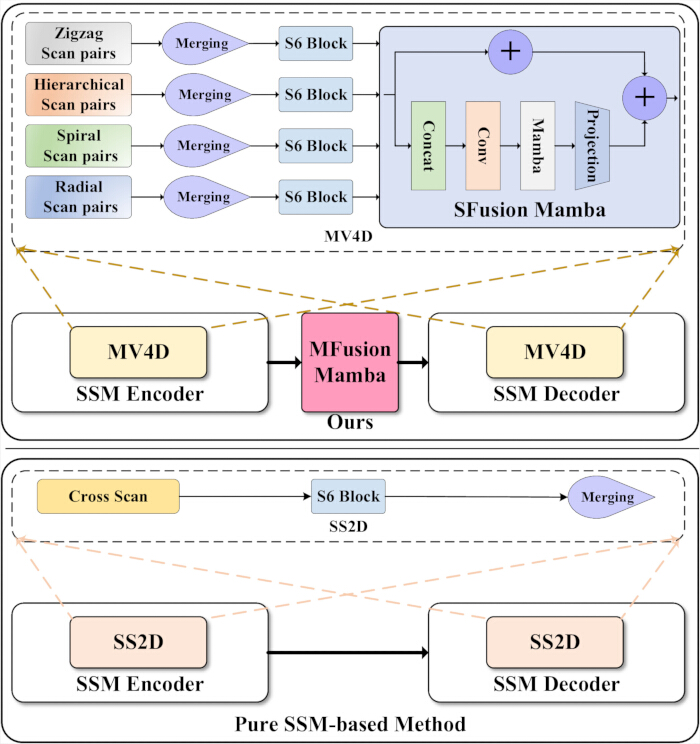
Figuur 1. Vergelijking van MVM-UNet met bestaande pure state-space-model (SSM)-gebaseerde segmentatiearchitecturen. Vergelijking tussen een conventioneel puur state-space model (SSM)-segmentatieframework en de voorgestelde Multi-View Mamba U-Net (MVM-UNet) architectuur. Het bovenste paneel illustreert MVM-UNet, waarin de Multi-View 4-Directional (MV4D) module complementaire kenmerken extrahereert met zigzag-, hiërarchische, spiraal- en radiale scanparen die worden geïntegreerd door Spatial Fusion Mamba (SFusion Mamba), terwijl Multistage Fusion Mamba (MFusion Mamba) multiscale encoderkenmerken aggregeert voordat het wordt gedecodeerd. Het onderste paneel toont een representatieve pure SSM-gebaseerde architectuur met Selective Scan 2-Dimensional (SS2D) modules met cross-scanning. De figuur benadrukt de architecturale verschillen tussen conventionele SSM-gebaseerde segmentatienetwerken en het voorgestelde MVM-UNet. Klik hier om een grotere versie van deze figuur te bekijken.
SSM-gebaseerde methoden combineren de wereldwijde modelleringscapaciteit van Transformers met lineaire computationele complexiteit. De Mamba-architectuur verwerkt selectief invoerinformatie met behulp van een selectief toestandsruimtemodel (Selective-SSM), waardoor het model zijn parameters dynamisch kan aanpassen aan de invoer, terwijl irrelevante informatie wordt gefilterd en informatieve kenmerken worden benadrukt. Vim13 en VMamba14 passen de Mamba-architectuur aan voor computer vision-taken. U-Mamba15 gebruikt een hybride CNN–SSM-architectuur om de toepassing van SSM's in medische beeldsegmentatie te verkennen, terwijl Mamba-UNet16 een volledig SSM-gebaseerde encoder–decoder-architectuur hanteert voor medische beeldsegmentatie. Deze methoden leveren concurrerende prestaties met aanzienlijk minder parameters. Huidige SSM/Mamba-gebaseerde methoden extraheren echter voornamelijk beeldkenmerken met behulp van eenvoudige beeldpatches en SS2D-scanstrategieën, wat verschillende beperkingen met zich meebrengt voor medische beeldsegmentatie. Ten eerste zijn SS2D- en patchgebaseerde technieken voornamelijk ontworpen voor algemene computer vision-taken. Local Mamba17 en Motion Mamba18 hebben gesuggereerd dat de SS2D-scanstrategie onvoldoende is voor alle visuele taken omdat verschillende scanstrategieën verschillende soorten visuele informatie vastleggen. Ten tweede is de SS2D-scanstrategie relatief eenvoudig, waarbij alleen wordt vertrouwd op horizontale en verticale scanrichtingen. Daardoor kan het complexe ruimtelijke relaties en fijne structurele details mogelijk niet adequaat vastleggen. Medische beeldsegmentatie vereist gelijktijdige modellering van zowel de globale ruimtelijke context als precieze lokale anatomische kenmerken. Bovendien bieden huidige SSM/Mamba-gebaseerde methoden beperkte functiefusie tussen de encoder en decoder. Architecturen zoals UNet++ en FATNet verbeteren de segmentatienauwkeurigheid door verbeterde feature-fusie, wat het belang van effectieve feature-integratie voor medische beeldsegmentatie benadrukt.
Om deze beperkingen aan te pakken, stelt dit artikel een nieuw Mamba-gebaseerd medisch beeldsegmentatiekader voor, genaamd MVM-UNet. Zoals weergegeven in Figuur 1, dient de voorgestelde Multi-View Four-Directional (MV4D) module als het kernonderdeel van feature-extractie van MVM-UNet en is specifiek ontworpen voor medische beeldsegmentatie door informatie te integreren van vier verschillende scanstrategieën. Elke scanstrategie haalt complementaire beeldkenmerken uit en geeft een andere weergave van de invoerafbeelding weer. Zigzagscannen 19 wisselt de doorlooprichting af aan het einde van elke rij of kolom, waardoor lokale en globale ruimtelijke informatie in balans worden gebracht. Daarentegen bieden spiraal- en radiale scanschema's20 een uitgebreide dekking door zich uit te strekken vanuit het centrum of naar binnen vanaf de periferie. Hiërarchisch scannen18 legt zowel lokale als globale kenmerken op meerdere schalen vast. Om de robuustheid van elke scanstrategie te verbeteren, worden scanparen samengevoegd voordat ze in het S6-blok worden ingevoerd. De Scan-view Fusion Mamba (SFusion Mamba) module integreert vervolgens de functies die uit de vier scanmodaliteiten zijn geëxtraheerd. Om multiscale encoderfuncties effectief te benutten, stelt dit artikel verder een multiscale Mamba fusiemodule (MFusion Mamba) voor, die de uitgangen van elke encodertrap verzamelt en fuseert voordat de gefuseerde features aan de decoder worden doorgegeven. MVM-UNet werd geëvalueerd op de ISIC 2017, ISIC 2018 en Synapse datasets. Experimentele resultaten tonen aan dat MVM-UNet concurrerende segmentatieprestaties behaalt op de ISIC 2017, ISIC 2018 en Synapse datasets.
Representatieve segmentatiearchitecturen hebben de segmentatie van medische beelden verder verbeterd. U-Net is ook met succes toegepast op biomedische beeldanalysetaken zoals celtelling, detectie en morfometrie21. Aandacht-versterkte CNN-architecturen, zoals CA-Net22, verbeteren de featurerepresentatie via uitgebreide aandachtsmechanismen. Segmentatiekaders gebaseerd op representatieve transformers, waaronder TransUNet23, Pyramid Medical Transformer24, Swin U-Net25, TransAttUNet26 en TransCUNet27, tonen verder de effectiviteit van aandachtsgebaseerde globale feature-modellering voor medische beeldsegmentatie aan.
Het ontwerp van MVM-UNet wordt gemotiveerd door twee beperkingen van bestaande SSM/Mamba-gebaseerde segmentatiemethoden. Ten eerste vertrouwen veel huidige Vision Mamba-modellen op eenvoudige tweedimensionale scanstrategieën, die mogelijk onvoldoende zijn voor medische beelden met onregelmatige laesiegrenzen, kleine doelgebieden en multiscale anatomische structuren. Ten tweede dragen conventionele U-vormige encoder–decoder-architecturen vooral kenmerken over via overeenkomstige skipverbindingen, waardoor het directe gebruik van meertraps-encoderinformatie tijdens het decoderen wordt beperkt. Daarom introduceert MVM-UNet MV4D om multiview ruimtelijke modellering te verbeteren en MFusion Mamba om expliciet multistage encoderkenmerken te aggregeren. Dit ontwerp is bedoeld om Mamba-gebaseerde langeafstandmodellering aan te passen aan de specifieke eisen van medische beeldsegmentatie.
Hoewel MVM-UNet is gebaseerd op het algemene encoder–decoder-paradigma en Mamba-gebaseerde sequentiemodellering, ligt de nieuwigheid ervan in de manier waarop deze componenten worden aangepast en geïntegreerd voor medische beeldsegmentatie. In plaats van simpelweg een standaard Mamba-blok in een U-vormige netwerkruggengraat te integreren, herontwerpt het voorgestelde framework het ruimtelijke modelleringsproces via meerdere taakgerichte scan-paar-takken, introduceert SFusion Mamba om scan-specifieke representaties te integreren, verbetert het MVV Block met residuele en projectiepaden, en voegt MFusion Mamba in tussen de encoder en decoder om multistage encoderkenmerken te aggregeren voordat het decodert. Dit architectuurniveau ontwerp is bedoeld om de onregelmatige grenzen, kleine doelgebieden en multiscale anatomische structuren aan te pakken die vaak worden waargenomen in medische beelden.
Dit protocol is het meest geschikt voor segmentatietaken die gelijktijdige modellering vereisen van contextuele informatie over lange afstand, onregelmatige objectgrenzen en multiscale anatomische structuren in tweedimensionale medische beelden. In vergelijking met op CNN gebaseerde segmentatiemethoden biedt het Mamba-gebaseerde encoder–decoder-ontwerp een effectief contextmodelleringsmechanisme, terwijl het een U-vormige workflow behoudt die bekend is bij onderzoekers in medische beeldsegmentatie. In vergelijking met op Transformers gebaseerde methoden vermijdt het voorgestelde kader het directe gebruik van kwadratische zelfaandacht en is het bedoeld voor onderzoekers die globale contextuele modellering zoeken met een relatief efficiënt sequentiemodelleringsmechanisme. Dit protocol is dienovereenkomstig geschikt voor segmentatie van huidlaesies, segmentatie van buikorganen en vergelijkbare tweedimensionale medische beeldsegmentatietaken waarbij zowel globale structurele informatie als lokale grensdetails belangrijk zijn.
Dit protocol heeft ook beperkingen die vóór gebruik in overweging moeten worden genomen. Het is mogelijk niet nodig voor relatief eenvoudige segmentatietaken waarbij een lichtgewicht CNN al voldoende prestaties levert. Daarnaast is het niet direct ontworpen voor volledige driedimensionale volumetrische segmentatie zonder architecturale aanpassing. Onderzoekers met zeer beperkte geannoteerde data, beperkte grafische verwerkingsunits (GPU) of een vereiste voor zeer interpreteerbare klassieke modellen moeten deze beperkingen ook overwegen voordat ze het protocol toepassen. Al met al is deze methode bedoeld voor onderzoekers die een Mamba-gebaseerd U-vormig segmentatiekader willen reproduceren en evalueren dat een balans biedt tussen langetermijncontextmodellering, lokale grensrepresentatie en multifase-featurefusie.
De belangrijkste bijdragen zijn als volgt:
1. Dit artikel presenteert een nieuw Mamba-gebaseerd medisch beeldsegmentatiekader, genaamd MVM-UNet. In tegenstelling tot benaderingen die bestaande SS2D-gebaseerde of standaard Mamba-blokken direct integreren, introduceert MVM-UNet MV4D om medische beeldkenmerken te modelleren vanuit vier complementaire scan-paar-aanzichten, waaronder zigzag-, hiërarchische, spiraal- en radiale scanning.
2. Dit artikel ontwerpt SFusion Mamba en het MVV Block om scan-specifieke representaties te integreren en de transformatie van kenmerken te verbeteren. SFusion Mamba fuseert de kenmerken die uit verschillende scanpaartakken zijn geëxtraheerd, terwijl de residuele en Up-Down Projection-takken binnen het MVV-blok complementaire feature-routes bieden die feature-representaties stabiliseren en verrijken.
3. Dit artikel introduceert MFusion Mamba als een tussenliggende multitraps fusiemodule tussen de encoder en decoder. In tegenstelling tot conventionele skipverbindingen die voornamelijk corresponderende fase-features overdragen, aggregeert MFusion Mamba expliciet multi-traps encoderkenmerken via grove tot fijne fusie en levert verrijkte informatie voor decodering.
4. Uitgebreide experimentele resultaten tonen aan dat het voorgestelde MVM-UNet concurrerende segmentatieprestaties behaalt op de ISIC 2017- en ISIC 2018-datasets en sterke prestaties op de Synapse-multiorgansegmentatiedataset. Bovendien valideren uitgebreide ablatiestudies de bijdrage van elk onderdeel binnen MVM-UNet.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Deze studie gebruikte alleen openbaar beschikbare en gedeidentificeerde medische beelddatasets, waaronder ISIC 2017, ISIC 2018 en Synapse. In deze studie werden geen nieuwe menselijke deelnemers, dierlijke proefpersonen of identificeerbare privé medische dossiers verzameld. De ISIC 2017-dataset die in deze studie werd gebruikt, was de ISIC 2017 Challenge skin letion segmentation dataset, verkregen uit de officiële International Skin Imaging Collaboration challenge data repository (https://challenge.isic-archive.com/data/#2017). De datasetversie die in deze studie wordt gebruikt, komt overeen met de ISIC 2017 laesiesegmentatietaak, inclusief de officiële training, validatie en testpartities. De dataset werd gedownload op 15 maart 2024. De ISIC 2018-dataset die in deze studie werd gebruikt, was de ISIC 2018 Challenge Task 1 lesion boundary segmentation dataset, verkregen uit het officiële International Skin Imaging Collaboration challenge datarepository (https://challenge.isic-archive.com/data/#2018). De datasetversie die in deze studie wordt gebruikt, komt overeen met ISIC 2018 Taak 1: Segmentatie van laesiegrensen. De dataset werd gedownload op 8 juli 2024.
De Synapse-dataset die in deze studie werd gebruikt, was de Multi-Atlas Labeling Beyond the Cranial Vault abdominale CT-dataset, verkregen uit de Synapse-repository onder accessied-identificatie syn3193805 (https://www.synapse.org/Synapse:syn3193805). De dataset die in deze studie wordt gebruikt, komt overeen met de veelgebruikte dataset van 30 gevallen CT multiorgaan segmentatie. Het gedownloade archief was Abdomen/RawData.zip, beschikbaar onder accessiesyn3193805. Er werd bij de download geen apart versienummer, releaselabel of gedateerde releasetag verstrekt door de repository. Volgens de standaardverdeling die in eerdere studies was aangenomen, werden 18 gevallen gebruikt voor training en 12 cases voor testen. De gegevensverdeling volgde de casuslijst die werd gebruikt door TransUNet23. Specifiek waren de trainingscases case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0023, case0040, case0010, case0021, case0006, case0027, case0028 en case0037, terwijl de testcases case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025 en case0035 waren. De dataset werd gedownload op 9 juli 2024. Omdat deze studie alleen gebruikmaakte van publiek toegankelijke, gedeïdentificeerde datasets en geen nieuwe gegevens van mensen of identificeerbare privé-informatie omvatte, was goedkeuring van de institutionele beoordelingscommissie niet vereist voor de computationele experimenten zoals beschreven in dit protocol. Er is geen formele schriftelijke vaststelling van institutionele vrijstelling verkregen. Indien vereist door lokaal institutioneel beleid, dienen onderzoekers een institutionele vrijstellingsbepaling te verkrijgen voordat ze secundaire analyses van openbaar beschikbare datasets uitvoeren. Er was geen referentienummer voor institutionele ethische vrijstellingen of formele vrijstellingsdocumentatie beschikbaar voor deze studie.
1. Voorbereiding van datasets
- Download de ISIC 2017 huidlaesiesegmentatiedataset van de officiële International Skin Imaging Collaboration-repository. Gebruik de officiële trainings-, validatie- en testpartities. Controleer of de dataset 2.000 trainingsafbeeldingen, 150 validatiebeelden en 600 testbeelden bevat.
- Download de ISIC 2018 huidlaesiesegmentatiedataset van de officiële International Skin Imaging Collaboration-repository. Gebruik de officiële trainings-, validatie- en testpartities. Controleer of de segmentatiedataset 2.594 trainingsbeelden, 100 validatiebeelden en 1.000 testbeelden bevat.
- Download de dataset van Synapse multiorgan-segmentatie. Gebruik de standaardsplitsing bestaande uit 18 kasten (2.212 axiale sneden) voor training en 12 cases (1.567 axiale sneden) voor testen. Introduceer geen aparte validatieset.
- Reserveer de 12 testgevallen exclusief voor de definitieve evaluatie. Gebruik de testcases niet voor modeltraining, hyperparameterafstemming of modelselectie. De segmentatietaak omvat acht buikorganen: aorta, galblaas, milt, linker nier, rechternier, lever, alvleesklier en maag.
- Gebruik de volgende Synapse-datasetsplit. De 18 trainingszaken waren case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028 en case0037. De 12 testgevallen waren case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025 en case0035.
- Organiseer elke dataset in aparte mappen met afbeelding en masker. Zorg ervoor dat elke afbeelding een bijbehorend segmentatiemasker heeft met dezelfde case-identificatie.
- Zet elk huidlaeesiemasker om in een binaire segmentatiemap voor voorgrond en achtergrond. Bebehoud de oorspronkelijke multiclass orgellabels voor de Synapse-dataset.
- Voor de ISIC 2017 en ISIC 2018 datasets kent een labelwaarde van 0 toe aan achtergrondpixels en 1 aan laesie (voorgrond) pixels na binaire maskerconversie. Pixels met originele maskerwaarden groter dan 0 worden als voorgrond behandeld en omgezet naar 1, terwijl pixels met oorspronkelijke maskerwaarden gelijk aan 0 als achtergrond worden behandeld en als 0 worden behouden. Voor de Synapse-dataset behoudt u de oorspronkelijke gehele labelwaarden, waarbij 0 de achtergrondklasse vertegenwoordigt en 1–8 de acht voorgrondorgaanklassen.
- Verander ISIC 2017 en ISIC 2018 beelden en maskers naar 256 × 256 pixels zonder de originele beeldverhouding te behouden. Breng geen bijsnijden of padding aan.
- Verander elke Synapse CT-slice en bijbehorende labelmap naar 224 × 224 pixels. Gebruik bilineaire interpolatie voor RGB-afbeeldingen, derde-orde spline-interpolatie voor CT-slices, en naaste-buur-interpolatie voor segmentatiemaskers.
- Verander de grootte van afbeeldingen in Python.
- Voor de ISIC 2017- en ISIC 2018-datasets gebruik je de aangepaste myResize-transformatie geïmplementeerd in utils.py, die torchvision.transforms.functional.resize aanroept om zowel beeld- als maskertensoren te wijzigen tot 256 × 256 pixels. Specificeer geen expliciete interpolatiemodus of anti-aliasing-argument in deze transformatie.
- Voor de Synapse-dataset gebruik je scipy.ndimage.zoom in datasets/dataset.py. Verander CT-beeldslices tot 224 × 224 pixels met derde-orde spline-interpolatie (orde = 3), en hergrootte labelkaarten met nabijste-buurinterpolatie (orde = 0). Pas geen aparte anti-aliasing-operatie of een anti_aliasing=True-instelling toe tijdens het wijzigen van de grootte.
- Normaliseer elke ISIC RGB-afbeelding vóór tensorconversie met behulp van het dataset-specifieke gemiddelde en standaarddeviatie (SD) met Vergelijking 1 als volgt:
 (1)
Vervolgens schaal je het genormaliseerde beeld opnieuw op het bereik van 0–255 met behulp van min–max normalisatie.- Gebruik μ = 159,922 en σ = 28,871 voor de ISIC 2017 trainingsset en μ = 148,429 en σ = 25,748 voor de ISIC 2017 validatie- en testsets. Gebruik μ = 157,561 en σ = 26,706 voor de ISIC 2018 trainingsset en μ = 149,034 en σ = 32,022 voor de ISIC 2018 validatie- en testsets.
- Zet elke genormaliseerde afbeelding om in een tensor van vorm 3 × 256 × 256. Zet elk binair masker om in een tensor van vorm 1 × 256 × 256.
- Voer min–max normalisatie onafhankelijk uit voor elke afbeelding na dataset-specifieke gemiddelde en standaarddeviatie-normalisatie. Specifiek trek je het dataset-specifieke gemiddelde af van elke afbeelding en deel je door de bijbehorende standaarddeviatie.
- Bereken de minimum- en maximumintensiteitswaarden van het genormaliseerde beeld en schaal het beeld opnieuw naar het bereik 0–255 met behulp van deze per-beeld minimum- en maximumwaarden. Gebruik geen minimum- en maximumwaarden voor de hele dataset voor deze min–max herschalingsstap.
- Bereid elke Synapse CT-snee voor als een tweedimensionaal grijswaardenbeeld. Converteer elke CT-slice naar float32 en voeg een singleton-kanaaldimensie toe om een invoertensor te verkrijgen met vorm 1 × 224 × 224.
- Bebehoud elke Synapse-labelkaart als een enkelkanaals integer-masker met vorm 224 × 224. Pas geen extra media-SD-normalisatie op datasetniveau toe in de dataloader.
- Gebruik de voorbewerkte Synapse-bestanden die in .npz-formaat zijn geleverd voor het trainen van slices en .npy.h5-formaat voor het testen van volumes. Laad de image- en labelarrays direct uit elk .npz-bestand tijdens de training en direct uit elk .npy.h5-bestand tijdens het testen. Pas geen extra intensiteitsclipping, CT-venstering, normalisatie op datasetniveau of raw-volume resampling toe in de vrijgegeven dataloader.
- Tijdens het modeltraining converteer je elke geladen tweedimensionale slice naar float32, herschaal je deze naar de doelruimtelijke grootte met scipy.ndimage.zoom met order = 3 voor afbeeldingsslices en order = 0 voor labelmaps, en converteer je vervolgens de aangepaste arrays naar tensoren met een singleton-kanaaldimensie.
- Pas data-augmentatie alleen toe op de trainingsset. Voor ISIC 2017 en ISIC 2018 passen we willekeurige horizontale flipping toe (p = 0,5), willekeurige verticale flipping (p = 0,5) en willekeurige rotatie (p = 0,5) met een hoek van 0° tot 360°.
- Pas dezelfde geometrische transformatie toe op elk beeld-maskerpaar. Tijdens validatie en testen pas je alleen groottevergelijking, normalisatie en tensorconversie toe.
- Voor de Synapse-dataset pas je willekeurige rotatie en willekeurige flipping toe tijdens de training. Draai elk afbeeldingslabelpaar willekeurig met k × 90°, waarbij k ∈ {0,1,2,3}, draai het afbeeldingslabelpaar willekeurig om langs één ruimtelike as, of roteer het beeldlabelpaar willekeurig met een hoek van −20° tot 20°.
- Pas tijdens het testen geen stochastische augmentatie toe.
- Pas data-augmentatie toe op de Synapse-dataset met behulp van de wederzijds exclusieve takken die zijn geïmplementeerd in de RandomGenerator-transformatie.
- Voor elke trainingssteekproef wordt eerst de voorwaarde random.random() > 0,5 geëvalueerd. Als aan deze voorwaarde wordt voldaan, pas dan random_rot_flip toe, bestaande uit een willekeurige rotatie van 90° (k = 0, 1, 2 of 3) gevolgd door een willekeurige omdraai langs één ruimtelike as.
- Als de eerste tak niet wordt geselecteerd, evalueer dan een tweede conditie, random.random() > 0,5. Als aan deze voorwaarde wordt voldaan, pas random_rotate toe met een willekeurig gekozen rotatiehoek tussen −20° en 20°. Als aan geen van beide voorwaarden wordt voldaan, pas dan geen stochastische augmentatie toe op het monster.
- Pas dezelfde transformatie toe op zowel het invoerbeeld als de bijbehorende labelmap.
- Stel de willekeurige seed in vóór het laden van de dataset, preprocessing en training. Gebruik willekeurige zaden 1, 52 en 100 voor de belangrijkste vergelijkingsexperimenten en gebruik zaad 100 voor ablatiestudies, tenzij anders vermeld.
- Initialiseer de Python-, NumPy-, PyTorch-CPU-, PyTorch CUDA- en cuDNN-randomgeneratoren voordat je de dataloader bouwt. Houd de dataset-partitionen, preprocessingprocedures, augmentatie-instellingen, normalisatieparameters, groottevergelijkingsstrategie en evaluatie-preprocessing ongewijzigd over alle seed runs.
- Stel num_workers = 0 in voor zowel de ISIC- als Synapse-experimenten om dataladen uit te voeren in het hoofdproces. Voordat je de dataset construeert en de DataLoader aanmaakt, initialiseer je de globale random seed met de set_seed-functie om de Python, NumPy, PyTorch CPU, PyTorch CUDA en cuDNN random number generators te seeden. Definieer geen aparte worker_init_fn of DataLoader-specifieke random generator, aangezien deze niet worden gebruikt in de uitgebrachte implementatie.
2. Bouw van de MVM-UNet-architectuur
- Bouw de voorgestelde Multi-view Vision Mamba UNet (MVM-UNet) met behulp van een U-vormige encoder-decoder architectuur.
- Stel de ingangsbeelddimensie in op H × W × 3. Stuur het invoerbeeld door de patch-embeddinglaag.
- Implementeer de patch-embeddinglaag met behulp van een 2D-convolutie met een kernelgrootte van 4 × 4, stride van 4, drie inputkanalen en 96 outputkanalen.
- Transformeer de invoerfunctie naar een ruimtelijke resolutie van H/4 × W/4 met C = 96 uitgangskanalen.
- Bouw vier encoderstages en vier decoderstages. Verminder de ruimtelijke resolutie met de helft en verdubbel de kanaaldimensie na elke encoderfase.
- Gebruik een symmetrische encoder-decoder configuratie. Stel het aantal MVV-blokken in zowel de encoder als decoder in op {2, 2, 2, 2}.
- Plaats twee MVV Blocks in elke encoderfase en twee MVV Blocks in elke decoderfase.
- Plaats een MVV Block in elke encoder- en decoderfase. Gebruik de MV4D-module als de kernmodule voor het extractie van functies binnen elk MVV-blok.
- Plaats de MFusion Mamba-module tussen de encoder en decoder. Gebruik deze module om multistage encoderfuncties te fuseren voordat je decodeert.
- Configureer de algehele MVM-UNet workflow. Gebruik MV4D voor feature extraction door de hele encoder.
- Behou de uitgangen van de encoder als skipverbindingen. Geef de uitgangen van de encoder door aan de bijbehorende decodertrappen.
- Geef de encoderfuncties door aan MFusion Mamba voordat je decodeert. Haal geleidelijk de fused representatie op via de decoder en genereer de uiteindelijke segmentatiekaart met behulp van de segmentatiekop.
- Voer de invoerafbeelding I ∈ RB×H×W×3 door de patch-embeddinglaag om Hier te verkrijgen
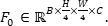 , C = 96.
- Genereer encoder-featuremaps: E1 ∈ RB×H/4×W/4×C, E2 ∈ RB×H/8×W/8×2C, E3 ∈ RB×H/16×W/16×4C, en E4 ∈ RB×H/32×W/32×8C. Gebruik MVV Blocks met MV4D in elke encoderfase.
- Behoud elke encoderfunctie voor de bijbehorende skipverbinding. Geef alle encoderfuncties door aan MFusion Mamba voor multistage feature fusion.
- Lijn encoderkenmerken uit op een gemeenschappelijke featureruimte vóór grove en fijne fusie binnen MFusion Mamba. Geef de gefuseerde representatie door aan de decoder.
- Stap naar naar de weergave van de decoder. Fuse de decoderfuncties met E3 bij H/16 × W/16, E2 bij H/8 × W/8, en E1 bij H/4 × W/4.
- Upgrade de definitieve decoderfunctie naar de oorspronkelijke beeldresolutie. Genereer de voorspellingskaart
 ∈ RB×H×W×K. Hier geldt K = 1 voor binaire laesiesegmentatie en K = 8 voor synaps-multiorgaansegmentatie.
- Zie Figuur 2 voor de algemene netwerkarchitectuur en Aanvullende Tabel 1 voor de volledige laag-voor-laag architectuurspecificatie, inclusief de bewerkingen, hoofdparameters en uitvoerfunctiedimensies voor elke fase
- Encoder–decoder overgangslagen
- Downsample encoderfuncties met patch-merging overgangslagen. Voor elke overgang neem je vier ruimtelijk onderling verweefde featuregroepen uit een 2 × 2 buurt, verbind je deze langs de kanaaldimensie, pas je Layer Normalization (LayerNorm) toe en projecteer je het resulterende 4C-dimensionale kenmerk op 2C-kanalen met behulp van een biasvrije lineaire laag. Deze bewerking vermindert de ruimtelijke resolutie met een factor 2 en verdubbelt de kanaaldimensie.
- Upsample-decoderfuncties met patch-uitbreidende overgangslagen. Pas een biasvrije lineaire projectie toe, herschik de uitgebreide kenmerken ruimtelijk om de resolutie met een factor 2 te verhogen, en pas LayerNorm toe na ruimtelijke expansie. Herhaal deze bewerking om de featurekaarten van H/32 × W/32 tot H/16 × W/16, H/8 × W/8 en H/4 × W/4 te reconstrueren.
- Lijn encoderkenmerken uit binnen de MFusion Mamba-module door ze te schalen naar de doelruimtelijke resolutie met bilineaire interpolatie (align_corners = False) en vervolgens een leerbare lineaire kanaalprojectie toe te passen vóór feature-fusie.
- Segmentatiekop
- Upgrade de feature map van de uiteindelijke decoder van H/4 × W/4 naar de oorspronkelijke beeldresolutie (H × W) met behulp van de laatste patch-uitbreidende laag. Pas lineaire projectie toe, voer ruimtelijke herschikking uit met een expansiefactor van 4, en pas LayerNorm toe.
- Projecteer de gereconstrueerde featuremap naar K uitgangskanalen met behulp van een 1 × 1 convolutie nadat je de tensor naar kanaal-eerst hebt omgezet.
- Genereer de definitieve voorspelling tijdens de evaluatie door een sigmoidactivatiefunctie toe te passen voor binaire laesiesegmentatie of een softmax-activatie gevolgd door argmax voor Synapse multiorgansegmentatie. Pas geen activatiefunctie toe binnen de segmentatiekop zelf.
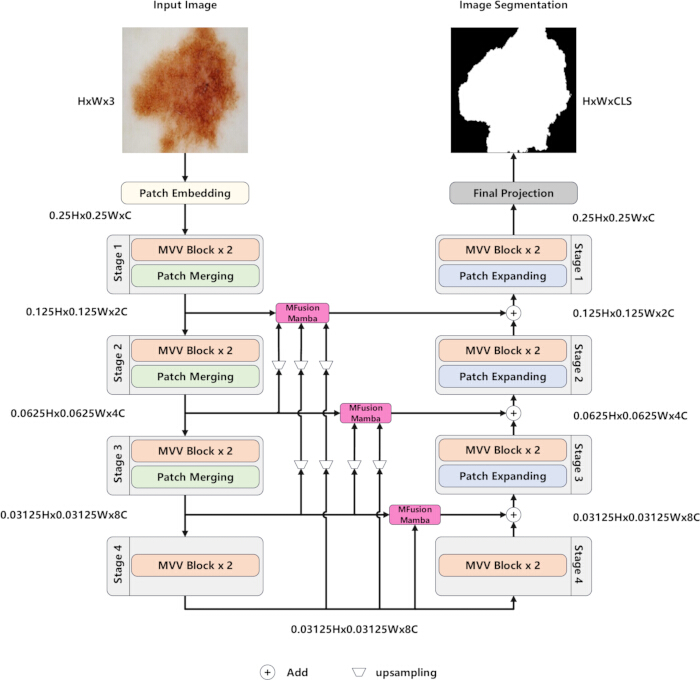
Figuur 2. Algemene architectuur van Multi-View Mamba U-Net (MVM-UNet). Overzicht van de voorgestelde Multi-View Mamba U-Net (MVM-UNet) architectuur. Het invoerbeeld wordt omgezet in patch-embeddings en verwerkt via vier encoder-fasen, bestaande uit Multi-View Vision (MVV) blokken, gescheiden door patch-merging operaties. Encoderkenmerken worden geaggregeerd door Multi-stage Fusion Mamba (MFusion Mamba) en via skipverbindingen naar de decoder verspreid. De decoder herstelt geleidelijk de ruimtelijke resolutie met behulp van patch-uitbreidingsoperaties en genereert de uiteindelijke segmentatiekaart via de projectielaag. Klik hier om een grotere versie van deze figuur te bekijken.
3. Bouw van de MV4D-module
- Gebruik de MV4D-module als de basisunit voor feature-extractie in het MVV Block. Voer de invoerfunctiepatches in vier scanpaar-takken. Raadpleeg Algoritme 1, Supplementair Bestand 1 voor de volledige pseudocode van ruimtelijke afvlakking, scan-paarindexconstructie, sequentieverzameling, S6/Mamba-verwerking, inverse ruimtelijke herordening, scan-paarfusie, SFusion Mamba-fusie, projectie en outputhervorming.
- Gebruik exact de zigzag-, hiërarchische, spiraal- en radiale scan-indexgeneratieprocedures die zijn geïmplementeerd in modellen/mvmunet/core.py. Voor elke scanstrategie gebruik je de voorwaartse scanvolgorde en de omgekeerde volgorde als één bidirectioneel scanpaar.
- Bouw het zigzag-scanpaar. Doorloop de afbeelding in afwisselende richtingen aan het einde van elke rij of kolom. Gebruik dit scanpatroon om lokale en globale ruimtelijke informatie in balans te brengen.
- Construeer het hiërarchische scanpaar. Leg kenmerken vast op meerdere ruimtelijke schalen. Gebruik dit scanpatroon om de extractie van zowel lokale als globale representaties te versterken.
- Stel het spiraalscanpaar samen. Scan de beeldkenmerken van het midden naar de grens of van de grens naar het midden. Gebruik dit scanpatroon om de extractie van globale contourinformatie te verbeteren.
- Bouw het radiale scanpaar. Scan beeldkenmerken langs meerdere radiale richtingen. Gebruik dit scanpatroon om de extractie van lokale grens- en randdetails te verbeteren.
- Voeg elk scanpaar samen voordat je de samengevoegde sequentie in het S6-blok invoert. Gebruik het gekoppelde ontwerp om de robuustheid van elke scanstrategie te verbeteren terwijl de rekenefficiëntie behouden blijft.
- Voer de uitvoersequentie van elke scan-paar tak in een S6-blok. Verkrijg vier feature-representaties die overeenkomen met de zigzag-, hiërarchische, spiraal- en radiale scanningsweergaven.
- Fuse de vier geëxtraheerde feature-representaties met behulp van de SFusion Mamba-module. Gebruik twee parallelle fusiepaden. In het eerste pad integreer je de vier kenmerken door elementgewijze toevoeging te geven.
- In het tweede SFusion Mamba-pad, verbind de vier kenmerken. Verwerk de samengevoegde representatie met behulp van Conv1d en Mamba. Verminder de kanaaldimensie met een projectielaag om overeen te komen met de S6-blokuitgangsdimensie.
- Configureer het S6/Mamba-blok met de feature-dimensie C als modeldimensie. Gebruik een projectielaag om elk samengevoegd scanpaarkenmerk terug te mappen naar kanaaldimensie C vóór de fusie.
- In SFusion Mamba voer je elementgewijze optelling uit in het eerste pad. Verbind de vier scan-view features in het tweede pad vóór Conv1d, Mamba en lineaire projectie. Gebruik de normalisatie-, lineaire projectie-, diepte-separabele convolutie en activatiebewerkingen rondom MV4D zoals beschreven in Stap 4.
- Tel de uitgangen van de twee fusiepaden op om de uiteindelijke uitgang van de MV4D-module te verkrijgen.
- Bouw vier complementaire scanparvertakkingen in plaats van alleen horizontale en verticale scanrichtingen te gebruiken. Gebruik zigzag-scanning om continue ruimtelijke doorgang te benadrukken, hiërarchisch scannen om de multiscale-representatie te versterken, spiraal-scannen om informatie van het centrum tot de grens vast te leggen, en radiaal scannen om de grensgeoriënteerde lokale detailextractie te verbeteren.
- Verwerk elke scan-paar tak onafhankelijk. Fuse de resulterende features met SFusion Mamba. Kaart elke verwerkte sequentie terug naar de oorspronkelijke ruimtelijke volgorde vóór de fusie.
- Gegeven een invoerkenmerkafbeelding X ∈ RB×H×W×C, vlakk deze af tot Xseq ∈ RB×L×C, waarbij L = H × W.
- Herschik de afgeplatte sequentie volgens de scanindices voor elke scanpaar-tak. Verwerk elke herschikte sequentie met behulp van het S6-blok. Herstel de verwerkte sequentie naar de oorspronkelijke ruimtelijke volgorde.
- Fuse de vier scan-view functies via de additieve route en de SFusion Mamba-route om de uiteindelijke MV4D-uitgang te verkrijgen. Zie Figuur 3 voor de MV4D-architectuur en Algoritme 1, Aanvullend Bestand 1 voor de volledige implementatieworkflow op tensorniveau.
- Gebruik de volledige software-implementatie in models/mvmunet/core.py. Dit bestand bevat de scan-indexgeneratoren, PairwiseScanMamba, SequenceS6, SFusion Mamba en de MV4D-wrappermodule.
- Genereer multiview scanindices
- Genereer de scanindices door de uitgebrachte implementatie in modellen/mvmunet/core.py te volgen. Voor een invoerkenmerkkaart van ruimtelijke grootte H × W, vlak elke pixellocatie af tot een eendimensionale index met behulp van: index = r × W + c, waarbij r en c respectievelijk de rij- en kolomcoördinaten aanduiden.
- Genereer de zigzag-scan door diagonalen van beelden te doorlopen met constante r + c. Verzamel de geldige pixelindices voor elke diagonaal en wissel de doorlooprichting af door de volgorde van elke even diagonaal om te keren.
- Genereer de hiërarchische scan door het beeld recursief in vier kwadranten te verdelen. Bezoek achtereenvolgens de boven-links, boven-rechts, linksonder- en rechteronderkwadranten totdat de hoogte of breedte van de subregio niet groter is dan 2 pixels, en doorloop vervolgens de resterende pixels in rij-hoofdvolgorde.
- Genereer de spiraalscan door de buitenste beeldgrens van links naar rechts langs de bovenste rij, omlaag langs de rechterkolom, van rechts naar links langs de onderste rij, en omhoog langs de linker kolom, terwijl de grens geleidelijk verkleind wordt richting het beeldcentrum.
- Genereer de radiale scan door elke pixel te sorteren op de kwadratische afstand tot het beeldcentrum en vervolgens op basis van de polaire hoek, berekend met de atan2-functie.
- Genereer de omgekeerde scan voor elke scanstrategie door de bijbehorende voorwaartse scanvolgorde om te keren. Combineer de voorwaartse en achteruit-scansequenties om één scanpaar te vormen voor elke scanstrategie voordat de scanparen aan de MV4D-module worden doorgegeven.
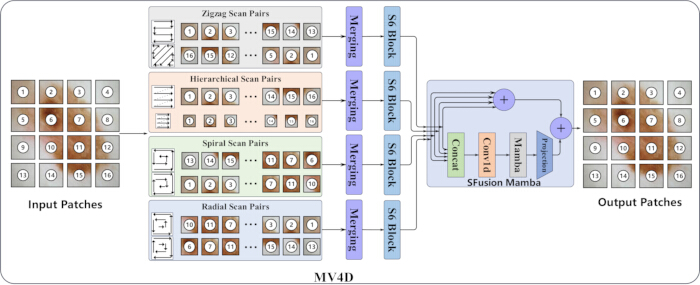
Figuur 3. Architectuur van de Multi-View 4-directional (MV4D) module. Structuur van de Multi-View 4-Directional (MV4D) feature-extractiemodule. Invoerpatches worden verwerkt via vier complementaire scanpaarvertakkingen, waaronder zigzag-, hiërarchische, spiraal- en radiale scanning. Kenmerken die uit de vier takken worden geëxtraheerd, samengevoegd, verwerkt met behulp van toestandsruimteblokken en geïntegreerd door Spatial Fusion Mamba (SFusion Mamba) om de uitvoer-featurerepresentatie te genereren. Klik hier om een grotere versie van deze figuur te bekijken.
4. Bouw van het MVV-blok
- Bouw het MVV Block met één hoofdtak en twee hulpvertakkingen. Gebruik de algemene structuur die in Figuur 4 wordt getoond.
- Pas laagnormalisatie toe op de invoerfunctie in de hoofdvertakking. Voer het genormaliseerde kenmerk in een lineaire laag. Geef het getransformeerde kenmerk door naar de diepte-separeerbare convolutie.
- Verwerk het getransformeerde kenmerk met behulp van de diepte-separabele convolutie. Pas de GELU-activatiefunctie toe. Voer de geactiveerde functie in de MV4D-module.
- Construeer de eerste hulptak als een identiteitsresiduele verbinding. Verbind de invoerfunctie direct met de uiteindelijke uitgang. Gebruik deze tak om de oorspronkelijke representatie te behouden en de training te stabiliseren.
- Bouw de tweede hulptak als een projectie-down-up branch. Comprimer de invoerfunctie met een down-projectielaag. Herstel de feature-dimensie met behulp van een up-projectielaag.
- Meng de uitgangen van de hoofdtak en beide hulptakken. Verkrijg de uiteindelijke MVV Block-uitvoer. Zie Figuur 4 voor de volledige architectuur.
- Stel de verborgen dimensie van de hoofdtak in gelijk aan de ingangskanaaldimensie Cs. Pas LayerNorm(Cs) toe vóór de hoofdlineaire projectie en gebruik een lineaire laag met de afmetingen Cs→Cs. Gebruik een dieptegewijze separabele convolutie bestaande uit een 3×3 dieptegewijze convolutie met opvulling 1, groepen = Cs, en geen bias, gevolgd door een 1×1 puntgewijze convolutie zonder bias.
- Pas de GELU-activatiefunctie toe na de diepte-separable convolutie. Voer de geactiveerde functie in MV4D en pas een lineaire uitvoerprojectie toe met de afmetingen Cs→Cs. Configureer de projectie-down-up tak met behulp van LayerNorm(Cs), een projectieverhouding van 4, een down-projection Cs→Cs/4, GELU-activatie en een up-projectie Cs/4→Cs.
- Combineer de identiteitsbranch, projectie down-up branch en drop-path-processed main branch met element-wise addition om de uiteindelijke MVV Block-output te verkrijgen.
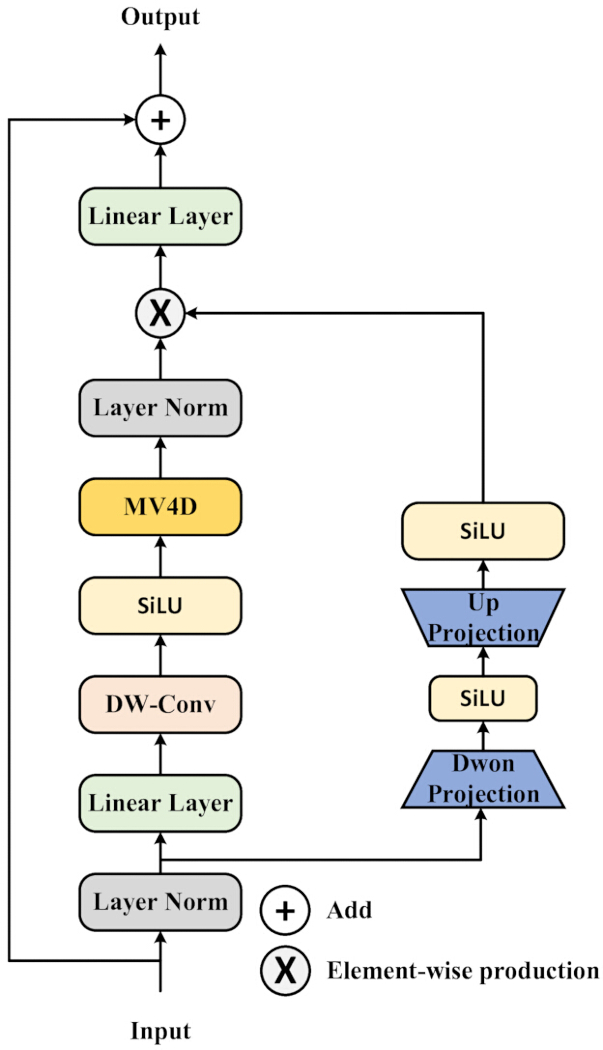
Figuur 4. Architectuur van het Multi-View Vision (MVV) blok. Structuur van het Multi-View Vision (MVV) blok. Het blok bestaat uit een hoofd-feature-extractietak die de Multi-View 4-Directional (MV4D) module bevat, samen met diepteconvolutie-, normalisatie- en lineaire projectielagen. Een hulp-up-down projectietak biedt gegated feature-modulatie via element-vir-element vermenigvuldiging voordat residuele optelling wordt uitgevoerd om de uitvoer-featurerepresentatie te genereren. Klik hier om een grotere versie van deze figuur te bekijken.
5. Bouw van MFusion Mamba
- Verzamel de featuremaps van alle encoder-levels. Lijn de encoderkenmerken uit op een uniforme representatieruimte door ze te vergroten of te projecteren wanneer nodig. Zie Algoritme 2, Aanvullend Bestand 1 voor de volledige implementatieworkflow op tensorniveau.
- Pas de encoderkenmerken aan op de ruimtelijke resolutie van het doel wanneer nodig. Projectfuncties met verschillende kanaalafmetingen in dezelfde kanaaldimensie. Lijn alle encoderfuncties uit voordat je meerstapsfusie hebt.
- Voer de uitgelijnde encoderkenmerken in de Coarse Fusion-component. Voer grove fusie uit met het Hadamard-product. Genereer de grove fused representatie.
- Voer de grove fuseerde representatie in de Fine Fusion-component. Bouw twee parallelle fijnfusiepaden. Verwerk beide paden onafhankelijk.
- Verwerk het eerste fijnfusiepad met behulp van een lineaire laag. Verwerk het tweede Fine Fusion-pad met behulp van opwaartse projectie, Conv1d, Mamba en neerwaartse projectie. Herstel de feature-dimensie na downprojectie.
- Samenvoeg de uitgangen van de twee fijnfusiepaden met behulp van het Hadamard-product. Breng de uiteindelijke lineaire laag aan. Verkrijg de MFusion Mamba-uitvoer.
- Voer de MFusion Mamba-uitgang in de decoder. Decodeer de gefuseerde meertrapsrepresentatie samen met de encoder-decoder skipfuncties. Genereer de definitieve segmentatiekaart.
- Lijn encoderkenmerken uit verschillende fasen uit in een uniforme featureruimte voordat je groffus. Verwerk de uitgelijnde feature-representaties met behulp van de grove en fijne fusiefasen. Zie Figuur 5 voor de MFusion Mamba-architectuur en Supplementary Algorithm 2 voor de volledige implementatieworkflow op tensorniveau.
- Gebruik de implementatieparameters van MFusion Mamba als volgt. Voor elke encoderkenmerk Ei projecteer je de kanaaldimensie van Ci naar Ct. Herschal geprojecteerde kenmerken naar de ruimtelijke grootte van het doel met behulp van bilineaire interpolatie met align_corners=False wanneer nodig.
- Pas het Hadamard-product toe om groffusie uit te voeren over de uitgelijnde encoderfuncties. Configureer het eerste Fine Fusion-pad met behulp van een lineaire laag met de afmetingen Ct → Ct. Configureer het tweede Fine Fusion-pad met behulp van een opwaartse projectie Ct → 2Ct, Conv1d, een Mamba/S6-blok met modeldimensie 2Ct, één scanrichting, toestandsdimensie 16, en een downprojectie 2Ct → Ct.
- Fuse de uitgangen van de fijnfusiepaden met behulp van het Hadamard-product. Pas een definitieve lineaire projectie toe met dimensies Ct op Ct. Voer de gefuseerde meertrapsrepresentatie in de decoder.
- Fuse-multitraps encoderfuncties met MFusion Mamba
- Verzamel de encoderkenmerken van alle vier de encoderstages (E1, E2, E3 en E4) en gebruik deze als input voor de MFusion Mamba-module. Selecteer niet alleen de coroderfunctie in de corresponderende fase voor decoderfusie.
- Lijn alle encoderkenmerken uit op de ruimtelijke resolutie die vereist is voor de huidige decoderfase. Verander de grootte van de encoder-features naar de doelresolutie en projecteer deze op de vereiste kanaaldimensie vóór feature-fusie.
- Herhaal de feature-uitlijningsprocedure voor elke decoderfase. Wanneer de decoder werkt op H/16 × W/16, H/8 × W/8 en H/4 × W/4, herschal en projecteert men E1, E2, E3 en E4 naar de overeenkomstige doel-featureruimte.
- Fuse de uitgelijnde multitraps encoderfuncties met behulp van de Coarse Fusion- en Fine Fusion-operaties van de MFusion Mamba-module, en combineer de gefuseerde representatie met de decoderfuncties op de overeenkomstige schaal.
- Voer de featureprojectie, grootteverandering en fusie uit volgens de uitgebrachte implementatie in models/mvmunet/core.py.
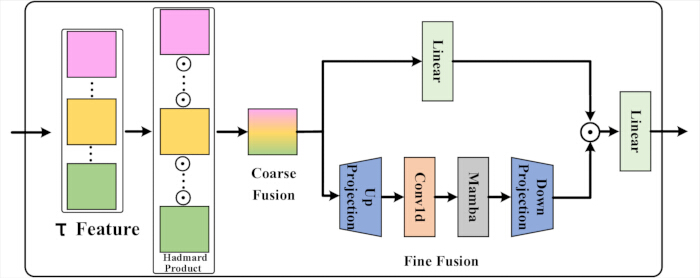
Figuur 5. Architectuur van de Multi-stage Fusion Mamba (MFusion Mamba) module. Structuur van de Multi-stage Fusion Mamba (MFusion Mamba) module. Multi-scale encoderkenmerken worden eerst gecombineerd door grove fusie en vervolgens verfijnd via de Fine Fusion-module, bestaande uit lineaire projectie, eendimensionale convolutie (Conv1d), een Mamba-blok en featureprojectielagen voordat de fused feature-representatie die door de decoder wordt gebruikt wordt gegenereerd. Klik hier om een grotere versie van deze figuur te bekijken.
6. Modeltraining
- Train MVM-UNet op Ubuntu 22.04.1 met Linux kernel versie 6.8.0. Gebruik een werkstation uitgerust met een 13e generatie Intel Core i9-13900K CPU en een NVIDIA A800 GPU. Gebruik dezelfde hardwareconfiguratie tijdens training en evaluatie.
- Implementeer en train het model met PyTorch 2.0.1 met CUDA 11.8. Installeer alle benodigde softwareafhankelijkheden voordat je traint.
- Gebruik de AdamW-optimizer met een initiële leersnelheid van 3 × 10⁻⁵, β1 = 0,9, β2 = 0,999, ε = 1 × 10⁻⁸ en een gewichtsafname van 0,01. Stel de batchgrootte in op 32, tenzij anders aangegeven.
- Train elk model voor 300 epochs. Gebruik een cosinus-annealing leertempo met ηmin = 1 × 10⁻⁵. Stel de ingangsbeeldgrootte in op 256 × 256 voor ISIC 2017 en ISIC 2018 en op 224 × 224 voor Synapse.
- Gebruik drie onafhankelijke willekeurige zaden (1, 52 en 100) voor de belangrijkste vergelijkingsexperimenten. Herhaal de volledige trainings- en evaluatieprocedure voor elk zaadje. Rapporteer de definitieve kwantitatieve resultaten als gemiddelde ± SD over de drie runs.
- Gebruik een vaste willekastige seed van 100 voor alle ablatiestudies, tenzij anders vermeld. Houd de dataset-partitionen, preprocessingstrategie, netwerkarchitectuur, optimizer, leersnelheid, batchgrootte en aantal trainingsepochs ongewijzigd in alle ablatie-experimenten.
- Gebruik het BCE-Dice verlies voor binaire laesiesegmentatie op ISIC 2017 en ISIC 2018. Stel de BCE- en dobbelsteengewichts in op 1,0. Gebruik het CE-Dice verlies voor Synapse en stel zowel de cross-entropie als het Dice verliesgewicht in op 1,0.
- Verander de grootte, normaliseer en vul de ISIC 2017 en ISIC 2018 trainingsbeelden aan met behulp van de preprocessingprocedure beschreven in Stap 1. Pas het aanpassen van de grootte, willekeurige rotatie en willekeurige flipping toe op Synapse-trainingsbeelden zoals beschreven in Stap 1. Gebruik identieke preprocessing-instellingen tijdens alle trainingsruns.
- Selecteer modelcontrolepunten volgens het dataset-specifieke validatieprotocol. Bewaar het checkpoint met de beste validatieprestaties voor ISIC 2017 en ISIC 2018, en voer elke 30 epochs validatie uit. Train Synapse voor 300 epochs zonder validatieset en gebruik het laatste trainingscheckpoint voor testen.
- Gebruik de officiële validatieset alleen voor modelselectie op ISIC 2017 en ISIC 2018. Gebruik de Synapse-testset niet voor training, hyperparameter-afstemming of checkpointselectie. Reserveer alle testgegevens exclusief voor de definitieve evaluatie.
- Gebruik de volgende trainingsparameters voor reproduceerbaarheid. Stel de batchgrootte in op 32 voor alle datasets. Gebruik AdamW met een initiële leersnelheid van 3 × 10⁻⁵, β1 = 0,9, β2 = 0,999, ε = 1 × 10⁻⁸, en een gewichtsafname van 1 × 10⁻².
- Configureer de cosinus-annealing leersnelheidsplanner met Tmax = 50 en ηmin = 1×10⁻⁵ voor ISIC 2017 en ISIC 2018. Configureer de scheduler met Tmax = 100 en ηmin = 1×10⁻⁵ voor Synapse. Houd de planningsconfiguratie ongewijzigd voor alle herhaalde experimenten.
- Train alle modellen met behulp van vol-precisie FP32-rekenkunde. Schakel automatische mixed-precision training uit. Pas geen gradient clipping toe tijdens optimalisatie.
- Houd de precisie-instellingen, gradiëntupdatestrategie, optimizerconfiguratie, leersnelheidsschema en random-seed-protocol ongewijzigd in alle vergelijkingsexperimenten, ablatiestudies en reproduceerbaarheidsruns.
- Kies het beste modelcontrolepunt
- Evalueer het model op de validatieset na elk trainingstijdperk voor de ISIC 2017- en ISIC 2018-datasets.
- Bereken het Binaire Cross-Entropie (BCE)-dobbelsteenverlies voor elke validatiebatch en bereken het gemiddelde validatieverlies over de gehele validatieset.
- Bewaar het huidige model als het beste controlepunt wanneer het gemiddelde validatieverlies lager is dan het eerder geregistreerde minimale validatieverlies.
- Noteer tijdens validatie de gemiddelde Intersection over Union (mIoU), de dobbelsteengelijkheidscoëfficiënt (DSC), nauwkeurigheid (Acc), specificiteit (Spe) en gevoeligheid (Sen) tijdens validatie, uitsluitend voor prestatiemonitoring. Gebruik deze metrieken niet als criterium voor de selectie van checkpointen.
7. Modelevaluatie
- Evalueer het getrainde model met behulp van de officiële testset voor elke dataset. Gebruik de testset alleen voor de eindbeoordeling van de prestaties.
- Voor ISIC 2017 en ISIC 2018 bereken je de mIoU, DSC, Acc, Sen en Spe. Gebruik pixelniveau true positives (TP), false positives (FP), true negative (TN) en false positives (FN) voor alle berekeningen.
- Pas een sigmoid-activatiefunctie toe op de modeloutput van ISIC 2017 en ISIC 2018. Zet de kanskaart om in een binair segmentatiemasker met een drempel van 0,5. Bereken de evaluatiemetrieken met behulp van Vergelijkingen 2–6:
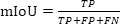 (2)
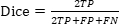 (3)
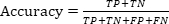 (4)
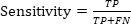 (5)
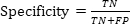 (6)
- Voor Synapse past je de softmax-activatiefunctie toe op de modeluitvoer. Wijs elke pixel of voxel toe aan de klasse met de hoogste kans met behulp van de argmax-operatie. Bereken de DSC en de 95e percentiel Hausdorff-afstand (HD95) voor elk voorgrondorgaan en rapporteer de gemiddelde waarden over alle testgevallen.
- Vergelijk MVM-UNet met representatieve CNN-gebaseerde, Transformer-gebaseerde en state-space model (SSM)-gebaseerde segmentatiemethoden. Gebruik identieke dataset-partities, preprocessingprocedures, inputresoluties en evaluatiemetrics voor alle methoden.
- Gebruik de officiële trainings-, validatie- en testpartities voor ISIC 2017 en ISIC 2018. Gebruik de standaardverdeling van 18 trainingsgevallen en 12 testcases voor Synapse. Stel de inputresolutie in op voor ISIC-datasets en voor Synapse.
- Reproduceer basismethoden met hun officiële implementaties wanneer beschikbaar. Rapporteer de resultaten als gemiddelde ± SD over herhaalde runs. Behoud de door literatuur gerapporteerde waarden zoals oorspronkelijk gepubliceerd en onderscheid deze in de bijbehorende tabelnotities.
- Voer ablatiestudies uit met het vaste willekeurige zaad van 100, tenzij anders vermeld. Houd de dataset-partitionen, preprocessingprocedure, inputresolutie, optimizer, leersnelheidsschema, batchgrootte, aantal epochs, verliesfunctie en evaluatiemetrics ongewijzigd over alle ablatie-experimenten.
- Evalueer de bijdragen van MV4D, SFusion Mamba, de Up-Down Projection-tak in het MVV Block, MFusion Mamba, de grootte van het invoerbeeld, de dropoutwaarde en de configuratie van de encoder-decoder laag. Pas alleen de doelcomponent of parameter aan in elk ablatie-experiment.
- Voer de Wilcoxon teken-rank test uit met gepaarde per-beeldresultaten voor ISIC 2017 en ISIC 2018 en gepaarde per-geval resultaten voor Synapse. Beschouw een p-waarde kleiner dan 0,05 om statistische significantie aan te geven.
- Evalueer de rekenefficiëntie met dezelfde hardwareomgeving en inputresolutie voor alle methoden. Meet de trainingstijd per epoch, inferentietijd per afbeelding, piek GPU-geheugengebruik tijdens training, aantal modelparameters en floating-point operations (FLOPs). Bereken FLOPs met een enkele voorwaartse pass.
- Selecteer representatieve kwalitatieve voorbeelden alleen uit de testset na het voltooien van modelevaluatie. Vergelijk het originele beeld, het grond-waarheidsmasker en het voorspelde masker met identieke testgevallen over alle methoden heen. Kies representatieve voorbeelden die kleine doelen, onregelmatige grenzen, ambigue grenzen en representatieve multi-organstructuren omvatten.
- Bereken evaluatiemetrics en voer statistische analyses uit
- Bereken de segmentatiemetrics voor de ISIC 2017 en ISIC 2018 datasets in Python met behulp van NumPy en sklearn.metrics.confusion_matrix. Beperk de voorspelde kanskaart op 0,5, verkrijg de pixelniveau TP, FP, TN en FN, en bereken de mIoU, DSC, Acc, Sen en Spe uit deze waarden.
- Bereken de DSC en de HD95 voor de Synapse-dataset met behulp van medpy.metric.binary.dc en medpy.metric.binary.hd95, respectievelijk. Pas softmax gevolgd door argmax toe op de modeloutput voordat je de evaluatie-metrics berekent.
- Bereken het aantal FLOPs en trainbare parameters met thop.profile met een enkele voorwaartse pass.
- Voer de Wilcoxon signed-rank test uit in Python met scipy.stats.wilcoxon. Gebruik gepaarde per-beeldmetriekwaarden voor de ISIC 2017- en ISIC 2018-datasets en gepaarde per-case-metriekwaarden voor de Synapse-dataset.
8. Definitie van verliesfunctie
- Gebruik het standaard Cross-Entropy (CE) verlies voor multiclass-segmentatie en het standaard BCE-verlies voor binaire segmentatie. Gebruik de standaard Dice verliesformulering voor segmentatie. Vergelijkingen 7–11 definiëren de verliesfuncties die in dit protocol worden gebruikt.
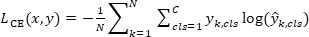 (7)
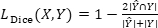 (8)
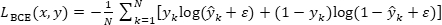 (9)
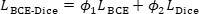 (10)
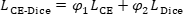 (11)
- Stel de BCE- en dobbelsteengewichts in op 1,0 voor ISIC 2017 en ISIC 2018, zodat
 1 = 1,0 en 2 = 1,0 is. Stel de CE- en dobbelsteengewichts in op 1,0 voor Synapse, zodanig φ1 = 1,0 dat en φ2 = 1,0.
- Implementeer de verliesfuncties in utils.py. Gebruik nn. BCELoss voor de BCE-term en nn. CrossEntropyLoss voor de CE-term. Bereken het binaire dobbelsteenverlies door elk voorspeld masker en grondwaarheidsmasker af te vlakken, het dobbelsteenverlies per monster te berekenen en het verlies over de batch te middelen. Bereken het multiclass Dice-verlies door de target labelmap om te zetten naar one-hot formaat, softmax toe te passen op de modeloutput, het Dice-verlies voor elke klasse te berekenen en het verlies over alle klassen te middelen.
- Stel de gladmakingsconstante in op 1 voor het binaire dobbelsteenverlies en op 1×10⁻⁵ voor het multiclass dobbelsteenverlies. Voer het BCE-Dice-Cube-verlies uit met de BceDiceLoss-klasse met wb = 1 en wd = 1. Implementeer het verlies van CE-Dice met de CeDiceLoss-klasse met loss_weight = [1, 1]. Houd de gladmaakconstanten, reductiestrategie en software-implementatie ongewijzigd voor alle datasets, willekeurige zaadjes en experimenten.
- Configureer de verliesreductie
- Instansieer nn. BCELoss() en nn. CrossEntropyLoss() zonder expliciet het reductieargument te specificeren.
- Gebruik de standaard PyTorch verliesreductie-instelling (reductie = "gemiddelde") voor beide verliesfuncties. Gebruik geen reductie = "som" of een ongereduceerd verliesoutput.
9. Reproduceerbaarheidsinstellingen en uitvoering
- Download de uitgebrachte implementatie van https://github.com/LIXUEGUANG002/MVM-UNet. Gebruik de repository samen met de softwarepakketten, datasets, hardwarespecificaties en rekenbronnen die in de Table of Materials staan vermeld.
- Kloneer de repository en ga in de projectmap door git clone https://github.com/LIXUEGUANG002/MVM-UNet.git uit te voeren, gevolgd door cd MVM-Unet.
- Configureer het ISIC 2017- of ISIC 2018-experiment door de naam van de dataset, het pad van de dataset, invoergrootte, batchgrootte, aantal epochs, verliesfunctie, optimizer, leersnelheidsplanner en willekeurige seed in configuraties/config_setting.py in te stellen. Voer het trainingsscript uit vanaf de repository-root met Python train.py.
- Configureer het Synapse-experiment door de naam van de dataset, het trainingsdatapad, het testvolumepad, lijstenmap, invoergrootte, aantal klassen, batchgrootte, aantal epochs, verliesfunctie, optimizer, leersnelheidsplanner en willekeurige seed in te stellen in configuraties/config_setting_synapse.py. Voer het trainingsscript uit vanaf de repository-root met Python train_synapse.py.
- Voer alleen inferentie-evaluatie uit door only_test_and_save_figs = Waar in te stellen, best_ckpt_path naar het getrainde checkpoint en img_save_path naar de uitvoermap in het bijbehorende configuratiebestand. Voer python train.py uit voor ISIC 2017 of ISIC 2018, of gebruik python train_synapse.py voor Synapse om voorspellingsresultaten en kwalitatieve cijfers te genereren.
- Gebruik de vrijgegeven broncodeversie
- Klon de uitgebrachte GitHub-repository en bekijk commit ee891b42c2f083c4990eed72f1d4463adc5e103e op de masterbranch voordat je de datasets, trainingsscripts en evaluatie-instellingen configureert.
- Gebruik deze commit om de experimenten die in deze studie zijn gerapporteerd te reproduceren. Er was geen getagde releaseversie beschikbaar voor de repository ten tijde van de manuscriptrevisie.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Verwachte uitkomsten en interpretatie
Wanneer dit protocol correct is geïmplementeerd, wordt verwacht dat het getrainde MVM-UNet-model stabiele segmentatieprestaties levert over herhaalde runs, met slechts kleine variaties tussen verschillende willekeurige seeds voor de meeste evaluatiemetrics. Voor ISIC 2017 en ISIC 2018 worden succesvolle uitkomsten weerspiegeld door hoge DSC-, mIoU-, Acc-, Sen- en Spe-waarden, samen met voorspelde laesiemaskers die nauw aansluiten ...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Dit protocol beschrijft MVM-UNet, een op Mamba gebaseerd medisch beeldsegmentatieframework. De methode is ontworpen om twee beperkingen van bestaande segmentatiemodellen aan te pakken. Ten eerste hebben conventionele CNN-gebaseerde methoden beperkte mogelijkheden om langeafstandsafhankelijkheden en hiërarchische contextuele informatie te modelleren in complexe medische beelden43. Ten tweede kunnen op transformers gebaseerde methoden globale context modelleren, maa...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs verklaren dat zij geen concurrerende financiële belangen hebben.
Dankbetuigingen
Dit onderzoek kreeg geen externe financiering.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Hardware - GPU workstation or GPU server | Institutional computing platform / local workstation | Custom-built local GPU workstation; Ubuntu 22.04.1 with Linux kernel 6.8.0; Intel Core i9-13900K CPU; NVIDIA A800 GPU; 128 GB RAM; 512 GB lokale opslag. | Computational platform for training, validation, testing, ablation, and inference-only experiments. |
| Hardware - Graphics processing unit (GPU) | NVIDIA Corporation | NVIDIA A800 GPU (80 GB geheugen). | GPU-accelerated model training and inference. |
| Hardware - Central processing unit (CPU) | Intel Corporation / AMD | 13th Gen Intel Core i9-13900K CPU. | Host processor for data loading, preprocessing, and experiment execution. |
| Hardware - System memory (RAM) | Institutional computing platform / local workstation | 128 GB systeemmageheugen | Geheugen voor het laden van datasets, preprocessing en training. |
| Hardware - Opslag | Institutional computing platform / local workstation | 2 TB NVMe solid-state drive. | Opslag voor datasets, checkpoints, logs en gegenereerde voorspellingsfiguren. |
| Software environment - Operating system | Canonical Ltd. | Aanbevolen: Ubuntu 22.04.1 LTS | Besturingssysteem voor de computationele omgeving. |
| Software environment - Conda environment | Anaconda, Inc. / Miniconda | Omgevingsnaam: mvmunet | Python-omgeving gebruikt om afhankelijkheden te installeren en te isoleren. |
| Software environment - Python | Python Software Foundation | Python 3.8 | Programmeertaal gebruikt voor implementatie en experimentuitvoering. |
| Software environment - CUDA toolkit | NVIDIA Corporation | CUDA Toolkit 11.8 | GPU computing backend vereist door PyTorch en Mamba-gerelateerde packages. |
| Software environment - cuDNN | NVIDIA Corporation | cuDNN 8.7.0. | GPU-accelerated deep-learning primitieven gebruikt via PyTorch. |
| Python package - PyTorch | PyTorch | torch == 2.0.1 | Deep-learning framework voor modeltraining, verliesberekening, optimalisatie en inferensie. |
| Python package - Torchvision | PyTorch | torchvision == 0.14.0 | Afbeeldingstransformatiehulpmiddelen gebruikt bij preprocessing en augmentatie. |
| Python package - Torchaudio | PyTorch | torchaudio == 0.13.0 | Geïnstalleerd met de aanbevolen PyTorch-omgeving. |
| Python package - timm | timm developers | timm == 0.4.12 | Modelcomponent- of hulpprogramma-afhankelijkheid vermeld in de omgevingsinstructies van het repository. |
| Python package - triton | OpenAI / Triton developers | triton == 2.0.0 | Afhankelijkheid gebruikt door GPU-geaccelereerde sequentiemodelleringscomponenten. |
| Python package - causal-conv1d | causal-conv1d developers | causal_conv1d == 1.0.0 | Efficiënte causale convolutieafh. vereist door de Mamba-implementatie. |
| Python package - mamba-ssm | Mamba SSM developers | mamba_ssm == 1.0.1 | Staat-ruimtesequentiemodelleringspakket gebruikt voor Mamba/S6-gerelateerde componenten. |
| Python package - NumPy | NumPy developers | NumPy-versie 1.24.3. | Numerieke berekening en arraybewerkingen. |
| Python package - SciPy | SciPy developers | SciPy-versie 1.10.1. | Wetenschappelijke berekening; scipy.ndimage.zoom wordt geïmporteerd in utils.py. |
| Python package - SimpleITK | Insight Software Consortium | SimpleITK-versie 2.2.1. | Medische beeldinvoer/uitvoer en preprocessinghulpprogramma geïmporteerd in utils.py. |
| Python package - MedPy | MedPy developers | MedPy-versie 0.4.0. | Pakket voor medische beeldmetriekberekening geïmporteerd in utils.py. |
| Python package - scikit-image | scikit-image developers | scikit-image-versie 0.21.0. | Afhankelijkheid voor beeldverwerking vermeld in README. |
| Python package - scikit-learn | scikit-learn developers | scikit-learn-versie 1.3.2. | Pakket voor machine-learninghulpprogramma vermeld in README. |
| Python package - matplotlib | Matplotlib developers | Matplotlib-versie 3.7.2. | Gebruikt voor het opslaan van kwalitatieve visualisatiefiguren. |
| Python package - h5py | h5py developers | h5py-versie 3.9.0. | HDF5-bestandsondersteuning voor Synapse-testvolumes. |
| Python package - thop | THOP developers | THOP-versie 0.1.1.post2209072238. | Gebruikt bij het berekenen van FLOPs en parametergerelateerde computationele kosten. |
| Python package - packaging | Python Packaging Authority | packaging-versie 23.1. | Afhankelijkheid vermeld in README. |
| Python package - pytest | pytest developers | pytest-versie 7.4.0. | Afhankelijkheid vermeld in README. |
| Python package - chardet | chardet developers | chardet-versie 5.2.0. | Afhankelijkheid vermeld in README. |
| Python package - yacs | YACS developers | yacs-versie 0.1.8. | Configuratiehulpprogramma-afhankelijkheid vermeld in README. |
| Python package - termcolor | termcolor developers | termcolor-versie 2.3.0. | Logging/terminalhulpprogramma-afhankelijkheid vermeld in README. |
| Python package - submitit | submitit developers | submitit-versie 1.4.5. | Experiment/jobhulpprogramma-afhankelijkheid vermeld in README. |
| Python package - tensorboardX | tensorboardX developers | tensorboardX-versie 2.6.2.2. | Traininglogvisualisatiehulpprogramma vermeld in README. |
| Python package - ml-collections | ml_collections developers | ml-collections-versie 0.1.1. | Geïmporteerd door configs/config_setting_synapse.py. |
| Dataset - ISIC 2017 Challenge dataset | International Skin Imaging Collaboration | ISIC 2017 skin lesion segmentation dataset | Publieke, geanonimiseerde dermoscopische huidlesiebeeldbeelden en maskers gebruikt voor binaire segmentatie. |
| Dataset - ISIC 2018 Challenge Task 1 dataset | International Skin Imaging Collaboration | ISIC 2018 Task 1: Lesion Boundary Segmentation | Publieke, geanonimiseerde dermoscopische huidlesiebeeldbeelden en maskers gebruikt voor binaire segmentatie. |
| Dataset - Synapse Multi-Atlas Labeling Beyond the Cranial Vault dataset | Synapse / Sage Bionetworks | Toegangsidentificator: syn3193805 | Publiek abdominaal CT multi-orgaansegmentatiedataset. |
| Data organization - ISIC 2017 data folder | Authors / repository layout | data/isic2017 |
Referenties
- Zhang F, et al. Cross co-teaching for semi-supervised medical image segmentation. Pattern Recognit. 2024;152:110485.
- Gu Y, et al. Dual-scale enhanced and cross-generative consistency learning for semi-supervised medical image segmentation. Pattern Recognit. 2025;158:111140.
- Zhu X, Wang W, Zhang C, Wang H. Polyp-Mamba: A hybrid multi-frequency perception gated selection network for polyp segmentation. Inf Fusion. 2025;115:103161.
- Iqbal S, et al. TBConvL-Net: A hybrid deep learning architecture for robust medical image segmentation. Pattern Recognit. 2025;158:111147.
- Zhao Z, et al. Balanced feature fusion collaborative training for semi-supervised medical image segmentation. Pattern Recognit. 2025;157:110986.
- Zhou T, et al. MambaYOLACT: You only look at Mamba prediction head for head-neck lymph nodes. Artif Intell Rev. 2025;58(6).
- Zhao Y, et al. MGF-GCN: Multimodal interaction Mamba-aided graph convolutional fusion network for semantic segmentation of remote sensing images. Inf Fusion. 2025;122:103268.
- Ronneberger O, Fischer P, Brox T. U-Net: Convolutional networks for biomedical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2015.
- Zhou Z, Siddiquee MMR, Tajbakhsh N, Liang J. UNet++: Redesigning skip connections to exploit multiscale features in image segmentation. IEEE Trans Med Imaging. 2019;39(6):1856-1867.
- Shaker A, et al. UNETR++: Delving into efficient and accurate 3D medical image segmentation. IEEE Trans Med Imaging. 2024;43(9):3377-3390.
- Zhou HY, et al. nnFormer: Volumetric medical image segmentation via a 3D Transformer. IEEE Trans Image Process. 2023;32:4036-4045.
- He A, et al. H2Former: An efficient hierarchical hybrid Transformer for medical image segmentation. IEEE Trans Med Imaging. 2023;42(9):2763-2775.
- Zhu L, et al. Vision Mamba: Efficient visual representation learning with bidirectional state space model. In: Proceedings of the 41st International Conference on Machine Learning (ICML). 2024.
- Liu Y, et al. VMamba: Visual state space model. Adv Neural Inf Process Syst. 2024;37:103031-103063.
- Ma J, Li F, Wang B. U-Mamba: Enhancing long-range dependency for biomedical image segmentation. arXiv. 2024;arXiv:2401.04722.
- Wang Z, et al. Mamba-UNet: UNet-like pure visual Mamba for medical image segmentation. arXiv. 2024;arXiv:2402.05079.
- Huang T, et al. LocalMamba: Visual state space model with windowed selective scan. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Zhang Z, et al. Motion Mamba: Efficient and long sequence motion generation. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Hu VT, et al. Zigma: A DiT-style zigzag Mamba diffusion model. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Rahman MM, et al. Mamba in vision: A comprehensive survey of techniques and applications. arXiv. 2024;arXiv:2410.03105.
- Falk T, et al. U-Net: Deep learning for cell counting, detection, and morphometry. Nat Methods. 2019;16(1):67-70.
- Gu R, et al. CA-Net: Comprehensive attention convolutional neural networks for explainable medical image segmentation. IEEE Trans Med Imaging. 2020;40(2):699-711.
- Chen J, et al. TransUNet: Rethinking the U-Net architecture design for medical image segmentation through the lens of Transformers. Med Image Anal. 2024;97:103280.
- Zhang Z, Zhang W. Pyramid medical Transformer for medical image segmentation. arXiv. 2021;arXiv:2104.14702.
- Cao H, et al. Swin-Unet: UNet-like pure Transformer for medical image segmentation. In: European Conference on Computer Vision (ECCV). Springer; 2022.
- Chen B, et al. TransAttUNet: Multi-level attention-guided U-Net with Transformer for medical image segmentation. IEEE Trans Emerg Top Comput Intell. 2023.
- Jiang S, Li J. TransCUNet: UNet cross-fused Transformer for medical image segmentation. Comput Biol Med. 2022;150:106207.
- Wu R, Liu Y, Liang P, Chang Q. H-vmunet: High-order Vision Mamba UNet for medical image segmentation. Neurocomputing. 2025;624:129447.
- Liu J, et al. Swin-UMamba: Adapting Mamba-based vision foundation models for medical image segmentation. IEEE Trans Med Imaging. 2024.
- Huang X, et al. MISSFormer: An effective Transformer for 2D medical image segmentation. IEEE Trans Med Imaging. 2023;42(5):1484-1494.
- Ruan J, et al. MALUNet: A multi-attention and lightweight U-Net for skin lesion segmentation. In: 2022 IEEE International Conference on Bioinformatics and Biomedicine (BIBM). IEEE; 2022.
- Ruan J, Xiang S. VM-UNet: Vision Mamba UNet for medical image segmentation. arXiv. 2024;arXiv:2402.02491.
- Valanarasu JMJ, Patel VM. UNeXt: MLP-based rapid medical image segmentation network. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2022.
- Ren S, Li X. HResFormer: Hybrid residual Transformer for volumetric medical image segmentation. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10558-10566.
- Karimijafarbigloo S, Azad R, Kazerouni A, Merhof D. MedScale-Former: Self-guided multiscale Transformer for medical image segmentation. Med Image Anal. 2025;103.
- Yan S, et al. Multi-scale convolutional attention frequency-enhanced Transformer network for medical image segmentation. Inf Fusion. 2025;119.
- Gao Y, Zhou M, Metaxas DN. UTNet: A hybrid Transformer architecture for medical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2021.
- Mei J, et al. SANet: A slice-aware network for pulmonary nodule detection. IEEE Trans Pattern Anal Mach Intell. 2021;44(8):4374-4387.
- Hu XZ, Jeon WS, Rhee SY. ATT-UNet: Pixel-wise staircase attention for weed and crop detection. In: 2023 International Conference on Fuzzy Theory and Its Applications (iFUZZY). IEEE; 2023.
- Wang X, et al. Transferable normalization: Towards improving transferability of deep neural networks. Adv Neural Inf Process Syst. 2019;32.
- Azad R, et al. TransDeepLab: Convolution-free Transformer-based DeepLabV3+ for medical image segmentation. In: International Workshop on Predictive Intelligence in Medicine (PRIME). Springer; 2022.
- Ruan J, Gao J, Xie M, Xiang S. Learning multi-axis representation in frequency domain for medical image segmentation. Mach Learn. 2025;114(1):10.
- Goodfellow I, Bengio Y, Courville A. Deep Learning. MIT Press; Cambridge, MA; 2016.
- Milletari F, Navab N, Ahmadi SA. V-Net: Fully convolutional neural networks for volumetric medical image segmentation. In: 2016 Fourth International Conference on 3D Vision (3DV). IEEE; 2016.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.