Deze cross-sectionele enquête onderzocht de verbanden tussen het gebruik van generatieve kunstmatige intelligentie, onderwijsstijl, digitale geletterdheid, motivatie, angst en creativiteit bij Saudische undergraduate studenten Engels als vreemde taal, waarbij motivatie werd geïdentificeerd als een belangrijke mediator van de waargenomen relaties.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Generatieve Artificiële Intelligentie, Motivatie, Angst en Creativiteit in Saoedische Klaslokalen voor Engels als Vreemde Taal: Een Dwarsdoorsnedeverkenning
In dit artikel
Samenvatting
Samenvatting
Tools voor kunstmatige intelligentie (AI), zoals ChatGPT, worden in toenemende mate geïntegreerd in het onderwijs Engels als vreemde taal (EFL); er is echter beperkt bewijs beschikbaar over hoe het gebruik ervan zich verhoudt tot de onderwijsstijl, digitale geletterdheid, motivatie, angst in de vreemdetalenklas (FLCA) en creativiteit binnen de Saoedi-Arabische context. Deze studie onderzocht de associaties tussen deze constructen en analyseerde de mediërende rol van motivatie binnen een uniform conceptueel kader. Er werd een kwantitatief, cross-sectioneel onderzoek uitgevoerd onder 280 EFL-studenten in de bacheloropleiding aan een publieke universiteit in Saoedi-Arabië met behulp van gevalideerde vragenlijsten. De voorgestelde relaties werden geanalyseerd met behulp van Partial Least Squares Structural Equation Modeling (PLS-SEM). De resultaten gaven aan dat het gebruik van ChatGPT, de onderwijsstijl en digitale geletterdheid positief geassocieerd waren met de motivatie van studenten. Een hogere motivatie was geassocieerd met lagere niveaus van FLCA en hogere niveaus van creativiteit. Motivatie medieerde daarnaast de associaties tussen het gebruik van ChatGPT, de onderwijsstijl, digitale geletterdheid en FLCA. Deze bevindingen suggereren dat de motivationele ervaringen van studenten nauw verbonden zijn met de relaties tussen onderwijspraktijken, technologiegebruik en resultaten van taalverwerving. De studie levert bewijs dat de integratie van passende onderwijstrategieën, generatieve AI-tools en digitale geletterdheid binnen het Engels taalonderwijs ondersteunt, terwijl het belang wordt benadrukt van het overwegen van de motivationele en emotionele ervaringen van studenten bij het implementeren van technologie-ondersteunde leeromgevingen.
Inleiding
Het Koninkrijk Saudi-Arabië ondergaat een transformatieve agenda voor onderwijshervorming onder Vision 2030, waarbij prioriteit wordt gegeven aan de ontwikkeling van vaardigheden voor de 21e eeuw, digitale competentie en innovatieve pedagogische benaderingen op alle onderwijsniveaus1. Binnen deze nationale context blijft het onderwijs in Engels als vreemde taal (EFL) geconfronteerd worden met aanhoudende uitdagingen, waaronder een examengerichte cultuur die uitgaat van uit het hoofd leren en testprestaties boven communicatieve competentie2,3. Beperkte mogelijkheden voor authentieke interactie in de Engelse taal buiten het klaslokaal, samen met een hoog niveau van angst voor het leren van vreemde talen in de klas (FLCA), beperken bovendien de bereidheid van studenten om te communiceren en op betekenisvolle wijze met de doeltaal om te gaan4. Deze uitdagingen hebben opvoeders en beleidsmakers ertoe aangezet om innovatieve benaderingen te verkennen die motivationele tekortkomingen, emotionele barrières en creatief taalgebruik aanpakken. Kunstmatige intelligentie (AI) is naar voren gekomen als een veelbelovende weg voor het ondersteunen van taalverwerving en het transformeren van instructiemethoden5. Onder de AI-toepassingen in het onderwijs van de Engelse taal (ELT) heeft ChatGPT, een conversationeel generatief AI-model, aanzienlijke aandacht gekregen voor het bieden van interactieve taalpraktijk en directe geïndividualiseerde feedback in real-time conversationele contexten6. Deze kenmerken zijn bijzonder relevant in Saoedische EFL-klaslokalen, waar lerersonderwijs en beperkte interactie tussen studenten de creatieve taalproductie blijven beperken7. ChatGPT kan helpen deze beperkingen aan te pakken door mogelijkheden te bieden voor authentieke taalpraktijk met een AI-interlocutor in een omgeving met weinig angst8.
Recente onderwijshervormingen in Saoedi-Arabië hebben een overgang naar een leerlinggerichte pedagogiek gestimuleerd, waardoor er kansen zijn ontstaan om AI-technologieën te integreren die actieve participatie, kritisch denken en zelfgestuurd leren bevorderen9,10. Wanneer ChatGPT op de juiste manier wordt geïmplementeerd, kan het deze overgang ondersteunen door taalpraktijk uit te breiden buiten de traditionele klasactiviteiten11. De effectiviteit van AI-integratie hangt echter mede af van de digitale geletterdheid van studenten, gedefinieerd als hun vermogen om digitale technologieën voor leren effectief te evalueren, te gebruiken en ermee om te gaan12. Digitale geletterdheid stelt lerenden in staat om productief gebruik te maken van AI-tools, terwijl potentiële risico's, waaronder overmatige afhankelijkheid en misinformatie, worden geminimaliseerd13. Deze competentie is bijzonder belangrijk in het Saoedische hoger onderwijs, waar de digitale transformatie is versneld onder Vision 203014.
Hoewel in eerder onderzoek AI-tools, onderwijsstijl, digitale geletterdheid, motivatie, angst en creativiteit afzonderlijk zijn onderzocht, is er beperkt bewijs over hoe deze constructen binnen een verenigd kader interageren in niet-Westerse EFL-contexten, zoals in Saoedi-Arabië. Motivatie is consistent geïdentificeerd als een belangrijk mechanisme dat onderwijspraktijken verbindt met leerresultaten, waaronder een lagere angst, grotere creativiteit en aanhoudende betrokkenheid15. De relaties tussen het gebruik van ChatGPT, onderwijsstijl, digitale geletterdheid, motivatie, FLCA en creativiteit zijn echter nog niet uitgebreid onderzocht in de Saoedische EFL-context16. Het aanpakken van deze lacune kan theoretische en praktische inzichten bieden voor het ontwerpen van technologie-ondersteunde taal leeromgevingen die de motivationele, emotionele en creatieve ontwikkeling van studenten ondersteunen. Daarom onderzoekt deze studie de relaties tussen het gebruik van ChatGPT, onderwijsstijl, digitale geletterdheid, motivatie, FLCA en creativiteit onder Saoedische EFL-studenten aan de universiteit. Specifiek wordt onderzocht naar (1) de relaties van het gebruik van ChatGPT, de onderwijsstijl en digitale geletterdheid met de motivatie van studenten; (2) de relaties van motivatie met FLCA en creativiteit; en (3) de mediërende rol van motivatie in de relaties tussen het gebruik van ChatGPT, onderwijsstijl, digitale geletterdheid en de uitkomstvariabelen angst en creativiteit.
Deze studie draagt bij aan EFL-onderwijs en technologie-ondersteund leren door het gebruik van AI-tools te integreren in bestaande modellen van motivatie en taalverwerving, waardoor het begrip van technologie-ondersteund taalonderwijs in hedendaagse educatieve omgevingen wordt uitgebreid. Het biedt daarnaast bewijsmateriaal dat nuttig kan zijn voor docenten, curriculumontwerpers en beleidsmakers die AI-tools willen integreren in het Saoedische EFL-onderwijs. Door motivatie te onderzoeken als mediator die het gebruik van technologie en instructiepraktijken verbindt met FLCA en creativiteit, levert de studie contextspecifiek bewijs ter ondersteuning van de ontwikkeling van leerlinggericht taalonderwijs dat is afgestemd op de doelstellingen van de onderwijshervormingen in Saoedi-Arabië.
De Zelfbeschikkingstheorie (Self-Determination Theory, SDT) biedt een theoretisch kader om de relatie tussen onderwijspraktijken en studentenmotivatie in educatieve contexten te begrijpen17. Volgens de SDT worden intrinsieke motivatie en autonome vormen van extrinsieke motivatie ondersteund wanneer de drie basispsychologische behoeften van leerlingen — autonomie, competentie en verbondenheid — worden vervuld binnen de leeromgeving18. De onderwijsstijl is daarom een cruciale contextuele factor die de motivatie en betrokkenheid van studenten beïnvloedt19. Autonomie-ondersteunende onderwijspraktijken, die betekenisvolle keuzes bieden, rekening houden met de perspectieven van studenten en leeractiviteiten toelichten, bevorderen intrinsieke motivatie en zelfbeschikbare betrokkenheid20. In EFL-contexten zijn leerlinggerichte benaderingen, waaronder de rollen van facilitator en delegator in de onderwijsstijl, geassocieerd met een grotere inzet, participatie en interesse van studenten bij het taalverwervingsproces21,22. Omgekeerd kan docentgericht onderwijs de motivatie verminderen door de participatie en autonomie van studenten te beperken, terwijl de nadruk meer ligt op extrinsieke beloningen dan op intrinsieke interesse23,24. In de Saoedische EFL-context, waar traditioneel onderwijs historisch gezien de nadruk heeft gelegd op memorisatie en docentgerichte overdracht25, kan het adopteren van meer leerlinggerichte onderwijsaanpakken de motivatie van studenten ondersteunen26. Op basis van dit theoretische en empirische fundament wordt de volgende hypothese voorgesteld: H1: Onderwijsstijl heeft een positieve invloed op de motivatie van EFL-studenten.
De relatie tussen educatieve technologie en de motivatie van de lerende is uitgebreid onderzocht27,28. Het Technology Acceptance Model (TAM) suggereert dat de motivatie van lerenden om gebruik te maken van educatieve technologie wordt beïnvloed door de waargenomen bruikbaarheid en het waargenomen gebruiksgemak, welke de gedragsintenties en het technologiegebruik vormgeven29. Toegepast op ChatGPT suggereert dit kader dat studenten die de tool als nuttig en gemakkelijk in gebruik ervaren, eerder geneigd zijn deze in te zetten voor taalverwerving30. Empirische studies hebben positieve verbanden gerapporteerd tussen AI-ondersteund taalonderwijs en studentmotivatie, waarbij interactieve functies, onmiddellijke feedback en gepersonaliseerde oefeningen bijdragen aan aanhoudende betrokkenheid31,32. ChatGPT kan bovendien barrières met betrekking tot taalangst verminderen door mogelijkheden te bieden voor taalbeoefening zonder hoge druk, wat het voortdurende taalgebruik kan stimuleren33. Dit potentieel is bijzonder relevant in de Saoedische context, waar FLCA is geïdentificeerd als een belangrijke barrière voor motivatie en taalprestaties34. Op basis van deze theoretische en empirische bevindingen wordt de volgende hypothese voorgesteld: H2: Het gebruik van ChatGPT heeft een positieve invloed op de motivatie van EFL-studenten.
Digitale geletterdheid is een belangrijke determinant geworden van de motivatie van studenten in hedendaagse EFL-leeromgevingen35. Het verwijst naar het vermogen om digitale technologieën en media effectief te zoeken, evalueren en gebruiken voor het leren36. In EFL-contexten stelt digitale geletterdheid leerlingen in staat om effectief gebruik te maken van digitale bronnen, waaronder ChatGPT, leerbeheersystemen en multimedia-instrumenten, om taalverwerving en motivatie te ondersteunen37. Studenten met een hoger niveau van digitale geletterdheid maken vaker met vertrouwen gebruik van leertechnologieën, wat competentie en autonomie bevordert, welke geassocieerd worden met intrinsieke motivatie38. Zij zijn bovendien beter uitgerust om digitale instrumenten te gebruiken voor onafhankelijke taalbeoefening, feedback en aanhoudende betrokkenheid bij het leerproces39. Op basis van deze literatuur wordt de volgende hypothese voorgesteld: H3: De digitale geletterdheid van EFL-studenten heeft een positieve invloed op de motivatie van EFL-studenten.
FLCA en creativiteit zijn nauw verwante constructen in het EFL-onderwijs, hoewel hun relatie complex blijft40. Angst kan de prestaties van leerlingen beperken bij taken die creativiteit, cognitieve flexibiliteit, divergent denken en zelfexpressie vereisen41. FLCA weerspiegelt de angst van leerlingen om fouten te maken, negatieve evaluaties en een laag zelfvertrouwen, waarvan alle aspecten de creatieve taalproductie kunnen belemmeren42. Creativiteit is echter een belangrijke competentie bij het leren van EFL, omdat het contextueel passend en innovatief taalgebruik ondersteunt31. Eerdere studies hebben aangetoond dat leerlingen met een hogere mate van angst minder geneigd zijn om deel te nemen aan creatieve schrijf- en mondelinge communicatieactiviteiten43,44. Op basis van deze literatuur worden de volgende hypothesen voorgesteld: 1) H4: de motivatie van EFL-studenten is negatief gerelateerd aan hun angst, en 2) H5: de angst van EFL-studenten beïnvloedt hun creativiteit negatief.
Motivatie biedt een theoretisch mechanisme waardoor onderwijsstijl, het gebruik van ChatGPT en digitale geletterdheid verband kunnen houden met FLCA45. Gemotiveerde lerenden zijn eerder geneigd om actief deel te nemen, vol te houden bij uitdagingen en lagere niveaus van communicatieangst te ervaren46. Ondersteunende onderwijspraktijken, AI-ondersteund talenleren en een sterkere digitale geletterdheid zijn elk geassocieerd met een hogere motivatie en lagere angst in EFL-settings47,48,49. Voorgaand onderzoek suggereert daarnaast dat een grotere motivatie geassocieerd is met minder klasangst en verhoogde creativiteit, wat motivatie ondersteunt als een potentiële mediator die onderwijspraktijken en technologiegebruik verbindt met leerresultaten50,51,52. Op basis van deze literatuur worden de volgende hypothesen voorgesteld: 1) H6: Motivatie medieert de relatie tussen de onderwijsstijl en de angst van EFL-studenten; 2) H7: Motivatie medieert de relatie tussen het gebruik van ChatGPT en de angst van EFL-studenten; en 3) H8: Motivatie medieert de relatie tussen de digitale geletterdheid van EFL-studenten en hun angst. Figuur 1 illustreert het gehypothetiseerde model waarin onderwijsstijl, ChatGPT-gebruik en digitale geletterdheid geassocieerd zijn met de motivatie van EFL-studenten, wat op zijn beurt hun relaties met FLCA en creativiteit medieert.
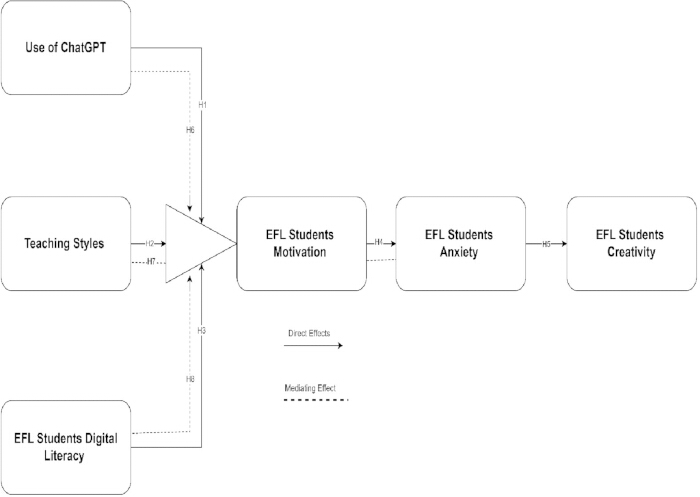
Figuur 1. Gehypothetiseerd onderzoeksmodel. Het model beeldt de gehypothetiseerde relaties uit tussen het gebruik van ChatGPT, de onderwijsstijl, digitale geletterdheid, motivatie, angst in de vreemde taal klas en creativiteit bij studenten Engels als vreemde taal (EFL). Doorgetrokken lijnen vertegenwoordigen directe gehypothetiseerde relaties en gestreepte lijnen vertegenwoordigen mediërende relaties, zoals aangegeven in de figuur. Klik hier om een grotere versie van deze figuur te bekijken.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Hoewel de studie geen formele ethische goedkeuring van een institutionele toetsingscommissie vereiste vanwege het niet-experimentele, anonieme enquêteontwerp zonder fysieke interventies, manipulatie of misleiding van deelnemers, werden alle procedures uitgevoerd in overeenstemming met de ethische principes van de Verklaring van Helsinki en de richtlijnen van de American Psychological Association voor onderzoek met menselijke participanten. Geïnformeerde toestemming werd van alle deelnemers verkregen voorafgaand aan de gegevensverzameling. De instelling vereiste of verstrekte geen formele ethische goedkeuring of vrijstelling voor dit type studie. Alle respondenten werden expliciet geïnformeerd over het doel van het onderzoek, hun vrijwillige deelname, hun recht om op elk gewenst moment zonder gevolgen terug te trekken en de strikte vertrouwelijkheidsmaatregelen die op hun gegevens werden toegepast. Er werden geen persoonlijk identificeerbare gegevens verzameld of gerapporteerd, en alle gegevens werden uitsluitend gebruikt voor geaggregeerde academische analyse. Er werd bijzondere aandacht besteed aan niet-indringende, respectvolle formuleringen om ervoor te zorgen dat de enquête geen hinder vormde voor de academische activiteiten of het psychologische welzijn van de deelnemers. Zie Supplementary File 1 voor het formulier van geïnformeerde toestemming. Bovendien staan de in deze studie gebruikte materialen vermeld in de Table of Materials.
Onderzoeksontwerp
Deze sectie beschrijft het onderzoeksontwerp, de procedures voor gegevensverzameling en de details van de steekproef die in de studie zijn gebruikt om de relaties tussen onderwijsstijl, ChatGPT-gebruik, digitale geletterdheid, motivatie, angst en creativiteit bij EFL-studenten te onderzoeken. Deze studie maakte gebruik van een kwantitatief, crosssectioneel onderzoeksontwerp om de mediërende rol van motivatie te onderzoeken in de relaties tussen onderwijsstijl, ChatGPT-gebruik, digitale geletterdheid en angst bij EFL-studenten, en hoe deze variabelen gezamenlijk gerelateerd zijn aan creativiteit. Er is gekozen voor een gestructureerde enquête-methodologie om primaire gegevens te verzamelen, waardoor standaardisatie en betrouwbaarheid bij het meten van de constructen werden gewaarborgd. In de studie werden gevalideerde schalen gebruikt om alle variabelen te beoordelen, waaronder onderwijsstijl, ChatGPT-gebruik, digitale geletterdheid, motivatie, FLCA en creativiteit.
Data en Monster
De gegevens voor deze studie werden verzameld bij EFL-studenten die ingeschreven stonden aan de Universiteit van Jeddah, een openbare universiteit in Saudi-Arabië die bekend staat om haar nadruk op taalonderwijs en de integratie van technologie in het onderwijs. De deelnemers werden geselecteerd met behulp van een doelgerichte steekproefmethode (purposive sampling), wat als passend werd beschouwd voor deze studie gezien de specifieke inclusiecriteria waarbij deelnemers actieve ervaring moesten hebben met AI-tools zoals ChatGPT in hun leeromgeving. Deze niet-probabilistische steekproefaanpak was noodzakelijk omdat de onderzoeksvragen van de studie gericht waren op een specifieke populatie: EFL-studenten die waren blootgesteld aan zowel traditionele als technologie-ondersteunde leermethoden, en random sampling zou de inclusie van deelnemers die aan deze criteria voldoen niet hebben gegarandeerd. Hoewel doelgerichte steekproefname de generaliseerbaarheid van de resultaten naar de bredere populatie beperkt, was dit voor dit verkennende onderzoek gerechtvaardigd om ervoor te zorgen dat deelnemers over de relevante ervaringen en perspectieven beschikten die nodig waren om de onderzoeksdoelstellingen te behalen. Om de beperkingen van doelgerichte steekproefname te verzachten, is getracht deelnemers met uiteenlopende academische achtergronden en verschillende niveaus van technologische vaardigheid te includeren, waardoor de representativiteit van de steekproef binnen de doelpopulatie werd vergroot. De uiteindelijke steekproef bestond uit 280 EFL-studenten in de bachelorfase, een omvang die als adequaat werd beschouwd voor de gehanteerde statistische technieken.
De bepaling van de adequaatheid van de steekproefomvang was gebaseerd op vastgestelde richtlijnen voor Structural Equation Modeling (SEM). Onderzoekers bevelen een minimale ratio van 10 gevallen per geschatte parameter aan voor SEM, waarbij conservatievere richtlijnen 20 gevallen per parameter suggereren voor Partial Least Squares SEM (PLS-SEM). Het meetmodel bestond uit 29 items voor digitale geletterdheid, 25 items voor onderwijsstijl en 32 items voor FLCA, naast aanvullende items voor het gebruik van ChatGPT, motivatie en creativiteit. PLS-SEM-richtlijnen bevelen daarnaast een minimale steekproefomvang aan die gelijk is aan 10 maal het grootste aantal formatieve indicatoren of het grootste aantal structurele paden gericht op een specifiek construct; daarom overtrof de steekproef van 280 participanten deze minimale vereisten. Bovendien gaf een post hoc poweranalyse met G*Power53 aan dat een steekproef van 280 participanten een statistische power van meer dan 0,95 bood voor het detecteren van gemiddelde effectgroottes (f2 = 0,15) met α = 0,05, wat de algemeen aanbevolen drempelwaarde van 0,80 overschrijdt. Deze steekproefomvang biedt betrouwbare parameterschattingen en voldoende statistische power om betekenisvolle relaties tussen de studievariabelen te detecteren, terwijl rekening wordt gehouden met de complexiteit van de voorgestelde meet- en structurele modellen.
Deelnemers en procedure
De participanten waren EFL-studenten in de leeftijd van 18 tot 25 jaar, waarvan de meerderheid eerste- en tweedjaars bachelorstudenten waren die ingeschreven stonden voor cursussen Engelse taal. De enquête werd uitgevoerd tussen september en oktober 2025, waarbij studenten werden uitgenodigd om vrijwillig deel te nemen. Het wervingsproces verliep via officiële universitaire kanalen, waaronder e-mails en aankondigingen in de lessen. De participanten waren EFL-studenten van 18–25 jaar die als eerste- of tweedjaars bachelorstudenten waren ingeschreven voor cursussen Engelse taal. De geschiktheid werd bepaald aan de hand van vooraf gedefinieerde in- en uitsluitingscriteria. Participanten kwamen in aanmerking als zij (a) officieel ingeschreven stonden voor bachelorcursussen Engelse taal aan de University of Jeddah, (b) 18–25 jaar oud waren en (c) geregistreerd stonden als eerste- of tweedjaarsstudenten. Studenten werden uitgesloten als zij (a) graduate studenten waren of bachelorstudenten in een hoger jaar buiten de fundamentele cursusreeks, (b) buiten de gespecificeerde leeftijdscategorie vielen, of (c) betrokken waren bij de pre-testfase van de vragenlijst. Om geïnformeerde toestemming te waarborgen, werden de participanten geïnformeerd over het doel van het onderzoek, het vrijwillige karakter van hun deelname en de vertrouwelijkheid van hun antwoorden. Het instrument voor gegevensverzameling was een gestructureerde, zelf in te vullen vragenlijst die zowel fysiek als elektronisch werd verspreid via een beveiligd online platform. Gevalideerde schalen werden aangepast voor het meten van onderwijsstijl, ChatGPT-gebruik, digitale geletterdheid, studentmotivatie, FLCA en creativiteit. Participanten werd gevraagd hun antwoorden te scoren op een 5-punt Likert-schaal, variërend van 1 (Helemaal mee oneens) tot 5 (Helemaal mee eens). De pre-test van de vragenlijst werd uitgevoerd met een kleine groep van 30 studenten om de duidelijkheid en betrouwbaarheid te waarborgen. Op basis van de pre-testresultaten werden kleine aanpassingen in de formulering gedaan om het begrip van de items te verbeteren, en er werden geen significante problemen met de betrouwbaarheid of validiteit van de schaal vastgesteld. Om de integriteit van de gegevens te behouden en eerlijke antwoorden te stimuleren, werd anonimiteit gegarandeerd en kregen de participanten de zekerheid dat hun gegevens uitsluitend voor onderzoeksdoeleinden zouden worden gebruikt. Van de initieel verzamelde 300 reacties werden er 280 als geldig beschouwd na screening op onvolledige of inconsistente gegevens, wat resulteerde in een retentiegraad van 93%. De procedures voor gegevensscreening omvatten het onderzoeken van antwoordpatronen op straight-lining, overmatig veel missende gegevens (meer dan 10%) en multivariate uitschieters met behulp van de Mahalanobis-afstand. Deze methodologische aanpak biedt een robuuste basis voor het analyseren van de relaties tussen de studievariabelen en biedt waardevolle inzichten in de rol van onderwijsstijl, AI-tools en digitale geletterdheid bij het vormgeven van de motivatie, angst en creativiteit van EFL-studenten.
Na de gegevensverzameling werden 20 reacties uit de initiële pool van 300 uitgesloten op basis van vooraf gedefinieerde criteria: 12 reacties werden verwijderd vanwege overmatige ontbrekende gegevens die meer dan 10% van de vragenlijstitems besloegen, 5 werden geëlimineerd omdat ze straight-lining respons-patronen vertoonden (uniforme antwoorden op alle items, wat duidt op een gebrek aan betrokkenheid), en 3 werden geïdentificeerd als multivariate uitschieters met behulp van de Mahalanobis-afstand (p < 0,001) en vervolgens verwijderd om vervorming van de SEM-resultaten te voorkomen. Ontbrekende waarden voor de behouden gevallen werden behandeld via gemiddelde imputatie wanneer de ontbrekende gegevens minimaal waren (minder dan 5% per geval), aangezien deze aanpak acceptabel is voor kleine proporties ontbrekende gegevens in grootschalig enquêteonderzoek. De uiteindelijke behoudsgraad van 93% (280 geldige reacties van de 300 verzamelde vragenlijsten) vertegenwoordigt de proportie bruikbare reacties die behouden zijn gebleven van het totaal aantal verzamelde vragenlijsten; dit mag echter niet worden geïnterpreteerd als een werkelijke responsgraad, aangezien het exacte aantal uitgenodigde deelnemers niet kon worden berekend omdat de gecombineerde fysieke en elektronische distributiemethoden via officiële universiteitskanalen een nauwkeurige tracking van het totaal aantal uitnodigingen verhinderden. Deze beperking wordt erkend, en het cijfer van 93% wordt daarom gerapporteerd als de proportie geldige reacties die behouden zijn gebleven uit de verzamelde vragenlijsten, in plaats van als een responsgraad ten opzichte van de totale uitgenodigde populatie.
Instrumenten en Maatregelen
Deze studie maakte gebruik van goed gevestigde en gevalideerde schalen, zorgvuldig aangepast aan de context van het EFL-onderwijs, om de kernconstructen te meten: onderwijsstijl, digitale geletterdheid, het gebruik van ChatGPT, FLCA, motivatie en creativiteit. Elke schaal werd geselecteerd op basis van de relevantie en volledigheid in het vastleggen van de respectievelijke dimensies van de onderzochte variabelen. Digitale geletterdheid werd gemeten met een aangepaste schaal gebaseerd op Rodríguez-de-Dios et al.54, bestaande uit zes dimensies met 29 items. Deze dimensies omvatten technologische vaardigheden, persoonlijke beveiligingsvaardigheden, kritische vaardigheden, apparaatbeveiligingsvaardigheden, informatievaardigheden en communicatievaardigheden, waardoor een uitgebreide beoordeling mogelijk was van de bekwaamheid van studenten in digitale vaardigheden die essentieel zijn voor moderne educatieve contexten. Het gebruik van ChatGPT werd geëvalueerd met een schaal van 8 items, aangepast naar Abbas et al.55, waarbij de nadruk lag op de interactie van studenten met de AI-tool voor taalleertoepassingen. De onderwijsstijl werd beoordeeld met een aangepaste versie van de Teaching Style Inventory van Grasha56. Dit instrument meet vijf dimensies van onderwijsstijlen: Autoriteit, Expert, Persoonlijk Model, Facilitator en Delegeerder. Deze dimensies weerspiegelen verschillende instructiebenaderingen die de leerervaringen van EFL-studenten beïnvloeden. FLCA werd gemeten met een aangepaste schaal gebaseerd op Briesmaster en Briesmaster57. Dit instrument onderzocht angst over drie dimensies: communicatieangst (10 items), testangst (10 items) en angst voor negatieve evaluatie (7 items). De motivatie van studenten werd beoordeeld met een schaal aangepast naar Kanoksilapatham et al.58, waarbij drie dimensies werden gemeten: instrumentele promotie en preventie, etnocentrisme en integratieve motivatie, en houding tegenover het leren van Engels. De schaal bevatte in totaal 20 items. De creativiteit van EFL-studenten werd gemeten met een schaal aangepast naar Govindasamy et al.59, waarmee vier dimensies werden beoordeeld: originaliteit, flexibiliteit, vloeiendheid en uitwerking. Elke dimensie werd gemeten met drie items. Om de culturele en contextuele geschiktheid van de instrumenten voor de EFL-omgeving te waarborgen, werd een systematische aanpassingsprocedure toegepast. Omdat de oorspronkelijke schalen in het Engels waren ontwikkeld, hebben twee tweetalige EFL-experts de taal beoordeeld en vereenvoudigd om de duidelijkheid voor undergraduate studenten op gemiddeld niveau te verbeteren, terwijl de oorspronkelijke betekenis van elk construct behouden bleef. De aangepaste versies werden vervolgens door een onafhankelijke vertaler terugvertaald naar de moedertaal van de deelnemers om de linguïstische en conceptuele equivalentie te verifiëren, en eventuele discrepanties werden opgelost door overleg binnen het onderzoeksteam. Vervolgens hebben drie ervaren EFL-docenten de aangepaste instrumenten geëvalueerd op inhoudelijke relevantie, culturele geschiktheid en duidelijkheid van de items, wat leidde tot kleine tekstuele revisies en de vervanging van cultureel onbekende voorbeelden waar适当. Tot slot werden de herziene instrumenten gepilot bij 30 studenten (zie sectie Procedure), en de feedback van deelnemers werd gebruikt voor aanvullende kleine tekstuele verfijningen om de begrijpelijkheid te verbeteren. Dit proces in meerdere stappen zorgde ervoor dat de aangepaste instrumenten hun oorspronkelijke psychometrische eigenschappen behielden, terwijl ze geschikt bleven voor de doelgroep van EFL-studenten. Voor de volledige aangepaste vragenlijst, zie Supplementary File 2.
Methoden voor data-analyse
De voor deze studie verzamelde gegevens werden geanalyseerd met behulp van het Statistical Package for the Social Sciences (SPSS 26) en SmartPLS 4, waarbij gebruik werd gemaakt van PLS-SEM. Deze tweeledige methode zorgde voor een uitgebreide analyse van de gegevens, waarbij zowel descriptieve als inferentiële aspecten werden behandeld, terwijl de gehypothetiseerde relaties en mediatie-effecten in het onderzoekmodel werden getest. Aanvankelijk werd SPSS gebruikt voor de preliminaire data-analyse, inclusief datacleaning, beschrijvende statistiek en betrouwbaarheidstesten. De datascreening hield het controleren op missende waarden, uitbijters en normaliteit in om de kwaliteit en integriteit van de dataset te waarborgen. Beschrijvende statistiek, waaronder het gemiddelde, de standaarddeviatie en frequentieverdelingen, werden berekend om de kenmerken van de steekproef samen te vatten. De hoofdanalyse werd uitgevoerd met SmartPLS 4. PLS-SEM werd gekozen vanwege de geschiktheid voor het analyseren van complexe modellen met meerdere constructen en de robuustheid bij kleine tot middelgrote steekproefgroottes. De analyse werd in twee fasen uitgevoerd: de evaluatie van het meetmodel en de evaluatie van het structurele model. Bij de beoordeling van het meetmodel werden de indicatorbetrouwbaarheid, de interne consistentiebetrouwbaarheid (met behulp van composite reliability [CR]), de convergente validiteit (met behulp van average variance extracted [AVE]) en de discriminerende validiteit (met behulp van de heterotrait–monotrait ratio [HTMT]) geëvalueerd.
Na validatie van het meetmodel werd het structurele model beoordeeld om de gehypothetiseerde relaties tussen onderwijsstijl, ChatGPT-gebruik, digitale geletterdheid, motivatie, angst en creativiteit te evalueren. Padcoëfficiënten werden geanalyseerd om de sterkte en significantie van de directe en indirecte effecten te bepalen, waarbij de significantie werd beoordeeld middels bootstrapping met 5.000 resamples. Om de significantie van directe, indirecte en mediating effecten te beoordelen, werden bias-gecorrigeerde (BC) bootstrap-betrouwbaarheidsintervallen geconstrueerd met behulp van 5.000 bootstrap-resamples met een betrouwbaarheidsniveau van 95%. De mediating effecten van motivatie op de relaties tussen onderwijsstijl, ChatGPT-gebruik, digitale geletterdheid en angst werden eveneens geëvalueerd met behulp van gebootstrapte betrouwbaarheidsintervallen. De model fit en voorspellende kracht werden beoordeeld aan de hand van de determinatiecoëfficiënt (R2), de voorspellende relevantie (Q2) en de gestandaardiseerde root mean square residual (SRMR).
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Beschrijvende Statistiek
Beschrijvende statistieken geven een overzicht van de steekproefkenmerken en de verdeling, centrale tendens en variabiliteit van de studievariabelen. In deze studie werden beschrijvende analyses uitgevoerd om de deelnemerssteekproef te karakteriseren en de belangrijkste variabelen samen te vatten voordat de structurele analyses werden uitgevoerd.
Tabel 1 vat de demografische kenmerken samen van de 280 bachel...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Deze studie onderzocht de relaties tussen onderwijsstijl, het gebruik van ChatGPT, digitale geletterdheid, motivatie, FLCA en creativiteit bij Saoedische EFL-studenten in de bachelorfase, met specifieke aandacht voor de mediërende rol van motivatie. De resultaten leveren bewijs voor de relaties tussen pedagogische praktijken, technologiegebruik en leerlingkenmerken in technologie-ondersteund taalonderwijs. De positieve associatie tussen onderwijsstijl en de motivatie van EFL-studenten (H1 ondersteund) is consistent met S...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
Belangenverstrengeling:
De auteur verklaart geen belangenverstrengeling.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| ChatGPT-gebruiksschaal (aangepast) | Auteurs; aangepast naar Abbas et al. | N/A | Vragenlijst met acht items die het gebruik van ChatGPT door studenten voor taalverwerving beoordeelt. |
| Creativiteitsschaal (aangepast) | Auteurs; aangepast naar Govindasamy et al. | N/A | Vragenlijst met twaalf items die originaliteit, flexibiliteit, vloeiendheid en uitwerking beoordeelt. |
| Schaal voor digitale geletterdheid (aangepast) | Auteurs; aangepast naar Rodríguez-de-Dios et al. | N/A | Vragenlijst met negenentwintig items die zes dimensies van digitale geletterdheid meet. |
| Schaal voor angst in de vreemde taalklas (FLCA) (aangepast) | Auteurs; aangepast naar Briesmaster & Briesmaster | N/A | Vragenlijst met zevenentwintig items die communicatieangst, toetsangst en angst voor negatieve beoordeling meet. |
| G*Power | Heinrich Heine University Düsseldorf | Versie 3.1.9.7; RRID: SCR_013726 | Software gebruikt voor post-hoc statistische poweranalyse. |
| IBM SPSS Statistics | IBM Corp. | Versie 26; RRID: SCR_002865 | Statistische software gebruikt voor datacleaning, beschrijvende statistiek, betrouwbaarheidsanalyses en voorlopige analyses. |
| Mahalanobis-afstandsanalyse | IBM SPSS Statistics | Versie 26; RRID: SCR_002865 | Statistische procedure geïmplementeerd in IBM SPSS Statistics om multivariate uitschieters te identificeren. |
| Motivatieschaal (aangepast) | Auteurs; aangepast naar Kanoksilapatham et al. | N/A | Vragenlijst met twintig items die de motivatie van de leerling beoordeelt. |
| Papieren vragenlijst | Auteurs | N/A | Geprinte versie van de gestructureerde, zelf in te vullen vragenlijst gebruikt voor fysieke datacollectie. |
| Beveiligd online enquêteplatform | Google LLC | N/A | Google Forms-platform gebruikt voor de elektronische distributie van de vragenlijst. |
| SmartPLS | SmartPLS GmbH | Versie 4; RRID: SCR_036419 | Software gebruikt voor Partial Least Squares Structural Equation Modeling (PLS-SEM), inclusief evaluatie van het meetmodel, analyse van het structurele model, bootstrapping (5.000 resamples) en mediatieanalyse. |
| Gestructureerde zelf in te vullen vragenlijst | Auteurs | N/A | Vragenlijst afgenomen in papieren en elektronische vorm met gebruik van een 5-punt Likert-schaal (1 = Sterk mee oneens tot 5 = Sterk mee eens). |
| Teaching Style Inventory (aangepast) | Auteurs; aangepast naar Grasha's Teaching Style Inventory | N/A | Vragenlijst die de onderwijsstijlen Autoriteit, Expert, Persoonlijk Model, Facilitator en Delegator meet. |
| Communicatiekanalen van de universiteit | University of Jeddah | N/A | Officiële e-mail en aankondigingen in de klas gebruikt voor de werving van deelnemers. |
Referenties
- Ansa H. Exploring the role of artificial intelligence (AI) in enhancing EFL education in Saudi Arabia: A review of opportunities, obstacles, and future directions. Educ Sci. 2026;16(6):981.
- Alshehri A, Aldossary S, Jamshed M, Banu S. Incorporating ChatGPT in Saudi EFL classrooms: Oscillating between expectations and anxiety. J Lang Teach Res. 2025;16(5):1673-81.
- Alzubi AA, Alelaiwi AS. Exploring EFL university teachers’ perceptions of AI-generative tools in Saudi Arabia: A mixed-methods study. Discov Comput. 2025;28(1):282.
- Alzubi AA, Nazim M, Alyami N. Do AI-generative tools kill or nurture creativity in EFL teaching and learning? Educ Inf Technol. 2025;30(11):15147-84.
- Allehyani FS, Albedah F, Jamshed M, Warda WU. Exploring Saudi EFL learners’ engagement with AI generative tools in educational settings: Perceptions, practices, and pedagogical outcomes. Theory Pract Lang Stud. 2025;15(6):1959-66.
- Almusharraf A, Bailey D. Generative AI use among Saudi and Korean language learners in higher education: Examination through a modified TAM framework. SAGE Open. 2025;15(4):21582440251387804.
- Alharbi MA, Hassan Al-Ahdal AA. Exploring Saudi EFL learners’ engagement with ChatGPT: A mixed-methods study of perceptions, attitudes, and intentions. SAGE Open. 2025;15(4):21582440251392080.
- Khoso AK, Honggang W, Darazi MA. Empowering creativity and engagement: The impact of generative artificial intelligence usage on Chinese EFL students’ language learning experience. Comput Hum Behav Rep. 2025;18:100627.
- Alalwi FS, Alqahtani N, Jamshed M, Ahmmed MF. AI-driven feedback for pedagogical innovation: Assessing ChatGPT’s impact on Saudi EFL learners’ writing proficiency. World. 2026;16(5).
- Alshehri N. Speaking with AI: Exploring EFL learners’ attitudes, engagement, and satisfaction through ChatGPT conversations. 2026. 10.2139/ssrn.6595190
- Metwally AA, Bin-Hady WR. Probing the necessity and advantages of AI integration training for EFL educators in Saudi Arabia. Cogent Educ. 2025;12(1):2472462.
- Elmahdi OE, et al. AI-Driven Vocabulary Acquisition in EFL Higher Education: Interdisciplinary Insights into Technological Innovation, Ethical Challenges, and Equitable Access. Forum Linguist Stud. 2025;7(4):477–491.
- Al-Nofaie H, Alwerthan TA. Appreciative inquiry into implementing artificial intelligence for the development of language student teachers. Sustainability (Basel). 2024;16(21):9361.
- Alshayban A. Exploring EFL learners’ use of AI outside the classroom. J Lang Teach Res. 2026;17(1).
- Abdelhalim SM, Alsehibany RA. Integrating AI-powered tools in EFL pronunciation instruction: Effects on accuracy and L2 motivation. Comput Assist Lang Learn. 2025;38:1-25.
- Khoso AK, Honggang W, Darazi MA. Trust and attitude towards AI as pathways to creativity: A TAM model study of EFL students’ digital literacy and AI acceptance. Humanit Soc Sci Commun. 2025;13(1):69.
- Xiong X. Influence of teaching styles of higher education teachers on students’ engagement in learning: The mediating role of learning motivation. Educ Chem Eng. 2025;51:87-102.
- Bartholomew KJ, et al. Beware of your teaching style: A school-year-long investigation of controlling teaching and student motivational experiences. Learn Instr. 2018;53:50-63.
- Wiangga IA. The impact of educators’ teaching styles on secondary school learners’ motivation in English. J Educ Manag Strategy. 2024;3(2):136-44.
- Sheikh A, Mahmood N. Effect of different teaching styles on students’ motivation towards English language learning at secondary level. Sci Int (Lahore). 2014;26:825-30.
- Marina I, Natalia M, Tatiana K, Nataliya S. The influence of the teaching style of communication on the motivation of students to learn foreign languages. J Lang Educ. 2019;5(2):67-77.
- Zalukhu FS, Laoli A, Zebua EP, Daeli H. The influence of teacher teaching styles on English learning motivation of eighth-grade students at SMP Negeri 1 Afulu. J Pembelajaran Bahasa dan Sastra. 2026;5(2):1545-54.
- Yue X, Hou X, Zhang J, Li M. The impact of controlling teaching style on student engagement and academic achievement: Differences across varied motivation profiles. Teach Teach Educ. 2026;176:105479.
- Idhaufi NL, Ashari ZM. Relationship between motivation and teachers’ teaching style among secondary school students in Kulai. Man India. 2017;97(12):299-307.
- Zolfaghari M, Janghorbanian Z, Krevan Brojerdi K, Aghaziarati A. Investigation of the role of teaching styles and student-teacher interaction in students’ academic achievement motivation. Educ Strateg Med Sci. 2020;13(3):220-8.
- Avecilla PA, Capiña XE, Javier AY. Teachers’ teaching style as perceived by students and its influence on students’ level of self-regulation and motivation in learning psychology. Technium Soc Sci J. 2023;43:213-24.
- Khoso AK, et al. The dual forces of AI: How generative AI and perceived AI dependency influence fear of missing out (FoMO) and EFL students’ vocabulary acquisition. J Vis Exp. 2025;(226):e69637.
- Ali JK, Shamsan MA, Hezam TA, Mohammed AA. Impact of ChatGPT on learning motivation: Teachers’ and students’ voices. J Engl Stud Arabia Felix. 2023;2(1):41-9.
- Song C, Song Y. Enhancing academic writing skills and motivation: Assessing the efficacy of ChatGPT in AI-assisted language learning for EFL students. Front Psychol. 2023;14:1260843.
- Khoso AK, et al. Integrating Sustainable Development Goals (SDGs) and generative AI to enhance language digital literacy and creativity in EFL learning environments. J Vis Exp. 2026;(228):e69445.
- Balcı Ö. The role of ChatGPT in English as a foreign language (EFL) learning and teaching: A systematic review. Int J Curr Educ Stud. 2024;3(1):66-82.
- Yamaoka K. ChatGPT’s motivational effects on Japanese university EFL learners: A qualitative analysis. Int J TESOL Stud. 2024;6(3).
- Afkarin MY, Asmara CH. Investigating the implementation of ChatGPT in English language education: Effects on student motivation and performance levels. Journey J Engl Lang Pedagogy. 2024;7(1):57-66.
- Alrabai F. The influence of teachers’ anxiety-reducing strategies on learners’ foreign language anxiety. Innov Lang Learn Teach. 2015;9(2):163-90.
- Kang S, Kim Y. Examining the quality of mobile-assisted video-making task outcomes: The role of proficiency, narrative ability, digital literacy, and motivation. Lang Teach Res. 2024;28(6):2326-53.
- Honggang W, Khoso AK, Althubyani AR. Technostress, digital fatigue, and AI dependency as antecedents of burnout and SDG-4 achievement in EFL classrooms. Sci Rep. 2026;16:15412.
- Sari AA, Ningsih SK. The influence of digital literacy in social media use on high school students’ intrinsic motivation in EFL learning. IDEAS J Engl Lang Teach Learn Linguist Lit. 2025;13(2):6634-51.
- Zhang Y. Impact of digital literacy on college students’ English proficiency: The mediating role of learning motivation and the moderating effect of technological self-efficacy. Acta Psychol (Amst). 2025;259:105452.
- Bender SM. Awareness of artificial intelligence as an essential digital literacy: ChatGPT and Gen-AI in the classroom. Changing Engl. 2024;31(2):161-74.
- Khoso AK, et al. The impact of ESL teachers’ emotional intelligence on ESL students’ academic engagement, reading and writing proficiency: Mediating role of ESL students’ motivation. Int J Early Child Spec Educ. 2022;14:3267-80.
- He M, Abbasi BN, He J. AI-driven language learning in higher education: An empirical study on self-reflection, creativity, anxiety, and emotional resilience in EFL learners. Humanit Soc Sci Commun. 2025;12(1):1-20.
- Wang HC. Exploring the relationships of achievement motivation and state anxiety to creative writing performance in English as a foreign language. Think Skills Creat. 2021;42:100948.
- Khan MA, Mahjabeen AN, Hussain F, Ur Rehman M. Investigating the correlation between writing anxiety and English creativity in Pakistani ESL students. Russ Law J. 2021;9(1):214-24.
- McDonough K, Crawford WJ, Mackey A. Creativity and EFL students’ language use during a group problem-solving task. TESOL Q. 2015;49(1):188-99.
- Rubino C, Luksyte A, Perry SJ, Volpone SD. How do stressors lead to burnout? The mediating role of motivation. J Occup Health Psychol. 2009;14(3):289-304.
- Halbesleben JRB, Bowler WM. Emotional exhaustion and job performance: The mediating role of motivation. J Appl Psychol. 2007;92(1):93-106.
- van Emmerik IJH, et al. The route to employability: Examining resources and the mediating role of motivation. Career Dev Int. 2012;17(2):104-19.
- Dana LP, et al. The impact of entrepreneurial education on technology-based enterprise development: The mediating role of motivation. Adm Sci (Basel). 2021;11(4):105.
- Kholifah N, Nurtanto M, Mutohhari F, et al. The mediating role of motivation and professional development in determining teacher performance in vocational schools. Cogent Educ. 2024;11(1):2421094.
- Güngör P. The relationship between reward management system and employee performance with the mediating role of motivation: A quantitative study on global banks. Procedia Soc Behav Sci. 2011;24:1510-20.
- Danish RQ, Khan MK, Shahid AU, et al. Effect of intrinsic rewards on task performance of employees: Mediating role of motivation. Int J Organ Leadersh. 2015;4:33-46.
- Mavhungu D, Bussin MH. The mediation role of motivation between leadership and public sector performance. SA J Hum Resour Manag. 2017;15(1):1-11.
- Faul F, Erdfelder E, Buchner A, Lang AG. Statistical power analyses using G*Power 3.1: Tests for correlation and regression analyses. Behav Res Methods. 2009;41(4):1149-60.
- Rodríguez-de-Dios I, Igartua JJ, González-Vázquez A. Development and validation of a digital literacy scale for teenagers. In: Proceedings of the Fourth International Conference on Technological Ecosystems for Enhancing Multiculturality; 2016. p. 1067-72.
- Abbas M, Jam FA, Khan TI. Is it harmful or helpful? Examining the causes and consequences of generative AI usage among university students. Int J Educ Technol High Educ. 2024;21(1):10.
- Grasha AF. Teaching with style: The integration of teaching and learning styles in the classroom. Alliance Publishers; Pittsburgh (PA); 1996.
- Briesmaster M, Briesmaster-Paredes J. The relationship between teaching styles and NNPSETs’ anxiety levels. System. 2015;49:145-56.
- Kanoksilapatham B, et al. Motivation of Thai university students from two disciplinary backgrounds using a hybrid questionnaire. LEARN J Lang Educ Acquis Res Netw. 2021;14(1):455-91.
- Govindasamy P, Cumming TM, Abdullah N. Validity and reliability of a needs analysis questionnaire for the development of a creativity module. J Res Spec Educ Needs. 2024;24(3):637-52.
- Hair JF, Risher JJ, Sarstedt M, Ringle CM. When to use and how to report the results of PLS-SEM. Eur Bus Rev. 2019;31(1):2-24.
- Zhang R, et al. Mediating effect of learning motivation and engagement on the relationship between generative artificial intelligence implementation and English as a foreign language proficiency. 2026. https://doi.org/10.21203/rs.3.rs-9075280/v1.
- Almira NF, Almira ZF, Vircavani C, Agustina E. A systematic review of teachers’ teaching styles and their impact on EFL student learning outcomes. J Appl Linguist Engl Educ. 2025;3(1):1-5.
- Reeve J. Teachers as facilitators: What autonomy-supportive teachers do and why their students benefit. Elem Sch J. 2006;106(3):225-36.
- Huang S, Dong L, Wang W, et al. Language is not all you need: Aligning perception with language models. In: Advances in Neural Information Processing Systems. 2023;36:72096-109.
- Liu L. An international graduate student’s ESL learning experience beyond the classroom. TESL Can J. 2011;29(1):77-92.
- van Laar E, van Deursen AJAM, van Dijk JAGM, De Haan J. The relation between 21st-century skills and digital skills: A systematic literature review. Comput Hum Behav. 2017;72:577-88.
- Al-Kahtani N. A survey assessing health science students’ perceptions of online learning at a Saudi higher education institution during the COVID-19 pandemic. Heliyon. 2022;8(9):e10688.
- Dewaele JM, Chen X, Padilla AM, Lake J. The flowering of positive psychology in foreign language teaching and acquisition research. Front Psychol. 2019;10:2128.
- Liu W, Li Y. A qualitative study of question-posing anxiety in Chinese postgraduates in UK TESOL programs. Sci Rep. 2025;16(1):2081.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.