Deze studie presenteert een lichtgewicht framework voor het verminderen van hallucinaties in grote taalmodellen via verificatie op beweringeniveau en adaptieve statistische drempelwaardes. Door onondersteunde beweringen selectief te corrigeren met behulp van Natural Language Inference, verbetert deze aanpak de feitelijke nauwkeurigheid terwijl een lage responstijd en praktische implementatie-efficiëntie behouden blijven.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Adaptieve NLI-gestuurde claimverificatie met statistische beslissingsmodellering voor het verminderen van hallucinaties met lage latentie in grote taalmodellen
In dit artikel
Samenvatting
Samenvatting
Grote taalmodellen (Large Language Models, LLM's) vertonen een kritieke neiging om feitelijk onjuiste maar linguïstisch vloeiende outputs te genereren - een fenomeen dat hallucinatie wordt genoemd - wat ernstige risico's inhoudt in toepassingen waarbij precisie essentieel is. Bestaande mitigatiestrategieën, waaronder retrieval-augmented generation en self-consistency sampling, introduceren ofwel aanzienlijke inferentielatentie of zijn afhankelijk van externe kennisinfrastructuur, wat hun toepasbaarheid in real-time implementaties beperkt. Dit artikel stelt een lichtgewicht tweestaps framework voor voor claimverificatie, dat LLM-responsen ontleedt in atomaire feitelijke claims en elke geëxtraheerde claim onafhankelijk verifieert tegenover een afzonderlijk gegenereerde referentie, geproduceerd via een geïsoleerde factual recall prompt. Hoewel de generator en verificator hetzelfde onderliggende taalmodel delen, vermindert het scheiden van responsgeneratie en feitelijke herinnering de directe conditionering van de respons en mitigeert het confirmation bias tijdens de verificatie door gebruik te maken van Natural Language Inference (NLI). Er wordt een adaptieve statistische drempel toegepast - gedefinieerd als τ = µ + kσ over de distributie van de NLI-confidentiescores - om selectief alleen tegengesproken claims te corrigeren. In tegenstelling tot eerdere NLI-gebaseerde methoden die vertrouwen op vaste beslissingsgrenzen, past het voorgestelde framework zijn verificatiedrempel dynamisch aan de confidentiedistributie van elke respons aan, wat consistente prestaties laat zien over de geëvalueerde benchmarks zonder dat modelretraining vereist is. Geëvalueerd op TruthfulQA en FEVER, reduceert het framework de hallucinatiegraad op TruthfulQA van 28% naar 9% - een relatieve reductie van 67,9% - terwijl er slechts 160 ms extra latentie optreedt ten opzichte van het basis-LLM, en het framework beter presteert dan SelfCheckGPT en FActScore in de nauwkeurigheid van hallucinatiedetectie. Deze resultaten geven aan dat het framework een gunstig evenwicht kan bieden tussen feitelijke betrouwbaarheid en responslatentie op de geëvalueerde benchmarks, hoewel verdere validatie over verschillende domeinen en implementatie-instellingen noodzakelijk is.
Inleiding
Large Language Models (LLM's) zijn ontstaan als fundamentele componenten van moderne systemen voor kunstmatige intelligentie en vertonen een opmerkelijk vermogen over een breed spectrum aan taken in natuurlijke taal, waaronder tekstgeneratie, vraag-antwoordinteracties, samenvattingen en complex redeneren1. Hun vermogen om vloeiende, contextueel coherente antwoorden te produceren heeft de adoptie versneld in domeinen met een grote impact, zoals klinische beslissingsondersteuning, juridische analyse, software engineering en educatieve technologie2. Echter, een kritieke en hardnekkige beperking ondermijnt hun betrouwbaarheid in deze omgevingen: hallucinatie, waarbij modellen antwoorden genereren die taalkundig vloeiend zijn, maar feitelijk onjuist, ononderbouwd of volledig gefabriceerd zijn 3. Empirische studies rapporteren hallucinatiepercentages variërend van 15% tot meer dan 40%, afhankelijk van de taak en het model, waarbij zelfs state-of-the-art systemen zoals GPT-4 meetbare feitelijke inconsistenties vertonen bij domeinspecifieke evaluaties2,3. Deze beperking brengt ernstige ris's met zich mee in precisie-kritische toepassingen waar foutieve outputs kunnen leiden tot desinformatie, misdiagnoses of gebrekkige besluitvorming4. Hallucinaties komen fundamenteel voort uit de probabilistische aard van taalmodellering - LLM's genereren tokens door statistisch waarschijnlijke vervolgen van inputsequenties te voorspellen, in plaats van geverifieerde feitelijke kennis op te halen of daarover te redeneren5. Bijgevolg kunnen gegenereerde outputs plausibel klinkende maar onjuiste beweringen bevatten, ononderbouwde stellingen introduceren of semantisch verwante maar feitelijk verschillende concepten met elkaar verwarren6.
Bestaande mitigatiestrategieën pakken dit probleem aan via verschillende paradigma's, elk met aanzienlijke beperkingen. Retrieval-Augmented Generation (RAG) vermindert hallucinaties door antwoorden te baseren op extern opgehaalde documenten, maar introduceert een aanzienlijke latentie-overhead, vereist toegang tot bijgehouden kennisbanken en blijft gevoelig voor ophaalfouten in gespecialiseerde domeinen of domeinen met beperkte middelen7,8,9.
Hoewel de responsgenerator en de referentiegenerator worden geïnstantieerd met hetzelfde onderliggende GPT-3.5 Turbo-model, opereren ze onder verschillende prompting-doelstellingen en uitvoeringscontexten. De responsgenerator produceert een ongeconstringeerd antwoord op de query van de gebruiker, terwijl de referentiegenerator een geïsoleerde taak van feitelijke herinnering uitvoert zonder toegang tot de eerder gegenereerde respons. Deze scheiding vermindert directe responsconditioneringseffecten en beperkt bevestigingsvooroordelen tijdens de verificatie van claims. Het raamwerk beschouwt de gegenereerde referentie daarom als procedureel onafhankelijk in plaats van statistisch onafhankelijk.
Recent onderzoek heeft ook gekeken naar lichtgewicht decoderingstrategieën om hallucinaties bij tekstgeneratie te verminderen zonder te vertrouwen op externe retrieval of herhaalde verificatie. Een representatieve aanpak hiervan is Decoding by Contrasting Layers (DoLA), die de feitelijkheid verbetert door representaties van tussenliggende en uiteindelijke transformer-lagen tijdens het decoderen tegen elkaar af te zetten. In tegenstelling tot raamwerken voor verificatie na generatie, grijpen dergelijke methoden direct in tijdens de token-generatie en optimaliseren ze daarom een andere fase van het taalgeneratieproces. Deze complementaire strategieën tonen aan dat het beperken van hallucinaties kan worden bereikt tijdens het decoderen of via verificatie na generatie, waarbij elke benadering specifieke afwegingen biedt op het gebied van computationele overhead, implementatiecomplexiteit en feitelijke betrouwbaarheid.
Zelfconsistentie-methoden verbeteren de feitelijke betrouwbaarheid door meerdere responsen te samplen en de meest frequente of coherente output te selecteren, maar hun computationele kosten schalen lineair met het aantal samples, waardoor ze ongeschikt zijn voor implementaties waarbij latentie van kritiek belang is8. Iteratieve verfijningsbenaderingen, die outputs herhaaldelijk herzien via self-feedback-loops, verminderen de foutmarges geleidelijk, maar verlengen de inferentietijd aanzienlijk bij elke extra doorloop9. NLI-gebaseerde verificatiemethoden bieden een gerichter alternatief door de semantische implicatie tussen gegenereerde beweringen en referentieteksten te evalueren, maar bestaande implementaties vertrouwen op vaste beslissingsdrempels die er niet in slagen zich aan te passen aan variërende betrouwbaarheidsdistributies, domeinen of modelgedragingen10,11. Collectief leggen deze benaderingen ofwel een onaanvaardbare computationele overhead op, zijn ze afhankelijk van externe infrastructuur, of missen ze de adaptiviteit die vereist is voor gegeneraliseerde implementatie. Een vergelijking van de belangrijkste kenmerken van deze hallucinatie-verificatiebenaderingen wordt gegeven in Aanvullende Tabel 1.
Dit artikel stelt een lichtgewicht, tweestaps raamwerk voor voor claimverificatie, ontworpen om hallucinaties in LLM-outputs te verminderen terwijl een lage responstijd behouden blijft. In de eerste stap genereert de LLM een initiële respons, die vervolgens wordt ontleed in atomaire feitelijke claims. In de tweede stap wordt elke claim geverifieerd met behulp van Natural Language Inference (NLI) ten opzichte van een afzonderlijk gegenereerde feitelijke referentie, geproduceerd via een geïsoleerde redeneringsstap die geen toegang heeft tot de oorspronkelijk gegenereerde respons; een statistisch afgeleide betrouwheidsdrempel bepaalt vervolgens de beslissing om de claim te accepteren of te corrigeren. De belangrijkste bijdragen van dit werk zijn als volgt: (1) een tweestaps verificatiepijplijn op claimniveau die responsgeneratie scheidt van feitelijke validatie, waardoor een onafhankelijke en gerichte evaluatie van elke atomaire claim mogelijk is zonder dat externe retrieve-acties of volledige regeneratie van de respons vereist zijn; (2) een adaptief statistisch drempelmechanisme gebaseerd op de distributie van NLI-betrouwheidsscores (τ = µ + kσ), dat dynamisch de grenzen voor acceptatie en correctie bepaalt in plaats van te vertrouwen op vaste beslisregels, wat de robuustheid bij variërende betrouwheidsdistributies verbetert; (3) een selectieve correctiestrategie die regeneratie beperkt tot enkel die claims die als tegenstrijdig zijn geclassificeerd, wat de computationele overhead aanzienlijk vermindert in vergelijking met volledige resampling van de respons of iteratieve verfijningsmethoden; (4) een empirische evaluatie op een benchmark gericht op hallucinaties, waaruit blijkt dat het voorgestelde raamwerk de hallucinatiepercentages reduceert van 28% naar 9%, terwijl de responstijd binnen praktische grenzen voor implementatie blijft.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Deze studie omvatte geen menselijke deelnemers, dieren, biologische monsters of patiëntgegevens. Daarom waren institutionele ethische goedkeuring en geïnformeerde toestemming niet vereist.
Overzicht van het onderzoeksontwerp
Er werd een tweestaps verificatiekader geïmplementeerd om de feitelijke betrouwbaarheid van outputs van grote taalmodellen (LLM's) te verbeteren. De procedure bestond uit responsgeneratie, claimextractie, de constructie van geïsoleerde referenties, Natural Language Inference (NLI)-gebaseerde verificatie, adaptieve statistische besluitvorming, selectieve correctie en de uiteindelijke samenstelling van de respons. Het kader werd geëvalueerd met behulp van de TruthfulQA- en FEVER-benchmarkdatasets.
Algemene workflow
Gebruikersvraag → Genereren van initiële respons → Extractie van claims → Onafhankelijke generatie van referenties → NLI-verificatie → Berekening van statistische drempelwaarden → Correctie van claims → Definitieve geverifieerde respons. De algehele workflow van het adaptieve framework voor claimverificatie is geïllustreerd in Figuur 1.
Datasetvoorbereiding
De TruthfulQA-dataset12, bestaande uit 817 feitelijke vragen, werd gedownload en klaargezet voor evaluatie. De FEVER-dataset13 bevat 185.445 geannoteerde claims die zijn gelabeld als 'Supported', 'Refuted' of 'Not Enough Information'; voor de evaluatie werden de gelabelde ontwikkelingsgegevens gebruikt, inclusief de velden voor claim, bewijs en het ground-truth label. Elke claim werd geëvalueerd op basis van het verstrekte bewijs, waarbij het oorspronkelijke FEVER-label werd behouden als referentie-uitkomst voor verificatie. De FEVER-dataset, die paren van claims en bewijzen voor feitenverificatie bevat, werd verkregen en voorbewerkt. Invoervragen en claims werden omgezet naar een gestandaardiseerd tekstformaat. Dubbele vermeldingen en onvolledige monsters werden voor de experimenten verwijderd. TruthfulQA werd verdeeld in validatie- en testsubsets. Ongeveer 20% van de TruthfulQA-monsters (164 vragen) werd gebruikt voor het afstellen van de drempelwaarde, terwijl de resterende 653 vragen werden gereserveerd voor de prestatie-evaluatie. Voor FEVER werden de in de benchmark verstrekte claims direct als verificatie-eenheden gebruikt en ondergingen zij niet de procedure voor responsgeneratie en claimextractie die bij TruthfulQA is toegepast. De kenmerken van de benchmark-datasets die zijn gebruikt voor de ontwikkeling en evaluatie van het raamwerk zijn samengevat in Tabel 1.
Initiële responsgeneratie
Elke query werd ingediend bij het basis taalmodel. Responsen werden gegenereerd met nucleus sampling met een temperatuur van 0.7 en een top-p van 0.9. De maximale outputlengte werd beperkt tot 256 tokens. De gegenereerde responsen werden opgeslagen zonder enige post-processing of handmatige aanpassing. De gegenereerde tekst werd direct doorgestuurd naar de fase van claimextractie.
Extractie van claims
Elk gegenereerd antwoord werd ontbonden in onafhankelijk verifieerbare feitelijke beweringen. Er werd gebruikgemaakt van een gestructureerde decompositieprompt om atomaire claims te identificeren. Samengestelde beweringen werden gesplitst in minimale feitelijke eenheden. Subjectieve meningen, stilistische uitdrukkingen en conversationele opvulling werden verwijderd. Elke geëxtraheerde claim werd opgeslagen als een onafhankelijke verificatie-eenheid.
Voorbeeld:
Originele reactie:
"Marie Curie was een in Polen geboren natuurkundige en chemicus die pionierswerk verrichtte op het gebied van radioactiviteit."
Geëxtraheerde claims: (1) Marie Curie was in Polen geboren; (2) Marie Curie was een natuurkundige en chemicus; (3) Marie Curie deed onderzoek naar radioactiviteit.
Geïsoleerde referentieconstructie:
Voor elke geëxtraheerde claim werd een onafhankelijke feitelijke referentie gegenereerd. Het verificatiemodel ontving uitsluitend de oorspronkelijke query van de gebruiker. De toegang tot het oorspronkelijke gegenereerde antwoord was beperkt om bevestigingsvooroordelen te voorkomen. Er werd gebruikgemaakt van een prompt voor feitelijke herinnering om beknopte, op bewijzen gebaseerde antwoorden te stimuleren. De gegenereerde referenties werden opgeslagen voor latere verificatie.
Verificatie van natuurlijke taalinferentie
Elk claim-referentiepaar werd ingediend bij een vooraf getraind NLI-model. Het NLI-model classificeerde de relatie als: Entailment, Neutral of Contradiction. De betrouwbaarheidskans voor alle drie de klassen werd vastgelegd. Er werd een getekende verificatiescore toegekend: een positieve waarde voor entailment, nul voor neutraal of een negatieve waarde voor contradictie. Alle verificatiescores werden verzameld voor de berekening van de drempelwaarde.
Adaptieve berekening van de statistische drempelwaarde
De verificatiebetrouwbaarheid die door het NLI-model wordt gegenereerd, varieert aanzienlijk per antwoord, omdat verschillende queries leiden tot een verschillend aantal claims, variërende niveaus van semantische complexiteit en uiteenlopende betrouwbaarheidsverdelingen. Een vaste wereldwijde drempelwaarde gaat ervan uit dat alle antwoorden een vergelijkbaar betrouwbaarheidsprofiel volgen, wat in de praktijk zelden wordt waargenomen. Om deze variabiliteit op te vangen, schat het voorgestelde framework de beslissingsgrens individueel voor elk antwoord, op basis van het gemiddelde en de standaarddeviatie van de verificatiescores. Het gemiddelde weerspiegelt het algemene betrouwbaarheidsniveau van het antwoord, terwijl de standaarddeviatie de spreiding van de betrouwbaarheidswaarden tussen de geëxtraheerde claims vastlegt. Deze adaptieve formulering maakt het mogelijk dat het acceptatiecriterium zich aanpast aan de onzekerheid die specifiek is voor het antwoord, in plaats van te vertrouwen op één enkele drempelwaarde voor alle inputs.
Het gemiddelde (µ) en de standaarddeviatie (σ) van alle getekende verificatiescores werden berekend.
De adaptieve beslissingsdrempel werd als volgt berekend:

waarbij τ de adaptieve drempelwaarde vertegenwoordigt, µ de gemiddelde verificatiescore aanduidt, σ de standaarddeviatie aanduidt en k de sensitiviteitsparameter vertegenwoordigt.
De sensitiviteitsparameter werd geïnitialiseerd op 0,7. Beweringen die werden geclassificeerd als Entailment met scores groter dan of gelijk aan +τ werden geaccepteerd. Beweringen die werden geclassificeerd als Contradiction met scores kleiner dan of gelijk aan −τ werden gemarkeerd voor correctie. Beweringen met scores binnen het interval (−τ, +τ) werden als neutraal behouden.
Selectieve correctie van claims
Een bewering werd alleen ter correctie doorgestuurd wanneer het NLI-model het bewering-referentiepaar classificeerde als Tegenstrijdigheid (Contradiction), en de bijbehorende getekende verificatiescore voldeed aan het adaptieve drempelcriterium si ≤ -τ. De beslissing tot correctie werd dus gezamenlijk bepaald door het NLI-klassificatielabel en de responspecifieke statistische drempelwaarde. Beweringen die werden geclassificeerd als Implicatie (Entailment) met si ≥ τ werden geaccepteerd, terwijl beweringen die binnen het interval -τ < si < τ vielen, als neutraal werden beschouwd en zonder correctie werden behouden. Dit gecombineerde criterium waarborgde dat correctie alleen werd toegepast op beweringen die zowel semantische tegenstrijdigheid als voldoende sterk negatief verificatiebewijs vertoonden.
Reconstructie van de respons
Geaccepteerde en gecorrigeerde claims werden in hun oorspronkelijke volgorde geplaatst. Zinsgrenzen werden hersteld om de leesbaarheid te behouden. Waar nodig zijn kleine grammaticaal aanpassingen doorgevoerd. De samengestelde output werd opgeslagen als de definitieve geverifieerde reactie.
Prestatie-evaluatie
Het raamwerk werd geëvalueerd met behulp van vier metrieken: (1) Nauwkeurigheid: Het aandeel antwoorden dat na verificatie feitelijk correct bleef; (2) F1-score: Het harmonisch gemiddelde van de precisie en recall van de hallucinatiedetectie; (3) Reactietijd: De totale verwerkingstijd van het indienen van de query tot het genereren van het geverifieerde antwoord; (4) Hallucinatiesnelheid
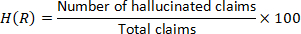
De latentie werd gerapporteerd als de gemiddelde uitvoeringstijd over herhaalde metingen. Omdat individuele latentiewaarden per run niet zijn bewaard, zijn er geen standaarddeviaties en betrouwbaarheidsintervallen berekend.
Correctheidsevaluatie specifiek voor benchmarks
Voor TruthfulQA werd de definitieve geverifieerde respons vergeleken met de door mensen gevalideerde antwoordreferenties en lijsten met incorrecte antwoorden van de benchmark. Een respons werd als correct geteld wanneer de feitelijke beweringen in overeenstemming waren met de geaccepteerde antwoordinformatie en geen inhoud bevatten die overeenkwam met de geïdentificeerde patronen van incorrecte responsen. Voor FEVER werd elke bewering in de uiteindelijke output geëvalueerd aan de hand van de bijbehorende bewijslast en de oorspronkelijke FEVER-annotatie; 'Supported'-beweringen werden beschouwd als feitelijk geverifieerd, terwijl 'Refuted'-beweringen als incorrect werden geteld. Gevallen van 'Not Enough Information' werden als onbepaald behouden in plaats van als positief feitelijk bewijs te worden behandeld. De resulterende beslissingen op beweringsniveau werden over elke benchmark geaggregeerd om de gerapporteerde nauwkeurigheid (Accuracy) en hallucinatiegraad (Hallucination Rate) te berekenen.
Experimentele omgeving
Het raamwerk is geïmplementeerd met Python 3.9. Gegevensverwerkingsoperaties werden uitgevoerd met behulp van bibliotheken voor numerieke en tabulaire analyse. Het NLI-model werkte in inferentiemodus zonder aanvullende fine-tuning. De experimenten werden uitgevoerd op een workstation uitgerust met een Intel Core i5-processor, 16 GB RAM en een 64-bits besturingssysteem. Alle evaluaties werden uitgevoerd met een single-pass inferentie-instelling om een lage latentie te garanderen. Alle experimenten werden uitgevoerd met identieke hardware- en softwareconfiguraties om een consistente evaluatie over datasets en baseline-methoden te waarborgen.
Verwacht resultaat
Het protocol is ontworpen om verificatiebeslissingen op claimniveau te genereren door potentieel ononderbouwde claims te identificeren en sterk tegengesproken claims selectief door te sturen voor correctie. De verwachte output is een geverifieerd antwoord met minder feitelijke inconsistenties en beperkte extra verwerkingskosten, afhankelijk van de prestaties die tijdens de experimentele evaluatie worden waargenomen.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Initiële generatie van de respons
Het basis taalmodel genereerde vloeiende en contextueel relevante antwoorden op vragen uit beide benchmark-datasets. Een gedetailleerde analyse onthulde echter niet-onderbouwde en feitelijk onjuiste beweringen in verschillende antwoorden. In de TruthfulQA-dataset vertoonde het basissysteem een hallucinatiepercentage van 28%, terwijl in de FEVER-dataset een hallucinatiepercentage van 26% werd waargenomen. Deze bevindingen bevestigden dat direct...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Het voorgestelde raamwerk verbeterde de prestaties van de feitelijke verificatie, terwijl herhaald campioneren en externe opvraging werden vermeden. Op TruthfulQA daalde het hallucinatiepercentage van 28% voor het basis-LLM naar 9% met het volledige raamwerk, terwijl de nauwkeurigheid toenam van 0,72 naar 0,87. Op FEVER daalde het hallucinatiepercentage van 26% naar 10%, waarbij de nauwkeurigheid steeg van 0,74 naar 0,89. Deze vergelijkingen moeten worden geïnterpreteerd binnen de experimentele instellingen en implementa...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs hebben geen belangenverstrengelingen te verklaren.
Dankbetuigingen
De auteurs willen hun oprechte dank uitspreken tot hun instelling voor het bieden van de academische omgeving en de computationele middelen die nodig waren om dit onderzoek uit te voeren. De auteurs erkennen tevens de ontwikkelaars en beheerders van de publiek toegankelijke benchmark-datasets die in deze studie zijn gebruikt, welke een uitgebreide evaluatie van het voorgestelde raamwerk mogelijk maakten. Er wordt waardering uitgesproken naar collega's en reviewers voor hun constructieve feedback, die heeft geholpen de kwaliteit en duidelijkheid van dit werk te verbeteren. De auteurs erkennen verder de open-source onderzoeksgemeenschap voor het leveren van de softwarebibliotheken en tools die experimenten, data-analyse en visualisatie van resultaten hebben gefaciliteerd. Hun voortdurende inspanningen hebben het onderzoek naar natuurlijke taalverwerking en betrouwbare kunstmatige intelligentie significant vooruitgestuwd. De auteurs verklaren dat er voor dit onderzoek geen externe financiële steun of financiering is ontvangen.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| FEVER-benchmarkdataset | FEVER Shared Task (Thorne et al.) | https://fever.ai/dataset/fever.html | Publiek beschikbare dataset voor feitverificatie van claim-bewijs-paren gebruikt voor evaluatie |
| GPT-3.5 Turbo (groot taalmodel B10+2:12:12 | OpenAI | Model-ID: gpt-3.5-turbo; https://developers.openai.com/api/docs/models/gpt-3.5-turbo | Gebruikt als zowel de responsgenerator als de onafhankelijke referentiegenerator, ontsloten via de OpenAI API |
| NumPy | NumPy-ontwikkelaars (open source) | https://numpy.org/ | Numerieke rekenbibliotheek gebruikt voor statistische berekeningen, inclusief het gemiddelde en de standaarddeviatie van NLI-verificatiescores |
| Openai (Python API-clientbibliotheek) | OpenAI | https://github.com/openai/openai-python | Python-clientbibliotheek die wordt gebruikt om prompts te verzenden naar en completions op te halen van GPT-3.5 Turbo |
| pandas | pandas Development Team (open source) | https://pandas.pydata.org/ | Bibliotheek voor tabulaire data-analyse gebruikt voor preprocessings van datasets en het verwerken van resultaten |
| Voorgetraind classificatiemodel voor Natural Language Inference (NLI) | Hugging Face model hub (model gebouwd op de DeBERTa-v3-large architectuur van Microsoft) | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli | Gebruikt in inferentiemodus, zonder fine-tuning, om elk claim-referentiepaar te classificeren als entailment, neutraal of contradictie |
| Python | Python Software Foundation | Versie 3.9; https://www.python.org/downloads/release/python-390/ | Primaire programmeertaal die is gebruikt voor de implementatie van het verificatieraamwerk |
| SciPy | SciPy-ontwikkelaars (open source) | https://scipy.org/ | Wetenschappelijke computerbibliotheek gebruikt ter ondersteuning van de statistische analyse van experimentele resultaten |
| Transformers (Hugging Face Transformers-bibliotheek) | Hugging Face | https://github.com/huggingface/transformers | Python-bibliotheek die wordt gebruikt om het vooraf getrainde NLI-model te laden en uit te voeren |
| TruthfulQA benchmark-dataset | Oorspronkelijk gepubliceerd door Lin, Hilton en Evans | https://github.com/sylinrl/TruthfulQA | Openbaar beschikbare benchmark van 817 feitelijke vragen die worden gebruikt voor drempelwaardetuning en evaluatie |
| Workstationcomputer | Niet gespecificeerd in het manuscript (gelieve fabrikant/model te bevestigen) | Intel Core i5-processor; 16 GB RAM; 64-bits besturingssysteem | Hardware die is gebruikt om alle experimenten onder identieke configuraties uit te voeren |
| Opmerking: Alle bovenstaande URL's zijn gecontroleerd en bevestigd als actief op de datum van deze tabel. |
Referenties
- Dai Z, et al. Promptagator: Few-shot dense retrieval from 8 examples [conference presentation]. Presented at: The Eleventh International Conference on Learning Representations; 2022. [https://iclr.cc/virtual/2023/poster/10937]
- Achiam J, et al. GPT-4 technical report. arXiv. 2023;arXiv:2303.08774. [https://arxiv.org/abs/2303.08774]
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):1-38.
- Bender EM, McMillan-Major A, Shmitchell S, Gebru T. On the dangers of stochastic parrots: Can language models be too big? [conference presentation]. Presented at: 2021 ACM Conference on Fairness, Accountability, and Transparency; 2021. [https://dl.acm.org/doi/10.1145/3442188.3445922]
- Devlin J, et al. BERT: Pre-training of deep bidirectional transformers for language understanding [conference presentation]. Presented at: 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2019. [https://arxiv.org/abs/1810.04805]
- Maynez J, Narayan S, Bohnet B, McDonald R. On faithfulness and factuality in abstractive summarization [conference presentation]. Presented at: 58th Annual Meeting of the Association for Computational Linguistics; 2020. [https://arxiv.org/abs/2005.00661]
- Brown T, et al. Language models are few-shot learners. Adv Neural Inf Process Syst. 2020;33:1877-901.
- Guu K, et al. Retrieval augmented language model pre-training [conference presentation]. Presented at: International Conference on Machine Learning; 2020. [https://arxiv.org/abs/2002.08909]
- Izacard G, Grave E. Leveraging passage retrieval with generative models for open domain question answering [conference presentation]. Presented at: 16th Conference of the European Chapter of the Association for Computational Linguistics; 2021. [https://arxiv.org/abs/2007.01282]
- Bowman SR, Angeli G, Potts C, Manning CD. A large annotated corpus for learning natural language inference [conference presentation]. Presented at: 2015 Conference on Empirical Methods in Natural Language Processing; 2015. [https://arxiv.org/abs/1508.05326]
- Platt J. Probabilistic outputs for support vector machines and comparisons to regularized likelihood methods. Adv Large Margin Classif. 1999;10(3):61-74.
- Lin S, Hilton J, Evans O. Truthfulqa: Measuring how models mimic human falsehoods. InProceedings of the 60th annual meeting of the association for computational linguistics (volume 1: long papers) 2022 May (pp. 3214-3252).
- Thorne J, Vlachos A, Christodoulopoulos C, Mittal A. FEVER: A large-scale dataset for fact extraction and verification [conference presentation]. Presented at: 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2018. [https://aclanthology.org/N18-1074/]
- Williams A, Nangia N, Bowman SR. A broad-coverage challenge corpus for sentence understanding through inference. arXiv. 2017;arXiv:1704.05426.
- Manakul P, Liusie A, Gales M. SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models [conference presentation]. Presented at: 2023 Conference on Empirical Methods in Natural Language Processing; 2023.
- Min S, et al. FActScore: Fine-grained atomic evaluation of factual precision in long-form text generation. arXiv. 2023;arXiv:2305.14251.
- Cohen J. Statistical power analysis for the behavioral sciences. Routledge; New York; 2013.
- Kadavath S, et al. Language models (mostly) know what they know. arXiv. 2022;arXiv:2207.05221.
- Hendrycks D, et al. Aligning AI with shared human values. arXiv. 2020;arXiv:2008.02275.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-74.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Herprints en machtigingen
Dit artikel is gepubliceerd
Video binnenkort beschikbaar