Dit artikel presenteert een uitlegbaar CNN-gebaseerd raamwerk voor de classificatie van huidlaesies dat een hoge diagnostische nauwkeurigheid combineert met interpreteerbaarheid van het model. Het classificeert beelden van laesies en genereert visuele verklaringen voor de voorspellingen. De resultaten tonen sterke prestaties en verbeterde transparantie aan, wat de klinische besluitvorming ondersteunt en dermatologen helpt bij de vroege detectie van huidaandoeningen.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Een uitlegbaar computerondersteund raamwerk voor de classificatie van huidlaesies met behulp van deep learning
In dit artikel
Samenvatting
Samenvatting
Het gebruik van diepe convolutionele neurale netwerken voor het diagnosticeren van huidaandoeningen is in verschillende studies gebleken vergelijkbare nauwkeurigheidsniveaus op te leveren als die van dermatologen. Desalniettemin blijven er veel uitdagingen bestaan, waaronder onvoldoende prestaties en een gebrekkige generalisatie in sommige gevallen, evenals een lage interpreteerbaarheid die verband houdt met het gebruik van black box-modellen. Dit vormt een aanzienlijke belemmering voor de praktische implementatie, aangezien naast accurate diagnostiek ook uitlegbaarheid vereist is, wat het noodzakelijk maakt om een oplossing te vinden. Om de genoemde moeilijkheden te overwinnen, is in deze studie een uitlegbaar deep learning-framework voor de classificatie van huidlaesies (EDLF-SLC) ontwikkeld. Het framework maakt in drie fasen gebruik van diverse benaderingen uit machine learning en uitlegbare kunstmatige intelligentie (XAI) om verbeteringen te waarborgen in zowel nauwkeurigheid als interpreteerbaarheid. In de eerste fase worden diepe representaties, geëxtraheerd uit meerdere vooraf getrainde CNN-architecturen, gefuseerd om complementaire discriminerende informatie te behouden die door verschillende netwerkarchitecturen is geleerd, alvorens classificatie plaatsvindt met een SVM met een radial basis function-kernel. Vervolgens worden Support Vector Machine (SVM)-classificatoren met een radial basis function-kernel gebruikt om de verkregen kenmerken te classificeren. Ten slotte worden de door het model gemaakte voorspellingen geïnterpreteerd via local interpretable model-agnostic explanations (LIME). Experimentele resultaten tonen aan dat EDLF-SLC een nauwkeurigheid van 88,0%, een precisie van 89,0%, een recall van 87,0% en een F1-score van 88,0% bereikt, wat wijst op concurrerende prestaties in vergelijking met verschillende recent gerapporteerde methoden onder de in deze studie overwogen experimentele omstandigheden.
Inleiding
Huidlaesies vormen een groot probleem in de dermatologie en oncologie, omdat ze variëren van goedaardige afwijkingen tot maligne kankers zoals melanoom, de dodelijkste vorm van huidkanker. In 2020 was melanoom verantwoordelijk voor ongeveer 325.000 nieuwe gevallen en meer dan 57.000 sterfgevallen wereldwijd1. Hoewel vooruitgang in screening en behandeling de patiëntresultaten heeft verbeterd, blijven vertraagde diagnose en beperkte toegang tot gezondheidszorg bijdragen aan een hoge mortaliteit en het verlies van gezonde levensjaren, vooral onder jongere populaties2,3.
Traditionele diagnostiek vertrouwt primair op visueel onderzoek en dermoscopie, waardoor het proces afhankelijk is van de expertise van clinici en vatbaar is voor subjectiviteit, inter-observatorvariabiliteit, onnodige biopsieën en langere onderzoekstijden4,5,6. Om deze beperkingen aan te pakken, is deep learning, en in het bijzonder CNN's, naar voren gekomen als een effectieve oplossing voor de geautomatiseerde classificatie van huidlaesies. Modellen gebaseerd op CNN, waaronder DDCNN-F7, YOLOv7-XAI8 en diverse andere architecturen9,10,11,12,13, hebben een hoge diagnostische nauwkeurigheid aangetoond door automatisch discriminerende beeldkenmerken aan te leren. Ondanks hun succes functioneren de meeste deep learning-modellen als "black boxes," wat het vertrouwen van clinici beperkt en de adoptie in de routinematige medische praktijk hindert. Technieken voor uitlegbare kunstmatige intelligentie zijn daarom geïntroduceerd om de transparantie van modellen te verbeteren door visuele verklaringen van voorspellingen te leveren. Onder deze methoden genereert Local Interpretable Model-Agnostic Explanations interpreteerbare lokale verklaringen door de beeldregio's te identificeren die de beslissingen van het model het meest beïnvloeden14.
De classificatie van huidlaesies is geëvolueerd van traditionele klinische beoordeling naar geavanceerde AI-gebaseerde diagnostische systemen, gedreven door de behoefte aan nauwkeurige, betrouwbare en vroege detectie van huidkanker. Deze evolutie is verlopen via vijf hoofdfasen — traditionele diagnostische methoden, computerondersteunde diagnose (CAD), ML, DL en, meer recentelijk, XAI en federated learning (FL) — wat de voortdurende inspanningen weerspiegelt om de diagnostische nauwkeurigheid, consistentie, schaalbaarheid en klinische betrouwbaarheid te verbeteren, terwijl de beperkingen van conventioneel onderzoek worden overwonnen. Vroege computationele methoden probeerden klinisch redeneren na te bootsen via handmatig ontworpen beelddescriptors afgeleid van de ABCD-regel, waaronder asymmetrie, onregelmatige randen, kleurvariatie en laesiediameter. Deze kenmerken werden gecombineerd met Bayesiaanse netwerken, beslissingsbomen, expertsystemen en fuzzy-inferentiemodellen om de diagnose van melanomen te ondersteunen, waarbij verschillende studies classificatienauwkeurigheden rapporteerden die boven de 90% lagen15,16,17. Hoewel deze methoden een belangrijke basis vormden voor computerondersteunde diagnose, waren ze volledig afhankelijk van handmatig ontwikkelde kenmerken en vooraf gedefinieerde diagnostische regels. Bijgevolg vertoonden ze een beperkte robuustheid tegen variaties in beeldkwaliteit, laesiemorfologie, belichting en acquisitiecondities.
Om deze tekortkomingen aan te pakken, ontstonden klassieke CAD-systemen als een tussenstap tussen conventionele beeldanalyse en moderne AI-gebaseerde frameworks. CAD-systemen combineerden handmatige feature-extractie met conventionele classifiers om de diagnostische consistentie te verbeteren en de klinische besluitvorming te ondersteunen. Verschillende hybride benaderingen integreerden hiërarchische clustering met recurrente neurale netwerken en long short-term memory-architecturen, waarbij classificatienauwkeurigheden van bijna 99,5% werden behaald18. Andere CAD-gebaseerde frameworks bevatten gradient boosting-classifiers met SHAP-gebaseerde verklaringen, wat een concurrerende diagnostische nauwkeurigheid demonstreerde terwijl de transparantie van het model werd verbeterd19. Hoewel deze systemen een aanzienlijke verbetering vormden ten opzichte van puur regelgebaseerde benaderingen, bleven ze sterk afhankelijk van handmatige feature-extractie, uitgebreide preprocessing, zorgvuldig geannoteerde datasets en meerstaps verwerkingspipelines.
Technieken voor machine learning hebben de geautomatiseerde classificatie van huidlaesies verder vooruitgeholpen door datagestuurd leren mogelijk te maken in plaats van expliciet regelontwerp. Hybride raamwerken die convolutionele neurale netwerken combineren met conventionele machine learning-classificatoren, waaronder logistische regressie en k-nearest neighbors, vertoonden sterke classificatieprestaties op benchmarkdatasets, met nauwkeurigheden die 95% overschreden9. Zelfgesuperviseerd multimodaal leren verbeterde de kenmerkrepresentatie verder door dermoscopische en klinische beelden gezamenlijk te benutten, waardoor de afhankelijkheid van uitgebreide handmatige annotatie werd verminderd terwijl de classificatieprestaties verbeterden20. Aanvullende studies combineerden CNN's met gegeneraliseerde discriminantanalyse, SURF-descriptoren en optimalisatiealgoritmen om de kenmerkdiscriminatie en classificatienauwkeurigheid te verbeteren21. Automatische technieken voor kenmerkselectie met gebruik van DenseNet-201, InceptionV3 en binaire boomoptimalisatiealgoritmen verbeterden de kenmerkrepresentatie verder, terwijl een concurrerende diagnostische prestatie behouden bleef22. Transfer learning-benaderingen die gebruikmaken van vooraf getrainde architecturen zoals AlexNet en GoogLeNet vertoonden ook veelbelovende classificatiecapaciteiten, ondanks beperkte trainingsgegevens23. Desondanks bleven de meeste ML-methoden afhankelijk van zorgvuldig ontworpen voorbewerkingsprocedures, handmatige optimalisatiestrategieën, gebalanceerde datasets en uitgebreide hyperparameter-tuning. Hun beperkte externe validatie en gevoeligheid voor klasse-onbalans beperkten bovendien hun praktische toepasbaarheid in diverse klinische omgevingen.
De introductie van DL heeft de geautomatiseerde classificatie van huidlaesies fundamenteel getransformeerd door end-to-end leren direct vanuit ruwe beeldgegevens mogelijk te maken. CNN's elimineerden de noodzaak voor handmatige feature engineering, terwijl de diagnostische prestaties over meerdere benchmark-datasets aanzienlijk werden verbeterd. De meeste CNN-gebaseerde benaderingen vertoonden significante verbeteringen in de classificatie van laesies door steeds geavanceerdere architecturen. Symmetry-aware CNN-modellen onderzochten klinisch relevante kenmerken van laesies, maar behaalden slechts een matige gebalanceerde nauwkeurigheid24. Anderen integreerden EfficientNet-architecturen met LIME- en SHAP-uitleg om de interpreteerbaarheid te verbeteren, terwijl ze kwantitatieve betrouwbaarheidsmaten introduceerden25. Hybride DL-systemen die laesiesegmentatie, ensemble learning en CNN's combineerden, behaalden uitstekende prestaties op meerdere ISIC-datasets, maar bleven gevoelig voor de kwaliteit van de segmentatie en klasse-onbalans26.
Onlangs hebben steeds geavanceerdere hybride architecturen de classificatienauwkeurigheid verder verbeterd door complementaire DL-technieken te integreren. Conditionele generative adversarial networks in combinatie met YOLOv5 en onafhankelijke componentanalyse bereikten classificatienauwkeurigheden van meer dan 99%, hoewel hun computationele complexiteit de praktische implementatie beperkte 27. Op soortgelijke wijze leerden hybride LSTM–ResNet-architecturen effectief spatio-temporele representaties, maar vereisten zij aanzienlijk meer computationele middelen28. Transformer-gebaseerde modellen, waaronder Sap-Former, maakten gebruik van globale contextuele informatie om de kenmerkrepresentatie te verbeteren, maar vereisten uitgebreide preprocessing, grootschalige geannoteerde datasets en aanzienlijke rekenkracht29. Lichtgewicht alternatieven zoals S-MobileNet probeerden een balans te vinden tussen computationele efficiëntie en diagnostische nauwkeurigheid30, terwijl ongesuperviseerde domeinadaptatiemethoden de cross-domein generalisatie verbeterden, ondanks een verminderde effectiviteit wanneer slechts beperkte trainingsmonsters beschikbaar waren31. Attention-enhanced hybride netwerken met gemodificeerde convolutionele attention-modules en snapshot ensemble learning toonden eveneens veelbelovende prestaties voor de classificatie van apenpokken-huidlaesies, hoewel uitdagingen met betrekking tot klassen-imbalans, beelddiversiteit en beperkte uitlegbaarheid onopgelost bleven32. Aangepaste residual-architecturen die gebruikmaakten van diepere netwerkontwerpen en hybride loss-functies verbeterden de classificatienauwkeurigheid verder tot boven de 99%, maar gingen gepaard met een aanzienlijk grotere computationele overhead en trainingstijd33. Uitgebreide reviewstudies concludeerden consistent dat DL aanzienlijk beter presteert dan traditionele handcrafted-benaderingen door automatisch discriminatieve beeldrepresentaties te leren, terwijl zij gelijktijdig aanhoudende uitdagingen identificeerden met betrekking tot beeldartifacten, variabiliteit in verlichting, computationele complexiteit en beperkte klinische generalisatie34.
Hoewel DL de diagnostische nauwkeurigheid drastisch heeft verbeterd, hebben zorgen over modeltransparantie, onzekerheidsschatting en betrouwbare klinische implementatie geleid tot een groeiende belangstelling voor XAI en federated learning. Verschillende studies hebben technieken voor onzekerheidskwantificering onderzocht, waaronder conformal prediction, Monte Carlo dropout en evidential deep learning, waarbij werd aangetoond dat een betrouwbare betrouwbaarheidsschatting de beslissingsondersteuning aanzienlijk kan verbeteren, ondanks het opleggen van extra computationele en datagerelateerde beperkingen35. Er zijn ook Transformer-gebaseerde mutual learning-frameworks voorgesteld om klasse-onbalans aan te pakken en tegelijkertijd de efficiëntie van feature learning te verbeteren36. Andere benaderingen combineerden CNN's met volledige resolutie met graafgebaseerde optimalisatietechnieken om de segmentatie en classificatie van laesies te verbeteren37, terwijl hybride deep learning-frameworks die meerdere complementaire feature-representaties integreren classificatienauwkeurigheden behaalden die de 99,5% naderden, ondanks dat hiervoor uitgebreide preprocessing vereist was38.
Recent onderzoek heeft zich in toenemende mate gericht op het direct integreren van uitlegbaarheid in DL-frameworks om het vertrouwen van clinici te vergroten en de praktische klinische adoptie te vergemakkelijken. Uitlegbare systemen die gebruikmaken van meerdere convolutionele neurale netwerkarchitecturen samen met Grad-CAM en Score-CAM slaagden erin diagnostisch relevante laesiegebieden te lokaliseren, terwijl ze een concurrerende classificatieprestatie behielden op zowel interne als externe datasets39. Hybride CNN–Transformer frameworks die dermoscopische beelden combineerden met klinische metadata verbeterden de voorspellende prestaties verder, terwijl SHAP en Grad-CAM werden gebruikt om klinisch betekenisvolle visuele verklaringen te genereren40. Aanvullende hybride architecturen op basis van transformers die EfficientNetV2S, Swin Transformers, gemodificeerde Xception-netwerken en graph attention-mechanismen integreerden, legden effectief complementaire globale en lokale laesiekenmerken vast, hoewel hun grote aantal parameters en beperkte prestaties bij minderheidsklassen de praktische inzet beperkten41. Op soortgelijke wijze demonstreerden hybride YOLOv8–Vision Transformer frameworks verbeterde laesielokalisatie, multiclass-classificatie en visuele interpreteerbaarheid door adaptieve augmentatie samen met SHAP- en Grad-CAM-verklaringen; deze methoden bleven echter primair vertrouwen op benchmark-datasets en vertoonden beperkte robuustheid voor minderheidscategorieën van laesies42. Verschillende overzichtsartikelen hebben deze ontwikkelingen samengevat, waarbij zowel de opmerkelijke vooruitgang die is geboekt met moderne deep learning-technieken als de aanhoudende uitdagingen met betrekking tot computationele efficiëntie, uitlegbaarheid, dataset-afhankelijkheid en klinische validatie werden benadrukt43,44,45. Tabel 1 vat enkele recent gepubliceerde werken samen die deep learning-algoritmen gebruiken voor de classificatie van huidlaesies.
Ondanks de opmerkelijke vooruitgang die recentelijk is geboekt met DL-methoden voor de classificatie van huidlaesies, blijven de meeste bestaande benaderingen beperkt door een hoge computationele complexiteit, afhankelijkheid van grote geannoteerde datasets, beperkte interpreteerbaarheid van het model en onvoldoende validatie in diverse klinische praktijksituaties. Om deze beperkingen te overwinnen, stelt dit artikel het EDLF-SLC-raamwerk voor, dat complementaire kenmerken uit meerdere CNN-architecturen integreert met een SVM-classifier voor een robuuste en accurate classificatie. Het raamwerk maakt bovendien gebruik van verbeterde preprocessing om de beeldkwaliteit te verhogen en klasse-onbalans aan te pakken, terwijl de LIME-techniek wordt geïncorporeerd om visuele uitleg van individuele voorspellingen te verschaffen, waardoor de transparantie van het model en het klinische vertrouwen worden vergroot.
De bijdragen van deze studie zijn drieledig. Ten eerste stellen de auteurs een robuust raamwerk voor, EDLF-SLC, dat geavanceerde convolutionele neurale netwerken (CNN's) integreert met een support vector machine (SVM) classifier om een nauwkeurige en betrouwbare classificatie van huidlaesies te bereiken. Ten tweede implementeren de auteurs verbeterde voorbewerkingstechnieken om klassenonbalans aan te pakken en beeldruis te verminderen, waardoor de kwaliteit van de invoerbeelden en de algehele prestaties van het classificatiemodel worden verbeterd. Ten derde incorporeren de auteurs de Local Interpretable Model-agnostic Explanations (LIME) methode om individuele modelvoorspellingen te visualiseren en te interpreteren door de beeldregio's te markeren die de classificatiebeslissingen het sterkst beïnvloeden, waardoor de transparantie en interpreteerbaarheid van het voorgestelde raamwerk worden vergroot.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Deze studie omvatte geen werving van menselijke deelnemers of de verzameling van identificeerbare patiëntgegevens. Alle experimenten werden uitgevoerd met behulp van de publiek beschikbare ISIC 2020 huidlaesie-dataset verkregen uit de Kaggle-repository; daarom waren goedkeuring van een institutionele ethische commissie en geïnformeerde toestemming niet vereist. Alle materialen die in deze studie zijn gebruikt, staan in de Tabel van Materialen.
Kenmerkextractie en fusie
Afbeeldingen van huidlaesies werden verwerkt met behulp van meerdere vooraf getrainde CNN-modellen. Diepe kenmerkvectoren, geëxtraheerd uit de geselecteerde vooraf getrainde CNN-architecturen, worden samengevoegd om een uniforme kenmerkrepresentatie voor elke afbeelding van de huidlaesie te construeren. De toegepaste fusiestrategie behoudt complementaire visuele informatie die door verschillende CNN-architecturen is aangeleerd, waardoor de daaropvolgende SVM-classifier zowel laagwaardige textuurkenmerken als hoogwaardige semantische representaties kan benutten. Hoewel dimensiereductietechnieken, zoals principale componentanalyse of op wederzijdse informatie gebaseerde kenmerkselectie, de dimensionaliteit van de kenmerken kunnen verminderen, is de volledige gefuseerde representatie bewust behouden omdat de gefuseerde kenmerkruimte computationeel hanteerbaar blijft voor de gebruikte RBF-SVM-classifier, terwijl de complementaire diagnostische informatie uit de heterogene CNN-backbones behouden blijft.
Classificatie
De gefuseerde kenmerkvectoren werden gebruikt om een SVM-classifier met een RBF-kernel te trainen. Er werden technieken voor hyperparameteroptimalisatie toegepast om de optimale classificatie-instellingen te bepalen. De classifier categoriseerde vervolgens de huidlaesies in hun respectievelijke klassen.
Uitlegbaarheid
Om de interpreteerbaarheid te verbeteren, werd LIME toegepast om visuele verklaringen te genereren die de beeldregio's markeren die het meest significant bijdragen aan de classificatieresultaten. Deze verklaringen zouden clinici helpen bij het begrijpen en valideren van de beslissingen van het model.
Evaluatieplan
Het voorgestelde framework is geëvalueerd met behulp van een benchmarkdataset van huidlaesies. De prestaties zijn beoordeeld op basis van accuratesse, precisie, recall en de F1-score. Er zijn vergelijkende experimenten uitgevoerd ten opzichte van bestaande benaderingen van machine learning en deep learning om de effectiviteit van het voorgestelde framework aan te tonen.
Verwachte resultaten
Van de studie werd verwacht dat deze zou leiden tot een accuraat en interpreteerbaar classificatiesysteem voor huidlaesies. Voorlopige experimentele resultaten tonen aan dat EDLF-SLC een nauwkeurigheid van 88,0%, precisie van 89,0%, recall van 87,0% en een F1-score van 88,0% behaalt, waarmee het meerdere concurrerende methoden overtreft. De integratie van LIME-uitleggen was bedoeld om de betrouwbaarheid te verhogen en de adoptie van AI-ondersteunde diagnostische systemen in de klinische praktijk te vergemakkelijken.
Betekenis
Dit onderzoek draagt bij aan het groeiende veld van uitlegbare AI in de gezondheidszorg door zowel prestatie- als transparantie-uitdagingen bij de diagnose van huidlaesies aan te pakken. Het voorgestelde raamwerk heeft de potentie om dermatologen te ondersteunen bij het nemen van betrouwbaardere en interpreteerbare diagnostische beslissingen, wat uiteindelijk de patiëntzorg verbetert. Bovendien verstrekken de auteurs in deze sectie informatie over de materialen en de methodologie die in deze onderzoeksstudie zijn toegepast. Specifiek beginnen de auteurs met de beschrijving van de dataset die voor de experimenten is gebruikt, gevolgd door een gedetailleerde bespreking van het Explainable Deep Learning Framework voor de classificatie van huidlaesies.
Dataset
Het gepresenteerde werk is gebaseerd op de publiekelijk toegankelijke ISIC 2020-dataset (International Skin Imaging Collaboration), die kan worden geraadpleegd op de Kaggle-website (https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign). De ISIC-repository wordt erkend als een van de beste bronnen op het gebied van dermatologische beeldvorming, aangezien deze een grote variëteit aan dermoscopische beelden van verschillende soorten huidlaesies biedt, zoals weergegeven in Figuur 1. Cruciaal is dat de dataset beelden bevat van zowel benigne als maligne aandoeningen, waardoor deze geschikt is voor het uitvoeren van binaire classificatietaken voor huidkanker 46. De huidige dataset bevat 3.297 beelden, waarvan er 1.800 benigne en 1.497 maligne zijn. Voor efficiëntere experimenten moest de data worden opgesplitst in een trainingsset en een testset. In het bijzonder zijn er 2.637 trainingsbeelden, waaronder 1.440 benigne en 1.197 maligne, terwijl de testset bestaat uit 660 beelden, waarvan 360 benigne en 300 maligne zijn. Een samenvatting van de dataset is weergegeven in Tabel 2.
Het voorgestelde EDLF-SLC-model
In dit artikel is een efficiënte en begrijpelijke oplossing voorgesteld voor het classificeren van huidlaesies in goedaardige en kwaadaardige categorieën, met behulp van een nieuwe uitlegbare deep learning-techniek gebaseerd op een hybride benadering die de voordelen van meerdere vooraf getrainde convolutionele neurale netwerkmodellen combineert. Convolutionele neurale netwerken zijn zeer effectief gebleken in het extraheren van hoogwaardige semantische kenmerken uit medische beelden. Door gebruik te maken van deze capaciteit, benut het voorgestelde uitlegbare deep learning-framework voor de classificatie van huidlaesies (EDLF-SLC) meerdere vooraf getrainde CNN-modellen om superieure prestaties te behalen. Om de noodzakelijke transparantie van het medische besluitvormingsproces te waarborgen, is LIME in de voorgestelde benadering geïmplementeerd om lokale, voor mensen leesbare verklaringen voor de resultaten te genereren. Het volledige framework kan worden onderverdeeld in drie hoofdfasen, zoals geïllustreerd in Figuur 2, namelijk: (1) datapreprocessing, (2) kenmerkextractie en classificatie, en (3) interpreteerbaarheid.
Modelarchitectuur en integratie
Als voorbereidende stap werden zeven populaire deep learning-modellen (MobileNetV2, ResNet50, EfficientNetB0, Xception, InceptionResNetV2, NASNetLarge en MobileNet) geselecteerd en afzonderlijk geëvalueerd op de validatiedataset, waarbij de vier meest effectieve modellen (ResNet50, EfficientNetB0, MobileNet en Xception) zijn gekozen voor de fase van kenmerkextractie. In het voorgestelde raamwerk is elke inputafbeelding x onafhankelijk door de geselecteerde pretrained modellen geleid. De laatste volledig verbonden laag is uit elk van deze modellen verwijderd, waardoor kenmerkvectoren uit de voorgaande lagen zijn verkregen. fResNet50(x), fEfficientNetB0(x), fMobileNet(x) en fXception(x) verwijzen naar de output-kenmerkvectoren van elk van de bovengenoemde modellen. Door deze kenmerkvectoren samen te voegen, wordt een nieuwe geaggregeerde kenmerkvector F(xi) verkregen:
F(xi) = [f(ResNet50)(xi);f(EfficientNetB0)(xi);f(MobileNet)(xi);f(Xception)(xi)] (1)
Vervolgens is F(xi) door een SVM-classifier met een radial basis function (RBF)-kernel geleid om het classificatieresultaat te verkrijgen. Het volledige algoritme voor het voorgestelde framework staat beschreven in Aanvullend Bestand 1.
Het voorgestelde raamwerk maakt gebruik van directe fusie op kenmerkniveau, omdat elke vooraf getrainde CNN-architectuur verschillende onderscheidende kenmerken van huidlaesies vastlegt via zijn specifieke netwerkarchitectuur en aangeleerde kenmerkhierarchie. Bijgevolg behoudt het samenvoegen van deze heterogene kenmerkrepresentaties complementaire informatie, wat bijdraagt aan een meer uitgebreide karakterisering van de laesies voorafgaand aan de classificatie. Hoewel dimensiereductietechnieken zoals principale componentenanalyse (PCA) of kenmerkselectie op basis van wederzijdse informatie de dimensionaliteit van de gefuseerde representatie kunnen verminderen, is de volledige gefuseerde kenmerkvector bewust behouden; de dimensionaliteit hiervan blijft namelijk computationeel beheersbaar voor de gebruikte RBF-SVM-classifier, terwijl de complementaire diagnostische informatie die door de verschillende CNN-backbones is geëxtraheerd, behouden blijft. Dit ontwerp geeft daarom prioriteit aan het behouden van complementaire diepe representaties in plaats van het elimineren van potentieel informatieve kenmerken vóór de classificatie.
Datapreparetie
De datapreparatie omvatte preprocessing en het splitsen van de dataset in trainings- en testsets. Preprocessing is gericht op het verbeteren van de datakwaliteit door inconsistenties te elimineren, dubbele elementen te verwijderen, inputafbeeldingen te formatteren en feature scaling uit te voeren voor een stabiele training van een goed model. Alle afbeeldingen zijn genormaliseerd naar het bereik van [−1, 1] middels Z-score normalisatie:
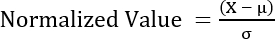 (2)
waarbij µ en σ respectievelijk staan voor de gemiddelde waarde en de standaarddeviatie van de overeenkomstige afbeelding. De dataset is verdeeld in twee subsets, namelijk een trainingsset (70,0%) en een testset (30,0%).
Data-augmentatie
Om overfitting te voorkomen en het generalisatievermogen van het model te vergroten, zijn enkele augmentaties toegepast op de trainingsset. Beeldaugmentaties houden in dat afbeeldingen worden gewijzigd om de dataset kunstmatig uit te breiden zonder de essentiële kenmerken van medische aandoeningen te veranderen. De augmentatie-pipeline is opgebouwd met behulp van de Keras Sequential API. Er is gebruikgemaakt van transformaties zoals willekeurige horizontale spiegeling, rotatie binnen een kleine hoek, herschalen, schalen, aanpassing van helderheid/contrast, zoomen en enkele kleine verschuivingen. Representatieve voorbeelden van geaugmenteerde afbeeldingen zijn weergegeven in Figuur 3.
Pretrained modellen
Verschillende pretrained deep learning-modellen zijn toegepast in het voorgestelde raamwerk om kenmerken uit de invoerbeelden te extraheren. Deze modellen omvatten MobileNet, ResNet50, EfficientNetB0, Xception, NASNetLarge, Inception-ResNet-v2 en MobileNetV2. MobileNet en MobileNetV2 zijn lichtgewicht deep learning-modellen voor efficiënte berekeningen met behulp van depth-wise separable convolutions. ResNet50 maakt gebruik van het mechanisme van residual connections voor het trainen van het model, waardoor het probleem van vanishing gradients tijdens de training wordt voorkomen. EfficientNetB0 slaat een brug tussen efficiëntie en precisie via de aanpak van compound scaling. Xception breidt het Inception-netwerk uit met behulp van depthwise separable convolutions. NASNetLarge maakt gebruik van neural architecture search om optimale deep neural network-structuren te bouwen, en Inception-ResNet-v2 vormt een hybride van het Inception-model en het mechanisme van residual connections. Kenmerkvectoren geëxtraheerd uit ResNet50 (1.024 kenmerken), EfficientNetB0 (1.280 kenmerken), MobileNet (1.024 kenmerken) en Xception (2.048 kenmerken) worden geconcateneerd om een uniforme 5.376-dimensionale representatie te produceren. Deze fusiestrategie is gekozen om complementaire representaties die door de verschillende CNN-architecturen zijn geleerd te behouden, in plaats van de representatie vóór de classificatie te reduceren. De resulterende kenmerkvector wordt vervolgens aangeboden aan de RBF-SVM-classifier, die de optimale niet-lineaire beslissingsgrens binnen de gefuseerde kenmerkruimte bepaalt.
Uitlegbaar AI-model (LIME)
Om enige lokale interpreteerbaarheid van de modelvoorspellingen te bieden, maken de auteurs gebruik van de methode waarbij lokale, voor mensen leesbare verklaringen worden gegenereerd voor elke specifieke modelvoorspelling, genaamd LIME47. Voor elke invoerafbeelding verdeelt LIME deze eerst in kleinere eenheden, genaamd superpixels. Vervolgens worden er perturbaties gegenereerd op basis van de oorspronkelijke afbeelding, en worden de voorspellingen van het deep neural model geschat voor elke perturbatie. Daarna wordt een gewogen lineair model gefit op de perturbaties, waarbij gebruik wordt gemaakt van gewichten die afhangen van hun nabijheid tot de oorspronkelijke invoerinstantie. Na het fitten van het lineaire model worden de scores voor feature-belangrijkheid geschat, die de rol van elke superpixel in de voorspelling van het uiteindelijke label aangeven. Deze belangrijkheidsscores worden visueel geaccentueerd in de uiteindelijke verklarende afbeelding. Het LIME-algoritme is weergegeven in Aanvullend Bestand 2.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
De prestatiebeoordeling van het ontwikkelde classificatiekader is gebaseerd op traditionele evaluatiematen afgeleid van de verwarringsmatrix. Een verwarringsmatrix maakt het mogelijk om een volledig inzicht te krijgen in de prestaties van de classifier door de weergave van het aantal juiste en onjuiste classificaties per gedefinieerde klasse. Op deze manier kunnen alle typen fouten worden geanalyseerd. Zo zijn zowel fout-positieven als fout-negatieven bijzonder belangrijk bij de diagnose van ziekten. Hoge waarden voor fo...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Het voorgestelde verklaarbare deep learning-framework voor de classificatie van huidlaesies (EDLF-SLC) demonstreert dat het combineren van complementaire deep feature-representaties met verklaarbare kunstmatige intelligentie zowel de classificatieprestaties als de transparantie van het model kan verbeteren. Door meerdere voorgetrainde CNN-architecturen (ResNet50, EfficientNetB0, MobileNet en Xception) te integreren voor feature-extractie en een Support Vector Machine (SVM) te gebruiken voor de uiteindelijke classificatie...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteurs verklaren dat er geen sprake is van een belangenconflict.
Dankbetuigingen
De auteurs willen hun oprechte dank uitspreken aan de Taif University voor het bieden van de onderzoeksomgeving en de institutionele ondersteuning die de voltooiing van dit werk mogelijk hebben gemaakt.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| ISIC 2020 Skin Lesion Dataset | International Skin Imaging Collaboration (ISIC) | ISIC 2020 Challenge Dataset | Dermoscopische imagedataset gebruikt voor modelontwikkeling en evaluatie. |
| Keras | Keras Team | Geïntegreerd met TensorFlow | Constructie en training van deep learning-modellen. |
| LIME (Local Interpretable Model-Agnostic Explanations) | Ribeiro et al. | Python-pakket | Generatie van lokale visuele verklaringen voor modelvoorspellingen. |
| Matplotlib | Matplotlib Developers | Laatste compatibele versie | Visualisatie van leercurves, confusiematrices en evaluatieplots. |
| NumPy | NumPy Developers | Laatste compatibele versie | Numerieke berekeningen en array-manipulatie. |
| NVIDIA Tesla T4 GPU | NVIDIA Corporation | 16 GB VRAM | Acceleratie van modeltraining en inferentie. |
| Pandas | Pandas Development Team | Laatste compatibele versie | Gegevensverwerking en beheer van experimentele resultaten. |
| Pretrained CNN Models | TensorFlow/Keras Applications | ResNet50, EfficientNetB0, MobileNet, Xception | Deep feature-extractie uit dermoscopische beelden. |
| Python | Python Software Foundation | Versie 3.9 | Programmeertaal gebruikt voor implementatie. |
| PyTorch | PyTorch Foundation | Versie 2.3.1 | Deep learning-framework gebruikt voor feature-extractie en modelimplementatie. |
| Scikit-learn | Scikit-learn Developers | Laatste compatibele versie | Support Vector Machine (SVM), evaluatiemetrieken en data-preprocessie. |
| Support Vector Machine (RBF Kernel) | Scikit-learn | SVC | Classificatie van gefuseerde deep feature-representaties. |
| TensorFlow | Google LLC | Versie 2.x | Deep learning-framework voor modeltraining en inferentie. |
| Ubuntu Operating System | Canonical Ltd. | Ubuntu 20.04 | Experimentele werkomgeving. |
Referenties
- Chan S, Reddy V, Myers B, Thibodeaux Q, Brown-Stone N, Liao W. Machine learning in dermatology: current applications, opportunities, and limitations. Dermatol Ther (Heidelb). 2020;10:365-386.
- Olsen CM. Global trends in melanoma mortality differ by sex and age. Br J Dermatol. 2020;183(6):985-986.
- Sun Y, Shen Y, Liu Q, Zhang H, Jia L, Chai Y, et al. Global trends in melanoma burden: a comprehensive analysis from the Global Burden of Disease Study, 1990-2021. J Am Acad Dermatol. 2025;92(1):100-107.
- Monika MK, Vignesh NA, Kumari CU, Kumar M, Lydia EL. Skin cancer detection and classification using machine learning. Mater Today Proc. 2020;33:4266-4270.
- Hosny KM, Elshora D, Mohamed ER, Vrochidou E, Papakostas GA. Deep learning and optimization-based methods for skin lesions segmentation: a review. IEEE Access. 2023.
- Baghdadi NA, Farghaly Abdelaliem SM, Malki A, Gad I, Ewis A, Atlam ES. Advanced machine learning techniques for cardiovascular disease early detection and diagnosis. J Big Data. 2023;10(1):144.
- Veeramani N, Jayaraman P, Krishankumar R, Ravichandran KS, Gandomi AH. DDCNN-F: double decker convolutional neural network feature fusion as a medical image classification framework. Sci Rep. 2024;14(1).
- Veeramani N, Jayaraman P. YOLOv7-XAI: multiclass skin lesion diagnosis using explainable artificial intelligence with fair decision making. Int J Imaging Syst Technol. 2024;34(6).
- Shetty B, Fernandes R, Rodrigues AP, Chengoden R, Bhattacharya S, Lakshmanna K. Skin lesion classification of dermoscopic images using machine learning and convolutional neural network. Sci Rep. 2022;12(1):18134.
- Ali AR, Li J, Yang G, O'Shea SJ. A machine learning approach to automatic detection of irregularity in skin lesion border using dermoscopic images. PeerJ Comput Sci. 2020;6:e268.
- Pham TTH, Luu TN, Nguyen TV, Huynh NT, Phan QH, Le TH. Polarimetric imaging combining optical parameters for classification of mice non-melanoma skin cancer tissue using machine learning. Heliyon. 2023;9(11).
- Liu N, Rejeesh M, Sundararaj V, Gunasundari B. ACO-KELM: anti coronavirus optimized kernel-based softplus extreme learning machine for classification of skin cancer. Expert Syst Appl. 2023;232:120719.
- Masud M, Almars AM, Rokaya MB, Meshref H, Gad I, Atlam ES. A novel lightweight convolutional neural network model to predict Alzheimer's disease applying weighted loss function. J Disabil Res. 2024;3(4):20240042.
- Kumar A, Veeraiah V, Gongada TN, Ahamad S, Khan H, Gupta A. Explainable machine learning models for clinical decision support systems. In: 2024 15th International Conference on Computing Communication and Networking Technologies (ICCCNT). Piscataway (NJ): IEEE; 2024. p. 1-6.
- Shahzad K, Wasim M, Pires IM, Garcia NM. Multi-classification of skin lesions using a deep learning-based convolutional neural network. Procedia Comput Sci. 2024;241:588-593.
- Celebi ME, Kingravi HA, Uddin B, Iyatomi H, Aslandogan YA, Stoecker WV, et al. A methodological approach to the classification of dermoscopy images. Comput Med Imaging Graph. 2007;31(6):362-373.
- Li CX, Shen CB, Xue K, Shen X, Jing Y, Wang ZY, et al. Artificial intelligence in dermatology: past, present, and future. Chin Med J (Engl). 2019;132(17):2017-2020.
- Ramprasad M, Nagesh S, Sahith V, Lankalapalli RK. Hierarchical agglomerative clustering based skin lesion detection with region-based neural networks classification. Meas Sens. 2023;29:100865.
- Khater T, Ansari S, Mahmoud S, Hussain A, Tawfik H. Skin cancer classification using explainable artificial intelligence on pre-extracted image features. Intell Syst Appl. 2023;20:200275.
- Wang H, Ahn E, Bi L, Kim J. Self-supervised multi-modality learning for multi-label skin lesion classification. Comput Methods Programs Biomed. 2025;265:108729.
- Thapar P, Rakhra M, Alsaadi M, Quraishi A, Deka A, Naga Ramesh JV. A hybrid grasshopper optimization algorithm for skin lesion segmentation and melanoma classification using deep learning. Healthc Anal. 2024;5:100326.
- Kumar S, Nath VK, Hazarika D. Blend of deep features and binary tree growth algorithm for skin lesion classification. Symmetry (Basel). 2023;15(12):2213.
- Chandrahaas BV, Mohanty SN, Panda SK, et al. An empirical study on classification of monkeypox skin lesion detection. EAI Endorsed Trans Pervasive Health Technol. 2023;9:e4.
- Talavera-Martínez L, Bibiloni P, Giacaman A, Taberner R, de Paz Hernando LJD, González-Hidalgo M. A novel approach for skin lesion symmetry classification with a deep learning model. Comput Biol Med. 2022;145:105450.
- Ieracitano C, Morabito FC, Hussain A, Suffian M, Mammone N. TIXAI: a trustworthiness index for explainable artificial intelligence in skin lesion classification. Neurocomputing. 2025;630:129701.
- Hasan MK, Elahi MTE, Alam MA, Jawad MT, Martí R. DermoExpert: skin lesion classification using a hybrid convolutional neural network through segmentation, transfer learning, and augmentation. Inform Med Unlocked. 2022;28:100819.
- Koparde S, Kotwal J, Deshmukh S, Adsure S, Chaudhari P, Kimbahune V. Conditional generative adversarial networks and YOLOv5 Darknet-based skin lesion localization and classification using an independent component analysis model. Inform Med Unlocked. 2024;47:101515.
- Padhy S, Dash S, Kumar N, Singh SP, Kumar G, Moral P. Temporal integration of ResNet features with LSTM for enhanced skin lesion classification. Results Eng. 2025;25:104201.
- Xin C, Liu Z, Ma Y, Wang D, Zhang J, Li L, et al. Transformer-guided self-adaptive network for multi-scale skin lesion image segmentation. Comput Biol Med. 2024;169:107846.
- Sulthana R, Chamola V, Hussain Z, Albalwy F, Hussain A. A novel end-to-end deep convolutional neural network-based skin lesion classification framework. Expert Syst Appl. 2024;246:123056.
- Chamarthi S, Fogelberg K, Brinker TJ, Niebling J. Mitigating the influence of domain shift in skin lesion classification: a benchmark study of unsupervised domain adaptation methods. Inform Med Unlocked. 2024;44:101430.
- Maity S, Paul S, Guha S, Dasgupta S, Ghosh M. Automated classification of monkeypox skin lesions using a hybrid deep learning model. Biomed Signal Process Control. 2026;126:110955.
- Nasir S, Bilal M, Khalidi H. Detection and classification of skin cancer by using CNN-enabled cloud storage data access control algorithm based on blockchain technology. Int J Theor Appl Comput Intell. 2025:145-169.
- Saba T. Computer vision for microscopic skin cancer diagnosis using handcrafted and non-handcrafted features. Microsc Res Tech. 2021;84(6):1272-1283.
- Fayyad J, Alijani S, Najjaran H. Empirical validation of conformal prediction for trustworthy skin lesion classification. Comput Methods Programs Biomed. 2024;253:108231.
- Liu P, Qian W, Li H, Cao J. A relationship-aware mutual learning method for lightweight skin lesion classification. Digit Commun Netw. 2025;11(3):603-612.
- Adla D, Reddy GVR, Nayak P, Karuna G. A full-resolution convolutional network with a dynamic graph cut algorithm for skin cancer classification and detection. Healthc Anal. 2023;3:100154.
- Thamizhamuthu R, Maniraj SP. Deep learning-based dermoscopic image classification system for robust skin lesion analysis. Trait Signal. 2023;40(3).
- Di Giammarco M, Santone A, Cesarelli M, Martinelli F, Mercaldo F. A method for skin lesion detection and localization by means of deep learning and reliable prediction explainability. Image Vis Comput. 2025;162:105675.
- Haq IU, Joarder HA, Khan AA, Shi X, Alsayaydeh JAJ, Yusof MFB, et al. XAAI-ledger: an explainable CNN-transformer-based multimodal deep learning framework for early detection of melanoma and non-melanoma skin cancers using dermoscopic and clinical data. Biomed Signal Process Control. 2026;123:110410.
- Saeed K, Shehzad M, Malik MGA, Ahmed S, Azar AT. TransXV2S-NET: a novel hybrid deep learning architecture with dual-contextual graph attention for multi-class skin lesion classification. Knowl Based Syst. 2026;337:115407.
- AbuAlkebash H, Saleh RAA, Ertunç HM. Automated explainable deep learning framework for multiclass skin cancer detection and classification using hybrid YOLOv8 and vision transformer (ViT). Biomed Signal Process Control. 2025;108:107934.
- Hasan MK, Ahamad MA, Yap CH, Yang G. A survey, review, and future trends of skin lesion segmentation and classification. Comput Biol Med. 2023;155:106624.
- Li H, Pan Y, Zhao J, Zhang L. Skin disease diagnosis with deep learning: a review. Neurocomputing. 2021;464:364-393.
- Wu Y, Chen B, Zeng A, Pan D, Wang R, Zhao S. Skin cancer classification with deep learning: a systematic review. Front Oncol. 2022;12:893972.
- Fanconic. Skin cancer: malignant vs benign dataset. Kaggle; 2023. Available from: https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD '16). New York (NY): ACM; 2016. p. 1135-1144.
- Bassel A, Abdulkareem AB, Alyasseri ZAA, Sani NS, Mohammed HJ. Automatic malignant and benign skin cancer classification using a hybrid deep learning approach. Diagnostics (Basel). 2022;12(10):2472.
- Bhardwaj A, Rege PP. Skin lesion classification using deep learning. In: Advances in Signal and Data Processing: Select Proceedings of ICSDP 2019. Singapore: Springer; 2021. p. 575-589.
- Keerthana D, Venugopal V, Nath MK, Mishra M. Hybrid convolutional neural networks with SVM classifier for classification of skin cancer. Biomed Eng Adv. 2023;5:100069.
- Ahmed A, Siam AI, Atwa MA, Atwa EM, Abdelrahim EM, Atlam ES. An explainable YOLO-based deep learning framework for pneumonia detection from chest X-ray images. Algorithms. 2025;18(11):703.
- Farsi M, ZainEldin H, Sayed RF, El-Agamy ES, Atlam SA, Alsaedi M, et al. Deep learning for pathology: YOLOv8 with EigenCAM for reliable colorectal cancer diagnostics. Bioengineering (Basel). 2025;12(11):1203.
- Atwa EA, Atlam ES, Ahmed A, Atwa MA, Abdelrahim EM, Siam AI. Interpretable deep learning models for arrhythmia classification based on ECG signals using the PTB-XL dataset. Diagnostics (Basel). 2025;15(15):1950.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.