Dit artikel stelt een nieuw model voor, gated-slot linear attention graph neural networks voor sessiegebaseerde aanbevelingen, dat gebruikmaakt van gated-slot linear attention op basis van een dubbel geconstrueerde sessiegraaf. Het verbetert de nauwkeurigheid en efficiëntie van aanbevelingen en presteert beter dan de SOTA op drie openbare datasets.
Onderzoeksartikel
Gated-Slot Linear Attention Graph Neural Networks voor sessiegebaseerde aanbevelingen
In dit artikel
Samenvatting
Samenvatting
Sessiegebaseerde aanbevelingssystemen (Session-based Recommendation, SBR) hebben tot doel het volgende item te voorspellen waarmee een gebruiker waarschijnlijk zal interageren, gebaseerd op de reeks gedragingen binnen de huidige sessie. Recente benaderingen die gebruikmaken van het Transformer-aandachtsmechanisme (bijv. GC-SAN) hebben superieure prestaties getoond ten opzichte van traditionele methoden; zij hebben echter last van een zware computationele werklast en ruimtecomplexiteit vanwege de kwadratische kosten van self-attention. Om deze beperkingen aan te pakken, wordt een nieuw model voorgesteld genaamd GSLA4Rec (gated‑slot linear attention graph neural networks for session‑based recommendation), dat lineaire attention integreert met een leerbaar gating-mechanisme en een slot-gebaseerde geheugenupdate-strategie geïnspireerd door gated‑slot attention. Specifiek construeert GSLA4Rec eerst twee grafen: een sessiegraaf om itemovergangen binnen de sessie vast te leggen en een globale burengraaf om collaboratieve signalen over verschillende sessies heen te coderen, waardoor zowel lokale als globale contextinformatie wordt gemodelleerd. De voorgestelde aanpak is gecentreerd rond het gated-slot lineaire attention-mechanisme, dat (1) gating-units gebruikt om ruis van irrelevante of redundante interacties in lange sessies te onderdrukken, (2) slot-units benut om compacte sessierepresentaties dynamisch op te slaan en bij te werken — wat de geheugenbelasting vermindert, en (3) self-attention vervangt door lineaire attention om een lineaire tijdcomplexiteit te bereiken. Samen verbeteren deze componenten aanzienlijk de voorspellende nauwkeurigheid van het model en de efficiëntie bij het vastleggen van evoluerende gebruikersinteresses. Uitgebreide experimenten op meerdere openbare benchmarkdatasets, waaronder Diginetica, Tmall en NowPlaying, tonen aan dat GSLA4Rec consistent beter presteert dan SOTA SBR-methoden in aanbevelingsprestaties, wat de effectiviteit van het GSLA-mechanisme valideert.
Inleiding
Met de snelle ontwikkeling van online diensten (zoals e-commerce, platforms voor korte video's en nieuwsfeeds) is het probleem van informatieoverload steeds prominenter en ernstiger geworden. Aanbevelingssystemen1,2 bieden gepersonaliseerde en nauwkeurige informatiepushdiensten door gebruikersgedragsgegevens diepgaand te analyseren. Echter, in veel praktische toepassingen die worden gekenmerkt door anonieme toegang, niet-ingelogde gebruikers, privacybescherming en korte interactieduur, beperken traditionele aanbevelingsmethoden zoals collaborative filtering3 en matrixfactorisatie4,5 de toepasbaarheid van aanbevelingsalgoritmen aanzienlijk. Om deze uitdagingen aan te pakken, is SBR6,7,8,9 ontstaan. SBR richt zich op de interactiesequentiegegevens binnen de huidige sessie van gebruikers om het volgende potentiële interessepunt te voorspellen. Dit paradigma vermijdt niet alleen de afhankelijkheid van langetermijngegevens uit de gebruikershistorie, maar legt ook scherp kortstondige dynamische interesseveranderingen vast, waardoor het een unieke toepasbaarheidswaarde demonstreert in scenario's zoals e-commerce, korte video's, muziekaanbevelingen en dergelijke.
Vroege methoden vertrouwden voornamelijk op Markov-ketens5,10,11,12 om transitiekansen tussen items in sessiesequenties te modelleren. Hoewel deze methoden eerstegraads sequentieafhankelijkheden konden vastleggen, bleef de karakterisering van complexe hogere-orde afhankelijkheden en niet-lineaire dynamiek van gebruikersinteresses beperkt, wat de effectiviteit van de modellen in complexe scenario's beperkte. Met de ontwikkeling van deep-learningtechnologie13,14 zijn methoden op basis van neurale netwerken breed toegepast in SBR. GRU4REC15 was de eerste die recurrente neurale netwerken14 (RNN's) toepaste op sessiegebaseerde aanbevelingen, waardoor temporele afhankelijkheden in sequenties effectief werden vastgelegd; NARM16 verbeterde het vermogen om de kerninteresses van gebruikers te analyseren door aandachtmechanismen te integreren met RNN's; STAMP17 maakte gebruik van multi-layer perceptrons (MLP's) in combinatie met aandachtmechanismen om zich te concentreren op het vastleggen van kortetermijninteresses van gebruikers. Hoewel deze methoden enige vooruitgang boekten in sequentiemodellering, stonden ze nog steeds voor uitdagingen zoals de moeilijkheid bij het verwerken van langetermijnafhankelijkheden en gevoeligheid voor ruis.
In recente jaren hebben Graph Neural Networks (GNN's)18,19,20,21 een nieuw perspectief gebracht op de SBR-taak. Modellen zoals SR-GNN22 modelleren expliciet complexe transitierelaties door een sessiegraph (SG) te construeren, waardoor aanzienlijke verbeteringen in de aanbevelingsnauwkeurigheid worden behaald. De meeste bestaande GNN-gebaseerde methoden voeren de graph-constructie en message passing echter uit binnen individuele sessies, waardoor effectief gebruik van globale itemcorrelatie-informatie ontbreekt. Om dit probleem aan te pakken, integreert GCE-GNN23 globale semantiek en sessiegraphs met een self-attention mechanisme om het belang van items adaptief te wegen door een neighbor global graph (NGG) te construeren, wat leidt tot aanzienlijke prestatieverbeteringen. Desondanks kampen bestaande GNN-gebaseerde methoden nog steeds met twee belangrijke knelpunten: Ten eerste groeit de complexiteit van het self-attention mechanisme kwadratisch met de sessielengte, wat resulteert in een aanzienlijke computationele overhead bij het verwerken van lange sessies; Ten tweede missen traditionele GNN's het vermogen om het belang van items dynamisch te reguleren tijdens de informatieaggregatie, waardoor het moeilijk is om onderscheid te maken tussen ruis en kritieke gedragingen, wat de kwaliteit van de representatie beïnvloedt.
Om deze uitdagingen aan te pakken, stelt dit artikel een gated-slot lineair attention graph neural network voor voor sessiegebaseerde aanbevelingen (GSLA4Rec): (1) Het ontwerpen van een gated-slot-mechanisme dat ruis filtert via gating en belangrijke semantische informatie opslaat in sessieslots, waardoor de robuustheid van het model wordt verbeterd en de opslagoverhead wordt verminderd; (2) Het introduceren van het lineaire attention-mechanisme dat de computationele complexiteit reduceert van O(N2) naar O(N), waarbij N de sessielengte is, terwijl het vermogen om lange-afstandsafhankelijkheden te modelleren behouden blijft; (3) Het uitvoeren van uitgebreide experimenten op drie openbare benchmarkdatasets (Diginetica, Tmall en NowPlaying), waaruit blijkt dat GSLA4Rec aanzienlijk beter presteert dan bestaande SOTA-methoden, waarbij vooral duidelijke voordelen worden aangetoond in scenario's met lange sessies en schaarse gegevens.
Protocol
Ervaring met sessiegebaseerde aanbevelingen
Sessiegebaseerde aanbeveling kan vanuit drie perspectieven worden onderzocht: SBR, global context learning en GSLA (zie Tabel met Materialen). Er waren geen menselijke deelnemers of dieren betrokken bij deze studie. Alle experimentele datasets die in dit werk zijn gebruikt, zijn openbaar beschikbaar en ingediend als Aanvullend Bestand: GSLA4Rec. zip.
Sessiegebaseerde aanbeveling
Sessiegebaseerde aanbeveling (SBR) was een systeem van kunstmatige intelligentie dat via meerrondige natuurlijke taaldialogen met gebruikers interacteerde om gebruikersvoorkeuren dynamisch te begrijpen en gepersonaliseerde aanbevelingen te doen. SBR evolueerde van traditionele methoden naar deep learning-gebaseerde en hybride benaderingen, om vervolgens verder te ontwikkelen richting oplossingen op basis van Large Language Models (LLM).
Traditionele sessiegebaseerde aanbeveling
Traditionele SBR werd doorgaans gerepresenteerd door methoden op basis van Markov-ketens en Collaborative Filtering. De eerste methode genereerde aanbevelingen door gebruikersspecifieke probabilistische transitiematrices te ontleden. Zo stelde Guy Shani24 een aanbevelingsmethode voor op basis van een Markov-beslissingsproces die aanbevelingen produceerde door de overeenkomstige matrices te ontleden; Wanrong Gu25 verbeterde de prestaties van aanbevelingen door Markov-ketens te integreren met aankooptijdsintervallen. De laatste methode genereerde aanbevelingen door middel van matrixfactorisatie verborgen sequentiële relaties tussen opeenvolgende interactieve items te extraheren. Bijvoorbeeld, Sarwar B1 berekende de gelijkenis tussen items op basis van het historische gedrag van gebruikers (zoals scores en klikken) om items aan te bevelen die aansluiten bij de eerdere voorkeuren van gebruikers. Als gebruiker A item a leuk vond en item c sterk leek op a, beveelt het systeem c aan bij A; Rendle S5 stelde FPMC voor, een model voor sequentie-aanbevelingen dat matrixfactorisatie combineert met Markov-ketens om verborgen sequentiële relaties tussen opeenvolgende interactieve items vast te leggen. Dergelijke traditionele SBR richtte zich echter op sequentiële relaties tussen opeenvolgende items, waardoor het modelleren van complexe afhankelijkheidsrelaties bemoeilijkt werd.
Sessiegebaseerde aanbeveling via deep learning
Sessiegebaseerde aanbevelingen via deep learning zijn geëvolueerd via fasen met Convolutionele Neurale Netwerken (CNN's)26,27,28,29, RNN's en GNN's. Op CNN gebaseerde SBR maakte gebruik van operaties zoals convolutie en pooling om representaties van elke sessiecontext te leren, die vervolgens werden gebruikt voor opeenvolgende aanbevelingen. Caser30 zette de L meest recente items waarmee een gebruiker had geïnteracteerd om in d-dimensionale vectoren via een embedding-laag, waardoor een embedding-matrix ontstond die werd behandeld als een "afbeelding" geprojecteerd in de tijd en de latente ruimte. Vervolgens werden drie convolutionele filters voor sequentiepatronen gebruikt — op puntniveau, op unieniveau zonder overslag, en op unieniveau met één keer overslag — om sequentiële patronen te leren voor betere SBR-prestaties. Tuan et al.31 modelleerden sessie-clickstreams en inhoudelijke kenmerken uniform via 3D-convolutiekernels om gezamenlijke ruimtelijk-temporele-inhoudelijke representaties te vormen.
RNN's waren een klasse van neurale netwerkarchitecturen die specifiek waren ontworpen voor het verwerken van sequentiële gegevens. De kernidee was om temporele afhankelijkheden vast te leggen via recurrente structuren zoals long short-term memory-netwerken (LSTM)13 en gated recurrent units (GRU's)32, en ze werden op grote schaal gebruikt in vakgebieden zoals natuurlijke taalverwerking (NLP)33, spraakherkenning34, tekstvertaling35, reizen36,37, criminaliteit38, en het voorspellen van toekomstige trends39 (bijv. verkeer40, aandelenmarkten41,42 en meteorologie43). GRU4Rec, voorgesteld door Hidasi et al., was een mijlpaal in SBR-onderzoek; het introduceerde als eerste RNN's in SBR en legde de sequentiële gedragspatronen van gebruikers vast via GRU om gepersonaliseerde aanbevelingen te realiseren.
GNNs44 hebben een sterke expressieve kracht aangetoond bij het modelleren van complexe relaties binnen grafiekgestructureerde gegevens, en sommige onderzoekers hebben GNNs geïntroduceerd om complexe overgangen binnen of tussen sessies te modelleren. Afhankelijk van de verschillende GNN-modelarchitecturen werden GNN-gebaseerde methoden voor SBR over het algemeen gecategoriseerd in gated graph neural networks (GGNNs)45, graph convolutional networks (GCNs)46 en graph attention networks (GATs)47. SR-GNN was de eerste die GNNs toepaste op SBR door sessiesequenties weer te geven als gerichte grafieken en GGNNs te gebruiken om complexe item-overgangsrelaties binnen sessies vast te leggen, gecombineerd met attention-mechanismen om de uiteindelijke sessie-embedding te verkrijgen, waardoor de aanbevelingsprestaties werden verbeterd. Chen L48 stelde een multi-view GNN-framework voor dat gestructureerde attributen en ongestructureerde trefwoorden combineert om multidimensionale productassociaties te modelleren, wat de nauwkeurigheid van SBR verbeterde. Driss E49 ontwierp een innovatief sessie-aanbevelingssysteem dat gebruikmaakt van capsule graph neural networks om complexe itemkenmerken vast te leggen en de voorspellingsnauwkeurigheid voor SBR te verhogen.
De bovengenoemde deep-learningtechnieken hebben de onderzoekscope van SBR verrijkt en de prestaties effectief verbeterd, maar ze hadden nog steeds bepaalde beperkingen, die zich voornamelijk manifesteerden in: 1) Voor nieuw opkomende items of zeer schaarse sessies was het voor de modellen moeilijk om nauwkeurige voorspellingen te doen vanwege het gebrek aan globale context; 2) Ze konden de globale patronen die in alle historische sessies besloten liggen niet benutten.
Hybride sessiegebaseerde aanbeveling
Hybride sessiegebaseerde aanbevelingen integreerden de sterke punten van verschillende technieken, zoals collaborative filtering, Deep-Learning en aandachtmechanismen, om de prestaties van SBR te verbeteren. GC-SAN50 incorporeerde een self-attention mechanisme op basis van SR-GNN om interactie-informatie van belangrijke items binnen een sessie beter vast te leggen. FGNN51 aggregeerde vervolgens informatie van naburige items via een multi-head attention mechanisme om meerdere relaties van het doelitem te leren. SR-HetGNN52 behoorde tot SBR met heterogene grafen; door het introduceren van items van meerdere typen (gebruiker, item, sessie) en multi-relationele randen (klik, aankoop, co-occurrentie, attribuutassociatie), construeerde het een globaal kennisnetwerk, waardoor de beperking van enkelvoudige itemsequenties werd doorbroken. Dit was in recente jaren een belangrijke methode voor het modelleren van het gedrag van anonieme gebruikers en cross-sessie interesseassociaties. KGSR-SAP53 construeerde een kennisgraaf door items te verbinden met randen van meerdere relaties om diverse gebruikers-iteminteracties te beschrijven, waarmee het probleem van informatieverlies werd opgelost wanneer de globale graaf slechts randen van één type (gebruikers-iteminteractie) bevat. Wang ZH54 stelde DiffSBR voor, een diffusiegebaseerd sessie-aanbevelingsmodel. Dit genereert betrouwbare voorkeuren voor het volgende item door ruisonderdrukking (denoising) te simuleren, wat de modellering van dynamische kliksequenties van gebruikers verbetert. Qiao ST55 bouwde een SBR-framework dat multi-view intentie-leren en LLM-alignment combineerde. Het mineerde impliciete gebruikersintenties vanuit diverse perspectieven en maakte gebruik van taalmodellen om semantische kenmerken af te stemmen voor een betere verbetering van de aanbevelingsprestaties.
Globale context
Om het tekortkoming van het "geïsoleerd bekijken van sessies" te overwinnen, realiseerden onderzoekers zich dat globale informatie kon worden gebruikt om het representatievermogen van de huidige sessie te verbeteren, om zo problemen zoals dataschaarsheid, de cold start en de semantische kloof in traditionele SBR op te lossen. Tegelijkertijd was bij het construeren van de globale context vereist om globale informatie in een enkele sessie te integreren, terwijl ruisinterferentie tot een minimum werd beperkt. CSRM56 optimaliseerde de representatie op sessieniveau door collaboratieve informatie tussen de huidige sessie en naburige sessies te integreren, waarbij een outer memory encoder (OME) werd gebruikt om collaboratieve intentie uit de collaboratieve informatie te extraheren. CA-TCN57 stelde een cross-session aware temporal convolutional network-model voor, waarbij globale grafen en sessiecontextgrafen werden geconstrueerd om de impact van cross-session op items en sessies te simuleren, terwijl het temporal convolutional network (TCN) het receptieve veld uitbreidt via dilated convolutions, waarbij het aantal lagen sequenties van exponentiële lengte bestrijkt (receptief veld = ), wat het probleem van de gradiëntverdwijning bij RNN's oplost. Chen58 stelde een SBR-methode voor op basis van hypergraph neural networks (SR-HGNNs), die mixed-order (lage orde en hoge orde) propagatie en attentiemechanismen integreert om het over-smoothing probleem van traditionele GNN's in korte sessies op te lossen en het belang van verschillende propagatieordes te onderscheiden, waardoor afhankelijkheden nauwkeuriger kunnen worden vastgelegd en ruisinterferentie kan worden vermeden. GCE-GNN gebruikte multi-order co-occuerende itemparen om een ongerichte gewogen graaf te construeren, waarbij de frequenties van co-occurente items werden geteld om het belang van items in de sessie te reflecteren; AGNN-GC59 gebruikte cross-session item-transitierelaties om een globale collaboratieve graaf te construeren, waarbij item-transitiekansen in de globale graaf werden berekend om interesseveranderingen in de sessie te reflecteren; DA-GCN60 gebruikte het kortste pad om de adjacentiematrix bij te werken voor de constructie van een dynamische gewogen graaf, waarbij de globale graaf co-occurrence frequentie en de padafstand tussen items werden berekend. Geïnspireerd door de bovenstaande literatuur stelde dit artikel voor om een globale graaf te construeren via een neighbor-based methode, d.w.z. door de Jaccard-similariteitscoëfficiënt te gebruiken om gelijkaardige sessies te berekenen, wat niet alleen globale informatie benutte maar ook ruis filterde (het wegfilteren van irrelevante items), waardoor het doel van het nauwkeurig construeren van de globale context werd bereikt en een solide basis werd gelegd voor het daaropvolgende SBR-algoritme.
Gated-slot lineaire aandacht
Traditionele transformers61 veroorzaakten een hoge spatiotemporele complexiteit vanwege de noodzaak van volledig verbonden attention-operaties over de gehele sequentie als volgt:
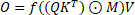 (1)
Waarbij Q, K, V ∈ RN×d lineaire transformaties waren van de input-items, M = {Mij = 1 als i ≥ j, anders −∞ } het causale masker was om lekkage van toekomstige informatie te voorkomen, ⊙ elementgewijze vermenigvuldiging aanduidde, en f de activatiefunctie softmax aanduidde.
Om lineaire aandacht62 te bereiken, was het meest directe idee om de softmax-activeringsfunctie te verwijderen. Wanneer de softmax-activeringsfunctie echter direct zou worden verwijderd, zou lineaire aandacht ongetwijfeld tot enkele potentiële problemen leiden: het verlies van de krachtige expressieve vermogens van neurale netwerken en het onvermogen om complexe praktijkproblemen op te lossen.
Slot linear attention met begrensd geheugengebruik
Uitgaande van de noodzaak om de softmax-activeringsfunctie te behouden, werden K en V afzonderlijk gecomprimeerd tot K̃, Ṽ ∈ Rm×d. Vanuit het perspectief van het geheugennetwerk hadden K̃ and Ṽ geheugenslots waarvan de lengte toeneemt met de sequentie, dat wil zeggen dat het aantal slots m = N. Indien m vaststond, was linearisatie overduidelijk mogelijk. Geïnspireerd door Bounded-memory Control63, was vereist dat elk token in de input-items met een lengte van N competitief in m slots werd geschreven.
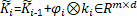 ,
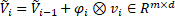 ,
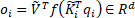 (2)
Hierbij was f de softmax-activeringsfunctie en φi de vector om de effectieve input te beheersen voor het controleren van de sleutelwaarde ki als volgt.
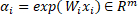 ,
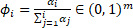 (3)
Hierbij stelde (φi)j de schrijfintensiteit van het ide token voor de jde slot voor, wat werd verkregen met behulp van een cumulatieve softmax-functie.
Om een efficiënte lineaire berekening te bewerkstelligen, werd formule (2) herschreven als formule (4), waarbij οi werd berekend uit qi, ki en vi (Eq. 4) via {οi|i=1T, qi, ki, vi)|i=1T} en werd een sequentiële berekening in twee fasen toegepast:
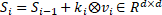 ,
 (4)
Hieruit konden SLA-operaties worden afgeleid:
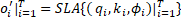 ,
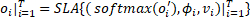 (5)
Waarbij oi′ ∈ ℝm, οi ∈ ℝd. Daarom kan SLA hardware-efficiënte lineaire-tijd chunk-gewijze training verkrijgen64.
Gated-slot lineaire aandacht
Slot lineaire aandacht met begrensd geheugenbeheer zou de computationele en ruimtelijke complexiteit kunnen verminderen. Echter, de accumulatie van informatie zou ook ruis in de sessie-interactie kunnen introduceren, waardoor data-afhankelijk verval zeer belangrijk was voor het selectief behouden en vergeten van informatie; dit selectieve mechanisme is recentelijk opnieuw onderzocht in selectieve state-space modellen65. GSLA met data-afhankelijk verval kan als volgt worden uitgedrukt:
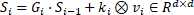 ,
 (6)
Hier werden de vervalpoorten geparametriseerd door een vorm van het buitenproduct Gi = αi ⊗ βi, αi, βi ∈ [0,1]d. In het vervolg kan GSLA ook in de volgende equivalente vorm worden geschreven door gewoonlijk βt = 1 te stellen en matrixvermenigvuldiging te gebruiken zoals in64:
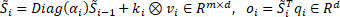 (7)
Waar αi en ki respectievelijk de forget gate en de input gate aanduiden, kunnen de twee gates gekoppeld worden als ki = 1 − αi, geïnspireerd door de literatuur over gated RNN's. Het was duidelijk dat GSLA geformuleerd kon worden met een sequentieel computationeel proces in twee stappen, zoals weergegeven in Vergelijking (8). De tweede-orde structuur ondersteunde blok-parallelle training om de trainingsefficiëntie te verbeteren, en de invoeging van de softmax-operatie in het midden van de tweede-orde structuur verbeterde het modelleringsvermogen van het finite slot memory.
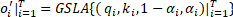 ,
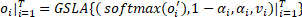 (8)
Transformeren van sessiegegevens
Probleemdefinitie
Stel dat de gegeven sessievolgorde S = {v1s, v2s, ⋯, vns} is, waarbij vis het ide aangeklikte item aanduidt. Door het klikgedrag van de gebruiker binnen deze volgorde te analyseren, voorspelde het systeem het volgende item vn+1s waarin de gebruiker mogelijk geïnteresseerd is.
Constructie van de graaf
Constructie van de sessiegrafiek
Voor een sessie S = {v1s, v2s, ⋯, vns} werd een gericht grafiek Gs = (Vs, εs) geconstrueerd, waarbij Vs de itemset van de gegeven sessie S was, en εs = {eijlocal|vi, vj, vi, vj ∈ Vs} de verzameling randen van de gegeven sessie S was. ε(vi-1s, vis) representeerde de opeenvolgende aangeklikte items in deze sessie. De rand eijlocal kon worden onderverdeeld in vier typen: ein, eout, ein-out, eself. Aangezien hetzelfde item herhaaldelijk in de sequentie kon voorkomen, werd de gewogen waarde voor elke rand geteld.
De huidige sessie s = [v1, v2, v4, v2, v3] is omgezet in een SG, zoals weergegeven in Figuur 1A.
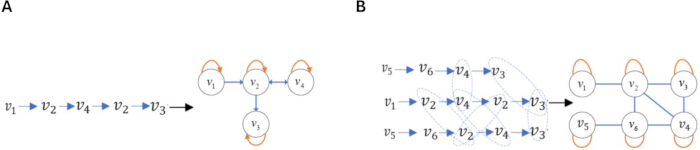
Figuur 1: Interactieve items worden omgezet in grafiekstructuren. (A) Illustratie van de constructie van een sessiegrafiek (SG) door een sessie om te zetten in een grafiek. (B) Illustratie van de constructie van een neighbor global graph (NGG) door vele sessies in een grafiek te combineren. Deze figuur is zelf getekend via Visio met volledig aangepaste elementen. Er zijn geen auteursrechtelijk beschermde externe grafische bronnen gebruikt, waardoor er geen aanvullende licenties van derden nodig waren. Het auteursrecht van de figuur is in handen van de auteurs en zal bij acceptatie voldoen aan de auteursrechtregels van het tijdschrift. Klik hier om een grotere versie van deze figuur te bekijken.
Constructie van de globale neighbor-graaf
Op basis van de huidige sessie S werd de corresponderende NGG Gg = (Vg, εg) geconstrueerd om het representatieleerproces van de huidige sessie op cross-session wijze te verrijken. Vg was de itemset met alle items in Gg, en εg = {eijglobal|vi, vj, vi, vj ∈ Vg} was de randset van Gg. ε(vi-1g, vig) representeerde de direct interagerende items vi-1g en vig in de NGG Gg. Dit proces bestond uit twee stappen: de acquisitie van buursessies en de constructie van de NGG.
Acquisitie van buursessies
Over de gehele dataset werden sessies gezocht met het maximale aantal items dat gelijktijdig voorkwam met de huidige sessie. De top-N sessies met de hoogste co-occurentie-aantallen werden geselecteerd om een kandidaat-buursessie-set S samen te stellen. Vervolgens werd de Jaccard-gelijkeniscoefficiënt gebruikt om de gelijkenis tussen de huidige sessie cu en een sessie Sr ∈ S uit de kandidaatset S te berekenen, zoals weergegeven in Vergelijking (9).
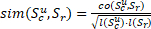 (9)
Hier gaf co(Scu, Sr) het aantal items aan dat gelijktijdig voorkomt in zowel Scu als Sr, terwijl l(Scu) en l(Sr) respectievelijk de lengtes van Scu en Sr vertegenwoordigden, en Scu en Sr stonden voor de huidige sessie en een naburige sessie. Sessies met een gelijkenis onder een bepaalde drempelwaarde (die als hyperparameter kon worden ingesteld) werden weggefilterd, en de resterende sessies vormden de naburige sessieset Ns voor de huidige sessie.
Constructie van de globale buren-graaf
Op basis van de set naburige sessies Ns, werd de NGG geconstrueerd, zoals geïllustreerd in Figuur 1BTijdens de constructie van de redundantiematrix wordt, indien twee items (vi, vj) een interactie had, de overeenkomstige vermelding Aij werd ingesteld op 1, anders werd het ingesteld op 0. Daarnaast werden de interacties tussen items verwerkt als ongericht en voorzien van self-loops, gevolgd door normalisatie, zoals weergegeven in Tabel 1.
| 1 | 2 | 3 | 4 | 5 | 6 | |
| 1 | 1/2 | 1/2 | 0 | 0 | 0 | 0 |
| 2 | 0 | 1/4 | 1/4 | 1/2 | 0 | 0 |
| 3 | 0 | 0 | 1 | 0 | 0 | 0 |
| 4 | 0 | 1/4 | 1/2 | 1/4 | 0 | 0 |
| 5 | 0 | 0 | 0 | 0 | 1/3 | 2/3 |
| 6 | 0 | 1/3 | 0 | 1/3 | 0 | 1/3 |
Tabel 1: Genormaliseerde adjacentiematrix van de globale buurgraaf. De tabel presenteert de genormaliseerde adjacentiematrix die de gewogen verbindingen tussen knopen in de geconstrueerde globale buurgraaf beschrijft.
Ontwerpen van een sessiegebaseerd aanbevelingsalgoritme
Deze sectie geeft een gedetailleerde beschrijving van het voorgestelde innovatieve model GSLA4Rec, dat de prestaties van SBR heeft verbeterd door het GSLA-mechanisme te introduceren over de gezamenlijke kenmerkrepresentatie van SG en NGG.
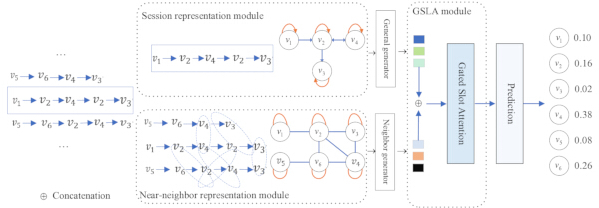
Figuur 2: GSLA4Rec-framework. Dit framework integreerde structureel leren van sessiegrafen en globale buurgrafen, filterde interactieruis met een gating-mechanisme, balanceerde opslag en efficiëntie met een memory slots-mechanisme en legde itemrelevantie vast met een lineair aandachtmechanisme om de volgende klikvoorkeur van de gebruiker te voorspellen. Deze figuur is zelf getekend via Visio met volledig aangepaste elementen. Er zijn geen auteursrechtelijk beschermde externe grafische bronnen gebruikt, waardoor geen aanvullende licenties van derden nodig waren. Het auteursrecht van de figuur is in handen van de auteurs en zal bij acceptatie voldoen aan de auteursrechtregels van het tijdschrift. GSLA4Rec staat voor gated-slot linear attention graph neural networks voor SBR. Klik hier om een grotere versie van deze figuur te bekijken.
Figuur 2 presenteert het raamwerk van GSLA4Rec, dat uit vier hoofdcomponenten bestond: 1) Itemrepresentatie op sessieniveau. Hierbij werd een GNNs-model op SG gebruikt om item-embeddings op sessieniveau binnen de huidige sessie te leren; 2) Itemrepresentatie op globaal buurniveau. Hierbij werden item-embeddings op globaal niveau over alle sessies geleerd door een GRU te gebruiken om recursief de buurembeddings van elk item te integreren op basis van de NGG; 3) GSLA. Hiermee werd de voorkeur van de gebruikers in de huidige sessie gemodelleerd door de geleerde itemrepresentaties op zowel sessie- als globaal niveau te aggregeren; 4) Voorspellingslaag. Deze gaf de voorspelde waarschijnlijkheden voor de kandidaat-items weer. De vier componenten worden in het vervolg in detail beschreven.
Sessie-representatie
Bij SBR was het begrijpen van het interactiegedrag van gebruikers cruciaal. Hiervoor werden een SG en een NGG geconstrueerd voor session representation learning, met als doel het interactiegedrag van gebruikers uitgebreid te begrijpen en zo de meer authentieke intentie van de gebruikers vast te leggen.
Itemrepresentatie op sessieniveau
Op basis van de SG in Figuur 1A werd een Weighted Bidirectional Graph Attention (WBGAT)-methode toegepast om kenmerken van de SG te extraheren. Deze methode introduceerde randgewichten en itemrichting (In-neighbor en Out-neighbor) op basis van het standaard GAT-mechanisme, waardoor het effect van het versterken van belangrijke randen en het vastleggen van bidirectionele afhankelijkheden werd bereikt, waarmee de tekortkomingen van traditionele GAT met betrekking tot asymmetrische itemrelaties en interactiesterkte werden aangepakt. Het berekeningsproces was als volgt:
Ten eerste wordt de berekening van de normalisatiegewichten voor de in-degree van items uitgevoerd.
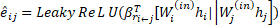 (10)
waarbij eij het eerste-orde in-neighbor gewicht van de kenmerken van item j naar item i aanduidde,  de relatie tussen item i en item j was, β* ∈ ℝd de gewichtsvectoren waren, hi en hj respectievelijk de representaties van item i en j waren, Wi(in) ∈ ℝd*d en Wj(in) ∈ ℝd*d trainbare parameters waren, en || de concatenatie-operatie representeerde. Om verschillende in-degree relaties te onderscheiden, werden twee gewichtsvectoren, namelijk rin en rin-self, getraind. LeakyReLU werd gebruikt als de activatiefunctie.
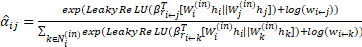 (11)
Om coëfficiënten tussen verschillende items vergelijkbaar te maken, werden de attention-gewichten genormaliseerd via de softmax-functie. Waarbij Ni(in) de eerstegra in-neighbor set van item i was,  het in-neighbor gewicht van de gerichte rand (i←j) in SG, stelde deze methode het model in staat om correlaties tussen item-kenmerken te leren terwijl de inherente verbindingssterkte-informatie van de grafstructuur behouden bleef door het logaritme van de randgewichten te nemen en deze toe te voegen aan de oorspronkelijke attention-score eij.
Ten tweede, de berekening van de normalisatiegewichten voor de out-degree van items.
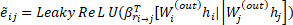 (12)
waarbij ẽij het eerstegraads uitgaande-buurgewicht van de kenmerken van item j naar item i aangeeft,  de relatie was tussen item i en j, en twee gewichtsvectoren, namelijk rout en rout-self, werden getraind.
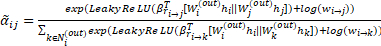 (13)
Waarbij Ni(out) de eerstegraads out-neighbor set was van item i,  het out-neighbor gewicht was van de gerichte rand (i→j) in SG.
Ten derde, informatieaggregatie. De bijgewerkte embedding van een item kan worden verkregen na het wegen en sommeren van de eerstegra in-degree en out-degree embeddings van item i.
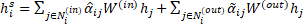 (14)
Waarbij  en α̃ij respectievelijk de in-degree en out-degree gewichten van item i aanduiden, en
 de bijgewerkte representatie van item i aanduidde.
Itemrepresentatie op globaal niveau van buren
Recent onderzoek is er consistent over eens dat het construeren van een globale graaf de datarepresentatie kan verbeteren en daarmee de SBR-prestaties kan verhogen; dit stond buiten kijf. Echter, het globaal verbeteren van data kan ook irrelevante informatie, zoals ruis, introduceren. In het voorgestelde model is een near-neighbor globale graaf geconstrueerd om globale data-augmentatie te bereiken terwijl ruis tot in het grootste mogelijke extent wordt geminimaliseerd.
Op basis van de NGG in Figuur 1B en de genormaliseerde redundantiematrix in Tabel 1, werden de huidige sessie en de naburige sessies getransformeerd naar een NGG, waarna een GGNNs45-methode werd toegepast om kenmerken van de NGG te extraheren. Het leerproces van itemvectoren in de NGG werd weergegeven in Vergelijking (15).
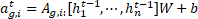
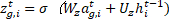
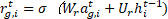
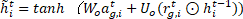
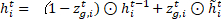 (15)
W ∈ ℝd×2d aangeduide controlegewichten, zg,i en Hier is de vertaling.g,i vertegenwoordigden respectievelijk de update-gate en de reset-gate. [h1t-1, ⋯, hnt-1] vertegenwoordigde de lijst van alle itemvectoren in de sessie s. σ(U heeft geen brontekst opgegeven om te vertalen. Voer a.u.b. de Engelse tekst in die u naar het Nederlands vertaald wilt hebben.) = 1/(1 + e-U heeft geen brontekst opgegeven om te vertalen. Voer a.u.b. de Engelse tekst in die u naar het Nederlands vertaald wilt hebben.) was de logistische sigmoïdefunctie, ⊙ duidt elementgewijze vermenigvuldiging aan, en hi ∈ ℝd vertegenwoordigde de vector na de gated updating. De adjacencymatrix As ∈ ℝn×n gaf de connectiviteit aan tussen items in opeenvolgende sessies, en As,i: ∈ ℝ1×n stelde een kolomblok voor As overeenkomstig met item vs,i in de nabijheidsmatrix. Voor de huidige sessie s = [v1, v2, v4, v2, v3], de NGG en de genormaliseerde adjacentiematrix werden getoond in Figuur 1B en Tabel 1respectievelijk.
Representatie van items
De itemrepresentatie werd verkregen door de itemvector op sessieniveau op te tellen bij de globale itemvector van de buren, zoals weergegeven in Vergelijking (16):
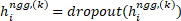
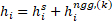 (16)
Waarbij dropout werd toegepast op itemrepresentaties van buren op globaal niveau om overfitting te verminderen.
Gated-slot lineaire aandacht
De gated-slot lineaire aandacht (GSLA) in dit artikel integreerde lineaire aandacht met begrensd-geheugencontrole en een datagebaseerd gating-mechanisme. Enerzijds erfde het het mechanisme met eindige geheugenslots van het attention-based controller (ABC) model, waarbij sleutel-waarde-paren die oorspronkelijk groeiden met de sequentielengte werden gecomprimeerd tot een vast aantal slots, waarbij elk slot via competitief schrijven werd bijgewerkt om het probleem van de computationele complexiteit van transformer globale aandacht aan te pakken. Anderzijds introduceerde het een fijnmazig gating-mechanisme vergelijkbaar met GLA, waarbij inputgegevens de retentieratio van historische informatie dynamisch aanpasten via een forget gate αi, wat het ruisprobleem oploste dat werd veroorzaakt door het ontbreken van een vergeetmechanisme in ABC.
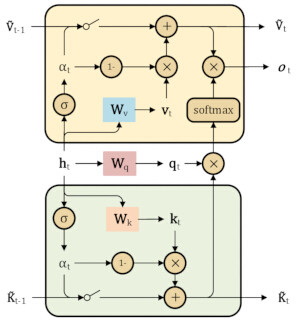
Figuur 3: Schematisch diagram van GSLA. De inputvector werd respectievelijk afgebeeld op de queryvector, keywordvector en waardevector, en vervolgens verwerkt door lineaire aandacht met bounded-memory controle en een datagestuurd gating-mechanisme om de bijgewerkte queryvector, keywordvector, waardevector en outputvector te verkrijgen. Deze figuur is zelf getekend via Visio met volledig aangepaste elementen. Er zijn geen auteursrechtelijk beschermde externe grafische bronnen gebruikt, waardoor geen aanvullende licenties van derden nodig waren. Het auteursrecht op de figuur is in handen van de auteurs en zal bij acceptatie voldoen aan de auteursrechtregels van het tijdschrift. GSLA staat voor gated-slot linear attention. Klik hier om een grotere versie van deze figuur te bekijken.
Zoals specifiek geïmplementeerd in Figuur 3, werd de inputvector afzonderlijk afgebeeld op de queryvector, keyvector en waardevector64:
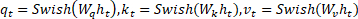 (17)
Waarbij Wq, Wk, Wv ∈ ℝd×d de transformatie-gewichtmatrices vertegenwoordigden die respectievelijk overeenkomen met de query, key en value, en ht de embedding-vector aanduidde bij de tde tijdstap in de sessie-invoersequentie. De Swish-functie werd gedefinieerd als Swish(x) = x · σ(x) en was een self-gated activatiefunctie, waarbij σ de Sigmoid-functie was; deze presteerde beter dan de traditionele ReLU-activatiefunctie in meerdere Deep-Learning-taken.
GSLA maakte gebruik van een forget gate αi en een input gate 1 − αi, afhankelijk van de inputgegevens, om de informatie in het ide geheugenslot dynamisch bij te werken. Het proces verliep als volgt64:
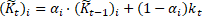 (18)
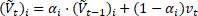 (19)
Hierbij representeerden K̃t en Ṽt de key-vectorslots en value-vectorslots op tijdstap t, terwijl K̃t-1 en Ṽt-1 de key-vectorslots en value-vectorslots representeerden op tijdstap t−1. De forget gate αi = σ(Wαht)1/τ, waarbij Wα ∈ ℝd de transformatie-gewichtmatrix was, σ de Sigmoid-functie was, en τ de dempingscoëfficiënt was (doorgaans ingesteld op 8), die werd gebruikt om de zachtheid van de forget gate te regelen. Hierdoor kon GSLA de vergetingssnelheid van historische informatie vloeiend aanpassen: hoe groter de αi, hoe meer GSLA vertrouwde op historische informatie; hoe kleiner de αi, hoe meer GSLA zich richtte op de huidige input.
De sleutelvector-slots K̃t en waardvector-slots Ṽt van de slots bij de tde stap werden in matrixvorm genoteerd, zoals weergegeven65 in Vergelijkingen (20) en (21):
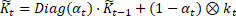 (20)
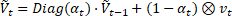 (21)
Vervolgens werd de GSLA met eigenschappen van tweede orde (zie Vergelijking (8)) gebruikt om de output oi |i=1T voor elke tijdstap i ∈ [1, …, T] te berekenen. Op de output van elke tijdstap werd een lineaire transformatie toegepast om het resultaat h̃t te verkrijgen. Ten slotte werd de gemiddelde waarde van de representaties van alle items in de sessiesequentie berekend om de sessie-embedding S̃e met dynamische geheugenupdates te genereren:
 (22)
 (23)
Hier representeerde ot de output van Gated-Slot op tijdstap t, en duidde h̃t het resultaat aan van het toepassen van een lineaire transformatie op ot. S̃e duidde de gemiddelde waarde van h̃t aan over alle tijdstappen.
Voorspellingslaag
Op basis van de verkregen sessierepresentatie S̃e en de initiële embedding van item i, werd een dot product-operatie uitgevoerd om de score voor elk kandidaat-item hi te berekenen. Vervolgens werd de softmax-functie gebruikt om de aanbevelingskansen van kandidaat-item i te verkrijgen:
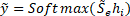 (24)
Hier representeerde ỹ de aanbevelingskansen van het kandidaatitem, duidde hi de vector van het kandidaatitem aan, en werd de cross-entropy verliesfunctie gebruikt voor de training van het model.
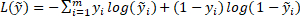 (25)
Hier was y de one-hot gecodeerde representatie van de ground truth.
Resultaten
Datasets en voorbewerking
In de experimenten werden drie openbare SBR-datasets, afgeleid van echte transactiegegevens in praktische applicatiescenario's, geselecteerd om de modelprestaties te evalueren: Diginetica, die is geëxtraheerd uit de CIKM Cup 2016-wedstrijd en transactie- en klikgegevens van gebruikers bevat; Tmall, die gaat over gebruikerslogs van het Tmall-platform en het browse- en aankoopgedrag van gebruikers vastlegt; en Nowplaying, die muziekgegevens bevat over de afspeelgeschiedenis van gebruikers op muziekplatforms. Deze datasets worden veelvuldig gebruikt in SBR-onderzoek en kunnen de effectiviteit en toepasbaarheid van het model op een uitgebreide manier evalueren.
In de fase van data-voorbewerking werden de datasets gestandaardiseerd om consistentie in de datakwaliteit te waarborgen. Specifiek werden alle sessies met een lengte van minder dan 2 weggefilterd en items die minder dan 5 keer voorkwamen verwijderd. Bovendien werden voor elke sessie S = {v1, v2, ..., vn} meerdere subsequenties gegenereerd voor de training en het testen van het model. Deze subsequenties hadden de vorm: ([v1]|v2), ([v1, v2]|v3), ..., ([v1, v2, ..., vn-1]|vn). Na voltooiing van de bovengenoemde voorbewerking werden statistische analyses op de datasets uitgevoerd; gedetailleerde informatie is gepresenteerd in Tabel 2.
| Dataset | Diginetica | Tmall | Nu aan het afspelen |
| klik | 982961 | 818479 | 1367963 |
| trainen | 719470 | 351268 | 825304 |
| test | 60858 | 25898 | 60417 |
| items | 43097 | 40728 | 60417 |
| gem. len. | 5.12 | 6.69 | 7.42 |
Tabel 2: Beschrijving van de dataset. De tabel vat de statistieken van de Diginetica-, Tmall- en Nowplaying-datasets samen, inclusief het aantal klikken, trainings- en testsamples, items en de gemiddelde sessielengte.
Experimentele instellingen
Instellen van parameters
Om de eerlijkheid van het experiment te waarborgen, werden preprocessing-methoden toegepast op drie datasets, terwijl de parameters van het GSLA4Rec-model werden vooraf ingesteld. Voor de Diginetica- en Nowlaying-datasets werd de batch size ingesteld op 150, en op 300 voor de Tmall-dataset. De parameters van dit model werden geïnitialiseerd met een Gaussische distributie met een gemiddelde van 0 en een standaarddeviatie van 0,1, waarbij de dimensie werd ingesteld op 100. Als optimizer werd Adam gebruikt met een initiële learning rate van 0,001; de learning rate werd elke 3 epochs met een factor 0,1 vermenigvuldigd. De training werd uitgevoerd gedurende in totaal 30 epochs op een NVIDIA TITAN V GPU en PyTorch 1.11.0 met cu113 (zie Table of Materials) om de beste waarde te bepalen. De drempelwaarde voor het filteren van naburige sessies werd ingesteld op 0,5 en er werd L2 regularisatie toegepast in het experiment. Voor elke dataset werden de laatste 10% van de gegevens, gesorteerd op transactietijd, geselecteerd als testset, terwijl de resterende 10% en 80% respectievelijk willekeurig werden geselecteerd als validatie- en trainingsets. Het aantal memory slots in GSLA werd ingesteld op een waarde uit {0, 1, 2, 3, 4, 5}.
Evaluatiemetrieken
In dit artikel zijn P@N (Precision@N, N = 10/20) en MRR@N (Mean Reciprocal Rank@N, N = 10/20) toegepast. P@N werd gebruikt om het aandeel correcte aanbevelingen binnen de eerste N aanbevelingsresultaten te meten; MRR@N werd gebruikt om de gemiddelde reciproke rangschikking van correcte projecten te berekenen, waarbij een hogere MRR-waarde duidt op een betere sorteerprestatie.
Prestatieanalyse
De effectiviteit van het GSLA4Rec-model werd geëvalueerd ten opzichte van baselines die verschillende stadia van technologische ontwikkeling vertegenwoordigen. In de beginfase werden machine learning-methoden gebruikt voor SBR; zo werd FPMC5 gebruikt om sequentiële effecten te voorspellen op basis van een Markov-keten. Vervolgens werd deep learning breed toegepast voor SBR met de ontwikkeling van kunstmatige intelligentie; GRU4Rec10 was bijvoorbeeld gebaseerd op RNN's die de SBR modelleren door meerdere lagen GRU's te stapelen en gespecialiseerde verliesfuncties te ontwerpen om de SBR te optimaliseren, NARM16 introduceerde AM om de belangrijkste interesses van gebruikers vast te leggen en genereerde een uiteindelijke embedding-representatie van het volgende mogelijke aanbevelingsitem, en STAMP17 maakte gebruik van AM-verbeterde multi-layer perceptrons om gelijktijdig de algemene en onmiddellijke interesse van de gebruikers vast te leggen. In recente jaren zijn ook graph neural networks veelvuldig gebruikt in SBR vanwege hun krachtige vermogen om niet-Euclidische data te leren. Zo paste SR-GNN22 voor het eerst GNN's toe op SBR, waarbij complexe item-transitierelaties werden verkregen via GGNN's en de focus lag op de onmiddellijke interesses van gebruikers in combinatie met AM, GCE-GNN23 maakte gebruik van GAT's om item-transferrelaties in lokale en globale contexten te verkrijgen en genereerde sessierepresentaties via RPE en soft-AM, en S2-DHCN66 transformeerde de sessiedata in een hypergraaf en line-graaf en maakte gebruik van zelfgesuperviseerd leren om SBR te verbeteren.
Onlangs is een uitgebreide aanpak aangenomen om de prestaties van SBR te verbeteren. Zo combineerde GC-SAN50 GNN's met multilayer self-attention netwerken om de aanbevelingsprestaties te bevorderen door kortetermijn- en langetermijnafhankelijkheden te modelleren; TASRec67 integreerde temporele informatie via de constructie van een sequentie van dynamische graaf-snapshots op verschillende tijdstippen; CT-GNN68 maakte gebruik van GNN's met gecombineerde temporele informatie om de extra temporele associatie-informatie tussen items te leren; CORE69 fuseerde de co-occurrence informatie en temporele informatie van de items om de uiteindelijke sessierepresentatie te verkrijgen; RESTC70 stelde spatio-temporele interactiepatronen voor, geïnspireerd door de uniformiteits- en uitlijningseigenschappen van contrastief leren; COTRec66,71 paste zelfgesuperviseerd leren toe op twee sessiegraaf-weergaven en co-training om de dataschaarsheid van SBR op te lossen; RAIN71 maakte gebruik van edge masking en structurele reconstructie, en trainde gezamenlijk een edge-indicator om ruisachtige randen expliciet te identificeren en te elimineren, wat de nauwkeurigheid en robuustheid van SBR aanzienlijk verbeterde.
| Datasets | Diginetica | Tmall | Nu aan het afspelen | ||||||||||
| Methodenklasse- ificatie | Meetwaarden | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 |
| Machine learning | FPMC | 15.42 | 22.10 | 6.20 | 6.66 | 13.12 | 16.05 | 7.10 | 7.30 | 5.28 | 7.35 | 2.66 | 2.82 |
| Deep-learning | GRU4REC | 17.92 | 30.80 | 7.73 | 8.20 | 9.47 | 10.93 | 5.78 | 5.89 | 6.74 | 7.92 | 4.40 | 4.48 |
| Deep Learning | NARM | 35.44 | 48.32 | 15.12 | 16.00 | 19.16 | 23.30 | 10.40 | 10.70 | 13.60 | 18.59 | 6.62 | 6.92 |
| Deep-learning | STAMP | 33.97 | 46.62 | 14.26 | 15.13 | 22.63 | 26.47 | 13.10 | 13.35 | 13.20 | 17.65 | 6.57 | 6.88 |
| GNN's | SR-GNN | 38.42 | 51.26 | 16.89 | 17.76 | 23.41 | 27.57 | 13.46 | 13.72 | 14.17 | 18.86 | 7.15 | 7.47 |
| GNN's | S2 -DHCN | 40.21 | 53.66 | 17.59 | 18.51 | 26.22 | 31.42 | 14.60 | 15.05 | 17.35 | 23.50 | 7.87 | 8.18 |
| GNN's | GCE-GNN | 41.16 | 54.22 | 18.15 | 19.04 | 28.01 | 33.42 | 15.08 | 15.42 | 16.94 | 22.37 | 8.03 | 8.40 |
| GNN's+Att | TASRec | 39.85 | 52.53 | 17.19 | 18.22 | 25.72 | 29.58 | 14.22 | 14.51 | 16.35 | 20.52 | 7.30 | 7.78 |
| GNN's+Att | GC-SAN | 38.40 | 51.30 | 16.80 | 17.80 | 23.50 | 27.60 | 13.50 | 13.80 | 14.20 | 18.90 | 7.20 | 7.50 |
| GNN's+Tem | CT-GNN | 39.40 | 52.71 | 17.50 | 18.56 | 25.95 | 31.42 | 14.52 | 15.00 | 16.55 | 22.28 | 7.75 | 8.06 |
| GNN's+Tem | KERN | 41.03 | 52.84 | 17.95 | 18.47 | 32.97 | 39.16 | 18.72 | 19.16 | 17.65 | 21.81 | 7.92 | 7.35 |
| GNN's+Tem | RESTC | 42.35 | 55.93 | 18.75 | 19.65 | 35.57 | 42.47 | 18.05 | 18.52 | 18.39 | 24.79 | 8.31 | 8.72 |
| GNN's+COT | COTRec | 39.87 | 54.18 | 17.53 | 19.07 | 30.62 | 36.35 | 17.65 | 18.04 | - | - | - | - |
| GNN's+ReStr | REGEN | - | 55.50 | - | 19.20 | - | 38.73 | - | 19.12 | - | 24.17 | - | 8.47 |
| GNN's+Gated-Slot | GSLA4Rec | 43.35 | 56.47 | 19.38 | 19.98 | 36.56 | 43.60 | 19.46 | 19.96 | 19.80 | 27.10 | 8.86 | 9.32 |
| SD | ±0.0009 | ±0.0011 | ±0.0008 | ±0.0009 | ±0.0018 | ±0.0021 | ±0.0016 | ±0.0018 | ±0.0028 | ±0.0031 | ±0.0024 | ±0.0026 | |
| p-waarde | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.01 | |
| Tinferentie | 0.294 | 0.296 | 0.295 | 0.297 | 0.168 | 0.169 | 0.169 | 0.171 | 0.472 | 0.478 | 0.475 | 0.479 | |
Tabel 3: Prestatievergelijking op drie datasets. De tabel vergelijkt GSLA4Rec met machine-learning, deep-learning, GNN-gebaseerde, attention-gebaseerde, temporele en andere aanbevelingsmethoden op de Diginetica-, Tmall- en Nowplaying-datasets met behulp van P@10, P@20, MRR@10 en MRR@20. SD en p-waarden worden ook gerapporteerd voor GSLA4Rec.
Om de prestaties van het GSLA4Rec-model te verifiëren en de willekeur van prestatieverbeteringen door toevallige factoren uit te sluiten, werden meerdere groeperingsexperimenten en statistische analyses uitgevoerd op de testset. Specifiek werd de testset verdeeld in groepen van 150 sessies per batch, wat 30 keer werd herhaald met behulp van de random seed-methode. De gemiddelde resultaten en het tijdsverbruik van alle groeperingsexperimenten werden respectievelijk berekend als de prestaties en de inferentietijd van het GSLA4Rec-model. De standaarddeviatie (SD) en de statistische significantie van de t-toets van het GSLA4Rec-model werden berekend om de stabiliteit en zekerheid van de prestatieverbetering van het GSLA4Rec-model verder te verifiëren. Tabel 3 presenteert de prestaties, SD, p-waarde en Tinference van het voorgestelde aanbevelingsmodel, GSLA4Rec, vergeleken met baselines op de drie datasets. De onderstreepte getallen geven de beste baseline-methode aan, en het model met de beste prestaties voor elke evaluatiemetriek is gemarkeerd in vetgedrukt zwart.
Aanbevelingsmethoden op basis van machine-learning: Bij SBR-taken vertoonde de traditionele FPMC-methode de slechtste prestaties, voornamelijk omdat Markov-ketenmodellen er niet in slaagden complexe transitiepatronen tussen items vast te leggen. 2) Aanbevelingsmethoden op basis van deep-learning: Modellen zoals GRU4REC, NARM en STAMP maakten gebruik van sequentiële modelleringsbenaderingen en behaalden bepaalde prestatieverbeteringen. Hiervan demonstreerden NARM en STAMP betere aanbevelingsresultaten dan GRU4REC, voornamelijk omdat NARM een attention-mechanisme introduceerde om de primaire interesses van gebruikers vast te leggen. 3) Aanbevelingsmethoden op basis van GNN's: De adoptie van GNN's in SBR bracht aanzienlijke prestatieverbeteringen. Zo presteerde SR-GNN, dat als eerste sessiesequenties omzette in grafstructuren om ruimtelijke structurele informatie over items vast te leggen, beter dan deep-learningmethoden vertegenwoordigd door STAMP met een verbetering van 0.36–4.64%, wat het ruimtelijke voordeel van grafstructuren bij het verwerken van sequentiële gegevens aantoont. S2-DHCN maakte gebruik van dual-channel hypergraph-convolutie om hogere-orde afhankelijkheden tussen items vast te leggen en combineerde dit met zelf-gesuperviseerd contrastief leren om representaties te verbeteren; hiermee werd de beperking van traditionele GNN's, die slechts paarsgewijze relaties modelleren en onvoldoende informatie bevatten, aangepakt, waardoor de prestaties 1.30–7.04% hoger lagen dan die van deep-learningmethoden vertegenwoordigd door STAMP. GCE-GNN presteerde, door effectief informatie van enkelvoudige sessies en globale sessies te integreren, 1.46–7.60% beter dan deep-learningmethoden vertegenwoordigd door STAMP en 0.88–5.85% beter dan SR-GNN, wat aangeeft dat grafstructuurmethoden die globale contextuele informatie bevatten de SBR-prestaties aanzienlijk kunnen verbeteren. 4) Aanbevelingsmethoden op basis van GNN's + attention-mechanisme: TASRec was erop gericht om korte-termijn- en lange-termijnvoorkeuren in gebruikersgedragssequenties nauwkeuriger vast te leggen door een tijd-bewust mechanisme te introduceren; de prestaties waren 0.73–5.91% hoger dan die van deep-learningmethoden en 0.30–2.31% hoger dan die van het SR-GNN-model, maar bleven 0.59–3.84% achter bij het GCE-GNN-model. GC-SAN combineerde grafstructuren die waren omgezet vanuit sessiesequenties met multi-head self-attention-mechanismen om lokale en lange-termijnafhankelijkheden binnen sessies succesvol vast te leggen; de prestaties waren vergelijkbaar met of iets sterker dan die van het SR-GNN-model, maar inferieur aan zowel het TASRec- als het GCE-GNN-model. Dit suggereerde dat het introduceren van attention-mechanismen de SBR-prestaties effectief kan verbeteren, hoewel de verbetering minder significant was dan die bereikt door globale informatie, wat het belang van globale contextuele informatie herbevestigt. 5) Aanbevelingsmethoden op basis van GNN's + tijdsencodering: CT-GNN was de eerste die grafstructuren combineerde met temporele encodering om gelijktijdig "ruimtelijke structuur" en "temporele dynamiek" vast te leggen, waarmee het GC-SAN-model met 0.55–3.82% werd overtroffen. CORE legde lange-termijnvoorkeuren en korte-termijnintenties vast door respectievelijk de co-occurentie-frequenties van items uit globale sessies statistisch te analyseren en temporele positieweging voor huidige sessies te ontwerpen, en voegde deze co-occurentie- en temporele informatie samen om de uiteindelijke sessierepresentatie te verkrijgen; de prestaties overtroffen het TASRec-model met 0.25–9.58% en het GC-SAN-model met 0.67–11.56%, met een significante verbetering van 3.64–5.74% ten opzichte van het GCE-GNN-model op de Tmall-dataset. RESTC introduceerde een contrastief leermodel op basis van spatio-temporele GNN's om problemen in traditionele GNN's aan te pakken, zoals de focus uitsluitend op ruimtelijke grafstructuren, het negeren van temporele informatie en onvoldoende spatio-temporele fusie; de prestaties overtroffen het CORE-model met 0.39–3.31% en het GCE-GNN-model met 0.28–7.56%, wat aangeeft dat zowel temporele encodering als contrastief leren de SBR-prestaties effectief verbeteren. RAIN maakte gebruik van edge-masking en structurele reconstructietechnieken om gezamenlijk een edge-indicator te trainen voor het expliciet identificeren en elimineren van ruisvolle randen, waarmee prestaties werden behaald die dicht bij die van het RESTC-model lagen.
Het voorgestelde model, GSLA4Rec, integreerde globale contextuele informatie en een gated-slot lineair aandachtmechanisme om de contextuele informatie van gebruikers effectief vast te leggen, terwijl ruis werd gefilterd en de computationele complexiteit werd verminderd. Het toonde prestatieverbeteringen over alle datasets, waarbij het de twee best presterende baselines overtrof: het RESTC-model met 0,54–2,31% en het GCE-GNN-model met 0,83–10,18%. Dit was bijzonder prominent bij het verwerken van sequentiële afhankelijkheden in scenario's met lange sessies in SBR (specifiek verbeteringen van 10,18% en 4,73% vergeleken met GCE-GNN en van 1,44% en 2,31% vergeleken met RESTC op respectievelijk de Tmall- en Nowplaying-datasets). Kort samengevat incorporeerde het voorgestelde GSLA4Rec-model een efficiënte graafconstructie om gebruikerscontexten vast te leggen en ruis te filteren; de prestaties overtroffen consistent de SOTA over alle datasets.
Efficiëntie analyseren
Zoals weergegeven in Figuur 4experimentele resultaten op de Diginetica-dataset toonden aan dat de voorgestelde GSLA4Rec een snellere trainingssnelheid behaalde dan de baselines wat betreft de trainingstijd per epoch, waarbij alle experimenten werden uitgevoerd op een NVIDIA TITAN V GPU en ongeveer 9300 MB geheugen verbruikten. Modellen op basis van deep learning, waaronder STAMP, NARM en GRU4Rec, werkten efficiënt maar leverden de zwakste prestaties; TASRec- en GC-SAN-modellen op basis van GNN's en het self-attention-mechanisme verbeterden de prestaties, maar waren aanzienlijk tijdrovender. Hoewel S2-DHCN en CORE op basis van GNN's zorgden voor een lichte stijging in de rekentijd, maar de algehele prestaties vertoonden een opmerkelijke verbetering, in het bijzonder het voorgestelde GSLA4Rec-model, dat een aanzienlijke prestatieverbetering liet zien. De belangrijkste reden hiervoor was dat het GSLA4Rec-model minder tijd besteedde aan graafconstructie dan de baselines; bovendien maakte het gebruik van een two-pass gated linear attention-mechanisme met vaste geheugenslots. m, wat resulteert in een lineaire tijdcomplexiteit O(Ldm). Dit ontwerp was aanzienlijk efficiënter dan standaard self-attention O(L2dterwijl een sterke geheugencapaciteit behouden blijft door middel van softmax-verbeterde slot-uitlezing. Er worden prestatie-experimenten uitgevoerd op de testset om de statistische inferentietijd te synchroniseren, zoals weergegeven in de laatste rij van Tabel 3toonde het efficiëntievoordeel van het GSLA4Rec-model aan, waardoor werd voorkomen dat "onjuist hoge nauwkeurigheid maar niet beschikbaar" en het daadwerkelijk bereiken van een balans tussen effectiviteit en efficiëntie.
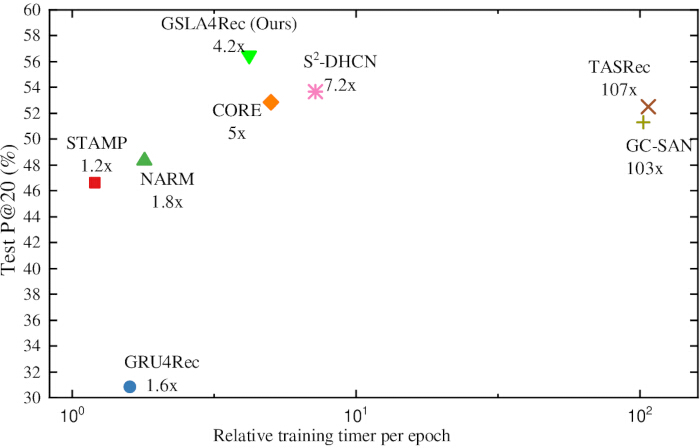
Figuur 4: Prestaties gedurende de runtime van GSLA4Rec op Diginetica. De figuur laat zien dat ons voorgestelde GSLA4Rec-model en de baseline-modellen zijn uitgevoerd op een NVIDIA TITAN V GPU met behulp van Diginetica voor de relatieve trainingstijd per epoch, waarbij GSLA4Rec een snellere trainingssnelheid behaalde dan de baseline-modellen. Deze figuur is zelf getekend via OriginPro met volledig aangepaste elementen. Er zijn geen auteursrechtelijk beschermde externe grafische bronnen gebruikt, waardoor geen aanvullende licenties van derden nodig waren. Het auteursrecht van de figuur is eigendom van de auteurs en zal bij acceptatie voldoen aan de auteursrechtregels van het tijdschrift. GSLA4Rec staat voor gated-slot linear attention graph neural networks voor SBR. Klik hier om een grotere versie van deze figuur te bekijken.
Samenvattend presteerde de efficiëntie van het voorgestelde GSLA4Rec-model met linear-complexity gated-slot attention consistent beter dan de SOTA over alle datasets. In het bijzonder behaalde GSLA4Rec significante prestatiewinst in scenario's voor aanbevelingen bij lange sessies op de Tmall- en Nowplaying-datasets, en vertoonde het een superieur vermogen tot modellering van sequentiële afhankelijkheden.
Analyse van ablatie-experimenten
Impact van SG en NGG en GSLA
Om de impact van de SG, de NGG, het gating-mechanisme, de memory slots en de lineaire aandacht op de huidige SBR te evalueren, werden ablatiestudies uitgevoerd op de Diginetica-, Tmall- en Nowplaying-datasets. GSLA4Rec‑NotSG sloot de SG-feature-codering uit terwijl de NGG-codering behouden bleef, GSLA4Rec‑NotNGG liet de NGG-codering vallen en voerde feature-extractie uitsluitend uit op basis van SG, GSLA4Rec‑NotGM verwijderde alleen het gating-mechanisme binnen GSLA, GSLA4Rec‑NotMS elimineerde enkel de memory slots van GSLA, en GSLA4Rec‑NotLA liet alleen de lineaire aandachtmodule in GSLA weg.
| Dataset | Diginetica | Tmall | Nu aan het spelen | |||
| Maten | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Recs-NotSG | 54.28 | 18.87 | 31.40 | 15.11 | 22.48 | 7.45 |
| GSLA4Recs-NotNGG | 52.65 | 17.67 | 28.90 | 14.61 | 20.17 | 7.74 |
| GSLA4Rec-NotGM | 53.82 | 18.21 | 39.26 | 16.52 | 23.14 | 7.62 |
| GSLA4Rec-NotMS | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-NotLA | 51.86 | 16.92 | 29.12 | 13.96 | 20.82 | 7.28 |
Tabel 4: Prestaties van de GSLA4Rec-ablatie-experimenten. De tabel rapporteert de ablatieprestaties van GSLA4Rec na het verwijderen van individuele modelcomponenten op de Diginetica-, Tmall- en Nowplaying-datasets, geëvalueerd met behulp van P@20 en MRR@20.
Tabel 4 toonde de resultaten van de ablatiestudie op verschillende datasets; alle prestatiemetrieken namen af in vergelijking met het volledige model. De afname in prestaties bij het verwijderen van de near-neighbor global session graph encoding (GSLA4Rec-NotNGG) was sterker dan bij het verwijderen van de session graph feature encoding (GSLA4Rec-NotSG). Het verwijderen van elk submodule in GSLA leidde tot een verslechtering van de prestaties, waarbij de mate van prestatieverlies van hoog naar laag was gerangschikt voor linear attention, memory slots en het gating-mechanisme. De reden hiervoor was dat het belang van elk item in SBR duidelijk verschilt en dat er behoefte is aan associatief geheugen tussen items. Hieruit kon worden opgemaakt dat GSLA een essentieel onderdeel was van het model in dit artikel.
Impact van verschillende aggregatiemethoden
Om de impact van verschillende methoden voor informatieaggregatie op de prestaties van het GSLA4Rec-model te evalueren, werden de volgende drie klassieke aggregatiemethoden onderzocht: 1) Average Pooling: het uitvoeren van een average pooling-operatie op de vectoren gegenereerd door de SG en de NGG; 2) Vector Concatenation: het concateneren van de vectoren gegenereerd door SG en NGG; 3) Vector Summation: het sommeren van de vectoren gegenereerd door SG en NGG. De resultaten werden weergegeven in Tabel 5. GSLA4Rec met Vec-Sum behaalde de beste prestaties op Diginetica, Tmall en Nowplaying. Daarentegen leverde Mean-pooling slechte resultaten op over alle datasets. De inferieure prestaties van gemiddelde aggregatie en concatenatie-aggregatie kunnen voortkomen uit overfitting veroorzaakt door excessieve parameters, wat de algehele modelprestaties verslechterde.
| Dataset | Diginetica | Tmall | Nowplaying | |||
| Maten | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| Mean-Pooling | 45.26 | 15.63 | 38.84 | 16.3 | 23.56 | 7.55 |
| Vec-Concating | 51.77 | 17.24 | 39.83 | 18.24 | 24.06 | 8.88 |
| Vec-Sum | 56.47 | 19.98 | 43.6 | 19.96 | 27.1 | 9.32 |
Tabel 5: Effecten van verschillende aggregatiemethoden. De tabel vergelijkt de effecten van mean pooling, vectorconcatenatie en vectorsommatie op de prestaties van GSLA4Rec over de Diginetica-, Tmall- en Nowplaying-datasets met behulp van P@20 en MRR@20.
Analyse van hyperparameterinstellingen
Effecten van verschillende geheugenslotgroottes
Geheugenslots sloegen informatie van voorgaande tijdstappen op, wat bijzonder belangrijk was voor taken met temporele afhankelijkheden. In deze sectie werd het effect van de grootte van de geheugenslots m = [0, 1, 2, 3, 4, 5] op de SBR-prestaties onderzocht. De experimentele resultaten, weergegeven in Tabel 6, gaven aan dat wanneer de grootte van de geheugenslots m op 3 werd ingesteld, de metrieken P@20 en MRR@20 optimaal presteerden over de drie datasets. Dit suggereerde dat een gematigde grootte van de geheugenslots de aanbevelingsnauwkeurigheid en de rankingskwaliteit van het model effectief verbeterde; kleinere geheugenslots hadden moeite om voldoende historische informatie te onthouden en richtten zich meer op kortetermijninteresses van gebruikers, terwijl het model bij een toename van de grootte van de geheugenslots naar 4 of meer overmatige historische informatie opsloeg, waardoor het te veel ging leunen op historische interesses en kritischere huidige inputinformatie verwaarloosde, wat leidde tot een verslechtering van de aanbevelingsprestaties.
| Dataset | Diginetica | Tmall | Nowplaying | |||
| Maten | P@20 | MRR@20 | P@20 | MRR@20 | P@20 | MRR@20 |
| GSLA4Rec-m0 | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-m1 | 55.43 | 18.92 | 41.55 | 17.12 | 25.60 | 8.43 |
| GSLA4Rec-m2 | 56.02 | 19.35 | 42.90 | 18.25 | 26.62 | 8.95 |
| GSLA4Rec-m3 | 56.47 | 19.98 | 43.60 | 19.96 | 27.10 | 9.32 |
| GSLA4Rec-m4 | 53.96 | 19.25 | 43.06 | 19.09 | 26.34 | 8.35 |
| GSLA4Rec-m5 | 52.18 | 18.03 | 42.12 | 17.56 | 24.86 | 8.85 |
Tabel 6: Effecten van verschillende geheugenslotgroottes. De tabel geeft de prestaties van GSLA4Rec weer met verschillende geheugenslotconfiguraties (m0–m5) op de Diginetica-, Tmall- en Nowplaying-datasets met gebruik van P@20 en MRR@20.
Effecten van verschillende dropout-ratio's
Om overfitting te voorkomen, is dropout-regularisatie geïntroduceerd. Voordat de itemvector op sessieniveau en de itemvector op mondiaal buurniveau werden opgeteld, werden de outputs van neuronen in de itemvector op mondiaal buurniveau hingg,(k) willekeurig weggelaten om de robuustheid en het generalisatievermogen van het GSLA4Rec-model te verbeteren.
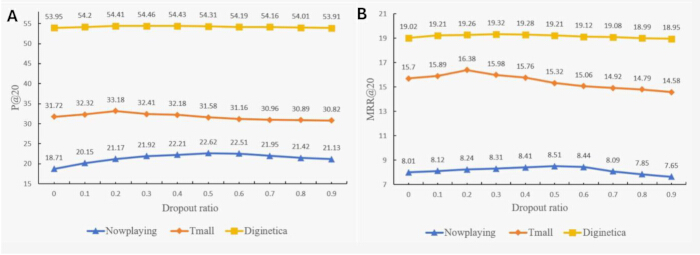
Figuur 5: Prestaties van GSLA4Rec onder verschillende dropout-ratio's. (A) P@20 en (B) MRR@20 van GSLA4Rec onder verschillende dropout-ratio's op de Nowplaying-, Tmall- en Diginetica-datasets. De prestaties namen aanvankelijk toe en namen vervolgens af naarmate de dropout-ratio steeg, wat de robuustheid en het generalisatievermogen van het model aantoont. GSLA4Rec, gated-slot linear attention graph neural networks voor sessiegebaseerde aanbevelingen (SBR). Deze figuur is zelf getekend met OriginPro met volledig aangepaste elementen. Er zijn geen auteursrechtelijk beschermde externe grafische bronnen gebruikt; daarom was geen aanvullende licentie van derden vereist. Het auteursrecht van de figuur is in handen van de auteurs en zal bij acceptatie voldoen aan de auteursrechtregels van het tijdschrift. Klik hier om een grotere versie van deze figuur te bekijken.
Figuur 5A–B toonde de impact van verschillende dropout-ratio's in Vergelijking (16) op de modelprestaties. Experimentele resultaten gaven aan dat het model slecht presteerde wanneer de dropout-ratio laag was, maar naarmate de dropout-ratio toenam, verbeterden de prestaties van het model geleidelijk totdat een optimaal niveau werd bereikt. Specifiek was de optimale dropout-ratio 0.3 voor de Diginetica-dataset, 0.2 voor de Tmall-dataset en 0.5 voor de Nowplaying-dataset. Wanneer de dropout-ratio deze optimale waarden overschreed, begonnen de prestaties van het model af te nemen, voornamelijk omdat overmatige neuron-dropout verhinderde dat het model effectief belangrijke kenmerken uit de sessiegegevens leerde.
Effecten van verschillende embedding-groottes
Om de computationele overhead zoveel mogelijk te minimaliseren terwijl de optimale modelprestaties behouden blijven, is de impact van verschillende embedding-dimensies d op de prestaties van het GSLA4Rec-model onderzocht. Zoals getoond in Figuur 6A–B, presteerde het GSLA4Rec-model slecht op drie openbare datasets, Diginetica, Tmall en Nowplaying, wanneer de embedding-dimensie d tussen 10 en 40 lag; de prestaties van het model stegen echter snel naarmate de waarde van d toenam. De prestatie-indicatoren neigden tot stabilisatie wanneer de waarde van d in het bereik van 80 tot 120 lag, waarna de prestaties feitelijk afnamen bij een verdere toename van d, mogelijk door overfitting veroorzaakt door een grote embedding-dimensie. Daarom is de dimensie van de item-embeddingvector uiteindelijk vastgesteld op 100.
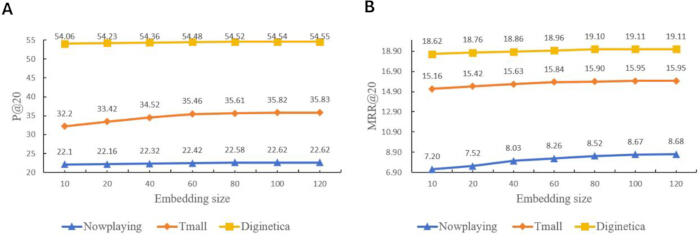
Figuur 6: Prestaties van GSLA4Rec bij verschillende embedding-groottes. (A) P@20 en (B) MRR@20 van GSLA4Rec bij verschillende embedding-groottes op de datasets Nowplaying, Tmall en Diginetica. De modelprestaties namen geleidelijk toe naarmate de embedding-grootte toenam en bereikten uiteindelijk een plateau. GSLA4Rec, gated-slot linear attention graph neural networks voor session-based recommendation (SBR). Deze figuur is zelf getekend met OriginPro met volledig aangepaste elementen. Er zijn geen auteursrechtelijk beschermde externe grafische bronnen gebruikt; daarom was geen aanvullende copyrightlicentie van derden vereist. Het auteursrecht van de figuur is in handen van de auteurs en zal bij acceptatie voldoen aan de copyrightregels van het tijdschrift. Klik hier om een grotere versie van deze figuur te bekijken.
Effecten van verschillende sessielengtes
Het stond bekend dat de lengte van elke sessie varieert over de drie real-world SBR-datasets (Diginetica, Tmall en Nowplaying). Om de robuustheid van het GSLA4Rec-model te verifiëren ten opzichte van de baselines bij verschillende sessielengtes, werden alle sessies in Diginetica en Tmall verdeeld in drie groepen: de korte groep (S), de middelste groep (M) en de lange groep (L), respectievelijk van 1 tot 6, 7 tot 12 en groter dan 12. MRR@20 werd gebruikt om de prestaties van de methoden te verifiëren in plaats van P@20, aangezien de MRR de rankingkwaliteit van correcte resultaten beter kan weerspiegelen. Figuur 7A–B toonde aan dat het GSLA4Rec-model beter presteerde dan de sequentie-gebaseerde baseline NARM, de GNN-gebaseerde baseline SR-GNN, de met contrastief leren uitgebreide GNN-baseline S2-DHCN en de spatio-temporele baseline RESTC bij verschillende sessielengtes. Tegelijkertijd werd waargenomen dat de prestaties van alle methoden afnamen naarmate de sequentielengte toenam, omdat itemovergangen over lange afstand het moeilijker maakten om gebruikersvoorkeuren vast te leggen; het voorgestelde GSLA4Rec-model vertoonde echter de traagste daling vergeleken met de baselines, omdat het Gated-slot-mechanisme irrelevante items kon wegfilteren. De prestaties van GSLA4Rec overtroffen respectievelijk die van het NARM-model met 6,3 en 8,85 in de lange groepen van Diginetica en Tmall.
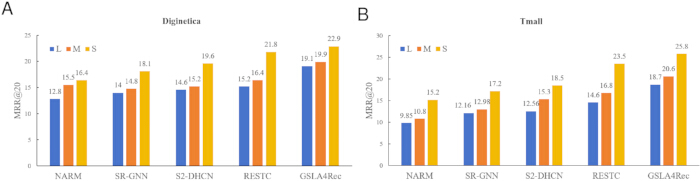
Figuur 7: Prestaties van GSLA4Rec bij verschillende sessielengtes. Prestaties van GSLA4Rec en baseline-modellen bij verschillende groepen sessielengtes op de (A) Diginetica- en (B) Tmall-datasets, geëvalueerd met behulp van MRR@20. De groepen sessielengtes worden aangeduid als L, M en S. GSLA4Rec, gated-slot linear attention graph neural networks voor sessiegebaseerde aanbevelingen (SBR). Deze figuur is zelf getekend met OriginPro met volledig aangepaste elementen. Er zijn geen auteursrechtelijk beschermde externe grafische bronnen gebruikt; daarom was geen aanvullende licentie voor auteursrecht van derden vereist. Het auteursrecht van de figuur is eigendom van de auteurs en zal bij acceptatie voldoen aan de auteursrechtregels van het tijdschrift. Klik hier om een grotere versie van deze figuur te bekijken.
Conclusie
Dit artikel stelt een global context gated-slot lineair attentienetwerk voor voor SBR. Door SG en NGG te combineren en een gated-slot lineair attentie-mechanisme te introduceren, stelt deze methode het netwerk in staat om te focussen op sleutelitems in de sessievolgorde, zowel lange- als kortetermijnafhankelijkheden vast te leggen, ruis effectief te verminderen en de computationele complexiteit te verlagen. Experimentele resultaten bevestigen dat deze methode een uitstekende aanbevelingsnauwkeurigheid en efficiëntie vertoont op drie openbare datasets, waarbij hij bijzonder uitblinkt in taken voor het modelleren van lange-termijnafhankelijkheden.
DATAbeschikbaarheid:
Drie veelgebruikte openbare datasets (Diginetica, Tmall en Nowplaying, de URL's zijn te vinden in de Tabel met Materialen) die de bevindingen van deze studie ondersteunen, zijn openbaar beschikbaar op het internet. Tegelijkertijd zijn drie veelgebruikte openbare datasets en de broncode voor dit werk ingediend als Aanvullende map: GSLA4Rec.zip. Klik hier om dit bestand te downloaden.
Discussie
In vergelijking met de basismodellen behaalt het GSLA4Rec-model een tweeledige verbetering in prestatie en efficiëntie om drie hoofdredenen. Ten eerste vermindert het toepassen van sluizenmechanismen op NGG gegevensschaarste en filtert het effectief ruis. Ten tweede zorgt het geheugenslotmechanisme voor een balans tussen opslagcapaciteit en efficiëntie via hyperparameters m aanpassing. Ten derde berekent het lineaire aandachtsmechanisme itemcorrelaties op een O(N) complexiteit, veel lager dan de O(N2)61Het GSLA4Rec-model is overmatig afhankelijk van gebruikers' interactievolgordes en negeert de multimodale eigenschappen van items48Ondertussen gebruikt de NGG-constructie een vaste Jaccard-drempel zonder functie voor dynamische aanpassing, en de geheugensleuven m kan geen adaptieve aanpasbaarheid bereiken65.
Het GSLA4Rec-model, dat SG opbouwt&NGG en gebruikt gegateerde lineaire aandacht met sleuven, wat bijzonder geschikt is voor aanbevelingen in anonieme sessies39 over e-commerce- en onlinestreamingplatforms heen. In e-commerceplatforms raadt dit model passende producten aan gebruikers aan door hun browse-, klik- of toevoeggedrag aan de winkelwagen te analyseren, zonder afhankelijk te zijn van kenmerken van de gebruiker. De in dit artikel gebruikte datasets Diginetica en Tmall zijn e-commerceaanbevelingsdatasets. Voor kortvideoplatforms en muziekstreamingplatforms analyseert deze methode gebruikers' afspeelvolgordes om hun impliciete voorkeuren te achterhalen, werkt inhoudssamenvattingen bij om gebruikers te behouden en verlengt de kijktijd. De dataset Nowplaying die in dit artikel wordt gebruikt, is de muziekaanbevelingsdataset.
Er zijn alternatieve oplossingen die de gated slot lineaire aandachtsarchitectuur kunnen vervangen. De opkomende Mamba65 op basis van een toestandsruimtemodel, als alternatief, heeft de kenmerken van selectieve opslagruimte voor toestanden en lineaire rekenkundige complexiteit, waarbij een balans wordt gevonden tussen lineaire complexiteit en het vermogen om lange sequenties aan te passen, en gecombineerd met de GGT55 verbeteringskader, het extraheert de gebruikers' impliciete intentie uit het oorspronkelijke interactielogboek, waardoor een goede aanbevelingsprestatie en efficiëntie worden bereikt. Toekomstig onderzoek kan GSLA4Rec vanuit meerdere perspectieven optimaliseren: het opbouwen van een dynamische NGG om de vaste Jaccard-filtering te vervangen, het implementeren van variabele geheugensleuven om automatisch sessies van verschillende lengtes aan te passen, en het integreren van multimodale gebruikersinformatie om de nauwkeurigheid van de aanbevelingen te verbeteren. Daarnaast, met behulp van door LLM-augmentatie ondersteunde modellen55, gebruikers' impliciete intenties kunnen worden afgeleid uit interactievolgordes, en ruisige gespreksgegevens kunnen nauwkeuriger worden gefilterd72.
Openbaarmakingen
De auteurs verklaren dat zij geen bekende concurrerende financiële belangen of persoonlijke relaties hebben die het in dit artikel beschreven werk zouden hebben beïnvloed.
Dankbetuigingen
De auteur bedankt de reviewers voor hun doordachte feedback en suggesties tijdens het reviewproces, en professor Jiang Nan, mijn promotiebegeleider, voor zijn zorgvuldige begeleiding. Deze studie werd gedeeltelijk ondersteund door de National Science Foundation of China onder Grant No.6217072713 en Grant No.62061019, en open onderzoeksonderwerpen gedeeltelijk door Jiangxi Province unmanned sensing system and artificial intelligence technology Engineering Research in 2025, en gedeeltelijk door het Jiangxi Provincial Key Laboratory of Advanced Electronic Materials and Devices (No.2024SSY03012).
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| CUDA 11.3 | NVIDIA | GEEN | CUDA 11.3 is een versie van een parallel computing-platform en programmeermodel uitgebracht door NVIDIA in 2021, bedoeld om de prestaties en ontwikkelingsflexibiliteit van GPU-versnelde applicaties te verbeteren. |
| Diginetica | Diginetica | GEEN | Diginetica is de officiële wedstrijddataset van de 2016 CIKM (International Information Retrieval Conference) Cup, die werd gebruikt in de CIKM-algoritmecompetitie om het probleem van gepersonaliseerde productretrieval in e-commerce met zoekcontext op te lossen. Inmiddels is het de meest gangbare standaard e-commerce benchmarkdataset geworden in het veld van Session based Recommendation (SBR). |
| Nowplaying | Zenodo | GEEN | Dit is een grootschalige dataset van muziekbeluisteringsgedrag, geconstrueerd op basis van het minen van tweets met de tag "# nowplaying"; de kern wordt gebruikt voor onderzoek naar muziekconversatie-aanbevelingen, contextbewuste aanbevelingen en sentimentcorrelatieanalyse. |
| OriginPro 2024 (64-bit) SR1 | OriginLab Corporation | GEEN | OriginPro is commerciële professionele software voor wetenschappelijk tekenen en data-analyse ontwikkeld door OriginLab Corporation, veel gebruikt voor het maken van grafieken op publicatieniveau, datastatistieken, curve fitting, signaalverwerking, etc. In dit artikel wordt OriginPro gebruikt om experimentele vergelijkingsgrafieken, lijngrafieken en staafdiagrammen te tekenen. |
| PyTorch 1.11.0 | PyTorch Foundation | GEEN | PyTorch is een open-source deep learning-framework voor machine learning en deep learning, in 2016 uitgebracht door Facebook. Het implementeert voornamelijk automatische differentiatie en introduceert dynamische computationele grafieken om het bouwen van modellen flexibeler te maken. |
| TITAN V GPU | NVIDIA | GEEN | NVIDIA TITAN V is een vlaggenschip-videokaart die eind 2017 door NVIDIA is gelanceerd, voornamelijk gericht op high-performance computing en kunstmatige intelligentie. |
| Tmall | Tmall | GEEN | Vanuit de IJCAI 2015 Alibaba Tmall Recommendation Competition heeft Alibaba Tianchi publiekelijk gedesensitiseerde echte Tmall online logs vrijgegeven. Dit is een van de drie standaarddatasets in het SBR-veld (Diginetica, Yoocoose, Tmall) en de voorkeursevaluatieset voor Chinese e-commerce scenario's. |
| visio 2021 | Microsoft | GEEN | Visio is een vector-tekensoftware ontwikkeld door Microsoft, gebruikt om modelstructuurdiagrammen, stroomdiagrammen, raamwerkschema's en netwerktopologiediagrammen in wetenschappelijke onderzoeksartikelen te tekenen, en om vectordiagrammen uit te voeren voor illustraties in artikelen |
Referenties
- Sarwar B, Karypis G, Konstan J, Riedl J. Item-based collaborative filtering recommendation algorithms. In: Proceedings of the 10th International Conference on World Wide Web; 2001 May 1–5; Hong Kong, China. ACM; 2001.p.285-295.
- Zhao ZD, Shang MS. User-based collaborative-filtering recommendation algorithms on hadoop. In: 2010 Third International Conference on Knowledge Discovery and Data Mining; 2010 Jan 9–10; Washington, DC, USA. IEEE; 2010.p.478-481.
- Koren Y, Rendle S, Bell R. Recommender Systems Handbook. Berlin: Springer; 2022.
- Koren Y, Bell R, Volinsky C. Matrix factorization techniques for recommender systems. Computer. 2009;42(8):30-37.
- Rendle S, Freudenthaler C, Schmidt-Thieme L. Factorizing personalized markov chains for next-basket recommendation. In: Proceedings of the 19th International Conference on World Wide Web; 2010 Apr 26–30; Raleigh, North Carolina, USA. ACM; 2010.p.811-820.
- Wang S et al. A survey on session-based recommender systems. ACM Comput Surv. 2021; 54(7): 1-38.
- Ninichuk M, Namiot D. Survey On Methods For Building Session-Based Recommender Systems. Int J Open Inf Technol. 2023;11(5):22-32.
- Saxena A. A Survey of Session-Based Recommender Systems. In: 2023 5th International Conference on Advances in Computing, Communication Control and Networking. IEEE, 2023.
- Ravanmehr R, Mohamadrezaei R. Session-Based Recommender Systems Using Deep Learning. Berlin: Springer; 2023.
- He R, McAuley J. Fusing similarity models with markov chains for sparse sequential recommendation. In: 2016 IEEE 16th International Conference on Data Mining; 2016 Dec 12–15; Barcelona, Spain. IEEE; 2016.p.191-200.
- Chen R, Fan J, Wu M. MC-RGN: Residual graph neural networks based on Markov chain for sequential recommendation. Inf Process Manag. 2023;60(6):103519.
- Ni S, Hu S, Li L. An intention-aware markov chain based method for top-k recommendation. IEEE Trans Autom Sci Eng. 2022;21(1):581-592.
- Yu Y, Si X, Hu C, Zhang J. A review of recurrent neural networks: LSTM cells and network architectures. Neural Comput. 2019;31(7):1235-1270.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517.
- Hidasi B, Karatzoglou A, Baltrunas L, Tikk D. Session-based recommendations with recurrent neural networks. In: Bengio Y, LeCun Y, editors. Proceedings of International Conference on Learning Representations; 2016 May 2–4; San Juan, Puerto Rico.
- Li J et al. Neural attentive session-based recommendation. In: Proceedings of the 2017 ACM Conference on Information and Knowledge Management; 2017 Nov 6–10; Singapore. ACM; 2017. p.1419-1428.
- Liu Q, Zeng Y, Mokhosi R, Zhang H. STAMP: short-term attention/memory priority model for session-based recommendation. In: Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining; 2018 Aug 19–23; London, United Kingdom. ACM; 2018.p.1831-1839.
- Zhou J et al. Graph neural networks: A review of methods and applications. AI open. 2020;1:57-81.
- Scarselli F, Gori M, Tsoi AC, Hagenbuchner M, Monfardini G. The graph neural network model. IEEE Trans Neural Netw. 2009;20(1):61‑80.
- Corso G, Stark H, Jegelka S, Jaakkola T, Barzilay R. Graph neural networks. Nat Rev Methods Primers. 2024;4(1):17.
- Zheng Y, Yi L, Wei Z. A survey of dynamic graph neural networks. Front Comput Sci. 2025;19(6):196323.
- Wu S et al. Session-based recommendation with graph neural networks. In: Proceedings of the AAAI Conference on Artificial Intelligence; 2019 Jan 27‑Feb 1; Honolulu, USA. AAAI Press; 2019.p.346-353.
- Wang Z et al. Global context enhanced graph neural networks for session‑based recommendation. In: Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2020 Jul 25‑30; Virtual conference. ACM; 2020.p.169‑178.
- Shani G, Heckerman D, Brafman RI. An MDP‑based recommender system. J Mach Learn Res. 2005;6:1265‑1295.
- Gu W, Dong S, Zeng Z. Increasing recommended effectiveness with Markov chains and purchase intervals. Neural Comput Appl. 2014;25(5):1153‑1162.
- O'shea K, Nash R. An introduction to convolutional neural networks. arXiv preprint arXiv:1511.08458, 2015.
- Wu J. Introduction to convolutional neural networks. Nanjing: National Key Lab for Novel Software Technology, Nanjing University; 2017.
- Li Z, Yang W, Peng S, Liu F. A survey of convolutional neural networks: analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2021;33(12):6999‑7019.
- Krichen M. Convolutional neural networks: A survey. Computers. 2023;12(8):151.
- Tang J, Wang K. Personalized top-n sequential recommendation via convolutional sequence embedding. In: Proceedings of the 11th ACM International Conference on Web Search and Data Mining; 2018 Feb 5–9; Marina Del Rey, California, USA. ACM; 2018.p.565-573.
- Tuan T, Phuong T. 3D convolutional networks for session-based recommendation with content features. In: Proceedings of the 11th ACM Conference on Recommender Systems; 2017 Aug 27–31; Como, Italy. ACM; 2017.p.138-146.
- Graves A. Generating sequences with recurrent neural networks. arxiv preprint arxiv: 1308.0850, 2013.
- Tang D, Qin B, Liu T. Document modeling with gated recurrent neural network for sentiment classification. In: Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing; 2015 Sep 17‑21; Lisbon, Portugal. Association for Computational Linguistics; 2015.p.1422‑1432.
- Chan W, Jaitly N, Le Q, Vinyals O. Listen, attend and spell: a neural network for large vocabulary conversational speech recognition. In: 2016 IEEE International Conference on Acoustics, Speech and Signal Processing; 2016 Mar 20‑25; Shanghai, China. IEEE; 2016.p. 4960‑4964.
- Sutskever I, Vinyals O, Le QV. Sequence to sequence learning with neural networks. In: Advances in Neural Information Processing Systems 27; 2014 Dec 8‑13; Montreal, Canada.
- Xiao C, Li Z, Tang J, Lee J. United prediction of travel modes and purposes in travel chains based on multitask learning deep neural networks. Mathematics. 2025;13(9):1528.
- Chmielewski J, Wójcik M. The use of deep neural networks (DNN) in travel demand modelling. Appl Sci. 2025;15(20):11290.
- Shahmoradi N, Alesheikh AA, Jafari A, Lotfata A. Hybrid ST-ResNet and LSTM approach for precise crime hotspot prediction. Sci Rep. 2025;15:18672.
- Park J, Yi D, Ji SM. Analysis of recurrent neural network and predictions. Symmetry.2020;12(4): 615.
- Ramakrishnan N, Soni T. Network traffic prediction using recurrent neural networks. In: 2018 17th IEEE International Conference on Machine Learning and Applications; 2018 Dec 17‑20; Orlando, Florida, USA. IEEE; 2018.p.187‑193.
- Yu P, Yan X. Stock price prediction based on deep neural networks. Neural Comput Appl. 2020;32(6):1609‑1628.
- Zhao J, Zeng D, Liang S, Kang H, Liu Q. Prediction model for stock price trend based on recurrent neural network. J Ambient Intell Humaniz Comput. 2021;12:745‑753.
- Zaytar MA, Chaker EA. Sequence to sequence weather forecasting with long short-term memory recurrent neural networks. Int J Comput Appl. 2016;143(11):7-11.
- Xu L, Peng J, Jiang X, Chen E, Luo B. Graph neural network based on graph kernel: a survey. Pattern Recognit. 2025;161:111307.
- Li Y, Tarlow D, Brockschmidt M, Zemel R. Gated graph sequence neural networks. arxiv preprint arxiv: 1511.05493, 2015.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. arXiv preprint arXiv:1609.02907;2016.
- Veličković P et al. Graph attention networks. arXiv preprint arXiv:1710.10903;2017.
- Chen L, Zhu X, Zhu G. Exploiting attributes and keywords for session-based recommendation with multi-view graph neural network. Expert Syst Appl. 2025;128990.
- Driss El Alaoui et al. A novel session-based recommendation system using capsule graph neural network. Neural Netw. 2025;185:107176.
- Xu C et al. Graph contextualized self‑attention network for session‑based recommendation. In: Proceedings of the 28th International Joint Conference on Artificial Intelligence; 2019 Aug 10‑16; Macao, China. 2019.p.3940‑3946.
- Qiu R, Huang Z, Li J, Chen H. Rethinking the item order in session‑based recommendation with graph neural networks. In: Proceedings of the 28th ACM International Conference on Information and Knowledge Management; 2019 Nov 3‑7; Beijing, China. ACM; 2019.p.579‑588.
- Chen J, Ji J, Li H, Zhang X. SR‑HetGNN: session‑based recommendation with heterogeneous graph neural network. Knowl Inf Syst. 2024;66(2):1111‑1134.
- Wang Y et al. Knowledge graph‑based session recommendation with session‑adaptive propagation. In: Companion Proceedings of the ACM Web Conference 2024; 2024 May 13‑17; Singapore. ACM; 2024.p.264‑273.
- Wang Z, Jin B. DiffSBR: a diffusion model for session-based recommendation. Inf. Process. Manag. 2026;63(1):104284.
- Qiao S et al. Multi-view intent learning and alignment with large language models for session-based recommendation. ACM Trans. Inf. Syst. 2025;43(4):91.
- Wang M et al. A collaborative session‑based recommendation approach with parallel memory modules. In: Proceedings of the 42nd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2019 Jul 21‑25; Paris, France. ACM; 2019. p.345‑354.
- Ye R, Zhang Q, Luo H. Cross-session aware temporal convolutional network for session-based recommendation. In: 2020 International Conference on Data Mining Workshops; 2020 Nov 16–19; Sorrento, Italy. IEEE Computer Society; 2020.p.220-226.
- Chen Y, Huang L, Wang C, Lai J. Hybrid-order gated graph neural network for session-based recommendation. IEEE Trans Ind Inform. 2021;18(3):1458‑1467.
- Chen Y, Tang Y, Yuan Y. Attention-enhanced graph neural networks with global context for session-based recommendation. IEEE Access. 2023;11:26237-26246.
- Tang L, Wang X, Wang H, Shi C, Song L. DA‑GCN: a domain‑aware attentive graph convolution network for shared‑account cross‑domain sequential recommendation. In: Proceedings of the 30th International Joint Conference on Artificial Intelligence; 2021 Aug 19‑27; Montreal, Canada.
- Vaswani A et al. Attention is all you need. In: Advances in Neural Information Processing Systems 30; 2017 Dec 4‑9; Long Beach, USA.
- Lu Y, Letey M, Zavatone‑Veth JA, Maiti A, Pehlevan C. Asymptotic theory of in‑context learning by linear attention. Proc. Natl. Acad. Sci. U.S.A. 2025;122(28):e2502599122.
- Peng H, Pappas N, Yogatama D, Kong L. ABC: attention with bounded‑memory control. In: Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics; 2022 May 22‑27; Dublin, Ireland. Association for Computational Linguistics; 2022.p.7469‑7483.
- Yang S et al. Gated linear attention transformers with hardware‑efficient training. In: Proceedings of the 41st International Conference on Machine Learning; 2024 Jul 21‑27; Vienna, Austria. PMLR; 2024.
- Yuan H et al. DG‑mamba: robust and efficient dynamic graph structure learning with selective state space models. In: Proceedings of the 39th AAAI Conference on Artificial Intelligence; 2025 Feb 25‑Mar 4; Philadelphia, Pennsylvania, USA. AAAI Press; 2025.p.22272‑22280.
- Xia X et al. Self‑supervised graph co‑training for session‑based recommendation. In: Proceedings of the 30th ACM International Conference on Information and Knowledge Management; 2021 Oct 25‑29; Virtual Event. ACM; 2021.p.2180‑2190.
- Zhou H, Zhang D, Song M, Han W. Temporal augmented graph neural networks for session‑based recommendations. In: Proceedings of the 44th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2021 Jul 11‑15; Montreal, Canada. ACM; 2021. p. 1798‑1802.
- Chen Q, Jiang F, Wang Y, Li Y, Zhang Y. Combine temporal information in session‑based recommendation with graph neural networks. Expert Syst Appl. 2024;238:121969.
- Hou Y, Hu B, Zhang Z, Zhao W. Core: simple and effective session‑based recommendation within consistent representation space. In: Proceedings of the 45th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2022 Jul 11‑15; Madrid, Spain. ACM; 2022.p.1796‑1801.
- Wan Z et al. Spatio‑temporal contrastive learning‑enhanced GNNs for session‑based recommendation. ACM Trans. Inf. Syst. 2023;42(2):1‑26.
- Zeng X et al. RAIN: reconstructed‑aware in‑context enhancement with graph denoising for session‑based recommendation. Neural Netw. 2025;184:107056.
- Zhan H et al. Capturing dynamic interests with deformable attention mechanism for session-based recommendation. Int J Mach Learn Cybern. 2026;17:375.