Deze studie vergeleek vijf machine learning-algoritmen voor de classificatie van schildklierknobbels met behulp van super-resolutie echografie-kenmerken. SVM presteerde het beste (nauwkeurigheid 68,6%, Area Under the Curve 0,690), waarbij microcalcificatie en post-contrast vergroting werden geïdentificeerd als belangrijke bijdragers, maar de bevindingen vereisen externe validatie voordat ze klinisch kunnen worden toegepast.
Onderzoeksartikel
Kwantitatieve superresolutie-echografische microvasculaire kenmerken voor machine learning-gebaseerde classificatie van schildklierknobbels
69 weergaven
⸱
11 september 2026
* These authors contributed equally
In dit artikel
Samenvatting
Samenvatting
Deze studie vergeleek vijf machine learning-algoritmen—Random Forest (RF), Support Vector Machine (SVM), Decision Tree (DT), eXtreme Gradient Boosting (XGBoost) en Gradient Boosting (GB)—voor het classificeren van schildklierknobbels met behulp van kwantitatieve kenmerken afgeleid van conventionele echografie, contrast-versterkte echografie (CEUS) en superresolutie-echografie (SRUS). De retrospectieve studie omvatte 68 schildklierknobbels van 63 patiënten (30 benigne en 38 bevestigd als papillair schildkliercarcinoom [PTC]) en werd geanalyseerd aan de hand van 25 kwantitatieve kenmerken via vijfvoudige patiëntgegroepeerde kruisvalidatie, waarbij werd gewaarborgd dat alle knobbels van dezelfde patiënt aan dezelfde fold werden toegewezen. De modelprestaties werden samengevat over de folds en op basis van gepoolde out-of-fold (OOF) voorspellingen, en er werd een gerichte OOF SHapley Additive exPlanations (SHAP) analyse uitgevoerd met een permutatiegebaseerde explainer voor de best presterende SVM. De SVM behaalde de hoogste gemiddelde nauwkeurigheid (0,686 ± 0,120) en de hoogste gemiddelde Receiver Operating Characteristic-Area Under Curve (ROC-AUC) (0,690 ± 0,164), met een gepoolde OOF sensitiviteit van 0,842 en specificiteit van 0,500, waarbij microcalcificaties en vergroting na contrasttoediening werden geïdentificeerd als de meest significante model-specifieke SHAP-bijdragers. RF bood een gebalanceerde prestatie (nauwkeurigheid 5,9%, sensitiviteit 55,3%, specificiteit 56,7%), terwijl DT slecht presteerde (nauwkeurigheid 0,429, ROC-AUC 0,47), wat dicht bij willekeurig gissen lag. De studie toonde aan dat kwantitatieve SRUS-metingen kunnen worden geïntegreerd in conventionele classifiers; de bevindingen blijven echter exploratief en vereisen prospectieve, multicentrische validatie met grotere cohorten vóór klinische implementatie.
Inleiding
Schildklierknobbels vormen een zeer veelvoorkomende klinische bevinding, met detectiepercentages die bijna 68% bereiken in asymptomatische populaties bij onderzoek via echografie1. Recente meta-analyses hebben aangetoond dat de wereldwijde prevalentie van schildklierknobbels is gestegen van 21,53% in de periode 20-201 naar 29,29% in de periode 2012-2022, waardoor ongeveer één op de vier personen in de algemene bevolking wordt getroffen2,3. Van deze knobbels wordt uiteindelijk bij 7–15% schildklierkanker gediagnosticeerd, waarbij papillair schildkliercarcinoom (PTC) het dominante subtype is4,5. PTC is verantwoordelijk voor 80–90% van alle schildkliermaligniteiten en is een van de snelst groeiende kankertypes geworden, met incidentiecijfers die stegen van 4,8 naar 14,9 per 10.0 tussen 1975 en 20126.
Conventionele echografie blijft de hoeksteen voor de evaluatie van schildklierknobbels en biedt een niet-invasieve, kosteneffectieve en breed toegankelijke diagnostische modaliteit7. Traditionele sonografische kenmerken die wijzen op maligniteit zijn onder meer uitgesproken hypo-echogeniciteit, onregelmatige marges, microcalcificaties en een vorm waarbij de hoogte groter is dan de breedte8,9. Echter is deze methode fundamenteel beperkt door de akoestische diffractiebarrière, waardoor de ruimtelijke resolutie wordt beperkt tot ongeveer 10 micrometers10. Deze beperking belemmert aanzienlijk het vermogen om de microvascularisatie te visualiseren en de fijne vasculaire morfologie te beoordelen, wat cruciale parameters zijn voor het onderscheid tussen benigne en maligne schildklierlaesies1. Color Doppler flow imaging (CDFI) en contrast-enhanced ultrasound (CEUS) verbeteren weliswaar de detectie van de bloedstroom, maar kunnen alleen vaten visualiseren met stroomsnelheden hoger dan 1 cm/s en blijven beperkt door de diffractie-gelimiteerde resolutie12,13.
Super-resolutie echografie (SRUS) is een transformerende technologie die de traditionele diffractielimiet van conventionele echografiesystemen overwint14,15. Door contrastmicrobellen te gebruiken als puntdoelen voor lokalisatie en tracking, bereikt SRUS een ruimtelijke resolutie op micron-schaal, waardoor visualisatie en kwantificering van de microvasculatuur op een ongekend gedetailleerd niveau mogelijk wordt16,17. Deze techniek kan zowel de microvasculaire dichtheid (MVD) als de microvasculaire stroomsnelheid (MFR) meten, wat structurele en functionele beoordelingen mogelijk maakt die via niet-invasieve beeldvorming nauwkeurig onbereikbaar zijn17,18. Pilotstudies hebben aangetoond dat goedaardige schildkliernoduli een significant hogere MFR vertonen dan maligne noduli, met gemiddelde waarden van respectievelijk 16.76 ± 6.82 mm/s tegenover 9.86 ± 4.54 mm/s19. De introductie van "ultrasound microvasculomics"—een high-throughput extractie van kwantitatieve kenmerken uit SRUS-beelden—vergroot het potentieel voor een nauwkeurige en gepersonaliseerde microvasculaire beoordeling verder.
Machine learning (ML) heeft de medische beeldanalyse gerevolutioneerd, in het bijzonder bij de karakterisering van schildkliernoduli20,21. Deep learning-modellen, met name convolutionele neurale netwerken (CNN's), hebben in eerdere studies Receiver Operating Characteristic-Area Under Curve (ROC-AUC)-waarden behaald die hoger liggen dan 0,902,23,24. Ensemble machine learning-benaderingen die meerdere algoritmen combineren — waaronder Random Forest (RF), Support Vector Machines (SVM), Decision Trees (DT), Gradient Boosting (GB) en eXtreme Gradient Boosting (XGBoost) — blijken veelbelovend voor het verbeteren van de diagnostische nauwkeurigheid en robuustheid over heterogene datasets21. Zoals Habchi et al.25 onlangs uitgebreid hebben beoordeeld, is het veld van kunstmatige intelligentie (AI) voor schildklierkanker snel uitgebreid tot visuele converters, grote taalmodellen en hybride architecturen, wat de ontwikkeling van het vakgebied naar steeds complexere beeldgebaseerde diagnostische kaders weerspiegelt.
Hoewel conventionele echografische kenmerken uitgebreid zijn bestudeerd in combinatie met AI-algoritmen, blijft de combinatie van superresolutie-microvasculaire parameters met ML-modellen grotendeels onontdekt. Ondanks het veelbelovende potentieel van SRUS-technologie en de bewezen effectiviteit van machine learning-algoritmen in medische beeldvorming, blijven verschillende kritische vragen onbeantwoord. Ten eerste: welke machine learning-architectuur — of het nu gaat om traditionele algoritmen zoals RF en SVM, of geavanceerde ensemble-methoden zoals XGBoost en GB — presteert optimaal wanneer deze wordt toegepast op uit SRUS afgeleide microvasculaire kenmerken? Ten tweede: hoe verhouden deze modellen zich tot elkaar wat betreft sensitiviteit, specificiteit en algemene diagnostische accuratesse bij het differentiëren van benigne van maligne schildklierknobbels? Ten derde: welke microvasculaire parameters, geëxtraheerd uit SRUS-beelden, dragen het meest significant bij aan de classificatieprestaties? Het beantwoorden van deze vragen is essentieel voor het vaststellen van evidence-based kaders voor de klinische vertaling van SRUS-ondersteunde diagnose van schildklierknobbels.
Hiertoe is deze studie erop gericht om de prestaties van vijf ML-algoritmen (RF, SVM, DT, XGBoost en GB) uitgebreid te evalueren voor de classificatie van schildklierknobbels met behulp van gegevens van superresolutie ultrasone microvasculaire beeldvorming. Door deze benaderingen systematisch te vergelijken en de meest informatieve microvasculaire biomarkers te identificeren, streeft dit onderzoek ernaar het diagnostische paradigma voor de karakterisering van schildklierknobbels te verbeteren en bij te dragen aan de groeiende hoeveelheid bewijs die het klinische nut van SRUS-technologie in oncologische beeldvorming ondersteunt. Wij stelden als hypothese dat de vooraf vastgestelde set van 25 variabelen een discriminatie tussen goedaardige knobbels en knobbels die rapporteerden als papillair schildkliercarcinoom zou opleveren die beter is dan op basis van toeval. Om informatielekkage te verminderen werd gebruikgemaakt van patiëntgroeps-kruisvalidatie, en er werd een gerichte SHAP-analyse toegevoegd om te beschrijven hoe de geselecteerde classifier de gemeten variabelen gebruikte. Beide analyses waren exploratief.
Protocol
Studie-opzet en patiëntenpopulatie
Deze retrospectieve studie analyseerde schildklier-echografieonderzoeken die zijn uitgevoerd tussen 13 juni 2024 en 13 januari 2025. Het studieprotocol is goedgekeurd door de ethische commissie van het Beijing Friendship Hospital, Capital Medical University (goedkeuringsnummer BFHHZS20240300) en is uitgevoerd in overeenstemming met de ethische principes zoals uiteengezet in de Verklaring van Helsinki; geïnformeerde toestemming isnweggelaten vanwege het retrospectieve ontwerp. De dataset bestond uit 68 schildklierknutten van 63 patiënten (30 benigne en 38 maligne), waarbij de knutte de analytische eenheid vormde. Referentiediagnoses waren gebaseerd op echogeleide dunne-naald-aspiratiecytologie (FNAC). De maligne groep bestond uit 38 knutten die op basis van FNAC werden gerapporteerd als papillair schildkliercarcinoom.
Inclusiecriteria
In aanmerking komende patiënten moesten voldoen aan al de volgende criteria: (1) ondergingen conventionele grijswaarden- en Doppler-echografie, gevolgd door CEUS met een bevredigende beeldkwaliteit die daaropvolgende analyse van microvasculaire flow-imaging mogelijk maakte; (2) hadden een cytopathologische diagnose van PTC bevestigd door een dunne-naaldaspiratiebiopsie, met of zonder gelijktijdige positieve BRAFV600E-mutatietest; of hadden een cytologieresultaat in Bethesda categorie III (atypie van onbepaalde significantie), maar met een gelijktijdige positieve BRAFV600E-mutatietest; (3) hadden een cytopathologische diagnose van benigne, proliferatieve noduli, adenomateuze noduli of benigne folliculaire noduli in Bethesda categorie II zonder gelijktijdige positieve BRAFV600E-mutatietest.
Exclusiecriteria
Patiënten werden uitgesloten van de studie als een van de volgende condities aanwezig was: (1) CEUS-beelden van slechte kwaliteit of een onvoldoende microbel-signaal waardoor een betrouwbare beoordeling van de microvasculaire flow niet mogelijk was; (2) afwezigheid van cytologische of pathologische resultaten; (3) histopathologische diagnose van een zeldzaam of speciaal subtype schildkliercarcinoom (bijv. anaplastische varianten); (4) cytologische bevindingen die wijzen op een folliculair neoplasma (Bethesda Categorie IV) of elke laesie met een onbepaalde folliculaire oorsprong, ongeacht de mutatiestatus; (5) thyreoïditis van Hashimoto
Echografie, CEUS- en SRUS-acquisitie
Alle onderzoeken werden uitgevoerd met het geraadpleegde echografie-systeem en een lineaire transducer. Patiënten werden in rugligging geplaatst met de nek in extensie. De doelknobbel werd gelokaliseerd en gemeten via B-mode echografie; microcalcificaties werden genoteerd en hetzelfde, op de laesie gecentreerde beeldvlak werd gebruikt om de intranodulaire vascularisatie met Color Doppler te beoordelen.
Nadat de intraveneuze toegang was vastgesteld, werd het systeem overgeschakeld naar een CEUS/URM-modus met een lage mechanische index (URM staat voor Ultra-Resolution Microscopy imaging). CEUS werd uitgevoerd met een intraveneuze bolusinjectie van 1,2 mL SonoVue, direct gevolgd door een spoeling van 5 ml zoutoplossing; de timer op het scherm en de continue cine-acquisitie werden gestart bij het toedienen van de bolus. De probe werd in een vast vlak gehouden met minimale druk, en de patiënt werd gevraagd om niet te slikken tijdens de wash-in en wash-out.
Voor kwantitatieve CEUS werd een op de laesie beperkt interessegebied gebruikt om de tijd-intensiteitsparameters af te leiden. Voor SRUS lokaliseerde en volgde de URM-workflow microbel-signalen na bewegingscontrole en genereerde metingen van vatenverhouding, complexiteit, microvasculaire dichtheid, perfusie-index en stroomsnelheid. De representatieve geëxporteerde afbeeldingen toonden instellingen van VSP 4, RES 2, CTR 3, SM 2, VEN 3 en CPT 10 s; overeenkomstige instellingen waren niet beschikbaar voor de resterende onderzoeken.
De 25 model-inputvariabelen zijn vermeld in Tabel 1 en gegroepeerd per acquisitiemodaliteit: leeftijd en geslacht; B-mode microcalcificatie; Color Doppler intranodulaire vasculariteit; kwalitatieve CEUS; kwantitatieve CEUS; en 11 SRUS microvasculaire metingen.
Kenmerkselectie
Alle 25 kwantitatieve kenmerken werden behouden in de machine learning-modellen. Alleen numerieke kenmerken werden gebruikt; patiëntnamen, registratienummers en velden voor laesiegrootte werden uitgesloten. Er is geen datagestuurde kenmerkselectie uitgevoerd, en dezelfde vooraf gespecificeerde predictoren werden in elke classifier ingevoerd.
Standaardisatie van kenmerken
Er werd geen transformatie, imputatie of globale schaling toegepast vóór de kruisvalidatie. Standaardisatie werd uitsluitend toegepast op de radial-basis-function SVM via een StandardScaler-pipeline. De scaler werd gefit op de trainingsknopen van elke fold en vervolgens toegepast op de validatieknopen van diezelfde fold. Boomgebaseerde classificeerders ontvingen de oorspronkelijke numerieke schalen:

waarbij x de oorspronkelijke kenmerkwaarde is, µ het gemiddelde van de trainingsfold is en σ de standaarddeviatie van de trainingsfold is. Preprocessing per fold voorkomde dat validatie-observaties bijdroegen aan de schalingsparameters van de SVM.
Datapartitionering
De primaire prestatie-evaluatie maakte gebruik van vijfvoudige StratifiedGroupKFold cross-validatie met shuffle = True en random_state = 42. Een patiënt-identificatie definieerde 63 groepen, en alle nodules van dezelfde patiënt werden aan dezelfde fold toegewezen. Geen enkele patiënt leverde nodules voor zowel de trainings- als de validatiesubset van een fold.
Training en validatie van het model
Trainingsprotocol
Vijf classificatiemodellen werden geëvalueerd: random forest (100 trees; random_state = 42), radial-basis-function SVM (C = 1.0; gamma = scale; probability = True; StandardScaler pipeline; random_state = 42), decision tree (Gini-criterium; onbeperkte diepte; random_state = 42), XGBoost (100 estimators; learning_rate = 0.3; max_depth = 6; subsample = 1.0; colsample_bytree = 1.0; random_state = 42) en gradient boosting (100 estimators; learning_rate = 0.1; max_depth = 3; random_state = 42). Er is geen gebruikgemaakt van grid search, Bayesiaanse optimalisatie, drempelwaardebepaling of genestelde modelselectie.
Kruisvalidatie
Binnen elk van de vijf patiëntgebaseerde folds werden modellen getraind op de overige patiëntgroepen en geëvalueerd op de uitgesloten groepen. Accuraatheid, sensitiviteit, specificiteit, precisie, F1-score en ROC-AUC werden voor elke fold berekend en samengevat als gemiddelde ± SD. OOF-voorspellingen werden gepoold over alle 68 nodules om één gecrossvalideerde ROC-curve en één confunditiematrix per model te genereren.
Prestatie-evaluatie
Evaluatiemetrieken
De prestaties van het model werden beoordeeld binnen elke op patiënten gegroepeerde validatie-fold en op basis van gepoolde OOF-voorspellingen met behulp van de volgende metrieken:
Nauwkeurigheid: Algeheel aandeel correcte voorspellingen
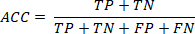
Sensitiviteit (Recall): Aandeel van de werkelijke maligne noduli dat correct is geïdentificeerd


Specificiteit: Aandeel van daadwerkelijk goedaardige noduli dat correct is geïdentificeerd
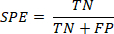
Precisie (Positieve Voorspellende Waarde): Aandeel van de voorspelde maligne gevallen dat daadwerkelijk maligne was
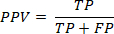
F1-score: Harmonisch gemiddelde van precisie en recall
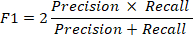
Oppervlakte onder de Receiver Operating Characteristic-curve (ROC-AUC): Maatstaf voor het vermogen van het model om onderscheid te maken tussen goedaardige en kwaadaardige noduli over alle classificatiedrempels heen
waarbij TP = terecht-positieven (correct geïdentificeerde maligne noduli), TN = terecht-negatieven (correct geïdentificeerde benigne noduli), FP = fout-positieven (benigne noduli die onjuist als maligne zijn geclassificeerd) en FN = fout-negatieven (maligne noduli die onjuist als benigne zijn geclassificeerd).
Analyse van de verwarringsmatrix
OOF-confusiematrices werden gegenereerd door de voorspellingen te poolen die voor elke nodulus alleen waren gedaan in de fold waarin die patiënt was weggelaten. Zo ontving elke nodulus een voorspelling van een model dat was getraind op nodulussen van andere patiënten.
Analyse van het belang van kenmerken
Voor het Random Forest-model werden de scores voor de belangrijkheid van kenmerken berekend op basis van de gemiddelde afname van de Gini-onzuiverheid over alle beslissingsbomen. De 15 belangrijkste kenmerken werden geïdentificeerd en gerangschikt om te bepalen welke microvasculaire parameters het meest significant bijdroegen aan de classificatieprestaties.
Exploratieve SHAP-analyse
Voor de SVM werd een gerichte OOF SHAP-analyse uitgevoerd met een permutatiegebaseerde explainer. Voor elke uitgesloten nodule werden enkel de bijbehorende waarnemingen van de trainingsfold gebruikt als achtergronddistributie (128 antithetische permutaties; random seed = 20260716). Gemiddelde absolute SHAP-waarden vatten de omvang van de bijdragen samen, en getekende waarden gaven de richting aan. De analyse was exploratief en werd niet gebruikt om causaliteit af te leiden, onafhankelijke biomarkers te identificeren of klinische drempelwaarden te definiëren.
Statistische analyse
Vergelijkende analyse
De modelprestaties werden beschrijvend samengevat over de vijf op patiënten gegroepeerde validatiefolds en in samengevoegde OOF-voorspellingen. Er werd geen formele hypothesetest tussen de modellen of rangschikking op basis van P-waarden uitgevoerd, omdat de folds gerelateerd zijn en de cohort klein is.
Voor vergelijkingen van de baselinegroepen werd de normaliteit van continue variabelen binnen elke uitkomstgroep beoordeeld met de Shapiro-Wilk-test. De Welch's t-test werd gebruikt wanneer beide groepen compatibel waren met normaliteit; anders werd een tweezijdige Mann-Whitney U-test gebruikt. Categorische variabelen werden beoordeeld met de chi-kwadraat-toets van Pearson, waarbij de exacte toets van Fisher werd gebruikt voor schaarse 2 x 2-tabellen. P-waarden waren tweezijdig, exploratief en niet gecorrigeerd (alpha = 0,05).
Reproduceerbaarheid
De reproduceerbaarheid werd gewaarborgd door een gespecificeerde definitie van de patiëntengroep, een vaste random seed (42), vaste classifier-configuraties en fold-gewijze preprocessing. Identificatoren werden uitsluitend gebruikt voor groepering en werden niet ingevoerd als predictoren of geëxporteerd met de modeluitvoer.
Resultaten
Patiëntkenmerken en studiepopulatie
In totaal werden 68 schildkliernoduli van 63 patiënten geïncludeerd, bestaande uit 30 goedaardige noduli en 38 PTC's. De nodulus was de analytische eenheid, en groepering per patiënt voorkwam dat noduli van dezelfde patiënt zowel in de trainings- als in de validatiesubset voorkwamen. De basiskenmerken zijn samengevat in Tabel 2.
Figuur 1 toont technisch succesvolle laesie-beperkte SRUS/URM-reconstructies van een representatieve goedaardige nodule en een nodule die volgens echogeleide FNAC als PTC is gerapporteerd. Beide voorbeelden tonen de omtrek van de laesie, de gereconstrueerde microvasculaire kaart en de door het apparaat gegenereerde kwantitatieve overlay. Deze voorbeelden demonstreerden een succesvolle acquisitie en reconstructie in beide referentieklassen, maar stellen op zichzelf geen diagnostische scheiding of modelprestaties vast.
Vijf classificatoren werden geëvalueerd met behulp van vijfvoudige, op patiënt gegroepeerde kruisvalidatie van de dataset met 68 noduli. Prestatiemetrieken worden gerapporteerd als het gemiddelde per fold ± SD en de gepoelde OOF-waarden in Tabel 3. Figuur 2, Figuur 3en Figuur 4 toon de OOF ROC-curves, de samenvattingen van de metrieken per groep-fold en de OOF-confusiematrices.
Figuur 4 toont de samengevoegde OOF-confusiematrices, waarin elke nodule uitsluitend werd voorspeld door een model dat was getraind zonder nodules van dezelfde patiënt. SVM classificeerde 32 van de 38 maligne nodules correct (sensitiviteit 0,842), maar classificeerde 15 van de 30 benigne nodules onterecht als maligne (specificiteit 0,500). De beslissingsboom vertoonde het grootste aantal fout-negatieve en fout-positieve classificaties. Deze patronen tonen aan waarom nauwkeurigheid alleen onvoldoende is en illustreren zowel succesvolle als suboptimale resultaten.
In de gerichte OOF SHAP-analyse (Figuur 5 en Tabel 4) leverden microcalcificaties en contrastversterkte vergroting de grootste modelspecifieke bijdragen aan de SVM-maligniteitswaarschijnlijkheid, gevolgd door de homogeniteit van de contrastversterking en geslacht. Deze bevindingen beschrijven hoe de gefitte SVM de gemeten variabelen in deze cohort gebruikte en stellen geen onafhankelijk klinisch belang vast.
Verklaring over beschikbaarheid van gegevens
De gegevens ten grondslag aan dit artikel worden op redelijk verzoek gedeeld door de corresponderende auteur.
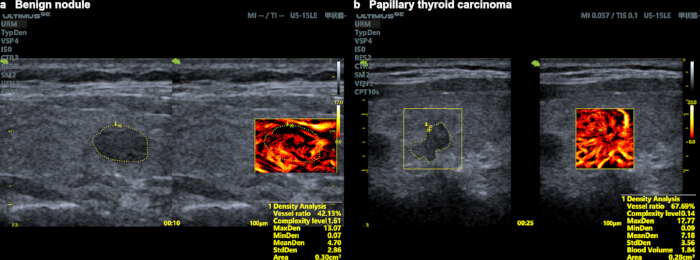
Figuur 1. Representatieve SRUS/URM-beelden beperkt tot de laesie. (A) Goedaardige schildkliernodule. (B) Papillair schildkliercarcinoom op basis van echogeleide FNAC. Elk paneel toont de omtrek van de laesie en de bijbehorende microvasculaire reconstructie met de door het apparaat gegenereerde kwantitatieve overlay. De voorbeelden illustreren een succesvolle acquisitie en reconstructie en worden niet gebruikt om de diagnostische nauwkeurigheid te schatten. Afkortingen: SRUS = super-resolution ultrasound; URM = ultra-resolution microscopic imaging; FNAC = fine needle aspiration cytology. Klik hier om een grotere versie van deze figuur te bekijken.
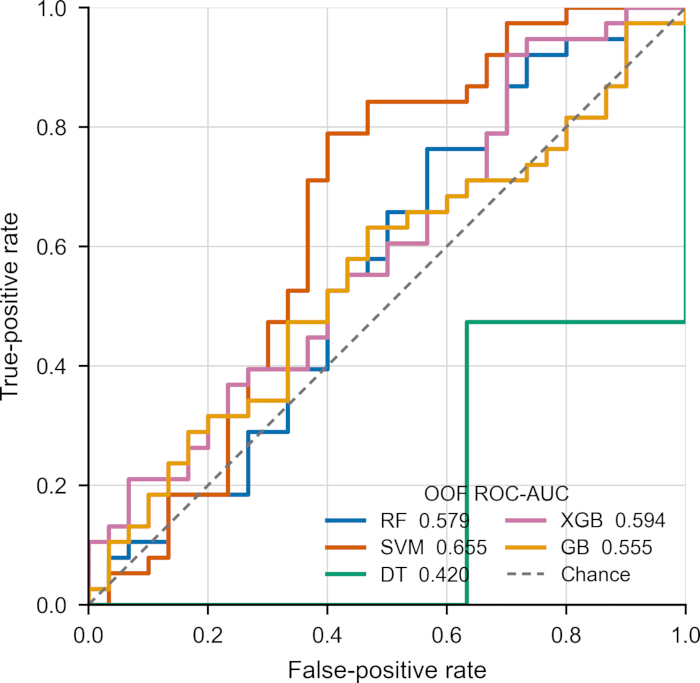
Figuur 2Op patiënt gegroepeerde OOF ROC-curves voor de vijf classifiers. Elke curve vat één uitgesloten voorspelling per nodule samen; de gestreepte diagonaal geeft toevalsdiscriminatie aan. Afkortingen: RF = Random Forest; SVM = Support Vector Machine; DT = Decision Tree; XGB = eXtreme Gradient Boosting; GB = Gradient Boosting; OOF = Out-of-fold; ROC-AUC = Receiver Operating Characteristic-Area Under Curve. Klik hier om een grotere versie van deze figuur te bekijken.
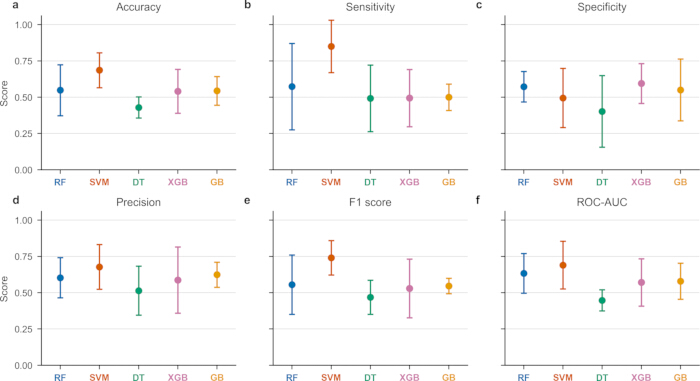
Figuur 3. Gemiddelde ± SD van accuratesse, sensitiviteit, specificiteit, precisie, F1-score en ROC-AUC over vijf patiëntgegrupoeerde validatiefolds. Afkortingen: SD = standaarddeviatie; ROC-AUC = Receiver Operating Characteristic-Area Under Curve. Klik hier om een grotere versie van deze figuur te bekijken.
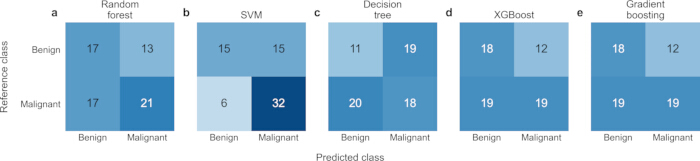
Figuur 4. Op patiënt gegroepeerde OOF-confusiematrices. Rijen tonen de referentieklasse en kolommen de voorspelde klasse. Elke nodule werd voorspeld door een model dat was getraind zonder enige nodules van dezelfde patiënt. Afkorting: OOF = Out-of-fold. Klik hier om een grotere versie van deze figuur te bekijken.
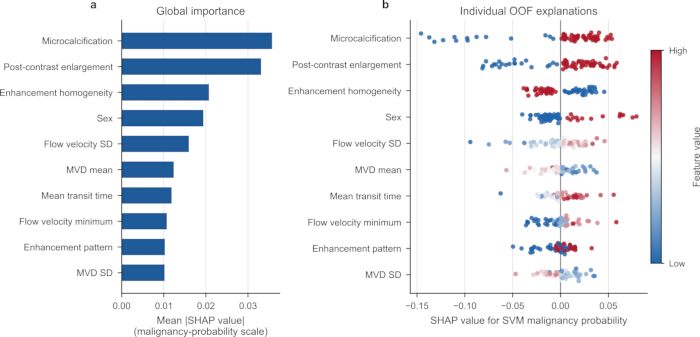
Figuur 5. OOF SHAP-analyse van de SVM met gebruik van een permutatiegebaseerde explainer. (A) De tien grootste gemiddelde absolute SHAP-waarden zijn gerangschikt. (B) Getekende SHAP-waarden voor dezelfde variabelen over 68 uitgesloten voorspellingen. Afkortingen: OOF = Out-of-fold; SHAP = SHapley Additive exPlanations; SVM = Support Vector Machine; MVD = microvasculaire dichtheid. Klik hier om een grotere versie van deze figuur te bekijken.
| Acquisitiebron | Predictoren | Hantering van het model |
| Demografie | Leeftijd; geslacht | Numerieke werkbladvariabelen; beide behouden als vooraf gespecificeerde modelinputs. |
| B-mode echografie | Microcalcificatie | Numeriek werkbladvariabele; geen globale schaling. |
| Kleurdoppler | Intranodulaire vasculariteit (bloeddoorstroming) | Geclassificeerd als een Color Doppler-voorspeller in plaats van een B-modus-voorspeller. |
| Kwalitatieve CEUS | Vergroting na contrasttoediening; contrastversterkingspatroon; homogeniteit van de contrastversterking | Numerieke werkbladvariabelen; behouden als vooraf gespecificeerde inputs. |
| Kwantitatieve CEUS | AUC, piekintensiteit, tijd tot piek, aankomsttijd, stijgtijd, gemiddelde transitietijd, tijd tot halve-piekintensiteit | Zeven variabelen van de tijd-intensiteitscurve; geen imputatie of globale schaling. |
| SRUS microvasculair | Vatratio, complexiteit, MVD maximum/minimum/gemiddelde/SD, perfusie-index, stroomsnelheid maximum/minimum/gemiddelde/SD | Elf microvasculaire variabelen; geen a priori kenmerkselectie. |
Tabel 1: Kwantitatieve variabelen en preprocessing. De 25 vooraf gespecificeerde predictoren zijn gegroepeerd per acquisitiebron: leeftijd en geslacht; B-mode microcalcificatie; Color Doppler intranodulaire vasculariteit; kwalitatieve en kwantitatieve CEUS-metingen; en SRUS-microvasculaire metingen. Namen, registratie-ID's en velden voor laesiegrootte werden uitgesloten. Er waren geen ontbrekende waarden in de matrix van 25 variabelen. De patiëntidentiteit werd uitsluitend gebruikt voor groepering. De StandardScaler werd alleen toegepast binnen de SVM-trainingsfolds. Afkortingen: CEUS = contrast-enhanced ultrasound; SRUS = Super-resolution ultrasound; SVM = Support Vector Machine.
| Acquisitiebron | Kenmerk | Benigne noduli | Maligne noduli | p-waarde |
| (n = 30) | (n = 38) | |||
| Demografische gegevens | Leeftijd, jaren | 48 (42, 55) | 48 (41, 52) | 0.551 |
| Demografische gegevens | Geslacht, n (%) | 0.012 | ||
| Demografische gegevens | Vrouw | 26 (86.7%) | 27 (71.1%) | |
| Demografische gegevens | Man | 4 (13.3%) | 11 (28.9%) | |
| B-mode echografie | ||||
| B-mode echografie | Microcalcificatie, n (%) | 0.001 | ||
| B-mode echografie | Afwezig | 12 (40.0%) | 2 (5.3%) | |
| B-mode echografie | Aanwezig | 18 (60.0%) | 36 (94.7%) | |
| Color Doppler | Bloedstroom, n (%) | 0.1 | ||
| Color Doppler | Afwezig | 7 (23.3%) | 8 (21.1%) | |
| Color Doppler | Aanwezig | 23 (76.7%) | 30 (78.9%) | |
| Kwalitatieve CEUS | Vergroting na contrast, n (%) | 0.001 | ||
| Kwalitatieve CEUS | Nee | 16 (53.3%) | 5 (13.2%) | |
| Kwalitatieve CEUS | Ja | 14 (46.7%) | 33 (86.8%) | |
| Kwalitatieve CEUS | Homogeniteit van contrastversterking, n(%) | 0.087 | ||
| Kwalitatieve CEUS | Heterogeen | 11 (36.7%) | 23 (60.5%) | |
| Kwalitatieve CEUS | Homogeen | 19 (63.3%) | 15 (39.5%) | |
| Kwalitatieve CEUS | Patroon van contrastversterking, n (%) | |||
| Kwalitatieve CEUS | Hypo-enhancement | 18 (60.0%) | 20 (52.6%) | |
| Kwalitatieve CEUS | Iso-enhancement | 3 (10.0%) | 0 (0.0%) | |
| Kwalitatieve CEUS | Hyper-enhancement | 9 (30.0%) | 18 (47.4%) | |
| Kwantitatieve CEUS | ||||
| Kwantitatieve CEUS | Oppervlakte onder de curve (AUC), dB·s | 3255.49 (2457.15, 4048.94) | 3620.76 (3096.36, 4066.75) | 0.201 |
| Kwantitatieve CEUS | Piekintensiteit (PI), dB | 48.93 (40.93, 55.78) | 50.22 (42.49, 56.82) | 0.621 |
| Kwantitatieve CEUS | Tijd tot piek (TTP), s | 17.78 (16.47, 19.30) | 20.42 (17.53, 23.47) | 0.045 |
| Kwantitatieve CEUS | Aankomsttijd (AT), s | 9.88 (8.23, 11.53) | 9.88 (8.64, 11.53) | 0.1 |
| Kwantitatieve CEUS | Stijgtijd (RT), s | 8.43 (6.92, 9.55) | 9.55 (7.00, 12.11) | 0.164 |
| Kwantitatieve CEUS | Gemiddelde transitietijd (MTT), s | 69.38 (60.17, 87.84) | 82.82 (64.22, 99.15) | 0.102 |
| Kwantitatieve CEUS | Tijd tot halve piekintensiteit (THP), s | 81.62 (70.53, 99.93) | 95.34 (73.60, 109.44) | 0.157 |
| SRUS microvasculair | ||||
| SRUS microvasculair | Vatenratio, % | 56.29 (43.34, 71.44) | 57.81 (41.49, 70.24) | 0.772 |
| SRUS microvasculair | Complexiteitsniveau | 1.68 (1.59, 1.73) | 1.62 (1.57, 1.69) | 0.083 |
| SRUS microvasculair | Microvasculaire dichtheid—maximum | 15.24 (10.59, 17.88) | 13.28 (9.60, 15.92) | 0.142 |
| SRUS microvasculair | Microvasculaire dichtheid—minimum | 0.07 (0.05, 0.07) | 0.06 (0.04, 0.07) | 0.385 |
| SRUS microvasculair | Microvasculaire dichtheid—gemiddeld | 6.20 (3.46, 7.45) | 4.71 (3.74, 6.78) | 0.161 |
| SRUS microvasculair | Microvasculaire dichtheid—SD | 3.15 (2.12, 3.64) | 2.56 (1.94, 3.04) | 0.085 |
| SRUS microvasculair | Perfusie-index | 6.81 (4.53, 9.05) | 7.12 (4.52, 9.90) | 0.666 |
| SRUS microvasculair | Maximale stroomsnelheid, mm/s | 25.13 (22.24, 26.43) | 26.32 (23.86, 28.00) | 0.152 |
Tabel 2: Basiskenmerken van 30 benigne en 38 maligne schildklierknobbels. Demografische basiskenmerken en beeldvormingskenmerken voor benigne (n = 30) en maligne (n = 38) knobbels. Waarden zijn n (%) of mediaan (interkwartielafstand). Referentielabels werden toegewezen op basis van echogeleide FNAC; postoperatieve histopathologie was niet beschikbaar. Afkortingen: EUS = contrast-enhanced ultrasound; SRUS = Super-resolution ultrasound.
| Classificator | Nauwkeurigheid | Sensitiviteit | Specificiteit | Precisie | F1-score | ROC-AUC | |
| Random Forest | StratifiedGroupKFold-validatie | 0.548 ± 0.176 | 0.573 ± 0.297 | 0.572 ± 0.105 | 0.603 ± 0.139 | 0.555 ± 0.204 | 0.633 ± 0.137 |
| gepoolde OOF | 0.559 | 0.553 | 0.567 | 0.618 | 0.583 | 0.579 | |
| SVM | StratifiedGroupKFold-validatie | 0.686 ± 0.120 | 0.850 ± 0.180 | 0.495 ± 0.204 | 0.678 ± 0.154 | 0.740 ± 0.118 | 0.690 ± 0.164 |
| gepoolde OOF | 0.691 | 0.842 | 0.5 | 0.681 | 0.753 | 0.655 | |
| Beslissingsboom | StratifiedGroupKFold-validatie | 0.429 ± 0.073 | 0.492 ± 0.229 | 0.402 ± 0.247 | 0.514 ± 0.169 | 0.468 ± 0.117 | 0.447 ± 0.073 |
| gepoolde OOF | 0.426 | 0.474 | 0.367 | 0.486 | 0.48 | 0.42 | |
| XGBoost | StratifiedGroupKFold-validatie | 0.541 ± 0.151 | 0.494 ± 0.197 | 0.595 ± 0.137 | 0.587 ± 0.228 | 0.530 ± 0.202 | 0.571 ± 0.163 |
| gepoolde OOF | 0.544 | 0.5 | 0.6 | 0.613 | 0.551 | 0.594 | |
| Gradient Boosting | StratifiedGroupKFold-validatie | 0.544 ± 0.099 | 0.500 ± 0.091 | 0.550 ± 0.213 | 0.624 ± 0.087 | 0.546 ± 0.053 | 0.579 ± 0.124 |
| gepoolde OOF | 0.544 | 0.5 | 0.6 | 0.613 | 0.551 | 0.555 |
Tabel 3: Prestaties bij vijfvoudige patiëntgegroepeerde kruisvalidatie en gepoolde OOF-prestaties.Alle noduli van dezelfde patiënt werden aan dezelfde fold toegewezen. Waarden zijn het gemiddelde ± SD over vijf StratifiedGroupKFold-validatiefolds. De 68 noduli waren afkomstig van 63 patiëntengroepen; elke fold hield 12–5 noduli uit 12–13 patiëntengroepen apart. Elke gepoolde OOF-waarde maakt gebruik van één voorspelling per nodulus, gedaan in de validatiefold waarin alle noduli van die patiënt waren uitgesloten. Figuur 3 rapporteert de overeenkomstige gepoolde OOF-confusiematrices. Afkortingen: OOF = out-of-fold; SVM = Support Vector Machine.
| Rangschikking | Kenmerk | Gemiddelde |SHAP| | Vouwwoud SD van het gemiddelde |SHAP| |
| 1 | Microcalcificatie | 0.0357 | 0.023 |
| 2 | Vergroting na contrasttoediening | 0.0331 | 0.0165 |
| 3 | Homogeniteit van de contrastversterking | 0.0207 | 0.008 |
| 4 | Geslacht | 0.0194 | 0.0109 |
| 5 | Standaarddeviatie van de stroomsnelheid | 0.0159 | 0.01 |
| 6 | MVD-gemiddelde | 0.0124 | 0.0086 |
| 7 | Gemiddelde transitietijd | 0.0118 | 0.0069 |
| 8 | Minimale stroomsnelheid | 0.0107 | 0.0061 |
| 9 | Contrastversterkingspatroon | 0.0103 | 0.0112 |
| 10 | MVD SD | 0.0102 | 0.0077 |
Tabel 4: Mondiale OOF SHAP feature-rangschikking voor de SVM. SHAP-waarden kwantificeren bijdragen aan de malignantiewaarschijnlijkheid van de SVM. Elk nodulus werd één keer verklaard in de eigen uitgesloten, op patiënt gegroepeerde validatie-fold. Mondiale waarden zijn de gemiddelde absolute SHAP-waarden over 68 OOF-verklaringen; fold SD is de SD van de fold-specifieke gemiddelde absolute waarden over vijf folds. Rangschikkingen zijn model-specifieke exploratieve samenvattingen en zijn geen causale effecten, onafhankelijke biomarkers of klinische drempelwaarden. Afkortingen: OOF = out-of-fold; SVM = Support Vector Machine; MVD = microvascular density; SHAP = SHapley Additive exPlanations.
Discussie
Huidige diagnostische benaderingen voor schildklierknobbels vertrouwen voornamelijk op conventioneel echografisch onderzoek, dat inherent afhankelijk blijft van de uitvoerder en onderhevig is aan inter-observervariabiliteit5 en het onvermogen om microvasculatuur onder de diffractielimiet te visualiseren. Voor zover wij weten is onze studie de eerste uitgebreide evaluatie van meerdere machine learning-algoritmen toegepast op super-resolutie echografie (SRUS) microvasculaire beeldgegevens, waarmee een objectieve kwantitatieve beoordeling van het risico op PTC in schildklierknobbels in een onderzoekssetting is bereikt.
De belangrijkste bijdrage van deze studie is een analytisch kader op patiëntniveau dat lokalisatiegebaseerde contrast-microbel SRUS-metingen integreert met B-mode echografie, Color Doppler, kwalitatieve en kwantitatieve CEUS en klinische variabelen om schildklierknobbels te classificeren. De nieuwheid ligt in het incorporeren van experimenteel gemeten microvasculaire informatie in een vooraf gespecificeerde multimodale set van 25 kenmerken en het evalueren hiervan middels lekbestendige patiëntgroepering, in plaats van in een nieuwe classifier-architectuur. Alle knobbels van dezelfde patiënt werden in één enkele fold gehouden; de SVM-scaler werd alleen gefit op elke trainingsfold; en de modelbeoordeling maakte gebruik van vijfvoudige patiëntgegroepeerde validatie, gepoolde OOF-voorspellingen en een gerichte OOF SHAP-analyse. Binnen dit kader vertoonde de SVM de hoogste gemiddelde nauwkeurigheid (0,686 ± 0,120) en gemiddelde ROC-AUC (0,690 ± 0,164), maar de gepoolde OOF-specificiteit was slechts 0,50 en de prestaties varieerden per fold. Gecombineerd vestigen deze bevindingen een reproduceerbare aanpak voor het evalueren van gecombineerde microvasculaire en conventionele echografiegegevens op patiëntniveau, terwijl ze tegelijkertijd gebieden aanstippen die verdere verfijning vereisen vóór klinische implementatie.
Eerder onderzoek naar de schildklier stelde de haalbaarheid van contrast-microbubble SRUS vast en rapporteerde verschillen op groepsniveau in de microvasculaire doorstroming in een pilotcohort van 24 noduli26. Onze studie breidt dat bewijs van imaging-haalbaarheid uit op drie specifieke punten. Ten eerste werden SRUS-afgeleide vaten-densiteit, stroomsnelheid en perfusiemetingen geanalyseerd samen met B-mode microcalcificaties, Color Doppler intranodulaire vasculariteit, kwalitatieve en kwantitatieve CEUS, en leeftijd en geslacht, in plaats van als een geïsoleerde SRUS-vergelijking. Ten tweede werd de patiënt gedurende de preprocessing en validatie als de scheidingseenheid behandeld, waardoor werd voorkomen dat noduli van dezelfde patiënt zowel in de trainings- als in de validatiedata voorkwamen. Ten derde koppelde hetzelfde patiëntgegroepeerde raamwerk de modelprestaties aan gepoolde OOF-voorspellingen en een gerichte OOF SHAP-analyse. Samen verbinden deze elementen acquisitie, kwantitatieve microvasculaire karakterisering, modelevaluatie en verklaring in één reproduceerbare workflow, wat een basis vormt waarop toekomstige studies kunnen voortbouwen.
We hebben een aantal recente studies geïdentificeerd naar de toepassing van AI en deep learning bij de diagnose van maligne schildkliernoduli. Het is nuttig om onze benadering van deze te onderscheiden. Feng et al. ontwikkelden een multicenter, multimodaal model voor preoperatieve risicostratificatie van papillair schildkliercarcinoom27, terwijl Gatta et al. extern geëvalueerde machine-learningmodellen synthetiseerden voor de diagnose benigne versus maligne op basis van conventionele echobeelden van de schildklier28. Li et al. pasten computationele single-image super-resolutie toe op conventionele echografie voor noduluslokalisatie29, en He et al. gebruikten GAN-enhanced B-mode radiomics om een niet-diagnostisch (Bethesda I) FNA-resultaat te voorspellen30. Geometry-aware, transfer-learning en Transformer-gebaseerde benaderingen illustreren verder de algoritmische diversiteit van onderzoek naar schildklier-echografie31. Deze studies maken gebruik van conventionele echobeelden, multimodale klinische of beeldvormingsvariabelen, of computationeel verbeterde beeldrepresentaties; zij lokaliseren geen geïnjecteerde contrast-microbellen en kwantificeren niet direct de microvasculaire dichtheid en flow op laesieniveau. Habchi et al. pasten een op VGG19 gebaseerd transfer learning-framework toe op conventionele echobeelden van de schildklier en rapporteerden een hoge classificatienauwkeurigheid op een publieke dataset32. Hoewel hun werk het potentieel van deep learning in dit veld aantoonde, was het uitsluitend gebaseerd op B-mode beeldkenmerken.
In vergelijking hiermee is de specifieke bijdrage hier het gebruik van lokalisatie-gebaseerde SRUS om experimenteel gemeten microvasculaire variabelen te verkrijgen, de integratie daarvan met conventionele echografie- en CEUS-kenmerken, en hun evaluatie per patiëntgroep. De geciteerde studies blijven complementair in plaats van directe prestatievergelijkers, omdat hun inputs, eindpunten, referentiestandaarden en validatieontwerpen verschillen; wij beschouwen deze complementariteit als een kracht, aangezien het wijst op meerdere onafhankelijke wegen naar een verbeterde risicostratificatie. Opmerkelijk is dat onze bevindingen ook complementair zijn aan deep learning-gebaseerde benaderingen, zoals het geometrie-bewuste Bandelet Transform-raamwerk van Habchi et al.31 en de transfer learning-benchmarks van Xu et al., die zich richten op conventionele B-mode beeldclassificatie in plaats van kwantitatieve hemodynamische biomarkers3—fundamenteel verschillende inputmodaliteiten die verschillende aspecten van de tumorbiologie vastleggen.
Onze resultaten wijzen op significante verschillen in de prestaties van de vijf evaluatieclassificatoren. SVM presteert het best wat betreft de gemiddelde nauwkeurigheid (0,686 ± 0,120) en ROC-AUC (0,690 ± 0,164), en vertoont de laagste standaarddeviatie bij kruisvalidatie, wat de robuuste prestatie bij taken met kleine steekproeven aantoont. Gepoolde OOF-validatie bevestigde verder dat de sensitiviteit van de SVM 84,2% was (32 van de 38 maligne noduli werden correct geïdentificeerd), en de F1-score was 0,753, de hoogste van alle modellen. Deze krachtige detectiecapaciteit heeft een aanzienlijke waarde in de klinische praktijk, aangezien een gemiste diagnose tot ernstige gevolgen kan leiden. De specificiteit was echter slechts 50,0% (15 van de 30 benigne noduli werden verkeerd geclassificeerd), een patroon dat een zorgvuldige interpretatie vereist. Deze bescheiden specificiteit weerspiegelt waarschijnlijk de hoogdimensionale aard van onze dataset (25 predictoren versus 30 benigne monsters). In een dergelijke schaarse kenmerkruimte wordt de beslissingsgrens van de SVM onevenredig beïnvloed door een paar benigne noduli met maligne-achtige microvasculaire kenmerken, waardoor de classificator wordt gedwongen een conservatieve strategie te hanteren — waarbij ambigue gevallen als maligne worden gelabeld — om fout-negatieven te minimaliseren. Vanuit een klinisch perspectief is deze afruil acceptabel in screeningsscenario's; de gevolgen van een gemiste diagnose van PTC kunnen veel ernstiger zijn dan die van een onnodige FNAC. In toekomstig onderzoek is het raadzaam om prioriteit te geven aan een grotere steekproefcohort, in het bijzonder door meer benigne monsters toe te voegen, en om opnieuw cost-sensitive learning of methoden voor dimensionaliteitsreductie te proberen om de sensitiviteit te behouden terwijl de specificiteit wordt verbeterd.
RF vertoont een gemiddelde nauwkeurigheid (0,548 ± 0,176), wat lager is dan bij SVM. RF toonde echter een gebalanceerde gepoolde OOF-prestatie (nauwkeurigheid 55,9%, sensitiviteit 5,3%, specificiteit 56,7%), wat waardevol is voor klinische beslissingsondersteunende systemen. De op onzuiverheid gebaseerde belangrijkheid classificeerde de gemiddelde MVD, de gemiddelde stroomsnelheid en de perfusie-index als leidende variabelen, wat duidt op een betekenisvol SRUS-signaal. XGBoost en Gradient Boosting presteerden gemiddeld; geen van beide presteerde beter dan RF, waarschijnlijk door de gevoeligheid van hyperparameters gezien de beperkte steekproefomvang (n = 68) en conservatieve regularisatie. DT presteerde slecht (nauwkeurigheid 0,429, ROC-AUC 0,47), wat dicht bij willekeurig gokken ligt—een verwacht resultaat gezien de overfitting van een enkele boom. Samenvattend geniet SVM de voorkeur wanneer het maximaliseren van de sensitiviteit prioriteit heeft, terwijl RF voordelen biedt voor gebalanceerde prestaties en interpreteerbaarheid; beide vereisen verder onderzoek.
De gerichte SHAP-analyse identificeerde microcalcificatie, vergroting na contrastmiddeltoediening en homogeniteit van de contrastversterking als de drie belangrijkste voorspellende factoren, gevolgd door geslacht en SRUS-parameters, waaronder de standaarddeviatie van de bloedstroomsnelheid, de gemiddelde MVD en de gemiddelde transmissietijd. Conventionele kenmerken domineren, maar SRUS-parameters leveren onafhankelijke incrementele informatie. Het belang van SRUS-indicatoren is consistent met hun fysieke voordelen. SRUS kan een resolutie van ~10 µm bereiken, terwijl de resolutie van traditionele Doppler beperkt is tot ~20–30µm. Zhang et al. bevestigden dat maligne noduli een lagere stroomsnelheid (9.86 vs.16.76 mm/s, p < 0.01) en MVD vertonen19, wat de fibrotische en lymfatisch-dominante biologie van PTC weerspiegelt. Onze SHAP-bevindingen zijn biologisch plausibel, en de concordantie met TI-RADS-criteria ondersteunt klinisch betekenend patroonleren8.
Een nauwkeurige risicostratificatie heeft aanzienlijke implicaties voor de patiëntenzorg en de klinische besluitvorming. Als nodules met een hoog risico kunnen worden geïdentificeerd via ML-analyse van SRUS-beeldvorming, kunnen patiënten sneller een FNAC ondergaan, wat angst vermindert en kankerprogressie voorkomt. Geselecteerde nodules met een laag risico kunnen in plaats daarvan via echografie worden gemonitord. Kwantitatieve microvasculaire metingen kunnen dit proces uiteindelijk aanvullen naast de conventionele observaties. De huidige studie heeft echter niet getest of de output van de classifier de prestaties van artsen verbetert, onnodige FNAC-procedures vermindert of patiëntuitkomsten verandert. De output van het model mag daarom nog niet worden gebruikt om klinische beslissingen te sturen. In plaats daarvan moeten ze worden beschouwd als tools van onderzoeksniveau die een proof of principle aantonen en een basis bieden voor prospectieve evaluatie. Tijdens de analyse moeten alle nodules van één enkele patiënt in dezelfde fold blijven, en de preprocessing moet worden aangepast met gebruik van uitsluitend het trainingsgedeelte van die fold.
Er moeten enkele beperkingen in overweging worden genomen. Ten eerste was dit een retrospectieve, single-center studie van 68 noduli van 63 patiënten, zonder externe validatie; de kleine steekproefomvang kan het risico op overfitting verhogen. Desalniettemin biedt patiëntgegroepeerde kruisvalidatie enige geruststelling. Ten tweede waren alle referentielabels afgeleid van echogeleide FNAC in plaats van postoperatieve histopathologie. FNAC levert cytologisch bewijs, maar is niet gelijk aan postoperatieve histologische bevestiging en kan classificatiefouten introduceren, met name bij noduli die als benigne zijn aangemerkt, hoewel we de reikwijdte van benigne noduli hebben beperkt en BRAFV60E-gentesten bij alle noduli hebben uitgevoerd. Ten derde was de maligne groep beperkt tot noduli die via FNAC als PTC waren gerapporteerd, wat de generaliseerbaarheid naar andere schildkliermaligniteiten beperkt. Ten vierde werden aanvullende klinische factoren (schildklierfunctie, familiegeschiedenis) niet systematisch geregistreerd. Ten slotte is er geen systematische hyperparameteroptimalisatie, kalibratieanalyse of onafhankelijke vergelijking met deep-learning op basis van beelden uitgevoerd. Ondanks deze beperkingen bieden de consistentie van onze bevindingen met de biologische plausibiliteit en de bestaande literatuur vertrouwen in hun validiteit. Toekomstig onderzoek zou prioriteit moeten geven aan: (1) prospectieve multi-center validatie in grotere cohorten met postoperatieve histopathologie; (2) multimodale fusie waarbij SRUS wordt geïntegreerd met elastografie en conventionele echografie, (3) serumbiomarkers, gestandaardiseerde acquisitieprotocollen en kwaliteitscontrolecriteria34, en optimalisatie van feature engineering.
Concluderend demonstreert deze studie de haalbaarheid van het toepassen van conventionele machine learning-algoritmen op kwantitatieve SRUS-microvasculaire metingen om de exploratieve classificatie van schildklierknobbels te ondersteunen. SVM vertoonde een hoge sensitiviteit maar een beperkte specificiteit, wat de potentiële rol ervan als screeningshulpmiddel ondersteunt in plaats van als vervanging voor diagnostiek. Hoewel deze resultaten preliminair zijn, vestigen onze bevindingen een reproduceerbare, lekbestendige evaluatiepijplijn die prospectieve validatie in grotere cohorten rechtvaardigt.
Openbaarmakingen
De auteurs hebben geen belangenconflicten te verklaren.
Dankbetuigingen
De auteurs danken het personeel van de afdeling echografie van het Beijing Friendship Hospital, Capital Medical University, voor hun hulp bij de verzameling van patiëntgegevens.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Decision Tree classifier | scikit-learn | Version 1.5.2 | Machine learning-classifier |
| Fijnnaaldaspiratiebiopsienaald | Gebruikt voor echogeleide FNAC | ||
| Gradient Boosting classifier | scikit-learn | Version 1.5.2 | Machine learning-classifier |
| Intraveneuze katheter | Gebruikt voor contrasttoediening | ||
| Python | Python Software Foundation | Version 3.1.9 | Programmeertaal gebruikt voor de machine-learning-analyse |
| Random Forest classifier | scikit-learn | Version 1.5.2 | Machine learning-classifier |
| SHAP (permutation explainer) | SHAP Developers | Version 0.46.0 | Analyse van modeluitlegbaarheid |
| SonoVue contrastmiddel | Bracco | Ultrasound-contrastmiddel voor CEUS/SRUS-beeldvorming | |
| StandardScaler | scikit-learn | Version 1.5.2 | Kenmerkstandaardisatie voor de SVM-pipeline |
| Steriele normale zoutoplossing | Gebruikt voor intraveneuze spoeling na contrastinjectie | ||
| StratifiedGroupKFold | scikit-learn | Version 1.5.2 | Op patiënt gegroepeerde kruisvalidatie |
| Support Vector Machine (SVM) classifier | scikit-learn | Version 1.5.2 | Classifier met radial-basis-function kernel |
| U5-15LE linear-array transducer | VINNO Technology | U5-15LE | Lineaire echoprobe |
| ULTIMUS 9E echosysteem | VINNO Technology | ULTIMUS 9E | Echobeeldvormingssysteem gebruikt voor B-mode, Color Doppler, CEUS en SRUS-beeldvorming |
| XGBoost | XGBoost Developers | Version 2.1.1 | Gradient boosting-framework |
Referenties
- Mu C, et al. Mapping global epidemiology of thyroid nodules among general population: a systematic review and meta-analysis. Front Oncol. 2022;12:1029926.
- Moon JH, et al. Prevalence of thyroid nodules and their associated clinical parameters: a large-scale, multicenter-based health checkup study. Korean J Intern Med. 2018;33(4):753-62.
- Dean DS, Gharib H. Epidemiology of thyroid nodules. Best Pract Res Clin Endocrinol Metab. 2008;22(6):901-11.
- Uppal N, Collins R, James B. Thyroid nodules: global, economic, and personal burdens. Front Endocrinol (Lausanne). 2023;14:1113977.
- Durante C, et al. The diagnosis and management of thyroid nodules: a review. JAMA. 2018;319(9):914-24.
- Lim H, Devesa SS, Sosa JA, Check D, Kitahara CM. Trends in thyroid cancer incidence and mortality in the United States, 1974-2013. JAMA. 2017;317(13):1338-48.
- Gharib H, et al. American Association of Clinical Endocrinologists, American College of Endocrinology, and Associazione Medici Endocrinologi medical guidelines for clinical practice for the diagnosis and management of thyroid nodules—2016 update. Endocr Pract. 2016;22(5):622-39.
- Tessler FN, et al. ACR Thyroid Imaging, Reporting and Data System (TI-RADS): white paper of the ACR TI-RADS Committee. J Am Coll Radiol. 2017;14(5):587-95.
- Petranović Ovčariček P, et al. The 2025 ATA guidelines for differentiated thyroid cancer—ten years of professional debate and measured progress. Eur J Nucl Med Mol Imaging. 2026;53(4):2213-6.
- Christensen-Jeffries K, et al. Super-resolution ultrasound imaging. Ultrasound Med Biol. 2020;46(4):865-91.
- Carmeliet P. Angiogenesis in health and disease. Nat Med. 2003;9(6):653-60.
- Zhang B, et al. Utility of contrast-enhanced ultrasound for evaluation of thyroid nodules. Thyroid. 2010;20(1):51-7.
- Rago T, Vitti P. Role of thyroid ultrasound in the diagnostic evaluation of thyroid nodules. Best Pract Res Clin Endocrinol Metab. 2008;22(6):913-28.
- Xia S, et al. Super-resolution ultrasound and microvasculomics: a consensus statement. Eur Radiol. 2024;34(11):7503-13.
- Song P, Rubin JM, Lowerison MR. Super-resolution ultrasound microvascular imaging: is it ready for clinical use? Z Med Phys. 2023;33(3):309-23.
- Errico C, et al. Ultrafast ultrasound localization microscopy for deep super-resolution vascular imaging. Nature. 2015;527(7579):499-502.
- Couture O, Hingot V, Heiles B, Muleki-Seya P, Tanter M. Ultrasound localization microscopy and super-resolution: a state of the art. IEEE Trans Ultrason Ferroelectr Freq Control. 2018;65(8):1304-20.
- Gao JY, Hou C. Progresses and clinical application of super-resolution ultrasound imaging: a narrative review. Ultrasound J. 2025;17(1):29.
- Zhang G, et al. Ultrasound super-resolution imaging for the differential diagnosis of thyroid nodules: a pilot study. Front Oncol. 2022;12:978164.
- Wildman-Tobriner B, et al. Using artificial intelligence to revise ACR TI-RADS risk stratification of thyroid nodules: diagnostic accuracy and utility. Radiology. 2019;292(1):112-9.
- Toro-Tobon D, et al. Artificial intelligence in thyroidology: a narrative review of the current applications, associated challenges, and future directions. Thyroid. 2023;33(8):903-17.
- Peng S, et al. Deep learning-based artificial intelligence model to assist thyroid nodule diagnosis and management: a multicentre diagnostic study. Lancet Digit Health. 2021;3(4):e250-9.
- Chen C, et al. Deep learning to assist composition classification and thyroid solid nodule diagnosis: a multicenter diagnostic study. Eur Radiol. 2024;34(4):2323-33.
- Bini F, et al. Artificial intelligence in thyroid field: a comprehensive review. Cancers (Basel). 2021;13(19):4740.
- Habchi Y, Kheddar H, Himeur Y, Ghanem MC. Machine learning and transformers for thyroid carcinoma diagnosis. J Vis Commun Image Represent. 2026;115:104668.
- Zhang M, Wang X, Deng Y, Tang K. Multimodal ultrasound integration pathways and paradigm innovations in precision diagnosis and treatment of thyroid cancer. Acad Radiol. 2026. Epub ahead of print.
- Feng JW, et al. Development and validation of the multidimensional machine learning model for preoperative risk stratification in papillary thyroid carcinoma: a multicenter, retrospective cohort study. Cancer Imaging. 2025;25(1):98.
- Gatta E, et al. Machine learning for diagnosis of malignant thyroid nodules based on thyroid ultrasound: systematic review and meta-analysis of studies with external datasets. Eur J Radiol Open. 2026;16:100716.
- Li J, Guo Q, Peng S, Tan X. Super-resolution based nodule localization in thyroid ultrasound images through deep learning. Curr Med Imaging. 2024;20(1):e15734056269264.
- He S, et al. Super-resolution ultrasound radiomics for pre-FNA prediction of nondiagnostic (Bethesda I) thyroid nodules. Front Endocrinol (Lausanne). 2026;17:1710097.
- Habchi Y, Kheddar H, Ghanem MC, Hwaidi J. Adaptive bandelet transform and transfer learning for geometry-aware thyroid cancer ultrasound classification. Diagnostics (Basel). 2026;16(4):554.
- Habchi Y, Kheddar H, Himeur Y. Adaptive bandelet transform and transfer learning for geometry-aware thyroid cancer ultrasound classification [conference paper]. In: 2024 International Conference on Telecommunications and Intelligent Systems (ICTIS). IEEE; 2024. p. 1-6.
- Xu Y, Xu M, Geng Z, Liu J, Meng B. Thyroid nodule classification in ultrasound imaging using deep transfer learning. BMC Cancer. 2025;25(1):544.
- Gou TH, et al. Application value of super-resolution ultrasound imaging in the diagnosis of American College of Radiology Thyroid Imaging Reporting and Data System category 4 and 5 thyroid nodules. Zhongguo Yi Xue Ke Xue Yuan Xue Bao. 2026. doi:10.3881/j.issn.1000-503X.16808.