Deze cross-sectionele latente profielanalyse bij 1.420 Chinese studenten identificerde vier verschillende slaapprofielen aan de hand van de PSQI. Gezondere slaapprofielen waren significant geassocieerd met hogere niveaus van matig tot intensieve fysieke activiteit, wat wijst op slaappatroon-specifieke doelstellingen voor gezondheidsbevordering op de campus.
Een abonnement op JoVE is vereist om deze inhoud te bekijken. Log in of start vandaag met uw gratis proefperiode.
Onderzoeksartikel
Latente profielanalyse van slaappatronen en de associatie daarvan met fysieke activiteitsniveaus onder Chinese universiteitsstudenten
* These authors contributed equally
In dit artikel
Samenvatting
Samenvatting
Deze cross-sectionele studie was erop gericht om latente profielen van slaappatronen bij studenten te identificeren en de associaties daarvan met fysieke activiteitsniveaus (PA) te onderzoeken, om zo empirisch bewijs te leveren voor gerichte gezondheidsinterventies in universiteitsomgevingen. In totaal werden 1.420 studenten geworven via meerfasige gestratificeerde clustersteekproeven van drie uitgebreide universiteiten in Zuid-China. Slaapkwaliteit en PA werden respectievelijk beoordeeld met de Pittsburgh Sleep Quality Index (PSQI) en de International Physical Activity Questionnaire-Short Form (IPAQ-SF). Latente profielanalyse (LPA), chi-kwadraattoetsen en multinomiale logistische regressieanalyses werden uitgevoerd met behulp van geschikte statistische software. Op basis van modelgeschatte klaswaarschijnlijkheden werden vier latente slaapprofielen geïdentificeerd: gezonde slaap (44,7%), onvoldoende slaap (24,8%), slechte slaapkwaliteit (20,3%) en ernstige slaapstoornissen (10,2%); de overeenkomstige waargenomen proporties op basis van de meest waarschijnlijke klastoewijzing waren 45,0%, 25,0%, 20,0% en 10,0% (n = 639, 355, 284 en 142, respectievelijk). Geslacht en PA-niveau verschilden significant tussen de profielen. In vergelijking met studenten in de groep met ernstige slaapstoornissen waren studenten in de groep met gezonde slaap vaker geneigd om matige PA (odds ratio (OR) = 4,69, 95% betrouwbaarheidsinterval (CI): 2,92–7,51) en hoge PA (OR = 7,55, 95% CI: 4,41–12,91) te rapporteren. Studenten in de groep met onvoldoende slaap waren eveneens vaker geneigd om matige PA (OR = 2,98, 95% CI: 1,83–4,86) en hoge PA (OR = 5,02, 95% CI: 2,84–8,87) te rapporteren. De slaappatronen van studenten vertoonden een duidelijke heterogeniteit. Gunstige slaappatronen waren geassocieerd met hogere PA-niveaus. Vanwege het cross-sectionele ontwerp kunnen er geen causale relaties worden afgeleid. Gedifferentieerde interventiestrategieën moeten worden ontwikkeld op basis van subgroepspecifieke slaapkenmerken, en de bevordering van PA kan worden beschouwd als een potentieel gedragsdoel voor studenten met een slechte slaap.
Inleiding
Slaap is essentieel, niet alleen voor het behoud van basisphysiologische functies, maar ook voor het ondersteunen van de fysieke en mentale gezondheid, de cognitieve ontwikkeling en de emotionele regulatie1,2. In de hedendaagse snelを変ende samenlevingen zijn slaapstoornissen echter een wereldwijd probleem voor de volksgezondheid geworden. Slaapproblemen komen bijzonder veel voor bij studenten, die na hun intrede aan de universiteit vaak te maken krijgen met verminderd ouderlijk toezicht en kampen met academische druk, interpersoonlijke aanpassingsproblemen en overmatig gebruik van elektronische apparaten3. Epidemiologische studies hebben aangetoond dat ongeveer 25%–60% van de studenten wereldwijd variërende gradaties van een slechte slaapkwaliteit of slaapgebrek rapporteert4,5. Aanhoudende slaapproblemen kunnen de functie van het centrale zenuwstelsel verslechteren, wat leidt tot onoplettendheid en een afname van het geheugen; ze kunnen ook het risico op internaliserende mentale gezondheidsproblemen verhogen, zoals depressie en angst6,7, evenals het toekomstige risico op hart- en vaatziekten en het metabool syndroom8.
Eerdere slaapstudies hebben voornamelijk een variabele-gecentreerd analytisch perspectief gehanteerd, waarbij de slaapstatus op groepsniveau werd geëvalueerd aan de hand van totale scores van gestandaardiseerde schalen zoals de Pittsburgh Sleep Quality Index (PSQI) of de gemiddelde scores van specifieke dimensies9. Hoewel deze benadering een intuïtieve schatting geeft van de algemene ernst van de slaapstoornissen, gaat zij er impliciet van uit dat de onderzoekspopulatie homogeen is. In werkelijkheid is slaap een multidimensionaal fysiologisch proces dat slaapduur, slaaplatentie, slaapefficiëntie, nachtelijke ontwakkingen en overdag optredende disfunctie omvat10. Individuen met dezelfde totale PSQI-score kunnen aanzienlijk verschillende combinaties van symptomen vertonen; zo kan de ene student bijvoorbeeld primair moeite hebben met het inslapen, terwijl een andere student last heeft van vroegontwaken en slaperigheid overdag. In recente jaren is er toenemende aandacht voor persoons-gecentreerde benaderingen. Latente profielanalyse (LPA) kan niet-geobserveerde heterogene subgroepen in de data identificeren door de verschillen tussen profielen te maximaliseren en de verschillen binnen profielen te minimaliseren11,12. Met behulp van LPA kunnen onderzoekers specifieke slaapprofielen onder universiteitsstudenten nauwkeuriger karakteriseren13, waardoor preciezere doelwitten voor interventies kunnen worden vastgesteld.
Lichamelijke activiteit (LA) wordt breed aanbevolen door de Wereldgezondheidsorganisatie en andere richtlijnen voor de volksgezondheid als een hoeksteen van gezondheidsbevordering gedurende de gehele levensloop14,15. Empirische studies en meta-analyses hebben aangetoond dat regelmatige matige tot intensieve lichamelijke activiteit de cardiorespiratoire conditie kan verbeteren en de mortaliteit kan verminderen16,17, terwijl het ook helpt bij het verlichten van psychologische stress en het verbeteren van de cognitieve functie18,19. Lichamelijke activiteit wordt ook beschouwd als een effectieve niet-farmacologische interventie voor slaapproblemen20,21. Positieve associaties tussen lichamelijke activiteit en slaapkwaliteit zijn gerapporteerd in cohortstudies met objectieve apparatuur zoals accelerometers22,23,24 en in cross-sectionele studies op basis van zelfgerapporteerde vragenlijsten25,26. Bovendien lijken beweging en slaap een bidirectionele relatie te hebben: voldoende slaap kan de motivatie en het uithoudingsvermogen voor lichamelijke activiteit verhogen, terwijl energieverbruik overdag de slow-wave slaap 's nachts kan bevorderen27,28.
Hoewel er een brede overeenstemming bestaat over de voordelen van fysieke activiteit voor de algemene slaapkwaliteit, vertoont de bestaande literatuur verschillende beperkingen. De meeste studies hebben fysieke activiteit behandeld als een onafhankelijke variabele die een enkele slaapscore voorspelt, waardoor de mogelijkheid is over het hoofd gezien dat verschillende slaappatronen kunnen corresponderen met verschillende combinaties van levensstijlkenmerken29,30. Of fysieke activiteitsniveaus verschillen tussen latente slaapprofielen bij studenten aan de hogeschool of universiteit, is nog onvoldoende begrepen.
Tegen deze achtergrond was dit onderzoek erop gericht om: (1) met behulp van LPA latente profielen te identificeren op basis van multidimensionale indicatoren van slaapkwaliteit bij Chinese universiteitsstudenten; en (2) de associaties tussen slaapprofielen en fysieke activiteitsniveaus (laag, matig en hoog) te onderzoeken na correctie voor demografische variabelen. We stelden hypothese dat er meerdere heterogene slaapprofielen aanwezig zouden zijn onder universiteitsstudenten en dat studenten met een gezond slaappatroon vaker matig tot intensieve fysieke activiteitsniveaus zouden bereiken dan studenten met ernstige slaapstoornissen.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Protocol
Deze studie is goedgekeurd door de Biomedische Ethiekcommissie van Jishou University (Goedkeuringsnummer JSDX-2023-034). Alle deelnemers waren voltijdse bachelorstudenten in de leeftijd van 18–25 jaar en gaven voorafgaand aan deelname schriftelijke geïnformeerde toestemming. Toestemming is verkregen van de deelnemende universiteiten. De enquêtegegevens werden uitsluitend gebruikt voor academisch onderzoek en werden anoniem geanalyseerd. De studie is uitgevoerd in overeenstemming met de Verklaring van Helsinki en de lokale institutionele vereisten.
Werving van deelnemers en steekproefontwerp
Tussen september en december 2025 werd een cross-sectioneel onderzoek uitgevoerd onder bachelorstudenten van drie comprehensive universities in Zuid-China, waarbij gebruik werd gemaakt van een multistage stratified cluster random sampling design. In de eerste fase werden drie comprehensive universities geselecteerd uit een lijst van openbare comprehensive universities in Zuid-China via gestratificeerde steekproeftrekking, waarbij de strata werden gedefinieerd op basis van de provinciale administratieve regio om geografische representativiteit te waarborgen. In de tweede fase werden binnen elke geselecteerde universiteit willekeurig twee tot drie intacte klassen per jaarlaag (eerste- tot vierdejaars) gekozen als clustersteekproefeenheden met behulp van door de computer gegenereerde willekeurige getallen, wat resulteerde in totaal 28 klassen over de drie universiteiten. Alle studenten in de geselecteerde klassen werden uitgenodigd om deel te nemen, zoals weergegeven in Figuur 1. De inclusiecriteria waren als volgt: (1) status als fulltime bachelorstudent; (2) een leeftijd tussen 18 en 25 jaar; en (3) vrijwillige deelname met schriftelijke geïnformeerde toestemming. De exclusiecriteria waren: (1) recente ernstige fysieke aandoeningen of contra-indicaties voor lichaamsbeweging, zoals fracturen of ernstige hartaandoeningen; (2) huidig gebruik van psychiatrische medicatie, zoals behandeling voor ernstige depressie of schizofrenie; en (3) een invultijd van de vragenlijst van minder dan 180 s of duidelijke logische inconsistenties, zoals het selecteren van dezelfde optie voor alle items. In totaal werden 1.50 vragenlijsten verspreid. Van de 80 ongeldige vragenlijsten die tijdens de datacleaning werden uitgesloten, werden er 24 uitgesloten vanwege een invultijd onder de 180 s, 20 vanwege logische inconsistenties (bijv. identieke antwoorden op alle items of tegenstrijdige antwoorden), 18 vanwege een leeftijd buiten de range van 18–25 jaar, 1 vanwege overmatig veel ontbrekende gegevens (meer dan 20% van de items) en 7 vanwege zelfgerapporteerde ernstige fysieke aandoeningen of huidig gebruik van psychiatrische medicatie. Dit liet 1.420 geldige vragenlijsten over voor analyse, met een effectieve responsgraad van 94,67%.
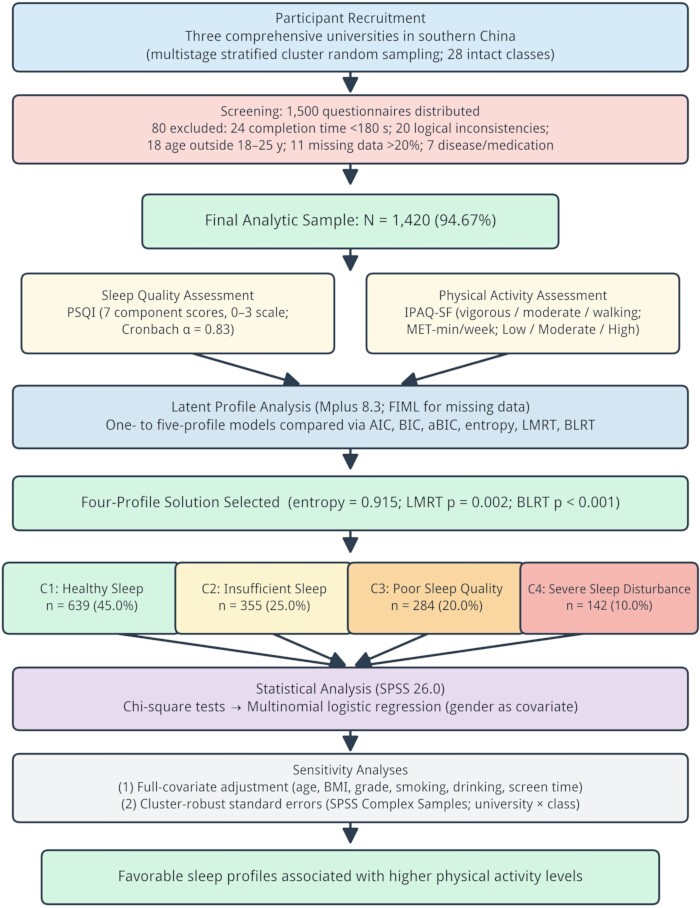
Figuur 1Studieopzet en analytische workflow. Schematisch overzicht van de werving en screening van deelnemers (1.50 verspreide vragenlijsten; 80 uitgesloten; N = 1.420 geïncludeerd), beoordeling met de PSQI en IPAQ-SF, latente profielanalyse (vergelijking van modellen met één tot vijf profielen met behulp van AIC, BIC, aBIC, entropie, LMRT en BLRT), toewijzing aan vier slaapprofielen, bivariante chi-kwadraattoetsen, multinomiale logistische regressie met geslacht als covariabele en sensitiviteitsanalyses (volledige correctie voor covariabelen en cluster-robuuste standaardfouten). Klik hier om een grotere versie van deze figuur te bekijken.
Beoordeling van demografie en levensstijl
Een zelfontworpen vragenlijst werd gebruikt om demografische en sociologische kenmerken te verkrijgen, waaronder geslacht (man/vrouw), leeftijd (in jaren), studiejaar (eerste/tweede/derde/vierde jaar), plaats van herkomst (stedelijk/landelijk), bodymassindex (BMI), rookgeschiedenis, drinkgeschiedenis en gemiddelde dagelijkse schermtijd. De BMI werd berekend als het lichaamsgewicht in kilogram gedeeld door het kwadraat van de lengte in meters (BMI = gewicht [kg] / lengte [m]2). Zelfgerapporteerde lengte en gewicht werden vóór de analyse gescreend op onwaarschijnlijke waarden; gevallen met een lengte <140 cm of >20 cm, een gewicht <30 kg of >150 kg, of een BMI <12 kg/m2 of >40 kg/m2 werden gemarkeerd en geverifieerd aan de hand van de originele dossiers, waarbij bevestigde uitschieters werden uitgesloten. De rookstatus werd gecategoriseerd als nooit, incidenteel (roken op sommige dagen, maar niet dagelijks) of regelmatig (dagelijks roken), gebaseerd op het zelfgerapporteerde rookgedrag gedurende de afgelopen maand. Alcoholconsumptie werd over de afgelopen maand gecategoriseerd als nooit, incidenteel (minder dan één keer per week drinken) of regelmatig (minstens één keer per week drinken). De gemiddelde dagelijkse schermtijd werd beoordeeld door deelnemers te vragen het totale aantal uren per dag dat aan smartphones, computers, tablets en televisie werd besteed over de afgelopen maand te rapporteren, wat werd geregistreerd als een continue variabele. De vragenlijst is voorafgaand aan de formele gegevensverzameling voorlopig getest onder 30 bachelorstudenten om de duidelijkheid van de items en de voltooiingstijd te beoordelen; op basis van de feedback uit deze pilottest zijn kleine aanpassingen in de bewoordingen doorgevoerd. Eerdere studies hebben gesuggereerd dat deze variabelen de associatie tussen slaap en fysieke activiteit kunnen beïnvloeden30,31. Alle instrumenten, software en materialen die in deze studie zijn gebruikt, staan vermeld in de Tabel met Materialen.
Beoordeling van de slaapkwaliteit
De PSQI, ontwikkeld door Buysse et al.9, werd gebruikt om de slaapkwaliteit van de deelnemers over de afgelopen maand te beoordelen. De schaal bevat 19 zelfgerapporteerde items die zeven componenten vormen: subjectieve slaapkwaliteit, slaaplatentie, slaapduur, gebruikelijke slaapefficiëntie, slaapstoornissen, gebruik van hypnotica en overdag disfunctie. Elke component wordt gescoord van 0 (geen problemen) tot 3 (ernstige problemen). De scores van deze zeven continue componenten werden gebruikt als geobserveerde indicatoren voor LPA. De PSQI heeft een goede betrouwbaarheid en validiteit aangetoond onder populaties van studenten in China en internationaal30. In de huidige studie was de Cronbachs alpha voor de schaal 0,83.
Beoordeling van fysieke activiteit
De IPAQ-SF, ontwikkeld door Craig et al.32, werd gebruikt om de fysieke activiteit van de deelnemers over de voorafgaande zeven dagen te beoordelen. De vragenlijst registreert de frequentie (dagen/week) en duur (minuten/dag) van intensieve fysieke activiteit, matig-intensieve fysieke activiteit en wandelen. De metabole equivalenten van taken (MET)-waarden werden berekend volgens het IPAQ-scoreprotocol: wandelen MET-min/week = 3,3 × duur × frequentie; matig-intensief MET-min/week = 4,0 × duur × frequentie; en intensief MET-min/week = 8,0 × duur × frequentie. De MET-waarden voor de drie activiteitstypen werden opgeteld om de totale fysieke activiteit te bepalen. Deelnemers werden ingedeeld in hoge PA, matige PA en lage PA volgens de IPAQ-SF-scorecriteria die zijn gevalideerd bij universiteitsstudenten3. Hoge PA werd gedefinieerd als intensieve activiteit op ten minste drie dagen met een totaal fysiek activiteitsniveau van ten minste 1.500 MET-min/week, of elke combinatie van wandelen, matig-intensieve of intensieve activiteiten op zeven of meer dagen met een totaal fysiek activiteitsniveau van ten minste 3.0 MET-min/week. Matige PA werd gedefinieerd als intensieve activiteit op ten minste drie dagen gedurende ten minste 20 minuten per dag, of matig-intensieve activiteit en/of wandelen op ten minste vijf dagen gedurende ten minste 30 minuten per dag, of elke combinatie van activiteiten die ten minste 60 MET-min/week bereikte. Lage PA werd gedefinieerd als het niet voldoen aan de criteria voor matige of hoge PA. De datareiniging volgde het officiële IPAQ-scoreprotocol: deelnemers die meer dan 16 h totale activiteit per dag rapporteerden, werden uitgesloten; de dagelijkse duur per categorie werd afgekapt op 180 min vóór de MET-minuutberekening; en gevallen met logisch inconsistente antwoorden werden tijdens de datareiniging verwijderd.
Statistische analyse
Voer eerst een LPA uit met behulp van software voor latent profielmodelleren (zie Tabel met Materialen)34. Van de 1.420 deelnemers hadden er 3 (2,3%) gedeeltelijk ontbrekende gegevens in de PSQI, waarbij 69 van de 9.940 antwoorden op componentniveau ontbraken (0,69%; d.w.z. 1.420 deelnemers × zeven PSQI-componentscores). De full-information maximum likelihood (FIML)-methode werd gebruikt om deze ontbrekende waarden te behandelen onder de aanname van missing-at-random. Modellen met één tot vijf profielen werden sequentieel geschat. De modelpassing werd geëvalueerd met behulp van het Akaike-informatiecriterium (AIC), het Bayesian-informatiecriterium (BIC), het op steekproefomvang aangepaste BIC (aBIC), entropie, de Lo-Mendell-Rubin likelihood ratio test (LMRT) en de bootstrap likelihood ratio test (BLRT). Lagere AIC-, BIC- en aBIC-waarden duiden op een betere relatieve passing, terwijl entropiewaarden dichter bij 1 duiden op een hogere classificatienauwkeurigheid. De LMRT en BLRT werden gebruikt om te bepalen of een model met k profielen significant beter paste dan een model met k − 1 profielen. De optimale profieloplossing werd geselecteerd door gezamenlijk te kijken naar statistische passing-indices, entropie, klassengrootte (geen enkel profiel mocht minder dan 5% van de steekproef bevatten) en inhoudelijke interpreteerbaarheid, volgens vastgestelde richtlijnen voor latente profielanalyse11,35. Nadat de optimale profieloplossing was geselecteerd, werd het meest waarschijnlijke klaslidmaatschap van individuen geëxporteerd naar statistische analyse-software (zie Tabel met Materialen) voor verdere analyses. Pearson chi-kwadraattoetsen werden gebruikt om verschillen in demografische kenmerken en fysieke activiteitsniveaus tussen de slaapprofielen te onderzoeken. Bivariate chi-kwadraattoetsen toonden aan dat alleen geslacht en fysiek activiteitsniveau significant verschilden tussen de vier slaapprofielen (beide p < 0,01), terwijl leeftijd, leerjaar, BMI, roken, drinken en schermtijd dat niet deden (allemaal p > 0,05; zie Aanvullende Tabel 1). Daarom werd alleen geslacht als covariaat opgenomen in het multinomiaal logistisch regressiemodel, in overeenstemming met het principe van parsimonie. Een sensitiviteitsanalyse waarbij werd gecorrigeerd voor alle verzamelde covariaten leverde hetzelfde patroon en dezelfde significantie van resultaten op (Aanvullende Tabel 2). Multinomiale logistische regressie werd uitgevoerd met het fysieke activiteitsniveau als afhankelijke variabele (lage PA = 0, matige PA = 1, hoge PA = 2) en het slaapprofiel als de belangrijkste onafhankelijke variabele. Odds ratio's (ORs) en 95% betrouwbaarheidsintervallen (CIs) werden berekend. Alle toetsen waren tweezijdig en de statistische significantie werd vastgesteld op p < 0,05. Omdat deelnemers werden geworven via intacte klassen genest binnen universiteiten, hebben we een sensitiviteitsanalyse uitgevoerd met de complex-samples module van de statistische software (zie Tabel met Materialen), waarbij universiteit en klas als clusteringsvariabelen zijn gespecificeerd om ontwerp-gecorrigeerde standaardfouten te verkrijgen. De resultaten waren consistent met die van de standaard multinomiale logistische regressie (Aanvullende Tabel 3). De gedeïdentificeerde ruwe dataset met Engelse variabelenamen en een codeboek is beschikbaar als Aanvullend Bestand 1.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Resultaten
Er werden modellen met één tot vijf latente profielen geëxtraheerd. Zoals weergegeven in Tabel 1, namen de AIC, BIC en aBIC af naarmate het aantal profielen toenam. Het vier-profielenmodel had de hoogste entropiewaarde (0,915), en zowel de LMRT als de BLRT waren significant (p < 0,01). Daarentegen was de LMRT voor het vijf-profielenmodel niet significant (p = 0,085) en nam de entropie af tot 0,80. Daarom werd, hoewel het vijf-profielenmodel lagere informatiecriteria vertoonde, het vier-profielenmodel ...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Discussie
Met behulp van een relatief grote dwarsdoorsnedensteekproef paste deze studie een persoonscentrerende LPA-benadering toe om vier heterogene slaapprofielen te identificeren onder Chinese universiteitsstudenten en onderzocht vervolgens de associaties tussen deze profielen en verschillende niveaus van fysieke activiteit. De bevindingen bieden een nuttig perspectief voor het begrijpen van de clustering van slaap- en bewegingsgerelateerde gezondheidsgedragingen bij universiteitsstudenten en bieden preciezere doelwitten voor p...
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Openbaarmakingen
De auteur(s) verklaren dat dit werk is uitgevoerd in afwezigheid van commerciële of financiële relaties die als een potentieel belangenconflict kunnen worden beschouwd.
Dankbetuigingen
Wij zijn dankbaar aan de deelnemende universiteiten en alle studenten die de enquête hebben ingevuld. Dit werk werd ondersteund door het Humanities and Social Sciences Research Project for Young Scholars van het Ministerie van Onderwijs (Grant No. 23YJC890059); het Hunan Provincial Education and Teaching Reform Research Project (Grant No. 202502000069).
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| Vragenlijst over demografie en levensstijl | Zelf ontworpen door het onderzoeksteam | N/A | Gebruikt voor het verzamelen van gegevens over geslacht, leeftijd, leerjaar, plaats van herkomst, body mass index, rookgeschiedenis, drinkgeschiedenis en gemiddelde dagelijkse schermtijd. |
| Pittsburgh Sleep Quality Index (PSQI) | Buysse et al., 1989 | DOI: 10.1016/0165-1781(89)90047-4 | Gebruikt om de slaapkwaliteit over de afgelopen maand te beoordelen. Zeven component-scores werden gebruikt als geobserveerde indicatoren voor latente profielanalyse. |
| International Physical Activity Questionnaire-Short Form (IPAQ-SF) | Craig et al., 2003 | DOI: 10.1249/01.MSS.0000078924.61453 .FB | Gebruikt om wandelen, fysieke activiteit van matige intensiteit en intensieve fysieke activiteit over de afgelopen zeven dagen te beoordelen. |
| Schriftelijk formulier voor geïnformeerde toestemming | Onderzoeksteam en deelnemende universiteiten | Ethische goedkeuring No. JSDX-2023-0034 | Gebruikt om de vrijwillige deelname van bachelorstudenten in de leeftijd van 18-25 jaar te documenteren. |
| Procedure voor gegevensverzameling via vragenlijsten | Deelnemende universiteiten in Zuid-China | N/A | Gebruikt voor meerfasige gestratificeerde clustersteekproeven en het afnemen van vragenlijsten tussen september en december 2025. |
| Mplus | Muthen & Muthen | Versie 8.3 | Gebruikt voor het uitvoeren van latente profielanalyse op basis van de zeven PSQI component-scores. |
| IBM SPSS Statistics | IBM | Versie 26.0 | Gebruikt voor het uitvoeren van chi-kwadraattoetsen en multinomiale logistische regressieanalyses. |
| Microsoft Excel | Microsoft | N/A | Gebruikt voor het voorbereiden van afzonderlijke JoVE-tabelbestanden voor upload. |
Referenties
- Chaput JP, et al. Sleeping hours: What is the ideal number and how does age impact this? Nat Sci Sleep. 2018;10:421–430.
- Li J, et al. Sleep in normal aging. Sleep Med Clin. 2018;13(1):1–11.
- Becker SP, et al. Sleep in a large, multi-university sample of college students: Sleep problem prevalence, sex differences, and mental health correlates. Sleep Health. 2018;4(2):174–181.
- Lund HG, et al. Sleep patterns and predictors of disturbed sleep in a large population of college students. J Adolesc Health. 2010;46(2):124–132.
- Chen X, et al. Sleep characteristics and health-related quality of life among a national sample of American young adults. Sleep. 2014;37(4):793–799.
- Steptoe A, et al. Sleep duration and health in young adults. Arch Intern Med. 2006;166(16):1689–1692.
- Zhai L, et al. Sleep duration and depression among adults: A meta-analysis of prospective studies. Depress Anxiety. 2015;32(9):664–670.
- Grandner MA, et al. Sleep: Important considerations for the prevention of cardiovascular disease. Curr Opin Cardiol. 2016;31(5):551–565.
- Buysse DJ, et al. The Pittsburgh Sleep Quality Index: A new instrument for psychiatric practice and research. Psychiatry Res. 1989;28(2):193–213.
- Hirshkowitz M, et al. National Sleep Foundation’s sleep time duration recommendations: Methodology and results summary. Sleep Health. 2015;1(1):40–43.
- Nylund-Gibson K, et al. Ten frequently asked questions about latent class analysis. Transl Issues Psychol Sci. 2018;4(4):440–461.
- Nylund KL, et al. Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study. Struct Equ Modeling. 2007;14(4):535–569.
- Lanza ST, et al. Latent class analysis: An alternative perspective on subgroup analysis in prevention and treatment. Prev Sci. 2013;14(2):157–168.
- Bull FC, et al. World Health Organization 2020 guidelines on physical activity and sedentary behaviour. Br J Sports Med. 2020;54(24):1451–1462.
- U.S. Department of Health and Human Services. Physical Activity Guidelines for Americans. 2nd ed. U.S. Department of Health and Human Services; Washington, DC; 2018.
- Stamatakis E, et al. Sitting time, physical activity, and risk of mortality in adults. J Am Coll Cardiol. 2019;73(16):2062–2072.
- Nystoriak MA, et al. Cardiovascular effects and benefits of exercise. Front Cardiovasc Med. 2018;5:135.
- Biddle SJH, et al. A systematic review of physical activity and health in emerging adults. J Sci Med Sport. 2015;18(6):633–638.
- Lubans D, et al. Physical activity for cognitive and mental health in youth: A systematic review of mechanisms. Pediatrics. 2016;138(3):e20161642.
- Kredlow MA, et al. The effects of physical activity on sleep: A meta-analytic review. J Behav Med. 2015;38(3):427–449.
- Wang F, et al. The effect of physical activity on sleep quality: A systematic review. Eur J Physiother. 2021;23(1):11–18.
- Buman MP, et al. Objectively measured physical activity and sleep in older men. J Sleep Res. 2014;23(2):164–171.
- Loprinzi PD, et al. Association between objectively-measured physical activity and sleep, NHANES 2005–2006. Ment Health Phys Act. 2011;4(2):65–69.
- Vandelanotte C, et al. Associations between objective sleep characteristics and physical activity and sedentary behaviours. J Sci Med Sport. 2019;22(5):565–570.
- Pedisic Z, et al. State of health in Australian adults: Does physical activity mitigate the negative impact of poor sleep? J Sci Med Sport. 2014;17(1):60–65.
- Memon AR, et al. Sleep and physical activity in university students: A systematic review and meta-analysis. Sleep Med Rev. 2021;58:101482.
- Kline CE. The bidirectional relationship between exercise and sleep: Implications for exercise adherence and sleep improvement. Am J Lifestyle Med. 2014;8(6):375–379.
- Dolezal BA, et al. Interrelationship between sleep and exercise: A systematic review. Adv Prev Med. 2017;2017:1364387.
- Gerber M, et al. Fitness and exercise as correlates of sleep complaints: Is it all in our minds? Med Sci Sports Exerc. 2010;42(5):893–901.
- Wu X, et al. Low physical activity and high screen time can increase the risks of mental health problems and poor sleep quality among Chinese college students. PLoS One. 2015;10(3):e0119607.
- Carter B, et al. Association between portable screen-based media device access or use and sleep outcomes: A systematic review and meta-analysis. JAMA Pediatr. 2016;170(12):1202–1208.
- Craig CL, et al. International Physical Activity Questionnaire: 12-country reliability and validity. Med Sci Sports Exerc. 2003;35(8):1381–1395.
- Dinger MK, et al. Validity and reliability of the International Physical Activity Questionnaire in college students. Am J Health Educ. 2006;37(6):337–343.
- Muthén LK, Muthén BO. Mplus User’s Guide. 8th ed. Muthén & Muthén; Los Angeles, CA; 1998–2017.
- Spurk D, et al. Latent profile analysis: A review and “how to” guide of its application within vocational behavior research. J Vocat Behav. 2020;120:103445.
- Rebar AL, et al. A meta-meta-analysis of the effect of physical activity on depression and anxiety in non-clinical adult populations. Health Psychol Rev. 2015;9(3):366–378.
- Yang PY, et al. Exercise training improves sleep quality in middle-aged and older adults with sleep problems: A systematic review. J Physiother. 2012;58(3):157–163.
- Irish LA, et al. The role of sleep hygiene in promoting public health: A review of empirical evidence. Sleep Med Rev. 2015;22:23–36.
- Driver HS, et al. Exercise and sleep. Sleep Med Rev. 2000;4(4):387–402.
- Morin CM, et al. Chronic insomnia. Lancet. 2012;379(9821):1129–1141.
Toegang beperkt. Log in of start een proefperiode om deze inhoud te bekijken.