Dit protocol beschrijft het genereren van een op het weer gebaseerde dataset en de systematische evaluatie van machine learning-, deep learning- en hybride modellen voor het voorspellen van atmosferische attenuatie in optische vrije-ruimtecommunicatie onder diverse Iraakse omgevingsomstandigheden, waaronder stofstormen, mist, regen en sneeuw.
Onderzoeksartikel
Machine learning presteert beter dan deep learning voor de voorspelling van atmosferische attenuatie in optische vrije-ruimtecommunicatie onder Iraakse weersomstandigheden
In dit artikel
Samenvatting
Samenvatting
Optische communicatiesystemen in de vrije ruimte bieden een hoge bandbreedte, verhoogde beveiliging en licentievrije werking, maar worden sterk beïnvloed door prestatievermindering als gevolg van atmosferische demping veroorzaakt door verstrooiing en absorptie. De nauwkeurigheid van de voorspelling van demping is nog belangrijker in Irak, waar de omgeving op willekeurige wijze heet, stoffig, mistig en regenachtig is. Het doel van deze studie is om de prestaties van machine learning, deep learning en hybride modelleringsmethoden te beoordelen voor de voorspelling van atmosferische demping in optische communicatiesystemen in de vrije ruimte onder verschillende Iraakse weersomstandigheden. Een synthetische dataset van 1500 monsters werd gecreëerd met behulp van goed gevestigde fysische voortplantingsmodellen voor vijf weersregimes: heldere hemel, mist, regen, stofstormen en sneeuw. Vijftien voorspellende modellen werden systematisch geëvalueerd, bestaande uit zes machine learning-technieken (Random Forest [RF], Extreme Gradient Boosting, Light Gradient Boosting Machine, Support Vector Regression, Lineaire Regressie en K-Nearest Neighbors), zes deep learning-architecturen (Multilayer Perceptron, Deep Neural Network, Long Short-Term Memory [LSTM], Eendimensionaal Convolutioneel Neuraal Netwerk [CNN], CNN–LSTM en Attention-based Network) en drie hybride benaderingen. De resultaten toonden aan dat RF het beste presteerde (R2 = 0,9654, root mean square error = 1,324 dB/km) in vergelijking met deep learning-benaderingen (beste R2 = 0,7766) en hybride methoden (beste R2 = 0,9571). Het belang van de kenmerken werd geanalyseerd met Shapley Additive exPlanations, waarbij stofconcentratie (67,3%) en zichtbaarheid (21,2%) de meest invloedrijke factoren bleken te zijn. Hoewel RF resulteerde in aanzienlijk snellere training en inferentie, toonde statistische toetsing geen significant verschil aan tussen RF en de best presterende hybride benadering (p = 0,083). De prestaties van conventionele machine learning-technieken blijken zeer efficiënt te zijn voor de schatting van atmosferische demping in FSO-communicatiesystemen onder ongunstige omgevingsomstandigheden, in overeenstemming met bekende fysische voortplantingsbiotheorieën. We benadrukken echter dat deze conclusies zijn gebaseerd op synthetische gegevens en gevalideerd moeten worden door reële atmosferische metingen voordat ze kunnen worden gebruikt in operationele FSO-systemen.
Inleiding
Optische communicatienetwerken in de vrije ruimte (FSO) bieden over het algemeen een hogere capaciteit en betere beveiliging, maar atmosferische attenuatie door verstrooiing en absorptie is een belangrijke beperkende factor voor de communicatieafstand1. In dit werk bieden we een gedetailleerde analyse van machine-learning, deep-learning en hybride benaderingen2 om de FSO-signaalattenuatie te beoordelen in de uitdagende omgeving van Irak, met hoge temperaturen, stofstormen en onregelmatige regenval.
FSO-communicatiesystemen zijn naar voren gekomen als een van de veelbelovende oplossingen voor draadloze connectiviteit met een hoge bandbreedte3, met datasnelheden die 100 Gbps overschrijden over afstanden van honderden meters tot enkele kilometers4. In tegenstelling tot conventionele radiofrequentiesystemen werken FSO-verbindingen in het zichtbare en infrarode spectrum, wat voordelen biedt zoals licentievrije werking, immuniteit voor elektromagnetische interferentie, verbeterde beveiliging door een smalle bundeldivergentie en een grote bandbreedtecapaciteit5. Deze kenmerken maken FSO een aantrekkelijke technologie voor backhaul-toepassingen, verbindingen tussen gebouwen, rampenherstelnetwerken en last-mile connectiviteit waar de aanleg van glasvezel prohibitief duur is6. Echter is communicatie via verstrooiing, bundelafbuiging en absorptie7,8 sterk afhankelijk van de omgevingsomstandigheden wat betreft beschikbaarheid en prestaties. Deze uitdaging is een van de belangrijkste beperkingen van optische communicatiesystemen in de vrije ruimte. Weersomstandigheden veroorzaken grote variaties in attenuatieniveaus (dB/km). Onder onbewolkte omstandigheden kan de attenuatie minder dan 0,5 dB/km zijn, terwijl hevige mist kan leiden tot attenuatie van ≥50 dB/km bij 1550 nm (volgens het Kim-mistmodel, dat attenuatiewaarden tot 50 dB/km voorspelt voor een zichtbaarheid onder 50 m bij 1550 nm)9,10 en hevige regenval kan leiden tot attenuatie tot 20–30 dB/km, afhankelijk van de neerslagintensiteit (voorspelling volgens het Carbonneau-model)11. Daarom is een nauwkeurige voorspelling van de attenuatie nodig voor een betrouwbaar ontwerp van de verbinding, netwerkplanning en adaptieve transmissiestrategieën. De conventionele methoden zijn gebaseerd op fysieke voortplantingsmodellen, zoals het Kim-model voor mist12, het Carbonneau-model voor regen13 en de Mie-verstrooiingstheorie voor aerosoldeeltjes14. Hoewel deze modellen een goede theoretische basis bieden, vertrouwen ze vaak op nauwkeurige atmosferische parameters die in de praktijk niet altijd beschikbaar zijn, en houden ze frequent geen rekening met de complexe interacties tussen gelijktijdige meerdere meteorologische fenomenen15.
De extreme milieuvariabiliteit in Irak vormt aanzienlijke uitdagingen voor de implementatie van optische communicatiesystemen in de vrije ruimte. De transmissieomstandigheden worden verder gecompliceerd door minimale regenval en incidentele mistepisodes, terwijl wintertemperaturen onder het vriespunt kunnen dalen en zomertemperaturen kunnen stijgen tot boven de 50 °C16. Bij veelgebruikte spectra zoals 1550 nm in normale golflengten kunnen stofstormen, lokaal aangeduid als "al-haboob," het zicht beperken tot minder dan 100 meter, wat leidt tot dempingswaarden die 20dB/km overschrijden17. Om FSO-systemen succesvol te kunnen implementeren in Irak en andere landen in het Midden-Oosten, is het noodzakelijk om betrouwbare voorspellingsmodellen te ontwikkelen die de prestaties van het systeem onder deze uiteenlopende milieuomstandigheden nauwkeurig kunnen inschatten18.
Nieuwe ontwikkelingen in machine learning bieden levensvatbare alternatieven voor conventionele modelleringstechnieken op basis van de natuurkunde. Het vermogen van machine learning-technieken om direct complexe niet-lineaire correlaties tussen attenuatie en atmosferische factoren te leren, maakt de detectie van minuscule interacties mogelijk die traditionele analytische modellen over het hoofd zouden kunnen zien19. Bij diverse klimatologische voorspellingenstaken hebben Random Forest (RF) en gradient-boosting-strategieën sterke prestaties getoond20. Evenzo hebben deep learning-technieken opmerkelijk succes behaald in natuurlijke taalverwerking, computer vision en tijdserievoorspellingen21. Deze benaderingen zijn echter onvoldoende onderzocht voor de voorspelling van FSO-attenuatie, in het bijzonder bij beperkte datasets en sterk variabele weersomstandigheden22. Om dit gat te vullen, presenteert dit werk een grondige analyse van machine learning, deep learning en hybride benaderingen voor het voorspellen van FSO-signaalattenuatie onder de atmosferische omstandigheden in Irak. Dit wordt bereikt door het construeren van een zorgvuldig ontworpen synthetische dataset op basis van bekende fysische voortplantingsmodellen23. Wij stellen als hypothese dat voor tabulaire omgevingsdatasets van gemiddelde omvang met enkele dominante voorspellende variabelen, de voorspellende prestaties van boomgebaseerde ensemblemethoden beter zullen zijn dan die van complexe deep learning-architecturen. De hoofddoelen zijn om (1) een basismethodologie vast te stellen voor de vergelijking van voorspellingsmethoden in een gecontroleerde simulatieomgeving, (2) de beste algoritmische strategieën te identificeren voor het voorspellen van atmosferische attenuatie, en (3) de kenmerkbelangrijkheid en modelinterpreteerbaarheid te beoordelen om inzicht te krijgen in de omgevingsfactoren die de attenuatie het meest beïnvloeden. In dit werk worden synthetische gegevens gebruikt, maar hiermee wordt de basis gelegd voor latere validatie met experimentele metingen uit de praktijk, wat is voorzien voor toekomstig werk. Bovendien zijn analyses van kenmerkbelangrijkheid en interpreteerbaarheid opgenomen om de belangrijkste omgevingsfactoren te bepalen die de attenuatie beïnvloeden.
Protocol
Deze studie betrok geen menselijke proefpersonen of gewervelde dieren, noch het bemonsteren van weefsel. Alle gegevens die voor dit onderzoek zijn gebruikt, werden synthetisch gegenereerd met behulp van fysische voortplantingsmodellen en publiek toegankelijke meteorologische parameters. Daarom was er geen ethische goedkeuring van een Institutional Review Board (IRB) of Institutional Animal Care and Use Committee (IACUC) vereist.
Datasetgeneratie op basis van de fysische voortplantingstheorie. De dataset is opgebouwd om de uurlijkse atmosferische omstandigheden voor een optisch communicatiesysteem in vrije ruimte na te bootsen voor een volledig kalenderjaar (2024) onder Iraakse atmosferische omstandigheden. We hebben een synthetische database gemaakt met 1.500 monsters per uur.
Ten eerste werden de weersomstandigheden willekeurig toegewezen op basis van regionale trends: onbewolkte hemel (54,3%), stof (24,9%), mist (10,5%), regen (7,4%) en sneeuw (2,8%). Ten tweede werd voor elk monster het overeenkomstige fysische attenuatiemodel toegepast op basis van de weersomstandigheid, namelijk de wet van Beer-Lambert voor onbewolkte hemel, het Kim-model voor mist, de Carbonneau-theorie voor regen en de Mie-verstrooiingstheorie voor stofstormen. Ten derde werden de parameters van het FSO-systeem als volgt ingesteld: een zendvermogen van 20 dBm, een golflengte van 1550 nm, een transmissieafstand van 3 km, een zendopening van 2,5 cm en een ontvangstopening van 20 cm. Ten vierde werd de attenuatie in dB/km berekend voor elk monster. Ten slotte werd de volledige dataset willekeurig verdeeld in 1.200 trainingsmonsters (80%) en 300 testmonsters (20%). De gesimuleerde condities omvatten grote stofconcentraties in verband met zandstormen, regenstormen en temperatuurveranderingen van −4,89°C tot 47,99°C. De weersomstandigheden en parameterdistributies werden gekozen op basis van de Iraakse klimaatgegevens uit de periode 2020–2024. De vijf weersregimes (onbewolkte hemel, mist, regen, stofstormen en sneeuw) werden gekozen omdat ze het volledige spectrum aan atmosferische condities dekken die de FSO-attenuatie in Irak beïnvloeden, waarbij stofstormen bijzonder prevalent zijn in het Midden-Oosten. De historische meteorologische gegevens die in de Iraakse regio's zijn verzameld, werden gebruikt om de waarschijnlijkheidsdistributie voor elke weersomstandigheid te creëren. De resulterende distributie was als volgt: 54,3% onbewolkte hemel (de dominante toestand), 24,9% stof (representatief voor het zandstormprobleem in Irak), 10,5% mist (veelvoorkomend in de winters in Noord-Irak), 7,4% regen (lage neerslaghoeveelheden die typisch zijn voor Irak) en 2,8% sneeuw (soms in noordelijke berggebieden). De relevante meteorologische parameters werden gemodelleerd met waarschijnlijkheidsdistributies voor elke weersomstandigheid als volgt: de temperatuur werd gemodelleerd met een normale distributie (gemiddelde 28,55±11,18°C) tussen −4,89°C en 47,99°C op basis van Iraakse seizoensestremen; de vochtigheid werd gemodelleerd met een uniforme distributie (gemiddelde 42,01±25,56%) van 0% tot 100%; het zicht werd gemodelleerd met een log-normale distributie tussen 0,05 km en 29,99 km (gemiddelde 13,10±10,91 km) om rekening te houden met de frequente gebeurtenissen van laag zicht tijdens stofstormen; de stofconcentratie werd gemodelleerd met een exponentiële distributie tussen 0 en 4,96 mg/m3 (gemiddelde 0,74±1,30 mg/m3) met hogere waarschijnlijkheden voor lage concentraties en lange staarten voor extreme stofgebeurtenissen.
Het communicatiesysteem werd ontworpen met een zendvermogen van 20 dBm, een golflengte van 1550 nm, een transmissieafstand tot 3 km, een zendopening van 2,5 cm en een ontvangstopening van 20 cm om het divergentieverlies te compenseren. De parameters van het FSO-systeem werden verdeeld in twee groepen: vaste parameters die voor alle monsters gelijk bleven, en variabele parameters die werden gewijzigd tijdens het genereren van de dataset. Voor alle 1.500 monsters waren de volgende parameters vastgesteld: zendvermogen (20 dBm), werkingsgolflengte (1550 nm), zendopening (diameter 2,5 cm, efficiëntie 0,7) en ontvangstopening (diameter 20 cm, efficiëntie 0,7). Deze parameters waren vast omdat ze de fysieke specificaties van de FSO-systeemhardware zijn en niet veranderen bij verschillende weersomstandigheden. De dataset werd samengesteld uit 1.500 monsters waarbij de volgende parameters varieerden: temperatuur (−4,89°C tot 47,99°C), vochtigheid (0% tot 100%), zichtbaarheid (0,05 km tot 29,99 km), stofconcentratie (0 tot 4,96 mg/m3) en weersomstandigheid (heldere hemel, mist, regen, stof, sneeuw). Deze parameters werden aangepast volgens kansverdelingen afgeleid van Iraakse klimaatgegevens voor de jaren 2020–2024. Voor elk monster werd de attenuatiewaarde (dB/km) berekend met behulp van het overeenkomstige fysieke attenuatiemodel, op basis van de specifieke combinatie van weersomstandigheden en variabele parameters.
Fysische attenuatie werd gemodelleerd met behulp van het Carbonneau-model voor regen, de wet van Beer-Lambert voor onbewolkte lucht, de Mie-verstrooiingstheorie voor stof en het Kim-model voor mist24. De wet van Beer-Lambert is van toepassing bij onbewolkte hemelcondities, waarbij de attenuatie wordt gedomineerd door moleculaire verstrooiing en absorptie, die exponentieel afnemen met de afstand25. De extinctiecoëfficiënt α bij 1550 nm is te wijten aan Rayleigh-verstrooiing door luchtmoleculen en absorptie door atmosferische gassen26. Het Kim-model is een specifiek model voor mist dat attenuatie relateert aan het zicht via empirische coëfficiënten, afgeleid van grootteverdelingen van mistdruppels. De golflengte-afhankelijke exponent q houdt rekening met Mie-verstrooiing27. De belangrijkste parameter van het Carbonneau-model is de neerslaghoeveelheid R, aangezien de regenattenuatie afhankelijk is van de grootte en dichtheid van de regendruppels; de coëfficiënten zijn empirisch afgeleid bij 1550 nm en specifiek gekalibreerd voor optische golflengten28. De Mie-verstrooiingstheorie is toepasbaar op stofcondities, aangezien de grootte van stofdeeltjes (0,1–100 μm straal) vergelijkbaar is met de golflengte (1550 nm), en de complexe brekingsindex m = 1,55–0,005i voor stof uit het Midden-Oosten zowel verstrooiing als absorptie omvat29. De volgende fysieke attenuatiemodellen zijn geïmplementeerd met hun respectievelijke vergelijkingen en parameterinstellingen.
Voor heldere hemelomstandigheden werd de wet van Beer-Lambert gebruikt:
Aclear = 10×log₁₀(e(α×d)) (1)
waarbij α de extinctiecoëfficiënt is (gevarieerd met een normale verdeling gecentreerd op 0,02 dB/km met een variatie van ±0,005 dB/km bij 1550 nm onder heldere omstandigheden), en d de transmissieafstand is (vastgesteld op 3 km). Voor mistige omstandigheden is het Kim-model geïmplementeerd met behulp van de volgende vergelijking:
Afog = 10×ln(10)/V×(λ/550)−q (2)
waarbij V de zichtbaarheid in kilometers is (variërend van 0,05km tot 10km), λ de golflengte in nanometers is (vastgesteld op 1550nm), en q de coëfficiënt van de deeltjesgrootteverdeling is, berekend als: q=1,6 voor V>50 km, q=1,3 voor 6<V<50 km, q=0,585×V(1/3) voor 1 <V<6km, q=0 voor 0,5<V<1km, en q=0,5 voor V<0,5km. Voor regenomstandigheden werd het Carbonneau-model gebruikt:
Arain=0.023×R0.93 (3)
waarbij R de regenintensiteit is in mm/h (variërend tussen 0,25 en 50 mm/h volgens Iraakse regenregisters). De relatie voor extinctie-efficiëntie werd gebruikt voor de omstandigheden tijdens stofstormen met behulp van Mie-verstrooiing:
Adust=10×log₁₀(e(τ×L)) (4)
waarbij τ=∫₀^∞ πr2Qext(r,λ,m)N(r)dr, r de partikelstraal is (0,1–100μm volgens de Iraakse stofsamenstelling), Qext de extinctie-efficiëntie is berekend met de Mie-theorie, λ=1550nm, m=1,55–0,005i de complexe brekingsindex is voor stof uit het Midden-Oosten, en N(r) de partikelgrootteverdeling is gemodelleerd met een log-normale verdeling met een geometrisch gemiddelde straal van 2,5 μm en een standaarddeviatie van 2,0. Het attenuatiemodel werd als volgt geïmplementeerd voor sneeuwcondities:
Asnow = 0.1×S0.75 (5)
waarbij S de sneevalsnelheid is in mm/h (0,5–15 mm/h). Deze empirische vergelijking is gekozen op basis van werk uit de literatuur30, waarin attenuatiemodellen voor optische propagatie door sneeuw werden ontwikkeld met behulp van de Mie-verstrooiingstheorie toegepast op grootteverdelingen van sneeuwvlokken. De vergelijking is geldig voor sneevalsnelheden tussen 0,5 en 15 mm/h en gaat uit van droge sneeuwcondities met typische diameters van sneeuwvlokken van 1–10 mm. De coëfficiënt 0,1 en exponent 0,75 zijn verkregen uit curve-fitting van Mie-verstrooiingsberekeningen30 voor sneeuw bij 1550 nm. De vergelijking is niet gecorrigeerd voor natte sneeuw of gemengde neerslag, die variabele attenuatie-eigenschappen kunnen hebben, hoewel het een redelijke schatting biedt voor droge sneeuw. Omdat de aanpak computationeel efficiënt is, vaak wordt geciteerd in FSO-publicaties en geschikt is voor de voorspelde sneeuwomstandigheden in Noord-Irak (Koerdistan-regio in januari en februari), is deze gekozen voor dit onderzoek. Met behulp van Numpy voor numerieke berekeningen zijn alle modellen geïmplementeerd in Python 3.9. Het bijbehorende model werd toegepast op de willekeurig gekozen weersomstandigheid en bemonsterde omgevingsgegevens om de attenuatiewaarde voor elk monster te berekenen. De verkregen weersverdeling omvatte 814 onbewolkte omstandigheden (54,27%), 375 stofgebeurtenissen (25,00%), 157 mistgebeurtenissen (10,47%), 111 regengebeurtenissen (7,40%) en 43 sneeuwgebeurtenissen (2,87%).
Voor het vaststellen van de proporties van weerssituaties is gebruikgemaakt van het onderzoek naar historische meteorologische informatie die tussen 2020 en 2024 is verzameld via Iraakse meteorologische stations in verschillende regio's (Bagdad, Basra, Mosul en Ramadi). De oorspronkelijke gegevens werden geleverd door het Iraakse Ministerie van Transport en de Iraqi Meteorological Organization and Seismology (IMOS). De gegevens bevatten dagelijkse weerverslagen waarin de actuele atmosferische omstandigheden voor elke dag werden genoteerd. Specifieke kenmerken die uit deze verslagen werden geëxtraheerd, waren onder meer temperatuur (dagelijks minimum, maximum en gemiddelde), relatieve vochtigheid, zicht, hoeveelheid neerslag en het voorkomen van stofstormen. Het open dataportaal van de Iraakse overheid (https://www.motrans.gov.iq/) biedt toegang tot een deel van de IMOS-gegevens; de specifieke verslagen die in deze studie zijn gebruikt, zijn echter niet openbaar opgeslagen in een centrale repository. De klimaatgegevens die zijn gebruikt om de percentages van weersomstandigheden en parameterwaarden te berekenen, zijn samengevat in Tabel 1. Onbewolkte dagen werden gedefinieerd als dagen zonder neerslag, met een zicht groter dan 10 km en geen stofactiviteit, wat 54,27% van de 1.825 geregistreerde dagen besloeg. Dagen met stofstormen (inclusief volledige stofstormen (zicht < 1 km) en zwevend stof (zicht 1–5 km)) maakten 25,00% van de dagen uit, wat wijst op de hoge frequentie van zandstormgebeurtenissen in het aride en semi-aride klimaat van Irak. Dagen met een zicht van minder dan 1 km als gevolg van de suspensie van waterdruppels (exclusief zichtvermindering door stof) werden geclassificeerd als mistdagen. Het percentage mistdagen was 10,47%, en mistdagen kwamen voornamelijk voor in de winter in de noordelijke regio's van Irak. Regendagen, dagen met meetbare neerslag >0,1 mm, bedroegen 7,40%, wat overeenkomt met de lage gemiddelde jaarlijkse neerslag in Irak van 150–200 mm per jaar. Sneeuwdagen (dagen met accumulatie van bevroren neerslag) maakten 2,87% van de dagen uit en waren beperkt tot bergachtige noordelijke gebieden (Koerdistan-regio) in januari en februari. Deze proporties werden later gebruikt als waarschijnlijkheidsgewichten voor willekeurige bemonstering bij de generatie van de dataset. De synthetische dataset reflecteert zo de reële frequentie van elke weersomstandigheid in de Iraakse omgeving.
Overwegingen met betrekking tot bias bij de generatie van synthetische data
Om mogelijke bias te verminderen, zijn verschillende stappen ondernomen:
(1) Selecteer de distributie: De statistische eigenschappen van de brongegevens van het klimaat werden gebruikt om kansdistributies te selecteren. De temperatuur was normaal verdeeld met een gemiddelde en standaarddeviatie zoals geregistreerd door de IMOS. De luchtvochtigheid was uniform verdeeld over het gehele waargenomen bereik (0-100%). Er werd aangenomen dat het zicht een log-normale distributie volgde om rekening te houden met het frequente voorkomen van gebeurtenissen met gering zicht tijdens stofstormen. De stofconcentratie volgde een exponentiële distributie, waarbij er hogere kansen waren bij lage concentraties en lange staarten bij extreme stofgebeurtenissen31. Dit was consistent met de waargenomen frequentie van stofgebeurtenissen in Irak32.
(2) Aandelen weersomstandigheden: Analyse van IMOS-gegevens voor 2020–2024, bestaande uit 1.825 dagelijkse waarnemingen in alle vier de regio's, leverde de volgende aandelen op: 54,3% onbewolkt, 24,9% stof, 10,5% mist, 7,4% regen en 2,8% sneeuw. Dagen zonder neerslag, met een zichtbaarheid >10 km en zonder stofactiviteit werden gedefinieerd als onbewolkte dagen. Dagen met stofstormen omvatten zowel volledige stofstormen (zichtbaarheid <1 km) als zwevend stof (zichtbaarheid 1–5 km). Een mistdag werd gedefinieerd als een dag waarop de zichtbaarheid minder dan 1 km was en de oorzaak een suspensie van waterdruppeltjes was (geen stof). Regendagen werden gedefinieerd als dagen met meetbare neerslag >0,1 mm. Sneeuwdagen werden gedefinieerd als dagen met opgehoopte bevroren neerslag33.
(3) Parameterbereiken: De parameterbereiken waren gebaseerd op de waargenomen extremen in de IMOS-gegevens: de temperatuur varieerde van −4.89 °C (Mosul, winter) tot 47.99 °C (Basra, zomer), het zicht varieerde van 0.05 km (zware stofstormen) tot 29.99 km (heldere omstandigheden), en de stofconcentratie varieerde van 0 tot 4.96 mg/m3 (gebaseerd op de waargenomen maximale stofconcentratie tijdens zware haboob-gebeurtenissen)34.
(4) Aannames over onafhankelijkheid: We gingen ervan uit dat de omgevingsparameters onafhankelijk werden bemonsterd, wat een vereenvoudiging is van praktijkomstandigheden waarin atmosferische variabelen gecorreleerd zijn (bijv. een hoge stofconcentratie correleert vaak met een laag zicht). Om een gecontroleerde simulatieomgeving te bieden voor een methodische modelvergelijking, is deze aanname van onafhankelijkheid gehanteerd 35. De gevolgen van deze aannames worden behandeld in de Discussie.
(5) Gestratificeerde splitsing: De train-test split werd gestratificeerd op basis van de categorie weersomstandigheid (heldere lucht, mist, regen, stof, sneeuw) om ervoor te zorgen dat de proportie van elke weersomstandigheid in de trainings- en testsets overeenkwam met de distributie van de oorspronkelijke dataset. Op deze manier is de testset niet ongebalanceerd met betrekking tot zeldzame weersomstandigheden (met name sneeuw met 2,87%)36.
Erkenning van deterministische doelwitgeneratie
Het is belangrijk om op te merken dat de goede voorspellende prestaties die hier worden waargenomen, gedeeltelijk kunnen worden toegeschreven aan het feit dat het model de deterministische fysische vergelijkingen leert of benadert die zijn gebruikt om de synthetische doelwaarden te genereren37. In tegenstelling tot experimentele metingen in de echte wereld, die meetruis, instrumentfouten en niet-gemodelleerde fysische fenomenen bevatten, biedt de synthetische dataset een zuivere, ruisvrije relatie tussen de inputkenmerken en de attenuatiedoelwaarde. Dit komt doordat de attenuatiewaarden rechtstreeks zijn berekend uit de fysische propagatiemodellen (Beer-Lambert-wet, Kim-model, Carbonneau-model en Mie-verstrooiingstheorie) op basis van de inputparameters. Daarom vertegenwoordigen de kwantitatieve prestatiegegevens (R2, RMSE, MAE) de prestaties op uit vergelijkingen afgeleide synthetische gegevens en mogen zij niet worden geïnterpreteerd als de verwachte prestaties bij ruisgevoelige observationele of experimentele gegevens. De resultaten moeten primair worden beschouwd als een vergelijkende evaluatie van modelleringsmethodologieën in een gecontroleerde simulatieomgeving38.
Volledige kenmerkenset voor modeltraining
De trainingsdataset bevatte 10 inputkenmerken voor de modeltraining:
1. Temperatuur (°C)
2. Luchtvochtigheid (%)
3. Zichtbaarheid (km)
4. Stofconcentratie (mg/m3)
5. Neerslagintensiteit (mm/h)
6. Sneevalsnelheid (mm/h)
7. Windsnelheid (m/s)
8. Luchtdruk (hPa)
9. Maand (numeriek, 1–12)
10. Seizoen (one-hot gecodeerd: lente, zomer, herfst, winter)
Belangrijke verduidelijking: De weersomstandigheden (heldere hemel, mist, regen, stof, sneeuw) werden gebruikt als een categorische variabele voor stratificatie tijdens de splitsing van de dataset en werden niet opgenomen als invoerkenmerken voor enig model. De SHAP-analyse bevat alleen de hierboven genoemde 10 kenmerken. De seizoensvariabele werd one-hot gecodeerd (4 categorieën: lente, zomer, herfst, winter), en voor de SHAP-analyse werden de bijdragen van de one-hot gecodeerde seizoensvariabelen over de seizoenen opgeteld om één enkele waarde voor de seizoensbijdrage te verkrijgen. Deze gecombineerde waarde vertegenwoordigt de totale bijdrage van alle seizoensgerelateerde variabelen aan de voorspelling van de attenuatie. Voordat de samenvattende figuur werd gemaakt, werden de vier one-hot gecodeerde seizoenskolommen geïdentificeerd en werden hun SHAP-waarden voor elk monster bij elkaar opgeteld. Deze methode garandeert dat het gebruik van het seizoen door het model als een samengestelde categorische variabele consistent is met de SHAP-analyse.
De belangrijkste omgevingsfactoren die de optische attenuatie via fysieke mechanismen direct beïnvloedden, waren kenmerken 1–6. De toevoeging van kenmerken 7 en 8 (windsnelheid en druk) als aanvullende meteorologische factoren kan een indirect effect hebben op de attenuatie door de luchtstabiliteit en aerosolverspreiding te beïnvloeden. Om rekening te houden met seizoensvariaties in de atmosferische omstandigheden, werden kenmerken 9–10 (maand en seizoen) opgenomen als temporele beschrijvers. De attenuatiewaarde (dB/km) werd gebruikt als de doelvariabele voor alle modellen. Belangrijke statistieken van de dataset omvatten temperatuur (28,55°C ± 11,18°C), vochtigheid (42,01% ± 25,56%), zichtbaarheid (13,10 ± 10,91 km; bereik: 0,05–29,99 km), stofconcentratie (0,74 ± 1,30 mg/m3; maximum: 4,96 mg/m3), attenuatie (4,80 ± 7,20 dB/km; bereik: 0,09–50,93 dB/km), operationeel bereik (5,74 ± 1,97 km), en signaal-ruisverhouding (64,88 ± 15,07 dB). Het operationele bereik en de SNR werden berekend uit de attenuatiewaarden met behulp van standaard FSO-linkbudgetvergelijkingen.
Berekening van het werkbereik
Het operationele bereik (in km) werd berekend met behulp van de linkbudgetvergelijking:
Prx=Ptx×Gt×Gr×(λ/(4πR))2×10(−A×R/10) (6)
waarbij: Prx = ontvangen vermogen (ingesteld op een minimale gevoeligheid van −30 dBm); Ptx = zendvermogen (vastgesteld op 20 dBm); Gt = zenderversterking (berekend op basis van de apertuurafmetingen); Gr = ontvangerversterking (berekend op basis van de apertuurafmetingen); λ = golflengte (1550 nm); R = bereik in km; A = atmosferische demping in dB/km (berekend op basis van de fysische modellen).
Versterking van zender en ontvanger: De zenderversterking (Gt) werd berekend als: Gt = 10×log₁₀[0.7×(π×0.025/1.55×10⁻6)2] ≈ 44.2 dBi. De ontvangerversterking (Gr) werd berekend als: Gr = 10×log₁₀[0.7×(π×0.20/1.55×10⁻6)2] ≈ 62.3 dBi. De zendopening had een diameter van 2.5 cm, met een efficiëntie van 0.7. De ontvangstopening had een diameter van 20 cm, met een efficiëntie van 0.7. De vergelijking werd iteratief opgelost voor R om de maximaal haalbare verbindingsafstand voor elke attenuatiewaarde te bepalen.
Berekening van de signaal-ruisverhouding
De SNR (signaal-ruisverhouding) in dB werd berekend met de volgende vergelijking:
SNR=Prx−10×log₁₀(kTB)−NF (7)
waarbij: Prx = ontvangen vermogen in dBm (berekend op basis van de linkbudget); k = 1.38×10⁻23 J/K (constante van Boltzmann); T = 290 K (ontvangerstemperatuur); B = 109 Hz (bandbreedte ontvanger, 1 GHz); NF = 3 dB (ruisgetal ontvanger). De ruisvloer werd als volgt berekend:
10 × log10(kTB) ≈ −84 dBm (8)
Voor elk monster werd, na het berekenen van de demping A met behulp van het toepaselijke fysische model, het werkingsbereik afgeleid door het linkbudget op te lossen voor R, en werd de SNR berekend op basis van het resulterende ontvangen vermogen Prx bij dat bereik.
Operationele bereikwaarden per weersomstandigheid: Het operationele bereik varieerde afhankelijk van de weersomstandigheden: heldere hemel (7,12 ± 1,85 km), mist (5,81 ± 1,92 km), sneeuw (5,42 ± 1,56 km), regen (3,81 ± 0,98 km) en stof (3,72 ± 1,08 km). In de huidige berekeningen is geen marge van 3 dB toegepast; het operationele bereik vertegenwoordigt het theoretische maximale bereik zonder systeemmarge. Het gerapporteerde operationele bereik (5,74 ± 1,97 km) is het algemene gemiddelde over alle weersomstandigheden39.
Vaste transmissieafstand: de transmissieafstand in de fysieke attenuatiemodellen werd ingesteld op 3 km. Dit is de linkafstand waarvoor de attenuatieberekeningen zijn uitgevoerd. Het gerapporteerde operationele bereik is de theoretische maximale afstand berekend met de linkbudgetvergelijking, welke kan afwijken van de vaste transmissieafstand van 3 km. Weerspecifieke attenuatiewaarden werden vastgelegd voor heldere omstandigheden (0,27±0,06 dB/km), mist (1,88±1,92 dB/km), sneeuw (6,45±2,54 dB/km), regen (13,58±6,32 dB/km) en stof (13,10±7,32 dB/km). Alle in dit manuscript gerapporteerde kwantitatieve waarden worden gepresenteerd als gemiddelde ± standaarddeviatie (SD), tenzij anders aangegeven40.
De cross-validatie R2 voor Random Forest wordt gerapporteerd als 0,960±0,007. In bepaalde gevallen, zoals temperatuur (−4,89 tot 47,99°C), zichtbaarheid (0,05 tot 29,99km), stofconcentratie (0 tot 4,96 mg/m3) en attenuatie (0,09 tot 50,93dB/km), wordt het bereik (laagst tot hoogst) verbaal weergegeven. De dataset werd gesplitst in subgroepen voor testen (300 monsters; 20%) en training (1.200 monsters; 80%). Voor de train-test split werd gestratificeerde steekproefname gebruikt. Om ervoor te zorgen dat het percentage van elke weersomstandigheid in de trainingsset (80%) en de testset (20%) overeenkwam met de distributie van de oorspronkelijke dataset, werd stratificatie toegepast op basis van de categorie weersomstandigheid (heldere hemel, mist, regen, stof en sneeuw). In het bijzonder werden 1.200 (80%) van de 1.500 monsters toegewezen aan de leerset en 300 (20%) aan de testset. Monsters werden willekeurig gekozen voor elke categorie meteorologische omstandigheden, waarbij de oorspronkelijke proporties werden behouden: van de 814 monsters met heldere hemel (54,27%) werden er 651 toegewezen aan training en 163 aan testen; van de 375 stofmonsters (25,00%) gingen 300 naar training en 75 naar testen; van de 157 mistmonsters (10,47%) gingen 126 naar training en 31 naar testen; van de 111 regenmonsters (7,40%) gingen 89 naar training en 22 naar testen; van de 43 sneeuwmonsters (2,87%) gingen 34 naar training en 9 naar testen. De willekeurige steekproefname binnen elk stratum werd uitgevoerd met een random seed van 42 om reproduceerbaarheid te garanderen. Deze gestratificeerde aanpak werd gekozen om een ongebalanceerde representatie van zeldzame weersomstandigheden (met name sneeuw met 2,87%) in de testset te voorkomen, wat anders zou kunnen leiden tot een onbetrouwbare prestatie-evaluatie voor die omstandigheden.
Evaluatie van het machine learning-model
Zes machine learning-methoden werden geëvalueerd, waaronder Support Vector Regression (SVR) met een radial basis function-kernel (C = 100), K-Nearest Neighbors (KNN; k = 10, afstandsgewogen), RF (200 bomen, maximale diepte = 20), Extreme Gradient Boosting (XGBoost; 200 estimators, maximale diepte = 10, learning rate = 0.1), Light Gradient Boosting Machine (LightGBM; 200 estimators, maximale diepte = 10, learning rate = 0.1), en een baseline Lineaire Regressie. Voor alle machine learning- en deep learning-modellen werd hyperparametermodificatie uitgevoerd voor de meest kritische parameters, terwijl voor niet-gespecificeerde parameters de standaardwaarden werden behouden. Voor machine learning-modellen werden de volgende parameters expliciet afgesteld met behulp van grid search met 5-voudige cross-validatie op de trainingsset: 1) Random Forest: aantal bomen (getest: 50, 100, 150, 200, 250) en maximale diepte (getest: 10, 15, 20, 25, geen limiet), waarbij optimale waarden van 200 bomen en diepte 20 werden geselecteerd. 2) XGBoost: aantal estimators (getest: 100, 150, 200, 250), maximale diepte (getest: 6, 8, 10, 12), en learning rate (getest: 0.05, 0.1, 0.2), met optimale waarden van 200 estimators, diepte 10 en learning rate 0.1. 3) LightGBM: identieke afstellingsbereiken werden gebruikt, wat resulteerde in 200 estimators, diepte 10 en learning rate 0.1. 4) SVR: de regularisatieparameter C (getest: 1, 10, 50, 100) en de kernelcoëfficiënt gamma (getest: 'scale', 'auto', 0.1, 0.01) werden afgestemd, met een optimale C = 100 en RBF-kernel. 5) KNN: het aantal buren k (getest: 3, 5, 7, 10, 15) werd afgestemd, met een optimale k = 10 en ingeschakelde afstandsgewogen stemming.
Alle overige parameters voor deze modellen zijn op hun standaardwaarden gelaten zoals gedefinieerd in scikit-learn (zie Tabel met Materialen voor de versie; bijv. Random Forest: bootstrap=True, min_samples_split=2, min_samples_leaf=1; XGBoost: subsample=1.0, colsample_bytree=1.0, gamma=0). Voor deep learning-modellen werden de architectuur (aantal lagen en eenheden per laag) en de dropout-rate (20%) handmatig afgesteld via iteratieve experimenten op de validatieset, terwijl de optimizer (Adam), de initiële learning rate (0.001), het geduld voor early stopping (20 epochs) en de parameters voor de verlaging van de learning rate (factor 0.5, geduld 10) werden ingesteld op basis van standaardpraktijken in de literatuur en constant werden gehouden voor alle deep learning-experimenten.
Bronnen van klimaatgegevens
De historische meteorologische informatie die tussen 2020 en 2024 is verzameld bij Iraakse weerstations op verschillende locaties (Bagdad, Basra, Mosul en Ramadi) werd gebruikt om de proporties van de weertoestanden en de verdelingen van de variabelen te berekenen. De ruwe gegevens werden verstrekt door het Iraakse Ministerie van Transport en de Iraqi Meteorological Organization and Seismology (IMOS). De gegevens bevatten dagelijkse weerregistraties met details over de overheersende atmosferische toestand voor elke dag. Specifieke variabelen die uit deze registraties zijn verkregen, omvatten de temperatuur (dagelijks minimum, maximum en gemiddelde), relatieve vochtigheid, zichtbaarheid, neerslaghoeveelheid en het voorkomen van stofstormen. De IMOS-gegevens zijn gedeeltelijk beschikbaar via het open dataportaal van de Iraakse overheid (https://www.motrans.gov.iq/), hoewel de specifieke records die in deze studie zijn gebruikt niet openbaar zijn gearchiveerd in een centrale repository. Een samenvatting van de klimaatgegevens die zijn gebruikt om de proporties van de weersomstandigheden en de parameterbereiken te bepalen, wordt gegeven in Tabel 1.
Vijfvoudige kruisvalidering werd toegepast op de trainingset (1.200 monsters) om hyperparameters af te stemmen en de prestaties van alle machine learning-modellen te schatten. Alle invoervariabelen (temperatuur, luchtvochtigheid, zichtbaarheid, stofconcentratie, neerslagsnelheid, sneevalsnelheid, windsnelheid, druk) werden geschaald via standaardisatie (Z-score normalisatie): x_scaled = (x − μ)/σ, waarbij μ en σ het gemiddelde en de standaarddeviatie van de trainingset zijn. Om datalekken te voorkomen, vond de standaardisatie binnen elke kruisvalideringsfold plaats op basis van uitsluitend de statistieken van de trainingsfold. Boomgebaseerde modellen (Random Forest, XGBoost, LightGBM) zijn schaalinvariant, maar om de consistentie tussen alle machine learning-modellen te waarborgen, werd dezelfde standaardisatie toegepast. Voor deep learning-modellen werd min-max normalisatie gebruikt: x_scaled = (x−x_min)/(x_max−x_min), wat kenmerken schaalt naar [0, 1] op basis van de min/max-waarden van de trainingset. Begrensde invoer leidt tot een snellere convergentie van neurale netwerken, wat de reden was voor deze keuze. De testset werd geschaald met behulp van de parameters die uit de trainingset waren verkregen en werd niet gebruikt voor modelselectie of het afstemmen van hyperparameters.
Volledige prestatiemetrieken werden vastgelegd, waaronder de determinatiecoëfficiënt van de test (R2), de root mean square error (RMSE), de mean absolute error (MAE), de R2 van de kruisvalidatie en de trainingstijd. De trainingstijden voor alle machine learning- en deep learning-modellen worden gerapporteerd in seconden (s) voor de snellere modellen (Lineaire Regressie, KNN, SVR, Random Forest, XGBoost, LightGBM) en in minuten (min) voor de tragere modellen (deep learning-architecturen). Alle modellen werden getraind in dezelfde computeromgeving om een eerlijke vergelijking te garanderen41.
De trainingstijd werd gemeten met de Python time-module, oftewel de verstreken kloktijd vanaf het begin tot het einde van de model-fittingfunctie, exclusief de tijd die nodig was voor het laden en voorbewerken van de gegevens. De trainingstijd voor een deep learning-model is de tijd die nodig is om alle epochs te voltooien tot aan de early stopping. Dit omvat forward propagation, backward propagation en validatiecontroles. Alle experimenten werden uitgevoerd terwijl het systeem geen andere rekenintensieve processen draaide om consistente tijdmetingen te verkrijgen. De tijden zijn het gemiddelde van 5 onafhankelijke runs (standaarddeviaties)42.
Evaluatie van deep learning-modellen
Zes deep learning-architecturen werden geëvalueerd met behulp van GPU-acceleratie, waaronder een Multilayer Perceptron (MLP; 64-32-16), een Deep Neural Network (DNN) met batch-normalisatie (128-64-32-16), een Long Short-Term Memory-netwerk (LSTM; 64-32 units, sequentielengte = 10), een eendimensionaal convolutioneel neuraal netwerk (1D-CNN), een hybride CNN–LSTM-model en een attention-gebaseerd netwerk. Alle deep learning-modellen werden geïmplementeerd met TensorFlow via de Keras API en uitgevoerd met GPU-acceleratie (zie Tabel met Materialen voor hardware/softwareversies). De 1D-CNN-architectuur bestond uit drie convolutionele lagen (64, 128 en 256 filters, kernelgrootte 3, ReLU-activatie, padding=’same’), twee MaxPooling1D-lagen (poolgrootte 2), een GlobalAveragePooling1D-laag, een Dense-laag met 128 units en ReLU-activatie, een Dropout-laag (0,2) en een Dense outputlaag (1 unit, lineaire activatie), met in totaal ongeveer 245.000 trainbare parameters. De hybride CNN-LSTM-architectuur accepteerde inputsequenties van 10 tijdstappen met 5 kenmerken, gebruikmakend van twee Conv1D-lagen (64 en 128 filters, kernelgrootte 3, ReLU, padding=’same’), een MaxPooling1D-laag (poolgrootte 2), twee LSTM-lagen (64 en 32 units, return_sequences=False), Dropout-lagen (0,2), een Dense-laag (32 units, ReLU) en een Dense outputlaag (1 unit, lineaire activatie), met in totaal ongeveer 198.000 trainbare parameters. Het attention-gebaseerde netwerk maakte gebruik van een multi-head attention-mechanisme met 4 heads (key- en value-dimensies van 64), waarbij de input werd geprojecteerd naar 64 dimensies, gevolgd door scaled dot-product attention (formule: Attention(Q, K, V) = softmax(QKT/√d_k), residuale verbindingen, layer-normalisatie, een feedforward-netwerk (128→64 units), global average pooling, Dropout (0,2), een Dense-laag (32 units, ReLU) en een Dense outputlaag (1 unit, lineaire activatie), met in totaal ongeveer 167.000 trainbare parameters43.
Alle modellen maakten gebruik van early stopping (patience = 20), verlaging van de leersnelheid (factor = 0.5, patience = 10), dropout (20%) en de Adam-optimizer (leersnelheid = 0.001). Voor alle deep learning-modellen was de batchgrootte ingesteld op 32 samples, het maximale aantal trainings-epochs was 200 met early stopping (patience = 20, herstel van beste gewichten), en de verliesfunctie was de gemiddelde kwadratische fout (MSE). De verdeling tussen training en validatie was als volgt: van de oorspronkelijke 1.200 trainingssamples (na de 80/20 train-test split) werd 80% (960 samples) gebruikt voor training en 20% (240 samples) voor validatie. We hebben de train-validatie split gestratificeerd op basis van weersomstandigheden om de distributie te behouden. De validatieset werd uitsluitend gebruikt voor early stopping, verlaging van de leersnelheid en het monitoren van overfitting; deze werd nooit gebruikt voor modelselectie of het afstemmen van hyperparameters buiten deze geautomatiseerde procedures. We hebben geen aparte validatieset gereserveerd voor de machine learning-modellen; in plaats daarvan hebben we vijfvoudige kruisvalidatie toegepast op de 1.200 trainingssamples om hyperparameters af te stemmen en de prestaties te schatten44.
Rechtvaardiging voor de evaluatie van LSTM- en CNN–LSTM-architecturen
De belangrijkste dataset bestaat uit onafhankelijk gegenereerde weermonsters, maar we hebben ook LSTM- en CNN–LSTM-architecturen getest om de volgende redenen: (1) atmosferische omstandigheden in de echte wereld zijn temporeel autocorrelated en het testen van sequentiegebaseerde modellen stelt ons in staat om te bepalen of het vastleggen van dergelijke afhankelijkheden de voorspellingsnauwkeurigheid kan verbeteren; (2) recent onderzoek naar atmosferische voorspellingen heeft de potentiële waarde van sequentiële architecturen aangetoond voor het modelleren van de temporele evolutie van meteorologische parameters34; (3) het testen van een diverse reeks architecturen zorgt voor een uitgebreide vergelijking van methodologische benaderingen, wat een belangrijke bijdrage van deze studie is; en (4) de hybride CNN–LSTM-architectuur combineert ruimtelijke kenmerkextractie met temporele modellering, wat gunstig kan zijn voor het vastleggen van de complexe interacties tussen meerdere atmosferische variabelen45.
Dataformatteing voor sequentiële modelinvoer
Voor de sequentiële architecturen (LSTM en CNN–LSTM) werden de inputgegevens via een sliding-windowbenadering omgevormd van onafhankelijke monsters naar pseudo-sequenties. In het bijzonder werden de 1.200 trainingsmonsters eerst gegroepeerd in categorieën van weersomstandigheden om de fysieke consistentie te behouden. Binnen elke weercategorie werden de monsters geordend op basis van hun gegenereerde tijdstempels (gesimuleerde uurlijkse waarnemingen voor het kalenderjaar 2024). Vervolgens werd een sliding window met een lengte van 10 toegepast om inputsequenties van 10 opeenvolgende tijdstappen te produceren (elk met 5 kenmerken: temperatuur, vochtigheid, zichtbaarheid, stofconcentratie en neerslagintensiteit) om de attenuatie op de 11e tijdstap te voorspellen. Deze methode behoudt de temporele volgorde van de gesimuleerde waarnemingen, terwijl sequentiële modellen in staat worden gesteld om temporele afhankelijkheden te leren. De structuur van de testset was identiek, met dezelfde windowgrootte en set kenmerken. We erkennen dat deze pseudo-sequentiële structurering een methodologische vereenvoudiging is en geen weerspiegeling vormt van temporele dynamiek in de echte wereld. We hebben dit als een beperking benoemd in de sectie Discussie.
Evaluatie van hybride benaderingen
Er werden drie hybride benaderingen onderzocht. De eerste benadering was een Voting Ensemble dat de voorspellingen van de Random Forest-, XGBoost- en Deep Neural Network-modellen middelde met gelijke gewichten (elk model kreeg een gewicht van 1/3), waarbij de uiteindelijke voorspelling als volgt werd berekend:
ŷensemble=(1/3)ŷRF+(1/3)ŷXGB+(1/3)ŷDNN (9)
Er werd gekozen voor gelijke weging om het introduceren van extra hyperparameters te voorkomen en om de baseline-prestaties van het ensemble te evalueren zonder bias ten opzichte van een individueel model. De tweede aanpak maakte gebruik van Ridge meta-learner stacking. De base learners waren Random Forest, XGBoost en een Deep Neural Network (gebaseerd op Attention). De stacking-procedure bestond uit twee fasen: eerst werd elke base learner getraind op de volledige trainingsset van 1.200 samples met behulp van 5-voudige kruisvalidatie om out-of-fold voorspellingen te genereren, waardoor een nieuwe meta-feature matrix van 1.200×3 ontstond (één voorspelling per base model per sample). Ten tweede werd een Ridge-regressie meta-learner (L2-regularisatieparameter alpha=1.0) getraind op deze meta-features, waarbij de oorspronkelijke attenuatiewaarden als target werden gebruikt, om de optimale combinatiegewichten voor de base learners te bepalen. De uiteindelijke stacking-voorspelling was:
ŷstacking=wRF×ŷRF+wXGB×ŷXGB+wDNN×ŷDNN (10)
waarbij de gewichten w werden aangeleerd door de Ridge meta-learner. De derde benadering was een Physics-Informed Neural Network dat 70% van de voorspellingen van het neurale netwerk combineerde met 30% van het Kim-model voor monsters onder mistige omstandigheden. De combinatie werd uitgevoerd door middel van een vaste gewogen gemiddelde met behulp van de volgende formule:
ŷhybrid=0.7×ŷneural+0.3×ŷKim (11)
waarbij ŷneural de output is van het op aandacht gebaseerde neurale netwerk, en ŷKim de attenuatie is die is berekend via het Kim-mistmodel op basis van de input voor zichtbaarheid. Voor monsters zonder mist werd het fysieke deel op 0 ingesteld en werd het model uitgevoerd als een puur neuraal netwerk. De wegingen (70% neuraal en 30% fysica) werden vastgesteld op basis van voorlopige experimenten op de validatieset (niet de testset), waarbij we de wegingscombinaties 90:10, 80:20, 70:30, 60:40 en 50:50 hebben getest. De 70/30-verdeling werd gekozen omdat deze de beste validatie R2 opleverde en nog steeds voldoende fysieke beperking vanuit het Kim-model behield om voorspellingen te regulariseren en fysiek onplausibele outputs te voorkomen, vooral bij mist waarbij het Kim-model vastgestelde theoretische attenuatiegrenzen biedt.
Analyse van kenmerkbelang en interpreteerbaarheid
Het Random Forest-model met op onzuiverheid gebaseerde kenmerkbelangrijkheid (variantiereductie) werd gebruikt om de belangrijkheidsrangschikking van alle 10 inputkenmerken te extraheren. De analyse toonde aan dat stofconcentratie (67,3%) en zichtbaarheid (21,2%) de belangrijkste voorspellers waren, die samen 88,5% van de totale voorspellende belangrijkheid verklaarden. Het op een na belangrijkste kenmerk was de regenvalintensiteit (6,0%), gevolgd door windsnelheid (2,1%), temperatuur (1,5%), luchtvochtigheid (0,9%), maand (0,5%), seizoen (0,3%), sneeuwvalintensiteit (0,1%) en atmosferische druk (0,1%). De lage belangrijkheidsscores voor de temporele kenmerken (maand en seizoen) geven aan dat seizoensvariaties in atmosferische attenuatie primair worden vastgelegd door onderliggende omgevingsparameters en niet uitsluitend door tijdsgebonden patronen.
Er werd een SHAP-analyse (Shapley Additive exPlanations) uitgevoerd om de relaties tussen omgevingsfactoren en attenuatie te evalueren. De gebruikte SHAP-implementatie was de TreeExplainer-module van de SHAP-bibliotheek, die specifiek is geoptimaliseerd voor boomgebaseerde modellen, waaronder Random Forest, XGBoost en LightGBM (zie Tabel met materialen voor versie). De configuratie voor de SHAP-analyse was als volgt: het getrainde Random Forest-model werd doorgegeven aan de TreeExplainer, die de SHAP-waarden berekende met de interventional (marginale) feature-attributiebenadering op basis van de conditionele verwachting van de output van het model. SHAP-waarden werden berekend voor alle 300 monsters van de testset, wat resulteerde in een matrix van 300 × 10 (één SHAP-waarde per kenmerk per monster). Voor elk kenmerk representeerde de SHAP-waarde de bijdrage aan de voorspelling ten opzichte van de baseline (de gemiddelde modelvoorspelling). Negatieve SHAP-waarden duidden op een neerwaartse verschuiving, terwijl positieve SHAP-waarden aantoonden dat het kenmerk de voorspelling van de attenuatie versterkte. De sterkte van de bijdrage werd aangegeven door de grootte van de SHAP-waarde. De distributie van SHAP-getallen voor elk kenmerk (met behulp van beeswarm-plots), de richting van de invloed (de correlatie tussen kenmerkwaarden en SHAP-waarden) en de rangschikking van het belang van kenmerken werden allemaal gevisualiseerd met behulp van summary plots. De ingebouwde plotfuncties van de SHAP-bibliotheek — shap.summary_plot() voor de beeswarm-plot en shap.bar_plot() voor het globale belang van kenmerken — werden gebruikt om alle SHAP-visualisaties te maken.
Verwerking van one-hot-gecodeerde variabelen: Om de seizoensvariabele te coderen, werden eerst vier binaire kolommen (lente, zomer, herfst en winter) gebruikt. Om voor de SHAP-analyse één enkele bijdrage-waarde voor het "seizoen" per monster te creëren, werden de bijdragen van deze vier one-hot-gecodeerde variabelen gecombineerd door de SHAP-waarden voor elke seizoenscategorie bij elkaar op te tellen. Om deze groepering te realiseren, werden alle kolommen die overeenkwamen met de one-hot-gecodeerde seizoensgroepen geïdentificeerd, werden hun SHAP-waarden voor elk monster geëxtraheerd en vervolgens elementsgewijs gesommeerd. De resulterende gecombineerde SHAP-waarden representeren de totale bijdrage van het seizoen aan de voorspelling van de attenuatie. Deze methode maakt een enkele rij voor "seizoen" in de SHAP-samenvattingsplot mogelijk en garandeert consistentie met het gebruik van het seizoen als samengestelde categorische variabele in het model. Omdat het gecombineerde getal een begrijpelijker beeld geeft van de totale bijdrage van het seizoen, werden de SHAP-waarden voor het seizoen niet afzonderlijk per seizoenscategorie weergegeven.
Resultaten
De kenmerken van de synthetische dataset zijn samengevat in Figuur 1A–F. De dataset omvatte omstandigheden met heldere lucht, stof, mist, regen en sneeuw (Figuur 1A), met monsters verdeeld over warme-droge en koele-natte seizoenen (Figuur 1B) en over dag- en nachtperioden (Figuur 1C). De distributies van temperatuur, vochtigheid en zicht onder verschillende weersomstandigheden worden getoond in Figuur 1D–F.
De machine learning-modellen vertoonden sterke voorspellende prestaties bij het schatten van de atmosferische attenuatie (Figuur 2A–D; Tabel 3). RF behaalde de sterkste algehele prestaties van de geëvalueerde modellen, met een test R2 van 0,9654 en een RMSE van 1,324 dB/km (Figuur 2A; Tabel 3). RF verklaarde 96,54% van de waargenomen variatie, terwijl een voorspellingsfout van minder dan 1,5 dB/km werd behouden. XGBoost presteerde ook goed (Figuur 2C), gevolgd door LightGBM (Figuur 2B). De robuustheid van het model werd ondersteund door vijfvoudige kruisvalidatie, waarbij RF een kruisvalidatie R2 van 0,960 ± 0,007 behaalde (Figuur 2D). In tegenstelling hiermee vertoonde K-Nearest Neighbors tekenen van overfitting, met een trainings- R2 van 1,000 en een test R2 van 0,7341, terwijl Lineaire Regressie een matige voorspellende prestatie behaalde (Figuur 2A; Tabel 3).
De analyse van het belang van de kenmerken voor de 10 hierboven genoemde inputkenmerken wordt weergegeven in Figuur 3A. De relatieve belangrijkheidsscores zijn als volgt gerangschikt: stofconcentratie (67,3%), zicht (21,2%), regenintensiteit (6,0%), windsnelheid (2,1%), temperatuur (1,5%), luchtvochtigheid (0,9%), maand (0,5%), seizoen (0,3%), sneeuvalintensiteit (0,1%) en druk (0,1%). De variabele 'weersomstandigheid' wordt gebruikt voor de stratificatie van de dataset, maar is niet opgenomen in de analyse van het belang van de kenmerken omdat het een categorische samengestelde variabele is die verschillende onderliggende fysische parameters vertegenwoordigt, en het effect ervan wordt opgevangen door de individuele omgevingskenmerken. Analyses van het belang van kenmerken en de interpreteerbaarheid identificeerden de omgevingsvariabelen die het sterkst geassocieerd zijn met attenuatie (Figuur 3A,B). Stofconcentratie (67,3%), zicht (21,2%) en regenintensiteit (6,0%) waren gezamenlijk verantwoordelijk voor 94,4% van het totale voorspellende belang (Figuur 3A). SHAP-analyse toonde verder aan dat een toenemende stofconcentratie en een afnemend zicht geassocieerd waren met verhoogde attenuatievoorspellingen (Figuur 3B).
Deep learning-modellen vertoonden een lagere voorspellende prestatie dan de machine learning-benaderingen (Figuur 4A–D). Het best presterende deep learning-model, het Attention-based netwerk, behaalde een R2 van 0,7766 en een RMSE van 3,362 dB/km (Figuur 4A). Recurrente architecturen vertoonden een bijzonder slechte prestatie, waarbij zowel de LSTM- als de CNN–LSTM-modellen R2-waarden nabij nul en RMSE-waarden boven de 7,19 dB/km produceerden (Figuur 4B). De relatief slechte prestatie van de LSTM- en CNN-LSTM-architecturen (R2 = 0,0110 en 0,0109, respectievelijk; RMSE = 7,193 dB/km en 7,196 dB/km) kan gedeeltelijk worden verklaard door het pseudo-sequentiële karakter van de inputgegevens, die de werkelijke temporele dynamiek van atmosferische omstandigheden niet volledig vastleggen.
In tegenstelling tot real-time series-toepassingen, waarbij sequentiële afhankelijkheden sterk en duidelijk gedefinieerd zijn, bestond onze dataset voornamelijk uit onafhankelijke monsters met een kunstmatig opgelegde temporele volgorde. De slechte voorspellende prestaties van deze architecturen suggereren dat de temporele informatie die via de sliding-window-methode werd geëxtraheerd, ofwel onvoldoende was of niet representatief voor de werkelijke atmosferische evolutie (Figuur 4C). Dit ondersteunt onze conclusie dat voor datasets van deze aard eenvoudigere machine learning-benaderingen geschikter zijn dan complexe, op sequenties gebaseerde deep learning-modellen. De validatieprestaties voor alle deep learning-architecturen zijn samengevat in Figuur 4D.
De prestaties van machine learning, deep learning en hybride benaderingen zijn samengevat in Figuur 5A,B en Tabel 3. Onder de hybride methoden behaalde het Voting Ensemble een R2 van 0,9340 en een RMSE van 1,827 dB/km (Figuur 5A,B; Tabel 3). Ridge meta-learner stacking behaalde een R2 van 0,9571 en een RMSE van 1,473 dB/km (Figuur 5A,B; Tabel 3), wat de prestaties van RF benaderde, maar aanzienlijk langere trainingstijden vereiste. Het Physics-Informed Neural Network behaalde een R2 = 0,8269 en RMSE = 2,960 dB/km (Figuur 5A,B; Tabel 3) en presteerde beter dan de deep learning-modellen, maar niet zo goed als de beste machine learning-benaderingen. Statistische vergelijking tussen de RF- en Stacking Ensemble-modellen wees op geen significant verschil in voorspellende prestaties (Tabel 3; gepaarde t-toets: t = −1,74, p = 0,083). Daarom was, hoewel RF de hoogste numerieke R2 behaalde, het verschil met de beste hybride benadering statistisch niet significant.
Over het algemeen ondersteunen de resultaten de hypothese dat machine learning-benaderingen de atmosferische demping onder Iraakse weersomstandigheden nauwkeurig kunnen voorspellen. RF behaalde consistent de hoogste voorspellende prestaties (Figuur 2A,B; Tabel 3), terwijl analyses van feature-importance en SHAP stofconcentratie en zicht als de dominante omgevingsfactoren identificeerden die de demping beïnvloeden (Figuur 3A,B).
Verklaring over validatiegegevens: Alle modelevaluaties zijn uitgevoerd op de synthetische dataset die in de sectie Methoden wordt beschreven. Er zijn geen experimentele of observationele gegevens over atmosferische attenuatie gebruikt bij de modelvalidatie. De synthetische dataset is aangemaakt met behulp van bekende fysische propagatiemodellen (de wet van Beer-Lambert, het Kim-model, het Carbonneau-model en de Mie-verstrooiingstheorie), waarbij meteorologische parameters zijn geselecteerd uit kansverdelingen gebaseerd op Iraakse klimaatgegevens. Zoals vermeld in de sectie Methoden, kan de sterke voorspellende prestatie gedeeltelijk het resultaat zijn van het leerproces van het model of de benadering van de deterministische fysische vergelijkingen die zijn gebruikt om de doelwaarden te genereren. De kwantitatieve prestatiemetriek (R2, RMSE, MAE) representeert daarom de prestaties op basis van uit vergelijkingen afgeleide synthetische gegevens en moet worden geïnterpreteerd als relatieve vergelijkingen tussen modelleringsmethodologieën in een gecontroleerde simulatieomgeving, en niet als absolute prestatiegaranties voor operationele FSO-systemen. Deze aanpak biedt een gecontroleerde omgeving voor de comparatieve evaluatie van voorspellende modelleringsmethodologieën (zoals vermeld in Tabel 2), maar vervangt geen validatie met real-world FSO-attenuatiemetingen onder feitelijke Iraakse weersomstandigheden.
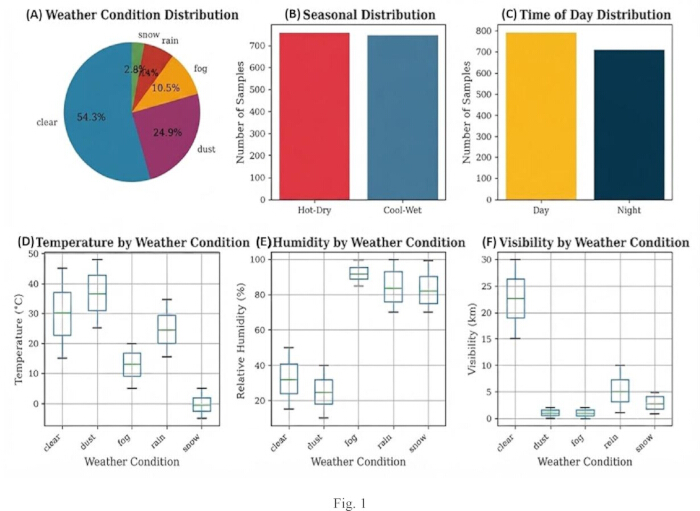
Figuur 1: Kenmerken van de synthetische dataset en omgevingsvariabelen gebruikt voor atmosferische attenuatiemodellering. (A) Verdeling van de in de dataset vertegenwoordigde meteorologische omstandigheden, waaronder situaties met onbewolkte hemel, stof, mist, regen en sneeuw. (B) Seizoensgebonden verdeling van monsters over warme-droge en koele-natte perioden. (C) Verdeling van monsters verzameld tijdens dag- en nachtomstandigheden. (D) Temperatuurverdelingen voor elke weersomstandigheid. (E) Vochtigheidsverdelingen voor elke weersomstandigheid. (F) Zichtbaarheidsverdelingen voor elke weersomstandigheid. Boxplots tonen de mediaan (middellijn), het interkwartielbereik (box) en de minimum- en maximumwaarden (whiskers). Temperatuur wordt gerapporteerd in °C, vochtigheid in % en zichtbaarheid in km. Klik hier om een grotere versie van deze figuur te bekijken.
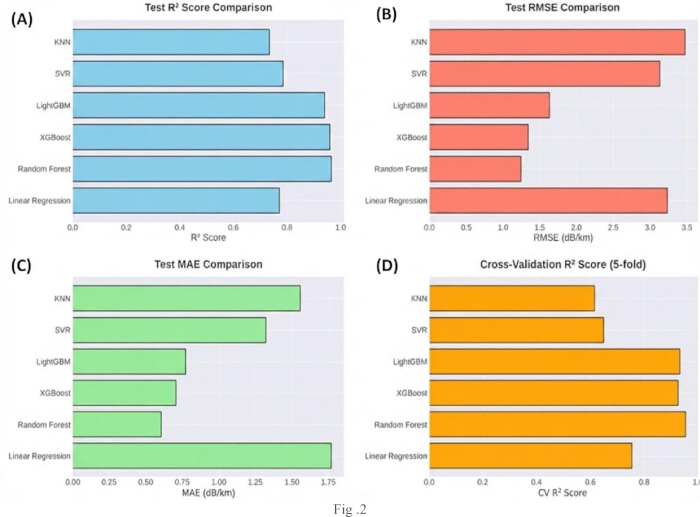
Figuur 2: Prestatievergelijking van machine learning-modellen voor de voorspelling van atmosferische demping. (A) Testscores van de determinatiecoëfficiënt (R2) voor de geëvalueerde machine learning-modellen, waaronder Lineaire Regressie, Random Forest, Extreme Gradient Boosting (XGBoost), Light Gradient Boosting Machine (LightGBM), Support Vector Regression (SVR) en K-Nearest Neighbors (KNN). (B) Testwaarden van de root mean square error (RMSE) voor elk machine learning-model. (C) Testwaarden van de mean absolute error (MAE) voor elk machine learning-model. (D) Scores van de determinatiecoëfficiënt (R2) bij cross-validatie, verkregen via vijfvoudige cross-validatie. Hogere R2-waarden en lagere RMSE- en MAE-waarden duiden op een verbeterde voorspellende prestatie. RMSE en MAE zijn weergegeven in dB/km. Klik hier om een grotere versie van deze figuur te bekijken.
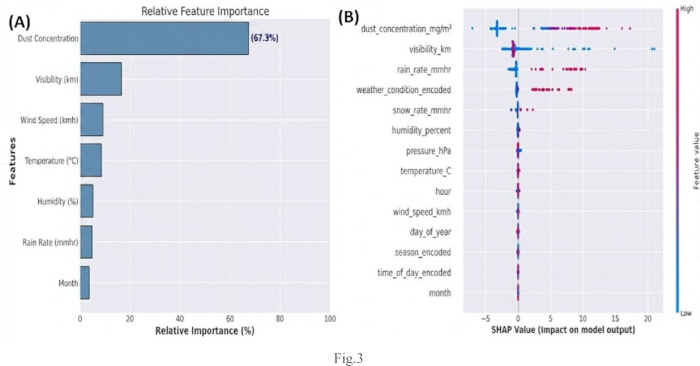
Figuur 3: Analyse van kenmerkbelang en modelinterpreteerbaarheid voor de voorspelling van atmosferische attenuatie. (A) Rangschikking van kenmerkbelang op basis van relatieve onzuiverheid van het Random Forest-model, waarin de bijdrage van alle 10 omgevings- en temporele variabelen aan de attenuatievoorspelling wordt weergegeven. Het meest invloedrijke kenmerk was de stofconcentratie (67,3%), gevolgd door zichtbaarheid (21,2%), regenintensiteit (6,0%), windsnelheid (2,1%), temperatuur (1,5%), luchtvochtigheid (0,9%), maand (0,5%), seizoen (0,3%), sneeuvalsnelheid (0,1%) en atmosferische druk (0,1%). Het relatieve belang is een percentage van het totale modelbelang. (B) SHapley Additive exPlanations (SHAP) samenvattingsplot die de impact van individuele kenmerken op de modelvoorspellingen illustreert. De SHAP-matrix werd berekend voor 300 testset-monsters (300 × 10 kenmerken). Voor de one-hot-gecodeerde seizoensvariabele (oorspronkelijk vier binaire kolommen: lente, zomer, herfst, winter) werden de SHAP-waarden gecombineerd door de vier categorieën op te tellen om één enkele bijdrage-waarde voor het 'seizoen' per monster te produceren. Elk punt vertegenwoordigt een monster, en de kleurenschaal geeft de waarde van het kenmerk aan, variërend van laag (blauw) naar hoog (rood). Positieve SHAP-waarden duiden op een toename van de voorspelde attenuatie, terwijl negatieve SHAP-waarden duiden op een afname van de voorspelde attenuatie. Klik hier om een grotere versie van deze figuur te bekijken.
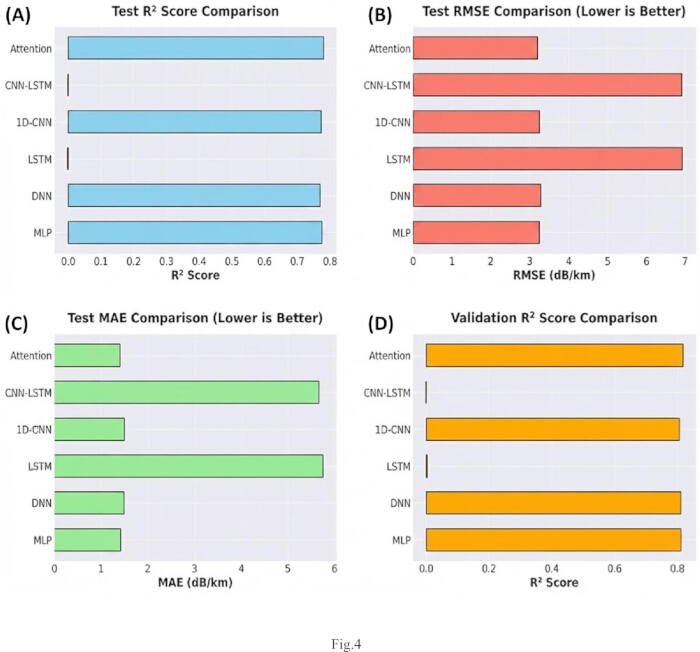
Figuur 4: Prestatievergelijking van deep learning-modellen voor de voorspelling van atmosferische attenuatie. (A) Testscores van de determinatiecoëfficiënt (R2) voor de geëvalueerde deep learning-architecturen, waaronder Multilayer Perceptron (MLP), Deep Neural Network (DNN), Long Short-Term Memory (LSTM), een eendimensionaal convolutioneel neuraal netwerk (1D-CNN), Convolutional Neural Network–Long Short-Term Memory (CNN–LSTM) en Attention-gebaseerde modellen. (B) Testwaarden van de root mean square error (RMSE) voor elk deep learning-model. (C) Testwaarden van de mean absolute error (MAE) voor elk deep learning-model. (D) Validatiescores van de determinatiecoëfficiënt (R2) voor de geëvalueerde deep learning-modellen. Hogere R2-waarden en lagere RMSE- en MAE-waarden duiden op een verbeterde voorspellingsprestatie. RMSE en MAE worden gerapporteerd in dB/km. Klik hier om een grotere versie van deze figuur te bekijken.
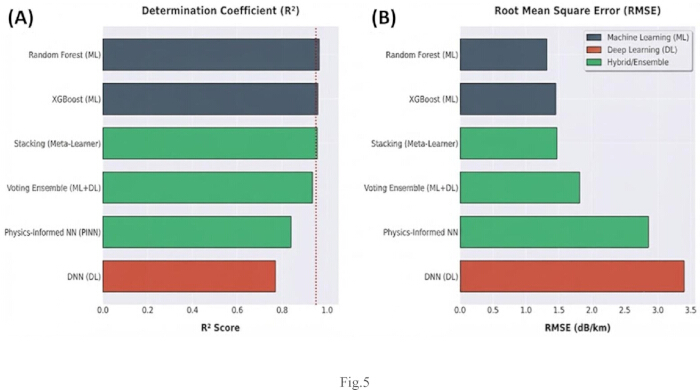
Figuur 5: Vergelijkende prestaties van machine learning-, deep learning- en hybride modellen voor de voorspelling van atmosferische demping. (A) Determinatiecoëfficiënt (R2) waarden voor representatieve machine learning-, deep learning- en hybride benaderingen, waaronder Random Forest, Extreme Gradient Boosting (XGBoost), Deep Neural Network (DNN), Voting Ensemble, Stacking en Physics-Informed Neural Network modellen. (B) Root mean square error (RMSE) waarden voor dezelfde modellen. Machine learning (ML), deep learning (DL) en hybride/ensemble technieken zijn de drie categorieën waarin de modellen kleurgecodeerd zijn. Een verbeterde voorspellende prestatie wordt aangegeven door hogere R2 en lagere RMSE waarden. RMSE is uitgedrukt in dB/km. Klik hier om een grotere versie van deze figuur te bekijken.
| Weersomstandigheid | Proportie | Temperatuurbereik | Vochtigheidsbereik | Zichtbaarheidsbereik | Bereik van de primaire parameter |
| Heldere Hemel | 54,27% (814 monsters) | −4,89 tot 47.99°C | 0–100% | >10 km | — |
| Stof | 25,00% (375 monsters) | 10–45°C | 10–60% | 0,05–5 km | Stof: 0–4,96 mg/m³3 |
| Mist | 10,47% (157 monsters) | −5 tot 20°C | 70–100% | 0,05–1 km | — |
| Regen | 7,40% (111 monsters) | 5–30°C | 60–100% | 1–10 km | Regen: 0,25–50 mm/u |
| Sneeuw | 2,87% (43 monsters) | −10 tot 5°C | 50–100% | 0,5–5 km | Sneeuw: 0,5–15 mm/u |
Tabel 1: Prestatiemaatstaven van machine learning-modellen voor het voorspellen van atmosferische attenuatie.
| Model | Test R2 | RMSE (dB/km) | MAE (dB/km) | CV R2 | Trainingstijd (s) |
| Random Forest | 0.9654 | 1.324 | 0.815 | 0.960 ± 0.007 | 1.6 |
| XGBoost | 0.9582 | 1.455 | 0.892 | 0.953 ± 0.009 | 2.1 |
| LightGBM | 0.9507 | 1.581 | 0.971 | 0.946 ± 0.011 | 1.8 |
| Support Vector Regression (SVR) | 0.8874 | 2.389 | 1.445 | 0.879 ± 0.015 | 3.2 |
| Lineaire regressie | 0.8358 | 2.889 | 1.791 | 0.831 ± 0.018 | 0.2 |
| K-dichtstbijzijnde buren (K-Nearest Neighbors, KNN) | 0.7341 | 3.671 | 2.296 | 0.721 ± 0.022 | 0.8 |
Tabel 2: Vergelijkende evaluatie van specifieke deep learning-, hybride- en machine learning-modellen.
| Model | Categorie | Test R2 | RMSE (dB/km) | Rangschikking |
| Random Forest | ML | 0.9654 | 1.324 | 1 |
| XGBoost | ML | 0.9582 | 1.455 | 2 |
| Stacking Ensemble | Hybride | 0.9571 | 1.473 | 3 |
| LightGBM | ML | 0.9507 | 1.581 | 4 |
| Voting Ensemble | Hybride | 0.934 | 1.827 | 5 |
| Physics-Informed Neural Network | Hybride | 0.8269 | 2.96 | 6 |
| Attention | DL | 0.7766 | 3.362 | 7 |
| LSTM / CNN–LSTM | DL | −0.0006 | 7.195 | — |
Tabel 3: Vergelijking van de computationele efficiëntie (training en inferentie) van elk beoordeeld model.
DATA BESCHIKBAARHEID:
De volledige synthetische dataset van 1.500 monsters met alle inputkenmerken (temperatuur, vochtigheid, zichtbaarheid, stofconcentratie, neerslagsnelheid, sneevalsnelheid, windsnelheid, atmosferische druk, maand, seizoen en weersomstandigheid) en de doelvariabele (attenuatie in dB/km) is als aanvullend bestand bij dit manuscript beschikbaar via https://doi.org/10.5281/zenodo.21792999. De dataset is zo geformatteerd dat elk monster één rij beslaat, inclusief alle berekende variabelen (werkbereik en SNR).
De volledige implementatiecode, inclusief: scripts voor datageneratie (implementaties van fysische modellen); functies voor preprocessing en feature scaling; alle implementaties van machine learning-modellen; alle implementaties van deep learning-modellen; scripts voor evaluatie en visualisatie; en procedures voor hyperparametertuning en kruisvalidatie, is eveneens bedoeld om als aanvullend bestand te worden verstrekt.
Bron van klimaatgegevens: De klimaatgegevens die zijn gebruikt om de distributies van de synthetische gegevens te definiëren, zijn verkregen van de Iraqi Meteorological Organization and Seismology (IMOS) en het Iraakse Ministerie van Transport, over de periode 2020–2024. Een samenvatting van de klimaatgegevens die zijn gebruikt om de proporties van de weersomstandigheden en de parameterbereiken te bepalen, is opgenomen in Aanvullende Tabel 1. De specifieke IMOS-gegevens die in deze studie zijn gebruikt, zijn niet openbaar gearchiveerd in een centrale repository, maar kunnen rechtstreeks bij IMOS worden opgevraagd. De samenvattende statistieken en de afgeleide kansverdelingen zijn opgenomen in de aanvullende materialen om reproduceerbaarheid mogelijk te maken.
Informatie over de repository: De broncode en de dataset zijn ondergebracht in een openbare repository (Zenodo) via https://doi.org/10.5281/zenodo.21792999.
Discussie
Om de luchtverzwakking in FSO-communicatiesystemen die werken onder Iraakse weersomstandigheden te voorspellen, evalueerde de huidige studie machine learning, deep learning en hybride technieken. Aangezien atmosferische effecten een van de belangrijkste problemen blijven die de prestaties en beschikbaarheid van de verbinding beïnvloeden, hebben recente evaluaties de toenemende betekenis van voorspellende modellering voor FSO-systemen benadrukt21. De resultaten toonden aan dat klassieke machine learning-benaderingen, in het bijzonder RF en XGBoost, een hoge voorspellende nauwkeurigheid leverden en in sommige gevallen numeriek beter presteerden dan deep learning- en hybride methoden. Statistische tests toonden echter geen significant verschil (p=0,083) aan tussen RF en het beste hybride ensemble (Stacking), wat betekent dat beide benaderingen vergelijkbare resultaten kunnen bereiken op deze dataset. Onze bevindingen geven aan dat boomgebaseerde ensemblemethoden nog steeds zeer effectief zijn voor tabulaire omgevingsgegevens met gematigde steekproefgroottes en een klein aantal dominante predictorvariabelen. Analyse van de kenmerkbelangrijkheid toonde aan dat stofconcentratie en zichtbaarheid de belangrijkste drijvers van verzwakking waren, die samen het grootste deel van de voorspellende kracht verklaarden. Deze bevinding komt overeen met eerdere onderzoeken die de belangrijke invloed van mist, stof, aerosolen en atmosferische vervuiling op de voortplanting van het optische signaal aantonen22,23,24,25. Vergelijkbare resultaten zijn gerapporteerd in toepassingen voor milieumonitoring, waarbij machine learning-modellen vaak profiteren van datasets die een klein aantal zeer informatieve variabelen bevatten26,27,28,29,30,31,32. De SHAP-analyse verbeterde de interpreteerbaarheid van het model verder door de invloed van individuele omgevingsparameters op de voorspellingen van de verzwakking te kwantificeren.
De lagere prestaties van deep learning-modellen kunnen worden toegeschreven aan verschillende factoren. De omvang van de dataset was relatief bescheiden voor het trainen van complexe neurale architecturen (in https://doi.org/10.5281/zenodo.21792999), en de omgevingsvariabelen vertoonden een sterk geconcentreerde feature-belangrijkheid. Eerdere studies hebben aangetoond dat deep learning-methoden over het algemeen profiteren van grote datasets, hiërarchische feature-structuren en complexe niet-lineaire representaties33,34,35,36,37. Daarentegen bevatte de in deze studie gebruikte attenuatiedataset een beperkt aantal dominante predictoren en ontbraken de temporele afhankelijkheden die vereist zijn voor recurrente architecturen. De slechte prestaties van LSTM- en CNN–LSTM-modellen suggereren dat sequentiële leeringsmechanismen mogelijk geen aanzienlijke voordelen bieden voor deze toepassing.
De dominantie van stofconcentratie (67,3%) en zichtbaarheid (21,2%) als voorspellers van atmosferische attenuatie kan worden toegeschreven aan verschillende factoren. Ten eerste worden de moleculaire verstrooiing en absorptie bij 1550 nm overschaduwd door de Mie-verstrooiing van stofdeeltjes. In de Mie-theorie is de extinctie-efficiëntie Q_ext zeer gevoelig voor de deeltjesconcentratie, en de attenuatie schaalt bijna lineair met de stofconcentratie in het regime van gemiddelde tot hoge concentraties. Ten tweede is Irak onderhevig aan frequente stofstormen (25,00% van de dagen in onze klimaatgegevens), wat resulteert in attenuatiewaarden van 4–30 dB/km. Dit staat in contrast met mist (10,47%, 0,5–10 dB/km) en regen (7,40%, 2–25 dB/km). De grotere variabiliteit in stofattenuatie levert sterkere signalen op waar de modellen van kunnen leren. Ten derde produceert de exponentiële distributie van de stofconcentratie (0,4–4,96 mg/m3) een breed scala aan attenuatiewaarden. De lange staart voor extreme stofgebeurtenissen levert hoge attenuatiewaarden op, die essentieel zijn voor een nauwkeurige voorspelling. Ten vierde heeft het Mie-verstrooiingsmodel een eenvoudigere (bijna lineaire) afhankelijkheid van de stofconcentratie, wat voor boomgebaseerde modellen gemakkelijker te benaderen is vergeleken met de complexere relatie tussen zichtbaarheid en mistattenuatie in het Kim-model. Ten vijfde is deze bevinding van praktische betekenis omdat stofstormen een van de meest uitdagende omgevingscondities zijn voor FSO in het Midden-Oosten. Nauwkeurige voorspelling tijdens stofgebeurtenissen is essentieel voor de betrouwbare werking van het systeem.
De bevindingen stimuleren het onderzoek naar FSO-communicatie door praktische richtlijnen te bieden voor de selectie van algoritmen voor het voorspellen van atmosferische attenuatie. Nauwkeurige attenuatievoorspellingen zijn essentieel voor netwerkplanning, adaptief linkbeheer en de betrouwbare implementatie van optische communicatiesystemen in uitdagende omgevingen, zoals het Midden-Oosten23,28,30,36. Daarnaast kan de methodologie toepasbaar zijn op andere milieuvoorspellingsproblemen met betrekking tot luchtvoortplanting, atmosferische monitoring en de prestatiebeoordeling van optische netwerken38,39,40. Andere methoden om dit concept verder te onderzoeken zijn het gebruik van grotere real-world datasets, geavanceerde ensemble-leerstechnieken, transfer learning-frameworks of complexere physics-informed architecturen41,42,43,44,45.
Reikwijdte van conclusies en kwesties betreffende generaliseerbaarheid
De conclusies van dit werk zijn hoofdzakelijk gebaseerd op een synthetische dataset die is gegenereerd vanuit algemeen aanvaarde fysische propagatiemodellen (wet van Beer-Lambert, Kim-model, Carbonneau-model en Mie-verstrooiingstheorie). Deze methodologische aanpak heeft enkele implicaties voor de reikwijdte en generalisatie van onze bevindingen:
Conclusies uit gesimuleerde gegevens: (1) Vergelijkende prestatierangschikking van machine learning, deep learning en hybride benaderingen voor de voorspelling van atmosferische attenuatie. (2) Identificatie van stofconcentratie en zichtbaarheid als de dominante omgevingsvoorspellers van optische attenuatie onder de gemodelleerde omstandigheden. (3) Voordeel in computationele efficiëntie van tree-based ensemble-methoden ten opzichte van deep learning-architecturen. (4) Interpreteerbaarheid van feature-belang en SHAP-analyses om modelvoorspellingen toe te lichten.
Conclusies die bevestiging in de praktijk vereisen: (1) De absolute waarden van R2 en RMSE die door de geëvalueerde modellen zijn verkregen, zijn afhankelijk van de specifieke kenmerken van de synthetische dataset en kunnen weerspiegelen dat de modellen de deterministische fysische vergelijkingen hebben geleerd die zijn gebruikt om de doelwaarden te genereren. (2) Het moet nog worden bewezen of het beste model, Random Forest, kan worden toegepast op onbekende atmosferische omstandigheden in de echte wereld. (3) Veldvalidatie is noodzakelijk om de bevindingen toepasbaar te maken op operationele FSO-eenheden die in Irak zijn geïnstalleerd. (4) Het is noodzakelijk om te bevestigen dat de geïdentificeerde rangschikkingen van kenmerkbelang robuust zijn onder veldmeetcondities.
Het is belangrijk om onderscheid te maken tussen de prestaties op basis van synthetische gegevens afgeleid van vergelijkingen en de prestaties op basis van ruisbevatte observationele of experimentele gegevens. De synthetische dataset biedt een zuivere, ruisvrije relatie tussen de invoerkenmerken en het attenuatiedoel, wat kan leiden tot hogere indicatoren voor voorspellende prestaties dan wat kan worden behaald met praktijkgegevens met meetruis, instrumentfouten en niet-gemodelleerde fysische fenomenen. Wij bevelen aan dat toekomstig werk gericht wordt op het verkrijgen van reële FSO-attenuatiemetingen onder de Iraakse weersomstandigheden, om de in deze studie gepresenteerde resultaten te valideren en de werkelijke generaliseerbaarheid van de voorgestelde methodologieën te beoordelen.
Implicaties van synthetische data voor de generaliseerbaarheid van modellen
De implicaties van het gebruik van synthetische data in deze studie moeten zorgvuldig worden overwogen met het oog op de generaliseerbaarheid van de modellen:
Voordelen van de synthetische benadering De dataset is fysiek consistent en is, door het gebruik van gevestigde fysieke voortplantingsmodellen, gebaseerd op erkende theoretische kaders. Meteorologische parameters zijn geëxtraheerd uit meteorologische registers van Irak om de dataset te laten reflecteren op de statistische eigenschappen van de werkelijke weersomstandigheden in Irak. Naast het vermijden van storende variabelen van veldmetingen (zoals meetfouten, kalibratie van apparatuur of onvoldoende dataregisters), maakt deze gecontroleerde setting een methodische analyse van modelleringsmethodieken mogelijk.
Beperkingen voor generaliseerbaarheid De synthetische dataset heeft beperkingen in het vastleggen van de volledige complexiteit van werkelijke atmosferische attenuatie, waaronder: (1) de interactie van meerdere atmosferische fenomenen die gelijktijdig optreden; (2) niet-lineair en niet-stationair gedrag van atmosferische parameters; (3) klimaatvariabiliteit op lange termijn die niet wordt weerspiegeld in de steekproefverdelingen; (4) lokale microklimatische effecten die de FSO-voortplanting aanzienlijk kunnen beïnvloeden; en (5) ruis en onzekerheid die inherent zijn aan gegevensverzameling in de echte wereld.
Overwegingen met betrekking tot bias bij synthetische datageneratie De aanname van onafhankelijke bemonstering van omgevingsparameters (zie Methoden) is een versimpeling van praktijkomstandigheden, waarbij atmosferische variabelen vaak gecorreleerd zijn (bijv. hoge stofconcentraties zijn vaak gecorreleerd met een laag zicht). Om een systematische modelvergelijking mogelijk te maken, is voor een gecontroleerde simulatieomgeving uitgegaan van een onafhankelijkheidsaanname. Deze methode kan echter mogelijk niet de volledige complexiteit van de interacties tussen atmosferische parameters vastleggen. Wij maken gebruik van een gestratificeerde splitsingsmethode (waarbij de ratio's van weersomstandigheden in de trainings- en testsets behouden blijven) om de kans op een ongebalanceerde representatie van zeldzame omstandigheden in de testset te minimaliseren (met name sneeuw bij 2,87%).
Deterministische doelwaarde-generatie: De hoge voorspellende prestaties die in deze studie zijn waargenomen, kunnen gedeeltelijk worden verklaard door het feit dat de modellen de deterministische fysische vergelijkingen hebben aangeleerd die zijn gebruikt om de doelwaarden te genereren. In tegenstelling hiermee bevatten experimentele gegevens uit de praktijk meetruis, instrumentfouten en niet-gemodelleerde fysische fenomenen, waardoor voorspellingen uitdagender worden. Daarom moeten de kwantitatieve prestatiemetrieken (R2, RMSE, MAE) worden geïnterpreteerd als relatieve vergelijkingen tussen methodologieën in een gecontroleerde simulatieomgeving, en niet als absolute prestatiegaranties voor operationele FSO-systemen.
Daarom, hoewel de vergelijkende resultaten van de modelprestatie-ranglijsten waarschijnlijk robuust zijn (vanwege de fysieke consistentie van de synthetische gegevens), mogen de absolute prestatiemetrieken (R2, RMSE, MAE) niet worden beschouwd als indicatief voor de verwachte prestaties in operationele FSO-systemen. Het is noodzakelijk om de generaliseerbaarheid van het model naar praktijksituaties te testen met behulp van experimentele metingen van de luchtdemping, verkregen onder verschillende weersomstandigheden in Irak.
Er zijn enkele beperkingen waar rekening mee gehouden moet worden. Ten eerste vertrouwde de studie, in plaats van op veldobservaties, op een synthetische dataset die is gegenereerd met behulp van bekende fysische propagatiemodellen. Zoals eerder vermeld, moeten de kwantitatieve prestatiemetrieken (R2, RMSE, MAE) worden beschouwd als relatieve vergelijkingen van benaderingen in een gecontroleerde simulatieomgeving, in plaats van absolute prestatiegaranties voor operationele FSO-systemen. Ten tweede zijn standaardmodellen versus deep learning-modellen mogelijk niet in staat geweest om robuuste kenmerkrepresentaties te leren vanwege de omvang van de dataset. Ten derde zijn andere FSO-prestatieindicatoren, zoals verbindingsbeschikbaarheid, pointing-fouten en turbulentie-geïnduceerde fading, niet meegenomen ten gunste van de attenuatievoorspelling. Ten vierde zijn historische gegevens van 2020 tot 2024 gebruikt om de proporties van weersomstandigheden te berekenen, wat mogelijk de variaties in de Iraakse klimatologische patronen van jaar tot jaar niet nauwkeurig weerspiegelt. Ten vijfde is de pseudo-sequentiële invoergegevensstructuur van de CNN–LSTM- en LSTM-modellen een methodologische vereenvoudiging die de temporele dynamiek van praktijktoepassingen mogelijk niet adequaat vastlegt. Bij de evaluatie van de resultaten moeten deze beperkingen in overweging worden genomen, aangezien ze van invloed kunnen zijn op de generaliseerbaarheid van de bevindingen.
Aanbevolen prioriteit: Verificatie in de echte wereld. Het verzamelen en analyseren van werkelijke FSO-attenuatiemetingen onder Iraakse weersomstandigheden is de meest cruciale route voor toekomstig werk. Dit zou het volgende moeten omvatten: (1) het opzetten van FSO-testbeds in verschillende delen van Irak (bijv. Bagdad, Basra, Mosul, Ramadi) om regionale klimaatvariaties vast te leggen; (2) het gebruik van gekalibreerde instrumenten op FSO-locaties om gelijktijdig atmosferische parameters (temperatuur, vochtigheid, zichtbaarheid, stofconcentratie) te meten; (4) het documenteren van de attenuatie tijdens extreme weersomstandigheden (stofstormen, dichte mist, hevige regen); (5) het publiekelijk beschikbaar maken van de verzamelde gegevens om reproduceerbaarheid en vergelijkend onderzoek mogelijk te maken; en (3) het voortzetten van de monitoring gedurende ten minste één volledige jaarcyclus om de seizoensfluctuaties vast te leggen. Dergelijke praktische validatie zou de kans bieden om de generaliseerbaarheid van het model te beoordelen en de in dit onderzoek ontwikkelde voorspellingstechnieken te verbeteren.
Om de gegenereerde modellen te valideren en te verbeteren, zou toekomstig onderzoek zich moeten richten op de integratie van werkelijke FSO-metingen die zijn verkregen onder Iraakse weersomstandigheden. Aanvullend onderzoek zou transfer learning-strategieën kunnen onderzoeken die gebruikmaken van relevante atmosferische datasets, online leerprogramma's die zich aanpassen aan veranderende omgevingsfactoren, en hybride experimenteel-simulatiestrategieën die gemeten gegevens combineren met fysische modellen. Aanvullend onderzoek naar explainable AI en geavanceerde physics-based learning-benaderingen kan mogelijk meer licht werpen op de mechanismen die ten grondslag liggen aan luchtverzwakking en de robuustheid van toekomstige voorspellingssystemen versterken.
Openbaarmakingen
Belangenverstrengeling: De auteurs verklaren dat er geen belangenverstrengeling is.
Dankbetuigingen
De auteurs verklaren dat er geen externe financiering is ontvangen voor dit onderzoek. Wij betuigen onze dank aan het International Applied and Theoretical Research Center (IATRC), Bagdad Quarter, Irak.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| CUDA Toolkit | NVIDIA Corporation | 11.8 | GPU-acceleratiebibliotheek voor training van deep learning |
| cuDNN | NVIDIA Corporation | 8.6.0 | GPU-versnelde bibliotheek voor diepe neurale netwerken |
| GPU (graphics processing unit) | NVIDIA Corporation | GeForce RTX 4090, 24 GB VRAM | Gebruikt voor GPU-versnelde training van deep learning |
| CPU (central processing unit) | Intel Corporation | Core i9-13900K, 24 cores/32 threads | Workstation-processor voor alle modeltraining/evaluatie |
| Systeemgeheugen (RAM) | n/a | 64 GB DDR5, 5200 MHz | Workstation-geheugen |
| Keras API | Open source (onderdeel van TensorFlow) | bundled with TensorFlow 2.11.0 | High-level deep learning API gebruikt voor alle DL-architecturen |
| LightGBM | Open source (Microsoft) | 3.3.5 | Gradient boosting framework |
| NumPy | Open source (NumFOCUS) | 1.23.5 | Bibliotheek voor numerieke berekeningen |
| Besturingssysteem | Canonical Ltd. | Ubuntu 22.04 LTS | Besturingssysteem van het workstation |
| Python | Python Software Foundation | 3.9 | Programmeertaal gebruikt voor alle datageneratie en modellering |
| scikit-learn | Open source | 1.2.2 | Machine learning bibliotheek (RF, SVR, KNN, Lineaire Regressie, kruisvalidatie, schaling) |
| SHAP (SHapley Additive exPlanations) | Open source | 0.41.0 | Bibliotheek voor modelinterpreteerbaarheid, TreeExplainer module |
| TensorFlow | Open source (Google) | 2.11.0 | Deep learning framework gebruikt voor alle zes DL-architecturen |
| XGBoost | Open source | 1.7.5 | Extreme Gradient Boosting bibliotheek |
Referenties
- Kadhim MS, Hussein H, Elwi TA. Hybrid ANN-Z method for modeling carbon nanotube-based reconfigurable intelligent surfaces for terahertz beam steering. J Vis Exp. 2026;in press.
- Raham JK, Alshaibi M, Elwi TA. SMS optical fiber laser sensor for transformer oil temperature monitoring-based IoT of AI control. Prog Electromagn Res B. 2026;118:72–86.
- Abdulkareem ZJ, Hamad TK, Elwi TA. Reconfigurable metasurface based on graphene optical antennas for dynamic beam steering. Sustain Eng Innov. 2025;7:127–136.
- Abdulsattar RK, et al. Optical-microwave sensor for real-time measurement of water contamination in oil derivatives. AEU Int J Electron Commun. 2023;170:154798. doi:10.1016/j.aeue.2023.154798.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote control of miniaturized 3D reconfigurable CRLH printed self-powered MIMO antenna array for 5G applications. Micromachines. 2022;13(12):2061. doi:10.3390/mi13122061.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote-controlled miniaturized 3D reconfigurable CRLH-printed MIMO antenna array for 5G applications. Microw Opt Technol Lett. 2023;65(2):603–610.
- Jassim DA, Elwi TA. Optical nano monopoles for interconnection of electronic chip applications. Optik. 2022;249:168142. doi:10.1016/j.ijleo.2021.168142.
- Elwi TA. A novel approach for modeling the geometry and constitutive parameters of an armchair single-wall carbon nanotube antenna operating in the NIR regime. Al-Ma’mon Coll J. 2014;(24):261–285.
- Mohammed, AB.F.A., Al-hadeethi, S.T., Al-khaylani, H.H. et al. An investigation of success probability and fidelity of quantum repeater in asymmetry in midpoint placement in fiber-based quantum networks. J Opt (2025). https://doi.org/10.1007/s12596-025-02866-6.
- Kim II, McArthur B, Korevaar EJ. Comparison of laser beam propagation at 785 nm and 1550 nm in fog and haze for optical wireless communications [conference paper]. Presented at: Optical Wireless Communications III; Boston, MA, USA; 2000. Proc SPIE. 2001;4214:26–37. https://doi.org/10.1117/12.417512.
- Okbi ZA, Alak IK, Abdulla EN, Al-Khaylani HH. Design and security analysis of an image encryption based on a gigabit passive optical network employing fiber-FSO protection at the last mile. J Opt Commun. 2025. doi:10.1515/joc-2025-0466.
- Ojo JS, Olaitan JA, Ojo OL. Characterization of fog-induced attenuation for optimizing optical propagation links in Nigeria. Results Opt. 2022;9:100279. doi:10.1016/j.rio.2022.100279.
- Khidher SA. Dust storms in Iraq: Past and present. Theor Appl Climatol. 2024;155:4721–4735.
- Ali, Alaa Hussein, Abdulla, Essam N. and Al-Azawi, Razi J.. "Security and network performance analysis of coexistence TWDM – NG-PON2, GPON and 10G-EPON systems based on Hill Cipher" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0435.
- Lionis A, et al. Using machine learning algorithms for accurate received optical power prediction of an FSO link over a maritime environment. Photonics. 2021;8(6):212. doi:10.3390/photonics8060212.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA, USA; 2016. p. 785–794. https://doi.org/10.1145/2939672.2939785.
- Bai Y, et al. Air pollutants concentrations forecasting using back propagation neural network based on wavelet decomposition with meteorological conditions. Atmos Pollut Res. 2016;7(3):557–566.
- LeCun Y, Bengio Y, Hinton G. Deep learning. Nature. 2015;521:436–444.
- Mousa, Ekhlass, Abdulla, Essam N. and Adnan, Salah A.. "Enhancing network security based on 10G-EPON with the use of the Hill cipher algorithm" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0201.
- Lu G, et al. A survey of deep learning for time series forecasting: Theories, datasets, and state-of-the-art techniques. Comput Mater Contin. 2025;85(2):2403–2441.
- Liu J, Yang X, Wei Y, Zhao F. Integrated THz/FSO communications: A review of practical constraints, applications and challenges. Micromachines. 2025;16(11):1297. doi:10.3390/mi16111297.
- Bott A, Sievers U, Zdunkowski W. A radiation fog model with a detailed treatment of the interaction between radiative transfer and fog microphysics. J Atmos Sci. 1990;47:2153–2166.
- Fadhil HA, et al. Optimization of free space optics parameters: An optimum solution for bad weather conditions. Optik. 2013;124(19):3969–3973.
- Osipov S, et al. Severe atmospheric pollution in the Middle East is attributable to anthropogenic sources. Commun Earth Environ. 2022;3:203. doi:10.1038/s43247-022-00514-6.
- Castellanos P, et al. Mineral dust optical properties for remote sensing and global modeling: A review. Remote Sens Environ. 2024;303:113982. doi:10.1016/j.rse.2023.113982.
- Lolli S. Urban PM2.5 concentration monitoring: A review of recent advances in ground-based, satellite, model, and machine learning integration. Urban Clim. 2025;63:102566. doi:10.1016/j.uclim.2025.102566.
- Ridha, Fay F., Abdulla, Essam N. and Abdulhadi, Ali H.. "Machine learning based on raw ensemble predictions scheme for TWDM-PON" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0373.
- Khalid H, Sajid SM, Cheema MI, Leitgeb E. Optical signal attenuation through smog in controlled laboratory conditions. Photonics. 2024;11(2):172. doi:10.3390/photonics11020172.
- Ejike O, Ndị D, Shakir MZ. Comparative study of machine learning-based rainfall prediction in tropical and temperate climates. Climate. 2025;13(8):167. doi:10.3390/cli13080167.
- Esmail MA, Fathallah H, Alouini MS. An experimental study of FSO link performance in desert environment. IEEE Commun Lett. 2016;20(9):1888–1891.
- Kshirsagar MP, Khare KC. Support vector regression models of stormwater quality for a mixed urban land use. Hydrology. 2023;10(3):66. doi:10.3390/hydrology10030066.
- Mosso S, Lapo K, Stiperski I. Revealing the drivers of turbulence anisotropy over flat and complex terrain: An interpretable machine learning approach. Boundary Layer Meteorol. 2025;191:51. doi:10.1007/s10546-025-00946-5.
- Mohsen S, Ali AM, Emam A. Automatic modulation recognition using CNN deep learning models. Multimed Tools Appl. 2024;83:7035–7056.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517. doi:10.3390/info15090517.
- Castelli M, et al. Generative adversarial networks for generating synthetic features for Wi-Fi signal quality. PLoS One. 2021;16(11). doi:10.1371/journal.pone.0260308.
- Al-Imran, Chowdhury MZ, Mofidul RB, Jang YM. Machine learning and deep learning in FSO communication: A comprehensive survey. ICT Express. 2025;11(6):1026–1046.
- Grose MG, Watson EA. Forecasting atmospheric turbulence conditions from prior environmental parameters using artificial neural networks. Appl Opt. 2023;62:3370–3379.
- Radhi SS, et al. Design a secure TWDM-PON via the Hill cipher algorithm. Opt Contin. 2025;4:1051–1064.
- Mushatet, Adil Fadhil, Fadil, Elaf A. and Abdulla, Essam N.. "High bit rate secure FSO system utilizing Hill coding" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0147.
- Musadaq R, Abdulwahid SN, Abd Alwahed NN, Abdulla EN. Security analysis of an image encryption algorithm based on Blowfish in GPON. J Opt Commun. 2025. doi:10.1515/joc-2025-0109.
- Raissi M, Yazdani A, Karniadakis GE. Hidden fluid mechanics: Learning velocity and pressure fields from flow visualizations. Science. 2020;367(6481):1026–1030.
- Vasiliauskaite V, Antulov-Fantulin N. Generalization of neural network models for complex network dynamics. Commun Phys. 2024;7:348. doi:10.1038/s42005-024-01837-w.
- Oh S, Hong SK. Physics-informed neural modeling of 2D transient electromagnetic fields. Appl Sci. 2025;15(23):12612. doi:10.3390/app152312612.
- Pradhan S, Bhattarai JS, Murugavel M, Sharma OP. Machine learning approaches to surpass the limitations of the Beer–Lambert law. ACS Omega. 2025;10(16):16597–16601.
- Pavlyshenko B. Using stacking approaches for machine learning models [conference paper]. Presented at: 2018 IEEE Second International Conference on Data Stream Mining and Processing (DSMP); Lviv, Ukraine; 2018. p. 255–258. https://doi.org/10.1109/DSMP.2018.8478522.