Hier presenteren wij een protocol voor het verrijken van mitochondriaal DNA uit individuele menselijke oocyten met behulp van Exonuclease V en het voorbereiden van duplex sequencing-libraries voor zeer nauwkeurige detectie van varianten in mitochondriaal DNA met behulp van Illumina-compatibele sequencing-platforms.
Methodenartikel
Protocol voor duplexsequencing van mitochondriaal DNA in enkele menselijke oocyten
In dit artikel
Samenvatting
Samenvatting
Oocyten zijn dicht gepakt met mitochondriën, de energieproducerende organellen die hun eigen genoom bevatten, het mitochondriaal DNA (mtDNA). Elke cel bevat meerdere kopieën van mtDNA, waarbij het kopiegetal varieert per weefseltype. Oocyten bezitten het hoogste mtDNA-kopiegetal, met honderdduizenden mtDNA-moleculen per cel. Omdat mitochondriën uitsluitend via de moederlijke lijn worden overgeërfd, is de nauwkeurige detectie van mtDNA-varianten essentieel voor studies naar overerving, veroudering en ziekten. De aanwezigheid van meerdere mtDNA-kopieën maakt het mogelijk dat wild-type en mutante moleculen binnen dezelfde cel co-existeren, een conditie die bekend staat als heteroplasmie, waarbij laagfrequente en de novo varianten kunnen voorkomen met frequenties onder de 1%. Conventionele next-generation sequencing (NGS) beschikt niet over voldoende nauwkeurigheid om deze zeldzame varianten betrouwbaar te onderscheiden van fouten die worden geïntroduceerd tijdens de bibliotheekpreparatie en sequencing. Hier presenteren we een protocol voor het verrijken van mtDNA uit individuele menselijke oocyten met behulp van Exonuclease V om lineair DNA te verwijderen, gevolgd door duplex sequencing bibliotheekpreparatie voor een zeer nauwkeurige mtDNA-analyse. Deze workflow maakt foutgecorrigeerde sequencing van individuele oocyten mogelijk, wat de betrouwbare detectie van laagfrequente mtDNA-varianten en de analyse van heteroplasmie en de novo mutagenese faciliteert. Het protocol biedt een reproduceerbare aanpak voor het onderzoeken van variatie in het mitochondriaal genoom in individuele oocyten met behulp van Illumina-compatibele sequencingplatforms.
Inleiding
Mitochondriën spelen een fundamentele rol in essentiële cellulaire processen, waaronder energieproductie, apoptose, signalering en calciumhomeostase1. Ze beschikken over hun eigen genoom, mitochondriaal DNA (mtDNA), een circulair, dubbelstrengs molecuul van ongeveer 16,6 kb lengte bij zoogdieren. Hoewel de meeste ancestrale mitochondriale genen tijdens endosymbiose naar het nucleaire genoom zijn overgebracht, bevat mtDNA nog steeds 37 genen die coderen voor 13 oxidatieve fosforylatie (OXPHOS) polypeptiden, 22 transfer-RNA's (tRNA's) en twee ribosomaal RNA's (rRNA's)2. Mutaties in mtDNA kunnen de mitochondriale genexpressie en functie belemmeren en kunnen leiden tot ernstige aandoeningen3. Omdat mitochondriën uitsluitend via de moederlijke lijn worden overgeërfd, speelt het mtDNA van de oöcyt een kritieke rol bij de bevruchting, embryonale ontwikkeling en de gezondheid van het nageslacht4. Bijgevolg zijn de detectie en karakterisering van mtDNA-mutaties en hun frequenties van aanzienlijk belang. Zo is inzicht in kiembaanmutagenese geassocieerd met veroudering en ziekte een belangrijke voorwaarde voor de ontwikkeling van therapeutische strategieën voor vrouwelijke onvruchtbaarheid.
In tegenstelling tot nucleair DNA is mtDNA in meerdere kopieën per cel aanwezig, variërend van honderden tot duizenden kopieën in somatische cellen, afhankelijk van het weefseltype, en overstijgend aan 100.000 kopieën in mature oocyten4. Dit hoge mtDNA-kopiegetal maakt oocyten zeer geschikt voor het onderzoeken van mitochondriële mutagenese op single-cell niveau. Het detecteren van de novo mtDNA-mutaties, met name die aanwezig zijn bij zeer lage frequenties, blijft echter uitdagend omdat de foutmarges van conventionele next-generation sequencing (NGS) hoger zijn dan de frequenties van veel echte varianten5. Foutgecorrigeerde sequentiemethoden zijn daarom vereist om echte mutaties te onderscheiden van artefacten die zijn geïntroduceerd tijdens de library-preparatie, amplificatie en sequencing. Een dergelijke benadering is duplex sequencing (DS)6,7. Bij DS worden DNA-fragmenten vóór amplificatie geligeerd aan adapters die dubbelstrengs gerandomiseerde moleculaire tags van 12 nucleotiden bevatten. Deze unieke moleculaire identificatoren labelen elk origineel DNA-molecuul aan beide uiteinden, waardoor sequencing-reads die afkomstig zijn van dezelfde template-streng kunnen worden gegroepeerd in families op basis van hun gedeelde tag-sequentie. Een single-strand consensus sequence (SSCS) wordt gegenereerd uit elke familie van reads, waarna complementaire SSCS'en afgeleid van de oorspronkelijke DNA-duplex worden gecombineerd om een duplex consensus sequence (DCS) te produceren. Alleen varianten die zijn gedetecteerd in de meerderheid van de reads binnen beide complementaire SSCS'en en bevestigd zijn in de resulterende DCS, worden beschouwd als echte mutaties, wat foutmarges mogelijk maakt die verschillende grootteordes lager liggen dan die van conventionele NGS-benaderingen8. Deze strategie is bijzonder voordelig voor het detecteren van laagfrequente mtDNA-varianten en heteroplasmie in single cells.
Een belangrijke beperking van de meeste gepubliceerde duplex sequencing-protocollen is de vereiste voor relatief grote hoeveelheden input-DNA tijdens de library-preparatie, waardoor deze methoden ongeschikt zijn voor single-cell-toepassingen6,7,9. Het algemene doel van dit protocol is om zeer nauwkeurige duplex sequencing van mtDNA uit enkele menselijke oocyten mogelijk te maken via een geoptimaliseerde workflow voor mtDNA-verrijking, library-preparatie en sequencing. Om de sequencing van nucleaire mitochondriale DNA-segmenten (NUMTs) te minimaliseren en de sequencing-efficiëntie te verbeteren, bevat dit protocol een op Exonuclease V gebaseerde verrijkingstap die selectief lineair DNA afbreekt terwijl circulair mtDNA behouden blijft. De resulterende workflow biedt een praktische benadering voor nauwkeurige mtDNA-variantdetectie in enkelvoudige oocyten en is geschikt voor studies die heteroplasmie, de novo mutagenese, veroudering en mitochondriale ziekten onderzoeken.
Protocol
De verzameling en verwerking van menselijke oocyten zijn goedgekeurd door de ethische commissie van de Johannes Kepler University Linz (goedkeuringsnummer 1293/2020). Voer alle procedures uit in overeenstemming met de institutionele richtlijnen, inclusief geïnformeerde toestemming, anonimisering van monsters en alle geldende regelgeving met betrekking tot het gebruik van menselijk weefsel.
OPMERKING: Hoewel dit protocol is beschreven voor menselijke oocyten, kunnen de soortspecifieke primers worden aangepast om de workflow toe te passen op andere soorten. Gebruik gedurende het gehele protocol DNA low-binding verbruiksartikelen (bijv. buisjes en pipetpunten) om monsterverlies te minimaliseren. Voer alle stappen tot de eerste zuivering uit in het oorspronkelijke low-binding buisje voor de oocytenverzameling. Vortex de monsters niet, aangezien vortexen de DNA-strengen kan beschadigen. Meng de reactiecomponenten in plaats daarvan door voorzichtig te pipetteren of door zachtjes tegen het buisje te tikken, gevolgd door een korte centrifugatie. Voer, indien mogelijk, de DNA-isolatie, de bereiding van de mastermix en de opzet van de reactie uit in speciale polymerasekettingreactie (PCR)-werkstations of fysiek gescheiden laboratoriumruimten om contaminatie te minimaliseren.
1. Bereiding van buffers en reagentia
- Bereid de Oocyte Lysis Buffer (OLB), 10 mM Tris-HCl, TE-buffer, TElow-buffer en 10 mM Tris-NaCl volgens Tabel 1 door de gespecificeerde volumes van de stamoplossingen te combineren en elke oplossing aan te vullen tot het aangewezen eindvolume met water van moleculaire biologie-kwaliteit. Verdeel de bereide buffers in aliquoten van 1 mL, bewaar deze aliquoten bij 4°C en gebruik ze binnen 1 jaar.
Tabel 1: Samenstelling van de buffers die gedurende het protocol worden gebruikt. Buffersamenstellingen en eindconcentraties voor de bereiding van 10 mM Tris-HCl, TE-buffer, TElow-buffer, 10 mM Tris-NaCl en oocytenlysebuffer (OLB). Bereid alle buffers met water van moleculaire biologie-kwaliteit. Pas indien nodig de pH van de Tris-HCl- en EDTA-stamlopingen aan vóór de bufferbereiding, volgens de aanbevelingen van de fabrikant. OLB wordt onmiddellijk vóór de monsterlyse aangevuld met thermolabiel proteinase K, zoals beschreven in het protocol. Klik hier om dit bestand te downloaden.
2. Collectie van enkele oocyten
OPMERKING: De menselijke oocyten die in dit protocol zijn gebruikt, werden verzameld bij patiënten die waren ingepland voor intracytoplasmatische spermainjectie (ICSI) in het Kinderwunsch Zentrum (vruchtbaarheids centrum) van het Kepler University Hospital in Linz, Oostenrijk. De protocollen voor ovariële stimulatie waren gebaseerd op de voorspelde ovariële respons van de patiënt, en de doseringen werden aangepast op basis van individuele kenmerken, waaronder leeftijd, anti-Müller hormoon (AMH)-spiegels en lichaamsgewicht, in overeenstemming met de aanbevelingen van de European Society of Human Reproduction and Embryology (ESHRE)10. Hypofyse-suppressie werd bereikt met behulp van protocollen met gonadotropin-releasing hormone (GnRH)-agonisten of GnRH-antagonisten in combinatie met gonadotropine-stimulatie om de folliculaire rijping te bevorderen. De folliculaire groei werd regelmatig gemonitord via transvaginale echografie voordat de ovulatie werd geïnduceerd. De oocyten werden vervolgens verkregen via transvaginale folliculaire aspiratie, waarbij de folliculaire vloeistof die de cumulus-oocytencomplexen (COC's) bevatte, werd verzameld11. Alleen onrijpe of onbevruchte oocyten die niet konden worden gebruikt voor de ICSI-behandeling van de patiënt en anders zouden zijn weggegooid, waren beschikbaar voor onderzoek nadat geïnformeerde toestemming was verkregen. Patiënten met een hoger aantal antrale follikels (AFC's) werden bij voorkeur benaderd voor oocytdonatie, omdat zij vaker onrijpe of onbevruchte oocyten produceerden die geschikt waren voor onderzoek. Alle procedures die worden uitgevoerd vóór de selectie van oocyten voor onderzoek moeten voldoen aan de nationale regelgeving met betrekking tot in vitro fertilisatie en het gebruik van menselijk weefsel. Behandel alle materialen onder steriele omstandigheden in een laminaire flowkast. Zorg ervoor dat alle CE-gecertificeerde materialen en kweekmedia die in direct contact komen met de oocyten steriel zijn, zijn voorverwarmd tot 37°C en een pH van 7.20–7.40 behouden.
- Verzamel de COC's uit de follikelvloeistof en breng deze over in 750 µL GM501 Cult-medium onder steriele minerale olie na gecontroleerde ovulaire hyperstimulatie en transvaginale oöcytopunctie.
- Verwijder de omringende cumuluscellen van de zona pellucida (ZP) door enzymatische digestie met hyaluronidase. Incubeer de oöcyten in 500 µL GM501 Hyaluronidase (80 U/mL) gedurende 30–60 s bij 37°C, gevolgd door drie wasbeurten in 750 µL GM501 Cult-medium. Verwijder eventuele resterende cumuluscellen voorzichtig mechanisch met denudatiepipetten.
- Open bij telofase I (TI) of metafase II (MII) oöcyten de ZP met een reeks laserpulsen naast het polaire lichaam en verwijder het eerste polaire lichaam met micromanipulatoren. Pas de laserinstellingen aan op basis van de dikte van de ZP (1–3 pulsen; pulsduur 1,5–2,6 ms; spotdiameter 16–20 µm). Gebruik de laser om alle resterende cumuluscellen te verwijderen, om zo contaminatie van de oöcyt met somatisch cel-DNA te minimaliseren.
- Breng elke oöcyt afzonderlijk over in 2–3 µL 1× fosfaatgebufferde zoutoplossing (PBS) in een 200 µL low-binding tube. Vries de tube onmiddellijk in bij −20°C. Breng de bevroren oöcyten voor langdurige bewaring over naar −80°C.
OPMERKING: Voer na het ontdooien het resterende protocol continu en zonder onderbreking uit tot de voltooiing van de eerste amplificatiestap. - Om potentiële contaminatie met omgevings-DNA gedurende het protocol te monitoren, dient een negatieve controle bestaande uit 2 µL 1× PBS zonder oöcyt te worden meegenomen tijdens de library-preparatie (vanaf stap 4). Behandel de negatieve controle op identieke wijze als alle oöcytmonsters. Er mag in geen enkele fase van het protocol detecteerbaar DNA in de negatieve controle worden waargenomen.
3. Synthese van adapters
OPMERKING: Bereid de adapters voor voordat u begint met de bibliotheekpreparatie. Bewaar gesynthetiseerde adapters bij −80°C voor maximaal 3 maanden. Bereid aliquots om herhaalde vries-dooi-cycli te vermijden, en vries adapters na het ontdooien niet opnieuw in. Alle oligonucleotidesequenties die in dit protocol worden gebruikt, staan vermeld in Tabel 2.
Tabel 2: Oligonucleotiden en primers gebruikt gedurende het protocol. De tabel bevat alle oligonucleotiden die zijn gebruikt voor adaptersynthese, bibliotheekamplificatie, kwantitatieve polymerasekettingreactie (qPCR), bibliotheekkwantificering en schatting van de mitochondriale DNA (mtDNA)-verrijking, samen met hun sequenties, zuiveringsmethoden, geleverde hoeveelheden of aanbevolen voorraadconcentraties en de fabrikant. De weergegeven carrier-oligonucleotide-sequentie is de voorbeeldsequentie die in dit protocol is gebruikt. Het asteriskteken (*) in de primersequenties duidt op een fosforothioaatverbinding. De gerandomiseerde nucleotiden (N) in de mws55-adapter vertegenwoordigen de unique molecular identifier (UMI), terwijl Y staat voor de degeneratieve pyrimidinebase (C of T). Tenzij anders aangegeven, werden de oligonucleotiden gesynthetiseerd met behulp van standaard ontzoutingszuivering. Klik hier om dit bestand te downloaden.
- Bereid een aliquot van 96% ethanol (EtOH) voor en bewaar deze bij −20°C voor volgende zuiveringsstappen. Bereid 80% EtOH vers vlak voor gebruik.
- Meng telkens 20,5 µL van 100 µM mws51_short en 100 µM mws55 oligonucleotiden in een 200 µL low-binding buisje om een totaalvolume van 41 µL te verkrijgen (2.000 pmol van elk oligonucleotide).
- Incubeer de gecombineerde oligonucleotiden bij 95°C gedurende 5 min in een thermocycler waarbij de temperatuur van het deksel is ingesteld op 110°C. Start de timer nadat het monster 95°C heeft bereikt, schakel de thermocycler na 5 min uit en laat de buisjes 1 u in de thermocycler staan voor langzame afkoeling naar kamertemperatuur (RT) en annealing (“geannealede adapter”).
- Bereid een Extension Master Mix door 1× NEB Buffer 2 (5,6 µL van 10× stock), 3,5 mM deoxynucleotide trifosfaten (dNTP's; 5,6 µL van 10 mM stock), 11,5 U Klenow-fragment (2,3 µL van 5 U/µL stock) en 2,5 µL water van moleculaire biologie-kwaliteit te combineren tot een eindvolume van 16 µL.
- Neem 1 µL van de geannealede adapter die in stap 3.3 is bereid, verdun deze 1:20 in TElow buffer, label de aliquot als “geannealed” en bewaar deze bij 4°C voor agarosegelelektroforese.
- Voeg 16 µL van de Extension Master Mix toe aan de resterende 40 µL geannealede oligonucleotiden en meng grondig.
- Incubeer de reactie bij 37°C gedurende 1 u met het deksel van de thermocycler ingesteld op 47°C.
- Zuiver de verlengde oligonucleotiden door EtOH-precipitatie. Voeg 28 µL ammoniumacetaat (NH4OAc) toe aan het reactiemengsel van 56 µL en meng grondig.
- Overbreng de gehele reactie naar een 1,5 mL low-binding buisje en voeg 168 µL ijskoude 96% EtOH toe.
- Keer het buisje enkele keren om en incubeer bij −20°C gedurende 30 min om het DNA te precipiteren.
- Bereid 1 mL verse 80% EtOH en koel deze af tot −20°C. Koel de centrifuge vooraf af tot 4°C.
- Centrifugeer bij 14.000 × g gedurende 30 min.
- Verwijder voorzichtig het supernatant zonder het pellet te verstoren. Voeg 1 mL ijskoude 80% EtOH toe zonder het buisje te mengen of om te keren.
- Centrifugeer bij 14.000 × g gedurende 5 min.
- Verwijder alle resterende EtOH en laat het DNA-pellet 10–15 min aan de lucht drogen, totdat er geen zichtbare vloeistof meer over is en het pellet transparant lijkt. Droog de oligonucleotiden niet te veel uit.
- Resuspendeer het pellet in 41 µL water van moleculaire biologie-kwaliteit.
- Neem 1 µL, verdun deze 1:20 in TElow buffer, label de aliquot als “verlengd” en bewaar deze bij 4°C.
- Bereid een Restriction Master Mix door 47 µL water van moleculaire biologie-kwaliteit, 1× CutSmart Buffer (10 µL van 10× stock) en 15 U HpyCH4III (3 µL van 5 U/µL stock) te combineren tot een eindvolume van 60 µL.
- Voeg 60 µL van de Restriction Master Mix toe aan 40 µL gezuiverde oligonucleotiden en meng grondig.
- Incubeer de reactie bij 37°C gedurende 16 u met het deksel van de thermocycler ingesteld op 47°C.
- Bereid 6,5 mL verse 80% EtOH en koel deze af tot −20°C. Koel de centrifuge vooraf af tot 4°C.
- Overbreng de gedigesteerde adapters naar een 1,5 mL low-binding buisje en voeg 900 µL water van moleculaire biologie-kwaliteit toe.
- Voeg 500 µL NH4OAc toe en meng grondig.
- Verdeel de oplossing in zes aliquots van 250 µL in 1,5 mL low-binding buisjes. Voeg aan elk buisje 500 µL ijskoude 96% EtOH toe.
- Keer de buisjes enkele keren om en incubeer bij −20°C gedurende 30 min om het DNA te precipiteren.
- Centrifugeer bij 14.000 × g gedurende 30 min. Verwijder voorzichtig het supernatant zonder het pellet te verstoren. Voeg aan elk buisje 1 mL ijskoude 80% EtOH toe zonder te mengen of om te keren. Centrifugeer bij 14.000 × g gedurende 5 min.
- Verwijder alle resterende EtOH en laat de adapter-pellets aan de lucht drogen.
- Resuspendeer elk pellet in 6,7 µL Tris-NaCl buffer en voeg alle zes suspensies samen om een eindvolume van 41 µL te verkrijgen. Neem 1 µL, verdun deze 1:10 in TElow buffer, label de aliquot als “geknipt” en bewaar deze bij 4°C.
- Bereid aliquots van de adapter-stock en bewaar deze bij −80°C. Meet de adapterconcentratie en bepaal de A260/280 en A260/230 absorptieverhoudingen van de “geknipte” aliquot met een spectrofotometer. De verwachte adapterconcentratie is 30–50 µM, met een A260/280 verhouding van >1,7 en een A260/230 verhouding van >1,9.
- Laad de “geannealede”, “verlengde” en “geknipte” aliquots op een 2% agarosegel bij 125 V gedurende 45 min om de vorming van de adapter en de volledige restrictiedigestie te verifiëren (Figuur 1).
OPMERKING: De “geannealede” aliquot zou twee banden moeten bevatten die de geannealede en niet-geannealede fracties vertegenwoordigen. De geannealede adapter wordt verwacht te migreren bij ongeveer 90 bp en bestaat uit een dubbelstrengs regio van 13 bp met een enkelstrengs overhang van 68 nt, terwijl de niet-geannealede oligonucleotiden migreren bij ongeveer 60 bp. Na verlenging bestaat de adapter uit een dubbelstrengs regio van 37 bp met een Y-vormige overhang van 44 nt en wordt verwacht te migreren bij ongeveer 110 bp. Na restrictiedigestie wordt een fragment van 8 bp uit de adapter verwijderd. Drie banden zouden zichtbaar moeten zijn: een dominante band bij ongeveer 100 bp (finale adapter) en twee zwakke banden bij ongeveer 60 bp (resterende niet-geannealede oligonucleotiden) en 8 bp (restrictiefragment).
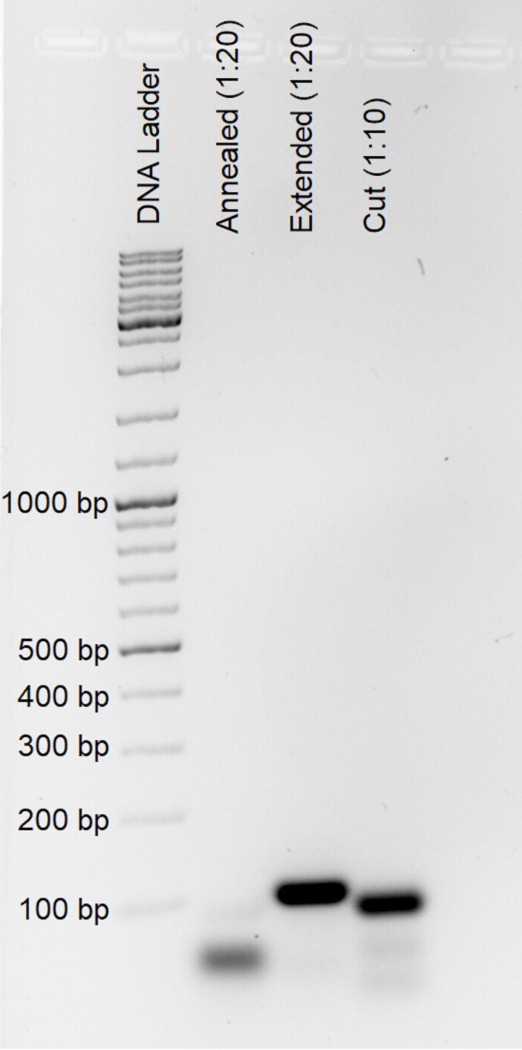
Figuur 1. Representatieve fragmentgrootteanalyse van tussenproducten en uiteindelijke duplex sequencing-adapters. Aliquoten verzameld tijdens de adaptersynthese na het uitvoeren van oligonucleotide-annealing (“annealed,” verdund 1:20), fill-in extensie (“extended,” verdund 1:20) en HpyCH4III-restrictiedigestie (“cut,” verdund 1:10) werden geanalyseerd via 2% agarosegelelektroforese om de correcte vorming van duplex sequencing-adapters te verifiëren. Klik hier om een grotere versie van deze figuur te bekijken.
4. Lyse van een enkele oöcyt
- Bereid OLB aangevuld met thermolabiele proteinase K (OLB+) door 1 µL thermolabiele proteinase K (0,120 U/µL) toe te voegen aan 99 µL OLB om een uiteindelijke proteinase K-concentratie van 0,0012 U/µL te verkrijgen.
- Ontdooi de oocyten bij RT. Voeg onmiddellijk 4 µL OLB+ toe aan elke oocyt. Spoel de wanden van de buis meerdere keren met de lysisbuffer om volledige overdracht van de oocyt in de buffer te garanderen en te voorkomen dat het monster aan de wand van de buis hecht.
- Meng het monster grondig, centrifugeer kort om de inhoud op de bodem van de buis te verzamelen en incubeer 16 u bij 37°C in een thermocycler met de dektemperatuur ingesteld op 47°C.
OPMERKING: Voorafgaand aan de fragmentatie wordt geen onafhankelijke beoordeling van de oocytlysis uitgevoerd. Een incubatie van 16 u onder de gespecificeerde lysiscondities is over het algemeen voldoende voor volledige lysis van een enkele oocyt. De hoeveelheid teruggewonnen DNA kan niettemin variëren door monsterverlies tijdens de behandeling en verschillen in mtDNA-kopieaantal tussen oocyten. - Inactiveer de thermolabiele proteinase K door de monsters 15 min bij 55°C te incuberen in een thermocycler met de dektemperatuur ingesteld op 75°C.
OPMERKING: Voltooi de daaropvolgende workflow zonder onderbreking na de lysis en inactivering van proteinase K, tenzij een latere protocolstap expliciet een stopmoment aangeeft.
5. Exonuclease V-digestie
- Laat de monsters equilibreren naar RT voordat u verdergaat.
- Bereid een Exonuclease V Master Mix voor door 4 µL van 25 mM magnesiumchloride (MgCl₂), 1 µL van 10 mM Tris-HCl, 1 µL van 10 mM adenosinetrifosfaat (ATP) en 1 µL Exonuclease V (10 U/µL stock) te combineren om een eindvolume van 7 µL te verkrijgen.
- Bereid een 1 mg/mL ribonuclease A (RNase A) werkoplossing door 1 µL van de 10 mg/mL RNase A stock te verdunnen met 99 µL water van moleculaire biologie-kwaliteit. Voeg ongeveer 0,1 µL van de verdunde RNase A-oplossing toe aan elk gelyseerd oocytenmonster.
OPMERKING: Gebruik een geschikte pipette voor deze stap. Bij het gelijktijdig verwerken van meerdere monsters kan een geschikte meerkanaalpipet worden gebruikt, mits er voorzorgsmaatregelen worden genomen om kruiscontaminatie tussen monsters te voorkomen. Omdat de pipetteernauwkeurigheid kan afnemen bij het dispenseren van zulke kleine volumes met een meerkanaalpipet, moeten alle kanalen zorgvuldig worden gecontroleerd. Als alternatief is het kort onderdompelen van de pipetpunt in de verdunde RNase A-oplossing voldoende om ongeveer 0,1 µL over te dragen. Kleine afwijkingen van dit volume hebben geen invloed op de uitvoering van het protocol. Verifieer het benaderde overgedragen volume vooraf met een enkelkanaalpipet. - Voeg 7 µL van de Exonuclease V Master Mix toe aan elk gelyseerd oocytenmonster en meng grondig. Incubeer de monsters 1 u bij 37°C in een thermocycler waarbij de dekktemperatuur is ingesteld op 47°C.
- Voeg 38 µL TE-buffer toe aan elk monster om een eindreactievolume van ongeveer 51 µL te verkrijgen. Heat-inactiveer de enzymen door de monsters 30 min bij 70°C te incuberen in een thermocycler waarbij de dekktemperatuur is ingesteld op 75°C.
- Ga onmiddellijk over tot de bibliotheekvoorbereiding.
6. Fragmentatie
- Shear het DNA tot een gemiddelde fragmentgrootte van ongeveer 550 baseparen (bp) middels sonicatie.
OPMERKING: Dit protocol beschrijft DNA-fragmentatie met gebruik van een Covaris M220 focused-ultrasonication instrument, hierna aangeduid als de sonicator; vergelijkbare systemen kunnen echter ook worden gebruikt. Omdat de monsters na lysis naast DNA ook cellulair debris bevatten, dienen de fragmentatiecondities voor het specifieke instrument en monstertype te worden geoptimaliseerd om een relatief nauwe fragmentgrootteverdeling te verkrijgen die gecentreerd is rond de beoogde fragmentgrootte. - Overbreng het volledige monstervolume (ongeveer 51 µL) naar een 50 µL focused-ultrasonication tube.
- Shear het DNA gedurende 70 s met een Duty Factor van 10%, Peak Incident Power van 75 W en 200 Cycles per Burst bij 20°C.
- Overbreng direct elk gesheard monster (ongeveer 50 µL) vanuit de shearing tube naar een 200 µL low-binding tube, aangezien de shearing tubes geen low-binding eigenschappen hebben. De oorspronkelijke tube voor de oocytenverzameling kan hiervoor opnieuw worden gebruikt. Controleer het deksel van de shearing tube op resterende vloeistof en verzamel alle overgebleven monster om het monsterherstel te maximaliseren.
- Ga direct over tot end repair en A-tailing.
7. Endherstel/A-tailing
- Bereid een End Repair/A-Tailing Master Mix voor bestaande uit 7 µL End Prep Reaction Buffer en 3 µL End Prep Enzyme Mix.
- Voeg 10 µL van de End Repair/A-Tailing Master Mix toe aan elk monster om een eindreactievolume van 60 µL te verkrijgen. Meng grondig door 10 keer op en neer te pipetteren.
- Incubeer de monsters 30 min bij 20°C met het deksel van de thermocycler uitgeschakeld, gevolgd door incubatie bij 65°C gedurende 30 min met de dekeltemperatuur ingesteld op 75°C.
- Ga onmiddellijk over tot de adapterligatie.
8. Ligeren van adapters
- Bereid een Ligation Master Mix voor bestaande uit 30 µL Ligation Mix en 1 µL Ligation Enhancer.
- Ontdooi één aliquot van de gesynthetiseerde adapter en verdun deze 1:4000 in Tris-NaCl buffer.
- Voeg 1,5 µL van de verdunde adapter toe aan elk end-repaired en A-tailed DNA-monster. Voeg 31 µL Ligation Master Mix toe en meng grondig.
- Incubeer de monsters gedurende 15 min bij 20°C. Voeg 1 µL van de verdunde adapter toe aan elk monster om een finaal reactievolume van 93,5 µL te verkrijgen. Meng grondig en incubeer gedurende 16 h bij 4°C.
- Ga onmiddellijk over tot zuivering.
9. Zuivering van adapter-geligeerd DNA
- Laat de magnetische beads en de TElow-buffer ten minste 30 min lang equilibreren tot RT. Bereid tijdens deze tijd verse 80% EtOH. Bereid een carrier-oligonucleotide-oplossing door 1 µL van het carrier-oligonucleotide (sequentie niet aanwezig in het menselijk genoom; zie Tabel 2) toe te voegen aan 99 µL TElow-buffer om een eindconcentratie van 1 nM te verkrijgen.
- Overbreng 74,8 µL magnetische beads, wat overeenkomt met een bead-to-sample ratio van 0,8×, naar een 1,5 mL low-binding tube. Voeg het volledige volume van 93,5 µL adapter-geligeerd DNA toe en meng grondig.
- Incubeer het bead-sample mengsel 15 min bij RT. Meng de suspensie na 7,5 min voorzichtig en centrifugeer de tube kort.
- Centrifugeer de tube kort, plaats deze op een magnetisch rek en incubeer 5 min om volledige scheiding van de beads mogelijk te maken. Verwijder en gooi het heldere supernatant voorzichtig weg en sluit de tube vervolgens onmiddellijk.
- Voeg 400 µL 80% EtOH toe, incubeer 30 s en verwijder de EtOH. Voeg 200 µL 80% EtOH toe, incubeer 30 s en verwijder de EtOH.
- Haal de tube uit het magnetische rek en centrifugeer deze kort. Plaats de tube terug in het magnetische rek, verwijder eventuele resterende EtOH en laat de beads minder dan 5 min aan de lucht drogen.
- Voeg 50 µL TElow-buffer toe, aangevuld met carrier-oligonucleotiden. Haal de tube uit het magnetische rek en resuspendeer de beads grondig door te pipetteren.
- Incubeer de suspensie 5 min bij RT onder af en toe mengen. Centrifugeer de tube kort, plaats deze terug in het magnetische rek en incubeer nogmaals 5 min.
- Bereid tijdens de laatste 5 min van de eerste magnetische scheiding een nieuwe 1,5 mL low-binding tube voor met 40 µL magnetische beads. Overbreng 50 µL van het eluaat naar de voorbereide tube om de tweede zuivering uit te voeren bij een bead-to-sample ratio van 0,8×.
- Meng grondig en incubeer 15 min bij RT. Meng de suspensie na 7,5 min voorzichtig en centrifugeer de tube kort.
- Plaats de tube op het magnetische rek en incubeer 5 min om volledige scheiding van de beads mogelijk te maken. Verwijder en gooi het heldere supernatant voorzichtig weg en sluit de tube vervolgens onmiddellijk.
- Voeg 400 µL 80% EtOH toe, incubeer 30 s en verwijder de EtOH. Voeg 200 µL 80% EtOH toe, incubeer 30 s en verwijder de EtOH.
- Haal de tube uit het magnetische rek en centrifugeer deze kort. Plaats de tube terug in het magnetische rek, verwijder eventuele resterende EtOH en laat de beads minder dan 5 min aan de lucht drogen.
- Voeg 15,5 µL Tris-HCl toe aan elk sample. Haal de tube uit het magnetische rek en resuspendeer de beads grondig door te pipetteren.
- Incubeer de suspensie 5 min bij RT onder af en toe mengen. Centrifugeer de tube kort, plaats deze terug in het magnetische rek en incubeer nogmaals 5 min.
- Overbreng 15 µL van het eluaat naar een nieuwe 200 µL low-binding tube. Neem 1 µL van het eluaat en verdun dit 1:10 in Tris-HCl voor attomole kwantitatieve PCR (qPCR) en mitochondrieel DNA (mtDNA) enrichment qPCR analyses.
10. Attomol-schatting
OPMERKING: Bepaal de geschatte hoeveelheid adapter-geligeerde DNA om de DNA-input en het aantal cycli in de daaropvolgende amplificatie- en indexerings-PCR's aan te passen. Omdat de monsterhoeveelheid beperkt is, zijn directe concentratiemetingen mogelijk niet betrouwbaar; schat de DNA-hoeveelheid daarom in via qPCR. Analyseer de amplificatieproducten met agarosegelelektroforese om de fragmentgrootteverdeling te beoordelen en residuele adapter-dimeren te detecteren. Cq-waarden kunnen variëren afhankelijk van de gebruikte reagentia en het real-time PCR-instrument. Aanpassingen van Cq-waarden op basis van de detectie van adapter-dimeren, evenals de stroomafwaartse DNA-inputhoeveelheden en het aantal PCR-cycli, zijn primair gebaseerd op empirische waarnemingen en kunnen optimalisatie vereisen voor individuele bibliotheekvoorbereidingen.
- Bereid een attomole qPCR Master Mix voor bestaande uit 5 µL 2× KAPA HiFi HotStart Reaction Mix (hierna aangeduid als de 2× high-fidelity PCR-mix), 1 µL van de Dual-NEBNext Universal PCR Primer voor Illumina (10 µM; hierna aangeduid als de universele library-primer), 1 µL mws20-primer (10 µM), 0,5 µL 20× EvaGreen en 0,5 µL water van moleculaire biologie-kwaliteit per reactie.
- Voeg 8 µL van de Master Mix toe aan elke aangewezen put van een qPCR-compatibele 96-wells plaat. Voeg 2 µL van het 1:10 verdunde monster toe om een definitief reactievolume van 10 µL te verkrijgen.
- Sluit de plaat af en centrifugeer deze kort voordat u deze in het real-time PCR-instrument plaatst.
- Voer de qPCR uit met de volgende thermische cyclusparameters: 45 s bij 98°C, gevolgd door 45 cycli van 15 s bij 98°C, 30 s bij 65°C en 45 s bij 72°C.
- Bepaal de kwantificatiecyclus (Cq) door de fluorescentiedrempel in te stellen op 1.000 relatieve fluorescentie-eenheden (RFU).
OPMERKING: Selecteer een fluorescentiedrempel die compatibel is met het real-time PCR-instrument en gebruik dezelfde drempel in alle experimenten om vergelijking van Cq-waarden mogelijk te maken. - Scheid de qPCR-amplificatieproducten op een 1,5% agarosegel bij 125 V gedurende 40 min.
- Inspecteer de gel op residuele adapterdimeren. Adapterdimeren migreren bij ongeveer 130 bp (Figuur 2).
- Als adapterdimeren zichtbaar zijn, pas dan de Cq-waarde aan met de toepasbare attomole Cq-correctiefactor (ACF) zoals weergegeven in Figuur 2. Selecteer de ACF op basis van de intensiteit van de adapterdimer-band die in de agarosegel wordt waargenomen, waarbij de representatieve voorbeelden in Figuur 2 als referentie dienen. Een ACF-gecorrigeerde attomole Cq-waarde van 22–26 is optimaal; waarden <29 zijn echter over het algemeen acceptabel.
OPMERKING: In plaats van de Cq-waarde te corrigeren, kan indien nodig een extra zuivering worden uitgevoerd; dit kan echter leiden tot aanzienlijk library-verlies. Monsters met sterke adapterdimer-banden zijn doorgaans geassocieerd met hoge attomole qPCR Cq-waarden, wat duidt op een lage DNA-input. Monsters met Cq-waarden ≥29 produceren over het algemeen grote family-sizes en lage sequentiedieptes voor mitochondriaal DNA (<100×) en kunnen daarom worden uitgesloten van sequencing. Omdat Cq-waarden afhangen van het real-time PCR-instrument en de assay-condities, dient u laboratoriumspecifieke afkapwaarden vast te stellen bij de implementatie van dit protocol.
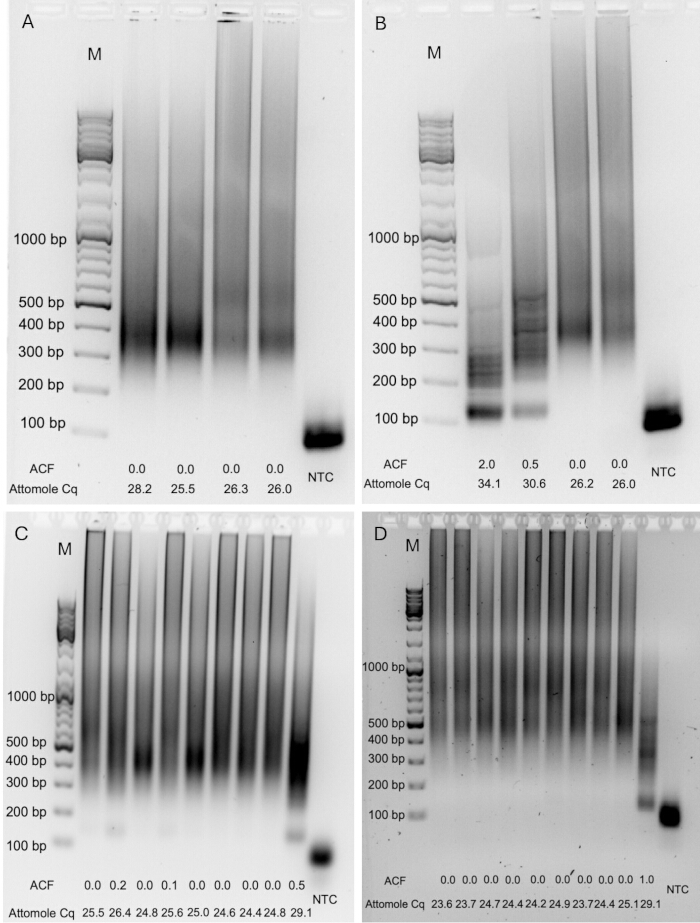
Figuur 2. Representatieve attomole kwantitatieve PCR (qPCR) producten gebruikt om de library-input te schatten en adapter/primer-dimeren te identificeren. Geamplificeerde attomole qPCR-producten werden geanalyseerd via 1,5% agarosegelelektroforese om de fragmentgrootteverdeling te beoordelen en residuele adapter/primer-dimeren te detecteren. (A–D) Representatieve voorbeelden die libraries tonen met verschillende hoeveelheden adapter-geligeerde DNA en variërende niveaus van adapter/primer-dimeren. De attomole Cq-correctiefactor (ACF) en de bijbehorende ongecorrigeerde kwantificatiecyclus (Cq) worden voor elk monster weergegeven. M, DNA-groottemarker; NTC, non-template control. Klik hier om een grotere versie van deze figuur te bekijken.
11. Schatten van de verrijking van mitochondriaal DNA (Optioneel)
OPMERKING: Schat de verrijking van mitochondriaal DNA (mtDNA) via qPCR met behulp van primers die gericht zijn op het mitochondriale ND6-gen en nucleaire Alu-elementen. Bereken het verschil in Cq-waarden tussen de nucleaire en mitochondriale targets om de mtDNA-verrijking te schatten. Gebruik de absolute Cq-waarde van het mitochondriale target om de hoeveelheid mtDNA in het monster te schatten. Cq-waarden kunnen variëren afhankelijk van de gebruikte reagentia, verbruiksartikelen en het real-time PCR-instrument. Pas de primersequenties aan voor andere soorten. Raadpleeg eerdere publicaties voor muis- en makaakspecifieke primers12,13. Deze stap is optioneel en biedt een ruwe schatting van de mtDNA-verrijking voorafgaand aan de sequencing.
- Bereid afzonderlijke Master Mixes voor de mitochondriale en nucleaire targets voor. Combineer voor elke reactie 5 µL 2× PowerUp SYBR Green Mix, 0,4 µL van elke primer in het respectievelijke primerpaar (elk 10 µM) en 2,1 µL water van moleculair-biologische kwaliteit.
- Voeg 8 µL van de juiste Master Mix toe aan elke aangewezen well van een qPCR-compatibele 96-well plaat. Voeg 2 µL van het 1:10 verdunde monster toe om een finaal reactievolume van 10 µL te verkrijgen.
- Sluit de plaat af en centrifugeer deze kort voordat deze in het real-time PCR-instrument wordt geplaatst.
- Voer qPCR uit met de volgende thermische cycluscondities: 2 min bij 95°C, gevolgd door 45 cycli van 15 s bij 95°C, 20 s bij 56°C en 30 s bij 72°C.
- Bepaal de Cq door de fluorescentiedrempel in te stellen op 100 RFU.
OPMERKING: Selecteer een fluorescentiedrempel die compatibel is met het real-time PCR-instrument en gebruik dezelfde drempel in alle experimenten om vergelijking van Cq-waarden mogelijk te maken. Correleer de Cq-waarden met de uit sequencing afgeleide verrijkingsefficiënties na sequencing en gebruik deze waarden als referenties voor daaropvolgende library-preparaties. - Bereken de met verrijking geassocieerde ΔCq door de nucleaire-target Cq af te trekken van de mitochondriale-target Cq (CqmtDNA − CqnDNA). Zodra de initiële sequencingdata beschikbaar zijn, kan een laboratoriumspecifieke standaardcurve worden gegenereerd om het aandeel sequencing-reads afgeleid van mtDNA te schatten.
OPMERKING: Indien sequencingdata nog niet beschikbaar zijn, kan Vergelijking 1 worden gebruikt om een ruwe schatting te maken van het verwachte percentage mtDNA-afgeleide sequencing-reads met behulp van een voorbeeldstandaardcurve gegenereerd uit zeven oocyten-libraries (ΔCq = −0,8, 16,83%; ΔCq = −2,1, 33,62%; ΔCq = −3,0, 45,57%; ΔCq = −3,9, 60,34%; ΔCq = −5,0, 77,98%; ΔCq = −6,2, 89,25%; ΔCq = −8,4, 95,09%). Een ΔCq-waarde <−1 moet worden behaald om een efficiënte verwijdering van nucleair DNA te garanderen. Lagere verrijkingsefficiënties kunnen worden gecompenseerd door extra sequencing-reads toe te wijzen om voldoende mtDNA-sequencingdiepte te verkrijgen; dit kan echter de contaminatie met nucleair mitochondriaal DNA-segmenten (NUMT) verhogen. Omdat de relatie tussen ΔCq en mtDNA-gehalte afhankelijk is van reagentia, verbruiksartikelen, instrumentatie en experimentele condities, moet Vergelijking 1 worden beschouwd als een voorbeeldkalibratie en moeten er, indien mogelijk, laboratoriumspecifieke standaardcurves worden vastgesteld.
Geschat mtDNA (%) = −11,006 × ΔCq + 13,776 (1)
12. Amplificatie van de bibliotheek
OPMERKING: Voer de eerste amplificatie uit in twee opeenvolgende PCR-stappen. Voer de eerste PCR uit met een enkele primer om lineaire amplificatie te genereren. Voeg vervolgens de tweede primer toe om exponentiële amplificatie tijdens de tweede PCR mogelijk te maken.
- Bepaal de DNA-input voor de eerste amplificatie-PCR aan de hand van de resultaten van de attomole qPCR.
- Gebruik voor bibliotheken van enkele oocyten monsters met een attomole qPCR Cq-waarde die doorgaans groter is dan 22. Als een monster een lagere Cq-waarde heeft, verdun dit dan tot een Cq-waarde van ongeveer 22 volgens Tabel 3. Bibliotheken met Cq-waarden van ≥29 produceren doorgaans grote familieformaten en ondiepe mtDNA-sequencingdieptes en worden daarom niet aanbevolen voor verdere bibliotheekvoorbereiding of sequencing.
- Bereid een amplificatie Master Mix voor die per reactie 20 µL 2× high-fidelity PCR-mix en 4 µL mws20-primer (10 µM) bevat.
- Voeg 24 µL van de Amplificatie Master Mix toe aan 14 µL van het verdunde monster.
- Voer de lineaire amplificatie-PCR uit met de volgende thermische cyclusomstandigheden: 45 s bij 98°C, gevolgd door 12 cycli van 15 s bij 98°C, 30 s bij 60°C en 45 s bij 72°C, gevolgd door 2 min bij 72°C.
- Voeg 4 µL van de universele bibliotheekprimer (10 µM) toe en meng grondig.
- Voer de exponentiële amplificatie-PCR uit met de volgende thermische cyclusomstandigheden: 45 s bij 98°C, gevolgd door 9 cycli van 15 s bij 98°C, 30 s bij 65°C en 45 s bij 72°C, gevolgd door een extensie van 2 min bij 72°C.
OPMERKING: Na voltooiing van de eerste amplificatie kunnen de monsters worden bewaard bij 4°C en kan het protocol indien nodig later worden hervat. Voer alle voorafgaande stappen, van oocytlyse tot de eerste amplificatie, zonder onderbreking uit. - Voeg 10 µL water van moleculair-biologische kwaliteit toe aan elk monster.
- Zuiver het geamplificeerde DNA met 40 µL magnetische beads (0,8× het monstervolume), volgens de tweede magnetische-bead zuiveringsprocedure beschreven in stappen 9.9–9.15. Was de beads twee keer met 200 µL 80% EtOH, elueer het DNA in 15,5 µL Tris-HCl en breng 15 µL van het eluaat over naar een nieuwe low-binding buis van 200 µL.
OPMERKING: Dit is een geschikt stoppunt. Bewaar het gezuiverde DNA bij 4°C of ga direct over tot indexering.
Tabel 3: Verdunningsfactoren en overeenkomstige correctiefactoren voor de kwantificatiecyclus (Cq) van de kwantitatieve polymerasekettingreactie (qPCR), gebruikt om de DNA-input voor de eerste polymerasekettingreactie (PCR) voor bibliotheekamplificatie te standaardiseren. Monsters met attomolaire qPCR Cq-waarden onder de doelwaarde werden verdund met water van moleculaire biologie-kwaliteit vóór de eerste amplificatie-PCR. De gecorrigeerde Cq-waarde werd verkregen door de juiste verdunningscorrectiefactor op te tellen bij de experimenteel gemeten Cq-waarde en werd vervolgens gebruikt om het aantal cycli voor de indexerings-PCR en de doelsequentie-diepte te bepalen (Tabel 4). De volumes van het monster en het water resulteren in een finaal inputvolume van 14 µL voor de eerste amplificatie-PCR. Het asteriskteken (*) geeft aan dat de vermelde verdunningscorrectiefactor moet worden opgeteld bij de experimenteel gemeten attomolaire qPCR Cq-waarde om de gecorrigeerde Cq te verkrijgen. De correctiefactoren werden empirisch bepaald voor deze workflow. Klik hier om dit bestand te downloaden.
13. Indexering
- Bepaal het aantal indexing PCR-cycli aan de hand van de dimeer- en verdunningsgecorrigeerde attomole qPCR Cq-waarde volgens Tabel 4.
- Bereid voor elk monster een indexing mastermix voor bestaande uit 25 µL 2× high-fidelity PCR-mix en 10 µL van een 10 µM Unique Dual Index Primer Pair.
- Voeg 35 µL van de indexing mastermix toe aan 15 µL van elk geamplificeerd monster.
- Voer de indexing PCR uit met de volgende thermische cyclusparameters: 45 s bij 98°C, gevolgd door het juiste aantal cycli bestaande uit 15 s bij 98°C, 30 s bij 65°C en 45 s bij 72°C, afgesloten met een finale extensie bij 72°C gedurende 2 min.
- Zuiver de geïndexeerde libraries met 40 µL magnetische beads (0,8× monstervolume). Was de beads tweemaal met 80% EtOH en elueer het DNA in 21 µL TElow buffer.
- Breng het eluaat over naar een DNA low-binding buisje.
- Meet de DNA-concentratie met een Qubit High Sensitivity DNA Assay of een equivalente fluorometrische assay.
- Bewaar de libraries bij 4°C vóór sequencing of bij −80°C voor langdurige opslag.
OPMERKING: Dit is een veilig stoppunt.
Tabel 4: Aantallen indexerings-polymerasekettereactie (PCR)-cycli en beoogde sequentiediepte, bepaald op basis van de gecorrigeerde attomol kwantitatieve polymerasekettereactie (qPCR) kwantificatiecyclus (Cq).De gecorrigeerde Cq-waarde omvat de experimenteel gemeten attomol qPCR Cq samen met elke toepasbare adapter-dimeercorrectiefactor (Figuur 2) en verdunningscorrectiefactor (Tabel 3). De gecorrigeerde Cq-waarde werd gebruikt om zowel het aantal indexerings-PCR-cycli als het aanbevolen aantal paired-end sequencing reads te bepalen dat aan elke bibliotheek wordt toegewezen voor pooling. De toewijzingen van de beoogde sequencing reads dienen als een eerste richtlijn en kunnen laboratoriumspecifieke optimalisatie vereisen, afhankelijk van het real-time PCR-instrument, het sequencingplatform, de multiplexingstrategie en de experimentele vereisten. Klik hier om dit bestand te downloaden.
14. Kwaliteitscontrole
- Beoordeel de bibliotheekkwaliteit, de fragmentgrootteverdeling en de aanwezigheid van residuele adapter- of primerdimeren met een Bioanalyzer, TapeStation of een equivalent instrument voor nucleïnezuurfragmentanalyse. De fragmentgroottes moeten variëren van ongeveer 300 tot 1.000 bp. Kleine residuele pieken (<5% van de fluorescentie-intensiteit van het monster [RFU] in het Bioanalyzer-spoor) waren over het algemeen acceptabel (Figuur 3A–D). Residuele adapter- of primerdimeren verschenen als duidelijke pieken bij ongeveer 70–150 bp (Figuur 3E–H). De uiteindelijke bibliotheekconcentratie moet ten minste 5 ng/µL zijn. Raadpleeg Supplementary File 1 (Troubleshooting Guide) als een van deze kwaliteitscriteria niet wordt behaald.
- (Optioneel) Indien adapter- of primerdimeren worden gedetecteerd (Figuur 3E–H), breng het bibliotheekvolume aan met water van moleculaire biologie-kwaliteit tot 50 µL, voeg 40 µL magnetische beads toe (0,8× monstervolume) en voer een extra zuivering uit. Was de beads twee keer met 80% EtOH en elueer de gezuiverde bibliotheek in 21,5 µL TElow buffer.
- (Optioneel) Herhaal de kwaliteitscontroleanalyse (Stap 14.1) om de volledige verwijdering van adapter- en primerdimeren te bevestigen.
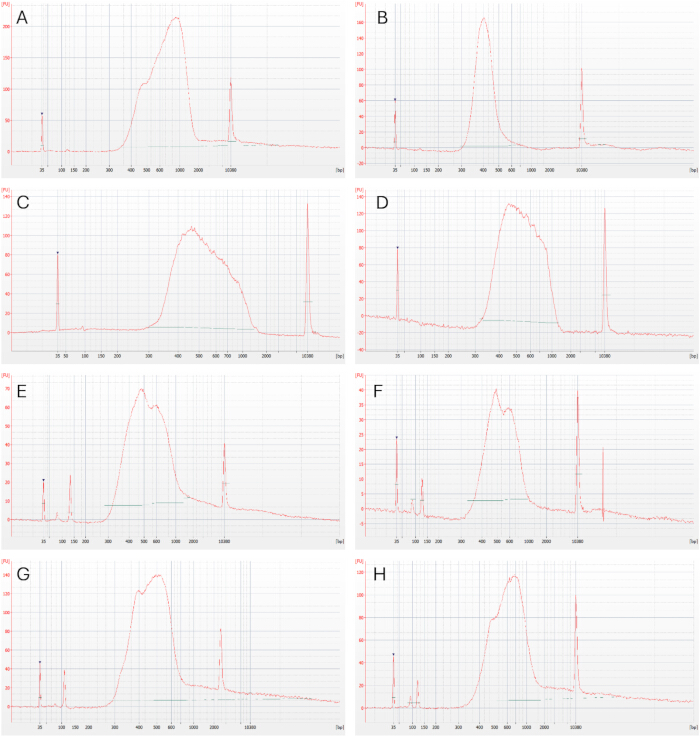
Figuur 3. Representatieve fragmentanalyse van geïndexeerde sequencing-bibliotheken. Representatieve elektroferogrammen gegenereerd door Bioanalyzer fragmentanalyse, die de kwaliteit van de bibliotheek na de indexerings-PCR tonen. (A–D) Bibliotheken met de verwachte fragmentgrootteverdeling (ongeveer 300-1000 bp) en geen detecteerbare adapter-/primerdimeren, geschikt voor sequencing zonder aanvullende zuivering. (E–H) Bibliotheken die residuele adapter- en/of primerdimeren bevatten en een aanvullende zuivering met magnetische beads vereisen vóór sequencing. Pieken bij ongeveer 35 bp en 10.380 bp komen respectievelijk overeen met de onderste en bovenste interne markers. Klik hier om een grotere versie van deze figuur te bekijken.
15. Poolen en sequensen
- Meet de concentratie van elke geïndexeerde library met een op qPCR gebaseerde library-kwantificatieassay die compatibel is met Illumina-geprepareerde libraries, zoals de Collibri Library Quantification Kit, volgens het protocol van de fabrikant. Verdun elke library 1:100.000 in de meegeleverde library-verdunningsbuffer en analyseer elk monster in ten minste dubbel; drievoudige metingen worden aanbevolen. Analyseer de standaarden in drievoud.
- Bereken de gemiddelde kwantificatiecyclus (Cq)-waarde voor elk monster en elke standaard. Genereer een standaardcurve op basis van de gemiddelde Cq-waarden van de standaarden en bereken de concentratie van elke library volgens de instructies van de fabrikant.
- Pool de libraries op basis van het beoogde aantal paired-end reads, bepaald uit de adapter-dimeer- en verdunningsgecorrigeerde attomole qPCR Cq-waarde verkregen in stap 10 en de toewijzingen vermeld in Tabel 4.
OPMERKING: De poolverhouding hangt af van de gecorrigeerde Cq-waarde van elke oocyten-library en het bijbehorende doelgetal van paired-end reads. De waarden in Tabel 4 zijn benaderingen en kunnen variëren tussen verschillende real-time PCR-instrumenten. Stel laboratoriumspecifieke waarden vast voor optimale prestaties. - Bereken de relatieve poolfractie voor elke library door het doelgetal van paired-end reads te delen door de som van de doelreads die aan alle libraries zijn toegewezen. Bepaal de vereiste hoeveelheid van elke library door deze fractie te vermenigvuldigen met de totale molaire hoeveelheid van de uiteindelijke pool, en bereken vervolgens het overeenkomstige library-volume op basis van de gemeten molaire concentratie. Combineer de berekende volumes om de uiteindelijke pool te genereren.
- Sequence de gepoolde libraries met een Illumina-sequencingplatform of een ander platform dat compatibel is met Illumina-adaptersequenties. Gebruik een paired-end configuratie met een minimale read-lengte van 2 × 150 bp. Langere reads, zoals 2 × 250 of 2 × 300 bp, worden aanbevolen omdat ze het vermogen verbeteren om reads afkomstig van kortere nucleaire mitochondriale DNA-segmenten (NUMTs) te identificeren en te filteren.
- Sequence de gepoolde libraries, bijvoorbeeld op een Illumina NovaSeq 6000-platform met twee-kanaals sequencing-by-synthesis-chemie met een SP Reagent Kit v1.5 (500 cycli) en een paired-end configuratie van 2 × 250 bp inclusief een 5% PhiX spike-in. Laad de library en voer de sequencing uit volgens de instructies van de fabrikant. Representatieve sequencingprestaties moeten resulteren in ≥75% van de basen met een kwaliteitsscore van ≥Q30 en ≥60% van de clusters die de filter passeren.
16. Bioinformatische Analyse
OPMERKING: De volgende workflow beschrijft de data-analyse in Galaxy met behulp van de Du Novo-analysetools8,14,15. De analyse kan ook worden uitgevoerd met een lokale installatie van Du Novo of andere software die is ontwikkeld voor duplex sequencing-data.
- Upload de gedemultiplexte paired-end FASTQ-bestanden, gegenereerd met BCL Convert of een equivalent demultiplexing-instrument, naar een lokale Galaxy-installatie of een publiek toegankelijke Galaxy-instantie14.
- Beoordeel de kwaliteit van de sequencing-reads met FastQC (Galaxy-versie 0.72+galaxy1). Inspecteer minimaal de modules Per Base Sequence Quality, Per Sequence GC Content en Adapter Content.
- Genereer single-strand consensussequenties (SSCS'en) en DCS'en uit de gedemultiplexte paired-end FASTQ-bestanden met de Du Novo-pipeline (Galaxy-versie 3.0.2). Gebruik een minimale familiegrootte van drie reads voor SSCS-vorming en bepaal een consensusnucleotide wanneer deze aanwezig is in ten minste 70% van de reads15. Schakel barcode-foutcorrectie in met maximaal drie mismatches. Raadpleeg de Du Novo-tutorial van het Galaxy Training Network voor gedetailleerde instructies over het gebruik van de pipeline16.
- Gebruik Sequence Content Trimmer (Galaxy-versie 0.2.3) om basen gerepresenteerd door "NRYSWKMBDHV" te verwijderen en verwerp reads die korter zijn dan 10 bp.
- Trim de eerste 10 nucleotiden van het 5′-uiteinde van elke DCS met FASTQ Trimmer (Galaxy-versie 1.1.5) om bias geassocieerd met end-repair te verminderen. Aligneer de getrimde DCS-reads met het menselijk referentiegenoom, zoals GRCh38.p14 dat de herziene Cambridge Reference Sequence (rCRS; NC_012920.1) bevat, met behulp van BWA-MEM (Galaxy-versie 0.7.17.1).
OPMERKING: Andere menselijke genoomassemblages, waaronder T2T-CHM13v2.0 of nieuwere assemblages, kunnen worden gebruikt. - Filter de BAM-bestanden met BAMTools Filter BAM datasets on a variety of attributes (Galaxy-versie 2.5.2+galaxy1). Behoud reads met een mapping-kwaliteit >20 die mappen naar chrM, primaire alignments vertegenwoordigen, gepaard zijn, correct gepaard zijn en een gemapte mate hebben. Deze criteria verminderen potentiële NUMT-afgeleide alignments17.
- Lijn de reads links uit met Bam Left Align (Galaxy-versie 1.3.1). Clip overlappende regio's van gepaarde DCS-reads met BAMUtil clipOverlap (Galaxy-versie 1.0.15+galaxy1).
- Bepaal single-nucleotide varianten (SNV'en) en inserties/deleties (indels) met Call variants with LoFreq (Galaxy-versie 2.1.5+galaxy2) met de standaardinstellingen.
- Sluit paired-end DCS-reads die meer dan twee varianten bevatten, indien aanwezig, uit om potentiële NUMT-contaminatie te verminderen. Monsters met een efficiënte mtDNA-verrijking zijn doorgaans vrij van detecteerbare NUMT-afgeleide reads; onvoldoende depletie van nucleair DNA kan echter leiden tot NUMT-afgeleide sequenties.
- Inspecteer elke library op potentiële kruiscontaminatie tussen monsters met behulp van monster-specifieke mtDNA-sequentieverschillen, inclusief gefixeerde varianten en hoogfrequente heteroplasmieën. Als kruiscontaminatie wordt gedetecteerd, pas dan de voorzorgsmaatregelen toe die beschreven zijn in Supplementary File 1 (Troubleshooting Guide). Als de fragmentgrootteverdeling het aanbevolen bereik overschrijdt of de gemiddelde fragmentgrootte >900 bp is, voer dan een dubbele grootte-selectieve zuivering uit zoals eerder beschreven18.
- Voer downstream-analyses uit van de gedetecteerde varianten overeenkomstig de doelstellingen van de studie.
- Neem voor downstream-analyse alleen monsters op met een gemiddelde mitochondriale DCS sequencing-diepte van ≥100×. Er zijn geen vaste minimumdrempels toegepast voor het aantal paired-end reads of de SSCS- of DCS-opbrengst.
Resultaten
Duplex sequencing-libraries werden voorbereid van menselijke oocyten die verschillende rijpingsstadia vertegenwoordigden, waaronder kiemblaasjes- (GV), metafase I (MI), MII, pronucleus-stadium (0PN) en TI-oocyten. Succesvol voorbereide libraries werden gesequenced op een Illumina NovaSeq 6000-platform met gebruik van een SP flow cell met 2 × 250 bp paired-end reads. De data-analyse werd uitgevoerd in Galaxy met de Du Novo-pipeline voor het groeperen van read-families en het genereren van consensus-reads8,14,15. Representatieve sequencing-metrieken voor succesvol verwerkte libraries zijn samengevat in Aanvullende Tabel 1, terwijl monsters die suboptimale resultaten opleverden tijdens de library-voorbereiding en werden uitgesloten van sequencing zijn samengevat in Aanvullende Tabel 2.
Gedurende de bibliotheekpreparatie werden verschillende kwaliteitscontrole-stappen uitgevoerd om de hoeveelheid adapter-geligeerd DNA, de mtDNA-verrijking, de bibliotheekconcentratie en de fragmentgrootteverdeling te beoordelen. De eerste kwaliteitscontrole-stap was de attomole qPCR-assay, die werd gebruikt om de hoeveelheid adapter-geligeerd DNA te schatten (Figuur 4A,B). De berekende quantificatiecyclus (Cq)-waarde werd aangepast wanneer adapter- of primerdimeren werden gedetecteerd via agarosegelelektroforese van de qPCR-amplificatieproducten (Figuur 2A–D). Adapter- of primerdimeren werden doorgaans waargenomen in monsters met hogere Cq-waarden, wat duidt op lagere hoeveelheden adapter-geligeerd DNA. Met de in dit protocol beschreven condities werd een gemiddelde aangepaste attomole qPCR Cq-waarde van 25,8 verkregen (Aanvullende Tabel 1). Op basis van de gecorrigeerde Cq-waarde werd de DNA-input voor de eerste amplificatie-PCR aangepast volgens het verdunningsschema in Tabel 3. Monsters met gecorrigeerde Cq-waarden van ≥22 werden zonder verdunning gebruikt, terwijl monsters met gecorrigeerde Cq-waarden van <22 vóór de amplificatie werden verdunn). Deze aanpassing werd uitgevoerd om de read-familiegrootte te optimaliseren en het aantal benodigde sequencing-reads te verminderen. Monsters met gecorrigeerde Cq-waarden van >28 produceerden over het algemeen grotere read-families (gemiddelde familiegrootte 21,8), wat resulteerde in minder DCS'en en een gemiddelde mtDNA-sequencingdiepte van <200× (Aanvullende Tabel 1). Het aanpassen van de gecorrigeerde Cq-waarde naar 22–28 resulteerde in een gemiddelde familiegrootte van 7,91, wat dicht bij de familiegrootte van ongeveer zes ligt die eerder als optimaal voor duplex sequencing is gerapporteerd6,7. Grotere familiegrootten kunnen niettemin voordelig zijn voor monsters met een zeer lage input, zoals enkele oocyten, omdat ze de sequencingdiepte kunnen verhogen.
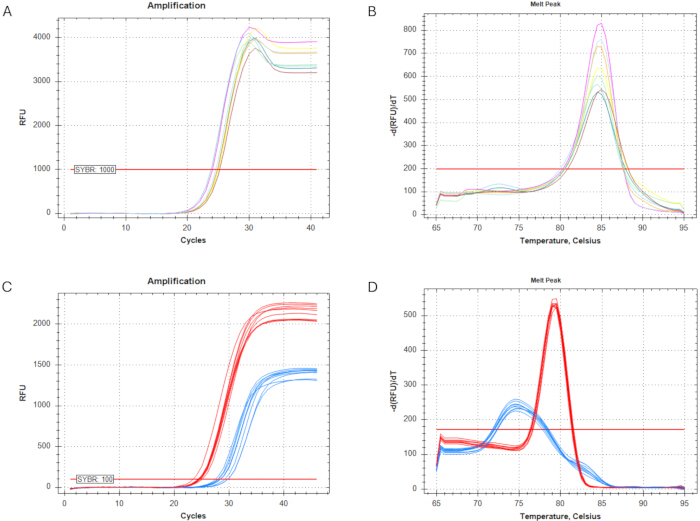
Figuur 4. Quantitative PCR (qPCR)-assays gebruikt voor bibliotheekkwantificering en schatting van de verrijking van mitochondriaal DNA (mtDNA). Gezuiverd adapter-geligeerd DNA werd 1:10 verdund vóór de qPCR-analyse. (A) Amplificatiecurves van de attomol qPCR-assay gebruikt om de hoeveelheid adapter-geligeerd DNA te schatten. De fluorescentiedrempel werd ingesteld op 1.000 relatieve fluorescentie-eenheden (RFU). (B) Smeltcurve-analyse van de attomol qPCR-assay. (C) Amplificatiecurves van de mtDNA-verrijkings qPCR-assay. De fluorescentiedrempel werd ingesteld op 100 RFU. Amplificatie van het mitochondriale NADH-dehydrogenase subeenheid 6 (ND6) target is in rood weergegeven, en amplificatie van het nucleaire Alu-repetitieve-element target is in blauw weergegeven. (D) Smeltcurve-analyse van de mitochondriale en nucleaire qPCR-producten. Klik hier om een grotere versie van deze figuur te bekijken.
Voor het samenvoegen van de bibliotheken werden alle bibliotheken geanalyseerd met een Bioanalyzer of TapeStation om de fragmentgrootteverdeling te beoordelen en residuele adapter- of primerdimeren te detecteren. Representatieve voorbeelden van optimale bibliotheken en bibliotheken die residuele adapter- of primerdimeren bevatten, zijn weergegeven in Figuur 3A–H. Adapter- of primerdimeren verschenen als pieken bij ongeveer 70–150 bp (Figuur 3E–H); wanneer deze werden gedetecteerd, werden de bibliotheken onderworpen aan een aanvullende zuivering met magnetische beads vóór de sequencing. Omdat selectie op grootte opzettelijk werd weggelaten om monsterverlies te minimaliseren, hadden de gesequenced bibliotheken een mediane insertgrootte van 275 bp (Aanvullende Tabel 1).
mtDNA-verrijking werd geschat via qPCR met behulp van mitochondriale en nucleaire target-loci, waardoor de proportie sequencing-reads die naar verwachting in het mitochondriale genoom zouden mappen, kon worden voorspeld (Figuur 4C,D). De gemiddelde Cq-waarden waren 25,2 voor het mitochondriale target en 29,7 voor het nucleaire target (Aanvullende Tabel 1), wat overeenkwam met een gemiddelde ΔCq (CqmtDNA − CqnDNA) van −4,5. Gemiddeld mapte 67,5% van de paired-end sequencing-reads naar het mitochondriale referentiegenoom. Zowel de schatting van de mtDNA-verrijking als de gecorrigeerde attomolaire qPCR Cq-waarde werden meegewogen tijdens het poolen van de libraries. Libraries met hogere gecorrigeerde Cq-waarden en een efficiëntere mtDNA-verrijking kregen proportioneel minder sequencing-reads toegewezen volgens het sequencing-allocatieschema in Tabel 4, om een gebalanceerde sequencing-output over de monsters te bevorderen.
Op basis van de gecorrigeerde attomole qPCR Cq-waarden werd een gemiddelde doelallocatie van 4 miljoen paired-end reads per bibliotheek toegewezen (Tabel 4). Vanwege inefficiënte clustergeneratie werd na sequencing een gemiddelde van 1,3 miljoen paired-end reads per bibliotheek verkregen; deze sequencing-opbrengst was echter voldoende voor de daaropvolgende duplex sequencing-analyse (Aanvullende Tabel 1). Het mappen van de DCS'en op het mitochondriale referentiegenoom leverde een mediane sequencing-diepte van 567× op over het mitochondriale genoom (Figuur 5A,B,D; Aanvullende Tabel 1). Gemiddeld werden er 344.554 SSCS'en en 96.322 DCS'en per bibliotheek gegenereerd (Aanvullende Tabel 1). De resulterende bibliotheken hadden een gemiddelde read-family grootte van 8,32, waarbij grotere family-groottes over het algemeen werden waargenomen in bibliotheken met hogere gecorrigeerde attomole qPCR Cq-waarden (Figuur 5C,E; Aanvullende Tabel 1). Deze resultaten zijn consistent met die verkregen in een eerdere studie uitgevoerd bij een optimale clusterdichtheid, waarin een mediane mtDNA sequencing-diepte van 1.440× werd bereikt19.
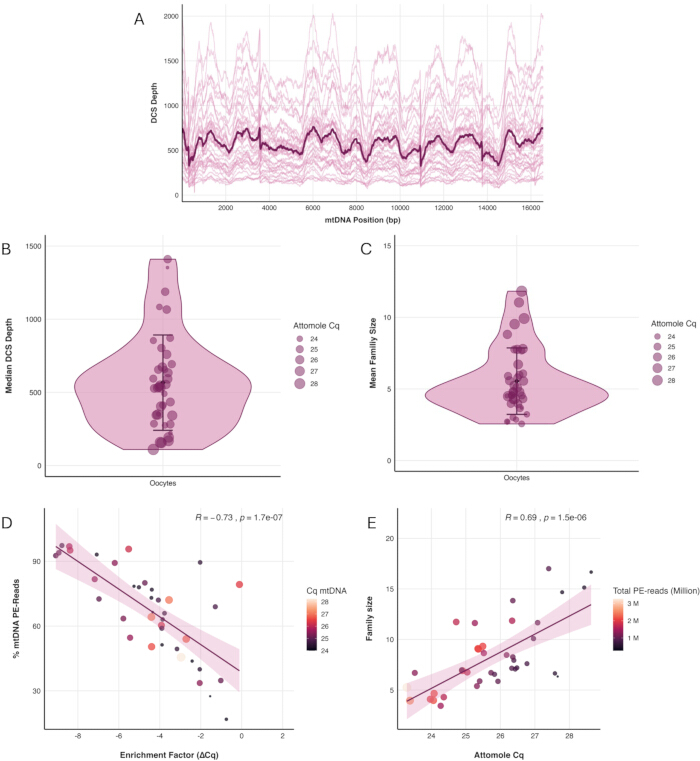
Figuur 5. Sequentieprestaties van duplex sequencing-libraries van individuele oocyten. (A) Duplex consensus sequence (DCS) diepte over het mitochondriale genoom. Dunne lijnen vertegenwoordigen individuele libraries, en de dikke lijn vertegenwoordigt de gemiddelde diepte over alle libraries. (B) Verdeling van de mediaan DCS-diepte voor individuele libraries. (C) Verdeling van de gemiddelde DCS-familiesize voor individuele libraries. In (B) en (C) vertegenwoordigt elk punt één library, en de kleur van het punt geeft de attomole qPCR-kwantificatiecyclus (Cq) aan. (D) Pearson-correlatie tussen de mtDNA-verrijking-schatting (ΔCq) en de proportie sequentie-reads die zijn uitgelijnd met het mitochondriale referentiegenoom. (E) Pearson-correlatie tussen de attomole qPCR Cq-waarde en de gemiddelde DCS-familiesize. In (D) en (E) vertegenwoordigt elk punt één library; de kleur van het punt geeft de attomole qPCR Cq-waarde aan, en de grootte van het punt vertegenwoordigt het totale aantal paired-end reads verkregen voor die library. n = 39 libraries. Klik hier om een grotere versie van deze figuur te bekijken.
Aanvullende tabel 1. Sequentiemetrieken en bibliotheekkwaliteitsmetrieken voor optimale duplex-sequencingbibliotheken van menselijke oocyten. Deze tabel vat de kwaliteitsmetrieken van de bibliotheek vóór sequencing samen, inclusief metingen via kwantitatieve polymerasekettingreactie (qPCR), sequencingprestaties en resultaten van de duplex-sequencinganalyse voor bibliotheken die de kwaliteitscontrole hebben doorstaan en zijn opgenomen in de daaropvolgende analyses. De gerapporteerde parameters omvatten het ontwikkelingsstadium van de oocyt, qPCR-resultaten van de mitochondriële DNA (mtDNA)-verrijking, attomool-qPCR-metingen, de adapter-dimeer correctiefactor (ACF), het aantal PCR-cycli voor indexering, de beoogde paired-end sequencingdiepte, de bibliotheekconcentratie, de sequencingopbrengst, mtDNA-verrijking, het aantal reads van de single-strand consensus sequence (SSCS) en duplex consensus sequence (DCS), statistieken over de familieomvang, de sequencingdiepte en de insert-grootteverdelingen. Monsteridentificatoren werden geanonimiseerd voorafgaand aan de analyse. De beoogde aantallen paired-end reads werden toegewezen op basis van de gecorrigeerde attomool qPCR-kwantificatiecyclus (Cq)-waarde (Tabel 4). Klik hier om dit bestand te downloaden.
Aanvullende tabel 2. Kwaliteitsmetrieken vóór sequencing voor suboptimale menselijke oocyten-bibliotheken die zijn uitgesloten van downstream duplex sequencing-analyses. Deze tabel vat de resultaten van de kwaliteitscontrole vóór sequencing samen voor bibliotheken die niet voldeden aan de criteria voor opname in downstream sequencing-analyses. De gerapporteerde parameters omvatten de monsteridentificatie, het ontwikkelingsstadium van de oocyt, de resultaten van de quantitative polymerase chain reaction (qPCR) voor verrijking van mitochondriaal DNA (mtDNA), de adapter-dimeercorrectiefactor (ACF), de gecorrigeerde attomole qPCR-kwantificatiecyclus (Cq), het aantal cycli van de indexerings-polymerasekettingreactie (PCR) en de bibliotheekconcentratie gemeten met de Qubit High Sensitivity DNA Assay. Bibliotheken werden uitgesloten volgens de in het protocol beschreven kwaliteitscontrolecriteria. Klik hier om dit bestand te downloaden.
Aanvullend bestand 1. Gids voor het oplossen van problemen bij de bibliotheekpreparatie voor duplex sequencing van mitochondriaal DNA uit een enkele oöcyt. Dit aanvullende bestand biedt aanbevelingen voor het oplossen van problemen bij kritieke stappen van de workflow, waaronder het voorkomen van monsterverlies, adapterpreparatie en kwaliteitsbeoordeling, zuivering met magnetische beads, kwaliteitscontrole van de bibliotheek, sequencingprestaties, contaminatie tussen monsters en contaminatie door nucleaire mitochondriale DNA-segmenten (NUMT). De gids is een aanvulling op het hoofdprotocol en dient geraadpleegd te worden wanneer de kwaliteitsmetrieken van de bibliotheek of de sequencingprestaties buiten de aanbevolen bereiken vallen. Klik hier om dit bestand te downloaden.
Discussie
mtDNA-varianten die in oocyten worden geïdentificeerd, weerspiegelen een combinatie van de novo mutagenese, verschuivingen in heteroplasmie over generaties heen en de effecten van veroudering en ziekte op de vrouwelijke kiemlijn. Dit protocol beschrijft een methode voor het verrijken van mtDNA uit enkelvoudige oocyten, gevolgd door de preparatie en sequencing van een duplex sequencing-library, wat een zeer nauwkeurige detectie en analyse van mtDNA-mutaties mogelijk maakt. Ondanks het hoge aantal mtDNA-kopieën dat in oocyten aanwezig is, vereist deze workflow de preparatie van een volledige sequencing-library uit één enkele cel. Bijgevolg is een zorgvuldige monsterbehandeling essentieel gedurende de gehele procedure, zoals ook gedetailleerd in Supplementary File 1 (Troubleshooting Guide). Ondanks zorgvuldige monsterbehandeling kan ongeveer 5% van de library-preparaties mislukken door verlies van oocyten tijdens de initiële handelingen of monsterverlies tijdens de library-preparatie.
Kwaliteitscontrole tijdens en na de bibliotheekpreparatie is essentieel om de succesvolle adapterligatie te verifiëren, de mtDNA-verrijking te beoordelen, de DNA-input voor amplificatie te optimaliseren, residuele adapter- of primerdimeren te detecteren en te bepalen of aanvullende zuiverings- of amplificatiestappen vereist zijn. Het gebruik van hetzelfde real-time qPCR-instrument voor alle bibliotheekpreparaties zorgt voor consistente reactieomstandigheden en verbetert de vergelijkbaarheid, reproduceerbaarheid en betrouwbaarheid van de metingen die worden gebruikt voor downstream kwaliteitscontrole en protocoloptimalisatie. De PCR-cyclusaantallen voor bibliotheekamplificatie en indexering die in dit protocol worden beschreven, kunnen aanpassing vereisen wanneer er andere instrumenten, enzymen of reagentia worden gebruikt. De initiële amplificatiestap is onderverdeeld in een lineaire amplificatiefase met gebruik van een enkele primer, gevolgd door exponentiële amplificatie na toevoeging van de tweede primer. Deze strategie minimaliseert de kans dat fouten die tijdens de eerste amplificatiecyclus zijn geïntroduceerd, worden voortgeplant tot niveaus waarop ze moeilijk te onderscheiden zijn van echte DNA-mutaties. De aanbevolen cyclusaantallen zijn gekozen om een optimale read-family grootte te bereiken voor duplex sequencing-analyse; deze kunnen echter optimalisatie vereisen, afhankelijk van de hoeveelheid en kwaliteit van het input-DNA. Monsters met een lagere DNA-input kunnen extra amplificatiecycli vereisen, terwijl monsters met een hogere DNA-input mogelijk minder cycli nodig hebben om overamplificatie te voorkomen en de complexiteit van de bibliotheek te behouden.
Hoewel dit protocol wordt gedemonstreerd met gebruik van enkele menselijke oocyten, is de workflow niet beperkt tot menselijke monsters. Wij hebben eerder dezelfde aanpak toegepast om kiemlijnmutagenese bij muizen en makaakapen te onderzoeken12,13, wat aangeeft dat de voorbereiding van duplex sequencing-libraries toepasbaar is op oocyten van meerdere soorten na optimalisatie van soortspecifieke primersequenties en, waar nodig, andere experimentele parameters. Ondanks de brede toepasbaarheid van duplex sequencing is de hier beschreven workflow voor mtDNA-verrijking en library-voorbereiding niet direct overdraagbaar naar enkele somatische cellen, omdat hun mtDNA-kopieaantallen doorgaans meerdere grootteordes lager zijn dan die van oocyten, wat de hoeveelheid input-DNA beschikbaar voor library-voorbereiding beperkt. Desalniettemin kunnen duplex sequencing-libraries worden gegenereerd uit bulkmonsters van somatische cellen wanneer dit wordt gecombineerd met geoptimaliseerde mtDNA-verrijking voorafgaand aan de library-voorbereiding. Een andere beperking van duplex sequencing is de vereiste voor DNA-fragmentatie, wat artefactuele fouten kan introduceren, met name nabij de uiteinden van de fragmenten. Bijgevolg worden basen aan de uiteinden van fragmenten doorgaans uitgesloten van downstream-analyses, en de detectie en karakterisering van inserties en deleties kunnen ook worden beïnvloed door het fragmentatieproces. Recente vorderingen in long-read sequencing-technologieën, in het bijzonder die ontwikkeld door Oxford Nanopore Technologies, kunnen uiteindelijk zeer nauwkeurige sequencing van volledige mitochondriale DNA-moleculen zonder fragmentatie mogelijk maken. Het bereiken van de nauwkeurigheid die vereist is voor betrouwbare mutatiedetectie is echter momenteel afhankelijk van de analyse van native, niet-geamplificeerde DNA-moleculen. Omdat de hoeveelheid DNA in een enkele oocyt onvoldoende is voor deze benaderingen, is de toepassing ervan op dit monstertype momenteel niet praktisch.
Vergeleken met benaderingen die in eerdere studies zijn gebruikt, waaronder long-range PCR en conventionele massaal parallelle sequencing20,21,22, biedt dit protocol verschillende voordelen. Elke amplificatiestap brengt het risico met zich mee dat er artefactuele mutaties worden geïntroduceerd die de detectie van laagfrequente varianten kunnen bemoeilijken, waardoor vaak drempels voor de frequentie van het minder voorkomende allel van ten minste 1% noodzakelijk zijn. Daarentegen verbetert de aanzienlijk lagere foutmarge die met duplex sequencing wordt behaald de nauwkeurigheid van de mutatie-calling en overtreft deze die van conventionele sequencing-benaderingen5. Bijgevolg biedt deze methode een betrouwbaarder kader voor het detecteren en kwantificeren van zeldzame mtDNA-mutaties. Met deze workflow hebben we eerder aangetoond dat oocyten, in tegenstelling tot de meeste somatische weefsels, grotendeels ontsnappen aan de leeftijdgerelateerde accumulatie van mtDNA-mutaties19. Of dit schijnbare beschermende effect behouden blijft bij ziektebeelden die de ovariële micro-omgeving veranderen, zoals endometriose, en de kwaliteit van de oocyten in gevaar brengen, is nog onbekend en rechtvaardigt verder onderzoek.
Openbaarmakingen
De auteurs verklaren dat er geen concurrerende belangen zijn.
Dankbetuigingen
Wij danken het team van het In Vitro Fertilisatiecentrum van het Kepler University Hospital Linz hartelijk voor hun ondersteuning bij de verzameling van oocyten. Tevens danken wij N. Stoler en A. Nekrutenko voor het ontwikkelen van de duplex sequencing-analyse-instantie op Galaxy en voor de begeleiding bij de data-analyse. Dit werk werd ondersteund door de Austrian Science Fund (FWF) Schrödinger Fellowship (DOI: 10.55776/J4096; BA) en het FWF Stand-Alone Project (DOI: 10.55776/P36928; BA). KDM werd gedeeltelijk ondersteund door National Institutes of Health grant R01GM116044 en door het Willaman Chair Endowment Fund van de Eberly College of Science aan The Pennsylvania State University.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| 96 unieke dual index primer-paren | New England Biolabs | E6440S/L | Unieke dual-index primer-paren voor indexerings-PCR |
| Absolute ethanol, moleculaire biologie-kwaliteit, 96% | Fisher BioReagents | 15518181 | Bereid verse 80% ethanol met water van moleculaire biologie-kwaliteit |
| Agarose, lage elektro-endosmose | Biozym | 840000 | Voor de bereiding van 1,5% en 2% agarosegels |
| Ammoniumacetaatoplossing, 5 M | Thermo Fisher Scientific | J60688.AD | Gebruikt voor ethanolprecipitatie |
| ATP, 10 mM | New England Biolabs | P0756S/L | Gebruikt voor Exonuclease V-digestie |
| Geautomatiseerd elektroforese-instrument | Agilent Technologies | G2992AA | De uit de handel genomen Agilent 2100 Bioanalyzer werd gebruikt; een 4150 TapeStation of een equivalent instrument voor fragmentanalyse van nucleïnezuren kan worden gebruikt. |
| Bioanalyzer High Sensitivity DNA Kit | Agilent Technologies | 5067-4626 | Voor bepaling van de grootteverdeling van de library en beoordeling van adapter-/primer-dimeren |
| Carrier-oligonucleotide | Integrated DNA Technologies (IDT) | Custom synthesis | Sequentie is niet complementair aan het menselijk genoom. Een voorbeeldsequentie wordt gegeven in Tabel 2. Bereid een 100 nM stockoplossing en verdun deze tot een uiteindelijke concentratie van 1 nM. |
| CFX96 Touch Real-Time PCR Detection System | Bio-Rad | 12011319 | Het in deze studie gebruikte instrument is uit de handel genomen; een CFX Opus 96 of een equivalent real-time PCR-instrument kan worden gebruikt, hoewel Cq-waarden kunnen variëren. |
| Collibri Library Quantification Kit | Invitrogen | A38524100 | Voor kwantificering van geïndexeerde libraries vóór het poolen |
| Medium voor verwijdering van cumuluscellen met hyaluronidase (80 U/mL) | Gynemed | 4 HY 0010 | GM501 Hyaluronidase |
| DNA low-binding PCR-buisje, 200 µL | Corning | PCR-02-L-C | Axygen Maximum Recovery-buisje |
| DNA low-binding buisje, 0,5 mL | Biozym | 710136 | |
| DNA low-binding buisje, 1,5 mL | Biozym | 710176 | |
| DNA-polymerase I, groot (Klenow) fragment (5 U/µL) | New England Biolabs | M0210S/L | Gebruikt tijdens adapterextensie |
| dNTP-mix (equimolaire dATP, dCTP, dGTP en dTTP), 10 mM | New England Biolabs | N0447S/L | Gebruikt tijdens adapterextensie |
| EDTA, 0,5 M (pH 8,0) | Fisher BioReagents | 10628203 | Component van TE- en TElow-buffers |
| EvaGreen-kleurstof, 20× | Biotium | 31077-T | Gebruikt in attomole qPCR |
| Exonuclease V (RecBCD), 10 U/µL | New England Biolabs | M0345S/L | Gebruikt voor digestie van lineair DNA |
| Kam met vaste hoogte | Bio-Rad | 1704446EDU | Voor agarosegelelektroforese |
| Gefocust ultrasonisatie-instrument | Covaris | 500295 | M220 gefocuste ultrasonicator |
| Gefocust ultrasonisatie-buisje, 50 µL | Covaris | 520166 | microTUBE-50 AFA Fiber Screw-Cap |
| Gel-laadkleurstof, 6× | Thermo Fisher Scientific | R1161 | TriTrack DNA Loading Dye |
| GM501 minerale olie | Gynemed | 4 MO 0100 | Gebruikt als overlay op het medium voor oöcytverzameling om verdamping te voorkomen en stabiele steriele kweekcondities te handhaven, inclusief temperatuur, osmolaliteit en pH, tijdens de verwerking van oöcyten |
| High-fidelity PCR-mix, 2× | KAPA Biosystems | KK2602 | KAPA HiFi HotStart ReadyMix |
| Fluorometrische DNA-assaykit met hoge gevoeligheid | Invitrogen | Q32854 | Qubit dsDNA High Sensitivity Assay Kit |
| HpyCH4III restrictie-enzym (5 U/µL) | New England Biolabs | R0618S/L | Gebruikt voor restrictiedigestie van adapters |
| Laboratoriumcentrifuge, gekoeld | Eppendorf | 5406000313 | Moet 14.000 × g bij 4 °C ondersteunen |
| Lasersysteem voor opening van de zona pellucida | Vitrolife | 19310/0146 | Gebruikt voor verwijdering van het polaire lichaam |
| Kit voor library-bereiding | New England Biolabs | E7645S/L | NEBNext Ultra II DNA Library Prep Kit; bevat reagentia voor end-repair/A-tailing en ligatie |
| Magnesiumchlorideoplossing, 25 mM | New England Biolabs | B9021S/L | Gebruikt voor Exonuclease V-digestie |
| Magnetische bead-zuiveringsreagens | Beckman Coulter | A63881 | AMPure XP Beads |
| Magnetisch rek | Invitrogen | 12-321-D | Voor scheiding van magnetische beads |
| Micromanipulator | Luigs & Neumann GmbH | SM II/2 | Gebruikt voor verwijdering van het polaire lichaam |
| Microscoop | Olympus | IX51 | Gebruikt voor verwijdering van het polaire lichaam |
| Water van moleculaire biologie-kwaliteit | Thermo Fisher Scientific | 327290010 | Gebruikt voor de bereiding van reagentia en verdunningen |
| Oöcyt-kweekmedium | Gynemed | 4 GM 501H-20 | GM501 kweekmedium |
| PCR-plaat, 96-wells | Biozym | AF4TI-0960-C | Transparante wells, transparant frame, low-profile, met rand |
| PCR-plaatseal | Bio-Rad | MSB1001B | Compatibel met het real-time PCR-instrument |
| Fosfaatgebufferde zoutoplossing (PBS), 20× | Cell Signaling Technology | 9808S | Verdunnen tot 1× met water van moleculaire biologie-kwaliteit |
| Pipetten voor manipulatie en overdracht van cumulus–oöcytcomplexen (COC's) en oöcyten | CooperSurgical | MXL3-150 (150 µm) | Gebruikt voor mechanische verwijdering van cumuluscellen en overdracht van COC's en oöcyten. Raadpleeg de website van de fabrikant voor aanvullende pipetmaten. |
| Voeding voor gelelektroforese | Bio-Rad | 1645050 | PowerPac Basic Power Supply |
| PowerUp SYBR Green Master Mix, 2× | Applied Biosystems | 15350929 | Gebruikt voor mitochondriële en nucleaire qPCR-assays |
| Qubit-fluorometer | Invitrogen | Q33238 | De uit de handel genomen Qubit 1-fluorometer werd gebruikt; een nieuwere versie of een equivalent fluorometrisch instrument voor kwantificering van nucleïnezuren kan worden gebruikt. |
| RNase A, 10 mg/mL | Thermo Fisher Scientific | 10753721 | Verdunnen tot 1 mg/mL voor gebruik |
| Spectrofotometer | Thermo Fisher Scientific | NDULTRAGL | Het uit de handel genomen NanoDrop OneC-instrument werd gebruikt; een nieuwere versie of een equivalent microvolume-spectrofotometer kan worden gebruikt. |
| SYBR Safe DNA-gelkleurstof | Invitrogen | S33102 | Voor agarosegelelektroforese |
| Thermocycler | Bio-Rad | 1861096 | T100 Thermal Cycler |
| Thermolabiele proteinase K (0,120 U/µL) | New England Biolabs | P8111S/L | Gebruikt voor lyse van enkele oöcyten |
| Tris-acetaat-EDTA (TAE) buffer, 50× | Fisher Scientific | BP1332-1 | Verdunnen tot 1× voor agarosegelelektroforese |
| Tris-HCl (pH 8,0), 1 M | Fisher BioReagents | 10336763 | Gebruikt voor de bereiding van reagentia en verdunningen |
| Tween 20 | Fisher BioReagents | 11417160 | Component van de oöcyt-lysebuffer |
| Universele DNA-ladder | Thermo Fisher Scientific | SM0333 | GeneRuler Ready-to-Use DNA Ladder (100–1.000 bp) |
| Wide Mini-Sub Cell GT Cell | Bio-Rad | 1704468EDU | Voor agarosegelelektroforese |
| Wide Mini-Sub Cell GT UV-transparante gelbak (15 × 7 cm) | Bio-Rad | 1704426 | Voor agarosegelelektroforese |
Referenties
- Dyall SD, Brown MT, Johnson PJ. Ancient invasions: from endosymbionts to organelles. Science. 2004;304:253-257. doi:10.1126/science.1094884.
- Pakendorf B, Stoneking M. Mitochondrial DNA and human evolution. Annu Rev Genomics Hum Genet. 2005;6:165-183. doi:10.1146/annurev.genom.6.080604.162249.
- Ng YS, Turnbull DM. Mitochondrial disease: genetics and management. J Neurol. 2016;263:179-191. doi:10.1007/s00415-015-7884-3.
- Shoubridge EA, Wai T. Mitochondrial DNA and the mammalian oocyte. In: St John JC, editor. Current Topics in Developmental Biology. Vol. 77: The Mitochondrion in the Germline and Early Development. San Diego (CA): Academic Press; 2007. p. 87-111. doi:10.1016/S0070-2153(06)77004-1.
- Fox EJ, Reid-Bayliss KS, Emond MJ, Loeb LA. Accuracy of next generation sequencing platforms. Next Gener Seq Appl. 2014;1:1000106. doi:10.4172/jngsa.1000106.
- Kennedy SR, et al. Detecting ultralow-frequency mutations by Duplex Sequencing. Nat Protoc. 2014;9:2586-2606. doi:10.1038/nprot.2014.170.
- Schmitt MW, et al. Detection of ultra-rare mutations by next-generation sequencing. Proc Natl Acad Sci U S A. 2012;109:14508-14513. doi:10.1073/pnas.1208715109.
- Stoler N, et al. Family reunion via error correction: an efficient analysis of duplex sequencing data. BMC Bioinformatics. 2020;21:96. doi:10.1186/s12859-020-3419-8.
- Abascal F, et al. Somatic mutation landscapes at single-molecule resolution. Nature. 2021;593:405-410. doi:10.1038/s41586-021-03477-4.
- The ESHRE Guideline Group on Ovarian Stimulation, Ata B, Bosch E, Broer S, Griesinger G, Grynberg M, et al. ESHRE guideline: ovarian stimulation for IVF/ICSI: an update in 2025. Hum Reprod. 2026;41:498-514. doi:10.1093/humrep/deag018.
- The ESHRE Working Group on Ultrasound in ART, et al. Recommendations for good practice in ultrasound: oocyte pick up. Hum Reprod Open. 2019;2019:hoz025. doi:10.1093/hropen/hoz025.
- Arbeithuber B, et al. Age-related accumulation of de novo mitochondrial mutations in mammalian oocytes and somatic tissues. PLoS Biol. 2020;18:e3000745. doi:10.1371/journal.pbio.3000745.
- Arbeithuber B, et al. Advanced age increases frequencies of de novo mitochondrial mutations in macaque oocytes and somatic tissues. Proc Natl Acad Sci U S A. 2022;119:e2118740119. doi:10.1073/pnas.2118740119.
- The Galaxy Community. The Galaxy platform for accessible, reproducible, and collaborative data analyses: 2024 update. Nucleic Acids Res. 2024;52:W83-W94. doi:10.1093/nar/gkae410.
- Stoler N, Arbeithuber B, Guiblet W, Makova KD, Nekrutenko A. Streamlined analysis of duplex sequencing data with Du Novo. Genome Biol. 2016;17:180. doi:10.1186/s13059-016-1039-4.
- Nekrutenko A, Stoler N. Calling very rare variants. Galaxy Training Network. Available from: https://training.galaxyproject.org/training-material/topics/variant-analysis/tutorials/dunovo/tutorial.html. Accessed July 25, 2026.
- Barnett DW, et al. BamTools: a C++ API and toolkit for analyzing and managing BAM files. Bioinformatics. 2011;27:1691-1692. doi:10.1093/bioinformatics/btr174.
- Illumina. Double sided size selection and bead clean up. Illumina Knowledge Base. Available from: https://knowledge.illumina.com/library-preparation/general-library-prep/library-preparation-general-library-prep-reference_material-list/000006157. Accessed July 25, 2026.
- Arbeithuber B, et al. Allele frequency selection and no age-related increase in human oocyte mitochondrial mutations. Sci Adv. 2025;11:eadw4954. doi:10.1126/sciadv.adw4954.
- Mertens J, et al. Mitochondrial DNA variants segregate during human preimplantation development into genetically different cell lineages that are maintained postnatally. Hum Mol Genet. 2022;31:3629-3642. doi:10.1093/hmg/ddac059.
- Mertens J, et al. Children born after assisted reproduction more commonly carry a mitochondrial genotype associating with low birthweight. Nat Commun. 2024;15:1232. doi:10.1038/s41467-024-45446-1.
- Van Der Kelen A, et al. The interplay between mitochondrial DNA genotypes, female infertility, ovarian response, and mutagenesis in oocytes. Hum Reprod Open. 2025;2025:hoae074. doi:10.1093/hropen/hoae074.
Herprints en machtigingen
Dit artikel is gepubliceerd
Video binnenkort beschikbaar