Dit protocol stelt FedMediFormer-XAI voor, een multimodaal diabetes-intelligentiekader dat privacy waarborgt via federated learning, multimodale transformers, diffusie-gebaseerde augmentatie, grafiek-gebaseerde gepersonaliseerde medicijnrecommendatie en uitlegbare kunstmatige intelligentie, voor nauwkeurige voorspellingen, transparante besluitvorming en gepersonaliseerd diabetesbeheer.
Methodenartikel
FedMediFormer-XAI: Gefedereerde Multimodale Transformers met Diffusie-augmentatie en Graafgebaseerde Geneesmiddelenaanbeveling voor Diabetes
In dit artikel
Samenvatting
Samenvatting
Het beheer van diabetes staat voor een aantal hindernissen, zoals gefragmenteerde gezondheidszorggegevens, privacyzorgen, gebrekkige uitlegbaarheid en een gebrek aan gepersonaliseerde therapeutische begeleiding. Dit onderzoek introduceert FedMediFormer-XAI, een uniform en adequaat raamwerk dat federated learning, multimodale transformers, diffusiegebaseerde data-augmentatie, Graph Neural Networks (GNN's) voor medicijnrecomendaties en Explainable Artificial Intelligence (XAI) voor diabetesintelligentie incorporeert. Het systeem maakt gebruik van diverse typen gezondheidszorggegevens, zoals klinische dossiers, populatiegezondheidsindicatoren, gegevens van continue glucosemonitoring, retinafundusbeelden, metingen van draagbare sensoren en farmacologische informatie. Om synthetische monsters te genereren en klasse-onbalans aan te pakken, worden diffusiemodellen gebruikt, en multimodale transformer-architecturen worden aangewend om relaties tussen zeer verschillende gegevensbronnen te leren. Federated learning maakt collaboratieve training van modellen mogelijk op een privacybewarende manier zonder ruwe patiëntgegevens te delen. De GNN-component legt interacties tussen patiënt-medicijn en medicijn-medicijn vast voor gepersonaliseerde medicijnrecomendaties. Uitlegbaarheidsmethoden zoals SHapley Additive exPlanations (SHAP), attentievisualisatie, Integrated Gradients en counterfactual reasoning geven transparante interpretaties van voorspellings- en recomendatieresultaten. In de representatieve implementatie behaalde het voorgestelde raamwerk een nauwkeurigheid van 94.2%, een precisie van 93.1%, een recall van 92.8%, een F1-score van 92.9%, een Matthews Correlation Coefficient (MCC) van 0.88 en een Area Under the Receiver Operating Characteristic Curve (AUC-ROC) van 0.96. De graafgebaseerde recomendatiemodule behaalde een precisie = 0.89, recall = 0.84 en Normalized Discounted Cumulative Gain (NDCG) = 0.91. Het protocol biedt een gestructureerde aanpak voor het integreren van heterogene gezondheidszorggegevens met behulp van multimodale transformers, federated learning, diffusiegebaseerde augmentatie, graafgebaseerde recomendatie en uitlegbare kunstmatige intelligentie. De gerapporteerde computationele resultaten tonen het potentieel van het raamwerk aan voor diabetesvoorspelling en gepersonaliseerde medicijnrecomendatie, terwijl het gefedereerde ontwerp decentrale gegevensverwerking ondersteunt. Een prospectieve multicenter klinische evaluatie is vereist om het klinisch nut, de generaliseerbaarheid en de toepasbaarheid in de praktijk vast te stellen.
Inleiding
Diabetes mellitus behoort tot de belangrijkste chronische metabole ziekten die de mensheid treffen en vormt een groot volksgezondheidsprobleem vanwege de voortdurende groei, de langetermijneffecten en de enorme kosten voor de behandeling van patiënten1,2. Volgens een rapport leven er momenteel wereldwijd meer dan 537 miljoen volwassenen met diabetes, en naar verwachting zal dit aantal de komende decennia aanzienlijk stijgen3. Wanneer een hoge bloedsuikerspiegel niet wordt beheerst, kan de persoon ernstige complicaties ontwikkelen, zoals coronaire hartziekten4, nierschade5, zenuwschade6, visusverlies7 en een herseninfarct8. Daarom zijn het vroegtijdig herkennen van de ziekte, het regelmatig monitoren van de toestand van de patiënt en het bieden van training via geavanceerde medische benaderingen noodzakelijke stappen om patiënten te helpen een gezonder leven te leiden en daarmee de uitgaven van het nationale gezondheidszorgsysteem te verminderen9,10.
Tegenwoordig neemt het gebruik van elektronische patiëntendossiers (EPD's), draagbare apparaten, continue glucosemonitoringsystemen (CGM), retina-beeldvormingstechnologieën en mobiele gezondheidsapplicaties snel toe, waardoor grote volumes heterogene gezondheidszorggegevens worden gegenereerd die geanalyseerd kunnen worden11. Deze verschillende instrumenten voor gegevensverzameling kunnen diverse informatie verschaffen over het menselijk lichaam, het functioneringsvermogen in verschillende stadia van een ziekte, de reactie van de patiënt op verschillende soorten behandelingen en het gedrag in het dagelijks leven12. Kunstmatige intelligentie (AI) is gebleken de beste oplossing te zijn voor het verwerken van zeer complexe gegevens, het voorspellen van diabetes, het monitoren van de ziekte en het ondersteunen van artsen bij klinische beslissingen13. Bovendien hebben machine learning-algoritmen, waaronder random forests, support vector machines en gradient boosting-methoden, uitstekende resultaten opgeleverd bij het beoordelen van het risico op diabetes14. Recentelijk hebben deep learning-architecturen automatische feature-extractie mogelijk gemaakt en de voorspellende prestaties in diverse gezondheidszorgapplicaties verbeterd15.
Door gebruik te maken van multimodale leermethoden is de intelligentie op het gebied van diabetes aanzienlijk verbeterd door gestructureerde klinische dossiers, fysiologische metingen, retinabeelden en gedragsindicatoren te voegen in één enkel voorspellend raamwerk16. Door gebruik te maken van meerdere informatiebronnen kunnen multimodale modellen patronen identificeren die niet zichtbaar zijn wanneer elke modaliteit afzonderlijk wordt onderzocht17. Op Transformer-gebaseerde modellen zijn onlangs zeer effectief langeafstandsafhankelijkheden en contextuele relaties geleerd uit diverse typen gezondheidszorggegevens18. Problemen zoals ongebalanceerde klassen, ontbrekende gegevens, dataheterogeniteit en beperkte generaliseerbaarheid belemmeren echter nog steeds het wijdverbreide gebruik van multimodale AI-systemen in klinische settings19.
Ondanks deze ontwikkelingen vertrouwen veel bestaande intelligentiesystemen voor diabetes nog steeds op gecentraliseerde leerframeworks, die inherent vereisen dat patiëntgegevens van verschillende instellingen worden samengevoegd in één enkel depot20. Dergelijke methoden leiden reeds tot geschillen over de privacy van patiënten, het beheer van gegevens, cybersecurity en de naleving van regelgeving21. In feite zijn zorgaanbieders vanwege juridische en ethische overwegingen vaak beperkt in hun vermogen om gevoelige patiëntgegevens te delen22. In deze context wordt federated learning een levensvatbare oplossing, aangezien het mogelijk maakt om een collaboratief model te trainen zonder de daadwerkelijke patiëntgegevens te delen23. Door gedecentraliseerde optimalisatie en beveiligde parameteraggregatie maakt federated learning privacybeschermde gezondheidsanalyses mogelijk door gebruik te maken van kennis uit geografisch verspreide datasets24. Desalniettemin vormen de communicatie-overhead, client-heterogeniteit en convergentiestabiliteit nog steeds belangrijke problemen in scenario's van federated healthcare25.
Een ander nadeel van de diabetes-intelligentiesystemen die momenteel worden gebruikt, is het gebrek aan transparantie en ondersteuning voor gepersonaliseerde therapie. Veel deep learning-modellen fungeren als black boxes, wat een probleem is voor clinici die de redenering achter voorspellingen en aanbevelingen willen begrijpen26. Methoden voor uitlegbare kunstmatige intelligentie (XAI), zoals SHAP, Integrated Gradients, aandachtsvisualisatie en contrafeitelijke redenering, blijken een groot potentieel te hebben om de modeltransparantie en het vertrouwen van de clinicus te vergroten27. Daarnaast zijn graph neural networks (GNN's) de meest geavanceerde instrumenten geworden voor het vastleggen van patiënt-medicijn- en medicijn-medicijninteracties, wat resulteert in gepersonaliseerde medicijnaanbevelingen en evaluaties van de medicatieveiligheid28. Nieuwe diffusiemodellen hebben ook oplossingen geïntroduceerd voor het genereren van authentieke synthetische gezondheidszorggegevens en het aanpakken van klassenonevenwichtigheid29.
Transformers, federated learning, diffusie-gebaseerde synthetische datageneratie, graph neural networks en explainable artificial intelligence hebben elk veelbelovende resultaten laten zien in toepassingen voor de gezondheidszorg; hun integratie binnen één enkel reproduceerbaar framework voor diabetesintelligentie blijft echter beperkt. Bestaande benaderingen behandelen deze componenten gewoonlijk onafhankelijk van elkaar, waarbij de focus ligt op privacy-bewust leren zonder gepersonaliseerde behandelingsaanbevelingen, multimodale predictie zonder gedecentraliseerde training, of uitlegbaarheid zonder grafiekgebaseerde ondersteuning bij klinische besluitvorming. Hoewel diffusiemodellen kunnen bijdragen aan klassenbalancering en transformer-architecturen relaties tussen heterogene modaliteiten in de gezondheidszorg kunnen leren, blijven gestandaardiseerde protocollen voor de integratie van deze complementaire technologieën beperkt. Daarom presenteert dit werk een unified methodologisch protocol dat multimodale predictie, diffusie-gebaseerde augmentatie, federatieve optimalisatie, grafiekgebaseerde gepersonaliseerde medicatiewaanbevelingen en explainable artificial intelligence combineert binnen een reproduceerbare workflow, terwijl het een basis biedt voor toekomstige klinische validatie en vertaling.
In tegenstelling tot studies die uitgaan van de beschikbaarheid van multimodale datasets op patiëntniveau, integreert dit protocol heterogene publieke datasets zonder directe patiëntmatching uit te voeren. Er worden onafhankelijke modaliteitspecifieke modellen getraind voor elke gegevensbron, en latente kenmerk-embeddings worden gecombineerd via een cross-modaal aandachtsmechanisme. Dit ontwerp behoudt de methodologische nauwkeurigheid en maakt tegelijkertijd multimodale kennisintegratie mogelijk over diverse gezondheidszorgrepositories.
Het voorgestelde protocol is primair bedoeld voor methodologische ontwikkeling en gedistribueerde AI-omgevingen in de gezondheidszorg waarin heterogene gegevensbronnen beschikbaar zijn over verschillende repositories of instellingen en directe centralisatie van gegevens beperkt is. In de huidige implementatie zijn de modaliteitsspecifieke datasets onafhankelijk en zijn ze niet op patiëntniveau gekoppeld; daarom wordt multimodale integratie uitgevoerd op het niveau van de geleerde representatie in plaats van via directe correspondentie op patiëntniveau. Praktische toepassing zou gekoppelde multimodale patiëntgegevens, consistente preprocessing en uitkomstdefinities over de deelnemende locaties, een geschikte computationele infrastructuur en naleving van de toepasselijke ethische, privacy- en regelgevende vereisten vereisen.
Dit artikel introduceert FedMediFormer-XAI, een gefedereerd multimodaal transformer-framework dat privacybewuste diabetesintelligentie mogelijk maakt door voorspellings-, aanbevelings- en uitlegbaarheidsfuncties onder één overkoepelend systeem te verenigen. Dit framework integreert diffusiegebaseerde data-augmentatie om klasse-onbalans aan te pakken, multimodaal transformer-leren voor diabetesvoorspelling, gefedereerd leren voor collaboratieve modelontwikkeling, gepersonaliseerde medicijnaanbevelingen op basis van graph neural networks en methoden voor uitlegbare kunstmatige intelligentie om klinische beslissingen op een transparante manier te ondersteunen. De algemene architectuur en workflow van het voorgestelde FedMediFormer-XAI-framework zijn geïllustreerd in Figuur 1.
De belangrijkste bijdragen van het voorgestelde FedMediFormer-XAI-raamwerk worden als volgt samengevat: (1) Er wordt een uniform protocol gepresenteerd dat federated learning, multimodale transformers, diffusie-gebaseerde data-augmentatie, gepersonaliseerde medicijnrecommendatie op basis van graph neural networks en explainable artificial intelligence integreert binnen één reproduceerbare workflow voor diabetes-intelligentie. (2) Er is een privacy-bewarende federated learning-strategie ontwikkeld om collaboratieve modeltraining over gesimuleerde gedistribueerde gezondheidszorgcliënten mogelijk te maken zonder ruwe patiëntgegevens te delen. (3) Een multimodale transformer-architectuur is geïntroduceerd om gezamenlijk complementaire representaties te leren uit gestructureerde klinische dossiers, gegevens van continue glucosemonitoring, retina-fundusbeelden en populatiegezondheidsindicatoren. (4) Diffusie-gebaseerde synthetische datageneratie is geïntegreerd om klassenonbalans te verminderen en de robuustheid van het model te verbeteren, terwijl de statistische kenmerken van de oorspronkelijke trainingsgegevens behouden blijven. (5) Een GraphSAGE-gebaseerde heterogene graph learning-module wordt ingezet om patiënt-medicijn- en medicijn-medicijnrelaties te modelleren voor gepersonaliseerde medicatierecommendaties en interactie-bewuste behandelingsrangschikking. (6) Meerdere technieken voor explainable artificial intelligence, waaronder SHapley Additive exPlanations (SHAP), Integrated Gradients, attentie-visualisatie en counterfactual explanations, zijn geïntegreerd om de transparantie van het model te vergroten en interpreteerbare voorspellingen en recommendatie-outputs te leveren. (7) Er is een uitgebreid validatieprotocol verstrekt, inclusief predictieve evaluatie, beoordeling van federated learning, evaluatie van recommendaties, analyse van de uitlegbaarheid, evaluatie vanuit het perspectief van de clinicus, externe validatie en een reproduceerbaarheidsbeoordeling.
Protocol
Alle datasets die in deze studie zijn gebruikt, zijn verkregen uit openbaar toegankelijke repositories en bevatten gedeïdentificeerde patiënteninformatie. Deze omvatten de Pima Indians Diabetes Dataset, CDC Diabetes Health Indicators Dataset, OhioT1DM Dataset, APTOS 2019 Blindness Detection Dataset, Drug Review Dataset en Drug-Drug Interaction Dataset. Er was geen sprake van directe werving van patiënten, interventies, monstername of toegang tot identificeerbare persoonlijke gezondheidsinformatie. De studie was beperkt tot een secundaire analyse van openbaar beschikbare, geanonimiseerde datasets voor methodologische ontwikkeling en validatie, en werd uitgevoerd in overeenstemming met de institutionele vereisten voor het gebruik van dergelijke gegevens. De mensgerichte evaluatie die in dit protocol wordt beschreven, is bedoeld voor toekomstige implementatie en is niet uitgevoerd in de huidige studie. Onderzoekers die deze evaluatie uitvoeren, dienen de juiste goedkeuring van de Institutionele Ethiekcommissie te verkrijgen, schriftelijke geïnformeerde toestemming van alle deelnemers te verkrijgen en te voldoen aan de toepasselijke institutionele vereisten, overeenkomsten voor datagebruik en nationale regelgeving.
1. Configureer de computationele omgeving
- Installeer Python 3.11 als primaire programmeeromgeving. Installeer PyTorch 2.3 en TensorFlow 2.15 voor de ontwikkeling en training van deep learning-modellen. Installeer de Transformers-bibliotheek (v4.45) om transformer-gebaseerde architecturen te implementeren.
- Installeer PyTorch Geometric (v2.5) ter ondersteuning van de constructie en training van graph neural networks. Installeer SHAP (v0.47) en Captum (v0.8) om analyse van verklaarbaarheid en kenmerkattributie uit te voeren.
- Installeer NumPy, Pandas en Scikit-learn voor numerieke berekeningen, data-preprocessing en machine learning-hulpprogramma's. Installeer OpenCV en Matplotlib voor beeldverwerking en visualisatietaken. Installeer NetworkX om interactiegrafieken van geneesmiddelen te construeren en te analyseren.
- Installeer de CUDA Toolkit en compatibele NVIDIA GPU-stuurprogramma's om hardwareversnelde berekeningen mogelijk te maken. Configureer een NVIDIA RTX 4090 GPU met ten minste 32 GB systeemgeheugen. Stel de random seed in op 42 voor training, validatie en testen om reproduceerbare resultaten te garanderen. Controleer de installaties en compatibiliteit van de gebruikte softwarebibliotheken. Noteer de softwareversies, hardware-specificaties en modelconfiguratieparameters die voor de analyse zijn gebruikt.
2. Datasets voorbereiden en voorbewerken
- Download en organiseer de vereiste klinische, fysiologische, beeldvormende en farmacologische datasets in modaliteitsspecifieke repositories en verifieer hun integriteit. Bevestig de datasetkenmerken, voorspellingsdoelen en integratieniveaus zoals gespecificeerd in Tabellen 1 en 2De workflow is geïllustreerd in Figuur 2.
- Verwijder dubbele, ongeldige of inconsistente records en records waarin essentiële variabelen ontbreken. Verdeel elke toepasbare dataset in patiënt-onafhankelijke subsets voor training (70%), validatie (15%) en testen (15%). Pas mediaan-imputatie, Min-Max-schaling en categorische codering uitsluitend toe op de trainingssubset, en pas de bepaalde transformaties ongewijzigd toe op de validatie- en testsubsets. Voer synthetische datageneratie alleen uit op de trainingssubset. Verifieer de partitionering en het voorkomen van datalekken in overeenstemming met Aanvullende tabel 1.
- Importeer gegevens over glucose, voedselinname, insulinedosering, fysieke activiteit en slaap. Standaardiseer tijdstempels, lijn gebeurtenissen uit naar regelmatige intervallen, interpoleer niet-geregistreerde glucosewaarden lineair, verdeel continue records in vensters van vaste lengte en pas z-score-normalisatie toe om inputs voor de temporal transformer te genereren.
- Laad de afbeeldingen van het retinafundus en verwijder beschadigde of onleesbare bestanden, duplicaten, afbeeldingen met ontbrekende labels en afbeeldingen met ernstige artefacten of onvoldoende zichtbaarheid van het retina-veld.
- Pas de grootte van de behouden afbeeldingen aan naar 224 × 224 pixels, normaliseer de pixelintensiteiten naar [0, 1] en pas contrast-limited adaptive histogram equalization (CLAHE) toe.
- Vergroot de trainingsafbeeldingen door middel van willekeurige rotatie binnen ±15°, horizontaal spiegelen met een waarschijnlijkheid van 0,5, willekeurige zoomfactor tussen 0,9–1,1×, en helderheidsaanpassing binnen ±20%. Pas geen stochastische augmentatie toe op validatie- of testafbeeldingen. Sla de verwerkte afbeeldingen op voor de training van de Vision Transformer.
- Integreer de modaliteitspecifieke representaties volgens de dataset-integratiestrategie die is samengevat in Tabel 2Voer geen directe matching op patiëntniveau uit over onafhankelijke repositories wanneer gemeenschappelijke patiëntidentificatoren niet beschikbaar zijn.
- Sla elke openbare dataset op als een onafhankelijke modaliteitsspecifieke dataset, aangezien patiëntidentificatoren niet worden gedeeld tussen de repositories.
- Train modaliteitsspecifieke kenmerkextractoren onafhankelijk met behulp van de overeenkomstige datasets: (a) Klinische dossiers → TabTransformer-encoder; (b) Gezondheidsindicatoren van de populatie → TabTransformer-encoder; (c) Continue glucosemonitoring → Temporale Transformer; (d) Retinale fundusbeelden → Vision Transformer; (e) Farmacologische gegevens → GraphSAGE-module
- Extraheer latente kenmerk-embeddings onafhankelijk uit elke modaliteit. Fuseer uitsluitend de geleerde latente embeddings via de voorgestelde cross-modale attention-fusiemodule, in plaats van de ruwe patiëntgegevens samen te voegen.
- Zorg ervoor dat er geen kunstmatige patiëntkoppeling plaatsvindt tussen onafhankelijke openbare datasets. Handhaaf gedurende de voorbewerking, augmentatie en modelontwikkeling onafhankelijke train-, validatie- en testpartities voor elke dataset.
- Sla de gefuseerde multimodale kenmerkrepresentaties op voor downstream-voorspelling, federatief leren, uitlegbaarheid en gepersonaliseerde geneesmiddelenaanbeveling (Figuur 2).
3. Voer diffusiegebaseerde data-augmentatie uit
- Pas diffusiegebaseerde augmentatie toe op de gestructureerde tabulaire klinische datasets en datasets voor populatiemezondheid met behulp van TabDDPM. Genereer synthetische monsters uitsluitend uit de voorbewerkte trainingspartitie om informatielekkage te voorkomen. Configureer het model volgens Aanvullende tabel 2.
- Train TabDDPM voor maximaal 500 epochs met behulp van de Adam-optimizer (leersnelheid = 1 × 10⁻4; batchgrootte = 256). Pas early stopping toe als het validatieverlies gedurende 20 opeenvolgende epochs met ten minste 0,001 niet verbetert. Genereer synthetische monsters voor ondervertegenwoordigde klassen.
- Evalueer de kwaliteit van synthetische gegevens met behulp van Kolmogorov-Smirnov (KS)-statistieken, Jensen-Shannon-divergentie, Wasserstein-afstand, kenmerkgerichte correlatieanalyse en downstream-classificatieprestaties. Vergelijk de oorspronkelijke en synthetische kenmerkverdelingen met behulp van histogramoverlap, kernel-dichtheidsschatting en paarsgewijze correlatiecoëfficiënten.
- Accepteer synthetische monsters alleen wanneer de kenmerkdistributies per klasse consistent blijven met de oorspronkelijke trainingsgegevens (KS-toets, p > 0,05; Jensen-Shannon-divergentie < 0,10) en bevatten geen onrealistische klinische waarden. Combineer de geaccepteerde monsters met de oorspronkelijke trainingsdataset om een klassegebalanceerde dataset te genereren. De workflow voor augmentatie wordt weergegeven in Figuur 3.
- Valideer de synthetische gegevens door het diabetesvoorspellingsmodel opnieuw te trainen met behulp van de originele en de uitgebreide trainingsdatasets. Vergelijk de nauwkeurigheid, F1-score, MCC en AUC-ROC om veranderingen in de generalisatie van het model en de distributionele bias te beoordelen.
4. Ontwikkel het multimodale transformer-model
Configureer de multimodale transformer met modaliteitsspecifieke encoders voor gestructureerde klinische gegevens, CGM-sequenties en retinafundusbeelden, zoals geïllustreerd in Figuur 4. Integreer de resulterende representaties met behulp van cross-modale aandacht voor diabetesvoorspelling en grafiekgebaseerde gepersonaliseerde medicijnrecommendatie.
- Ontwikkel de Klinische Encoder
- Initialiseer de TabTransformer-encoderarchitectuur. Voer genormaliseerde klinische variabelen en populatiegezondheidsindicatoren in. Genereer contextuele kenmerkrepresentaties met behulp van transformer-attentiemechanismen.
- Configureer de TabTransformer-encoder met 32 gestructureerde klinische inputvariabelen, een embedding-dimensie van 128, vier transformer-lagen, acht attention heads, een feed-forward-dimensie van 512, een dropout-rate van 0.20 en Gaussian Error Linear Unit (GELU)-activatie.
- Leer latente klinische embeddings die relaties tussen patiëntkenmerken vastleggen. Sla de resulterende klinische embeddings op voor multimodale integratie.
- Ontwikkel de Encoder voor Continue Glucosemonitoring
- Initialiseer de temporele transformer-encoder. Voer sequenties van continue glucosemonitoring en fysiologische metingen in. Gebruik self-attention-mechanismen om temporele afhankelijkheden te coderen.
- Configureer de temporele transformer met een sequentielengte van 96 tijdstappen, een bemonsteringsinterval van 15 min, een embedding-dimensie van 128, vier transformer-lagen, acht attention heads, sinusvormige positionele codering en een dropout-rate van 0.20.
- Produceer sequentiële embeddings die de glucosedynamiek van de patiënt weerspiegelen. Houd de temporele embeddings gereed voor het volgende fusieproces.
- Ontwikkel de Vision Transformer-encoder
- Initialiseer de Vision Transformer-architectuur. Voer voorbewerkte retinafundusfoto's in. Verdeel de afbeeldingen in patches van vaste grootte.
- Configureer de Vision Transformer met een inputafbeeldingsresolutie van 224 × 224 pixels, een patchgrootte van 16 × 16 pixels, een embedding-dimensie van 768, 12 transformer-blokken, 12 attention heads en een dropout-rate van 0.10.
- Genereer kenmerkrepresentaties op patch-niveau. Verkrijg visuele kenmerken die wijzen op retinalpathologieën en ziektegerelateerde biomarkers. Bewaar de afbeeldingsembeddings voor multimodale fusie.
- Voer Cross-Modale Fusie uit
- Extraheer de latente representaties uit de klinische, CGM- en Vision Transformer-encoders en projecteer elk naar een gemeenschappelijke 256-dimensionale latente ruimte met behulp van onafhankelijke lineaire projecties gevolgd door Layer Normalization.
- Concateneer de geprojecteerde modaliteitstokens, voeg leerbare modaliteitstype-embeddings toe en pas multi-head cross-modale attention toe om informatie-uitwisseling tussen de klinische, CGM- en retinalrepresentaties mogelijk te maken. Configureer het attention-blok met acht heads, een 256-dimensionale modelruimte, een 1,024-dimensionale feed-forward-laag, GELU-activatie, 0.10 dropout, residual connections en Layer Normalization.
- Pas mean-pooling toe op elke modaliteitsspecifieke tokengroep en concateneer de resulterende representaties. Projecteer de geconcateneerde 768-dimensionale vector naar een 512-dimensionale uniforme multimodale representatie en behoud de attention-gewichten en gefuseerde representaties voor daaropvolgende explainability- en ablatieanalyses.
- Stuur de uniforme representatie door naar de modules voor diabetespredictie en GraphSAGE-gebaseerde medicijnrecommendatie. Behoud gedurende de fusie de oorspronkelijke modaliteitsspecifieke trainings-, validatie- en testpartities zonder kunstmatige matching op patiëntniveau over de onafhankelijke datasets heen.
- Configureer de multimodale transformer volgens de modelparameters die zijn samengevat in Supplementary Table 3.
5. Configure federated learning
- Configureer het federated learning-framework om collaboratieve modeltraining mogelijk te maken tussen geografisch verspreide gezondheidszorginstellingen zonder het uitwisselen van gegevens op patiëntniveau. Voer lokale modeloptimalisatie uit bij elke deelnemende instelling met behulp van lokaal beschikbare gegevens. Deel alleen beschermde modelparameters met de centrale aggregatieserver. Waarborg de privacy van patiënten terwijl de collaboratieve ontwikkeling van multimodale modellen wordt gefaciliteerd.
- Scheid de multimodale datasets en verdeel deze over meerdere federated clients om het scenario na te bootsen waarin verschillende gezondheidszorginstellingen samenwerken zonder hun gegevens te delen.
- Configureer het federated learning-netwerk met 10 deelnemende ziekenhuisclients, één centrale aggregatieserver, vijf lokale epochs per communicatieronde, 100 communicatieronden, een client-participatiefractie van 80%, willekeurige clientselectie bij elke communicatieronde en een minimum van acht deelnemende clients per ronde.
- Wijs aan elke client een dataset toe die toebehoort aan een specifieke instelling, zodat de gegevens lokaal en vertrouwelijk blijven. Partitioneer de multimodale trainingsgegevens over 10 gesimuleerde ziekenhuisclients met behulp van een Dirichlet-gebaseerde non-independent and identically distributed (non-IID) strategie om heterogene klasseverdelingen, demografische composities en client-datasetgroottes te genereren.
- Gebruik een vaste random seed om reproduceerbaarheid te garanderen. Verifieer de resulterende verdelingen op clientniveau en behoud deze partities gedurende de federated training. Houd de validatie- en testdatasets onafhankelijk van de client-partitions.
- Initialiseer elke lokale client met de globale modelparameters die zijn ontvangen van de centrale aggregatieserver. Train de lokale multimodale transformer gedurende vijf epochs met behulp van de lokale trainingsgegevens van de client. Optimaliseer het lokale model met de AdamW-optimizer met een learning rate van 1 × 10⁻4.
- Bereken de updates van de lokale modelparameters na voltooiing van de lokale training. Bescherm de lokale modelparameters vóór verzending naar de centrale aggregatieserver. Verzend de beschermde lokale modelparameters naar de centrale aggregatieserver voor globale aggregatie.
- Ontvang de beschermde modelparameters van alle deelnemende ziekenhuisclients. Verifieer de integriteit van de ontvangen modelupdates vóór aggregatie. Aggregeer de lokale modelgewichten met behulp van het Federated Averaging (FedAvg) algoritme. Werk de globale multimodale transformer bij met behulp van de geaggregeerde modelparameters.
- Herverdeel de bijgewerkte globale modelparameters naar de deelnemende ziekenhuisclients. Herhaal de lokale trainings- en globale aggregatieprocedures totdat 100 communicatieronden zijn voltooid of het vooraf gedefinieerde convergentiecriterium is behaald.
- Bescherm verzonden modelparameters met behulp van het gespecificeerde beveiligde aggregatiemechanisme en AES-256 encryptie. Authenticeer deelnemende clients met behulp van digitale certificaten.
- Stel versleutelde communicatiekanalen in met behulp van Transport Layer Security (TLS) 1.3. Behoud na voltooiing van elke communicatieronde alleen de geaggregeerde globale modelparameters.
- Evalueer privacy en beveiliging met behulp van assessments voor raw-data exposure, ongeoorloofd delen, membership inference en model inversion. Vergelijk voor membership inference de attack AUC-ROC met de random baseline (0,50); beoordeel inversion met behulp van de structural similarity index measure (SSIM) en de peak signal-to-noise ratio (PSNR) voor retina-afbeeldingen en de genormaliseerde reconstructiefout voor numerieke kenmerken.
- Verifieer de beveiligde aggregatie door te bevestigen dat de server geen toegang heeft tot individuele, niet-geaggregeerde client-updates. Verifieer de AES-256/TLS 1.3 bescherming en bevestig dat er geen onversleutelde verzendingen van model-updates plaatsvinden.
- Vergelijk indien van toepassing privacy-metrieken tussen federated en gecentraliseerde configuraties en rapporteer de metrieken die zijn gespecificeerd in Aanvullende Tabel 4.
- Schat de computationele complexiteit van de lokale transformer-training als O(N × L × d2), waarbij N het aantal samples vertegenwoordigt, L het aantal transformer-lagen en d de embedding-dimensie.
- Schat de computationele complexiteit van federated aggregatie als O(K × P) per communicatieronde, waarbij K het aantal deelnemende clients vertegenwoordigt en P het aantal trainbare modelparameters.
- Wissel tijdens elke communicatieronde alleen beschermde modelparameters uit tussen de deelnemende clients en de centrale aggregatieserver. Bereken de communicatie-overhead op basis van de modelgrootte, het aantal deelnemende clients en het aantal communicatieronden.
- Vergelijk de overhead van de parameteruitwisseling met de geschatte kosten voor het overdragen van de overeenkomstige multimodale gezondheidszorgdatasets. Configureer het federated learning-framework volgens de parameters die zijn samengevat in Aanvullende Tabel 4. De federated learning-workflow en het parameteraggregatieproces zijn geïllustreerd in Figuur 5.
6. Constructeer de module voor gepersonaliseerde medicijnaanbevelingen
- Importeer de farmacologische gegevens, medicatiegegevens, patiëntbehandelingsgegevens en gegevens over geneesmiddelinteracties in de computationele omgeving. Constructeer een heterogene gezondheidszorggrafiek bestaande uit knopen voor patiënten, geneesmiddelen, ziekten, laboratoriumtesten en klinische risicofactoren.
- Definieer patiënt-ziekte, patiënt-geneesmiddel, ziekte-geneesmiddel, geneesmiddel-geneesmiddelinteractie en patiënt-laboratoriumrelaties als grafiekranden. Verifieer de grafiekstructuur en verwijder dubbele, ongeldige of losgekoppelde relaties vóór de modeltraining.
- Representeer patiëntknopen aan de hand van leeftijd, geslacht, body mass index (BMI), HbA1c, bloedglucose, bloeddruk en diabetesduur. Representeer geneesmiddelknopen aan de hand van geneesmiddelklasse, werkingsmechanisme, dosering, toedieningsfrequentie en bekende bijwerkingen.
- Representeer ziekteknopen aan de hand van ziektesevereiteit, ziektestadium en geassocieerde complicaties. Codeer categorische attributen en normaliseer continue knoopkenmerken vóór de GraphSAGE-training.
- Initialiseer de knoop-embeddings met behulp van de gepreprocessede knoopkenmerken. Sample tot 25 naburige knopen voor elke doelknoop tijdens de buurtaggregatie. Aggregeer naburige knooprepresentaties met behulp van gemiddelde aggregatie. Werk de embeddings van de doelknoop bij met behulp van de geaggregeerde buurtrepresentaties.
- Pas de rectified linear unit (ReLU) activatiefunctie toe na elke GraphSAGE-laag. Normaliseer de resulterende knoop-embeddings. Herhaal de buurtaggregatieprocedure over drie GraphSAGE-lagen.
- Configureer het GraphSAGE-model met een verborgen dimensie van 256, een embeddingdimensie van 128, drie GraphSAGE-lagen, een neighbor-sampling grootte van 25, een dropoutrate van 0,30, een leerpercentage van 1 × 10⁻4, een batchgrootte van 512 en een maximum van 100 training-epochs. Optimaliseer het model met de Adam-optimizer.
- Bereken de patiëntspecifieke embedding vanuit het getrainde GraphSAGE-model. Bereken embeddings voor kandidaatmedicaties. Bereken geschiktheidsscores tussen de patiëntrepresentatie en de representaties van de kandidaatgeneesmiddelen. Rangschik de kandidaatmedicaties op basis van hun voorspelde geschiktheidsscores.
- Identificeer en verwijder gecontra-indiceerde of potentieel onveilige medicaties met behulp van beschikbare informatie over geneesmiddelinteracties. Geef de vijf hoogst gerangschikte geschikte medicaties terug als de gepersonaliseerde Top-5 aanbevelingen.
- Train het aanbevelingsmodel met behulp van Bayesian Personalized Ranking (BPR) loss. Optimaliseer het rangschikkingsdoel om klinisch passende medicaties hogere scores toe te kennen dan minder geschikte kandidaatmedicaties.
- Identificeer invloedrijke naburige knopen en klinisch relevante grafiekrelaties die bijdragen aan elke medicatieaanbeveling. Bereken feature-attributiescores voor patiënt-, ziekte-, laboratorium- en medicatierelateerde kenmerken die bijdragen aan de aanbeveling.
- Genereer visuele grafiekgebaseerde verklaringen die de relaties tonen die bijdragen aan elke gepersonaliseerde medicatieaanbeveling. Configureer het GraphSAGE-aanbevelingsmodel volgens de parameters die zijn samengevat in Aanvullende Tabel 5. De grafiekgebaseerde workflow voor gepersonaliseerde geneesmiddelaanbevelingen is geïllustreerd in Figuur 6.
7. Voer de uitlegbaarheidsbeoordeling uit
- Voer SHAP-analyse uit
- Laad de getrainde multimodale transformer en de uitgescheiden testdataset in de rekenomgeving.
- Initialiseer de SHAP-explainer met behulp van het getrainde predictiemodel en een achtergrondsteekproef van 100 trainingssamples, die uitsluitend uit de trainingsdataset zijn geselecteerd middels gestratificeerde random sampling op basis van de diabetes-uitkomstklasse. Behoud de benaderde klassedistributie van de volledige trainingspartitie in de achtergrondsteekproef en gebruik een vaste random seed van 42 om een reproduceerbare steekproefselectie te garanderen. Bereken de SHAP-waarden voor de geselecteerde testsamples.
- Bereken de globale feature-belangrijkheid op basis van de absolute SHAP-waarden, genereer globale en lokale SHAP-visualisaties en bewaar de berekende waarden voor daaropvolgende kwantitatieve en statistische analyses.
- Voer integrated gradients-analyse uit
- Selecteer representatieve correct geclassificeerde en foutief geclassificeerde samples uit de uitgescheiden testdataset. Definieer modaliteitspecifieke baseline-inputs voordat Integrated Gradients worden berekend. Gebruik een nul-baseline voor genormaliseerde klinische en CGM-numerieke features, wat een nul-bijdrage van de genormaliseerde feature representeert, en gebruik een nulwaardige baseline-afbeelding voor de genormaliseerde retina-afbeelding-input.
- Bereken Integrated Gradients-attributiescores met gebruik van 100 interpolatiestappen tussen de baseline en de oorspronkelijke input. Normaliseer de resulterende attributiescores om vergelijking tussen features en modaliteiten mogelijk te maken. Genereer attributie-visualisaties om invloedrijke klinische, temporele en beeldvormingsfeatures te identificeren die bijdragen aan individuele modelpredicties.
- Voer attention-visualisatie uit
- Extraheer attention-matrices uit de getrainde transformer-lagen voor representatieve testsamples. Bereken de gemiddelde attention-gewichten over de overeenkomstige attention-heads. Genereer attention-heatmaps om cross-modale interacties tussen klinische, temporele en retina-beeldvormingsrepresentaties te visualiseren. Identificeer de dominante klinische, temporele en retina-features die hoge attention-gewichten ontvangen tijdens de predictie.
- Extraheer de attention-gewichten uit de getrainde multimodale transformer voor een willekeurig geselecteerd uitgescheiden testsample en visualiseer de overeenkomstige klinische-feature, CGM-temporele, retina-spatiale en cross-modale attention-distributies.
- Genereer counterfactual-uitleg
- Selecteer representatieve patiëntendossiers uit de uitgescheiden testdataset. Definieer klinisch toelaatbare bereiken en beperkingen voor aanpasbare patiëntfeatures voordat counterfactual-samples worden gegenereerd. Beperk continue features tot hun waargenomen bereik in de trainingsdata en beperk categorische features tot geldige categorieën waargenomen in de trainingsdata. Pas onveranderlijke demografische kenmerken, waaronder leeftijd en geslacht, niet aan.
- Genereer counterfactual-samples door minimaal alleen de toegestane aanpasbare features te wijzigen, terwijl de vooraf gedefinieerde klinische en feature-domeinbeperkingen behouden blijven. Verwerp counterfactuals die waarden bevatten buiten het waargenomen bereik van de trainingsdata, ongeldige categorische toestanden of wijzigingen aan onveranderlijke features. Identificeer de kleinste klinisch plausibele feature-wijzigingen die nodig zijn om de voorspelde uitkomst te veranderen.
- Rapporteer de gewijzigde features, oorspronkelijke waarden, counterfactual-waarden en de overeenkomstige veranderingen in modelpredicties. De workflow voor de beoordeling van de uitlegbaarheid is geïllustreerd in Figuur 7, terwijl representatieve resultaten van de attention-visualisatie en counterfactual-uitleg worden gepresenteerd in Supplementary Figure 1.
- Evalueer de kwaliteit van de uitleg
- Bereken de fidelity om de overeenstemming tussen de gegenereerde uitleg en het gedrag van het predictiemodel te kwantificeren. Bereken de stabiliteit door herhaaldelijk uitleg te genereren onder kleine input-perturbaties en de resulterende attributiepatronen te vergelijken. Evalueer de consistentie door uitleg te vergelijken die is gegenereerd voor klinisch vergelijkbare testsamples.
- Bereken de sparsity door het aantal of het aandeel features te bepalen dat wezenlijk bijdraagt aan elke uitleg. Evalueer de volledigheid om te bepalen of de toegeschreven features de overeenkomstige modeloutput adequaat verklaren. Evalueer de sensitiviteit door veranderingen in attributiescores te meten na gecontroleerde perturbaties van de input-features.
- Bereken de infidelity om de onenigheid tussen feature-attributies en waargenomen veranderingen in modelpredicties te kwantificeren. Registreer alle kwantitatieve metrieken voor uitlegbaarheid voor daaropvolgende statistische analyse.
- Voer prospectieve validatie door clinici uit
- Voor toekomstige prospectieve klinische validatie dient goedkeuring van de betreffende institutionele ethische commissie te worden verkregen voordat klinische experts worden geworven. Na het verkrijgen van ethische goedkeuring worden 12 clinici geworven, bestaande uit zes endocrinologen, drie diabetologen en drie klinisch farmacologen, waarbij informed consent van alle deelnemers wordt verkregen voordat de evaluatie start.
- Selecteer willekeurig representatieve modelpredicties en hun overeenkomstige uitleg voor beoordeling door clinici. Presenteer de geselecteerde uitleg onafhankelijk aan elke deelnemende clinicus met behulp van een gestandaardiseerd evaluatieformaat.
- Vraag elke clinicus om het nut, de klinische relevantie, de interpreteerbaarheid en de betrouwbaarheid van de uitleg te evalueren met behulp van een vijfpunts Likert-schaal. Registreer geanonimiseerde beoordelingen van clinici en bereken de inter-beoordelaars-overeenstemming en de overeenkomstige statistische maten zoals gespecificeerd in Stap 7.7.
- Voer statistische analyse uit
- Beoordeel de distributie van de kwantitatieve evaluatiescores voordat de statistische vergelijkingstest wordt gekozen. Pas een gepaarde t-test toe op normaal verdeelde gepaarde metingen of de Wilcoxon signed-rank test op niet-normaal verdeelde gepaarde metingen, naar gelang van het geval.
- Bereken Fleiss' kappa om de inter-beoordelaars-overeenstemming tussen de deelnemende clinici te kwantificeren. Bereken 95% betrouwbaarheidsintervallen voor de belangrijkste metrieken voor uitlegbaarheid en clinici-evaluatie. Stel de drempel voor statistische significantie vast op p < 0.05.
- Rapporteer de berekende toetsstatistieken, betrouwbaarheidsintervallen en p-waarden samen met de overeenkomstige evaluatieresultaten. Evalueer en rapporteer de metrieken voor uitlegbaarheid volgens de criteria die zijn samengevat in Supplementary Table 6.
8. Evalueer de modelprestaties
- Vergelijk FedMediFormer-XAI met Logistic Regression, Random Forest, XGBoost, TabTransformer, Vision Transformer, Temporal Transformer en de gecentraliseerde multimodale transformer aan de hand van accuracy, precisie, recall, F1-score, MCC en AUC-ROC.
- Voer elke baseline-evaluatie uit met dezelfde vooraf gedefinieerde trainings-, validatie- en teststrategie om een consistente vergelijking met het voorgestelde raamwerk te waarborgen.
- Herhaal de modelevaluatie over onafhankelijke experimentele runs en leg de behaalde prestatiemetrieken per run vast. Bereken het gemiddelde, de standaarddeviatie (SD) en het 95% betrouwbaarheidsinterval (CI) voor Accuracy, Precisie, Recall, F1-score, MCC en AUC-ROC. Rapporteer de prestatieresultaten als gemiddelde ± SD samen met het bijbehorende 95% CI.
- Beoordeel de normaliteit van de gepaarde prestatieverschillen tussen FedMediFormer-XAI en elk baseline-model. Pas een gepaarde t-toets toe op normaal verdeelde gepaarde metingen en de Wilcoxon signed-rank test op niet-normaal verdeelde gepaarde metingen. Stel de drempel voor statistische significantie in op p < 0,05.
- Rapporteer de bijbehorende toetsstatistieken, p-waarden en 95% betrouwbaarheidsintervallen om de statistische significantie en onzekerheid van de waargenomen prestatieverschillen te kwantificeren.
- Stel het aantal communicatierondes vast totdat de modellen uiteindelijk convergeren. Monitor de prestaties van het globale model tijdens de federatieve training. Bestudeer hoe de convergentie in de loop van de communicatierondes verandert.
- Controleer hoe effectief de parameteraggregatie werkt. Onderzoek hoe gedecentraliseerd leren de voorspellende prestaties beïnvloedt. Maak een vergelijking tussen de resultaten van federatief leren en gecentraliseerd leren.
- Beoordeel de federatieve convergentie over de communicatierondes heen en vergelijk de federatieve en gecentraliseerde voorspellende prestaties. Evalueer medicijnaanbevelingen met behulp van Precision@5, Recall@5 en NDCG@5.
- Genereer negatieve samples–medicijnsamples uit de pool van in aanmerking komende kandidaat-medicijnen door medicatie te selecteren die niet is waargenomen als positieve patiënt-medicijninteractie voor de betreffende patiënt. Sluit alle bekende positieve interacties en alle gecontra-indiceerde medicatie uit de pool voor negatieve sampling. Handhaaf een vaste verhouding tussen negatieve en positieve sampling van 1:1 voor de training van aanbevelingen en gebruik een vaste random seed van 42 voor een reproduceerbare selectie van negatieve samples.
- Stel de relevante itemset voor elke patiënt uitsluitend vast op basis van de uitgescheiden evaluatiedata. Definieer de relevante-itemset Ru voor patiënt u als de set medicijnen die voldoen aan de positieve patiënt-medicijncriteria in de uitgescheiden ground-truth records. Gebruik geen modelvoorspellingen om Ru te construeren. Verwijder gecontra-indiceerde medicatie uit de set met kandidaat-aanbevelingen vóór de rangschikking.
- Genereer de vijf hoogst gerangschikte geschikte medicijnen voor elke evaluatiepatiënt. Bereken Precision@5 als de proportie van de vijf aanbevolen medicijnen die tot de relevante-itemset Ru van de patiënt behoren. Bereken Recall@5 als de proportie van de relevante medicijnen van de patiënt die zijn teruggevonden binnen de vijf aanbevelingen. Bereken NDCG@5 met behulp van de gegradeerde relevantie van de aanbevolen medicijnen, waarbij een hogere relevantie wordt toegekend aan klinisch passende medicijnen en een nulrelevantie aan niet-relevante medicijnen. Aggregeer de metrieken over alle evaluatiepatiënten en rapporteer de gemiddelde Precision@5, Recall@5 en NDCG@5.
- Construeer de ground truth voor aanbevelingen vóór de modelevaluatie en houd de uitgescheiden patiënt-medicijninteracties gescheiden van de data voor training van aanbevelingen. Gebruik geen medicijninteracties uit de testset, labels uit de testset of toekomstige behandelinformatie tijdens GraphSAGE-training, negatieve sampling of kandidaat-rangschikking.
- Meet de Fidelity om te controleren in hoeverre de verklaringen overeenkomen met het gedrag van het model. Beoordeel de stabiliteit van de verklaring via meerdere onderzoeken. Beoordeel de Begrijpelijkheid op basis van artsgerichte criteria.
- Onderzoek hoe consistent de verklaringen zijn over verschillende soorten data. Bevestig de klinische waarde van de gegenereerde verklaringen. De evaluatiemetrieken die gedurende de studie zijn gebruikt, zijn samengevat in Aanvullende Tabel 7.
9. Voer prospectieve validatie door clinici uit
- Voer een prospectieve klinische validatie uit nadat de juiste ethische goedkeuring en geïnformeerde toestemming zijn verkregen, volgens de procedures voor werving, evaluatie, gegevensverzameling en statistische analyse zoals beschreven in stappen 7.6–7.8. Het ontwerp van de prospectieve klinische validatie, inclusief de samenstelling van de deelnemers, de evaluatiecriteria, de vergelijkingscondities en de geplande statistische analyses, is samengevat in Aanvullende Tabel 8.
10. Voer de validatie en de beoordeling van de reproduceerbaarheid uit
- Voer ablatiestudies uit door systematisch individuele componenten uit het volledige FedMediFormer-XAI-framework te verwijderen, terwijl dezelfde datasetpartities, voorbehandelingsprocedures, trainingsinstellingen en evaluatiecriteria behouden blijven. Evalueer het volledige model en configuraties zonder diffusie-augmentatie, federated learning, GraphSAGE-gebaseerde medicijnaanbeveling en multimodale fusie.
- Vergelijk de geablateerde configuraties met het volledige FedMediFormer-XAI-framework met behulp van Accuracy, Precision, Recall, F1-score, MCC en AUC-ROC. Kwantificeer de verandering in elke prestatiemetriek om de bijdrage van elke frameworkcomponent te bepalen. Vergelijk validatieresultaten met interne testresultaten om de generaliseerbaarheid te evalueren. Voer statistische significantietoetsing uit om de betrouwbaarheid van de waargenomen prestatieverschillen vast te stellen.
- Beoordeel de generaliseerbaarheid van het framework met behulp van een onafhankelijke externe dataset, indien een dergelijke dataset met compatibele inputvariabelen en uitkomstdefinities beschikbaar is. Pas dezelfde voorbehandelings- en evaluatieprocedures toe als gebruikt voor de interne testdataset, en vergelijk de resulterende prestatiemetrieken met de interne testresultaten.
- Voer een statistische significantieanalyse uit over herhaalde experimentele runs. Beoordeel de normaliteit van gepaarde prestatieverschillen vóór de statistische toetsing. Pas een gepaarde t-toets toe op normaal verdeelde gepaarde metingen en de Wilcoxon signed-rank test op niet-normaal verdeelde gepaarde metingen. Stel de drempel voor statistische significantie vast op p < 0.05.
- Bereken het gemiddelde en het 95% betrouwbaarheidsinterval voor Accuracy, Precision, Recall, F1-score, MCC en AUC-ROC. Rapporteer de overeenkomstige toetsstatistieken, p-waarden en betrouwbaarheidsintervallen voor de belangrijkste modelvergelijkingen. Documenteer alle modelparameters, voorbehandelingsprocedures, trainingsconfiguraties en evaluatieprotocollen die nodig zijn om de gerapporteerde experimenten te reproduceren.
- Bewaar de broncode, configuratiebestanden, evaluatiescripts en specificaties van de getrainde modellen die zijn gebruikt voor de gerapporteerde experimenten. Houd gedetailleerde verslagen bij van modeltraining, experimentele instellingen, random seeds en evaluatieresultaten.
- Verifieer de volledigheid en consistentie van de beschikbare reproduceerbaarheidsmaterialen. Zorg ervoor dat de gedocumenteerde methoden en materialen voldoende informatie bieden voor onafhankelijke reproductie van de experimentele workflow.
- Vat de reproduceerbaarheidsbronnen en validatieprocedures die in de studie zijn gebruikt samen in Aanvullende Tabel 9. Documenteer de procedure voor de ablatiestudie en de evaluatiecriteria voor het beoordelen van de bijdrage van de belangrijkste frameworkcomponenten.
Resultaten
Analyse van de predictieve prestaties
FedMediFormer-XAI vertoonde verbeterde predictieve prestaties in vergelijking met de geëvalueerde unimodale en conventionele baselinemodellen. Augmentatie op basis van diffusie verbeterde de representatie van de minderheidsklasse, en de resulterende predictieve prestaties zijn samengevat in Tabel 3. De evaluatie via herhaalde runs toonde stabiele predictieve prestaties aan over de geëvalueerde modellen. FedMediFormer-XAI behaalde de hoogste algehele prestaties, met een nauwkeurigheid van 94.20 ± 0.34% (95% BI: 93.78–94.62), precisie van 93.10 ± 0.30% (95% BI: 92.73–93.47), recall van 92.80 ± 0.28% (95% BI: 92.45–93.15) en een F1-score van 92.90 ± 0.28% (95% BI: 92.5–93.25). Het model behaalde een MCC van 0.8 ± 0.02 (95% BI: 0.86–0.90) en een AUC-ROC van 0.96 ± 0.01 (95% BI: 0.95–0.97). De gecentraliseerde multimodale transformer leverde de op één na beste algehele prestaties, terwijl de unimodale en conventionele machine-learningmodellen een relatief lagere predictieve prestatie vertoonden. Deze resultaten geven aan dat multimodale representatieleersystemen, gecombineerd met federatieve optimalisatie, leiden tot verbeterde en stabielere prestaties bij de classificatie van diabetes.
Ablatiestudie
Componentgewijze ablatie werd gebruikt om de bijdrage van diffusie-augmentatie, federated learning, GraphSAGE-gebaseerde medicijnaanbeveling en multimodale fusie te beoordelen. Het volledige FedMediFormer-XAI-framework behaalde een nauwkeurigheid van 94,20 ± 0,34%, een precisie van 93,10 ± 0,30%, een recall van 92,80 ± 0,28%, een F1-score van 92,90 ± 0,28%, een MCC van 0,8 ± 0,02 en een AUC-ROC van 0,96 ± 0,01 over vijf onafhankelijke runs. Het verwijderen van diffusie-augmentatie verminderde de nauwkeurigheid tot 91,80 ± 0,42%, wat overeenkomt met een daling van 2,40 procentpunt, terwijl de F1-score en AUC-ROC respectievelijk afnamen tot 90,30 ± 0,38% en 0,94 ± 0,01. Deze afname duidt op de bijdrage van diffusie-gebaseerde augmentatie aan de representatie van minderheidsklassen en de predictieve robuustheid.
Het weglaten van federated learning resulteerde in een nauwkeurigheid van 93,10 ± 0,37%, wat een afname van 1,10 procentpunt vertegenwoordigt ten opzichte van het volledige raamwerk. De precisie, recall, F1-score, MCC en AUC-ROC waren eveneens gedaald tot respectievelijk 92,20 ± 0,34%, 91,80 ± 0,32%, 92,0 ± 0,3%, 0,86 ± 0,02 en 0,95 ± 0,01. Deze vergelijking demonstreert de bijdrage van de gefedereerde configuratie aan de voorspellende prestaties.
Het verwijderen van het op GraphSAGE gebaseerde component voor gepersonaliseerde medicijnrecommendatie resulteerde in een relatief kleine verandering in de prestaties van de diabetesvoorspelling, waarbij de nauwkeurigheid afnam tot 93.80 ± 0.35% en de F1-score tot 92.60 ± 0.30%. De overeenkomstige MCC en AUC-ROC waren respectievelijk 0.87 ± 0.02 en 0.96 ± 0.01. Dit resultaat geeft aan dat GraphSAGE primair bijdraagt aan de gepersonaliseerde medicijnrecommendatie en niet direct de prestaties van de diabetesclassificatie bepaalt.
De grootste afname werd waargenomen toen de multimodale fusie werd verwijderd. De nauwkeurigheid daalde naar 87.60 ± 0.5%, wat een afname van 6,60 procentpunt vertegenwoordigt, terwijl precisie, recall, F1-score, MCC en AUC-ROC respectievelijk daalden naar 86.80 ± 0.51%, 85.90 ± 0.54%, 86.30 ± 0.52%, 0.76 ± 0.03 en 0.91 ± 0.01. Dit resultaat demonstreert het belang van het gezamenlijk modelleren van complementaire informatie uit klinische, CGM- en retina-modaliteiten.
Federated learning-analyse
Het federated learning-raamwerk maakte collaboratieve modeltraining over gedistribueerde cliënten mogelijk, terwijl de gedecentraliseerde verwerking van ruwe patiëntgegevens behouden bleef. Tijdens de training werd het lokale model van elke cliënt individueel gefinetuned en gecombineerd via de Federated Averaging-methode. Na 10 communicatierondes convergeerde het globale model, en de voorspellende prestaties bleven consistent met gecentraliseerd leren. Het federated learning-raamwerk vertoonde een stabiele convergentie over de communicatierondes heen, ondanks heterogene datadistributies tussen de cliënten. De uitwisseling van beveiligde parameters waarborgde de gedecentraliseerde gegevensverwerking, terwijl het globale model een concurrerende voorspellende prestatie behield ten opzichte van de gecentraliseerde baseline. Tabel 4 vergelijkt de gecentraliseerde en gefedereerde implementaties. Federated learning vereiste extra trainingstijd vanwege de communicatie-overhead, terwijl de voorspellende prestaties vergelijkbaar bleven met gecentraliseerd leren.
Prestatieanalyse op datasetniveau
Om de generaliseerbaarheid over verschillende gezondheidszorgmodaliteiten te evalueren, hebben we de prestaties voor elke dataset afzonderlijk beoordeeld. Het multimodale FedMediFormer-XAI-model vertoonde sterke en over het algemeen concurrerende prestaties over de geëvalueerde datasets. Het behaalde een nauwkeurigheid van 91,8%, 93,1%, 92,4% en 94,2% op respectievelijk de Pima Indians Diabetes-, CDC Diabetes Health Indicators-, OhioT1DM- en APTOS 2019-datasets. Hoewel de APTOS 2019-dataset een iets hogere nauwkeurigheid (94,7%) en precisie (93,9%) behaalde dan het multimodale model, behield de voorgestelde multimodale benadering concurrerende prestaties over alle datasets en behaalde een AUC-ROC van 0,96, wat vergelijkbaar is met de hoogste AUC-ROC op datasetniveau. De algemene resultaten op datasetniveau worden gepresenteerd in Tabel 5. Voor enkelvoudige datasets behaalde de analyse van retina-afbeeldingen de beste prestaties wanneer deze alleen werd gebruikt, terwijl multimodale fusie de meest stabiele en goed gebalanceerde voorspellingen opleverde.
Analyse van gepersonaliseerde medicatieaanbevelingen
De op graph neural networks gebaseerde aanbevelingscomponent werd geëvalueerd met behulp van informatie over medicatie-effectiviteit en gegevens over geneesmiddelinteracties, waarbij kandidaat-medicatie werd gerangschikt op basis van geleerde scores voor de geschiktheid van de patiënt voor het medicijn en contra-indicaties werden uitgesloten tijdens het genereren van de aanbevelingen. Het gebruik van het heterogene graph-formaat en de modellering van patiënt-medicijn- en medicijn-medicijninteracties konden grondig worden uitgevoerd, waardoor gepersonaliseerde medicatiekeuzes en veiligheidsbeoordelingen werden ondersteund. Het GraphSAGE-aanbevelingsmodel legde effectief de complexe relaties tussen patiënten, ziekten, laboratoriumbevindingen en medicatie vast. Gepersonaliseerde aanbevelingen vertoonden een hoge ranking-prestatie, terwijl klinisch betekenisvolle verklaringen behouden bleven door middel van graph-buurtanalyse en feature-attributie.
Volgens Tabel 6 werd de module voor gepersonaliseerde medicijnaanbevelingen geëvalueerd met behulp van Precision@5, Recall@5 en NDCG@5. Deze metrieken kwantificeren de relevantie en de kwaliteit van de rangschikking van de vijf beste gepersonaliseerde medicatieaanbevelingen die zijn gegenereerd door de op GraphSAGE gebaseerde aanbevelingsmodule. Het aanbevelingssysteem behaalde sterke prestaties in de rangschikking, met een precision = 0.89, recall = 0.84 en NDCG = 0.91.
Uitlegbaarheidsanalyse
Het raamwerk bevat SHAP, Integrated Gradients, attention-visualisatie en contrafeitelijke verklaringen om de interpretatie van multimodale voorspellingen te ondersteunen. SHAP werd gebruikt om bijdragen op kenmerkniveau te kwantificeren, Integrated Gradients om voorspellingen toe te schrijven aan inputkenmerken, attention-visualisatie om de focus van het model over de modaliteiten te onderzoeken, en contrafeitelijke verklaringen om wijzigingen in kenmerken te identificeren die geassocieerd zijn met alternatieve voorspellingen. Figuur 8 toont een representatieve, door het model afgeleide SHAP-samenvattingsplot gegenereerd vanuit het getrainde FedMediFormer-XAI-model, terwijl Figuur 9 representatieve attention-visualisaties toont die zijn geëxtraheerd uit de getrainde transformer. Deze figuren vertegenwoordigen resultaten verkregen uit de modelevaluatie en zijn geen schematische illustraties van de voorgestelde architectuur.
In Figuur 8 worden de rangschikkingen van het belang van kenmerken op aggregaatniveau gepresenteerd. Kenmerken met hogere absolute SHAP-waarden hadden een grotere invloed op de modelvoorspellingen en stemden bovendien goed overeen met bestaande klinische kennis.
Figuur 9 presenteert representatieve attentie-visualisaties die direct zijn geëxtraheerd uit het getrainde FedMediFormer-XAI-model voor een willekeurig geselecteerd testmonster uit de hold-out set. De visualisaties omvatten attentie voor klinische kenmerken, temporele CGM-attentie, ruimtelijke retina-attentie en cross-modale attentie tussen de drie modaliteiten. De attentie-visualisatie demonstreerde verder de door het model geleerde allocatie van attentie over meerdere modaliteiten. Het geselecteerde monster vertoonde een relatief sterkere attentie voor HbA1c, diabetesduur en leeftijd binnen de klinische kenmerken, terwijl de CGM-attentiekaart verschillende perioden met prominente glucosevariabiliteit markeerde. De retina-attentiekaart identificeerde specifieke beeldregio's die bijdroegen aan de modelrepresentatie, en de cross-modale attentiematrix demonstreerde zowel intra-modale als cross-modale attentiepatronen. Zoals getoond in Figuur 9, markeren de representatieve, uit het model afgeleide attentiekaarten geselecteerde temporele glucosepatronen, invloedrijke klinische variabelen en diagnostisch relevante retina-beeldregio's in een testmonster uit de hold-out set.
Resultaten van de mensgerichte evaluatie
Er is een prospectief mensgericht evaluatieprotocol ontworpen om het vertrouwen van clinici, de interpreteerbaarheid, de bruikbaarheid, het klinisch nut en de relevantie van de uitleg te beoordelen onder condities van enkel voorspelling en voorspelling-plus-uitleg. De voorgestelde evaluatie zal endocrinologen, diabetesspecialisten en klinisch farmacologen betrekken, met de nodige goedkeuring van de Institutionele Ethische Commissie en geïnformeerde toestemming. Aangezien deze evaluatie bedoeld is voor toekomstige prospectieve implementatie, worden de uitkomstscores op clinici-niveau niet gerapporteerd in het huidige protocol.
Tabel 7 vat het voorgestelde prospectieve ontwerp voor de evaluatie door clinici samen en de vooraf gedefinieerde criteria voor het beoordelen van de effecten van uitleg op het vertrouwen van de clinicus, de interpreteerbaarheid en het waargenomen nut. De prospectieve evaluatie zal de beoordelingen van clinici van modelvoorspellingen met en zonder bijbehorende uitleg vergelijken aan de hand van vooraf gedefinieerde Likert-schaalcriteria. Het voorgestelde prospectieve, mensgerichte raamwerk voor de evaluatie van uitlegbaarheid wordt gepresenteerd in Figuur 10
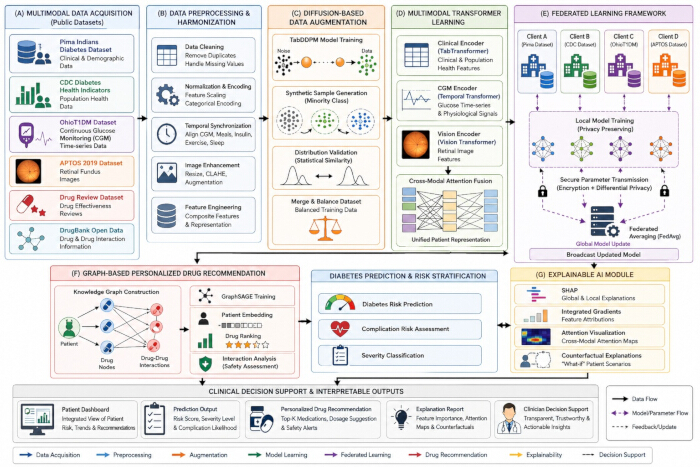
Figuur 1Algemene architectuur van het FedMediFormer-XAI-framework. Schematisch overzicht van het FedMediFormer-XAI-framework, met weergave van multimodale data-acquisitie en preprocessing, diffusiegebaseerde augmentatie, modaliteitspecifiek transformer-leren, gefedereerde modeltraining, GraphSAGE-gebaseerde gepersonaliseerde medicijnrecommendatie en uitlegbaarheidsanalyse. Het framework genereert diabetesvoorspellingen, gepersonaliseerde medicatieaanbevelingen en interpreteerbare modeloutputs. Klik hier om een grotere versie van deze figuur te bekijken.
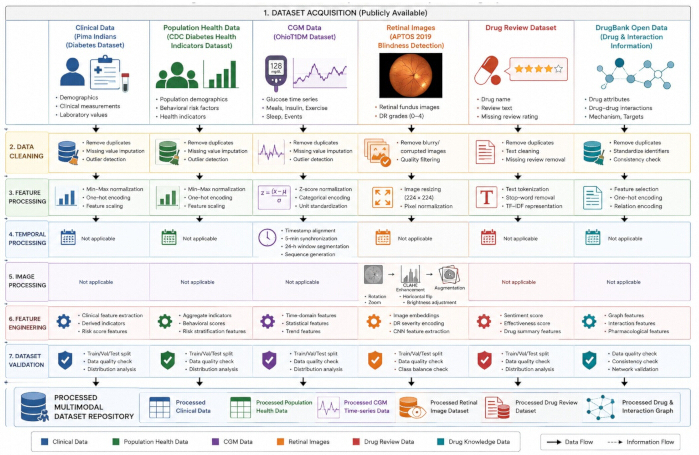
Figuur 2Multimodale datasetverwerving en preprocessing-pijplijn. Schematische workflow voor de acquisitie en preprocessing van de multimodale datasets die in FedMediFormer-XAI worden gebruikt. Klinische gegevens en populatiegezondheidsgegevens, CGM-registraties, retina-afbeeldingen en farmacologische informatie ondergaan modaliteitsspecifieke kwaliteitscontrole, preprocessing, normalisatie, codering en augmentatie voordat ze worden omgezet in model-klare representaties voor downstream-analyse. Klik hier om een grotere versie van deze figuur te bekijken.
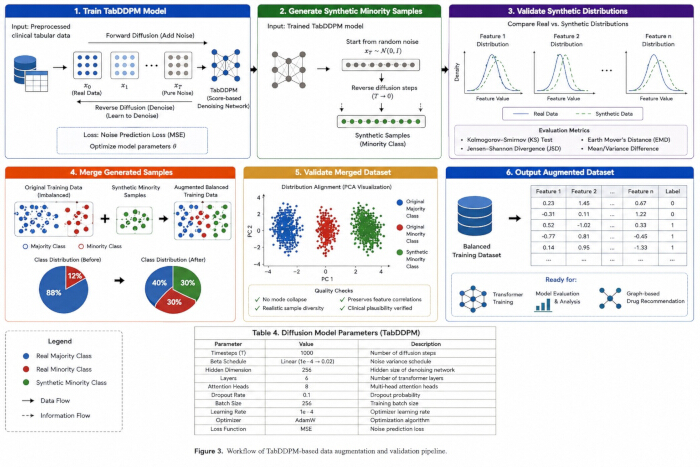
Figuur 3: Workflow voor data-augmentatie op basis van diffusie. Schematische workflow voor diffusie-gebaseerde augmentatie van gestructureerde tabulaire trainingsgegevens met behulp van TabDDPM. Gegenereerde monsters ondergaan beoordelingen van kwaliteit en distributiesimilariteit voordat ze worden geïntegreerd met de oorspronkelijke trainingsgegevens om de klassenbalans te verbeteren. Klik hier om een grotere versie van deze figuur te bekijken.
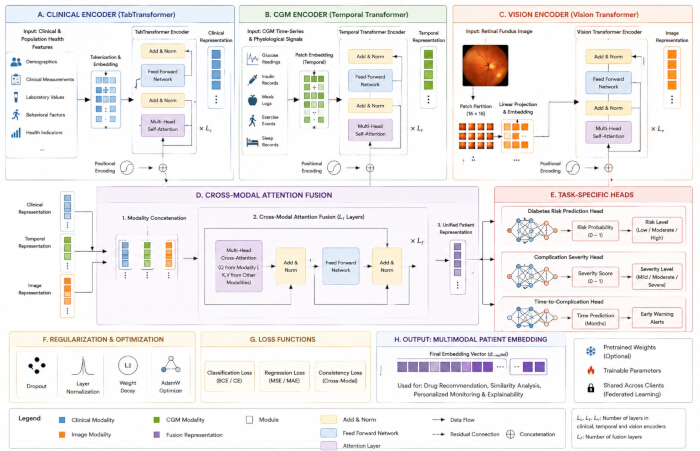
Figuur 4Architectuur van het voorgestelde multimodale transformer-raamwerk. Schematische architectuur bestaande uit (A) een TabTransformer-encoder voor klinische gegevens, (B) een temporele transformer-encoder voor CGM-gegevens, en (C) een Vision Transformer-encoder voor retinabeelden. (D) Modaliteitsspecifieke representaties worden geïntegreerd via cross-modale aandacht om een uniforme multimodale representatie te genereren. (E) Taakspecifieke predictiekoppen genereren modeloutputs. (F) Regularisatie- en optimalisatiecomponenten ondersteunen de modeltraining, en (G) classificatie-, regressie- en cross-modale consistentieverliezen sturen het optimalisatieproces aan. De resulterende multimodale representatie ondersteunt downstream-taken voor predictie, aanbeveling en uitlegbaarheid. Klik hier om een grotere versie van deze figuur te bekijken.
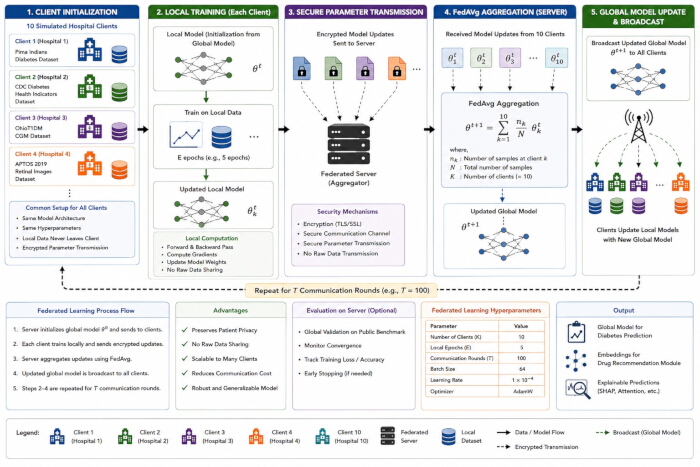
Figuur 5Communicatiekader voor federated learning. Schematische workflow voor gefedereerde training over gedistribueerde ziekenhuisclients. Lokale multimodale modellen worden getraind met cliëntspecifieke gegevens, en beschermde modelupdates worden verzonden naar een centrale server voor Federated Averaging. Het geaggregeerde globale model wordt herverdeeld over de clients voor opeenvolgende communicatierondes. Het framework illustreert tevens de beveiligde uitwisseling van parameters en de evaluatie van privacy-, communicatie- en computationele vereisten. Klik hier om een grotere versie van deze figuur te bekijken.
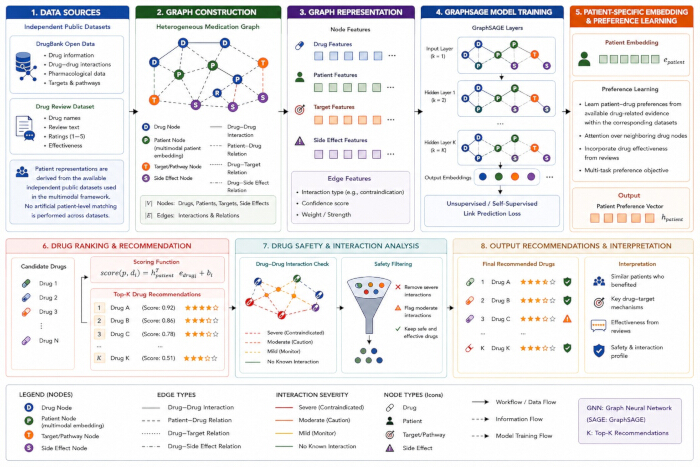
Figuur 6Graafgebaseerde workflow voor gepersonaliseerde geneesmiddelenaanbeveling. Schematische workflow voor gepersonaliseerde medicijnrecommendatie op basis van GraphSAGE. Farmacologische gegevens en patiëntrepresentatiegegevens worden georganiseerd in een heterogene graaf die relevante gezondheidszorgentiteiten en relaties bevat. GraphSAGE leert representaties van patiënten en medicijnen, die worden gebruikt om geschiktheidsscores voor patiënt-medicijncombinaties te berekenen en kandidaatmedicatie te rangschikken. Gecontra-indiceerde of onveilige medicijncombinaties worden gefilterd vóór de generatie van de uiteindelijke Top-K-aanbevelingen, waarbij graafgebaseerde informatie de interpretatie van de aanbevelingen ondersteunt. Klik hier om een grotere versie van deze figuur te bekijken.
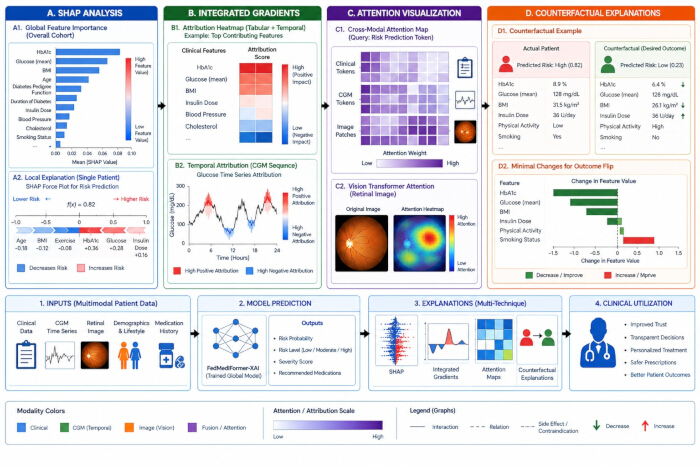
Figuur 7Raamwerk voor de beoordeling van uitlegbaarheid. Schematisch overzicht van de workflow voor uitlegbaarheid. (A) SHAP-analyse evalueert globale en lokale kenmerkbijdragen; (B) Integrated Gradients biedt attributiegebaseerde verklaringen; (C) aandachtsvisualisatie identificeert invloedrijke kenmerken en modaliteitsinteracties; en (D) Counterfactual analyse identificeert kenmerkswijzigingen die geassocieerd zijn met gewijzigde voorspellingen. De resulterende uitlegoutputs ondersteunen de interpretatie van modelvoorspellingen en gepersonaliseerde aanbevelingen. Klik hier om een grotere versie van deze figuur te bekijken.
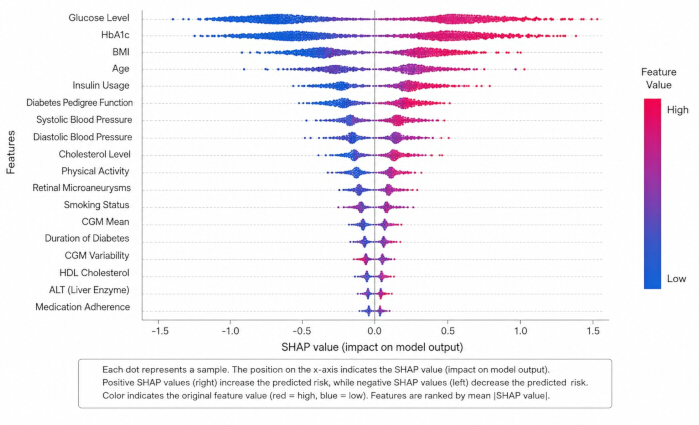
Figuur 8Representatieve model-afgeleide SHAP-feature-importance-analyse gegenereerd door het getrainde FedMediFormer-XAI-modelDe SHAP-samenvattingsplot toont de distributie van SHAP-waarden over de geëvalueerde monsters, waarbij kenmerken zijn gerangschikt op basis van hun gemiddelde absolute SHAP-bijdrage. Positieve SHAP-waarden duiden op bijdragen aan een hoger voorspeld risico op diabetes, terwijl negatieve waarden duiden op bijdragen aan een lager voorspeld risico. De kleur representeert de corresponderende kenmerkwaarde, waarbij hogere kenmerkwaarden in rood en lagere waarden in blauw worden weergegeven. De plot representeert een daadwerkelijke, uit het model afgeleide output voor uitlegbaarheid en is geen schematische illustratie. Klik hier om een grotere versie van deze figuur te bekijken.
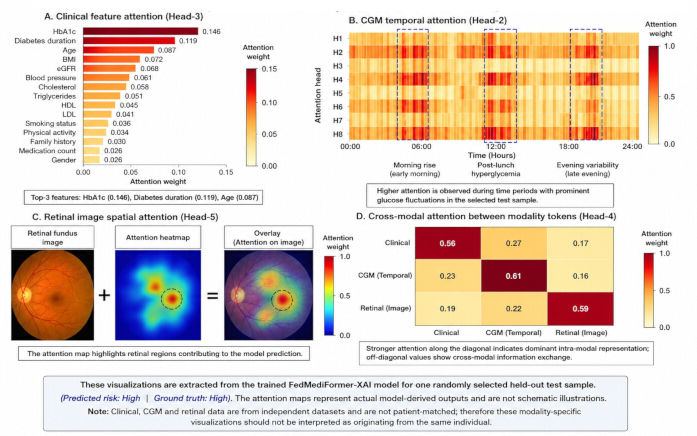
Figuur 9Representatieve attention-outputs gegenereerd door het getrainde FedMediFormer-XAI-model voor één willekeurig geselecteerd, buiten het trainingsproces gehouden testsample. (A) Aandacht voor klinische kenmerken verkregen uit een attention head van de multimodale transformer, waarin de relatieve aandachtsgewichten worden weergegeven die aan de klinische kenmerken zijn toegewezen. (B) Temporele aandacht over de CGM-sequentie, waarbij de tijdsperioden met een hogere modelaandacht worden geïllustreerd. (C) Ruimtelijke aandacht voor de afbeelding van het retina-fundus, inclusief de oorspronkelijke afbeelding, de attention heatmap en de attention overlay. (D) Crossmodale aandacht tussen klinische, CGM- en retina-modaliteitstokens, met weergave van intra-modale en crossmodale informatieweging. De getoonde visualisaties zijn modelafgeleide outputs die zijn gegenereerd door het getrainde model. De attentiegewichten worden getoond voor het geselecteerde testmonster en dienen te worden geïnterpreteerd als model-attentiepatronen en niet als onafhankelijke maten voor klinische causaliteit. Klik hier om een grotere versie van deze figuur te bekijken.
| Dataset | Gegevenstype | Monsters/Registers | Kenmerken/Inhoud | Doel | Openbare beschikbaarheid |
| Pima-indianen diabetesdataset | Klinische tabel | 768 patiënten | 8 klinische variabelen | Voorspelling van het risico op diabetes | Openbaar |
| CDC-gezondheidsindicatoren voor diabetes | Bevolkingsgezondheid | 253.680 records | Demografie, levensstijl, gezondheidsindicatoren | Populatierisicoanalyse | Openbaar |
| OhioT1DM-dataset | CGM-tijdreeksen | 12 proefpersonen | Glucose, insuline, maaltijden, lichaamsbeweging, slaap | Temporele diabetesmodellering | Openbaar |
| APTOS 2019 Detectie van Blindheid | Retinale beelden | 3.62 afbeeldingen | Fundusfoto's met ernstlabels | Analyse van diabetische retinopathie | Openbaar |
| Dataset met geneesmiddelenbeoordelingen | Farmacologisch | 215.063 beoordelingen | Effectiviteit van geneesmiddelen, beoordelingen, recensies | Medicijnadvies | Openbaar |
| DrugBank Open Data | Kennisgraaf van geneesmiddelen | Duizenden geneesmiddelen | Interacties tussen geneesmiddelen, targets, signaalpaden | Grafiekconstructie | Openbare/Academische Toegang |
Tabel 1: Kenmerken van de dataset. Overzicht van de in deze studie gebruikte publiek beschikbare datasets, inclusief datasettype, steekproefomvang, datamodaliteit, feature-inhoud, beoogde toepassing en beschikbaarheid.
| Dataset | Modaliteit | Voorspellingsdoel | Fusieniveau |
| Pima Indians Diabetes | Klinisch | Diabetesclassificatie | Feature embedding |
| CDC Diabetes Health Indicators | Bevolkingsgezondheid | Voorspelling van diabetesrisico | Feature embedding |
| OhioT1DM | Continue glucosemonitoring | Voorspelling van glucosetrend | Feature embedding |
| APTOS 2019 | Retinale fundusbeelden | Analyse van diabetische retinopathie | Feature embedding |
| Drug Review + DrugBank | Farmacologisch | Medicijnrecommendatie | Graph embedding |
Tabel 2: Integratiestrategie voor multimodale datasets. Overzicht van de datasets die zijn gebruikt voor multimodale diabetesintelligentie, inclusief de datamodaliteit, het voorspellingsdoel en het niveau waarop modaliteitsspecifieke representaties worden geïntegreerd. Klinische gegevens, populatiegezondheidsgegevens, gegevens van continue glucosemonitoring en retina-afbeeldingen worden weergegeven als feature-embeddings, terwijl farmacologische informatie wordt geïntegreerd via graph-embeddings voor gepersonaliseerde medicamenteuze aanbevelingen.
| Model | Nauwkeurigheid, Gemiddelde ± SD (95% BI) | Precisie, Gemiddelde ± SD (95% BI) | Recall, Gemiddelde ± SD (95% BI) | F1-score, Gemiddelde ± SD (95% BI) | MCC, Gemiddelde ± SD (95% BI) | AUC-ROC, Gemiddelde ± SD (95% BI) |
| Random Forest | 83.60 ± 0.74 (82.68–84.52) | 82.70 ± 0.60 (81.96–83.4) | 81.90 ± 0.56 (81.21–82.59) | 82.30 ± 0.56 (81.61–82.9) | 0.67 ± 0.03 (0.63–0.71) | 0.8 ± 0.01 (0.87–0.89) |
| XGBoost | 85.30 ± 0.71 (84.42–86.18) | 84.70 ± 0.60 (83.96–85.4) | 83.80 ± 0.56 (83.1–84.49) | 84.20 ± 0.56 (83.51–84.89) | 0.70 ± 0.03 (0.6–0.74) | 0.90 ± 0.01 (0.89–0.91) |
| TabTransformer | 87.50 ± 0.52 (86.85–8.15) | 87.0 ± 0.60 (86.26–87.74) | 86.20 ± 0.56 (85.51–86.89) | 86.60 ± 0.56 (85.91–87.29) | 0.75 ± 0.03 (0.71–0.79) | 0.92 ± 0.01 (0.91–0.93) |
| Vision Transformer | 8.80 ± 0.50 (88.18–89.42) | 8.20 ± 0.60 (87.46–8.94) | 87.60 ± 0.56 (86.91–8.29) | 87.90 ± 0.56 (87.21–8.59) | 0.78 ± 0.03 (0.74–0.82) | 0.93 ± 0.01 (0.92–0.94) |
| Temporal Transformer | 87.20 ± 0.51 (86.57–87.83) | 86.60 ± 0.60 (85.86–87.34) | 85.90 ± 0.56 (85.21–86.59) | 86.20 ± 0.56 (85.51–86.89) | 0.74 ± 0.03 (0.70–0.78) | 0.91 ± 0.01 (0.90–0.92) |
| CNN-LSTM | 86.90 ± 0.58 (86.18–87.62) | 86.30 ± 0.60 (85.56–87.04) | 85.60 ± 0.55 (84.92–86.28) | 85.90 ± 0.56 (85.21–86.59) | 0.73 ± 0.03 (0.69–0.7) | 0.91 ± 0.01 (0.90–0.92) |
| Centralized Multimodal Transformer | 91.30 ± 0.12 (91.15–91.45) | 90.70 ± 0.60 (89.96–91.4) | 90.10 ± 0.56 (89.41–90.79) | 90.40 ± 0.56 (89.71–91.09) | 0.83 ± 0.03 (0.79–0.87) | 0.95 ± 0.01 (0.94–0.96) |
| FedMediFormer-XAI | 94.20 ± 0.34 (93.78–94.62) | 93.10 ± 0.30 (92.73–93.47) | 92.80 ± 0.28 (92.45–93.15) | 92.90 ± 0.28 (92.55–93.25) | 0.8 ± 0.02 (0.86–0.90) | 0.96 ± 0.01 (0.95–0.97) |
Tabel 3: Prestaties van de diabetesvoorspelling. Vergelijkende voorspellende prestaties van FedMediFormer-XAI en baseline machine learning- en deep learning-modellen met gebruik van accuracy, precisie, recall, F1-score, MCC en AUC-ROC metrieken.
| Metriek | Gecentraliseerd leren | Gefedereerd leren |
| Nauwkeurigheid (%) | 94.7 | 94.2 |
| AUC-ROC | 0.97 | 0.96 |
| Privacybehoud | Nee | Ja |
| Delen van ruwe data vereist | Ja | Nee |
| Communicatierondes | Het is geen tekst opgegeven om te vertalen. Voer a.u.b. de brontekst in. | 100 |
| Trainingstijd (uren) | 4.8 | 5.6 |
| Naleving van regelgeving | Gematigd | Hoog |
Tabel 4: Prestaties van gefedereerd versus gecentraliseerd leren. Vergelijking van gecentraliseerde en gefedereerde leerimplementaties met betrekking tot voorspellende prestaties, vereisten voor het delen van ruwe gegevens, communicatierondes en trainingstijd.
| Dataset | Nauwkeurigheid (%) | Precisie (%) | Recall (%) | AUC-ROC |
| Pima Indians Diabetes Dataset | 91.8 | 90.5 | 89.8 | 0.93 |
| CDC Diabetes Health Indicators | 93.1 | 92.2 | 91.6 | 0.95 |
| OhioT1DM Dataset | 92.4 | 91.8 | 91.1 | 0.94 |
| APTOS 2019 Blindness Detection | 94.7 | 93.9 | 93.5 | 0.96 |
| Multimodale Fusie (FedMediFormer-XAI) | 94.2 | 93.1 | 92.8 | 0.96 |
Tabel 5: Resultaten op datasetniveau. Prestatieanalyse over individuele datasets en multimodale fusie-instellingen. De resultaten illustreren de bijdrage van verschillende datamodaliteiten aan de algehele voorspellende prestaties.
| Metriek | Waarde |
| Precisie@5 | 0.89 |
| Recall@5 | 0.84 |
| NDCG@5 | 0.91 |
| Nauwkeurigheid van de detectie van geneesmiddelinteracties | 0.95 |
| Dekking van aanbevelingen | 0.88 |
| Gemiddelde Wederkerige Rang (MRR) | 0.86 |
| Score voor naleving van de veiligheidsvoorschriften | 0.94 |
Tabel 6: Prestaties van gepersonaliseerde medicijnrecommendaties. Evaluatie van grafiekgebaseerde gepersonaliseerde medicijnrecommendaties met behulp van rankingsmetrieken, nauwkeurigheid van interactiedetectie, dekkingsgraad van recommendaties en beoordeling van medicatieveiligheid.
| Evaluatiecriterium | Voorgesteld evaluatieontwerp |
| Vertrouwen van de clinicus | Beoordeling met een vijfpunts Likert-schaal |
| Interpreteerbaarheid | Beoordeling via een vijfpunts Likert-schaal |
| Klinische relevantie | Beoordeling met een vijfpunts Likert-schaal |
| Nut van de uitleg | Beoordeling via een vijfpunts Likert-schaal |
| Waargenomen nut | Beoordeling via een vijfpunts Likert-schaal |
| Interbeoordelaarsbetrouwbaarheid | Fleiss' kappa, te berekenen na prospectieve evaluatie |
| Statistische vergelijking | Gepaarde statistische toets, naar gelang de dataverzameling |
| Deelnemers | 12 clinici, onder voorbehoud van ethische goedkeuring en geïnformeerde toestemming |
| Evaluatiestatus | Prospectieve/toekomstige evaluatie |
Tabel 7: Voorgestelde mensgerichte evaluatiecriteria. Voorgesteld prospectief, op de clinicus gericht evaluatiekader voor het beoordelen van het nut, de klinische relevantie, de interpreteerbaarheid, de betrouwbaarheid en de bruikbaarheid van FedMediFormer-XAI-uitleg. De evaluatie omvat een gestandaardiseerde beoordeling op een vijfpunts Likert-schaal, interbeoordelaarsbetrouwbaarheid met behulp van de kappa van Fleiss, statistische vergelijking tussen condities met alleen voorspellingen en condities met voorspellingen plus uitleg, en 95% betrouwbaarheidsintervallen. De evaluatie door de clinicus mag alleen worden uitgevoerd na goedkeuring van dedesbetreffende institutionele ethische commissie en na het verkrijgen van geïnformeerde toestemming.
Aanvullende tabel 1: Validatiestrategie van de datasetDatasetpartitionering, validatieprocedures, strategieën voor klassenbalancering en kwaliteitscontrolemaatregelen werden geïmplementeerd om reproduceerbaarheid en een betrouwbare modelevaluatie te waarborgen. Klik hier om dit bestand te downloaden.
Aanvullende tabel 2: Parameters van het diffusiemodelConfiguratie-instellingen voor het TabDDPM-diffusiemodel, inclusief trainingsparameters, optimalisatie-instellingen, latente dimensies, strategie voor noise scheduling en specificaties voor de generatie van synthetische monsters. Klik hier om dit bestand te downloaden.
Aanvullende tabel 3: Configuratie van de multimodale transformerConfiguratie van de multimodale transformer-architectuur, inclusief de klinische, temporele en beeldencoders, embedding- en fusiedimensies, attention heads, optimizer, leerpercentage, batchgrootte, trainings-epochs, early-stopping-criterium en de gecombineerde trainingsloss. Klik hier om dit bestand te downloaden.
Aanvullende tabel 4: Configuratie van gefedereerd leren. Parameters gebruikt voor privacybehoudende gefedereerde training, waaronder het aantal deelnemende ziekenhuizen, communicatierondes, lokale trainingsepocha's, cliëntparticipatiegraad, aggregatiealgoritme, optimizer, leerpercentage, encryptiemethode, communicatieprotocol en het beleid voor het delen van ruwe gegevens. Klik hier om dit bestand te downloaden.
Aanvullende tabel 5: GraphSAGE-configuratie. Configuratie van de heterogene GraphSAGE-gebaseerde module voor gepersonaliseerde medicijnaanbevelingen, inclusief graftype, verborgen en embedding-dimensies, aantal grafische lagen, buurtbemonsteringsgrootte, optimizer, leerpercentage, batchgrootte, trainingsepochs, Bayesian Personalized Ranking-verlies en het aantal topaanbevelingen voor medicatie. Klik hier om dit bestand te downloaden.
Aanvullende tabel 6: Evaluatiemetrieken voor uitlegbaarheid. Kwantitatieve en mensgerichte metrieken die worden gebruikt om de verklaarbaarheid van het FedMediFormer-XAI-framework te evalueren. De metrieken beoordelen de getrouwheid, stabiliteit, consistentie, sparsiteit, volledigheid, sensitiviteit en infideliteit van de uitleg, evenals de interbeoordelaarsbetrouwbaarheid en de door clinici waargenomen kwaliteit van de uitleg. Klik hier om dit bestand te downloaden.
Aanvullende tabel 7: EvaluatiemetriekenPredictieve metrieken, metrieken voor gefedereerd leren, aanbevelingsmetrieken en uitlegbaarheidsmetrieken worden gebruikt om de prestaties, robuustheid, rankingkwaliteit en interpreteerbaarheid van het framework te evalueren. Klik hier om dit bestand te downloaden.
Aanvullende tabel 8: Ontwerp van de mensgerichte evaluatieOntwerp van de op de clinicus gerichte evaluatiestudie, inclusief deelnemersgroepen, evaluatiecondities, beoordelingscriteria en statistische analyseprocedures. Klik hier om dit bestand te downloaden.
Aanvullende tabel 9: Asset voor reproduceerbaarheids. Overzicht van de datasets, implementatiespecificaties, configuratiebestanden, evaluatieprocedures, documentatie en experimentele verslagen die vereist zijn om de reproduceerbaarheid van het voorgestelde FedMediFormer-XAI-framework te ondersteunen. Klik hier om dit bestand te downloaden.
Discussie
Interpretatie van de belangrijkste bevindingen
De representatieve resultaten tonen aan dat het mogelijk is om multimodale transformer-learning, federated learning, diffusie-gebaseerde augmentatie, drug recommendation op basis van graph neural networks en uitlegbare kunstmatige intelligentie te combineren in een uniform framework voor diabetesintelligentie. Door klinische dossiers, populatiegezondheidsindicatoren, gegevens van continue glucosemonitoring, retina-fundusbeelden en farmacologische informatie te integreren, demonstreerde het voorgestelde FedMediFormer-XAI-framework sterke voorspellende prestaties, terwijl het interpreteerbare en gedecentraliseerde modelontwikkeling ondersteunde. De multimodale leermethode extraheerde informatieve kenmerken uit verschillende zorgmodaliteiten, wat leidde tot een betere diabetesvoorspelling en gepersonaliseerde behandelaanbevelingen.
Voordelen van federated learning
Een belangrijke bijdrage van het voorgestelde raamwerk is de integratie van federated learning om gedecentraliseerde collaboratieve modelbouw mogelijk te maken. Federated learning verschilt van traditionele gecentraliseerde leermethoden doordat meerdere instellingen kunnen deelnemen aan de modeltraining zonder direct ruwe patiëntgegevens te delen. De belangrijkste resultaten toonden aan dat federated learning een voorspellende nauwkeurigheid behield die vergelijkbaar was met gecentraliseerd leren, terwijl gedecentraliseerde gegevensverwerking werd ondersteund. Deze eigenschap is bijzonder relevant in scenario's in de gezondheidszorg waar het delen van gegevens wordt beperkt door institutionele richtlijnen en privacyvereisten.
Uitlegbaarheidsanalyse
De beoordeling van de uitlegbaarheid wees uit dat SHAP-analyse, Integrated Gradients, attention-visualisatie en contrafeitelijke verklaringen allemaal klinisch relevante inzichten kunnen verschaffen in het gedrag van het model. Mondiale en lokale verklaringen stemden grotendeels overeen over de belangrijkste predictoren vanuit klinisch perspectief (d.w.z. glucosemetingen, bodymassindex, leeftijd, patronen van insulietoediening en retinale afwijkingen). Attention-visualisaties toonden daarnaast aan dat de transformer-architectuur zich richtte op klinisch relevante temporele kenmerken en beeldkenmerken. Deze benaderingen verbeteren de transparantie door complementaire interpretaties te bieden van modelvoorspellingen en feature-bijdragen.
Gepersonaliseerde analyse voor medicijnrecommendaties
Wij stellen een op GNN gebaseerd recommendatiemodel voor dat, naast het modelleren van patiënt-medicijn- en medicijn-medicijnrelaties, gepersonaliseerde medicijnrecommendaties biedt. De heterogene graaftopologie faciliteerde inderdaad zowel het beheersen van patronen in de behandelingseffectiviteit als de overweging van de medicatieveiligheid. De uitstekende resultaten voor medicijnrecommendaties die in deze studie zijn behaald, illustreren de mogelijkheden van grafiekgebaseerde leermethoden voor de ontwikkeling van intelligentiesystemen voor diabetes die verder gaan dan ziektevoorspelling, richting een gepersonaliseerd therapeutisch ondersteuningskader.
Mensgerichte evaluatie
Het raamwerk bevat een prospectief mensgericht evaluatieprotocol om de effecten van uitlegbaarheid op het vertrouwen van clinici, de interpreteerbaarheid, de bruikbaarheid en de waargenomen klinische nuttigheid te beoordelen. De voorgestelde evaluatie zal condities met enkel voorspellingen vergelijken met condities met voorspellingen plus uitleg, gebruikmakend van gestandaardiseerde beoordelingscriteria. Toekomstige implementatie van deze evaluatie, na de juiste goedkeuring van de Institutionele Ethische Commissie en geïnformeerde toestemming, zal empirisch bewijs leveren over de acceptatie door clinici en het praktische nut van de gegenereerde uitleg.
Kritieke stappen voor een succesvolle en reproduceerbare implementatie
Verschillende fasen van het voorgestelde protocol vereisen bijzondere aandacht om de reproduceerbaarheid te waarborgen. Bij de preprocessing en partitionering van de dataset moet de scheiding op patiëntniveau behouden blijven om datalekken te voorkomen, terwijl de gespecificeerde non-IID client-distributies tijdens het gefedereerde leren bewaard moeten blijven. Bij de cross-modale fusie moeten de gedefinieerde latente dimensies, de configuratie van de attention, de modality-type embeddings, de normalisatie en de uiteindelijke projectie gehandhaafd worden. Voor diffusie-gebaseerde augmentatie moeten consistente preprocessing- en trainingsparameters worden gebruikt, terwijl bij de GraphSAGE-gebaseerde aanbeveling consistente patiënt-geneesmiddel representaties, interactiescreening, definities van relevante items en Top-K rankingcriteria moeten worden gehanteerd. Voor de analyse van de uitlegbaarheid moeten vaste SHAP background samples, Integrated Gradients baselines, procedures voor attention-extractie en klinisch toelaatbare counterfactual constraints worden gebruikt. Softwareversies, random seeds, modelconfiguraties, dataset-partities en evaluatieparameters moeten worden gedocumenteerd om implementatie-afhankelijke variatie te minimaliseren.
Beperkingen
Bij de interpretatie van de resultaten van deze studie moeten enkele beperkingen in overeenstemming worden gebracht. Ten eerste is het raamwerk ontwikkeld en geëvalueerd met behulp van openbaar beschikbare datasets, die mogelijk niet volledig representatief zijn voor de diversiteit van zorgpopulaties en klinische omgevingen in de praktijk. Ten tweede is federated learning geëvalueerd met behulp van gesimuleerde ziekenhuiscliënten, maar is er geen grootschalige validatie uitgevoerd waarbij onafhankelijke zorginstellingen betrokken waren. Ten derde introduceert federated learning extra communicatie- en rekenkosten die de schaalbaarheid in omgevingen met beperkte middelen kunnen beïnvloeden. Tot slot zijn de in deze studie gebruikte technieken voor uitlegbaarheid primair post hoc interpretatiemethoden en vatten zij mogelijk het gedrag van het complexe model niet volledig samen.
Het voorgestelde mensgerichte validatieprotocol maakt gebruik van een initieel panel van 12 klinische experts, bestaande uit endocrinologen, diabetologen en klinisch farmacologen. Deze steekproefomvang is bedoeld voor een voorlopige beoordeling van de bruikbaarheid en interpreteerbaarheid, en niet voor een definitieve klinische validatie. Het relatief kleine expertpanel kan de statistische kracht en generaliseerbaarheid beperken. Toekomstige prospectieve studies zouden daarom grotere, multicentrische cohorten van clinici moeten omvatten die diverse klinische settings en specialismen vertegenwoordigen.
Een belangrijke beperking van het voorgestelde raamwerk is dat de klinische, CGM, retina-imaging en medicatie-gerelateerde modaliteiten zijn afgeleid van onafhankelijke openbare datasets in plaats van patiënt-gematchte multimodale dossiers. Bijgevolg dient de cross-modale fusiecomponent te worden geïnterpreteerd als een methodologisch raamwerk voor het integreren van complementaire modaliteitsrepresentaties, en niet als bewijs afgeleid van simultane multimodale metingen bij dezelfde patiënten. Verschillen in populatiekenmerken, acquisitieprotocollen, kenmerkdistributies en ziektedefinities tussen de brondatasets kunnen distributieverschillen introduceren en de mate waarin de geleerde cross-modale relaties werkelijke associaties op patiëntniveau vertegenwoordigen, beperken. Hoewel het protocol expliciet kunstmatige matching op patiëntniveau tussen onafhankelijke datasets vermijdt, beperkt dit ontwerp de directe beoordeling van patiëntspecifieke multimodale interacties en kan dit de klinische generaliseerbaarheid beïnvloeden. De gerapporteerde multimodale prestaties mogen daarom niet worden geïnterpreteerd als equivalent aan validatie in een prospectief verzamelde, patiënt-gematchte multimodale cohort. Toekomstige studies dienen het raamwerk te valideren met grotere, onafhankelijk verzamelde datasets die gesynchroniseerde klinische, CGM, retina- en behandelingsinformatie van dezelfde patiënten bevatten.
Probleemoplossing en protocolwijzigingen
Verschillende praktische overwegingen kunnen de implementatie van het voorgestelde protocol beïnvloeden. Onbalans in klassen kan de voorspellende prestaties verminderen wanneer minderheidsklassen ondervertegenwoordigd zijn; deze uitdaging kan worden verzacht door augmentatie op basis van diffusie en resampling-strategieën. Ontbrekende waarden en inconsistente gegevensformattering kunnen de stabiliteit van het model beïnvloeden en moeten worden aangepakt via strikte preprocessing-procedures. De convergentie van federated learning kan instabiel worden wanneer client-datasets aanzienlijke heterogeniteit vertonen; het aanpassen van lokale trainingsepochs, leerfrequenties en aggregatiefrequenties kan de stabiliteit verbeteren. Hardwarebeperkingen kunnen ook de trainingsefficiëntie beïnvloeden, vooral bij het verwerken van grote multimodale datasets en transformer-architecturen. In dergelijke gevallen kan het verkleinen van de batchgrootte of modelcomplexiteit de computationele haalbaarheid verbeteren, terwijl de reproduceerbaarheid behouden blijft.
Toekomstige richtingen
Toekomstig onderzoek kan zich richten op de integratie van digital twin-technologieën voor gepersonaliseerde ziektesimulatie en behandelplanning. Foundation-modellen die zijn getraind op grootschalige multimodale gezondheidszorgdatasets kunnen het representatieleren en de generalisatie van modellen verder verbeteren. Causale verklaarbaarheidstechnieken zouden dieper inzicht kunnen verschaffen in ziekte mechanismen en behandelingseffecten, voorbij verklaringen die op correlatie zijn gebaseerd. Daarnaast kunnen reinforcement learning-benaderingen adaptieve optimalisatie van behandelingen en dynamische strategieën voor medicatieaanbevelingen ondersteunen. Deze vorderingen zouden de klinische bruikbaarheid en de personalisatiemogelijkheden van diabetes-intelligentiesystemen verder kunnen verbeteren. Bovendien moeten door AI gegenereerde voorspellingen en medicatieaanbevelingen worden beschouwd als beslissingsondersteunende instrumenten en niet als vervangingen voor professioneel klinisch oordeel. Passend menselijk toezicht blijft essentieel voor de verantwoordelijke en ethische inzet van kunstmatige intelligentiesystemen in de gezondheidszorg.
Conclusie
FedMediFormer-XAI biedt een reproduceerbaar raamwerk dat multimodale leerprocessen, gefedereerde training, gepersonaliseerde medicatie-aanbevelingen en uitlegbaarheid integreert voor diabetesintelligentie. Representatieve resultaten ondersteunen de haalbaarheid van de voorgestelde workflow, terwijl verdere validatie met patiënt-gematchte multimodale datasets, grotere klinische settings en prospectieve evaluatie door clinici vereist is vóór klinische implementatie.
Openbaarmakingen
De auteurs verklaren dat zij geen concurrerende financiële belangen, belangenconflicten of persoonlijke relaties hebben die het in deze studie gerapporteerde werk zouden hebben beïnvloed. Artificiële intelligentietools zijn uitsluitend gebruikt ter ondersteuning bij de taalverfijning, de organisatie van het manuscript, de opmaak en de redactie tijdens de voorbereiding van dit artikel. Alle wetenschappelijke inhoud, het onderzoeksontwerp, de methodologie, de data-analyse, de interpretatie van de resultaten en de conclusies zijn ontwikkeld, geverifieerd en goedgekeurd door de auteurs. De auteurs dragen de volledige verantwoordelijkheid voor de nauwkeurigheid, integriteit en originaliteit van het in dit manuscript gepresenteerde werk.
Dankbetuigingen
De auteurs betuigen hun dank aan de ontwikkelaars en beheerders van de openbaar beschikbare datasets en open-source softwarebronnen die in deze studie zijn gebruikt.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| AES-versleuteling | NIST | AES-256 | Data-at-rest / versleuteling van beschermde modelparameters in federated learning |
| APTOS 2019 Blindness Detection Dataset | Kaggle/APTOS | 2019 Release | Dataset met retinafundusbeelden; publiek toegankelijk en gedeïdentificeerd; https://www.kaggle.com/competitions/aptos2019-blindness-detection/data |
| Captum | Meta AI | Version 0.8 | Modelinterpreteerbaarheid en attributieanalyse |
| CUDA Toolkit | NVIDIA | Version 12.2 | GPU-versnelde berekeningen |
| Diabetes Health Indicators Dataset (CDC BRFSS 2015) | CDC/BRFSS; Kaggle | 2015 Release | Gezondheidsindicatoren van de populatie; publiek toegankelijk en gedeïdentificeerd; https://www.kaggle.com/datasets/alexteboul/diabetes-health-indicators-dataset |
| Diabetic Retinopathy Detection Dataset | Kaggle | Public Release | Dataset met retinabeelden; publiek toegankelijk en gedeïdentificeerd; https://www.kaggle.com/c/diabetic-retinopathy-detection/data |
| Digitale certificaten | - | - | Clientauthenticatie in federated learning |
| Drug Interaction Dataset | Kaggle | Public Release | Graafgegevens van geneesmiddel-geneesmiddelinteracties; publiek toegankelijk en gedeïdentificeerd; https://www.kaggle.com/datasets/rohanharode07/drug-drug-interaction |
| Drug Review Dataset | UCI Machine Learning Repository | Dataset 462 | Dataset met effectiviteit en beoordelingen van geneesmiddelen; publiek toegankelijk en gedeïdentificeerd; https://archive.ics.uci.edu/dataset/462/drug+review+dataset+drugs+com |
| Matplotlib | Matplotlib Developers | Version 3.9 | Visualisatie |
| MTS Diabetes Dataset | Kaggle | Public Release | Dataset voor draagbare sensoren / diabetesvoorspelling; publiek toegankelijk en gedeïdentificeerd; https://www.kaggle.com/datasets/marshalpatel3558/diabetespredictiondataset |
| NetworkX | NetworkX Developers | Version 3.3 | Constructie en analyse van interactiegrafen van geneesmiddelen |
| NumPy | NumPy Developers | Version 1.26 | Numerieke berekeningen |
| NVIDIA RTX 4090 GPU | NVIDIA | RTX 4090 | Modeltraining en inferentie; minimaal 32 GB systeemgeheugen |
| OhioT1DM Dataset | Ohio University | Public Release | Dataset voor continue glucosemonitoring; publiek toegankelijk en gedeïdentificeerd; https://webpages.charlotte.edu/rbunescu/data/ohiot1dm/OhioT1DM-dataset.html |
| OpenCV | OpenCV Foundation | Version 4.10 | Beeldbewerking |
| Pandas | PyData | Version 2.2 | Gegevensverwerking en preprocessing |
| Pima Indians Diabetes Dataset | UCI Machine Learning Repository | Dataset 34 | Klinische dataset voor diabetesvoorspelling; publiek toegankelijk en gedeïdentificeerd; https://archive.ics.uci.edu/dataset/34/diabetes |
| Python | Python Software Foundation | Version 3.11 | Primaire programmeeromgeving |
| PyTorch | Meta AI | Version 2.3 | Ontwikkeling en training van deep learning-modellen |
| PyTorch Geometric | PyG Team | Version 2.5 | Constructie en training van graph neural networks |
| Scikit-learn | Scikit-learn Developers | Version 1.5 | Machine learning-hulpprogramma's en evaluatie |
| Mechanisme voor veilige aggregatie | - | - | Beschermde aggregatie van lokale modelparameters in federated learning |
| SHAP | SHAP Developers | Version 0.47 | Explainable AI en feature-attributieanalyse |
| TensorFlow | Version 2.15 | Ontwikkeling en training van deep learning-modellen | |
| Transformers | Hugging Face | Version 4.45 | Implementatie van Transformer-gebaseerde architectuur |
| Transport Layer Security | IETF | TLS 1.3 | Versleuteld communicatiekanaal voor federated parameteruitwisseling |
| Workstation | Generic | - | Computationele omgeving; minimaal 32 GB systeemgeheugen |
Referenties
- Al-Hejri AM, et al. A hybrid explainable federated-based vision transformer framework for breast cancer prediction via risk factors. Sci Rep. 2025;15:18453.
- Dosovitskiy A, et al. An image is worth 16×16 words: transformers for image recognition at scale [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2010.11929]
- Touvron H, et al. Training data-efficient image transformers & distillation through attention [conference presentation]. Presented at: 38th International Conference on Machine Learning; 2021. [https://arxiv.org/abs/2012.12877]
- Kotelnikov A, Baranchuk D, Rubachev I, Babenko A. TabDDPM: modelling tabular data with diffusion models [conference presentation]. Presented at: 40th International Conference on Machine Learning (ICML); 2023. [https://arxiv.org/abs/2209.15421]
- Pinaya WHL, et al. Brain imaging generation with latent diffusion models [conference presentation]. Presented at: International Conference on Medical Image Computing and Computer-Assisted Intervention (MICCAI); 2022. [https://arxiv.org/abs/2209.07162]
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. [https://arxiv.org/abs/2006.11239]
- Song Y, et al. Score-based generative modeling through stochastic differential equations [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2011.13456]
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60.
- Kairouz P, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-11.
- Sheller MJ, et al. Federated learning in medicine: facilitating multi-institutional collaborations without sharing patient data. Sci Rep. 2020;10:12598.
- McMahan HB, et al. Communication-efficient learning of deep networks from decentralized data [conference presentation]. Presented at: International Conference on Artificial Intelligence and Statistics (AISTATS); 2017. [https://arxiv.org/abs/1602.05629]
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Ribeiro MT, Singh S, Guestrin C. Why should I trust you? Explaining the predictions of any classifier [conference presentation]. Presented at: ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD); 2016. [https://arxiv.org/abs/1602.04938]
- Wachter S, Mittelstadt B, Russell C. Counterfactual explanations and algorithmic recourse in healthcare AI. AI Ethics. 2021;1(2):123-37.
- Chen J, Liao W, Yu W. Explainable AI for precision medicine: a systematic review. Brief Bioinform. 2024;25(2):bbae045.
- Zitnik M, Agrawal M, Leskovec J. Modeling polypharmacy side effects with graph neural networks. Bioinformatics. 2020;36(2):i457-i466.
- Wu Z, et al. A comprehensive survey on graph neural networks. IEEE Trans Neural Netw Learn Syst. 2021;32(1):4-24.
- Hamilton WL. Graph representation learning. Morgan & Claypool Publishers; San Rafael (CA); 2020.
- Shang J, Ma T, Xiao C, Sun J. Pre-training of graph augmented transformers for medication recommendation [conference presentation]. Presented at: International Joint Conference on Artificial Intelligence (IJCAI); 2021. [https://arxiv.org/abs/1906.00346]
- Wang X, et al. Neural graph collaborative filtering. IEEE Trans Knowl Data Eng. 2021;33(5):2136-49.
- Yu KH, Beam AL, Kohane IS. Artificial intelligence in healthcare. Nat Biomed Eng. 2021;5(8):719-31.
- Muhammad G, Hossain MS, Kumar N. EEG-based pathology detection for home health monitoring. IEEE J Sel Areas Commun. 2021;39(2):603-10.
- Alshehri F, Muhammad G. Internet of Things and edge computing in healthcare: a survey. IEEE Access. 2021;9:3660-78.
- Vaid A, et al. Federated learning of electronic health records to improve mortality prediction. JMIR Med Inform. 2021;9(1):e24207.
- Lim WYB, et al. Dynamic contract design for federated learning in smart healthcare applications. IEEE Internet Things J. 2021;8(23):16853-62.
- Chikumo OT, et al. Transformer-based models for disease prediction using electronic health records: a systematic review. J Appl Artif Intell Comput. 2026;10(1):1-18.
- Lai T. Interpretable medical imagery diagnosis with self-attentive transformers: a review of explainable AI for healthcare. Diagnostics (Basel). 2023;13(18):3021.