Dit protocol presenteert een reproduceerbare workflow voor landgebruiksprojecties in meerdere scenario's, de beoordeling van koolstofopslag en topografische associatieanalyse in het Yixian–Huangshan Werelderfgoedlandschap.
Methodenartikel
Projectie van landgebruik in meerdere scenario's en beoordeling van koolstofopslag in het werelderfgoedlandschap van Yixian-Huangshan
In dit artikel
Samenvatting
Samenvatting
Veranderingen in landgebruik beïnvloeden de terrestrische koolstofopslag, maar reproduceerbare workflows voor het evalueren van scenario-gebaseerde veranderingen blijven beperkt in op toerisme gerichte Werelderflandschappen. Dit protocol integreert een aangepast Markov cellulair automaton, een koolstofboekhouding met vier pools die gelijkstaat aan het Integrated Valuation of Ecosystem Services and Tradeoffs-raamwerk, en een op optimale parameters gebaseerde geografische detector om veranderingen in landgebruik en koolstofopslag te beoordelen in Yixian en aangrenzende gebieden van Huangshan in het zuiden van Anhui, China. China Land Cover Dataset-kaarten uit 2005, 2010 en 2015 werden gebruikt voor kalibratie en validatie buiten de periode. Vier verkennende scenario's—Business As Usual, Toeristische Expansie en Ontwikkeling, Prioriteit voor Ecologische Conservatie, en Dorpsrevitalisering en Activering—werden gesimuleerd voor 2030 en 2050. Validatie over 4.632.329 geldige pixels leverde een totale nauwkeurigheid op van 96,61%, een Kappa-coëfficiënt van 0,850 en een Figure of Merit van 0,107. De basislijn voor koolstofopslag was 59,505 teragrams koolstof, waarbij bossen voor 95,9% bijdroegen. De geprojecteerde koolstofverliezen tegen 2050 varieerden van 5,01% onder Prioriteit voor Ecologische Conservatie tot 13,49% onder Toeristische Expansie en Ontwikkeling. Gematched one-at-a-time perturbaties ondersteunden dezelfde scenario-volgorde. De op optimale parameters gebaseerde geografische detector identificeerde helling, reliëf en hoogte als de sterkste beoordeelde topografische associaties. De geleverde inputs, parameters, outputs en scripts ondersteunen de reproduceerbaarheid; de scenario's moeten echter worden geïnterpreteerd als vergelijkende stresstests in plaats van gekalibreerde voorspellingen.
Inleiding
Terrestrische ecosystemen slaan koolstof op in vegetatie, bodem en dood organisch materiaal, waarmee ze bijdragen aan de klimaatregulatie1,2. Landconversie kan deze voorraden snel veranderen; ruimtelijk expliciete beoordeling is daarom belangrijk voor landgebruiksplanning en koolstofbeheer.
Het analytische gebied in het zuiden van Anhui omvat uitgestrekte subtropische bossen, landbouwbekkens en gebieden die geassocieerd zijn met de Werelderfgoedlocaties van Mount Huangshan en Xidi–Hongcun3,4. Onderzoek naar landbedekking van cultureel erfgoed, toerisme bij Werelderfgoed en het behoud van traditionele dorpen wijst uit dat de ecologische toestand, de bezoekersdruk en de plaatsidentiteit in deze context een geïntegreerde overweging vereisen5,6,7.
Scenario-gebaseerde landgebruiksmodellen vertalen waargenomen overgangen naar ruimtelijk expliciete projecties, en koolstofpool-boekhouding kwantificeert de gevolgen van deze patronen. Eerdere studies hebben Patch-generating Land Use Simulation (PLUS) of cellular automaton–Markov (CA–Markov) allocatie gecombineerd met het Integrated Valuation of Ecosystem Services and Tradeoffs (InVEST) framework en de optimal parameters-based geographical detector (OPGD) in China en andere landschappen, inclusief recente geïntegreerde toepassingen8,9,10,11,12,13,14,15,16,17,18,19,20. Deze studies bieden methodologische precedenten, hoewel de hier gebruikte simulator een aangepaste Markov cellular automaton (Markov-CA) implementatie is in plaats van PLUS.
Gerelateerd onderzoek heeft beleidsgeconditioneerde koolstofbanen, gekoppelde satelliet- en landgebruiksmodellen, terreingevoelige koolstofopslag, stedelijke en campustoepassingen, bodemkoolstofbeheer, overgangen van landbouwgrond, nationale boskaarting en schaalafhankelijkheid geëvalueerd21,22,23,24,25,26,27,28,29,30,31,32,33,34. Samen ondersteunen deze studies multi-scenariovergelijkingen, terwijl ze aantonen dat conclusies afhankelijk zijn van de dataschaal, klasovergangen, koolstofparameters en gemodelleerde beleidsaannames. De aangepaste implementatie die in de huidige studie is gebruikt, biedt een transparante workflow waarin de transitiematrix, scenariomultiplicatoren, allocatieprocedure, koolstofdichtheid-lookup, gevoeligheidsanalyse en topografische associatieanalyse kunnen worden onderzocht binnen één enkel reproduceerbaar framework. In de huidige studie is de praktische waarde van de aangepaste workflow dat de transitiematrix, scenarioparameters, pixel-allocatieregels, validatie, gevoeligheidsanalyse, koolstofboekhouding en topografische associatieanalyse zijn geïmplementeerd en gedocumenteerd binnen een reproduceerbaar computationeel framework. Deze structuur maakt het mogelijk om de aannames en tussenliggende analytische stappen die in de scenarioanalyse zijn gebruikt, te inspecteren en te reproduceren. Omdat de workflow niet direct is gebenchmarkt tegen PLUS of andere CA–Markov-implementaties, wordt er geen claim gelegd over superieure nauwkeurigheid, efficiëntie of voorspellende prestaties.
Onderzoek naar topografische en edafische controles, geomorfische persistentie van bodemkoolstof, effecten op ruimtelijke schaal, OPGD-toepassingen, de productiviteit van Huangshan, landschapsmetrieken, wetlands en boskoolstof ondersteunt verder een voorzichtige, op associaties gebaseerde interpretatie van terreineffecten35,36,37,38,39,40,41,42,43,44. Tegen deze achtergrond is het algemene doel van de huidige methode om een transparante en reproduceerbare workflow te bieden voor landgebruiksprojecties in meerdere scenario's, de beoordeling van koolstofopslag en topografische associatieanalyse in het Yixian–Huangshan World Heritage-landschap. De workflow maakt gebruik van een aangepaste Markov-CA-implementatie met een InVEST-equivalente koolstofboekhouding met vier pools en OPGD, valideert het model buiten de periode voor 2005–2015 en voert een sensitiviteitsanalyse uit met 28 runs via de one-at-a-time-methode. De bijbehorende rasters, scenarioregels, verwarringsmatrix, omgevingsbestanden en scripts maken directe inspectie en reproductie van de aangepaste simulatieworkflow mogelijk. De workflow is bedoeld voor toepassingen met compatibele categorische landcover-rasters, klasse-specifieke koolstofdichtheidsparameters en passende topografische gegevens, waarbij het doel een vergelijkende scenariobeoordeling is in plaats van een precieze ruimtelijke voorspelling.
Deze studie had drie doelstellingen: (1) het simuleren van het landgebruik voor 2030 en 2050 onder stresstests voor Business As Usual (BAU), Toeristische Expansie en Ontwikkeling (TED), Prioriteit voor Ecologische Conservering (ECP) en Dorpsrevitalisering en Activering (VRA); (2) het kwantificeren van koolstofopslag met behulp van een volledige opzoektabel met negen klassen en vier pools; en (3) het beoordelen van de individuele en gezamenlijke associaties van hoogte, helling, noordelijkheid en topografisch reliëf met de koolstofdichtheid in 20158,9,10. Deze doelstellingen integreren landgebruiksprognoses, koolstofboekhouding en terreinassociatieanalyse binnen één reproduceerbare workflow, waarbij het onderscheid tussen gesimuleerde landgebruiksresultaten en statistische associaties met topografische variabelen behouden blijft.
De scenario-labels duiden vergelijkende aannames aan in plaats van gefitte prognoses of gecodeerde wettelijke plannen. Bijgevolg is de methode het meest geschikt voor een reproduceerbare vergelijking van alternatieve aannames over landgebruik en de daarmee samenhangende resultaten van koolstofopslag, in plaats van het interpreteren van de resulterende kaarten als gekalibreerde voorspellingen van toekomstig landgebruik.
Protocol
Er waren geen menselijke proefpersonen, dieren of beschermde soorten betrokken. De analyse gebruikte uitsluitend openbaar beschikbare remote-sensingproducten en gepubliceerde koolstofdichtheidsparameters; daarom was goedkeuring door een ethische commissie niet vereist.
Voer alle computationele procedures uit in Python 3.11 binnen een open en reproduceerbare werkvloei. Volg zeven secties: (1) definieer het studiegebied; (2) verkrijg en verwerk de invoer; (3) schat de overgangsmatrix en initialiseer de aangepaste Markov-CA; (4) stel de scenario’s, gevoeligheidstests en toekomstsimulaties in; (5) kalibreer en valideer het model; (6) bereken de koolstofopslag; en (7) detecteer terreinassociaties met OPGD. Volg de volledige werkvloei zoals weergegeven in Figuur 1.
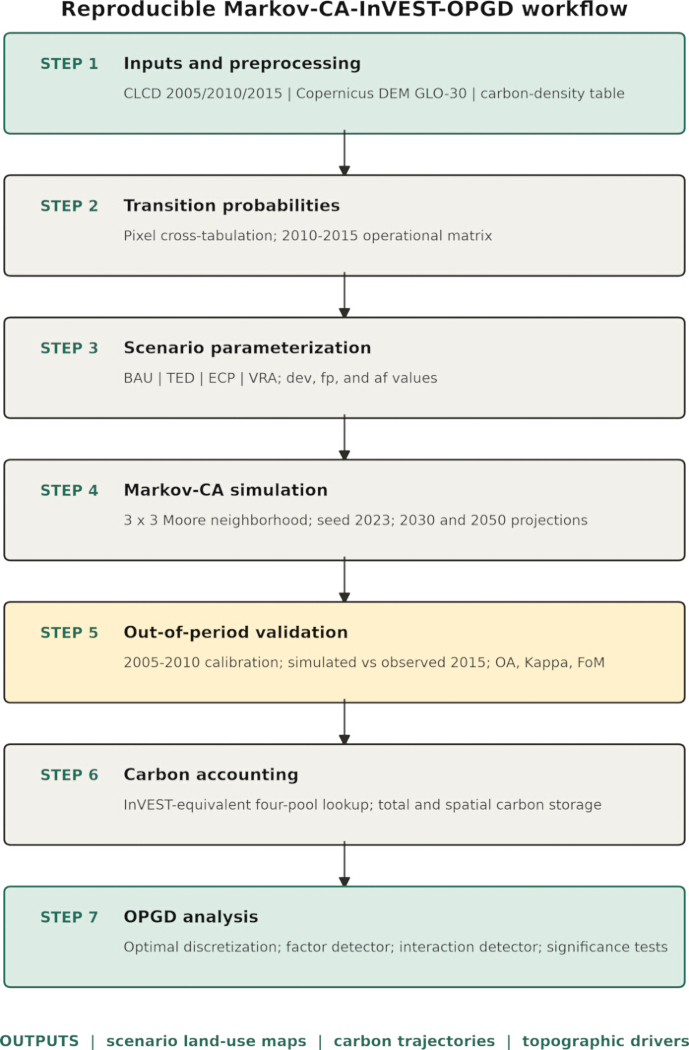
Figuur 1Reproduceerbare werkvloei voor projectie van meerdere landgebruiksscenario's, beoordeling van koolstofopslag en analyse van topografische associaties. De zevenstapsworkflow omvat (1) voorbereiding en voorverwerking van invoer met behulp van kaarten van de China Land Cover Dataset (CLCD), gegevens van het Copernicus Digital Elevation Model (DEM) GLO-30 en de koolstofdichtheidstabel; (2) schatting van overgangskansen door pixelcross-tabulatie; (3) parameterisering van de scenario's Business As Usual (BAU), Tourism Expansion and Development (TED), Ecological Conservation Priority (ECP) en Village Revitalization and Activation (VRA); (4) Markov-cellulaire automaton (Markov-CA)-simulatie met behulp van een 3 × 3 Moore-omgeving; (5) validatie buiten de periode met behulp van algehele nauwkeurigheid (OA), Kappa en Figure of Merit (FoM); (6) koolstofaccounting met behulp van een viercompartimenten opzoekmodel, gelijkwaardig aan Integrated Valuation of Ecosystem Services and Tradeoffs (InVEST); en (7) geografische detectoranalyse op basis van optimale parameters (OPGD). De werkvloei levert landschapsgebruiktekeningen per scenario, koolstofopslagtrajecten en beoordelingen van topografische associaties op. Klik hier om een grotere versie van deze afbeelding te bekijken.
1. Studiegebied
- Definieer het analyserooster als 117,60–118.38°E en 29,72–30.22°N. Behandel de Mount Huangshan en Xidi–Hongcun World Heritage-eigenschappen uitsluitend als geografische context; interpreteer de rechthoekige analytische uitgestrektheid of geldige masker niet als een officiële bestuurlijke of World Heritage-grens3,4.
- Reprojecteer het raster naar EPSG:32650 en pas de geldige masker toe om 4.632.329 cellen met een resolutie van 30 m te verkrijgen, wat overeenkomt met 4.169,1 km2. Gebruik dit gebied, dat Yixian County, aangrenzende delen van het landschappelijk gebied Huangshan en het noorden van Xiuning County omvat, voor alle rasteranalyses (Figuur 2).
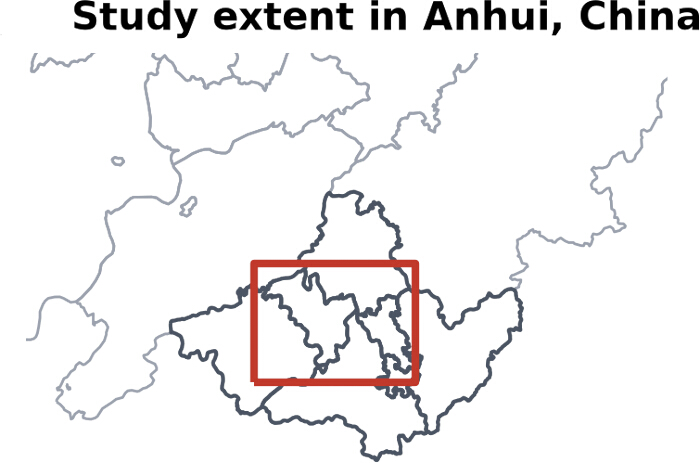
Figuur 2. Onderzoeksbereik van de Yixian–Huangshan-landschap in het zuiden van Anhui, China. Locatie van de analytische uitgestrektheid binnen de provincie Anhui, China, met het onderzoeksgebied aangegeven door de rode rechthoek. De topografische variabelen die zijn gebruikt in de associatieanalyse, zijn weergegeven in figuur 5. Klik hier om een grotere versie van deze afbeelding te bekijken.
2. Gegevensbronnen
- Gebruik drie invoergroepen: jaarlijkse landbedekkingsgegevens van CLCD, terreingegevens van Copernicus DEM GLO-30 en een klasse-specifieke koolstofdichtheidstabel met vier pools. Noteer de tijdsdekking, resolutie, herkomst en analytische rol van elk invoerelement in Tabel 1.
- Extraheer de CLCD-lagen van 2005, 2010 en 2015 met een resolutie van 30 m. Behoud de negen klassen: akkerland, bos, struikgewas, grasland, water, sneeuw/ijs, kaal terrein, ondoordringbaar oppervlak en moeras45.
- Afleiden van hoogte, helling, noordwaarts gerichtheid en topografische reliëf uit Copernicus DEM GLO-3046Wijs de volledige waarden van de negenklassen koolstofpool toe zoals gerapporteerd in tabel 6 van Cheng et al.; pas geen niet-geciteerde standaard- of nulwaardemethode toe47.
- Reprojecteer alle lagen naar WGS 84 / UTM zone 50N (EPSG:32650) op het gemeenschappelijke 30 m-raster. Gebruik nearest-neighbor-resampling voor categorische landbedekkingsgegevens en bilineaire resampling voor continue terreingegevens.
- Pas dezelfde geldige masker toe op elke laag alvorens kruistabulatie, validatie, koolstofaccounting en OPGD-steekproeven te verrichten.
- Gebruik Python 3.11.9 met numpy 2.4.6, scipy 1.17.1, rasterio 1.4.4, matplotlib 3.11.0, pandas 3.0.3, geopandas 1.1.4 en shapely 2.1.2. Raadpleeg de gearchiveerde omgevingsbestanden en scripts met relatieve paden voor exacte reproductie.
- Configureer de Markov-CA met een 3 × 3 Moore-omgeving en seed 2023. Initialiseer een onafhankelijke gezaaide generator voor elk scenario-jaar en elke sensitiviteitsrun, en gebruik seed 42 voor OPGD-steekproefneming.
| Dataset | Tijdsbestrijking | Natuurlijke ruimtelijke resolutie | Primaire bron / permanente identifier | Rol in de analytische werkstroom |
| China Land Cover Dataset (CLCD; Yang & Huang45) | 2005, 2010 en 2015 | 30 m | Zenodo DOI: 10.5281/zenodo.4417810 | Landgebruiksclassificatie, veranderingdetectie, validatie, schatting van overgangsmatrix, geobserveerde uitgangssituatie en invoer voor Markov-celautomaat |
| Copernicus Digital Elevation Model (DEM) GLO-30 | referentie-epoche van 2019; statisch in deze studie | 30 m | Copernicus Data Space Ecosysteem / Microsoft Planetary Computer STAC | Verhoging en afleiding van helling, noordelijkheid en topografische reliëf met behulp van een omgeving van 450 m straal |
| Parameters voor karendichtheid | Statisch | Per landgebruiksklasse; opzoeken van klasse (Mg C ha⁻¹) | Cheng et al.47 Tabel 6 | Volledige negenklassen-, vierpool-opzoekfunctie gebruikt voor integrale waardering van ecosystemen en synergieën-equivalente koolstofboekhouding (Tabel 3) |
| Analyse-omvang en -grens van het studiegebied | Statisch | Vector / 30 m masker | Reconstrueerd uit de mate van het manuscript: 117,60–118.38°E, 29,72–30.22°N; gearchiveerde GeoJSON en masker | Gemeenschappelijke ruimtelijke masker, analyse-omvang en analyse-raster |
Tabel 1: Primaire ruimtelijke en tabulaire datasets gebruikt in de analytische werkvloei. De tabel vat de tijdsbestrijking, de oorspronkelijke ruimtelijke resolutie, de bron of persistente identifier en de analytische rol samen van de China Land Cover Dataset (CLCD), het Copernicus Digitaal Elevation Model (DEM) GLO-30, klasse-specifieke parameters voor koolstofdichtheid en de analyse-omvang van het studiegebied. Koolstofdichtheidswaarden zijn uitgedrukt in megagram koolstof per hectare (Mg C ha⁻¹).−1).
3. Schat de overgangsmatrix en initialiseer het Markov-CA-model
- Kruistabuleer geldige CLCD-pixels van 2010 tot 2015. Voor bronklasse i en doelklasse j, bereken .
- Gebruik het resulterende 9 × 9 overgangsmatrix voor toekomstscenario's. Leid een afzonderlijke 2005 af–Overgangsmatrix van 2010 voor modelvalidatie.
- Voer de simulator uit als een aangepaste Python-implementatie van Markov-CA; roep PLUS niet aan8.
- Neem bij elke vijf jaar een synchrone momentopname van de beginstatus. Bereken de overgangsaantallen op basis van die momentopname.
- Evalueer doelklassen 1–9 en bronklassen 1–9 in oplopende volgorde. Verwijder elke geselecteerde bronpixel uit verdere toewijzing, zodat deze maximaal één keer kan overgaan tijdens de vijfjaarlijkse stap.
- Rangschik in aanmerking komende kandidaatpixels op basis van het aantal buurpixels van de doelklasse aan het begin van de stap binnen een 3 × 3 Moore-venster plus uniforme willekeurige jitter van 0 tot 0,5.
- Bereken het gevraagde aantal pixels voor elke overgang van bron naar doel als het afgeronde product van het aantal geldige pixels in de bronklasse, de bijbehorende overgangskans en de toepasselijke schaalfactor.
- Gebruik een schaalfactor van ontwikkeling voor overgangen naar ondoordringbaar land en ontwikkeling × fp voor overgangen van bos naar ondoordringbaar; anders gebruik een schaalfactor van 1. Beperk het gevraagde aantal tot het aantal in aanmerking komende kandidaatpixels.
- Als het gevraagde aantal kleiner is dan het aantal in aanmerking komende kandidaten, selecteer dan de hoogst gerangschikte kandidaten op basis van de score van de doelklasse-omgeving in combinatie met de uniforme willekeurige variatie zoals hierboven beschreven; als het gevraagde aantal gelijk is aan het aantal in aanmerking komende kandidaten, selecteer dan alle in aanmerking komende kandidaten.
4. Configureer scenario's, gevoeligheidstests en toekomstsimulaties
- Pas drie parameters toe op de gemeenschappelijke overgangsmatrix. Laat ontwikkeling schaal verwachte overgangen naar ondoordringbare klasse 8, pas toe fp alleen naar overgangen van bos naar ondoordringbaar oppervlak, en definiëren uit als de per stap waarschijnlijkheid dat akkerland zonder een ondoordringbare Moore-buur wordt omgezet naar bos.
- Stel in (ontwikkelen, fp, uit) naar (1,4, 1,0, 0,005) voor BAU, (6,0, 2,0, 0,001) voor TED, (0,4, 0,4, 0,025) voor ECP en (2,5, 0,7, 0,012) voor VRA. Gebruik Tabel 2 voor de bijbehorende computationele regels, beleidsverhalen en parameterwaarden.
- Interpreteer de vermenigvuldigingsfactoren als transparante stressproeven met lage, matige en hoge ontwikkeling rond de empirische overgangsmatrix. Behandel ze niet als coëfficiënten die zijn geschat op basis van gegevens over toerisme, dorpse knooppunten, zonering, vervoer, beschermd gebied of ecologische rode lijnen.
- Gebruik de beleidslabels uitsluitend om relatieve parameter richtingen te beschrijven. Interpreteer de labels niet als juridische of ruimtelijke beperkingen die in het model zijn gecodeerd.
- Behandel ontwikkeling, fp, en uit als door de auteur gedefinieerde exploratieve stress-testparameters in plaats van empirisch geschatte of gekalibreerde coëfficiënten. De nominale waarden geven numerieke scenario-aannames aan met betrekking tot ontwikkelingsdruk (ontwikkeling), bescherming van bossen (fp), en aanplanting (uit); ze werden niet aangepast aan de geobserveerde landgebruiksveranderingen na 2015 noch geïnterpreteerd als schattingen van specifieke beleidseffecten. Gebruik deze nominale waarden voor de primaire scenariovergelijkingen en beoordeel hun robuustheid aan de hand van de hieronder beschreven sensitiviteitsanalyse waarbij telkens één parameter tegelijk wordt gewijzigd.
- Voer voor elk scenario het nominale geval van 2050 uit. Herhaal de simulatie nadat u een van de ontwikkeling, fp, of uit met 0,5 of 1,5 terwijl de andere parameters constant worden gehouden.
- Herinitialiseer de seed 2023 voor elk van de 28 runs. Vergelijk koolstofopslag, koolstofverlies, bosdekking en aandeel ondoordringbaar oppervlak, en rapporteer de gerangschikte gevallen en de volledige OAT-bereiken zonder deze als probabilistische betrouwbaarheidsintervallen te beschouwen.
- Initialiseer elke toekomstige simulatie vanuit de geobserveerde CLCD 2015. Voor de toewijzing van ondoordringbare oppervlakken, laat akkerland in aanmerking komen binnen de geldige masker, en vereis dat bronpixels van niet-akkerland grenzen aan ondoordringbare cellen aan het begin van de stap.
- Na de toewijzing per klasse, converteer in aanmerking komende akkerland onafhankelijk naar bos met een kans van uitVoer drie vijfjaarlijkse stappen uit voor de prognose voor 2030 en zeven vijfjaarlijkse stappen voor de prognose voor 2050.
- Behoud klasse 0 buiten de geldige masker. Exporteer elke geprojecteerde kaart met een resolutie van 30 m.
| Scenario | Geïmplementeerde computationele regel | Beleidsnarratief (geen gecodeerde beperking) | Parameters (dev / fp / af) |
| Zaken als gewoonlijk (ZAG) | Matige ondoordringbaarheidsvermenigvuldiger; basislijn bosgevoeligheid; 0,5% geïsoleerde akkerbouwbegrazing per stap | Voortzettingsbenchmark | 1.4 / 1.0 / 0.005 |
| Toerisme-uitbreiding en -ontwikkeling (TED) | Sterke ondoordringbare vermenigvuldiger; verdubbelde bos-naar-ondoordringbaar gevoeligheid; zwakke aanplanting van bossen | Test onder hoge ontwikkelingsstress | 6.0 / 2.0 / 0.001 |
| Ecologische Behoudsprioriteit (ECP) | Verminderde omzetting van ondoordringbaar oppervlak en verlaagde bosgevoeligheid; sterkste bebossing | Ecologisch-conserveringsbelastingtest | 0.4 / 0.4 / 0.025 |
| Dorpsvernieuwing en -activering (VRA) | Intermediaire ondoordringbare vermenigvuldiger; bosgevoeligheid onder BAU; intermediaire bebossing | Narratief voor dorpsvernieuwing; geen dorpsknooppuntlaag | 2.5 / 0.7 / 0.012 |
Tabel 2: Berekeningsregels en parameterniveaus voor de vier landgebruiksscenario's. De tabel vat de geïmplementeerde computationele regels, beleidsverhalen en parameterwaarden samen voor de scenario's Business As Usual (BAU), Toerisme-uitbreiding en Ontwikkeling (TED), Ecologische Behoudsprioriteit (ECP) en Dorpsvernieuwing en -activering (VRA). Beleidsverhalen beschrijven de beoogde interpretatie van elk scenario en zijn geen gecodeerde ruimtelijke beperkingen. dev, multiplikator voor ondoordringbare verstedelijking; fp, multiplikator voor de vatbaarheid van bos voor ondoordringbare verandering; af, fractie bebossing van geïsoleerde akkerbouwgrond per simulatiestap.
5. Kalibreer en valideer het landgebruiksmodel
- Schat de calibratiematrix op basis van de geobserveerde 2005–Wijziging in 2010. Simuleer 2015 vanuit geobserveerde gegevens uit 2010 met zaad 2023.
- Vergelijk de gesimuleerde kaart van 2015 pixel voor pixel met de geobserveerde CLCD-kaart van 2015 binnen de geldige masker. Bereken de totale nauwkeurigheid, Kappa, de 9 × 9 verwaringsmatrix en FoM voor gewijzigde cellen48.
- Sluit ongeldige cellen uit van zowel de teller als de noemer van de validatieberekeningen om te voorkomen dat nullen buiten de maskeringsgrens de overeenstemming verhogen.
- Interpreteer de algehele nauwkeurigheid en Kappa samen met FoM, omdat stabiel bos en akkerland de voorgaande metrieken domineren, terwijl FoM de kleinere verzameling veranderde cellen evalueert. Gebruik de validatieresultaten om regionale scenariovergelijkingen te ondersteunen; interpreteer deze niet als een vaststelling van nauwkeurige voorspellingen van veranderingen in locatie.
6. Bereken de koolstofopslag
- Wijs voor elke geldige pixel de vier klasse-specifieke dichtheden van koolstofreservoirs toe die zijn opgesomd in Tabel 3. Tel de dichtheden van de vier pools op om de totale koolstofdichtheid in Mg C ha⁻¹ te verkrijgen⁻1.
- Vermenigvuldig de totale koolstofdichtheid met het pixeloppervlak van 0,09 ha. Converteer de resulterende waarden van Mg C naar Tg C.
- Pas deze opzoekberekening toe als de algebraïsche equivalent van de InVEST Carbon Storage-formulering. Pas geen sequestratiesnelheid-, waarderings- of economische module toe9,47.
| Landgebruiksklasse (CLCD) | Boven de grond C (Mg C ha⁻¹) | Ondergrondse C (Mg C ha⁻¹) | Bodem C (Mg C ha⁻¹) | Dode organische C (Mg C ha⁻¹) | Totale C (Mg C ha⁻¹) | Bron |
| 1 Akkerland | 3.56 | 7.45 | 26.9 | 9.82 | 47.73 | Cheng et al.47, Tabel 6 |
| 2 Bos | 53.59 | 17.36 | 84.85 | 2.8 | 158.6 | |
| 3 Strauch | 4.25 | 4.65 | 72.9 | 1.59 | 83.39 | |
| 4 Weidegrond | 4.15 | 16.58 | 78.2 | 1.55 | 100.48 | |
| 5 Water | 6.38 | 0 | 0 | 0.12 | 6.5 | |
| 6 Sneeuw/ijs | 0 | 0.33 | 5.35 | 0 | 5.68 | |
| 7 Kaalstaande strepen | 1.3 | 0.33 | 21.6 | 0 | 23.23 | |
| 8 Ondoordringbaar | 0 | 0 | 9.28 | 0 | 9.28 | |
| 9 Ven | 12.24 | 9.18 | 95.73 | 4.08 | 121.23 |
Tabel 3: Parameters voor koolstofdichtheid voor de negen landgebruiksklassen van de China Land Cover Dataset die worden gebruikt in koolstofboekhouding. Boven- en ondergrondse, bodem-, dode organische en totale koolstofdichtheidswaarden worden verstrekt voor elke landgebruiksklasse van de China Land Cover Dataset (CLCD). De totale koolstofdichtheid stelt de som voor van de vier koolstofpools. Alle koolstofdichtheidswaarden zijn uitgedrukt in megagram koolstof per hectare (Mg C ha⁻¹).−1). De waarden zijn afkomstig van Cheng et al.47, Tabel 6.
7. Detecteer topografische associaties met OPGD
- Gebruik de kachtdichtheid van 2015 als responsvariabele en hoogte, helling, noordoriëntatie en topografische reliëf als verklarende factoren. Neem een steekproef van 200.000 geldige pixels met zaadgetal 42.
- Voor elke verklarende factor, toets 2–15 kwintielintervallen. Behoud de discretisatie die het maximum oplevert q-waarde
- Bereken analytische F-toets p-waarden en permutatie p-waarden aan de hand van 999 permutaties. Bereken de permutatie p-waarde als p = (overschrijdingen + 1) / 1000
- Combineer de geoptimaliseerde strata voor elk paar verklarende factoren om de interactieresultaten te berekenen. Interpreteer alle factoren en interactie-uitkomsten als ruimtelijke associaties in plaats van causale effecten.10.
Resultaten
Ruimtelijke distributie en temporele dynamiek van landgebruik
De analytische workflow, de omvang van het onderzoek en de primaire inputdatasets zijn samengevat in Figuur 1, Figuur 2en Tabel 1respectievelijk. Figuur 1 presenteert de zevenstaps-workflow die wordt gebruikt voor landgebruiksprognoses, validatie, koolstofboekhouding en analyse van topografische associaties. Figuur 2 toont de locatie en de analytische omvang van het studiegebied. Tabel 1 vat de temporele dekking, ruimtelijke resolutie, herkomst en analytische rol van de primaire ruimtelijke en tabulaire datasets samen. Een vergelijking van de gesimuleerde situatie van 2015 met de geobserveerde CLCD 2015 over 4.632.329 geldige pixels leverde een OA = 96,61%, Kappa = 0,850 en FoM = 0,107 op. De overeenstemming werd gedomineerd door stabiel bos en akkerland, terwijl de op verandering gerichte FoM wees op een beperkte nauwkeurigheid bij het reproduceren van de locaties van verandering. De validatie ondersteunt daarom eerder een vergelijkende scenarioanalyse dan een nauwkeurige ruimtelijke prognose. Aanvullende tabel 1 (werkblad S3)biedt de validatiemetrieken, change hits, misses, valse alarmen en de volledige confusiematrix. Het archief bevat het validatieraster en het exacte script dat voor de berekening is gebruikt.
Over de 28 sensitiviteitsanalyses behield elke overeenkomstige perturbatie de rangorde ECP > BAU > VRA > TED. De bereiken van koolstofverlies waren 4,22–5,86% voor ECP, 6,87–8,55% voor BAU, 6,99–9,61% voor VRA en 10,45–15,84% voor TED. De bereiken van BAU en VRA overlappen; daarom is de interpretatie beperkt tot de volgorde van overeenkomstige gevallen in plaats van een volledige scheiding van de OAT-bereiken. De volledige sensitiviteitsresultaten worden gepresenteerd in Aanvullende Tabel 1 (werkblad S4) en Aanvullende Figuur 1. De operationele matrix van 2010–2015, opgenomen in Aanvullende Tabel 1 (werkblad S1), toonde retentiekansen van 98,23% voor bos, 94,66% voor landbouwgrond en 99,43% voor ondoordringbaar land. De grootste off-diagonale overgangen waren van landbouwgrond naar ondoordringbaar land (3,39%), van landbouwgrond naar bos (1,71%) en van bos naar landbouwgrond (1,71%). Over dezelfde periode nam de bosbedekking af van 87,63% naar 86,27%, terwijl landbouwgrond toenam van 10,99% naar 11,92% en ondoordringbaar land toenam van 1,08% naar 1,50%. Figuur 3A,B presenteert respectievelijk de waargenomen landgebruikspatronen van 2010 en 2015, en Figuur 4 presenteert de overeenkomstige veranderingsklassen zonder drijfveren af te leiden die niet in de analyse waren opgenomen.
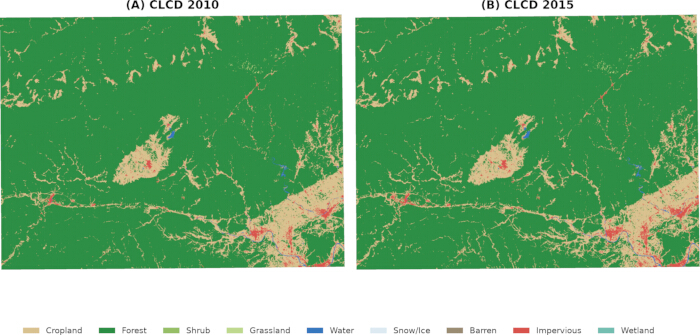
Figuur 3. Waargenomen landgebruikspatronen in het Yixian–Huangshan landschap in 2010 en 2015. China Land Cover Dataset (CLCD) kaarten die de ruimtelijke distributie van negen landgebruiksklassen binnen het analysegebied tonen. (A) Waargenomen landgebruik in 2010. (B) Waargenomen landgebruik in 2015. De landgebruiksklassen omvatten landbouwgrond, bos, struikgewas, grasland, water, sneeuw/ijs, braakliggend land, ondoordringbare oppervlakken en wetlands. Klik hier om een grotere versie van deze figuur te bekijken.
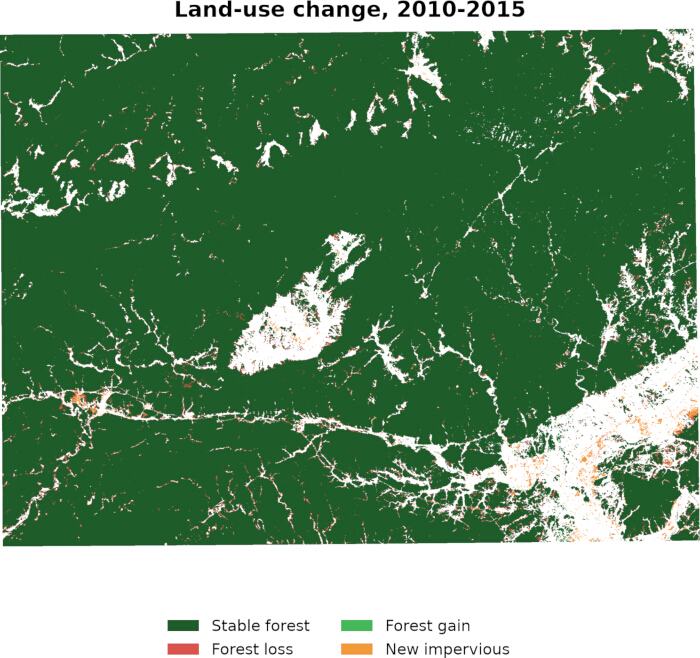
Figuur 4. Waargenomen landgebruikswijziging in het Yixian–Huangshan landschap van 2010 tot 2015. De kaart toont de ruimtelijke verdeling van stabiel bos, bosverlies, bostoerust en nieuw ontwikkelde ondoorlatende oppervlakken tussen de China Land Cover Dataset kaarten van 2010 en 2015. Witte gebieden vertegenwoordigen locaties die niet zijn geclassificeerd in deze vier weergegeven wijzigingscategorieën. Klik hier om een grotere versie van deze figuur te bekijken.
Terreinkenmerken en topografische heterogeniteit
Binnen het geldige masker varieerde de hoogte van 82.3 tot 1,830.3 m (gemiddelde, 388.0 m), de hellingshoek van 0 tot 87.3° (gemiddelde, 22.4°), de noordelijkheid van −1 tot 1, en het topografisch reliëf van 3.2 tot 1,398.2 m (gemiddelde, 230.0 m). Reliëf werd gedefinieerd als het lokale hoogteverschil binnen een cirkelvormige omgeving met een straal van 450 m, geïmplementeerd met een footprint van 31 × 31-pixels. Figuur 5A–D tonen respectievelijk de hoogte, hellingshoek, noordelijkheid en het topografisch reliëf. Deze lagen karakteriseren de ruimtelijke terreinvariatie; elk overeenkomstig ecologisch mechanisme wordt behandeld als een hypothese in plaats van een causaal resultaat35,36,37,38,39,40,41,42,43,44.
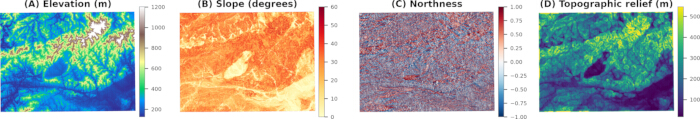
Figuur 5. Topografische variabelen gebruikt in de associatieanalyse. Ruimtelijke verdelingen van de vier topografische variabelen over het analysegebied: (A) hoogte, uitgedrukt in meters; (B) helling, uitgedrukt in graden; (C) noordelijkheid, uitgedrukt op een schaal van −1 tot 1; en (D) topografisch reliëf, uitgedrukt in meters. Deze variabelen werden gebruikt in de geografische detectoranalyse op basis van optimale parameters voor hun individuele en gezamenlijke associaties met de koolstofdichtheid in 2015. Klik hier om een grotere versie van deze figuur te bekijken.
Landgebruiksprognoses voor meerdere scenario's
De gemeenschappelijke transitiematrix en scenarioparameters, samengevat in Tabel 2, produceerden verschillende aggregaattrajecten met behulp van de numerieke landbedekkingsklasse-identificatoren die zijn verstrekt in Aanvullende Tabel 2. Figuur 6 presenteert de geobserveerde en geprojecteerde aandelen van bos, landbouwgrond en ondoordringbare oppervlakken, terwijl Figuur 7A–D respectievelijk de ruimtelijke projecties voor 2030 tonen voor BAU, TED, ECP en VRA, en Figuur 7E–H de overeenkomstige projecties voor 2050 tonen. Tegen 2050 werd geprojecteerd dat de bostezicht 78,0% zou bedragen onder BAU, 74,6% onder TED, 80,3% onder ECP en 78,2% onder VRA; de overeenkomstige aandelen ondoordringbaar oppervlak waren 6,3%, 17,6%, 2,8% en 9,0%. Ten opzichte van de geobserveerde situatie in 2015 was de geprojecteerde uitbreiding van ondoordringbaar oppervlak ongeveer 202 km2 onder BAU, 675 km2 onder TED, 57 km2 onder ECP en 317 km2 onder VRA. Deze waarden zijn resultaten van stresstests en geen gefitte voorspellingen. Geprojecteerde veranderingen zijn ruimtelijk geclusterd omdat de rangschikking van kandidaten gebruikmaakt van tellingen van buurten van de doelklasse en de conversie van niet-landbouwgrond naar ondoordringbaar land beperkt is tot randcellen. Het model bevat geen laag voor transportcorridors, dorpsknooppunten, beschermde gebieden, ecologische roodlijnen of wettelijke planning; daarom representeert een schijnbare uitlijning met specifieke infrastructuur of gereguleerde zones geen gecodeerd effect.
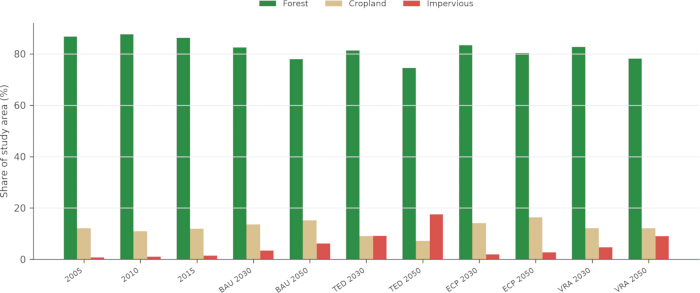
Figuur 6. Waargenomen en geprojecteerde aandelen van de belangrijkste landgebruiksklassen onder vier scenario's. Het percentage van het studiegebied dat in beslag wordt genomen door bos, landbouwgrond en ondoordringbare oppervlakken wordt weergegeven voor de waargenomen jaren 2005, 2010 en 2015 en voor projecties tot 2030 en 2050 onder de scenario's Business As Usual (BAU), Tourism Expansion and Development (TED), Ecological Conservation Priority (ECP) en Village Revitalization and Activation (VRA). De staven representeren het gemodelleerde aandeel van het totale studiegebied voor elke landgebruiksklasse; foutenbalken zijn niet van toepassing omdat de waarden deterministische scenario-outputs zijn en geen schattingen gebaseerd op replicaten. Klik hier om een grotere versie van deze figuur te bekijken.
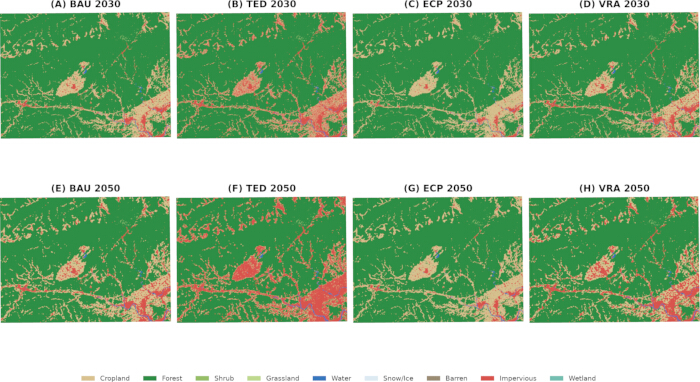
Figuur 7. Geprojecteerde ruimtelijke verdeling van landgebruik onder vier scenario's in 2030 en 2050. Geprojecteerde landgebruikspatronen onder de scenario's Business As Usual (BAU), Tourism Expansion and Development (TED), Ecological Conservation Priority (ECP) en Village Revitalization and Activation (VRA). (A–D) respectievelijk BAU-, TED-, ECP- en VRA-projecties voor 2030. (E–H) respectievelijk BAU-, TED-, ECP- en VRA-projecties voor 2050. Landgebruiksklassen omvatten akkerland, bos, struikgewas, grasland, water, sneeuw/ijs, braakliggend land, ondoordringbare oppervlakken en wetland. Alle scenario-simulaties zijn geïnitialiseerd vanaf de waargenomen CLCD-kaart van 2015; cellen zonder gesimuleerde landgebruiksovergang behouden daarom hun landgebruiksklasse en ruimtelijke basispatroon van 2015. Klik hier om een grotere versie van deze figuur te bekijken.
Koolstofopslagdynamiek onder projecties van meerdere scenario's
Toepassing van de volledige vier-pool opzoekmethode in Tabel 3 leverde 59,505 Tg C op voor 2015, wat gelijk staat aan een gemiddelde dichtheid van 142,73 Mg C ha−1. Bos was verantwoordelijk voor 57,04 Tg C (95,9%), terwijl landbouwgrond verantwoordelijk was voor 2,37 Tg C (4,0%). Ondoordringbaar land leverde een kleine maar niet-nul bijdrage, omdat de gehanteerde bron aan deze klasse 9,28 Mg C ha−1 toekent. Binnen de bosklasse vertegenwoordigden de bodem-, bovengrondse, ondergrondse en dode-organische pools respectievelijk 53,5%, 33,8%, 10,9% en 1,8% van de totale koolstof31,32,33,34,44,47. Alle scenario's leverden in 2050 een lagere koolstofopslag op dan in 2015. De geprojecteerde opslag was 54,895 Tg C onder BAU (een verlies van 7,75%), 51,475 Tg C onder TED (13,49%), 56,523 Tg C onder ECP (5,01%) en 54,540 Tg C onder VRA (8,34%). Het verschil tussen ECP en TED was 5,048 Tg C. Deze contrasten zijn het resultaat van de opgelegde numerieke parameters en schatten de effecten van specifieke beleidsmaatregelen niet in. Figuur 8A presenteert de totale koolstofopslag in 2015 en de scenarioprojecties voor 2030 en 2050; Figuur 8B presenteert de overeenkomstige gemiddelde koolstofdichtheden; Figuur 8C presenteert het koolstofverlies tegen 2050 ten opzichte van de nulmeting van 2015; en Figuur 8D toont de relatie tussen het geprojecteerde bosaandeel en het koolstofverlies. De waarden zijn deterministische scenario-outputs in plaats van schattingen gebaseerd op replicaten.
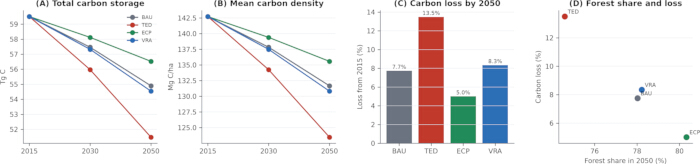
Figuur 8Geprojecteerde koolstofopslag en de relatie daarvan met de bosbedekking onder vier landgebruikscenario's. (A) Totale koolstofopslag in 2015 en geprojecteerd voor 2030 en 2050 onder de scenario's Business As Usual (BAU), Tourism Expansion and Development (TED), Ecological Conservation Priority (ECP) en Village Revitalization and Activation (VRA), uitgedrukt in teragrammen koolstof (Tg C). (B) Gemiddelde koolstofdichtheid voor de overeenkomstige jaren en scenario's, uitgedrukt in megagrammen koolstof per hectare (Mg C ha⁻¹).-1). (C) Percentageverlies van de totale koolstofopslag tegen 2050 ten opzichte van de referentieperiode 2015 voor elk scenario. (D) Relatie tussen het geprojecteerde bosareaalaandeel van het studiegebied in 2050 en het percentage koolstofverlies ten opzichte van 2015 voor elk scenario. Waarden zijn deterministische scenario-outputs; foutenbalken zijn niet van toepassing. Klik hier om een grotere versie van deze figuur te bekijken.
Topografische associaties met de ruimtelijke heterogeniteit van koolstofopslag
De OPGD factor-detector rangschikte helling als eerste (q = 0,557), gevolgd door topografisch reliëf (q = 0,460), hoogte (q = 0,352) en noordelijkheid (q = 0,003), zoals weergegeven in Figuur 9A. Bij 999 permutaties was de permutatie p-waarde voor elke factor 0,001, de laagst haalbare waarde; analytische F-test p-waarden lagen eveneens onder 0,001. De volledige factor- en interactie-detectorstatistieken, inclusief geoptimaliseerde discretisatie-intervallen en analytische en permutatie p-waarden, zijn opgenomen in Aanvullende Tabel 3. Statistische significantie wordt hier onderscheiden van effectgrootte: de associatie met noordelijkheid was in praktische zin verwaarloosbaar, en alle q-waarden representeren associaties binnen de vier beoordeelde terreinvariabelen in plaats van causale effecten10,40. Alle factorparen leverden interactie q-waarden op die groter waren dan de grootste van hun individuele q-waarden. De sterkste interacties waren helling ∩ reliëf (q = 0,628), hoogte ∩ helling (q = 0,618) en hoogte ∩ reliëf (q = 0,510), zoals weergegeven in Figuur 9B. Deze waarden duiden op sterkere gestratificeerde associaties voor gepaarde factoren, maar leggen geen geomorfologisch mechanisme vast omdat bodem, klimaat, bosleeftijd, beheer en toegankelijkheid niet zijn gemodelleerd.
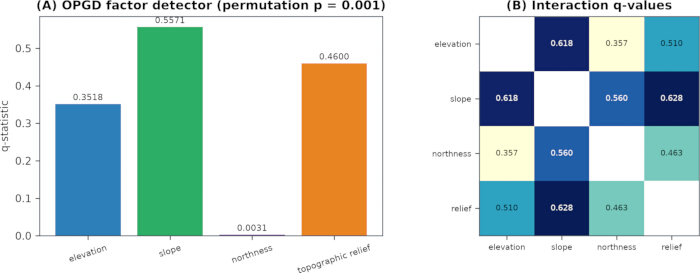
Figuur 9. Topografische associaties met de koolstofdichtheid in 2015, geïdentificeerd met behulp van de optimal parameters-based geographical detector. (A) Factor-detector q-statistieken voor hoogte, helling, noordelijkheid en topografisch reliëf. De respectievelijke q-waarden zijn 0.3518, 0.5571, 0.0031 en 0.4600; permutatietests gaven p = 0.001. (B) Interaction-detector q-waarden voor paarsgewijze combinaties van de vier topografische variabelen. Hogere q-waarden duiden op sterkere statistische associaties met de ruimtelijke distributie van de koolstofdichtheid in 2015. OPGD, optimal parameters-based geographical detector. Klik hier om een grotere versie van deze figuur te bekijken.
Algemene resultaten
Figuur 10A–D vat de belangrijkste resultaten van de workflow samen: respectievelijk het geprojecteerde bosareaalaandeel, de totale koolstofopslag, de rangschikking van topografische associaties en de belangrijkste kwantitatieve indicatoren. De analytische nulmeting van 2015 bevatte 59,505 Tg C. Over de vier verkennende parametersets varieerden de geprojecteerde verliezen tegen 2050 van 5,01% tot 13,49%, en alle overeenkomstige sensitiviteitsgevallen behielden de rangschikking ECP > BAU > VRA > TED. Helling en reliëf vertoonden de sterkste beoordeelde terreinassociaties. Gezien FoM = 0,107 en het weglaten van expliciete plannings-, socio-economische en klimaatlagen, ondersteunen de resultaten een vergelijkende regionale beoordeling in plaats van een deterministische ruimtelijke voorspelling.
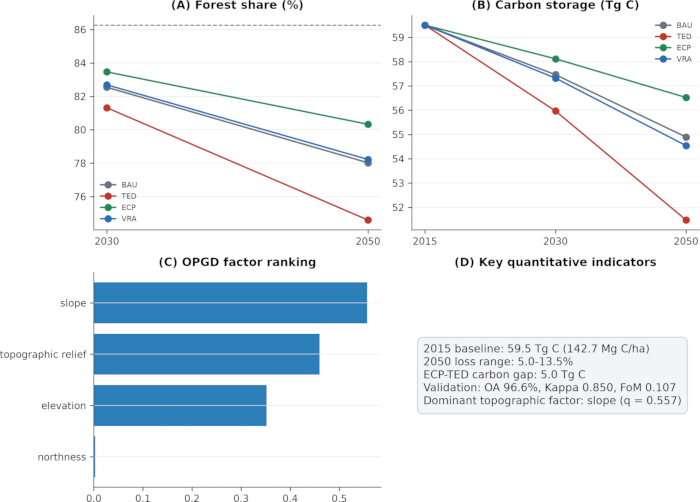
Figuur 10. Samenvatting van de geprojecteerde resultaten voor landgebruik en koolstofopslag en de topografische associaties. (A) Geprojecteerd bosareaal van het studiegebied in 2030 en 2050 onder de scenario's Business As Usual (BAU), Tourism Expansion and Development (TED), Ecological Conservation Priority (ECP) en Village Revitalization and Activation (VRA); de stippellijn geeft het bosareaal van de basislijn uit 2015 aan. (B) Totale koolstofopslag in 2015 en geprojecteerd voor 2030 en 2050 onder de vier scenario's, uitgedrukt in teragrammen koolstof (Tg C). (C) Rangschikking van hoogte, helling, noordelijkheid en topografisch reliëf volgens de q-statistieken verkregen met de optimal parameters-based geographical detector (OPGD), waarbij grotere q-waarden duiden op sterkere statistische associaties met de koolstofdichtheid in 2015. (D) Samenvatting van belangrijke kwantitatieve indicatoren, inclusief basislijn koolstofopslag en -dichtheid, geprojecteerde range van koolstofverlies in 2050, verschil in koolstofopslag tussen de ECP- en TED-scenario's, validatiemetrieken en de sterkst beoordeelde topografische associatie. OA, overall accuracy; FoM, Figure of Merit; Mg C ha-1, megagrammen koolstof per hectare. Klik hier om een grotere versie van deze figuur te bekijken.
Aanvullende figuur 1. One-at-a-time gevoeligheidsanalyse van de koolstofopslag in 2050 onder de vier landgebruikscenario's. (A) Nominale koolstofopslag in 2050 en het volledige OAT-gevoeligheidsbereik voor BAU, TED, ECP en VRA. De punten geven de nominale scenario-waarden aan en de verticale bereiken geven de minimum- en maximumwaarden van de koolstofopslag aan, verkregen door een van dev, fp of af te vermenigvuldigen met 0,5 of 1,5 terwijl de andere parameters constant werden gehouden. (B) Verandering in de koolstofopslag in 2050 ten opzichte van de overeenkomstige nominale scenario-waarde na 0,5× en 1,5× perturbaties van dev, fp en af. Waarden boven nul duiden op een grotere koolstofopslag dan in het nominale geval, en waarden onder nul duiden op een lagere koolstofopslag. De bereiken representeren deterministische one-at-a-time parameterperturbaties en zijn geen probabilistische betrouwbaarheidsintervallen.Klik hier om dit bestand te downloaden.
Aanvullende tabel 1. Landgebruiksovergangsmatrix, scenario-parametrisering, modelvalidatie en resultaten van de 'one-at-a-time' gevoeligheidsanalyse. Het werkboek bevat vier werkbladen: S1, de operationele landgebruiksovergangsmatrix voor 2010–2015; S2, parameterwaarden, geïmplementeerde regels en interpretatiegrenzen voor de vier scenario's; S3, de 9 × 9 confusiematrix en bijbehorende modelvalidatieresultaten; en S4, nominale en 'one-at-a-time' gevoeligheidsresultaten verkregen door dev, fp en af met 0,5× en 1,5× te variëren terwijl de andere parameters constant werden gehouden. Gevoeligheidsbereiken vertegenwoordigen deterministische parameterperturbaties en zijn geen probabilistische betrouwbaarheidsintervallen.Klik hier om dit bestand te downloaden.
Aanvullende Tabel 2. Identificaties van landbedekkingsklassen gebruikt in de computationele workflow. De tabel vermeldt de numerieke klasse-identificaties en de overeenkomstige landbedekkingsklassen die zijn gebruikt in de rasteranalyses. Klasse 0 duidt NoData buiten het geldige masker van het studiegebied; klassen 1–9 duiden respectievelijk akkerland, bos, struikgewas, grasland, water, sneeuw/ijs, kaal land, ondoordringbaar oppervlak en wetland.Klik hier om dit bestand te downloaden.
Aanvullende Tabel 3. Resultaten van de OPGD-factor- en interactiedetectie voor de koolstofdichtheid in 2015. De tabel rapporteert geoptimaliseerde q-statistieken, het aantal discretisatie-intervallen, analytische F-test p-waarden en permutatie p-waarden gebaseerd op 999 permutaties voor hoogte, helling, noordelijkheid en topografisch reliëf. Resultaten van paarsgewijze interacties rapporteren de interactie q-statistiek, individuele factor q-statistieken en de interactieclassificatie. De gerapporteerde statistieken representeren ruimtelijke associaties en stellen geen causale effecten vast.Klik hier om dit bestand te downloaden.
Aanvullende Nota 1. Paneel-voor-paneel beschrijvingen, databronnen en interpretatienota's voor de figuren in het manuscript. Deze nota identificeert de inhoud en de onderliggende databron voor individuele figuurpanelen en biedt informatie over gedeelde ruimtelijke omvang, gedupliceerde informatie en de interpretatie van de weergegeven variabelen.Klik hier om dit bestand te downloaden.
Aanvullend data-archief (gezipped). Het archief bevat 26 analyse-klare GeoTIFF-bestanden, begrenzingsbestanden, metadata, resultaten, scripts, figuren, werkboeken, bestanden voor de exacte computationele omgeving, een README-bestand en SHA-256 checksums.
Discussie
Over de vier stresstests heen nam de koolstofopslag af naarmate gesimuleerde transities de verhoudingen van landbedekkingsklassen met een hoge en lage dichtheid veranderden. TED veroorzaakte de grootste afname, terwijl ECP de kleinste veroorzaakte. Een cruciale stap bij het toepassen van het protocol is daarom de configuratie en interpretatie van de dev, fp en af parameters. Omdat de verschillen tussen de scenario's voortvloeien uit deze opgelegde waarden, vertegenwoordigen zij conditionele modelresponsen in plaats van geobserveerde effecten van toeristische ontwikkeling, dorpsrevitalisering of ecologische regulering. Tegen 2050 was de geprojecteerde koolstofopslag onder TED 5,048 Tg C lager dan onder ECP. Volgens de gehanteerde opzoektabel vermindert de omzetting van één hectare bos naar ondoordringbaar land de toegewezen voorraad met 149,32 Mg C, terwijl omzetting van landbouwgrond naar ondoordringbaar land deze vermindert met 38,45 Mg C. Deze contrasten in de boekhouding verklaren de sterke invloed van gesimuleerde bosomzetting op de totale opslag. Het vertrouwen op waarden uit de literatuur zonder lokale kalibratie introduceert echter onzekerheid in de absolute schattingen.
Een andere cruciale stap is de afleiding en discretisatie van de terreinvariabelen die in OPGD worden gebruikt. Topografisch reliëf was geassocieerd met koolstofdichtheid na geoptimaliseerde discretisatie (q = 0,460). Reliëf werd gedefinieerd als het lokale hoogtemverschil binnen een cirkelvormige buurt met een straal van 450 m, geïmplementeerd met een footprint van 31 × 31 pixels. Cellen met een hoog reliëf kunnen samenvallen met steil, bebost terrein, maar OPGD kan geen onderscheid maken tussen terrein, toegankelijkheid, landgebruikshistorie, bodem, beheer en andere gecorreleerde verklaringen. Gepaarde terreinstrata produceerden sterkere q-waarden dan individuele factoren, met name voor helling ∩ reliëf (q = 0,628). Dit patroon is beschrijvend en niet mechanistisch. Op dezelfde manier bewijst de kleine q-waarde voor noordelijkheid (0,003) niet dat contrasten in zonnestraling zwak zijn; het testen van deze verklaring vereist metingen van straling, microklimaat, vegetatie en veldmetingen.
De methode ondersteunt het genereren van regionale hypothesen: het beperken van gesimuleerde bosconversie, het matigen van de uitbreiding van ondoordringbare oppervlakken en het verhogen van de overgang van landbouwgrond naar bos behouden meer toegewezen koolstof. Plaatspecifieke voorschriften vereisen aanvullend bewijs. Voor aanpassing van de workflow naar beslissingsgerichte toepassingen moeten geverifieerde lagen voor beschermde gebieden, ecologische begrenzingen, transport, percelen en dorpsknopen worden geïntegreerd, samen met beoordelingen van stakeholderparticipatie, trade-offs in ecosysteemdiensten, prikkels, restauratiekosten, culturele diensten, bestaansmiddelen en biodiversiteit49,50,51,52,53,54,55,56. Deze uitbreidingen zijn belangrijk omdat het huidige protocol dergelijke ruimtelijke of sociaaleconomische beperkingen niet codeert. De bredere literatuur geeft ook aan dat opslagstrategieën voor planten, bosstructuur, niet-boomvegetatie, toeristisch gedrag en levenscyclus-effecten van de gebouwde omgeving analyses vereisen die verschillen van de huidige landbedekkingsboekhouding57,58,59,60,61.
Verschillende beperkingen bepalen het juiste gebruik en de interpretatie van de methode. Deze omvatten uit de literatuur afgeleide koolstofdichtheden zonder lokale veldkalibratie, potentiële CLCD-classificatiefouten, een vereenvoudigd aangepast Markov-CA, een op verandering gerichte validatie-FoM van 0,107, niet-gefitte stress-testparameters en een stochastische beoordeling met één seed. Aanvullende beperkingen zijn het ontwerp waarbij één factor tegelijk wordt gevarieerd in plaats van een probabilistische onzekerheidsanalyse, het weglaten van lagen voor planning, socio-economie, toegankelijkheid, bodem, bosleeftijd en klimaatverandering, en niet-causale OPGD-associaties. Deze beperkingen betekenen dat de workflow geschikt is voor vergelijkende regionale scenariobeoordelingen, maar geen deterministische ruimtelijke voorspellingen, lokaal gekalibreerde koolstofinventarissen of causale schattingen van beleidseffectiviteit verschaft.
Met betrekking tot bestaande en alternatieve benaderingen ligt het belang van het protocol in de integratie van landgebruikssimulatie, koolstofboekhouding met vier pools, validatie, sensitiviteitstesten en terreinassociatie-analyse binnen een reproduceerbare workflow, terwijl expliciete beperkingen voor de interpretatie behouden blijven. Probleemoplossing en modificatie moeten zich in het bijzonder richten op de stappen die de stroomafwaartse interpretatie het sterkst beïnvloeden: preprocessing en maskering van de landbedekking, parameterisering van transities en scenario's, modelvalidatie, toewijzing van koolstofdichtheid en terreindiscretisatie.
De workflow kan worden toegepast voor de vergelijkende beoordeling van alternatieve landgebruikstrajecten en voor het identificeren van ruimtelijke associaties die verdere onderzoek rechtvaardigen, terwijl locatie-specifieke toepassingen aanvullend lokaal geverifieerd bewijs vereisen. Prioriteiten voor toekomstig onderzoek omvatten het verzamelen van lokale koolstofmetingen, het vergelijken van alternatieve allocatiemodellen en random seeds, het afstemmen van parameters op onafhankelijke drijfveren, en het propageren van onzekerheden in classificatie, parameters en klimaat. Deze ontwikkelingen zouden de huidige workflow uitbreiden voorbij vergelijkende stresstesten en een sterkere basis bieden voor het evalueren van resultaten met betrekking tot landgebruik en koolstofopslag onder aanvullende bronnen van onzekerheid.
Openbaarmakingen
De auteurs verklaren dat er geen belangenverstrengeling is.
Dankbetuigingen
De auteurs danken de verstrekkers van de CLCD- en Copernicus DEM GLO-30-datasets.
Materialen
| Naam | Bedrijf | Catalogusnummer | Opmerkingen |
|---|---|---|---|
| China Land Cover Dataset (CLCD) | Wuhan University (Yang J & Huang X) | 1985–jaarproduct 2022; 30 m; Zenodo DOI: 10.5281/zenodo.4417810 | Basis input voor landbedekking; lagen van 2005, 2010 en 2015 gebruikt voor kalibratie, validatie, schatting van de transitiematrix en basisanalyse |
| Copernicus DEM GLO-30 | Europese Ruimtevaartorganisatie / Copernicus-programma | Referentie-epoch 2019; publieke release 2021; 30 m | Terreininvoer gebruikt voor het afleiden van hoogte, helling, noordelijkheid en topografisch reliëf voor OPGD-analyse |
| Aangepaste Markov-cellulaire automaat | Aangepaste Python-implementatie | Python 3.11; seed 2023; synchrone update; 3 × 3 Moore-buurt; gearchiveerde bron | Simulatie van landgebruikscenario's; aangepaste implementatie zonder gebruik van PLUS |
| geopandas (Python-bibliotheek) | geopandas-ontwikkelaars | 1.1.4 | Verwerking van vectordata, ruimtelijke queries en grensoperaties |
| InVEST-formulering voor koolstofopslag in vier pools | Natural Capital Project | InVEST-documentatie; aangepaste Python-opzoekberekening; gearchiveerd script | Klassegebaseerde koolstofboekhouding met vier pools; zonder module voor sequestratie-snelheid, waardering of economie |
| matplotlib (Python-bibliotheek) | Matplotlib-ontwikkelaars | 3.11.0 | Figuurrendering en wetenschappelijke visualisatie |
| numpy (Python-bibliotheek) | NumPy-ontwikkelaars | 2.4.6 | Numerieke berekeningen op array-niveau |
| OPGD-factor- en interactiedetectoren | Aangepaste Python-implementatie gebaseerd op de OPGD-methodologie | Seed 42; monster van 200.000 pixels; 2–15 kwantielintervallen; 999 permutaties; gearchiveerd script | Factor- en interactieanalyse van associaties tussen de koolstofdichtheid in 2015 en hoogte, helling, noordelijkheid en topografisch reliëf |
| pandas (Python-bibliotheek) | pandas-ontwikkelaars | 3.0.3 | Verwerking van tabelgegevens en analytische outputverwerking |
| Python-programmeertaal | Python Software Foundation | 3.11.9 | Computationele omgeving voor preprocessing, simulatie, validatie, koolstofboekhouding, OPGD-analyse en postprocessing |
| rasterio (Python-bibliotheek) | rasterio-beheerders | 1.4.4 | Raster-invoer/uitvoer, herprojectie, resampling en verwerking van landcover- en terreinrasters |
| scipy (Python-bibliotheek) | SciPy-ontwikkelaars | 1.17.1 | Numerieke en morfologische bewerkingen gebruikt bij terreinverwerking |
| shapely (Python-bibliotheek) | Shapely-ontwikkelaars | 2.1.2 | Geometrische bewerkingen ter ondersteuning van vector- en ruimtelijke verwerking |
| Omvang van het studiegebied en geldig masker | Op maat gemaakte studie-input gereconstrueerd vanuit manuscriptcoördinaten | EPSG:32650; 30 m; gearchiveerd GeoJSON en GeoTIFF; 4.632.329 geldige cellen | Definieert de 4.169,1 km² gemeenschappelijk analysegebied en geldig rastermasker |
Referenties
- Costanza R, et al. The value of the world's ecosystem services and natural capital. Nature. 1997;387(6630):253-260. doi:10.1038/387253a0.
- Millennium Ecosystem Assessment. Ecosystems and Human Well-Being: Synthesis. Island Press; Washington, DC; 2005.
- UNESCO World Heritage Centre. Mount Huangshan [Internet]. UNESCO; Paris; [cited 2026 Aug 18]. Available from: https://whc.unesco.org/en/list/547
- UNESCO World Heritage Centre. Ancient Villages in Southern Anhui—Xidi and Hongcun [Internet]. UNESCO; Paris; [cited 2026 Aug 18]. Available from: https://whc.unesco.org/en/list/1002
- Megarry WP, et al. Land use and land cover analysis of cultural World Heritage to inform assessments of climate vulnerability. Journal of Cultural Heritage. 2026;77:243-253. doi:10.1016/j.culher.2025.11.008.
- Wang Y, Chen S, Rabeeu A. Does world heritage site initiation promote tourism? A difference-in-difference approach. Tourism Economics. 2024;30(8):2111-2133. doi:10.1177/13548166241253306.
- Wang Y, Sulaiman MKAM, Harun NZ. Reframing place identity for traditional village conservation: A theoretical model with evidence from Dali Dong Village. Heritage. 2025;8(10):427. doi:10.3390/heritage8100427.
- Liang X, et al. Understanding the drivers of sustainable land expansion using a patch-generating land use simulation (PLUS) model: A case study in Wuhan, China. Comput Environ Urban Syst. 2021;85:101569. doi:10.1016/j.compenvurbsys.2020.101569.
- Sharp R, et al. InVEST User's Guide: Integrated Valuation of Ecosystem Services and Tradeoffs. [Internet]. Natural Capital Project, Stanford University; 2020. Available from: https://naturalcapitalproject.stanford.edu/software/invest
- Song Y, Wang J, Ge Y, Xu C. An optimal parameters-based geographical detector model enhances geographic characteristics of explanatory variables for spatial heterogeneity analysis: cases with different types of spatial data. GISci Remote Sens. 2020;57(5):593-610. doi:10.1080/15481603.2020.1760434.
- Bozali N. Spatiotemporal simulation of land use and land cover changes in Türkiye through a CA–Markov framework. Scientific Reports. 2026;16(1). doi:10.1038/s41598-026-35807-9.
- Gita B, Pankaj L. Modeling alternative futures: Scenario-based land-use and land-cover projections for Nepal (2030–2050). Land. 2026;15(5):873. doi:10.3390/land15050873.
- Cui J, et al. An integrated land use–carbon modeling framework for net carbon emissions and spatial optimization in Northeast China. Journal of Cleaner Production. 2025;525:146545. doi:10.1016/j.jclepro.2025.146545.
- Tang H, et al. Analysis of spatiotemporal variations and driving factors of carbon storage based on the PLUS-InVEST-OPGD model: A case study of Tai'an City. Sustainability. 2026;18(8):4017. doi:10.3390/su18084017.
- Zhang Y, Liao X, Sun D. A coupled InVEST-PLUS model for the spatiotemporal evolution of ecosystem carbon storage and multi-scenario prediction analysis. Land. 2024;13(4):509. doi:10.3390/land13040509.
- Huang M, et al. Integrated assessment of land use and carbon storage changes in the Tulufan-Hami Basin under the background of urbanization and climate change. Int J Appl Earth Obs Geoinf. 2024;135:104261. doi:10.1016/j.jag.2024.104261.
- Ma Y, et al. Assessing carbon storage dynamics and policy impacts: Application of InVEST-PLUS framework in the Qinling Mountains, China. Land Use Policy. 2026;164:107947. doi:10.1016/j.landusepol.2026.107947.
- Li Z, Yan T, Du Y. Scenario-based simulation of carbon storage in Chengdu using MCCA-InVEST: land use change, spatial patterns, and driving mechanisms. Carbon Balance Manag. 2025;20:40. doi:10.1186/s13021-025-00328-x.
- Zhao H, Guo B, Wang G. Spatial-temporal changes and prediction of carbon storage in the Tibetan Plateau based on PLUS-InVEST model. Forests. 2023;14(7):1352. doi:10.3390/f14071352.
- Hasan F, Makhtoumi Y, Chen G. Impact of land use and land cover changes on ecosystem services: a multi-module InVEST-LCM analysis. Earth Syst Environ. 2026;10:7019-7041. doi:10.1007/s41748-025-00995-3.
- Zhang H, Luo J, Wu J, Dong H. Dynamic response of carbon storage to future land use/land cover changes motivated by policy effects and core driving factors. J Plant Ecol. 2024;17(4):rtae042. doi:10.1093/jpe/rtae042.
- Lu L, et al. Spatiotemporal variation and quantitative attribution of carbon storage based on multiple satellite data and a coupled model for Jinan City, China. Remote Sens. 2023;15(18):4472. doi:10.3390/rs15184472.
- Ma J, Hao Z, Shen Y, Zhen Z. Spatial-temporal evolution of carbon storage and its driving factors in the Shanxi section of the Yellow River Basin, China. Ecological Modelling. 2025;502:111039. doi:10.1016/j.ecolmodel.2025.111039.
- Mi Y, Li S, Wu B. Study on the variation of carbon storage in the Chang-Zhu-Tan urban agglomeration in China based on topographic relief. Frontiers in Environmental Science. 2024;12. doi:10.3389/fenvs.2024.1481540.
- Li C, Huang J, Luo Y, Wang J. Spatial synergy between carbon storage and emissions in coastal China: Insights from PLUS-InVEST and OPGD models. Remote Sensing. 2025;17(16):2859. doi:10.3390/rs17162859.
- Ocloo DM, Mizunoya T. Carbon storage and land use dynamics in Ghanaian university campuses: A scenario-based assessment using the InVEST model. Land. 2025;14(10):1987. doi:10.3390/land14101987.
- Wang Z, Zhang Y, Zhang Z. Scenario analysis of carbon reduction potential through forest carbon sink mechanisms in the Beijing–Tianjin–Hebei Region, China. Sustainability. 2025;17(17):7992. doi:10.3390/su17177992.
- Ma J, Shi P. Remotely sensed inter-field variation in soil organic carbon content as influenced by the cumulative effect of conservation tillage in northeast China. Soil and Tillage Research. 2024;243:106170. doi:10.1016/j.still.2024.106170.
- Li M, Cui Y, Dong J, Qin Y. Abandoned cropland compensates the decrease in net ecosystem productivity of impervious surface expansion in China. Environmental Impact Assessment Review. 2024;104:107363. doi:10.1016/j.eiar.2023.107363.
- Wang J, Zhang M, Zhou S, Huang Y. Research on the spatiotemporal evolution and driving factors of forest carbon sink increment—based on data envelopment analysis and production theoretical decomposition model. Forests. 2025;16(1):104. doi:10.3390/f16010104.
- Cai Y, et al. Dynamics of China's forest carbon storage: the first 30 m annual aboveground biomass mapping from 1985 to 2023. Earth System Science Data. 2025. doi:10.5194/essd-17-6993-2025.
- Piao S, et al. The carbon balance of terrestrial ecosystems in China. Nature. 2009;458(7241):1009-1013. doi:10.1038/nature07944.
- Fuller M, et al. Global carbon storage in harvested wood products: a forest sector model inter-comparison. Environmental Research Letters. 2025;20. doi:10.1088/1748-9326/ae0ce0.
- Milodowski D, Smallman T, Williams M. Scale variance in the carbon dynamics of fragmented, mixed-use landscapes estimated using model–data fusion. Biogeosciences. 2023. doi:10.5194/bg-20-3301-2023.
- Zeyu X, et al. Topographic and edaphic drivers of community structure and species diversity in a subtropical deciduous broad-leaved forest in eastern China. Forests. 2025;16(12):1837. doi:10.3390/f16121837.
- Hunter BD, Roering JJ, Silva LCR, Moreland KC. Geomorphic controls on the abundance and persistence of soil organic carbon pools in erosional landscapes. Nature Geoscience. 2024;17(2):151-157. doi:10.1038/s41561-023-01365-2.
- Li L, et al. Spatial scale effects of interacting abiotic and biotic factors on aboveground carbon storage in a subtropical evergreen broadleaf forest in southern China. Journal of Forestry Research. 2024;36(1). doi:10.1007/s11676-024-01804-9.
- Zhaoxue G, et al. Temporal and spatial characteristics and influencing factors of carbon storage in black soil area under topographic gradient. Land. 2024;14(1):16. doi:10.3390/land14010016.
- Nie Q, et al. Exploring scaling differences and spatial heterogeneity in drivers of carbon storage changes: a comprehensive geographic analysis framework. Ecological Indicators. 2024. doi:10.1016/j.ecolind.2024.112193.
- Liu J, et al. Analysis of the evolution characteristics and driving mechanisms of salinization in arid regions based on multi-factor interaction with optimized parameter geographic detector (OPGD)1. Journal of Environmental Management. 2025;394:127487. doi:10.1016/j.jenvman.2025.127487.
- Wang Z, Zhou Y, Sun X, Xu Y. Estimation of NPP in Huangshan District based on deep learning and CASA model. Forests. 2024;15(8):1467. doi:10.3390/f15081467.
- Vancine MH, et al. ATLANTIC SPATIAL: a dataset of landscape, topographic, hydrological, and anthropogenic metrics for the Atlantic Forest. Ecology. 2026;107(4). doi:10.1002/ecy.70360.
- Qiu M, et al. Spatio-temporal changes and hydrological forces of wetland landscape pattern in the Yellow River Delta during 1986–2022. Landscape Ecology. 2024;39. doi:10.1007/s10980-024-01850-y.
- Anand S, Khushboo K, Garkoti S. Influence of vegetation and soil properties on carbon stocks in Shorea robusta. forests under different disturbance regimes. Journal of Environmental Management. 2025;380:124916. doi:10.1016/j.jenvman.2025.124916.
- Yang J, Huang X. The 30 m annual land cover dataset and its dynamics in China from 1990 to 2019. Earth Syst Sci Data. 2021;13(8):3907-3925. doi:10.5194/essd-13-3907-2021.
- Copernicus Data Space Ecosystem. Copernicus DEM GLO-30 [Internet]. European Union; [cited 2026 Aug 18]. Available from: https://documentation.dataspace.copernicus.eu/Data/Others/CCM.html
- Cheng Z, et al. Identification of eco-functional zones based on ecosystem service bundles: a case study of the Fujiang River Basin. Front Environ Sci. 2026;14:1754712. doi:10.3389/fenvs.2026.1754712.
- Pontius RG Jr, et al. Comparing the input, output, and validation maps for several models of land change. Ann Reg Sci. 2008;42(1):11-37. doi:10.1007/s00168-007-0138-2.
- Li Y, et al. Dissemination, manipulation or monopolization? Understanding the influence of stakeholder information sharing on resident participation in neighborhood rehabilitation of urban China. Land Use Policy. 2024;147:107359. doi:10.1016/j.landusepol.2024.107359.
- Peng J, et al. A landscape ecological approach to spatial conservation planning—ecological security pattern. Trends in Ecology & Evolution. 2025. doi:10.1016/j.tree.2025.07.014.
- Roh H, Park J, Chon J. Trade-off analysis of ecosystem services in regulated river areas: supporting, regulating, and cultural services. Sustainability. 2025;17(9):3788. doi:10.3390/su17093788.
- Roy Chowdhury PK, Brown DG. Modeling the effects of carbon payments and forest owner cooperatives on carbon storage and revenue in Pacific Northwest forestlands. Land Use Policy. 2023;131:106725. doi:10.1016/j.landusepol.2023.106725.
- Savo V, et al. Evaluation of main regulating, provisioning, and supporting ecosystem services of urban street trees: a literature review. Ecosystem Services. 2025;71:101690. doi:10.1016/j.ecoser.2024.101690.
- Shibo Z, Gui J. The cost of ecological protection and restoration: evidence from the impact of the Shan-shui project on land values. Land Use Policy. 2026;164:107919. doi:10.1016/j.landusepol.2026.107919.
- Deng H, Zhou X, Liao Z. Ecological redline delineation based on the supply and demand of ecosystem services. Land Use Policy. 2024;140:107109. doi:10.1016/j.landusepol.2024.107109.
- Xu H, et al. Revealing youth-perceived cultural ecosystem services for high-density urban green space management: a deep learning spatial analysis of social media photographs from central Beijing. Landscape Ecology. 2025;40. doi:10.1007/s10980-025-02115-y.
- Binter J, Doležal J. High-elevation angiosperms maintain extensive living storage tissue with large non-structural carbohydrate pools. Annals of Botany. 2026. doi:10.1093/aob/mcag023.
- Arayaselassie A, Bekele T, Lulekal E. An insight into Northern Wollo Monastery Forests: examining plant species diversity, vegetation structure, and regeneration analysis of these relict ecosystems. PLoS ONE. 2025;20. doi:10.1371/journal.pone.0330689.
- Slate ML, et al. Impact of changing climate on bryophyte contributions to terrestrial water, carbon, and nitrogen cycles. New Phytologist. 2024;242. doi:10.1111/nph.19772.
- Sun D, Yang D, Wang J, Tan F. How animal metaphors increase tourists' waste classification intention? Environmental Research Communications. 2024;6(10):105012. doi:10.1088/2515-7620/ad82b0.
- Sindhu Pradeep M, Rismanchi B, Stephan A, Ngo T. Synergising circularity and temporal dynamics into life cycle sustainability assessment of prefabricated buildings: a system dynamics-based assessment with static–dynamic comparison. Building and Environment. 2026;302:114795. doi:10.1016/j.buildenv.2026.114795.
Herprints en machtigingen
Dit artikel is gepubliceerd
Video binnenkort beschikbaar